はじめに:重みが配られるモデルが、最上位の表に入ってきた
2026年10月23日、中国の Moonshot AI が新しいモデル Kimi K3.1 Pro と、その高速版 Kimi K3.1 Pro Highspeed を公開しました。発表の目玉は、コーディングエージェントの代表的なベンチマーク Terminal-Bench 4.0 で 65.7% と、GPT-6 Astra(58.2%)を上回り、Claude Opus 5.5(66.4%)に迫ったという数字です。しかも 11月4日までにモデルの重み(学習済みのパラメータそのもの)を公開する予定です。
ここ数年、「重みが公開されるモデル(オープンウェイト)は、最上位の非公開モデルより1世代ほど遅れる」というのが半ば常識でした。その常識が、少なくともコーディングエージェントの分野では崩れかけています。
とはいえ、開発元が出した表だけで「Opus 5.5 並み」と受け取るのは早計です。この記事では、次の3つの問いに順番に答えます。
- どれくらい強いのか:開発元の表と、第三者が同じ条件で測り直した数字を分けて読む
- 何が得意で、何が苦手なのか:14 項目の比較から、勝ち負けの「形」を見る
- 自分の仕事で使えるのか:料金・速さ・使い方、そして自分のリポジトリで比べる手順
想定している読者は、Claude Code や Codex で日常的に開発していて、「新しいモデルが出たけれど、乗り換える価値があるのか」を判断したい人です。専門用語には短い説明を添えます。
まず結論を1枚にまとめました。総合・得意・苦手・値段の順に強調していきます。
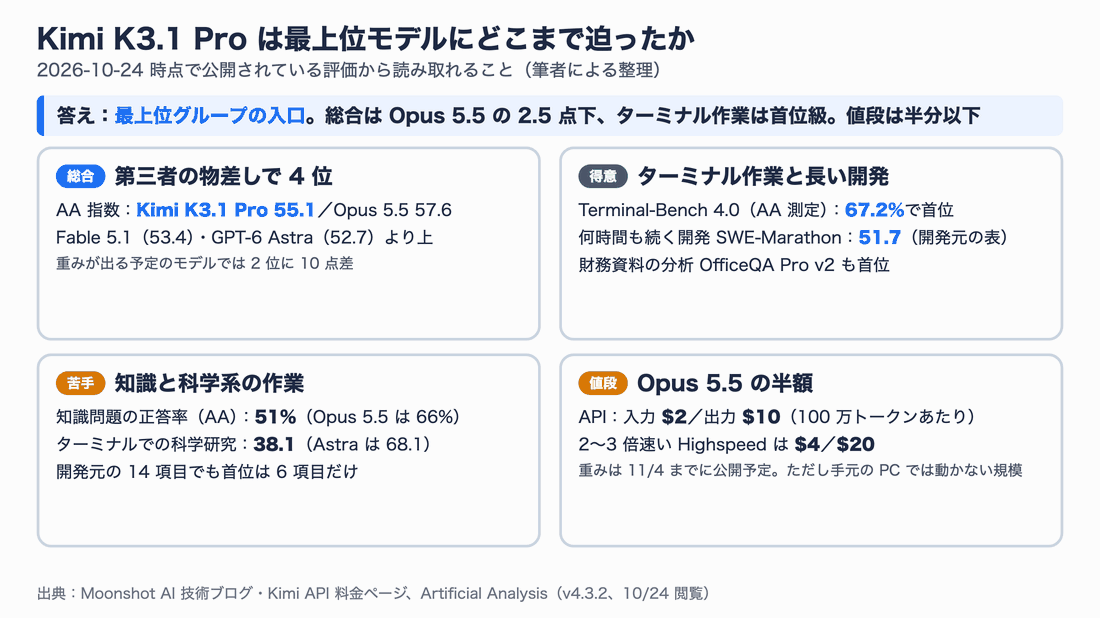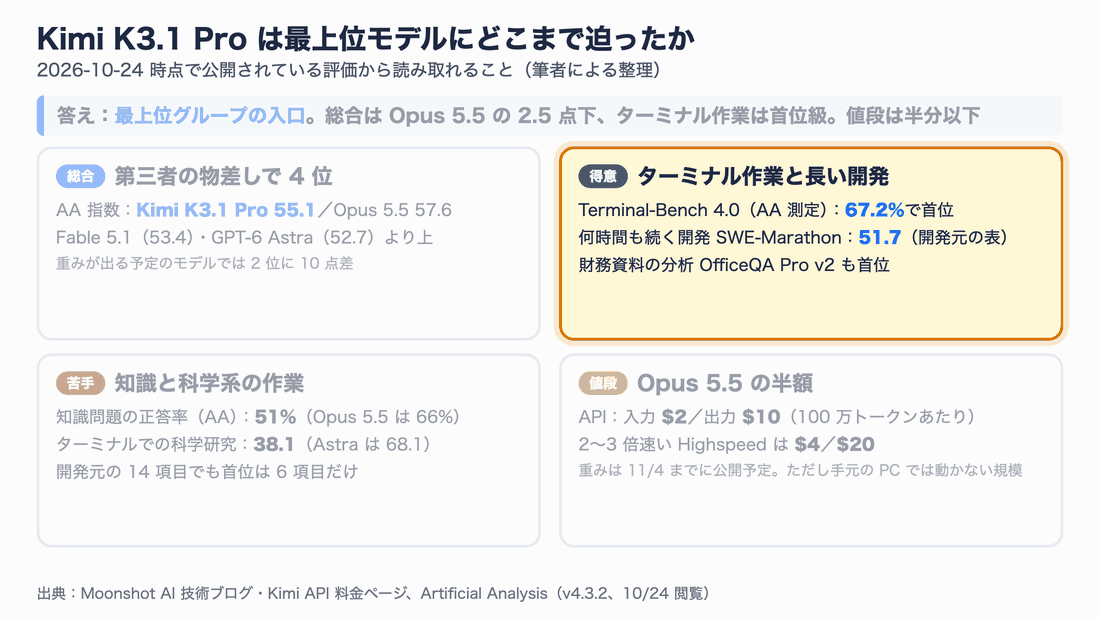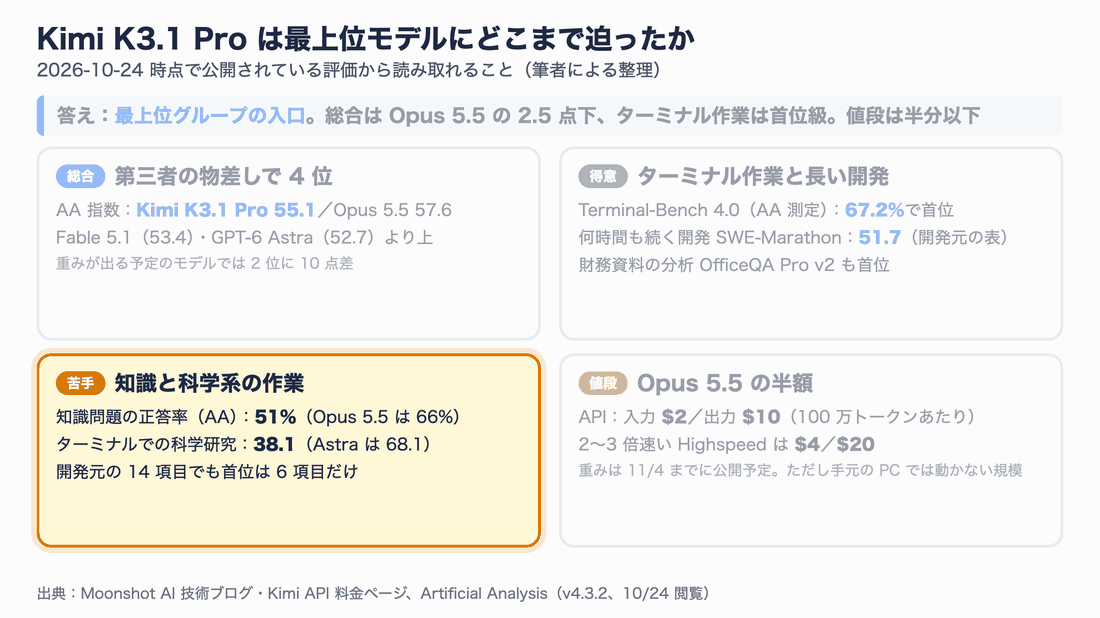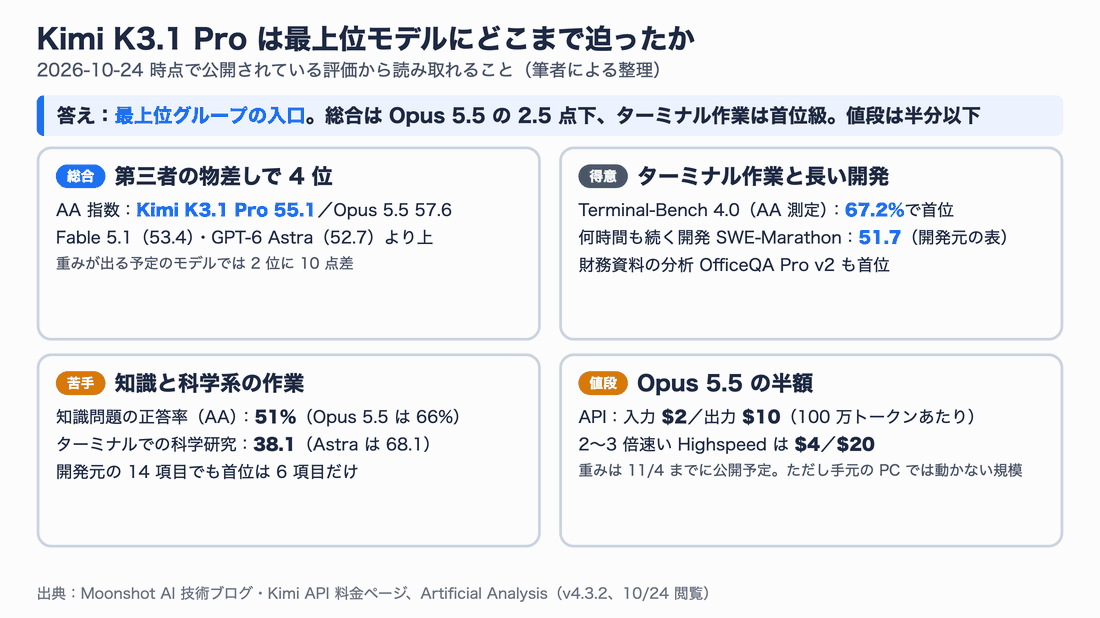
図1:この記事の結論。最上位グループの入口に立ち、作業をやり切る仕事に強く、知識を問う仕事は一段下
この記事の確認範囲
- 確認日:2026年10月24日(日本時間)。数字は Moonshot AI の技術ブログ(比較表の画像)、Kimi API と Kimi Code の公式ドキュメント、Artificial Analysis(以下 AA)の公開データから取りました
- 筆者は Kimi K3.1 Pro をまだ動かしていません。手元にある Vercel AI Gateway の無料枠で呼び出したところ、最上位モデル扱いで 403(利用不可)が返りました。この記事は公開情報の比較です
- その代わり、Claude Code と Codex を Kimi の API につなぐ設定は、ダミーのキーで接続先まで届くこと(Kimi から認証エラー 401 が返ること)を確かめました。後半の比較スクリプトは、Claude Code と Codex の実際の出力で動作を確認しています
- ベンチマークの数字は、どれも開発元か評価機関の発表値です。筆者が追試した値ではありません
Kimi K3.1 Pro とは:K3 を「追加で鍛えた」版
3か月で出てきた理由
最初に押さえておきたいのは、K3.1 Pro がゼロから作り直したモデルではないことです。7月16日に公開された Kimi K3 を土台に、後半の学習(後学習)へ大量の計算を足した版です。
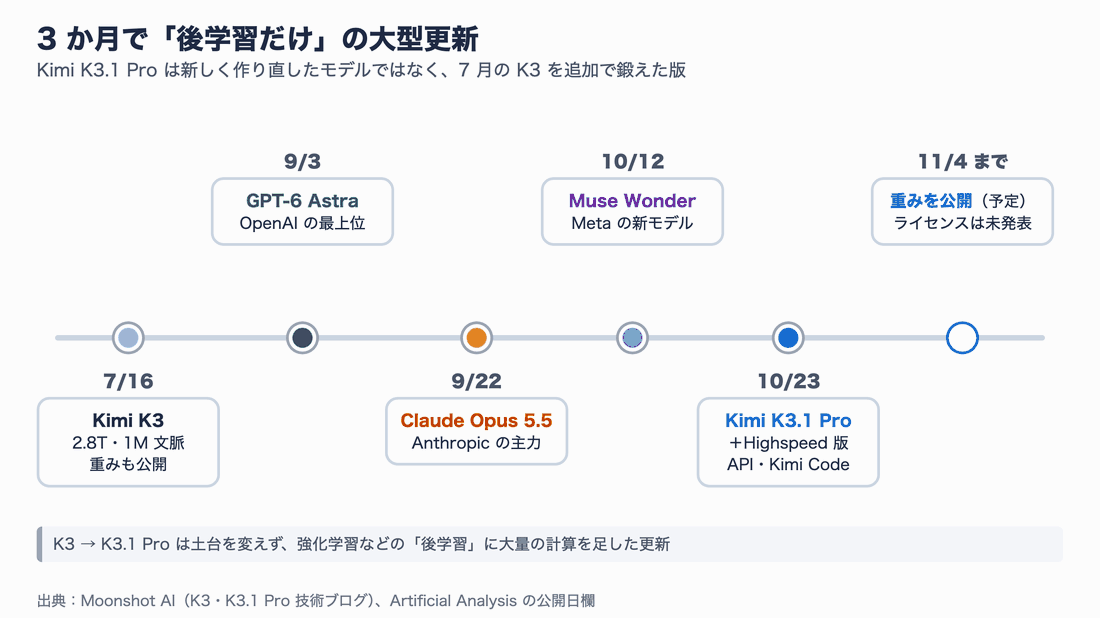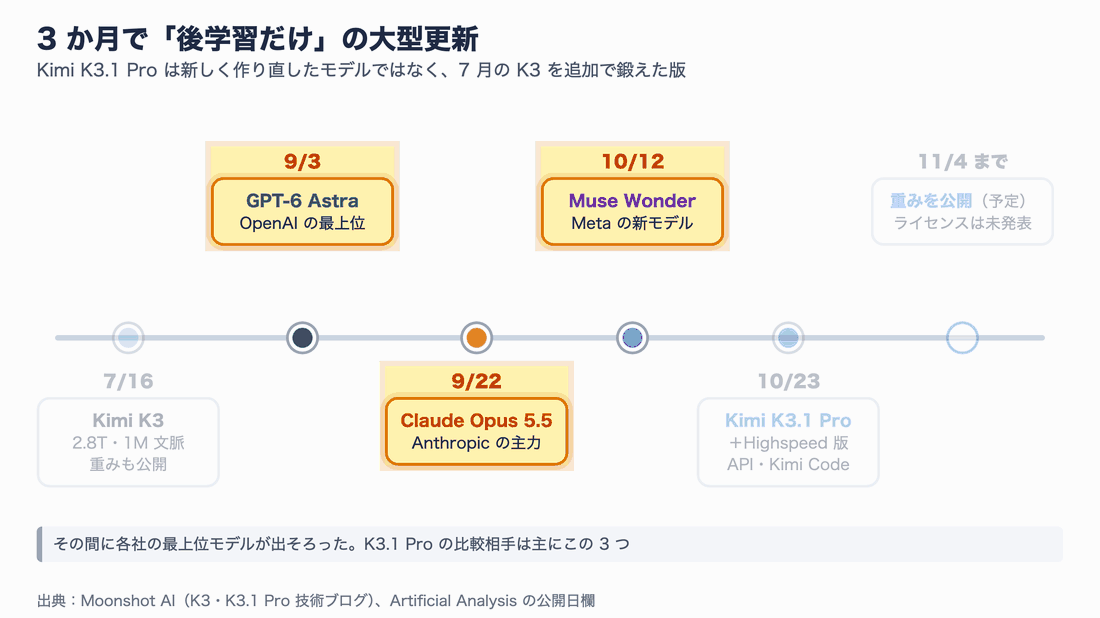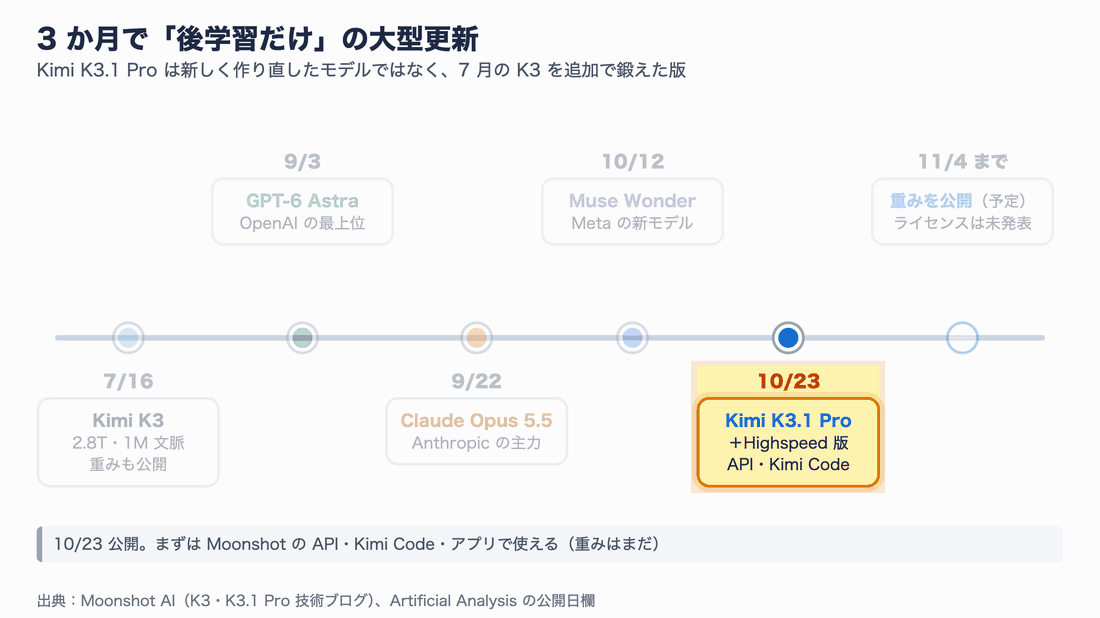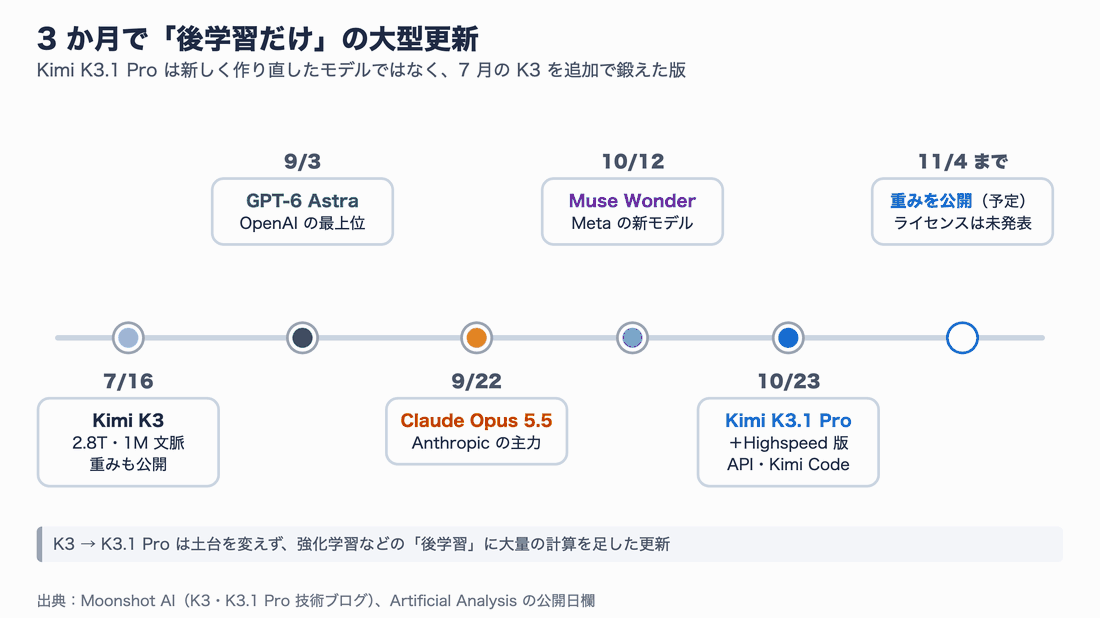
図2:K3 の公開から3か月で K3.1 Pro。その間に各社の最上位モデルが出そろい、それが今回の比較相手になります
仕様を表にまとめます。土台が同じなので、大きさと文脈の長さは K3 と変わりません。
| 項目 | Kimi K3 | Kimi K3.1 Pro | K3.1 Pro Highspeed |
|---|---|---|---|
| 公開日 | 2026-07-16 | 2026-10-23 | 2026-10-23 |
| パラメータ | 2.8 兆(1 回に使うのは約 1,040 億) | 同じ(公式表記は「3T 級」) | 同じ |
| 仕組み | 896 個の専門家(エキスパート)から 16 個を選んで使う MoE | 同じ | 同じ |
| 文脈の長さ | 100 万トークン | 100 万トークン | 100 万トークン |
| 思考(推論) | low/high/max | 常にオン(low/high/max、既定 max) | 同じ |
| API 料金(100 万トークンあたり) | 入力 $3/出力 $15 | 入力 $2/出力 $10 | 入力 $4/出力 $20 |
| 速さ | ― | 基準 | 公称 2〜3 倍 |
| 重み | 公開済み(Kimi K3 License) | 11/4 までに公開予定 | 同上 |
MoE(Mixture of Experts、専門家の混合) は、巨大なモデルの中に小さな「専門家」を大量に用意し、入力ごとに一部だけを動かす作り方です。総パラメータは 2.8 兆でも、1 回の計算で使うのは約 1,040 億なので、同じ大きさの普通のモデルより安く速く動かせます。総パラメータとアクティブ数は K3 の技術ブログと AA の掲載値です。K3.1 Pro の公式ブログは「3T 級」とだけ書いています。
K3 より値下げされている点にも注目です。入力・出力とも 3 分の 1 安くなりました。
何を足したのか:数百の分野で同時に強化学習
公式ブログによると、K3.1 Pro は K3 に対して「はるかに大きな後学習の計算」を投入し、数百の分野で同時に強化学習を回しています。そのために、強化学習の仕組み、長い文脈の推論、サンドボックス(隔離された実行環境)、課題の割り当て、採点環境の品質チェックまで、全部の層を作り直したそうです。
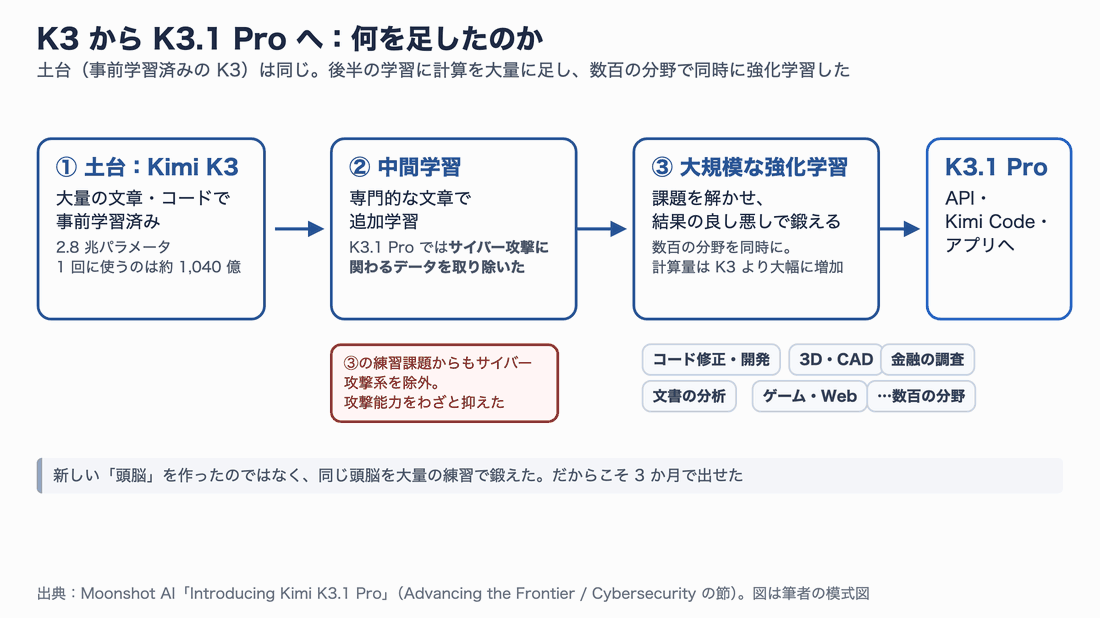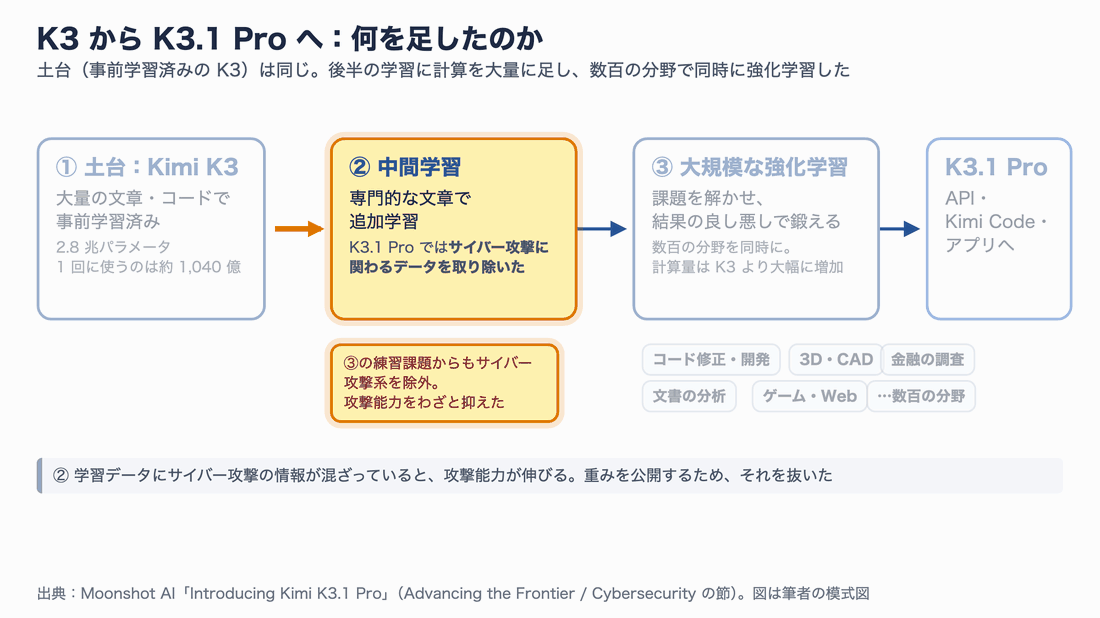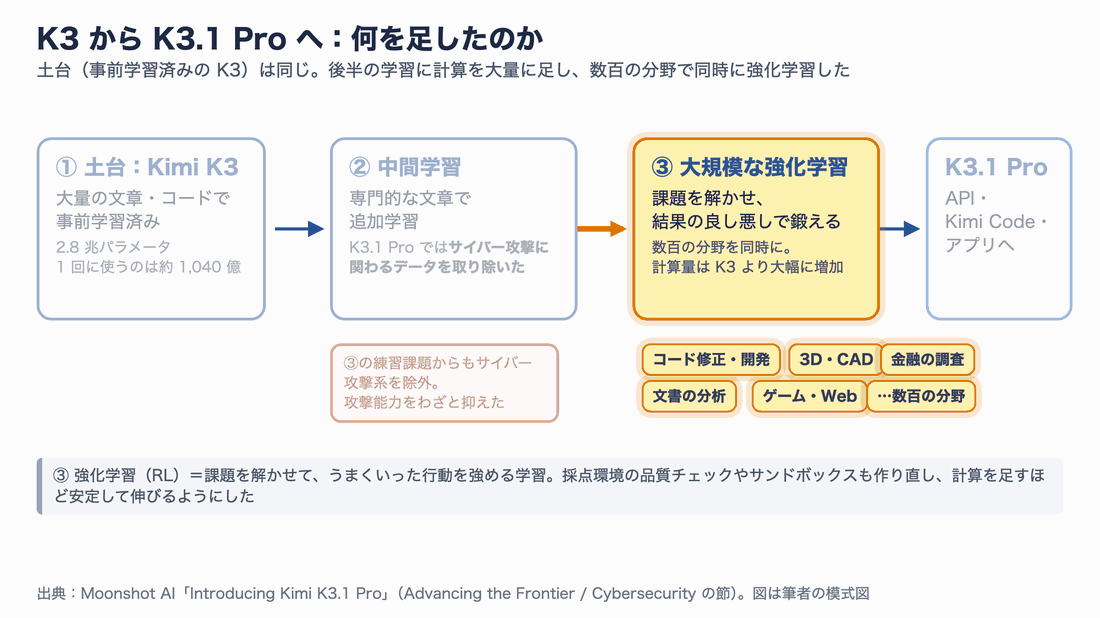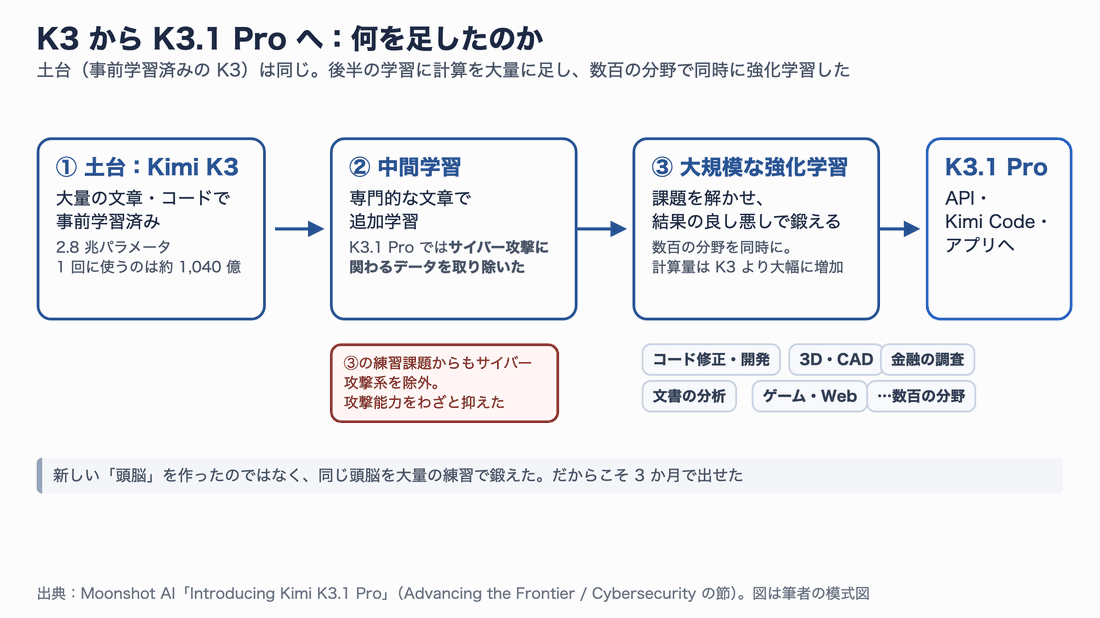
図3:土台は同じで、②③に手を入れた。②では重みの公開に備えて攻撃系のデータを抜いています
強化学習(RL) は、モデルに課題を解かせ、うまくいった行動を強めていく学習です。数学やコーディングのように「正解かどうか」を機械で判定できる課題と相性がよく、最近のモデルの伸びの多くはここから来ています。Moonshot は「計算を足すほど、どの分野でも安定して伸びるようにした」と説明しています。
公式ブログには、長時間の作業の例も載っています。人体の骨格 296 個・筋肉 402 個を持つオープンソースの人体モデルを使って歩行シミュレーターを作らせたところ、167 回の作業と 420 回の検証を経て、数秒で倒れていた人形が 11.2 秒歩き続けるようになった、というものです。報酬の調整で腕の動きが直らなかったとき、K3.1 Pro はシミュレーターそのものを調べ、肩の筋肉の計算にあった 36 個の誤りを見つけて直したそうです。これは開発元が選んだ1例なので、能力の「上限の見本」として読むのがよいでしょう。
ベンチマークを読む前に:同じ名前でも数字が違う
Terminal-Bench 4.0 の2つの表
発表の目玉は Terminal-Bench 4.0 です。ターミナル(コマンドを打つ黒い画面)の中で、エージェントに実際の開発作業をやらせ、課題ごとの厳しいテストで合否を判定するベンチマークです。コーディングエージェントの実力を測る代表的な物差しの1つです。
ところが、この同じベンチマークの数字が、出どころによって違います。
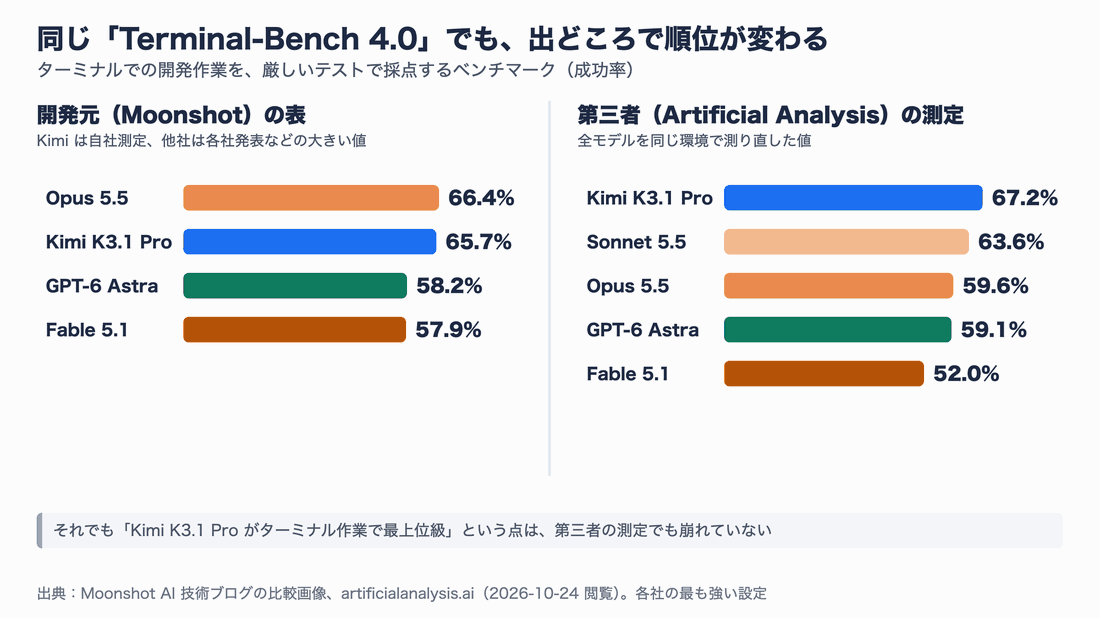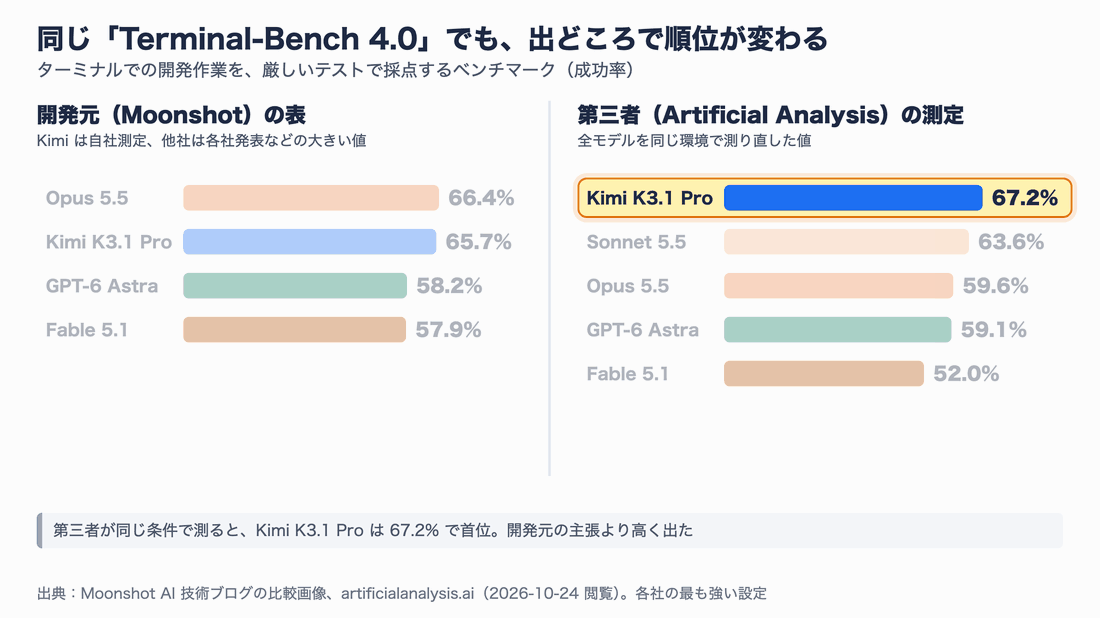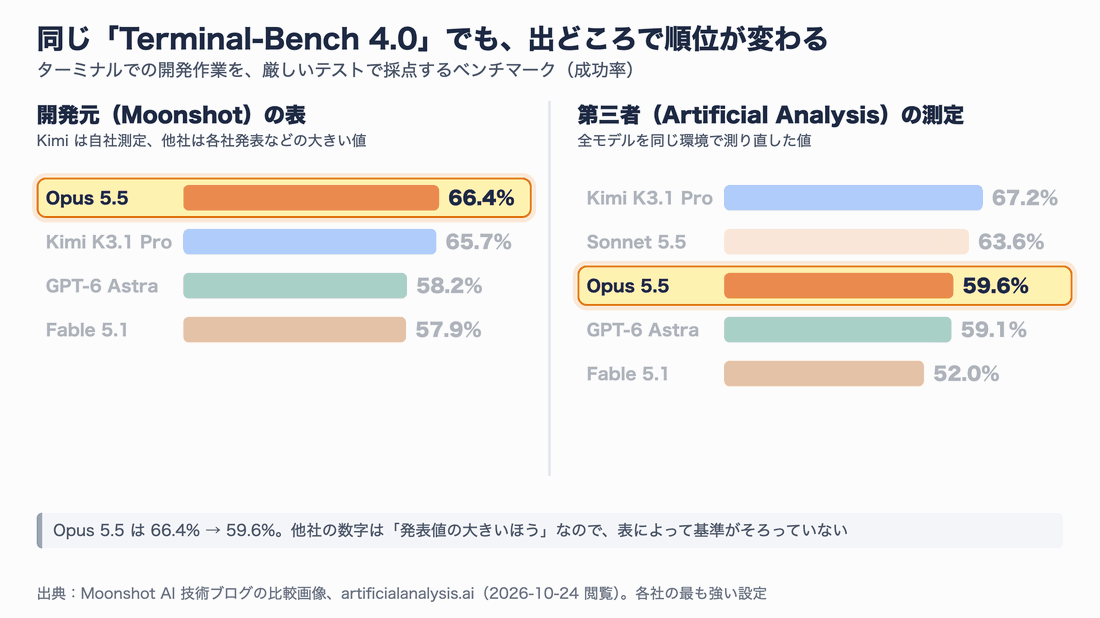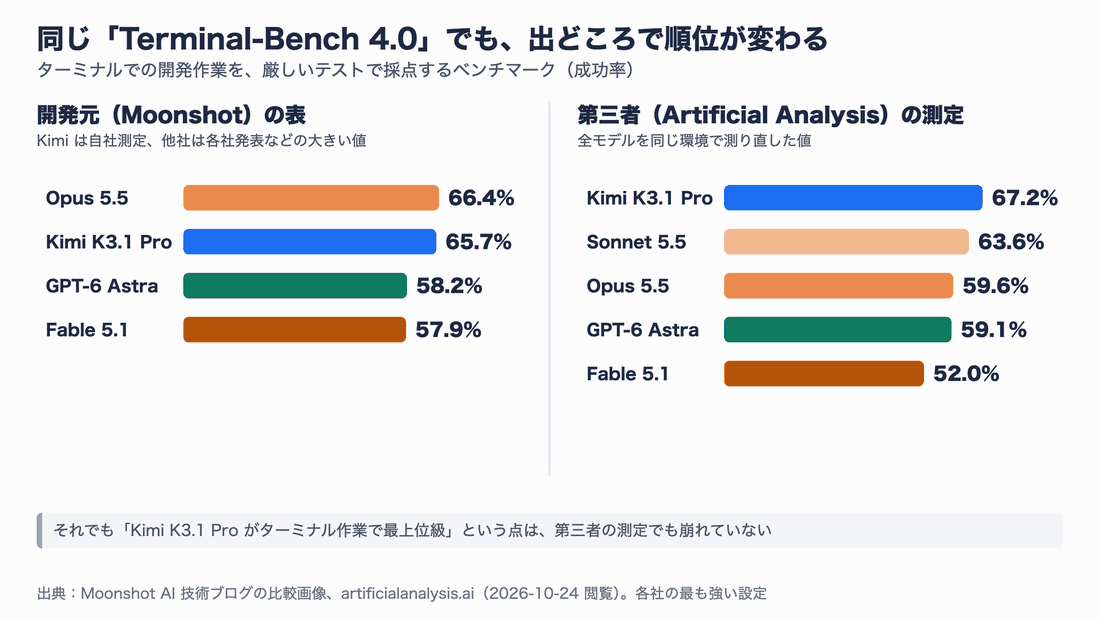
図4:同じ Terminal-Bench 4.0 でも、開発元の表では Kimi が2位、第三者の測定では Kimi が首位
違いが出る理由は、測り方にあります。
| 開発元(Moonshot)の表 | 第三者(AA)の測定 | |
|---|---|---|
| Kimi K3.1 Pro の測り方 | 自社で測定。Claude Code をハーネスに使用、思考 max | AA が自社の環境で測定 |
| 他社モデルの数字 | 各社のブログか公式リーダーボードの「大きいほう」 | AA が同じ環境で測り直した値 |
| Opus 5.5 | 66.4% | 59.6% |
| Kimi K3.1 Pro | 65.7% | 67.2% |
ハーネスとは、モデルにファイル操作やコマンド実行をさせる「外側の仕組み」のことです。Claude Code や Codex がその代表です。同じモデルでも、どのハーネスで、どれだけ考えさせ、何回測るかで、成功率は数ポイントから十数ポイント動きます。開発元の表は、他社の数字を「各社の発表値の大きいほう」で埋めているので、測り方がそろっていません。
ここで大事なのは、第三者が条件をそろえて測ると、Kimi K3.1 Pro はむしろ開発元の主張より上に出たことです。少なくとも「ターミナル作業で最上位級」という主張は、独立した測定でも崩れていません。一方で、表をまたいで数字を比べる(開発元の表の Opus 66.4% と、AA の Kimi 67.2% を並べる、など)のは避けるべきです。
開発元の表の全体像
公式ブログに載っている比較表を、そのまま載せておきます。14 項目で、Kimi K3.1 Pro(青)と Opus 5.5・GPT-6 Astra・Fable 5.1・DeepSeek・GLM を比べています。
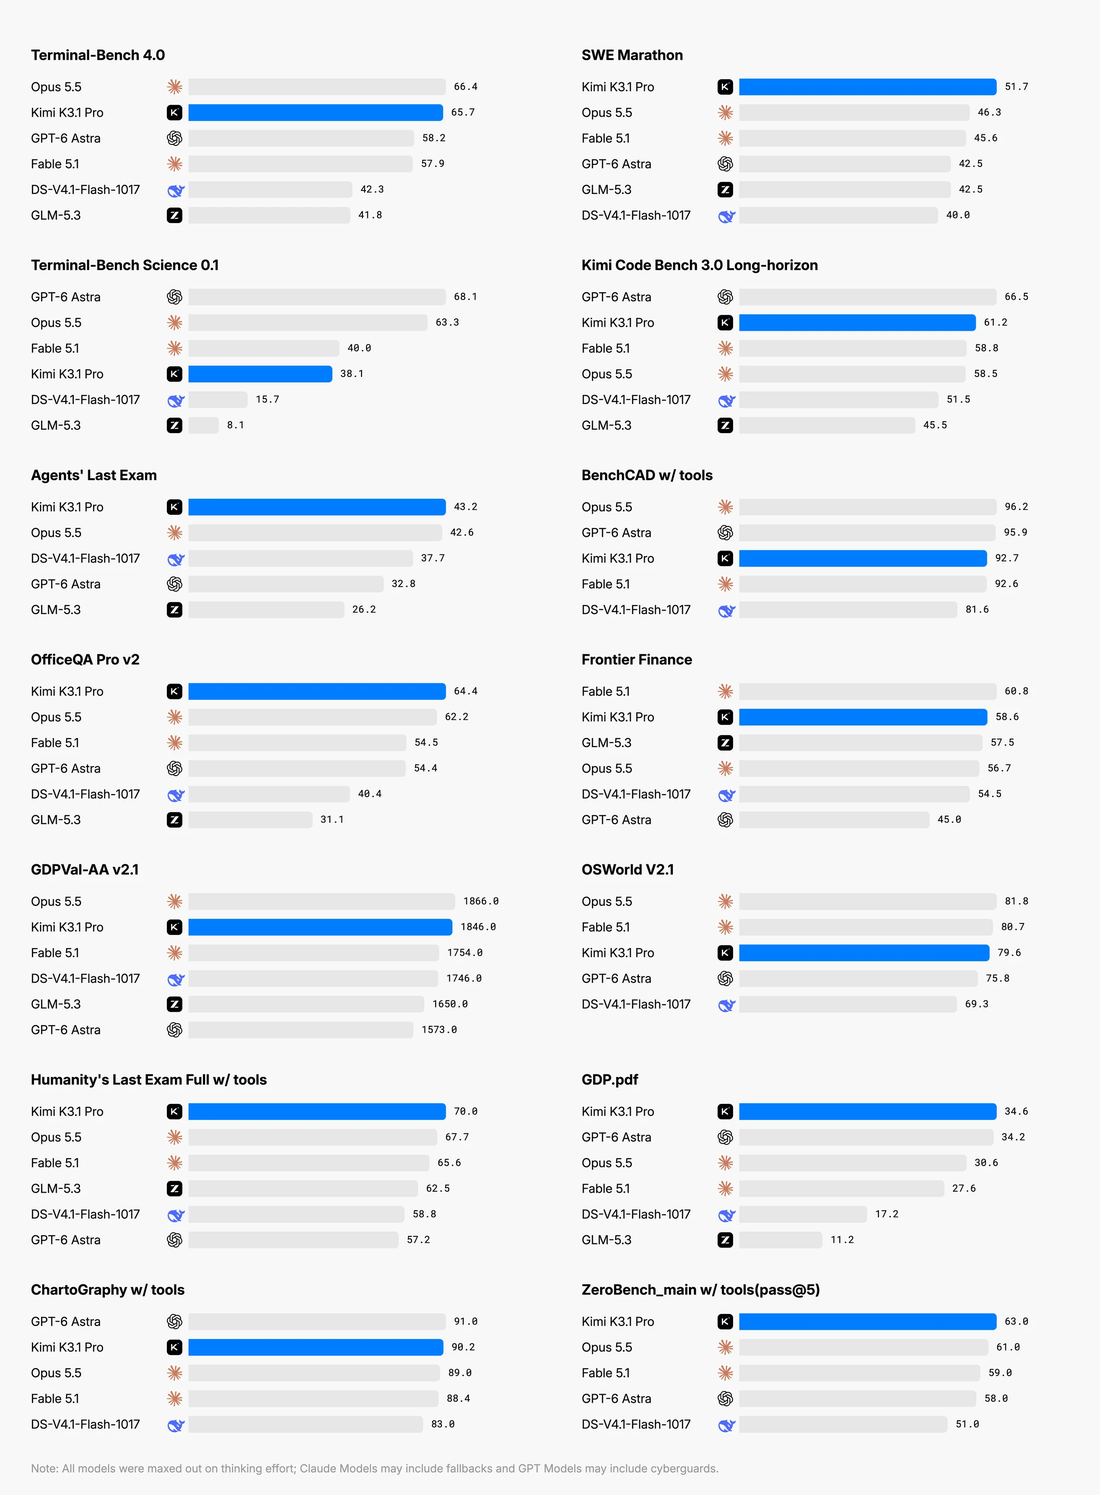
図5:Moonshot AI「Introducing Kimi K3.1 Pro」の比較表(出典:kimi.com/blog/kimi-k3-1-pro)。表の下には「Claude は fallback を含む場合があり、GPT は cyberguard を含む場合がある」と注記があります
注記にある fallback は、Claude が安全上の理由で応答を別の動作に切り替えることがある仕組み、cyberguard は GPT がサイバー攻撃に関わる依頼を抑える仕組みを指していると読めます。どちらも他社モデルの点数を下げる方向に働き得るので、開発元の表では他社が少し不利に出ている可能性があります。
得意・苦手を見る:14 項目の勝ち負け
開発元の表でも、首位は 13 項目中 6 つ
比較表の数字から、Kimi K3.1 Pro の点数と「Opus 5.5・GPT-6 Astra・Fable 5.1 のうち最高の点数」の差を計算しました。右に伸びれば Kimi の勝ちです(単位が Elo の GDPval-AA は除き、13 項目)。
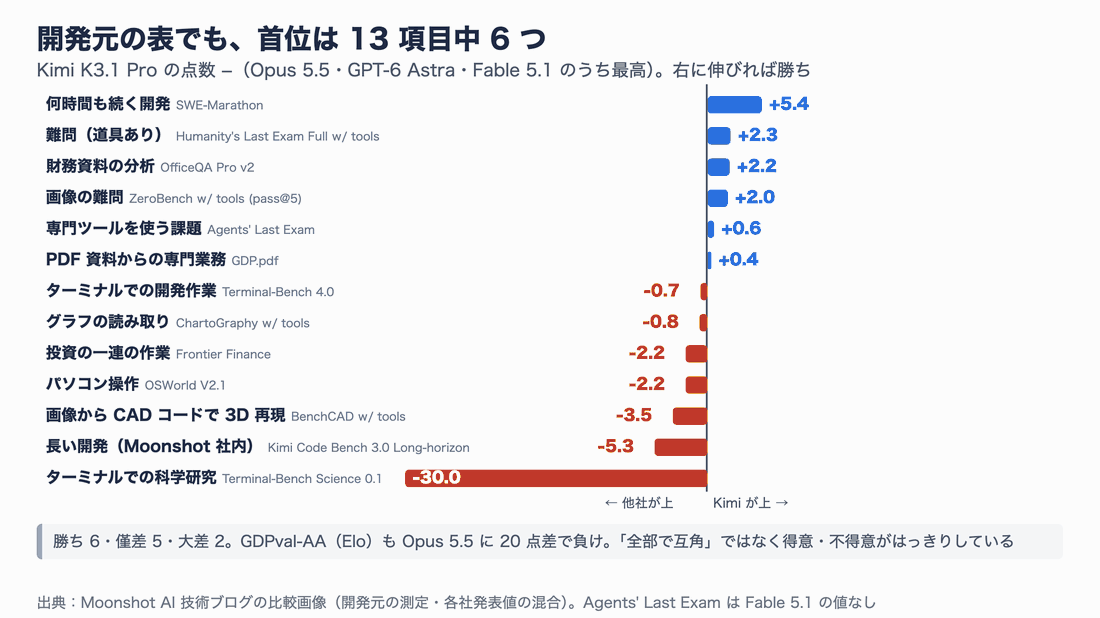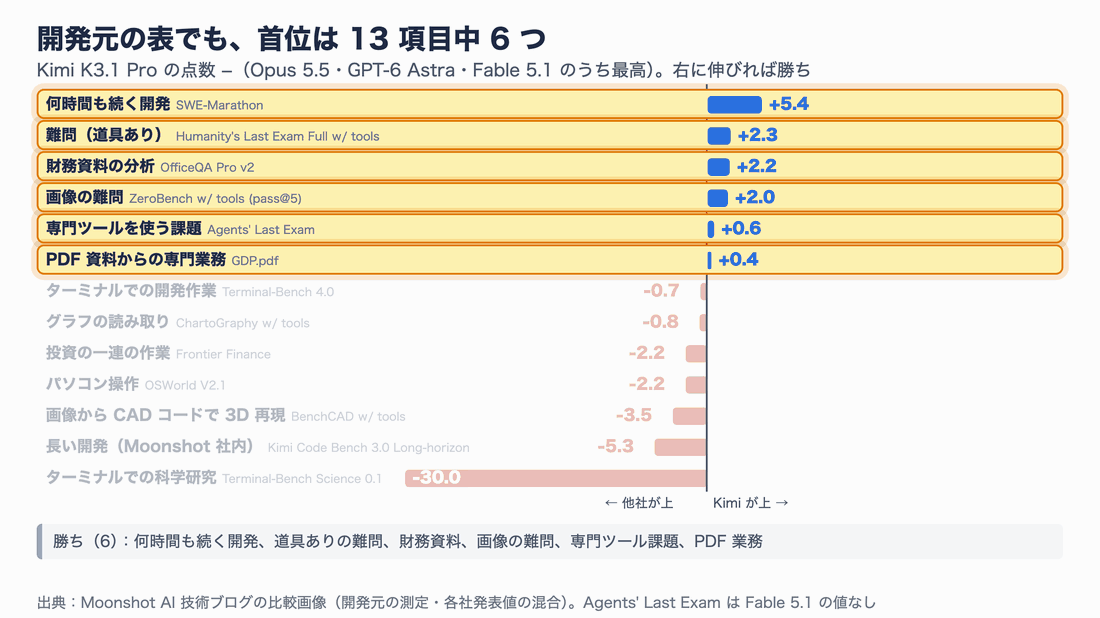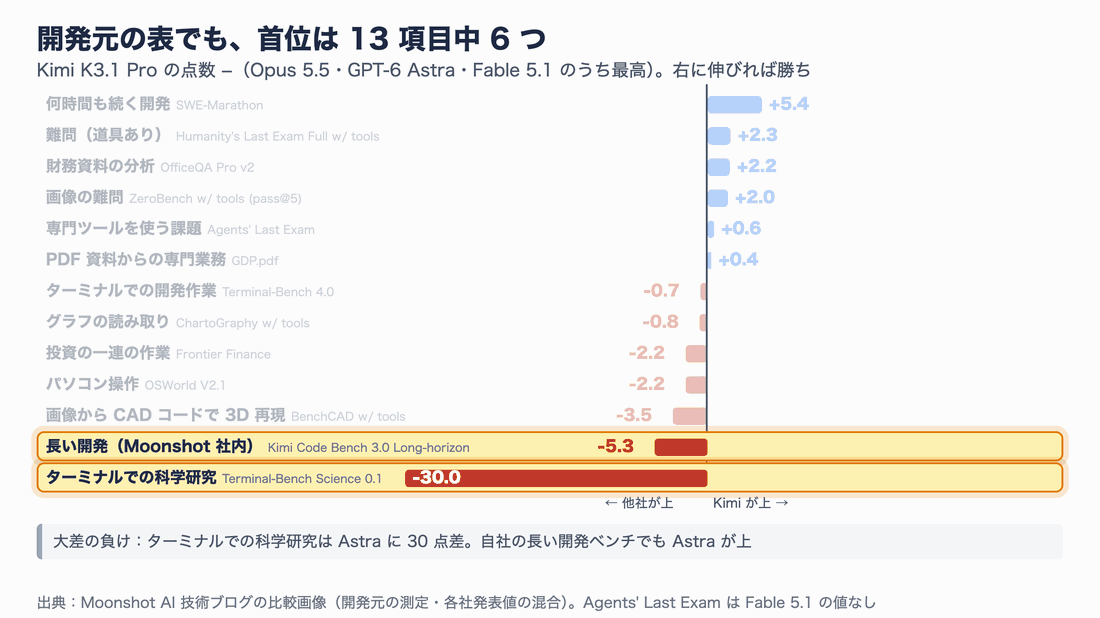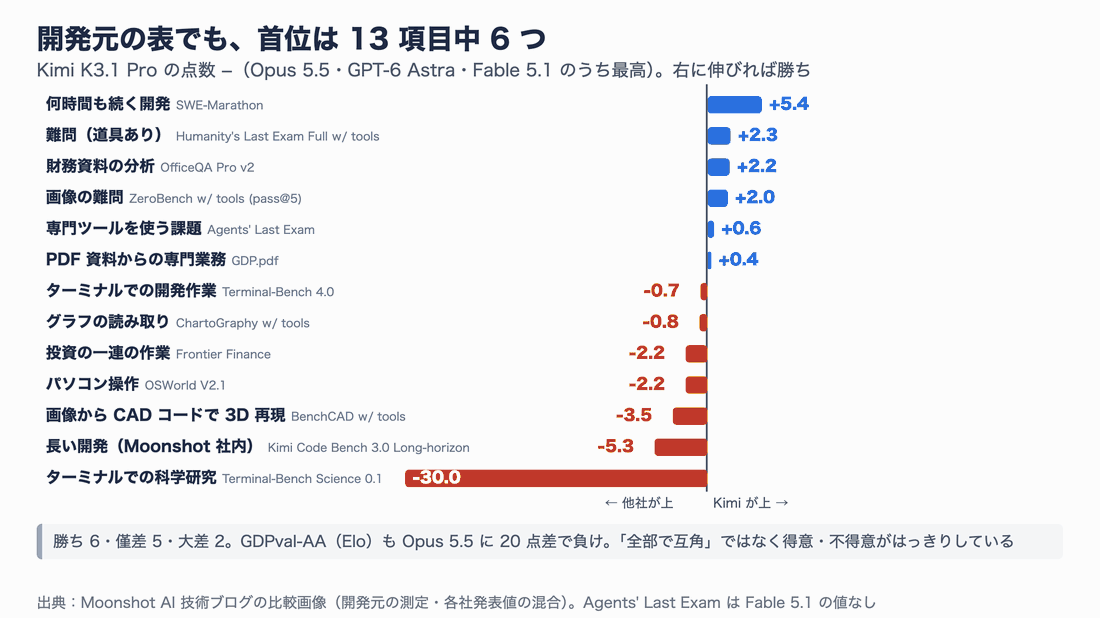
図6:勝ち 6・僅差の負け 5・大差の負け 2。得意と苦手がはっきり分かれています
数字を表でも示します(開発元の表の値。太字はその行の首位)。
| ベンチマーク | 何を測るか | Kimi K3.1 Pro | Opus 5.5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|---|
| SWE-Marathon | 何時間も続く開発 | 51.7 | 46.3 | 42.5 | 45.6 |
| Humanity’s Last Exam(道具あり) | 専門家レベルの難問 | 70.0 | 67.7 | 57.2 | 65.6 |
| OfficeQA Pro v2 | 財務資料の分析 | 64.4 | 62.2 | 54.4 | 54.5 |
| ZeroBench(道具あり) | 画像の難問 | 63.0 | 61.0 | 58.0 | 59.0 |
| Agents’ Last Exam | 専門ツールを使う課題 | 43.2 | 42.6 | 32.8 | ― |
| GDP.pdf | PDF 資料からの専門業務 | 34.6 | 30.6 | 34.2 | 27.6 |
| Terminal-Bench 4.0 | ターミナルでの開発作業 | 65.7 | 66.4 | 58.2 | 57.9 |
| ChartoGraphy(道具あり) | グラフの読み取り | 90.2 | 89.0 | 91.0 | 88.4 |
| Frontier Finance | 投資の一連の作業 | 58.6 | 56.7 | 45.0 | 60.8 |
| OSWorld V2.1 | パソコン操作 | 79.6 | 81.8 | 75.8 | 80.7 |
| BenchCAD(道具あり) | 画像から CAD コードで 3D 再現 | 92.7 | 96.2 | 95.9 | 92.6 |
| Kimi Code Bench 3.0 | 長い開発(Moonshot 社内) | 61.2 | 58.5 | 66.5 | 58.8 |
| Terminal-Bench Science 0.1 | ターミナルでの科学研究 | 38.1 | 63.3 | 68.1 | 40.0 |
| GDPval-AA v2.1(Elo) | 実務の成果物 | 1846 | 1866 | 1573 | 1754 |
ここから読み取れることを3つに分けます。
得意:長く続く作業と、文書を読み込む仕事
勝っている項目には共通点があります。何時間もかけて作業をやり切る(SWE-Marathon)、専門ツールや資料を使いこなす(Agents’ Last Exam、OfficeQA Pro v2、GDP.pdf)といった、道具を使って手を動かし続けるタイプの課題です。大規模な強化学習で「作業を最後まで進める力」を鍛えた、という説明と合っています。
金融では、Moonshot 社内の評価でも K3 から大きく伸びています。財務モデル作成が 50.4 → 57.6、根拠付きの調査が 58.8 → 70.4、経営シミュレーションが 8.9 → 37.0(約 4.2 倍)です。
僅差の負け:最上位とほぼ同じ水準
ターミナル作業・グラフ読み取り・投資・パソコン操作・CAD は、いずれも首位と 4 点以内です。CAD は「道具なし」で比べると Kimi 72.8・Opus 5.5 73.0 とさらに近く、Fable 5.1(60.6)は大きく引き離しています。このあたりは「最上位と同じ土俵にいる」と言ってよい範囲です。
大差の負け:科学系の作業と、自社のベンチ
目立つのは Terminal-Bench Science で、GPT-6 Astra に 30 点差をつけられています。生命科学・物理・地球科学などの研究作業をターミナルで進める課題で、専門知識と長い作業の両方が要ります。
意外なのは、Moonshot 自身が作った長い開発のベンチ(Kimi Code Bench 3.0)でも GPT-6 Astra が首位なことです。自社に不利な結果も表に残している点は、表の信頼性を考えるうえで好材料です。
第三者の物差しで見る総合力
Artificial Analysis の総合指数で 4 番手
開発元の表は、測り方がそろっていないという弱点がありました。そこで、第三者の Artificial Analysis Intelligence Index(AA が 10 種類の評価を全モデル同じ条件で実行して合成した総合指数、v4.3.2)を見ます。
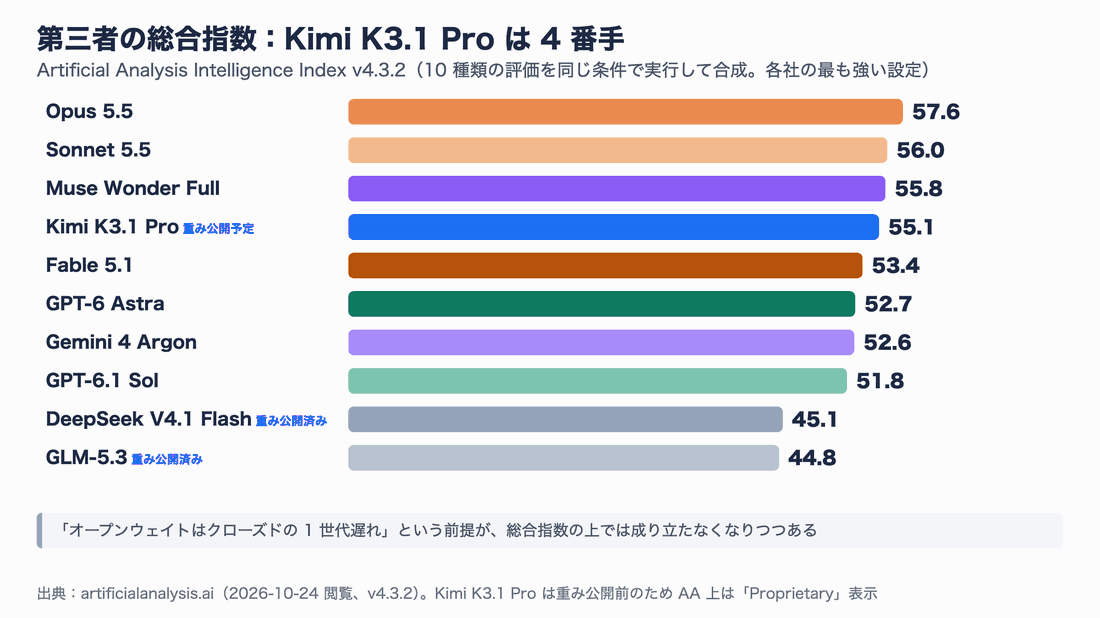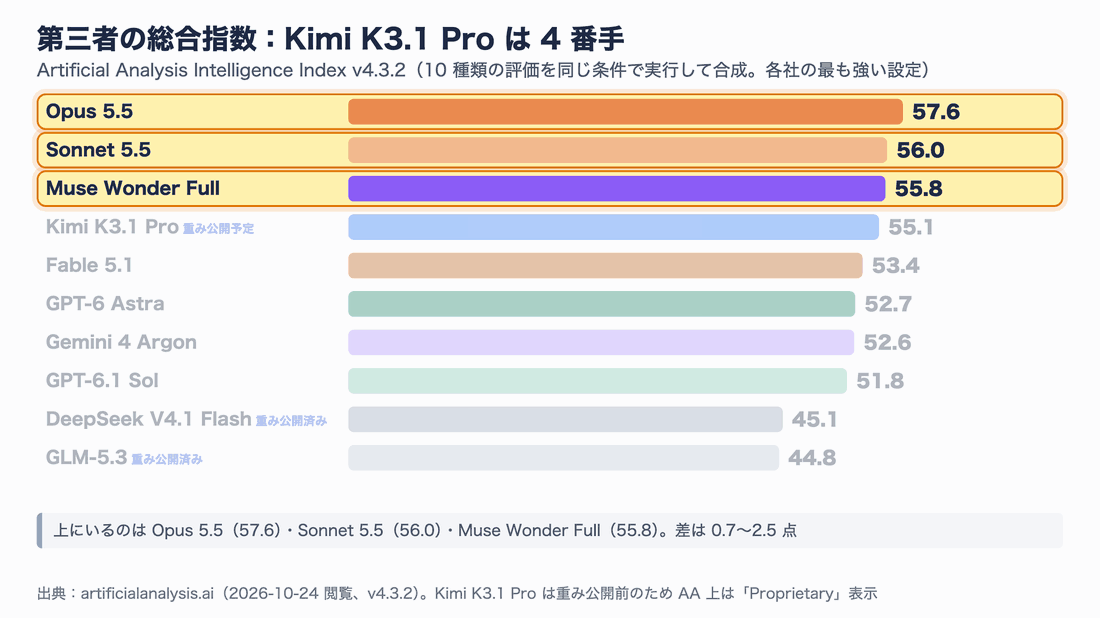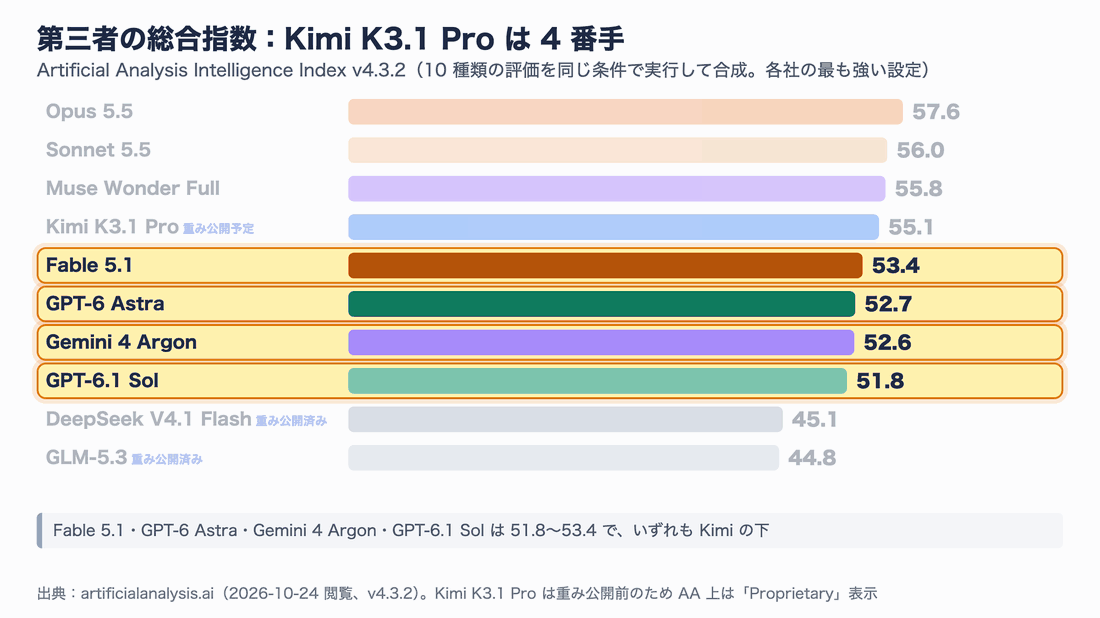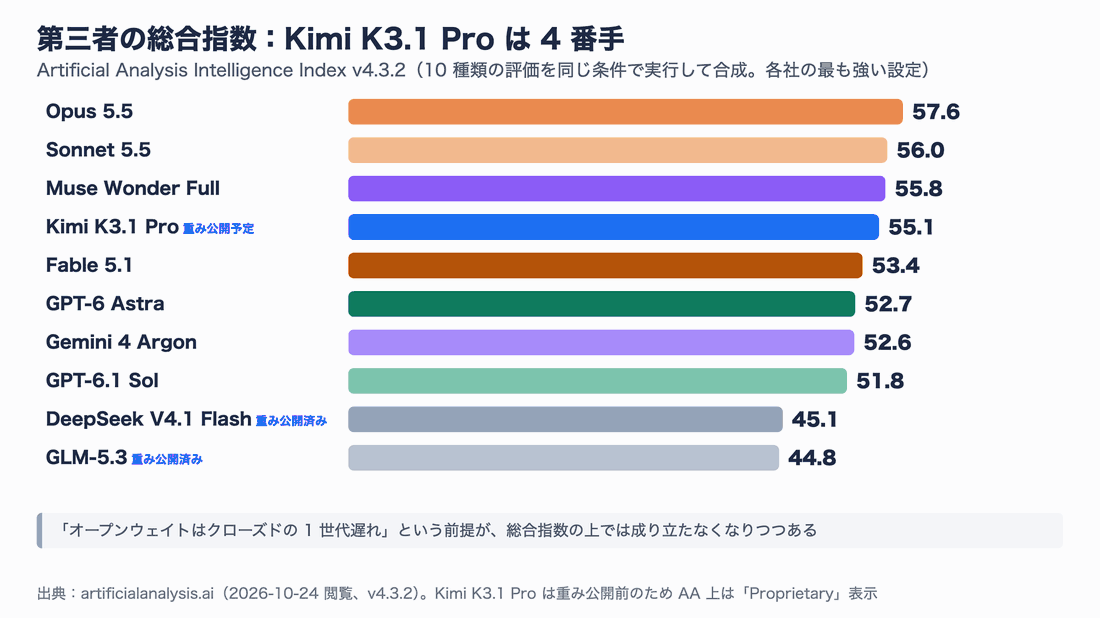
図7:Kimi K3.1 Pro は 55.1 で、AA の一覧 215 モデル中 4 位。重みが公開済みのモデルの最高(約 45)を 10 点上回ります
上にいるのは Claude Opus 5.5(57.6)、Claude Sonnet 5.5(56.0)、Meta の Muse Wonder Full(55.8)の3つだけです。Fable 5.1・GPT-6 Astra・Gemini 4 Argon は Kimi の下に来ています。
もう1つ注目したいのは、重みが公開済みのモデルとの差です。現時点の最高は DeepSeek V4.1 Flash の 45.1 と GLM-5.3 の 44.8。Kimi K3.1 Pro の重みが 11/4 に出れば、「手元で動かせるモデル」の上限が一気に約 10 点上がります。なお AA は、重みが出るまで Kimi K3.1 Pro を「Proprietary(非公開)」として扱っています。
得意と苦手は、第三者の数字でも同じ形
AA の個別の評価を見ると、開発元の表で見えた「得意・苦手の形」がそのまま現れます。
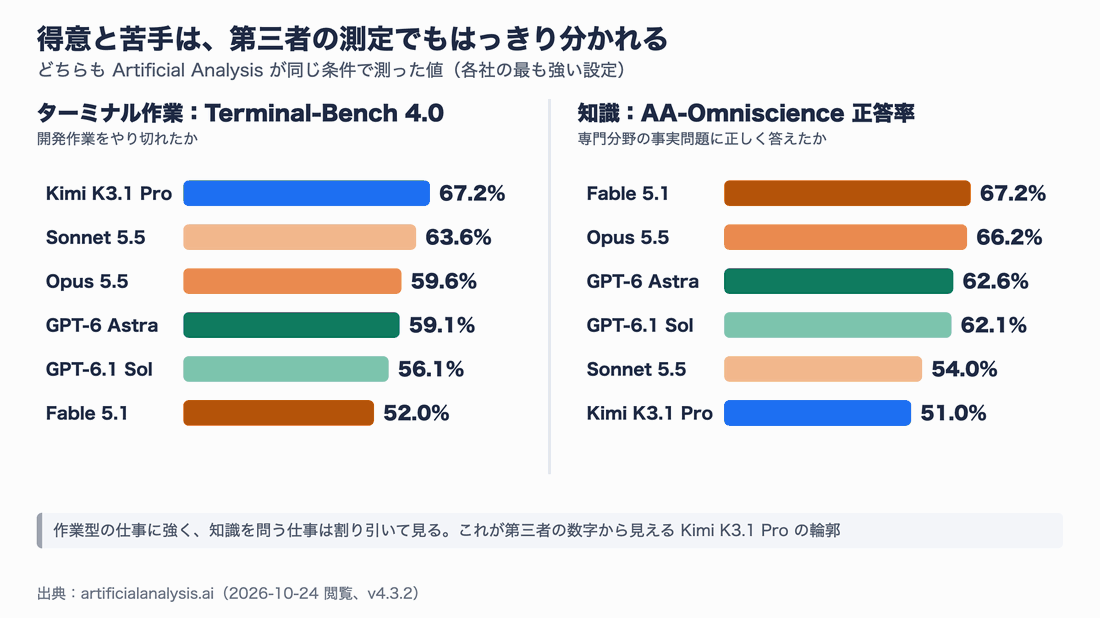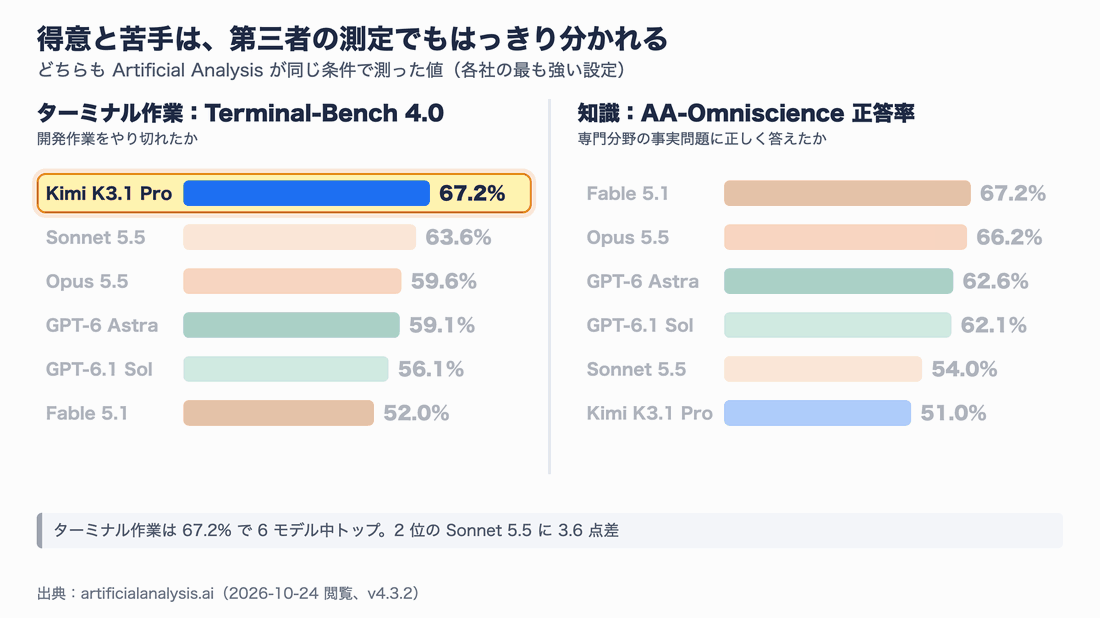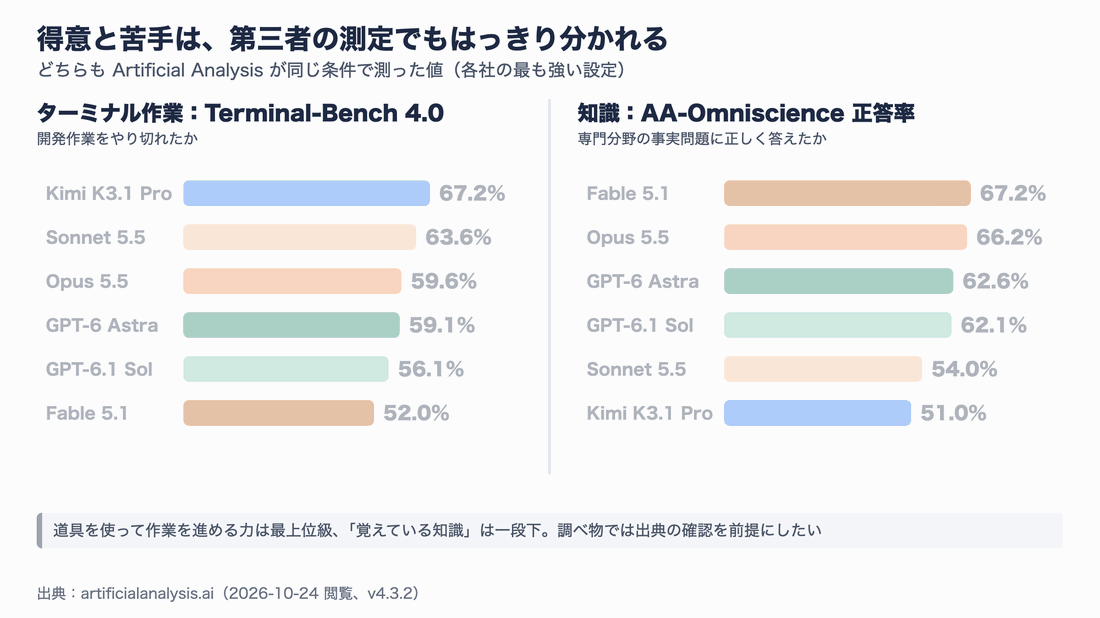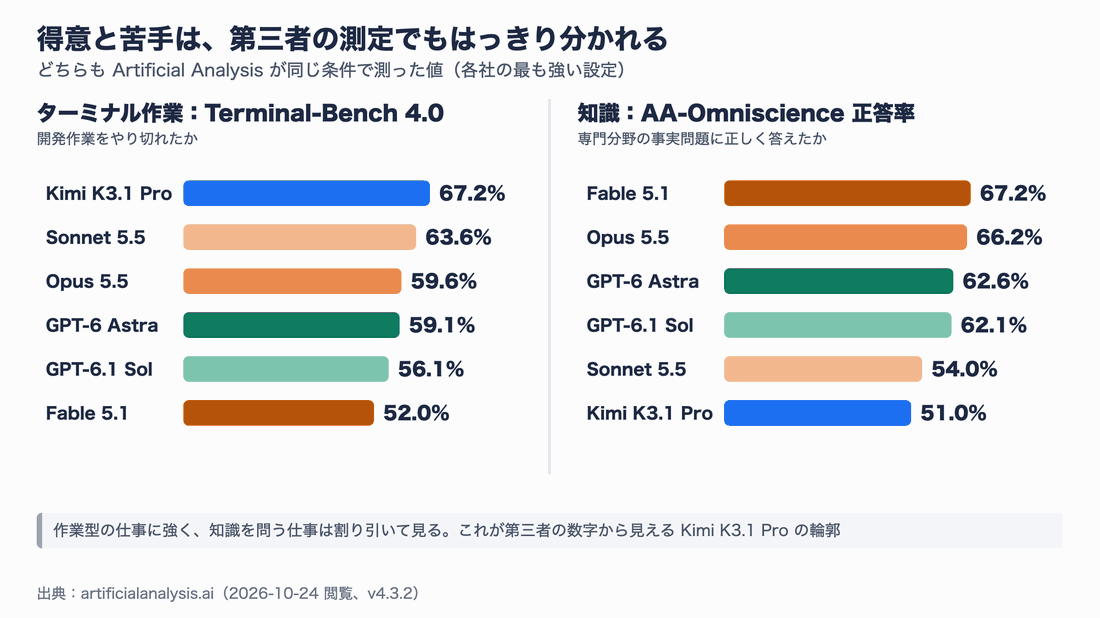
図8:作業をやり切る力は首位、覚えている知識は最下位。同じモデルの中で、これだけ差がはっきり出ます
AA-Omniscience は、専門分野の事実を問う問題で、正しく答えられるか、分からないときに「分からない」と言えるかを測る評価です。Kimi K3.1 Pro の正答率は 51.0% で、Opus 5.5(66.2%)や Fable 5.1(67.2%)より 15 点以上低くなっています。AA が測った難問集 Humanity’s Last Exam も 52.5% で、Opus 5.5 の 61.4% に届きません。
開発元の表では、検索などの道具を使える条件の Humanity’s Last Exam で Kimi が首位(70.0)だったことを思い出してください。検索やコード実行などの道具を使えば強いが、モデル自身が覚えている知識は一段下。これが2つの表を突き合わせて見える Kimi K3.1 Pro の輪郭です。
ハルシネーションの数字は「何を測ったか」に注意
開発元は、事実の誤り(ハルシネーション:もっともらしい誤りを出すこと)を減らしたとも主張しています。
| 評価(開発元の社内) | GPT-6 Astra | Kimi K3.1 Pro | Opus 5.5 | Fable 5.1 | K3 |
|---|---|---|---|---|---|
| Kimi Hallu Bench(道具なし) | 4.2% | 5.4% | 6.8% | 11.4% | ― |
| Kimi Hallu Bench Hard(道具あり) | 5.5% | 8.3% | 15.0% | 23.3% | 23.4% |
これは「回答の中の事実の主張のうち、誤りを含む割合」で、低いほど良い数字です。K3 の 23.4% から 8.3% へ大きく下がり、Opus 5.5 より低くなっています。ただし、誤りやすい場面をわざと集めたストレステストで、日常の誤り率ではないと開発元自身が断っています。
AA の正答率(知っているか)と、この誤り率(書いた主張が正しいか)は、測っているものが違います。「知識は多くないが、書くときは慎重」という読み方もできますが、どちらにしても調べものでは出典に戻って確かめる前提で使うのが安全です。
値段と速さ:単価は半分、ただし「よく考える」
API の料金
Kimi API(従量課金)の料金は次のとおりです。
| モデル | 入力 | キャッシュ読み出し | キャッシュ書き込み(5分/1時間) | 出力 |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $0.20 | $2.00/$4.00 | $10.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $4.00/$8.00 | $20.00 |
| kimi-k3(参考) | $3.00 | $0.30 | $3.00/$6.00 | $15.00 |
(100 万トークンあたりの米ドル。税別)
キャッシュは、前の要求と同じ先頭部分(システムの指示や読み込んだファイルなど)を保存しておき、次から安く読み出す仕組みです。コーディングエージェントは同じ文脈を何十回も送り直すので、実際の費用の大半はキャッシュ読み出しになります。
単価・1 タスクの費用・速さを並べる
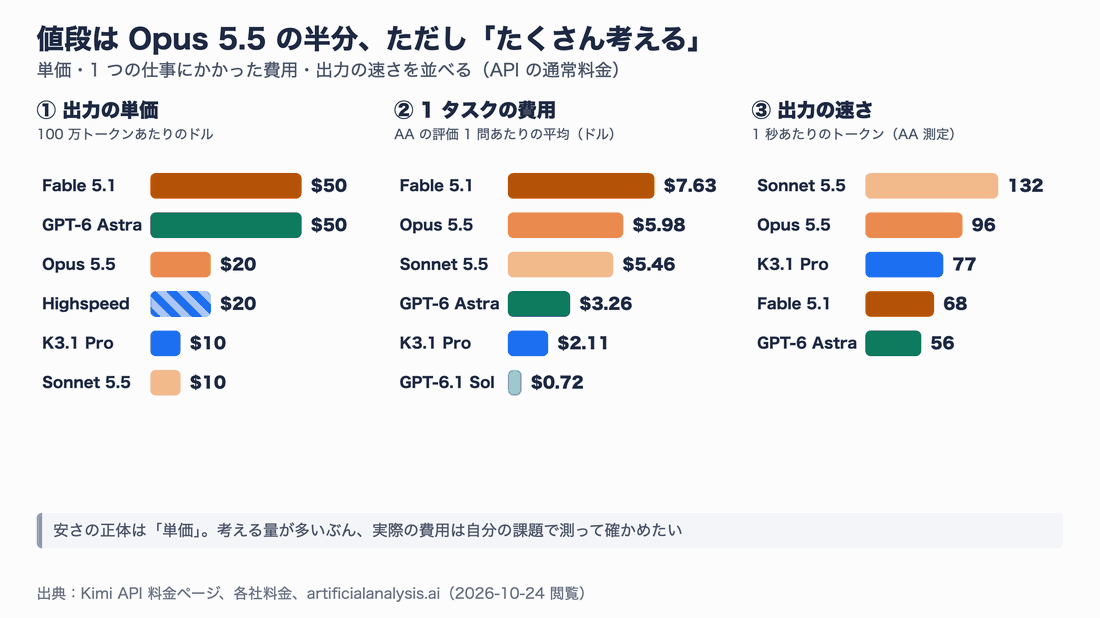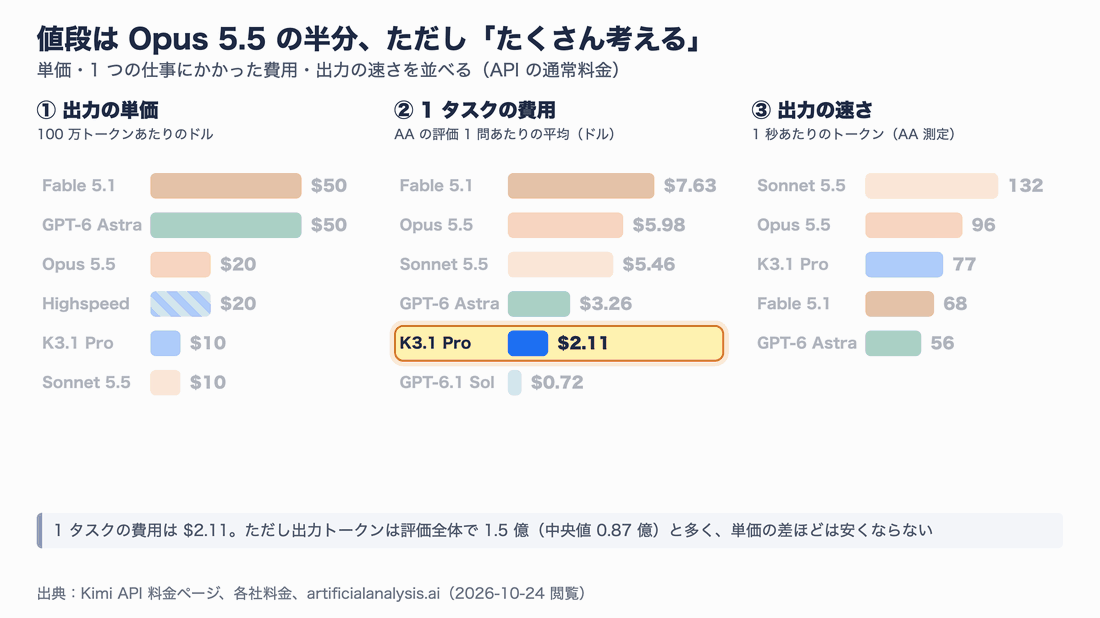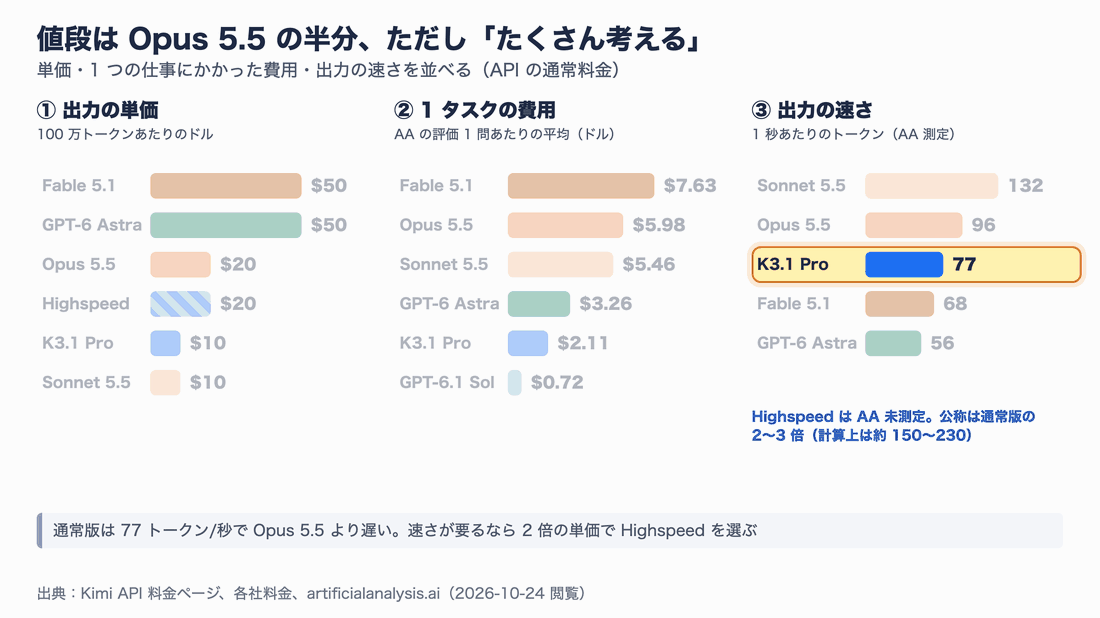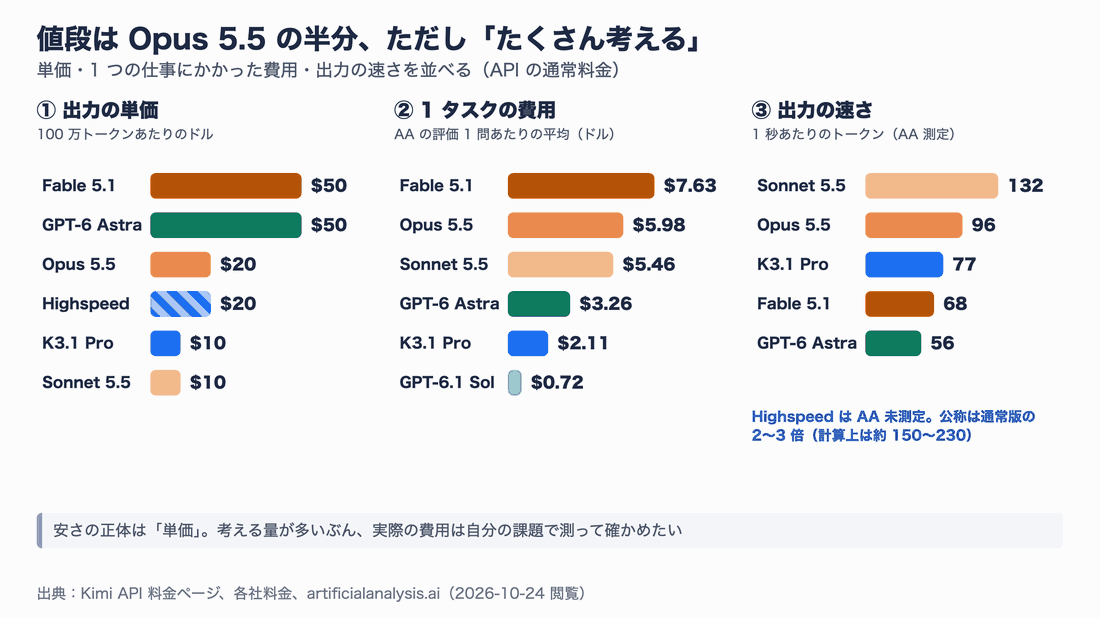
図9:単価は Opus 5.5 の半分。1 タスクの費用も安いが、通常版の速さは Opus 5.5 より遅い
3つの点に気をつけてください。
- 単価:入力 $2・出力 $10 は Sonnet 5.5 と同じで、Opus 5.5 の半分、Fable 5.1・GPT-6 Astra の5分の1です
- 1 タスクの費用:AA の評価 1 問あたり $2.11 で、Opus 5.5($5.98)の約3分の1です。ただし Kimi はよく考えるモデルで、評価全体の出力トークンは 1.5 億と、中央値(0.87 億)の倍近くあります。単価の差ほどは安くなりません
- 速さ:通常版は 77 トークン/秒で、Opus 5.5(96)より遅く、Sonnet 5.5(132)の6割ほどです。速さが要る場面では、2倍の単価の Highspeed(公称 2〜3 倍速、AA は未測定)を選ぶことになります
1 回の修正作業でいくらかかるか(試算)
コーディングエージェントの1回の修正作業を「入力 200 万トークン(うち 9 割はキャッシュ読み出し)、出力 5 万トークン」と仮定して、単価だけで試算してみます。キャッシュ書き込みの割増は含めていません。
| モデル | 新しい入力 20 万 | キャッシュ読み 180 万 | 出力 5 万 | 合計 |
|---|---|---|---|---|
| Kimi K3.1 Pro | $0.40 | $0.36 | $0.50 | $1.26 |
| K3.1 Pro Highspeed | $0.80 | $0.36 | $1.00 | $2.16 |
| Claude Sonnet 5.5 | $0.40 | $0.18 | $0.50 | $1.08 |
| Claude Opus 5.5 | $0.80 | $0.36 | $1.00 | $2.16 |
| Claude Fable 5.1 | $2.00 | $0.45 | $2.50 | $4.95 |
| GPT-6 Astra | $2.00 | $1.80 | $2.50 | $6.30 |
同じトークン数なら、Kimi K3.1 Pro は Opus 5.5 の6割弱です。ただし前述のとおり、Kimi は考える量(出力トークン)が多めなので、実際には出力の列が膨らみます。仮に出力が 2 倍になっても $1.76 で、まだ Opus 5.5 より安い計算です。とはいえ、これは単価の試算にすぎません。失敗してやり直す回数まで含めた「成功 1 件あたり」の費用は、自分の課題で測るしかありません。その手順は後半で紹介します。
通常版と Highspeed の選び方
Highspeed は「同じ能力で速い」版です。値段は API で2倍、Kimi Code の利用枠も2倍消費します。どちらを選ぶかは、人が待つかどうかで決めるのが分かりやすいでしょう。
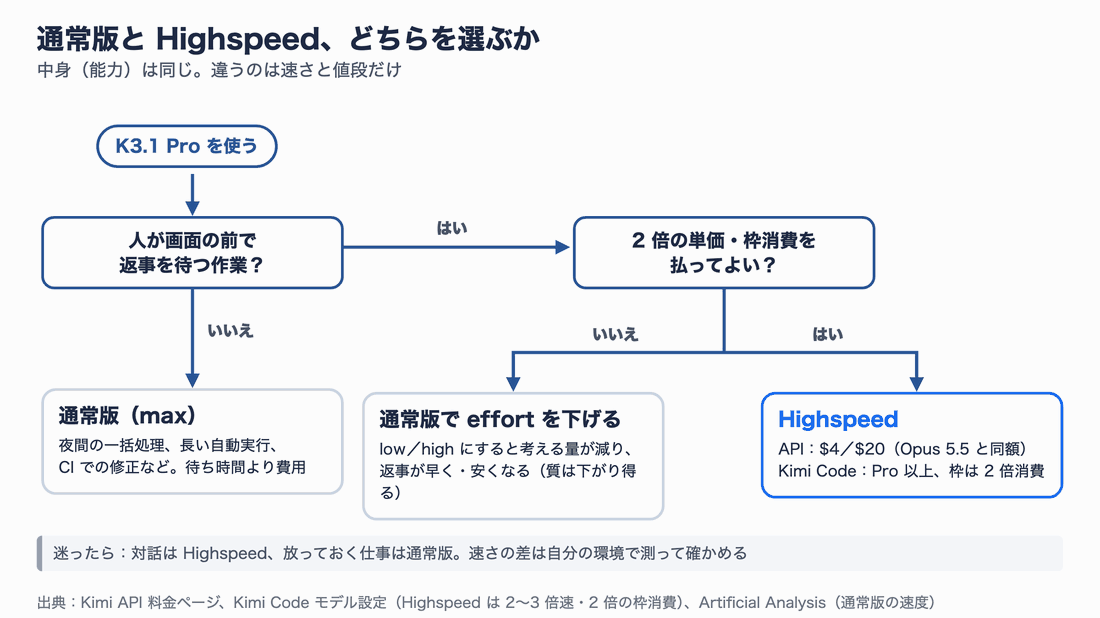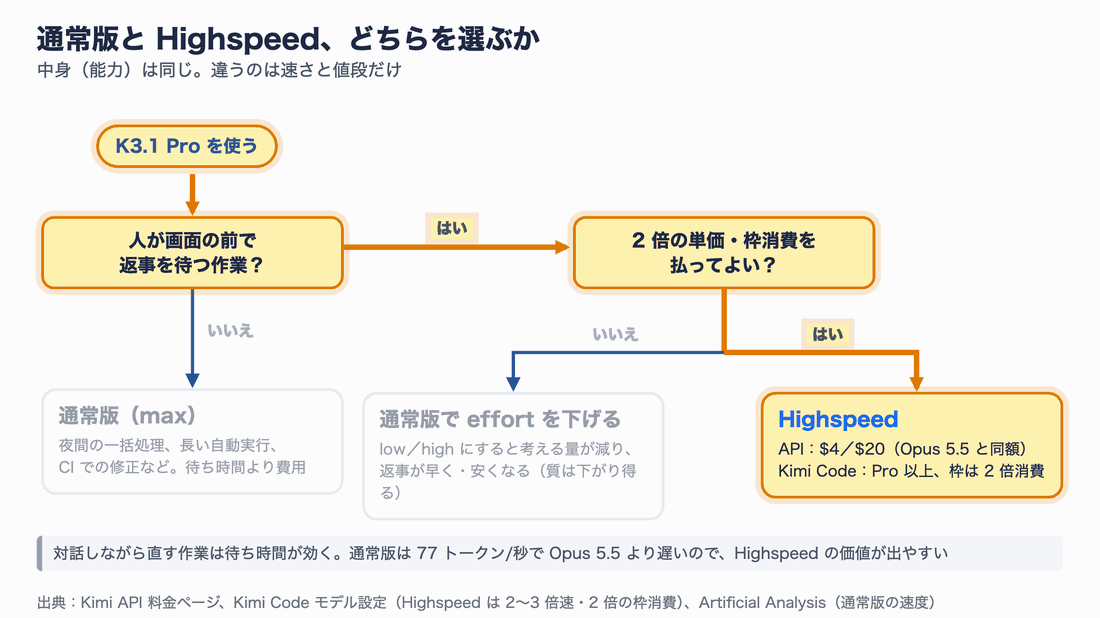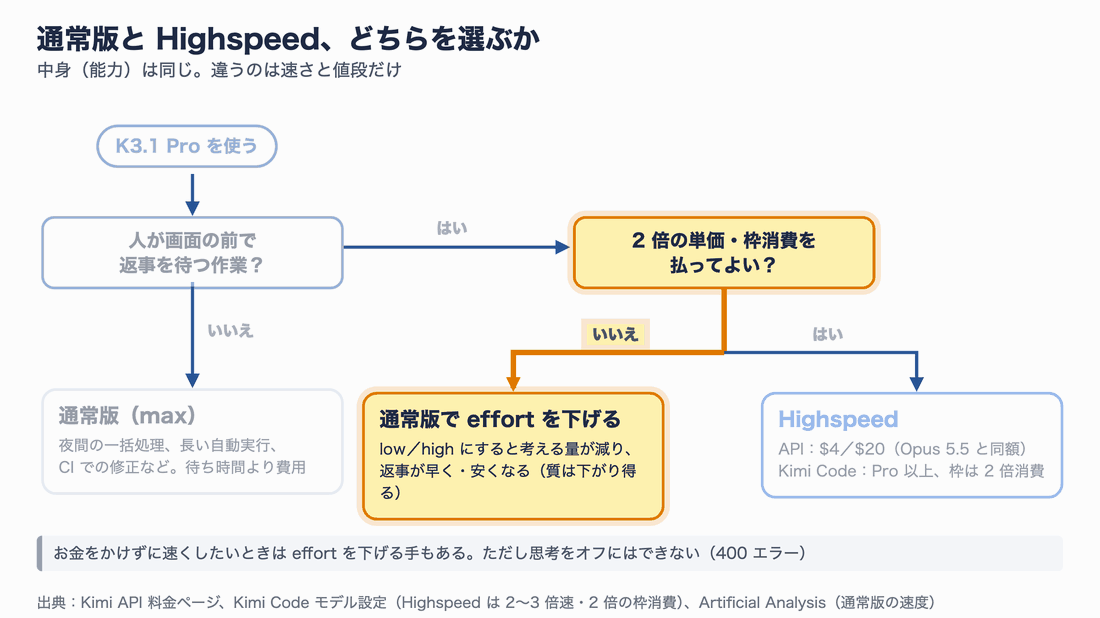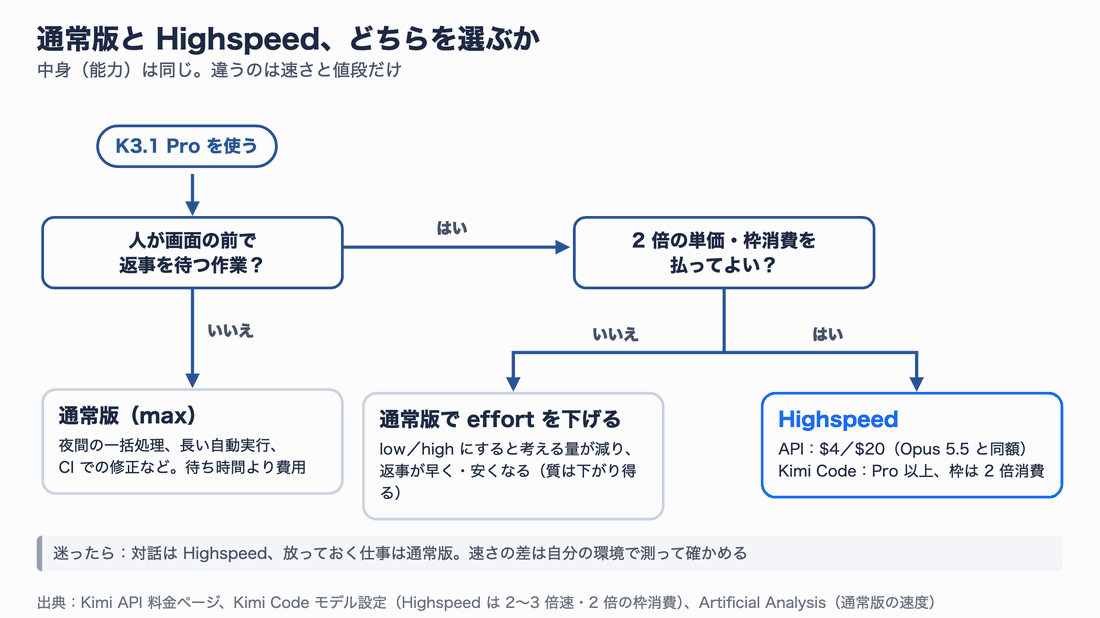
図10:対話しながら直すなら Highspeed、放っておく仕事なら通常版
Highspeed の単価($4/$20)は、ちょうど Opus 5.5 と同じです。つまり「Opus 5.5 と同じ値段で、少し速く(AA の Opus は 96 トークン/秒、Highspeed は公称で通常版 77 の 2〜3 倍)、ターミナル作業はやや強い」モデルとして使えることになります。速さは公称値なので、実際の環境で確かめてください。
使い方:Kimi Code・API・Claude Code・Codex から呼ぶ
入り口は2種類の API
K3.1 Pro を使う入り口は大きく2つあり、API キーもモデル ID も別です。ここを混同するとつまずきます。
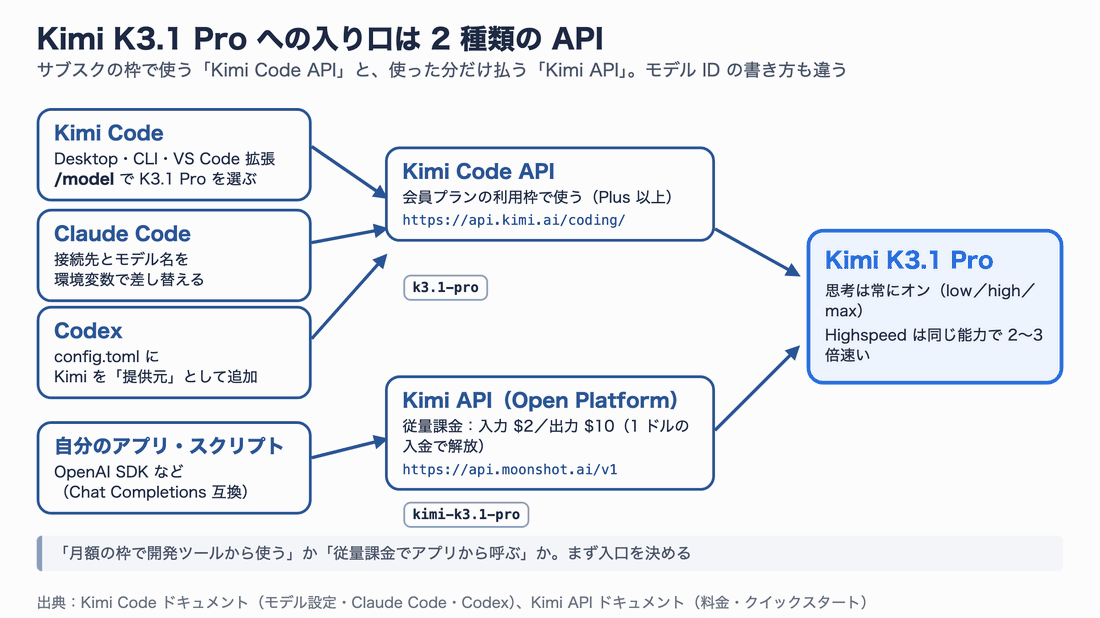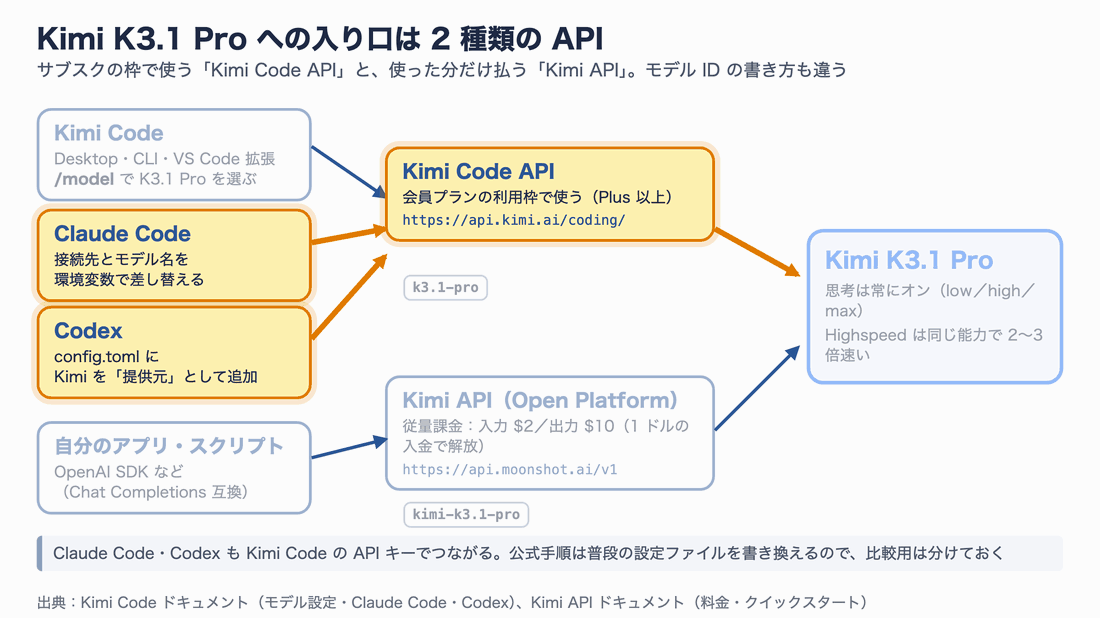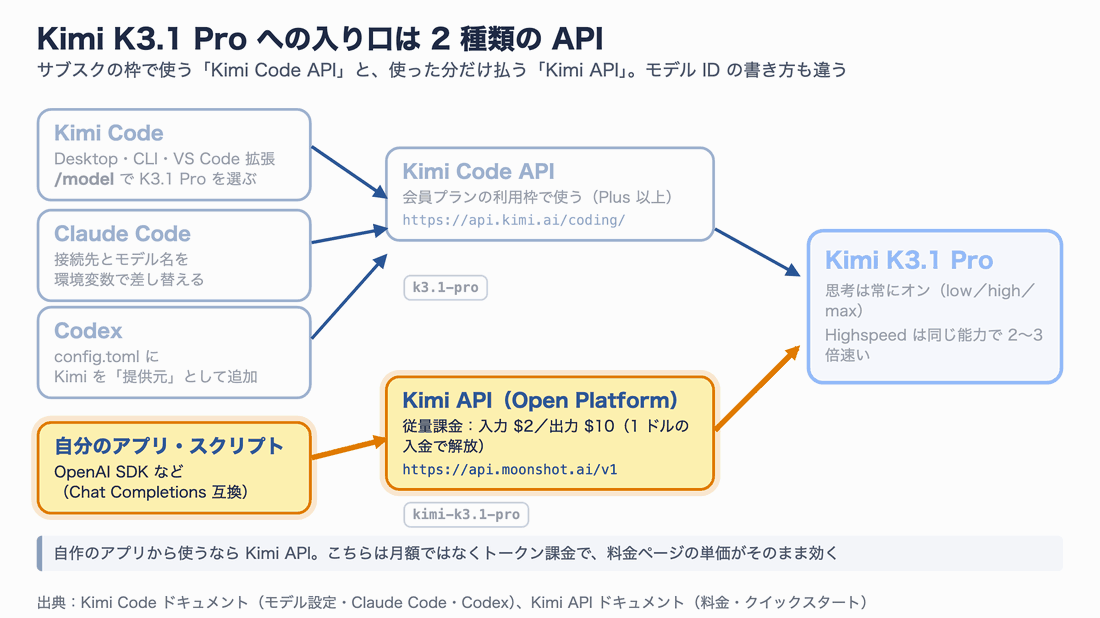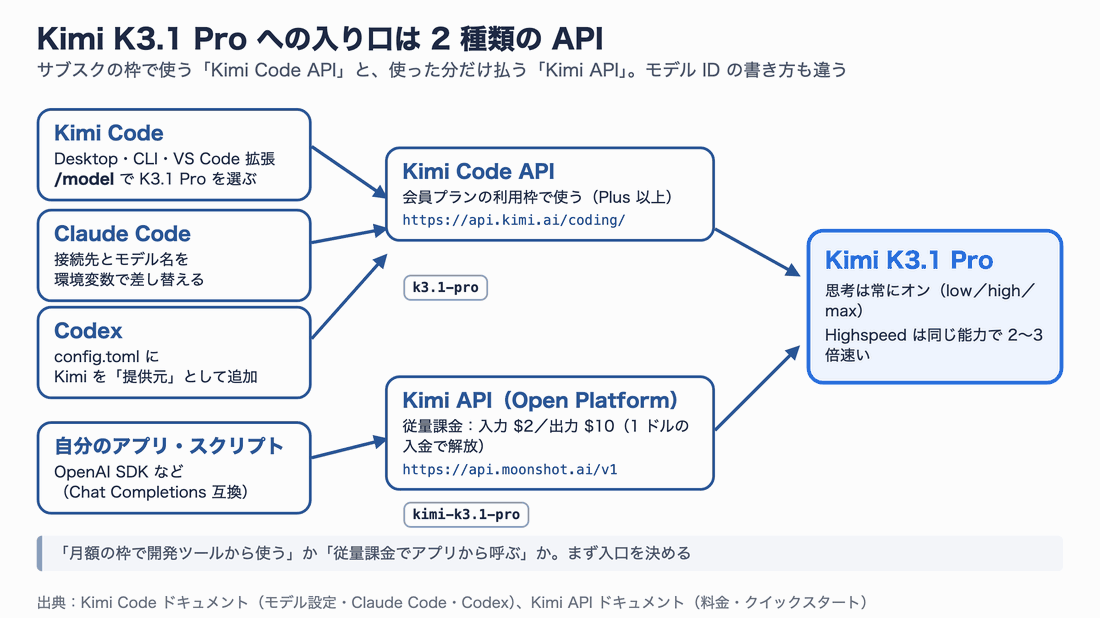
図11:サブスクの枠で開発ツールから使うか、従量課金でアプリから呼ぶか。モデル ID の書き方も違います
| Kimi Code API | Kimi API(Open Platform) | |
|---|---|---|
| 支払い | Kimi の会員プラン(月額)の利用枠 | 使った分だけ(1 ドル以上の入金で K3.1 Pro が解放) |
| キーを作る場所 | Kimi Code コンソール | Kimi API Platform |
| 接続先(海外向け) | https://api.kimi.ai/coding/(Anthropic 互換)/https://api.kimi.ai/coding/v1(OpenAI 互換) | https://api.moonshot.ai/v1(OpenAI 互換) |
| モデル ID | k3.1-pro/k3.1-pro-highspeed | kimi-k3.1-pro/kimi-k3.1-pro-highspeed |
| 使えるプラン | K3.1 Pro は Plus 以上(1M 文脈は Pro 以上)、Highspeed は Pro 以上 | 制限なし(入金額で速度制限が変わる) |
プランの月額は公式の料金ページで確認してください(Kimi Code のドキュメントには料金の記載がありません)。
いちばん手軽なのは Kimi Code
Moonshot 自身のコーディングエージェント Kimi Code には、デスクトップアプリ・CLI・VS Code 拡張があります。CLI なら /model と打って K3.1 Pro を選ぶだけです。
- Kimi Code の CLI かデスクトップアプリを最新にする(モデルが一覧に出ないときは、CLI なら
/logout→/login) - 新しいセッションを始める
/modelでK3.1 Pro(またはK3.1 Pro Highspeed)を選ぶ
2 の「新しいセッション」が大事です。公式ドキュメントは、K3 などの古いモデルのセッションの途中で K3.1 Pro に切り替えると、出力の質が落ち、キャッシュも効きにくくなると注意しています。思考の強さ(effort)を途中で変えるのも、キャッシュが無効になるので避けたほうがよいとされています。
自分のアプリから呼ぶ(Kimi API)
Kimi API は OpenAI の Chat Completions と互換です。OpenAI の Python SDK がそのまま使えます。
# OpenAI の Python SDK を入れる(Python 3.9 以上)
python3 -m pip install --upgrade 'openai>=1.0'

# Kimi API Platform で作ったキーを環境変数に入れる
export MOONSHOT_API_KEY=<YOUR_KIMI_API_KEY>
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",  # Kimi API(従量課金)の接続先
)

resp = client.chat.completions.create(
    model="kimi-k3.1-pro",        # Highspeed なら kimi-k3.1-pro-highspeed
    reasoning_effort="high",      # low / high / max(省略すると max)
    messages=[{"role": "user", "content": "このエラーログの原因を3行で説明して: ..."}],
)
print(resp.choices[0].message.content)
使うときの注意を表にまとめます(公式のクイックスタートより)。
| 注意点 | 内容 |
|---|---|
| 思考はオフにできない | K3.1 Pro は常に思考モード。オフにすると 400 エラー |
| サンプリングの値は固定 | temperature=1.0・top_p=0.95 などは固定。指定せずに省く |
| 出力の上限 | max_completion_tokens は既定 131,072、最大 1,048,576 |
| 会話を続けるとき | 返ってきた assistant メッセージを丸ごと次の要求に入れる(本文だけにしない) |
| 画像の入力 | 公開 URL は不可。base64 かアップロードしたファイル ID で渡す |
| 利用の解放 | 1 ドル以上の入金で K3.1 Pro が使えるようになる |
Claude Code から使う
Claude Code は、接続先(ANTHROPIC_BASE_URL)とモデル名を環境変数で差し替えれば、Kimi Code API につながります。Kimi の公式手順は ~/.claude/settings.json に書き込む方法を勧めていますが、それだと普段の Claude Code まで Kimi に切り替わります。比較のためなら、1 つのターミナルだけに効く環境変数で分けるほうが安全です。
次のファイルを作り、Kimi で試したいターミナルでだけ読み込みます。
# Claude Code の接続先を Kimi Code API に切り替える(このファイルを source したターミナルだけに効く)
# 使い方: export KIMI_CODE_KEY=<Kimi Code コンソールで作ったキー> のあと  source ./kimi-env.sh
export ANTHROPIC_BASE_URL=https://api.kimi.ai/coding/
export ANTHROPIC_API_KEY="${KIMI_CODE_KEY:?KIMI_CODE_KEY を先に設定してください}"
export ANTHROPIC_MODEL="${KIMI_MODEL:-k3.1-pro}"          # Highspeed なら KIMI_MODEL=k3.1-pro-highspeed
export ANTHROPIC_DEFAULT_FABLE_MODEL=$ANTHROPIC_MODEL      # 裏で使う小さなモデル枠もすべて Kimi にそろえる
export ANTHROPIC_DEFAULT_OPUS_MODEL=$ANTHROPIC_MODEL
export ANTHROPIC_DEFAULT_SONNET_MODEL=$ANTHROPIC_MODEL
export ANTHROPIC_DEFAULT_HAIKU_MODEL=$ANTHROPIC_MODEL
export CLAUDE_CODE_SUBAGENT_MODEL=$ANTHROPIC_MODEL
export CLAUDE_CODE_EFFORT_LEVEL=max
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=262144              # Plus プランは 256K。Pro 以上で 1M にするならモデル名を k3.1-pro[1m] に
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=262144
# Kimi Code コンソールで作ったキーを入れてから読み込む(このターミナルだけ Kimi になる)
export KIMI_CODE_KEY=<YOUR_KIMI_CODE_KEY>
source ./kimi-env.sh

# 自分の ~/.claude/settings.json の env が環境変数より優先されるので、比較中は読み込ませない
claude --setting-sources project,local
起動したら /status を打ち、接続先が https://api.kimi.ai/coding/ になっていれば成功です。画面上のモデル名が Claude のままに見えることがありますが、要求は Kimi に送られています。思考の強さは /effort で変えられ、Claude Code の medium/high は Kimi の high、xhigh/max は max に対応します。
筆者はダミーのキーでこの設定を試し、Claude Code の要求が Kimi の API に届いて「キーが無効」という Kimi のエラー(401)が返ることを確認しました。そのとき気づいた落とし穴が1つあります。キーが間違っていると、Claude Code は 401 を最大 10 回まで待ち時間を延ばしながら再試行するので、止まったように見えます。1分以上何も起きないときは、キーを疑ってください。
Codex から使う
Codex も、Kimi Code API を「提供元(provider)」として追加すれば使えます。ここでも、普段の ~/.codex を書き換えずに済むよう、別フォルダを Codex の設定置き場(CODEX_HOME)にする方法を勧めます。
# Kimi 用の設定フォルダを作る(普段の ~/.codex とは別)
mkdir -p ~/codex-kimi
~/codex-kimi/config.toml を次の内容で作ります。model_catalog_json は自分の環境の絶対パスに書き換えてください。
# CODEX_HOME=~/codex-kimi で起動したときだけ使われる
model = "k3.1-pro"
model_provider = "kimi"
model_reasoning_effort = "max"
model_catalog_json = "/Users/<YOUR_NAME>/codex-kimi/models.json"

[model_providers.kimi]
name = "Kimi"
base_url = "https://api.kimi.ai/coding/v1"
env_key = "KIMI_API_KEY"
wire_api = "responses"
models.json は、Codex に「このモデルは 100 万トークンの文脈を持ち、思考の強さは low/high/max」と教えるためのファイルです。公式ドキュメントの例をそのまま ~/codex-kimi/models.json に保存します(長いので、最初のモデルの部分だけ載せます。Highspeed も使うなら k3.1-pro-highspeed の項目を同じ形で足します)。
{
  "models": [
    {
      "slug": "k3.1-pro",
      "display_name": "K3.1 Pro",
      "description": "K3.1 Pro, 1M context",
      "default_reasoning_level": "max",
      "supported_reasoning_levels": [
        { "effort": "low", "description": "Light reasoning" },
        { "effort": "high", "description": "Enhanced reasoning" },
        { "effort": "max", "description": "Deep reasoning" }
      ],
      "shell_type": "shell_command",
      "apply_patch_tool_type": "freeform",
      "visibility": "list",
      "supported_in_api": true,
      "priority": 0,
      "base_instructions": "",
      "supports_reasoning_summaries": true,
      "default_reasoning_summary": "none",
      "support_verbosity": false,
      "truncation_policy": { "mode": "bytes", "limit": 10000 },
      "context_window": 1048576,
      "max_context_window": 1048576,
      "effective_context_window_percent": 95,
      "supports_parallel_tool_calls": true,
      "experimental_supported_tools": [],
      "input_modalities": ["text", "image"]
    }
  ]
}
起動するときだけ CODEX_HOME を指定します。
# Kimi Code コンソールで作ったキーを入れて、このフォルダの設定で Codex を起動する
export KIMI_API_KEY=<YOUR_KIMI_CODE_KEY>
cd /path/to/your/project
CODEX_HOME=~/codex-kimi codex
起動時の表示に model: k3.1-pro と provider: kimi が出れば設定は読めています。筆者の環境(Codex CLI 0.159.2)では、この設定で reasoning effort: max と表示され、要求が https://api.kimi.ai/coding/v1/responses に届いて 401(ダミーのキーのため)が返ることを確認しました。
自分のリポジトリで比べる
5つの手順
ここまで見てきた数字は、どれも他人が他人の課題で測ったものです。乗り換えるかどうかは、自分の課題で「成功 1 件あたりの時間と費用」を比べて決めるのが確実です。
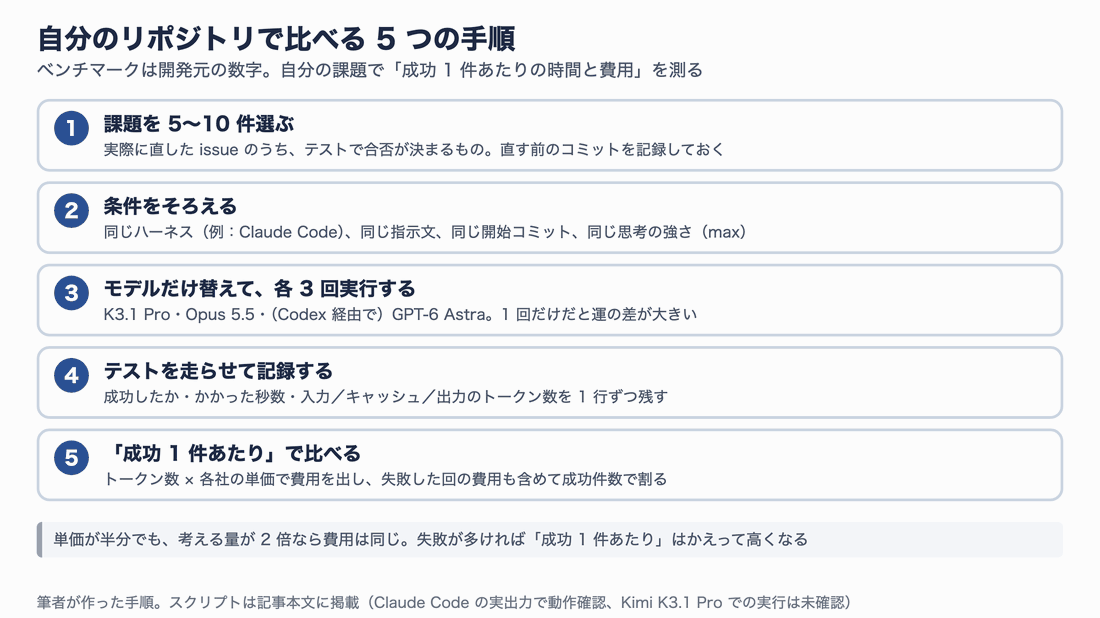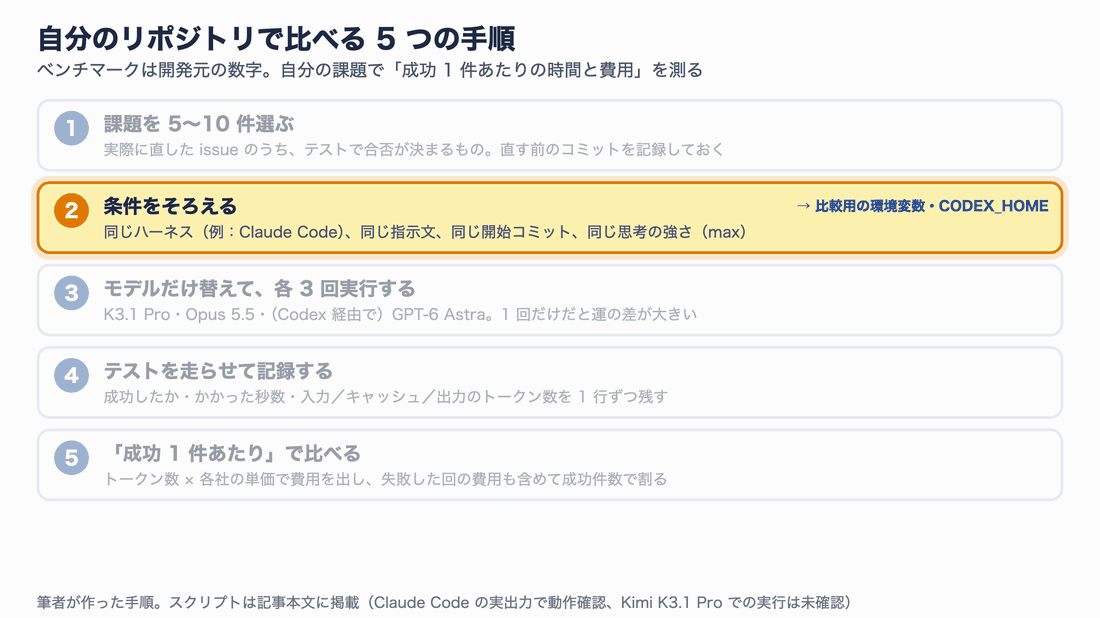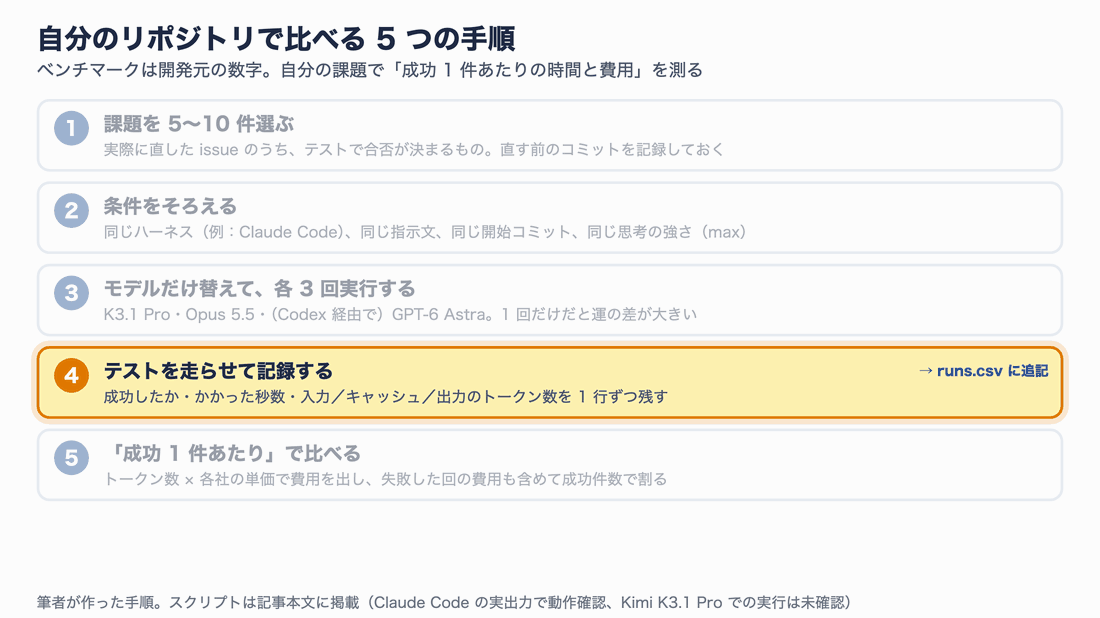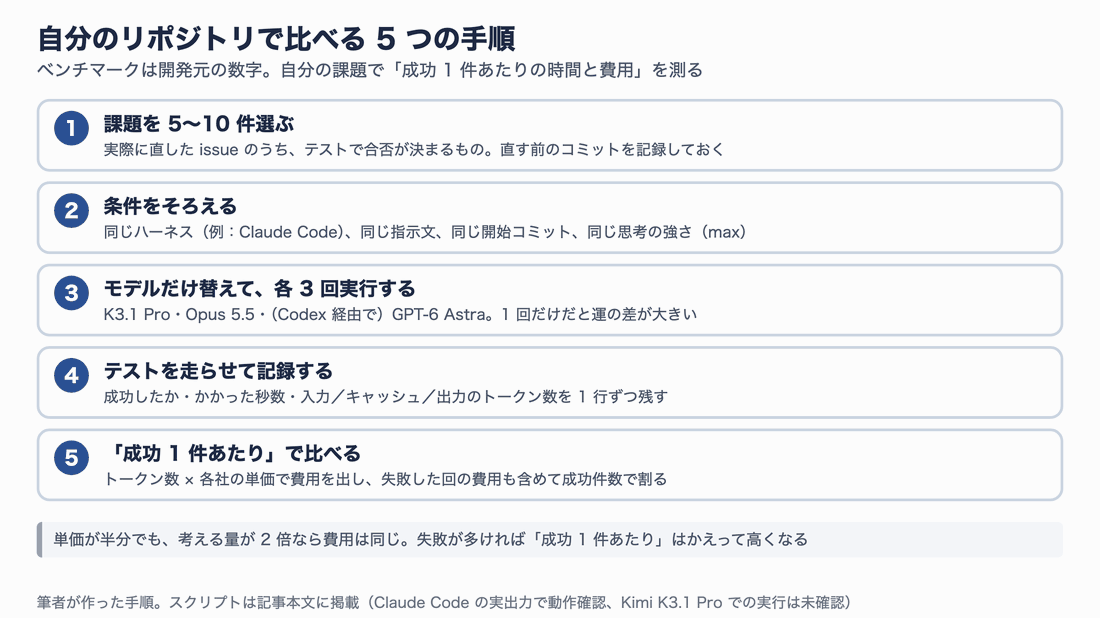
図12:1回だけの実行では運の差が大きいので、各モデル3回ずつ。失敗した回の費用も含めて成功件数で割ります
課題選びのコツは、テストで合否が決まるものを選ぶことです。過去に自分で直した issue なら、直す前のコミットと、直した後に通るようになったテストがそろっています。課題文は tasks/T1.md のように1件1ファイルで書いておきます。
1回分を実行して記録するスクリプト
Claude Code をハーネスに固定し、モデルだけを替えて実行するスクリプトです。元のリポジトリには触らず、使い捨てのコピーの中で解かせます。
#!/usr/bin/env bash
# 1 つの課題を 1 つのモデルで 1 回解かせ、テストの合否とトークン数を runs.csv に追記する
# 使い方: ./run_one.sh <モデル> <リポジトリ> <開始コミット> <課題ファイル> "<テストコマンド>"
#   <モデル> : kimi / kimi-hs(Kimi Code API 経由) / それ以外は Claude Code の --model にそのまま渡す(例 claude-opus-5-5)
# 例: ./run_one.sh kimi ~/work/myapp a1b2c3d tasks/T1.md "npm test"
set -euo pipefail
model=$1; repo=$2; start=$3; task=$(cd "$(dirname "$4")" && pwd)/$(basename "$4"); test_cmd=$5
here=$(cd "$(dirname "$0")" && pwd)
work=$(mktemp -d)/repo
git clone -q "$repo" "$work"                 # 元のリポジトリには触らない。使い捨てのコピーで解かせる
git -C "$work" checkout -q "$start"
mkdir -p "$here/results"
out="$here/results/$(basename "$task" .md)-$model-$(date +%Y%m%d-%H%M%S).json"

model_args=()
case "$model" in
  kimi)    export KIMI_MODEL=k3.1-pro;           source "$here/kimi-env.sh" ;;
  kimi-hs) export KIMI_MODEL=k3.1-pro-highspeed; source "$here/kimi-env.sh" ;;
  *)       model_args=(--model "$model" --effort max) ;;
esac

# --setting-sources project,local : 自分の ~/.claude/settings.json(env の上書きやフック)を比較に混ぜない
# --strict-mcp-config            : 手元の MCP サーバーのツール定義でトークンが膨らむのを防ぐ
# --dangerously-skip-permissions : 確認なしで編集・実行させる。必ず使い捨てのコピーの中だけで使う
( cd "$work" && claude -p "$(cat "$task")" "${model_args[@]}" --output-format json \
    --setting-sources project,local --strict-mcp-config --dangerously-skip-permissions < /dev/null ) > "$out" || true

# テストが通れば成功
if ( cd "$work" && bash -c "$test_cmd" ) > "$out.test.log" 2>&1; then ok=1; else ok=0; fi
python3 "$here/summarize_runs.py" add "$here/runs.csv" "$out" --task "$(basename "$task" .md)" --success "$ok" --label "$model"
使い方の例です。各モデル3回ずつ回します。
chmod +x run_one.sh
export KIMI_CODE_KEY=<YOUR_KIMI_CODE_KEY>

for i in 1 2 3; do
  ./run_one.sh kimi            ~/work/myapp a1b2c3d tasks/T1.md "npm test"
  ./run_one.sh claude-opus-5-5 ~/work/myapp a1b2c3d tasks/T1.md "npm test"
done
GPT-6 Astra は Codex で動かします。Codex の exec --json の出力を保存し、かかった秒数と一緒に記録します。
# 使い捨てのコピーで Codex(GPT-6 Astra)に解かせる。stdin を閉じないと入力待ちで止まる
work=$(mktemp -d)/repo && git clone -q ~/work/myapp "$work" && git -C "$work" checkout -q a1b2c3d
t0=$(date +%s)
( cd "$work" && codex exec --json -m gpt-6-astra --sandbox workspace-write "$(cat tasks/T1.md)" < /dev/null ) > astra-T1.jsonl
t1=$(date +%s)
( cd "$work" && npm test ) && ok=1 || ok=0
python3 summarize_runs.py add-codex runs.csv astra-T1.jsonl --task T1 --success $ok --label astra --model gpt-6-astra --seconds $((t1 - t0))
記録をまとめるスクリプト
記録を集計し、モデルごとの成功率・平均時間・費用・成功 1 件あたりの費用を出します。費用は、各社の単価 × トークン数で計算します(Kimi Code の月額プランで使った場合も、従量課金に換算した目安として出します)。
#!/usr/bin/env python3
"""同じ課題を複数のモデルで解かせた記録から、成功率・時間・費用をまとめる。

使い方:
  # Claude Code(claude -p --output-format json)の結果を 1 行追加
  python3 summarize_runs.py add runs.csv result.json --task T1 --success 1 --label kimi
  # Codex(codex exec --json の出力)の結果を 1 行追加。秒数は自分で測って渡す
  python3 summarize_runs.py add-codex runs.csv events.jsonl --task T1 --success 0 --label astra --model gpt-6-astra --seconds 312
  # モデルごとに集計
  python3 summarize_runs.py summary runs.csv
"""
import csv, json, sys, os
from collections import defaultdict

# 100 万トークンあたりの米ドル(2026-10-24 時点の各社の料金ページ)
# Kimi Code の月額プランで使う場合も、従量課金(Kimi API)に換算した目安として計算する
PRICES = {
    # Kimi API。キャッシュ書き込みは 5 分 TTL の単価(1 時間 TTL なら 4.00 / 8.00)
    "k3.1-pro":           {"input": 2.00,  "cache_read": 0.20, "cache_write": 2.00,  "output": 10.00},
    "k3.1-pro-highspeed": {"input": 4.00,  "cache_read": 0.20, "cache_write": 4.00,  "output": 20.00},
    # Anthropic。Claude Code は 1 時間キャッシュを書くので書き込み=入力×2
    "claude-opus-5-5":    {"input": 4.00,  "cache_read": 0.20, "cache_write": 8.00,  "output": 20.00},
    "claude-sonnet-5-5":  {"input": 2.00,  "cache_read": 0.10, "cache_write": 4.00,  "output": 10.00},
    "claude-haiku-5-5":   {"input": 0.10,  "cache_read": 0.01, "cache_write": 0.20,  "output": 0.50},
    # OpenAI(Codex 経由。入力 272K トークン以下の料金)
    "gpt-6-astra":        {"input": 10.00, "cache_read": 1.00, "cache_write": 12.50, "output": 50.00},
    "gpt-6.1-sol":        {"input": 2.00,  "cache_read": 0.10, "cache_write": 2.50,  "output": 10.00},
}
FIELDS = ["label", "model", "task", "success", "seconds", "turns", "input", "cache_read", "cache_write", "output", "cost_usd"]

def price_of(model):
    # Claude Code は "k3.1-pro[1m]" や "claude-opus-5-5-20260922" のように後ろに付け足すことがある
    for key in sorted(PRICES, key=len, reverse=True):
        if model.startswith(key):
            return PRICES[key]
    return None

def cost_of(model, tokens):
    p = price_of(model)
    if p is None:
        return None
    return sum(float(tokens[k]) * p[k] for k in ("input", "cache_read", "cache_write", "output")) / 1_000_000

def append(csv_path, row):
    new = not os.path.exists(csv_path)
    with open(csv_path, "a", newline="") as f:
        w = csv.DictWriter(f, fieldnames=FIELDS)
        if new:
            w.writeheader()
        w.writerow(row)
    print("added:", row)

def add(csv_path, json_path, task, success, label):
    d = json.load(open(json_path))
    # modelUsage はモデル別の合計(裏で動く小さなモデルやサブエージェントの分も入る)。
    # 費用はモデルごとの単価で計算して足し、記録には主モデル(出力が最多)の名前を残す
    usage = d.get("modelUsage", {})
    if not usage:
        print("modelUsage がありません(途中で失敗した可能性):", json_path)
    model = max(usage.items(), key=lambda kv: kv[1].get("outputTokens", 0))[0] if usage else "unknown"
    keys = {"input": "inputTokens", "cache_read": "cacheReadInputTokens", "cache_write": "cacheCreationInputTokens", "output": "outputTokens"}
    costs = [cost_of(m, {k: u.get(v, 0) for k, v in keys.items()}) for m, u in usage.items()]
    append(csv_path, {"label": label, "model": model, "task": task, "success": success,
                      "seconds": round(d.get("duration_ms", 0) / 1000, 1), "turns": d.get("num_turns", 0),
                      **{k: sum(u.get(v, 0) for u in usage.values()) for k, v in keys.items()},
                      "cost_usd": "" if (not costs or None in costs) else round(sum(costs), 5)})

def add_codex(csv_path, jsonl_path, task, success, label, model, seconds):
    inp = cached = out = turns = 0
    for line in open(jsonl_path):
        try:
            ev = json.loads(line)
        except json.JSONDecodeError:
            continue
        if ev.get("type") == "turn.completed":
            u = ev.get("usage", {})
            inp += u.get("input_tokens", 0); cached += u.get("cached_input_tokens", 0)
            out += u.get("output_tokens", 0); turns += 1
    # Codex の input_tokens はキャッシュ分を含むので、差し引いた残りを通常の入力とする
    row = {"label": label, "model": model, "task": task, "success": success, "seconds": seconds,
           "turns": turns, "input": inp - cached, "cache_read": cached, "cache_write": 0, "output": out}
    c = cost_of(model, row)
    append(csv_path, {**row, "cost_usd": "" if c is None else round(c, 5)})

def summary(csv_path):
    by = defaultdict(list)
    for r in csv.DictReader(open(csv_path)):
        by[r["label"]].append(r)
    print(f'{"label":16} {"回数":>4} {"成功率":>6} {"平均秒":>7} {"合計$":>9} {"成功1件$":>9}')
    for m, rows in by.items():
        ok = sum(int(r["success"]) for r in rows)
        costs = [float(r["cost_usd"]) if r["cost_usd"] else None for r in rows]
        total = None if None in costs else sum(costs)
        per_ok = (total / ok) if (total is not None and ok) else None
        fmt = lambda x: "      ---" if x is None else f"{x:9.4f}"
        print(f'{m:16} {len(rows):4d} {ok / len(rows):6.0%} {sum(float(r["seconds"]) for r in rows) / len(rows):7.1f} '
              f'{fmt(total)} {fmt(per_ok)}')

def opt(args, name, default=None):
    return args[args.index(name) + 1] if name in args else default

if __name__ == "__main__":
    a = sys.argv[1:]
    if a[:1] == ["add"]:
        add(a[1], a[2], opt(a, "--task"), opt(a, "--success"), opt(a, "--label", "?"))
    elif a[:1] == ["add-codex"]:
        add_codex(a[1], a[2], opt(a, "--task"), opt(a, "--success"), opt(a, "--label", "?"),
                  opt(a, "--model"), opt(a, "--seconds", "0"))
    elif a[:1] == ["summary"] and len(a) == 2:
        summary(a[1])
    else:
        print(__doc__)
# モデルごとに集計する
python3 summarize_runs.py summary runs.csv
筆者の環境でこのスクリプトの動作を確かめた結果です。Claude Code(Haiku 5.5)の実際の出力と、Codex(GPT-6.1 Sol、low)に小さなバグ修正をさせた実行で、トークン数と費用が手計算と一致しました。
label              回数    成功率     平均秒       合計$     成功1件$
haiku               1   100%     3.8    0.0024    0.0024
sol-low             1   100%    18.0    0.0282    0.0282
Kimi K3.1 Pro 自体での実行は、キーがないため確認できていません。Kimi 経由の Claude Code の出力でも modelUsage に k3.1-pro という名前でトークン数が入る想定で、単価表の k3.1-pro で計算されます。名前が違った場合は PRICES に追加してください。
使う前に知っておきたい注意点
重みが公開されても、手元の PC では動かない
「オープンウェイト」と聞くと、自分のパソコンで動かせるように思えるかもしれません。しかし土台の K3 の重みは、4bit 相当に圧縮した形式(MXFP4)でも約 1.56TB あります。vLLM の公式レシピは、NVIDIA GB300 を 8 枚以上(本番は複数ノード)、または AMD MI355X を 8 枚以上と案内しています。K3.1 Pro も同じ大きさなので、個人の PC や Mac で動かせる規模ではありません。
重みが公開される意味は、「自社のデータセンターやクラウドの GPU で、外部にデータを出さずに最上位級のモデルを動かせる」「自社の用途に合わせて追加学習できる」ことにあります。
ライセンスは未発表
K3.1 Pro の重みのライセンスは、まだ発表されていません。参考までに、土台の K3 は Kimi K3 License という MIT ライセンスをもとにした独自ライセンスで、次の条件が付いています。
| 条件 | 内容 |
|---|---|
| 基本 | 利用・改変・再配布・商用利用は自由(著作権表示を残す) |
| API などで提供する事業 | 推論や追加学習を第三者に提供する事業で、12 か月の売上が 2,000 万ドルを超えると別契約が必要 |
| 大規模な製品 | 月間 1 億人超、または月 2,000 万ドル超の売上の製品では、画面に「Kimi K3」と表示 |
| 対象外 | 社内だけの利用と、Moonshot 公式・認定パートナー経由の利用には上の条件がかからない |
K3.1 Pro が同じ条件になるかは分かりません。業務で重みを使う予定がある場合は、11/4 の公開時にライセンスを確認してください。
攻撃に使える力は「わざと」抑えてある
今回の発表で珍しいのが、サイバー攻撃の能力を意図的に下げたと明言している点です。
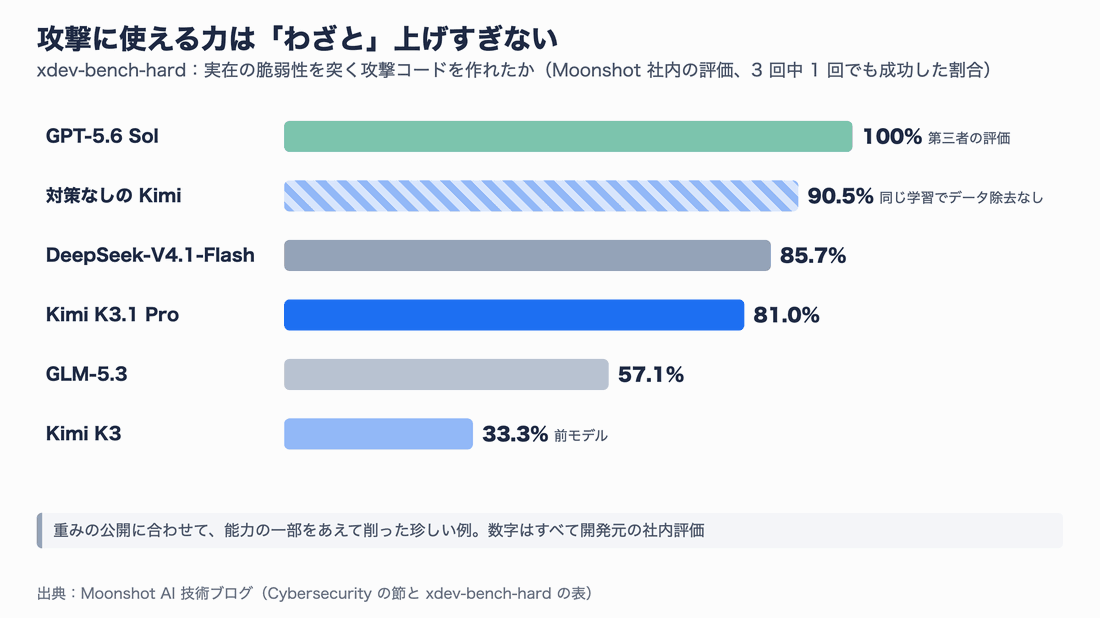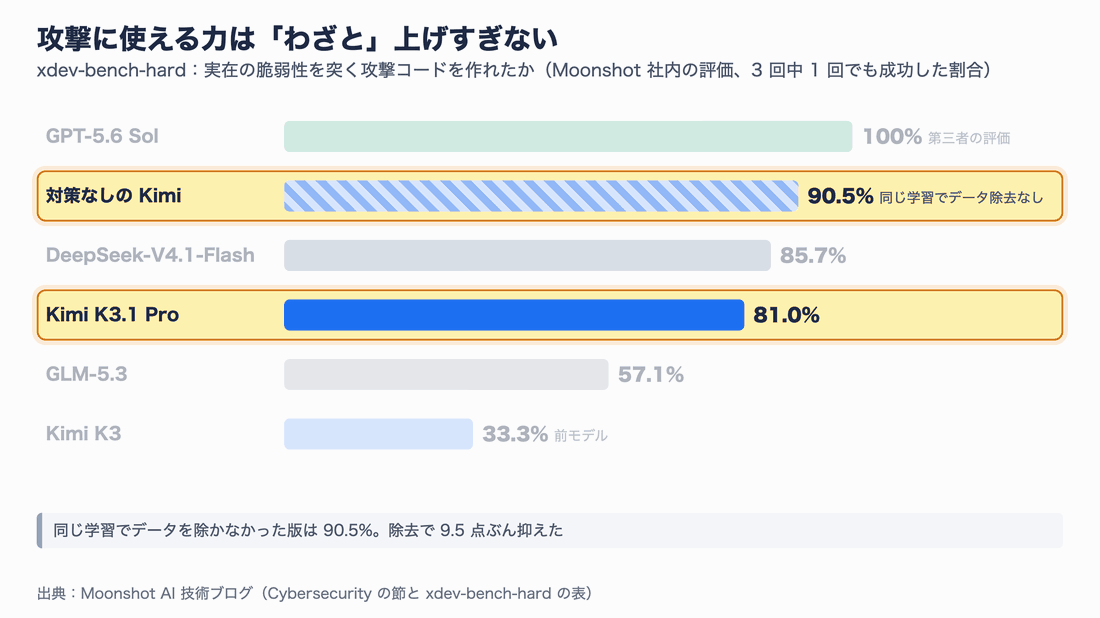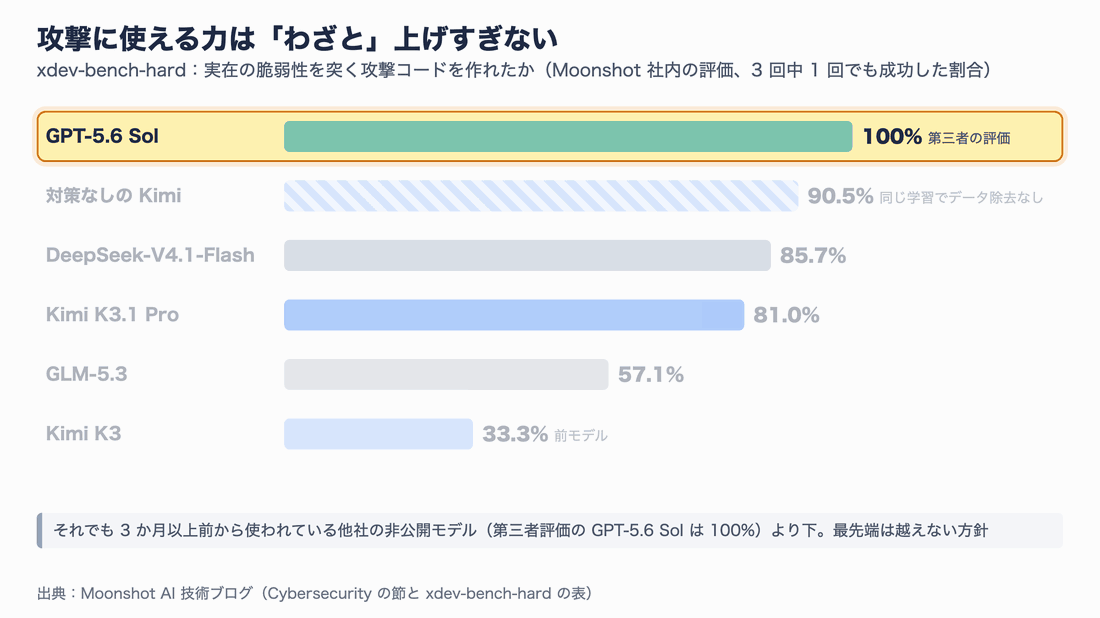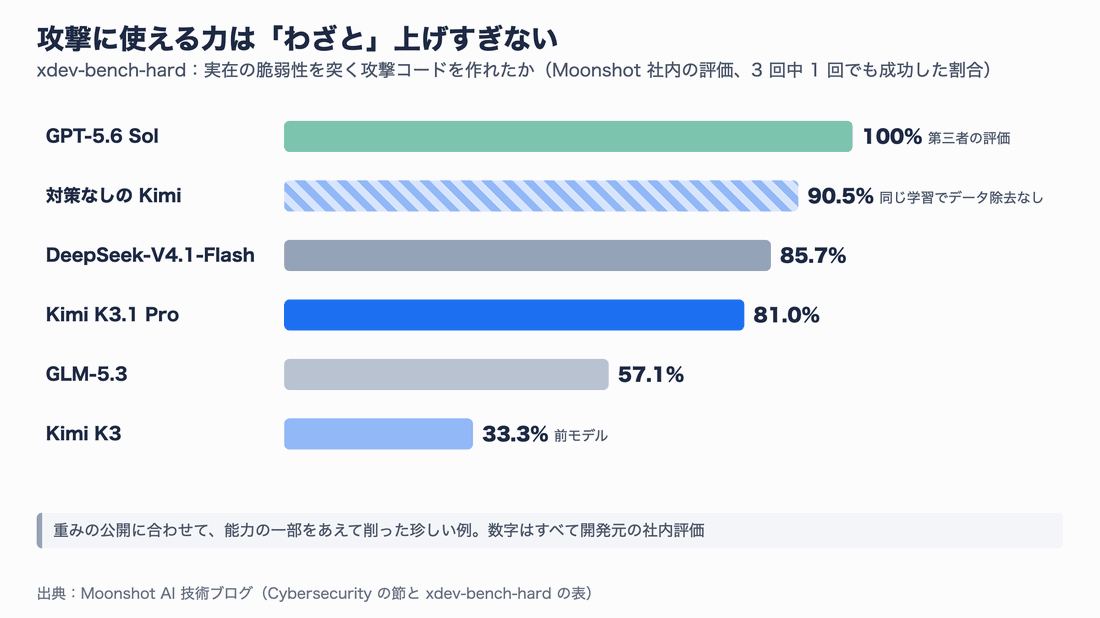
図13:開発力が上がると攻撃の課題も解けるようになる(K3 の 33.3% → 81.0%)。データを除かなかった版の 90.5% より 9.5 点抑えています
Moonshot によると、学習を進めるにつれて脆弱性の調査能力が伸び続け、原因をたどると、一般的な学習データの中にサイバー攻撃の情報が混ざっていたこと、強化学習の課題にも攻撃系の課題が含まれていたことが分かったそうです。そこで重みの公開版では、中間学習と強化学習の両方から攻撃系のデータを取り除きました。
方針として、「重みを配る以上、最先端の攻撃能力は広げない。ただし防御のために使える水準は少しずつ上げていく」と説明しています。脆弱性の調査を防御目的で使いたい人にとっては、最上位の非公開モデルより一段低い水準に設定されている、と理解しておくとよいでしょう。
データの扱い
API の利用者は Zero Data Retention(要求と応答をサーバーに残さない設定)を選べます。会社で使う場合、Kimi Enterprise の管理者が K3.1 Pro を有効にする必要があり、公開時点では既定でオフです。社外の API にソースコードを送ってよいかは、自社のルールを確認してください。
つまずきやすいポイント
設定や使い方で引っかかりやすい点を、症状から引けるようにまとめます。
| 症状 | 原因 | 対処 |
|---|---|---|
| Claude Code が止まったまま進まない | キーが無効で、401 を最大 10 回再試行している | KIMI_CODE_KEY を作り直して入れ直す |
| 400 エラーが返る(API) | 思考をオフにしようとした、または temperature などを指定した | 思考はオフにできない。サンプリングの値は指定しない |
| 答えの質が急に落ちた | モデル ID の打ち間違いで別モデルに落ちた(Kimi Code では思考なしの K2.8 Preview) | /status や起動時の表示でモデル名を確認する |
| 途中から質が落ち、費用が増えた | セッションの途中でモデルや effort を切り替えた | 切り替えるときは新しいセッションを始める |
| Claude Code の設定が効かない | ~/.claude/settings.json の env が環境変数より優先されている | 比較中は --setting-sources project,local で起動する |
| Codex で「Model metadata not found」と出る | models.json が読めていない | model_catalog_json のパスを確認する(筆者は絶対パスで指定し、この表示が出ないことを確認) |
| Codex が「Missing environment variable: KIMI_API_KEY」 | キーの環境変数がない | 起動するターミナルで export KIMI_API_KEY=... |
| 100 万トークン使えない | プランが Plus(Claude Code・Codex 経由は 256K まで) | Pro 以上にするか、256K の設定(kimi-env.sh の既定)で使う |
どの仕事に、どのモデルを第一候補にするか
ここまでの評価を、仕事の種類ごとの目安にまとめます。
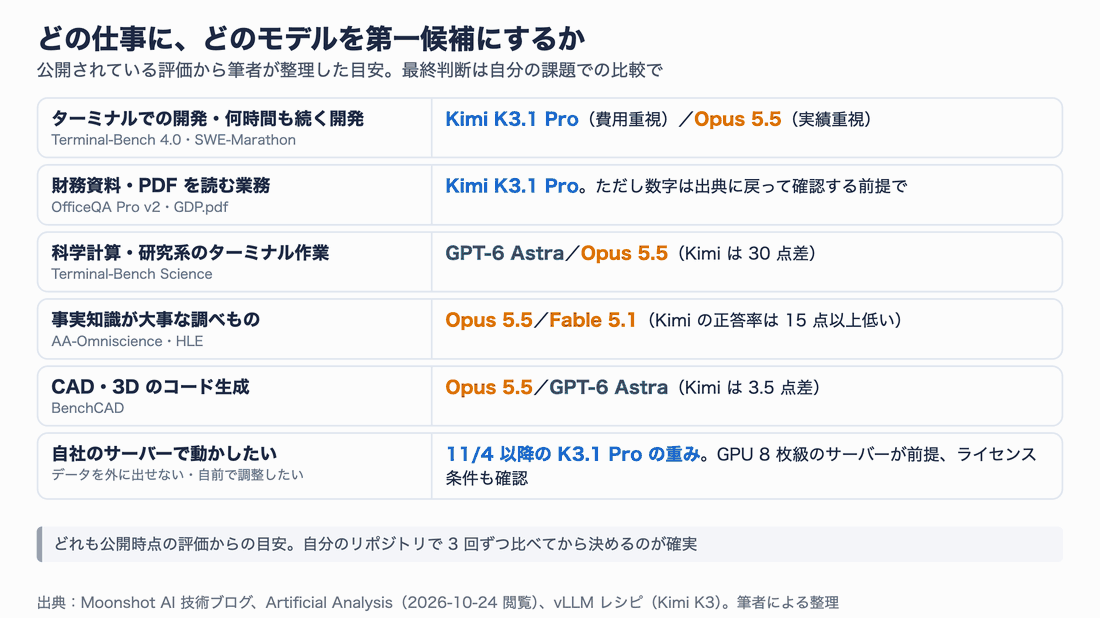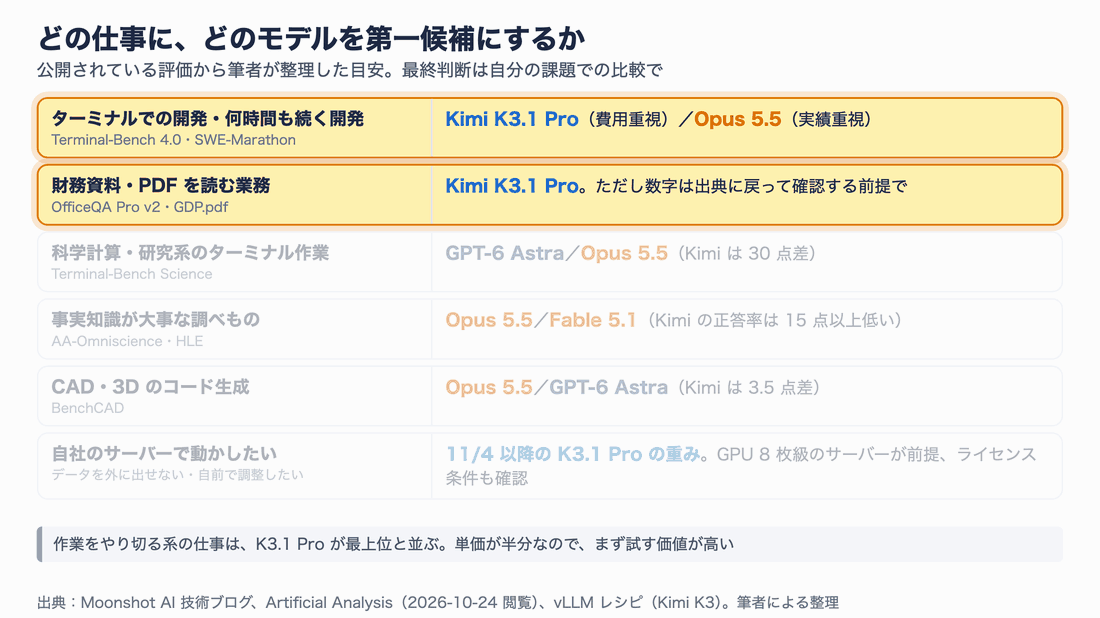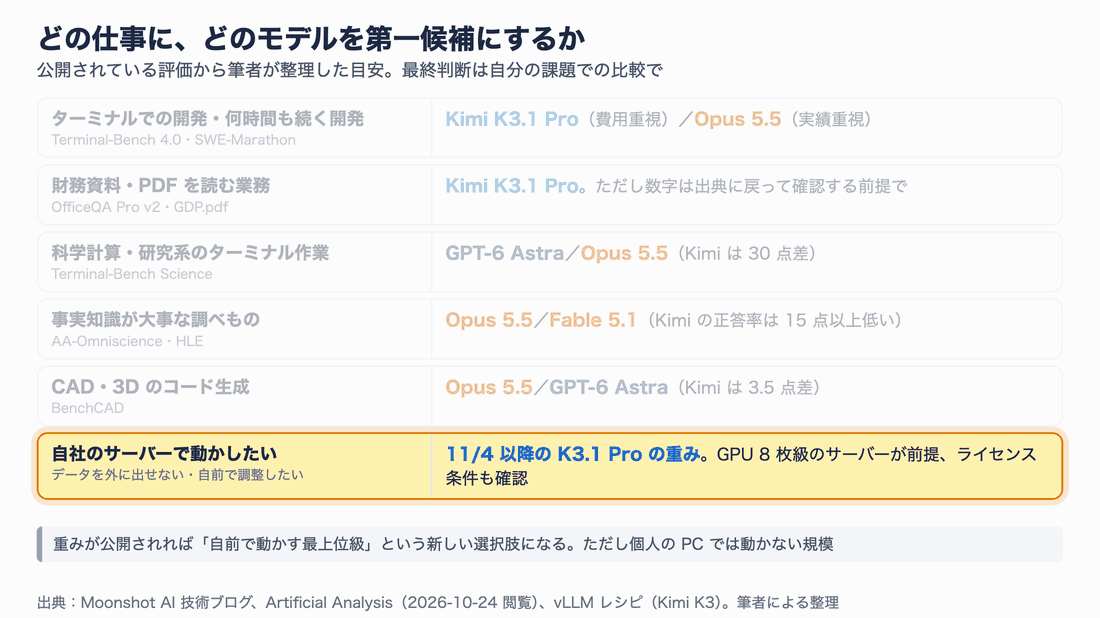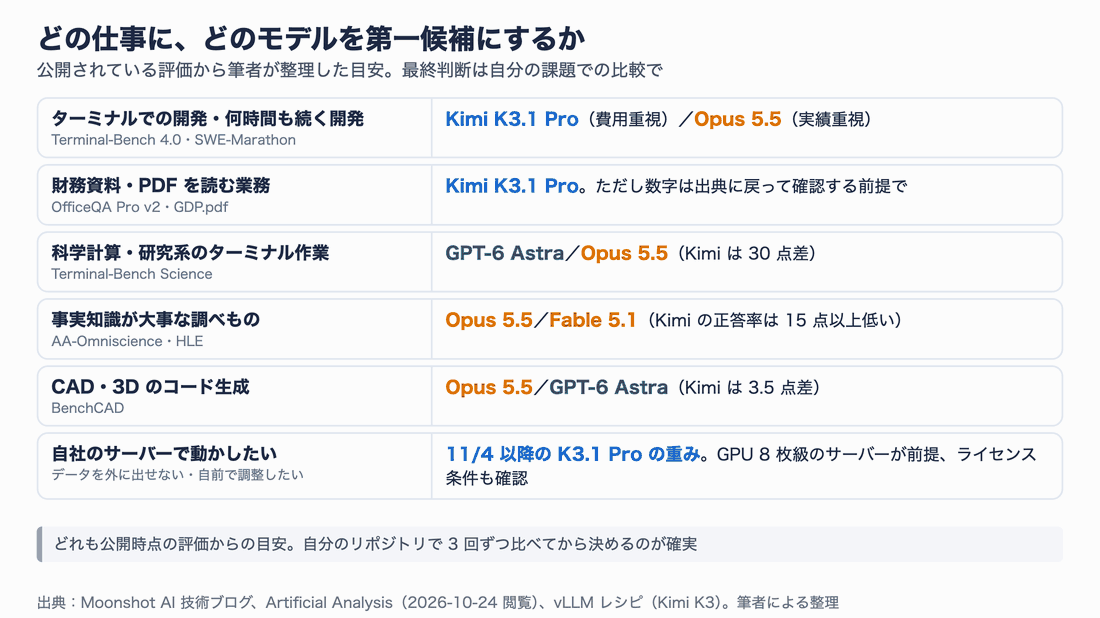
図14:作業をやり切る系は K3.1 Pro を候補に、知識と科学系は Opus 5.5・Astra
- ターミナルでの開発・長い開発:K3.1 Pro は第三者の測定でも首位級で、単価は Opus 5.5 の半分です。まず試す価値が最も高い分野です
- 財務資料・PDF の業務:開発元の表で首位です。ただし数字の読み取りは出典に戻って確認する前提で
- 科学系の作業・事実知識:まだ Opus 5.5・GPT-6 Astra・Fable 5.1 が上です。ここは無理に乗り換えなくてよいでしょう
- 自社サーバーで動かしたい:11/4 以降の重みが、最上位級で初めての現実的な選択肢になります。ただし GPU 8 枚級のサーバーが前提です
まとめ
Kimi K3.1 Pro は、K3 を土台に大規模な強化学習を足した「後学習だけの大型更新」です。公開情報を整理すると、次のことが言えます。
- 総合力:第三者の総合指数で 55.1、215 モデル中 4 位。Opus 5.5(57.6)には届かないものの、Fable 5.1・GPT-6 Astra より上です
- 得意:ターミナル作業は第三者の測定で首位(67.2%)。何時間も続く開発、財務資料の分析でも首位です
- 苦手:事実知識の正答率は比較した中で最下位(51.0%)。科学系のターミナル作業は Astra に 30 点差です
- 値段:入力 $2・出力 $10 で Opus 5.5 の半分。ただしよく考えるぶん、トークンは多めに使います
- 重み:11/4 までに公開予定。重みが公開済みのモデルの上限を約 10 点引き上げますが、動かすには GPU 8 枚級のサーバーが要ります
「オープンウェイトは1世代遅れ」という前提は、少なくともコーディングエージェントの分野では崩れつつあります。次の一歩は、自分のリポジトリで Opus 5.5 や GPT-6 Astra と同じ課題を3回ずつ解かせ、成功 1 件あたりの時間と費用を比べることです。記事内のスクリプトは、そのまま使えるように書いてあります。11/4 に重みとライセンスが出たら、その条件もあわせて確かめてみてください。
参考リソース
- Moonshot AI「Introducing Kimi K3.1 Pro」 https://www.kimi.com/blog/kimi-k3-1-pro
- Kimi API 料金 https://platform.kimi.ai/docs/pricing/chat
- Kimi API「Kimi K3.1 Pro」クイックスタート https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- Kimi Code モデル設定 https://www.kimi.com/code/docs/en/kimi-code/models
- Kimi Code 更新情報(10月23日) https://www.kimi.com/code/docs/en/kimi-code/whats-new.html
- Kimi Code × Claude Code https://www.kimi.com/code/docs/en/third-party-tools/claude-code.html
- Kimi Code × Codex https://www.kimi.com/code/docs/en/third-party-tools/codex.html
- Moonshot AI「Kimi K3」技術ブログ https://www.kimi.com/blog/kimi-k3
- Hugging Face moonshotai/Kimi-K3(Kimi K3 License) https://huggingface.co/moonshotai/Kimi-K3
- vLLM レシピ Kimi-K3 https://recipes.vllm.ai/moonshotai/Kimi-K3
- Artificial Analysis「Kimi K3.1 Pro」 https://artificialanalysis.ai/models/kimi-k3-1-pro
- Artificial Analysis LLM Leaderboard https://artificialanalysis.ai/leaderboards/models