2026年10月1日に公開された Cloudflare の発表記事(blog.cloudflare.com)
この記事の確認範囲
この記事は、Cloudflare が 2026年10月1日に公開した判定モデル Clef(クレフ) と Clef-flash について、公式ブログ・開発者ドキュメント・Hugging Face のモデルカードを読み、実際に筆者の Mac から動かした結果をまとめたものです。
| 項目 | 内容 |
|---|---|
| 確認日 | 2026年10月2日(日本時間 13:30〜15:00) |
| 検証した場所 | 東京の自宅回線。Cloudflare 側は東京(NRT)の Worker から呼び出し |
| 手元の環境 | MacBook Pro(Apple M5 Max / メモリ 128GB)、macOS 26.6、Node.js 22.23、Python 3.12、wrangler 4.145.0 |
| ローカル実行 | PyTorch 2.14.1(MPS)、transformers 5.18.0、torchvision 0.29.1 |
| 比較相手 | TypeSafe の Jev(jev-latest、応答上の実体は jev-1.13.0)、Workers AI の gpt-oss-120b |
| 公式情報 | 公式ブログ、Workers AI の変更履歴・モデルページ・料金ページ、Hugging Face の Cloudflare/clef と Cloudflare/clef-flash |
ベンチマークや速度の数字のうち、「公式」「Cloudflare 発表」と書いたものは Cloudflare 自身の測定です。「実測」と書いたものは、この記事のために筆者が測った値です。両者は条件が違うので、混ぜずに読んでください。
はじめに:エージェントの「小さな判断」は誰がやるべきか
AI エージェントを作っていると、本題の前に細かい判断が何度も挟まります。「この問い合わせは緊急か」「最初に呼ぶツールはどれか」「この操作は人の承認なしで実行してよいか」「取ってきた文書だけで答えられるか」といった判断です。
多くの場合、これを大きな LLM に「次の JSON 形式で答えて」と頼んで処理しています。動きはしますが、判断 1 回ごとに文章を生成させるので、時間もお金もかかります。しかも返ってくるのは「technical」という 1 語だけで、どのくらい自信があるのかは分かりません。
そこで 2026年9月に話題になったのが、TypeSafe の Jev に代表される 判定モデル(decision model) です。文章を書かずに、決められた選択肢それぞれの確率だけを返します。そして 10月1日、Cloudflare が同じ形で使える判定モデル Clef を、重みごと Apache 2.0 で公開しました。
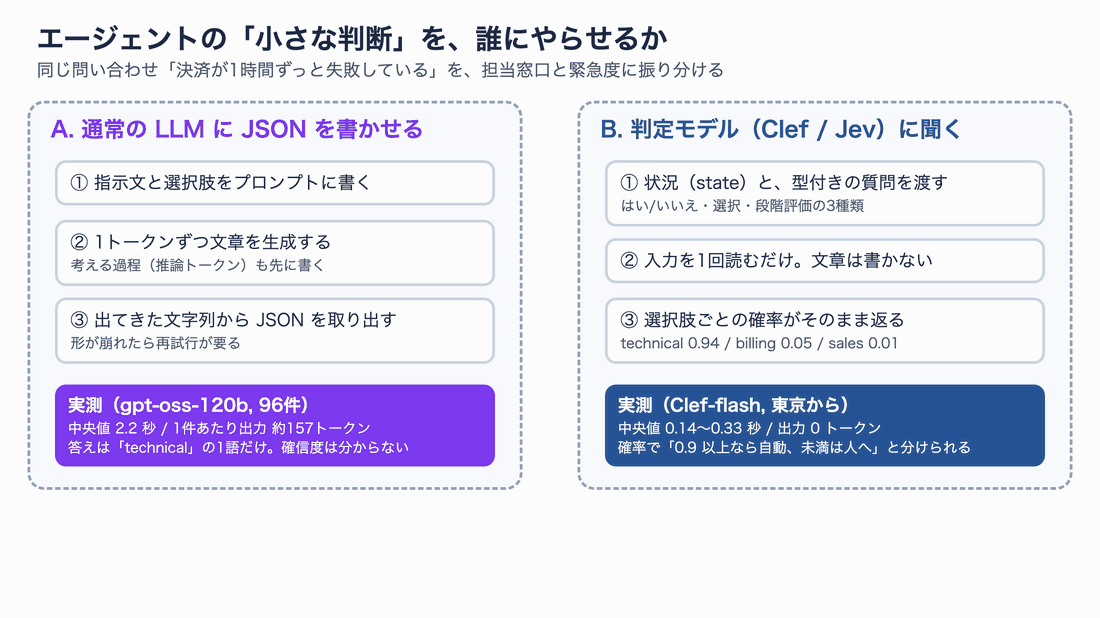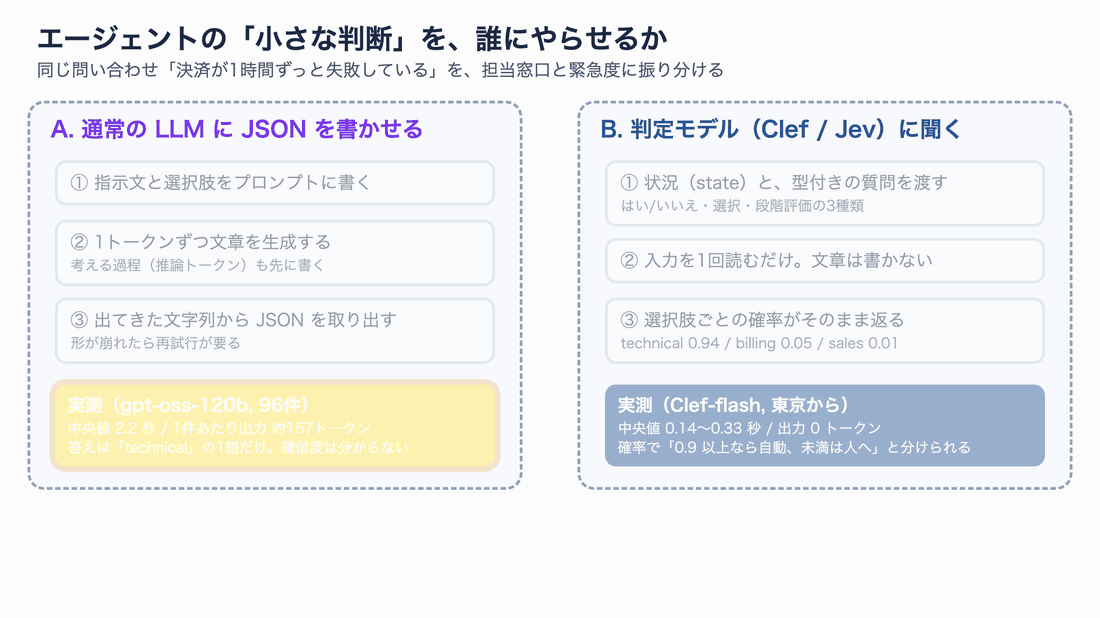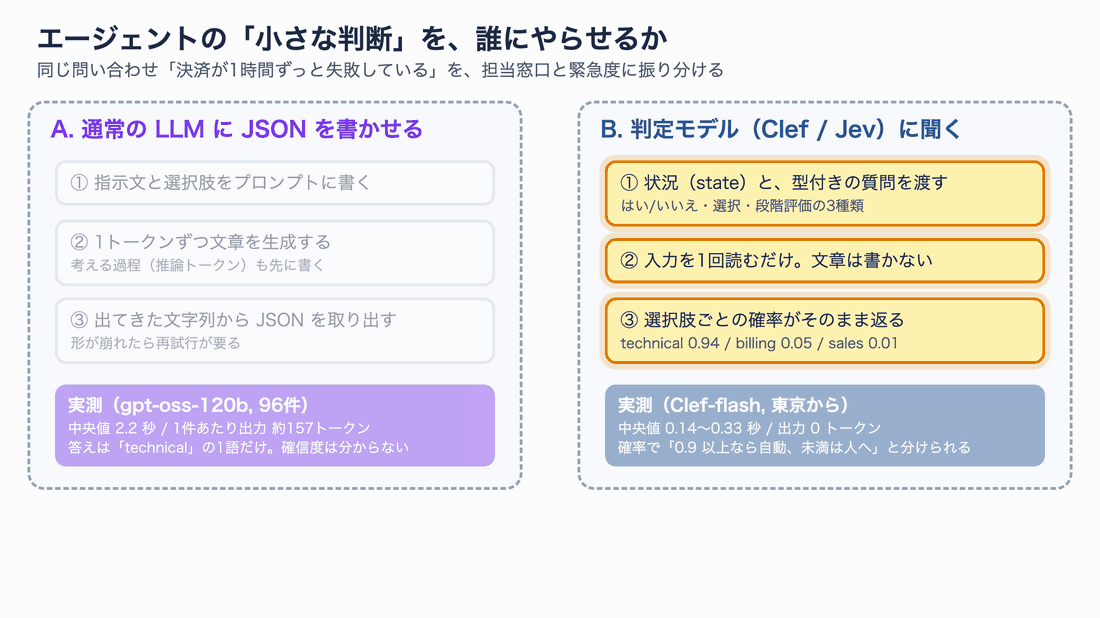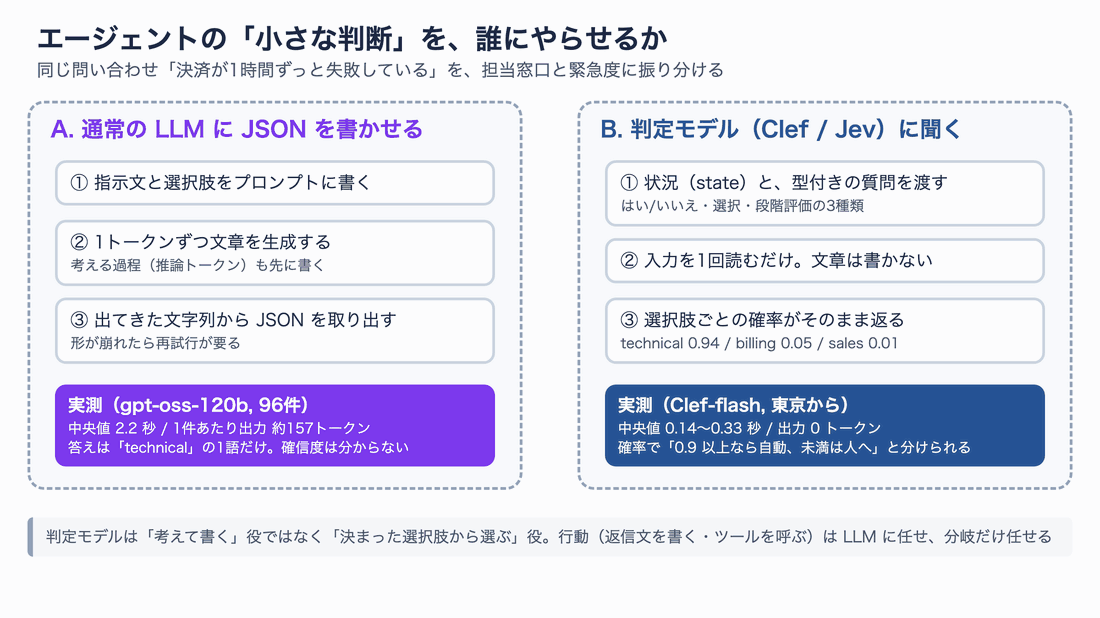
図1:同じ振り分けを LLM と判定モデルにやらせた場合の違い。数字は後述の実測値
この記事では、次の 4 つの疑問に、公式情報と手元での検証の両方から答えます。
- Clef は本当に Jev と同じコードで呼べるのか(互換性)
- 日本語の業務判定と公開ベンチマークで、Jev とどちらが当たるのか(精度)
- 公式の「Jev の 13 倍速い」は、日本から使っても成り立つのか(速度)
- 1 万回判定したらいくらかかるのか、手元の Mac でも動くのか(料金・ローカル実行)
想定読者は、LLM を使ったアプリやエージェントを作ったことがあり、判定部分を速く安くしたいと考えている方です。Jev を使ったことがなくても読めるように、基本から説明します。
判定モデルとは何か
判定モデルは、状況(state) と 型の決まった質問(questions) を受け取り、質問ごとに 選択肢の確率 を返すモデルです。LLM のように自由な文章は書きません。
質問の型は Jev と Clef で共通の 3 種類です。1 回のリクエストに最大 64 問まで混ぜられ、答えは自分で付けた質問 ID ごとに返ってきます。
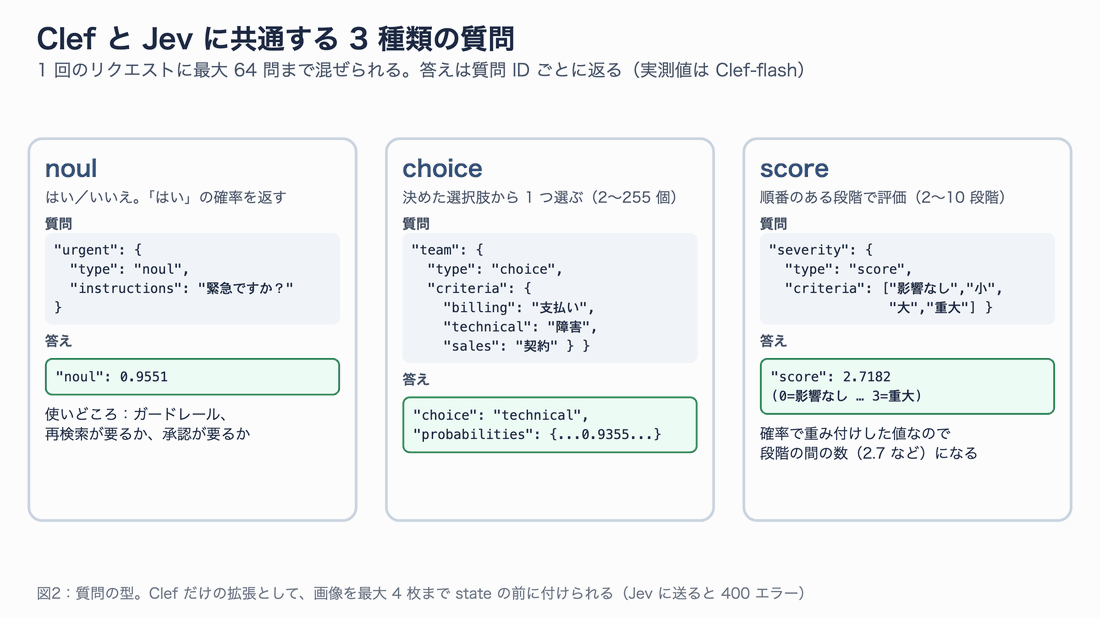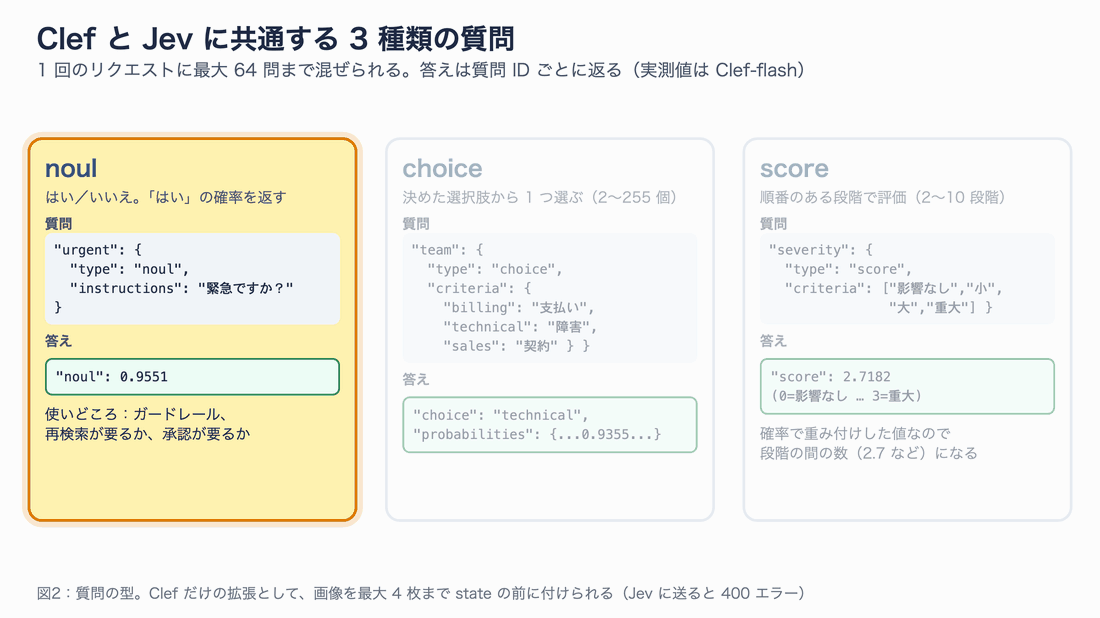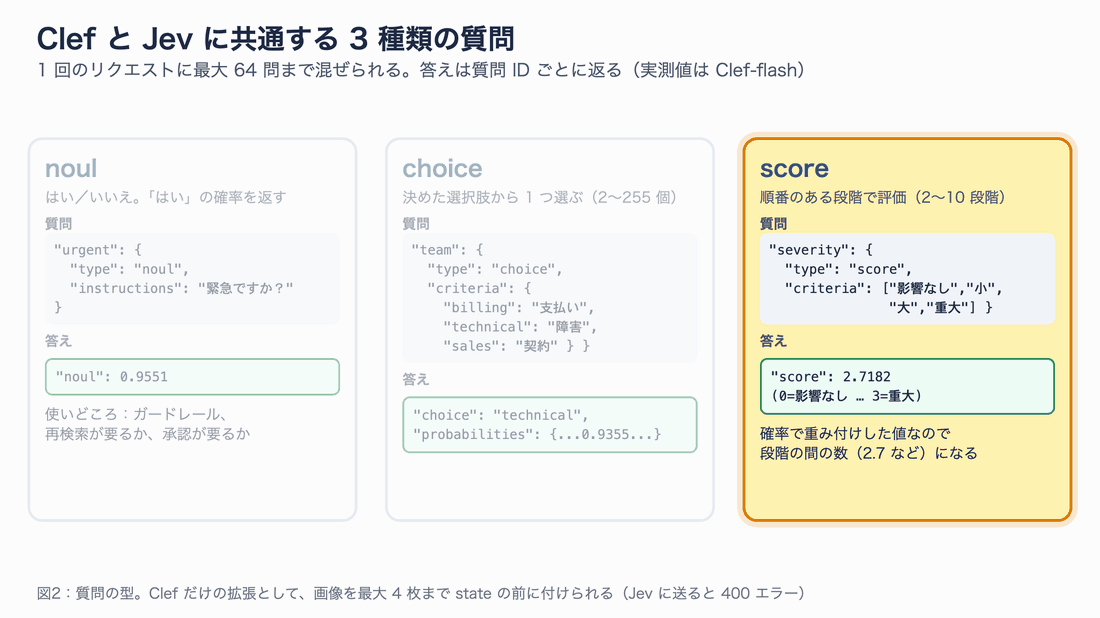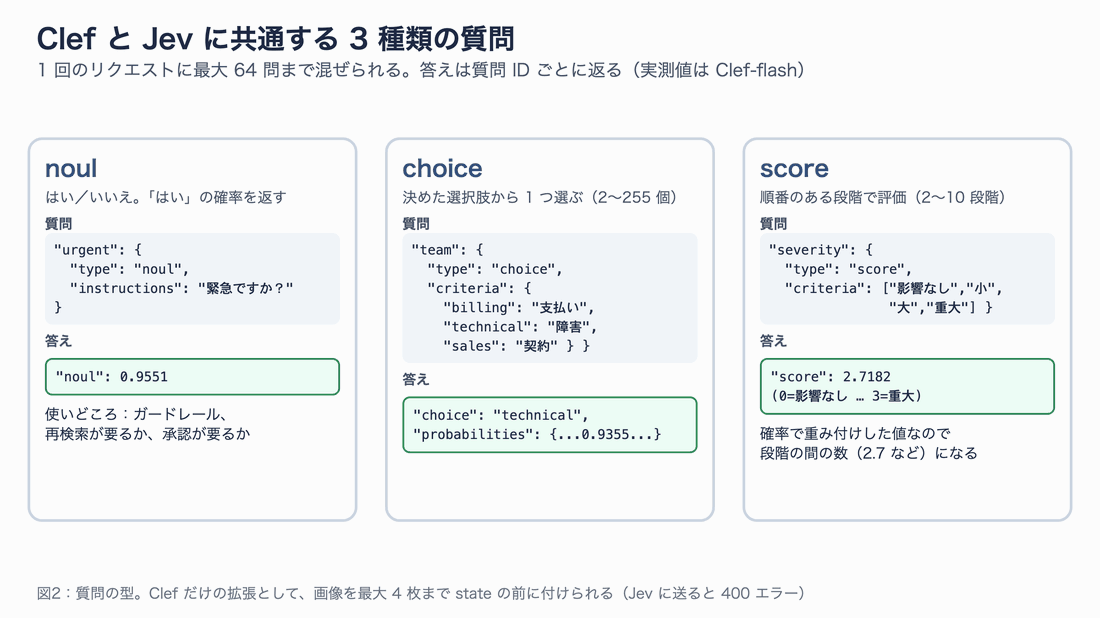
図2:3 種類の質問。答えの数字は Clef-flash の実測値
| 型 | 何を聞くか | 返ってくる値 | 使いどころの例 |
|---|---|---|---|
noul | はい/いいえ | 「はい」の確率(0〜1) | ガードレール、再検索の要否 |
choice | 自分で決めた選択肢から 1 つ(2〜255 個) | 選んだ選択肢と、各選択肢の確率 | 担当窓口、ツール選択 |
score | 順番のある段階(2〜10 段階) | 確率で重み付けした段階の値 | 深刻度、リスクの高さ |
確率で返ってくることの利点は、しきい値で自動化の範囲を決められることです。たとえば「担当窓口の確率が 0.9 以上なら自動で振り分け、それ未満は人が見る」という運用が、if 文 1 つで書けます。
noul は Jev の API で使われている型名で、Clef もこの名前をそのまま採用しています。
Clef と Clef-flash の中身
2 つのモデルの比較
Clef は Cloudflare の Workers AI チームが初めて自分たちで学習したモデルです。大きさの違う 2 種類があり、どちらも Workers AI からすぐ呼べ、Hugging Face から重みもダウンロードできます。
| 項目 | Clef | Clef-flash | Jev(参考) |
|---|---|---|---|
| 提供元 | Cloudflare | Cloudflare | TypeSafe |
| 大きさ | 27B(約 273 億パラメータ) | 9B(約 94 億) | 非公開 |
| 土台のモデル | Qwen3.8-27B | Qwen3.5-9B | 非公開 |
| 入力できる長さ | 64K トークン | 64K トークン | 32K(Cloudflare 発表による) |
| 画像入力 | ○(最大 4 枚) | ○(最大 4 枚) | ×(文章のみ) |
| 重みの公開 | Apache 2.0 | Apache 2.0 | 非公開 |
| 入力単価(100 万トークン) | $0.24 | $0.09 | $0.042 |
| 出力単価 | 課金なし | 課金なし | 無料 |
| Workers AI の ID | @cf/cloudflare/clef | @cf/cloudflare/clef-flash | — |
Jev の単価は TypeSafe 公式ブログ、Clef の単価は Workers AI の料金ページ(2026年10月2日時点)の値です。トークンあたりの単価だけを見ると、Clef-flash は Jev の約 2 倍、Clef は約 6 倍 になります。後で実際のトークン数で計算し直します。
文章を書かずに確率を出す仕組み
LLM が遅い理由の 1 つは、答えを 1 トークンずつ順番に書くことです。考える過程まで書かせると、さらに時間がかかります。Clef はこの「書く」工程をまるごと省いています。
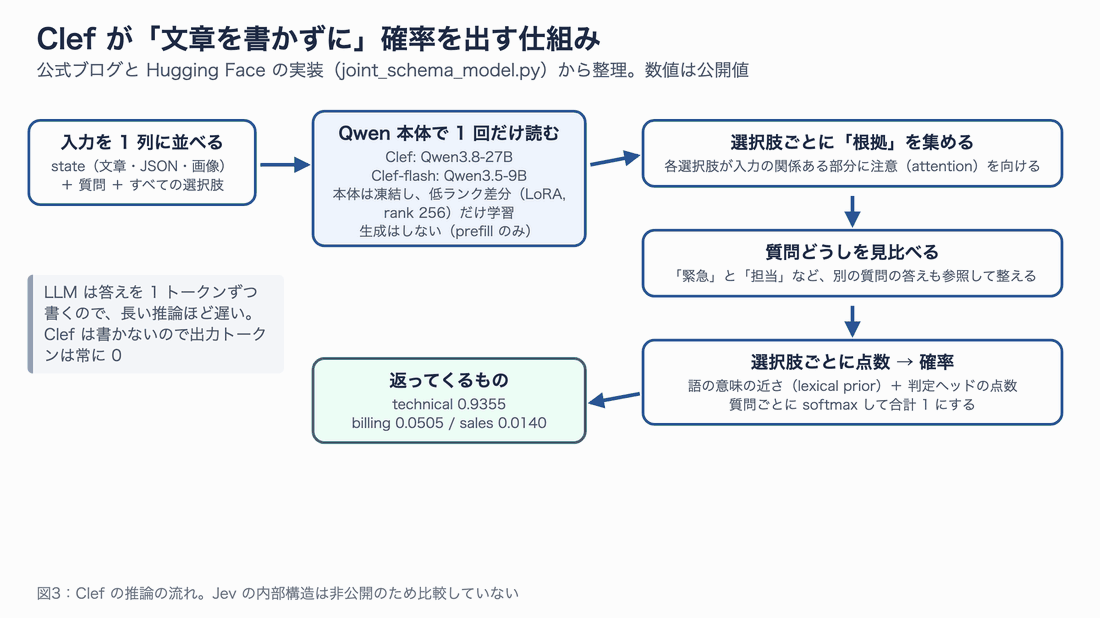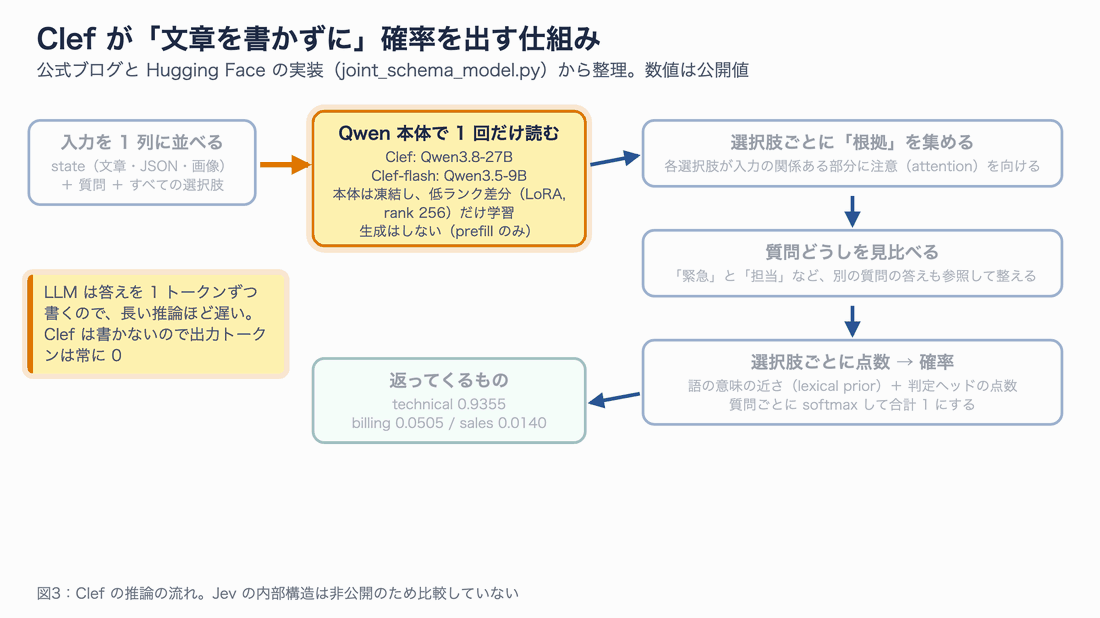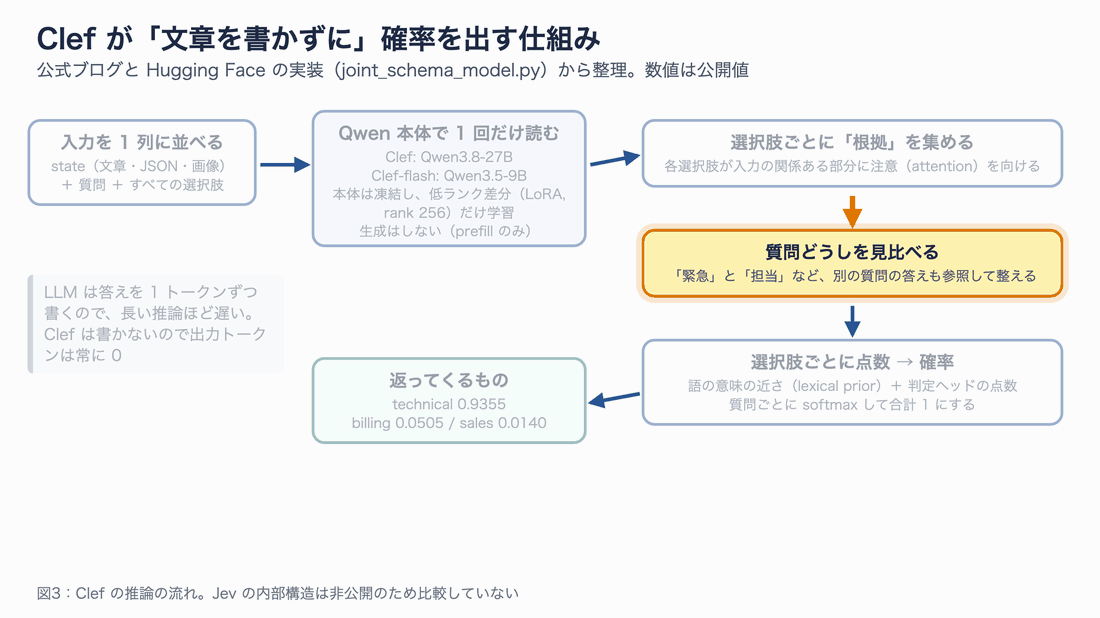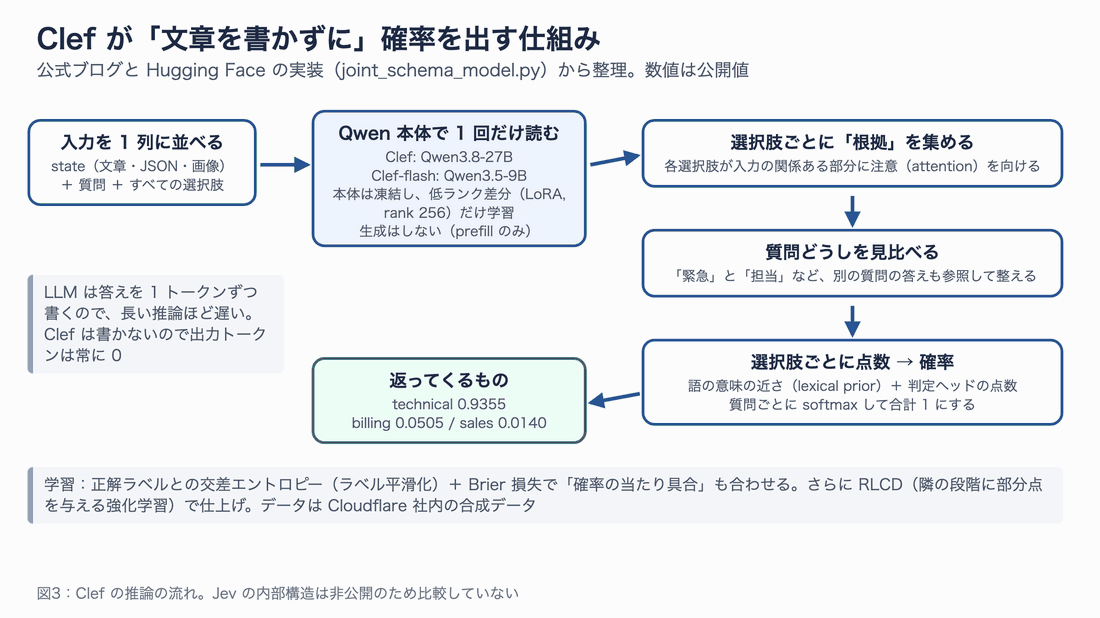
図3:公式ブログと Hugging Face の実装(joint_schema_model.py)から整理した推論の流れ
流れを順に説明します。
- 入力を 1 列に並べる:状況・質問・すべての選択肢を 1 つの入力にまとめます。
- Qwen 本体で 1 回だけ読む:入力を読み込む処理(prefill)だけを行い、文章の生成はしません。
- 選択肢ごとに根拠を集める:各選択肢が、入力の中で自分に関係がある部分に注意(attention)を向けます。
- 質問どうしを見比べる:「緊急か」と「担当はどこか」のように、別の質問の答えとも整合を取ります。
- 点数を確率にする:選択肢の言葉の意味の近さ(lexical prior)と、判定用の小さな部品(判定ヘッド)が付けた点数を合わせ、質問ごとに合計 1 の確率にします。
学習の方法も公開されています。Qwen 本体は凍結し、判定ヘッドと rank 256 の低ランク差分(LoRA) を一緒に学習しています。損失関数は、正解ラベルとの交差エントロピーに加えて Brier 損失(確率のずれの二乗)を使い、「当たるかどうか」だけでなく「確率の当たり具合」も合わせ込んでいます。仕上げに RLCD(Reinforcement Learning for Calibrated Decisions)という強化学習で、隣の段階を選んだときに部分点を与えるなどの調整をしています。
ここで 1 点、補足があります。「本体は凍結」と書かれていますが、学習した差分は配布用の重みに合成済みです。Hugging Face の読み込み関数の説明にも「merged backbone」とあります。つまり 配布されている Clef の本体は、元の Qwen とまったく同じ重みではありません。「Qwen をそのまま使い、頭だけ付け替えた」と理解すると少しずれるので注意してください。
公式ベンチマークの読み方
Cloudflare は、コミュニティが運営する「Jev Decision Index」という評価セット(バージョン 0.2.1)で、Clef が首位だと発表しています。
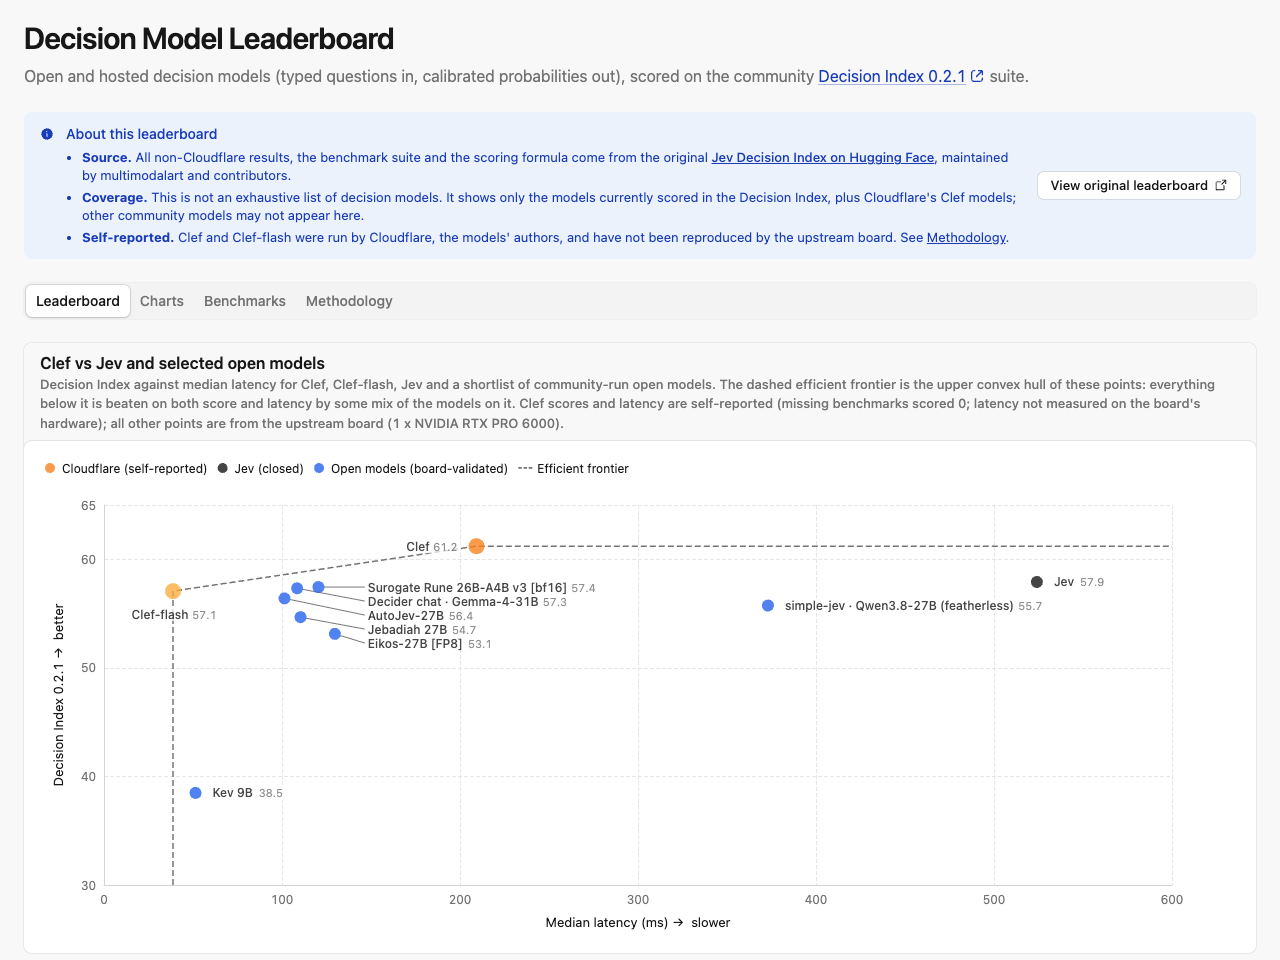
Cloudflare が公開したリーダーボード(clef-evals.workers-ai-mle.workers.dev)。青い注記欄に「Self-reported」とある
この画面で大事なのは、上部の注記です。Clef と Clef-flash の点数は Cloudflare が自分で測ったもので、元の Decision Index(Hugging Face 上のコミュニティのボード)ではまだ再現されていません。Jev 以外のオープンモデルの速度は RTX PRO 6000 1 枚での測定で、Clef の速度は Cloudflare 自社のハードウェアでの測定です。条件が揃っていない点は、割り引いて読む必要があります。
個別のベンチマークを見ると、Clef が全部で勝っているわけではありません。主な結果を抜き出します。
| ベンチマーク | Clef | Clef-flash | Jev | 何を測るか |
|---|---|---|---|---|
| BANKING77(macro-F1) | 94.2 | 90.9 | 79.7 | 銀行問い合わせ 77 分類 |
| API-Bank(正解率) | 91.9 | 93.1 | 88.2 | API 呼び出しの選択 |
| CLINC150+OOS(macro-F1) | 97.4 | 66.8 | 89.3 | 意図分類と対象外の検出 |
| When2Call(正解率) | 72.4 | 65.6 | 81.0 | ツールを呼ぶべきかの判断 |
| GPQA Diamond(正解率) | 48.0 | 51.0 | 78.3 | 専門的な科学の知識問題 |
| BBH(正解率) | 73.7 | 68.9 | 92.9 | 多段階の推論 |
| 中央値の応答時間(ms) | 209.3 | 38.8 | 524.1 | Cloudflare 計測 |
分類や意図理解では Clef が強く、知識や多段階の推論が要る問題では Jev が大きく上回っています。Clef-flash は速い代わりに、CLINC150(対象外の検出)や RAGTruth(ハルシネーションの検出)で大きく点を落としています。「Clef-flash は Clef の速い版で、精度はほぼ同じ」とは言い切れない点に注意してください。
検証の準備
検証構成
手元の Mac から、次の 4 つの経路で同じ質問を流しました。
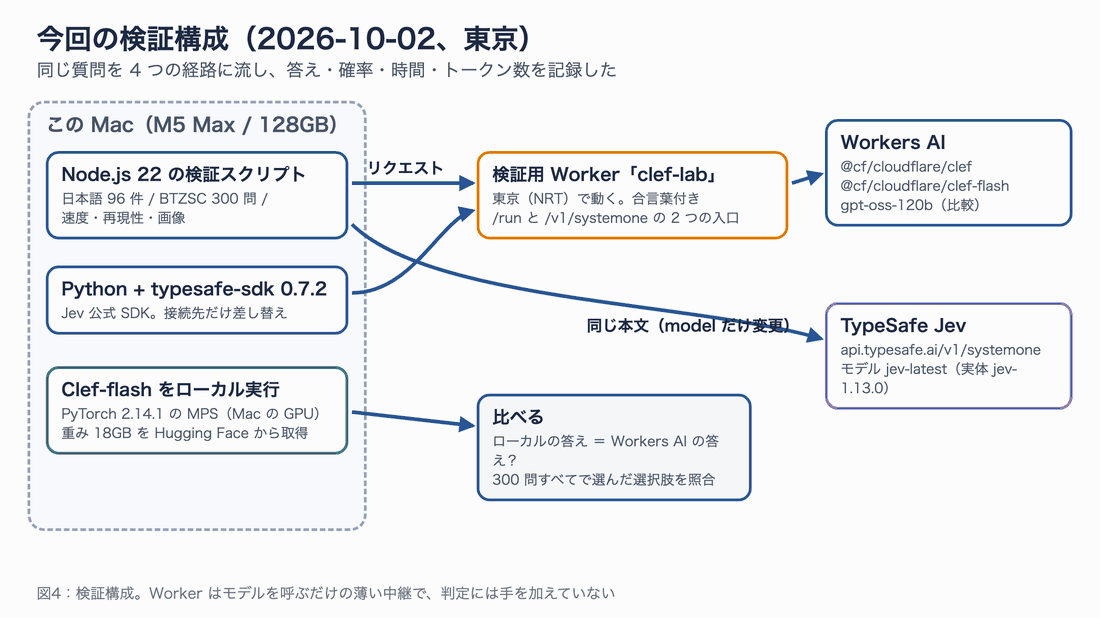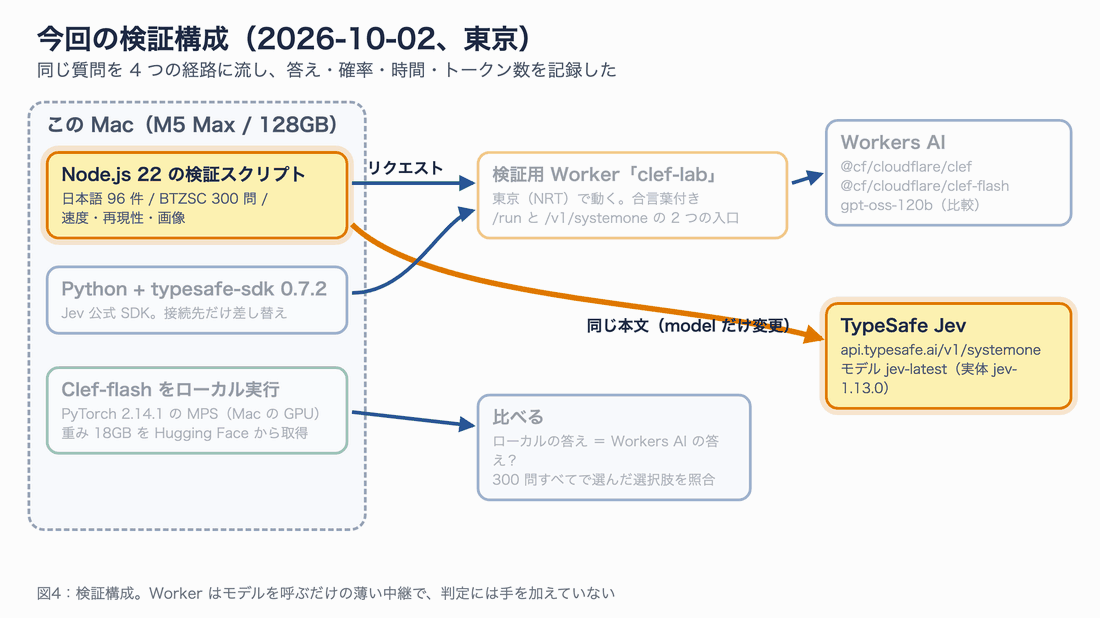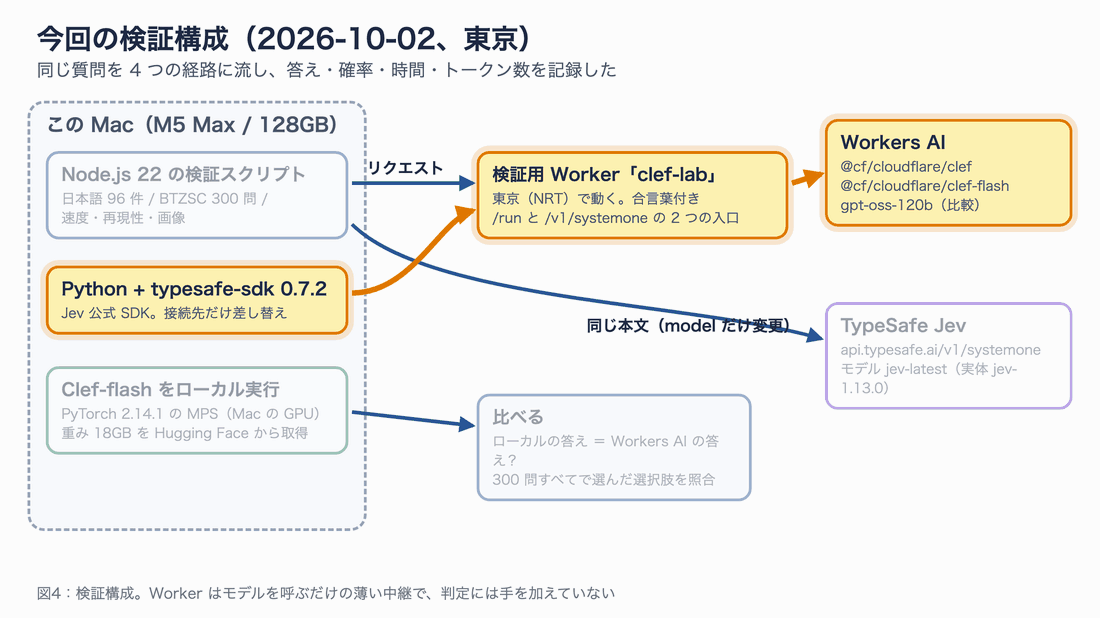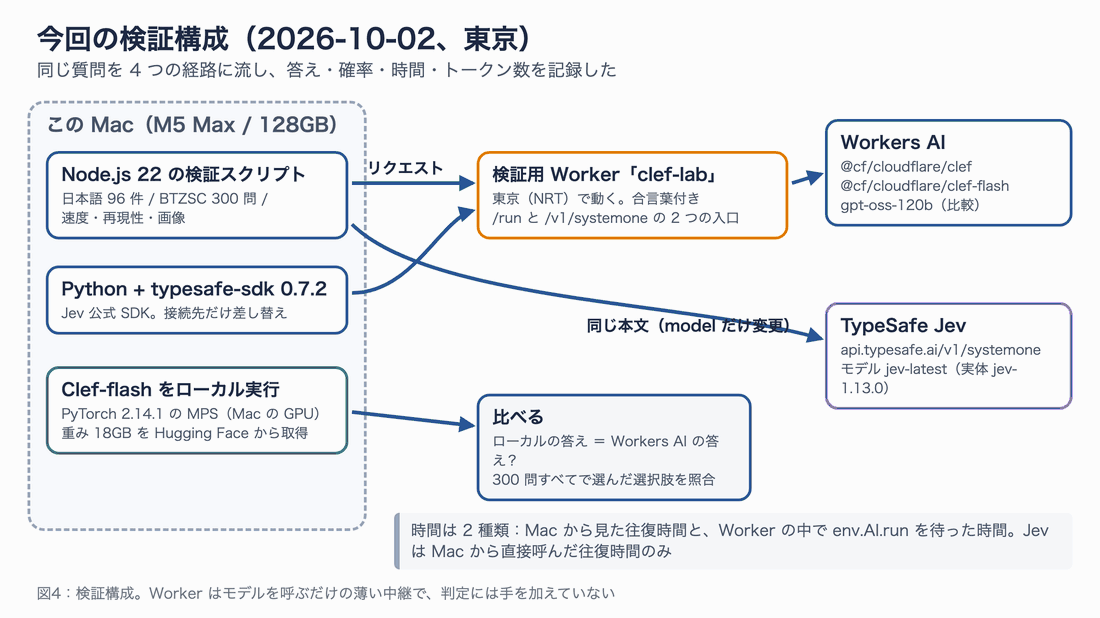
図4:今回の検証構成
Workers AI のモデルは、Worker の中から env.AI.run() で呼ぶのが基本です。そこで、モデルを呼んで結果と所要時間を返すだけの小さな Worker を作り、合言葉(LAB_TOKEN)を知っているリクエストだけ通すようにしました。
1. Worker を作る
作業用のフォルダで、次の 2 ファイルを作ります。
// wrangler.jsonc
{
  "name": "clef-lab",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-01",
  "ai": { "binding": "AI" }
}
// src/index.ts — /run は検証用、/v1/systemone は Jev と同じ形の入口
export interface Env {
  AI: Ai;
  LAB_TOKEN: string;
}

const MODELS: Record<string, string> = {
  clef: "@cf/cloudflare/clef",
  "clef-flash": "@cf/cloudflare/clef-flash",
  llm: "@cf/openai/gpt-oss-120b",
};

export default {
  async fetch(request, env): Promise<Response> {
    const url = new URL(request.url);

    // Jev と同じ入口。本文はそのまま Clef に渡し、結果もそのまま返す
    if (url.pathname === "/v1/systemone") {
      if (request.headers.get("authorization") !== `Bearer ${env.LAB_TOKEN}`)
        return new Response("unauthorized", { status: 401 });
      const body = (await request.json()) as any;
      const id = body.model?.trim() === "clef" ? MODELS.clef : MODELS["clef-flash"];
      return Response.json(await env.AI.run(id as any, body));
    }

    // 検証用の入口。Worker の中で待った時間も返す
    if (request.headers.get("x-lab-token") !== env.LAB_TOKEN)
      return new Response("forbidden", { status: 403 });
    const { model, body } = (await request.json()) as { model: string; body: any };
    const t0 = performance.now();
    const result = await env.AI.run(MODELS[model] as any, body);
    return Response.json({ ms: performance.now() - t0, colo: (request as any).cf?.colo, result });
  },
} satisfies ExportedHandler<Env>;
2. 合言葉を登録してデプロイする
# Cloudflare にログイン済みであることを確認する
npx wrangler whoami

# 合言葉を作って Worker のシークレットに登録する(値は .dev.vars にも保存しておく)
echo "LAB_TOKEN=$(openssl rand -hex 16)" > .dev.vars
cut -d= -f2 .dev.vars | npx wrangler secret put LAB_TOKEN

# デプロイする
npx wrangler deploy
npx wrangler dev でローカル実行することもできますが、AI バインディングはローカル開発中でも常に Cloudflare 側のモデルを呼ぶため、料金が発生します。実行時に警告も表示されます。
3. 最初の 1 回を送る
公式ドキュメントのサンプルと同じ内容を送ってみます。
curl -s https://clef-lab.<YOUR_SUBDOMAIN>.workers.dev \
  -H "x-lab-token: <YOUR_LAB_TOKEN>" \
  -d '{"model":"clef","body":{
    "model": "clef",
    "state": "Checkout has been failing for every customer for the last hour.",
    "questions": {
      "urgent": { "type": "noul", "instructions": "Is this support request urgent?" },
      "team": { "type": "choice", "instructions": "Which team should handle this request?",
        "criteria": { "billing": "Payments, invoices, and refunds",
                      "technical": "Outages, errors, and configuration",
                      "sales": "Plans and upgrades" } },
      "severity": { "type": "score", "instructions": "How severe is the customer impact?",
        "criteria": ["No impact", "Minor", "Major", "Critical"] }
    }}}'
実際に返ってきた結果(抜粋)です。output_tokens が 0 になっている点に注目してください。
{
  "ms": 596, "colo": "NRT",
  "result": {
    "model": "clef",
    "answers": {
      "urgent":   { "type": "noul", "noul": 0.9906 },
      "team":     { "type": "choice", "choice": "technical",
                    "probabilities": { "billing": 0.1762, "technical": 0.8088, "sales": 0.015 },
                    "confidence": 0.5281 },
      "severity": { "type": "score", "score": 2.9573, "confidence": 0.922,
                    "probabilities": { "0": 0.0042, "1": 0.0043, "2": 0.0215, "3": 0.97 } }
    },
    "usage": { "input_tokens": 346, "output_tokens": 0 }
  }
}
「障害担当(technical)で、緊急(0.99)、深刻度はほぼ最大(3 段階目が 0.97)」という、納得できる判定です。wrangler ai models の一覧にも @cf/cloudflare/clef と @cf/cloudflare/clef-flash が載っており、分類上は「Text Generation」として登録されていました。
検証1:Jev のコードはそのまま動くか
Cloudflare は「Clef は Jev の API と完全互換で、エンドポイントとモデル名を変えるだけで切り替えられる」と説明しています。これを 2 段階で確かめました。
同じ本文を 3 つに送る
まず、上と同じリクエスト本文を、model だけ変えて Clef・Clef-flash・Jev に送りました。返ってきた形を並べると次のとおりです。
| 項目 | Clef | Clef-flash | Jev |
|---|---|---|---|
model | clef | clef-flash | jev-1.13.0 |
team.choice | technical | technical | technical |
team の確率 | 0.8088 | 0.9355 | 1 |
urgent.noul | 0.9906 | 0.9551 | 0.96 |
severity.score | 2.9573 | 2.7182 | 2.99 |
| 数字の桁 | 小数 4 桁 | 小数 4 桁 | 小数 2 桁 |
usage | 入力 346・出力 0 | 入力 346・出力 0 | 入力 402・出力 68 |
答えの構造(answers の中身、型ごとの項目名)は完全に一致しました。違いは、数字の桁数と、usage の数え方です。Jev は出力トークンを 68 と数えますが、Jev は出力が無料なので料金には影響しません。
Jev 公式 SDK を Clef に向ける
次に、Jev の公式 Python SDK(typesafe-sdk 0.7.2)を使ったコードを、1 行も変えずに Clef に向けられるか試しました。SDK は接続先を環境変数 TYPESAFE_BASE_URL で変えられるので、先ほどの Worker の /v1/systemone を指定します。
# 09_sdk_swap.py — Jev 用に書いた判定コード(Clef 用の変更は一切なし)
import os
from typesafe_sdk import TypeSafeClient, Choice, Noul, Score

client = TypeSafeClient(model=os.environ.get("MODEL", "jev-latest"))
res = client.system_one(
    state="決済画面で全員エラーになっていて、1時間ずっと注文が通りません。",
    questions={
        "urgent": Noul(instructions="今すぐ対応が必要な問い合わせですか。"),
        "team": Choice(instructions="担当する窓口はどこですか。", criteria={
            "billing": "支払い・請求・返金", "technical": "障害・エラー・設定", "sales": "プラン・契約変更"}),
        "severity": Score(instructions="お客様への影響の大きさは?", criteria=["影響なし", "小", "大", "重大"]),
    },
)
print("model:", res.model)
print("team:", res.choices["team"].choice, res.choices["team"].probabilities)
print("usage:", res.usage)
pip install typesafe-sdk

# 1) いつもの Jev(TYPESAFE_API_KEY は Jev のキー)
python 09_sdk_swap.py

# 2) 同じコードのまま、接続先・キー・モデル名だけ変える
TYPESAFE_BASE_URL=https://clef-lab.<YOUR_SUBDOMAIN>.workers.dev \
TYPESAFE_API_KEY=<YOUR_LAB_TOKEN> \
MODEL=clef-flash python 09_sdk_swap.py
実際に動かした様子です。
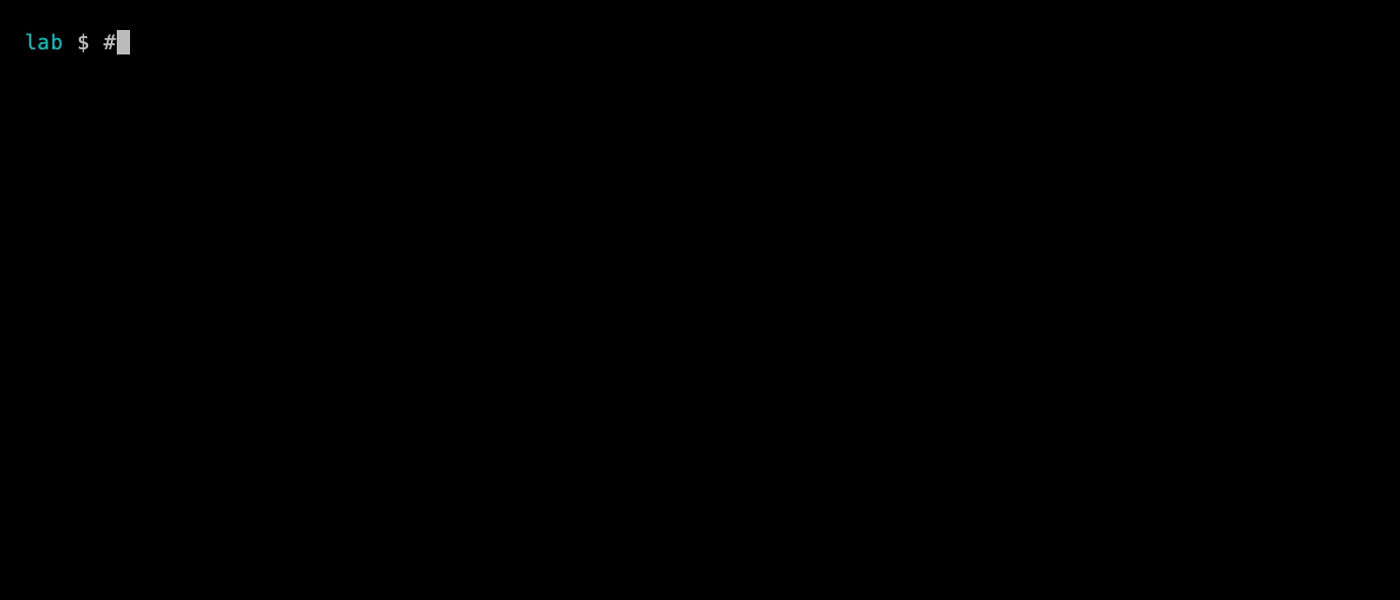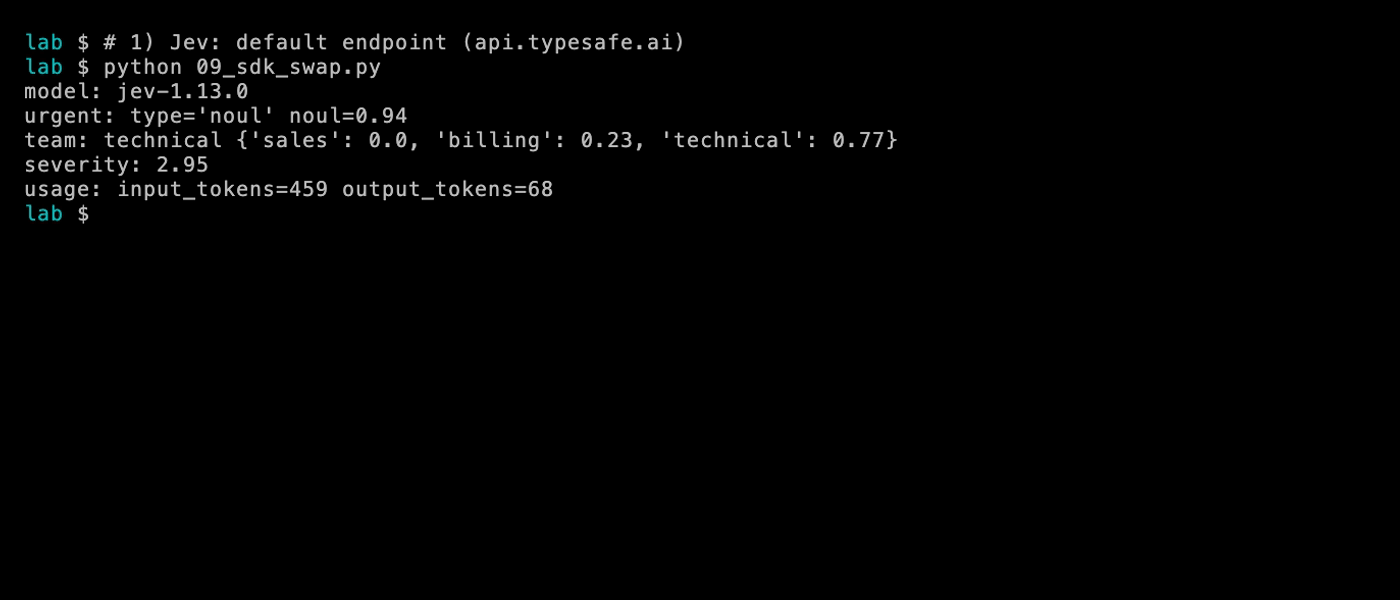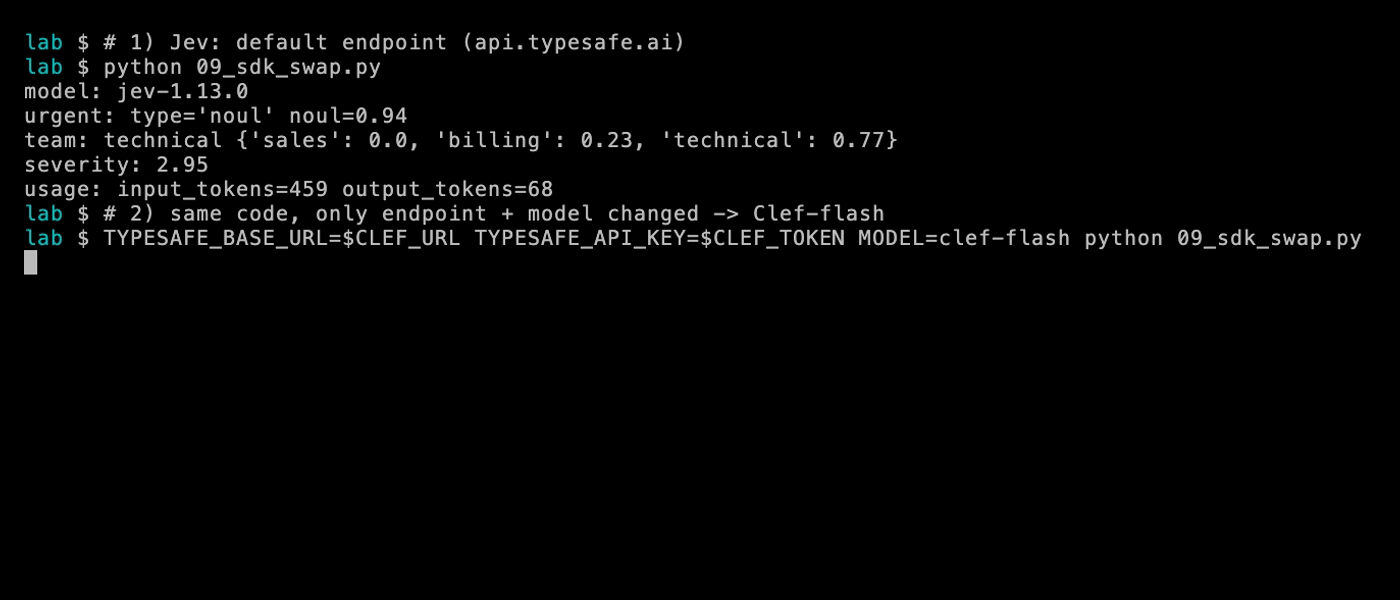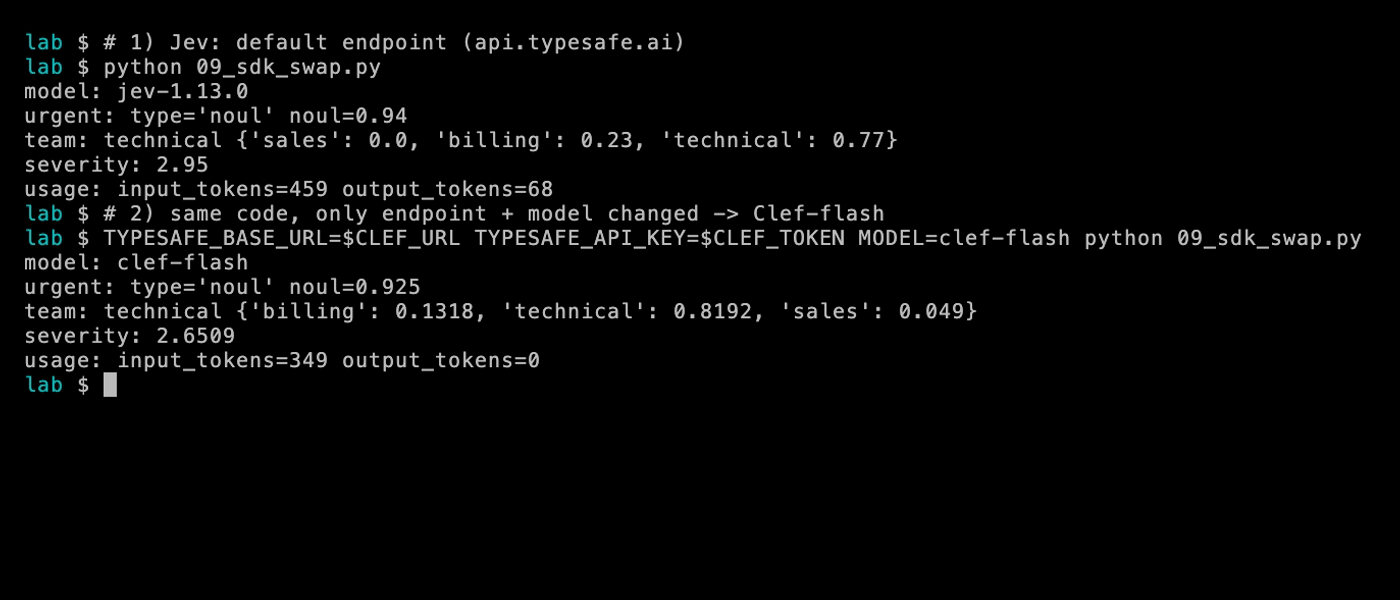
SDK のコードはそのままで、環境変数だけ変えて Jev → Clef-flash に切り替えた様子
SDK は Clef の応答をエラーなく読み込み、res.choices["team"] などの使い方もそのまま通りました。互換性の主張は、応答の形については正しいと言えます。
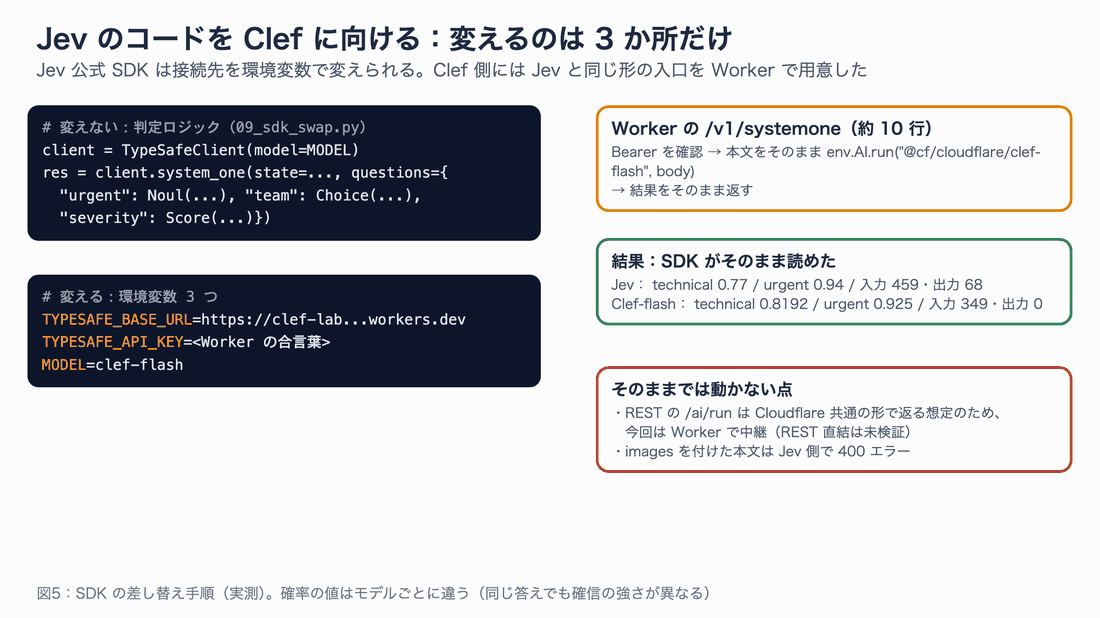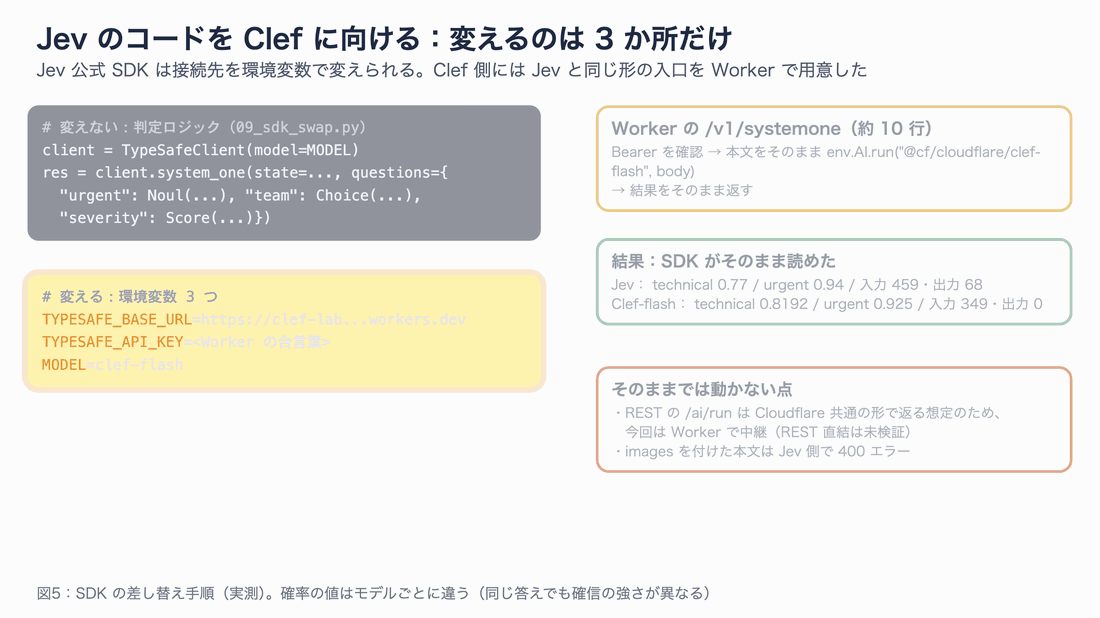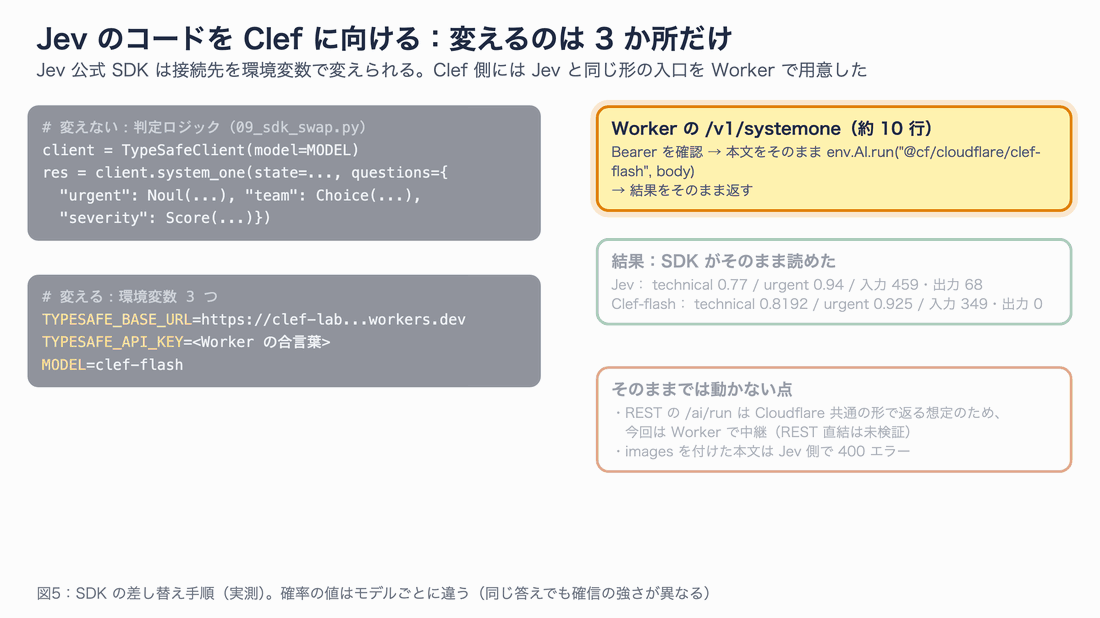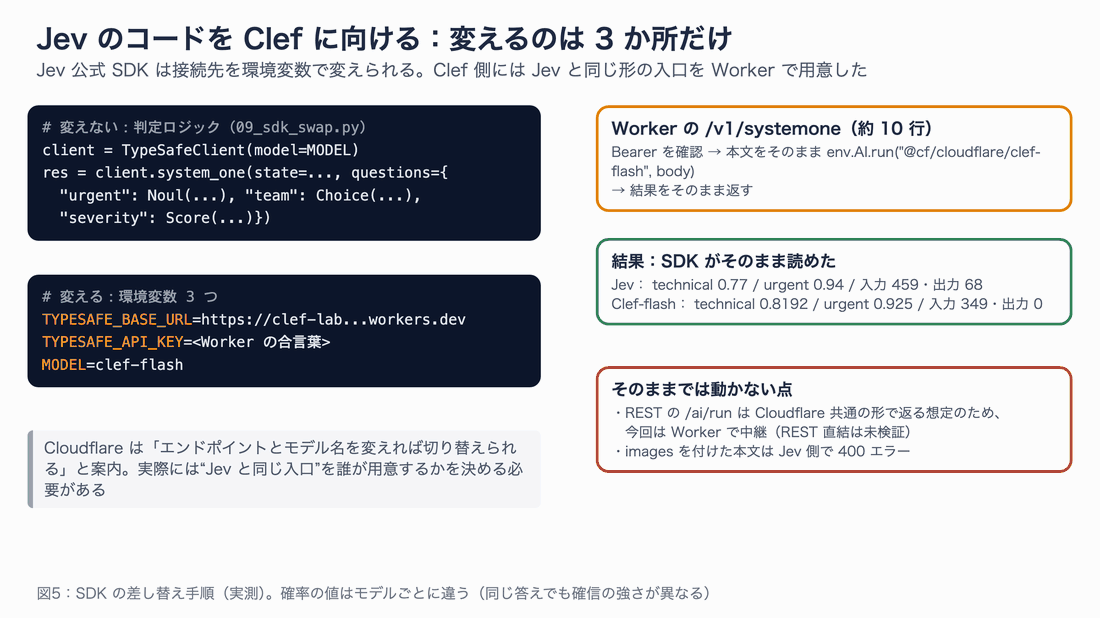
図5:差し替えの手順と注意点
ただし、「エンドポイントを変えるだけ」には条件があります。Workers AI には Jev と同じ /v1/systemone という URL はありません。今回は Worker で 10 行ほどの入口を自作しました。REST API(/ai/run/@cf/cloudflare/clef)は Cloudflare API 共通の形で応答が包まれる仕様のため、Jev の SDK から直接つなぐことは今回試していません。
また逆方向の互換性はありません。Clef 独自の images を付けた本文を Jev に送ると、HTTP 400(Invalid request.) が返りました。画像を使い始めると、Jev には戻せなくなります。
検証2:精度は Jev とどちらが上か
日本語の業務判定 96 件
まず、エージェントで実際によく使う判定を日本語で 96 件用意しました。正解は筆者が付けています。
| タスク | 件数 | 質問 |
|---|---|---|
| 問い合わせの振り分け | 48 件 | 担当窓口 6 択(choice)+ 返金を求めているか(noul)+ 今日中の対応が必要か(noul) |
| ツール選択 | 16 件 | 最初に呼ぶツールを 6 つから選ぶ(choice) |
| ガードレール | 16 件 | 人の承認なしで実行してよい操作か(noul) |
| RAG の再検索判定 | 16 件 | 取得した文書だけで答えられるか(noul) |
問い合わせ 48 件は、以前 Julia-1 と Jev を比べた記事で作ったものを再利用しました。比較用に、Workers AI の gpt-oss-120b にも同じ質問を JSON Schema 付きで答えさせています。
| 判定 | Clef | Clef-flash | Jev | gpt-oss-120b |
|---|---|---|---|---|
| 担当窓口(6 択) | 48/48 | 47/48 | 48/48 | 48/48 |
| 返金を求めているか | 44/48 | 45/48 | 45/48 | 46/48 |
| 今日中の対応が必要か | 46/48 | 44/48 | 43/48 | 47/48 |
| ツール選択(6 択) | 16/16 | 16/16 | 16/16 | 15/16 |
| ガードレール | 16/16 | 16/16 | 16/16 | 15/16 |
| RAG の再検索判定 | 15/16 | 15/16 | 15/16 | 15/16 |
| 合計(192 判定) | 96.4% | 95.3% | 95.3% | 96.9% |
結果は、4 つとも 95% を超え、差は 1〜3 判定でした。この程度の難しさでは、どれを使っても実用上の差は出ません。日本語でも Clef は問題なく使えることが分かりました。
間違え方には傾向がありました。Clef は「二重請求されている」「身に覚えのない引き落とし」を返金の要求と見なさず、Jev は「パスワードを入れてもログインできない」「SMS の確認コードが届かない」を緊急と見なしませんでした。どちらも人によって判断が分かれる問いで、判断基準を instructions や criteria に具体的に書くことが精度に直結します。gpt-oss-120b は 1 件、3 回再試行しても有効な JSON を返さず失敗扱いになりました。判定モデルではこの種の失敗は起きませんでした。
公開データ BTZSC 300 問
差を見るために、もっと難しい公開データでも比べました。以前の記事で使った jev-benchmarks の pilot-v1 と同じ 300 問(BTZSC から各 100 問、マニフェストの SHA-256 が ec064c52… で一致)を、同じ書き方で 3 つのモデルに解かせています。
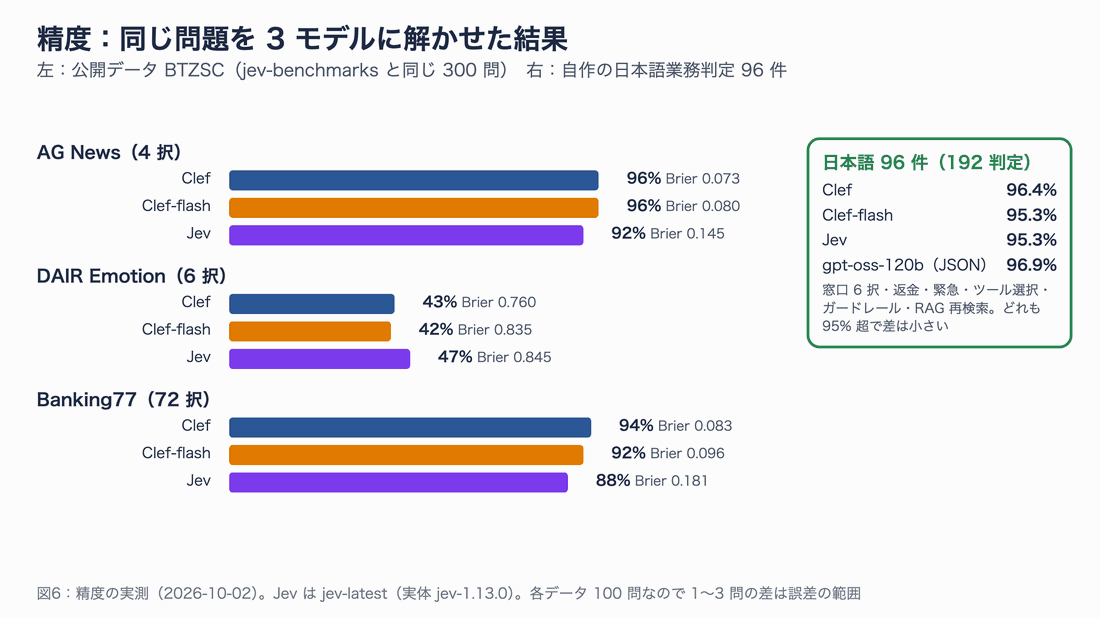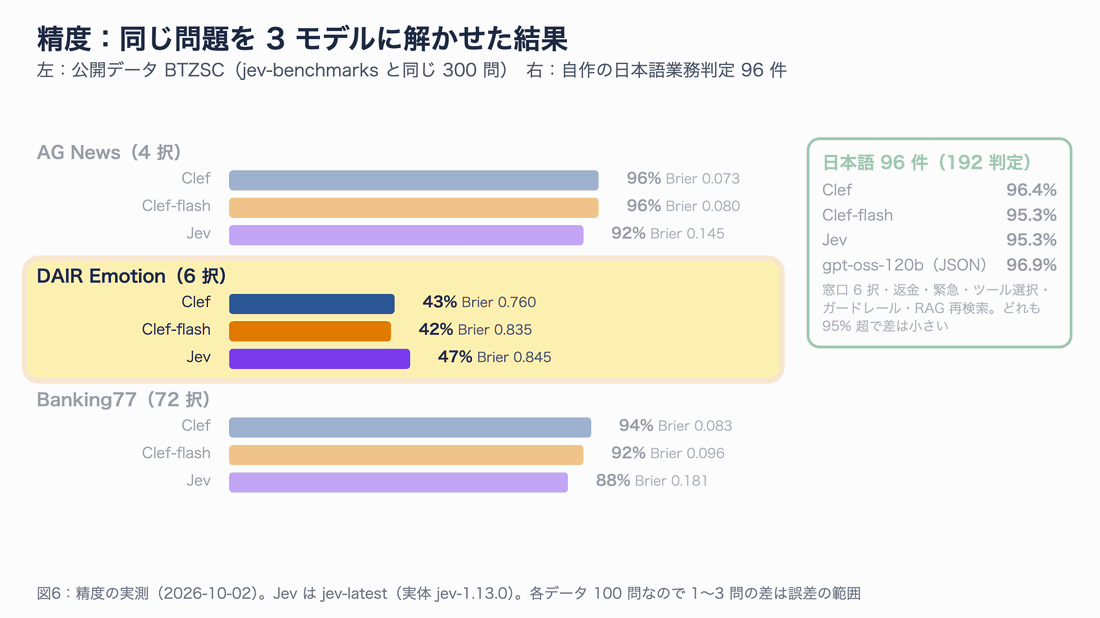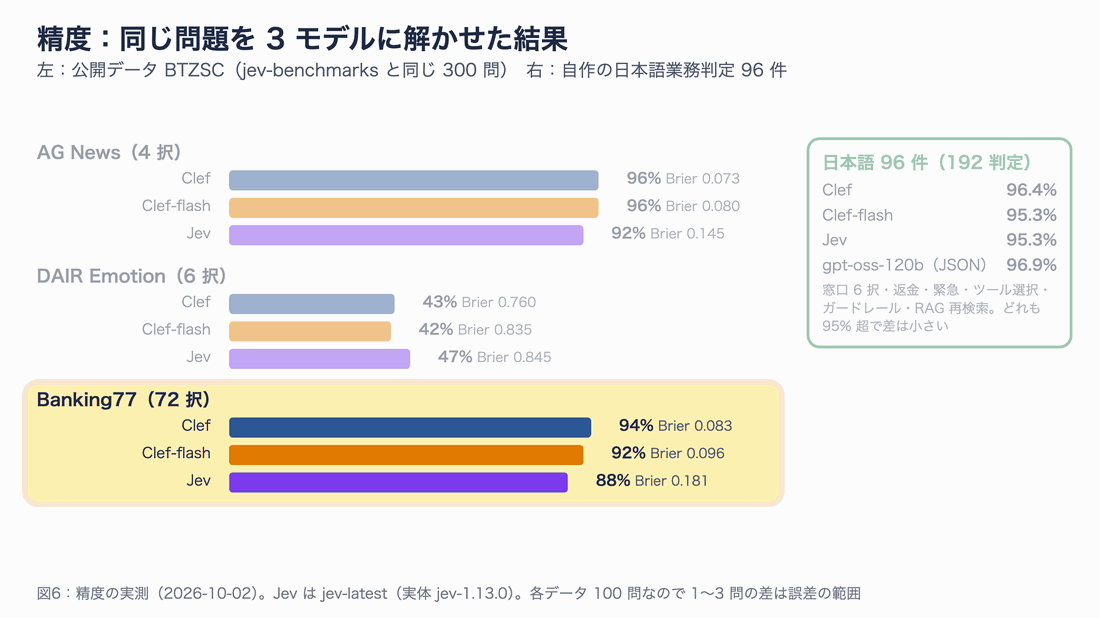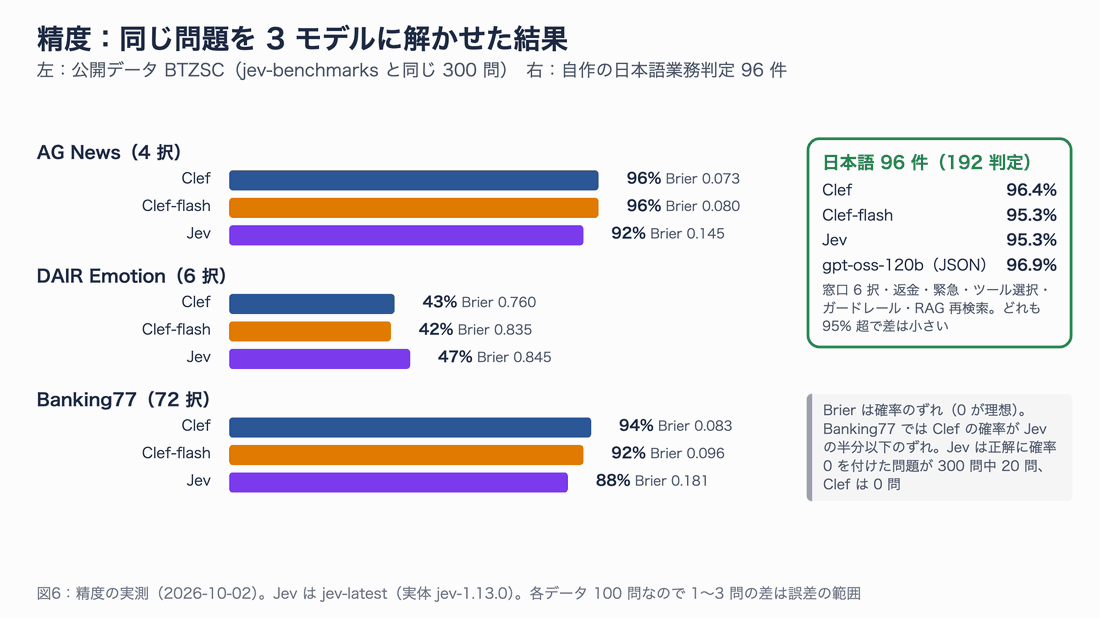
図6:精度の実測。Brier は 0 に近いほど確率が正確
| データ | 選択肢 | Clef | Clef-flash | Jev(今回) | Jev(2026年9月の第三者記録) |
|---|---|---|---|---|---|
| AG News | 4 | 96% | 96% | 92% | 91% |
| DAIR Emotion | 6 | 43% | 42% | 47% | 48% |
| Banking77 | 72 | 94% | 92% | 88% | 87% |
| 合計 | — | 233/300 | 230/300 | 227/300 | — |
Jev の今回の結果は、9月の第三者の記録とほぼ同じでした。測り方が揃っていることの確認になります。
正解率の差は、各データ 100 問なので 1〜4 問の差は誤差の範囲です。それよりはっきり差が出たのが 確率の質 です。Banking77 の Brier スコアは Clef が 0.083、Jev が 0.181 で、Clef の確率のずれは Jev の半分以下でした。さらに、Jev は 300 問中 20 問で正解の選択肢に確率 0 を付けていました(小数 2 桁に丸めるため)。Clef は 0 問です。
これは運用上の差になります。「確率が低い答えだけ人に回す」設計では、正解に 0 を付けるモデルは、自信満々に間違える場面が増えるからです。感情分類(DAIR Emotion)はどのモデルも 4 割台で、選択肢の意味が重なる問題は判定モデル全般の苦手分野です。
検証3:速度は公式どおりか
公式の「Clef は Jev の 2.5 倍、Clef-flash は 13 倍速い」を確かめるため、1 件ずつ順番に送って時間を測りました。日本語の問い合わせ 48 件を順に使う測定と、公式サンプルを使う測定を、時間を変えて 2 回ずつ行っています。
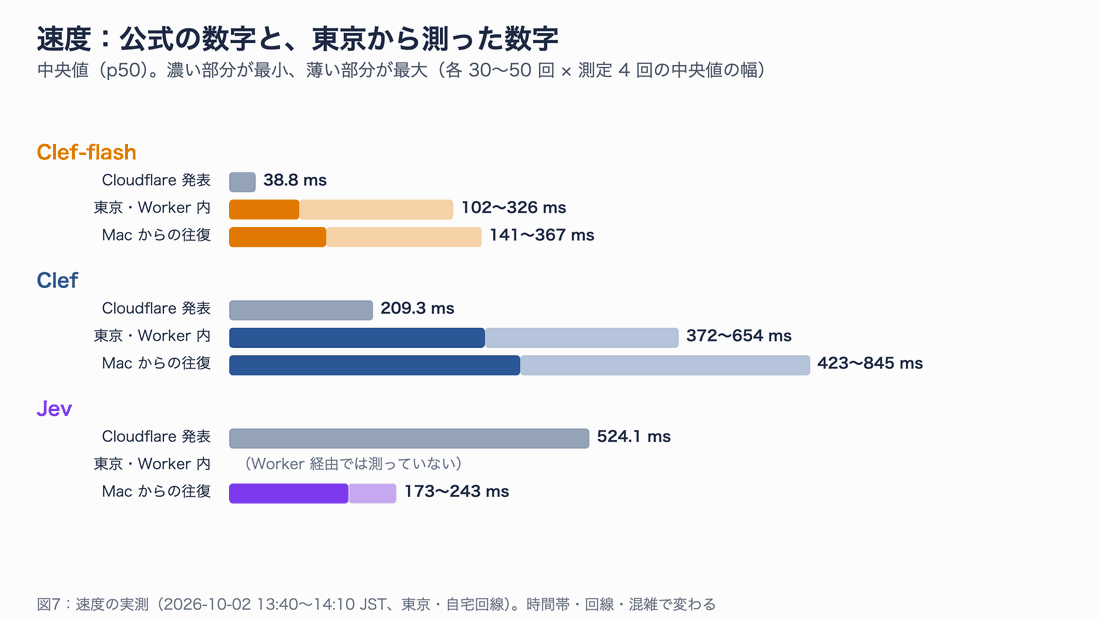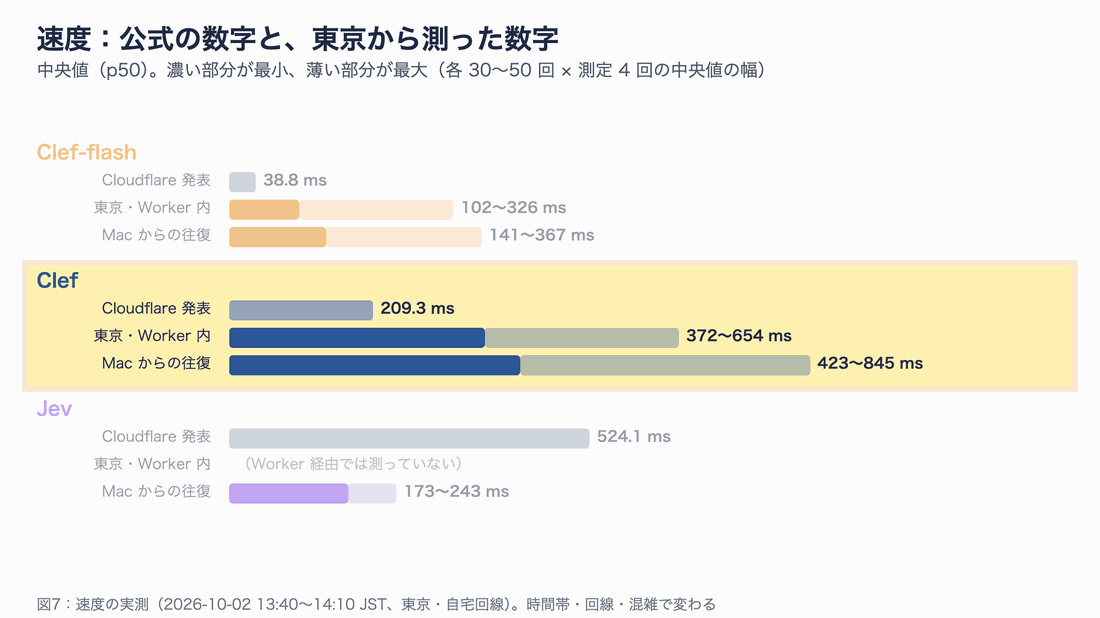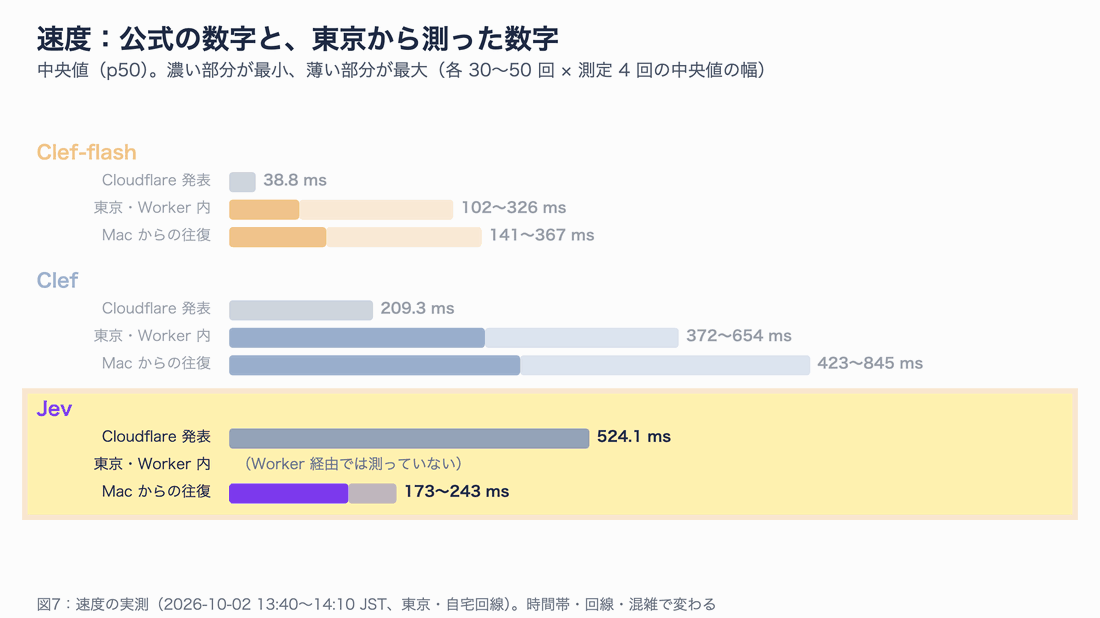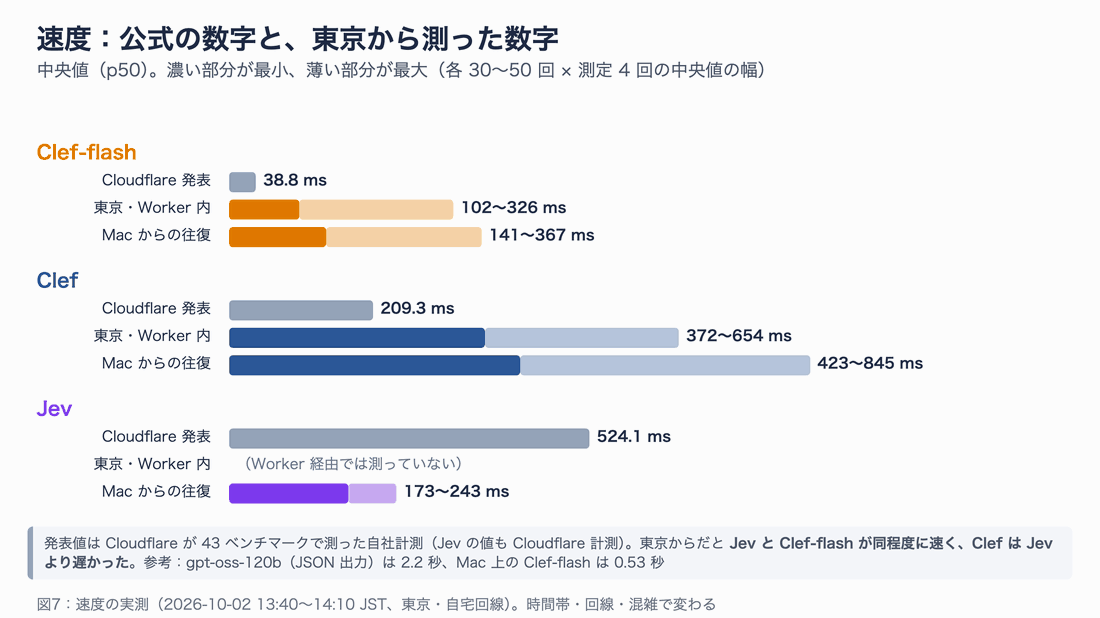
図7:速度の実測。濃い部分が 4 回の測定の最小、薄い部分が最大
| モデル | Cloudflare 発表(中央値) | 東京・Worker 内(中央値) | Mac からの往復(中央値) |
|---|---|---|---|
| Clef-flash | 38.8 ms | 102〜326 ms | 141〜367 ms |
| Clef | 209.3 ms | 372〜654 ms | 423〜845 ms |
| Jev | 524.1 ms | — | 173〜243 ms |
| gpt-oss-120b(JSON) | — | — | 約 2,200 ms(4 並列時) |
結果は 公式の数字とかなり違いました。東京からだと Jev と Clef-flash がほぼ同じくらい速く、Clef は Jev より遅かったのです。
理由として考えられるのは次の 3 つです。
- 測っている区間が違う:公式値は 43 のベンチマークを回したときの中央値で、Cloudflare 社内の条件です。Worker 内で測った時間には、東京のデータセンターから GPU のある場所までの往復が含まれます。
- GPU の場所と混雑:東京の Worker から呼んでも、GPU は別の地域にある可能性があります。公開初日で利用が集中していたことも考えられます。
- Jev の値も Cloudflare が測ったもの:表の Jev 524.1ms は Cloudflare 側からの測定で、Jev 自身は「70〜500ms」と案内しています。日本からの Jev は 0.2 秒前後でした。
LLM(gpt-oss-120b)と比べれば、どちらの判定モデルも 1 桁速いのは確かです。ただし 「Jev から乗り換えると速くなる」とは、日本からの利用では言えません。速度を理由に選ぶなら、自分の地域と回線で測ってから決めてください。
検証4:同じ入力に毎回同じ答えを返すか
判定を自動化するなら、同じ入力に毎回同じ確率を返してほしいところです。公式サンプルとまったく同じリクエストを 10 回ずつ送りました。
| モデル | 10 回のうち異なる結果の数 | 揺れた値 |
|---|---|---|
| Clef | 1 種類(完全一致) | なし |
| Clef-flash | 1 種類(完全一致) | なし |
| Jev | 2 種類 | urgent が 0.96 と 0.97 で揺れた |
Clef は 10 回とも小数 4 桁まで完全に同じ値を返しました。Jev も実用上は十分安定していますが、しきい値ちょうどの値では結果が入れ替わる可能性があります。なお Jev は選択肢の 並び順 が毎回変わって返ってきました。文字列のまま比較するテストを書いている場合は、キーで並べ替えてから比べる必要があります。
検証5:画像だけで判定できるか
Clef は Qwen の画像エンコーダーを引き継いでいるため、画像を最大 4 枚まで渡せます。架空の画面を 4 枚作り、state には文章の情報を入れず、画像だけで判定させました。
// 画像は data URL で渡す(外部 URL は受け付けない)
const b64 = readFileSync("vision/phish.png").toString("base64");
const body = {
  model: "clef-flash",
  state: "添付したスクリーンショットを見て答えてください。",
  images: [`data:image/png;base64,${b64}`],
  questions: {
    page_type: { type: "choice", instructions: "この画像はどの種類の画面ですか。",
      criteria: { login: "ログイン・本人確認の入力画面", recipe: "料理レシピ・ブログ記事",
                  receipt: "レシート・領収書", error: "システムのエラー画面" } },
    phishing: { type: "noul", instructions: "パスワードや暗証番号をだまし取ろうとするフィッシング詐欺の疑いがある画面ですか。" },
    outage: { type: "noul", instructions: "サービス障害・システムエラーが起きていることを示す画面ですか。" },
    total: { type: "score", instructions: "画像から読み取れる買い物の合計金額はどの範囲ですか。",
      criteria: ["金額なし", "500円未満", "500〜999円", "1,000円以上"] },
  },
};
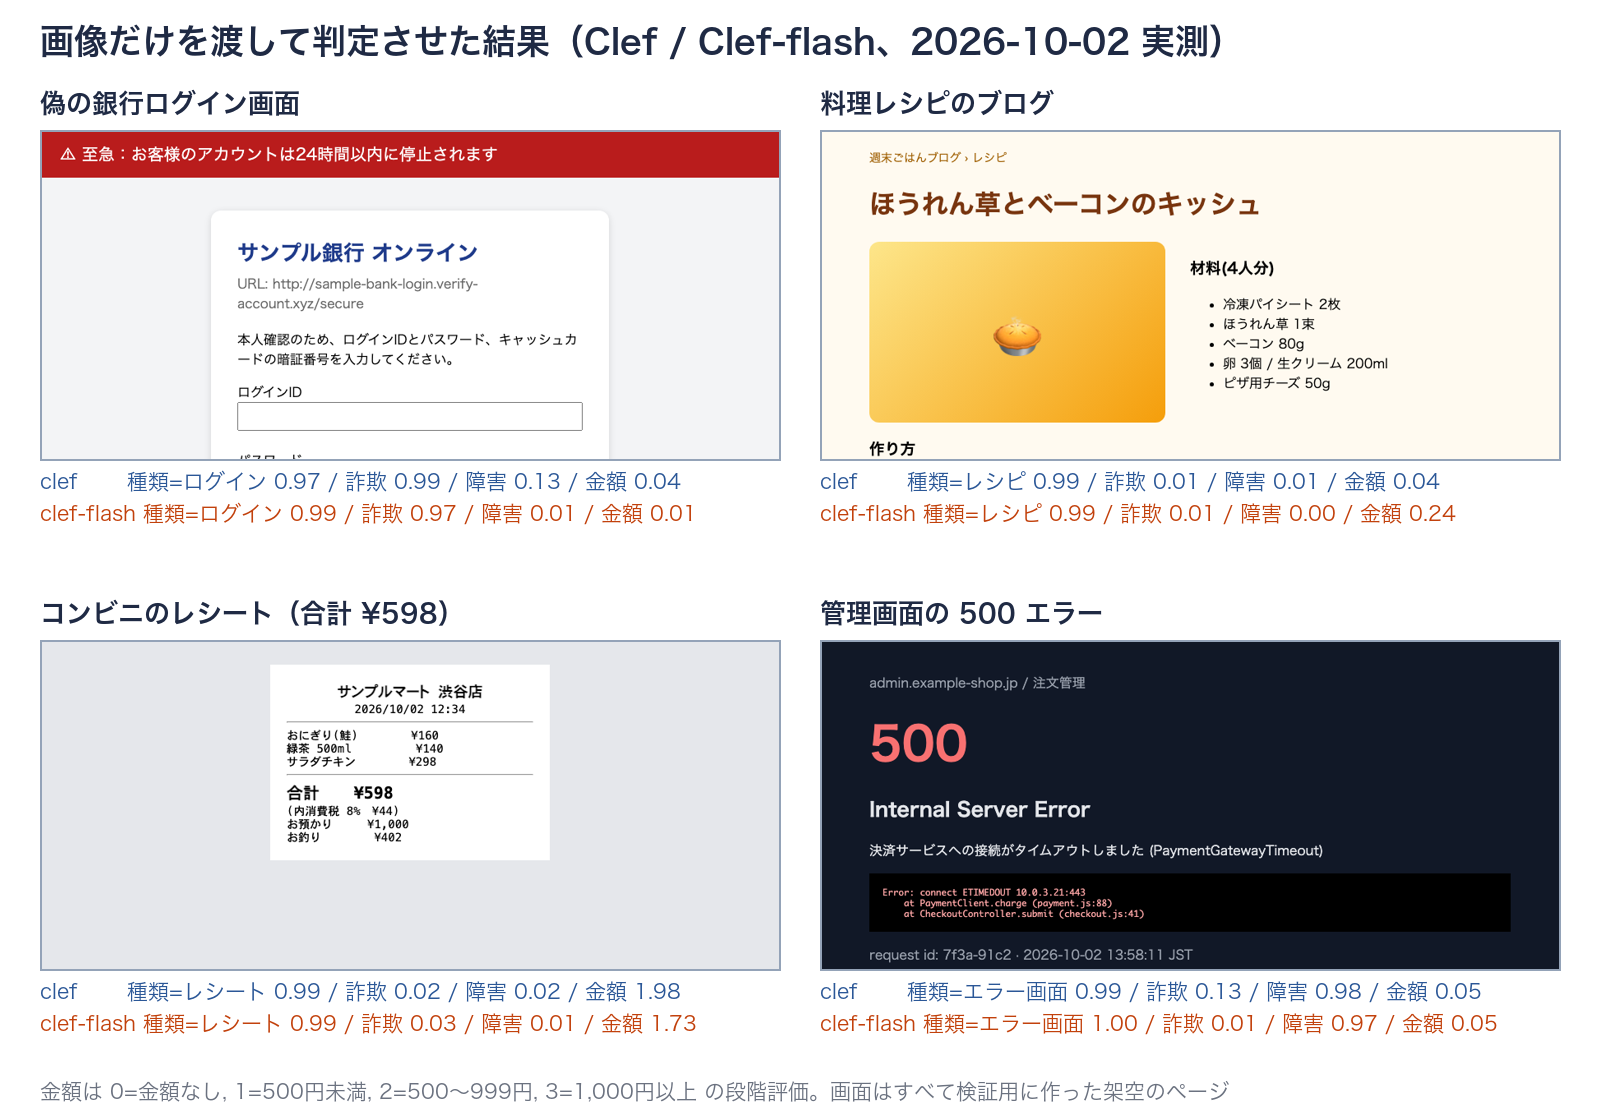
画像だけを渡した判定結果。画面はすべて検証用に作った架空のページ
4 枚とも、画面の種類を 0.97 以上の確率で正しく分類しました。偽の銀行ログイン画面は詐欺の疑い 0.97〜0.99、500 エラーの管理画面は障害 0.97〜0.98 です。レシートの合計 598 円は「500〜999 円(段階 2)」が正解で、Clef は 1.98、Clef-flash は 1.73 と、Clef のほうが正確に読み取れていました。
1 枚あたりの入力は 1,066 トークンで、Clef-flash なら約 $0.0001(1 ドル 150 円換算で約 0.015 円)です。スクリーンショットからの不審サイト判定や、レシート画像の一次仕分けには十分使える手応えでした。Cloudflare 自身も、Browser Run でサイトを描画して分類する使い方で、gpt-oss-120b の 4.7 秒に対し 2.2 秒で済んだと紹介しています。
検証6:手元の Mac で動かす
重みが公開されているので、データを外に出さずに自分のマシンで動かせます。Hugging Face のモデルカードは「H200 1 枚で確認」としていますが、Apple Silicon の GPU(MPS)でも動くか試しました。
Hugging Face の Clef-flash のページ(公開翌日の時点で、第三者の量子化版が 10 個登録されていた)
手順
# Python 3.12 の仮想環境を作る
python3.12 -m venv .venv && source .venv/bin/activate

# 必要なパッケージ(torchvision は文章だけ使う場合も必要)
pip install "torch>=2.11" "transformers>=5.10" torchvision huggingface_hub pillow accelerate safetensors

# 重みをダウンロードする(Clef-flash は約 18GB、Clef は約 55GB)
hf download Cloudflare/clef-flash
読み込みと推論は、モデルに同梱されている joint_schema_model.py を使います。systemone() 関数が Jev と同じ形の入出力を受け持ってくれます。
# 06_local.py — Clef-flash を Mac の GPU(MPS)で動かす
import json, sys, time
import torch
from huggingface_hub import snapshot_download

path = snapshot_download("Cloudflare/clef-flash")
sys.path.insert(0, path)
from joint_schema_model import load_release_model, systemone

model, processor = load_release_model(path, device="mps")  # 既定は bfloat16

req = {
    "model": "clef-flash",
    "state": "Checkout has been failing for every customer for the last hour.",
    "questions": {
        "urgent": {"type": "noul", "instructions": "Is this support request urgent?"},
        "team": {"type": "choice", "instructions": "Which team should handle this request?",
                 "criteria": {"billing": "Payments, invoices, and refunds",
                              "technical": "Outages, errors, and configuration",
                              "sales": "Plans and upgrades"}},
    },
}
for i in range(3):  # 1 回目はウォームアップ
    t = time.perf_counter()
    res = systemone(model, processor, req)
    torch.mps.synchronize()
    print(f"run{i} {1000 * (time.perf_counter() - t):.0f} ms")
print(json.dumps(res, ensure_ascii=False, indent=1))
結果
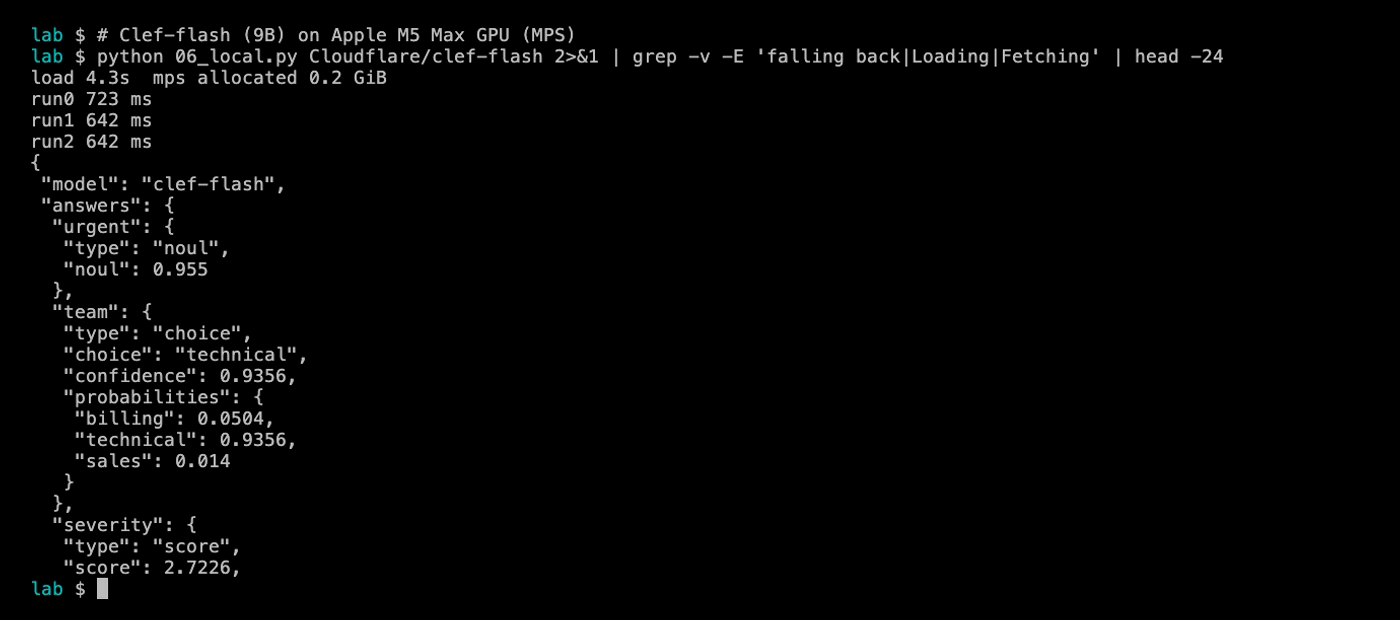
Mac の GPU で Clef-flash を動かした画面。答えは Workers AI とほぼ同じ値になった
| 項目 | Clef-flash(Mac) | Clef(Mac) | 参考:Workers AI |
|---|---|---|---|
| 重みのサイズ | 約 18 GB | 約 55 GB | — |
| 使用メモリ(GPU) | 約 18 GB | 約 52 GB | — |
| 公式サンプルの判定時間 | 約 0.64 秒 | 約 2.0 秒 | Flash 0.1〜0.3 秒 / Clef 0.4〜0.65 秒 |
technical の確率 | 0.9356 | 0.8112 | Flash 0.9355 / Clef 0.8088 |
| BTZSC 300 問の正解数 | 230 | 233 | Flash 230 / Clef 233 |
| Workers AI と同じ選択肢を選んだ数 | 300/300 | 300/300 | — |
| 確率の差(各問の最大差の中央値) | 0.0009 | 0.0014 | — |
| 1 件の時間(4〜6 択 / 72 択) | 0.52 秒 / 4.3 秒 | 1.7〜1.8 秒 / 13.5 秒 | — |
Mac で動かした Clef-flash と Clef は、どちらも 300 問すべてで Workers AI と同じ答えを選びました。確率の差も小数 3 桁目以下で、クラウド版と同じモデルが動いていると考えてよさそうです。27B の Clef も、128GB の Mac なら量子化(重みを小さくする加工)なしでそのまま動きました。
速度は、Clef-flash でも 4〜6 択なら 1 件約 0.52 秒ですが、72 択の Banking77 では約 4.3 秒かかりました。Clef では 13.5 秒です。Mac には Qwen3.5 以降の構造で使う高速な計算部品(causal_conv1d や flash-linear-attention)が入らず、遅い参照実装で動いているためです。実行時にも警告が出ます。社内データを外に出さずに夜間にまとめて判定する、といった用途なら十分実用的です。
もう 1 点、confidence の値は Workers AI と手元で意味が違いました。手元の実装は「最大の確率」をそのまま入れますが、Workers AI は「確率から導いた確信度」で、最大確率 0.8088 に対し 0.5281 のように別の値になります。しきい値は confidence ではなく probabilities で決めておくと、クラウドとローカルを行き来しても挙動が変わりません。
料金:1 万回判定するといくらか
単価だけでなく、実際に数えられたトークン数で比べます。同じ文章でも、Jev はトークンを多めに数えました(日本語の問い合わせで Clef の約 1.3 倍)。
| 1 万回あたり | 1 回の入力(実測平均) | Clef | Clef-flash | Jev | gpt-oss-120b |
|---|---|---|---|---|---|
| 日本語の問い合わせ(質問 3 つ) | Clef 487 / Jev 643 トークン | $1.17 | $0.44 | $0.27 | $2.41 |
| BTZSC(選択肢 4〜72 個) | Clef 972 / Jev 1,056 トークン | $2.33 | $0.87 | $0.44 | — |
gpt-oss-120b は入力 352 トークン・出力 157 トークンの平均で計算しました。最も安いのは Jev で、Clef-flash はその約 1.6〜2 倍、Clef は約 4〜5 倍です。それでも LLM に JSON を書かせるより Clef-flash は 5 分の 1 程度で済みます。
Workers AI には 1 日 10,000 Neurons(Workers AI の計算量の単位)の無料枠 があります。Clef-flash は 100 万トークンあたり 8,182 Neurons なので、無料枠で 1 日約 122 万トークン、今回の問い合わせ判定なら 1 日約 2,500 回まで無料 で試せます。Clef は 1 日約 940 回です。
RL ファインチューニング基盤:何が発表されたのか
モデルと同時に、Clef を自社の判断に合わせて鍛える強化学習(RL)の仕組みも発表されました。Cloudflare の既存製品をつないで、データ集めから再配置までを 1 つの社内で回す構想です。
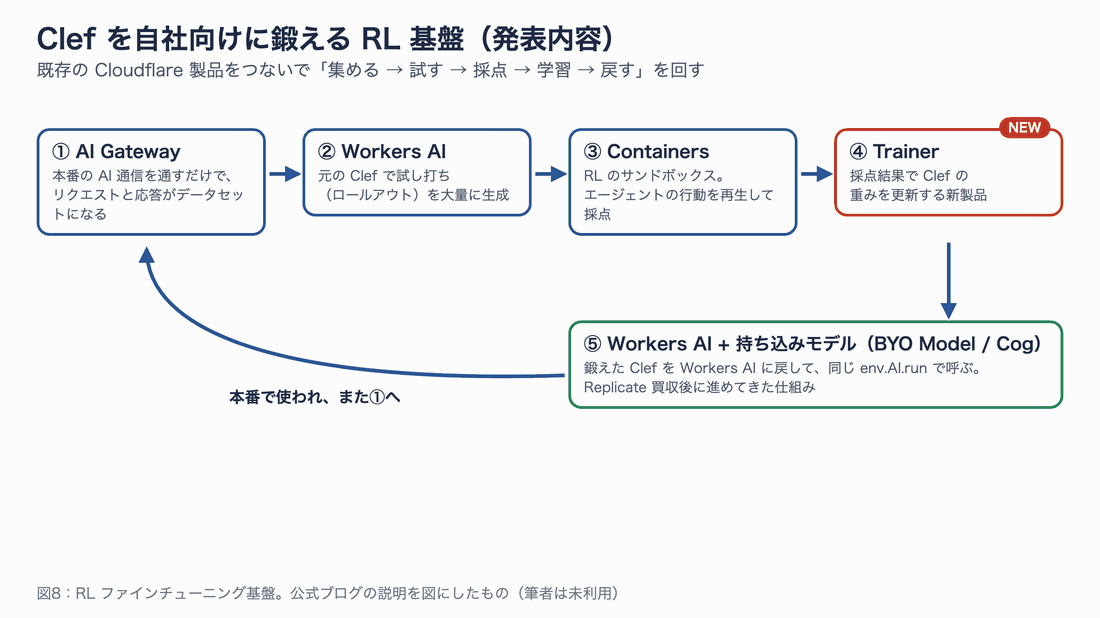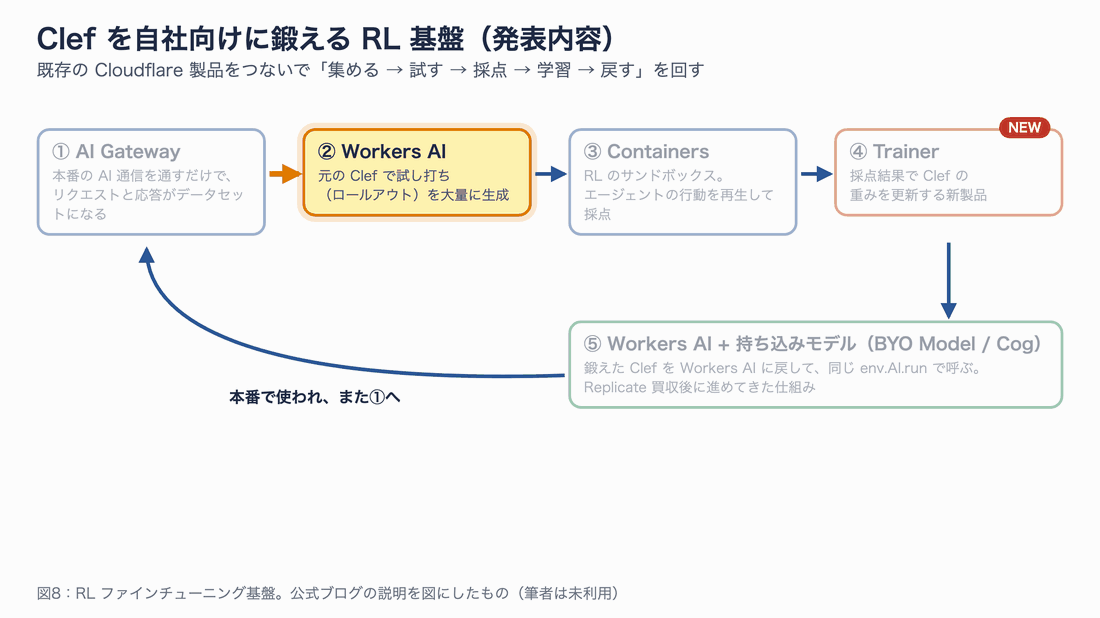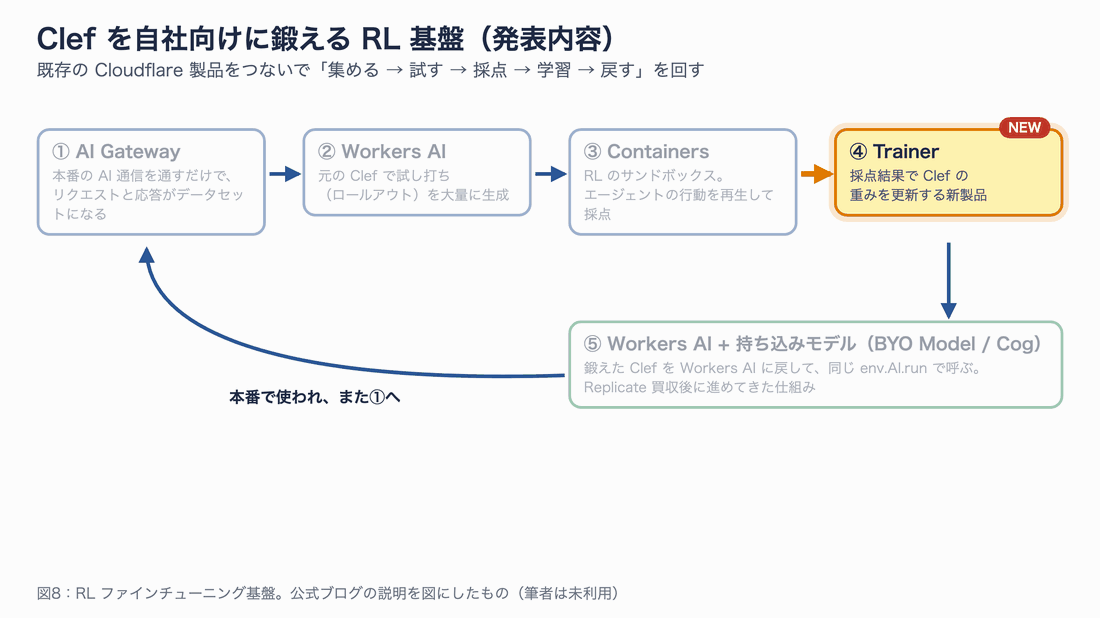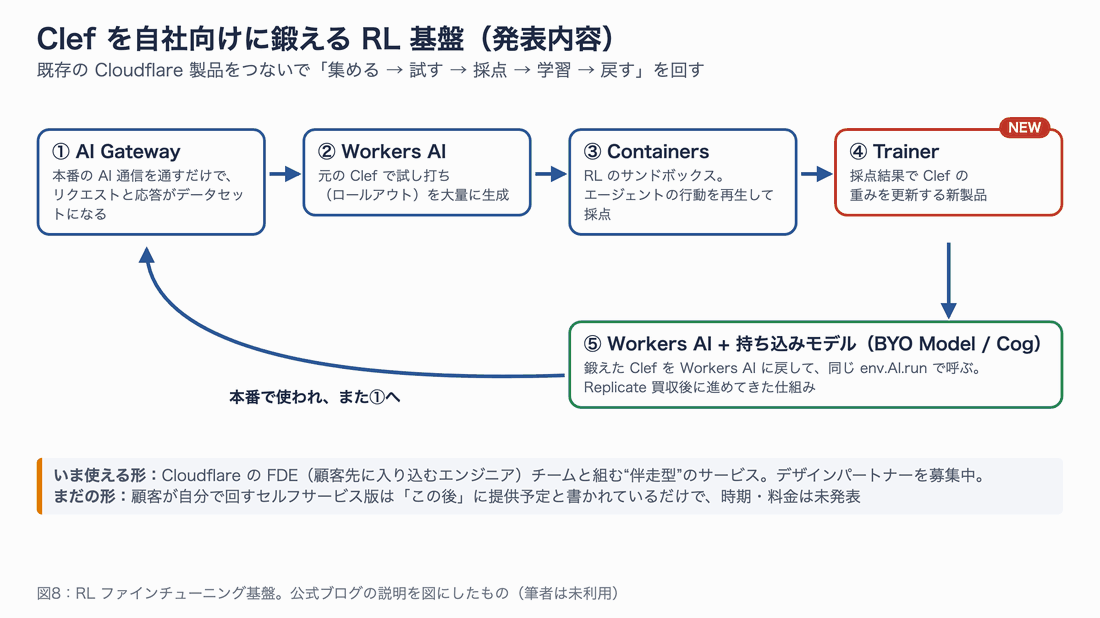
図8:公式ブログの説明を図にしたもの。筆者はこの基盤を利用していない
| 段階 | 使う製品 | 役割 |
|---|---|---|
| ① データを集める | AI Gateway | 本番の AI 通信を通すだけで、リクエストと応答がデータセットになる |
| ② 試し打ち | Workers AI | 元の Clef で大量の回答(ロールアウト)を作る |
| ③ 採点 | Containers | 強化学習用のサンドボックス。エージェントの行動を再生して採点する |
| ④ 学習 | Trainer(新製品) | 採点結果で Clef の重みを更新する |
| ⑤ 戻す | Workers AI の持ち込みモデル(Cog) | 鍛えた Clef を Workers AI に配置し、同じ env.AI.run() で呼ぶ |
ここは期待と現状を分けて読む必要があります。いま申し込めるのは、Cloudflare の FDE(顧客先に入り込んで開発を手伝うエンジニア)チームと組む伴走型のサービスで、デザインパートナーを募集している段階です。顧客が自分で回せるセルフサービス版は「その後に作る」と書かれているだけで、時期や料金は出ていません。
Cloudflare 社内では、Trust & Safety の申告の評価、サポート問い合わせの振り分け、ボットの良し悪しの判定などで、何年分もの人の判断データを使って鍛える計画だと説明されています。15 年分のネットワークデータを持つ Cloudflare ならではの使い方で、一般の利用者が同じ効果を得るには、まず自分の判断の記録をためることが前提になります。
どれから試すか
ここまでの結果をもとに、筆者の目安を図にしました。
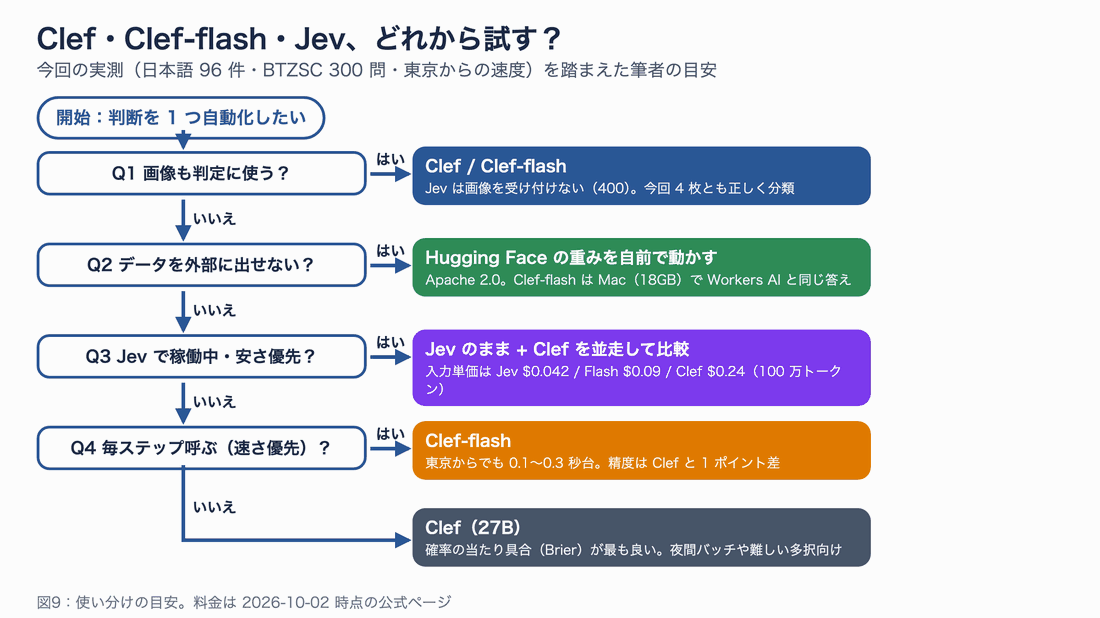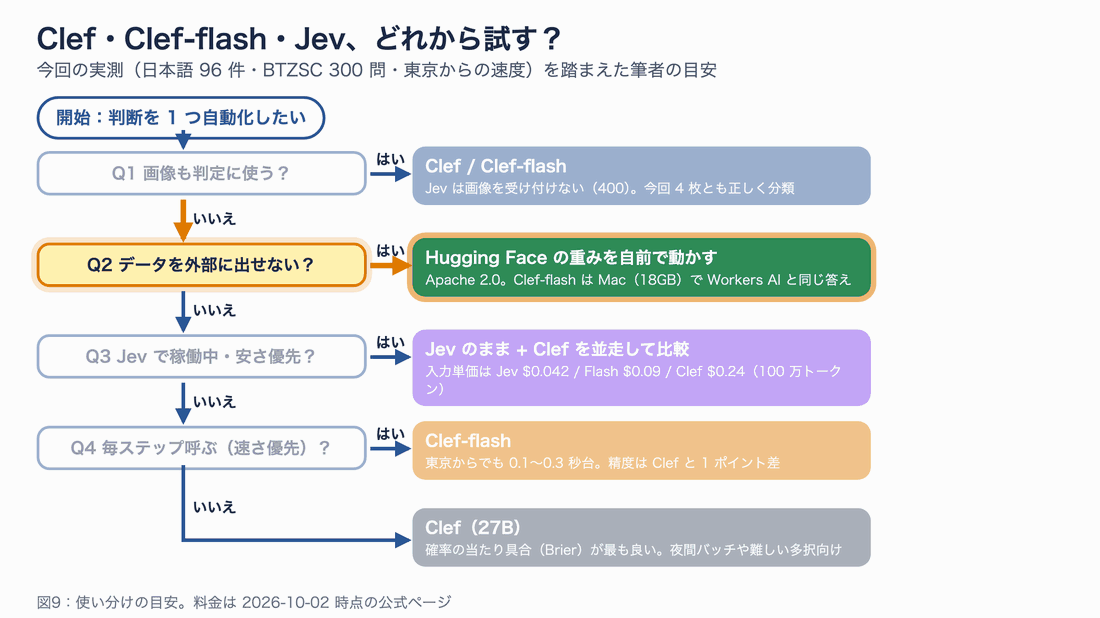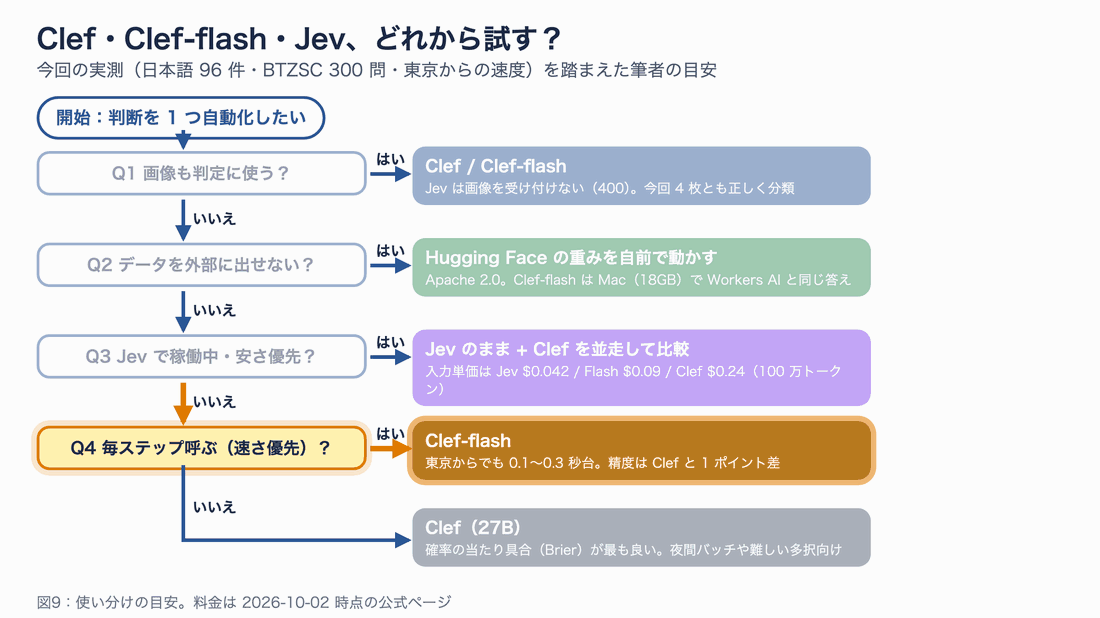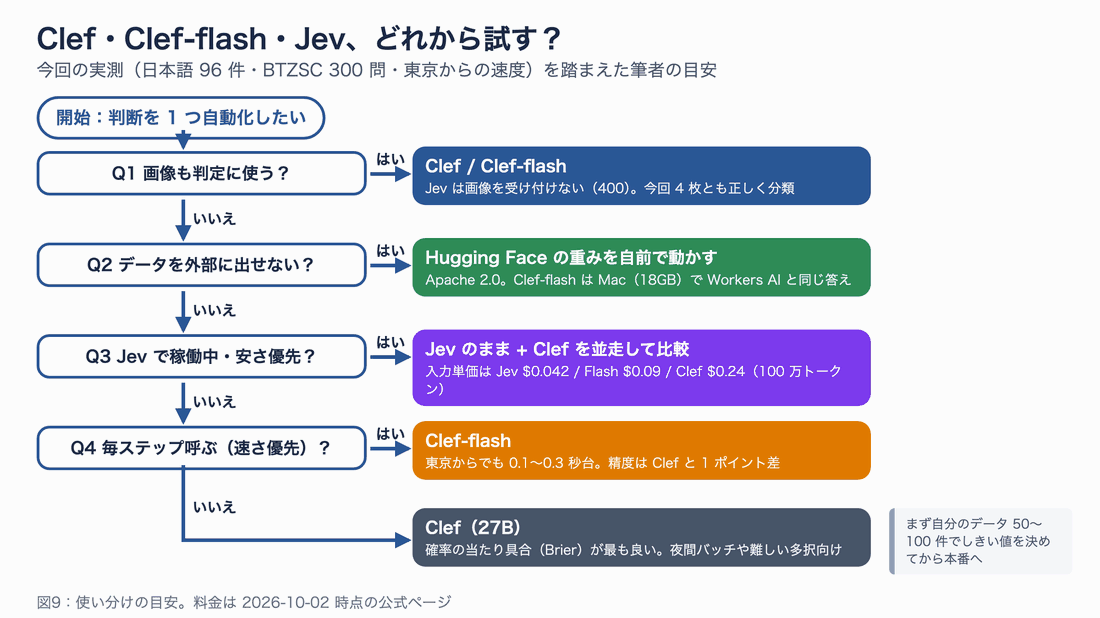
図9:使い分けの目安
- 画像も判定に使いたい:Clef 系一択です。Jev は画像を受け付けません。
- データを外部に出せない:Hugging Face の重みを自前の GPU や Mac で動かせます。Clef-flash なら 18GB のメモリで動き、クラウド版と同じ答えを返しました。
- すでに Jev で動いていて、費用を最優先:Jev のままで構いません。Clef をもう 1 本の判定として並走させ、自分のデータで差を確かめるのがおすすめです。
- エージェントの毎ステップで呼ぶ:Clef-flash が候補です。東京からでも Jev と同程度の速さで、精度は Clef と 1 ポイント程度の差でした。
- 夜間のバッチや、選択肢が多い難しい判定:確率の質が最も良かった Clef を選びます。
どれを選ぶ場合も、本番に入れる前に 自分の業務データ 50〜100 件で「このしきい値なら何割を自動化でき、誤りは何件か」を測ることをおすすめします。判定モデルの価値は、正解率よりも、確率を使って人と機械の分担を決められる点にあるからです。
トラブルシューティング
今回の検証で実際にぶつかった問題を、確認する順に並べます。
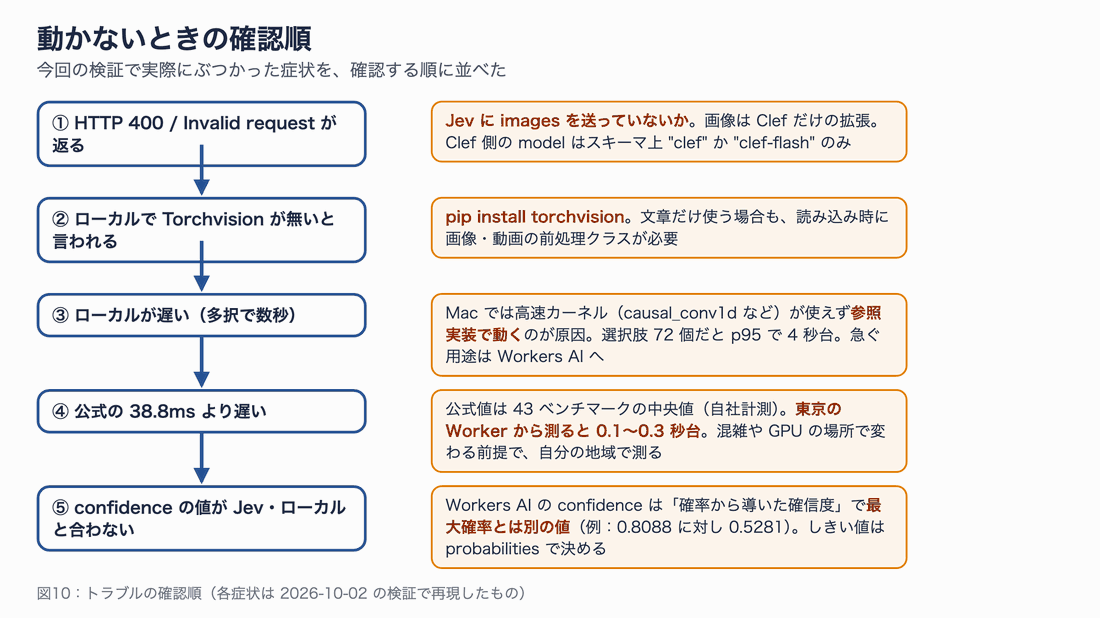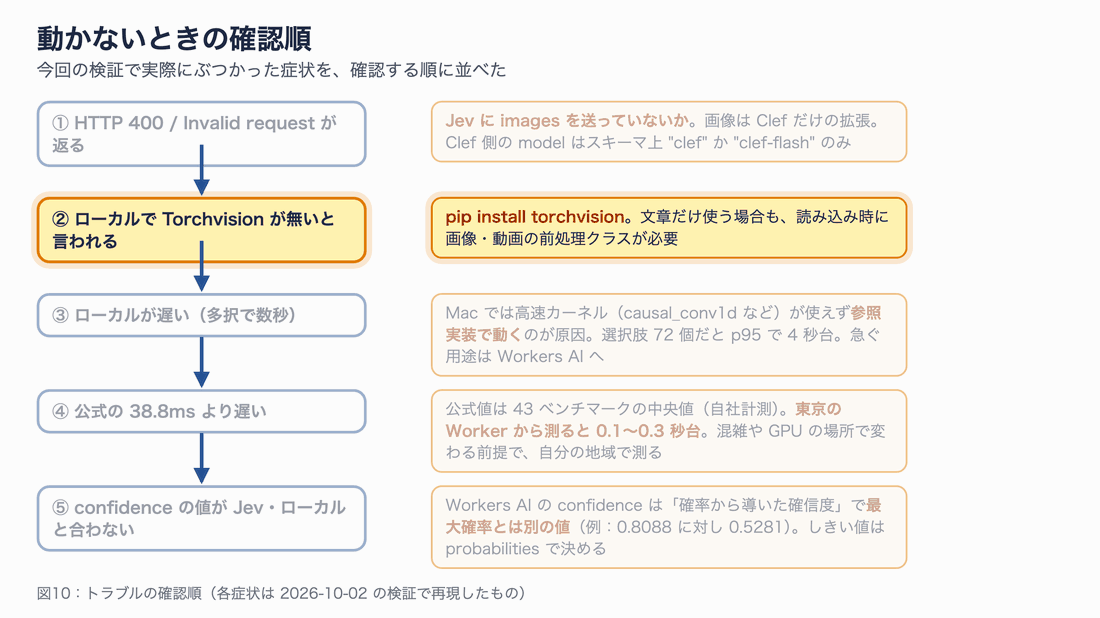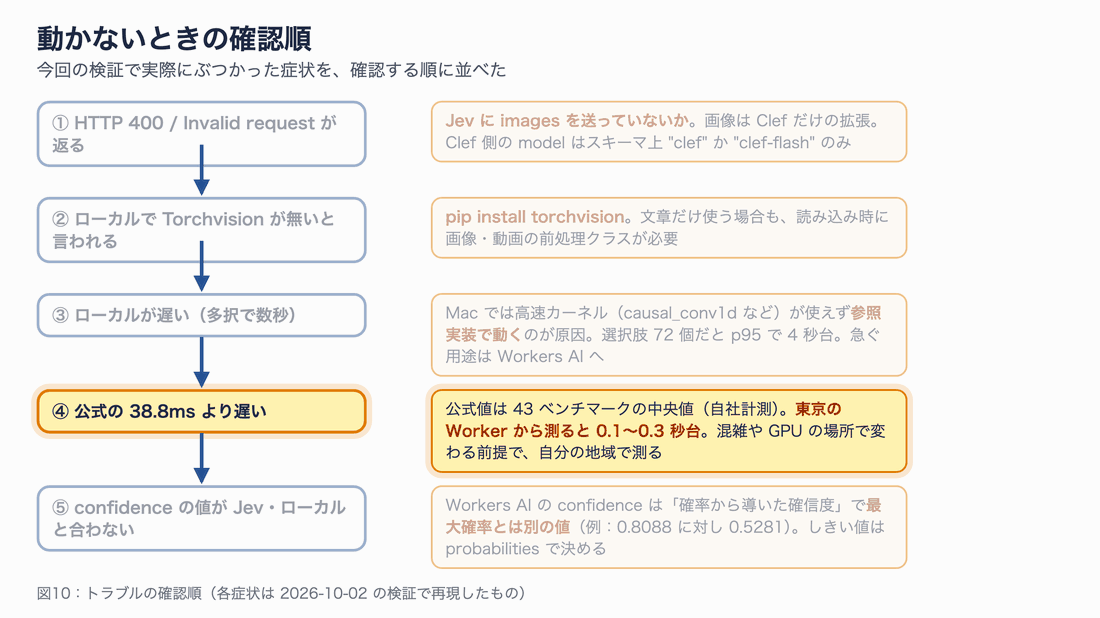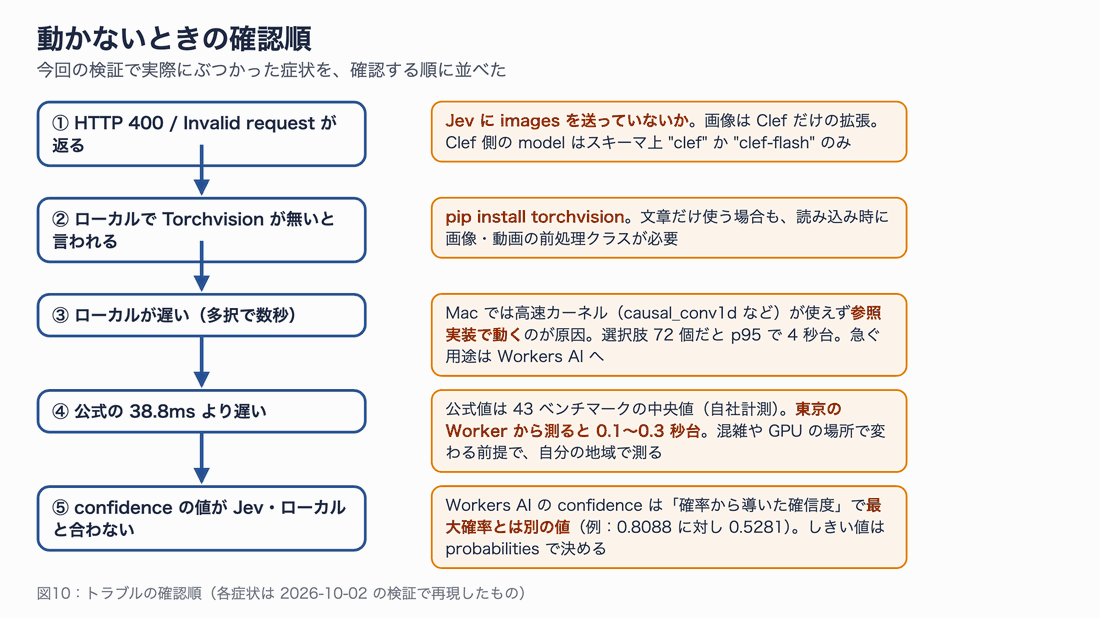
図10:トラブルの確認順
| 症状 | 原因 | 対処 |
|---|---|---|
Jev が 400 Invalid request. を返す | images は Clef だけの拡張 | Jev に送る本文から images を外す |
Qwen3VLVideoProcessor requires the Torchvision library | 読み込み時に画像・動画の前処理クラスが必要 | pip install torchvision |
| ローカルで多択の判定が数秒かかる | Mac では高速カーネルが使えず参照実装で動く | 急ぐ用途は Workers AI を使う。夜間バッチに回す |
| 公式の 38.8ms より遅い | 公式値は社内条件の中央値。地域・混雑で変わる | 自分の地域の Worker から測る |
confidence が Jev やローカルと合わない | Workers AI は最大確率とは別の確信度を返す | しきい値は probabilities で決める |
| Jev の結果が文字列比較で一致しない | 選択肢の並び順が毎回変わる | キーで並べ替えてから比較する |
wrangler dev で警告が出る | AI バインディングはローカルでも本番のモデルを呼ぶ | 料金が発生する前提で使う。remote: true を明記すると警告は消える |
まとめ
Cloudflare の Clef と Clef-flash を、公式情報と手元の検証の両方から確かめました。
- 互換性:答えの形は Jev と完全に同じで、Jev の公式 SDK も接続先を変えるだけで Clef を読めました。ただし Workers AI に Jev と同じ URL はなく、入口は自分で用意する必要があります。
- 精度:日本語の業務判定では 4 方式とも 95% 超で差はわずかでした。公開データでは Clef がやや上回り、特に確率の質(Brier)は Jev の半分以下のずれでした。
- 速度:東京からの実測では、公式の「Jev の 2.5〜13 倍速い」は再現せず、Jev と Clef-flash が同程度、Clef は Jev より遅い結果でした。
- 料金:トークン単価も実際の課金額も Jev が最安です。Clef-flash はその約 2 倍ですが、LLM に JSON を書かせるより 5 分の 1 程度で済みます。
- 独自の強み:画像を判定できること、重みが Apache 2.0 で公開され、Mac でも Clef・Clef-flash ともにクラウドと 300 問すべて同じ答えが出せることは、Jev にはない明確な利点です。
元の紹介文にあった「Tool Selection・RAG 再検索・Support Routing・Guardrail で、Jev・Clef・Clef-flash・通常 LLM を同じデータで比べる」という提案を実際にやってみると、モデルの差よりも、質問文と選択肢の説明の書き方の差のほうが大きいというのが正直な感想です。判定モデルを入れるときは、モデル選びの前に、判断基準を言葉にして criteria に書くところから始めてみてください。
次の一歩としては、自分のプロダクトの判断ログを AI Gateway に流してためておくことをおすすめします。RL 基盤がセルフサービスになったとき、そのデータがそのまま学習の材料になります。
参考リソース
- Introducing Clef: our open-source decision models, and new RL fine-tuning platform(Cloudflare Blog, 2026-10-01)
- Introducing Clef: Cloudflare’s first open-source decision models, now on Workers AI(Workers AI Changelog)
- clef モデルページ(Cloudflare Docs) / clef-flash モデルページ
- Workers AI の料金
- Cloudflare/clef(Hugging Face) / Cloudflare/clef-flash
- Decision Model Leaderboard(Cloudflare)
- Jev Decision Index(Hugging Face Space)
- Introducing System One models and Jev(TypeSafe)
- jev-benchmarks(GitHub)
- RL fine-tuning のデザインパートナー募集(Cloudflare)