はじめに
2026 年 10 月 12 日、NVIDIA が技術ブログで ReplaySSM を紹介しました。NVIDIA と、プリンストン大学の Dao AI Lab の共同研究です。Dao AI Lab を率いる Tri Dao 氏は、FlashAttention や Mamba の開発者として知られています。論文(arXiv、10 月 9 日)とコード(GitHub)も公開されています。
Qwen3.5〜3.8、Nemotron 3、Kimi-K3 のような ハイブリッド LLM は、Transformer の注意層(Attention)に加えて、SSM(State Space Model、状態空間モデル) という層を大量に使っています。ReplaySSM は、この SSM 層のデコード(1 トークンずつ文章を生成する処理)を速くする手法です。発想は「状態を毎回書き戻さない」という、驚くほど単純なものです。
この記事では、次のことを順に説明します。
- 「速いはず」の SSM 層が、サーバーでは遅くなってしまう理由
- ReplaySSM が変えたこと(入力をためておき、満杯のときだけ書き戻す)
- 公式の数字(通常デコード 1.20〜1.47 倍、投機的デコーディング 1.85〜2.10 倍)と、その条件
- 自分の Mac(M5 Max)で仕組みを再現し、速さと精度を測った結果
- vLLM・SGLang・TensorRT-LLM で使うときのフラグと、効かない条件
想定する読者は、LLM を自分のサーバーで動かしている方や、推論の高速化の仕組みを知りたいエンジニアです。数式は最小限にし、用語は初めて出たところで説明します。
まず全体像です。下の図は、16 ステップのあいだに「状態」を何回読み書きするかを、通常のデコードと ReplaySSM で比べたものです。赤い「書」の数に注目してください。
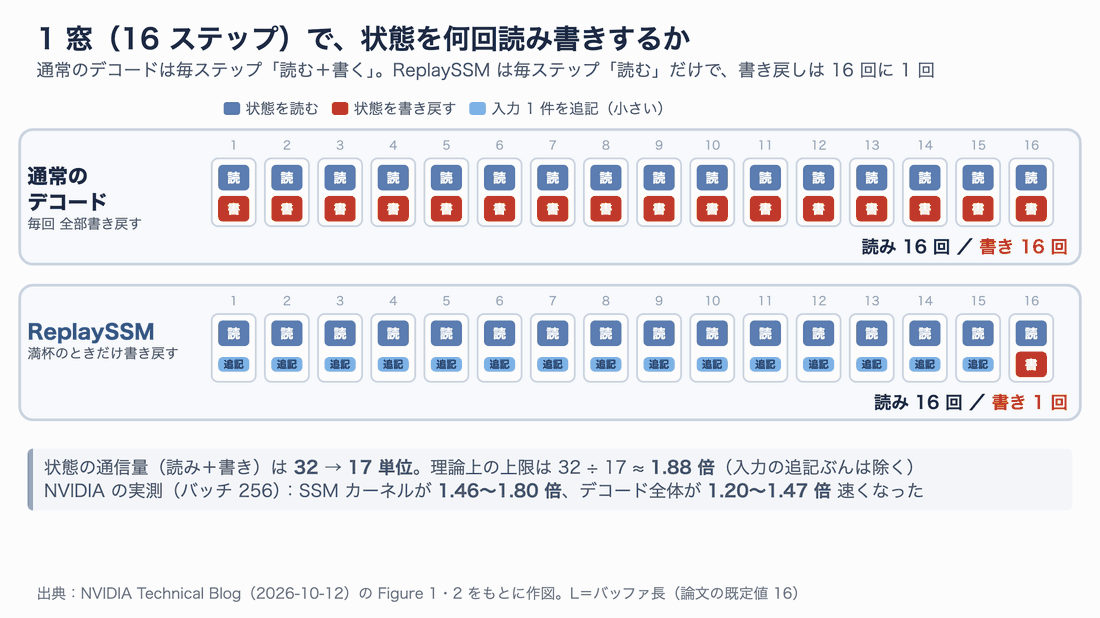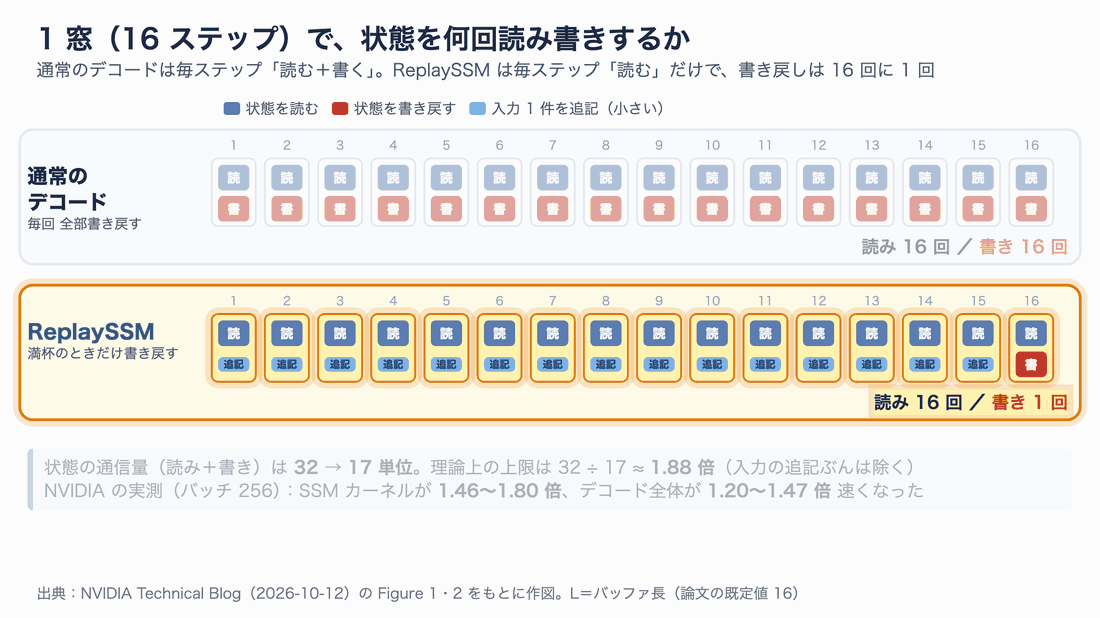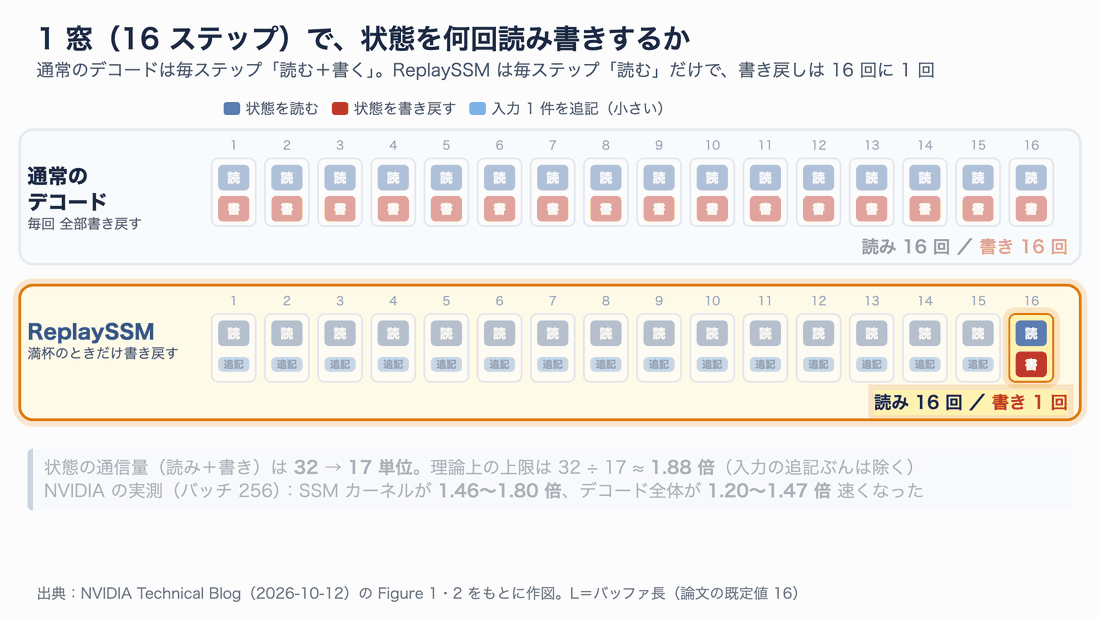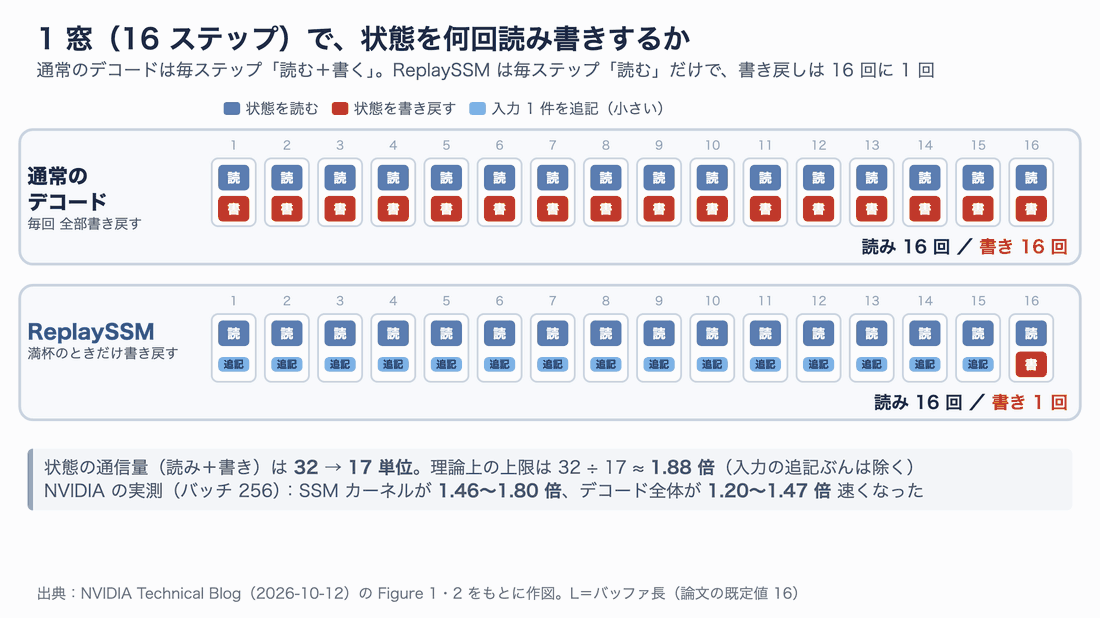
通常は毎ステップ「読む+書く」。ReplaySSM は書き戻しを 16 回に 1 回に減らし、主な通信量をほぼ半分にします
この記事の確認範囲
数字と仕様は、次の一次情報で確かめました(2026 年 10 月 13 日時点)。
| 種類 | 確認したもの |
|---|---|
| 公式の解説 | NVIDIA Technical Blog(10 月 12 日)、Dao AI Lab のブログ(6 月) |
| 論文・コード | arXiv 2610.13778(10 月 9 日)、GitHub Johnny-Liou/ReplaySSM の README |
| 組み込み状況 | vLLM・SGLang・TensorRT-LLM・FlashInfer の PR と、vLLM v0.31.0・SGLang v0.5.21 のソース |
| 筆者の検証 | MacBook Pro(M5 Max、メモリ 128GB)で、NumPy と MLX(Metal カーネルを自作)による仕組みの再現 |
NVIDIA GPU と vLLM での実測はしていません。 本文の GPU の数字はすべて NVIDIA の発表値です。また、6 月の Dao AI Lab 版と 10 月の NVIDIA 版では数字が少し違います(例:通常デコードの最大値が 1.48 倍と 1.47 倍)。本文は新しい 10 月版の数字を使います。
ハイブリッド LLM と SSM 層のおさらい
注意層は「メモを増やす」、SSM 層は「要約を書き換える」
Transformer の注意層は、読んだトークンごとにキーと値(KV)を保存していきます。これが KV キャッシュで、文章が長くなるほど大きくなります。
一方の SSM 層は、過去の情報を決まった大きさの「状態」(行列)1 つに要約します。何トークン読んでも状態の大きさは変わりません。Mamba-2、Gated DeltaNet(GDN)、Kimi Delta Attention(KDA)は、いずれもこの仲間です。長い文章でもメモリが増えないため、「デコードが速い層」として期待されてきました。
ハイブリッド LLM は、この 2 種類を混ぜたモデルです。NVIDIA の記事で評価に使われたモデルは、次のような構成です。
| モデル | SSM 層の種類 | SSM 層 / 注意層 |
|---|---|---|
| Nemotron-3-Nano-4B | Mamba-2 | 21 / 4 |
| Nemotron-3-Super-120B-A12B | Mamba-2 | 40 / 8 |
| Qwen3.5-4B | GDN | 24 / 8 |
| Qwen3.5-122B-A10B | GDN | 36 / 12 |
どのモデルも、SSM 層が注意層の約 3〜5 倍あります。下の図は、Nemotron-3-Super の層の並びと、2 種類の層がメモリをどう使うかを示したものです。
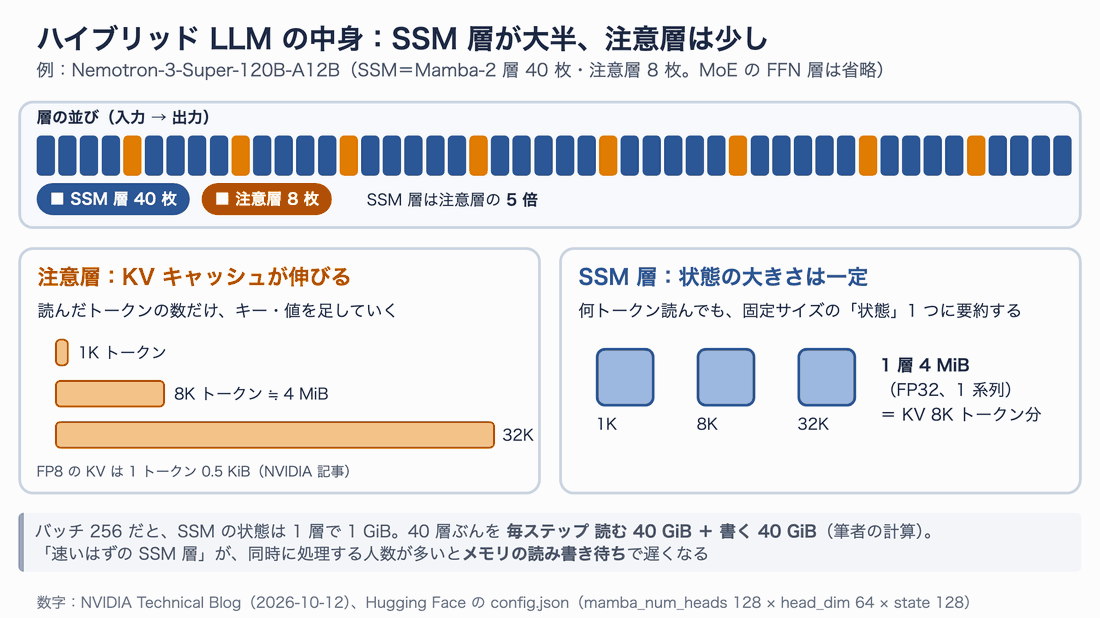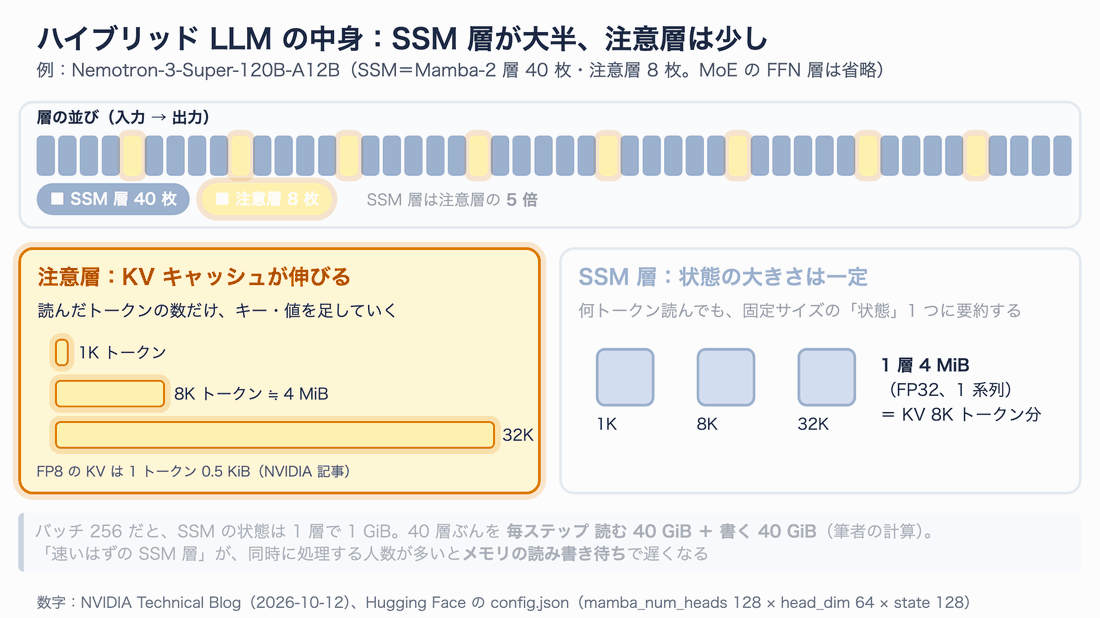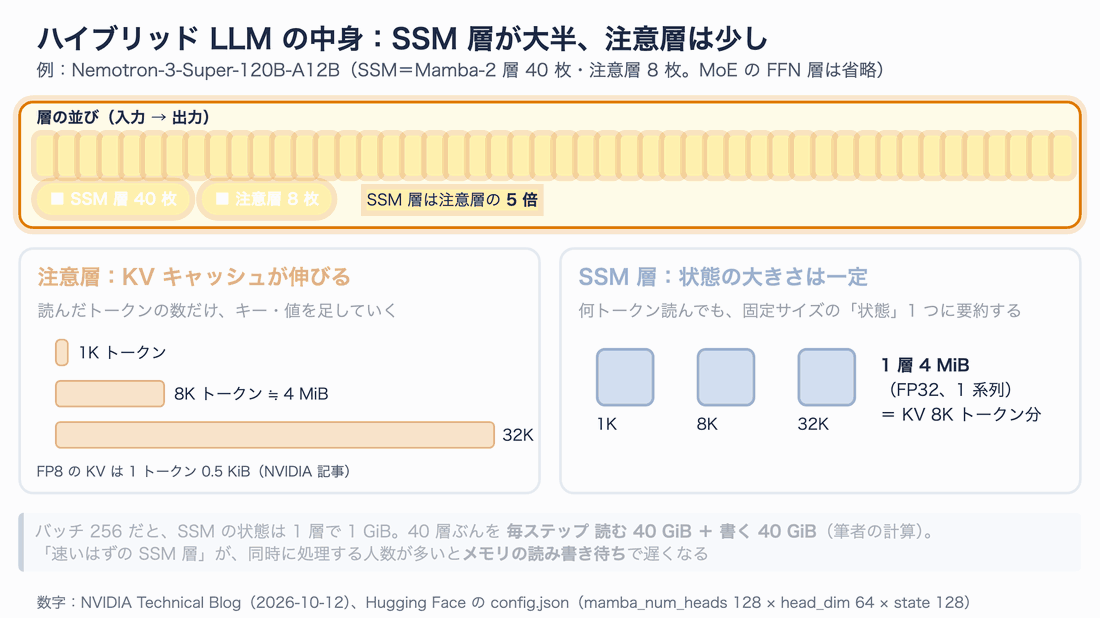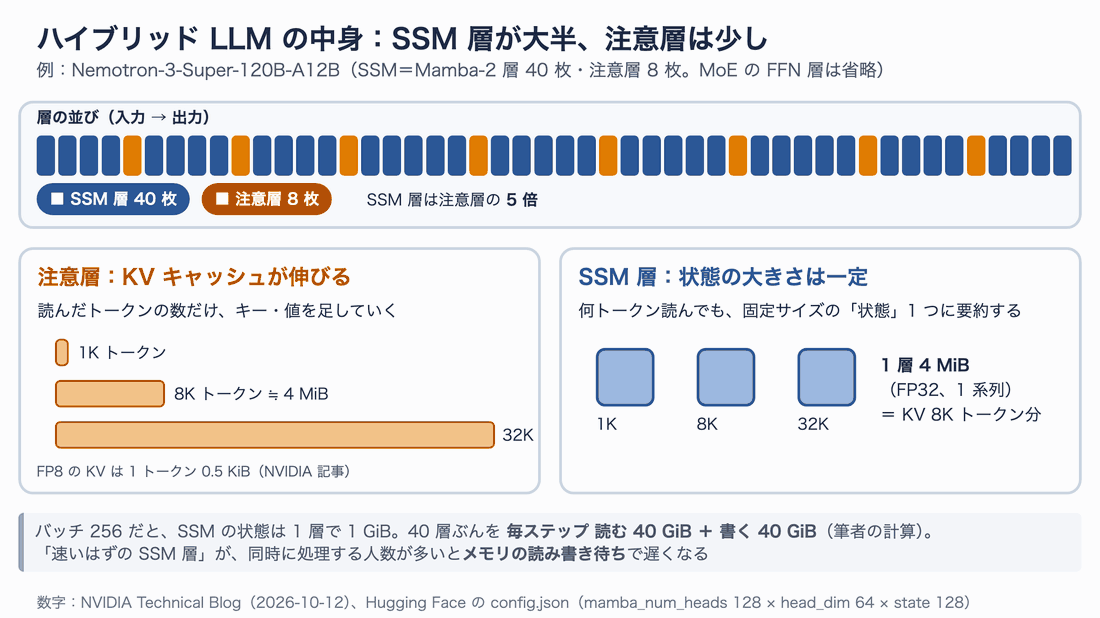
SSM 層の状態は 1 層・1 系列で 4 MiB(FP32)。FP8 の KV キャッシュに換算すると 8K トークン分です
4 MiB という大きさは、Hugging Face の設定ファイル(config.json)から計算できます。Nemotron-3-Super の Mamba 層はヘッドが 128 個あり、1 ヘッドの状態は 64 × 128 の行列です。128 × 64 × 128 = 約 105 万個の値を、FP32(1 個 4 バイト)で持つので 4 MiB になります。
なぜ SSM 層がボトルネックになるのか
課題 1:毎ステップ、状態を丸ごと読み書きする
SSM 層は、1 トークンごとに次の計算をします。
S_t = α_t × S_(t-1) + v_t × k_tᵀ     (状態の更新:古い状態を少し薄め、新しい情報を足す)
o_t = S_t × q_t                      (出力:更新した状態から、今のトークンの出力を読み出す)
α は減衰(どれだけ忘れるか)、v・k・q はそのトークンから作る値・キー・クエリです。
この計算は、GPU のメモリ(HBM)から状態を読み、少し計算し、書き戻すだけです。計算量は 1 バイトあたり約 1 回と非常に少なく、H100 が得意とする「1 バイトあたり約 300 回」には遠く及びません(Dao AI Lab のブログより)。つまり、計算ではなくメモリの読み書きの速さ(メモリ帯域)で速度が決まる処理です。
そして状態は、リクエスト(会話)ごとに 1 つずつ必要です。同時に 256 件を処理するなら、1 層だけで 4 MiB × 256 = 1 GiB。Nemotron-3-Super なら 40 層ぶんを、毎ステップ 40 GiB 読んで 40 GiB 書く計算になります(筆者の計算)。NVIDIA の記事によると、Nemotron-3-Super(NVFP4)を B300 1 枚・バッチ 256 で動かすと、文脈が 10 万トークンになるまで、注意層ではなく SSM 層がデコード時間の最大の部分を占めていました。
ただし、これは同時に処理する数が多いときの話です。vLLM の PR に載っている測定では、従来の SSM カーネルが使えているメモリ帯域は、バッチによって大きく変わります。
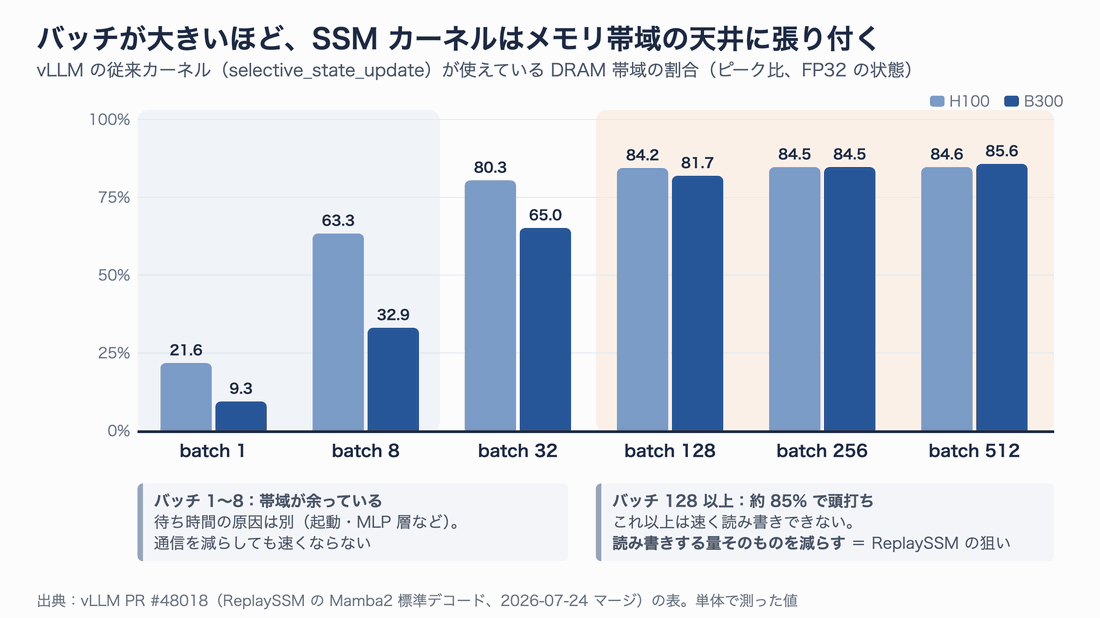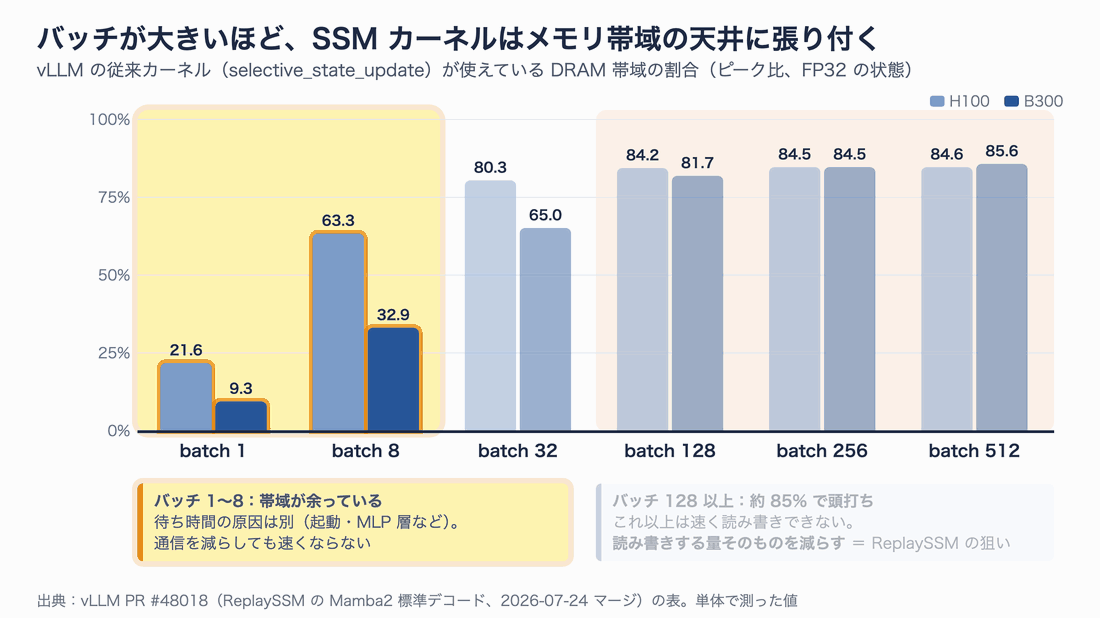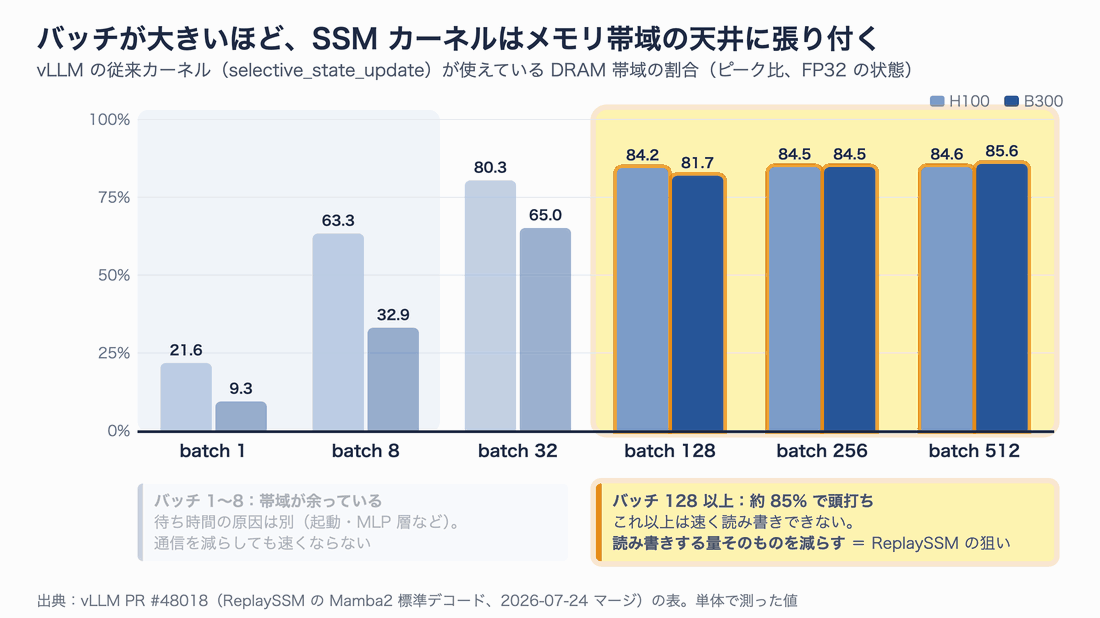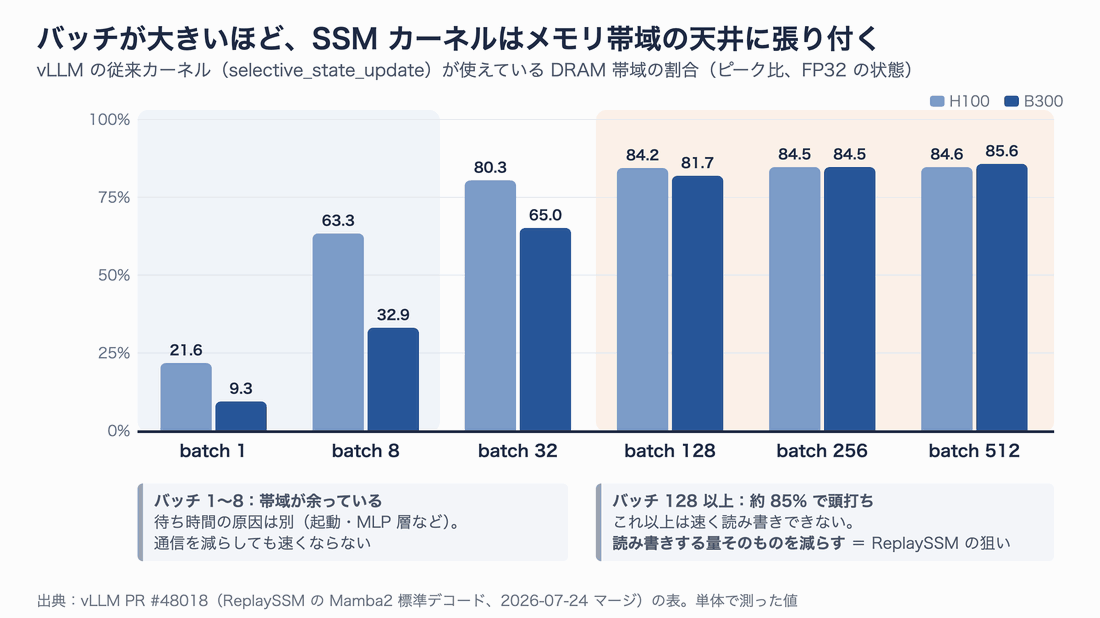
バッチ 1 では帯域が余っていて、待ち時間の原因は別にある。バッチ 128 以上では約 85% で頭打ち=「読み書きの量」を減らすしかない
この図が、あとで出てくる「バッチ 1 では速くならない」という結果の理由です。ReplaySSM は読み書きの量を減らす手法なので、帯域が天井に張り付いているときにしか効きません。
課題 2:投機的デコーディングの巻き戻しが重い
投機的デコーディング(speculative decoding)は、小さな下書き役が数トークン先まで予想し、本体のモデルが 1 回でまとめて検証する高速化の手法です。最近のモデルは、本体に下書き用の頭(MTP、Multi-Token Prediction)を持っていることが多くあります。
検証で不採用になった下書きは、なかったことにしなければなりません。注意層なら、KV キャッシュの「どこまで有効か」を示すポインタを戻すだけです。しかし SSM 層は、下書きを状態に混ぜて要約してしまうと元に戻せません。
そこで vLLM などは、下書き 1 個ごとに状態のスナップショットを保存し、採用された数に合うものを選んでいます。下書きが T 個なら、毎ステップ状態を T 回書くことになり、メモリも T 倍必要です。NVIDIA の記事は、このせいで投機的デコーディングが「サーバーのバッチサイズではほとんど効かない」と指摘しています。
課題 3:低精度にすると誤差がたまる
メモリの読み書きを減らす定番は、データを低精度(例:4 ビットの NVFP4)にすることです。KV キャッシュは FP8 などに落としてもよく動きます。保存した値を何度も読むだけで、その値自体を書き換えることはないからです。
SSM の状態は違います。丸めた状態が次のステップの更新の材料になるので、丸め誤差が毎回たまっていきます。たとえば Qwen3.5-122B-A10B-NVFP4 は、重みを NVFP4、KV キャッシュを FP8 にしていますが、SSM の状態は FP32 のままです。
3 つの課題と ReplaySSM の答えを、1 枚にまとめます。
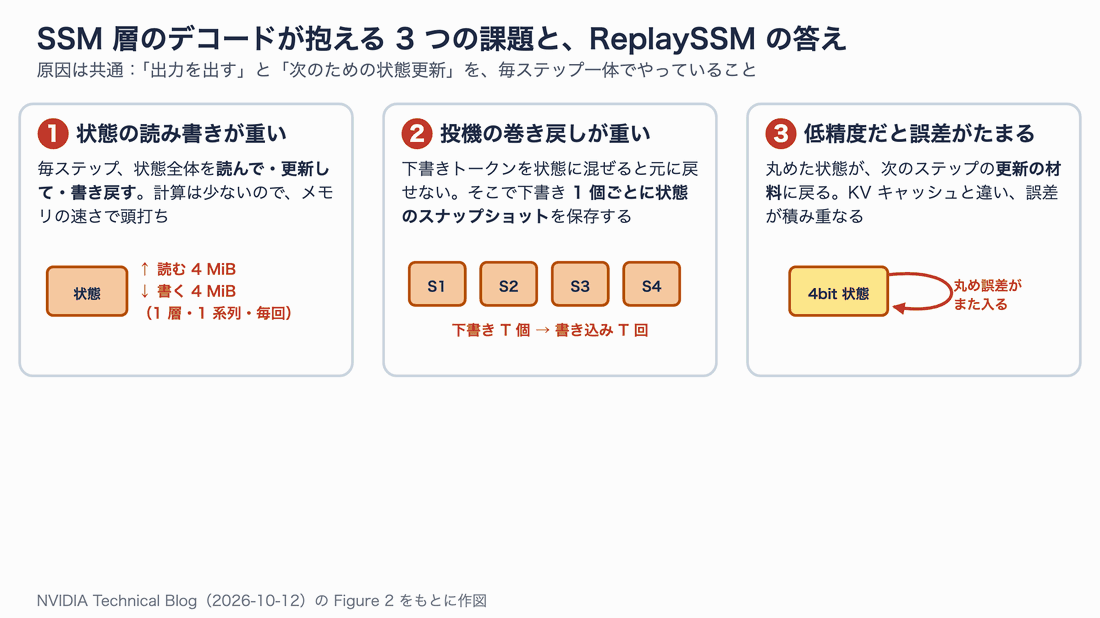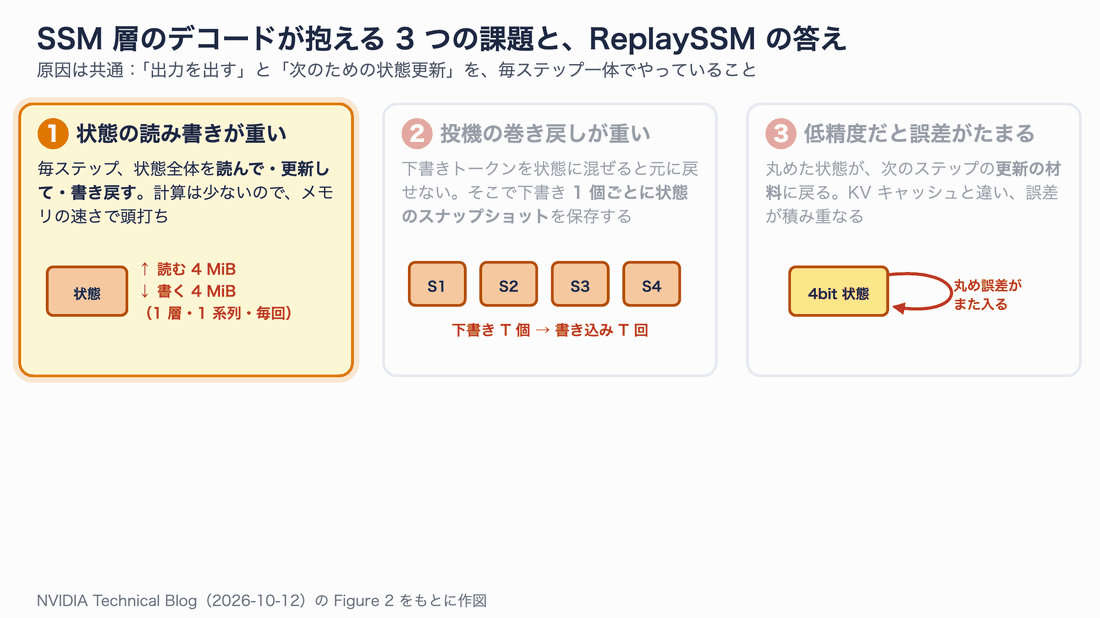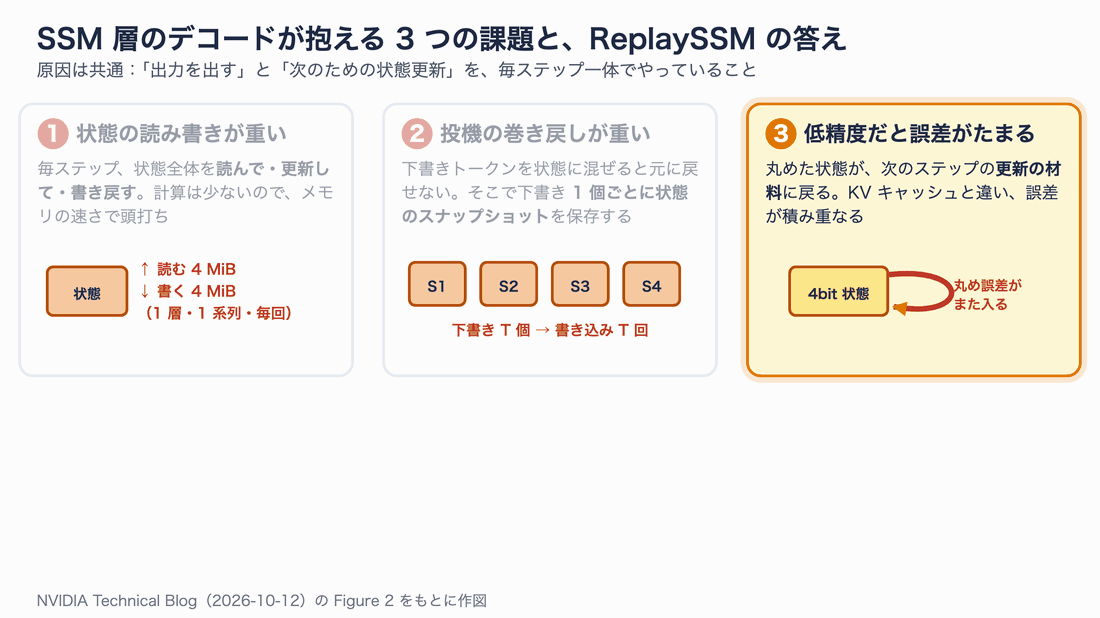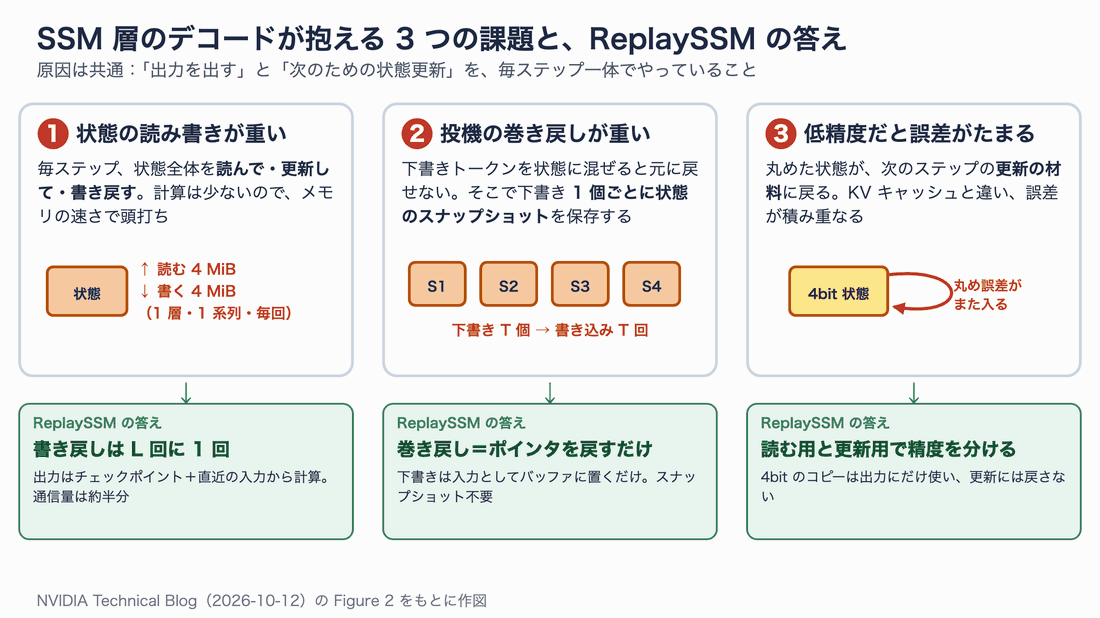
原因は共通で、「出力を出す」と「次のための状態更新」を毎ステップ一体で行っていること
ReplaySSM の仕組み:状態ではなく「入力」をキャッシュする
漸化式を「窓」でほどく
ReplaySSM の出発点は、先ほどの更新式を数ステップぶん展開すると、次の形に書き直せることです。
S_t = γ × S_ckpt + Σ(j = 1〜h) γ_j × v_j × k_jᵀ
言葉にすると「今の状態 = 少し前の状態(チェックポイント)を減衰させたもの + その後に入ってきた h 件の入力の寄与の合計」です。γ は減衰の積み重ねです。
ということは、状態そのものを毎回保存しなくても、チェックポイント 1 つと、直近の入力の記録(Mamba-2 なら α・v・k)さえ持っていれば、いつでも今の状態を計算し直せます。入力の記録は 1 件あたりベクトル数本ぶんで、状態(行列)よりずっと小さいのがポイントです。記録しておいた入力を「再生(replay)」すれば、状態はいつでも組み立て直せる、という発想です。
NVIDIA の公式の図では、次のように表現されています。
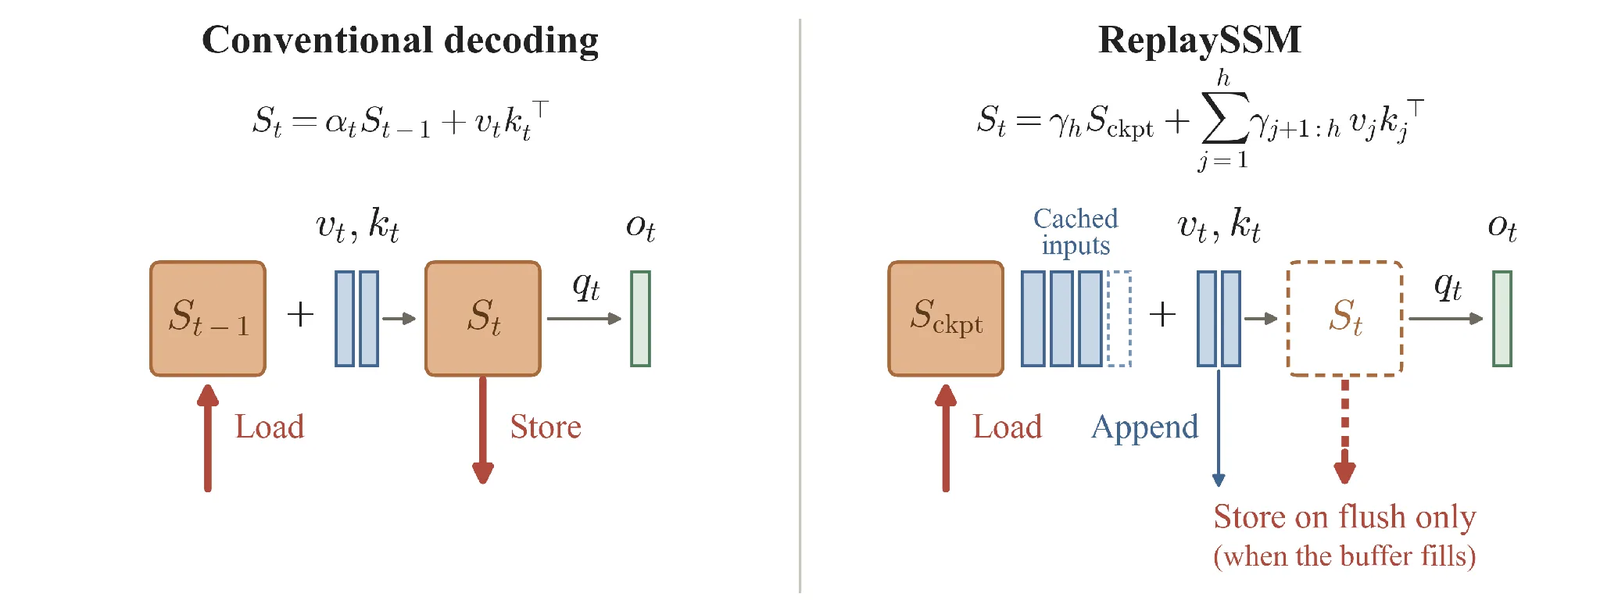
出典:NVIDIA Technical Blog「ReplaySSM: Rethinking State Storage for Faster Hybrid-Model Decoding」Figure 1(2026 年 10 月 12 日)
非フラッシュとフラッシュ
実際の動きを、バッファ長 L = 4 に縮めた例で追ってみます(論文と vLLM の既定値は 16 です)。各ステップで何を読み、何を書くかを見てください。
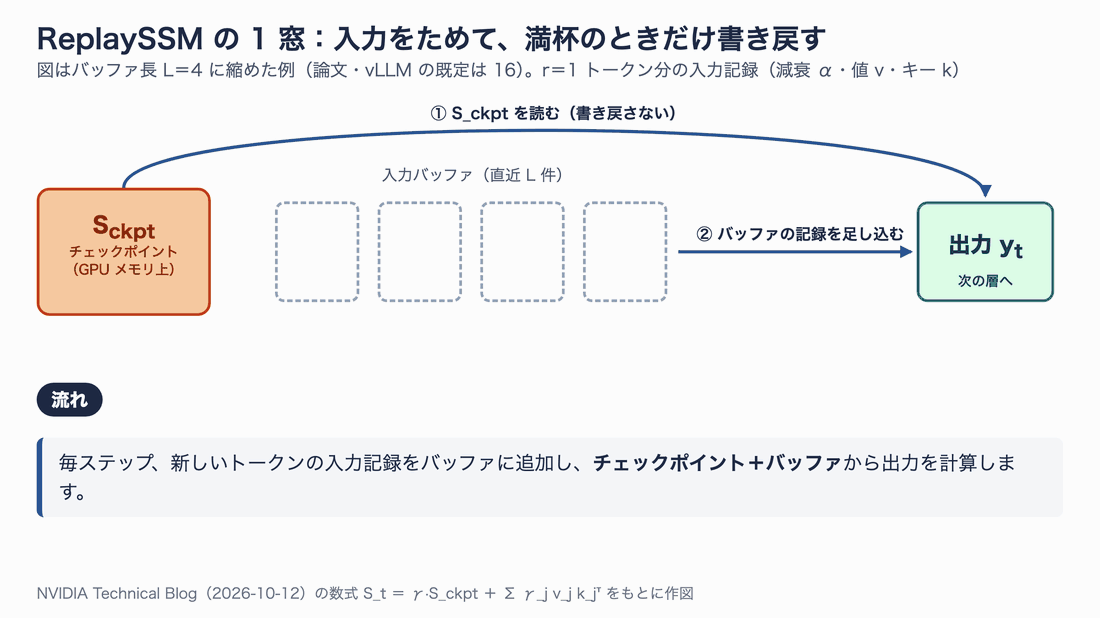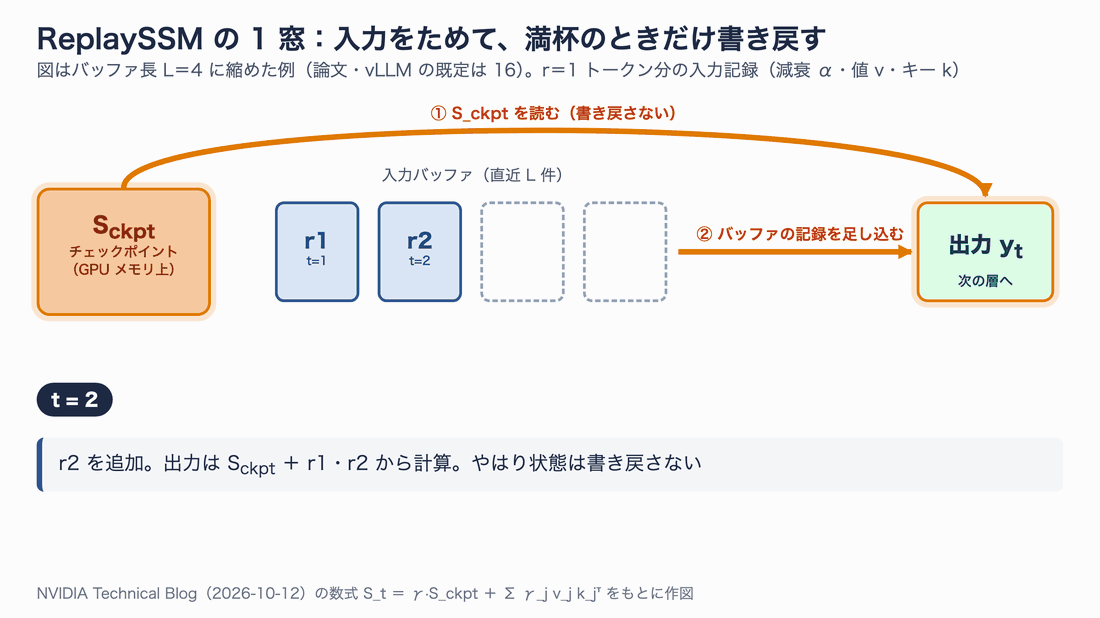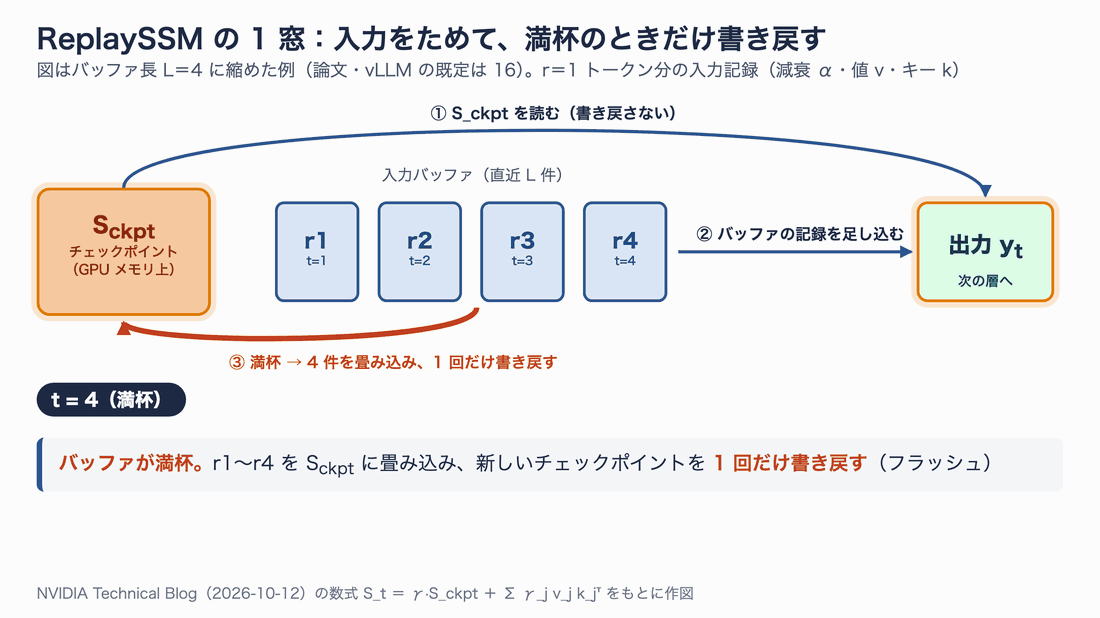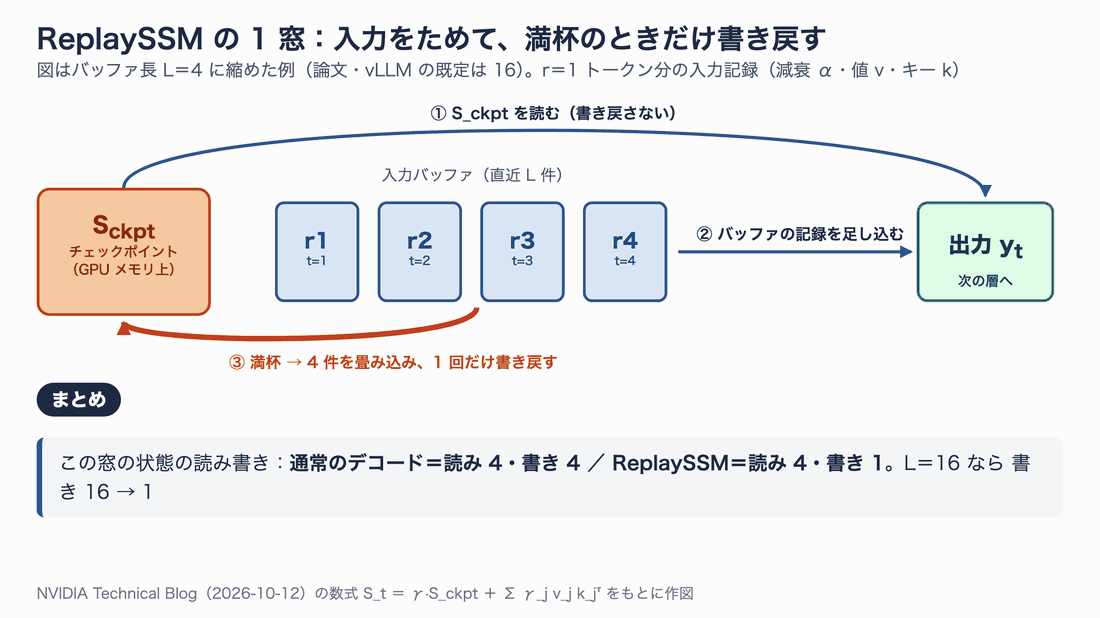
t=1〜3 は「読むだけ」。満杯になった t=4 で 1 回だけ書き戻し、バッファを空にして次の窓へ
ReplaySSM は、ステップを 2 種類に分けています。
| ステップ | すること | 状態の書き込み |
|---|---|---|
| 非フラッシュ(ほとんどのステップ) | 入力の記録をバッファに追加し、チェックポイント+バッファから出力を計算 | なし(小さな記録 1 件だけ) |
| フラッシュ(L ステップに 1 回) | バッファの記録をチェックポイントに畳み込み、書き戻してバッファを空にする | 1 回 |
L ステップのあいだ、通常のデコードは状態を L 回読んで L 回書きます。ReplaySSM は L 回読んで 1 回書くだけです。L = 16 なら、読み書きの合計は 32 回ぶんから 17 回ぶんに減り、理論上は最大 32 ÷ 17 ≒ 1.88 倍速くなります(バッファの読み書きは除いた概算)。出力は、通常のデコードと浮動小数点の誤差の範囲で一致します。
状態を作らずに出力だけを出す
もう 1 つの工夫が、計算の順番の入れ替えです。非フラッシュのステップで必要なのは出力だけで、更新後の状態は要りません。そこで、次の恒等式を使います。
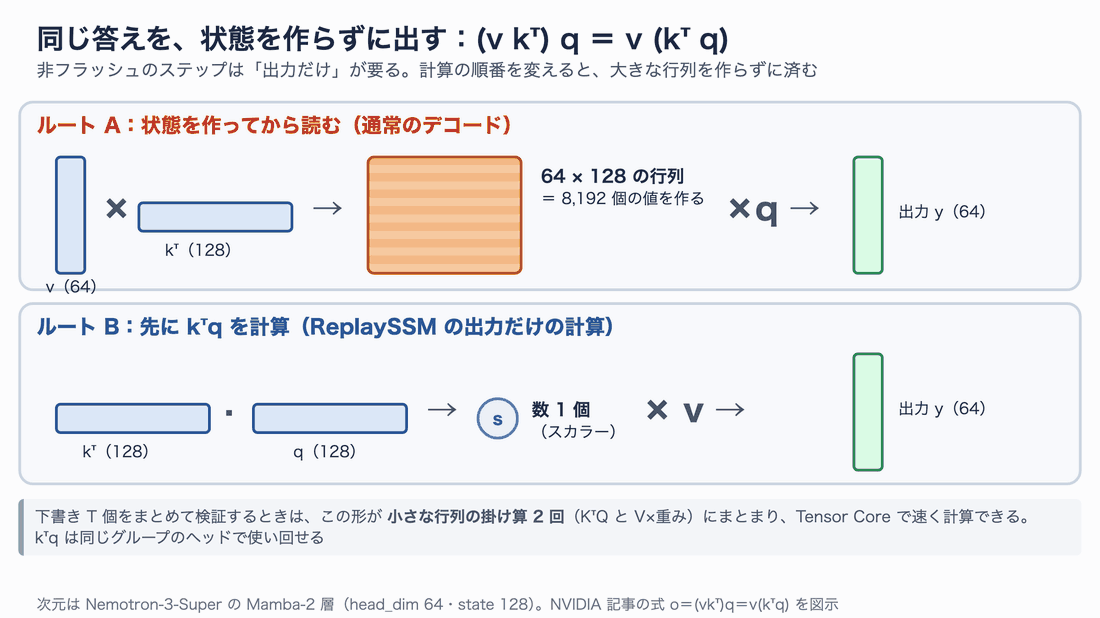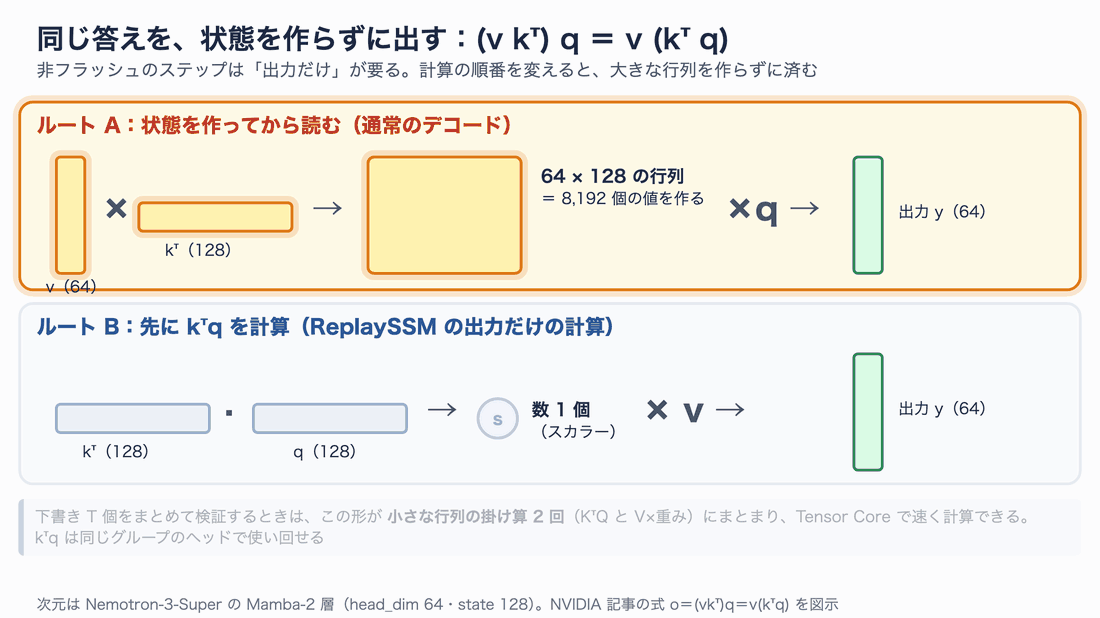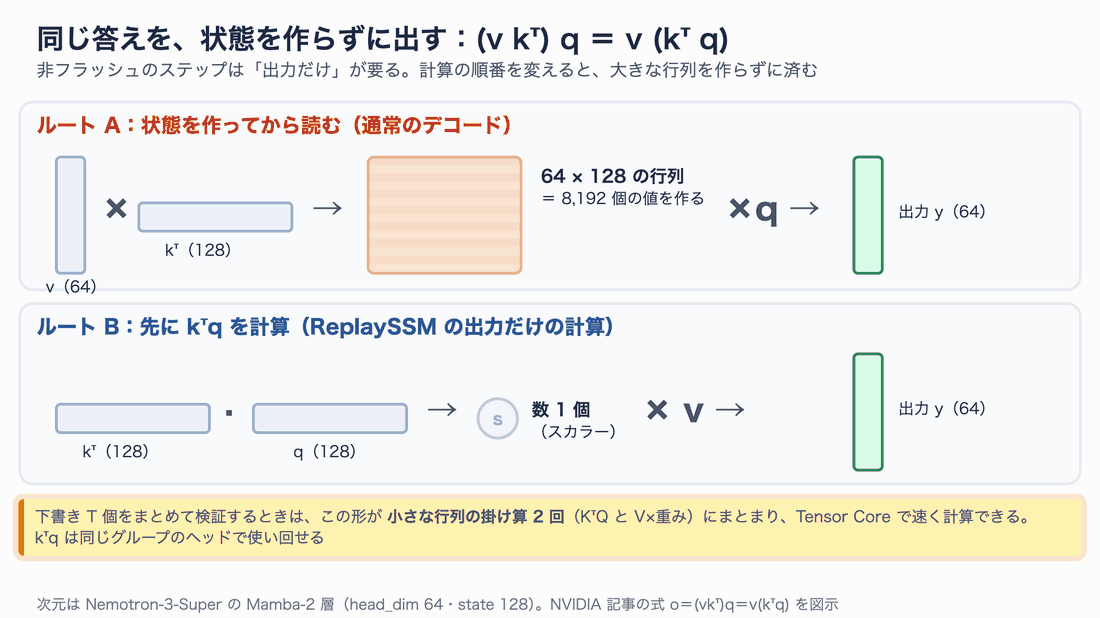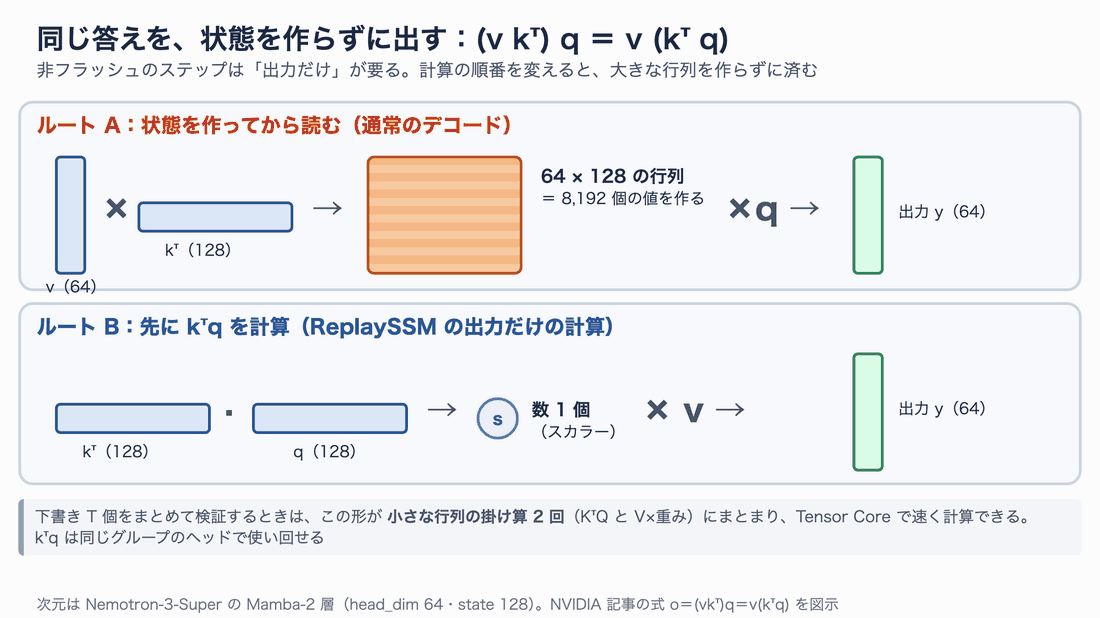
(v kᵀ) q と v (kᵀ q) は同じ答え。後者なら 8,192 個の値を持つ行列を作らずに済みます
NVIDIA の記事では、これを output-only evaluation(出力だけの計算) と呼んでいます。下書き T 個をまとめて検証するときは、チェックポイントの読み出し 1 回と、小さな行列の掛け算 2 回にまとまります。プレフィル(入力文をまとめて読む処理)が使う「チャンク単位の計算」と同じ形なので、Tensor Core(行列計算の専用回路)で速く計算できます。
なお、Qwen3.5 などが使う GDN は「デルタ則」という補正つきの更新をするため、生の値 v をためるだけでは再生できません。ReplaySSM は GDN では補正後の値 u などを記録します(Dao AI Lab のブログより)。考え方は同じで、ためる中身が違うだけです。
公式の数字で見る 3 つの効果
効果 1:通常のデコードが 1.20〜1.47 倍
NVIDIA は、4 つのハイブリッドモデルで、vLLM に ReplaySSM を実装し、チューニング済みの vLLM のカーネルと比べました。状態は FP32、バッファ長 L = 16 です。
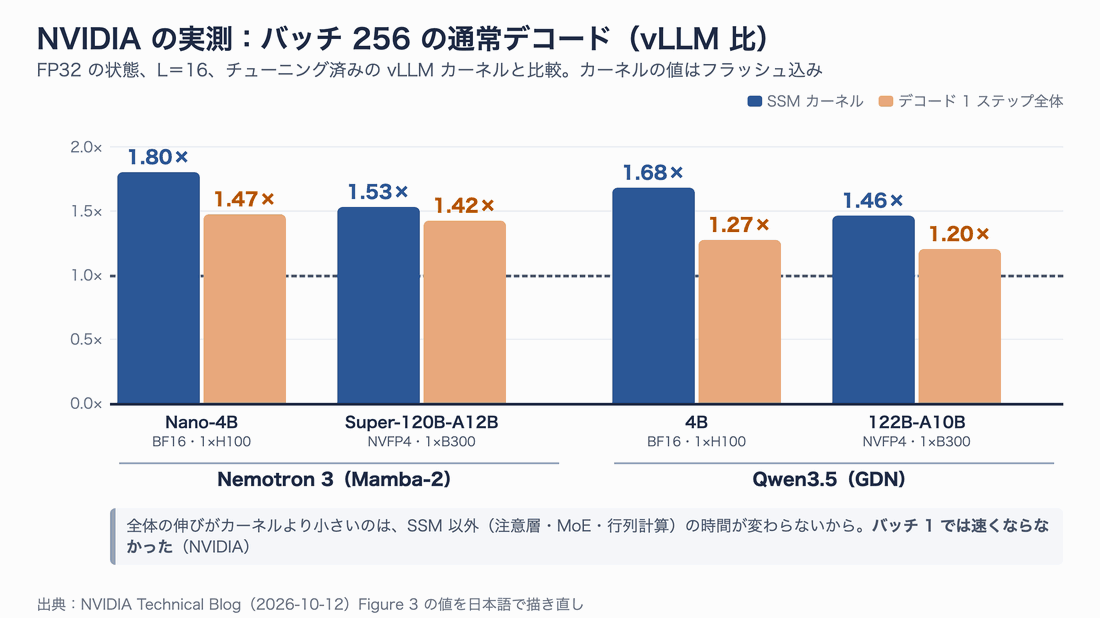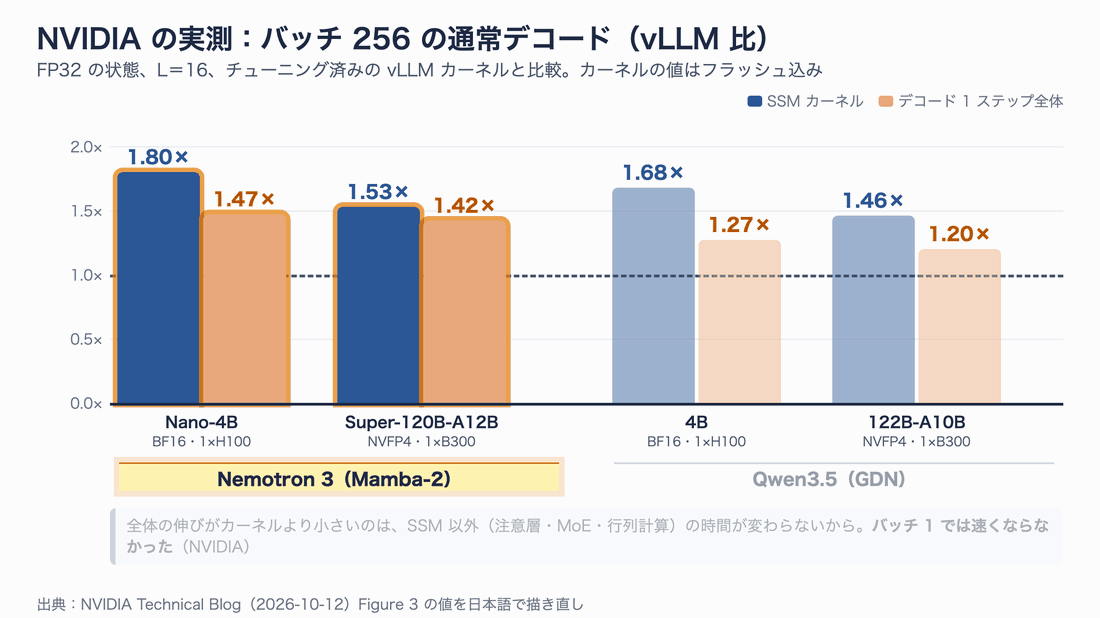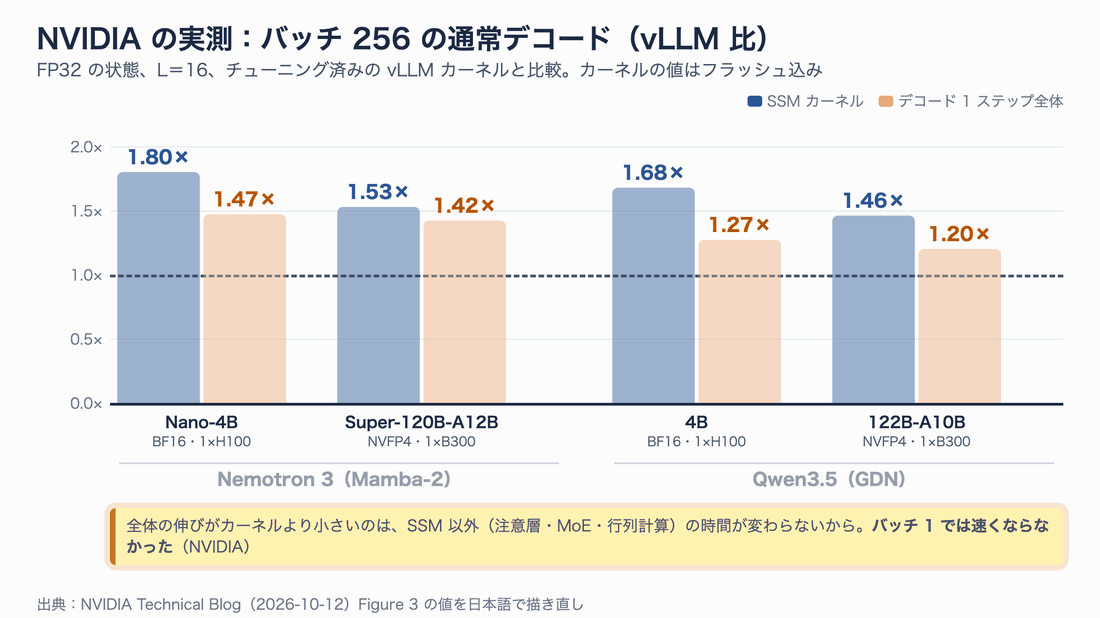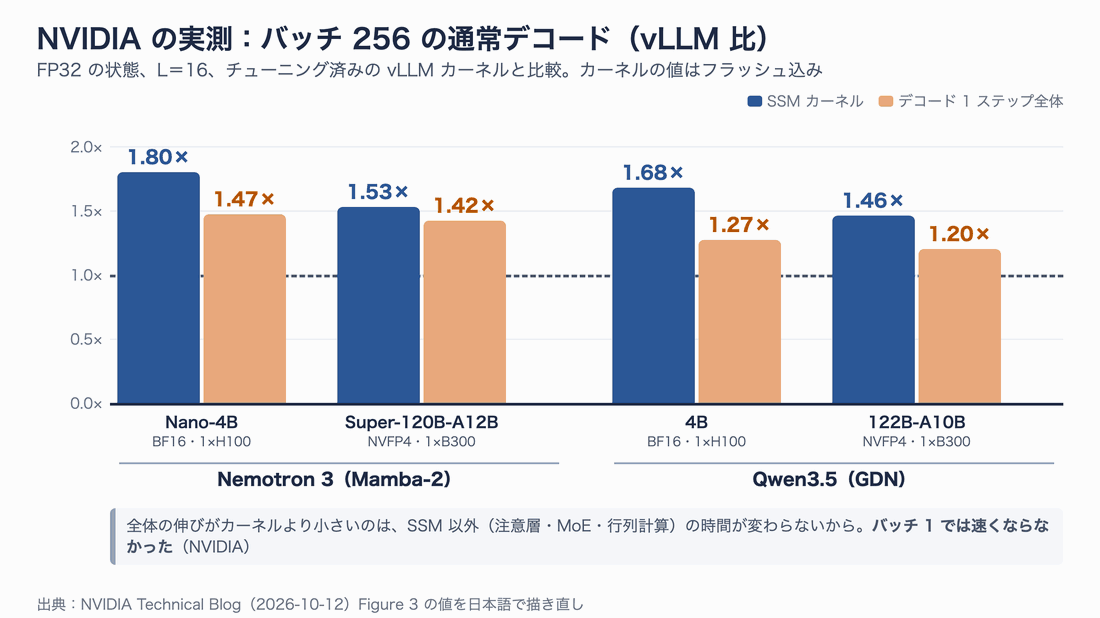
カーネル単体は 1.46〜1.80 倍。SSM 以外の時間は変わらないので、ステップ全体では 1.20〜1.47 倍
押さえておきたい条件は 3 つです。
- バッチ 256 での数字です。 NVIDIA は「バッチ 1 では、ほかの待ち時間が支配的で、ReplaySSM による高速化はなかった」と明記しています。
- 全体の伸びはバッチが大きいほど大きくなります。 バッチが増えると、ステップ全体に占める SSM 層の割合が増えるためです。
- Mamba-2(Nemotron 3)のほうが伸びが大きめです。 GDN(Qwen3.5)は全体で 1.20〜1.27 倍にとどまりました。
効果 2:投機的デコーディングが 1.85〜2.10 倍
投機的デコーディングでは、ReplaySSM は下書き T 個の入力をバッファに足すだけです。検証が終わったら、採用された数だけバッファのポインタを進めます。不採用の記録はポインタの先に残りますが、無視され、次の追記で上書きされます。KV キャッシュの巻き戻しと同じ扱いになるわけです。
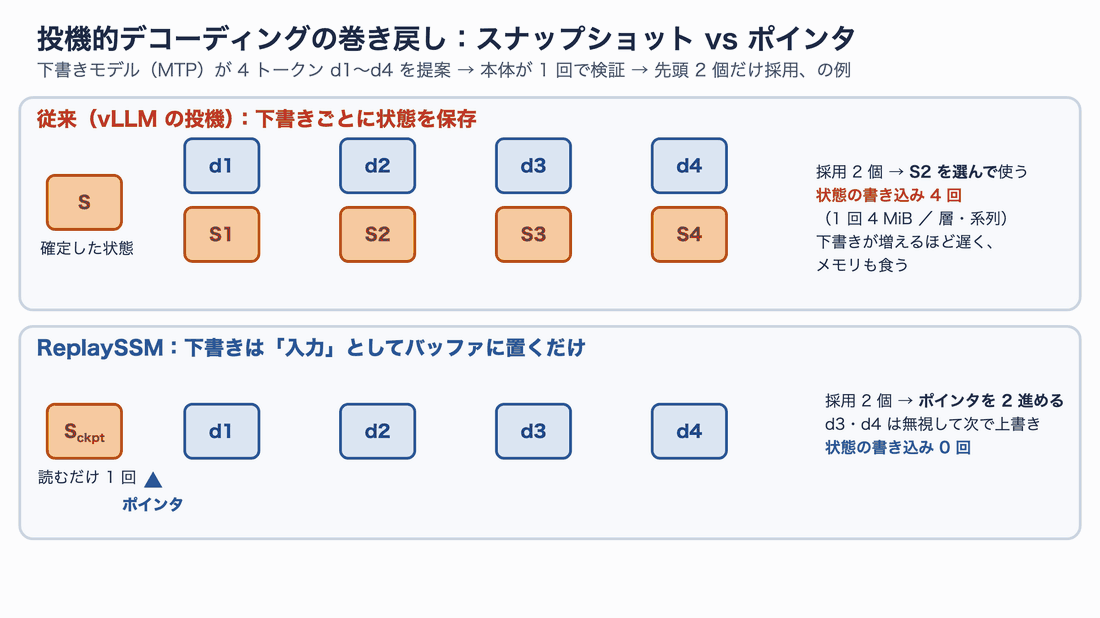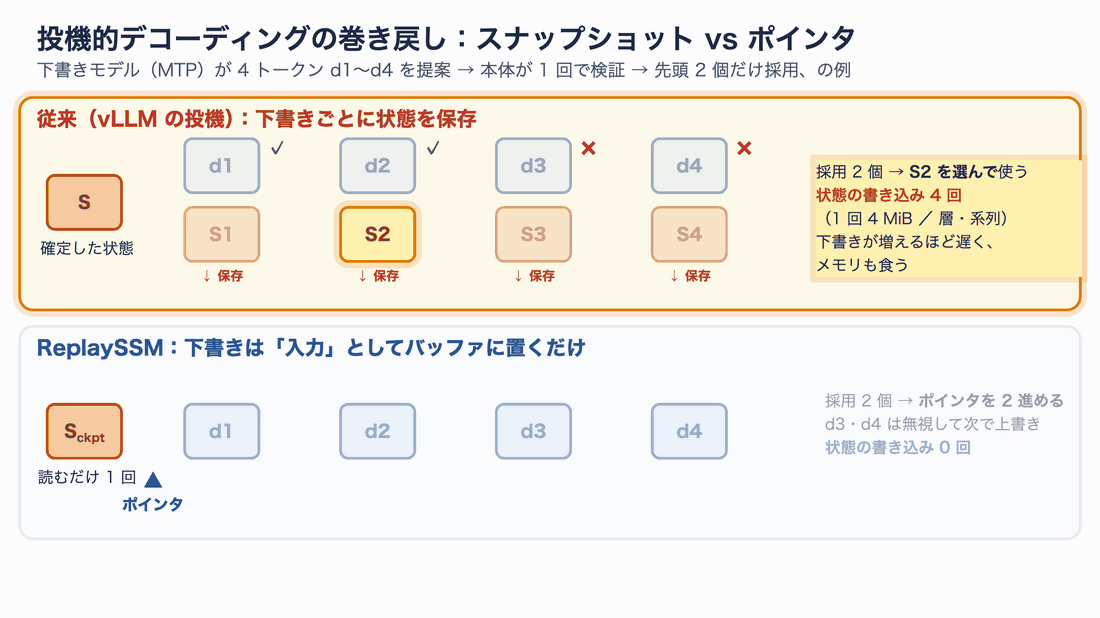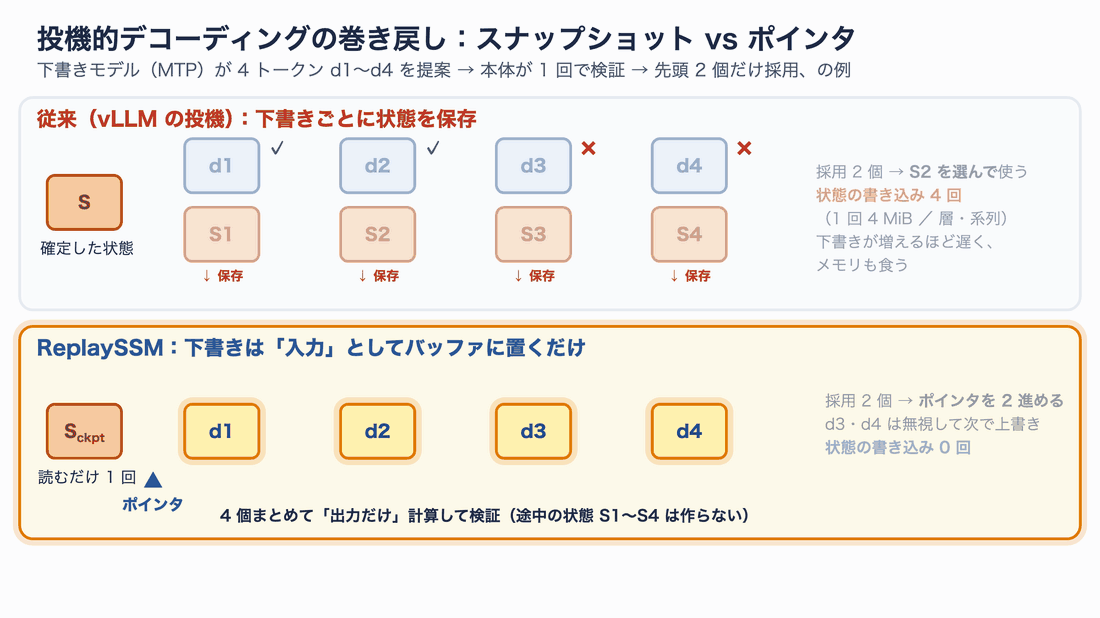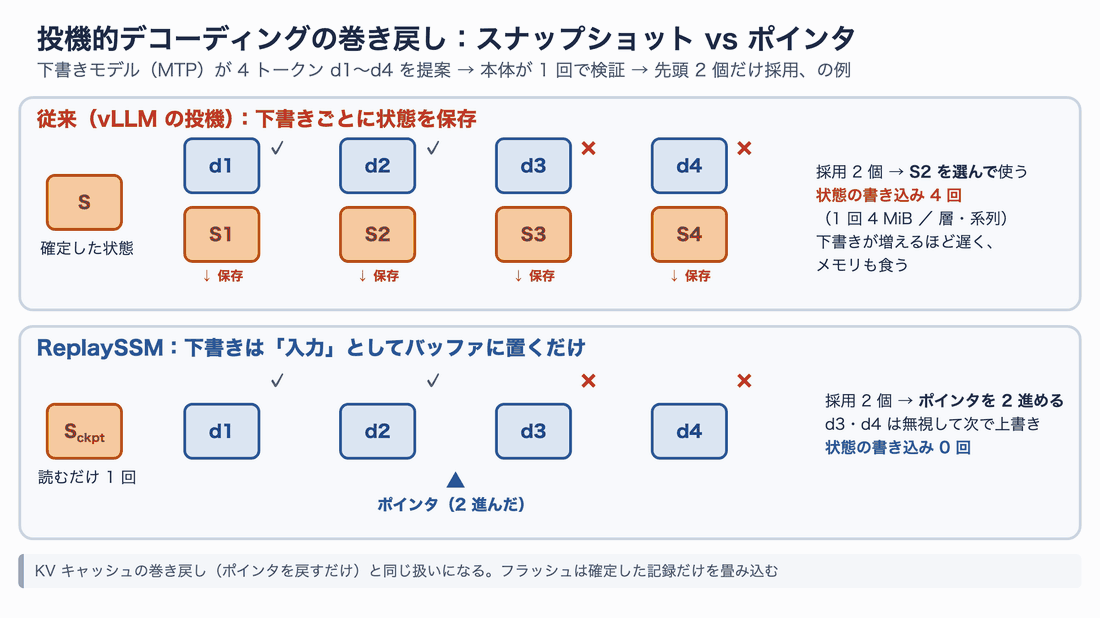
スナップショットは不要。巻き戻しはポインタを戻すだけで、状態の書き込みは 0 回
Dao AI Lab のブログによると、フラッシュは「バッファ内の確定済みの件数 + 2T が L を超えたら」行います。次の窓で下書き T 個ぶんの空きを必ず確保するために、1 窓早めに書き戻すわけです。
効果は、検証の速さと、同時に処理できる数の両方に出ています。
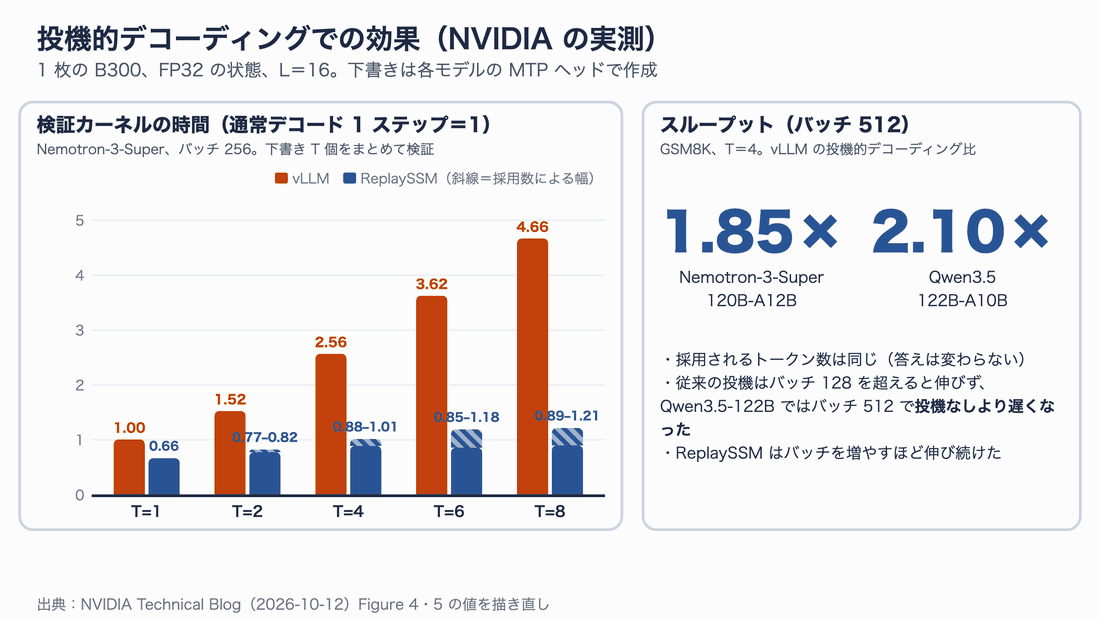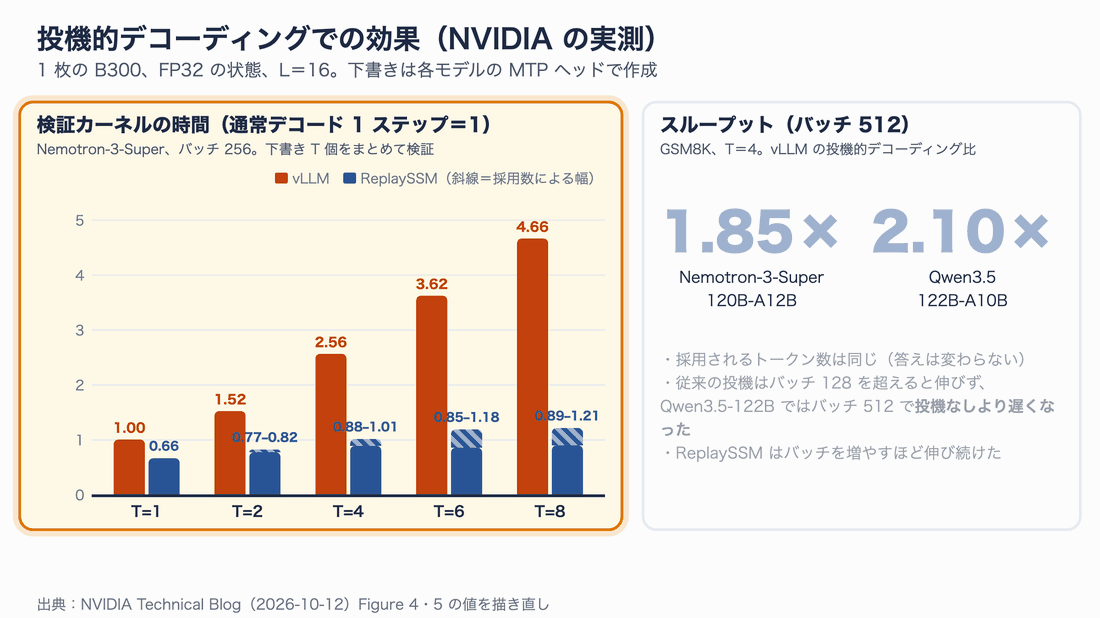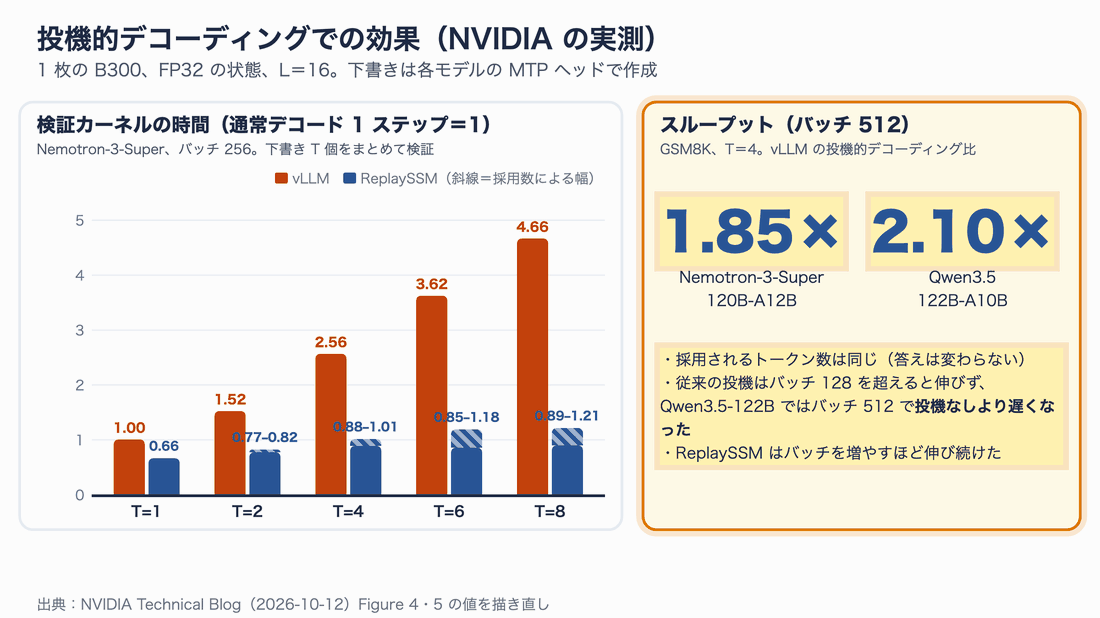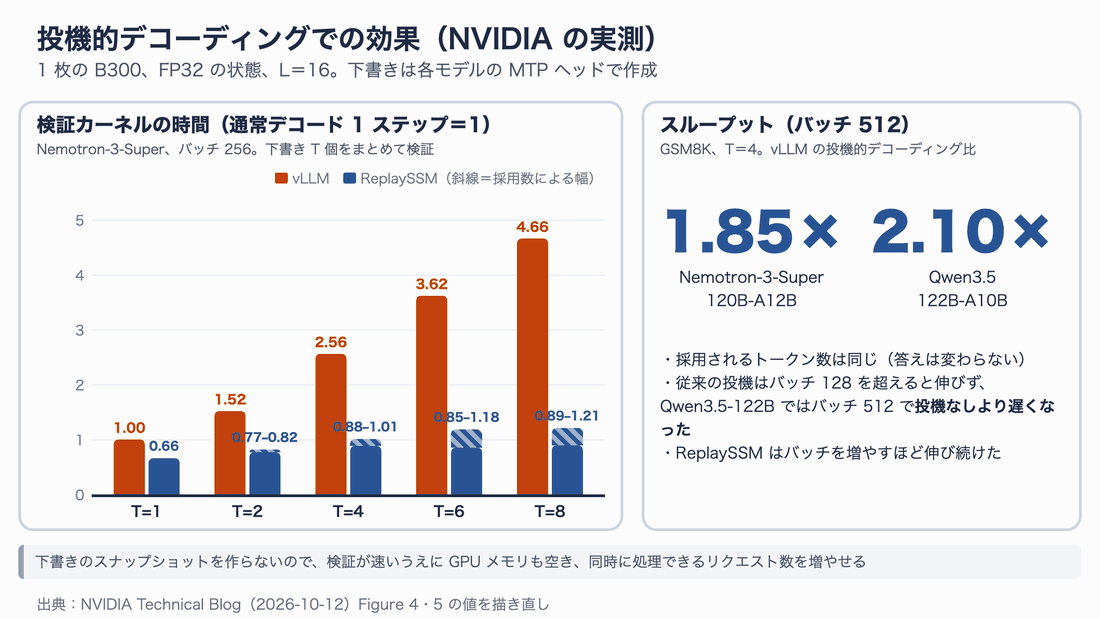
T=8 の検証に、vLLM は通常 1 ステップの約 4.7 倍かかるが、ReplaySSM はほぼ 1 ステップ分
バッチ 512 では、vLLM の投機的デコーディングに比べて、Nemotron-3-Super で 1.85 倍、Qwen3.5-122B で 2.10 倍のスループットでした。採用されたトークン数は同じなので、生成結果は変わりません。従来の投機的デコーディングは、スナップショットがメモリを圧迫してバッチ 128 を超えると伸びず、Qwen3.5-122B ではバッチ 512 で投機なしより遅くなっていました。
効果 3:低精度の状態でも誤差がたまりにくい
非フラッシュのステップは状態を「読むだけ」です。そこで ReplaySSM は、更新用の高精度なチェックポイントと、出力を出すときに読む低精度のコピーを分けて持てます。低精度のコピーはフラッシュのときに高精度版から作り直すので、丸め誤差は更新に戻りません。
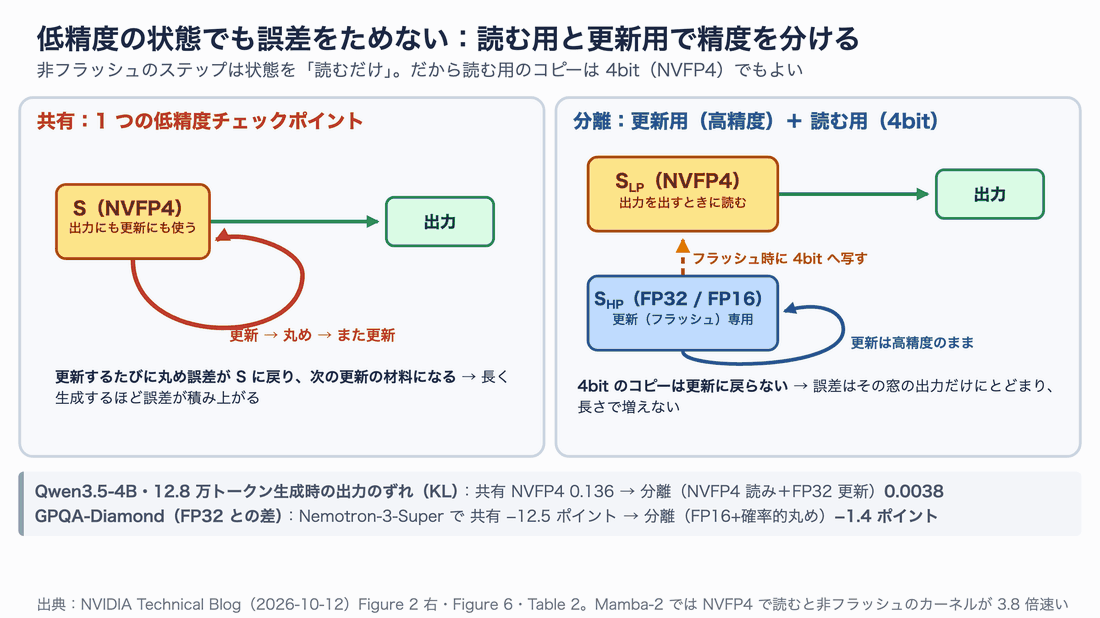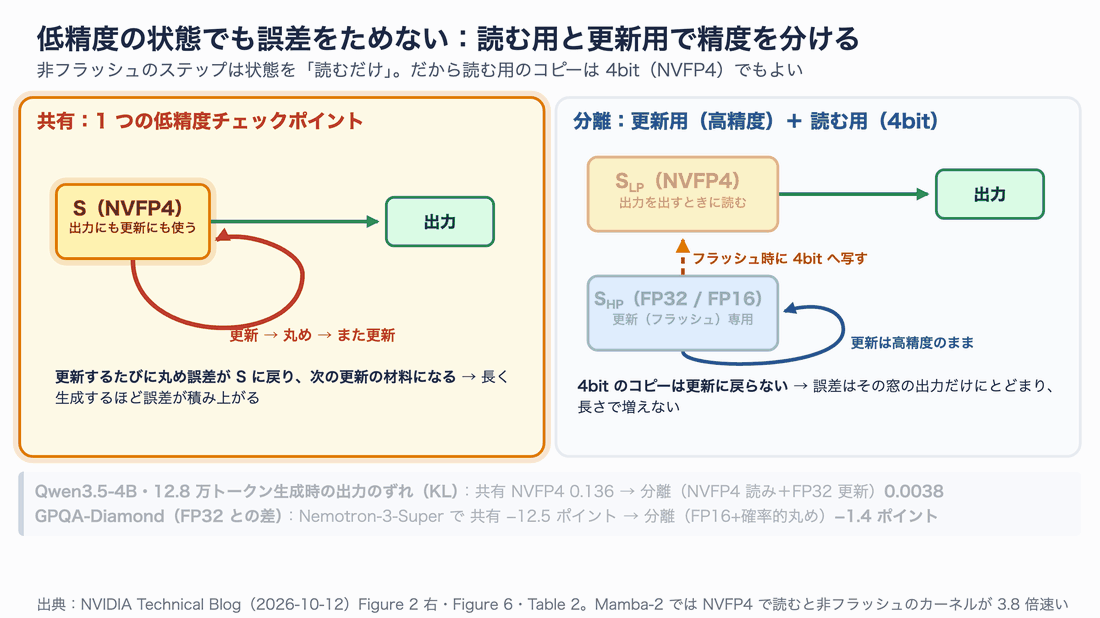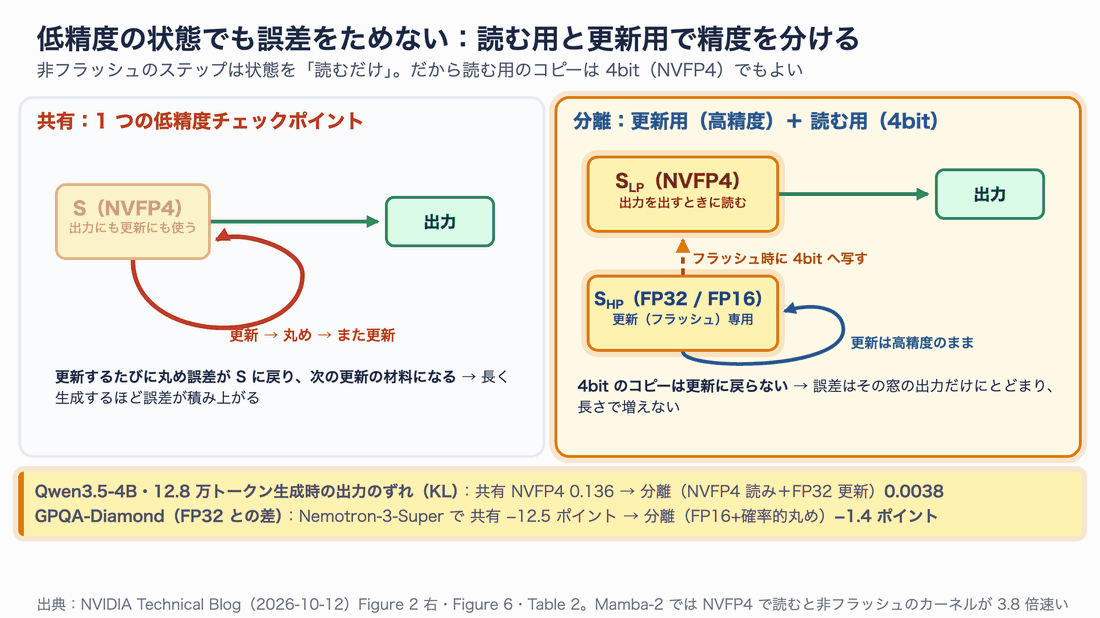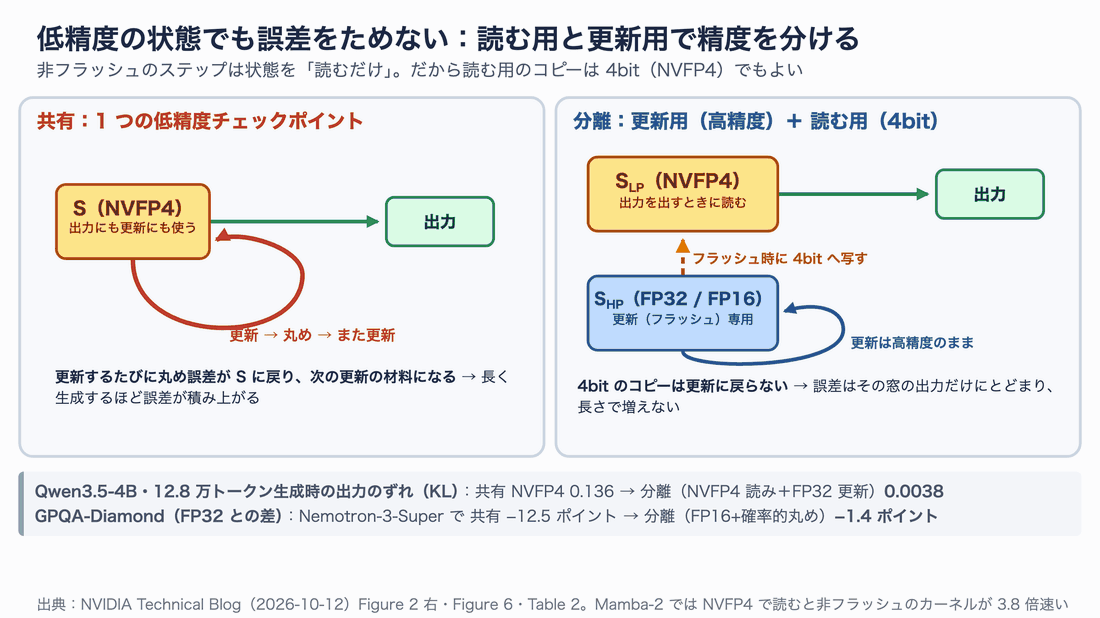
読む用のコピーは 4bit でも、更新は高精度のまま。誤差はその窓の出力にしか影響しない
NVIDIA の測定では、Mamba-2 の非フラッシュのカーネルは、状態を FP32 ではなく NVFP4 で読むと 3.8 倍速くなりました。精度への影響は、Qwen3.5-4B で 12.8 万トークン生成したときの出力のずれ(KL ダイバージェンス)が、共有 NVFP4 の 0.136 から、分離構成(NVFP4 で読む+FP32 で更新)では 0.0038 に下がっています。
長い推論が必要な GPQA-Diamond での正答率の変化(FP32 との差、ポイント)は次のとおりです。
| モデル | FP32 の正答率 | 共有 NVFP4 | NVFP4 読み+FP16(確率的丸め)更新 | NVFP4 読み+FP8(確率的丸め)更新 |
|---|---|---|---|---|
| Nemotron-3-Nano-4B | 56.7 | −31.3 | −6.7 | −5.6 |
| Nemotron-3-Super-NVFP4 | 79.3 | −12.5 | −1.4 | −1.4 |
| Qwen3.5-4B | 76.3 | −3.2 | +0.7 | +1.5 |
| Qwen3.5-122B-A10B-NVFP4 | 82.7 | −5.2 | −2.0 | −1.7 |
共有の NVFP4 だと最大 31 ポイント落ちますが、精度を分ければ 4 モデル中 3 モデルが FP32 との差 約 2 ポイント以内に収まりました。ただし Nemotron-3-Nano-4B は分離しても 5〜7 ポイント落ちています。低精度の状態を使うなら、自分のモデルで正答率を確かめる必要があります。
自分の Mac で仕組みを再現してみた
公式の実装は NVIDIA GPU 向け(Triton・CUDA)なので、Mac では動きません。そこで、ReplaySSM の考え方そのものを自分で実装し、Mac で 3 つのことを確かめました。
- 本当に、通常のデコードと同じ出力になるのか(NumPy)
- Mac の GPU でも、バッチが大きいと速くなるのか(MLX の Metal カーネル)
- 低精度の状態で、誤差のたまり方はどう違うのか(NumPy の模擬実験)
環境は MacBook Pro(Apple M5 Max、メモリ 128GB、macOS 26.6.2)、Python 3.12、MLX 0.32.3、NumPy 2.5 です。Apple Silicon の GPU も、状態の読み書きはメモリ帯域で頭打ちになるので、傾向は比べられるはずだと考えました。ただし、これは Mamba-2 型の層 1 枚だけを取り出した実験で、モデル全体のデコードを測ったものではありません。
1. 同じ出力になるか:NumPy の最小コード
まずは正しさです。次のコードは、通常のデコードと ReplaySSM を同じ入力で 1000 ステップ動かし、出力の差と書き戻しの回数を比べます。NumPy だけで動くので、コピーしてそのまま試せます。
# 作業用の仮想環境を作って NumPy を入れる(Python 3.10 以降)
python3 -m venv replayssm-lab && source replayssm-lab/bin/activate
pip install numpy
# replayssm_mini.py : ReplaySSM の考え方を確かめる最小コード(NumPy だけで動く)
import numpy as np

rng = np.random.default_rng(0)
D, N, L, T = 64, 128, 16, 1000           # 値の次元・状態の次元・バッファ長・ステップ数
A = -0.01                                # 減衰の強さ(1 ヘッドぶん)

dt = np.log1p(np.exp(rng.normal(size=T)))   # 刻み幅(正の値)
x = rng.normal(size=(T, D))                 # 値ベクトル
k = rng.normal(size=(T, N)) / np.sqrt(N)    # キー
q = rng.normal(size=(T, N)) / np.sqrt(N)    # クエリ

# --- 通常のデコード:毎ステップ 状態を更新して書き戻す ---
S = np.zeros((D, N)); y_conv = []; writes_conv = 0
for t in range(T):
    S = np.exp(dt[t] * A) * S + dt[t] * np.outer(x[t], k[t])   # 読む → 更新
    writes_conv += 1                                           # 書き戻す
    y_conv.append(S @ q[t])

# --- ReplaySSM:チェックポイント+直近 L 件の入力から出力だけを計算 ---
S0 = np.zeros((D, N)); buf = []; y_rep = []; writes_rep = 0
for t in range(T):
    buf.append(t)                                    # 入力記録(ここでは番号)を追記
    d = dt[buf]
    after = d[::-1].cumsum()[::-1] - d               # 各記録より後ろの dt の合計
    w = d * np.exp(A * after)                        # 各記録の重み
    decay = np.exp(A * d.sum())                      # チェックポイントにかかる減衰
    if len(buf) < L:                                 # 非フラッシュ:状態を作らない
        kq = k[buf] @ q[t]                           # kᵀq はスカラー(記録の数だけ)
        y_rep.append(decay * (S0 @ q[t]) + x[buf].T @ (w * kq))
    else:                                            # フラッシュ:畳み込んで 1 回だけ書き戻す
        S0 = decay * S0 + (x[buf].T * w) @ k[buf]
        writes_rep += 1
        buf = []
        y_rep.append(S0 @ q[t])

y_conv, y_rep = np.array(y_conv), np.array(y_rep)
print("出力の最大相対誤差:", np.abs(y_conv - y_rep).max() / np.abs(y_conv).max())
print("状態の書き戻し回数: 通常", writes_conv, "回 / ReplaySSM", writes_rep, "回")
python replayssm_mini.py
手元の実行結果は次のとおりです。
出力の最大相対誤差: 6.643038224935253e-16
状態の書き戻し回数: 通常 1000 回 / ReplaySSM 62 回
出力の差は 10⁻¹⁶ 程度、つまり計算機の丸め誤差だけで、同じ答えです。そのうえで、状態の書き戻しは 1000 回から 62 回(16 回に 1 回)に減りました。
同じ考え方で、投機的デコーディングも確かめました(lab/replayssm_ref.py)。下書き 4 個を検証して先頭から 0〜4 個をランダムに採用する、を 300 回繰り返し、ReplaySSM は採用数だけポインタを進めます。採用された 574 トークンの出力は、1 個ずつ通常デコードした結果と最大相対誤差 2.3×10⁻¹⁵ で一致しました。状態の書き込みは、スナップショット方式の 1,200 回に対して ReplaySSM は 58 回(フラッシュのときだけ)でした。
2. Mac の GPU で速さを測る:Metal カーネル
次は速さです。MLX の mx.fast.metal_kernel で、Metal(Apple の GPU 向けの言語)のカーネルを 3 つ書きました。状態の大きさは Nemotron-3-Super の Mamba 層と同じ(ヘッド 128 × 64 × 128、FP32、1 系列 4 MiB)です。
| カーネル | すること | 状態の読み書き |
|---|---|---|
| 通常方式 | 状態を読む → 更新 → 書き戻す → 出力 | 読み 1・書き 1 |
| ReplaySSM(非フラッシュ) | チェックポイントを読み、バッファの記録を足して出力 | 読み 1 |
| ReplaySSM(フラッシュ) | バッファ L 件を畳み込み、書き戻して出力 | 読み 1・書き 1 |
ReplaySSM の非フラッシュの中心部分は、次のように「読むだけ」になっています(抜粋)。
// 1 つの simdgroup(32 スレッド)が状態の 1 行(128 要素 = float4 × 32)を担当
float acc = metal::dot(s0[lane], qq[lane]);   // チェックポイントを読むだけ(書き戻さない)
// ... バッファ m 件の重み w_j と k_j・q(前計算済み)を 32 レーンで分担して足し込む ...
acc = metal::simd_sum(acc);
extra = metal::simd_sum(extra);
if (lane == 0) y[bh * D_ + i] = metal::exp(Ah * carry) * acc + extra;
各カーネルは float64 の正解と比べ、相対誤差 1.3×10⁻⁶ 以下で一致することを確かめてから測りました。バッファ長 L = 16 で、1 窓(16 ステップ)ぶんを続けて GPU に積み、窓の終わりで 1 回だけ同期して時間を測っています。設定ごとに 25 秒休ませ、3 周の中央値を取りました。
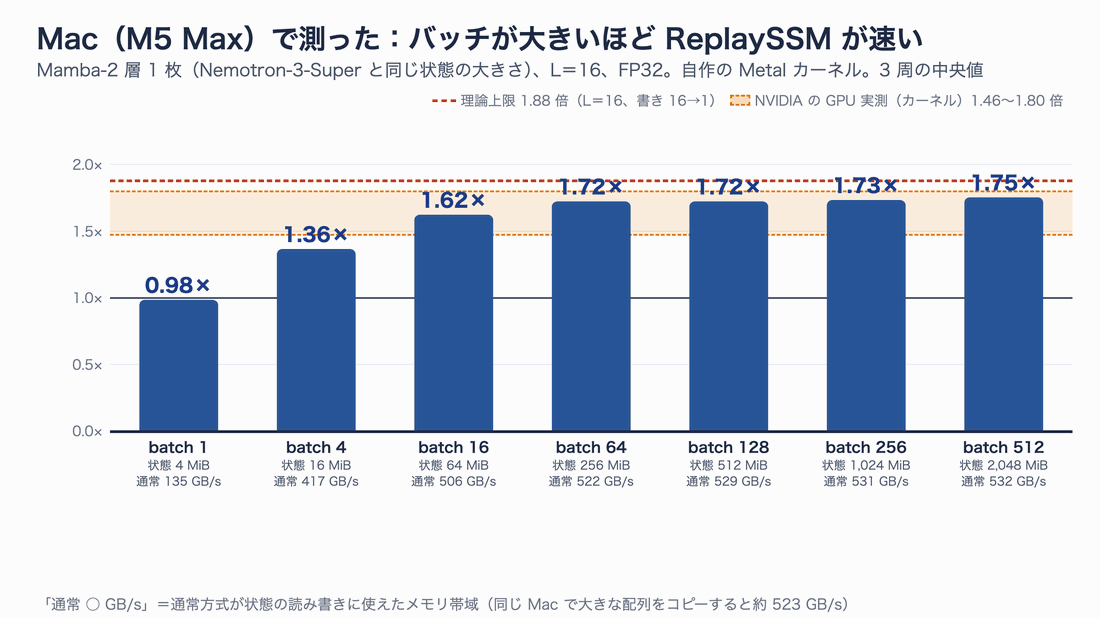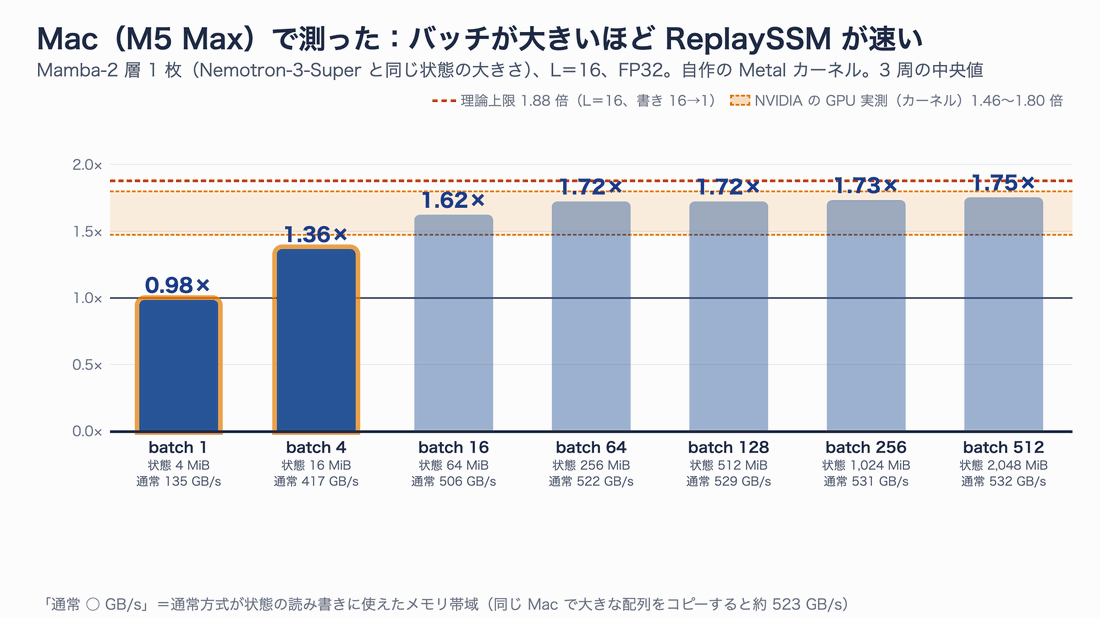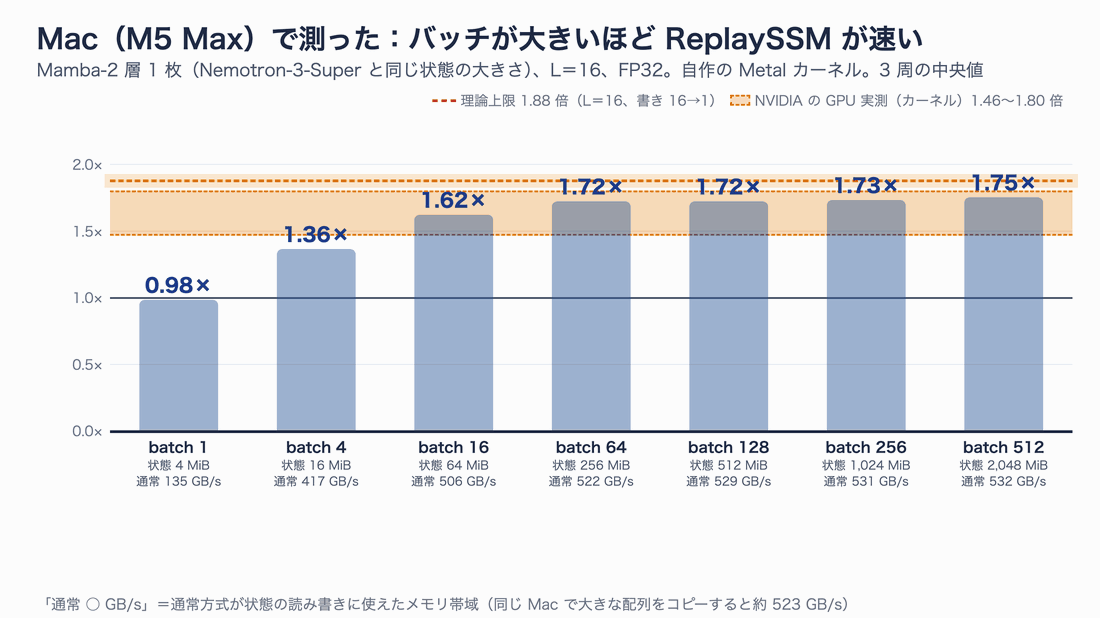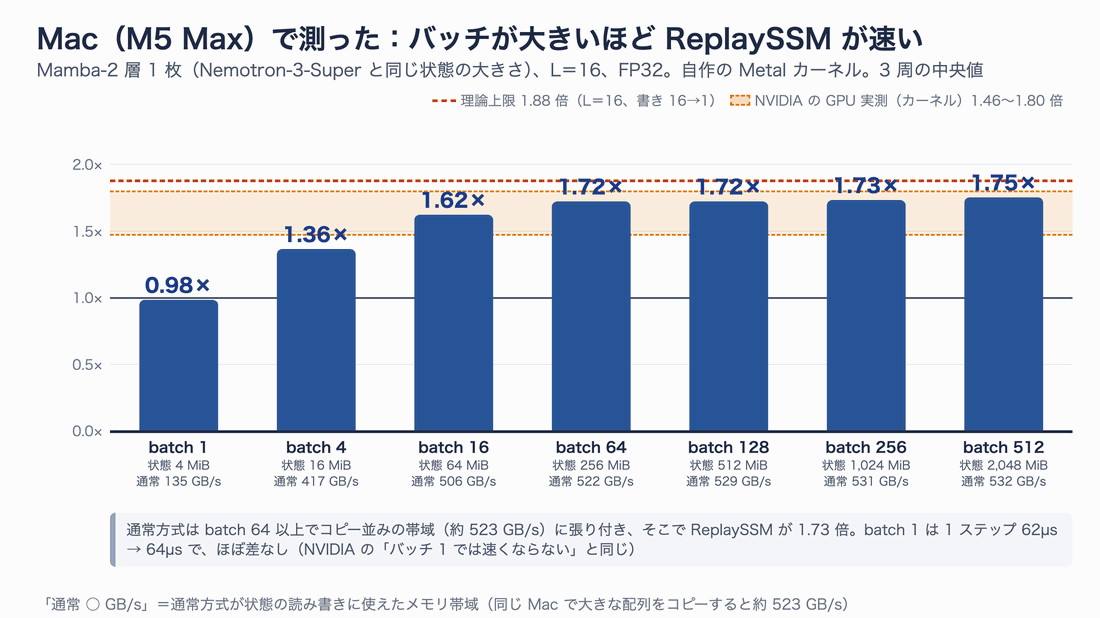
バッチ 64 以上では、通常方式がコピー並みの帯域に張り付き、ReplaySSM が約 1.73 倍。バッチ 1 はほぼ差なし
| バッチ | 状態の大きさ | 通常方式(1 ステップ) | ReplaySSM(1 ステップ) | 倍率 |
|---|---|---|---|---|
| 1 | 4 MiB | 62.3 µs | 63.9 µs | 0.98 倍 |
| 4 | 16 MiB | 80.4 µs | 59.1 µs | 1.36 倍 |
| 16 | 64 MiB | 265.1 µs | 163.6 µs | 1.62 倍 |
| 64 | 256 MiB | 1,028.8 µs | 597.7 µs | 1.72 倍 |
| 128 | 512 MiB | 2,031.5 µs | 1,183.3 µs | 1.72 倍 |
| 256 | 1,024 MiB | 4,043.2 µs | 2,338.0 µs | 1.73 倍 |
| 512 | 2,048 MiB | 8,077.4 µs | 4,630.7 µs | 1.75 倍 |
結果は、NVIDIA の発表とよく似た形になりました。
- バッチ 1 では速くならない(0.98 倍)。状態が 4 MiB しかなく、GPU に仕事を投げる固定の時間が大半を占めるためです。実際、通常方式でもメモリ帯域を 135 GB/s しか使えていません。
- バッチ 64 以上で約 1.72〜1.75 倍。通常方式は、同じ Mac で大きな配列をコピーしたときの帯域(約 523 GB/s)とほぼ同じ速さで読み書きしており、まさに帯域の天井です。ここで書き戻しを減らした分が、そのまま速さになりました。
- 理論上限の 1.88 倍には届きません。ReplaySSM はバッファの記録を読む分と、重みの計算の分が増えるからです。
3. バッファ長と発熱の影響
バッファ長 L を変えた結果と、休ませずに 5 分間回し続けた結果も見ておきます。
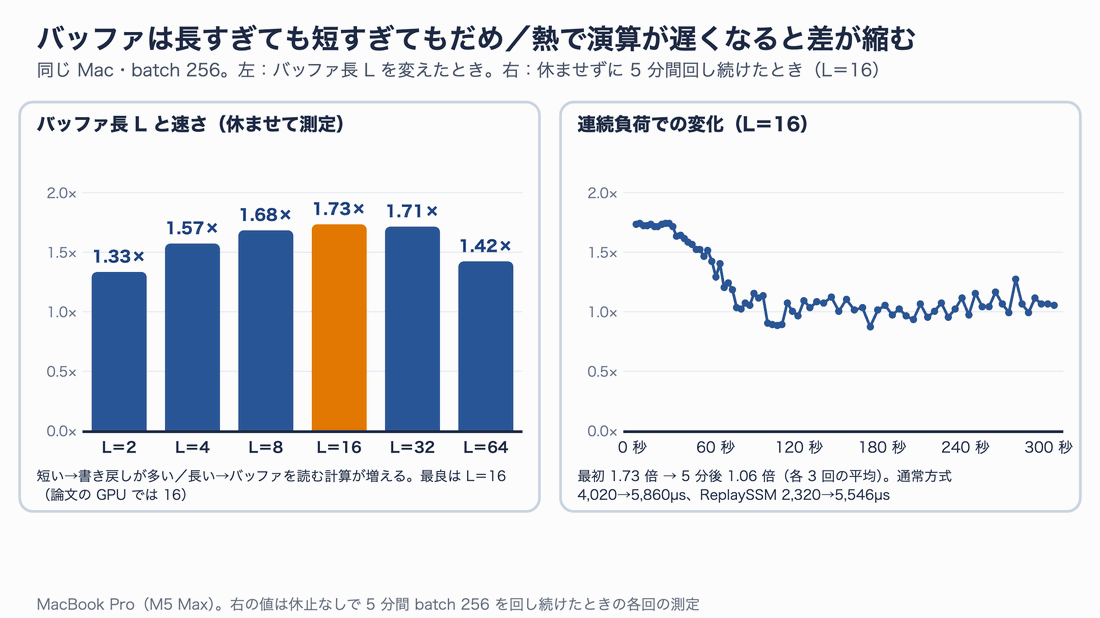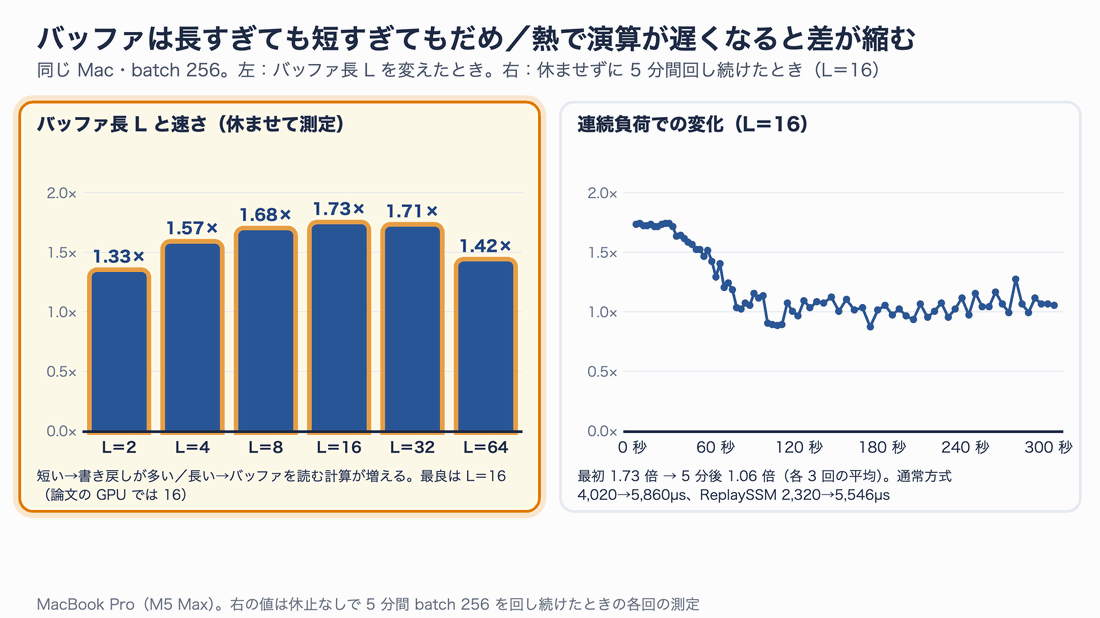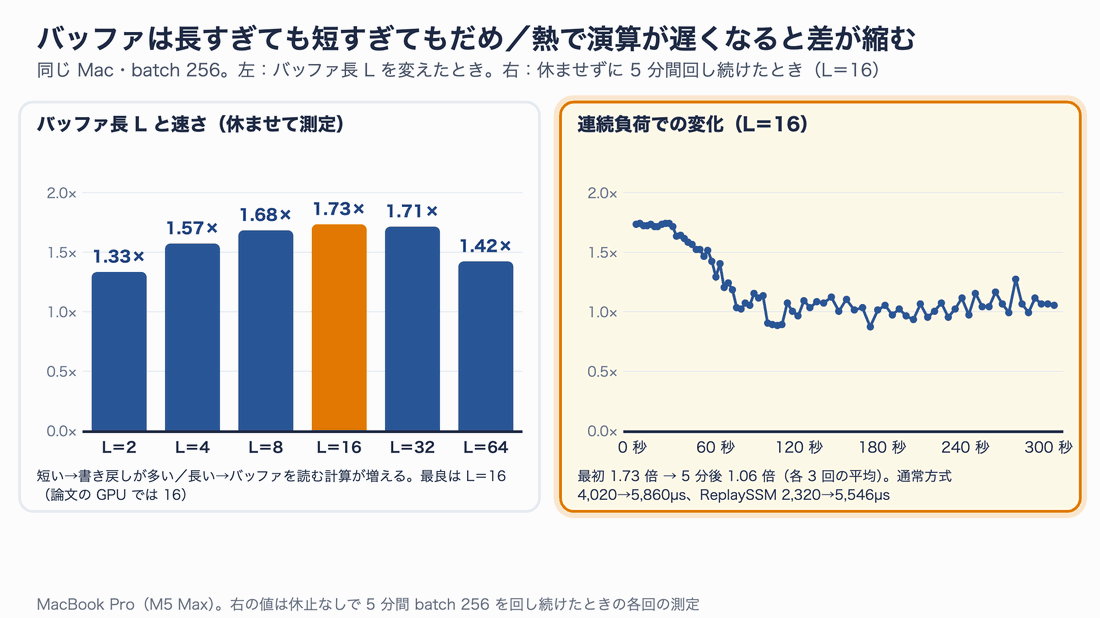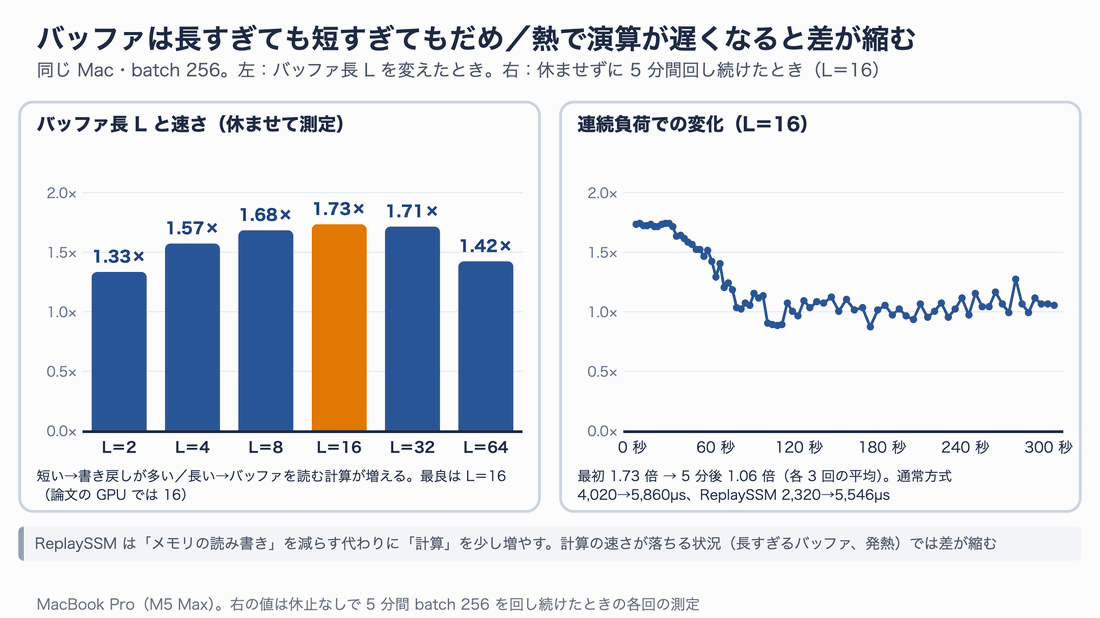
L は短すぎても長すぎても遅い。連続負荷で演算が遅くなると、ReplaySSM の差が縮む
L が短いと書き戻しの回数が増え、長いとバッファの記録を読む計算が増えます。そのため、中くらいの L が最も速い山型になりました(最良は L = 16 で 1.73 倍、L = 64 では 1.42 倍)。Dao AI Lab のブログでもバッファ長の効果は山型で、NVIDIA の記事では 4 モデルとも L = 16 が最良でした。
右は、休みを入れずに 5 分間回し続けた結果です。最初の 29 秒ほどは 1.73 倍を保ちましたが、その後は下がり続け、75 秒ほどで約 1 倍になりました(最後の数回は 1.06 倍)。どちらの方式も遅くなっていますが、通常方式(4,020µs → 5,860µs、約 1.5 倍)より ReplaySSM(2,320µs → 5,546µs、約 2.4 倍)の遅れのほうが大きく、差がほぼなくなりました。
実は最初の測定では、ステップごとに GPU と同期していたうえ、休みを入れずに 3 周続けて回したため、周を重ねるごとに倍率が下がっていく現象が出ました(バッチ 256 で 1.41 倍 → 1.09 倍 → 0.99 倍)。このとき通常方式は約 2 割遅くなっただけでしたが、ReplaySSM は約 75% 遅くなっていました。MacBook Pro が熱で GPU の演算を絞ると、計算を少し増やしてメモリの読み書きを減らす ReplaySSM のほうが大きく影響を受けるのだと考えています。測り方を「窓ごとに同期・設定ごとに休止」に改めたところ、3 周とも同じ結果に安定しました。ReplaySSM は「メモリと計算の交換」なので、計算に余裕がある状況で最も効くことが、手元の実験からも分かります。
4. 低精度の状態で誤差はどうたまるか
最後に、効果 3 の「精度を分ける」効果を模擬しました(lab/precision_sim.py)。乱数の入力で Mamba-2 型の 1 層を 32,768 ステップ動かし、float64 で計算した正解との出力のずれ(相対誤差)を比べます。NVFP4 は、16 個ごとに FP8 の倍率を持つ 4 ビットの形式を NumPy で簡易的に再現しました。実モデルではないので、数値そのものは論文と比べられません。見るのは、長さに対する誤差の増え方です。
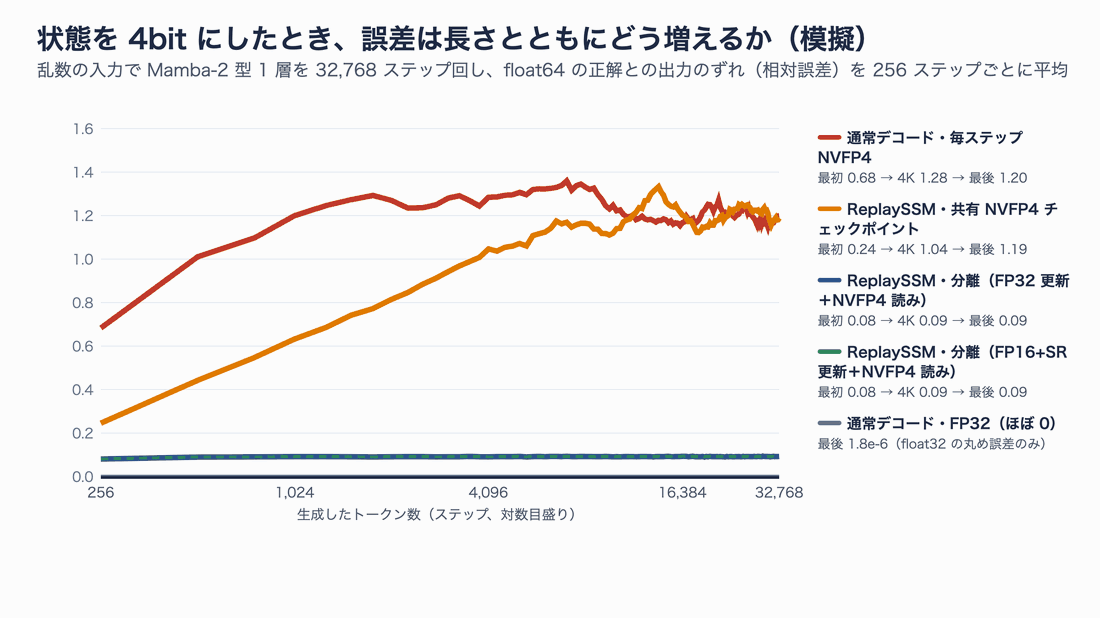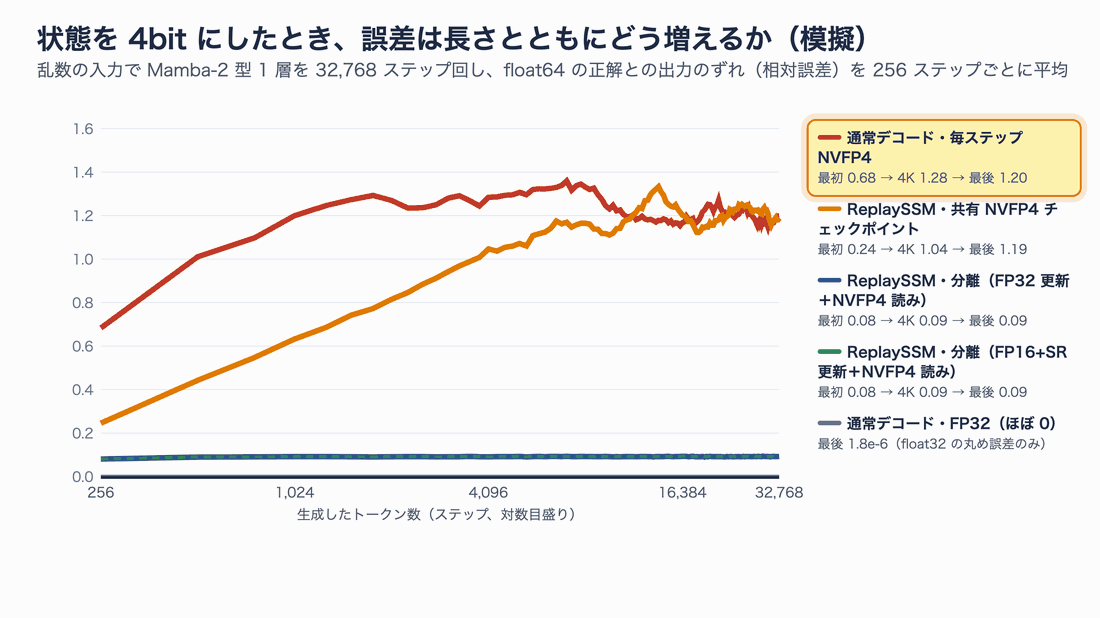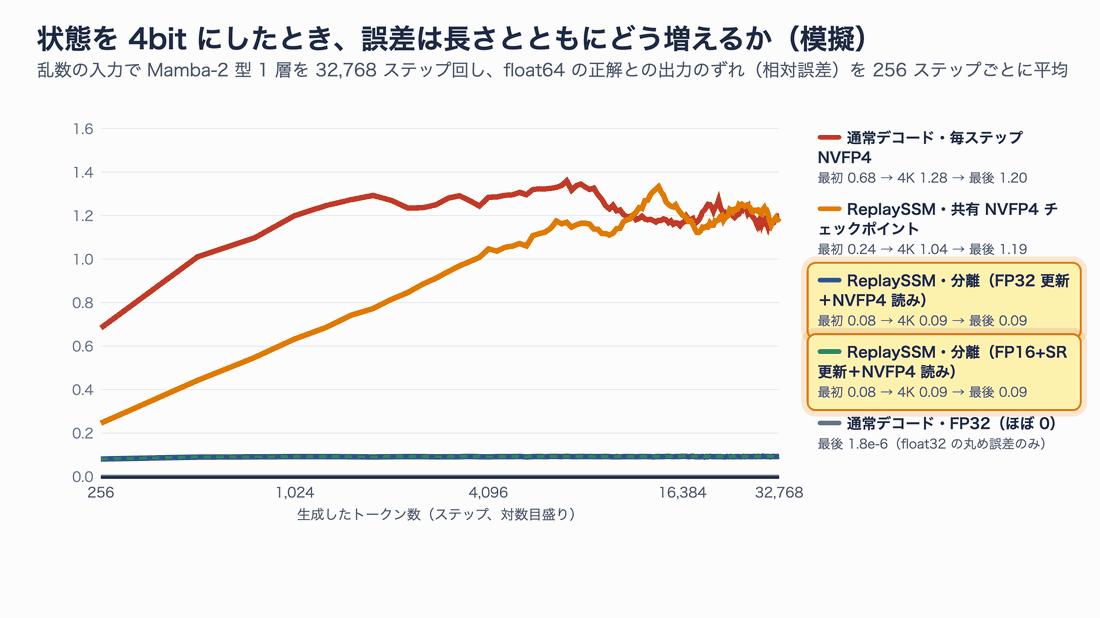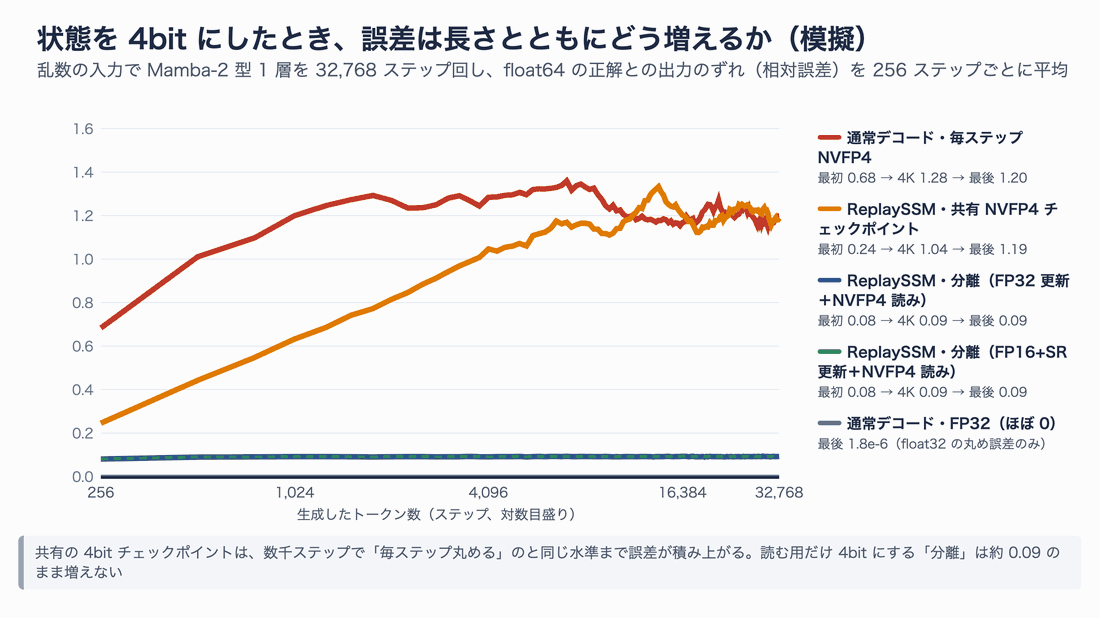
更新に使う状態を 4bit にすると誤差が積み上がる。読む用だけ 4bit にすれば、誤差は一定
| 構成 | 最初(1〜256) | 1,024 ステップ目まで | 4,096 ステップ目まで | 最後(32,768 まで) |
|---|---|---|---|---|
| 通常デコード・FP32 | 1.8e-07 | 5.0e-07 | 1.0e-06 | 1.8e-06 |
| 通常デコード・毎ステップ NVFP4(確率的丸め) | 0.681 | 1.198 | 1.282 | 1.198 |
| ReplaySSM・共有 NVFP4 チェックポイント(確率的丸め) | 0.243 | 0.630 | 1.044 | 1.187 |
| ReplaySSM・分離(FP32 で更新+NVFP4 で読む) | 0.078 | 0.089 | 0.088 | 0.090 |
| ReplaySSM・分離(FP16+確率的丸めで更新+NVFP4 で読む) | 0.079 | 0.089 | 0.089 | 0.091 |
(数字は直前の 256 ステップの平均の相対誤差。1.0 を超えると、ずれが出力そのものより大きい状態です)
NVIDIA の Figure 6 と同じく、共有の 4bit チェックポイントは長さとともに誤差が増え、分離構成は一定でした。共有の場合、最初は毎ステップ丸めるより誤差が小さいものの(丸める回数が 16 分の 1 なので)、数千ステップで同じ水準まで積み上がります。丸める回数を減らすだけでは、誤差が更新に戻る問題は解決しないということです。
分離構成に残る約 0.09 の誤差は、4bit で読むことそのものの誤差で、長さには比例しません。また、更新用を FP16(確率的丸め)にしても FP32 とほぼ同じ曲線になり、「更新用は半精度で十分」という NVIDIA の結果とも合っています。なお、この模擬では 4bit の誤差がかなり大きく出ています。乱数の入力と、とても長く記憶するヘッドを含めた設定のためで、実際のモデルの劣化の大きさは前に挙げた GPQA-Diamond の表で判断してください。
再現実験から分かったこと
手元の実験をまとめると、次のとおりです。
- ReplaySSM は近似ではない。通常のデコードと同じ出力を、少ない書き戻しで出せる
- 効くのはメモリ帯域が天井のときだけ。Mac でもバッチ 1 では差がなく、バッチ 64 以上で約 1.72〜1.75 倍
- バッファ長には最適値があり、計算の余裕(発熱・長すぎるバッファ)で効果が変わる
- 「読む用だけ低精度」にすれば、誤差は長さで増えない
自分のサーバーで使うには
どのエンジンで使えるか(2026 年 10 月 13 日時点)
NVIDIA の記事は「TensorRT-LLM、vLLM、SGLang、FlashInfer に組み込まれている」と書いています。ただし、各プロジェクトの PR とソースを確かめると、SSM 層の種類によって使えるエンジンが違います。まずは自分のモデルの config.json で SSM 層の種類を確かめてください。
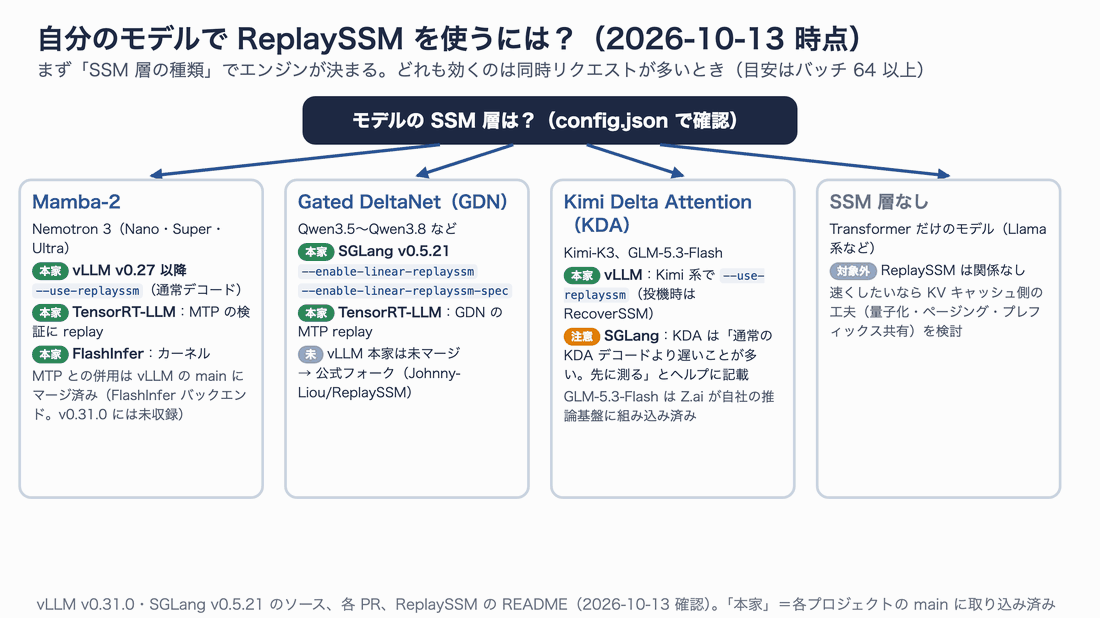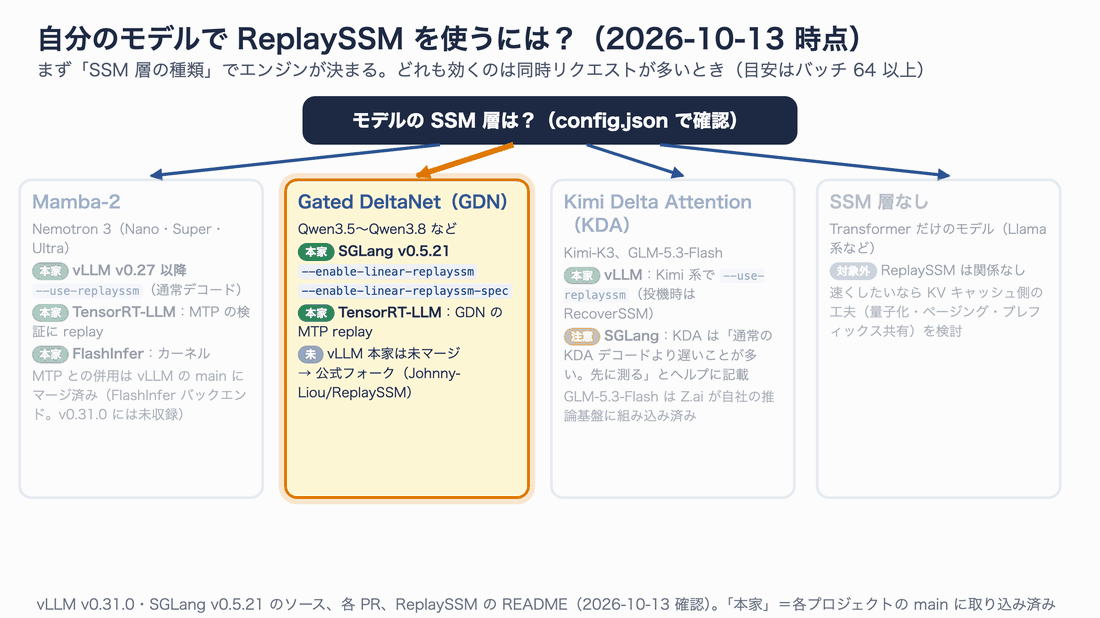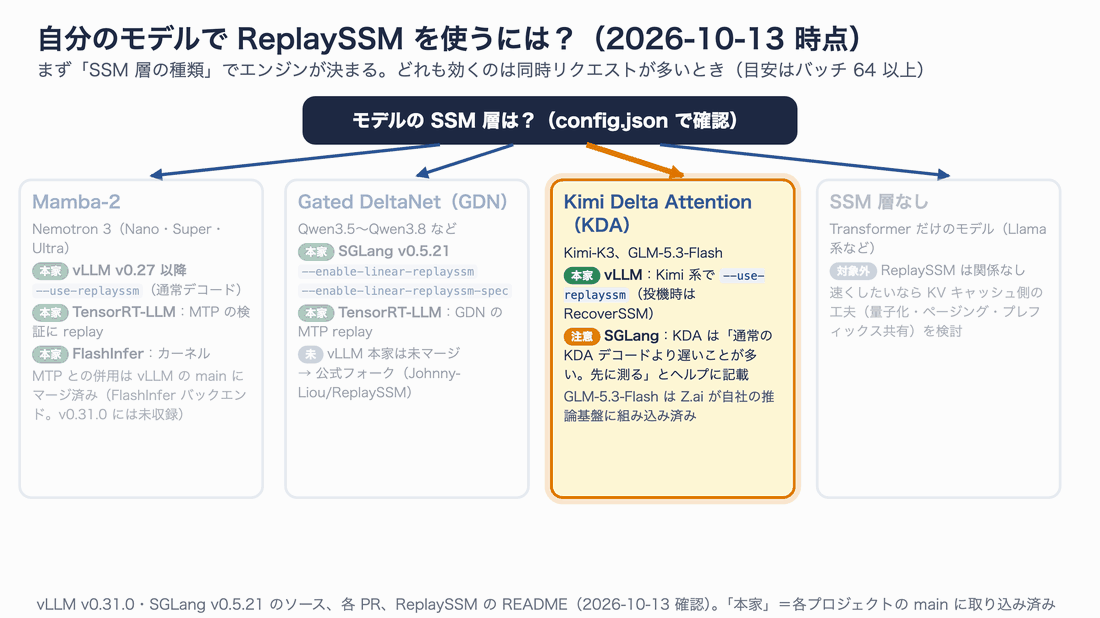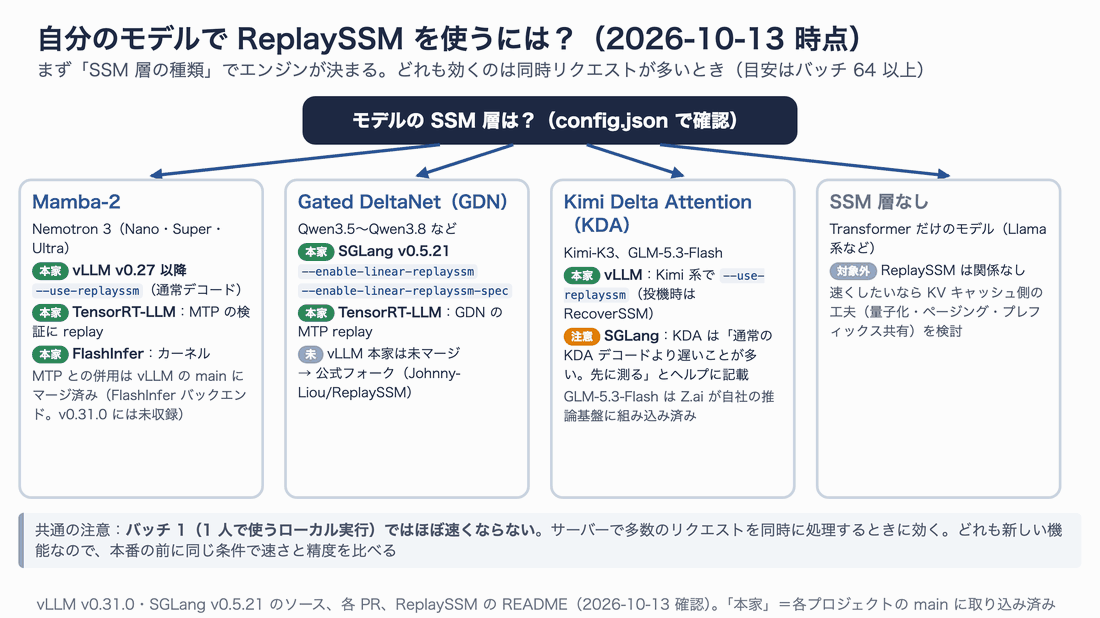
Nemotron 3(Mamba-2)は vLLM、Qwen3.5 系(GDN)は SGLang か TensorRT-LLM が入り口
| エンジン | 取り込み済みの範囲 | 有効にする方法 |
|---|---|---|
| vLLM | Mamba-2 の通常デコード(v0.27.0 以降)、Kimi 系 | --use-replayssm、--replayssm-buffer-len 16 |
| vLLM(main のみ) | Mamba-2 で MTP と併用(FlashInfer バックエンド) | v0.31.0 には未収録 |
| SGLang v0.5.21 | GDN・KDA の通常デコード、投機の検証 | --enable-linear-replayssm、--enable-linear-replayssm-spec |
| TensorRT-LLM | Mamba-2 と GDN の MTP 検証 | PR #14203・#16464(マージ済み) |
| FlashInfer | カーネル(Mamba-2、GDN の投機) | 各エンジンから呼ばれる部品 |
| 公式フォーク | 4 経路すべて+精度のエミュレーション | Johnny-Liou/ReplaySSM(vLLM 0.23.1 ベース) |
注意したいのは、vLLM 本家では GDN(Qwen3.5 系)用の PR が未マージのまま閉じられていることです。Qwen3.5〜3.8 を vLLM で動かしていて「フラグを付ければ速くなる」とは、まだなりません。vLLM v0.31.0 で ReplaySSM を受け付けるのは、ソースで確かめた限り Nemotron 系(NemotronH)と Kimi 系のアーキテクチャだけでした。
vLLM で Nemotron 3 を試すコマンド
以下は vLLM v0.31.0 のソースで確かめたフラグを使った例です。筆者は NVIDIA GPU を持っていないため、実行はしていません。 前提は、CUDA 対応の NVIDIA GPU(NVIDIA の記事では H100)と、vLLM が動く Linux 環境です。
# vLLM を入れる(ReplaySSM の Mamba-2 版は v0.27.0 以降に入っている)
pip install "vllm>=0.31.0"

# ① 基準:ReplaySSM なし
vllm serve nvidia/NVIDIA-Nemotron-3-Nano-4B-BF16 --max-num-seqs 256 --port 8000
# ② ReplaySSM あり
# v0.31.0 は既定で Model Runner V2 を使うが、Triton 版の ReplaySSM は V1 専用なので V1 を指定する
VLLM_USE_V2_MODEL_RUNNER=0 vllm serve nvidia/NVIDIA-Nemotron-3-Nano-4B-BF16 \
  --max-num-seqs 256 --port 8000 \
  --use-replayssm --replayssm-buffer-len 16
V2 のまま使いたい場合は、--mamba-backend flashinfer を付けると FlashInfer 版になります。ただし vLLM の PR には「対応する FlashInfer の版が必要で、古い版では起動時の検証で止まる」とあるので、まずは Triton 版を試すのが無難です。
速さは、サーバーを起動したまま別の端末から vllm bench serve で測ります。同時リクエスト数(--max-concurrency)を 1・16・64・256 と変えて、①と②の両方で同じコマンドを流してください。
# 同時 256 リクエストで、入力 1024・出力 1024 トークンを 1024 件流す
vllm bench serve --model nvidia/NVIDIA-Nemotron-3-Nano-4B-BF16 --port 8000 \
  --dataset-name random --random-input-len 1024 --random-output-len 1024 \
  --num-prompts 1024 --max-concurrency 256 --ignore-eos \
  --save-result --result-filename replayssm-c256.json
--ignore-eos は、途中で文章が終わらず必ず指定の長さまで生成させるオプションです。比べるときに出力の長さがそろいます。
SGLang で Qwen3.5 を試すコマンド
GDN を使う Qwen3.5 系は、SGLang v0.5.21 の --enable-linear-replayssm で試せます。こちらも未実行の例です。SGLang のヘルプには「GDN のデコード帯域の最適化で、バッチ 64 以上で約 1.2〜1.5 倍」と書かれています。
# ReplaySSM あり(線形注意のデコードは既定の Triton、Mamba のキャッシュ戦略は no_buffer が条件)
python -m sglang.launch_server --model-path Qwen/Qwen3.5-4B --port 30000 \
  --enable-linear-replayssm --linear-replayssm-cache-len 16 \
  --mamba-radix-cache-strategy no_buffer
# 測定(基準はフラグを外して起動し直し、同じコマンドを流す)
python -m sglang.bench_serving --backend sglang --port 30000 \
  --dataset-name random --random-input-len 1024 --random-output-len 1024 \
  --num-prompts 1024 --max-concurrency 256 --output-file replayssm-c256.jsonl
投機的デコーディング(MTP)と組み合わせる場合は、--enable-linear-replayssm の代わりに --enable-linear-replayssm-spec を使います。2 つは同時に指定できません。また、下書きは一直線の形(--speculative-eagle-topk が 1)である必要があります。KDA については、ヘルプに「通常の KDA デコードより遅いことが多いので、先に測ること」と書かれています。
効果を確かめる手順
測るときは、ReplaySSM のフラグ以外を一切変えないことが大切です。下の 5 段で比べると、効果と副作用を見落としにくくなります。
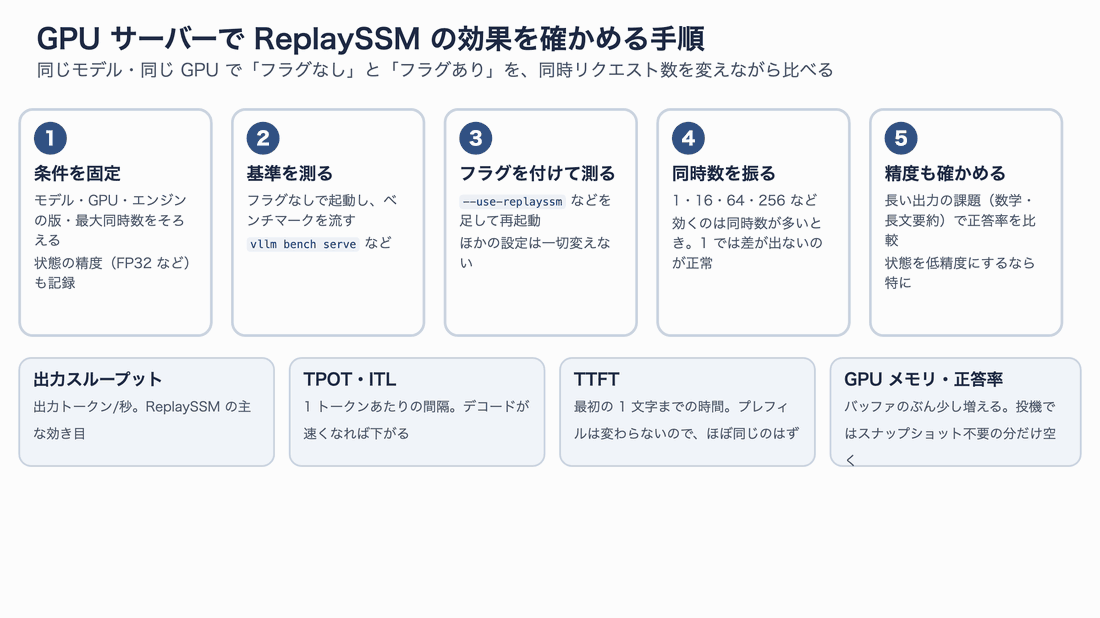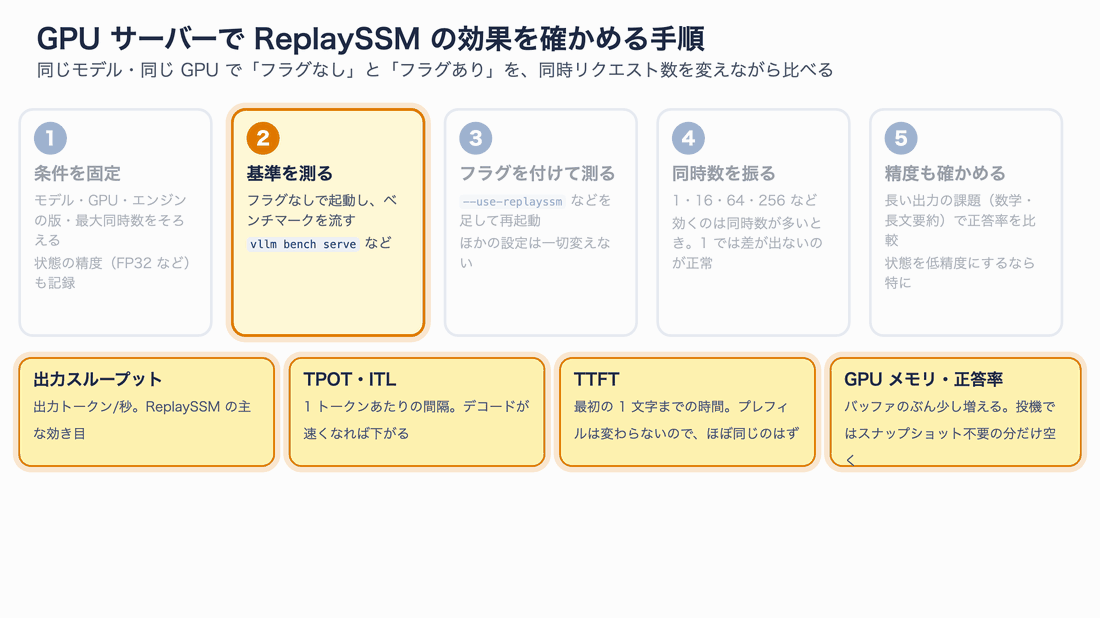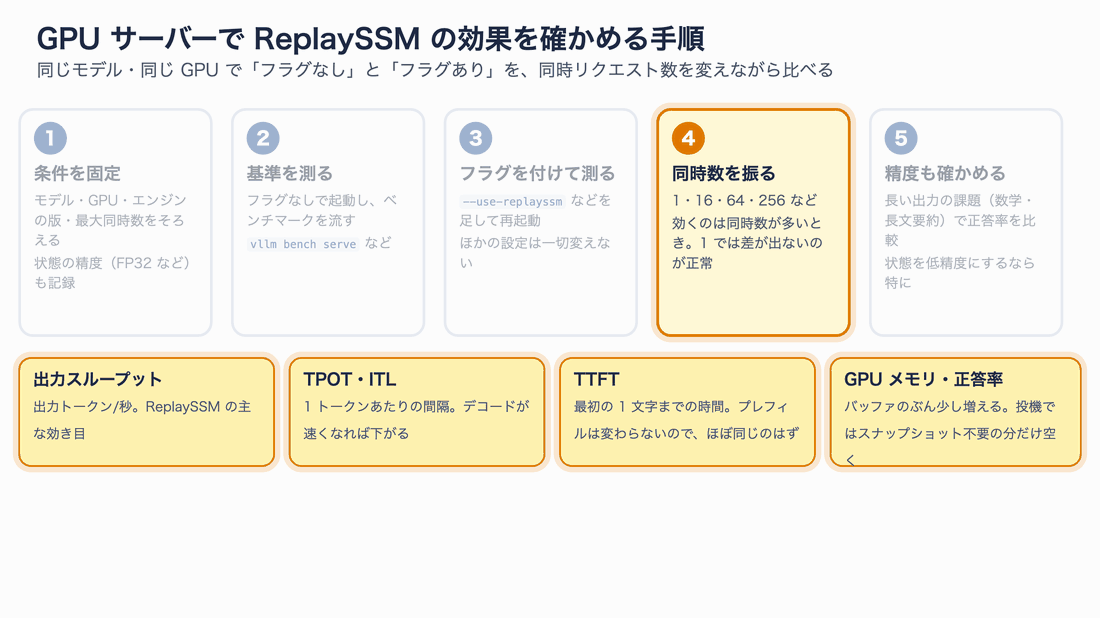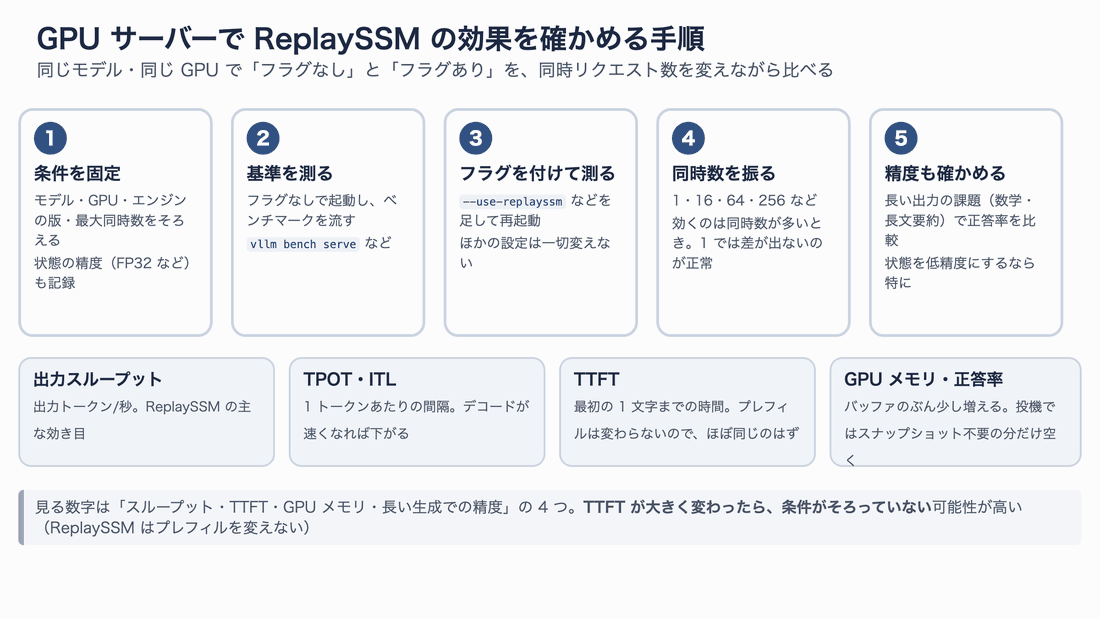
TTFT(最初の 1 文字までの時間)は、ReplaySSM ではほぼ変わらないはず。大きく変わったら条件がそろっていない
見る指標と、期待される変化をまとめておきます。
| 指標 | 意味 | ReplaySSM で期待される変化 |
|---|---|---|
| 出力スループット | 1 秒あたりの出力トークン数 | 同時数が多いほど増える |
| TPOT・ITL | 1 トークンあたりの生成間隔 | 同時数が多いほど短くなる |
| TTFT | 最初の 1 トークンまでの時間 | ほぼ変わらない(プレフィルは対象外) |
| GPU メモリ | 状態とバッファの使用量 | バッファぶん少し増える |
| 正答率 | 長い出力の課題での精度 | FP32 の状態なら変わらないはず。低精度にするなら必ず測る |
向いている場面・向かない場面
ここまでの内容を、使いどころとしてまとめます。
| 場面 | 効果 | 理由 |
|---|---|---|
| サーバーで多数のリクエストを同時に処理(バッチ 64 以上) | 大きい | SSM 層がメモリ帯域の天井に張り付いている |
| SSM 層が多いモデル(Nemotron 3 など) | 大きい | ステップ全体に占める SSM 層の割合が大きい |
| MTP などの投機的デコーディングを使う | 特に大きい | スナップショットが不要になり、検証が速く、メモリも空く |
| 状態を低精度にしたい | 有効 | 読む用だけ低精度にでき、誤差がたまりにくい |
| 1 人で使うローカル実行(バッチ 1) | ほぼなし | 帯域が余っており、待ち時間の原因が別にある |
| 入力が長く出力が短い処理(要約・分類) | 小さい | プレフィルが中心で、デコードの時間が短い |
| Transformer だけのモデル | なし | SSM 層がない |
トラブルシューティング
vLLM v0.31.0 は、ReplaySSM の条件に合わないと起動時にエラーで止まります。ソースにあるエラー文と対処をまとめました(筆者は GPU で実行していないため、実際に出たものではなく、ソースから拾った文面です)。
| エラー文(抜粋) | 原因 | 対処 |
|---|---|---|
--use-replayssm is not supported for architecture ... | モデルが対応していない(例:Qwen3.5 系) | SGLang など別のエンジンを使う |
Triton ReplaySSM requires Model Runner V1 | 既定の V2 で Triton 版を使おうとした | VLLM_USE_V2_MODEL_RUNNER=0 を付けるか、--mamba-backend flashinfer |
--use-replayssm requires --mamba-backend triton or flashinfer | 別のバックエンド(cpu など)を指定している | --mamba-backend triton に戻す |
--use-replayssm supports prefix caching only in align mode | Mamba のキャッシュモードが all | --mamba-cache-mode align か none |
FlashInfer ReplaySSM does not support --mamba-cache-mode align yet | FlashInfer 版と align モードの組み合わせ | --mamba-cache-mode none |
--use-replayssm is incompatible with KV connectors | プレフィルとデコードを分ける構成や KV のオフロードを使っている | その構成では使えない |
速くならないときは、次の順で確かめてください。
- 同時リクエスト数は十分か:同時 1〜8 では差が出ないのが正常です。64 以上で比べます。
- 出力は十分に長いか:
--ignore-eosを付け、出力 1024 トークン以上で測ります。 - フラグが入っているか:起動コマンドを見直します。vLLM は条件に合わない組み合わせだと起動時にエラーで止まるので、エラーが出ずに無視されることはありません。
- バッファ長は適切か:論文の GPU では 16 が最良でした。8〜32 の範囲で振ってみます。
まとめ
ReplaySSM は、SSM 層の「状態」を毎ステップ書き戻す代わりに、チェックポイントと直近の入力として持つ手法です。ポイントを振り返ります。
- ハイブリッド LLM の SSM 層は、同時処理が多いサーバーではメモリの読み書き待ちで遅くなる
- ReplaySSM は書き戻しを L 回に 1 回にし、主な通信量をほぼ半分にする(出力は変わらない)
- 公式の数字は、バッチ 256 の通常デコードで 1.20〜1.47 倍、バッチ 512 の投機的デコーディングで 1.85〜2.10 倍。バッチ 1 では速くならない
- 巻き戻しがポインタの移動だけになり、低精度の状態でも誤差が更新に戻らない
- 自分の Mac でも、バッチが大きいときだけ速くなる・バッファ長に最適値がある、という傾向を再現できた
- 使えるエンジンは SSM 層の種類で違う。Nemotron 3 は vLLM、Qwen3.5 系は SGLang か TensorRT-LLM
KV キャッシュの最適化が Transformer の推論を大きく速くしたように、これからはハイブリッド LLM の「状態の持ち方」が推論の速さを左右しそうです。Qwen や Nemotron を自分のサーバーで動かしているなら、同じモデル・同じ GPU で、フラグの有無と同時リクエスト数を変えて比べてみてください。
参考リソース
- ReplaySSM: Rethinking State Storage for Faster Hybrid-Model Decoding(NVIDIA Technical Blog、2026 年 10 月 12 日)
- ReplaySSM: Cache SSM Inputs, Not State(arXiv 2610.13778)
- ReplaySSM: Cache SSM Inputs, Not State(Dao AI Lab のブログ)
- GitHub:Johnny-Liou/ReplaySSM
- vLLM PR #48018(Mamba-2 の通常デコード)
- vLLM RFC #47572(ReplaySSM の取り込み計画)
- TensorRT-LLM PR #14203・#16464
- FlashInfer PR #3975・#4081
- SGLang v0.5.21