はじめに:コーディング AI の待ち時間は「同じ文章の書き直し」に使われている
Claude Code や Codex のようなコーディングエージェント(自分でファイルを読み、コードを直し、テストを動かす AI)を使っていると、修正パッチやテスト結果が 1 文字ずつ流れてくるのを眺める時間があります。よく見ると、その中身の多くはさっき読んだコードや、さっき出たログの書き写しです。
2026 年 10 月 1 日に arXiv で公開された論文「AgSpec」(韓国 KAIST のチーム)は、この「書き写し」に目をつけました。過去の文章から続きを先回りして写し、モデルにまとめて確かめさせることで、コーディングエージェントの生成速度を通常の最大 4.37 倍(同時に 1 件処理)、4.76 倍(同時に 16 件処理)にしたと報告しています。
この記事では、AgSpec の考え方を専門用語をかみくだきながら説明し、そのうえで仕組みの半分ほどを自分で実装して、Mac の上で本当に速くなるのかを確かめた結果を紹介します。
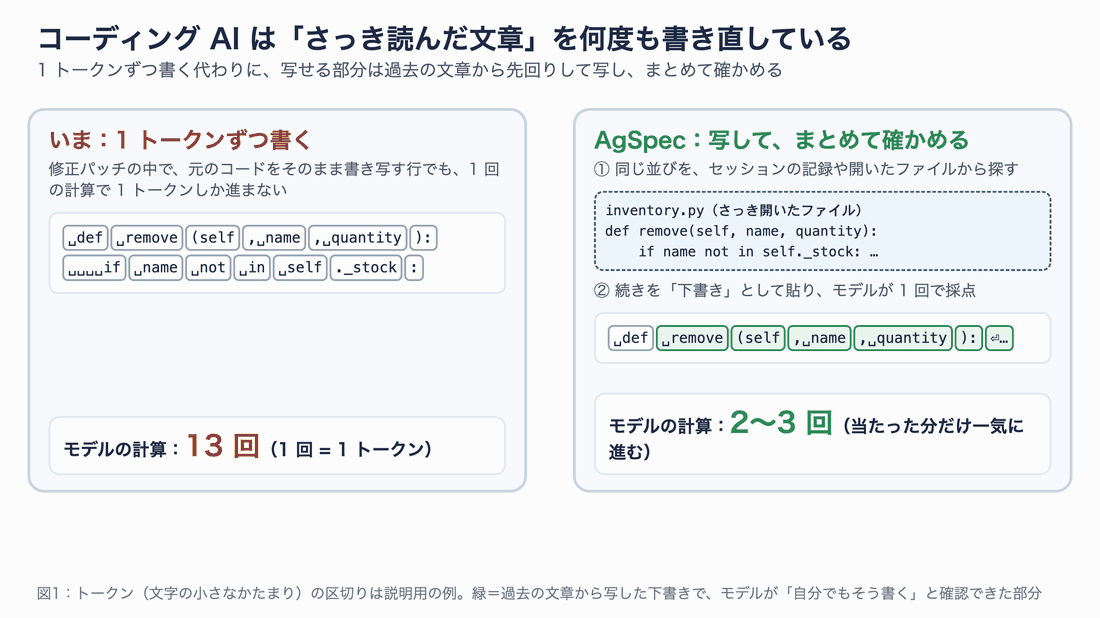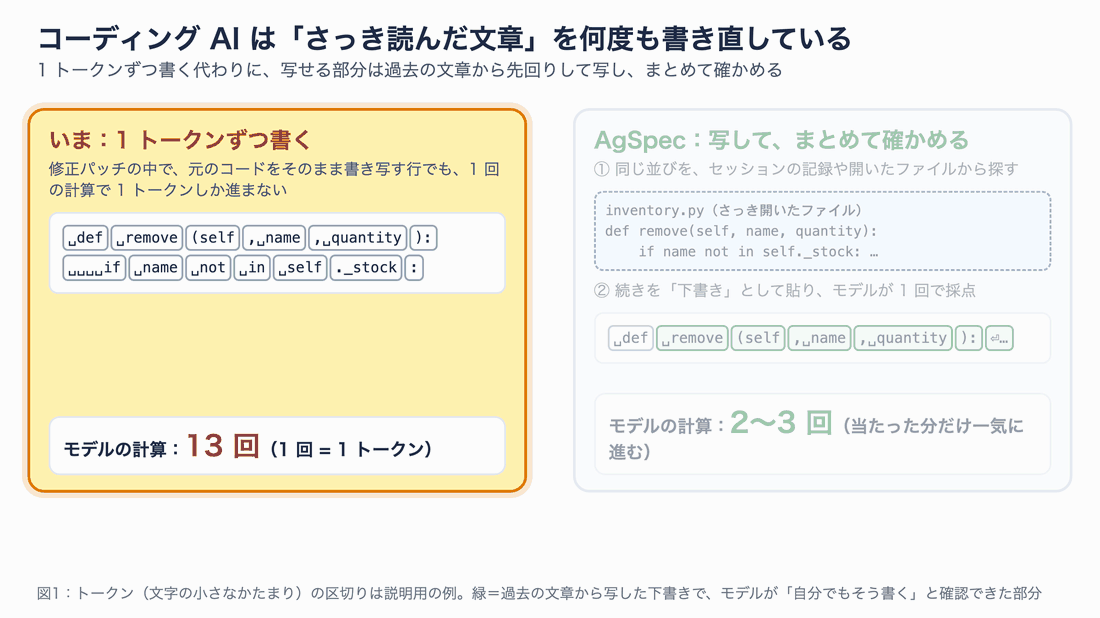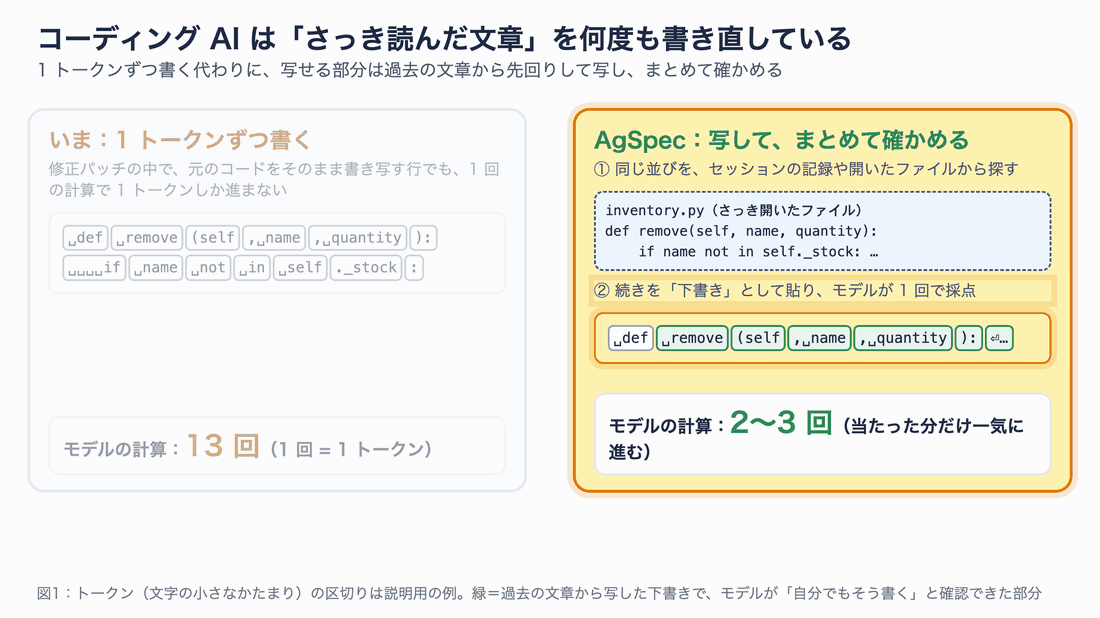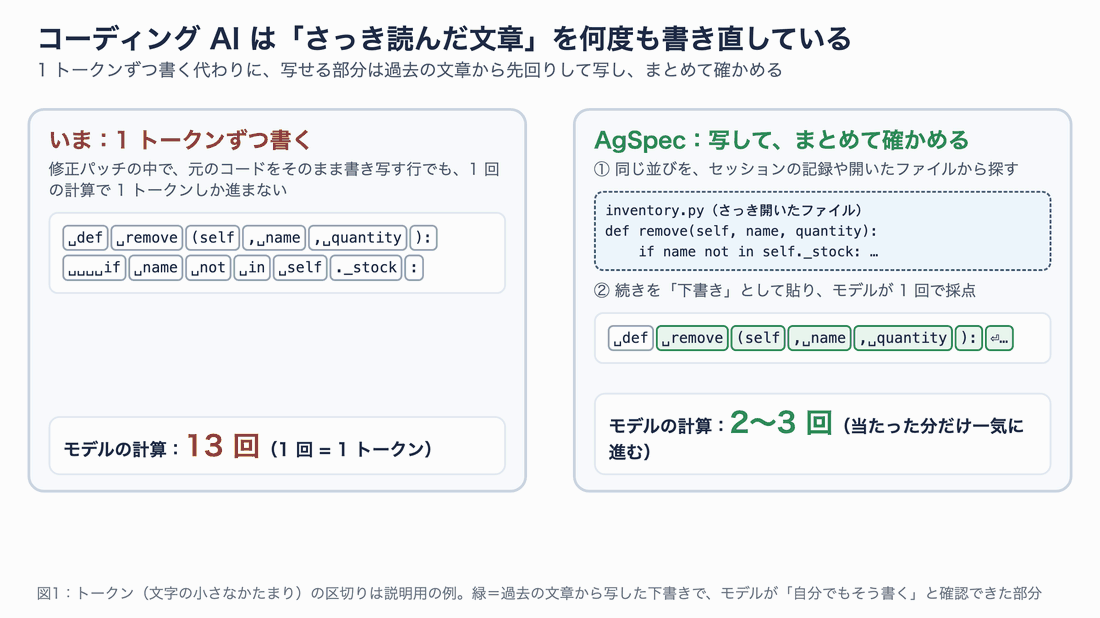
図1:左がふつうの生成、右が AgSpec の考え方。写せる部分は過去の文章から写し、モデルは「自分でもそう書く」かを確かめるだけにする
この記事で分かることは次の 4 つです。
- 大規模言語モデル(LLM)の生成が遅い理由と、それを速くする「投機的デコーディング」の基本
- コーディングエージェントならではの「写し書き」と、AgSpec がそれをどう利用するか
- 論文が報告した数値と、どの工夫がどれだけ効いたか
- 手元で半分だけ実装して測った結果と、実際に導入するときの注意点
想定している読者は、AI ツールを使ってはいるけれど推論の仕組みには詳しくない方から、推論サーバーを運用しているエンジニアまでです。前半は仕組みの説明、後半は検証と実務の話になっています。
この記事の確認範囲
- 論文:Sumin Lee ほか「AgSpec: Pushing the Limits of Retrieval-Based Speculative Decoding in Coding Agent Pipelines」arXiv:2610.01108v1(2026-10-01 投稿)。本文と付録を読んで確認しました。執筆時点で公式のコードは見つかりませんでした
- 検証:2026-10-04 に MacBook Pro(Apple M5 Max、メモリ 128GB)で実施。モデルは論文でも使われた Devstral-Small-2507 の MLX 4bit 版です
- 論文の数値は論文の記載、手元の数値は筆者の計測として、文中で区別して書きます
LLM はなぜ 1 トークンずつしか進めないのか
1 回の計算で 1 トークン
LLM は、文章を「トークン」という小さなかたまり(英単語なら 1 語前後、日本語なら 1〜数文字)に分けて扱います。そしてそれまでの文章をすべて見て、次の 1 トークンを決めることをくり返して文章を作ります。この進め方を自己回帰(じこかいき)生成と呼びます。
ここで困るのが、次のトークンを決めるには前のトークンが決まっていないといけないことです。つまり 500 トークンの修正パッチを書くには、モデル全体の計算を 500 回、順番に行う必要があります。
しかも 1 回の計算の大部分は、モデルの重み(数十 GB)をメモリから読み出す時間です。1 トークン分の計算でも 10 トークン分の計算でも、重みを読む手間はほとんど同じです(データセンター向け GPU で 1 件ずつ処理する場合。Mac での事情は後の検証で見ます)。「1 回の計算で 1 トークンしか進まない」のがもったいない、というのが出発点になります。
投機的デコーディング:下書きをまとめて採点する
そこで考えられたのが投機的デコーディング(Speculative Decoding)です。何か安い方法で「たぶん次はこう続く」という下書きを数トークン分作り、本物のモデル(論文では「ターゲットモデル」)に1 回の計算でまとめて採点してもらいます。
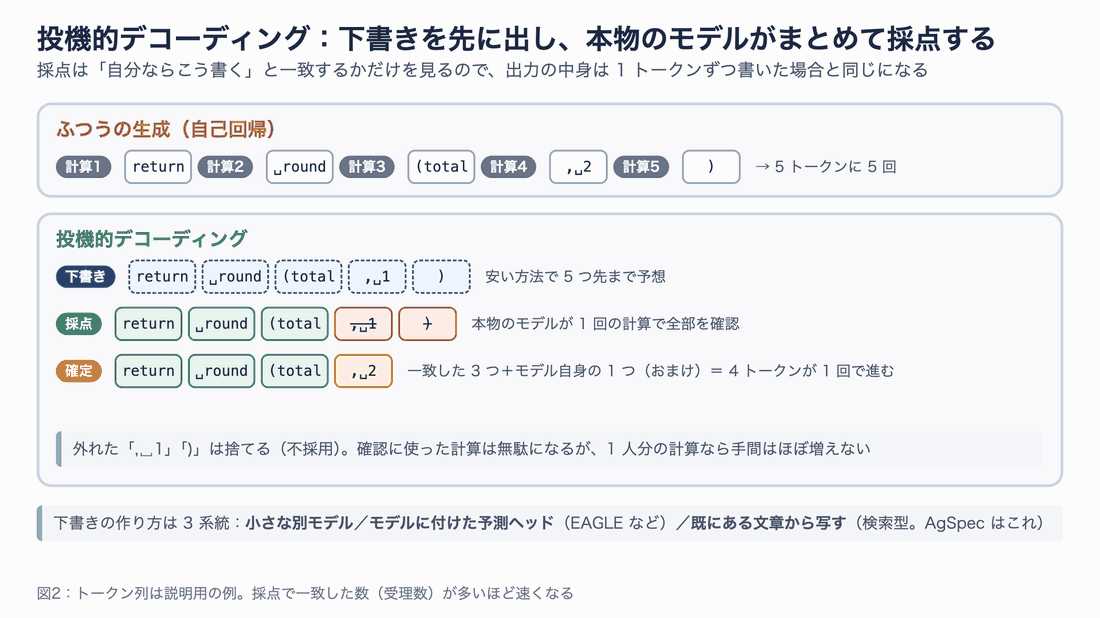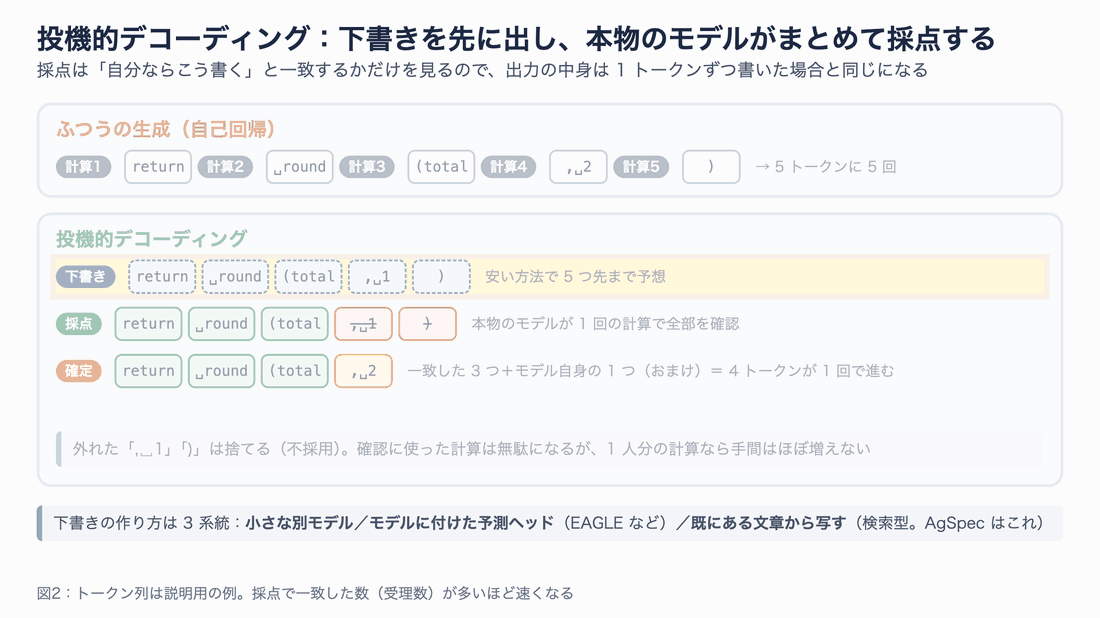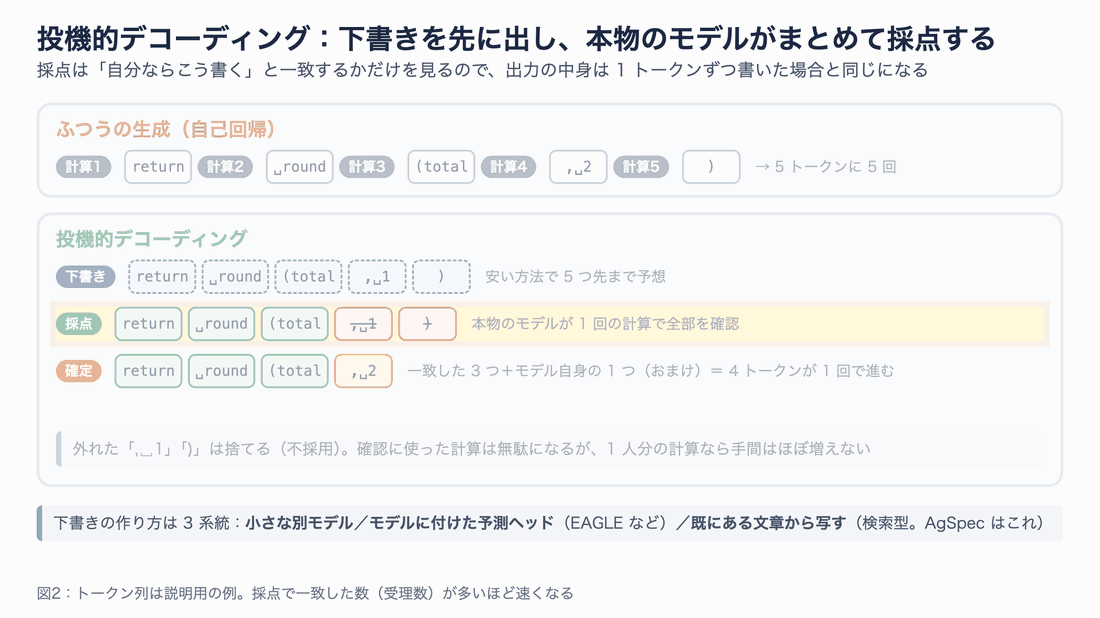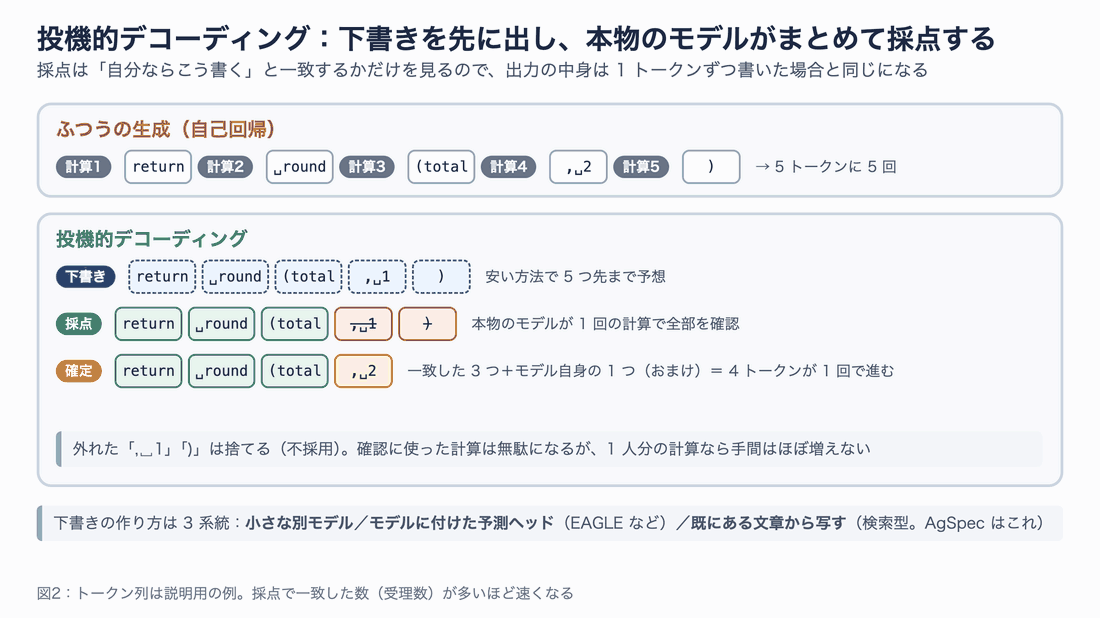
図2:下書きのうち、先頭から連続して一致した部分だけを採用する。外れた部分は捨てる
採点のしかたはシンプルです。モデルは下書きの各位置で「自分ならここに何を書くか」を一度に計算します。下書きと一致していれば採用、最初に食い違ったところで打ち切り、その位置にはモデル自身の答えを使います。そのため、下書きが全部外れても最低 1 トークンは進みます。
この方法の大事な性質は、出力の中身が変わらないことです。採用されるのはモデル自身が選ぶトークンと一致したものだけなので、1 トークンずつ書いた場合と同じ文章になります(最も確率の高いトークンを選ぶ「貪欲法」の場合。確率に従って選ぶ場合も、受理の規則を工夫して分布を保てます)。ただし後で書くとおり、コンピューターの数値計算の細かな事情で、実際には完全には一致しないことがあります。
下書きの作り方は 3 系統
下書きの作り方には大きく 3 つの系統があります。
| 系統 | 下書きの作り方 | 長所 | 短所 |
|---|---|---|---|
| 小さな別モデル | 同じ系列の小型モデルに先に書かせる | どんな文章にも使える | 小型モデルを動かすコストとメモリが要る |
| 予測ヘッド(EAGLE、MTP など) | 本体に付けた小さな部品で数トークン先を予測 | 当たりやすい | モデルごとに学習が必要 |
| 検索型(Retrieval-based) | すでにある文章から、同じ並びの続きを写す | 追加のモデルが要らず、ほぼタダ | 写せる文章がないと当たらない |
AgSpec は 3 番目の検索型です。検索型の代表例には、プロンプトの中から続きを探す Prompt Lookup Decoding(PLD)や、過去の回答を木構造にためて探す SuffixDecoding などがあります。
コーディングエージェントは「写し書き」だらけ
検索型は「写せる文章」がある場面で強く、コーディングエージェントはまさにその場面です。論文は、エージェントの作業をセッション(1 つの依頼を片付けるまでのやり取り全体)として見ています。1 つのセッションの中で、役割の違う複数のエージェントが順番に呼ばれます。
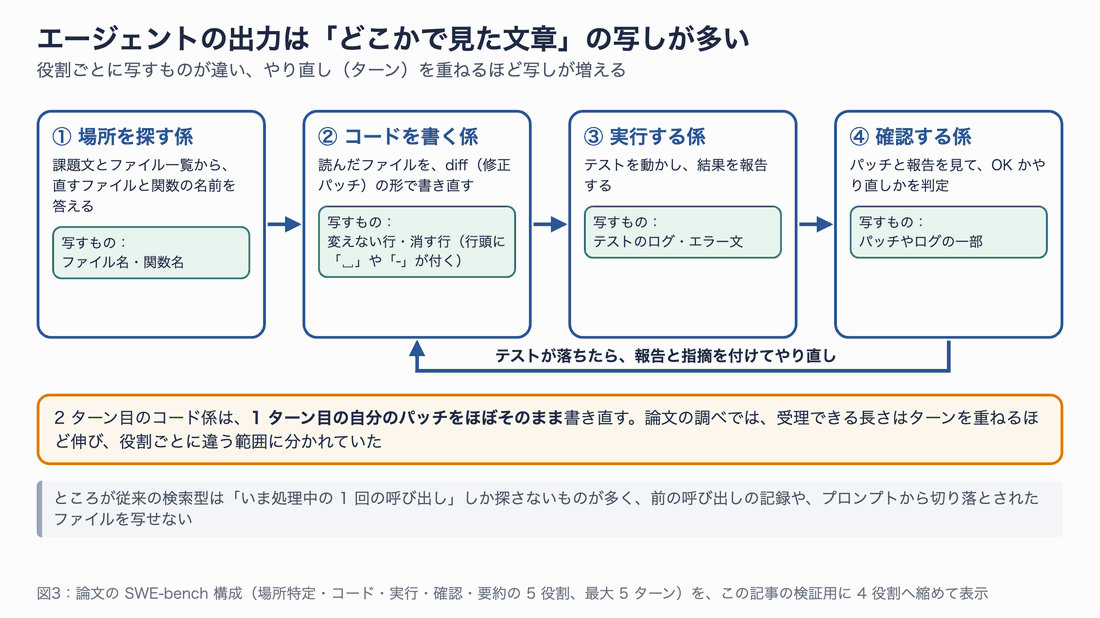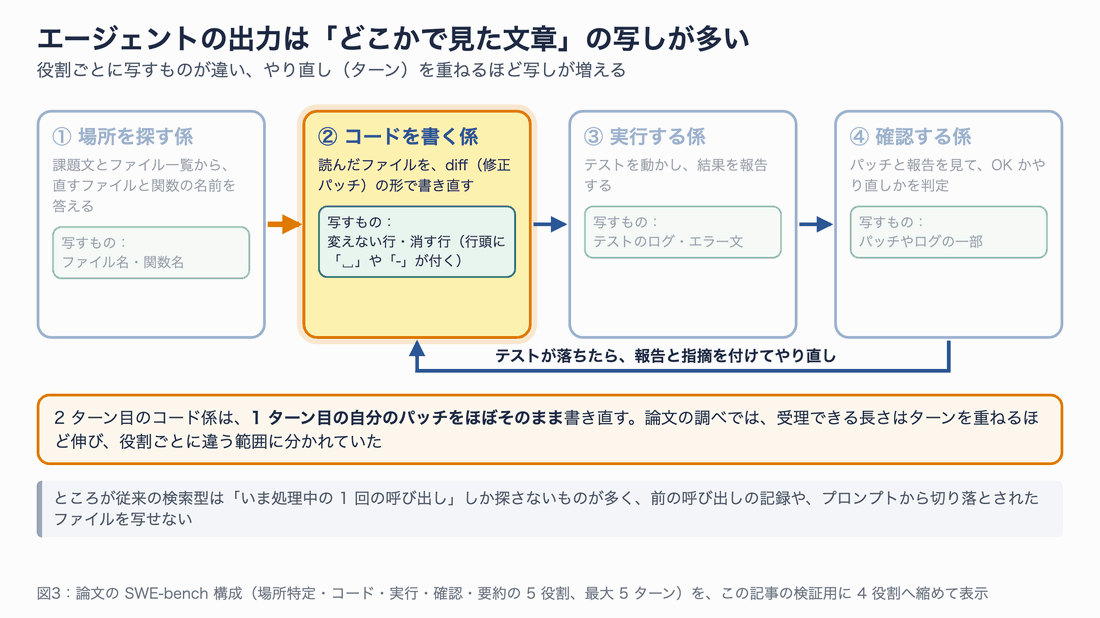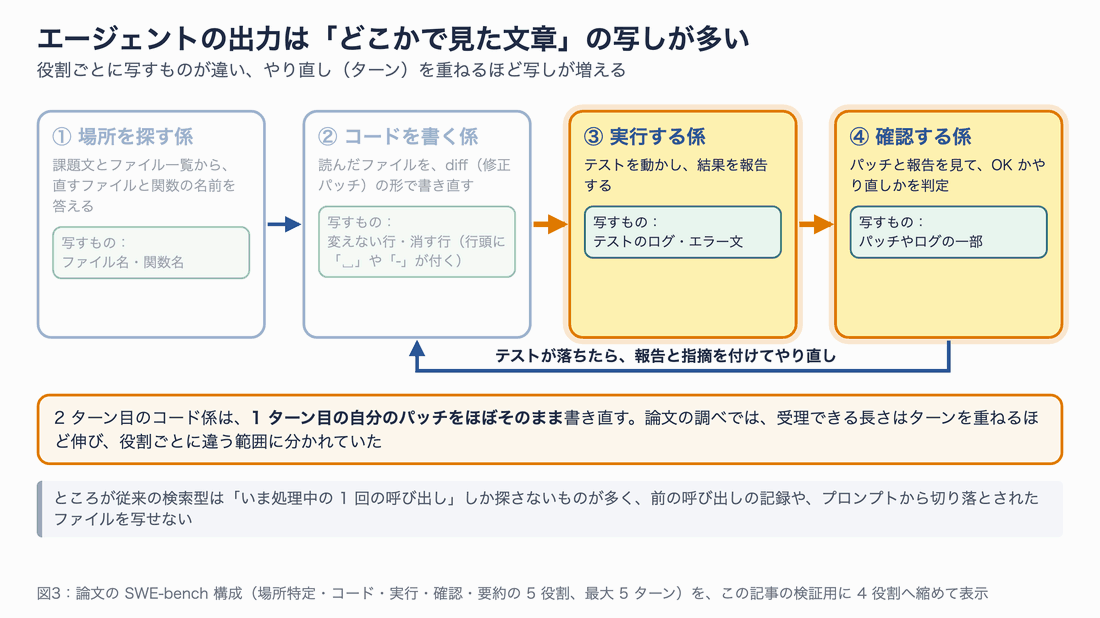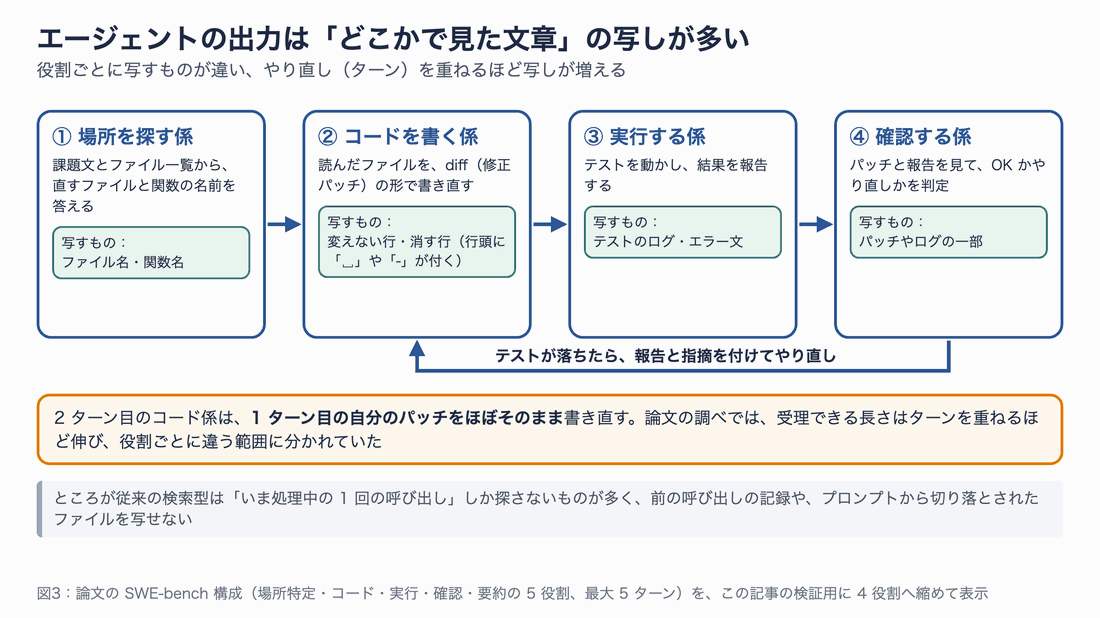
図3:役割ごとに写すものが違い、やり直しを重ねるほど写しが増える
たとえばコードを書く係は、読んだファイルを unified diff(行頭に「␣」「-」「+」を付けた修正パッチの書式)で書き直します。変えない行や消す行は、元のファイルの写しです。実行する係はテストのログを引用し、確認する係はパッチやログの一部を引用します。テストが落ちてやり直すと、2 回目のパッチは 1 回目とほとんど同じになります。
ところが、従来の検索型にはこの写しを取りこぼす理由が 2 つありました。
- 探す範囲が狭い:多くは「いま処理中の 1 回の呼び出し」の入力と出力しか探さない。前の呼び出しの出力(1 回目のパッチやログ)は、呼び出しが終わった時点で探せなくなる。ファイルが長くてプロンプトから切り落とされた場合も同じ
- 形が違う:ファイルは原文のまま登録されるが、エージェントは diff の形で書き出す。行頭に「␣」が 1 文字付くだけで、トークンの並びが変わって一致しなくなる
さらに、何トークン先まで下書きするかも問題です。論文の調べでは、受理できる長さは役割ごとに違う範囲に分かれ、ターンを重ねるほど変わっていきました。固定の長さでは、写す場面では短すぎ、自由に書く場面では長すぎることになります。
AgSpec の工夫①:どこから写すか
探す場所を「出どころ」で 3 つに分ける
AgSpec は、探す対象(コーパス=文章の集まり)を出どころ別に 3 つ持ちます。
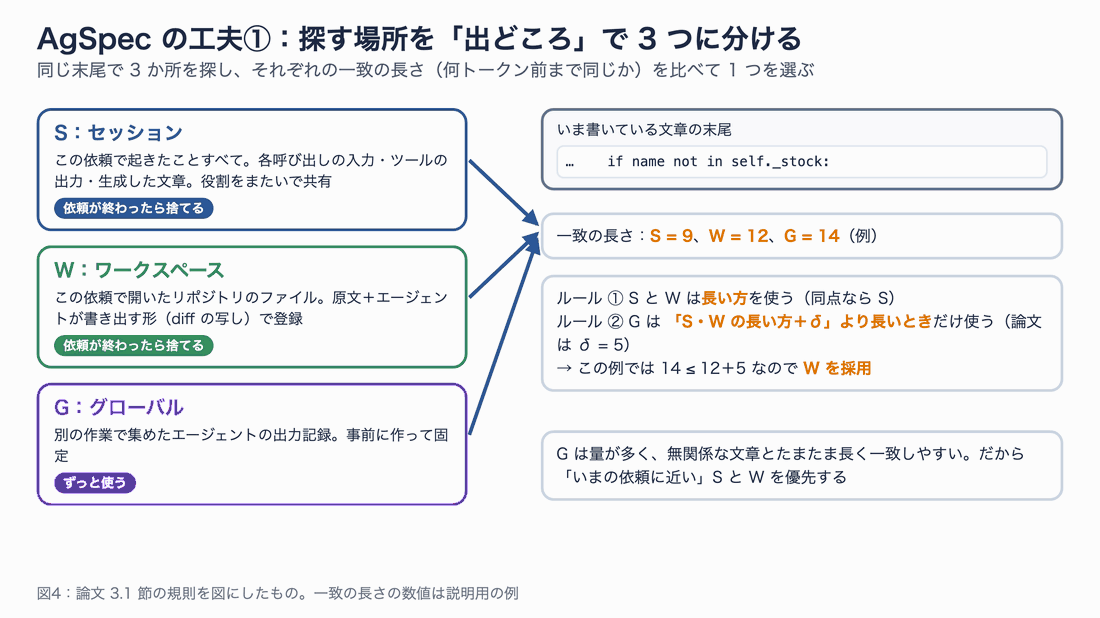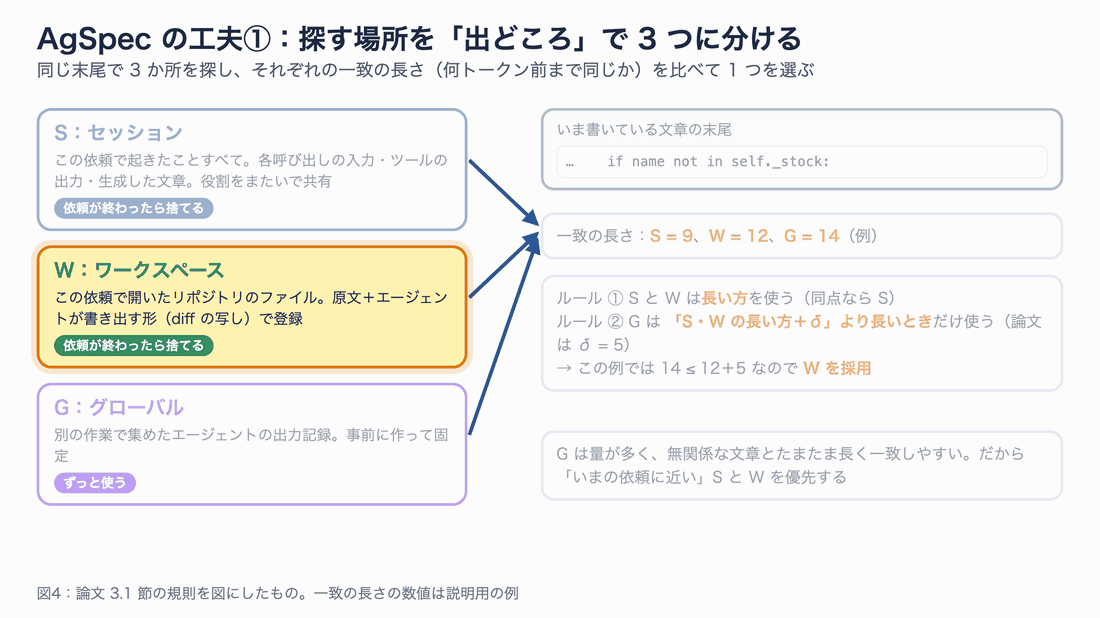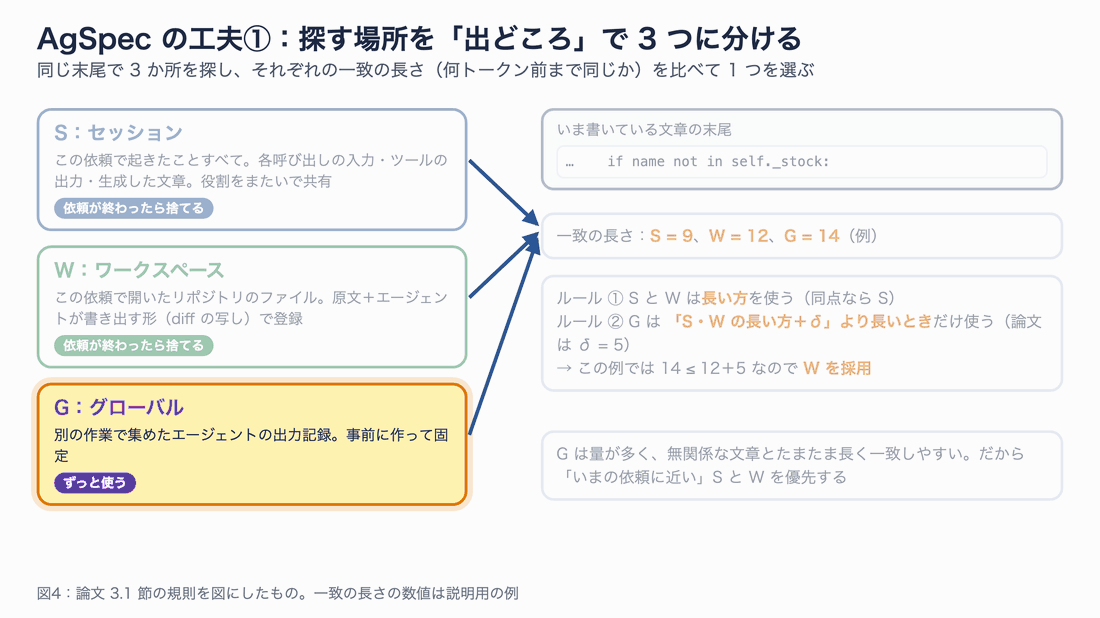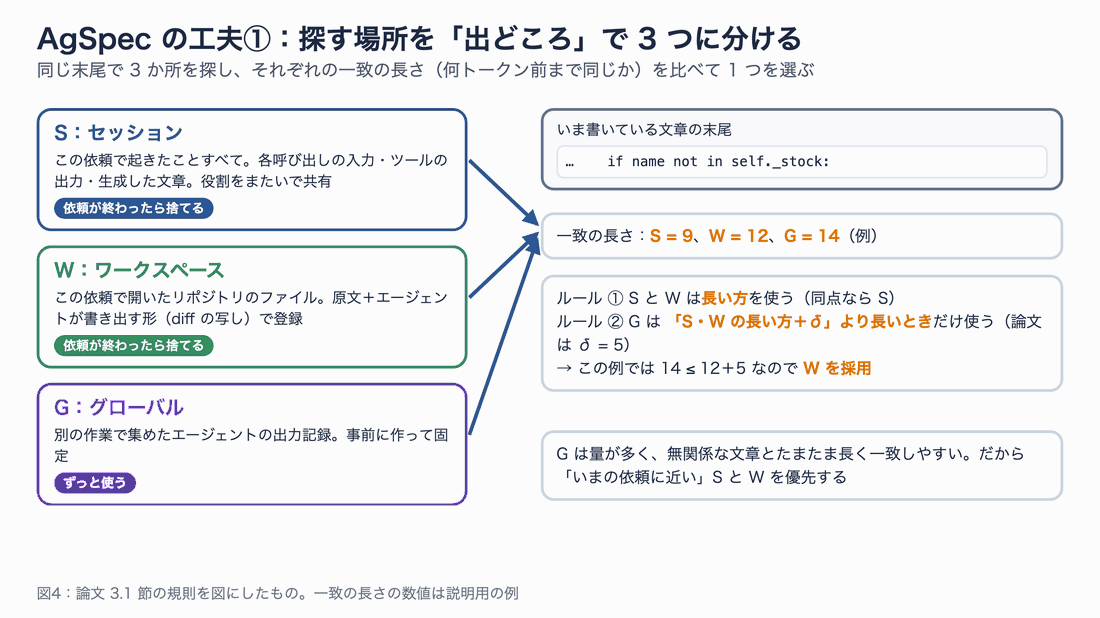
図4:3 つの探し場所と、どれを使うかの規則
| コーパス | 中身 | いつまで残すか |
|---|---|---|
| S:セッション | この依頼での全呼び出しの入力・ツール出力・生成文。役割をまたいで共有 | 依頼が終わったら捨てる |
| W:ワークスペース | この依頼で開いたリポジトリのファイル(原文+書き出す形) | 依頼が終わったら捨てる |
| G:グローバル | 別の作業で集めたエージェントの出力記録 | 事前に作って固定 |
下書きを作るときは、いま書いている文章の末尾と同じ並びを 3 か所で探し、何トークン前まで一致しているか(一致の長さ)を比べます。長く一致しているほど、その続きも当たりやすいと考えるからです。
選び方の規則は次のとおりです。S と W は長い方を使い、同じ長さなら S を使います。G は量が多くて無関係な文章とたまたま一致しやすいので、S と W の長い方より δ(デルタ、論文では 5 トークン)を超えて長いときだけ使います。
同じ一致がコーパス内に何か所もあるときは、S と G では「続く 3 トークン」が同じものをまとめて一番多いグループを選び(同数なら新しい方)、W では最初に出てくる箇所を選びます。
ファイルを「書き出す形」でも登録する
2 つ目の工夫は、ワークスペースのファイルをエージェントが書き出す形でも登録することです。
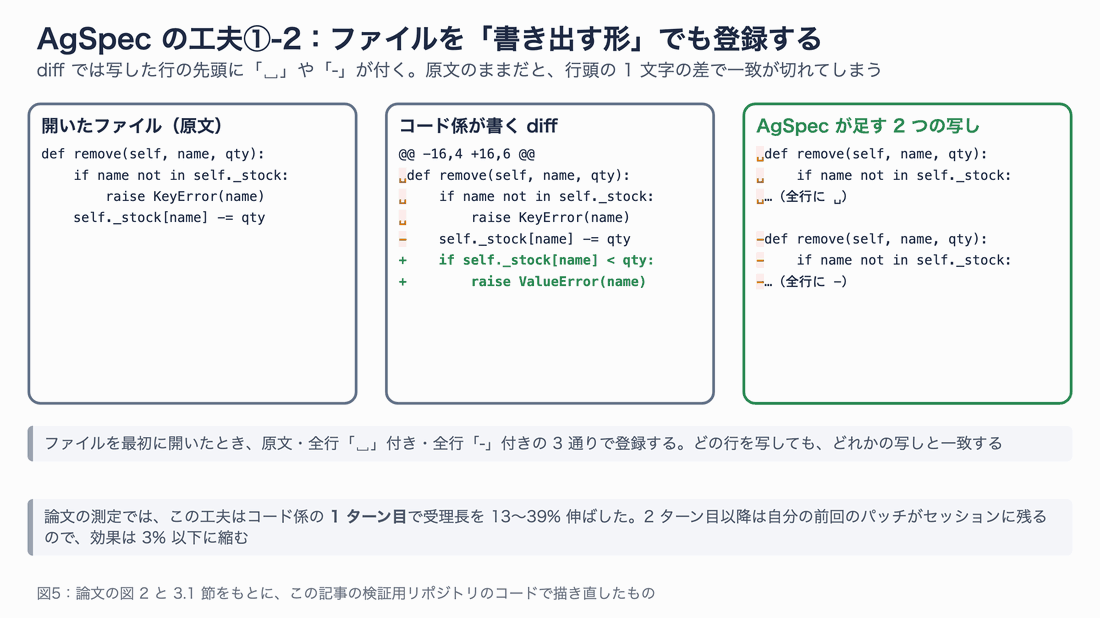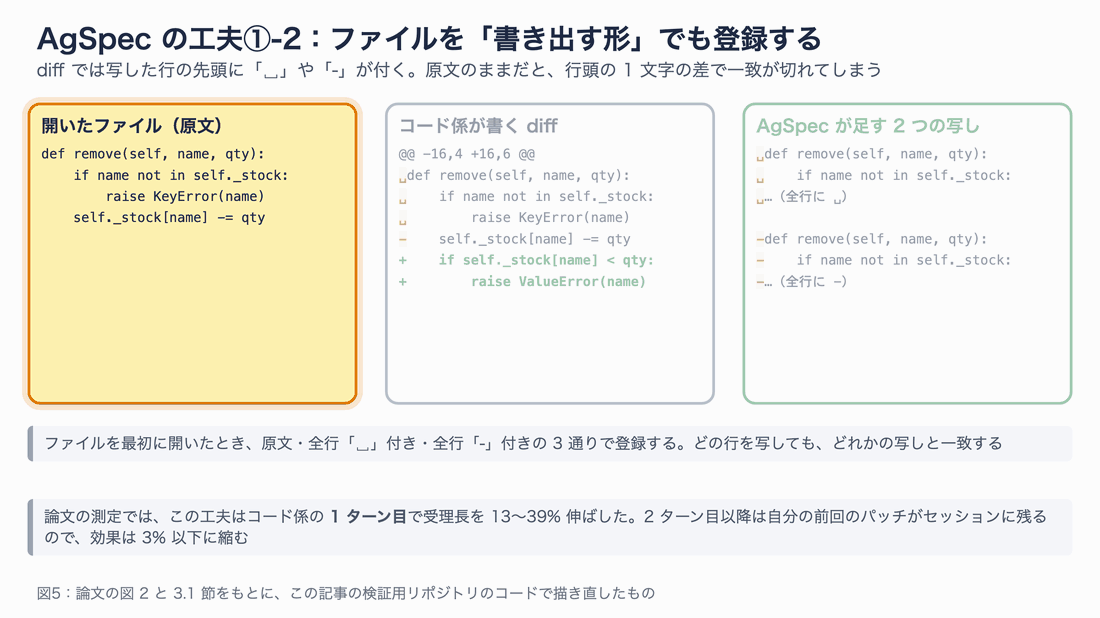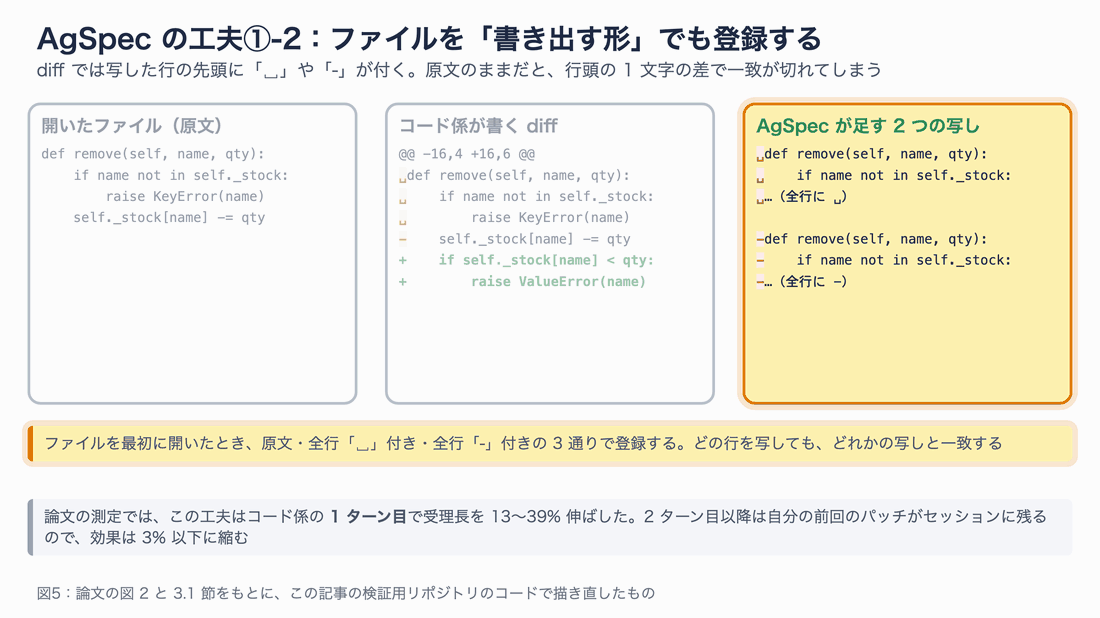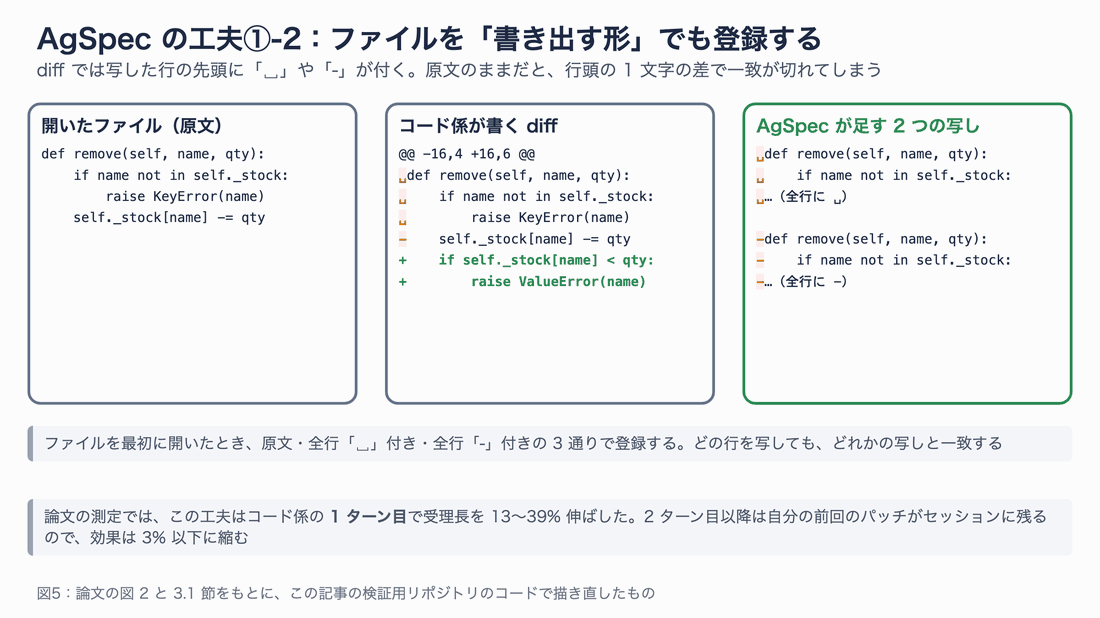
図5:原文のままでは行頭の 1 文字の差で一致が切れる。書き出す形の写しを足すと、どの行を写しても一致する
ファイルを最初に開いたとき、AgSpec は「原文」「全行の先頭に␣を付けた写し」「全行の先頭に-を付けた写し」の 3 通りを W に入れます。diff の変えない行は␣付き、消す行は-付きなので、どちらかの写しと必ず一致します。ファイル全体を書き直す形式のツールなら、改行や引用符をエスケープした写しを 1 つ足す、と論文は説明しています。
AgSpec の工夫②:何トークン先まで写すか
外れた下書きは「みんなの時間」を使う
下書きが当たれば得をしますが、外れた分の採点は無駄になります。1 件だけ処理しているときは、その無駄はほとんど目立ちません。ところが推論サーバーが同時に何件もまとめて処理(バッチ処理)していると、外れた下書きの採点もバッチ全体の計算に乗るので、全員が少しずつ遅くなります。
論文はこの損得を「損益分岐点 λ(ラムダ)」で表します。λ は「下書きを 1 トークン増やして採点する手間が、何トークン分の生成に相当するか」です。下書きの k 番目が当たる確率が λ より高ければ、その位置まで下書きする価値があります。
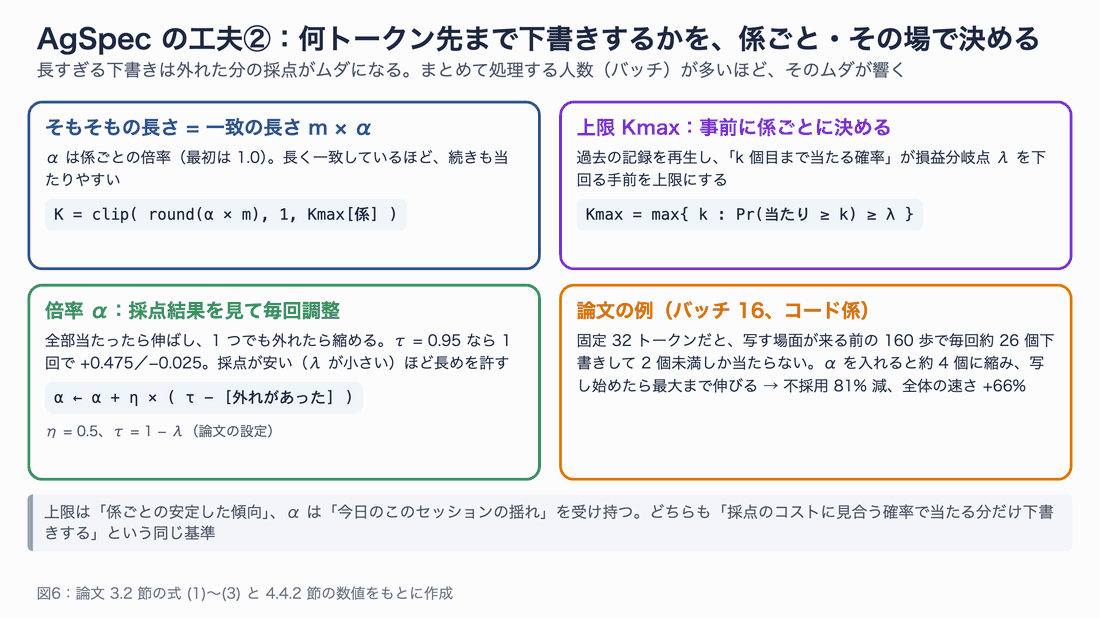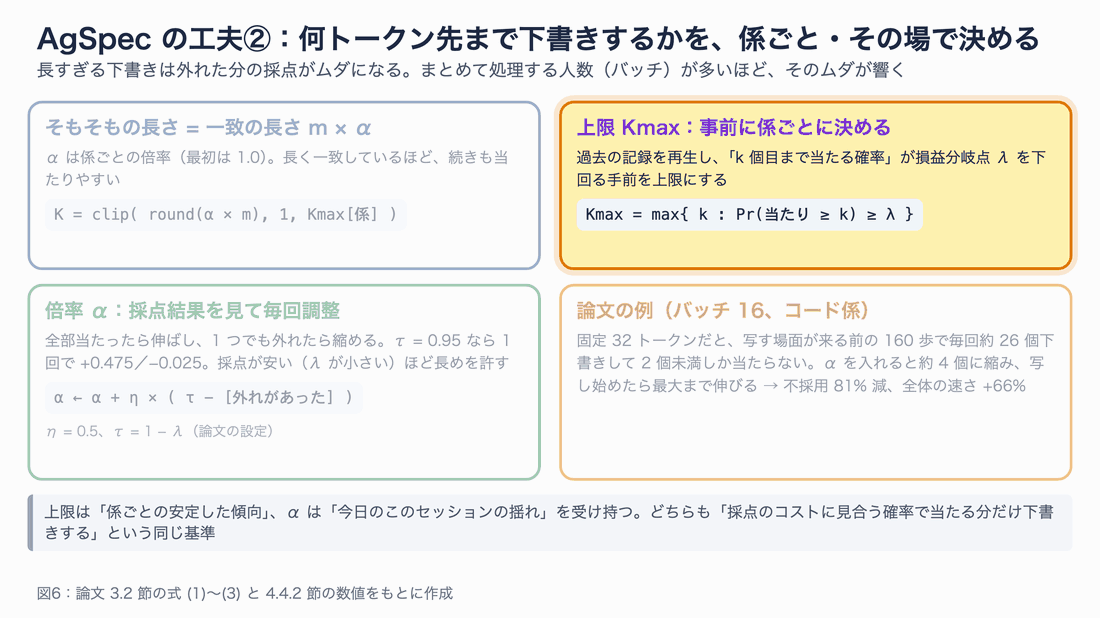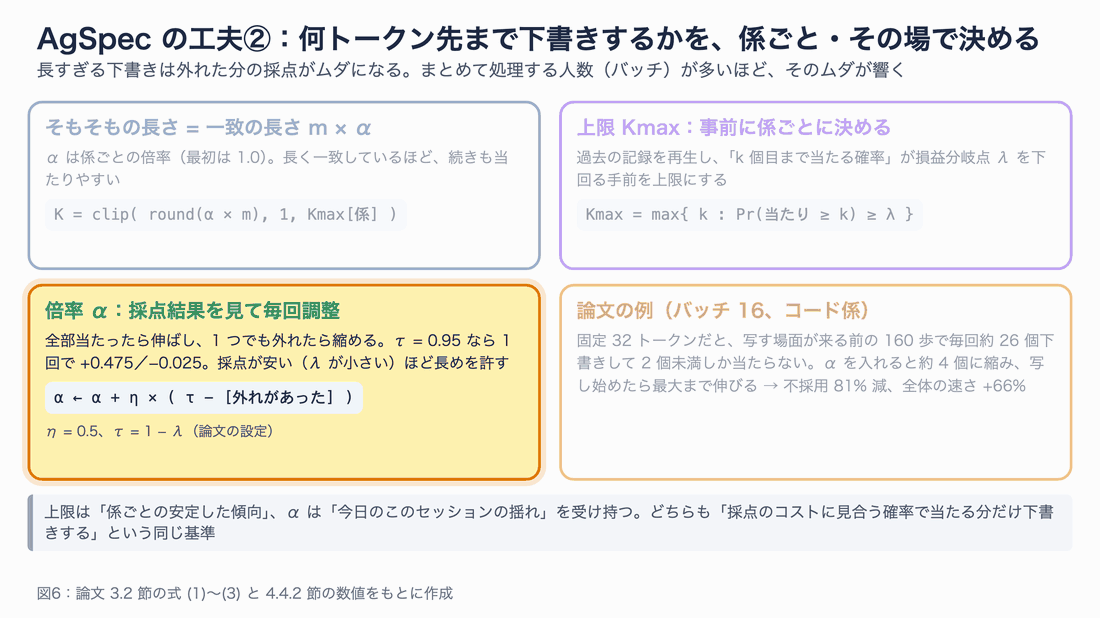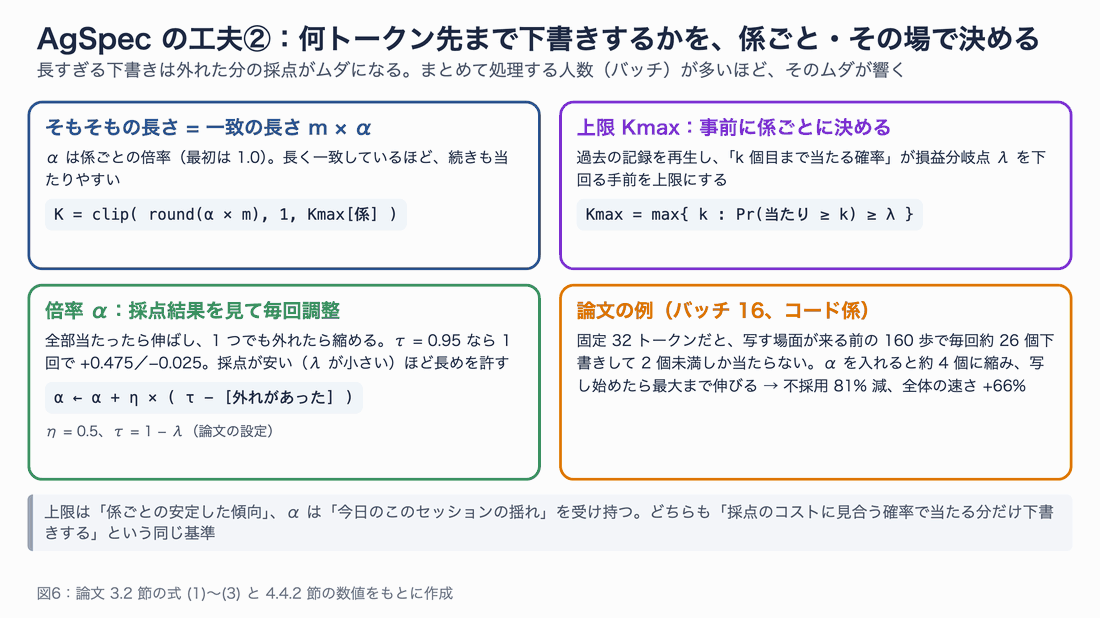
図6:下書きの長さは「一致の長さ × 倍率 α」を、係ごとの上限 Kmax で抑えて決める
上限は事前に、倍率はその場で
AgSpec の長さの決め方は、次の 1 行の式です。
K = clip( round(α × m), 1, Kmax[係] )
  m     : いま見つかった一致の長さ
  α     : 係ごとの倍率(最初は 1.0)
  Kmax  : 係ごとの上限(事前に決める)
上限 Kmax は、グローバルコーパスを作るのに使った過去の記録を再生して決めます。記録の各場面で「検索した続きが、実際の出力と何トークン先まで一致していたか(R)」を数え、係ごとに「k 個目まで当たる確率 Pr(R ≥ k)」を出します。この確率が λ を下回る手前が上限です。論文の例では、λ = 0.1 のとき 11 個目が当たる確率 0.12、12 個目が 0.09 なら上限は 11 になります。
倍率 α は、採点のたびに更新します。
α ← α + η × ( τ − [1 つでも外れたら 1、全部当たったら 0] )
  η = 0.5(更新の幅)、τ = 1 − λ
τ = 0.95 なら、全部当たると +0.475、1 つでも外れると −0.025 です。外れが続く場面(自由に文章を書いている場面)では少しずつ縮み、写しが始まって全部当たるようになると一気に伸びます。論文によると、この更新は「R/m の τ 分位点(上位 5% の位置)」を追いかける形になっていて、上限と同じ損益分岐点の考え方を、その場の状況に合わせて当てはめたものだと説明されています。
論文の結果:どの工夫がどれだけ効いたか
論文は、vLLM(推論サーバーのソフトウェア)の上に AgSpec を実装し、NVIDIA RTX PRO 6000 Blackwell(96GB)1 枚で測っています。モデルは Devstral-24B、Gemma3-27B、Qwen3.6-27B の 3 つ(いずれも 4bit 量子化)、ベンチマークは SWE-bench Verified(実在の GitHub の不具合を直す課題)と TeamBench(役割分担したチームでの課題)です。
AgSpec は、下書きを探す「エンジン」は既存のもの(SAM-Decoding の接尾辞オートマトン、SuffixDecoding の接尾辞木)をそのまま使い、何を探すか・何トークン写すかという方針だけを入れ替える作りです。それぞれ AgSpec-SAM、AgSpec-Suffix と呼ばれています。
全体の速さ
| 条件 | 通常の生成に対する速さ(AgSpec) | 補足 |
|---|---|---|
| SWE-bench・TeamBench、バッチ 1 | 2.27〜4.37 倍 | 最大は Devstral・TeamBench の 4.37 倍 |
| 同上、バッチ 16 | 1.08〜4.76 倍 | 最大は Qwen3.6・SWE-bench の 4.76 倍 |
| 既存の最速手法との比較 | 平均 18.0% 速い | 12 条件すべてで 1 位か 2 位 |
| LiveCodeBench(リポジトリなし) | 4.87〜7.94 倍 | ワークスペースなしでも効く |
| Terminal-Bench(エージェント 1 体) | 既存の最速より 9.3〜27.2% 速い | 役割の区別なしでも効く |
比較対象には、PLD、REST、FastCoder、SuffixDecoding、SAM-Decoding という 5 つの検索型と、予測ヘッド型の EAGLE-3 が入っています。エンジンごとに見ると、SuffixDecoding に AgSpec を載せると平均 16.5% 速く、SAM-Decoding に載せると平均 64.6% 速くなりました。SuffixDecoding はもともと過去の回答をためて長さも一致に合わせて変えるので、伸びしろが小さかったと論文は説明しています。
一方で、バッチ 16 の TeamBench では Qwen3.6 で 1.08 倍にとどまり、どの手法もほぼ速くなっていない条件もあります。「いつでも 4 倍」ではない点は押さえておきたいところです。
工夫ごとの効き目
論文は、記録した会話を再生するシミュレーションで、コーパスを 1 つずつ足したときの受理長(1 回の採点で進んだトークン数)も調べています。
| 工夫 | 論文が報告した効果 |
|---|---|
| 呼び出しごとのコーパス → セッション全体のコーパス | 受理長 1.6〜2.1 倍(一番大きい) |
| ワークスペースを足す | 単独で +26〜47%、セッションに重ねても +2.2〜7.0% |
| 書き出す形での登録 | コード係の 1 ターン目で +13〜39%、5 ターン目には 3% 以下 |
| 全部入り | グローバルだけの場合の 2.9〜4.8 倍の受理長 |
| 下書きの長さの制御(Devstral、SWE-bench) | 固定 8 に対しバッチ 1 で +25%、バッチ 16 で +16% |
| 固定 32 に倍率 α だけ足す(バッチ 16) | 速さ +66%、不採用の割合 78% → 50% |
特に面白いのが長さの制御の結果です。固定 32 トークンは、バッチ 1 では固定 8 より 14% 速いのに、バッチ 16 では 30% 遅くなりました。外れた下書きの採点が、バッチ全体の計算を食うためです。AgSpec は不採用を固定 8 並みに抑えつつ、固定 32 の 83〜89% のトークンを受理していました。
手元で「半分だけ」実装してみる
論文のコードは公開されていないので、AgSpec の考え方を自分で小さく組み直し、Mac の上で本当に速くなるかを確かめました。目標は「論文と同じ数字を出すこと」ではなく、どの工夫が、どんな場面で、どれくらい効くのかを自分の目で確かめることです。
何を実装し、何を省いたか
| 論文の要素 | この記事の実装 | 備考 |
|---|---|---|
| 検索エンジン(接尾辞オートマトン/接尾辞木) | 2 トークン組の索引から後ろへ一致を伸ばす簡易版 | 一致長の測り方は同じ。速さの工夫は省略 |
| S:セッションコーパス | 実装 | 前の呼び出しの入力・出力をすべて登録(論文は入力の末尾 2,048 トークン+出力) |
| W:ワークスペース(原文) | 実装 | 開いたファイルを登録 |
| W:書き出す形(␣付き・-付き) | 実装 | 論文どおり 2 通りの写しを追加 |
| G:グローバル | 実装(小規模) | 評価に使わない 1 タスクの出力記録だけ。論文は 70〜213 タスク分 |
| コーパスの選び方(δ = 5) | 実装 | 同じ一致長が複数あるときは「新しい方」を選ぶ簡易版(論文は続く 3 トークンの多数決) |
| 上限 Kmax の事前プロファイル | 実装 | 別タスクの記録を再生して係ごとに決める |
| 倍率 α のオンライン更新 | 実装 | η = 0.5、α は 0.05〜12 に制限 |
| バッチ処理での評価 | 省略 | 生成はバッチ 1 のみ。採点の重さだけバッチ 1・4・16 で測定 |
| vLLM への組み込み | 省略 | Apple の MLX(mlx-lm)で動かす |
「半分」と言っているのは、方針の部分(どこから探すか・何トークン写すか)は一通り実装した一方で、エンジンの高速化と、サーバーとしての同時処理を省いたからです。
検証の環境
| 項目 | 内容 |
|---|---|
| マシン | MacBook Pro(Apple M5 Max、メモリ 128GB)、macOS 26 |
| ソフト | Python 3.12、mlx 0.32.3、mlx-lm 0.32.0 |
| モデル | mlx-community/Devstral-Small-2507-4bit(論文と同じ Devstral-Small-2507 の 4bit 版、約 13GB) |
| 生成 | 貪欲法(毎回いちばん確率の高いトークンを選ぶ) |
| 注意 | 計測中、同じ Mac で別の作業(別モデルの評価、動画の書き出しなど)が GPU を使っていた |
モデルには、論文で使われていた Devstral を選びました。最初は手元にあった Qwen 系の新しい 27B モデルを使うつもりでしたが、設定を見ると「線形注意」という層が混ざった構成でした。この種の層は過去の情報を 1 つの状態にまとめて持つため、外れた下書きの分だけ巻き戻す、という投機的デコーディングに必須の操作が簡単にはできません。そこで、ふつうの注意(attention)だけでできたモデルに切り替えています。
題材:小さなリポジトリを 4 つ用意した
エージェントに解かせる題材として、バグのある小さな Python リポジトリを 4 つ作りました。どれも 40〜60 行ほどのモジュールとテストの組です。
| タスク | 中身 | 使いみち |
|---|---|---|
| t0_textstats | 単語数を数える関数が句読点を数えてしまう | 事前プロファイルとグローバルコーパス用(評価には使わない) |
| t1_inventory | 在庫がマイナスになる・合計金額の丸め | 評価 |
| t2_config | 設定ファイルの行内コメント・空白・真偽値の表記ゆれ | 評価 |
| t3_cart | 割引が商品ごとに何度もかかる・送料無料の判定ミス | 評価 |
エージェントは、論文の SWE-bench 構成を 4 役割に縮めたものです。場所特定係がファイルを答え、コード係が unified diff を書き、実際に patch で当ててから pytest を動かし、実行係がテスト結果を報告し、確認係が判定します。テストが通らなければ、報告と指摘を付けてコード係からやり直します(最大 3 ターン)。
計測の流れ
計測は 2 段階に分けました。
- 記録:エージェントを通常の生成で 1 回走らせ、各呼び出しの入力・出力・開いたファイルを JSON に保存する(
agent.py) - 再生:記録を先頭から順に再生し、呼び出しごとに 8 つの方式で同じ入力から生成し直して、速さを測る(
bench.py)
再生方式にしたのは、すべての方式を「同じ会話の同じ時点」で比べるためです。セッションのコーパスには記録どおりの入出力を積み上げるので、方式によって会話の流れが変わることはありません。また、同じ呼び出しの中で 8 方式を続けて実行するので、Mac で別の作業が動いて速さが揺れても、その影響が特定の方式に偏りにくくなります。時間は入力の読み込み(プレフィル)を除いた、生成部分だけを測っています。論文と同じ考え方です。
比べた方式は次の 8 つです。①〜⑤は探す場所を 1 つずつ増やし、⑥⑦は下書きの長さの決め方を比べます。
| 方式 | 探す場所 | 下書きの長さ |
|---|---|---|
| 通常の生成 | なし | 下書きなし |
| ① 呼び出し内だけ(PLD 相当) | 今回の呼び出しの入力と出力 | 固定 10 |
| ② +セッション | ①+前の呼び出しすべて | 固定 10 |
| ③ +開いたファイル(原文) | ②+W(原文) | 固定 10 |
| ④ +書き出す形 | ③+W(␣付き・-付き) | 固定 10 |
| ⑤ +グローバル | ④+G(別タスクの出力) | 固定 10 |
| ⑥ 長さ固定 32 | ⑤と同じ | 固定 32 |
| ⑦ AgSpec 式 | ⑤と同じ | K = clip(round(α·m), 1, Kmax[係]) |
実装の要点①:一致の長さを測って続きを取り出す
検索の中心は、コーパスの中で「いま書いている文章の末尾」と最も長く一致する場所を探す処理です。直前 2 トークンの組で候補の位置を引き、そこから後ろ向きに何トークン一致するかを数えます。
class Corpus:
    """トークン列+2-gram 索引。prefer='recent' なら同じ一致長で新しい方を選ぶ。"""

    def search(self, ctx, min_match=2):
        cands = self.index.get((ctx[-2], ctx[-1]))  # 直前 2 トークンが同じ位置
        if not cands:
            return 0, -1
        t, best_m, best_p = self.tokens, 0, -1
        for p in reversed(cands[-256:]):             # 新しい方から最大 256 か所
            if p >= len(t):                           # 続きが無い位置は使えない
                continue
            m = 2
            while m < 64 and m < len(ctx) and p - m - 1 >= 0 \
                    and t[p - m - 1] == ctx[-m - 1]:
                m += 1                                # 後ろ向きに一致を伸ばす
            if m > best_m:
                best_m, best_p = m, p
        return best_m, best_p                         # 一致長と、続きの開始位置
3 つのコーパスの使い分けは、論文の規則をそのまま書いています。
best = max(live, key=lambda x: x[0])        # S と W のうち一致が長い方(同点は S)
if use_global:
    mg, pg = glob.search(ctx)
    if mg > best[0] + delta:                 # G は δ を超えて長いときだけ
        best = (mg, pg, glob, "global")
書き出す形の写しは、ファイルの全行に「␣」または「-」を付けるだけです。
def emission_forms(text):
    lines = text.splitlines()
    return ["\n".join(" " + l for l in lines) + "\n",   # 変えない行の形
            "\n".join("-" + l for l in lines) + "\n"]   # 消す行の形
実装の要点②:下書きをまとめて採点する
採点では、直前のトークンと下書きをつなげてモデルに 1 回だけ通し、各位置の「モデルならこう書く」を取り出します。先頭から一致した数だけ採用し、外れた分の KV キャッシュ(過去のトークンの計算結果の置き場)を捨てます。
inp = mx.array([y] + draft, mx.uint32)              # 直前のトークン+下書き
logits = model(inp[None], cache=cache)              # 1 回の計算でまとめて採点
pred = mx.argmax(logits[0], axis=-1).tolist()       # 各位置でモデルが選ぶトークン
n = 0
while n < len(draft) and draft[n] == pred[n]:       # 先頭から一致した数
    n += 1
new = draft[:n] + [pred[n]]                         # 採用分+モデル自身の 1 つ
trim_prompt_cache(cache, len(draft) - n)            # 外れた分の KV を巻き戻す
trim_prompt_cache は mlx-lm に入っている関数で、KV キャッシュの末尾を指定した数だけ削ります。先ほどの「線形注意の層があると巻き戻せない」というのは、この操作ができないという意味です。
実装の要点③:長さの制御
下書きの長さは、論文の式 (1)〜(3) をそのまま書きました。
@dataclass
class LengthController:
    tau: float                      # τ = 1 − λ
    eta: float = 0.5
    kmax: dict = field(default_factory=dict)   # 係ごとの上限(事前プロファイル)
    alpha: dict = field(default_factory=dict)  # 係ごとの倍率(最初は 1.0)

    def k(self, role, m):
        a = self.alpha.get(role, 1.0)
        return max(1, min(round(a * m), self.kmax.get(role, 32)))

    def update(self, role, accepted, drafted):
        cap = self.kmax.get(role, 32)
        if accepted == drafted == cap:     # 上限で打ち切られた観測は使わない
            return
        a = self.alpha.get(role, 1.0)
        a += self.eta * (self.tau - (1.0 if accepted < drafted else 0.0))
        self.alpha[role] = min(12.0, max(0.05, a))
上限 Kmax は、評価に使わない t0_textstats の記録から事前に決めます(profile.py)。モデルを動かさず、記録された出力に対して「検索した続きが何トークン先まで当たっていたか」を数え、係ごとに Pr(R ≥ k) が λ を下回る手前を上限にします。λ は本来、採点するトークンを 1 つ増やしたときの時間の増え方から計算します(論文の付録)。ただし今回は後で書く事情で手元の λ を安定して測れなかったため、主な比較では論文の SWE-bench 設定と同じ τ = 0.95(λ = 0.05)を使い、別に手元の推定値 λ = 0.2 でも比べました。
再現する手順
検証に使ったコードは、上で紹介した部分を含めて 6 本のスクリプト(specdec.py・agent.py・bench.py・profile.py・cost.py・numerics.py)とグラフ用の plots.py、題材の 4 リポジトリです。同じ構成で試す場合の流れは次のとおりです。
# 作業フォルダと Python 環境(uv を使う例)
mkdir agspec-lab && cd agspec-lab
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python mlx-lm matplotlib pytest

# モデル(約 13GB)。途中で止まるときは curl -C - で再開できる取り方に切り替える
.venv/bin/hf download mlx-community/Devstral-Small-2507-4bit

# 記録 → 採点の重さ → 事前プロファイル → 8 方式の比較 → λ=0.2 版 → 数値の切り分け → グラフ
MODEL=mlx-community/Devstral-Small-2507-4bit ./run_all.sh
M5 Max では、記録に約 25 分、8 方式の比較に約 40 分かかりました(別の作業と GPU を共有した状態)。Devstral を transformers のトークナイザーで読むと分割規則の警告が出るので、読み込み時に fix_mistral_regex=True を付けています(specdec.py の load_model)。
検証結果:何が効き、何が効かなかったか
エージェントの記録
まず、エージェントを通常の生成で走らせた記録です。評価に使ったのは t1〜t3 の 3 タスク、合わせて 21 回の呼び出しで、モデルが書いた出力は 2,490 トークンでした。
| タスク | 結果 | ターン数 | 呼び出し | 出力トークン |
|---|---|---|---|---|
| t0_textstats(プロファイル用) | 3 ターン目で全テスト合格 | 3 | 10 | 1,440 |
| t1_inventory | 2 ターン目で全テスト合格 | 2 | 7 | 834 |
| t2_config | 3 ターンでは直しきれず(5 件中 4 件合格) | 3 | 10 | 1,357 |
| t3_cart | 1 ターン目で全テスト合格 | 1 | 4 | 299 |
最初の記録では、モデルの書いた diff が patch でも git apply でも当たらず、3 ターンとも同じ失敗をくり返していました。中身の修正は正しいのに、関数の間の空行が 1 行足りない、新しく足した行に「+」を付け忘れて文脈行として書く、といった細かな誤りがあったためです。そこで、行番号や空行のずれ、ファイルにない文脈行を許して当てる方法を併用し、記録を取り直しました。実際のエージェント基盤でも、モデルの diff をそのまま厳密に当てることは少なく、似た工夫が入っています。
結果①:探す場所を増やすほど、1 回で進むトークンが増えた
8 つの方式で、21 回の呼び出しを生成し直した結果です。ここで示す「1 回の採点で進んだトークン数」(論文の受理長=AL)と「外れた下書きの数」は、モデルを何回呼んだかを数えたもので、マシンの混み具合に左右されません。
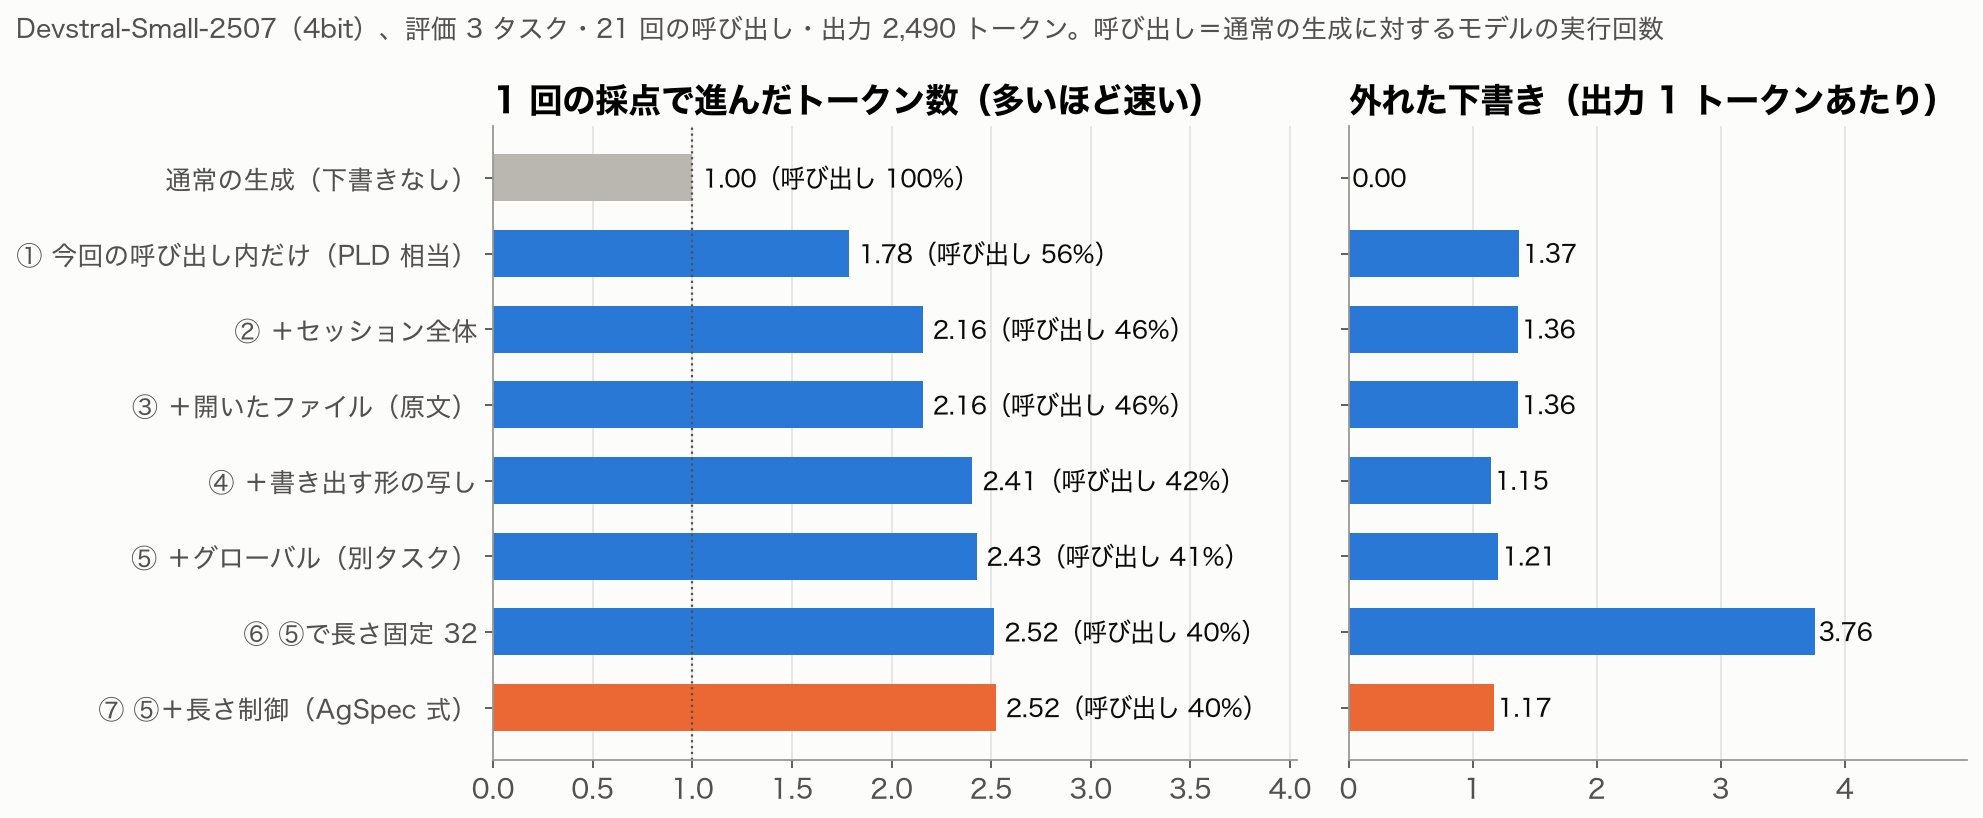
図7:方式ごとの「1 回の採点で進んだトークン数」(左)と「外れた下書きの数」(右)。括弧内は、通常の生成に対してモデルを呼んだ回数の割合
| 方式 | 1 回で進んだトークン数 | モデルを呼んだ回数 | 外れた下書き(出力 1 トークンあたり) |
|---|---|---|---|
| 通常の生成 | 1.00 | 100% | 0 |
| ① 呼び出し内だけ(PLD 相当) | 1.78 | 56% | 1.37 |
| ② +セッション | 2.16 | 46% | 1.36 |
| ③ +開いたファイル(原文) | 2.16 | 46% | 1.36 |
| ④ +書き出す形の写し | 2.41 | 42% | 1.15 |
| ⑤ +グローバル | 2.43 | 41% | 1.21 |
| ⑥ 長さ固定 32 | 2.52 | 40% | 3.76 |
| ⑦ AgSpec 式 | 2.52 | 40% | 1.17 |
読み取れることは 4 つあります。
- セッションの記録が一番効く:①→②で 1.78 → 2.16。論文でもセッション全体のコーパスが最大の効果でした
- 原文のファイルは効かず、書き出す形の写しは効く:③は②と同じ値で、原文のワークスペースからの下書きは 1 回も選ばれませんでした。今回はコード係のプロンプトにファイル全文が入っているので、原文の一致は②の時点ですでに見つかるからです。一方、␣付き・-付きの写しを足した④では 2.41 に伸び、ワークスペース由来の下書き 76 回で 479 トークンが受理されました(1 回あたり 6.3 トークン)
- グローバルはほとんど使われない:⑤で G が選ばれたのは 13 回だけでした。別タスク 1 つ分の小さな記録で、しかも δ = 5 の差を付けているので、出番が少ないのは想定どおりです
- 長さ制御は「同じ成果を少ない外れで」:⑥長さ固定 32 と⑦AgSpec 式は、どちらも 2.52 トークン進みました。ところが下書きの数は 1 回あたり 10.97 個と 4.48 個、外れの割合は 86% と 66% です。⑦は⑥の 4 割ほどの下書きで、同じだけ当てています
結果②:コード係と実行係の 2 ターン目以降で大きく伸びる
係とターンに分けると、論文の図 1(b) と同じく、係ごとに受理長の範囲がはっきり分かれました。
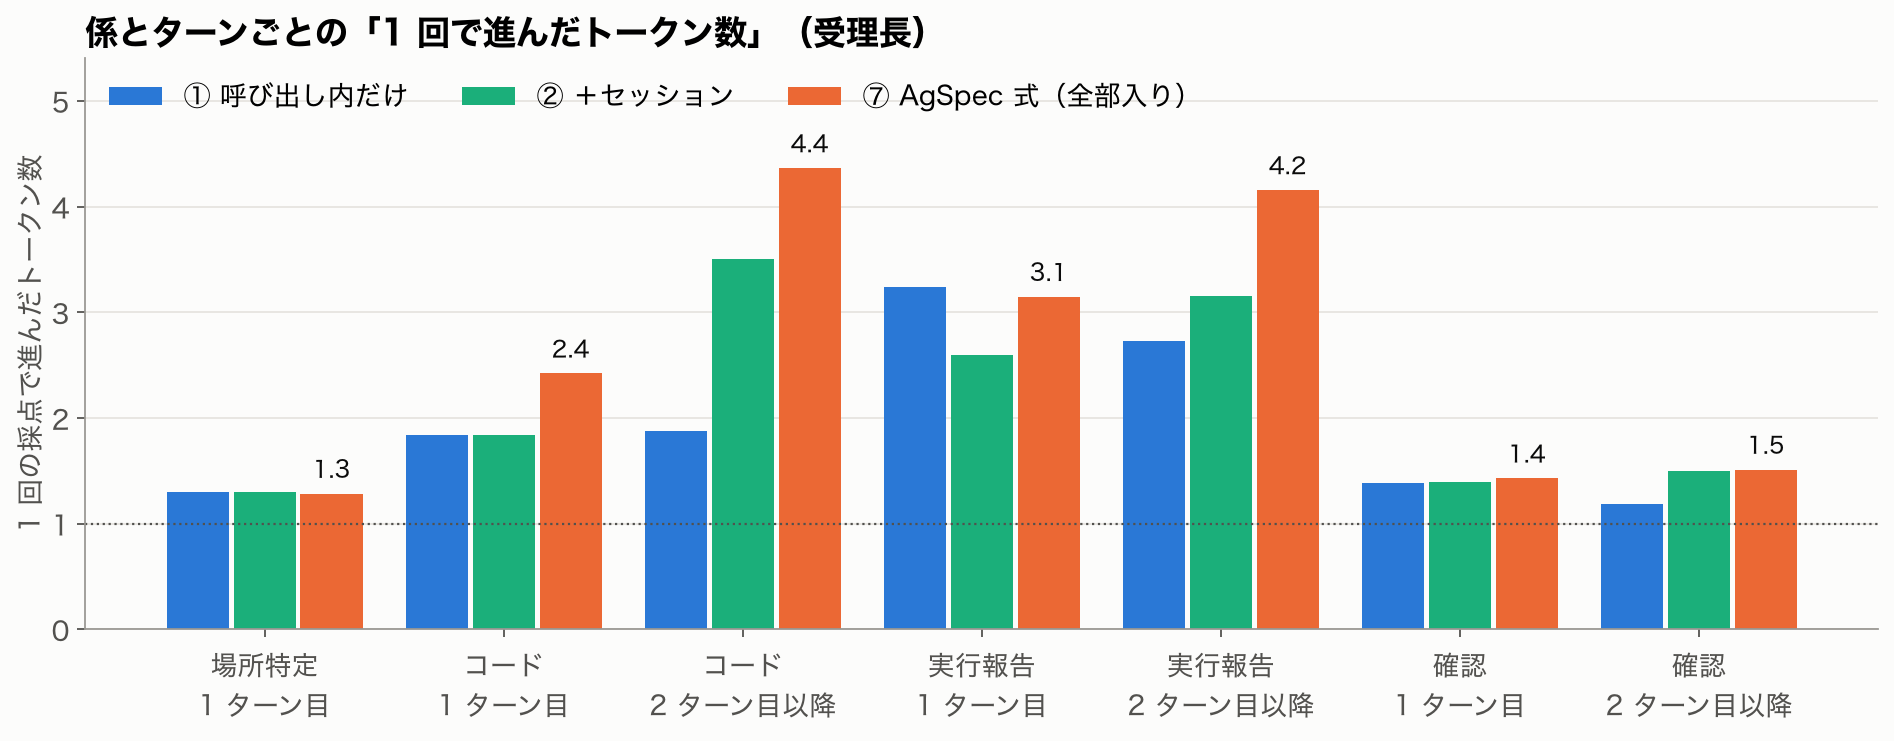
図8:係とターンごとの受理長。①呼び出し内だけ(青)、②+セッション(緑)、⑦AgSpec 式(橙)
| 係・ターン | ① 呼び出し内だけ | ② +セッション | ⑦ AgSpec 式 |
|---|---|---|---|
| コード 1 ターン目 | 1.84 | 1.84 | 2.42 |
| コード 2 ターン目以降 | 1.88 | 3.51 | 4.37 |
| 実行報告 1 ターン目 | 3.24 | 2.60 | 3.15 |
| 実行報告 2 ターン目以降 | 2.73 | 3.15 | 4.16 |
| 場所特定・確認 | 1.2〜1.4 | 1.3〜1.5 | 1.3〜1.5 |
コード係の 1 ターン目は、セッションを足しても変わりません(まだ自分のパッチが無いため)。ここを押し上げたのが書き出す形の写しで、1.84 → 2.42(+32%)でした。論文の「1 ターン目で +13〜39%」とほぼ同じ範囲です。2 ターン目以降は前回の自分のパッチがセッションにあるので、②だけで 3.51、⑦で 4.37 まで伸びました。
一方で、実行係の 1 ターン目は②の方が①より低くなりました(3.24 → 2.60)。テストのログを写す場面で、セッション側の「より長く一致した別の箇所」(プロンプトに入っていたコードなど)を選んでしまい、続きが外れたためです。長く一致した場所が正しい続きとは限らない、という検索型の弱点で、論文が同じ一致の中から「続く 3 トークンの多数決」で選んでいるのは、こうした外れを減らすためだと考えられます(今回の簡易版は「新しい方」を選んでいます)。
場所特定と確認の係は、どの方式でもほとんど伸びませんでした。自分の言葉で短い判断を書く係なので、写せる部分が少ないのです。事前プロファイルで決まった上限も、場所特定 4・コード 20・実行報告 16・確認 4 と、係による違いがはっきり出ました。
結果③:長さ制御は、外れそうな場面で下書きを縮める
長さ固定 32 と AgSpec 式で、1 回の呼び出しの中の動きを並べたのが次の図です(t2_config のコード係、1 ターン目)。
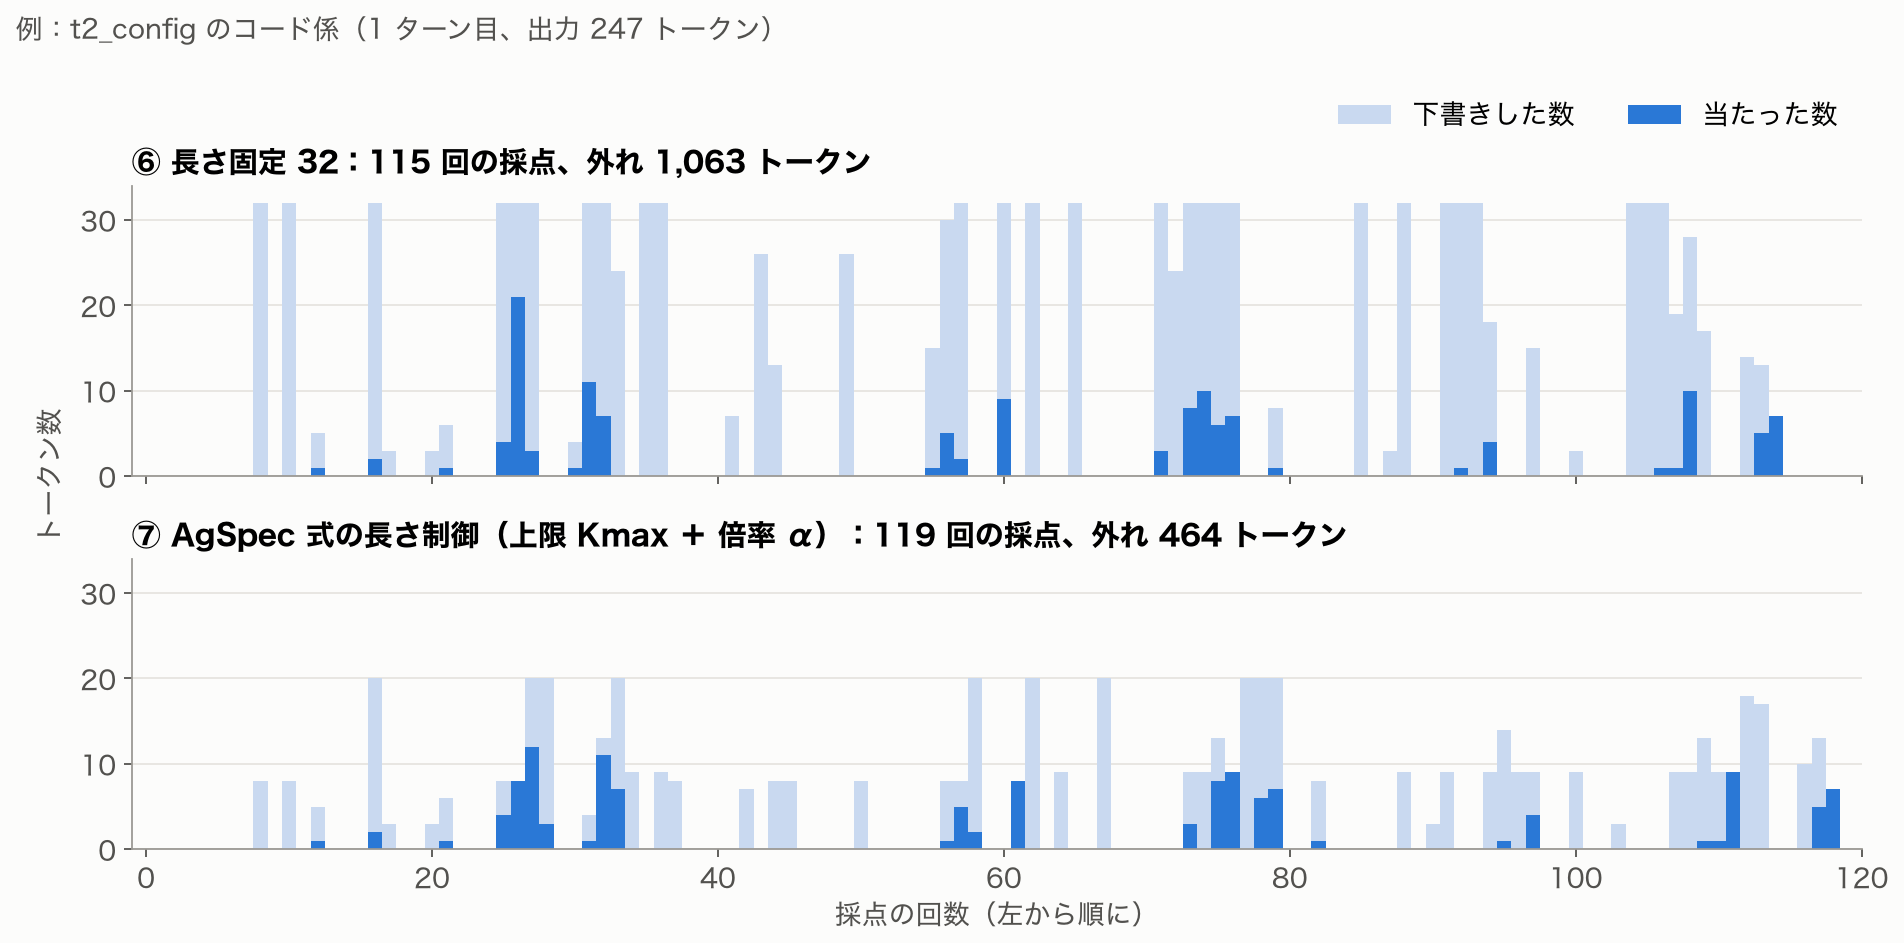
図9:採点ごとの「下書きした数」(薄い青)と「当たった数」(濃い青)。上が長さ固定 32、下が AgSpec 式
採点の回数は 115 回と 119 回でほぼ同じ、受理したトークンも 132 と 128 でほぼ同じです。それでいて、外れた下書きは 1,063 トークンから 464 トークンへ 56% 減りました。倍率 α は呼び出しをまたいで学習され、最後には コード係 6.3、実行係 6.4、場所特定 1.8、確認 1.7 と、係ごとに大きく分かれていました。
結果④:Mac では「まとめて確かめる」のがタダではなかった
ここまでの指標は混み具合に左右されない数え方でしたが、最後に実際の時間も見ます。ただし今回は、同じ Mac で別の作業(別のモデルの評価や動画の書き出し)が GPU を使い続けていて、時間の測定はかなり揺れました。呼び出しごとに全方式を続けて測って偏りはならしていますが、ここからの数値は参考値として読んでください。
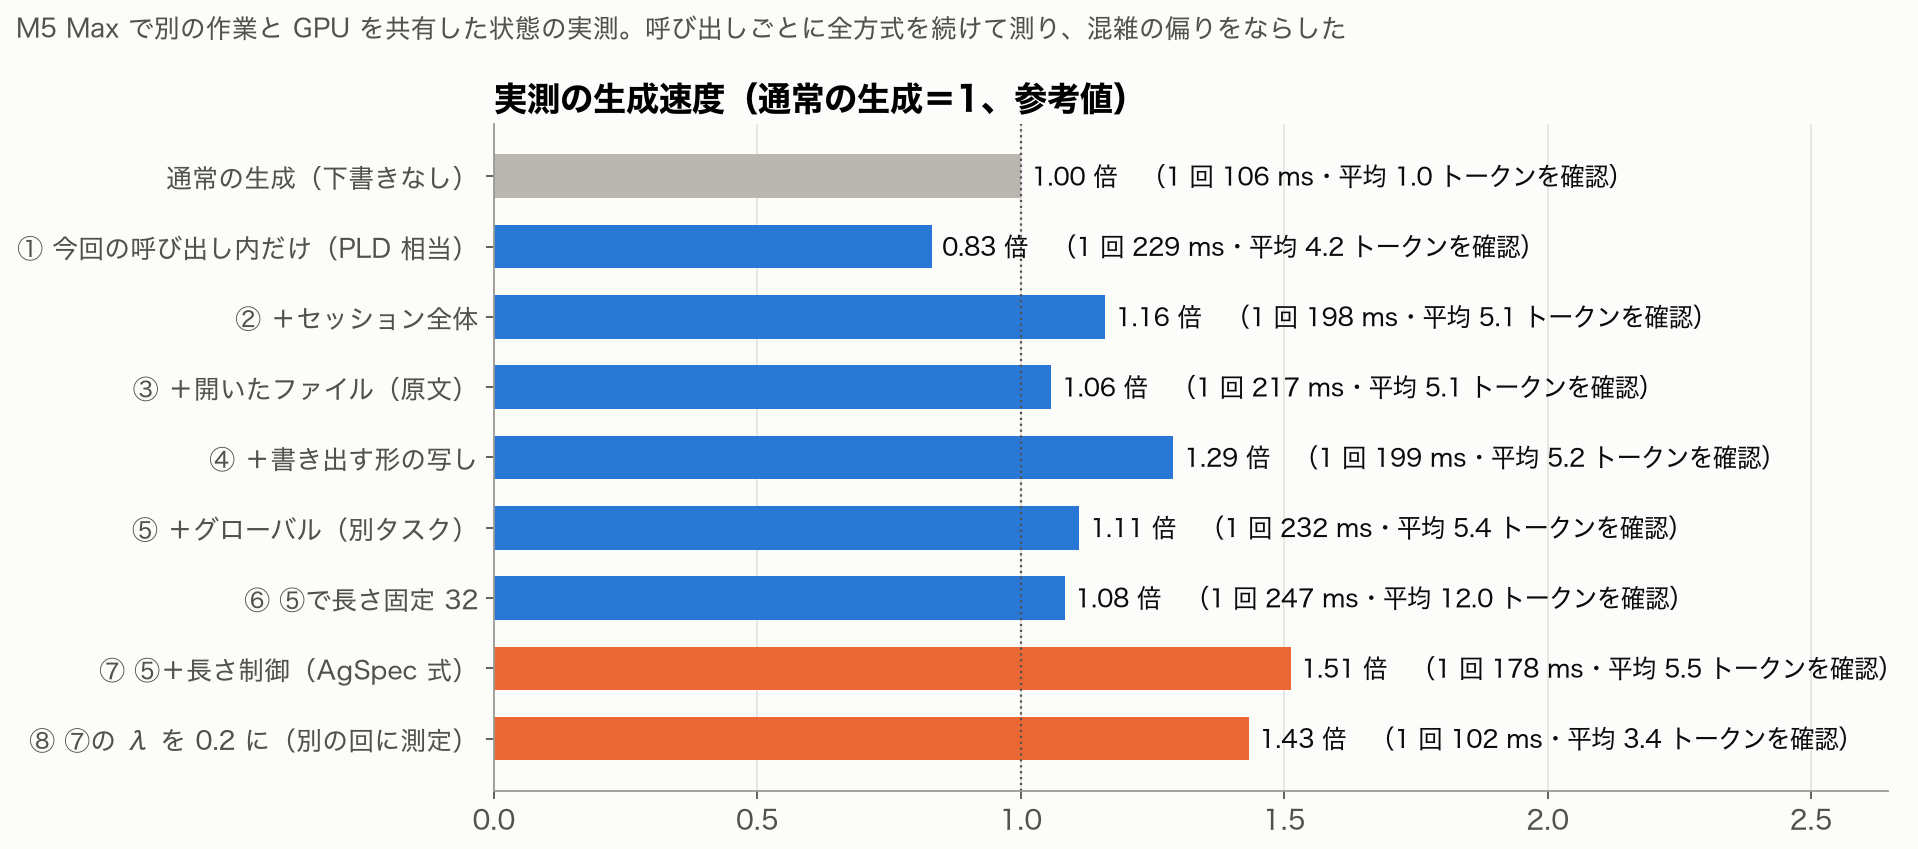
図10:実測の生成速度(通常の生成=1)。括弧内は 1 回の採点にかかった時間と、確かめた平均トークン数
| 方式 | 実測の速さ | 1 回の採点の時間 | 1 回に確かめた平均トークン数 |
|---|---|---|---|
| 通常の生成 | 1.00 倍(毎秒 9.4 トークン) | 106 ms | 1.0 |
| ① 呼び出し内だけ | 0.83 倍 | 229 ms | 4.2 |
| ② +セッション | 1.16 倍 | 198 ms | 5.1 |
| ④ +書き出す形の写し | 1.29 倍 | 199 ms | 5.2 |
| ⑥ 長さ固定 32 | 1.08 倍 | 247 ms | 12.0 |
| ⑦ AgSpec 式 | 1.51 倍 | 178 ms | 5.5 |
いちばん意外だったのは、①呼び出し内だけ(PLD 相当)が 通常の生成より遅くなったことです。原因は、Mac の上では「まとめて確かめる」のがタダではないことでした。
21 回の呼び出しの記録から、1 回の採点の時間を「固定の部分」と「下書き 1 トークンあたりの部分」に分けて推定すると、下書き 1 トークンにつき約 15.5 ms かかっていました。通常の 1 歩が 64〜119 ms(混み具合で変動)なので、下書きを 1 つ足すごとに 1 歩の 13〜25% ずつ時間が延びる計算です。念のため、モデル全体ではなく 4bit の行列の掛け算 1 つだけを測っても、1 行で 0.50 ms、4 行で 0.91 ms、16 行で 1.06 ms と、1 行のときの 2 倍ほどかかりました。
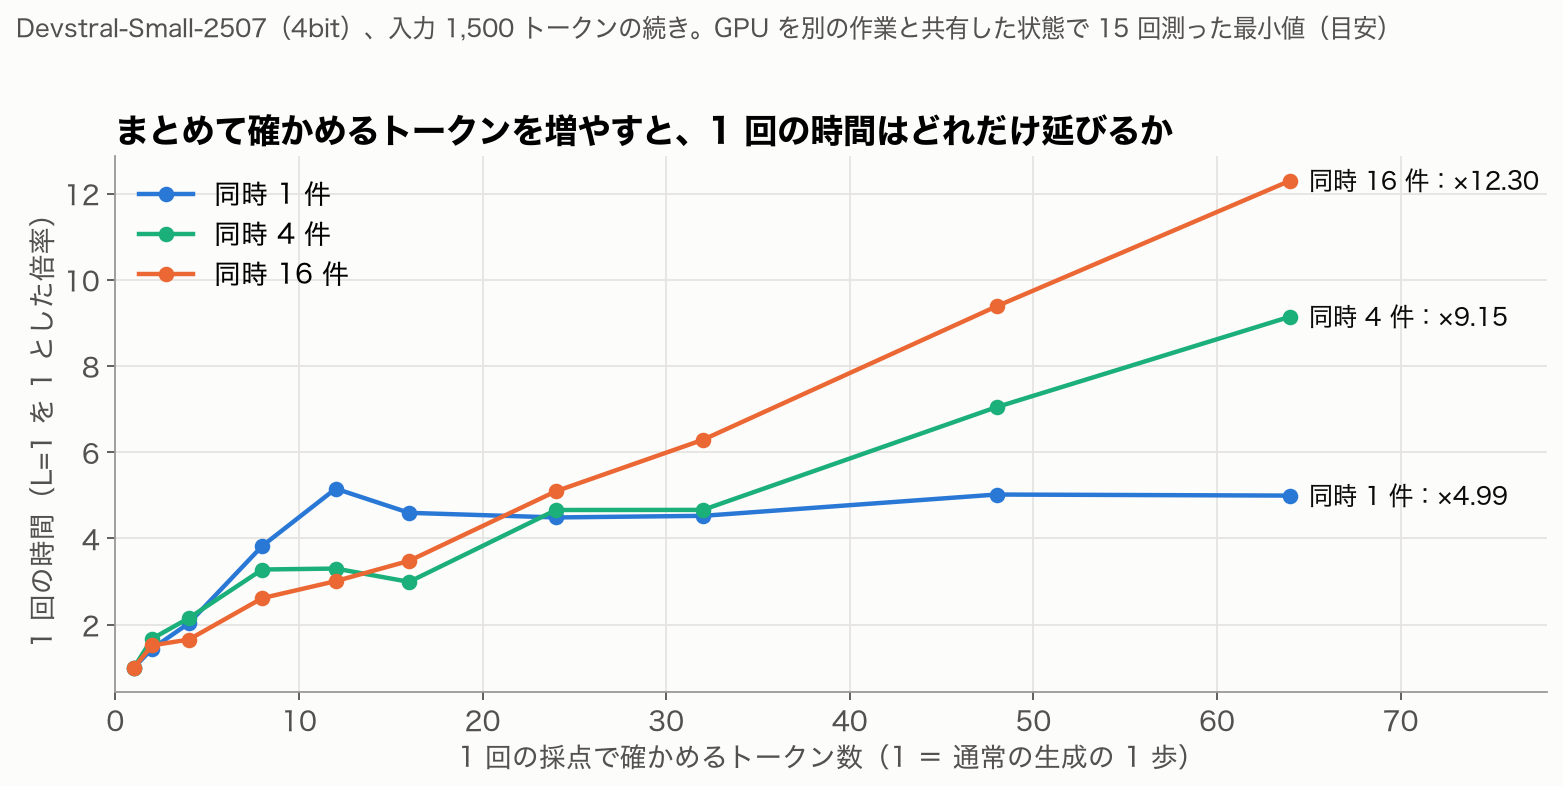
図11:まとめて確かめるトークン数と 1 回の時間(1 トークンのときを 1 とした倍率)。GPU を別の作業と共有した状態で 15 回測った最小値なので、細かな凸凹は誤差を含む目安
データセンター向けの GPU でバッチ 1 なら、数トークン増やしても時間はほとんど変わらない、というのが投機的デコーディングの前提です。ところが今回の Mac(MLX の 4bit 計算)では、この前提が成り立っていませんでした。そのため、1 回で 1.78 トークンしか進まない①は、採点の重さに負けて遅くなったのです。
裏を返すと、採点が重い環境ほど、AgSpec の 2 つの工夫がそのまま速さの差になります。②〜⑤で写せる量を増やすと 1.1〜1.3 倍まで回復し、⑦で外れを減らすと 1.5 倍に届きました。⑥長さ固定 32 は、⑦と同じだけ進んでいるのに、1 回に平均 12 トークンも確かめるので 1.08 倍にとどまります。論文がバッチ 16 で示した「長い固定の下書きは、外れの採点で遅くなる」という現象が、Mac ではバッチ 1 から起きていた、と言えます。
結果⑤:損益分岐点 λ を手元の値にすると
論文の式では、損益分岐点 λ が上限 Kmax と倍率の目標 τ を決めます。今回の主な比較では、GPU の混雑で λ を安定して測れなかったため、論文の SWE-bench 設定と同じ τ = 0.95(λ = 0.05)を使いました。ところが上の推定からすると、この Mac の λ は 0.2〜0.3 程度です。
そこで λ = 0.2(τ = 0.8)で上限を決め直し、別の回にもう一度比べました。上限は 場所特定 2・コード 9・実行報告 7・確認 2 と、λ = 0.05 のとき(4・20・16・4)の半分ほどになります。
| 設定 | 1 回で進んだトークン数 | 外れた下書き(1 トークンあたり) | 1 回の下書き数 | 実測の速さ(同じ回の通常の生成比) |
|---|---|---|---|---|
| ⑦ λ = 0.05 | 2.52 | 1.17 | 4.48 | 1.51 倍 |
| ⑧ λ = 0.2 | 2.29 | 0.49 | 2.41 | 1.43 倍(同じ回の⑤は 1.13 倍) |
外れはさらに 6 割減りましたが、1 回で進むトークン数も少し下がり、実測の速さはほぼ同じでした。混み具合の揺れを考えると、この 2 つの差ははっきりしません。言えるのは、λ を変えると「どれだけ攻めて下書きするか」が素直に変わり、どちらも固定長の⑤⑥より速いということです。λ は環境ごとに違うので、使う機材で測ってから決めるのが筋です。
結果⑥:出力は通常の生成と一致したか
投機的デコーディングは原理上は出力を変えないはずですが、実際には 21 回の呼び出しのうち、通常の生成と最後まで完全に一致したのは方式ごとに 13〜15 回でした。残りは途中のどこかで 1 トークン食い違い、その後の文章が少し変わっています。
これがバグなのか数値の問題なのかを切り分けるため、下書きを使わずに「記録された正解の出力を、k トークンずつまとめてモデルに通し、各位置でモデルが選ぶトークンが記録と同じか」を調べました(numerics.py)。
| まとめる数 k | 食い違った位置(2,490 トークン中) |
|---|---|
| 1(通常の生成と同じ計算) | 0 |
| 4 | 10 |
| 16 | 8 |
下書きの仕組みを一切通さなくても、まとめて計算するだけで 0.3〜0.4% の位置で選ばれるトークンが入れ替わりました。1 トークンずつと複数トークンまとめてでは、GPU の計算の順序が変わり、丸め誤差がわずかに違います。最有力の候補と 2 番手の確率がほぼ同じ場所では、その差で順位が入れ替わるのです。
つまり、今回のずれは投機のバグではなく数値の揺れです。論文は vLLM の貪欲法で同じ出力が保たれる前提で書かれていますが、実際の環境では、まとめて計算することによるわずかな揺れはあり得ます。厳密な再現性が必要な用途では、この点を自分の環境で確かめておくと安心です。
実務への示唆:どこで、どう使えるか
いま使える検索型の投機的デコーディング
AgSpec そのものはまだ公開されていませんが、土台になっている検索型の仕組みは、主要な推論サーバーですでに使えます。たとえば vLLM の公式ドキュメント(Speculative Decoding のページ、2026-10-04 確認)には、プロンプトから続きを探す ngram と、過去の回答を木構造にためて探す suffix(SuffixDecoding)が載っています。どちらも追加のモデルなしで、起動時の設定 1 つで有効にできます。
# 例1:プロンプト内の n-gram から下書きを作る(PLD と同じ考え方)
vllm serve <TARGET_MODEL> \
  --speculative-config '{"method": "ngram", "num_speculative_tokens": 4,
                         "prompt_lookup_min": 2, "prompt_lookup_max": 5}'

# 例2:過去の回答もためて探す SuffixDecoding(AgSpec-Suffix の土台)
vllm serve <TARGET_MODEL> \
  --speculative-config '{"method": "suffix", "num_speculative_tokens": 8,
                         "suffix_decoding_max_tree_depth": 24,
                         "suffix_decoding_max_spec_factor": 1.0}'
設定のキーや既定値はバージョンによって変わることがあるので、使う前に手元の vLLM のドキュメントで確認してください。この記事では vLLM での動作は確かめていません。
AgSpec の論文が示しているのは、こうした「エンジン」はそのままに、セッション単位の記録と、開いたファイルの書き出す形の写しを渡し、係ごとに下書きの長さを変えるだけで、さらに速くなる余地があるということです。エージェントの基盤側(どのファイルを開いたか、どの係の呼び出しか)と、推論サーバー側(下書きを作る仕組み)をつなぐ情報の受け渡しが、実装上の鍵になりそうです。
量子化・キャッシュとは削るものが違う
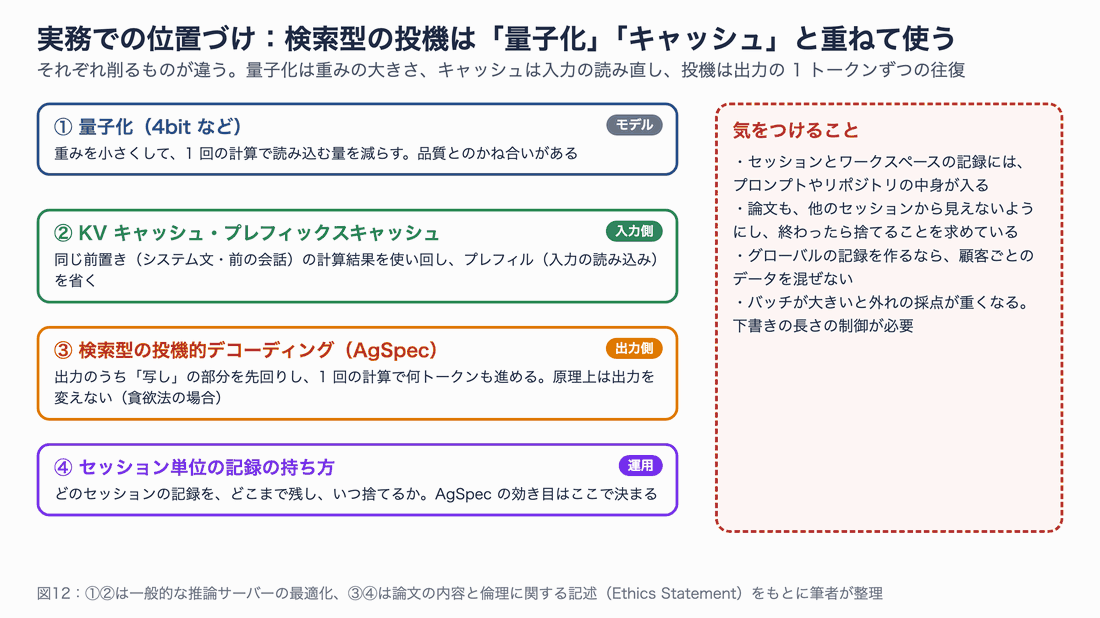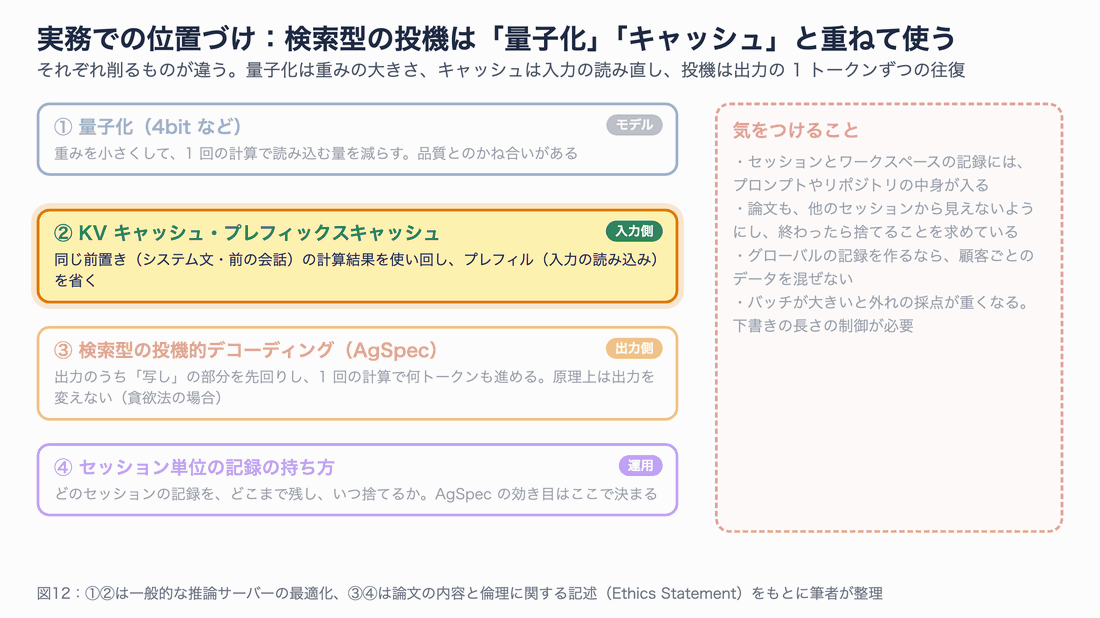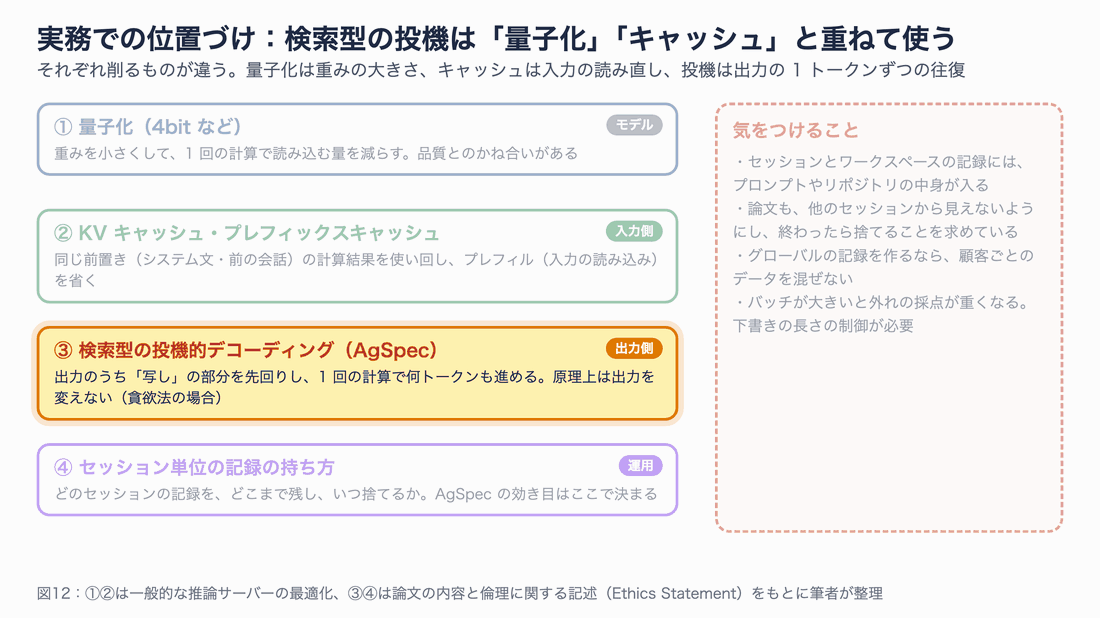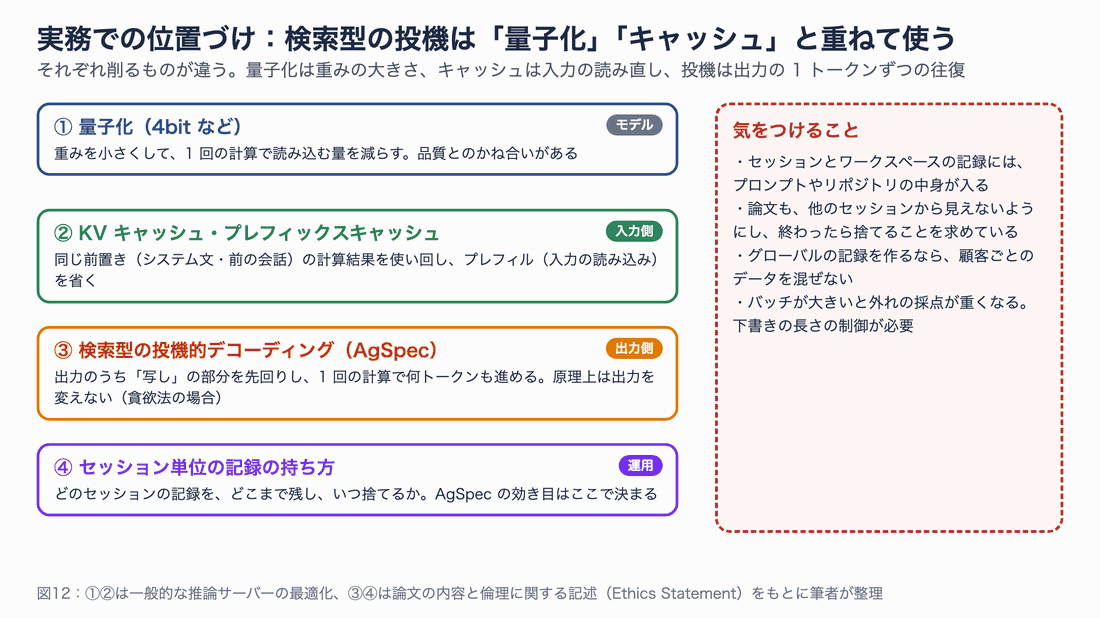
図12:推論の速さを上げる手段は、削るものがそれぞれ違うので重ねて使える
コーディングエージェントを大量に動かす立場から見ると、速さを上げる手段は 3 層に分けて考えると整理しやすくなります。
- 量子化:重みを 4bit などに小さくし、1 回の計算で読む量を減らす。品質とのかね合いがある
- KV キャッシュ・プレフィックスキャッシュ:同じ前置き(システムプロンプトや前の会話)の計算結果を使い回し、入力の読み込み(プレフィル)を省く
- 検索型の投機:出力のうち写しの部分を先回りして、1 回の計算で何トークンも進める
エージェントは入力も出力も長く、しかも前の呼び出しと重なりが大きいので、入力側のキャッシュと出力側の投機の両方が効きやすい仕事です。どちらも「同じセッションの記録を賢く使い回す」という点で発想が共通しています。
記録の扱いには注意が要る
セッションやワークスペースのコーパスには、ユーザーのプロンプトやリポジトリの中身、ツールの出力がそのまま入ります。論文も倫理に関する記述の中で、各セッションのコーパスへのアクセスを制限し、他のセッションに漏れないようにし、終わったら捨てるべきだと書いています。
特にグローバルコーパスは、全ユーザーで共有する前提の仕組みです。投機的デコーディングは出力の中身を変えないので、別のユーザーの文章が出力に紛れ込むことはありません。ただ、下書きが当たるかどうかで返答の速さが変わるため、「ある文章がコーパスに入っているか」を速さの差から推し量られる余地はあると筆者は考えています(論文はこの点を扱っていません)。社内のコードや顧客のデータを含む記録は、共有のコーパスに入れない方が安全です。論文がワークスペースを G に混ぜずに分けている理由の 1 つも、ユーザーごとにリポジトリが違う実運用を想定したものでした。
つまずきやすい点:自分の環境で試す前に
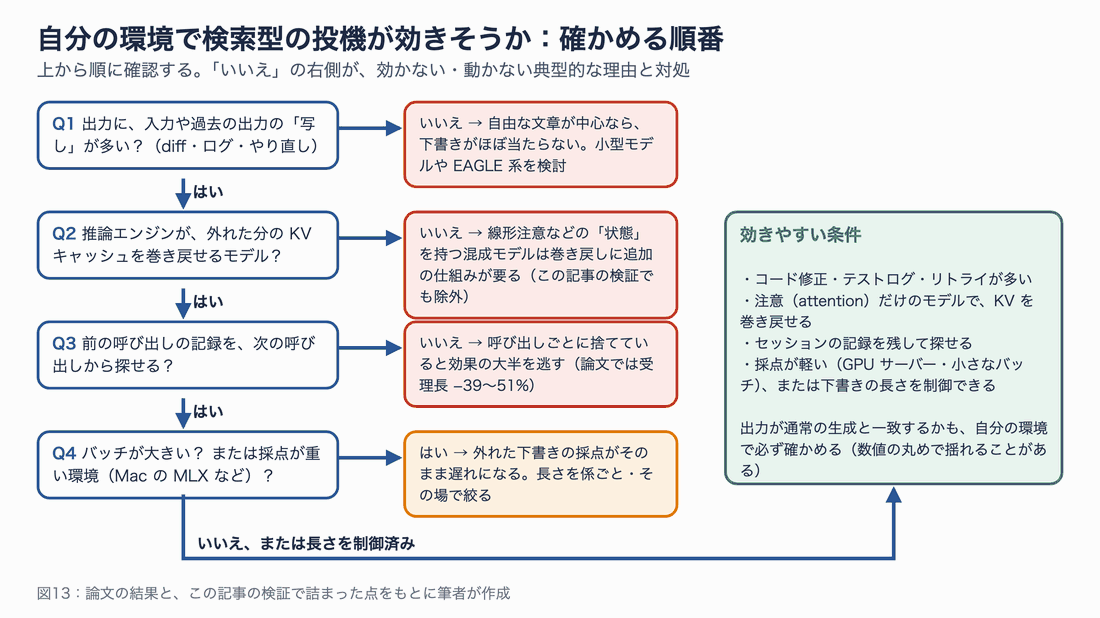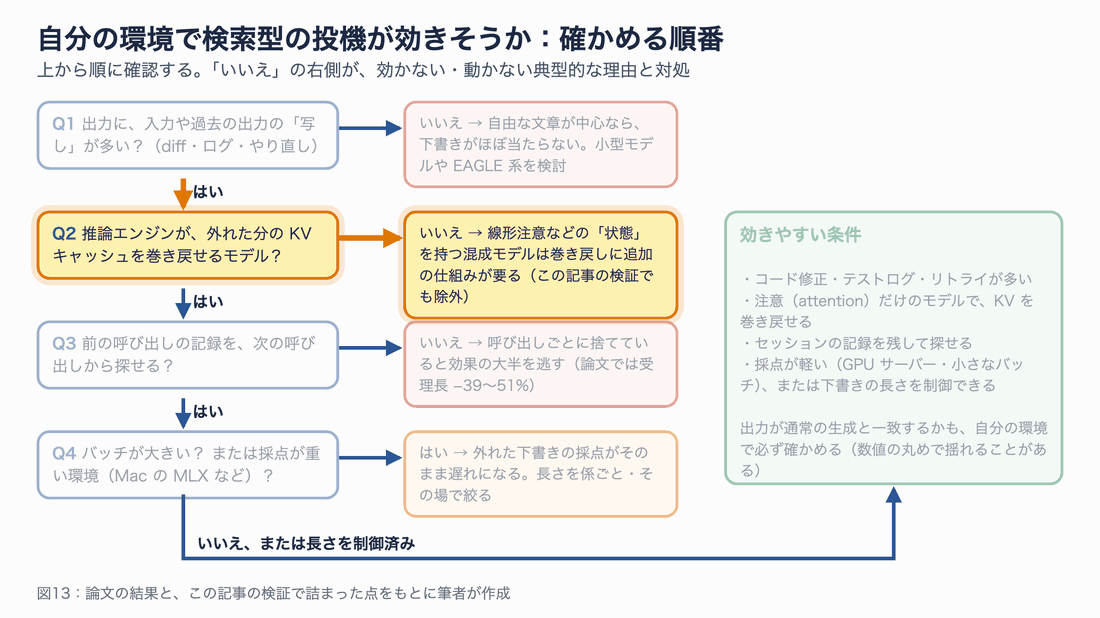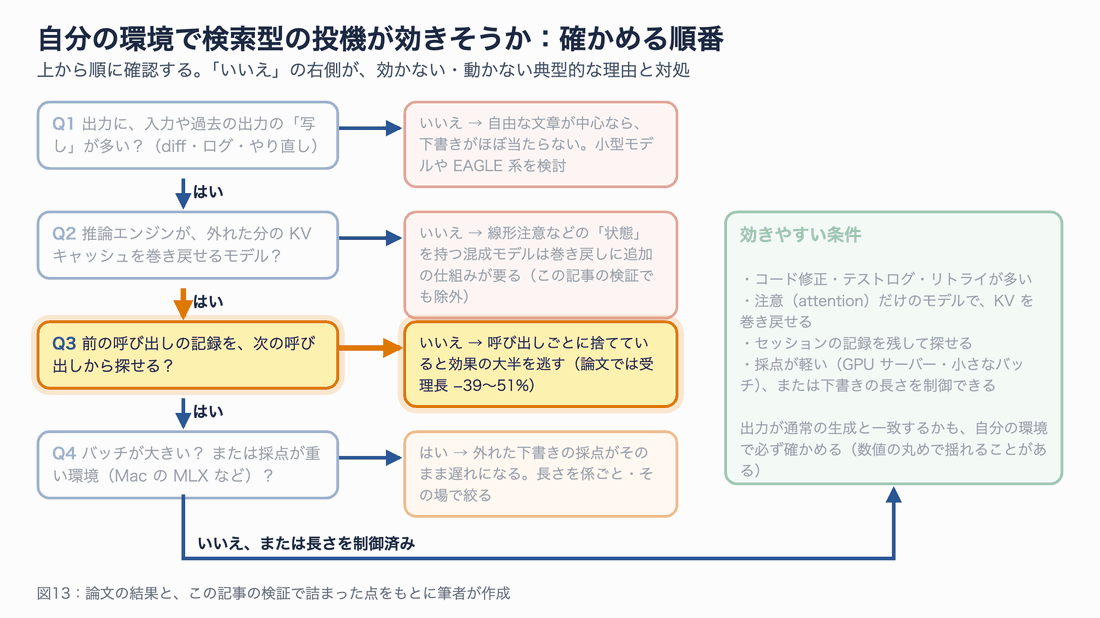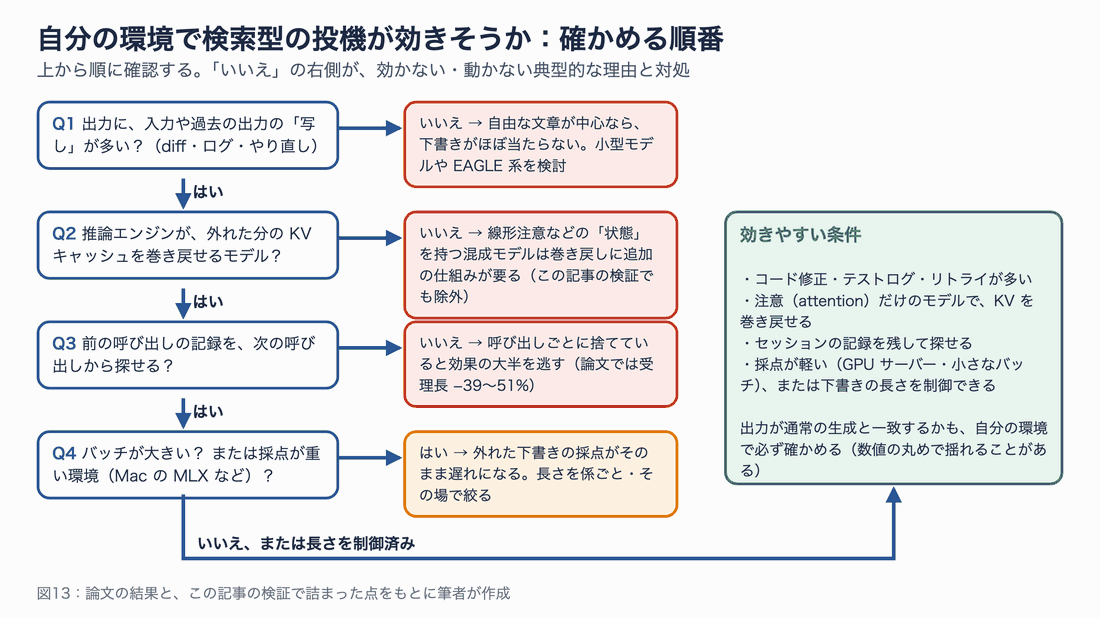
図13:検索型の投機が効きそうかを確かめる順番
今回の検証で実際に詰まった点と、その対処をまとめます。
| 症状 | 原因 | 対処 |
|---|---|---|
| 下書きの仕組みを入れても「巻き戻せない」と言われる | 線形注意などの層を含む混成モデルは、KV キャッシュを末尾から削れない | ふつうの注意だけのモデルを使う。または状態を保存して戻す仕組みのあるエンジンを使う |
| 出力が通常の生成と少し違う | まとめて計算したときと 1 トークンずつ計算したときで、数値の丸めが変わる | 想定どおりの揺れか、1 トークンずつ/まとめての比較で確かめる(結果⑥) |
| Devstral で「正規表現が誤っている」と警告が出る | 配布されているトークナイザー設定の分割規則の不具合 | transformers で読み込むときに fix_mistral_regex=True を付ける |
モデルの書いた diff が patch でも git apply でも当たらない | 関数の間の空行が 1 行足りない、行番号の見出しがずれている、追加行に「+」を付け忘れる、など細かな誤り | 行番号・空行のずれと、ファイルにない文脈行を許して当てる方法を併用(agent.py の lenient_apply) |
| ダウンロードが途中で止まる | 回線や同時ダウンロードの影響 | curl -C - で再開できる取り方に切り替える |
| 書き出す形の写しがほとんど使われない | プロンプトにファイル全文が入っていて、セッション側で先に一致してしまう | 正常。ファイルがプロンプトから切り落とされる長いリポジトリで効く |
まとめ
AgSpec は、「コーディングエージェントの出力は、どこかで見た文章の写しが多い」という観察を、推論の速さに変える研究でした。要点を振り返ります。
- 投機的デコーディングは、下書きをまとめて採点することで、出力を変えずに生成を速くする仕組み。検索型は、既にある文章から下書きを写す
- AgSpec の工夫は 2 つ。どこから写すか(セッション・ワークスペース・グローバルの 3 つ、ファイルは diff の書き出す形でも登録)と、何トークン写すか(係ごとの上限と、採点結果で毎回調整する倍率)
- 論文では、通常の生成の最大 4.37 倍(バッチ 1)・4.76 倍(バッチ 16)。効果の大半はセッション全体の記録を探せるようにしたことから来ていた
- 手元の半分実装でも同じ傾向が出た。セッションの記録で 1 回あたり 1.78 → 2.16 トークン、書き出す形の写しでコード係の 1 ターン目が +32%、長さ制御で外れた下書きを 3 分の 1 に減らした
- ただし Mac(MLX)では採点がタダではなく、呼び出し内だけを探す方式はかえって遅くなった。写せる量を増やし、外れを減らす AgSpec の 2 つの工夫が、そのまま速さの差になった
次に試すなら、vLLM の suffix や ngram の投機を GPU サーバーで有効にして、自分のエージェントの記録で受理長を測ってみるのがおすすめです。今回の bench.py のように「記録を再生して比べる」形にしておくと、条件をそろえた比較がしやすくなります。
参考リソース
- Sumin Lee, Sukmin Cho, Suengjae Lim, Youngjin Kwon「AgSpec: Pushing the Limits of Retrieval-Based Speculative Decoding in Coding Agent Pipelines」arXiv:2610.01108(2026-10-01)https://arxiv.org/abs/2610.01108
- vLLM ドキュメント「Speculative Decoding」https://docs.vllm.ai/en/latest/features/speculative_decoding/
- Prompt Lookup Decoding(Apoorv Saxena)https://github.com/apoorvumang/prompt-lookup-decoding
- SuffixDecoding(Oliaro ほか、NeurIPS 2025)、SAM-Decoding(Hu ほか、ACL 2025)、REST(He ほか、NAACL 2024)。いずれも論文の参考文献より
- mlx-lm(Apple の MLX で LLM を動かすライブラリ)https://github.com/ml-explore/mlx-lm
- 使ったモデル:mlx-community/Devstral-Small-2507-4bit https://huggingface.co/mlx-community/Devstral-Small-2507-4bit