はじめに:AIエージェントは「考えごと」まで全部書き出している
ChatGPT や Claude に難しい質問をすると、答えの前に長い「考える過程」が流れることがあります。AIエージェントも同じで、検索や Python を呼ぶ前後に、「まずこれを調べて」「この結果からすると」と、考えたことを一語ずつ文字にしながら進みます。
人間に置きかえると、暗算の途中経過まで毎回ノートに書いてから次へ進むようなものです。読み返せる安心感はありますが、そのぶん時間もお金もかかります。
2026年10月13日に arXiv で公開された論文「Hybrid Reasoning Agents」(Stanford 大学・Together AI・UIUC・Meta)は、この習慣を見直しました。提案された HybridAgent は、頭の中の考えごとは文字にせずモデル内部の数値のまま進め、検索や Python の呼び出しなど外とのやりとりだけを文字で行います。論文では、同じ大きさの「文字だけ」のエージェントと比べて生成ステップを 35.5〜54.7% 減らし、推論を 1.8〜2.6 倍速くしたと報告しています。
まずは、何が変わるのかを図で見てください。上が今のエージェント、下が HybridAgent です。
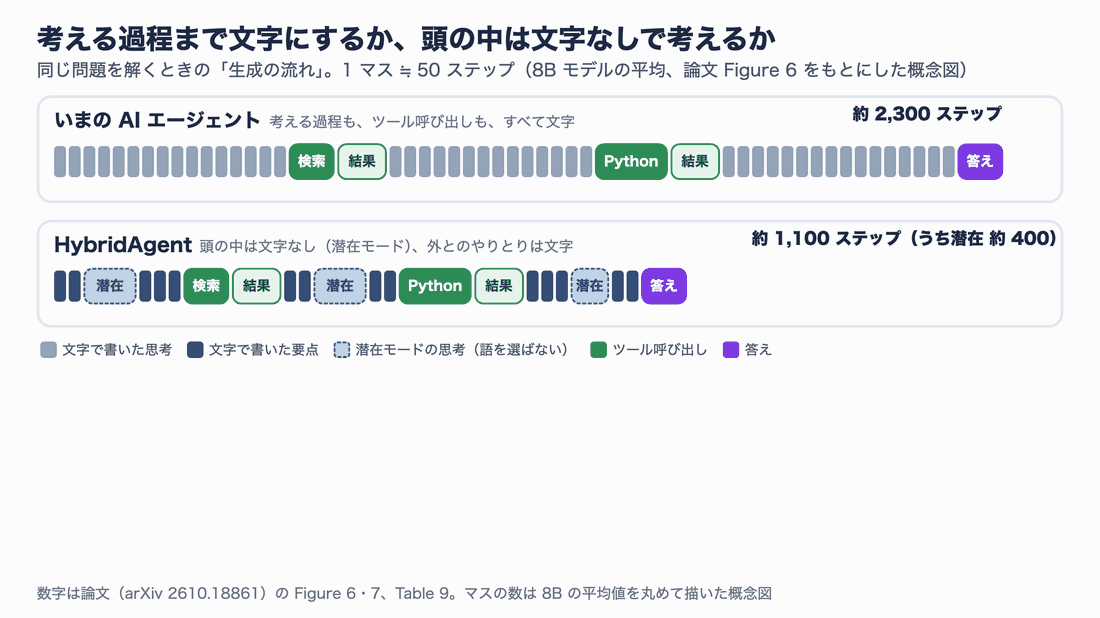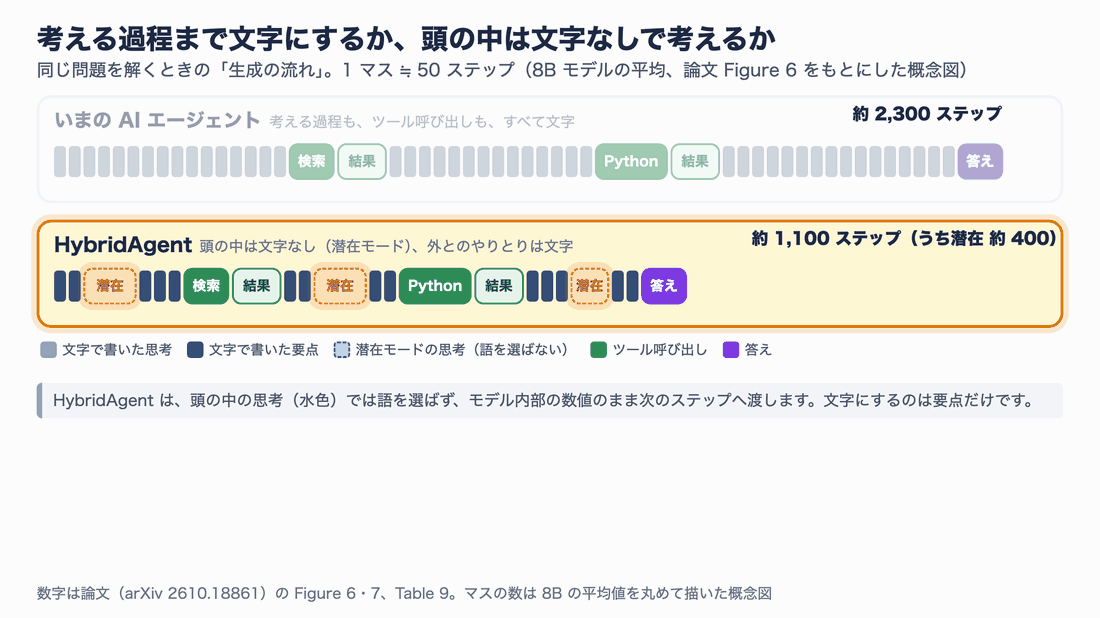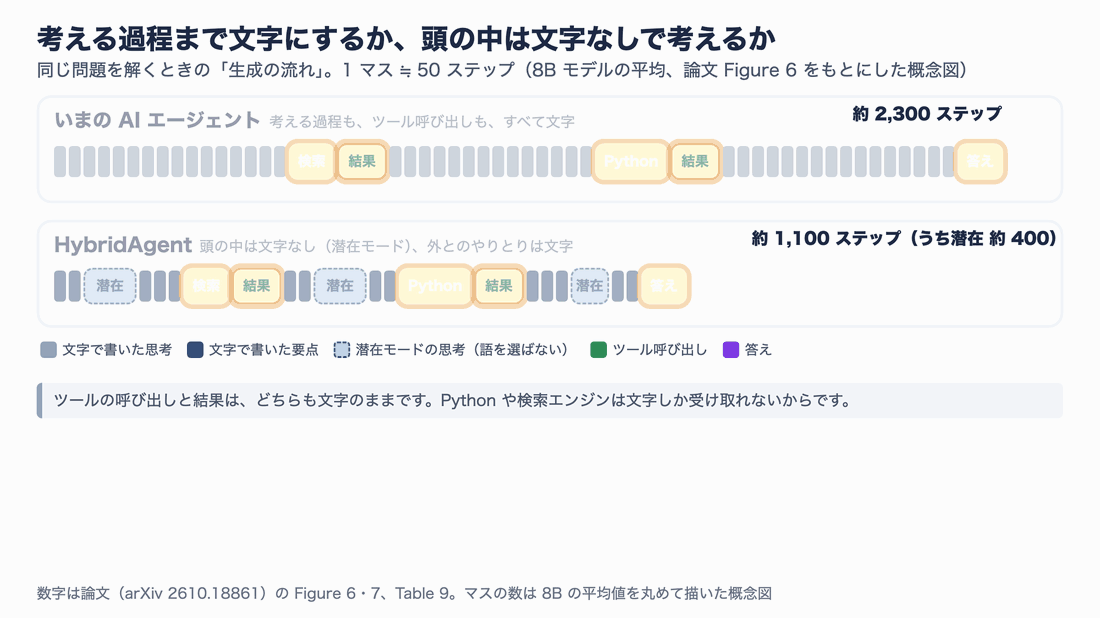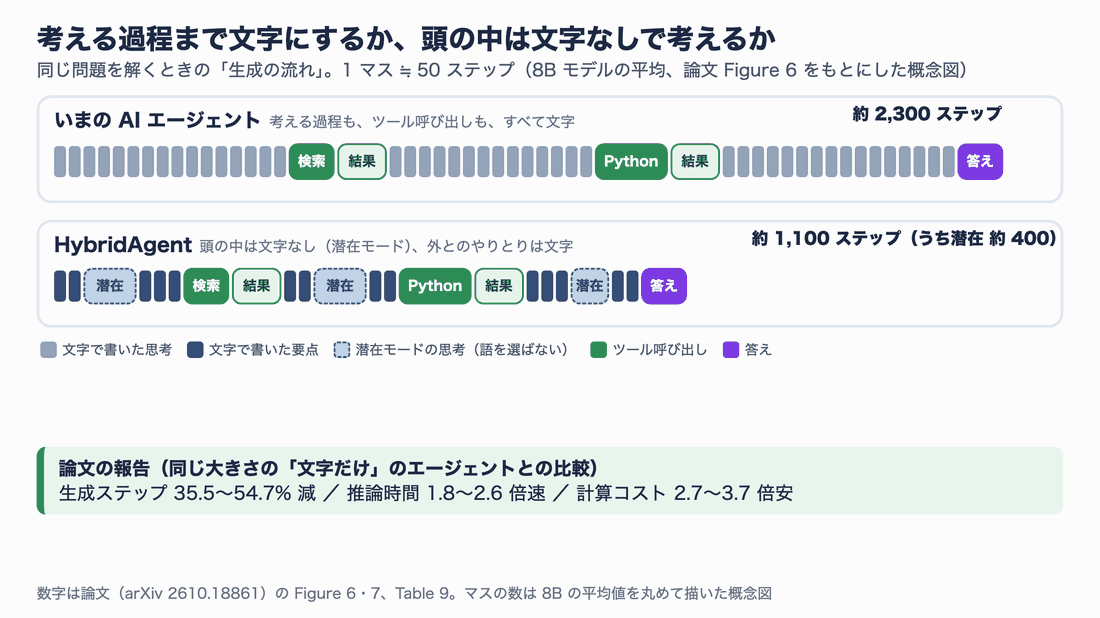
考えごとは「潜在モード」(水色)で語を選ばずに進め、ツールの呼び出しと結果だけを文字で扱う。8B モデルの平均で、生成ステップは約2,300から約1,100に減った(論文 Figure 6 をもとにした概念図)。
この記事では、HybridAgent の仕組みを専門用語をできるだけ使わずに解説し、論文の数字を「何と比べた値なのか」まで分けて読みます。さらに、公開されている 8B モデルを手元の Mac(Apple M5 Max)で実際に動かし、潜在モードの中身を読み出したり、潜在モードを禁止した場合と比べたりしました。
想定読者は、AI エージェントを使ったり作ったりしている人、論文の要約を見て「結局なにがすごいの?」と感じた人です。数式は出てきません。
この記事の確認範囲
| 項目 | 内容 |
|---|---|
| 論文 | arXiv:2610.18861 v1(2026-10-13 投稿、査読前、CC BY 4.0) |
| 公式コード | github.com/togethercomputer/HybridAgent(MIT ライセンス、2026-10-25 時点のコミット 1b41ceb) |
| 公開モデル | HybridAgent-8B-Agentic・14B-Agentic(MIT、土台は Qwen3-Base)。論文の 4B は未公開 |
| 手元で動かしたもの | 8B モデルを Mac(M5 Max・メモリ128GB・macOS 26)の GPU(MPS)で実行。MATH500 の 30 問を、ハイブリッドと潜在モード禁止で交互に解かせて比較。検索ツールは使わず Python ツールのみ |
| 手元で動かしていないもの | 学習(HybridSFT・HybridRL)、14B、論文のベンチマーク全体の再現 |
先に結論
- HybridAgent は、考えるときは潜在モード、動くときは文字モードを 1 回の生成の中で切り替える。切り替えの部品(HybridLink)は 8B で本体の約 0.4% と小さい
- 論文の「トークン 35.5〜54.7% 削減」は、生成ステップの総数の減り方。文字トークンだけなら 2.2〜3.1 倍少ない
- 「平均 10.4% 向上」は同じ大きさ・同じ学習量のエージェントとの比較。大型のフロンティアモデルには、道具を使う課題で勝ち、専門知識の課題(HLE)では大きく負けている
- 手元の Mac では、公式の 8B モデルがそのまま動いた。MATH500 の 30 問で潜在モードを禁止した場合と比べると、正答は 25 問対 20 問、生成ステップは合計で 53% 減った。ただし減った分の多くは、潜在を禁止した側が上限まで止まらなかった 8 問によるもので、それを除くと 29% 減
- いまのところ、Claude や GPT の API で使える技術ではない。オープンな重みと専用の生成エンジンが必要
そもそも言語モデルはどうやって「考えて」いるのか
HybridAgent の工夫を理解するには、普通の言語モデルが文字を書く仕組みを知っておくと近道です。
言語モデルは、文章を一度に書くのではなく、次の 1 語を選んでは、それを次の入力にすることをくり返しています。ここでいう「語」は、正確にはトークン(単語や単語の一部に当たる単位)です。
1 回のくり返しの中身は、次の図のようになっています。
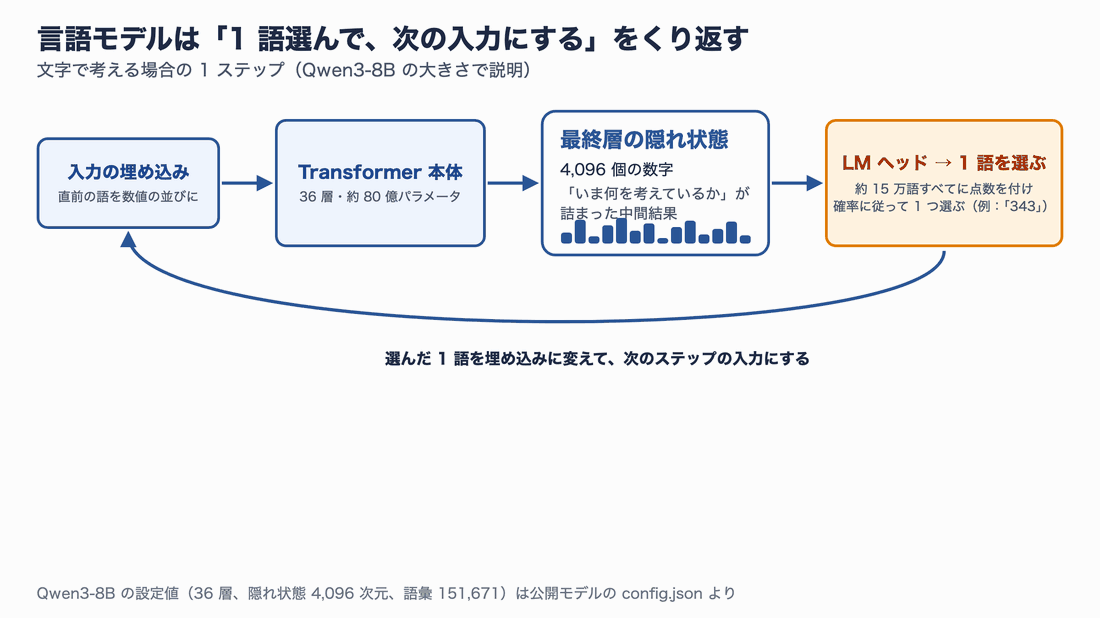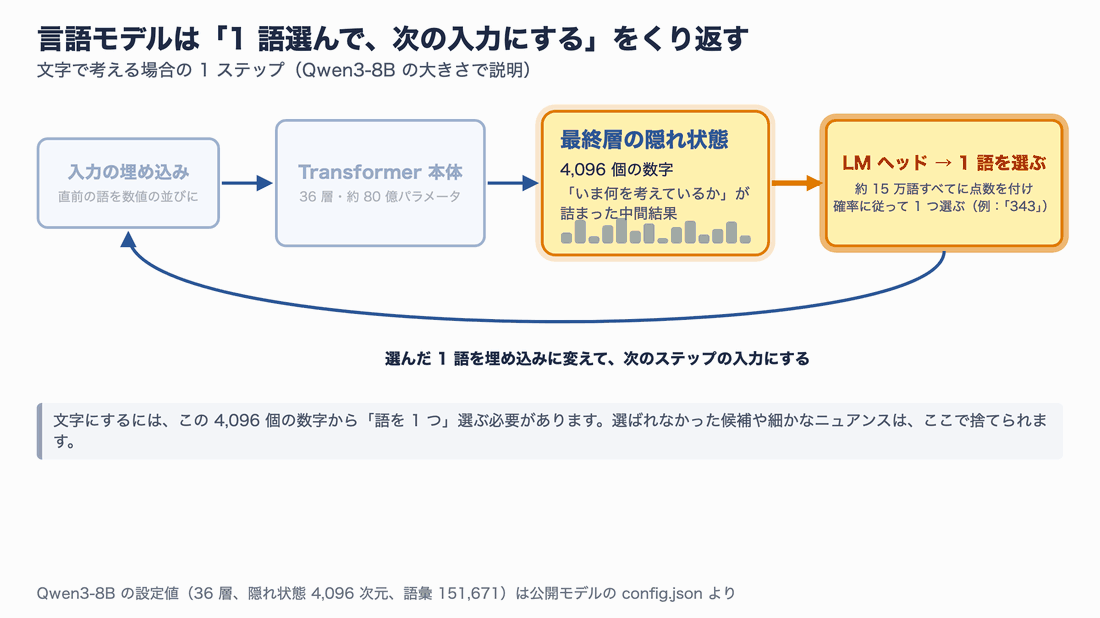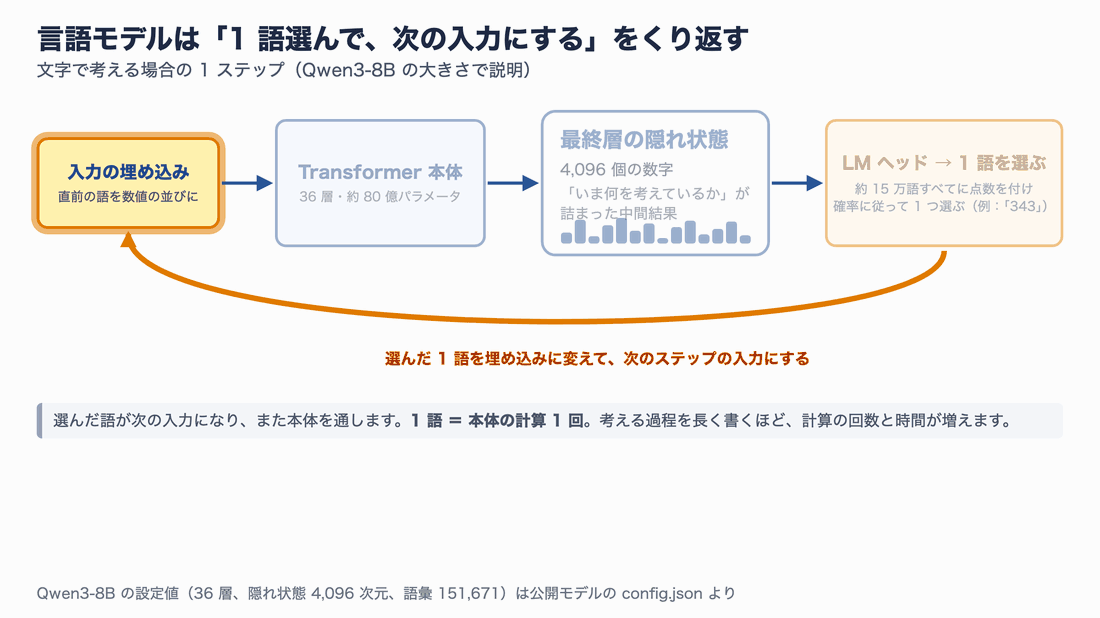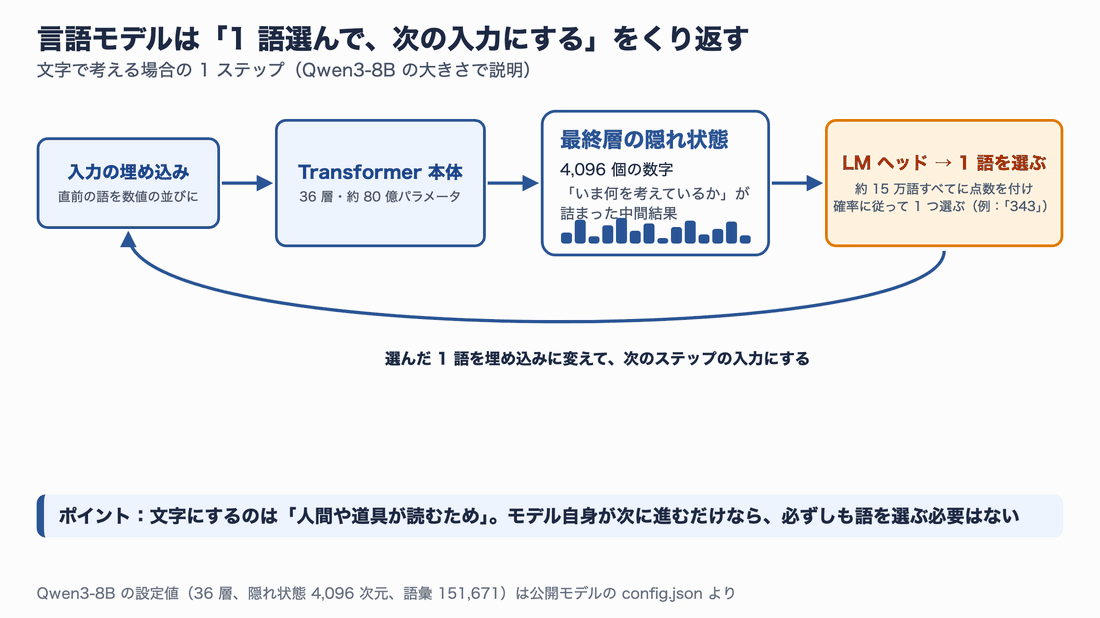
本体が 1 回計算するたびに「隠れ状態」(4,096 個の数字)が出てくる。文字にするにはここから 1 語を選ぶ必要があり、選ばれなかった情報は捨てられる。
ポイントは 2 つあります。
1 つ目は、1 語 = 本体の計算 1 回だということです。8B(80億パラメータ)のモデルなら、1 語書くたびに 80 億個の重みを使った計算が走ります。考える過程を長く書けば書くほど、時間と費用が比例して増えます。
2 つ目は、語を選ぶ瞬間に情報が細ることです。本体が出した隠れ状態には、「次は 343 と言いたい。でも 340 の可能性も少しある」のような豊かな情報が数値として詰まっています。ところが文字にするには、約 15 万語の中から 1 つを選ばなければなりません。選ばれなかった候補は、次のステップには渡りません。
この 2 つの弱点を避けようという研究が、潜在推論(latent reasoning)です。
2 つの流れ:文字の推論と潜在推論
潜在推論の代表例が、2024年に Meta などが発表した Coconut です。Coconut は、語を選ぶ段階を飛ばし、隠れ状態をそのまま次の入力に戻します。前の図のオレンジの点線がそれです。
「潜在」は、表に出てこない内部の数値で考える、という意味です。文字に変換しないので速く、選ばれなかった候補の情報も失いません。
ただし、潜在推論には大きな弱点が 2 つありました。
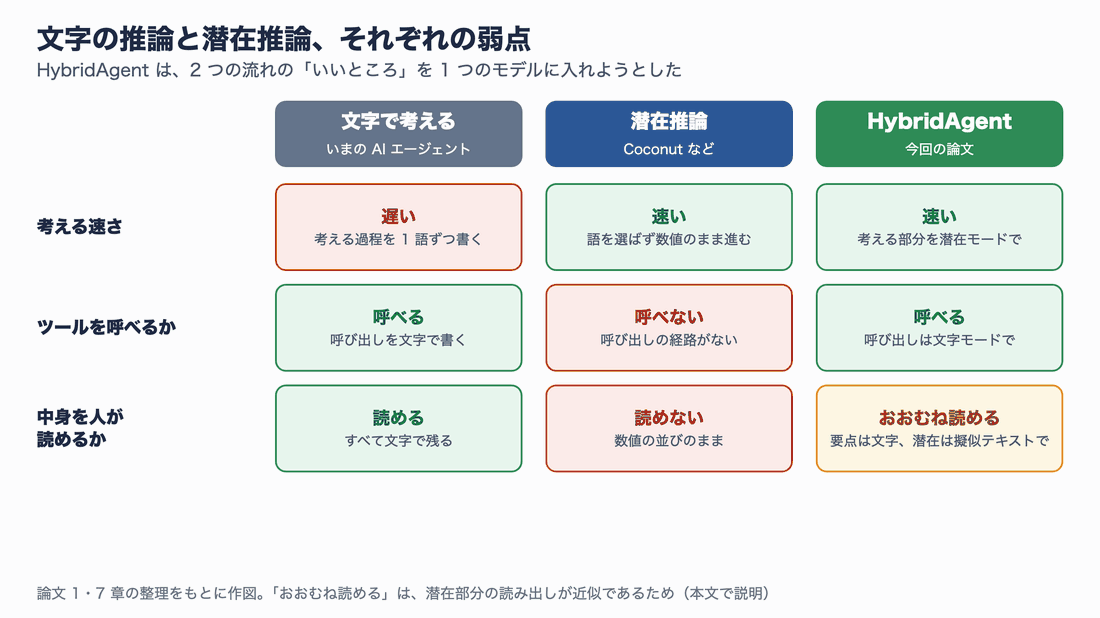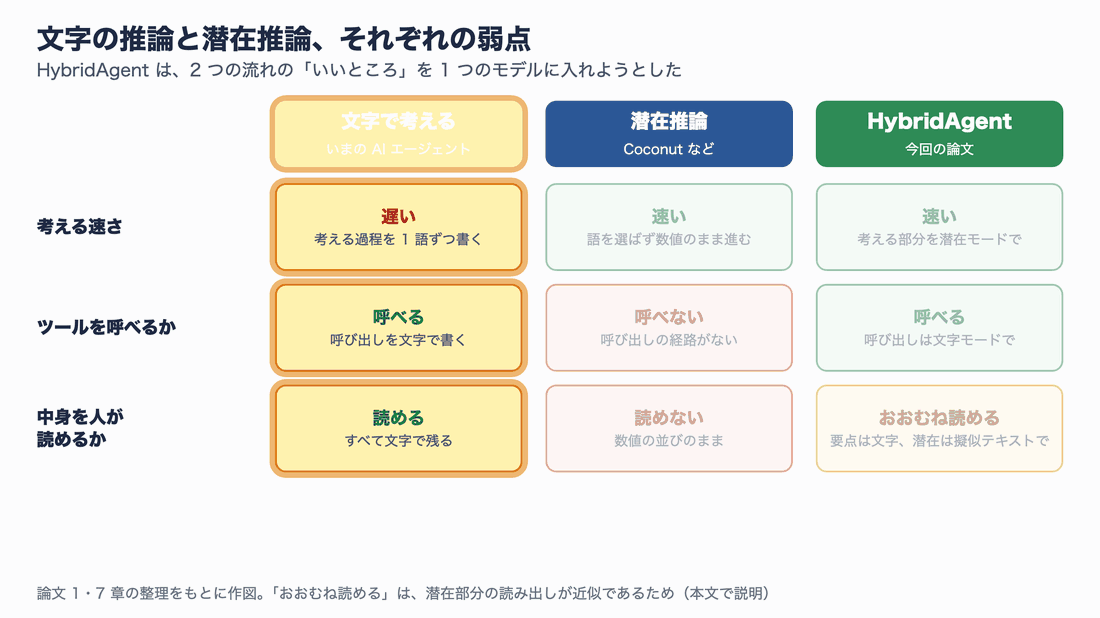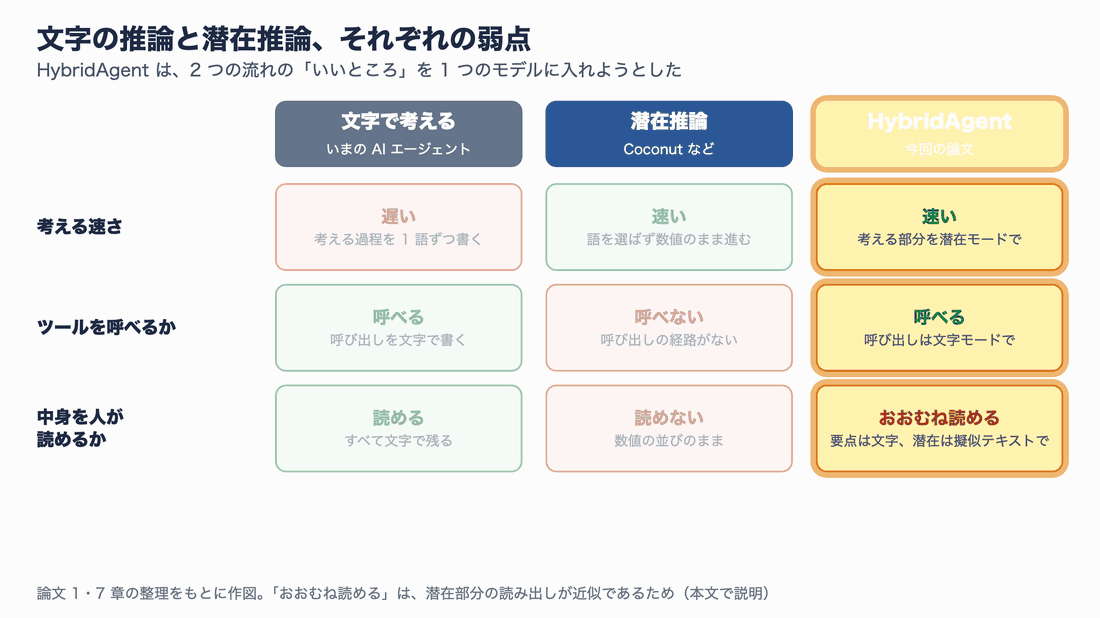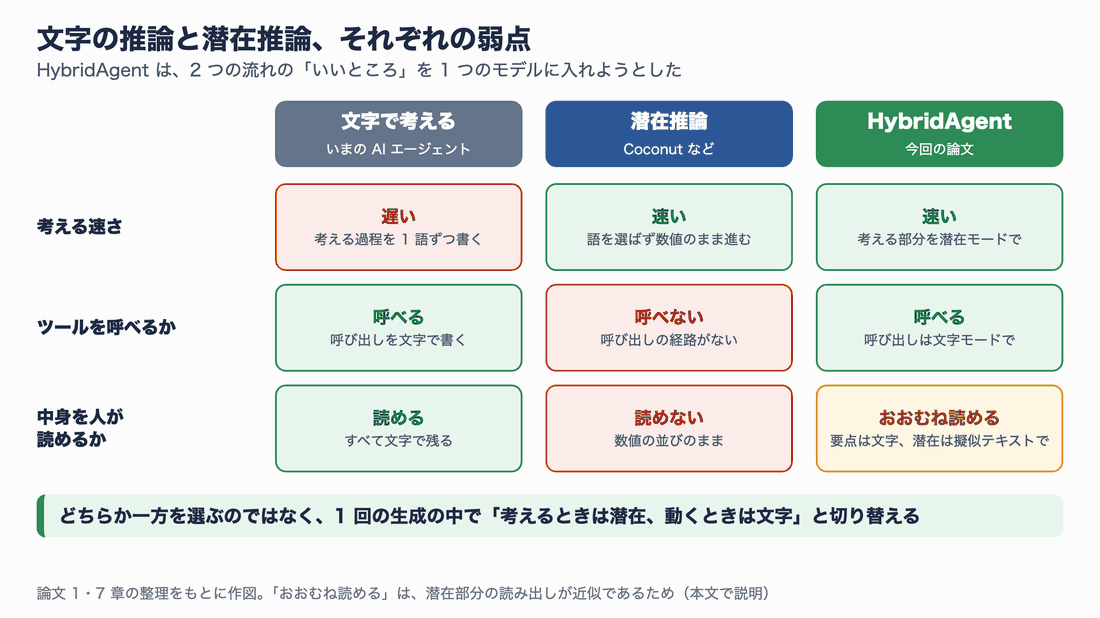
文字の推論は遅いが道具を使えて読める。潜在推論は速いが、道具を呼べず中身も読めない。HybridAgent は両方の長所を 1 つのモデルに入れようとした。
1 つ目は、道具を呼べないことです。検索エンジンや Python は文字しか受け取れません。数値の並びのまま考えているモデルには、「この検索をして」と頼む手段がありません。
2 つ目は、中身が読めないことです。AI の安全性の研究では、モデルが考えた過程を人間や別の AI が読んで、危ない行動を事前に見つける「思考の監視」が重視されています。数値の並びでは、それができません。
論文はこの状況を「エージェントとしてのやりとり」と「効率のよい内部の推論」が、それぞれ別の手段(文字と数値)を必要としてきた、と整理しています。HybridAgent は、この 2 つを 1 つのモデルの中でつなぐ試みです。
HybridAgent の仕組み
全体像:普通の LLM に小さな部品を 1 つ足しただけ
HybridAgent の作りは意外なほど単純です。土台は普通の言語モデル(論文では Qwen3-Base)で、そこに HybridLink という小さな部品を 1 つ足しています。論文の全体図を見てみましょう。
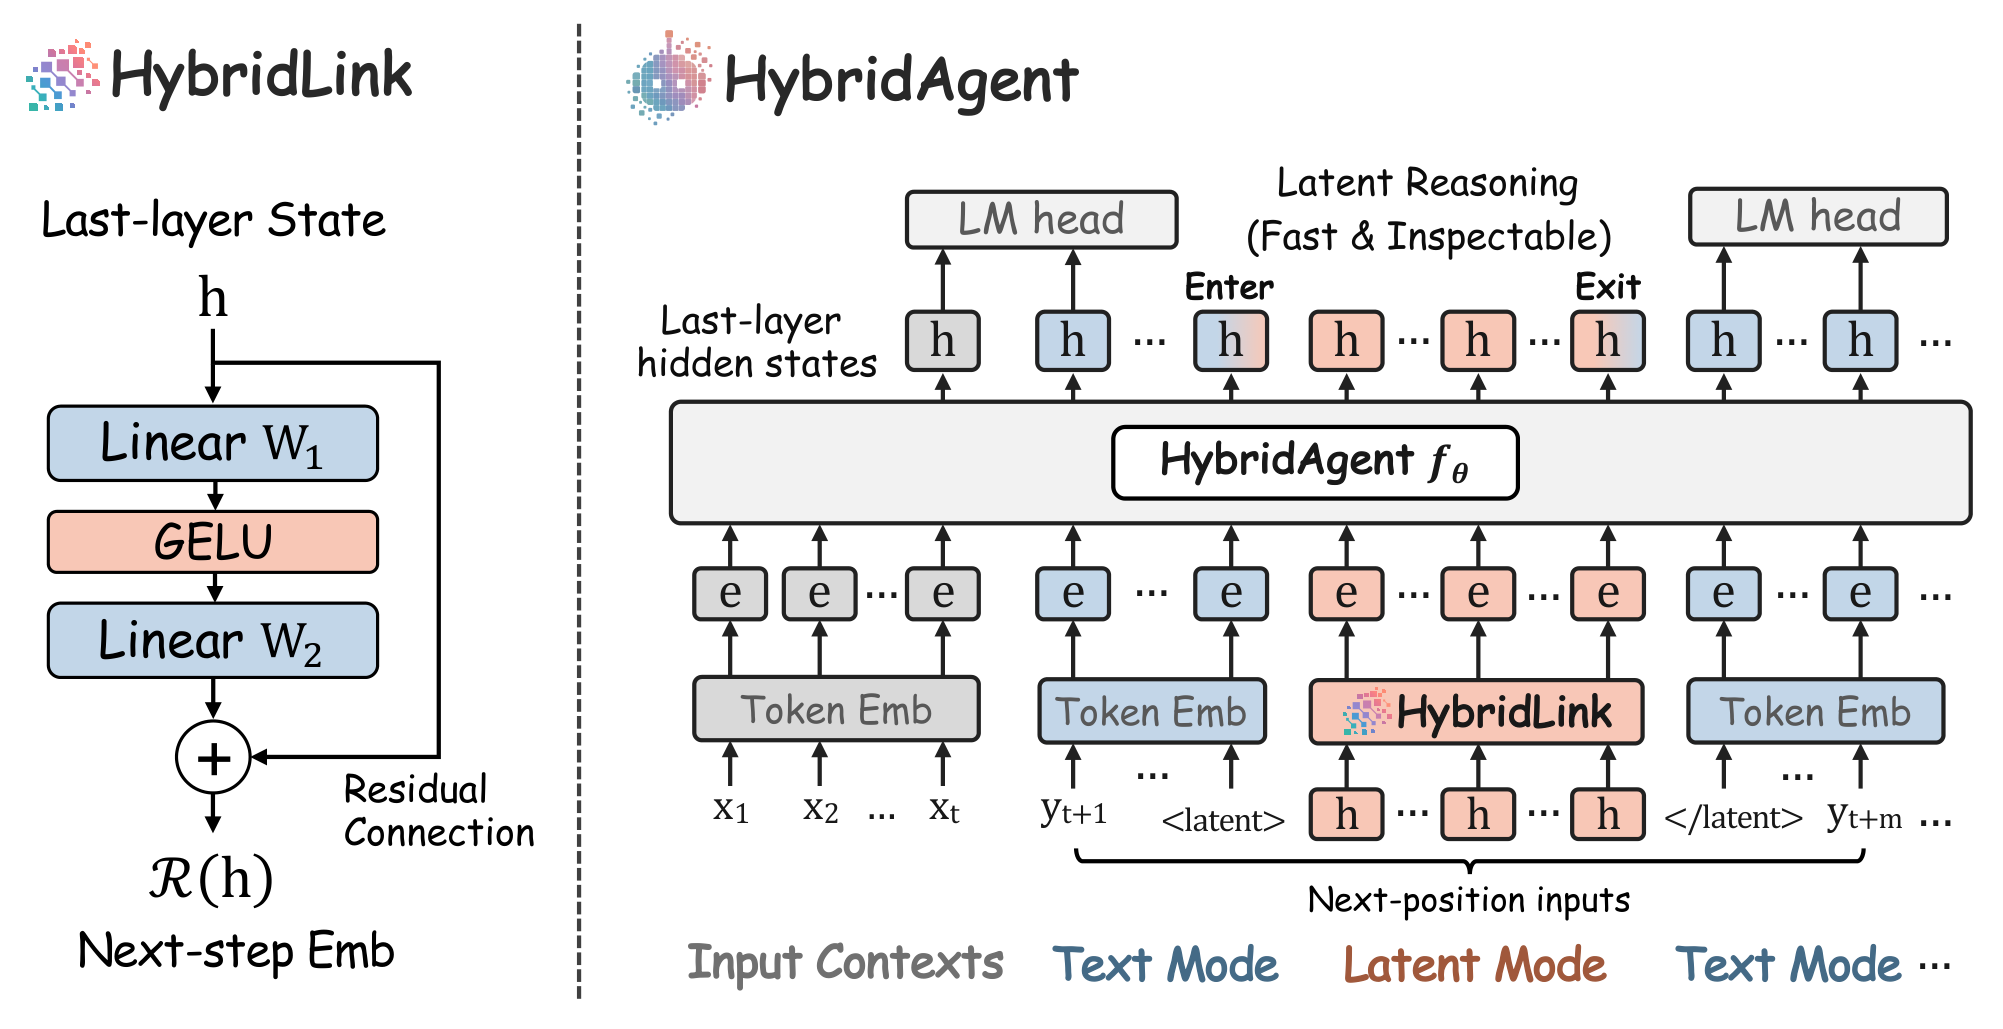
論文 Figure 1(Zou et al., 2026, CC BY 4.0)。左が HybridLink、右が文字モード → 潜在モード → 文字モードと切り替わる生成の流れ。
右側を左から読むと、最初は文字モードで普通に語を書き、<latent> という特別な語を書いたところで潜在モードに入ります。潜在モードの間は、LM ヘッド(語を選ぶ部分)を使わず、隠れ状態 h を HybridLink に通して次の入力にします。</latent> で潜在モードを抜けると、また文字モードに戻ります。
ここからは、この仕組みを 3 つの部品に分けて見ていきます。
部品 1:HybridLink は「数値のくせ」を直す翻訳係
Coconut のように隠れ状態をそのまま入力に戻すと、何が困るのでしょうか。
言語モデルの中では、入力側の「語の埋め込み」(語を数値の並びにしたもの)と、出力側の「隠れ状態」は、どちらも 4,096 個の数字の並びです。形は同じですが、数値の分布、いわばくせが違います。くせの違うものを入力に入れると、モデルは戸惑い、文字モードとの行き来がうまくいきません。
そこで HybridLink は、隠れ状態を「語の埋め込みらしい数値」に直してから入力に戻します。
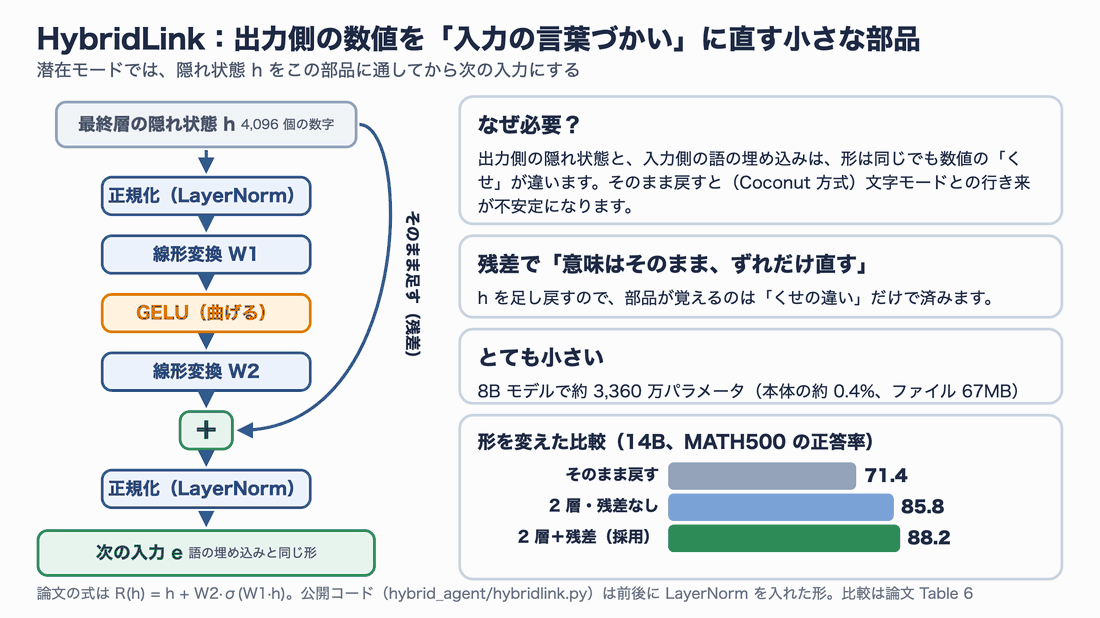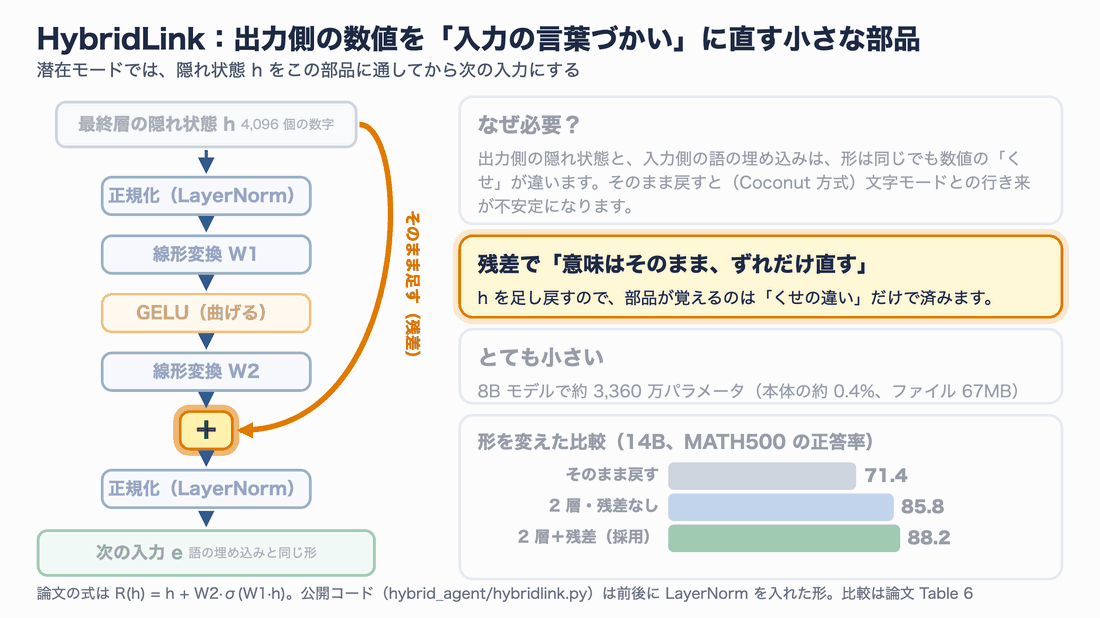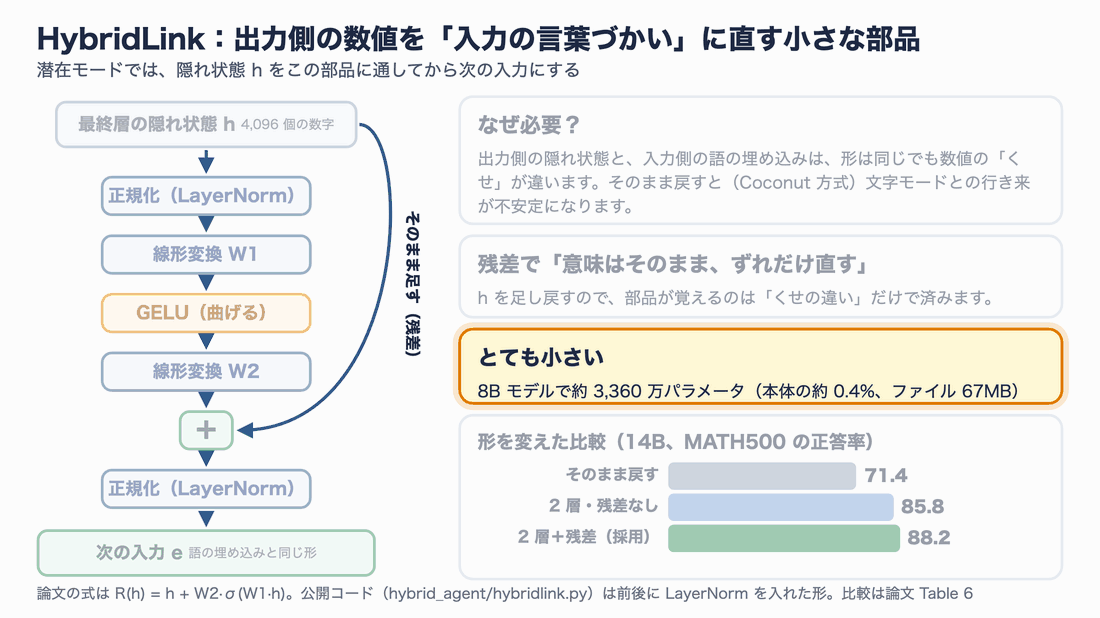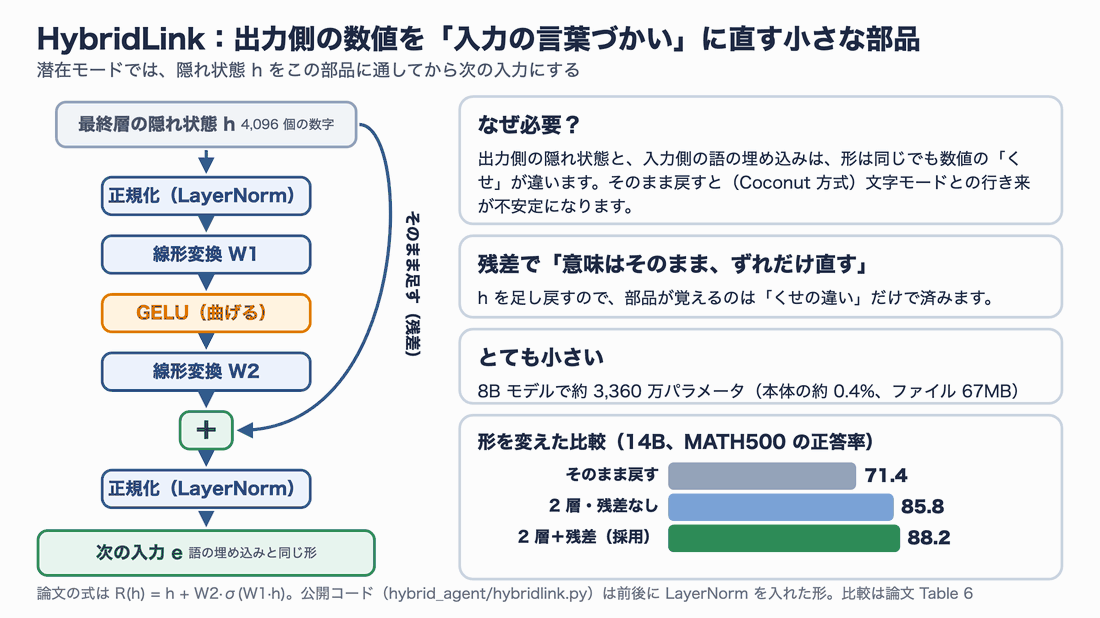
HybridLink は小さな 2 層のネットワーク。元の h を足し戻す「残差」のおかげで、意味はそのままにくせの違いだけを直せる。
注目したいのは残差接続(入力をそのまま出力に足す配線)です。h を足し戻すので、HybridLink がゼロから変換を覚える必要はなく、「くせの違い」だけを学べば済みます。論文の比較では、14B モデルの MATH500(数学の問題集)の正答率が、そのまま戻すと 71.4%、2 層で残差なしだと 85.8%、2 層+残差(採用した形)だと 88.2% でした。
大きさも小さく、8B モデルでは約 3,360 万パラメータ、本体の約 0.4% です。公開されている重みファイル(adapter.pt)は 67MB しかありません。
なお、論文の式は「h + 2 層の変換」ですが、公開コード(hybrid_agent/hybridlink.py)では前後に正規化(LayerNorm)が入っています。論文の説明は骨組みで、実装は安定させるための工夫を足した形だと読めます。
部品 2:入口と出口はモデル自身が決める
次に、文字モードと潜在モードをいつ切り替えるのかです。
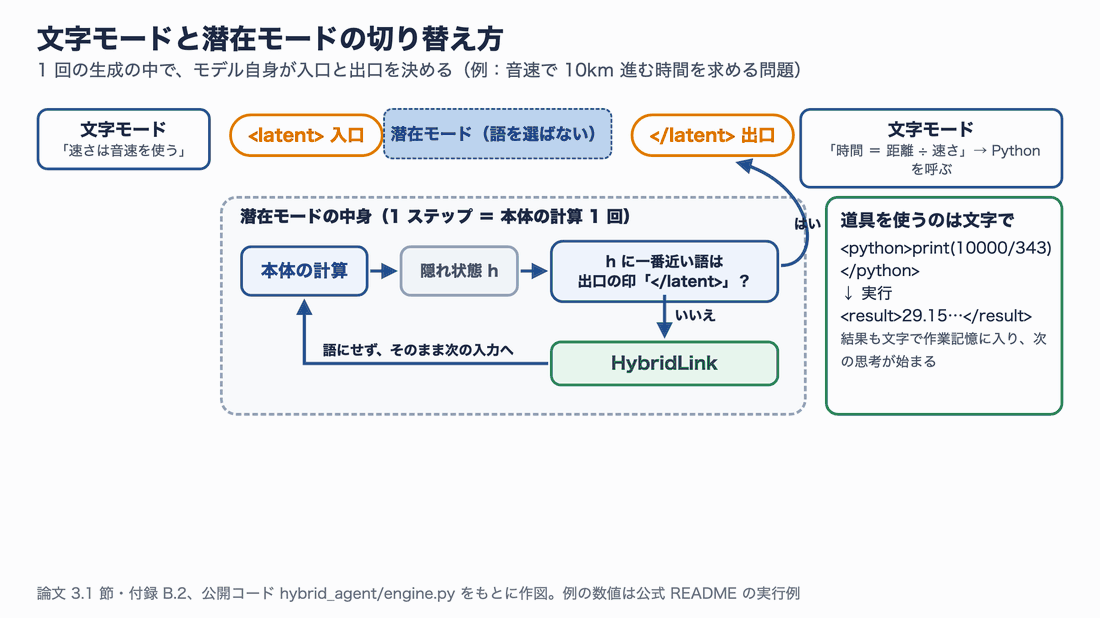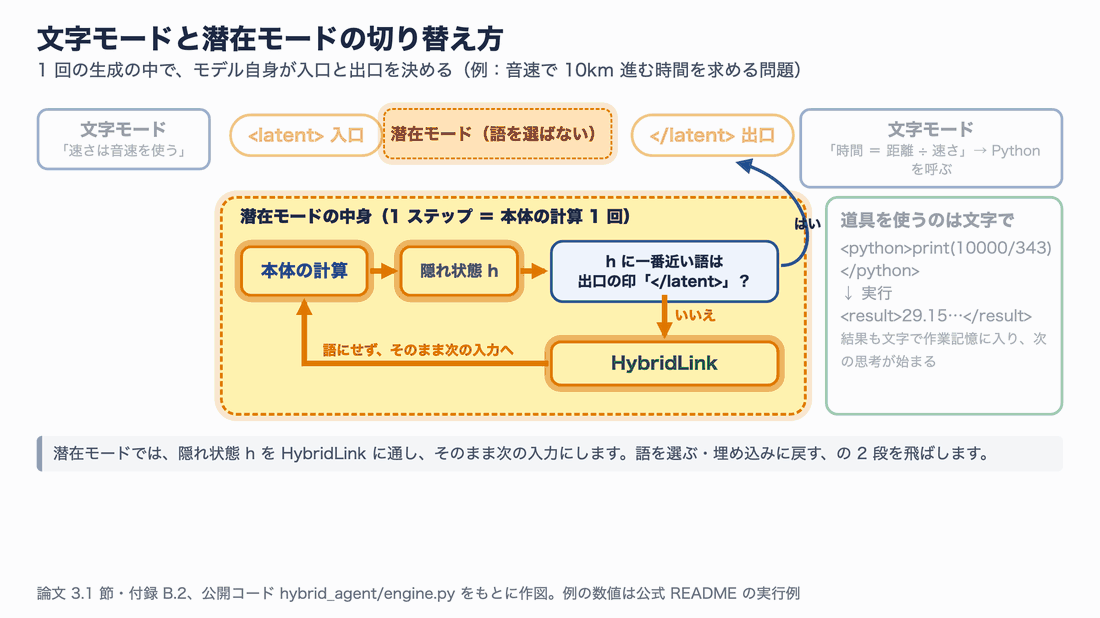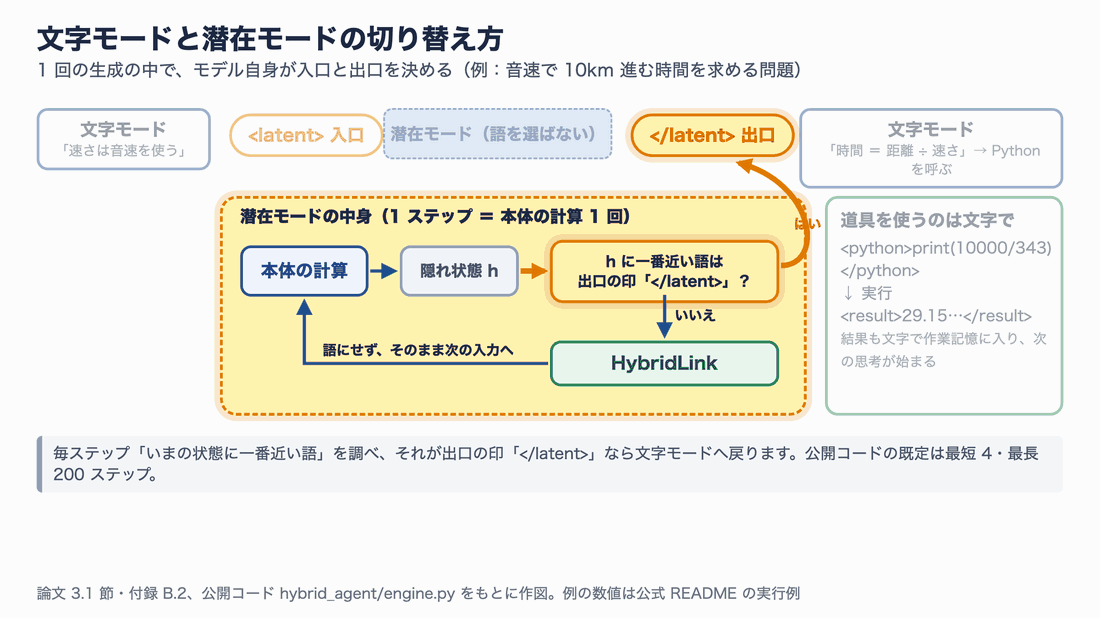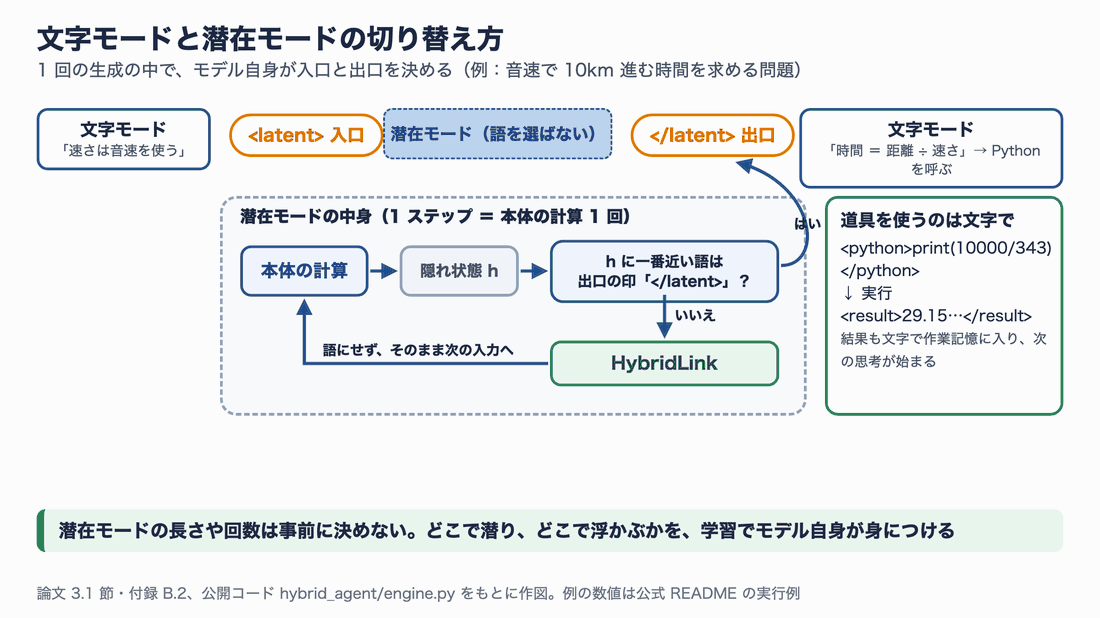
入口は普通の語として <latent> を選んだとき。出口は、潜在モードの各ステップで「いまの状態に一番近い語」が </latent> になったとき。
入口は簡単です。文字モードで次の語を選ぶとき、候補の中に <latent> という特別な語が入っていて、それが選ばれたら潜在モードに入ります。普通の語を選ぶのと同じ仕組みです。
出口は少し工夫されています。潜在モードでは語を選ばないので、「ここで出よう」と書く手段がありません。そこで、毎ステップ「いまの状態に一番近い語」を調べ、それが出口の印 </latent> になったら文字モードに戻ります。論文では HybridLink の出力に一番近い語の埋め込み(コサイン類似度)で判定すると説明しており、公開コードでは LM ヘッドが一番点数を付けた語で判定しています。どちらも「モデルが </latent> と言いたくなったら出る」という考え方は同じです。
公開コードの既定値では、潜在モードは最短 4 ステップ、最長 200 ステップです。それ以外は、どこで潜ってどれだけ考えるかを事前に決めていません。この「潜り方」は学習でモデル自身が身につけます。
道具を呼ぶときは、必ず文字モードです。<python>print(10000/343)</python> のように呼び出しを文字で書き、結果も <result>29.15…</result> のように文字で戻ってきます。ここが、潜在推論だけのモデルとの大きな違いです。
部品 3:作業記憶で「考えたこと」を次のターンへ持ち越す
エージェントは、考える → 道具を呼ぶ → 結果を読む → また考える、と何ターンも進みます。ここで、潜在の思考ならではの問題が出てきます。
普通のエージェントは、ターンが変わるたびに「それまでの履歴(文字)」を入力し直します。ところが潜在の思考は数値の並びなので、文字に戻せません。文字の履歴だけでは、前のターンで考えたことが抜け落ちてしまいます。
HybridAgent は、この問題を作業記憶で解きました。
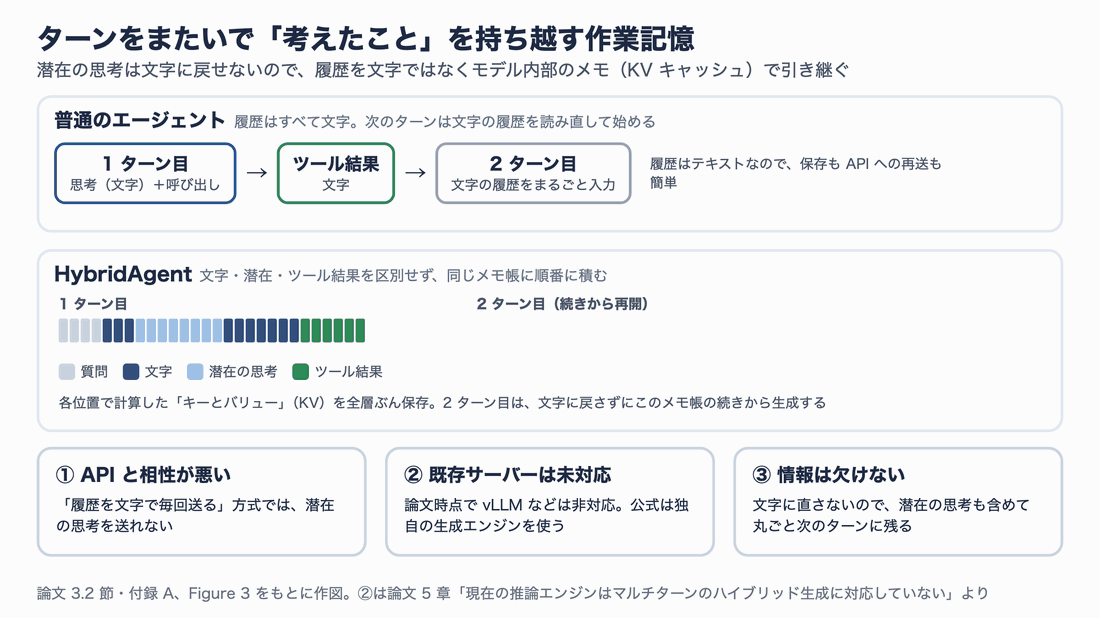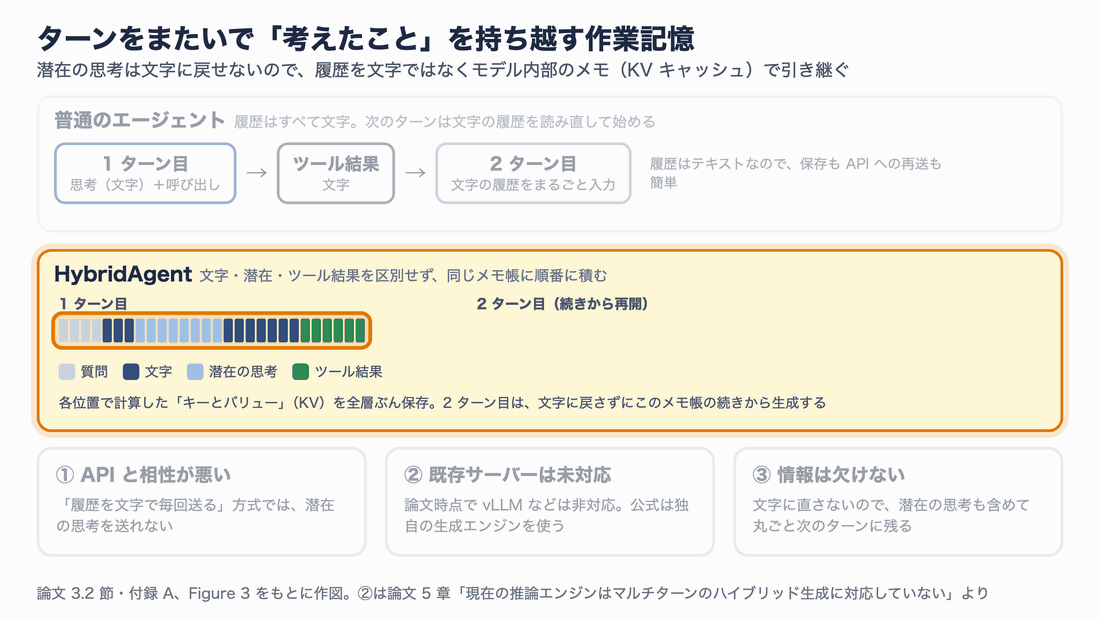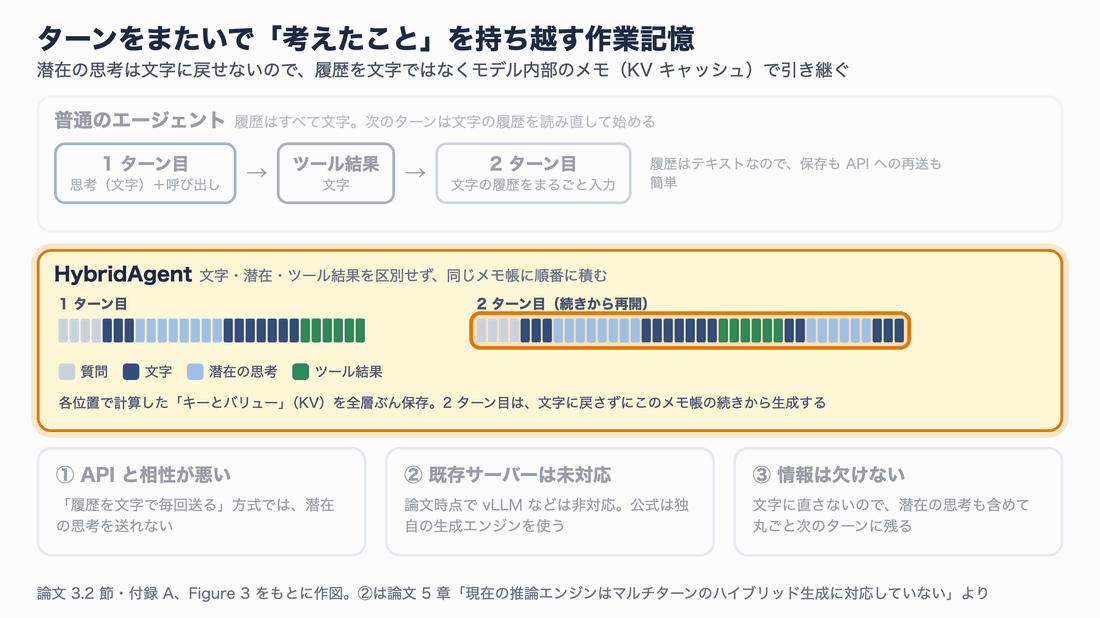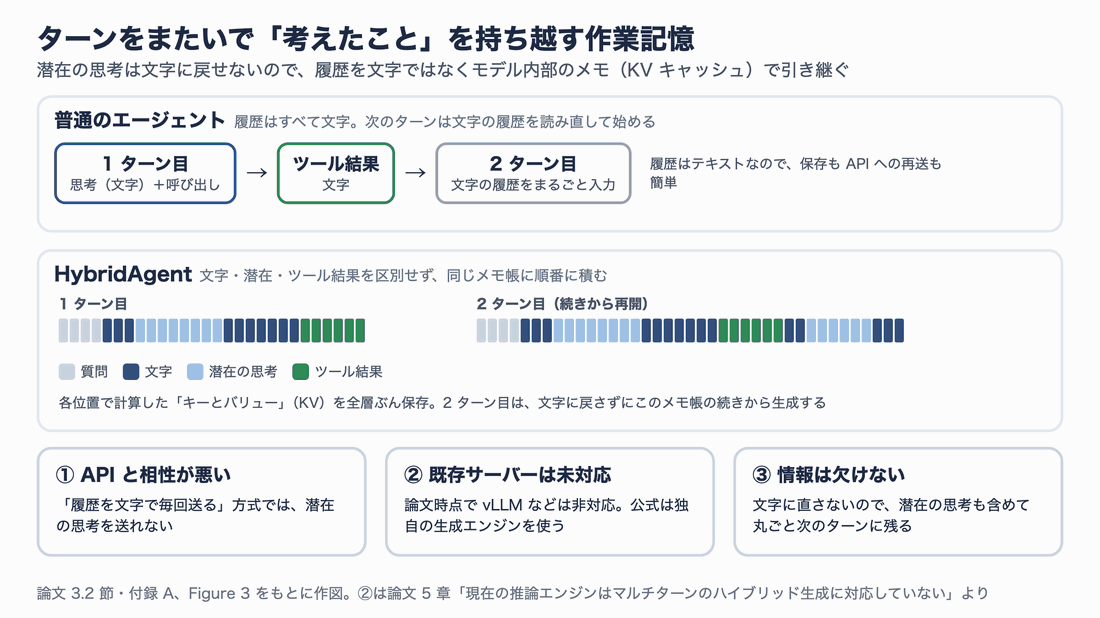
文字・潜在の思考・ツール結果を区別せず、モデル内部のメモ(KV キャッシュ)に順番に積む。次のターンは文字に戻さずに、このメモの続きから生成する。
言語モデルは、読み込んだ各位置について「キーとバリュー」(KV)という中間結果を計算し、次の語を書くときに参照します。普段は「同じ計算をくり返さないための一時保存(キャッシュ)」として使われるものです。HybridAgent は、この KV をターンをまたいで捨てずに持ち続け、作業記憶として使います。潜在の思考も KV の形なら保存できるので、情報が欠けません。
これは実用面で大きな意味があります。
- API と相性が悪い:Claude や GPT の API のように「会話の履歴を文字で毎回送る」方式では、潜在の思考を送れません。サーバー側で KV を持ち続ける仕組みが要ります
- 既存の推論サーバーは未対応:論文は、現在の推論エンジン(vLLM など)がこの「ターンをまたぐハイブリッド生成」に対応していないと明記しており、公式は独自の生成エンジンを用意しています
- 長い作業ほどメモリを使う:文字の履歴を要約して縮める、といった普段の工夫がそのままでは使えません
どうやって覚えさせたのか:3 段階の追加学習
HybridAgent は、モデルの作りをほとんど変えていないので、ゼロから学習し直す必要はありません。普通の LLM に、次の 3 段階の追加学習をします。
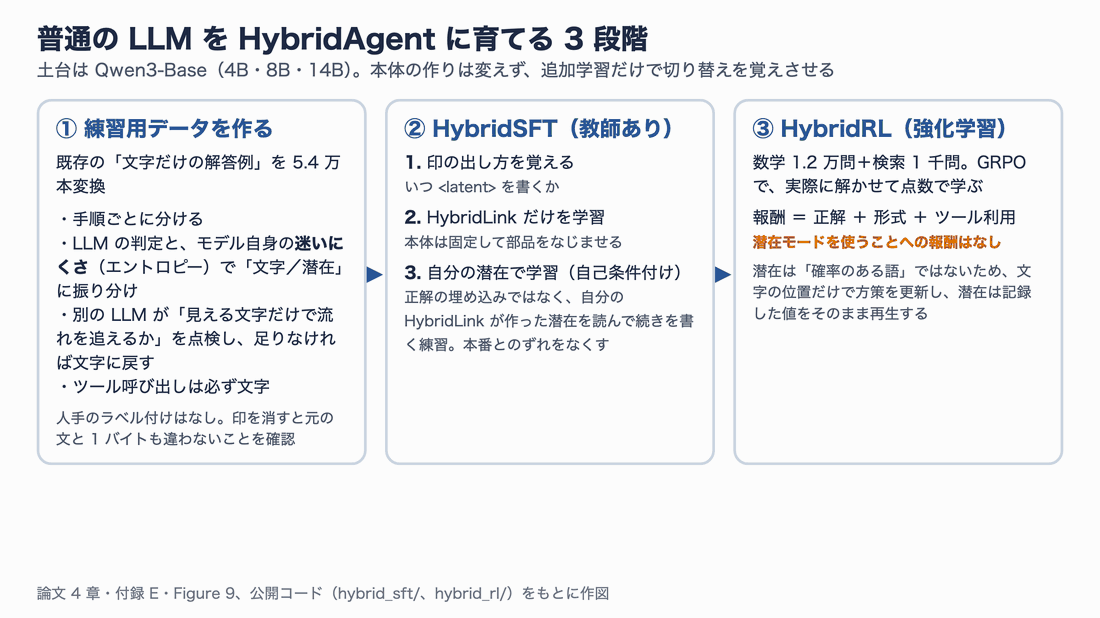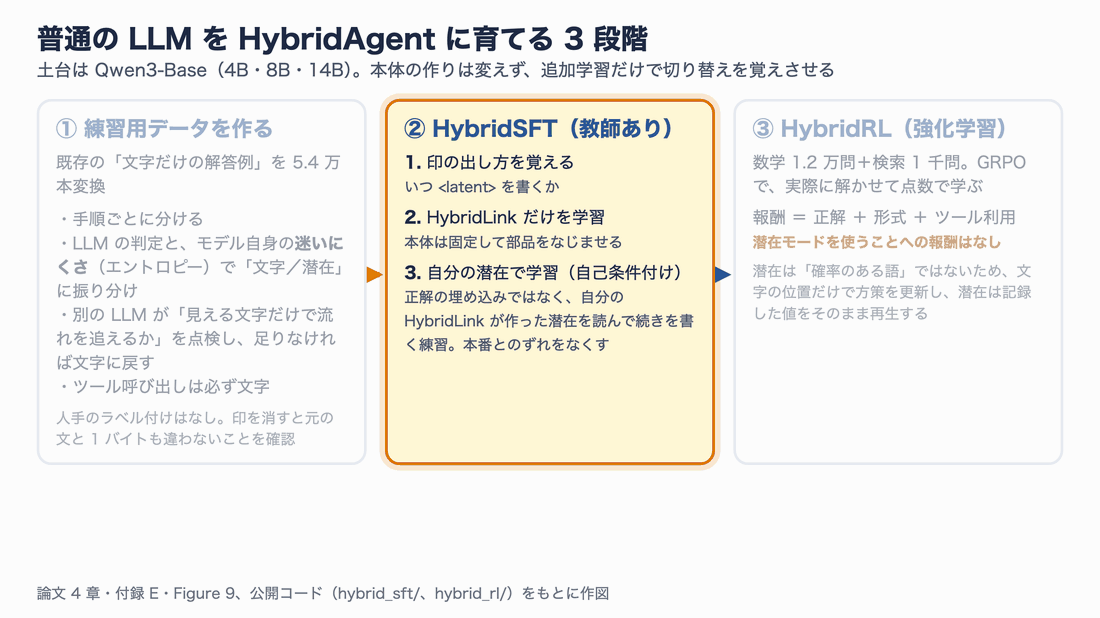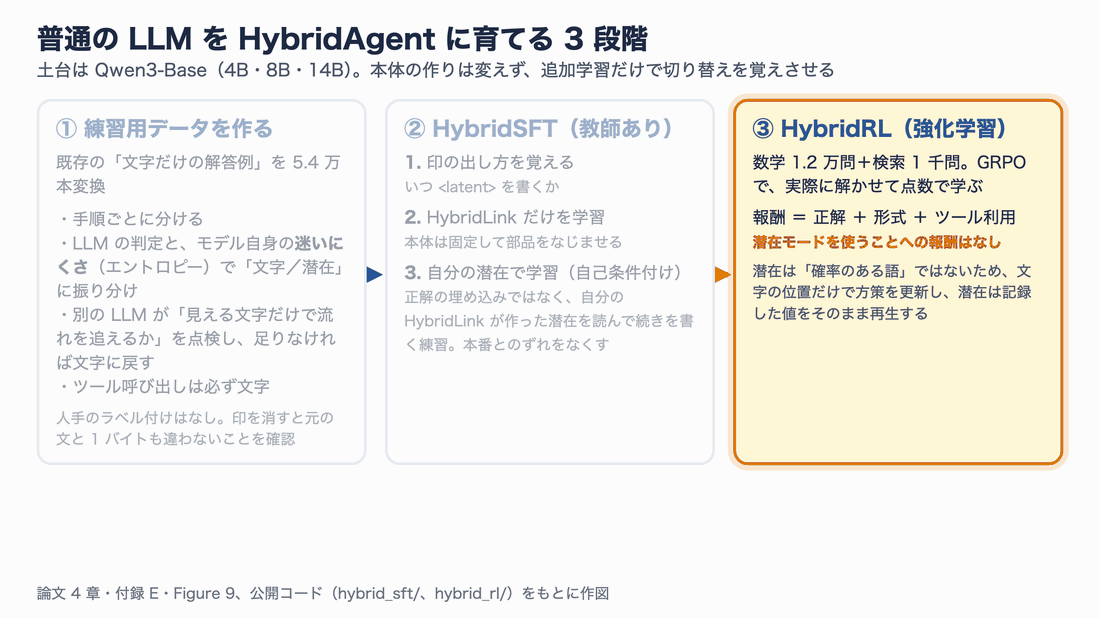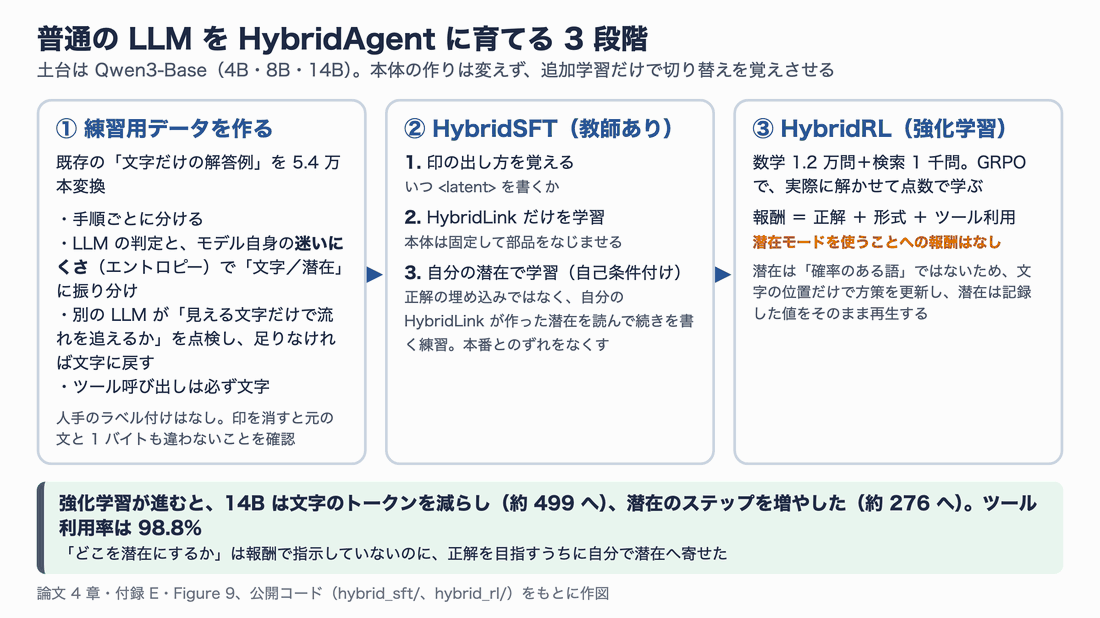
人手のラベル付けなしで練習用データを作り、教師あり学習(HybridSFT)で切り替えを安定させ、強化学習(HybridRL)で「いつ潜るか」を磨く。
① 練習用データを作る:既存の「文字だけの解答例」を 5.4 万本集め、手順ごとに「文字で書く部分」と「潜在にする部分」を自動で振り分けます。判断材料は、外部の LLM の判定と、土台のモデル自身のエントロピー(次の語をどれだけ迷うか)です。迷わず書ける手順は潜在へ、要点や道具の呼び出しは文字へ回します。最後に別の LLM が「見えている文字だけで流れを追えるか」を点検し、大事な情報が隠れていたら文字に戻します。
② HybridSFT(教師あり学習):まず <latent> を書くタイミングを覚え、次に本体を固定して HybridLink だけをなじませます。最後が肝心で、自分の HybridLink が作った潜在を読んで続きを書く練習をします。正解データの埋め込みだけで練習すると、本番で自分の作った少しずれた潜在を読んだときに崩れるからです。論文では、この「自己条件付け」を足すと数学 3 種の正答率が平均 30.5% 上がり、文字だけの学習と同じ水準に追いつきました。
③ HybridRL(強化学習):実際に問題を解かせ、正解したかどうかで学習します。報酬は「正解」「形式を守る」「道具を使う」の 3 つで、潜在モードを使うことへの報酬はありません。それでも学習が進むと、14B モデルは文字のトークンを減らして約 499 に、潜在のステップを増やして約 276 にしていきました。「どこを潜在にすれば正解しやすいか」を、モデルが自分で見つけたことになります。
技術的には、潜在の位置には「この語を選ぶ確率」がないため、普通の強化学習(GRPO など)をそのまま当てはめられません。論文は、文字の位置だけで学習すれば十分なことを示し、潜在の値は生成時に記録したものをそのまま再生して計算し直す方法で解決しています。
論文の結果を読む
軽さ:ステップが半分前後、時間は約半分
まず、どれだけ軽くなったかです。比べる相手は、同じ土台・同じ学習量で育てた「文字だけ」のエージェントです。
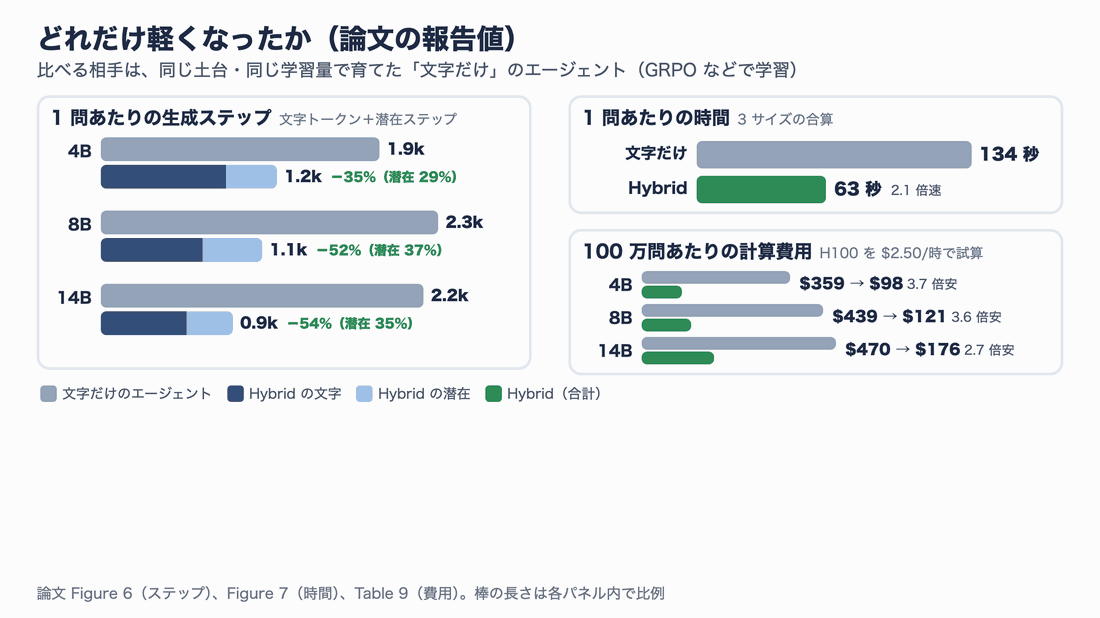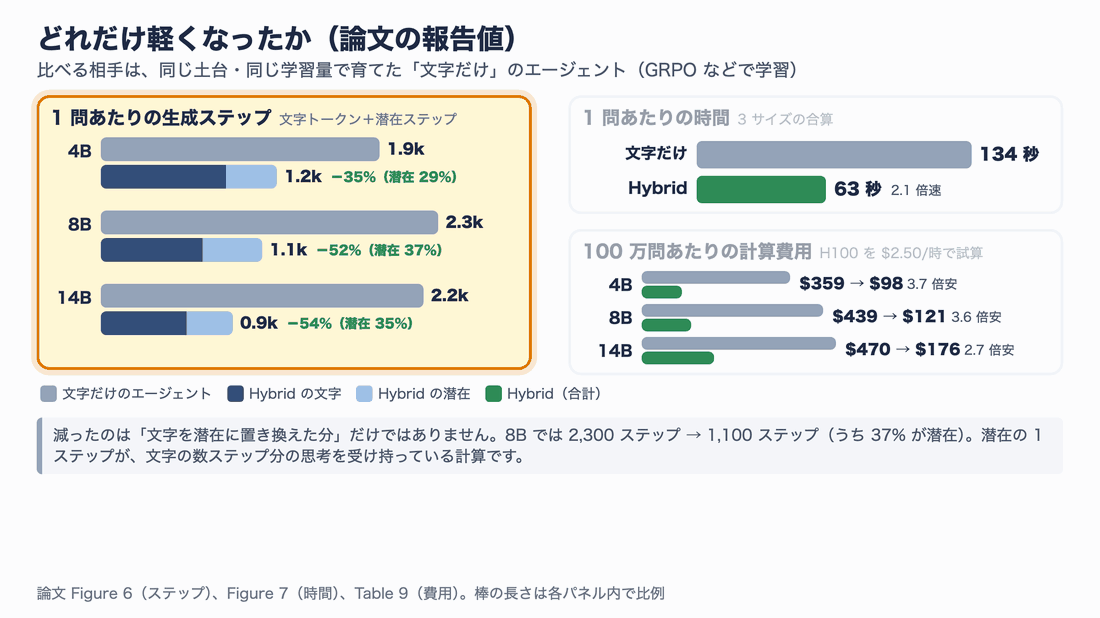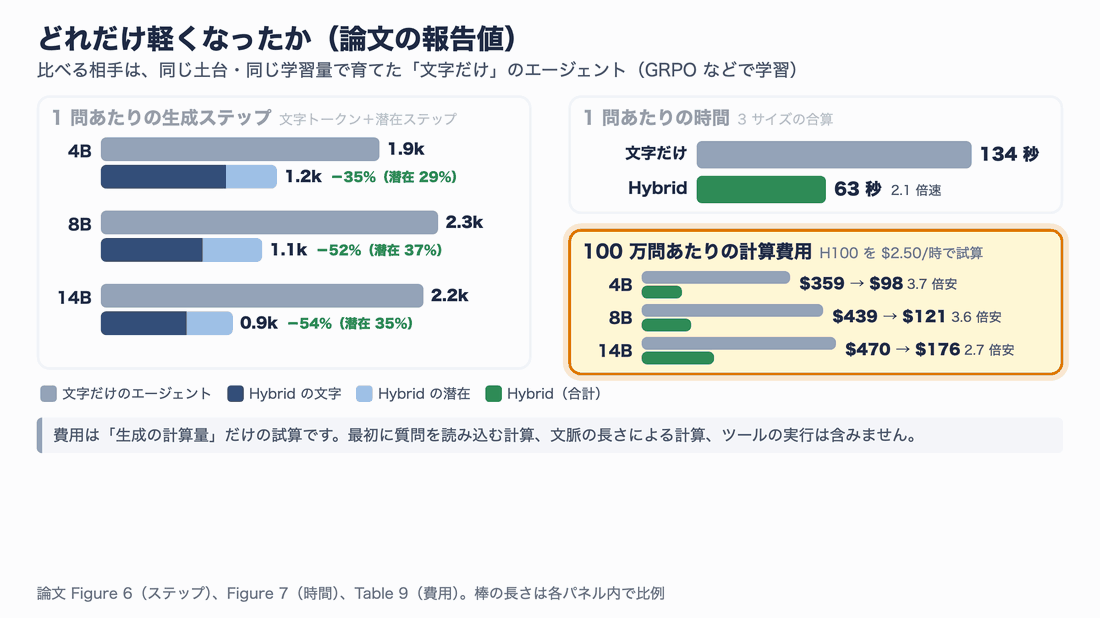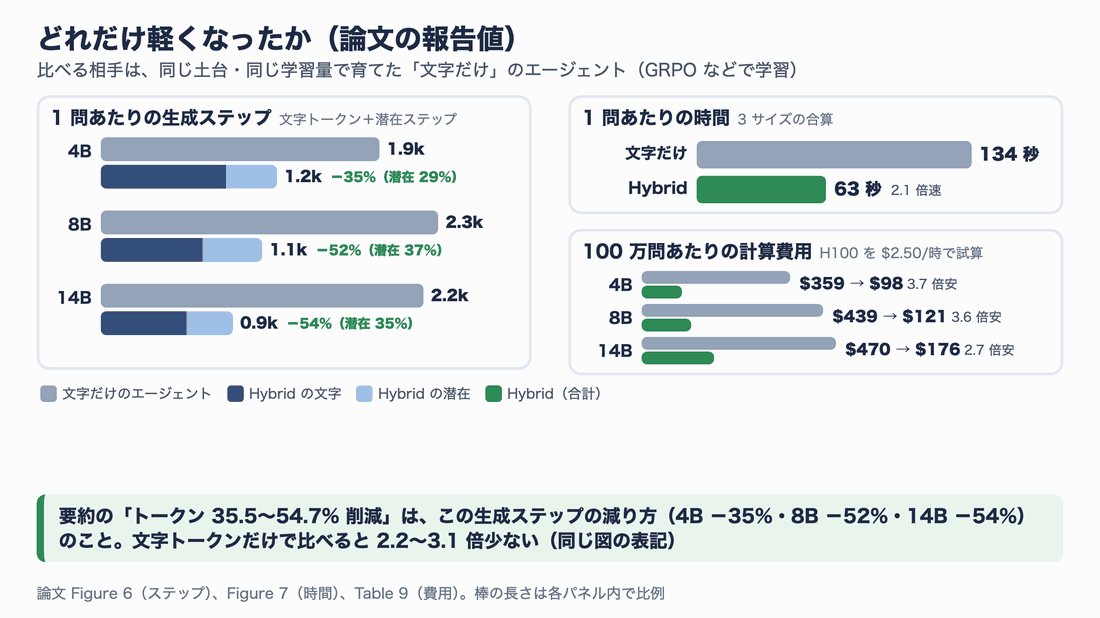
論文の要約にある「トークン 35.5〜54.7% 削減」は、生成ステップ(文字トークン+潜在ステップ)の減り方のこと。
ここで誤解しやすい点が 2 つあります。
1 つ目は、潜在の 1 ステップも、文字の 1 語と同じく本体の計算 1 回ぶんかかることです。潜在モードは「1 ステップが軽い」わけではありません。速くなるのは、ステップの総数が減るからです。8B では 2,300 ステップが 1,100 ステップになり、そのうち 37% が潜在でした。潜在の 1 ステップが、文字の数ステップ分の考えごとを受け持っている計算になります。
2 つ目は、費用の試算(Table 9)が「生成の計算量」だけを数えている点です。最初に質問を読み込む計算、文脈が長くなることによる計算、道具の実行時間は含まれていません。実際のサービスでの費用削減は、これより小さくなる可能性があります。
賢さ:同じ大きさ同士では全勝、大型モデルとは一長一短
軽くなっても、賢さが落ちては意味がありません。論文は数学・科学・医療・検索・エージェント課題の 11 種類のテストで評価しています。
数学と知識の課題(Table 2)では、8B の HybridAgent が MATH500 で 84.6%(文字だけの GRPO は 82.0%、ARPO は 82.8%)、AIME26 で 43.3%(同 39.4%、41.5%)と、同じ大きさの文字エージェントをすべての項目で上回りました。
エージェント系の課題(Table 1)は、比べる相手によって見え方が変わります。
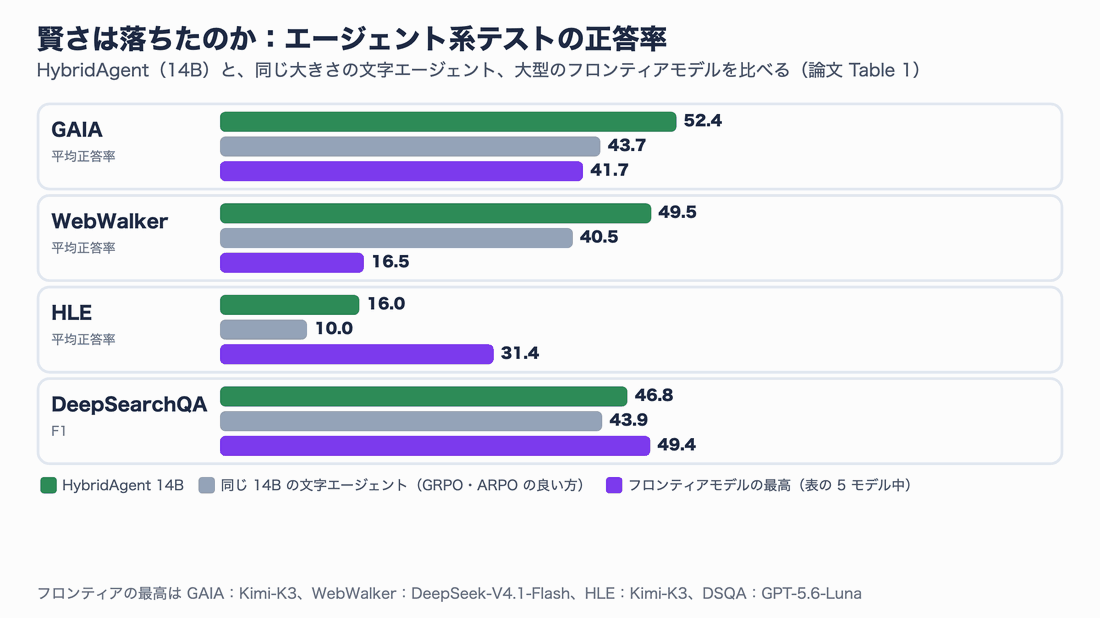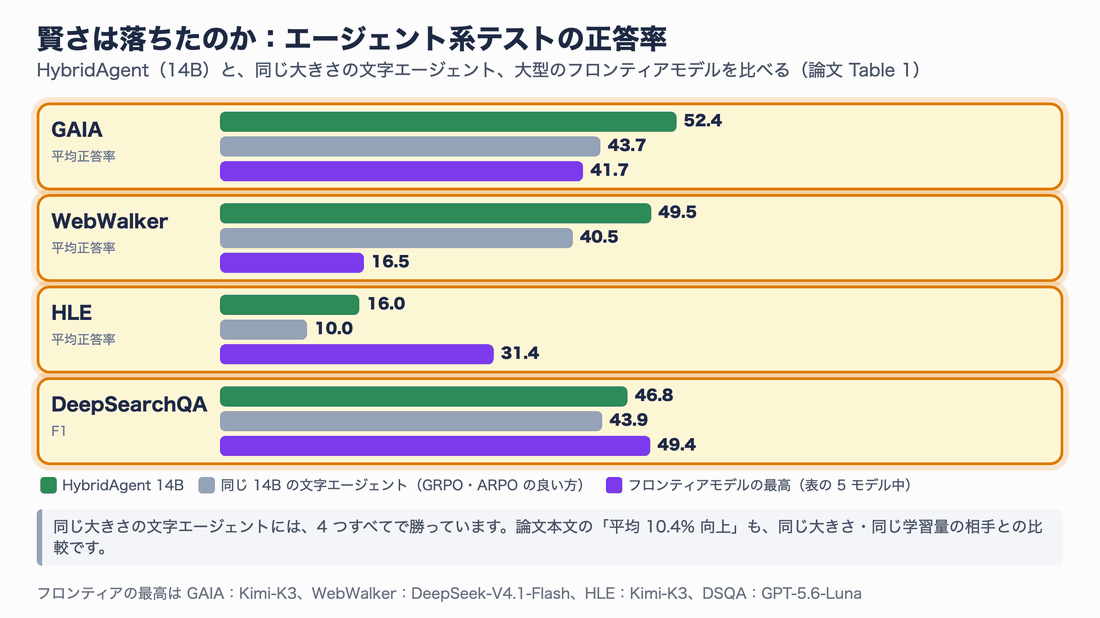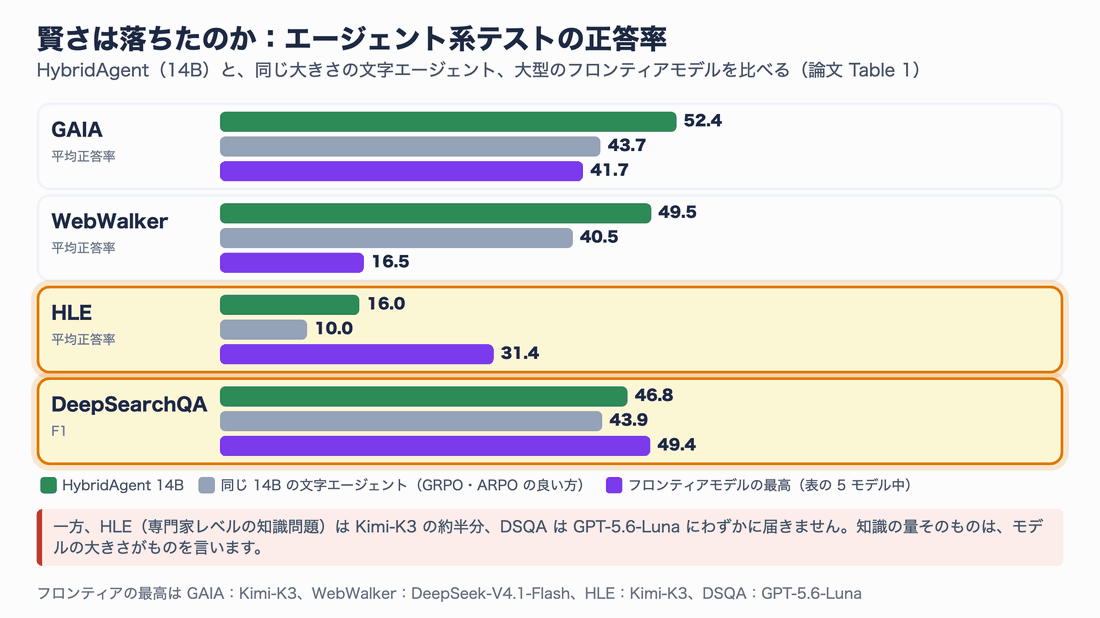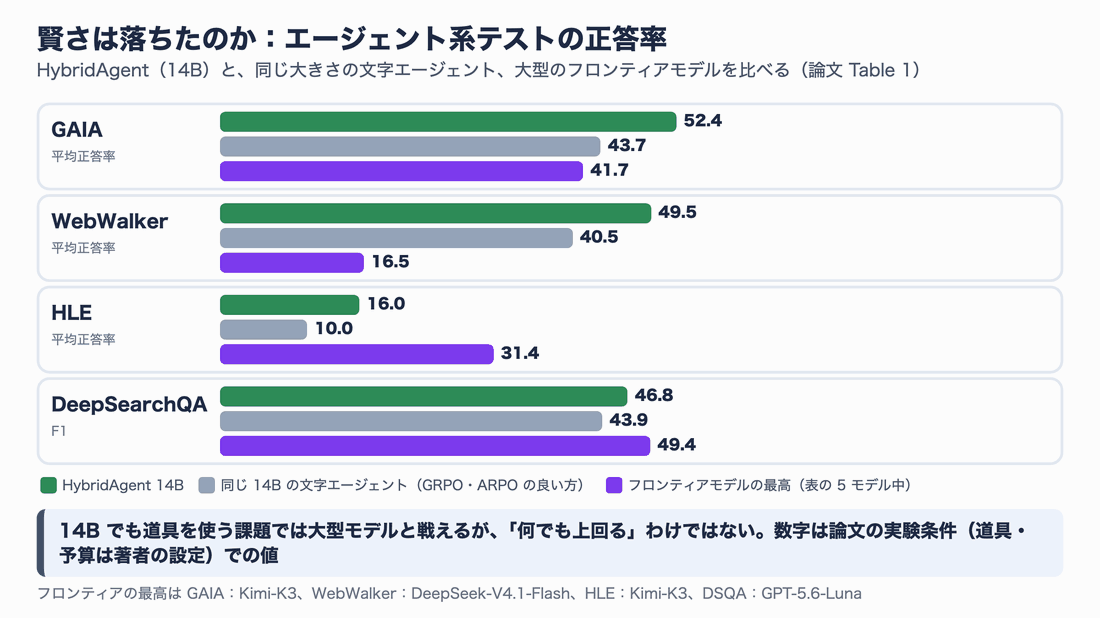
14B の HybridAgent は、同じ大きさの文字エージェントには 4 つすべてで勝つ。大型モデルには、道具を使う課題で勝ち、知識の課題で負ける。
要約で紹介されることの多い「平均 10.4% 向上」は、論文本文では同じ大きさ・同じ学習量のエージェントとの比較(強化学習の段階)として説明されています。大型のフロンティアモデル(GPT-5.6-Luna、Kimi-K3 など)と比べると、GAIA(調べものと道具の組み合わせ)や WebWalker(サイトの奥まで探す)では上回る一方、HLE(専門家レベルの知識問題)は Kimi-K3 の 31.4% に対して 16.0% と約半分でした。知識の量そのものは、モデルの大きさがものを言うということでしょう。
また、フロンティアモデルの数字は、著者が用意した道具・回数の上限など、論文の実験条件で測った値です。各社が公式に出している数字とは条件が違うので、そのまま並べないよう注意してください。
本当に潜在の思考を使っているのか
「潜在モードは、実は何もしていない飾りでは?」という疑問にも、論文は実験で答えています。8B と 14B の潜在ベクトルにわざと手を加え、MATH500 の正答率がどう変わるかを調べました。
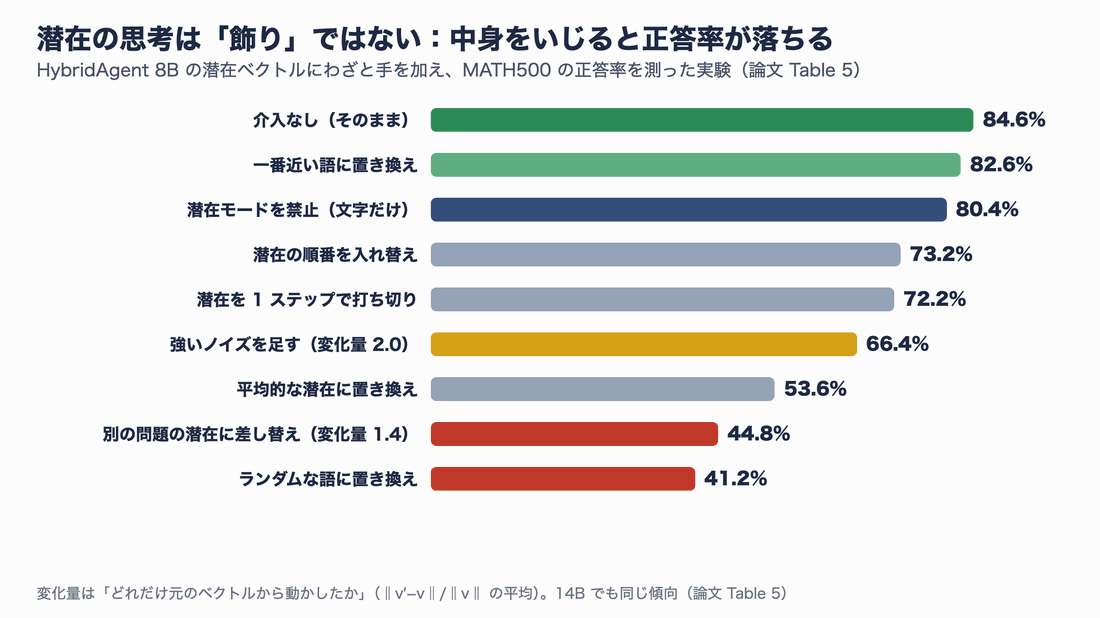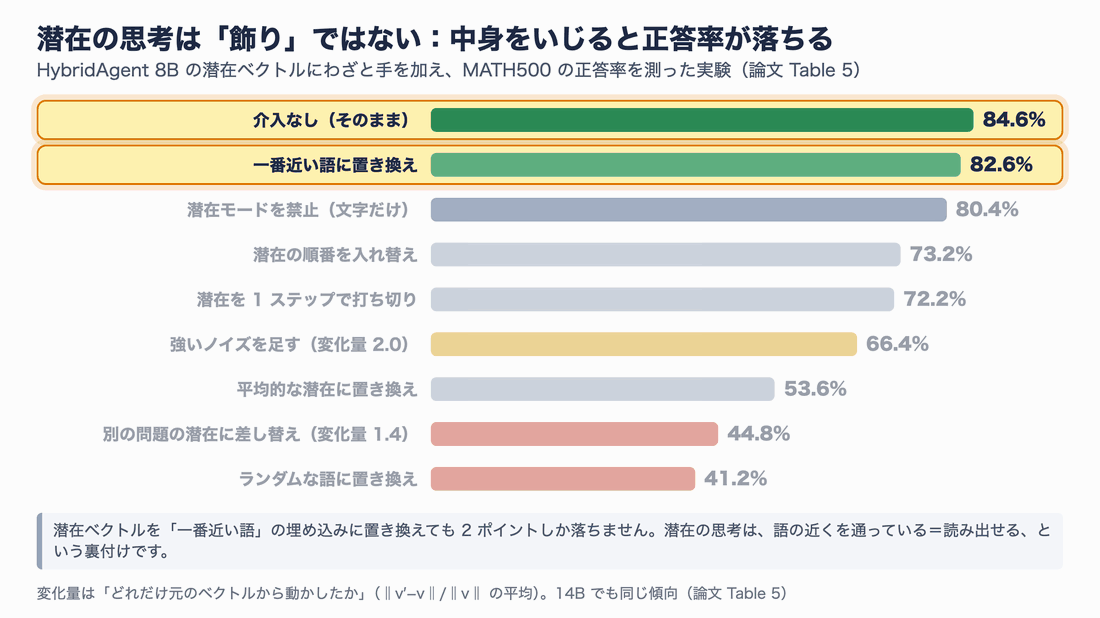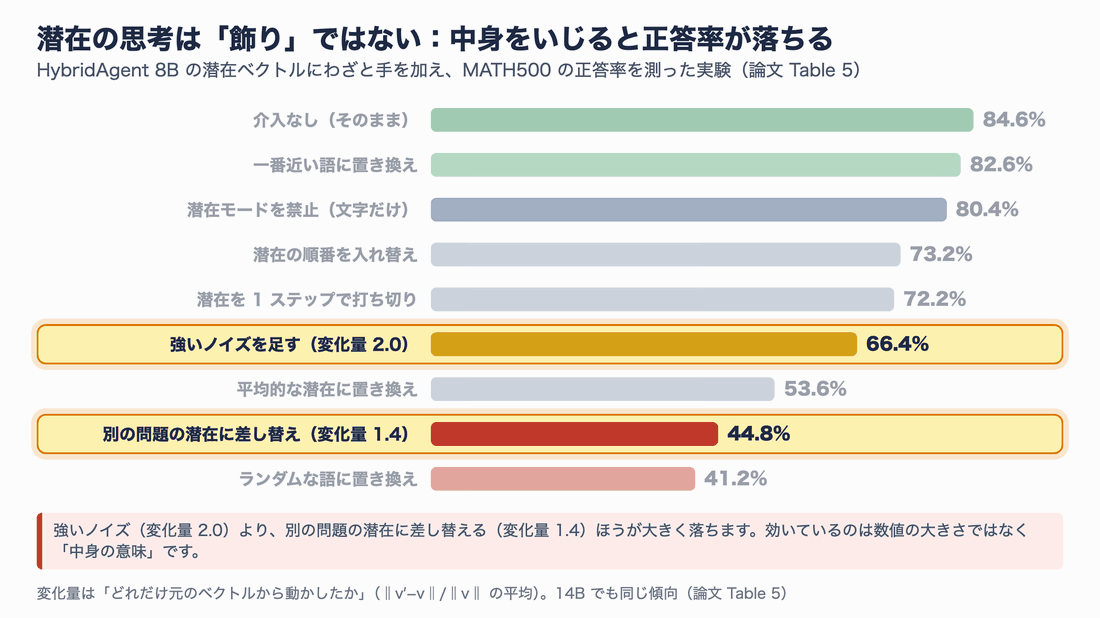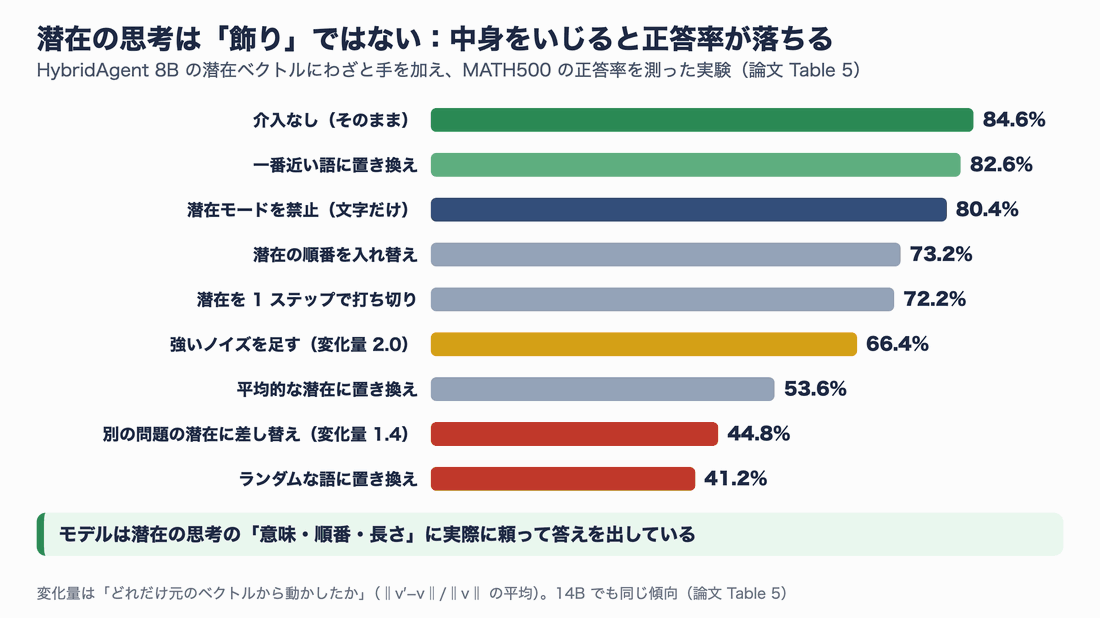
別の問題の潜在に差し替えると、強いノイズを足すより大きく落ちる。効いているのは数値の大きさではなく、中身の意味。
この結果から、3 つのことが読み取れます。
- 中身の意味が効いている:強いノイズ(元のベクトルから 2.0 倍ぶん動かす)より、別の問題の潜在に差し替える(1.4 倍ぶん)ほうが大きく落ちます
- 順番と長さも効いている:順番を入れ替える、1 ステップで打ち切ると、どちらも 10 ポイント以上落ちます
- 潜在の思考は語の近くを通っている:一番近い語の埋め込みに置き換えても 2 ポイントしか落ちません。これが、次に紹介する「中身を読み出せる」性質の裏付けになっています
潜在モードを禁止して文字だけで考えさせると 80.4% で、切り替えて使ったほうが正答率も高い結果でした。
外から監視できるのか
思考の一部が潜在になると、外から見える文字は減ります。それで監視ができるのかを、論文は数学 560 問で調べています(Table 7)。
| 指標 | HybridAgent 8B | 文字だけ 8B | HybridAgent 14B | 文字だけ 14B |
|---|---|---|---|---|
| 見える文字(1問あたり) | 302 トークン | 596 トークン | 284 トークン | 497 トークン |
| 潜在のステップ(1問あたり) | 170 | – | 183 | – |
| 弱い監視役が正誤を当てる精度(AUROC) | 0.840 | 0.772 | 0.860 | 0.818 |
| 強い監視役の精度(AUROC) | 0.961 | 0.935 | 0.989 | 0.990 |
| 失敗した解答で最初の誤りを特定できた割合 | 99.2% | 94.2% | 98.1% | 100.0% |
見える文字は半分近くに減りましたが、監視役(GPT-4o-mini や GPT-5.6-Luna)が正誤を当てる精度はほぼ同じか高めでした。HybridAgent は要点だけを文字で書くので、100 トークンあたりの「大事な手順」の数がかえって 26〜28% 増えているのが理由だと、論文は説明しています。
ただし、これは「見える文字だけで監視できるか」の実験で、潜在部分に何かが隠れていないことの証明ではありません。この点は後の「限界」で触れます。
Mac で動かしてみた
ここからは手元の実験です。公開されている HybridAgent-8B-Agentic を、Mac の GPU(Apple Silicon の MPS)で動かしました。
環境
| 項目 | 内容 |
|---|---|
| マシン | Apple M5 Max、メモリ 128GB、macOS 26 |
| Python | 3.12(uv で仮想環境) |
| 主なライブラリ | torch 2.11.0、transformers 5.13.0(公式 requirements.txt と同じ版) |
| モデル | togethercomputer/HybridAgent-8B-Agentic(bf16、約 16.4GB) |
| ツール | Python のみ(サンドボックス内で実行)。検索ツール(Tavily)は使わず「結果なし」を返す代役 |
| 生成設定 | 公式の既定値(温度 0.6、top-p 0.95、top-k 20、最大 4,096 ステップ、道具は 5 回まで) |
公式の README は CUDA(NVIDIA の GPU)向けの手順ですが、コードの中身は PyTorch と transformers だけで書かれており、Mac でも少しの変更で動きました。
手順 1:コードとモデルを用意する
# 作業フォルダを作って公式コードを取得する
mkdir -p ~/hybridagent-lab && cd ~/hybridagent-lab
git clone https://github.com/togethercomputer/HybridAgent.git

# Python 3.12 の仮想環境を作り、公式と同じ版のライブラリを入れる
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python torch==2.11.0 transformers==5.13.0 accelerate==1.14.0 \
  safetensors==0.8.0 tokenizers==0.22.2 huggingface-hub==1.22.0 numpy pandas pyarrow \
  math-verify==0.9.0 python-dotenv tqdm tavily-python datasets
uv pip install --python .venv/bin/python --no-deps -e HybridAgent

# 8B モデル(約 16.4GB)をダウンロードする
.venv/bin/hf download togethercomputer/HybridAgent-8B-Agentic --local-dir models/HybridAgent-8B-Agentic
ダウンロードが途中で極端に遅くなったときは、hf download を止めて curl -C - で続きから取り直すと速くなりました(後述のトラブルシューティング参照)。
手順 2:モデルが書いた Python をサンドボックスに閉じ込める
HybridAgent は、問題を解く途中で Python のコードを書いて実行します。公式の Python ツールには時間とメモリの制限がありますが、コードの注釈にも「セキュリティのサンドボックスではない」と書かれており、生成されたコードはあなたの権限でファイルにもネットにも触れます。
そこで macOS 標準の sandbox-exec を使い、ネットワークを遮断し、書き込みを作業用フォルダだけに絞りました。以下は mac/ フォルダに置く 2 つのファイルです(パスは自分の環境に合わせて書き換えてください)。
; mac/python-sandbox.sb:モデルが書いた Python 用のサンドボックス設定
(version 1)
(allow default)
; ネットワークに出さない
(deny network*)
; 書き込みは作業用フォルダだけ
(deny file-write*)
(allow file-write* (subpath "/Users/<YOU>/hybridagent-lab/mac/pytmp") (literal "/dev/null") (regex #"^/dev/fd/"))
; ホームの中は Python 本体と作業用フォルダ以外の中身を読ませない
(deny file-read-data (subpath "/Users/<YOU>"))
(allow file-read-data (literal "/Users/<YOU>") (subpath "/Users/<YOU>/hybridagent-lab/.venv")
       (subpath "/Users/<YOU>/.local/share/uv") (subpath "/Users/<YOU>/hybridagent-lab/mac/pytmp"))
#!/bin/sh
# mac/sbpython:サンドボックスの中で仮想環境の Python を動かす
cd "/Users/<YOU>/hybridagent-lab/mac/pytmp"
export TMPDIR="/Users/<YOU>/hybridagent-lab/mac/pytmp" HOME="/Users/<YOU>/hybridagent-lab/mac/pytmp" PYTHONDONTWRITEBYTECODE=1
exec /usr/bin/sandbox-exec -f "/Users/<YOU>/hybridagent-lab/mac/python-sandbox.sb" \
  "/Users/<YOU>/hybridagent-lab/.venv/bin/python" "$@"
# 動作確認:計算はできるが、ホームへの書き込み・設定ファイルの読み取り・通信はできない
mkdir -p mac/pytmp && chmod +x mac/sbpython
mac/sbpython -c "import math; print(math.factorial(10))"                  # 3628800
mac/sbpython -c "open('/Users/<YOU>/Desktop/x.txt','w')"                   # PermissionError
mac/sbpython -c "print(open('/Users/<YOU>/.zshrc').read())"                # PermissionError
mac/sbpython -c "import urllib.request as u; u.urlopen('https://example.com')"  # URLError
realpath が親フォルダの情報を読むため、file-read* をまるごと禁止すると Python が起動しません。中身の読み取り(file-read-data)だけを禁止するのがコツです。
手順 3:Mac 用の実行スクリプトを書く
公式の実行スクリプトは、GPU が CUDA でなければ CPU を選ぶ作りなので、Mac の GPU(MPS)を使う薄いスクリプトを用意しました。公式の生成エンジン(HybridGenerationEngine)をそのまま使い、次の 3 点だけを足しています。
- 装置に
mpsを指定し、乱数の生成器も MPS 上に作る - Python ツールをサンドボックス版に差し替え、検索ツールは「結果なし」を返す代役にする
- 比較用に、
<latent>を選べないようにして「潜在モード禁止(文字だけ)」でも動かせるようにする
# mac/run_mac.py(抜粋)。全文は記事末尾の「付録」に掲載
class MacEngine(HybridGenerationEngine):
    """ステップごとの時間を入力の種類別に集計する。block_latent=True なら <latent> を出させない。"""

    def __init__(self, *args, block_latent: bool = False, **kwargs):
        super().__init__(*args, **kwargs)
        self.step_time = {"latent": 0.0, "text": 0.0, "feed": 0.0}
        self.step_count = {"latent": 0, "text": 0, "feed": 0}
        if block_latent:
            # 文字モードで <latent> を選べないようにする(潜在モード禁止)
            for key in self._blocked_masks:
                self._blocked_masks[key] = self._blocked_masks[key].clone()
                self._blocked_masks[key][self.latent_open_id] = True

    @torch.no_grad()
    def _lockstep_forward(self, inputs_embeds, real_rows):
        # このステップの入力が「潜在」「文字」「ツール結果」のどれかを記録して時間を測る
        mode = self.rows[0].mode
        kind = "latent" if mode == LATENT else "feed" if mode == FEED else "text"
        t0 = time.perf_counter()
        super()._lockstep_forward(inputs_embeds, real_rows)
        torch.mps.synchronize()  # MPS は非同期なので、待ってから時間を測る
        self.step_time[kind] += time.perf_counter() - t0
        self.step_count[kind] += 1
# 問題ファイル(1 行に {"id", "question", "answer"})を、ハイブリッドと潜在モード禁止で交互に解く
# 結果は results/math30-hybrid.jsonl と results/math30-text.jsonl に追記される(途中から再開できる)
cd mac
../.venv/bin/python run_mac.py --model ../models/HybridAgent-8B-Agentic \
  --questions math500_sample.jsonl --mode both --out results/math30
math500_sample.jsonl は、MATH500(HuggingFaceH4/MATH-500)から難易度 1〜5 を 6 問ずつ選んだファイルです。
結果 1:潜在モードの中身を読んでみる
まずは公式の例題「100! の末尾に 0 はいくつ並ぶか」(答えは 24)を解かせました。ターミナルには、次のような 1 行が出ます。
[1/1] q4 hybrid ok=True pred='24' gold='24' text=430 latent=78 steps=508 py=1 t=27.9s end=eos
文字 430 トークン、潜在 78 ステップ、Python を 1 回呼んで、正解の 24 にたどり着きました。生成ステップのうち潜在は 15% です。
この記録を公式の可視化ツール(interpretable_latent_mode)で HTML にすると、潜在の思考が擬似テキストとして文字の思考の間に表示されます。次の画像は、手元で作った HTML を開いて撮ったものです。
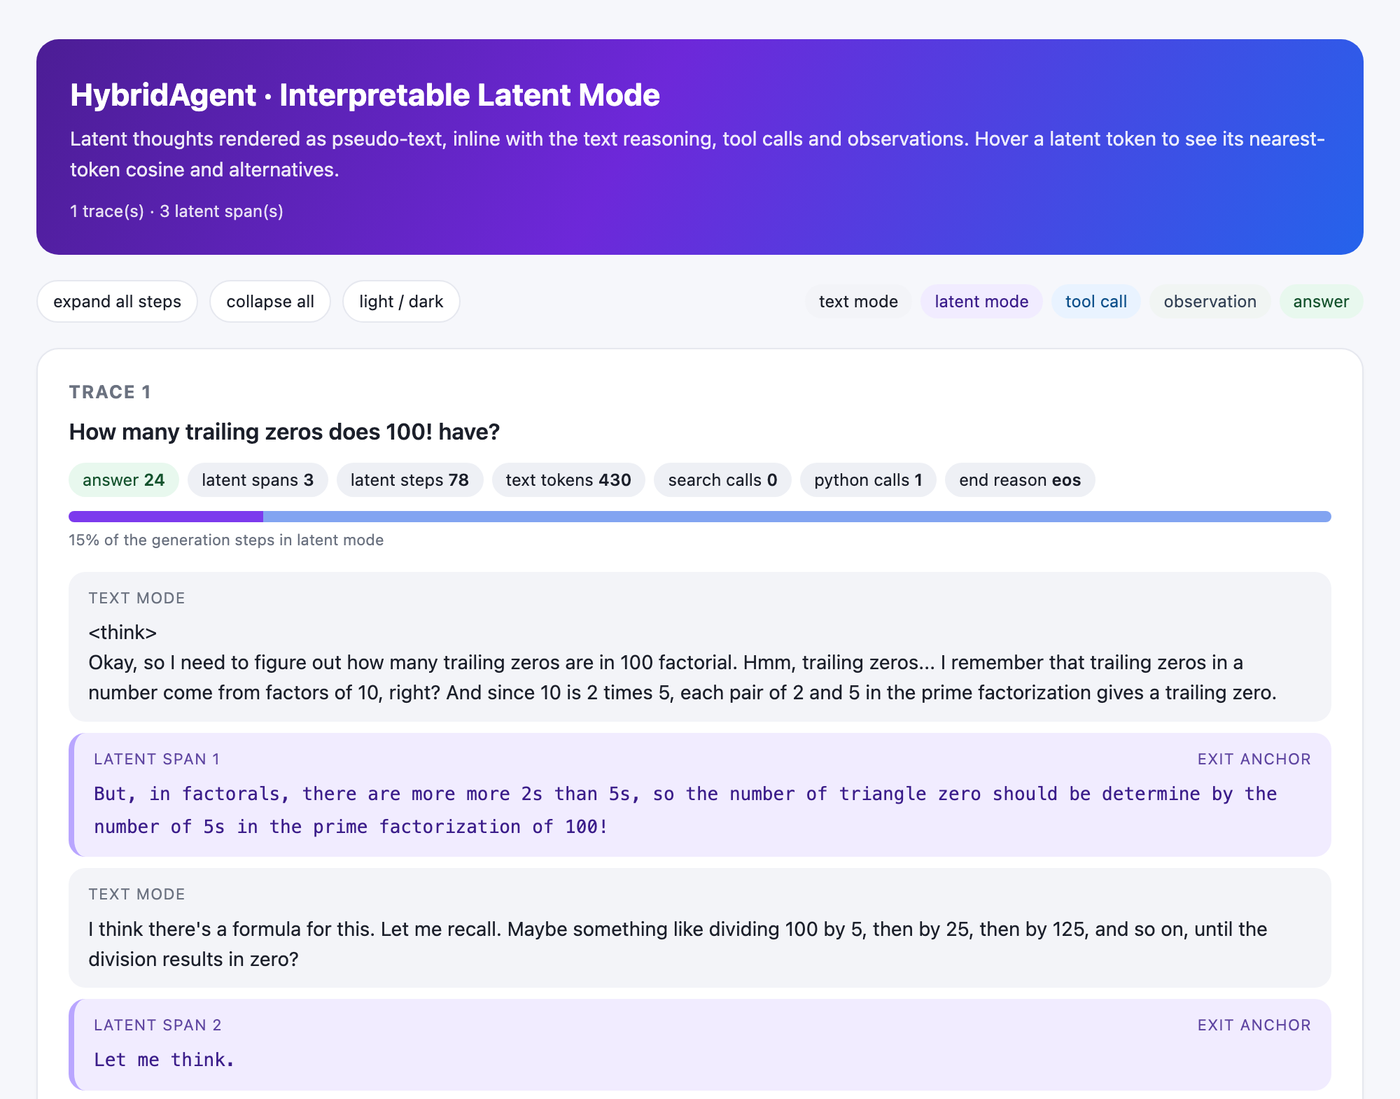
手元の Mac で作った公式レポートの実画面(上部のみ)。紫の枠が潜在モードの区間で、中身は「一番近い語」を並べた擬似テキスト。
この擬似テキストがどう作られているのかを、図で確かめておきましょう。
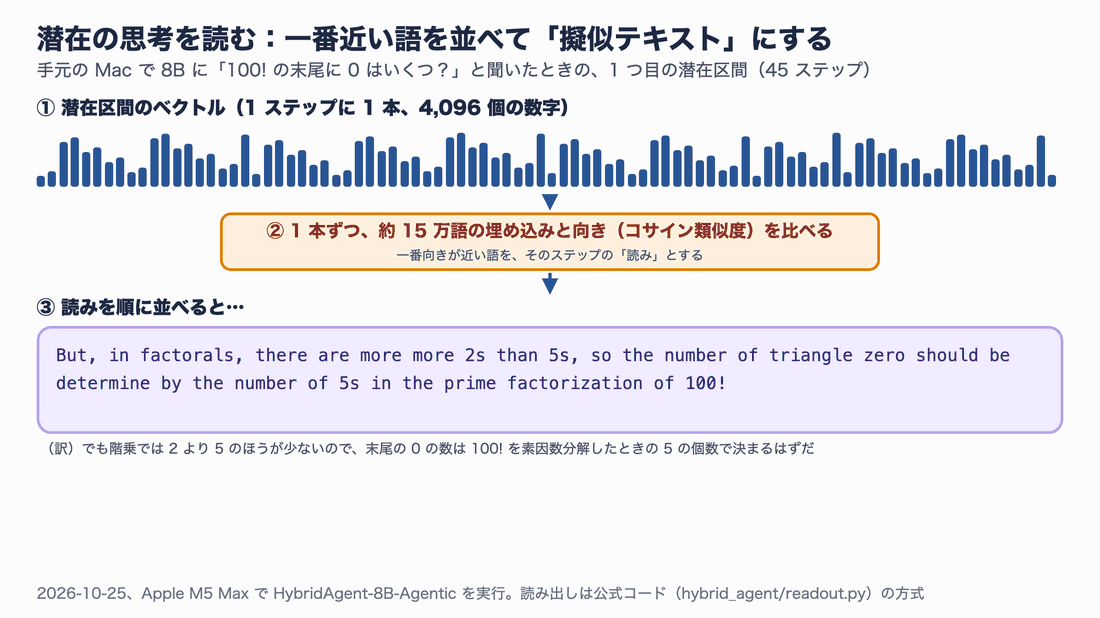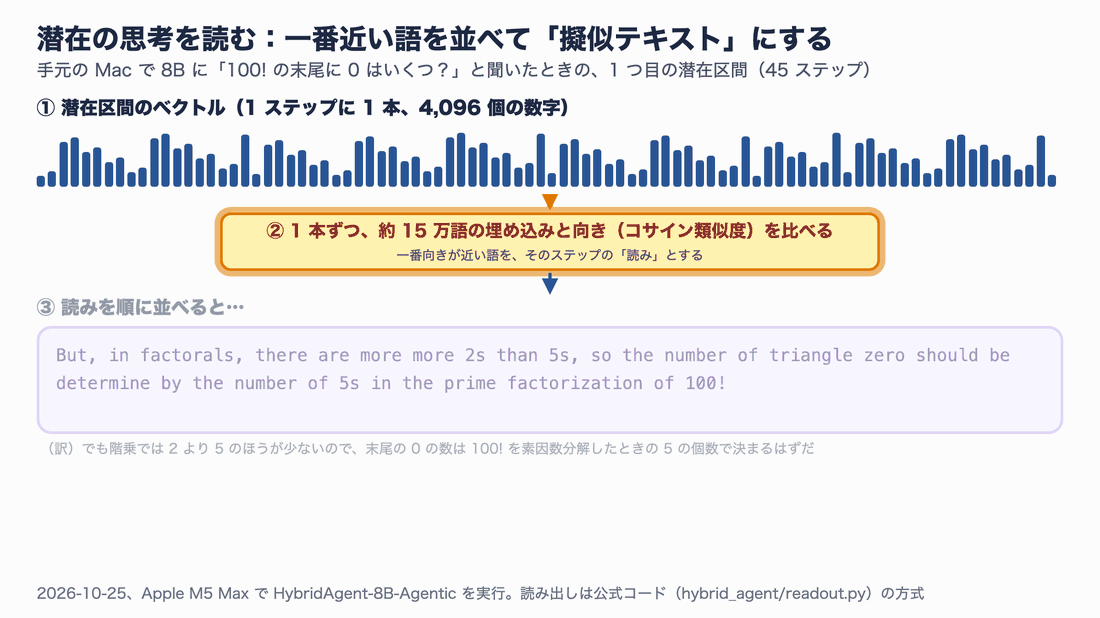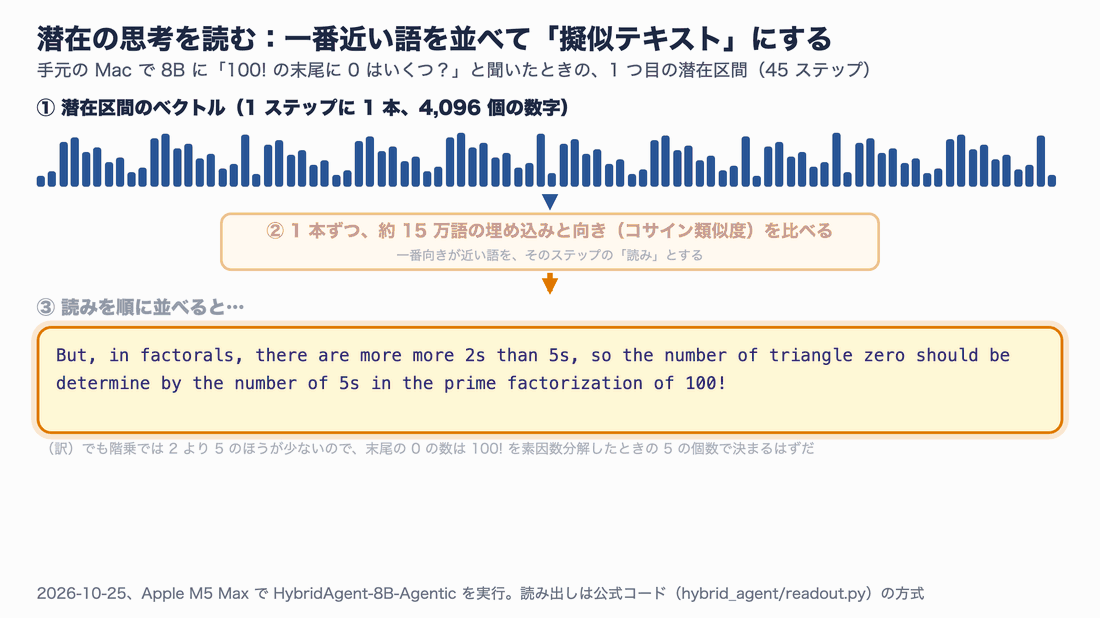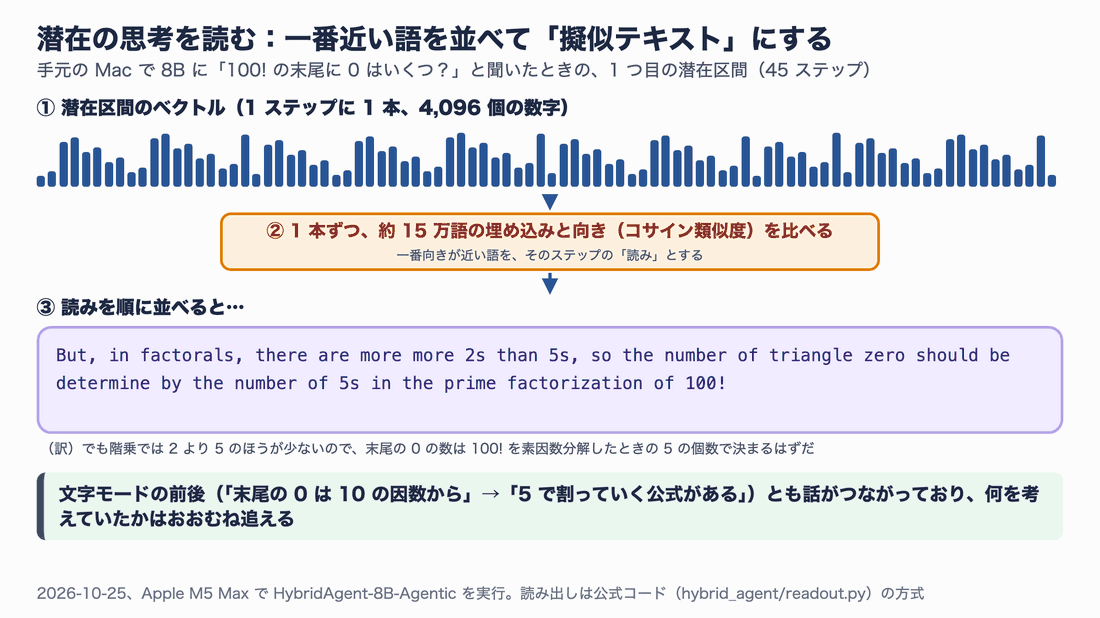
潜在のベクトル 1 本ずつに「一番向きが近い語」を当てて並べたもの。つづりの崩れは混じるが、何を考えていたかはおおむね追える。
1 つ目の潜在区間(45 ステップ)は、「階乗では 2 より 5 のほうが少ないので、末尾の 0 の数は 5 の個数で決まるはずだ」と読めます。直前の文字モードで「末尾の 0 は 10 = 2×5 から生まれる」と書き、直後に「5、25、125 で割っていく公式がある」と続けているので、話の流れとして自然です。
一方で、別の問題(1/(x−5) > 0 を解く)では、「分母が 0 になってはいけないので、x は 5 になれる」と、否定が抜けたように読める箇所もありました。直後の文字モードでは正しく x > 5 と進んでいるので、思考そのものが間違っていたというより、読み出しで語が落ちたと考えるのが自然です。擬似テキストはあくまで近似だと実感できる例でした。
結果 2:30 問で「ハイブリッド」と「潜在モード禁止」を比べる
次に、MATH500(数学の問題集)から難易度 1〜5 を 6 問ずつ選び、同じ問題・同じ乱数の種で「ハイブリッド」と「潜在モードを禁止した文字だけ」を解かせて比べました。潜在モードの禁止は、文字モードで <latent> を選べないようにするだけで、重みは同じです。論文の Table 5 にある「潜在モードの禁止」と同じ考え方です。
Mac の状態(発熱など)で 1 ステップの時間が変わるので、2 つの条件は 1 問ずつ交互に、順番も問題ごとに入れ替えて走らせました。時間は、スリープなどの待ち時間を含まない「本体の計算時間の合計」で比べています。
なお、条件は論文と同じではありません。公開されているのはエージェント課題向けに学習した版(HybridAgent-8B-Agentic)で、論文が数学の評価に使った数学向けの版は公開されていません。道具は Python だけで検索は使っておらず、道具を呼べる回数の上限も公式コードの既定値の 5 回(論文は 10 回)です。正答率を論文の表の数字とそのまま並べないでください。
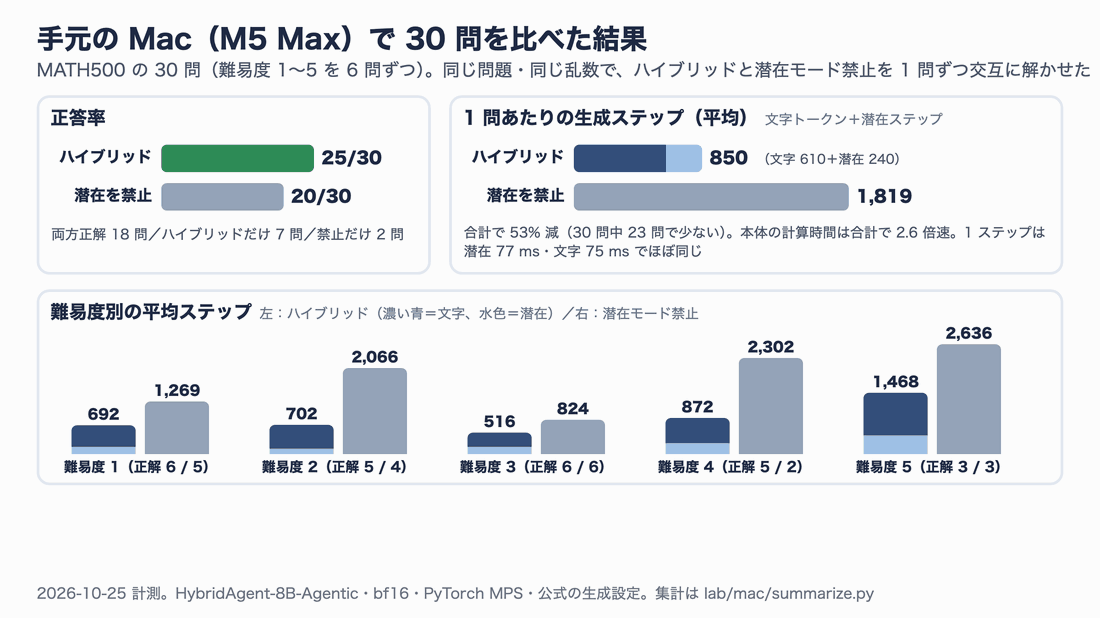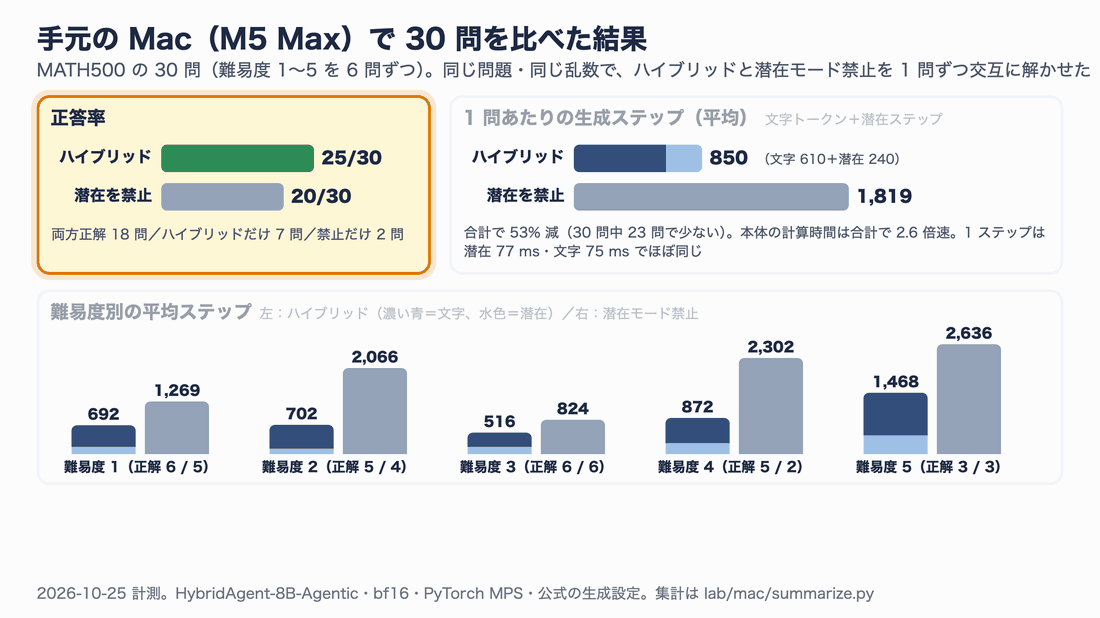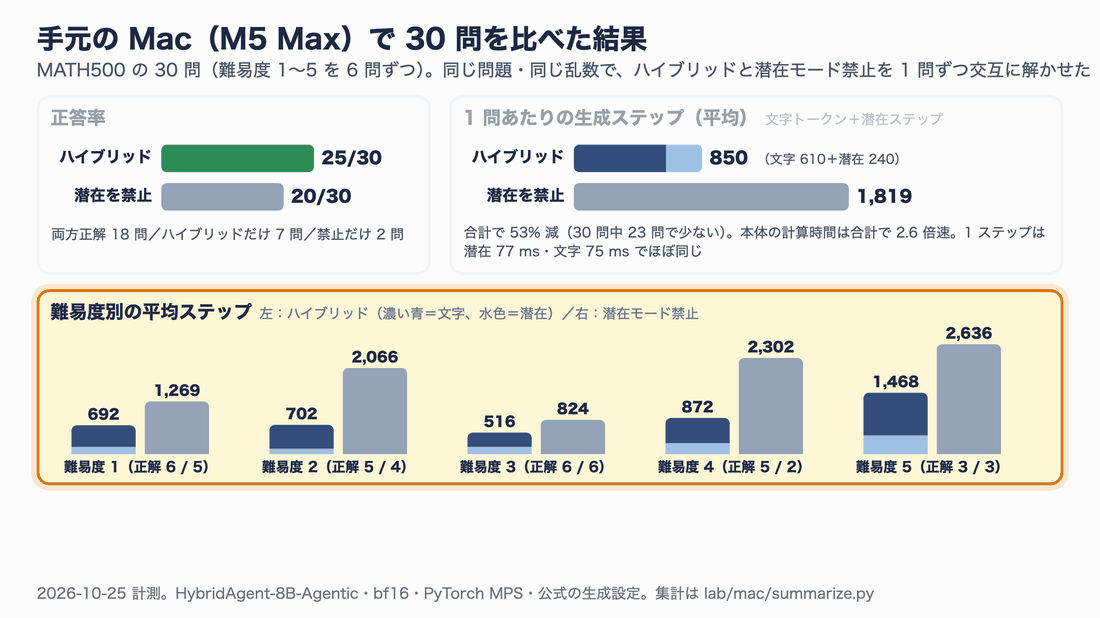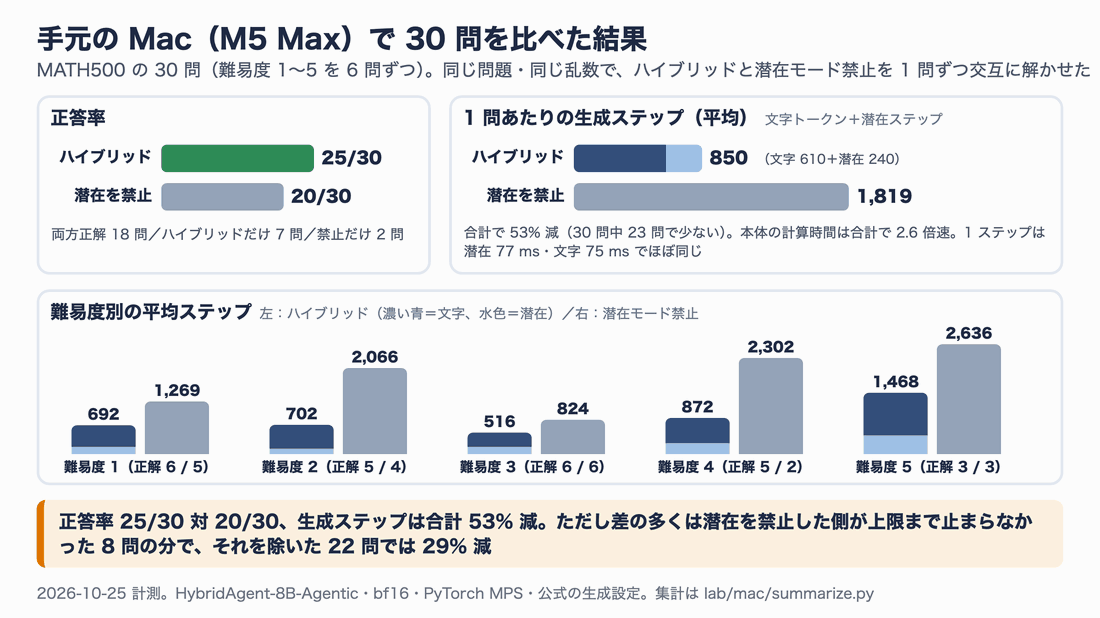
30 問の平均。潜在を禁止した側は、難しい問題ほど長く書き、上限の 4,096 ステップまで止まらないことがあった。
| 項目 | ハイブリッド | 潜在モード禁止(文字だけ) |
|---|---|---|
| 正解した問題 | 25 / 30 | 20 / 30 |
| 1 問あたりの文字トークン(平均) | 610 | 1,819 |
| 1 問あたりの潜在ステップ(平均) | 240 | 0 |
| 1 問あたりの生成ステップ(平均/中央値) | 850 / 687 | 1,819 / 1,210 |
| 上限(4,096 ステップ)まで止まらなかった問題 | 0 | 8 |
| 本体の計算時間の合計 | 2,002 秒 | 5,217 秒 |
合計で見ると、生成ステップは 53% 減り、本体の計算時間は 2.6 分の 1 になりました。数字だけなら論文の 8B(−52%)とよく似ています。正解した問題もハイブリッドのほうが 5 問多く、論文の Table 5(潜在あり 84.6%、潜在禁止 80.4%)と同じ向きです。
ただし、中身を見ると 2 つの効果が混ざっていました。
1 つ目は、潜在を禁止した側が止まらなくなることです。30 問中 8 問で、文字だけの側が上限の 4,096 ステップまで書き続けて答えを出せませんでした。ハイブリッドでは 0 問です。この 8 問が合計の差の多くを占めています。出力の終わりを読むと、8 問すべてが同じ言葉のくり返しに陥っていました。5 問は「Hmm.」を数百回書き続け、2 問は正しい答えにたどり着いたのに「答えは〜」と書き続けて締めくくれず、1 問は自信のない推測をくり返していました。HybridAgent は「決まりきった考えごと(迷い・確認・言い直し)は潜在で」と学習しているので、潜在に入れない状態では、その部分がうまく書けずに空回りするのだと考えられます。論文が比べているのは、文字だけで学習した別のエージェントなので、この点は手元の比較ならではの注意点です。
2 つ目が、普通に解き終わった問題でのステップの減り方です。どちらかが上限まで止まらなかった問題を除いた 22 問では、平均 992 → 699 ステップで 29% 減(問題ごとの中央値は 24% 減)、本体の計算時間は約 1.4 倍速でした。ハイブリッドのほうが少なかったのは 22 問中 15 問で、短い問題ではかえって長くなることもあります。論文の −52% ほどではないものの、ステップは減る傾向でした。
難易度別に見ると、次のとおりです。
| 難易度 | 問題数 | ハイブリッドの平均ステップ | 潜在禁止の平均ステップ |
|---|---|---|---|
| 1 | 6 | 692(6/6 正解) | 1,269(5/6 正解) |
| 2 | 6 | 702(5/6 正解) | 2,066(4/6 正解) |
| 3 | 6 | 516(6/6 正解) | 824(6/6 正解) |
| 4 | 6 | 872(5/6 正解) | 2,302(2/6 正解) |
| 5 | 6 | 1,468(3/6 正解) | 2,636(3/6 正解) |
1 ステップの時間は、ハイブリッドの全問をまとめると潜在 77 ミリ秒、文字 75 ミリ秒で、ほぼ同じでした(最初の 1 問は冷えた状態で潜在 47.0・文字 48.2 ミリ秒)。潜在を禁止した側は 95 ミリ秒と少し遅く、これは文章が長くなるほど 1 ステップの計算が重くなるためです。ステップ数の差に加えてこの差も乗るので、計算時間の差はステップ数の差より大きくなりました。
潜在の割合は平均 27%(2%〜43%)で、論文の 8B の 37% よりやや低めです。差し引きで見ると、潜在の 1 ステップが文字の約 5 トークン分を受け持っていた計算になります。
手元の実験でわかったこと
手元で動かしてわかったことを、論文の主張と照らし合わせてまとめます。
- Mac でも動く:公式コードは CUDA 前提の書き方ですが、中身は PyTorch と transformers だけなので、装置の指定と乱数の生成器を MPS にするだけで動きました。8B の重み(bf16)は約 16.4GB です
- 速さはステップ数で決まる:潜在の 1 ステップと文字の 1 語は同じ時間でした。論文の「生成ステップの削減がそのまま速さになる」という説明どおりです
- ステップは減るが、手元の差は論文より小さい:30 問の合計では 53% 減ったが、その多くは潜在を禁止した側が止まらなくなった分。普通に解き終わった 22 問だけなら 29% 減だった
- 潜在を禁止すると崩れやすい:同じ重みで潜在を禁止すると、30 問中 8 問で上限まで止まらず、正解も 25 問 → 20 問に減った。潜在モードは「あれば速い」だけでなく、このモデルにとっては考え方の一部になっている
- 擬似テキストは読めるが、近似:流れは追える一方、つづりの崩れや否定語の欠落のように読める箇所がありました
- 同じ種なら同じ結果:同じ問題・同じ乱数の種で 2 回動かすと、ステップ数まで一致しました。比較実験がしやすい作りです
日本語での質問、検索ツール(Tavily)を使う課題、14B モデル、文字だけで学習した別のエージェントとの比較は、今回は確かめていません。
使いどころと限界
HybridAgent は面白い研究ですが、明日から仕事のエージェントに組み込める段階ではありません。どんな状況なら試す価値があるかを、筆者の整理として図にまとめました。
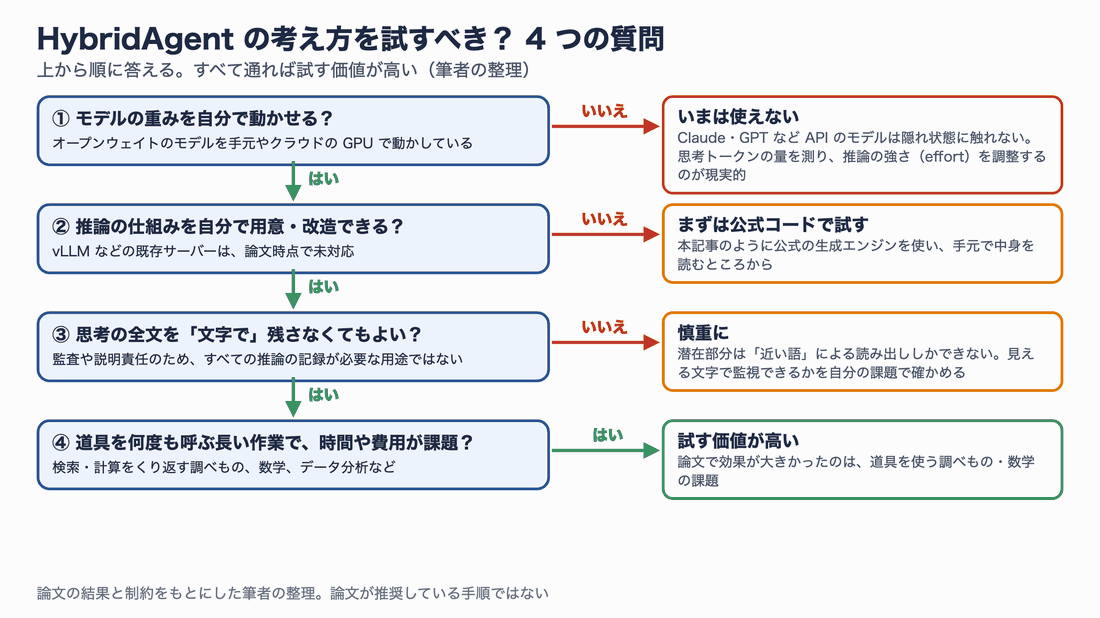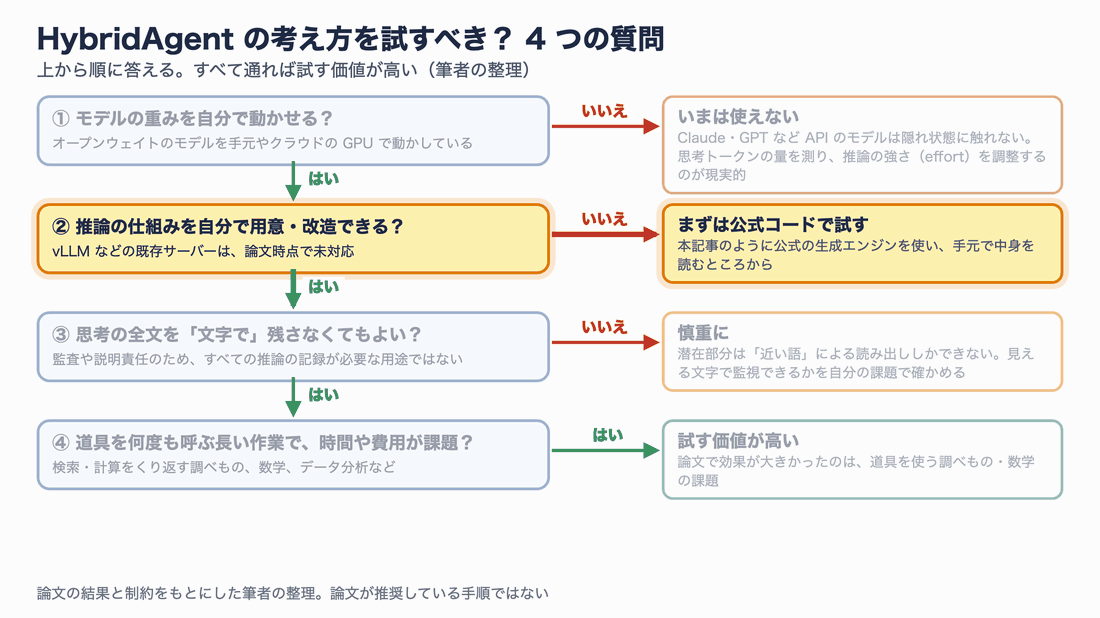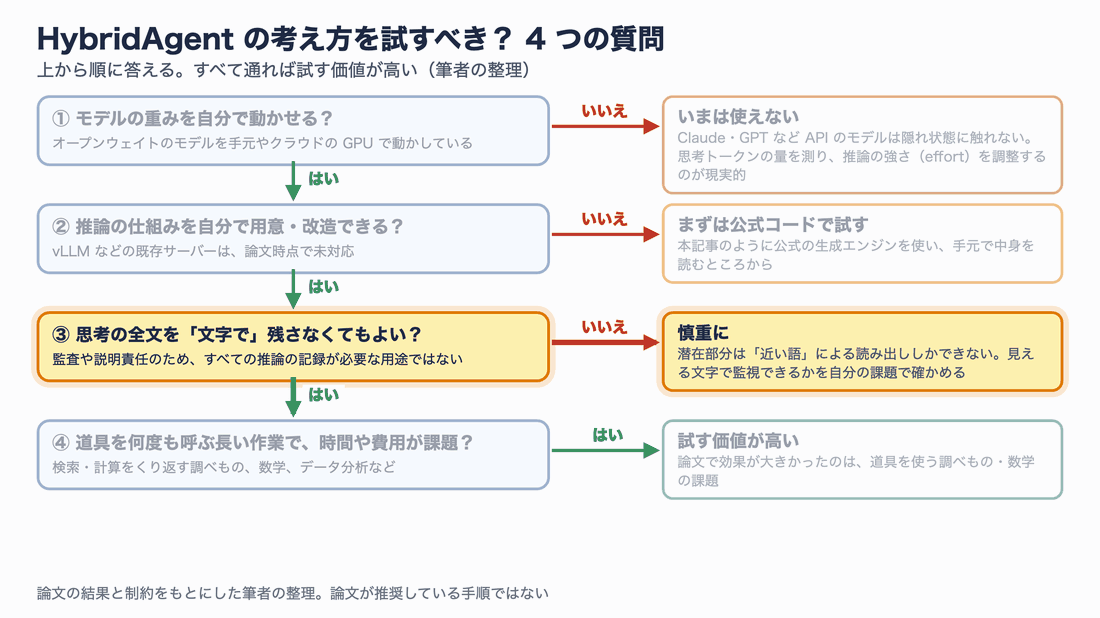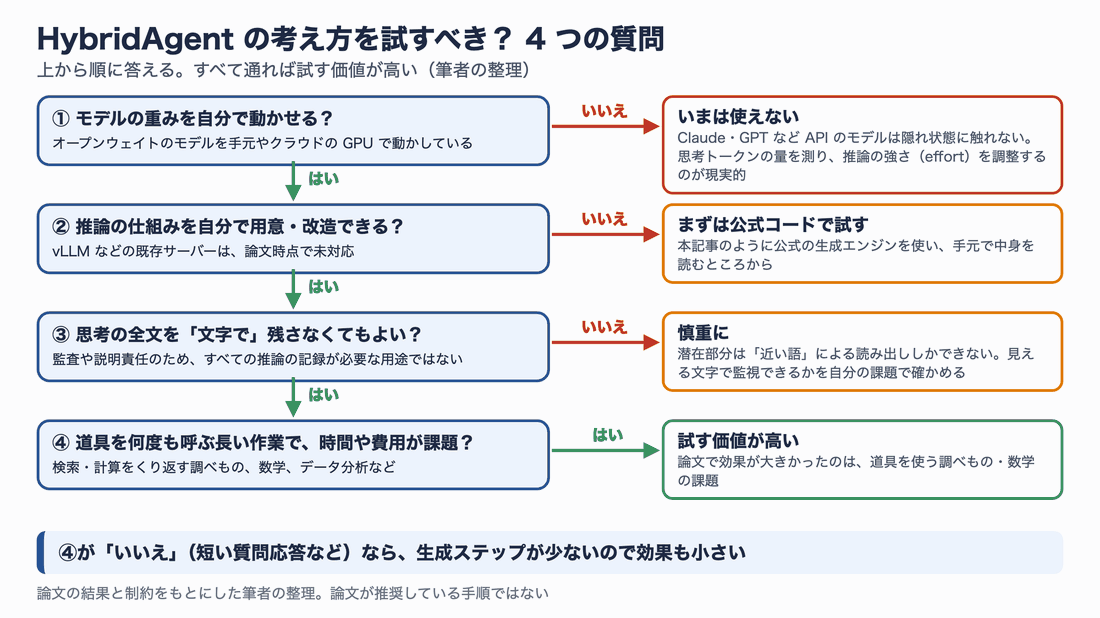
上から順に答え、すべて通れば試す価値が高い。API のモデルしか使っていないなら、いまは使えない(筆者の整理)。
限界として、次の 4 点を押さえておくとよいでしょう。
1. オープンな重みと専用エンジンが前提:HybridLink を通すには、モデルの隠れ状態に直接触れる必要があります。Claude や GPT など API 経由のモデルでは使えません。推論サーバーも、vLLM・Ollama・LM Studio などの既存のものは、論文時点で対応していません。Hacker News では「llama.cpp で 14B を動かしたら同じ文をくり返した」という報告もありましたが、これは専用エンジンを使わず普通の言語モデルとして動かした結果と考えられます。
2. 潜在部分の読み出しは近似:「一番近い語」を並べた擬似テキストは、潜在の思考そのものではなく、近くを通っている語を拾った近似です。手元の実験でも、読める文の中に崩れた語が混じりました。読み出しに表れない情報が潜在に含まれている可能性は残ります。
3. 思考の監視をどう考えるか:論文は、潜在の思考は提供者が持つ HybridLink を通さないと読めないので、思考が外に漏れにくく、提供者は全体を監視できる、と利点として述べています。一方で、利用者からは見えない思考が増えることでもあります。AI の安全性の研究では「思考を読めること」自体が重要な安全装置と考えられており、Hacker News でもこの点への懸念が最も多く挙がっていました。どちらの見方にも一理があり、監視の方法とセットで議論が続きそうです。
4. 小さいモデルでの結果:論文の実験は 4B〜14B です。大型モデルで同じ効果が出るかは、まだわかりません。
トラブルシューティング
Mac で動かしたときにつまずいた点を、確認する順番にまとめます。
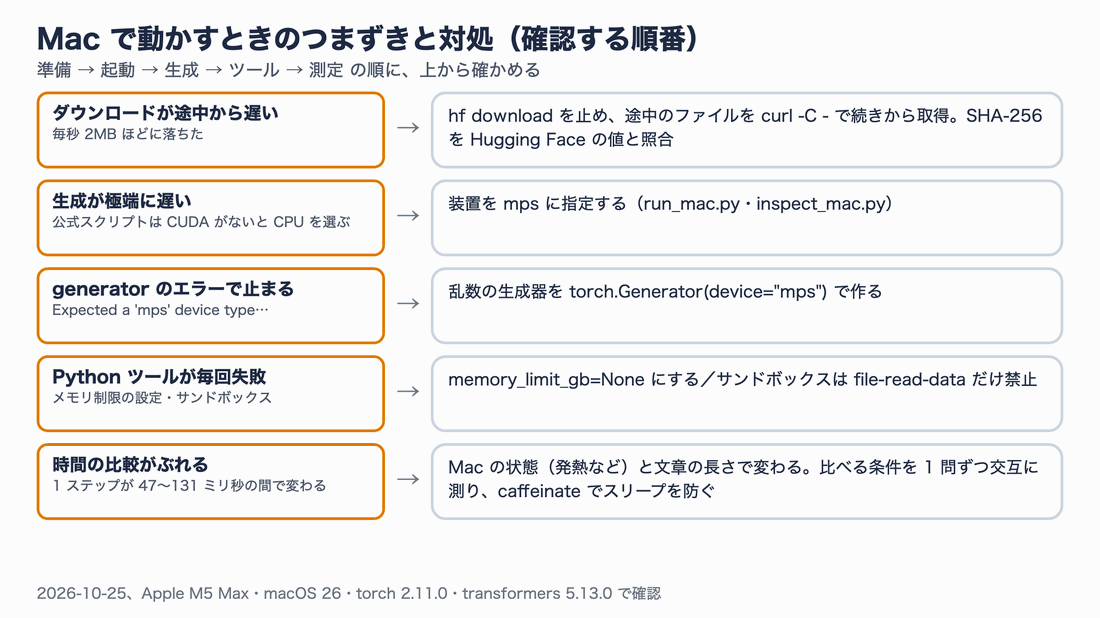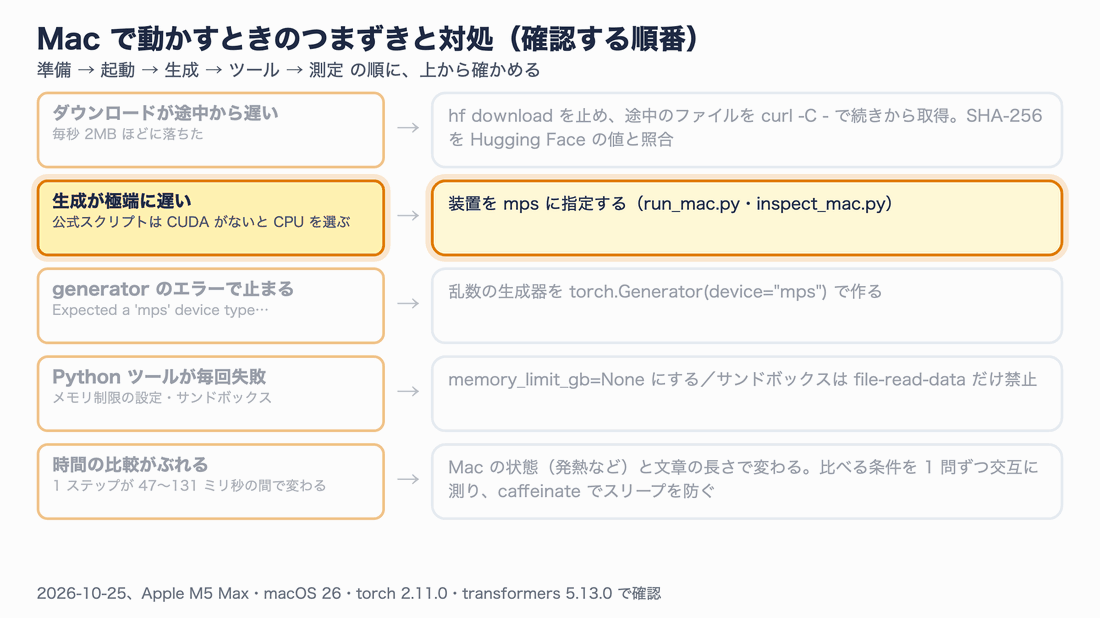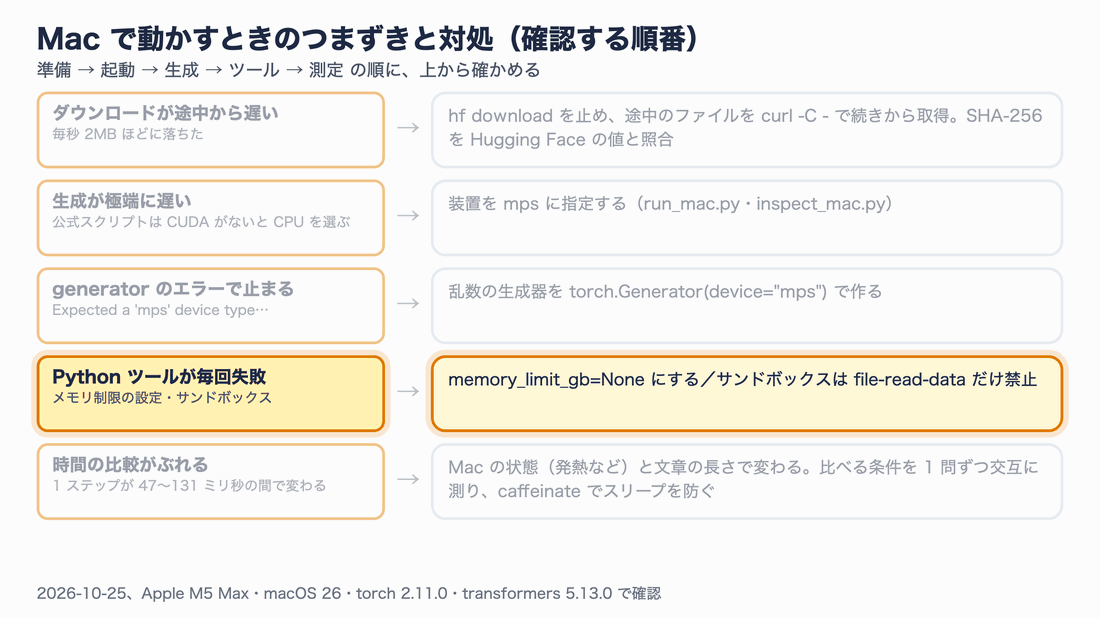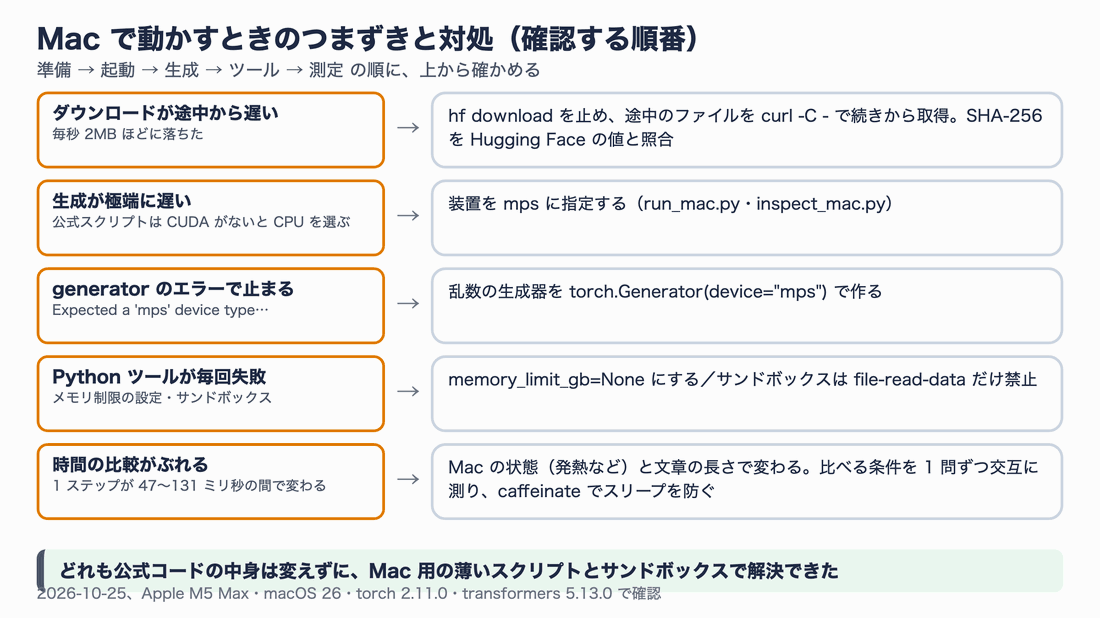
準備 → 起動 → 生成 → ツール → 測定の順に確かめる。どれも公式コードを書き換えずに解決できた。
| 症状・エラー | 原因 | 対処 |
|---|---|---|
| 公式スクリプトが CPU で動き、極端に遅い | torch.cuda.is_available() が偽だと CPU を選ぶ作り | 装置に torch.device("mps") を指定する(本記事の run_mac.py・inspect_mac.py) |
Expected a 'mps' device type for generator but found 'cpu' | 乱数の生成器が CPU 上にある | torch.Generator(device="mps").manual_seed(…) で作る |
RuntimeError: TAVILY_API_KEY is required | 検索ツールのキーがない | Tavily のキーを .env に書くか、検索ツールを代役にする(本記事は代役) |
Python ツールが MemoryLimitConfigurationError で毎回失敗する | macOS では RLIMIT_AS の設定が current limit exceeds maximum limit で失敗する | PythonTool(memory_limit_gb=None) にして、メモリ制限はサンドボックス側で考える |
サンドボックスで realpath: … Operation not permitted | file-read* を禁止すると、親フォルダの情報も読めなくなる | 禁止するのは file-read-data(中身の読み取り)だけにする |
| ダウンロードが途中から毎秒数 MB に落ちる | 接続が絞られた | hf download を止め、.incomplete を curl -C - で続きから取得し、SHA-256 を照合する |
| 同じ文をくり返して終わらない | 最大ステップ(既定 4,096)まで生成が続く。本記事では潜在モードを禁止した側で 30 問中 8 問 | max_response_tokens で上限を決め、終了理由(end_reason)が budget の問題を確認する |
| 長い実行が終了コード 137 で止まる | プロセスが強制終了された(本記事では 29 問目で 1 回。原因の記録なし) | run_mac.py は 1 問ずつ記録するので、同じコマンドで続きから再開できる |
| Mac がスリープすると実行が止まる | 手動スリープ中は処理が進まず、自動起床中に GPU を回すと熱の保護で再びスリープする | 実行中は Mac を起こしておく。caffeinate -is を付けて実行すると、放置による自動スリープは防げる |
まとめ
- HybridAgent は、考えるときは潜在モード、道具を使うときは文字モードを 1 回の生成の中で切り替える AI エージェントです。切り替えは小さな部品 HybridLink と、2 つの特別な語
<latent>・</latent>で行います - 潜在の思考は文字に戻せないため、ターンをまたぐ履歴は作業記憶(KV キャッシュ)で持ち越します。これが、既存の API や推論サーバーと相性が悪い理由でもあります
- 論文の「35.5〜54.7% 削減」は生成ステップの総数、「10.4% 向上」は同じ大きさのエージェントとの比較です。大型モデルには、道具を使う課題で勝ち、知識の課題で負けています
- 手元の Mac でも公式の 8B モデルが動きました。30 問の比較では、潜在を禁止した場合より正解が多く(25 対 20)、普通に解き終わった問題では生成ステップが 29% 減りました。潜在の 1 ステップと文字の 1 語は同じ時間なので、速さはステップ数で決まります
次の一歩としては、公式の interpretable_latent_mode で潜在の思考を自分の目で読んでみるのがおすすめです。思考を「どこまで文字にするか」は、これからの AI エージェントの速さ・費用・安全性を同時に左右するテーマになりそうです。
参考リソース
- 論文:Zou et al.「Hybrid Reasoning Agents」arXiv:2610.18861 https://arxiv.org/abs/2610.18861
- 公式コード:https://github.com/togethercomputer/HybridAgent
- 公開モデル:https://huggingface.co/togethercomputer/HybridAgent-8B-Agentic / https://huggingface.co/togethercomputer/HybridAgent-14B-Agentic
- 公開データ:https://huggingface.co/collections/togethercomputer/hybridagent
- Coconut(潜在推論の代表例):Hao et al.「Training Large Language Models to Reason in a Continuous Latent Space」arXiv:2412.06769
- Hacker News での議論:https://news.ycombinator.com/item?id=50145337
付録:Mac 用スクリプト全文
動作確認:2026-10-25、Apple M5 Max・macOS 26・torch 2.11.0・transformers 5.13.0。mac/ フォルダに置き、HybridAgent を pip install -e 済みの仮想環境で実行します。
# mac/run_mac.py
"""HybridAgent を Mac(Apple Silicon の MPS)で動かし、ハイブリッド推論と
「潜在モードを禁止した文字だけの推論」を同じ重みで比べるスクリプト。

  # 1 問ごとに「ハイブリッド」と「潜在モード禁止」を交互に解く(結果は results/math30-*.jsonl)
  python run_mac.py --model ../models/HybridAgent-8B-Agentic \
      --questions math500_sample.jsonl --mode both --out results/math30
  # 片方だけなら --mode hybrid / --mode text と、ファイル名をそのまま --out に渡す

- Python ツールは sandbox-exec の中で動かす(ネットワーク遮断・書き込みは pytmp だけ)
- 検索ツールは Tavily のキーがないので「結果なし」を返す代役にする
- 1 問ずつ(バッチ 1)。各ステップの順伝播時間を「潜在」「文字」「ツール結果の読み込み」に分けて記録する
"""
from __future__ import annotations

import argparse
import gc
import json
import os
import time
from pathlib import Path

import torch

from hybrid_agent import SYSTEM_PROMPT, HybridGenerationEngine, extract_answer, load_hybrid_agent
from hybrid_agent.engine import FEED, LATENT
from hybrid_agent.tools import ToolExecutor
from hybrid_agent.tools.base import BaseTool
from hybrid_agent.tools.python_tool import PythonTool

HERE = Path(__file__).resolve().parent

class NoSearchTool(BaseTool):
    """Tavily の代わり。常に「結果なし」を返す。"""

    calls = 0

    @property
    def name(self) -> str:
        return "no_search"

    @property
    def trigger_tag(self) -> str:
        return "search"

    def execute(self, content: str, **kwargs) -> str:
        NoSearchTool.calls += 1
        return "No search results found."

class MacEngine(HybridGenerationEngine):
    """ステップごとの時間を入力の種類別に集計する。block_latent=True なら <latent> を出させない。"""

    def __init__(self, *args, block_latent: bool = False, **kwargs):
        super().__init__(*args, **kwargs)
        self.step_time = {"latent": 0.0, "text": 0.0, "feed": 0.0}
        self.step_count = {"latent": 0, "text": 0, "feed": 0}
        if block_latent:
            for key in self._blocked_masks:
                self._blocked_masks[key] = self._blocked_masks[key].clone()
                self._blocked_masks[key][self.latent_open_id] = True

    @torch.no_grad()
    def _lockstep_forward(self, inputs_embeds, real_rows):
        mode = self.rows[0].mode
        kind = "latent" if mode == LATENT else "feed" if mode == FEED else "text"
        t0 = time.perf_counter()
        super()._lockstep_forward(inputs_embeds, real_rows)
        if self.device.type == "mps":
            torch.mps.synchronize()
        self.step_time[kind] += time.perf_counter() - t0
        self.step_count[kind] += 1

def is_correct(pred: str, gold: str) -> bool:
    from math_verify import parse, verify

    if not pred:
        return False
    try:
        g = parse("$" + gold + "$")
        p = parse("$" + pred + "$")
        if g and p and verify(g, p):
            return True
    except Exception:
        pass
    norm = lambda s: s.replace(" ", "").replace("\\!", "").replace("dfrac", "frac").strip("$")
    return norm(pred) == norm(gold)

def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("--model", required=True)
    ap.add_argument("--questions", required=True, help="JSONL: {id, question, answer}")
    ap.add_argument("--mode", choices=["hybrid", "text", "both"], default="hybrid",
                    help="both = 1 問ごとに hybrid と text を交互に(順番も問題ごとに入れ替える)")
    ap.add_argument("--out", required=True, help="both のときは <out>-hybrid.jsonl と <out>-text.jsonl に書く")
    ap.add_argument("--limit", type=int, default=0)
    ap.add_argument("--seed", type=int, default=0)
    ap.add_argument("--max_response_tokens", type=int, default=4096)
    args = ap.parse_args()

    device = torch.device("mps" if torch.backends.mps.is_available() else "cpu")
    t_load = time.time()
    model, tokenizer = load_hybrid_agent(args.model, device=device)
    print(f"loaded on {device} in {time.time() - t_load:.1f}s", flush=True)

    tools = ToolExecutor()
    tools.register_tool(PythonTool(python_path=str(HERE / "sbpython"), timeout=60, memory_limit_gb=None))
    tools.register_tool(NoSearchTool())

    questions = [json.loads(l) for l in open(args.questions, encoding="utf-8") if l.strip()]
    if args.limit:
        questions = questions[: args.limit]
    modes = ["hybrid", "text"] if args.mode == "both" else [args.mode]
    outs = {m: (f"{args.out}-{m}.jsonl" if args.mode == "both" else args.out) for m in modes}
    done = {m: set() for m in modes}
    for m, path in outs.items():
        Path(path).parent.mkdir(parents=True, exist_ok=True)
        if os.path.isfile(path):
            done[m] = {json.loads(l)["id"] for l in open(path, encoding="utf-8") if l.strip()}

    for i, q in enumerate(questions):
        order = modes if i % 2 == 0 else list(reversed(modes))
        for mode in order:
            if q["id"] in done[mode]:
                continue
            rec = run_one(model, tokenizer, device, tools, q, mode, args.seed + i, args.max_response_tokens)
            with open(outs[mode], "a", encoding="utf-8") as out:
                out.write(json.dumps(rec, ensure_ascii=False) + "\n")
            ms = {k: round(1000 * rec["step_time"][k] / max(rec["step_count"][k], 1), 1) for k in ("latent", "text")}
            print(
                f"[{i + 1}/{len(questions)}] {q['id']} {mode} ok={rec['correct']} pred={rec['pred']!r} gold={q.get('answer')!r} "
                f"text={rec['text_tokens']} latent={rec['latent_steps']} steps={rec['generation_steps']} "
                f"py={rec['python_calls']} t={rec['total_time']:.1f}s ms/step={ms} end={rec['end_reason']}",
                flush=True,
            )

def run_one(model, tokenizer, device, tools, q, mode, seed, max_response_tokens) -> dict:
    engine = MacEngine(
        model, tokenizer, device, tools, SYSTEM_PROMPT, q["question"],
        batch_size=1, max_response_tokens=max_response_tokens,
        max_tool_calls=5, max_search_calls=5, max_python_calls=5, terminate_on_tool_cap=True,
        temperature=0.6, top_p=0.95, top_k=20, repetition_penalty=1.1,
        record_latent_readout=(mode == "hybrid"), block_latent=(mode == "text"),
    )
    rng = torch.Generator(device=device).manual_seed(seed)
    engine.run(rng=rng)
    res = engine.row_result(engine.rows[0])
    pred = extract_answer(res["output"])
    rec = {
        "id": q["id"], "mode": mode, "level": q.get("level"), "subject": q.get("subject"),
        "answer": q.get("answer"), "pred": pred, "correct": is_correct(pred, str(q.get("answer", ""))),
        "text_tokens": res["generation_steps"] - res["latent_steps"], "latent_steps": res["latent_steps"],
        "generation_steps": res["generation_steps"], "latent_spans": res["latent_spans"],
        "anchor_exits": res["anchor_exits"], "forced_exits": res["forced_exits"],
        "python_calls": res["python_calls"], "search_calls": res["search_calls"],
        "end_reason": res["end_reason"],
        "total_time": engine.total_time, "llm_time": engine.llm_time, "tool_time": engine.tool_time,
        "step_time": engine.step_time, "step_count": engine.step_count,
        "output": res["output"], "output_rendered": res.get("output_rendered"),
        "latent_readouts": res.get("latent_readouts"),
    }
    # 問題ごとに作業記憶(KV キャッシュ)を捨て、MPS のメモリを返す
    del engine
    gc.collect()
    if device.type == "mps":
        torch.mps.empty_cache()
    return rec

if __name__ == "__main__":
    main()
# mac/inspect_mac.py(潜在の思考を HTML レポートにする)
"""Interpretable Latent Mode(潜在の思考を擬似テキストで読む)を Mac の MPS で動かす。

  python inspect_mac.py --model ../models/HybridAgent-8B-Agentic \
      --question "How many trailing zeros does 100! have?" --html results/report-q4.html

公式の `python -m interpretable_latent_mode` は CUDA か CPU しか選ばないので、
同じ inspect() を MPS で呼び、ツールは run_mac.py と同じもの(サンドボックスの Python・検索の代役)を使う。
"""
from __future__ import annotations

import argparse
import json
from pathlib import Path

import torch

from hybrid_agent import load_hybrid_agent
from hybrid_agent.tools import ToolExecutor
from hybrid_agent.tools.python_tool import PythonTool
from interpretable_latent_mode.render import render_html, render_text
from interpretable_latent_mode.trace import inspect

from run_mac import HERE, NoSearchTool

def main() -> None:
    ap = argparse.ArgumentParser()
    ap.add_argument("--model", required=True)
    ap.add_argument("--question", required=True)
    ap.add_argument("--html", required=True)
    ap.add_argument("--seed", type=int, default=0)
    args = ap.parse_args()

    device = torch.device("mps")
    model, tokenizer = load_hybrid_agent(args.model, device=device)
    tools = ToolExecutor()
    tools.register_tool(PythonTool(python_path=str(HERE / "sbpython"), timeout=60, memory_limit_gb=None))
    tools.register_tool(NoSearchTool())

    traces = inspect(model, tokenizer, args.question, device=device, tool_executor=tools,
                     readout_top_k=5, seed=args.seed, model_name=Path(args.model).name)
    Path(args.html).parent.mkdir(parents=True, exist_ok=True)
    Path(args.html).write_text(render_html(traces), encoding="utf-8")
    Path(args.html).with_suffix(".json").write_text(
        json.dumps([t.to_dict() for t in traces], ensure_ascii=False, indent=1), encoding="utf-8")
    for t in traces:
        print(render_text(t, color=False, show_steps=False))

if __name__ == "__main__":
    main()
# 例:100! の問題を解かせて、潜在の思考を HTML で見る
cd mac
../.venv/bin/python inspect_mac.py --model ../models/HybridAgent-8B-Agentic \
  --question "How many trailing zeros does 100! have?" --html results/report-q4.html
open results/report-q4.html