はじめに
最近、Mac mini に OpenClaw(オープンクロー)を入れて、AI エージェントを 24 時間動かす使い方が流行っています。そこへ NVIDIA が 2026 年 10 月 2 日、AI 専用の小型コンピュータ「DGX Spark」に、メモリ 64GB の安い版を出すと発表しました。価格は 4,999 ドルからです。
このニュースを見て、次のような疑問を持った方は多いはずです。
- DGX Spark の 64GB 版で、具体的に何ができるのか
- 流行りの Mac mini + OpenClaw と同じようなものなのか
- 買うなら、費用はどちらがどれだけ安いのか
先に結論を書きます。Mac mini + OpenClaw も DGX Spark も、「家や会社に置きっぱなしにして AI を動かす箱」という役割は同じです。違うのは、AI の「頭脳」をどこに置くかです。 Mac mini の定番構成では、頭脳はインターネットの向こうのクラウド AI に任せます。DGX Spark は、頭脳まで手元に置くための機械です。
費用は、クラウド AI をどれだけ使うかで逆転します。たまに使う程度なら Mac mini +クラウドが圧倒的に安く、エージェントを何本も回して API 代が月数万円になるなら、手元に頭脳を置く構成のほうが安くなります。
この記事では、AI ツールをこれから本格的に使いたい方、ローカル LLM(自分のパソコンで動かす AI)に興味がある方、社内で AI エージェントの導入を検討している方に向けて、3 つの構成を同じ物差しで比べます。
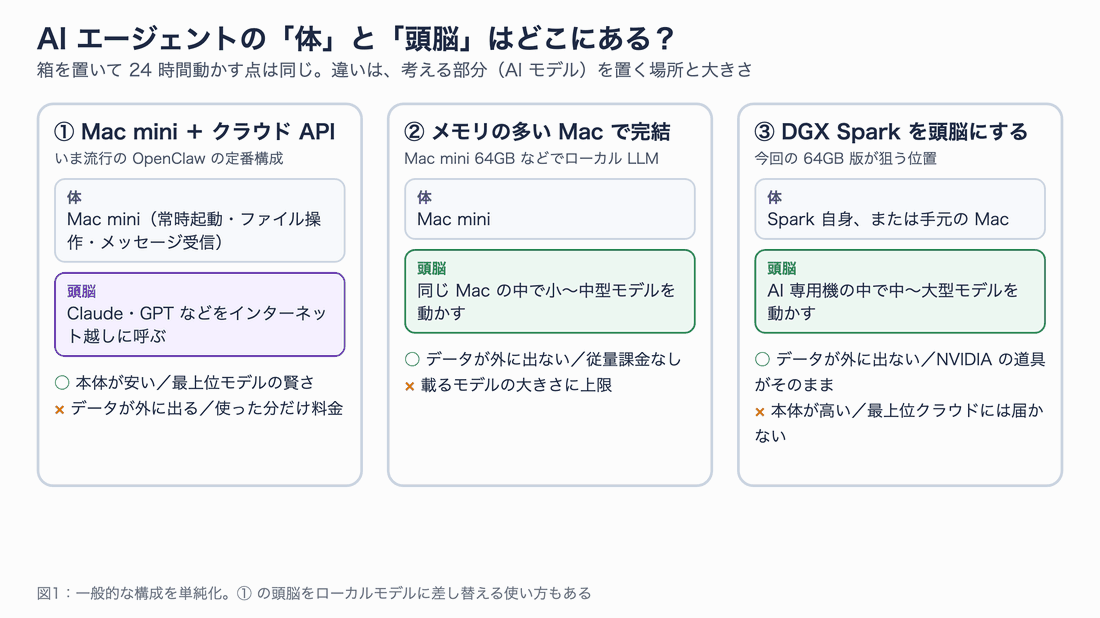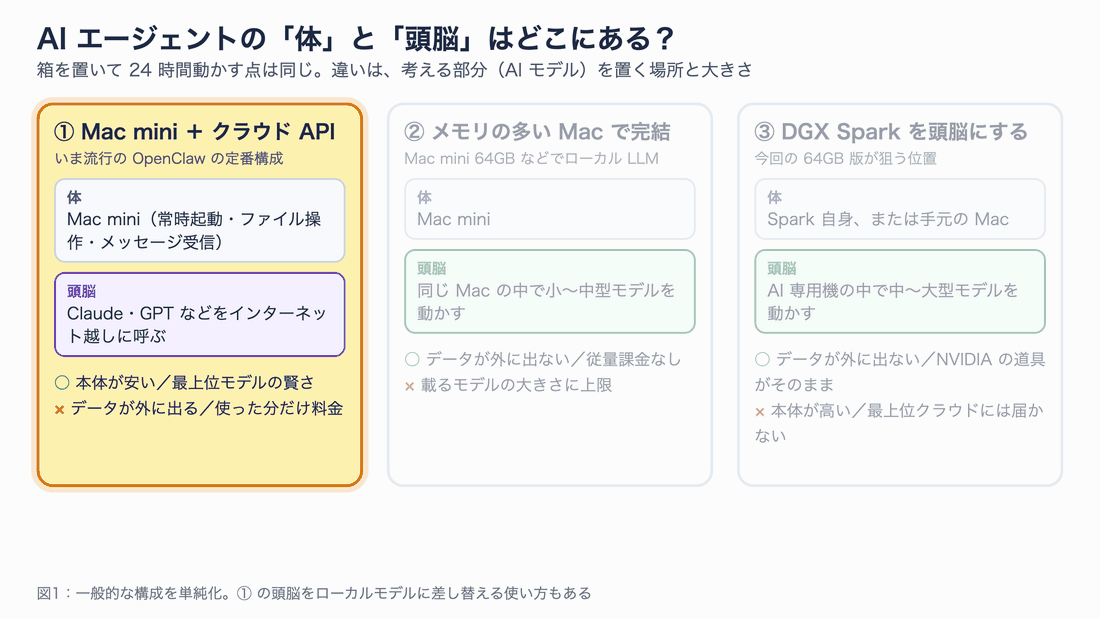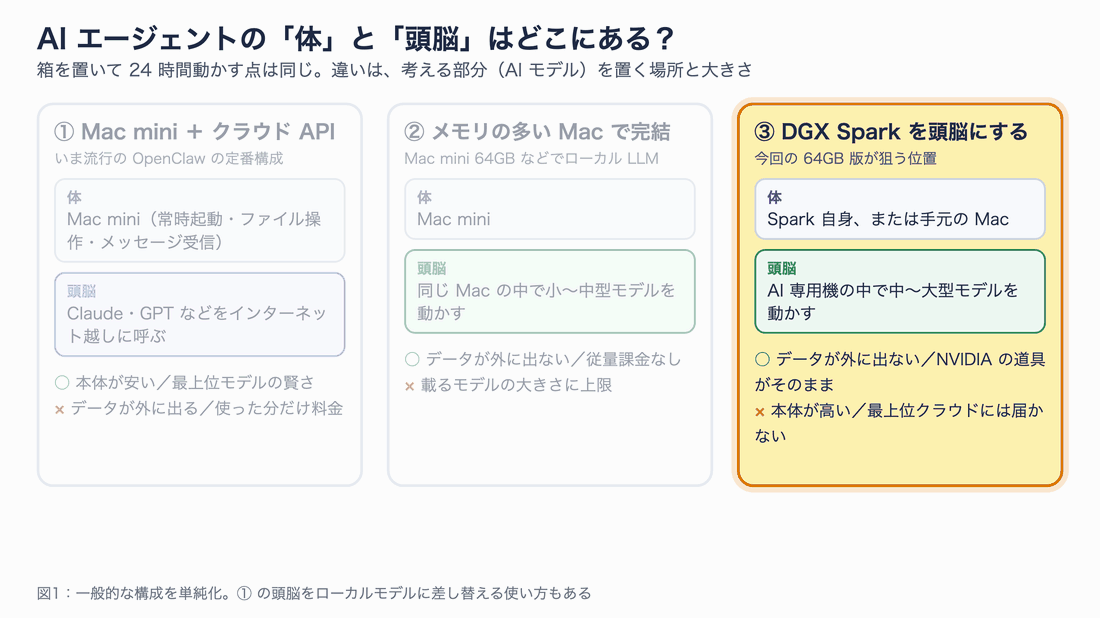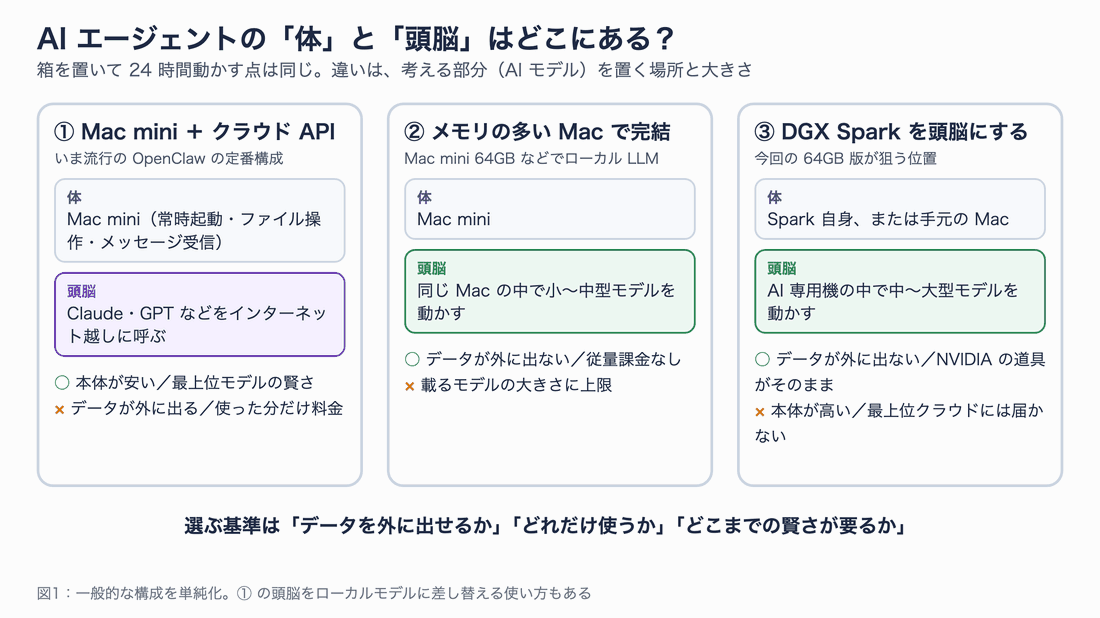
図1:3 つの構成の違いは「頭脳(AI モデル)を置く場所と大きさ」。選ぶ基準は、データを外に出せるか、どれだけ使うか、どこまでの賢さが要るか、の 3 点です。
この記事の確認範囲
- 確認日は 2026 年 10 月 4 日です。価格・仕様は NVIDIA と Apple の公式ページ、API 料金は Anthropic と OpenAI の公式料金ページで確認しました。
- 筆者は DGX Spark の実機を持っていません。速度は llama.cpp(ローカル LLM を動かす定番ソフト)などの公開ベンチマーク、費用は公表価格からの試算です。実測のように書いている箇所はありません。
- 「最大 100B」「1.7 倍」などは NVIDIA 自身の発表値です。第三者による検証はまだ出ていません。
- ドル円は 1 ドル≒158 円(2026 年 10 月 2 日の参考レート)、電気代は 31 円/kWh(家電の目安単価)で計算しています。
DGX Spark 64GB のニュースを整理する
まずは発表の中身を確認します。NVIDIA の公式ブログで、押さえておきたい段落に赤枠を付けました。
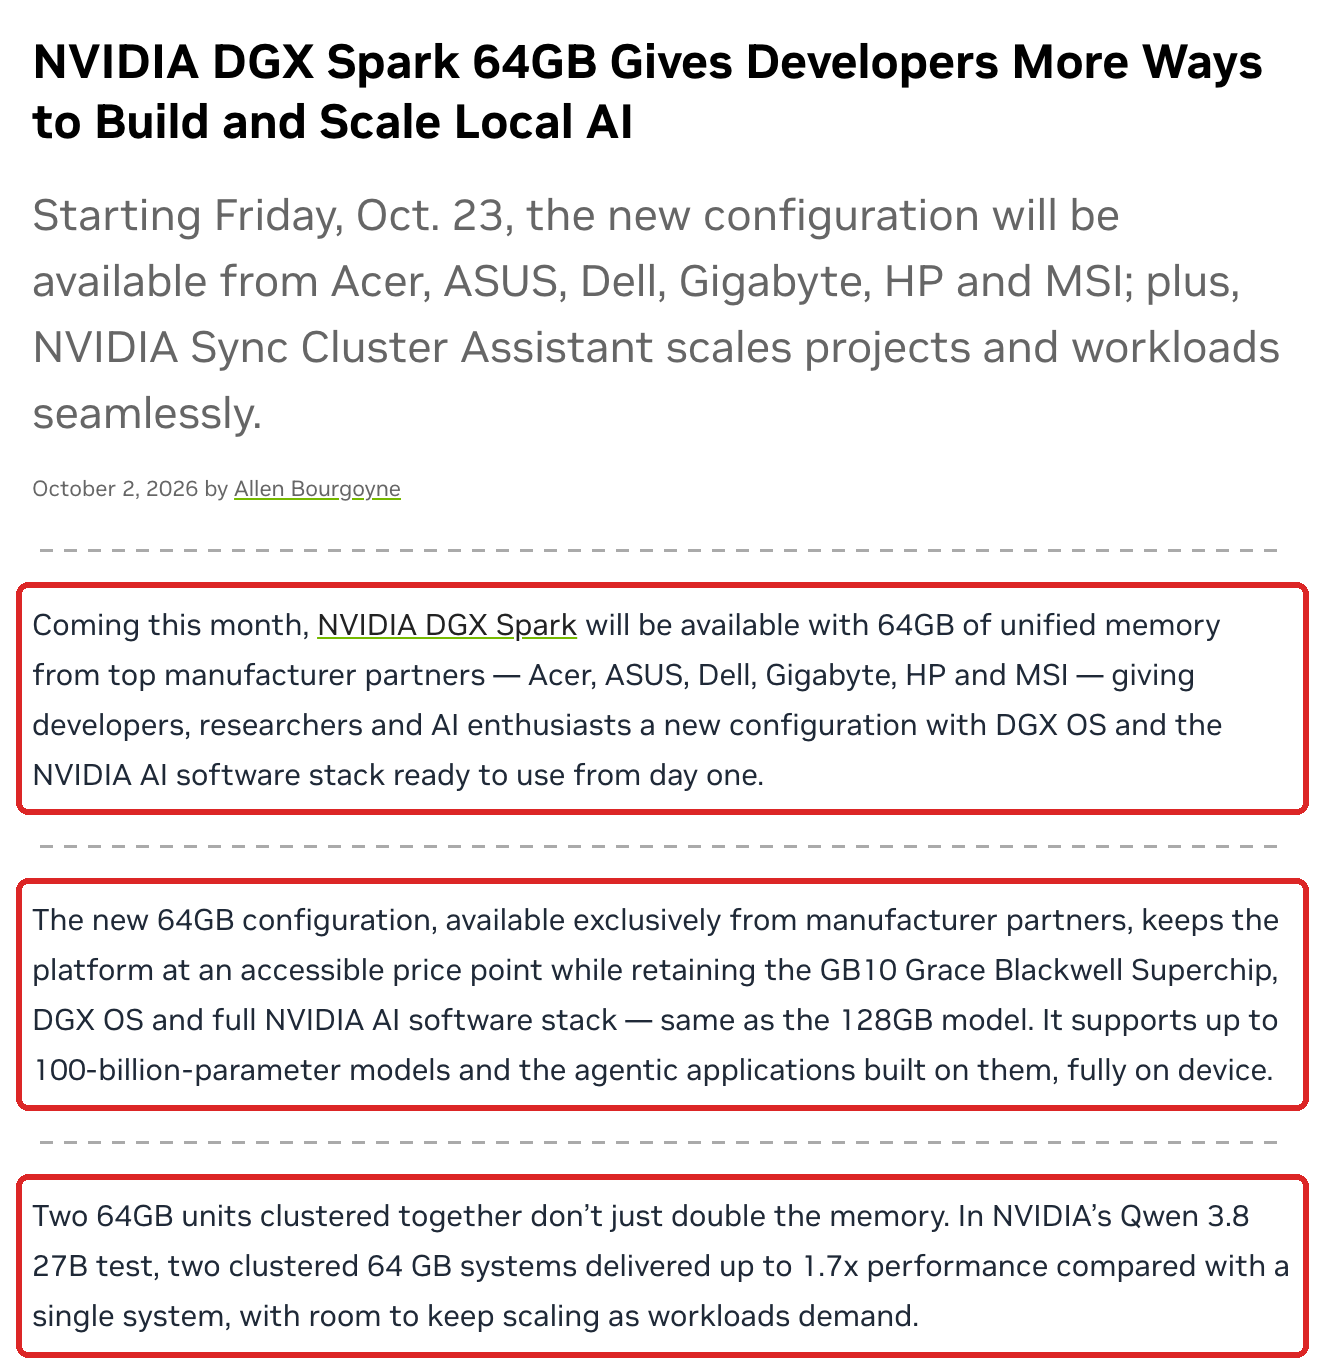
NVIDIA 公式ブログ(2026-10-02)。点線の箇所は途中の段落を省略しています。赤枠は上から、販売元、128GB 版との共通点と「最大 100B」、2 台構成の「最大 1.7 倍」。
要点を表にまとめます。
| 項目 | 内容 |
|---|---|
| 価格 | 4,999 ドルから(64GB メモリ+2TB ストレージの構成を想定した価格) |
| 発売日 | 2026 年 10 月 23 日 |
| 販売元 | Acer・ASUS・Dell・Gigabyte・HP・MSI。NVIDIA 直販の版はなし |
| 中身 | チップ(GB10 Grace Blackwell)、OS(DGX OS)、ソフト一式は 128GB 版と同じ |
| 1 台で動かせるモデル | 最大 1,000 億パラメータ(100B)級 |
| 2 台をつなぐと | 専用ケーブルで直結し、メモリ 128GB として最大 2,000 億パラメータ(200B)級。速さは 1 台の最大 1.7 倍(NVIDIA の Qwen 3.8 27B での試験) |
| 新しい道具 | NVIDIA Sync の「Cluster Assistant」が 2 台のネットワーク設定を自動化。モデルを配って起動する「Model Launcher」は 10 月末に登場予定 |
| 日本の価格 | 未発表 |
パラメータ数は、AI の「脳の大きさ」のようなものです。多いほど賢い傾向がありますが、そのぶん大量のメモリを使います。
値上げの流れも知っておく
64GB 版の登場は、メモリの値上がりと切り離せません。既存の 128GB 版の価格は、次のように 2 段階で上がっています。
| 時期 | 128GB 版の価格 | 出来事 |
|---|---|---|
| 2025 年 10 月 | 3,999 ドル | 発売 |
| 2026 年 2 月 | 4,699 ドル | メモリ供給の制約を理由に値上げ |
| 2026 年 10 月 2 日 | 6,950 ドル | 64GB 版の発表と同時に値上げ |
発売時から約 75% 上がったことになります。64GB 版の 4,999 ドルは、「値上がりした 128GB 版の代わりに、入りやすい価格帯を残す」ための製品と読むのが自然です。
DGX Spark は何をする機械か
ローカル LLM を動かすための専用機
ChatGPT や Claude は、質問を送ると、インターネットの向こうにある巨大なコンピュータが答えを作って返してくれます。これがクラウド型です。
これに対してローカル LLM は、AI の本体(モデル)を手元のコンピュータに入れて動かす方式です。データが外に出ない、ネットがなくても動く、使った分だけ料金がかかる従量課金がない、という利点があります。
ただし、賢いモデルほどサイズが大きく、動かすには大量のメモリが要ります。普通のパソコンでは小さめのモデルしか動かせないのが悩みでした。DGX Spark は、この悩みを解決するための弁当箱ほどの大きさ(15cm 四方、厚さ約 5cm、1.2kg)の AI 専用機です。
たとえるなら、クラウド AI は外食、普通のパソコンでのローカル LLM は自宅の小さなキッチン、DGX Spark は自宅に置いた業務用の厨房です。初期費用はかかりますが、食材(データ)を外に出さずに、好きなだけ料理できます。
Mac の外付け部品ではない
ここでよくある誤解があります。DGX Spark は、Mac に挿して速くする外付け GPU(eGPU)ではありません。中身は Ubuntu をもとにした Linux(DGX OS)で動く、独立したコンピュータです。Mac からは、同じネットワークにいる別のマシンとしてつないで使います。
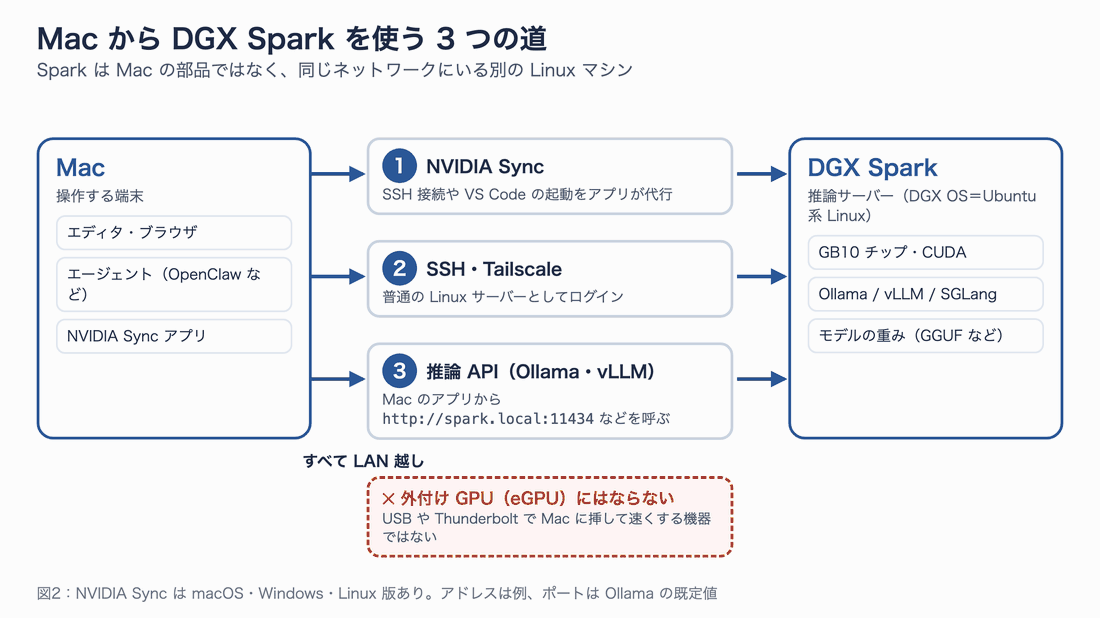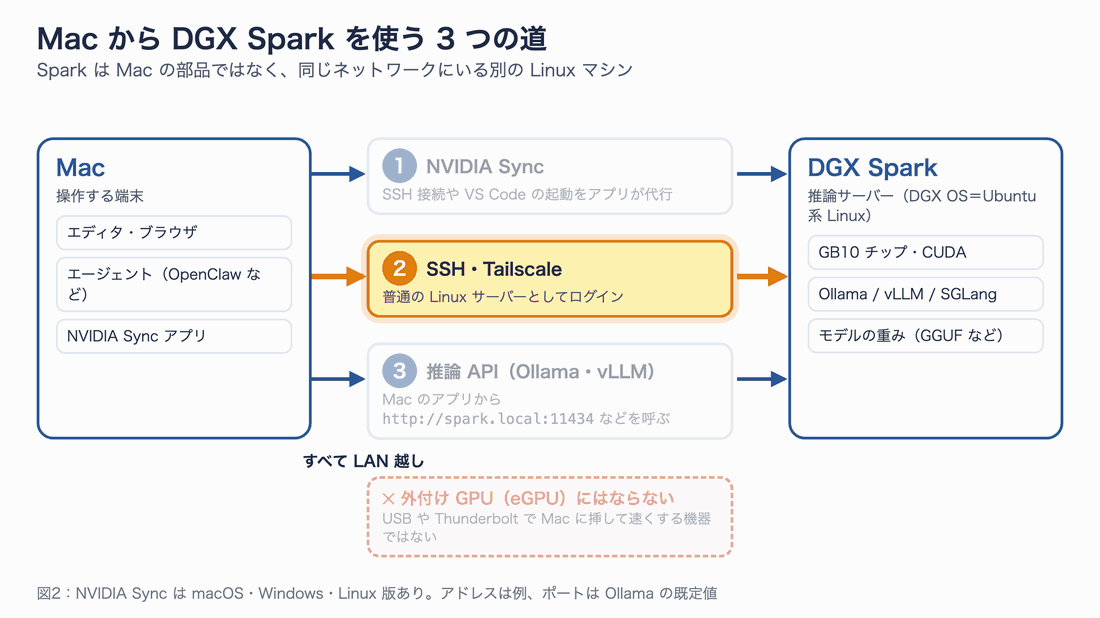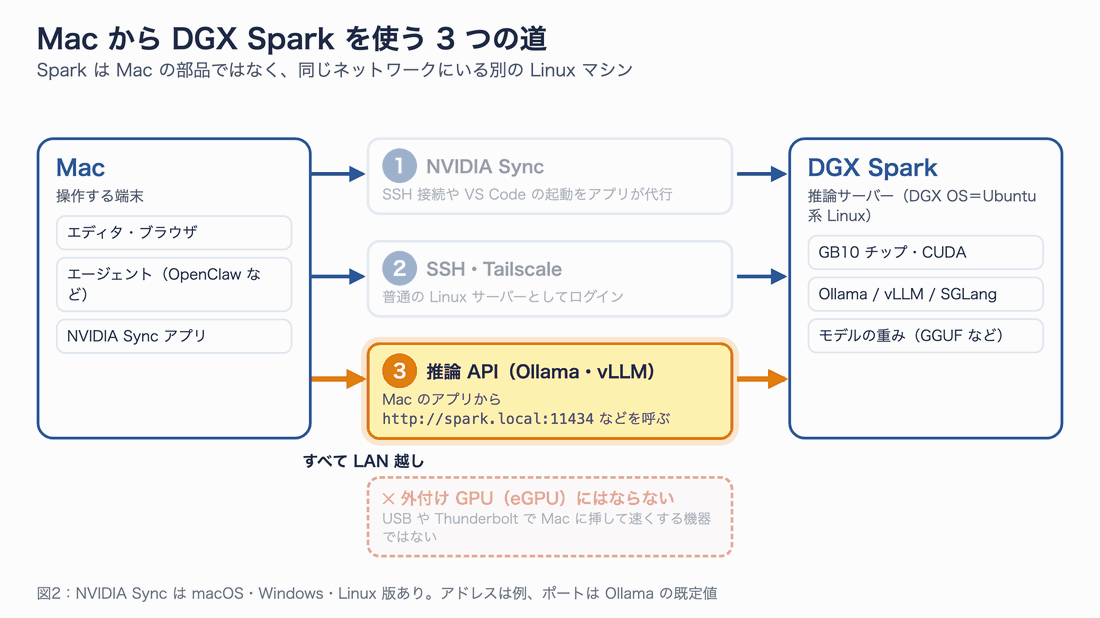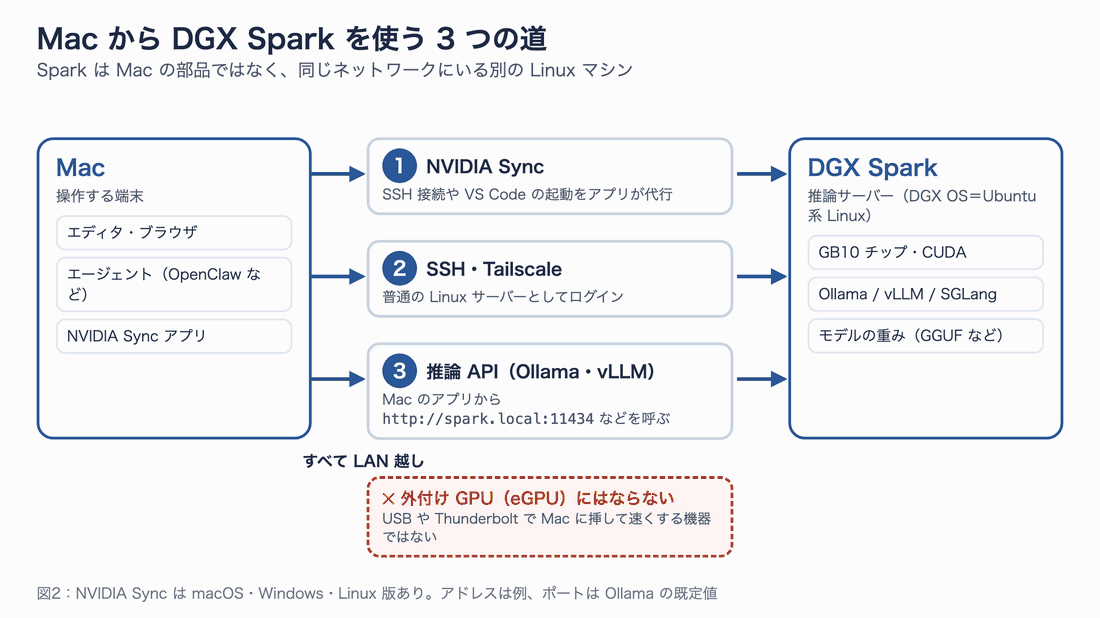
図2:Mac は操作する端末、DGX Spark は推論サーバー。どの方法も LAN 越しにつなぎます。
NVIDIA Sync は、DGX Spark にほかのパソコンからつなぐための公式アプリで、macOS 版(nvidia-sync.dmg)も配布されています。最初のセットアップでモニターとキーボードをつなぐか、ネットワーク越しに設定すれば、あとは Mac だけで運用できます。
Mac 用の資産がそのまま使えない点には注意してください。Apple 向けの MLX 形式のモデルや Metal 前提のコードは、DGX Spark では動きません。DGX Spark は NVIDIA の CUDA(GPU 用の開発基盤)が前提なので、モデルは GGUF 形式や vLLM 向けの形式で用意し直します。逆に言えば、NVIDIA 向けに作られた最新のツールが、そのまま動くのが DGX Spark の強みです。
64GB で何ができるか
メモリの計算は「パラメータ数 × 1 個あたりのビット数」
モデルがメモリに載るかどうかは、おおよそ次の式で見積もれます。
モデル本体のサイズ(バイト) ≒ パラメータ数 × 1 パラメータあたりのビット数 ÷ 8
たとえば 100B のモデルを 4 ビット(量子化と呼ばれる圧縮)で持つと、1,000 億 × 4 ÷ 8 = 500 億バイト、約 50GB です。実際の 4 ビット形式は目盛りの情報も持つので、4.5 ビット前後と考えると約 52GB になります。
NVIDIA のブログには、「最大 100B」がどの精度を前提にしているかは書かれていません。ただ、8 ビットなら 100GB になって 64GB には入らないので、4 ビット前後の量子化が前提と読むのが自然です。
さらに、メモリにはモデル本体のほかに、OS と「会話の記憶」も載せる必要があります。会話の記憶は KV キャッシュと呼ばれ、読ませる文章(文脈)が長いほど大きくなります。
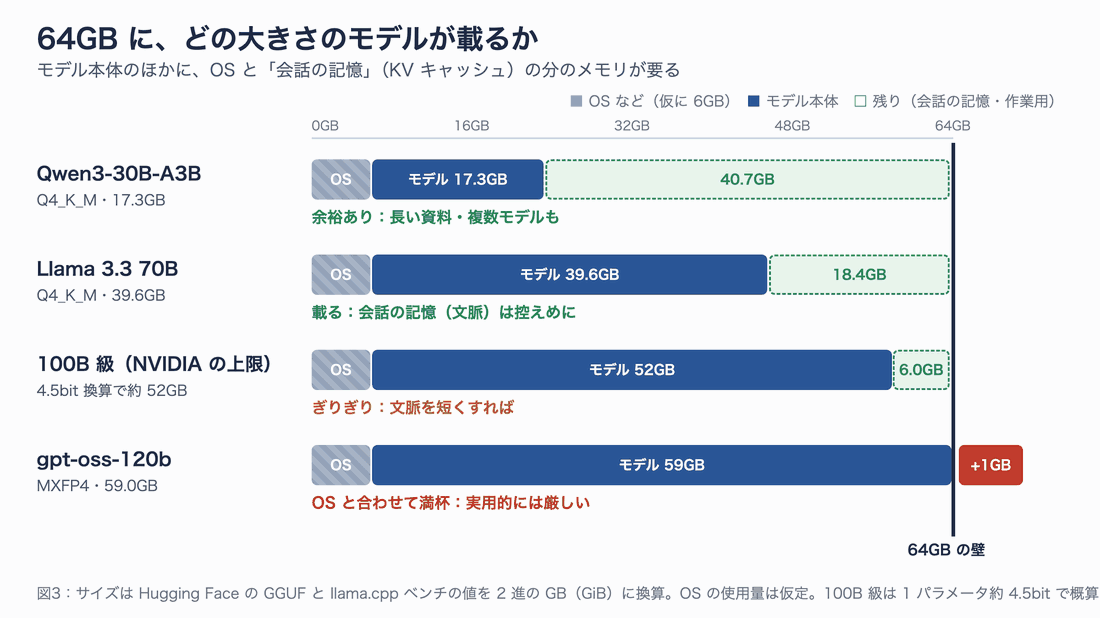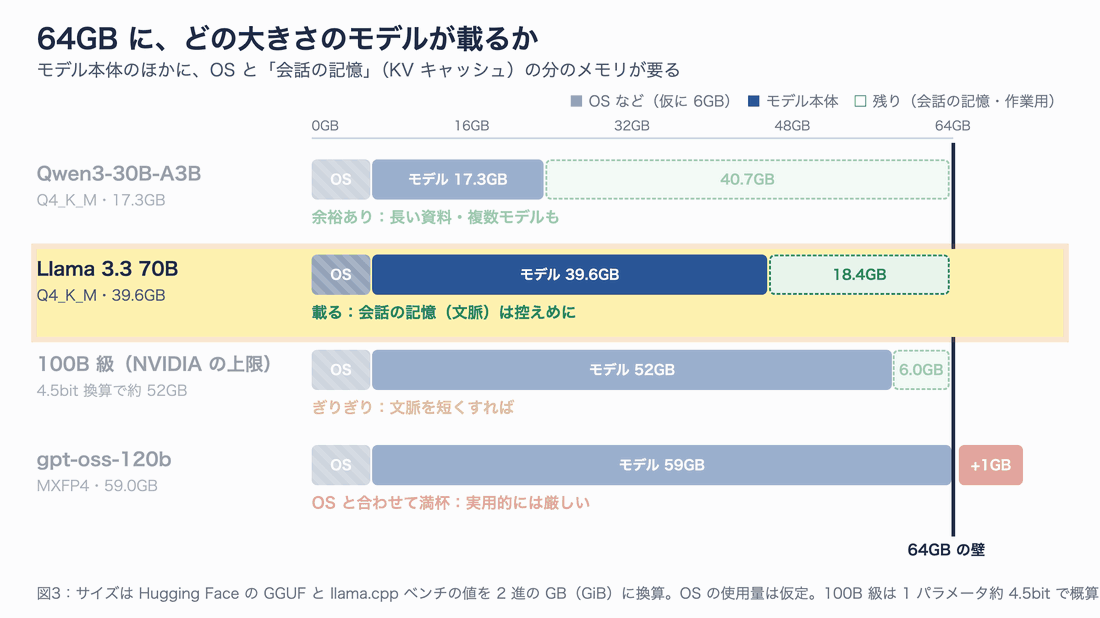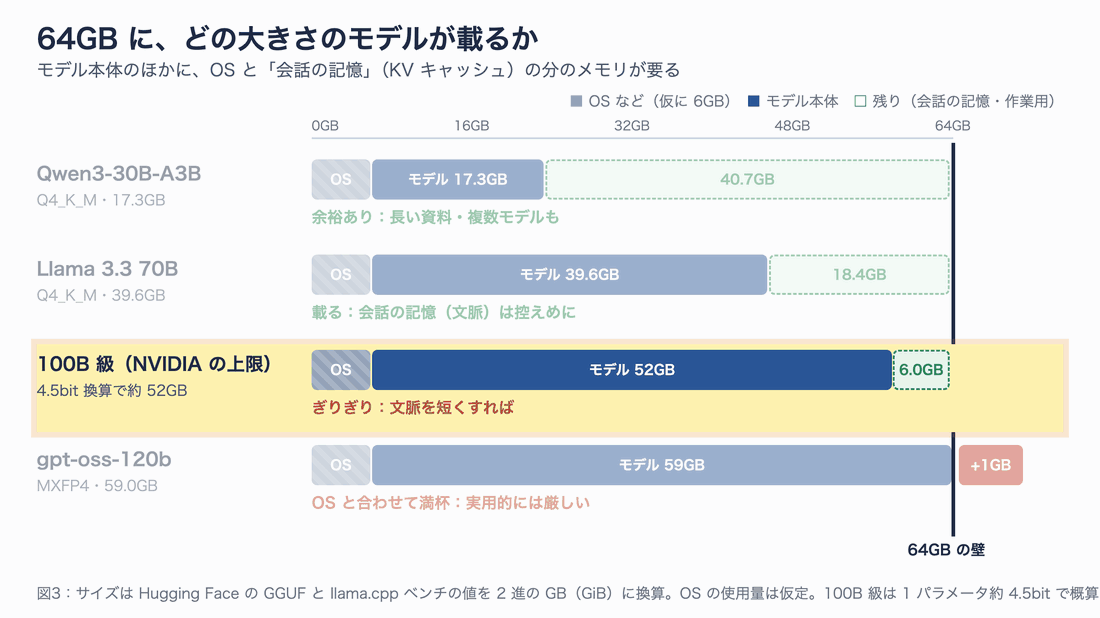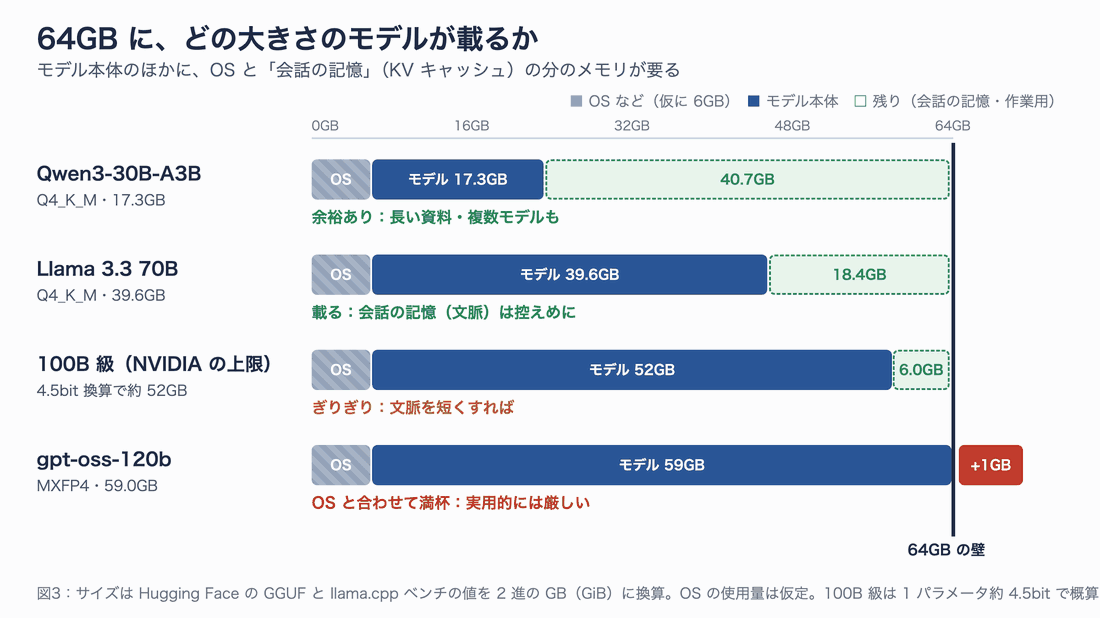
図3:OS を仮に 6GB とした内訳。70B 級までは現実的、100B 級はぎりぎり、gpt-oss-120b は実用的には厳しい、という線引きになります。
代表的なモデルで見ると、次のようになります。
| モデル | 形式とサイズ | 64GB での扱い |
|---|---|---|
| gpt-oss-20b | MXFP4・約 11.3GB | 余裕。長い資料も読ませられる |
| Qwen3-30B-A3B | Q4_K_M・約 17.3GB | 余裕。2 つのモデルを同時に置くこともできる |
| Qwen 3.8 27B | — | NVIDIA が 64GB 版の試験と Model Launcher で使うモデル |
| Llama 3.3 70B | Q4_K_M・約 39.6GB | 載る。文脈は控えめにする |
| 100B 級 | 4 ビット前後で約 50GB | NVIDIA の上限。文脈を短くすれば |
| gpt-oss-120b | MXFP4・約 59GB | OS と合わせて満杯。実用的には厳しい |
サイズはメモリと同じ 2 進の GB(GiB)にそろえています。オープンモデルの中で人気の高い gpt-oss-120b が 64GB 版では実用的に動かない点は、購入前に知っておきたいポイントです。120B 級を快適に使いたいなら、128GB 版を選ぶことになります。
速さは「読む」と「書く」で決め手が違う
AI が返事をするとき、内部では 2 つの段階があります。最初にプロンプトや資料をまとめて読み込む「プリフィル」と、答えを 1 トークン(単語のかけら)ずつ書き出す「デコード」です。
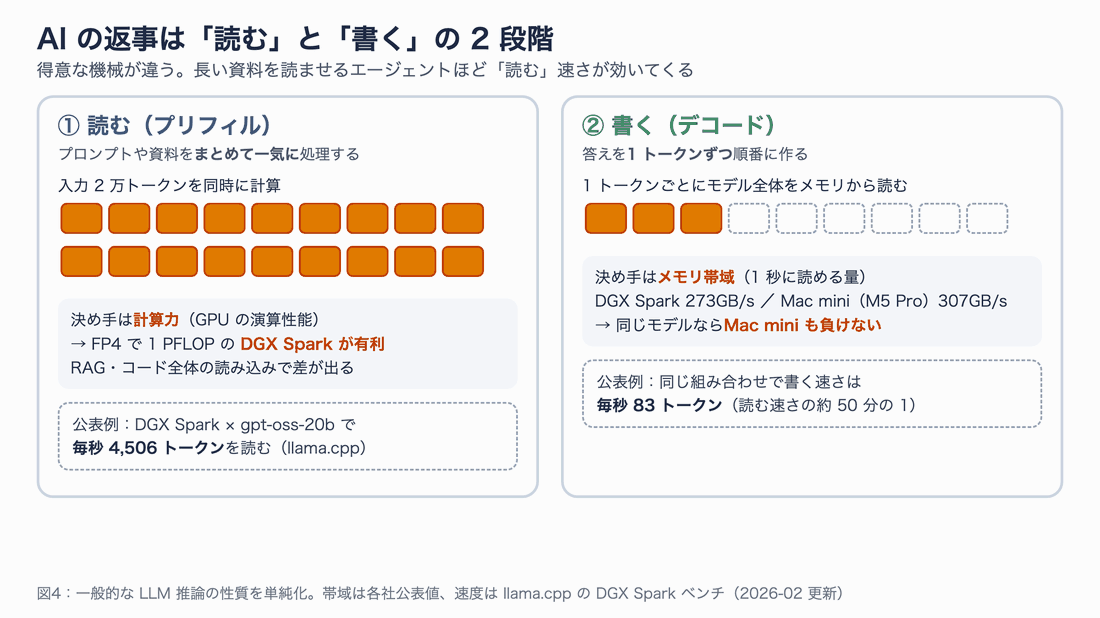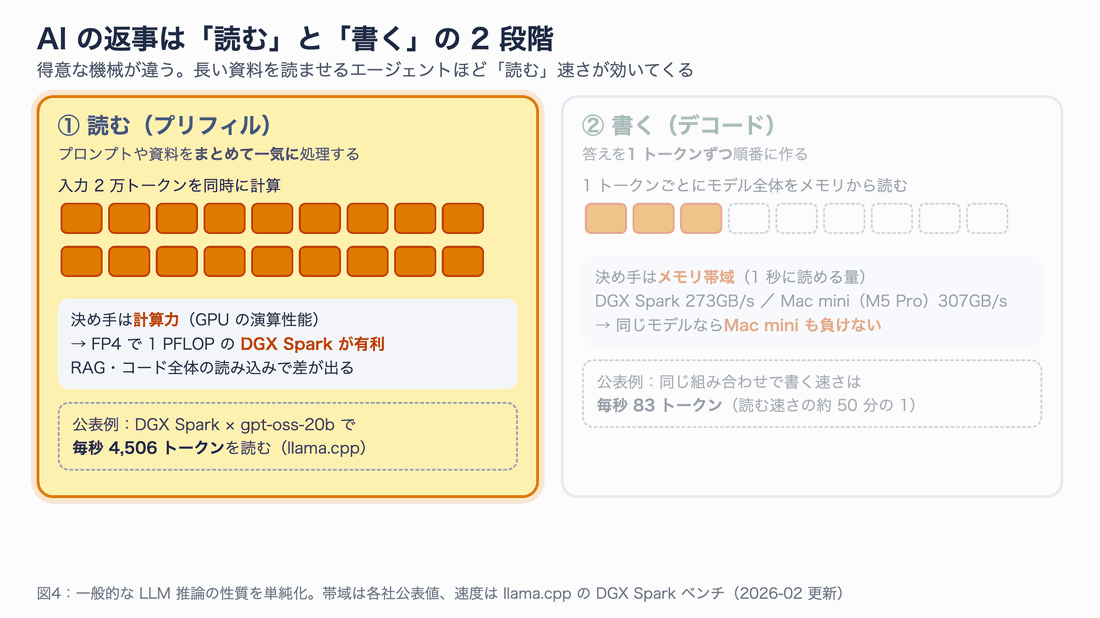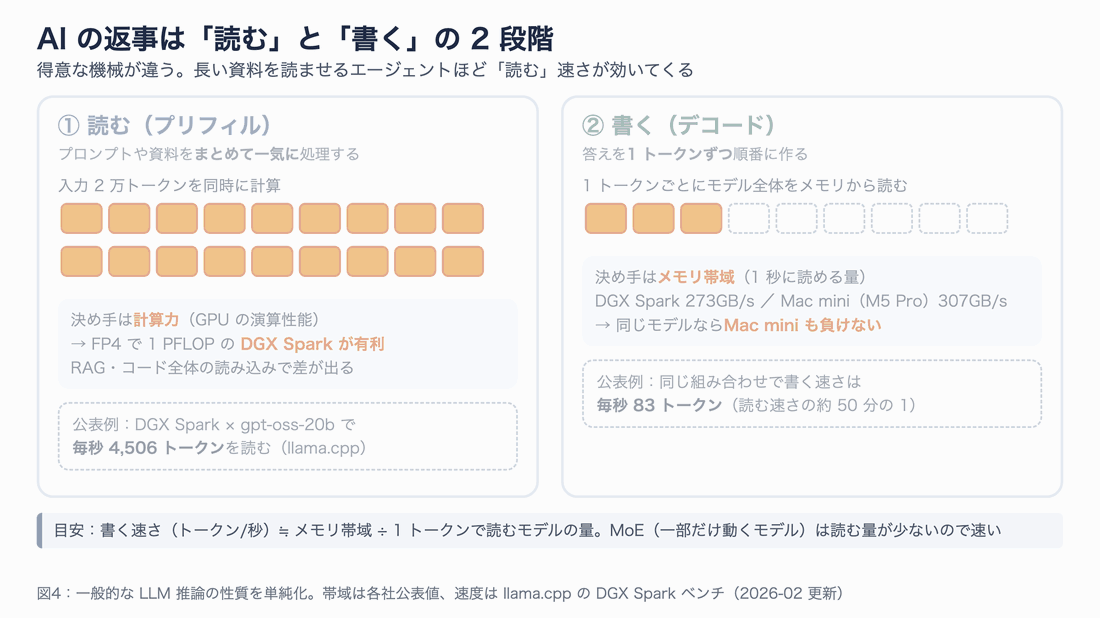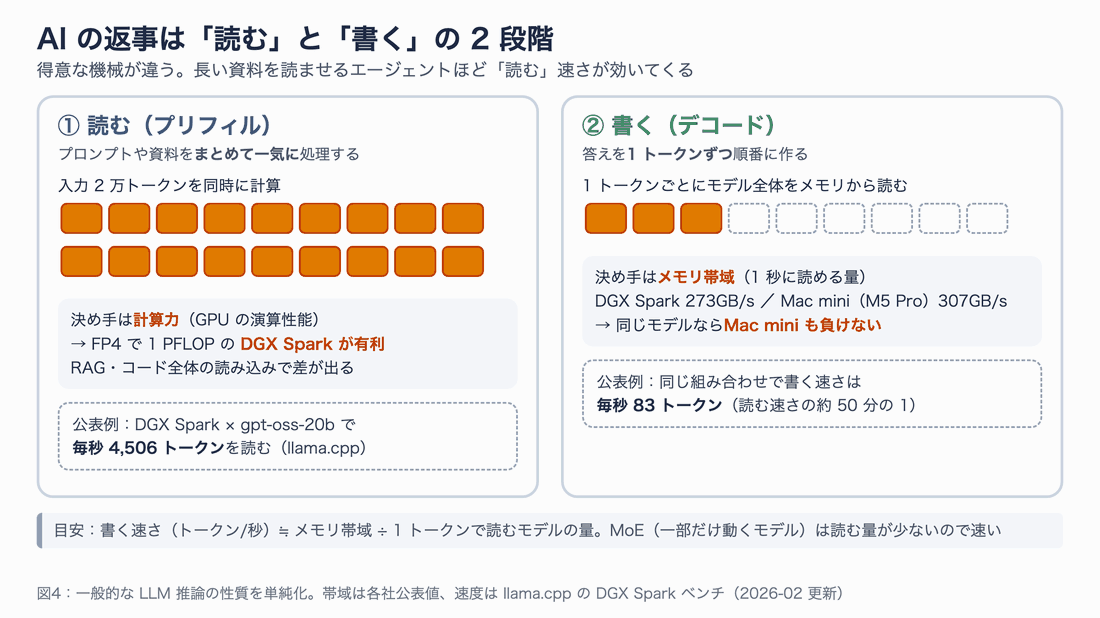
図4:読む速さは計算力、書く速さはメモリ帯域で決まります。DGX Spark の強みは「読む」側です。
読む段階は、たくさんのトークンを同時に計算するので、GPU の計算力が効きます。DGX Spark は 4 ビット計算(FP4)で最大 1 PFLOP(1 秒に 1,000 兆回)の性能を持ち、ここが得意です。
書く段階は、1 トークン作るたびにモデル全体をメモリから読み出すので、メモリ帯域(1 秒に読み出せる量)で速さがほぼ決まります。DGX Spark の帯域は 273GB/s で、実は Mac mini の M5 Pro(307GB/s)のほうが大きい値です。
llama.cpp の公式ベンチマークでは、DGX Spark の速さは次のとおりです(2026 年 2 月更新、文脈が短い条件)。
| モデル | 読む速さ(トークン/秒) | 書く速さ(トークン/秒) |
|---|---|---|
| gpt-oss-20b(MXFP4) | 4,506 | 83.4 |
| Qwen3-Coder-30B-A3B(Q8_0) | 2,987 | 61.1 |
| gpt-oss-120b(MXFP4、128GB 版での値) | 2,444 | 58.7 |
毎秒 60〜80 トークン書ければ、人が読むより十分速く感じます。gpt-oss-120b が 20B 版に近い速さで動くのは、MoE(質問ごとにモデルの一部だけを動かす仕組み)のおかげで、1 トークンあたりに読み出す量が少ないからです。
Mac mini と直接比べられる同じ条件のベンチマークは、まだ見つかっていません。条件の違う参考値として、7B 級のモデルを 8 ビットで動かした場合、書く速さは M5 Pro が毎秒 38.9 トークン、DGX Spark が 29.4 トークンでした。読む速さは DGX Spark が 1.4〜1.7 倍ほど速い結果です(M5 Pro の GPU コア数で変わります)。書く速さは互角かそれ以上、資料を大量に読ませると DGX Spark が速い、と覚えておけば大きく外れません。
2 台つなぐと何が変わるか
DGX Spark には ConnectX-7 という 200Gbps の高速ネットワークが付いていて、2 台を専用ケーブルで直結できます(最大 4 台まで)。2 台をつなぐと、メモリが 128GB になり、帯域も 2 倍になります。NVIDIA の試験では、Qwen 3.8 27B で 1 台の最大 1.7 倍の性能が出ました。ただし、何を測った数字(1 本あたりの速さか、同時処理の量か)なのかは書かれていません。
費用の面では注意が必要です。64GB 版を 2 台そろえると 9,998 ドルで、同じ 128GB なら 128GB 版 1 台(6,950 ドル)のほうが約 3,000 ドル安く済みます。2 台構成の利点は、1 台から始めて後で足せることと、帯域が 2 倍になることです。最初から 128GB が必要と分かっているなら、128GB 版 1 台が素直な選択です。
向いている用途・向いていない用途
ここまでの性質から、DGX Spark 64GB の向き不向きを整理します。
| 向いている用途 | 理由 |
|---|---|
| 社外に出せない資料を使う RAG(社内資料を検索して答える AI) | データが手元から出ない。大量の資料を読む処理(プリフィル)が速い |
| コーディングエージェントやリサーチエージェントの 24 時間稼働 | 従量課金がないので、回すほど得になる |
| 複数のエージェントから同時に使う推論サーバー | vLLM などで同時処理をまとめて効率よくさばける |
| CUDA を使う開発・学習の練習 | クラウドの GPU と同じ道具が手元で動く。NVIDIA はファインチューニング(追加学習)も用途に挙げている |
| NVIDIA の最新ツールを試す | NemoClaw、OpenShell などの手順書が DGX Spark 向けに用意されている |
| 向いていない用途 | 理由 |
|---|---|
| 最上位モデル並みの賢さが要る仕事 | 手元で動くのは 100B 級まで。クラウドの最上位モデルには届かない |
| ふだん使いのパソコンを兼ねたい | Linux の AI 専用機。画面・キーボードも別に要る |
| たまにしか AI を使わない | 本体代を回収できない。クラウド API のほうが安い |
| 120B 級のモデルを快適に動かしたい | 64GB では満杯。128GB 版が必要 |
| Mac 向け(MLX)の資産を活かしたい | そのままでは動かない |
Mac mini + OpenClaw とは何が違うのか
OpenClaw と Mac mini が流行った理由
OpenClaw は、自分のパソコンで動かす個人向けの AI アシスタントです。Slack、Discord、Telegram、WhatsApp、iMessage など 20 以上のメッセージアプリとつながり、メッセージで頼むとファイル操作や調べものをこなしてくれます。オープンソース(MIT ライセンス)で、財団が運営しています。
この OpenClaw を動かす専用機として、Mac mini が人気になりました。待機時の消費電力が 4〜6W と小さく、つけっぱなしでも電気代がほとんどかからないこと、iMessage と連携できるのが Mac だけであること、メインのパソコンと切り離して動かせることが主な理由です。メモリの多い Mac mini の納期が延びた時期もありました。Apple 自身も、2026 年 8 月に発表した新しい Mac mini を「常時稼働のエージェント用」として打ち出しています。
なお、2026 年 9 月 22 日に発売された新しい Mac mini は、M6 と M5 Pro の 2 種類です。メモリ 64GB を選べるのは M5 Pro だけで、M6 は最大 32GB です。
3 つの構成を定義する
比較のために、3 つの構成を決めておきます。
| 構成 | 中身 | 頭脳 |
|---|---|---|
| ① Mac mini +クラウド API | Mac mini(M6・16GB)に OpenClaw を入れる | Claude や GPT をインターネット越しに呼ぶ |
| ② Mac mini 64GB でローカル | Mac mini(M5 Pro・64GB)に OpenClaw とローカル LLM を入れる | 同じ Mac の中のモデル |
| ③ DGX Spark 64GB でローカル | DGX Spark にローカル LLM を入れ、OpenClaw は Spark か手元の Mac で動かす | DGX Spark の中のモデル |
①が、いま一番多い定番の構成です。②と③は、頭脳まで手元に置く構成です。
費用を比べる
本体の価格
まず本体の価格です。DGX Spark の日本価格はまだ出ていないので、比較は米国の税抜価格で行います。
| 構成 | 米国(税抜) | 日本(税込) |
|---|---|---|
| Mac mini M6・16GB・256GB | 899 ドル | 149,800 円 |
| Mac mini M5 Pro・64GB・512GB | 2,699 ドル | 約 479,800 円(構成の差額からの計算) |
| DGX Spark 64GB | 4,999 ドルから | 未発表(為替換算で約 79 万円+税) |
| 参考:DGX Spark 128GB | 6,950 ドル | 未発表 |
| 参考:Mac Studio M5 Max・128GB | 5,099 ドル | 約 887,800 円(構成の差額からの計算) |
Mac も 2026 年 6 月に値上げされています。本体価格だけでなく、メモリを増やす追加料金も上がりました。Mac mini の M5 Pro では、24GB から 64GB に増やすだけで 1,000 ドル(日本では 18 万円)かかります。
3 年間の総額
次に、本体・電気代・API 料金を合わせた 3 年間の総額を試算しました。API の使用量は、次の 3 段階を仮定しています。
| 使用量 | 1 か月の入力 | 1 か月の出力 | API 代(月) |
|---|---|---|---|
| ライト | 1,000 万トークン | 50 万トークン | 25 ドル(約 4,000 円) |
| ふつう | 5,000 万トークン | 250 万トークン | 125 ドル(約 2 万円) |
| ヘビー | 3 億トークン | 1,500 万トークン | 750 ドル(約 11.9 万円) |
API の料金は、Claude Sonnet 5.5(入力 100 万トークンあたり 2 ドル、出力 10 ドル)で計算しました。エージェントは、作業のたびに過去のやりとりやファイルの中身を読み直すので、入力トークンが出力よりずっと多くなります。
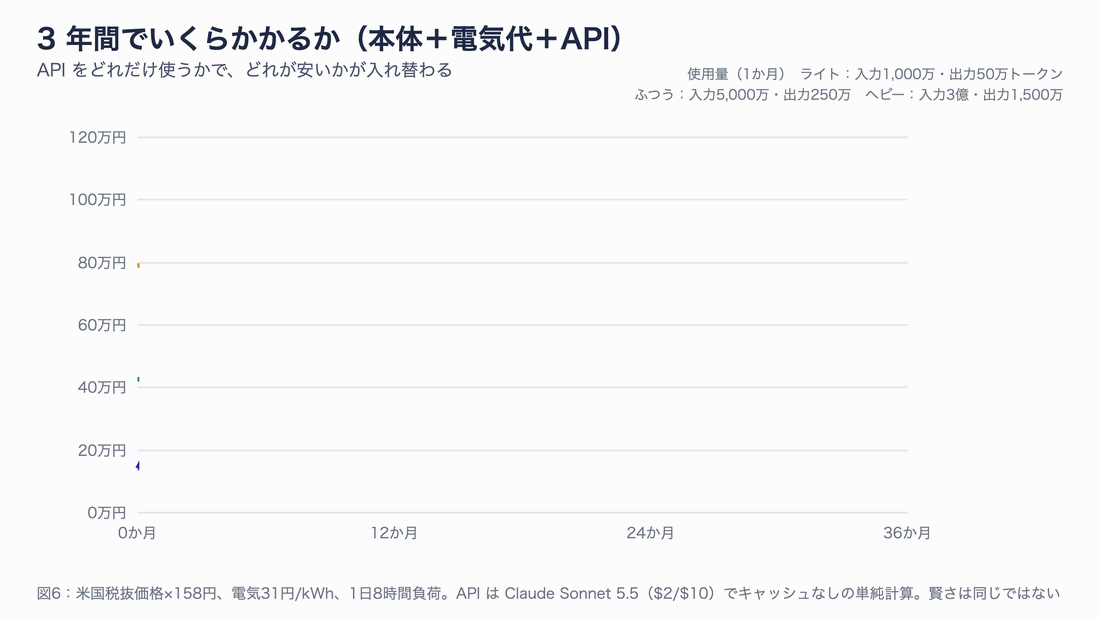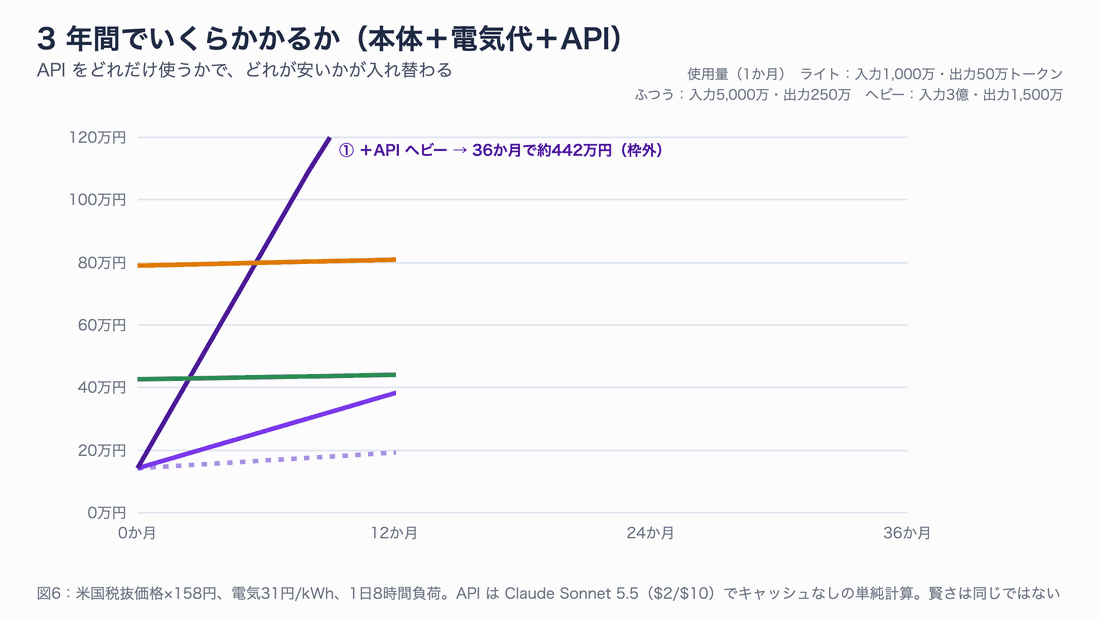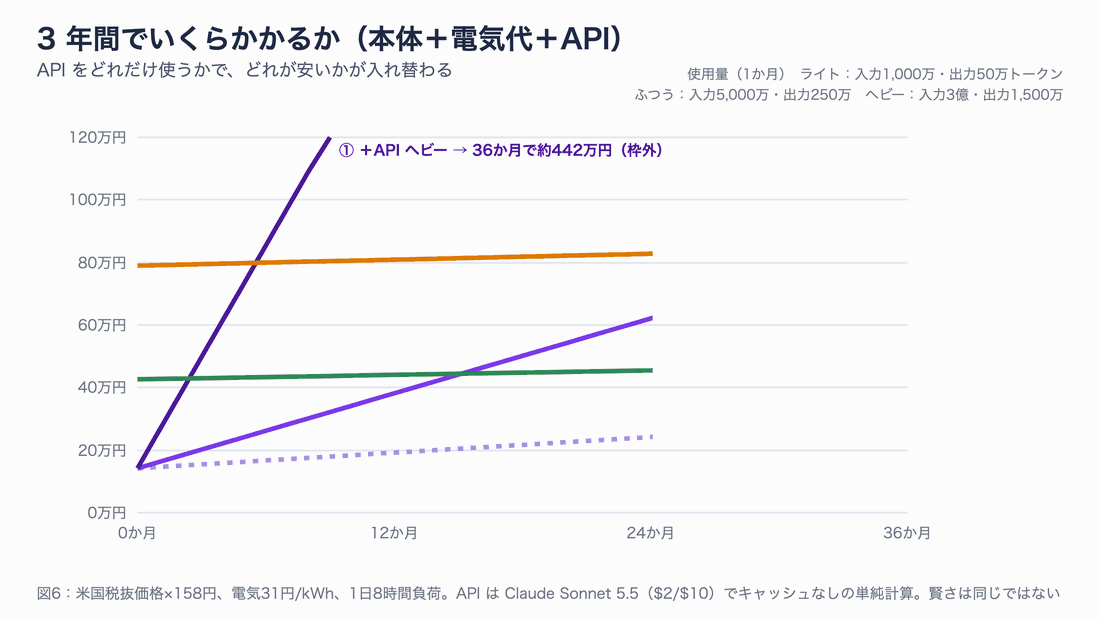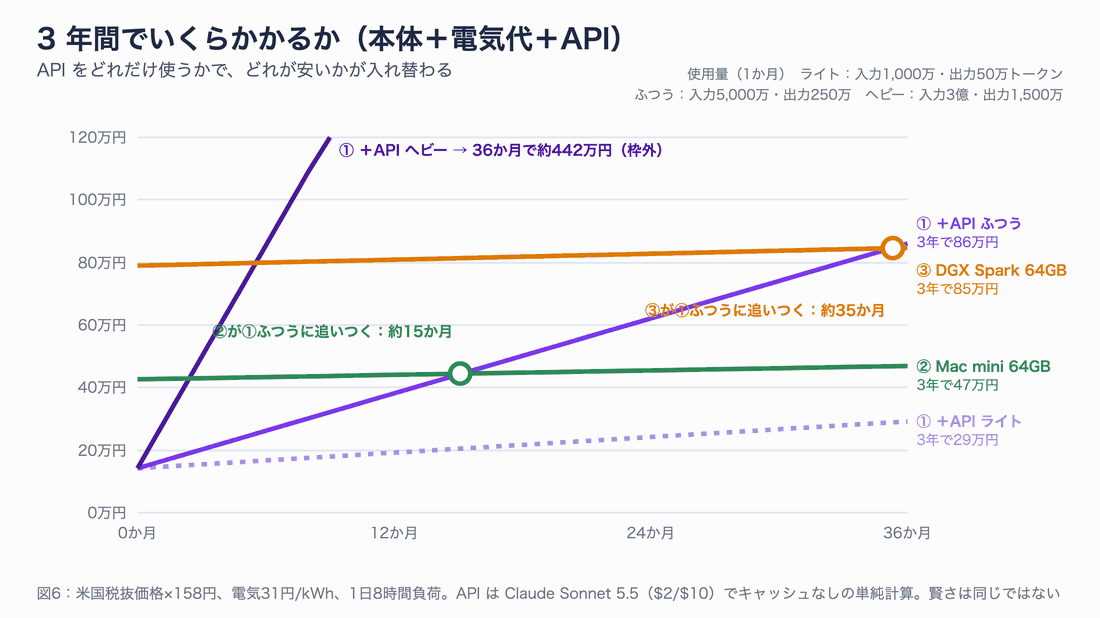
図6:API をどれだけ使うかで、どれが安いかが入れ替わります。ヘビーな使い方なら、DGX Spark でも約 6 か月で元が取れる計算です。
電気代は、1 日 8 時間は推論で負荷がかかり、残りは待機している、という前提で計算しました。DGX Spark は待機 25W・負荷 160W(Tom’s Hardware の実測)、Mac mini M5 Pro は待機 6W・最大 145W(Apple の公表値)です。
| 構成 | 本体 | 電気代(年) | 3 年間の総額 |
|---|---|---|---|
| ① +API ライト | 約 14.2 万円 | 約 2,500 円 | 約 29 万円 |
| ① +API ふつう | 約 14.2 万円 | 約 2,500 円 | 約 86 万円 |
| ① +API ヘビー | 約 14.2 万円 | 約 2,500 円 | 約 442 万円 |
| ② Mac mini 64GB | 約 42.6 万円 | 約 1.4 万円 | 約 47 万円 |
| ③ DGX Spark 64GB | 約 79.0 万円 | 約 1.9 万円 | 約 85 万円 |
ローカル構成が①に追いつくまでの期間は、次のとおりです。
| 使用量 | ② Mac mini 64GB | ③ DGX Spark 64GB |
|---|---|---|
| ライト | 約 8 年 | 約 21 年(実質、追いつかない) |
| ふつう | 約 15 か月 | 約 35 か月 |
| ヘビー | 約 2.4 か月 | 約 5.5 か月 |
この試算を読むときの注意
この試算は、比べやすくするために単純化しています。結論を出す前に、次の 4 点を押さえてください。
- 賢さは同じではありません。 ローカルで動く 30B〜70B 級のモデルは、クラウドの最上位モデルより明らかに賢さが劣ります。①は「高い賢さを従量課金で買う」、②③は「そこそこの賢さを定額で使い放題にする」構成です。
- API はもっと安くできます。 同じ入力を繰り返し読む場合はプロンプトキャッシュで入力料金を大きく下げられます。急がない処理は Batch API で半額になります。OpenAI の GPT-6 Luna(入力 0.10 ドル、出力 0.50 ドル)のような小型モデルなら、「ふつう」でも月 6 ドル程度です。
- API は高くもなります。 Claude Opus 5.5(入力 4 ドル、出力 20 ドル)を使えば、料金はちょうど 2 倍です。
- 本体代は値上がりの最中です。 メモリ不足で、DGX Spark も Mac も 1 年で大きく値上がりしました。DGX Spark 64GB の日本価格もまだ分かりません。
つまり、「DGX Spark のほうが得」と言えるのは、ヘビーな使い方をしていて、しかもローカルモデルの賢さで足りる仕事が多い場合です。費用だけで見ると、64GB 同士では Mac mini M5 Pro のほうが約 2,300 ドル安く、多くの人には Mac mini のほうが合理的です。
そのほかの比較軸
費用以外にも、選ぶときに効いてくる軸がいくつかあります。10 個の軸で 3 つの構成を並べました。
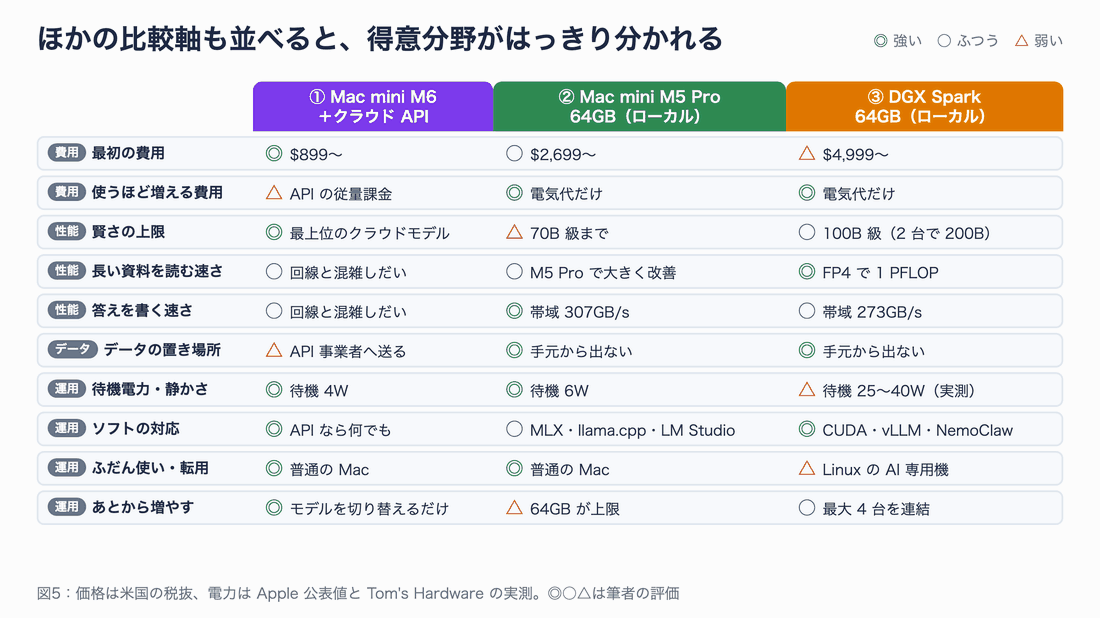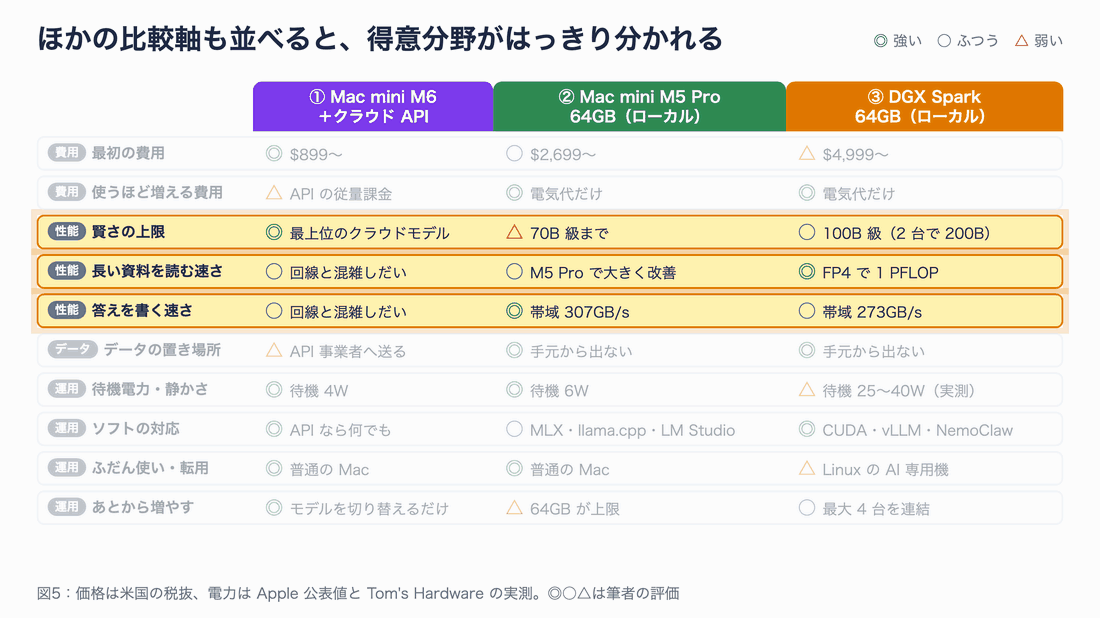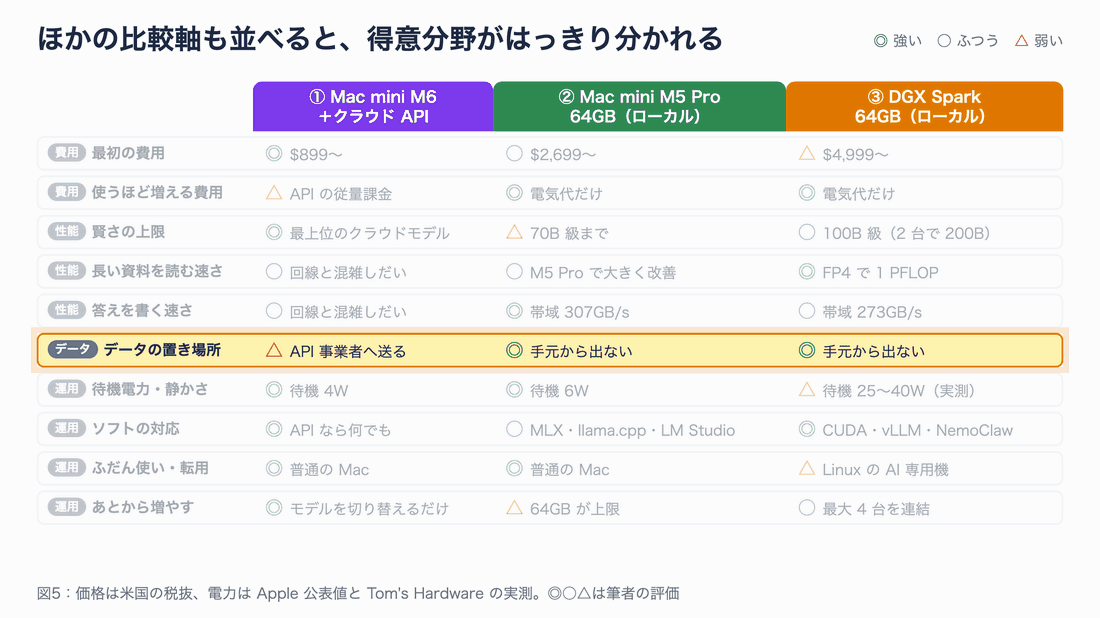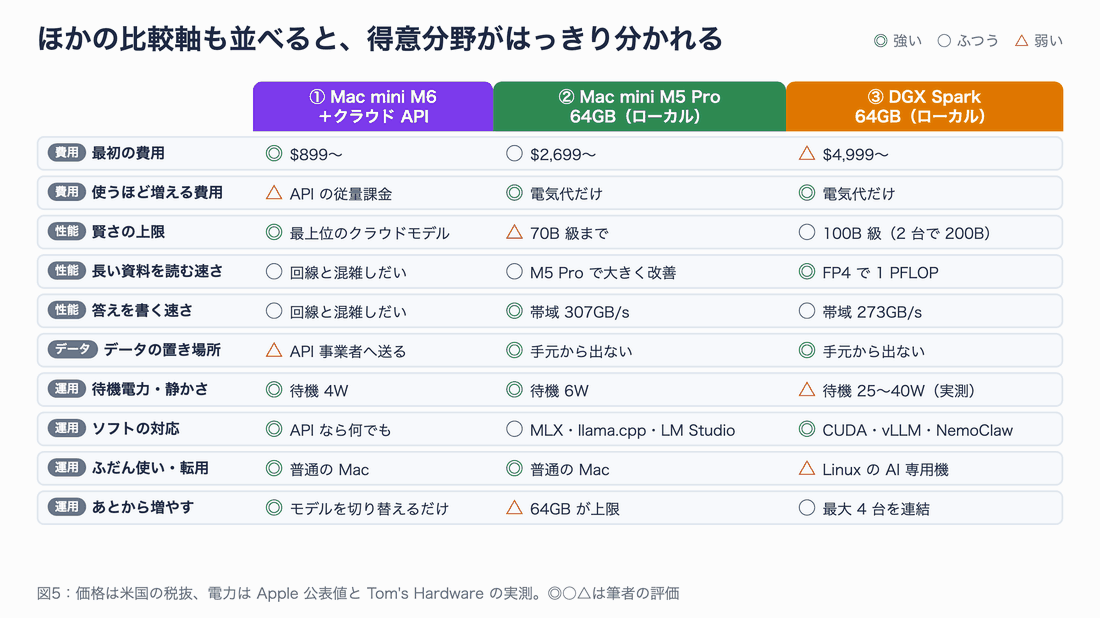
図5:費用・性能・データ・運用の 4 グループで並べると、得意分野がはっきり分かれます。◎○△は筆者の評価です。
表だけでは伝わりにくい軸を補足します。
データの置き場所:社外に出せない情報を AI に扱わせたいなら、②か③の一択です。①でも API 事業者の利用規約やゼロデータ保持の契約で守る方法はありますが、「そもそも外に出さない」とは違います。
待機電力と静かさ:DGX Spark は待機中でも 25〜40W 使います(ソフトの更新で 37W から 25W に下がったという報告があります)。Mac mini の 4〜6W と比べると 5 倍以上です。騒音は、NVIDIA の公表値で動作時 35dB と静かな部類ですが、寝室に置くなら Mac mini のほうが安心です。
ソフトの対応:DGX Spark は CUDA が動くので、vLLM、SGLang、TensorRT-LLM など、NVIDIA の GPU 向けに作られた推論ソフトがそのまま動きます。NVIDIA が OpenClaw を安全に動かすために出している NemoClaw も、対応するのは NVIDIA の機械だけです。Mac は MLX、llama.cpp、LM Studio、Ollama がよく整備されていて、個人で使う範囲なら困りません。
ふだん使い・転用:Mac mini は、AI に使わなくなっても普通のパソコンとして使え、中古でも売りやすい機械です。DGX Spark は Linux の AI 専用機なので、用途が限られます。
あとから増やす:Mac mini のメモリは購入時に決まり、64GB が上限です。DGX Spark は 2〜4 台をつないでメモリを増やせます。最初は 64GB 1 台で試し、足りなければ 2 台目を足すという段階的な投資ができるのは、DGX Spark ならではの利点です。
セキュリティ:どの構成でも、OpenClaw は強い権限を持つので注意が要ります。2026 年には、OpenClaw の拡張機能(スキル)の配布サイトで、Mac の情報を盗むマルウェア入りのスキルが見つかったと、Palo Alto Networks のセキュリティ研究チーム Unit 42 が報告しています。NVIDIA の手順書も、専用の隔離された環境で動かすこと、管理画面を認証なしで公開しないこと、信頼できるスキルだけを入れることを強く勧めています。メインのパソコンとは別の機械で動かすこと自体が、ひとつの安全対策です。
どれを選ぶか
ここまでの内容を、4 つの質問のフローチャートにまとめました。
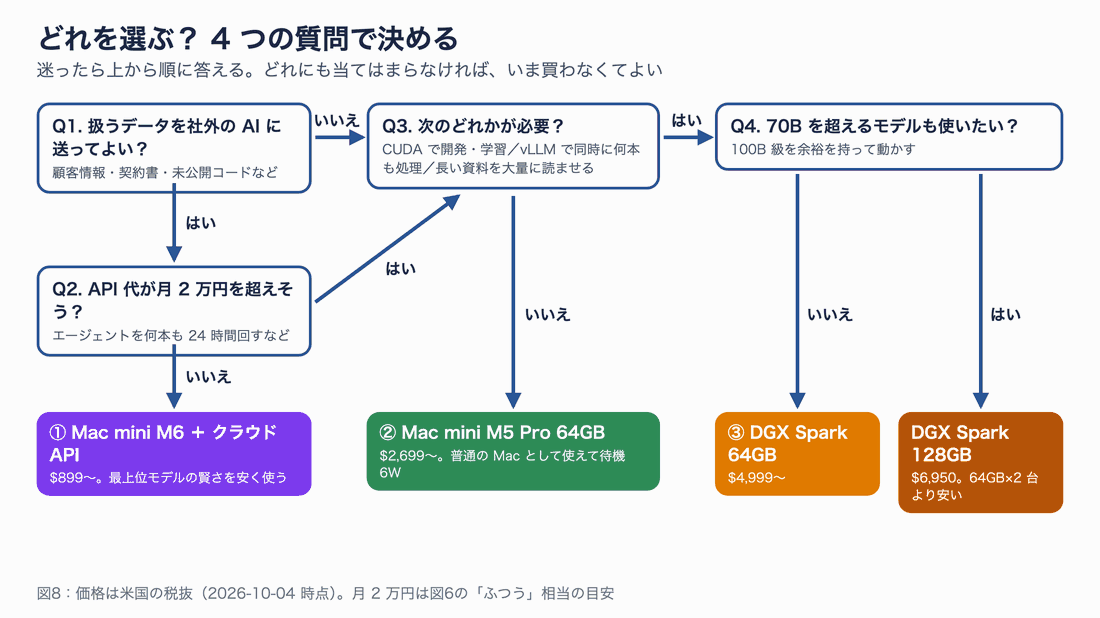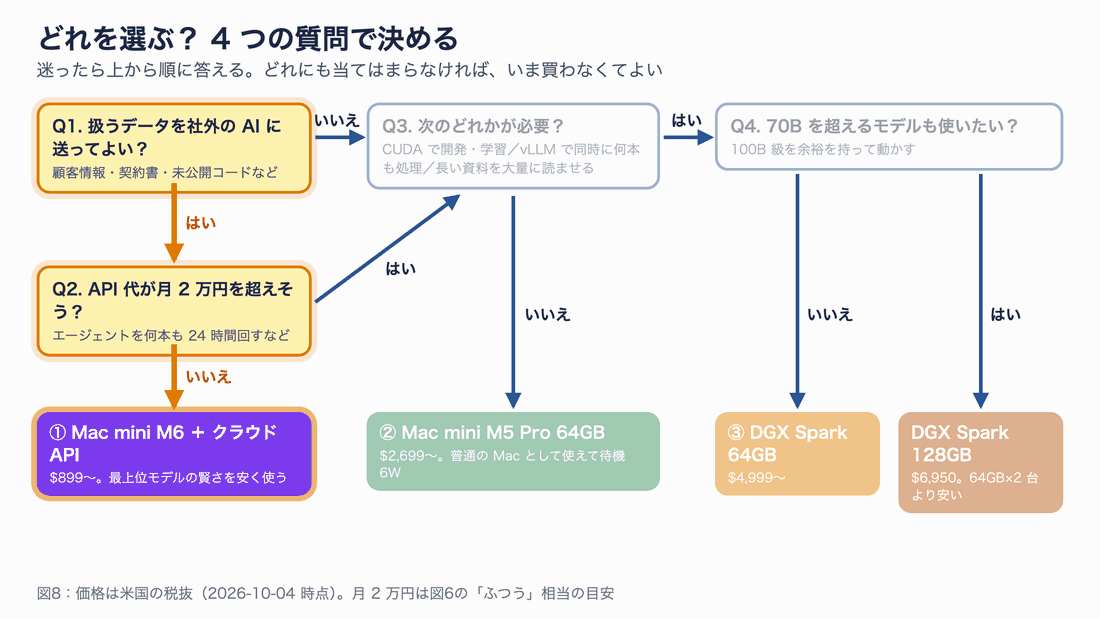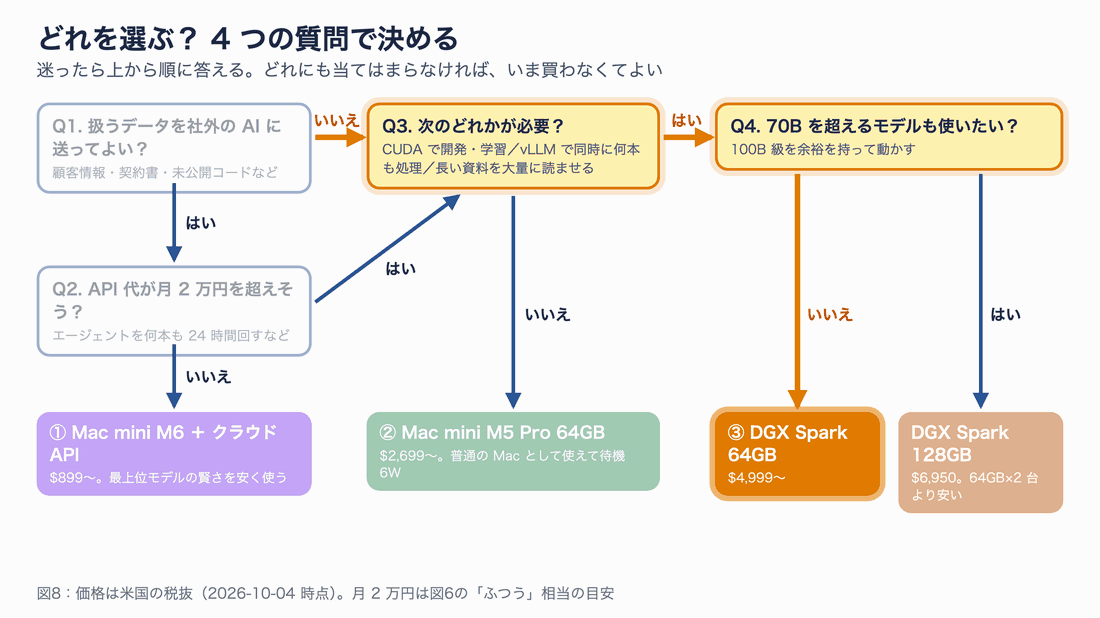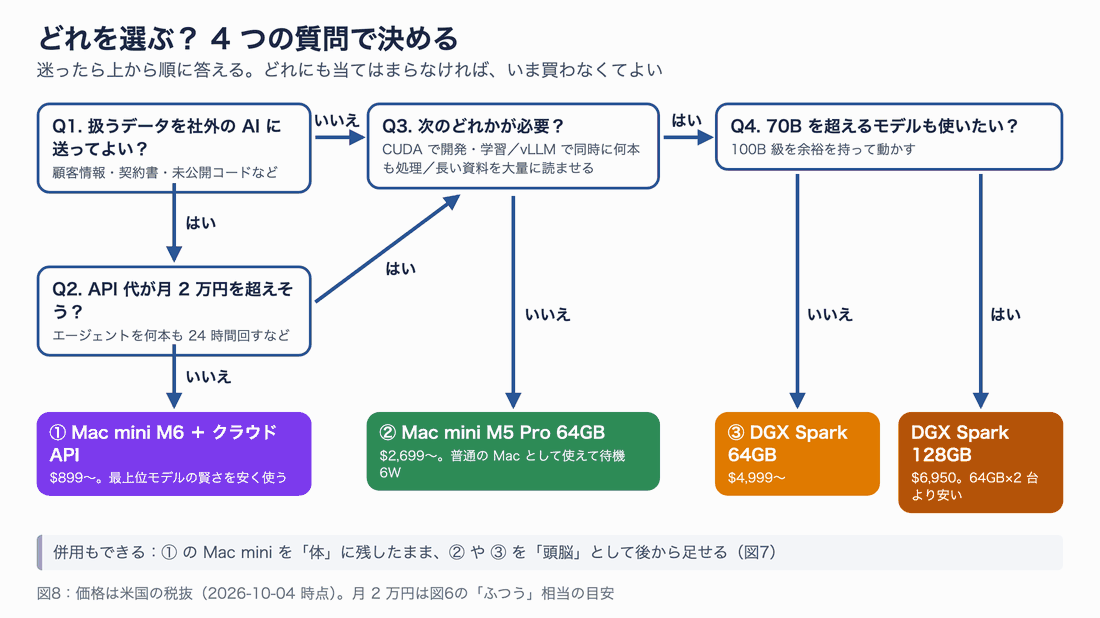
図8:迷ったら上から順に答えます。どれにも当てはまらなければ、いま買う必要はありません。
フローチャートの各結論を、言葉でも確認しておきます。
- データを外に出してよく、API 代も月 2 万円以下なら、① Mac mini M6 +クラウド API です。いちばん安く、いちばん賢い AI を使えます。
- データを外に出せない、または API 代がかさむが、CUDA も大量処理も要らないなら、② Mac mini M5 Pro 64GB です。普通の Mac として使え、待機電力も小さく済みます。
- CUDA での開発、複数エージェントからの同時利用、大量の資料の読み込みが必要なら、③ DGX Spark です。70B 級までで足りるなら 64GB 版、100B 級を余裕を持って動かしたいなら 128GB 版を選びます。
64GB 版は「まず試す」ための価格帯です。大きめのモデルを載せることが目的なら、本命は 128GB 版です。
現実的なのは併用。Mac からつなぐ手順
実際の現場では、どれか 1 つに絞るより、組み合わせて使う構成が増えています。普段の仕事は手元のモデルで回し、難しい仕事だけクラウドに投げる形です。
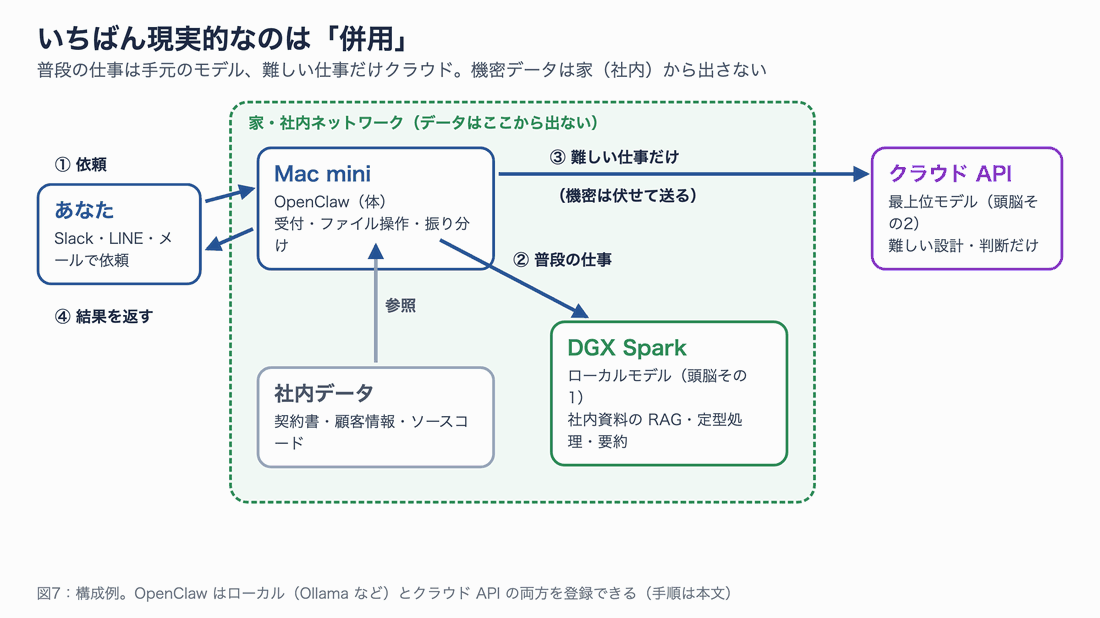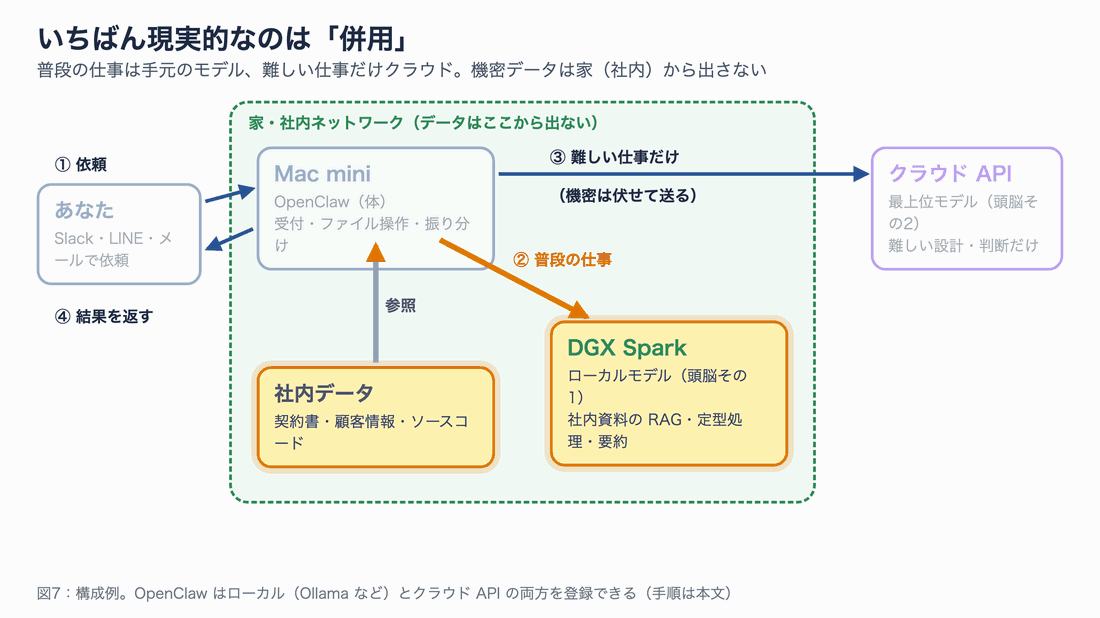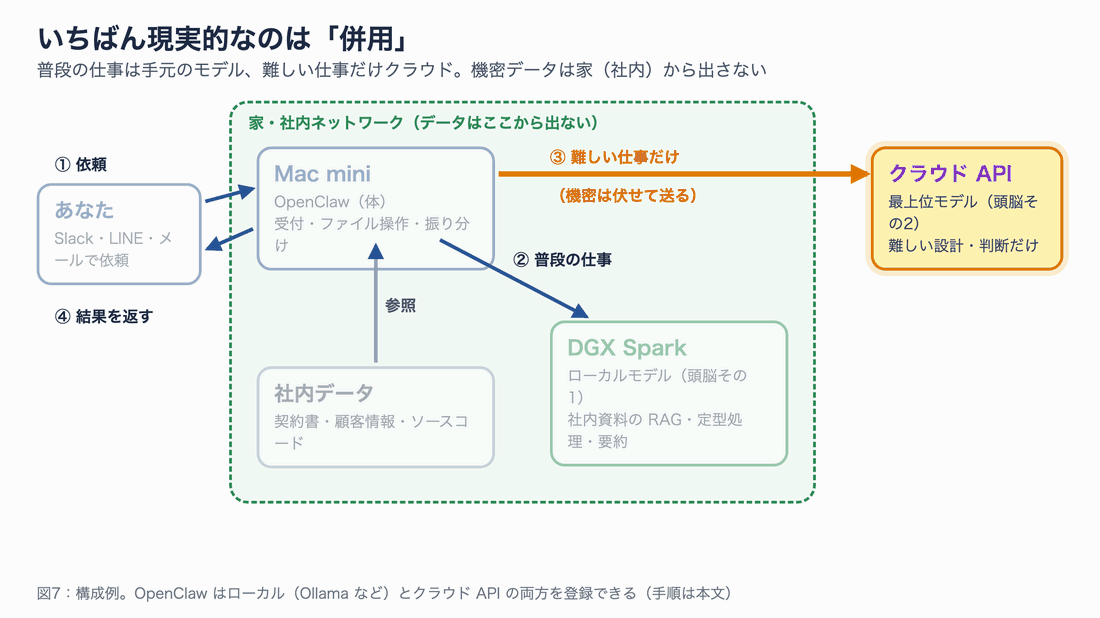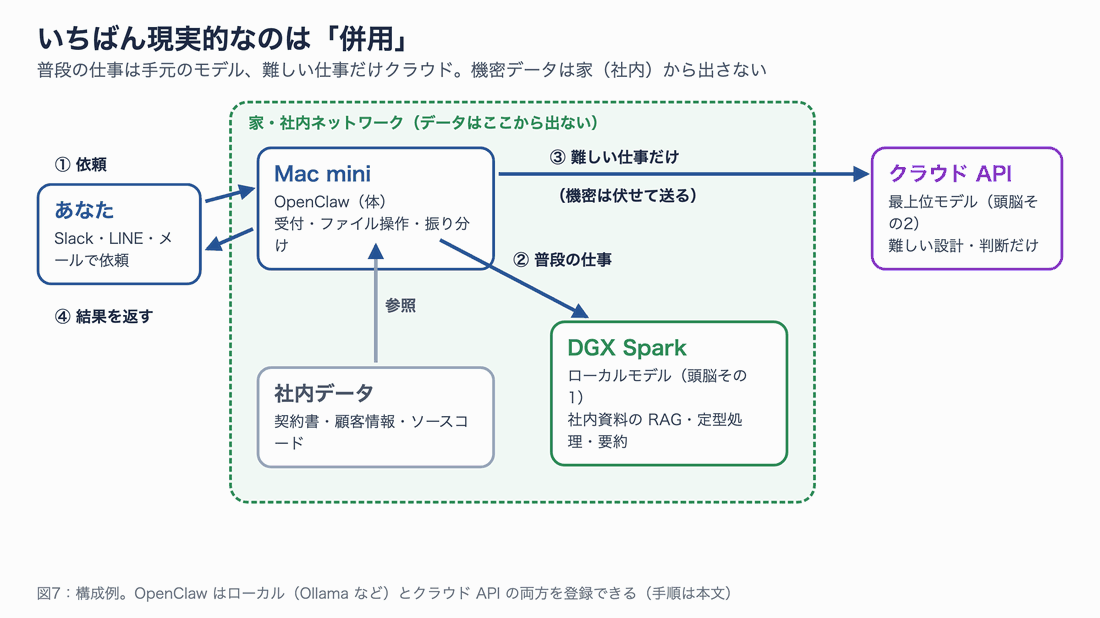
図7:Mac mini は「体」のまま残し、頭脳を後から足せます。機密データは社内ネットワークから出ません。
ここからは、DGX Spark を推論サーバーにして、Mac の OpenClaw からつなぐ手順の例を示します。筆者は DGX Spark の実機で試していません。 コマンドは Ollama、NVIDIA、OpenClaw の公式ドキュメントに沿ったもので、実際の操作では各公式ページで最新の手順を確認してください。
手順 1:Mac に NVIDIA Sync を入れる
NVIDIA の手順書ページ(build.nvidia.com の「Connect to your Spark」)から nvidia-sync.dmg をダウンロードして開き、アプリケーションフォルダに入れます。起動して DGX Spark を登録すると、SSH での接続や VS Code の起動をアプリから行えます。
手順 2:DGX Spark に Ollama を入れ、LAN から使えるようにする
DGX Spark にログインし、Ollama を入れてモデルを取り込みます。ここでは、64GB でも余裕を持って動く gpt-oss-20b を例にします。
# DGX Spark 上で実行する:Ollama をインストールする
curl -fsSL https://ollama.com/install.sh | sh

# モデルを取り込む(十数 GB のダウンロード)
ollama pull gpt-oss:20b
Ollama は、初期設定では同じマシンからの接続しか受け付けません。LAN 内の Mac から使えるように、待ち受けるアドレスを変えます。
# DGX Spark 上で実行する:Ollama の設定を上書きするファイルを開く
sudo systemctl edit ollama.service
開いたエディタに次の 2 行を書いて保存します。
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"
# 設定を読み込み直して、Ollama を再起動する
sudo systemctl daemon-reload
sudo systemctl restart ollama
この設定をすると、同じネットワークにいる誰でも Ollama を使えるようになります。家庭や社内の信頼できるネットワークだけで使い、インターネットに公開しないでください。
手順 3:Mac からつながるか確かめる
Mac のターミナルで、DGX Spark の Ollama に話しかけてみます。<SparkのIPアドレス> は自分の環境のものに置き換えます。
# Mac で実行する:取り込んだモデルの一覧が返ってくれば接続できている
curl http://<SparkのIPアドレス>:11434/api/tags

# 短い質問を送って、答えが返ってくるか確かめる
curl http://<SparkのIPアドレス>:11434/api/chat -d '{
  "model": "gpt-oss:20b",
  "messages": [{"role": "user", "content": "自己紹介を一文で"}],
  "stream": false
}'
手順 4:OpenClaw のモデルに DGX Spark を登録する
OpenClaw の初期設定(openclaw onboard)で、モデルの提供元に Ollama を選び、URL に DGX Spark のアドレスを入れます。対話形式で進めるのが分かりやすいですが、公式ドキュメントには一度に指定する書き方も載っています。
# Mac で実行する:対話形式で設定する(Ollama を選び、ローカルのみ/クラウドと併用などを選ぶ)
openclaw onboard

# 登録できたかを確かめる
openclaw models list --provider ollama
ここで大事な注意があります。OpenClaw の公式ドキュメントは、URL に /v1 を付けた OpenAI 互換の形(http://...:11434/v1)を使わないようにと明記しています。ツール呼び出しがうまく動かなくなるためです。http://<SparkのIPアドレス>:11434 のように、ポート番号までで止めてください。
クラウド API と併用する場合は、初期設定で「クラウドとローカルの両方」を選べば、普段はローカル、必要なときだけクラウドと使い分けられます。
NVIDIA は、64GB 版向けに「Run OpenClaw With a Local LLM(ローカル LLM で OpenClaw を動かす)」の手順書を近日公開するとしています。現在公開されている手順書は 128GB 版向けで、Qwen3.6-35B-A3B(NVFP4 形式)を vLLM で動かす構成を推奨しています。64GB 版を買ったら、公式の手順書が出るのを待ってから組むのも手です。
買う前によくある誤解
最後に、購入前につまずきやすい点を表にまとめます。
| よくある誤解 | 実際 |
|---|---|
| Mac に挿せば Mac が速くなる | 外付け GPU にはならない。LAN でつなぐ別の Linux マシン |
| 64GB で 120B 級が動く | gpt-oss-120b は約 59GB で、OS と合わせると満杯。快適に動かすなら 128GB 版 |
| 「最大 100B」ならどんな 100B モデルも載る | 4 ビット前後に圧縮した場合の上限と考える。長い文脈を使う余裕はほとんどない |
| 64GB を 2 台買えば 128GB 版よりお得 | 2 台で 9,998 ドル。128GB 版 1 台(6,950 ドル)のほうが安い |
| DGX Spark は何でも Mac より速い | 書く速さは Mac mini M5 Pro と互角かそれ以下。速いのは資料を読む段階 |
| Mac で作った MLX のモデルを持っていける | そのままは動かない。GGUF や vLLM 向けの形式で用意し直す |
| ローカルにすればクラウドと同じ賢さで無料になる | 賢さはクラウドの最上位モデルに届かない。無料なのは使用料だけで、本体代と電気代はかかる |
| 10 月 23 日に日本でも同じ値段で買える | 日本の価格・発売時期は未発表 |
まとめ
DGX Spark 64GB と Mac mini + OpenClaw の比較を振り返ります。
- 役割は同じ、頭脳の置き場所が違う。 どちらも置きっぱなしで AI を動かす箱ですが、Mac mini の定番構成は頭脳をクラウドに任せ、DGX Spark は頭脳まで手元に置きます。
- 64GB 版は 70B 級までが現実的。 「最大 100B」は 4 ビット前後で詰め込んだ場合の上限で、人気の gpt-oss-120b は実用的には厳しい容量です。
- 速さは用途しだい。 資料を大量に読ませる処理は DGX Spark が速く、答えを書く速さは帯域の大きい Mac mini M5 Pro と互角です。
- 費用は使用量で逆転する。 API 代が月 2 万円程度なら DGX Spark の回収に約 3 年、月 12 万円なら約半年です。64GB 同士なら Mac mini M5 Pro のほうが約 2,300 ドル安く済みます。
- DGX Spark を選ぶ理由は CUDA と拡張性。 NVIDIA の道具をそのまま使いたい、複数のエージェントで共有したい、後から台数を増やしたい、という人に向いた機械です。
次の一歩としては、まず手持ちの Mac で Ollama や LM Studio を使い、Qwen3-30B-A3B や gpt-oss-20b のような中型モデルを動かしてみるのがおすすめです。「この賢さで足りる仕事」がどれだけあるかが分かれば、DGX Spark を買うべきか、Mac mini で十分か、クラウドのままでよいかを判断できます。
参考リソース
- NVIDIA Blog:NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI(2026-10-02)
- NVIDIA DGX Spark 製品ページ(仕様)
- NVIDIA 開発者フォーラム:DGX Spark の価格改定のお知らせ(2026-02)
- PC Watch:NVIDIA、メモリ 64GB の DGX Spark(2026-10-02)
- NVIDIA:Run OpenClaw with a Local LLM(DGX Spark 向け手順書)
- NVIDIA:NVIDIA Sync のインストール
- llama.cpp:DGX Spark のベンチマーク
- llama.cpp:Apple Silicon のベンチマーク
- Apple Newsroom:新しい Mac mini(M6・M5 Pro)(2026-08-25)
- Apple:Mac mini の技術仕様
- Apple サポート:Mac mini の消費電力
- Tom’s Hardware:NVIDIA DGX Spark レビュー(消費電力)
- OpenClaw(GitHub)
- OpenClaw ドキュメント:Ollama の設定
- Palo Alto Networks Unit 42:OpenClaw のサプライチェーンリスク(2026-06-23)
- Anthropic:Claude の API 料金
- OpenAI:API の料金
- Ollama:Linux へのインストールと FAQ