はじめに:「新しい Astra に替える価値はあるのか」
2026 年 11 月 17 日(米国時間)、OpenAI は新しいフラッグシップモデル GPT-6.2 Astra を公開しました。9 月に出た GPT-6 Astra の後継で、OpenAI は「最も難しいプロジェクトのためのモデル」と位置づけています。
発表文には「スライドや Web サイト、3D デザインで違いが分かる」「1 タスクあたりの費用は旧 Astra の 3 分の 1 未満」といった強い言葉が並びます。ただ、普段 Codex や ChatGPT で旧 Astra を使っている人が知りたいのは、もっと具体的なことのはずです。
- ベンチマークの数字は、旧 Astra からどの分野で、どれくらい伸びたのか
- 実際にものを作らせると、出来上がりはどう変わるのか
- 乗り換えるときに気をつけることはあるのか
この記事では、OpenAI の発表記事のグラフに埋め込まれた元データと、第三者の測定(Artificial Analysis)を読み比べたうえで、同じ依頼文を旧 Astra と 6.2 Astra に出して、Web サイト・3D ゲーム・Excel・スライドを作らせた結果を並べます。さらに、実装・バグ修正・推論の定番 16 題を各 3 回ずつ解かせ、正答率・時間・費用を比べました。
まず結論を 1 枚にまとめます。
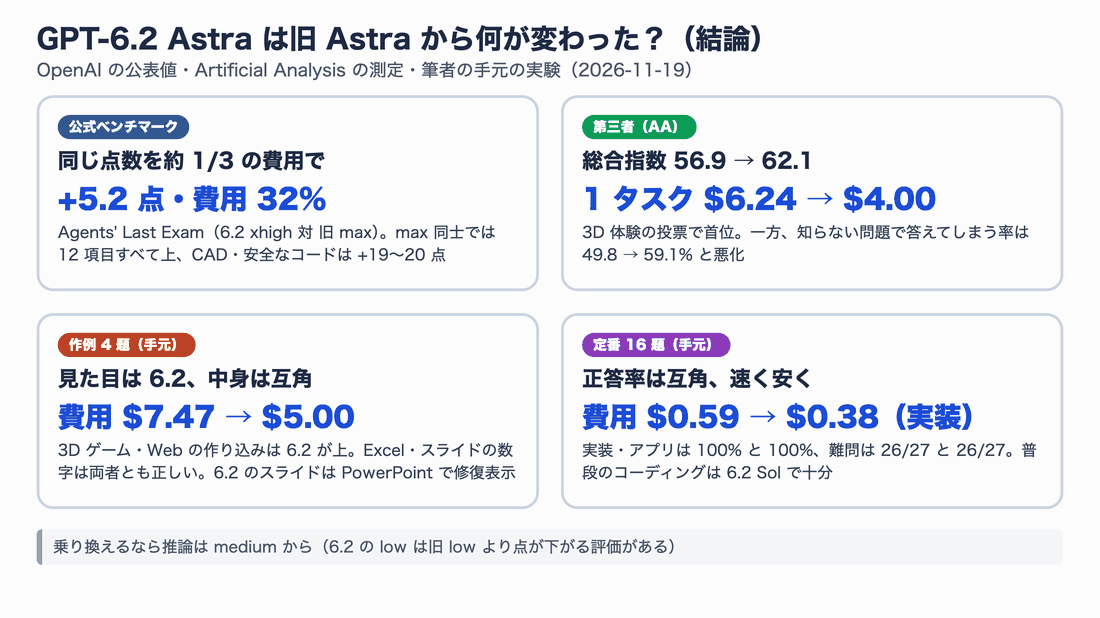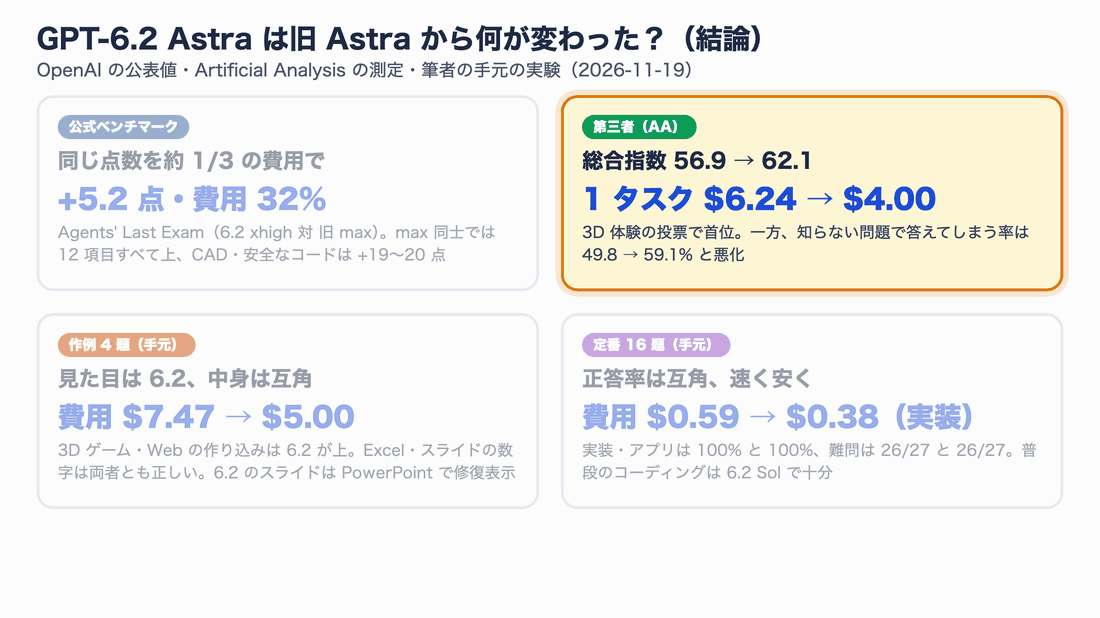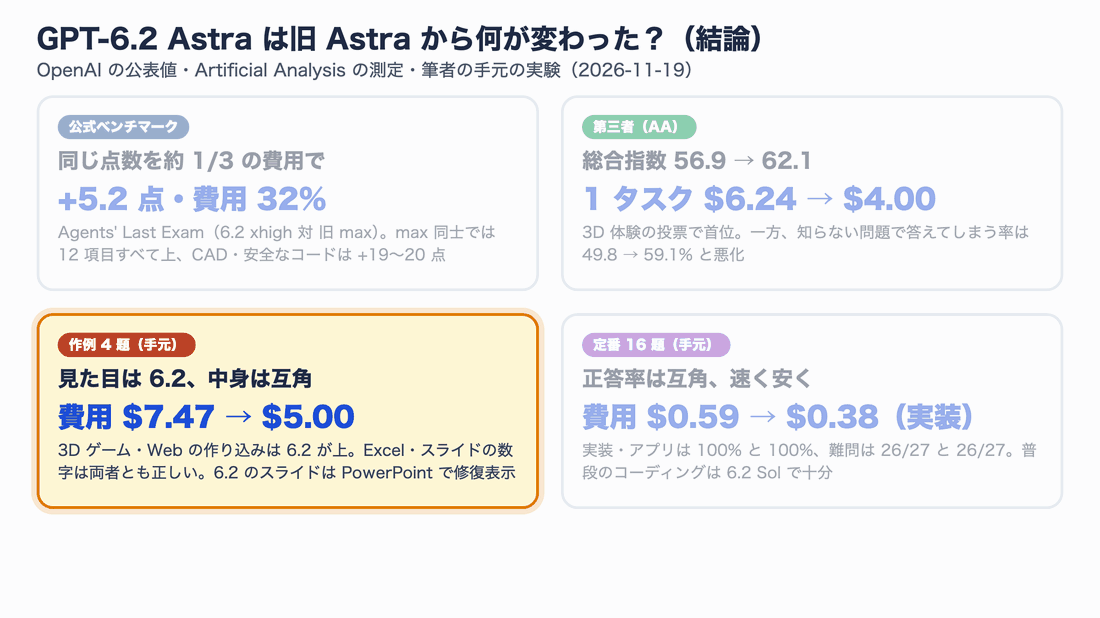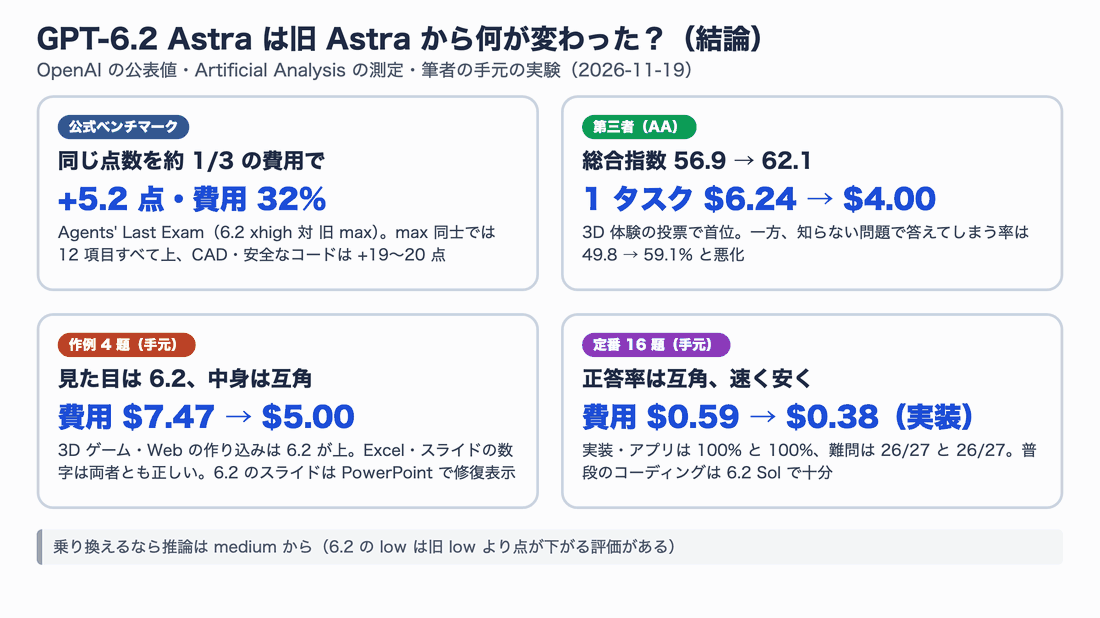
図1:この記事の結論。公式の数字では「同じ点数を約 3 分の 1 の費用で」、手元の作例では「中身は同等以上で、費用は約 3 分の 2」でした。
想定している読者は、Codex や ChatGPT Work で GPT のモデルを選んで使っている人、または API で GPT-6 Astra を組み込んでいる開発者です。専門用語には短い説明を添えます。
GPT-6.2 Astra とは:何が「6.2」になったのか
GPT-6 ファミリーの中での位置
OpenAI の GPT-6 世代には、性能と価格の違うモデルが並んでいます。いちばん上が Astra(難しい専門業務向け)、その下が Sol(日常業務の定番)、さらに Terra・Luna(安価・高速)です。今回は Astra と Sol が同時に 6.2 になりました。Sol は 6.1 → 6.2、Astra は 6 → 6.2 と、Astra は 6.1 を飛ばしています。
GPT-6.2 Astra は、ChatGPT Work と Codex で Plus・Pro・Enterprise・Edu の利用者が使えます(通常の Chat の画面には入りません)。API ではモデル ID gpt-6.2-astra で呼べます。Pro 500 の加入者は、追加の利用枠を使って速く返す Ultrafast(高速モード)も使えます。API でも Ultrafast を選べます(標準料金の 3 倍、2027 年 3 月からは 6 倍)。
仕様と料金のビフォーアフター
数字で比べると、変わったのは主に料金と知識の締め切りです。文脈長(一度に読める量)は 105 万トークンのままです。
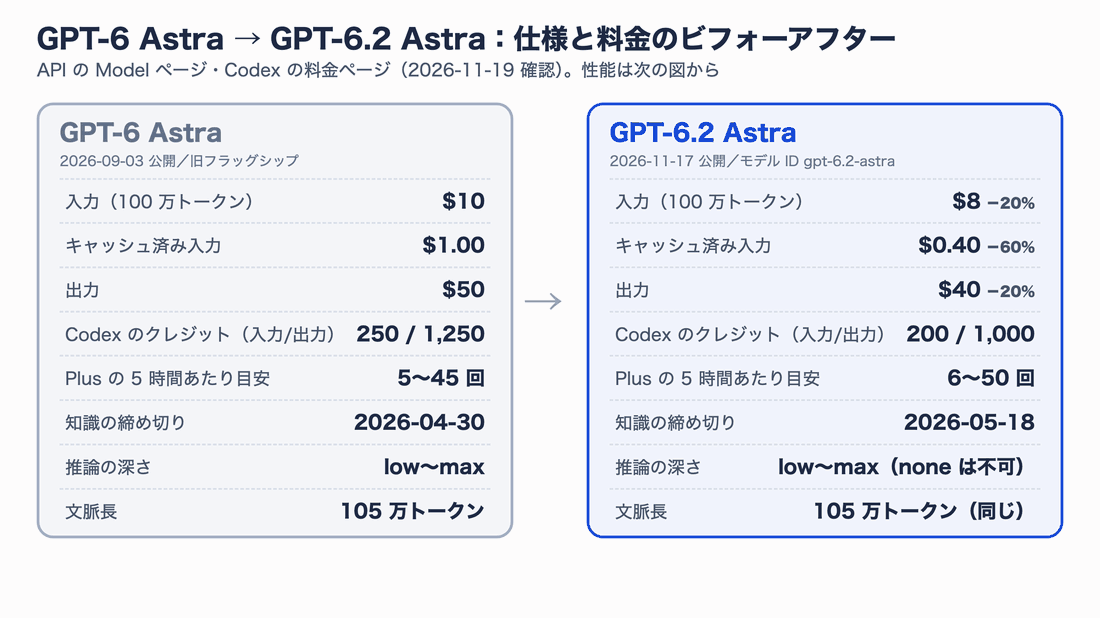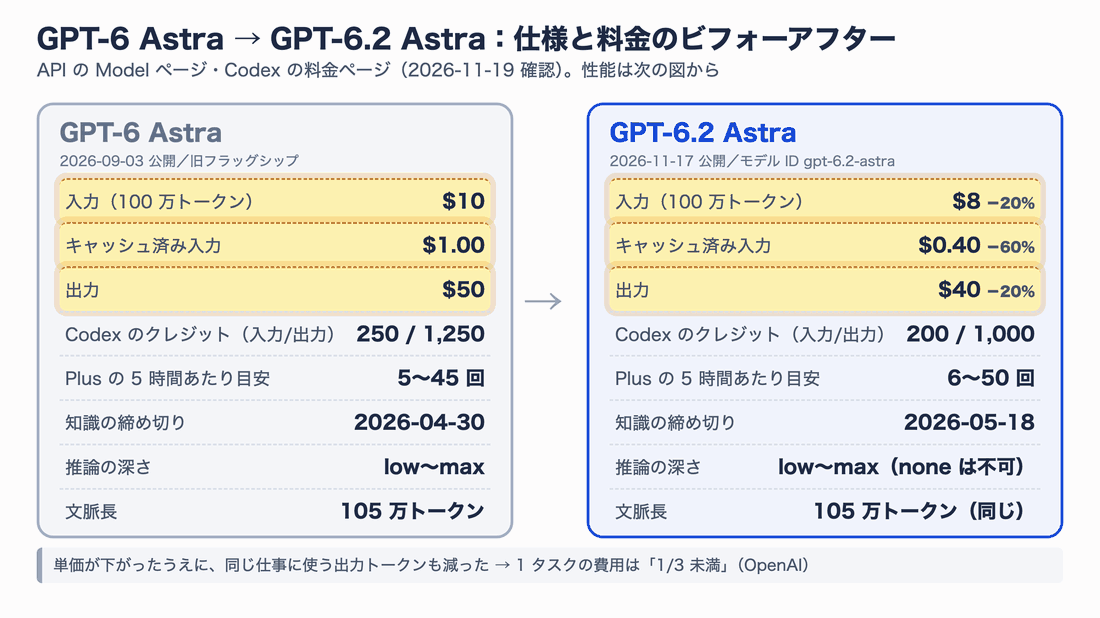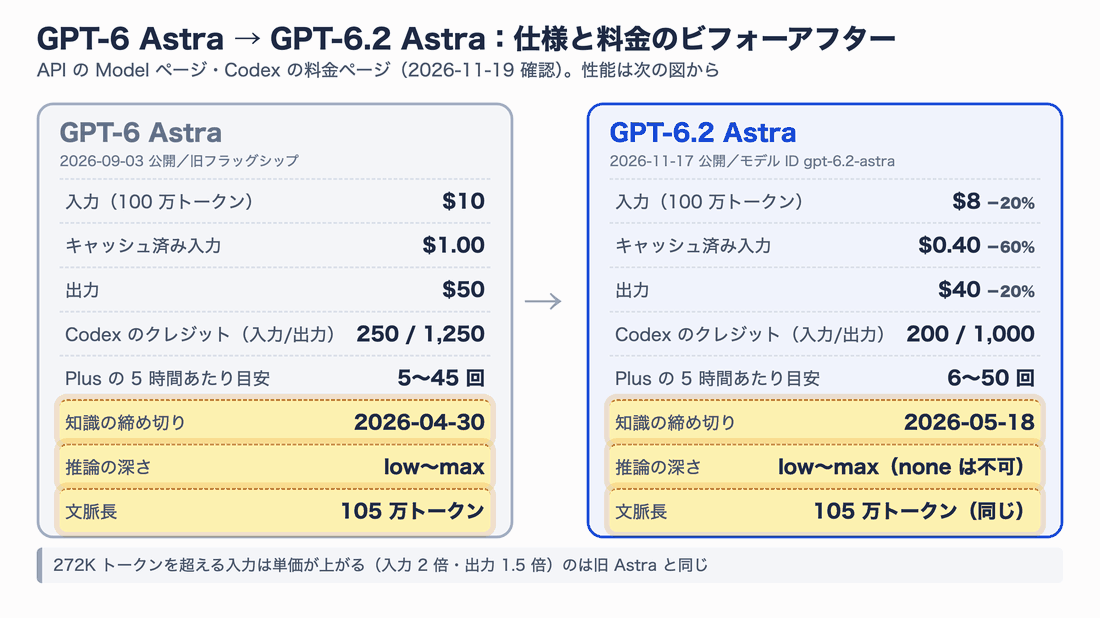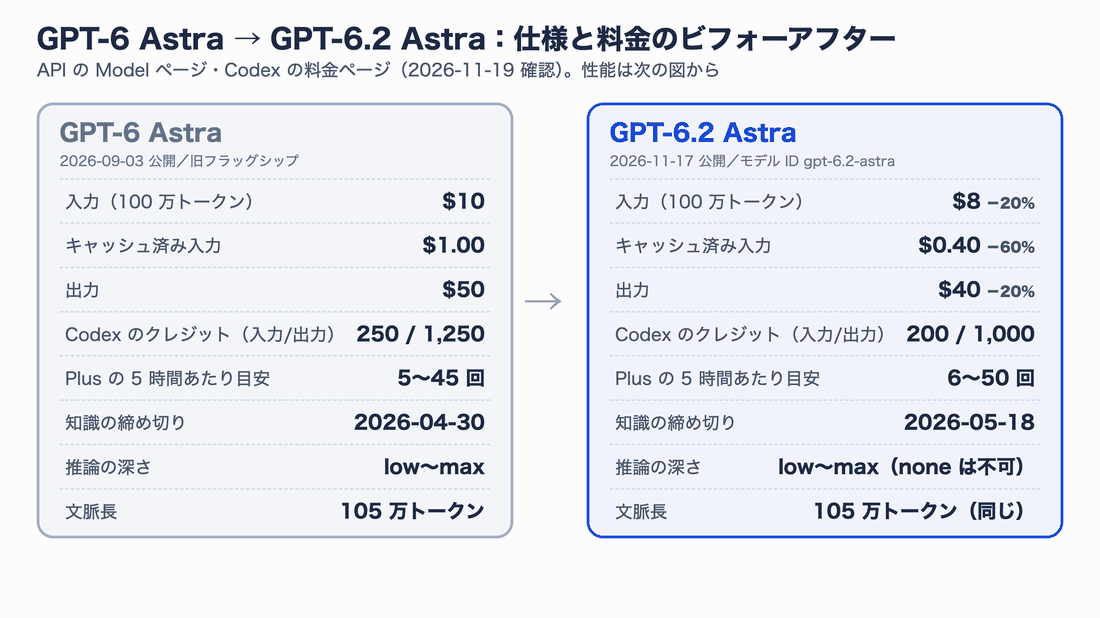
図2:API の Model ページと Codex の料金ページ(2026-11-19 確認)。入力・出力は 20%、キャッシュ済み入力は 60% 安くなりました。
| 項目 | GPT-6 Astra | GPT-6.2 Astra |
|---|---|---|
| 公開日 | 2026-09-03 | 2026-11-17 |
| 入力(100 万トークンあたり) | $10 | $8(−20%) |
| キャッシュ済み入力 | $1.00 | $0.40(−60%) |
| 出力 | $50 | $40(−20%) |
| Codex のクレジット(入力/キャッシュ/出力) | 250 / 25 / 1,250 | 200 / 10 / 1,000 |
| Plus の 5 時間あたりの目安 | 5〜45 回 | 6〜50 回 |
| 知識の締め切り | 2026-04-30 | 2026-05-18 |
| 推論の深さ(reasoning effort) | low〜max | low〜max(none は拒否) |
キャッシュ済み入力とは、同じ会話の前半など、直前に送った内容と同じ部分の料金です。エージェントのように長い会話を何十往復もする使い方では、ここが 60% 下がった影響がかなり大きくなります。OpenAI は 6.2 向けの注意として「会話の先頭(プロンプトの前半)は変えずに、新しい指示は末尾に足す」ことを勧めています。先頭を書き換えるとキャッシュが効かず、この割引を受けられないためです。
ベンチマークで見るビフォーアフター
ここからは、OpenAI の発表記事に載っている 16 個のグラフの元データを読みます。発表記事のグラフは、ページ内のスクリプトに数値(Vega-Lite という描画用の形式)として埋め込まれています。それを取り出し、旧 Astra と 6.2 Astra の点だけを比べました。どれも OpenAI 自身の測定なので、最後に第三者の数字と突き合わせます。
同じ点数を、ずっと安く取れるようになった
最初に見てほしいのが、複数ステップの専門業務を解かせる Agents’ Last Exam の、費用と点数の関係です。横軸が 1 タスクあたりの推定費用(左ほど安い)、縦軸が点数です。点は推論の深さ(low・medium・high・xhigh・max)ごとの結果です。
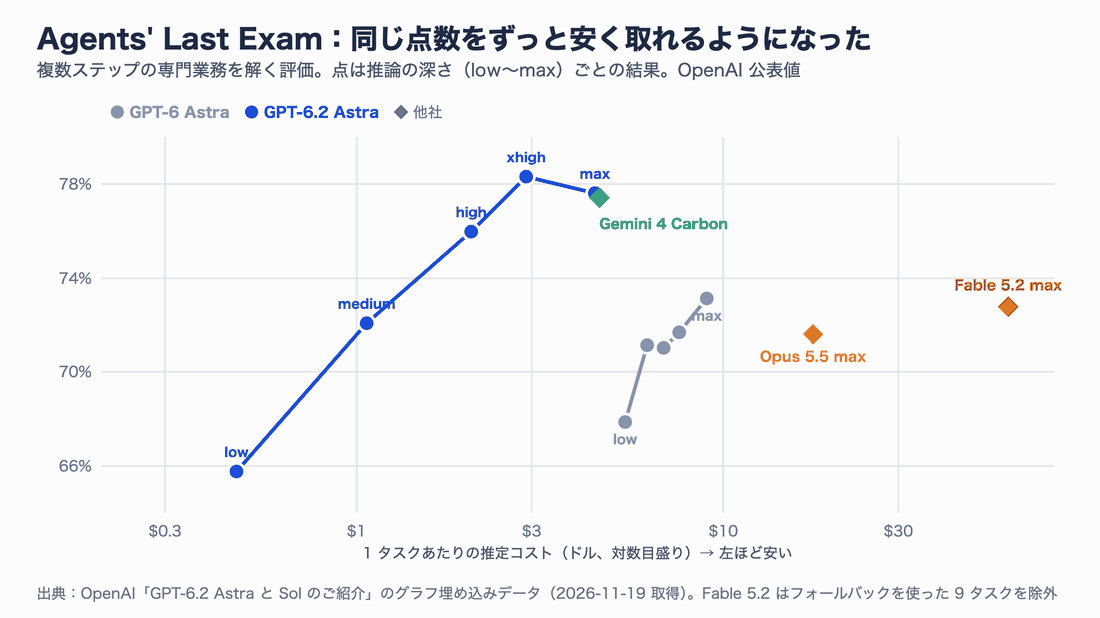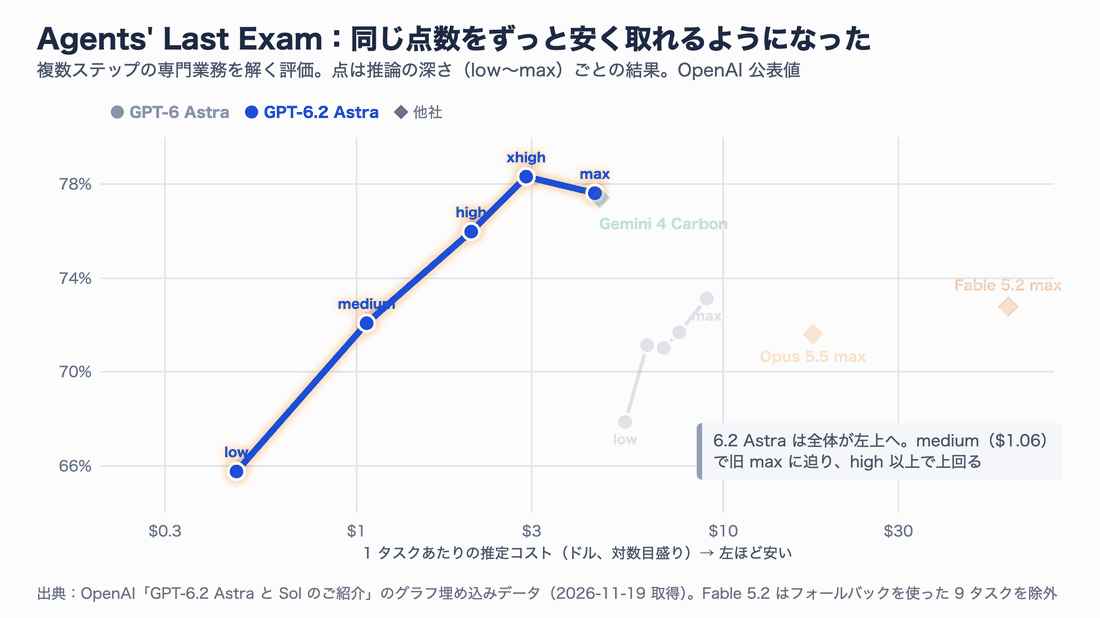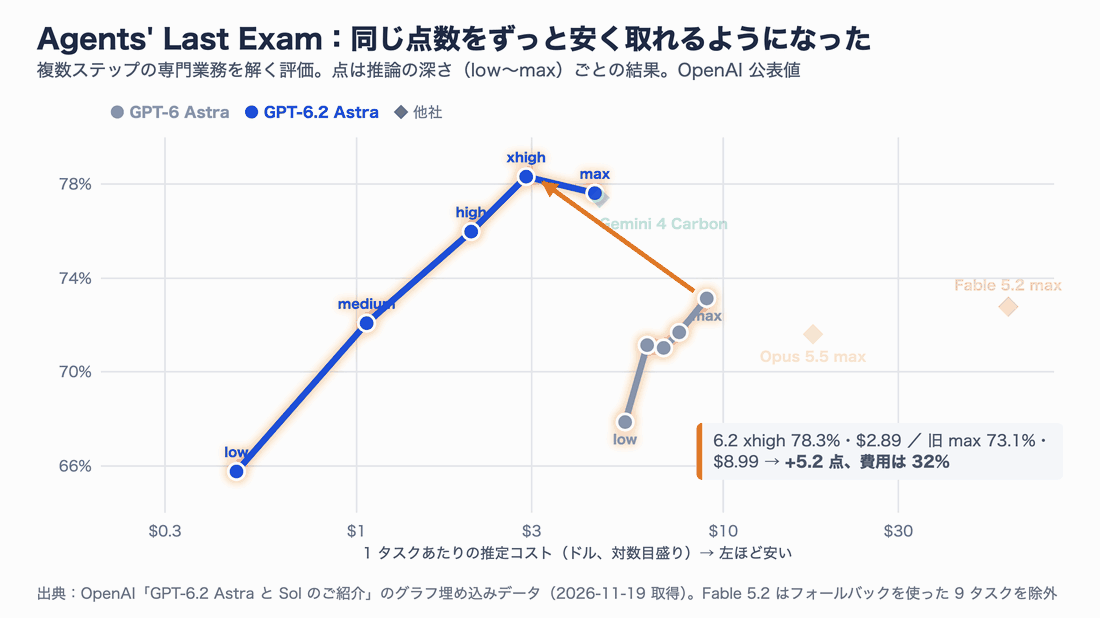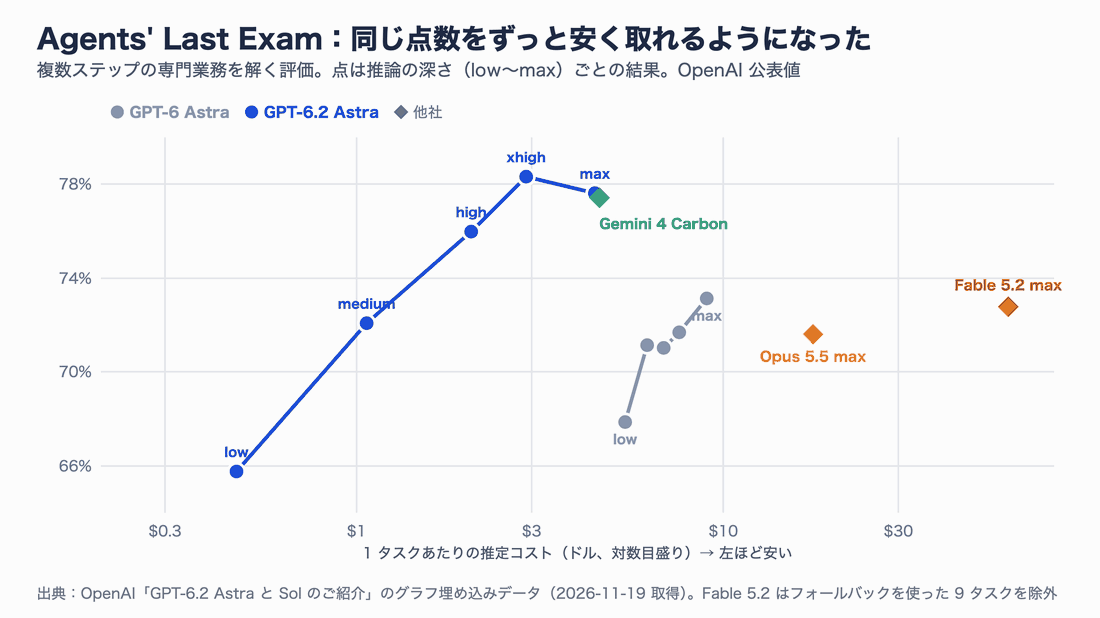
図3:灰色が旧 Astra、青が 6.2 Astra。6.2 の線は全体が左上(安くて高い)へ移りました。
旧 Astra は、いちばん浅い low でも 1 タスク約 5.4 ドルかかり、max で 73.1% でした。6.2 Astra は medium(約 1.06 ドル)で旧 max に迫り、xhigh では 78.3%・約 2.89 ドルです。旧 max と比べて 5.2 点高く、費用は 32% で、発表文の「3 分の 1 未満のコストで 5.2 ポイント上回る」はこの組み合わせです。
もう 1 つ読み取れるのは、6.2 では max が xhigh より点数が低いことです(77.6% 対 78.3%)。考える量を最大にしても点が伸びない評価があるので、「とりあえず max」は費用の無駄になりえます。
max 同士で比べると、12 項目すべてで 6.2 が上
次に、推論 max 同士で 12 個の評価を並べました。左の灰色の点が旧 Astra、右の青い点が 6.2 Astra、右端の数字が差(ポイント)です。
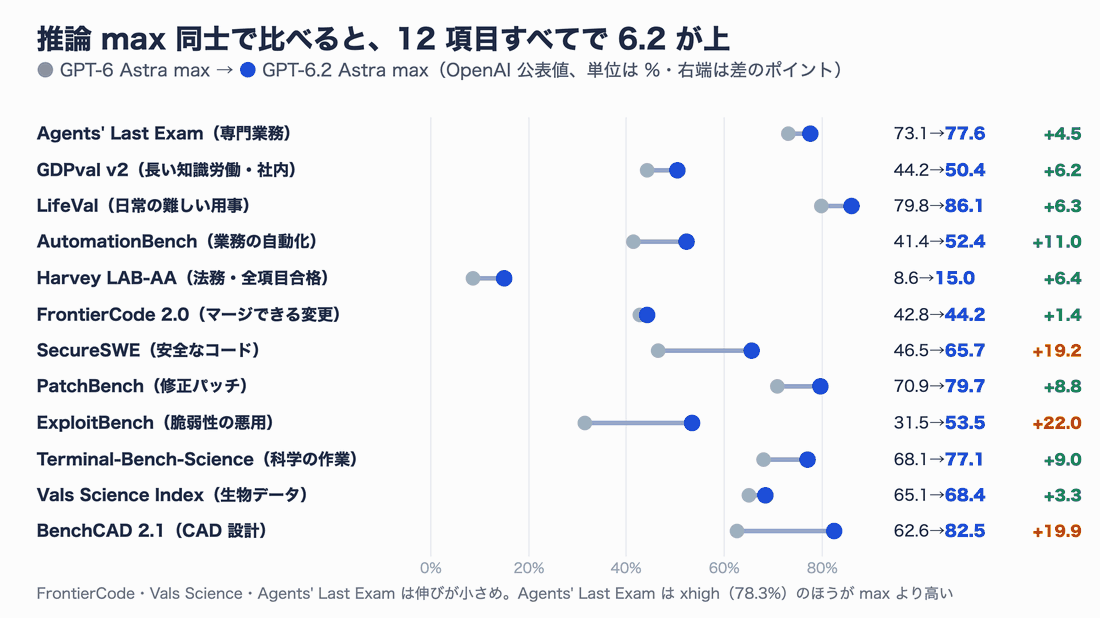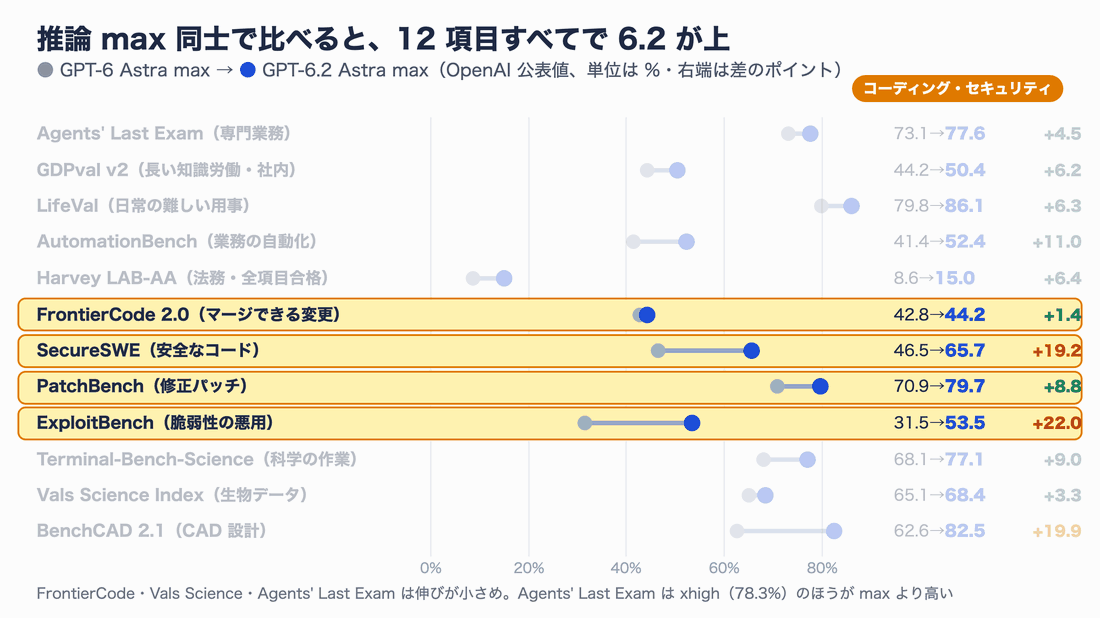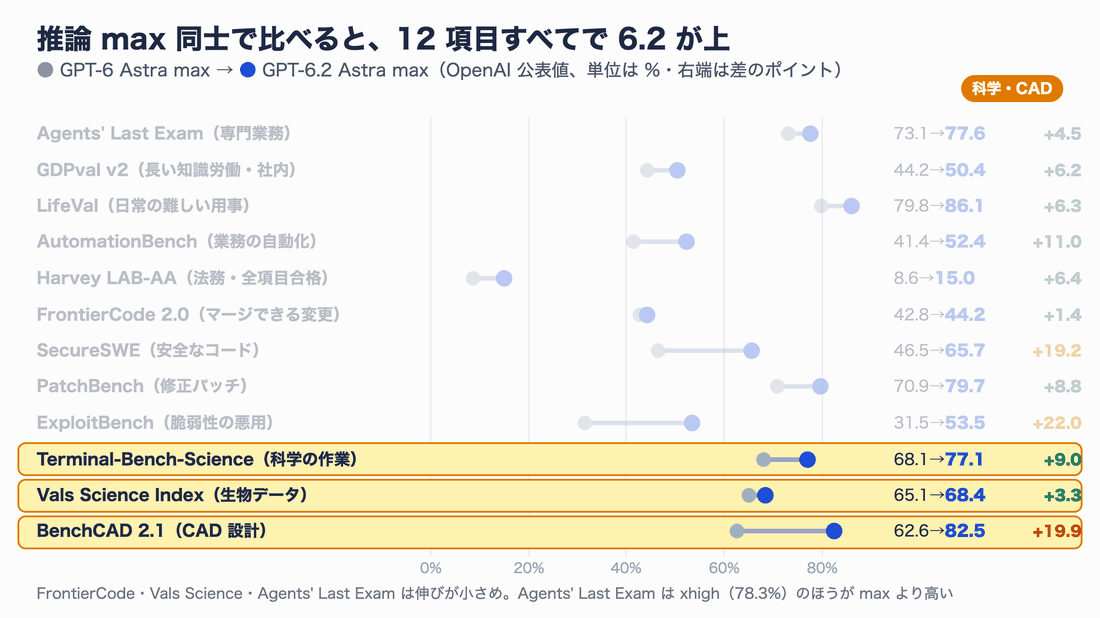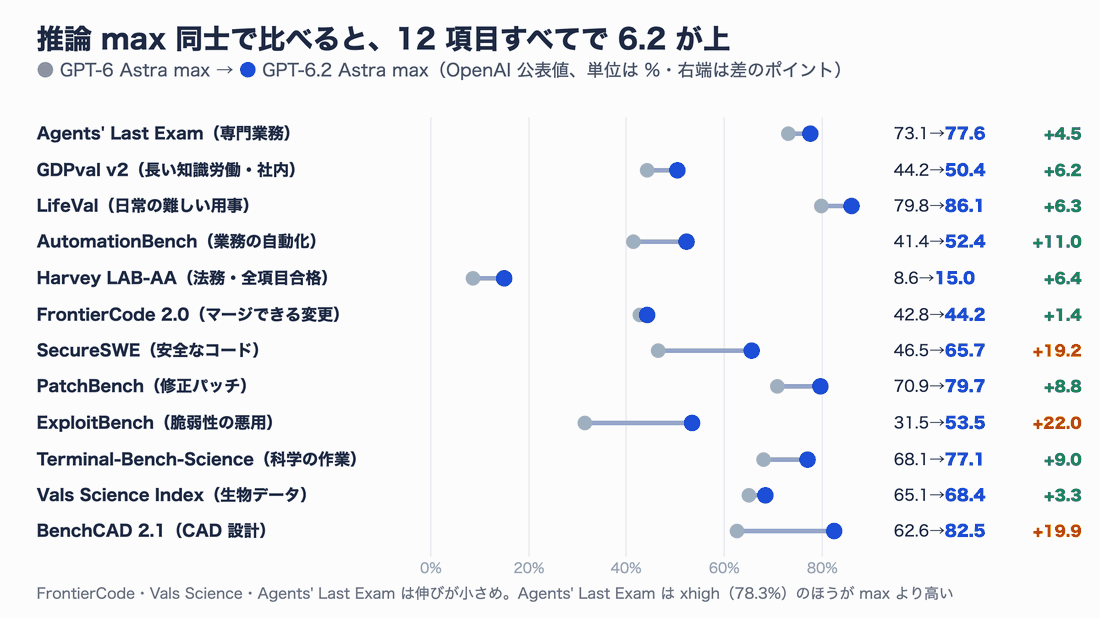
図4:すべての項目で 6.2 が上回りました。伸びの大きさには分野でかなりの差があります。
伸びが大きかったのは、次の 3 つです。
- BenchCAD 2.1(CAD 設計):62.6 → 82.5%(+19.9)。発表文で強調している「CAD やシミュレーションで部品や接続部まで扱える」の裏付けです
- SecureSWE(安全なコード):46.5 → 65.7%(+19.2)。ファイル配信やデータベース検索のような、セキュリティが重要な部品を正しく安全に書けるか
- ExploitBench(脆弱性の悪用):31.5 → 53.5%(+22.0)。攻撃側の能力も上がったことを意味し、OpenAI は危険度の高いサイバー関連の依頼への制限を強めて公開しています
反対に、伸びが小さかったのは FrontierCode 2.0(実際のリポジトリでマージできる変更を作れるか)の +1.4 点です。普段のコーディング作業そのものは、旧 Astra の時点ですでに高い水準にあり、6.2 で大きくは変わっていません。この点は、あとで紹介する手元の実験でも同じ傾向が出ました。
法務の評価 Harvey LAB-AA は 8.6 → 15.0% と倍近くになっていますが、これは「すべての採点基準を満たし、重大な誤りがない」ときだけ合格にする厳しい評価で、絶対値はまだ低いことにも注意してください。
1 タスクにかかる費用は、多くの評価で約半分
点数と同じグラフに、1 タスクあたりの費用も載っています。max 同士で比べると、こうなります。
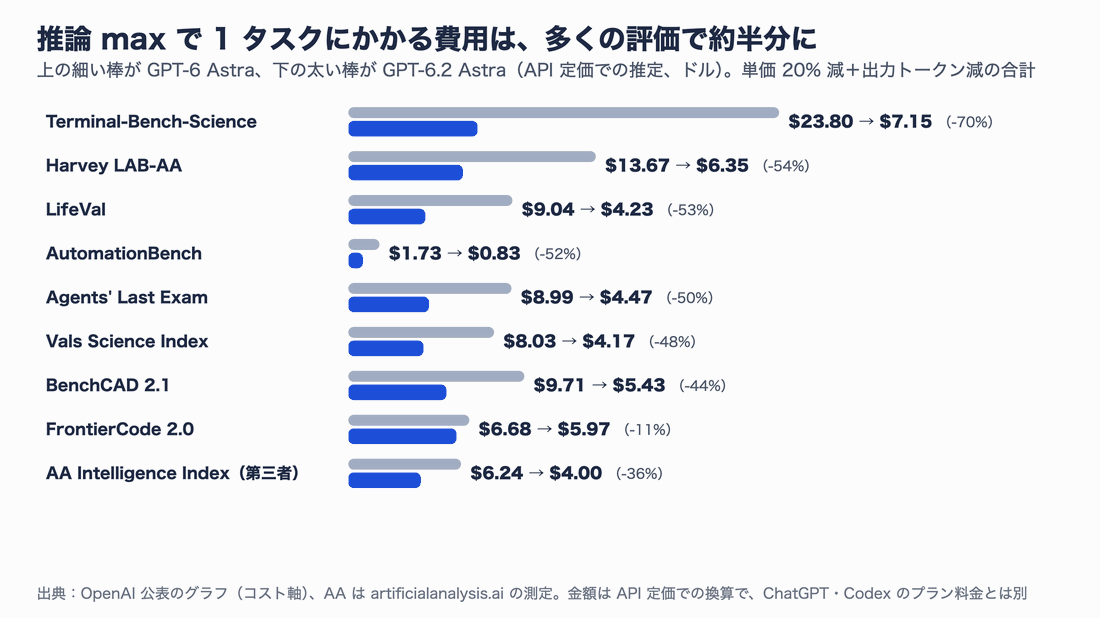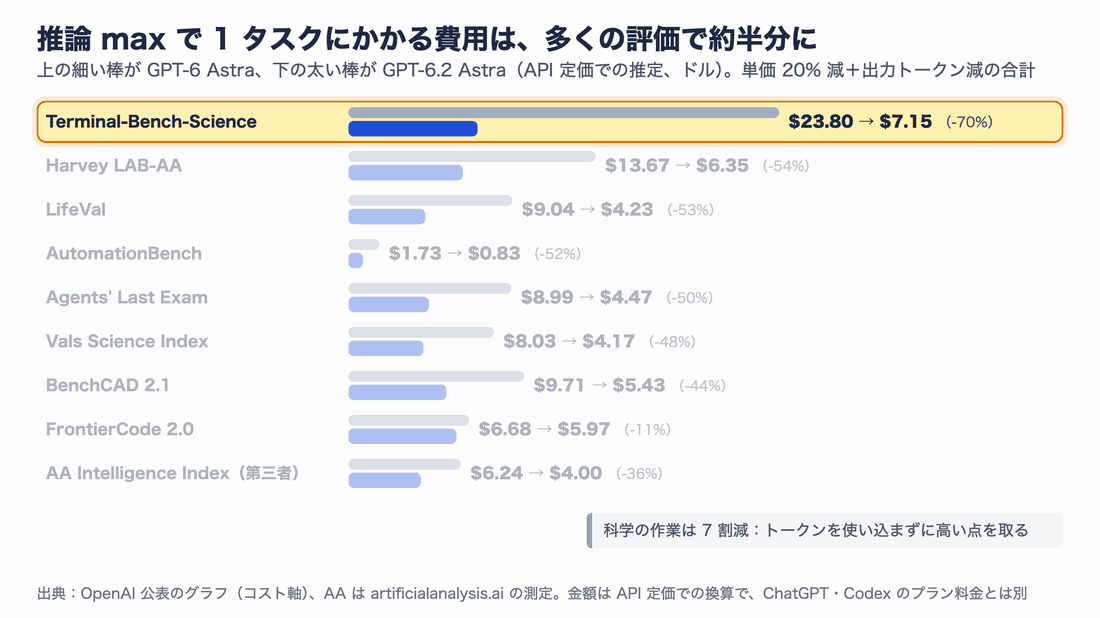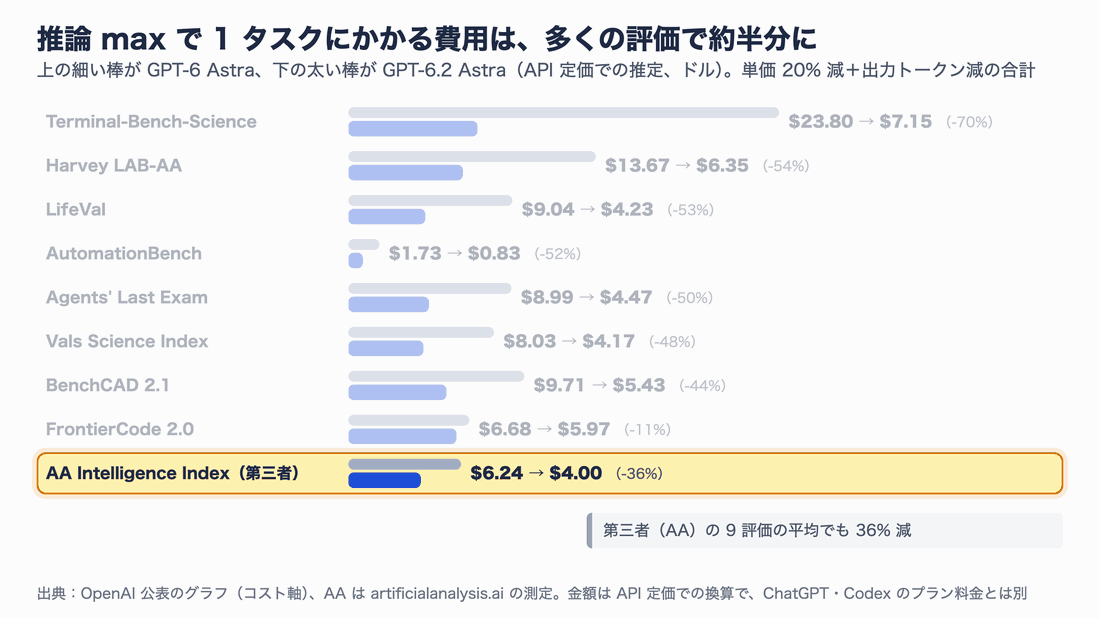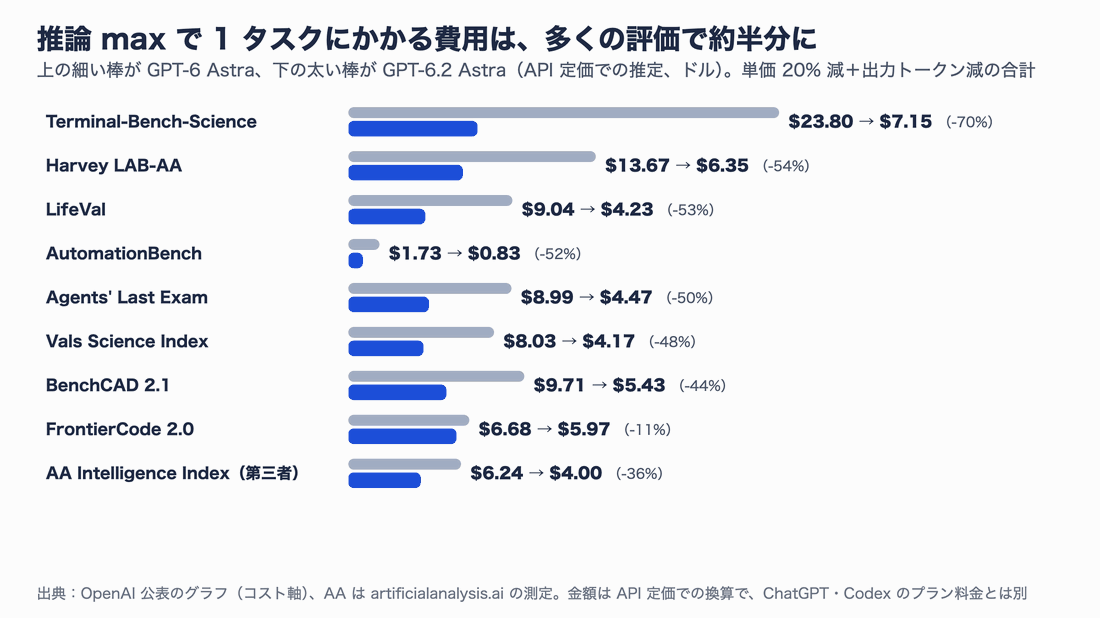
図5:上の細い灰色の棒が旧 Astra、下の青い棒が 6.2 Astra。
科学研究の作業を評価する Terminal-Bench-Science では、23.80 ドル → 7.15 ドルと 7 割減です。点数も 9 点上がっているので、「トークンを使い込まずに、より良い答えにたどり着く」ようになったと読めます。一方、FrontierCode は 1 割減にとどまります。
単価の下げ幅は 20% なので、それ以上に安くなっている評価は、同じ仕事に使う出力トークン自体が減ったことを示しています。OpenAI の社内評価 GDPval v2 では、max の出力トークンが 45,732 → 35,812(−22%)と、トークン数そのものも公表されています。
ただし推論 low は「安さ優先」に振られた
ここまでは良い話ばかりですが、同じ推論の深さ同士で比べると、注意点も見えてきます。
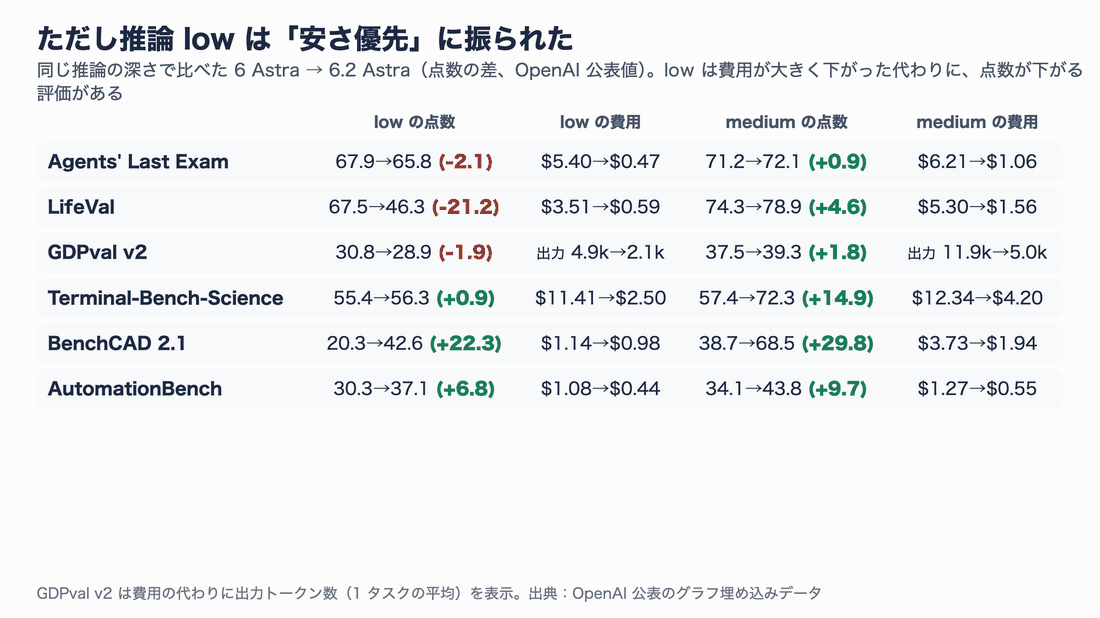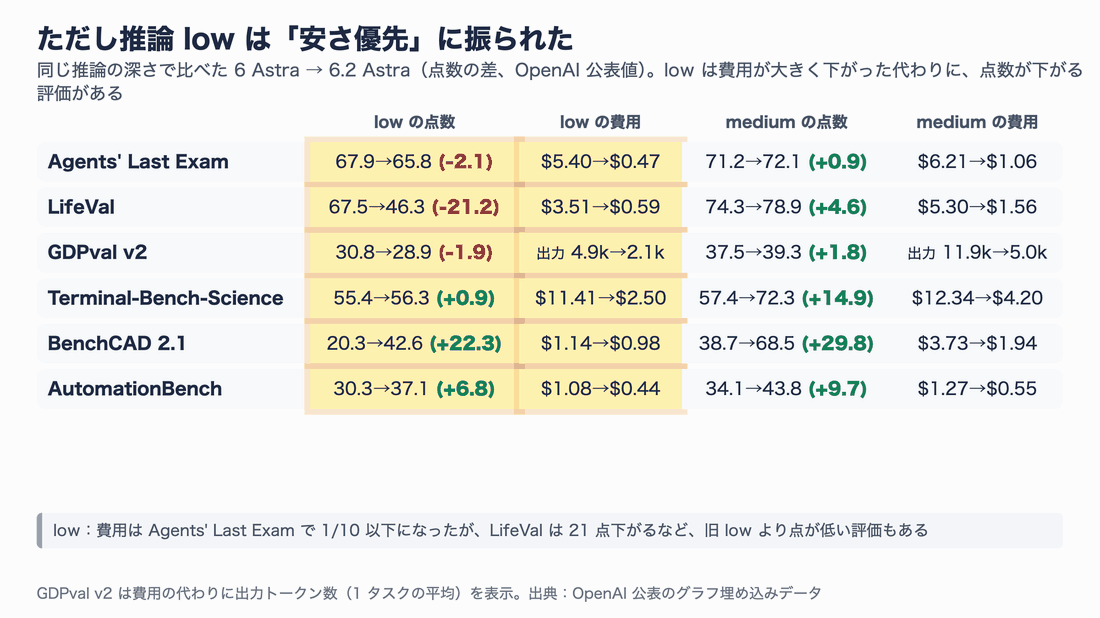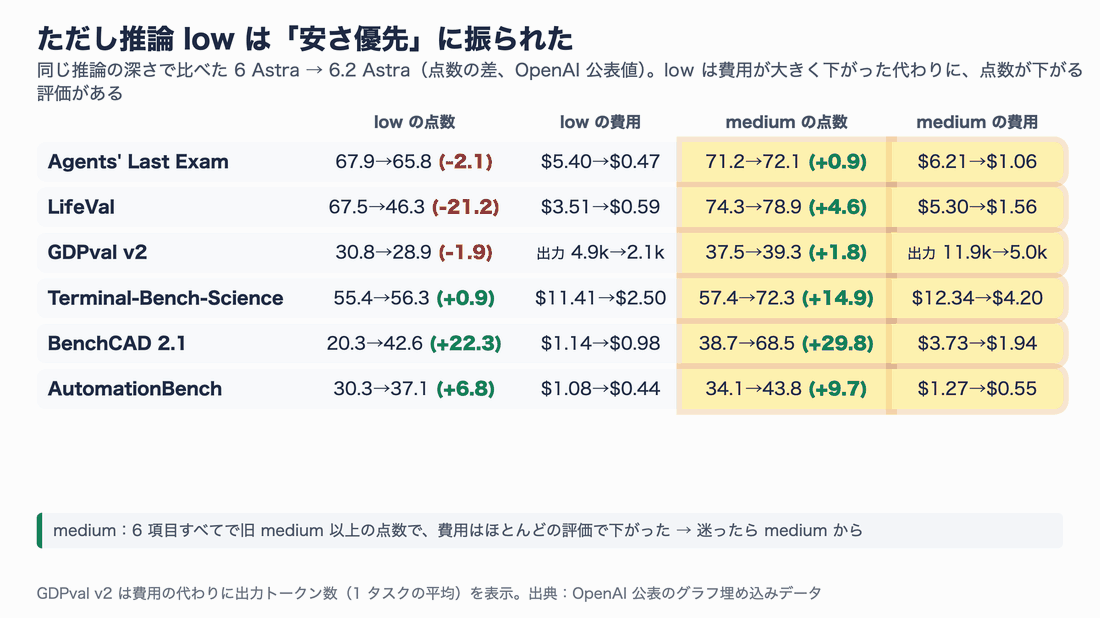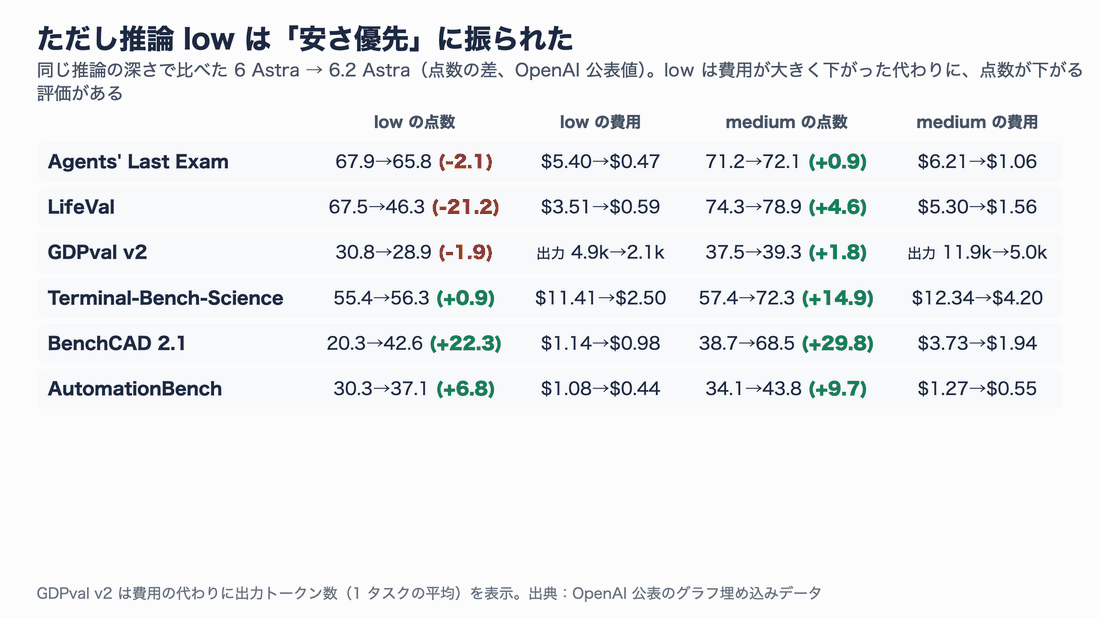
図6:low では点数が下がる評価があり、medium では 6 項目すべてで旧版以上でした。
6.2 Astra の low は費用が大幅に下がった(Agents’ Last Exam で 5.40 ドル → 0.47 ドル)代わりに、日常の難しい用事を解く LifeVal では 67.5% → 46.3% と 21 点も下がりました。Agents’ Last Exam や GDPval v2 でも、low 同士では旧版をわずかに下回ります。
つまり、旧 Astra を low で使っていた設定をそのまま 6.2 に移すと、かえって品質が下がる場面がありえます。medium にすると 6 項目すべてで旧 medium 以上の点で、費用もほとんどの評価で下がります。乗り換えるときは、まず medium から試すのが安全です。
第三者の測定(Artificial Analysis)でも伸びた。弱くなった所もある
ベンダー自身の数字だけで判断しないように、独立した評価会社 Artificial Analysis(AA) の測定値も確認しました。AA のモデルページに埋め込まれたデータから、旧 Astra と 6.2 Astra の推論 max 同士を並べています。
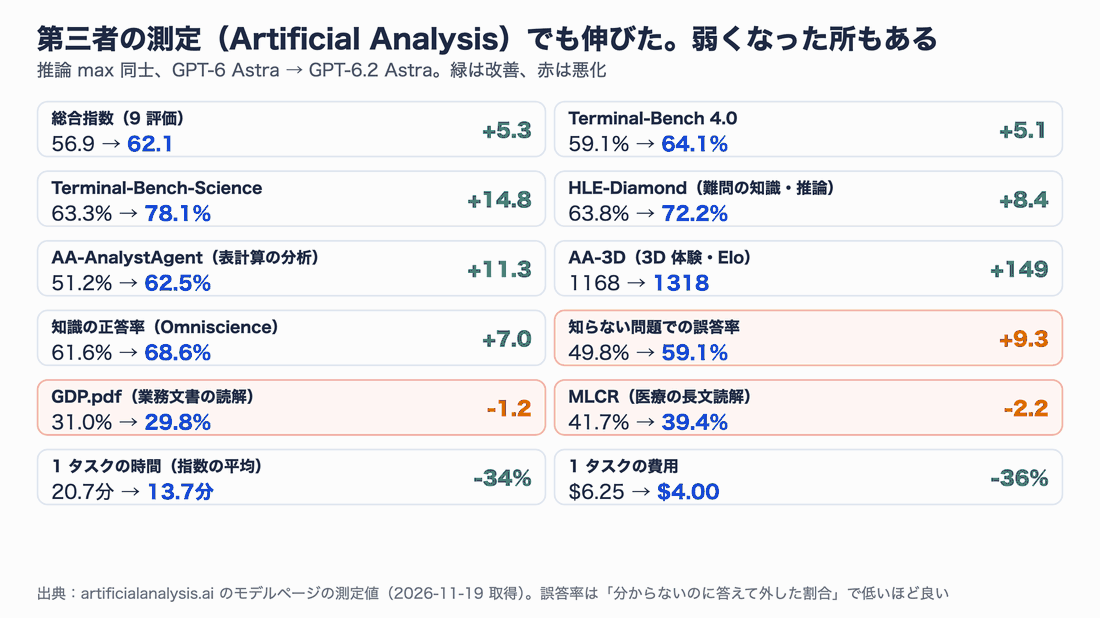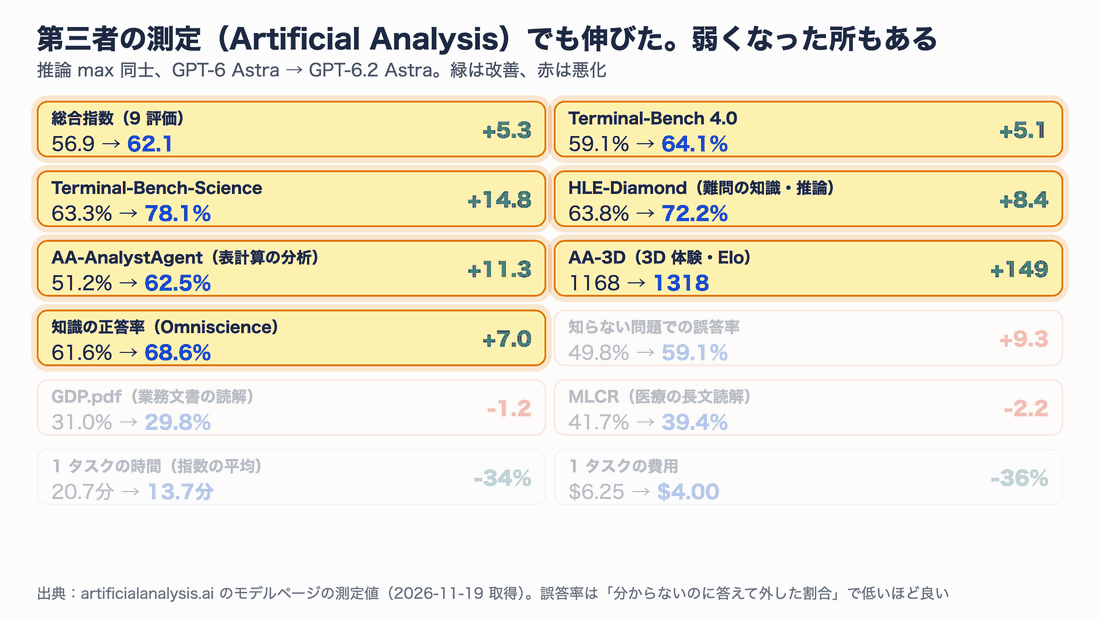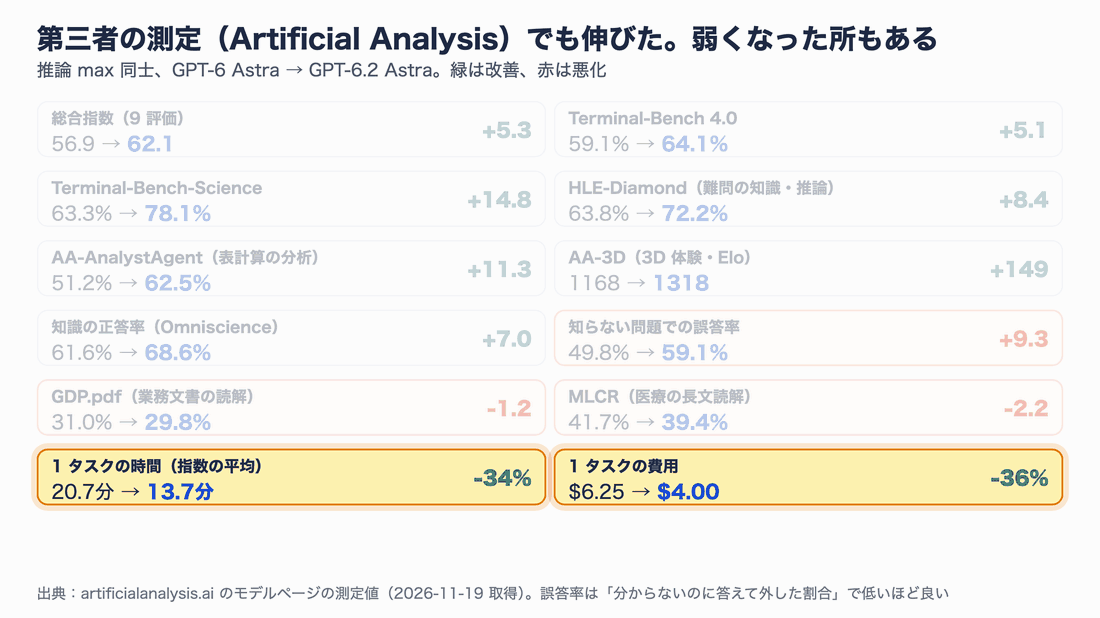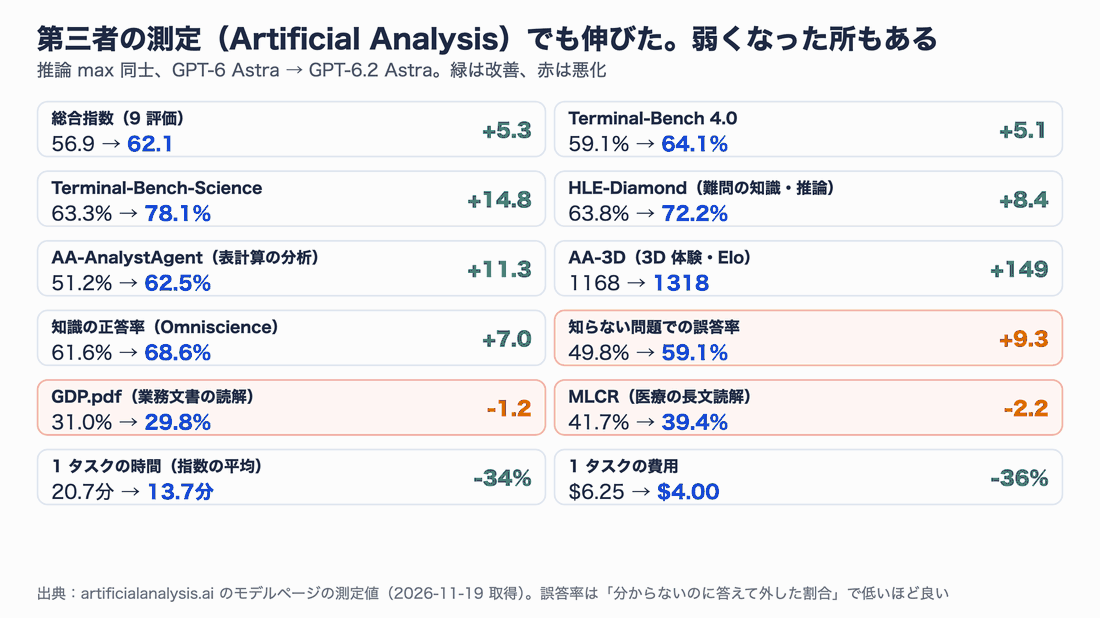
図7:緑が改善、赤が悪化。総合指数は 56.9 → 62.1 で、調査対象 96 モデル中 3 位でした。
AA の総合指数(9 つの評価をまとめたもの)は 56.9 → 62.1 に上がり、1 タスクあたりの時間は 20.7 分 → 13.7 分、費用は 6.24 ドル → 4.00 ドルに下がりました。人が 2 つの 3D 体験を遊び比べて投票する AA-3D では、Elo レーティング(対戦の勝ち負けから計算する強さの指標)が 1,168 → 1,318 で首位です。
一方で、悪化した項目もはっきり出ています。
| 項目(AA、max 同士) | 旧 Astra | 6.2 Astra | 読み方 |
|---|---|---|---|
| 知らない問題での誤答率 | 49.8% | 59.1% | 分からないのに答えてしまう割合。低いほど良い |
| GDP.pdf(業務文書の読解) | 31.0% | 29.8% | わずかに低下 |
| MLCR(医療の長文読解) | 41.7% | 39.4% | わずかに低下 |
特に 1 つ目は大事です。AA-Omniscience の正答率は 61.6% → 68.6% と上がったのに、知らない問題に「分かりません」と言わずに答えて外す割合も増えました。知識は増えたが、ハルシネーション(もっともらしい誤り)の出方が攻めた方向に変わった、と読むのが妥当でしょう。固有名詞や数字を扱う用途では、出典を確かめる手間を省かないほうが安全です。
実際に作らせてみた:同じ依頼文で 4 つの成果物
ベンチマークの数字が「出来上がり」にどう表れるのかを確かめるため、旧 Astra と 6.2 Astra にまったく同じ依頼文を出して、ものを作らせました。
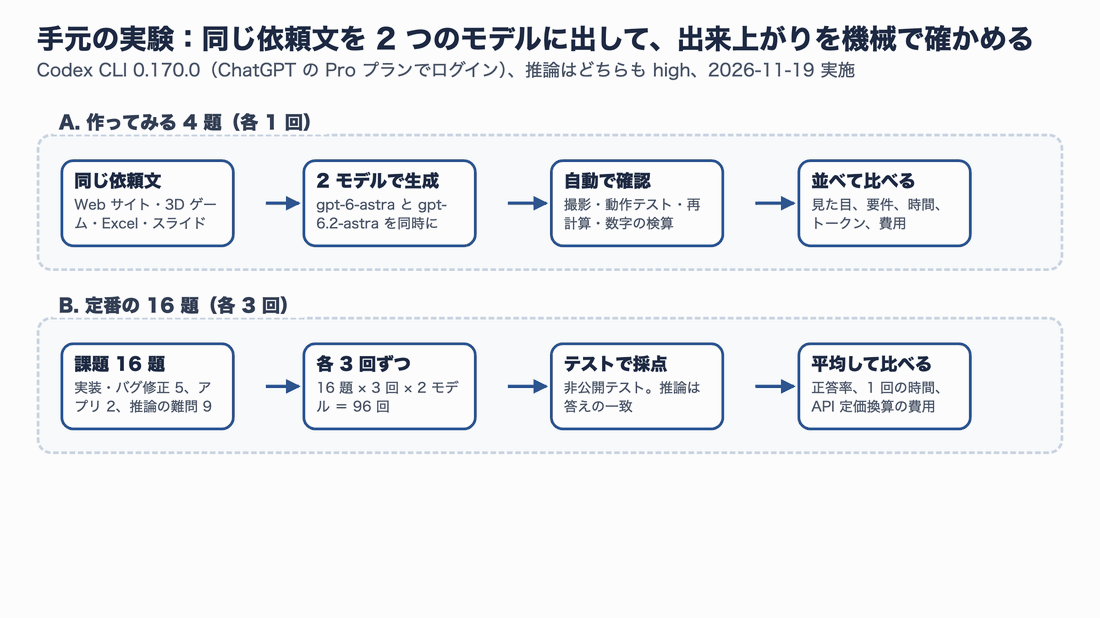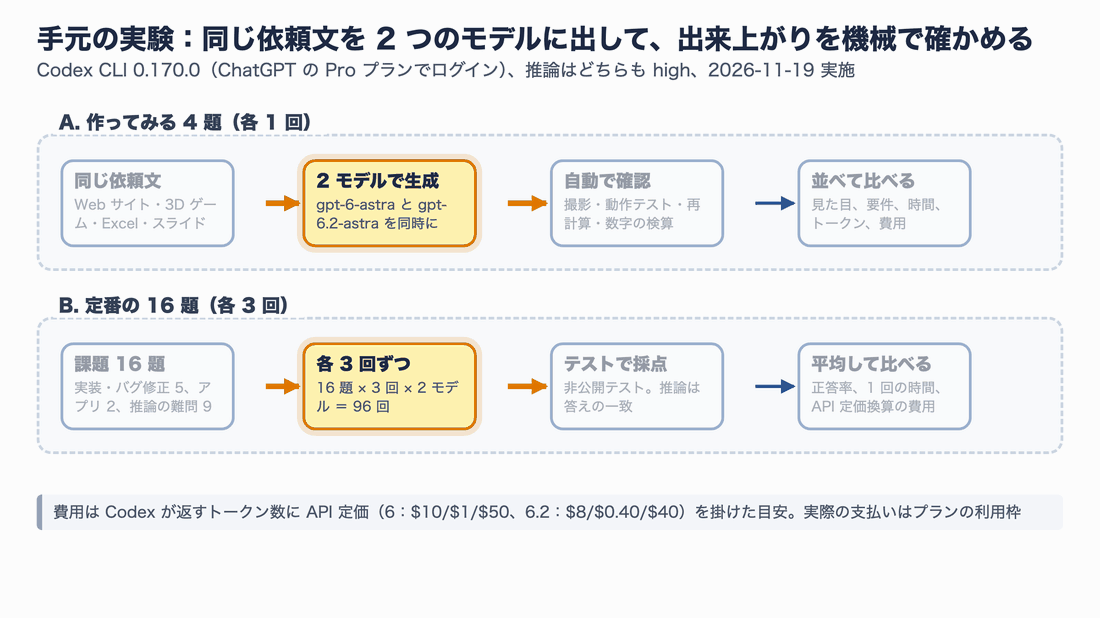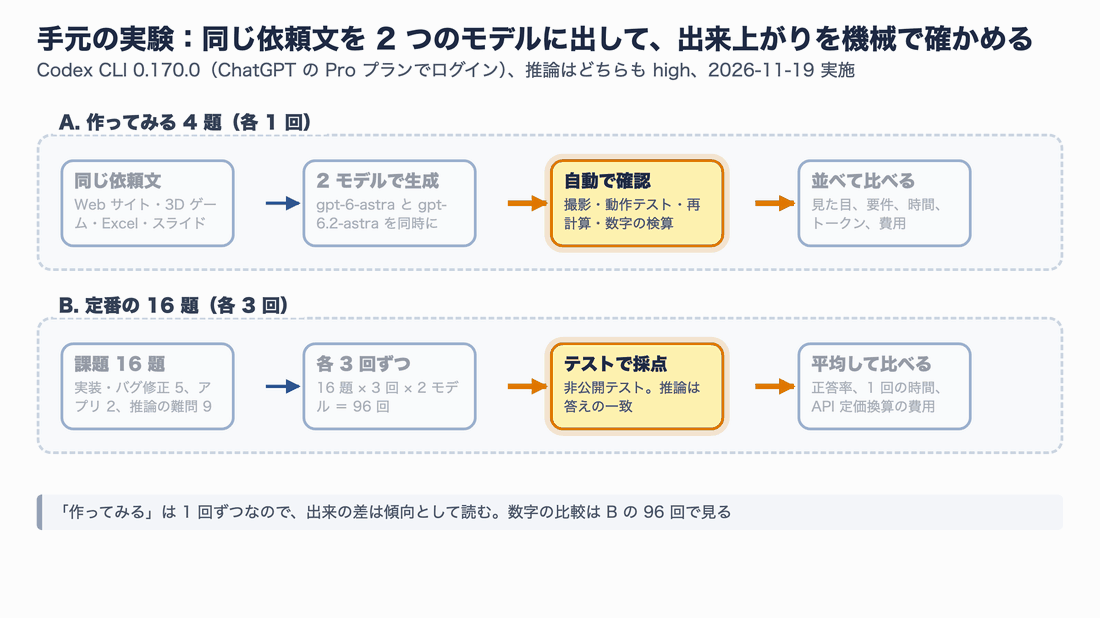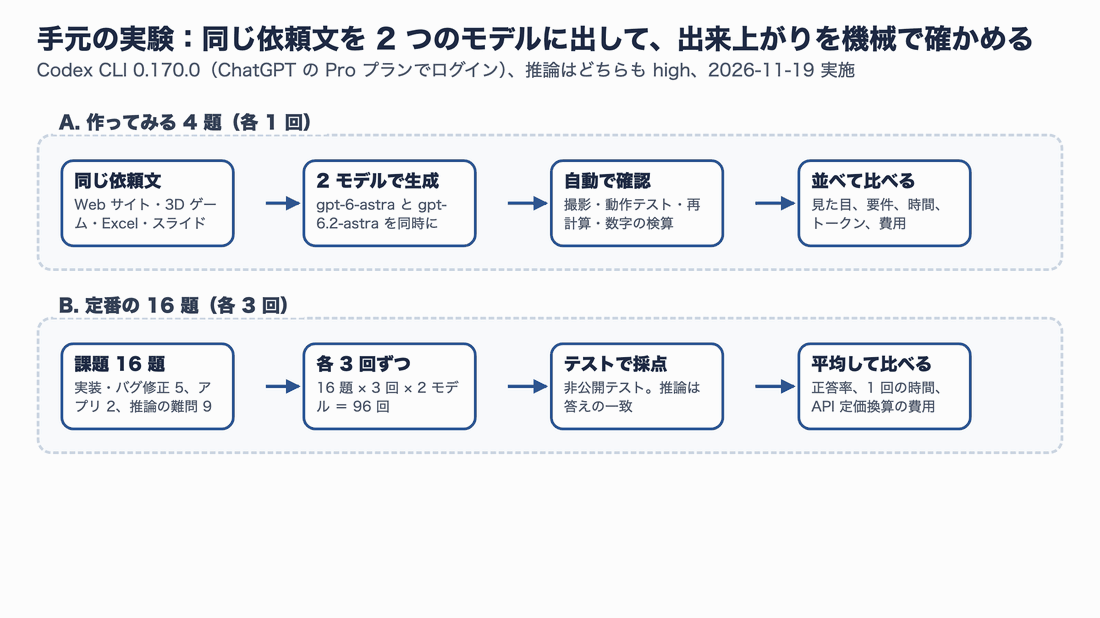
図8:実験の流れ。作例は各 1 回、定番の 16 題は各 3 回です。
条件は次のとおりです。
| 項目 | 内容 |
|---|---|
| 道具 | Codex CLI 0.170.0(2026-11-19 時点の最新)、ChatGPT の Pro プランでログイン |
| モデル | gpt-6-astra と gpt-6.2-astra、推論はどちらも high |
| 権限 | 作業フォルダの中だけ書き込み可(workspace-write)、ネット接続なし |
| 確認方法 | ヘッドレスブラウザでの撮影・操作、Python での再計算・検算 |
| 費用の目安 | Codex が返すトークン数 × API 定価(実際の支払いはプランの利用枠) |
4 題の時間と費用は次のとおりでした。
| 作例 | 時間(旧 → 6.2) | 出力トークン(旧 → 6.2) | 費用の目安(旧 → 6.2) |
|---|---|---|---|
| Web サイト | 415 秒 → 372 秒 | 19,348 → 14,649 | $1.46 → $0.96 |
| 3D ゲーム | 593 秒 → 726 秒 | 26,353 → 27,162 | $2.10 → $2.00 |
| Excel | 551 秒 → 255 秒 | 23,712 → 10,680 | $1.96 → $0.80 |
| スライド | 373 秒 → 366 秒 | 15,095 → 13,157 | $1.94 → $1.24 |
| 合計 | 1,932 秒 → 1,719 秒 | 84,508 → 65,648 | $7.47 → $5.00(−33%) |
3D ゲーム以外は 6.2 のほうが速く、4 題の合計費用は 3 分の 2 になりました。では、中身はどう違ったのでしょうか。
作例 1:Web サイト ── 目的に沿って短くまとめ、挿絵を描き込んだ
依頼は「架空の陶芸教室のサイトを index.html 1 ファイルで。目的は体験教室の予約。画像ファイル・外部の CDN・Web フォントは使わない」です(依頼文の全文は記事末尾の「再現手順」に載せています)。
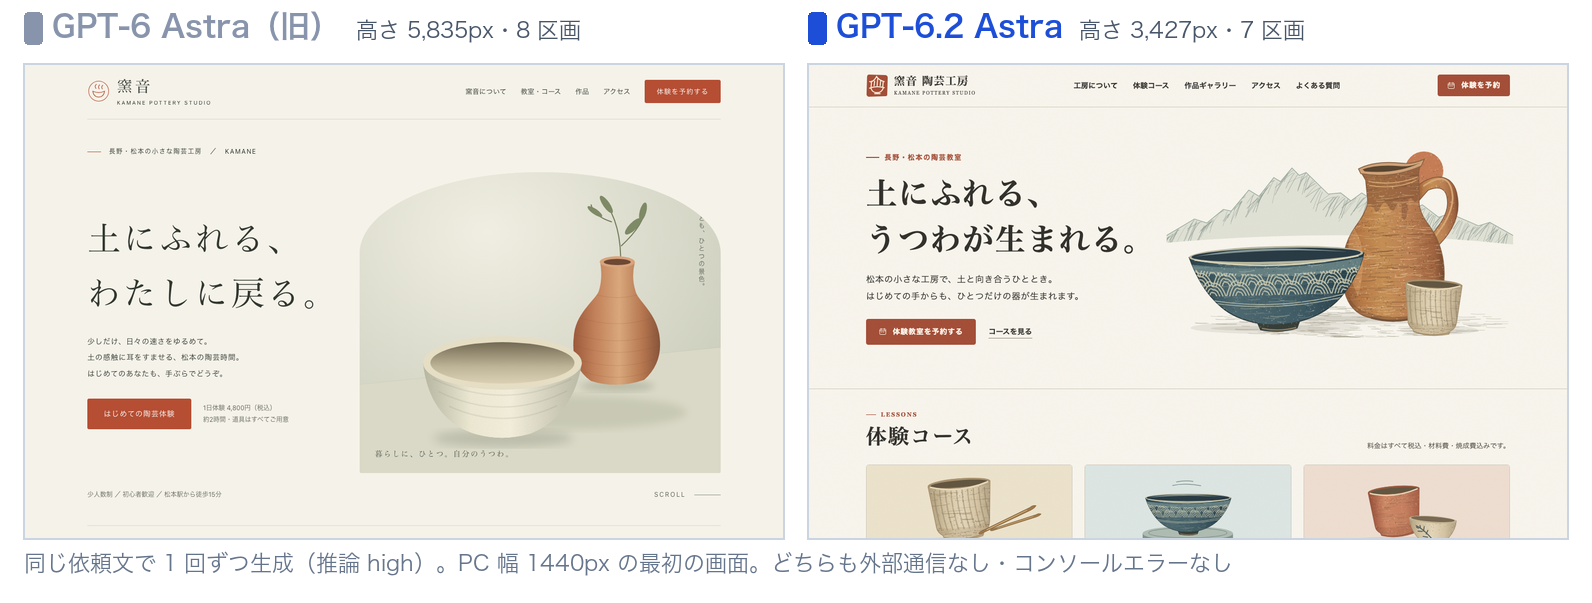
図9:PC 幅(1440px)の最初の画面。どちらも外部への通信なし、コンソールエラーなし。
どちらも、そのまま見せても通用する水準です。違いは方向性に出ました。
- 6.2 Astra は、コース 3 種と料金を最初のスクロールのすぐ下に置き、各コースのカードに「予約する」を付けました。ページの長さは 3,427px と旧版の約 6 割です。水差しや茶碗の挿絵は SVG(図形を数式で描く画像形式)で、器の模様や土の質感まで細かく描き込んでいます
- 旧 Astra は、余白を大きく取った雑誌のような構成で、講師の挿絵や「土曜日をつくろう」といった読ませる文章が多く、ページは 5,835px と長めです。予約フォームでは料金の合計を自動計算する機能も付けました
発表文の「サイト本来の目的に沿って要素を構築する」という説明どおり、6.2 は「予約してもらう」という目的に向けて情報を詰めた、と言えます。ただ、旧版の雰囲気のほうが好きな人もいるはずで、ここは好みが分かれるところです。
スマホ幅(390px)でも、どちらも横にはみ出さずに表示されました。予約フォームは、空のまま送ると必須項目のエラーが出て、入力して送ると画面上に完了メッセージが出ることを、自動操作で両方とも確かめています。
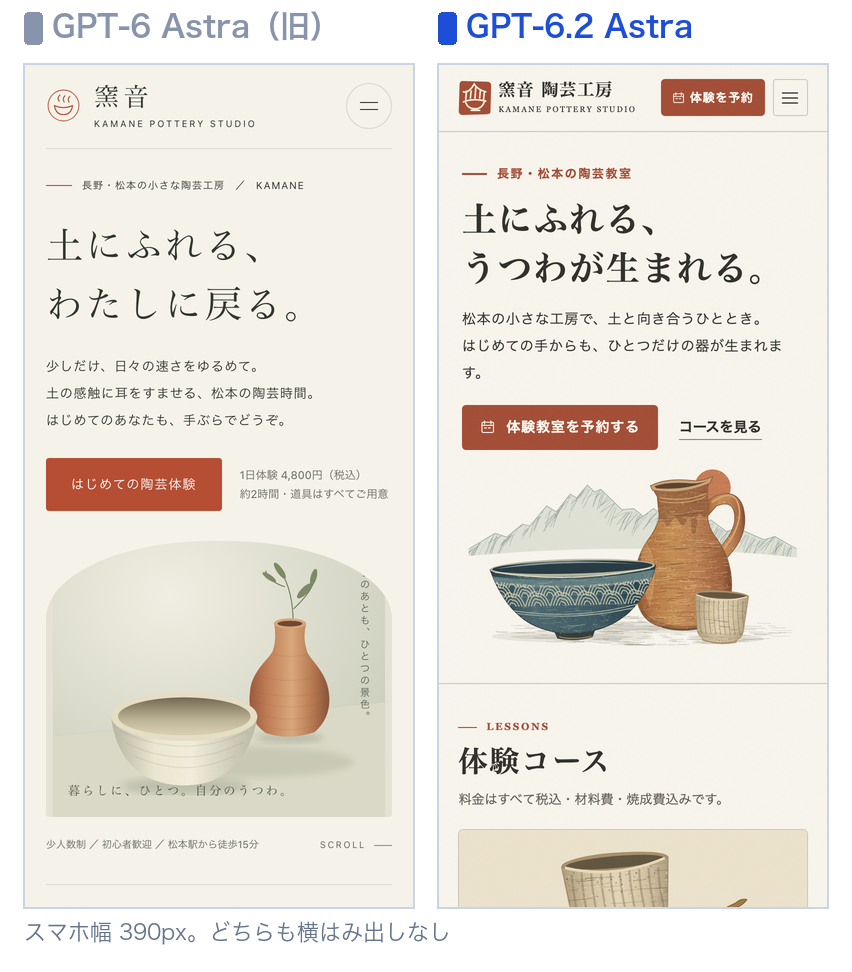
図10:スマホ幅の最初の画面。6.2 は画面上部に「体験を予約」ボタンを常に出し、最初の画面にコースの見出しまで入る。
作例 2:3D ゲーム ── 世界の作り込みが一段上がった
次は、Three.js(ブラウザで 3D を描くライブラリ)を使ったミニゴルフです。依頼では「3 ホール、起伏と動く障害物、マウスとタッチで打てる、スコア表示」に加えて、自動テストのために window.gameState(ゲームの状態)と window.shoot(角度, 強さ)(1 打打つ関数)を用意するよう指定しました。
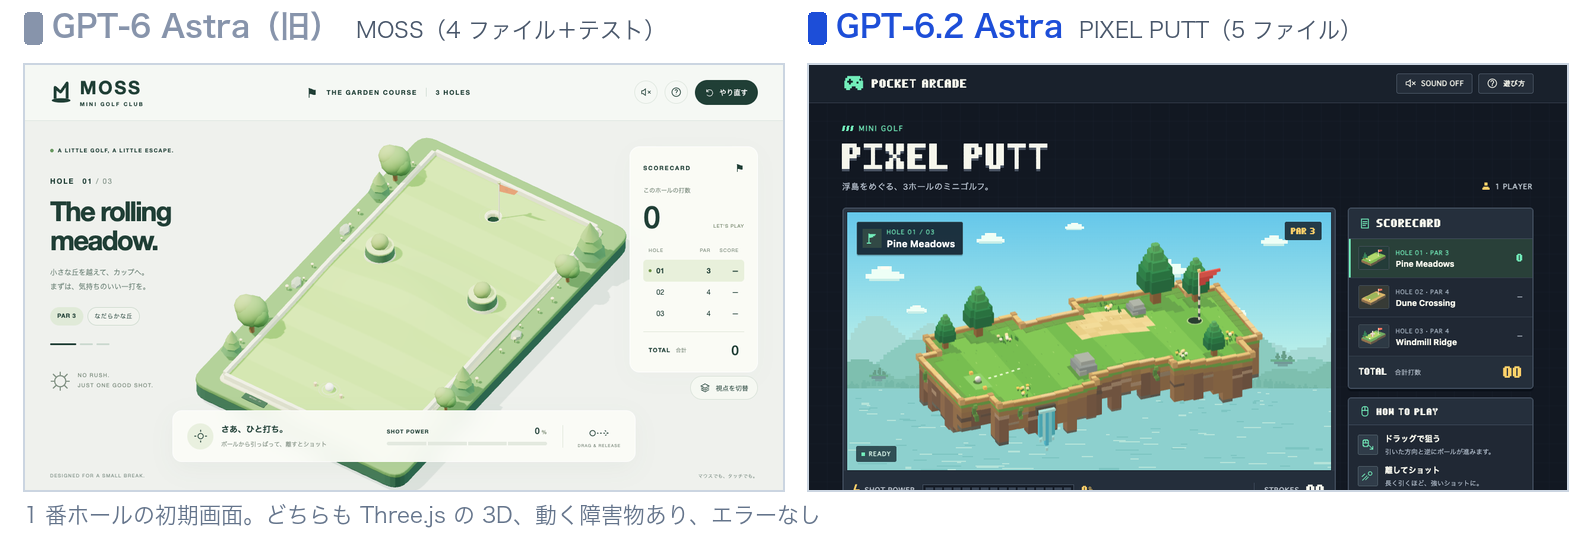
図11:1 番ホールの初期画面。
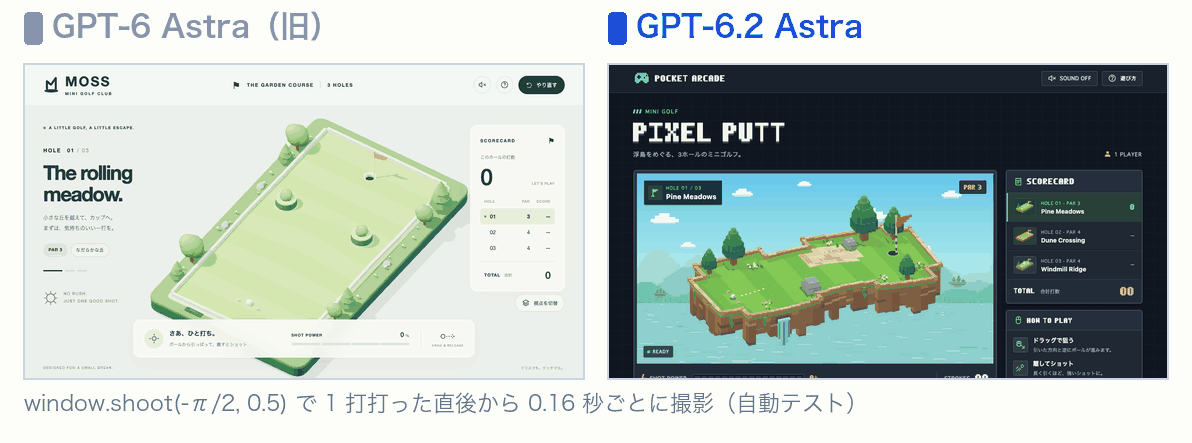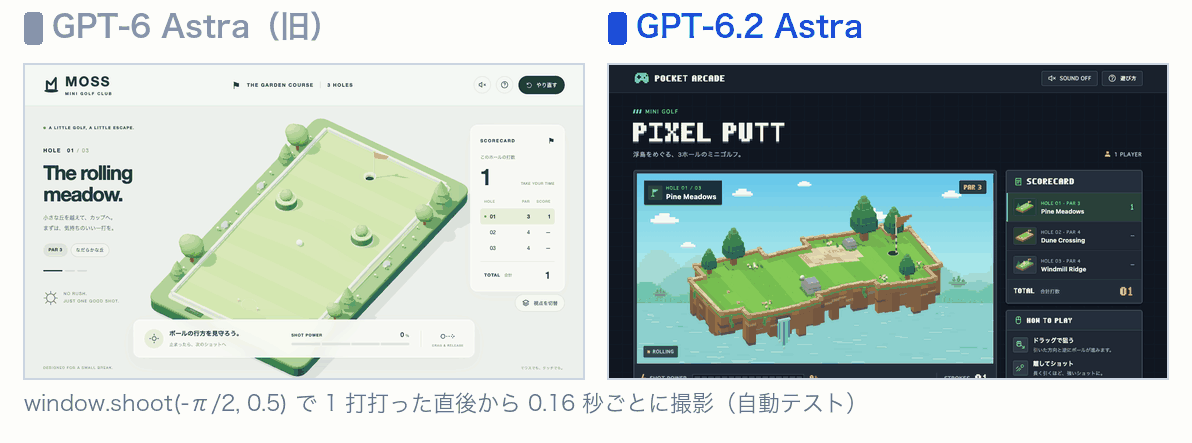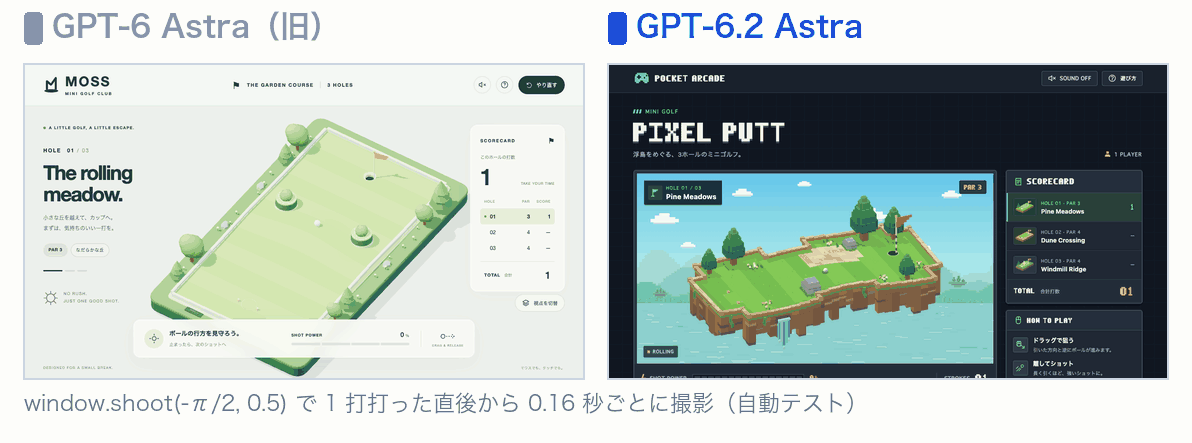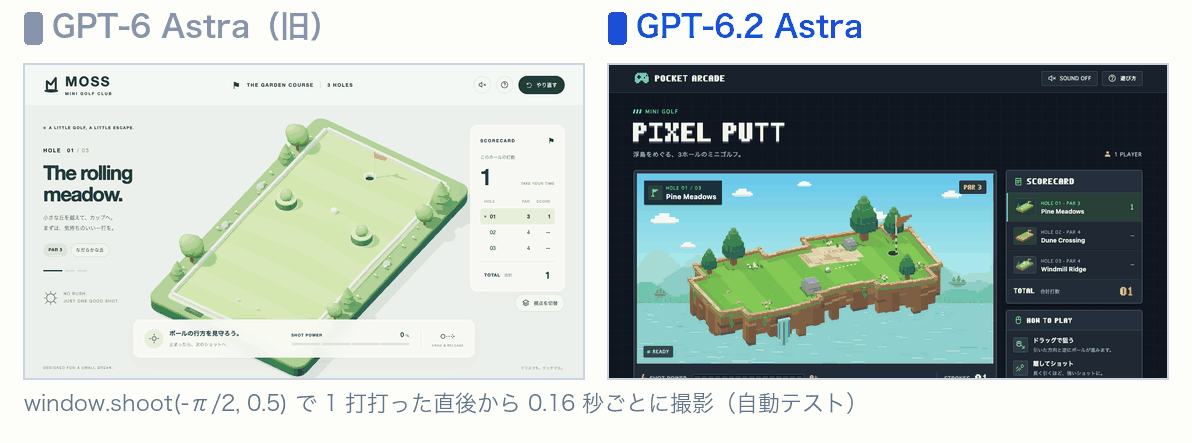
図12:window.shoot(-π/2, 0.5) で 1 打打った直後からの様子。どちらもボールが転がり、打数が 1 増えた。
どちらも要件はすべて満たし、エラーもありませんでした。自動テストで 60 打ほど打たせると、どちらも 2 番ホールへ進むことも確認できました。
見た目の差ははっきりしています。6.2 Astra(PIXEL PUTT)は、ボクセル(小さな立方体を積んだ表現)の浮島に、砂地・水面・滝・木・岩を配置し、2 番ホールに動くゲート、3 番に回る風車と、動く障害物を 2 種類入れました。打つ方向のガイド線も出ます。旧 Astra(MOSS)は落ち着いたデザインの芝のコースで、丘と円柱・壁の障害物、3 番ホールに動くゲートがあります。
作り方にも違いがありました。旧 Astra は物理計算を別ファイルに分け、単体テストと README まで残しました。6.2 Astra は確認用のスクリプトでブラウザの画面を撮って確かめ、そのファイルは最後に消していました(画面を撮って確かめる作業は旧 Astra もしています)。AA-3D の Elo が 150 上がったことと合わせると、見た目のある成果物を作り込む力は確かに伸びていると感じます。なお、この作例だけは 6.2 のほうが 2 分ほど長くかかっています。
作例 3:Excel ── 中身は同等、時間と費用は半分以下
3 題目は、架空の会社「あおば青果ロジ」の 3 年分の月次実績と前提条件(成長率・原価率・投資額など)から、経営会議用の Excel を作る依頼です。2026〜2028 年の予測を「投資する・しない」の両方で作り、前提を変えると数式で連動すること、感応度分析(条件を変えたときに結果がどれだけ動くかの表)を入れることを求めました。
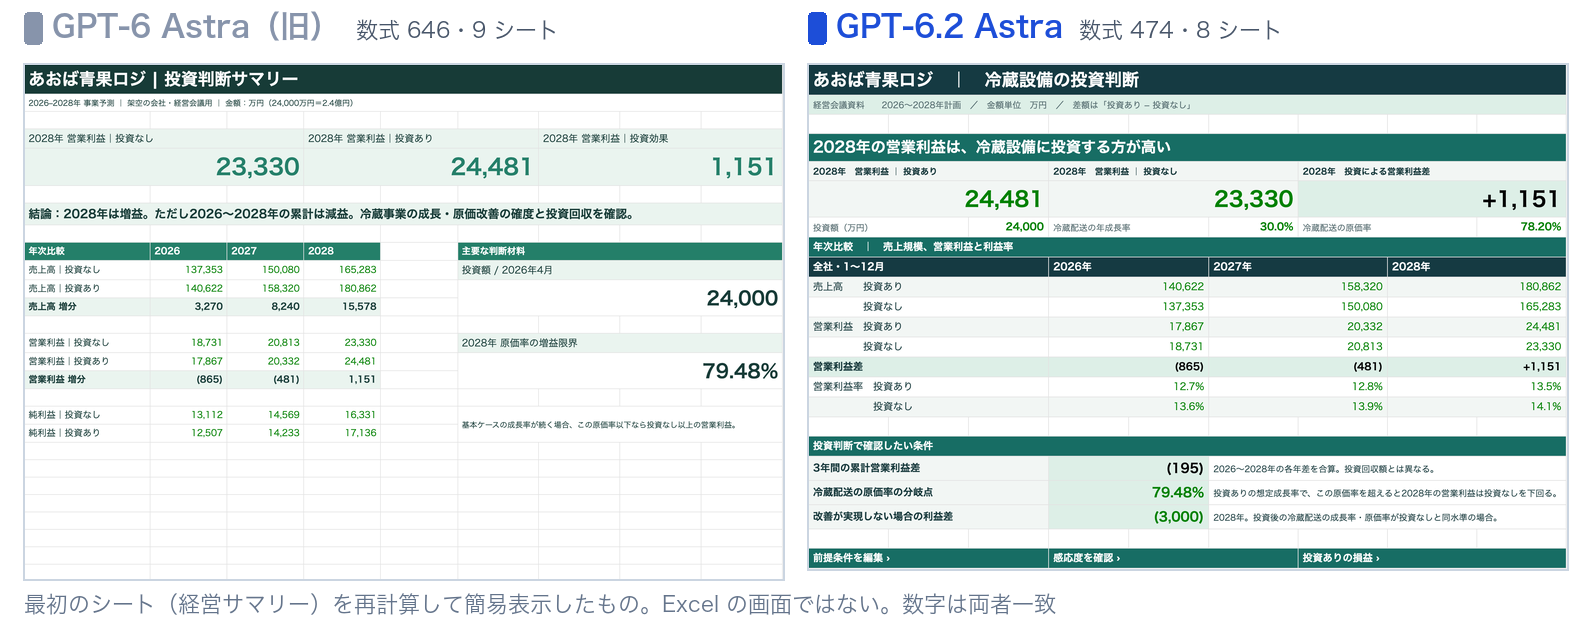
図13:最初のシートを Python で再計算し、値と書式を簡易表示したもの(Excel の画面ではありません)。
結果は、ほぼ互角でした。Python の Excel 計算ライブラリ(formulas)で両方のブックを再計算すると、どちらもエラー値は 0 件で、2028 年の営業利益の差額はどちらも +1,151 万円、原価率の分岐点はどちらも 79.48% と一致しました。前提シートの「投資時の冷蔵配送の成長率 30%」を 20% に書き換えると、どちらも最初のシートの数字が 17〜20 か所連動して変わります。
違いは作り方です。旧 Astra は数式 646 個・9 シートで、要約シートにグラフを入れ、検算用のシートまで用意しました。6.2 Astra は数式 474 個・8 シートと簡潔で、要約シートの下に「前提条件を編集 ›」のようなほかのシートへの案内を並べています。そのうえで、時間は 551 秒 → 255 秒、費用は 1.96 ドル → 0.80 ドルでした。
なお、6.2 Astra はブックを作った Python スクリプトを作業の最後に消していました。成果物だけ欲しいなら問題ありませんが、あとで作り直したい場合は「生成スクリプトも残して」と依頼に書いておくとよいでしょう。
作例 4:スライド ── 中身は互角、ただし PowerPoint で「修復」が出た
最後は、同じデータから「2026 年に冷蔵配送へ投資すべきか」を議論する 8 枚前後の資料を、PowerPoint で編集できるグラフ付きで作る依頼です。
ここで 1 つ問題が起きました。6.2 Astra の proposal.pptx を PowerPoint(Mac 版)で開くと、「コンテンツに問題が見つかりました。修復できる可能性があります」というダイアログが表示されたのです。ファイルの XML を旧版と比べましたが、表のセルの罫線指定やグラフの目盛り間隔など、旧版にない要素はあったものの、原因の特定まではできませんでした。PowerPoint の画面操作は今回行えなかったため、旧 Astra 版が同じ環境で問題なく開けるかも確かめられていません。1 回だけの観察ですが、AI が作った Office ファイルは、納品前に実機で開いて確かめるのが無難です。
そのため、見た目の比較は、両方のファイルを同じ方法で描く自作の簡易描画(Pillow という画像ライブラリで図形・文字・表・棒グラフを描く)で行いました。PowerPoint の描画とは細部が違う点に注意してください。
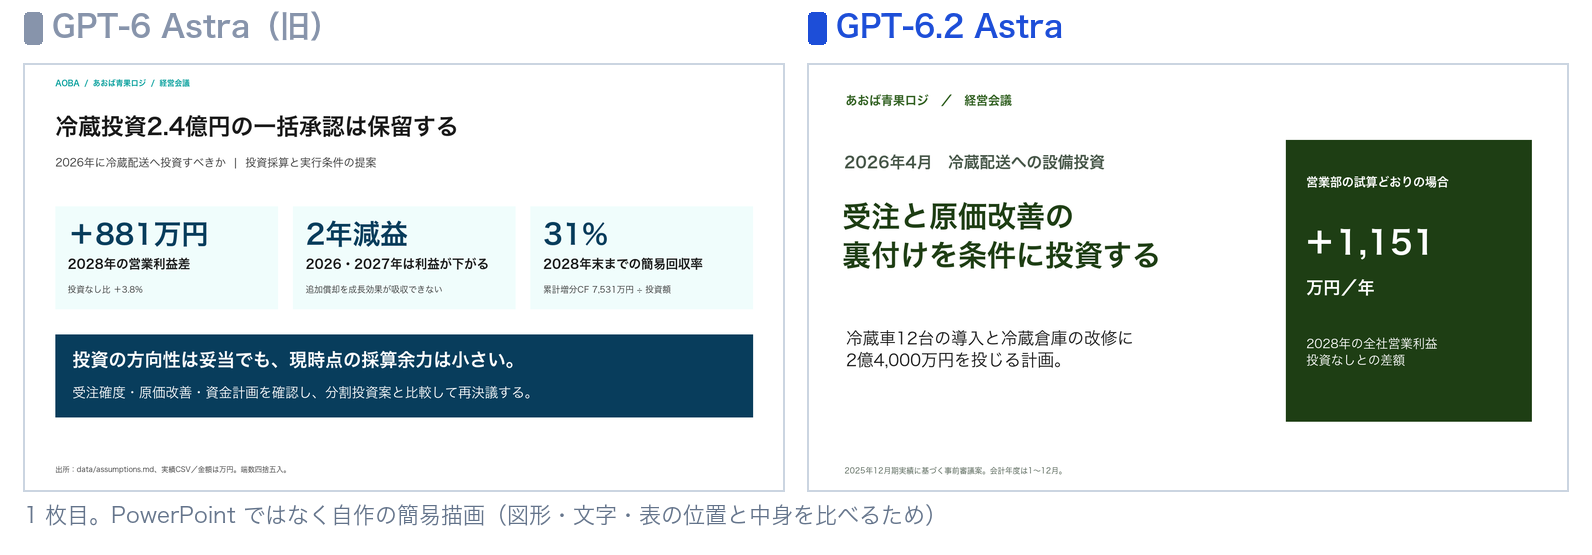
図14:1 枚目。どちらもタイトルに結論を書いている。
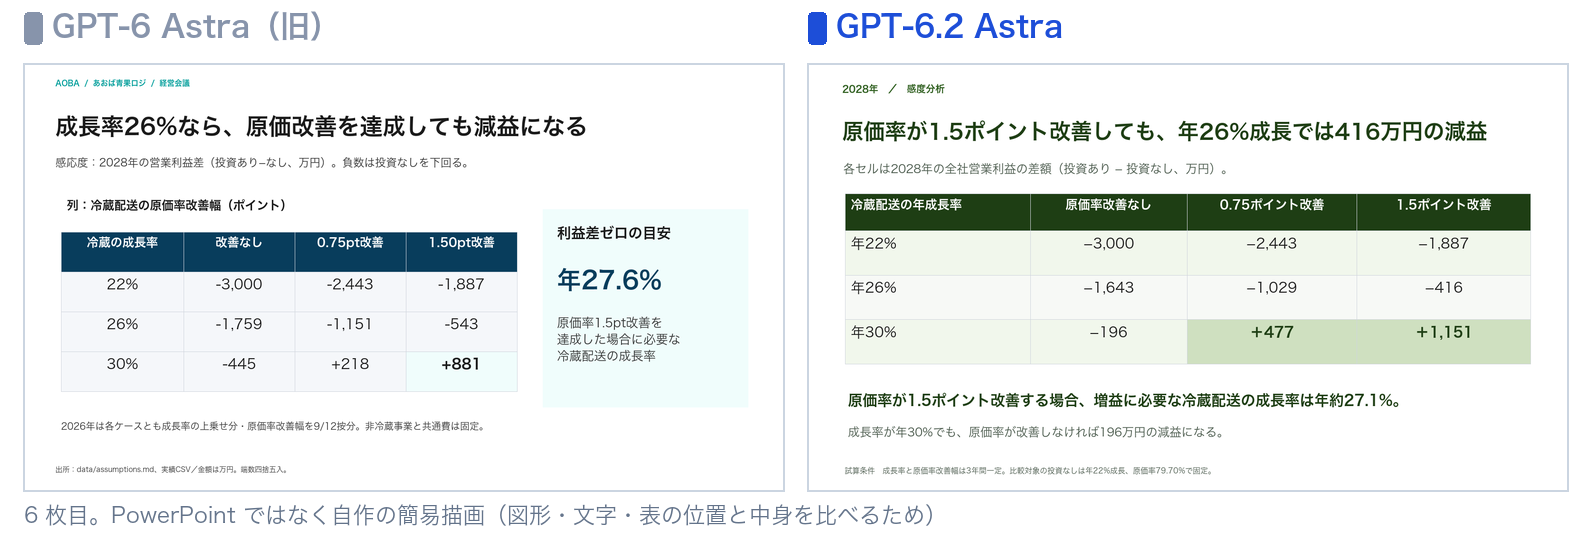
図15:6 枚目の感応度分析。表の形も結論もほぼ同じ。
中身はどちらもしっかりしていました。8 枚・16:9・ネイティブのグラフ(6.2 は 2 個、旧版は 3 個)・全スライドに話す内容のメモ付きで、タイトルは「成長率 26% なら、原価改善を達成しても減益になる」のように結論で書かれています。
面白かったのは、結論の数字が違ったことです。2028 年の営業利益の差額は、6.2 Astra が +1,151 万円、旧 Astra が +881 万円でした。自分で検算したところ、どちらも計算ミスはありません。違いは前提の読み方で、
- 6.2 Astra は、投資効果(成長率 30%・原価率 −1.5 ポイント)を 2026 年の 1 年間すべてに適用し、そのことを脚注に書いた
- 旧 Astra は、4 月に投資するので 2026 年の効果を 9 か月分に按分した
という差でした。前提条件には「2026 年は減価償却を 9 か月分」としか書いていないので、どちらも筋は通っています。ただ、旧 Astra はさらに「資料の 2026 年 4 月実行日はすでに過ぎている」と気づき、判断期限を 11 月 30 日に置き直しました。6.2 Astra の判断期限は 2026 年 3 月 31 日のままで、作業した日(2026 年 11 月)から見ると過去の日付です。こうした日付や前提の確認は、新しいモデルでも人が見るべき所として残りそうです。
定番の 16 題:正答率は互角、差は時間と費用
作例は 1 回ずつなので、数字の比較は定番の 16 題で行いました。これまでの記事でも使っている課題で、実装・バグ修正 5 題(仕様どおりに関数を実装する、請求額のずれを直すなど)、アプリ作成 2 題(家計簿の Web アプリ、売上 CSV からのレポート)、推論の難問 9 題(コマンドを使わず頭の中だけで答える)です。それぞれを 3 回ずつ、計 96 回解かせました。
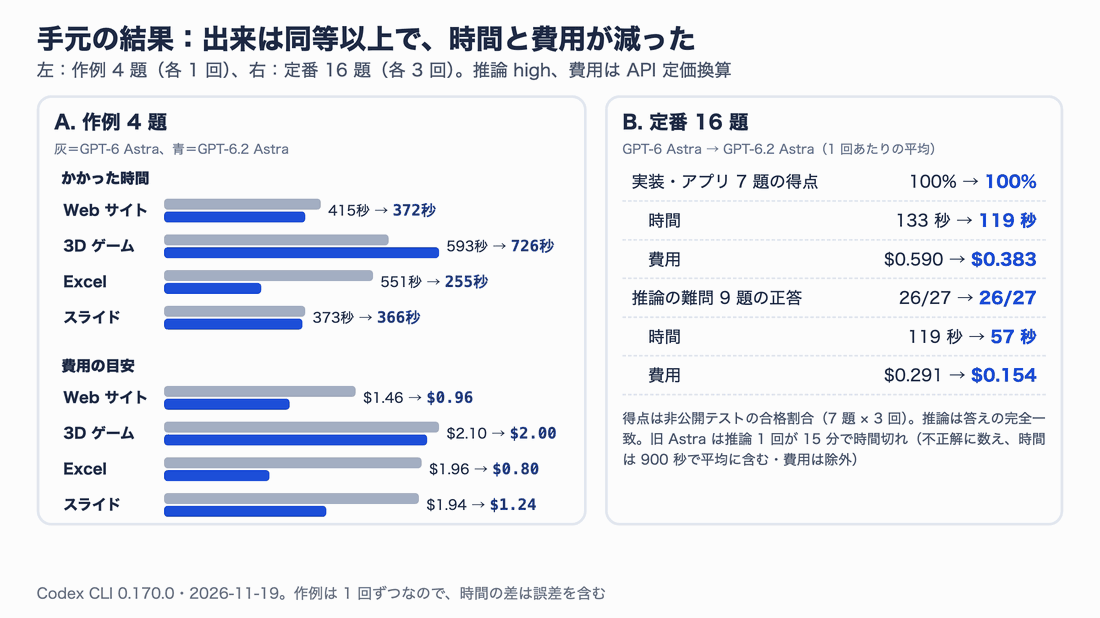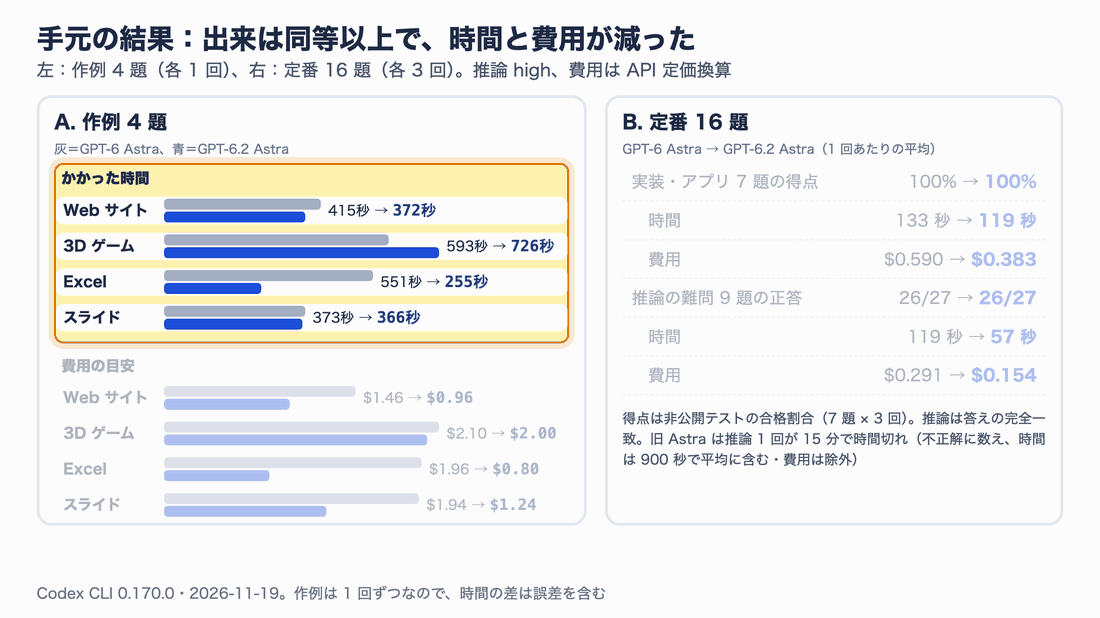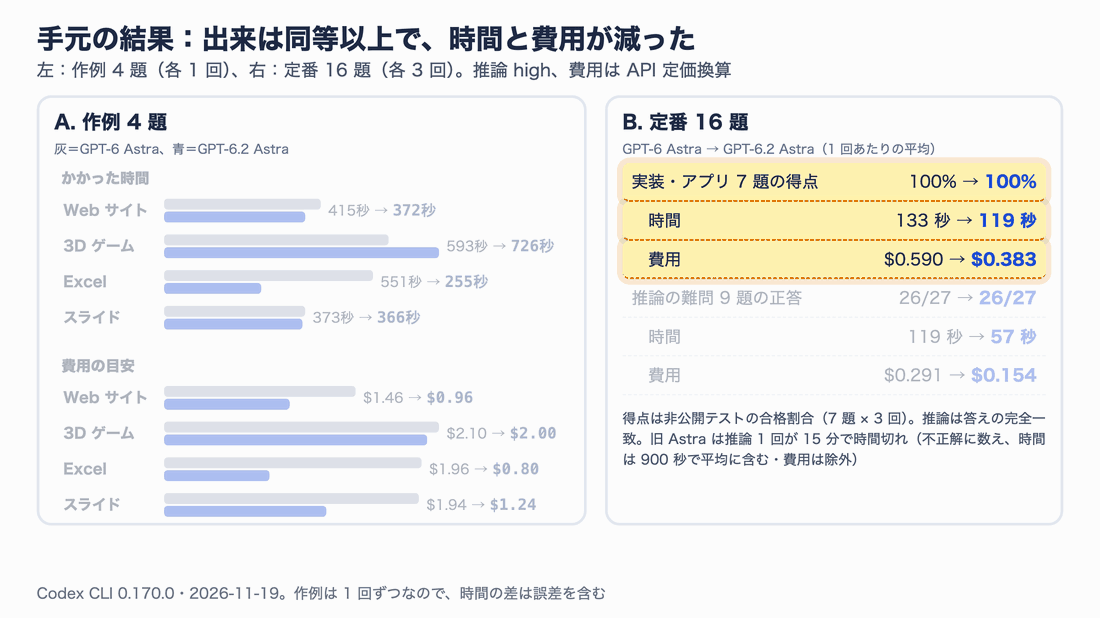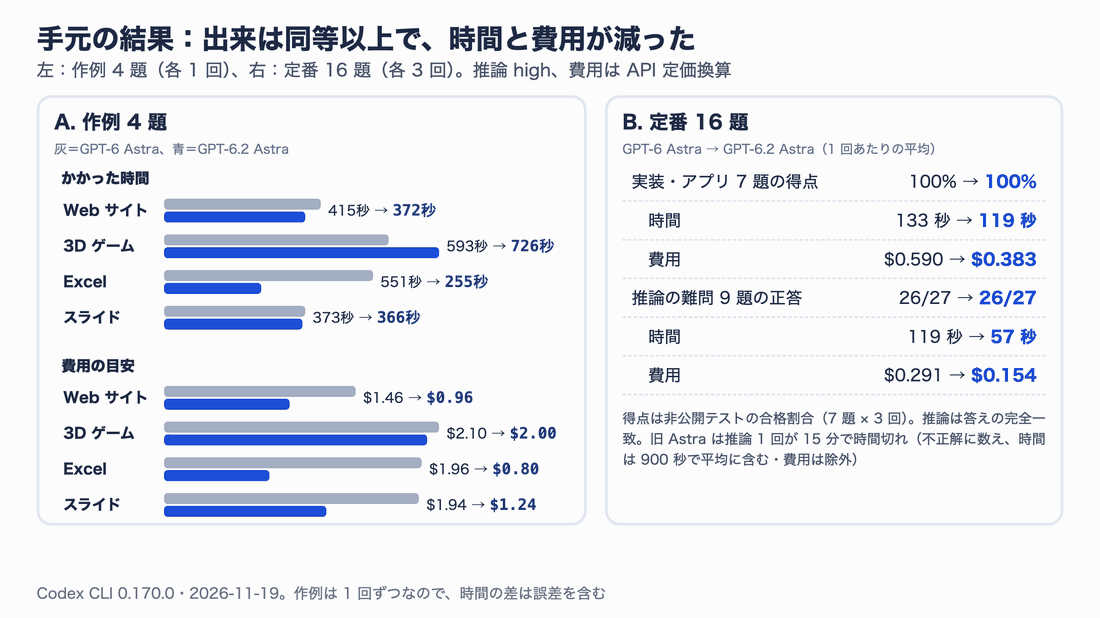
図16:左が作例 4 題、右が定番 16 題。正解率は同じで、時間と費用が減った。
| 項目(1 回あたりの平均) | GPT-6 Astra | GPT-6.2 Astra |
|---|---|---|
| 実装・アプリ 7 題の得点(21 回) | 100%(21/21 回が満点) | 100%(21/21 回が満点) |
| 時間(平均 / 中央値) | 133 秒 / 130 秒 | 119 秒 / 97 秒 |
| 出力トークン | 5,631 | 4,177 |
| 費用の目安 | $0.590 | $0.383(−35%) |
| 推論の難問 9 題の正解(27 回) | 26/27 | 26/27 |
| 時間 | 119 秒 | 57 秒 |
| 費用の目安 | $0.291 | $0.154(−47%) |
正解率はまったく同じでした。 実装・アプリは両者とも全 21 回が満点で、推論の難問も 27 回中 26 回正解です。どちらも外したのは同じ 1 問(順列の数え上げ)で、6.2 は 1 回目に、旧 Astra は 2 回目に外しました。旧 Astra のその 1 回は 15 分の制限時間を使い切って答えを出せずに終わっています(費用の平均からは除いています)。
差が出たのは時間と費用です。実装・アプリでは 1 回あたりの費用が 35% 減り、時間の中央値は 130 秒から 97 秒になりました。推論の難問では、時間が約半分(119 秒 → 57 秒)、出力トークンも約半分で、同じ答えにより短い思考でたどり着いています。
この 16 題は、旧 Astra ですでに満点近くの「易しめ」の課題です。そのため、ここで差が出ないのは、FrontierCode(実際のリポジトリでの変更)の伸びが +1.4 点と小さいことと同じ話だと考えられます。普段の開発作業では、6.2 は「正解率はそのまま、速く安く」なる、というのが手元での実感です。
6.2 で強くなった点のまとめ
ここまでの数字と作例を、強くなった点ごとに並べ直します。
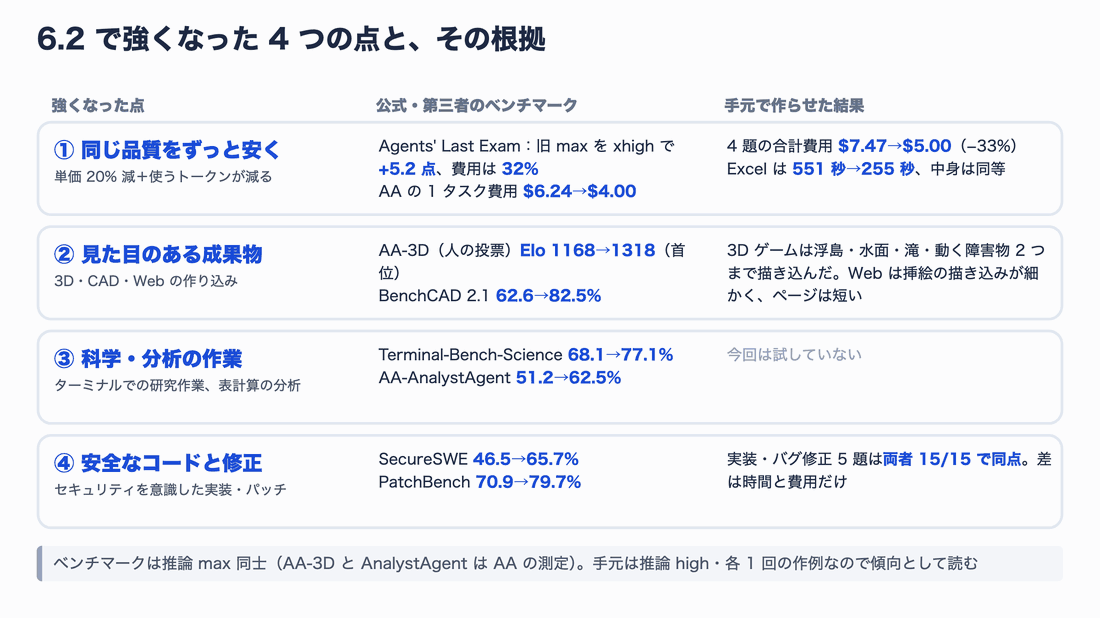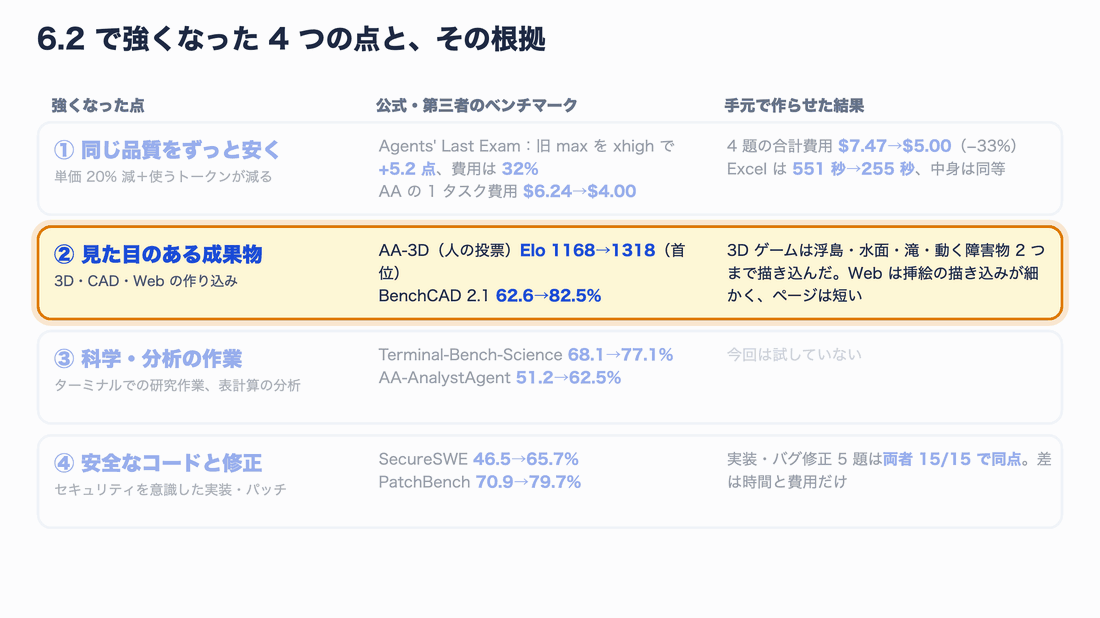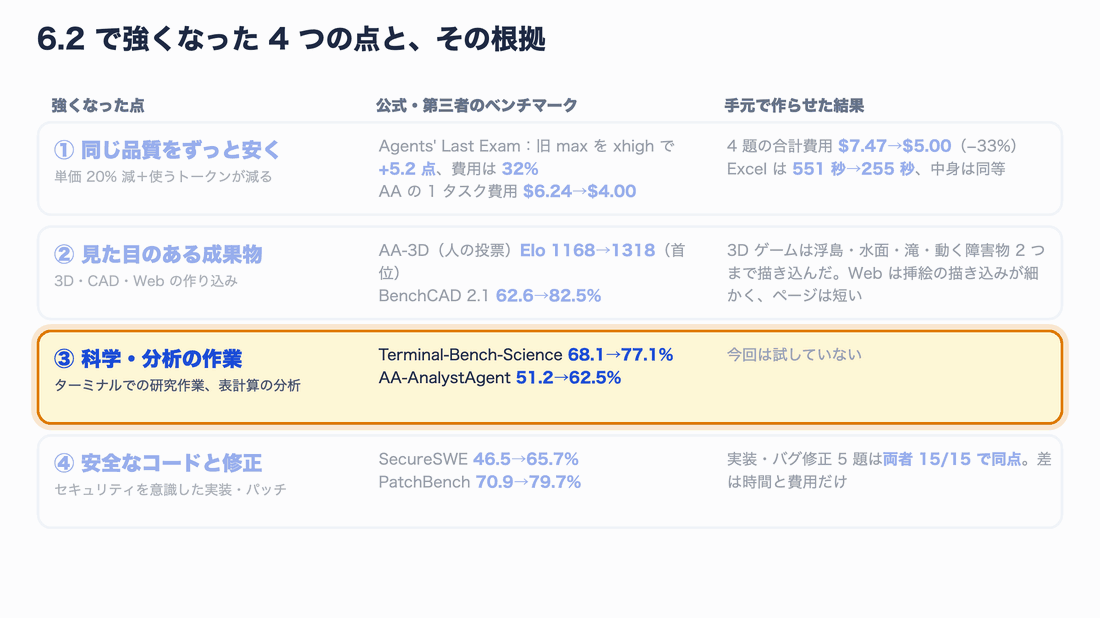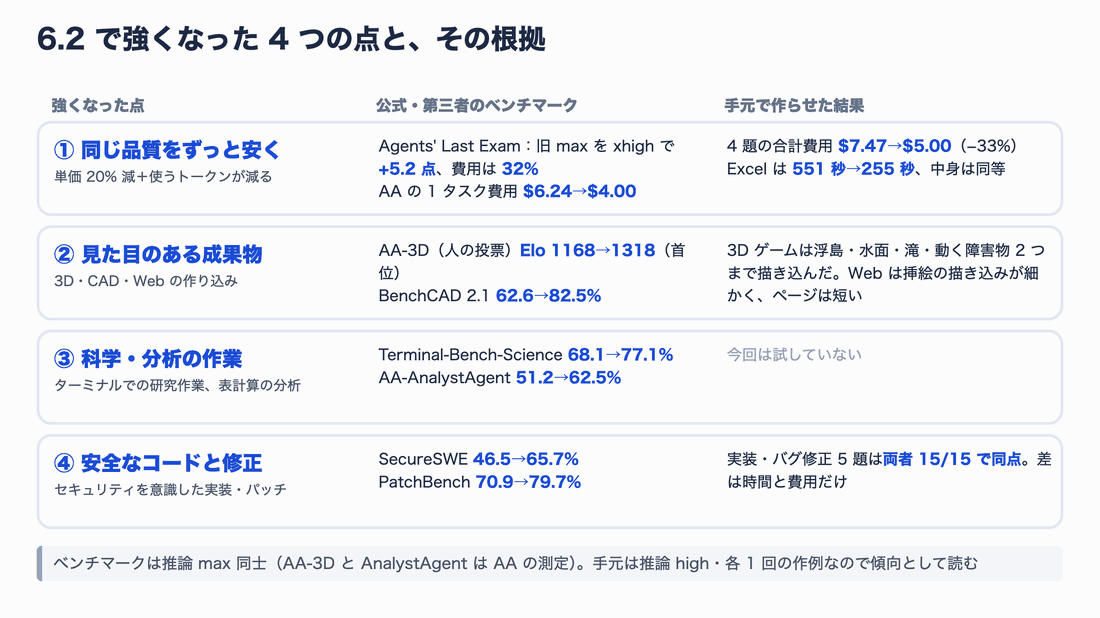
図17:ベンチマークで大きく伸びた分野と、手元で差が見えた所の対応。
- 同じ品質をずっと安く:単価 20% 減に加えて、使うトークンが減りました。Agents’ Last Exam では旧 max を超える点を 32% の費用で取り、手元の作例 4 題でも合計費用は 3 分の 2 でした
- 見た目のある成果物:3D・CAD の評価で 15〜20 点、AA-3D で Elo 150 の伸び。手元の 3D ゲームでも、世界の作り込みに差が出ました
- 科学・分析の作業:Terminal-Bench-Science +9 点、AA-AnalystAgent +11 点。今回は手元で試していないので、次の検証の候補です
- 安全なコードと修正:SecureSWE +19 点、PatchBench +9 点。ただし、手元の実装・バグ修正の課題は両者とも満点で、差は時間と費用だけでした
逆に言えば、普段の実装・バグ修正では、6.2 に替えても正解率は変わらず、速く安くなるだけです。公式の FrontierCode の伸び(+1.4 点)とも一致します。
乗り換えるときに気をつけたい 5 つのこと
旧 Astra から設定を書き換える前に、次の点を確認しておくと安心です。
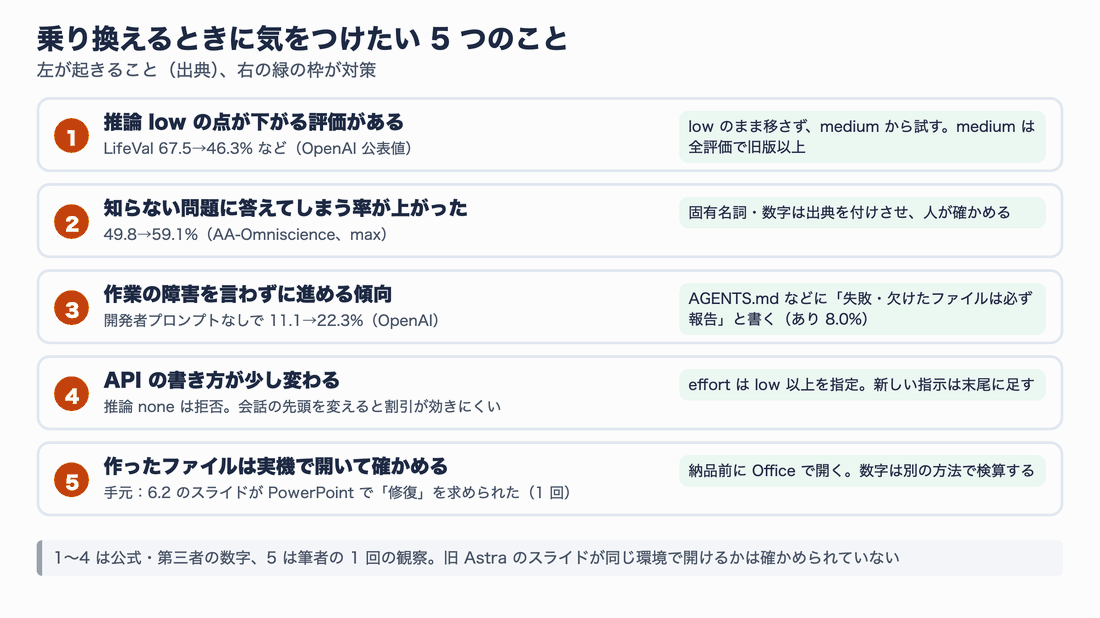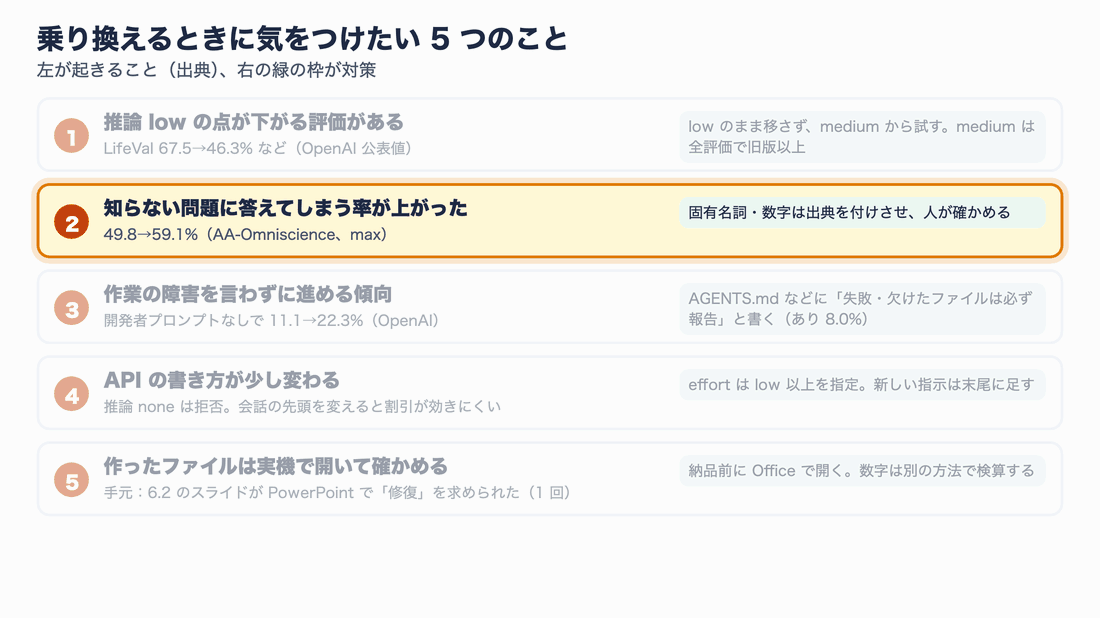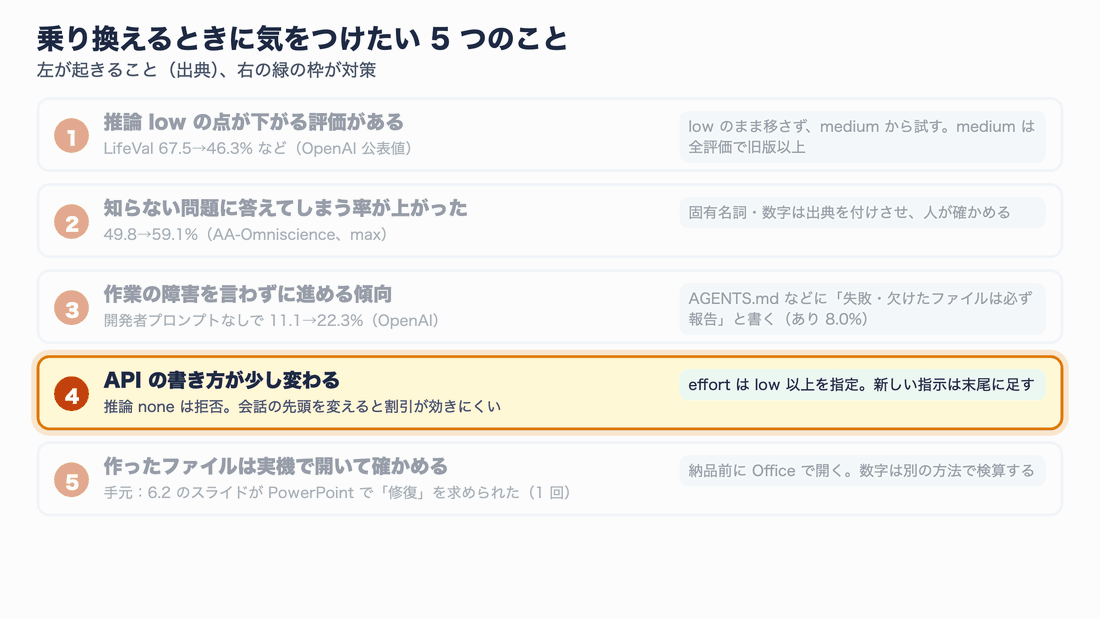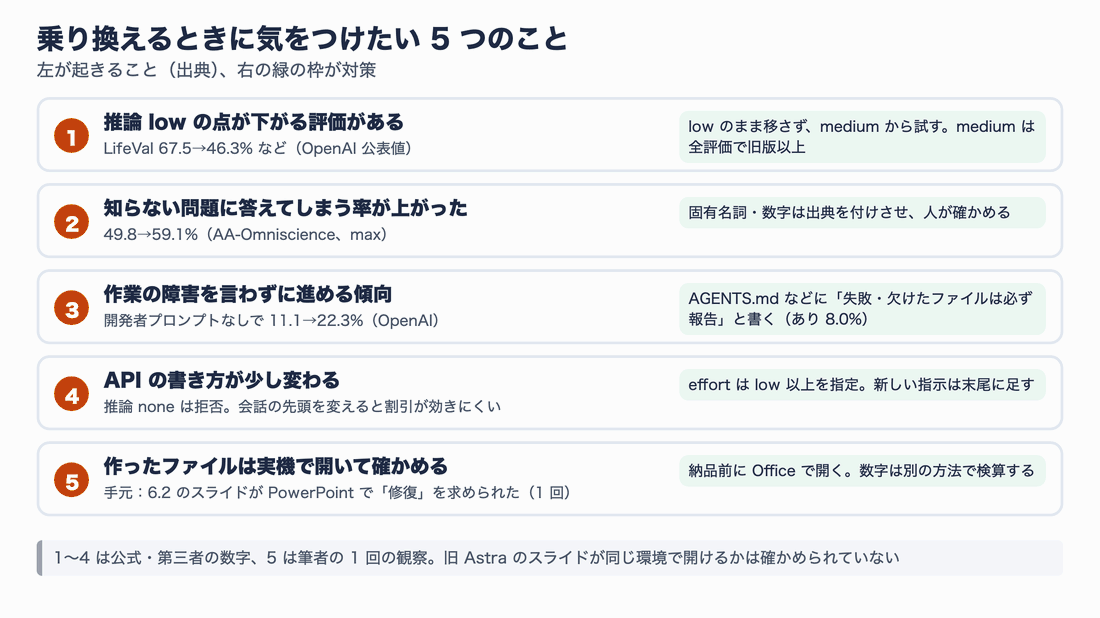
図18:1〜4 は公式・第三者の数字、5 は筆者の観察。
| # | 起きること | 対策 |
|---|---|---|
| 1 | 推論 low で点が下がる評価がある(LifeVal 67.5→46.3%) | low のまま移さず、medium から試す |
| 2 | 知らない問題に答えてしまう率が上がった(49.8→59.1%) | 固有名詞・数字には出典を付けさせ、人が確かめる |
| 3 | 作業の障害(ファイルの欠落など)を言わずに進める傾向(開発者プロンプトなしで 11.1→22.3%) | AGENTS.md などに「失敗や欠けたファイルは必ず報告」と書く(書いた場合は 8.0%) |
| 4 | API で推論 none が拒否される。会話の先頭を変えるとキャッシュ割引が効きにくい | effort は low 以上を指定し、新しい指示は末尾に足す |
| 5 | 手元で 6.2 のスライドが PowerPoint の「修復」ダイアログを出した(1 回) | 納品前に Office で開き、数字は別の方法で検算する |
3 つ目は OpenAI 自身がシステムカードで認めている点で、「Codex には言及漏れを大きく減らす指示を追加した」としています。Codex 以外のエージェントや、自前の API 実装で使う場合は、同じ趣旨の指示を自分で入れておくのがよいでしょう。
もう 1 つ、安全面の変化も知っておくと戸惑いません。6.2 Astra はサイバーセキュリティで OpenAI の安全基準の「Critical」、生物・化学で「High」に達しており、さらに AI の研究を加速する能力(AI 自己改善)で「High」に達した初めての外部公開モデルとされています。そのため、脆弱性の調査やセキュリティテストに関わる依頼の一部は、旧 Astra より断られやすくなっています。OpenAI は、承認制の防御者向けプログラム Daybreak に 6.2 のモデルを加える準備を進めているとしています。
使い分け:6.2 Astra か、6.2 Sol か
最後に、同時に出た GPT-6.2 Sol(API 単価 $2/$0.10/$10、Astra の 4 分の 1)との使い分けです。
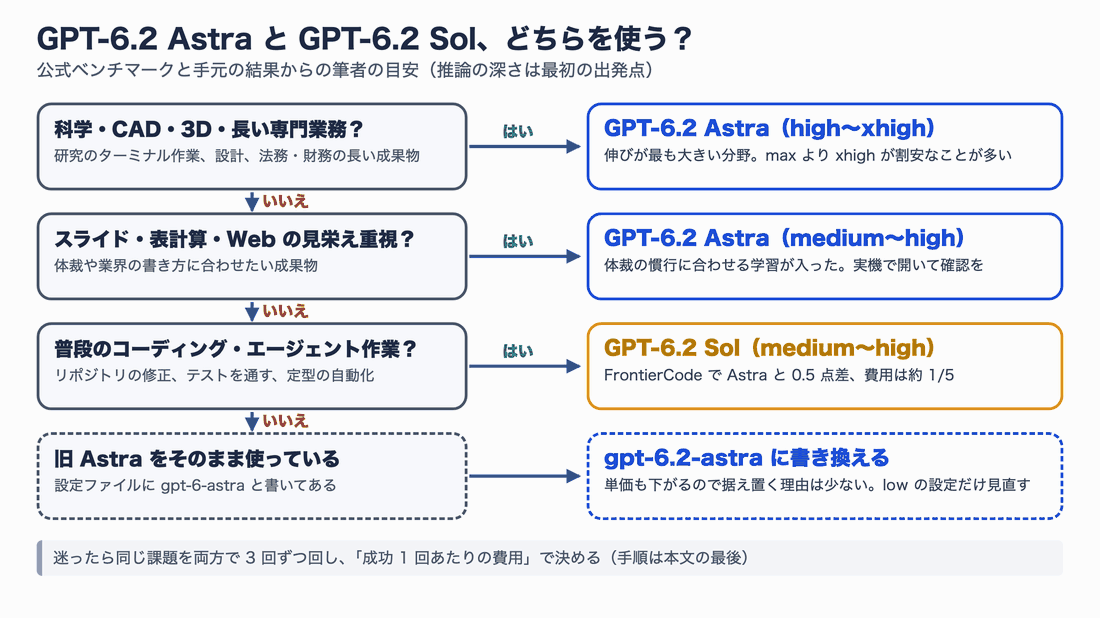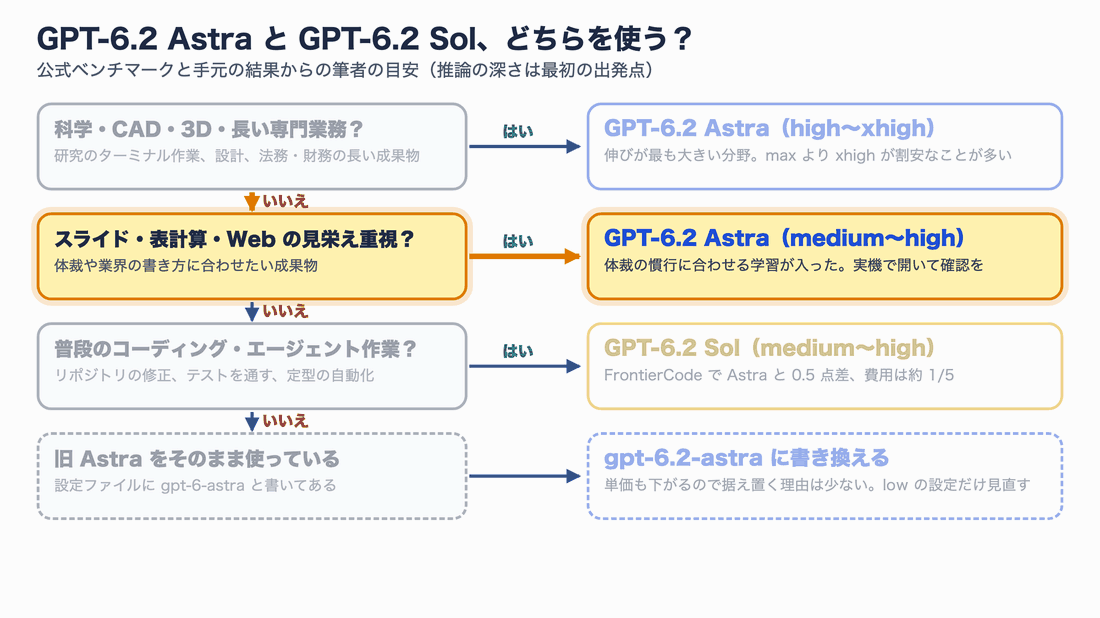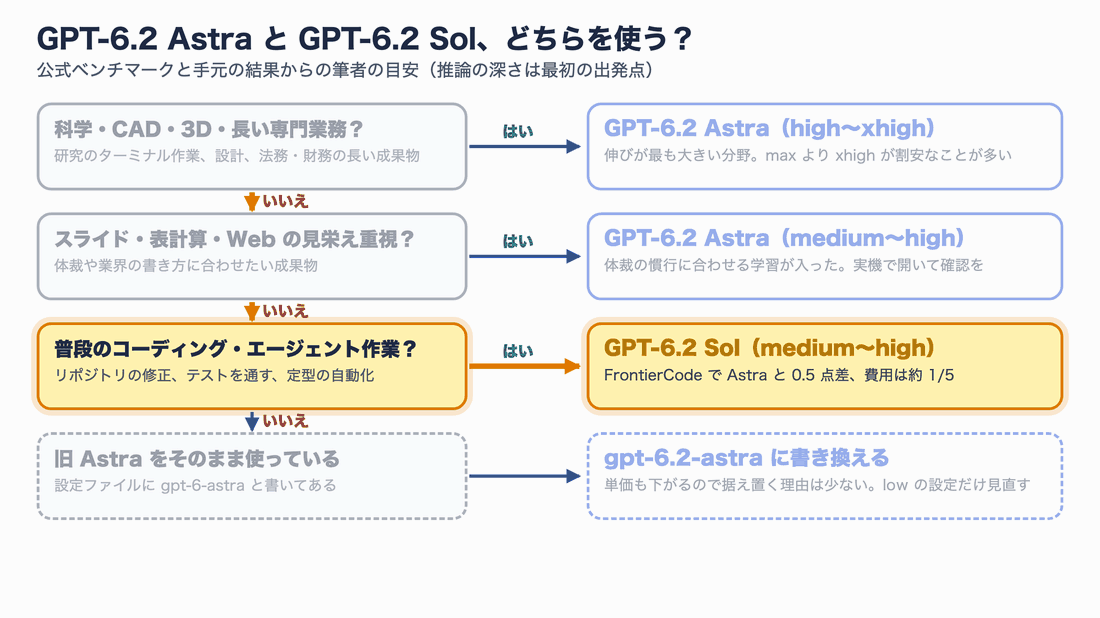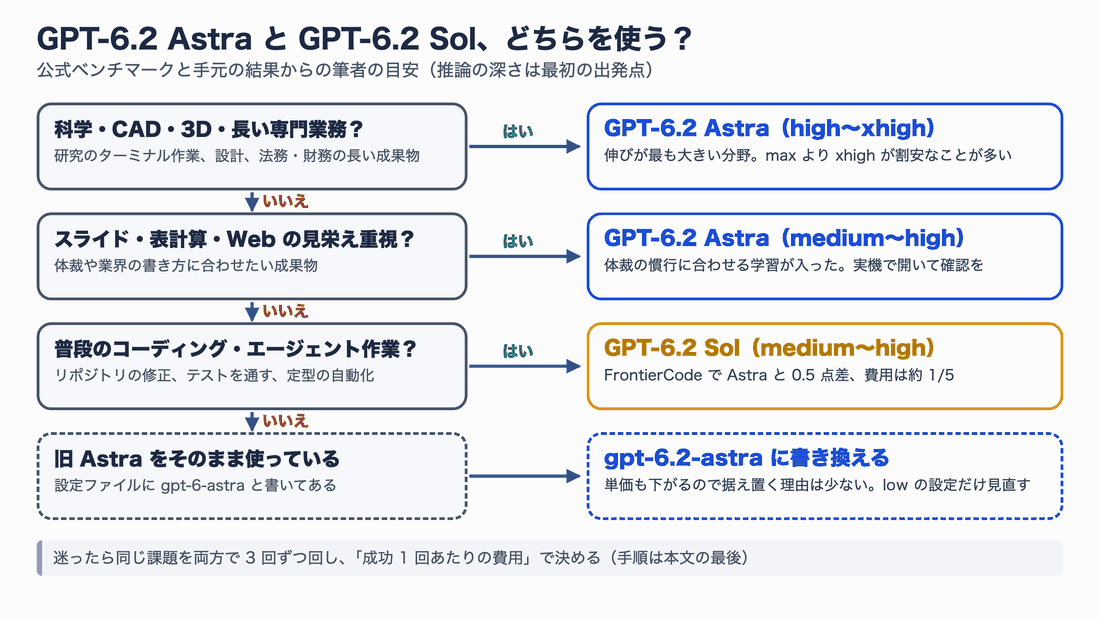
図19:筆者の目安。推論の深さは最初に試す値です。
OpenAI の数字では、6.2 Sol は FrontierCode 2.0 で 6.2 Astra と 0.5 点差(max 同士)、費用は約 5 分の 1 です。手元の実験でも、実装・バグ修正は旧 Astra ですら満点だったので、普段のコーディングは 6.2 Sol で十分というのが素直な結論です。
一方、科学研究の作業・CAD・3D・長い専門業務の成果物など、6.2 で大きく伸びた分野では、6.2 Astra を使う価値があります。そして、いま旧 Astra を設定ファイルに書いているなら、単価も下がるので、gpt-6.2-astra に書き換えない理由はほとんどありません。その際は推論 low の設定だけ見直してください。
再現手順:自分の課題で比べる
ここからは、この記事の比較を自分の環境で再現する手順です。Codex CLI と ChatGPT のプラン(Plus 以上)があれば、API キーなしで試せます。
1. Codex CLI を最新にする
GPT-6.2 Astra を指定するには、新しめの Codex CLI が必要です。グローバルに入れている場合は更新します。
# 入れている Codex CLI を最新にする(npm で入れた場合)
npm install -g @openai/codex@latest
codex --version   # この記事では 0.170.0
グローバルの設定を変えずに試したい場合は、作業フォルダの中にだけ入れる方法もあります(この記事の実験はこちらで行いました)。
mkdir -p astra-compare && cd astra-compare
npm install --prefix ./.cli @openai/codex@0.170.0
./.cli/node_modules/.bin/codex --version
2. 普段使うモデルを 6.2 Astra にする
対話で使うときは、~/.codex/config.toml のモデル名を書き換えます。
# ~/.codex/config.toml
model = "gpt-6.2-astra"
model_reasoning_effort = "medium"   # 旧 Astra で low を使っていた場合も、まず medium から
一時的に試すだけなら、起動時に指定できます。
codex -m gpt-6.2-astra -c model_reasoning_effort="high"
3. 同じ依頼文を 2 つのモデルに出す
比較では codex exec(対話なしで 1 回実行するモード)を使いました。Claude Code など別のツールから呼ぶ場合、標準入力が開いたままだと入力待ちで止まるので、< /dev/null で閉じておくのがコツです。
# 作業フォルダを 2 つ用意し、同じ依頼文を出す
mkdir -p run-old run-new
PROMPT='架空の陶芸教室「窯音(かまね)陶芸工房」の公式サイトを index.html の 1 ファイルで作ってください。目的は体験教室の予約です。画像ファイル・外部の CDN・Web フォントは使わないでください。'

codex exec --skip-git-repo-check -m gpt-6-astra   -c model_reasoning_effort="high" \
  -s workspace-write -C run-old "$PROMPT" < /dev/null
codex exec --skip-git-repo-check -m gpt-6.2-astra -c model_reasoning_effort="high" \
  -s workspace-write -C run-new "$PROMPT" < /dev/null
--json を付けると、1 行 1 イベントの JSON が出力され、最後の turn.completed にトークン数(input_tokens・cached_input_tokens・output_tokens)が入ります。これに API 定価を掛ければ、1 回あたりの費用の目安を出せます。
# トークン数から API 定価での費用の目安を出す(USD / 100 万トークン)
PRICE = {"gpt-6.2-astra": (8, 0.40, 40), "gpt-6-astra": (10, 1.00, 50)}

def cost(model, input_tokens, cached_input_tokens, output_tokens):
    p_in, p_cache, p_out = PRICE[model]
    fresh = input_tokens - cached_input_tokens   # キャッシュに当たらなかった入力
    return (fresh * p_in + cached_input_tokens * p_cache + output_tokens * p_out) / 1_000_000

print(round(cost("gpt-6.2-astra", 386_353, 357_632, 14_649), 4))  # 作例 1(Web)の 6.2 → 0.9588
4. API から呼ぶ場合
API では Responses API で次のように呼べます(今回の記事では API は使っておらず、このコードは公式ドキュメントの書き方に沿った例です)。
from openai import OpenAI

client = OpenAI()  # 環境変数 OPENAI_API_KEY に <YOUR_API_KEY> を設定しておく
resp = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "medium"},   # none は拒否される
    input="2026 年に冷蔵配送へ投資すべきか、3 行で論点を整理してください。",
)
print(resp.output_text)
5. 比べるときのコツ
- 同じ課題を最低 3 回ずつ回す。1 回だけだと、たまたまの差を性能差と見誤ります
- 正答率が同じなら、成功 1 回あたりの時間と費用で比べる
- 作らせたファイルは、本番と同じアプリで開く(今回のスライドのように、開けて初めて分かる問題があります)
- 数字が出る成果物は、別の方法で検算する(今回は Python で再計算しました)
まとめ
GPT-6.2 Astra は、旧 GPT-6 Astra と比べて次のように変わりました。
- 料金:入力・出力 20% 減、キャッシュ済み入力 60% 減。知識の締め切りは 2026 年 5 月 18 日に
- ベンチマーク:max 同士で 12 項目すべて上。CAD・安全なコード・科学で特に大きく伸び、普段のコーディング(FrontierCode)は +1.4 点と小さい。1 タスクの費用は多くの評価で約半分
- 作例:Web サイトと 3D ゲームは見た目の作り込みで 6.2 が上、Excel とスライドは中身が互角。4 題の合計費用は 3 分の 2
- 注意点:推論 low の品質低下、誤答率の上昇、障害を言わない傾向、Office ファイルの実機確認
「難しい仕事を、前より安く、見栄えよく」が 6.2 Astra の一番の変化です。一方で、普段の実装やバグ修正なら 6.2 Sol でも十分なので、まずは自分の代表的な課題を両方で 3 回ずつ回し、成功 1 回あたりの費用で選ぶことをおすすめします。
次の検証としては、今回試せなかった科学研究の作業(Terminal-Bench-Science で +9 点)や、長時間の業務フローでの差を確かめてみたいと考えています。
参考リソース
- OpenAI「GPT-6.2 Astra と Sol のご紹介」 https://openai.com/ja-JP/index/introducing-gpt-6-2-astra-sol/
- OpenAI API:GPT-6.2 Astra のモデルページ https://developers.openai.com/api/docs/models/gpt-6.2-astra
- OpenAI API:GPT-6 Astra のモデルページ https://developers.openai.com/api/docs/models/gpt-6-astra
- Codex の料金と利用枠 https://learn.chatgpt.com/docs/pricing
- OpenAI Developer Community「GPT-6.2 Astra and Sol are now available」 https://community.openai.com/t/gpt-6-2-astra-and-sol-are-now-available/1417531
- Artificial Analysis:GPT-6.2 Astra https://artificialanalysis.ai/models/gpt-6-2-astra
- Artificial Analysis:GPT-6 Astra https://artificialanalysis.ai/models/gpt-6-astra
(ベンチマークの数値は 2026 年 11 月 19 日に上記ページから取得したものです。手元の実験は同日に実施しました。)