はじめに
写真1枚と声の録音から「その人が話している動画」を作る AI は、ここ1年でぐっと身近になりました。ただ、試したことのある方なら、次のような不満を感じたことがあるかもしれません。
- 最初の数秒はきれいなのに、長くなるほど唇が赤くなったり、肌の質感が変わったりする
- 口を必要以上に大きく開けて、大げさな話し方に見える
- 公式のデモはきれいでも、自分の写真と声で作ると印象が違う
2026年11月15日、中国の美団(Meituan)の LongCat チームが、音声で動くアバター動画の生成モデル LongCat-Video-Avatar 1.6 を公開しました。10分を超える長い動画でも見た目が崩れにくく、口の動きが自然になったとうたっています。ライセンスは MIT です。
この記事では、前の版の 1.5 と 1.6 にまったく同じ写真・同じ音声・同じ乱数を渡し、26秒の動画を実際に作って比べました。公式のコードは NVIDIA の GPU が前提ですが、今回は Apple Silicon の Mac(M5 Max・メモリ128GB)で動かしています。
先に結果をお見せします。左が 1.5(従来)、右が 1.6(今回)です。
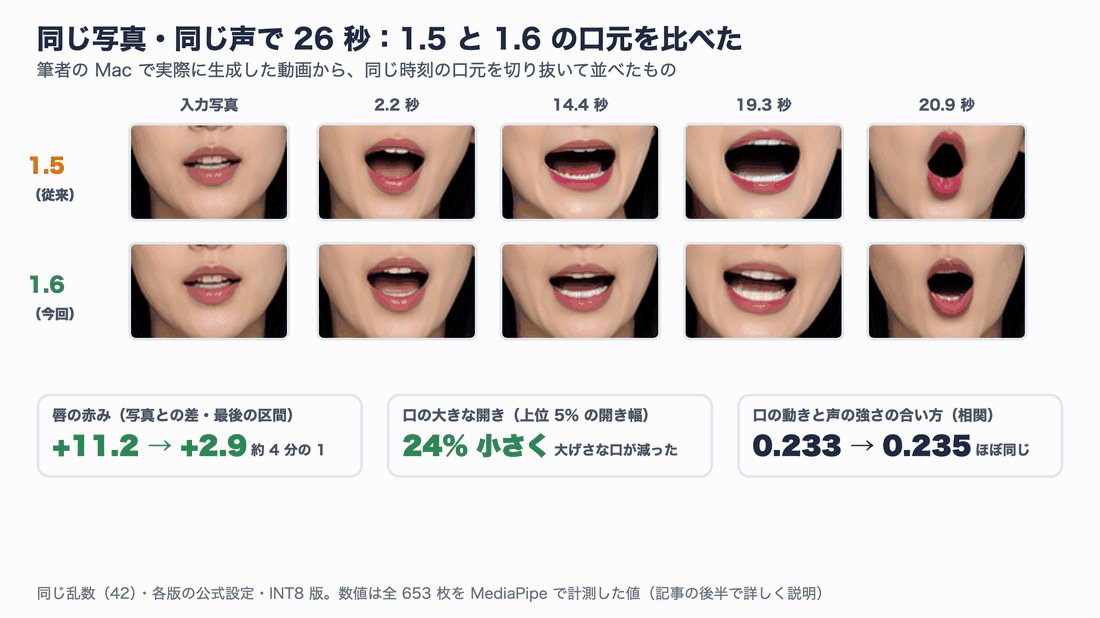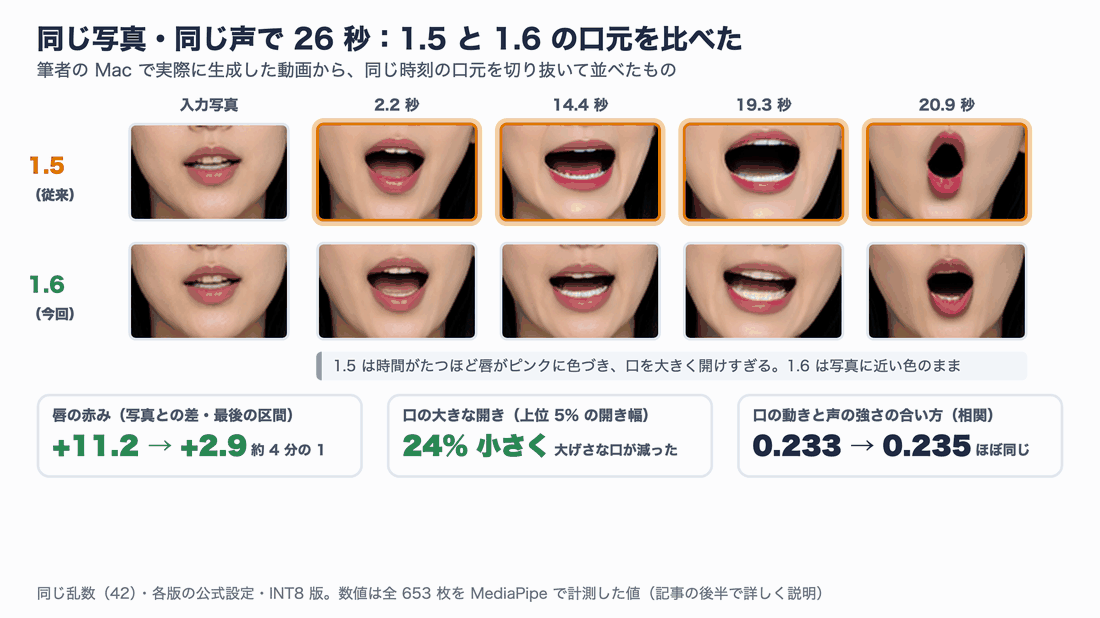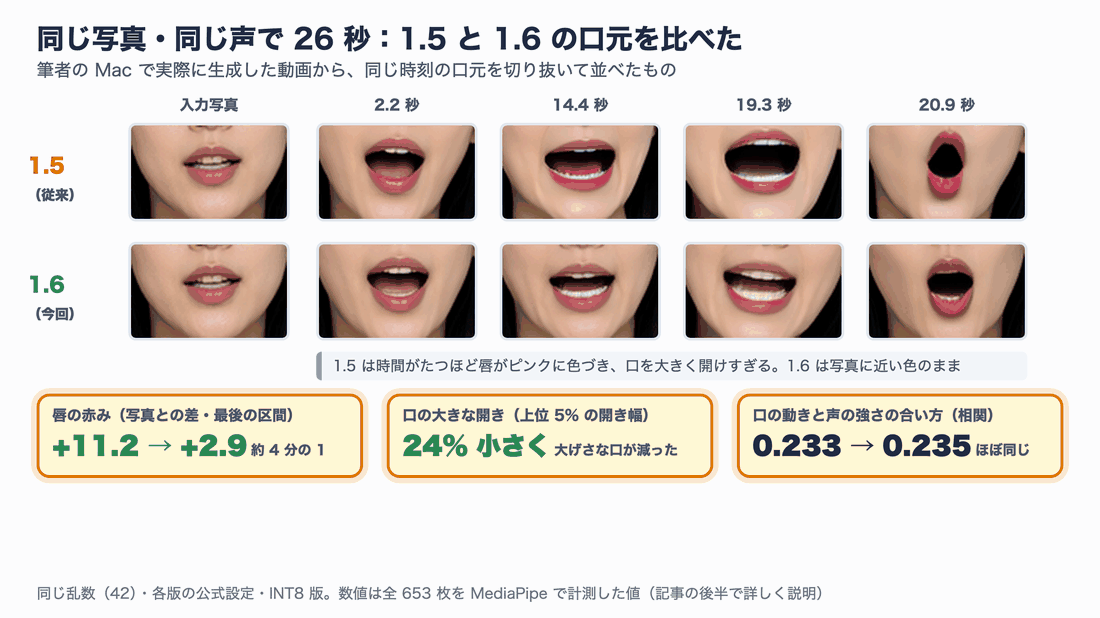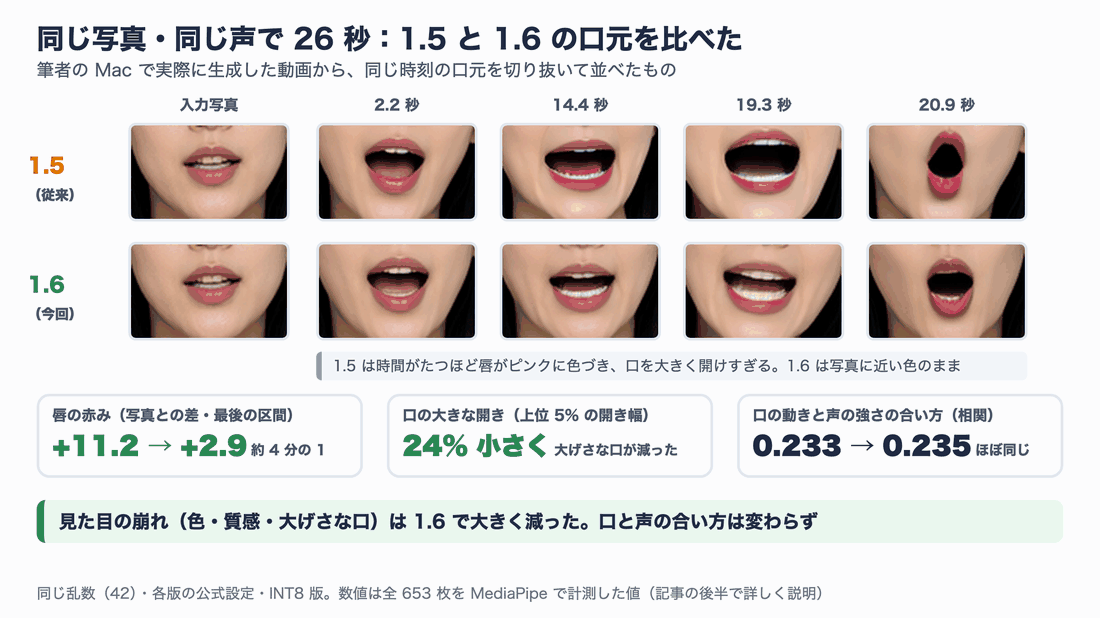
図1:同じ条件で作った動画の口元。1.6 は唇の色と口の開きが写真に近いまま保たれた
ひとことでまとめると、「続きを重ねるほど崩れていく見た目」は 1.6 で大きく改善し、「口と声の合い方」はほぼ変わらなかった、という結果でした。開発元の発表とも一致する傾向です。
この記事で分かることは次のとおりです。
- 1.5 と 1.6 の違いを、実際の動画と計測値で見たときの差
- LongCat-Video-Avatar が長い動画を作るしくみと、1.6 で変わった学習
- 開発元の評価の数字と、その読み方の注意点
- NVIDIA の GPU がない Mac で動かす具体的な手順と、つまずいた点
- 使う前に確認したいライセンスと倫理の注意
AI で動画を作ることに興味がある方、オープンソースのモデルを手元で試したい方を想定しています。Python と仮想環境の基本が分かれば、手順はそのまま追えます。
結論を先に:1.5 と 1.6 を同じ条件で比べた結果
細かい説明の前に、実測の結果を表にまとめておきます。数値は、生成した動画の全653枚の顔を計測したものです(計測方法は後で説明します)。
| 比べた点 | 1.5(従来) | 1.6(今回) | 判定 |
|---|---|---|---|
| 唇の赤み:入力写真との差(最初の区間 → 最後の区間) | +3.0 → +11.2 | +0.8 → +2.9 | 1.6 が大きく改善 |
| 顔の質感の変化(最初の区間を100としたくっきり具合) | 100 → 128 | 100 → 102 | 1.6 が改善 |
| 口の大きな開き(開き幅の上位5%) | 0.147 | 0.111(24%小さい) | 1.6 のほうが控えめ |
| 口の動きと声の強さの相関 | 0.233 | 0.235 | ほぼ同じ |
| 区間のつなぎ目での画面の変化(ふだんの変化に対する倍率) | 0.9倍 | 1.6倍 | 1.5 のほうが目立たない |
| 最初の区間(約3.7秒)の生成時間(Mac・同じ条件で測り直し) | 約19.2分 | 約18.5分 | ほぼ同じ |
唇の色と質感の変化は、どちらも続き生成での誤差の蓄積が原因です。開発元が1.6の目玉にしている改善点で、手元でもはっきり確認できました。一方、口と声の合い方は数値上ほとんど変わらず、つなぎ目の変化は 1.6 のほうがわずかに大きく出ました。良くなった点だけでなく、変わらなかった点もあわせて見ていきます。
写真1枚と音声から「話す動画」ができるしくみ
LongCat-Video-Avatar は、中国の美団(Meituan)の LongCat チームが公開している、音声で動かすアバター動画の生成モデルです。人物の写真と話し声の音声を渡すと、その人が音声に合わせて話している動画を作ります。口の形だけでなく、表情やうなずき、肩や手の小さな動きも音声から決めます。
まずは全体の流れを図で見てください。注目してほしいのは、動画を一度に作るのではなく、短い区間を作っては「続き」を足していく点です。
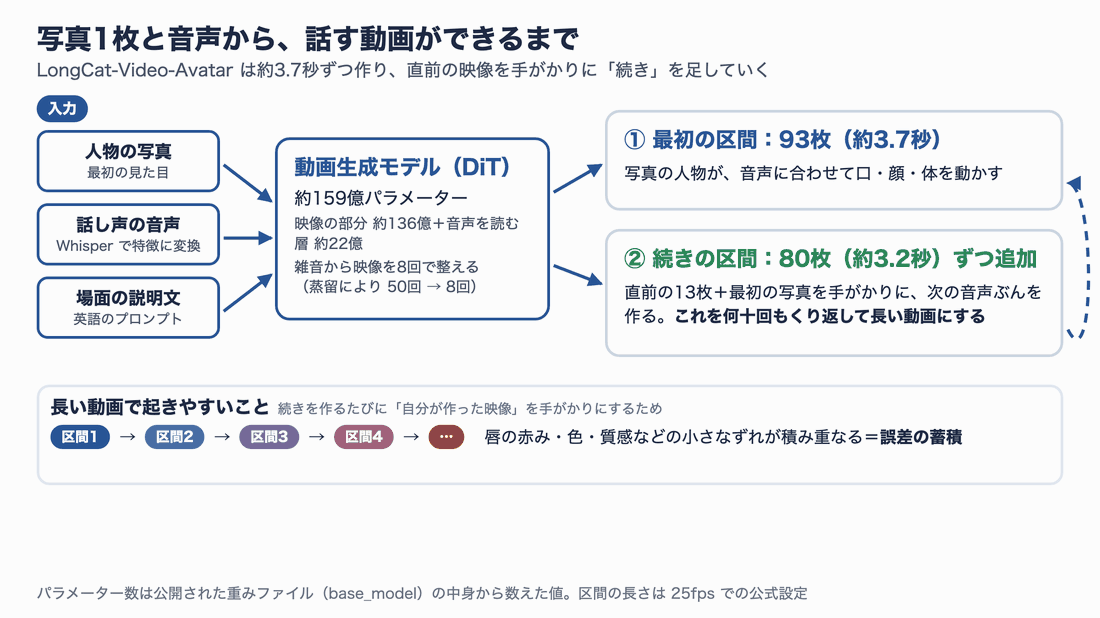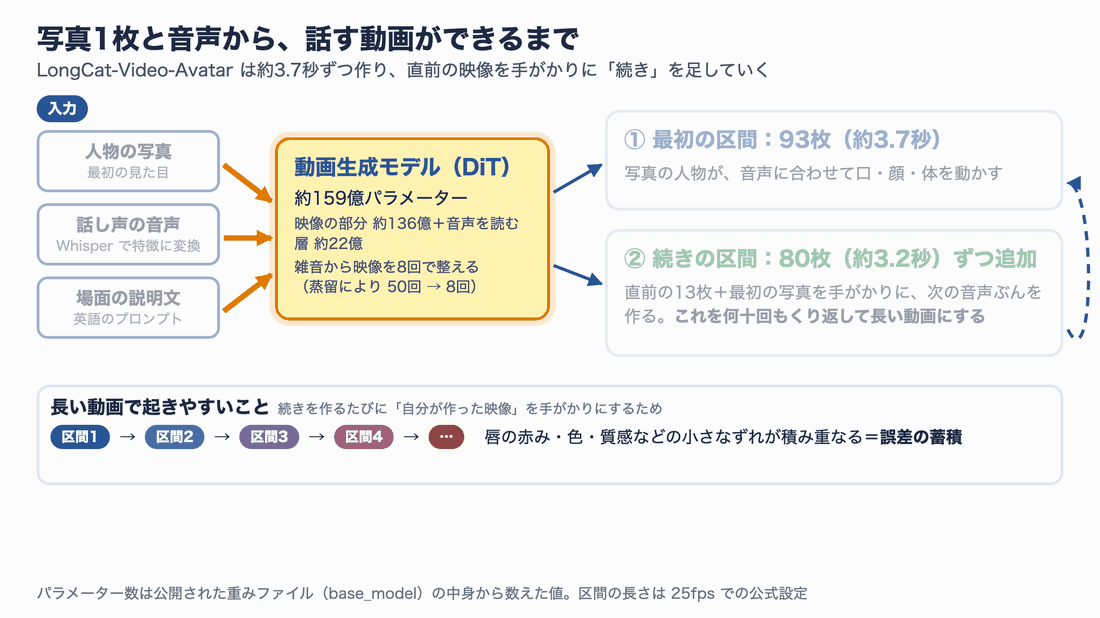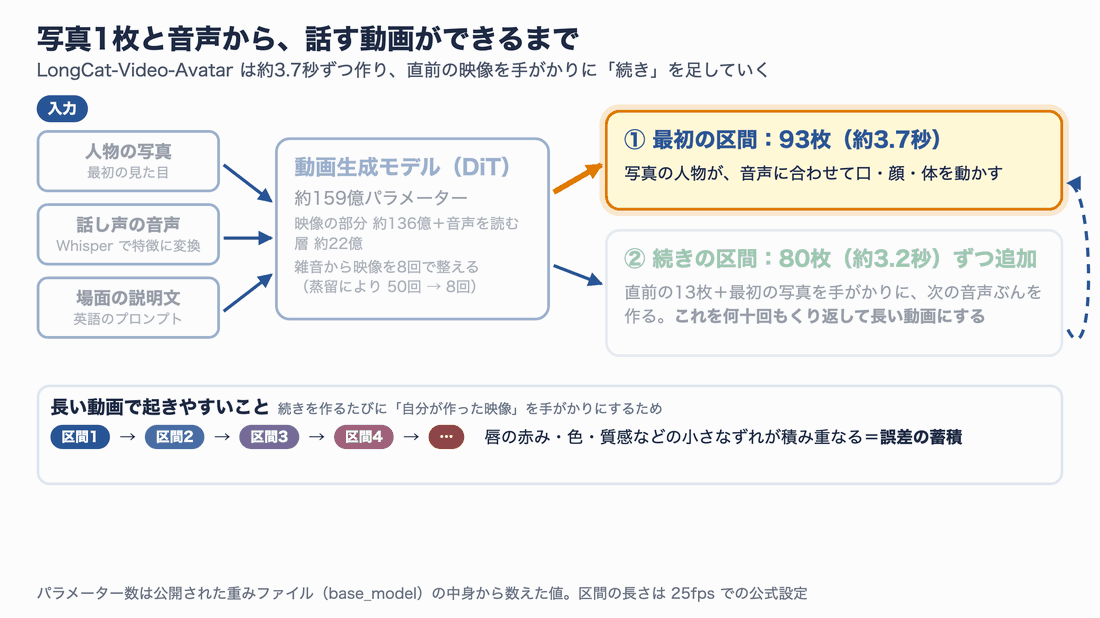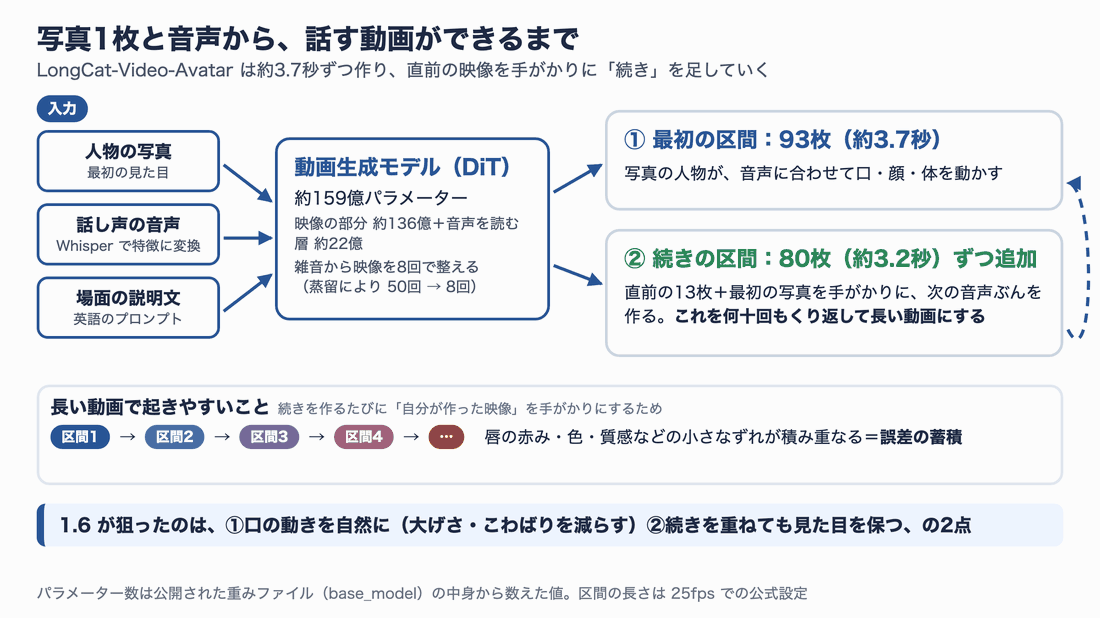
図2:LongCat-Video-Avatar が長い動画を作る流れ。続きを重ねるたびに小さなずれがたまる
入力は次の3つです。
| 入力 | 中身 | この記事で使ったもの |
|---|---|---|
| 人物の写真 | 動画の最初の見た目になる | 画像生成AIで作った架空のニュースキャスター |
| 話し声の音声 | 口や表情の動きを決める(Whisper-large-v3 で特徴に変換) | 合成音声で作った日本語のナレーション 26.3秒 |
| 場面の説明文 | 服装・場所・動き方などを英語で書く | 「オフィスのスタジオで落ち着いて話す」 |
生成の中心は DiT(Diffusion Transformer) と呼ばれる種類の動画生成モデルです。雑音だらけの映像から少しずつ雑音を取り除いて映像に仕上げます。公開された重みファイルの中身を数えると、約159億パラメーター(映像を作る部分が約136億、音声を読む層が約22億)ありました。本来は50回かけて雑音を取り除きますが、蒸留(大きな手順を少ない手順で真似するように学習させること)によって8回で済むようになっています。
長い動画では、ここに弱点があります。続きを作るとき、モデルは「自分が直前に作った映像」を手がかりにします。わずかに唇が赤くなった、少し肌の色がずれた、といった小さな誤差が次の区間に引き継がれ、区間を重ねるほど大きくなっていきます。これを誤差の蓄積と呼びます。10分の動画なら、続きの生成は180回以上くり返されるので、この問題は無視できません。
1.5 から 1.6 で変わったこと
1.6 の発表は 2026年11月15日です。前の版の 1.5 は 2026年5月の公開でした。開発元の README は、1.6 の改善点として次の3つを挙げています。
- 口の動きが自然で安定:大げさな口の開き、こわばり、唇が赤くなりすぎること、口元のちらつきを減らした
- 長い動画でも崩れにくい:続き生成での誤差の蓄積を抑え、10分を超える動画でも見た目と人物の同一性を保つ
- 生成が速い:処理の流れ全体とモデルの実行を最適化した
ここで大事なのは、モデルの構造(土台の作り)は 1.5 と同じだという点です。変わったのは「仕上げの学習」と、配布される重みの組み方です。
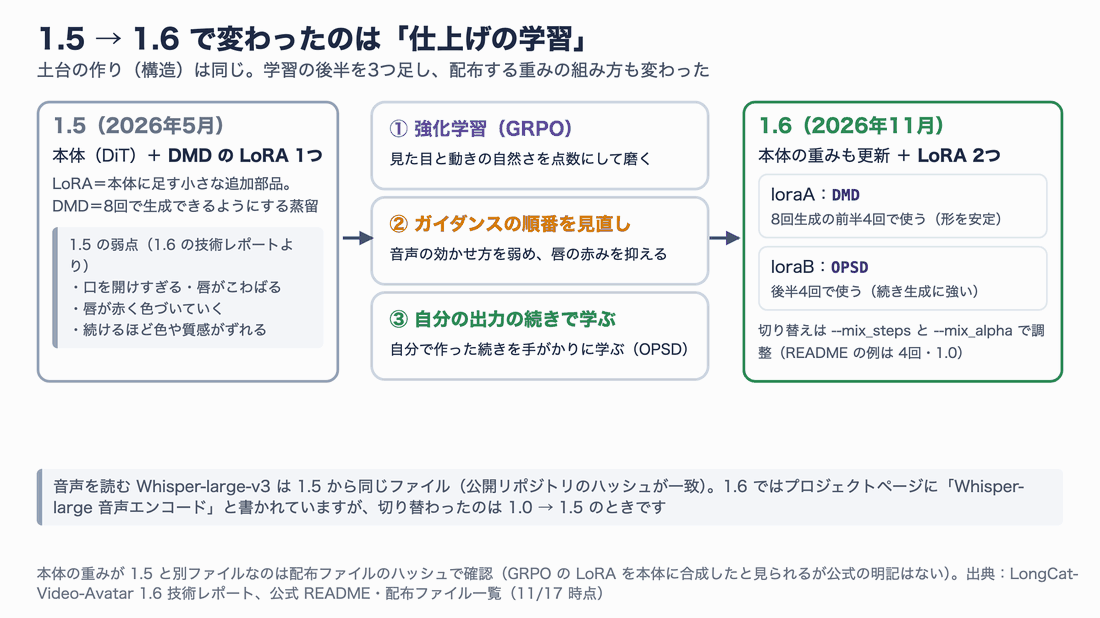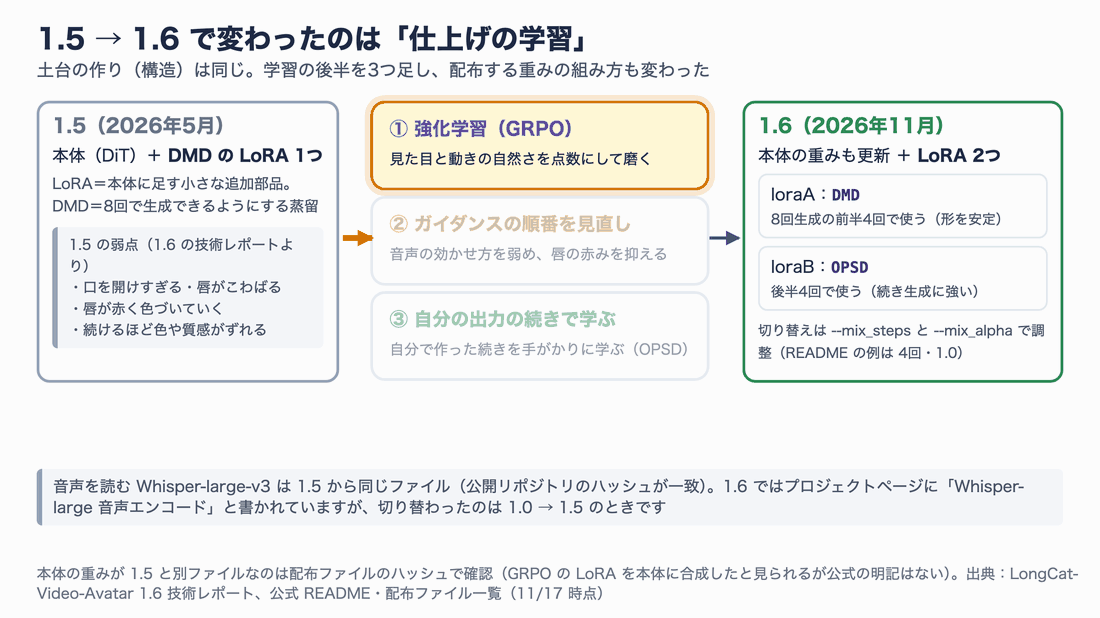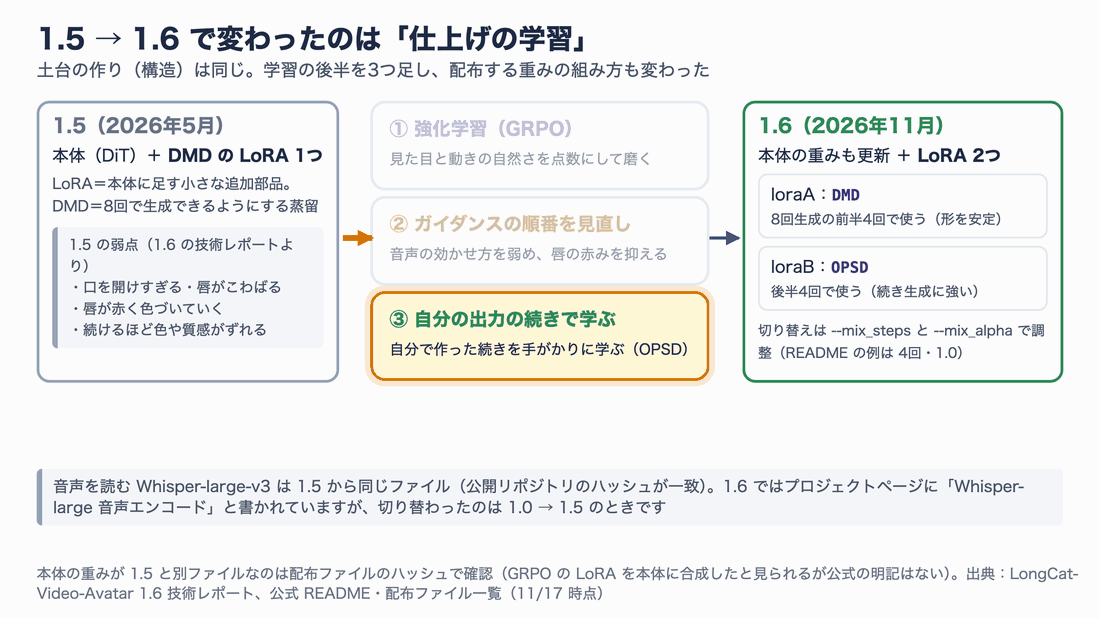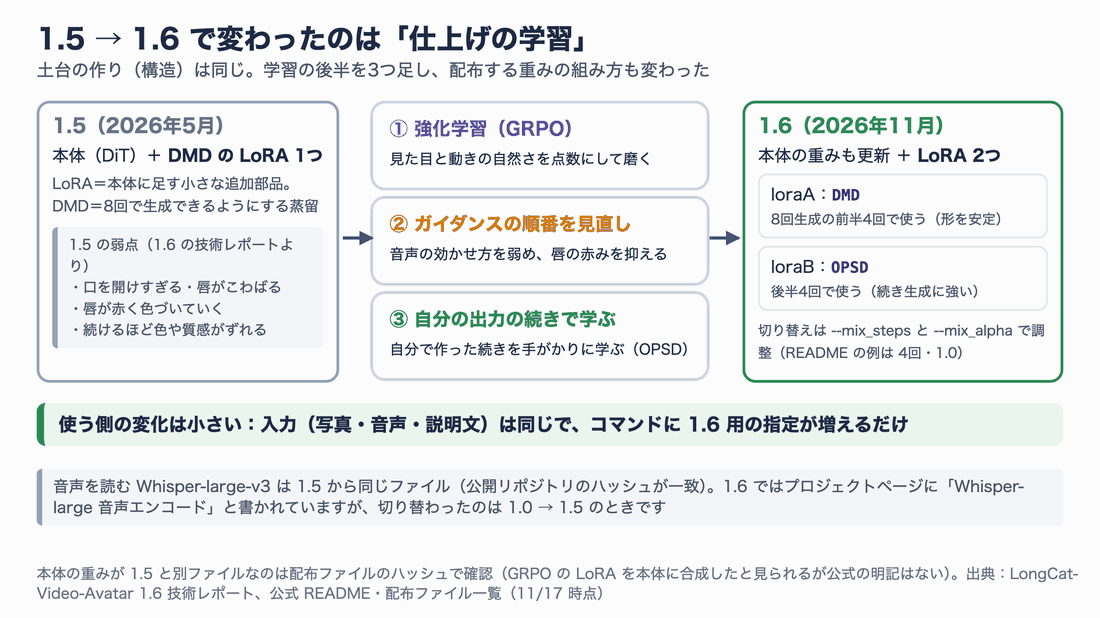
図3:1.5 → 1.6 で足された3つの学習と、配布される重みの違い
技術レポートに書かれている3つの追加学習を、たとえを交えて言い換えると次のようになります。
| 追加された学習 | ひとことで | ねらい |
|---|---|---|
| 強化学習(GRPO) | 見た目と動きの自然さを点数にして、点が上がる方向へ磨く | 大げさな口、こわばった唇を減らす |
| ガイダンスの順番の見直し | 「音声にどれだけ従うか」の効かせ方を弱める(強すぎると唇が赤くなった) | 唇の赤みを抑える |
| OPSD(自分の出力の続きで学ぶ) | 本番と同じく、自分で作った映像の続きを作る練習をする | 続き生成での誤差の蓄積を抑える |
LoRA(本体に足して使う小さな追加部品)は、1.5 では DMD(8回で生成できるようにする蒸留)用の1つでした。1.6 では DMD 用の loraA と OPSD 用の loraB の2つになり、8回の雑音除去のうち前半4回を loraA、後半4回を loraB で行うのが README の推奨設定です。前半で形を安定させ、後半で続き生成に強い仕上げをする、という分担です。
配布ファイルを見比べると、本体(base_model)の重みも 1.5 とは別のファイルに差し替わっていました。強化学習の結果は本体側に合成されたと見られますが、公式な明記は見当たりませんでした。また、プロジェクトページには Whisper-large-v3 による音声の読み取りが新しい要素のように書かれていますが、Whisper のファイルは 1.5 と 1.6 で同一(公開リポジトリのハッシュが一致)です。
開発元の評価:6システム中2位、ただし自社評価
開発元は、508組の「写真+音声」で6つのシステムに動画を作らせ、2本ずつ並べて人に選ばせる対戦形式の評価を行っています。有効票は 33,051 票です。
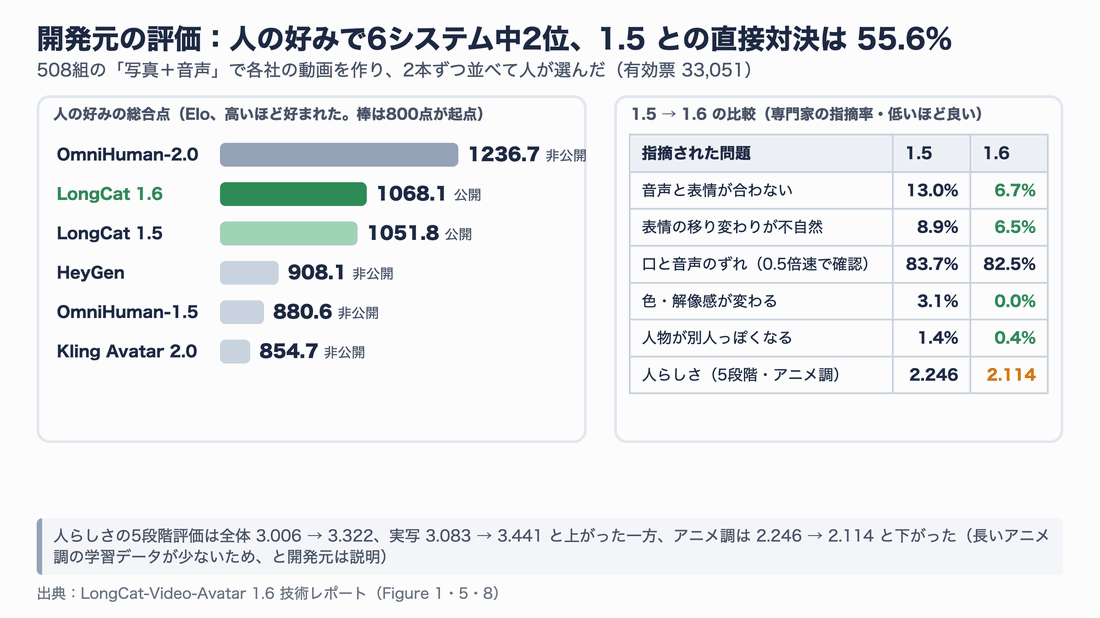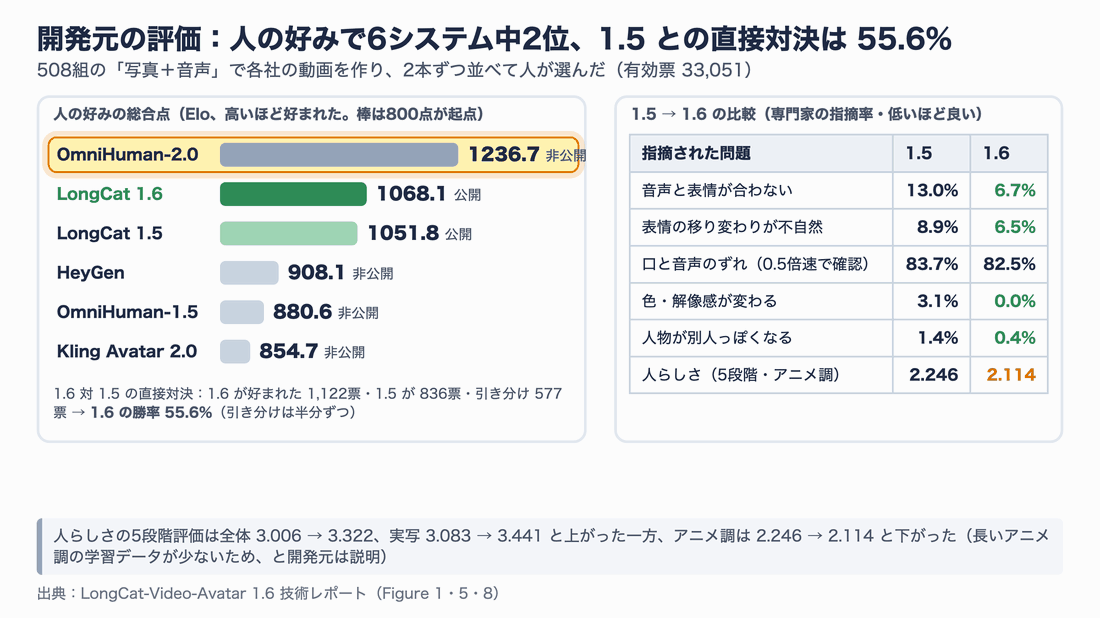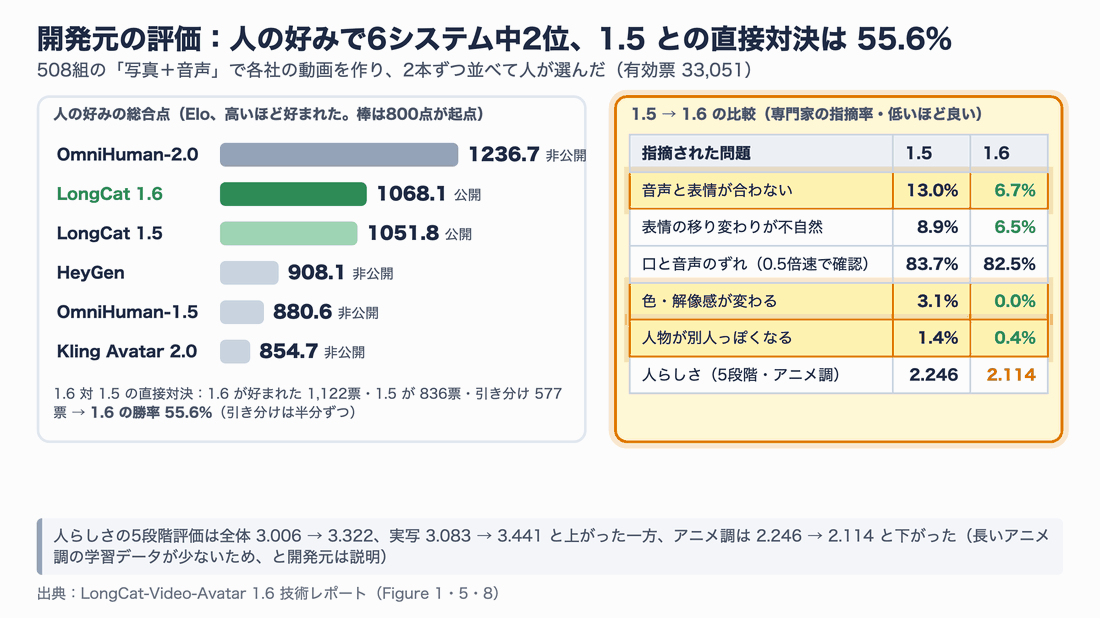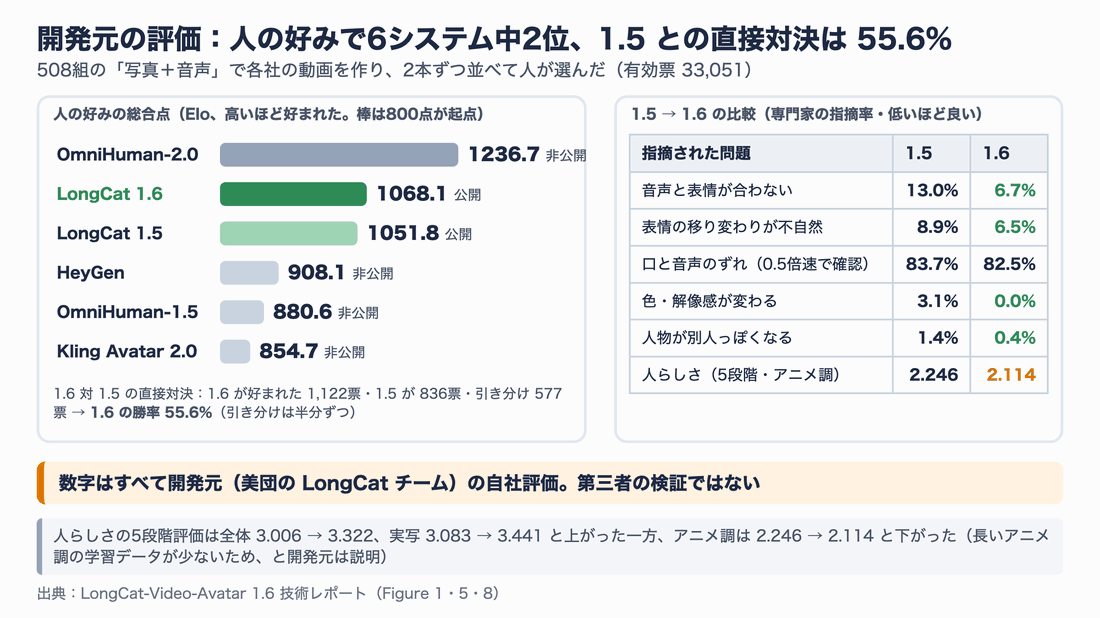
図4:開発元が公表した評価。数字はすべて開発元の自社評価
数字の読み方で気をつけたい点が3つあります。
1つ目は、1.6 と 1.5 の差はそれほど大きくないことです。Elo(対戦結果から計算する強さの点数)は 1068.1 と 1051.8 で、差は 16 点ほどです。直接対決でも、1.6 が好まれたのは 1,122 票、1.5 が 836 票、引き分けが 577 票で、勝率にすると 55.6% です。「明らかに別物」というより「並べると 1.6 がやや好まれる」くらいの差だと読めます。
2つ目は、大きく減ったのは見た目の崩れだという点です。専門家の指摘率を見ると、「色・解像感が変わる」は 3.1% → 0.0%、「別人っぽくなる」は 1.4% → 0.4%、「音声と表情が合わない」は 13.0% → 6.7% と下がりました。一方で、0.5倍速で見て口と音声のずれを探す厳しい確認では 83.7% → 82.5% とほぼ変わっていません。
3つ目は、アニメ調の人物では評価が下がったことです。人らしさの5段階評価は、全体で 3.006 → 3.322、実写で 3.083 → 3.441 と上がった一方、アニメ調では 2.246 → 2.114 と下がりました。開発元は、長いアニメ調の学習データが少ないためと説明しています。
そして何より、これらはすべて開発元自身の評価です。比べている商用サービスの設定や、評価に使った素材の選び方は第三者が確かめられません。だからこそ、この記事では同じ条件で 1.5 と 1.6 を実際に動かして、自分の目と計測で確かめることにしました。
実際に作って比べた:1.5 と 1.6 のビフォーアフター
ここからが本題です。開発元の数字ではなく、自分で用意した写真と声で、1.5 と 1.6 の差を確かめます。
検証の条件
比較で一番気をつけたのは、モデル以外の条件をそろえることです。片方だけ設定が有利になっていては、ビフォーアフターになりません。
| 項目 | そろえた内容 |
|---|---|
| 人物の写真 | 画像生成AI(Qwen-Image-2.1-Turbo)で作った架空のニュースキャスター。1280×704 |
| 音声 | 合成音声(Qwen3-TTS)で作った日本語のナレーション 26.3秒 |
| 説明文 | 「明るいオフィスのスタジオで、落ち着いて自然に話す」(英語) |
| 乱数 | 公式スクリプトの既定値 42 を両方で使用 |
| 長さ | 8区間=最初の93枚+続き80枚×7=653枚(26.1秒、25fps、832×480) |
| 生成の設定 | それぞれの版の README に書かれた公式の設定(1.6 は LoRA 2つの切り替え、1.5 は DMD の LoRA) |
| コード | 1.6 は最新版、1.5 は 1.6 が出る直前のコード |
| 本体の重み | どちらも公式の INT8 版 |
| 保存 | どちらも可逆圧縮(FFV1)で保存し、計測はその動画で行う |
最後の「保存」は見落としやすい点です。1.5 当時のコードと 1.6 のコードでは、動画を書き出すときの圧縮の強さが違います。そのまま比べると、圧縮による画質の差がモデルの差に見えてしまうため、両方とも同じ方法で書き出しました。
ナレーションの内容は「写真を一枚と、声の録音を用意するだけで、口の動きや表情、うなずきまで自動で付けてくれます」といった、この種の AI を紹介する短い原稿です。人物の写真も声も実在の人のものではありません。
動画で見る:最初の6秒と、後半の6秒
まずは最初の6秒です。この時点では、どちらも写真の人物がそのまま動き出したように見えます。違いは口の開き方くらいで、1.5 のほうが少し大げさです。
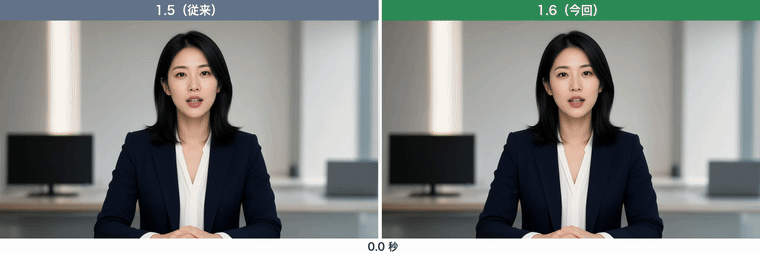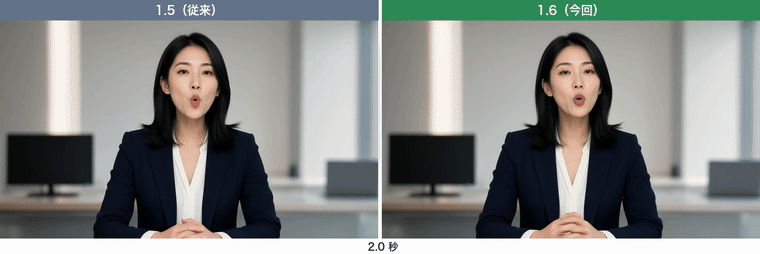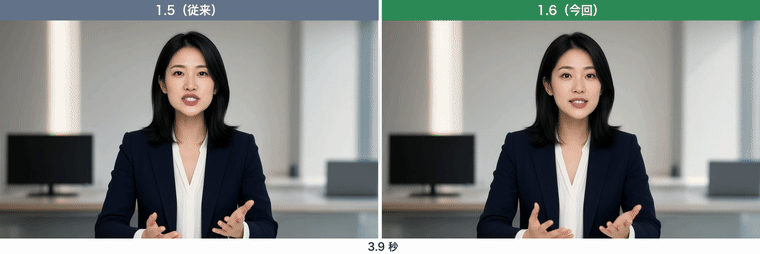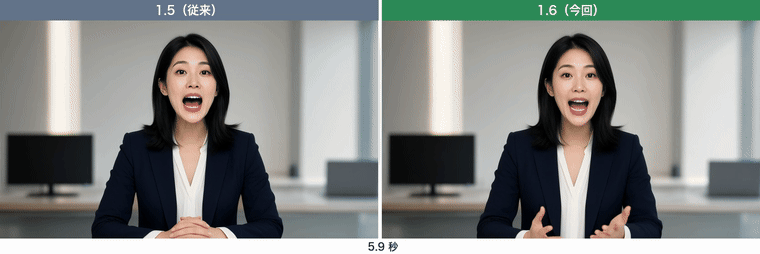
動画1:最初の6秒(0〜6秒)。左が 1.5、右が 1.6。音声つきの全編(MP4・26秒)
次に、続きを5回重ねた後の19〜25秒です。1.5 は唇がはっきりピンクに色づき、口元だけ質感が浮いて見えます。1.6 は最初の数秒とほとんど同じ見た目を保っています。
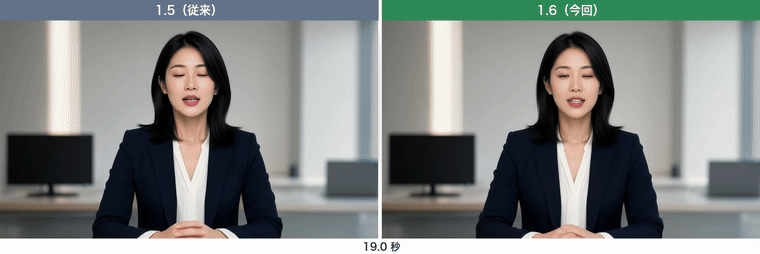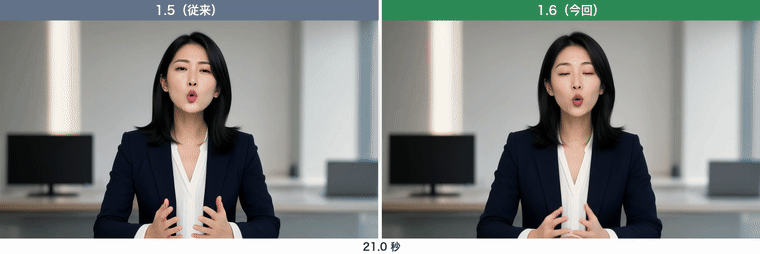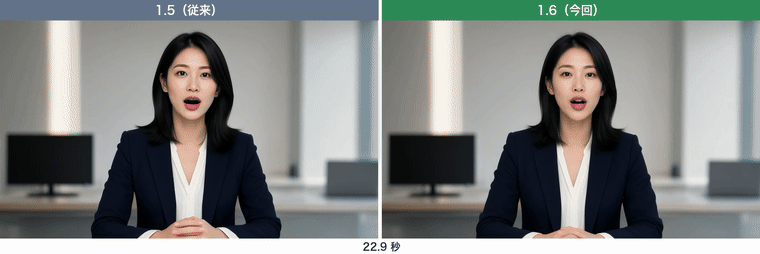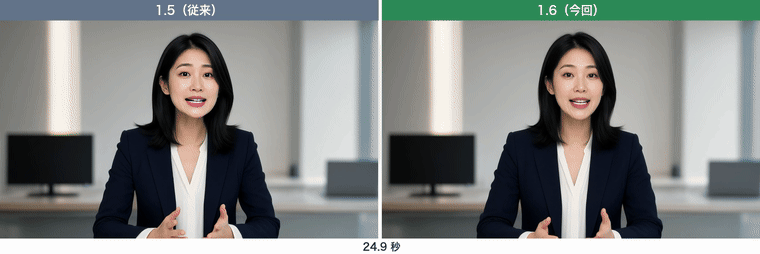
動画2:続きを重ねた後半(19〜25秒)。1.5 の唇の色の変化がはっきり分かる
全体の流れは、5秒ごとのフレームを並べると分かりやすくなります。0秒ではほぼ同じですが、5秒・10秒と進むにつれて 1.5 の唇だけが赤くなっていきます。
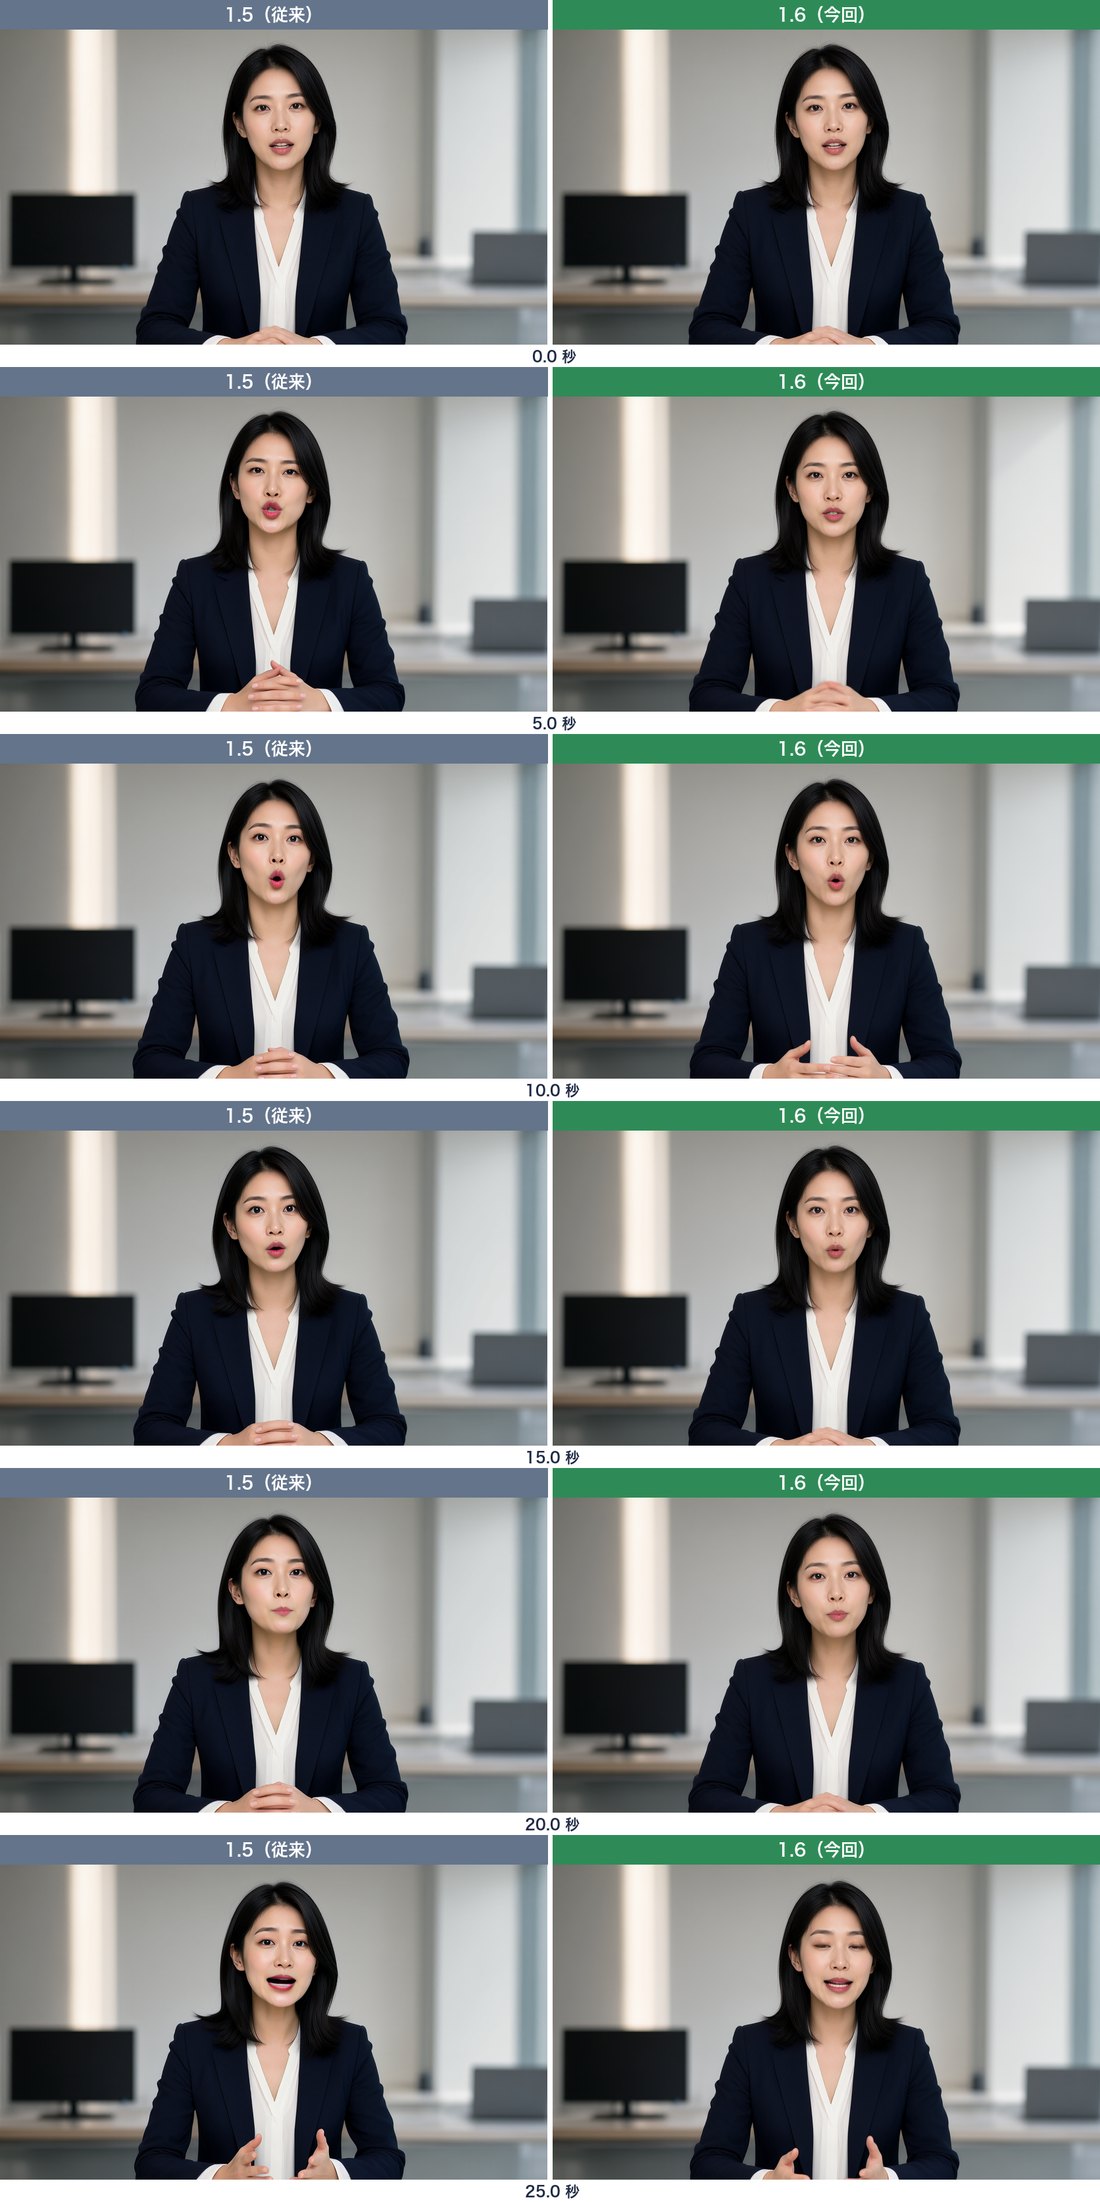
写真1:5秒ごとのフレーム。左が 1.5、右が 1.6
口元を拡大すると差がはっきりする
口の開きが大きい場面を6つ選び、同じ時刻の口元を拡大しました。1.5 は14秒を過ぎたあたりから唇がピンクに変わり、20.9秒では口紅を塗ったような色になっています。口の開き方も、声の大きさに比べて大げさです。1.6 は唇の色が写真に近く、開き方も控えめです。
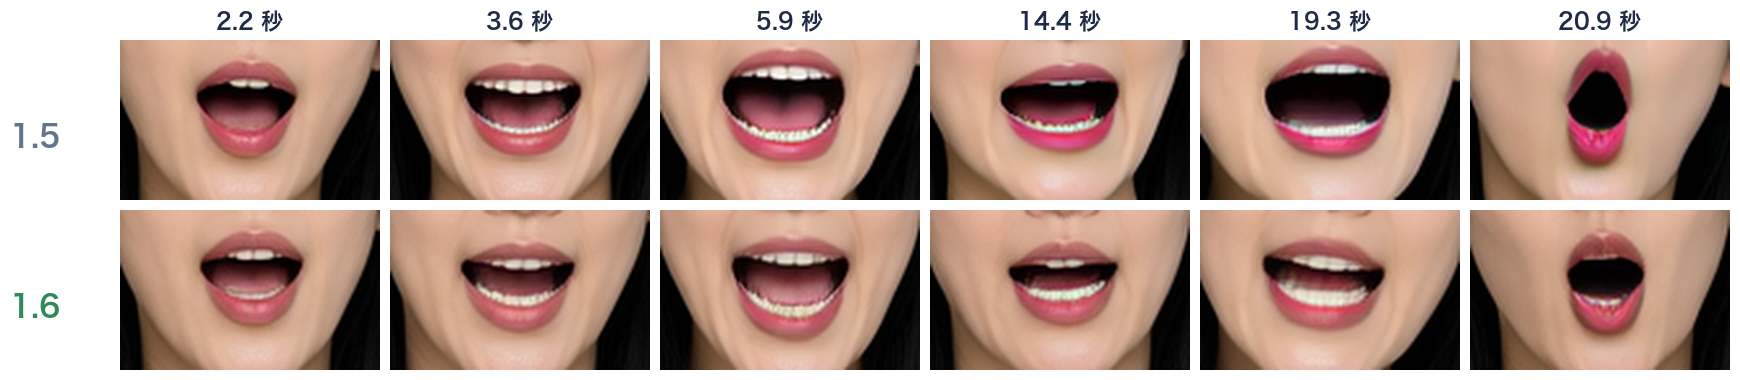
写真2:口の開きが大きい6つの場面。上が 1.5、下が 1.6
これは開発元が技術レポートで挙げていた 1.5 の弱点、「口を開けすぎる」「唇が赤く色づいていく」とそのまま一致します。1.6 で足された強化学習と、ガイダンスの見直しがねらっていた症状です。
数値で確かめる:唇の赤みと質感の変化
見た目の印象だけでなく、数値でも確かめました。計測には Google の MediaPipe Face Landmarker(顔の478点の位置を推定するモデル)を使い、全653枚それぞれで次の値を計算しています。
- 唇の赤み:唇の領域の平均色を CIELAB(人の見え方に近い色の表し方)に変換し、a*(赤みの強さ)を取る。入力写真の唇との差を見る
- 顔のくっきり具合:顔の範囲の画像のラプラシアン分散(輪郭や細かい模様の強さの目安)。最初の区間を100として、どれだけ変わったかを見る
- 口の開き:上唇と下唇の内側の距離を、顔の高さで割った値
- 口と声の合い方:口の開きと、同じ時刻の声の強さ(音量)の相関
区間ごとの平均を並べたのが次のグラフです。
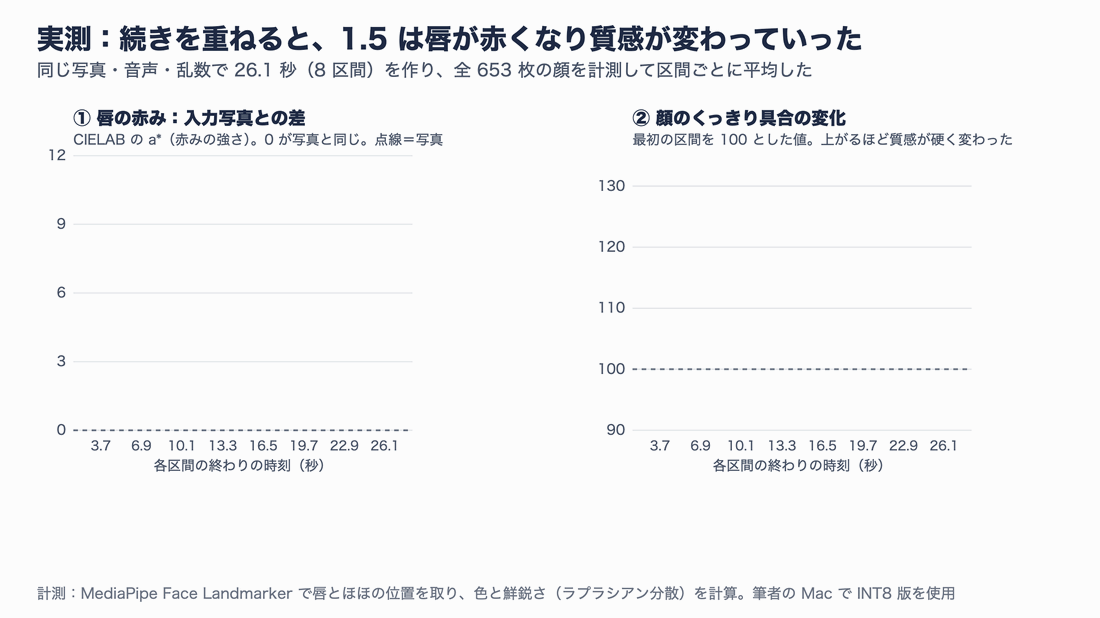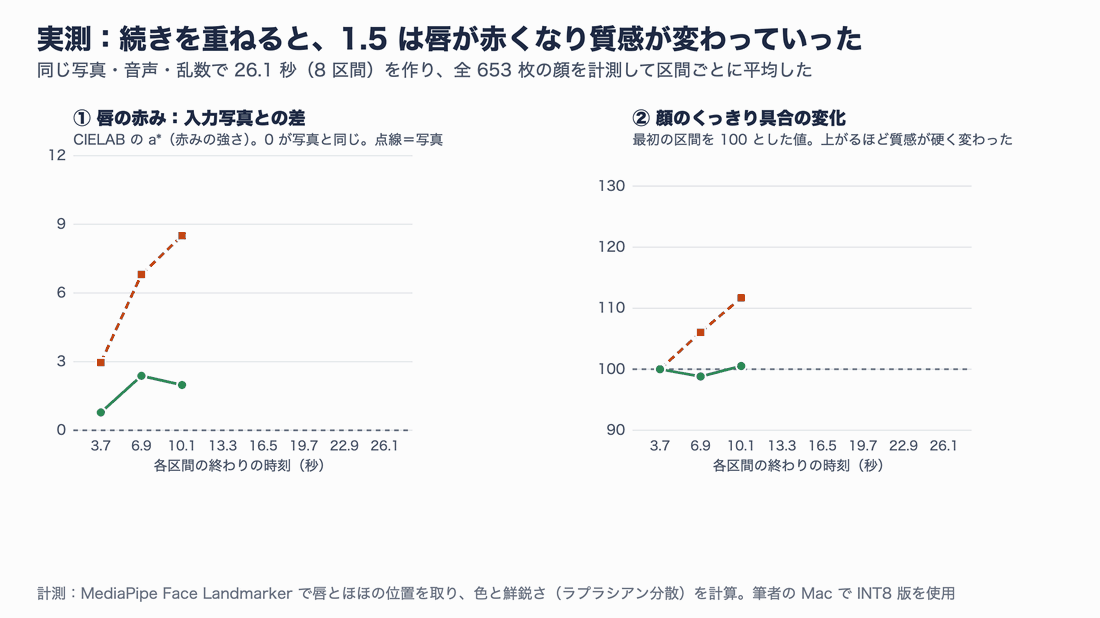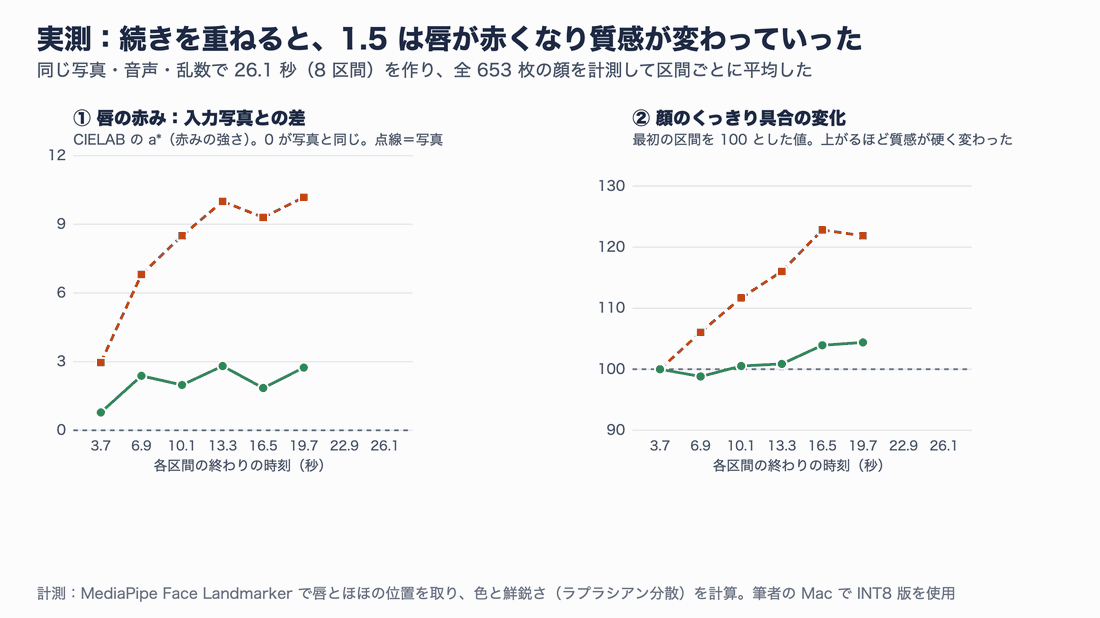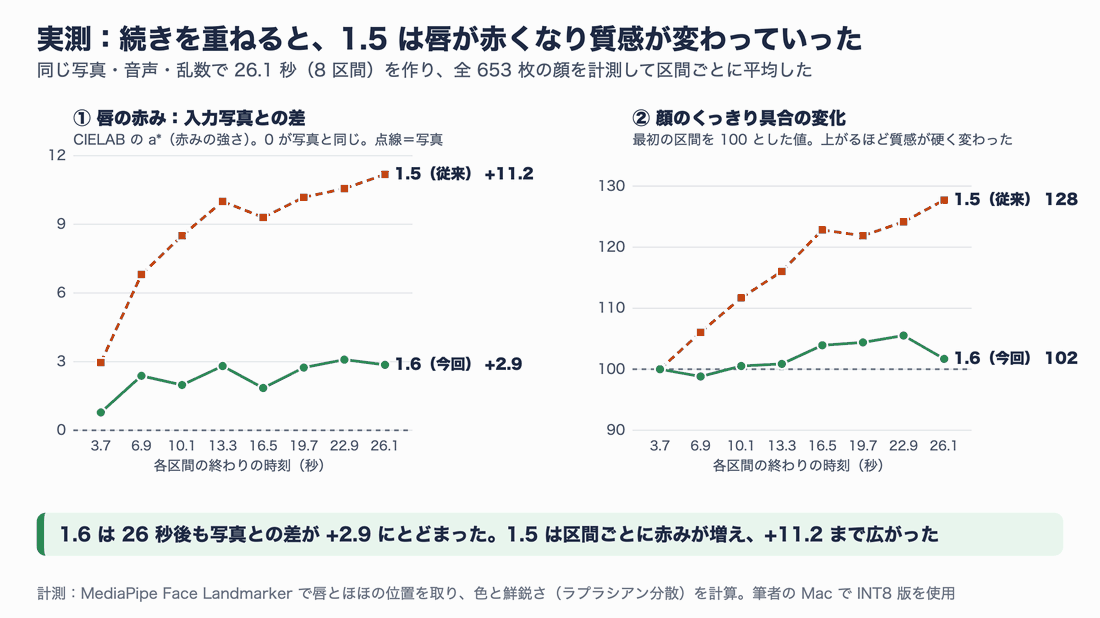
図5:区間ごとの変化。1.5 は続きを重ねるほど値が離れていき、1.6 はほぼ横ばい
左のグラフでは、1.5 の唇の赤みが区間ごとに約1ずつ増え、最後の区間では写真との差が +11.2 になりました。1.6 は +2.9 にとどまり、増え方は1区間あたり約0.2と、1.5 の4分の1ほどです。
右のグラフは質感の変化です。1.5 は顔のくっきり具合が最後に28%上がりました。数字だけ見ると「くっきりして良くなった」ようですが、実際の動画では肌や唇の質感が硬く、作りものっぽく変わっていく方向の変化です。1.6 は 2% の変化で、最初の見た目を保っています。
ほほの色(a と明るさ)は、どちらも変化が1以下で小さく、顔全体の色が変わったわけではありませんでした。崩れは口元に集中していた*ことになります。
変わらなかった点、1.6 のほうが不利だった点
良くなった点ばかりではありません。数値で見て、変わらなかった点と、1.6 のほうがわずかに不利だった点もありました。
1つ目は口と声の合い方です。口の開きと声の強さの相関は 1.5 が 0.233、1.6 が 0.235 で、ほぼ同じでした。開発元の評価でも、0.5倍速で見て口と声のずれを探す厳しい確認では 83.7% → 82.5% とほとんど変わっておらず、手元の結果と一致します。ただし、相関は音量だけを見る大まかな指標です。「あ」「い」のような口の形まで合っているかは測れていません。
2つ目は区間のつなぎ目です。続きを足した境目で、前後のフレームがどれだけ変わるかを測りました。1.6 はつなぎ目の変化がふだんのフレーム間の変化の約1.6倍で、1.5 の約0.9倍より大きく出ました。とはいえ、話しながら頭を動かしたときの大きめの変化(上位5%)よりは小さく、見ていて気になるほどではありませんでした。1.6 の公式設定は --mask_frame_range=0、1.5 は 3 で、つなぎ目の扱いが違うことが影響している可能性があります。
3つ目は、口を閉じているべき無音の場面での口の開きです。1.5 が 0.050、1.6 が 0.043 と、1.6 のほうがわずかに閉じていますが、差は小さいものでした。
この検証で言えること、言えないこと
今回の比較は、1組の写真と音声、1つの乱数で行ったものです。人物や声、説明文を変えれば結果は変わりえますし、乱数を変えて何度も生成したわけでもありません。
また、10分を超える長さは試せていません。26秒でもこれだけ差が開いたので、長くなるほど 1.6 の利点は大きくなると考えられますが、それは推測です。実写の人物だけで試しており、開発元が「評価が下がった」と書いているアニメ調の人物も確かめていません。
それでも、同じ条件で並べたときに、1.5 で起きていた唇の色の変化と大げさな口が、1.6 ではっきり減ったことは、動画と数値の両方で確認できました。
Mac での速さとメモリ
Mac でどれくらいの時間がかかるのかも気になるところです。GPU の取り合いがない状態で、最初の区間(93枚・約3.7秒)だけを 1.6 → 1.5 の順に作り直して測りました。
| 項目 | 1.5 | 1.6 |
|---|---|---|
| 1回の雑音除去(8回中の1回)の平均 | 約144秒 | 約139秒 |
| 最初の区間(約3.7秒)の生成 | 約19.2分 | 約18.5分 |
| 26.1秒(8区間)の生成(本番の実測) | 約2時間22分 | 約4時間49分※ |
| 生成中のメモリ(PyTorch が確保した量の最大) | 約57GB | 約39GB |
※1.6 の本番は、途中で別のアプリが GPU を使っていた時間帯と重なり、遅くなりました。GPU を取り合わなかった最後の区間は約19分で、1.5 の1区間(約17.5分)と同程度です。
同じ条件で測り直すと、差は4%ほどでした。同じ版でも区間によって数分変わるので、この差は誤差の範囲です。Mac では、1.6 になって速くなったとは言えません。
開発元が「生成が速くなった」と書いている最適化は、FlashAttention 3、FP8、torch.compile、複数 GPU 間の通信の改善など、NVIDIA の GPU 向けのものが中心です。Mac ではどれも使えないため、速さの改善は手元では確かめられません。
10分の動画を Mac で作るとどうなるかも計算してみます。10分は約188区間なので、1区間17分とすると約53時間かかります。試しに少し動かす分には Mac でも十分ですが、10分級の動画を作るなら NVIDIA の GPU を使うのが現実的です。
メモリは、128GB の Mac で余裕があるとは言えませんでした。最初は何も工夫せずに動かしたところ、区間を重ねるごとに使用量が増えてメモリの圧縮が起き、1ステップが約100秒から約400秒まで遅くなりました。そこで、出力を変えない範囲で次の工夫を加えています(どちらも後で紹介するラッパーに入れてあります)。
- 説明文のエンコード結果を使い回し、最初の区間の後はテキストエンコーダー(約11GB)をメモリから外す
- 音声の特徴を取り終えたら Whisper をメモリから外す
- 区間ごとに GPU のキャッシュを解放する
Mac で動かす手順
公式の手順は NVIDIA の GPU が前提です。README の例は torchrun で GPU 2枚を使い、FlashAttention(NVIDIA の GPU 向けに速くした注意機構の計算)を入れるところから始まります。Mac にはそのどちらもありません。
そこで、公式のファイルは1行も書き換えず、起動するときに CUDA 前提の部分だけを差し替える小さなラッパー(run_on_mac.py)を用意しました。生成のしくみ・設定・乱数はすべて公式のままです。
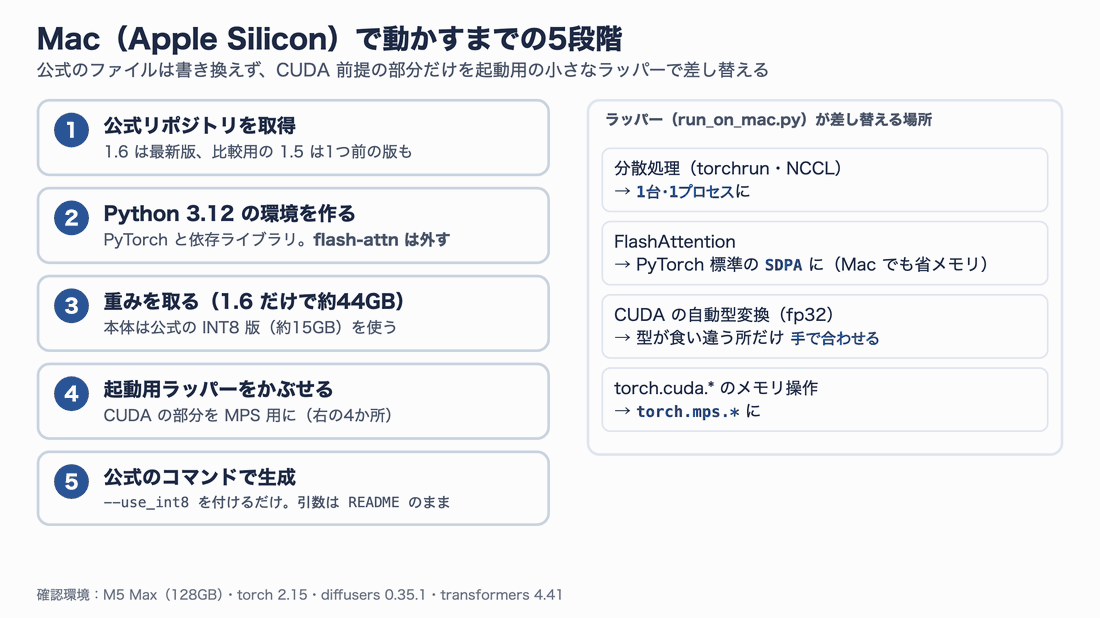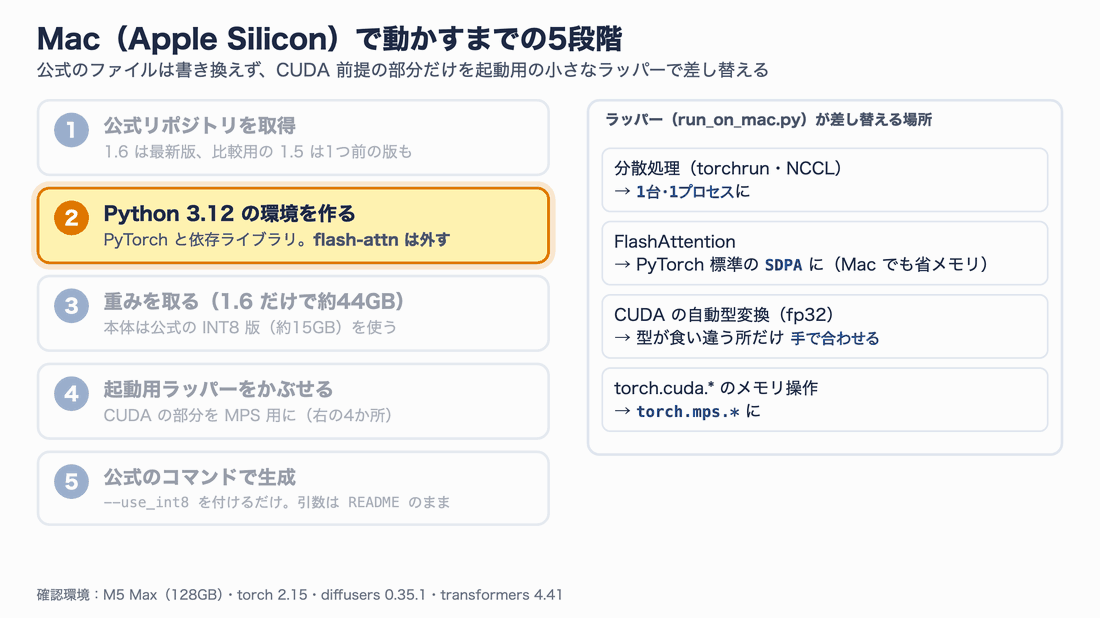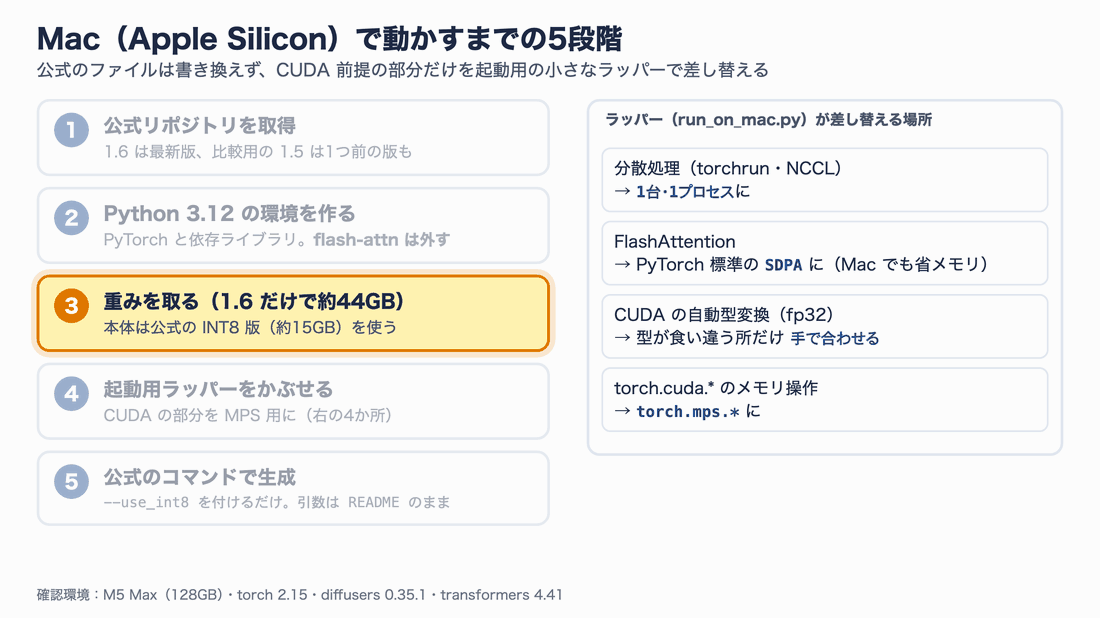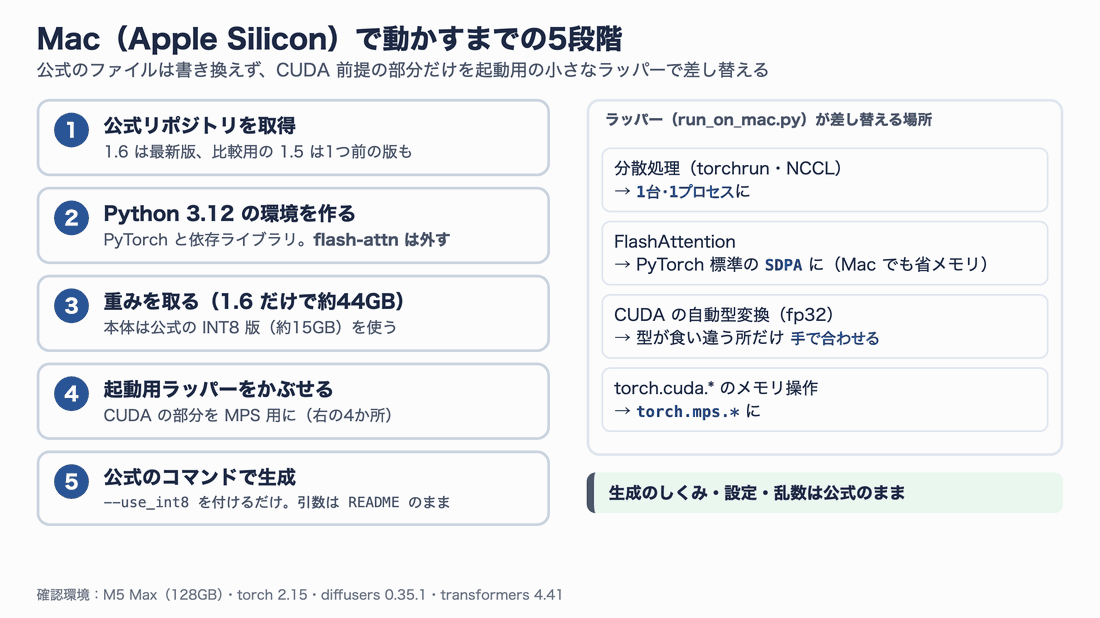
図6:Mac で動かすまでの5段階。右がラッパーの差し替える4か所
1. 公式リポジトリを取得する
# 作業フォルダーを作って、公式リポジトリを取得する
mkdir -p ~/longcat-avatar-lab && cd ~/longcat-avatar-lab
git clone https://github.com/meituan-longcat/LongCat-Video
1.5 と比べたい場合は、1.6 が取り込まれる直前のコミットを別のフォルダーに取り出します。1.6 のコードでも --model_type avatar-v1.5 は指定できますが、比較では「1.5 が公開されていた当時のコード」で動かすほうが公平です。
# 1.6 を取り込んだマージの1つ前(1.5 の時代のコード)を別フォルダーに
cd LongCat-Video
git worktree add ../LongCat-Video-v1.5code 58eb336^1
cd ..
2. Python の環境を作る
Python 3.12 の仮想環境に、PyTorch と依存ライブラリを入れます。公式の requirements.txt には flash-attn と CUDA 版の onnxruntime-gpu が入っているので、そのままでは Mac で失敗します。必要なものを直接指定して入れました。
# Python 3.12 の仮想環境(Homebrew の python@3.12 を使用)
/opt/homebrew/bin/python3.12 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip

# PyTorch(Mac 版は MPS に対応)と、公式の依存から CUDA 専用のものを外した一式
pip install torch torchvision torchaudio "numpy<2" \
  transformers==4.41.0 diffusers==0.35.1 "huggingface_hub<1.0" \
  loguru einops ftfy psutil av opencv-python imageio imageio-ffmpeg \
  scikit-learn scikit-image scipy soundfile soxr librosa \
  audio-separator==0.30.2 pyloudnorm onnxruntime \
  safetensors accelerate sentencepiece protobuf

# 動画の書き出しに ffmpeg を使う
brew install ffmpeg
transformers は公式と同じ 4.41.0 に固定してください。新しい huggingface_hub(1.0 以降)と組み合わせると読み込みで失敗したため、huggingface_hub<1.0 も合わせて指定しています。
3. 重みを取る
必要な重みは2つのリポジトリに分かれています。土台の LongCat-Video からは、文章を読む部品(テキストエンコーダー)・VAE(映像と圧縮表現を行き来する部品)・トークナイザーだけを使います。
| 取るもの | 容量(目安) | 補足 |
|---|---|---|
| LongCat-Video のテキストエンコーダー | 約21GB | 説明文を読む部品 |
| LongCat-Video の VAE・トークナイザー | 約0.5GB | |
| 1.6 の本体(INT8 版) | 約15GB | bf16 版は約31GB。この記事は INT8 版を使用 |
| 1.6 の LoRA 2つ(loraA・loraB) | 約5GB | |
| Whisper-large-v3 | 約3GB | 1.5 と同じファイル |
| 合計(1.6 だけ) | 約44GB |
本体は、公式が用意している INT8 版(重みだけを8ビット整数にしたもの)を使いました。容量が半分になるうえ、1.5 の README でも案内されている公式の選択肢です。比較では 1.5 も INT8 版にそろえています。
# 必要なフォルダーだけを取る(huggingface_hub<1.0 の CLI)
huggingface-cli download meituan-longcat/LongCat-Video \
  --include "tokenizer/*" "text_encoder/*" "vae/*" "scheduler/*" "model_index.json" \
  --local-dir weights/LongCat-Video
huggingface-cli download meituan-longcat/LongCat-Video-Avatar-1.6 \
  --exclude "base_model/*.safetensors" "assets/*" \
  --local-dir weights/LongCat-Video-Avatar-1.6
検証した日は Hugging Face の配信がとても遅かった(1接続あたり十数KB/秒)ため、実際には同じファイルを置いている ModelScope から取得し、ファイルごとに Hugging Face 側の SHA-256 と照合しました。ModelScope の URL は https://www.modelscope.cn/models/meituan-longcat/<リポジトリ名>/resolve/master/<ファイルのパス> の形です。
4. 起動用ラッパーをかぶせる
ラッパーが差し替えるのは次の4か所です。どれも「公式のコードが CUDA を前提にしている場所」で、計算の中身は変えていません。
| 公式のコードの前提 | Mac での差し替え |
|---|---|
torchrun と NCCL による複数 GPU の分散処理 | 1台・1プロセス・デバイス mps として実行 |
| FlashAttention 2 | 公式が用意している xformers 経路を選び、その中身を PyTorch 標準の scaled_dot_product_attention(SDPA)で実装 |
CUDA の自動型変換(autocast(float32)) | MPS では fp32 の autocast が使えないため、型が食い違う全結合層だけ「入力が fp32 なら fp32 で計算」 |
torch.cuda.empty_cache() など | torch.mps.empty_cache() に置き換え |
もう1つ、長尺の通常動画用の Block Sparse Attention は triton(CUDA 専用のコンパイラ)を読み込むため、アバター生成では使わない部品として空のものに差し替えています。また比較のため、動画の保存方法を両バージョンで同じ(可逆の FFV1 と、crf16 の MP4)にそろえました。
ラッパーは上の表の差し替えを並べたスクリプト(約260行)です。中心となる、FlashAttention の代わりの部分を抜き出すと次のとおりです。
import torch.nn.functional as F

def _sdpa_bmhk(q, k, v, q_chunk=8192):
    """xformers と同じ [B, M, H, K] 形式で受け取り、クエリを分割して SDPA を呼ぶ"""
    q, k, v = (t.transpose(1, 2) for t in (q, k, v))  # -> [B, H, M, K]
    outs = [F.scaled_dot_product_attention(q[:, :, i:i + q_chunk], k, v)
            for i in range(0, q.shape[2], q_chunk)]
    return torch.cat(outs, dim=2).transpose(1, 2)
MPS の SDPA は、注意の重み行列を丸ごと作らない省メモリの計算に対応しています。手元で3.7万トークン同士の注意を測ったところ、クエリを4096ずつに分けても約43兆回/秒(43 TFLOPS)出て、使ったメモリは約1.1GBでした。
5. 公式のコマンドで生成する
入力は公式の例と同じ形の JSON で渡します。パスは絶対パスで書いてください(公式のスクリプトはリポジトリのフォルダーで動く前提で、相対パスだとファイルが見つからないことがあります)。
{
  "prompt": "A Japanese woman news presenter in a navy blazer and white blouse sits at a desk in a bright modern office studio. She faces the camera and speaks naturally and calmly to the viewer, with subtle head movements, natural facial expressions and occasional small hand gestures.",
  "cond_image": "/Users/<YOUR_NAME>/longcat-avatar-lab/inputs/presenter.png",
  "cond_audio": {"person1": "/Users/<YOUR_NAME>/longcat-avatar-lab/inputs/voice.wav"}
}
コマンドは README の「写真+音声から動画を作り、続きを足す」例そのままです。torchrun の代わりにラッパーを通し、--use_int8 を足しただけです。
# 1.6:写真+音声 → 動画、続きを足して 8 区間(約26秒)
.venv/bin/python tools/run_on_mac.py --repo LongCat-Video -- \
  --checkpoint_dir=$PWD/weights/LongCat-Video-Avatar-1.6 \
  --stage_1=ai2v --input_json=$PWD/inputs/presenter.json \
  --num_segments=8 --ref_img_index=10 --mask_frame_range=0 \
  --use_distill --lora_path loraB/lora.safetensors \
  --model_type avatar-v1.6 --mix_steps=4 --mix_alpha=1.0 \
  --use_int8 --output_dir=$PWD/runs/presenter-v1.6
1.5 は、1.5 の時代のコードのフォルダーで、1.5 の README のコマンドを使います。1.6 との違いは、LoRA の指定がないこと(DMD の LoRA 1つを自動で読む)と、--mask_frame_range=3 です。
# 1.5:同じ写真・同じ音声・同じ乱数(既定の 42)
.venv/bin/python tools/run_on_mac.py --repo LongCat-Video-v1.5code -- \
  --checkpoint_dir=$PWD/weights/LongCat-Video-Avatar-1.5 \
  --stage_1=ai2v --input_json=$PWD/inputs/presenter.json \
  --num_segments=8 --ref_img_index=10 --mask_frame_range=3 \
  --use_distill --model_type avatar-v1.5 \
  --use_int8 --output_dir=$PWD/runs/presenter-v1.5
使う前に確かめたいこと
人の顔と声を動かす技術なので、性能より先に確認しておきたいことがあります。4つにまとめました。
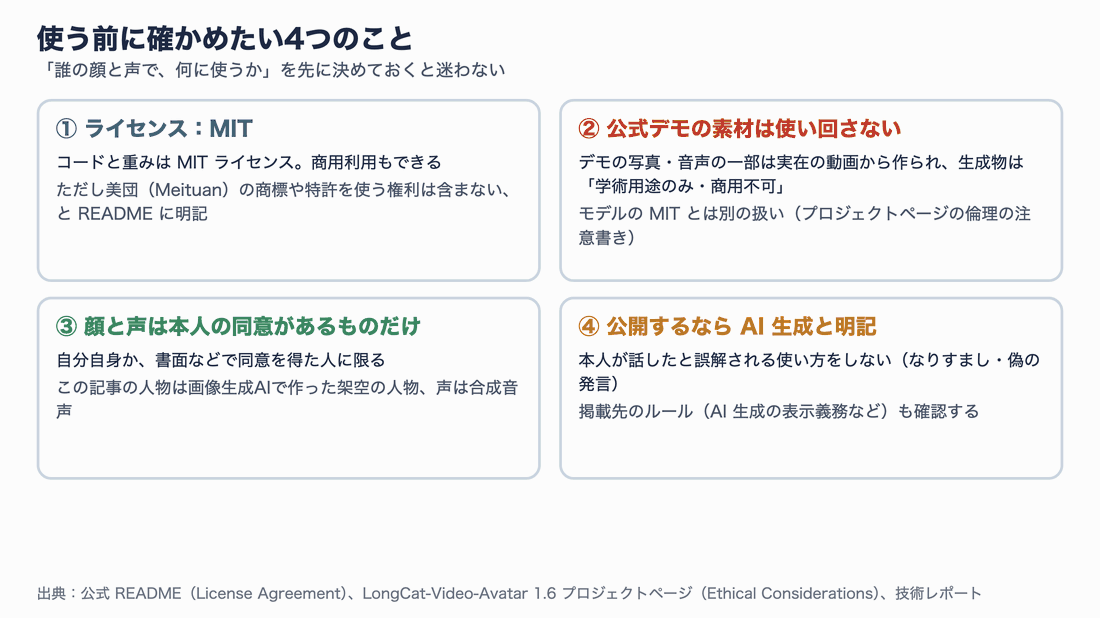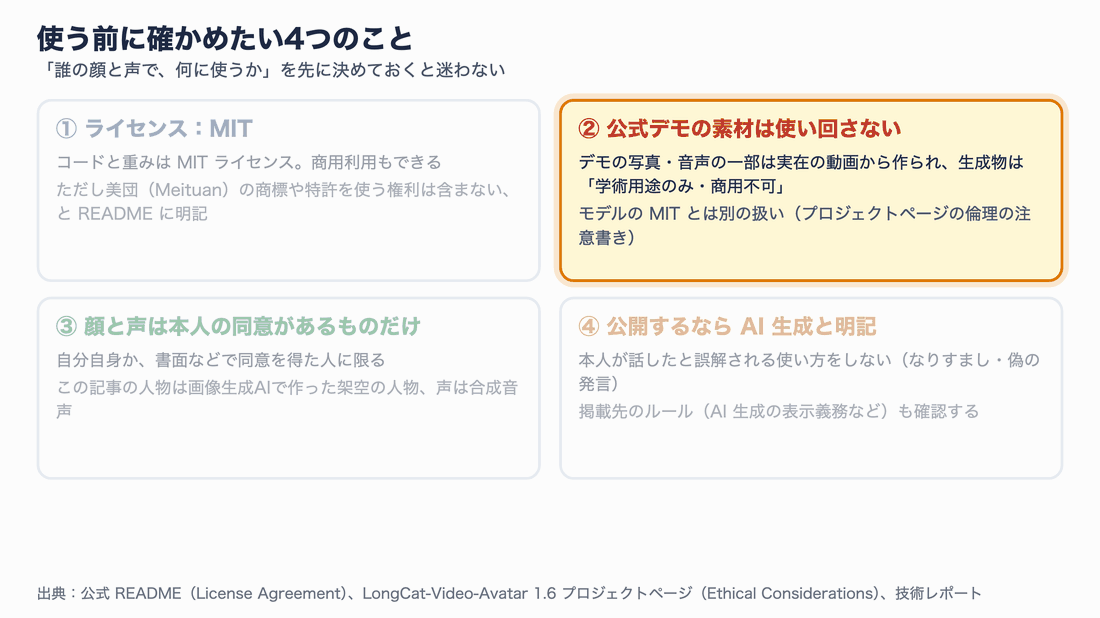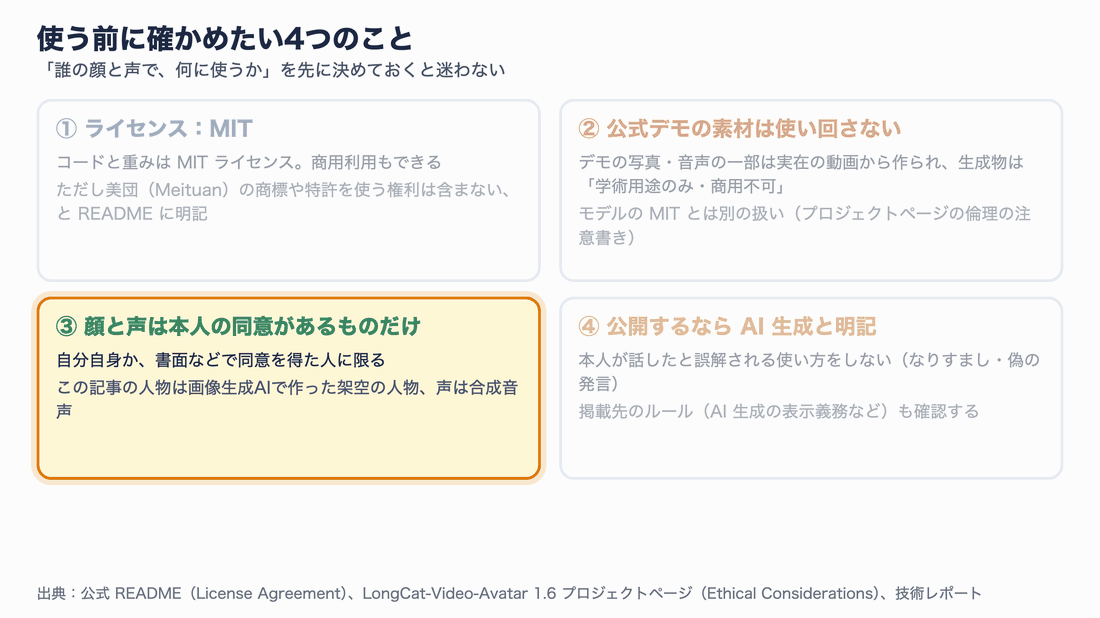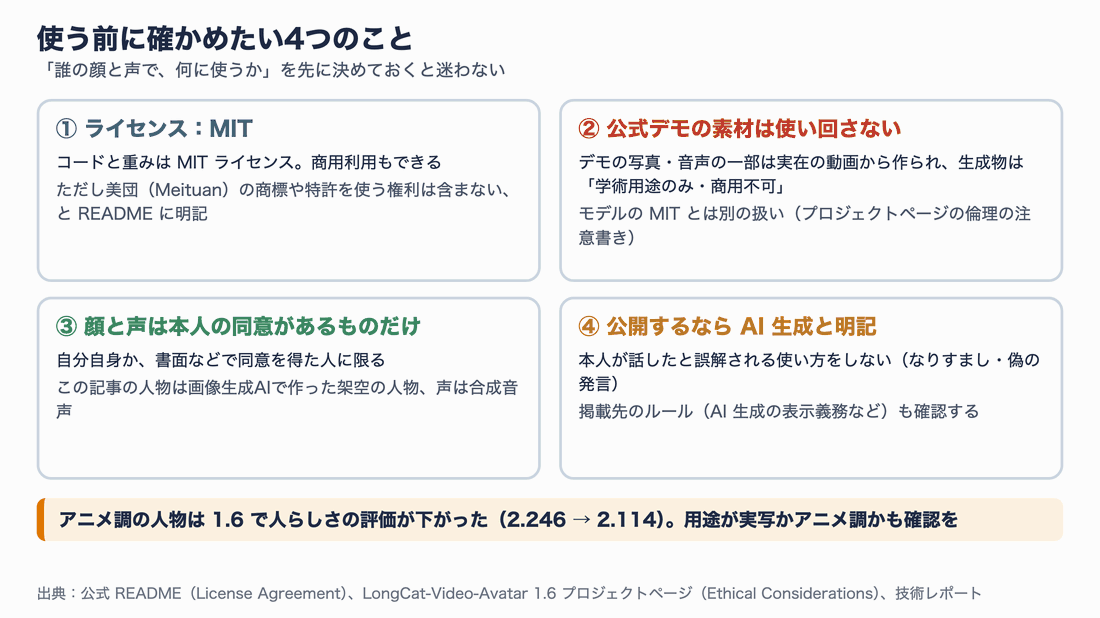
図7:使う前に確かめたい4つのこと
特に注意したいのは2つ目です。モデル(コードと重み)は MIT ライセンスですが、プロジェクトページのデモに使われている写真と音声の一部は実在の動画から作られています。開発元は、デモの生成物は学術用途のみで商用利用はできない、と注意書きを添えています。モデルが MIT だからといって、デモの素材を自分の動画に流用してよいわけではありません。
3つ目と4つ目は、技術というより使う人の責任の話です。他人の写真や声を本人の同意なしに使えば、なりすましや偽の発言を作ることになりかねません。この記事でも、画像生成AIで作った架空の人物と合成音声だけを使いました。
用途がアニメ調のキャラクターなら、1.6 で人らしさの評価が下がった点(2.246 → 2.114)も覚えておくとよいでしょう。実写の人物ほどの改善は期待しにくい可能性があります。
トラブルシューティング
Mac で動かすまでにつまずいた点を、起きる順に並べました。上から確かめていくと、原因に早くたどり着けます。
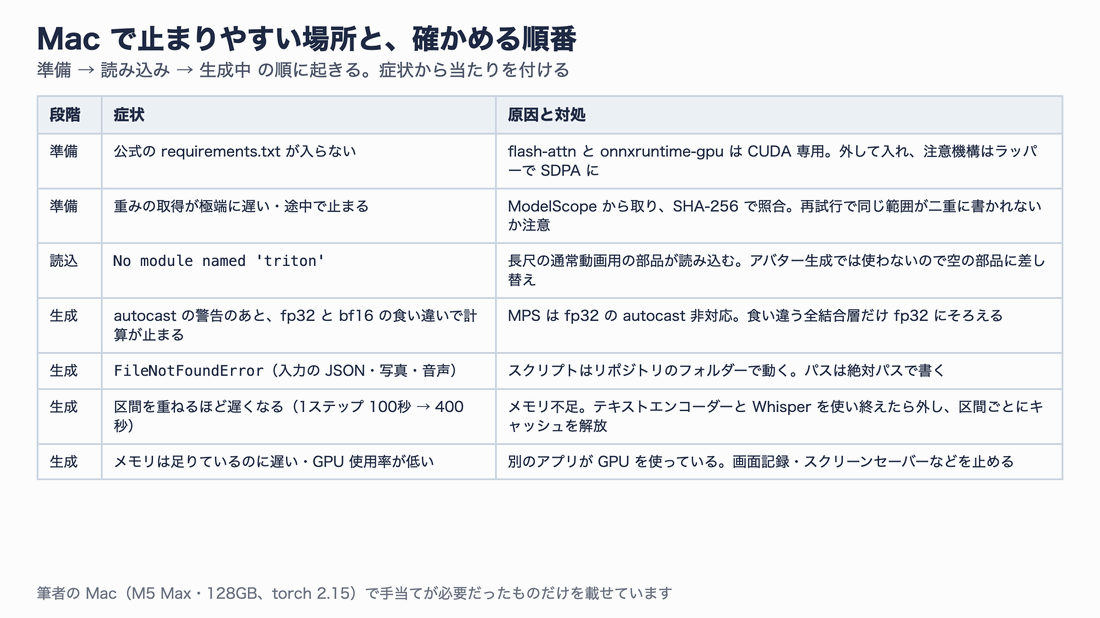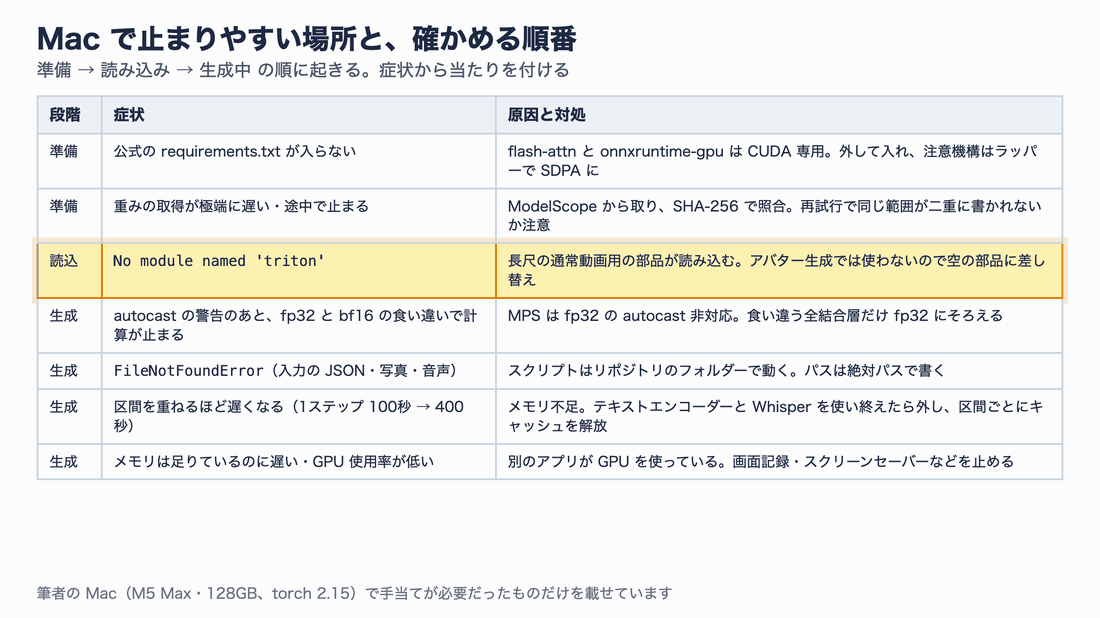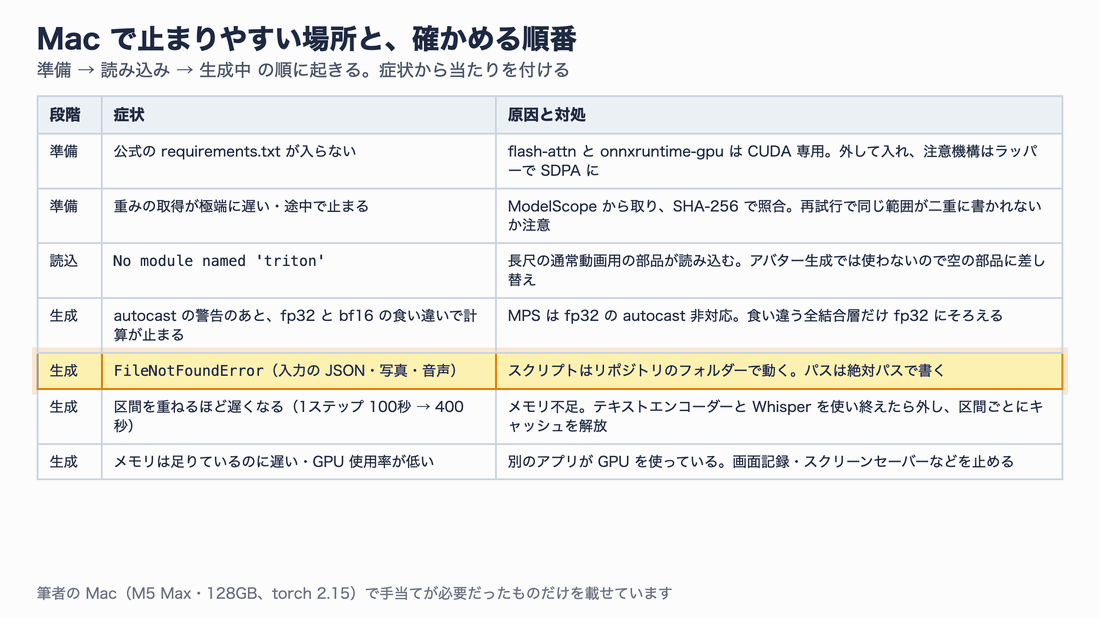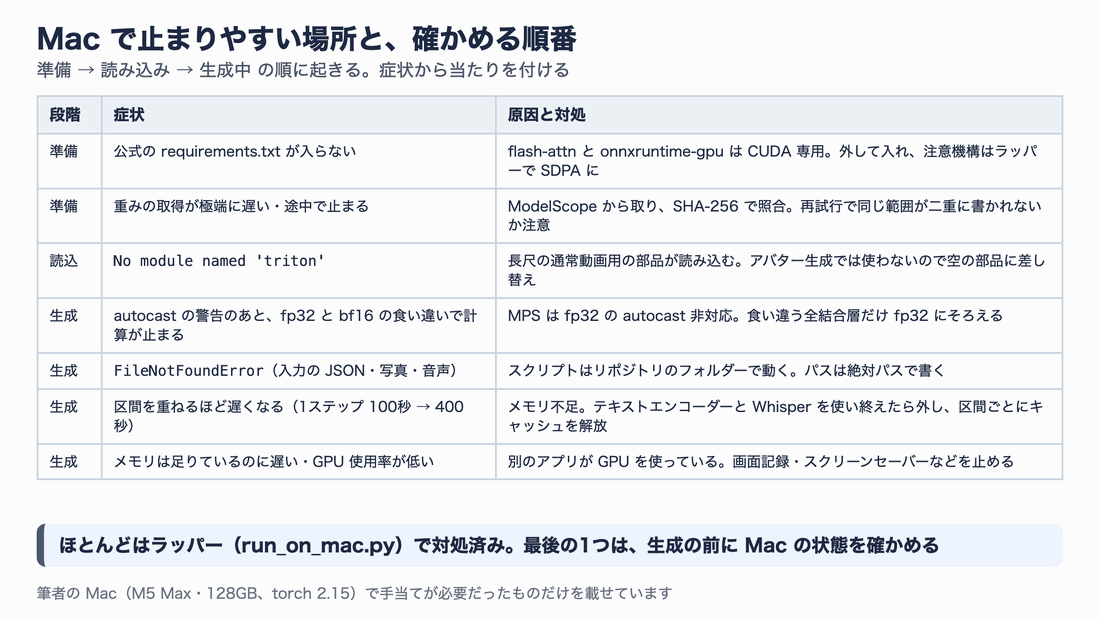
図8:Mac で止まりやすい場所と対処
図の中でも見落としやすいのが、最後の2つの「遅い」です。今回、生成の途中で1ステップが約100秒から400秒以上まで遅くなりました。原因は2つ重なっていました。
1つはメモリです。Mac は CPU と GPU が同じメモリを使うため、128GB あっても、ほかのアプリや仮想マシンと合わせると足りなくなります。足りなくなると macOS がメモリの中身を圧縮し始め、GPU が待たされます。テキストエンコーダーと Whisper を使い終えたら外すようにして、使用量を約39GBで安定させました。
もう1つは、ほかのアプリによる GPU の使用です。生成中に GPU の使用時間を調べると、生成とは関係のない画面描画のプロセスが GPU の時間の大半を使っていました。長時間放置した Mac でスクリーンセーバー(動く Aerial の映像)が動いていたことに加え、別のツールの画面記録や、同時に開いていた別のアプリも GPU を使っていました。生成を一時停止して行列計算の速さを測っても、空いていれば 54 TFLOPS 出るところが 7 TFLOPS ほどしか出ませんでした。
確かめ方は次のとおりです。生成中にほかのターミナルで実行します。
# GPU の使用率(%)を表示する。生成中なのに低ければ、GPU 以外で待たされている
ioreg -r -d 1 -c IOAccelerator | grep -oE '"Device Utilization %"=[0-9]+'

# メモリの圧縮量を見る。「stored in compressor」が数十GBなら、メモリ不足で遅くなっている
vm_stat | grep -E "compressor|Swap"

# 画面を今すぐ消す(スクリーンセーバーが GPU を使っているとき。設定は変わらない)
pmset displaysleepnow
エラー文と対処を表にもまとめておきます。
| 症状・エラー文 | 原因 | 対処 |
|---|---|---|
pip install -r requirements.txt が失敗 | flash-attn と onnxruntime-gpu は CUDA 専用 | 必要なパッケージを直接指定して入れる(手順2のコマンド) |
No module named 'triton' | 長尺の通常動画用の部品が読み込まれる | ラッパーで空の部品に差し替え |
| fp32 と bf16 の型の食い違いで停止 | MPS は fp32 の autocast に非対応 | ラッパーで型が食い違う全結合層だけ fp32 で計算 |
FileNotFoundError: ... presenter.json | 相対パスで指定した | JSON の中も含めて絶対パスで書く |
| 1ステップが区間ごとに遅くなる | メモリ不足でメモリが圧縮されている | 使い終えたエンコーダーを外す(ラッパーに実装済み) |
| メモリは足りているのに遅い | 別のアプリが GPU を使っている | 画面記録やスクリーンセーバーを止める |
| 重みのファイルのハッシュが合わない | ダウンロードの再試行で同じ範囲が二重に書かれた | 壊れたファイルを消して取り直し、SHA-256 で照合する |
最後の行は、自前の分割ダウンロードで起きたものです。curl の --retry は、途中で切れた範囲をもう一度書き足すことがあり、ファイルの中身が二重になりました。分割して取るときは、ファイルごとにハッシュを照合することをおすすめします。
まとめ
LongCat-Video-Avatar 1.6 を、1.5 と同じ条件で Mac で動かして比べました。要点を振り返ります。
- 長い動画の見た目の崩れは、1.6 で大きく減った。 26秒の動画で、1.5 は唇の赤みが写真との差 +11.2 まで広がり、質感も硬く変わっていった。1.6 は +2.9 にとどまり、質感もほぼ変わらなかった
- 大げさな口の動きも減った。 口の大きな開き(上位5%)は 1.6 のほうが24%小さかった
- 口と声の合い方は、ほぼ変わらなかった。 開発元の厳しい評価でもほぼ横ばいで、手元の計測とも一致した
- 使い方はほとんど変わらない。 入力は同じで、コマンドに 1.6 用の LoRA の指定が増えるだけ
- Mac でも動くが、長い動画には向かない。 1区間(約3.2秒)に 約17〜19分 かかり、10分の動画なら丸2日以上かかる計算。本格的に使うなら NVIDIA の GPU が現実的
開発元の評価は自社評価なので、そのまま信じる必要はありません。ただ、今回の手元の比較でも、1.6 の目玉である「続きを重ねても見た目を保つ」改善ははっきり確認できました。
次に試すなら、乱数や人物を変えて何本か作り、差が安定して出るかを確かめるとよいでしょう。NVIDIA の GPU があれば、1分以上の動画で 1.5 との差がどこまで開くかも見てみたいところです。
参考リソース
- LongCat-Video-Avatar 1.6 のモデル(Hugging Face):https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.6
- 同じモデル(ModelScope):https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.6
- 公式リポジトリ(GitHub):https://github.com/meituan-longcat/LongCat-Video
- 1.6 の技術レポート(PDF):https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.6-Tech-Report.pdf
- 1.6 のプロジェクトページ:https://meigen-ai.github.io/LongCat-Video-Avatar-1.6-Page/
- LongCat-Video-Avatar 1.5 のモデル(Hugging Face):https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
- MediaPipe Face Landmarker:https://ai.google.dev/edge/mediapipe/solutions/vision/face_landmarker
この記事で使ったラッパー(run_on_mac.py)と計測スクリプト(analyze.py・summarize.py)は筆者の手元のもので、この記事では要点だけを載せています。