はじめに
Claude Code なら CLAUDE.md、Codex なら AGENTS.md。AI のコーディングエージェント(指示を受けて、自分でファイルを読み、コマンドを実行し、コードを書き換える AI)を使い始めると、まず「リポジトリの説明書を置きましょう」と案内されます。/init と打てば AI が自動で書いてくれるので、とりあえず作ってそのままにしている方も多いと思います。
では、この説明書は本当に AI の仕事の出来を上げているのでしょうか。スイス連邦工科大学チューリッヒ校(ETH Zurich)と LogicStar.ai の研究チームが、これを初めて大きな規模で測りました。論文名は「Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?」です。
先に結論を3行でまとめます。
- 成功率はほとんど変わりません。 自動生成したファイルでは平均 0.5〜2 ポイント下がり、開発者が書いたファイルでは平均 2.4 ポイント上がりましたが、どちらも統計的には「差がある」と言えない大きさでした
- 費用は確実に増えます。 1課題あたりの費用は、どの条件でも平均 19〜23% 高くなりました
- 原因は「指示を無視するから」ではなく、その逆です。 エージェントは書かれたことに律儀に従い、テストやファイルの探索を増やします。その手間が成功率には結びついていませんでした
この記事は、AI ツールをこれから仕事で使う方に向けて、論文が何をどう測ったのか、なぜそうなるのか、そして自分の指示ファイルをどう直せばよいのかを順に説明します。後半では、公開されているデータと手元の実行で確かめたことも紹介します。
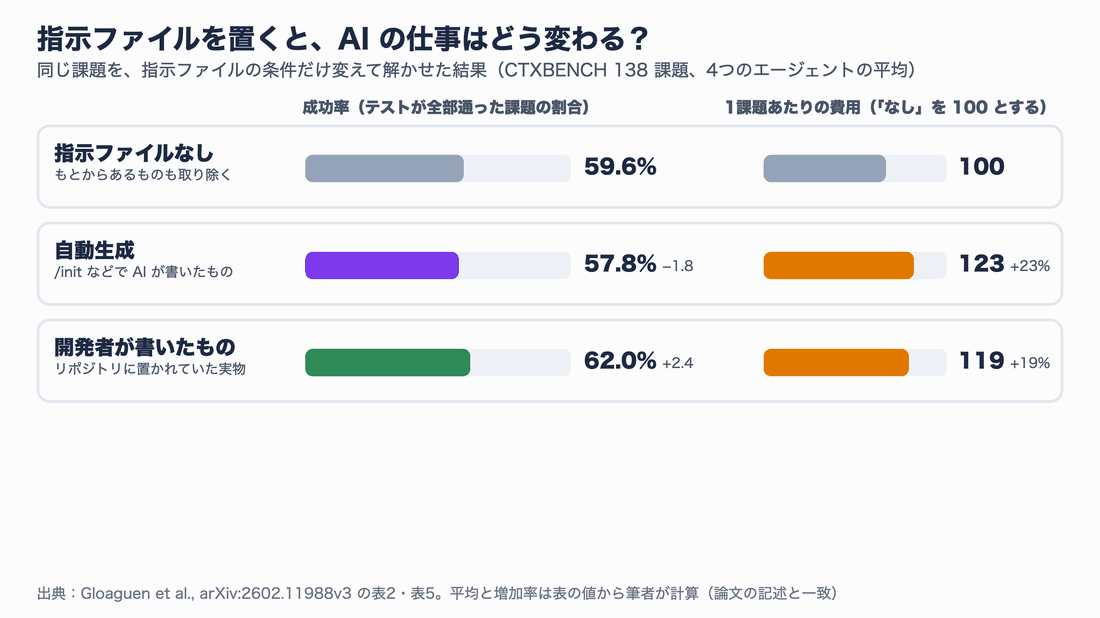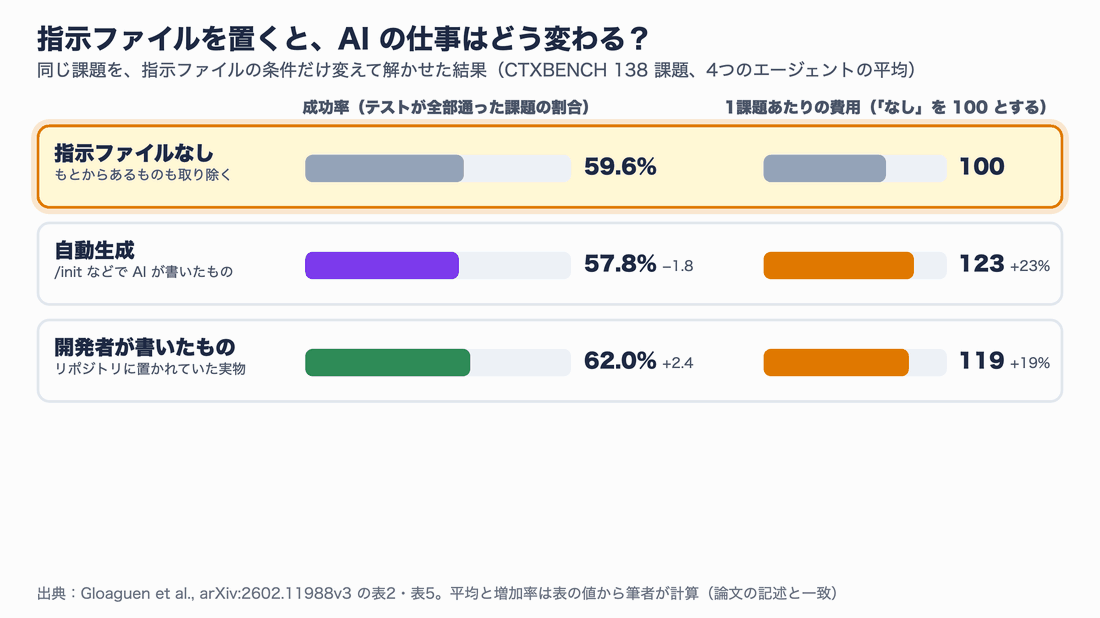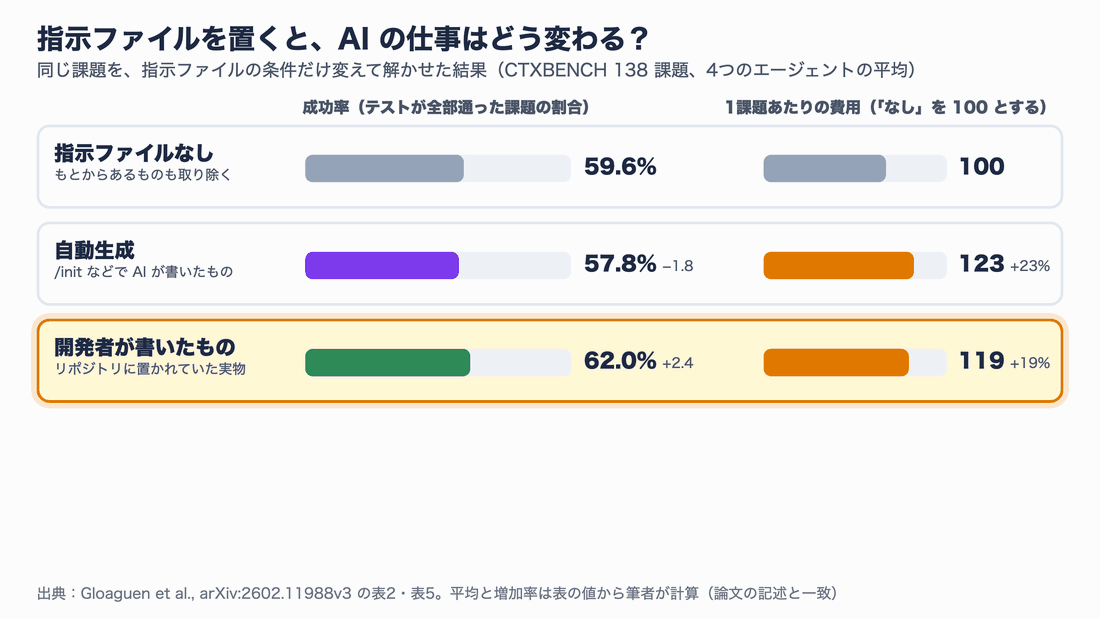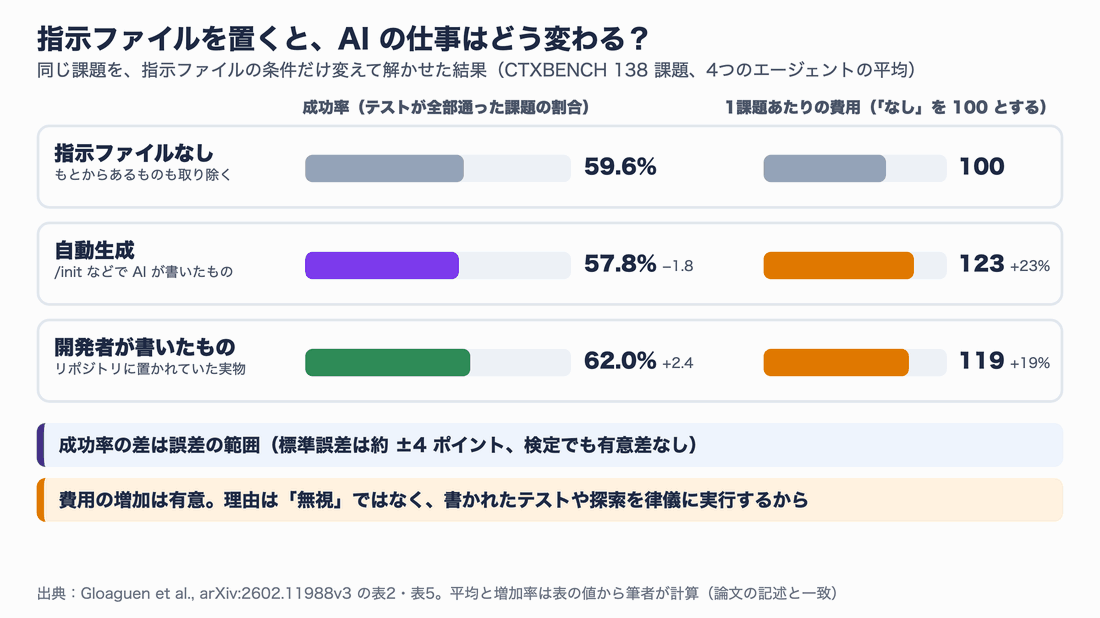
図1:3つの条件で同じ課題を解かせた結果の全体像。成功率は誤差の範囲で、費用だけがはっきり増えています
出回っている数字との違い
SNS や紹介記事では「自動生成で約 3% 低下、人が書くと約 4% 向上」という数字をよく見かけます。これは 2026 年 2 月の初版(v1)の導入部に書かれていた値です。2026 年 9 月の第 3 版(v3)では、検定の結果が加わり、数字と言い回しが次のように変わっています。
| 項目 | 初版(2026-02-12) | 第3版(2026-09-29) |
|---|---|---|
| 新しいベンチマークの名前 | AGENTbench | CTXBENCH |
| 自動生成ファイルの影響 | 導入部で「平均 3% 低下」 | 平均 −0.5 ポイント(SWE-bench Lite)、−2 ポイント(CTXBENCH)。有意差なし |
| 開発者が書いたファイルの影響 | 導入部で「平均 4% 向上」 | 平均 +2.4 ポイント。有意差なし(p = 0.21) |
| 要旨の言い方 | 成功率を下げる傾向がある | 一般には成功率を上げない |
| 書き方の提案 | 最小限の要件だけにする | README にない指示だけを書き、導入前に効果を確かめる |
この記事では、特に断らない限り第 3 版の数字を使います。
この記事の確認範囲(2026 年 11 月 12 日)
指示ファイルとは何か、なぜ疑われずに広まったのか
毎回かならず読まれる「AI 向けの README」
この記事では、AGENTS.md や CLAUDE.md をまとめて指示ファイルと呼びます(論文での呼び名は context file です)。リポジトリ(プロジェクトのコードをまとめて管理する場所)の一番上に置く Markdown のファイルで、エージェントは作業を始めるたびにこれを読み込みます。AGENTS.md の公式サイトは「エージェントのための README」と説明しており、6 万を超える公開プロジェクトで使われているとしています。
大事なのは「毎回かならず読まれる」という点です。バグを1つ直すだけの依頼でも、設計の説明やテストの手順が全部いっしょに渡されます。
/init が書く典型的な中身
多くのツールには、指示ファイルを自動で作るコマンドがあります。Codex の初期化プロンプト(/init の中身。公開リポジトリで読めます)は、次の5つの見出しを勧めています。論文が使ったものと、2026 年 11 月 12 日時点の最新版を比べたところ、「既存のファイルを上書きしない」という1文が増えただけで、勧める見出しは同じでした。
| 勧められている見出し | 書く内容 |
|---|---|
| プロジェクトの構成 | ソース・テスト・素材がどこにあるか |
| ビルド・テスト・開発のコマンド | よく使うコマンドと、その説明 |
| コーディングの流儀と命名 | インデント、命名、整形や静的チェックの道具 |
| テストの方針 | テストの枠組み、名前の付け方、走らせ方 |
| コミットとプルリクエスト | メッセージの書き方、PR に必要なもの |
論文の時点の Claude Code の /init は、「よく使うコマンド」と「複数のファイルを読まないと分からない全体の設計」を書くよう指示し、すぐ見つかる部品やファイル構成を並べないように、とも書いていました。
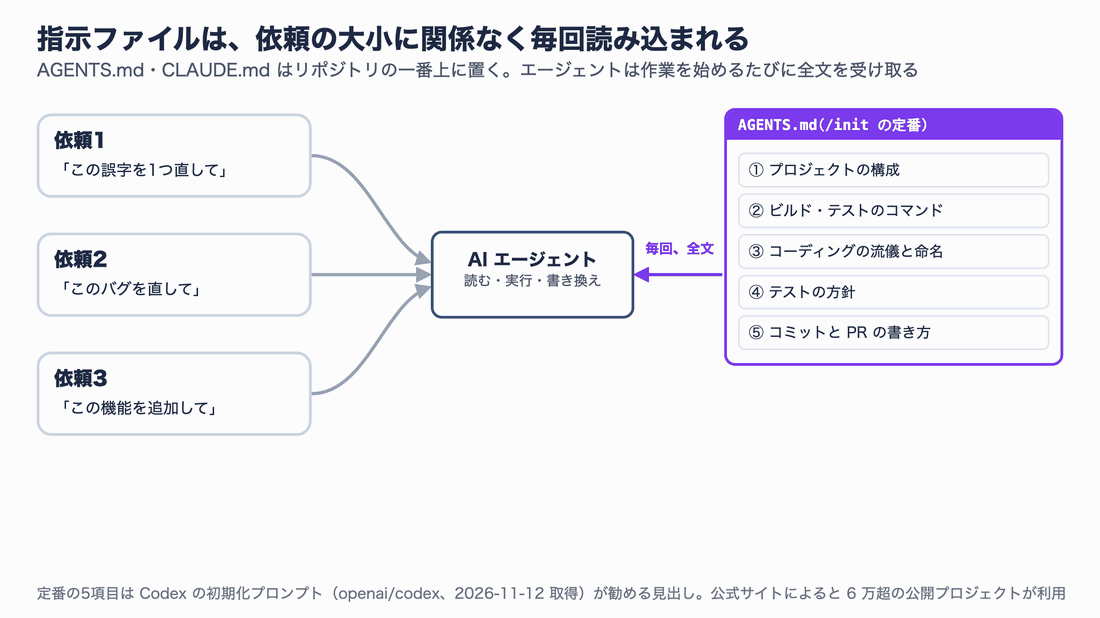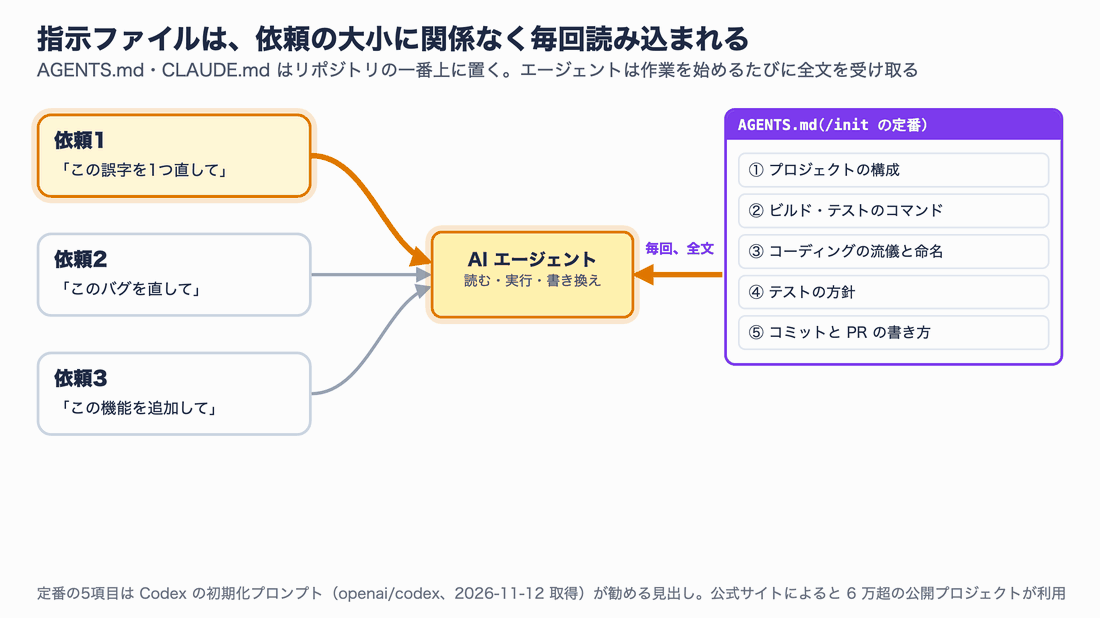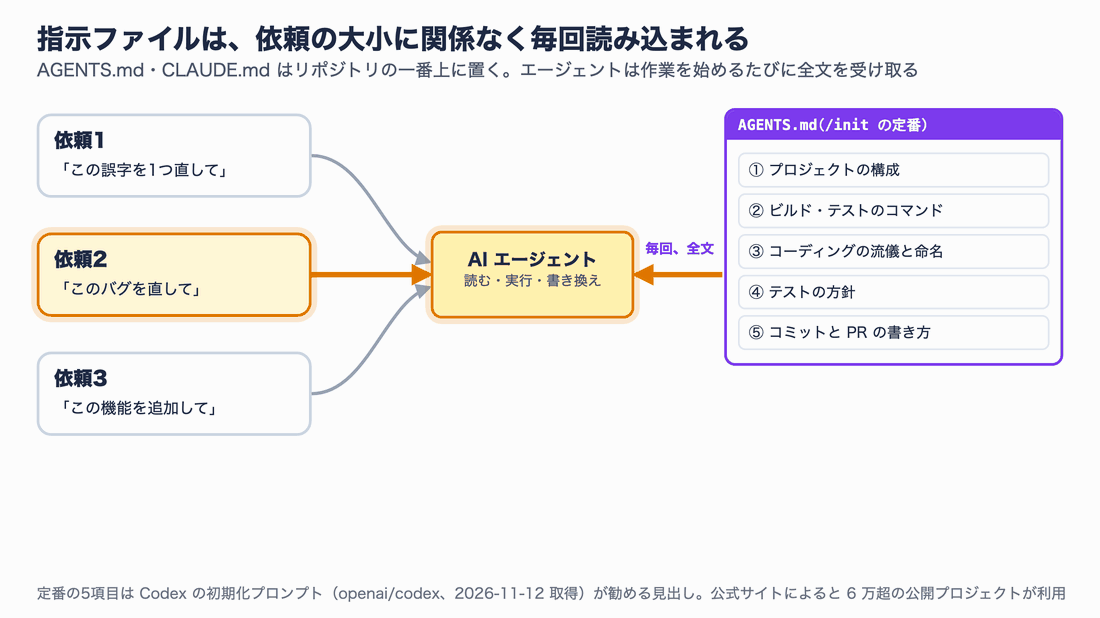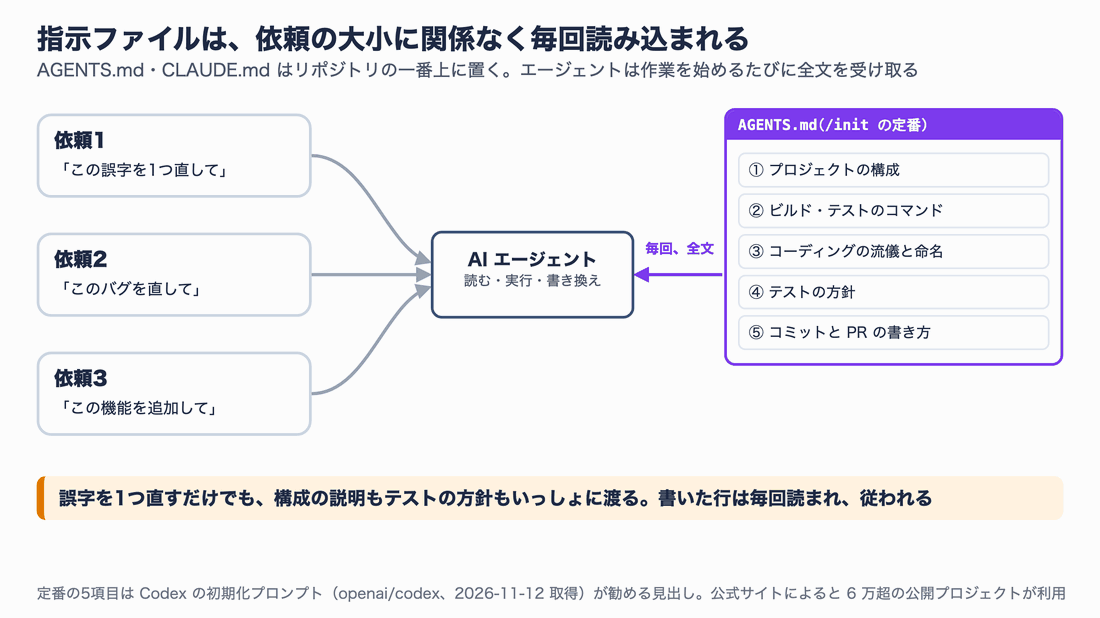
図2:指示ファイルは依頼の大小に関係なく毎回読み込まれます。自動生成では、構成の説明・コマンド・流儀・テスト方針が定番です
これまで誰も測れなかった理由
各社が強く勧めているのに、効果を確かめた研究はありませんでした。論文は理由を2つ挙げています。
- 仕組みが新しい。 AGENTS.md が形式として整ったのは 2025 年 8 月です。SWE-bench のような従来のベンチマーク(AI の実力を測る共通の問題集)が題材にしたリポジトリには、指示ファイルがありません
- 有名なリポジトリは代表にならない。 従来のベンチマークは Django のような有名プロジェクトから作られています。モデルは学習の段階でそれらをよく知っているので、説明書の効き目を測りにくくなります
そこで研究チームは、開発者が実際に指示ファイルを置いているリポジトリだけから、新しい問題集を作りました。
論文は何をどう測ったのか
2つの問題集
実験には、性格の違う2つの問題集が使われています。どちらも Python のリポジトリで、実際の GitHub の課題(バグ修正や機能追加)をもとにしています。
| 問題集 | 課題数 | リポジトリ | 指示ファイル |
|---|---|---|---|
| SWE-bench Lite | 300 | 有名な 11 個(Django など) | もともと無い。自動生成だけを試せる |
| CTXBENCH(新規) | 138 | 指示ファイルを置いている 12 個 | 開発者が書いたものがある |
CTXBENCH は、5,694 件のプルリクエストから絞り込んで作られました。小さなリポジトリは課題の説明が雑だったりテストが無かったりするので、課題文は AI に決まった形式で書き直させ、テストも AI に作らせています。作ったテストは人が全件を確認し、138 課題のうち 25 課題で、特定の実装に寄りすぎたテストを手で直したと書かれています。
3つの条件
同じ課題を、指示ファイルの条件だけ変えて解かせます。
- なし:指示ファイルを置かない(CTXBENCH では、もとからあるものを取り除く)
- 自動生成:各エージェントが勧める初期化コマンドとモデルで、課題に取りかかる前の状態のリポジトリから作る
- 開発者:リポジトリの開発者が書いたものを置く(CTXBENCH だけ)
4つのエージェントと測るもの
| エージェント | モデル | 設定 |
|---|---|---|
| Claude Code | Sonnet 4.5 | 既定の設定、温度 0。下請けのエージェント(Haiku 4.5)も有効 |
| Codex | GPT-5.2 | 既定の設定、温度 0 |
| Codex | GPT-5.1 Mini | 既定の設定、温度 0 |
| Qwen Code | Qwen3-30B-Coder | 研究チームの手元で動かしたモデル |
測ったのは3つです。成功率(エージェントの修正を当てたあと、用意したテストが全部通った課題の割合)、ステップ数(コマンドの実行やファイルの編集など、環境とのやり取りの回数)、費用(モデルの利用料)です。各課題は条件ごとに1回ずつ実行されています。さらに、エージェントが何をしたかの記録(トレース)を調べて、行動がどう変わったかも分析しています。
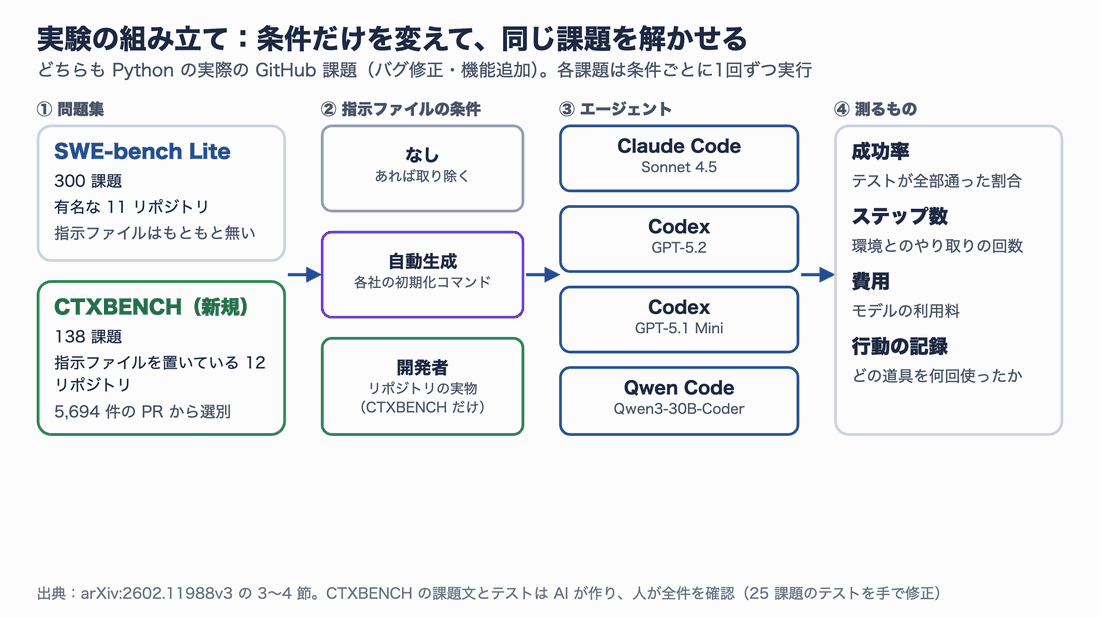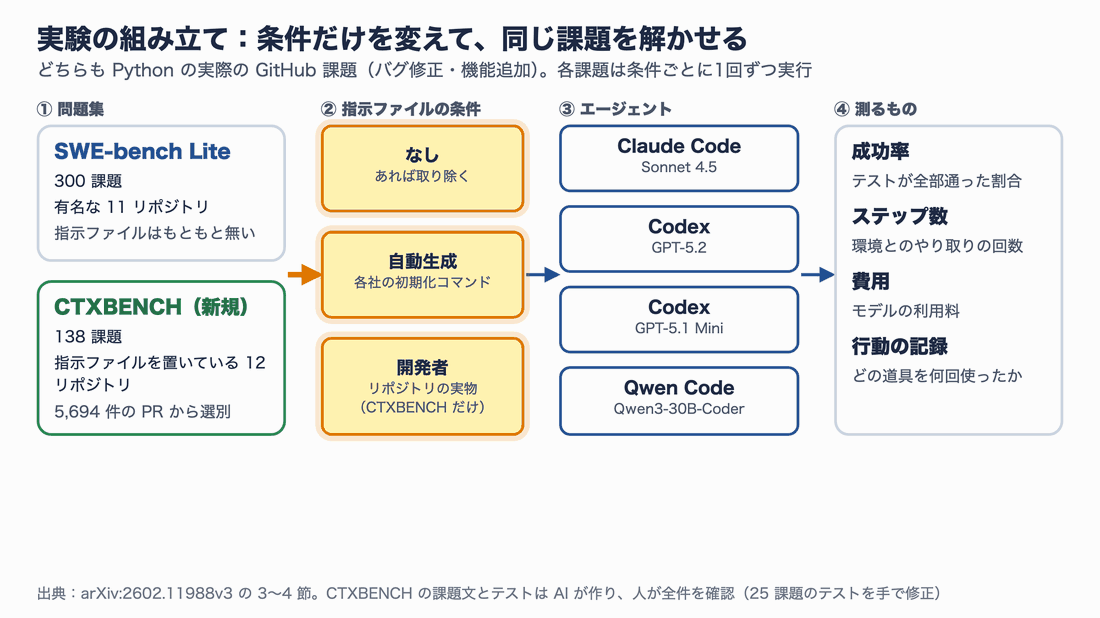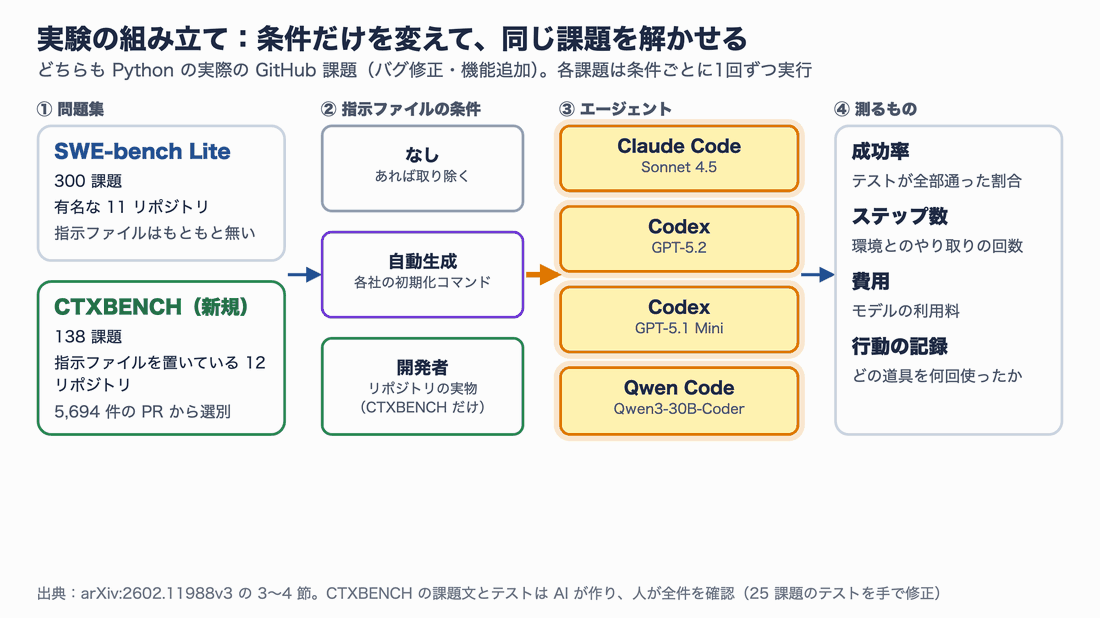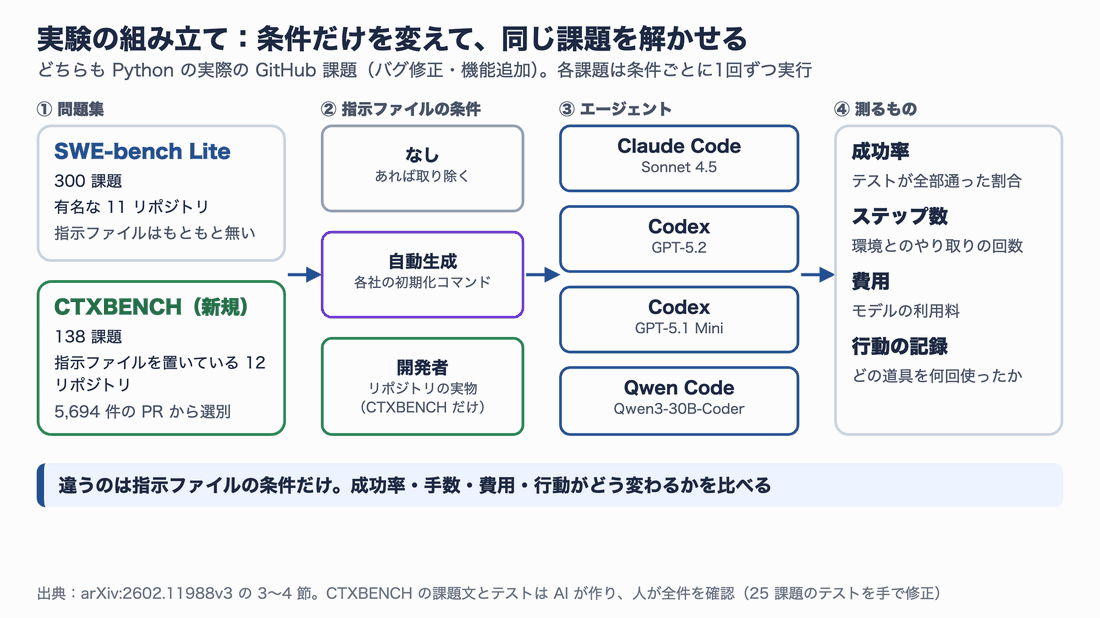
図3:実験の組み立て。条件だけを変え、成功率・ステップ数・費用・行動の記録を比べています
結果1:成功率はほとんど動かなかった
まず成功率です。論文の表5の値を、エージェントごとに並べます(単位は %。± は標準誤差で、CTXBENCH ではおよそ ±4 ポイントあります)。
| 問題集 | 条件 | Claude Code(Sonnet 4.5) | Codex(GPT-5.2) | Codex(GPT-5.1 Mini) | Qwen Code(Qwen3-30B) | 4つの平均 |
|---|---|---|---|---|---|---|
| SWE-bench Lite | なし | 59.9 | 56.6 | 47.7 | 31.1 | 48.8 |
| SWE-bench Lite | 自動生成 | 58.7 | 54.4 | 47.6 | 32.4 | 48.3 |
| CTXBENCH | なし | 73.2 | 65.2 | 54.3 | 45.7 | 59.6 |
| CTXBENCH | 自動生成 | 65.2 | 68.1 | 50.7 | 47.1 | 57.8 |
| CTXBENCH | 開発者 | 70.3 | 68.1 | 55.8 | 53.6 | 62.0 |
「4つの平均」は、表の値から筆者が計算した単純平均です。論文の本文にある「平均 0.5% 低下・2% 低下・2.4% 向上」は、この平均の差(−0.55、−1.83、+2.35 ポイント)と一致しました。
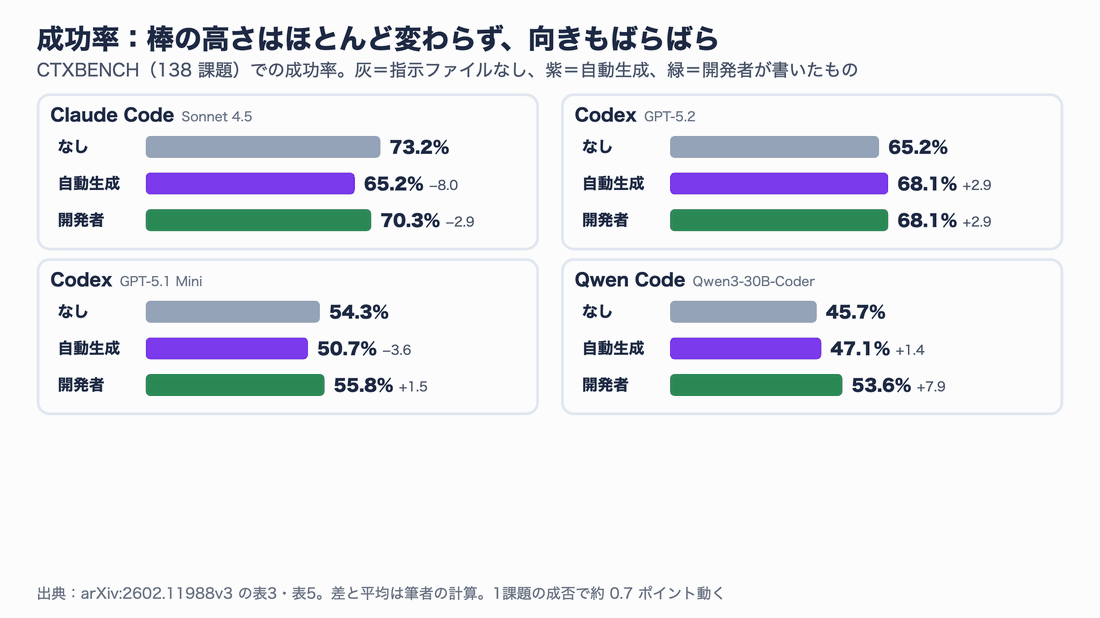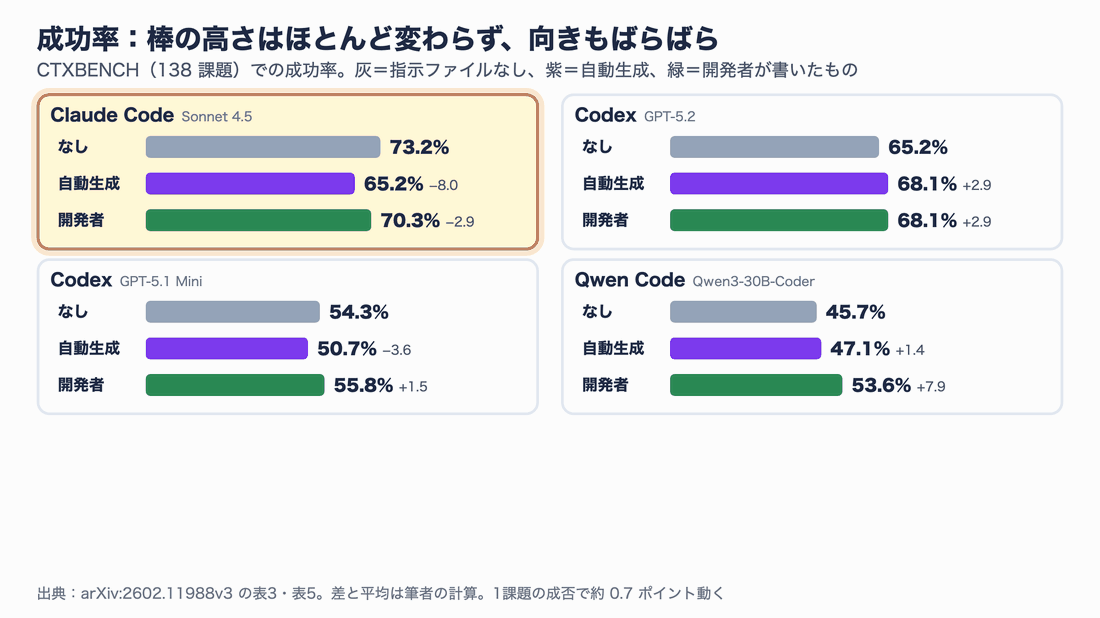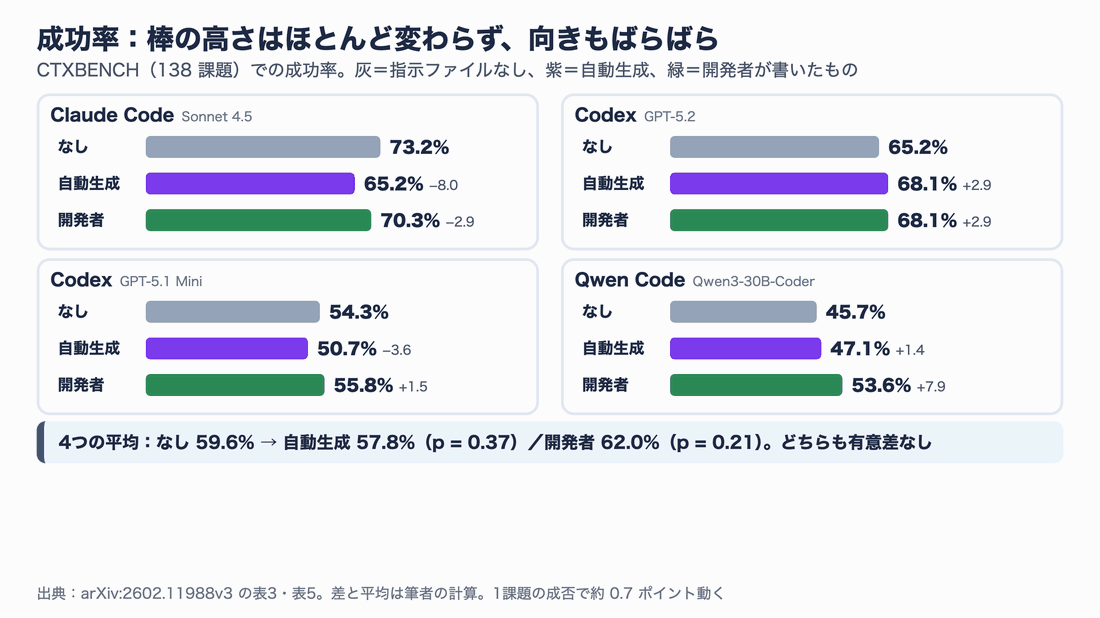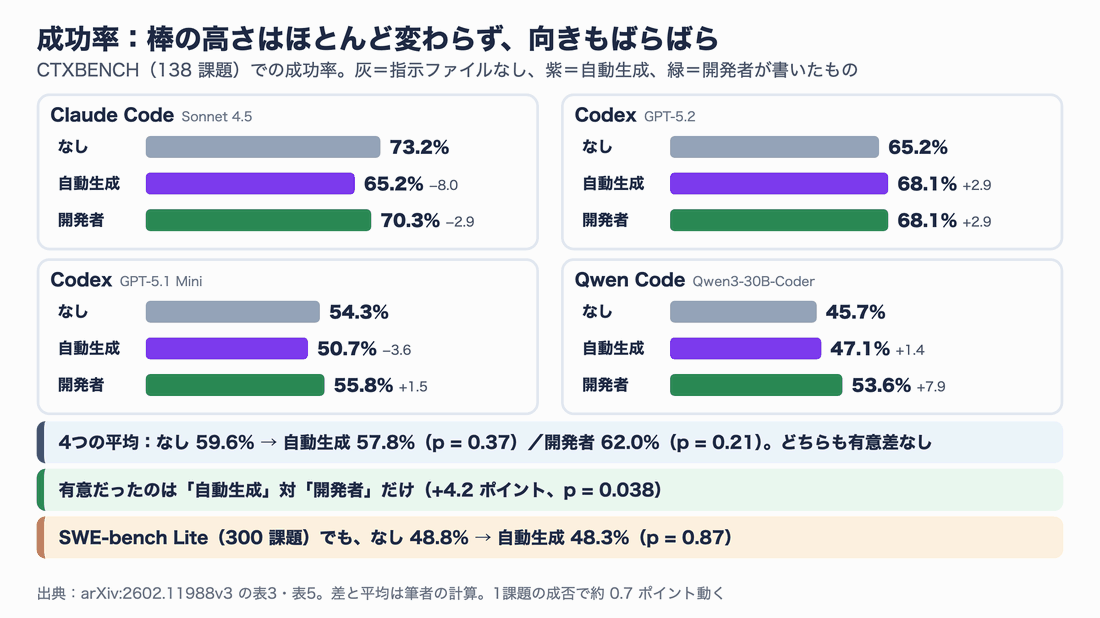
図4:条件ごとの成功率。棒の高さはほとんど変わらず、上下の向きもエージェントによってばらばらです
この表の読み方で、押さえておきたい点が3つあります。
1つ目は、差が小さいことです。 CTXBENCH は 138 課題なので、1課題の成否で成功率は約 0.7 ポイント動きます。平均 2 ポイントの差は、課題にして 3 件ほどです。論文は検定(コクラン・マンテル・ヘンツェル検定)にかけており、「なし」と「自動生成」の差は p = 0.87(SWE-bench Lite)と p = 0.37(CTXBENCH)、「なし」と「開発者」の差は p = 0.21 でした。どれも偶然で説明できる範囲です。
2つ目は、向きがそろっていないことです。 自動生成ファイルで成功率が下がったのは 8 通りのうち 5 通りで、残り 3 通りは上がっています。Claude Code は CTXBENCH で、指示ファイルが何もないときがいちばん高い成績でした(73.2%)。一方、いちばん小さなモデルの Qwen Code は、開発者が書いたファイルで 7.9 ポイント上がっています。
3つ目は、唯一の有意差です。 「自動生成」と「開発者」を直接比べると、開発者が書いたほうが平均 4.2 ポイント高く、これは有意でした(p = 0.038)。論文の導入部にある「7% の差」は、この 4.2 ポイントを比率で表した値です(57.8% に対して 7.2% 増)。つまり言えるのは「同じ置くなら、人が書いたもののほうがまし」までで、「置けば上がる」ではありません。
結果2:費用とステップ数は、どの条件でも増えた
成功率と違って、費用ははっきり動きました。論文の表2から、1課題あたりの平均費用(米ドル)を並べます。
| 問題集 | 条件 | Claude Code | Codex(GPT-5.2) | Codex(GPT-5.1 Mini) | Qwen Code |
|---|---|---|---|---|---|
| SWE-bench Lite | なし | 1.30 | 0.32 | 0.18 | 0.12 |
| SWE-bench Lite | 自動生成 | 1.51(+16%) | 0.43(+34%) | 0.22(+22%) | 0.13(+8%) |
| CTXBENCH | なし | 1.15 | 0.38 | 0.18 | 0.13 |
| CTXBENCH | 自動生成 | 1.33(+16%) | 0.57(+50%) | 0.20(+11%) | 0.15(+15%) |
| CTXBENCH | 開発者 | 1.30(+13%) | 0.54(+42%) | 0.19(+6%) | 0.15(+15%) |
かっこ内の増加率は筆者の計算です。4つのエージェントの増加率を平均すると、SWE-bench Lite の自動生成で +20%、CTXBENCH の自動生成で +23%、開発者で +19% になり、論文の記述と一致しました。ステップ数も、自動生成で平均 +2.45(SWE-bench Lite)と +3.92(CTXBENCH)、開発者で +3.34 増えています。こちらは検定でもすべて有意でした。
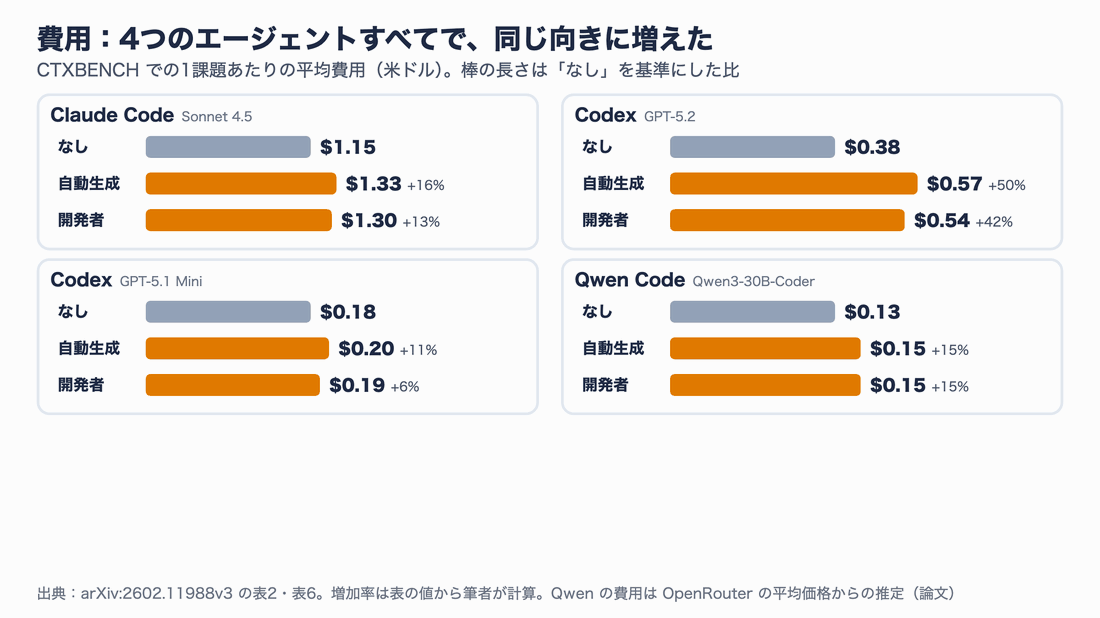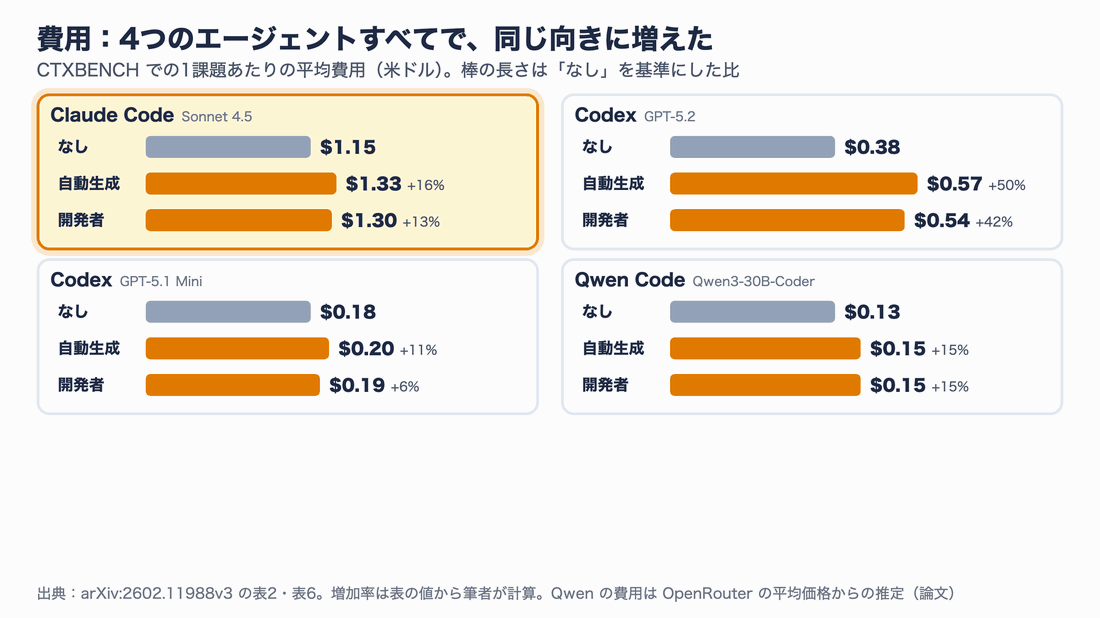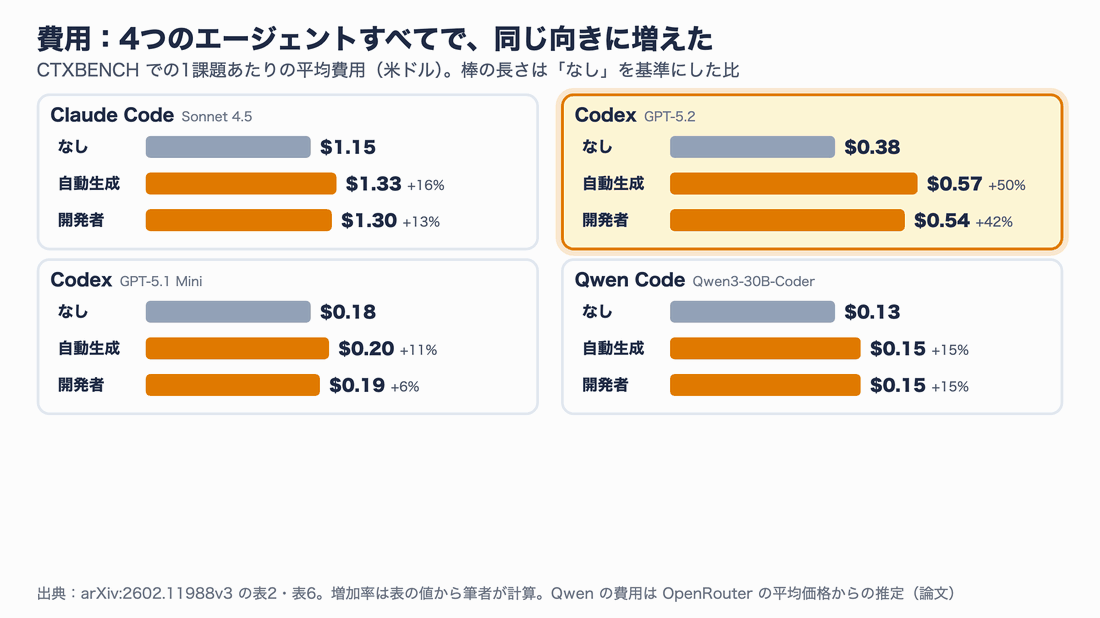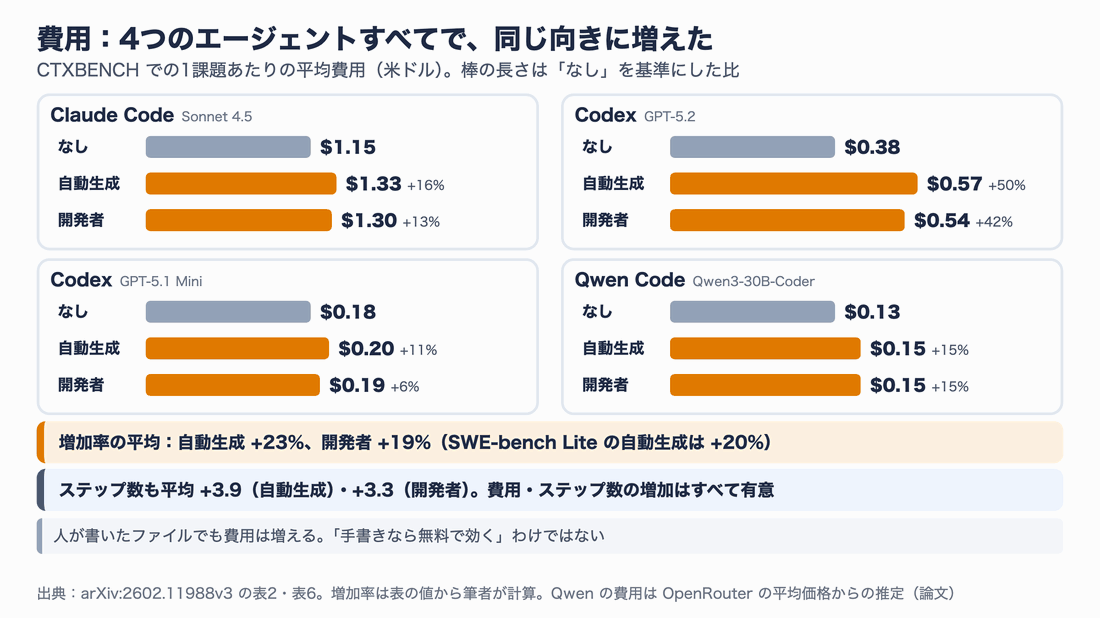
図5:1課題あたりの費用の変化。成功率と違い、全部のエージェントで同じ向きに動いています
人が書いたファイルでも費用は増える、という点は見落とされがちです。「自動生成はだめで、手書きならよい」という単純な話ではありません。
なぜそうなるのか:無視ではなく「従いすぎ」
「どうせ AI は指示ファイルを読み飛ばしているのでは」と思うかもしれません。論文が行動の記録を調べた結果は、その逆でした。
書かれた道具は、本当に使われる
指示ファイルに名前が出てくる道具は、はっきり多く使われていました。
| 道具 | 指示ファイルに名前がある | 名前がない |
|---|---|---|
uv(Python のパッケージ管理ツール) | 1課題あたり平均 1.6 回 | 0.01 回未満 |
| そのリポジトリ専用の道具 | 1課題あたり平均 2.5 回 | 0.05 回未満 |
つまり成功率が上がらないのは、指示に従う力が足りないせいではありません。従った結果として、やることが増えています。
論文の図5は、指示ファイルを置いたときに各道具の呼び出しが1課題あたり何回増えたかを示しています。右にあるほど増えたという意味で、テストの実行(pytest)、検索(Grep)、ファイルの読み込み(Read)が、多くのエージェントで右に寄っています。
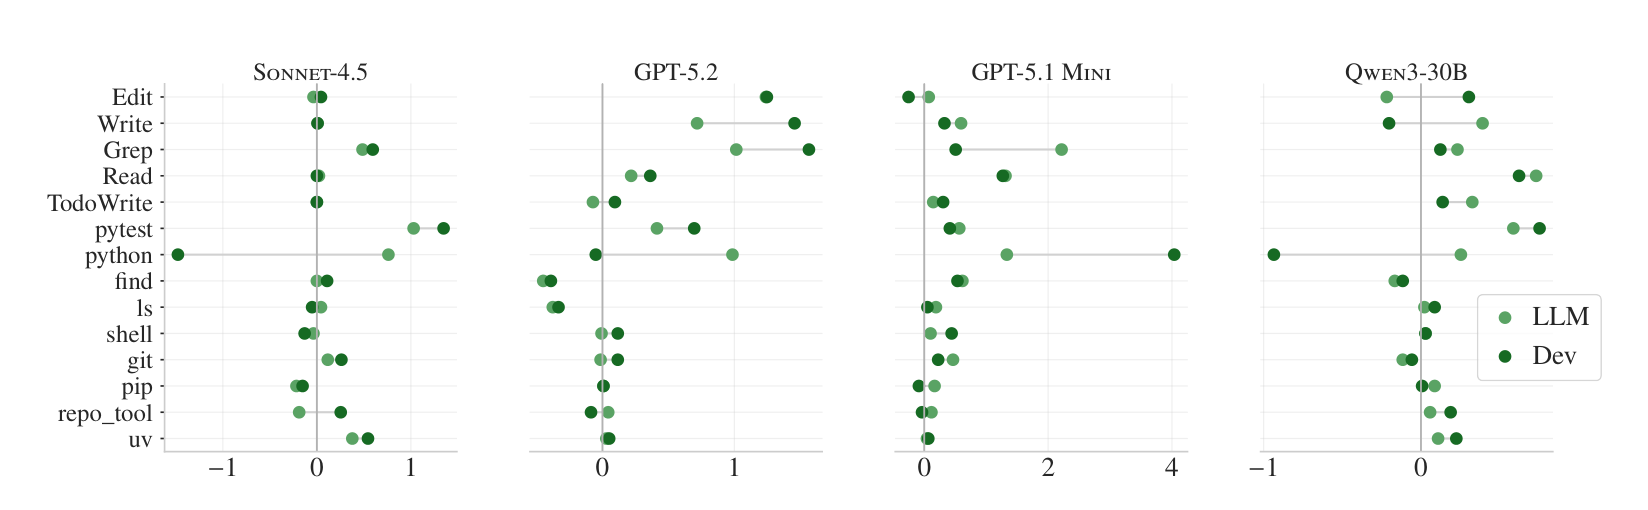
図6:指示ファイルを置いたときの、道具の呼び出し回数の増減(薄い緑=自動生成、濃い緑=開発者)。出典:Gloaguen et al., arXiv:2602.11988v3 の Figure 5(CC BY 4.0)
考える量も増えていました。GPT-5.2 が使った推論トークン(答える前に内部で考えるのに使った量)は、自動生成ファイルで 14〜22%、開発者のファイルで 20% 増えています。論文はこれを「指示が増えたぶん、課題が難しくなった」と解釈しています。
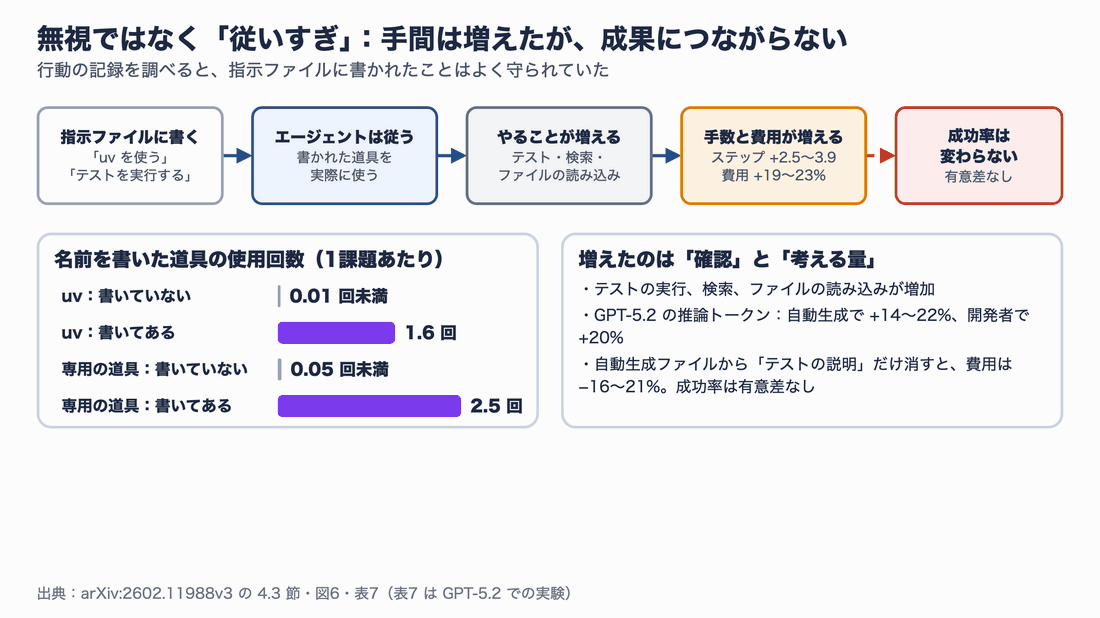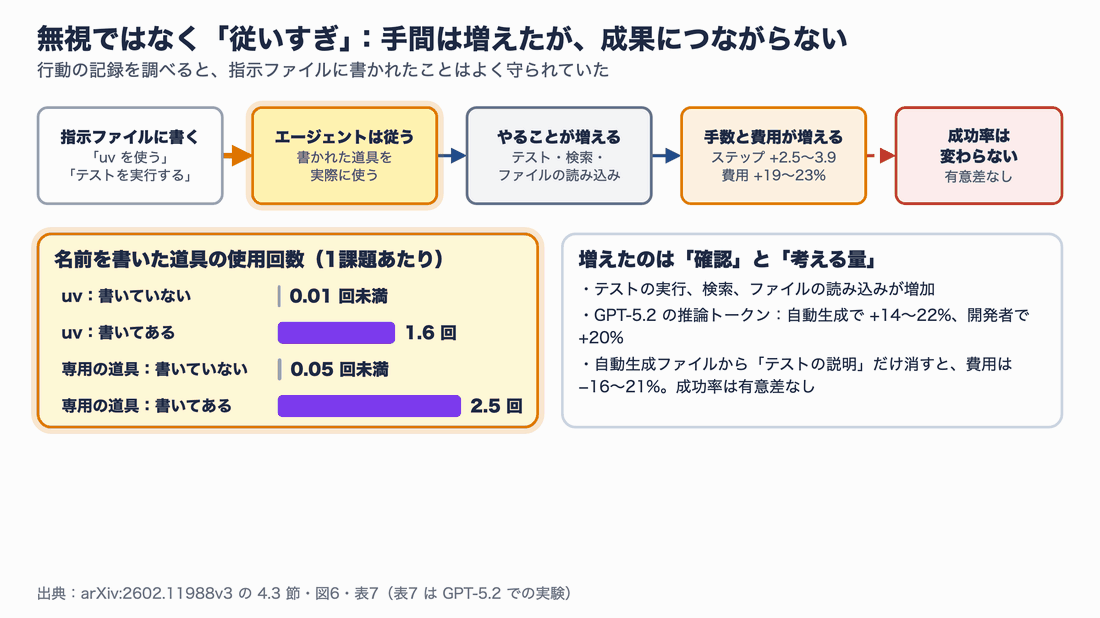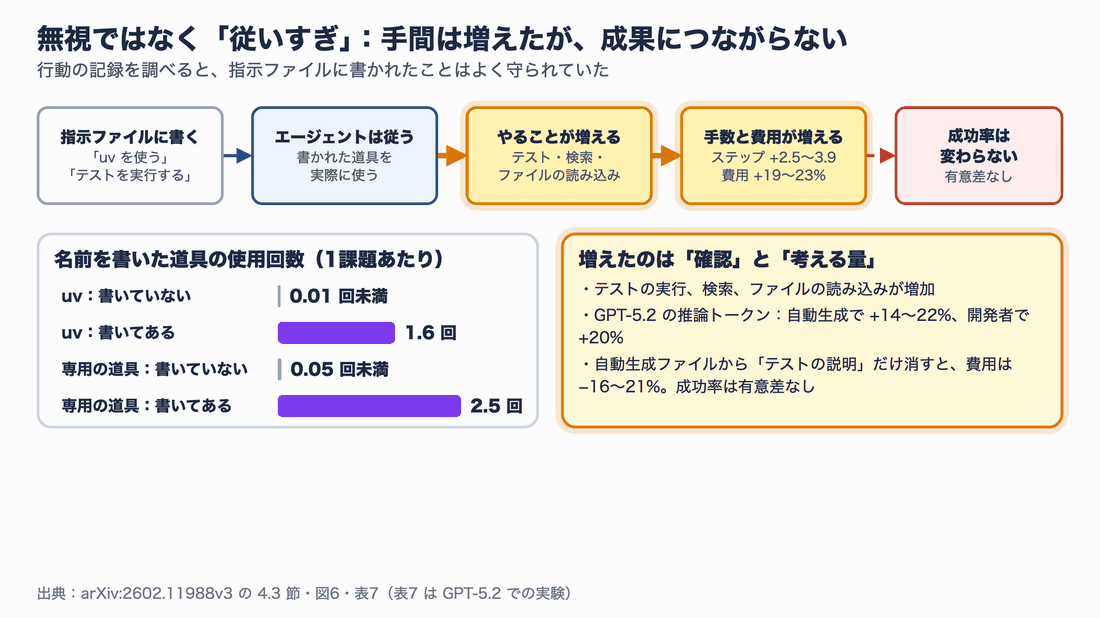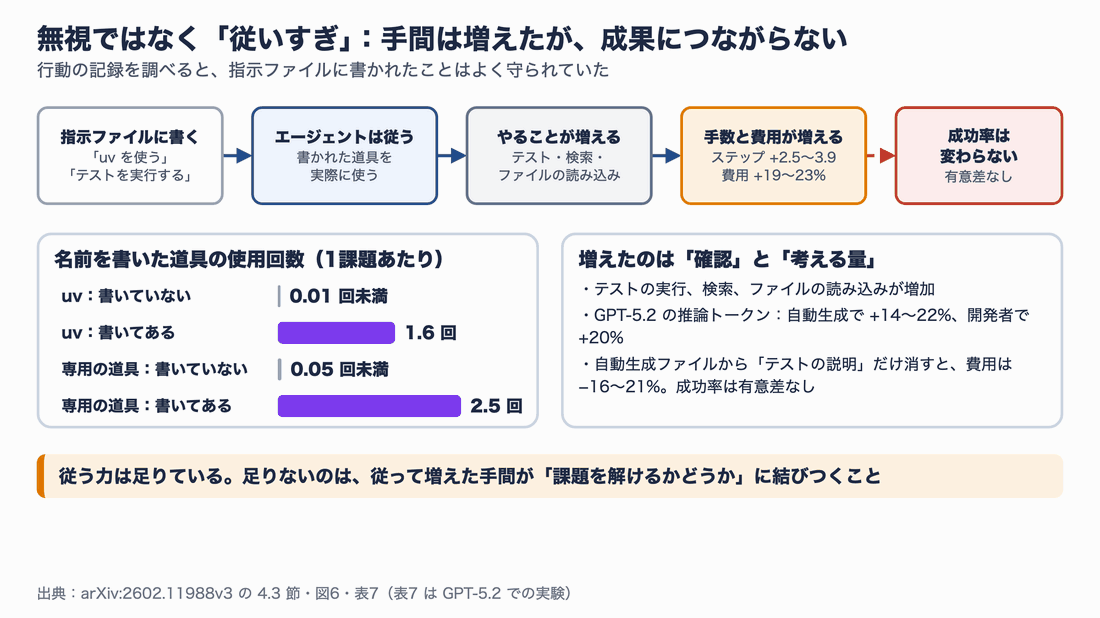
図7:指示 → 従う → 手間が増える → 費用が増える、という流れ。最後の「成功率」だけがつながっていません
どの部分が費用を押し上げているかも調べられています。GPT-5.2 が作った指示ファイルから「テストの説明」だけを取り除くと、費用は CTXBENCH で約 21%、SWE-bench Lite で約 16% 下がりました(どちらも有意)。成功率に有意な変化はありません。テストの走らせ方を丁寧に書くほど、エージェントは丁寧にテストを回し、その分の費用がかかる、ということです。
構成の説明は、探す手間を減らさなかった
指示ファイルの定番は「このフォルダには何がある」という構成の説明です。自動生成されたファイルのほとんどに入っていました(Sonnet 4.5 が作ったものは 100%、GPT-5.2 は 99%、Qwen3-30B は 95%)。開発者が書いた 12 個のうち 8 個にも、構成の説明があります。
これが役に立つなら、エージェントは直すべきファイルに早くたどり着くはずです。論文は「実際の修正で変更されたファイルに、エージェントが初めて触れるまでのステップ数」を測りました。結果は、指示ファイルがあっても意味のある短縮はなし。GPT-5.1 Mini ではむしろ大きく増えました。記録を見ると、すでに読み込まれている指示ファイルを、コマンドを何度も打って探し、繰り返し読み直していたそうです。
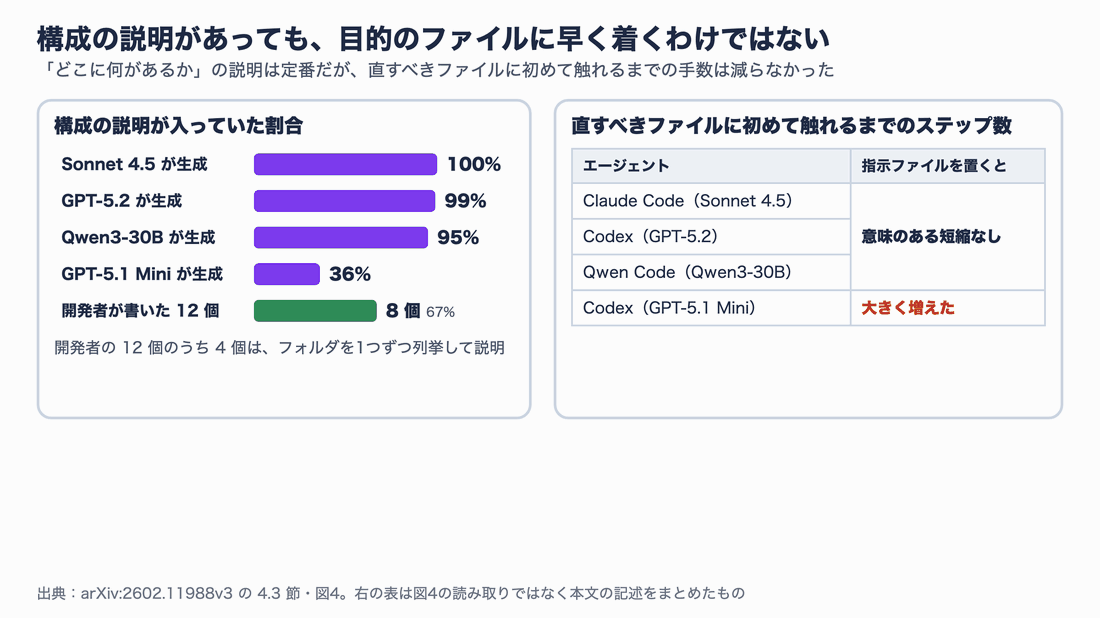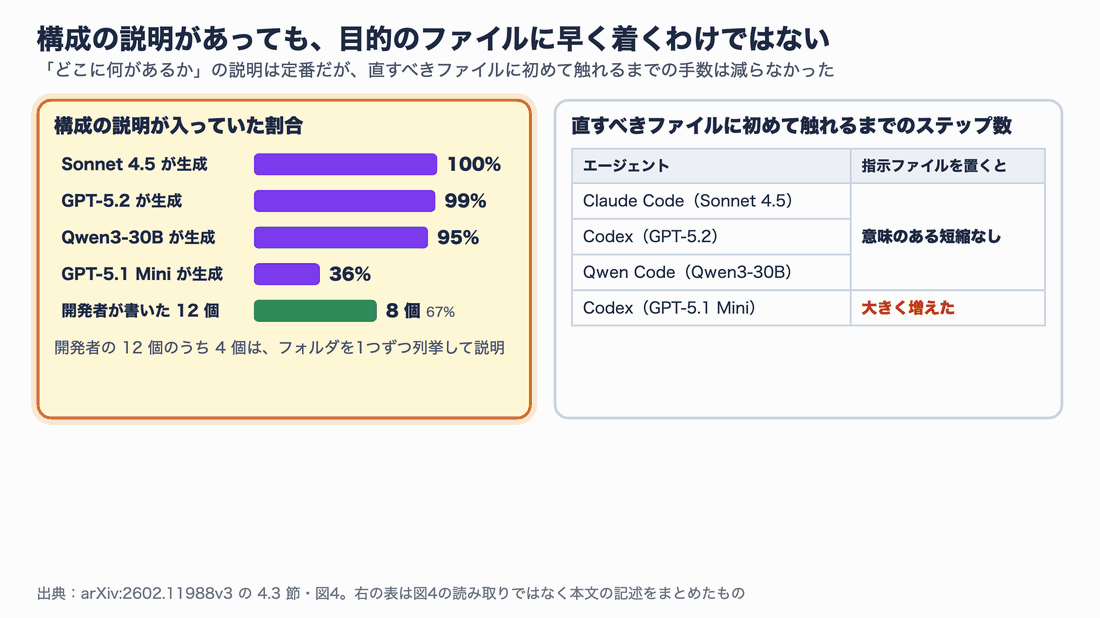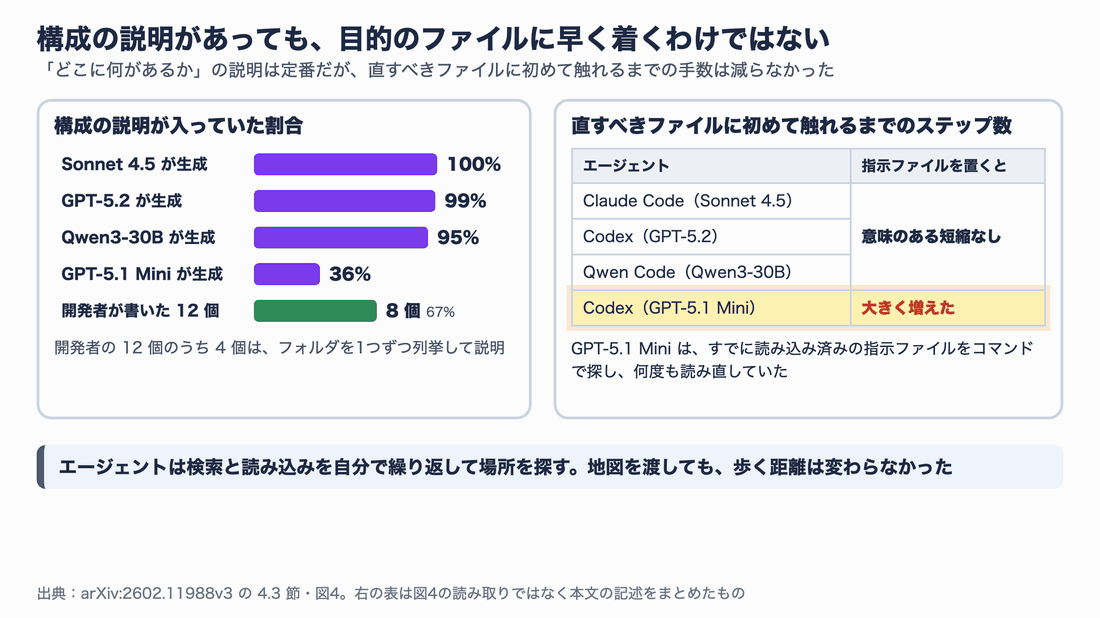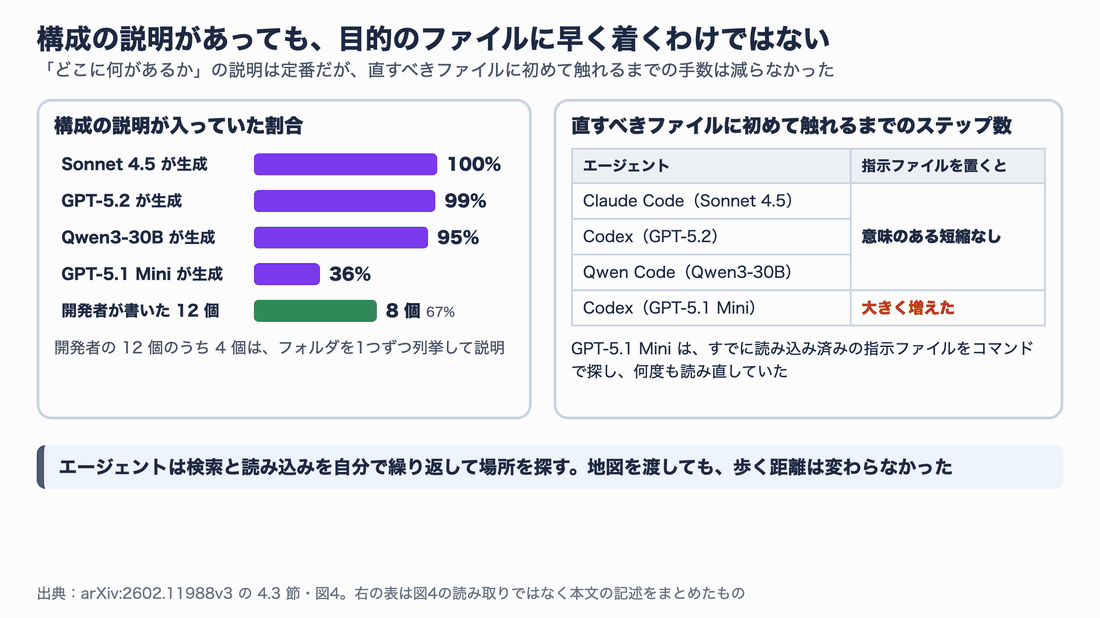
図8:構成の説明があっても、目的のファイルに着くまでの手数は減りませんでした
いまのエージェントは、検索とファイルの読み込みを自分で繰り返して場所を探します。地図を渡しても、結局は自分の足で確かめにいく、と考えると分かりやすいと思います。
文書を全部消すと、自動生成が逆転する
では、なぜ自動生成のファイルは役に立たないのでしょうか。研究チームの仮説は「すでにある文書の焼き直しだから」です。これを確かめるために、指示ファイルを作ったあとで、リポジトリから文書(.md のファイル、サンプルコード、docs/ の中身)を全部消して実験しています(費用の都合で Claude Code は除外)。
すると結果が変わりました。自動生成のファイルは成功率を平均 2.7 ポイント上げ、開発者が書いたファイルよりも良い成績になっています。
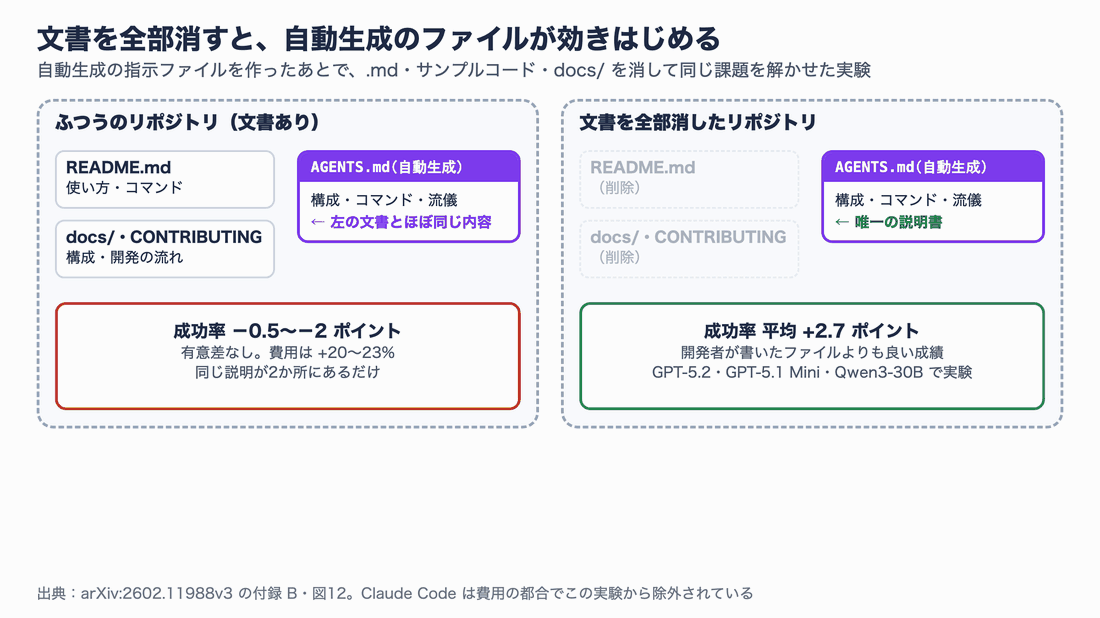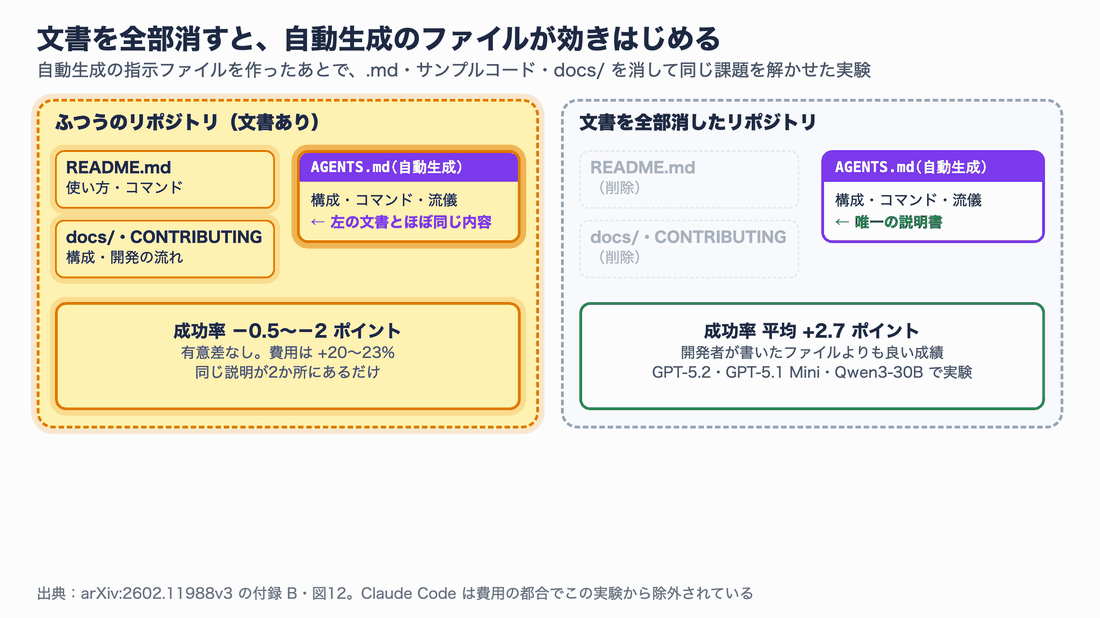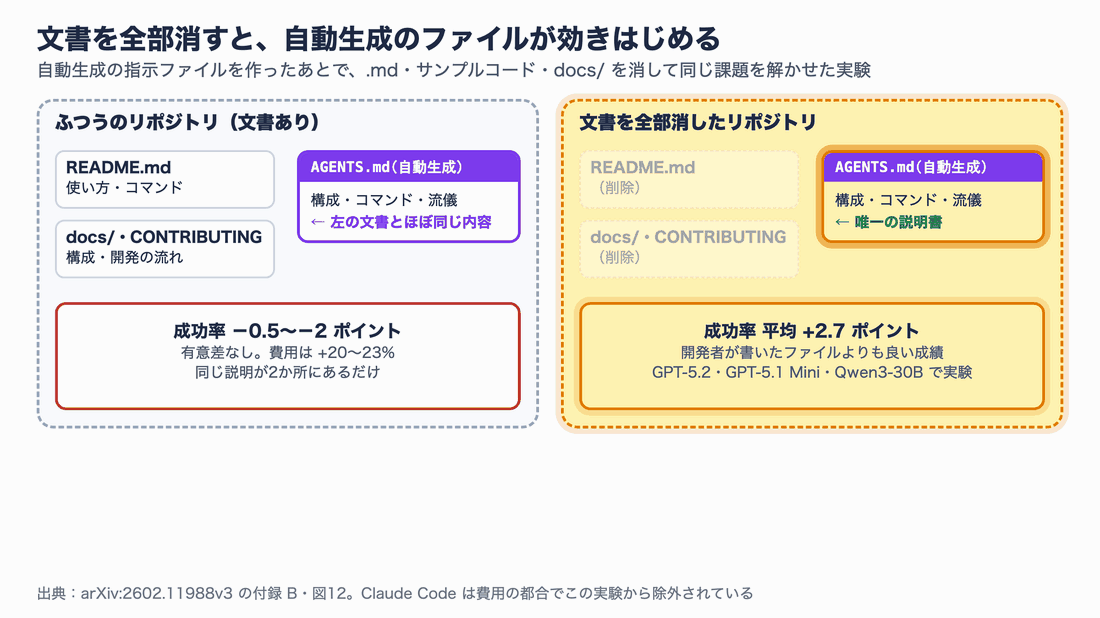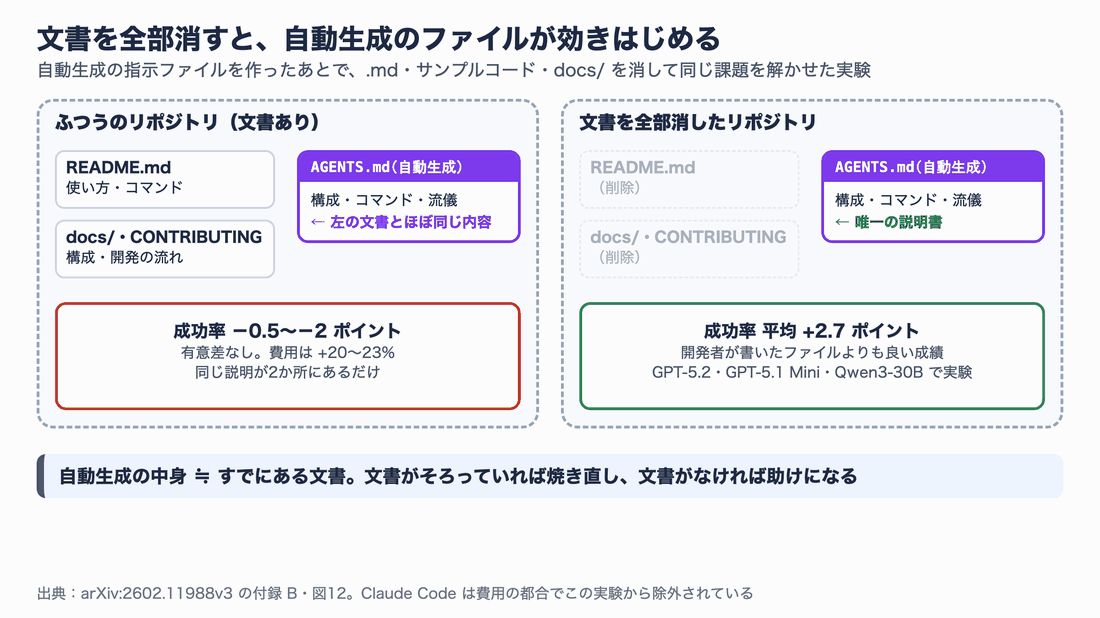
図9:文書がそろっているリポジトリでは焼き直しになり、文書がないリポジトリでは唯一の説明書として効きます
ここから分かることは2つあります。自動生成ファイルの中身は、README などを読めば分かることとほぼ重なっていること。そして、文書がほとんどないリポジトリでは、自動生成でも助けになることです。「指示ファイルを置いたら賢くなった」という体験談が多いのは、文書の少ない小さなプロジェクトでの話だからかもしれない、と論文は述べています。
小手先の工夫では変わらなかった
研究チームは、よくある改善案も試しています。
- もっと賢いモデルに書かせる:GPT-5.2 や Sonnet 4.5 が書いたファイルを小さなモデルに渡しても、SWE-bench Lite で平均 2 ポイント上がり、CTXBENCH で 3 ポイント下がりました。一貫した改善はありません
- 生成プロンプトを変える:Codex 用と Claude Code 用のプロンプトを入れ替えても、決まった優劣は出ませんでした
- 長さ:指示ファイルの長さと、成功率・費用のあいだに、はっきりした関係は見つかっていません
- 学習データの影響:モデルの知識の締め切りより前の課題と後の課題に分けても、傾向は同じでした
手元で確かめたこと
論文を読むだけでなく、公開されているものを使って3つ確かめました。
開発者が書いたファイルの実物は、24 語から 2,000 語まで
CTXBENCH の 138 課題について、実験で使われたはずの指示ファイルを GitHub から取得しました(公開されている実験用コードと同じ順番でファイルを選んでいます)。語数は平均 618 語、最小 24 語、最大 2,008 語で、論文の表1(平均 641 語、最小 24 語、最大 2,003 語)とほぼ一致しました。
「開発者が書いたファイル」とひとくくりにされていますが、中身の幅はとても広いです。
| リポジトリ | 語数 | 中身の例 |
|---|---|---|
| smolagents | 24 | 「オブジェクト指向の原則に従う」「Python らしく書く」「新しい機能にはテストを書く」の3行だけ |
| tinygrad | 約 100 | 設計の考え方と、インデントは空白2つ・1行 150 文字までという流儀 |
| wagtail | 162 | 詳しい文書の場所、PR に AI の関与を書くこと、AI が間違えやすい書き方の注意 |
| ansible | 2,008 | 開発の流れ全体を説明する長い手引き |
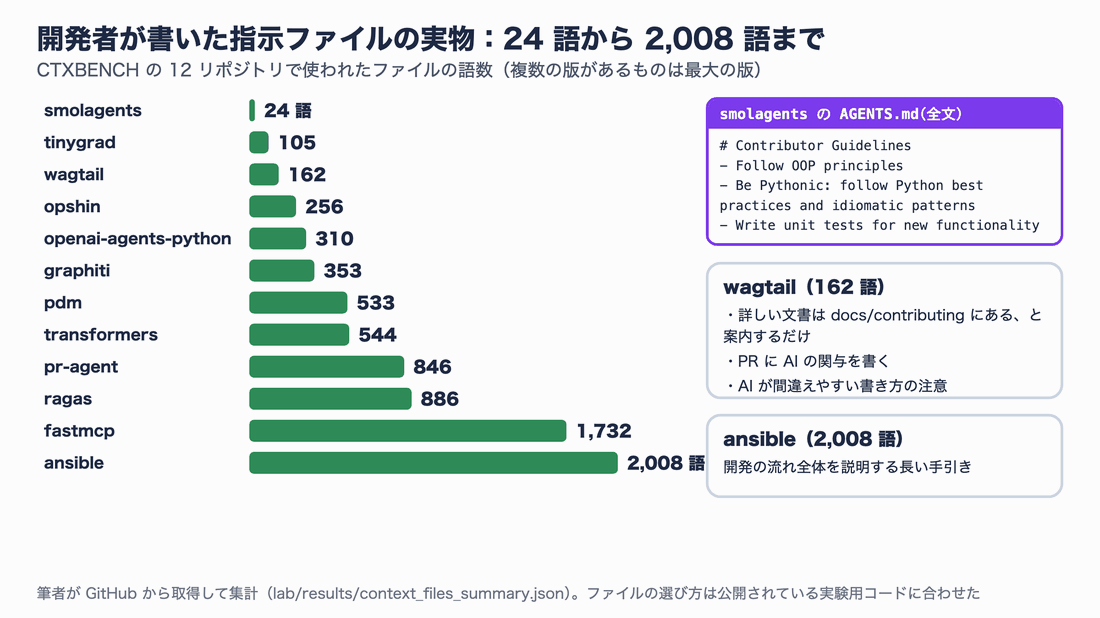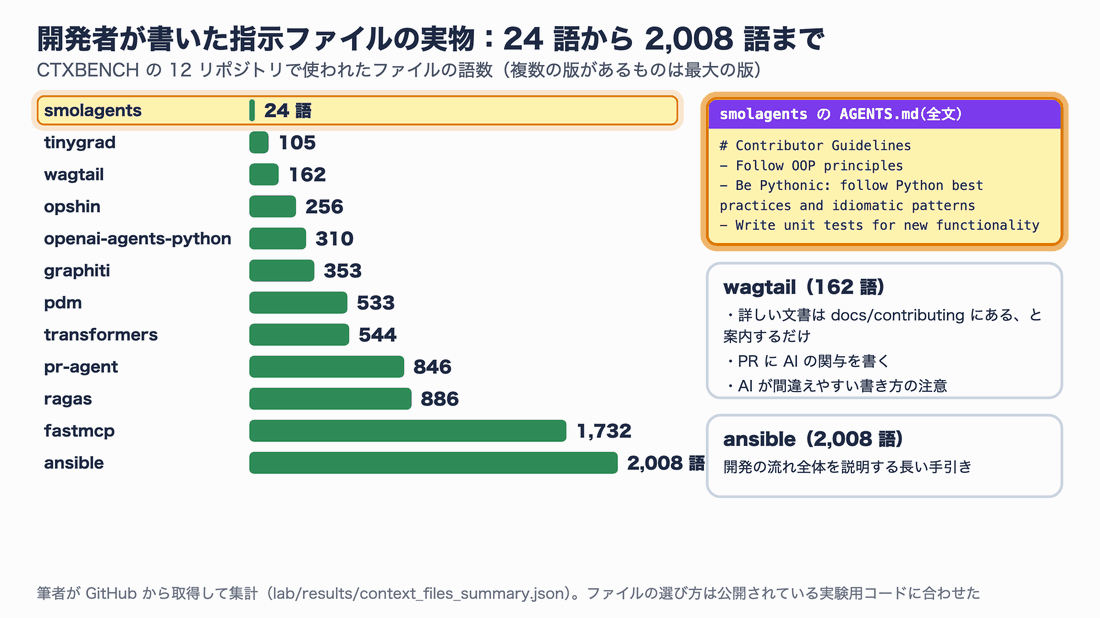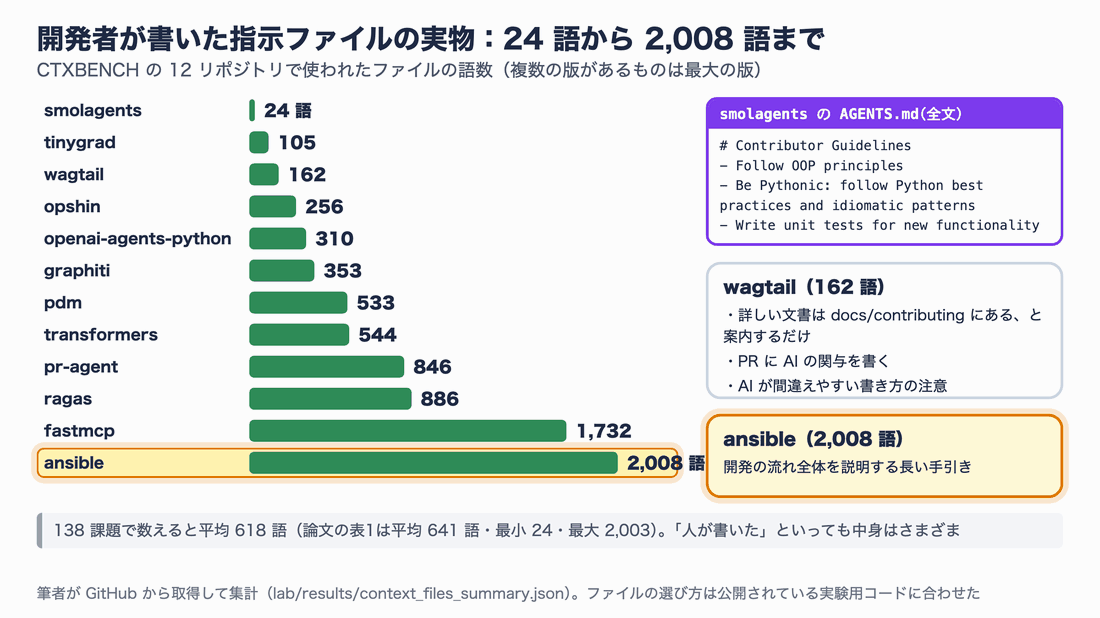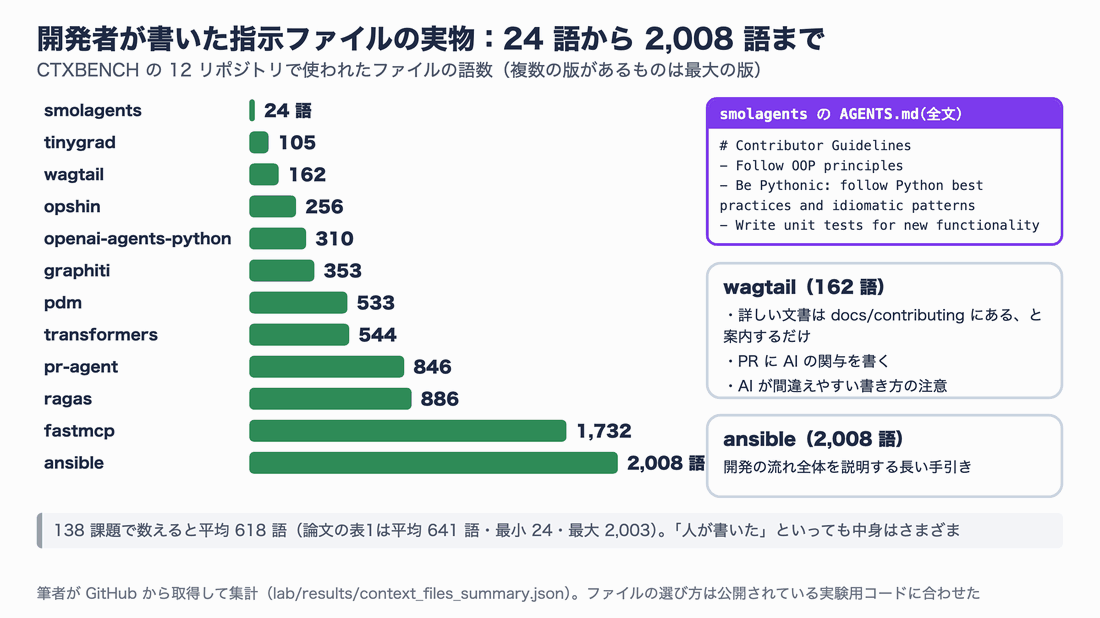
図10:12 リポジトリの指示ファイルの語数。3行だけのものから、2,000 語の手引きまであります
wagtail のファイルは、論文の提案(README にない指示だけを書く)にいちばん近い例です。全体の説明は既存の文書に任せ、AI が間違えやすい点だけを書いています。
課題の約4割は、指示ファイルができる前のコードだった
取得の途中で、気になる点が見つかりました。138 課題のうち 52 課題(38%)は、課題の出発点のコミットに AGENTS.md も CLAUDE.md もありません。 たとえば opshin の 14 課題は 2023 年 1 月〜2025 年 10 月のコードですが、opshin に AGENTS.md が追加されたのは 2025 年 12 月 22 日です。
公開されている実験用コード(2026 年 2 月 24 日時点)を読むと、この場合は「その後の履歴で最初に追加された版」を使う作りになっていました。筆者の集計では、55 課題がこの扱いにあたり、出発点のコードとファイルの追加日の差は中央値で 213 日、最大で 1,103 日あります。
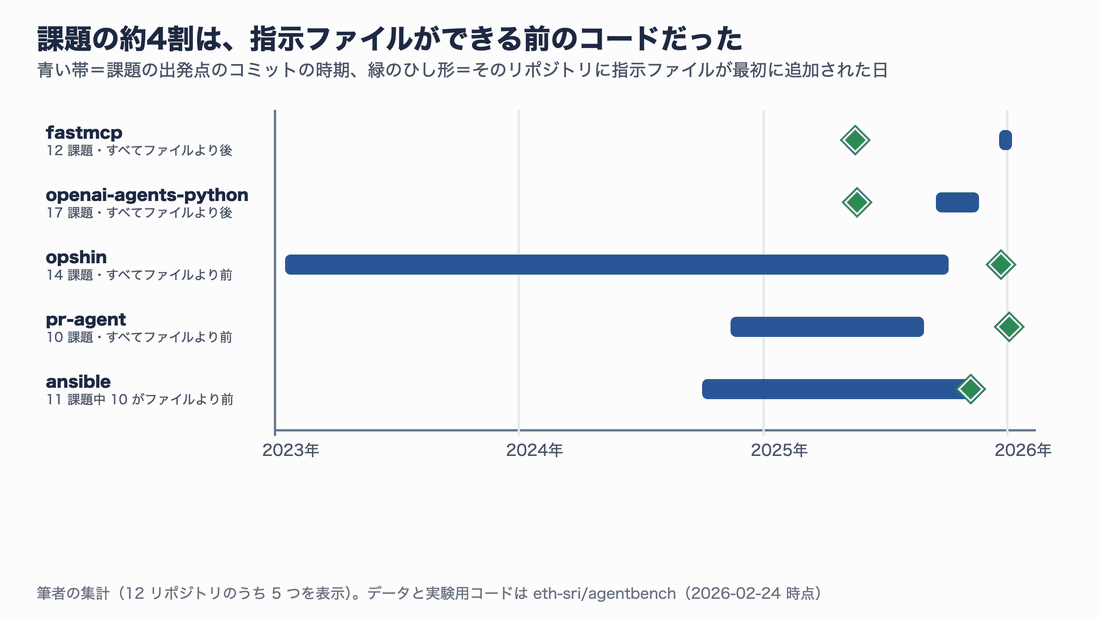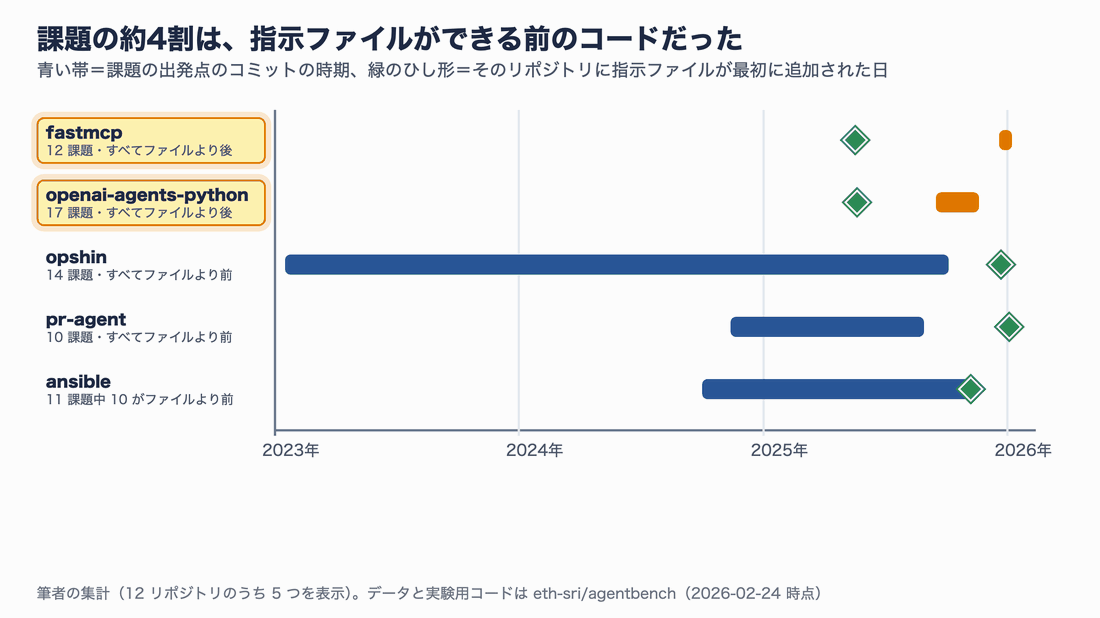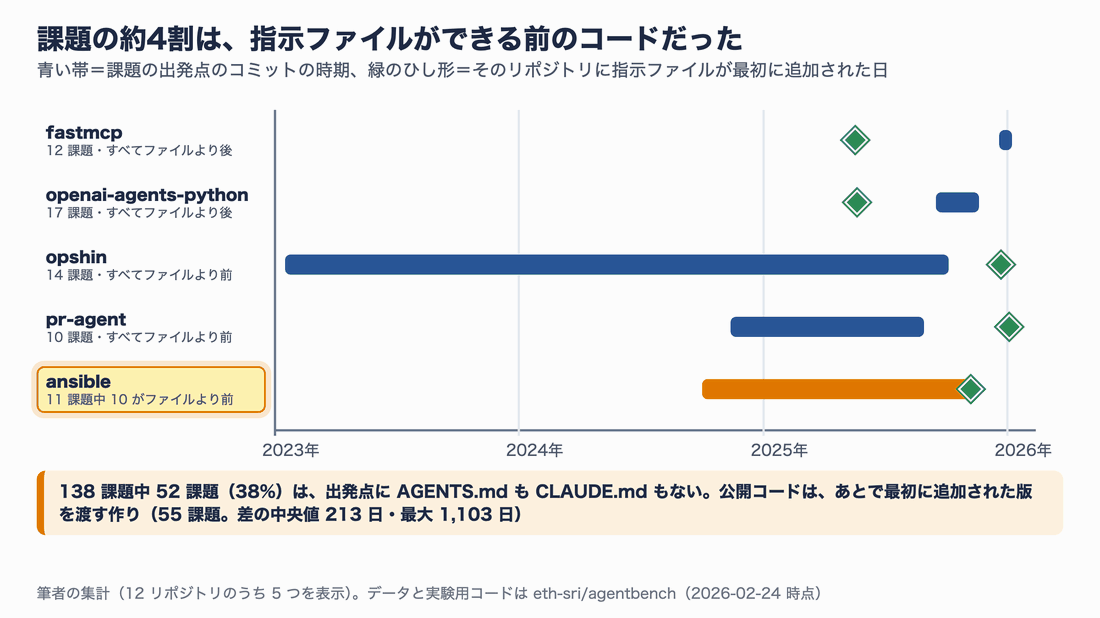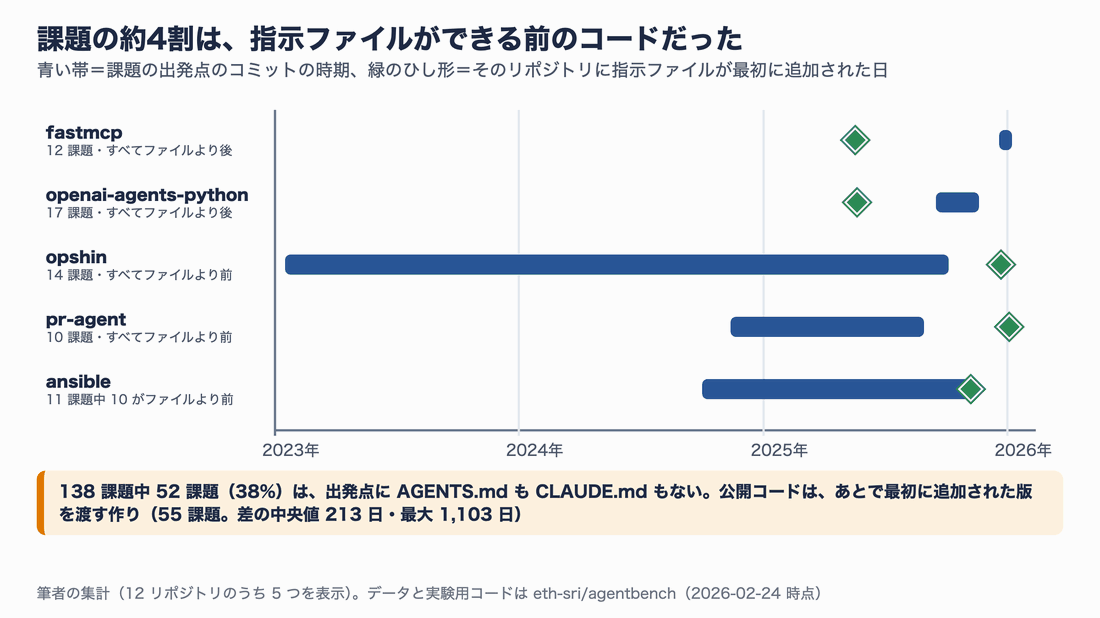
図11:出発点に指示ファイルがなかった課題では、あとから書かれた最初の版が使われる作りでした
論文の本文には「修正前の状態のリポジトリにある指示ファイルを使う」と書かれています。第 3 版の実験でこの扱いが変わったかどうかは、公開物からは確認できませんでした。確認できたのは、公開コードの作りと、データセットの出発点にファイルがない課題の数までです。
この点は、結論をひっくり返すものではありません。ただ「開発者が書いたファイル」の一部は、そのコードのために書かれたものではなく、数か月から数年後のコードのために書かれたものだった可能性があります。古いコードに合わない説明が混ざれば効果は小さく見え、逆にあとから分かった注意点が入っていれば大きく見えます。+2.4 ポイントという数字は、幅を持って受け取るのがよさそうです。
いまの /init は何を書くのか
論文のモデルは Sonnet 4.5 と GPT-5.2 です。そこで、いまのツールが作る指示ファイルを1つだけ見てみました。題材は CTXBENCH にも入っている pdm(Python のパッケージ管理ツール)で、2026 年 11 月 10 日時点のコードから指示ファイルを消し、それぞれ1回ずつ生成させています。
| 作り手 | 語数 | 構成・設計の説明が占める割合 | 名前が出てくる道具 |
|---|---|---|---|
pdm の開発者(いまの AGENTS.md) | 618 | 31% | 6 種類 |
| Codex CLI 0.159.2(GPT-6 Sol)+公式の初期化プロンプト | 342 | 18% | 11 種類 |
Claude Code 2.1.322(Fable 5.2)の /init | 1,064 | 54% | 12 種類 |
数えたのは、あとで紹介する点検スクリプトです。Claude Code が作ったファイルは 1,000 語を超え、半分以上が「Architecture」という見出しの下の設計の説明でした。内容は具体的で正確に見えますが、コードを読めば分かることでもあります。Codex は 200〜400 語という指定を守って短くまとめましたが、最初の見出しはやはり「プロジェクトの構成」でした。
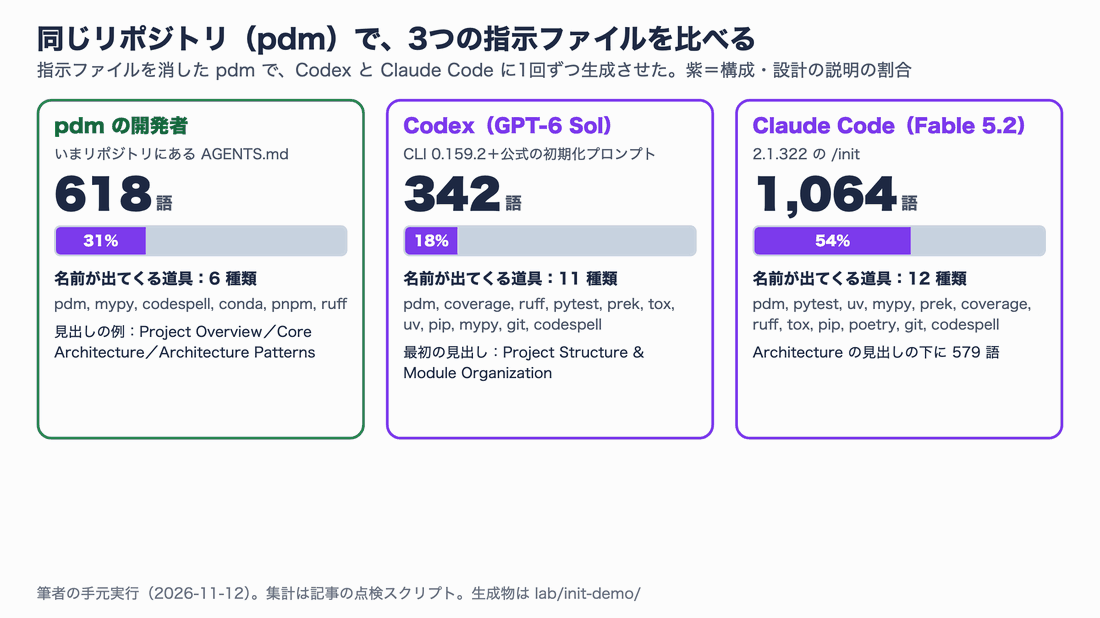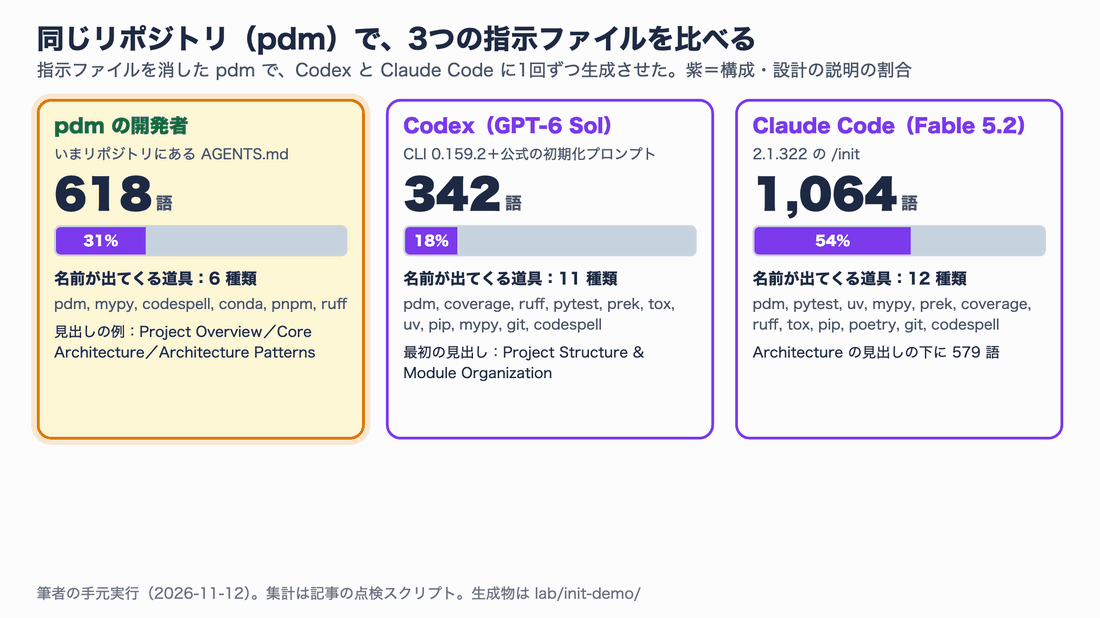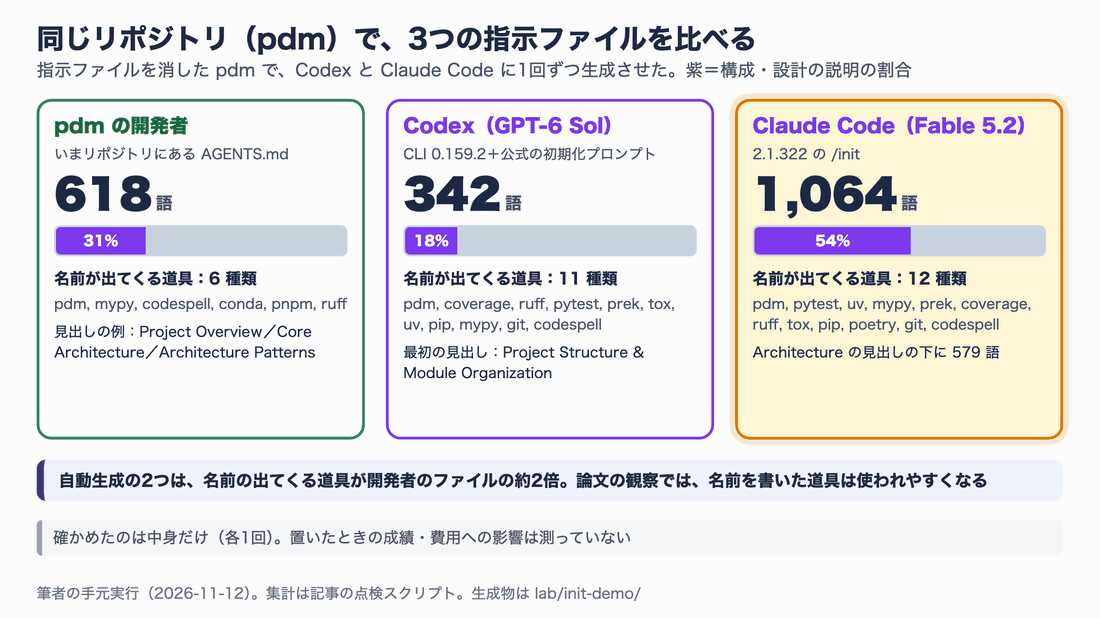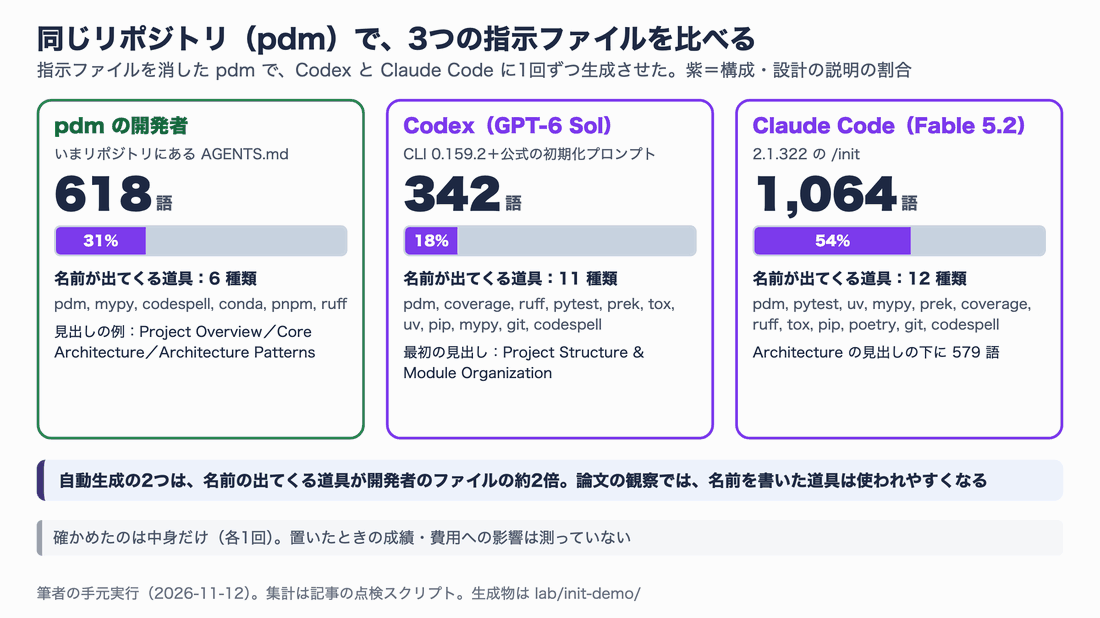
図12:pdm での比較(各1回)。自動生成の2つは、名前の出てくる道具が開発者のファイルの約2倍でした
どちらの自動生成も、pytest・tox・coverage・ruff など 11〜12 種類の道具の名前を挙げています。論文の観察どおりなら、名前を書いた道具は使われやすくなります。ここで確かめたのは生成されたファイルの中身だけで、これを置いたときにエージェントの成績や費用がどう変わるかは測っていません。1つのリポジトリで1回ずつの結果なので、傾向の目安として見てください。
この論文を読むときの注意
結論を自分の現場に当てはめる前に、条件を確認しておきます。
- Python だけ:モデルがよく知っている言語です。学習データの少ない言語や社内独自の道具では、指示ファイルがもっと効くかもしれません(論文自身が挙げている限界です)
- 測ったのは成功率だけ:テストが通るかどうかで判定しています。命名や設計の流儀を守ったか、安全なコードかどうかは測っていません。指示ファイルの本来の役目である「流儀をそろえる」効果は、この実験の外にあります
- モデルが1〜2世代前:Sonnet 4.5、GPT-5.2 などでの結果です。いまのモデルで同じになるかは分かりません
- 各課題1回ずつ:同じ条件を繰り返したときのばらつきは測られていません
- 課題文は AI が書き直したもの:CTXBENCH の課題文は丁寧に整えられています。同じ方法で SWE-bench の課題文を書き直すと、成功率が約 15 ポイント上がったと報告されています。雑な依頼文で使う場面とは条件が違います
自分の指示ファイルをどう直すか
論文の提案は短いものです。自動生成のファイルは当面置かない。人が書く場合は、README などにすでにある内容を繰り返さず、エージェントに必要な追加の指示(独自の流儀や、機能以外の要件)だけを書く。そして導入する前に効果を確かめる。
1行ずつ、残すかどうかを決める
これを実際の作業にすると、指示ファイルの1行ごとに次の順で判断することになります。
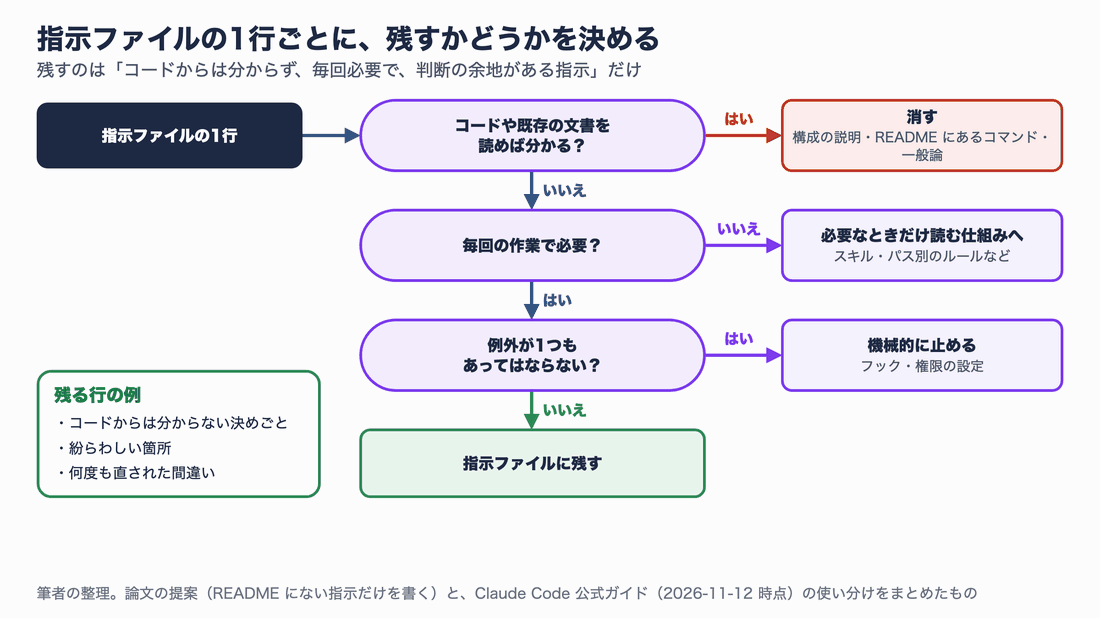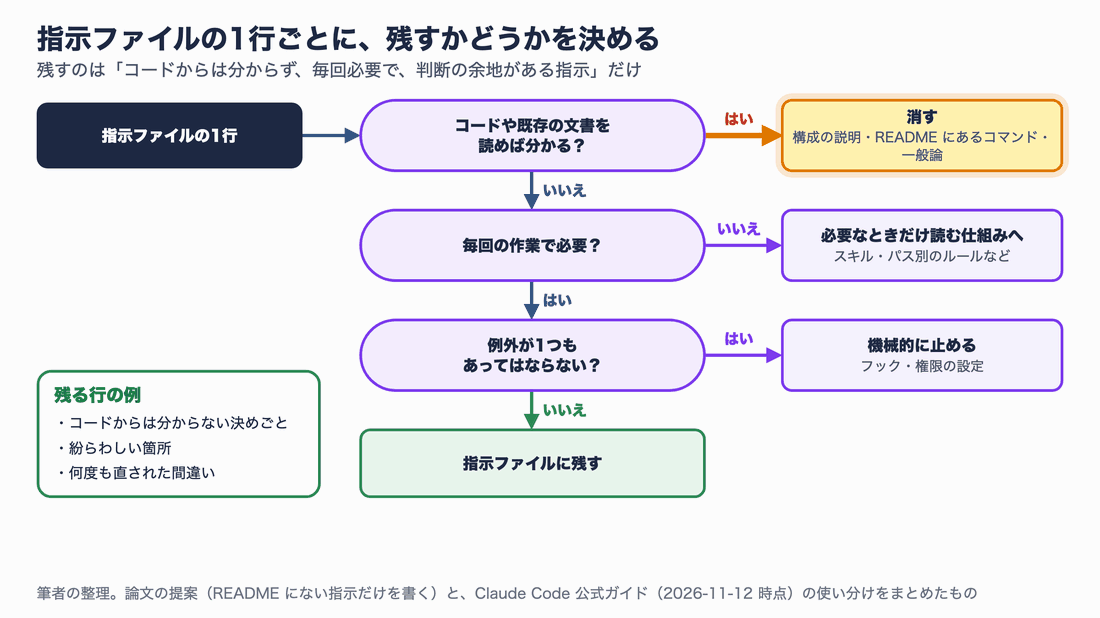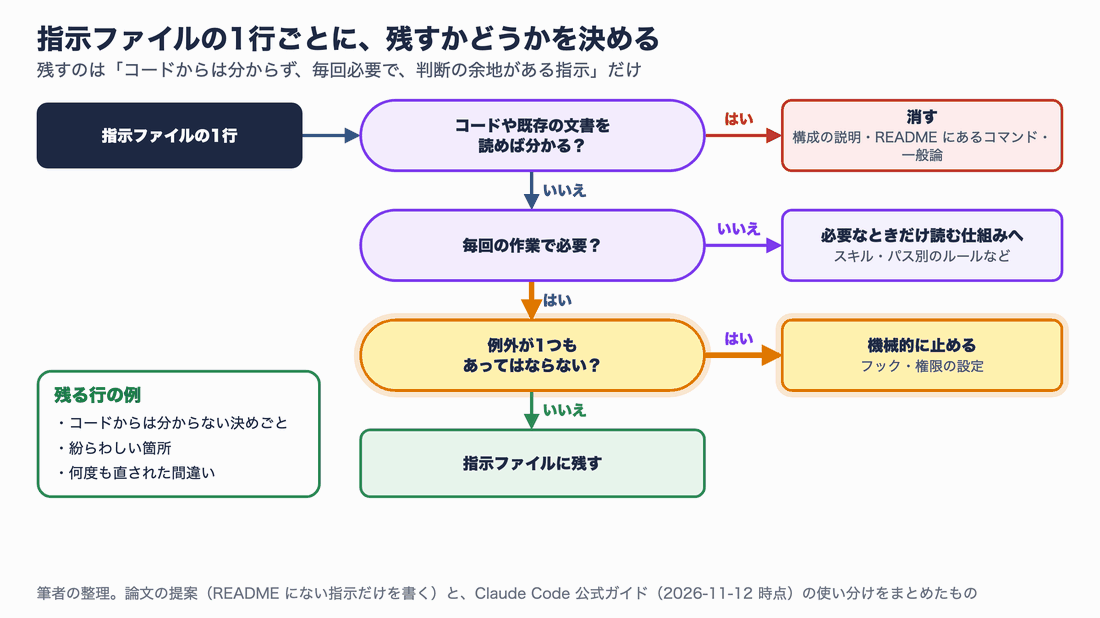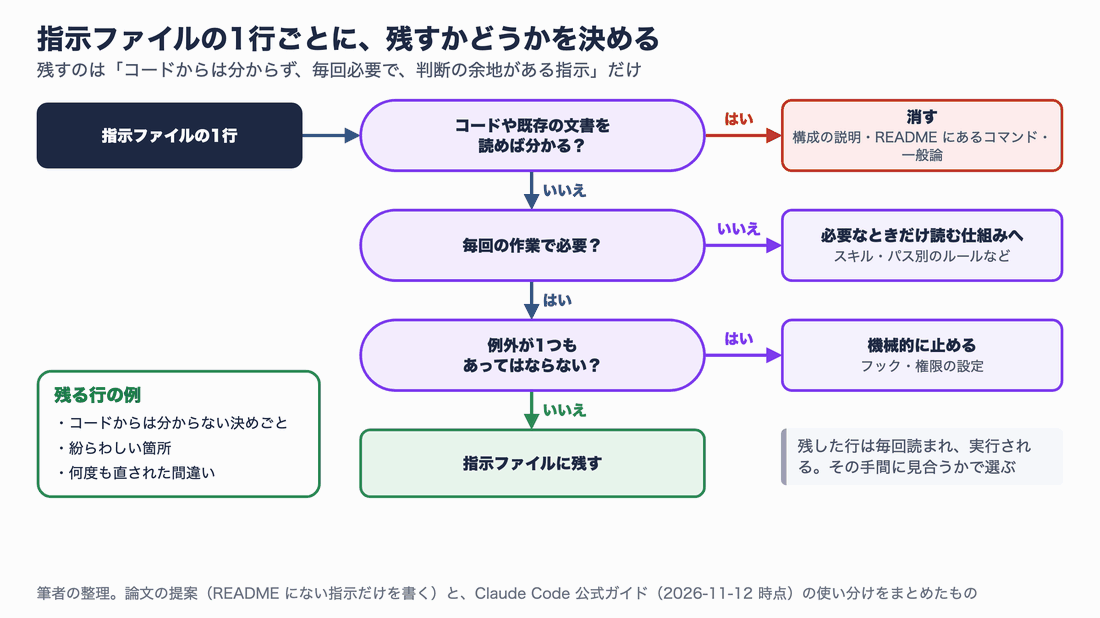
図13:1行ごとの判断の流れ(筆者の整理)。残すのは「コードからは分からず、毎回必要で、判断の余地がある指示」だけです
- コードや既存の文書を読めば分かるか。 分かるなら消します。構成の説明、README にあるコマンドの一覧、「テストを書く」のような一般論がこれにあたります
- 毎回の作業で必要か。 リリース手順のように特定の場面でしか使わないものは、必要なときだけ読み込まれる仕組み(Claude Code ならスキルやパス別のルール)に移します
- 例外が1つもあってはならないか。 「秘密情報のファイルを読まない」のような決まりは、指示ファイルではなく、フックや権限の設定で機械的に止めます
- 残ったものを書く。 コードからは分からない決めごと、紛らわしい箇所、何度も直された間違いです
書き直しの例
よくある自動生成のファイルと、絞ったあとの例を並べます(架空のプロジェクトです)。
<!-- 直す前:構成の説明と一般論が中心 -->
# Repository Guidelines
## Project Structure
- src/ にアプリ本体、tests/ にテスト、docs/ に文書があります
## Testing
- 変更したら必ず pytest で全テストを実行し、カバレッジも確認してください
## Style
- 読みやすいコードを書き、適切なエラーメッセージを返してください
<!-- 直した後:コードからは分からないことだけ -->
# このリポジトリの決めごと
- テスト1本だけ走らせる: uv run pytest tests/test_x.py::test_name
- エラーは src/lib/errors.py の関数で返す。文字列をそのまま raise しない
- src/legacy/ は現役だが、新しいコードで書き方をまねしない
- 結合テストは DATABASE_URL が必要(.env.example を参照)
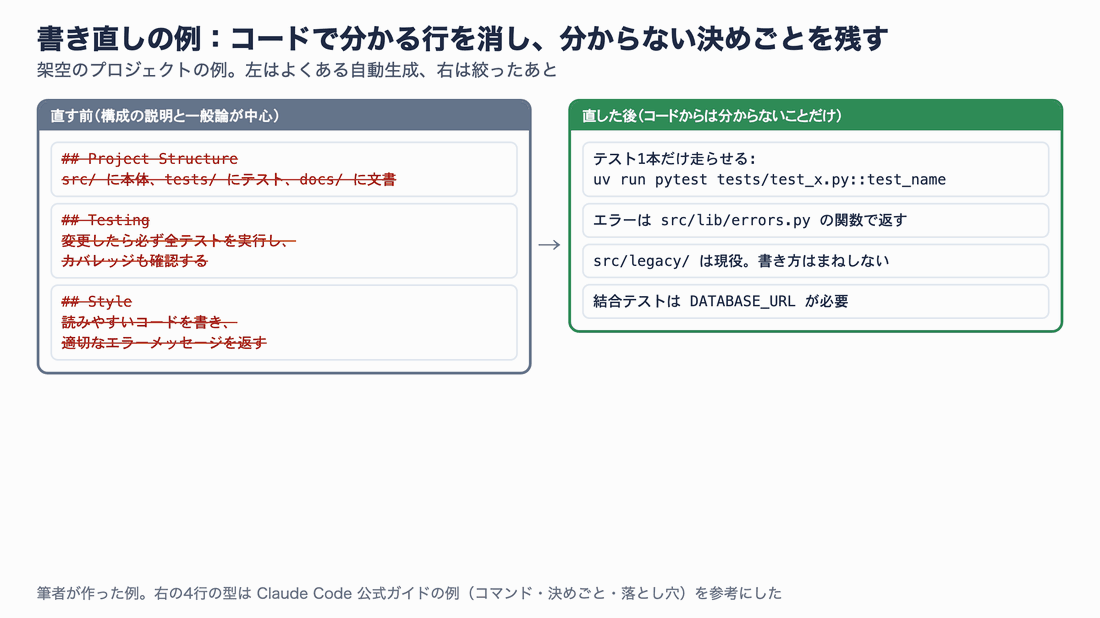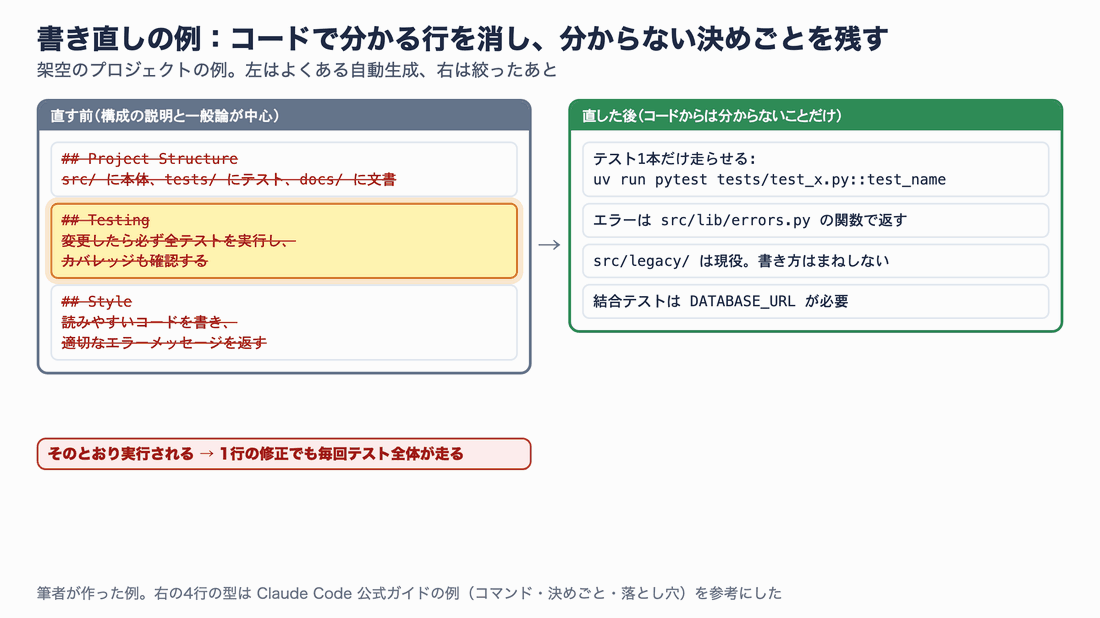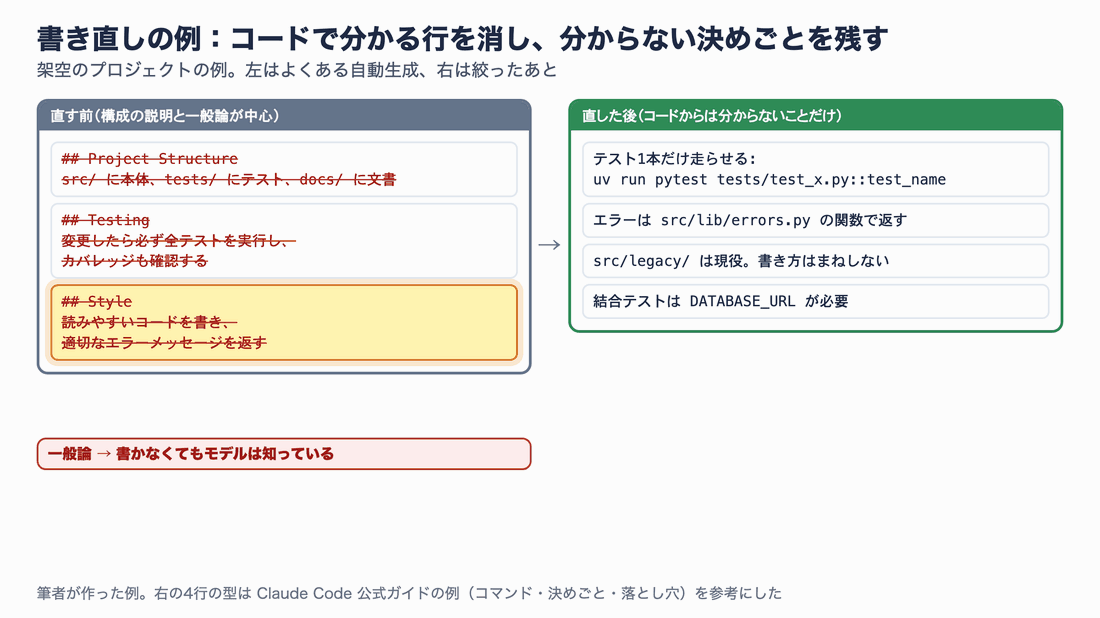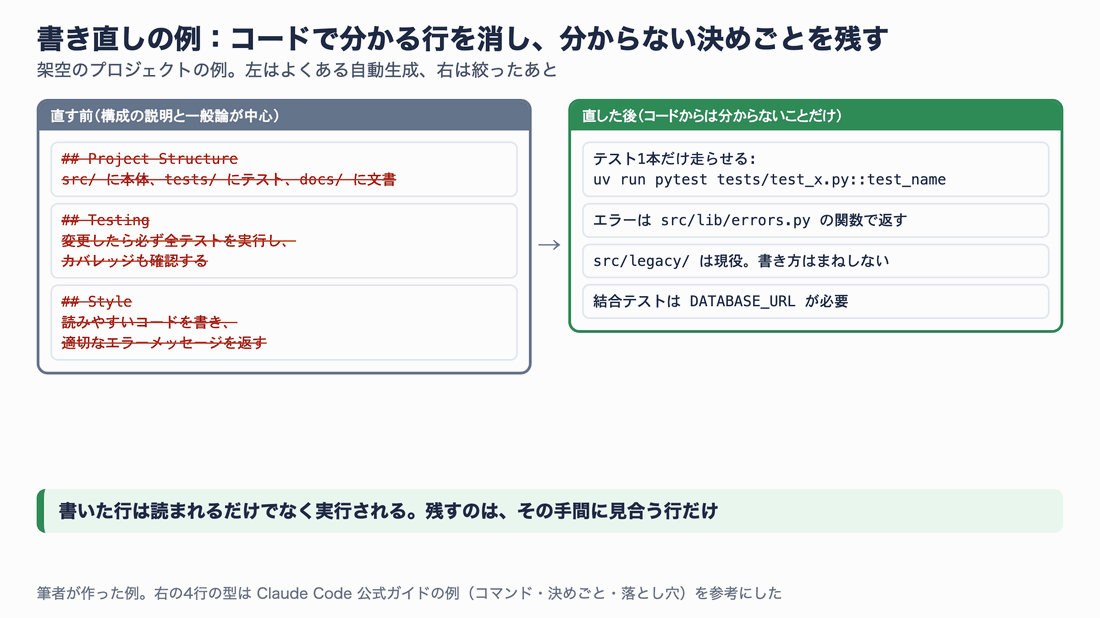
図14:書き直しの例。「全テストを実行」のような行は、そのとおり実行されて費用になります
直す前の「必ず全テストを実行し、カバレッジも確認」は、善意で書いた1行です。しかしエージェントはそのとおりに実行するので、1行の修正でも毎回テスト全体とカバレッジの計測が走ります。書いた行は読まれるだけでなく実行される、と考えて選ぶのがこつです。
公式ガイドも同じ方向に変わっている
2026 年 11 月 12 日時点の Claude Code の公式ガイド(ベストプラクティスのページ)は、指示ファイルに書くのは「コードからは分からないことだけ」とし、古くなった助言の一覧に「設計とファイル構成を CLAUDE.md に書く」を入れています。/init については「出発点を作るもので、そこからの作業は主に行を消すこと」と説明し、コードから分かる行の削除を提案する /doctor コマンドも用意されています。一方、AGENTS.md の公式サイトは、いまも定番の項目の最初に「プロジェクトの概要」を挙げています。
自分のファイルを点検する
手元の指示ファイルを、次のスクリプトで点検できます(全文は記事の最後にあります)。語数、構成の説明らしい見出し、名前が出てくる道具、そして既存の文書との重なりを表示します。ファイルを読むだけで、書き換えはしません。
# リポジトリの一番上で実行する
python3 audit_context_file.py AGENTS.md .
pdm の開発者が書いたファイルにかけた結果は次のとおりです。
分量: 618 語・123 行・見出し 19 個
概要らしい見出し: 3 個 ['## Project Overview', '## Core Architecture', '## Architecture Patterns'](その下の語数 189 語=全体の 31%)
名前が出てくる道具: pdm×29, mypy×2, codespell×2, conda×1, pnpm×1, ruff×1
`…` で囲んだ語句 16 個のうち、既存の文書にもあるもの: 5 個(31.2%)
「概要らしい見出し」と「名前が出てくる道具」が、見直しの候補です。数字はあくまで目安で、良し悪しを判定するものではありません。
効いているかを自分で測る
論文のいちばん大事な提案は「導入前に確かめる」です。大がかりな実験でなくても、同じ依頼を、指示ファイルあり・なしで何回かずつ実行して、手数と使用量を比べることはできます。作業用の複製を2つ作り、片方だけ指示ファイルを消します。
# 作業用の複製を2つ作る(git worktree は同じリポジトリの別の作業場所を作る機能)
git worktree add ../ab-with HEAD
git worktree add ../ab-without HEAD
rm ../ab-without/CLAUDE.md          # Codex なら AGENTS.md

# Claude Code:同じ依頼を両方で実行し、結果を JSON で保存する
(cd ../ab-with    && claude -p "$(cat ~/task.txt)" --output-format json > ~/with.json)
(cd ../ab-without && claude -p "$(cat ~/task.txt)" --output-format json > ~/without.json)

# やり取りの回数・出力トークン・所要秒を並べる
python3 -c "
import json
for f in ('with.json', 'without.json'):
    d = json.load(open(f))
    print(f, d['num_turns'], d['usage']['output_tokens'], round(d['duration_ms'] / 1000))
"
num_turns・usage・duration_ms という項目名は、Claude Code 2.1.322 の出力で確認しました。Codex の場合は codex exec --json "依頼文" < /dev/null の出力に、実行したコマンドが item.completed、使用量が turn.completed として1行ずつ記録されます(Codex CLI 0.159.2 で確認)。この手順を使った比較そのものは、この記事では行っていません。試すときは、ふだんの仕事に近い依頼を5〜10 個用意し、それぞれ複数回ずつ実行して、できあがった修正が正しいかも合わせて見てください。1回ずつでは、論文の実験と同じく偶然の差と区別できません。
つまずきやすい点
指示ファイルを見直すときによくある状況と、確認する順番をまとめます。
| 状況 | まず確認すること | 対処 |
|---|---|---|
| 簡単な修正なのに時間と費用がかかる | 指示ファイルに「必ず全テスト」「必ず lint」などの行がないか | 単体のテストを走らせるコマンドだけを書き、全体の実行は CI やフックに任せる |
| 指示ファイルを消したら流儀がばらついた | 消した行のうち、コードから読み取れない決めごとはどれか | その行だけ戻す。全部を戻さない |
| 書いたのに守られない | ファイルが長くなって埋もれていないか。例外を許さない決まりではないか | 短くする。例外なしの決まりはフックや権限の設定に移す |
| 文書がほとんどないリポジトリ | README や docs があるか | 自動生成が助けになる場面(論文の「文書を消した実験」)。生成した内容は README に置くほうが人にも役立つ |
| チームで意見が割れる | 効果を数字で見たか | 上の手順で、あり・なしを同じ依頼で比べる |
論文の結果と、内容が古くなる問題は別の話です。指示ファイルの中身がコードとずれると、エージェントは古い指示のほうに従ってしまうことがあります(別の論文 arXiv:2610.30571 の報告です)。行を減らしておけば、ずれる場所もそれだけ減ります。
まとめ
- 指示ファイル(AGENTS.md・CLAUDE.md)を置いても、Python の課題を解く成功率は意味のある大きさでは変わりませんでした。費用は 19〜23% 増えています
- エージェントは指示を無視しているのではなく、よく従っています。書かれたテストや道具を律儀に使い、その手間が成績に結びついていません
- 自動生成のファイルは、すでにある文書の焼き直しになりがちです。文書がないリポジトリでは逆に役立ちました
- 開発者が書いたファイルは自動生成より良い成績でしたが、「置かない」との差は誤差の範囲でした。公開物を見るかぎり、課題の約4割では、指示ファイルはそのコードより後に書かれたものでした
- 実務では、コードから分からず、毎回必要な指示だけを残し、効いているかどうかを自分の依頼で確かめるのがよさそうです
次の一歩としては、手元の指示ファイルを点検スクリプトにかけ、構成の説明と「必ず〜する」の行を1つずつ見直すところから始めてみてください。
参考リソース
- Thibaud Gloaguen, Niels Mündler-Sasahara, Mark Niklas Müller, Veselin Raychev, Martin Vechev「Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?」arXiv:2602.11988(v1:2026-02-12、v3:2026-09-29、CC BY 4.0)https://arxiv.org/abs/2602.11988
- 実験用コード:https://github.com/eth-sri/agentbench (MIT ライセンス)
- 課題データ:https://huggingface.co/datasets/eth-sri/agentbench
- AGENTS.md 公式サイト:https://agents.md/
- Claude Code 公式ドキュメント「Best practices」:https://code.claude.com/docs/en/best-practices
- Claude Code 公式ドキュメント「How Claude remembers your project」:https://code.claude.com/docs/en/memory
- Codex の初期化プロンプト:https://github.com/openai/codex/blob/main/codex-rs/tui/assets/prompt_for_init_command.md
付録:点検スクリプトの全文
audit_context_file.py という名前で保存して使います。Python 3.9 以上の標準機能だけで動きます(macOS の Python 3.9 と 3.12 で実行を確認)。
#!/usr/bin/env python3
"""指示ファイル(AGENTS.md / CLAUDE.md)の点検。読むだけで、何も書き換えない。

  python3 audit_context_file.py AGENTS.md            # ファイルだけ見る
  python3 audit_context_file.py AGENTS.md .          # リポジトリの文書との重なりも見る
  python3 audit_context_file.py AGENTS.md . --json   # 機械で読める形で出す

見るもの:
  1. 分量(語数・行数・見出し)
  2. 概要らしい見出し(構成・アーキテクチャの説明)… 論文で「探す手間は減らなかった」部分
  3. 名前が出てくる道具(pytest・uv など)… 書くと実際に使われ、その分ステップと費用が増える部分
  4. `バッククォート` で囲んだコマンドやパスのうち、README など既存の文書にも書いてある割合
"""
import json, re, sys
from pathlib import Path

OVERVIEW = re.compile(r"structure|overview|architecture|layout|organization|directory|module map|構成|概要|アーキテクチャ|ディレクトリ", re.I)
TOOLS = ["pytest", "unittest", "tox", "nox", "uv", "pip", "pdm", "poetry", "hatch", "conda", "make", "npm", "pnpm", "yarn", "bun",
         "ruff", "black", "flake8", "mypy", "pyright", "pylint", "eslint", "prettier", "tsc", "vitest", "jest", "pre-commit", "prek",
         "docker", "cargo", "go test", "gradle", "mvn", "git", "gh", "codespell", "coverage", "mkdocs", "sphinx"]
DOC_GLOBS = ["README*", "CONTRIBUTING*", "docs/**/*.md", "docs/**/*.rst", "doc/**/*.md", "DEVELOPMENT*", "HACKING*"]
NAMES = {"agents.md", "claude.md", "claude.local.md", "gemini.md"}

def audit(path, repo=None):
    txt = Path(path).read_text(encoding="utf-8", errors="replace")
    lines = txt.splitlines()
    heads, in_code = [], False
    for l in lines:
        if l.strip().startswith("```"): in_code = not in_code; continue
        if not in_code and re.match(r"^#{1,6}\s", l): heads.append(l.strip())
    # 概要らしい見出しの下(より深い見出しを含む)にある語数
    ov_words, cur, in_code = 0, None, False
    for l in lines:
        if l.strip().startswith("```"): in_code = not in_code
        m = None if in_code else re.match(r"^(#{1,6})\s+(.*)", l)
        if m:
            lv = len(m.group(1))
            if cur is not None and lv <= cur: cur = None
            if cur is None and OVERVIEW.search(m.group(2)): cur = lv
            continue
        if cur is not None: ov_words += len(l.split())
    low = txt.lower()
    tools = {t: len(re.findall(r"(?<![\w-])" + re.escape(t) + r"(?![\w-])", low)) for t in TOOLS}
    tools = {t: n for t, n in tools.items() if n}
    spans = sorted({s.strip() for s in re.findall(r"`([^`\n]{3,80})`", txt)})
    out = {"file": str(path), "words": len(txt.split()), "lines": len(lines), "headings": heads,
           "overview_headings": [h for h in heads if OVERVIEW.search(h)], "overview_words": ov_words, "tools_mentioned": tools,
           "backticked": len(spans)}
    if repo:
        docs = ""
        for g in DOC_GLOBS:
            for p in Path(repo).glob(g):
                if p.is_file() and p.name.lower() not in NAMES and p.resolve() != Path(path).resolve():
                    docs += p.read_text(encoding="utf-8", errors="replace") + "\n"
        hit = [s for s in spans if s in docs]
        out.update({"docs_chars": len(docs), "backticked_also_in_docs": len(hit),
                    "overlap_pct": round(100 * len(hit) / len(spans), 1) if spans else None,
                    "only_here": [s for s in spans if s not in docs][:40]})
    return out

if __name__ == "__main__":
    args = [a for a in sys.argv[1:] if not a.startswith("--")]
    if not args: sys.exit(__doc__)
    r = audit(args[0], args[1] if len(args) > 1 else None)
    if "--json" in sys.argv:
        print(json.dumps(r, ensure_ascii=False, indent=1)); sys.exit()
    print(f"== {r['file']}")
    print(f"分量: {r['words']} 語・{r['lines']} 行・見出し {len(r['headings'])} 個")
    print(f"概要らしい見出し: {len(r['overview_headings'])} 個 {r['overview_headings']}(その下の語数 {r['overview_words']} 語=全体の {round(100*r['overview_words']/max(r['words'],1))}%)")
    print("名前が出てくる道具: " + (", ".join(f"{t}×{n}" for t, n in sorted(r['tools_mentioned'].items(), key=lambda x: -x[1])) or "なし"))
    if "overlap_pct" in r:
        print(f"`…` で囲んだ語句 {r['backticked']} 個のうち、既存の文書にもあるもの: {r['backticked_also_in_docs']} 個({r['overlap_pct']}%)")
        print("この指示ファイルにしか出てこない語句(先頭 40 個まで):")
        for s in r["only_here"]: print("  -", s)