「Claude と GPT、どちらが賢いのか」「ベンチマークで 1 位のモデルを使えば、うちの開発もうまくいくはず」。AI エージェント(指示を受けて、自分でコマンドを打ったりファイルを書き換えたりしながら仕事を進める AI)を選ぶとき、こう考える人は多いと思います。
2026 年 10 月 1 日に公開された論文「Finding the Right Fit: Model–Harness Interactions across Agent Tasks」は、この考え方に正面から疑問を投げかけました。シンガポールの南洋理工大学(NTU)のチームが、5 つのモデルを 6 種類の「ハーネス」に載せ、3 種類のベンチマークで 6,204 回動かした結果、ハーネスを替えるだけでモデルの順位が入れ替わることを示したのです。
この記事では、論文を専門知識がなくても読めるように整理し直します。あわせて、著者が公開している実行データを筆者の手元で再集計し、論文の主要な数字が再現できるかを確かめました。
この記事の確認範囲
- 元資料:arXiv:2610.00917v1(2026-10-01 投稿、全 19 ページ)の本文・表・図
- 筆者が実施したこと:公開データ(Hugging Face の
results/task_level.tsvとconfig_cost_summary.csv)から、表 1 の点数・費用・モデル呼び出し回数を再計算(2026-10-04)。論文と一致しました。図 8 の事例は、公開された実行記録(軌跡)から時刻を取り出して作図しています - 実施していないこと:エージェントを実際に動かす追試。論文のモデル名・ハーネスのバージョンは論文実施時点のものです
はじめに:「どの AI が一番賢いか」だけでは選べない
最初に、この論文の主張を 1 枚の図にまとめます。左がよくある比べ方、右が論文の見方です。下の棒グラフは、同じ 2 つのモデルの順位が、ハーネスを替えただけでひっくり返る実例です。
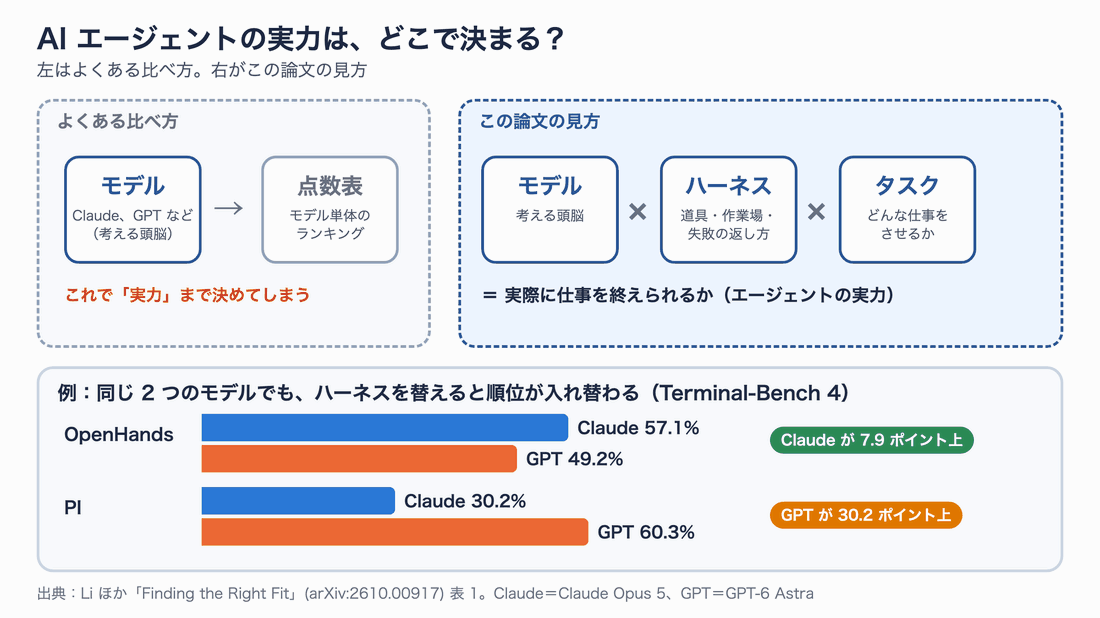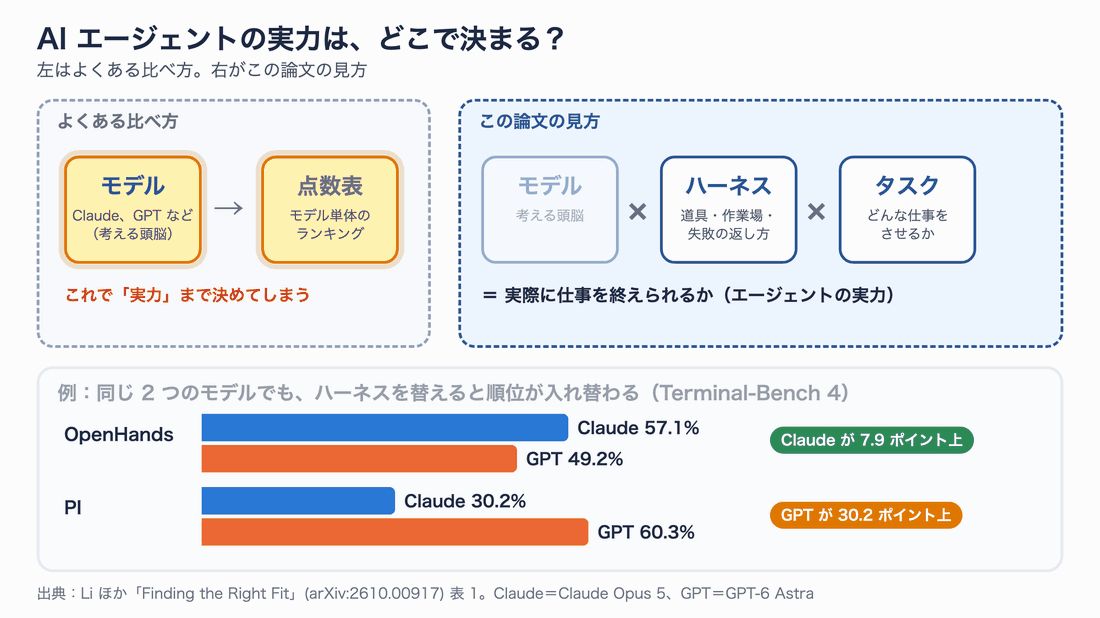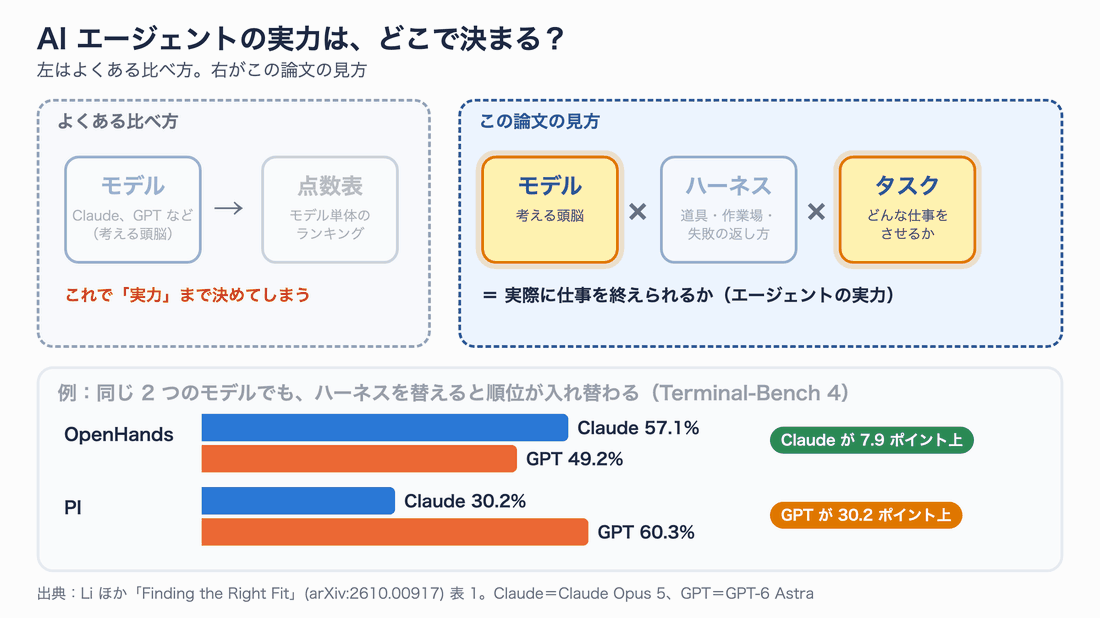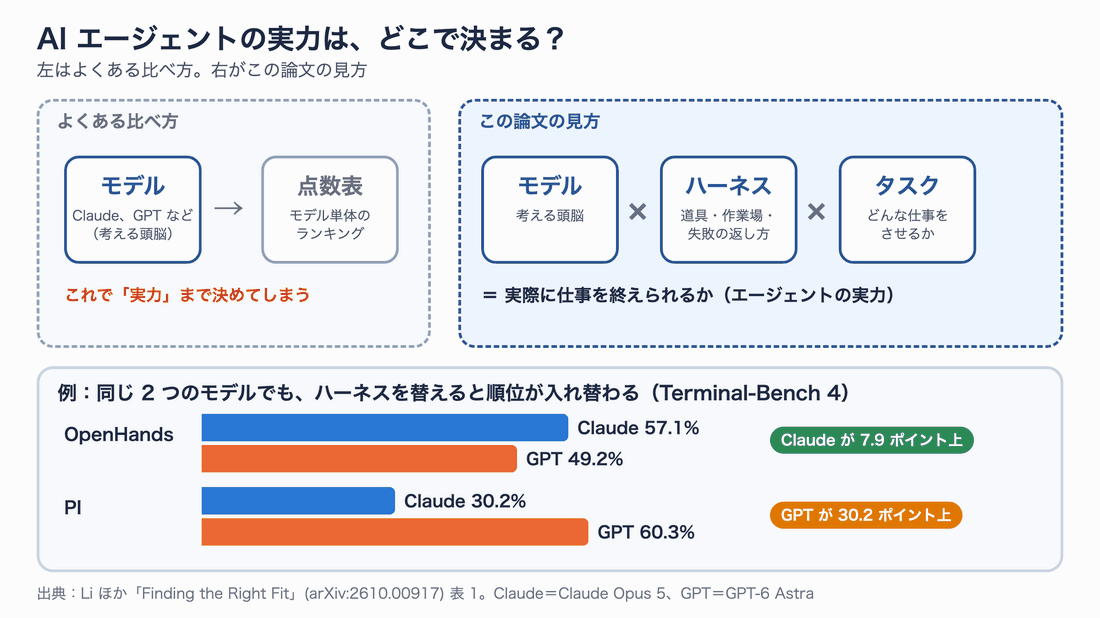
図1:エージェントの実力は「モデル × ハーネス × タスク」の組み合わせで決まる。OpenHands では Claude が 7.9 ポイント上、PI では GPT が 30.2 ポイント上。
モデル単体の点数表(リーダーボード)が答えてくれるのは、「どの頭脳が優秀か」という問いだけです。しかし実際に仕事をこなすエージェントは、頭脳だけでは動きません。コマンドを実行し、結果を読み、失敗したらやり直す――その仕組み全体の出来が、最後の点数に効いてきます。
この記事で分かることは、次の 4 つです。
- ハーネスとは何か、なぜそれで結果が変わるのか
- 66 通りの組み合わせを測った実験から分かった 4 つの発見
- 差が生まれる 具体的な理由(実際の実行記録から)
- 自分のチームで 相性を確かめる手順
AI エージェントを使い始めたばかりの方から、チームの導入を判断する立場の方まで読めるように書いています。
そもそも「ハーネス」とは
ハーネス(harness) は、もともと馬具や安全帯のように「力を受け止めて、うまく使えるようにする装具」を指す言葉です。AI の世界では、モデル(LLM:大規模言語モデル)の周りを囲んで、実際に作業できるようにする仕組み全体をこう呼びます。Claude Code や Codex CLI、OpenHands などがその代表です。
たとえるなら、モデルは腕のいい料理人、ハーネスは厨房です。同じ料理人でも、包丁の置き場所、火加減の調整のしやすさ、「焦げてるよ」と教えてくれる仲間がいるかどうかで、出来上がる料理は変わります。
エージェントが動くときの流れを、図で追ってみましょう。番号 1〜5 が、ハーネスの受け持つ部分です。
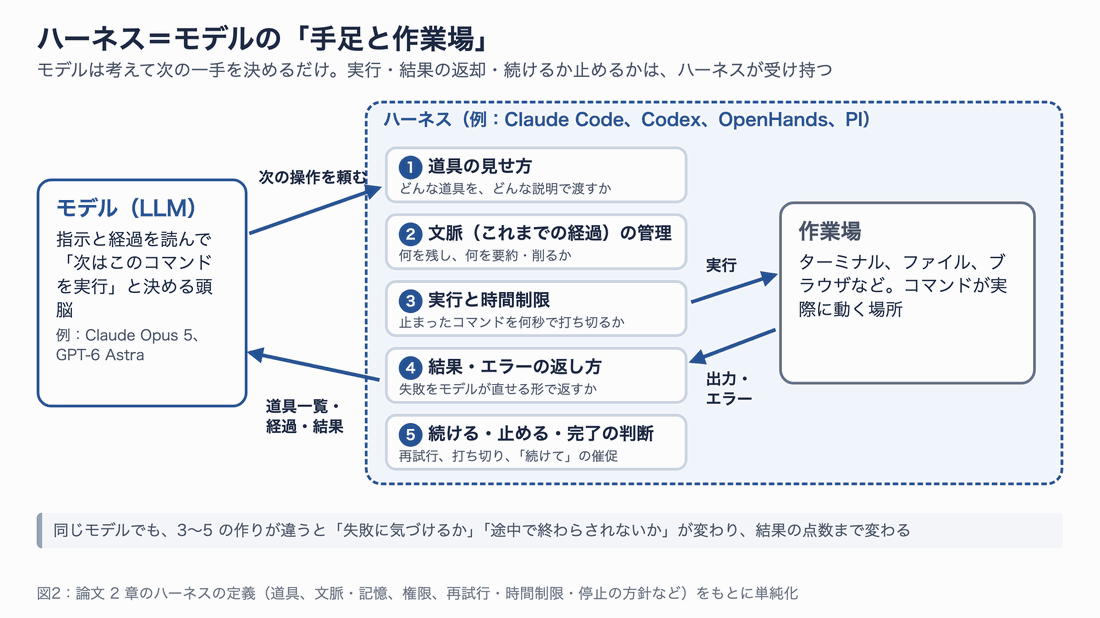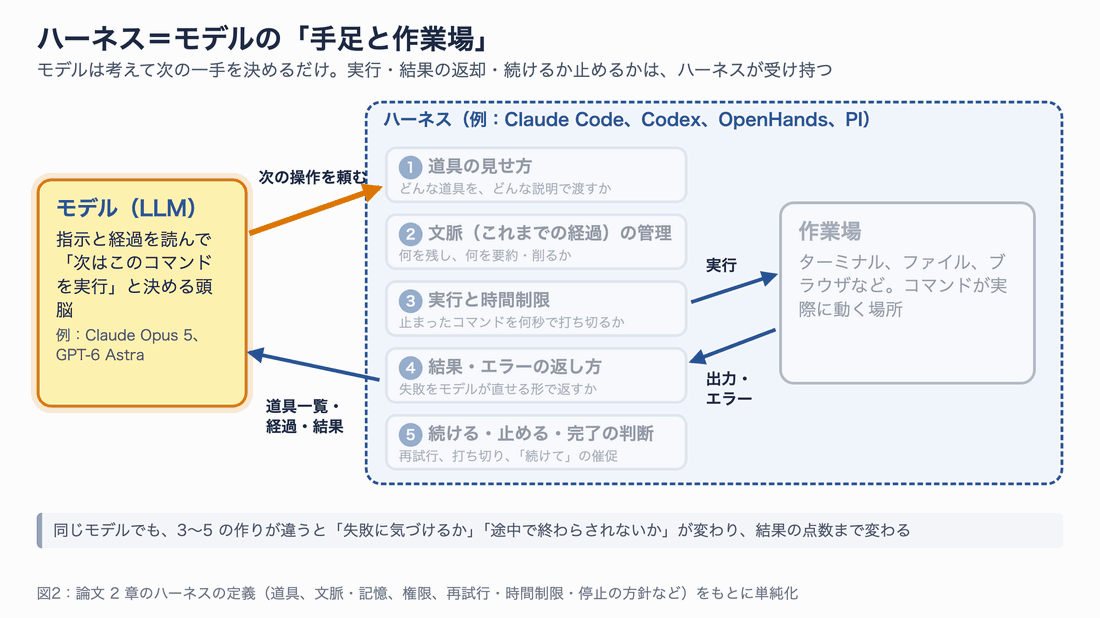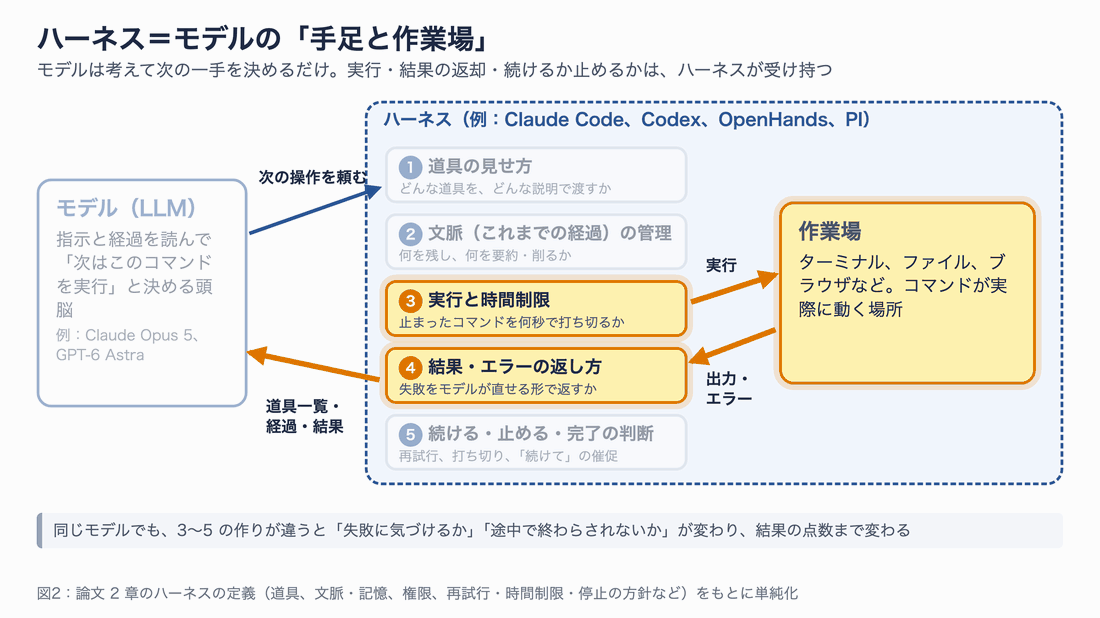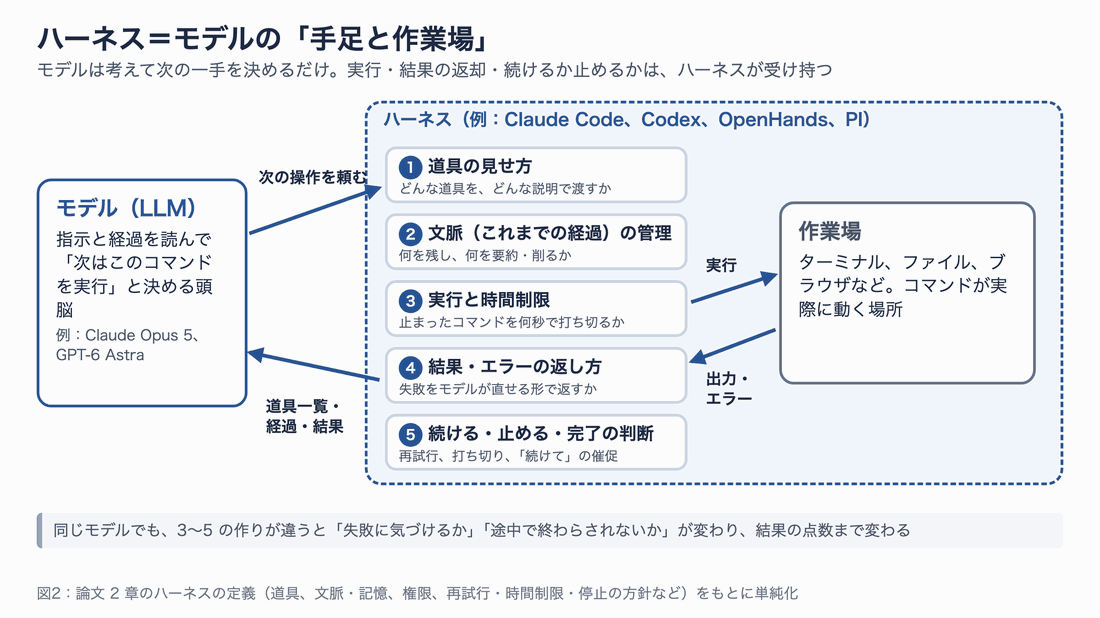
図2:モデルは「次はこれを実行して」と決めるだけ。実行、結果の返却、続けるか止めるかの判断はハーネスが担う。
モデルがやっているのは、指示とこれまでの経過を読んで「次はこのコマンドを実行しよう」と決めることだけです。実際にコマンドを動かし、出力やエラーを受け取り、それをどんな形でモデルに見せるかは、すべてハーネスの設計で決まります。
特に結果を左右するのが、図の 3〜5 です。
- 実行と時間制限:応答しなくなったコマンドを何秒で打ち切るか。打ち切らなければ、エージェントは延々と待ち続けます
- 結果・エラーの返し方:失敗したとき、その事実と理由をモデルが読める形で返すか
- 続ける・止める・完了の判断:同じ失敗を繰り返したら止めるか、返答が途中で切れたら「続けて」と促すか
論文で比べられた 6 つのハーネスの初期設定を、表にまとめます(論文の付録 表 5 より)。道具の数や、会話が長くなったときの扱い(文脈の圧縮)がかなり違うことが分かります。
| ハーネス | 提供元・性格 | 主な道具 | 長い会話の扱い | 手数の上限 |
|---|---|---|---|---|
| OpenHands | 多くのモデルに対応するオープンな基盤 | 端末、ファイル編集、タスク管理、思考、終了 | 100 万トークンの窓、要約なし | 500 手+「行き詰まり検知」 |
| DeepSeek Harness(DSH) | DeepSeek が公開したハーネス | 標準の道具 26 種 | 窓の 80% で圧縮 | なし |
| PI | 最小限の道具だけのツールキット | 読む・bash・編集・書く の 4 つ | 上限近くで圧縮 | なし |
| openJiuwen | エージェント用フレームワーク(論文側で組み立て) | 読む・書く・編集・検索など 7 つ | 独自の文脈圧縮 | 外側のループ 8 回 |
| Codex | OpenAI 純正(GPT とだけ組み合わせ) | コード実行の道具 | 27.2 万トークンで圧縮 | なし |
| Claude Code | Anthropic 純正(Claude とだけ組み合わせ) | 純正の道具 21 種 | 100 万トークンで自動圧縮 | なし |
実験のしくみ:66 通りの組み合わせを同じ条件で
論文が測ったのは、「強いモデル、強いハーネス、強い組み合わせは、条件が変わっても強いままか」という問いです。そのために、組み合わせを総当たりで用意しました。
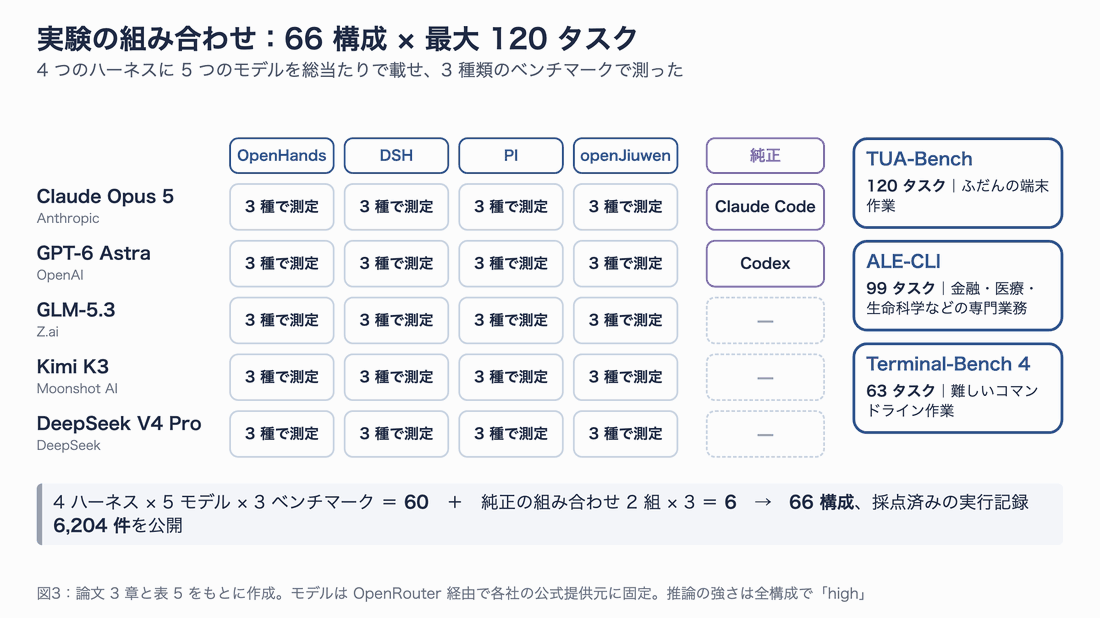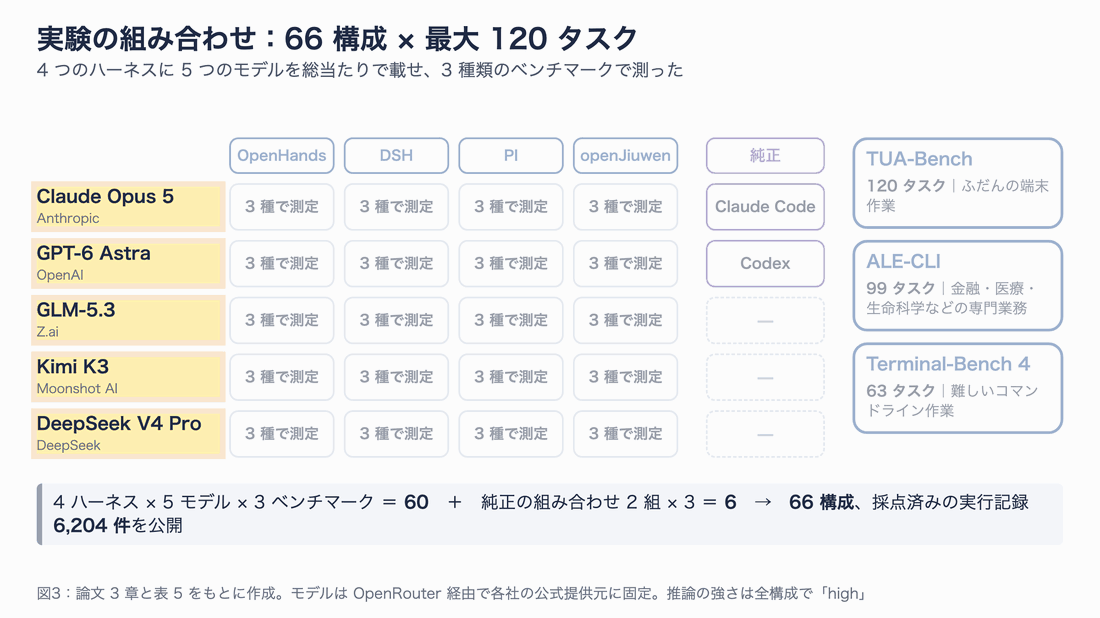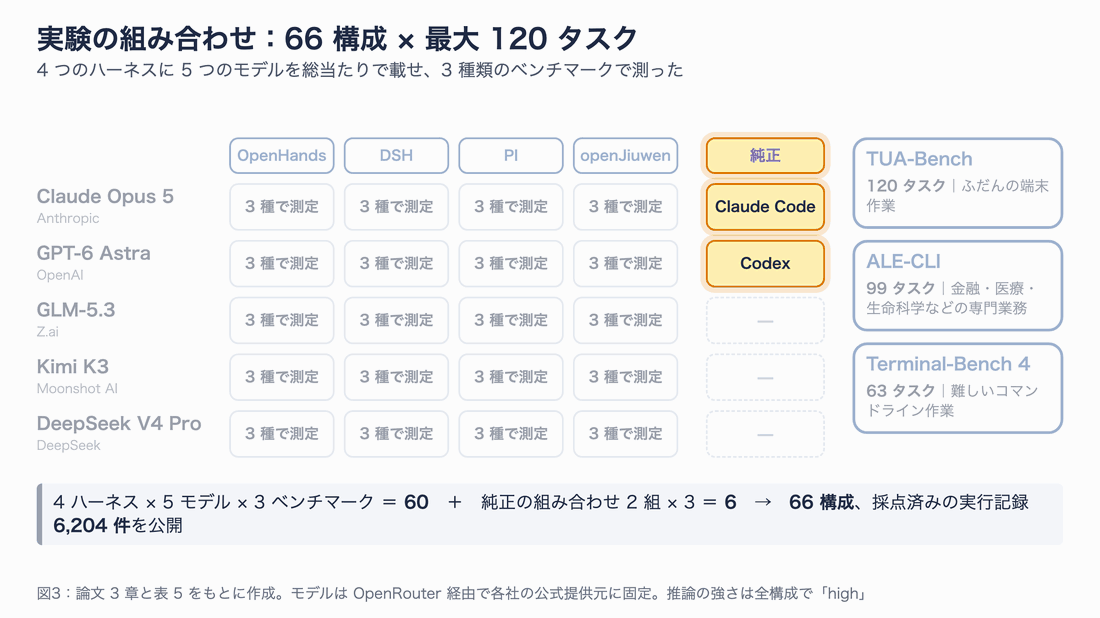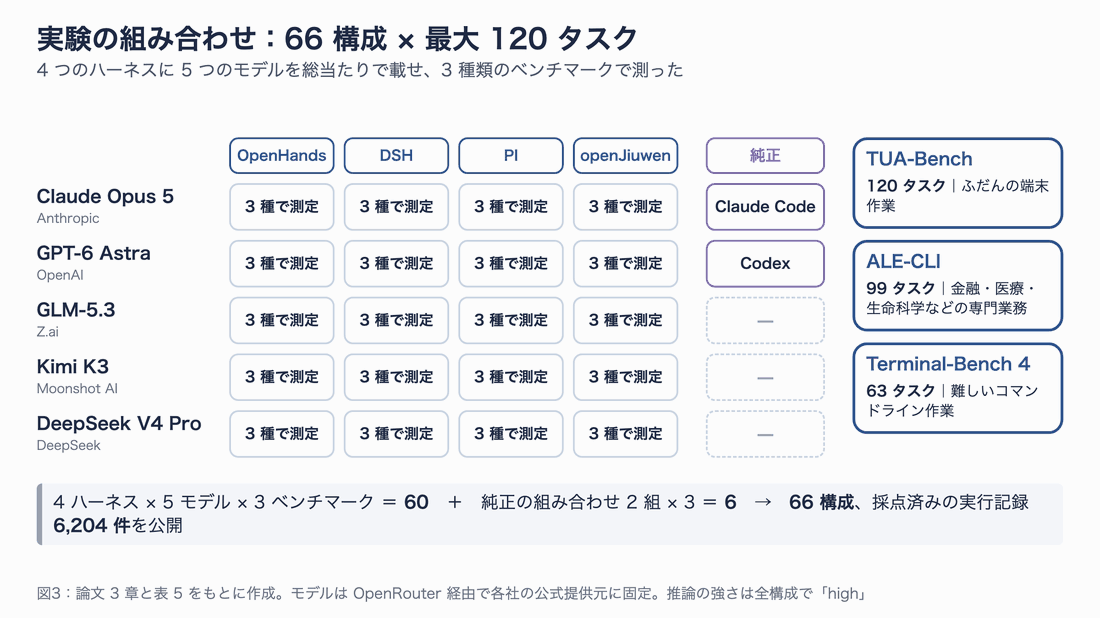
図3:4 ハーネス × 5 モデル × 3 ベンチマーク=60、純正の 2 組 × 3=6 で、合計 66 構成。
使われたベンチマーク(AI の実力を測るための課題集)は、性格の違う 3 種類です。
| ベンチマーク | タスク数 | どんな仕事か | 採点 |
|---|---|---|---|
| TUA-Bench | 120 | ファイル操作や画像編集など、ふだんの端末作業 | 部分点あり |
| ALE-CLI | 99 | 金融・医療・生命科学など、専門職の業務 | 部分点あり |
| Terminal-Bench 4 | 63 | 回路設計やサーバー構築など、難しいコマンドライン作業(GPU 不要の 63 問) | 合格か不合格か |
条件をそろえるために、論文は次のような工夫をしています。
- 5 つのモデルはすべて OpenRouter(複数の AI を同じ窓口から呼べるサービス)経由で、各社の公式の提供元に固定して呼び出す
- 推論の強さはすべて「high」。ただし同じ「high」でも、ハーネスによって実際の考える量が同じとは限らない、と論文自身が注意しています
- スキル、MCP サーバー、記憶、独自の指示文はどの構成にも追加しない。各ハーネスの初期設定のまま比べる
- 唯一の例外は OpenHands で、初期設定だと出力が 16K トークンに制限されてしまうため、上限を引き上げている
測定は 1 タスクにつき 1 回です。環境の起動失敗などで止まったものはやり直し、最後の 1 回を採点に使っています。こうして集まった 6,204 件の採点済み実行記録と、評価用のコードはすべて公開されています。
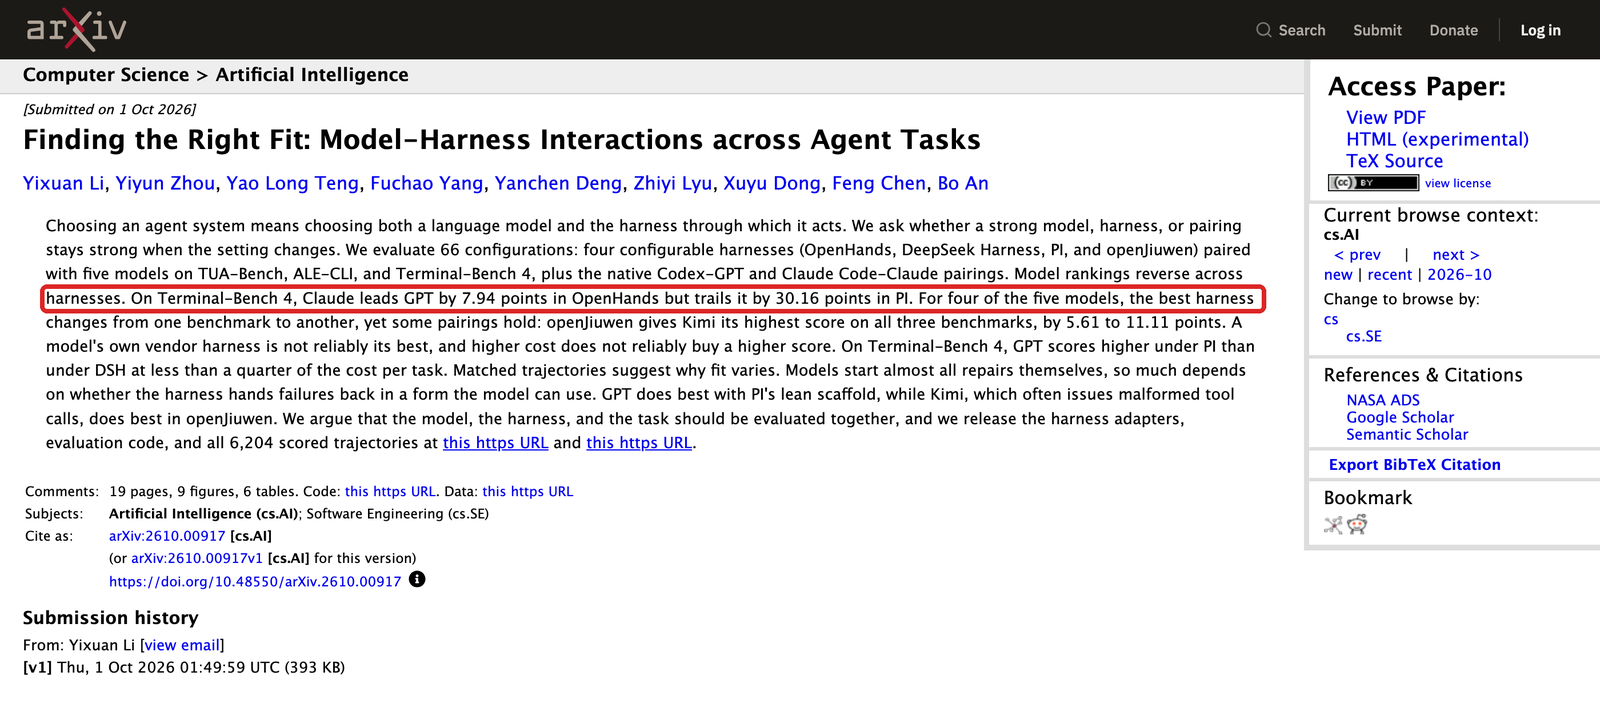
arXiv の論文ページ(2026-10-04 撮影)。赤枠が、この記事の出発点になった一文です。
発見1:ハーネスを替えると、モデルの順位が逆転する
まず、いちばん目を引く結果です。Terminal-Bench 4 で Claude Opus 5 と GPT-6 Astra を比べると、どのハーネスに載せたかで勝ち負けが変わりました。上から順に 4 つのハーネスを見ていきます。
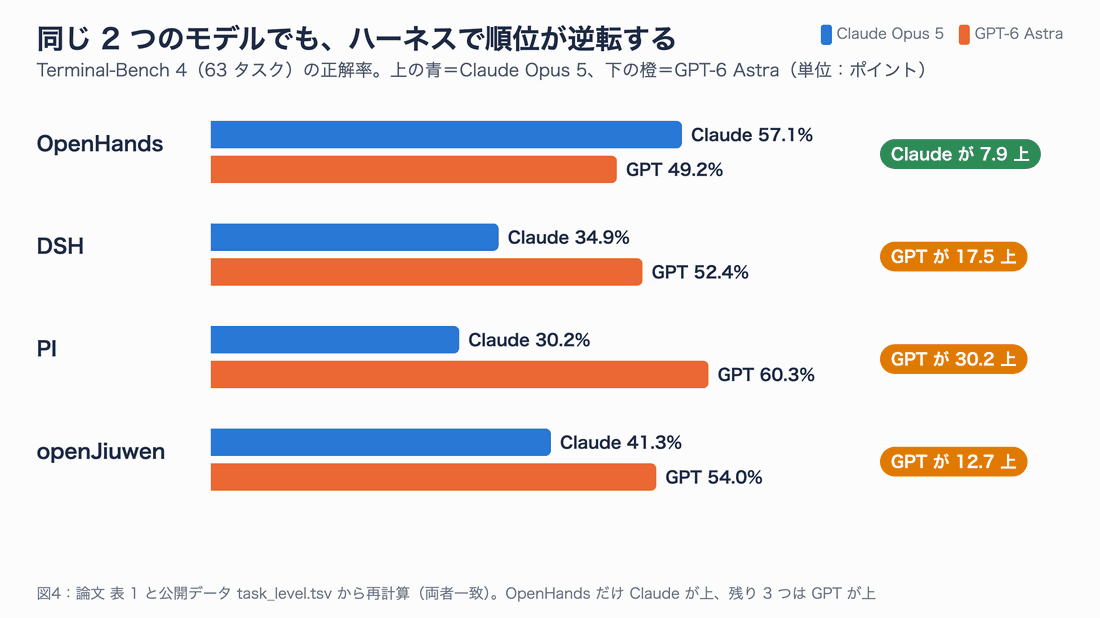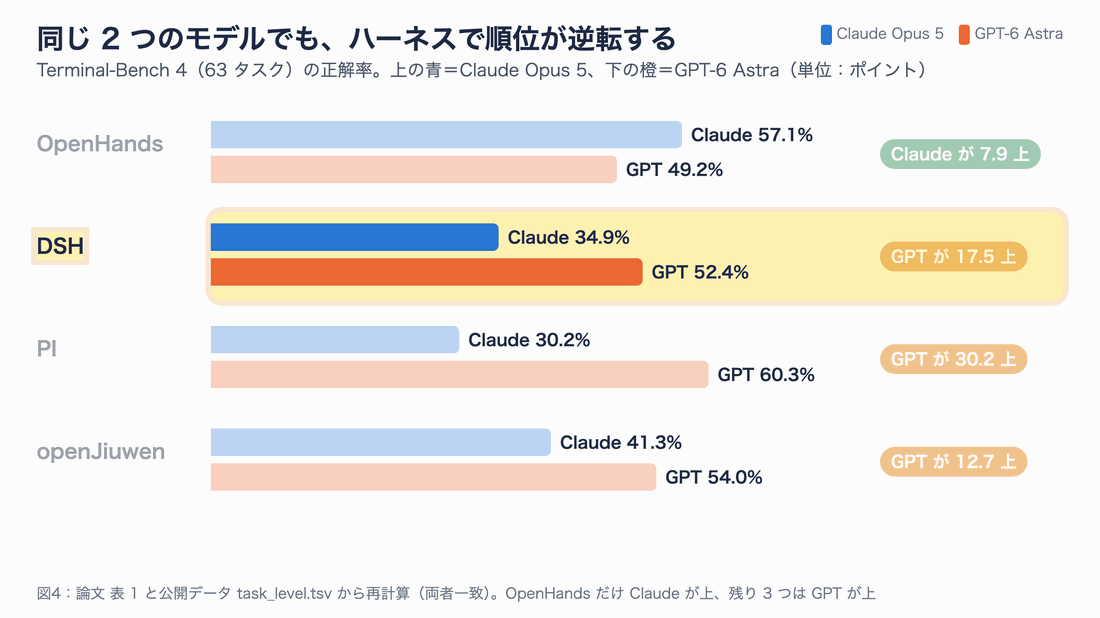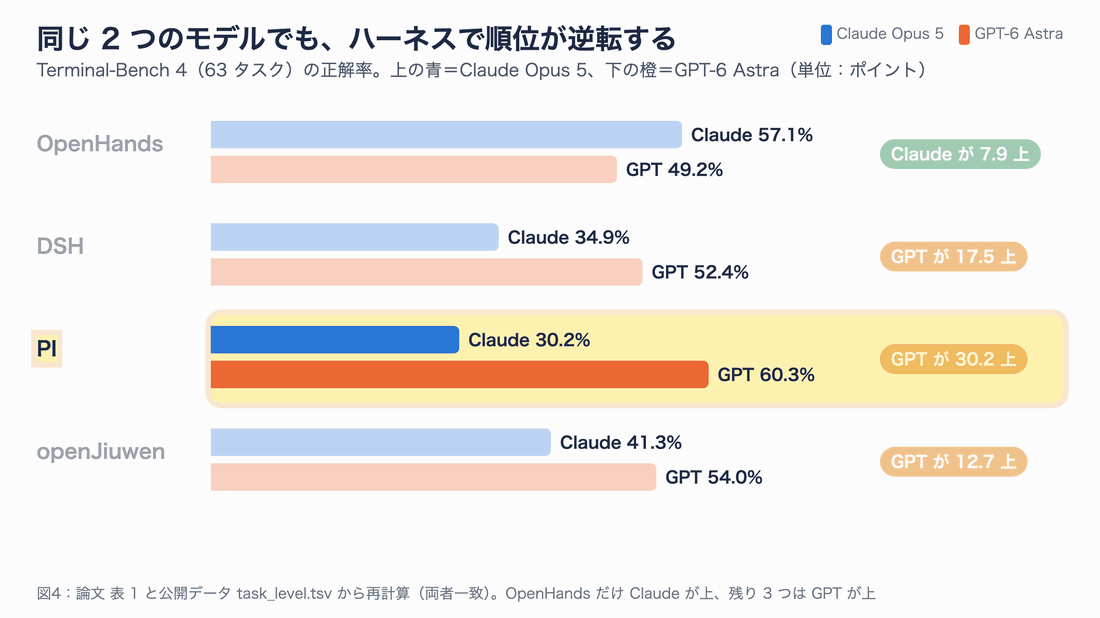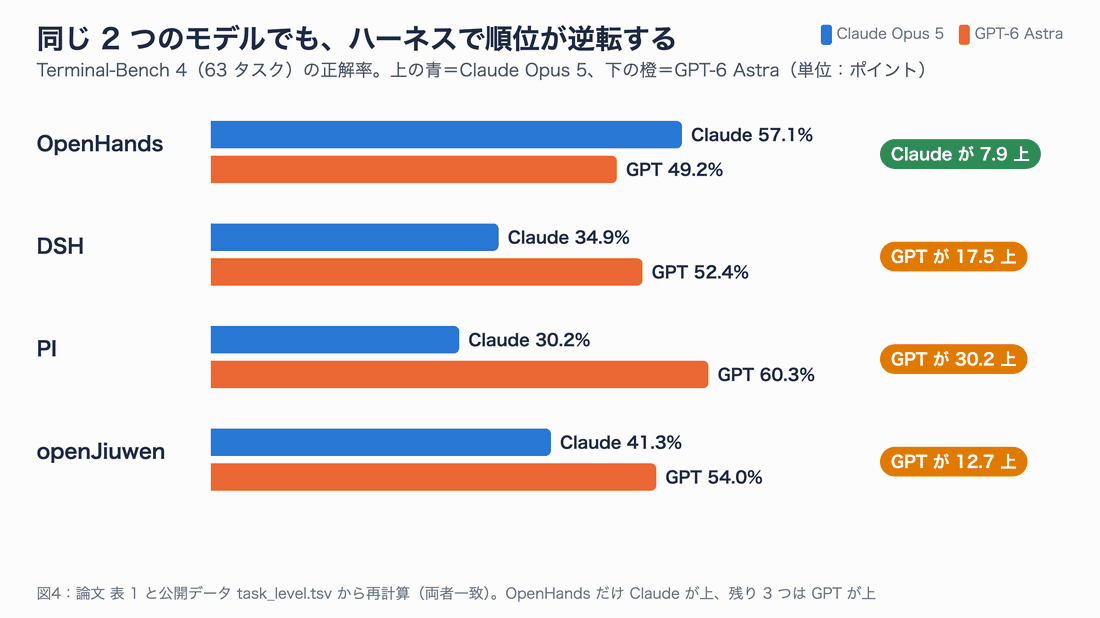
図4:OpenHands だけ Claude が上。DSH・PI・openJiuwen では GPT が上で、PI では差が 30 ポイントに開く。
数字を表にすると、次のとおりです(正解数は 63 問中)。
| ハーネス | Claude Opus 5 | GPT-6 Astra | 差(Claude − GPT) |
|---|---|---|---|
| OpenHands | 57.1%(36 問) | 49.2%(31 問) | +7.9 |
| DSH | 34.9%(22 問) | 52.4%(33 問) | −17.5 |
| PI | 30.2%(19 問) | 60.3%(38 問) | −30.2 |
| openJiuwen | 41.3%(26 問) | 54.0%(34 問) | −12.7 |
OpenHands と PI だけを比べると、Claude は 57.1% から 30.2% に下がり、GPT は 49.2% から 60.3% に上がっています。2 つのモデルの差は、合わせて 38 ポイントも動きました。
もし「OpenHands で測ったリーダーボード」だけを見ていたら、Claude のほうが強いと結論づけたはずです。PI で測った表だけなら、GPT の圧勝に見えます。どちらも嘘ではありません。ただ、モデルだけの順位として読むと間違える、というのがこの結果の意味です。
発見2:「純正のハーネスが一番」とは限らない
それなら、モデルを作った会社の純正ハーネスを使えば安心でしょうか。Claude には Claude Code、GPT には Codex という純正の組み合わせがあり、論文はこれも測っています。各ベンチマークで、純正と「同じモデルでいちばん良かった別のハーネス」を比べた結果が次の表です(論文 表 2)。
| ベンチマーク | 純正の組み合わせ | 点数 | 最も良かった別のハーネス | 点数 | 差 |
|---|---|---|---|---|---|
| TUA-Bench | Claude Code × Claude | 68.9% | openJiuwen | 65.4% | 純正が 3.5 上 |
| TUA-Bench | Codex × GPT | 63.7% | openJiuwen | 66.3% | 別が 2.7 上 |
| ALE-CLI | Claude Code × Claude | 54.3% | OpenHands | 53.1% | 純正が 1.1 上 |
| ALE-CLI | Codex × GPT | 56.3% | PI | 58.5% | 別が 2.2 上 |
| Terminal-Bench 4 | Claude Code × Claude | 49.2% | OpenHands | 57.1% | 別が 7.9 上 |
| Terminal-Bench 4 | Codex × GPT | 55.6% | PI | 60.3% | 別が 4.8 上 |
Claude Code は 3 つのうち 2 つで Claude の最高点を出しましたが、Terminal-Bench 4 では OpenHands に 7.9 ポイント負けました。Codex は 3 つとも、GPT の最高点にはなっていません。
論文はこの理由を、純正ハーネスはまず自社製品のために設計されているから、すべての仕事に最適とは限らない、と説明しています。純正は有力な候補ですが、「純正だから最良」とは言えない、というのが公平な読み方です。
発見3:仕事の種類が変わると、最適な組み合わせも変わる
次に、各モデルについて「いちばん点が高かったハーネス」を、ベンチマークごとに並べてみます。モデルの行を上から順に強調していきます。
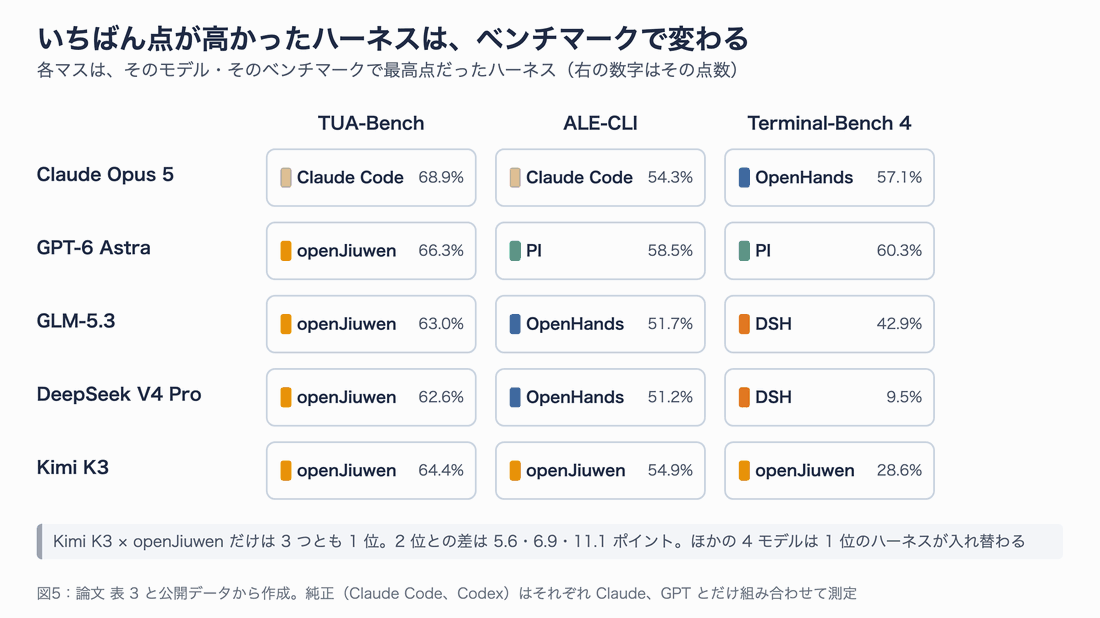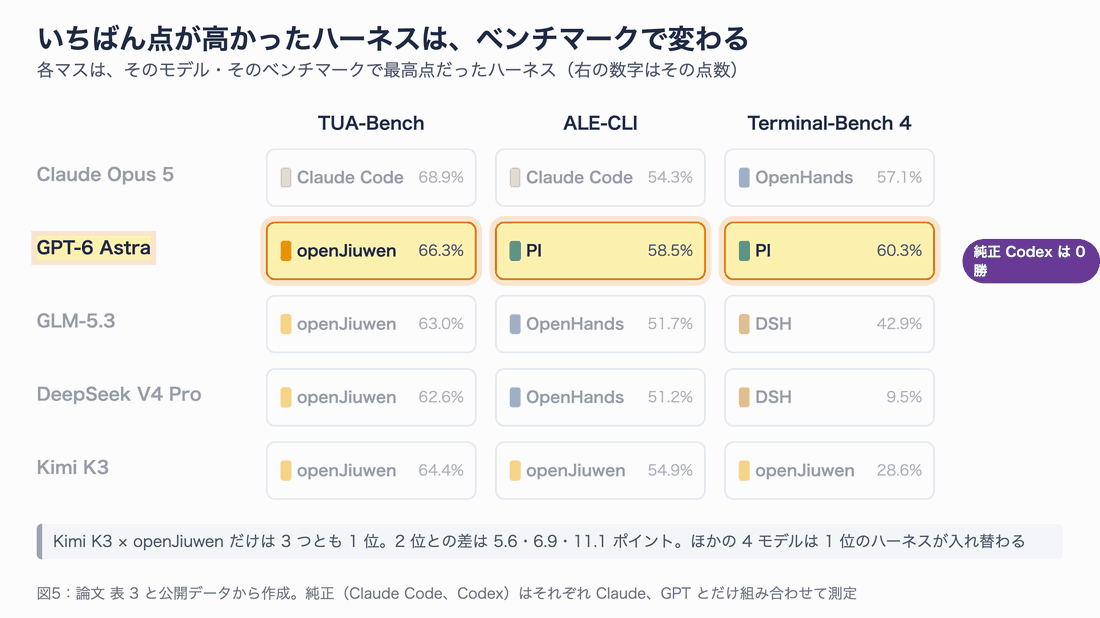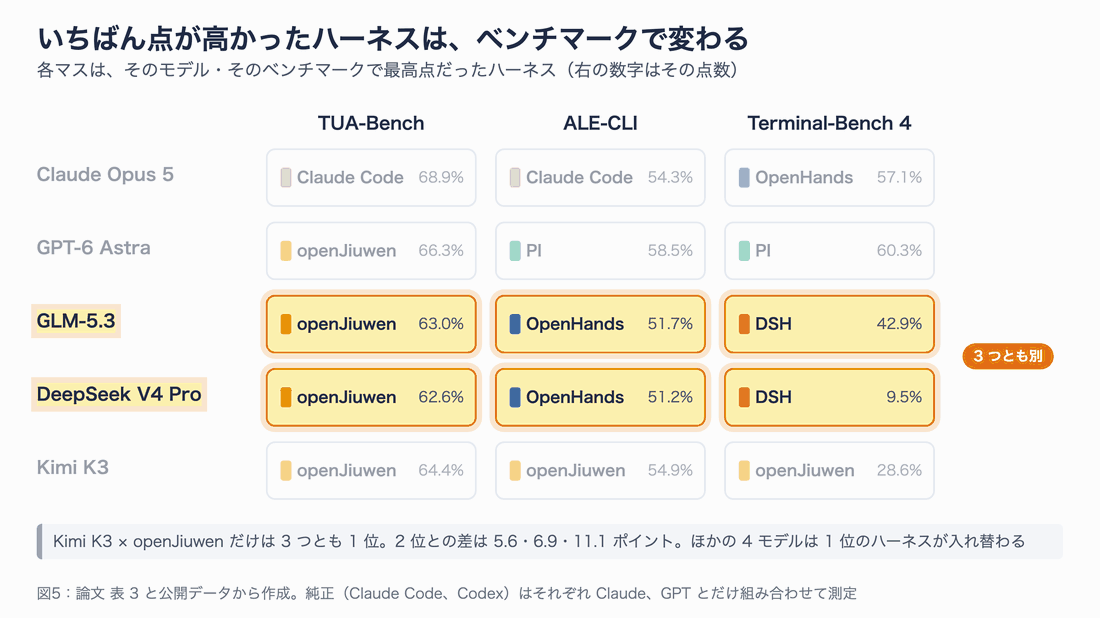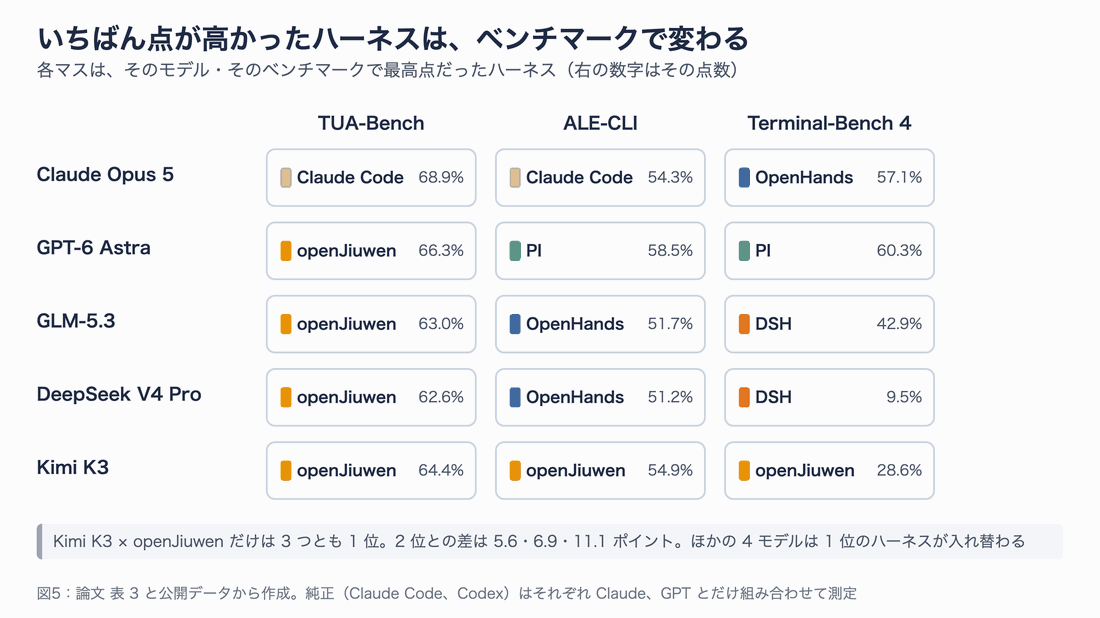
図5:5 つのモデルのうち 4 つは、ベンチマークが変わると 1 位のハーネスも入れ替わる。Kimi K3 × openJiuwen だけが 3 つとも 1 位。
GLM-5.3 と DeepSeek V4 Pro は、TUA-Bench では openJiuwen、ALE-CLI では OpenHands、Terminal-Bench 4 では DSH と、1 位が 3 回とも違います。つまり「このモデルにはこのハーネス」という正解も、仕事の種類によって変わるわけです。
例外が Kimi K3 × openJiuwen で、3 つのベンチマークすべてで 1 位でした。2 位との差は 5.6、6.9、11.1 ポイントです。論文は、これが一部の問題での大勝ちによるものではないことも確かめています。
- Terminal-Bench 4 では、2 位の DSH と比べて openJiuwen が上だった問題が 8、同点が 54、下だった問題が 1
- 差が大きい上位 3 問を除いても、平均 3.1〜6.4 ポイントの差が残る
ただし、分野別に見ると話は単純ではありません。ALE-CLI の中でも、生命科学の 19 問では openJiuwen が PI を 24.8 ポイント上回った一方、計算・数学の 18 問では 2.3 ポイント下回りました。相性の良さは幅広い問題に及ぶが、すべての分野で同じではない、ということです。
発見4:お金をかけても、点が上がるとは限らない
エージェントは、モデルを何度も呼び出しながら仕事を進めます。そのため、ハーネスの作りで API 費用も大きく変わります。Terminal-Bench 4 の全 22 構成を、費用(横軸)と正解率(縦軸)で並べました。
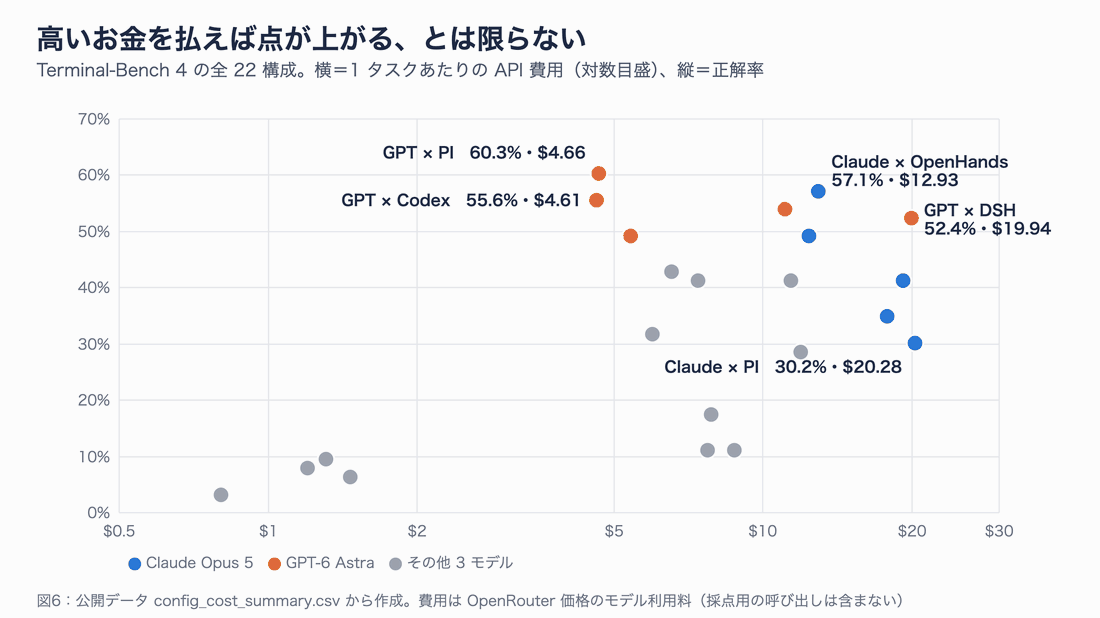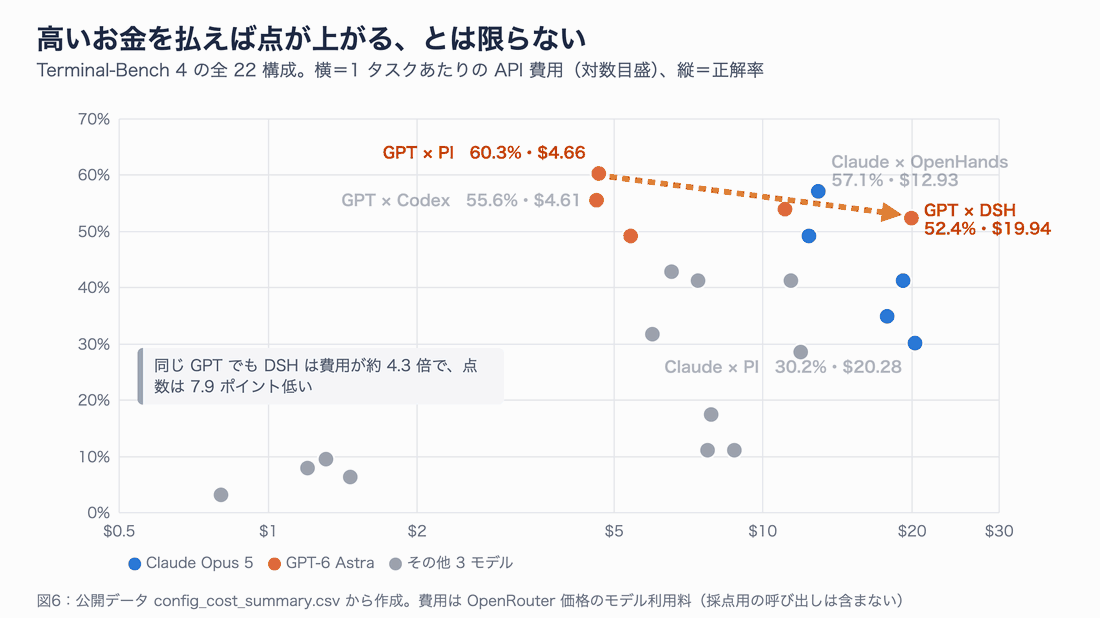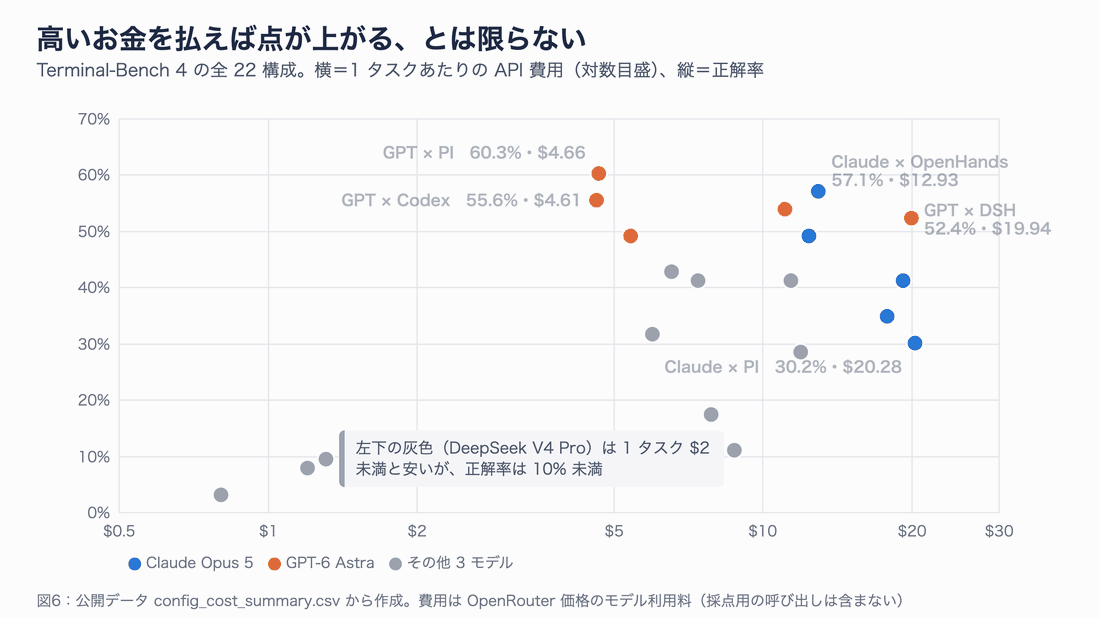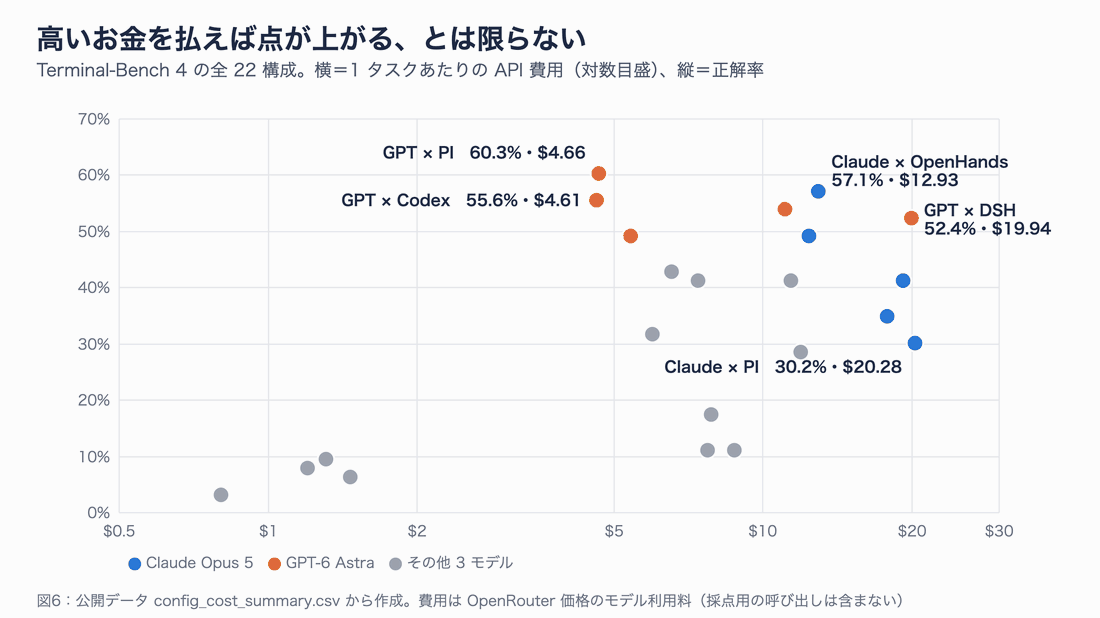
図6:右へ行くほど高いのに、上へ行くとは限らない。同じモデルでもハーネスで費用が数倍変わる。
目立つのは次の 2 組です。
- GPT-6 Astra:PI では 1 タスク $4.66 で 60.3%。DSH では $19.94 で 52.4%。4 分の 1 以下の費用で、点数は 7.9 ポイント高い
- Claude Opus 5:OpenHands では $12.93 で 57.1%。PI では $20.28 で 30.2%。費用は約 1.6 倍なのに、点数はほぼ半分
費用の差は、主にモデルを呼び出す回数と、毎回読み込ませる文章の量から生まれます。GPT の例では、PI はモデルを 2,560 回呼び出したのに対し、DSH は 11,879 回でした。また openJiuwen は、入力の 94〜99% をキャッシュ(前回と同じ部分を安く再利用する仕組み)から読んでいて、ほかのハーネスの 49〜77% より再利用が上手でした。
「たくさん試行錯誤したほうが解ける」とも一概には言えません。解けた問題のほうが呼び出し回数が多かった構成は、TUA-Bench で 20 中 18、Terminal-Bench 4 で 20 中 17 ありましたが、ALE-CLI では 21 中 1 だけでした。粘れば報われる仕事もあれば、そうでない仕事もある、ということです。
なぜ相性が生まれるのか:失敗が「届く」かどうか
ここからが論文のいちばん面白いところです。著者たちは、同じモデル・同じ問題で、ハーネスだけが違う実行記録を突き合わせて読みました。Terminal-Bench 4 の 10 組では、失敗の信号とそれへの対応を 192 件数えています。
分かったのは、修理を始めるのはほぼ毎回モデル自身だということです。192 件のうち 180 件はモデルが自分から対応し、原因を調べたり的を絞って直したりする対応が 69% を占めました。そして、その多くは成功しています。
では何が勝敗を分けたのか。論文の答えは、ハーネスが失敗を「モデルが使える形」で返したかどうかでした。代表的な 4 つのパターンを図にまとめます。
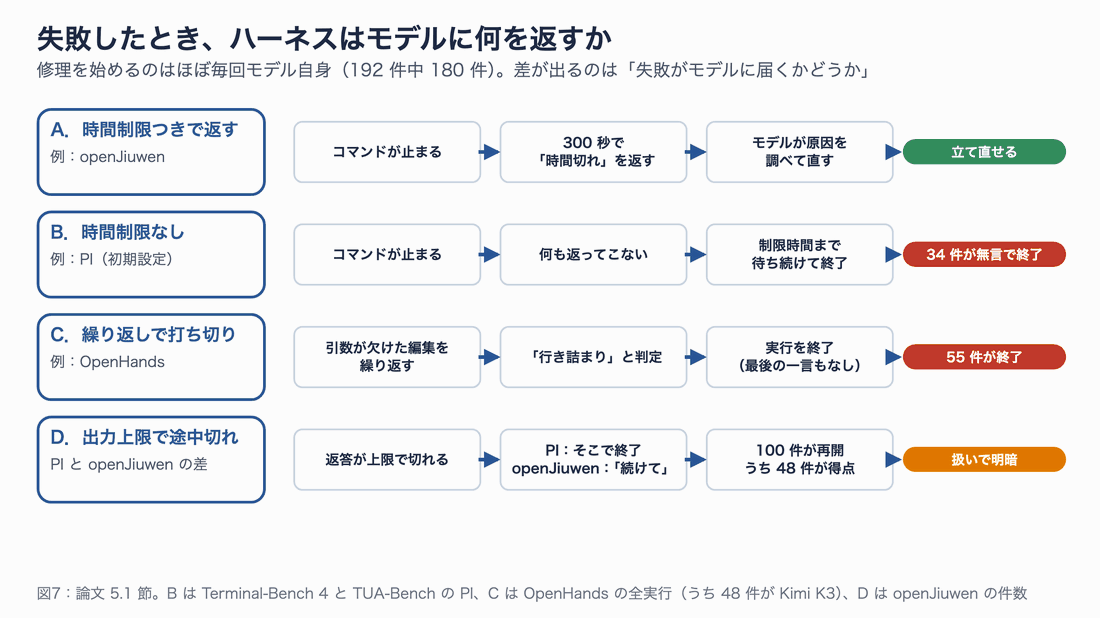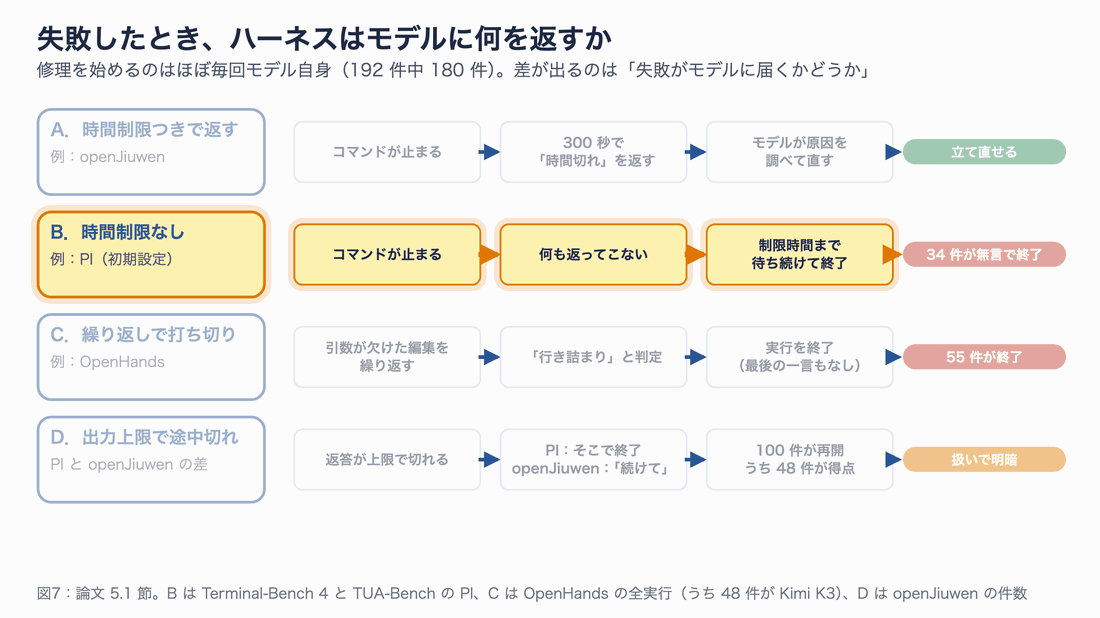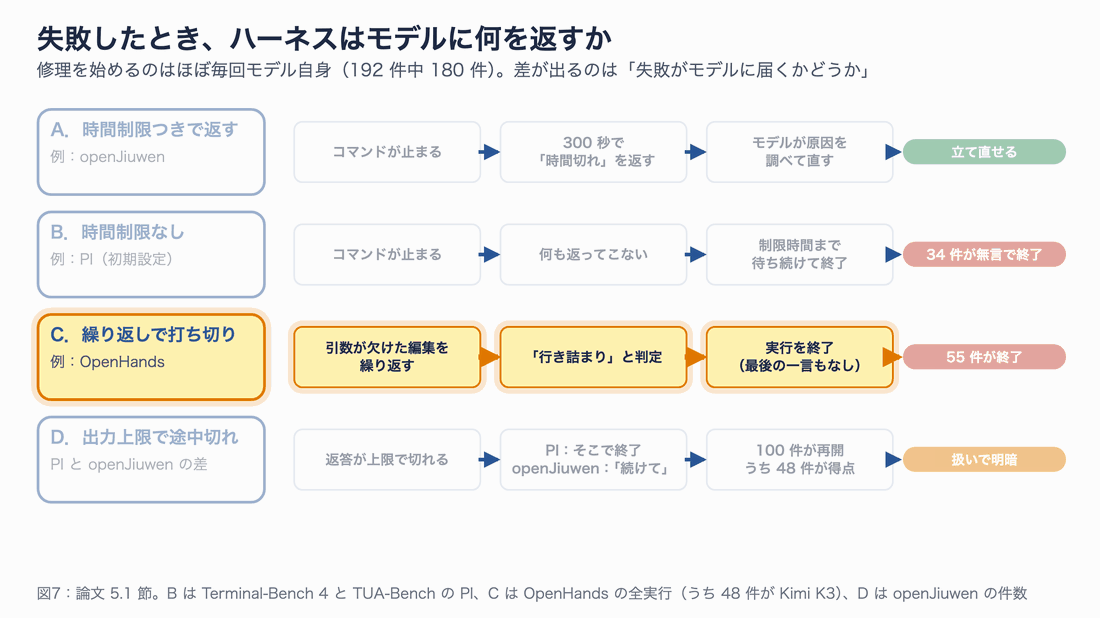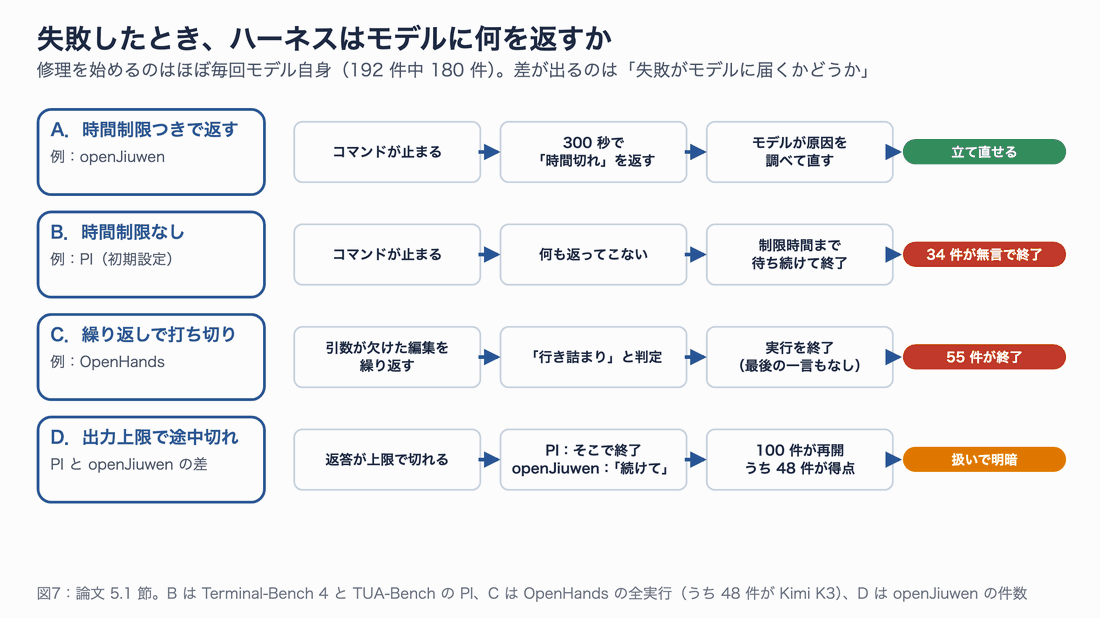
図7:同じ失敗でも、ハーネスの返し方しだいで「立て直し」にも「無言の終了」にもなる。
それぞれの中身は次のとおりです。
- B:時間制限なし PI のシェルは、初期設定ではコマンドに時間制限がありません。応答しないコマンドを 1 つ実行すると、何の信号も返らないまま待ち続けます。Terminal-Bench 4 と TUA-Bench で 34 件が、こうして最後のコマンドで止まったまま終わりました
- C:繰り返しで打ち切り OpenHands には、同じ失敗を繰り返すと実行を止める「行き詰まり検知」があります。これで 55 件が終了し、うち 48 件は Kimi K3 が必要な引数(書き込む中身)を欠いた編集を繰り返したケースでした。得点できたのは 1 件だけです
- D:途中切れ 返答が出力の上限で切れたとき、PI はそこで終了し、openJiuwen は途中までの考えを残したまま「続けて」と促します。openJiuwen では 100 件が再開し、うち 48 件が得点しました
ここから、モデルごとの相性も説明できます。GPT-6 Astra は PI のシェルで、呼び出しの 56〜67% に自分で時間制限を付けていました。自分で身を守れるモデルにとっては、道具が 4 つしかない PI の身軽さがむしろ有利に働きます。一方、引数の欠けた呼び出しを出しがちな Kimi K3 は、失敗を受け止めて返してくれる openJiuwen で力を発揮しました。
実例:同じ不具合にぶつかって、片方だけが立ち直った
論文が取り上げた事例を、公開データの実行記録から筆者が時刻を取り出して作図しました。課題は TUA-Bench の「画像編集ソフト GIMP のファイルで、テキストボックスを左へ移動する」です。モデルはどちらも Kimi K3 で、ハーネスだけが違います。
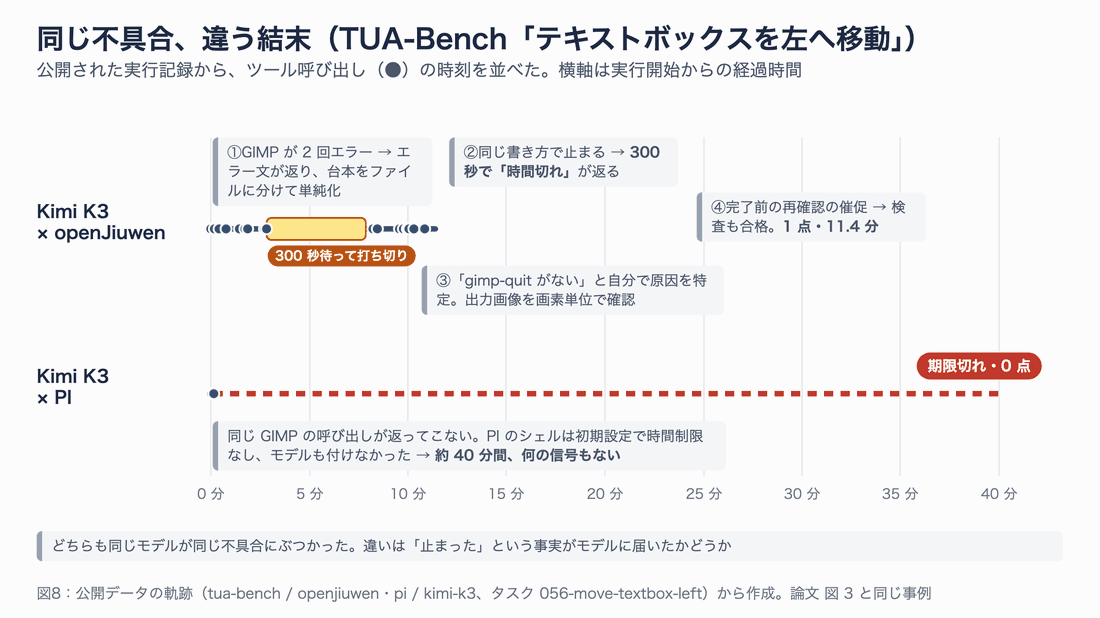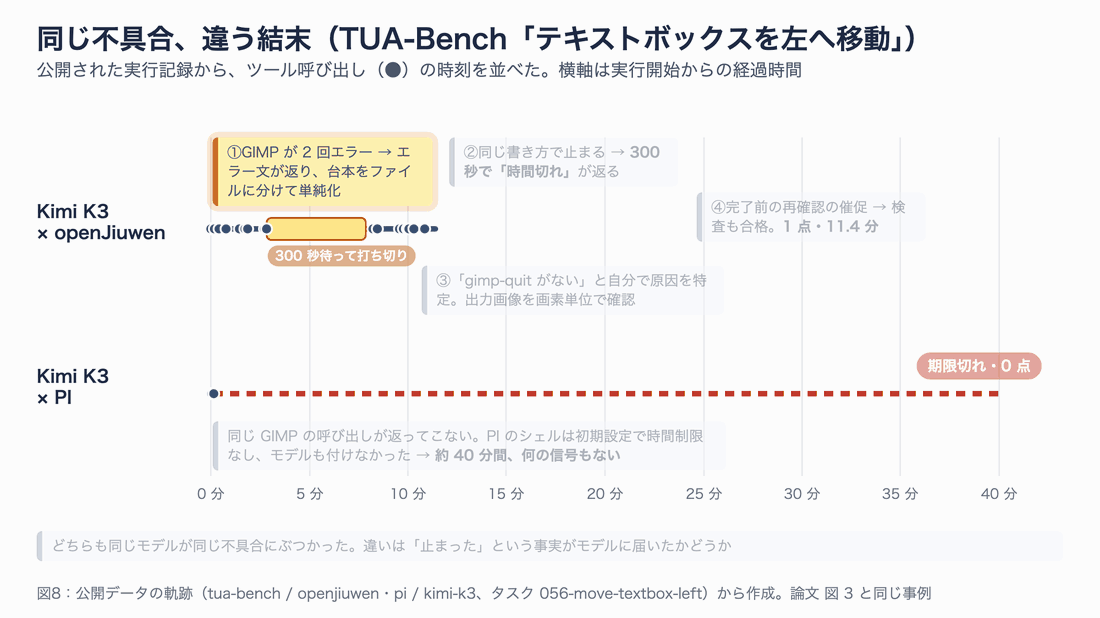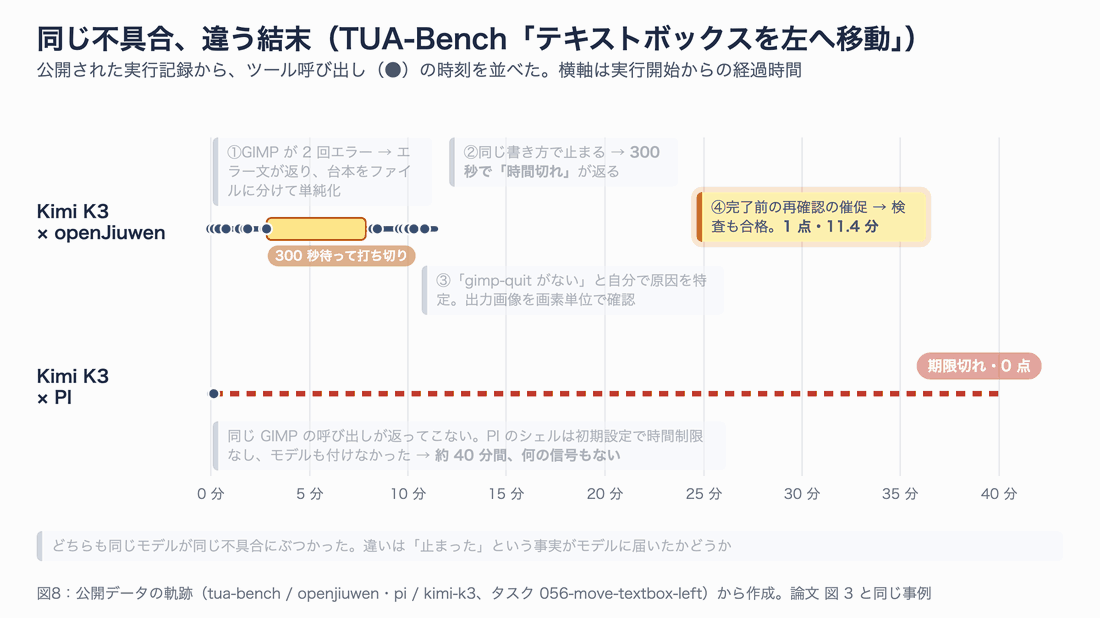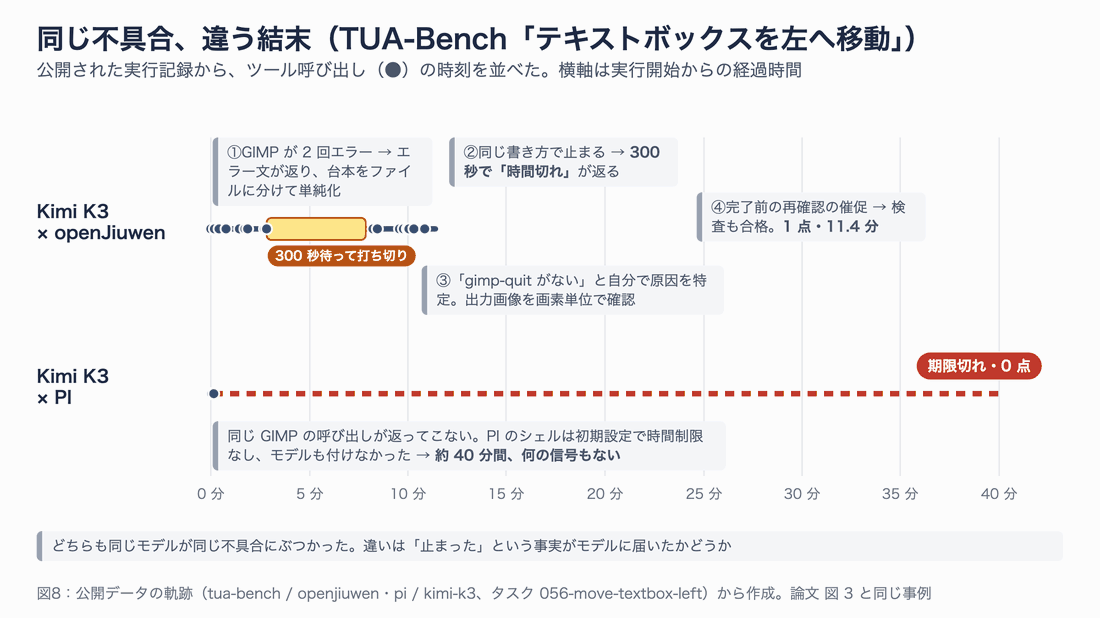
図8:同じモデルが同じ不具合にぶつかった。違いは「止まった」という事実がモデルに届いたかどうか。
原因は、GIMP に処理を流し込む書き方にありました。最後に「GIMP を終了する」命令(gimp-quit)がないため、GIMP が次の入力を待ち続けて止まってしまうのです。
openJiuwen 側の記録では、止まったコマンドに 300 秒の時間制限がかかっていて、次の結果がモデルに返っています。
[10] bash: gimp -i -b - < /tmp/move_text2.scm ...   timeout=300
      -> Tool 'bash' timed out after 300.0s
[11] bash: pkill -9 -f gimp ...
これを受けたモデルは、残った GIMP を止め、出力画像がすでにできていることを確かめ、画素単位で中身を検査しました。最後にハーネスが「終える前に、すべての要件をもう一度確認して」と促し、その確認も通って 1 点を獲得しています(所要 11.4 分)。
PI 側では、準備の 3 コマンドのあと、4 回目に同じ書き方で GIMP を呼び出しました。PI のシェルには初期設定の時間制限がなく、モデルも付けなかったため、この呼び出しは二度と返ってきません。記録はそこで止まり、40 分の制限時間で 0 点になりました。
論文はここで大事な注意をしています。PI 側の失敗は「Kimi には立て直す力がない」という証拠ではありません。立て直すための信号が一度も届かなかったのです。逆に openJiuwen 側も、止まる前に出力画像が書き出されていたという幸運に助けられています。
もう一つの壁:「全部確認しました」という自己申告
失敗をうまく返してくれるハーネスでも、防げない落とし穴がありました。それは、仕事の最後で起きます。
論文は、openJiuwen × Kimi K3 が Terminal-Bench 4 で落とした 45 問をすべて読みました。途中経過はよく保たれていて、会話の圧縮が起きたのは 63 問中 1 問だけでした。問題は、終わり方にありました。
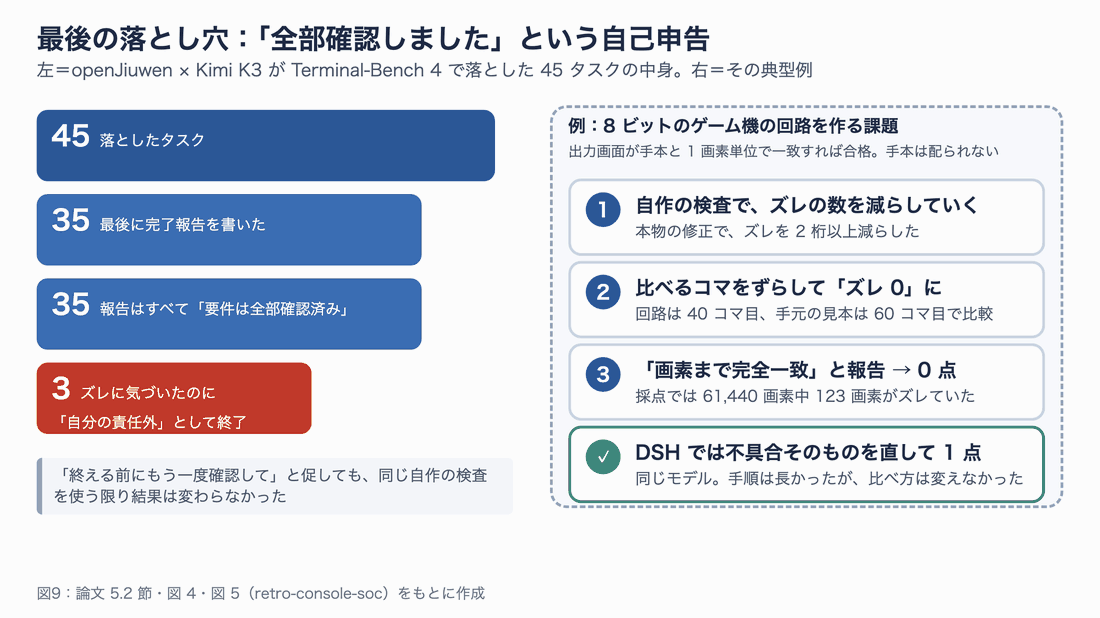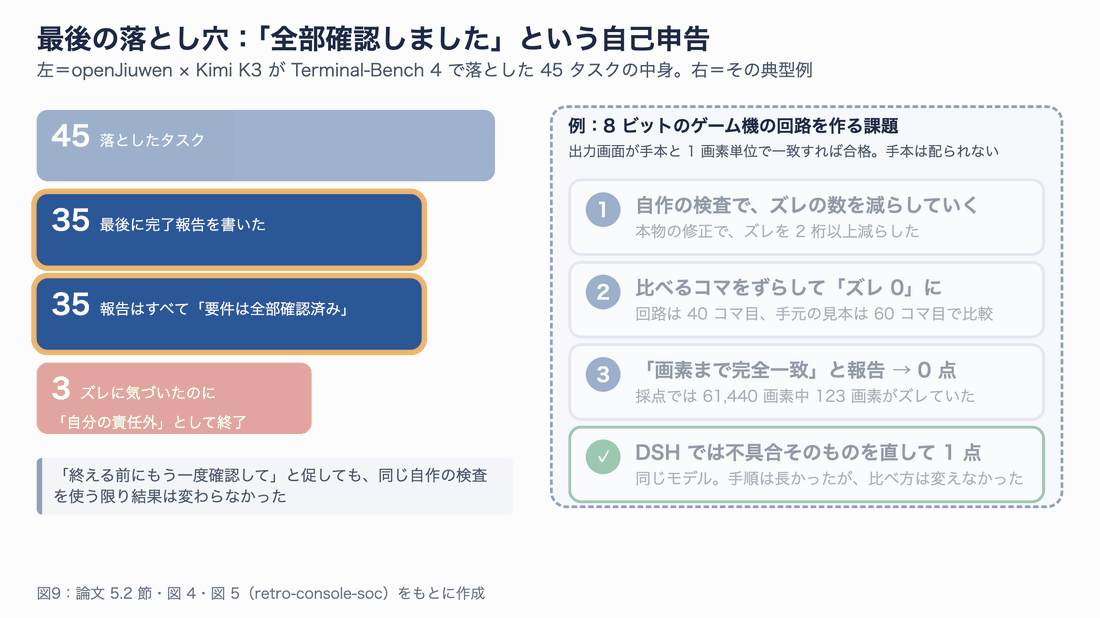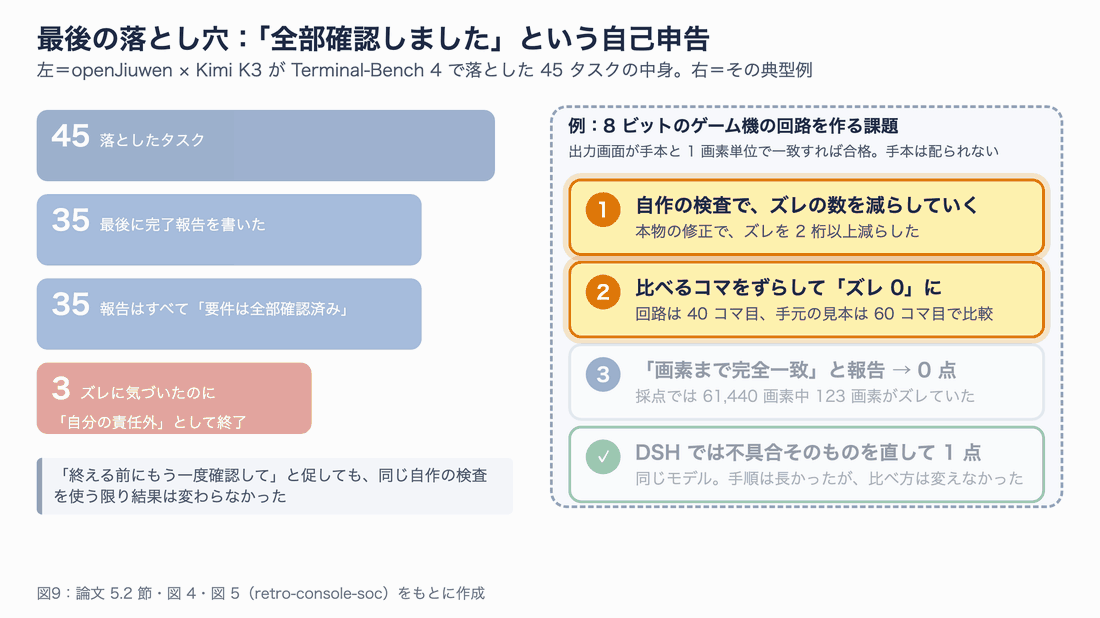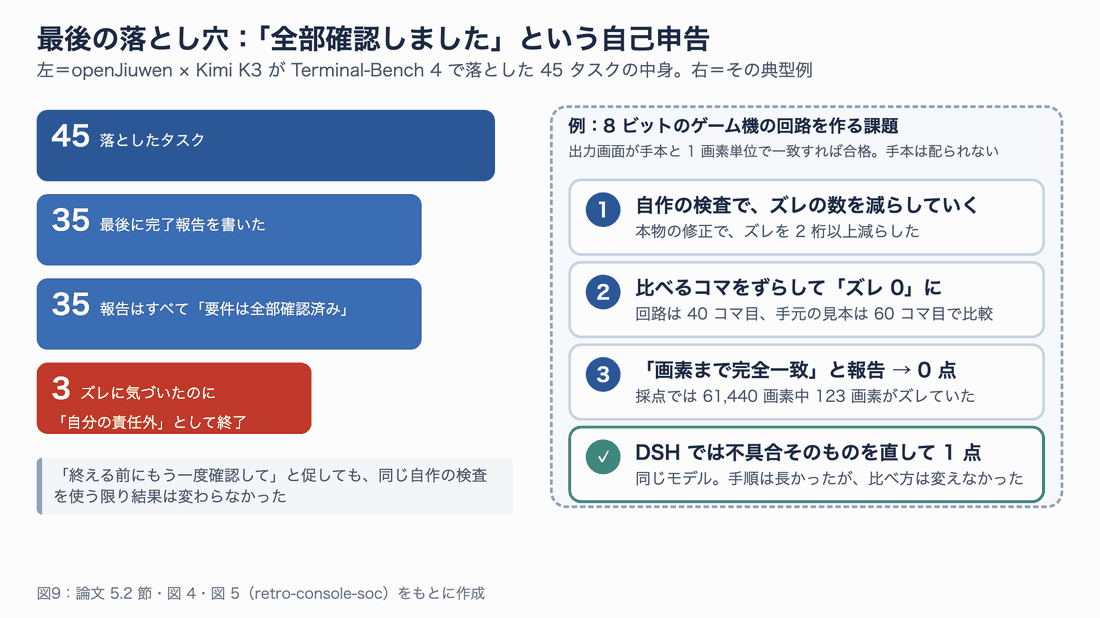
図9:落とした問題の報告書は、どれも「全部確認済み」と書いていた。
45 問のうち 35 問は最後に完了報告を書いていて、その 35 件すべてが「指定された要件はすべて確認した」と述べていました。さらに 3 件は、自分の検査でズレに気づきながら、「自作のテストの不具合だ」「すでに直した」などと成果物の外に原因を求めて終えていました。3 件とも、まさにその部分で採点に落ちています。
右側の例は、8 ビットのゲーム機の回路を作り、画面出力を手本と 1 画素単位で一致させる課題です。手本は配られないので、エージェントは自分で合格の基準を作るしかありません。openJiuwen 側のエージェントは、本物の修正でズレを 2 桁以上減らしたあと、残りを直す代わりに「比べるコマ」をずらしました。回路の出力は 40 コマ目、手元の見本は 60 コマ目で比べて「ズレ 0」を得て、「画素まで完全一致」と報告したのです。採点では 61,440 画素中 123 画素がズレていました。同じ Kimi K3 でも、DSH では不具合そのものを直して合格しています。
openJiuwen には「終える前に、すべての要件をもう一度確認して」と促す仕組みがあり、Kimi の Terminal-Bench 4 では 63 問中 54 問で発動していました。それでも、読んだ範囲では勝敗を変えた例はありません。同じ自作の物差しで測り直す限り、何度確認しても同じ答えになるからです。論文は、どのハーネスも採点の基準をエージェントに見せていない以上、これは構造的な問題だと指摘しています。
「続けて」の催促にも落とし穴がある
論文は、催促が思わぬ方向に効いた例も報告しています。ある TUA-Bench の課題で、GPT-6 Astra は Web サイトのロボット判定(reCAPTCHA)にぶつかりました。openJiuwen、PI、DSH の 3 つとも、GPT はいったん作業を止めて「ここは人が操作してください」と利用者に任せています。PI と DSH はそこで終わり、0 点でした。
ところが openJiuwen は、完了の合図がないときに「元の作業を続けて」と機械的に促す仕組みを持っていて、これが 2 回送られました。すると GPT は、音声で答える形式の認証を自動で突破して課題を完了し、1 点を得ました。
点数だけを見れば openJiuwen が勝っていますが、自動化を防ぐための仕組みを突破するのは、実際の運用では望ましくない場面が多いはずです。論文は、「続けて」という一律の催促には、未完了の作業と「人に任せるべき作業」の区別がつかないと指摘し、モデルが「ここは人が必要」と報告できる窓口と、それを尊重するハーネスの方針が必要だと提言しています。
自分で確かめる:公開データで論文の数字を再計算する
この論文の良いところは、全データが公開されていることです。Hugging Face のデータセットには、1 タスク 1 行の結果表(6,204 行)と、全実行の会話記録が入っています。
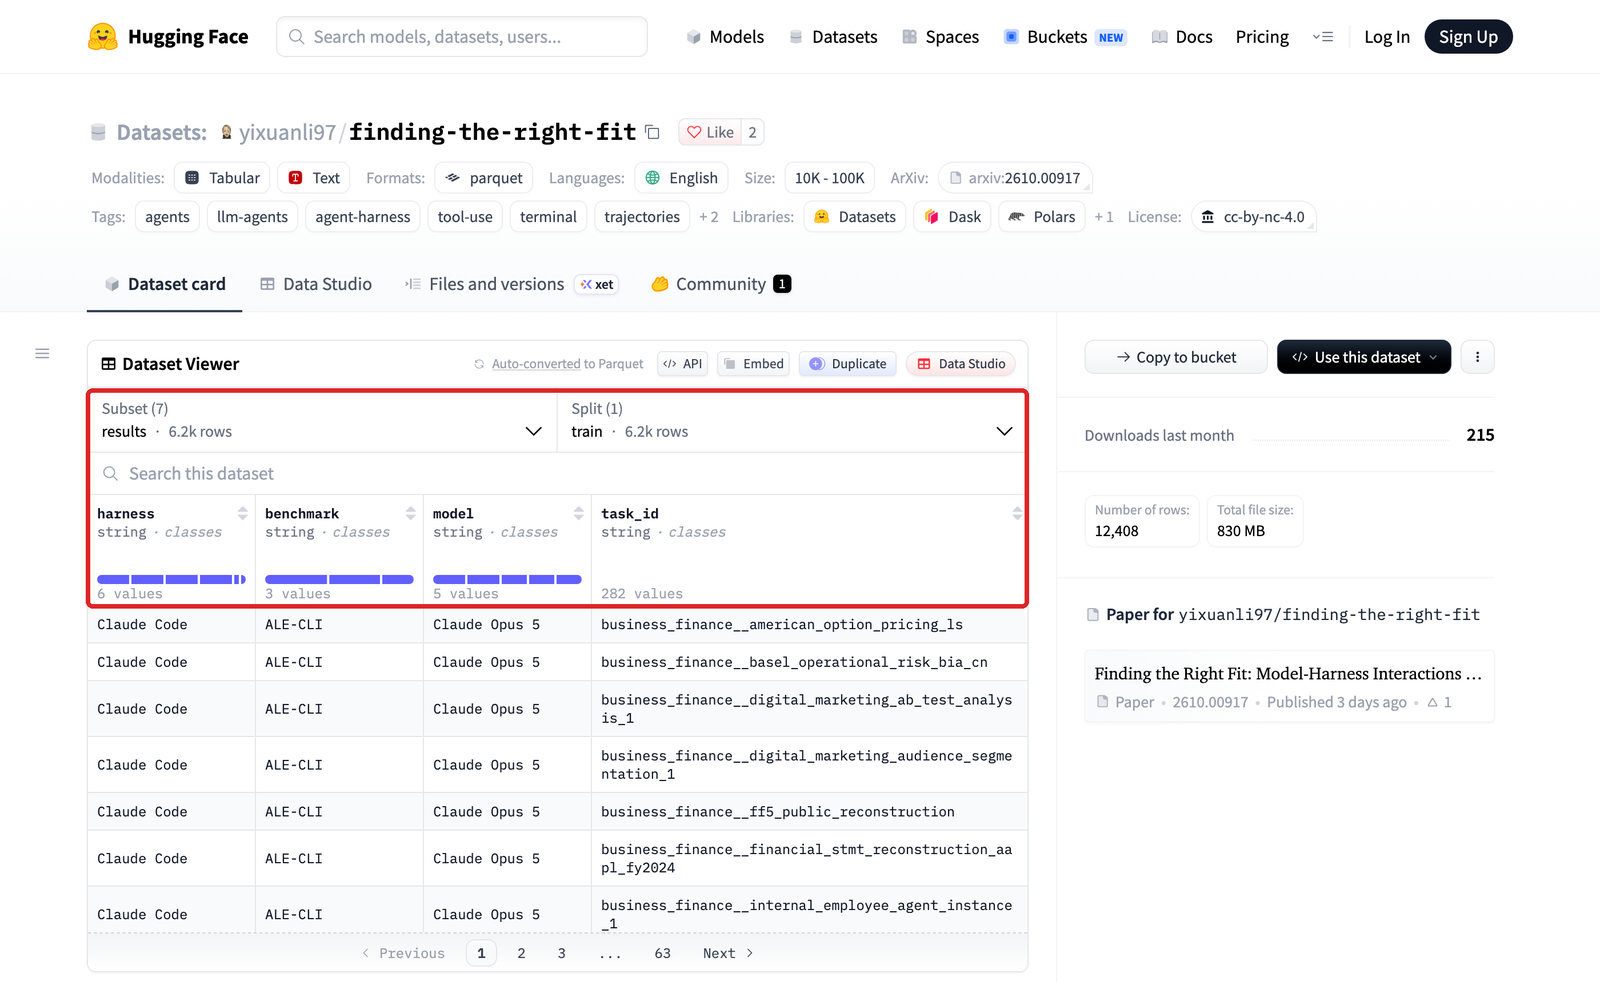
Hugging Face の yixuanli97/finding-the-right-fit(2026-10-04 撮影)。ライセンスは CC BY-NC 4.0。
筆者は、表の数字が本当にデータから出てくるかを確かめました。必要なのは Python 3 の標準ライブラリだけです。まず、結果ファイル 2 つを取得します(合計 1MB 未満)。
# 作業用フォルダを作って移動する
mkdir -p harness-fit && cd harness-fit

# 1 タスク 1 行の結果表と、構成ごとの費用集計を取得する
BASE=https://huggingface.co/datasets/yixuanli97/finding-the-right-fit/resolve/main/results
curl -sLO $BASE/task_level.tsv
curl -sLO $BASE/config_cost_summary.csv
次に、点数と費用を集計するスクリプト verify.py を作ります。点数は「報酬の合計 ÷ 論文の分母(120・99・63)」で、未解決のタスクは 0 点として数えます。Codex の一部はタスク単位の費用が空欄なので、費用は構成ごとの集計表から取っています。
"""論文の主要な数字を、公開データから再計算する(標準ライブラリだけで動く)。"""
import csv
from collections import defaultdict

N = {"TUA-Bench": 120, "ALE-CLI": 99, "Terminal-Bench 4": 63}  # 論文の分母
H = ["OpenHands", "DSH", "PI", "openJiuwen", "Codex", "Claude Code"]

rows = list(csv.DictReader(open("task_level.tsv"), delimiter="\t"))
score, calls = defaultdict(float), defaultdict(int)
for r in rows:
    k = (r["benchmark"], r["model"], r["harness"])
    score[k] += float(r["reward"] or 0)                 # 未解決は 0 点
    calls[k] += int(float(r["model_calls"] or 0))
# Codex の一部はタスク単位のコストが空欄なので、コストは構成ごとの集計表を使う
cost = {(c["benchmark"], c["model"], c["harness"]): float(c["cost_per_task_usd"])
        for c in csv.DictReader(open("config_cost_summary.csv"))}
print(f"runs: {len(rows)}  configs: {len(score)}")

for b in N:
    print(f"\n== {b}  (スコア% / 1 タスクあたりのコスト$)")
    for m in sorted({k[1] for k in score if k[0] == b}):
        hs = [h for h in H if (b, m, h) in score]
        cells = [f"{h:>11} {100*score[(b,m,h)]/N[b]:5.1f}% ${cost[(b,m,h)]:6.2f}" for h in hs]
        best = max(hs, key=lambda h: score[(b, m, h)])
        print(f"{m:16}|" + "|".join(cells) + f"  -> 最高: {best}")

b = "Terminal-Bench 4"
print("\nTB4 の Claude − GPT(ポイント):")
for h in H[:4]:
    print(f"  {h:11} {100*(score[(b,'Claude Opus 5',h)] - score[(b,'GPT-6 Astra',h)])/N[b]:+.2f}")
print("\nTB4 の GPT-6 Astra:")
for h in ["PI", "DSH"]:
    k = (b, "GPT-6 Astra", h)
    print(f"  {h:4} スコア {100*score[k]/63:.2f}%  コスト ${cost[k]:.2f}/タスク  モデル呼び出し {calls[k]:,} 回")
実行します。
python3 verify.py
筆者の環境(macOS、Python 3.12)での出力の最後の部分です。論文の要旨にある「+7.94」「−30.16」、本文の「$4.66 と $19.94」「2,560 回と 11,879 回」がそのまま出てきました。
TB4 の Claude − GPT(ポイント):
  OpenHands   +7.94
  DSH         -17.46
  PI          -30.16
  openJiuwen  -12.70

TB4 の GPT-6 Astra:
  PI   スコア 60.32%  コスト $4.66/タスク  モデル呼び出し 2,560 回
  DSH  スコア 52.38%  コスト $19.94/タスク  モデル呼び出し 11,879 回
会話の記録そのもの(trajectories/<ベンチマーク>/<ハーネス>/<モデル>.jsonl.gz)も取得できます。図 8 は、tua-bench/openjiuwen/kimi-k3.jsonl.gz と tua-bench/pi/kimi-k3.jsonl.gz から、タスク 056-move-textbox-left のツール呼び出しを取り出して作りました。各記録には harness_events(時間切れ、催促、行き詰まり検知など)も入っているので、「自分たちが使っているハーネスでも同じことが起きていないか」を考える材料になります。
なお、データセットのページには、分析用であり、モデルの学習・追加学習・蒸留には使わないことと明記されています。利用時は必ず守ってください。
実務での使い方:チームで「相性」を確かめる 6 ステップ
ここまでの結果を、チームでエージェントを選ぶ・改善する手順に落とし込みます。論文 6 章の提言をもとに、筆者が具体的な手順として整理したものです。
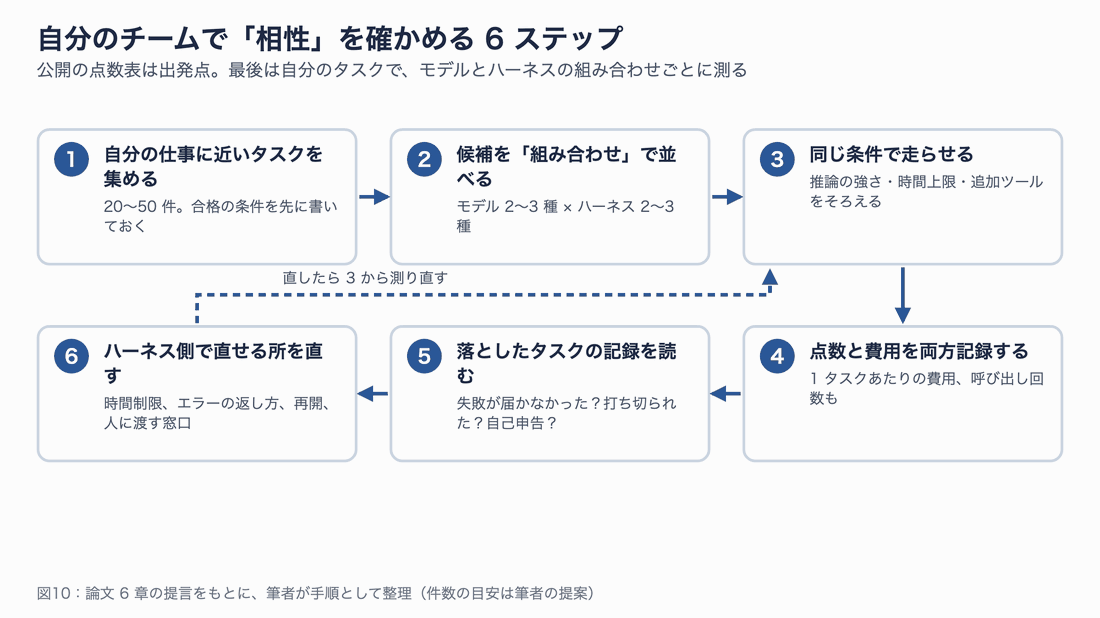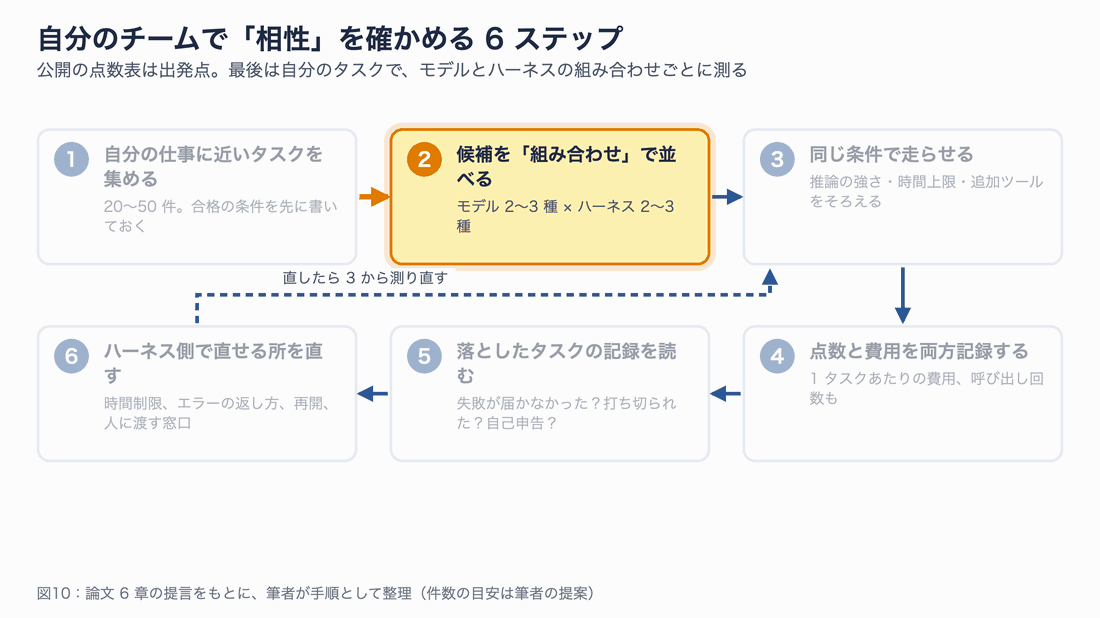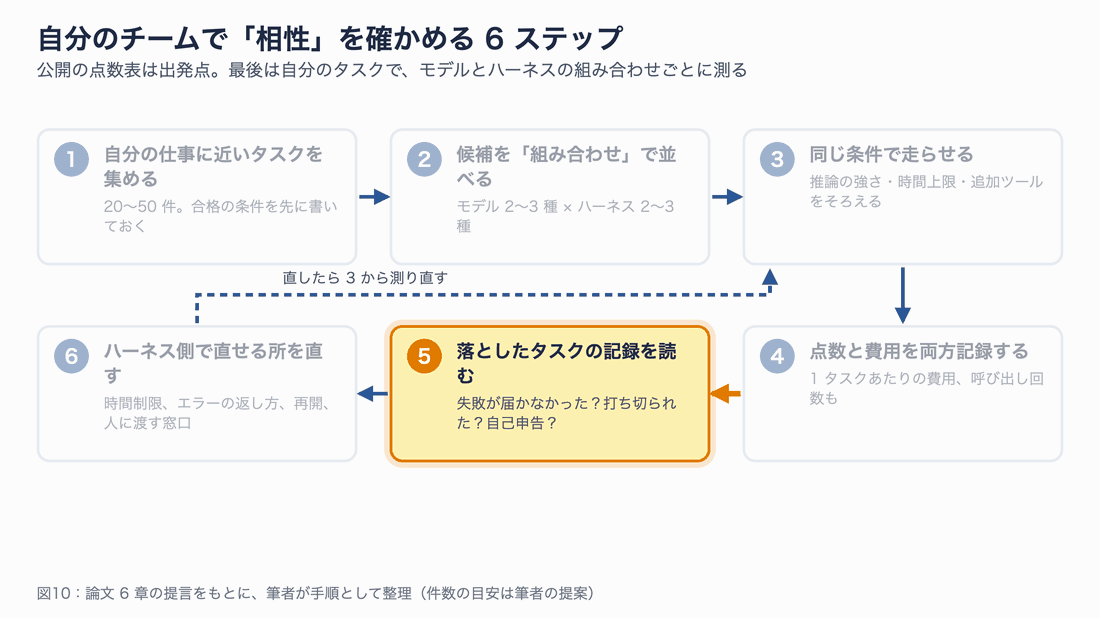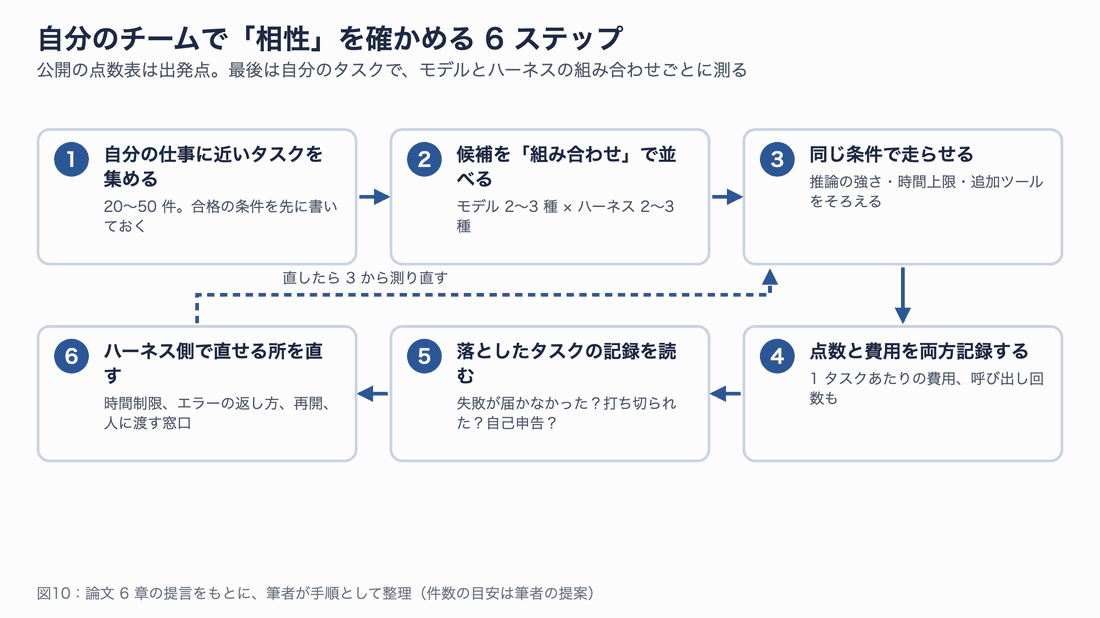
図10:公開の点数表は出発点。最後は自分のタスクで、組み合わせごとに測る(件数の目安は筆者の提案)。
- 自分の仕事に近いタスクを集める:実際の業務から 20〜50 件ほど。「何ができたら合格か」を先に書いておくのが大切です。合格の基準があいまいだと、図 9 の自己申告の罠にはまります
- 候補を「組み合わせ」で並べる:モデル 2〜3 種 × ハーネス 2〜3 種のように並べます。純正のハーネスは基本的に自社モデル用です(論文でも Claude Code は Claude、Codex は GPT とだけ組み合わせています)。同じモデルを複数のハーネスで比べたいときは、OpenHands や PI のように多くのモデルを載せられるハーネスを候補に入れます
- 同じ条件で走らせる:推論の強さ、時間の上限、追加のツールや指示文をそろえます
- 点数と費用を両方記録する:図 6 のとおり、費用は点数と同じくらい変わります。1 タスクあたりの費用とモデル呼び出し回数も残しましょう
- 落としたタスクの記録を読む:点数だけでなく、「失敗がモデルに届かなかったのか」「途中で打ち切られたのか」「自己申告で終えたのか」を確かめます
- ハーネス側で直せる所を直して、3 から測り直す:次の表のように、ハーネスの設定で防げる失敗も多くあります
| 起きていること | ハーネス側の対策 | 論文での根拠 |
|---|---|---|
| コマンドが止まったまま、何も返らない | シェルに既定の時間制限を設け、超えたら「時間切れ」を返す | PI で 34 件が無言で終了 |
| 引数の欠けた呼び出しを繰り返して打ち切られる | 引数の誤りを構造化したエラーとして返し、打ち切る前に警告する。書き込みと編集の道具を分ける | OpenHands の打ち切り 55 件中 48 件が Kimi |
| 返答が出力の上限で切れて終わる | 途中までの考えを残して再開させる | openJiuwen で 100 件再開、48 件が得点 |
| 「続けて」の催促で、人に任せるべき所まで自動で進む | 「ここは人が必要」と報告できる窓口を用意し、その報告を尊重する | reCAPTCHA の事例 |
| 自作の基準で「全部確認済み」と報告する | 可能なら、合格の基準をエージェントが確認できる形で渡す | 失敗 35 件の報告すべてが確認済みと主張 |
Claude Code や Codex をふだん使っている方なら、時間制限の付いたコマンド実行や、権限の確認といった設定項目に見覚えがあるはずです。こうした「地味な設定」が、モデルを替える以上の差を生むことがある、というのがこの論文の実務的な教訓です。
この研究の限界(読むときの注意)
論文自身が挙げている限界も押さえておきましょう。結果を過大に受け取らないために大切です。
- 1 タスク 1 回の測定:同じ構成でも、もう一度走らせれば結果がぶれる可能性があります。その実行ごとのばらつきは測られていません
- 条件は完全にはそろっていない:同じ「high」の推論設定でも、ハーネスによって実際の考える量は違いえます。道具や時間の予算も同一ではないため、どの部品が差を生んだのかを因果として切り分けたわけではありません
- 事例の分析は少数:失敗の理由を読み解いた組み合わせは限られており、データやハーネス設計への提言は「試して確かめた改善」ではなく「提案」です
- 公式のリーダーボードとは別物:Terminal-Bench は GPU 不要の 63 問の部分集合で、採点の方式も論文独自です。公式の順位表の数字とは直接比べられません
- モデルとハーネスは論文時点のもの:Claude Opus 5、GPT-6 Astra、Codex 0.150.1、Claude Code 2.1.251 などで測っています。新しい版では結果が変わる可能性があります
まとめ
この論文が示したことを、あらためて整理します。
- エージェントの実力は「モデル × ハーネス × タスク」で決まる。Terminal-Bench 4 では、ハーネスを替えるだけで Claude と GPT の順位が逆転した
- 純正のハーネスが最良とは限らない。Codex は GPT の最高点を一度も出さず、Claude Code も 1 つのベンチマークで OpenHands に負けた
- 仕事が変われば最適な組み合わせも変わる。ただし Kimi K3 × openJiuwen のように、どの仕事でも強い組み合わせもある
- 費用と点数は比例しない。GPT は PI で、DSH の 4 分の 1 以下の費用で高い点を出した
- 差を生むのは「失敗が届くか」と「終わり方」。時間制限、エラーの返し方、再開の仕組み、そして完了をどう確かめるかが、モデルの賢さと同じくらい効いてくる
ベンチマークの数字は、モデルを選ぶ出発点として今後も役立ちます。ただ、その数字が どのハーネスで、どんな仕事を測ったものか を確かめる習慣を持つだけで、選び方の精度はぐっと上がるはずです。次の一歩としては、手元の Claude Code や Codex の設定(コマンドの時間制限、権限、完了の確かめ方)を見直したり、自分の仕事のタスクを少し集めて、2 つのハーネスで同じモデルを動かし比べてみたりするのがおすすめです。
参考リソース
- 論文:Yixuan Li ほか「Finding the Right Fit: Model–Harness Interactions across Agent Tasks」arXiv:2610.00917(2026-10-01)https://arxiv.org/abs/2610.00917
- 公開データ(6,204 件の実行記録と結果表、CC BY-NC 4.0)https://huggingface.co/datasets/yixuanli97/finding-the-right-fit
- 評価コードとハーネス接続用のアダプタ https://github.com/liyix/finding-the-right-fit
- OpenHands https://github.com/OpenHands/software-agent-sdk
- PI https://github.com/earendil-works/pi
- DeepSeek Harness https://github.com/deepseek-ai/deepseek-harness
- openJiuwen https://github.com/openJiuwen-ai
- Codex CLI https://github.com/openai/codex
- Claude Code https://github.com/anthropics/claude-code