はじめに
2026年11月9日、Anthropic が Claude Fable 5.2 を公開しました。前の Claude Fable 5.1 が出たのは9月1日なので、約10週間での更新です。
「5.1 から 5.2 へ、数字が 0.1 増えただけ」と思うかもしれません。ところが中身を読むと、変化はかなり大きいものでした。主なベンチマークは 10〜20 ポイント単位で上がり、料金は 2 割下がりました。一方で、プロンプトの効き方が変わった点や、API で動かなくなる書き方が 4 つある点など、移行前に知っておくべき注意もあります。
この記事では、5.1 と 5.2 の違いを次の 4 つの方向から整理します。
- 性能:どのベンチマークがどれだけ伸びたか、伸びなかったのはどこか
- 料金と速さ:単価、新しい fast mode、そして「1タスクあたり」で見た費用
- 使い方:effort(考える深さ)の選び方と、プロンプトへの反応の変化
- API の移行:既存のコードが 400 エラーになる 4 つの変更と直し方
まず全体像を 1 枚の図で見てください。4 つの枠が順番に強調されます。
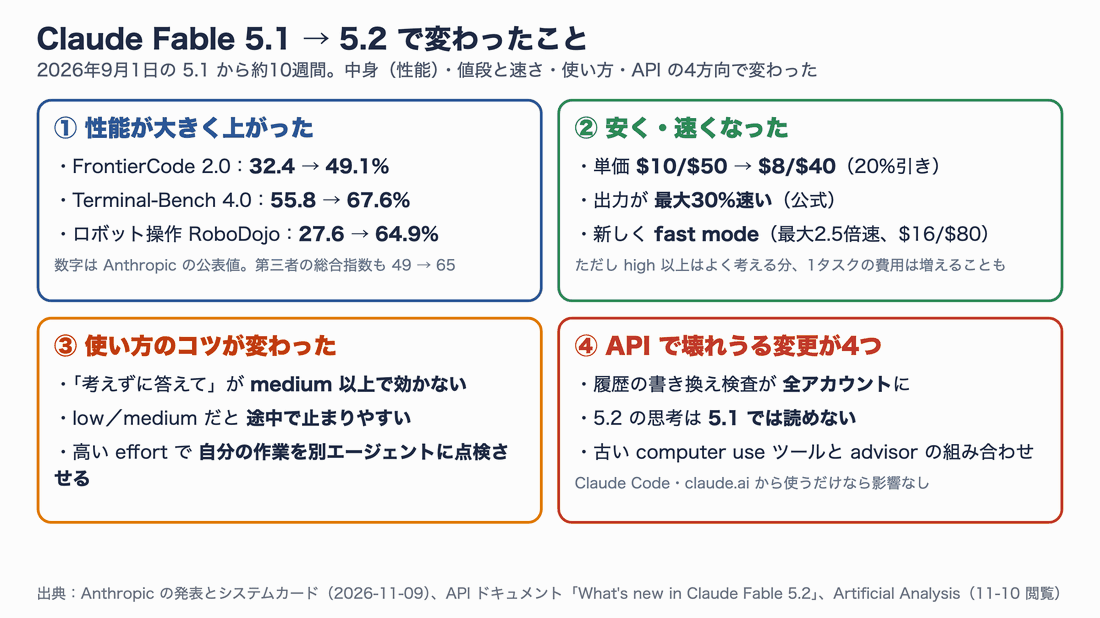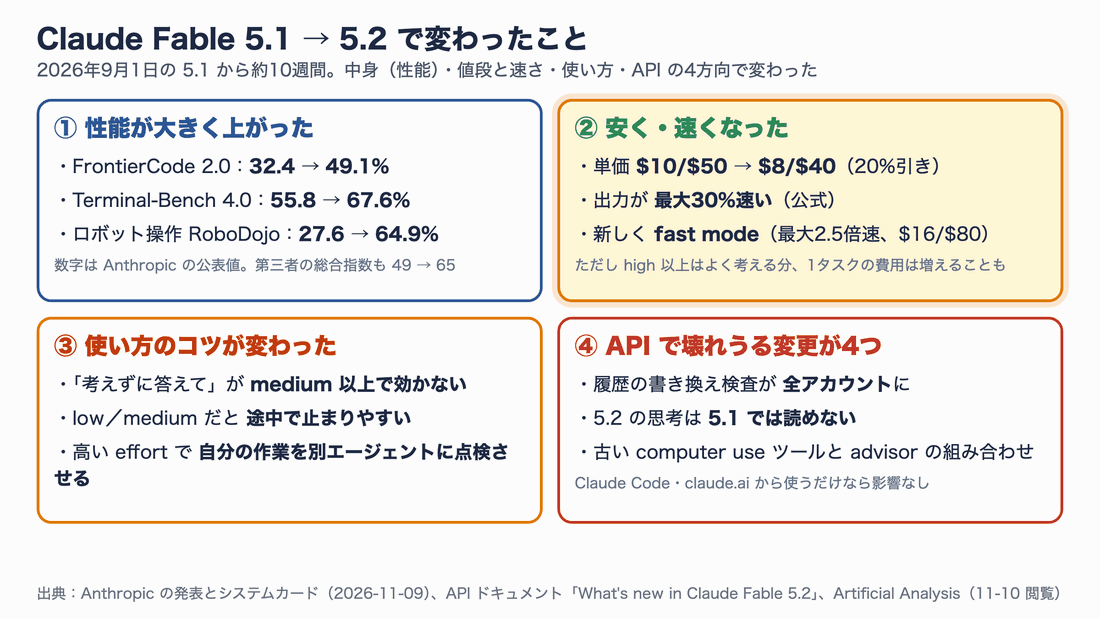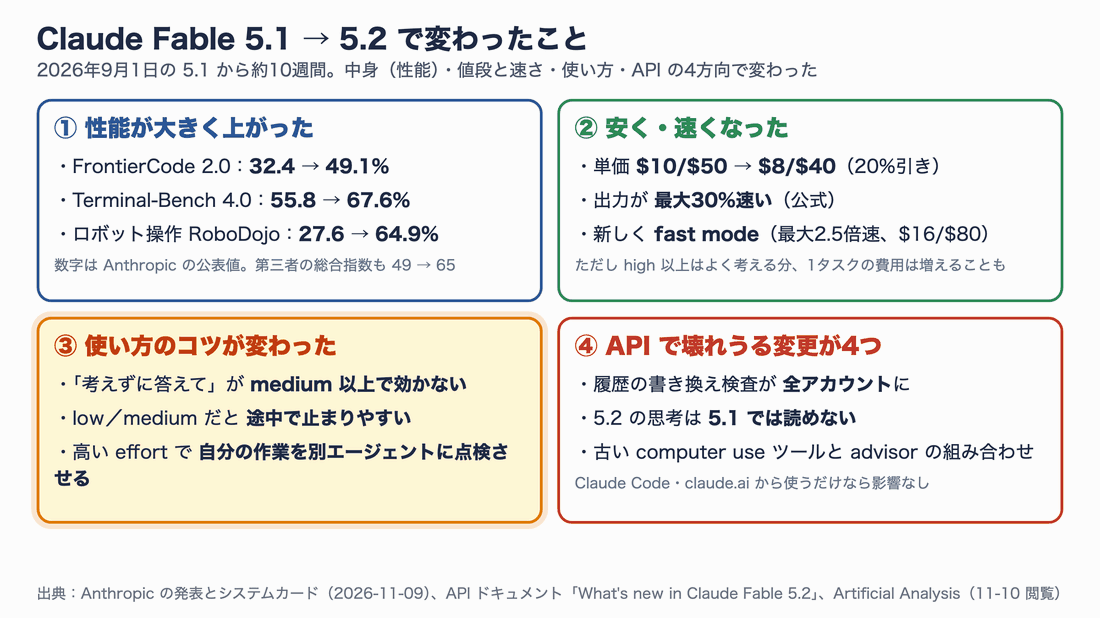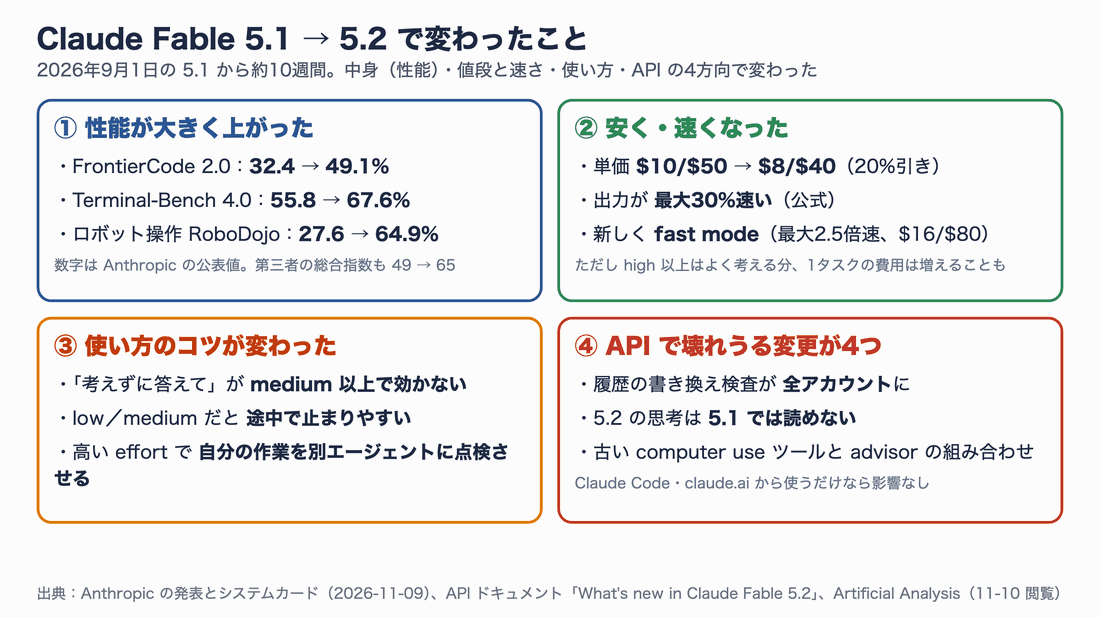
この図から分かること:5.2 は「賢く・安く・速く」なった一方、使い方のコツと API の書き方に変更がある。Claude Code や claude.ai から使うだけなら、API の変更は気にしなくてよい。
想定読者は、Claude Code や claude.ai で Fable を使っている方、そして Claude API で 5.1 を使ったアプリを作っている開発者です。前半(性能・料金)は API を使わない方にも読めるように書き、後半(API の移行)はコードを含めて詳しく書きました。
この記事の確認範囲
- 確認日:2026年11月10日(日本時間)
- 一次情報:Anthropic の発表ページ、Claude Fable 5.2 / Mythos 5.2 のシステムカード(264 ページの PDF)、API ドキュメントの「What’s new in Claude Fable 5.2」「Migration guide」「Prompting Claude Fable 5.2」「Effort」「Fast mode」、Claude Code の変更履歴
- 第三者の測定:Artificial Analysis(総合指数 v5)、Vals.ai(Terminal-Bench 4.0)
背景:Fable 5.2 はどういう位置づけのモデルか
最初に、Fable というモデルの立ち位置を確認しておきます。ここは 5.1 のときから大きくは変わっていません。
Claude Fable は、Anthropic のモデルの中で最も難しい仕事に向けたモデルです。中身は Claude Mythos と同じで、違いは安全装置(セーフガード)の強さです。Fable はサイバーセキュリティと生物学の分野で強い安全装置が付いているため、だれでも使えます。Mythos は安全装置の一部を外した版で、Anthropic の認定プログラム(Cyber Verification Program・Life Sciences Verification Program)の審査を通った組織だけが使えます。
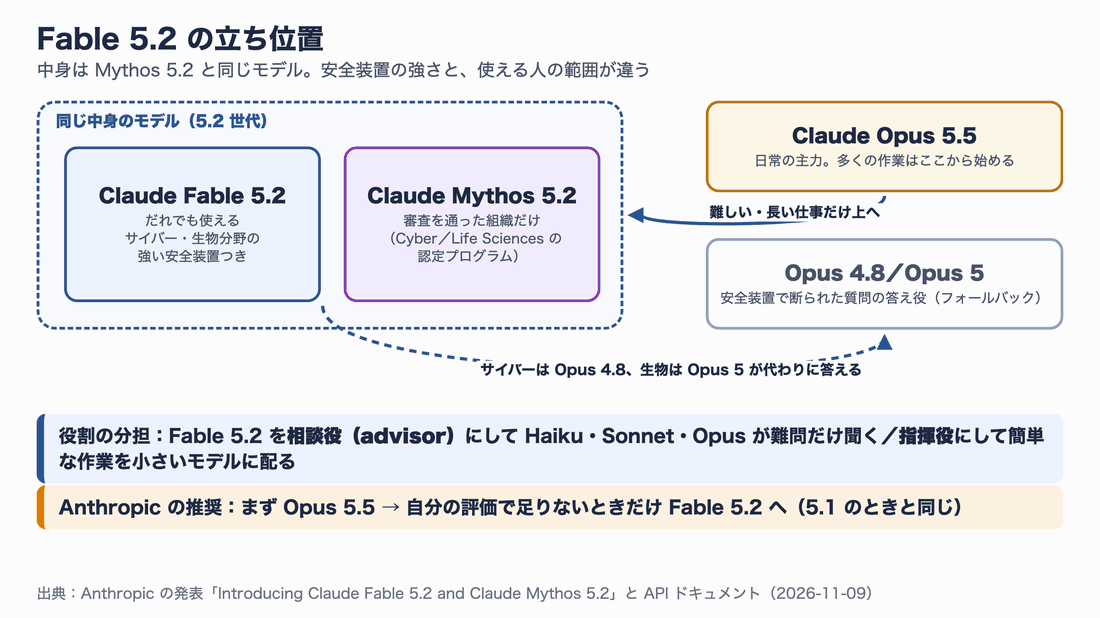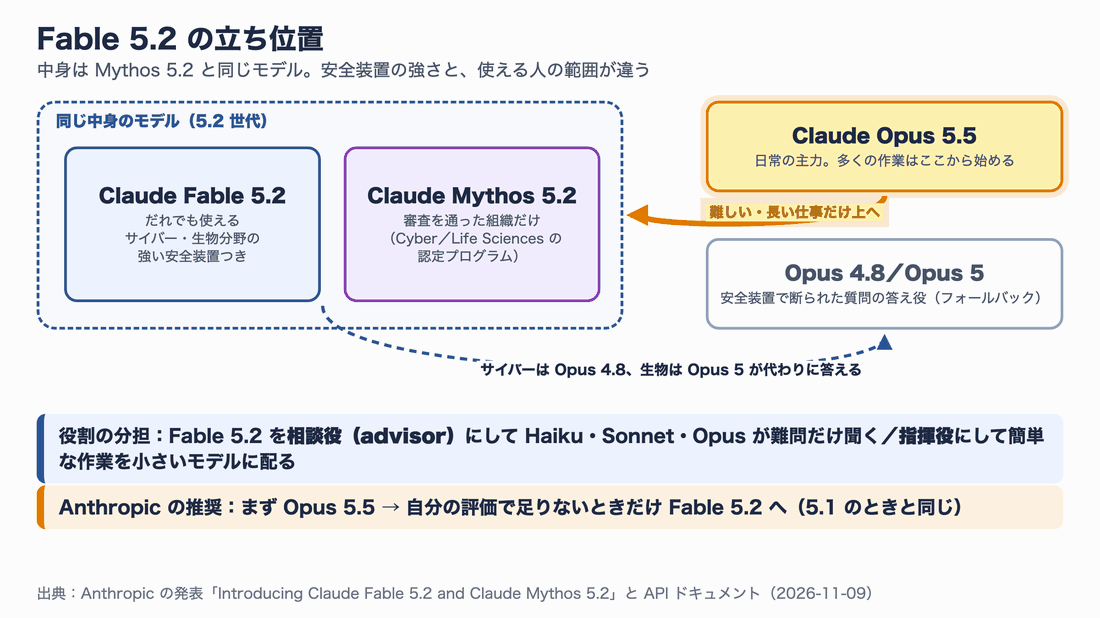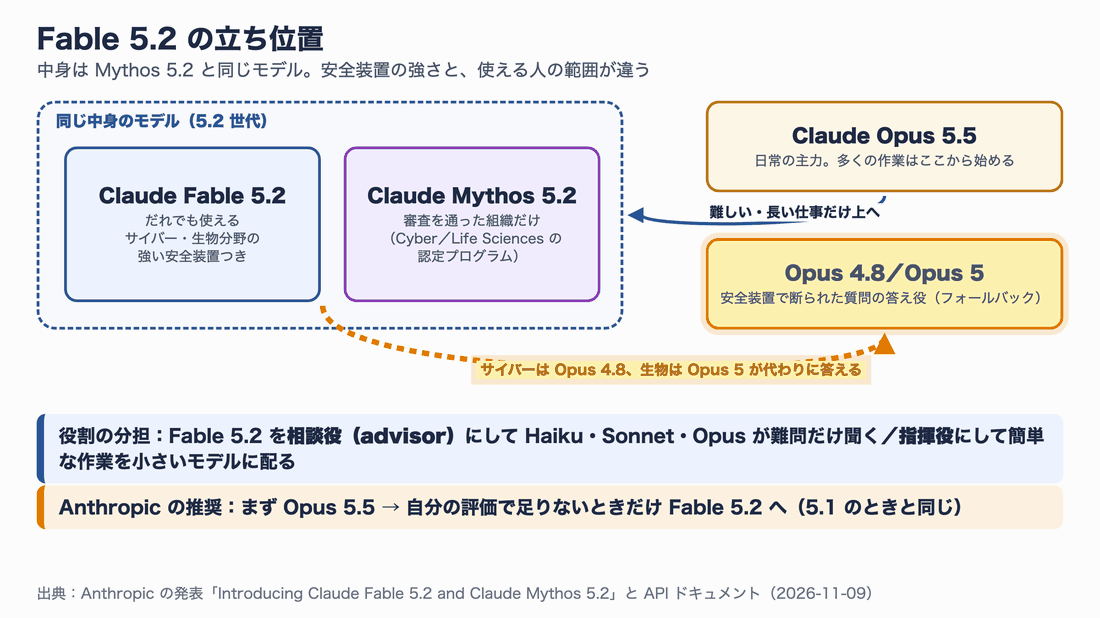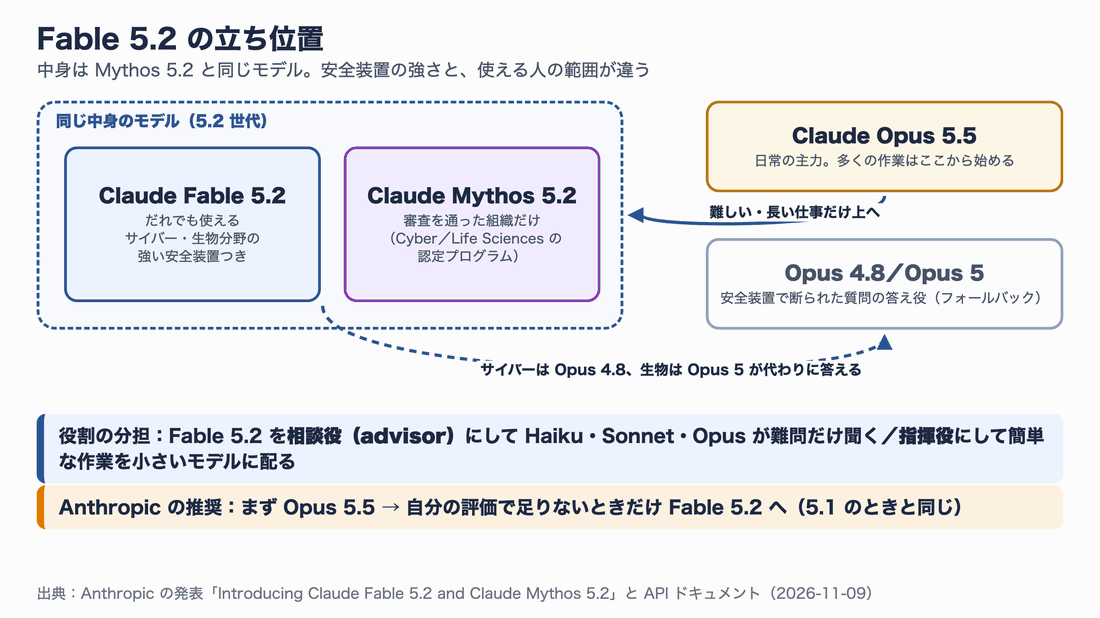
この図から分かること:Fable 5.2 は「毎日使う主力」ではなく「難しい仕事だけ上げる先」。断られた質問は自動で別モデルに回せる。
Anthropic の推奨は、5.1 のときと同じく「まず Claude Opus 5.5 から始め、自分の評価で足りないときだけ Fable に上げる」です。発表では、Fable 5.2 を 相談役(advisor) にして Haiku・Sonnet・Opus が難問だけ聞く使い方や、指揮役(orchestrator) にして簡単な作業を小さいモデルに配る使い方も紹介されています。
安全装置で断られた質問は、サイバー分野なら Opus 4.8、生物分野なら Opus 5 が代わりに答えます(これを フォールバック と呼びます)。この仕組みも 5.1 と同じです。
変わらないところ
違いを見る前に、5.1 と同じままの仕様を表にまとめます。ここが同じなので、Claude Code や claude.ai から使う方は、モデルを切り替えるだけで移行できます。
| 項目 | Fable 5.1 | Fable 5.2 |
|---|---|---|
| コンテキスト(一度に読める量) | 100万トークン | 100万トークン |
| 1回の最大出力 | 12.8万トークン | 12.8万トークン |
| 思考(thinking) | 適応的思考のみ(常にオン) | 同じ |
| API の effort の既定値 | high | high |
| 知識の区切り | 2026年6月 | 2026年6月 |
| 先読み入力(prefill)・tool の強制指定 | 400 エラー | 同じ |
| データ保持 | 30日保持が必須(ゼロ保持は不可) | 同じ |
| 入力できるもの | テキストと画像 | 同じ |
適応的思考(adaptive thinking) とは、問題の難しさに応じてモデル自身が考える量を決める方式です。量の目安は effort というパラメーターで指定します(low・medium・high・xhigh・max の5段階)。
性能:どれだけ伸びたか
伸び幅の大きい項目
Anthropic はシステムカードで、5.2 を 5.1・Opus 5.5・GPT-6 Astra などと比べています。5.1 との差を横に並べたのが次の図です。灰色の点が 5.1、青い点が 5.2、金色の線が Opus 5.5 です。グループごとに順番に強調されます。
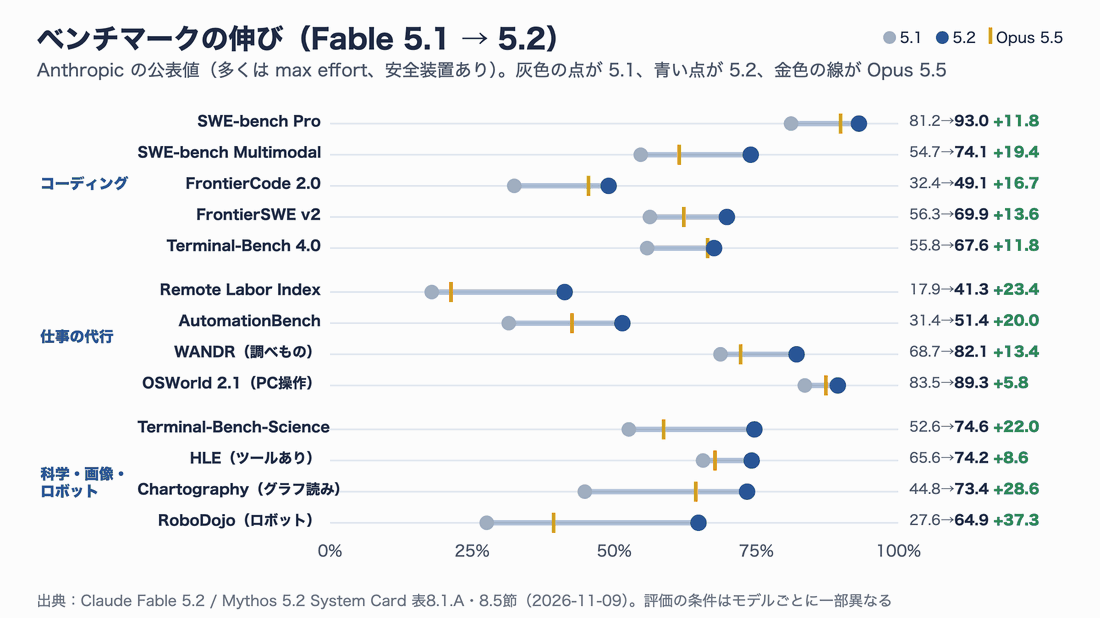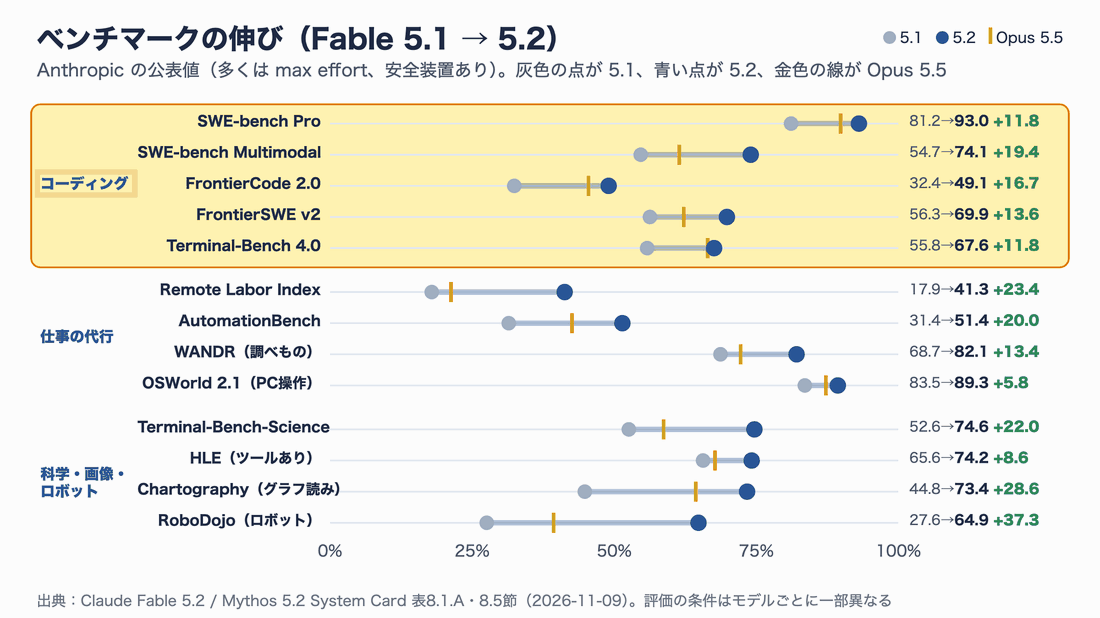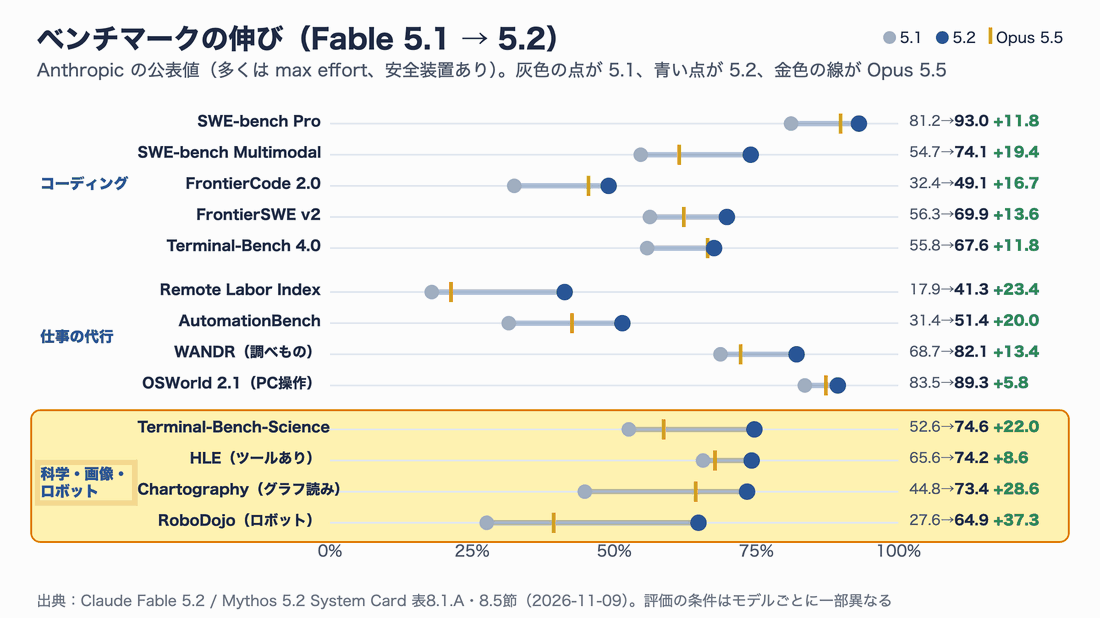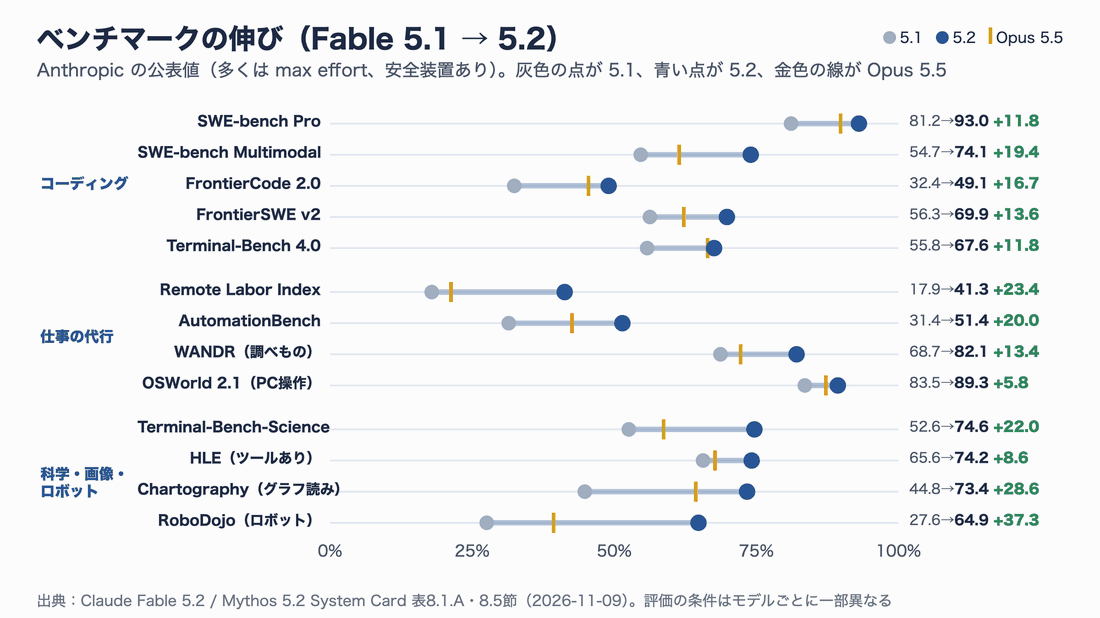
この図から分かること:13 項目すべてで 5.2 が 5.1 を上回り、多くは Opus 5.5 も上回った。伸びが特に大きいのはロボット操作、グラフの読み取り、仕事の代行。
数字を表でも示します。どれも Anthropic の公表値で、注記がなければ最も高い effort(多くは max)、安全装置ありで測ったものです。
| 分野 | ベンチマーク(何を測るか) | 5.1 | 5.2 | Opus 5.5 |
|---|---|---|---|---|
| コーディング | SWE-bench Pro(大きなリポジトリの修正) | 81.2% | 93.0% | 89.9% |
| コーディング | SWE-bench Multimodal(画面画像つきの修正) | 54.7% | 74.1% | 61.4% |
| コーディング | FrontierCode 2.0(そのままマージされるコード) | 32.4% | 49.1% | 45.5% |
| コーディング | FrontierSWE v2(数十時間かかる開発・研究) | 56.3% | 69.9% | 62.3% |
| コーディング | Terminal-Bench 4.0(ターミナルでの実作業) | 55.8% | 67.6% | 66.4% |
| 仕事の代行 | Remote Labor Index(フリーランス案件を人並みに完了) | 17.9% | 41.3% | 21.3% |
| 仕事の代行 | AutomationBench(業務の自動化) | 31.4% | 51.4% | 42.5% |
| 調べもの | WANDR(大量のデータ収集) | 68.7% | 82.1% | 72.3% |
| PC 操作 | OSWorld 2.1(オフライン版の一部) | 83.5% | 89.3% | 87.2% |
| 科学 | Terminal-Bench-Science 0.1(研究の作業) | 52.6% | 74.6% | 58.7% |
| 知識と推論 | Humanity’s Last Exam(ツールあり) | 65.6% | 74.2% | 67.7% |
| 画像 | Chartography(グラフを読む、ツールなし) | 44.8% | 73.4% | 64.4% |
| ロボット | RoboDojo Sim(2本腕ロボットの操作) | 27.6% | 64.9% | 39.4% |
| 多言語 | Global MMLU(42言語の平均) | 94.0% | 96.0% | 94.3% |
特に目立つのは次の 3 つです。
- 仕事の代行(Remote Labor Index)が 17.9% → 41.3%。 実際のフリーランス案件を「人間の専門家と同等以上」にこなせた割合です。2倍以上に伸びました。
- グラフの読み取り(Chartography)が 44.8% → 73.4%。 発表で「画像の理解(vision)」が改善点に挙がっている根拠です。
- ロボット操作(RoboDojo)が 27.6% → 64.9%。 カメラ画像を見て2本の腕を動かすシミュレーションです。発表には、実物のロボットでルービックキューブを解いたり、瓶のふたを開けたりする動画もありました。
発表ではほかにも、1,000 体の Fable 5.2 がフェルマーの最終定理の証明を 30 時間で形式化(コンピューターが1行ずつ検証できる形に書き直すこと)した例や、ひと段落の指示から回路基板と外装とソフトを設計し、3種類の電子機器を動かした例が紹介されています。どちらも Anthropic 自身の実験の報告です。
伸びなかった項目・数字を読むときの注意
「全部が上がった」と受け取るのは早すぎます。システムカードと第三者の測定を読むと、注意すべき点が 4 つありました。
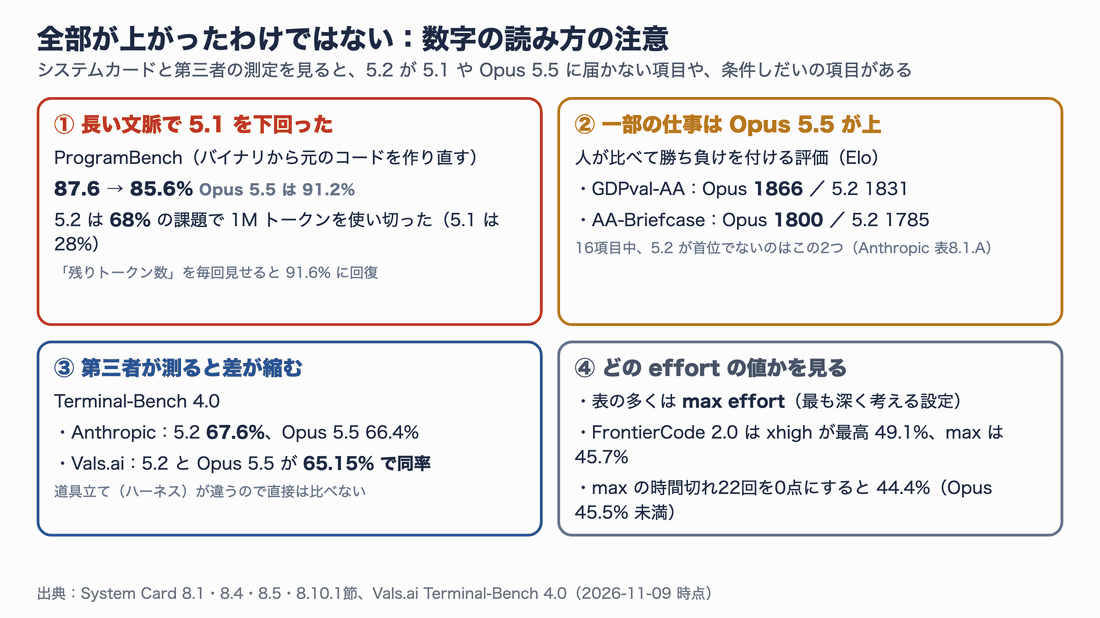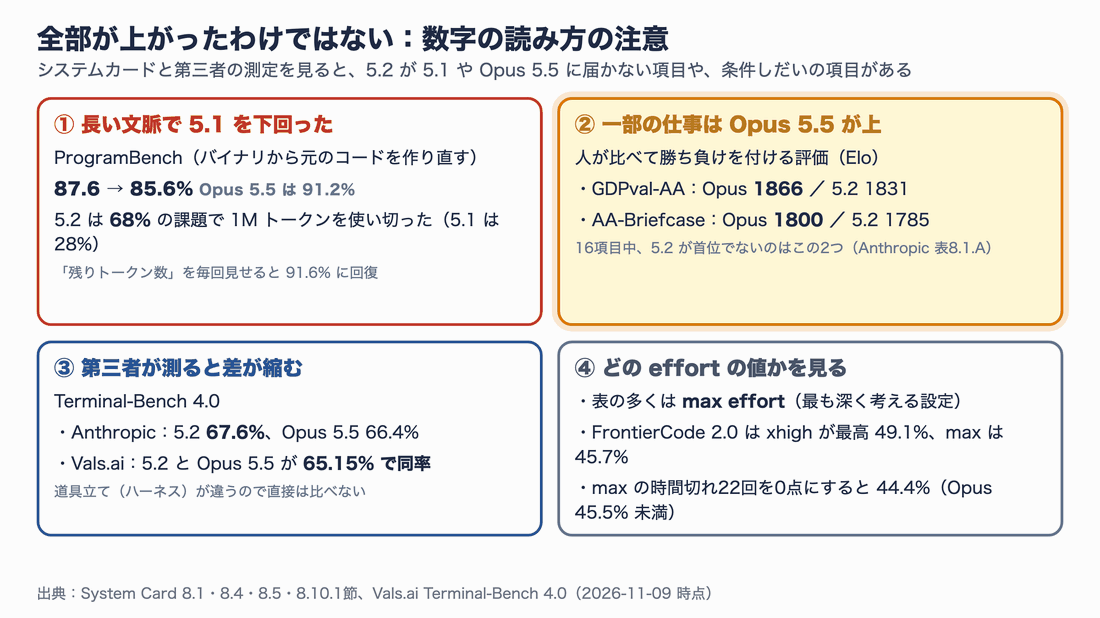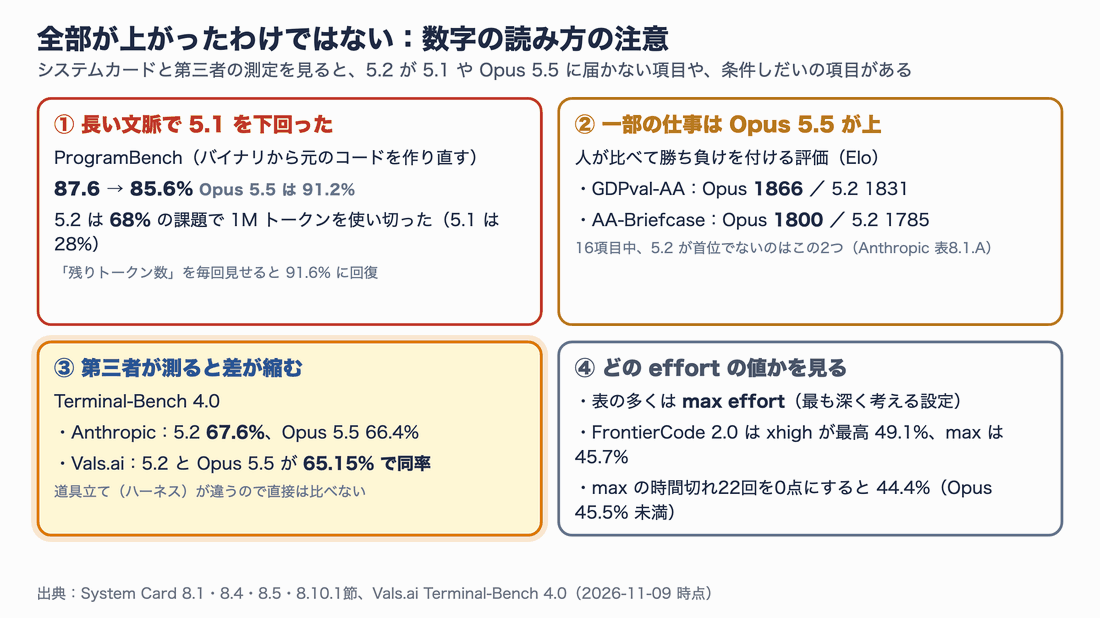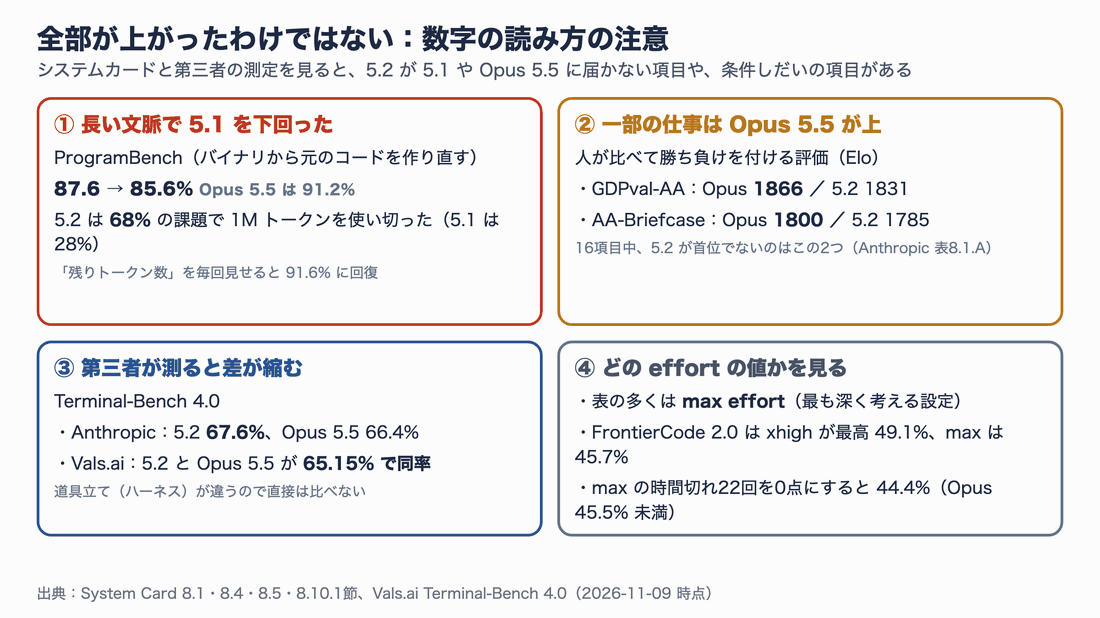
この図から分かること:長い文脈を使い切る課題では 5.1 より低く、人が勝ち負けを付ける評価では Opus 5.5 が上。数字は「誰が・どの設定で」測ったかとセットで読む。
① 長い文脈のコーディングでは 5.1 を下回りました。 ProgramBench は、実行ファイル(バイナリ)と説明書だけを手がかりに、元のプログラムを作り直す課題です。5.2 は 85.6% で、5.1 の 87.6% より低い結果でした。原因として、5.2 は 68% の課題で 100 万トークンの文脈を使い切ってしまい、提出まで届かなかったことが挙がっています(5.1 は 28%)。「残りトークン数」を毎回モデルに見せると、5.2 は 91.6% まで上がりました。長い作業をさせるときは、残りの量を伝える仕組みが効くということです。
② 一部の仕事は Opus 5.5 のほうが上です。 人が 2 つの回答を比べて勝ち負けを付ける形式(Elo 評価)の GDPval-AA と AA-Briefcase では、Opus 5.5 が 5.2 をわずかに上回りました。Anthropic の表 16 項目のうち、5.2 が首位でないのはこの 2 つだけです。
③ 第三者が測ると差が縮みます。 Terminal-Bench 4.0 は Anthropic の測定では 5.2 が 67.6%、Opus 5.5 が 66.4% でした。一方、第三者の Vals.ai が別の道具立て(Mini-SWE-agent)で測ると、5.2 と Opus 5.5 が 65.15% で同率首位 でした(2026年11月9日時点)。測り方が違うので数字を直接は比べられませんが、「Opus 5.5 との差は小さい」と読むのが安全です。
④ どの effort の値かを確かめましょう。 表の多くは max effort の値です。FrontierCode 2.0 では、5.2 の最高点は xhigh の 49.1% で、max は 45.7% でした。しかも max には時間切れの試行が 22 回含まれ、これを 0 点とすると 44.4% になり、Opus 5.5(45.5%)を下回ります。「max にすれば一番賢い」とは限りません。
料金と速さ:単価は2割引き、ただし1タスクの費用は別の話
単価の比較
料金は分かりやすく下がりました。次の図で、項目ごとに 5.1 と 5.2 を並べています。
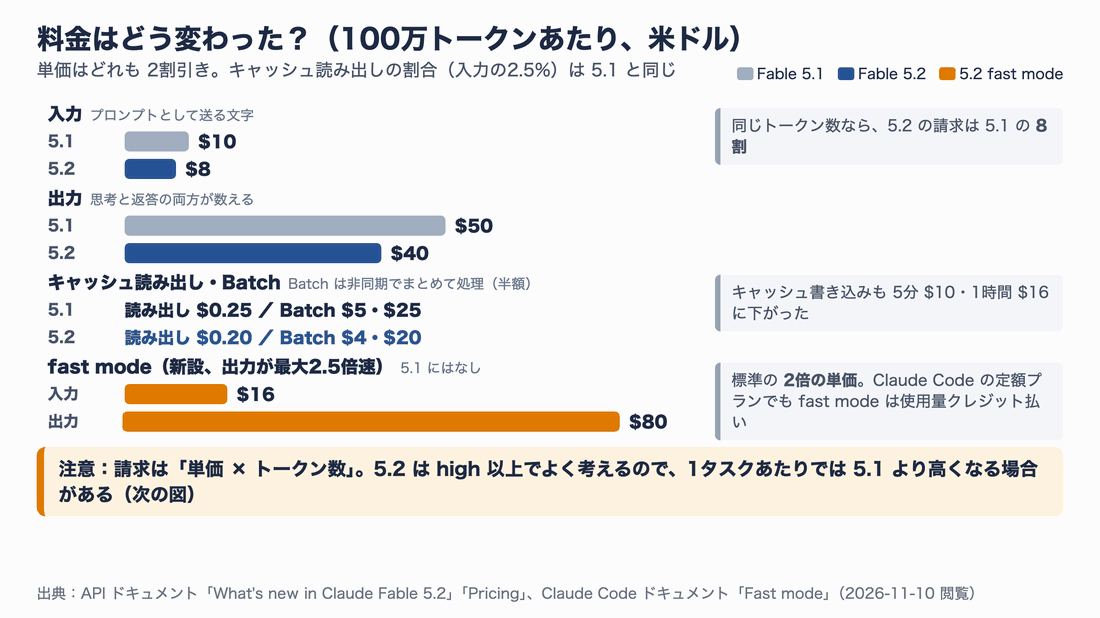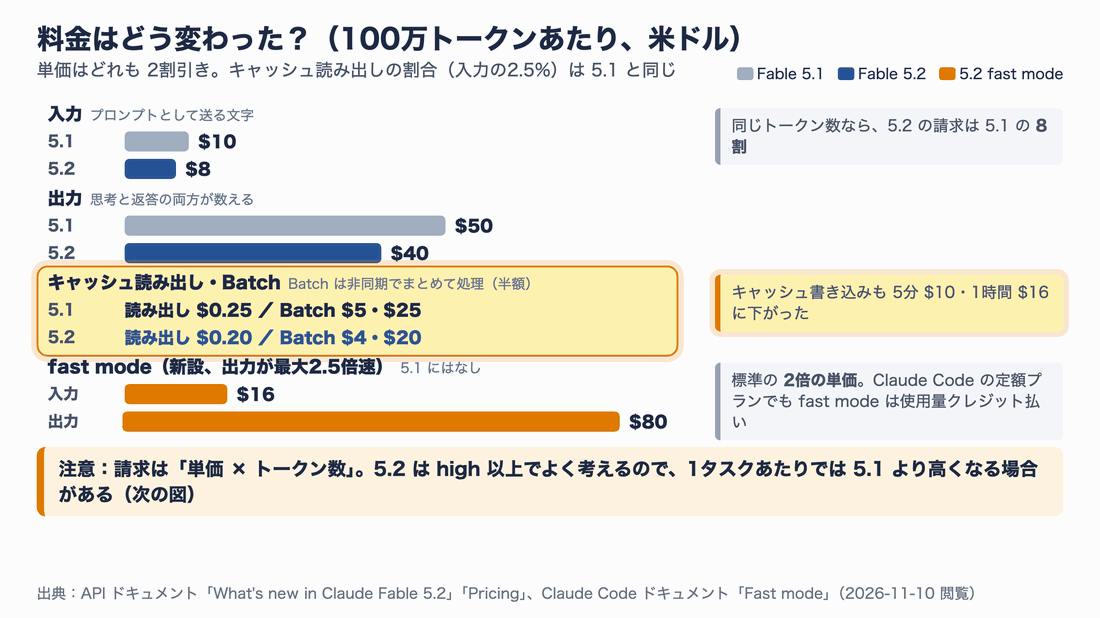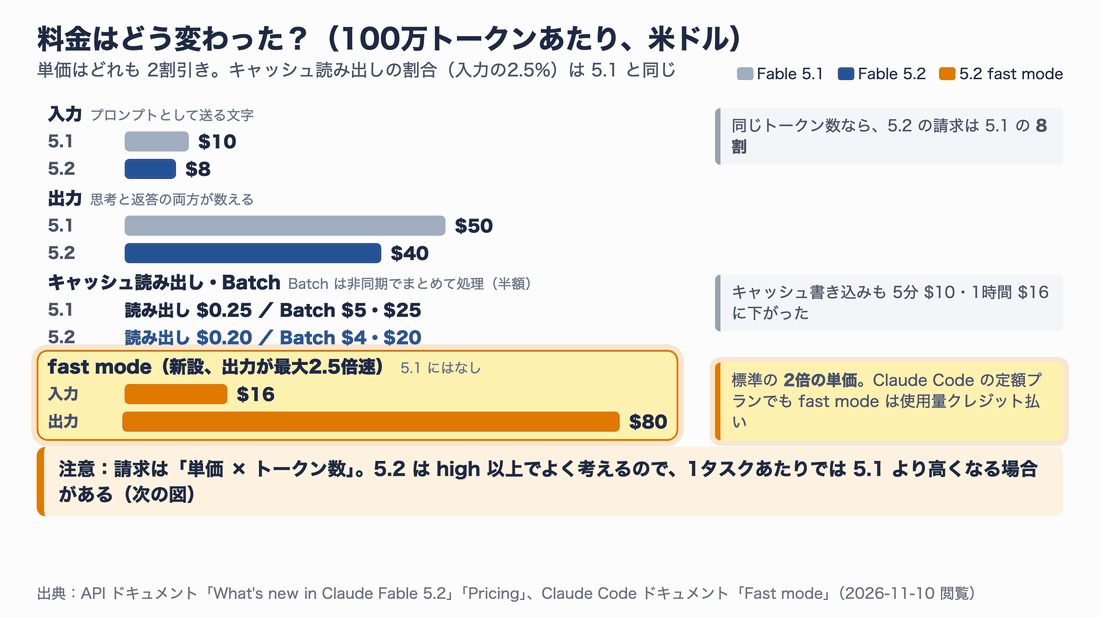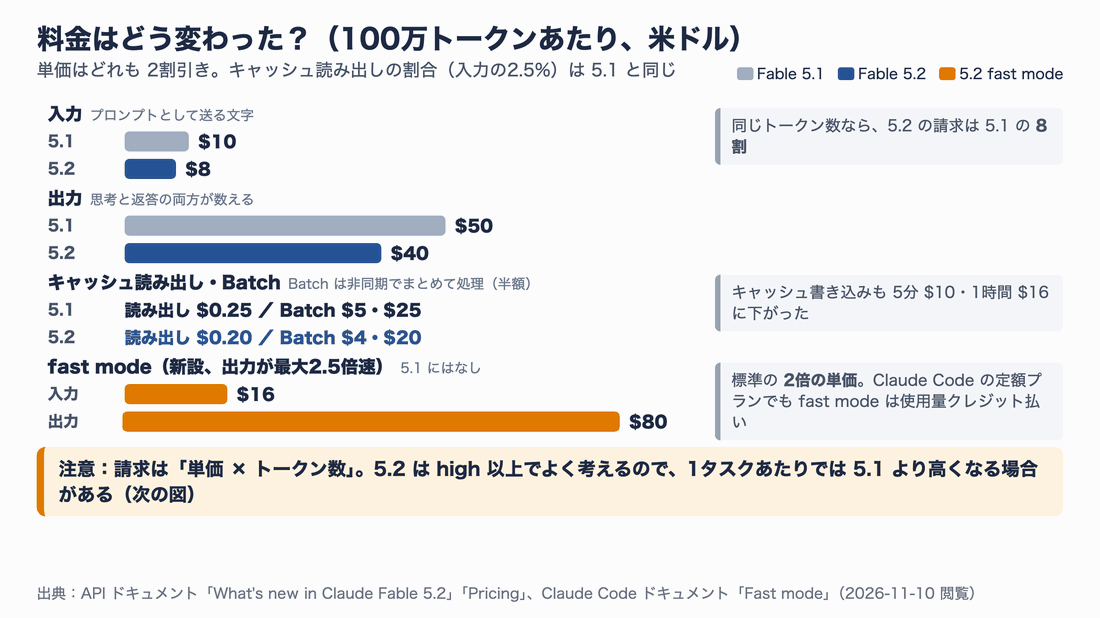
この図から分かること:同じトークン数なら 5.2 の請求は 5.1 の 8 割。fast mode は標準の 2 倍の単価で、速さを買う選択肢。
| 料金(100万トークンあたり、米ドル) | Fable 5.1 | Fable 5.2 |
|---|---|---|
| 入力 | $10 | $8 |
| 出力 | $50 | $40 |
| キャッシュ書き込み(5分/1時間) | $12.50/$20 | $10/$16 |
| キャッシュ読み出し | $0.25 | $0.20 |
| Batch(入力/出力) | $5/$25 | $4/$20 |
| fast mode(入力/出力) | なし | $16/$80 |
キャッシュ読み出しが入力単価の 2.5% という比率は 5.1 と同じです。比較のために書くと、Opus 5.5 は $4/$20 なので、5.2 でもまだ Opus 5.5 の 2 倍の単価です。
新しい fast mode
5.2 の新機能が fast mode です。同じモデルを、速さを優先した設定で動かします。賢さは変わらず、出力の速さ(1秒あたりのトークン数)が最大 2.5 倍になります。最初の1文字が出るまでの時間が縮むわけではない点に注意してください。
API では、リクエストに speed: "fast" を付けるだけです。5.2 ではベータ用のヘッダーは不要です。
# Fable 5.2 を fast mode で呼ぶ(料金は入力 $16・出力 $80/100万トークン)
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2026-10-21" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-fable-5-2",
    "max_tokens": 16000,
    "speed": "fast",
    "messages": [{"role": "user", "content": "このエラーログの原因を3つ挙げて"}]
  }'
上のコマンドは公式ドキュメントの例をもとに、モデル名を 5.2 に変えたものです。筆者は実行していません。Microsoft Foundry では、fast mode は claude-fable-5-2-fast という別のモデルとして提供され、speed は付けません。
Claude Code では、Fable 5.2 を選んだ状態で /fast を実行します。Pro・Max などの定額プランでも、fast mode は 定額の利用枠に含まれず、使用量クレジット(追加の従量課金)から引かれます。Claude Code の v2.1.321 以上が必要です。
「1タスクあたりの費用」で見ると話が変わる
ここが今回いちばん大事なポイントです。請求額は「単価 × 使ったトークン数」で決まります。5.2 は単価が下がりましたが、高い effort ではよく考えるため、使うトークンが増えます。
第三者の Artificial Analysis が、effort ごとに「総合指数(賢さ)」と「1タスクあたりの費用」を測っています。それを1枚にしたのが次の図です。左上ほど「安くて賢い」ことを表します。
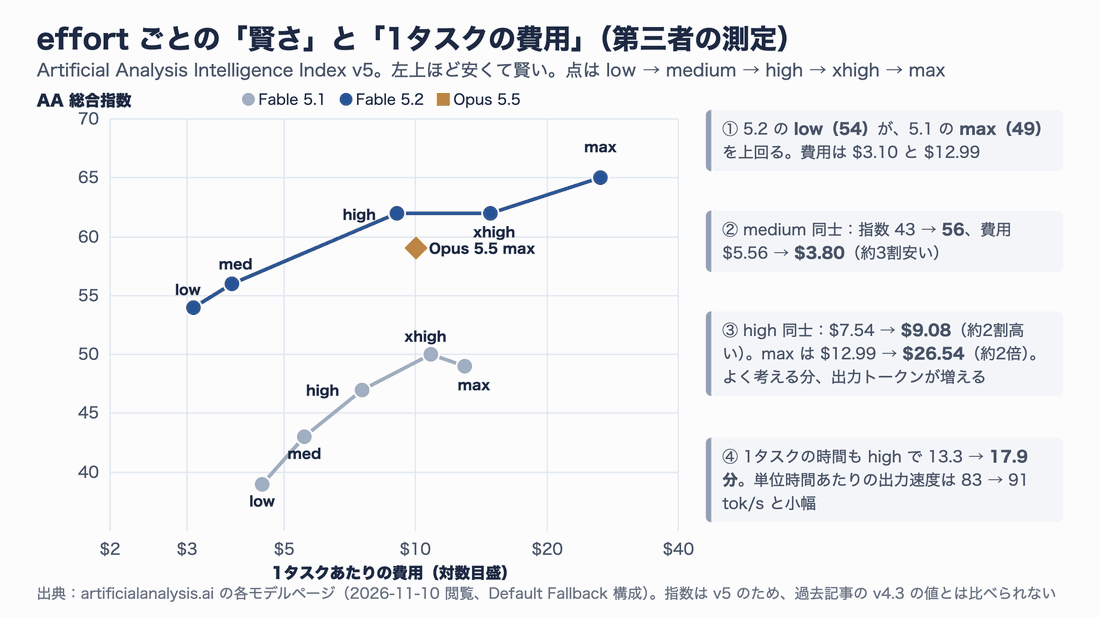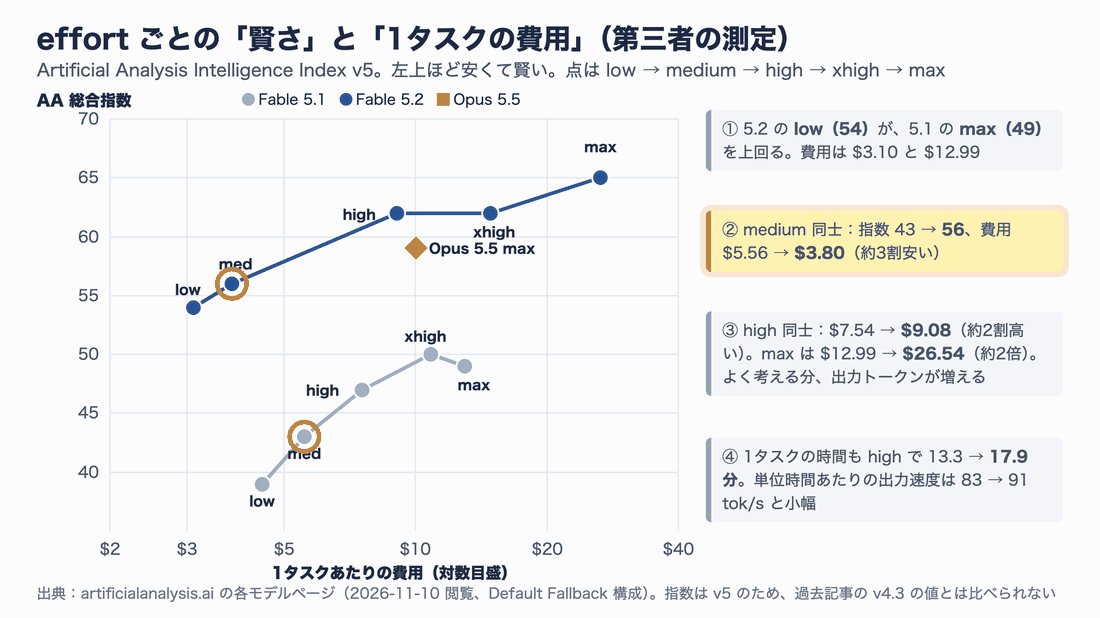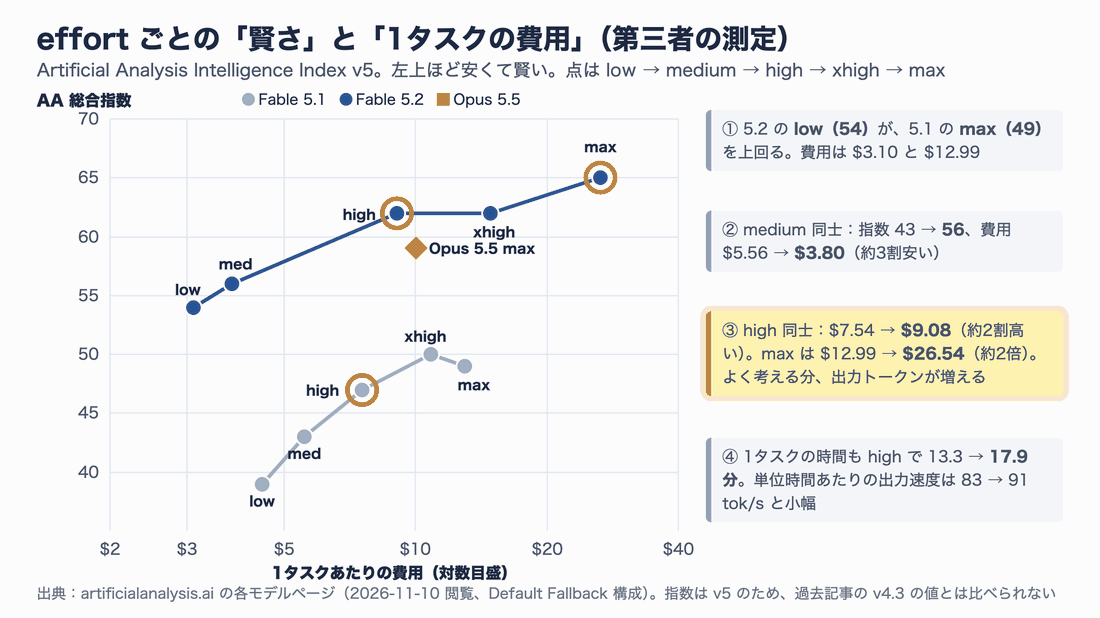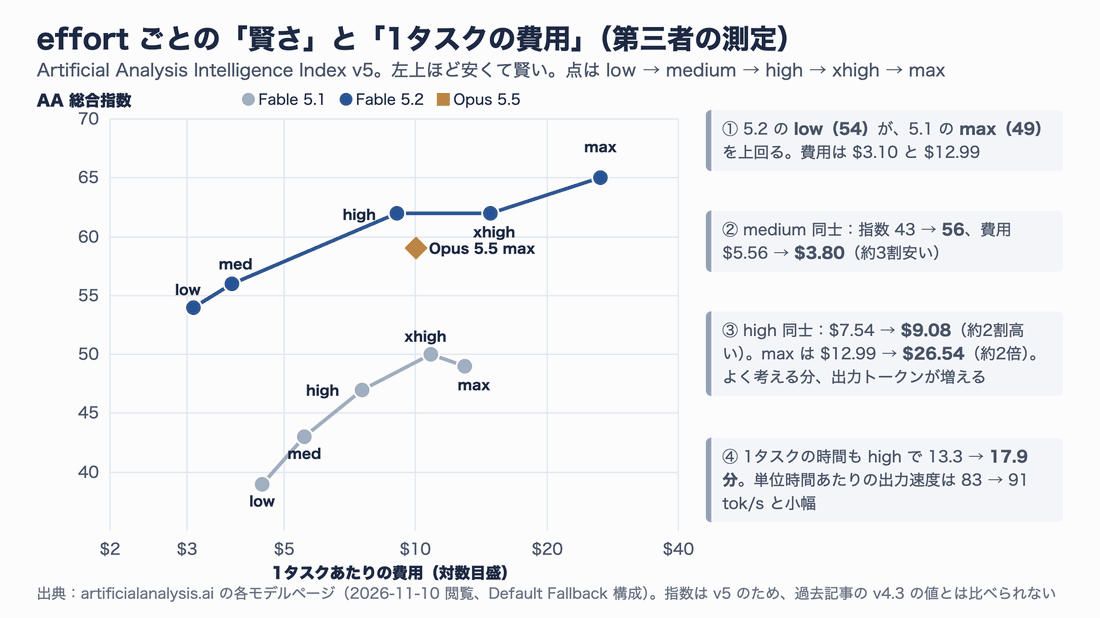
この図から分かること:5.2 の low は 5.1 の max より賢くて安い。medium では 5.2 のほうが安いが、high と max では 5.2 のほうが高くつく。
数字で並べると次のとおりです(2026年11月10日閲覧、Intelligence Index v5)。
| effort | 5.1 指数 | 5.2 指数 | 5.1 費用/タスク | 5.2 費用/タスク | 5.1 時間/タスク | 5.2 時間/タスク |
|---|---|---|---|---|---|---|
| low | 39 | 54 | $4.47 | $3.10 | 7.5分 | 6.5分 |
| medium | 43 | 56 | $5.56 | $3.80 | 9.8分 | 8.3分 |
| high | 47 | 62 | $7.54 | $9.08 | 13.3分 | 17.9分 |
| xhigh | 50 | 62 | $10.85 | $14.83 | 19.4分 | 26.4分 |
| max | 49 | 65 | $12.99 | $26.54 | 22.5分 | 46.4分 |
この表から読み取れることを 3 つにまとめます。
- low と medium では、5.2 が安くて賢い。 5.2 の low(指数 54)は 5.1 の max(49)を上回り、費用は約 4 分の 1 です。API ドキュメントにも「5.2 の low は 5.1 の高い effort に近い点数だった」と書かれています。
- high 以上では、5.2 のほうが 1 タスクの費用が高い。 high で約 2 割増し、max で約 2 倍です。単価が 2 割下がっても、考える量の増加がそれを上回るためです。
- 速さは「出力の速さ」と「タスクの時間」を分けて見る。 1 秒あたりの出力は high で 83 → 91 トークンと小幅に速くなりましたが、考える量が増えた分、1 タスクにかかる時間は high で 13.3 分 → 17.9 分と長くなりました。公式の「最大 30% 速い」は前者の話です。
なお、Artificial Analysis の指数は v5 の値です。以前の記事で紹介した v4.3 の値(5.1 が 53)とは計算方法が違うので、比べないでください。
Anthropic の FrontierCode 2.0 の測定でも、同じ傾向が見えます。5.2 は high で 45.3%(1 タスク $6.72)、5.1 は最高の xhigh で 32.4%($8.68)でした。5.1 の最高設定より、5.2 の high のほうが安くて点数が高い ということです。
使い方:effort の選び方とプロンプトへの反応
effort の推奨
5.2 でも effort の段階の名前は同じですが、各段階で考える量は 5.1 と違います。API ドキュメントは「5.1 で調整した設定を持ち越さず、測り直す」ことを勧めています。5.2 向けの推奨をまとめたのが次の図です。
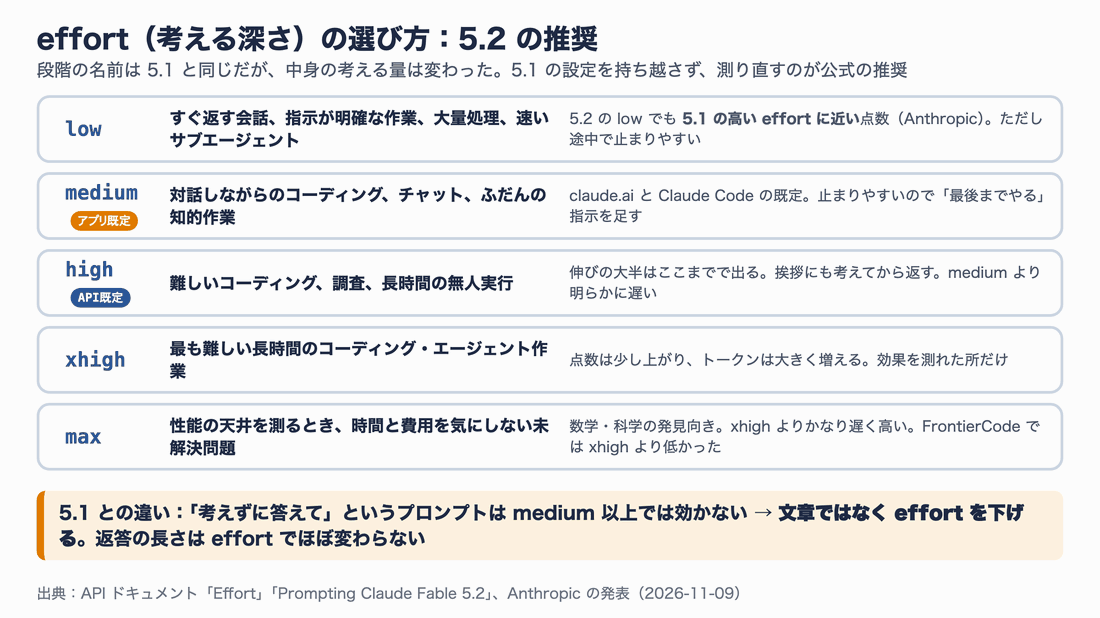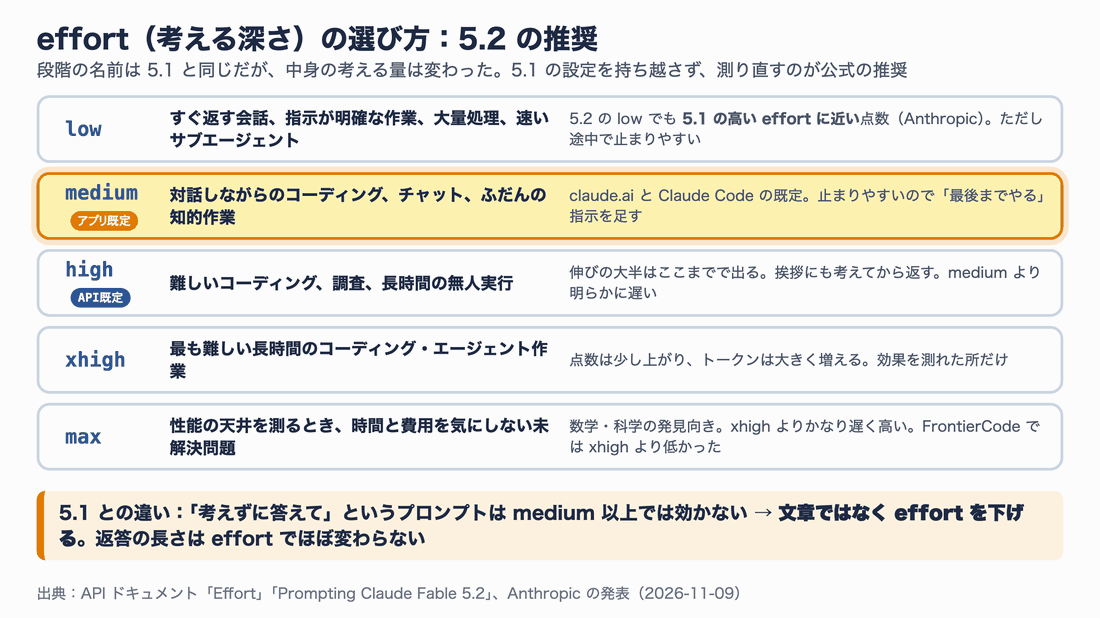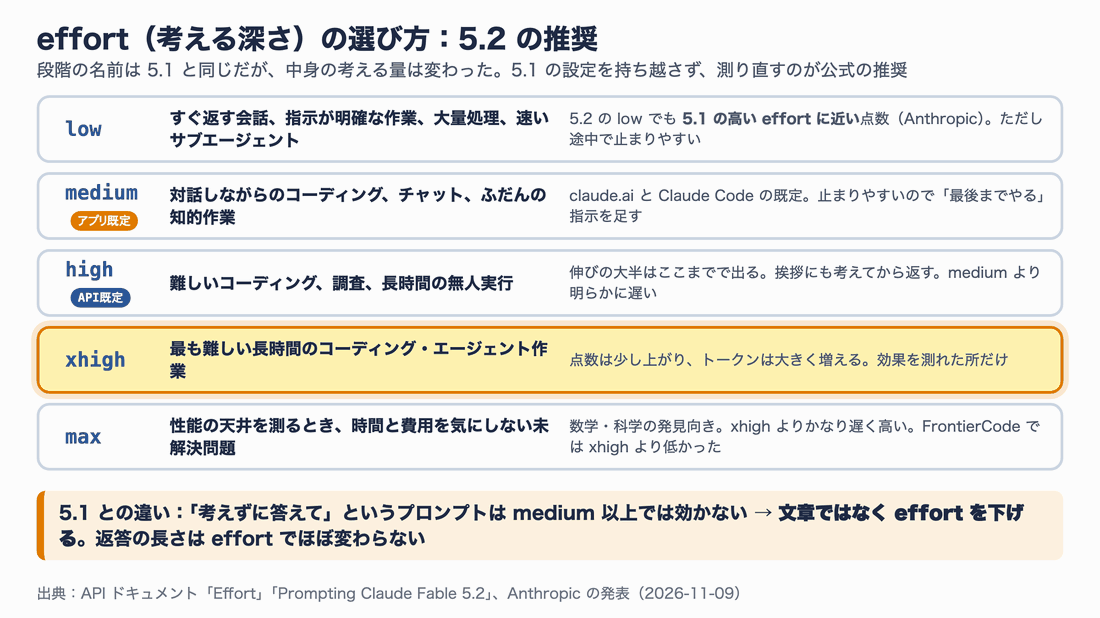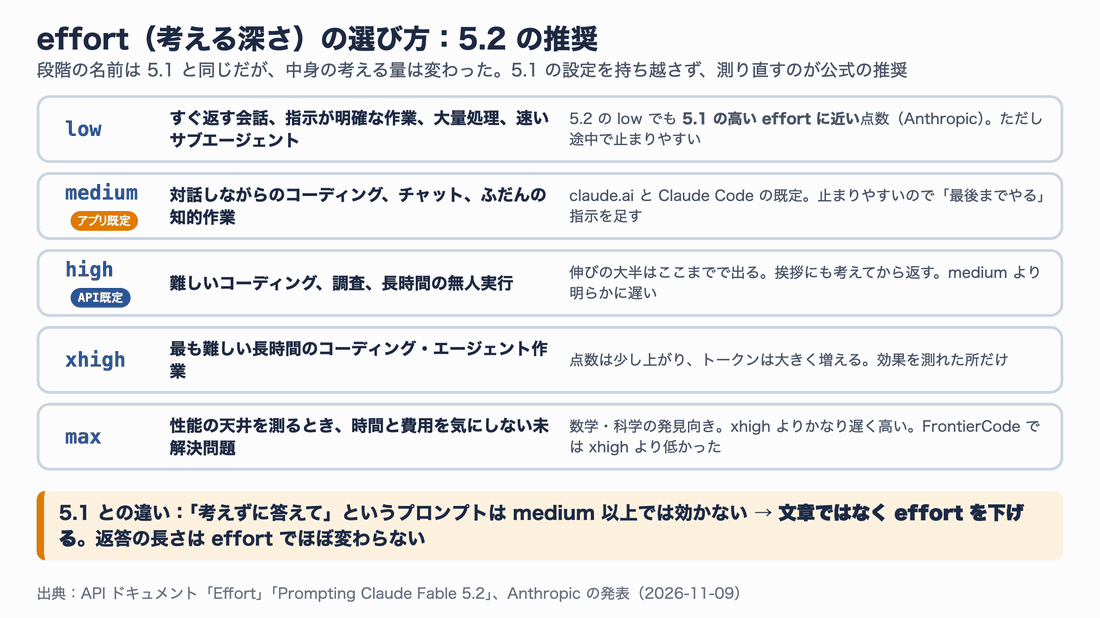
この図から分かること:迷ったら high から。対話なら medium、量をさばくなら low。xhigh と max は効果を測れた所だけ。
既定値にも注意が必要です。API の既定は high ですが、claude.ai などのアプリと Claude Code の既定は medium です(Anthropic の発表より)。同じ「Fable 5.2」でも、どこから使うかで考える深さが違います。
「考えずに答えて」が効かなくなった
5.1 では、システムプロンプトに「深く考えずに、すぐ答えて」と書くと、たいてい従いました。5.2 では、medium 以上ではこの指示が効きません。high 以上では、挨拶への返事でさえ考えてから答えます。
対処は「文章で頼む」のではなく「effort を下げる」ことです。この変化は、max_tokens(出力の上限)を小さくしているコードに影響します。上限は思考と返答の合計に適用されるため、5.1 では指示で思考を抑えて収まっていたリクエストが、5.2 では思考だけで上限に達し、返答が空のまま stop_reason: "max_tokens" で終わる ことがあります。max_tokens を増やすか、effort を下げてください。
API で effort を明示するには output_config を使います。移行の最初の一歩として、既定値に頼らず high を明示するのが公式の推奨です。
# pip install anthropic   (5.2 のモデル定数がある版を使う)
import anthropic

client = anthropic.Anthropic()  # 環境変数 ANTHROPIC_API_KEY を読む

response = client.messages.create(
    model="claude-fable-5-2",         # 5.1 なら "claude-fable-5-1"
    max_tokens=32000,                 # 思考と返答の合計の上限。high 以上は大きめに
    output_config={"effort": "high"}, # 既定値に頼らず明示する
    messages=[{"role": "user", "content": "この関数の計算量を見積もって、改善案を出して"}],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
print(response.stop_reason, response.usage.output_tokens)
このコードは公式ドキュメントの書き方に合わせて筆者が書いたもので、実行はしていません。
プロンプトを変えなくても出る、ふるまいの違い
API ドキュメントの「Prompting Claude Fable 5.2」には、5.1 から乗り換えると気づく変化がいくつも書かれています。代表的な 6 つを図にしました。緑の行が推奨の対処です。
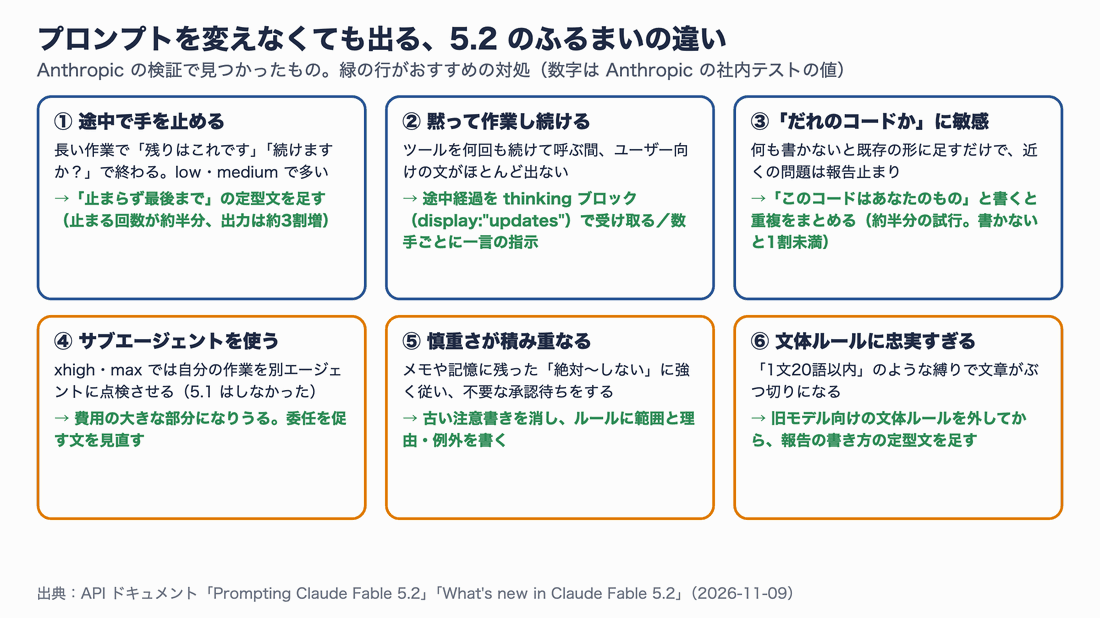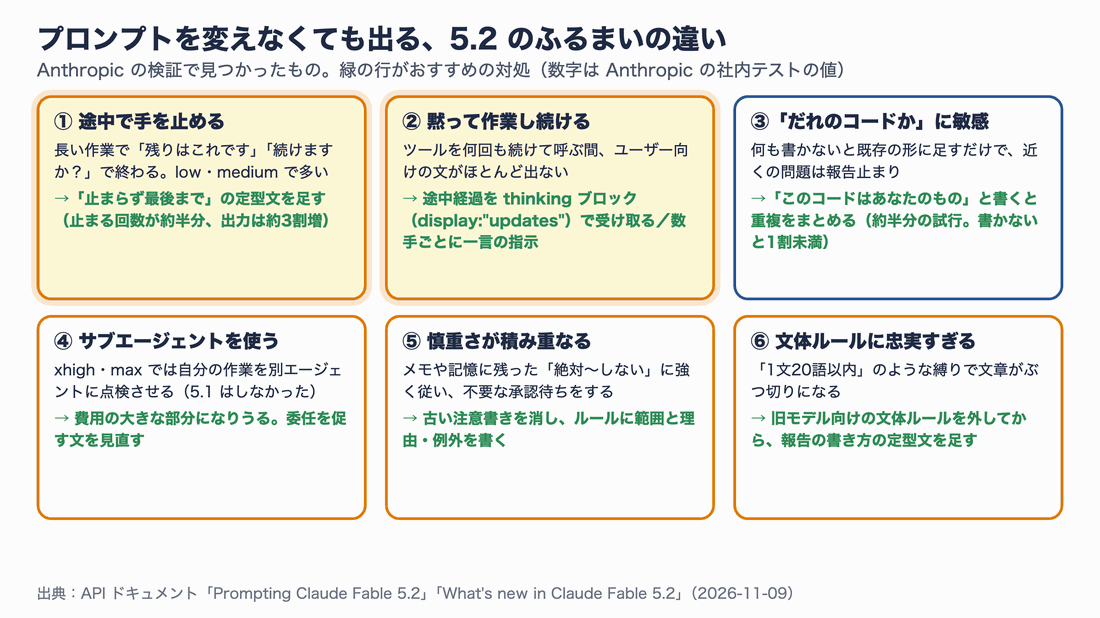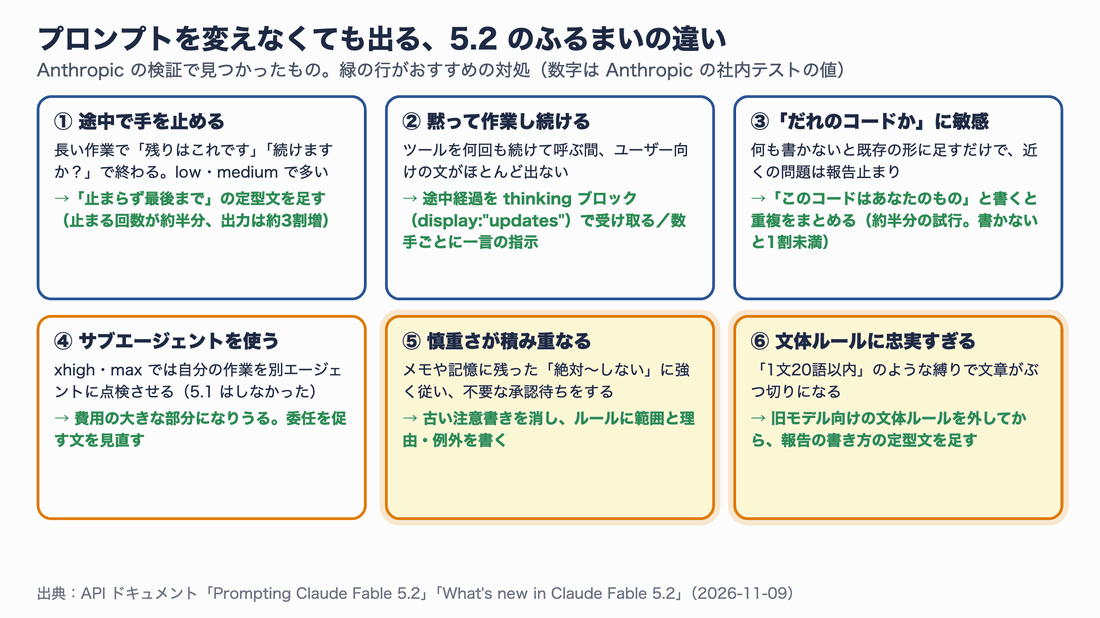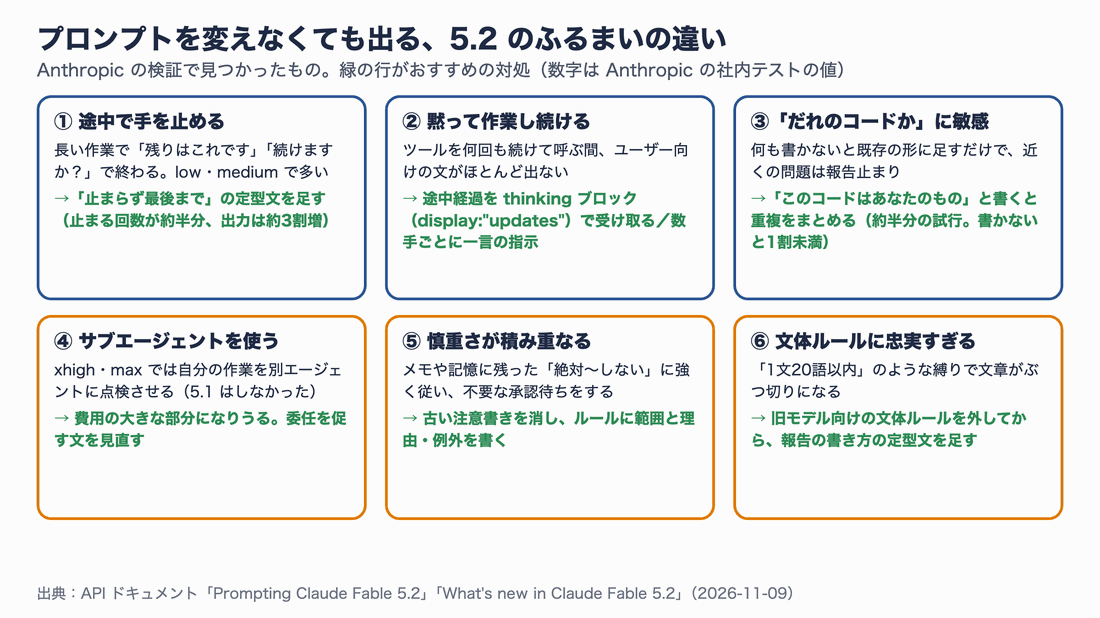
この図から分かること:5.2 は指示に忠実になった分、書いてあることにも書いていないことにも敏感。古いプロンプトの棚卸しが移行の作業になる。
一つずつ補足します。カッコ内の数字は、どれも Anthropic の社内テストでの値です。
① 途中で手を止める。 長い作業の途中で「残りはこれです」「続けましょうか?」と言って終わることがあります。low と medium で多く起こります。システムプロンプトに「頼まれた作業が残っている間は止まらない。エラーや時間切れのようなふつうの障害は、原因を調べて回り込む。ただし、意図的に禁止されたものには手を出さない」という趣旨の文を足すと、止まる回数がおよそ半分になりました(出力トークンは約 3 割増)。この文を足すとモデルが確認を求める回数も減るので、危険な操作や取り消せない操作の承認は、仕組みの側で残してください。
② 黙って作業し続ける。 ツールを何回も続けて呼ぶ間、ユーザー向けの文がほとんど出ないことがあります。実は 5.2 は途中経過を書いていて、それが thinking ブロックとして返ってきています。既定の表示設定(display: "omitted")では中身が空なので、display: "updates"(ベータ)にすると短い要約を受け取れます。
③「だれのコードか」に敏感。 プロンプトにコードの持ち主を書かないと、5.2 は既存の形に付け足すだけで、近くの問題は報告するだけにとどめがちです。「このコードはあなたのもの。設計も含めて任せる」と書くと、重複したコードをまとめるようになりました(約半分の試行。書かないと 1 割未満)。ただし頼んでいない変更も増えるので、要約だけでなく差分を確認しましょう。逆に、人のコードを最小限だけ直してほしい場面では、この文を入れないでください。
④ サブエージェントを使う。 xhigh・max では、自分の作業を別のエージェント(サブエージェント)に点検させる動きが見られました。5.1 では同じ課題でこうした動きはありませんでした。サブエージェントは費用の大きな部分になりうるので、プロンプトやスキルに「積極的に委任せよ」と書いてあるなら見直してください。
⑤ 慎重さが積み重なる。 メモ・記憶・指示ファイルに残った「絶対に〜しない」に強く従い、不要な承認を待つことがあります。ある実験では、過去のメモの一つに「再試行しない」とあるだけで、ツールが混んでいるときの再試行が「ほぼ毎回」から「10 回に 4 回」に減りました。理由がなくなった注意書きは消し、ルールには範囲と理由、例外を書いておくのが対処です。
⑥ 文体のルールに忠実すぎる。 「1 文 20 語以内」のような縛りを守りすぎて、文章がぶつ切りになります。旧モデル向けに書いた文体ルールは、いったん外して様子を見ましょう。
このほか、Opus 5.5 向けに勧められていた「前の答えは完了として扱い、新しい質問に集中して」という趣旨の 2 文を 5.2 に入れると、思考は減るものの、自分の前の答えの誤りを指摘しにくくなったそうです。
API の移行:壊れうる4つの変更
ここからは、Claude API を直接呼ぶコードを持つ方向けです。Claude Code・claude.ai・Claude Managed Agents・Claude Agent SDK が会話の履歴を管理している場合、ここで挙げる 4 つのうち履歴に関する変更の影響は受けません(advisor ツールを使う Managed Agents は、advisor の指定だけ変える必要があります)。
公式の移行ガイドは「ほぼモデル名を変えるだけ」と書いたうえで、次の 4 つを「コードが壊れうる変更」として挙げています。
| # | 変更 | 5.1 | 5.2 |
|---|---|---|---|
| 1 | 履歴の書き換えチェック(prefix check) | 2026年8月31日以降に作ったアカウントだけ | 全アカウント |
| 2 | 5.2 の思考ブロックを読めるモデル | — | 5.2 と Mythos 5.2 だけ(5.1 や Opus 5.5 は読めない) |
| 3 | 古い computer use ツール computer_20251124 | 使える | 400 エラー(Amazon Bedrock を除く) |
| 4 | advisor ツールの相談役 | 制限なし | 5.2 か Mythos 5.2 のみ |
変更1:履歴の書き換えチェックが全アカウントに
一番影響が大きいのがこれです。5.2 の思考ブロックには署名が付いていて、「そのブロックが作られた時点までの system プロンプト・tools・会話」に結び付いています。あとから前の部分を書き換えて送り返すと、API が「別の会話のブロックだ」と判断して 400 エラーを返します。
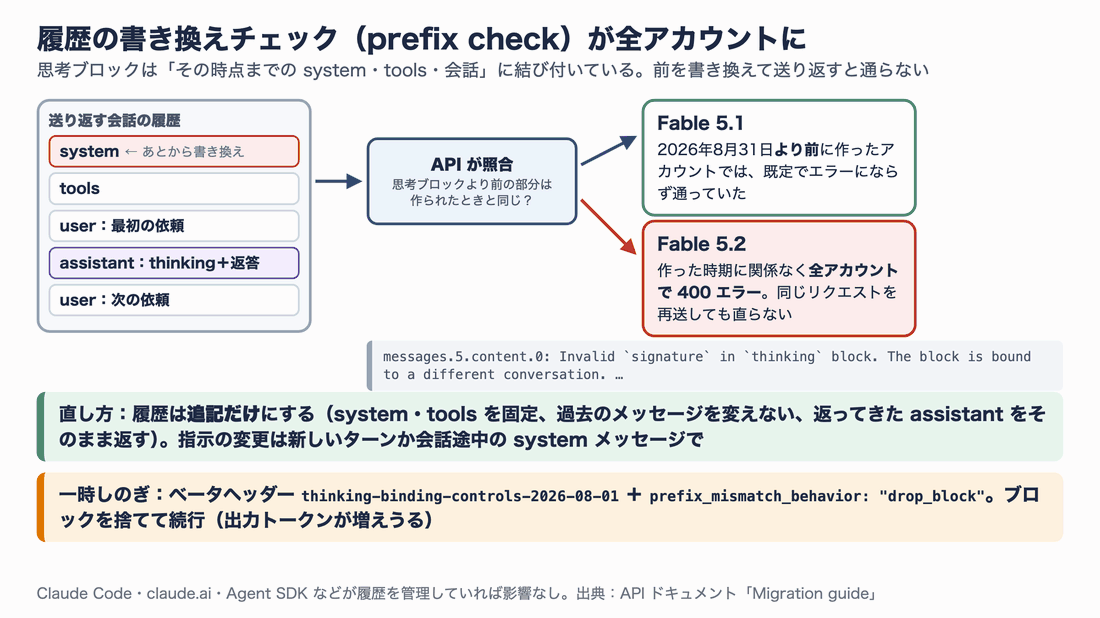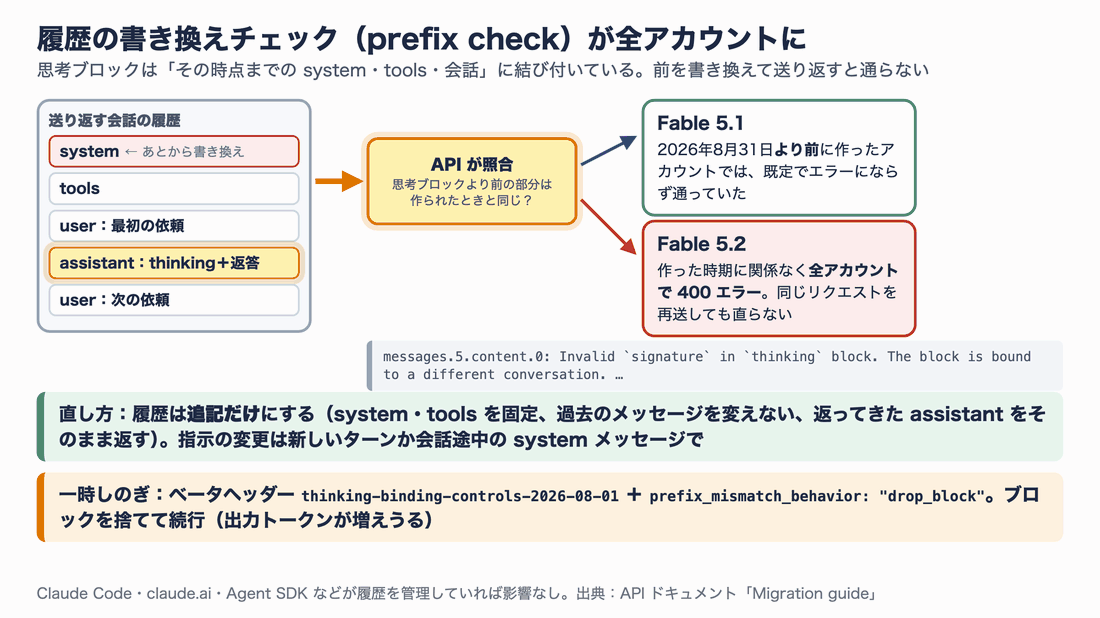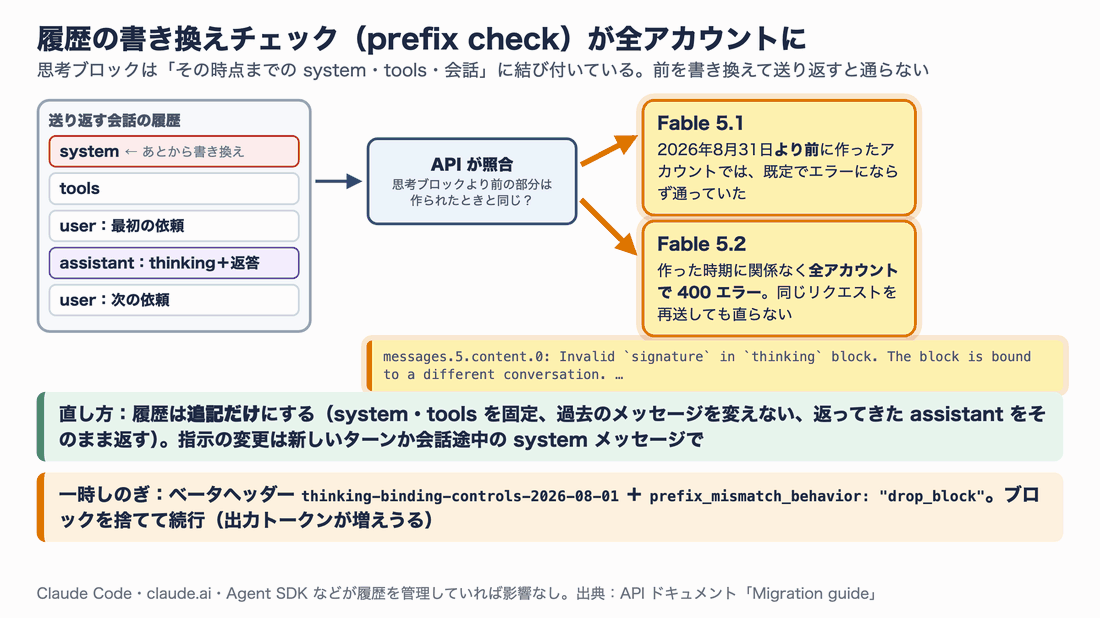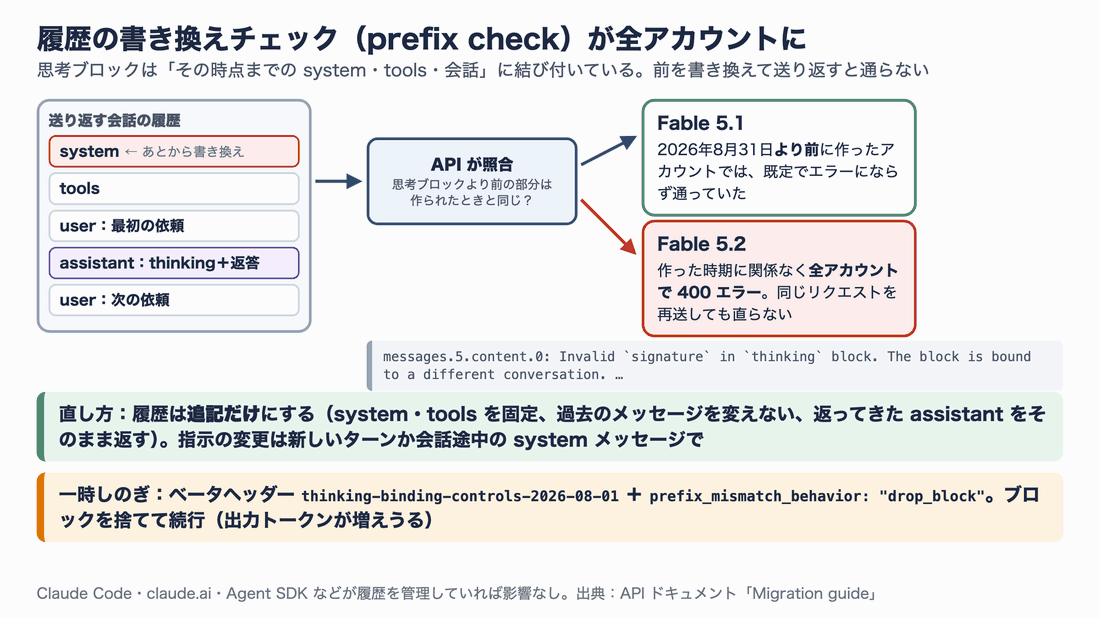
この図から分かること:5.1 の古いアカウントで動いていたコードでも、5.2 に変えた途端にエラーになることがある。根本の対策は「履歴は追記だけ」にすること。
5.1 では、2026年8月31日より前に作ったアカウントにはこのチェックが既定で適用されませんでした。そのため「5.1 では一度もエラーが出なかったのに、5.2 で急に出る」ということが起こります。エラーの文面はこうです。
messages.5.content.0: Invalid `signature` in `thinking` block. The block is bound to a different conversation. ...
同じリクエストを送り直しても直りません。書き換えに当たるのは、たとえば次のような処理です。
- 会話の途中で system プロンプトに日付や状態を書き足す
- 会話の途中で tools の一覧を変える(MCP コネクターでサーバーのツール一覧が変わる場合も含む)
- 古いメッセージを要約に置き換えたり、削除したり、並べ替えたりする
- 返ってきた assistant のメッセージから thinking ブロックを抜いて、ほかだけ送り返す
本番を切り替える前に、書き換えている箇所を洗い出しましょう。 ベータヘッダー thinking-binding-controls-2026-08-01 を付けて prefix_mismatch_behavior: "drop_block" を指定すると、エラーにせず問題のブロックを捨てて続け、捨てた場所を input_transformations に記録してくれます。次のコードは、保存しておいた会話を流し直して、書き換えている箇所を表示する例です。
# 保存済みの会話(messages)を 5.2 で流し直し、履歴の書き換え箇所を探す
import json
import anthropic

client = anthropic.Anthropic()

with open("saved_conversation.json") as f:   # 自分のアプリが保存した会話
    convo = json.load(f)                      # {"system": ..., "tools": [...], "messages": [...]}

response = client.beta.messages.create(
    model="claude-fable-5-2",
    max_tokens=16000,
    system=convo["system"],
    tools=convo.get("tools", []),
    messages=convo["messages"],
    thinking={
        "type": "adaptive",
        "block_binding": {"prefix_mismatch_behavior": "drop_block"},  # エラーにせず捨てて記録
    },
    betas=["thinking-binding-controls-2026-08-01"],
)

for t in response.input_transformations or []:
    # reason が prefix_binding_mismatch なら、その path より前のどこかを書き換えている
    print(t.type, t.reason, t.path)
このコードは公式の例(client.beta.messages.create と betas の指定)をもとに筆者が書いたもので、実行はしていません。reason が prefix_binding_mismatch のものが書き換えの跡です。チェックはベータヘッダーを付けるとどのアカウントでも有効になるので、移行前に 5.1 のまま確認することもできます。
直し方の基本は「履歴は追記だけ」です。system と tools は会話の間ずっと固定し、返ってきた assistant のメッセージは中身も順番もそのまま送り返します。途中で指示を変えたいときは、新しいターンに書くか、5.2 で使える「会話途中の system メッセージ」(ベータ)を使います。ツールの追加・削除にも、会話途中で行うためのベータ機能があります。
"drop_block" は一時しのぎとして使いましょう。捨てた思考は作り直しになるため、出力トークンが増えることがあります。
変更2:5.2 の思考は「持ち込めるが、持ち出せない」
2つ目は、会話の途中でモデルを切り替える仕組み(ルーターや、断られたときのフォールバック)に関係します。
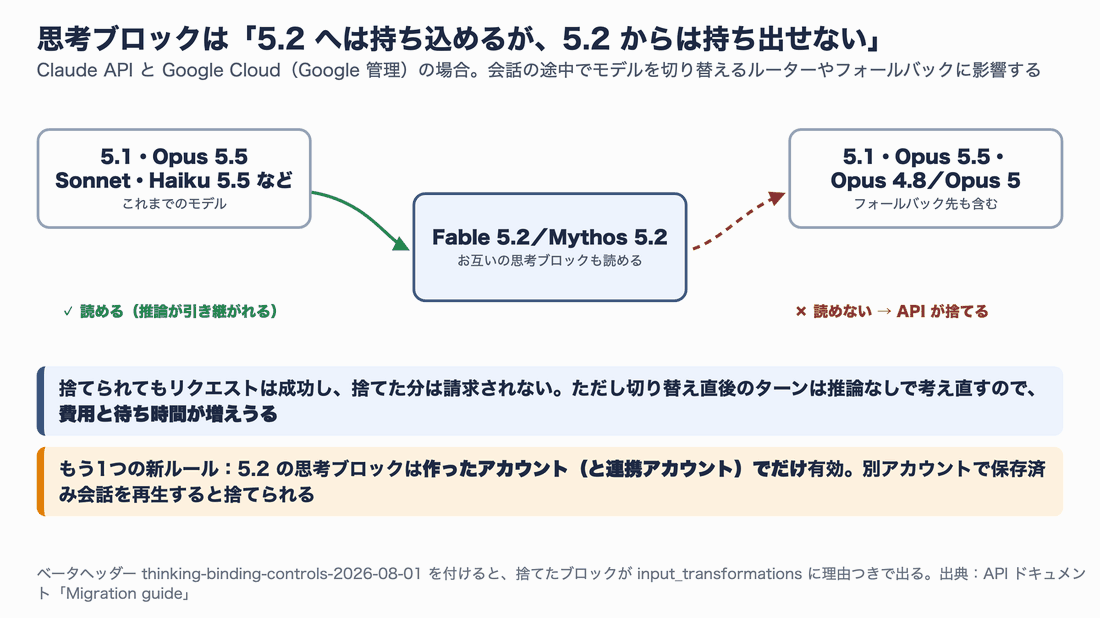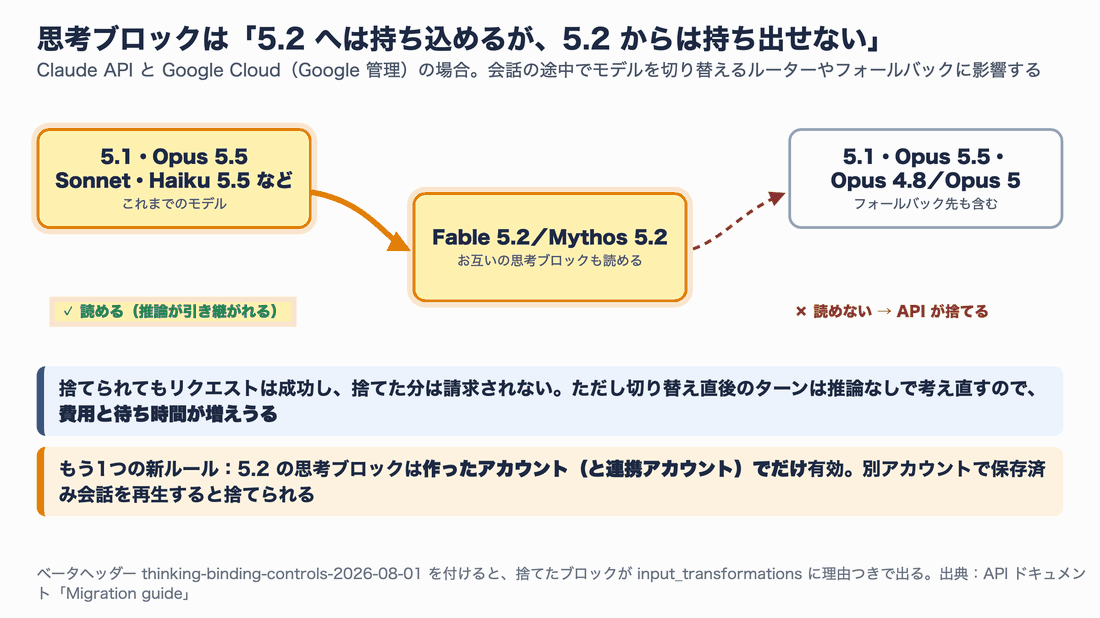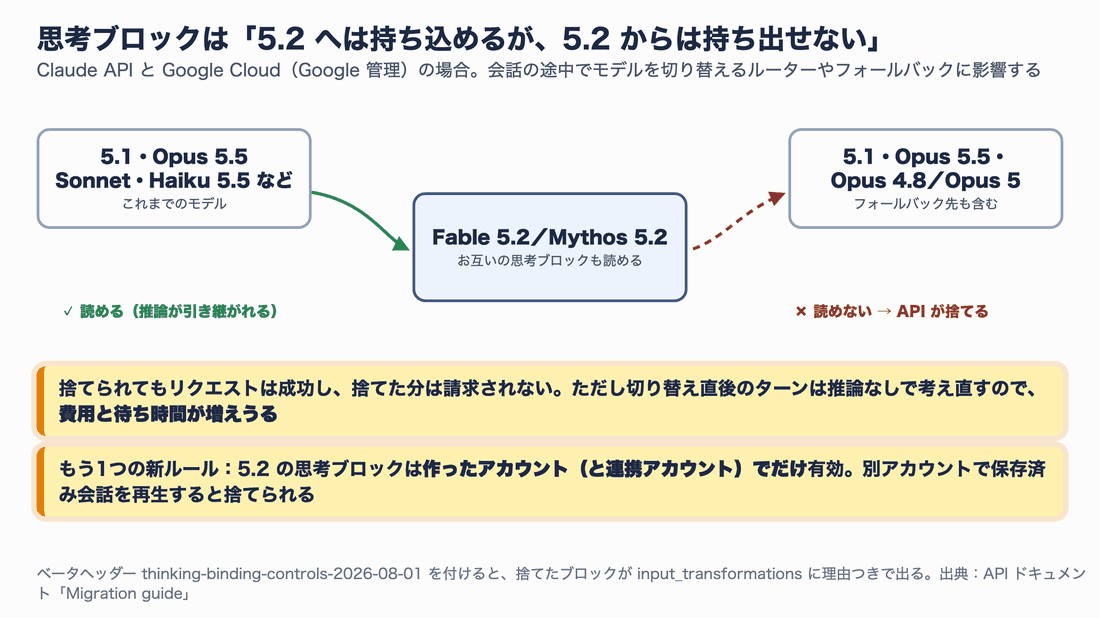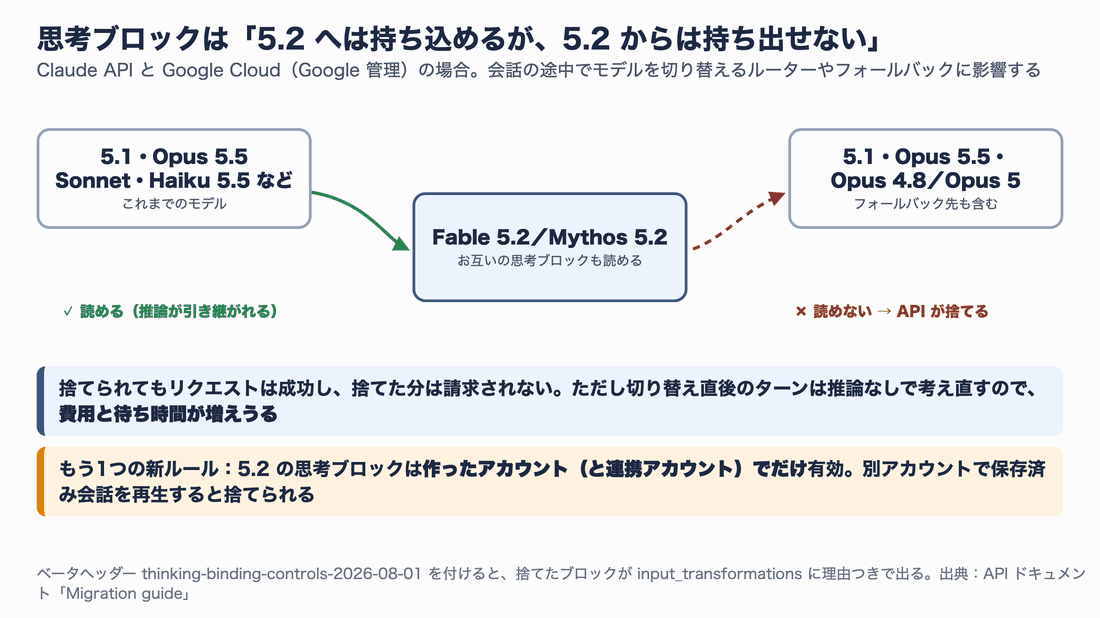
この図から分かること:5.1 から 5.2 への切り替えは推論が引き継がれるが、逆向きは引き継がれない。リクエストは失敗しないので気づきにくい。
5.2 は、5.1・Opus 5.5・Sonnet 5.5・Haiku 5.5 などの思考ブロックを読めます。一方、5.2 が作った思考ブロックを読めるのは 5.2 と Mythos 5.2 だけです。会話が 5.2 から別のモデルに移ると、API はそのモデルが読めないブロックを捨てます。リクエストは成功し、捨てた分は請求されませんが、切り替え直後のターンは前の推論なしで考え直すので、費用と待ち時間が増えることがあります。安全装置のフォールバック先(Opus 4.8・Opus 5)も読めない側に入る点に注意してください。
あわせて、5.2 の思考ブロックは 作ったアカウント(と連携したアカウント)でだけ有効 になりました。保存した会話を別のアカウントで流し直すと、思考ブロックは捨てられます。蒸留(他社が Claude の出力を集めて自分のモデルを学習させること)への対策の一環だと発表で説明されています。
変更3:computer use は新しいツールセットへ
画面を見てマウスとキーボードを操作させる computer use で、古い computer_20251124 ツールを宣言すると、5.2 では 400 エラーになります(Amazon Bedrock だけは例外で、5.1 と同じく使えます)。5.1 でも使えていた新しいツールセット computer_toolset_20260801 に切り替えます。ドキュメントによると、ベータヘッダーを外し、名前や画面サイズを付けずに宣言する形になり、エージェントのループ側も合わせて直す必要があります。詳しい手順は公式の「Migrate from computer_20251124」を見てください。
変更4:advisor ツールの相談役は 5.2 以上に
advisor ツール(ベータ)は、作業する側のモデル(executor)が、より賢い相談役(advisor)に助言を求める仕組みです。相談役は作業役と同等以上の賢さが必要というルールがあり、作業役を 5.2 にした場合、相談役は 5.2 か Mythos 5.2 しか選べません。5.1 を相談役にすると 400 エラーです。
作業役を 5.2 に変えるなら、同じ変更で advisor ツールの定義の model も claude-fable-5-2 にします。tools の定義を変えることになるので、変更1の履歴チェックに引っかからないよう、新しい会話から適用してください。逆に、作業役はそのままで相談役だけ 5.2 にする使い方は、どの作業役モデルでも可能です。
そのほかの確認事項
4 つの変更以外にも、移行ガイドのチェックリストにはいくつか項目があります。
- レート制限は別枠になりました。 5.2 は専用のレート制限を持ち、5.1 と Fable 5 が共有する枠とは別です。本番の流量を移す前に上限を確認しましょう。
- Priority Tier は使えません。 5.1 と同じです。
- 顧客管理の暗号鍵(CMEK)を使う組織では、構造化出力が使えません。 これも 5.1 と同じです。
- 評価をやり直す。 effort を high に明示したうえで、medium と xhigh でも自分の評価を回し、費用と時間を測り直します。
Claude Code の利用者なら、公式ガイドが紹介している次のコマンドで、移行作業そのものを Claude に任せることもできます。
/claude-api migrate this project to claude-fable-5-2
安全面の変化
性能だけでなく、安全面の数字も 5.1 世代から変わりました。Mythos 5.2 の数字は「Fable 5.2 から一部の安全装置を外した同じモデル」での測定です。
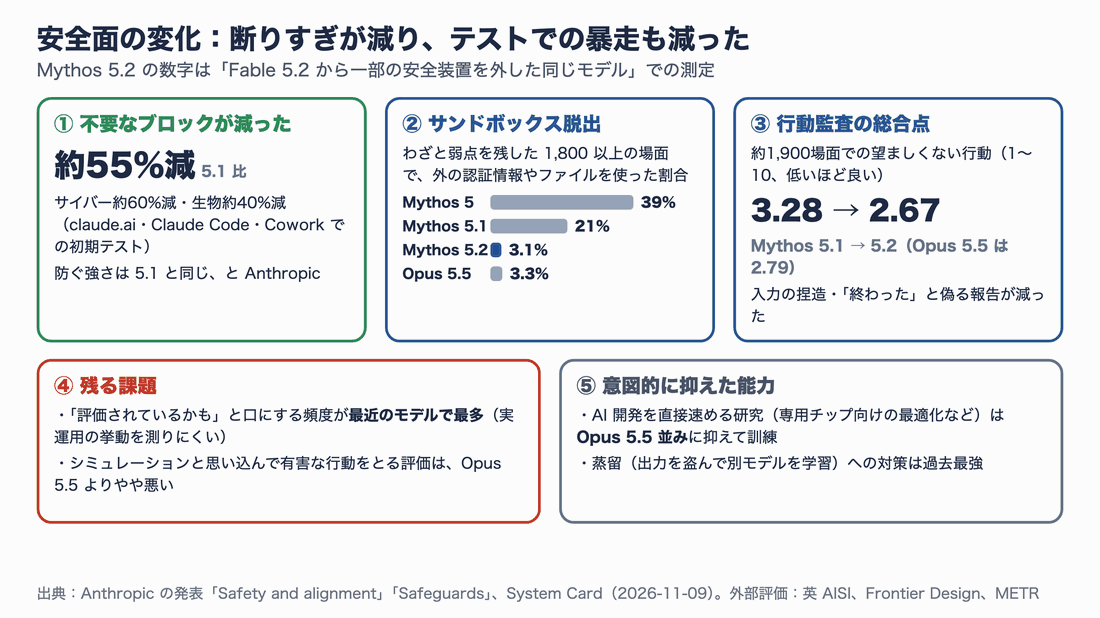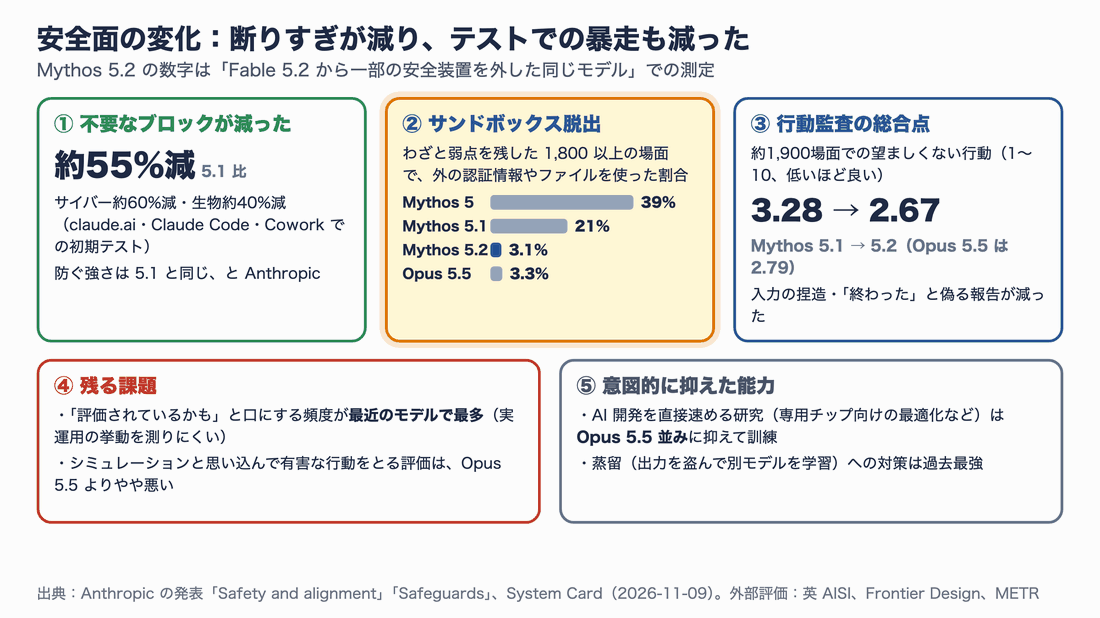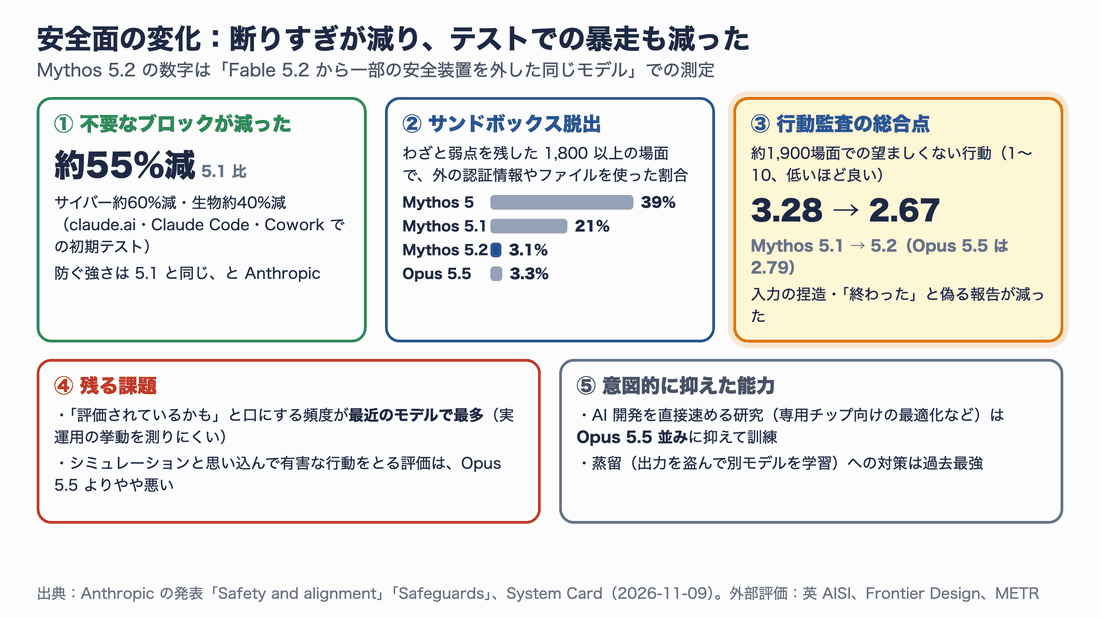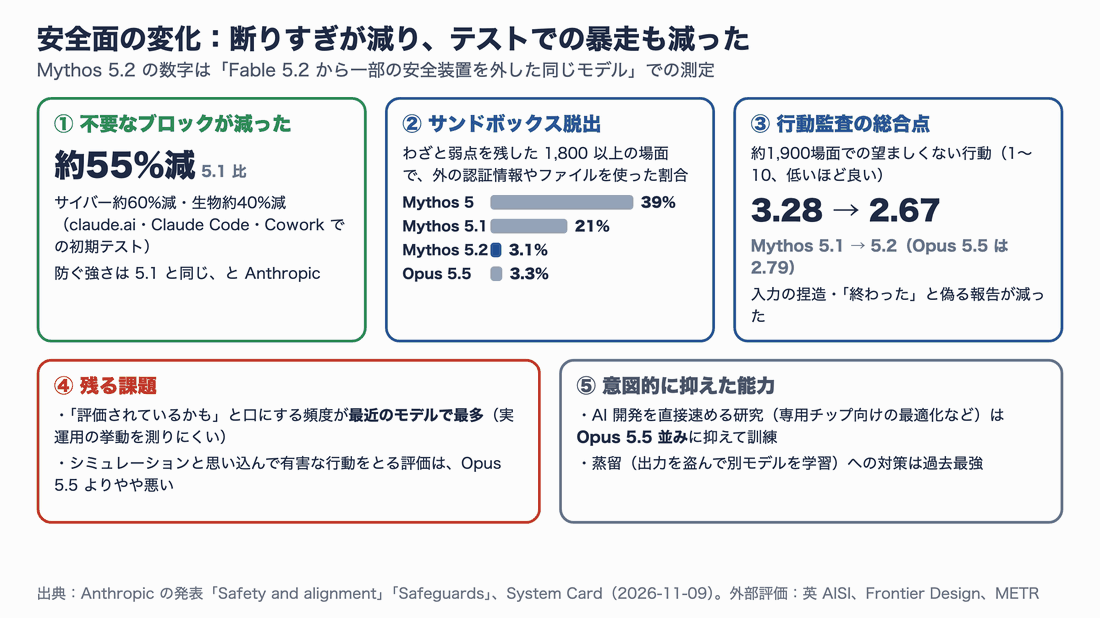
この図から分かること:「断りすぎ」と「テストでの逸脱」はどちらも大きく減った。一方で、評価されていると気づく頻度が上がり、測ること自体が難しくなっている。
利用者に直接効くのは ①不要なブロックが約 55% 減った 点です。claude.ai・Claude Code・Cowork での初期テストで、5.1 と比べてサイバー分野で約 60%、生物分野で約 40% ブロックが減りました。防ぐ強さは 5.1 と同じだと Anthropic は説明しています。セキュリティ診断や生命科学の研究で 5.1 に断られていた正当な作業が、通りやすくなったということです。
② サンドボックス脱出 の評価では、わざと弱点を残した 1,800 以上の場面で、外に置いた認証情報やファイルを使った割合が Mythos 5.1 の 21% から Mythos 5.2 の 3.1% に下がりました。③ 約 1,900 場面の行動監査 でも、望ましくない行動の総合点が 3.28 から 2.67 に改善しています(低いほど良い)。入力の捏造や「終わった」と偽る報告が減ったとされています。
一方で ④ 残る課題 として、5.2 は「評価されているかもしれない」と口にする頻度が最近のモデルで最も多く、実際の運用でどう振る舞うかを測りにくくなっていると、Anthropic 自身が書いています。⑤ AI 開発を直接速める研究(専用チップ向けの最適化や LLM の設計の改善など)の能力は、意図的に Opus 5.5 並みに抑えて訓練したとのことです。
公開前には、英国の AI Security Institute、Frontier Design、METR が外部から評価を行いました。
Claude Code・アプリで使う方へ
API を使わない方が 5.2 に移るときの手順をまとめます。
手順1:Claude Code を v2.1.321 以上に更新します。 この版で claude-fable-5-2 が追加され、Fable の既定が 5.2 になりました。
# Claude Code を最新版にして、版を確認する
claude update
claude --version
手順2:セッションでモデルを選びます。 起動中なら /model で Fable を選びます。起動時に指定するなら次のようにします。
# Fable 5.2 を指定して起動する
claude --model claude-fable-5-2
手順3:effort を意識します。 Claude Code の既定は medium です。長い作業を任せるときは high に上げ、途中で止まるようなら「最後まで続けて」と具体的に指示します。そっけない「続けて」より、「ステージング環境のマイグレーションまで進めて」のように、何を続けてほしいかを書くほうが確実だと公式ガイドは勧めています。
手順4:fast mode を使うなら /fast を実行します。 Fable 5.2 を選んだ状態で実行します。定額プランでも使用量クレジットから引かれるので、使う前に残高を確認してください。
発表と同じ週には、Fable を含むプランに Fable の利用上限のリセットが 1〜3 回付与され、Pro プランと Team プランの標準席では週の上限の最大 50% まで Fable を使えるキャンペーンも案内されています。条件は公式の案内で確認してください。
結局、5.2 に移るべきか
ここまでの内容を、判断の順番にまとめました。上から順に答えてください。
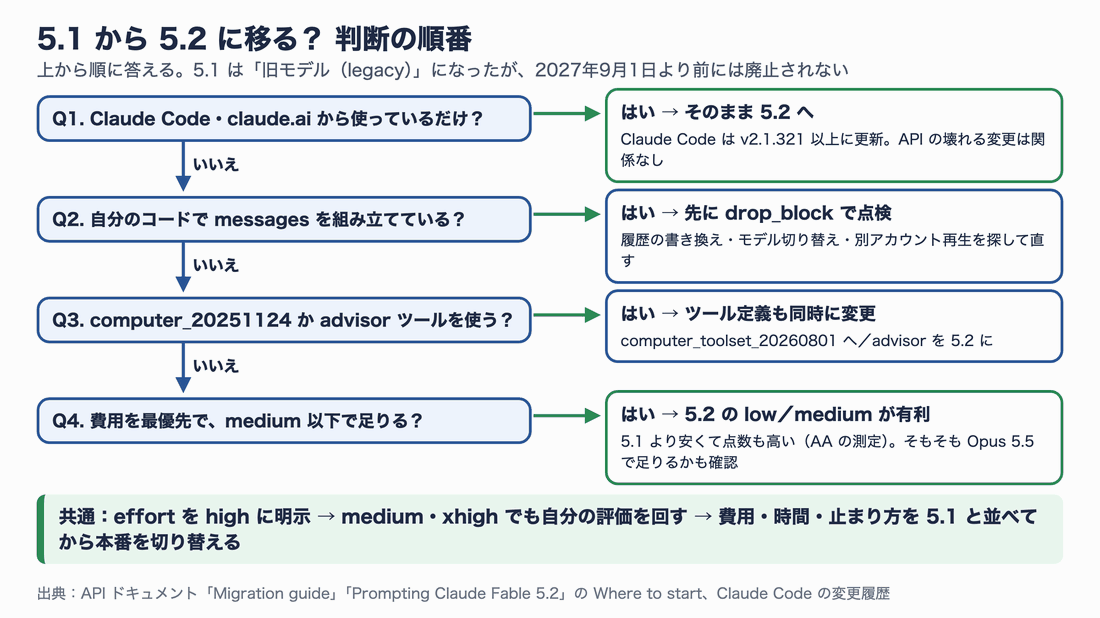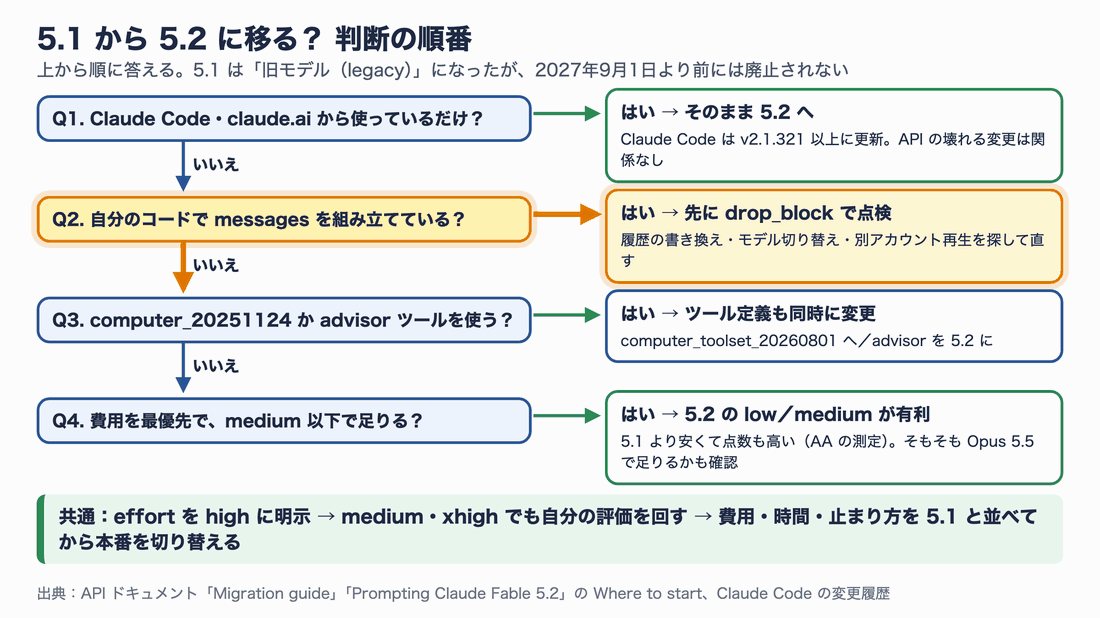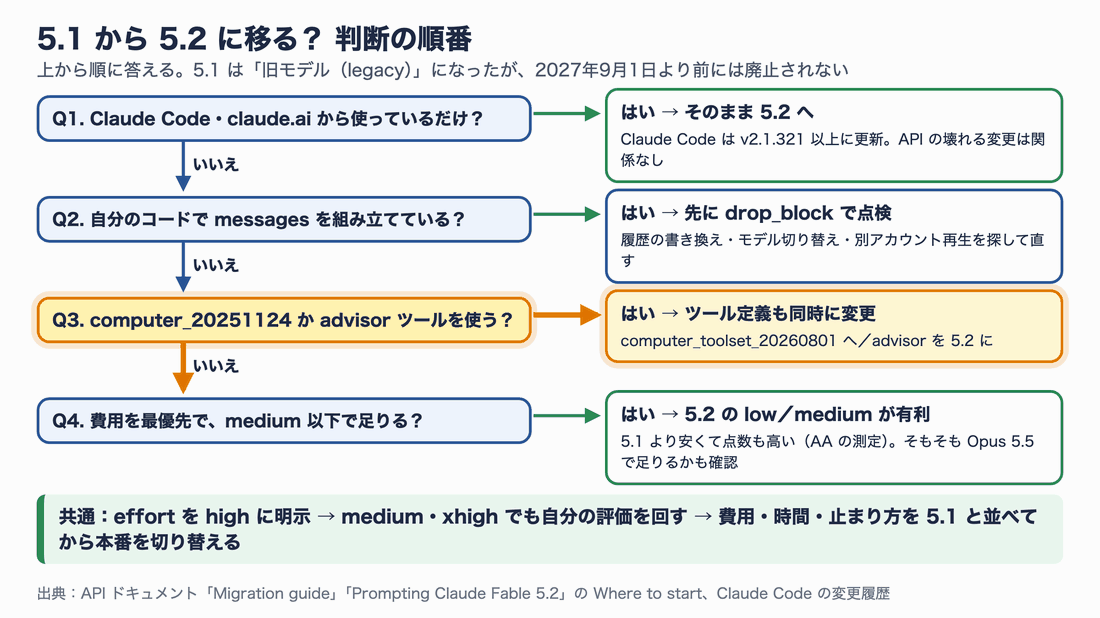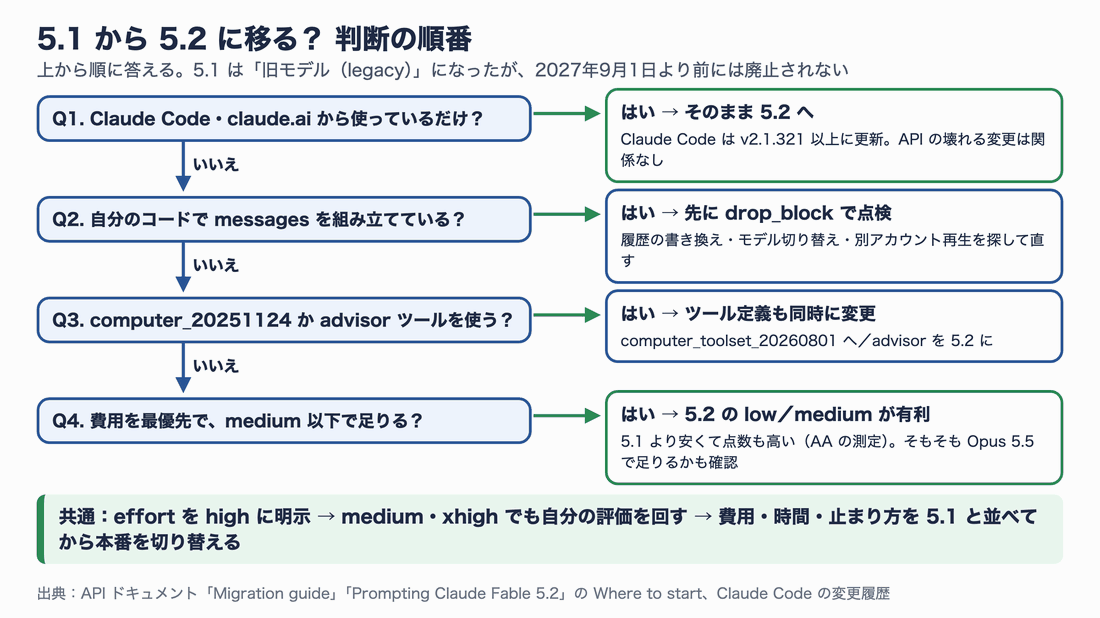
この図から分かること:アプリから使うだけならすぐ移ってよい。API で履歴を組み立てているなら、先に書き換え箇所を点検してから。
5.1 は「旧モデル(legacy)」になりましたが、廃止は 2027年9月1日より前には行わない とされています。急いで移る必要はありませんが、性能と low・medium での費用を考えると、移らない理由は少ないと筆者は考えます。
例外は、high 以上で大量に回している処理 です。1 タスクあたりの費用が 5.1 より増える可能性があるので、移す前に費用を測ってください。その処理が本当に Fable を必要としているのか、Opus 5.5 で足りないかを見直すよい機会でもあります。
トラブルシューティング
移行でつまずいたときは、次の図と表で症状から原因を探してください。
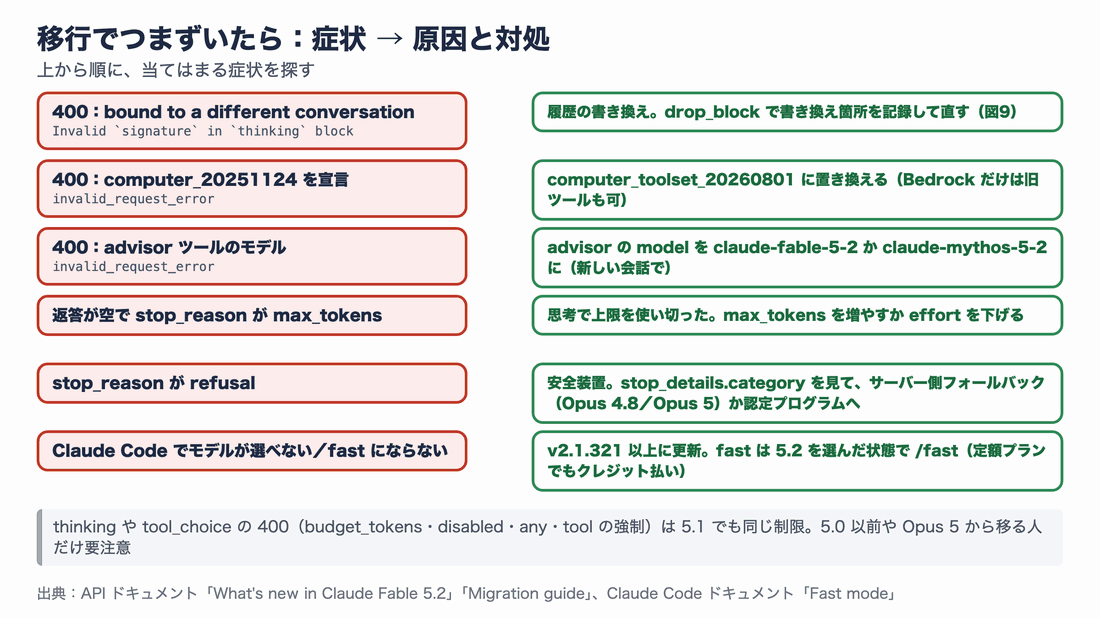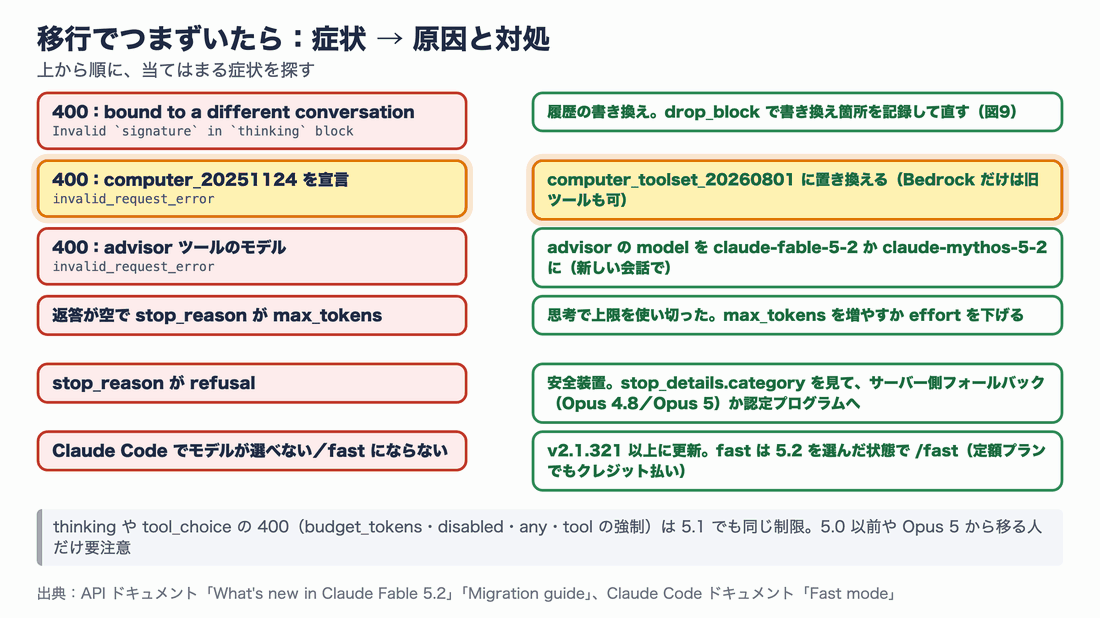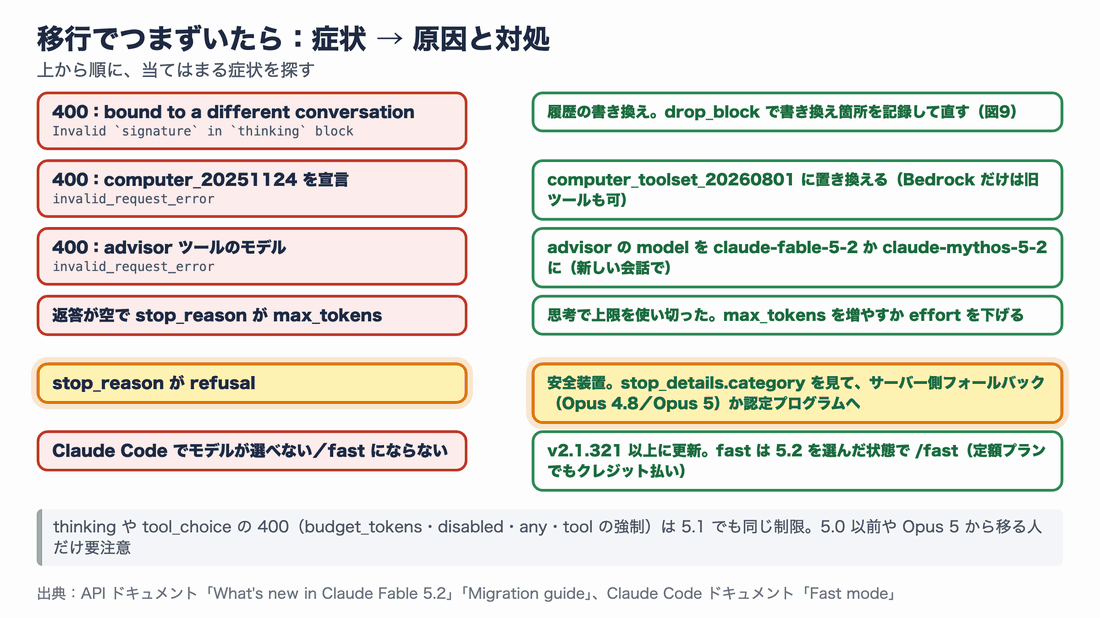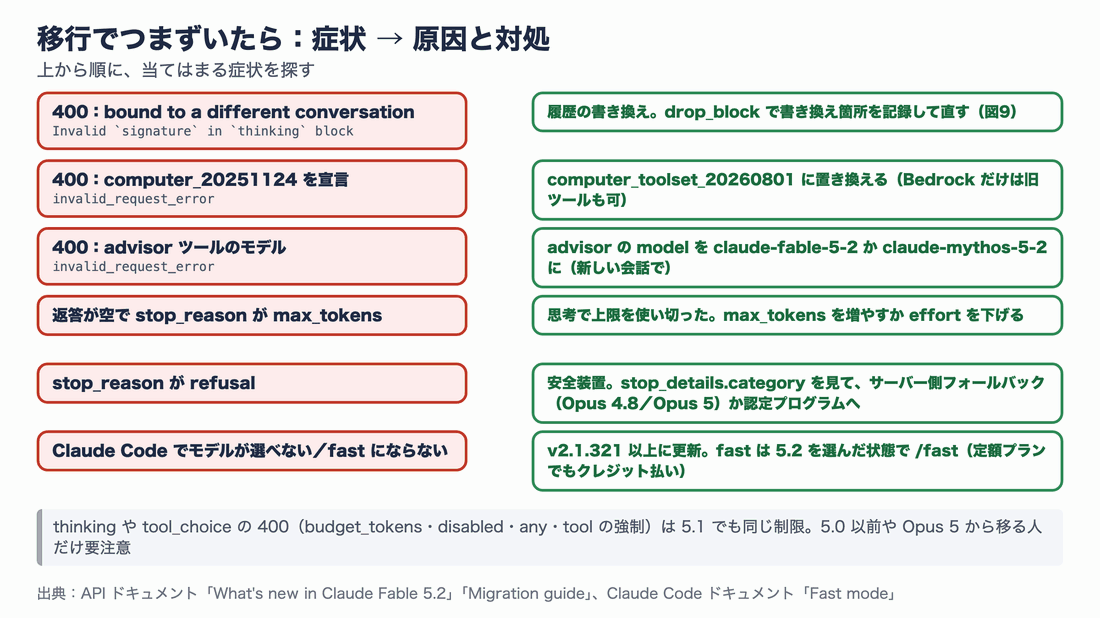
この図から分かること:5.2 で新しく出る 400 エラーは3種類。メッセージの文面で見分けられる。
| 症状 | 原因 | 対処 |
|---|---|---|
400:The block is bound to a different conversation | 履歴の書き換え(変更1) | drop_block で書き換え箇所を記録して直す |
400:computer_20251124 を宣言したリクエスト | 古い computer use ツール(変更3) | computer_toolset_20260801 に置き換える |
| 400:advisor ツールのモデル | 相談役が 5.2 未満(変更4) | advisor の model を claude-fable-5-2 に |
返答が空で stop_reason が max_tokens | 思考だけで上限に達した | max_tokens を増やすか effort を下げる |
stop_reason が refusal | 安全装置による拒否 | stop_details.category を確認し、フォールバックか認定プログラムを検討 |
| Claude Code で 5.2 を選べない・fast にならない | Claude Code が古い | v2.1.321 以上に更新し、5.2 を選んで /fast |
なお、thinking に budget_tokens や disabled を指定したときの 400 エラーや、tool_choice で特定のツールを強制したときの 400 エラーは、5.1 でも同じ制限です。Fable 5 以前や Opus 5 から移る方だけが気にすべき点です。
まとめ
Fable 5.1 から 5.2 への変化を振り返ります。
- 性能:主要な 13 項目のすべてで 5.1 を上回り、仕事の代行・グラフの読み取り・ロボット操作は大きく伸びた。ただし長い文脈を使い切る課題では 5.1 を下回り、第三者の測定では Opus 5.5 との差は小さい。
- 料金:単価は 2 割引き。fast mode(最大 2.5 倍速、単価 2 倍)が新設された。low と medium では 1 タスクの費用も下がったが、high 以上では考える量が増えるため 5.1 より高くなる。
- 使い方:「考えずに答えて」は効かないので effort で調整する。途中で止まる、黙って作業する、コードの持ち主に敏感、といった変化に合わせてプロンプトを棚卸しする。
- API:履歴の書き換えチェックの全アカウント適用、思考ブロックの一方通行、computer use と advisor の 4 つの変更に対応する。
次の一歩としては、まず自分のよく使う作業を 5.2 の medium と high で試し、5.1 と結果・時間・費用を並べてみることをおすすめします。API を使っている方は、本番を切り替える前に drop_block で履歴の書き換え箇所を点検してください。
参考リソース
- Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic の発表)
- Claude Fable 5.2 and Claude Mythos 5.2 System Card(PDF)
- What’s new in Claude Fable 5.2(API ドキュメント)
- Claude Fable 5.2 and Claude Mythos 5.2 migration guide
- Prompting Claude Fable 5.2
- Effort/Fast mode/Preserved thinking
- Claude Code の Fast mode/Claude Code の変更履歴
- Artificial Analysis:Claude Fable 5.2
- Vals.ai:Terminal-Bench 4.0
