はじめに
AI と声で会話するアプリ(音声エージェント)を作ると、最初にぶつかるのが「返事までの間(ま)」です。こちらが話し終えてから AI が返事をするまでに2秒もかかると、電話の相手が黙り込んだように感じます。この間を短くするには、文字起こし・返事の生成・読み上げのどこか1か所ではなく、流れ全体を速くする必要があります。
2026年10月1日、Microsoft AI がこの問題に向けたモデルを3つ同時に出しました。話している途中から文字を返すストリーミング文字起こし MAI-Transcribe-2-Streaming と、読み上げ用の MAI-Voice-2.1 / MAI-Voice-2.1-Flash です。発表では「最初の途中経過を100ミリ秒強で返す」「Artificial Analysis のストリーミング部門で精度1位」とされています。
ただ、この1位は英語中心のベンチマークでの結果です。日本語で使うとどうなのか、すでに使っている Google の Gemini と比べて速いのか、読み上げは日本語で使えるのかは、発表を読むだけでは分かりません。そこで筆者の Mac から実際に API を呼び、次の2組を同じ条件で比べました。
- 文字起こし:MAI-Transcribe-2-Streaming と Gemini 3.5 Transcribe Live(Google のストリーミング文字起こし)
- 読み上げ:MAI-Voice-2.1 / 2.1-Flash と Gemini 3.8 Flash TTS / Flash-Lite TTS
先に結論をまとめておきます。
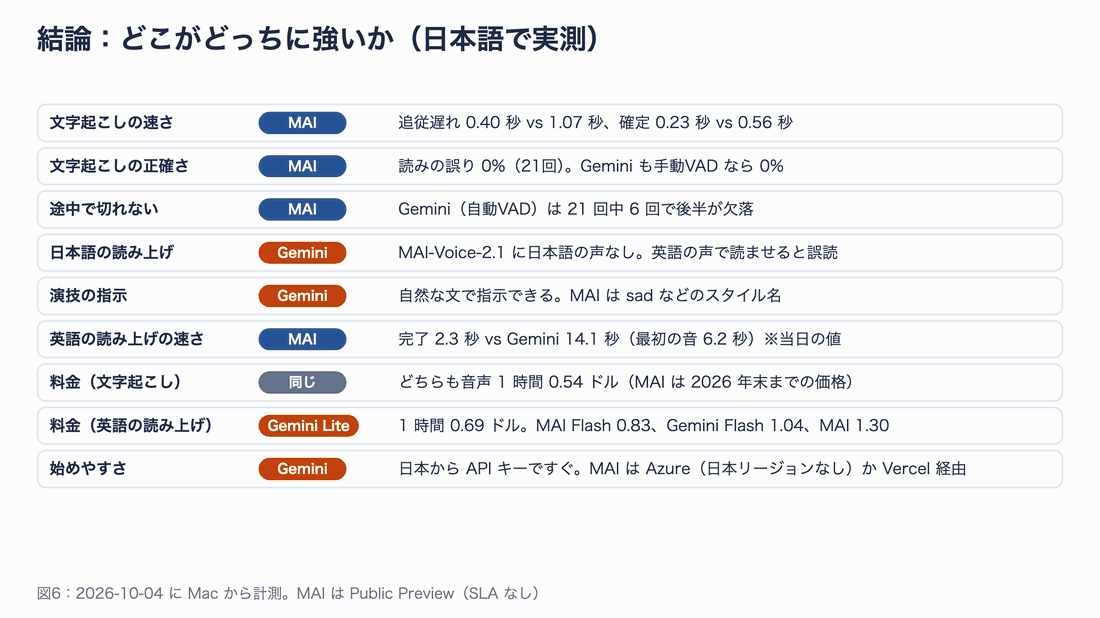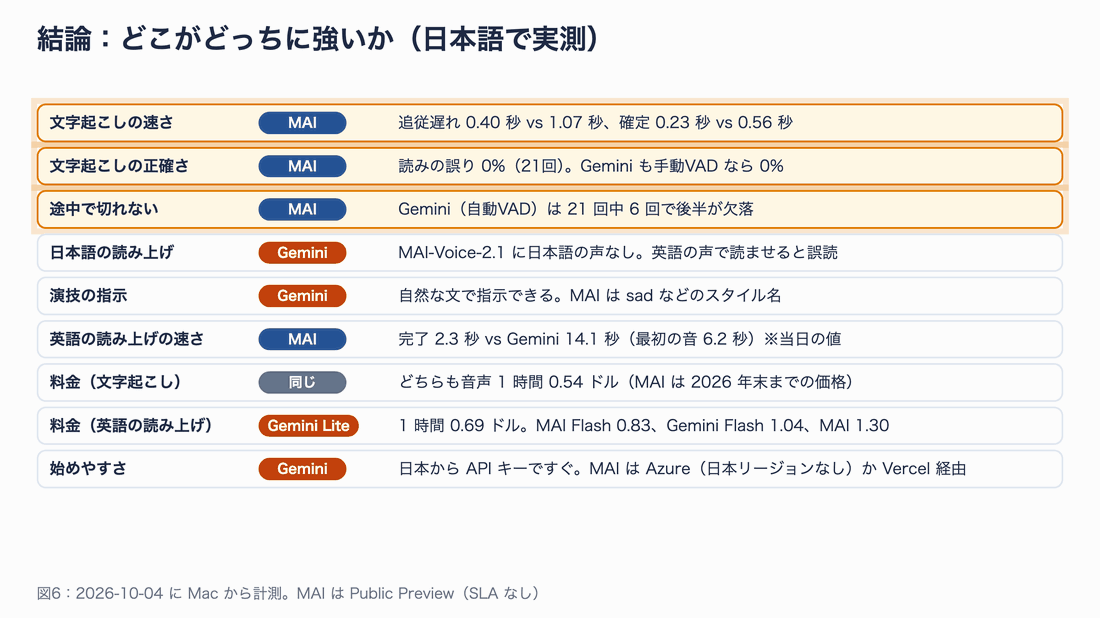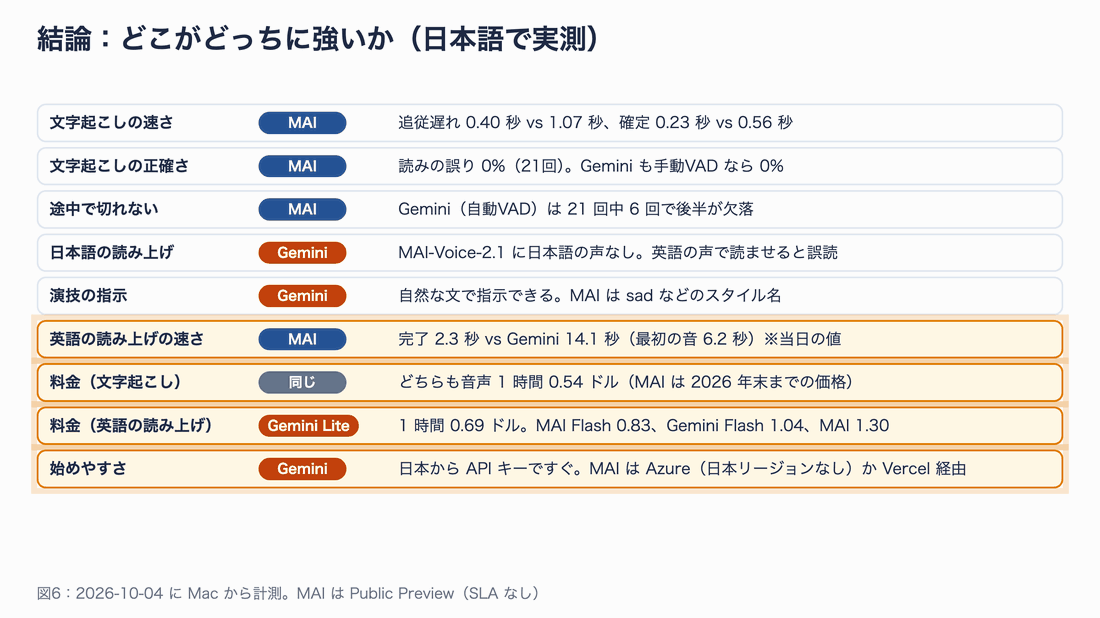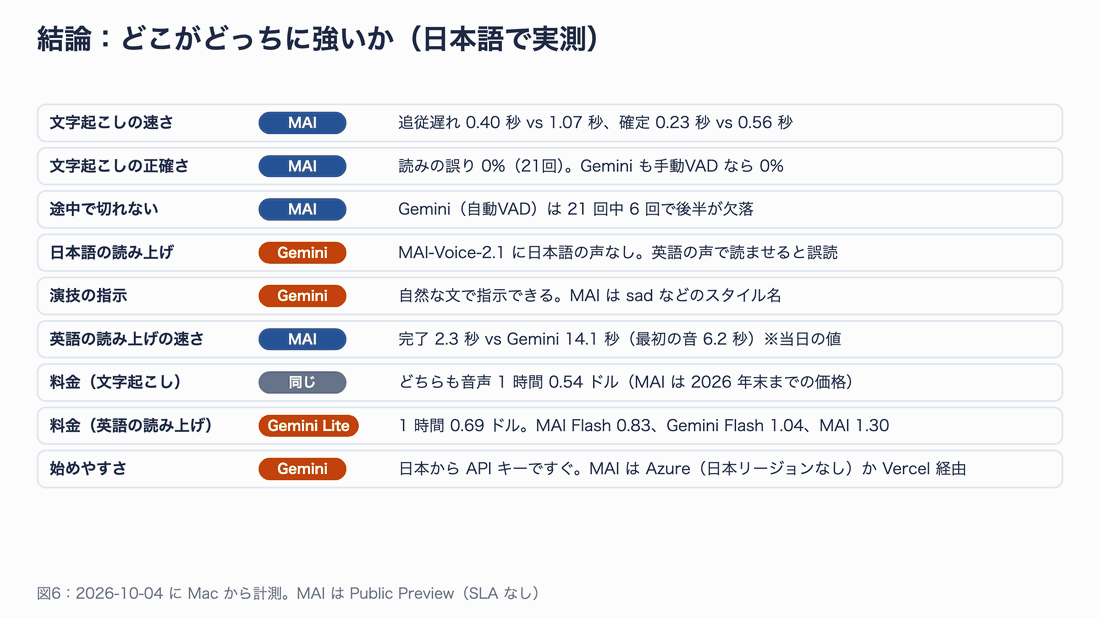
図6:今回の実測から見た「どこがどっちに強いか」。数字の根拠は本文で順に説明します
聞き取り(文字起こし)は MAI が速くて正確、読み上げは日本語なら Gemini 一択、というのが一番大きな結論です。とくに Gemini 3.5 Transcribe Live は、初期設定のままだと文の途中の短い間で聞き取りをやめてしまうことがあり、これは設定で回避できます。
この記事は、AI の API を使ったアプリ開発の経験がある人を想定しています。コードは Node.js で、すべて筆者の Mac で動作を確認したものです。
この記事の確認範囲
| 項目 | 内容 |
|---|---|
| 計測日時 | 2026年10月4日 8:30〜10:40(日本時間) |
| 計測した端末 | MacBook Pro(Apple M5 Max・メモリ128GB・macOS 26.6.2)、東京の家庭用回線 |
| 経路 | MAI は Vercel AI Gateway 経由。Gemini は Gateway 経由と Gemini API 直結の両方 |
| 使ったもの | Node.js 22.23.2、AI SDK(ai 7.0.127、@ai-sdk/gateway 4.0.103)、@google/genai 2.27.0、ffmpeg 9.0.2 |
| 回数 | 文字起こし:音声8本 × 3条件 × 3回=72回。読み上げ:英文で各モデル5回ほか |
| かかった費用 | Vercel AI Gateway で約0.18ドル(無料クレジットの範囲)、Gemini API で約0.1ドル(筆者の見積もり) |
MAI の3モデルはどれも Public Preview(試験提供) で、SLA(稼働の保証)はありません。数値は筆者の環境・時間帯での一例です。
背景:なぜ「途中経過」が大事なのか
音声エージェントの待ち時間は流れ全体で決まる
音声エージェントは、多くの場合「話し声 → 文字 → 返事を考える → 声にする」という4段の流れでできています。従来は、話し終わってから文字起こしを始め、文字がそろってから LLM(大規模言語モデル)に渡していました。各段の待ち時間がそのまま足し算になります。
ストリーミング文字起こしは、話している最中から途中経過(Partial transcript)を返します。LLM はこの途中経過を読んで、話し終わる前から返事を考え始められます。話し終わった瞬間に残っているのは「最後の数語の確定」だけになるので、全体の間がぐっと縮みます。
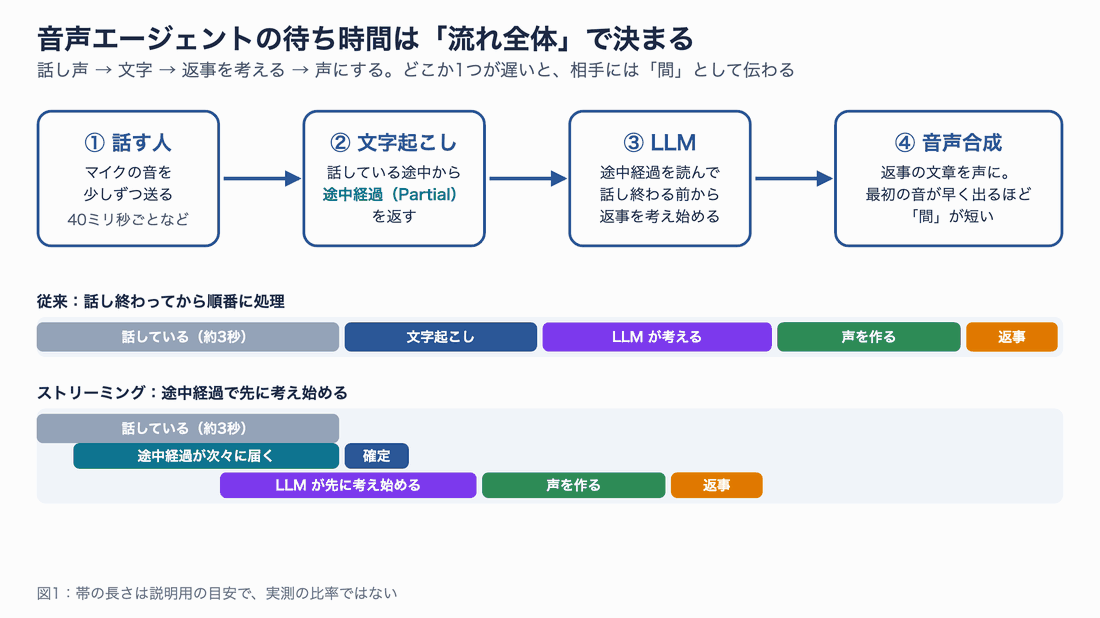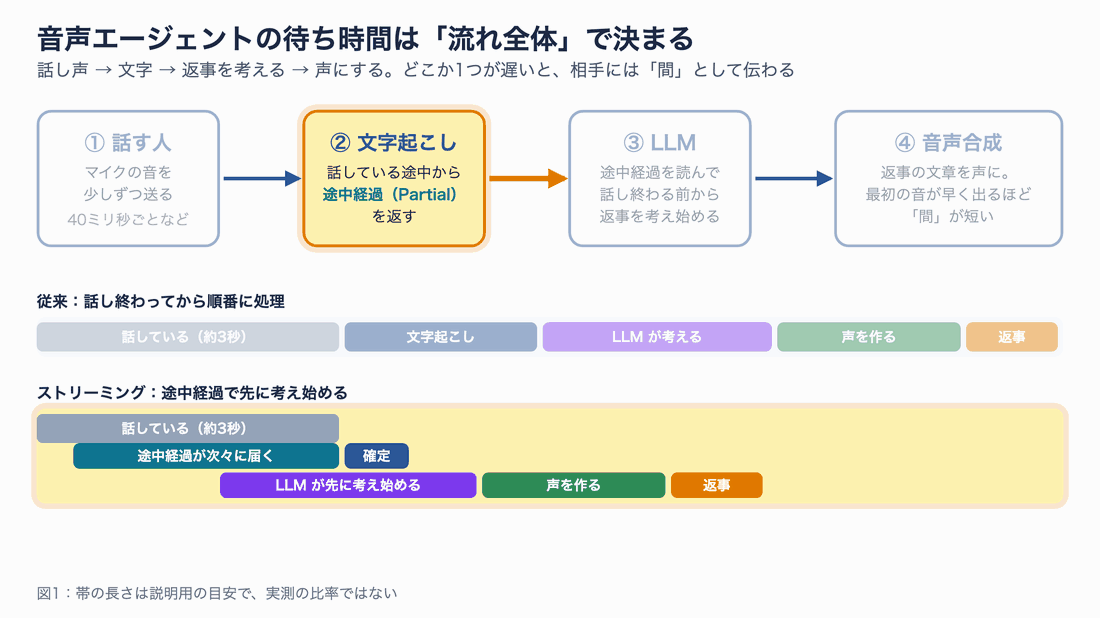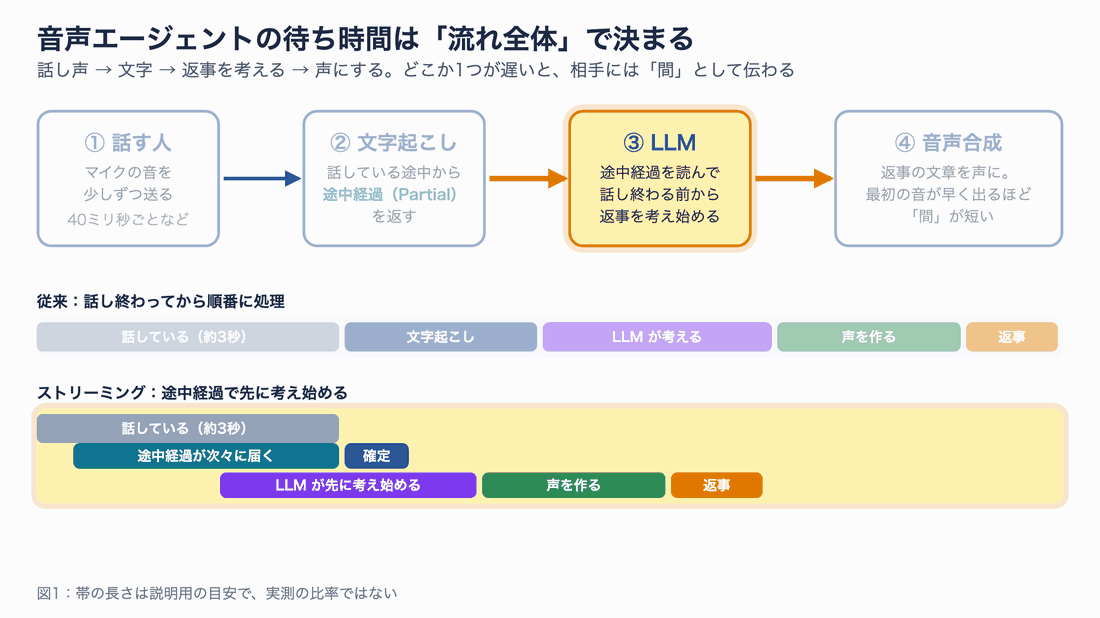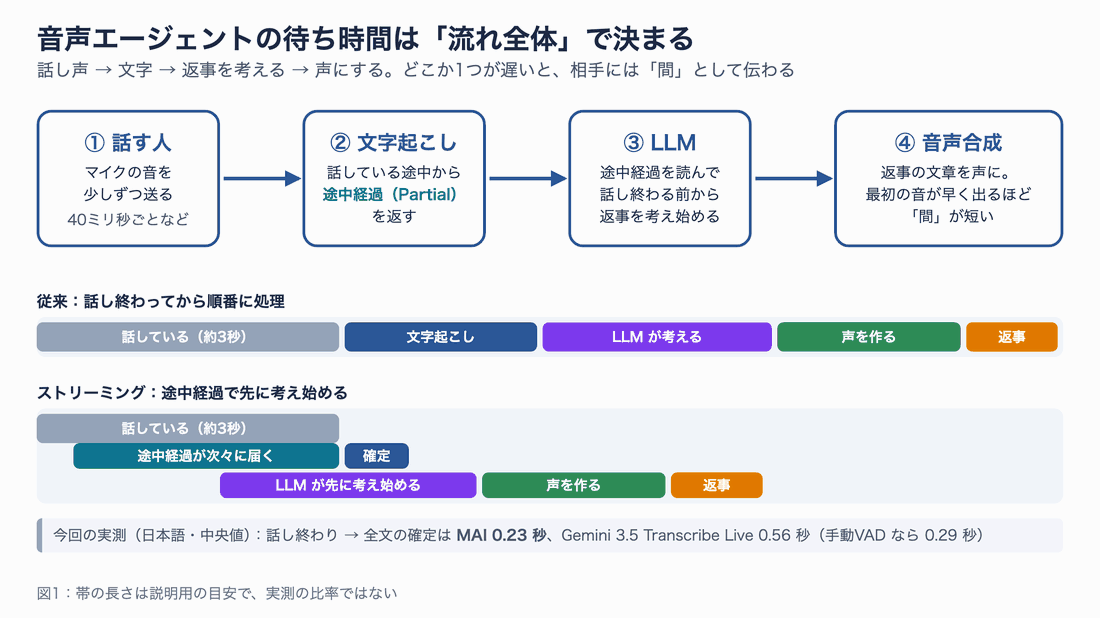
図1:話している途中で文字が届くと、LLM が先に考え始められる。帯の長さは説明用の目安です
ここで大事なのは、文字起こしを評価するときに「最終的に正しい文字になったか」だけでなく、話してから何秒で、正しい文字が画面に出てくるかを見ることです。元の発表記事でも「Whisper 系との比較は最終精度だけでなく、最初の途中経過までの時間で測るべき」と指摘されていました。今回はそれをさらに一歩進めて、途中経過が「正しく」なるまでの遅れも測ります。
発表の要点
Microsoft AI の発表と Microsoft Learn のドキュメントから、今回の検証に関係する点を抜き出します。
| 項目 | MAI-Transcribe-2-Streaming |
|---|---|
| 公開 | 2026年10月1日、Microsoft Foundry で Public Preview |
| 言語 | 60言語、自動判定。日本語(ja)も対応表にある |
| 接続方法 | Azure Speech SDK、または OpenAI Realtime API に似た WebSocket のやりとり |
| 音声の形式 | 16bit の生 PCM、モノラル、16kHz か 24kHz。10〜20ミリ秒ずつ送るのが推奨 |
| 返ってくるもの | 確定した文字(delta)と、MAI 独自の途中経過(intermediate) |
| 区切り | サーバー側の発話検出(VAD)はなし。区切りはアプリが commit で伝える |
| 料金 | 音声1時間0.54ドル(2026年末までの導入価格) |
| 提供地域 | Sweden Central、Central US、South India(日本リージョンはなし) |
| ほかの入口 | MAI Playground、Vercel AI Gateway、OpenRouter(一括版のみ)など |
発表で「1位」とされている Artificial Analysis のストリーミング部門を開くと、MAI は単語誤り率2.5%、話し終わりから確定まで0.13秒で、どちらも最上位でした。比較相手の Gemini 3.5 Transcribe Live は4.0%・0.40秒です。
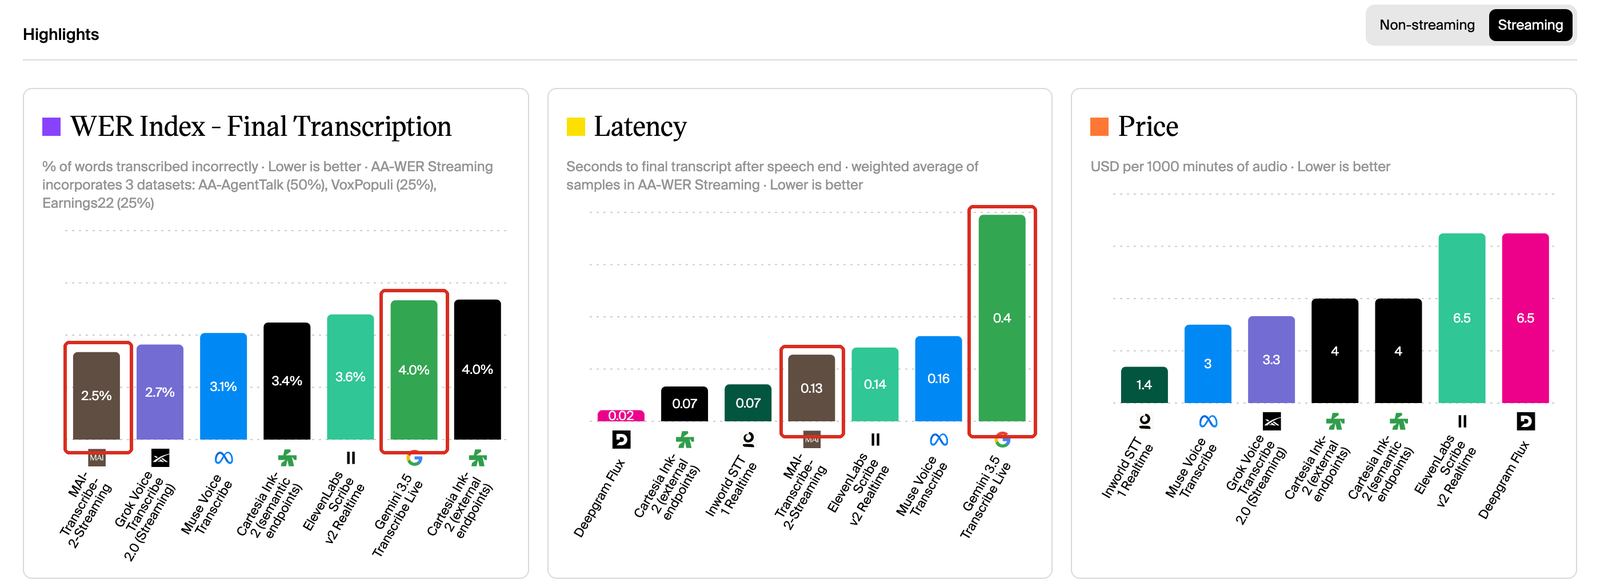
Artificial Analysis の Streaming 部門(2026-10-04 撮影、赤枠は筆者)。評価データは AA-AgentTalk・VoxPopuli・Earnings22 の3つで、どれも英語中心
ベンチマークの評価データは英語の会話や決算説明会の音声が中心です。日本語のように単語の区切りがなく、同じ読みに複数の漢字がある言語で同じ順位になるとは限りません。ここを確かめるのが今回の目的です。
ログインなしで試せる MAI Playground
まず雰囲気をつかみたいなら、ブラウザの MAI Playground(playground.microsoft.ai)が手軽です。ログインなしで、文字起こし・読み上げ・音声チャット(Chatter)を試せます。
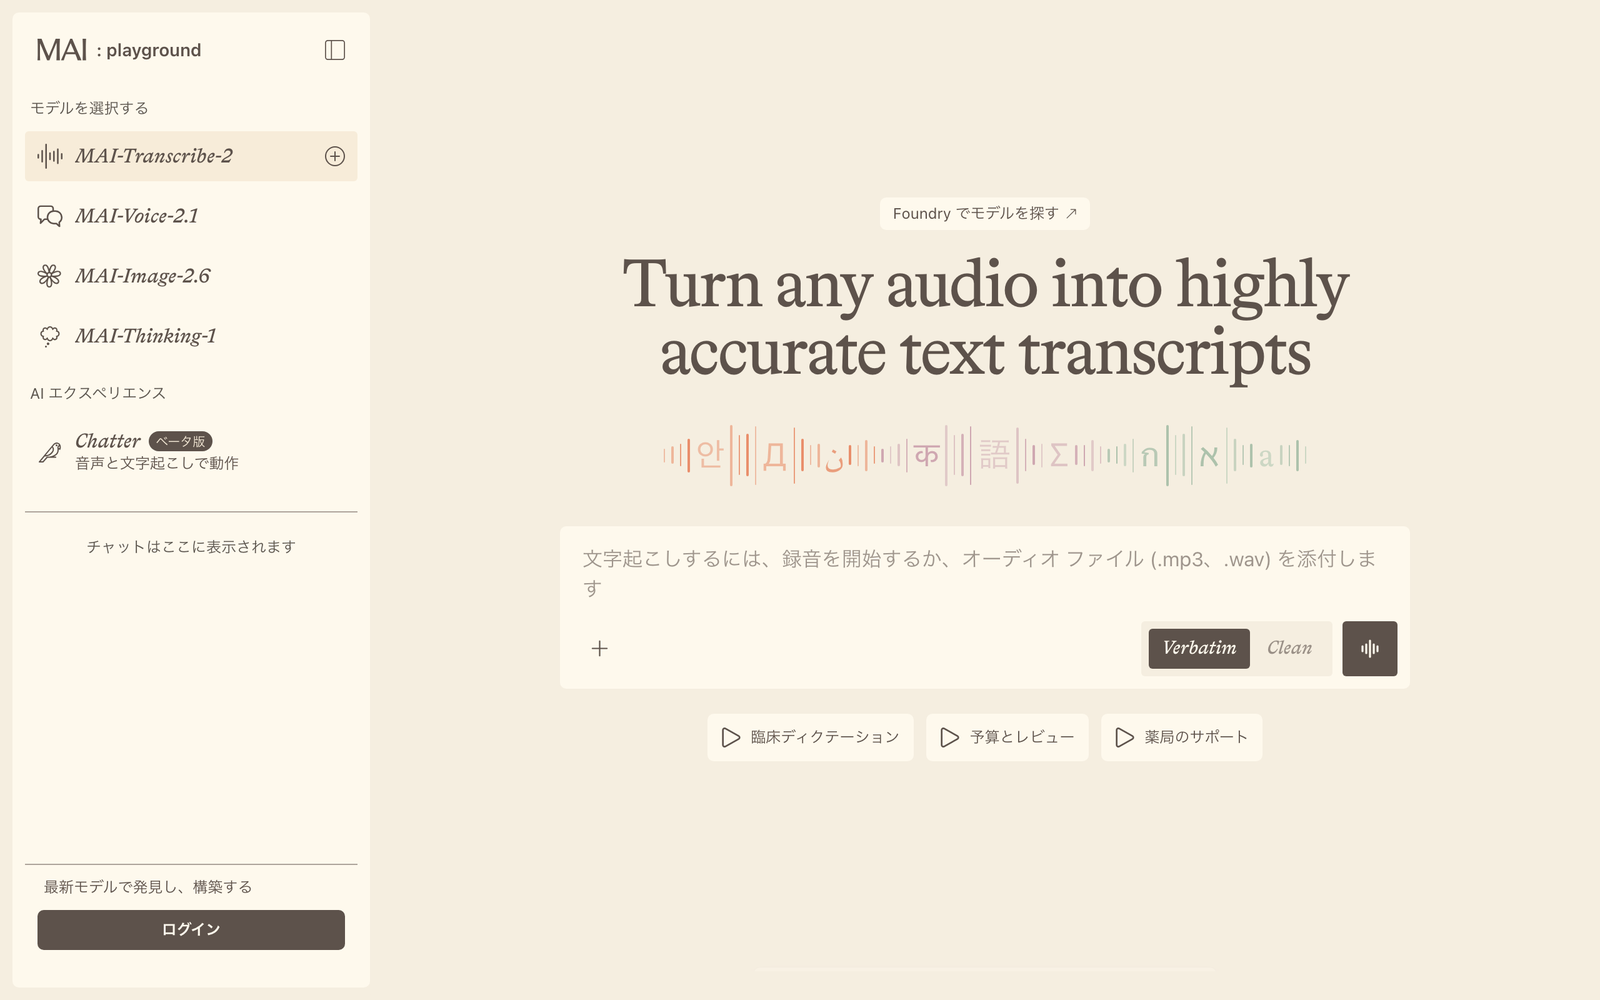
MAI Playground の文字起こし画面(2026-10-04 撮影)。マイクで話すか、MP3・WAV を添付する
ただし Playground では待ち時間を数値で測れません。ここからは API で計測します。
検証の準備
API をどこから呼ぶか
公式の手順では、Azure のサブスクリプションを作り、Microsoft Foundry のリソースを対応リージョンに作って、モデルをデプロイします。今回は、MAI と Gemini を同じ道具・同じ経路で比べたかったので、Vercel AI Gateway を使いました。1つの API キーで両社のモデルを呼べて、AI SDK の experimental_streamTranscribe でストリーミング文字起こしを扱えます。
準備は次の3つです。
- vercel.com にログインし、左メニューの AI Gateway → API Keys → Create Key でキーを作る
- 同じ画面でクレジットカードを登録する(登録すると毎月5ドルの無料クレジットが有効になる。登録前は残高0で、
requires a valid credit card on fileというエラーになる) - 作業フォルダの
.envにキーを書き、パッケージを入れる
# 作業フォルダを作ってパッケージを入れる
mkdir mai-lab && cd mai-lab
npm init -y
npm install ai @ai-sdk/gateway @google/genai dotenv

# キーを .env に保存(<YOUR_GATEWAY_KEY> は自分のキーに置き換える)
echo 'AI_GATEWAY_API_KEY=<YOUR_GATEWAY_KEY>' > .env

# 音声の変換に ffmpeg を使う(Mac の場合)
brew install ffmpeg
何を、どう測ったか
テスト音声は8本用意しました。macOS の読み上げ機能で作った日本語4本(声 Kyoko)と英語1本(声 Samantha)、筆者が以前ショート動画用に録音した肉声24秒、そして同じ問い合わせ文に悪条件を加えた2本です。
| 名前 | 内容 | 長さ |
|---|---|---|
| 予約の電話 | 明日の午後3時に、渋谷店で4名の予約をお願いします。名前は田中です。 | 6.9秒 |
| 英語まじり | Claude CodeでPull Requestを作って、GitHub Actionsのログを確認してください。 | 7.3秒 |
| 人名・地名 | 東海林さんと御手洗さんが、来週の水曜日に梅田で打ち合わせをします。 | 6.8秒 |
| 問い合わせ | 先月買ったワイヤレスイヤホンの右側だけ、音が出なくなりました。保証期間内なので、交換の手続きを教えてください。 | 10.5秒 |
| +雑踏 | 上の文に、ほかの話し声4本を重ねた雑音(SNR 5dB) | 10.5秒 |
| +電話音質 | 上の文を 8kHz・300〜3400Hz に落とした音 | 10.5秒 |
| 英語 | Please move my dentist appointment to Friday at four thirty, … | 6.2秒 |
| 本人の肉声 | AIに文章を読ませたら、ずっと同じ調子の棒読み。…(ナレーション) | 24.4秒 |
悪条件の2本は、次のような音です(雑踏版は、似た声が後ろで何人も話している状態です)。
これらを、話す速さと同じペースで40ミリ秒ずつ送り、届いた文字の時刻をすべて記録しました。
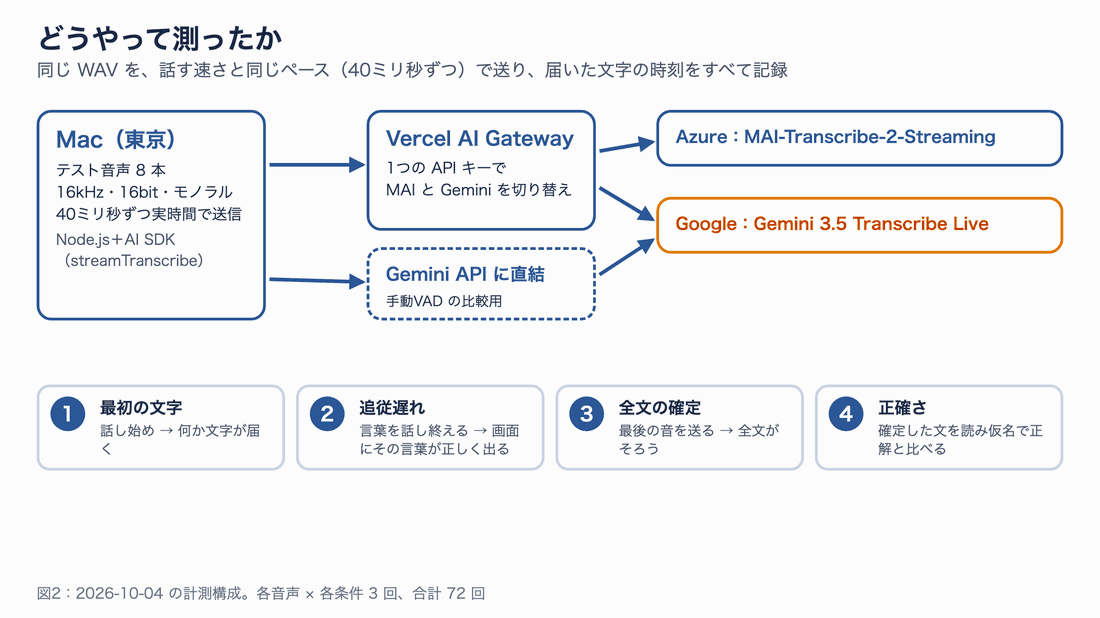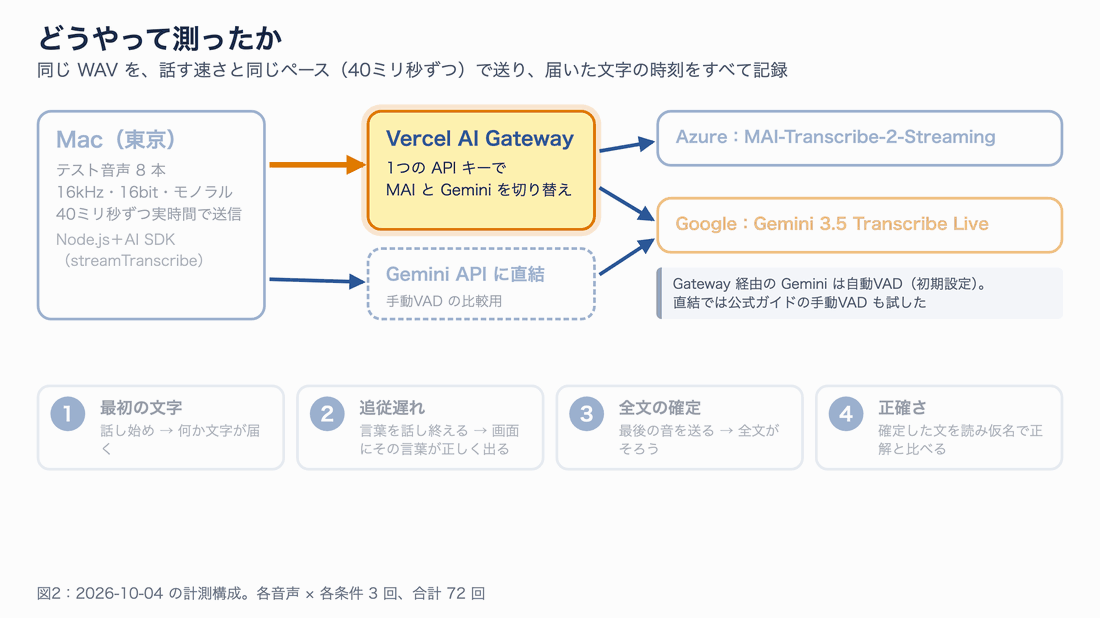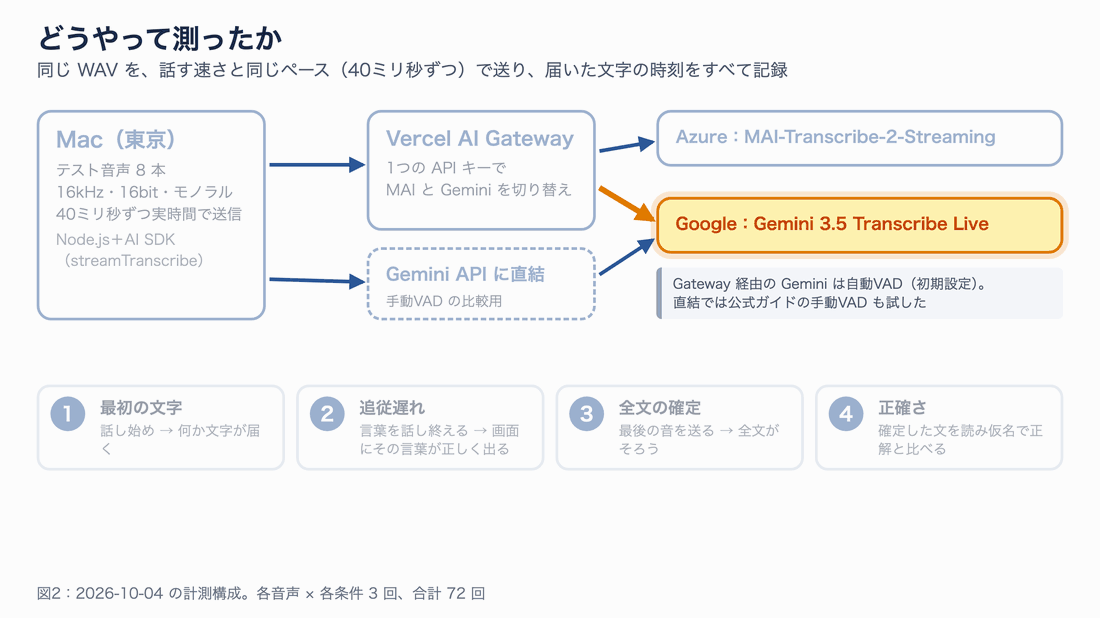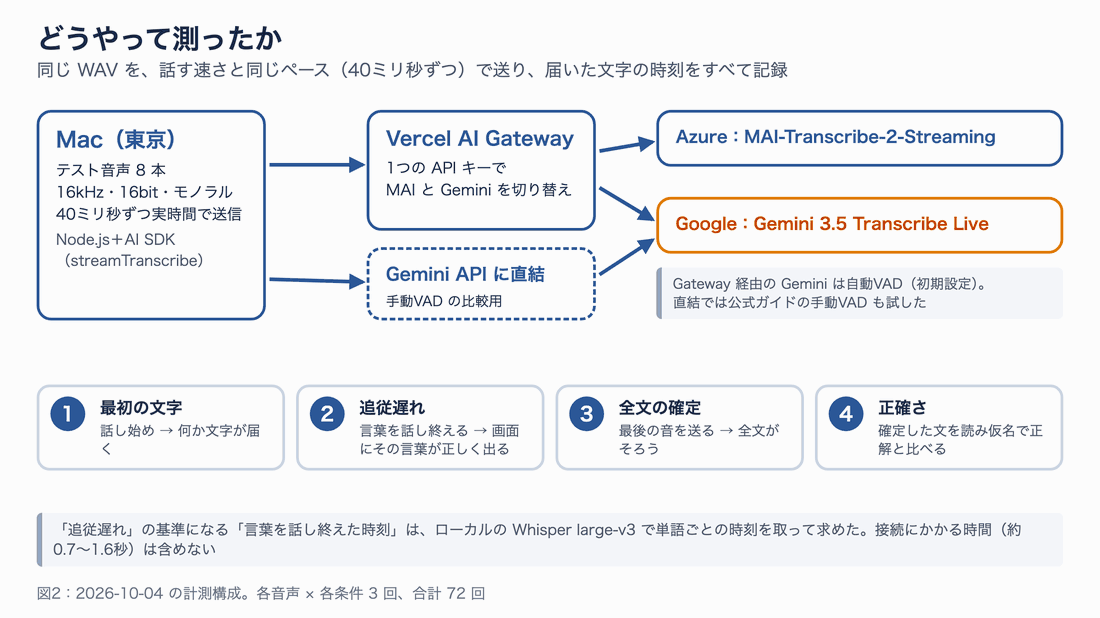
図2:計測の構成と4つの指標。接続にかかる時間(0.7〜1.6秒)は指標に含めていません
指標は4つです。
- 最初の文字:話し始めてから、何か文字が届くまで
- 追従遅れ:ある言葉を話し終えてから、画面にその言葉が正しく出るまで(全文字の中央値)
- 全文の確定:最後の音を送ってから、全文がそろうまで
- 正確さ:確定した文を、ひらがなの読みに直して正解と比べた誤り率(CER=文字単位の誤り率)
「追従遅れ」の基準になる「言葉を話し終えた時刻」は、ローカルの Whisper large-v3 で単語ごとの時刻を取って求めました。正確さを読みで比べるのは、「Claude Code」と「クロードコード」、「3時」と「三時」のような書き方の違いで不利にならないようにするためです。
結果1:文字起こしの速さ
追従遅れは MAI が約0.4秒、Gemini が約1.1秒
日本語7種の音声 × 3回の中央値です。Gemini は、Gateway 経由の初期設定(自動VAD)と、後で説明する手動VAD(直結)の2条件を並べています。
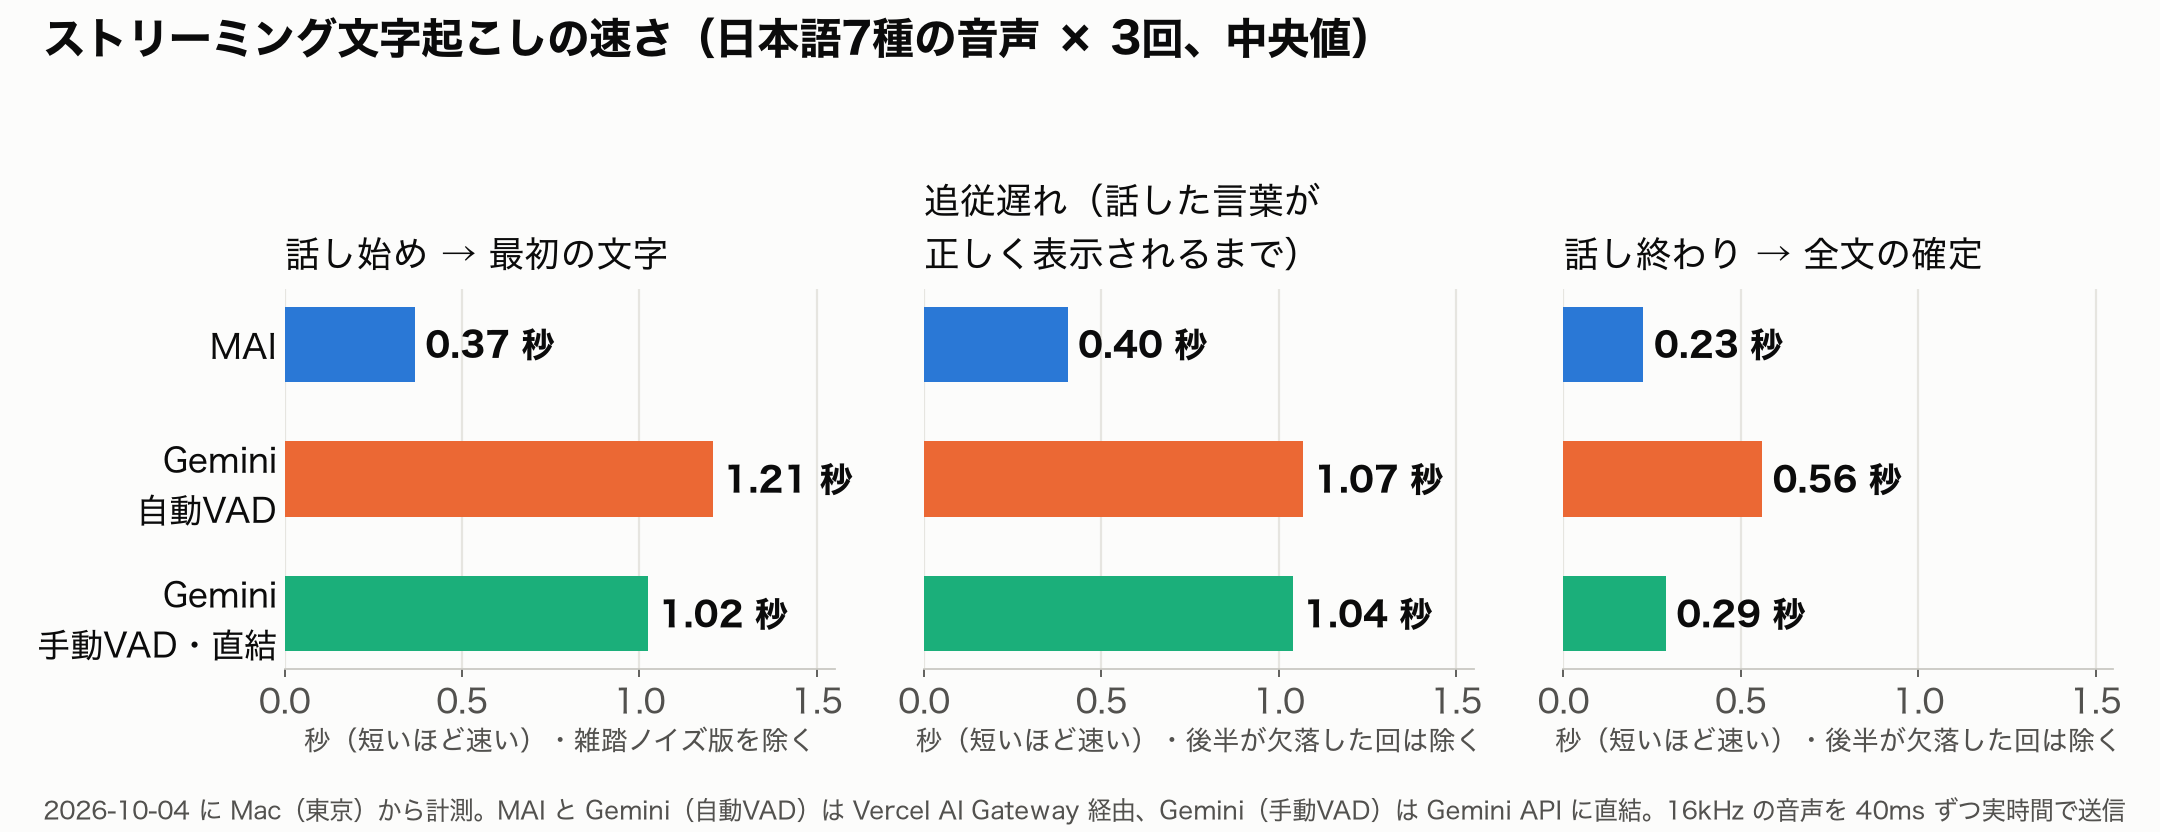
日本語での速さ。どの指標でも MAI が最も短い
3つの指標すべてで MAI が最速でした。体感にいちばん近い追従遅れは、MAI が0.40秒、Gemini が1.04〜1.07秒で、約0.65秒の差があります。話し終わりから全文がそろうまでも、MAI は0.23秒です。Gemini は手動VAD にすると0.29秒まで縮み、ここはかなり近づきます。
発表の「100ミリ秒強」とは数字が違って見えますが、測っている区間が違います。Artificial Analysis の0.12秒は「話し終わってから最初の途中経過まで」で、今回の0.37秒は「話し始めてから最初の文字まで」です。最初の1音だけでは文字にならないので、後者は長くなります。また今回は東京から米国の Gateway を経由しているので、その往復も含まれます。
実際の画面:同じ音声を2つ同時に流す
数字だけでは差が伝わりにくいので、同じ音声を2つのモデルに同時に流し、届いた文字を並べて表示するデモを作って録画しました。両方の接続がそろってから同じ時計で送り始めています。
問い合わせ文(10.5秒)。左が MAI、右が Gemini(自動VAD)。水色は途中経過、白は確定した文字。3回撮影し、本計測の中央値にいちばん近い回を載せています
MAI は話している声を追いかけるように文字が伸び、最後の音から0.21秒で全文が確定しました。Gemini は「先月買ったワイヤレスイヤホンの右側が」で止まり、そのあとの約6.7秒は一文字も出てきません。これは次の「正確さ」の結果にも表れています。
ばらつきにも注意
中央値では MAI が安定して速い一方で、たまに遅い回もありました。全文の確定は24回中4回が0.7秒を超え、最も遅い回は3.26秒です。デモの撮影中にも、確定まで5.6秒かかった回が1回ありました。Gemini 側も最大7.9秒の回があります。どちらも通信経路を含めた値なので、実際のアプリでは「確定が遅れたら途中経過で先に進む」ような作りにしておくと安心です。
結果2:文字起こしの正確さ
MAI は日本語7種すべてで読みの誤り0%
確定した文を、ひらがなの読みに直して正解と比べた誤り率です。
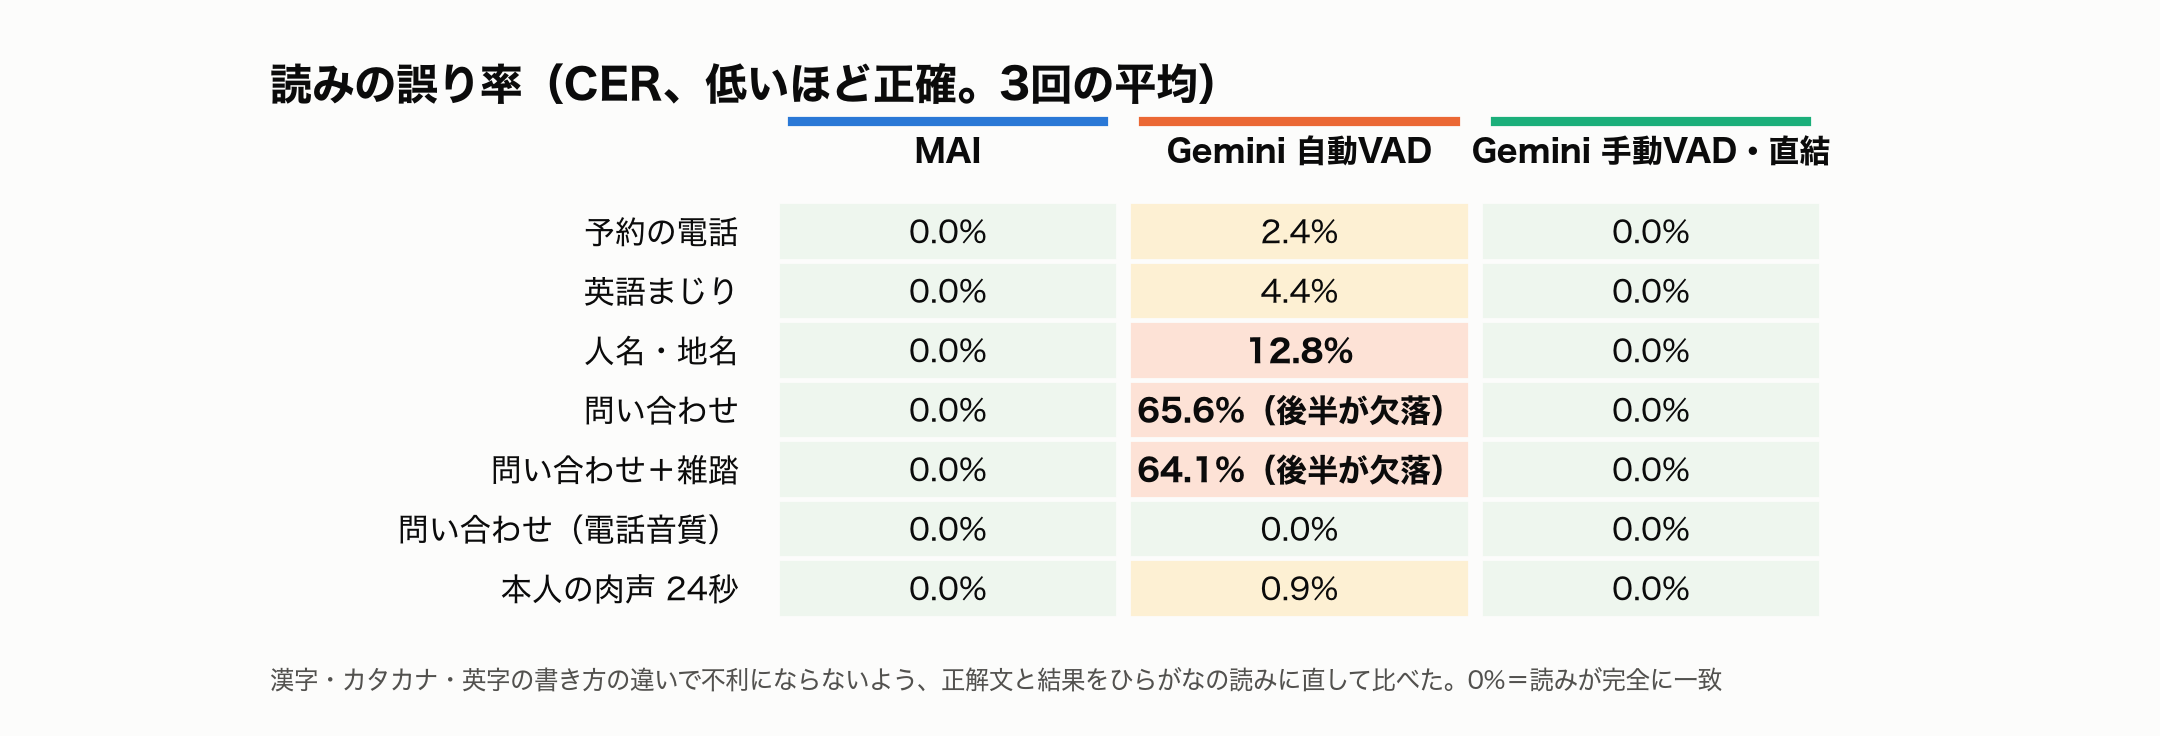
読みの誤り率(3回の平均)。0%は読みが完全に一致したことを表す
MAI は21回すべてで読みが完全に一致しました。雑踏ノイズ版でも、電話音質でも、東海林(しょうじ)・御手洗(みたらい)という読みにくい名字でも、確定した文字は正解どおりです。英語まじりの文では「Claude Code」を英字で、「Pull Request」をカタカナで書きましたが、読みは一致しています。
Gemini(自動VAD)は、問い合わせ文と雑踏版で後半がまるごと欠けることが3回中3回起きました。人名・地名の文では「御手洗さん」が「三田さん」になり、「梅田」が抜けています。一方、同じ Gemini でも手動VAD にすると、すべて0%になりました。つまり Gemini の誤りの多くは、聞き取る力ではなく区切り方の問題です。
Gemini が後半を落とす理由
Gemini 3.5 Transcribe Live は初期設定で、サーバーが話し始めと話し終わりを自動で判定します(自動VAD=Voice Activity Detection、声のある区間の検出)。イベントの記録を見ると、問い合わせ文では「右側だけ、」の読点の間で「話し終わり」と判定し、そのあと新しい話し始めを検出しませんでした。
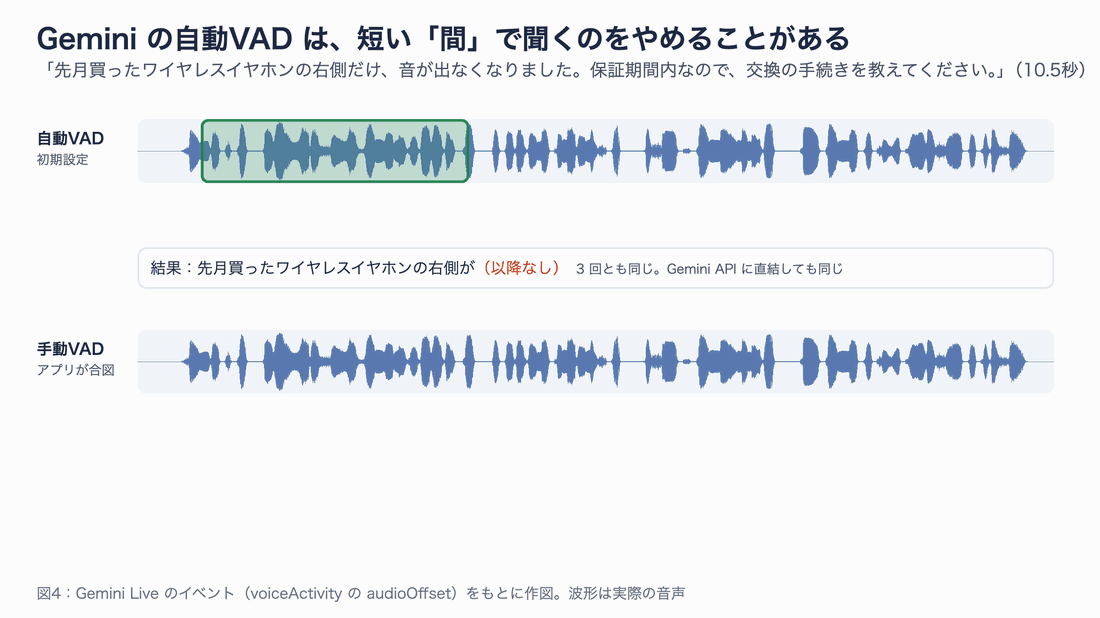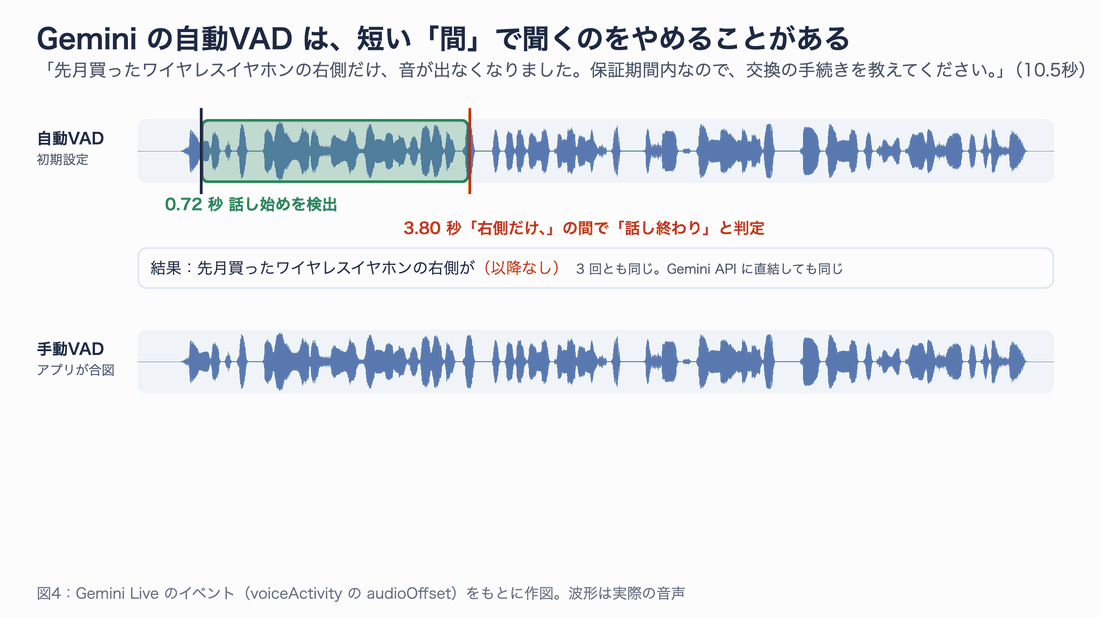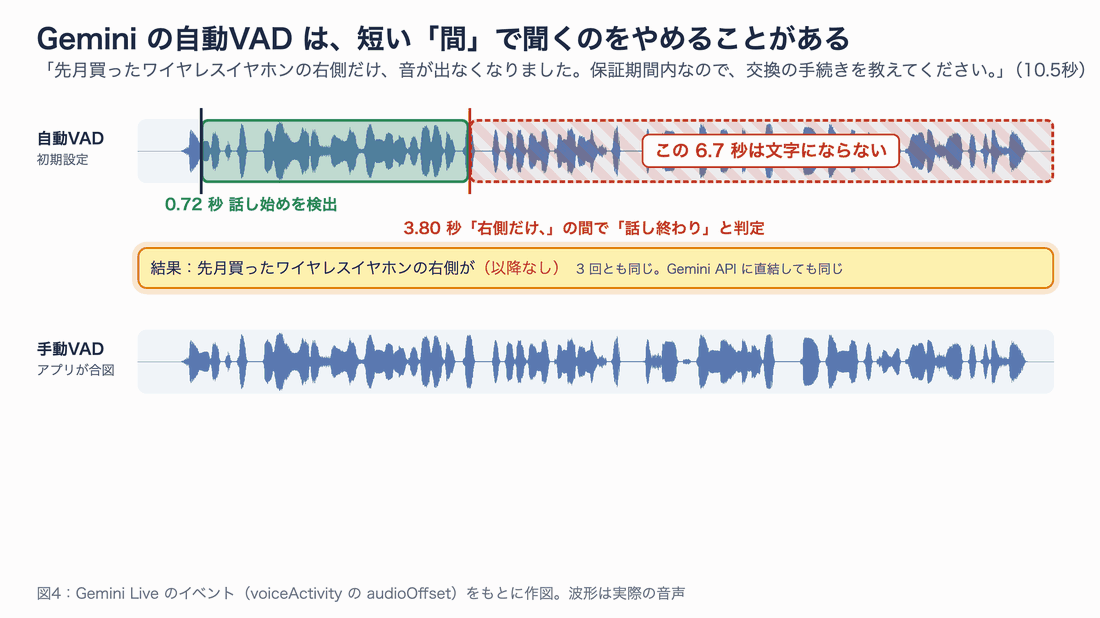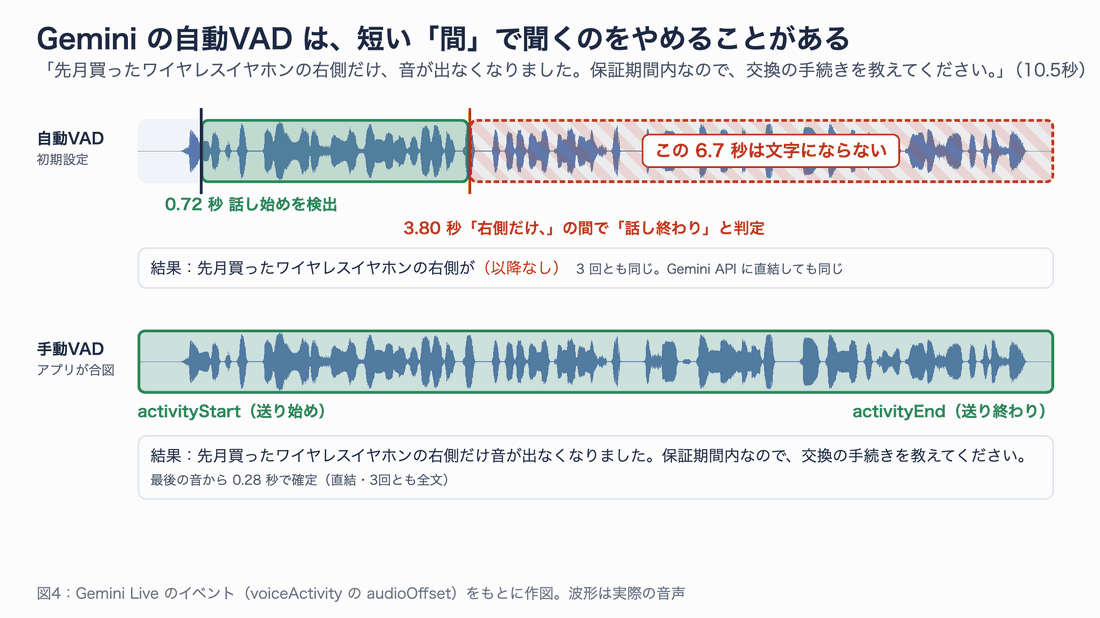
図4:自動VAD は短い間で区切り、そこで聞き取りが止まることがある。手動VAD ならアプリが区間を決める
Gateway を通さず Gemini API に直結しても、言語を日本語に指定しても、SMART モード(話し言葉を整える設定)にしても、結果は同じでした。Vercel の中継の問題ではなく、Gemini 側の挙動です。公式ガイドにある手動VAD(自動判定を切り、アプリが activityStart と activityEnd を送る方式)にすると、全文が正しく出て、最後の音から0.28秒で確定しました。
// Gemini 3.5 Transcribe Live を手動VADで使う(gemini-live-manual-vad.mjs)
// 使い方: GEMINI_API_KEY=... node gemini-live-manual-vad.mjs <音声ファイル>
import { execFileSync } from 'node:child_process';
import { GoogleGenAI, Modality } from '@google/genai';

const pcm = execFileSync('ffmpeg', ['-v', 'error', '-i', process.argv[2], '-ac', '1', '-ar', '16000', '-f', 's16le', '-']);
const ai = new GoogleGenAI({ apiKey: process.env.GEMINI_API_KEY });
let done;
const finished = new Promise(r => (done = r));

const session = await ai.live.connect({
  model: 'gemini-3.5-transcribe-live',
  config: {
    responseModalities: [Modality.TEXT],
    inputAudioTranscription: {},
    realtimeInputConfig: { automaticActivityDetection: { disabled: true } }, // 自動VAD を切る
  },
  callbacks: {
    onmessage: m => {
      const sc = m.serverContent;
      if (sc?.interimInputTranscription) console.log('途中 ', sc.interimInputTranscription.text);
      if (sc?.inputTranscription) { console.log('確定 ', sc.inputTranscription.text); done(); }
    },
  },
});

session.sendRealtimeInput({ activityStart: {} });              // 話し始め
for (let i = 0; i < pcm.length; i += 3200) {                   // 100ミリ秒ずつ実時間で送る
  session.sendRealtimeInput({ audio: { data: pcm.subarray(i, i + 3200).toString('base64'), mimeType: 'audio/pcm;rate=16000' } });
  await new Promise(r => setTimeout(r, 100));
}
session.sendRealtimeInput({ activityEnd: {} });                // 話し終わり → ここで確定が返る
await finished;
session.close();
実際のアプリでは、端末側の VAD(無音が一定時間続いたら区切る仕組み)や、「話す」ボタンを押している間だけ送る方式と組み合わせます。どこで区切るかを自分で決められるぶん、区切りの判断はアプリ側の責任になります。なお、今回 Vercel AI Gateway 経由でこの手動VAD を指定する方法は確認できませんでした。
途中経過は文脈がそろうと書き換わる
正確さで見落としがちなのが、途中経過の中身です。MAI は話し始めてすぐに文字を出しますが、最初の当て推量は外れることがあります。人名・地名の文で、実際のログを並べてみます。
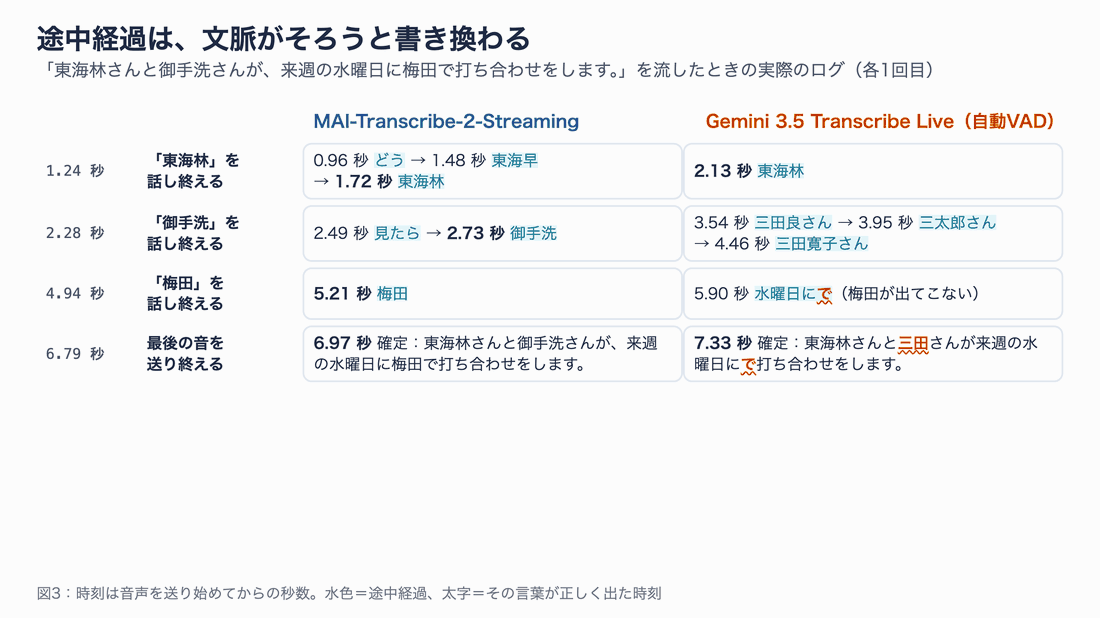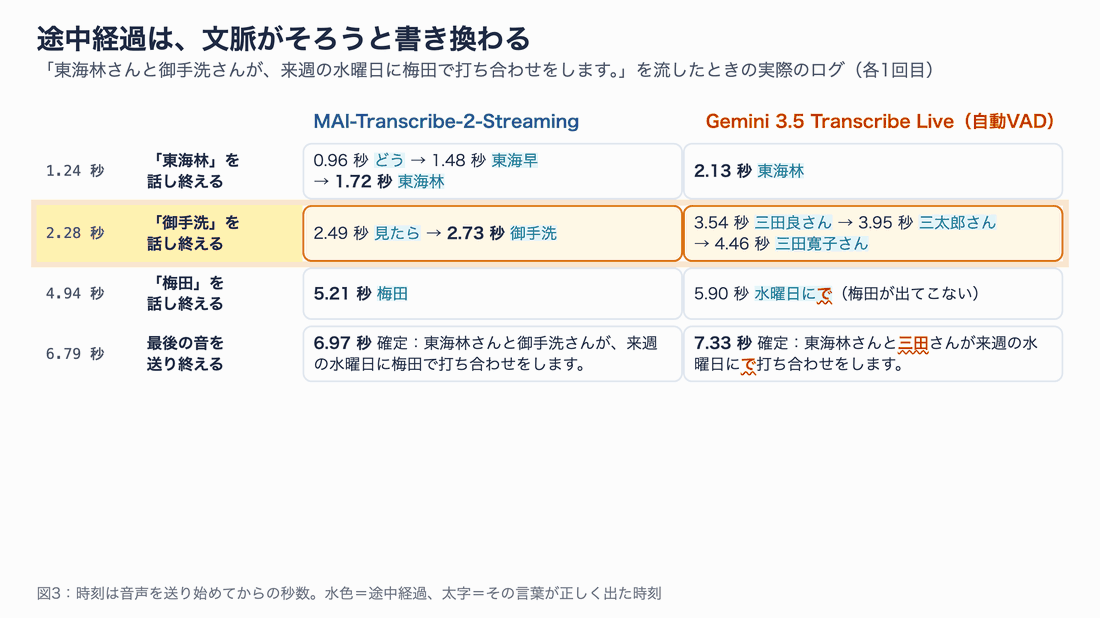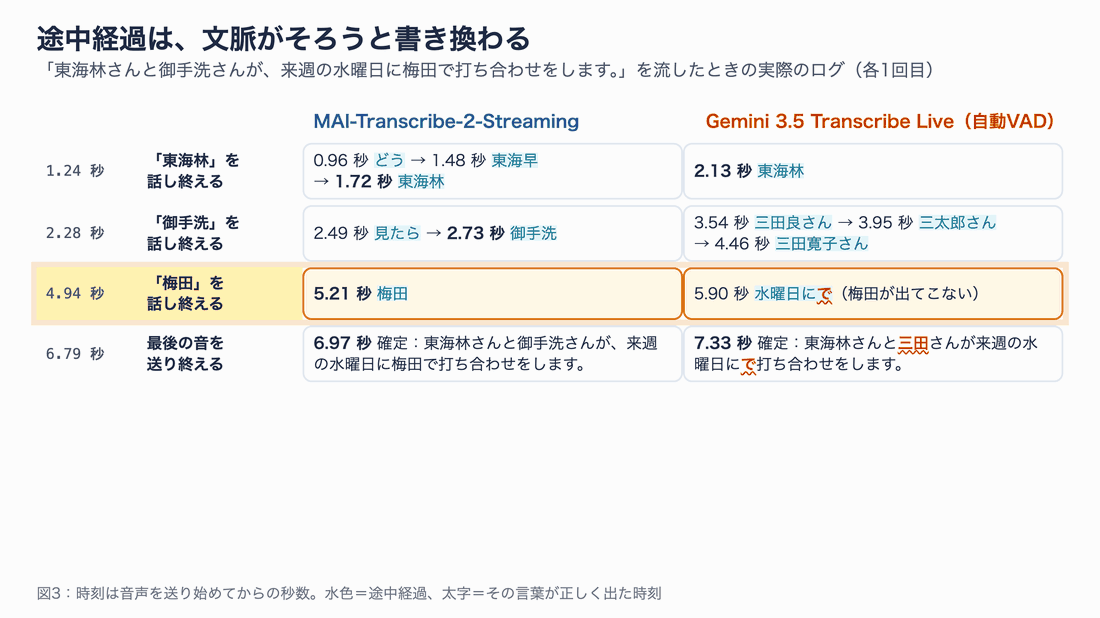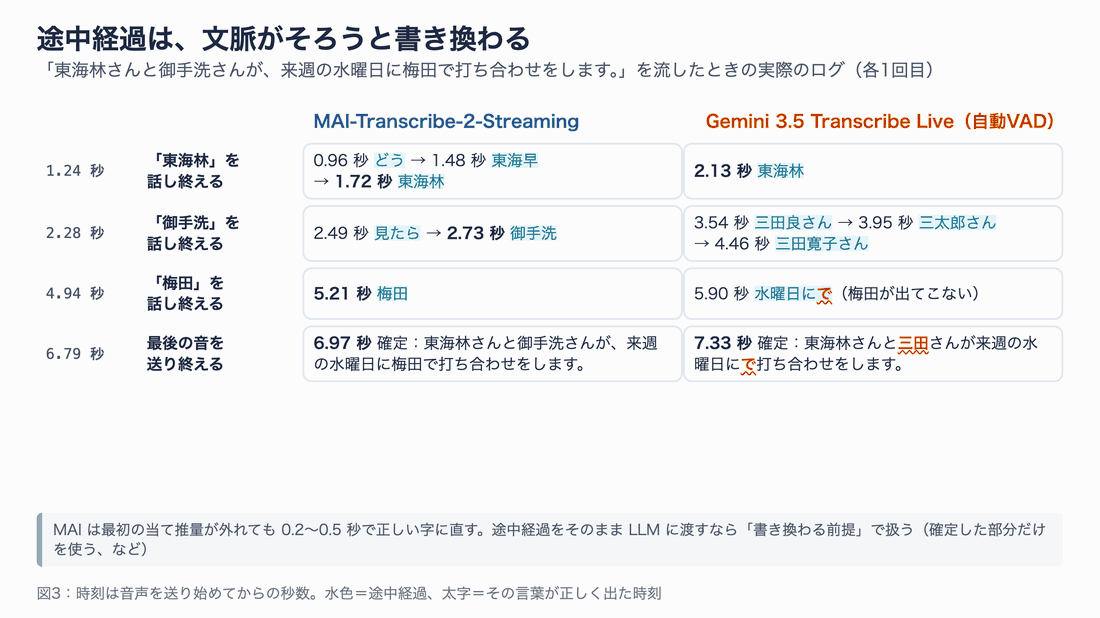
図3:途中経過の書き換わり方(各1回目の実ログ)
MAI は「どう → 東海 → 東海早 → 東海林」、「見たら → 御手洗」のように、続きの音が届くたびに直していきます。言葉を話し終えてから0.2〜0.5秒で正しい字になりました。Gemini は「三田良さん」「三太郎さん」「三田寛子さん」と迷った末に、確定では「三田さん」になっています。
途中経過をそのまま LLM に渡す場合は、書き換わる前提で扱う必要があります。確定した部分(delta)だけで返事の準備を始め、途中経過は画面の字幕にだけ使う、という分け方が扱いやすいです。
英語まじりの文でも、書き換わり方の違いがよく見えます。
英語まじりの依頼文(7.3秒)。MAI は「黒 → クロード → Claude Code」と書き換え、Gemini は「クロードコード」とカタカナで書いた。3回撮影し、本計測の中央値に近い回を載せています
手元で動かす:ストリーミング文字起こしの最小コード
MAI-Transcribe-2-Streaming を試す最小限のスクリプトです。WAV や MP3 を ffmpeg で 16kHz の生 PCM に変換し、40ミリ秒ずつ実時間で送って、途中経過と確定文字を表示します。
// WAV ファイルを実時間ペースで MAI-Transcribe-2-Streaming に流し、途中経過と確定文字を表示する
// 使い方: node stream-transcribe.mjs <音声ファイル> [モデル名]
import 'dotenv/config';
import { execFileSync } from 'node:child_process';
import { createGateway } from '@ai-sdk/gateway';
import { experimental_streamTranscribe as streamTranscribe } from 'ai';

const [file, model = 'microsoft/mai-transcribe-2-streaming'] = process.argv.slice(2);
const gateway = createGateway({ apiKey: process.env.AI_GATEWAY_API_KEY });

// ffmpeg で 16kHz・16bit・モノラルの生 PCM に変換(Gemini Live も同じ形式で受け付ける)
const pcm = execFileSync('ffmpeg', ['-v', 'error', '-i', file, '-ac', '1', '-ar', '16000', '-f', 's16le', '-']);
const CHUNK = 16000 * 2 * 0.04; // 40ミリ秒ぶん

let start = null, sent = 0;
const audio = new ReadableStream({
  async pull(controller) {
    start ??= performance.now();             // 接続できてから時計を始める
    const wait = start + (sent / CHUNK) * 40 - performance.now();
    if (wait > 0) await new Promise(r => setTimeout(r, wait));
    if (sent >= pcm.length) return controller.close();
    controller.enqueue(new Uint8Array(pcm.subarray(sent, sent + CHUNK)));
    sent += CHUNK;
  },
}, { highWaterMark: 0 });                    // 接続前に先読みさせない

const sec = () => ((performance.now() - start) / 1000).toFixed(2).padStart(5);
const result = streamTranscribe({
  model: gateway.experimental_transcription(model),
  audio,
  inputAudioFormat: { type: 'audio/pcm', rate: 16000 },
});
let fixed = '';
for await (const part of result.fullStream) {
  if (part.type === 'transcript-partial') console.log(`${sec()}s 途中  ${fixed}\x1b[36m${part.text}\x1b[0m`);
  if (part.type === 'transcript-delta') { fixed += part.delta; console.log(`${sec()}s 確定  ${fixed}`); }
  if (part.type === 'error') console.error('エラー:', part.error);
}
console.log('全文:', await result.text);
# 実行する(モデル名を変えれば Gemini 3.5 Transcribe Live でも同じように動く)
node stream-transcribe.mjs names.wav
node stream-transcribe.mjs names.wav google/gemini-3.5-transcribe-live
実行すると、水色の途中経過が次々に書き換わり、白い確定部分が少しずつ伸びていきます。
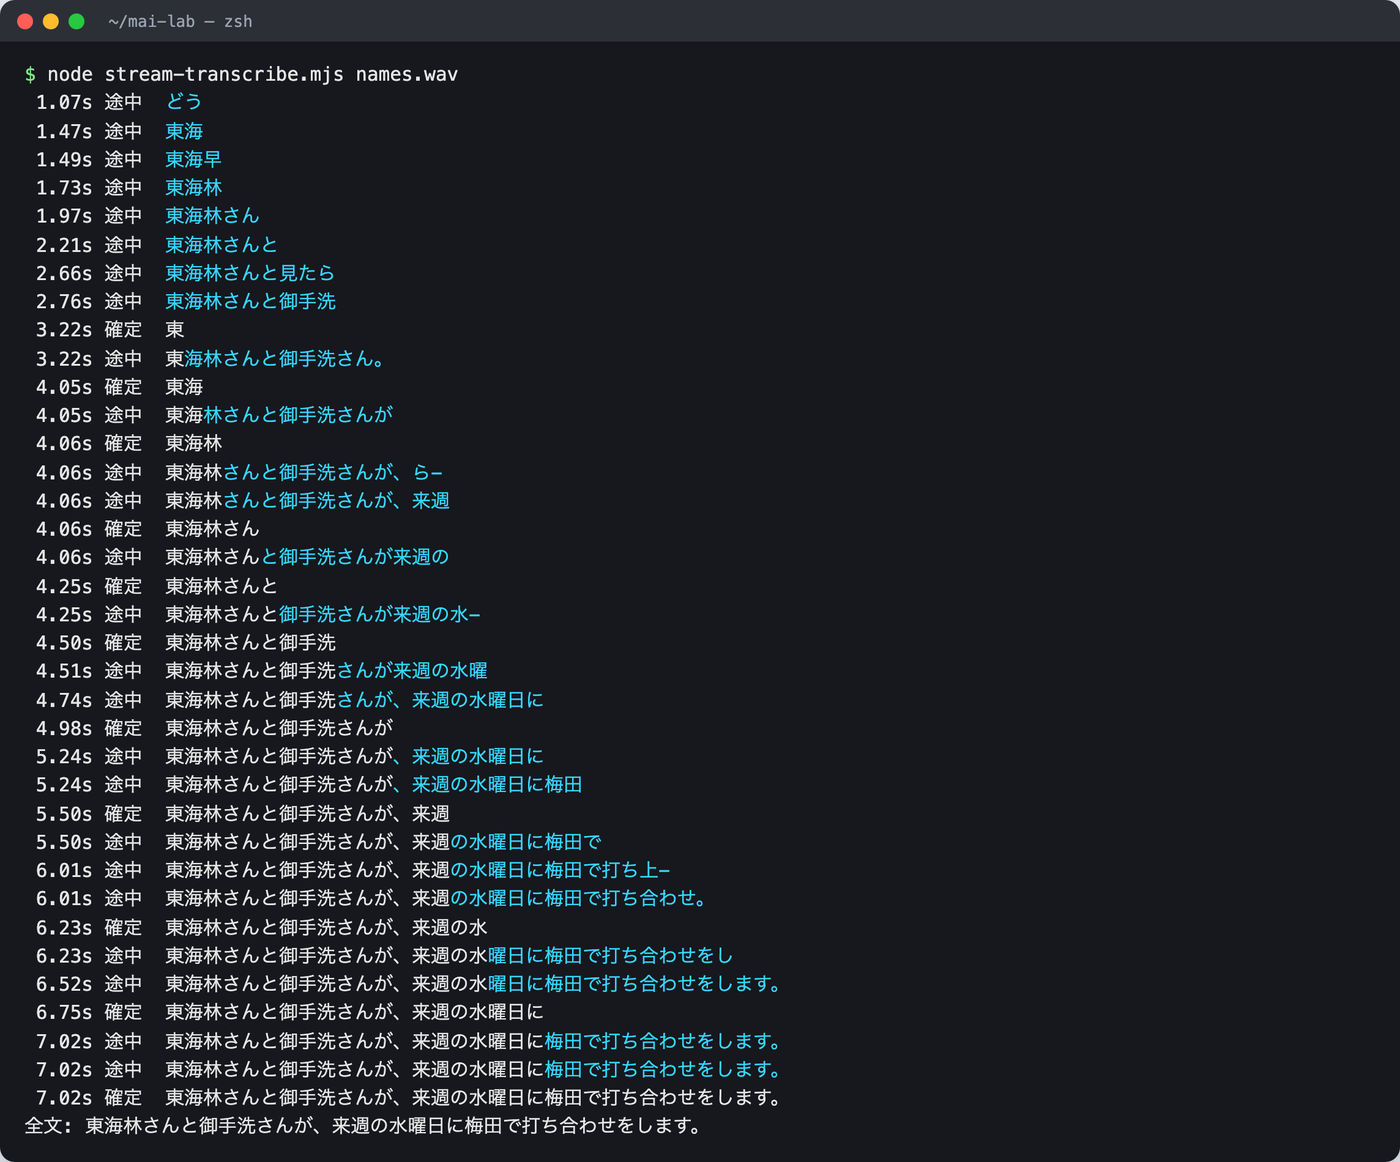
上のスクリプトを人名・地名の音声で実行した結果(2026-10-04、出力をそのまま画像化)。時刻は音声を送り始めてからの秒数
ポイントは2つあります。1つ目は highWaterMark: 0 と「接続できてから時計を始める」処理です。これがないと、WebSocket の接続を待つ1〜2秒の間に音声がたまり、つながった瞬間にまとめて送られます。筆者も最初はこれに気づかず、遅延を1秒以上多く測っていました。2つ目は 16kHz への変換です。Gemini 3.5 Transcribe Live は 24kHz を受け付けず、Unsupported inputAudioFormat になります。
結果3:読み上げ(MAI-Voice-2.1 と Gemini 3.8 TTS)
MAI-Voice-2.1 には日本語の声がない
読み上げで最も大きな違いは、MAI-Voice-2.1 に日本語の声がないことです。対応は23言語で、中国語・韓国語・ヒンディー語などはありますが、日本語は含まれていません。Playground の声の一覧でも、ITALIAN の次がすぐ KOREAN になっています。
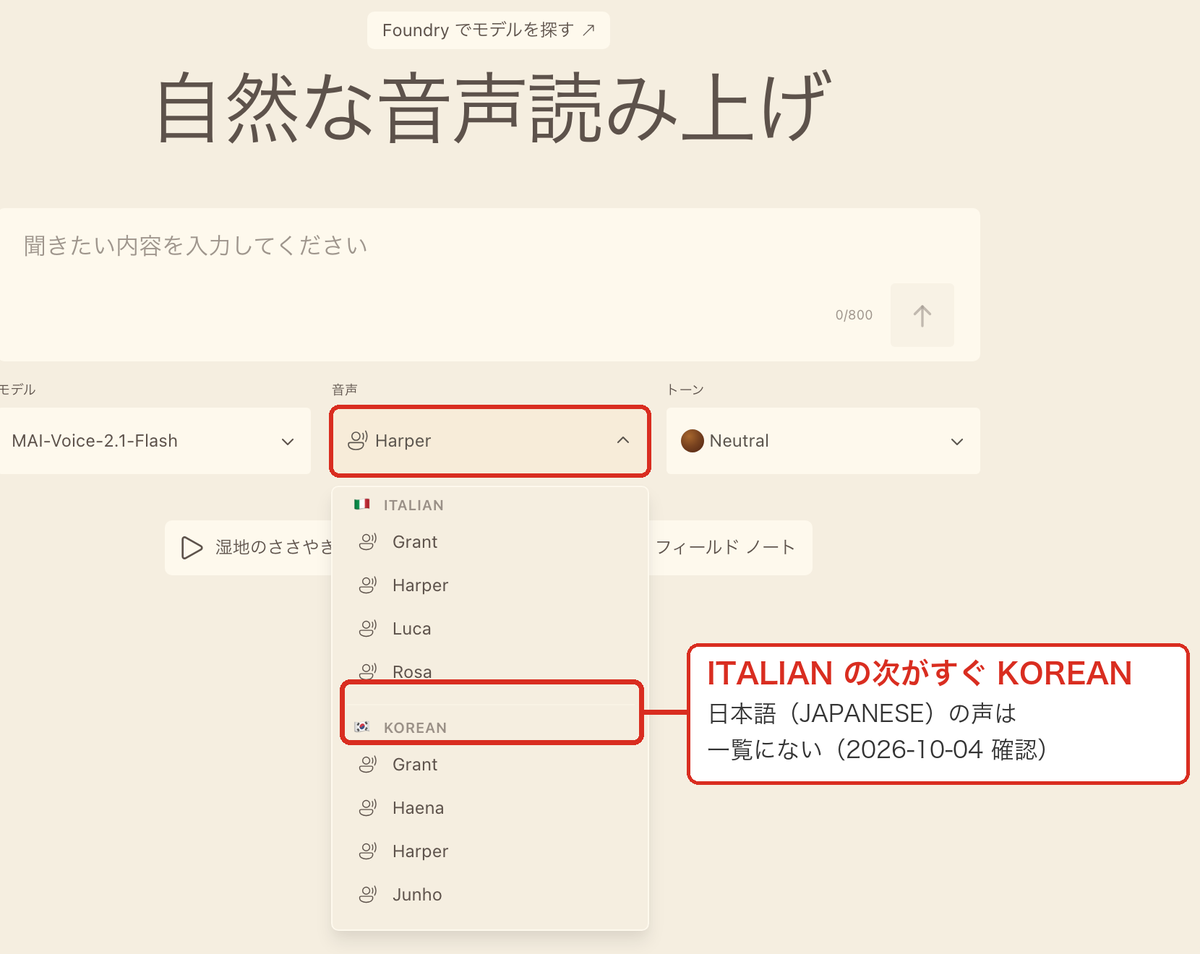
MAI Playground の声の一覧(2026-10-04 撮影、赤枠と注記は筆者)
API で ja-JP-Harper を指定すると、400エラーになりました。では、英語の声に日本語を読ませるとどうなるか。発表では「1つの声ですべての言語を母語のように話せる」とうたっているので、試しています。
台本は「お電話ありがとうございます。明日の午後3時、4名様でご予約を承りました。1時間前に、確認のメッセージをお送りします。」です。Whisper で文字に戻すと、MAI の音声は日本語として聞き取れましたが、「承りました」が「たたわりました」と書き起こされ、読み間違いがありました。Gemini は2モデルとも台本どおりです。言語を ja-JP と指定しても、MAI では「声が言語を決めるので無視した」という警告が返りました。日本語の読み上げに使うなら、現時点では Gemini を選ぶのが無難です。
今回の書き起こしで確かめられるのは「読み間違いがあるか」までです。アクセントや自然さは、ぜひ上の音声を聞き比べてみてください。
英語なら MAI がかなり速い
英語は両方が正式に対応しているので、同じ英文(約7.5秒ぶん)で速さを比べました。
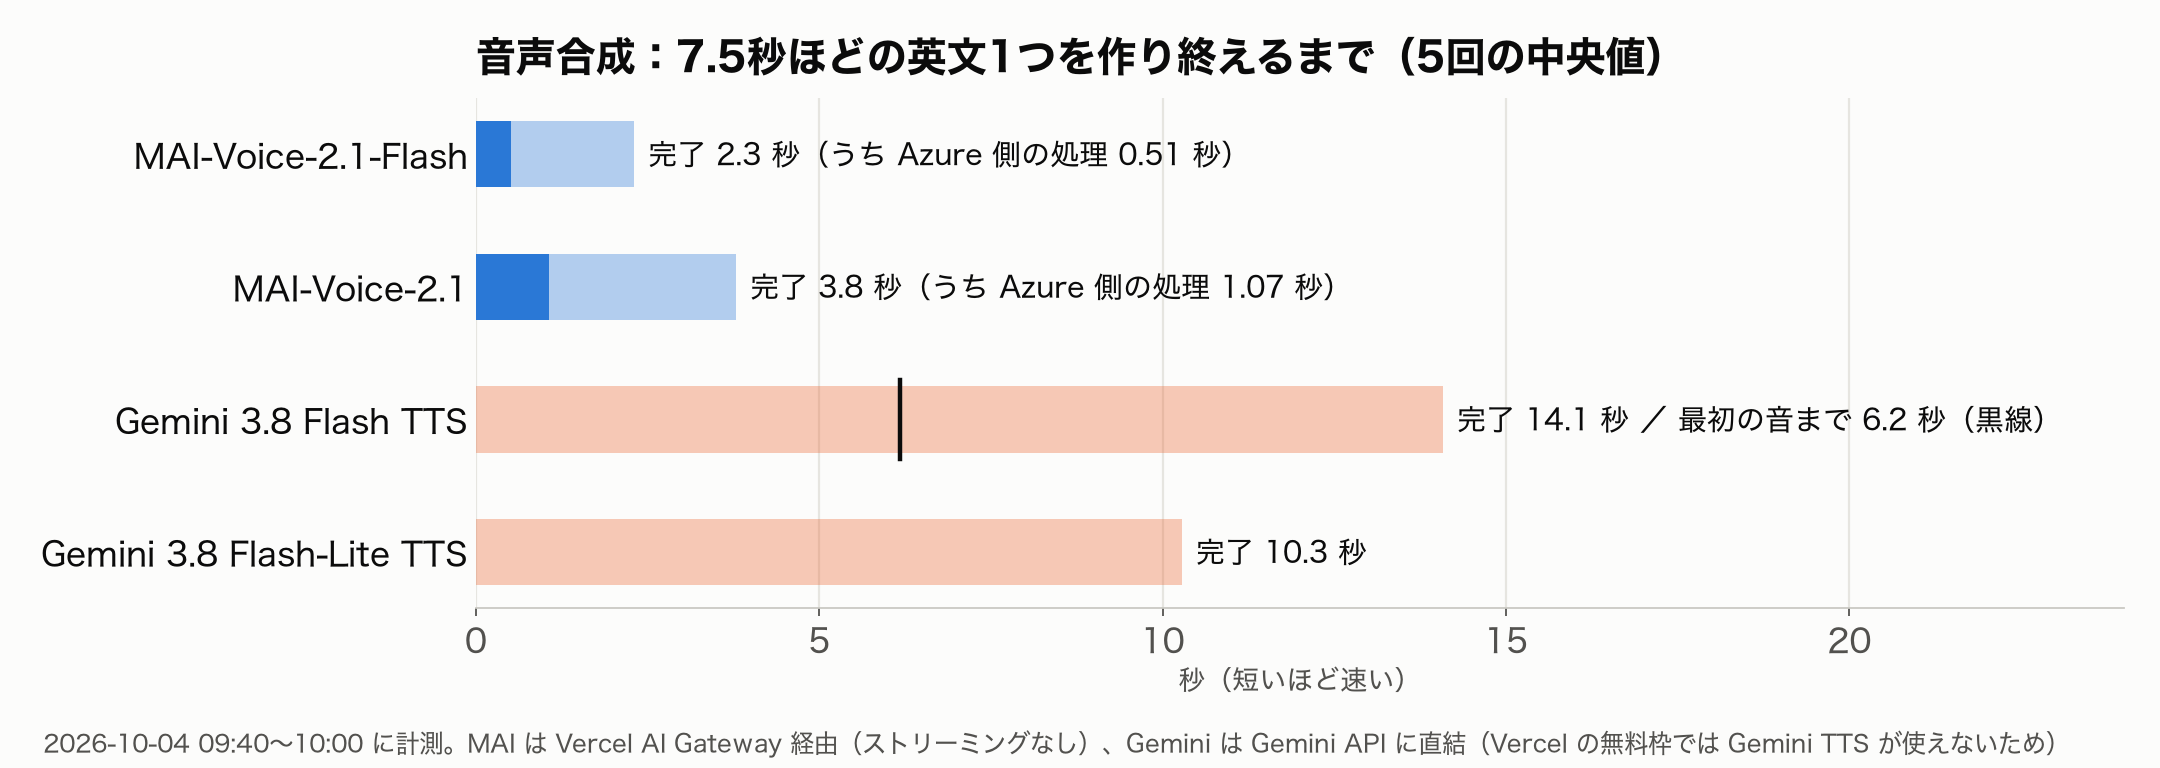
読み上げの速さ(5回の中央値)。濃い部分は Vercel の記録にある Azure 側の処理時間
MAI-Voice-2.1-Flash は完了まで2.3秒でした。Vercel の応答には Azure 側の処理時間も記録されていて、それは0.51秒です。残りの約1.8秒は、日本から米国の Gateway を経由する往復などの時間です。日本から直接 Azure につなげば、もっと短くなるはずです。
Gemini 3.8 Flash TTS は、ストリーミングで最初の音が届くまで6.2秒、生成し終わるまで14.1秒かかりました。1回は接続エラーもありました。ただ、筆者が9月24日に同じ方法で測ったときは、最初の音まで1.8秒でした。今回は日曜の朝(米国の土曜の夜)で、混雑していた可能性があります。Gemini TTS の遅さは、この日の値として読んでください。
聞き比べ用に、同じ英文の音声を置いておきます。
感情の付け方:MAI はスタイル名、Gemini は自然な文
感情の付け方も違います。MAI は SSML のスタイル名(sad、joyful など)を選び、Gemini は「涙をこらえながら悲しそうに」のような自然な文で指示します。AI SDK から MAI に感情を付けるときは、instructions ではなく providerOptions.azure.style を使います(instructions を渡すと「対応していない」という警告が出ます)。
MAI は sad を指定すると、同じ文が5.6秒から10.8秒になり、間を大きく取る読み方に変わりました。Gemini は8.8秒から9.6秒で、変化は控えめです。どちらが「悲しく聞こえるか」は、ぜひ聞いて判断してください。声のスタイルは声ごとに使えるものが違い、たとえば Harper は sad、joyful、whispering などに対応しています。
MAI-Voice を呼ぶコードは次のとおりです。
// MAI-Voice-2.1-Flash で英文を読み上げて MP3 に保存する(Vercel AI Gateway 経由)
// 使い方: node generate-speech.mjs "読ませたい英文" [スタイル名(例: sad)]
import 'dotenv/config';
import fs from 'node:fs';
import { createGateway } from '@ai-sdk/gateway';
import { experimental_generateSpeech as generateSpeech } from 'ai';

const [text, style] = process.argv.slice(2);
const gateway = createGateway({ apiKey: process.env.AI_GATEWAY_API_KEY });
const t0 = performance.now();
const { audio, providerMetadata } = await generateSpeech({
  model: gateway.speech('microsoft/mai-voice-2.1-flash'),
  voice: 'en-US-Harper',                                        // 声は「言語-地域-名前」。日本語(ja-JP)の声はない
  text,
  ...(style ? { providerOptions: { azure: { style } } } : {}),  // 感情はスタイル名で指定
});
fs.writeFileSync('out.mp3', audio.uint8Array);
console.log(`保存しました: out.mp3(${((performance.now() - t0) / 1000).toFixed(1)} 秒、料金 $${providerMetadata.gateway.cost})`);
Gemini 3.8 TTS は、Vercel AI Gateway の無料クレジットでは使えません(Free tier users do not have access to this model)。今回は Gemini API に直接つないで生成しました。呼び方は、筆者が以前書いた Gemini 3.8 TTS の検証記事と同じです。
料金の比較
公式の単価と、今回の実測(話す速さ・請求トークン)から、音声1時間あたりの料金に直しました。
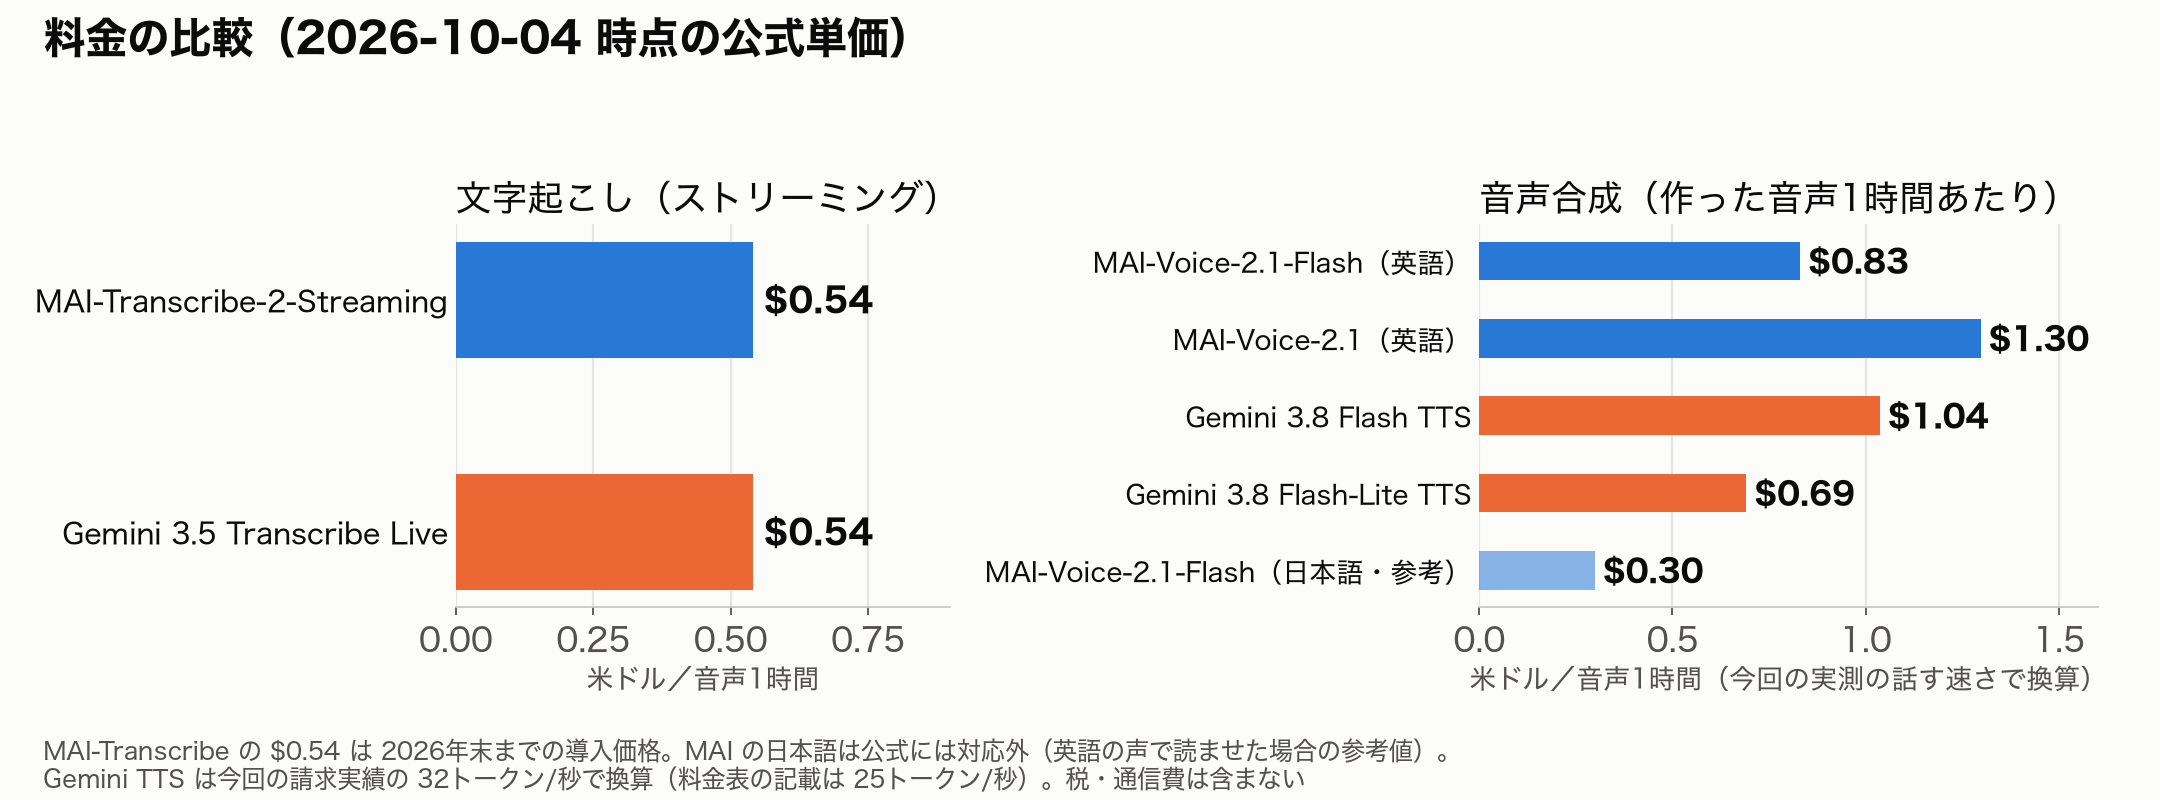
料金の比較(2026-10-04 時点の公式単価)。税と通信費は含みません
| 種類 | モデル | 公式の単価 | 音声1時間あたり(換算) |
|---|---|---|---|
| 文字起こし(ストリーミング) | MAI-Transcribe-2-Streaming | 0.54ドル/時(2026年末までの導入価格) | 0.54ドル |
| Gemini 3.5 Transcribe Live | 入力3.50ドル・出力21ドル/100万トークン(約0.009ドル/分) | 0.54ドル | |
| 読み上げ | MAI-Voice-2.1-Flash | 15ドル/100万文字 | 英語0.83ドル |
| MAI-Voice-2.1 | 22ドル/100万文字 | 英語1.30ドル | |
| Gemini 3.8 Flash TTS | 出力9ドル/100万トークン(2026年末まで) | 1.04ドル | |
| Gemini 3.8 Flash-Lite TTS | 出力6ドル/100万トークン(2026年末まで) | 0.69ドル |
文字起こしは、偶然にも両社とも1時間0.54ドルで同じでした。読み上げは、MAI が「文字数」、Gemini が「できた音声の長さ(トークン)」で課金されます。英語だと Gemini Flash-Lite が最も安く、MAI Flash がそれに続きます。
文字数課金の MAI は、1文字に情報が詰まった日本語だと計算上かなり安くなります(今回の音声では1時間0.30ドル)。ただし、日本語は正式な対応外なので参考値です。Gemini TTS の請求は、今回も1秒あたり32トークンでした。料金表には「25トークン/秒」とあり、9月24日の検証と同じく食い違っています。換算には実際の請求の32を使いました。
どっちを使うか
ここまでの結果を、日本語の音声アプリを作る場合の選び方にまとめます。
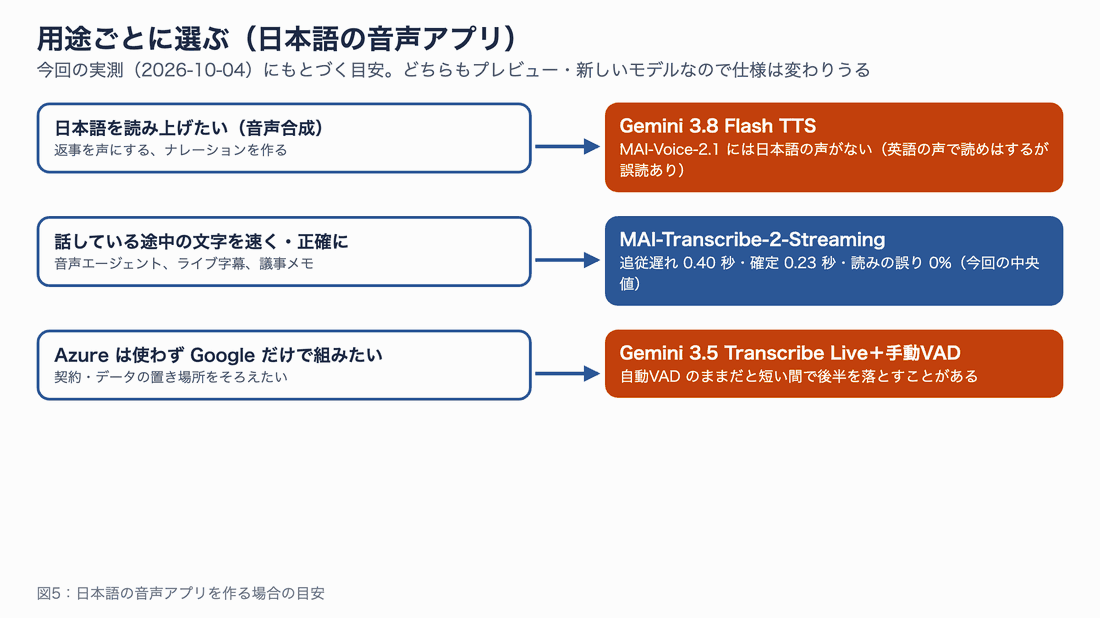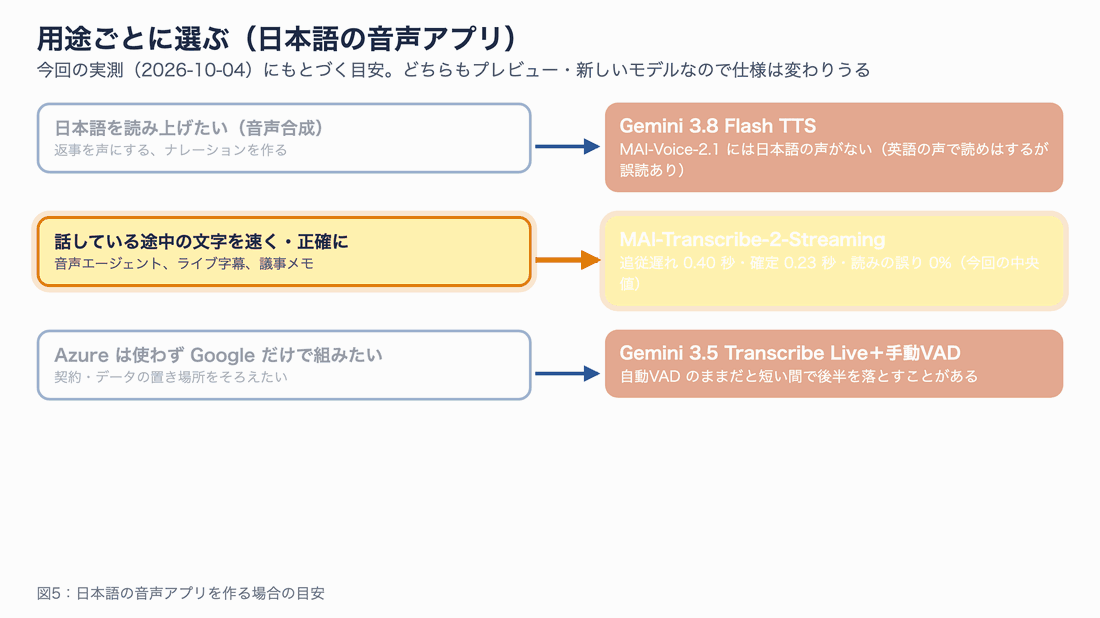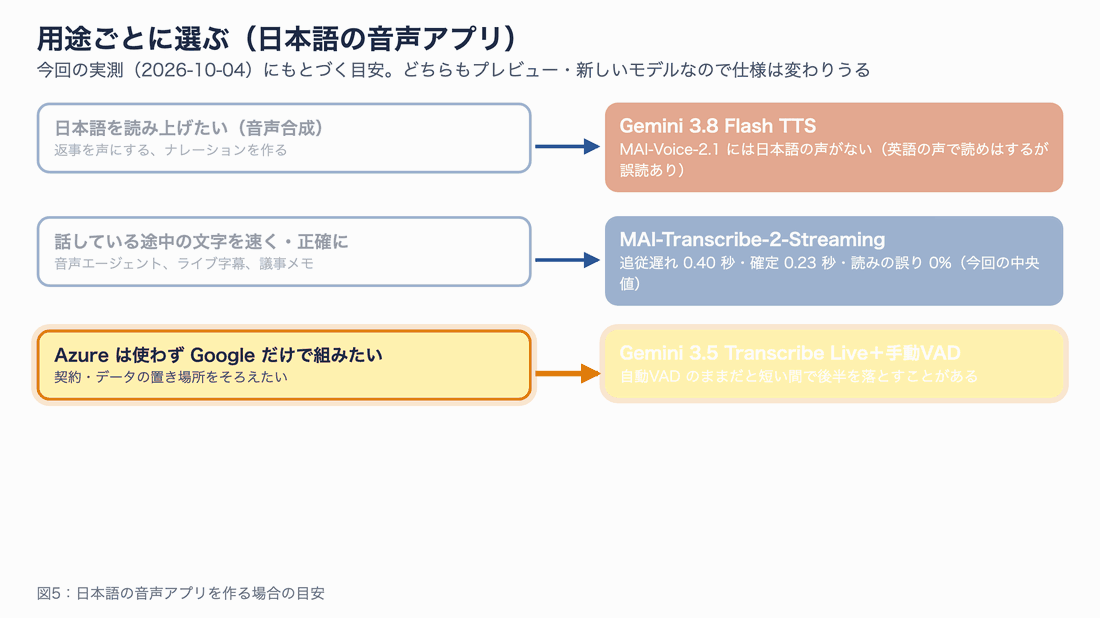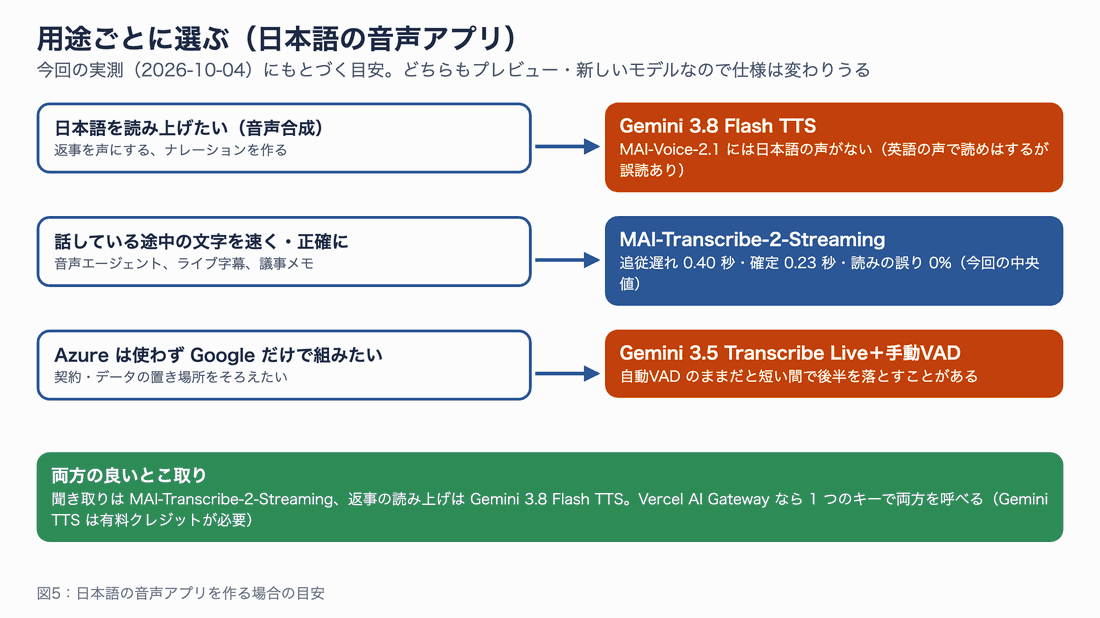
図5:用途ごとの選び方(2026-10-04 の実測にもとづく目安)
日本語の音声エージェントなら、聞き取りは MAI-Transcribe-2-Streaming、返事の読み上げは Gemini 3.8 Flash TTS という組み合わせが、今回の結果ではいちばん筋が良いです。Vercel AI Gateway を使えば1つのキーで両方を呼べます(Gemini TTS には有料クレジットが必要)。
Google だけで組みたい場合は、Gemini 3.5 Transcribe Live を手動VADで使ってください。初期設定のままだと、短い間で後半を落とすことがあります。手動VAD にすれば正確さは MAI と同じ0%で、確定までの時間も0.29秒と近くなります。ただし、追従遅れ(約1.0秒)は MAI(約0.4秒)より長いままです。
MAI を本番で使うときは、Preview であることに加えて、日本リージョンがない点も考えておく必要があります。データの置き場所に決まりがある業務では、Sweden Central などに音声が送られることを確認してから選びましょう。
トラブルシューティング
今回の検証で実際に出たエラーと現象を、直し方と一緒にまとめます。
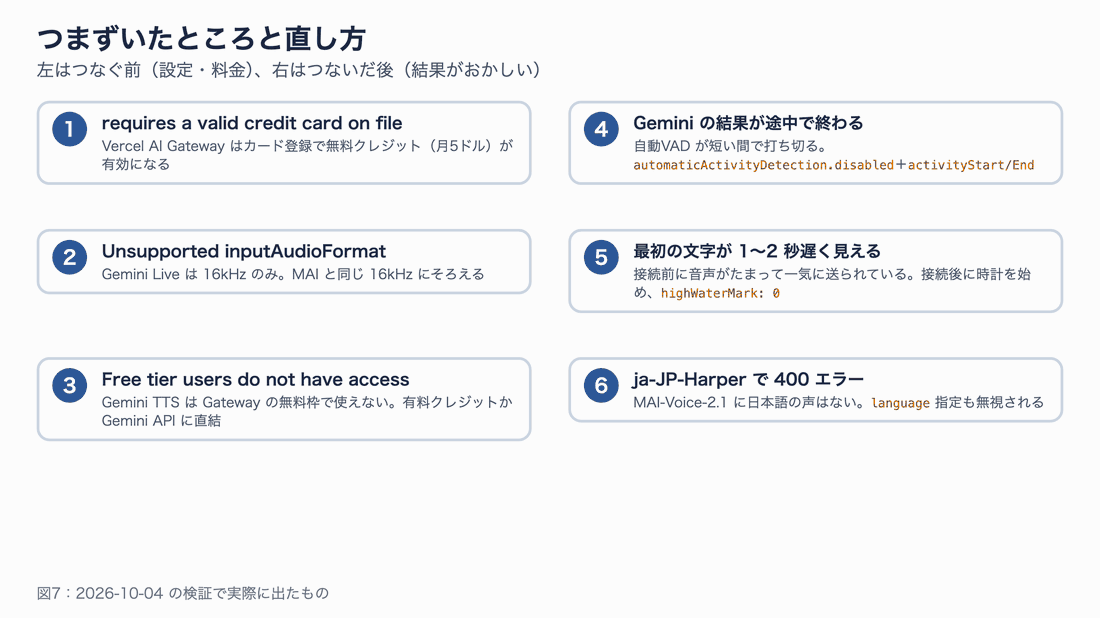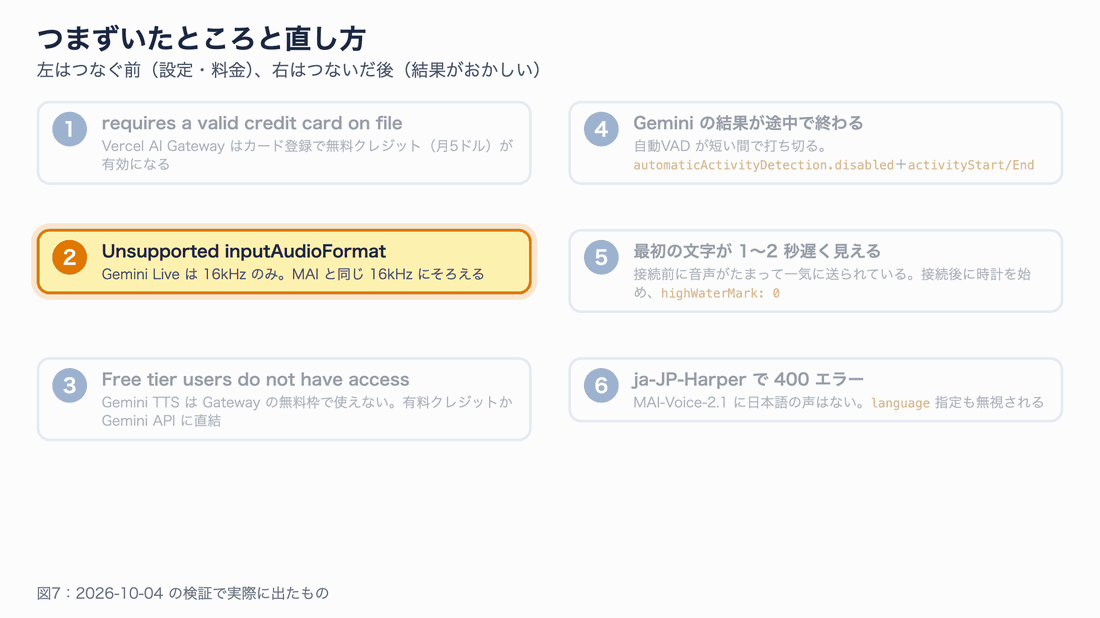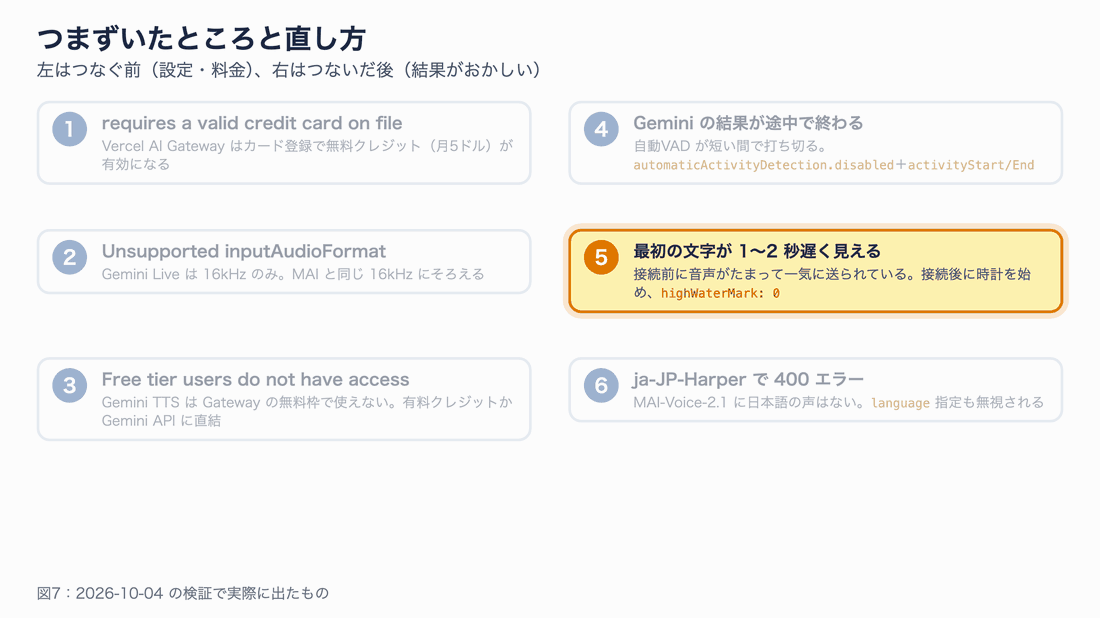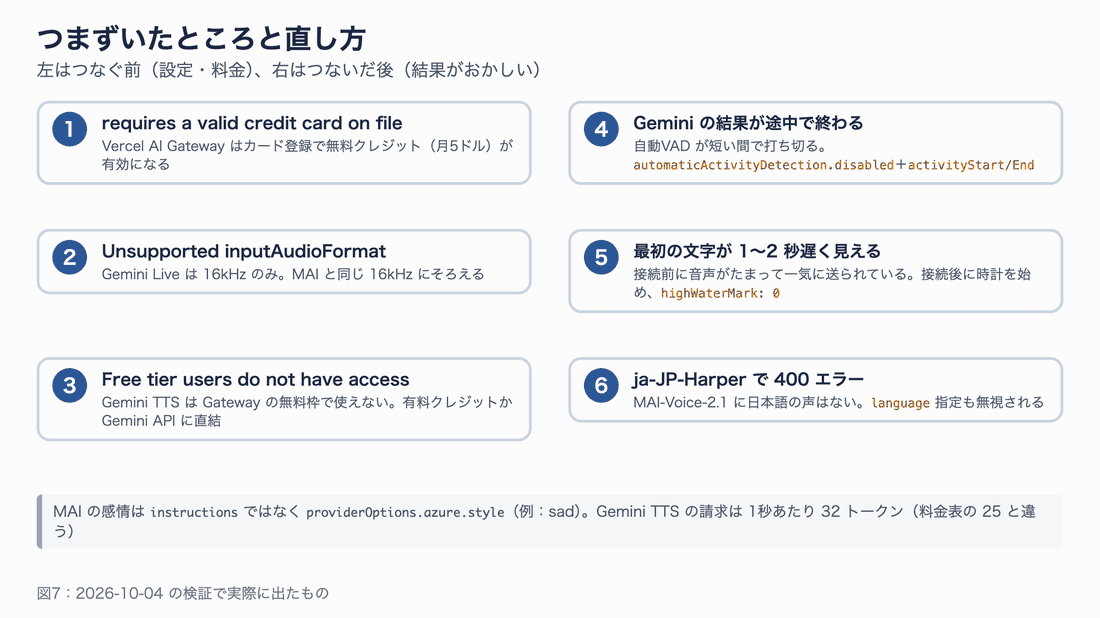
図7:検証中に実際に出たエラーと現象
| 症状・エラー | 原因 | 直し方 |
|---|---|---|
AI Gateway requires a valid credit card on file | Vercel にカードが未登録で、無料クレジットが0 | AI Gateway の画面でカードを登録(月5ドルの無料クレジットが有効になる) |
Unsupported inputAudioFormat | Gemini Live に 24kHz を送った | 16kHz にそろえる(MAI も 16kHz に対応) |
Free tier users do not have access to this model | Gemini TTS は Gateway の無料枠の対象外 | 有料クレジットを入れるか、Gemini API に直結する |
| Gemini の結果が文の途中で終わる | 自動VAD が短い間で「話し終わり」と判定 | automaticActivityDetection: { disabled: true } と activityStart / activityEnd |
| 最初の文字が1〜2秒遅く見える | 接続を待つ間に音声がたまり、まとめて送られた | 接続後に時計を始め、highWaterMark: 0 にする |
ja-JP-Harper で400エラー | MAI-Voice-2.1 に日本語の声はない | 日本語の読み上げは Gemini を使う |
| MAI に感情が付かない | instructions は MAI では無視される | providerOptions: { azure: { style: 'sad' } } |
| Gateway 経由の Gemini の終了が約3秒遅れる | 全文の確定後、接続を閉じるまでに待ちがある | 全文は確定イベントの時点で使い、ストリームの終了を待たない |
最後の項目は計測上の注意点でもあります。Gemini(Gateway 経由)は、確定した全文が届いてから、ストリームが閉じるまでさらに約3秒かかりました。「ストリームが終わるまで」で測ると Gemini が不当に遅く見えるので、今回は全文がそろったイベントの時刻で比べています。
まとめ
MAI-Transcribe-2-Streaming を日本語で試した結果、発表の「速くて正確」は日本語でもおおむね当てはまりました。
- 追従遅れ(話してから正しい文字が出るまで)は MAI 0.40秒、Gemini 1.04〜1.07秒。話し終わりから全文がそろうまでは MAI 0.23秒
- MAI は日本語7種・21回すべてで読みの誤り0%。雑踏・電話音質・読みにくい名字でも正解どおり
- Gemini 3.5 Transcribe Live は初期設定(自動VAD)だと、短い間で後半を落とすことがある。手動VAD なら誤り0%・確定0.29秒まで改善する
- 読み上げは、MAI-Voice-2.1 に日本語の声がない。英語の声で読めはするが誤読があり、日本語は Gemini 3.8 TTS が無難
- 英語の読み上げは MAI-Voice-2.1-Flash が速い(完了2.3秒、Azure 側0.51秒)。Gemini TTS はこの日は遅かった
- 文字起こしの料金は両社とも1時間0.54ドル。読み上げは英語なら Gemini Flash-Lite が最安
次に試すなら、Azure の Foundry に日本から直接つないだときの速さと、Azure Speech SDK 経由での MAI-Voice のストリーミング再生です。今回の「Azure 側の処理0.51秒」が、どこまで体感に近づくかを確かめたいところです。音声エージェント全体としては、MAI の途中経過を LLM に流し込み、返事の最初の一文を Gemini TTS で読ませるところまでつないで、話し終わりから最初の音までを測ってみる価値があります。
参考リソース
- Microsoft AI:Our first streaming transcription model debuts at no. 1 on Artificial Analysis(2026-10-01)
- Microsoft Learn:Use MAI-Transcribe-2-Streaming with the Realtime API
- Microsoft Learn:MAI-Voice-2.1 and MAI-Voice-2.1-Flash
- MAI Playground
- Artificial Analysis:Speech to Text(Streaming)
- Vercel AI Gateway:MAI-Transcribe-2-Streaming
- Gemini API:Live transcription
- Gemini API:料金