- はじめに:長く走らせるほど、AIエージェントは慎重になる
- 3行でいうと
- 前提:自動研究エージェントは、どう動いているのか
- 課題:予算を増やす3つのやり方が、どれも頭打ちになる
- なぜ頭打ちになるのか:過去の自分に「錨(いかり)」を下ろしてしまう
- 解決策:定期的に「忘れる」
- チームと組み合わせる:「共有」と「忘れる」は相性がいい
- 実験:4つの課題で比べる
- 結果1:4つの課題すべてで「忘れるチーム」が最良
- 結果2:伸びの大半は「1回目に忘れた直後」
- 結果3:「続ける」より「忘れる」ほうが、安くて伸びる
- 具体例:大胆な案 × 仲間の小技で、ラウンド最大の改善
- この研究の注意点と限界
- どこに活用できそうか
- アクションプラン:明日から試す4段階
- よくあるつまずきと対処
- まとめ
- 参考リソース
はじめに:長く走らせるほど、AIエージェントは慎重になる
Claude Code や Codex に「このコードをもっと速くして」と頼み、何度も改善を繰り返させた経験はないでしょうか。最初の数回は大胆に書き換えて目に見えて良くなるのに、しばらくすると数行いじるだけになり、最後には「これ以上の改善は難しいです」と言い出す。予算(お金や時間)をさらにつぎ込んでも、ほとんど伸びません。
2026年10月14日に公開された論文「Scaling Discovery Requires Forgetting(発見を伸ばし続けるには、忘れることが必要だ)」は、この現象に正面から取り組んだ研究です。UC Berkeley を中心に Stanford 大学・Bespoke Labs の研究者が参加しています。結論はシンプルで、「記憶を増やすより、あえて忘れさせる」 ほうが伸びる、というものです。
具体的には、改善の途中で定期的に「会話の履歴」と「途中の候補の記録」をすべて捨て、それまでで最も点数の高い成果物だけを持たせて、新しいエージェントに続きをやらせます。たったこれだけで、同じ予算のまま、1体で続けた場合より最大39%、4体を並列で走らせた場合より最大15%良い結果が出ました。
まずは全体像を1枚の図で見てください。左が従来のやり方、右が論文のやり方です。
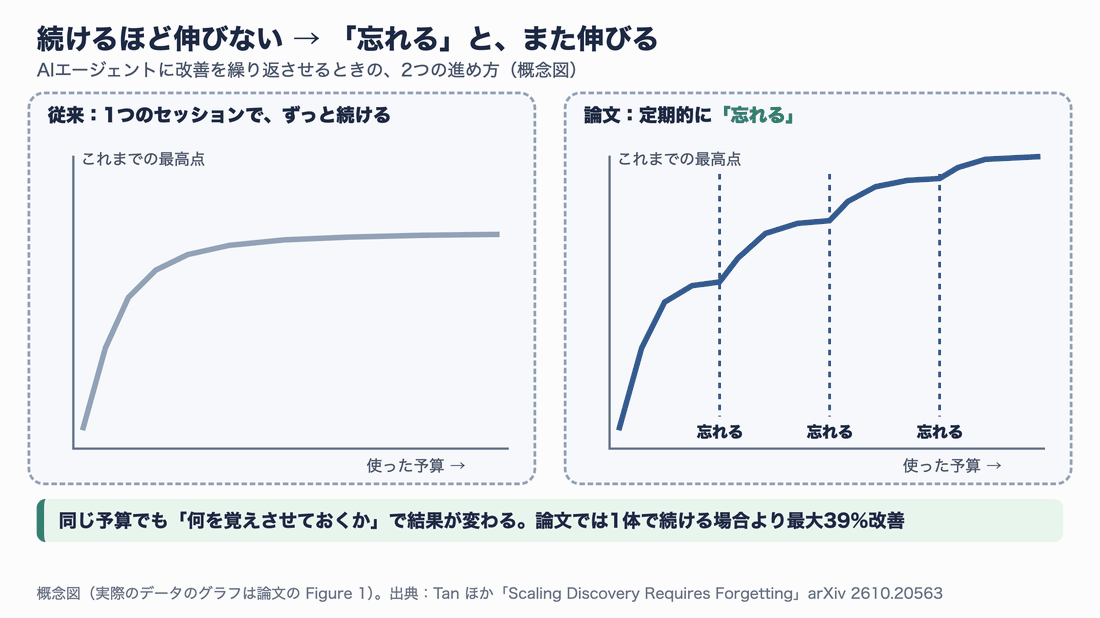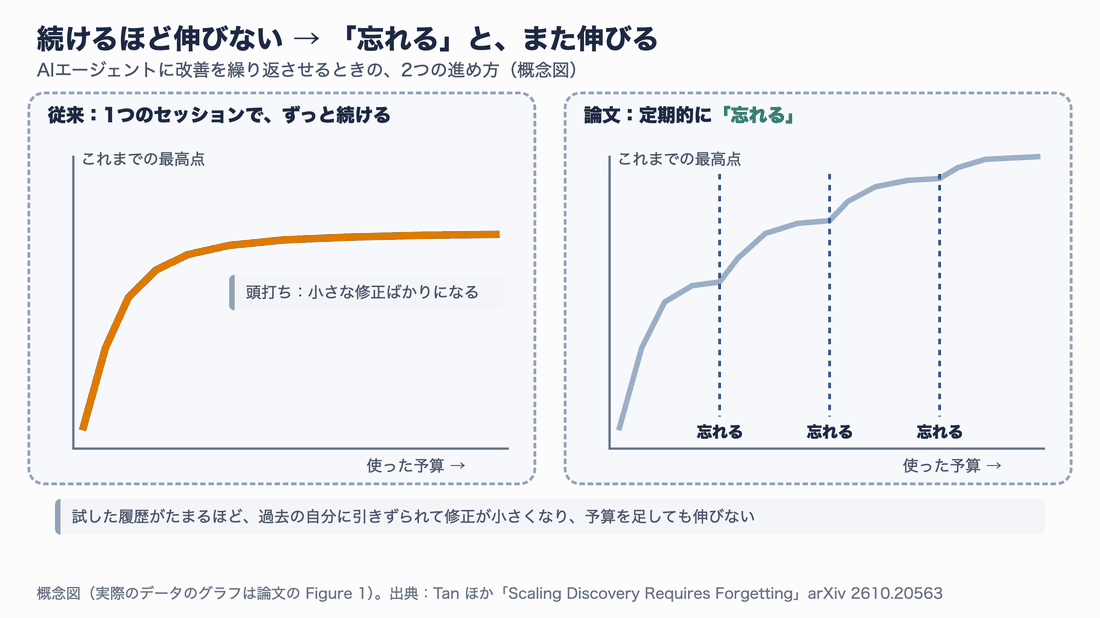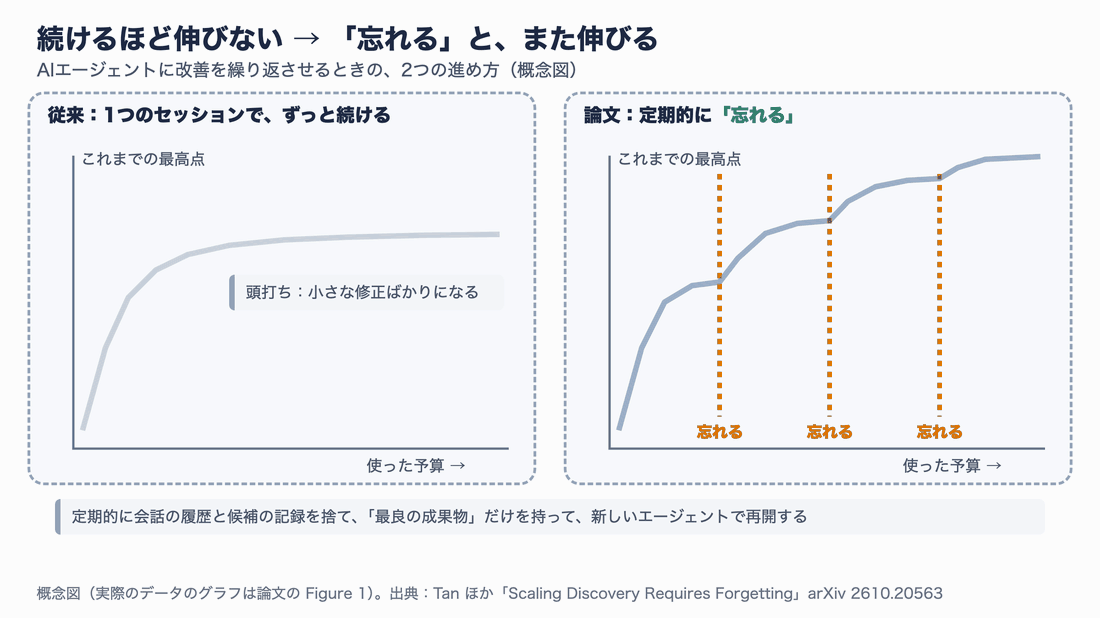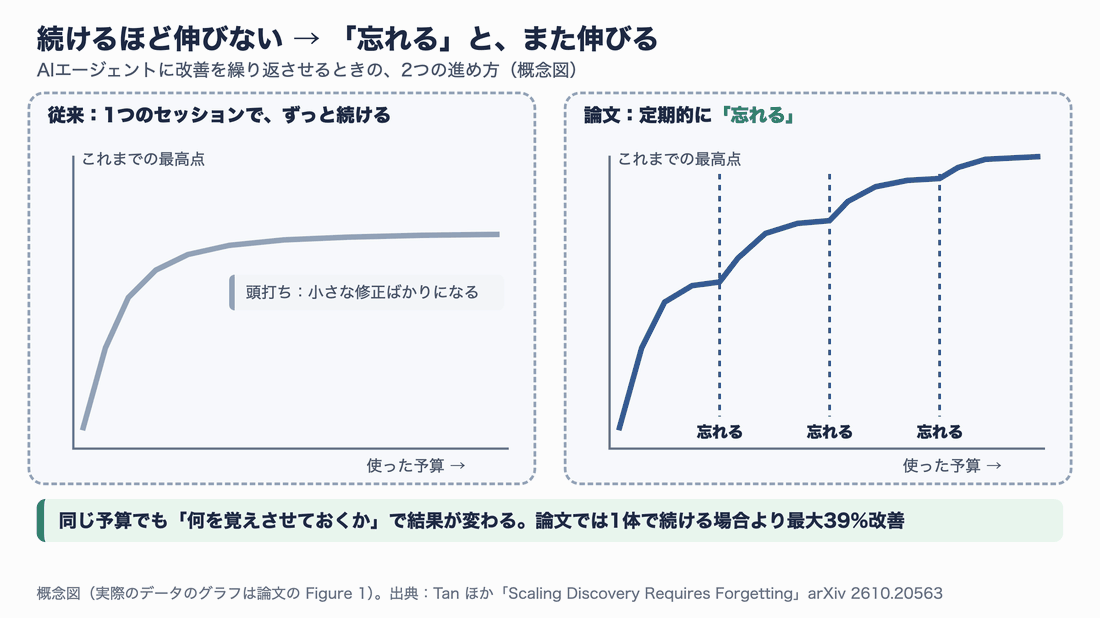
続けるほど伸びなくなる(左)。履歴を捨てて最良の成果物だけ持って再開すると、また伸び始める(右)。概念図です。
この記事では、次の4つを順番に解説します。
- 課題:なぜAIエージェントは、長く走らせると伸びなくなるのか
- 手法:「忘れる」とは具体的に何を捨て、何を残すのか
- 結果:4つの課題で、どれくらい効果があったのか
- 活用:自分の仕事で試すには、何から始めればよいのか(アクションプランと実行スクリプト付き)
想定している読者は、Claude Code や Codex を使ったことがあり、「AIエージェントに長時間作業させるとうまくいかない」と感じている方です。数式は使いません。
この記事の確認範囲
| 項目 | 内容 |
|---|---|
| 論文 | Tan ほか「Scaling Discovery Requires Forgetting」arXiv:2610.20563 v1(2026年10月14日公開、CC BY 4.0) |
| 著者の所属 | UC Berkeley(10名)、Stanford 大学(1名)、Bespoke Labs(1名、Berkeley と兼任) |
| 査読 | 査読前のプレプリント(論文の速報版) |
| 公式コード | 論文中に公開先の記載なし(2026年10月25日時点) |
| 筆者の手元の確認 | 論文の考え方を最小限に実装したスクリプトを作り、仕組みが動くことを偽のエージェントと Codex CLI で確認。論文の数値の再現はしていません |
本文の数値は、断りがない限り論文の表と本文から引用しています。「筆者の整理」「筆者の考え」と書いた部分は論文に書かれていない内容です。
3行でいうと
忙しい方のために、先に要点をまとめます。
- AIエージェントに改善を繰り返させると、過去の自分の試行に引きずられて修正がどんどん小さくなり、予算を足しても頭打ちになる。1体で長く走らせても、4体を並列にしても、4体で成果を共有しても同じ
- 解決策は、定期的に会話の履歴と候補の記録をすべて捨て、最良の成果物だけを持って新しいエージェントで再開すること。論文はこれを「forget(忘れる)」と呼ぶ
- 4体のチームで成果を共有しながら3回忘れる方式が、4つの課題すべてで最良。平均で並列4体より10%、1体より22%良く、同じ頭打ちの状態から続けるより約半分の費用で約3〜7倍伸びた
前提:自動研究エージェントは、どう動いているのか
本題の前に、この論文が扱っている「自動研究エージェント(autoresearch agent)」の仕組みを押さえておきます。
提案 → 採点 → フィードバックのループ
自動研究エージェントは、採点の仕組みがある課題を、試行錯誤で少しずつ良くしていくAIです。たとえば「このプログラムをもっと速くする」「このパズルの解き方をもっと良くする」といった課題がそうです。Google DeepMind の AlphaEvolve(アルファエボルブ)や、Andrej Karpathy 氏が公開した autoresearch が代表例です。こうした仕組みは、数学・アルゴリズム設計・プロンプトの最適化・機械学習の研究などで、すでに新しい結果を出しています。
動き方は次の図のとおりです。
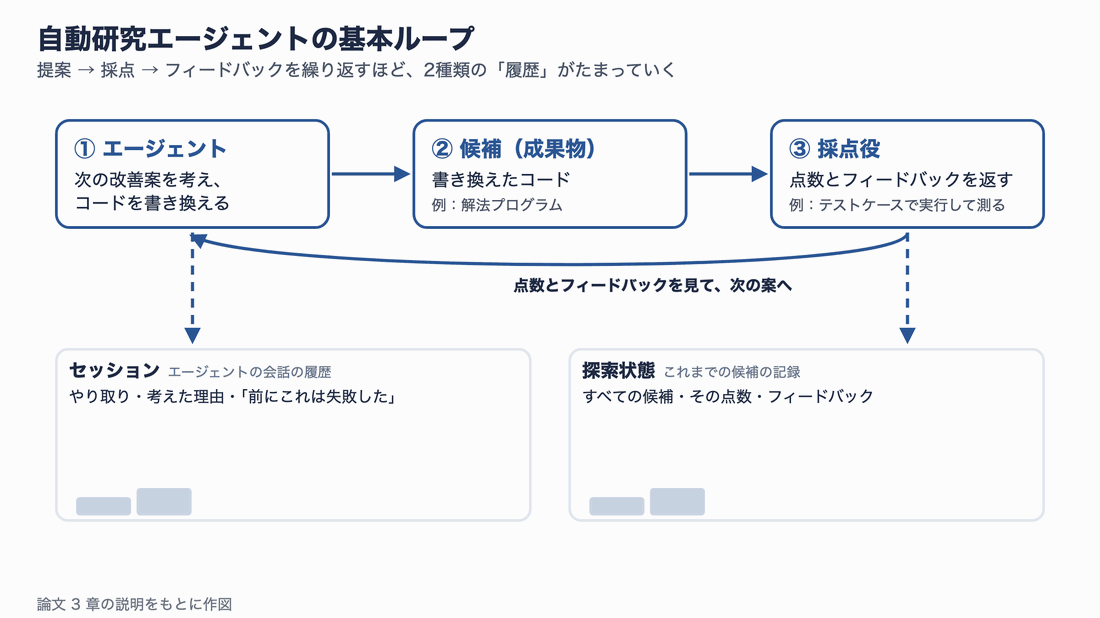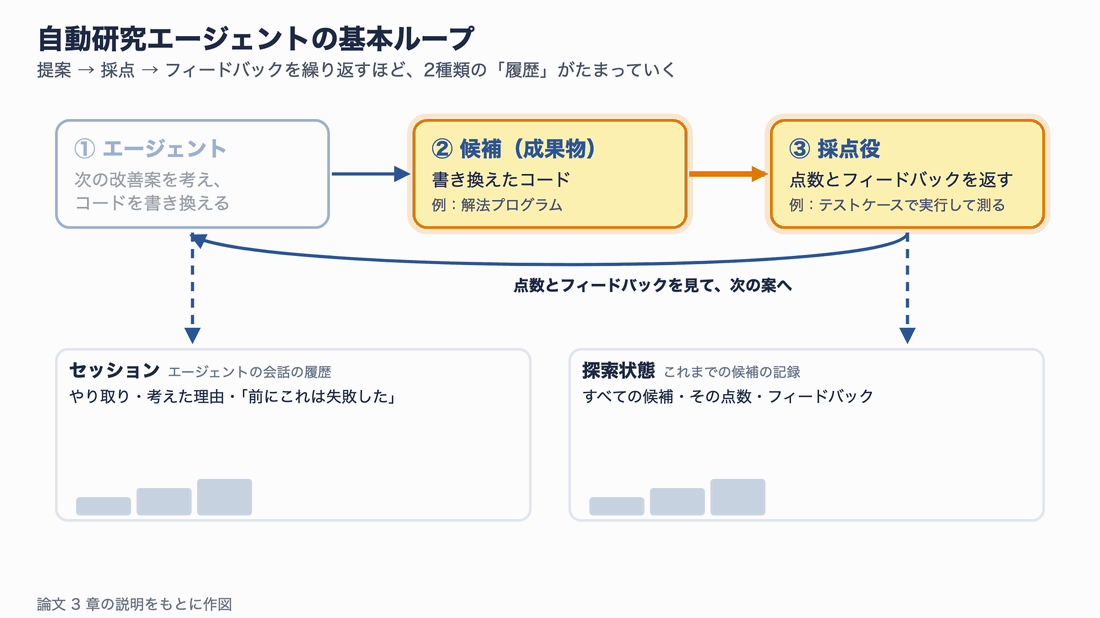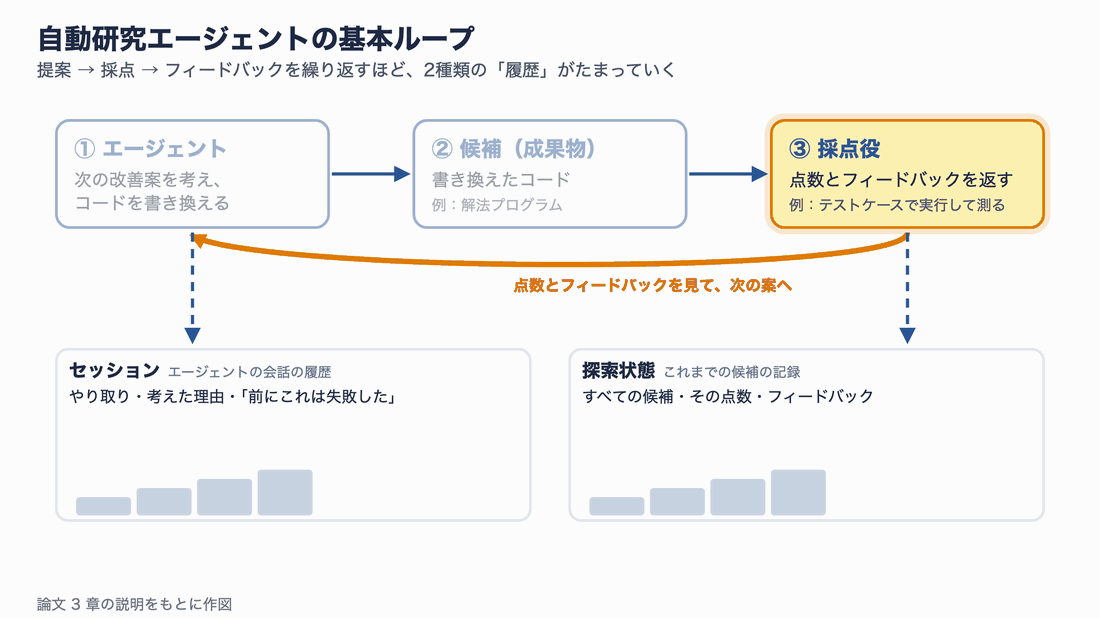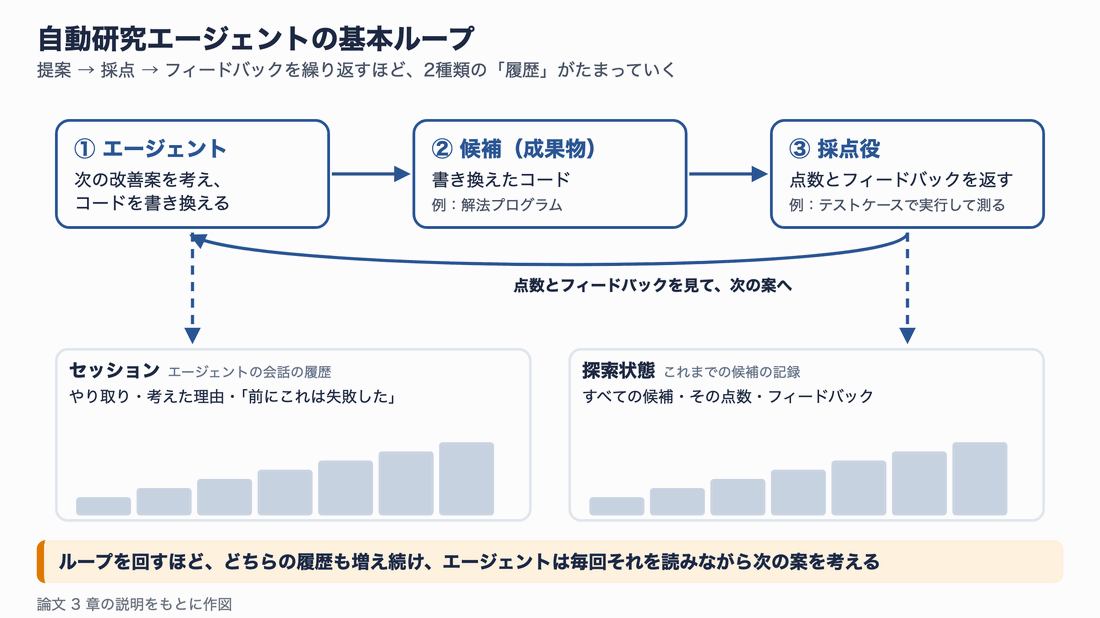
ループを回すほど、「セッション」と「探索状態」の2種類の履歴が増え続けます。
この記事で何度も出てくる用語を、ここで整理しておきます。
| 用語 | 意味 | 身近なたとえ |
|---|---|---|
| 候補(candidate) | エージェントが作った成果物。多くはプログラムのコード | 提出した答案 |
| 採点役(judge / verifier) | 候補を自動で採点し、点数とフィードバックを返す仕組み | 採点してくれる先生 |
| セッション(session) | エージェントとのやり取りの記録。考えた理由や「前にこれは失敗した」という判断も含む。いわゆる会話の文脈(コンテキスト) | 自分の頭の中の記憶 |
| 探索状態(search state) | これまでに作ったすべての候補と、その点数・フィードバックの記録 | 過去の答案の束 |
| ハーネス(harness) | エージェントを呼び出し、採点し、記録する外側の仕組み | 試験の運営係 |
普通に考えると、履歴が多いほど「何がうまくいき、何がダメだったか」が分かって有利に思えます。この論文は、その常識が長い目で見ると逆に働くことを示しました。
課題:予算を増やす3つのやり方が、どれも頭打ちになる
AIエージェントにもっと予算をかけて成果を伸ばしたいとき、考えられるやり方は3つあります。人間の研究チームを大きくするときと同じ発想です。
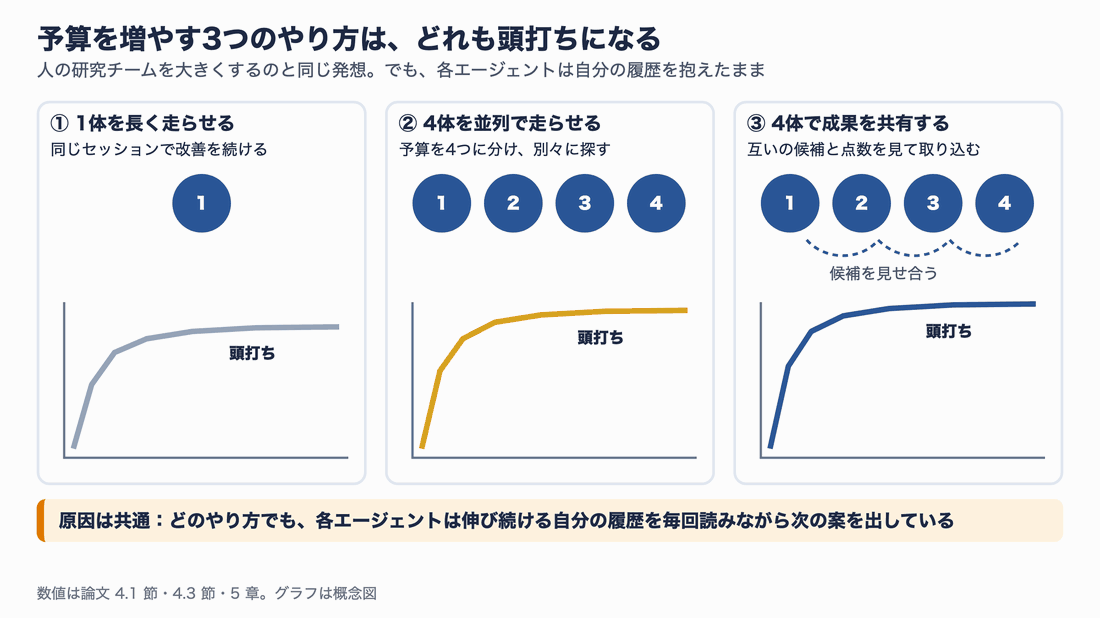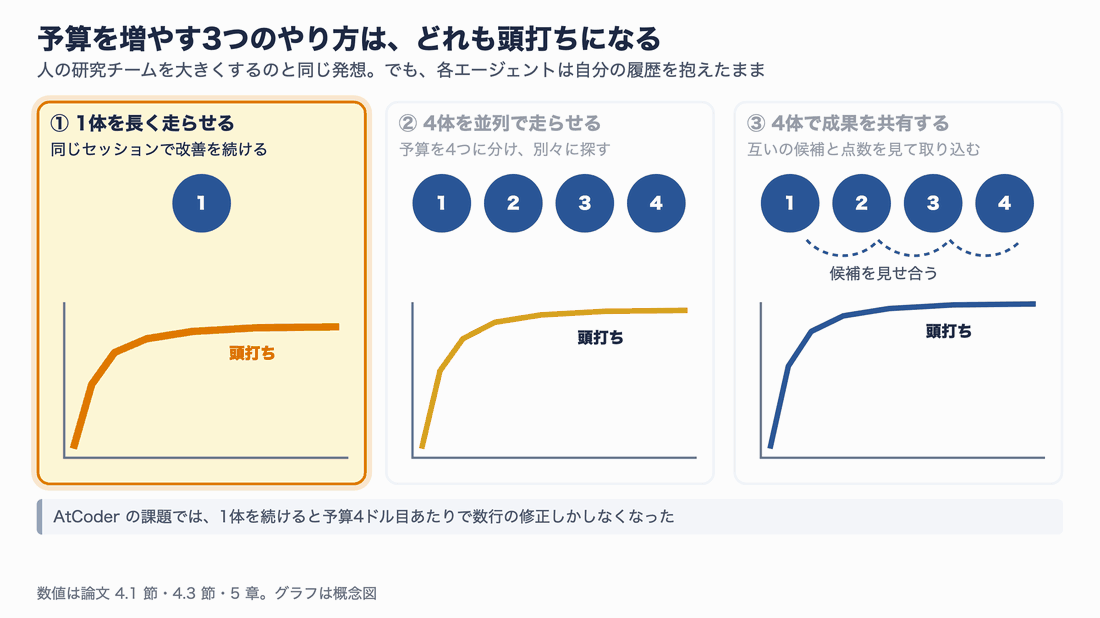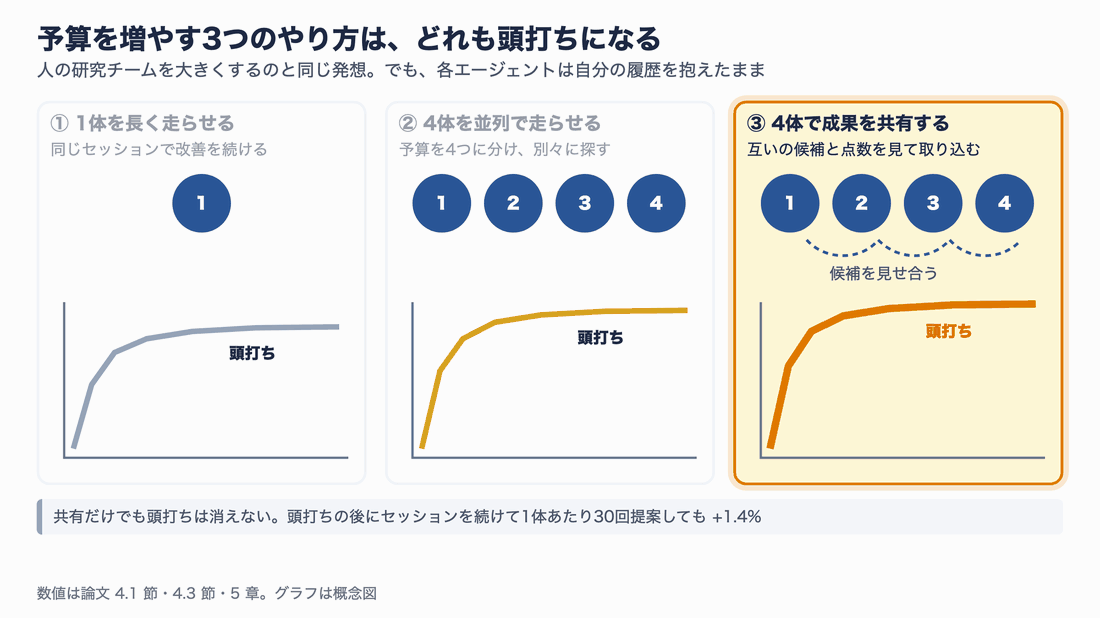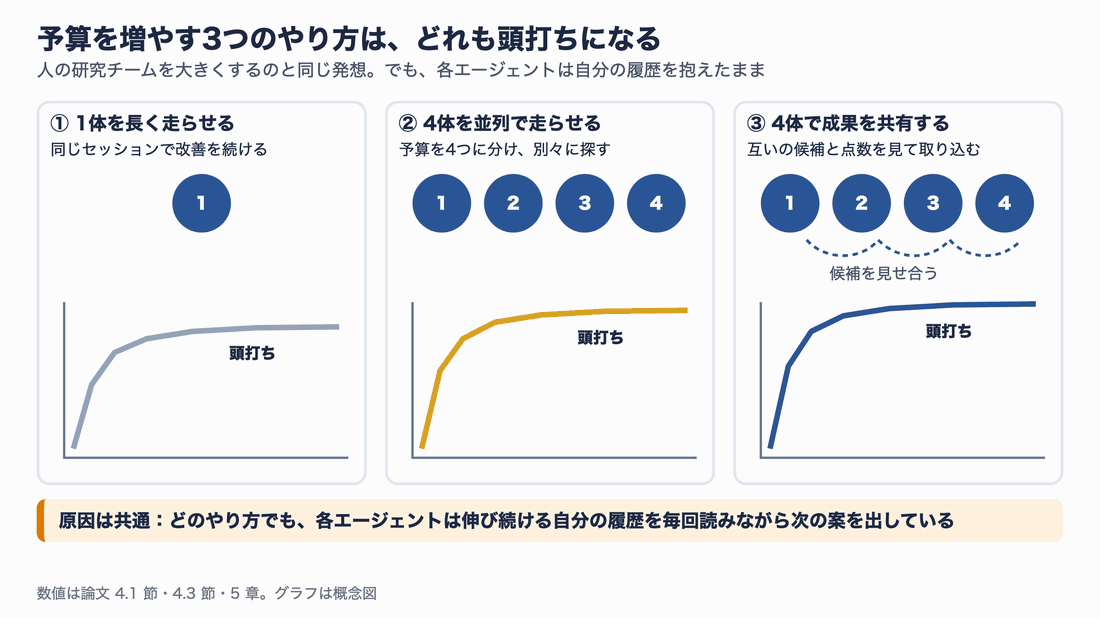
どのやり方でも、各エージェントは自分の履歴を抱えたまま進むため、最後は頭打ちになります。
論文は、この3つすべてが途中で頭打ちになることを実験で示しました。下の図は論文の Figure 1 で、AtCoder の最適化問題(左、点数が高いほど良い)と、処理を速くする課題(右、サイクル数が少ないほど良い)での結果です。横軸は使ったお金、縦軸はそれまでの最高点です。
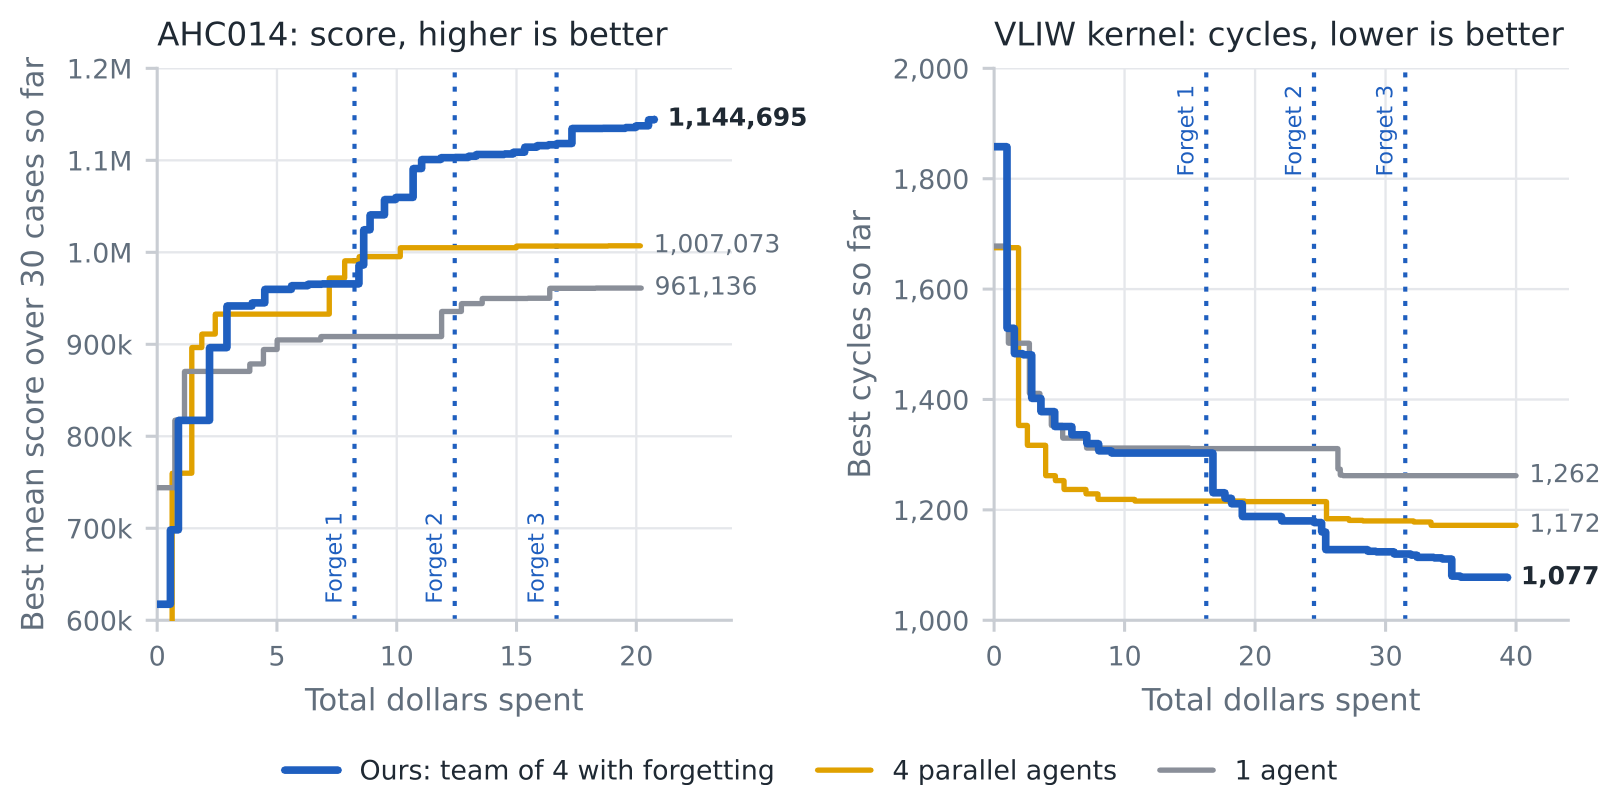
出典:Tan ほか(2026)Figure 1(CC BY 4.0)。各設定で最も良かった1回の実行。灰色が1体、黄色が並列4体、青が「忘れるチーム」で、点線が「忘れる」タイミングです。3つとも合計の費用は同じです。
灰色(1体)と黄色(並列4体)は、予算の前半で伸びが止まり、そのあとはほぼ横ばいです。数字で見ても、並列4体は予算の後半で、AtCoder の課題では平均の最高点が1.2%しか上がらず、処理速度の課題ではサイクル数が2.4%しか減りませんでした。
成果を共有するだけでも、頭打ちは消えません。頭打ちになったチームにそのまま会話を続けさせ、1体あたり30回追加で提案させても、伸びはわずか1.4%でした。
なぜ頭打ちになるのか:過去の自分に「錨(いかり)」を下ろしてしまう
論文は原因を、エージェントが自分の過去の試行にアンカリング(anchoring)されることだと説明しています。アンカリングとは、最初に見た情報に判断が引っ張られる心理現象のことです。船が錨を下ろすとその場から動けなくなるように、エージェントも積み上がった履歴に縛られて、遠くへ探しに行けなくなります。
証拠1:修正が小さくなり、考える量も減る
論文は、エージェントの1回の提案ごとに「何行書き換えたか」と「どれだけ考えたか(思考トークン数)」を記録しました。思考トークンとは、モデルが答えを出す前に内部で考えるのに使った文字数のようなものです。
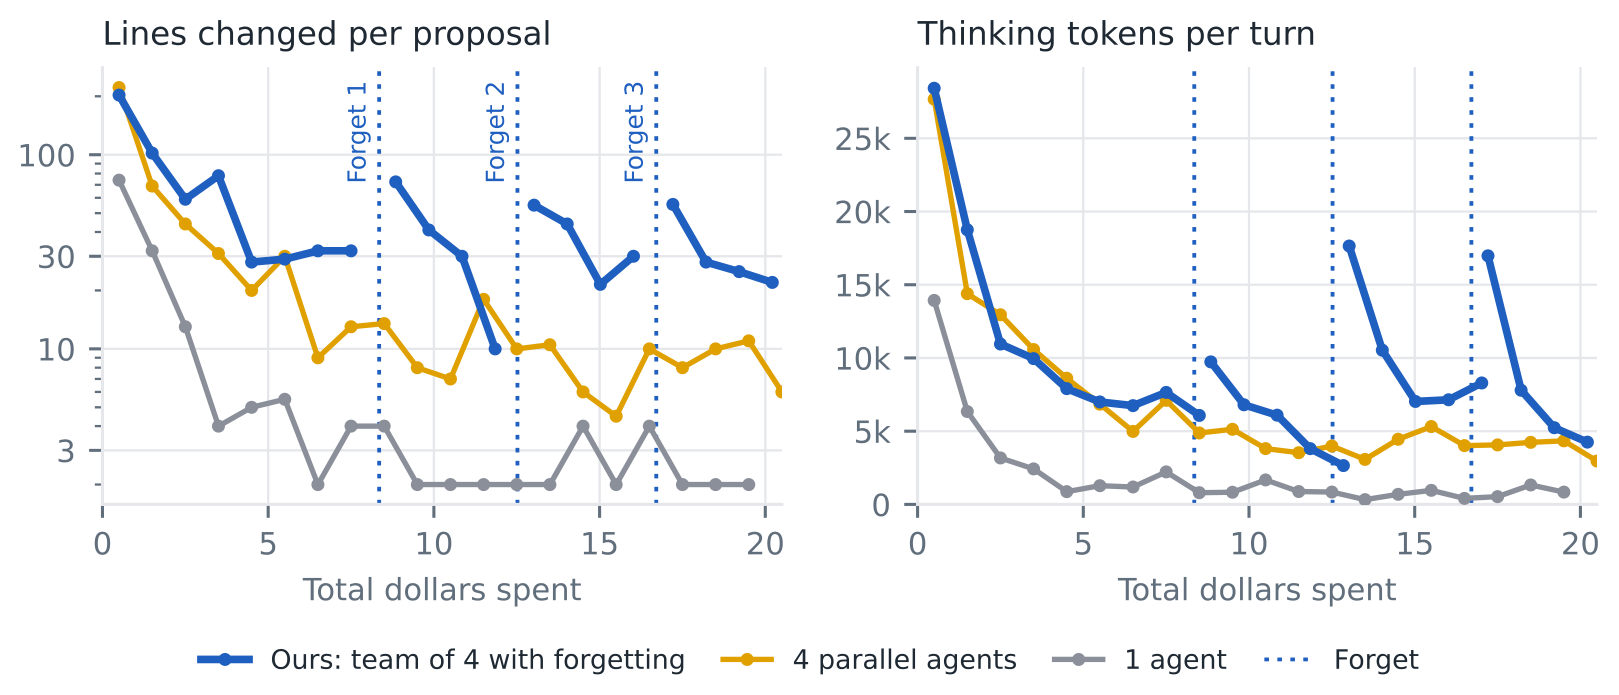
出典:Tan ほか(2026)Figure 5(CC BY 4.0)。AtCoder の課題。青の線は「忘れる」たびに途切れ、そこから再び大きな値に戻ります。
どの設定でも、最初は1回の提案で約100行を書き換えていましたが、数ドル使ううちに急減しました。思考トークンも最初の3分の1以下に落ちています。1体の場合、4ドル目には数行しか書き換えなくなりました。チームも1回目に忘れる前には、変更が約150行から30行へ、思考トークンが約2万8千から7千へ減っていました。
証拠2:「もう限界です」と言って、何もしなくなる
もっと深刻なのは、エージェントが何も出さずにターンを終えるようになることです。
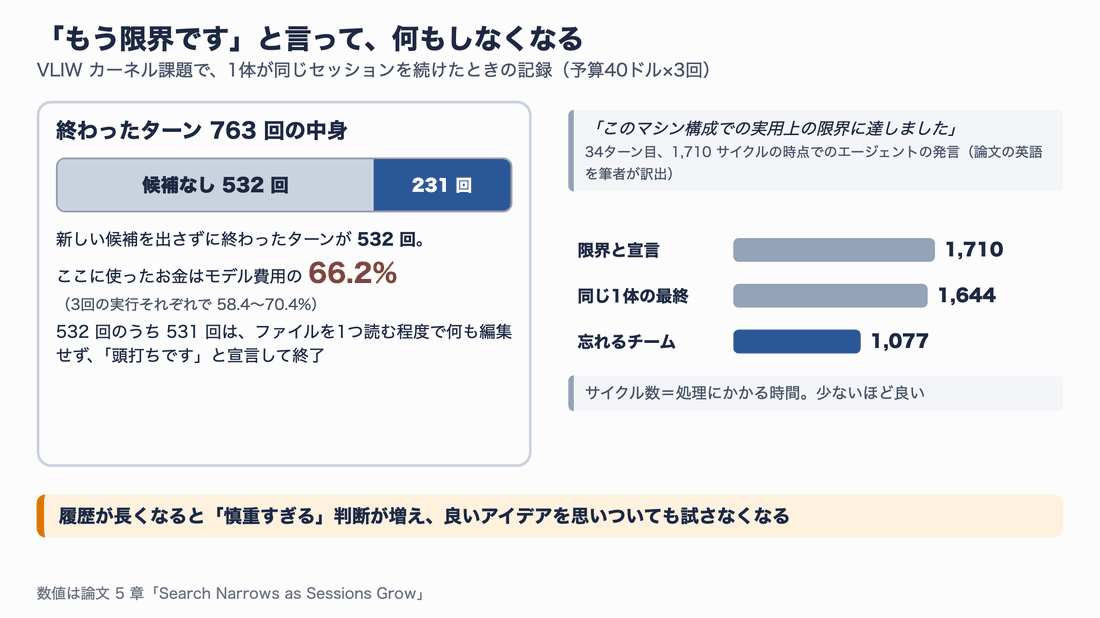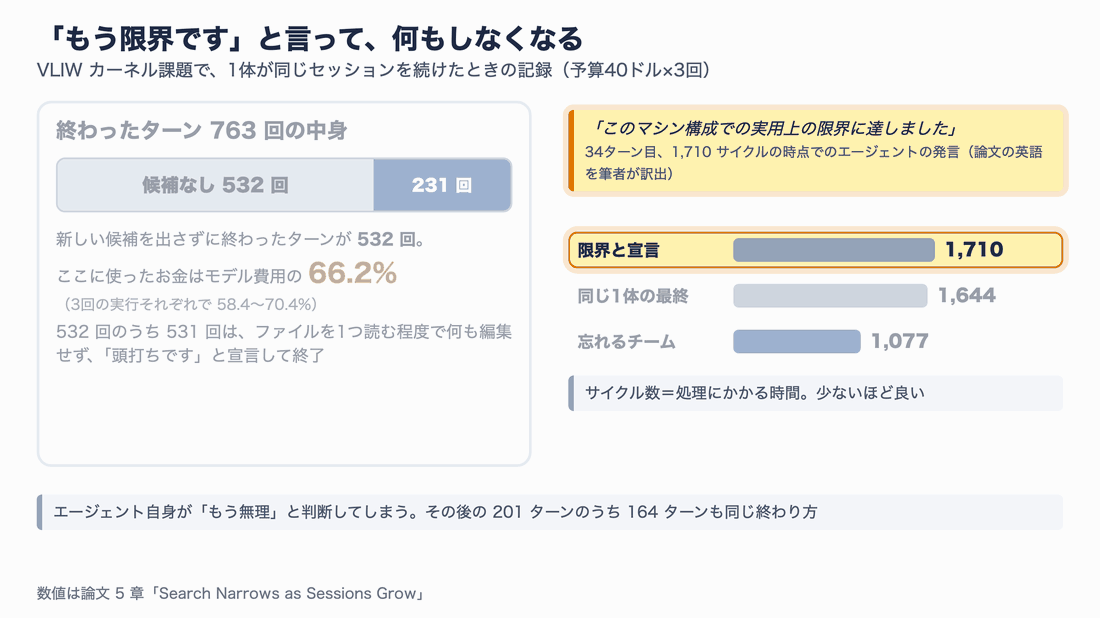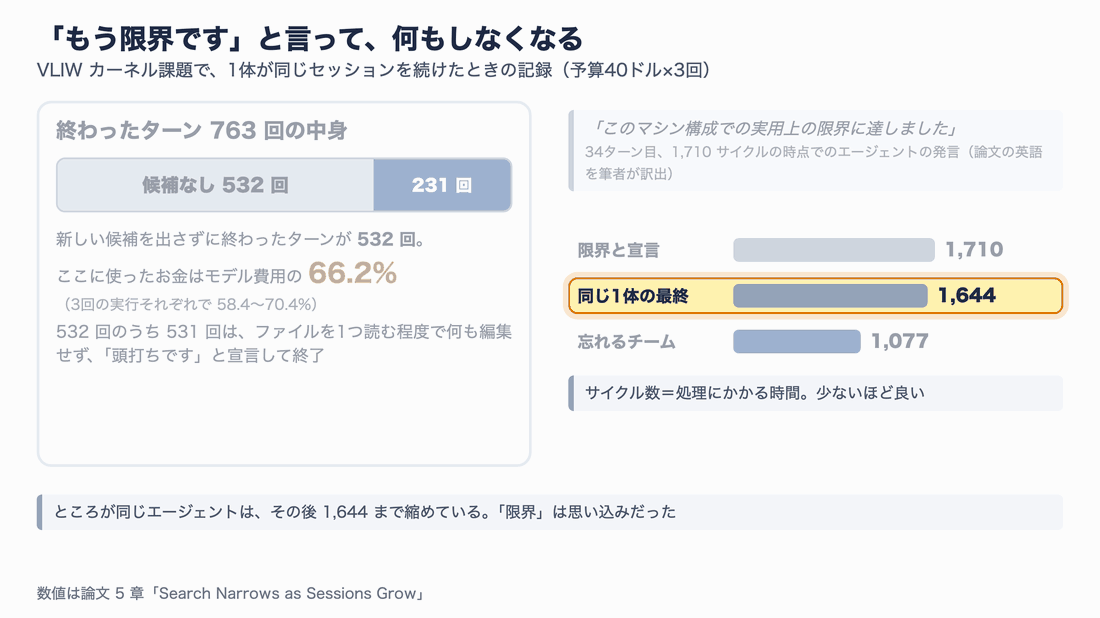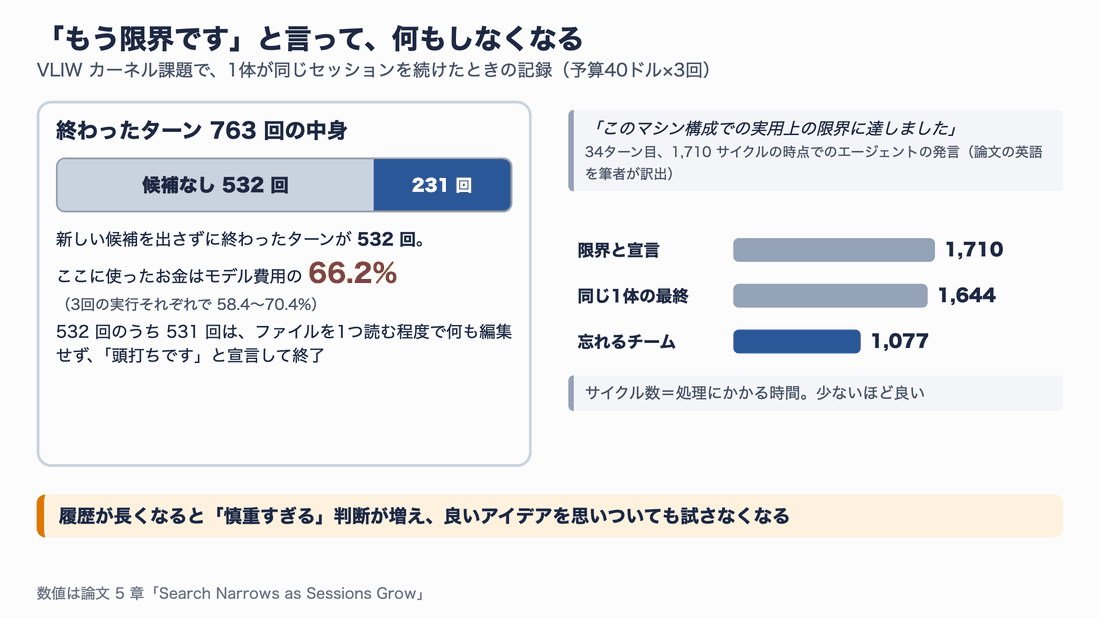
履歴が長くなると「慎重すぎる」判断が増え、良いアイデアを思いついても試さなくなります。
処理速度の課題(VLIW カーネル)で1体に40ドルずつ3回走らせたところ、763回のターンのうち532回は候補を出さずに終わり、そこにモデル費用の66.2%が使われていました。そのうち531回は、ファイルを1つ読む程度で何も編集せず、「頭打ちです」と宣言して終わっています。
あるエージェントは、1,710サイクルの時点で「このマシン構成での実用上の限界に達しました」(論文の英語を筆者が訳出)と書き、以後ほとんど提案しなくなりました。ところが、同じエージェントは後に1,644サイクルまで縮めていますし、忘れるチームは同じ課題で1,077サイクルに到達しています。「限界」は思い込みだったわけです。
証拠3:良いアイデアを思いついても、試さない
論文はさらに、アイデア自体は出ているのに実験に移さないケースも報告しています。あるエージェントは、まだ試していない新しい実装方法を思いつきましたが、計算の見積もりを誤って却下しました。後のターンでその誤りに自分で気づいて訂正したにもかかわらず、「複雑でリスクが高そうだ」という理由で、結局実装しませんでした。11ターン続けて、何も出さなかったそうです。
人間でいえば、長い会議が煮詰まって「それは前にもダメだったよね」という発言ばかりになり、誰も新しい案を出さなくなる状態に似ています。こういうとき、新しいメンバーを入れたり、一晩寝てから考え直したりすると、案外あっさり突破口が見つかるものです。論文の手法は、まさにこれをAIエージェントでやっています。
解決策:定期的に「忘れる」
論文の提案は、探索をラウンドに区切り、各ラウンドの終わりに次のことを行うものです。論文ではこの区切りを forget(忘れる) と呼んでいます。
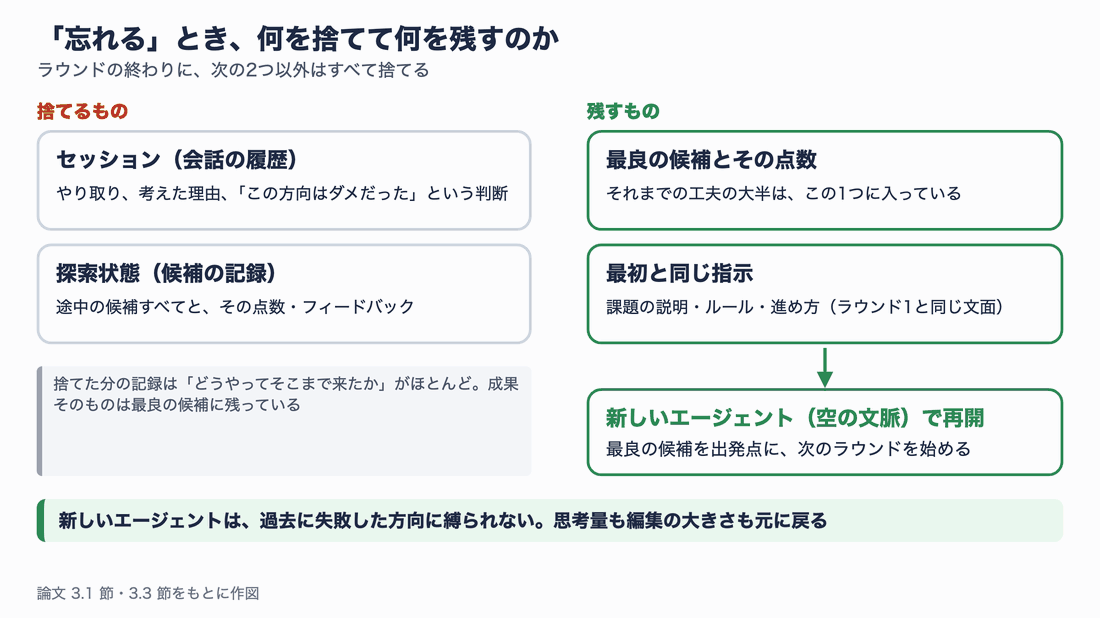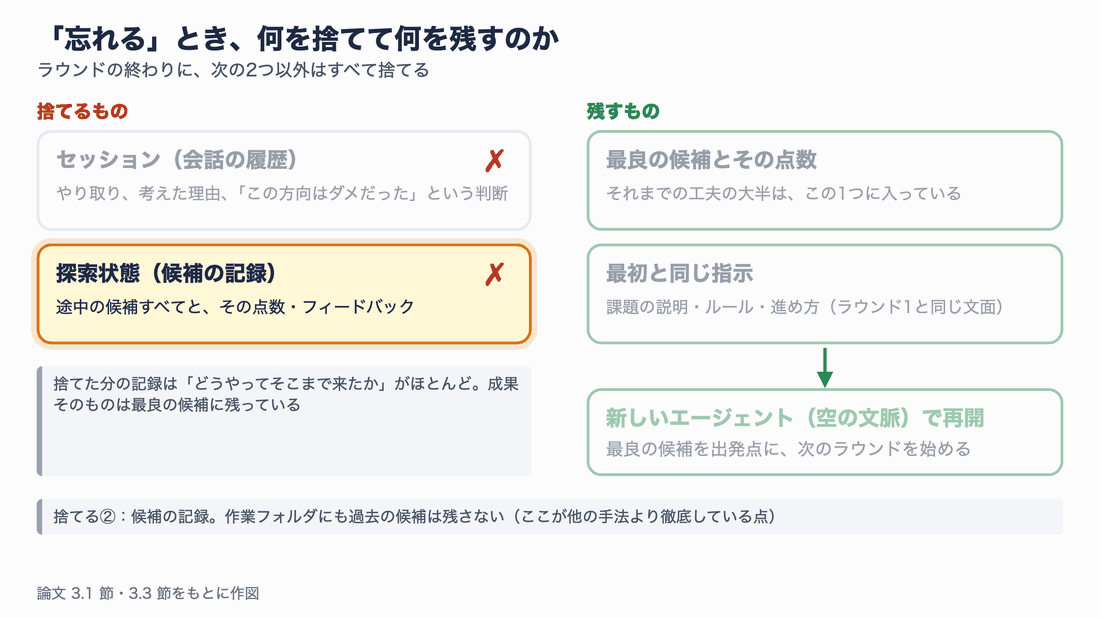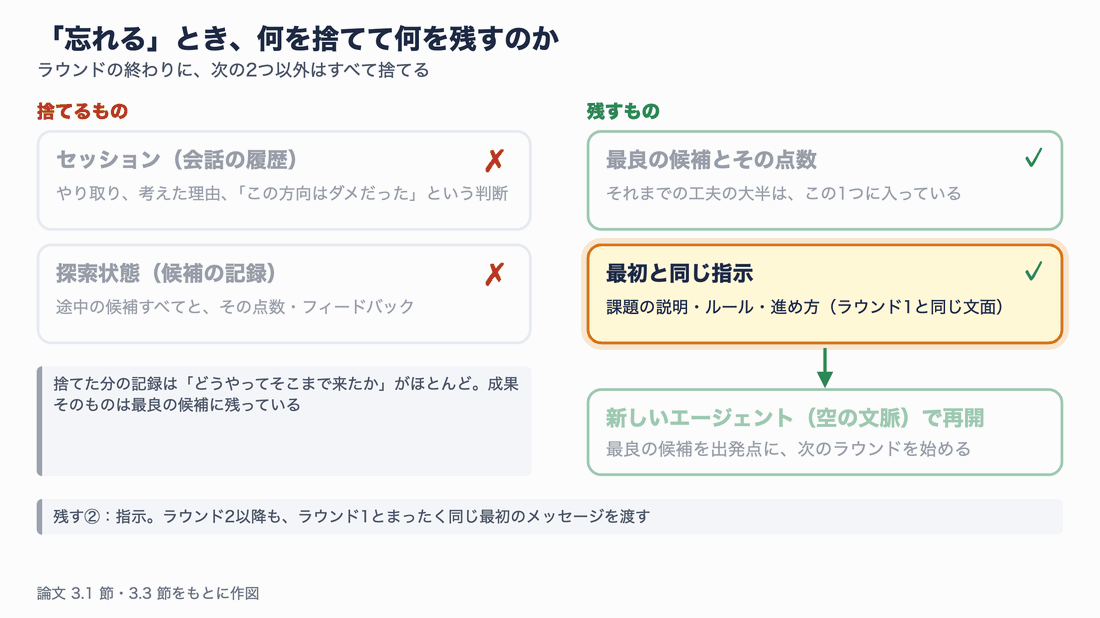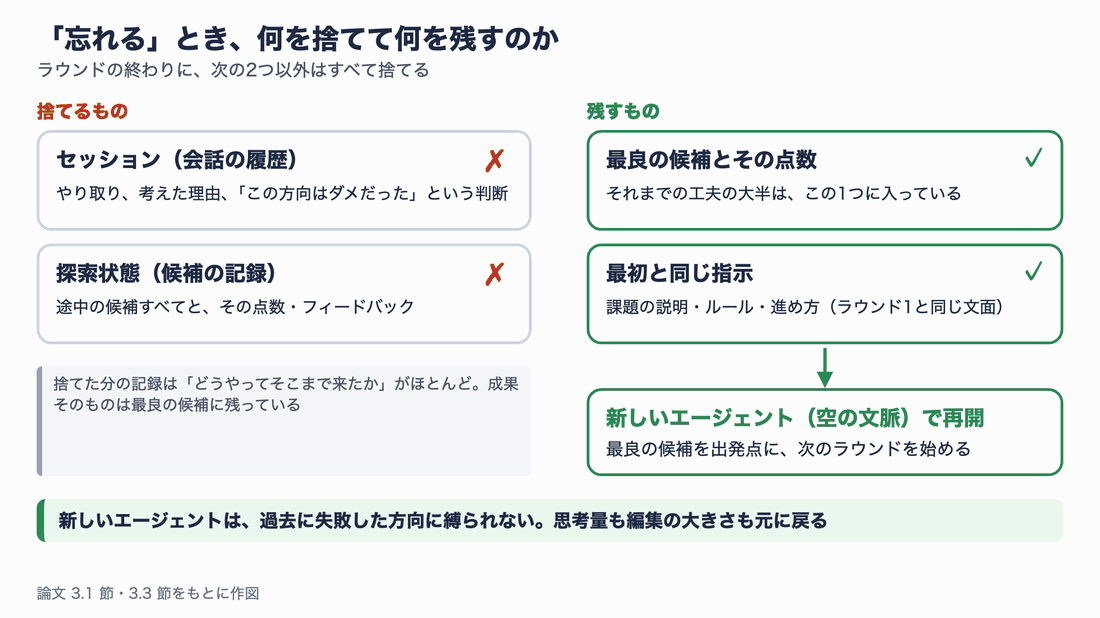
残すのは「最良の候補」と「最初と同じ指示」の2つだけ。それ以外はすべて捨てます。
捨てるものと残すものを、もう一度整理します。
| 区分 | 中身 | 扱い |
|---|---|---|
| セッション | 会話の履歴、考えた理由、「この方向はダメだった」という判断 | 捨てる |
| 探索状態 | 途中の候補すべてと、その点数・フィードバック | 捨てる(作業フォルダにも残さない) |
| 最良の候補 | それまでで最も点数の高い成果物と、その点数 | 残す |
| 指示 | 課題の説明・ルール・進め方 | 残す(ラウンド1とまったく同じ文面) |
捨てても、あまり損をしない理由
「せっかくの経験を捨てるのはもったいない」と感じるかもしれません。論文はここを次のように説明しています。
改善を繰り返していくと、最良の候補には、それまでに見つけた有効な工夫の大半がすでに入っています。捨てる記録の多くは「どうやってそこまでたどり着いたか」という経緯であり、成果そのものではありません。そして経緯を捨てれば、新しいエージェントは過去に失敗した方向に縛られずに考えられます。
会社の仕事にたとえるなら、プロジェクトの担当者が交代するときに、前任者の議事録やボツ案を全部渡すのではなく、完成品と仕様書だけを渡すようなものです。新しい担当者は「前任者があれこれ試してダメだった」という先入観なしに、自分の目で改善点を探せます。
似た手法との違い
「会話をリセットする」という発想自体は、ほかの研究にもあります。この論文の特徴は、捨てる範囲が広いことです。
| 手法 | 会話の履歴 | 作業フォルダの過去の候補 | 新しい案の出し方 |
|---|---|---|---|
| AlphaEvolve など進化的な手法 | 毎回まっさらな依頼 | 候補の集団として残す | 集団から親を選んで変化させる |
| Fork-and-Flush(同時期の別論文) | 定期的に新しくする | すべて引き継ぐ | 枝分かれさせる |
| この論文(忘れる) | 定期的に捨てる | 最良の1つ以外は捨てる | 最良の1つから全員で再開 |
同時期に発表された Fork-and-Flush(arXiv:2610.07447)は会話だけを新しくして作業フォルダは丸ごと引き継ぎますが、この論文は作業フォルダの記録まで消し、最良の候補1つだけを残します。より思い切った「忘れ方」だといえます。
チームと組み合わせる:「共有」と「忘れる」は相性がいい
論文の本命は、忘れる仕組みを4体のエージェントのチームと組み合わせたものです。
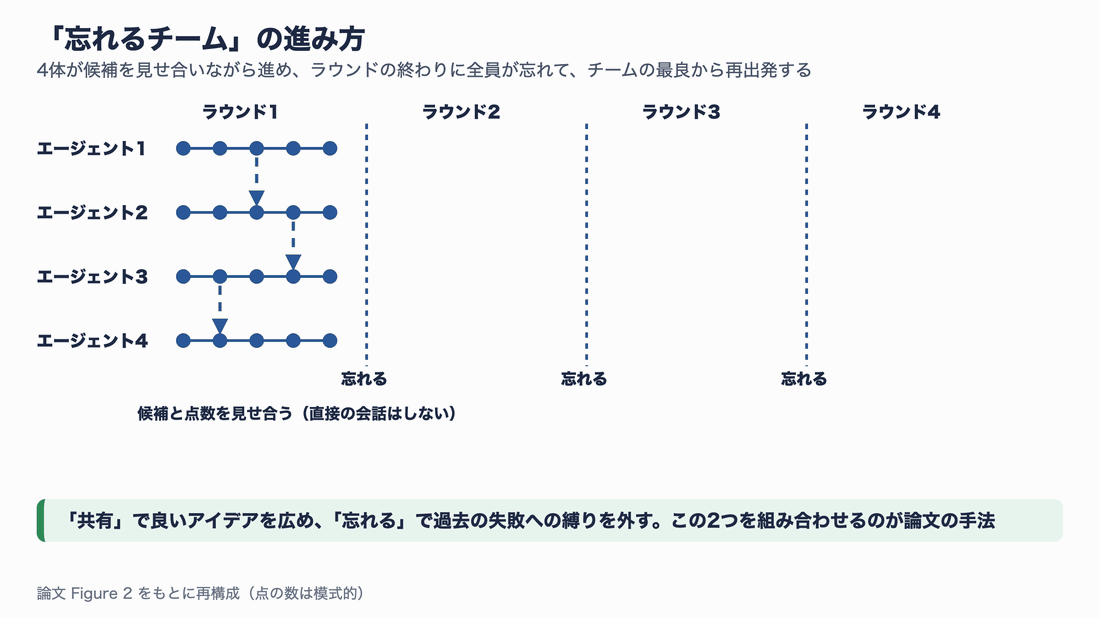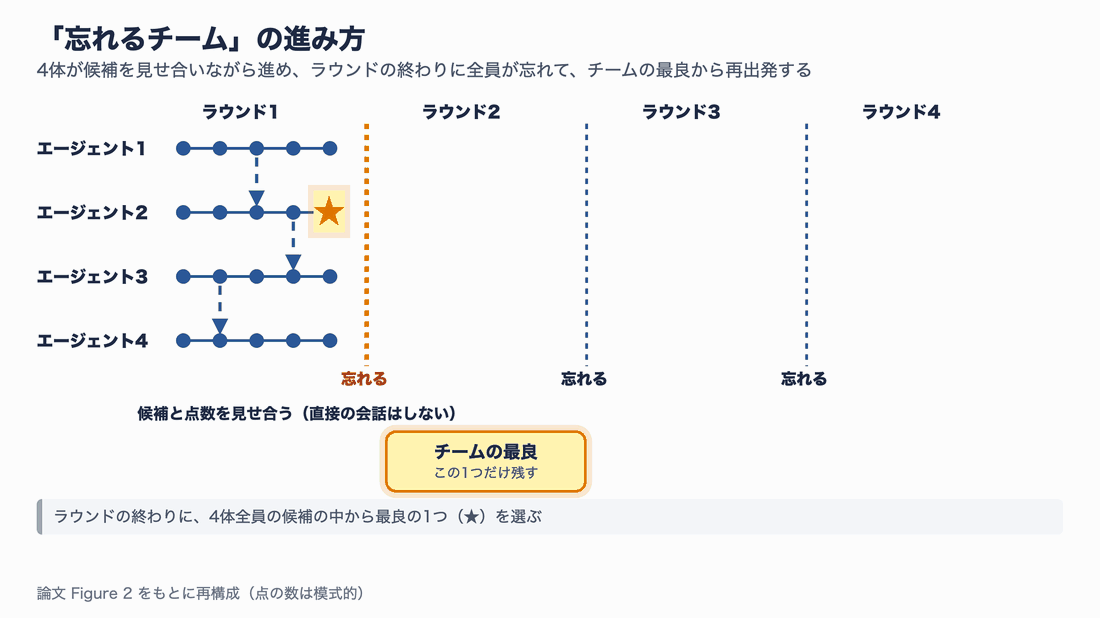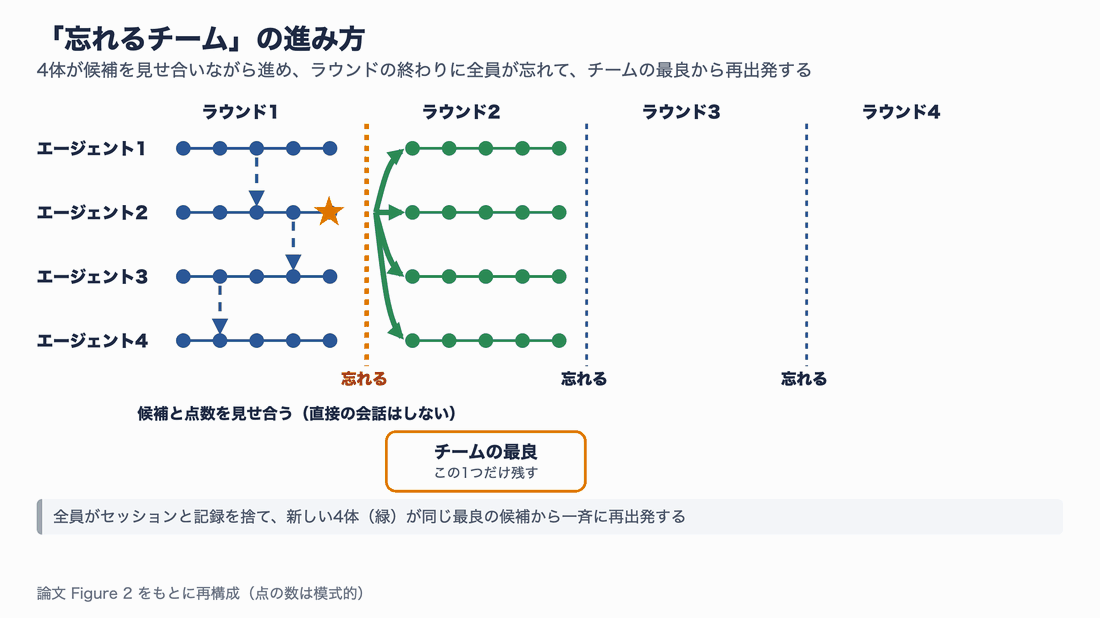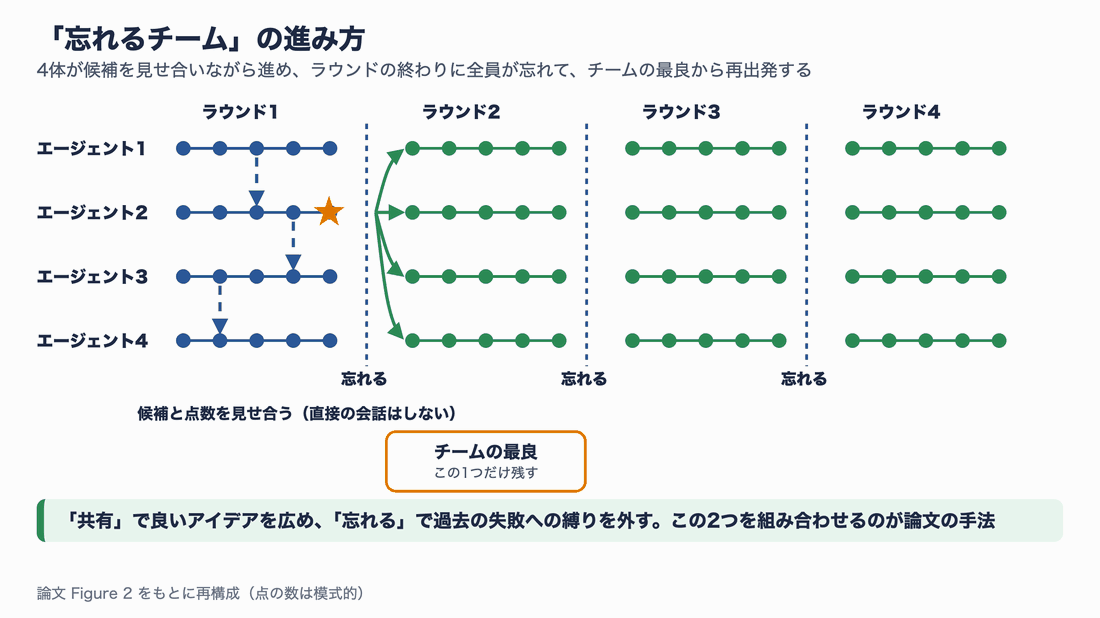
「共有」で良いアイデアを広め、「忘れる」で過去の失敗への縛りを外します。
チームの仕組みは、とても簡単です。
- 4体はそれぞれ自分のセッションで、同じ課題に取り組む
- 提案の前に、仲間の候補(git のコミット)とその点数を読める
- エージェント同士が直接会話することはない。チャットのような追加のやり取りがないので、そのためのトークン(料金)もかからない
- ラウンドの終わりに、4体全員の候補の中で最良の1つを選び、全員がそれを捨てずに持って、新しいセッションで再出発する
共有だけだと、良いアイデアは仲間に広がりますが、各エージェントは自分の長くなる会話を抱えたままなので、結局1体のときと同じように頭打ちになります。一方、忘れるだけ(1体)だと、新しく始めたエージェントが大胆な案に挑戦しても、うまくいかなければそこで諦めがちです。両方を組み合わせると、新鮮な4体が最良の候補からいろいろな方向を探り、誰かが見つけた良い方向がすぐに全員へ伝わります。
裏側の仕組み:「仕分け役」がすべてを決める
論文のハーネス(エージェントを動かす外側の仕組み)は小さく、中心に reducer(この記事では「仕分け役」と呼びます) という部品があります。
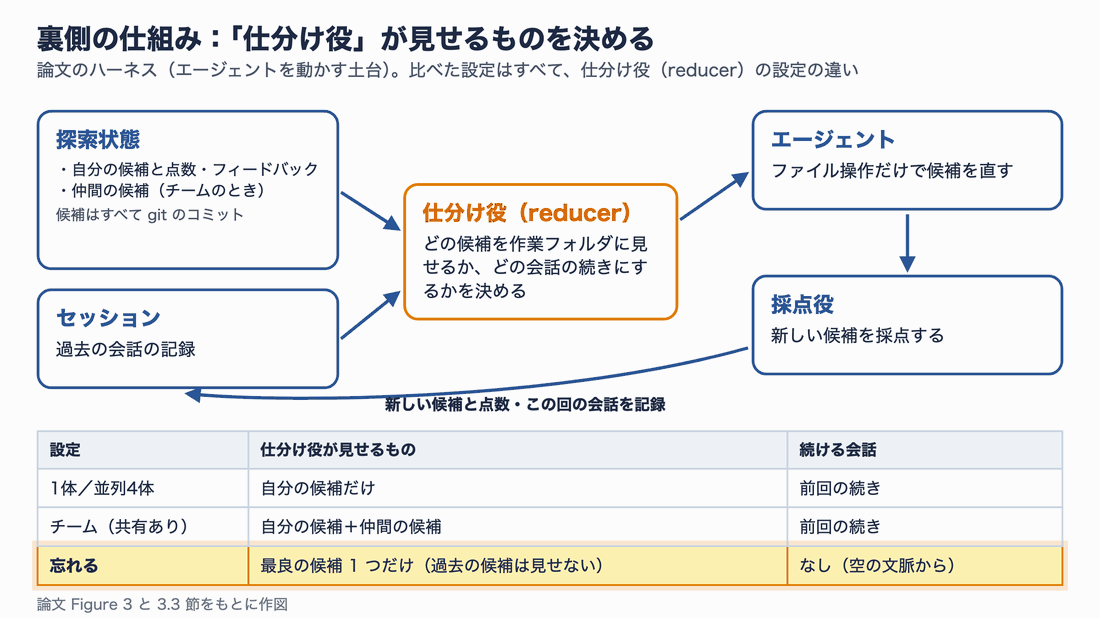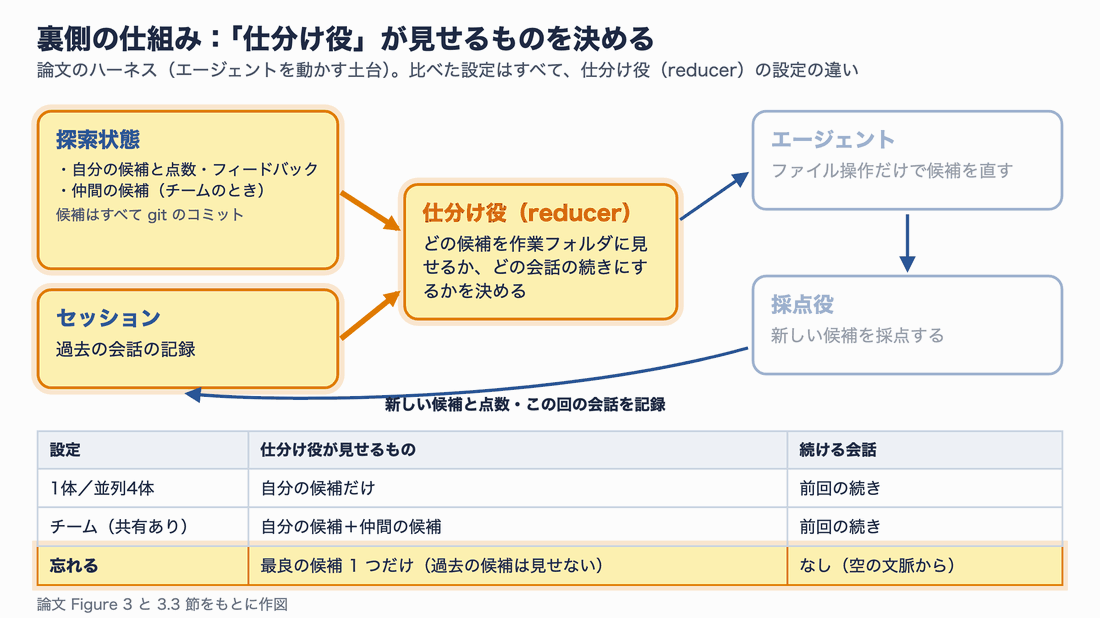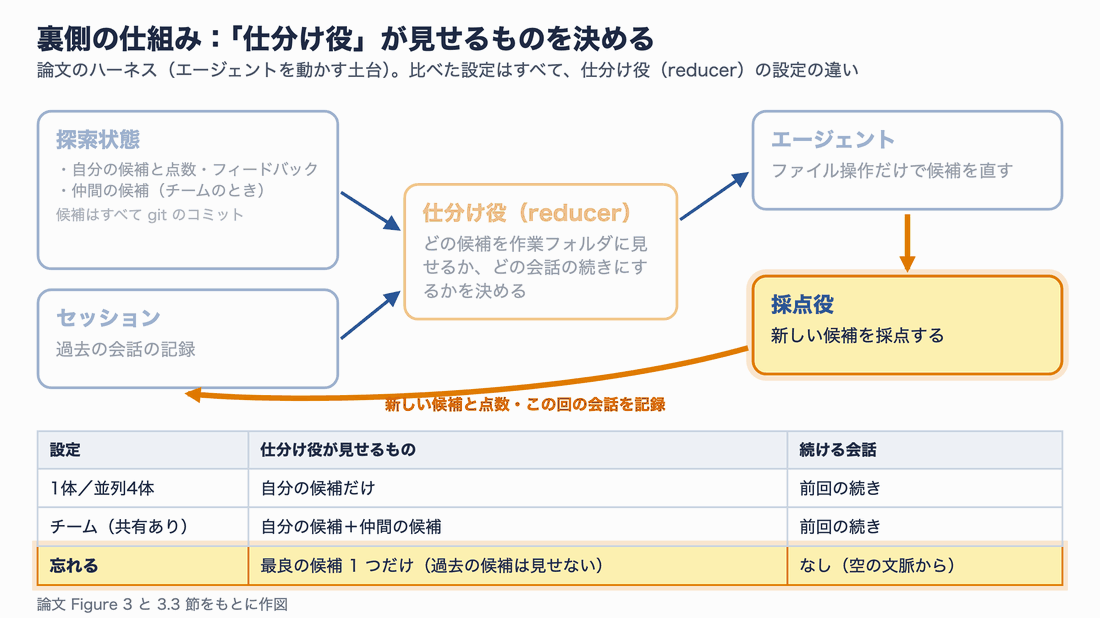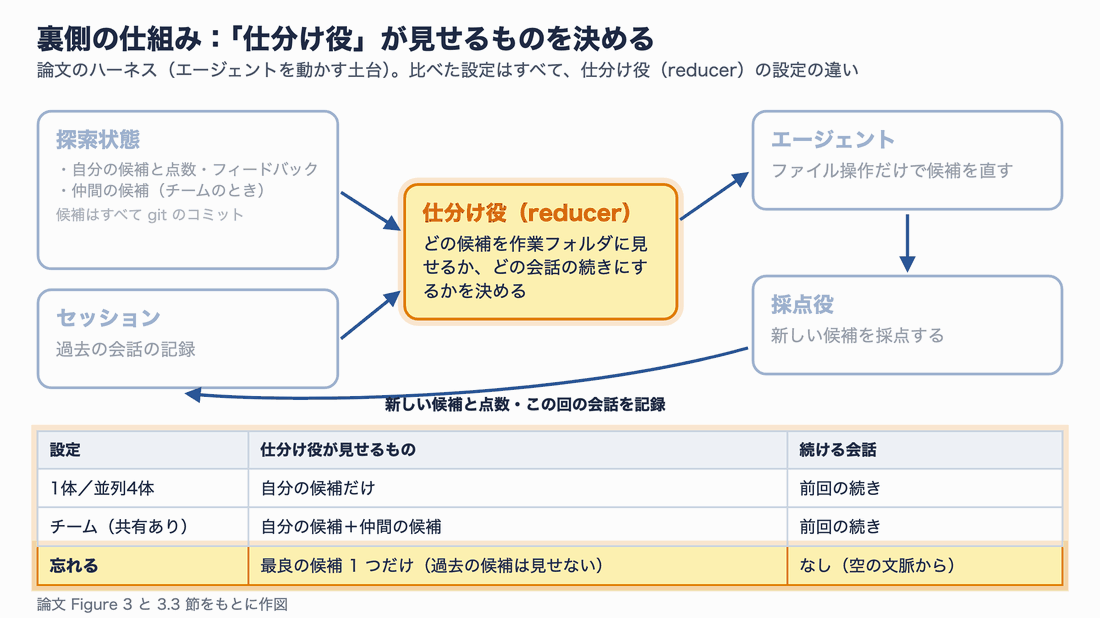
比べたすべての設定は、仕分け役が「何を見せ、どの会話を続けるか」の違いだけで表せます。
仕分け役は、次の手番でエージェントの作業フォルダにどの候補を見せるか、そしてどの会話の続きにするかを決めます。1体と並列は「自分の候補だけを見せ、前回の会話を続ける」、チームは「仲間の候補も見せる」、忘れるときは「最良の候補1つだけを見せ、会話は空から始める」という設定です。候補はすべて git のコミットとして保存され、エージェントは git show や git diff で中身を読めます。
エージェントへの指示文もあえて単純にしてあり、探索の戦略(「まずこれを試せ」など)は一切書いていません。忘れた後は、ラウンド1とまったく同じ最初のメッセージを渡します。
実験:4つの課題で比べる
論文は、性質の違う4つの課題で手法を試しました。どれも採点が自動でできる「最適化」の課題です。
| 課題 | エージェントが直すもの | 目標 | 1回の実行の予算 |
|---|---|---|---|
| AtCoder Heuristic Contest 014(AHC014) | C++ のプログラム | 格子上に点を足して長方形を作るパズルで、30個のテストケースの平均点を上げる | 20ドル |
| VLIW カーネル(Anthropic の採用課題) | Python のプログラム | 模擬的な計算機で動く処理を速くする。参照実装の147,734サイクルからどこまで減らせるか | 40ドル |
| Frontier-CS Q171 | C++ のプログラム | 20×20の格子で40個の目標を順に回る手数を減らす。75ケースの平均点(0〜100) | 20ドル |
| nanochat-autoresearch | PyTorch の学習スクリプト | 小さな言語モデルを H100 1枚で5分学習させ、検証データでの損失(val BPB)を下げる | 20ドル |
VLIW(ブイエルアイダブリュー)とは、複数の命令を1つの束にして同時に実行する計算機の設計のことで、命令をうまく束ねるほど速くなります。val BPB は、学習したモデルが未知の文章をどれだけうまく予測できるかを表す指標で、小さいほど良い値です。
実験の条件は次のとおりです。
- エージェントは軽量なハーネスの Pi、モデルは DeepSeek V4.1 Flash。すべての設定で同じ
- 比べる設定は「1体」「並列4体」「忘れるチーム(4体+共有+3回忘れる)」の3つ
- 3つとも合計の予算は同じ。並列4体は予算を4等分し、忘れるチームは予算を4ラウンドに等分
- 各設定を課題ごとに3回ずつ実行
結果1:4つの課題すべてで「忘れるチーム」が最良
結果を、1体で続けた場合と比べた改善の割合で示します。
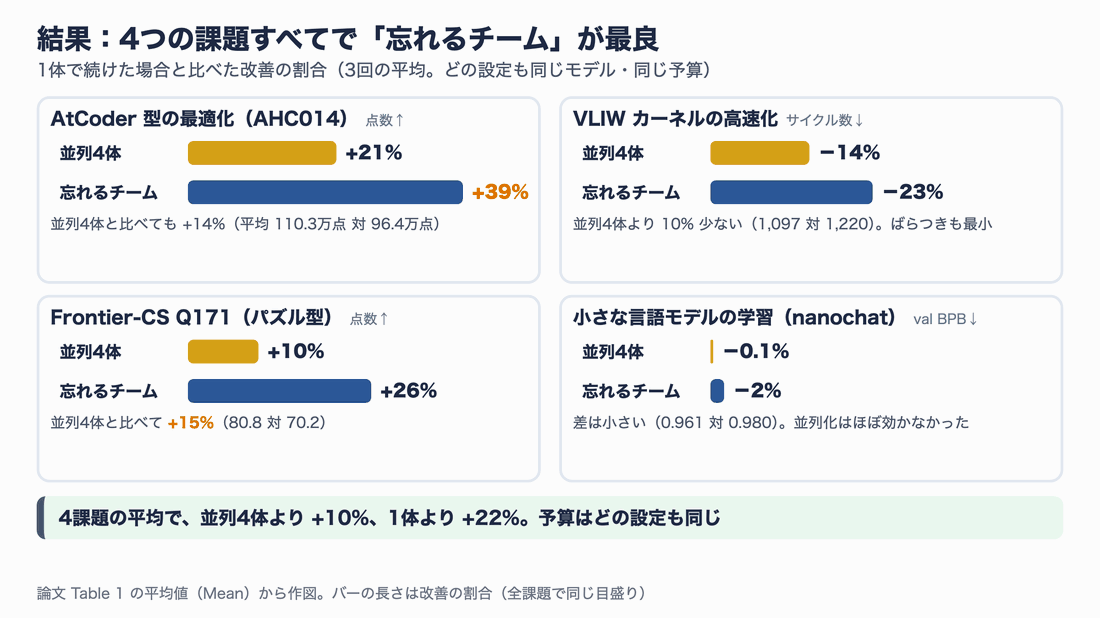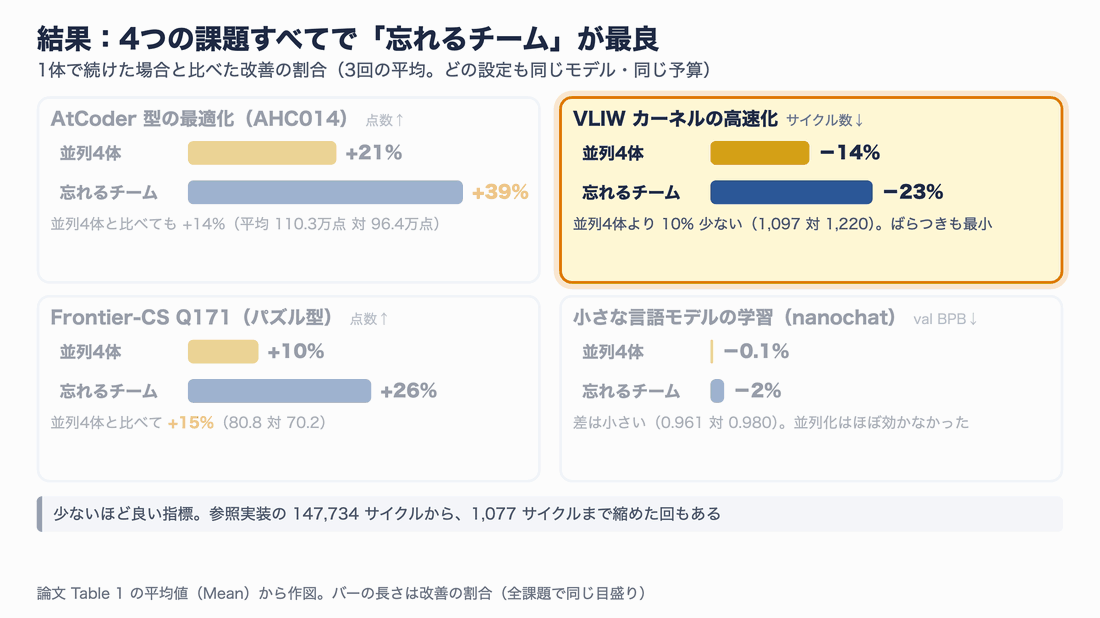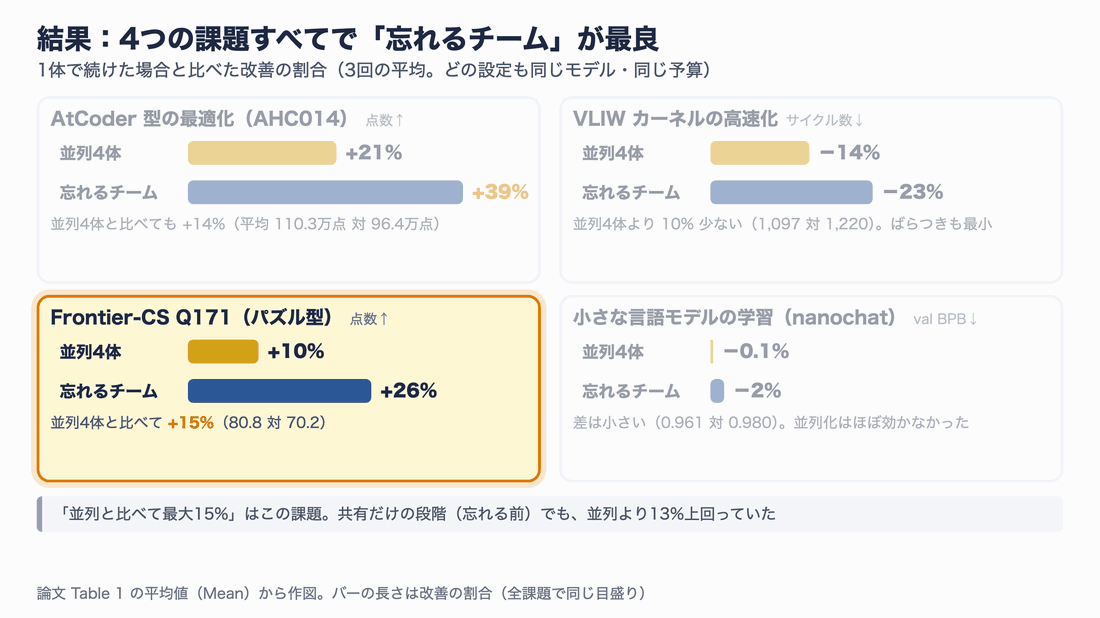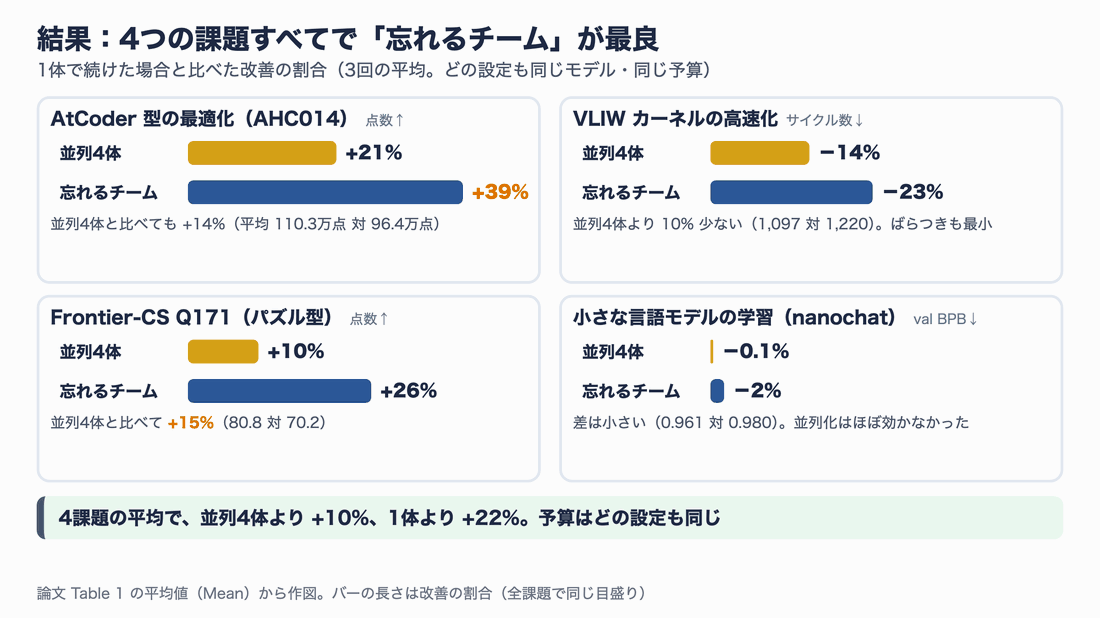
見出しの「最大39%」は AtCoder の課題、「並列と比べて最大15%」は Frontier-CS の課題での平均の差です。
論文の Table 1 の平均値を表にすると、次のようになります。
| 課題(良い方向) | 1体 | 並列4体 | 忘れるチーム | 1体比 | 並列4体比 |
|---|---|---|---|---|---|
| AHC014(点数↑) | 795,000 | 964,000 | 1,103,000 | +39% | +14% |
| VLIW(サイクル↓) | 1,426 | 1,220 | 1,097 | −23% | −10% |
| Frontier-CS Q171(点数↑) | 64.0 | 70.2 | 80.8 | +26% | +15% |
| nanochat(val BPB↓) | 0.980 | 0.980 | 0.961 | −2% | −2% |
ここで注意したいのは、見出しの数字が「最もうまくいった1回」ではなく、3回の実行の平均だという点です。1体の AHC014 は実行ごとのばらつきが大きく(標準偏差 ±210,000)、平均が低めに出ていることも、39%という大きな差の一因です。各設定で最も良かった1回同士を比べると、差は +19%(1体比)になります。
4課題の平均では、忘れるチームは並列4体より10%、1体より22%良い結果でした。nanochat の課題は差が小さいものの、並列化がまったく効かなかった課題でも忘れるチームだけは改善しています。
結果2:伸びの大半は「1回目に忘れた直後」
忘れるチームが、ラウンドごとにどれだけ伸びたかも見てみましょう。
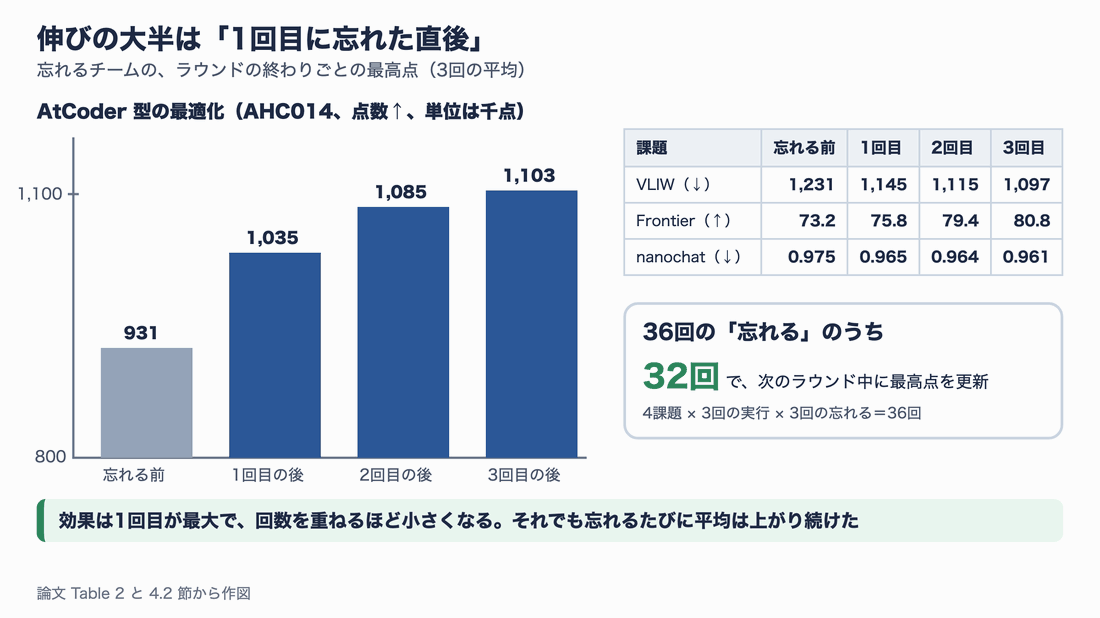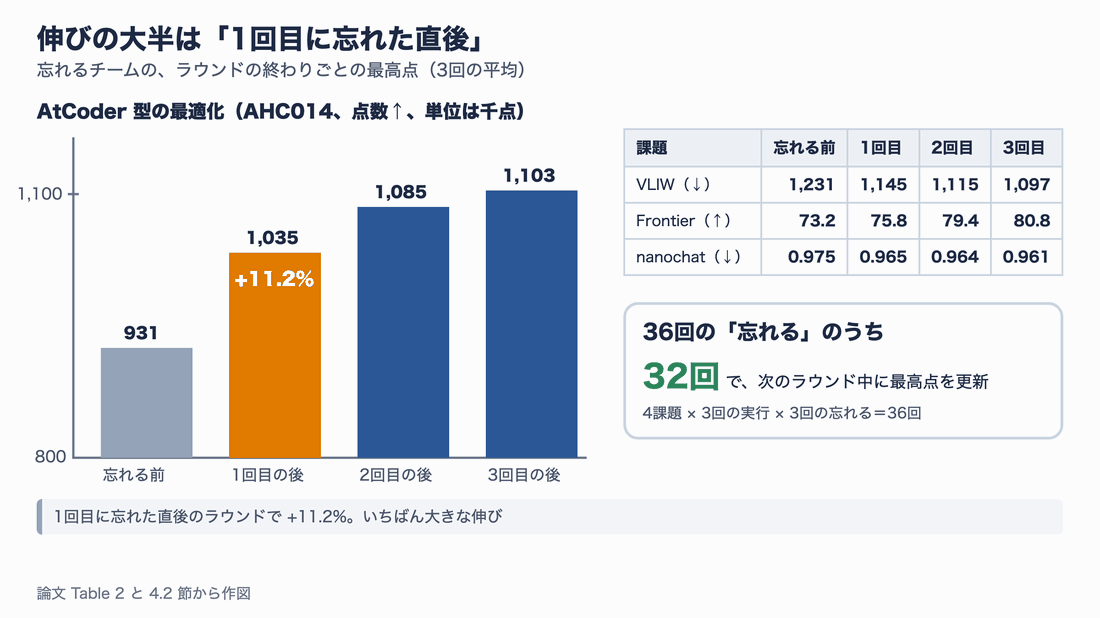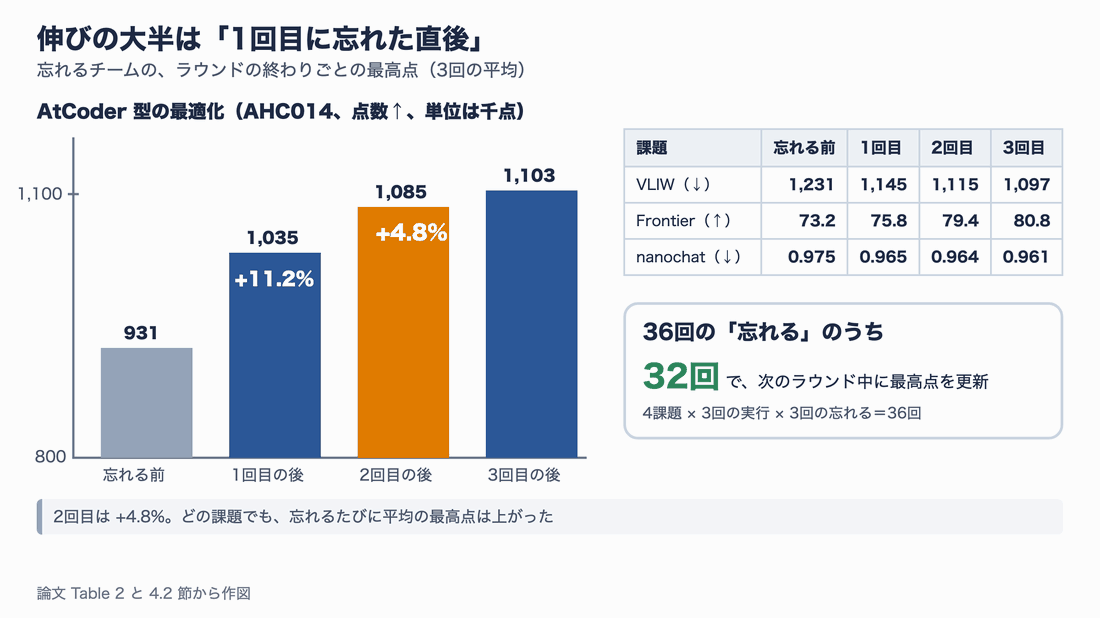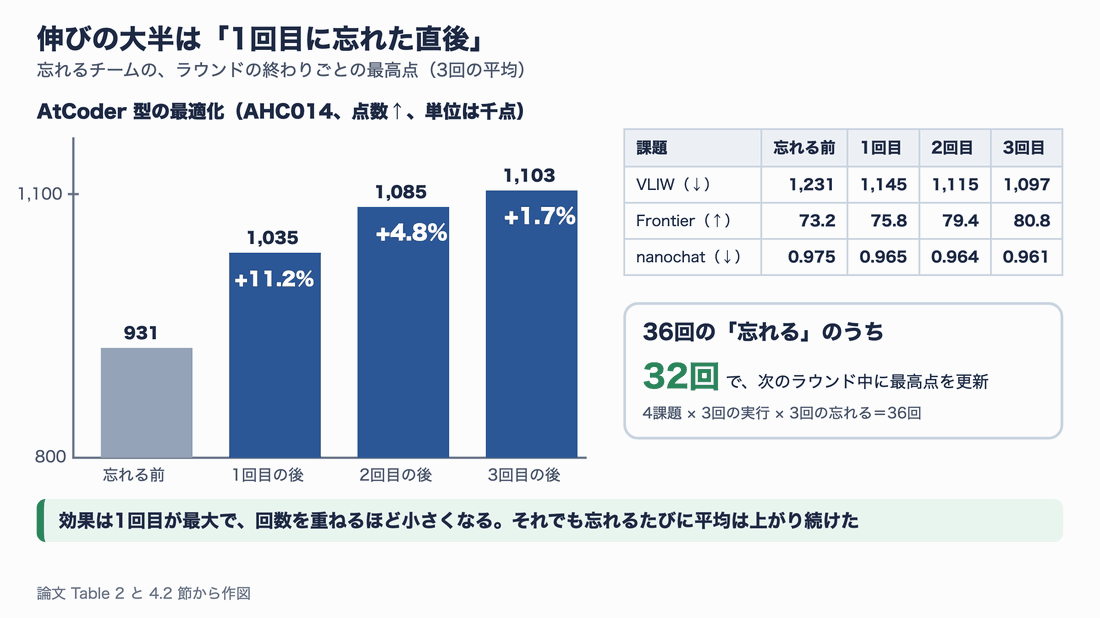
1回目の効果が最大で、回を重ねるほど小さくなります。それでも忘れるたびに平均は上がり続けました。
AHC014 では、1回目に忘れた直後のラウンドで +11.2%、2回目で +4.8%、3回目で +1.7% と、伸びは小さくなっていきます。これは自然なことで、多くの課題には理論上の上限があり、上限に近づくほど改善は難しくなるからです。
それでも、4つの課題すべてで、忘れるたびに平均の最高点は上がりました。合計36回の「忘れる」(4課題×3回の実行×3回)のうち、32回で次のラウンド中に最高点を更新しています。
結果3:「続ける」より「忘れる」ほうが、安くて伸びる
忘れることの効果を最もはっきり示しているのが、次の比較実験です。すでに頭打ちになった同じ状態から、「そのまま続ける」と「忘れる」の2通りで、1体あたり30回ずつ追加で提案させました。
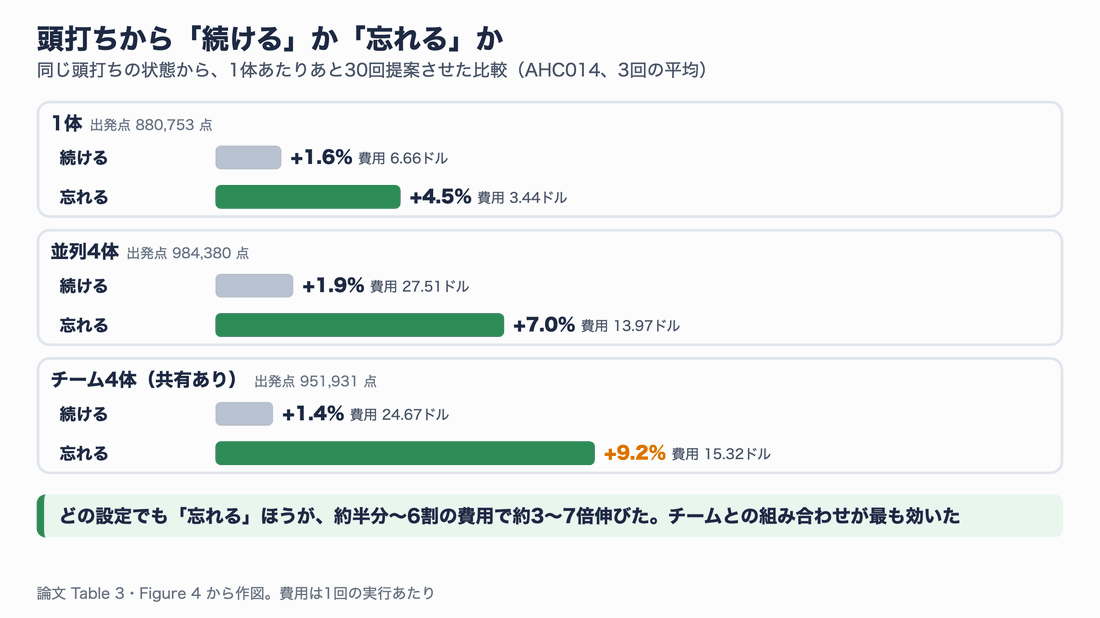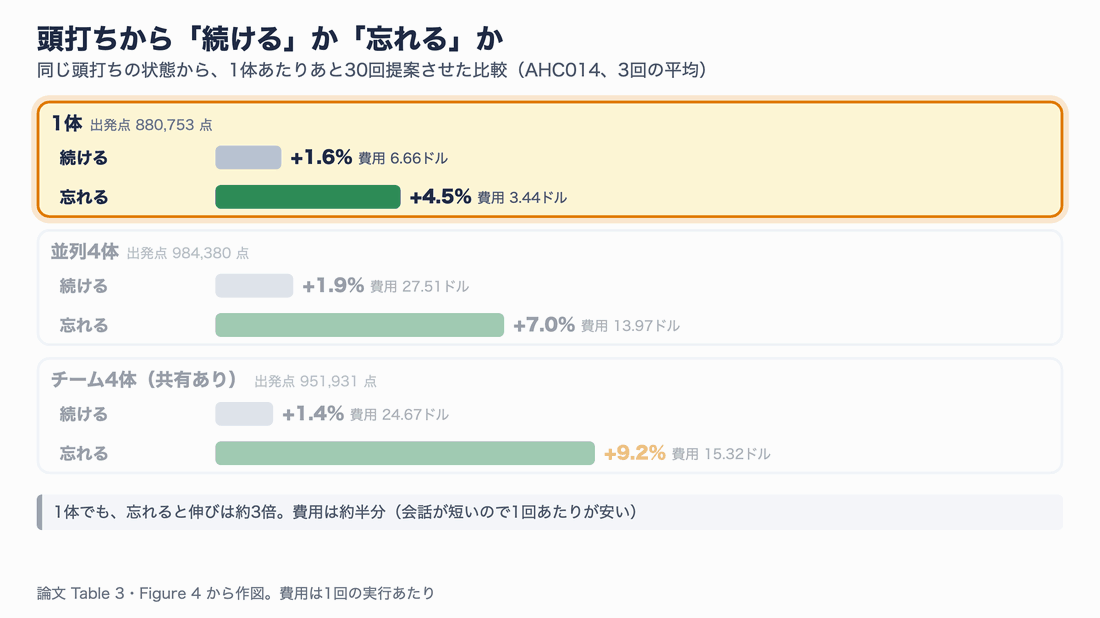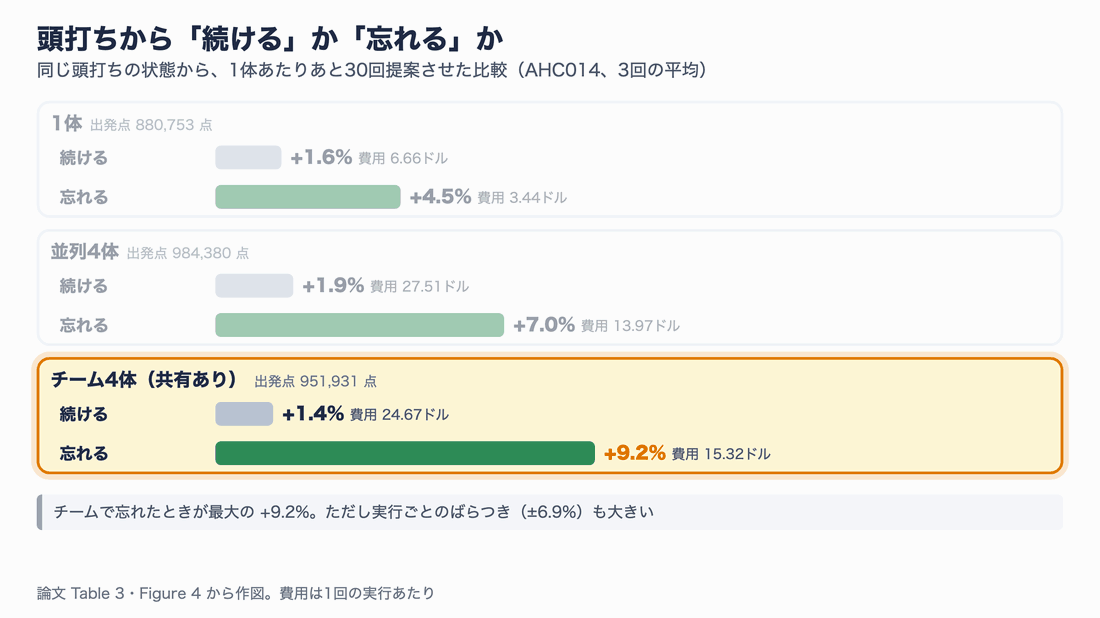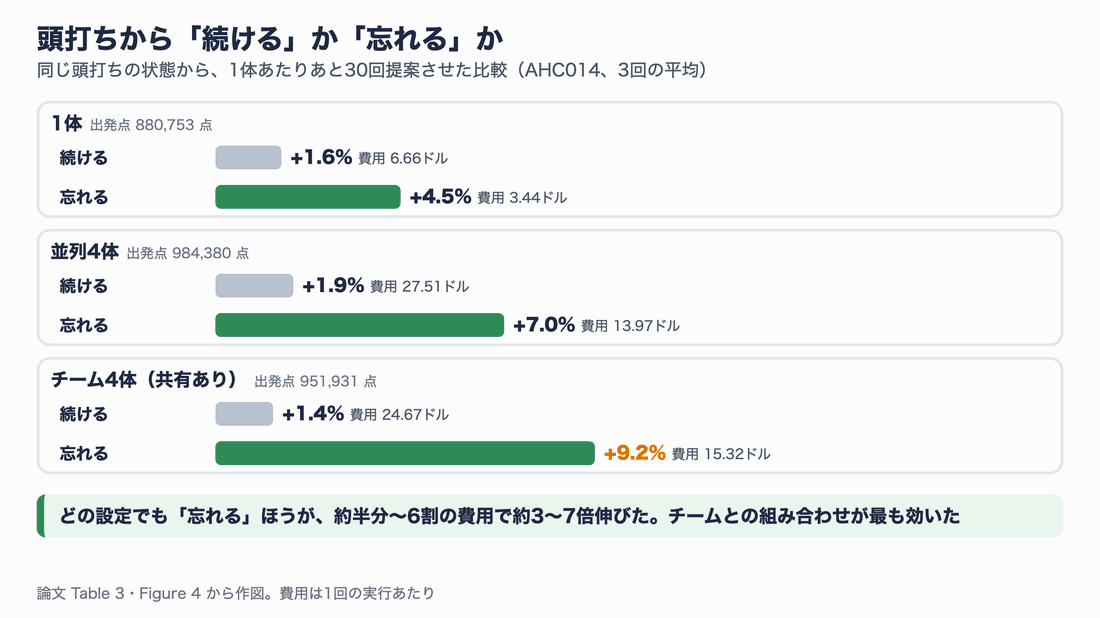
どの設定でも、忘れるほうが約半分〜6割の費用で約3〜7倍伸びました。
続けた場合の伸びは +1.4〜1.9% にとどまったのに対し、忘れた場合は +4.5〜9.2% 伸びました。しかも費用は、忘れたほうが安く済んでいます。理由は単純で、続ける場合は長くなった会話を毎回モデルに読み込ませるため、1回あたりの料金が高くなるからです。
忘れた後のエージェントは、行動も変わりました。最初の10回の提案で比べると、変更した行数の中央値は、続けた場合の6行に対して忘れた場合は40行、思考トークンは2,900に対して9,400でした。忘れることで、大胆に考えて大胆に書き換える姿勢が戻ったわけです。
ただし、チームで忘れた場合の +9.2% は、3回の実行でのばらつき(±6.9%)も大きい点には注意が必要です。
具体例:大胆な案 × 仲間の小技で、ラウンド最大の改善
論文には、忘れることと共有が組み合わさって成果につながった具体例が載っています。VLIW カーネルの課題での、あるチームの記録です。
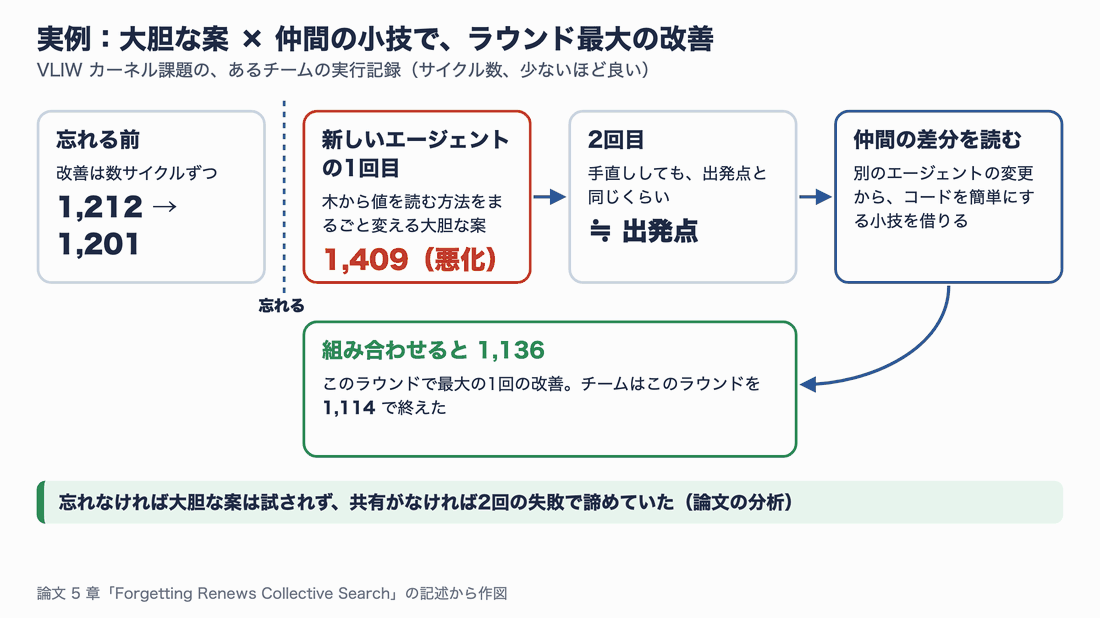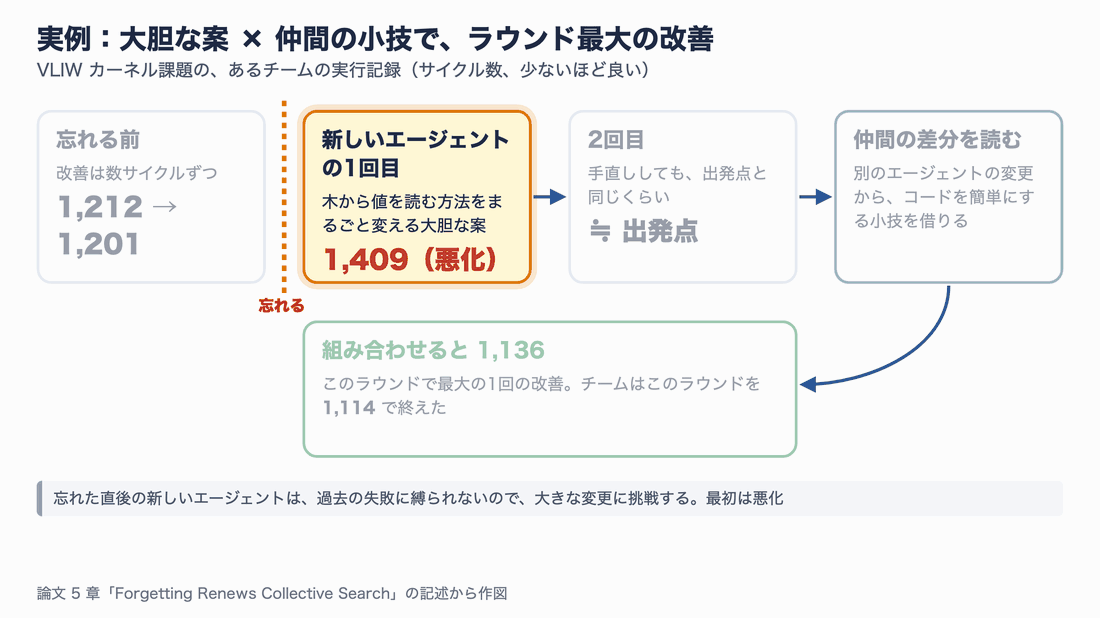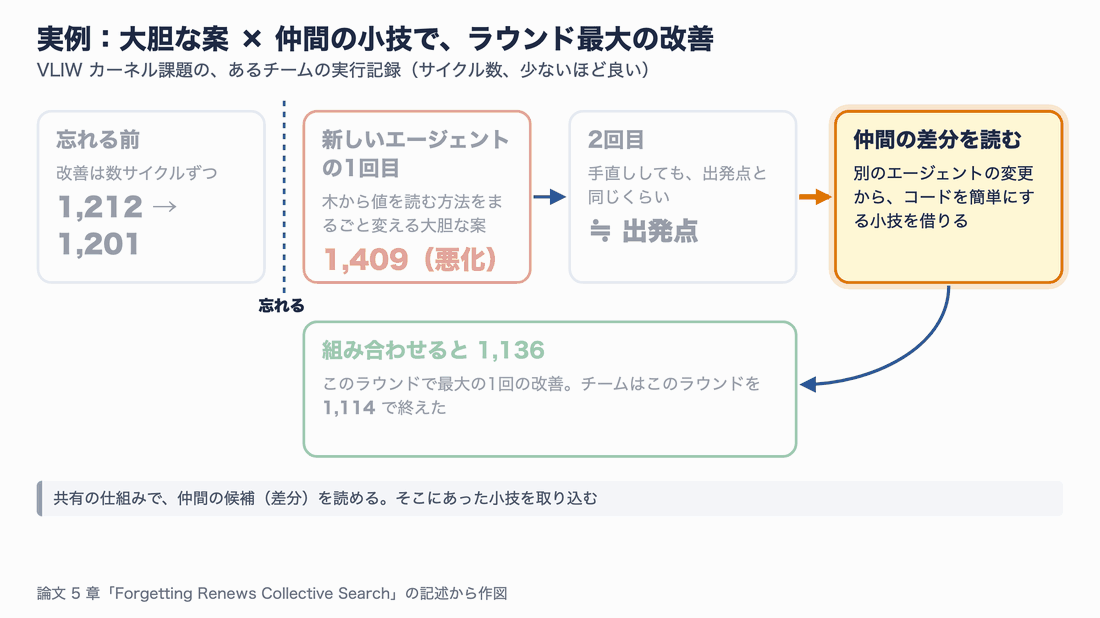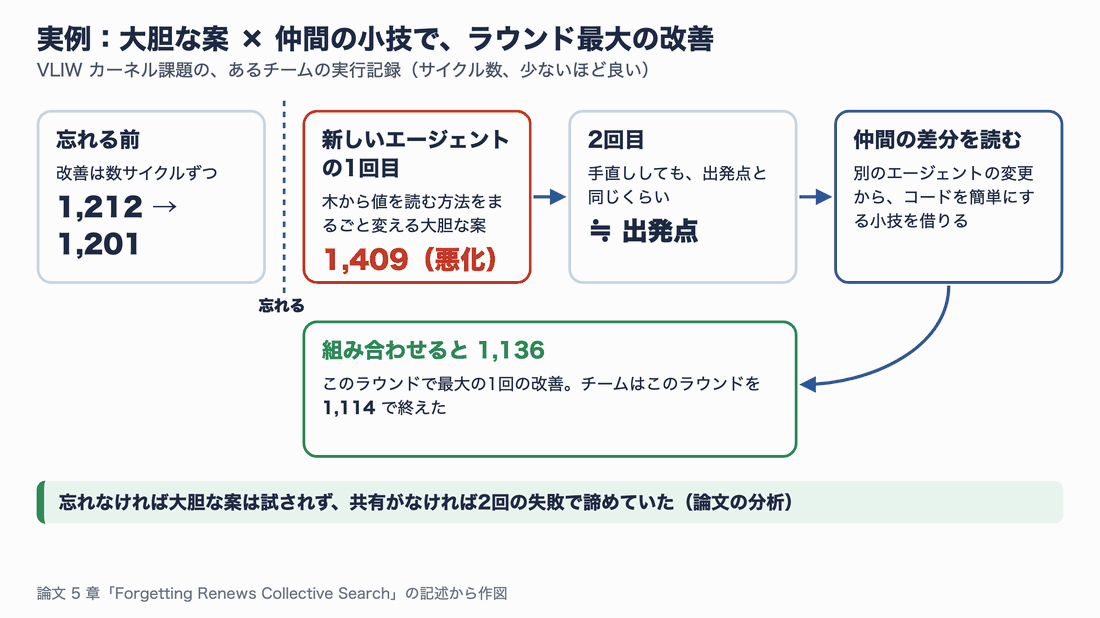
忘れなければ大胆な案は試されず、共有がなければ2回の失敗で諦めていた、と論文は分析しています。
1回目に忘れる前、チームの改善は1回あたり数サイクルずつで、1,212から1,201へとゆっくり進んでいました。忘れた直後、新しいエージェントの1体が、処理の中核部分(木構造から値を読む方法)をまるごと変える大胆な案に挑戦します。
最初の試みは1,409サイクルと、むしろ悪化しました。2回目も出発点と同じくらいです。そこでこのエージェントは、仲間の候補の差分を読み、コードを簡単にする小技を借りてきました。組み合わせた版は1,136サイクルとなり、このラウンドで最大の改善になりました。チームはこのラウンドを1,114サイクルで終えています。
論文はこの例を、「忘れなければ、エージェントは積み上がった文脈に縛られて小さな修正を続け、大胆な案を試さなかっただろう。共有がなければ、2回失敗した時点で、仲間の工夫を取り入れることなく諦めていただろう」と分析しています。
この研究の注意点と限界
結果は印象的ですが、そのまま一般化する前に、次の点を押さえておきましょう。
| 注意点 | 内容 |
|---|---|
| 採点できる課題だけ | 4課題とも点数が自動で出る最適化問題。文章の良し悪しのように採点が難しい作業での効果は分かっていない |
| モデルとハーネスは1種類 | DeepSeek V4.1 Flash と Pi だけで実験。Claude や GPT、Claude Code や Codex で同じ効果が出るかは未検証 |
| 予算が小さい | 1回20〜40ドル、各3回。長時間・大規模な実行で同じ傾向が続くかは分からない |
| 忘れるタイミングは固定 | 予算を4等分して3回忘れただけ。「いつ忘れるか」「何を覚えておくか」の最適化は、論文自身が今後の課題としている |
| ばらつきが大きい | 3回の平均で、標準偏差が大きい設定もある |
| 査読前 | プレプリントの段階 |
もう1つ、筆者が実務で気になるのは、会話の中にしかない大事な決定事項です。論文の課題は「課題の説明」と「採点」がはっきりしていて、守るべきルールが最初の指示にすべて書かれています。実際の仕事では、途中で人と相談して決めた制約(「このライブラリは使わない」など)が会話の中にしかないことがよくあります。そのまま忘れさせると、決定事項まで消えてしまう点には注意が必要です。
どこに活用できそうか
ここからは、論文の内容を自分の仕事に当てはめる方法を考えます。以降は論文に書かれていない、筆者の整理と提案です。
向いている作業を見分ける3つの質問
この手法が効きやすいのは、論文の実験と同じ性質を持つ作業です。次の3つの質問で見分けられます。
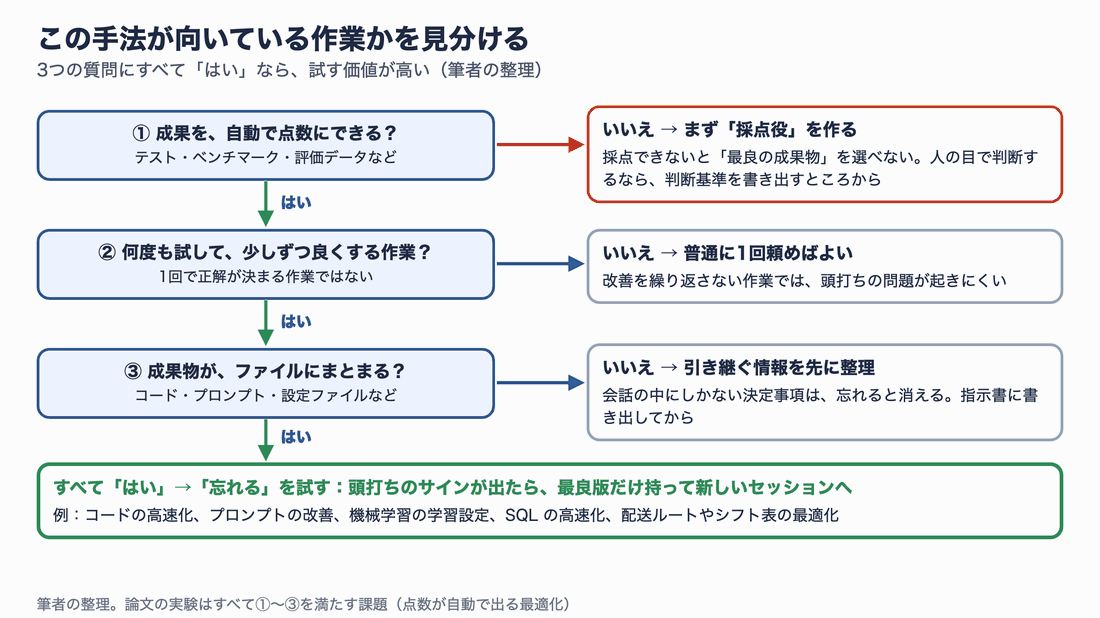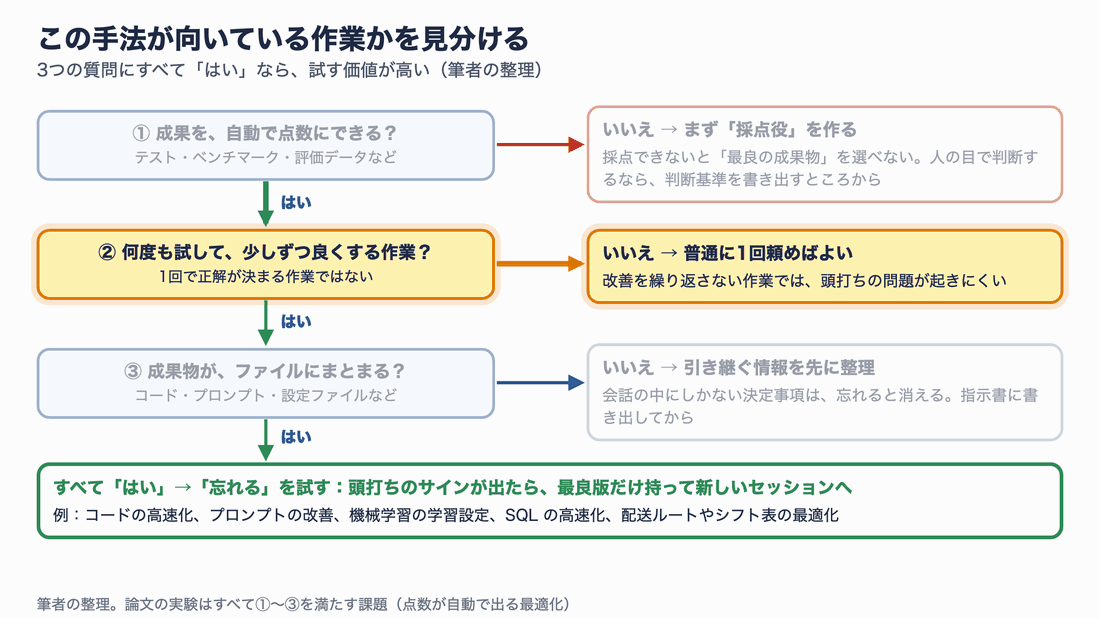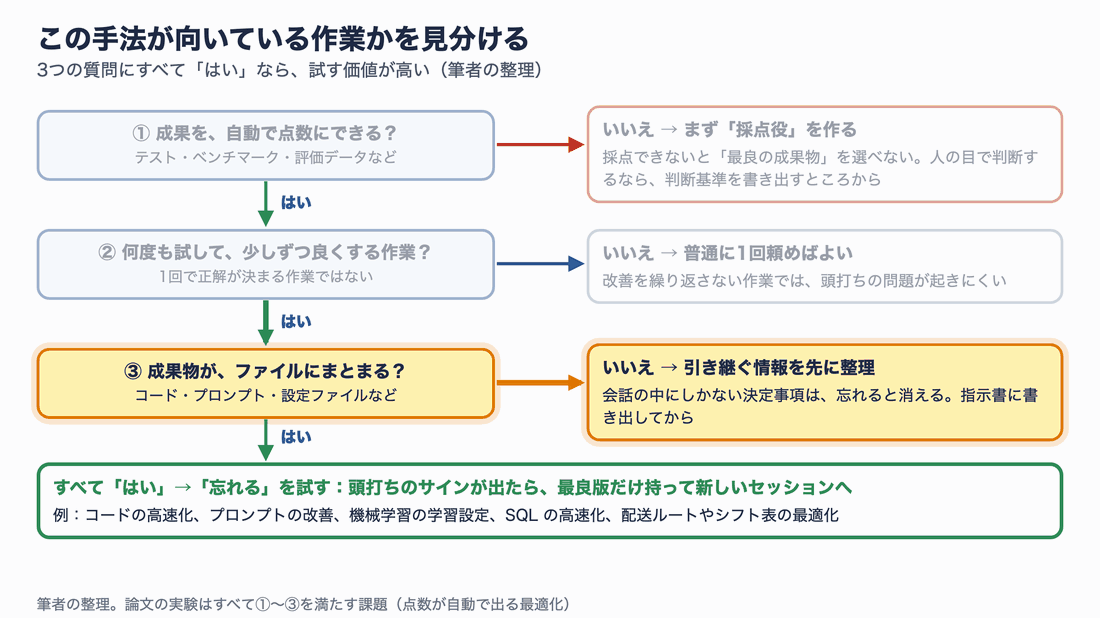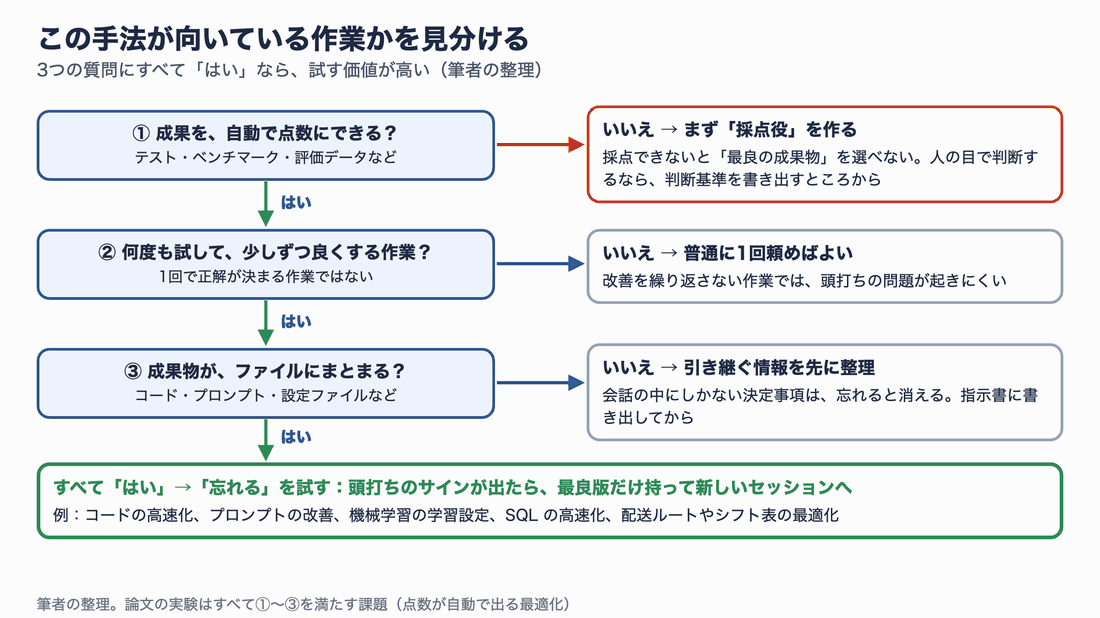
3つすべてが「はい」なら試す価値が高い作業です。
具体的には、次のような作業が当てはまります。
| 場面 | 成果物(最良版として残すもの) | 採点役の例 |
|---|---|---|
| プログラムの高速化 | ソースコード | ベンチマークの実行時間(テストが通ることが条件) |
| プロンプトの改善 | プロンプトのファイル | 評価データでの正答率 |
| 機械学習の学習設定 | 学習スクリプト・設定ファイル | 検証データでの損失や精度 |
| SQL・データ処理の高速化 | クエリ・処理コード | 実行時間(結果が元と一致することが条件) |
| 配送ルート・シフト表・在庫配置の最適化 | 解を作るプログラム | コスト・制約違反の数 |
| Web ページの表示速度 | フロントエンドのコード | Lighthouse などの計測値 |
逆に、向いていないのは次のような作業です。
- 採点できない作業:記事の文章の「良さ」など。AIに採点させる方法もありますが、採点がぶれると「最良版」の選び方自体があやしくなります
- 経緯そのものが成果の作業:障害の原因調査のように、「何を試してダメだったか」が次の判断に直接必要な作業
- 1回で終わる作業:改善を繰り返さないなら、頭打ちの問題自体が起きにくい
エージェントの「記憶」を3つに分ける
実務で使うときにいちばん大切なのは、エージェントが持っている情報を3つに分けて扱うことだと筆者は考えています。
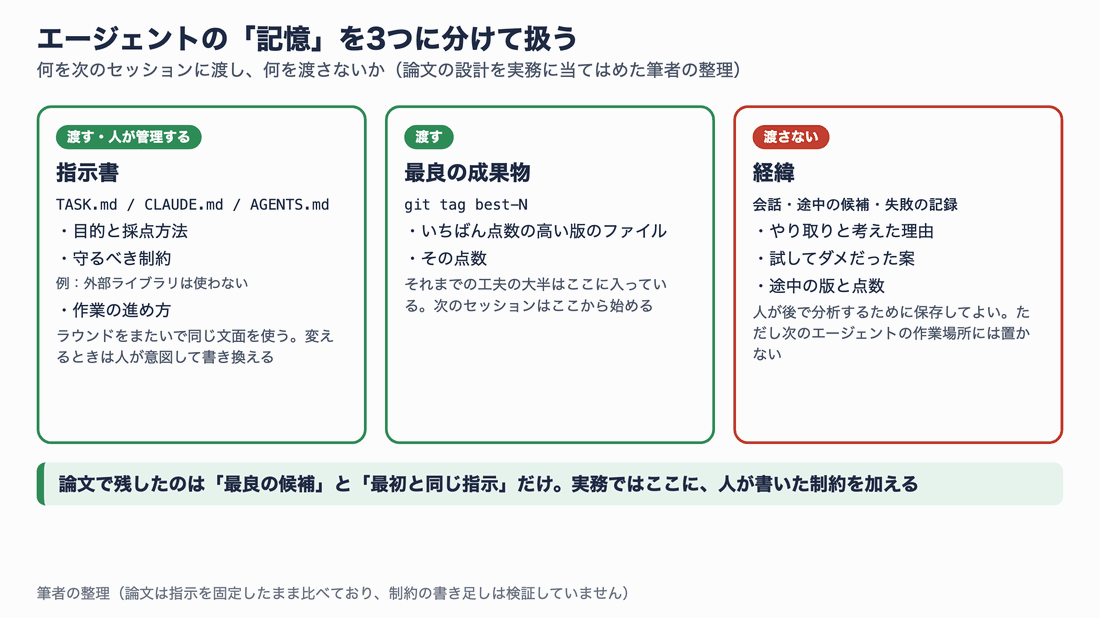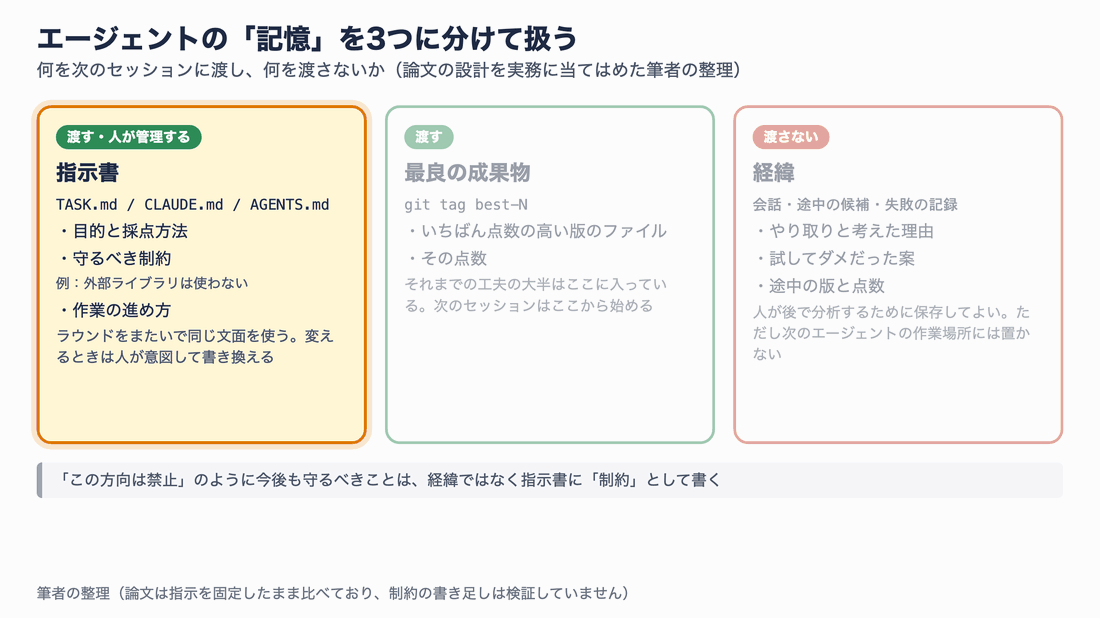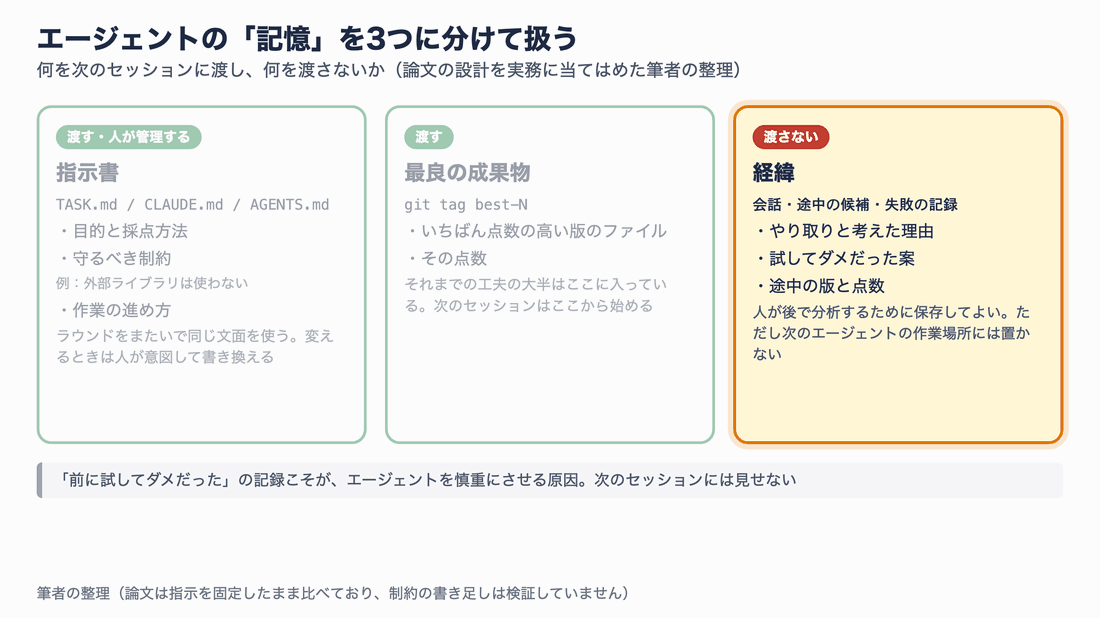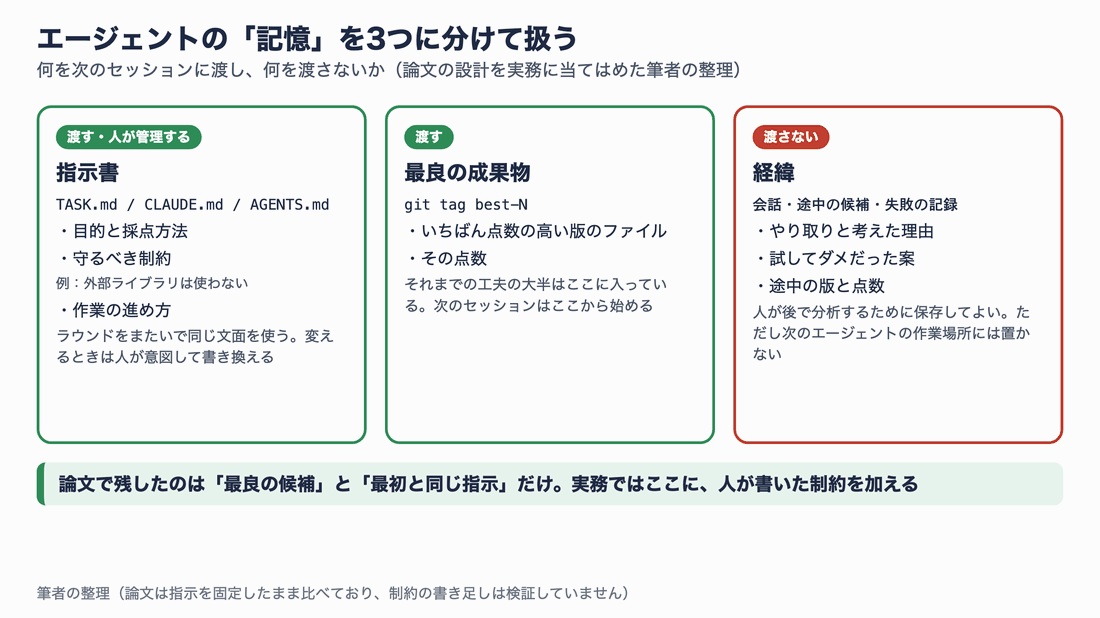
論文で残したのは「最良の候補」と「最初と同じ指示」だけ。実務ではここに、人が書いた制約を加えます。
ポイントは、今後も守るべきことは「経緯」ではなく「指示書」に書くことです。たとえば「標準ライブラリだけを使う」という決定は、会話の中に置いておくと忘れたときに消えますが、TASK.md や CLAUDE.md・AGENTS.md に「制約」として書いておけば、新しいセッションにも確実に伝わります。一方で「〇〇を試したら遅くなった」という失敗の記録は、論文の考え方に従えば次のセッションには見せません。人が後で振り返るために保存しておくのは問題ありません。
なお、Claude Code や Codex には、会話が長くなると要約して圧縮する機能(コンパクション)があります。これは経緯を要約の形で残すので、論文の「忘れる」とは別物です。要約にも「この方向はダメだった」という判断が残るため、縛りは完全には外れないはずです(論文は要約との比較をしていないので、ここは筆者の推測です)。
アクションプラン:明日から試す4段階
いきなり4体のチームを組むのではなく、小さく始めて効果を測ってから広げるのがおすすめです。
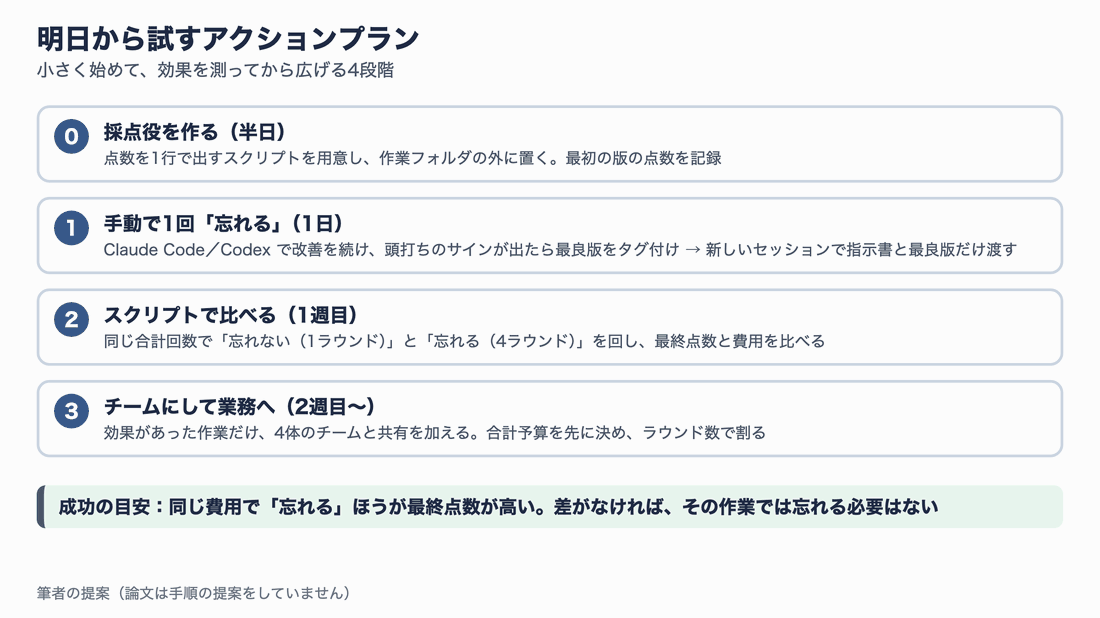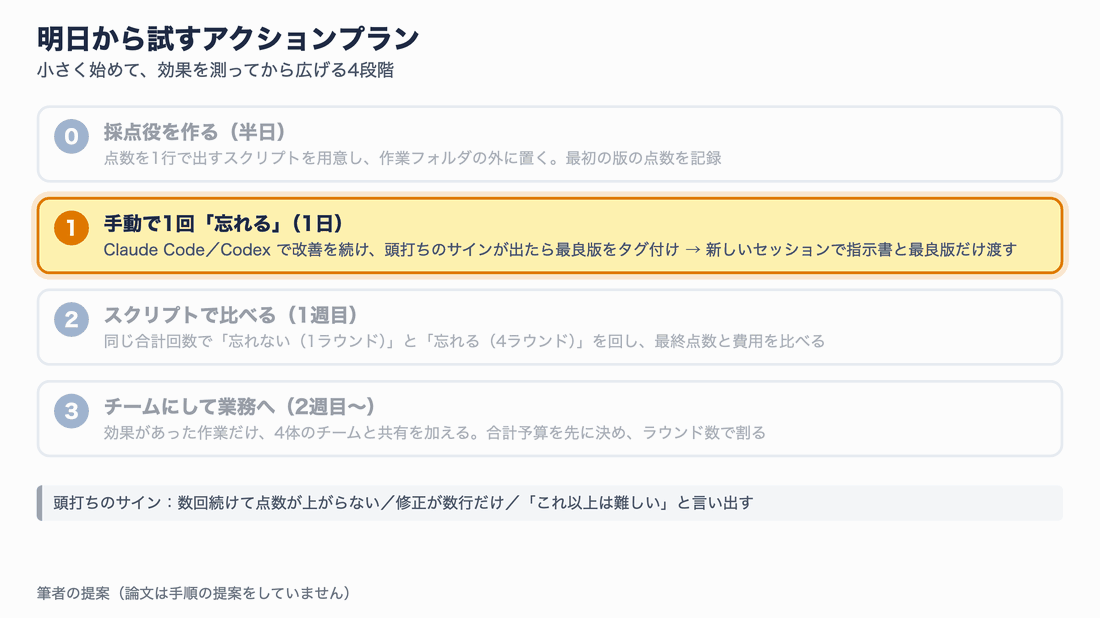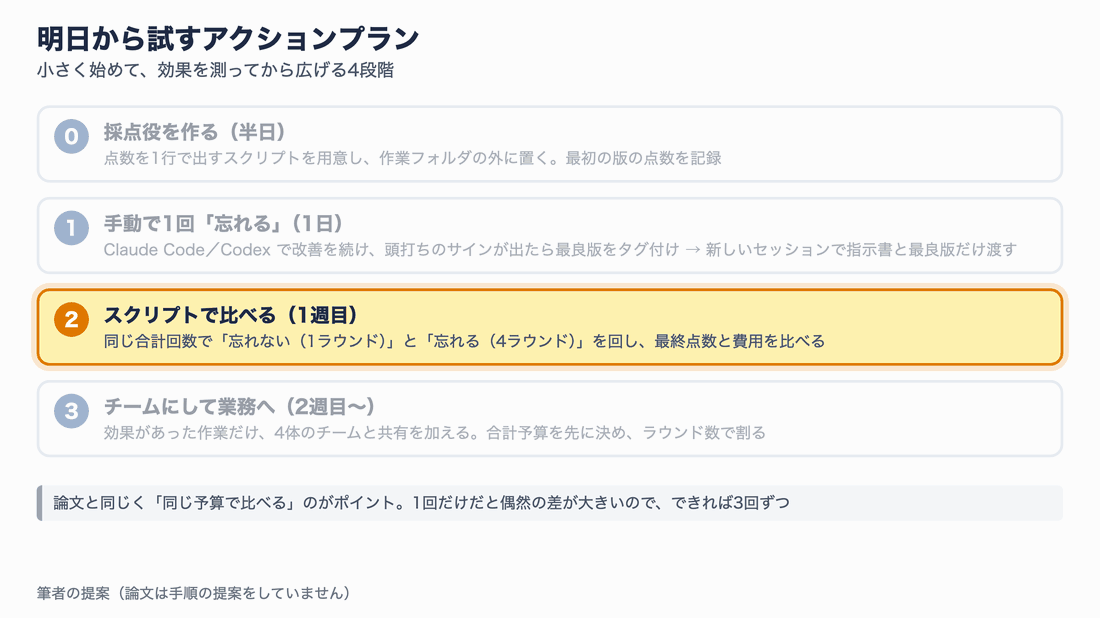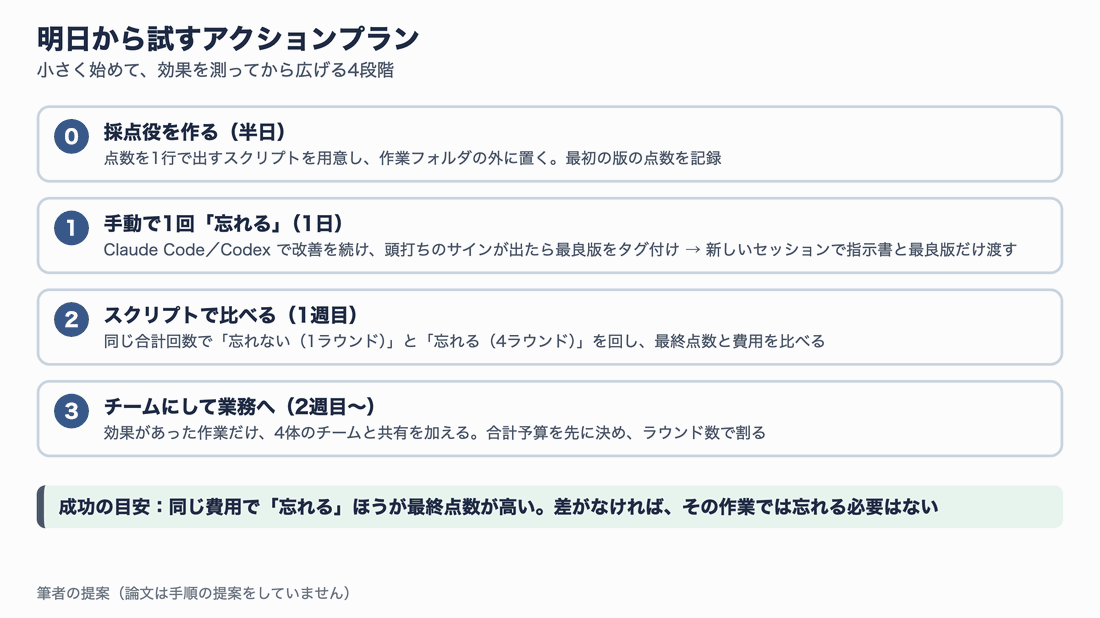
成功の目安は「同じ費用で、忘れるほうが最終点数が高いこと」。差がなければ、その作業では忘れる必要はありません。
| 段階 | 期間の目安 | やること | 終わったら確認すること |
|---|---|---|---|
| 0. 採点役を作る | 半日 | 点数を1行で出すスクリプトを作り、作業フォルダの外に置く | 最初の版の点数が出る |
| 1. 手動で1回忘れる | 1日 | 頭打ちのサインが出たら、最良版だけ持って新しいセッションへ | 忘れた後に点数が更新されたか |
| 2. スクリプトで比べる | 1週目 | 同じ合計回数で「忘れない」と「忘れる」を比べる | 最終点数と費用の差 |
| 3. チームで業務へ | 2週目〜 | 効果のあった作業だけ、4体+共有にする | 予算内で成果が上がるか |
ステップ0:採点役を作る
すべての出発点は、成果物を自動で採点できるようにすることです。点数を最後の行に1つだけ出すスクリプトを用意します。
ここで大事なのは、採点用のスクリプトをエージェントの作業フォルダの外に置くことです。作業フォルダの中にあると、エージェントが点数を上げるために採点役のほうを書き換えてしまうことがあります。
この記事では、例として「200都市をすべて回る、なるべく短い巡回路を求める」課題を用意しました。AtCoder の最適化問題を小さくしたような課題です。採点役は次のとおりです。
#!/usr/bin/env python3
"""採点役: 200 都市の巡回路の長さ(小さいほど良い)を最終行に出す。

候補のディレクトリで実行し、solve.py に都市の座標を標準入力で渡す。
都市は乱数の種 0 で毎回同じものを作るので、候補を書き換えても採点の条件は変わらない。
"""
import math, random, subprocess, sys

N, LIMIT = 200, 10
rng = random.Random(0)
pts = [(rng.randint(0, 1000), rng.randint(0, 1000)) for _ in range(N)]
inp = f"{N}\n" + "".join(f"{x} {y}\n" for x, y in pts)

try:
    out = subprocess.run([sys.executable, "solve.py"], input=inp, capture_output=True,
                         text=True, timeout=LIMIT).stdout.split()
    tour = [int(v) for v in out]
except Exception as e:
    print(f"error: {e}", file=sys.stderr)
    sys.exit(1)

if sorted(tour) != list(range(N)):
    print("error: 0..199 を 1 回ずつ並べた順列ではありません", file=sys.stderr)
    sys.exit(1)

length = sum(math.dist(pts[tour[i]], pts[tour[(i + 1) % N]]) for i in range(N))
print(round(length, 1))
最初の候補 candidate/solve.py は、都市を番号順に回るだけの単純なものです。
import sys

# 入力: 1 行目に都市数 N、続く N 行に x y
data = sys.stdin.read().split()
n = int(data[0])

# 最初の候補: 番号順にまわるだけ(改善の余地が大きい)
print(" ".join(str(i) for i in range(n)))
フォルダ構成は次のようにします。課題の説明 TASK.md と採点役 score.py は候補のフォルダの外です。
example-tsp/
├── TASK.md          # 課題の説明(エージェントに渡す指示書)
├── score.py         # 採点役(候補のフォルダの外に置く)
└── candidate/
    └── solve.py     # 改善していく候補
# candidate フォルダの中で採点役を動かし、最初の版の点数を確認する
cd example-tsp/candidate
python3 ../score.py
# 105470.7
ステップ1:手動で1回「忘れる」
次は、普段どおり Claude Code や Codex で改善を続けながら、頭打ちのサインが出たところで1回だけ忘れさせてみます。頭打ちのサインは、論文で観察された症状がそのまま目安になります。
- 数回続けて、点数が上がらない
- 1回の修正が数行だけになった(
git diff --statで確認できます) - 「これ以上の改善は難しいです」「限界に近いです」と言い出す
- 何も変更せずにターンを終える
サインが出たら、次の手順で忘れさせます。
# 1) いまの最良版に名前(タグ)を付けて保存する
git add -A && git commit -m "best: 10713.2"
git tag best-1

# 2) 過去の候補や履歴が見えない、新しいフォルダを最良版から作る
mkdir ../round-2
git archive best-1 | tar -x -C ../round-2
cd ../round-2
git init -q && git add -A && git commit -qm "round 2: best-1 から開始"
git archive は、指定した版のファイルだけを取り出すコマンドです。新しいフォルダには過去のコミットが1つもないので、エージェントが git log で失敗の歴史を読むこともありません。
あとは新しいフォルダで、新しいセッションを始めます。Claude Code なら新しく claude を起動するか、会話の中で /clear を実行します。Codex なら /new で新しい会話を始められます。会話の要約を残す /compact は、ここでは使いません。
新しいセッションに渡す最初の指示は、論文と同じく「課題の説明」と「現在の最良版」だけにします。
課題は TASK.md に書いてあります。
このフォルダの solve.py が、現時点で最も点数の高い版です(巡回路の長さ 10713.2、小さいほど良い)。
これを出発点に改善し、変更点を短く報告してください。
点数は python3 ../score.py で確認できます。
ここで「前のセッションでは〇〇を試してダメでした」と書き添えたくなりますが、ぐっとこらえましょう。それこそが、エージェントを慎重にさせる情報です。今後も守るべき制約だけを TASK.md に書き足します。
ステップ2:スクリプトで「忘れない」と「忘れる」を比べる
手動で手応えがあったら、スクリプトで自動化して、効果を数字で確かめます。論文の公式コードは公開されていないため、筆者が論文の仕組みを最小限に再現したハーネス forget_loop.py を用意しました。Python 3 の標準ライブラリと git だけで動きます。
このスクリプトがやっていることは、論文の図と同じです。
- 各ラウンドの最初に、最良の候補だけを入れた新しい git リポジトリを作る(過去の候補は入れない)
- 各エージェントは自分の作業フォルダ(git worktree)で、同じセッションを続けながら「直す → 採点」を繰り返す
- 2体以上なら、プロンプトに仲間のベスト(コミット ID と点数)を載せる。中身は
git showで読める - ラウンドの終わりに、チーム全体の最良だけを取り出して次のラウンドへ(忘れる)
使い方は次のとおりです。--rounds 1 にすると「忘れない」設定になるので、合計の提案回数をそろえて比べます。
# 忘れない設定:1体 × 1ラウンド × 8回(合計 8 回の提案)
python3 forget_loop.py \
  --candidate example-tsp/candidate --task example-tsp/TASK.md \
  --score "python3 $PWD/example-tsp/score.py" --minimize \
  --agent codex --agents 1 --rounds 1 --turns 8

# 忘れる設定:1体 × 4ラウンド × 2回(合計 8 回の提案、3回忘れる)
python3 forget_loop.py \
  --candidate example-tsp/candidate --task example-tsp/TASK.md \
  --score "python3 $PWD/example-tsp/score.py" --minimize \
  --agent codex --agents 1 --rounds 4 --turns 2
主な引数の意味です。
| 引数 | 意味 |
|---|---|
--candidate | 最初の候補のフォルダ |
--task | 課題の説明(各ラウンドの最初に毎回同じ文面で渡す) |
--score | 候補のフォルダで実行し、最終行に点数を出すコマンド(絶対パスで指定) |
--minimize | 点数が小さいほど良いとき(巡回路の長さ、実行時間など)に付ける |
--agent | codex か claude。cmd は動作確認用 |
--agents / --rounds / --turns | 人数 / ラウンド数(1なら忘れない)/ 1ラウンドあたり1体の提案回数 |
--agent-args | エージェントに追加で渡す引数(例:'-c model_reasoning_effort="low"') |
スクリプトの全文は次のとおりです。
#!/usr/bin/env python3
"""「忘れるエージェントチーム」の最小ハーネス。

論文 "Scaling Discovery Requires Forgetting"(arXiv 2610.20563)の考え方を、
Claude Code / Codex CLI で試すための小さな実装です(論文の公式コードではありません)。

- ラウンド内: 各エージェントは同じセッションを続けながら、候補を直す → 採点 を繰り返す
- チーム: 他のエージェントのベスト候補(コミット ID と点数)がプロンプトに載る
- 忘れる: ラウンドの終わりにセッションと候補の履歴をすべて捨て、
         チーム全体のベスト候補「だけ」を新しいリポジトリに入れて次のラウンドを始める

使い方の例:
  python3 forget_loop.py --candidate example-tsp/candidate --task example-tsp/TASK.md \
      --score "python3 $PWD/example-tsp/score.py" --minimize \
      --agent codex --agents 4 --rounds 4 --turns 5
"""
import argparse, json, os, shutil, subprocess, threading, time, uuid
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

FIRST = """# 課題
{task}

# 現在の状況
ラウンド {round}。あなたの現在の候補はコミット `{cur}`(点数 {cur_score})です。
{peers}
# 進め方
- このディレクトリの候補を改善し、何を変えたかを短く書いて終了してください。
- 採点は別のプロセスが行います。自分で採点用の仕組みを作る必要はありません。
- git commit はしないでください(ハーネスが作業ツリーをコミットして採点します)。
- このディレクトリの外は読み書きしないでください。
"""

LATER = """# 結果
ラウンド {round}。あなたの現在の候補はコミット `{cur}`(点数 {cur_score})です。
あなたのベストは `{mine}`(点数 {mine_score})です。
{peers}
続けて候補を改善し、変えた点を書いて終了してください。採点は別のプロセスが行います。
"""

def git(args, cwd):
    return subprocess.run(["git", *args], cwd=cwd, capture_output=True, text=True, check=True).stdout.strip()

def fmt(s):
    return "失敗" if s is None else f"{s:g}"

class Team:
    def __init__(self, a):
        self.a, self.lock = a, threading.Lock()
        self.run_dir = Path(a.out).resolve() / time.strftime("%Y%m%d-%H%M%S")
        self.best_dir = self.run_dir / "best"          # 次のラウンドへ持ち越す唯一のもの

    def better(self, a, b):
        """点数 a が b より良いか(None は採点失敗)。"""
        if a is None:
            return False
        if b is None:
            return True
        return a < b if self.a.minimize else a > b

    def score(self, wt):
        try:
            p = subprocess.run(self.a.score, shell=True, cwd=wt, capture_output=True, text=True,
                               timeout=self.a.score_timeout)
            return float(p.stdout.strip().splitlines()[-1])
        except Exception:
            return None

    def record(self, **row):
        with self.lock:
            with open(self.run_dir / "log.jsonl", "a") as f:
                f.write(json.dumps(row, ensure_ascii=False) + "\n")
        print(json.dumps(row, ensure_ascii=False), flush=True)

    # ---- エージェントの呼び出し(セッションを続けるか、新しく始めるか) ----
    def call_agent(self, wt, prompt, session, log_path):
        a, extra = self.a, self.a.agent_args.split()
        if a.agent == "claude":
            sid = session or str(uuid.uuid4())
            cmd = ["claude", "-p", "--permission-mode", "acceptEdits",
                   *(["--resume", sid] if session else ["--session-id", sid]), *extra, prompt]
        elif a.agent == "codex":
            sid = session
            cmd = (["codex", "exec", "resume", "--json", "--skip-git-repo-check", *extra, session, prompt]
                   if session else
                   ["codex", "exec", "--json", "-s", "workspace-write", "--skip-git-repo-check", *extra, prompt])
        else:  # 任意のコマンド(テスト用)。プロンプトとセッション ID を環境変数で渡す
            sid = session or str(uuid.uuid4())
            cmd = ["sh", "-c", a.agent_cmd]
        env = dict(os.environ, FORGET_PROMPT=prompt, FORGET_SESSION_ID=sid or "",
                   FORGET_NEW_SESSION="0" if session else "1")
        try:
            # stdin を閉じておく(codex exec は stdin が開いていると入力待ちで止まる)
            p = subprocess.run(cmd, cwd=wt, capture_output=True, text=True, env=env,
                               stdin=subprocess.DEVNULL, timeout=a.turn_timeout)
            out = p.stdout + p.stderr
        except subprocess.TimeoutExpired as e:
            out = f"timeout: {e}"
        log_path.write_text(out)
        if a.agent == "codex" and not sid:  # Codex のセッション ID は JSON イベントから取る
            for line in out.splitlines():
                try:
                    ev = json.loads(line)
                except ValueError:
                    continue
                if ev.get("type") == "thread.started":
                    sid = ev.get("thread_id")
        return sid

    # ---- 1 エージェントの 1 ラウンド ----
    def agent_round(self, r, k, repo, seed, seed_score, mine):
        wt = self.run_dir / f"round{r}" / f"agent{k}"
        git(["worktree", "add", "-q", "-b", f"agent{k}", str(wt), seed], repo)
        session, cur, cur_score = None, seed, seed_score
        for t in range(1, self.a.turns + 1):
            with self.lock:
                peers = "".join(f"エージェント{j}: ベスト `{c}`(点数 {fmt(s)})。`git show {c}:<ファイル>` で中身を読めます。\n"
                                for j, (c, s) in sorted(mine.items()) if j != k and self.a.agents > 1)
                my_c, my_s = mine[k]
            tpl = LATER if session else FIRST
            prompt = tpl.format(task=self.task, round=r, cur=cur[:8], cur_score=fmt(cur_score),
                                mine=my_c[:8], mine_score=fmt(my_s), peers=peers)
            session = self.call_agent(wt, prompt, session, wt.parent / f"agent{k}-turn{t}.log")
            git(["add", "-A"], wt)
            if git(["status", "--porcelain"], wt):
                git(["-c", "user.name=forget-loop", "-c", "user.email=forget@example.invalid",
                     "commit", "-q", "-m", f"round{r} agent{k} turn{t}"], wt)
            head = git(["rev-parse", "HEAD"], wt)
            if head == cur:  # 何も変えずに終わったターン(論文の「空のターン」)
                self.record(round=r, agent=k, turn=t, session=session, commit=None, score=None, empty=True)
                continue
            cur, cur_score = head, self.score(wt)
            with self.lock:
                if self.better(cur_score, mine[k][1]):
                    mine[k] = (cur, cur_score)
            self.record(round=r, agent=k, turn=t, session=session, commit=cur[:8], score=cur_score, empty=False)

    # ---- 全体 ----
    def run(self):
        a = self.a
        self.task = Path(a.task).read_text()
        shutil.copytree(a.candidate, self.best_dir, ignore=shutil.ignore_patterns(".git"))
        best_score = self.score(self.best_dir)
        print(f"start: score={fmt(best_score)}  run_dir={self.run_dir}")
        for r in range(1, a.rounds + 1):
            # 忘れる: 前のラウンドの候補・履歴・セッションは一切持ち込まず、ベストだけで新しいリポジトリを作る
            repo = self.run_dir / f"round{r}" / "repo"
            shutil.copytree(self.best_dir, repo)
            git(["init", "-q"], repo)
            git(["add", "-A"], repo)
            git(["-c", "user.name=forget-loop", "-c", "user.email=forget@example.invalid",
                 "commit", "-q", "-m", f"round{r} seed (score {fmt(best_score)})"], repo)
            seed = git(["rev-parse", "HEAD"], repo)
            mine = {k: (seed, best_score) for k in range(1, a.agents + 1)}
            with ThreadPoolExecutor(a.agents) as ex:
                for f in [ex.submit(self.agent_round, r, k, repo, seed, best_score, mine)
                          for k in range(1, a.agents + 1)]:
                    f.result()
            # ラウンドの終わり: チーム全体のベストだけを残す
            k_best, (c_best, s_best) = min(mine.items(), key=lambda kv: (
                kv[1][1] is None, kv[1][1] if a.minimize else -(kv[1][1] or 0)))
            if self.better(s_best, best_score):
                best_score = s_best
                shutil.rmtree(self.best_dir)
                self.best_dir.mkdir()
                arc = subprocess.run(["git", "archive", c_best], cwd=repo, capture_output=True, check=True).stdout
                subprocess.run(["tar", "-x", "-C", str(self.best_dir)], input=arc, check=True)
            print(f"round {r} done: team best={fmt(best_score)}" + (" -> forget" if r < a.rounds else ""))
        print(f"final best={fmt(best_score)}  files: {self.best_dir}")

if __name__ == "__main__":
    ap = argparse.ArgumentParser(description=__doc__, formatter_class=argparse.RawDescriptionHelpFormatter)
    ap.add_argument("--candidate", required=True, help="最初の候補(ディレクトリ)")
    ap.add_argument("--task", required=True, help="課題の説明(Markdown)")
    ap.add_argument("--score", required=True, help="候補のディレクトリで実行し、最終行に点数を出すコマンド")
    ap.add_argument("--minimize", action="store_true", help="点数は小さいほど良い")
    ap.add_argument("--agent", choices=["claude", "codex", "cmd"], default="codex")
    ap.add_argument("--agent-cmd", default="", help="--agent cmd のときに実行するコマンド")
    ap.add_argument("--agent-args", default="", help="claude / codex に追加で渡す引数")
    ap.add_argument("--agents", type=int, default=4, help="チームの人数(1 なら単独)")
    ap.add_argument("--rounds", type=int, default=4, help="ラウンド数(1 なら忘れない)")
    ap.add_argument("--turns", type=int, default=5, help="1 ラウンドあたり、1 エージェントの提案回数")
    ap.add_argument("--turn-timeout", type=int, default=900)
    ap.add_argument("--score-timeout", type=int, default=60)
    ap.add_argument("--out", default="runs")
    args = ap.parse_args()
    t = Team(args)
    t.run_dir.mkdir(parents=True)
    t.run()
結果は runs/<日時>/log.jsonl に1行ずつ記録されます。ラウンドごとの最高点と、空のターン(何も変えずに終わった回)の数を見れば、論文と同じ観点で比べられます。
筆者の手元での動作確認
このスクリプトは、2026年10月25日に次の2通りで動作を確認しました(macOS、Python 3、git)。
- 偽のエージェントでの確認(LLM は呼ばない):3体×3ラウンド×4回で実行し、ラウンドが変わるたびにセッション ID が新しくなること、新しいラウンドの作業フォルダでは
git logが1件(最良版だけ)に戻ること、仲間のベストがプロンプトに載ること、何も変えないターンを「空のターン」として記録することを確認しました - Codex CLI 0.159.2 での実走(モデル gpt-6-astra、推論の強さ low):2体×2ラウンド×2回で実行し、巡回路の長さは最初の105,470.7から10,713.2まで縮みました。同じラウンドの2回目は前の会話の続き(
codex exec resume)として動き、ラウンドが変わると新しいセッションで始まることを確認しました
ちなみに Codex の記録を見ると、同じセッションの2回目の呼び出しでは、モデルに渡した入力が1回目の約2.3倍(約8.2万→約19万トークン)に増えていました。会話を続けるほど1回あたりの費用がかさむという論文の観察(結果3)と同じ傾向です。
ただし、この課題は簡単すぎて1回目の提案でほぼ最適な値まで縮んだため、忘れることの効果を測る実験にはなっていません。また、Claude Code(--agent claude)での実走は、手元の CLI のログインが切れていたため未実施です(引数は claude --help で確認しました)。自分の課題で試すときは、もっと難しく、1回では伸び切らない課題を選んでください。
ステップ3:チームにして業務へ
スクリプトで「忘れる」ほうが良いと確かめられた作業だけ、--agents 4 にしてチームと共有を加えます。論文で効果が最も大きかったのはこの形です。
チームにするときは、合計の予算を先に決めてから、人数とラウンド数で割るのがポイントです。4体にすれば、同じ回数でも費用は4倍になります。論文も、すべての設定を同じ合計予算で比べています。
業務に組み込むときの、筆者のおすすめの設定は次のとおりです。
| 項目 | おすすめ | 理由 |
|---|---|---|
| ラウンド数 | 4(3回忘れる) | 論文と同じ。効果は1回目が最大なので、少なくとも2ラウンド |
| 1ラウンドの長さ | 頭打ちのサインが出るくらい | 短すぎると、大胆な案が実を結ぶ前に捨ててしまう |
| 採点役 | 作業フォルダの外、毎回同じ条件 | エージェントによる書き換えと、採点のぶれを防ぐ |
| 指示書 | 制約は人が書き足す。失敗の記録は書かない | 必要な決定は残し、縛りになる経緯は残さない |
| 記録 | ラウンドごとの最高点・費用・空のターンの数 | 効果があるかを数字で判断する |
よくあるつまずきと対処
実際に試すときにつまずきそうな点を、表にまとめます。
| 症状 | 原因 | 対処 |
|---|---|---|
| 忘れた後、同じ失敗を繰り返す | 守るべき制約が会話の中にしかなかった | 制約として TASK.md などの指示書に書く |
| 忘れた直後に点数が下がった | 新しいエージェントが大胆な案を試している | 想定どおり。最良版はタグで保存してあるので、ラウンド全体の最高点で判断する |
| 点数が上がりすぎて不自然 | エージェントが採点役を書き換えた | 採点役を作業フォルダの外に置き、絶対パスで呼ぶ |
| 実行のたびに点数がぶれる | 採点に乱数や実行環境の揺れがある | テストケースを増やして平均を取る(論文の AHC014 は30ケースの平均) |
codex exec が止まったまま動かない | 標準入力を読み込もうとして待っている | < /dev/null を付けるか、スクリプトから呼ぶときは標準入力を閉じる(forget_loop.py は対応済み) |
| 費用が想定より大きい | 人数・ラウンド数を増やした | 合計予算を先に決め、--agents × --rounds × --turns の総回数で管理する |
まとめ
この記事では、UC Berkeley などの研究チームによる論文「Scaling Discovery Requires Forgetting」を解説しました。要点を振り返ります。
- AIエージェントに改善を繰り返させると、過去の自分の試行に縛られて修正が小さくなり、考える量も減り、最後は「限界です」と何もしなくなる。予算を増やしても、並列にしても、共有させても、この頭打ちは消えない
- 解決策は、定期的に会話の履歴と候補の記録を捨て、最良の成果物だけを持って新しいエージェントで再開すること。成果の大半は最良の候補に入っているので、捨てても損は小さい
- 4体のチームで共有しながら3回忘れる方式が、4課題すべてで最良。1体より平均22%、並列4体より平均10%良く、同じ頭打ちから続けるより約半分の費用で約3〜7倍伸びた
- 実務では、指示書(残す)・最良の成果物(残す)・経緯(捨てる)の3つに分けて扱い、採点役を作るところから小さく始めるのがおすすめ
論文の最後には、「いつ忘れ、何を覚えておくかを決めることが、自然な次の一歩だ」と書かれています。AIエージェントの記憶の機能が増えていく中で、「何を覚えさせないか」を設計することも、同じくらい大切になりそうです。まずは手元の改善作業で、行き詰まったら一度会話を捨てて、最良版から新しく始めてみてください。
参考リソース
- Scaling Discovery Requires Forgetting(arXiv:2610.20563):本記事で解説した論文
- Fork-and-Flush: Escaping idea basins in autoresearch agents(arXiv:2610.07447):会話だけを定期的に新しくする、同時期の関連研究
- Stateless Language Agents(arXiv:2610.07625):状態を持たないエージェントで長時間の自動研究を行う関連研究
- AlphaEvolve(arXiv:2506.13131):LLM と自動採点を組み合わせた進化的探索の代表例
- karpathy/autoresearch(GitHub):1体のエージェントが学習スクリプトを改善し続ける自動研究の例(nanochat-autoresearch の元)
- AtCoder Heuristic Contest 014:実験に使われた最適化問題
- Anthropic’s original performance take-home(GitHub):VLIW カーネル課題の元になった、Anthropic の採用課題