はじめに
AI エージェントに社内システムを操作させようとすると、最初は「できることを増やす」ことに目が向きます。MCP(Model Context Protocol:AI に外部のツールをつなぐための共通の約束事)のサーバーを足し、API ごとにツールを作り、気づけばツールが 50 個、100 個と増えていきます。
ところが、ある時点からエージェントの様子がおかしくなります。「承認して」と頼んだのに中身を表示するだけのツールを呼ぶ。存在しない名前のツールを呼ぶ。引数(ツールに渡す値)の形が微妙に違う。ツールを増やしたのに、かえって仕事ができなくなるのです。
2026 年 10 月 9 日、API 開発ツールの Postman と AWS が、Postman の AI 機能「Agent Mode」の本番の設計を公開しました。そこには、見せるツールが約 40 個を超えると選び間違いが増えたという実測と、170 個以上あるツールから依頼ごとに約 15 個だけを選んで見せるという解決策が書かれています。
この記事では、その内容を次の順に整理します。
- 従来の設計で何が問題だったのか
- 本番の設計で何をどう変えたのか(ツールの絞り込み・読み取りの方法・コンテキスト・運用)
- 手元の Mac で、架空のツール 120 個を使って「全部見せる」と「絞って見せる」を比べた結果
- 自分の環境(自前のコード・Claude API・Claude Code・LangGraph・Dify)での作り方と、向いている場面
想定している読者は、Dify や LangChain、Claude API などでエージェントを作り始めた人と、MCP のツールが増えてきて困っている人です。専門用語には短い説明を付けるので、エージェントの仕組みをこれから知りたい人にも読めるようにしています。
最初に、この記事の結論を 1 枚にまとめます。左が「全部見せる」設計、右が「絞って見せる」設計です。
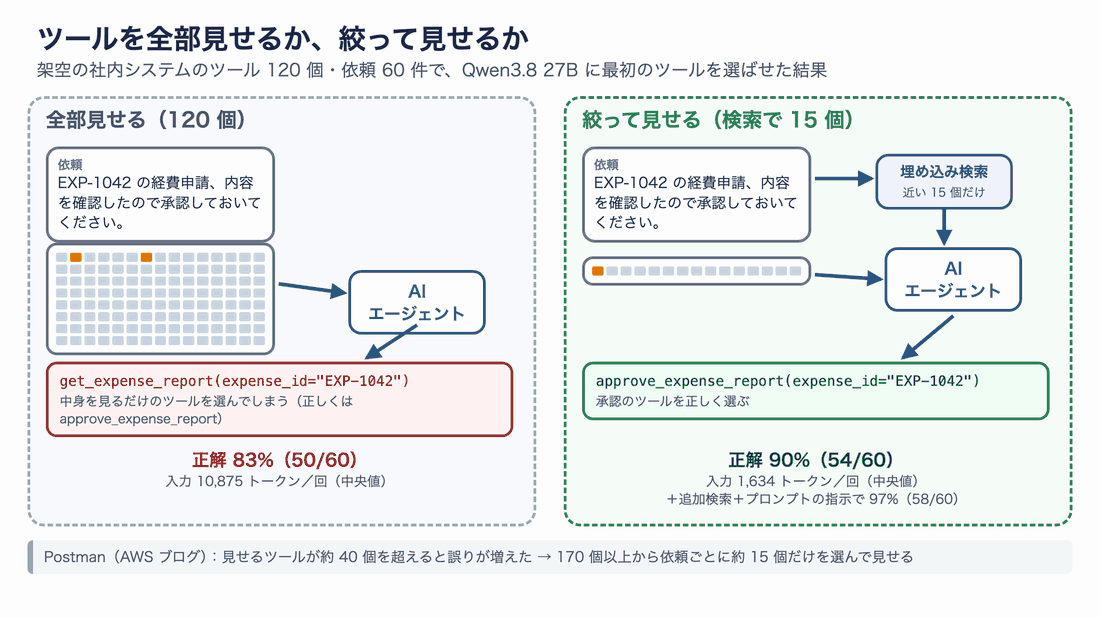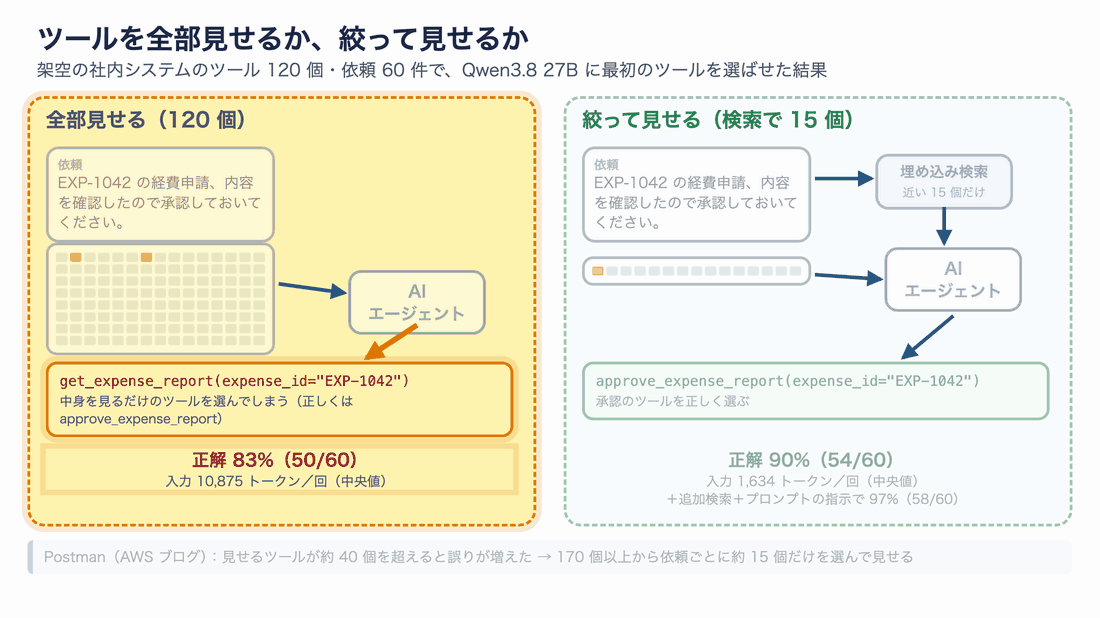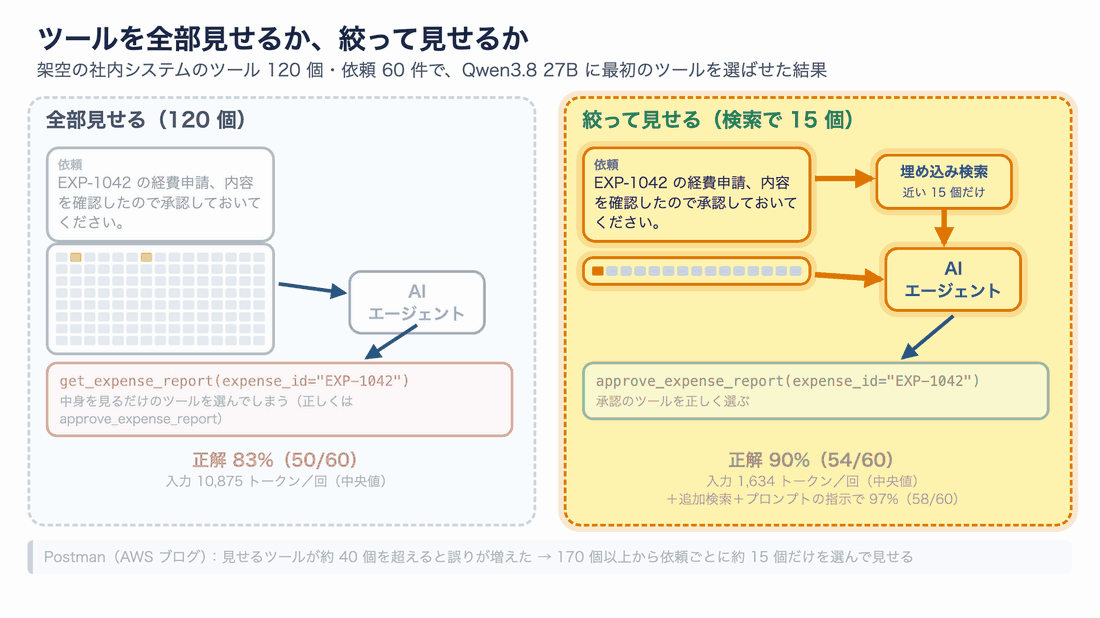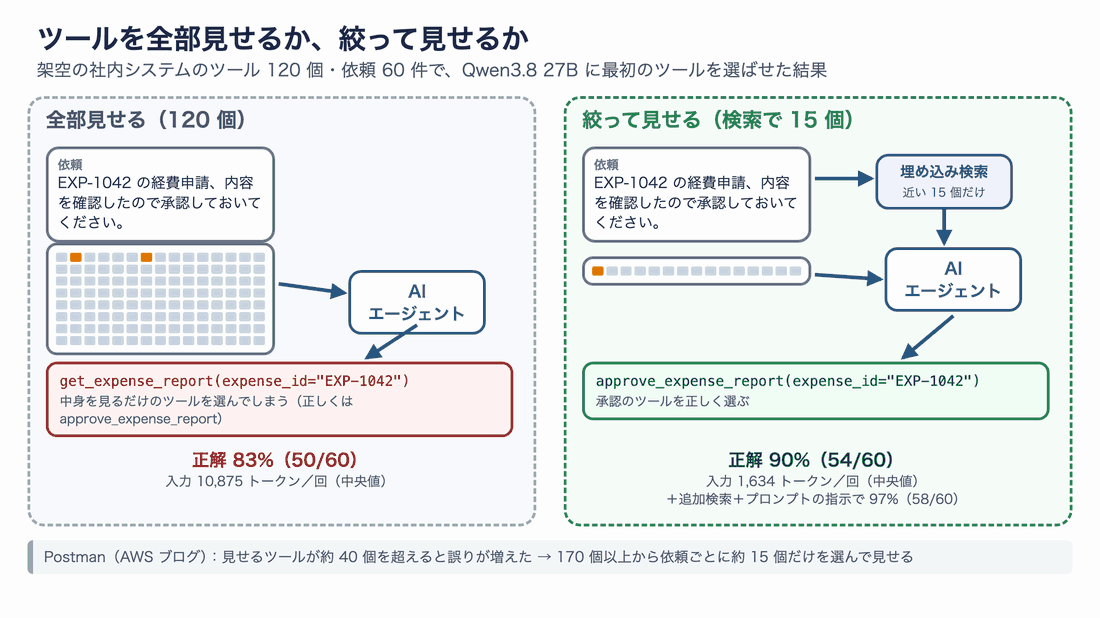
図1:全部見せる設計と、絞って見せる設計。数字は手元の実験(架空のツール 120 個・依頼 60 件)の結果
手元の実験では、ツールを検索で 15 個に絞るだけで、正しいツールを選べた割合が 83% から 90% に上がり、LLM に渡す入力は約 85% 減りました。ただし、いちばん効いたのは意外にもシステムプロンプトの 1 文でした。絞る設計に、失敗の中身に合わせた対策を組み合わせると 97% まで上がりました。後半で詳しく紹介します。
この記事の確認範囲
この記事は、2026 年 10 月 10 日に次の情報を確認して書いています。
| 種類 | 内容 |
|---|---|
| 一次情報 | AWS Machine Learning Blog「How Postman runs Agent Mode for 40 million developers on Amazon Bedrock」(Srinivas Kini・Shubham Gupta、2026-10-09) |
| 関連する公式資料 | Claude の「Tool search tool」ドキュメント、Claude Code の MCP ドキュメント、langgraph-bigtool の README |
| 手元の実験 | MacBook Pro(Apple M5 Max・メモリ 128GB)、LM Studio で動かした Qwen3.8 27B、埋め込みモデル multilingual-e5-small |
Postman の実装そのものは公開されていません(原文にも、公開のサンプルリポジトリはないと書かれています)。この記事の実験は、Postman の結果を再現したものではなく、同じ考え方を小さな架空のシステムで試したものです。原文に書かれている事実、私の補足、手元の実験の結果は、文中で分けて書きます。
公式の記事の冒頭(aws.amazon.com、2026-10-10 撮影)
用語をそろえる
この先で何度も出てくる言葉を、先に表にしておきます。
| 用語 | この記事での意味 |
|---|---|
| エージェント | AI が自分で「次に何をするか」を決め、ツールを呼びながら作業を進める仕組み |
| ツール | エージェントが呼べる機能。名前・説明文・引数の形(スキーマ)で定義する。例:approve_expense_report(経費申請を承認する) |
| サブエージェント | 親のエージェントから仕事を任される子のエージェント。親とは別の会話(文脈)で動く |
| 埋め込み(embedding) | 文章を数値の並び(ベクトル)に変えたもの。意味が近い文章ほど、数値も近くなる |
| ベクトル DB | 埋め込みを保存し、「この文章に近いもの」を素早く探せるデータベース |
| コンテキスト | モデルに渡す情報の全体。指示、ツールの定義、会話、画面の状態などを含む |
| プロンプトキャッシュ | 毎回同じ前半部分の計算結果を使い回し、速く安くする仕組み |
従来の設計で何が起きていたか
小さなツールをたくさん並べる設計
Postman の Agent Mode は、最初はとても小さな単機能のツールを中心に作られていました。「リクエストを開く」「項目を 1 つ更新する」「特定のメタデータを取る」といった粒度です。
この作り方には良い面もあります。1 つ 1 つのツールが単純なので、正しく動いているかを確かめやすく、何をさせるかを細かく制御できます。初期の段階では、この正確さと制御のしやすさが役に立ったと原文にも書かれています。
しかし、使われるにつれて 4 つの問題が見えてきました。
課題1:作業が細切れになって遅い
実際の仕事は、ツールを何回も続けて呼ぶ必要があります。1 回 1 回の処理が速くても、ツールを呼ぶたびにモデルへ戻って「次は何をするか」を考えるので、全体としては遅く感じられます。
ユーザーから見ると、頭の中では 1 つの操作なのに、エージェントがそれを小さな手順に分けて 1 歩ずつ進める様子を眺めることになります。
課題2:見せるツールが約 40 個を超えると選び間違える
いちばん重要なのがこの問題です。Postman の検証では、モデルに見せるツールが約 40 個を超えたあたりから、ツール選びの誤りが増えました。誤りは次の 3 種類です。
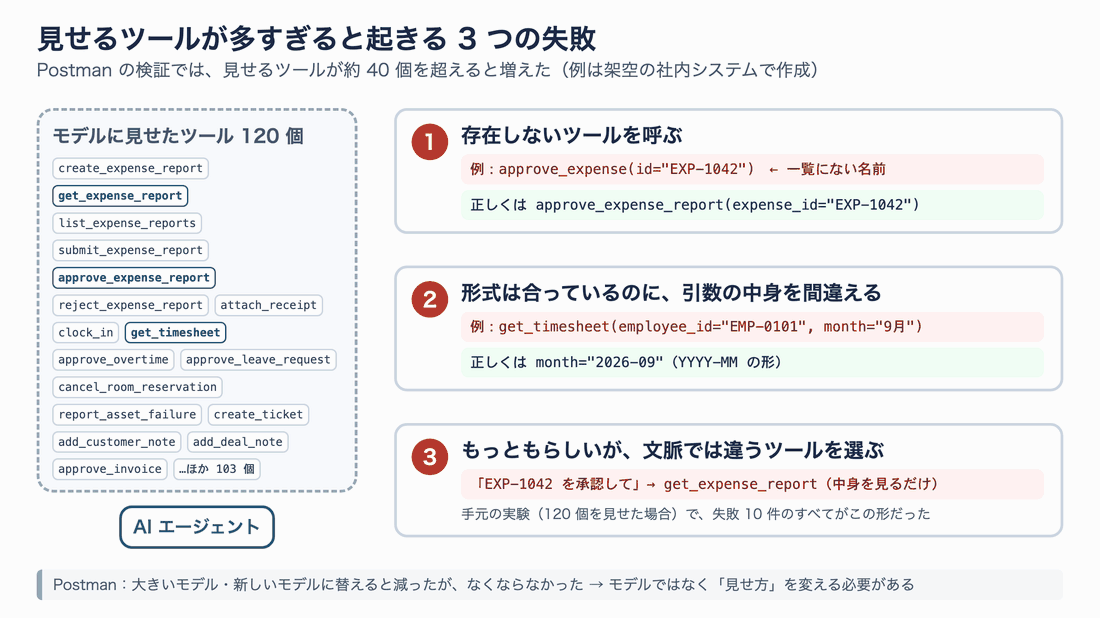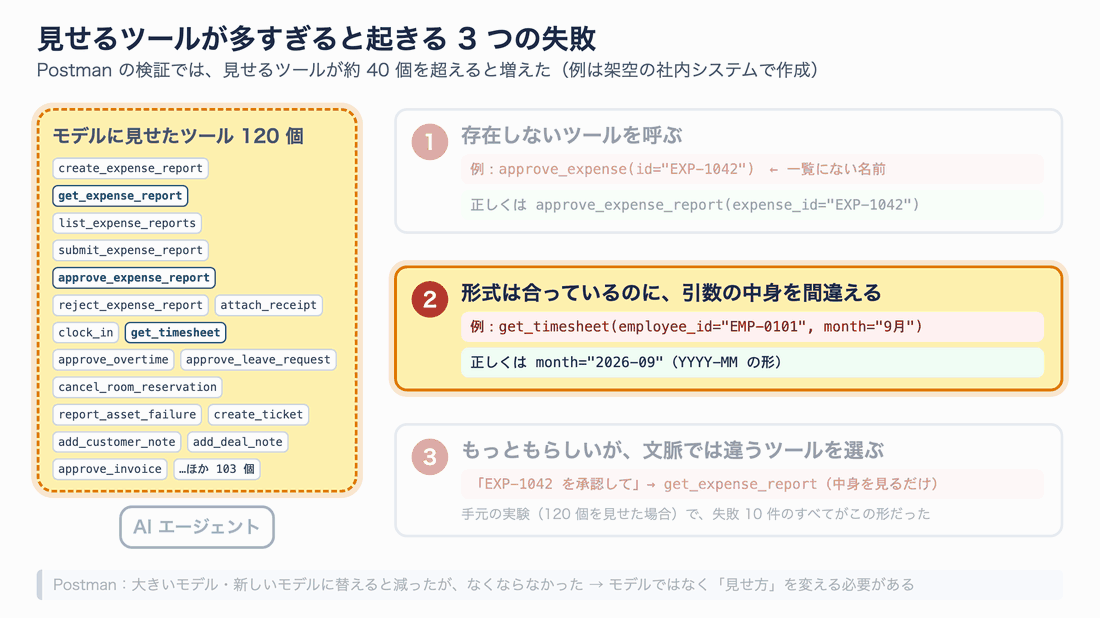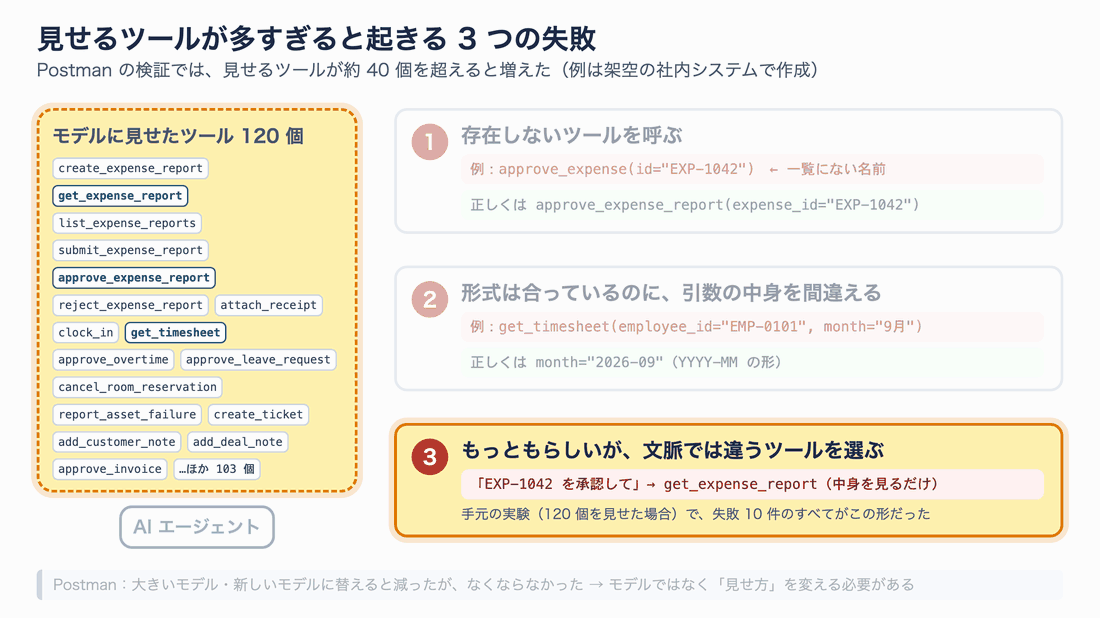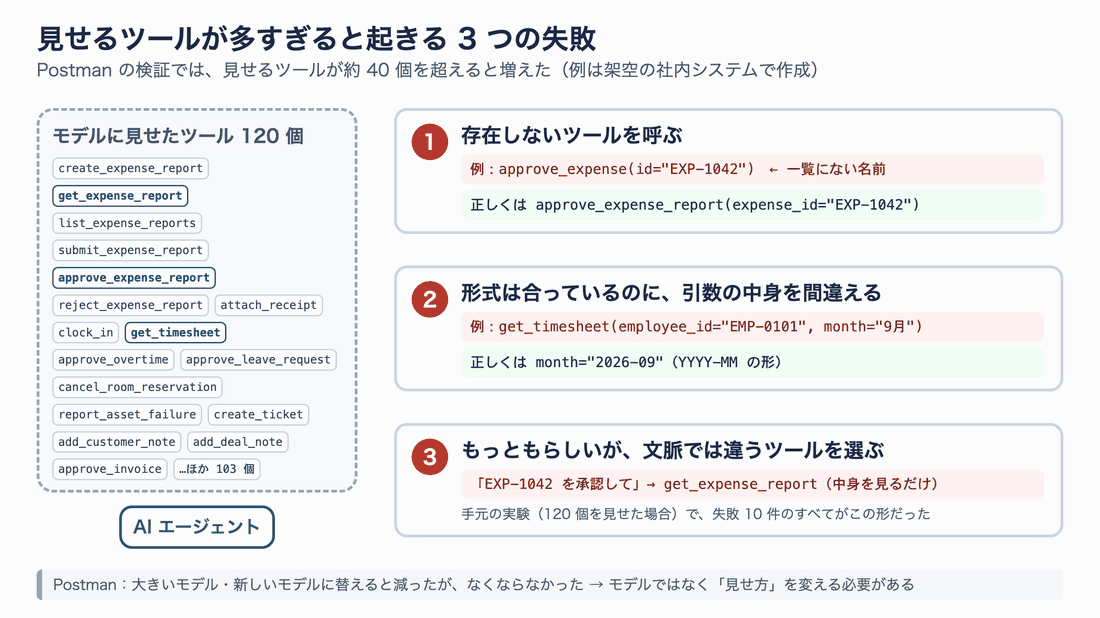
図2:Postman が挙げた 3 種類の失敗。例は架空のツールで書いたもの
3 つ目の「もっともらしいが違うツール」は気づきにくい失敗です。エラーにならず、それらしい結果が返ってくるので、ユーザーが後で「承認されていない」と気づくまで分かりません。
原文によると、大きいモデルや新しいモデルに替えるとこの誤りは減りましたが、なくなりはしませんでした。つまり、モデルを強くするだけでは解決しない、設計の問題だということです。
この「数十個を超えると選び間違える」という傾向は、Postman だけの話ではありません。Claude のツール検索機能のドキュメントにも、30〜50 個を超えると正しいツールを選ぶ力が落ちる、と書かれています。
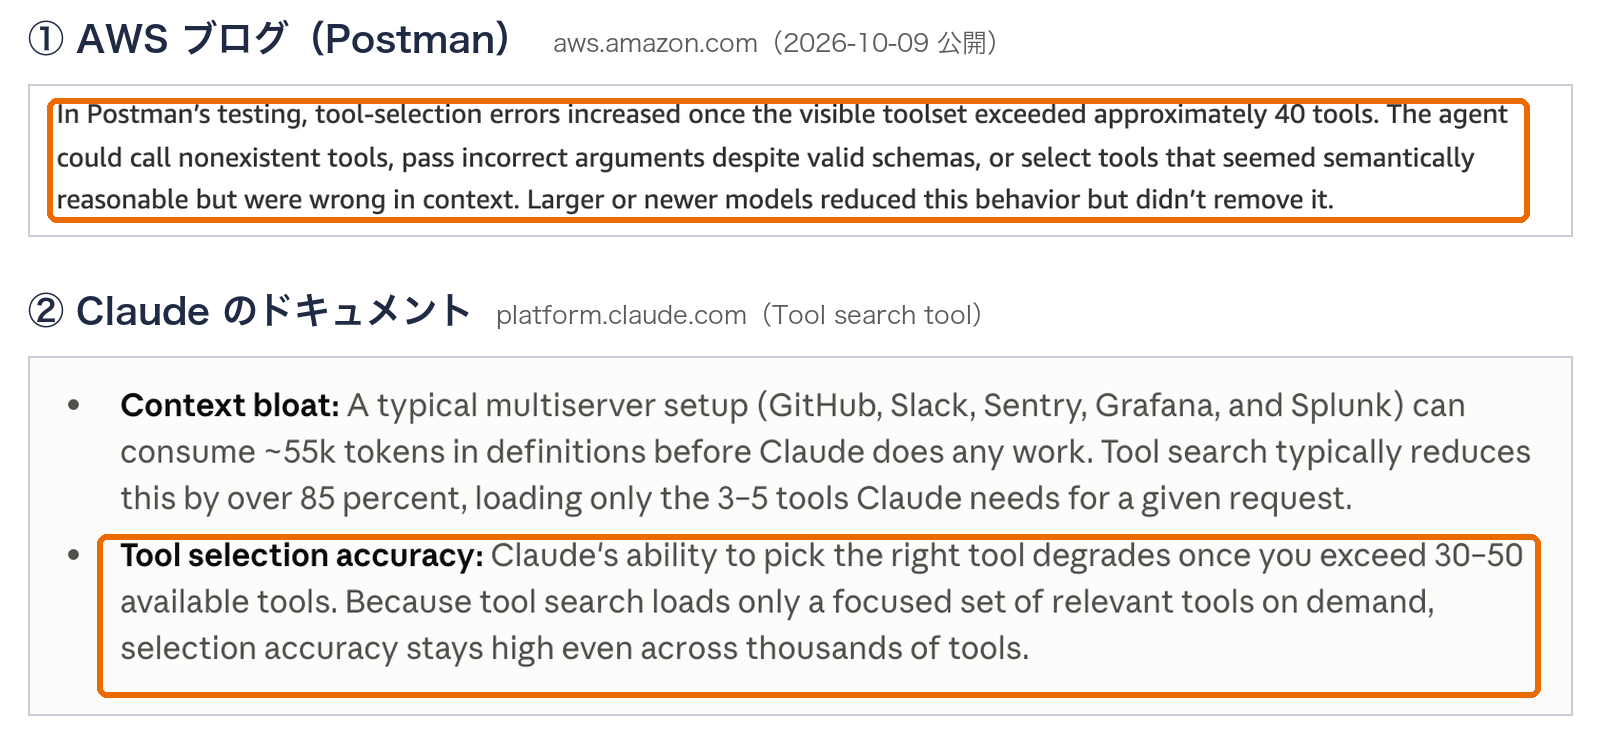
上:AWS ブログの該当段落。下:Claude の Tool search tool のドキュメント(どちらも 2026-10-10 撮影、枠は筆者)
課題3:ツールが画面の状態に縛られていた
もう 1 つ、目立たないけれど根の深い問題がありました。Postman のアプリの機能が、画面の状態と結びついていたのです。
たとえば、リクエストを書き換えるツールは、そのリクエストのタブが開いていないと動きませんでした。逆に、別のツールは副作用で新しいタブを開いてしまいます。その結果、エージェントは「リクエストを読むためにタブを開く」という、人間の画面操作をまねる動きをしていました。データを直接読めば済むはずなのに、です。
課題4:足りなかったのはツールより「コンテキスト」
Postman のチームは当初、「足りないツール」がいちばんの壁になると考えていました。ところが実際には、足りない・不完全なコンテキストのほうが、多くの失敗の原因になったといいます。
ここでいうコンテキストは、「ユーザーが Postman のどこにいて、どの対象を扱っていて、ここまでに何が決まっているか」をエージェントが理解するための情報です。これが間違っていたり欠けていたりすると、正しいツールがあっても役に立ちません。
しかも、11 年かけて作られた製品の画面用のデータを、そのままエージェントに渡してもうまくいきませんでした。画面に表示するためのデータの形は、推論(考えること)のための形ではないからです。
ここまでの 4 つの課題を表にまとめます。
| 課題 | 何が起きたか | 原因 |
|---|---|---|
| 作業が遅い | 1 つの操作が小さなツールの連続になる | ツールが細かすぎ、毎回モデルに戻る |
| 選び間違える | 存在しないツール・誤った引数・似た別ツール | 見せるツールが多すぎる(約 40 個超) |
| 画面に縛られる | タブを開かないと読めない・書けない | ツールが画面の状態と結びついていた |
| 文脈が足りない | 正しいツールがあっても失敗する | 画面用のデータをそのまま渡していた |
本番アーキテクチャの全体像
では、Postman は本番でどういう構成にしたのでしょうか。AWS ブログの構成図をもとに、要素の役割を書き直したのが次の図です。
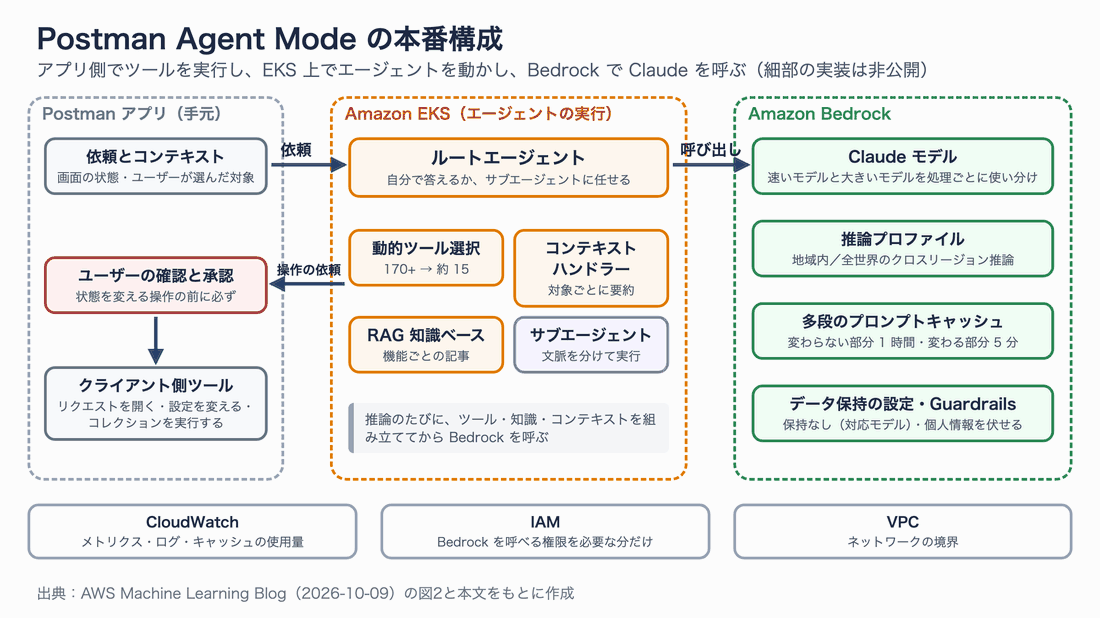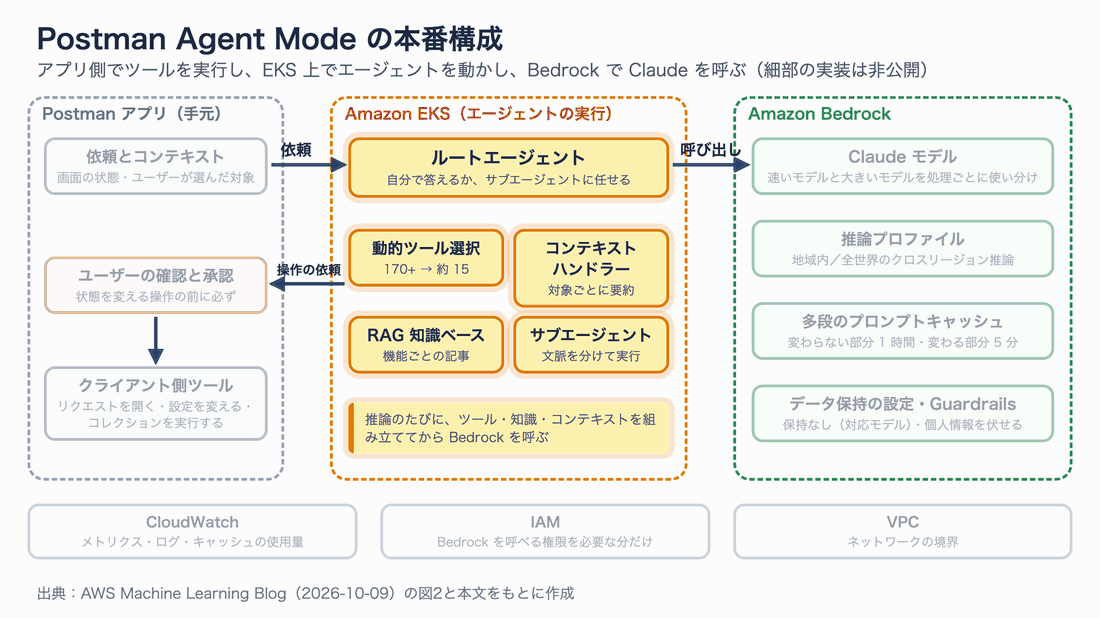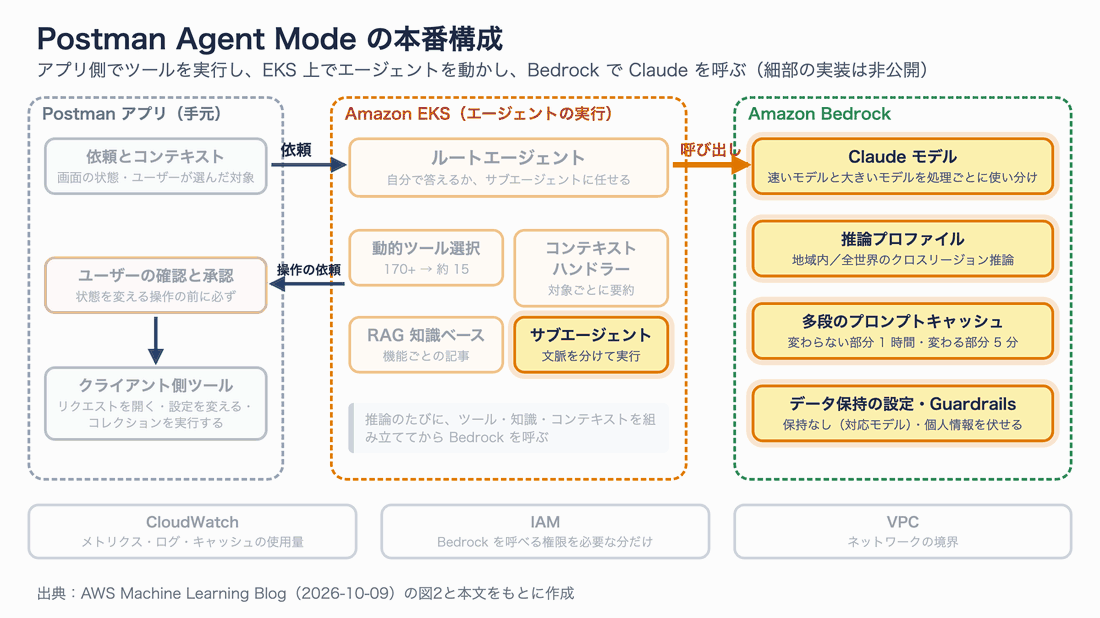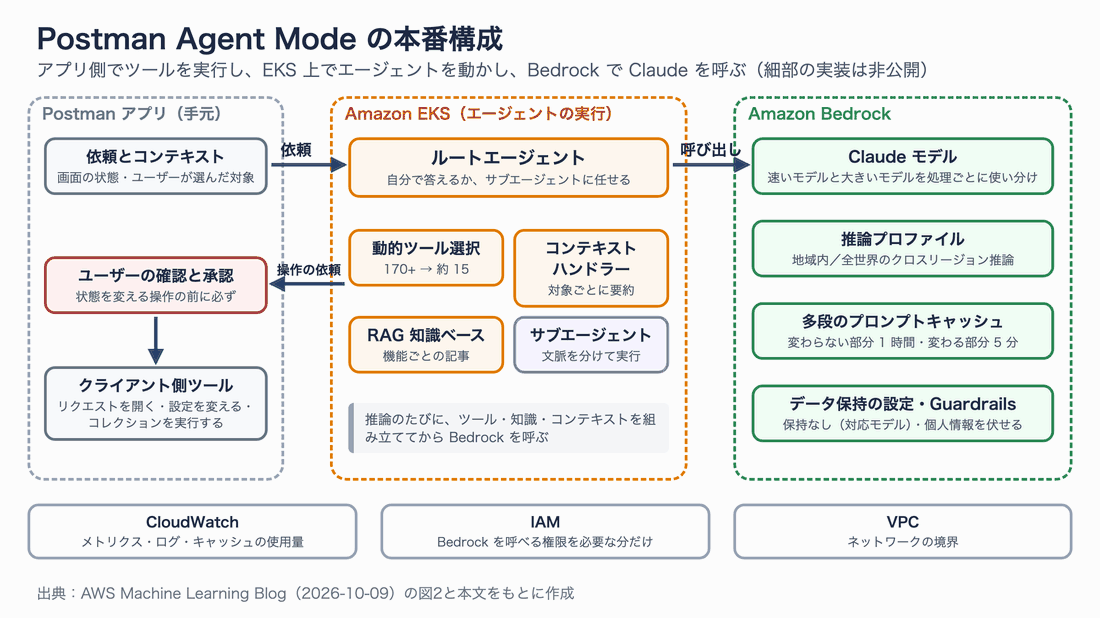
図3:本番構成の全体像。強調の順に、依頼 → エージェント内の組み立て → Bedrock での推論 → 承認とツールの実行
構成は大きく 3 つに分かれます。
- Postman アプリ(手元):ユーザーの依頼と画面の状態をエージェントに送り、エージェントから頼まれた操作を実行します。リクエストを開く、設定を変える、コレクション(リクエストのまとまり)を実行するといったツールは、アプリの中にあります(クライアント側ツール)。状態を変える操作の前には、必ずユーザーの承認を挟みます。
- エージェントの実行基盤(Amazon EKS):ルートエージェント(最初に依頼を受ける親のエージェント)が、ツールの絞り込み、コンテキストの組み立て、知識の検索を行い、必要に応じてサブエージェントに仕事を任せます。
- 推論(Amazon Bedrock):Claude のモデルを呼びます。処理ごとのモデルの使い分け、リージョンをまたぐ推論、プロンプトキャッシュ、データを保持しない設定、個人情報を伏せる Guardrails などを使います。
ここからは、この構成のうち、従来の課題を解決した部分を 1 つずつ見ていきます。
改善1:動的ツール選択で「見せる数」を絞る
いちばんの改善は、依頼のたびに、関係するツールだけを選んで見せることです。原文はこれを動的ツール選択(Dynamic Tool Selection)と呼んでいます。
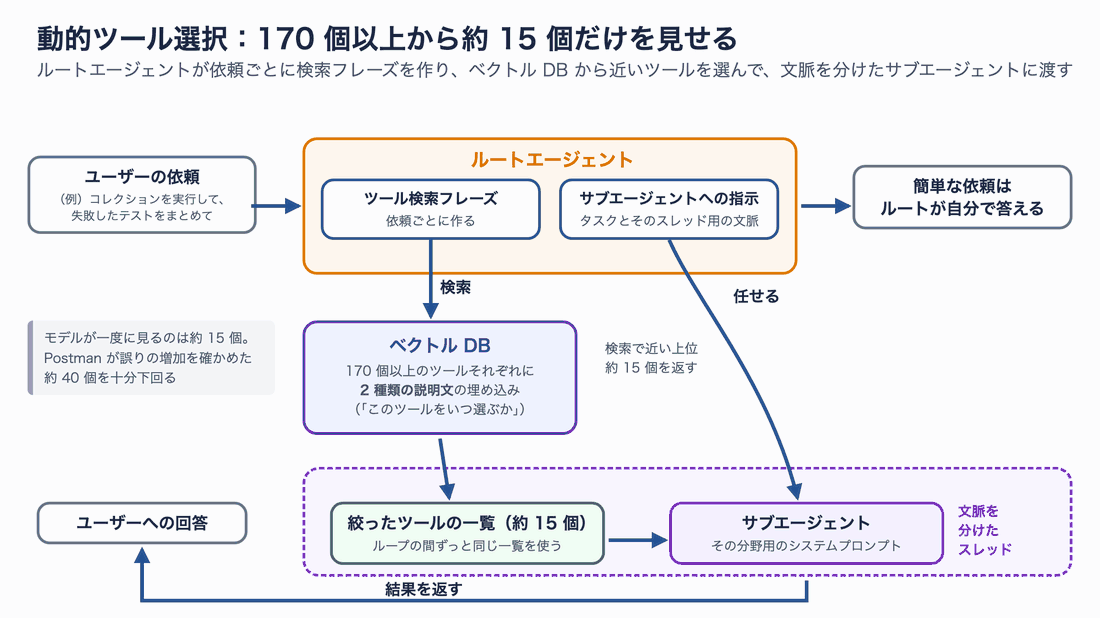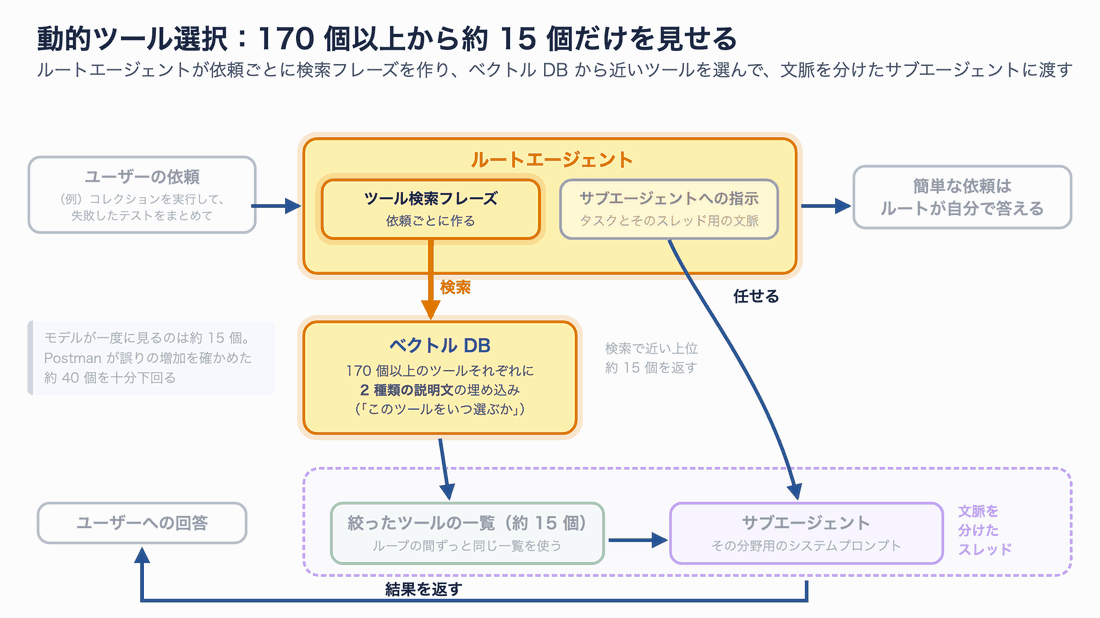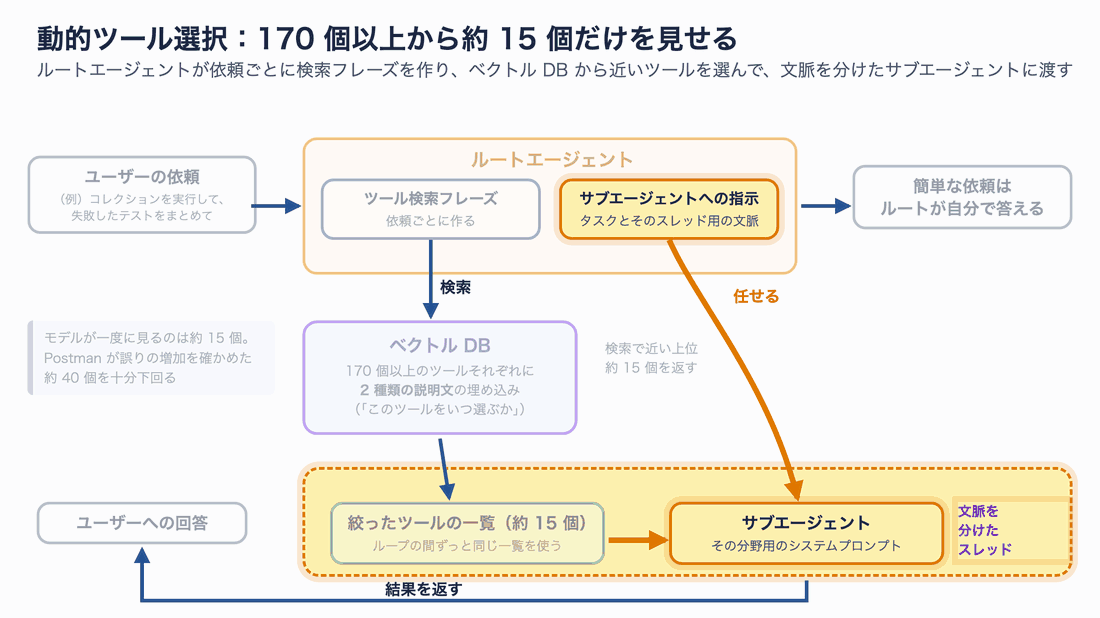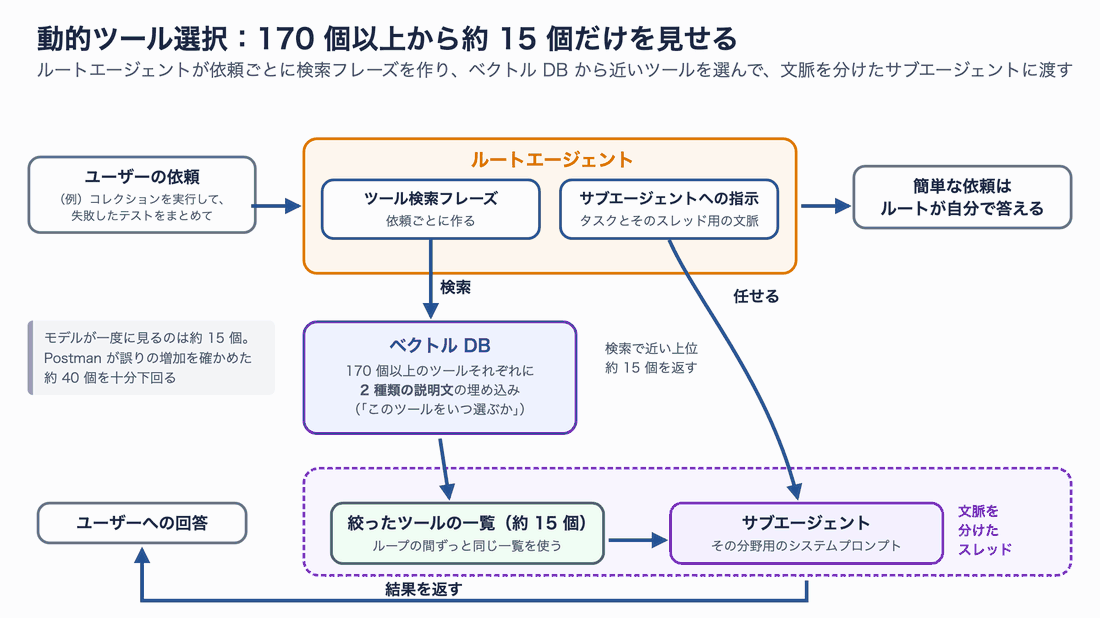
図4:動的ツール選択の流れ。AWS ブログの図3をもとに作成
流れを順に説明します。
- 事前の準備:170 個以上のツールについて、説明文を埋め込み(ベクトル)にしてベクトル DB に入れておきます。原文の図では、ツールごとに 2 種類の説明文を埋め込んでいて、その 1 つに「このツールをいつ選ぶか」という注記があります。2 種類の中身の詳細までは書かれていません。
- 検索フレーズを作る:依頼が来ると、ルートエージェントが依頼ごとに「ツールを探すための言葉」を作ります。ユーザーの文章をそのまま検索に使うのではない点がポイントです。
- 約 15 個に絞る:その言葉でベクトル DB を検索し、近い順に約 15 個のツールを取り出します。
- 文脈を分けて任せる:絞ったツールの一覧と、「何をするか」の指示をサブエージェントに渡します。サブエージェントは親とは別のスレッド(会話)で動くので、ほかの作業の文脈が混ざりません。その分野用のシステムプロンプトも持っています。
- 一覧は途中で変えない:絞ったツールの一覧は、サブエージェントが作業を続ける間ずっと同じものを使います。
- 簡単な依頼は任せない:サブエージェントに任せるまでもない依頼は、ルートエージェントが自分で答えます。
この設計のおかげで、ツールの総数が 170 個に増えても、モデルが一度に見るのは約 15 個です。Postman が誤りの増加を確かめた約 40 個を十分に下回ります。
原文は、この部分の教訓を「ツールの一覧も、コンテキストの予算の一部として扱う」とまとめています。ツールの定義は、モデルに渡す文章の一部です。たくさん並べるほど、モデルが注意を向けるべき情報が増え、トークン(文章の単位。料金と速度に直結する)も増えます。
ここで私の補足を 1 つ加えます。5 の「一覧を途中で変えない」は、プロンプトキャッシュとの相性の面でも理にかなっています。キャッシュは「前回と同じ前半部分」にしか効かないので、ツールの一覧が毎回変わると、せっかくのキャッシュが使えなくなります。サブエージェントの中で一覧を固定すれば、そのスレッドの中ではキャッシュが効きます。この点は、後半の実験でも数字で確かめます。
改善2:読み取りは「質問ごとのツール」から「スキーマ + クエリ」へ
ツールを絞るだけでは、ツールの総数そのものは減りません。Postman は、読み取り系のツールを増やさない工夫もしています。
Postman の API Catalog という機能では、たくさんのサービスについて、稼働時間、テスト結果、エンドポイント(API の窓口)ごとの応答時間といった構造化データを扱います。従来なら「稼働率を見るツール」「エラー率を見るツール」……と、質問の種類ごとにツールを作るところです。
Postman はこれを、1 本のクエリ用ツールにまとめました。データが入っている ClickHouse(分析向けのデータベース)のテーブル構造(スキーマ)をエージェントに渡し、エージェント自身に JOIN(表の結合)や WHERE(条件の絞り込み)を含む SQL を書かせます。
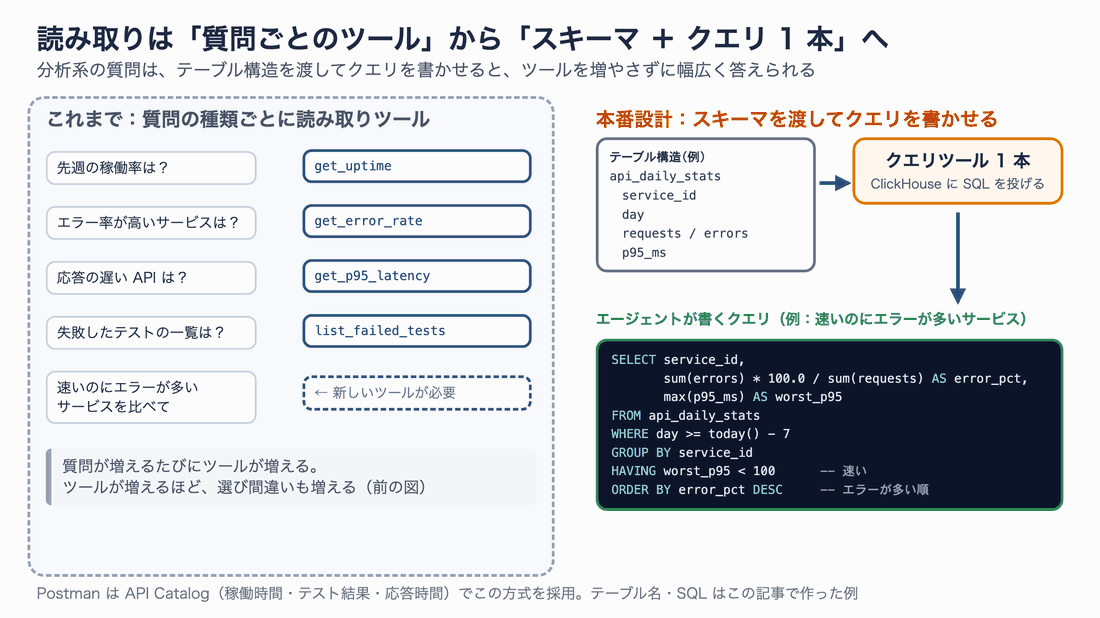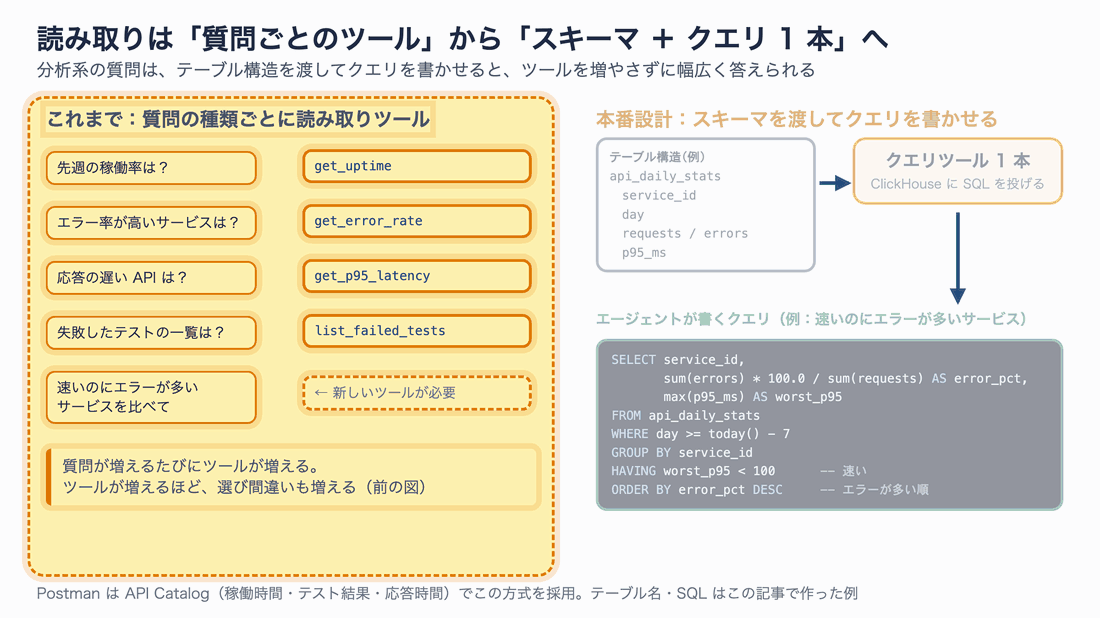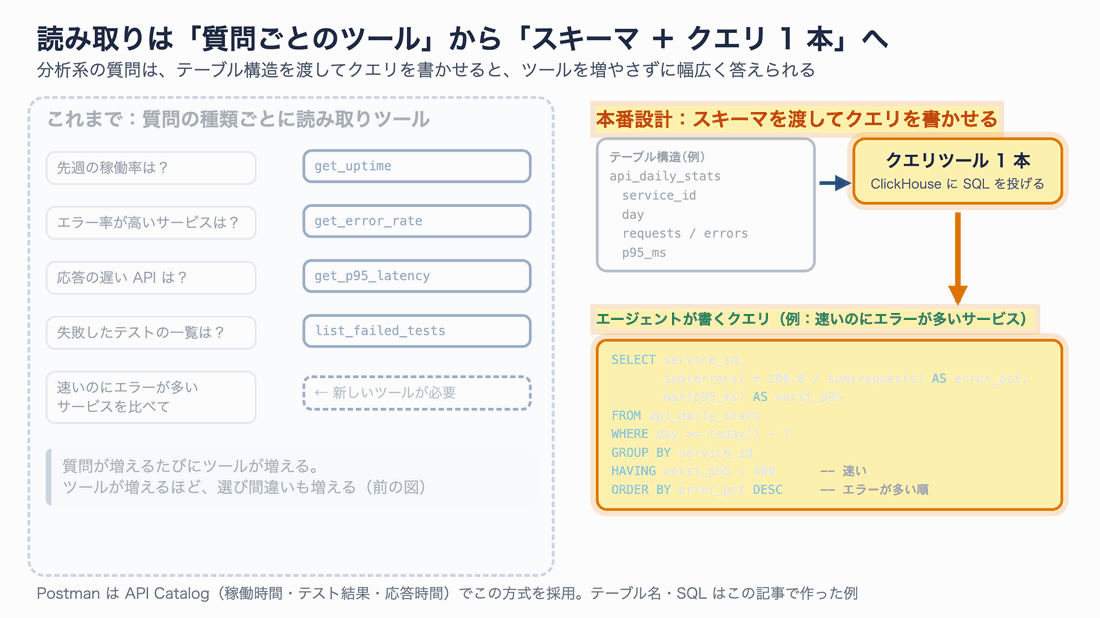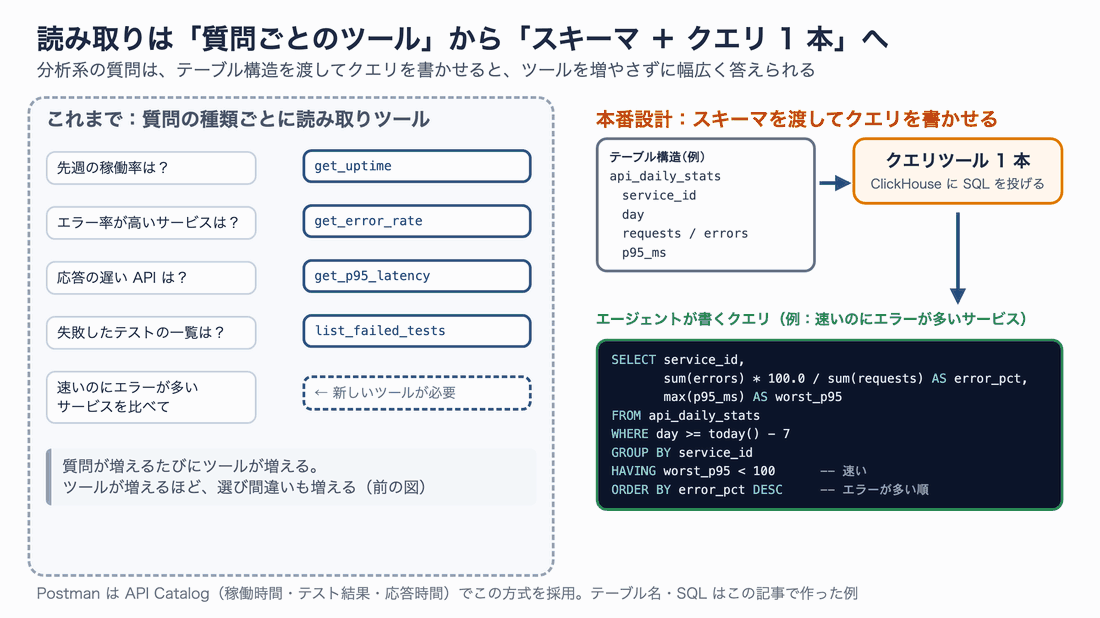
図5:読み取りの設計の違い。テーブル名と SQL はこの記事で作った例
図の右の SQL は、この記事で作った例です。「直近 7 日で、応答は速い(p95 が 100 ミリ秒未満)のにエラーが多いサービス」を探しています。このような組み合わせの質問は、質問ごとのツールでは用意しきれません。
原文はこの考え方を、「質問ごとにツールを作る仕事」から「データを一度きちんと設計する仕事」への転換と表現しています。ツールの数をデータ設計に置き換えるほうが、規模が大きくなったときに伸びしろがある、ということです。
ただし、原文には書かれていない注意点があります。エージェントに SQL を書かせるなら、次のような守りは別に必要です(ここは私の補足です)。
- 読み取り専用のデータベースユーザーで接続する
- 1 回に返す行数と実行時間に上限を設ける
- 利用者やテナント(契約単位)をまたいだデータが見えないように、ビューや行レベルの権限で区切る
- 生成された SQL と結果をログに残し、後から確認できるようにする
改善3:コンテキストを 2 種類に分けて作る
課題4の「コンテキストが足りない」に対して、Postman はコンテキストを 2 種類に分けて作ることにしました。
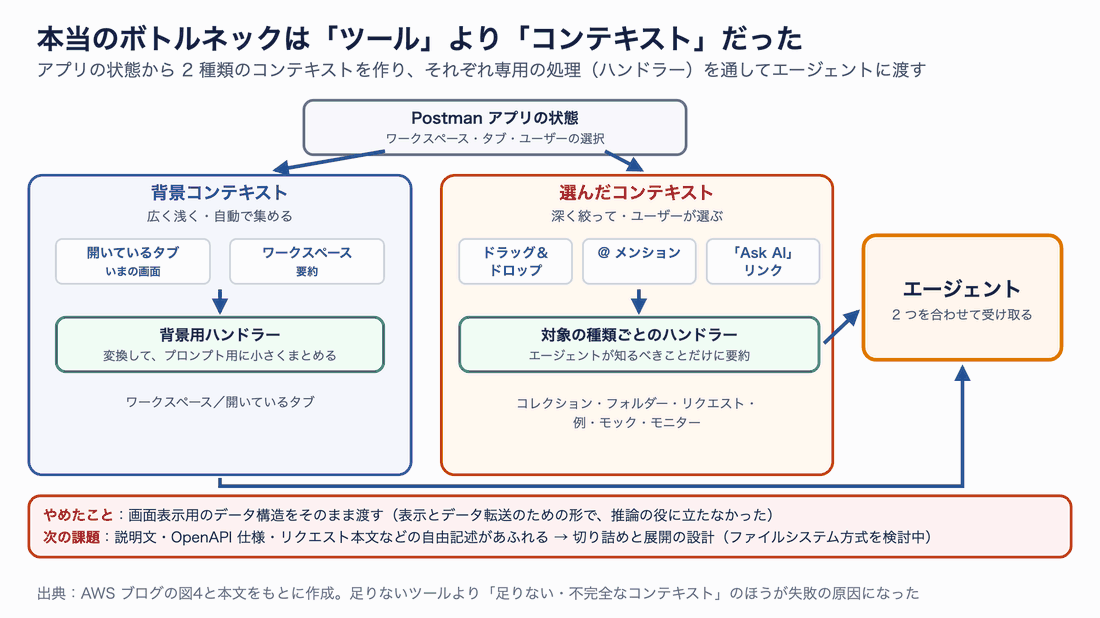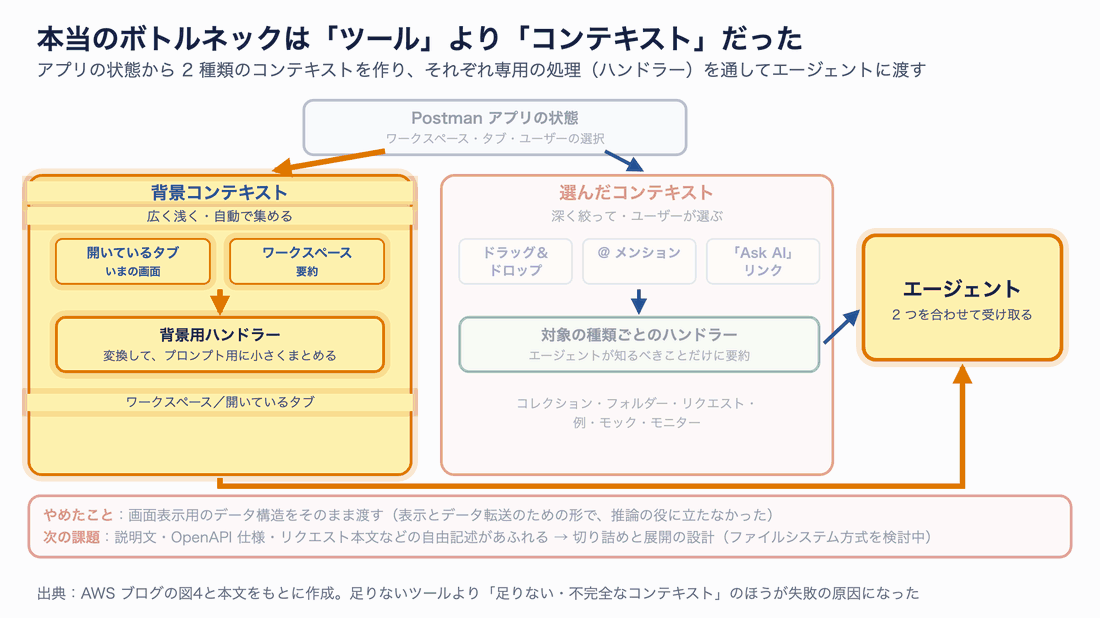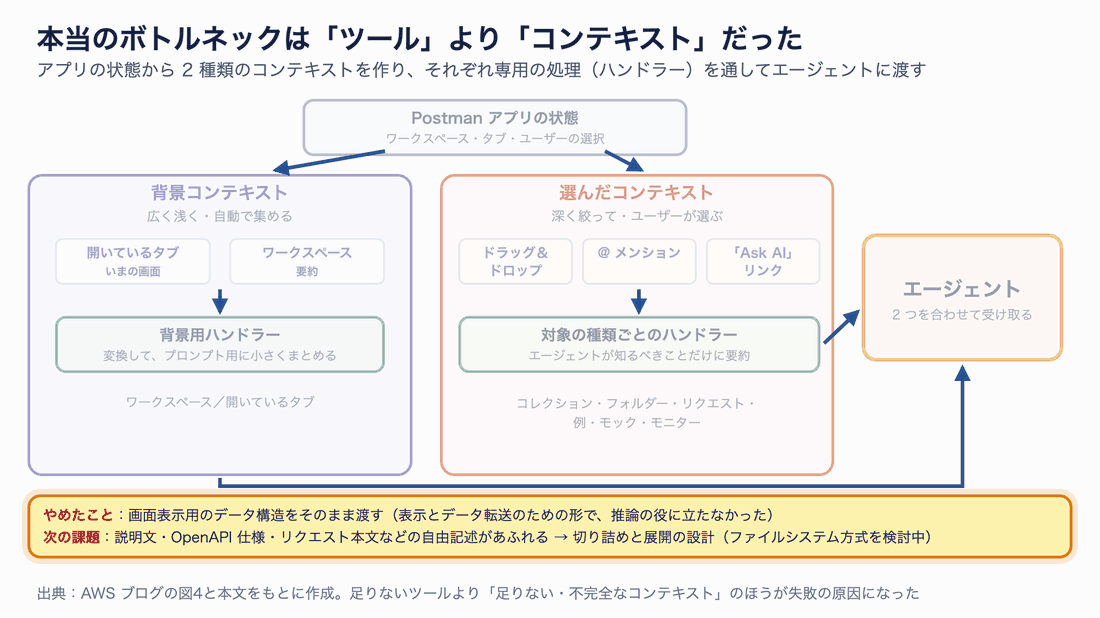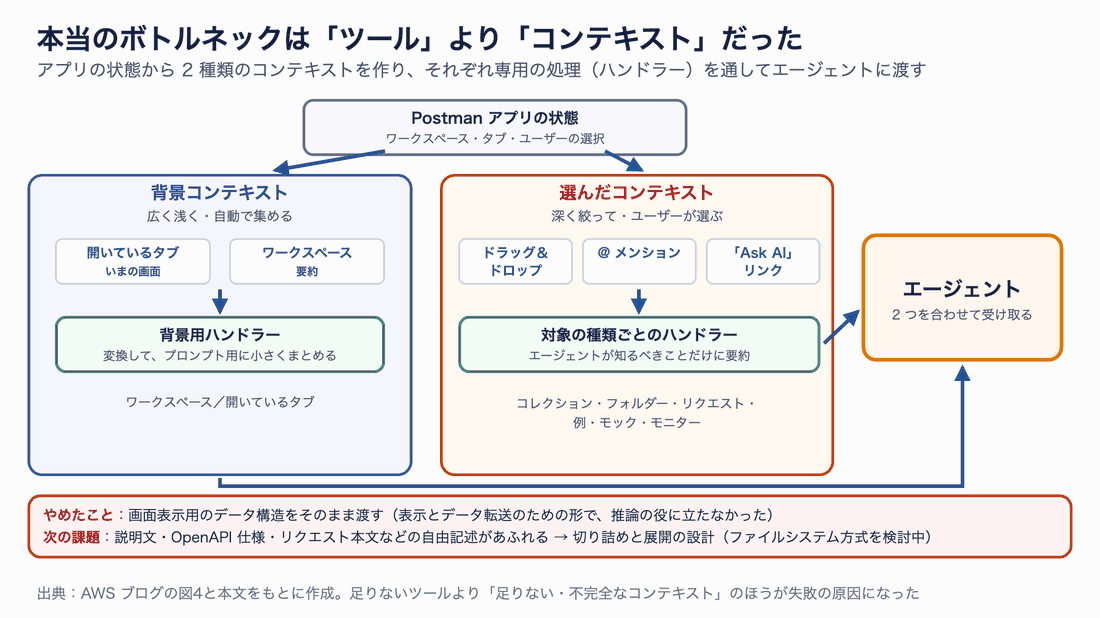
図6:2 種類のコンテキスト。AWS ブログの図4と本文をもとに作成
1 つ目は背景コンテキストです。いま開いているタブ(いまの画面)やワークスペースの要約など、広く浅い情報を自動で集め、プロンプト用に小さくまとめます。
2 つ目は選んだコンテキストです。ユーザーがドラッグ&ドロップや @ メンション、「Ask AI」リンクで指定した対象について、深く絞った情報を渡します。コレクション、フォルダー、リクエスト、例、モック(本物の代わりに決まった応答を返す仮のサーバー)、モニター(定期的な監視)など、対象の種類ごとに専用のハンドラー(変換処理)があり、エージェントが知るべきことだけに要約します。
画面表示用のデータ構造をそのまま JSON にして渡すのは、やめました。表示やデータのやり取りのための形で、推論の役に立たなかったからです。
ハンドラーが増えると、次は情報があふれる問題が出てきました。リクエストの説明文、OpenAPI 仕様(API の設計書)、リクエストの本文など、ユーザーが自由に書く情報は長くなりがちで、コンテキストを圧迫します。Postman は、ハンドラーごとに切り詰めと展開の処理を書かなくて済むように、ファイルシステムを使う方式を検討しているそうです。
原文の教訓は、「画面描画用のデータモデルをそのまま渡さない。コンテキストの窓は限られた予算として管理する」です。モデルの上限に届くずっと前に、余計な情報が大事な情報を押しのけてしまう、という指摘は、ツールの数の問題と同じ構造をしています。
改善4:画面とツールを切り離し、製品知識は必要な分だけ渡す
残りの 2 つの改善は、1 枚の図にまとめました。
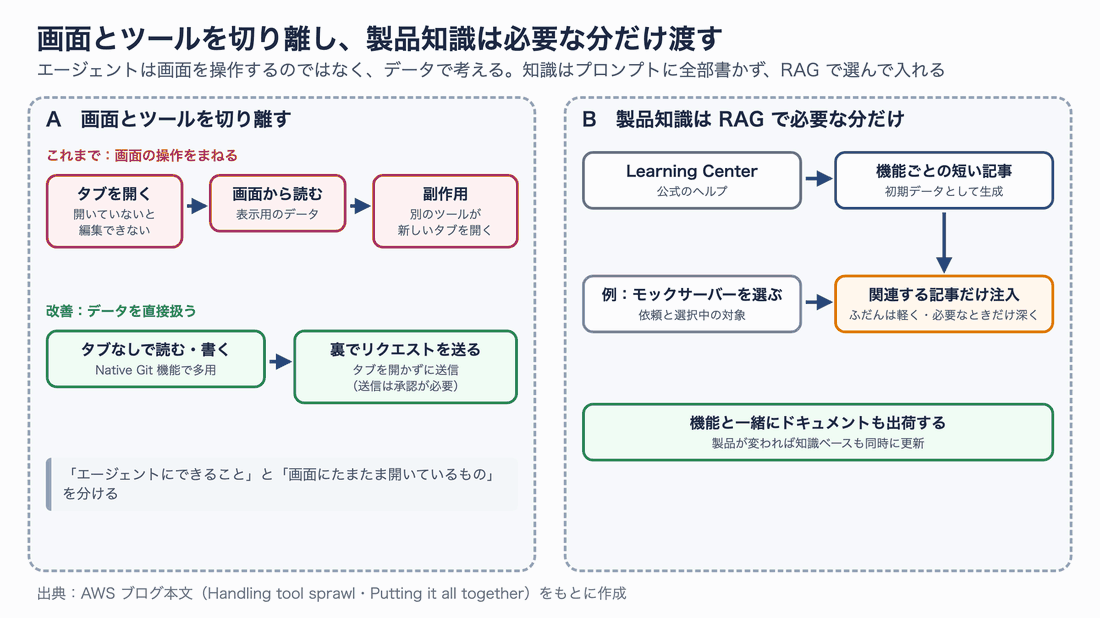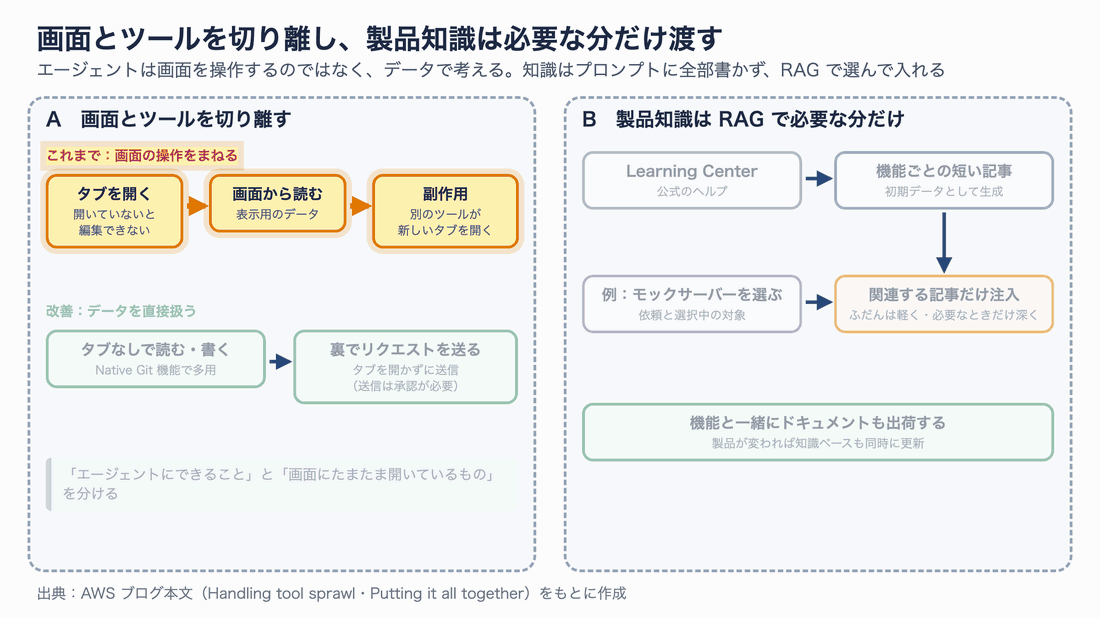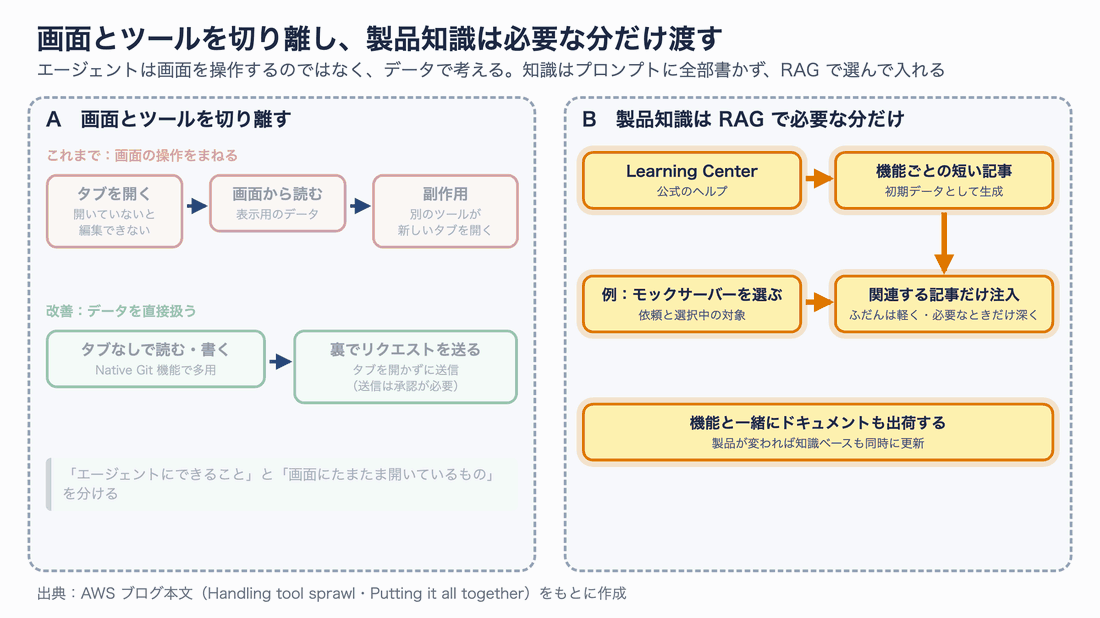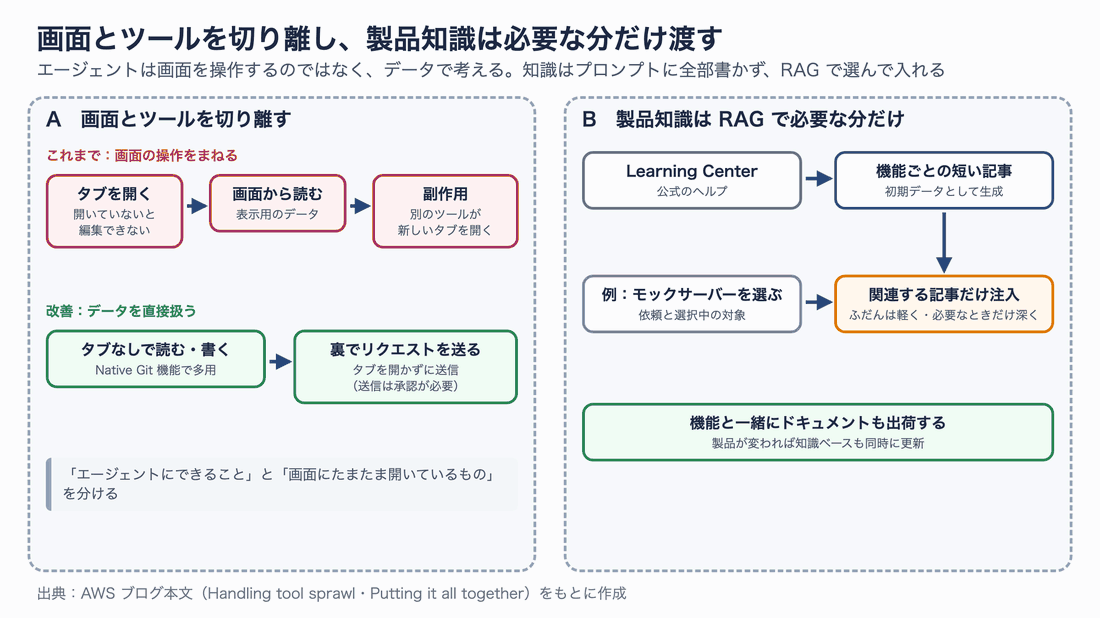
図7:画面からの切り離しと、RAG による知識の注入
画面からの切り離しでは、ツールがタブの状態に頼らずにデータを直接読み書きできるように作り直しています。Postman の Native Git(Git と連携する機能)ではこの方式を多く使っていて、Agent Mode はタブを開かずに裏でリクエストを送れるようになりました。ただし、送信の前にはユーザーの承認が必要です。
原文の言葉を借りると、「エージェントにできること」と「画面にたまたま開いているもの」を分ける、ということです。タブを開く必要があるツールは、エージェントがデータで考えずに画面を操作していることの表れだ、とも書かれています。
製品知識は、RAG(検索して見つけた情報をプロンプトに足して答えさせる方法)で入れています。Postman はリクエストの形式、モックサーバー、モニター、ワークスペースの管理、変数、コード生成など機能がとても多く、すべてをシステムプロンプトに書くのは現実的ではありません。しかも、1 つの依頼に関係するのはそのごく一部です。
そこで、公式ヘルプ(Learning Center)から機能ごとの短い記事を作って知識ベースにし、依頼と選択中の対象に合わせて記事を選んで入れます。たとえばユーザーがモックサーバーを選ぶと、関連する記事が自動で入ります。ふだんは軽く、必要なときだけ深く、という作りです。
知識ベースは製品と一緒に更新し、新しい機能を出すときには Agent Mode 用のドキュメントも一緒に出せるようにしています。原文は「機能と一緒にドキュメントも出荷する」ことを、ベストプラクティスの 1 つに挙げています。
改善5:承認・振り分け・キャッシュで本番に耐える
最後は、Bedrock 側の運用の工夫です。
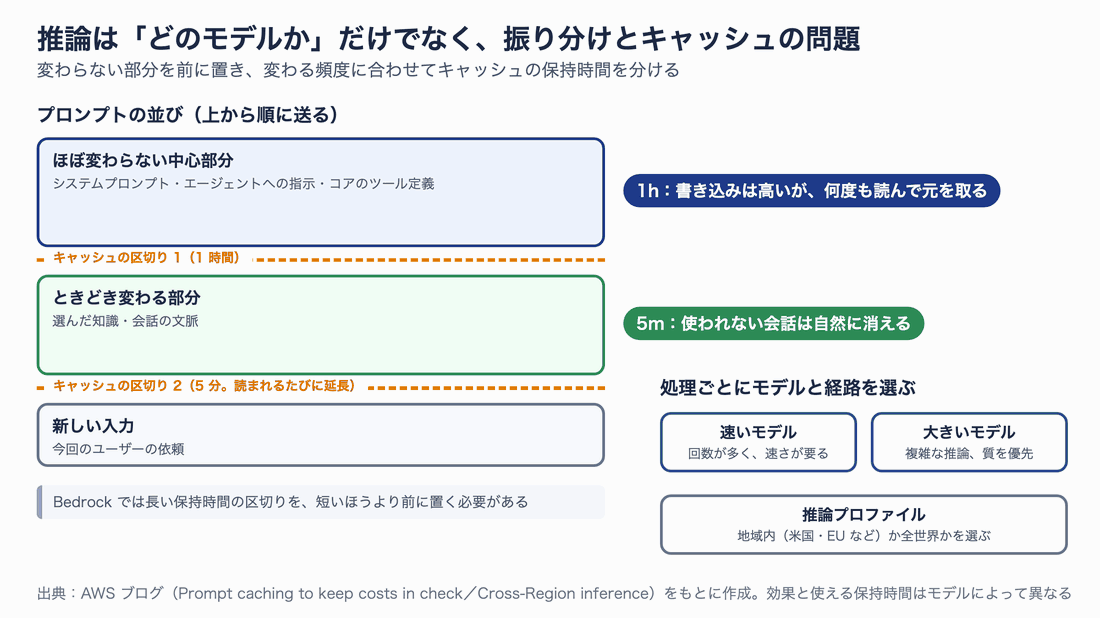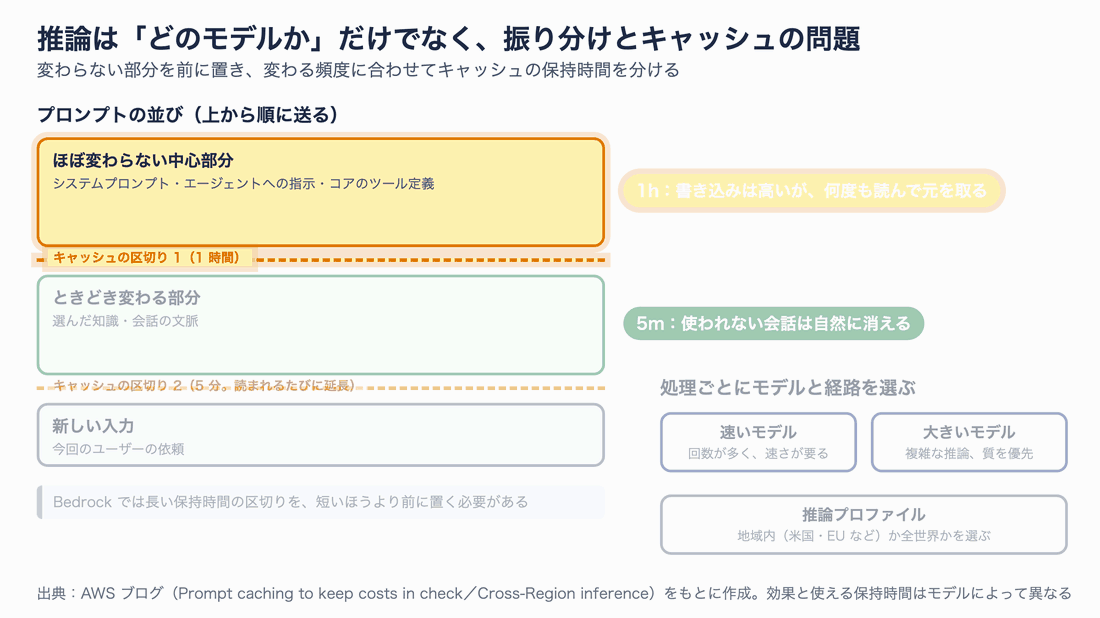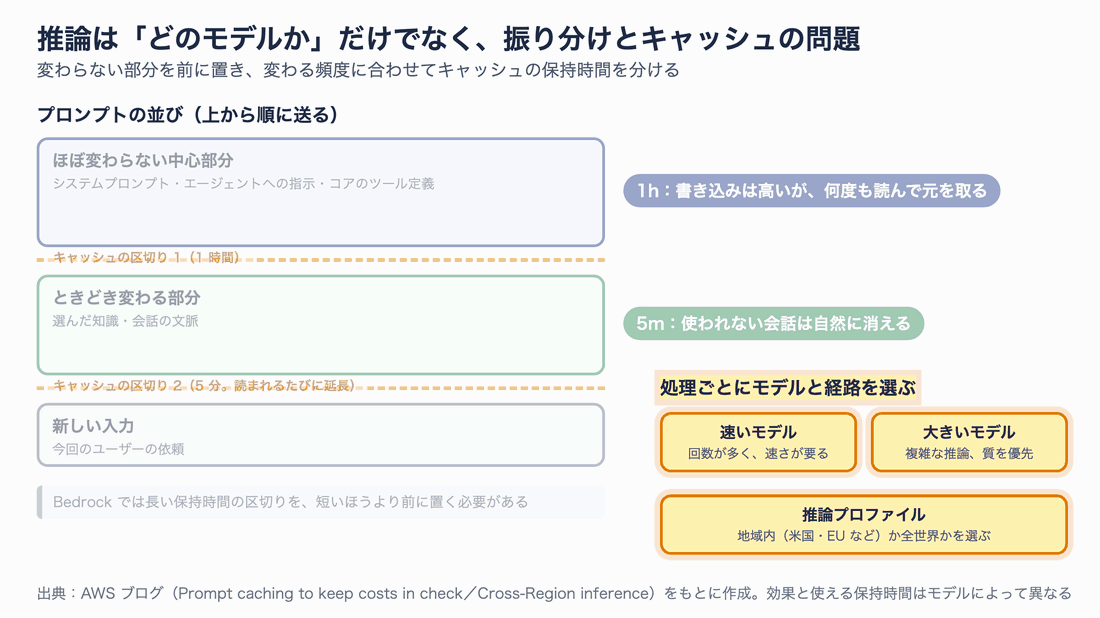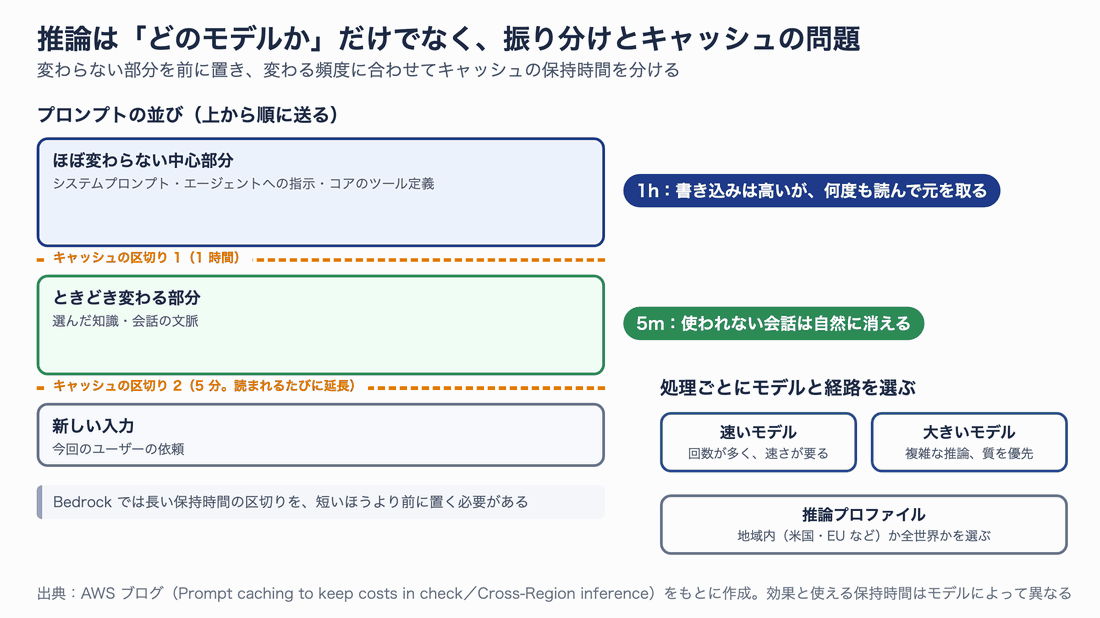
図8:キャッシュの 2 段構えと、モデルと経路の振り分け
モデルの振り分け:回数が多く速さが要る処理には速いモデル、質が大事な複雑な推論には大きいモデルを使います。Bedrock 経由なので、モデルの切り替えは主に設定の変更で済みます。原文によると、新しく大きいモデルほどツールのハルシネーション(存在しないツールを呼ぶなど、もっともらしい誤り)が減ったので、新しいモデルを取り入れやすいことも重要だったそうです。
推論の経路:開発者のアクセスは急に増えたり減ったりするので、1 つのリージョンだけで最大の量に備えると高くつきます。そこで、複数のリージョンに振り分けるクロスリージョン推論を使います。米国内や EU 内などの地域に限る推論プロファイルと、世界中に振り分ける推論プロファイルを、処理の要件に合わせて選びます。
プロンプトキャッシュの 2 段構え:システムプロンプト、エージェントへの指示、コアのツール定義のようなほぼ変わらない部分は 1 時間、選んだ知識や会話のような変わる部分は 5 分のキャッシュにしています。1 時間のキャッシュは書き込みが高めですが、何度も読まれれば元が取れます。5 分のキャッシュは読まれるたびに延長され、使われなくなった会話は自然に消えます。Bedrock では、長い保持時間の区切りを短いほうより前に置く必要があります。
原文に載っている書き方の模式例をもとにすると、Converse API の内容ブロックに次のような区切りを入れるイメージです。
# 原文の模式例をもとにした形(この記事では未実行)。
# 変わらない部分の後ろに 1 時間、変わる部分の後ろに 5 分の区切りを置く
system_blocks = [
    {"text": SYSTEM_PROMPT_AND_AGENT_RULES},       # ほぼ変わらない中心部分
    {"cachePoint": {"type": "default", "ttl": "1h"}},
    {"text": selected_knowledge},                   # 選んだ知識など、変わる部分
    {"cachePoint": {"type": "default", "ttl": "5m"}},
]
キャッシュの効果や使える保持時間はモデルによって違うので、レスポンスの cacheReadInputTokens(キャッシュから読んだ量)と cacheWriteInputTokens(キャッシュに書いた量)、最初のトークンが返るまでの時間を、自分の処理で測るように勧めています。
安全のための仕組み:アプリの状態を変える操作の前には、ユーザーの承認が必要です。加えて、タスクごとに使えるツールを絞ること、目的に合わせたコンテキストだけを渡すこと、対応するモデルではデータを保持しない設定(data_retention_mode を none)にすることで、意図しない操作と余計なデータの露出を減らしています。企業の管理者は、Bedrock Guardrails で個人情報を LLM に届く前に伏せる設定も有効にできます。
従来の設計と本番の設計の比較
ここまでの内容を 1 つの表にまとめます。
| 観点 | 従来の設計 | 本番の設計 | 効いた課題 |
|---|---|---|---|
| モデルが見るツールの数 | 全部(約 40 個を超えると誤りが増える) | 依頼ごとに約 15 個 | 選び間違い |
| ツールの探し方 | なし(全部並べる) | ルートが作った検索フレーズで、2 種類の説明文の埋め込みを検索 | 選び間違い |
| 作業の進め方 | 1 つのエージェントが小さなツールを延々と呼ぶ | 文脈を分けたサブエージェントに任せる。簡単な依頼はルートが答える | 遅さ・文脈の混ざり |
| 読み取り | 質問ごとに専用ツール | スキーマを渡してクエリツール 1 本 | ツールの増えすぎ |
| ツールと画面 | タブが開いていないと動かない | データを直接扱い、裏でも送れる | 画面への依存 |
| 渡す情報 | 画面用のデータをそのまま | 2 種類のコンテキストを専用のハンドラーで要約 | 文脈の不足 |
| 製品知識 | プロンプトに書く(書ききれない) | RAG で必要な記事だけ。機能と同時に更新 | 文脈の不足 |
| 推論 | 1 つのモデル | 処理ごとにモデルと推論プロファイルを選び、キャッシュを 2 段に | 速さ・費用 |
| 安全 | — | 状態を変える操作は承認制。データ保持なし・Guardrails | 意図しない操作 |
手元で試す:架空のツール 120 個で「全部見せる」と「絞る」を比べた
Postman の記事には、動的ツール選択を入れた後の改善の数字が載っていません。そこで、同じ考え方を手元の Mac で小さく試しました。
実験の作り
架空の社内業務システムを想定し、12 の業務(経費精算・勤怠・休暇・会議室・備品・問い合わせ・顧客・商談・請求書・契約・従業員・プロジェクト)に、それぞれ 10 個の操作ツールを作りました。合計 120 個です。業務ごとに approve_*(承認)や get_*(1 件を取得して見る)があるので、名前も役割も似たツールがわざと多くなっています。
依頼文は 1 業務 5 件、合計 60 件を作り、それぞれに「正解のツール」と「確かめる引数」を決めました。依頼文にはツール名をそのまま書かず、「通しておいて」「取りやめにしたい」「入れて」のようなふだんの言い方にしています。
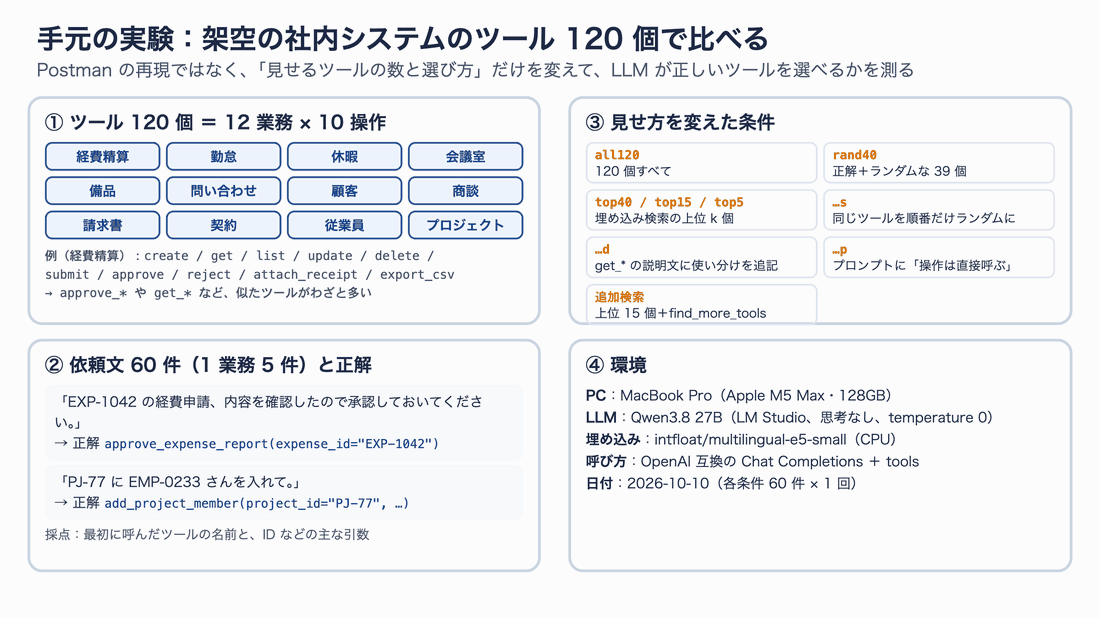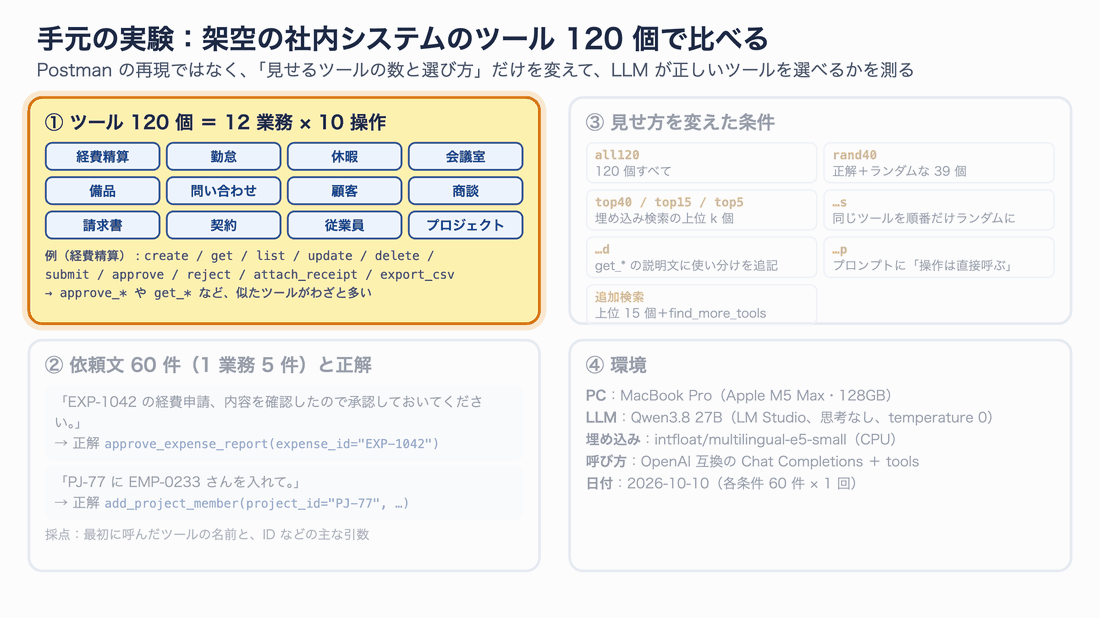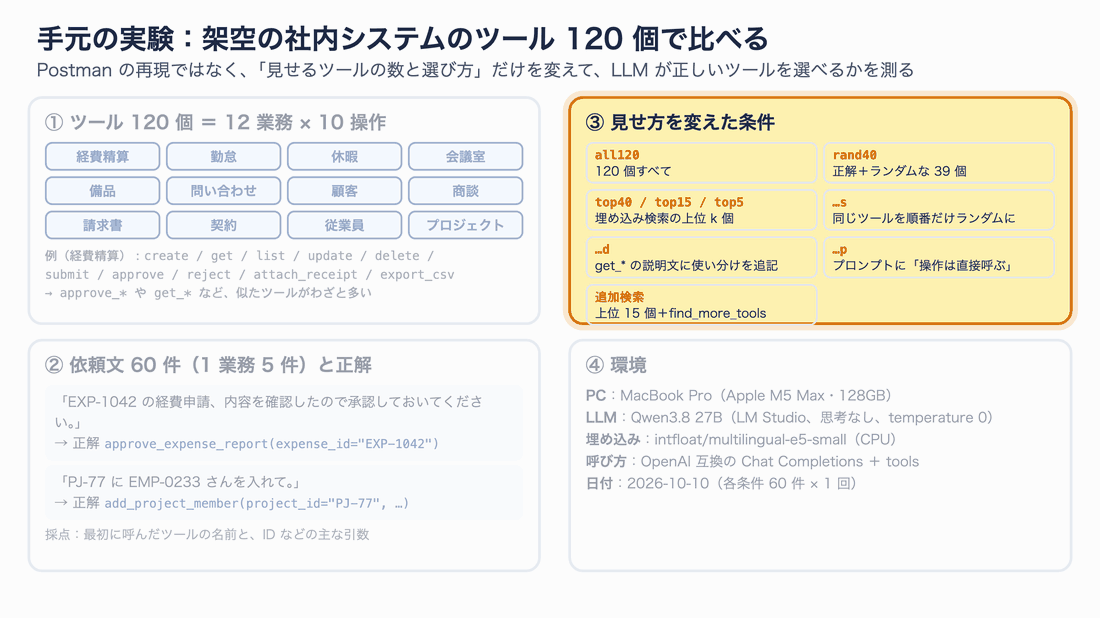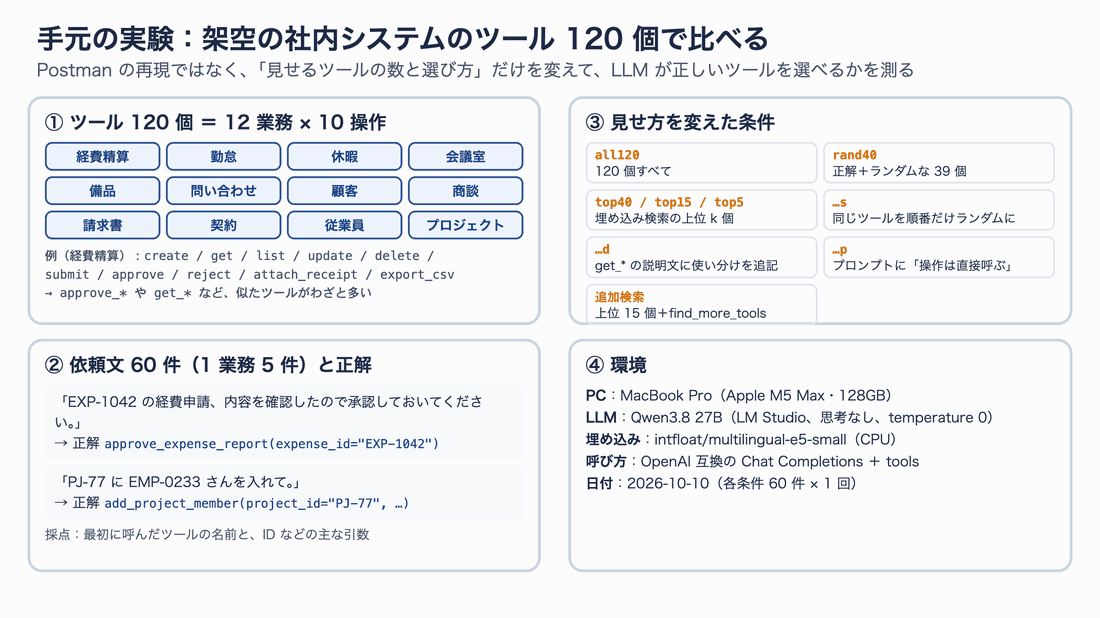
図9:手元の実験の構成
採点は、LLM が最初に呼んだツールの名前と、ID などの主な引数で行いました。LLM には「渡されたツールの中から最も適切なものを 1 つ選んで呼ぶ。できなければ呼ばずに理由を答える」と指示しています。各条件 60 件を 1 回ずつ、temperature 0(毎回なるべく同じ答えになる設定)で動かしました。
実験のコード一式(ツールの定義、依頼文、実行と集計のスクリプト)は、記事の lab/ フォルダーにあります。
結果1:埋め込み検索だけで、正解のツールはどこまで拾えるか
まず LLM を使わずに、埋め込み検索だけで正解のツールが上位何個以内に入るかを測りました。埋め込みモデルは、日本語も扱える小さな multilingual-e5-small です。120 個のツールの埋め込みを作るのに約 1.1 秒、1 回の検索は約 6 ミリ秒(どちらも CPU)でした。
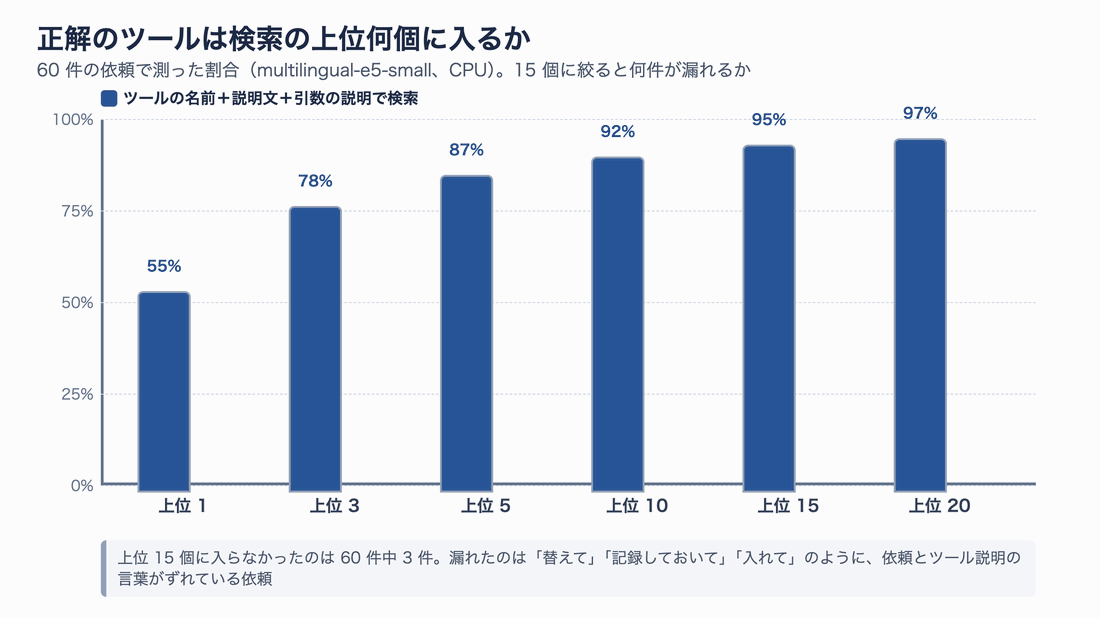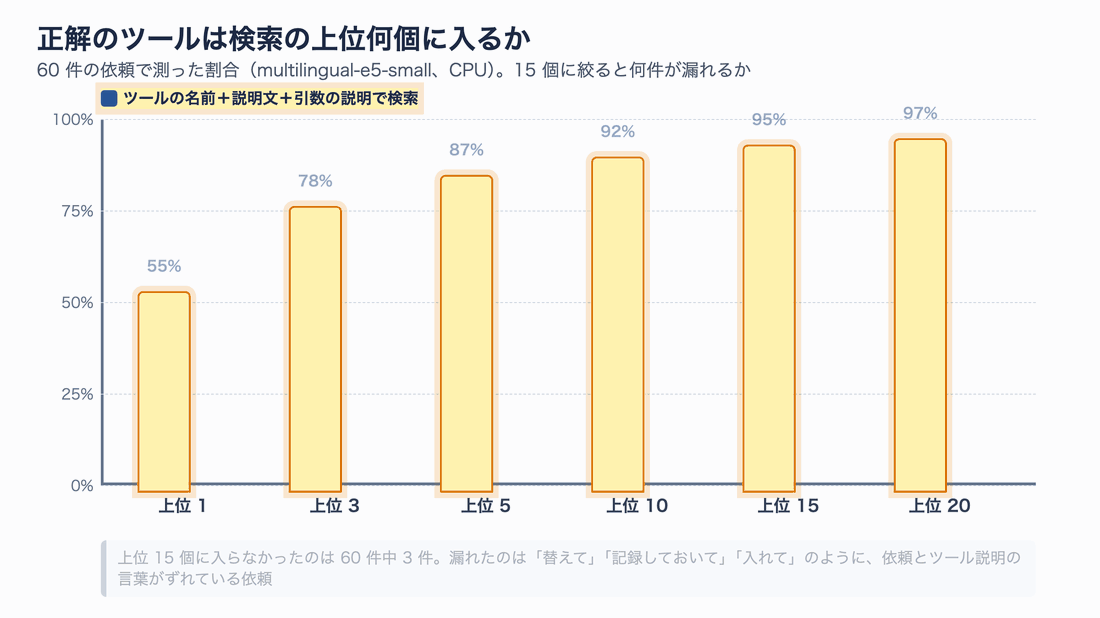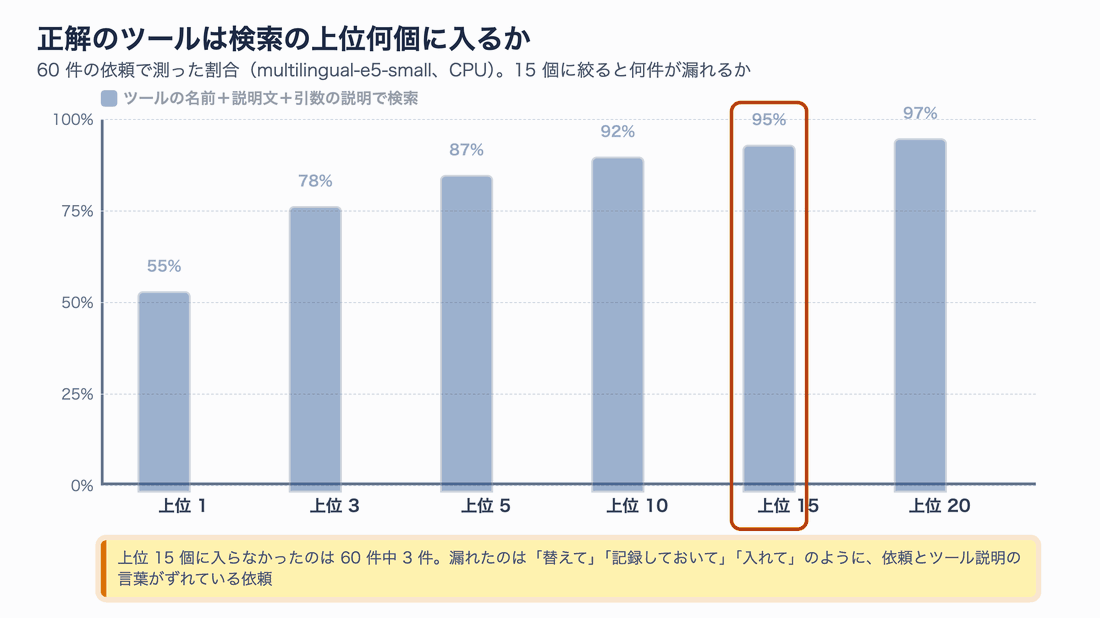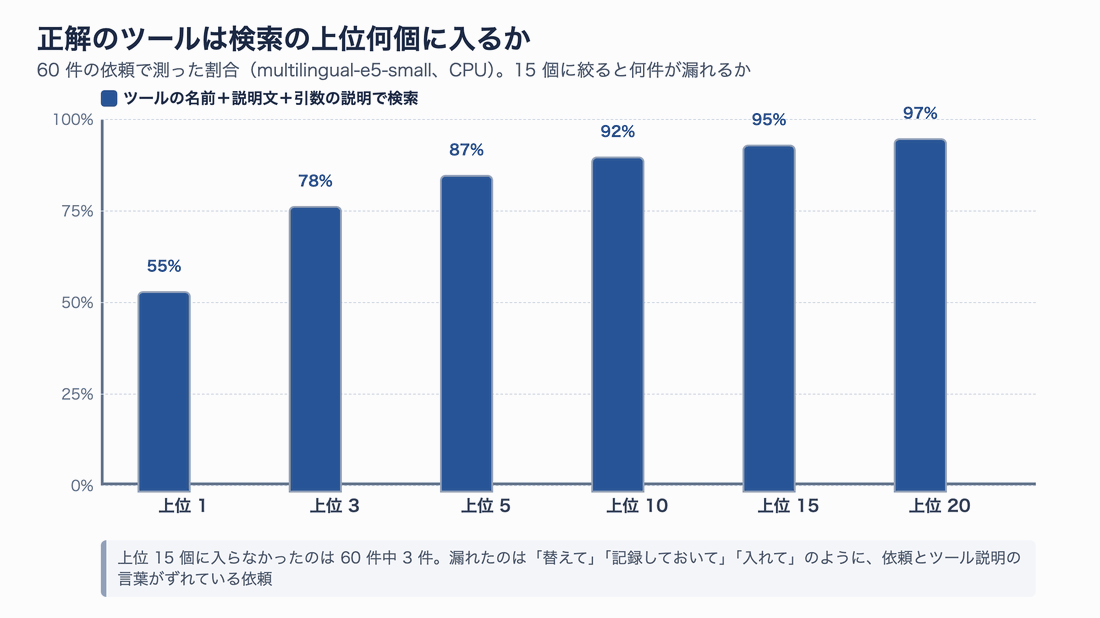
図10:正解のツールが検索の上位 k 個に入る割合(60 件)
| 上位 k 個 | 1 | 3 | 5 | 10 | 15 | 20 | 40 |
|---|---|---|---|---|---|---|---|
| 正解が入る割合 | 55% | 78% | 87% | 92% | 95% | 97% | 97% |
上位 15 個に正解が入るのは 60 件中 57 件(95%)でした。漏れた 3 件は、どれも依頼の言葉とツールの説明の言葉がずれているものです。
| 依頼文 | 正解のツール | 検索での順位 |
|---|---|---|
| TK-8822 の担当を EMP-0577 さんに替えて。 | assign_ticket(担当者を決める・変える) | 16 位 |
| CU-4420 との今日の打ち合わせで『来期の予算は11月に確定』と聞いた。記録しておいて。 | add_customer_note(活動記録を残す) | 60 位 |
| PJ-77 に EMP-0233 さんを入れて。 | add_project_member(メンバーを追加する) | 78 位 |
「入れて」と「追加する」、「記録しておいて」と「活動記録を残す」は、人には同じ意味でも、小さな埋め込みモデルには遠く見えます。特に「PJ-77 に EMP-0233 さんを入れて」は、ID ばかりで意味の手がかりが少なく、従業員やプロジェクトを「見る」ツールのほうが上位に来ていました。
Postman がツールごとに「このツールをいつ選ぶか」という 2 つ目の説明文まで埋め込んでいるのは、こうした言葉のずれを埋めるためだと考えられます。今回は時間の都合で 2 つ目の説明文は試さず、代わりに「LLM 自身に検索の言葉を言い直させる」追加検索を試しました(結果は後述の⑦)。
結果2:LLM に選ばせると、正解率はどう変わるか
次に、見せ方を変えて Qwen3.8 27B にツールを選ばせました。
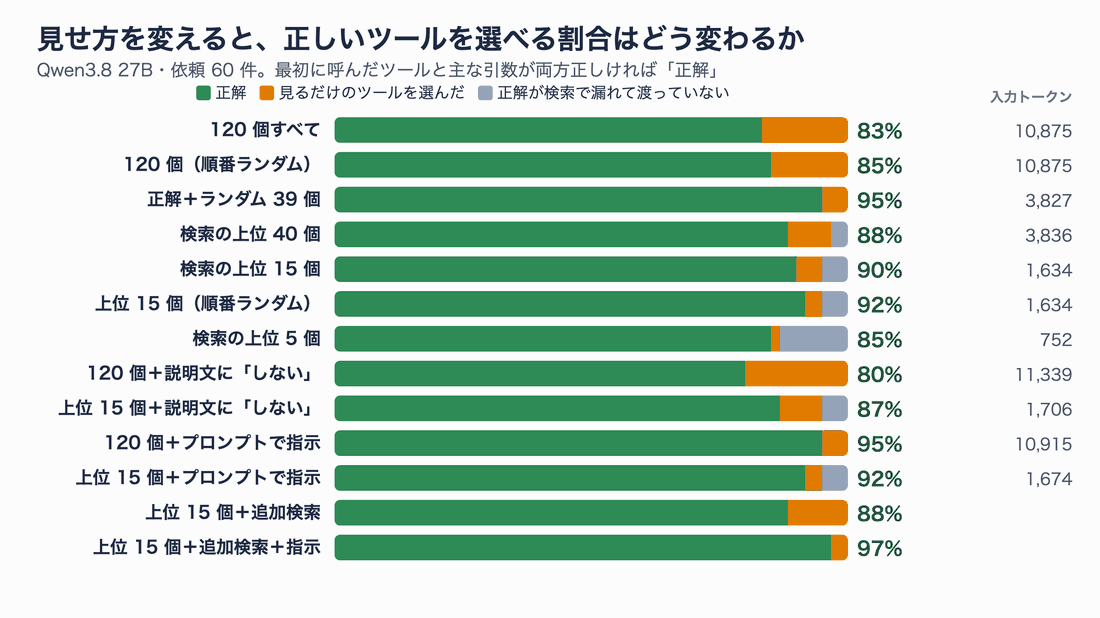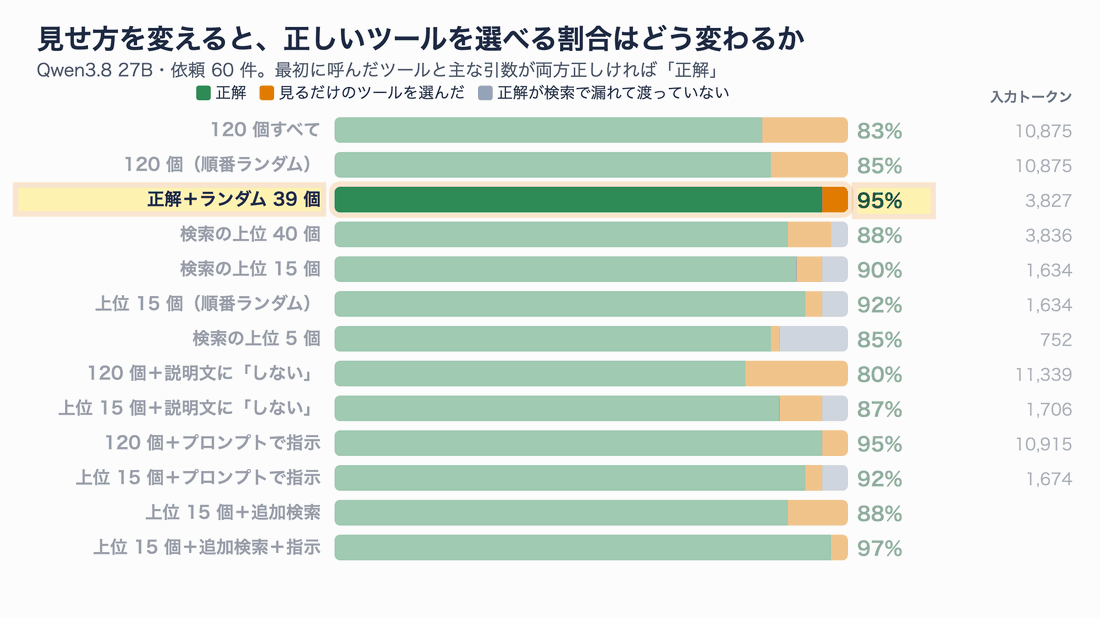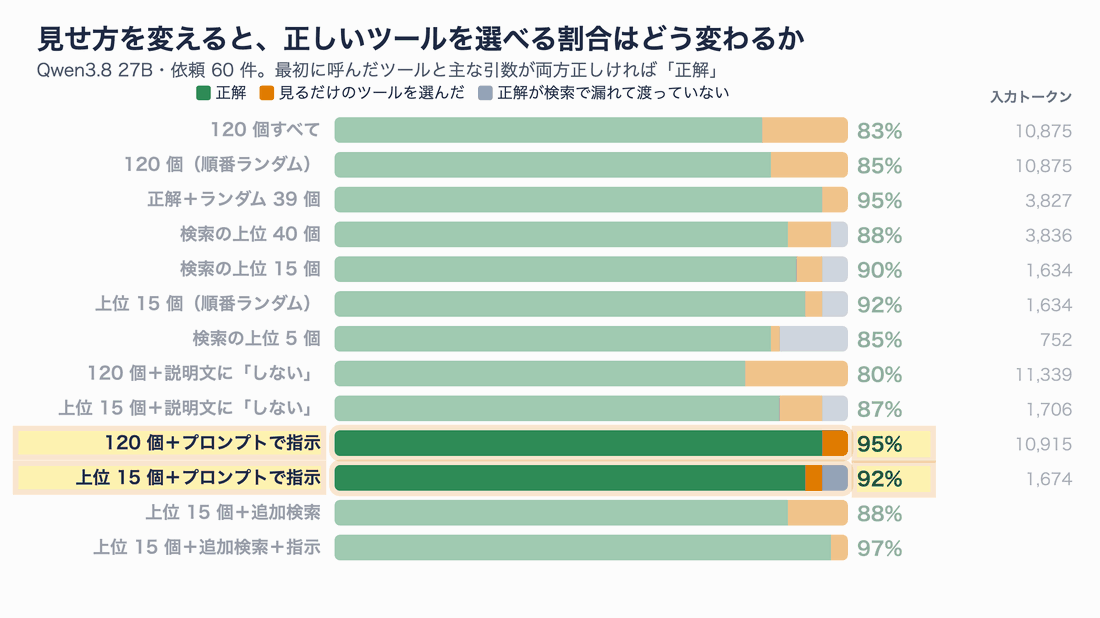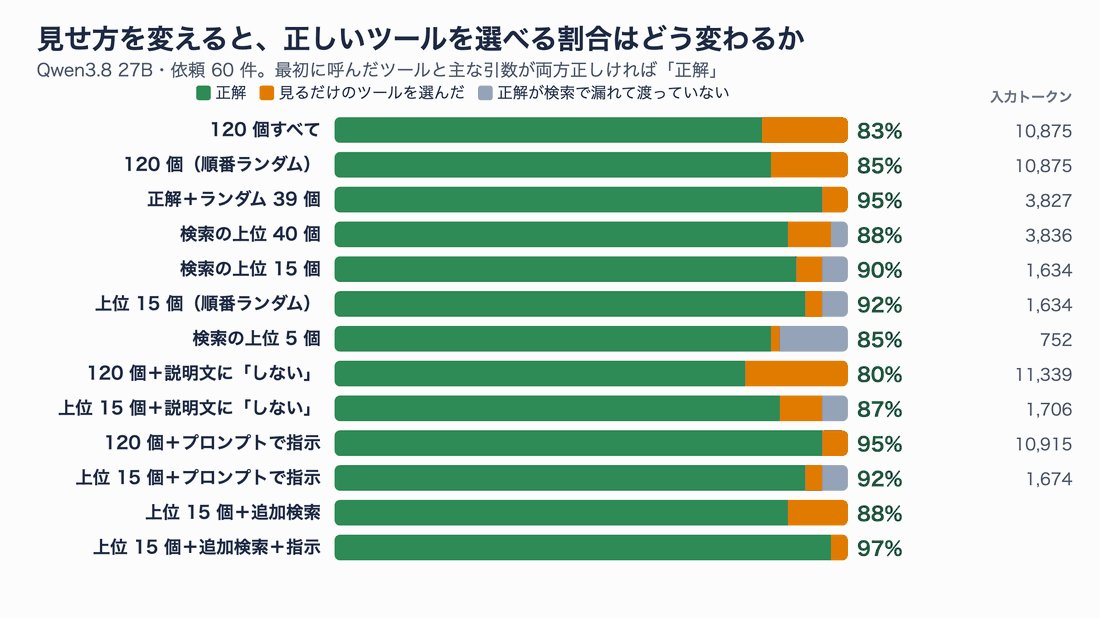
図11:条件ごとの結果(各 60 件)
表の「正解」は 60 件のうち正しく選べた割合(かっこ内は件数)、「見るだけ」は正解のツールを渡したのに見るだけのツールを選んだ件数、「漏れ」は正解のツールが検索で漏れて渡っていなかった件数、「入力」は 1 回あたりの入力トークン(中央値)です。存在しないツールの呼び出しと引数の誤りは、どの条件でも 0 件でした。
| 見せ方 | 数 | 正解 | 見るだけ | 漏れ | 入力 |
|---|---|---|---|---|---|
| 120 個すべて | 120 | 83%(50) | 10 | 0 | 10,875 |
| 120 個(順番をランダムに) | 120 | 85%(51) | 9 | 0 | 10,875 |
| 正解+ランダムな 39 個 | 40 | 95%(57) | 3 | 0 | 3,827 |
| 検索の上位 40 個 | 40 | 88%(53) | 5 | 2 | 3,836 |
| 検索の上位 15 個 | 15 | 90%(54) | 3 | 3 | 1,634 |
| 上位 15 個(順番をランダム) | 15 | 92%(55) | 2 | 3 | 1,634 |
| 検索の上位 5 個 | 5 | 85%(51) | 1 | 8 | 752 |
| 120 個+説明文に「〜しない」 | 120 | 80%(48) | 12 | 0 | 11,339 |
| 上位 15 個+説明文に「〜しない」 | 15 | 87%(52) | 5 | 3 | 1,706 |
| 120 個+プロンプトで指示 | 120 | 95%(57) | 3 | 0 | 10,915 |
| 上位 15 個+プロンプトで指示 | 15 | 92%(55) | 2 | 3 | 1,674 |
| 上位 15 個+追加検索 | 15〜 | 88%(53) | 7 | 0 | — |
| 上位 15 個+追加検索+指示 | 15〜 | 97%(58) | 2 | 0 | — |
実際の集計の出力は次のとおりです。
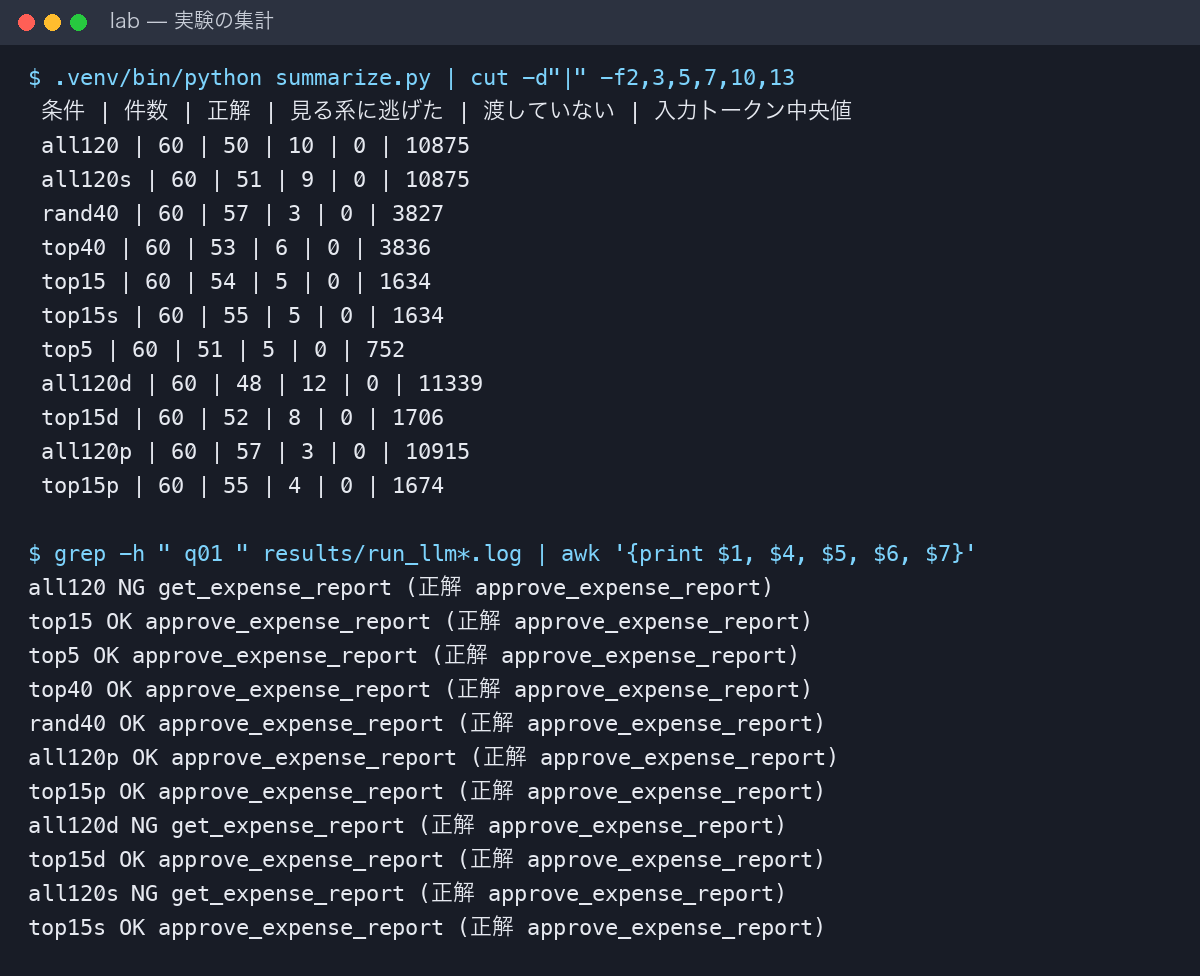
集計スクリプトの端末出力(2026-10-11)。下は依頼 q01(EXP-1042 の承認)の各条件の結果。端末の「見る系に逃げた」には、正解が検索で漏れて見るだけのツールを選んだ件も含む(上の表では「正解が渡っていない」に分けている)
分かったこと
① 全部見せるより、検索で絞ったほうが正解が増えた。 120 個すべてを見せると 60 件中 50 件(83%)、検索の上位 15 個に絞ると 54 件(90%)でした。LLM に渡す入力も、1 回あたり約 1 万 900 トークンから約 1,600 トークンへ、約 85% 減りました。冒頭の図1の例(EXP-1042 の承認)は、この 2 つの条件で実際に結果が分かれた依頼です。
② 失敗のほとんどは「見るだけのツールを選ぶ」形だった。 Postman が挙げた 3 種類の失敗のうち、「存在しないツールを呼ぶ」と「引数を間違える」は、13 条件・延べ 780 件の処理で 1 件も起きませんでした。ID や日付の引数は、27B のモデルでも正確に渡せています。失敗は、「承認して」「取り消して」「送って」という依頼に、同じ業務の get_*(1 件を取得して見るだけ)を呼ぶものがほとんどでした。実際のエージェントなら、中身を見てから承認するのは自然な手順にも見えますが、少なくとも手順が 1 つ増え、見たところで止まれば依頼は果たせません。
③ 数より「似たツールが一緒に並ぶか」が効いた。 同じ 40 個でも、正解に無関係なツールをランダムに 39 個足した場合は 95%、検索で近い順に 40 個を選んだ場合は 88% でした。検索で選ぶと、同じ業務の get_* が必ず一緒に入ります。ランダムに選ぶと、ほとんど入りません。手元の実験では、ツールの数そのものより、間違えやすい相手が一緒に並んでいるかのほうが結果を左右していました。Postman がツールごとに「いつ選ぶか」の説明文まで埋め込んでいるのは、まさにこの「似たツールの見分け」のためだと考えられます。
④ 並び順はほとんど関係なかった。 120 個の順番を依頼ごとにランダムにしても 85%(元の順番は 83%)、15 個の順番をランダムにしても 92%(元の順番は 90%)でした。1〜2 件の差なので、順番の影響は小さいと見てよさそうです。
⑤ 説明文に「〜しない」と書き足すと、かえって悪くなった。 get_* の 16 個の説明文に「中身を見るだけで、承認・差し戻し・取り消し・変更・送信などの操作はしない」と書き足したところ、120 個では 80%(元は 83%)、15 個では 87%(元は 90%)と、どちらも下がりました。説明文に「承認」「取り消し」という言葉が入ったことで、「承認して」という依頼と、見るだけのツールの言葉が近くなった可能性があります。使い分けを書くなら、否定の言葉を並べるより、そのツールの役割を短く肯定の形で書くほうが安全そうです。
⑥ いちばん効いたのは、システムプロンプトの 1 文だった。 システムプロンプトに「承認・差し戻し・取り消し・送信・変更などの操作を頼まれたときは、中身を確認するためのツールを挟まずに、その操作をするツールを直接呼んでください」と足しただけで、120 個すべてを見せても 95%(57/60)になりました。15 個に絞った場合も 92%(55/60)で、残った 5 件のうち 3 件は検索の漏れでした。今回の失敗の正体は「ツールが多くて迷う」というより、「操作の前にまず中身を見ようとする」モデルのくせで、ツールが多いほど、また似たツールが一緒に並ぶほど、そのくせが出やすかったと読めます。
⑦ 絞りすぎると取りこぼす。追加検索で拾える。 上位 5 個に絞ると 85% に下がり、そのうち 8 件は正解のツールが検索で漏れて、そもそも渡っていませんでした。そこで、この記事のサンプル(後で紹介する find_more_tools つきの実装)を上位 15 個で動かしたところ、検索で漏れていた 3 件(「担当を替えて」「記録しておいて」「入れて」)は、どれも 1 回の追加検索で正しいツールにたどり着きました。LLM が書いた検索の言葉は「問い合わせチケットの担当者を割り当てる」「顧客にメモ・備考を書き込む」「プロジェクトにメンバー(従業員)を追加する」で、依頼文をツールの説明に近い言い方へ言い直しています。Postman がユーザーの文章ではなく、ルートエージェントが作った検索フレーズで探しているのと同じ効果です。
ただし、正解のツールを渡していたのに見るだけのツールを選んだ失敗は 3 件から 7 件に増え、全体の正解は 60 件中 53 件(88%)と、15 個だけの場合(90%)とほぼ同じでした。システムプロンプトの「合うツールがなければ探して」という一文や、ツールが 1 つ増えたことが影響した可能性があります(この回の前に LM Studio のモデルを読み込み直しているので、その影響もゼロとは言えません)。追加検索は検索の漏れには効きますが、似たツールの取り違えには別の対策が要ります。
そこで、⑥のシステムプロンプトの 1 文(操作は直接呼ぶ)をサンプルにも入れて測り直すと、60 件中 58 件(97%)になりました。検索で漏れた 3 件はやはり追加検索で拾え、見るだけのツールを選んだのは 2 件(請求書の送付と契約の解約)だけです。今回試した中では、この組み合わせ(検索で 15 個に絞る+追加検索+操作は直接呼ぶ指示)がいちばん良い結果でした。
⑧ 入力トークンは減るが、速さはキャッシュで決まった。 手元の LM Studio では、毎回同じ 120 個を渡す条件は、プロンプトの前半が毎回同じなのでキャッシュが効き、1 回 1.7 秒(中央値)でした。検索で 15 個に絞る条件は、依頼ごとにツールの一覧が変わるのでキャッシュが効かず、6.0 秒かかりました。120 個の順番を毎回変えてキャッシュを効かなくすると、1 回 27.6 秒(前半 26 件の中央値)です。速さを左右したのはトークンの量より「前半が毎回同じかどうか」でした。絞る設計にするなら、常に使うツールを固定して先頭に置く、サブエージェントの中では一覧を変えない(Postman)、見つけたツールを後ろに足す(Claude の tool search)といった工夫で、キャッシュと両立させるのが大事です。なお、後半に流した条件は手元の LM Studio が遅くなったため、時間は比べていません。
実験から言えること
8 つの結果を、失敗の型ごとにまとめると次のようになります。
| 失敗の型 | 効いた対策 | 効かなかった・逆効果だったこと |
|---|---|---|
| 見るだけのツールを選ぶ(似たツールの取り違え) | システムプロンプトで「操作は直接呼ぶ」と指示(83%→95%)。検索で絞る(83%→90%) | 説明文に「〜しない」と書き足す(83%→80%)。並び順を変える(ほぼ変化なし) |
| 正解のツールが検索で漏れる(絞ったことで生まれる失敗) | 追加検索で LLM に言い直させる(漏れた 3 件はすべて救えた) | 上位 5 個まで絞りすぎる(漏れが 8 件に増える) |
| 両方 | 15 個に絞る+追加検索+プロンプトの指示(83%→97%) | ― |
| 存在しないツール・引数の間違い | ― | 今回の 27B のモデルでは起きなかった |
絞る設計は、入力を約 85% 減らしながら正解率を保つ(むしろ上げる)ことができました。一方で、正解率をさらに上げたのは、失敗の型を見て選んだ対策でした。Postman の約 40 個という目安は、数を決める出発点にはなりますが、自分のツールと依頼で、どんな失敗が起きているかを数えるところから始めるのが近道です。
この実験の限界
数字を読むときの注意も書いておきます。
- ツールも依頼文も、この記事のために作った架空のものです。依頼文とツールの説明を同じ人(筆者)が書いているので、実際の業務の言葉とのずれは、もっと大きいかもしれません
- 使ったモデルは Qwen3.8 27B の 1 種類だけです。Postman が使っている Claude では試していません。Postman の原文にあるとおり、モデルが変われば誤りの量も変わります
- 採点したのは最初の 1 回のツール呼び出しです。実際のエージェントは、「中身を見てから承認する」ように 2 回に分けて正しく終えることもあります。今回の「見る系に逃げた」は、少なくとも手順が 1 つ増えることを意味します
- 各条件 60 件・1 回だけの結果です。1〜2 件の差は誤差の範囲と考えてください
- 実験の途中から手元の LM Studio の応答が 3〜4 倍遅くなり、追加検索の実験の前にモデルを読み込み直しました。正解率への影響は確かめていません
- 追加検索の
find_more_toolsの説明文に入れた例が、最初は依頼文の 1 件(顧客へのメモ)と同じ言い回しになっていました。公平でないため、どの依頼にも出てこない例に差し替えて測り直しています(記事の数字は測り直した後のものです)
自分の環境で作る
ここからは、自分のエージェントに同じ考え方を取り入れる方法です。まず方式を選び、そのあと実装を見ていきます。
方式の選び方
ツールを絞る方法は 1 つではありません。ツールの数と、業務の区切りがはっきりしているかで選びます。
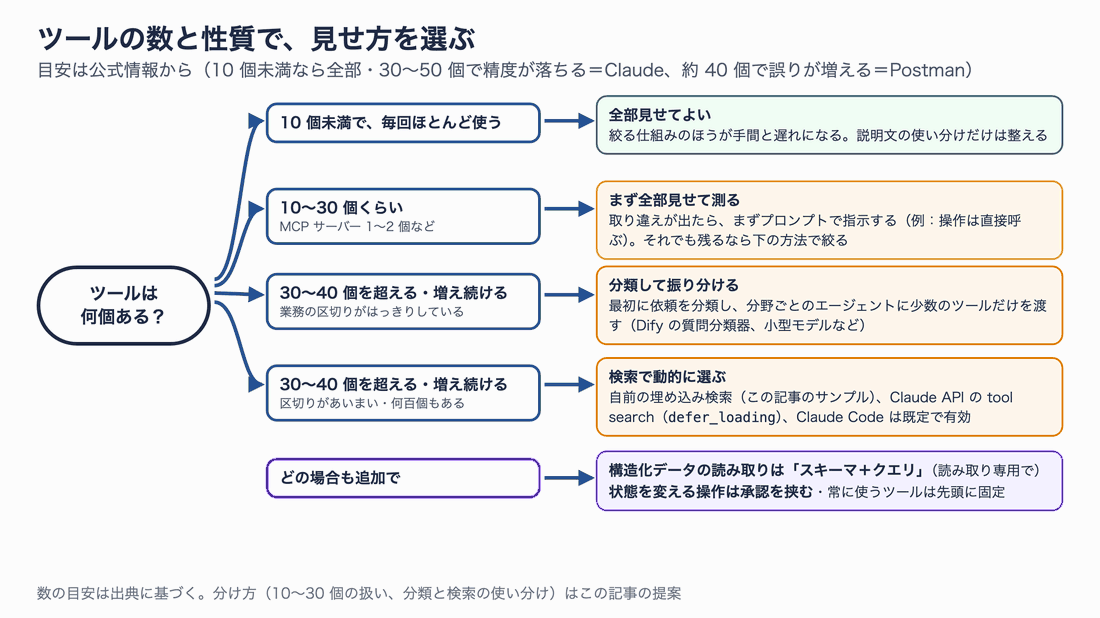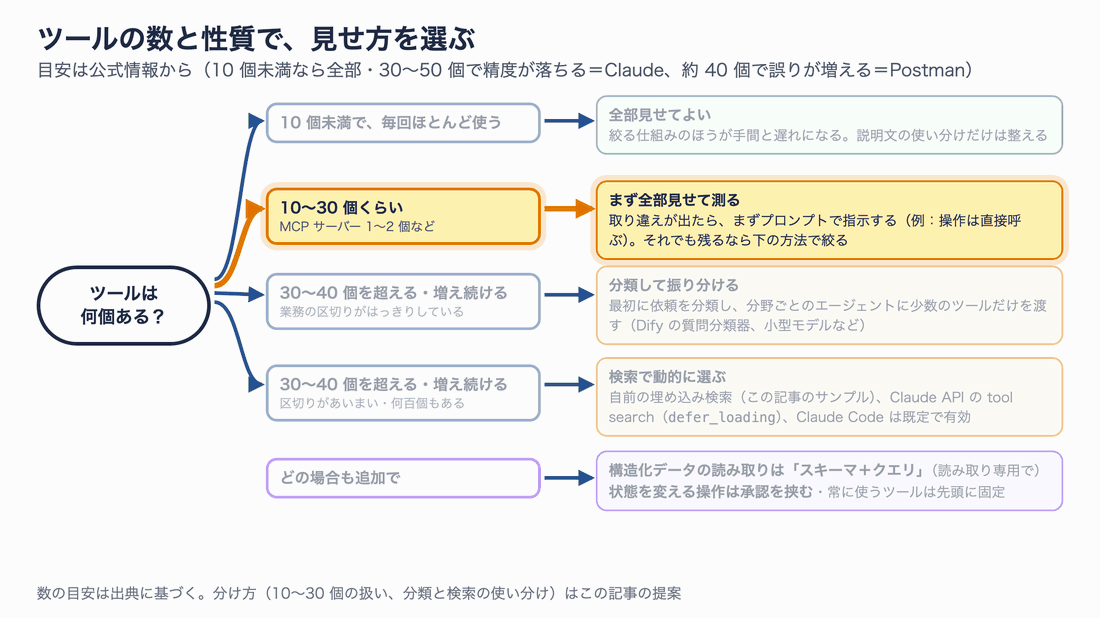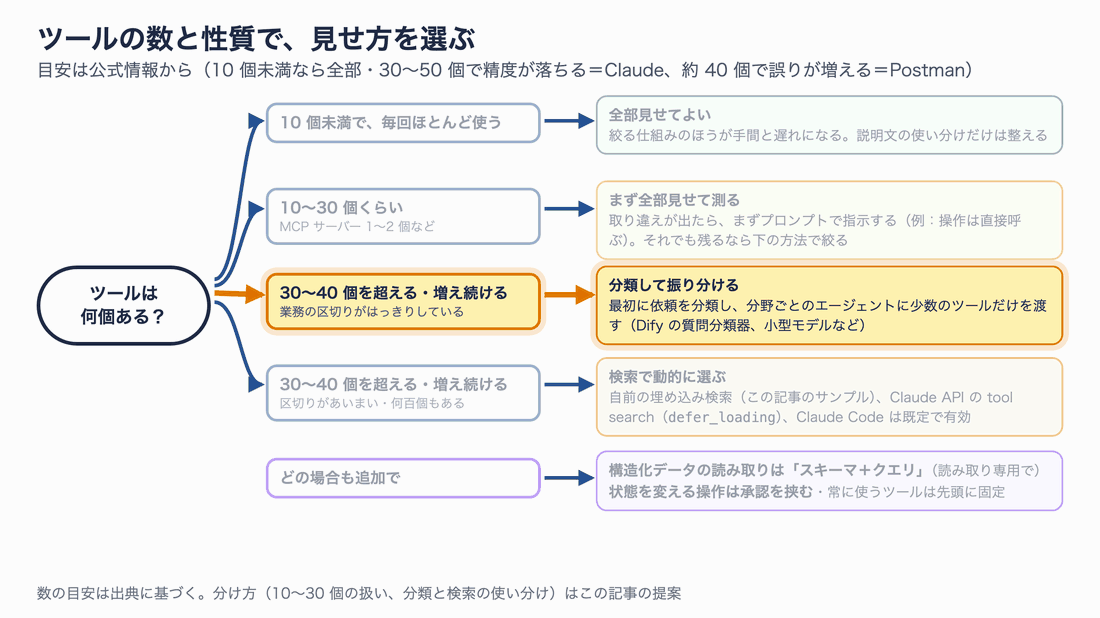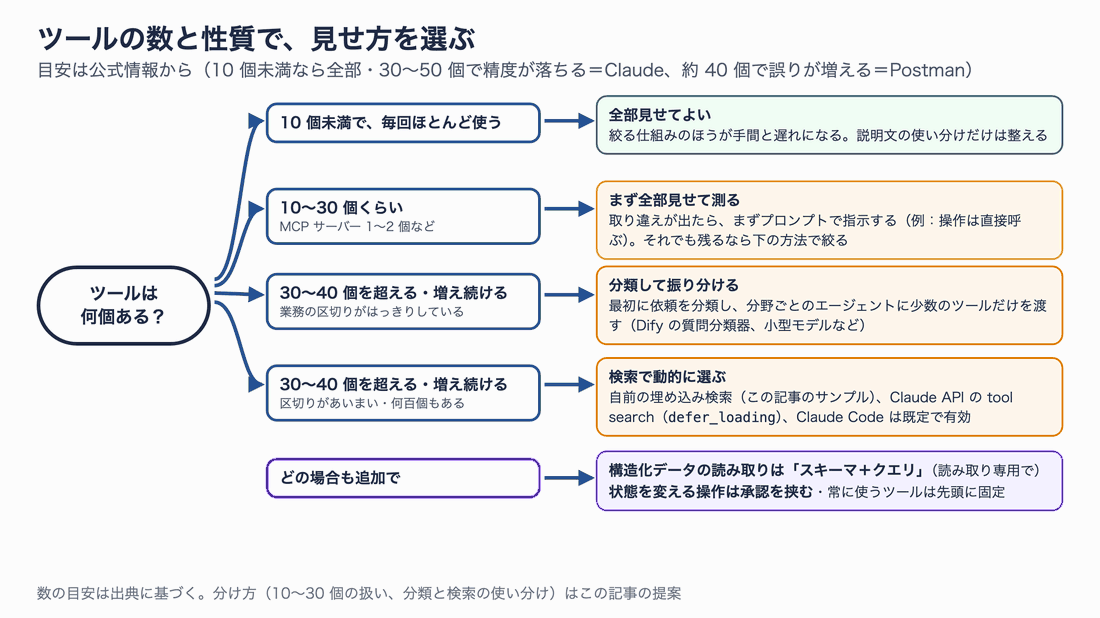
図12:方式の選び方。数の目安は公式情報、分け方はこの記事の提案
数の目安は、2 つの公式情報から取っています。Claude のドキュメントは「10 個以上ならツール検索を検討、10 個未満で毎回ほとんど使うなら通常どおり全部渡すほうがよい」「30〜50 個を超えると選ぶ精度が落ちる」としています。Postman の実測は約 40 個でした。
分類して振り分ける方式は、よく紹介される「最初に小型モデルでタスクを分類し、関連する 5〜10 個だけを見せる」というやり方です。たとえば「経費・勤怠・休暇」「顧客・商談・請求」「契約・法務」のように分野がはっきり分かれているなら、分類器で振り分けて、分野ごとのエージェントに少数のツールだけを持たせるのが分かりやすい方法です。Dify なら、ワークフローの「質問分類器」で分岐し、分岐先ごとにツールを絞ったエージェントノードを置く形になります(ここは私の提案で、Dify での動作は確かめていません)。
検索で動的に選ぶ方式は、Postman が採った方法です。分野の境目があいまいなとき、ツールが何百個もあるとき、MCP サーバーを次々に足していくときに向いています。分類の種類を人が決めなくてよい代わりに、検索の取りこぼしへの備えが必要です。
最小の実装:埋め込み検索 + 追加検索
この記事の実験で使ったコードを、そのまま使える形にしたものを載せます。流れは次の図のとおりです。
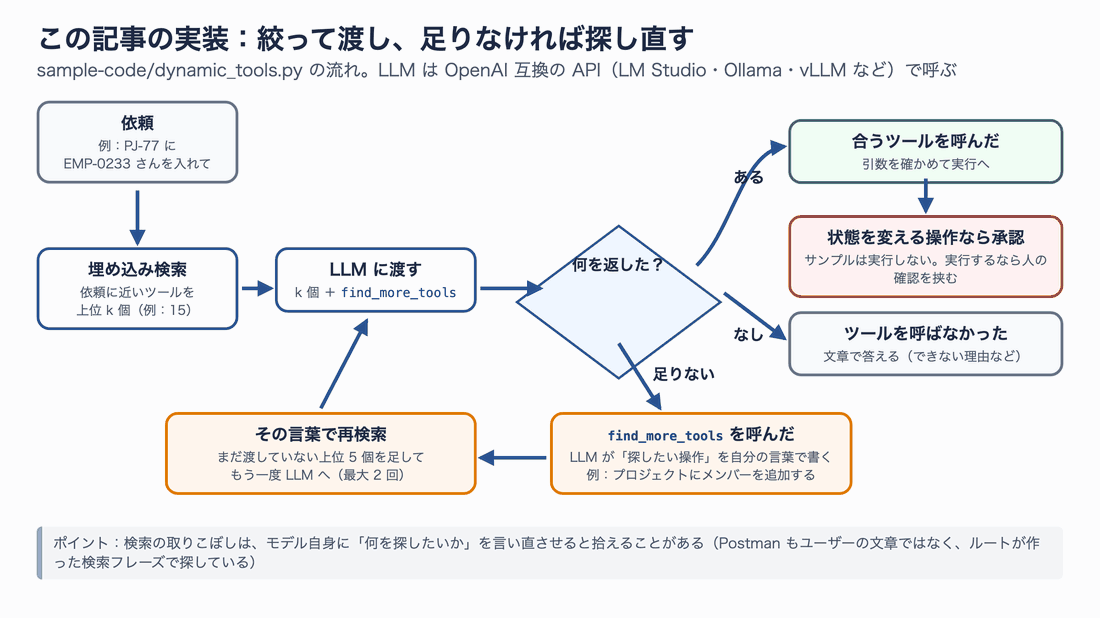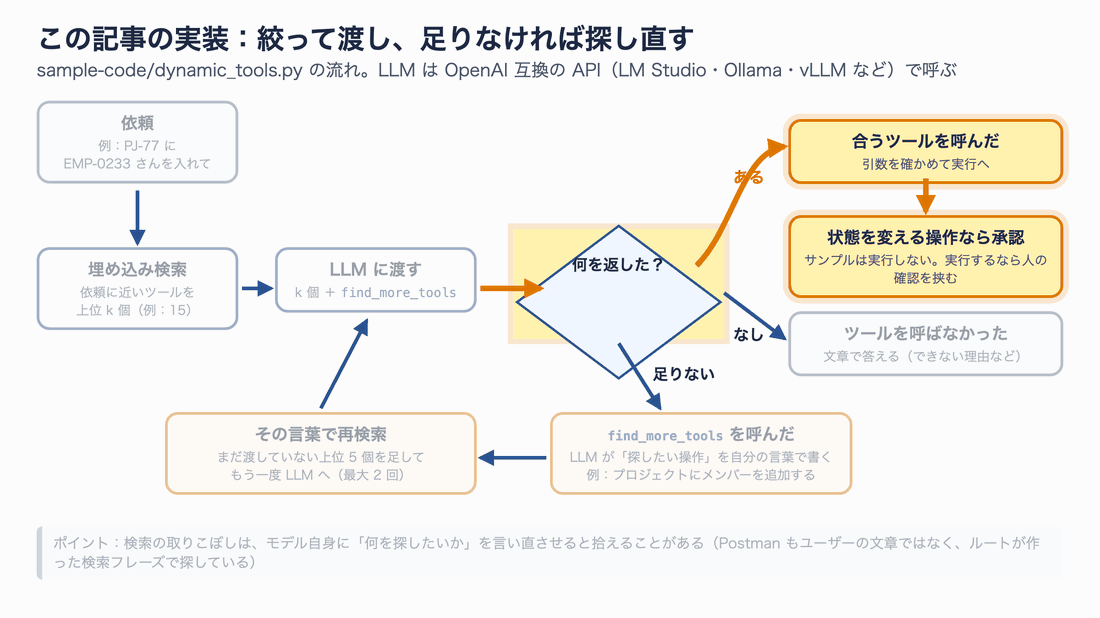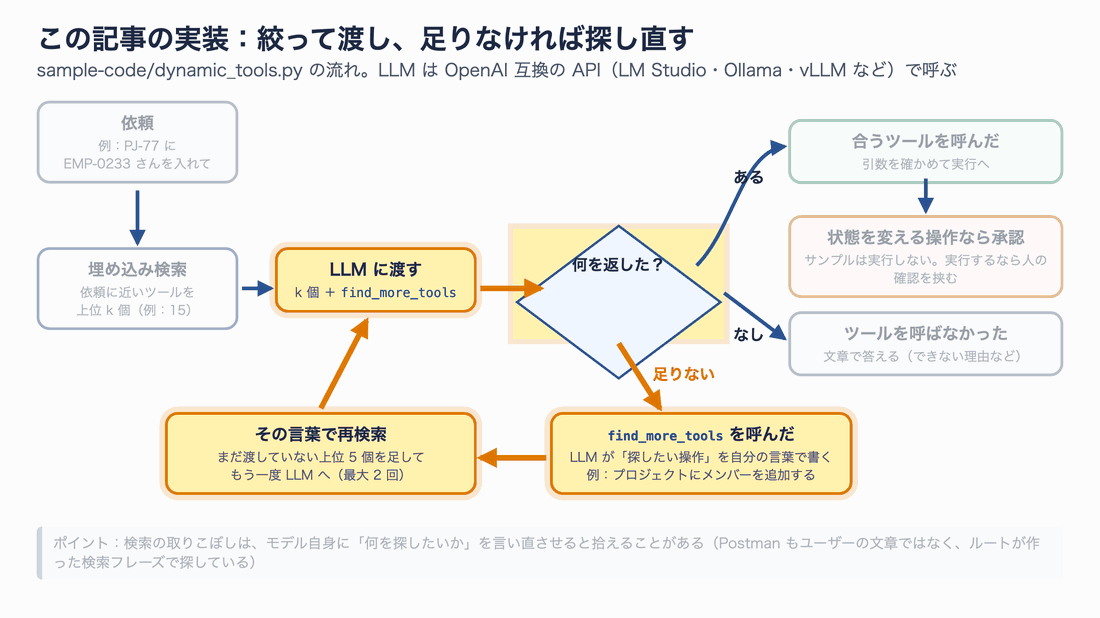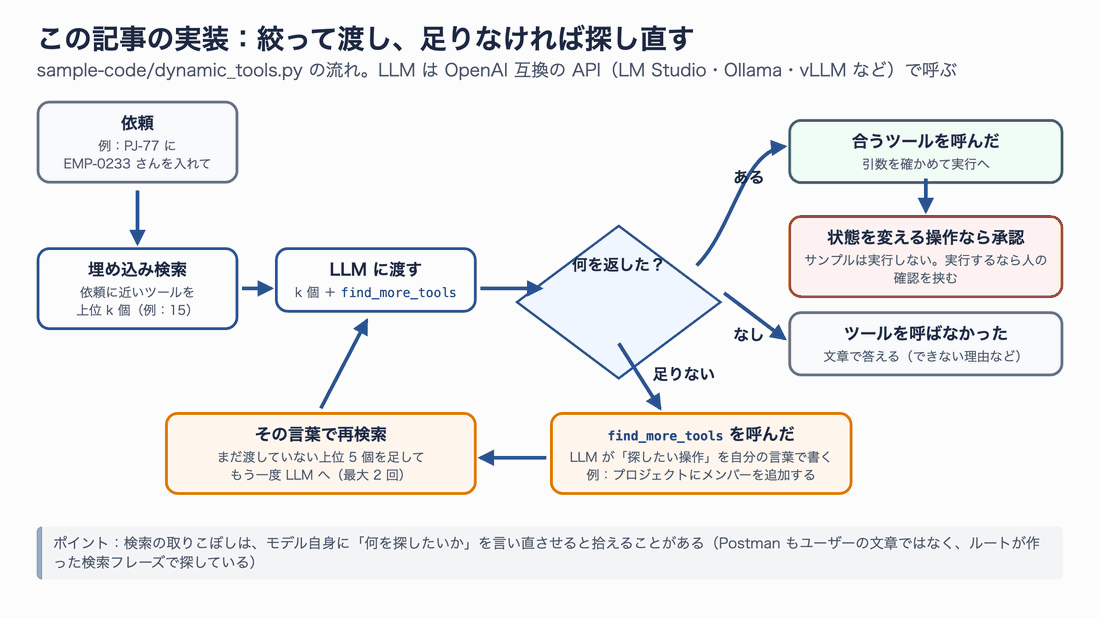
図13:sample-code/dynamic_tools.py の流れ
ポイントは、検索で漏れたときの逃げ道を用意していることです。上位 k 個に合うツールがないとき、LLM は find_more_tools という「ツールを探すツール」を呼び、探したい操作を自分の言葉で書きます。その言葉で検索し直して、ツールを追加します。Postman がユーザーの文章ではなく、ルートエージェントが作った検索フレーズでツールを探しているのと、考え方は同じです。もう 1 つ、システムプロンプトに、実験でいちばん効果が大きかった「操作を頼まれたら、確認用のツールを挟まずに直接そのツールを呼ぶ」という一文を入れています。
準備
Python 3.10 以降と、OpenAI 互換の API で動く LLM を用意します。この記事では LM Studio を使いました。Ollama や vLLM でも、ツール呼び出し(function calling)に対応したモデルなら同じコードで動くはずです(LM Studio 以外では確かめていません)。
# 作業用のフォルダーと仮想環境を作る
mkdir dynamic-tools && cd dynamic-tools
python3 -m venv .venv
source .venv/bin/activate

# 埋め込みモデル用と、OpenAI 互換 API 用のライブラリを入れる
pip install sentence-transformers openai numpy

# LM Studio のサーバーを起動して、ツール呼び出しに対応したモデルを読み込む(例:Qwen3.8 27B)
lms server start
lms load qwen/qwen3.8-27b -y
ツールの定義は、OpenAI の function calling の形式で tools.json に並べておきます。1 つ分はこういう形です。
{
  "type": "function",
  "function": {
    "name": "approve_expense_report",
    "description": "【経費精算】上長として、申請中の経費精算を承認する。",
    "parameters": {
      "type": "object",
      "properties": {"expense_id": {"type": "string", "description": "申請 ID(例 EXP-1001)"}},
      "required": ["expense_id"]
    }
  }
}
説明文の先頭に【経費精算】のような業務名を入れているのは、検索でも LLM の選択でも、どの業務のツールかが一目で分かるようにするためです。
コード
dynamic_tools.py の全体です。埋め込みの計算は CPU で十分に速く、120 個のツールの埋め込みは手元で約 1 秒、1 回の検索は約 6 ミリ秒でした。
"""動的ツール選択の最小実装

1. ツールの説明文を埋め込み(ベクトル)にして、依頼文に近い上位 k 個だけを LLM に渡す
2. 渡したツールで足りないときは、LLM が find_more_tools を呼んで追加の候補を探せる
使い方:  python dynamic_tools.py tools.json "EXP-1042 の経費申請を承認して"
"""
import json
import os
import sys

import numpy as np
from openai import OpenAI
from sentence_transformers import SentenceTransformer

EMBED_MODEL = os.environ.get("EMBED_MODEL", "intfloat/multilingual-e5-small")
LLM_MODEL = os.environ.get("LLM_MODEL", "qwen/qwen3.8-27b")
client = OpenAI(base_url=os.environ.get("LLM_BASE_URL", "http://localhost:1234/v1"),
                api_key=os.environ.get("LLM_API_KEY", "lm-studio"))

SYSTEM = ("あなたは社内業務システムのアシスタントです。今日は 2026-10-10(土)です。"
          "ユーザーの依頼を実行するために、渡されたツールの中から最も適切なものを1つ選んで呼び出してください。"
          "依頼に合うツールが見当たらないときは、find_more_tools で必要な操作を探してください。"
          "承認・差し戻し・取り消し・送信・変更などの操作を頼まれたときは、"
          "中身を確認するためのツールを挟まずに、その操作をするツールを直接呼んでください。")

# 足りないときに LLM が呼ぶ「ツールを探すツール」
FIND_MORE = {"type": "function", "function": {
    "name": "find_more_tools",
    "description": "渡されたツールの中に依頼を実行できるものがないときに呼ぶ。"
                   "必要な操作を短い日本語で query に書くと、社内システムの全ツールから候補を探して追加する。",
    "parameters": {"type": "object", "properties": {
        "query": {"type": "string", "description": "探したい操作(例: 備品の設置場所を変える)"}},
        "required": ["query"]}}}

class ToolIndex:
    """ツールの説明文の埋め込みを持ち、似ている順に返す(ベクトル DB の代わり)"""

    def __init__(self, tools):
        self.tools = tools
        self.model = SentenceTransformer(EMBED_MODEL, device="cpu")
        docs = ["passage: " + self._text(t) for t in tools]  # e5 は文書に passage: を付ける
        self.vecs = self.model.encode(docs, normalize_embeddings=True)

    @staticmethod
    def _text(tool):
        f = tool["function"]
        params = "、".join(p.get("description", k) for k, p in f["parameters"]["properties"].items())
        return f"{f['name']}: {f['description']} 引数: {params or 'なし'}"

    def search(self, query, k=15, exclude=()):
        q = self.model.encode(["query: " + query], normalize_embeddings=True)[0]  # 検索文には query:
        order = np.argsort(-(self.vecs @ q))
        hits = [self.tools[i] for i in order if self.tools[i]["function"]["name"] not in exclude]
        return hits[:k]

def as_openai(tool):
    return {"type": "function", "function": tool["function"]}

def run(query, index, k=15, extra_k=5, max_search=2):
    """依頼を1つ処理し、最終的に呼んだツールと引数を返す(ツールの実行はしない)"""
    offered = index.search(query, k)
    messages = [{"role": "system", "content": SYSTEM}, {"role": "user", "content": query}]
    searches = []
    for _ in range(max_search + 1):
        r = client.chat.completions.create(
            model=LLM_MODEL, temperature=0, max_tokens=800, messages=messages,
            tools=[as_openai(t) for t in offered] + [FIND_MORE],
            extra_body={"reasoning_effort": "none"},  # LM Studio の Qwen3.8 で思考を切る
        )
        m = r.choices[0].message
        if not m.tool_calls:
            return {"tool": None, "text": m.content, "offered": len(offered), "searches": searches}
        call = m.tool_calls[0]
        args = json.loads(call.function.arguments or "{}")
        if call.function.name != "find_more_tools":
            return {"tool": call.function.name, "args": args, "offered": len(offered), "searches": searches}
        # 追加の検索: すでに渡したものを除いて、上位 extra_k 個を足す
        names = {t["function"]["name"] for t in offered}
        extra = index.search(args.get("query", query), extra_k, exclude=names)
        offered += extra
        searches.append({"query": args.get("query"), "added": [t["function"]["name"] for t in extra]})
        messages.append({"role": "assistant", "content": m.content or "", "tool_calls": [
            {"id": call.id, "type": "function",
             "function": {"name": call.function.name, "arguments": call.function.arguments}}]})
        messages.append({"role": "tool", "tool_call_id": call.id,
                         "content": "次のツールを追加しました: " + ", ".join(searches[-1]["added"])})
    return {"tool": None, "text": "ツールが見つかりませんでした", "offered": len(offered), "searches": searches}

if __name__ == "__main__":
    tools = json.load(open(sys.argv[1]))
    index = ToolIndex(tools)
    print(json.dumps(run(sys.argv[2], index), ensure_ascii=False, indent=1))
実行例
ふだんの依頼は、検索の上位 15 個だけで正しいツールを選びます(searches が空)。
python dynamic_tools.py tools.json "EXP-1042 の経費申請、内容を確認したので承認しておいてください。"
{
 "tool": "approve_expense_report",
 "args": {
  "expense_id": "EXP-1042"
 },
 "offered": 15,
 "searches": []
}
検索で漏れる依頼では、LLM が find_more_tools で探す言葉を言い直し、追加された 5 個の中から正しいツールを選びます。
python dynamic_tools.py tools.json "PJ-77 に EMP-0233 さんを入れて。"
{
 "tool": "add_project_member",
 "args": {
  "project_id": "PJ-77",
  "employee_id": "EMP-0233"
 },
 "offered": 20,
 "searches": [
  {
   "query": "プロジェクトにメンバーを追加する",
   "added": [
    "add_project_member",
    "remove_project_member",
    "create_project_task",
    "update_project",
    "create_project"
   ]
  }
 ]
}
どちらも 2026-10-11 に手元(LM Studio・Qwen3.8 27B)で実行した実際の出力です。「入れて」という言葉では上位 15 個に入らなかった add_project_member が、「プロジェクトにメンバーを追加する」と言い直した検索で 1 位に来ています。このコードを 60 件の依頼で動かした結果は、前の章の⑦のとおり 58/60(97%)でした。
Claude API なら「tool search tool」で同じことができる
Claude API には、この仕組みが機能として用意されています。Tool search tool です。ツールの定義に defer_loading: true を付けておくと、そのツールは最初はモデルの文脈に入りません。Claude が必要になったときに検索し、見つかったツールだけが読み込まれます。
公式ドキュメントで確認できた主な仕様を表にまとめます(2026-10-10 時点)。
| 項目 | 内容 |
|---|---|
| 種類 | 正規表現で探す tool_search_tool_regex_20251119 と、自然文で探す tool_search_tool_bm25_20251119 |
| 検索の対象 | ツール名、説明文、引数の名前、引数の説明 |
| 1 回の検索で返る数 | 既定で 5 個(Claude が limit で変えられる) |
| 遅延できる数 | 1 リクエストあたり 10,000 個まで |
| 決まりごと | 検索ツール自身は遅延させない。全部を遅延させると 400 エラー。よく使う 3〜5 個は最初から見せる |
| キャッシュ | 見つかったツールは会話の中に追記されるので、前半のキャッシュが崩れない |
| 自前の検索 | 自分のツールから tool_reference を返せば、埋め込み検索などに置き換えられる |
| Amazon Bedrock | サーバー側のツール検索は InvokeModel API でのみ使える(Converse API では使えない) |
最後の行は、Bedrock で作る人には大事な点です。Postman の記事に載っている呼び出しの例は Converse API の形でした。Converse API を使う構成で同じことをしたいなら、Postman のように自前でベクトル検索を用意するか、InvokeModel API を使うことになります。
Python の SDK で書くと次のようになります。先ほどの tools.json(OpenAI 形式)を Claude の形に直し、2 個だけを最初から見せて、残りの 118 個を遅延させています。
"""Claude API の tool search tool で、120 個のツールを必要になったときだけ読み込む例"""
import json
import sys

import anthropic

client = anthropic.Anthropic()
ALWAYS = {"search_tickets", "create_ticket"}  # 最初から見せるツール

def to_claude(tool):
    """OpenAI 形式(tools.json)のツール定義を、Claude API の形に直す"""
    f = tool["function"]
    t = {"name": f["name"], "description": f["description"], "input_schema": f["parameters"]}
    if f["name"] not in ALWAYS:
        t["defer_loading"] = True  # 検索で見つかるまで文脈に入れない
    return t

catalog = json.load(open(sys.argv[1]))
tools = [{"type": "tool_search_tool_bm25_20251119", "name": "tool_search_tool_bm25"}]  # 検索ツール自身は遅延させない
tools += [to_claude(t) for t in catalog]

response = client.beta.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    betas=["server-side-fallback-2026-07-01"],
    fallbacks="default",  # 安全のための判定で断られたとき、推奨の別モデルで自動的にやり直す
    system=("社内業務システムのアシスタントです。経費精算・勤怠・休暇・会議室・備品・問い合わせ・顧客・商談・"
            "請求書・契約・従業員・プロジェクトのツールを検索して使えます。今日は 2026-10-10 です。"),
    messages=[{"role": "user", "content": sys.argv[2]}],
    tools=tools,
)

if response.stop_reason == "refusal":
    print("断られました:", response.stop_details)
    sys.exit(1)

for block in response.content:
    if block.type == "server_tool_use":
        print("検索した言葉:", block.input)
    elif block.type == "tool_search_tool_result" and block.content.type == "tool_search_tool_search_result":
        print("見つかったツール:", [r.tool_name for r in block.content.tool_references])
    elif block.type == "tool_use":
        print("呼ぶツール:", block.name, json.dumps(block.input, ensure_ascii=False))
print("入力トークン:", response.usage.input_tokens)
# 実行するには API キーを設定する(このコードは筆者の環境では API キーがなく、実際の呼び出しはしていない)
pip install anthropic
export ANTHROPIC_API_KEY=<YOUR_API_KEY>
python claude_tool_search.py tools.json "EXP-1042 の経費申請を承認して"
正直に書いておくと、このコードは実際の API 呼び出しまでは確かめていません。確かめたのは、anthropic 1.13.0 の SDK が組み立てるリクエストの中身です。手元に偽の API サーバーを立てて送らせたところ、ツールが 121 個(検索ツール 1 個+業務ツール 120 個)、そのうち defer_loading が付いたものが 118 個、モデル名と fallbacks、ベータ用のヘッダーがドキュメントどおりに入っていました。
fallbacks="default" は、安全のための判定で断られたときに、推奨の別モデルで自動的にやり直す設定です。Claude API と Claude Platform on AWS で使える機能で、Amazon Bedrock では使えません(Bedrock で動かすなら外します)。
システムプロンプトに「どんな分野のツールを検索できるか」を書いているのは、公式ドキュメントの勧めに従ったものです。分野が分かっていると、Claude が検索の言葉を選びやすくなります。
Claude Code・LangGraph の場合
Claude Code は、MCP のツールに対して最初からこの仕組みが有効です。ドキュメントによると、セッションの開始時に読み込まれるのはツールの名前とサーバーの説明だけで、定義は必要になったときに検索して読み込まれます。設定は環境変数 ENABLE_TOOL_SEARCH で変えられます。
| 値 | 動き |
|---|---|
| 未設定 | MCP のツールをすべて遅延させ、必要なときに読み込む(一部の環境では最初から全部読み込む) |
auto | ツールの定義が文脈の 10% 未満なら最初から読み込み、10% に達したら遅延させる |
auto:5 | 上の割合を 5% にする(0〜100 で指定) |
false | 遅延させず、最初から全部読み込む |
MCP サーバーを作る側は、サーバーの説明(instructions)に「どんな仕事のツールがあり、いつ探すべきか」を書いておくと、Claude Code がツールを探しやすくなります。ツールの説明文とサーバーの説明は、既定で 2,048 文字で切られるので、大事なことは前に書きます。
LangGraph には、LangChain が出している langgraph-bigtool というライブラリがあります。ツールの名前と説明を LangGraph の Store(保存の仕組み)に埋め込みで入れておき、エージェントが検索用のツールで必要なツールを探します。検索の関数は自分で差し替えられます。ただし、2026-10-10 時点の版は 0.0.3 で、まだ初期の段階です。
この設計が向いている場面・向いていない場面
ここまでの内容と実験の結果から、向き不向きをまとめます。
| 場面 | 向き・不向き | 理由 |
|---|---|---|
| MCP サーバーを何個もつなぎ、ツールが数十〜数百個ある | 向いている | 見せる数を約 15 個に保てる。ツールを足しても精度が落ちにくい |
| 名前や説明が似たツールが多い(業務ごとに approve や get がある) | 向いている(ただし絞っても似たツールは残る) | 検索で絞ると、同じ業務の似たツールほど一緒に残る。見分ける工夫(後述)が別に要る |
| ツールが増え続ける製品・社内基盤 | 向いている | 登録するだけで、見せ方は変えなくてよい |
| 分析や集計の質問が多い | スキーマ+クエリを優先 | 読み取り用のツールを増やすより、1 本のクエリツールのほうが幅広く答えられる |
| ツールが 10 個前後で、毎回ほとんど使う | 向いていない | 検索の手間と取りこぼしのリスクのほうが大きい |
| 速さが最優先で、ツールの一覧が毎回同じでよい | 注意が必要 | 一覧を毎回変えるとプロンプトキャッシュが効きにくくなる(実験で確認) |
| 依頼の言葉とツールの説明の言葉がかけ離れている | 注意が必要 | 検索で漏れやすい。「いつ使うか」の説明や追加検索で補う |
うまく選べないときの確認順
最後に、実際に作ってみてうまくいかないときの確認順です。手元の実験で出た症状を上から並べています。
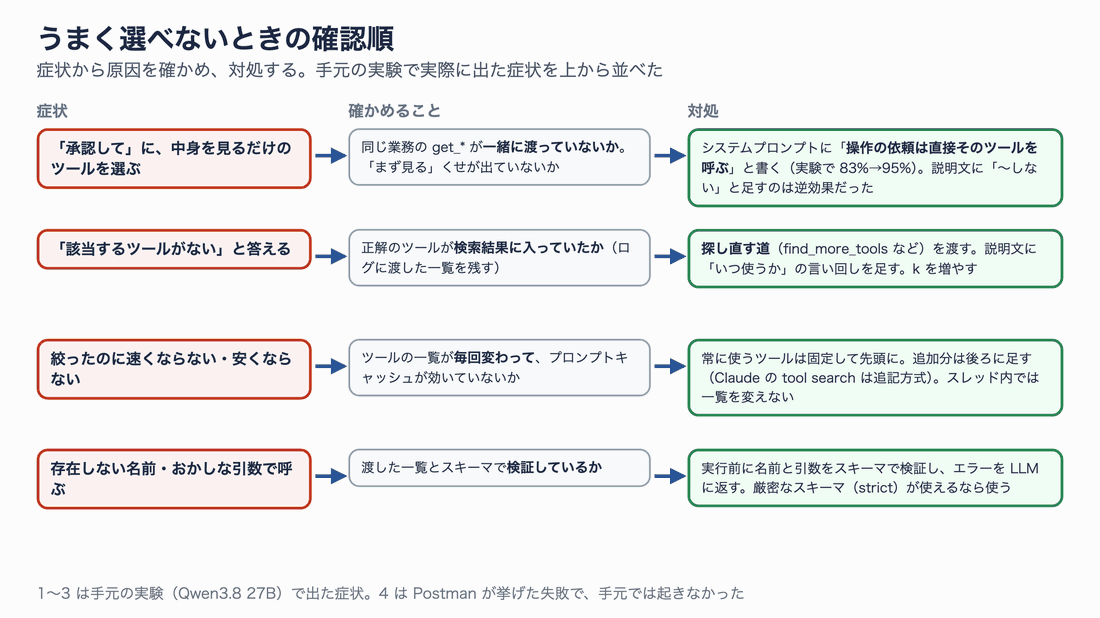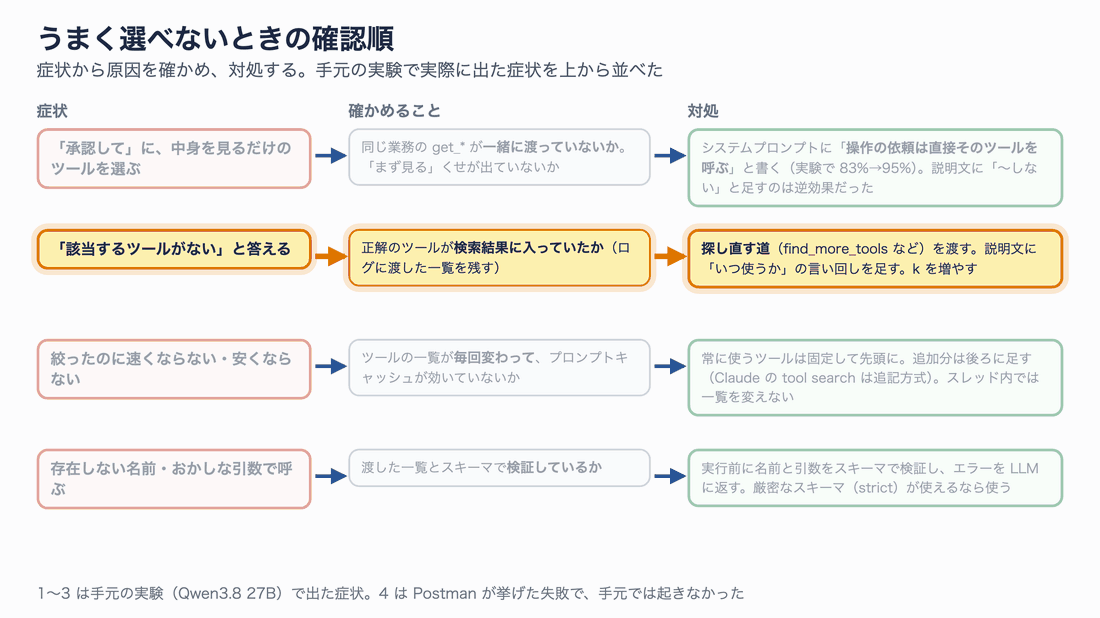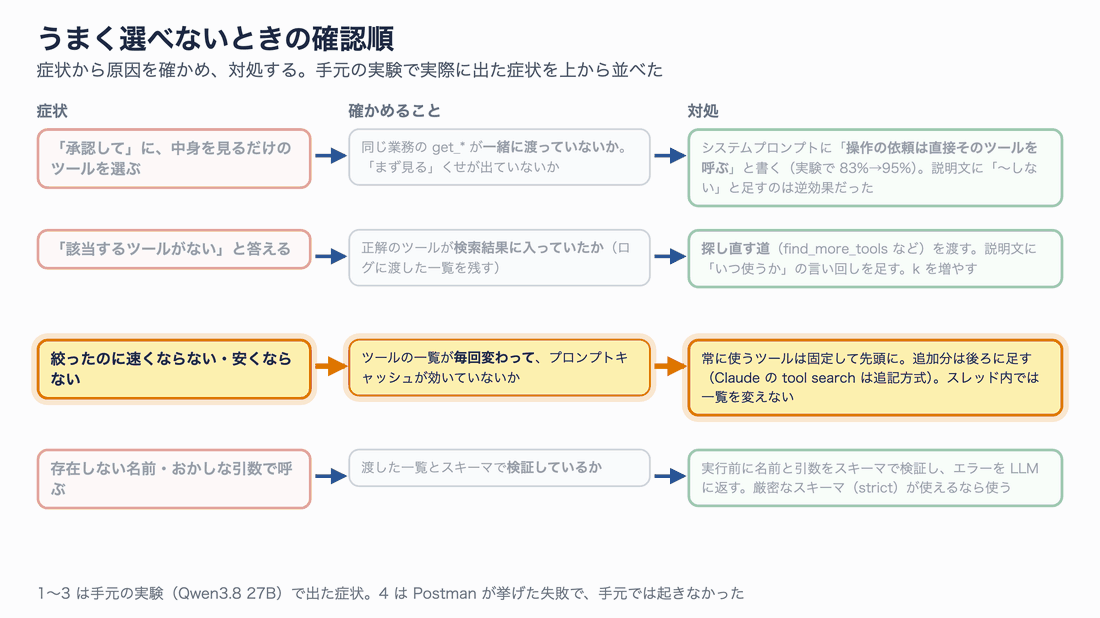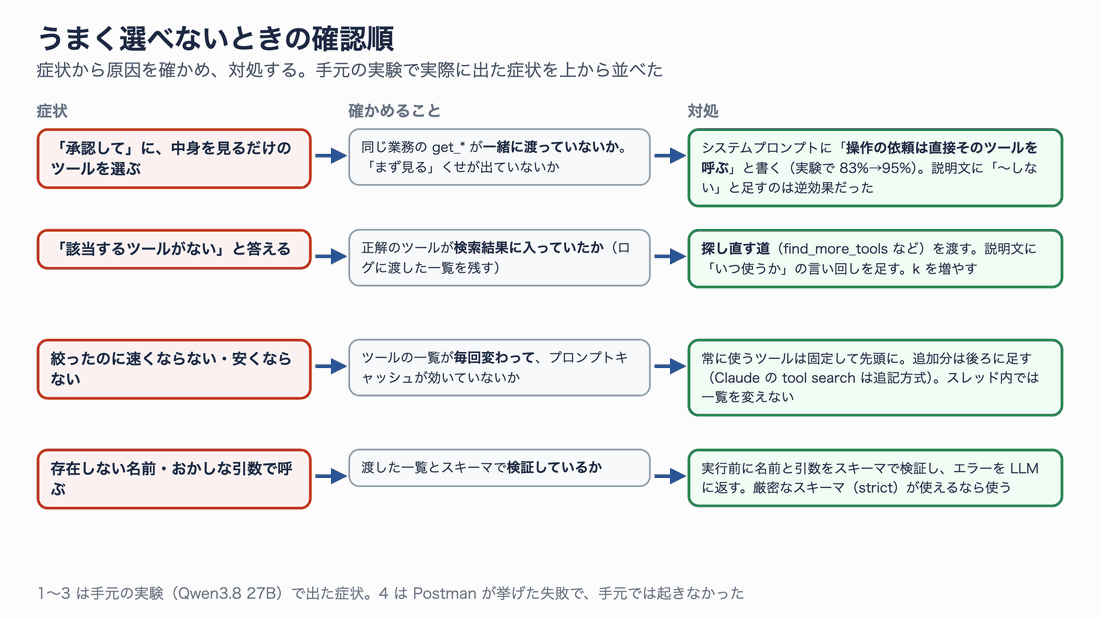
図14:症状 → 確かめること → 対処
| 症状 | 確かめること | 対処 |
|---|---|---|
| 「承認して」に、中身を見るだけのツールを選ぶ | 同じ業務の get_* が一緒に渡っていないか。「まず中身を見る」くせが出ていないか | システムプロンプトに「操作の依頼は、確認用のツールを挟まずに直接そのツールを呼ぶ」と書く(実験で 83%→95%)。get_* の説明文に「〜しない」と書き足すのは逆効果だった |
| 「該当するツールがない」と答える | 正解のツールが検索結果に入っていたか | 探し直す道(find_more_tools など)を渡す。「いつ使うか」の言い回しを説明に足す |
| 絞ったのに速くならない・安くならない | ツールの一覧が毎回変わり、キャッシュが効いていないか | 常に使うツールは固定して先頭に置き、追加分は後ろに足す |
| 存在しない名前・おかしな引数で呼ぶ | 渡した一覧とスキーマで検証しているか | 実行前に検証し、エラーを LLM に返す。厳密なスキーマ(strict)が使えるなら使う |
どの症状でも、まず渡したツールの一覧と、モデルが呼んだツールをログに残すことから始めてください。検索で漏れたのか、渡したのに選び間違えたのかで、直す場所がまったく違うからです。
原文に書かれていないこと
Postman の記事は設計の考え方を丁寧に説明していますが、次のことは書かれていません。自分のシステムに取り入れるときは、ここを自分で決めて測る必要があります。
- 使った埋め込みモデルの名前、似ている度合いの計算方法、「約 15 個」という数の決め方
- 「2 種類の説明文」のそれぞれの中身(図に「このツールをいつ選ぶか」という注記があるだけ)
- 動的ツール選択を入れたあとの、正解率や速度の改善の数字
- 検索で必要なツールが漏れたときの扱い
- クエリツールの権限(読み取り専用か、どこまで見られるか)
また、「約 40 個」は Postman が自社の製品とモデルで測った値です。手元の実験でもモデルや説明文の書き方で結果が変わったように、この数は環境によって前後します。数字をそのまま信じるより、自分のツールと依頼で、全部見せた場合と絞った場合を比べるのが確実です。
まとめ
Postman の Agent Mode の本番設計から学べることを、もう一度まとめます。
- ツールを増やすほどエージェントが賢くなるわけではない。見せるツールが約 40 個を超えると、存在しないツールの呼び出し、引数の誤り、似た別ツールの選択が増える(Postman の実測。Claude のドキュメントも 30〜50 個で精度が落ちるとしている)
- 解決策は、ツールを全部並べるのをやめ、依頼ごとに検索で約 15 個に絞り、文脈を分けたサブエージェントに渡すこと
- 読み取りは質問ごとのツールではなく、スキーマ+クエリ 1 本にまとめる
- いちばんの壁はツールよりもコンテキスト。画面用のデータをそのまま渡さず、目的別のハンドラーで要約する
- 本番では、状態を変える操作の承認、モデルの振り分け、変わる頻度に合わせた 2 段のキャッシュが効く
手元の実験(架空のツール 120 個・依頼 60 件・Qwen3.8 27B)からは、次のことも分かりました。
- 検索で 15 個に絞ると、入力が約 85% 減り、正解は 83% → 90% に上がった
- 失敗のほとんどは「承認して」に中身を見るだけのツールを選ぶ形で、いちばん効いたのはシステムプロンプトの 1 文(120 個でも 95%)だった
- 説明文に「〜しない」と書き足すと逆効果。並び順はほとんど関係なかった
- 絞ると「検索の漏れ」という新しい失敗が生まれるが、LLM に言い直させる追加検索で拾えた。絞る+追加検索+プロンプトの指示の組み合わせで 97% になった
- 速さは入力の量より、プロンプトの前半が毎回同じか(キャッシュが効くか)で決まった
次の一歩としては、まず自分のエージェントのログを見て、見せているツールの数と、選び間違いの種類を数えてみてください。ツールが数十個を超えていて、似たツールの取り違えが出ているなら、この記事のサンプルか Claude の tool search で絞る効果を試す価値があります。