はじめに:「最強」と書かれた表が、会社の数だけある
2026年10月12日、Meta Superintelligence Labs(Meta の AI 研究組織)が新しい最上位モデル「Muse Wonder」と、その上位版「Muse Wonder Full」を発表しました。発表文には「個人向け・業務向けのエージェント作業で最先端」と書かれています。
ただ、この 6 週間だけでも、Anthropic の Claude Fable 5.1 と Claude Opus 5.5、OpenAI の GPT-6 Astra が、それぞれ「最高性能」をうたって登場しています。各社の比較表は自社に有利な項目を選びがちで、同じベンチマーク名なのに表ごとに数字が違うことも珍しくありません。「結局どれが強いのか」が分かりにくい状況です。
この記事では、Muse Wonder を Claude Fable 5.1・GPT-6 Astra・Claude Opus 5.5 と並べ、次の順で確かめます。
- 各社の数字を比べる前に知っておきたい「数字の出どころ」の違い
- 第三者機関(Artificial Analysis・Vals AI)の総合評価での位置
- 分野ごとの勝ち負け(どの仕事に強く、どこが弱いか)
- 値段と、1 つの仕事を終えるまでの費用
- 実際に使う前の注意点と、自分の仕事で確かめる手順
先に結論を書くと、Muse Wonder は 最上位グループの一角 です。総合評価では Fable 5.1・GPT-6 Astra と同じくらいかやや上ですが、首位は Opus 5.5 のままです。強みは「何時間も続く開発」や「業務の手続きを最後までやり切る」仕事に集中していて、事実知識やゼロからの実装は苦手です。
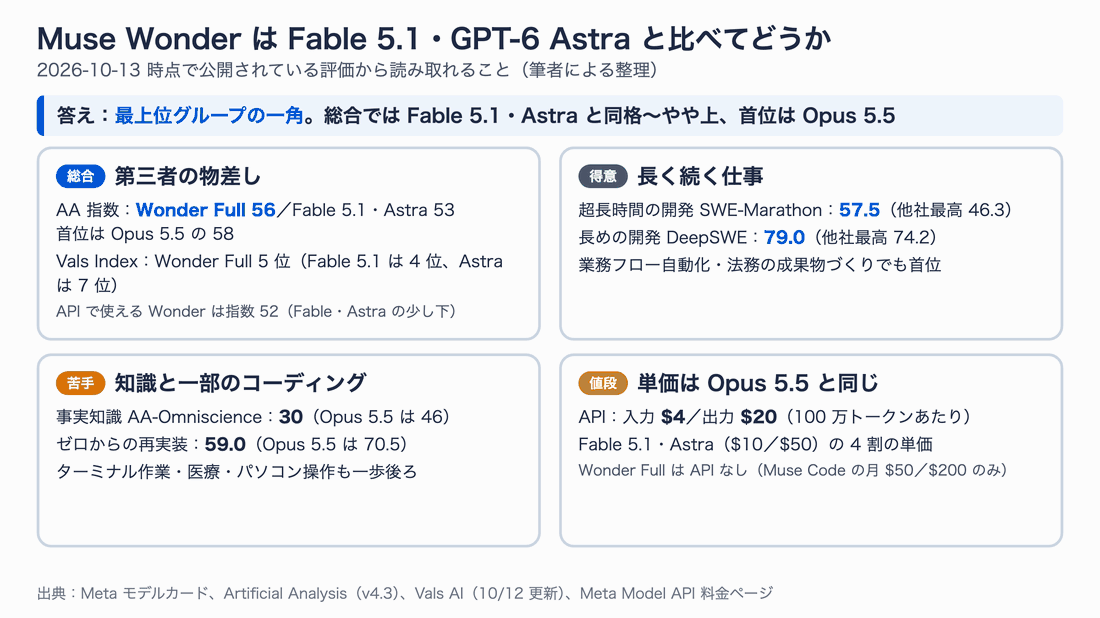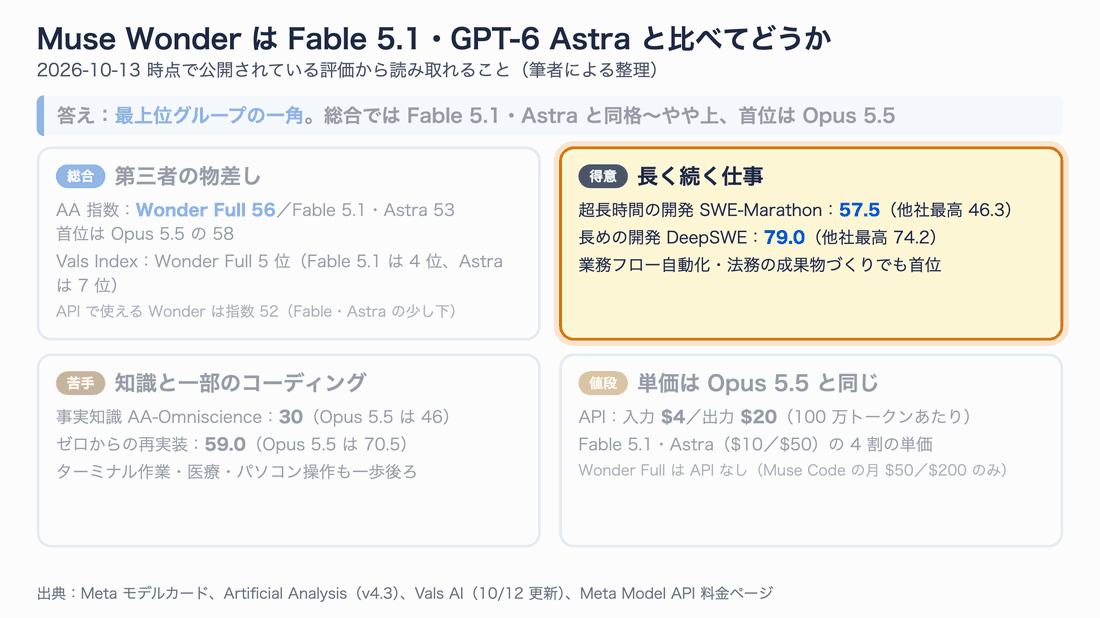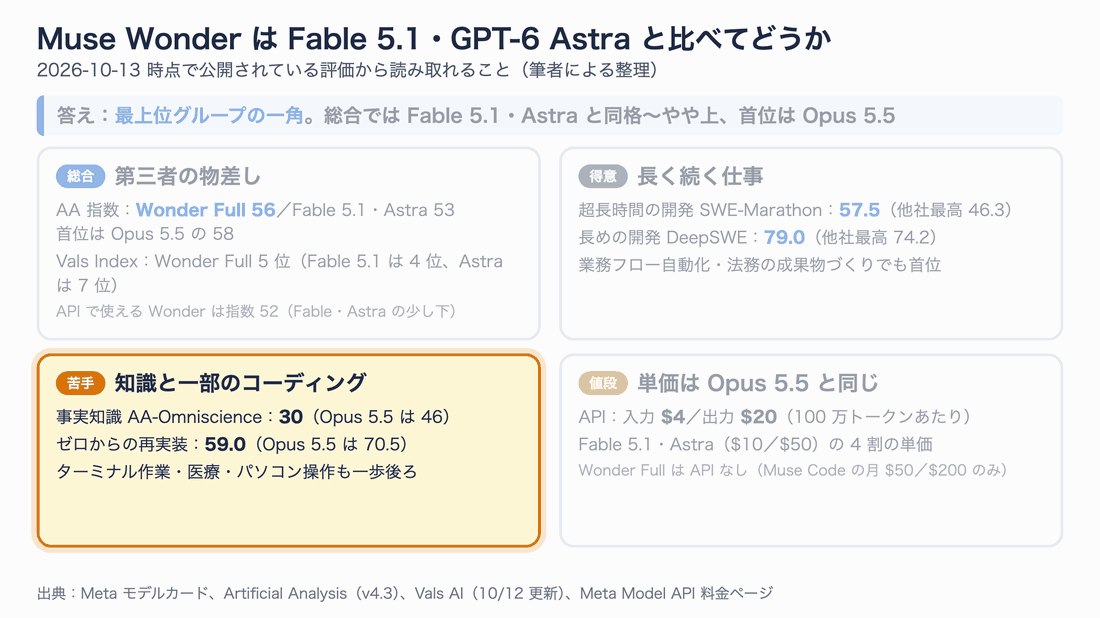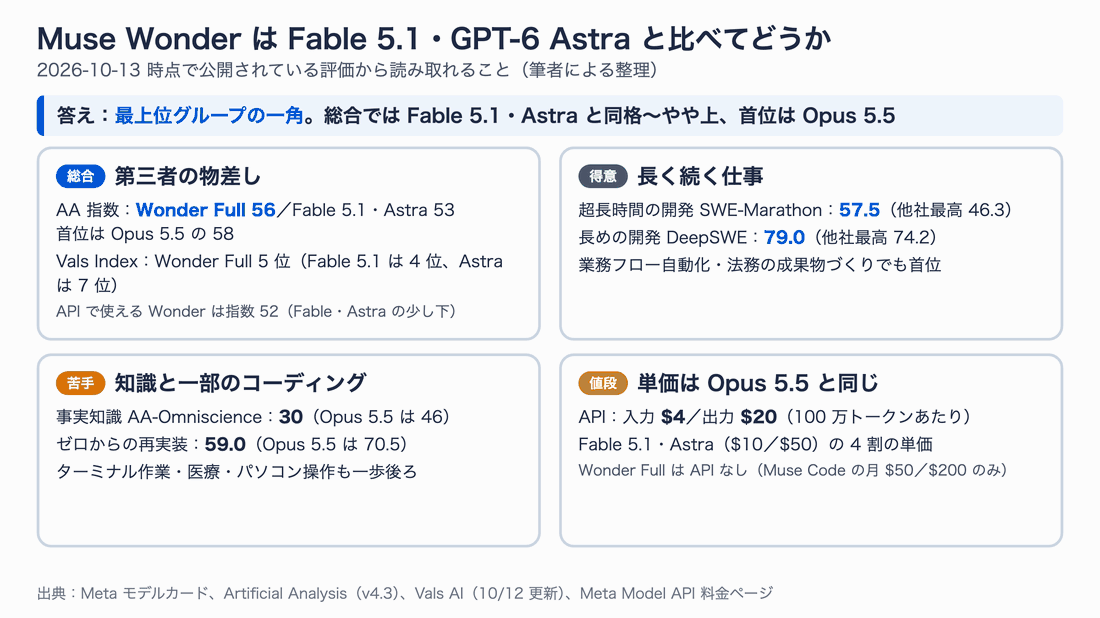
図1:この記事の結論。総合・得意・苦手・値段の順に強調していきます
この記事の確認範囲
- 確認日:2026年10月13日(日本時間)。数字は Meta のモデルカード、各社の発表ページと料金ページ、Artificial Analysis と Vals AI の公開リーダーボードから取りました
- 筆者は Muse Wonder を自分では動かしていません。Meta Model API のアカウントを持っておらず、この記事は公開情報の比較です。後半に、自分の課題で比べるための手順とスクリプトを載せています
- ベンチマークの数字は、どれも提供元か評価機関の発表値です。筆者が追試した値ではありません
想定読者は、Claude Code や Codex などの AI コーディングツールを使っていて、「新しいモデルに乗り換える価値があるか」を判断したい方です。ベンチマークの専門知識は前提にしません。
比べる 5 つのモデル
まず、登場人物を整理します。2026年9月から10月にかけて、最上位級のモデルが立て続けに発表されました。
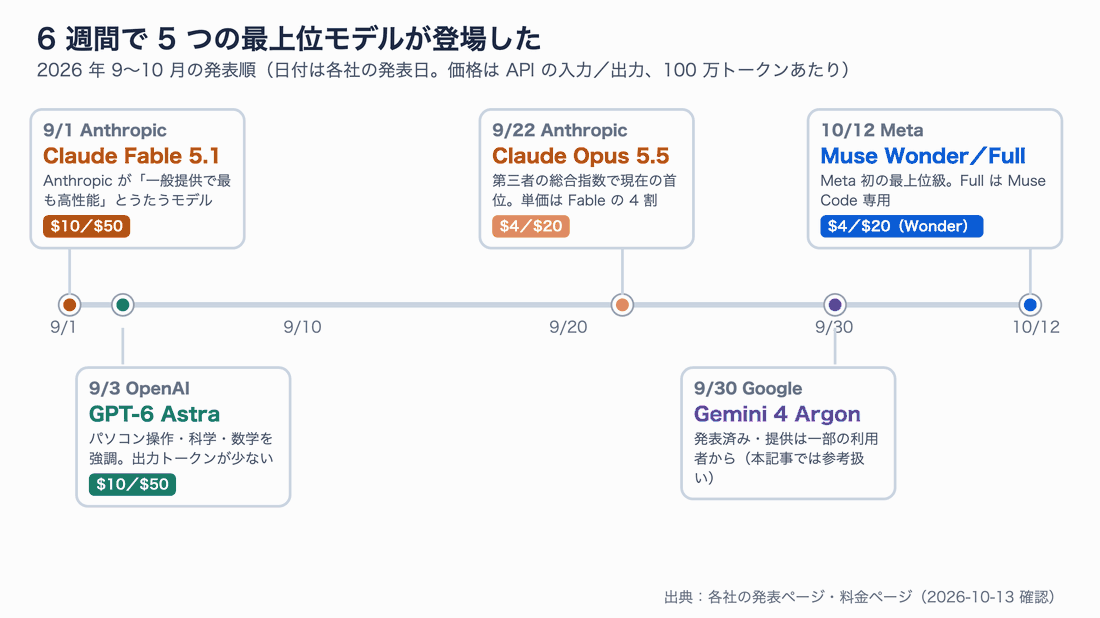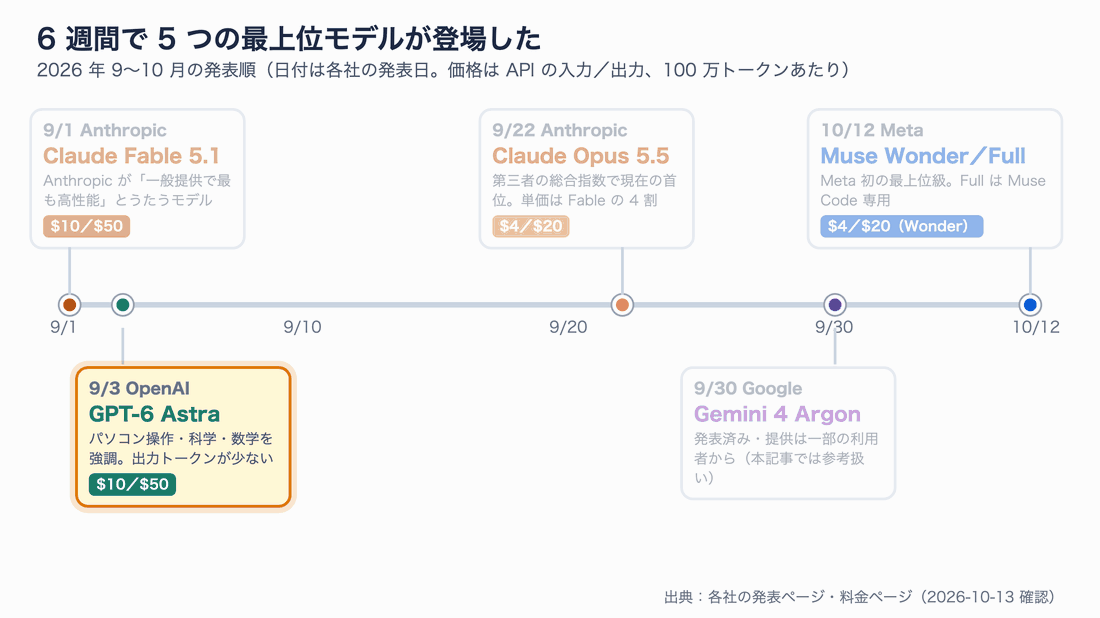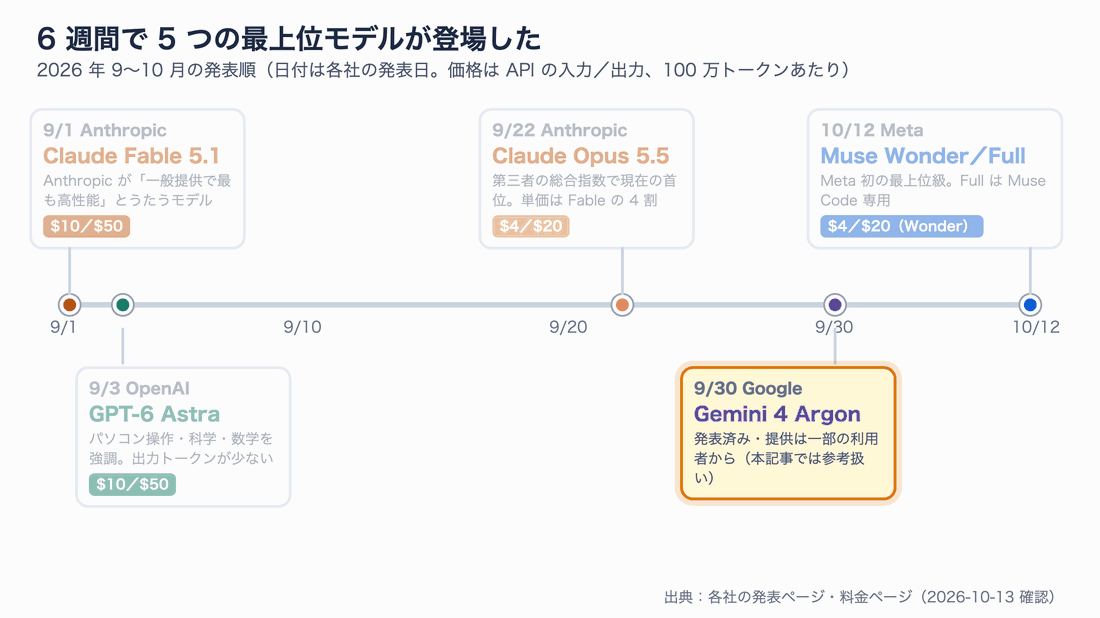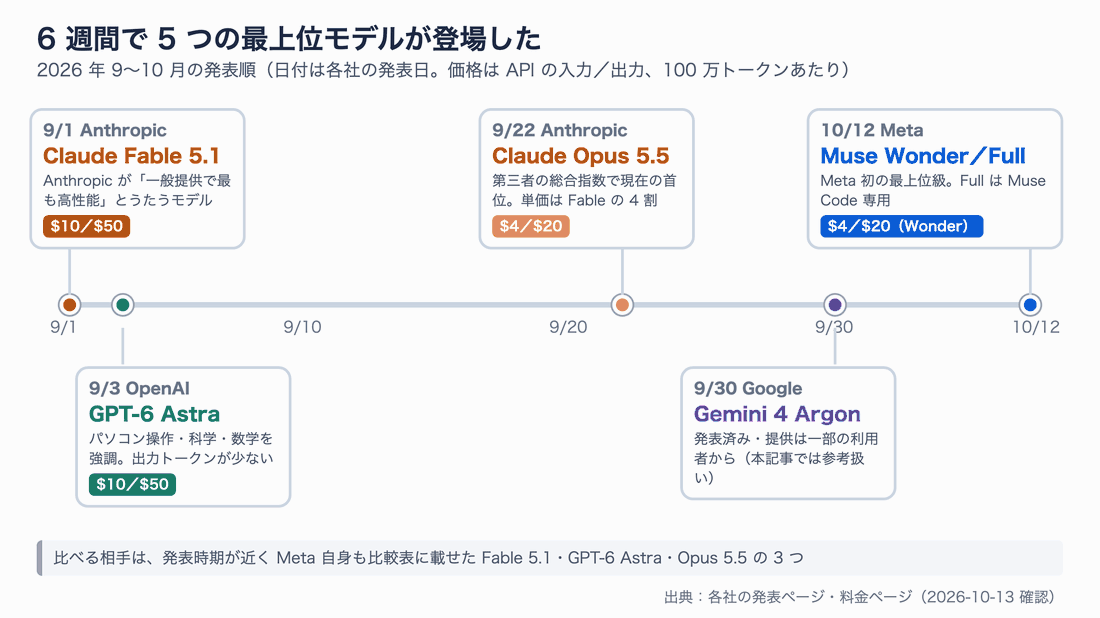
図2:6 週間で 5 つの最上位モデルが登場しました。価格は API の入力/出力(100 万トークンあたり)です
| モデル | 会社 | 発表日 | API の料金(入力/出力) | 使える場所 |
|---|---|---|---|---|
| Muse Wonder | Meta | 10月12日 | $4/$20 | Meta Model API(preview)、Muse Code |
| Muse Wonder Full | Meta | 10月12日 | API なし | Muse Code の有料プラン(月 $50・$200)のみ |
| Claude Fable 5.1 | Anthropic | 9月1日 | $10/$50 | Claude API、Claude アプリ、主要クラウド |
| GPT-6 Astra | OpenAI | 9月3日 | $10/$50 | OpenAI API、ChatGPT、Azure、Bedrock |
| Claude Opus 5.5 | Anthropic | 9月22日 | $4/$20 | Claude API、Claude アプリ、主要クラウド |
料金は 100 万トークンあたりの米ドルです。トークン(token)は、モデルが文章を処理するときの単位で、日本語ならおおよそ 1〜2 文字に 1 トークンと考えてください。
比較相手をこの 3 つにしたのは、発表時期が近く、Meta 自身もモデルカードの比較表に載せているからです。9月30日に Google が発表した Gemini 4 Argon も第三者の評価には登場しますが、提供が一部の利用者に限られていて一次情報も確認しきれていないため、この記事では参考扱いにします。
ひとつ補足があります。Anthropic は Fable 5.1 を「一般提供のモデルで最も高性能」と位置づけていますが、後で見る第三者の総合評価では、後から出た Opus 5.5 のほうが上です。Anthropic の説明によると、Fable 5.1 は本番用の安全装置(セーフガード)を付けたまま評価されていて、たとえばパソコン操作の評価 OSWorld 2.0 では、安全装置が介入した課題を 0 点として数えています。Anthropic 自身も「これがスコアを下げている可能性が高い」と注記しています。
Muse Wonder とは:2 つの版と 2 つの新機能
Wonder と Wonder Full は「入口」が違う
Muse Wonder シリーズには 2 つの版があります。ここを取り違えると、ベンチマークの数字を誤って読んでしまうので、先に確認しておきます。
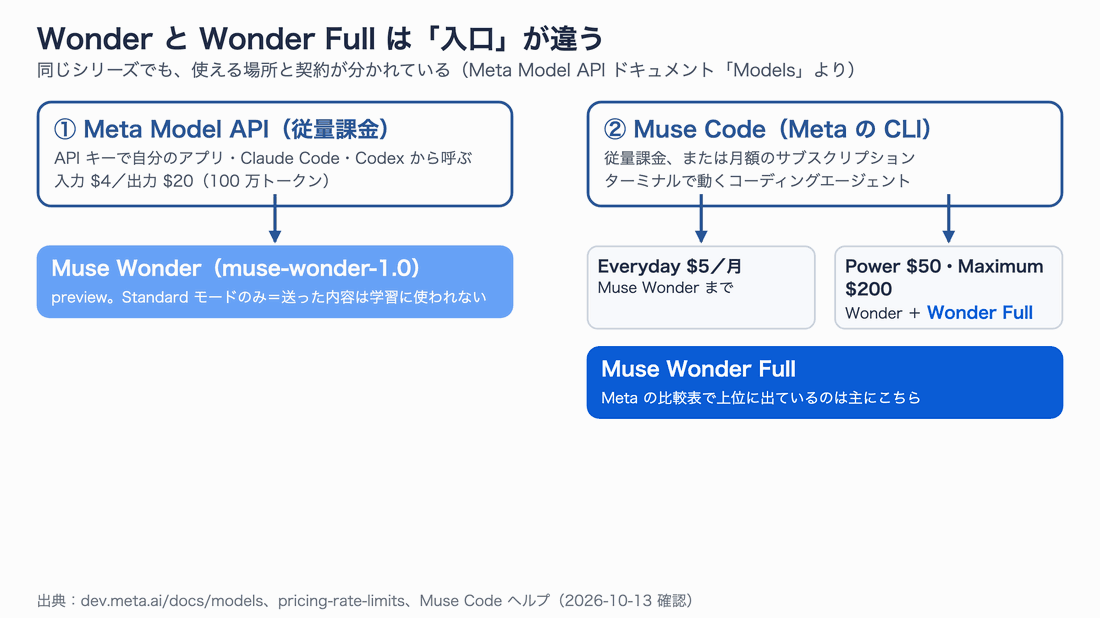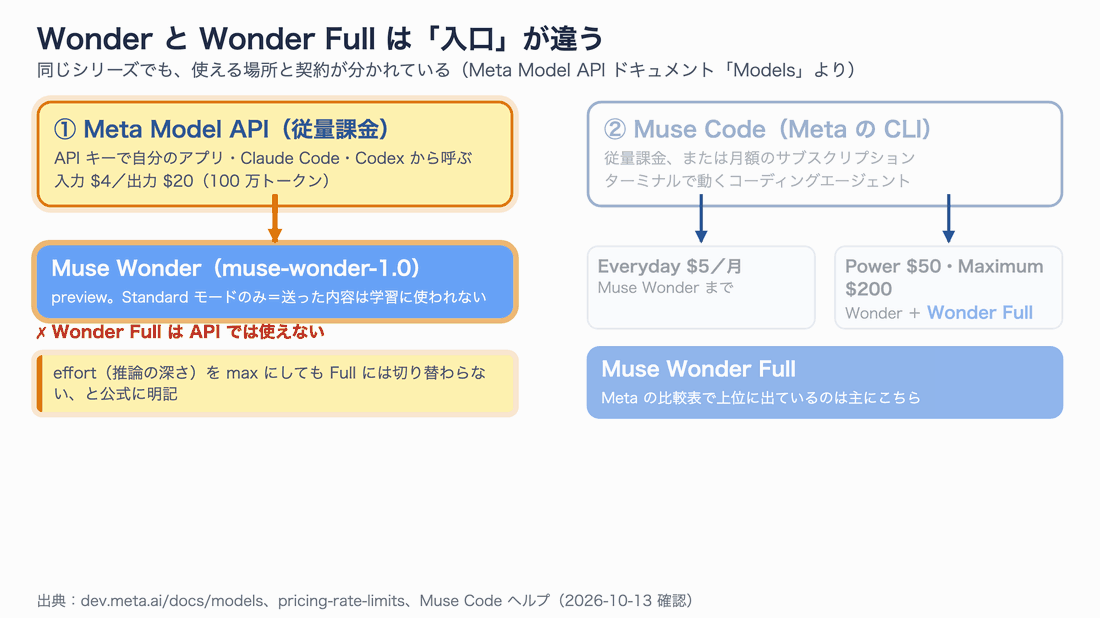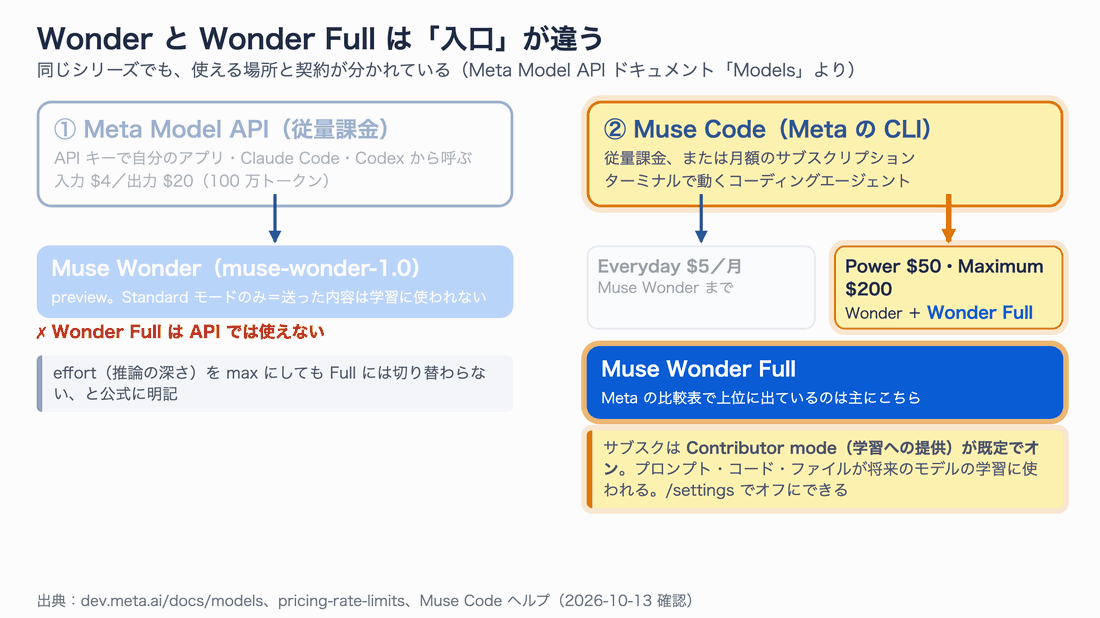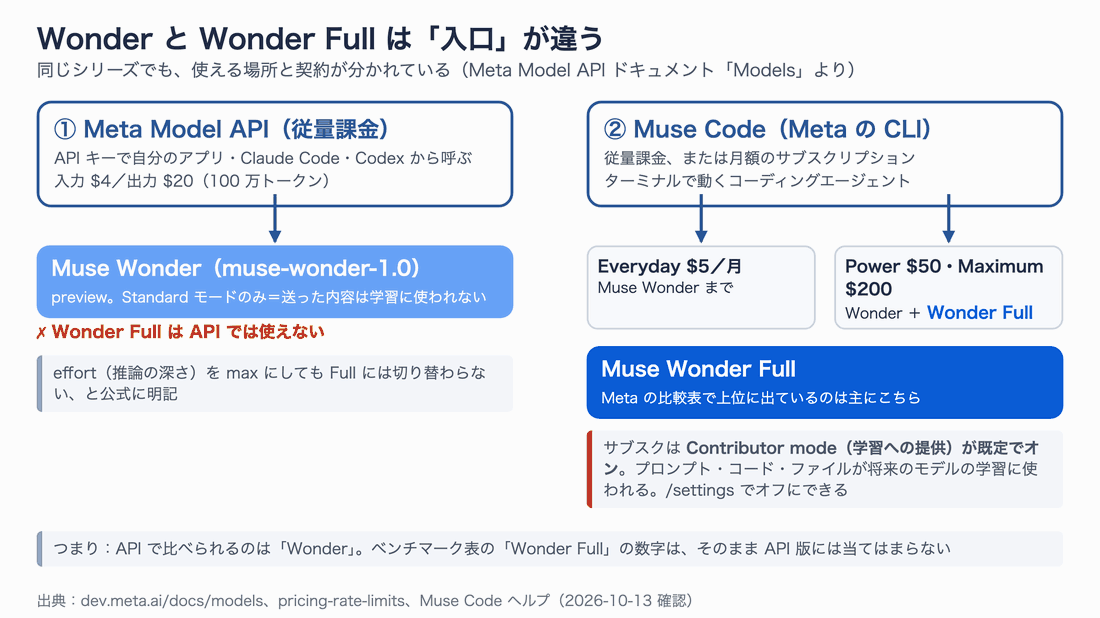
図3:API から使えるのは Wonder だけで、Wonder Full は Muse Code の上位プラン専用です
- Muse Wonder(モデル ID
muse-wonder-1.0):Meta Model API と Muse Code の両方で使えます。API 版は preview(先行公開)の扱いです - Muse Wonder Full:より大きく高性能な版です。Meta のコーディング CLI「Muse Code」の Power(月 $50)と Maximum(月 $200)プランでだけ使えます
Meta のドキュメントには「API で推論の深さ(effort)を max にしても Wonder Full には切り替わらない」と明記されています。ベンチマーク表で上位に出てくるのは主に Wonder Full なので、API で試せる Wonder の実力は、表の Wonder Full より一段低い と考えておく必要があります。
Active Memory と Active Focus
Meta が今回いちばん強調しているのが、次の 2 つの機能です。
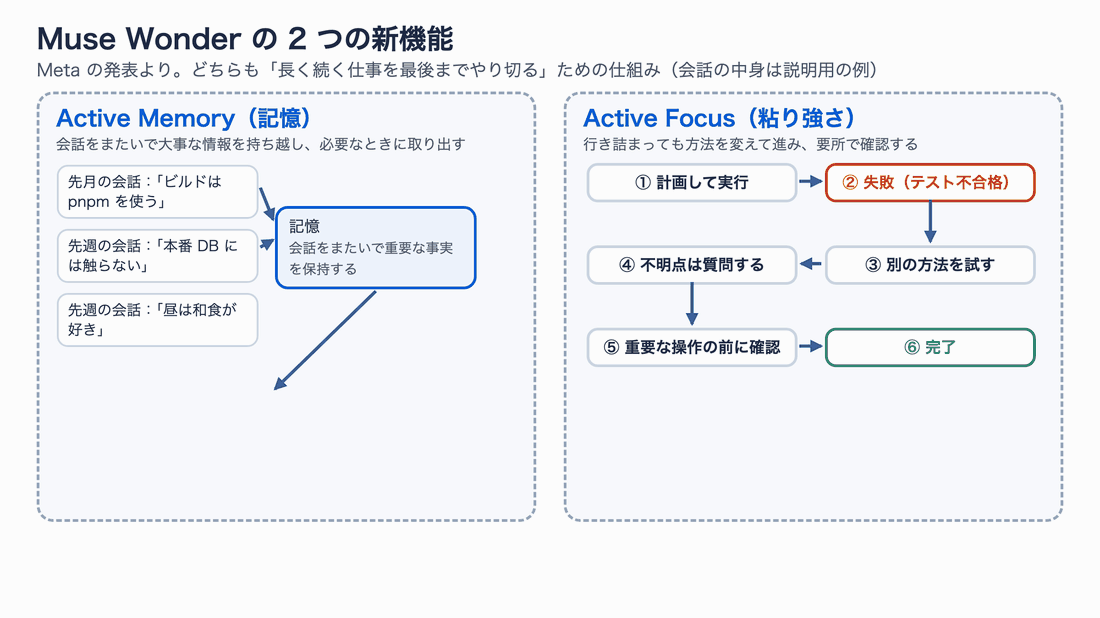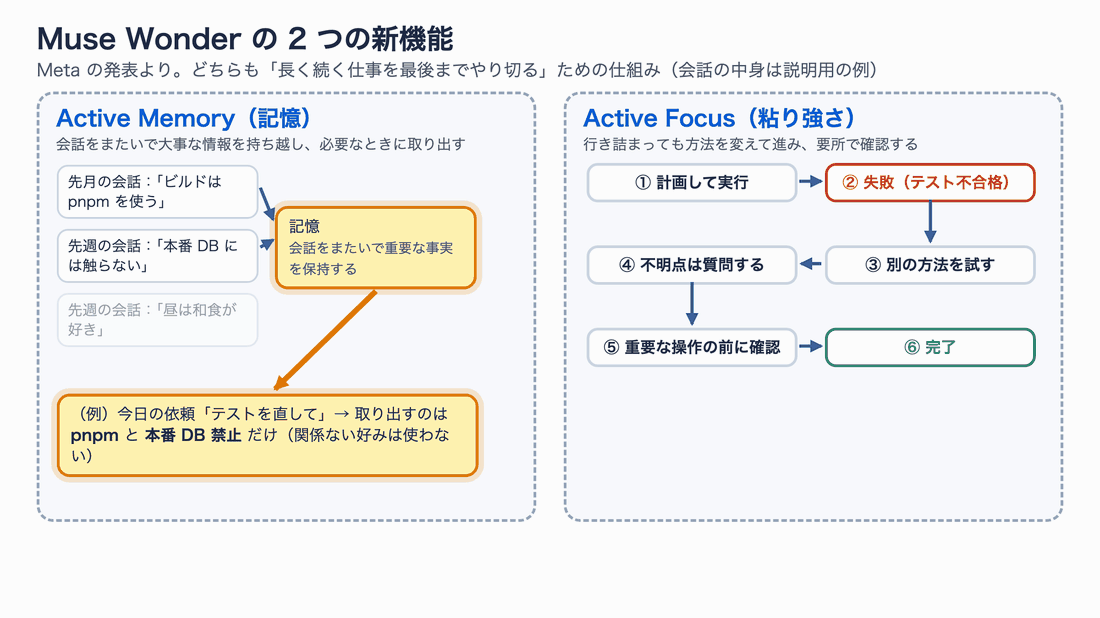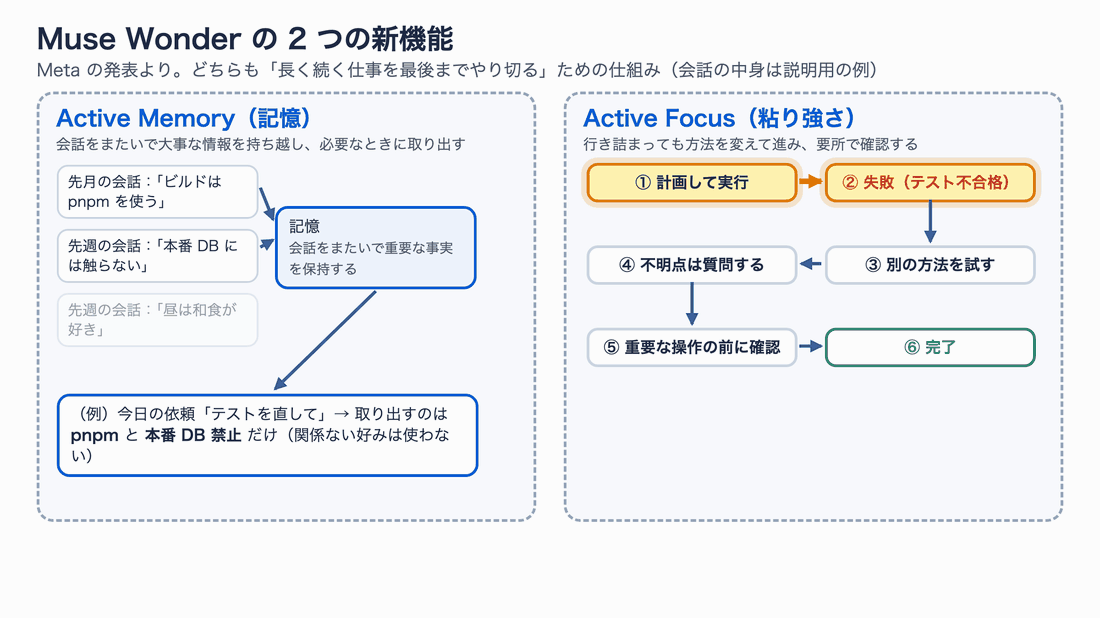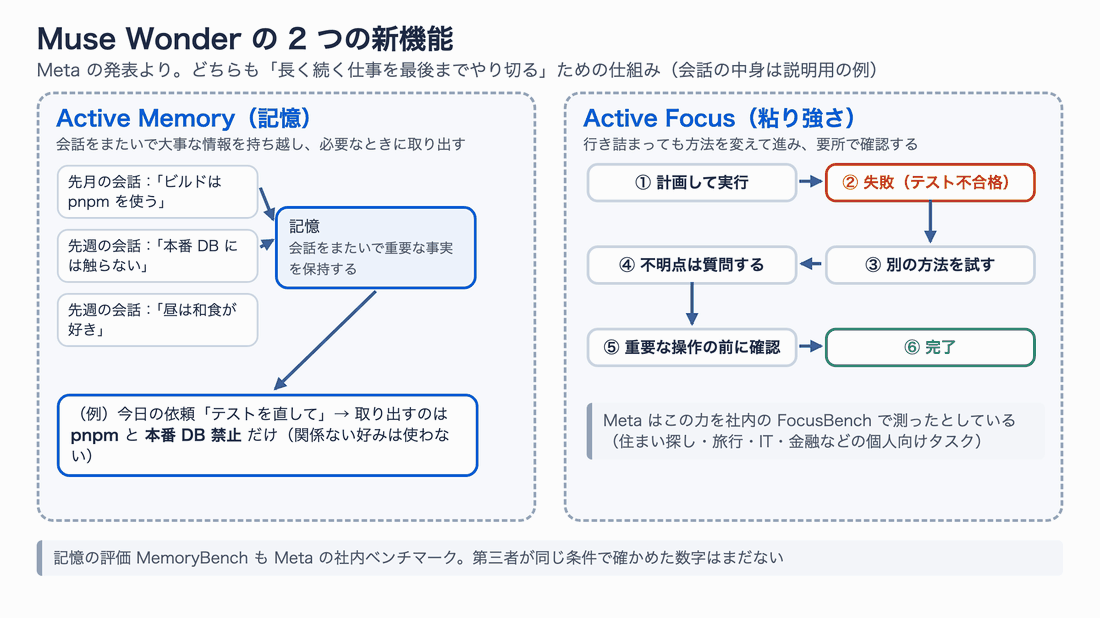
図4:2 つの新機能のイメージ。会話の中身は説明用の例です
Active Memory は、会話をまたいで大事な情報を持ち越し、今の作業に必要なときだけ取り出す機能です。毎回ゼロから説明し直さなくてよい「覚えているエージェント」を目指しています。
Active Focus は、難しい目標に向かって粘り強く作業を続ける力です。行き詰まったら別の方法を試し、新しい情報に合わせて計画を変え、分からないことは質問し、重要な操作の前には確認を求めます。
どちらも「長く続く仕事を最後までやり切る」ための仕組みです。ただし、記憶の力を測った MemoryBench と、粘り強さを測った FocusBench は、どちらも Meta の社内ベンチマーク です。第三者が同じ条件で確かめた数字は、まだ公開されていません。
このほか、モデルカードには次の仕様が書かれています。
| 項目 | 内容 |
|---|---|
| 入力 | テキスト・画像・動画・音声(API は PDF も可) |
| 出力 | テキスト |
| コンテキスト長 | 100 万トークン |
| 重みの公開 | なし(API と製品経由のみ) |
| 学習 | Meta の大規模データセンター「Prometheus」で事前学習と強化学習 |
| 苦手と明記された点 | 学習データにない新しい状況での多段の推論、3D などの空間的な推論 |
比べる前に:同じベンチマークでも数字が変わる
各社の表を見比べる前に、知っておきたいことがあります。同じ名前のベンチマークでも、誰がどの環境で測ったかによって数字が変わる という点です。
ベンチマーク(benchmark)は、AI の能力を測るための共通の試験問題のようなものです。ただ、AI エージェントの評価では、モデルに道具を渡して作業させる「ハーネス」(評価用の実行環境)の作り方で結果が大きく変わります。
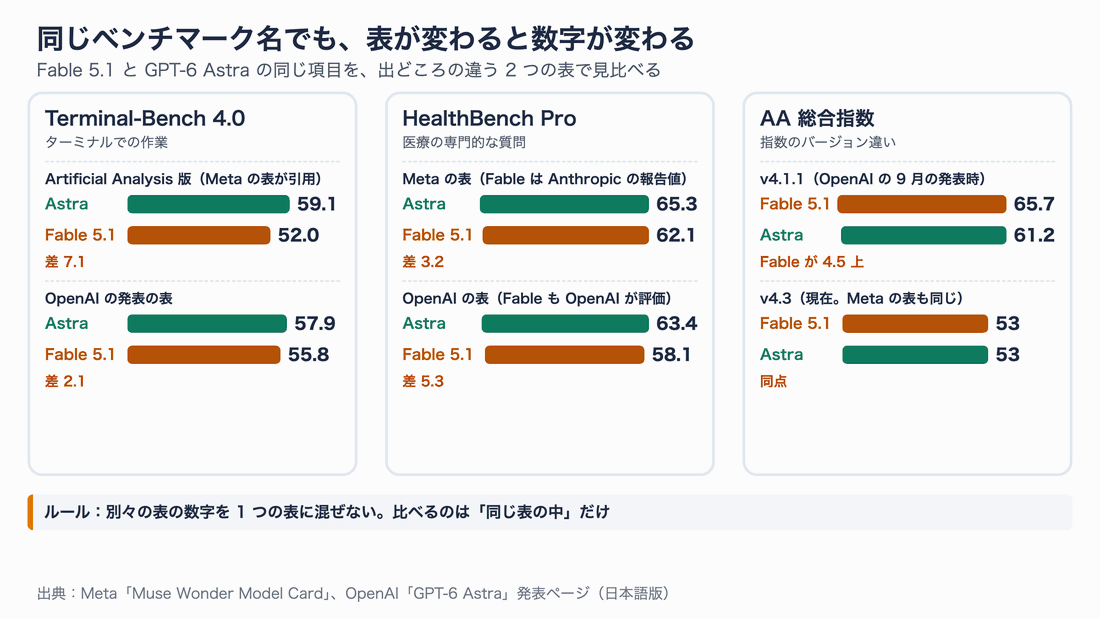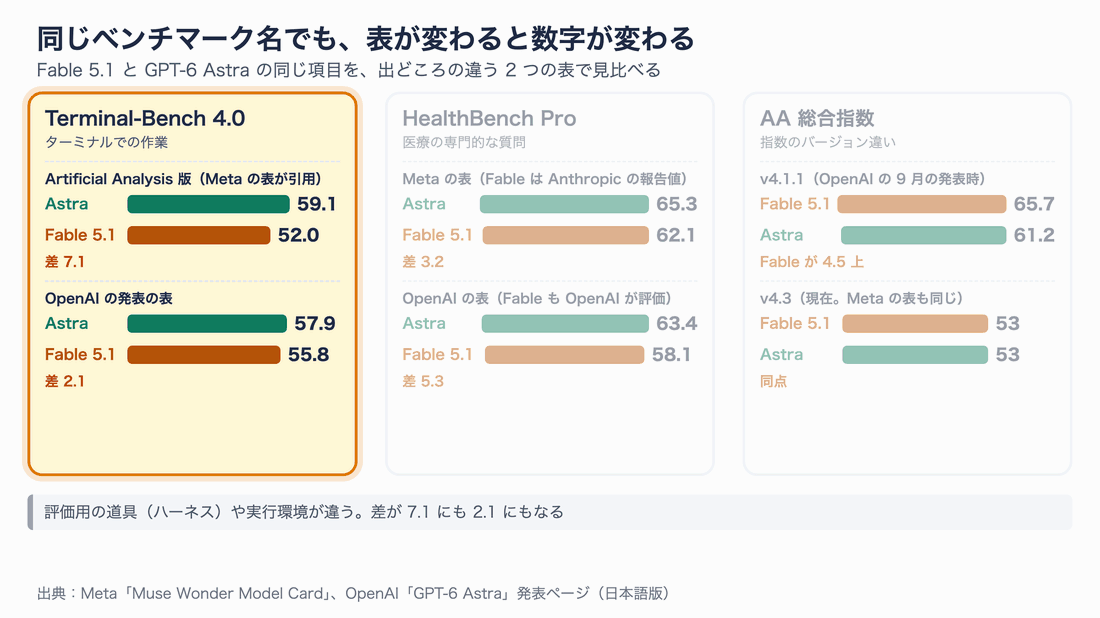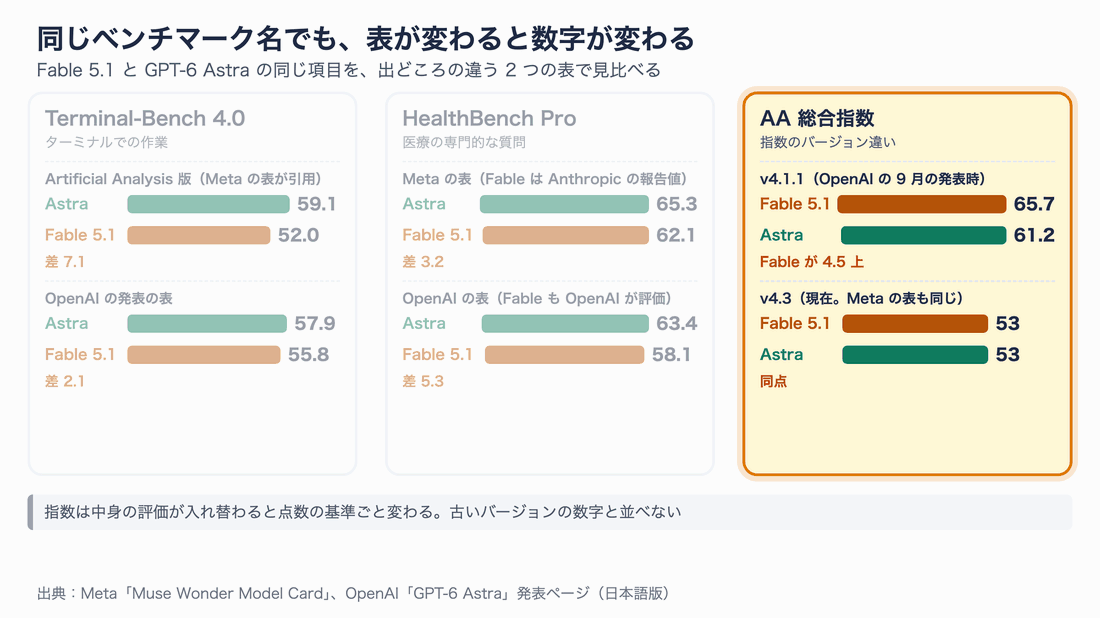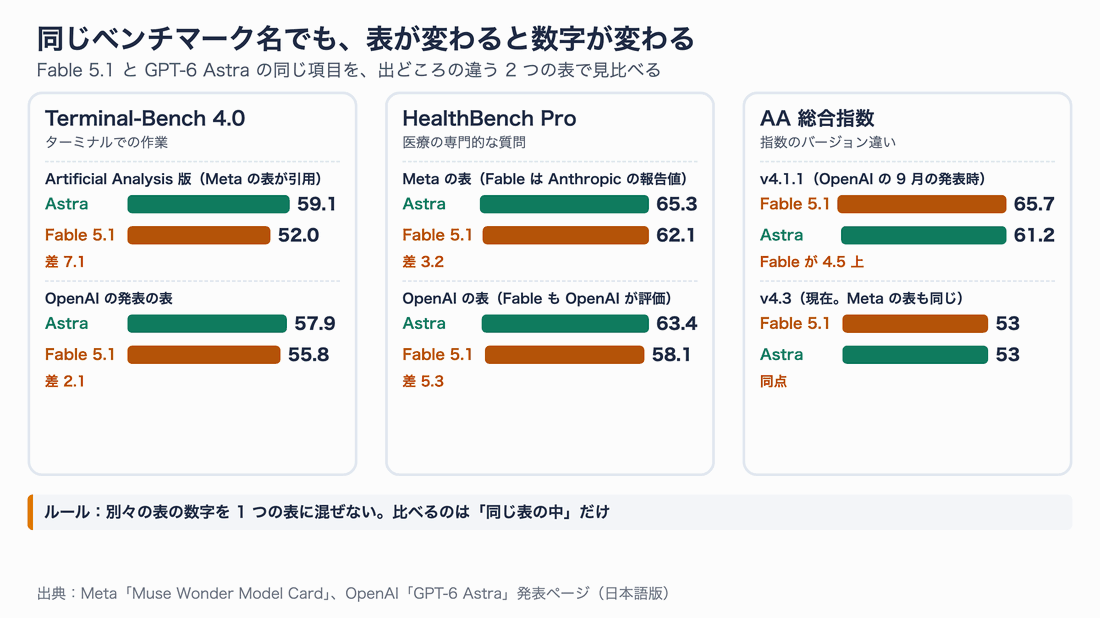
図5:同じ 2 モデル・同じ項目でも、出どころが違うと差の大きさや順位まで変わります
図5の 3 つの例を見てください。
- Terminal-Bench 4.0(ターミナル作業):Artificial Analysis 版では Astra と Fable 5.1 の差が 7.1 ポイントですが、OpenAI の発表の表では 2.1 ポイントしかありません
- HealthBench Pro(医療の質問):Meta の表は Fable 5.1 に Anthropic の報告値を使っています。OpenAI の表は Fable 5.1 も OpenAI が自分で評価していて、Fable の点が 4 ポイント低くなっています
- Artificial Analysis の総合指数:9月の OpenAI の発表時点(v4.1.1)では Fable 5.1 が 65.7、Astra が 61.2 でした。中身の評価が入れ替わった現在の v4.3 では、どちらも 53 です
Meta のモデルカードにも、比較の条件が細かく書かれています。要点は次のとおりです。
| 条件 | 内容 |
|---|---|
| 推論の深さ | 全モデルを max で比較(SWE-Marathon の Wonder Full だけ xhigh) |
| 他社モデルの実行 | Meta が社内で走らせた分は「ベストエフォート」。他社モデル向けに最適化はしていない |
| 他社の公表値 | 第三者や提供元の値がある場合はそれを採用 |
| SWE-Marathon | GPT-6 Astra は Codex、Fable 5.1 は Claude Code で測った値で、共通のハーネスではない |
| 拒否の扱い | モデルが回答を拒否した課題は 0 点として分母に残す |
つまり、比べてよいのは「同じ表の中の数字」だけ です。別々の発表から数字を拾って 1 つの表にまとめると、条件の違いが混ざってしまいます。この記事でも、表ごとに分けて読んでいきます。
第三者の物差しで見る総合力
Artificial Analysis Intelligence Index
最初の物差しは、独立系の評価機関 Artificial Analysis(AA)の総合指数です。業務文書の作成、ターミナル作業、科学コード、長文読解、知識問題など 10 種類の評価を、全モデル同じ条件で実行して 1 つの点数にまとめています。
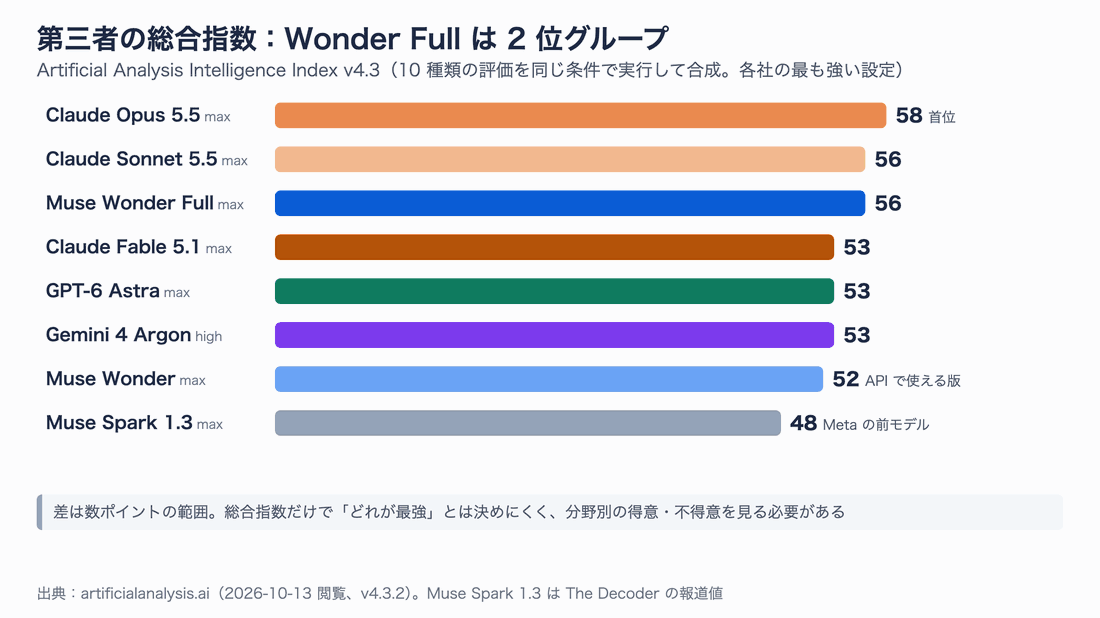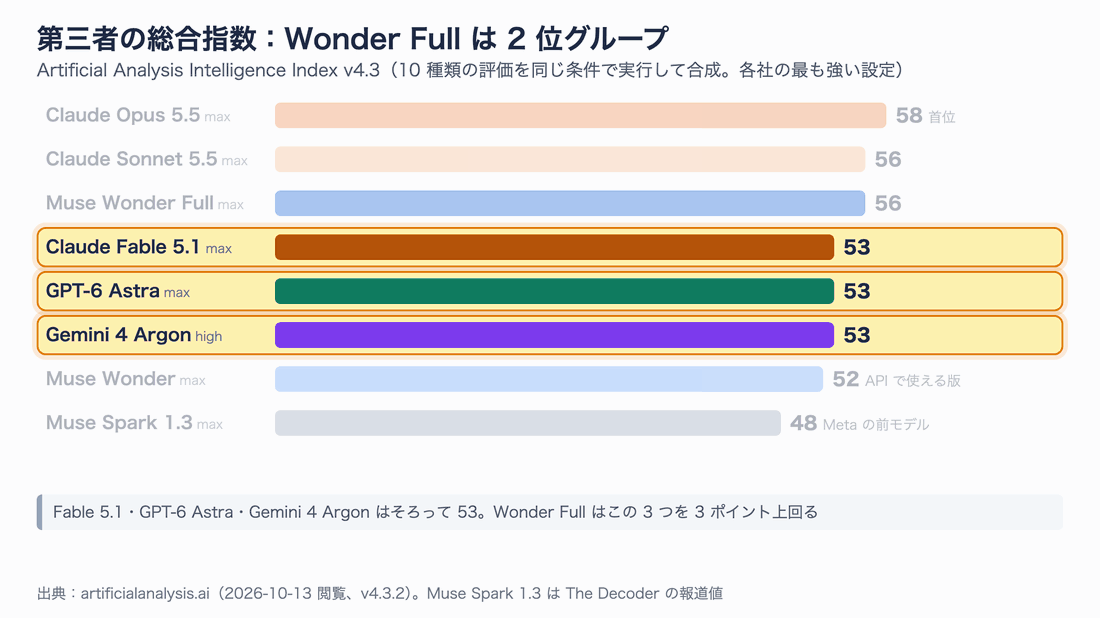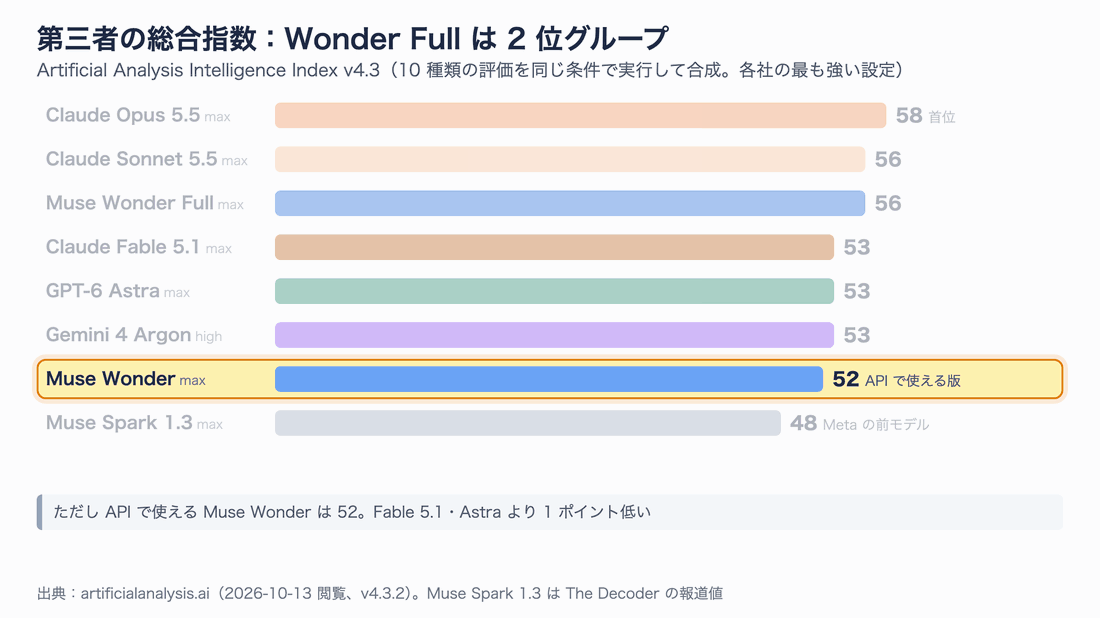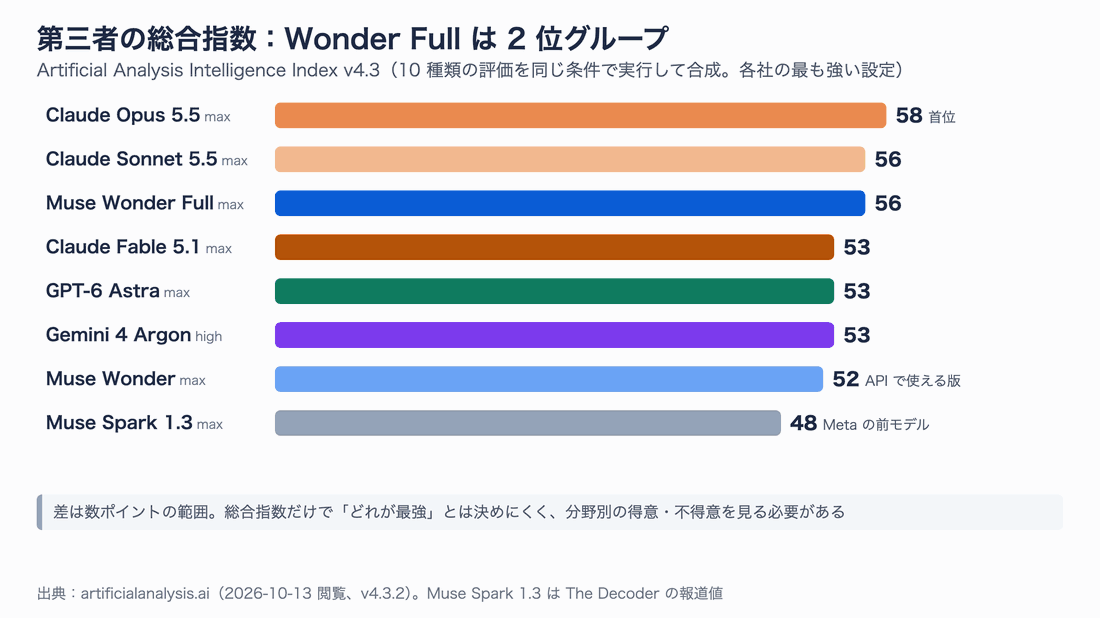
図6:第三者の総合指数では、Wonder Full は Opus 5.5 に次ぐ 2 位グループです
結果は次のとおりです。
- Muse Wonder Full は 56。首位の Opus 5.5(58)とは 2 ポイント差で、Claude Sonnet 5.5 と並びます
- Fable 5.1・GPT-6 Astra は 53。Wonder Full はこの 2 つを 3 ポイント上回りました
- API で使える Muse Wonder は 52。Fable 5.1・Astra より 1 ポイント低い位置です
- 前モデルの Muse Spark 1.3(48)からは 8 ポイントの上昇です
注目したいのは、Anthropic の中位モデルである Sonnet 5.5(API 単価 $2/$10)が Wonder Full と同点 という点です。総合指数で見る限り、Muse Wonder は「頭ひとつ抜けた新王者」ではなく、「最上位グループに加わった新顔」と言えます。
Vals Index
2 つ目の物差しは、Vals AI の総合指数です。金融(財務分析・Excel モデリング)、コーディング、法務、税務の実務評価を、各業界の経済規模に応じた重みで合成しています。より「仕事の成果物」に近い評価です。
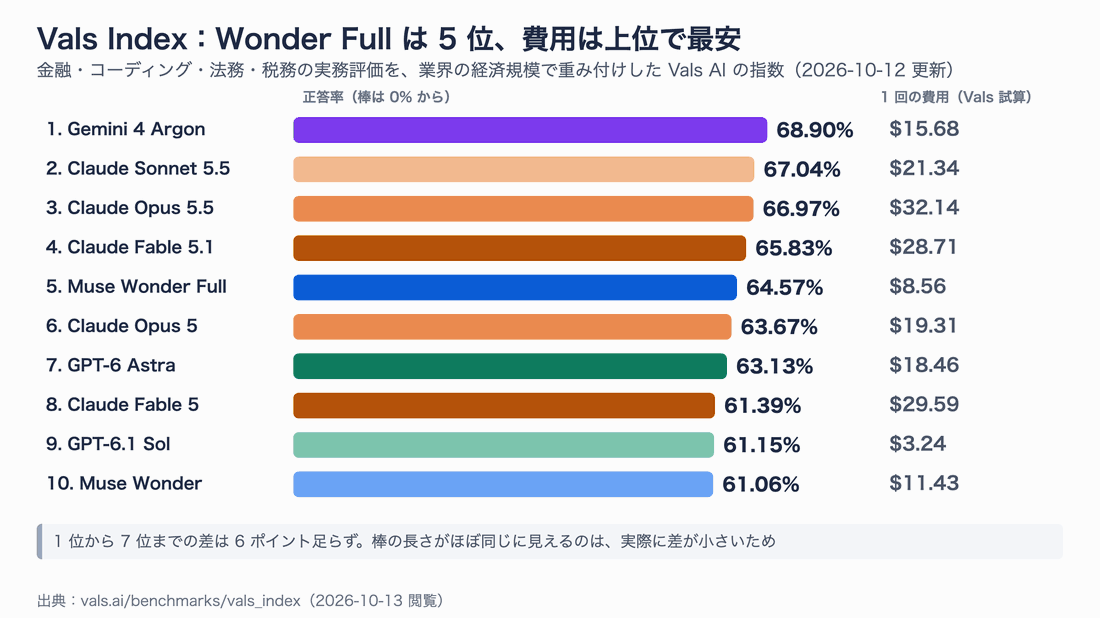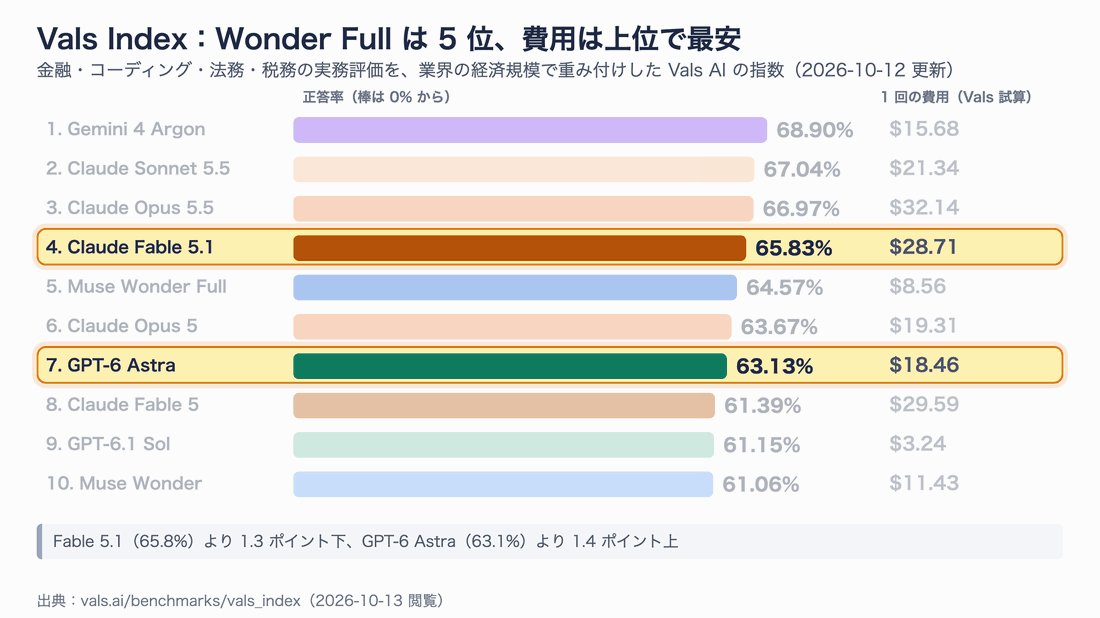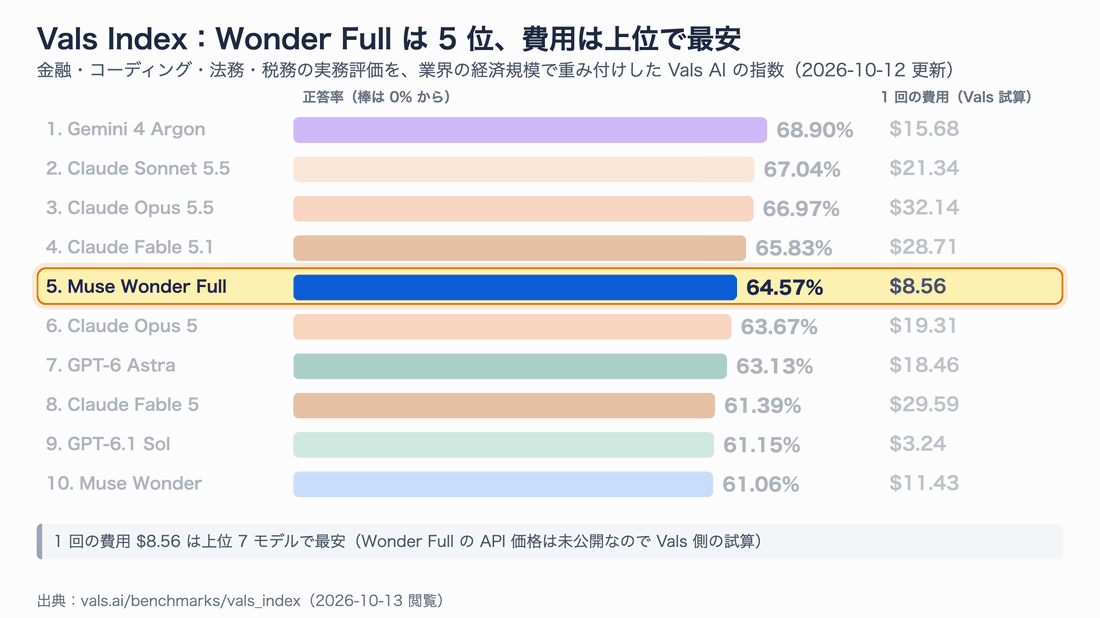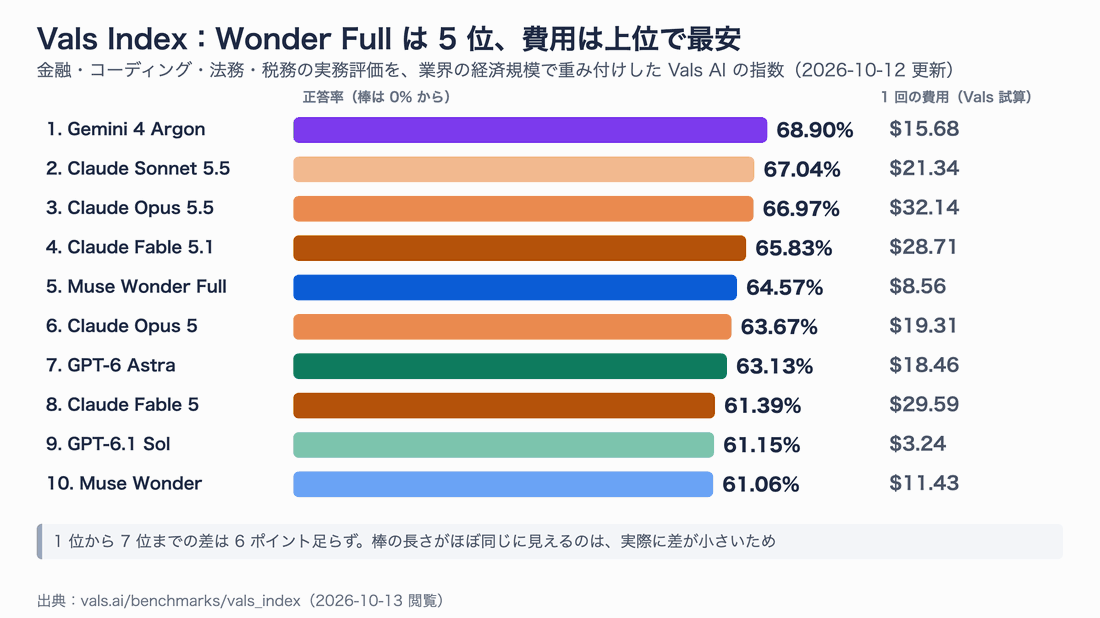
図7:Vals Index では Wonder Full は 5 位。1 回あたりの費用は上位 7 モデルで最も安い試算です
こちらでは、Wonder Full は 5 位(64.57%) でした。Fable 5.1(65.83%)より 1.3 ポイント低く、GPT-6 Astra(63.13%)より 1.4 ポイント高い位置です。API 版の Muse Wonder は 10 位(61.06%)でした。
目を引くのは費用の列です。Wonder Full の 1 回あたりの費用は $8.56 で、上位 7 モデルの中で最も安くなっています。ただし Wonder Full には API 価格がないため、これは Vals AI 側の試算です。
2 つの指数をまとめると、Fable 5.1・GPT-6 Astra との比較では「Wonder Full は同格〜やや上、API 版の Wonder は同格〜やや下」 という位置づけになります。
分野別:どこで勝ち、どこで負けたか
総合点だけでは、どんな仕事に向くのかが分かりません。ここからは Meta のモデルカードにある比較表を分野ごとに読んでいきます。下が Meta の公式の表です。
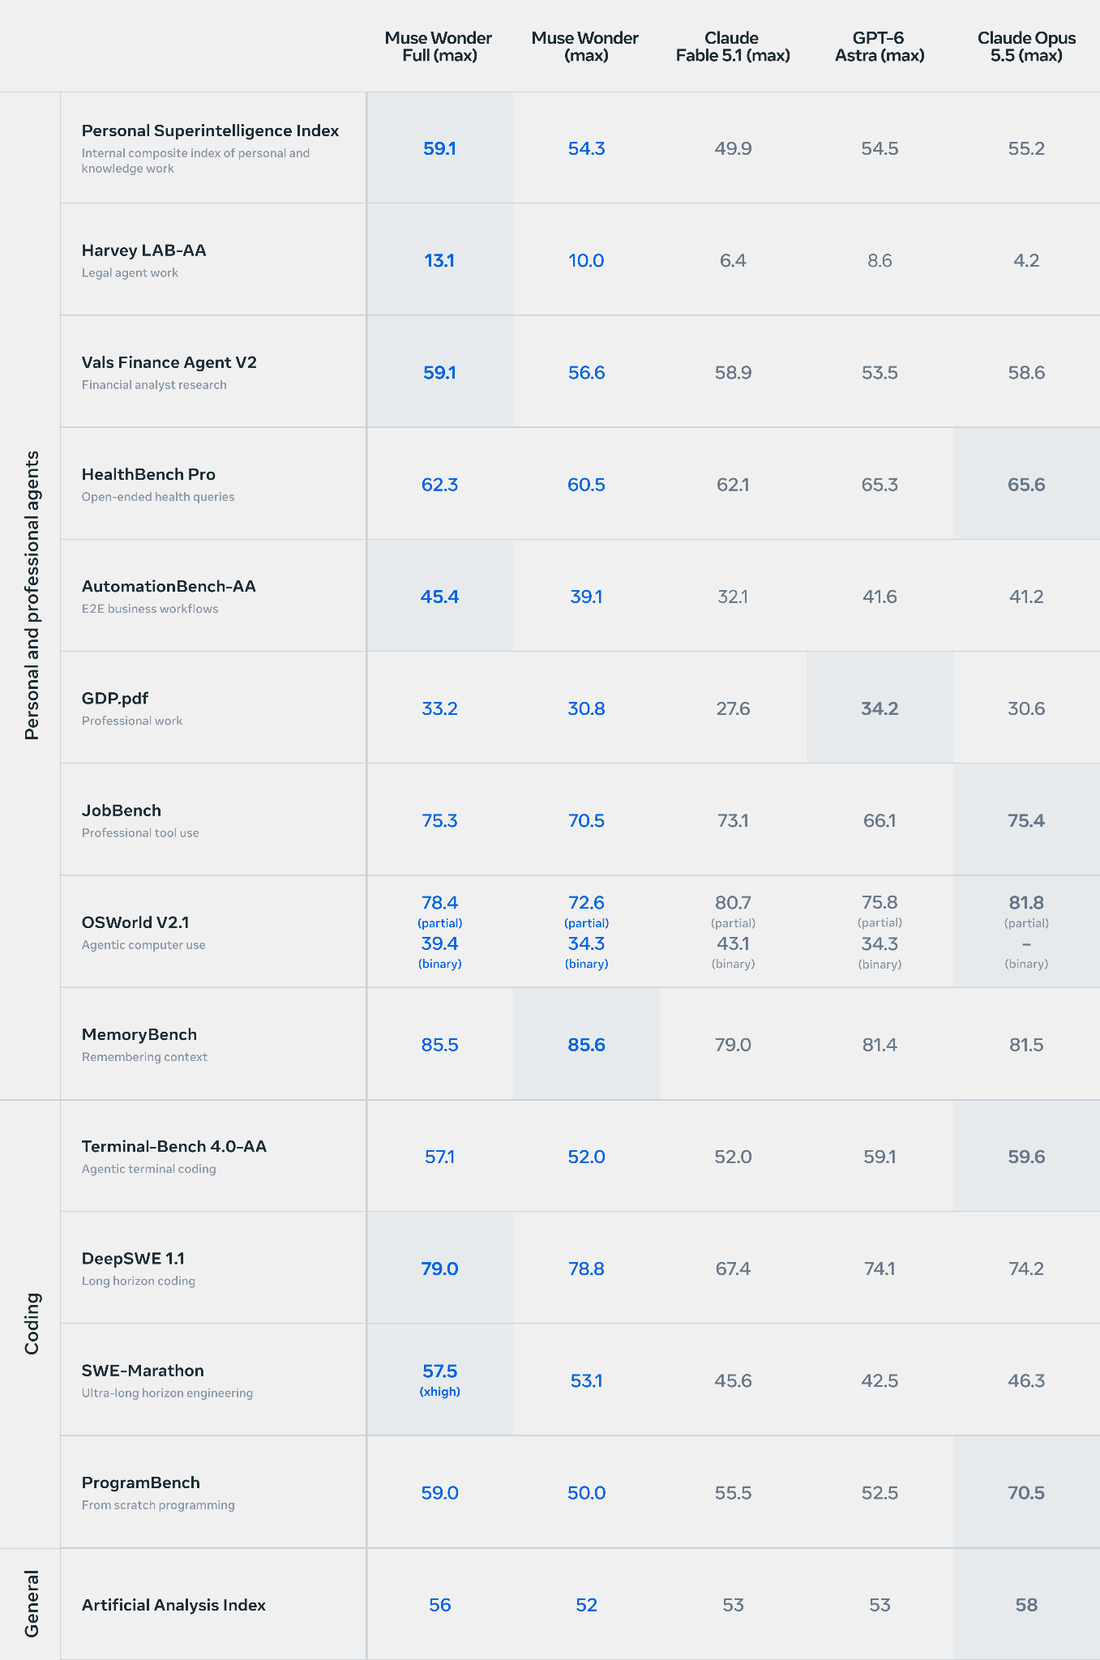
Meta「Muse Wonder Model Card」の比較表(全モデル max 設定)。出典:research.meta.ai
この表を読みやすくするため、各行で「Wonder Full の点」から「Fable 5.1・GPT-6 Astra・Opus 5.5 の中で最も高い点」を引いた差を図にしました。右に伸びれば Wonder Full の勝ち、左に伸びれば他社の勝ちです。
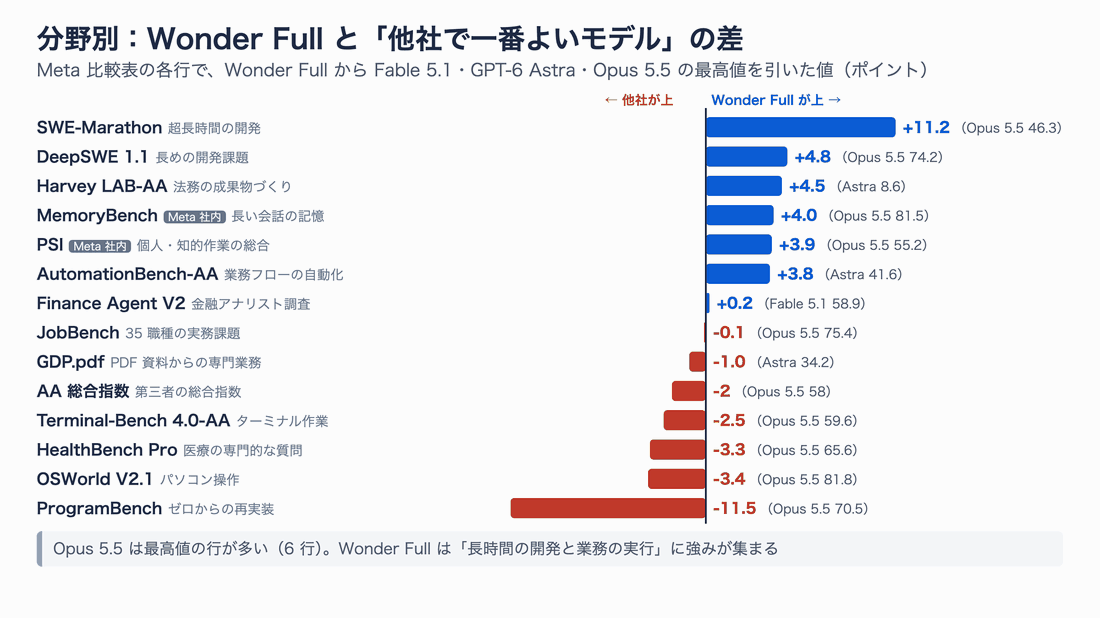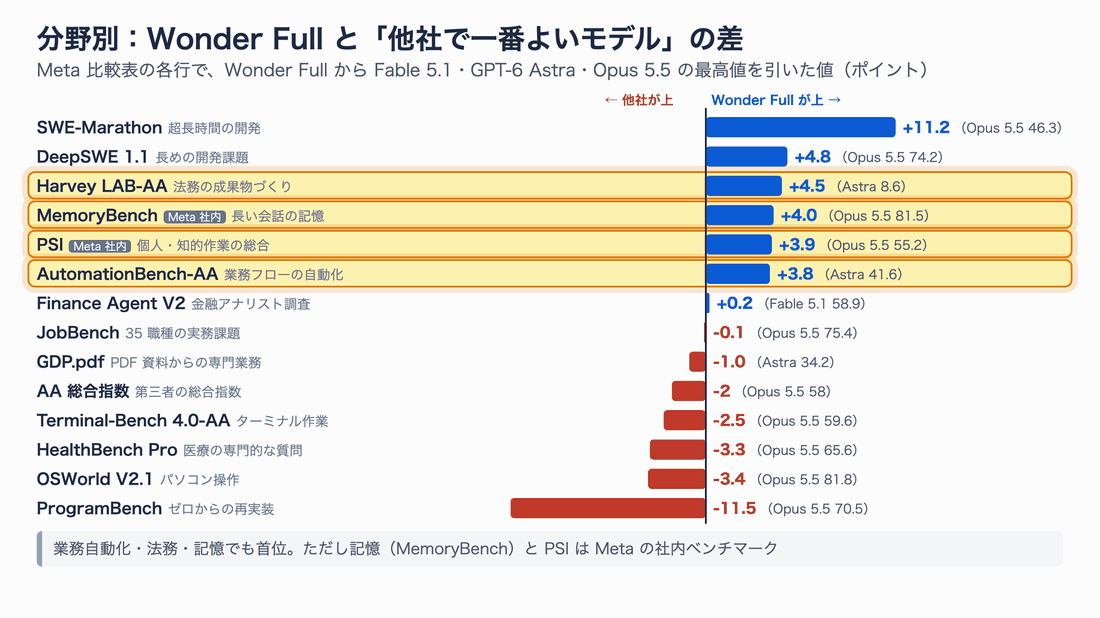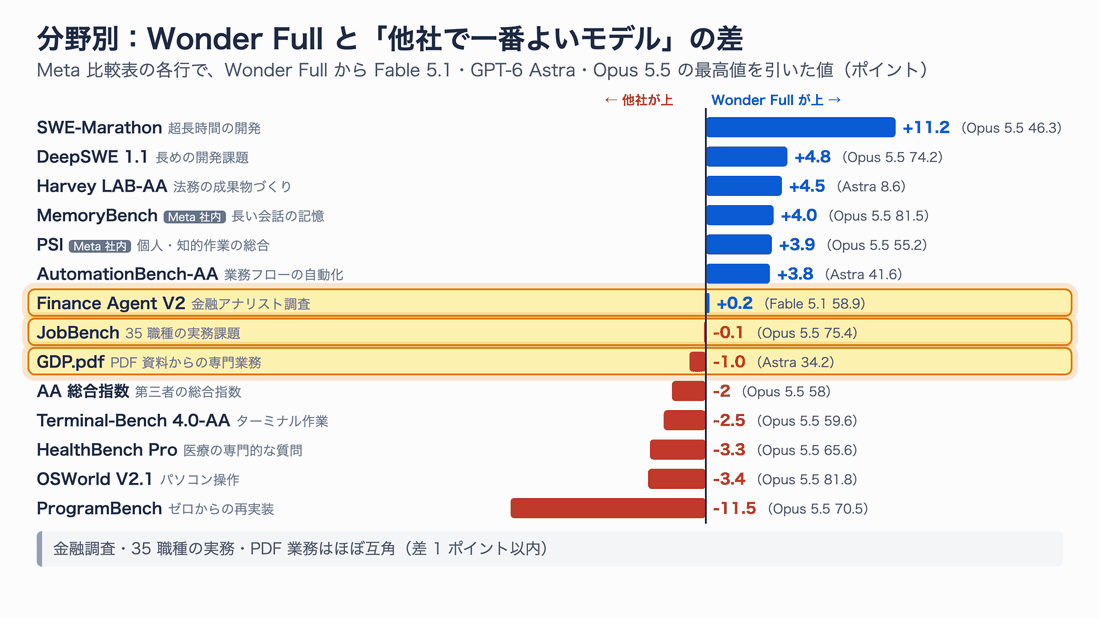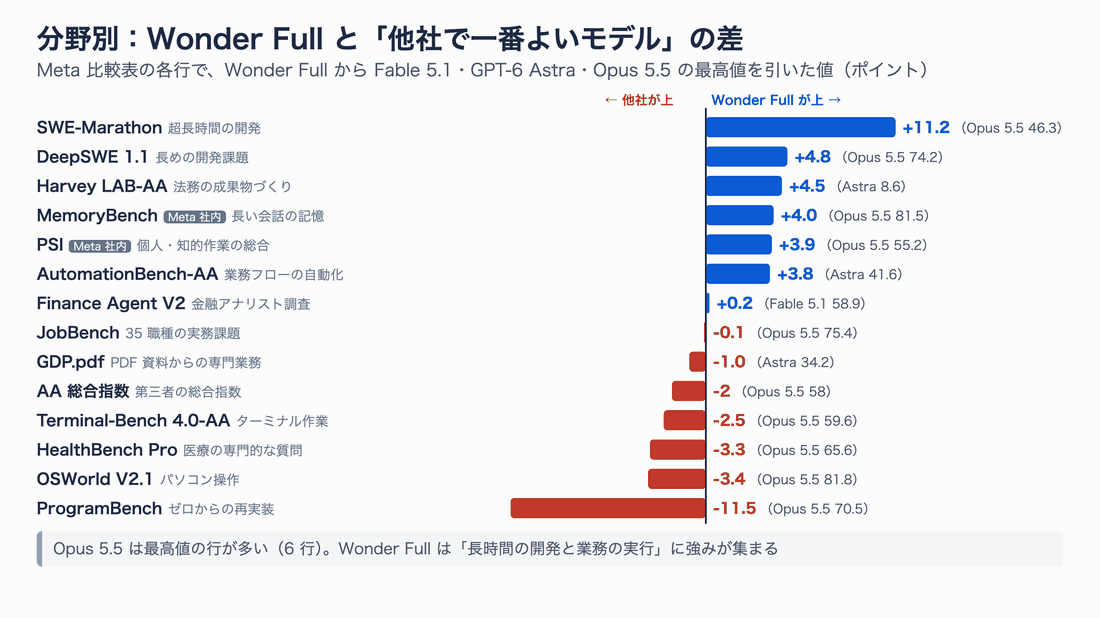
図8:勝ちは「長時間の開発」と「業務の実行」に、負けは「ゼロからの実装」「ターミナル」「医療」「画面操作」に集まっています
得意:長く続く開発と、業務を最後までやり切る仕事
いちばん大きな差がついたのは SWE-Marathon(何時間もかかる大きな開発課題)で、Wonder Full は 57.5、他社の最高は Opus 5.5 の 46.3 でした。11.2 ポイントの差です。長めの開発課題を集めた DeepSWE 1.1 でも、79.0 対 74.2 で首位でした。Active Focus で強調している「粘り強さ」が、長い作業ほど効いている形です。
業務系でも首位が並びます。アプリをまたいで業務フローを自動化する AutomationBench-AA は 45.4(他社最高 41.6)、法務の成果物を作る Harvey LAB-AA は 13.1(同 8.6)でした。ただし法務の点数は絶対値が低く、「法務の成果物を基準どおりに仕上げるのは、どのモデルにもまだ難しい」ことも読み取れます。
| 分野 | ベンチマーク | Wonder Full | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| 超長時間の開発 | SWE-Marathon | 57.5 | 45.6 | 42.5 | 46.3 |
| 長めの開発 | DeepSWE 1.1 | 79.0 | 67.4 | 74.1 | 74.2 |
| 業務フロー自動化 | AutomationBench-AA | 45.4 | 32.1 | 41.6 | 41.2 |
| 法務の成果物 | Harvey LAB-AA | 13.1 | 6.4 | 8.6 | 4.2 |
| 金融アナリスト調査 | Vals Finance Agent V2 | 59.1 | 58.9 | 53.5 | 58.6 |
| 長い会話の記憶(社内) | MemoryBench | 85.5 | 79.0 | 81.4 | 81.5 |
MemoryBench の首位は API 版の Muse Wonder(85.6)で、Wonder Full とほぼ同じ点です。ただし前述のとおり、これは Meta の社内ベンチマークです。
SWE-Marathon にも注意点があります。モデルカードの注記どおり、GPT-6 Astra は Codex、Fable 5.1 は Claude Code という「各社の製品のハーネス」で測った値で、共通の条件ではありません。差の大きさはそのまま受け取らず、「長時間の開発で有力な候補」くらいに読んでおくのが安全です。
苦手:ゼロからの実装、ターミナル、医療、画面操作
一方、負けた項目では Opus 5.5 が最高値を取っている行が多く、Opus 5.5 は 15 行中 6 行で全体の首位でした。
| 分野 | ベンチマーク | Wonder Full | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| ゼロからの再実装 | ProgramBench | 59.0 | 55.5 | 52.5 | 70.5 |
| ターミナル作業 | Terminal-Bench 4.0-AA | 57.1 | 52.0 | 59.1 | 59.6 |
| 医療の専門的な質問 | HealthBench Pro | 62.3 | 62.1 | 65.3 | 65.6 |
| パソコン操作(部分点) | OSWorld V2.1 | 78.4 | 80.7 | 75.8 | 81.8 |
| パソコン操作(完遂) | OSWorld V2.1 | 39.4 | 43.1 | 34.3 | - |
| PDF 資料からの業務 | GDP.pdf | 33.2 | 27.6 | 34.2 | 30.6 |
| 35 職種の実務 | JobBench | 75.3 | 73.1 | 66.1 | 75.4 |
いちばん差が大きいのは ProgramBench(仕様からプログラムを丸ごと作り直す課題)で、Opus 5.5 の 70.5 に対して 59.0 と 11.5 ポイント離されました。既存のコードを長時間かけて直すのは得意でも、まっさらな状態から全体を組み立てる仕事では Opus 5.5 が明確に上です。
Fable 5.1 は、Meta の表では全体に低めに出ています。これは先に触れた安全装置の影響や、Meta による「ベストエフォート」の実行条件も関係していると考えられます。それでも、パソコン操作を最後までやり切った割合(OSWorld の完遂率 43.1)では首位でした。
弱点:事実をどれだけ正しく知っているか
Meta の表には載っていませんが、Artificial Analysis の評価で、はっきりした弱点が見えています。知識の正確さを測る AA-Omniscience です。
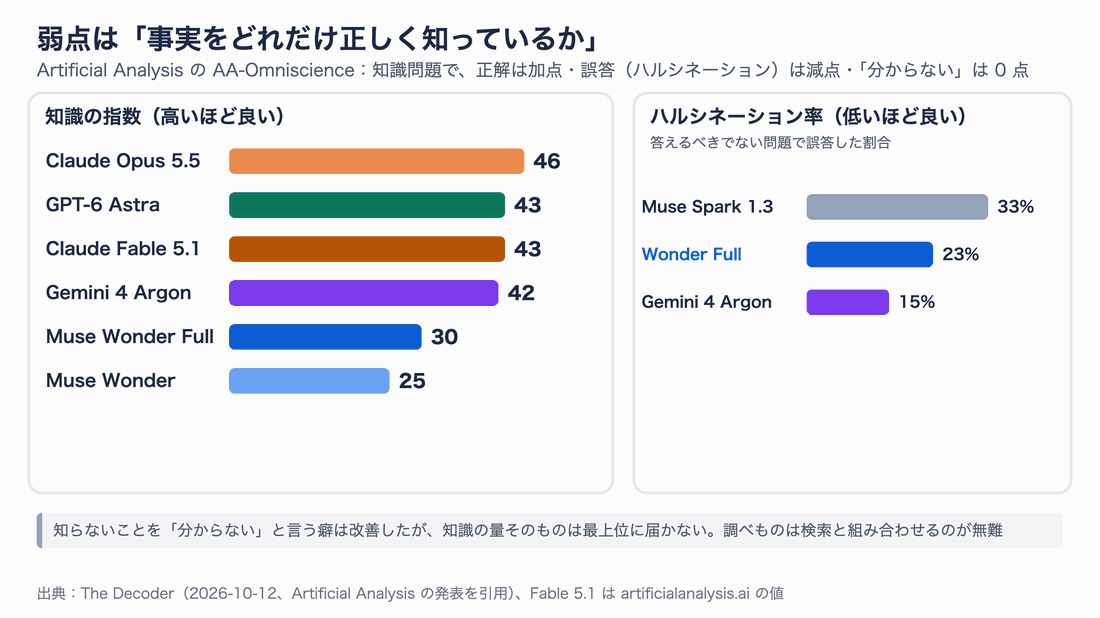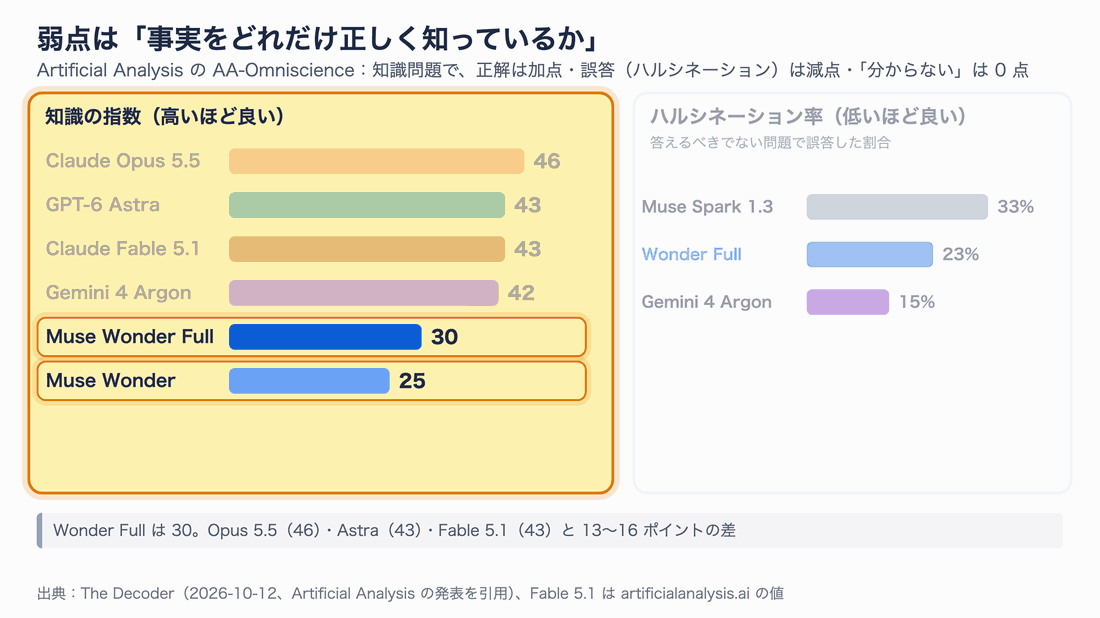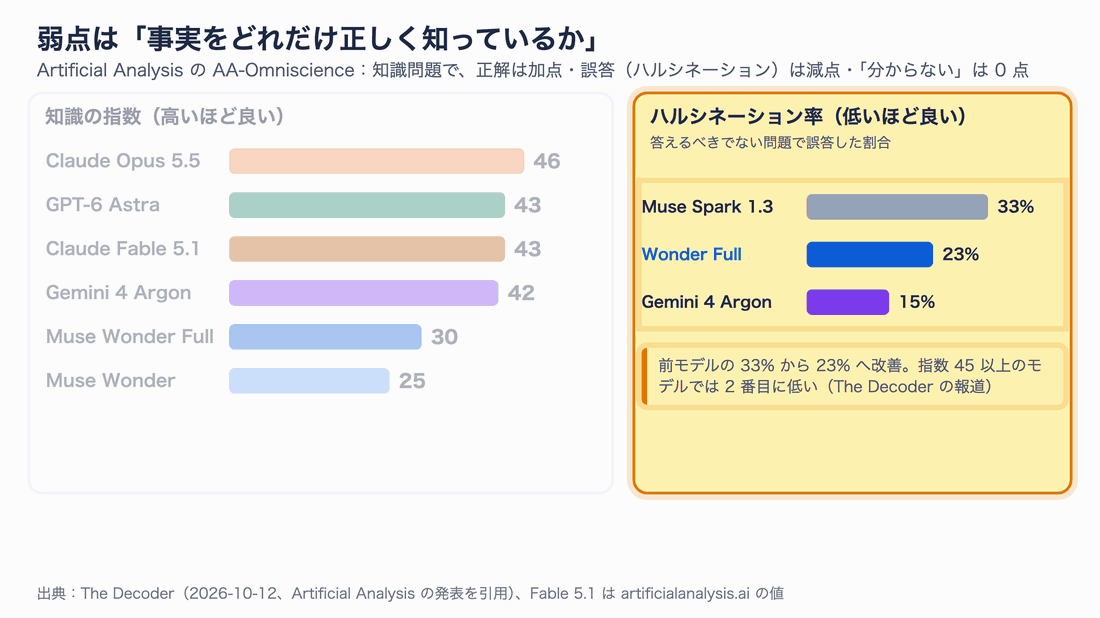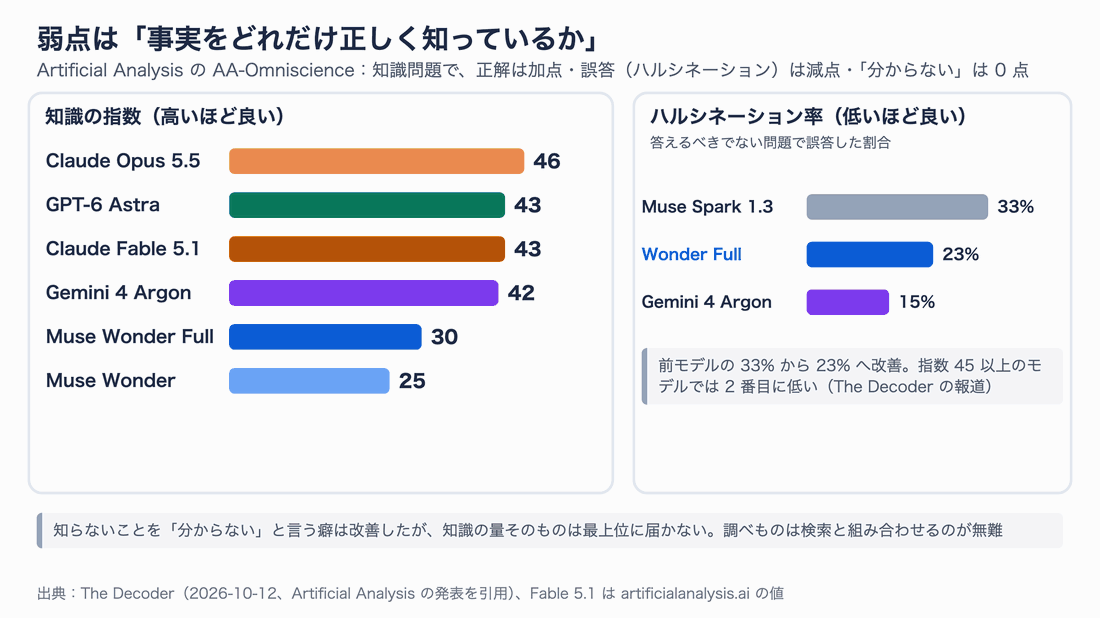
図9:知識の指数では 13〜16 ポイント離されています。一方、知らないことを誤答する率は前モデルから改善しました
AA-Omniscience は、知識問題に正解すると加点、誤答(ハルシネーション)すると減点、「分からない」と答えると 0 点、という採点の試験です。ハルシネーションとは、AI がもっともらしい誤りを事実のように答えてしまう現象のことです。
Wonder Full の指数は 30 で、Opus 5.5(46)、GPT-6 Astra(43)、Fable 5.1(43)とは 13〜16 ポイントの差がありました。API 版の Wonder は 25 です。
明るい材料もあります。答えるべきでない問題で誤答する割合(ハルシネーション率)は、前モデルの 33% から 23% に下がりました。The Decoder の報道によると、総合指数 45 以上のモデルの中では 2 番目に低い値です。「知らないことを知らないと言う」癖は良くなった一方で、知識の量そのものは最上位に届いていない、という読み方になります。調べものに使うときは、検索と組み合わせるのが無難です。
値段:単価と「1 つの仕事の費用」は別物
API の料金
まず、公式の料金表を並べます。単位は 100 万トークンあたりの米ドルです。
| モデル | 入力 | キャッシュ読み出し | 出力 | 補足 |
|---|---|---|---|---|
| Muse Wonder | $4.00 | $0.20 | $20.00 | Web 検索は 1,000 回 $2.50。Wonder Full は API なし |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 | |
| Claude Fable 5.1 | $10.00 | $0.25 | $50.00 | |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | 入力 27.2 万トークン超は割増(入力 $20・出力 $75) |
キャッシュ読み出しとは、前回と同じ前置き(システムプロンプトや過去の会話)を再利用したときの割安な料金です。エージェントは同じ前置きを何度も送るので、実際の請求ではこの単価が効いてきます。
Muse Wonder の単価は Opus 5.5 と同じで、Fable 5.1・GPT-6 Astra の 4 割 です。前モデルの Muse Spark 1.3(入力 $1.25・出力 $4.25)からは大きく値上がりしました。
1 タスクの費用は「単価 × 使うトークン量」で決まる
単価だけで「Muse Wonder は安い」と判断するのは早計です。モデルによって、同じ仕事に使うトークンの量が大きく違うからです。
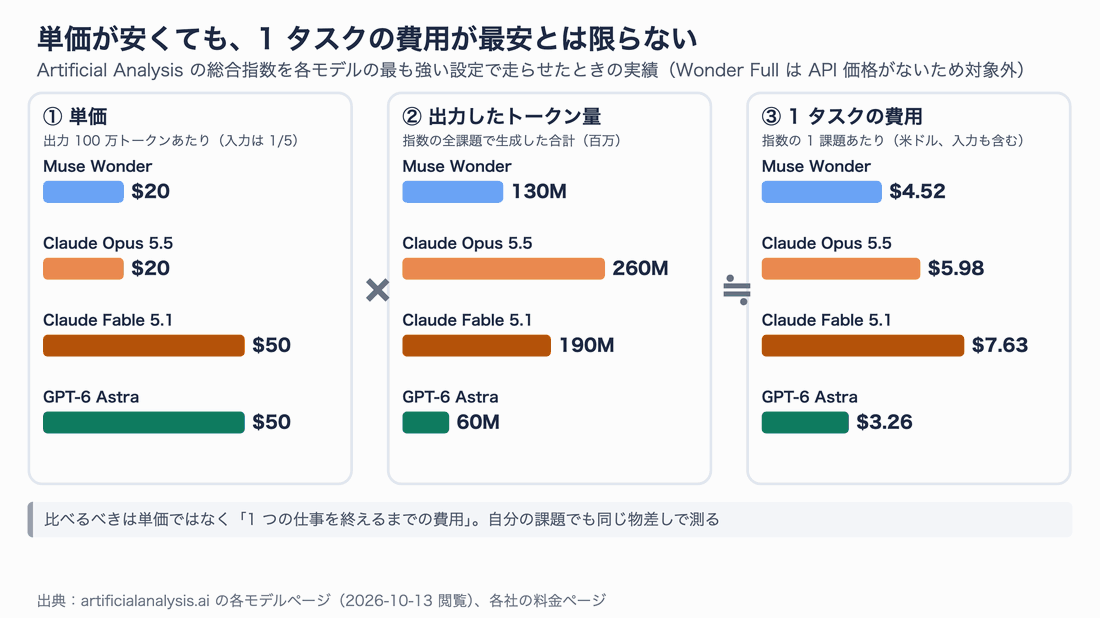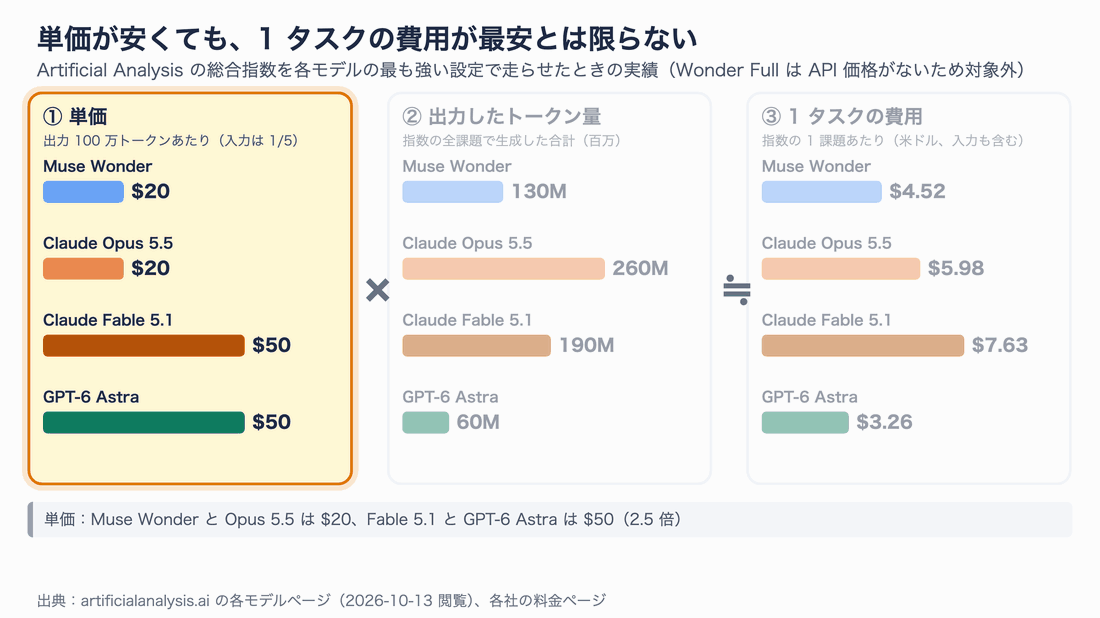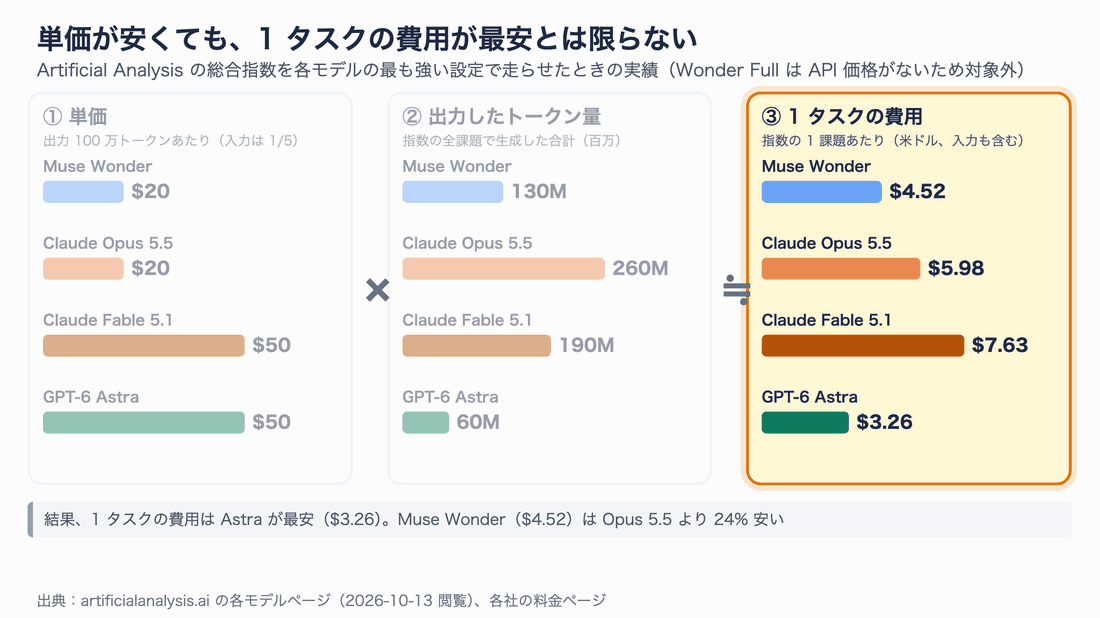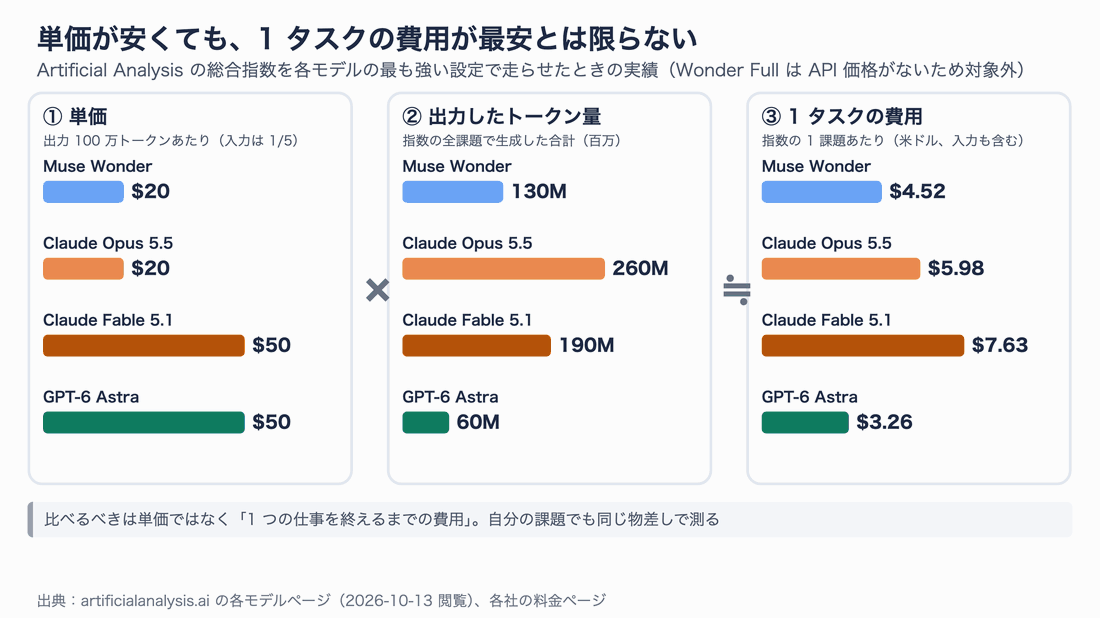
図10:単価が 2.5 倍の GPT-6 Astra が、使うトークンの少なさで 1 タスクあたり最安になります
Artificial Analysis の総合指数を、各モデルの最も強い設定で走らせたときの実績を見てみます。
- GPT-6 Astra は出力トークンが 6,000 万(60M)と最も少なく、1 タスクの費用は $3.26 で最安でした
- Muse Wonder は 1 億 3,000 万トークンを使い、1 タスク $4.52。Opus 5.5($5.98)より 24% 安い結果です
- Fable 5.1 は単価の高さとトークン量(1.9 億)が重なり、1 タスク $7.63 で最も高くなりました
出力の速さ(1 秒あたりのトークン数)は、Opus 5.5 が 95.6、Muse Wonder が 87.9、Fable 5.1 が 67.1、GPT-6 Astra が 65.8 でした。Muse Wonder は速さの面でも見劣りしません。
ここで大事なのは、比べるべきは単価ではなく「1 つの仕事を終えるまでの費用」 だということです。失敗してやり直した分も含めれば、「成功した仕事 1 件あたりの費用」がいちばん実態に近い物差しになります。後半の手順でも、この物差しで測ります。
使う前に知っておきたい注意点
性能と値段が分かったところで、実際に使い始める前の注意点をまとめます。特に 3 つ目のデータの扱いは、会社のコードを扱う方は必ず確認してください。
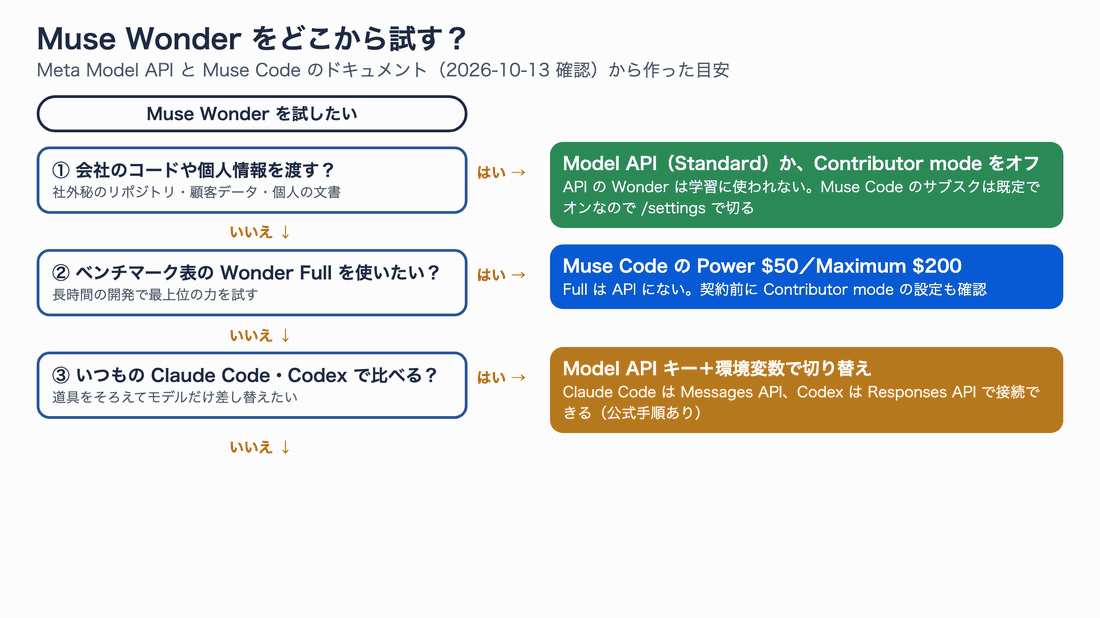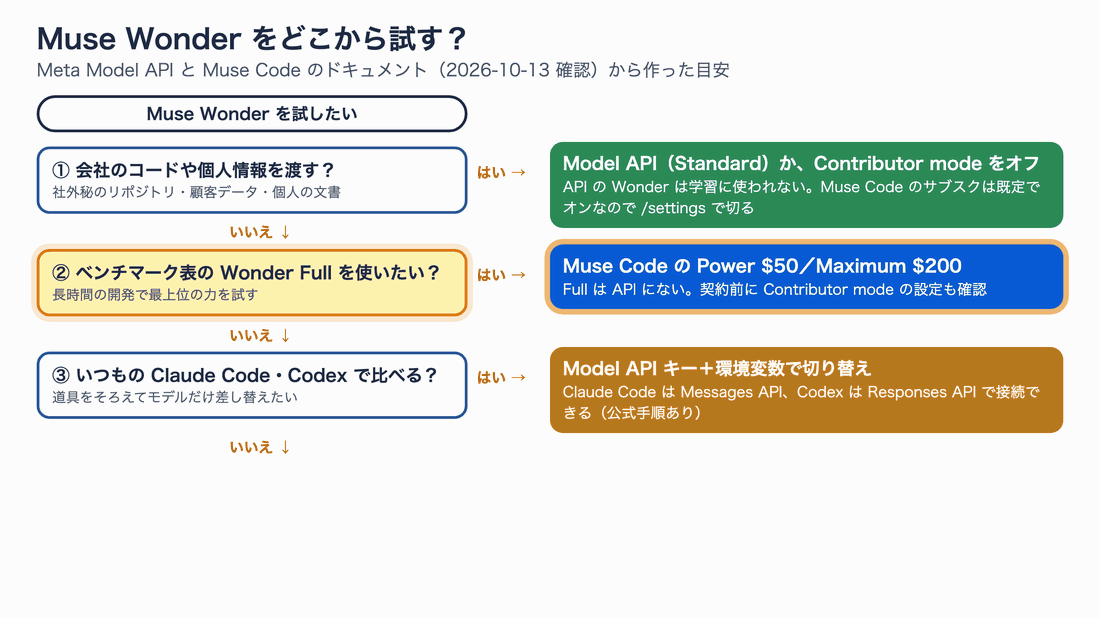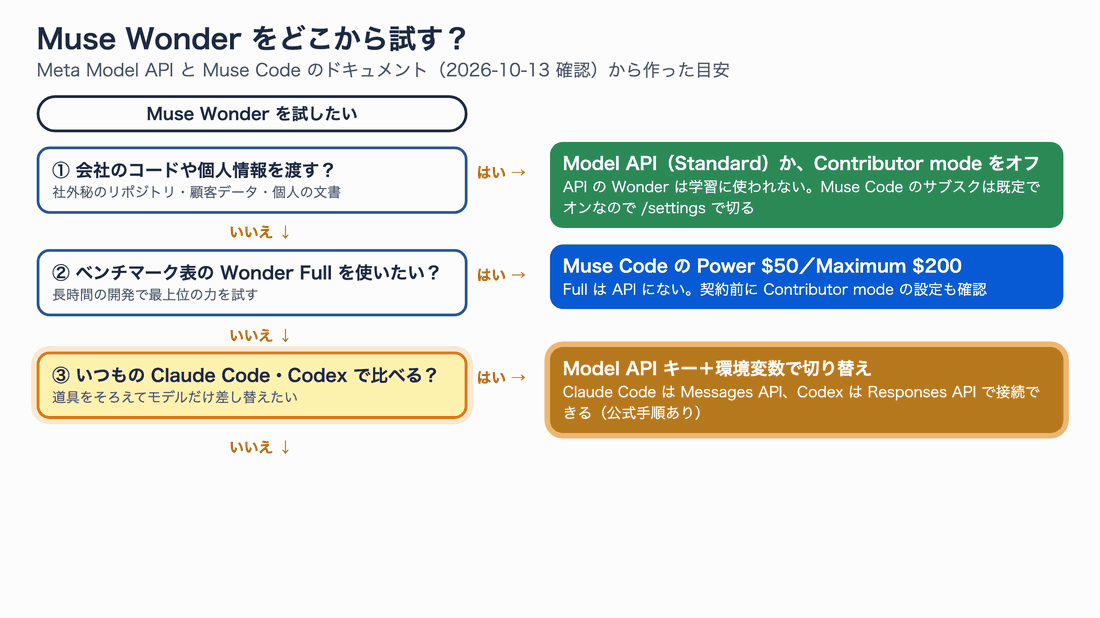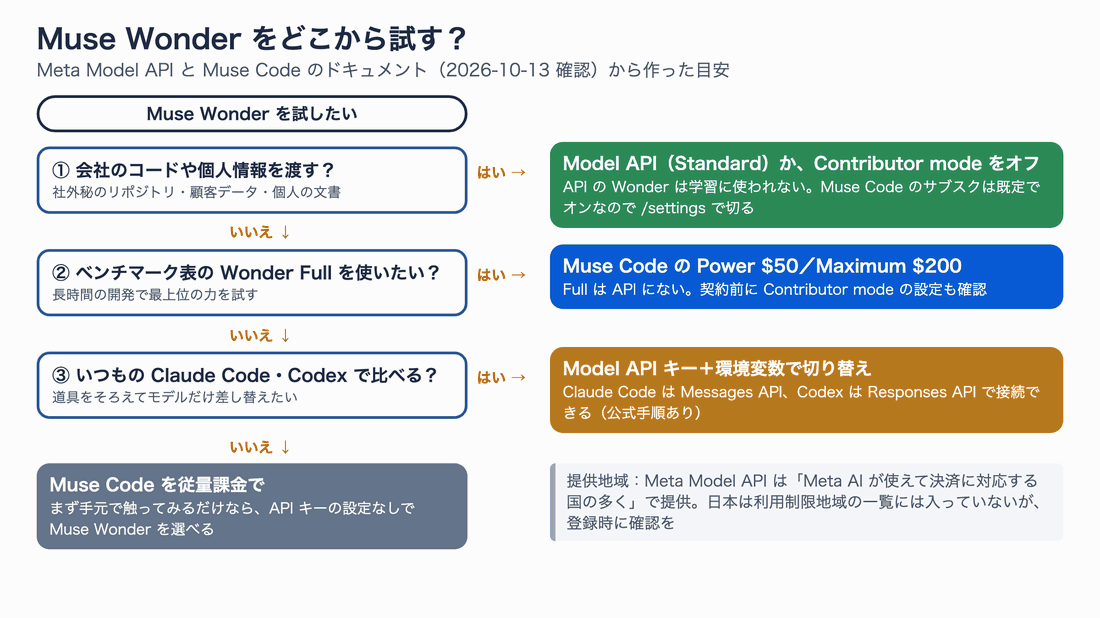
図11:目的別の入口。データの扱いを最初に確認します
- ベンチマーク上位の Wonder Full は API で使えない:Muse Code の Power(月 $50)か Maximum(月 $200)の契約が必要です。自社のアプリに組み込めるのは Wonder だけです
- API 版の Wonder は preview:仕様や料金が変わる可能性があります。レート制限は 1 分あたり 3,000 リクエスト・400 万トークンです
- Muse Code のサブスクは「Contributor mode」が既定でオン:送ったプロンプト・コード・ファイルと、モデルの回答が、将来のモデルの学習に使われます。Muse Code の
/settingsでオフにできますが、オフにすると使える量が減ります。Meta の規約も、このモードに機密情報や個人情報を送らないよう求めています。API の Muse Wonder は Standard モードのみで、学習には使われません - 重みは公開されていない:自社サーバーで動かすことはできません。手元で動かしたい場合は、Meta の別系統のオープンウェイトモデル Muse Glimmer になります
- 提供地域:Meta Model API は「Meta AI が使えて決済に対応する国の多く」で提供されています。Meta の利用制限地域の一覧に日本は入っていませんが、国別の一覧は公開されていないので、登録時に確認してください。なお、消費者向けの Muse アプリは米国から提供が始まっています
- 取り消せない操作には人の確認を:モデルカードは、エージェントとして実際の操作を任せるときに、取り消せない操作の前で人が確認する仕組み(human-in-the-loop)を入れるよう推奨しています
安全性の面では、Meta は Wonder Full を自社の安全基準で評価し、化学・生物分野では対策なしだと高リスクの水準に達する可能性を否定できないため、安全訓練と分類器による対策を入れたうえで公開した、と説明しています。
自分の仕事で確かめる:Claude Code・Codex のまま切り替える
ここまでの数字は、どれも他人が用意した試験の結果です。自分の仕事に向くかどうかは、自分の課題で測るのがいちばん確実です。
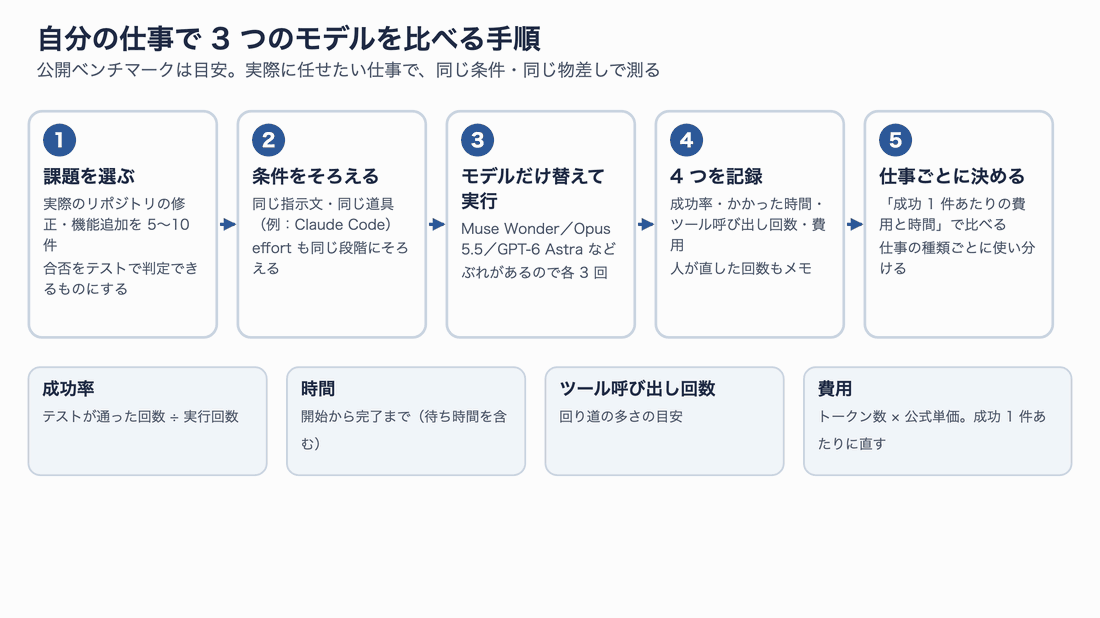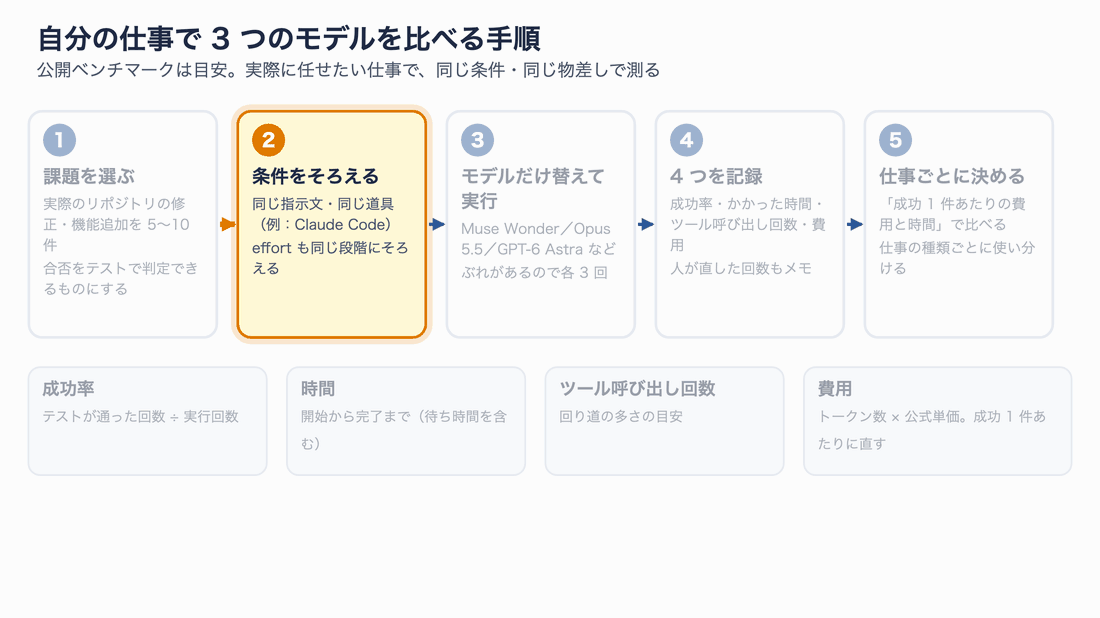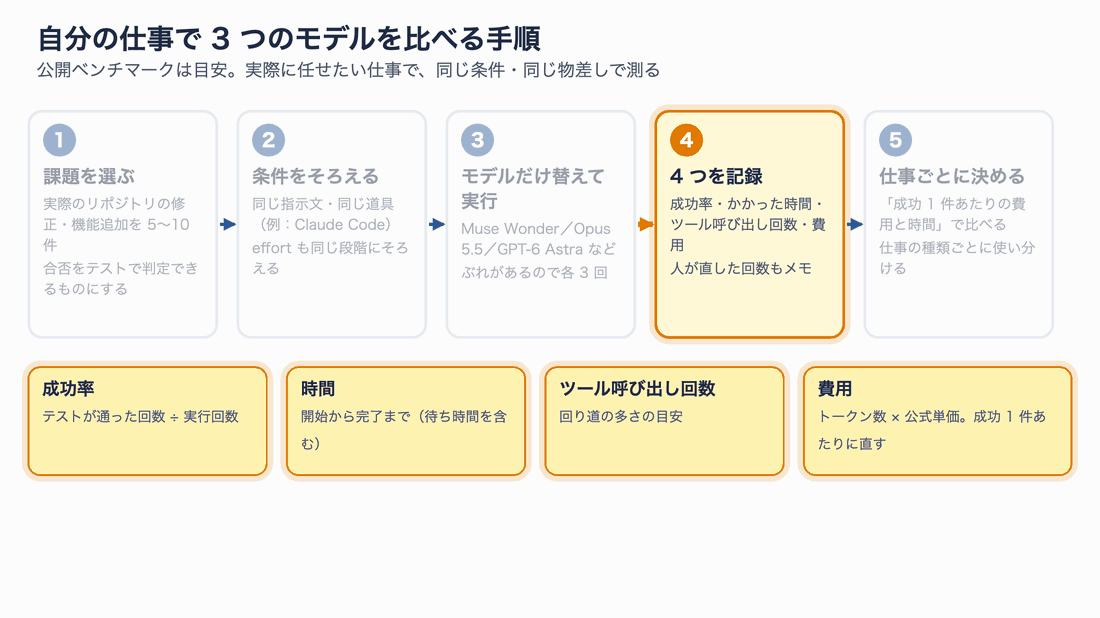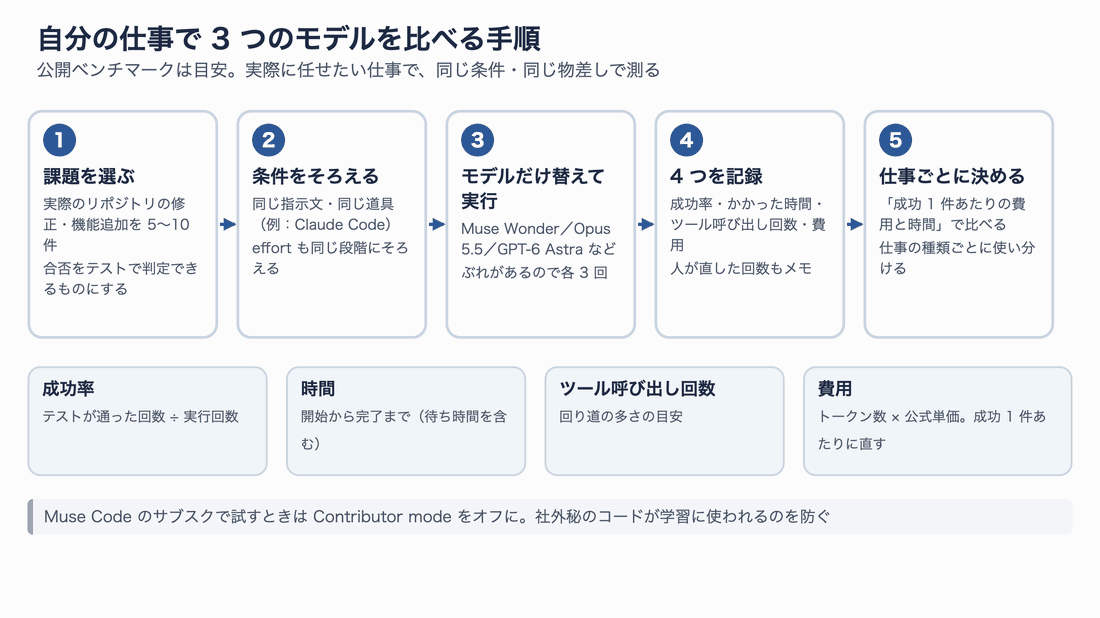
図12:同じ課題・同じ道具・同じ物差しで、モデルだけを替えて測ります
うれしいことに、Meta Model API は OpenAI 形式と Anthropic 形式の両方の API に対応しています。普段使っている Claude Code や Codex のまま、接続先だけを Muse Wonder に替えられます。道具をそろえてモデルだけを比べられるので、公平な比較がしやすくなります。
以下の設定は Meta の公式ドキュメント「Use Model API with coding agents」の手順を、モデル ID だけ
muse-wonder-1.0に替えたものです。筆者は API キーを持っていないため、Muse Wonder への接続は実行していません。
準備:API キーを用意する
Meta Model API のダッシュボードで API キーを作り、環境変数に入れておきます。
# Meta Model API のキーを環境変数に入れる(キーはダッシュボードの API keys で作成)
export MODEL_API_KEY="<YOUR_META_MODEL_API_KEY>"
Claude Code から Muse Wonder を使う
Claude Code は Anthropic の Messages API 形式で接続します。普段の設定を汚さないよう、比較用のターミナルだけ で環境変数を設定します。
# 比較用のターミナルで実行する。接続先を Meta にし、すべてのモデル指定を Muse Wonder にそろえる
export ANTHROPIC_BASE_URL="https://api.meta.ai"          # 末尾に /v1 は付けない
export ANTHROPIC_AUTH_TOKEN="$MODEL_API_KEY"              # ANTHROPIC_API_KEY ではなくこちら
export ANTHROPIC_MODEL="muse-wonder-1.0"
export ANTHROPIC_DEFAULT_OPUS_MODEL="muse-wonder-1.0"     # プランモードなどで使われる
export ANTHROPIC_DEFAULT_SONNET_MODEL="muse-wonder-1.0"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="muse-wonder-1.0"    # 要約などの裏方の処理で使われる
export CLAUDE_CODE_SUBAGENT_MODEL="muse-wonder-1.0"       # サブエージェントも同じモデルに
export ENABLE_TOOL_SEARCH="true"                          # MCP のツール検索を有効のままにする
claude
公式ドキュメントによると、どれか 1 つでも設定し忘れると、プランモードやサブエージェントが Claude のモデルを呼ぼうとして失敗します。また、Claude Code の画面に表示される費用は、Meta の料金を知らないため $0 と表示されることがあります。これはエラーではないので、費用は後でトークン数から計算します。
Codex から Muse Wonder を使う
Codex は OpenAI の Responses API 形式で接続します。CODEX_HOME を一時フォルダにすると、普段の ~/.codex の設定や履歴に触れずに試せます。
# 普段の Codex の設定と切り離して、Muse Wonder で起動する
export MODEL_API_KEY="<YOUR_META_MODEL_API_KEY>"
mkdir -p /tmp/codex-muse

CODEX_HOME=/tmp/codex-muse codex \
  -m muse-wonder-1.0 \
  -c 'model_provider="meta"' \
  -c 'model_providers.meta.name="Meta Model API"' \
  -c 'model_providers.meta.base_url="https://api.meta.ai/v1"' \
  -c 'model_providers.meta.env_key="MODEL_API_KEY"' \
  -c 'model_providers.meta.wire_api="responses"' \
  -c 'model_reasoning_effort="high"'
CODEX_HOME を分けずに普段の設定のまま使う場合は、OpenAI のアカウントで Codex にログインしていると OpenAI 側に接続されてしまうので、先に /logout するよう公式に注記されています。
同じ課題を各モデルで解かせて記録する
比較では、課題ごとに作業用のリポジトリを使い捨てのコピーにしてから実行します。モデルがファイルを書き換えるためです。下は Claude Code の非対話モード(claude -p)で、同じ課題文を Opus 5.5 に解かせ、結果を JSON で保存する例です。
# 課題文を task.md に書いておき、使い捨てのコピーの中で実行する
cp -R my-repo /tmp/run-opus-T1-1 && cd /tmp/run-opus-T1-1
claude -p "$(cat ~/bench/task.md)" \
  --model claude-opus-5-5 --effort high \
  --permission-mode bypassPermissions \
  --strict-mcp-config \
  --output-format json > ~/bench/runs/opus-T1-1.json
--strict-mcp-config は、普段つないでいる MCP サーバーのツール定義を読み込まないための指定です。筆者の以前の検証では、これを付けないとコネクタのツール定義だけで 1 回のリクエストが十数万トークンに膨らみ、費用の比較が狂いました。bypassPermissions は確認なしで操作を許すモードなので、必ず使い捨てのコピーの中で使ってください。
Muse Wonder で測るときは、前の節の環境変数を設定したターミナルで、--model claude-opus-5-5 を外して同じコマンドを実行します。Meta 側で --effort がどう扱われるかは、筆者は確認できていません。
記録をまとめるスクリプト
claude -p --output-format json の結果には、かかった時間(duration_ms)、やり取りの回数(num_turns)、モデル別のトークン数(modelUsage)が入っています。これを公式単価で費用に直し、モデルごとに集計するスクリプトを用意しました。
#!/usr/bin/env python3
"""同じ課題を複数のモデルで解かせた記録から、成功率・時間・ターン数・費用をまとめる。

使い方:
  python3 summarize_runs.py add runs.csv result.json --task T1 --success 1
  python3 summarize_runs.py summary runs.csv
  ※ Codex などの記録は次の列で runs.csv に手で追記できる
    model,task,success,seconds,turns,input,cache_read,cache_write,output
"""
import csv, json, sys, os
from collections import defaultdict

# 100 万トークンあたりの米ドル(2026-10-13 時点の公式料金ページ)
PRICES = {
    # Meta Model API。キャッシュ書き込みの料金は記載がないため入力単価で仮置き
    "muse-wonder-1.0":   {"input": 4.00,  "cache_read": 0.20, "cache_write": 4.00,  "output": 20.00},
    # Anthropic。Claude Code は 1 時間キャッシュを書くので書き込み=入力×2
    "claude-opus-5-5":   {"input": 4.00,  "cache_read": 0.20, "cache_write": 8.00,  "output": 20.00},
    "claude-fable-5-1":  {"input": 10.00, "cache_read": 0.25, "cache_write": 20.00, "output": 50.00},
    # OpenAI(入力 272K トークン以下の料金)
    "gpt-6-astra":       {"input": 10.00, "cache_read": 1.00, "cache_write": 12.50, "output": 50.00},
}
FIELDS = ["model", "task", "success", "seconds", "turns", "input", "cache_read", "cache_write", "output"]

def cost_usd(row):
    p = PRICES.get(row["model"])
    if p is None:
        return None
    return sum(float(row[k]) * p[k] for k in ("input", "cache_read", "cache_write", "output")) / 1_000_000

def add(csv_path, json_path, task, success):
    d = json.load(open(json_path))
    # modelUsage はサブエージェント分も含めたモデル別の合計。出力が最も多いモデルを記録に使う
    model, u = max(d.get("modelUsage", {}).items(), key=lambda kv: kv[1].get("outputTokens", 0))
    row = {"model": model, "task": task, "success": success,
           "seconds": round(d.get("duration_ms", 0) / 1000, 1), "turns": d.get("num_turns", 0),
           "input": u.get("inputTokens", 0), "cache_read": u.get("cacheReadInputTokens", 0),
           "cache_write": u.get("cacheCreationInputTokens", 0), "output": u.get("outputTokens", 0)}
    new = not os.path.exists(csv_path)
    with open(csv_path, "a", newline="") as f:
        w = csv.DictWriter(f, fieldnames=FIELDS)
        if new:
            w.writeheader()
        w.writerow(row)
    print("added:", row)

def summary(csv_path):
    by = defaultdict(list)
    for r in csv.DictReader(open(csv_path)):
        by[r["model"]].append(r)
    print(f'{"model":18} {"成功率":>6} {"平均秒":>7} {"平均ターン":>8} {"合計$":>9} {"成功1件$":>9}')
    for m, rows in by.items():
        ok = sum(int(r["success"]) for r in rows)
        costs = [cost_usd(r) for r in rows]
        total = None if None in costs else sum(costs)
        per_ok = (total / ok) if (total is not None and ok) else None
        fmt = lambda x: "  単価なし" if x is None else f"{x:9.4f}"
        print(f'{m:18} {ok / len(rows):6.0%} {sum(float(r["seconds"]) for r in rows) / len(rows):7.1f} '
              f'{sum(int(r["turns"]) for r in rows) / len(rows):8.1f} {fmt(total)} {fmt(per_ok)}')

if __name__ == "__main__":
    if len(sys.argv) >= 2 and sys.argv[1] == "add":
        args = sys.argv[2:]
        add(args[0], args[1], args[args.index("--task") + 1], args[args.index("--success") + 1])
    elif len(sys.argv) == 3 and sys.argv[1] == "summary":
        summary(sys.argv[2])
    else:
        print(__doc__)
成功したかどうかは、課題ごとにテストを実行して判定し、--success 1(成功)か 0(失敗)で渡します。
# 1 回分の結果を記録に追加する(テストが通ったら --success 1)
python3 summarize_runs.py add runs.csv runs/opus-T1-1.json --task T1 --success 1

# 全部そろったらモデルごとに集計する
python3 summarize_runs.py summary runs.csv
このスクリプトは、筆者の環境で Claude Haiku 5.5 の claude -p の実際の出力と、手で作った仮の行を使って、記録の追加・費用の計算・集計が動くことを確かめています。Muse Wonder の実際の出力では試していないので、modelUsage に入るモデル名が muse-wonder-1.0 と違う場合は、PRICES のキーを合わせてください。
測るときのコツを表にまとめます。
| 項目 | おすすめ |
|---|---|
| 課題の数 | 実際の仕事に近いものを 5〜10 件。テストで合否が決まるもの |
| 回数 | モデルごと・課題ごとに 3 回(同じ課題でも結果がぶれるため) |
| そろえる条件 | 課題文、ハーネス(Claude Code など)、effort の段階、MCP の有無 |
| 主な物差し | 成功 1 件あたりの費用と時間 |
| 補助の物差し | ターン数(回り道の多さ)、人が手直しした回数 |
| データの扱い | Muse Code のサブスクで試すなら Contributor mode をオフに |
どの仕事に、どのモデルを第一候補にするか
最後に、ここまでの公開データから「どの仕事なら、どのモデルを最初に試すか」の目安をまとめます。
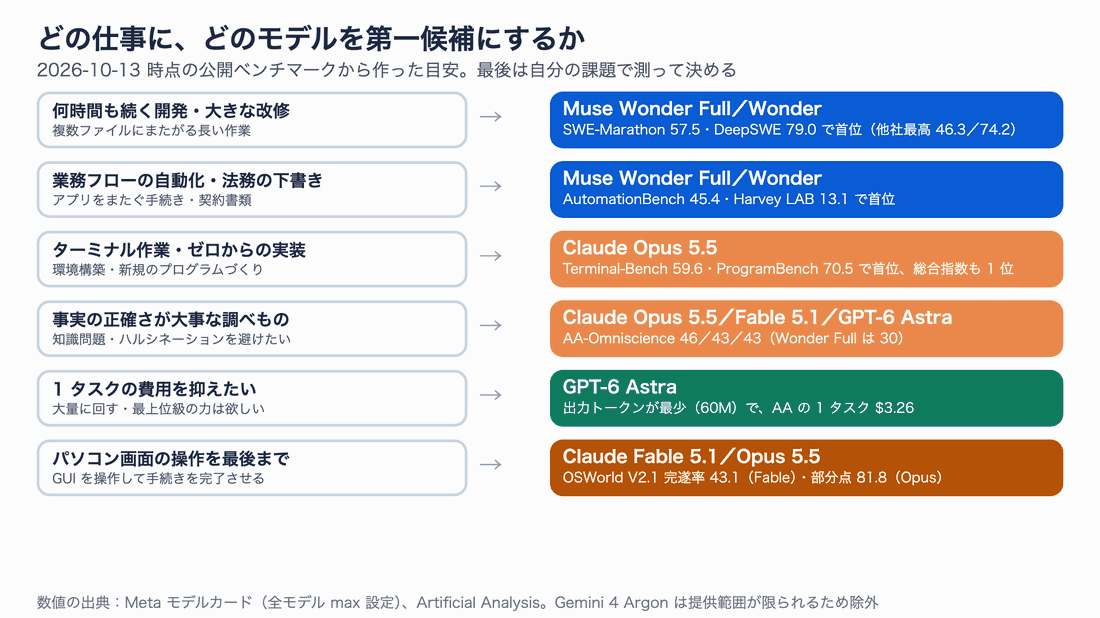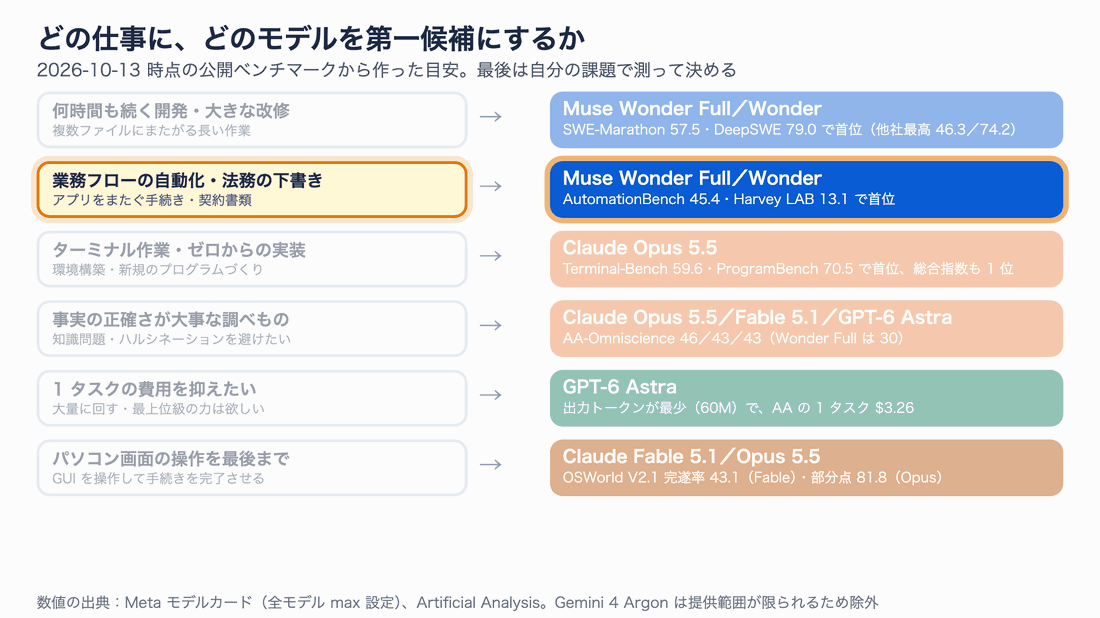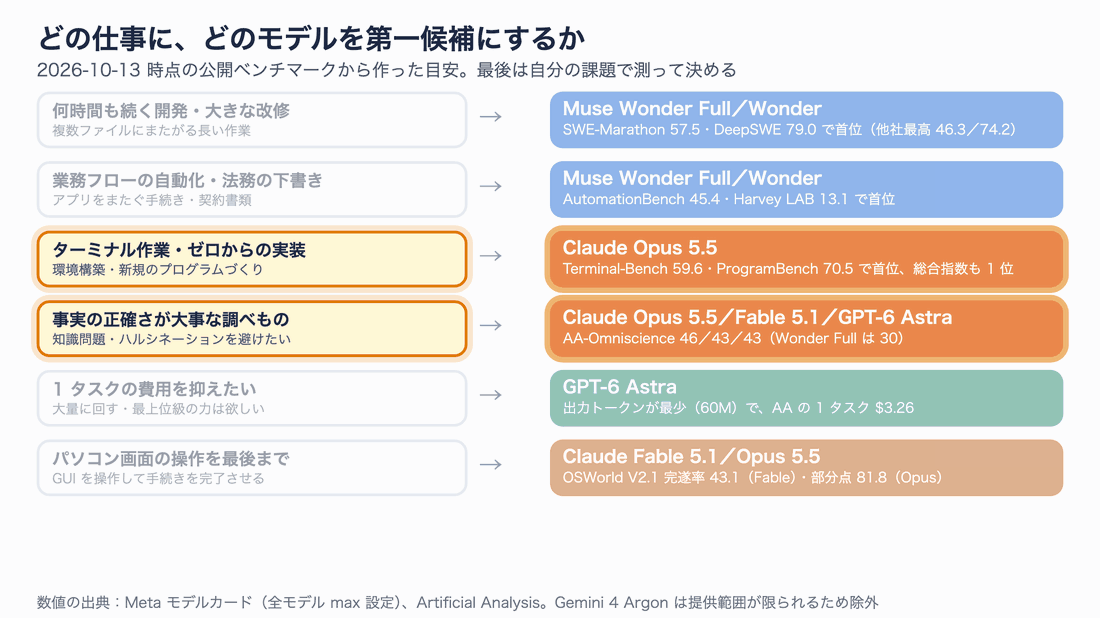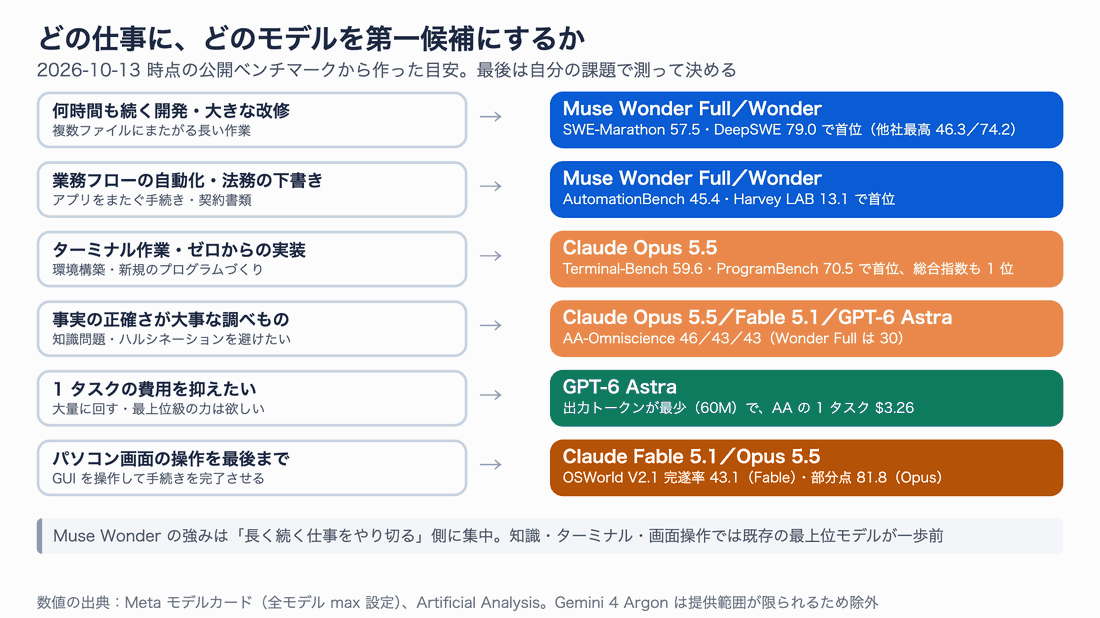
図13:公開ベンチマークから作った目安。最後は自分の課題で測って決めます
| 仕事 | 第一候補 | 根拠 |
|---|---|---|
| 何時間も続く開発・大きな改修 | Muse Wonder Full/Wonder | SWE-Marathon 57.5・DeepSWE 79.0 で首位 |
| 業務フローの自動化・法務の下書き | Muse Wonder Full/Wonder | AutomationBench 45.4・Harvey LAB 13.1 で首位 |
| ターミナル作業・ゼロからの実装 | Claude Opus 5.5 | Terminal-Bench 59.6・ProgramBench 70.5 で首位 |
| 事実の正確さが大事な調べもの | Opus 5.5/Fable 5.1/GPT-6 Astra | AA-Omniscience 46/43/43(Wonder Full は 30) |
| 1 タスクの費用を抑えたい | GPT-6 Astra | 出力トークンが最少で、AA の 1 タスク $3.26 |
| パソコン画面の操作を最後まで | Fable 5.1/Opus 5.5 | OSWorld V2.1 完遂率 43.1(Fable)、部分点 81.8(Opus) |
Muse Wonder を試す価値が特に高いのは、長いリファクタリングや機能追加を何時間も任せたい人 と、複数のアプリをまたぐ業務手続きを自動化したい人 です。逆に、新しいプログラムをゼロから作る仕事や、知識の正確さが求められる調べものでは、今使っている最上位モデルから乗り換える理由は今のところ見当たりません。
まとめ
Muse Wonder を、同時期の最上位モデルと比べた結果を振り返ります。
- 総合力:第三者の総合指数で Wonder Full は 56。Fable 5.1・GPT-6 Astra(53)を上回り、首位 Opus 5.5(58)に次ぐ 2 位グループに入りました。ただし API で使える Wonder は 52 で、Fable 5.1・Astra とほぼ同じか少し下です
- 得意:何時間も続く開発(SWE-Marathon で 11.2 ポイント差)、長めの開発、業務フローの自動化、法務の成果物づくり
- 苦手:事実知識(AA-Omniscience で 13〜16 ポイント差)、ゼロからの実装(ProgramBench で 11.5 ポイント差)、ターミナル作業、医療、画面操作
- 値段:API 単価は Opus 5.5 と同じで、Fable 5.1・Astra の 4 割。ただし 1 タスクの費用では、使うトークンが少ない GPT-6 Astra のほうが安い結果でした
- 注意点:ベンチマーク上位の Wonder Full は API で使えず、Muse Code のサブスクは学習への提供が既定でオンです
ベンチマークの数字は、誰がどの環境で測ったかで大きく変わります。今回見たとおり、同じ項目でも表によって差が 2 ポイントにも 7 ポイントにもなります。各社の発表は「どの仕事で試す価値があるか」の目安として読み、最終的には自分の課題で、成功 1 件あたりの費用と時間を測って決めるのがいちばん確実です。
次の一歩としては、普段の Claude Code や Codex の接続先を Muse Wonder に替えて、手元の長めの改修タスクを 1 つ解かせてみることをおすすめします。
参考リソース
- Meta「Muse Wonder」発表ブログ(2026-10-12)
- Meta「Muse Wonder Model Card」(比較表と評価方法、安全性評価)
- Meta Model API:Models/Pricing and rate limits/Use Model API with coding agents
- Muse Code の Contributor mode(ヘルプ)
- Artificial Analysis:モデルのリーダーボード
- Vals AI:Vals Index
- Anthropic:Claude Fable
- OpenAI:GPT-6 Astra/API の料金
- The Decoder:Meta’s new frontier model Muse Wonder Full breaks into the AI top tier
- VentureBeat:Meta’s new Muse Wonder and Muse Wonder Full models achieve frontier performance