はじめに
Claude Code や Codex に長い作業を任せていると、途中で「会話を圧縮しました」という表示が出ることがあります。その直後から、さっき読んだはずのファイルをもう一度開いたり、一度失敗したコマンドをまた実行したりする。そんな経験はないでしょうか。
これは、AI エージェント(指示を受けて自分で道具を使いながら作業する AI)が、記憶できる量の上限に近づいたときに過去のやりとりを要約文に置き換えるためです。要約は便利ですが、文章にした時点で、ツールの実行結果や細かな判断材料の一部が消えます。
2026年10月8日に公開された論文「REMORY: Learning Residual Memory for Context Compaction」は、この問題に「要約文はそのまま残し、そこに学習で作った記憶のトークンを足す」という方法で取り組みました。この記事では次の順番で解説します。
- Claude Code と Codex の圧縮は、いまどういう仕組みで動いているのか
- その仕組みのどこに問題があるのか
- REMORY はどういう仕組みで、その問題をどう補うのか
- 実験で何が分かり、何がまだ分からないのか
想定読者は、Claude Code や Codex を日常的に使っていて「圧縮のあと調子が落ちる理由」を知りたい方です。ニューラルネットワークの専門知識がなくても読めるよう、用語には短い説明を付けます。
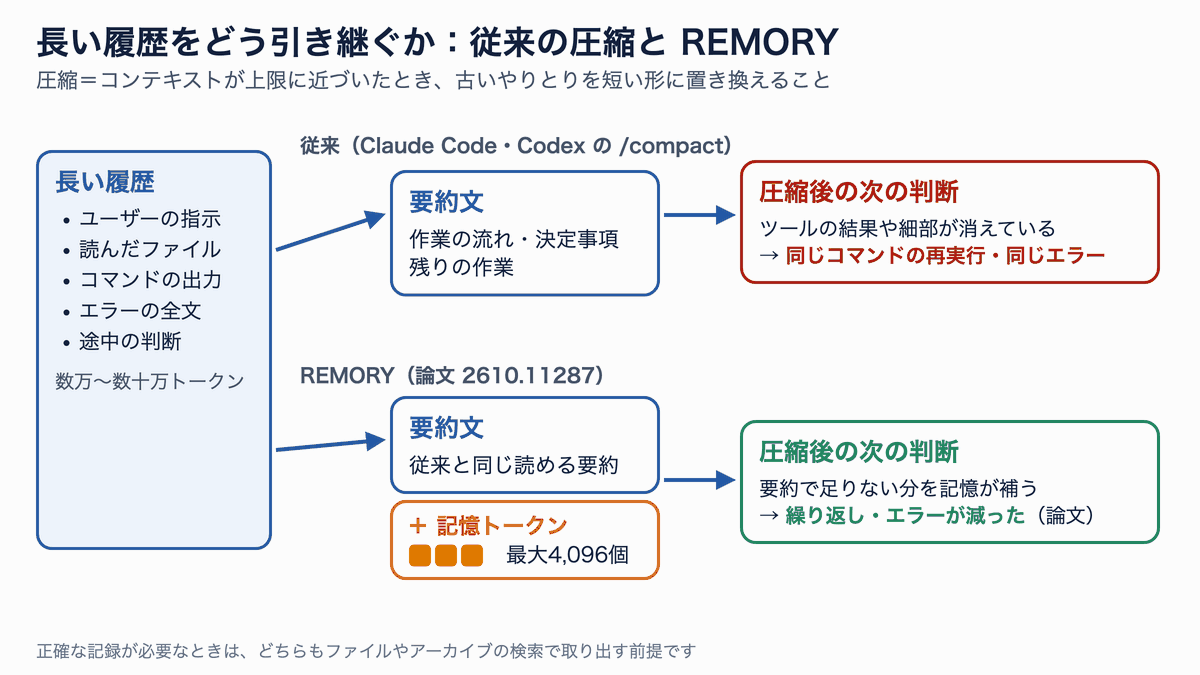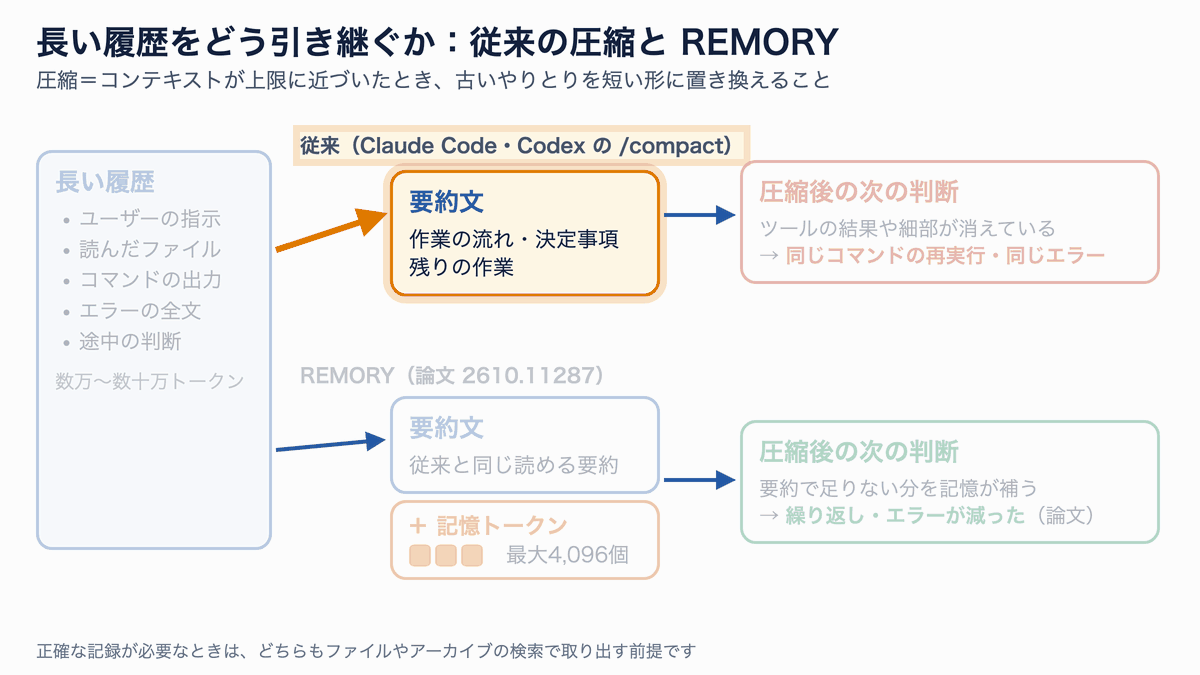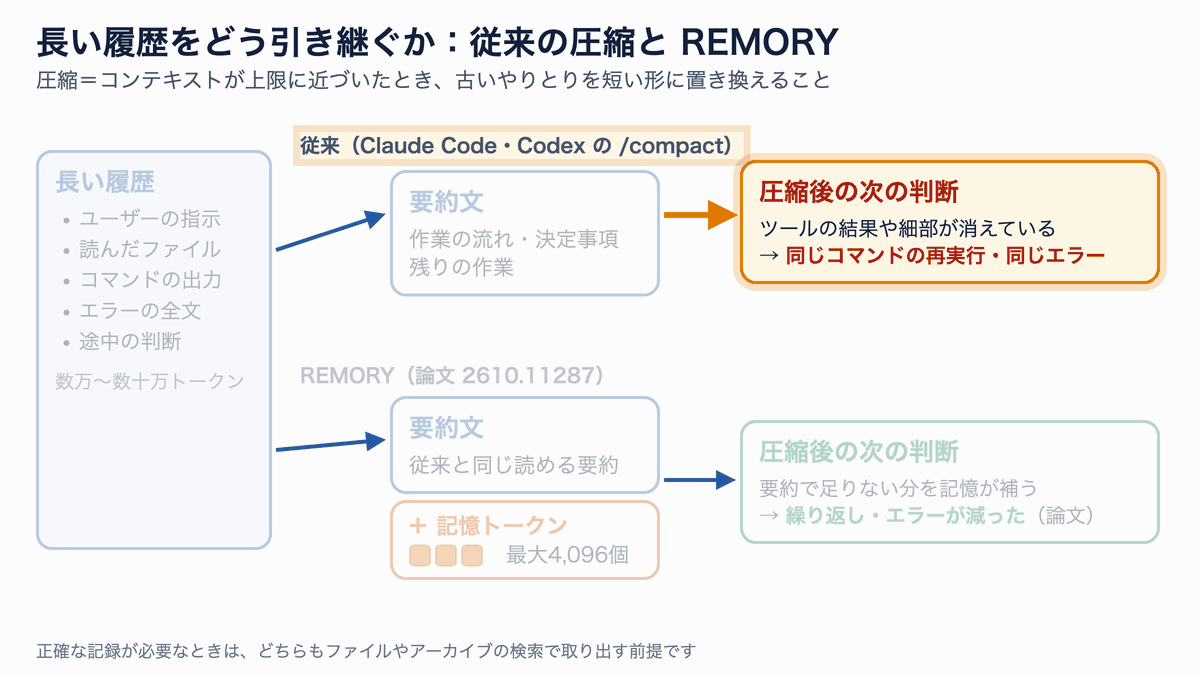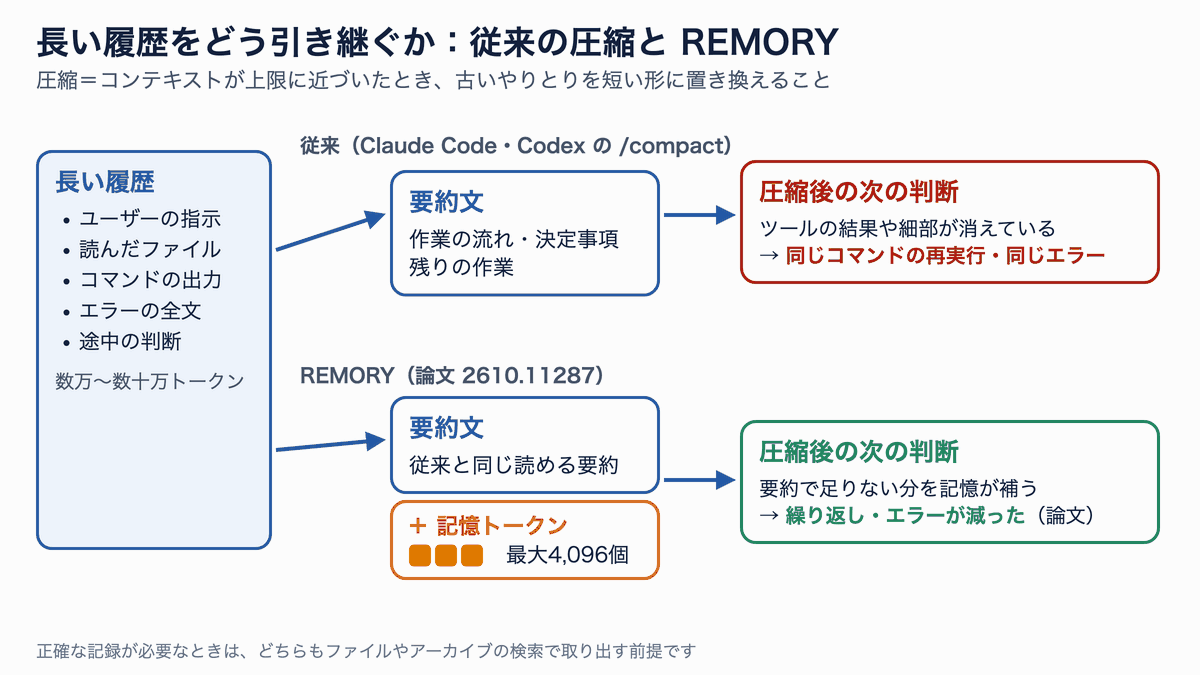
この記事の全体像。従来は「長い履歴→要約文」、REMORY は「長い履歴→要約文+記憶トークン」です。
この記事の確認範囲
- REMORY:arXiv の論文 v1(2610.11287、2026年10月8日)、公式 GitHub リポジトリ(コミット
7ee9e81)、Hugging Face のモデルカードを 2026年10月12日に読みました。 - Claude Code:公式ドキュメント「Explore the context window」「How Claude Code works」(2026年10月12日に閲覧)。
- Codex:公式リポジトリ
openai/codexのソース(2026年10月11日のコミットa9b0815)と、OpenAI の「Compaction」ガイド。 - 手元での実行:REMORY の本体は 80GB の GPU が2枚以上必要なため動かしていません。記憶の束ね方を決める計画部分(純粋な Python)だけを Mac で実行し、その結果を後半の表に使いました。
- 性能の数字はすべて論文の報告値です。著者以外による再現はまだ確認できていません。
コンテキスト圧縮とは何か
大規模言語モデル(LLM)は、一度に読める量に上限があります。この「作業机の広さ」をコンテキストウィンドウ(context window)と呼び、単位はトークン(文字や単語の断片。日本語ならおおよそ1〜2文字で1トークン)です。
エージェントは作業のたびに、指示、読んだファイル、コマンドの出力、自分の考えを机の上に積み上げていきます。机がいっぱいになると続きを書けません。そこで、古いやりとりを要約して机を片付けます。これがコンテキスト圧縮(context compaction、コンパクション)です。
圧縮が何度も起こると、入力の長さは「伸びる→ガクッと落ちる→また伸びる」というノコギリの歯の形になります。REMORY の論文もこの形を出発点にしています。
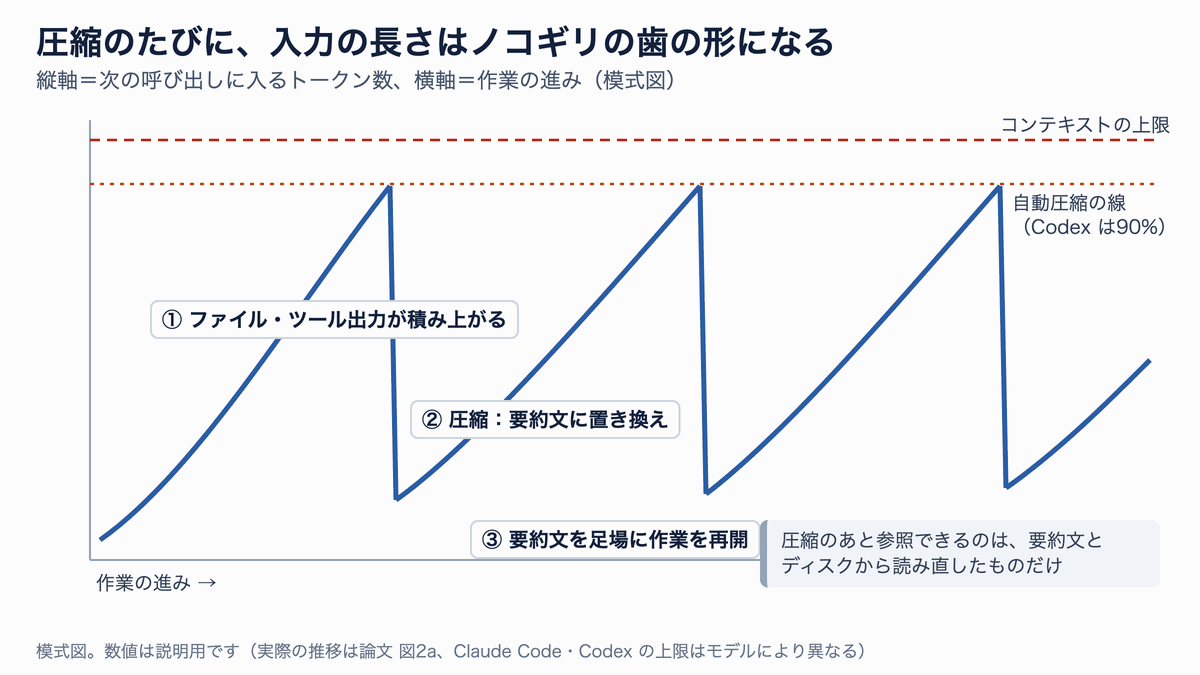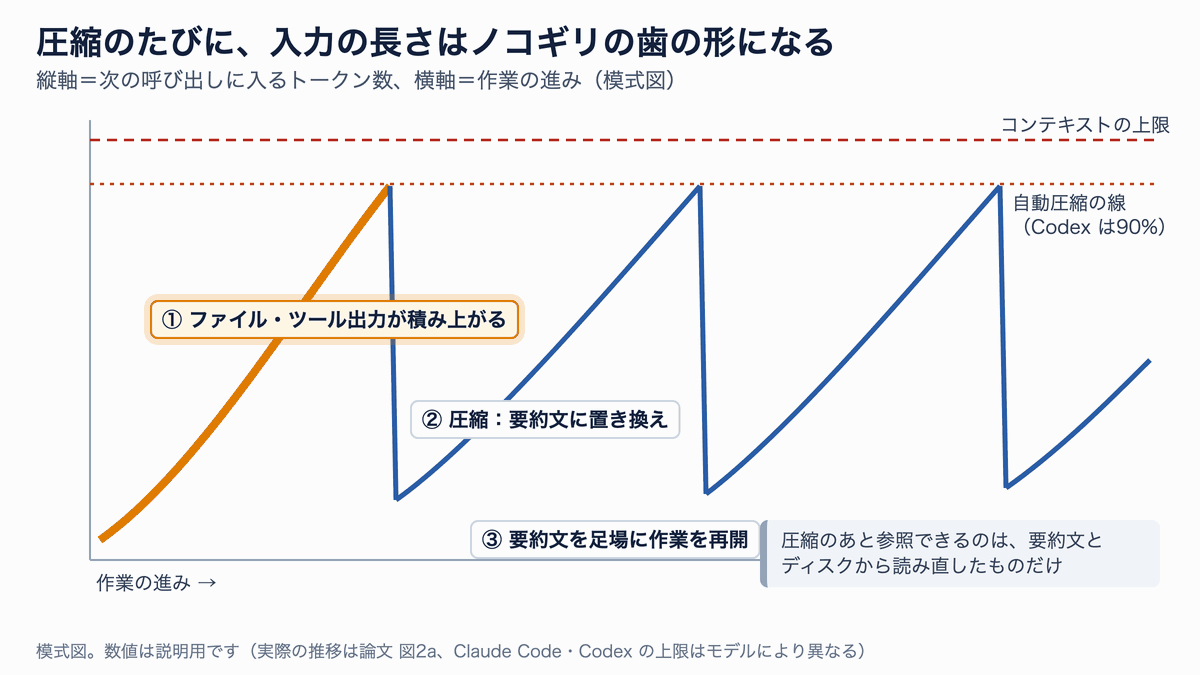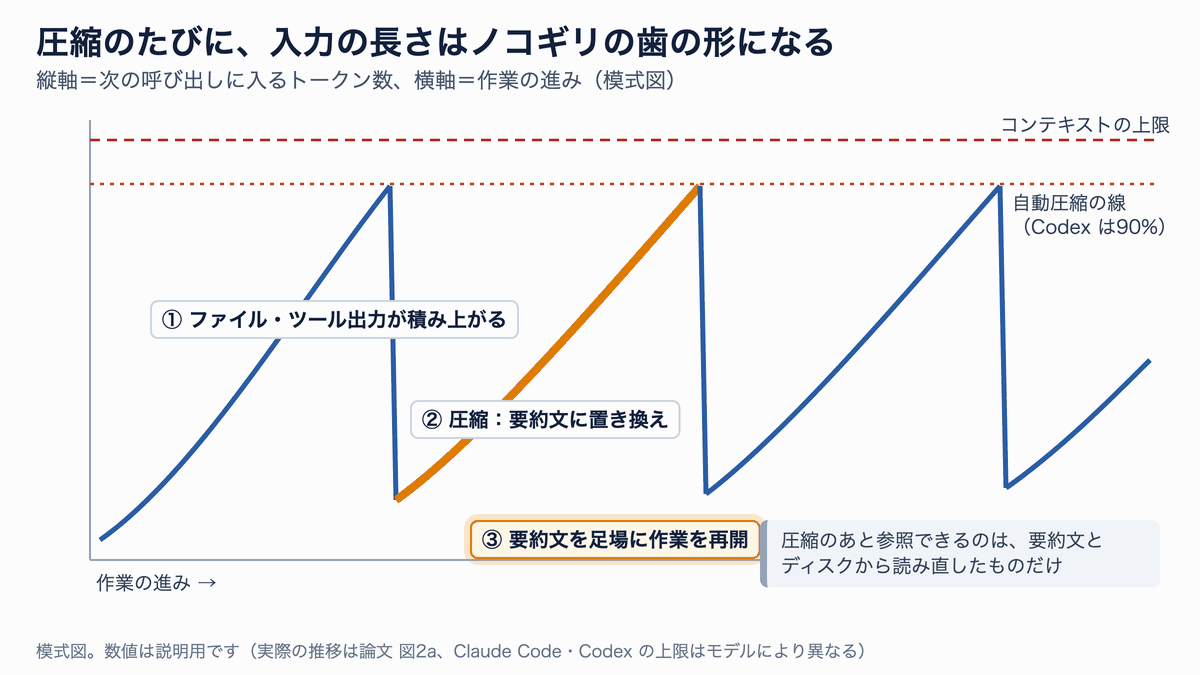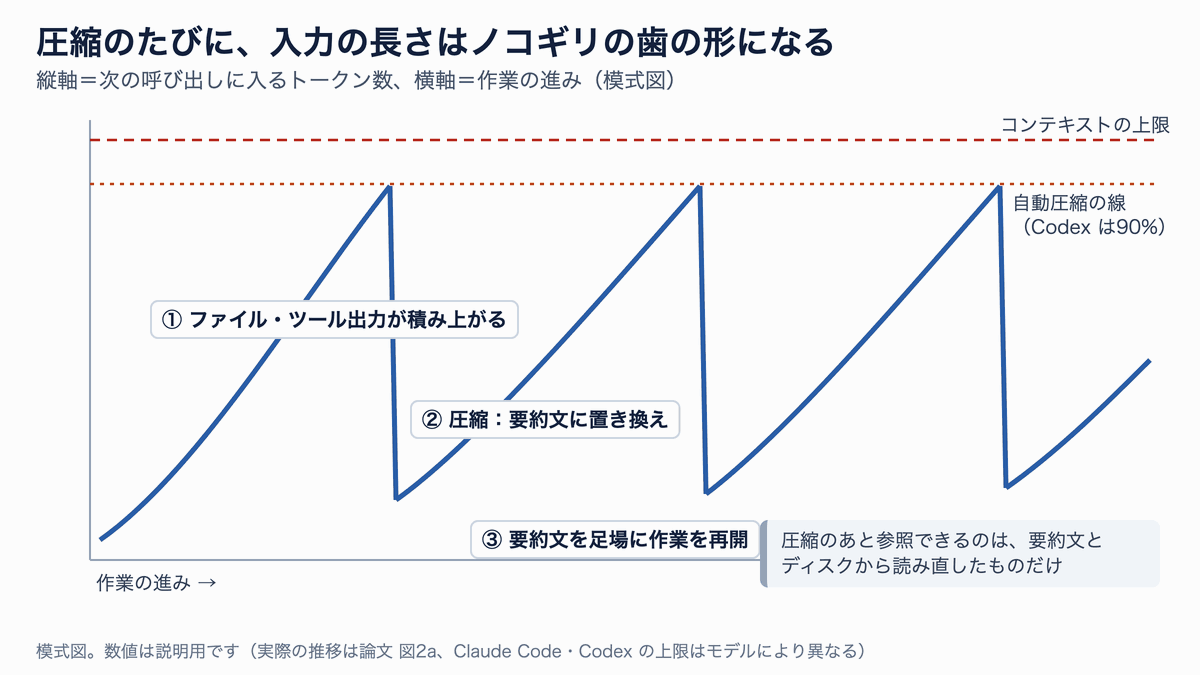
圧縮のたびに、それまでの履歴は要約文という「チェックポイント」に置き換わります。数値は説明用の模式です。
ここで大事なのは、圧縮のあと、エージェントは要約文を頼りに作業を再開するという点です。要約文に書かれていないことは、ファイルを読み直すなどしない限り、もう参照できません。
Claude Code の圧縮はどう動いているか
Claude Code の公式ドキュメントによると、圧縮は次の2段階で進みます。
- 上限に近づくと、まず古いツールの出力(コマンドの結果やファイルの中身)を片付ける
- それでも足りなければ、会話全体を構造化した要約に置き換える
要約に残るのは、ユーザーの依頼と意図、重要な技術的概念、調べたり変更したりしたファイルと重要なコード片、エラーとその直し方、残っているタスク、いま取り組んでいる作業です。逆に、ツールの出力そのものと途中の推論は消えます。
要約とは別に、ディスクから読み直されて復活するものもあります。
| 種類 | 圧縮のあと |
|---|---|
プロジェクト直下の CLAUDE.md、paths: なしのルール | ディスクから読み直す |
| 自動メモリ(MEMORY.md) | ディスクから読み直す |
| プランモードで書いた計画 | ディスクから読み直す |
| 最近変更したファイル | 最大5件を読み直す(5,000トークン超はパスだけ) |
| 使ったスキルの本文 | 1件5,000トークン、合計25,000トークンまで戻す |
paths: 付きのルール、下の階層の CLAUDE.md | 要約に含まれ、必要になったら読み直す |
| フックが途中で足した情報 | ほかの会話と一緒に要約される |
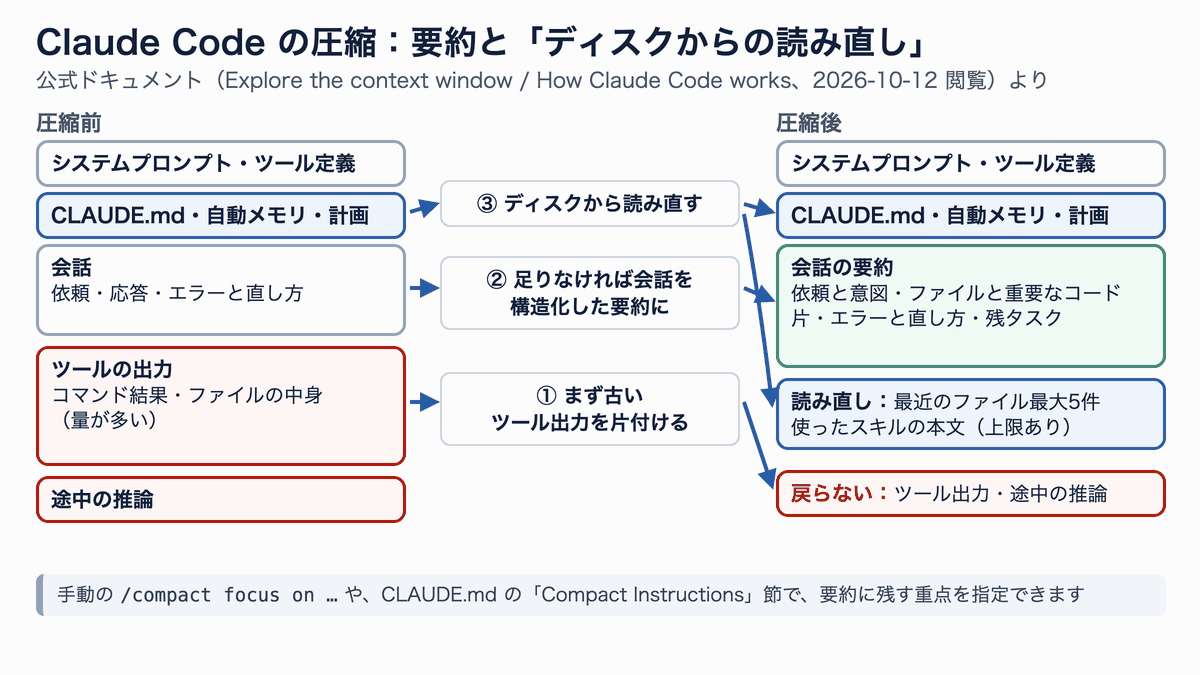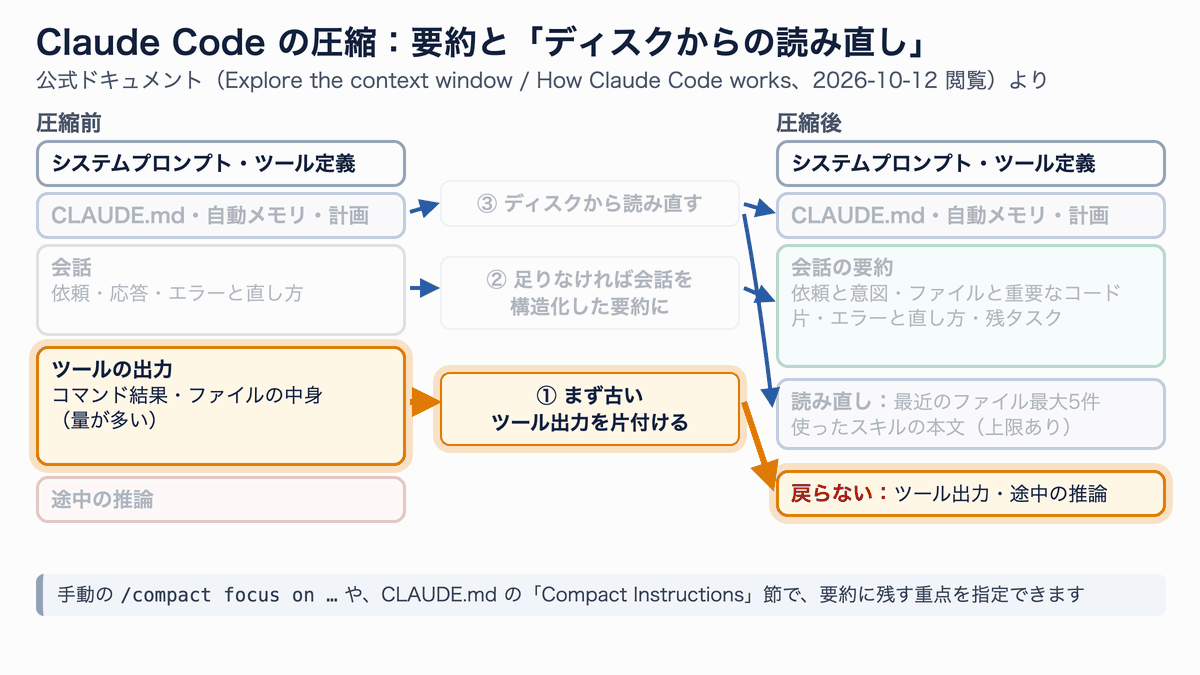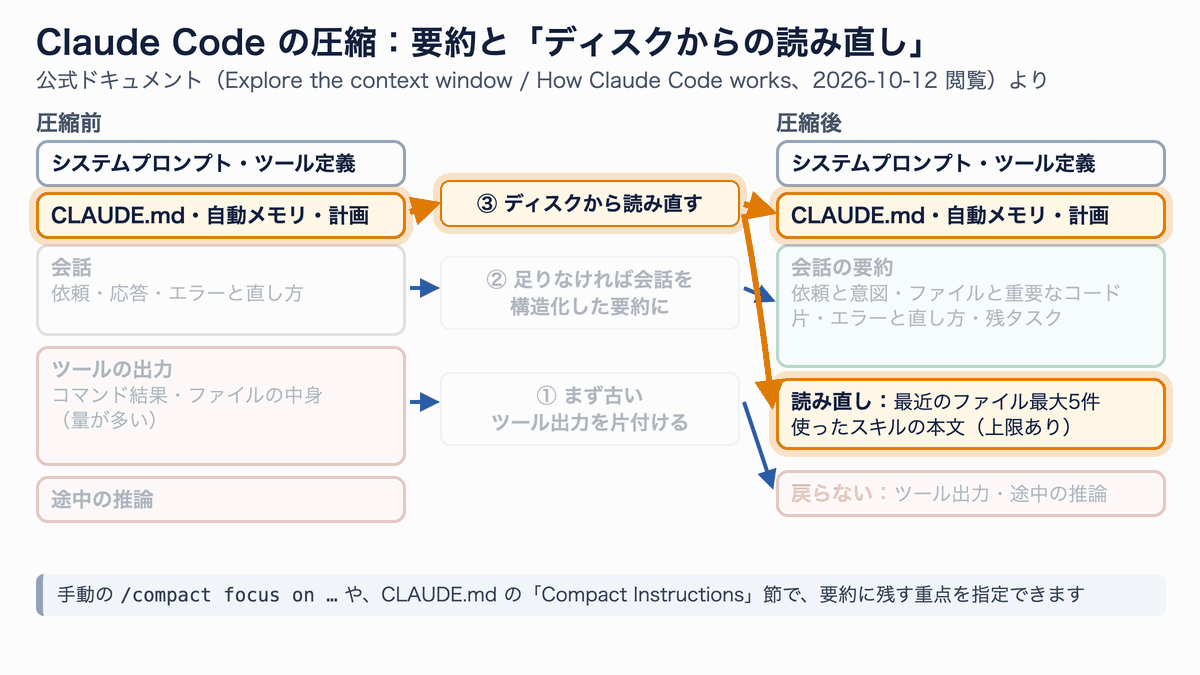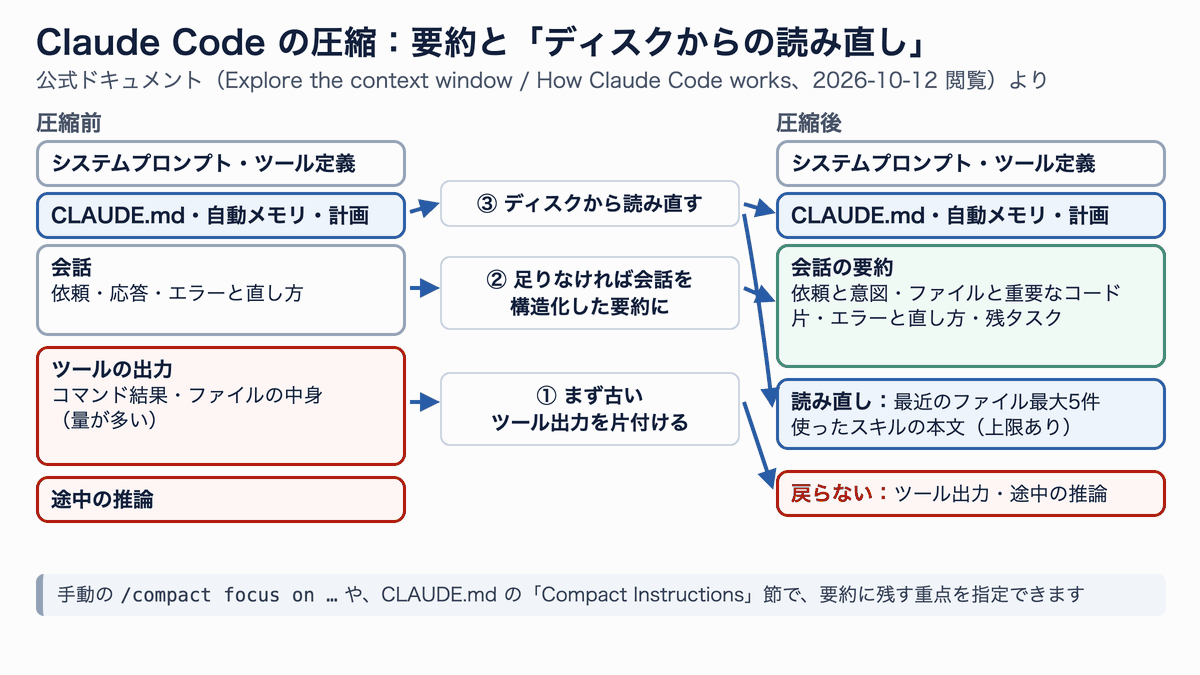
Claude Code は「要約文」と「ディスクからの読み直し」を組み合わせています。ツール出力の中身は戻りません。
手動で圧縮したいときは /compact を使います。/compact focus on the auth bug fix のように重点を指定したり、CLAUDE.md に「Compact Instructions」という節を作って残してほしいものを書いたりできます。
Codex の圧縮はどう動いているか
Codex CLI のソースを読むと、自動圧縮は既定でコンテキストウィンドウの90%に達したときに始まります(設定 model_auto_compact_token_limit でもっと早くできます)。そのあとの処理は、つないでいるモデル提供元によって2通りに分かれます。
リモート圧縮(OpenAI のモデルを使う場合)では、OpenAI の Responses API に圧縮を任せます。返ってくる「compaction item」は暗号化されていて人間は読めません。OpenAI のガイドは、これを以前の状態や推論を少ないトークンで引き継ぐものと説明しています。直近のユーザー発言は最大64,000トークンまで、そのまま残ります。
ローカル圧縮(それ以外の提供元)では、Codex 自身がモデルに要約を頼みます。依頼文は「別の LLM が作業を再開するための引き継ぎ要約を作れ」というもので、進捗と決定事項、制約、残りの作業、続けるのに必要なデータを含めるよう指示しています。新しい履歴は、直近のユーザー発言(最大20,000トークン)と、「別のモデルが途中まで解いた要約です」という前置き付きの要約文になります。
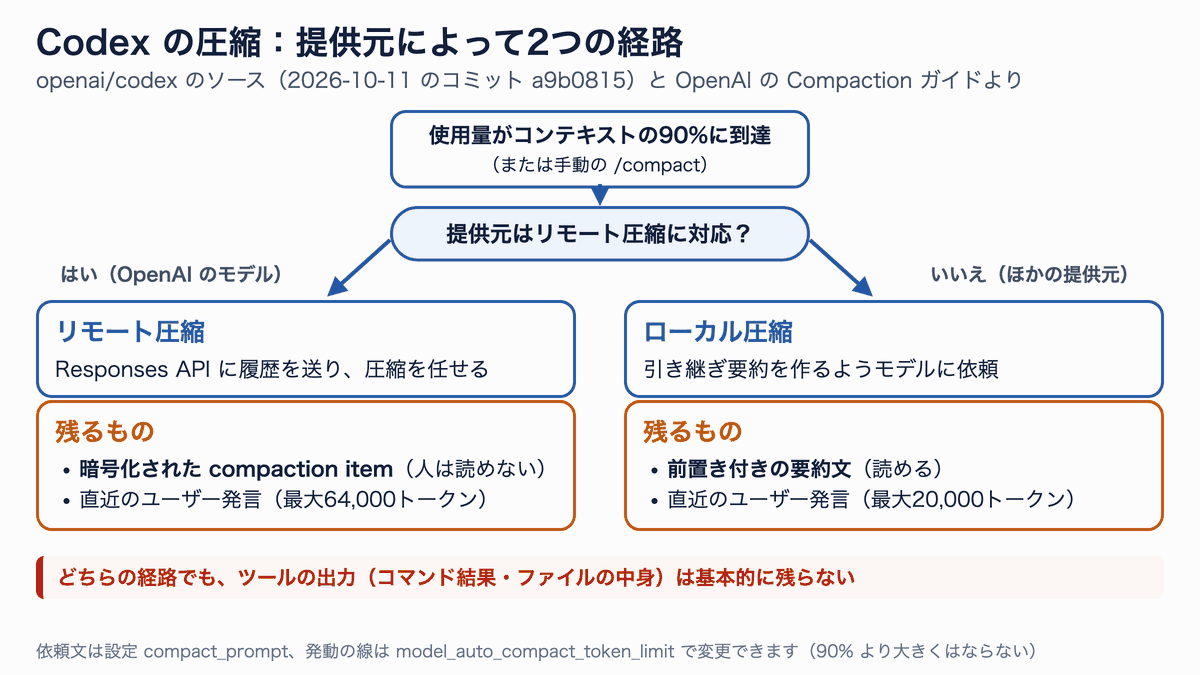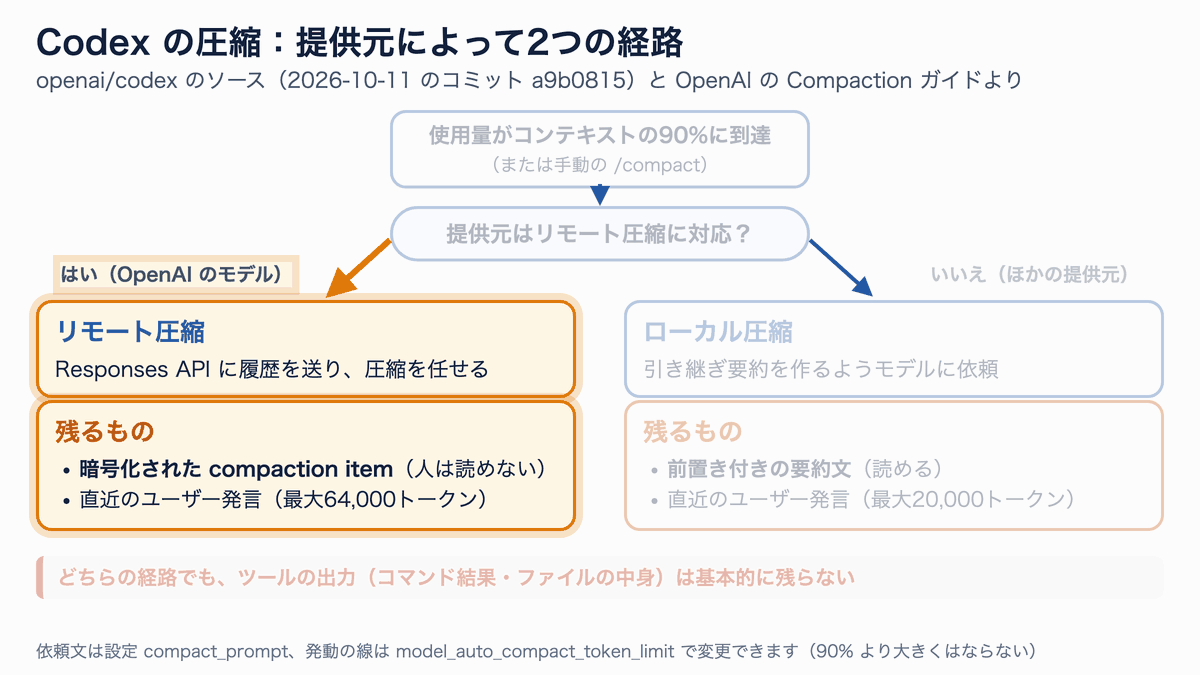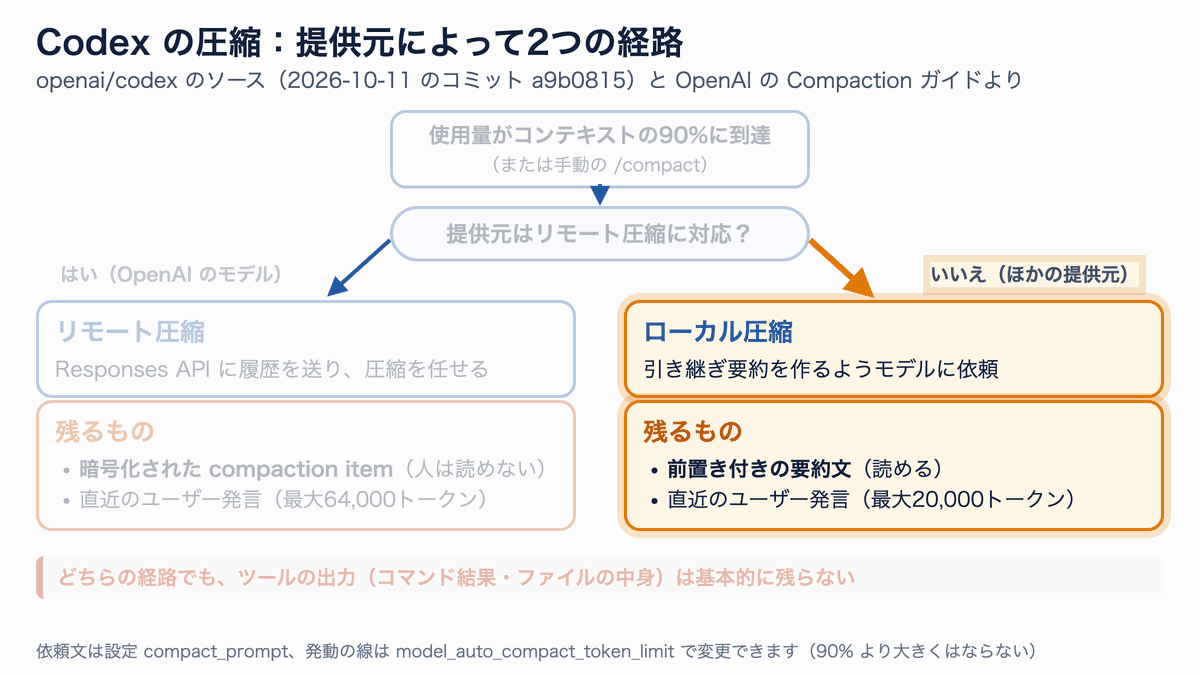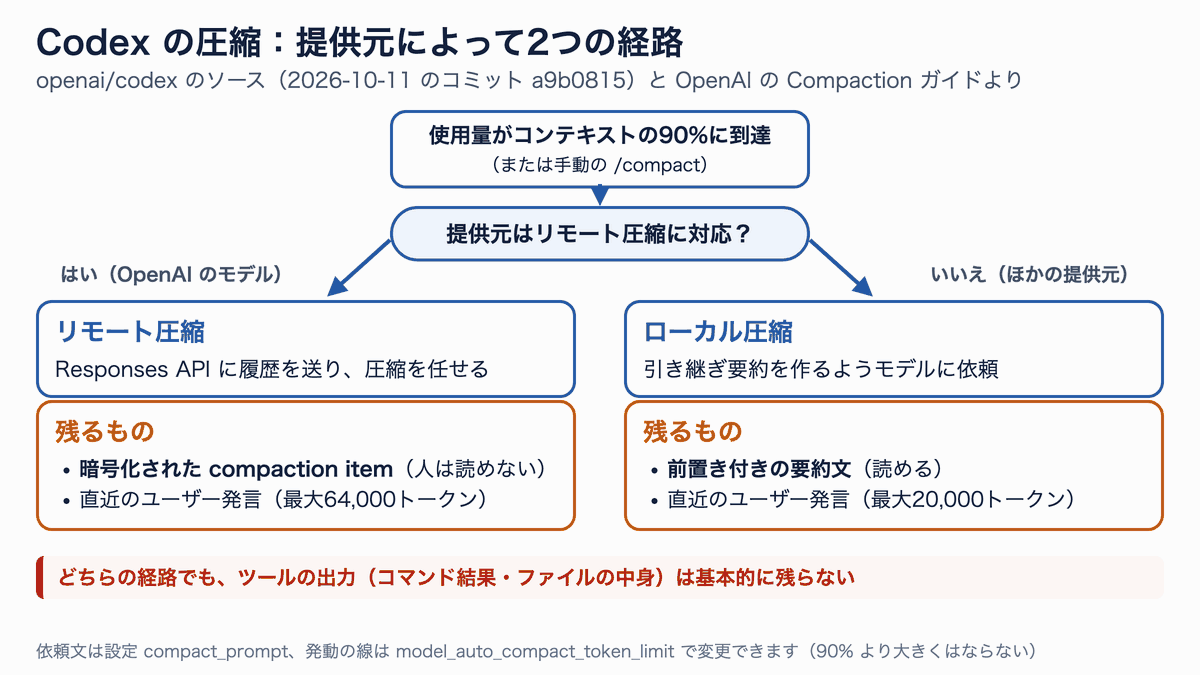
Codex は提供元に応じて2つの経路を使い分けます。どちらの経路でもツールの出力は基本的に残りません。
依頼文は設定 compact_prompt で差し替えられます。REMORY の論文は、評価の土台(ハーネス)に Codex CLI を使い、その /compact を比較の基準にしています。
要約文だけの圧縮が抱える問題
2つのツールは細部こそ違いますが、骨組みは同じです。長い履歴を、人間が読める要約文(とユーザー発言)に置き換え、ツールの出力は捨てる。この方式には、構造上の弱点が4つあります。
問題1:ツールの結果が消え、同じ作業を繰り返す
テストの失敗メッセージ、grep の結果、ファイルの該当行。こうした「実際に見た証拠」は量が多いので、要約では「テストが失敗していた」程度に縮みます。エージェントは中身を確かめるために同じコマンドをもう一度実行し、トークンと時間を使います。
問題2:何が後で必要になるかは、要約する時点では分からない
要約を書くのは圧縮の瞬間です。しかし、どの情報が大事かは作業が進むにつれて変わります。論文も「要約を超えて必要になる情報は、前もって特定も列挙もできない」という前提に立っています。
問題3:正確な細部ほど落ちやすい
ファイルのパス、実行したコマンドの正確な引数、どの資料のどこに書いてあったか。要約文は「流れ」を保つのは得意ですが、こうした細部はこぼれがちです。論文の事例では、リファクタリングで補助関数を消したあとに圧縮が起き、要約には「既知のエラー」と「バックアップの場所」は残ったものの、実際に打った編集コマンドは残りませんでした。
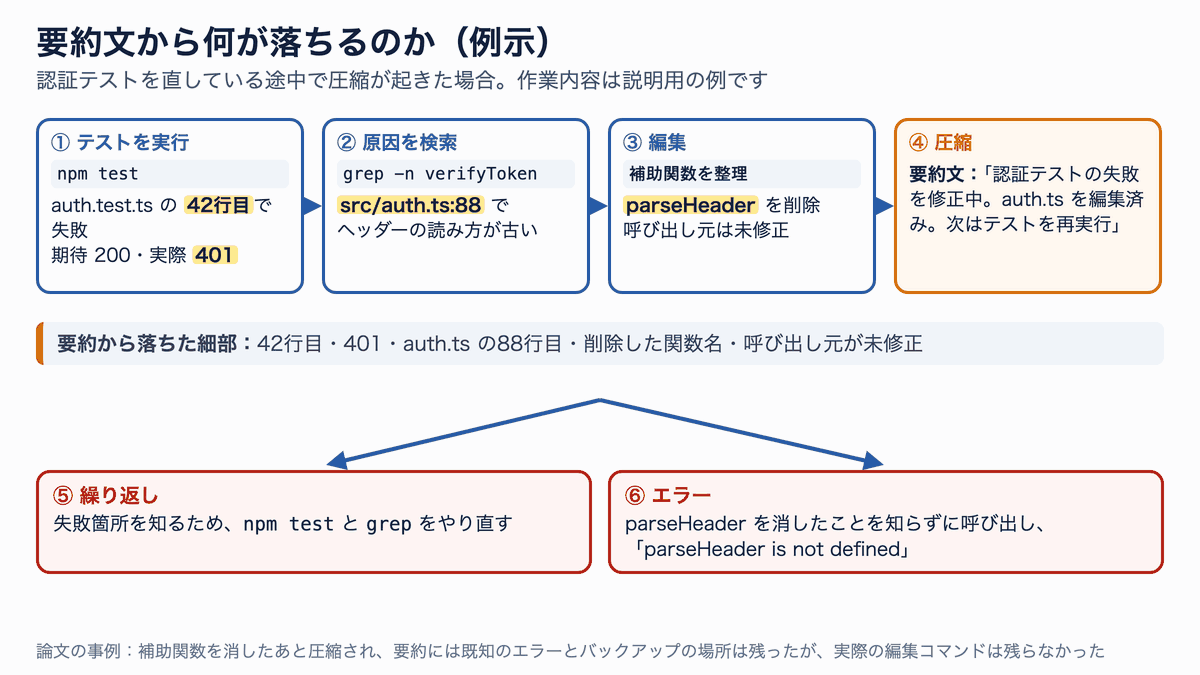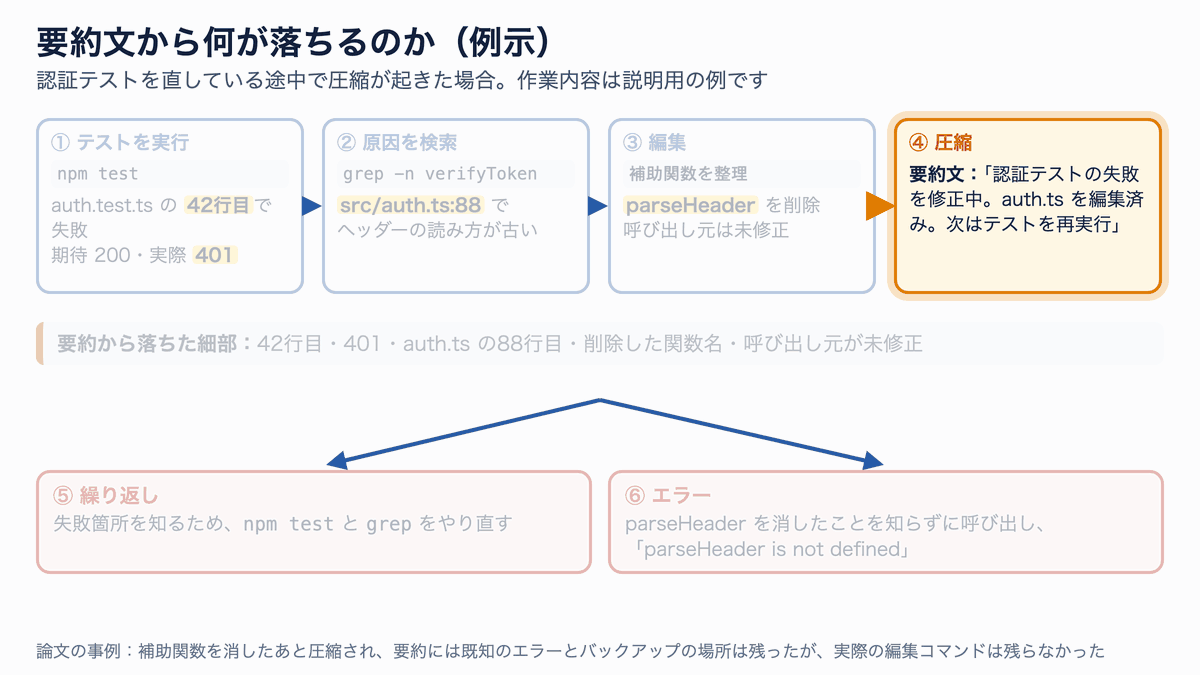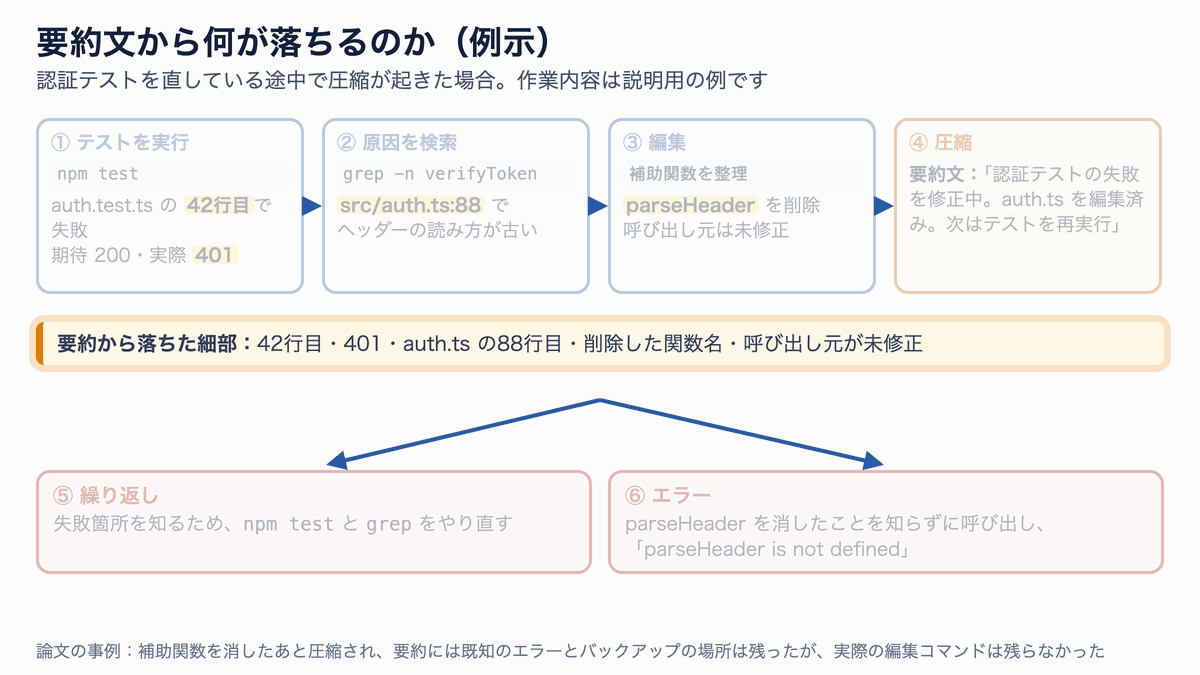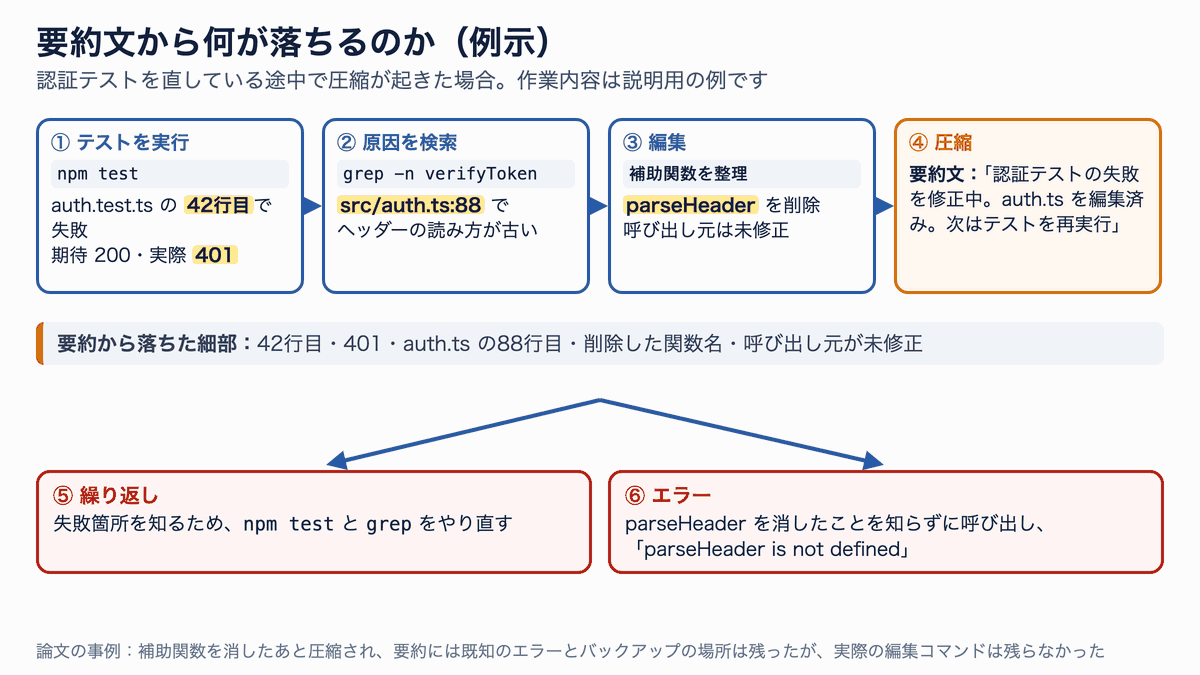
要約文に残るのは流れで、証拠の中身は残りにくい。圧縮後の「やり直し」はここから生まれます。図の作業内容は説明用の例示です。
問題4:要約文を長くしても、あまり良くならない
それなら要約を長くすればよい、と考えたくなります。ところが論文の実験では、要約文に同じ量の文章を足した条件(Summary++)の成績は、要約文だけの条件とほとんど変わりませんでした。文章で書き足すやり方そのものに限界がある、ということです。
いま利用者ができる対策(CLAUDE.md に書く、重要な結果をファイルに保存する、サブエージェントに調べ物を任せる)は有効ですが、どれも「何が大事かを人が先に決める」方式です。問題2は残ります。
REMORY の発想:要約文に「残差の記憶」を足す
REMORY は、要約文を捨てて別の何かに置き換えるのではありません。要約文はそのまま残し、そのすぐ後ろに、要約文では足りない分を補う記憶を並べるという発想です。
名前の由来は、画像認識で有名な 残差接続(residual connection)です。残差接続では、入力 x をそのまま次に渡しつつ、足りない差分 F(x) だけを学習して足し合わせます(x + F(x))。REMORY はこれを「文章の並び」の方向で行います。要約文 S をそのまま渡し、その後ろに、要約で埋まらなかった差分を表す記憶 M を並べて [S ; M] にします。
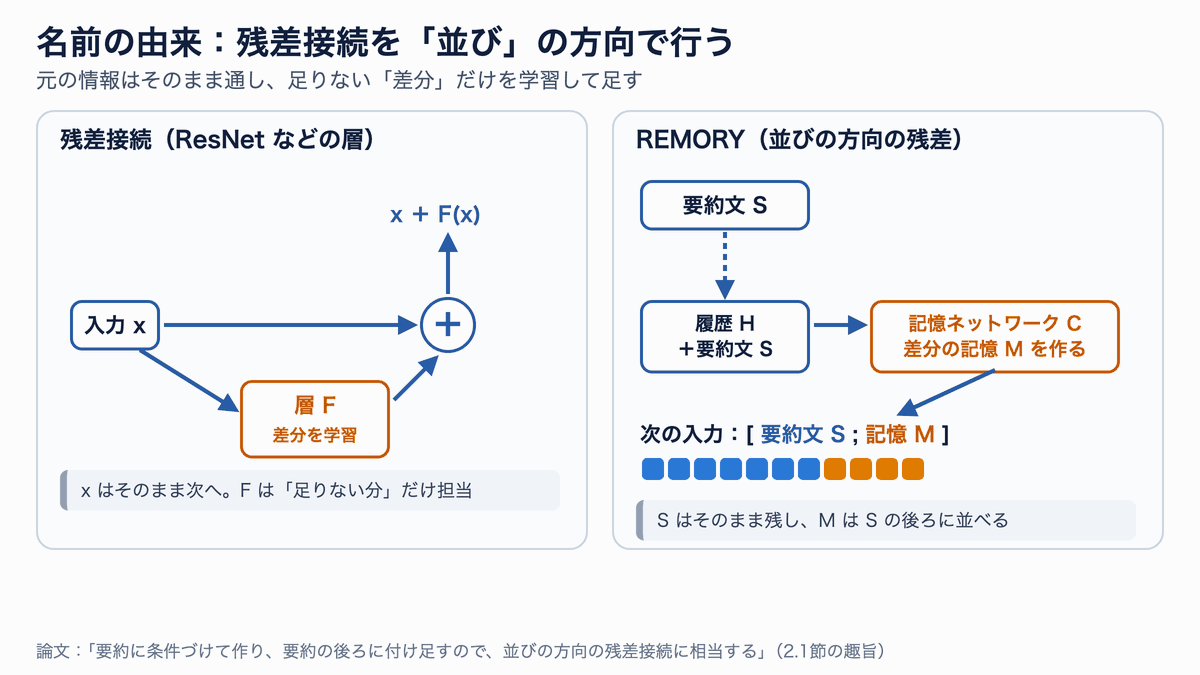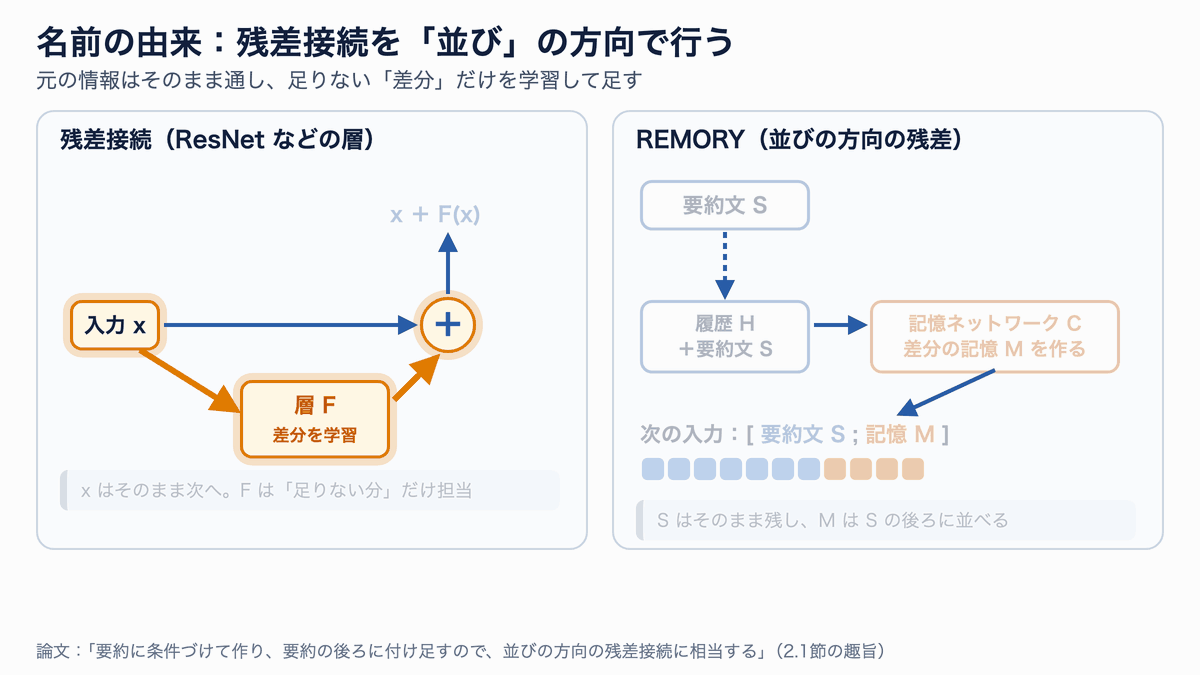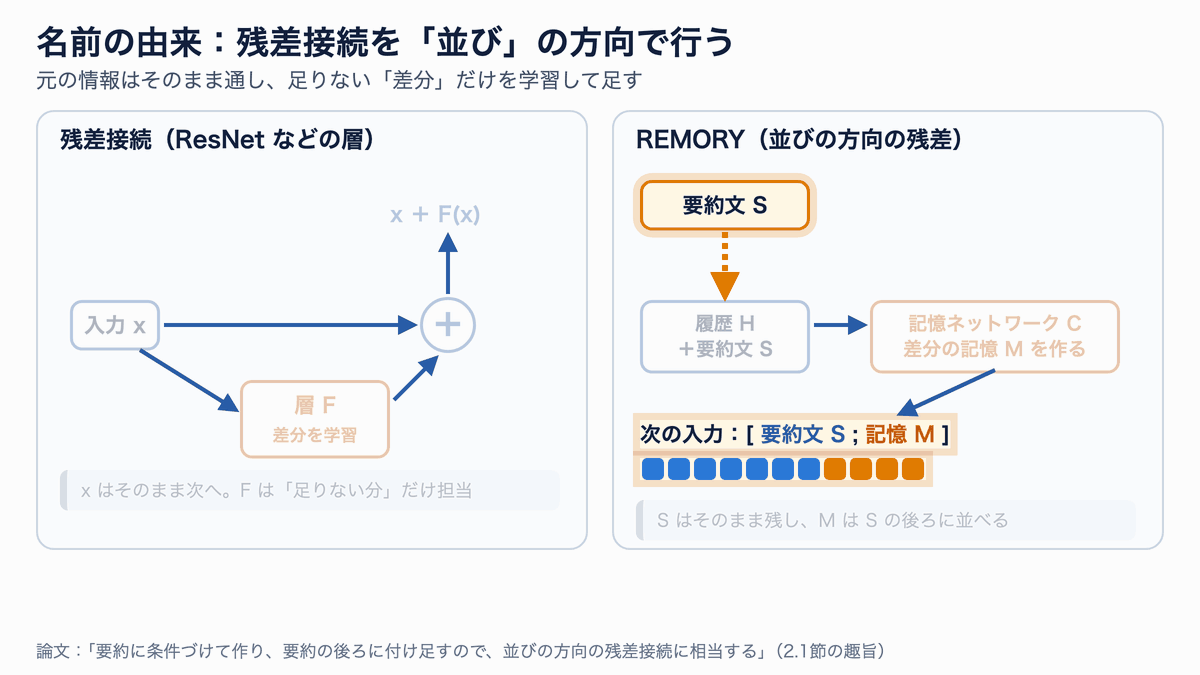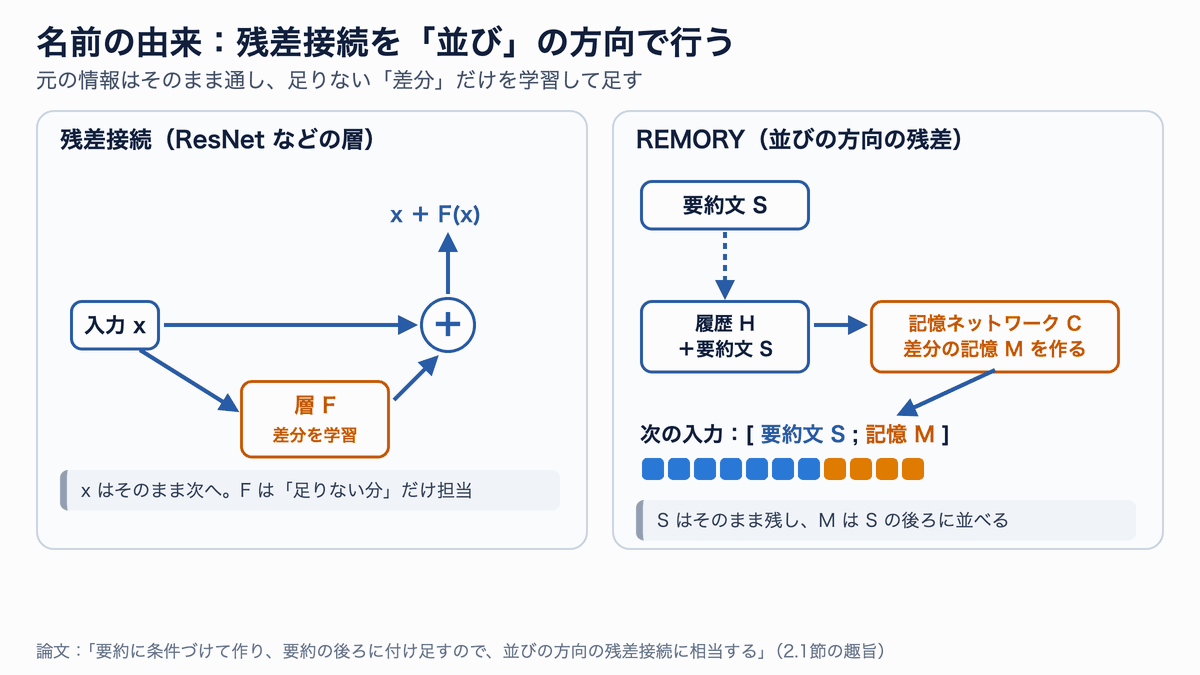
残差接続は「元の情報+足りない差分」。REMORY は要約文が元の情報、記憶トークンが差分にあたります。
こうすると役割分担がはっきりします。
| 担い手 | 役割 | 人間が読めるか |
|---|---|---|
| 要約文 | 作業の流れを伝える読めるチェックポイント | 読める |
| 記憶トークン | 次の判断に効く情報を、モデルが使える形で補う | 読めない |
| ファイルやアーカイブの検索 | 正確な記録が必要なときに取り出す | 読める |
3つ目の「検索」は REMORY が新しく作るものではなく、通常のツール操作のままです。REMORY は、要約文と検索の間を埋める部品です。
REMORY の仕組みを分解する
記憶トークンは「単語ではないトークン」
普通の入力は、単語を語彙表の番号に変え、その番号に対応するベクトル(数値の並び)を表から引いてモデルに入れます。REMORY の記憶トークンは、この表を経由しません。モデルの入力と同じ形のベクトルを、専用のネットワークが直接作ります。こうしたトークンをソフトトークン(soft token)と呼びます。
語彙にない値も取れるので、単語にすると何十語も必要な情報を、1個のベクトルに詰め込めます。その代わり、人が読んで中身を確かめることはできません。
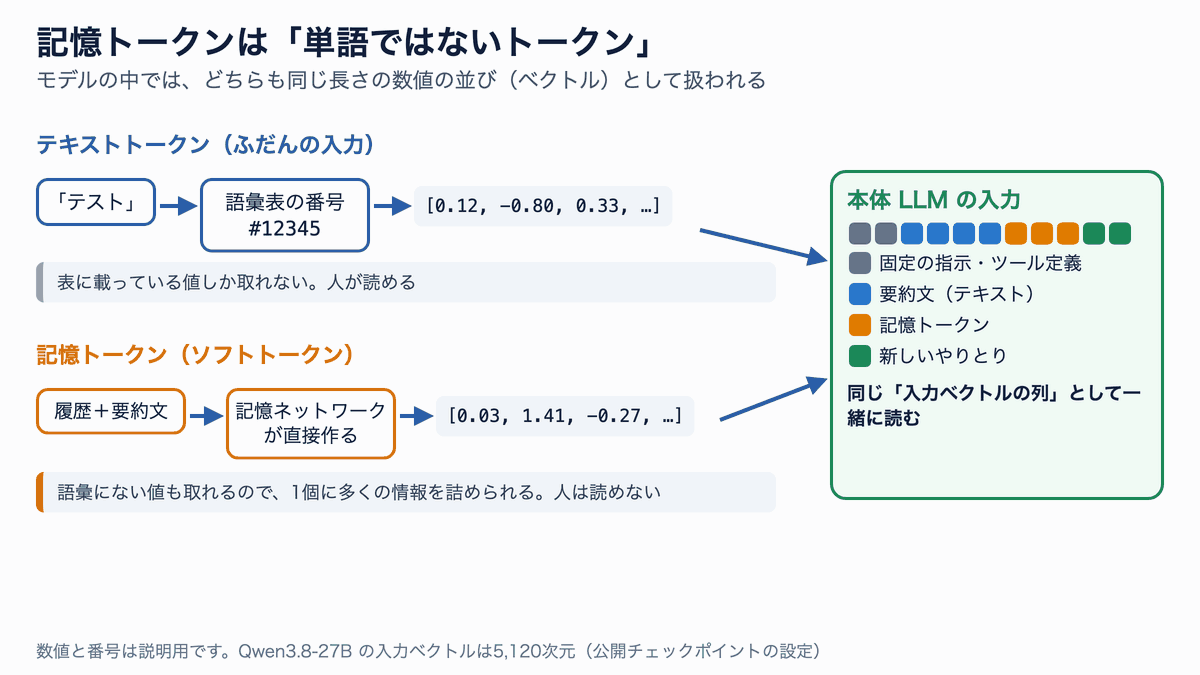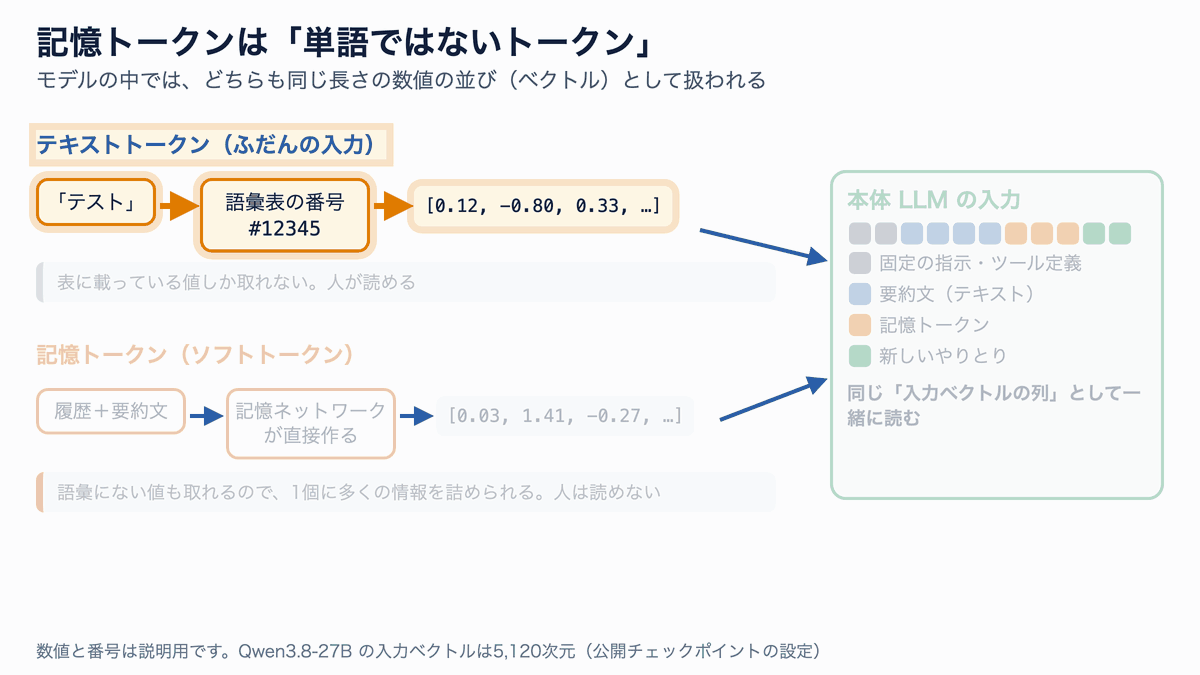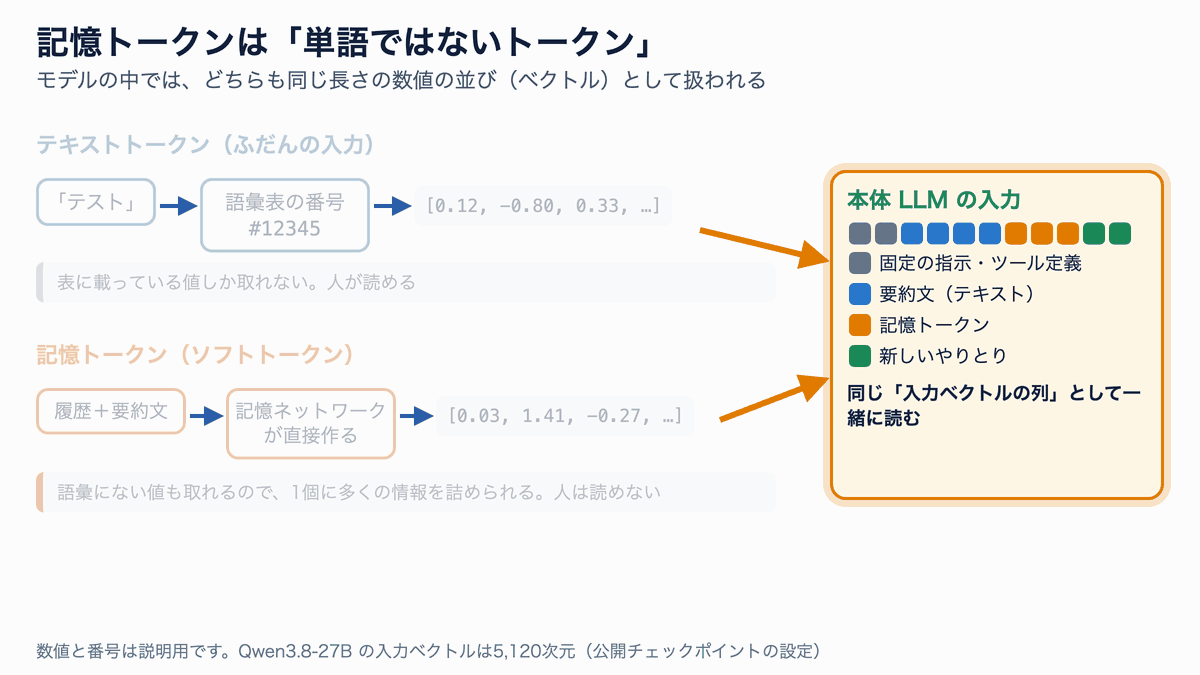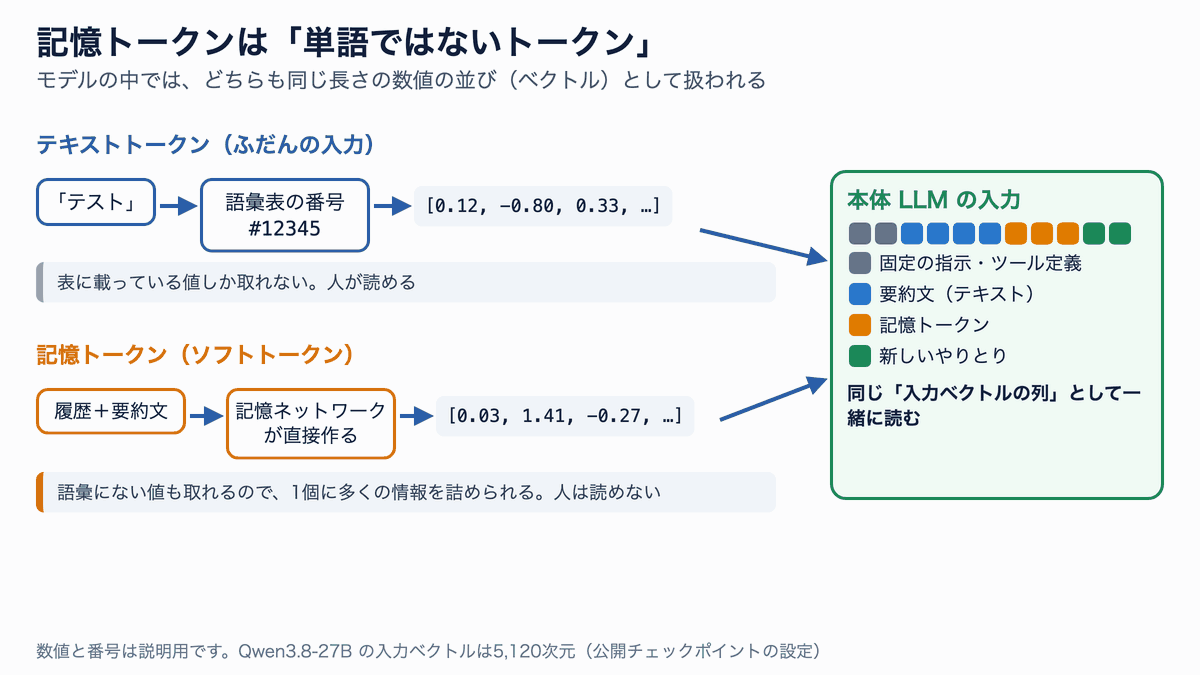
文章のトークンも記憶トークンも、モデルから見れば同じ「入力ベクトルの列」です。
記憶ネットワークが記憶を作る流れ
記憶を作るのは、本体の LLM(論文では「アクター」と呼びます)とは別の小さなネットワークです。Qwen3.8-27B 用は約19.4億パラメータで、高速生成の手法 DFlash の構造を流用しています。
作り方は次のとおりです。
- 本体 LLM に履歴を読ませ、途中の層の内部表現を取り出す(Qwen 版は第1・16・31・46・61層)
- 記憶ネットワークが、学習済みの「問い合わせ」を使ってその内部表現から必要な情報を集める
- その際、要約文をゲート付きのクロスアテンションで参照する(要約に書いてあることを踏まえて、足りない分に集中する)
- 履歴 1,024 トークンごとに 64 個の記憶トークンを作る(16分の1)
本体 LLM の重みは一切変えません。学習するのは記憶ネットワークだけです。
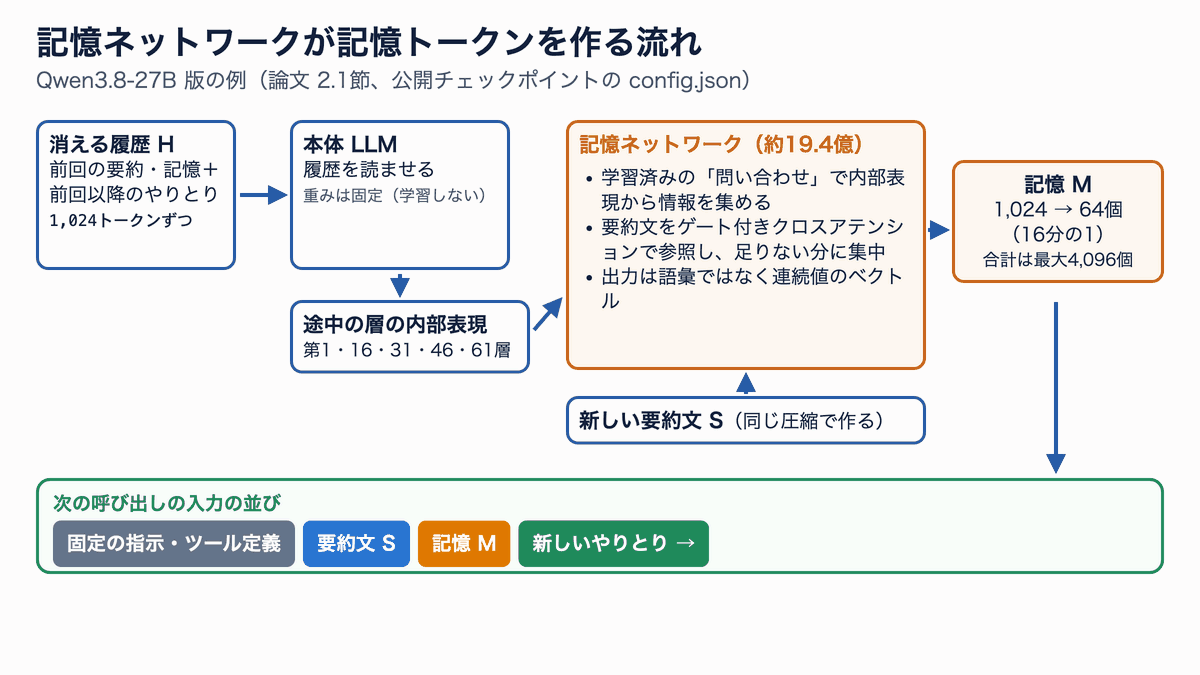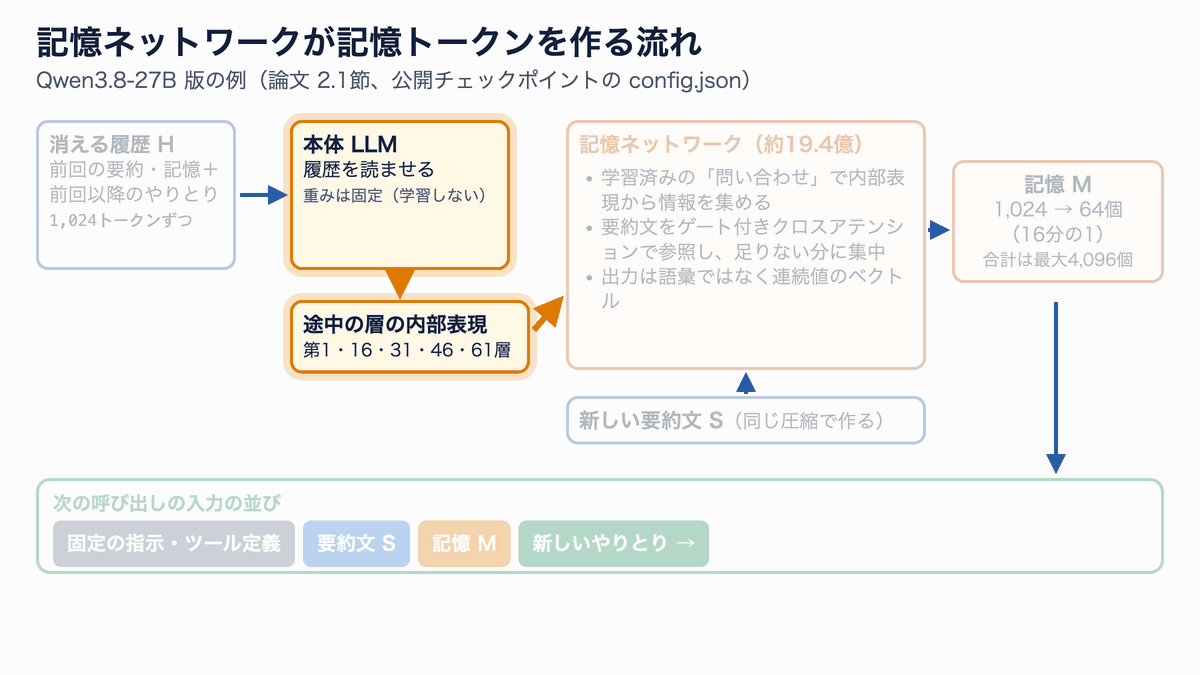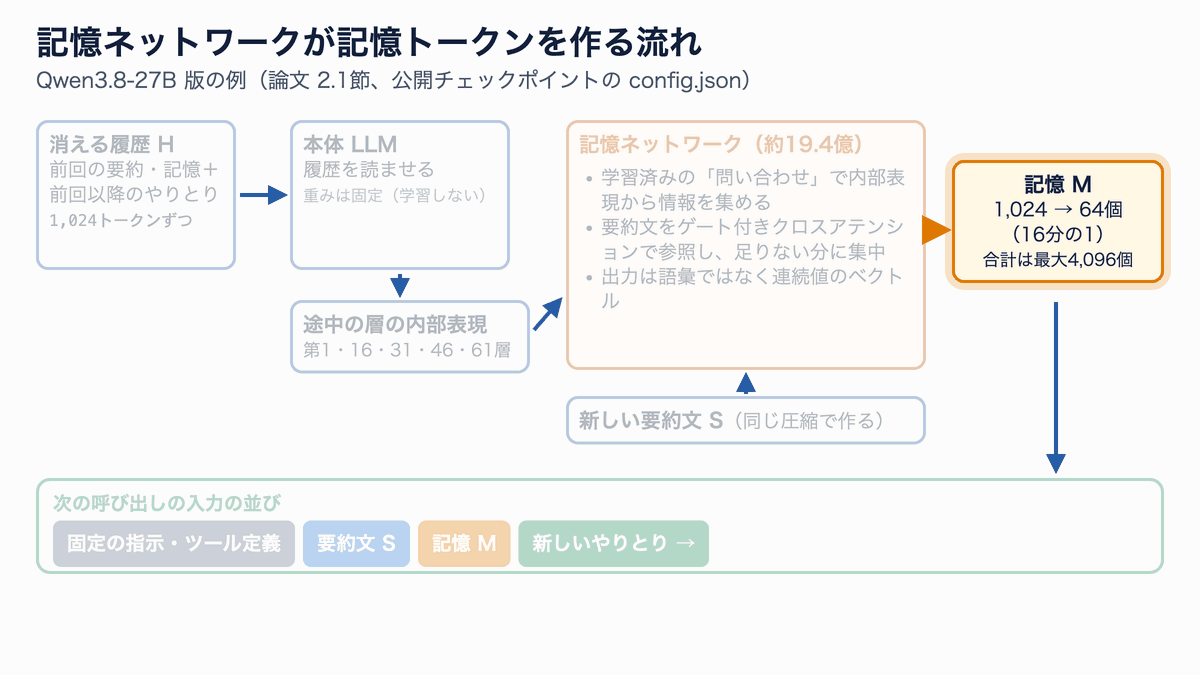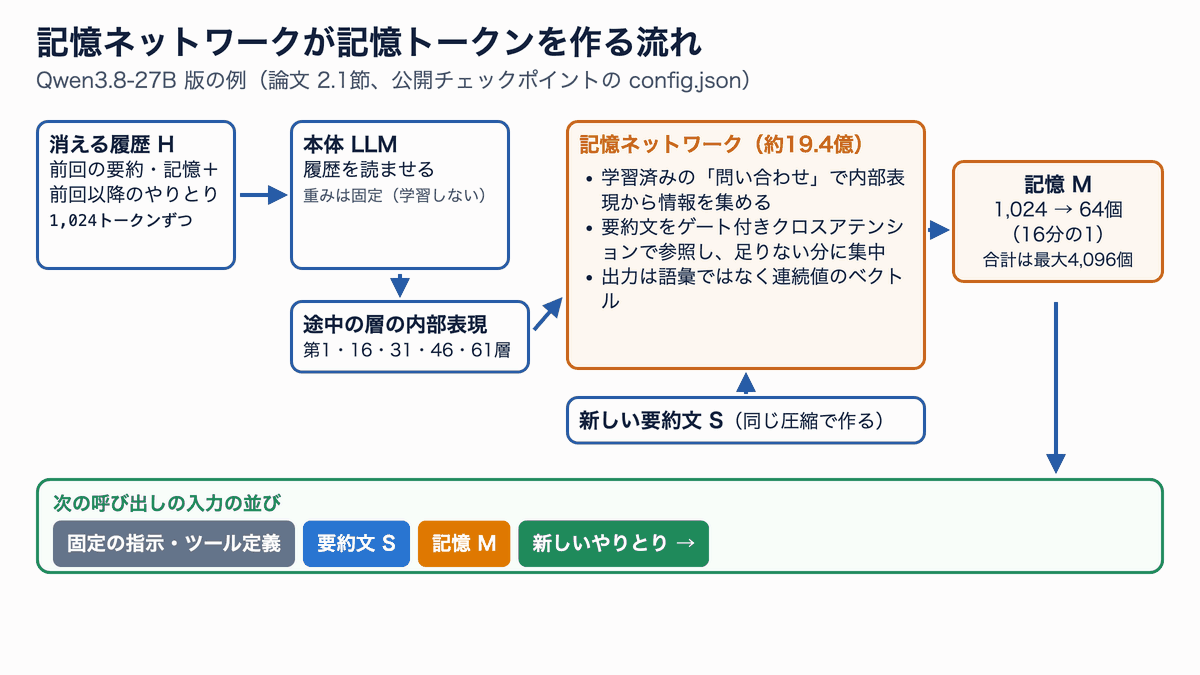
次の呼び出しでは「固定の指示とツール定義 → 要約文 → 記憶トークン → 新しいやりとり」の順に並びます。
上限は 4,096 個、古い履歴ほど粗く束ねる
履歴が長くなっても、記憶トークンは最大 4,096 個に抑えられます。上限を超えそうになると、古い側から隣り合う16個の塊を1つに束ねる、ピラミッド型の圧縮を行います。新しい履歴は細かく、古い履歴ほど粗く持つ形です。
この計画部分は公式リポジトリの pyramid.py で、モデルなしで動きます。Mac で履歴の長さを変えて実行した結果が次の表です。
| 履歴の長さ(トークン) | 記憶トークン数 | 元の長さに対する割合 | 最も粗い段 |
|---|---|---|---|
| 10,000 | 640 | 6.4% | 1段目 |
| 65,536 | 4,096 | 6.25% | 1段目 |
| 65,537 | 3,200 | 4.9% | 2段目 |
| 100,000 | 3,392 | 3.4% | 2段目 |
| 262,144 | 3,904 | 1.5% | 2段目 |
| 1,000,000 | 3,968 | 0.4% | 3段目 |
65,536 トークンでちょうど上限の 4,096 個になり、1トークン増えると最も古い16ブロックが1つに束ねられて 3,200 個に減ります。100万トークンでも 4,000 個弱に収まります。
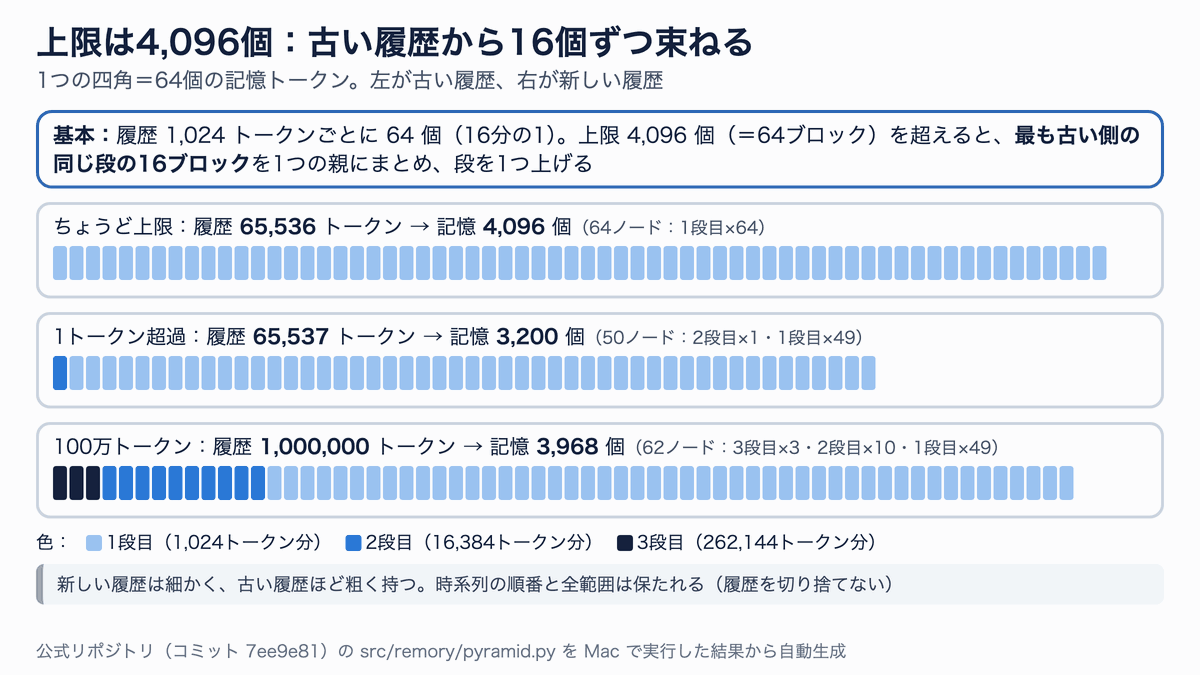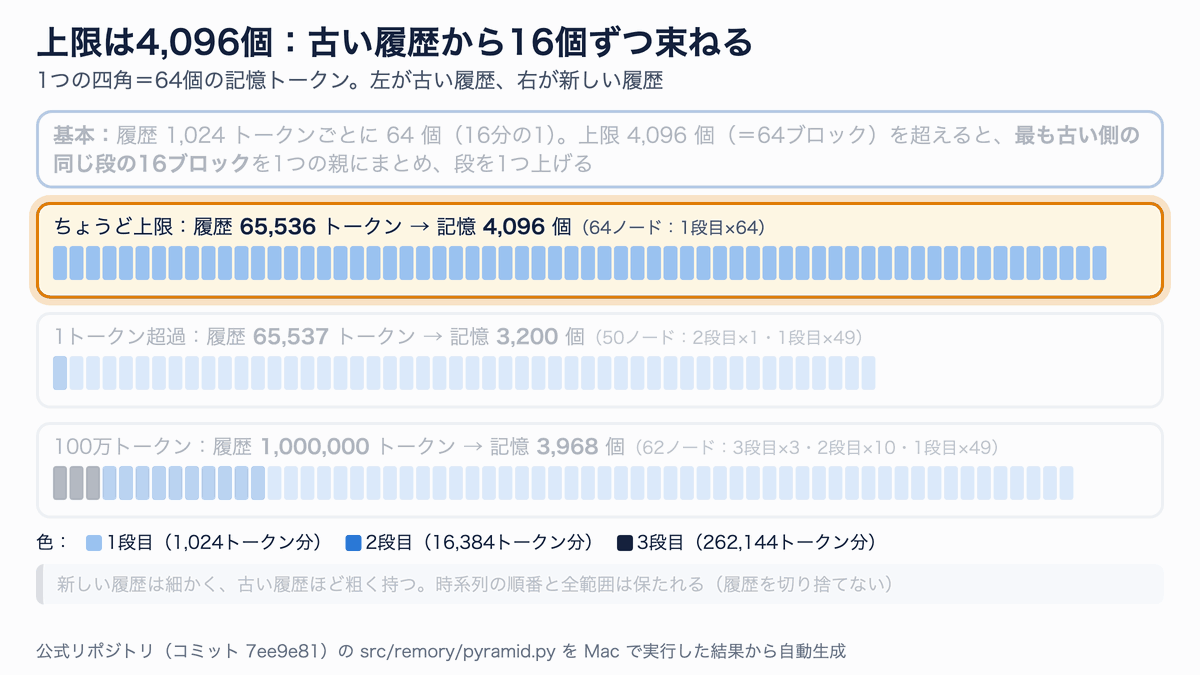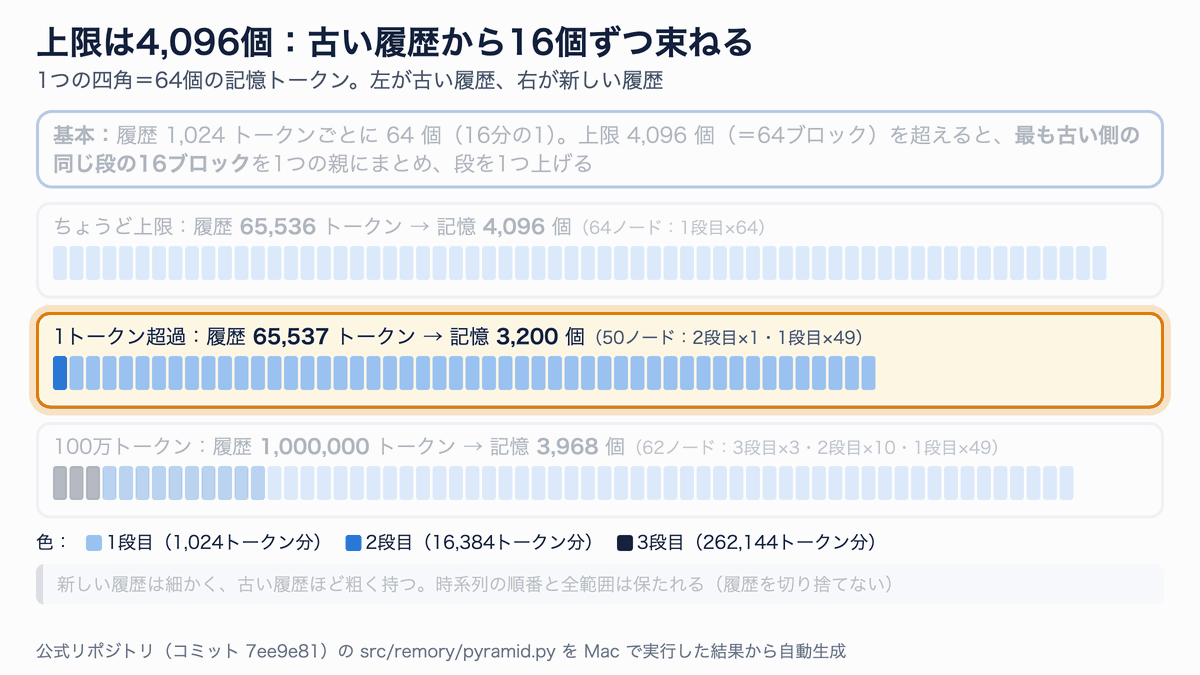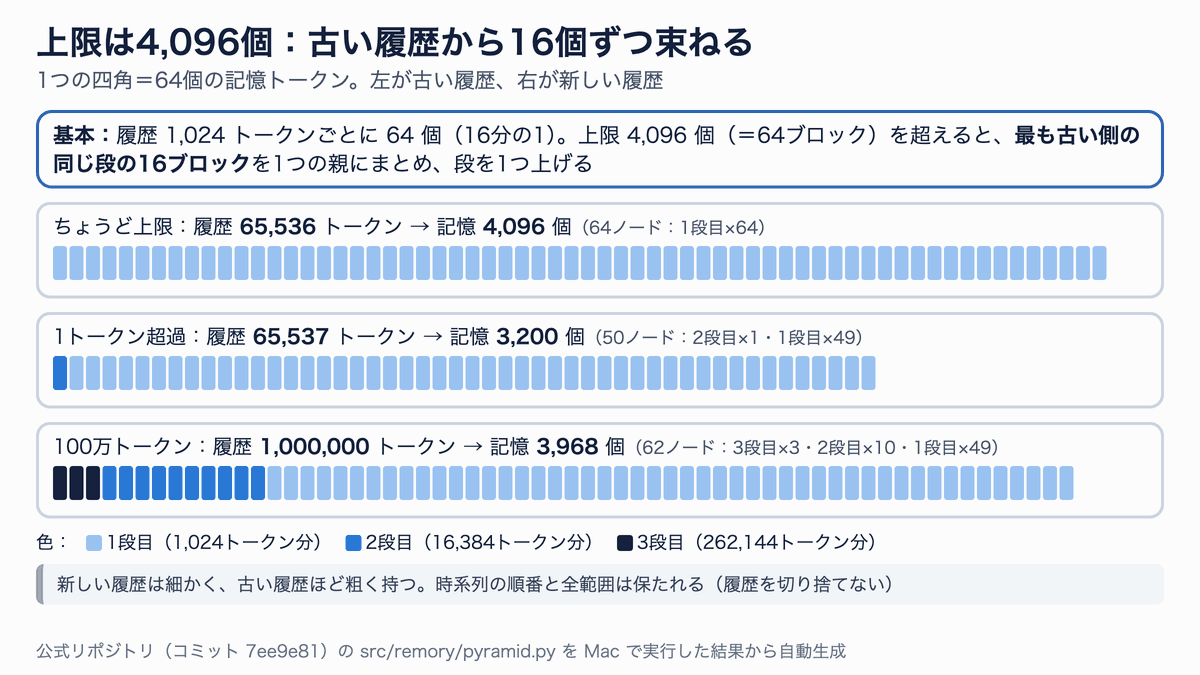
古い履歴を束ねても、時系列の順番は保たれます。数値は公式コードを手元で実行した結果です。
実行に使ったスクリプトは次のとおりです。GPU もモデルの重みも使いません。
# 公式リポジトリを取得(2026-10-12 時点のコミット 7ee9e81 で確認)
git clone https://github.com/fudan-generative-vision/Remory.git

# pyramid.py だけを読み込んで、履歴の長さごとの記憶トークン数を表示する
python3 - <<'PY'
import importlib.util
spec = importlib.util.spec_from_file_location("pyramid", "Remory/src/remory/pyramid.py")
m = importlib.util.module_from_spec(spec); spec.loader.exec_module(m)
for n in [10_000, 65_536, 65_537, 100_000, 262_144, 1_000_000]:
    plan = m.plan_pyramid(n, max_depth=None)   # サーバーと同じく段数の上限なし
    print(f"{n:>9,} tokens -> {plan.soft_tokens:>5,} soft tokens (max depth {plan.max_depth})")
PY
圧縮をまたいで記憶を引き継ぐ
2回目以降の圧縮では、前回の要約文と記憶トークン、そして前回以降の新しいやりとりをまとめて入力にし、新しい要約文と記憶を作ります。論文の式で書くと M_i = C(H_i ; S_i) です(H_i は前回の要約・記憶と新しいやりとり、S_i は新しい要約文)。これを繰り返すことで、何度圧縮しても情報を次へ運べます。
学習は「先生と生徒」の2段階
記憶ネットワークは、同じ本体 LLM を「先生」と「生徒」の2役に使って学習します。
- 第1段階(復元):先生には元の文章と「これを繰り返して」という指示を、生徒には文章の代わりに記憶トークンと同じ指示を渡します。両者の出力が近づくように学ばせ、記憶が元の情報を保てるようにします。
- 第2段階(要約を前提にした続き):先生には元の履歴すべてを、生徒には要約文と記憶トークンを渡し、どちらにも「次のアシスタントの応答」を予測させます。生徒の予測が先生に近づくように、記憶ネットワークだけを更新します。
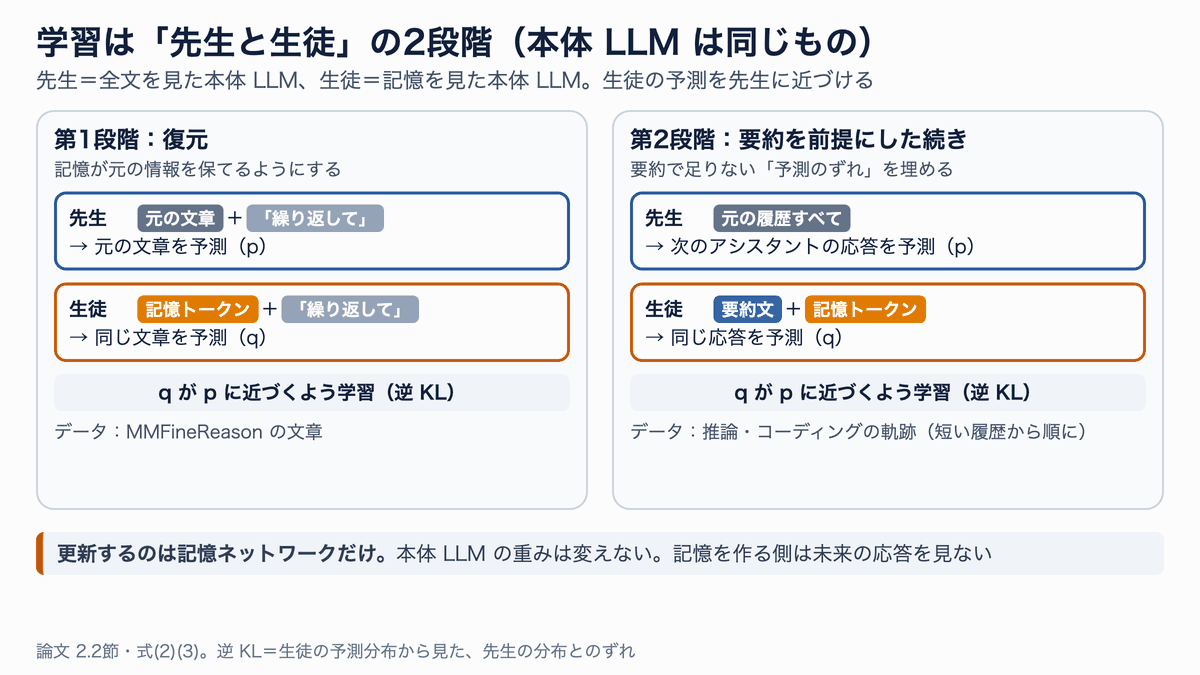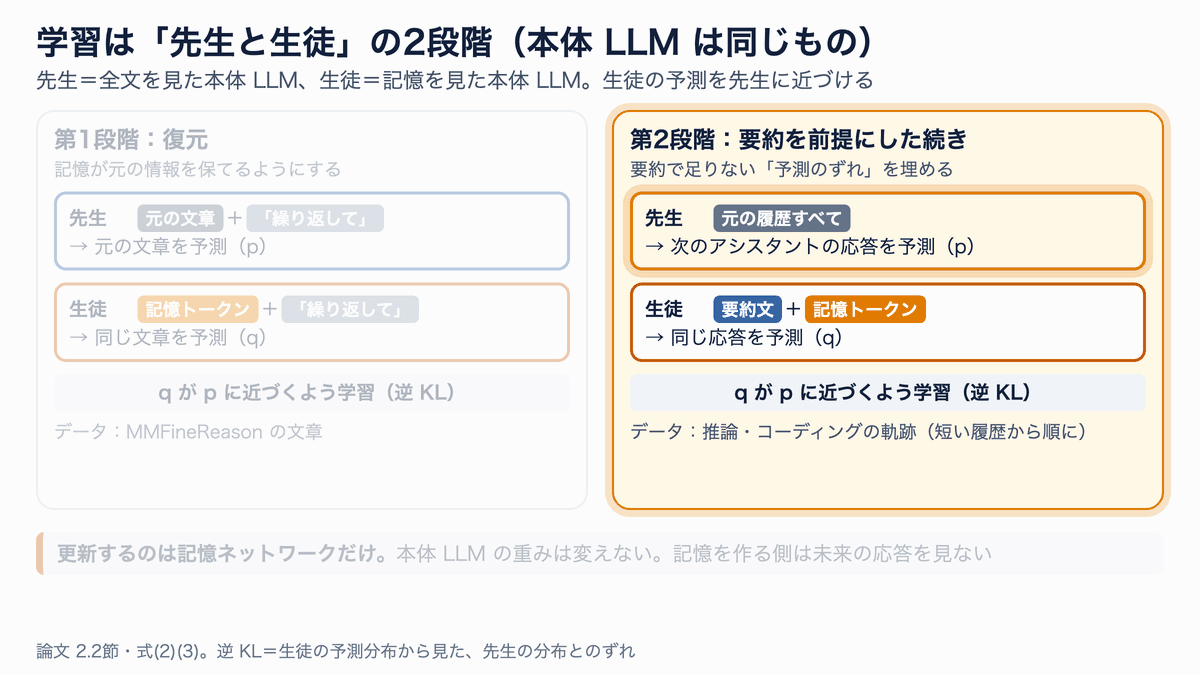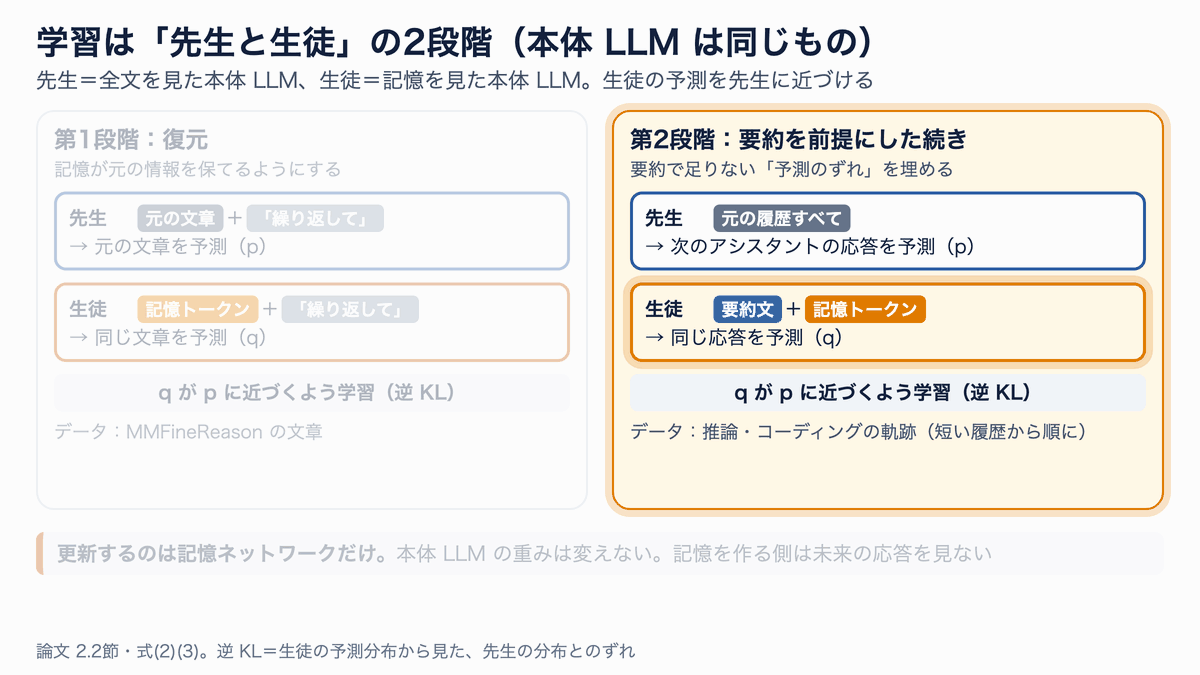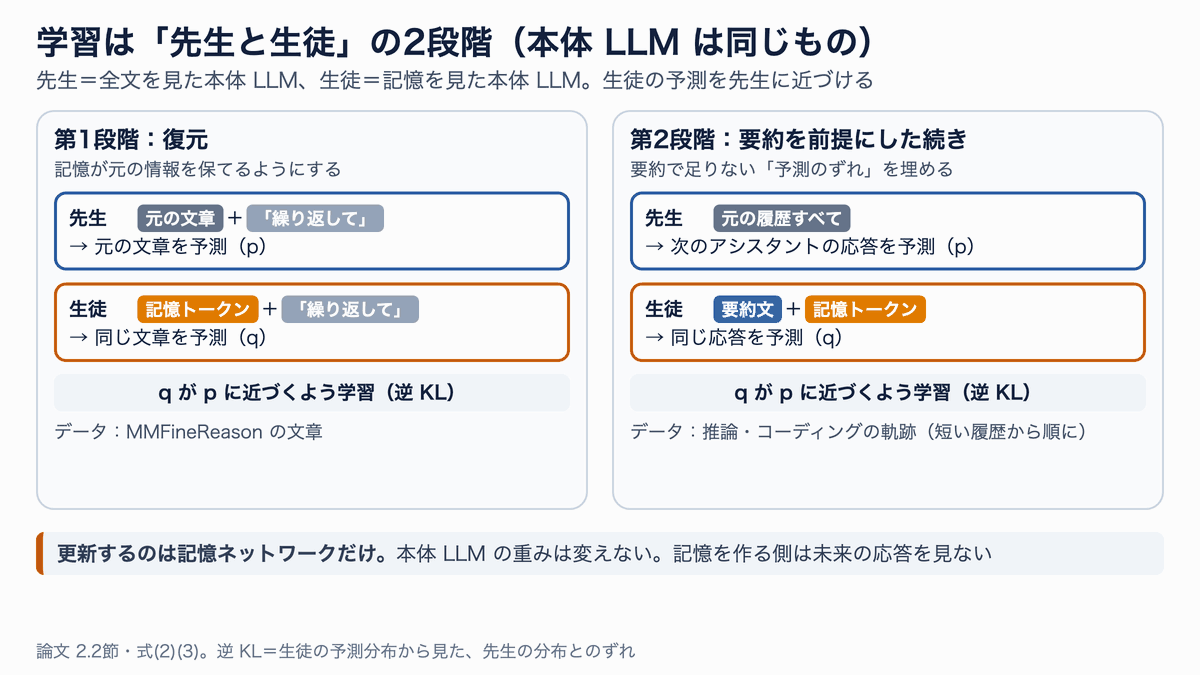
目標は「全文を見たときと同じ続きを書けること」。要約文がすでにある状態で学ぶので、記憶は要約で足りない部分に向かいます。
ポイントは第2段階です。要約文を与えたうえで学ぶので、記憶ネットワークは「要約に書いてあることをなぞる」より「要約では埋まらない予測のずれ」を埋める方向に育ちます。論文は、記憶が省かれた事実をすべて復元する必要はないとも書いています。目標は事実の再現ではなく、次の行動を全文を見たときに近づけることです。
実験で何が分かったか
SummHay:引用の正確さが上がった
SummHay は、大量の文書から問いに関係する要点を拾い(カバー率)、その要点がどの文書に書かれていたかを示せるか(引用 F1)を測るベンチマークです。Qwen3.8-27B で 92 問を評価した結果は次のとおりです。
| 入力の形 | カバー率 | 引用 F1 | 総合 | 平均の入力長 |
|---|---|---|---|---|
| 全文 | 72.46 | 56.60 | 43.41 | 96,872 |
| 要約文のみ | 67.55 | 56.98 | 39.84 | 1,393 |
| 要約文+同量の文章(Summary++) | 67.52 | 56.94 | 39.78 | — |
| 要約文+REMORY | 67.95 | 61.03 | 43.39 | 5,024 |
要約文+REMORY は、全文の 5.2% の長さで、総合点が全文とほぼ同じになりました。ただし中身は違います。カバー率は全文より低く、引用 F1 は全文より高いのです。論文はこれを「記憶は、思い出した主張を裏付けの証拠に結び付けるのを助けている」と解釈しています。
エージェントのベンチマーク:繰り返しとエラーが減った
Codex CLI をハーネスにして、記憶なしと記憶ありを比べています。どちらの条件でも元の履歴は検索で取り出せる設定です。
| モデル | ベンチマーク | 点数の伸び | 同じツール出力の繰り返し | ツールのエラー | 生成費用 |
|---|---|---|---|---|---|
| Qwen3.8-27B | Terminal-Bench 2.1 | +4.5 | −17.9% | −39.1% | −33.3% |
| Qwen3.8-27B | BrowseComp | +3.0 | −29.8% | −49.7% | −13.0% |
| GLM-5.3-Flash | Terminal-Bench 2.1 | +3.3 | −28.1% | −25.3% | −6.7% |
| GLM-5.3-Flash | BrowseComp | +4.1 | −29.8% | −27.8% | −11.5% |
| Qwen3.8-27B | AutomationBench(5回平均) | +9.8 | — | — | −10.2% |
| Qwen3.8-27B | JobBench(5回平均) | +7.6 | — | — | +3.9% |
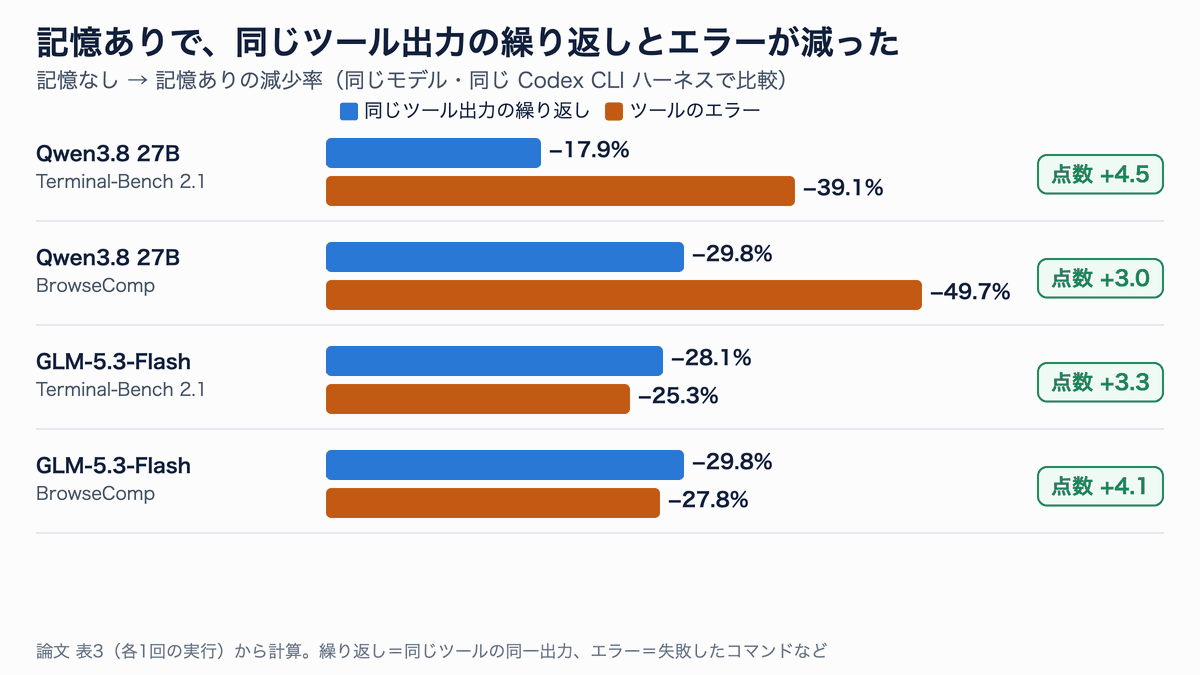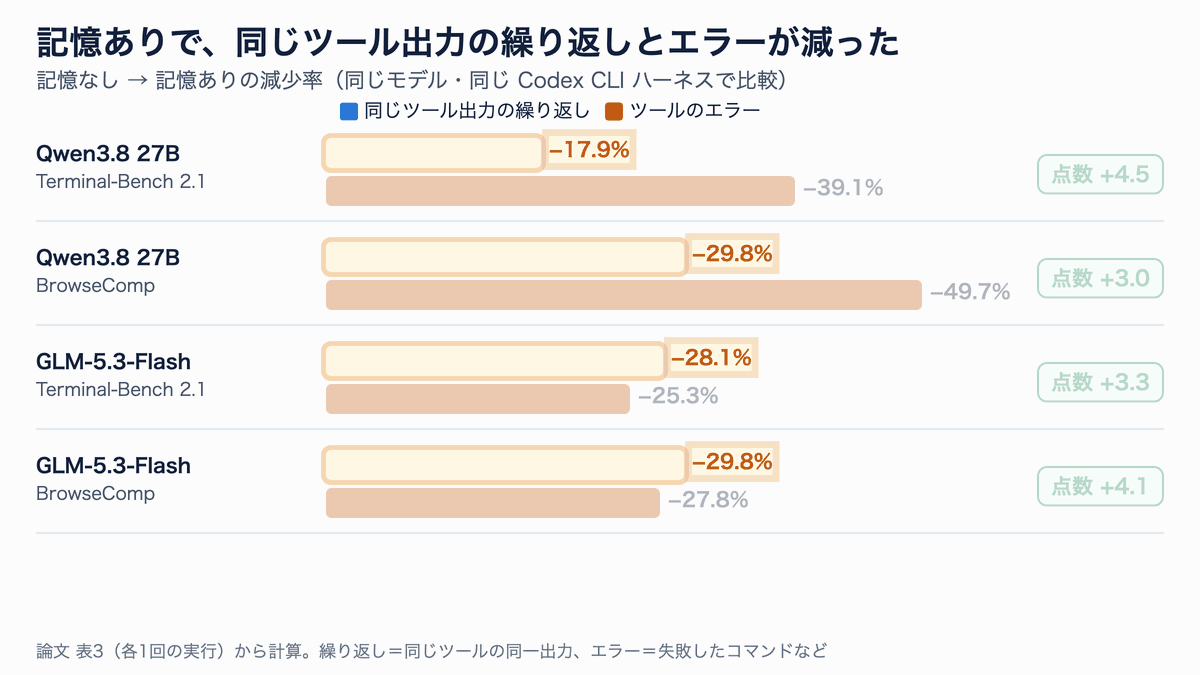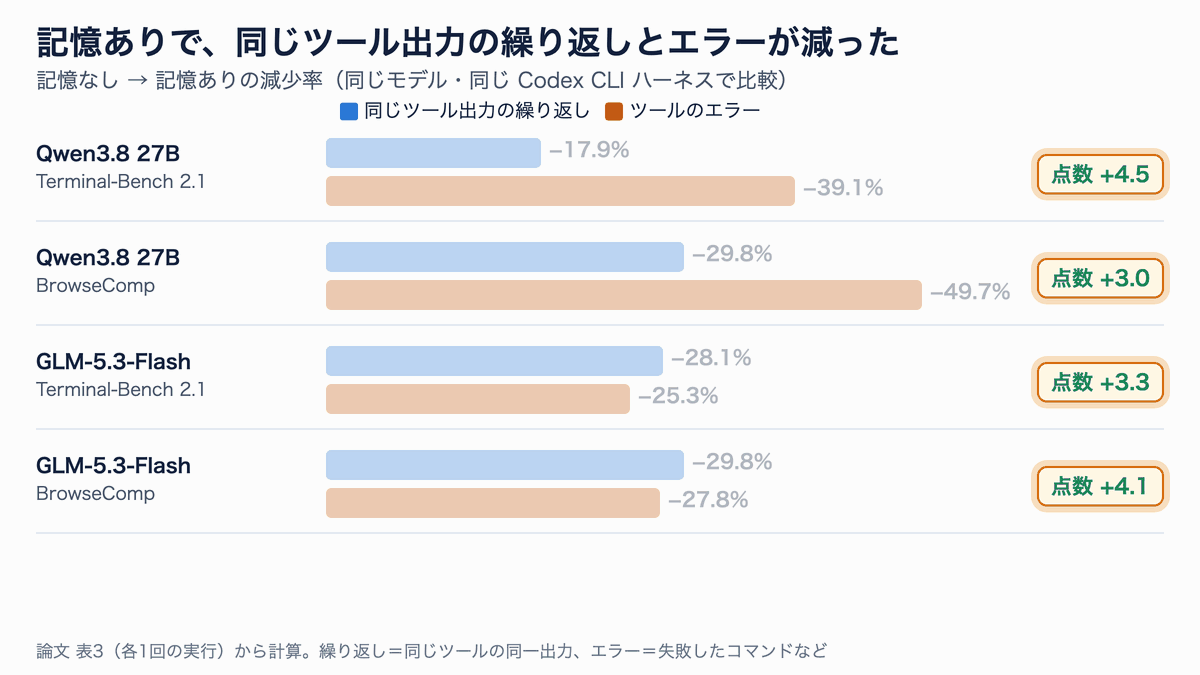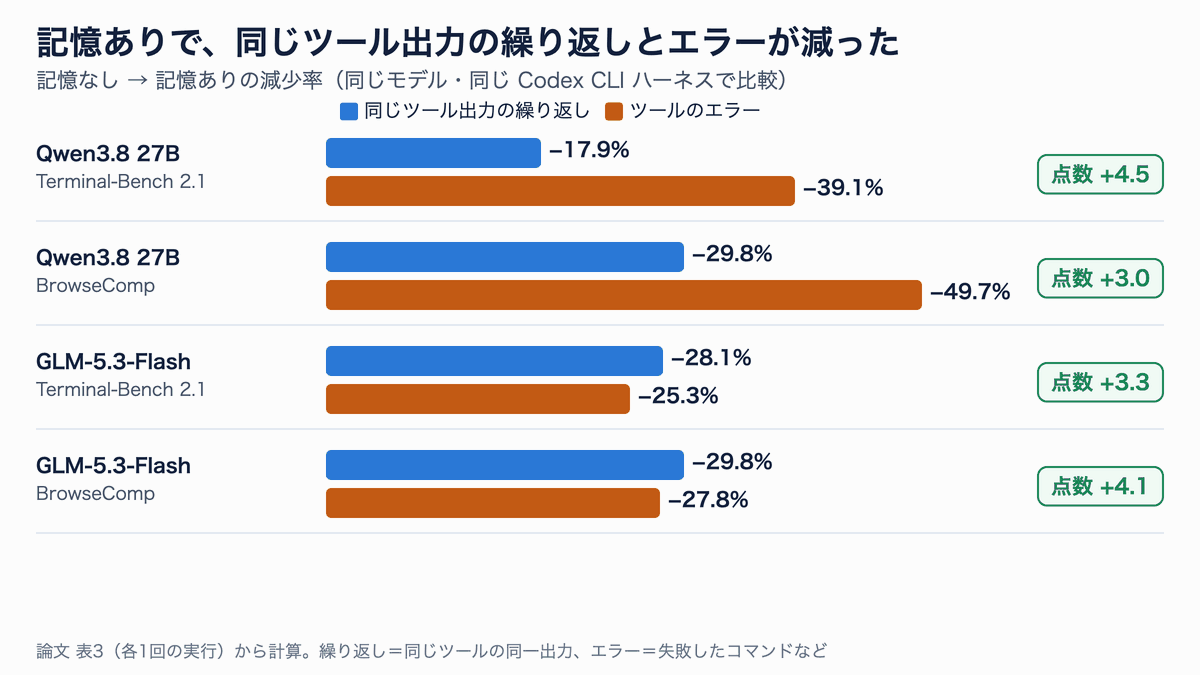
論文の表3から計算した減少率です。Terminal-Bench と BrowseComp は各1回の実行です。
繰り返しとエラーの減少は、記事の前半で挙げた問題1(ツール結果が消えて同じ作業を繰り返す)にそのまま対応する数字です。圧縮直後の最初の行動を 488 組比べた評価でも、記憶ありの行動が 70.7% で優れていると判定されました(引き分け 4.3%、負け 25.0%)。
数字を読むときの注意も挙げておきます。
- Terminal-Bench と BrowseComp は各1回の実行です。ばらつきは示されていません。
- 一部の採点は GPT-5.6-Sol による判定です。人の採点ではありません。
- 生成費用には、記憶ネットワーク自体を動かす計算は含まれていません。
- 論文の図1にある最先端モデルの点数は、別の条件で測った参考値で、公平な比較ではないと論文自身が書いています。
従来の圧縮の問題は、どう解決されるのか
ここまでの内容を、前半の4つの問題に当てはめて整理します。
| 従来の問題 | REMORY の対処 | 残る限界 |
|---|---|---|
| ツール結果が消え、同じ作業を繰り返す | 要約で落ちた情報を記憶トークンで次の判断に渡す | 正確な記録は、引き続きファイルやアーカイブの検索で取り出す |
| 何が後で必要か、事前に分からない | 「何を残すか」を人や要約役が決めず、次の応答の予測から学習する | 学習データ(推論・コーディングの軌跡)と違う作業での効き方は未知数 |
| 正確な細部が落ちる | 引用 F1 が要約文のみより約4ポイント上がった | どの細部が記憶から来たのかは特定できない(論文も認めている) |
| 要約文を長くしても良くならない | 同じ長さを文章に使うより、記憶トークンに使うほうが成績が良かった | 記憶は人が読めないので、中身の確認や監査ができない |
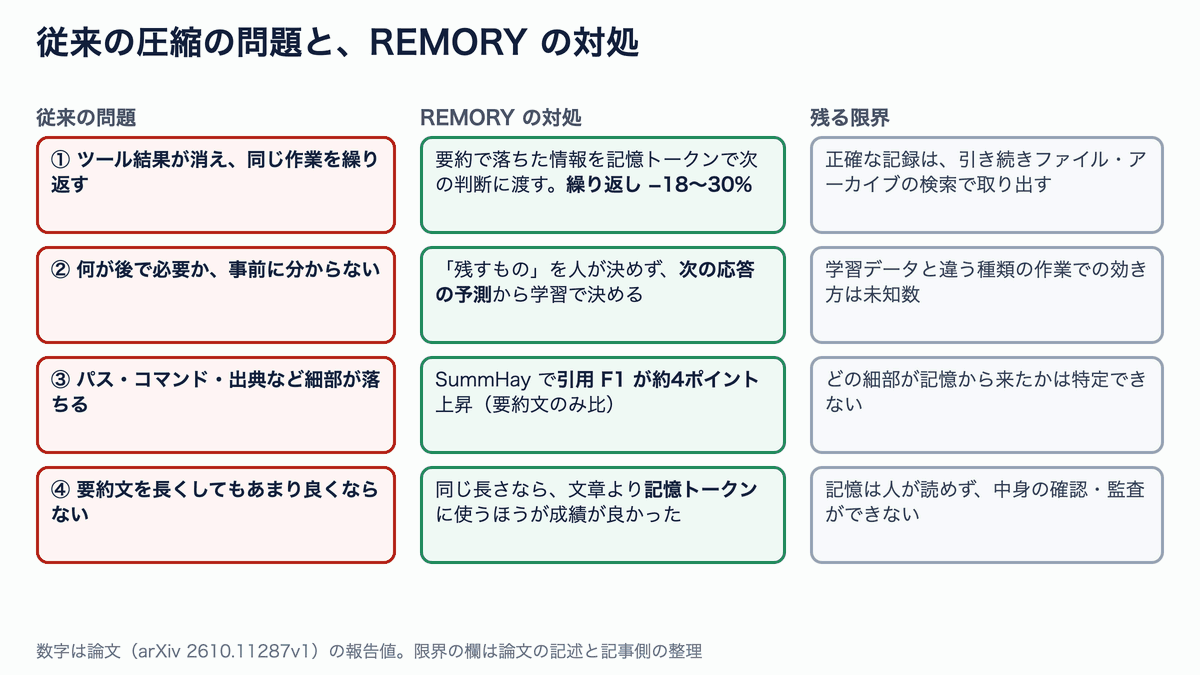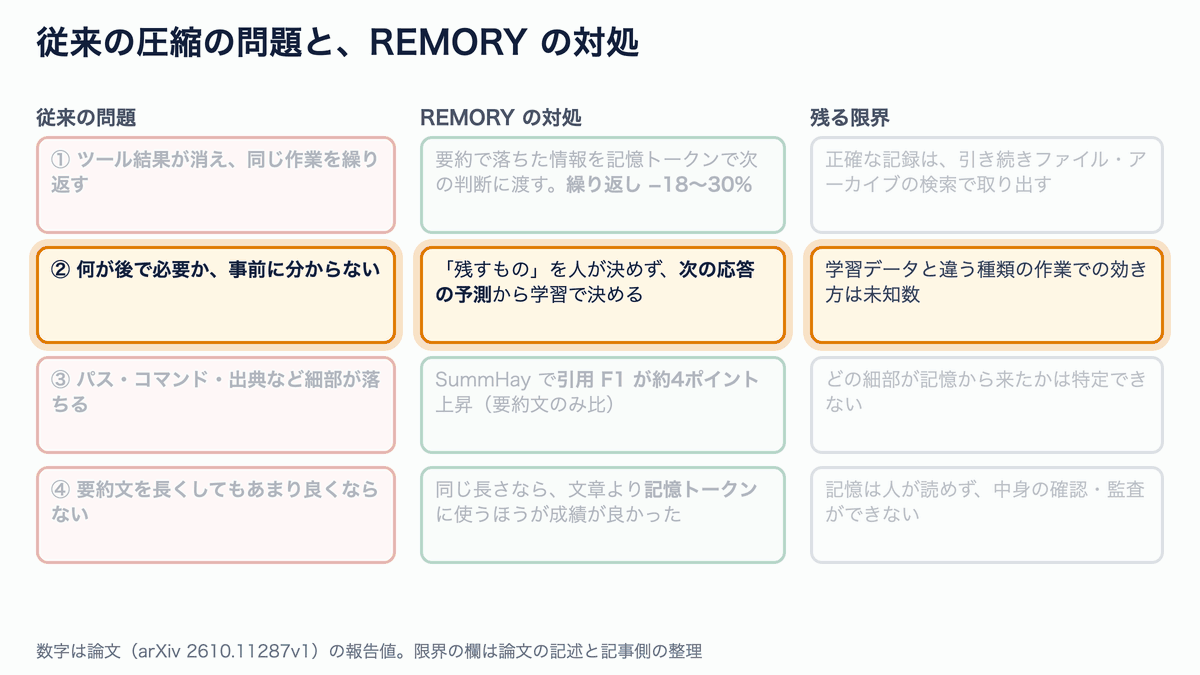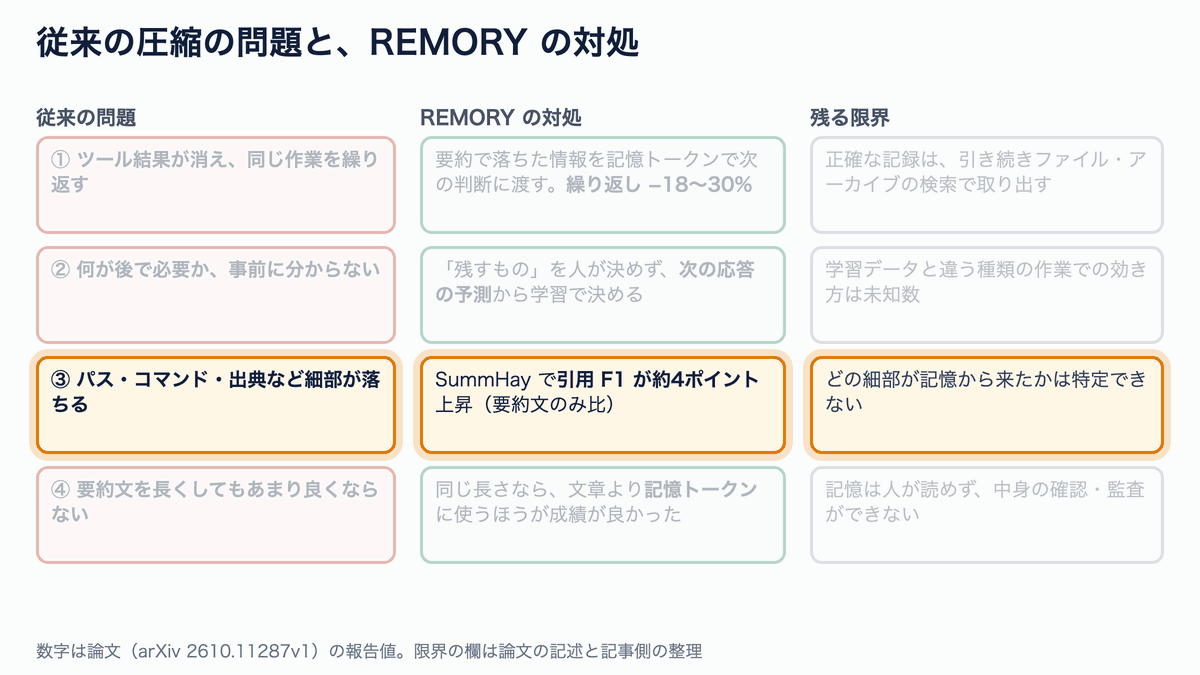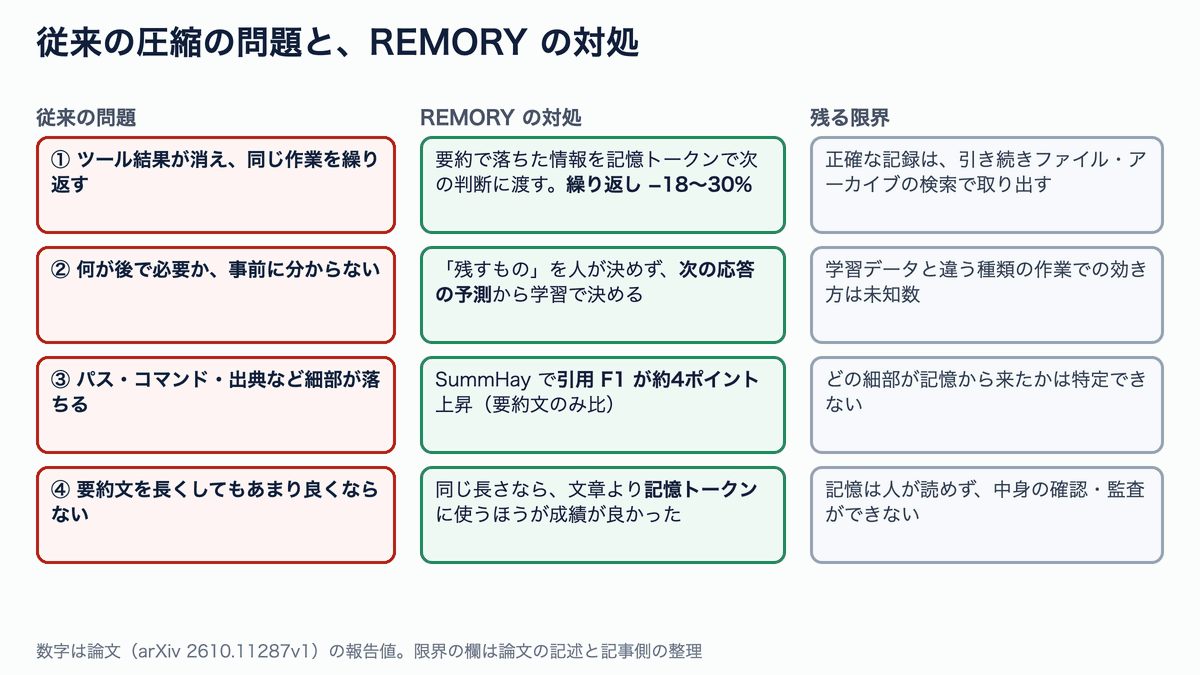
REMORY は要約文の代わりではなく、要約文と検索のすき間を埋める部品です。
一番大きな違いは、問題2への向き合い方だと思います。従来の対策は「大事なものを先に決めて残す」方式でした。REMORY は「全文を見たときの次の行動に近づける」という目標から逆算して、何を持ち越すかを学習で決めます。
自分の環境で使えるのか
結論から言うと、Claude Code や、OpenAI のモデルを使う Codex には、利用者の側で組み込めません。記憶トークンはモデルの入力層に直接ベクトルを差し込む仕組みなので、モデルの重みを手元に持ち、推論サーバーを自分で動かせる必要があるためです(記事側の整理)。
公開されているのは、Qwen3.8-27B 用(1.9B)と GLM-5.3-Flash 用(1.24B)の記憶ネットワークです。GLM 版は、論文に書かれた 1.502B 版とは別の、著者が手元の評価で使った版だと README に注記があります。さらに公式ドキュメントによると、この GLM 版の記憶ネットワークは要約文を読みません(要約文は記憶と並べて本体に渡すだけ)。論文で説明した「要約文を参照して足りない分に集中する」構造は Qwen 版のものと考えてください。ライセンスはどちらも MIT です。
動かすための条件は次のとおりです。
| 項目 | 条件(公式ドキュメント) |
|---|---|
| OS | Linux x86_64 |
| GPU | Qwen 版は 80GB を2枚以上。GLM 版の評価は約275GB の GPU を2枚使用 |
| ドライバー | CUDA 13.0 に対応するもの |
| ディスク | Qwen 版 100GB 以上、GLM 版 400GB 以上 |
| Python | 3.11 以上 |
CUDA 前提なので、Mac では動きません。条件を満たすサーバーがあれば、手順は次のとおりです(この記事では未実行です)。
# 取得と環境構築(SGLang の固定版と REMORY のフックが入る)
git clone https://github.com/fudan-generative-vision/Remory.git
cd Remory
python deploy/install.py
source .remory/venv/bin/activate

# 2枚の GPU で Qwen3.8-27B と記憶ネットワークを起動する
CUDA_VISIBLE_DEVICES=0,1 python -m remory.launch_server \
  --model-path Qwen/Qwen3.8-27B \
  --remory-checkpoint mocoV3/Qwen3.8-27B-REMORY-1.9B \
  --tp 2 --host 127.0.0.1 --port 8421

# 別のターミナルで「生成→圧縮→続きの生成」の例を動かす
source .remory/venv/bin/activate
python examples/quickstart.py
Codex と組み合わせる例もリポジトリにあります。Codex の「カスタム提供元」として Responses API 互換のサーバーを立て、その圧縮処理を「要約文の生成+記憶の作成」に差し替えます。Codex に返す compaction item の暗号化欄には、手元のデータベースを指す識別子が入ります。ただし README には、Codex の対話セッション全体での動作はまだ試していないと明記されています。
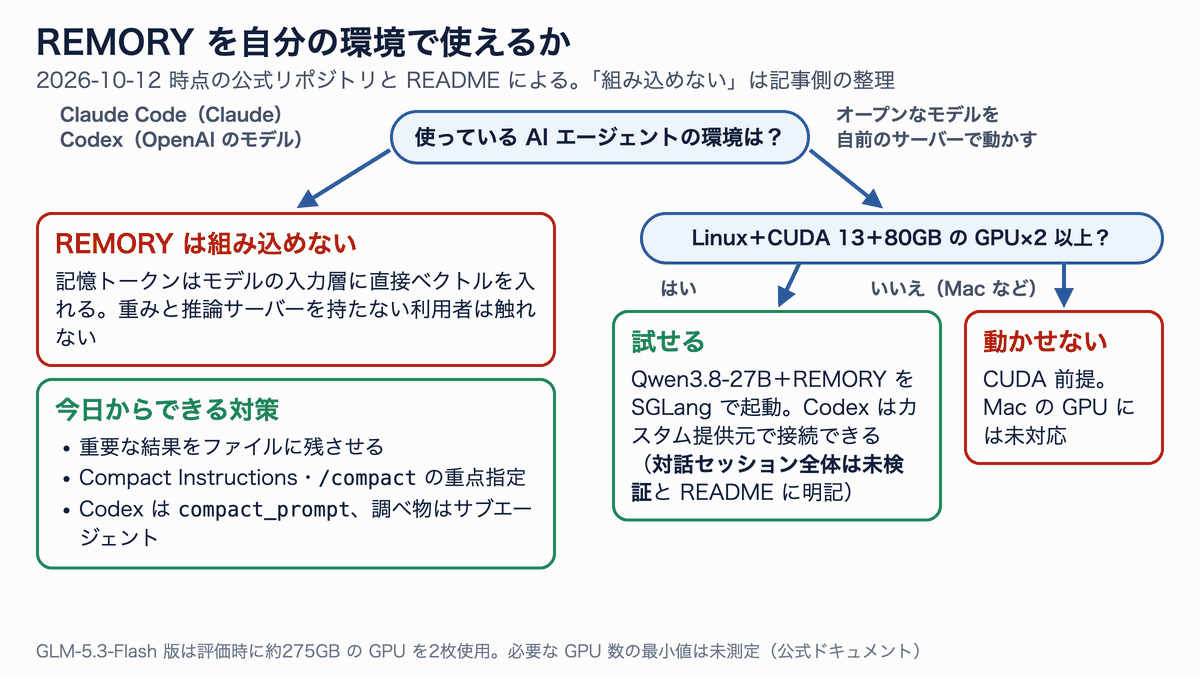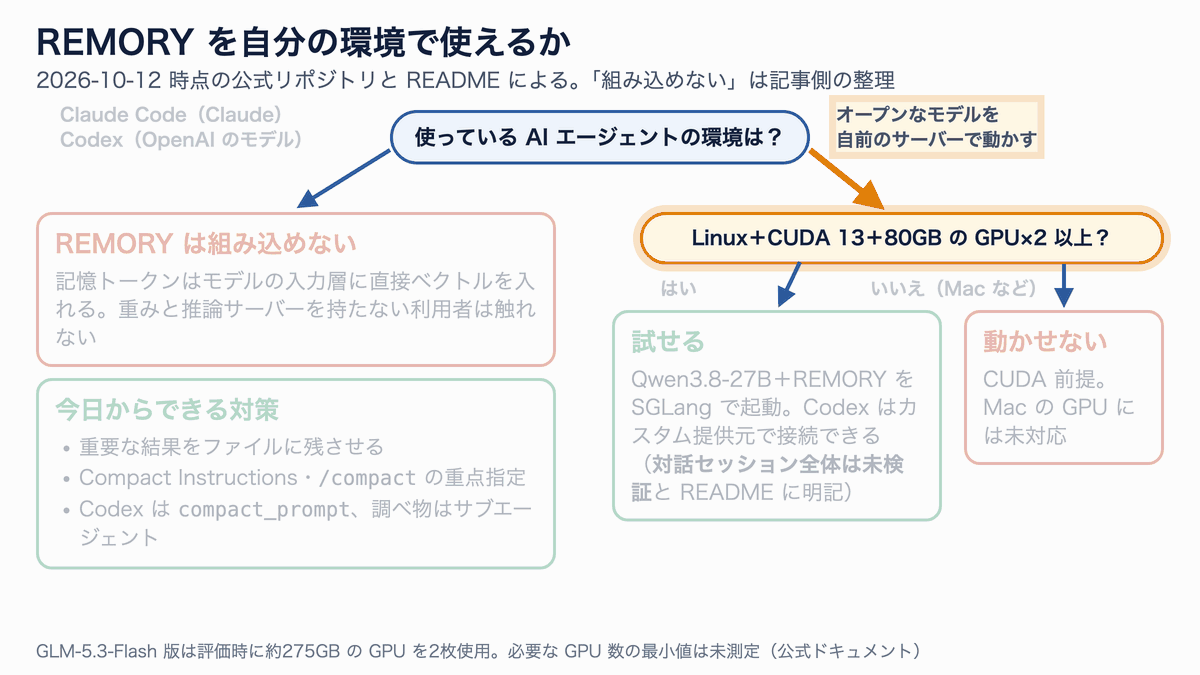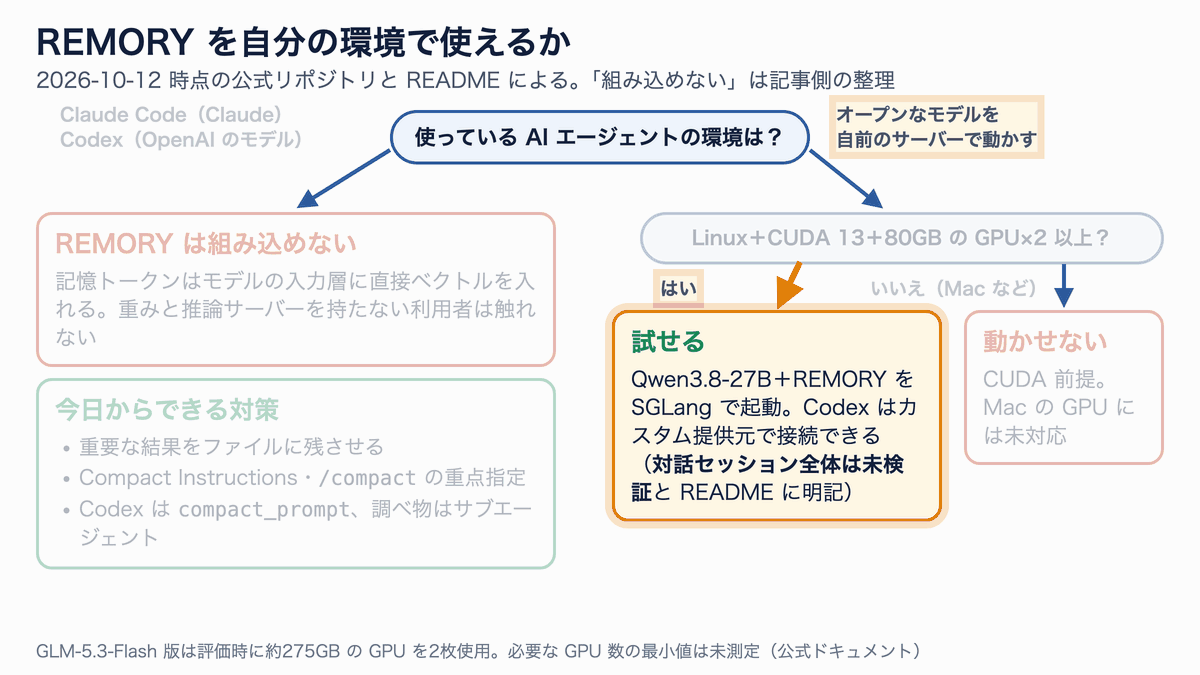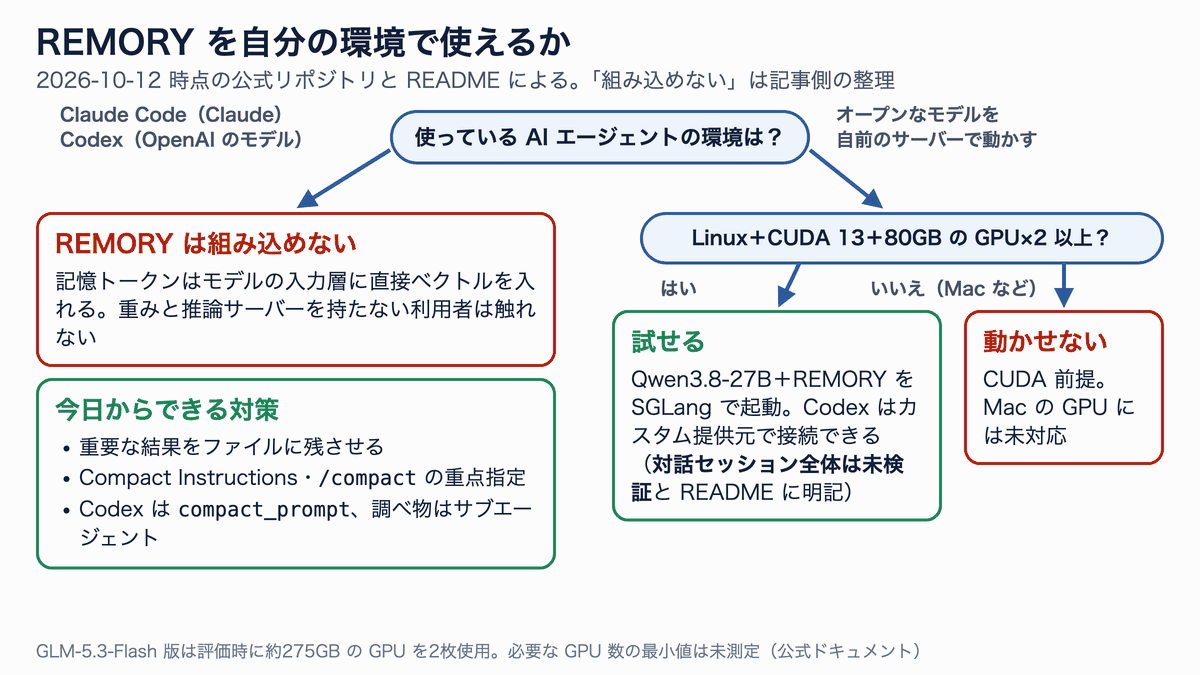
いま REMORY を試せるのは、オープンなモデルを自前の GPU サーバーで動かしている場合です。
今日からできること
REMORY をすぐ使えなくても、論文の考え方は日々の使い方に生かせます。論文自身も、正確な記録は通常のファイル検索で取り出す前提に立っています。
- 重要な結果はファイルに残させる:テスト結果や調査メモをファイルに書かせておけば、圧縮後に読み直せます。
- Claude Code:CLAUDE.md に「Compact Instructions」を書く、
/compactに重点を添える、残したいルールはpaths:を付けずにプロジェクト直下の CLAUDE.md に置く。 - Codex:
compact_promptで引き継ぎ要約の依頼文を調整する、AGENTS.md に変わらない前提を書く。 - 調べ物はサブエージェントに任せる:大量のツール出力を自分のコンテキストに積まずに済みます。
まとめ
- Claude Code と Codex の圧縮は、長い履歴を要約文(とユーザー発言)に置き換え、ツールの出力を捨てる方式です。Claude Code は CLAUDE.md や最近のファイルを読み直し、Codex は OpenAI のモデルなら暗号化された compaction item を使います。
- この方式では、ツールの結果や正確な細部が消え、圧縮後に同じ作業の繰り返しやエラーが起きやすくなります。何を残すべきかを事前に決めきれないことが根本の原因です。
- REMORY は、要約文の後ろに学習で作った記憶トークン(最大4,096個)を並べ、要約で足りない分を補います。本体 LLM は変えず、「全文を見たときと同じ続きを書けるか」で記憶ネットワークだけを学習します。
- 論文では、全文の5.2%の長さで全文並みの総合点を出し、ツール出力の繰り返しを約18〜30%、エラーを約25〜50%減らしました。ただし単回の実行や LLM による採点を含む、プレプリント段階の報告です。
- 動かすには 80GB の GPU が2枚以上必要で、Claude Code や OpenAI のモデルには組み込めません。
次に読むなら、論文の「関連研究」に挙がっている Gist Tokens や ICAE(文章を少数のベクトルに圧縮する先行研究)がおすすめです。REMORY が「要約文を残したまま足す」点で何が新しいのかが、よりはっきり見えてきます。
参考リソース
- 論文:REMORY: Learning Residual Memory for Context Compaction(arXiv 2610.11287)
- Hugging Face Papers:2610.11287
- 公式実装:GitHub fudan-generative-vision/Remory(復旦大学の Fusion Lab)
- 記憶ネットワーク:Qwen3.8-27B-REMORY-1.9B、GLM-5.3-Flash-REMORY-1.24B
- Claude Code:Explore the context window、How Claude Code works
- Codex:openai/codex の圧縮処理(compact.rs)、引き継ぎ要約の依頼文(prompt.md)
- OpenAI:Compaction(Responses API)