2026年10月9日に公開された Cloudflare の発表記事(blog.cloudflare.com)
この記事の確認範囲
Cloudflare が 2026年10月9日に公開した判定モデル Clef-omni(クレフ・オムニ) は、文章と画像に加えて 音声と動画をそのまま入力できる ようになりました。ただ、公式が出している精度の数字は文章中心のベンチマークだけで、「音声や動画でどれくらい正しく判定できるのか」は公表されていません。
そこでこの記事では、音声 508 件・動画 206 本のテストデータを自分で用意し、正解と照らし合わせて確かめました。
| 項目 | 内容 |
|---|---|
| 確認日 | 2026年10月10日(日本時間 9:00〜10:00 に実行) |
| 対象 | Workers AI の @cf/cloudflare/clef-omni(東京 NRT の Worker から呼び出し) |
| 比べた相手 | ① 文字起こし(Whisper large-v3-turbo)→ 判定(Clef-flash / Clef-omni)の 2 段構成、② 動画から切り出した静止画、③ Liquid AI の d1-omni-600M(手元の Mac で実行) |
| 手元の環境 | MacBook Pro(Apple M5 Max / メモリ 128GB)、macOS 26.6.2、Node.js 22.23.2、Python 3.12、wrangler 4.145.0、ffmpeg 9.0.2 |
| リクエスト数 | Clef-omni 約 2,280 回(入力 約 280 万トークン)、Whisper 152 回、Clef-flash 80 回 |
| 公式情報 | 公式ブログ、Workers AI の Changelog・モデルページ・料金ページ、Hugging Face の Cloudflare/clef-omni |
「公式」と書いた数字は Cloudflare 自身の発表、「実測」と書いた数字はこの記事のために測った値です。テストデータの多くは 合成音声やプログラムで描いた動画 です。実際の録音・映像では結果が変わりうる点に注意してください(詳しくは「検証のしかた」で説明します)。
はじめに:音声や動画で「判断」したいとき
AI に判断させたい場面は、文章だけとは限りません。たとえば次のような場面です。
- コールセンターの 通話録音 から、用件と緊急度を決めて担当に回したい
- 工場の 設備の映像と動作音 から、止まっていないか・変な音がしないかを見たい
- AI エージェントが操作した 画面の録画 から、処理が成功したかを確かめたい
これまでは、音声なら「文字起こし → 文章を判定」、動画なら「コマを切り出して画像にする」「音と映像を分ける」といった 前処理をいくつもつなぐ 必要がありました。Clef-omni は、録音や動画をそのまま渡すと、1 回の計算で質問ごとの確率を返します。
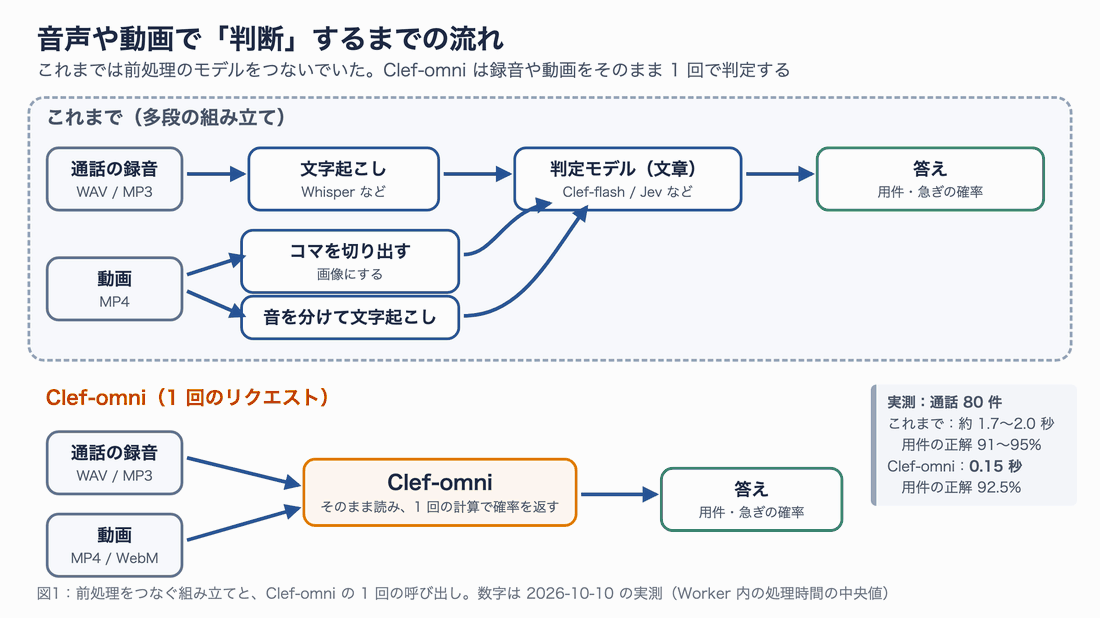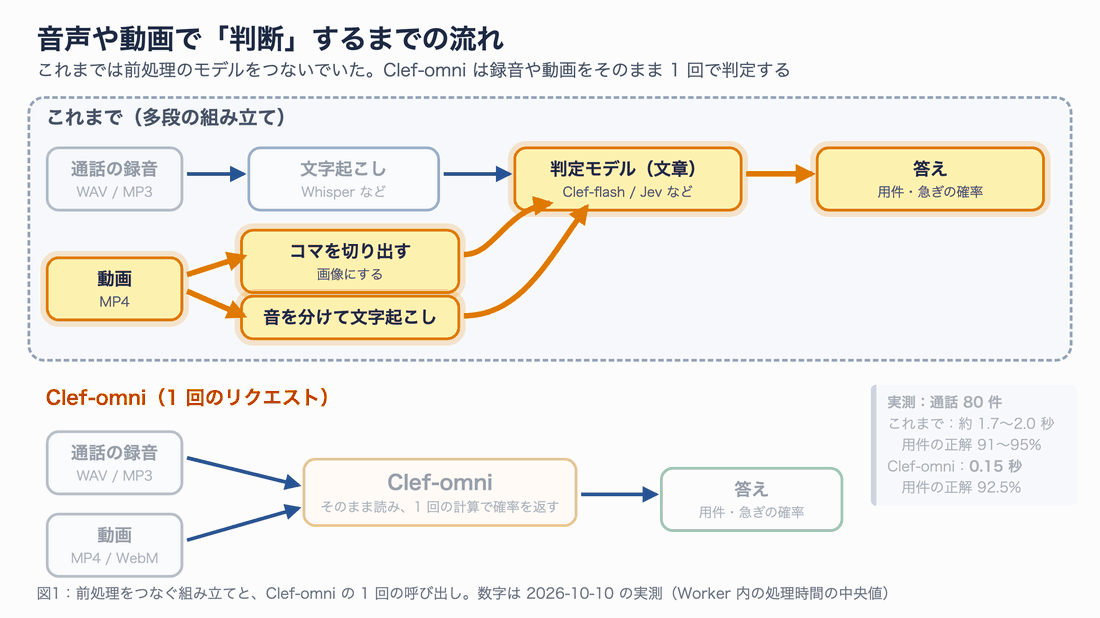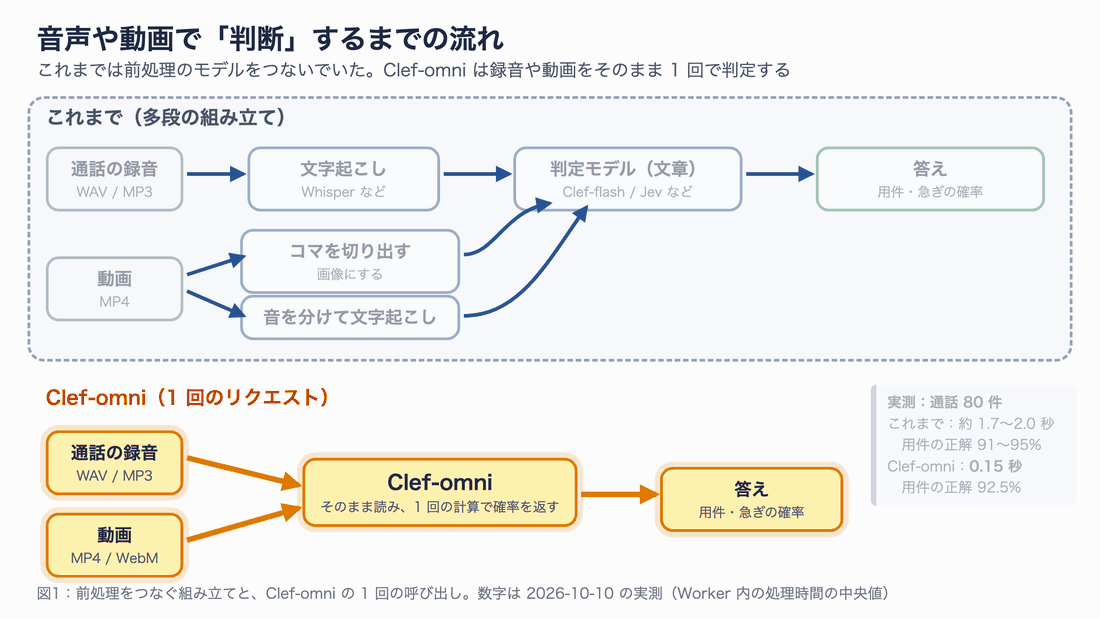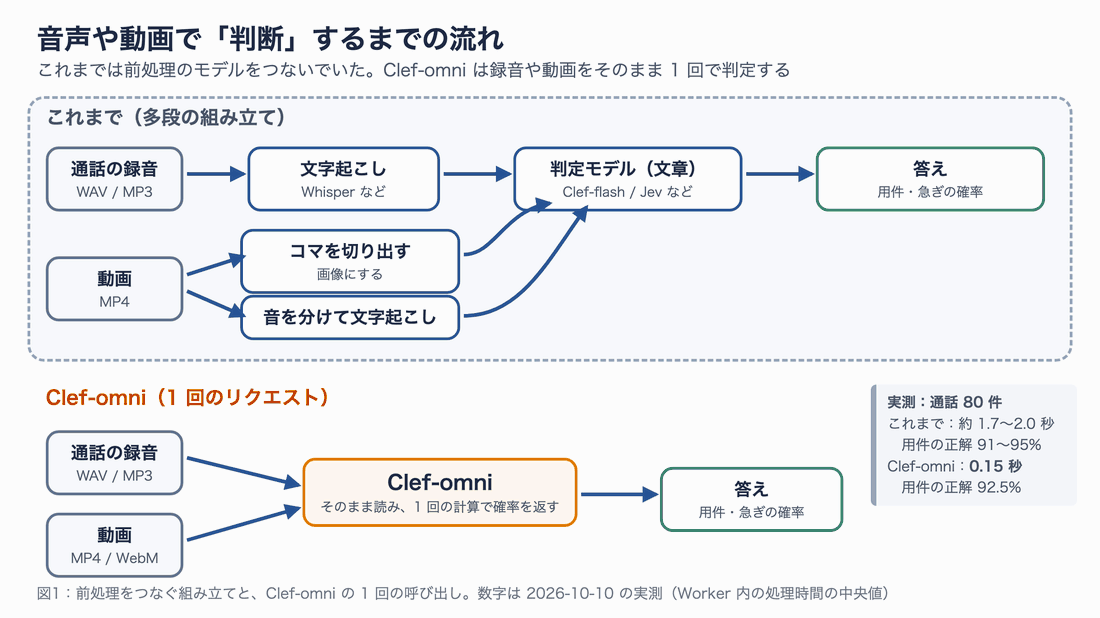
図1:従来の多段の組み立てと、Clef-omni の 1 回の呼び出し。右下の数字は今回の通話判定の実測
便利そうですが、気になるのは 「本当に当たるのか」 です。この記事では、次の 4 つの疑問に実測で答えます。
- 通話の録音をそのまま渡しても、文字起こしを挟んだときと同じくらい当たるのか
- 声の調子(怒っているか)や、機械の異常音のような 文字にならない情報 も判断できるのか
- 動画の「動き」や「時間の流れ」、映像と音の組み合わせを判断できるのか
- 速さと費用は公式の数字どおりか
先に結論をまとめておきます。
| 判断の種類 | 結果(実測) | ひとこと |
|---|---|---|
| 通話の用件(5 択)・急ぎかどうか | 用件 92.5%、急ぎ 100% | 文字起こし経由(91〜95%)と同等で、約 12 倍速い |
| 何語か・男女・環境音(50 種類) | 100%・94〜100%・86% | 音そのものの聞き分けは得意 |
| 声の感情(怒り・喜び・悲しみ・落ち着き) | 28〜31% | ほぼすべて「落ち着き」と答える。未対応と考えたほうがよい |
| 機械の異常音 | 「異常か」と聞くと 40 本中 3 本しか拾えない | 「カタカタ音がするか」と具体的に聞けば 10 本中 9 本 |
| 動画で扇風機が回っているか(最初の時点) | 79%(区切って聞くと 100%) | 「いつ」止まったかは苦手 |
| 画面録画で一瞬だけ出たエラー | 4 本中 4 本を検出 | 最後のスクリーンショットでは 0 本 |
| 映像と音の組み合わせ | 音声トラックは聞こえるが、映像に引っぱられる | 音は別の欄で渡すと改善 |
| 速さ | 文章 55ms、音声 10 秒 145ms、21 秒の動画 1.3 秒 | 公式ブログの数字に近く、Changelog の数字は再現せず |
想定読者は、LLM や判定モデルを使ったアプリを作っている方、または音声・動画の自動判定を検討している方です。判定モデルを使ったことがなくても読めるように、基本から説明します。
Clef-omni とは
判定モデルのおさらい
判定モデル(Decision Model) は、状況(state) と 型の決まった質問(questions) を受け取り、質問ごとに 選択肢の確率 を返すモデルです。LLM のように文章を書かないので、答えの形が崩れず、速くて安いのが特徴です。TypeSafe の Jev が先駆けで、Cloudflare の Clef は Jev と同じ形のリクエストで呼べます。
質問の型は 3 種類です。
| 型 | 何を聞くか | 返ってくる値 |
|---|---|---|
noul | はい/いいえ | 「はい」の確率(0〜1) |
choice | 自分で決めた選択肢から 1 つ(2〜255 個) | 選んだ選択肢と、選択肢ごとの確率 |
score | 段階評価(2〜10 段階) | 段階の確率と、その重み付き平均 |
Clef と Clef-flash の詳しい仕組みや Jev との比較は、前回の記事「Cloudflare の判定モデル Clef は Jev の代わりになるか」で検証しました。この記事では、新しく加わった 音声と動画 に絞ります。
何が新しくなったのか
Clef-omni は、Alibaba の Qwen3-Omni-30B-A3B-Instruct を土台にした判定モデルです。全体で 300 億パラメータ、1 回の計算で実際に使うのは約 30 億パラメータの MoE(Mixture of Experts:専門家を切り替える構造) です。土台のモデルが持っていた画像・音声・動画の読み取り部分をそのまま使い、音声を話す部分は外しています。重みは Apache 2.0 で Hugging Face に公開されています。
| 項目 | Clef-omni | Clef | Clef-flash |
|---|---|---|---|
| 入力 | 文章・画像・音声・動画 | 文章・画像(動画はコマの配列) | 文章・画像(動画はコマの配列) |
| 土台 | Qwen3-Omni-30B-A3B(MoE) | Qwen3.8-27B | Qwen3.5-9B |
| Workers AI の料金(入力 100 万トークン) | $0.15 | $0.24 | $0.038(10/9 に $0.09 から値下げ) |
| Workers AI の文脈長 | 64,000 | 64,000 | 24,000(10/9 に 64,000 から縮小) |
| 出力の料金 | 無料 | 無料 | 無料 |
音声と動画の渡し方には、いくつか決まりがあります。モデルページに書かれている主な制限は次のとおりです。
| 欄 | 形式 | 上限 |
|---|---|---|
audio | WAV・MP3 など。base64 の data URL | 最大 4 本、1 本 8MiB・300 秒まで |
videos | MP4・WebM。base64 の data URL | 最大 2 本、1 本 16MiB・60 秒まで。1 秒 2 コマ で読み取る |
images | PNG・JPEG・WebP | 最大 4 枚、1 枚 4MiB |
| 共通 | URL での指定は不可 | 音声と動画を合わせて 16MiB まで |
もう 1 つ大事な決まりがあります。動画の音声トラックは、リクエスト内のすべての動画に音声があるときだけ聞かれます。音ありと音なしの動画を混ぜると、音は使われません。
リクエストの形と、トークンの数え方
音声や動画は、文章と同じく 入力トークン に換算されて課金されます。公式の説明では、音声は 1 分あたり約 780 トークン、動画は 1 秒あたり最大 256 トークン(音声つきならさらに 1 分あたり約 780 トークン)です。
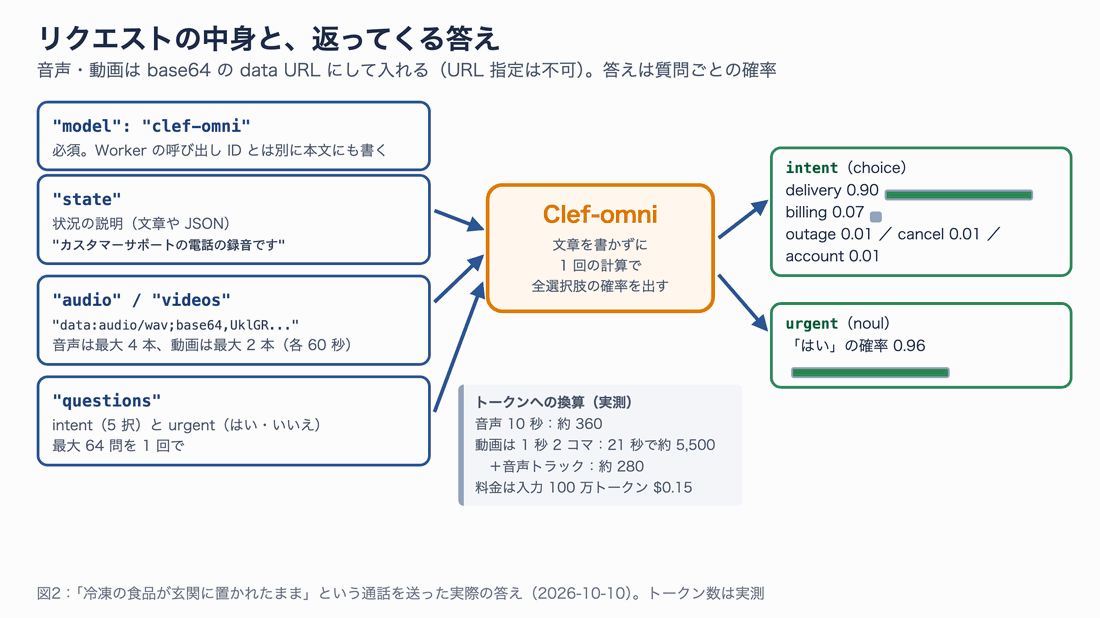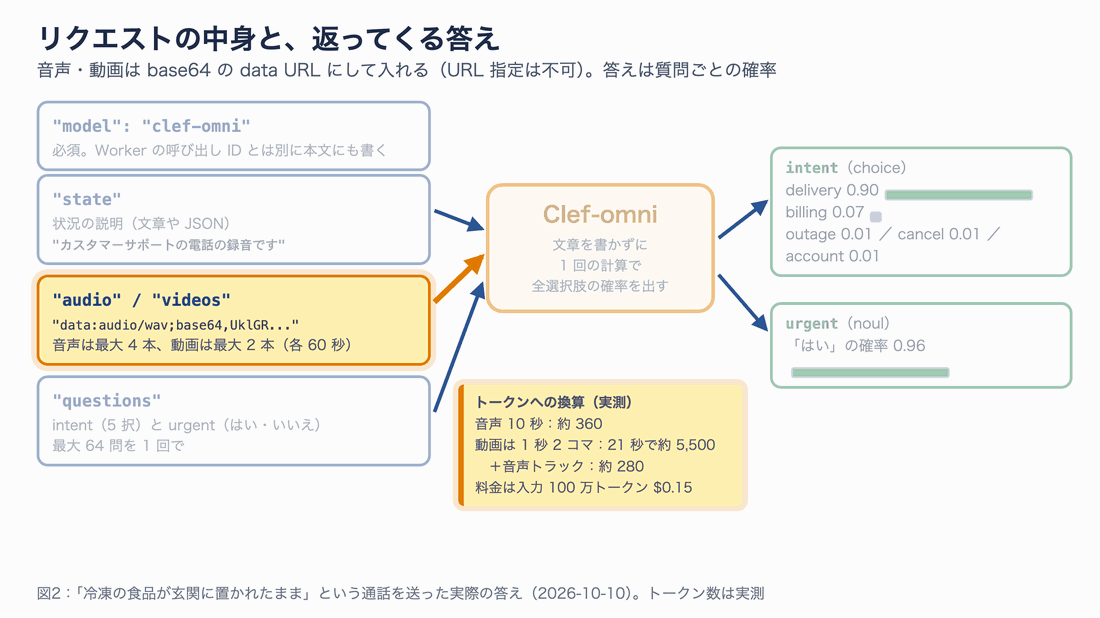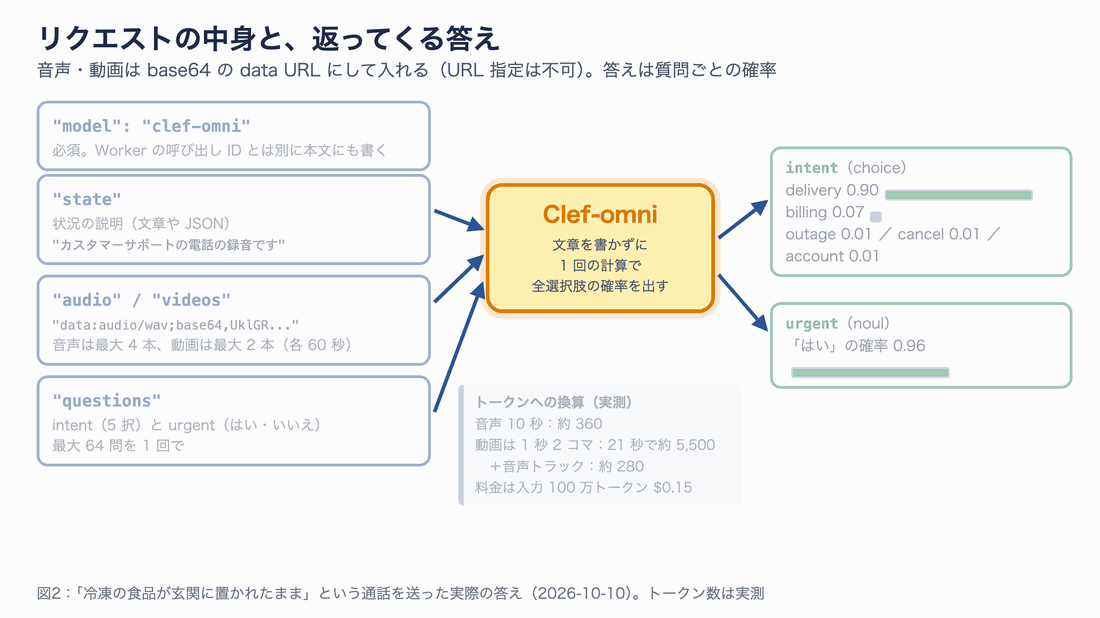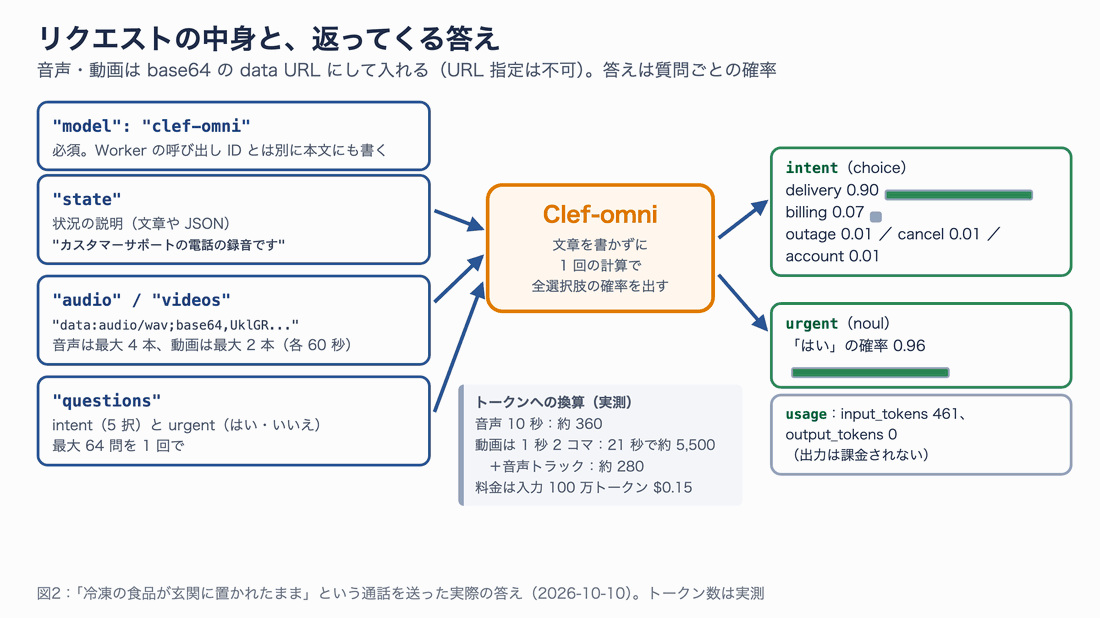
図2:リクエストの中身と、メディアがトークンになる仕組み。トークン数は実測
実際に測ると、640×480 や 854×480 の動画でも 1 秒あたり約 260 トークンで、ほぼ上限に達していました。1280×720 にしてもトークン数は同じ(21 秒で 5,802)でした。画質を上げてもトークンは増えない が、細かい文字が読みやすくなるわけでもない、ということです。
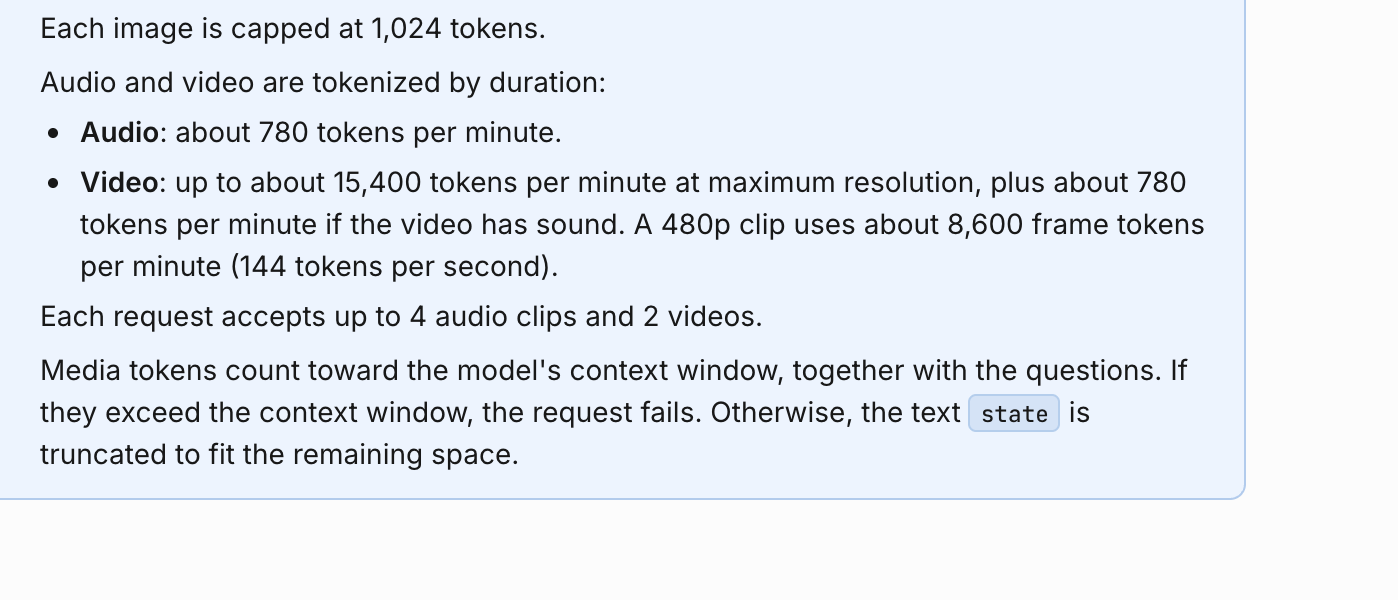
Workers AI のモデルページにある、音声・動画のトークン換算の説明(developers.cloudflare.com)。480p で 144 トークン/秒とあるが、今回の 854×480 では約 260 トークン/秒だった
公式の「速さ」の数字が 2 つある
紹介記事でよく引用される「テキスト約 20ms、21 秒の動画で約 300ms」という数字は、Cloudflare の Changelog に書かれたものです。ところが同じ日に出た 公式ブログ では「テキスト約 130ms、21 秒の動画で約 1.5 秒」と書かれています。5 倍ほどの差があります。
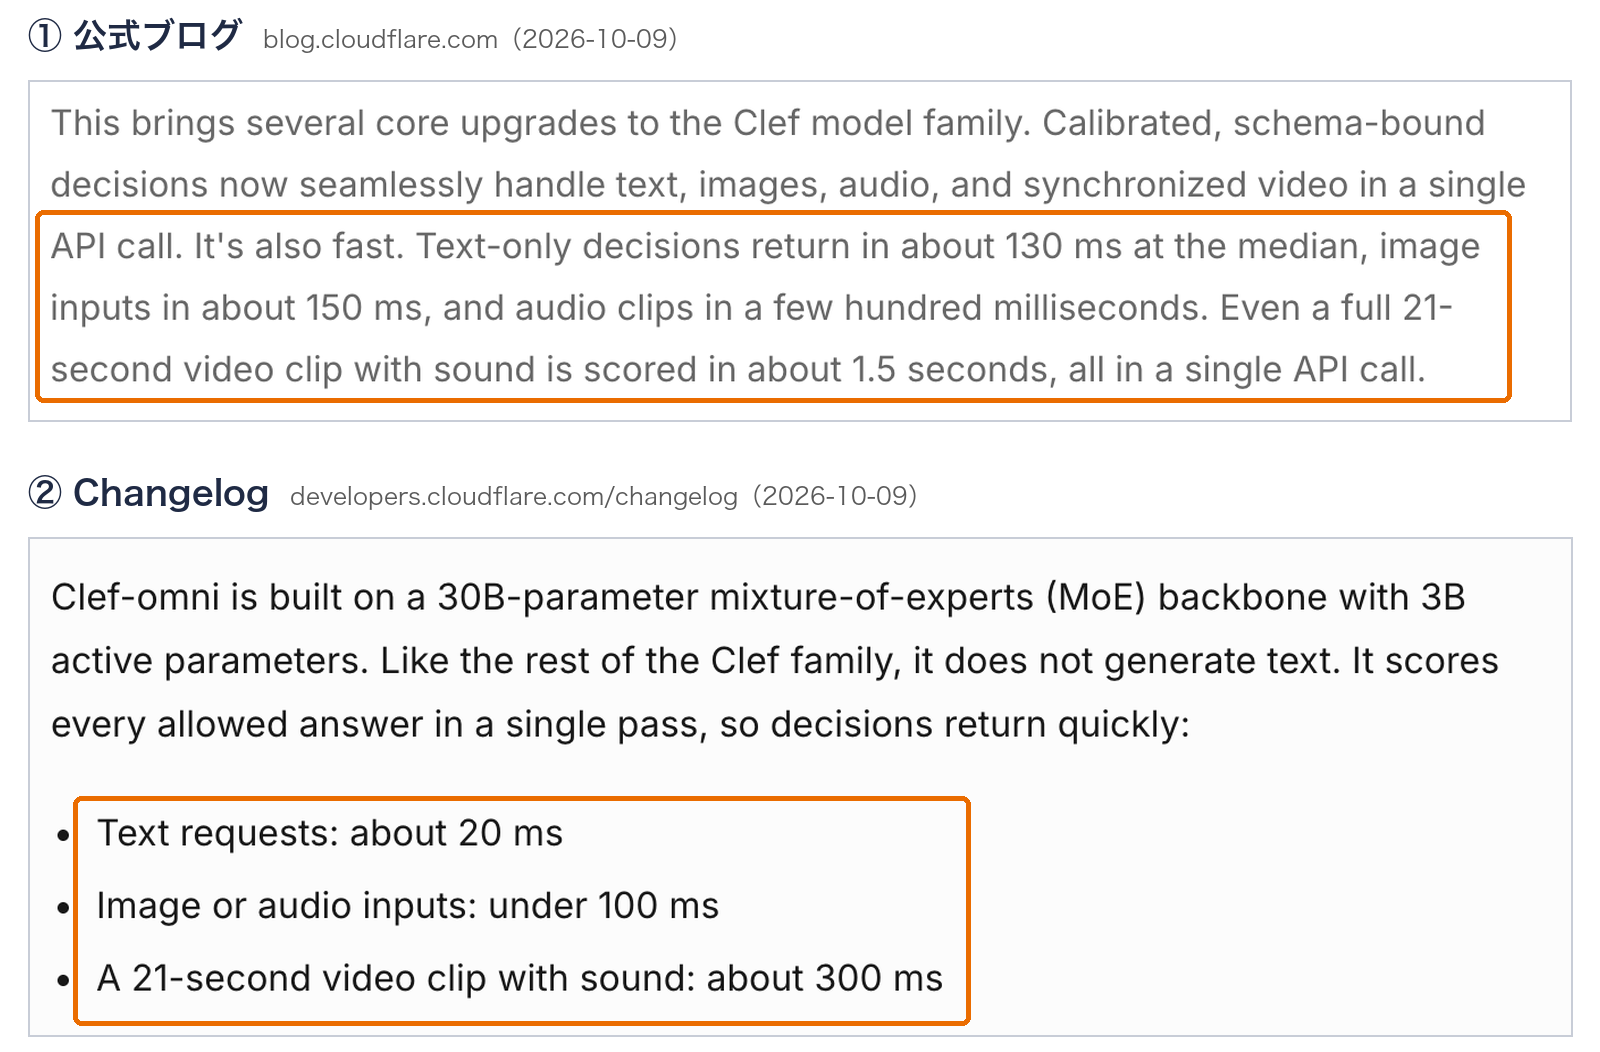
同じ 2026年10月9日に公開された 2 つのページで、速さの数字が食い違っている
どちらが実態に近いのかは、後半の「速さと費用」で実測します。先に書いておくと、公式ブログの数字に近い結果 でした。
検証のしかた
テストデータを作る
精度を測るには、正解が分かっているデータ が必要です。そこで、正解を自分で決められる合成データと、正解ラベルのついた公開データを組み合わせました。
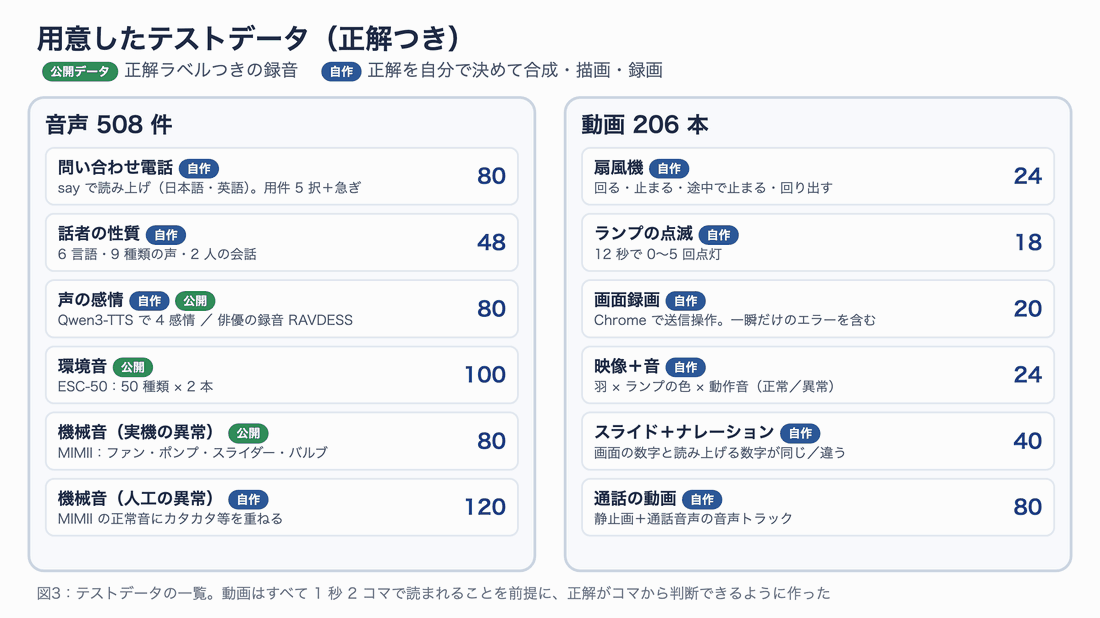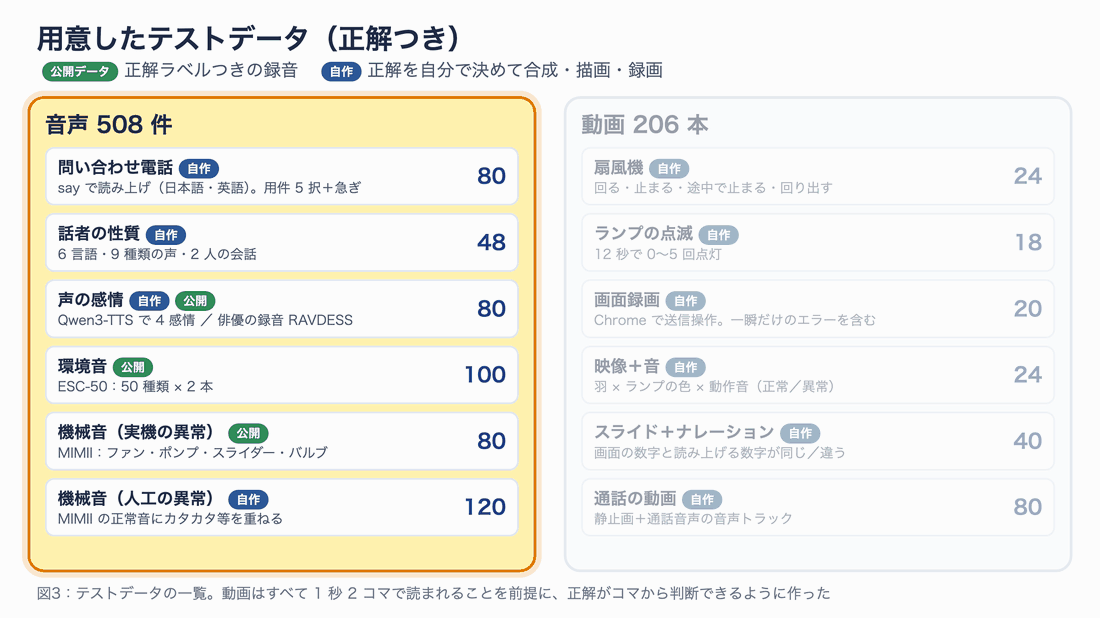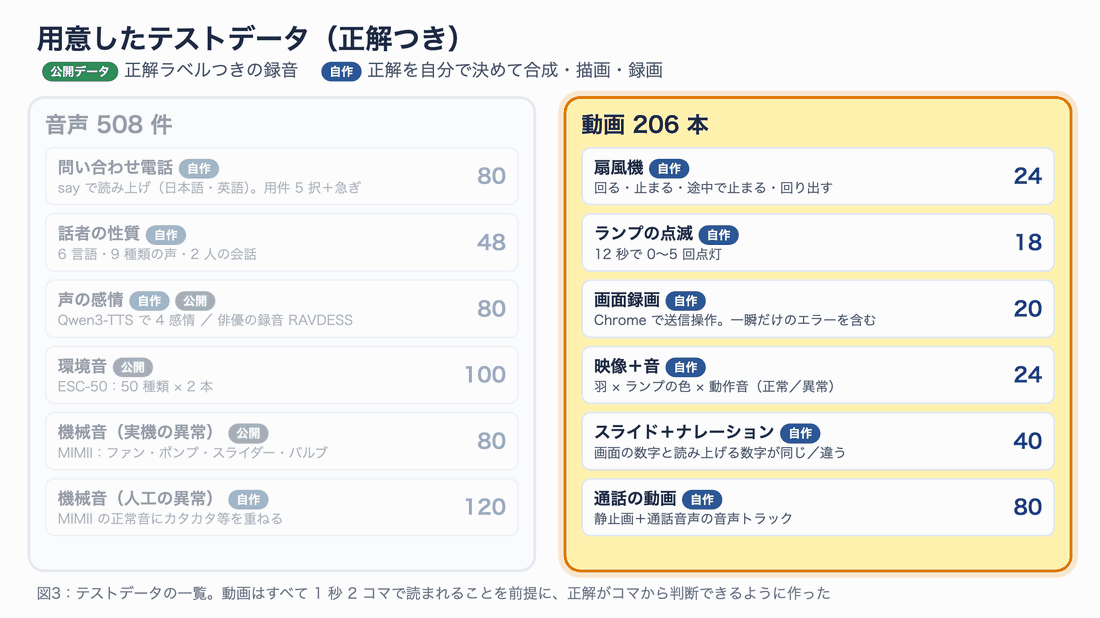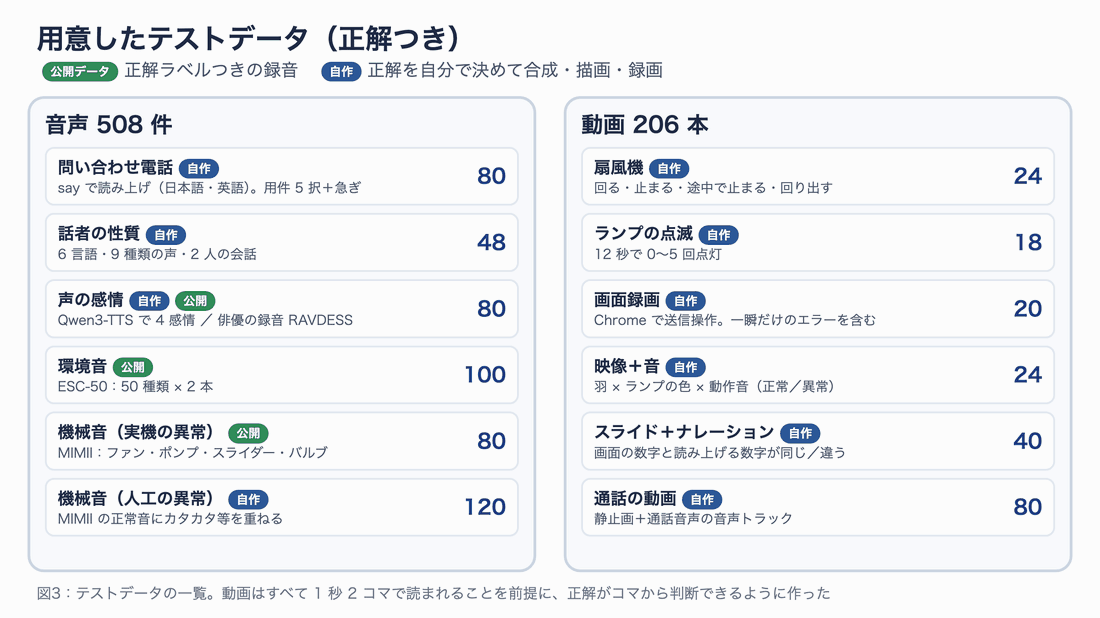
図3:用意したテストデータ。左が音声、右が動画。緑は公開データ、青は自作
| 区分 | テストデータ | 件数 | 作り方 | 何を確かめるか |
|---|---|---|---|---|
| 音声 | 問い合わせ電話 | 日本語 40・英語 40 | macOS の say(9 種類の声)で読み上げ | 用件(5 択)と急ぎかどうか |
| 音声 | 話者の性質 | 48 | say の 6 言語・9 種類の声、2 人の会話 | 何語か・男女・話者の人数 |
| 音声 | 声の感情 | 32+48 | Qwen3-TTS(感情を指示して読ませる)、俳優の録音 RAVDESS | 怒り・喜び・悲しみ・落ち着き |
| 音声 | 環境音 | 100 | 公開データ ESC-50(50 種類 × 2 本) | 何の音か、危険な音か |
| 音声 | 機械の音 | 80+120 | 工場の機械音の公開データ MIMII、それに人工の異常音を重ねたもの | 異常があるか |
| 動画 | 扇風機 | 24 | Python で描画(回る・止まる・途中で止まる・途中で回り出す) | 動いているか、いつ変わったか |
| 動画 | ランプの点滅 | 18 | 同上(0〜5 回点灯) | 回数を数えられるか |
| 動画 | 画面録画 | 20 | Chrome で経費精算フォームを操作して録画(5 通りの結末) | 成功したか、エラーが出たか |
| 動画 | 映像+音 | 24 | 扇風機の絵 × ランプ × モーター音(正常/異常) | 映像と音を一緒に判断できるか |
| 動画 | スライド+ナレーション | 40 | スライドの数字と、読み上げる数字を同じ/違うにする | 見たものと聞いたものの照合 |
| 動画 | 通話の動画 | 80 | 静止画に通話音声を音声トラックとして入れたもの | 動画の音声トラックを聞いているか |
合成音声は感情の表現が弱い可能性があるので、感情は プロの俳優が演じた RAVDESS でも確かめました。Qwen3-TTS の感情音声も、声の高さ・揺れ・速さを測り、「怒りは高く大きく揺れる、悲しみは低く遅い」と狙いどおりになっていることを確認しています。
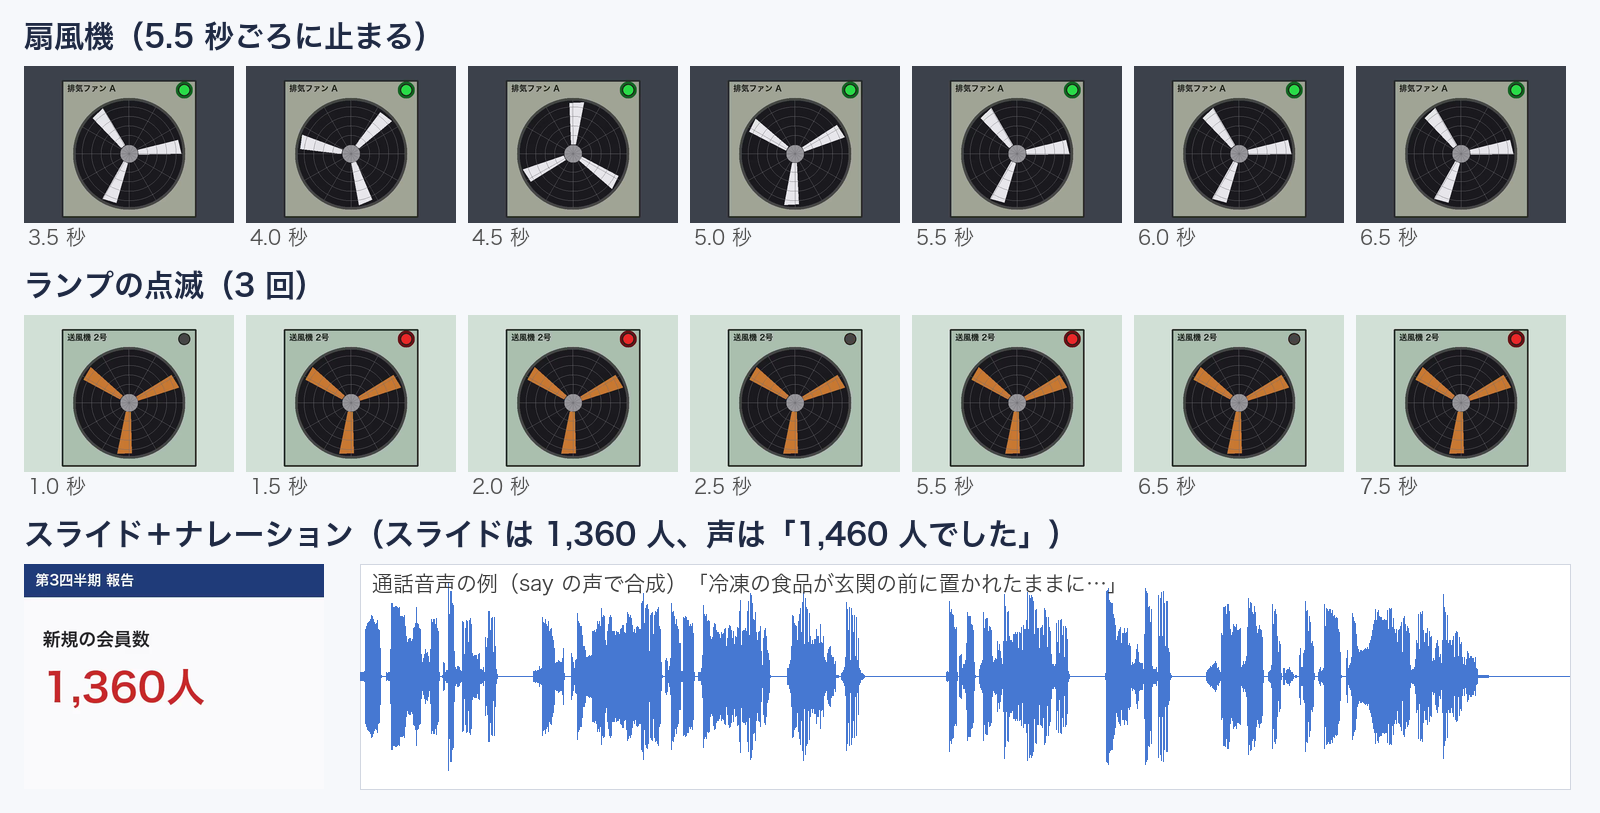
テストデータの実物。動画は Clef-omni と同じ「1 秒 2 コマ」で切り出して並べている
公開データのライセンスは、ESC-50 が CC BY-NC 3.0、MIMII が CC BY-SA 4.0、RAVDESS が CC BY-NC-SA 4.0 です。この記事では評価に使っただけで、音声そのものは再配布していません。
検証の構成
Clef-omni は、自分の Cloudflare アカウントに置いた Worker(Cloudflare 上で動く小さなプログラム) から呼びました。Worker の中で env.AI.run() にかかった時間を測れるので、通信の遅れと分けてモデルの速さを見られます。
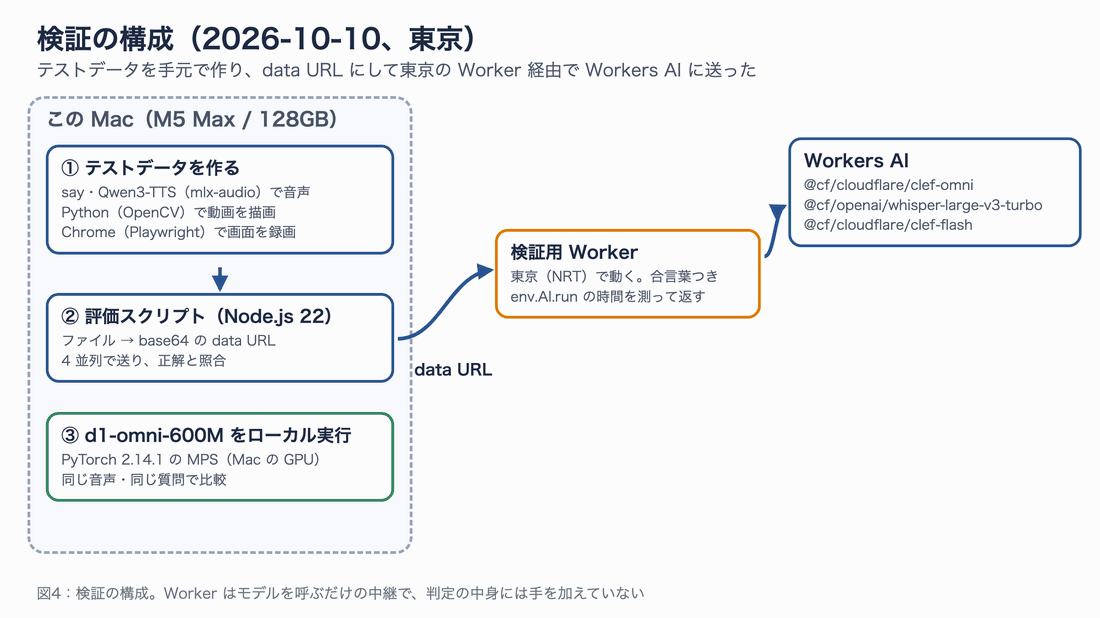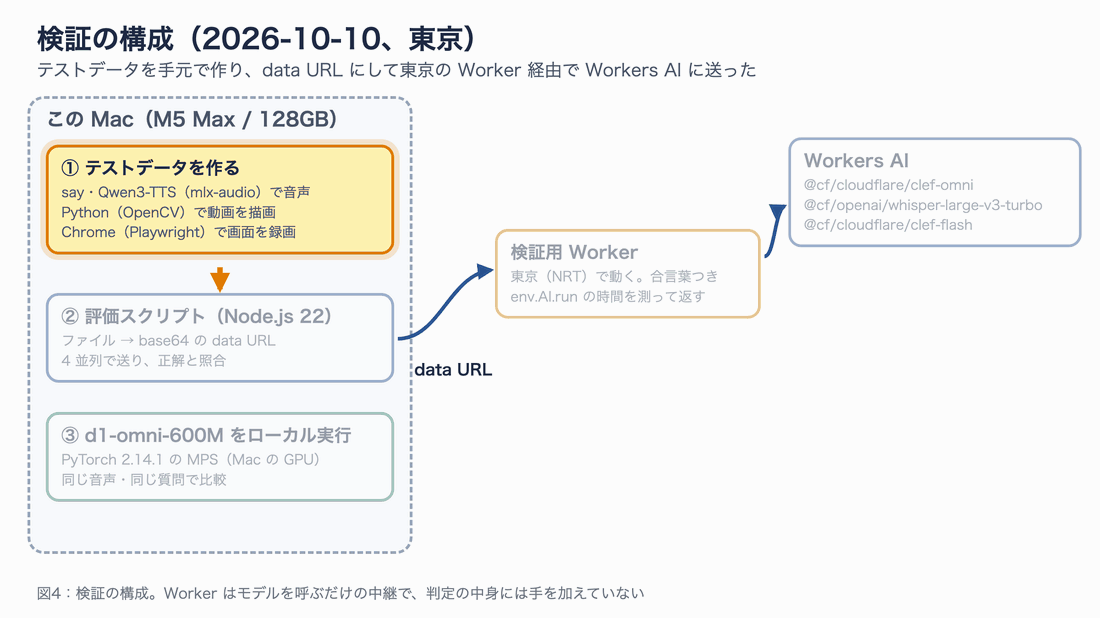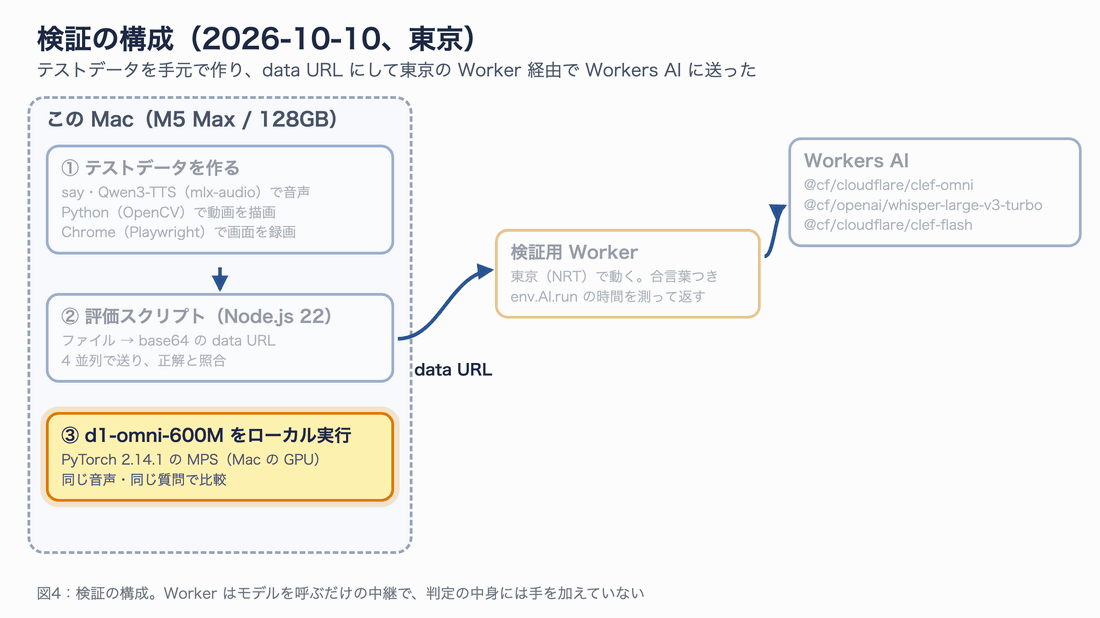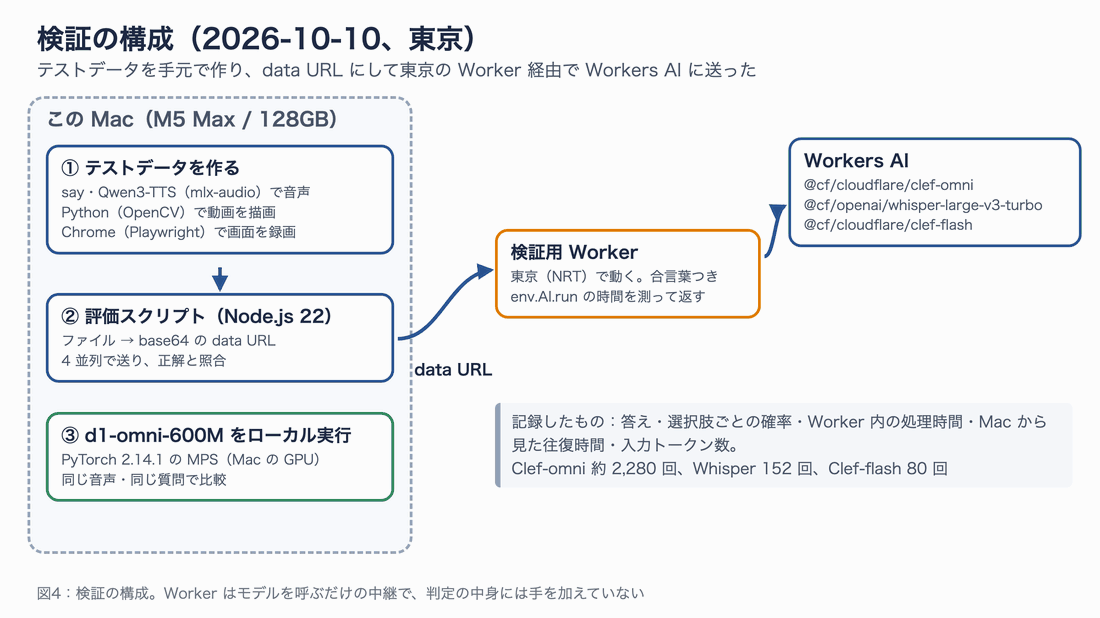
図4:検証の構成
Worker のコードは短く、受け取った本文をそのまま Clef-omni に渡すだけです。
// src/index.ts:Clef-omni を呼ぶだけの Worker。合言葉(LAB_TOKEN)が合わないリクエストは拒否する
export interface Env {
  AI: Ai;
  LAB_TOKEN: string;
}

export default {
  async fetch(request, env): Promise<Response> {
    if (request.method !== "POST") return new Response("POST only", { status: 405 });
    if (request.headers.get("x-lab-token") !== env.LAB_TOKEN) return new Response("forbidden", { status: 403 });
    const { body } = (await request.json()) as { body: any };
    const t0 = performance.now();
    const result = await env.AI.run("@cf/cloudflare/clef-omni", body);
    return Response.json({ ms: performance.now() - t0, result });
  },
} satisfies ExportedHandler<Env>;
設定ファイルでは、Workers AI を AI という名前で使えるようにします。
// wrangler.jsonc
{
  "name": "clef-omni-demo",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-09",
  "ai": { "binding": "AI" },
  "observability": { "enabled": true }
}
デプロイと合言葉の登録は、次の 2 つのコマンドです(Cloudflare へのログインは npx wrangler login で済ませておきます)。
# Worker をデプロイする
npx wrangler deploy

# 合言葉を登録する(実行すると値の入力を求められる)
npx wrangler secret put LAB_TOKEN
手元からは、音声や動画のファイルを base64 の data URL にして送ります。URL での指定はできないので、この変換が必須です。
// ask.mjs:音声(wav/mp3)は audio 欄、動画(mp4/webm)は videos 欄に入れて判定させる
// 使い方: WORKER_URL=https://<your-worker>.workers.dev LAB_TOKEN=<合言葉> node ask.mjs <ファイル>
import { readFileSync } from "node:fs";

const file = process.argv[2];
const ext = file.split(".").pop().toLowerCase();
const mime = { wav: "audio/wav", mp3: "audio/mpeg", mp4: "video/mp4", webm: "video/webm" }[ext];
const dataUrl = `data:${mime};base64,${readFileSync(file).toString("base64")}`;
const media = mime.startsWith("audio/") ? { audio: [dataUrl] } : { videos: [dataUrl] };

const body = {
  model: "clef-omni", // この欄は必須。"clef_omni" などと書くとエラーになる
  state: "カスタマーサポートにかかってきた電話の録音です。",
  ...media,
  questions: {
    intent: {
      type: "choice",
      instructions: "What does the caller want help with?",
      criteria: {
        outage: "Internet, an app or a system is down or not working properly",
        billing: "Charges, payments, invoices, receipts or refunds",
        delivery: "Shipping, delivery or receiving a package",
        cancel: "Ending or cancelling a contract, plan or membership",
        account: "Account details such as login, password, address, name or users",
      },
    },
    urgent: { type: "noul", instructions: "Does the caller need this handled urgently, today or right now?" },
  },
};

const t0 = performance.now();
const res = await fetch(process.env.WORKER_URL, {
  method: "POST",
  headers: { "content-type": "application/json", "x-lab-token": process.env.LAB_TOKEN },
  body: JSON.stringify({ body }),
});
const { ms, result } = await res.json();
console.log(`Workers AI ${Math.round(ms)} ms / 往復 ${Math.round(performance.now() - t0)} ms / 入力 ${result.usage.input_tokens} トークン`);
console.log("用件:", result.answers.intent.choice, result.answers.intent.probabilities);
console.log("急ぎ:", result.answers.urgent.noul);
「冷凍の食品が玄関の前に置かれたままになっていました。溶けてしまうので、今すぐ再配達か交換をお願いします」という通話を、音声ファイルのまま送った結果が次の画面です。下半分は、同じ通話を「静止画+音声トラック」の動画にして送った 結果です。
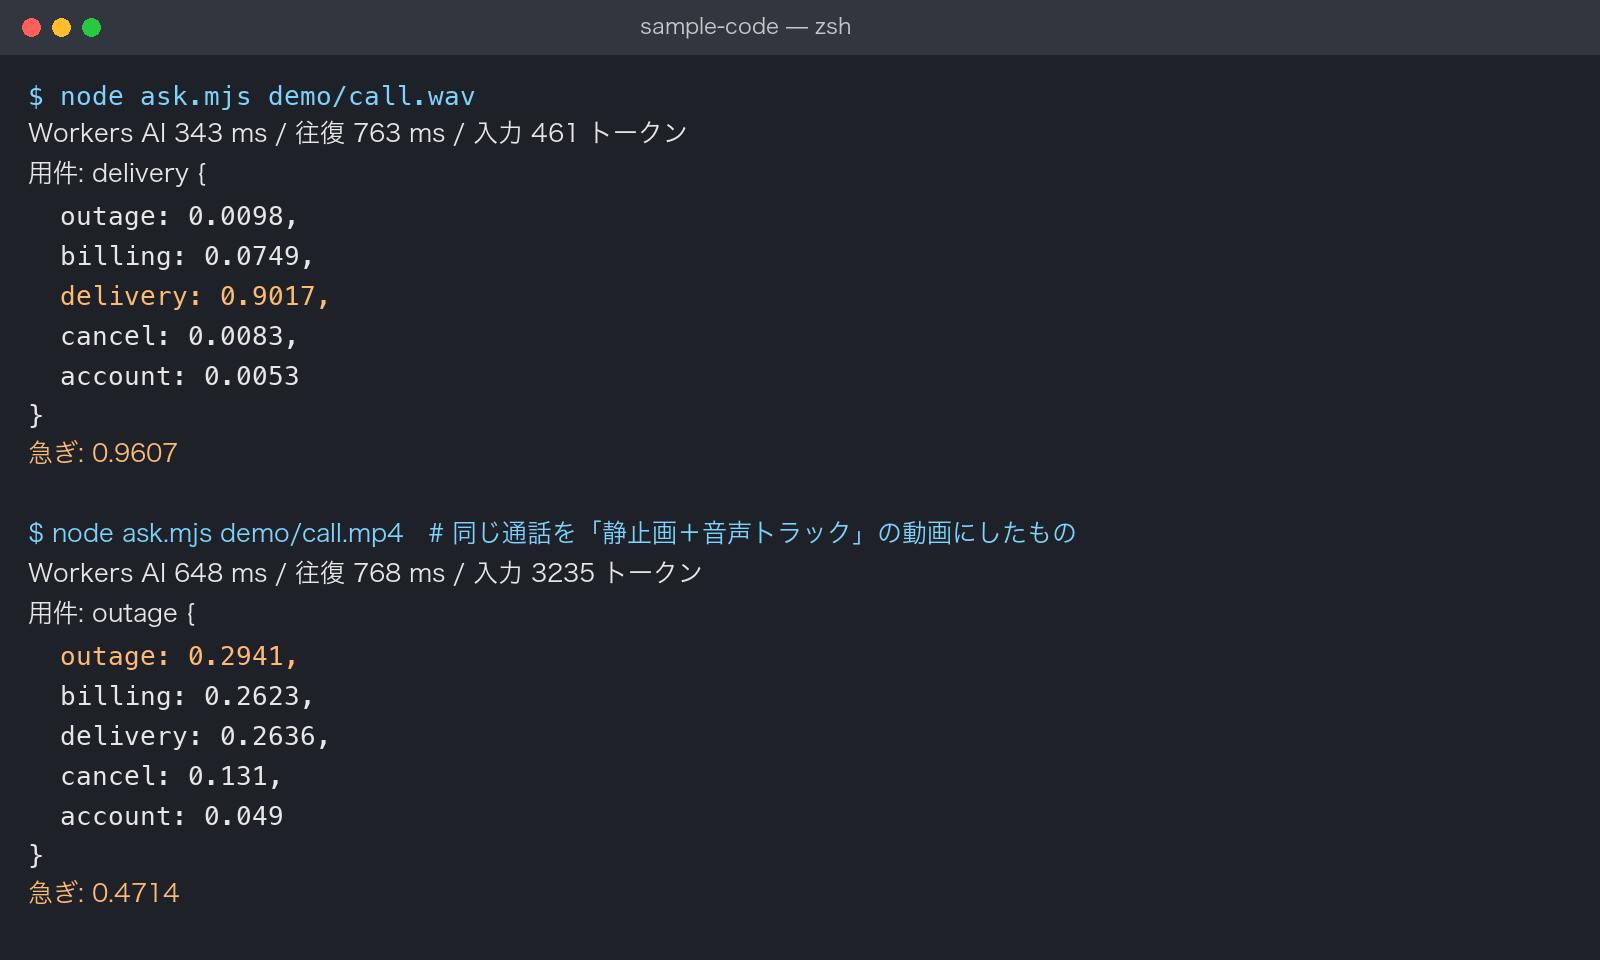
音声として渡すと「配送・急ぎ」と正しく判定できたが、動画の音声トラックにすると確信度が大きく下がった(実測)
同じ音なのに、渡し方で結果がここまで変わります。この理由は後半の「映像と音を一緒に判断できるか」で詳しく見ます。
比べる相手
結果を「良い・悪い」と言うには、比べる相手が必要です。今回は次の 3 つと比べました。
| 比べる相手 | 中身 | 何が分かるか |
|---|---|---|
| 文字起こし → 判定 | Workers AI の Whisper large-v3-turbo で文字にしてから、Clef-flash または Clef-omni(文章のみ)で判定 | 「前処理なしで渡す」ことの得失 |
| 静止画 | 動画から最後の 1 コマ、または等間隔の 4 コマを切り出して画像として渡す | 「動画で渡す」ことの得失 |
| d1-omni-600M | Liquid AI が 10月7日に公開した 6 億パラメータの判定モデル。文章+画像、または文章+音声を入力できる(動画は不可) | 小型の競合モデルとの差 |
d1-omni-600M は Mac(M5 Max、PyTorch 2.14.1 の MPS、transformers 5.19.0)で動かしました。モデルカードには 「音声は英語の話者とアシスタントの会話で学習した」 と注意書きがあり、30 秒を超える音声は切り捨てられます。
結果の全体像
まず、すべての結果を 1 枚にまとめます。緑が得意(85% 以上)、黄色がまあまあ、赤が苦手(当てずっぽうに近い)です。
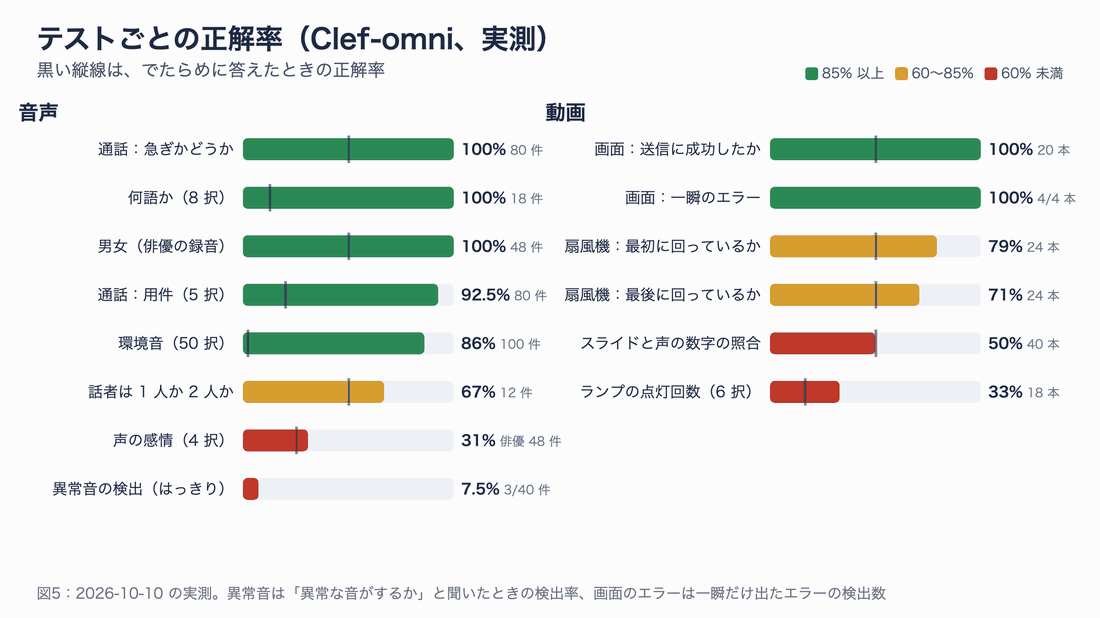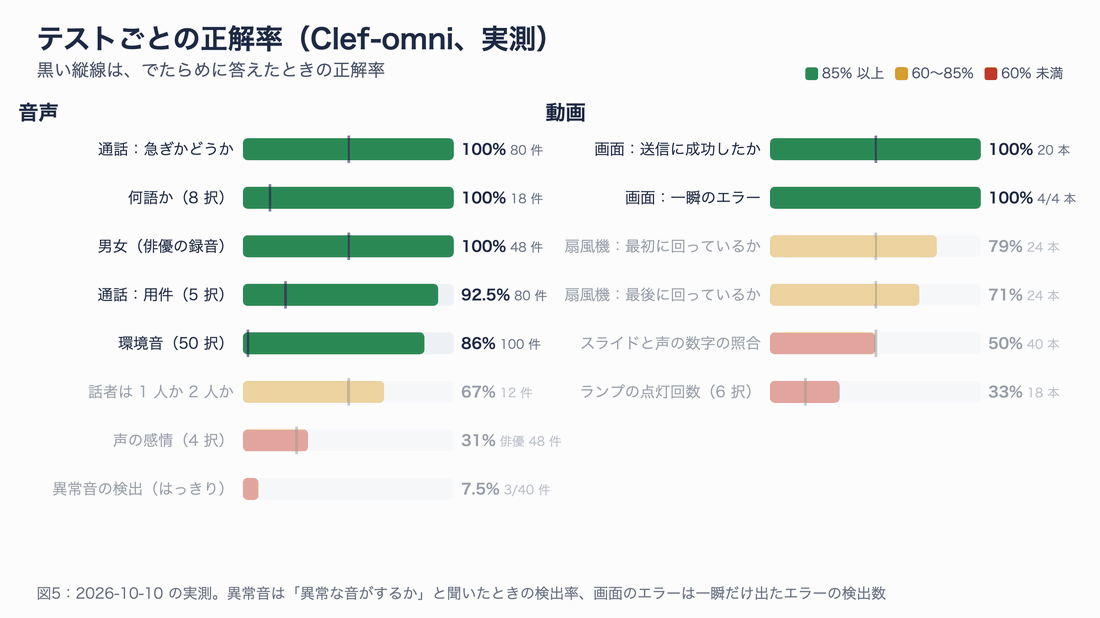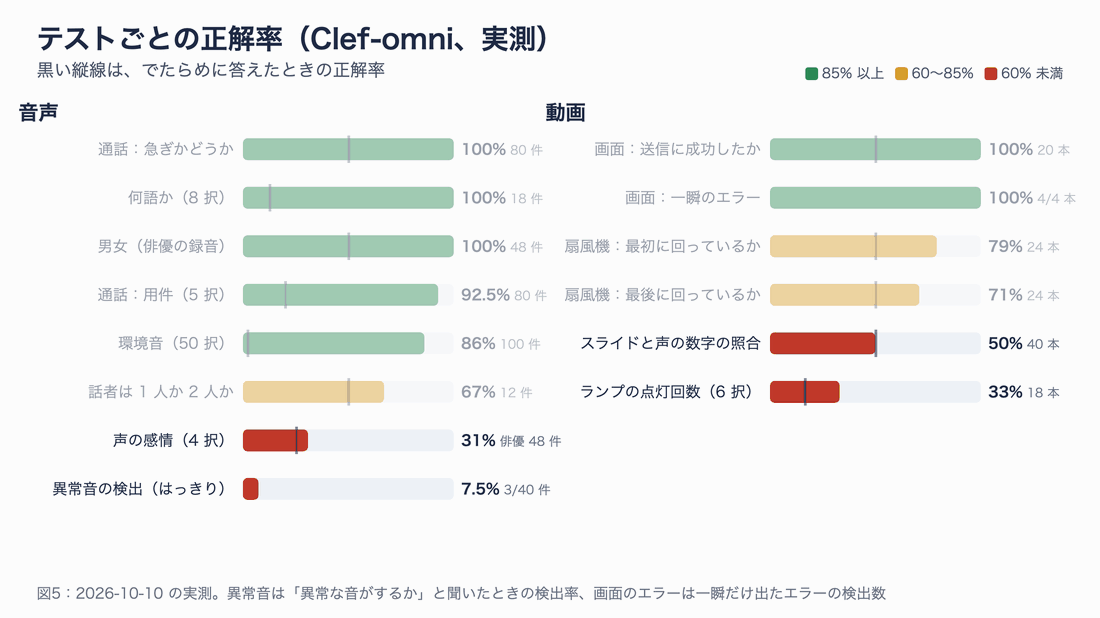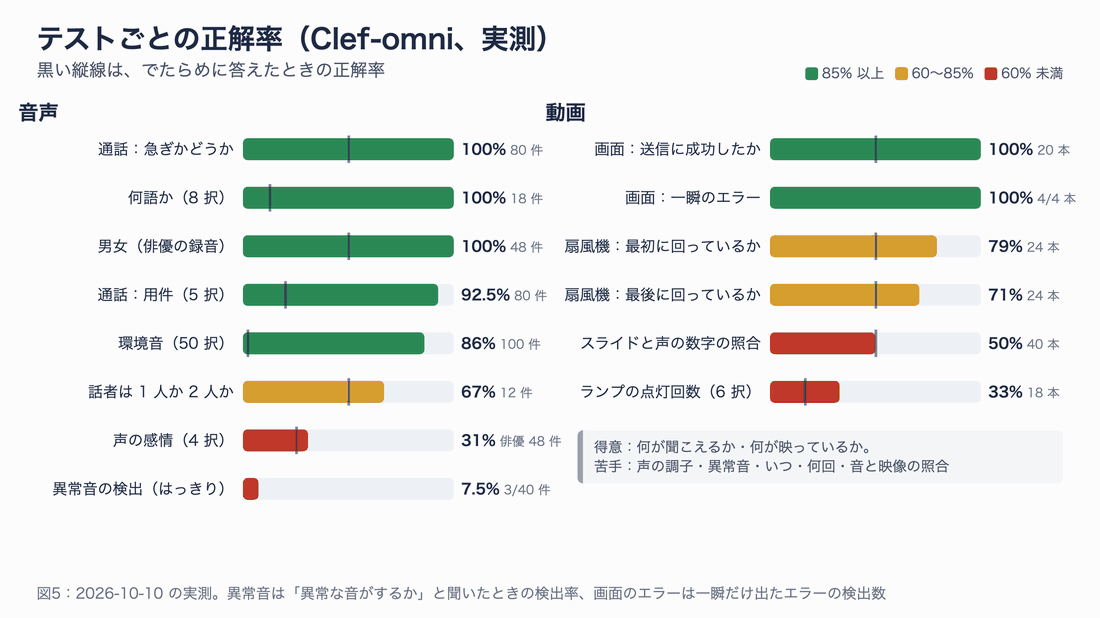
図5:テストごとの正解率(実測)。「当てずっぽう」は選択肢の数から計算した、でたらめに答えたときの正解率
傾向をひとことで言うと、「何が聞こえる・何が映っているか」は得意で、「どんな調子か・いつ・何回・どちらと食い違うか」は苦手 です。ここから、音声と動画の順に中身を見ていきます。
音声の結果
1. 通話の用件と緊急度:文字起こしなしで同じくらい当たる
日本語 40 件・英語 40 件の問い合わせ電話で、用件(障害・料金・配送・解約・登録情報の 5 択)と、急ぎかどうかを判定させました。電話の内容は「今朝から事務所のネットが全部止まってます。午後に大事なオンライン会議があるので…」のような、1〜3 文の短いものです。
| 渡し方 | 用件(日本語) | 用件(英語) | 急ぎかどうか | 処理時間(中央値) |
|---|---|---|---|---|
| Clef-omni に音声をそのまま | 36/40(90%) | 38/40(95%) | 80/80(100%) | 145ms |
| 同上、質問文を日本語にした場合 | 36/40(90%) | — | 40/40(100%) | 135ms |
| Whisper で文字起こし → Clef-flash | 35/40(88%) | 38/40(95%) | 80/80(100%) | 1,631ms + 328ms |
| Whisper で文字起こし → Clef-omni(文章) | 37/40(93%) | 39/40(98%) | 80/80(100%) | 1,631ms + 58ms |
| 参考:正しい文章を Clef-omni に | 38/40(95%) | 39/40(98%) | 80/80(100%) | 61ms |
処理時間は Worker の中で測った値で、Whisper(文字起こし)と判定の時間を分けて書いています。音声をそのまま渡しても、文字起こしを挟んだ場合とほとんど差がなく、処理時間は約 12 分の 1 でした。
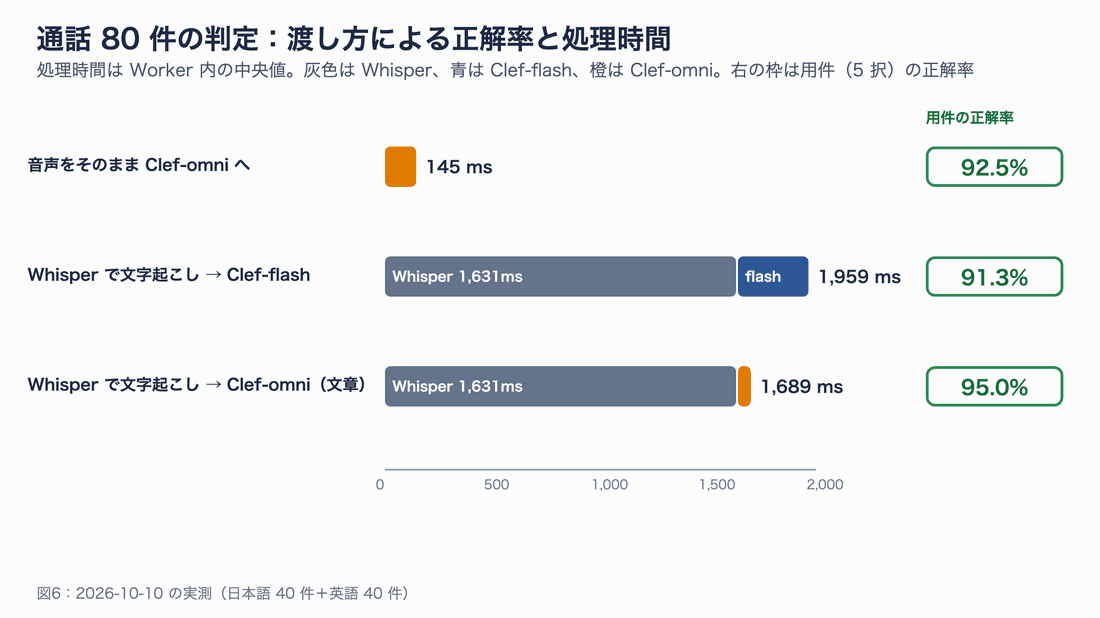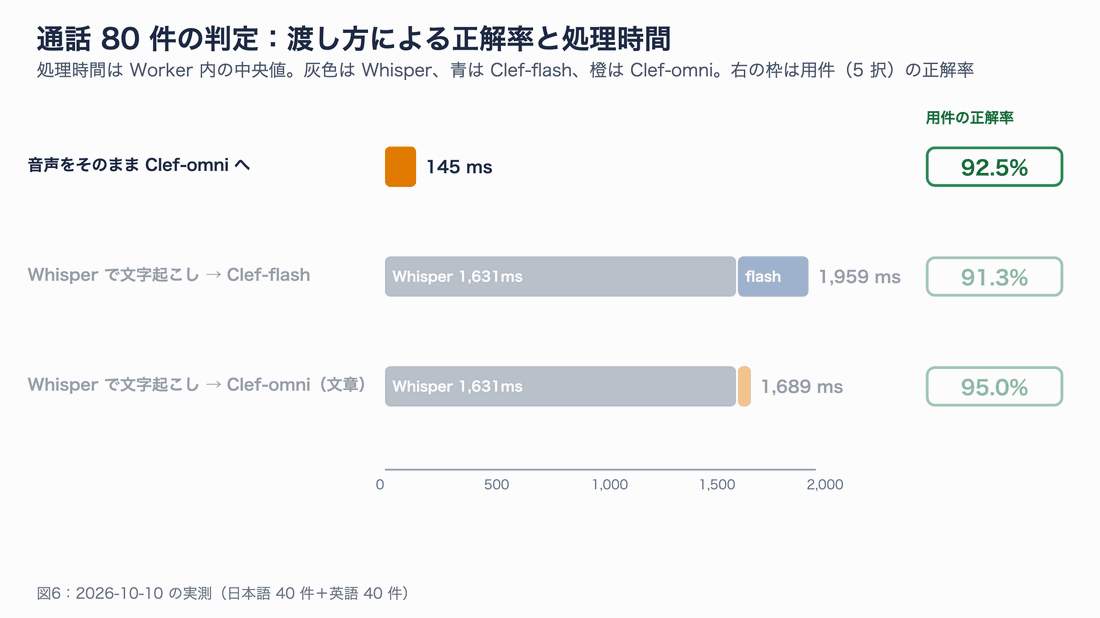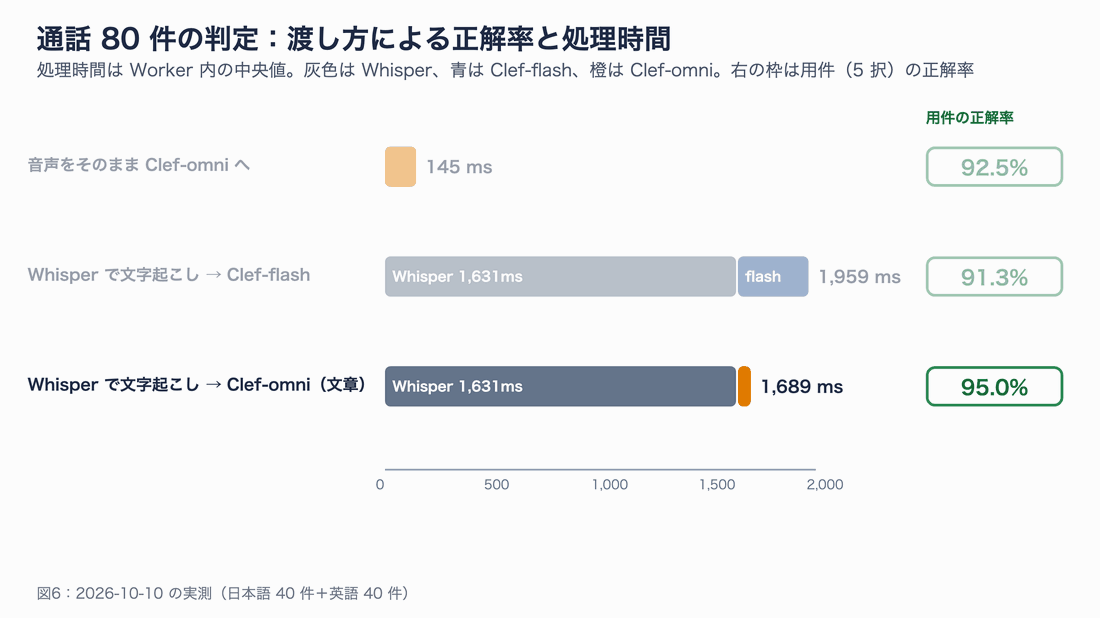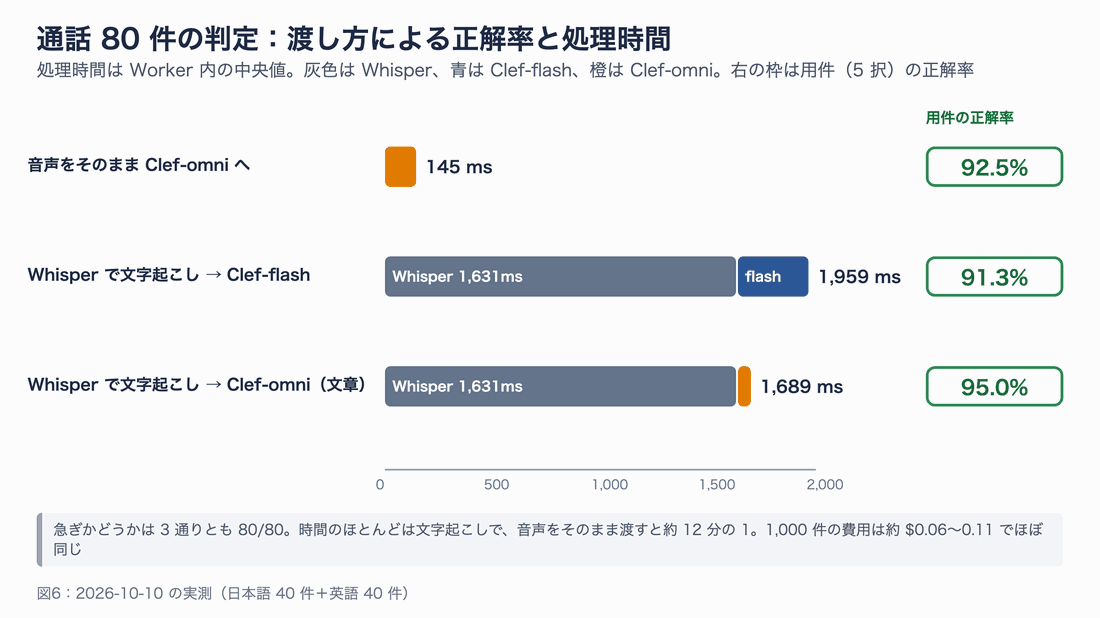
図6:通話の判定の正解率と処理時間(実測、80 件)。時間の大半は文字起こしにかかっている
間違えた 6 件を見ると、「携帯をなくして二段階認証のコードが受け取れない」を「障害」と答えるなど、文章で読んでも迷いそうなものが中心でした。音声だから起きた失敗というより、選択肢の線引きがあいまいなケース です。
費用も比べておきます。平均 7 秒の通話を 1,000 件判定した場合の概算です。
| 渡し方 | 1,000 件あたり | 内訳 |
|---|---|---|
| Clef-omni に音声をそのまま | 約 $0.06 | 平均 411 トークン × $0.15/100 万 |
| Whisper → Clef-flash | 約 $0.07 | Whisper $0.0005/分 × 7 秒 + 339 トークン × $0.038/100 万 |
| Whisper → Clef-omni(文章) | 約 $0.11 | Whisper + 338 トークン × $0.15/100 万 |
費用はほぼ同じで、手間と待ち時間が減る分だけ音声をそのまま渡すほうが有利 です。なお、Whisper の費用は音声の長さで按分して計算しました。
2. 何語か・男女・環境音:音そのものの聞き分けは得意
次に、文字起こしでは分からない「音そのもの」の性質を聞きました。
| テスト | 件数 | 結果 | 補足 |
|---|---|---|---|
| 何語か(8 択、6 言語) | 18 | 18/18(100%) | 日本語・英語・中国語・韓国語・フランス語・スペイン語 |
| 男性の声か女性の声か(合成音声) | 18 | 17/18(94%) | 「おばあさん」の声を男性と答えた 1 件だけ外れ |
| 男性の声か女性の声か(俳優の録音) | 48 | 48/48(100%) | RAVDESS の 12 人 |
| 環境音の種類(50 択) | 100 | 86/100(86%) | ESC-50。間違いは飛行機→エンジン、めんどり→おんどりなど似た音 |
| 危険な音の検出(5 種類) | 各 100 | 10 本中 9 本を検出、誤検知は 490 回中 5 回 | ガラスが割れる・サイレン・赤ちゃんの泣き声・火・犬 |
ESC-50 の 50 択で 86% は、人が聞き分けたときの正解率として論文で報告されている 81.3% を上回る数字です(条件は同じではないので目安です)。ガラスが割れる音の 1 本だけ、「はい」の確率が 0.44 で取りこぼしました。
3. 声の感情と話者の人数:ほぼ読み取れない
一方、声の調子 はほとんど読み取れませんでした。同じ文(「荷物は明日の午前中に届く予定です」など、内容に感情が出ない文)を、怒り・喜び・悲しみ・落ち着きの 4 通りで読ませています。
| テスト | 件数 | 4 択の正解率 | 「怒っているか」で怒りを検出 | 答えの偏り |
|---|---|---|---|---|
| Qwen3-TTS の感情音声(日本語) | 32 | 9/32(28%) | 0/8 | 31 件を「落ち着き」と回答 |
| 同上、質問文を日本語に | 32 | 9/32(28%) | 0/8 | 31 件を「落ち着き」と回答 |
| RAVDESS(俳優の演技、英語) | 48 | 15/48(31%) | 3/12 | 45 件を「落ち着き」と回答 |
| 参考:Whisper の文字起こしを判定 | 32 | 8/32(25%) | 0/8 | 32 件を「落ち着き」と回答 |
4 択なので、でたらめに答えても 25% は当たります。俳優が強く演じた怒りの声でも 12 件中 3 件しか「怒っている」と判定できず、文字起こしを判定したときとほとんど変わりませんでした。声の高さや強さの違いは聞こえていても、それを「感情」として判断する学習はされていないようです。
話者の人数(1 人で話しているか、2 人の会話か)も、12 件中 8 件の正解にとどまりました。2 人の会話は 6 件すべて正解でしたが、1 人で 4 文を読んだ録音の 6 件中 4 件を「2 人」と答えています。
4. 機械の異常音:「異常か」と聞くと見逃す
紹介記事で例に挙がっていた「工場設備の異常音」を確かめるため、工場の機械音の公開データ MIMII(ファン・ポンプ・スライダー・バルブの実機の音)を使いました。MIMII の異常音は「羽のバランスがずれている」「配管が詰まっている」などで、人が聞いても分かりにくいものです。そこで、MIMII の正常音に はっきり聞こえる人工の異常音(カタカタ・キーキー・ガリガリ・ゴツン)を重ねたデータも作りました。
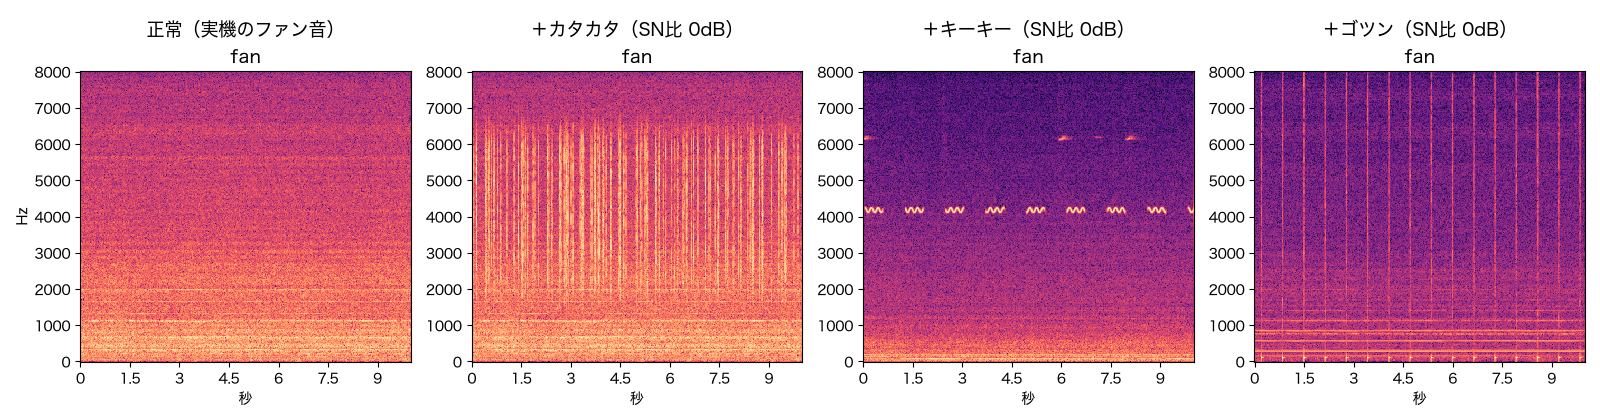
人工の異常音を重ねた音のスペクトログラム(音の高さと強さを色で表した図)。SN 比 0dB は、異常音と元の機械音が同じくらいの大きさという意味で、人が聞けばすぐ分かる
結果は、質問の仕方で大きく変わりました。
| 質問の仕方 | 実機の異常(40 本) | 人工の異常・はっきり(40 本) | 正常を異常と誤る |
|---|---|---|---|
| 「異常な音がするか(カタカタ・キーキー・ガリガリ・ゴツンなど)」 | 0/40 | 3/40 | 3/80 |
| 1 本目に正常な音を置き、「1 本目と比べて異常な音があるか」 | 1/40 | 5/40 | 0/80 |
| 公式ブログの例文「ガタつきやこすれなく滑らかに動いているか」 | 7/40 | 23/40 | 17/80 |
| 音の種類を名指しで聞く(「カタカタ音が聞こえるか」など 4 問) | — | カタカタ 9/10、キーキー 2/10、ガリガリ 0/10、ゴツン 0/10 | 12/40 |
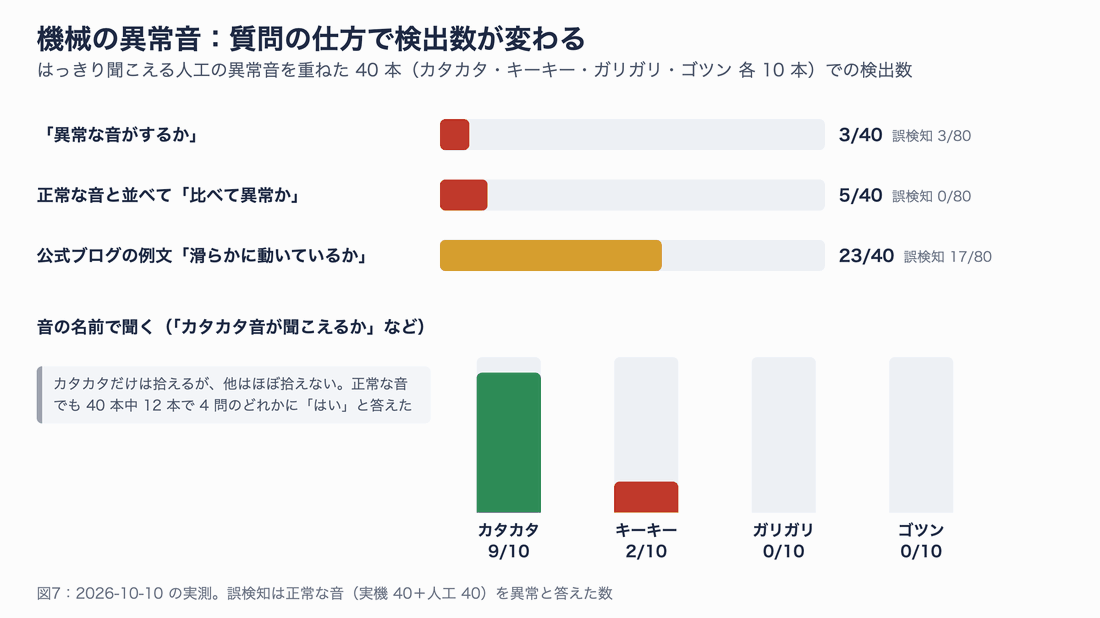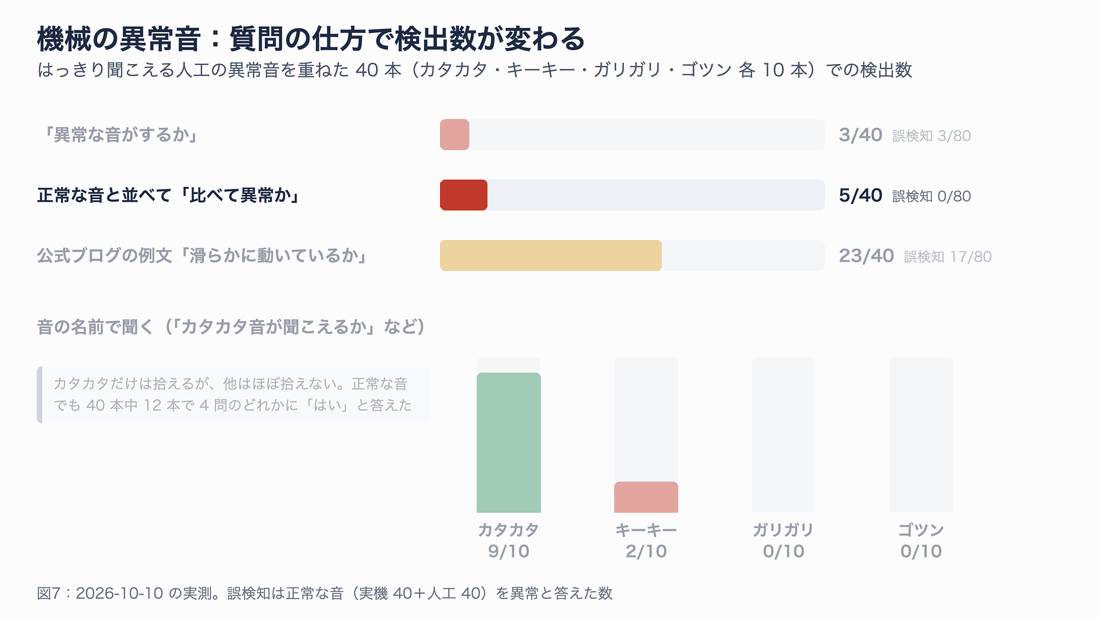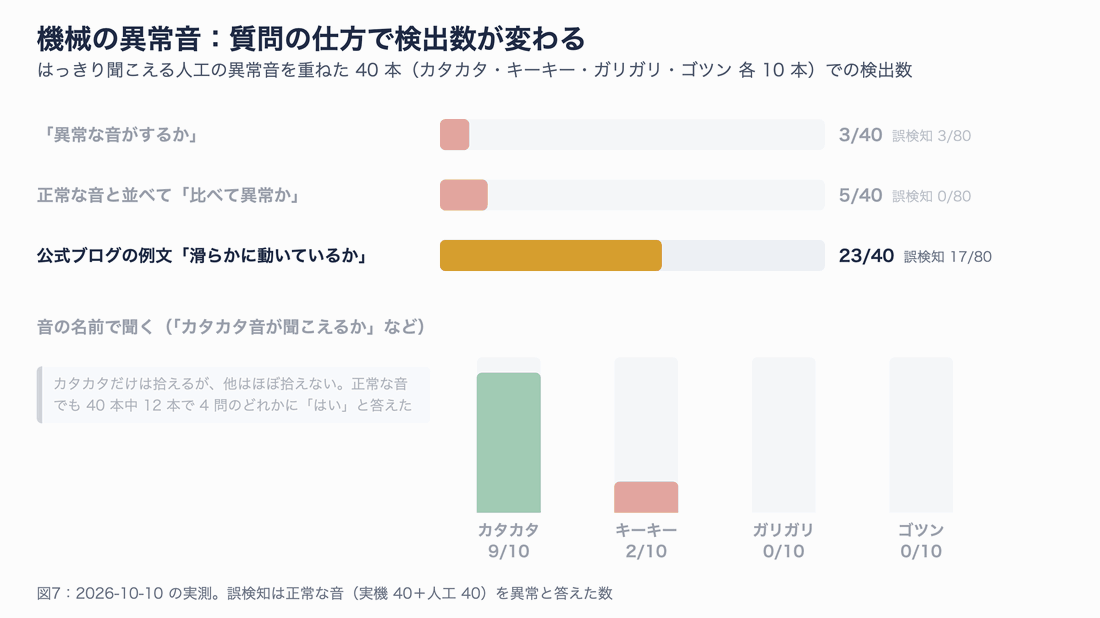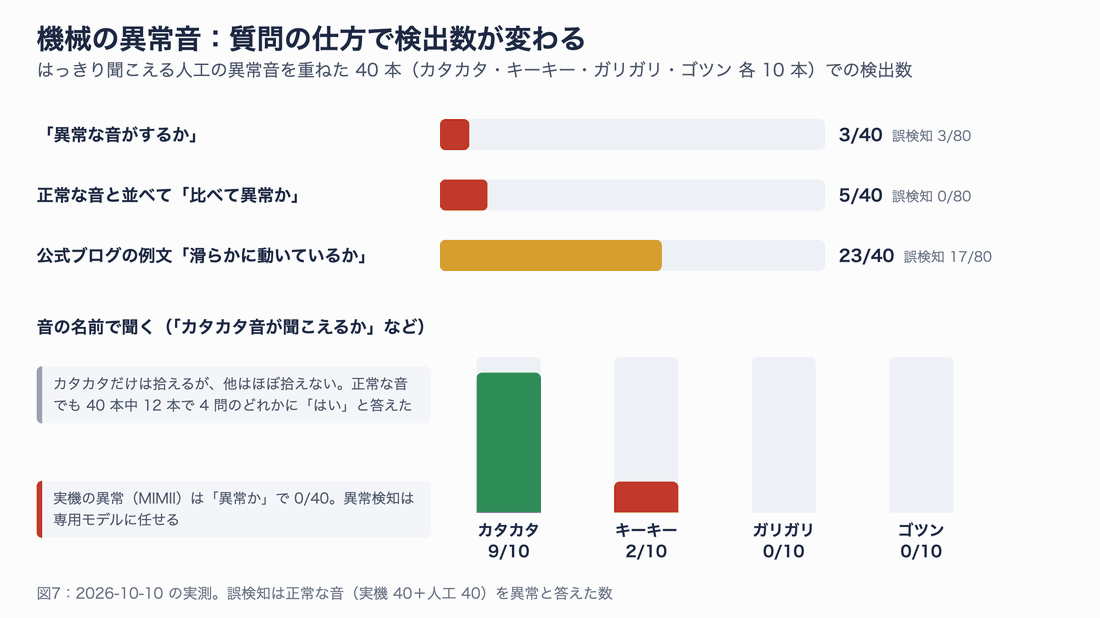
図7:機械の異常音の検出数(実測)。抽象的に聞くとほぼ見逃す
分かったことは 3 つです。
- 「異常か」という抽象的な質問には、ほとんど「正常」と答える。人が聞けばすぐ分かる音を重ねても、40 本中 3 本しか拾えませんでした
- 「カタカタ音が聞こえるか」と名指しで聞けば、カタカタは 10 本中 9 本拾える。ただし、キーキー・ガリガリ・ゴツンはほぼ拾えず、正常な音でも 40 本中 12 本で 4 問のどれかに「はい」と答えました
- 機械の 種類(ファンかポンプか)は 80 本中 58 本(73%)当たりました。ファンとバルブは 20/20 ですが、スライダーの多くを「ファン」と答えています
公式ブログの例文で聞くと検出数は増えますが、正常な音を異常と誤る数も増えます。つまり、確率の基準をずらしただけで、聞き分けられるようになったわけではありません。工場の異常音検知にそのまま使うのは難しく、正常時の音で学習させる専用の異常検知モデルを使うべき場面だと考えます。
5. d1-omni-600M との比較
同じ音声のテストを、Liquid AI の d1-omni-600M にも解かせました。手元の Mac で 1 件 25〜95ms で動く小さなモデルです。
| テスト | Clef-omni | d1-omni-600M |
|---|---|---|
| 通話の用件・英語(5 択) | 38/40(95%) | 19/40(48%) |
| 通話の用件・日本語(5 択) | 36/40(90%) | 9/40(23%) |
| 急ぎかどうか(英語 / 日本語) | 40/40 / 40/40 | 34/40 / 24/40 |
| 何語か(8 択) | 18/18 | 3/18(すべて「英語」と回答) |
| 男女(合成音声) | 17/18 | 8/18 |
| 環境音(50 択) | 86/100 | 2/100(95 本を「時計の音」と回答) |
| 声の感情(4 択) | 9/32 | 8/32(すべて「落ち着き」と回答) |
d1-omni-600M は、モデルカードの注意書きどおり 英語の話し言葉の内容を判断するためのモデル で、環境音や言語の聞き分けには向きません。今回のデータでは英語の通話でも約半分の正解で、Clef-omni との差ははっきりしていました。ただし d1-omni-600M は「実験的なチェックポイント」と明記されたモデルです。パラメータ数は Clef-omni の約 50 分の 1 で、手元の機器で動かせる点には別の価値があります。
d1-omni-600M は、次のように Python から動かしました(Hugging Face のモデルカードの手順どおりです)。
# d1-omni-600M を Mac(MPS)で動かす。音声は 16kHz・モノラル・16bit 整数で渡す
import soundfile as sf, torch
from transformers import AutoModel

model = AutoModel.from_pretrained("LiquidAI/d1-omni-600M", trust_remote_code=True, dtype=torch.float16).to("mps").eval()
audio, sr = sf.read("call_en_c01.wav", dtype="int16")  # sr は 16000 であること
questions = {"urgent": {"type": "noul", "instructions": "Does the caller need this handled urgently, today or right now?"}}
print(model.system_one("A recorded phone call to a customer support line.", questions, audio=audio))
動画の結果
1. 動いているか:分かるが、「いつ」は苦手
扇風機の動画 24 本(ずっと回る・ずっと止まる・5.5 秒ごろに止まる・5 秒ごろに回り出す × 6 種類の見た目)で、「最初に回っているか」「最後に回っているか」「途中で切り替わったか」を聞きました。羽の回転ぶれは描いていないので、1 枚の画像からは回っているか分からず、コマとコマの違いからしか判断できない データです。
| 渡し方 | 最初に回っているか | 最後に回っているか | 途中で切り替わったか |
|---|---|---|---|
| 動画(10 秒) | 19/24(79%) | 17/24(71%) | 15/24(63%) |
| 等間隔の 4 コマを画像で | 12/24(50%) | 14/24(58%) | 12/24(50%) |
| 最後の 1 コマを画像で | 13/24(54%) | 8/24(33%) | 12/24(50%) |
| 最初の 3 秒と最後の 3 秒に分けた 2 本の動画 | 24/24(100%) | 21/24(88%) | 13/24(54%) |
| 同上、2 つの答えから「切り替わったか」をコードで判定 | — | — | 21/24(88%) |
動画で渡すと、静止画よりはっきり当たります。ただ中身を見ると、途中で止まる動画の 6 本すべてで「最後も回っている」と答えていました。動画のどこかで動いていれば「回っている」と答えやすく、「最初は」「最後は」という時間の指定がうまく効いていないようです。
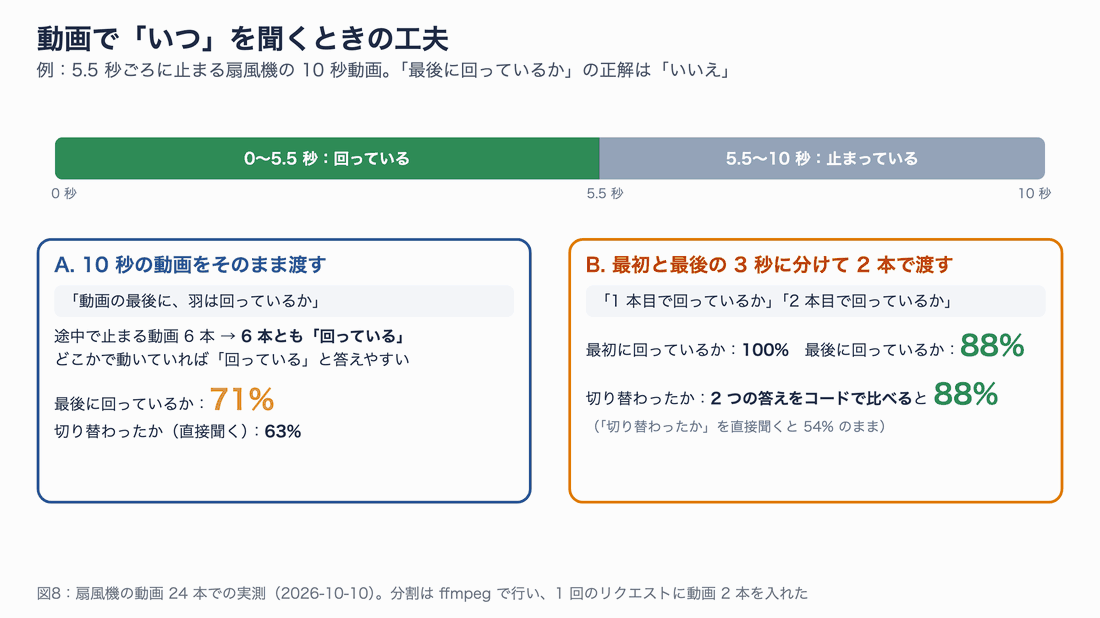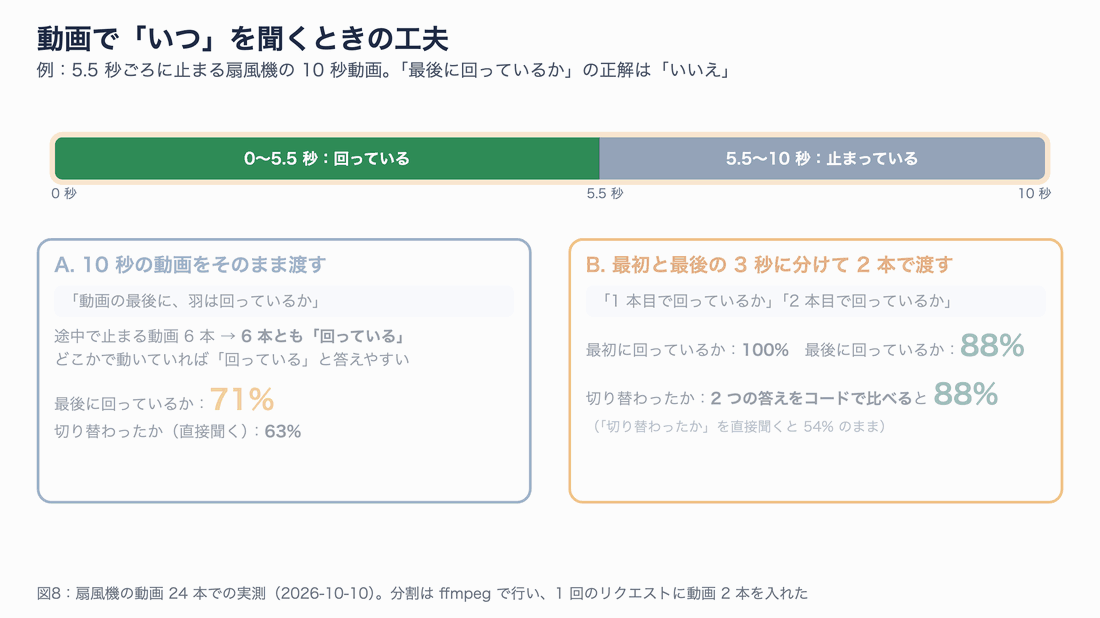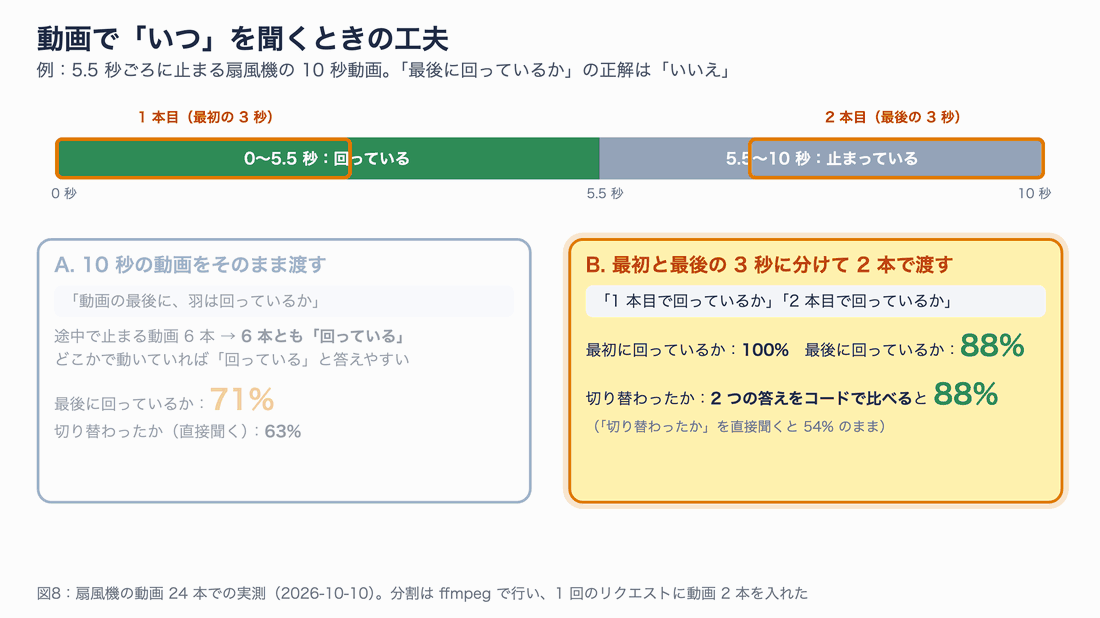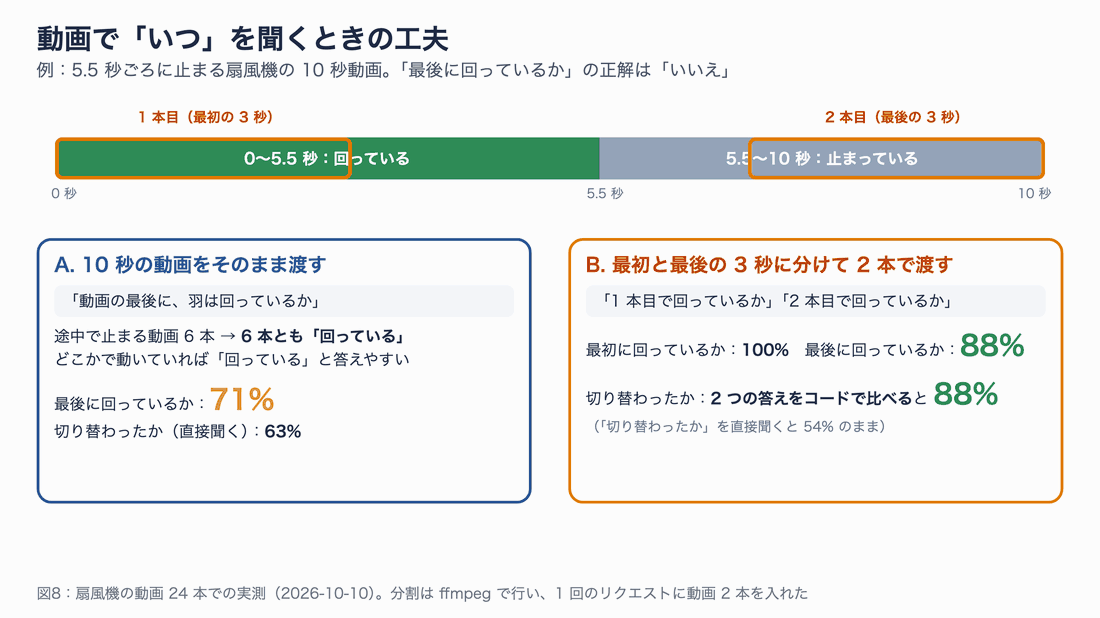
図8:時間に関する質問は、動画を区切って別々に聞き、答えの組み合わせはコードで判断すると当たりやすい
そこで、動画を 最初の 3 秒と最後の 3 秒の 2 本に分けて(1 回のリクエストに動画は 2 本まで入れられます)、「1 本目で回っているか」「2 本目で回っているか」を別々に聞くと、正解率が大きく上がりました。「途中で切り替わったか」を直接聞くと相変わらず 54% ですが、2 つの答えが違えば「切り替わった」とコードで判定すれば 88% になります。分け方は ffmpeg で簡単にできます。
#!/bin/bash
# split-media.sh:動画を「最初の 3 秒」「最後の 3 秒」に分け、音声トラックがあれば WAV に取り出す
# 使い方: bash split-media.sh input.mp4
set -euo pipefail
in="$1"; base="${in%.*}"
dur=$(ffprobe -v error -show_entries format=duration -of csv=p=0 "$in")
ffmpeg -loglevel error -y -i "$in" -t 3 -c:v libx264 -pix_fmt yuv420p -an "${base}_head.mp4"
ffmpeg -loglevel error -y -ss "$(echo "$dur - 3" | bc)" -i "$in" -t 3 -c:v libx264 -pix_fmt yuv420p -an "${base}_tail.mp4"
# 音声トラックがあるときだけ、音を WAV に分け、音なしの動画も作る
if ffprobe -v error -select_streams a -show_entries stream=index -of csv=p=0 "$in" | grep -q .; then
  ffmpeg -loglevel error -y -i "$in" -vn -ar 16000 -ac 1 "${base}_sound.wav"
  ffmpeg -loglevel error -y -i "$in" -c:v copy -an "${base}_mute.mp4"
fi
ls -la "${base}"_*
なお、扇風機の見た目のうち 2 種類は羽が 4 枚・5 枚で、0.5 秒ごとのコマでは羽が 9 度ずつしか動かないように見えます(3 枚羽は 39 度)。それでも正解率は 3 枚羽 69%、4・5 枚羽 75% とほぼ同じで、結果をゆがめてはいませんでした。
2. 回数を数える:苦手
赤いランプが 12 秒の間に 0〜5 回点灯する動画 18 本で、点灯の回数を聞きました。
| 渡し方 | 正解 | 内訳 |
|---|---|---|
| 動画(12 秒) | 6/18(33%) | 0 回は 3/3、1 回は 2/3、2 回以上は 12 本中 1 本 |
| 等間隔の 4 コマを画像で | 4/18(22%) | 0 回は 3/3 |
「点灯したかどうか」は分かっても、何回点灯したかは数えられません。2 回以上の答えは「1 回」か「3 回」にばらけました。回数が必要なら、動画を短く区切って「この区間で点灯しているか」を聞き、コードで数えるほうが確実です。
3. 画面録画:一瞬だけ出たエラーを捉えられる
AI エージェントの状態確認を想定して、経費精算フォームの送信を Chrome で録画した 20 本を使いました。結末は 5 通りで、「エラーが 1.5 秒だけ出て、元のフォームに戻る」 という意地悪なものを含めています。
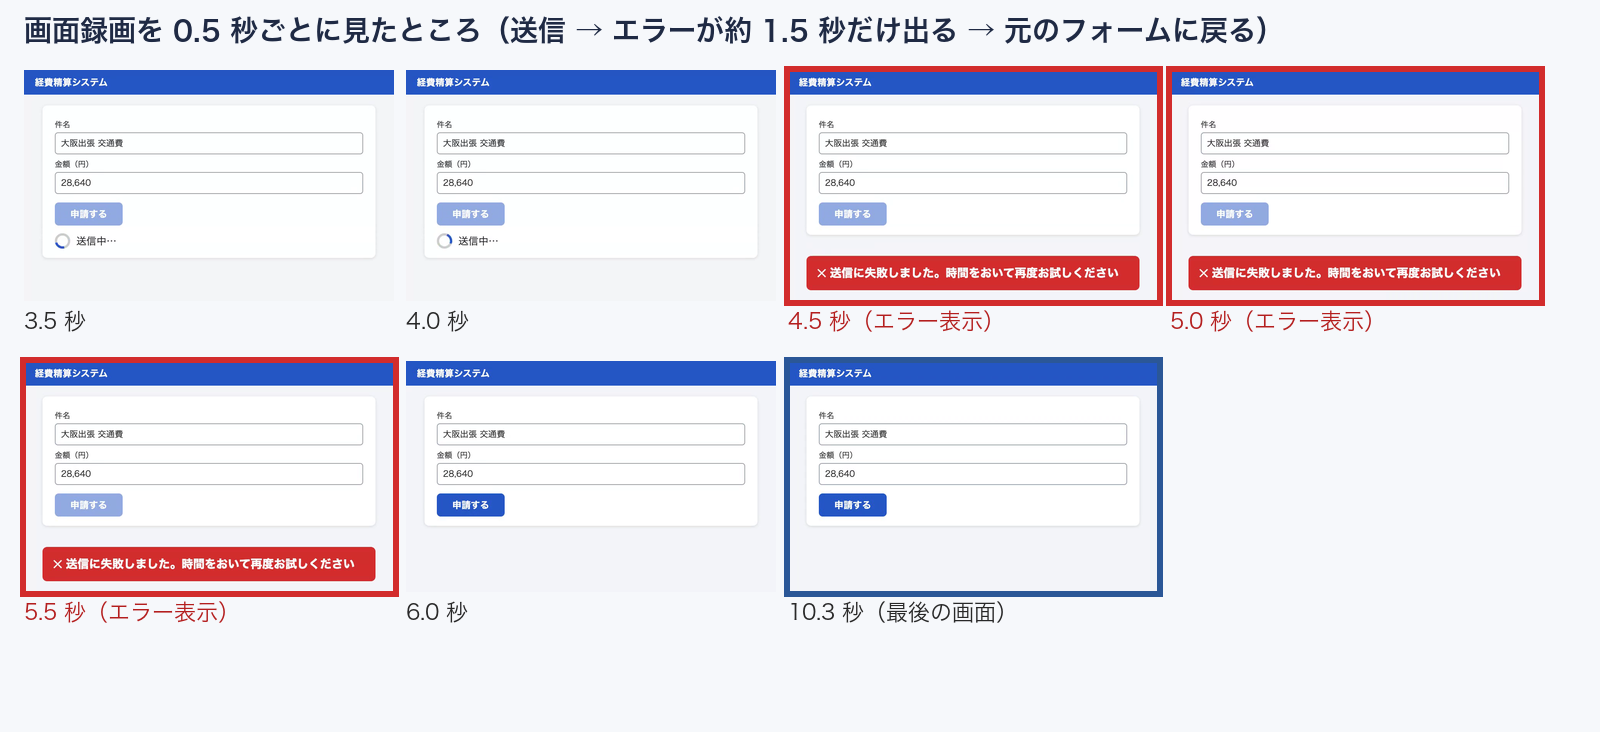
一瞬だけエラーが出る録画(実物)。最後の画面だけを見ると、何も起きなかったように見える
| 渡し方 | 送信に成功したか | 途中でエラーが出たか | 最後の画面は何か(5 択) |
|---|---|---|---|
| 最後のスクリーンショット 1 枚 | 20/20 | 12/20(一瞬のエラーは 0/4) | 20/20 |
| 画面録画(10.5 秒) | 20/20 | 16/20(一瞬のエラーは 4/4) | 17/20 |
| 画面録画 + 最後のスクリーンショット | 20/20 | 16/20(一瞬のエラーは 4/4) | 19/20 |
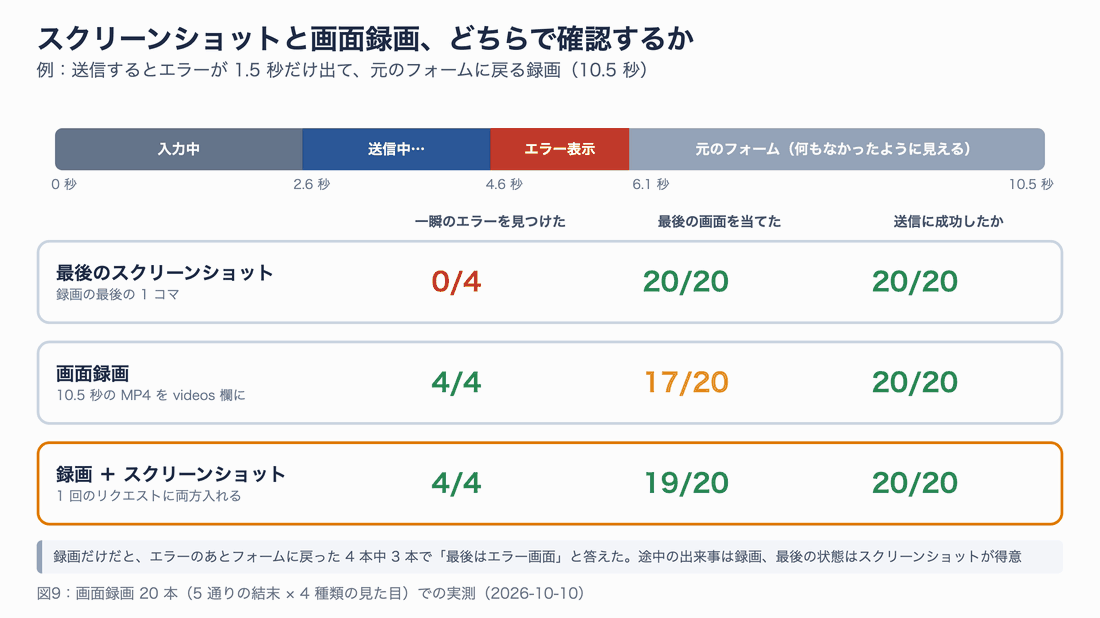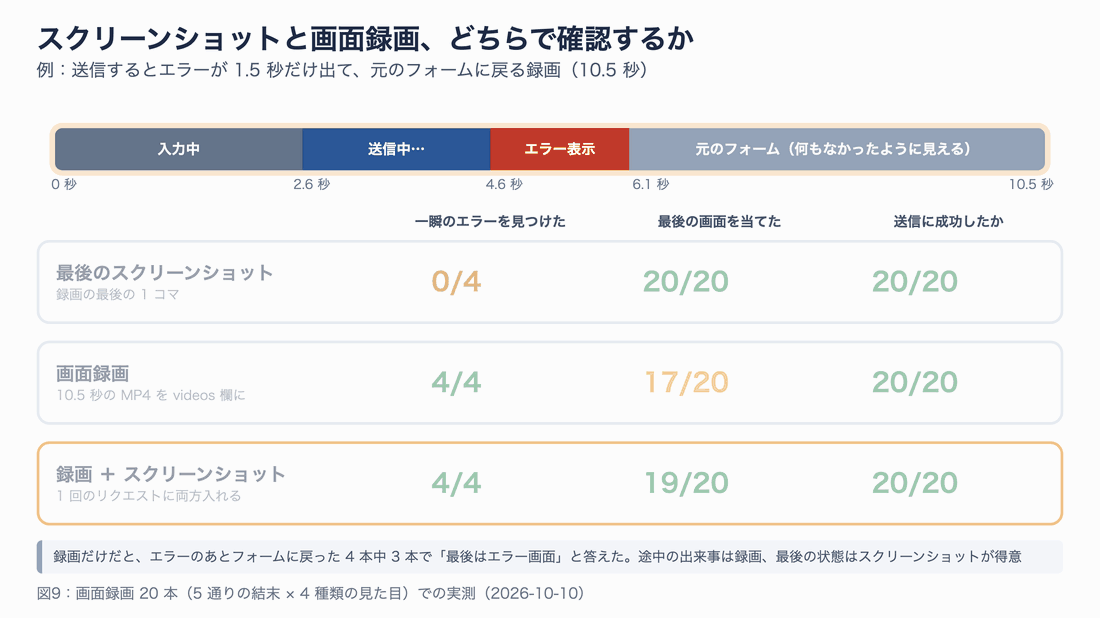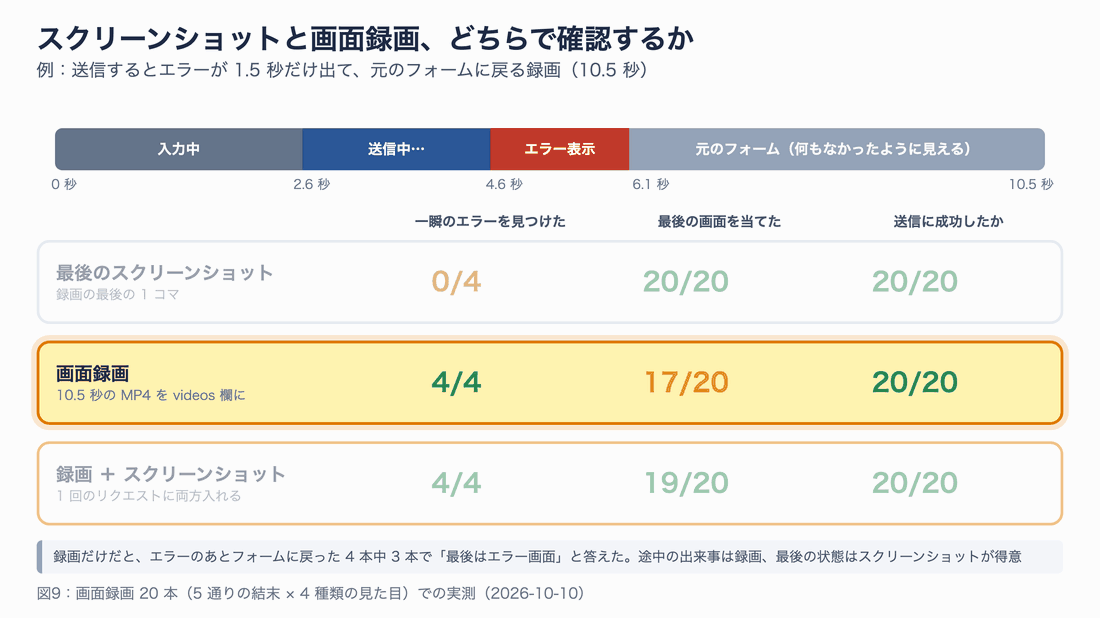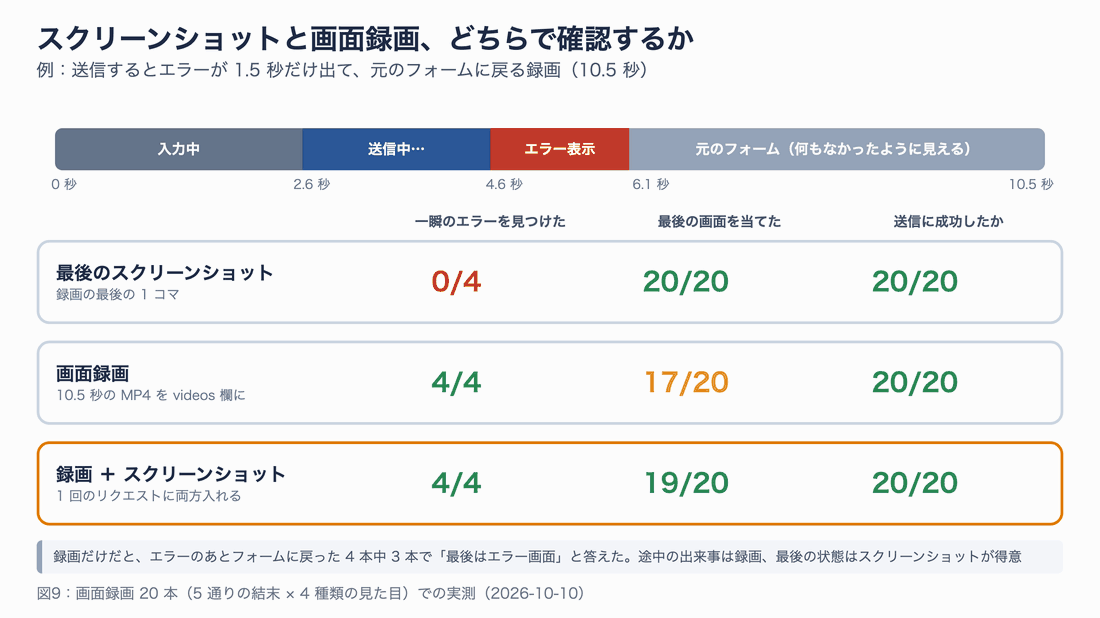
図9:画面録画は「途中で何があったか」、スクリーンショットは「最後にどうなったか」に強い。両方を 1 回のリクエストに入れられる
一瞬だけ出たエラーは、録画なら 4 本すべてで見つかりました。最後のスクリーンショットだけでは 1 本も見つかりません。これは動画で渡す大きな利点です。
一方で、録画だけだと「最後の画面は何か」を 3 本間違えました。いずれも一瞬のエラーのあとフォームに戻った録画で、「エラー画面で終わった」と答えています。動画のどこかに出たものを、最後の状態と取り違えやすいのは扇風機と同じ傾向です。録画と最後のスクリーンショットを一緒に渡す と 19/20 まで戻りました。
「途中でエラーが出たか」の間違い 4 本は、すべて「ログイン画面に戻された」録画です。黄色い枠で「セッションの有効期限が切れました」と出る画面を、エラーとみなしていました。これは質問の定義の問題でもあるので、実際に使うなら「赤いエラーメッセージが出たか」のように具体的に聞くのがよいでしょう。
4. 映像と音を一緒に判断できるか:音は聞こえるが、映像に引っぱられる
Clef-omni の売りの 1 つは「映像と音を合わせて判断できる」ことです。ここは 3 つのテストで確かめました。
① 動画の音声トラックを聞いているか。静止画に通話の音声を入れただけの動画 80 本で、通話の用件と緊急度を聞きました。
| 渡し方 | 用件(5 択) | 急ぎかどうか |
|---|---|---|
| 静止画+音声トラックの動画 | 64/80(80%) | 67/80(84%) |
| 同じ動画から音を抜いたもの | 16/80(20%、すべて「障害」と回答) | 48/80(60%) |
音を抜いた動画 + 音声を audio 欄に | 73/80(91%) | 80/80(100%) |
参考:音声だけを audio 欄に | 74/80(93%) | 80/80(100%) |
音を抜くと当てずっぽうになるので、音声トラックはちゃんと聞いています。ただし、同じ音声を audio 欄で別に渡したほうが、はっきり正確でした。
② 見たものと聞いたものを照合できるか。スライドに「1,360 人」と表示し、ナレーションでは「1,460 人でした」と読み上げるような動画 40 本(半分は一致、半分は不一致)で、数字が一致しているかを聞きました。
| 渡し方 | 一致しているか | 読み上げた数字(5 択) | スライドの数字(5 択) |
|---|---|---|---|
| 動画(音声トラックつき) | 20/40(50%) | 20/40(50%) | 40/40 |
| 同上、質問を英語に統一 | 20/40(50%) | — | — |
スライドの画像 + 音声を audio 欄に | 33/40(83%) | 33/40(83%) | 40/40 |
| 音声だけ | — | 40/40(100%) | — |
| スライドの画像 + Whisper の文字起こし | 38/40(95%) | — | — |
動画で渡すと、40 本すべてで「一致している」と答え、正解率は 50% でした。さらに「読み上げた数字は?」と聞くと、40 本すべてでスライドに書かれた数字を答えていました。音声だけなら 40 本すべて正しく聞き取れているので、聞こえていないのではなく、映像の文字が強すぎて音の情報が負けている と考えられます。
③ 装置の映像と動作音。扇風機(回る/止まる)× ランプ(緑/赤)× 動作音(滑らか/異常音入り)の 8 通り × 3 本の動画で、それぞれを聞きました。
| 渡し方 | 回っているか | ランプは赤か | 異常な音がするか | すべて正常か |
|---|---|---|---|---|
| 動画(音声トラックつき) | 21/24 | 24/24 | 12/24(すべて「いいえ」) | 21/24 |
| 音を抜いた動画 | 23/24 | 24/24 | 12/24 | 21/24 |
音を抜いた動画 + 音声を audio 欄に | 23/24 | 24/24 | 12/24 | 22/24 |
映像の判断(回っているか・ランプの色)はよく当たりますが、異常音は音声だけのテストと同じく拾えませんでした。「すべて正常か」の正解も、映像だけで決まっています。
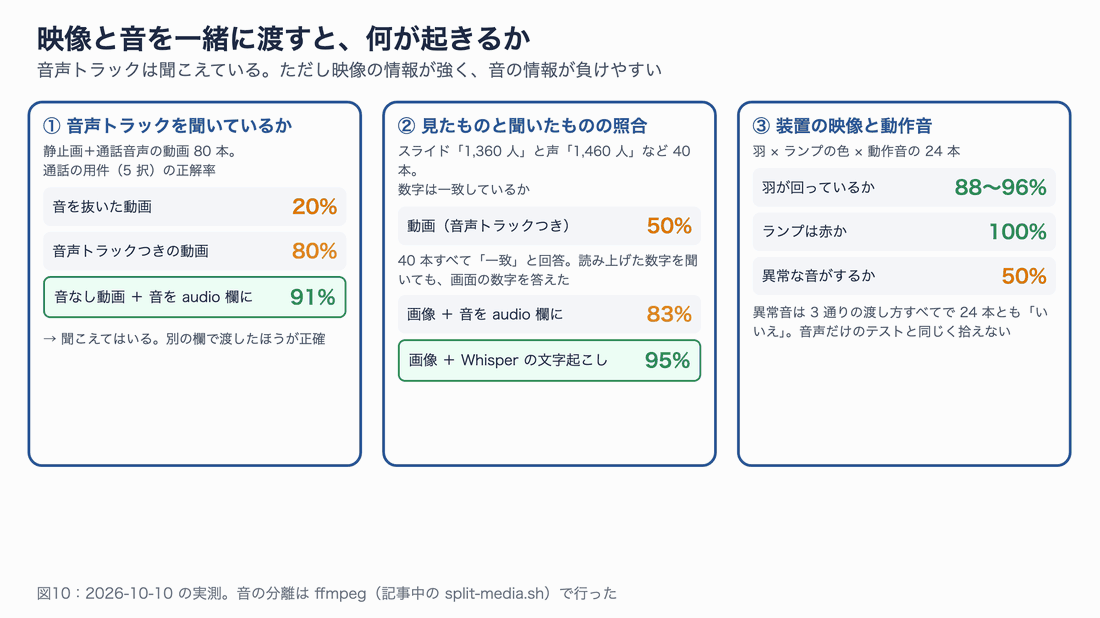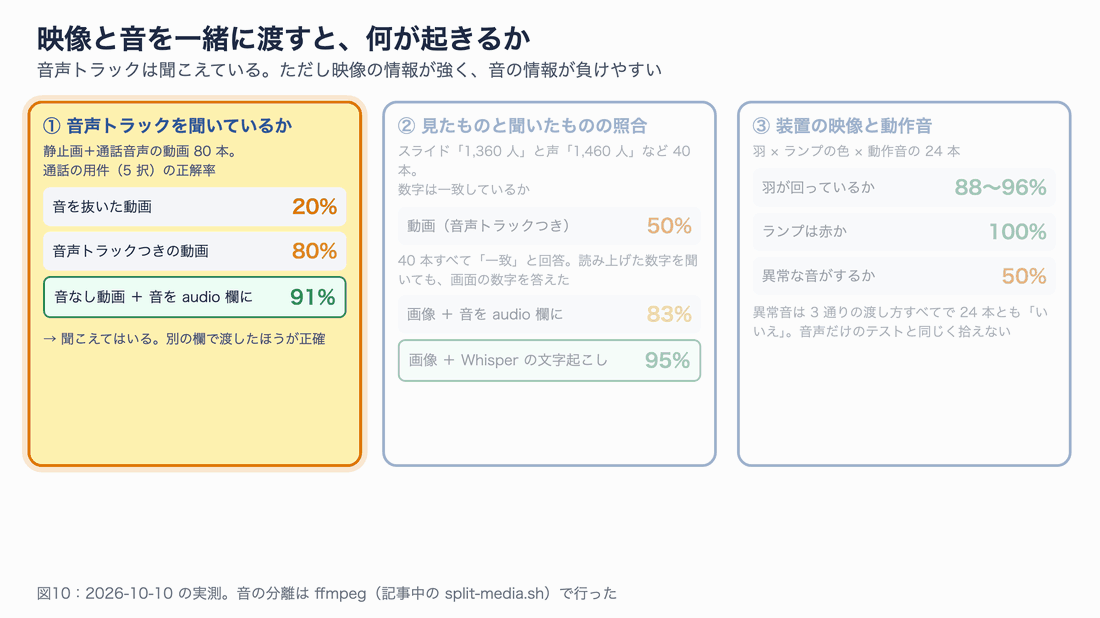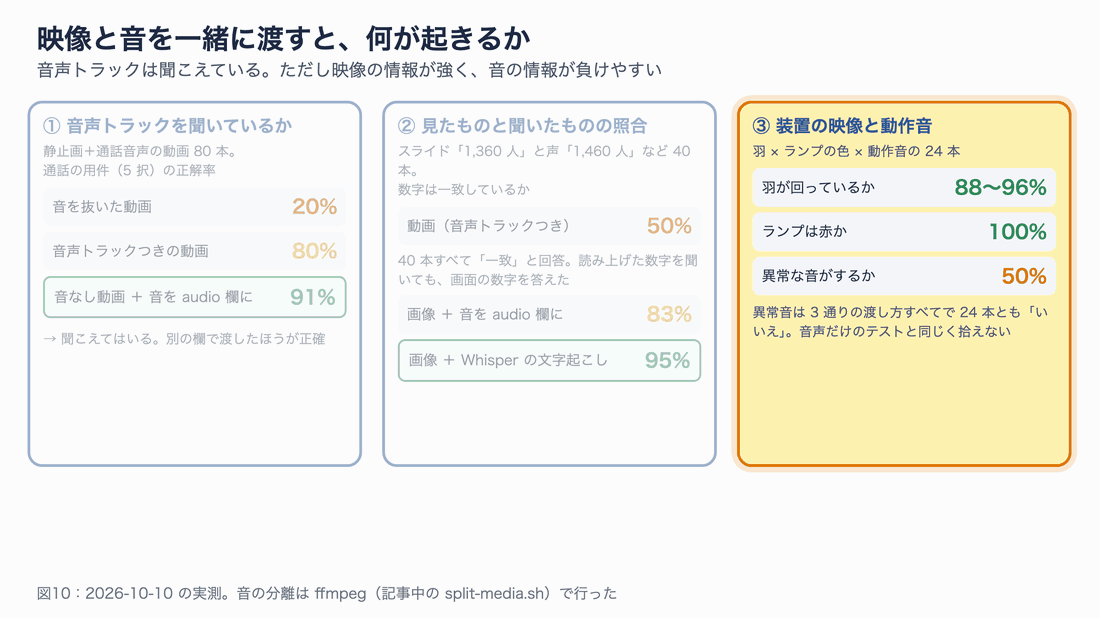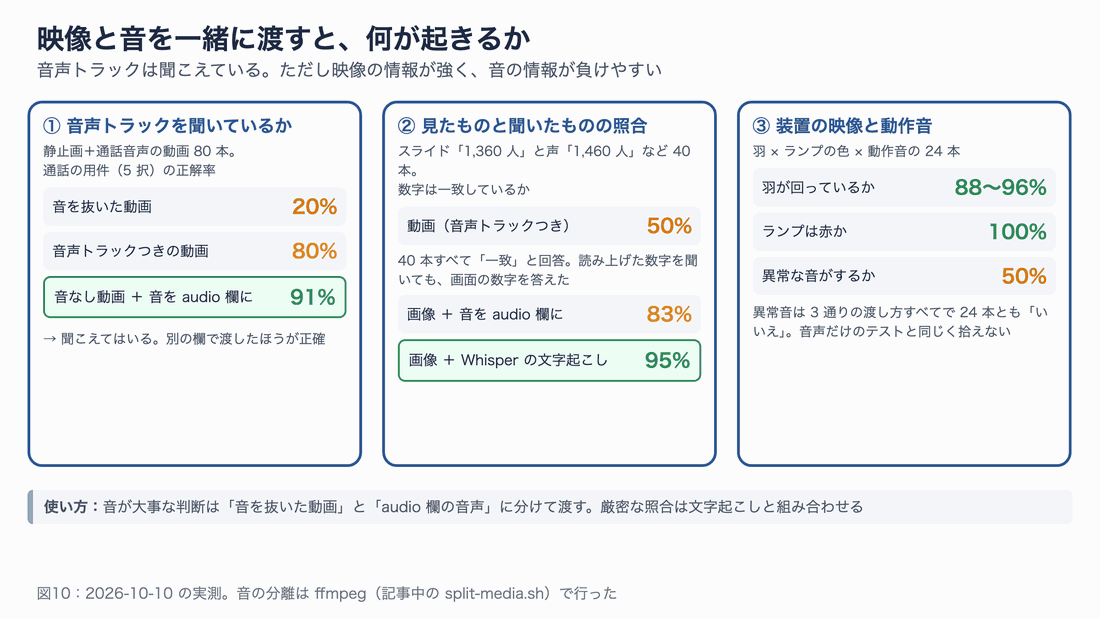
図10:映像と音を一緒に渡すときの注意。音は別の欄に分け、厳密な照合には文字起こしを組み合わせる
ここから言えるのは、音が大事な判断では、動画の音声トラックに頼らず、音を抜いた動画と audio 欄に分けて渡す ほうがよい、ということです。さらに「見たものと聞いたものが一致しているか」のような厳密な照合は、音声を文字に起こしてから画像と一緒に渡すのがいちばん確実でした(95%)。
速さと費用
速さ:公式ブログの数字に近い
入力の種類と長さを変えて、1 件ずつ順番に 15 回ずつ送りました(並列なし、順番は毎回シャッフル)。「Worker 内」は env.AI.run() にかかった時間、「往復」は東京の Mac から見た時間です。
| 入力 | Worker 内(中央値) | Worker 内(90%) | 往復(中央値) | 入力トークン | 公式ブログ | Changelog |
|---|---|---|---|---|---|---|
| 文章だけ | 55ms | 149ms | 73ms | 241 | 約 130ms | 約 20ms |
| 画像 1 枚(640×480) | 132ms | 208ms | 193ms | 534 | 約 150ms | 100ms 未満 |
| 音声 5 秒 | 113ms | 211ms | 202ms | 298 | 数百 ms | 100ms 未満 |
| 音声 10 秒 | 145ms | 227ms | 297ms | 363 | 〃 | 〃 |
| 音声 30 秒 | 278ms | 290ms | 600ms | 623 | 〃 | 〃 |
| 音声 60 秒 | 354ms | 440ms | 931ms | 1,013 | 〃 | 〃 |
| 動画 10 秒(480p・音あり) | 605ms | 720ms | 859ms | 2,887 | — | — |
| 動画 21 秒(480p・音なし) | 1,193ms | 1,380ms | 1,638ms | 5,526 | — | — |
| 動画 21 秒(480p・音あり) | 1,319ms | 1,459ms | 1,830ms | 5,802 | 約 1.5 秒 | 約 300ms |
| 動画 21 秒(720p・音あり) | 1,490ms | 1,607ms | 2,137ms | 5,802 | — | — |
| 動画 60 秒(480p・音あり) | 4,428ms | 4,612ms | 5,525ms | 16,137 | — | — |
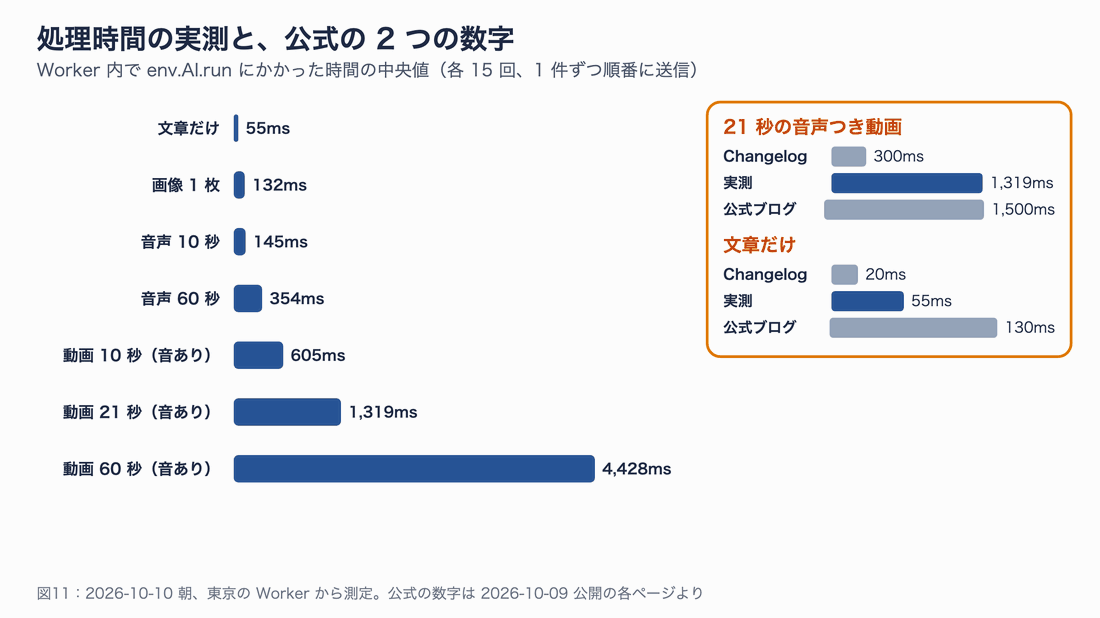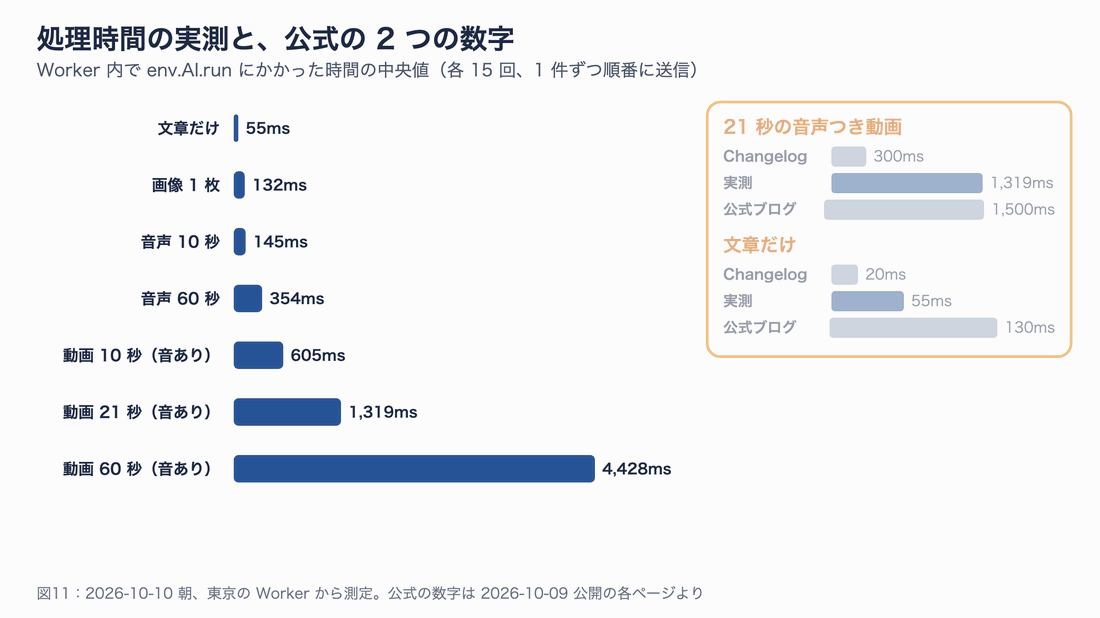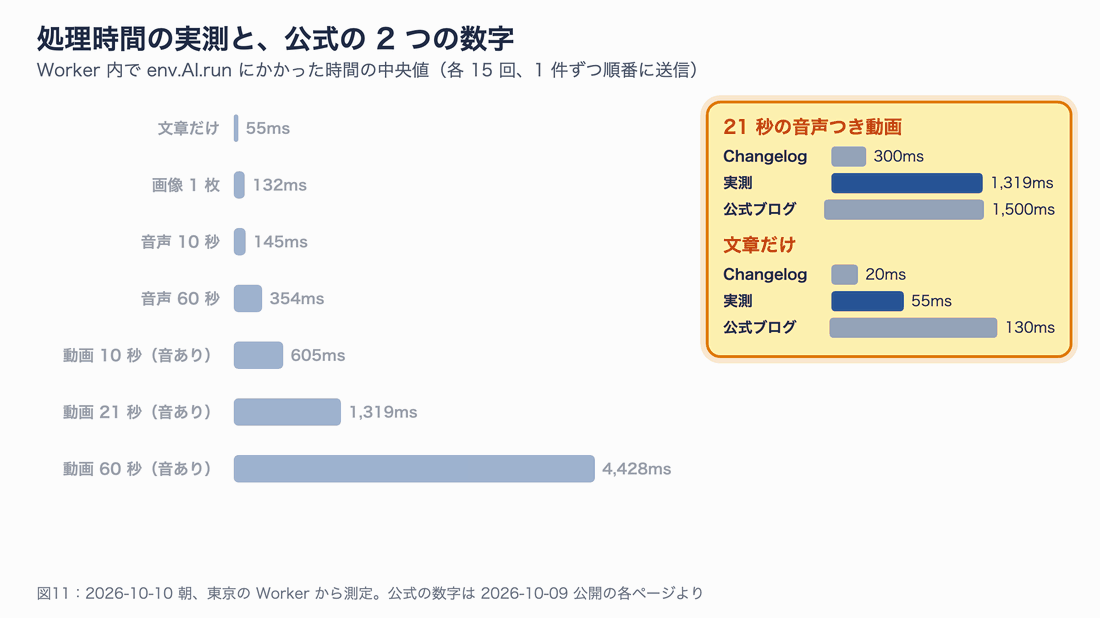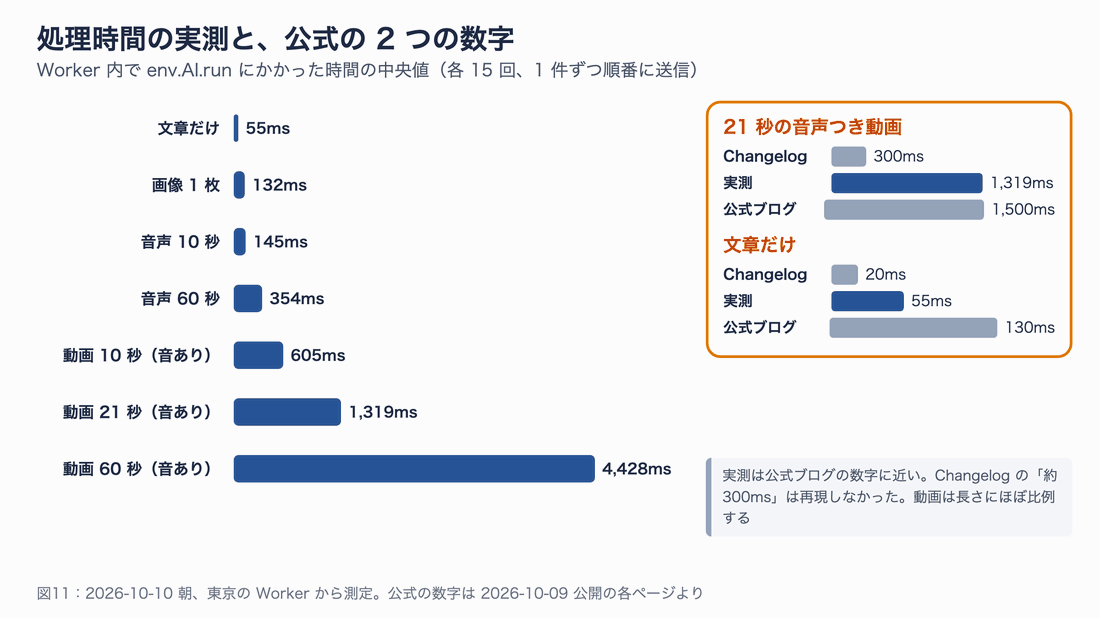
図11:処理時間の実測(Worker 内の中央値、各 15 回)と公式の 2 つの数字
21 秒の音声つき動画は 1.3 秒で、公式ブログの「約 1.5 秒」に近く、Changelog の「約 300ms」は再現しませんでした。文章だけの判定は公式ブログより速い 55ms でした。動画の処理時間はほぼ長さに比例し、60 秒の動画では 4.4 秒かかります。往復時間には data URL の送信時間が含まれるので、長い動画ほど差が開きます。
同じリクエストを 5 回ずつ送る再現性の確認では、音声 4 件・動画 4 件の 8 件すべてで確率が小数点以下 4 桁まで毎回同じ でした。
費用:動画は音声の 15 倍ほど
1 件あたりの費用は、入力トークン × $0.15/100 万で計算できます。
| 入力 | 1 件のトークン | 1,000 件の費用 | 無料枠(1 日 1 万 Neuron)で送れる件数 |
|---|---|---|---|
| 文章 | 241 | $0.036 | 約 3,000 件 |
| 音声 10 秒 | 363 | $0.054 | 約 2,000 件 |
| 音声 60 秒 | 1,013 | $0.15 | 約 720 件 |
| 動画 21 秒(音あり) | 5,802 | $0.87 | 約 126 件 |
| 動画 60 秒(音あり) | 16,137 | $2.42 | 約 45 件 |
Workers AI は「Neuron」という単位で課金され、Clef-omni は入力 100 万トークンあたり 13,636 Neuron です。無料プランでは 1 日 1 万 Neuron まで使えるので、21 秒の動画なら 1 日 126 件ほどで無料枠が尽きます。
実際、今回の検証では途中で無料枠を使い切りました。超えてもしばらくは処理されましたが、合計で約 3.8 万 Neuron に達したところで次のエラーが返るようになりました。無料プランなので請求はされず、日本時間の朝 9 時(UTC の 0 時)に枠が戻ります。
4006: you have used up your daily free allocation of 10,000 neurons, please upgrade to Cloudflare's Workers Paid plan if you would like to continue usage.
検証全体(Clef-omni 約 2,280 回、入力 約 280 万トークン)を有料プランで払った場合の概算は、約 $0.42 です。
実務で使うときのコツ
ここまでの結果を、使い方の判断にまとめます。
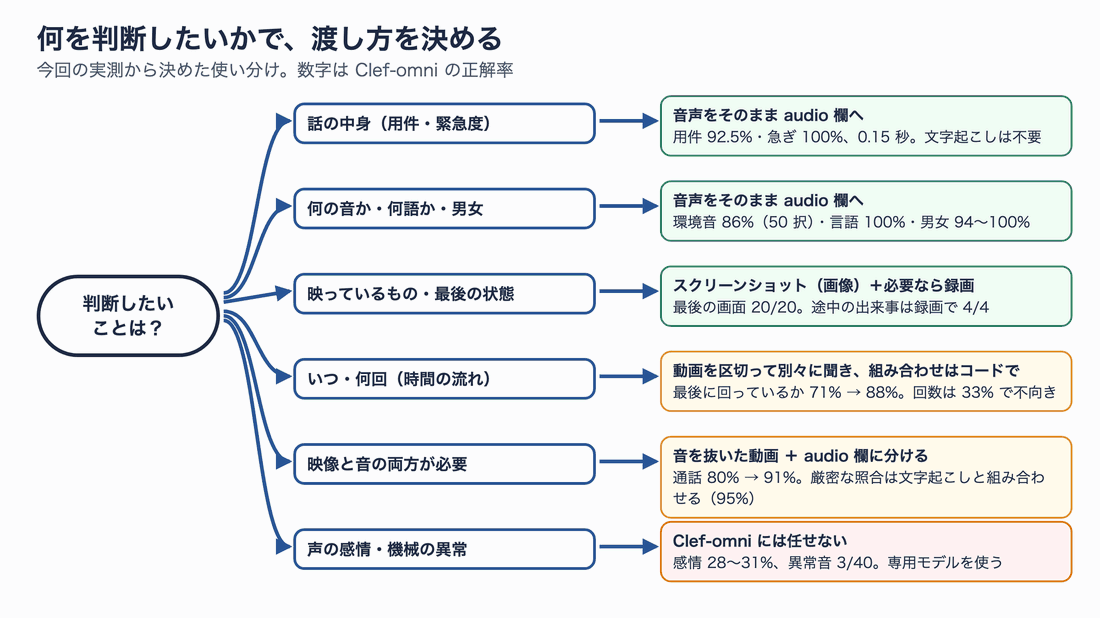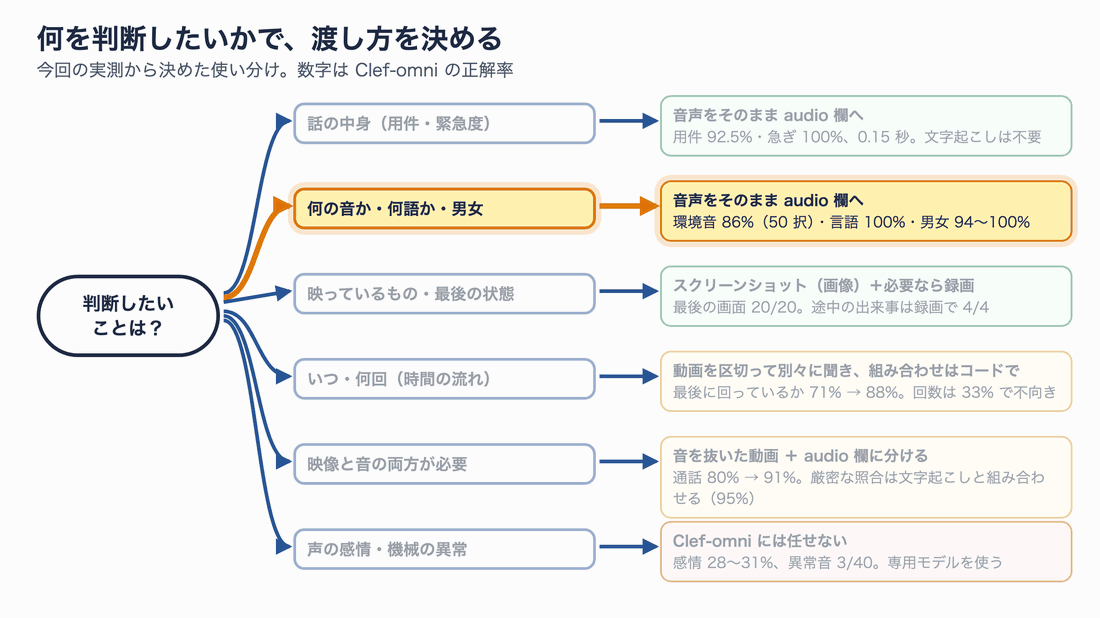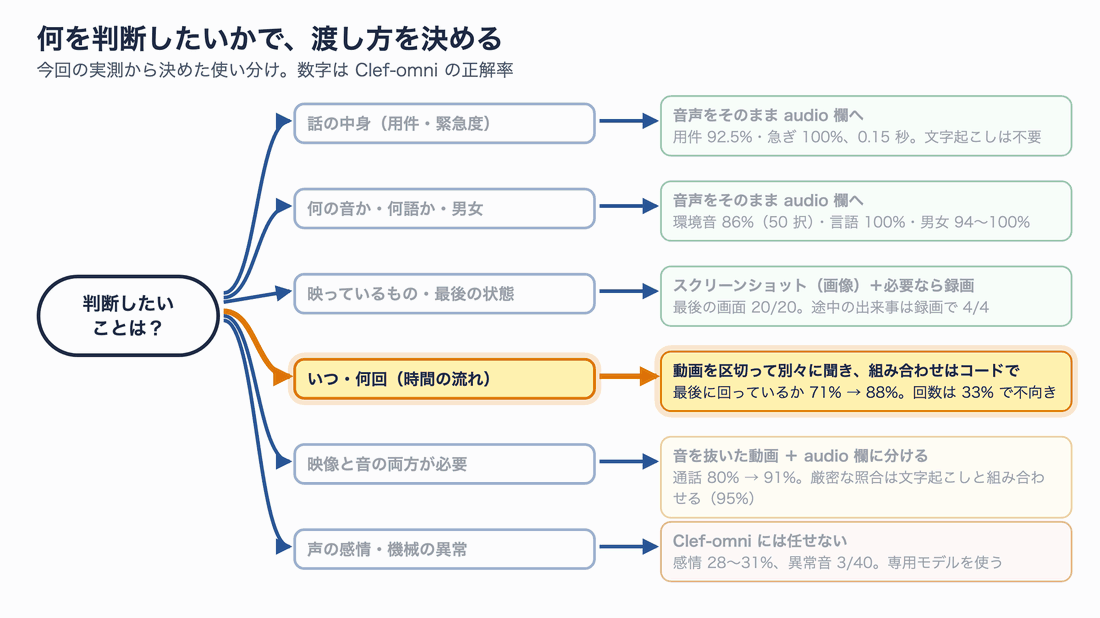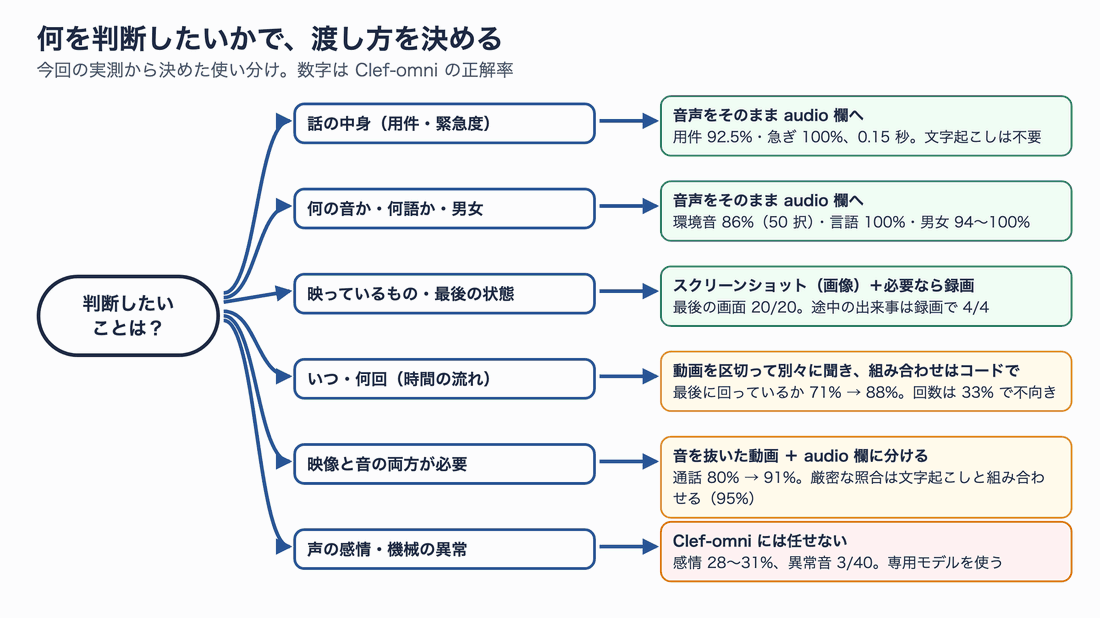
図12:判断したい内容ごとの渡し方
- 話の中身を判断するなら、音声をそのまま渡す。文字起こしを挟んでも精度はほぼ同じで、約 12 倍速くなります。日本語の通話でも 90% 当たりました
- 音が大事な動画は、音を抜いた動画と音声に分けて渡す。動画の音声トラックだと映像に引っぱられます。分けるだけで通話の用件は 80% → 91% に上がりました
- 見たものと聞いたものの照合は、入力を分けるか文字起こしと組み合わせる。動画のまま「一致しているか」を聞くと 50% でしたが、スライドの画像と音声を分けて渡すと 83%、音声を文字起こししてから渡すと 95% でした
- 「いつ」「何回」は区切って聞く。動画を最初と最後に分けると、扇風機の判定は 71% → 88% に上がりました
- 最終状態はスクリーンショットも一緒に渡す。録画は途中の出来事に、スクリーンショットは最後の状態に強く、両方入れると両方の良さが出ます
- 抽象的な質問より、具体的な音や物の名前で聞く。「異常か」ではなく「カタカタ音が聞こえるか」のほうが拾えます。ただし誤検知も多いので、最終判断には使わないでください
- 声の感情と機械の異常検知は、今は任せない。前者は感情認識の専用モデル、後者は正常時の音で学習する異常検知モデルを使うべき場面です
紹介記事にあった「工場設備の動画と動作音を入れて、異常音があるか・正常に動いているかを直接判定する」使い方は、「正常に動いているか(映像)」は使えるが、「異常音があるか」はこのままでは難しい というのが今回の結論です。
トラブルシューティング
検証中に実際に出たエラーと、ドキュメントに書かれている制限から、確認する順番をまとめます。
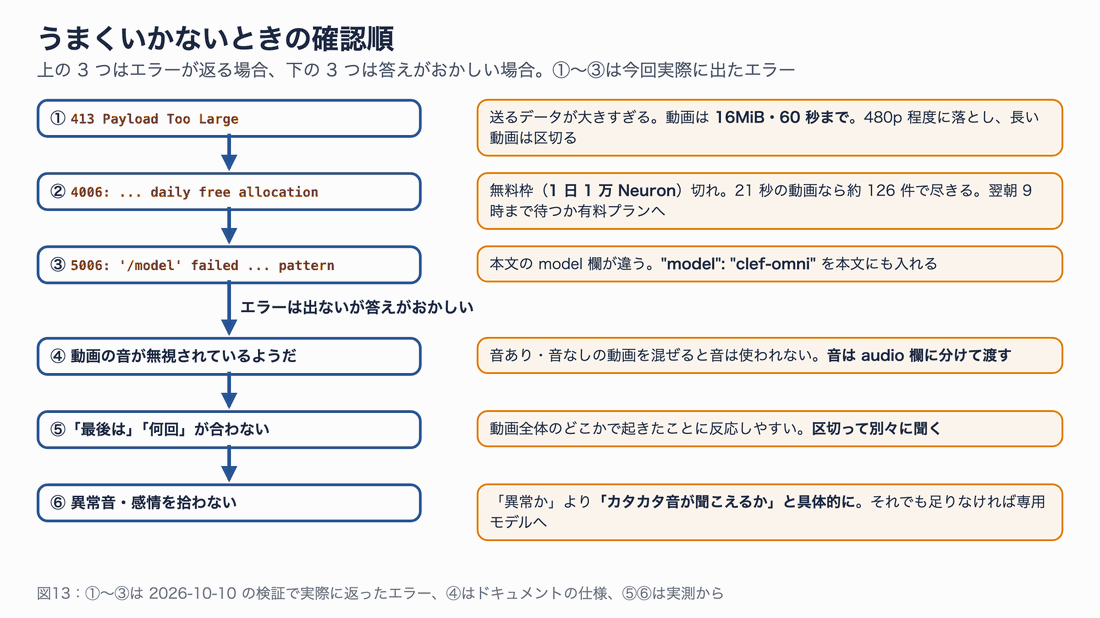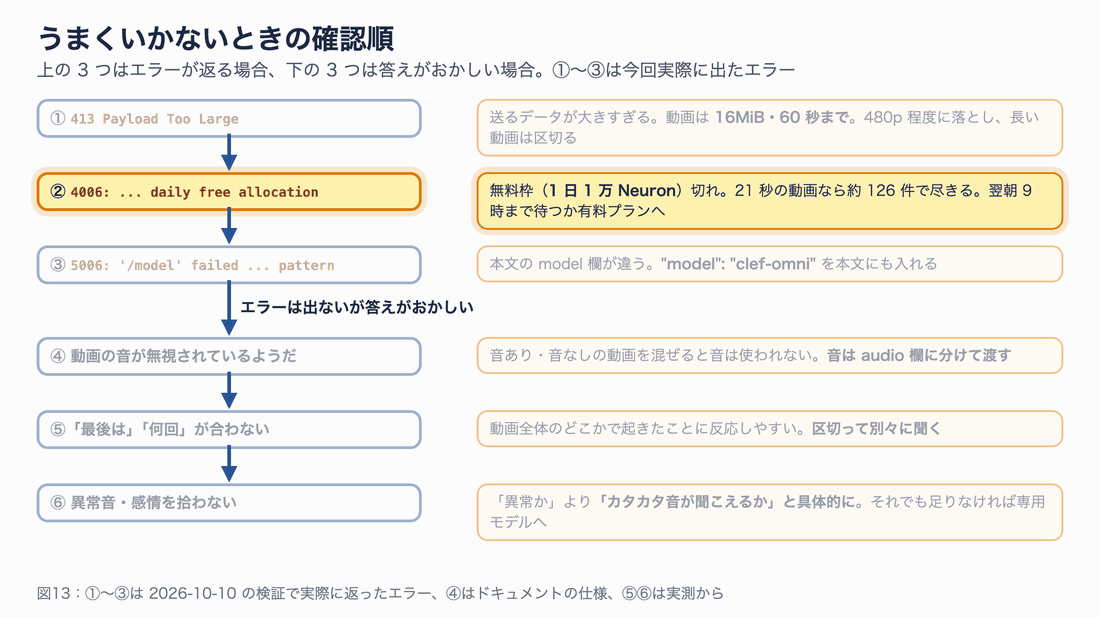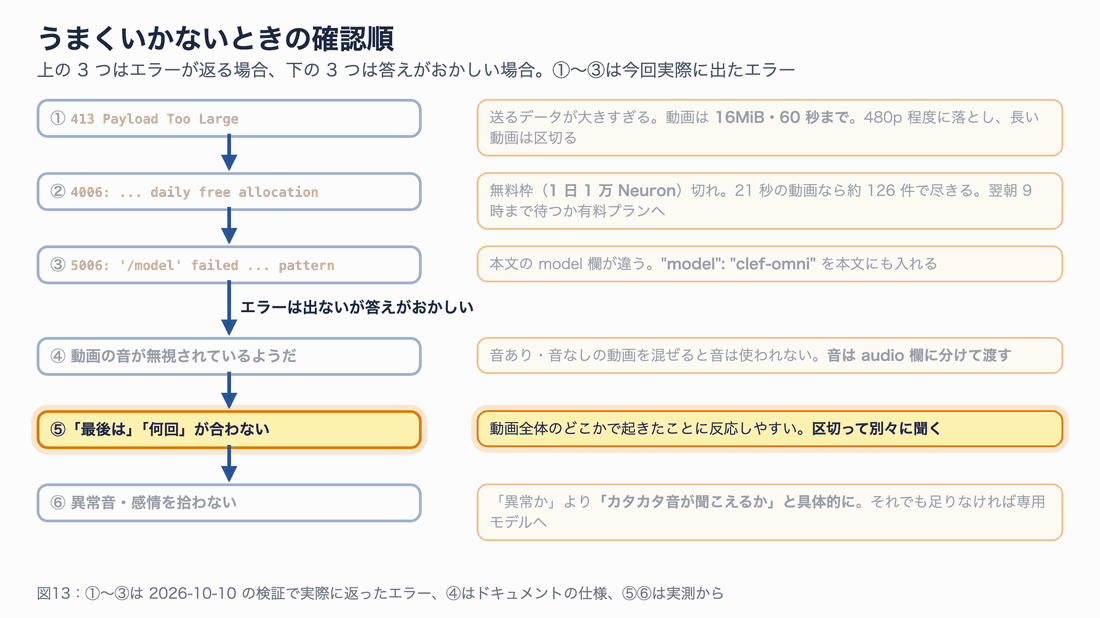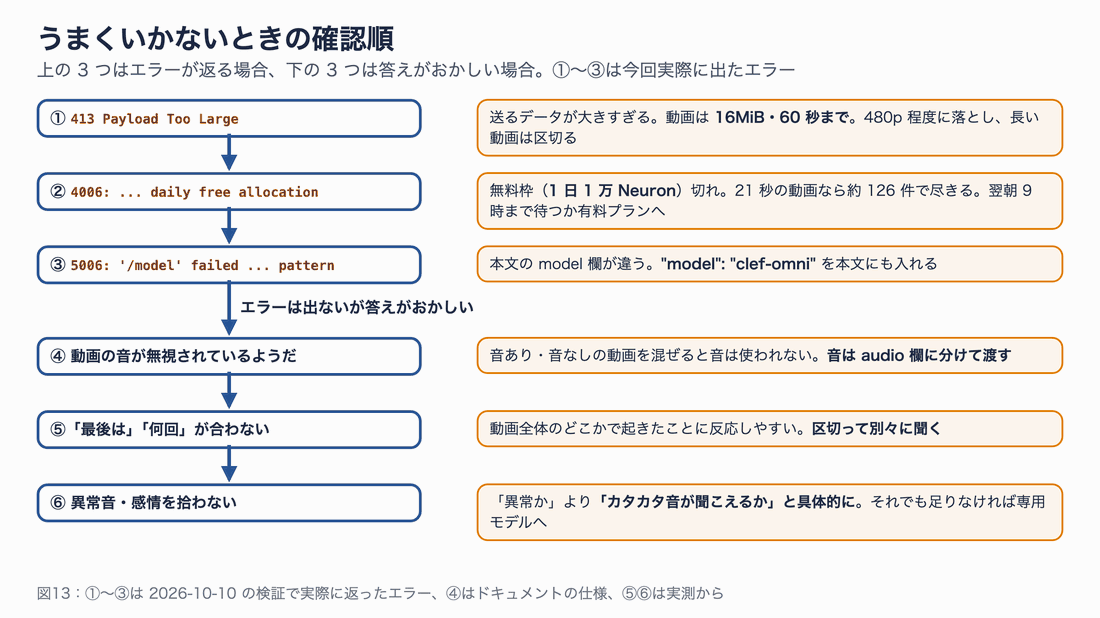
図13:うまくいかないときの確認順
| 症状・エラー | 原因 | 対処 |
|---|---|---|
413 Payload Too Large | 送ったデータが大きすぎる(今回は 195MB の動画で発生) | 動画は 16MiB・60 秒まで。解像度を 480p 程度に落とし、長い動画は区切る |
4006: you have used up your daily free allocation | Workers AI の無料枠(1 日 1 万 Neuron)を使い切った | 翌日(日本時間 9 時)まで待つか、Workers Paid プランにする |
5006: Error: '/model' failed test ^\s*clef-omni\s*$ patttern | リクエスト本文の model 欄が clef-omni ではない | 本文にも "model": "clef-omni" を入れる(Worker の呼び出し ID とは別に必要) |
| 動画の音が無視されているように見える | 音ありと音なしの動画を混ぜると、音声は使われない(ドキュメントの仕様) | 動画を 1 本にするか、音は audio 欄に分ける |
| 「読み上げた内容」を聞いても画面の文字を答える | 映像の文字に引っぱられる(今回の実測) | 音は audio 欄に分けて渡す。または文字起こしを使う |
| 「最後は」「最初は」が効かない | 動画全体のどこかで起きたことに反応しやすい(今回の実測) | 動画を区切って 2 本にし、別々に聞く |
| URL を渡したら失敗した | 画像・音声・動画とも URL での指定は不可(ドキュメントの仕様) | base64 の data URL にする |
公式の curl の例は次の形です(今回は Worker 経由で呼んだので、この REST API は試していません)。$CLOUDFLARE_AUTH_TOKEN には Workers AI の権限を持つ API トークンを入れます。
# 公式ドキュメントの形:REST API で音声つきのリクエストを送る(今回は未実行)
AUDIO=$(base64 -i call.mp3)   # macOS の場合。Linux では base64 -w0 call.mp3
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/cloudflare/clef-omni \
  -X POST \
  -H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN" \
  -H "Content-Type: application/json" \
  -d "{\"model\": \"clef-omni\", \"state\": \"A phone call.\", \"audio\": [\"data:audio/mpeg;base64,${AUDIO}\"],
       \"questions\": {\"urgent\": {\"type\": \"noul\", \"instructions\": \"Is the caller asking for urgent help?\"}}}"
長い音声を -d に直接埋め込むと、シェルの引数の長さ制限に引っかかることがあります。その場合は JSON をファイルに書き出して -d @request.json で渡してください。
この検証の限界
結果を読むときに注意してほしい点です。
- テストデータの多くは合成 です。通話は macOS の読み上げ音声、動画はプログラムで描いた絵です。実際の電話の雑音や、カメラ映像の揺れ・暗さがあると結果は変わりえます
- 件数は 1 テストあたり 12〜120 件 です。数件の差は誤差の範囲として読んでください
- 質問文は英語を中心に作りました。日本語の質問文も通話と感情で試し、結果はほぼ同じでした
- 比較相手の d1-omni-600M は「実験的」と明記された小型モデルで、同じ土俵の比較ではありません。Jev は音声・動画に対応していないため、今回は比べていません
- 速度は 2026年10月10日の朝、東京からの測定です。混み具合で変わります
まとめ
Cloudflare の Clef-omni を、音声 508 件・動画 206 本の自作テストデータで確かめました。
- 通話の用件や緊急度は、音声をそのまま渡しても文字起こし経由と同じくらい当たり(用件 92.5%、急ぎ 100%)、約 12 倍速い
- 何語か・男女・環境音のような 音そのものの聞き分けも得意(100%・94〜100%・86%)
- 一方、声の感情と機械の異常音はほぼ判定できない。異常音は「カタカタ音が聞こえるか」と具体的に聞けば一部拾える
- 動画は 何が映っているか・動いているかは分かるが、「いつ」「何回」は苦手。区切って聞くと改善する
- 画面録画なら 一瞬だけ出たエラーも見つかる。最後の状態はスクリーンショットを添えると確実
- 映像と音を一緒に渡すと 映像に引っぱられる。音は
audio欄に分けたほうがよい - 速さは 公式ブログの数字(21 秒の動画で約 1.5 秒)に近く、Changelog の「約 300ms」は再現しなかった
「前処理なしで音声や動画を判定に回せる」のは確かに大きな変化です。ただし、何でも任せられるわけではありません。話の中身や見た目の判断には積極的に使い、声の調子や異常検知、時間の流れが絡む判断は、区切り方や専用モデルとの組み合わせを考える のが、今の使いどころだと感じました。
次に試すなら、実際のコールセンター録音や監視カメラ映像での精度、そして Hugging Face で公開された重みを手元で動かしたときの結果を確かめてみたいところです。
参考リソース
- Introducing Clef-omni with full multimodality, plus a faster Clef and a cheaper Clef-flash(Cloudflare 公式ブログ、2026-10-09)
- Clef-omni adds audio and video input, Clef-flash is now cheaper, and Clef is faster(Cloudflare Changelog、2026-10-09)
- clef-omni モデルページ(Workers AI ドキュメント)
- Workers AI の料金
- Cloudflare/clef-omni(Hugging Face のモデルカード)
- Open d1: Edge decision models for text, vision, and audio(Liquid AI 公式ブログ、2026-10-07)と LiquidAI/d1-omni-600M
- ESC-50: Dataset for Environmental Sound Classification(CC BY-NC 3.0)
- MIMII Dataset(CC BY-SA 4.0)
- RAVDESS(CC BY-NC-SA 4.0)
- Qwen3-TTS(mlx-community/Qwen3-TTS-12Hz-1.7B-VoiceDesign-bf16)
- 前回の記事:Cloudflare の判定モデル Clef は Jev の代わりになるか