はじめに:「重みがもらえるフロンティア級」は本当に使えるのか
2026年9月22日、Xiaomi(シャオミ)のAIチーム「MiMo」が新しいモデル群 MiMo-V2.6 を公開しました。API経由で使えるだけでなく、モデル本体の重み(Weight:学習済みパラメータのファイル)も Hugging Face で配布されています。ライセンスの表示は MIT です。
ニュースを見て気になったのは、次の3点でした。
- 商用で使っていいのか? MITと書いてあるが、条件や落とし穴はないのか
- どれくらい賢いのか? いまのフロンティアモデルである Claude Fable 5.1 や GPT-6 Astra と比べてどうなのか
- 手元のPCで動くのか? 「オープンウェイト」と言っても、動かせなければ意味がない
この記事では、公式のモデルカード・技術レポート・利用規約と、第三者の評価機関 Artificial Analysis のデータを読み比べます。そのうえで、実際に MacBook Pro(M5 Max・メモリ128GB)へモデルを入れて動かし、コード生成やエージェント動作を試しました。検証のスクリーンショットと録画も載せています。
先に結論をまとめると、次のとおりです。
| 疑問 | この記事の結論 |
|---|---|
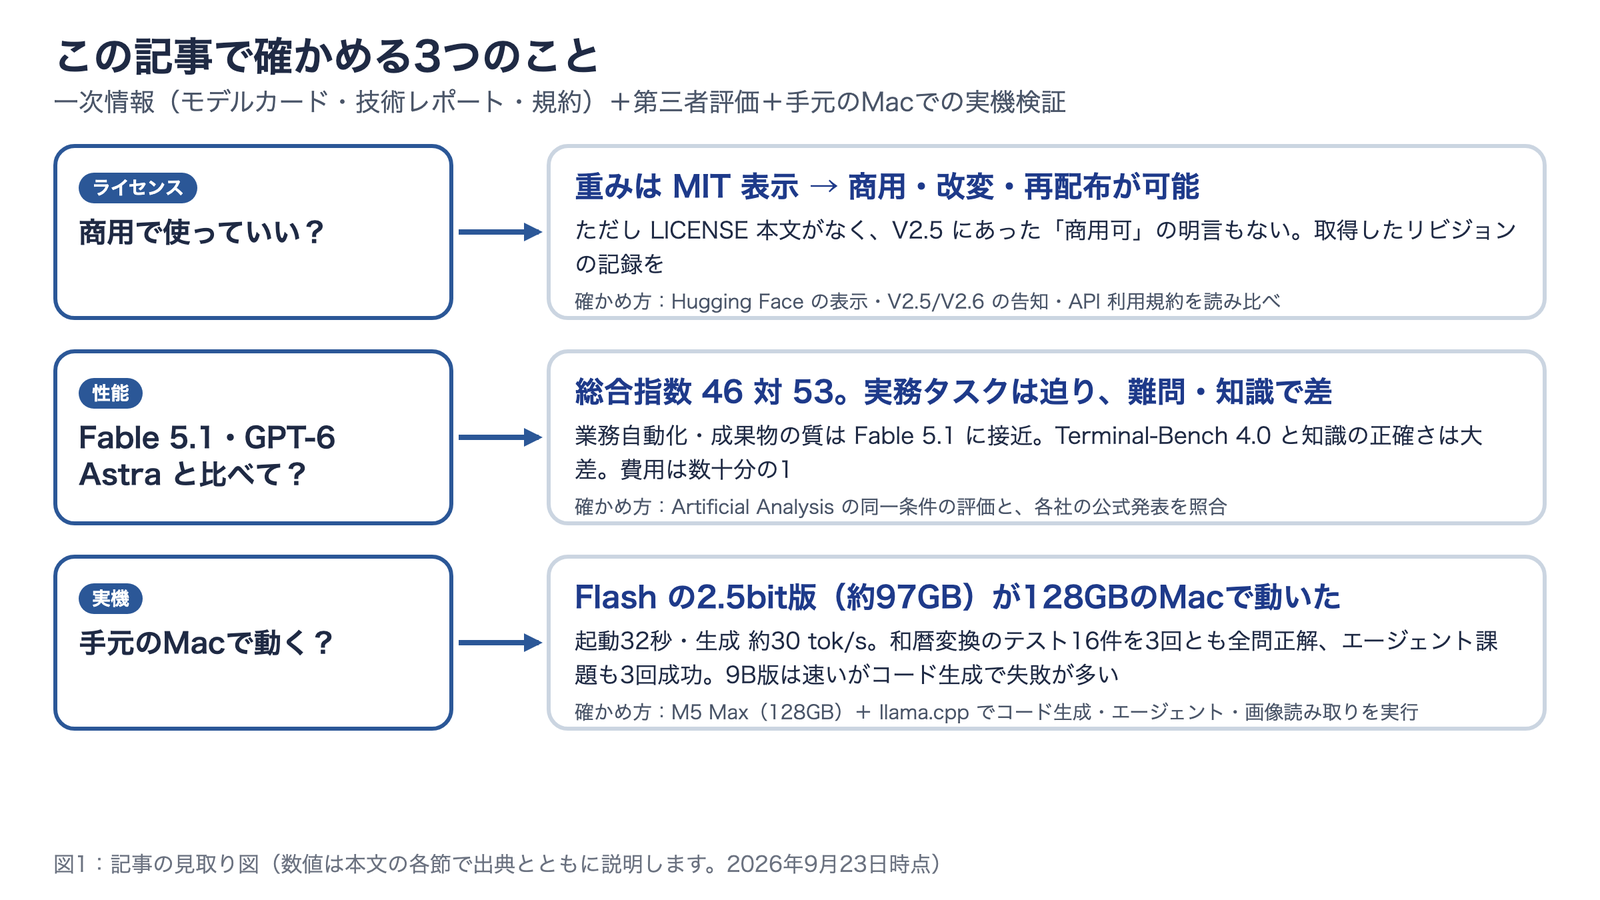
| 商用利用できる? | 重みは MIT表示で商用利用・改変・再配布が可能と読める。ただしリポジトリにLICENSE本文がなく、前バージョンにあった「商用可」の明言も今回は見当たらないため、取得したリビジョンとライセンス表示の記録は必須 |
| フロンティアとの差は? | 同じ物差し(Artificial Analysis)で総合指数 46 対 53。業務自動化や仕事の成果物では Fable 5.1 に迫る一方、難しいターミナル作業と知識の正確さでは大きな差が残る |
| 手元で動く? | 最上位の Pro(約574GB)は無理。Flash を2.5bitに圧縮した版(約97GB)なら128GBのMacで動いた。9Bの小型版はノートPCでも軽快 |
図1は、この記事で扱う3つの疑問と、検証の流れをまとめたものです。
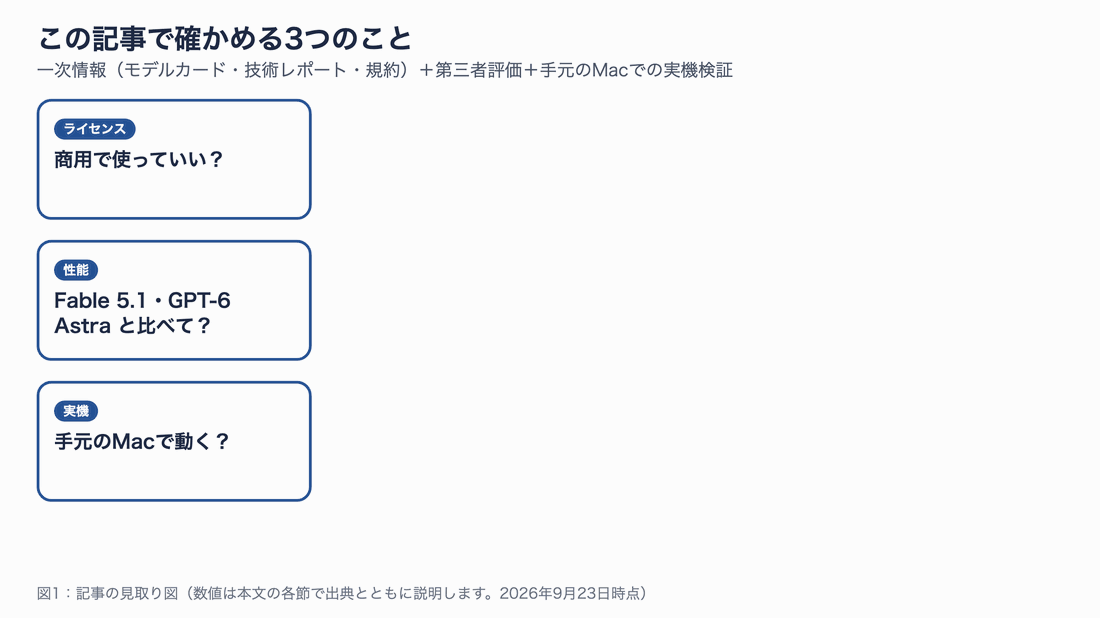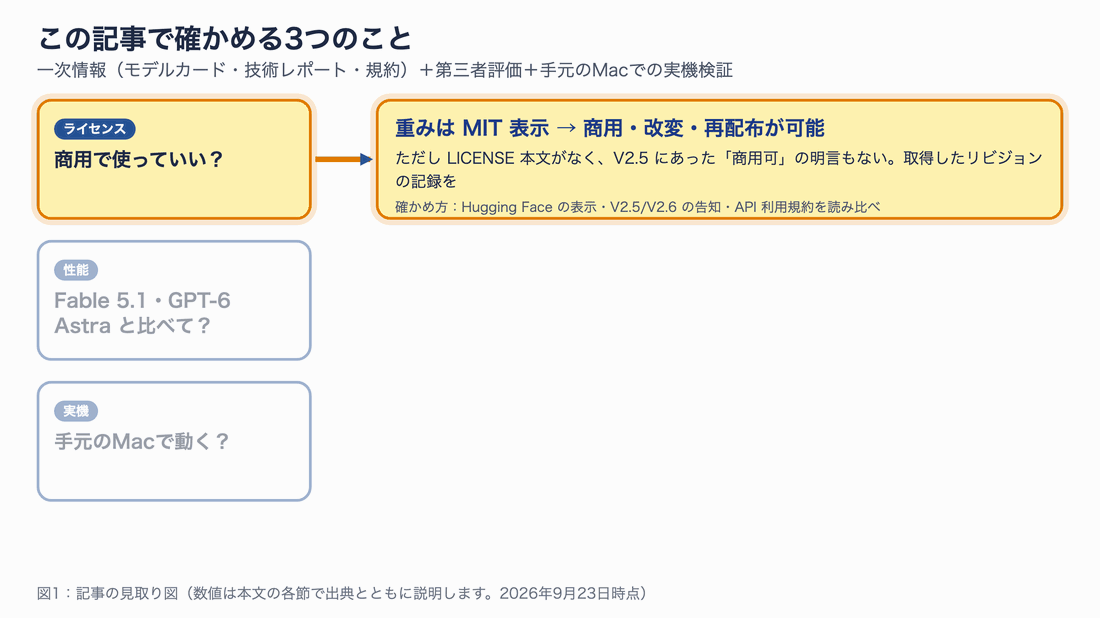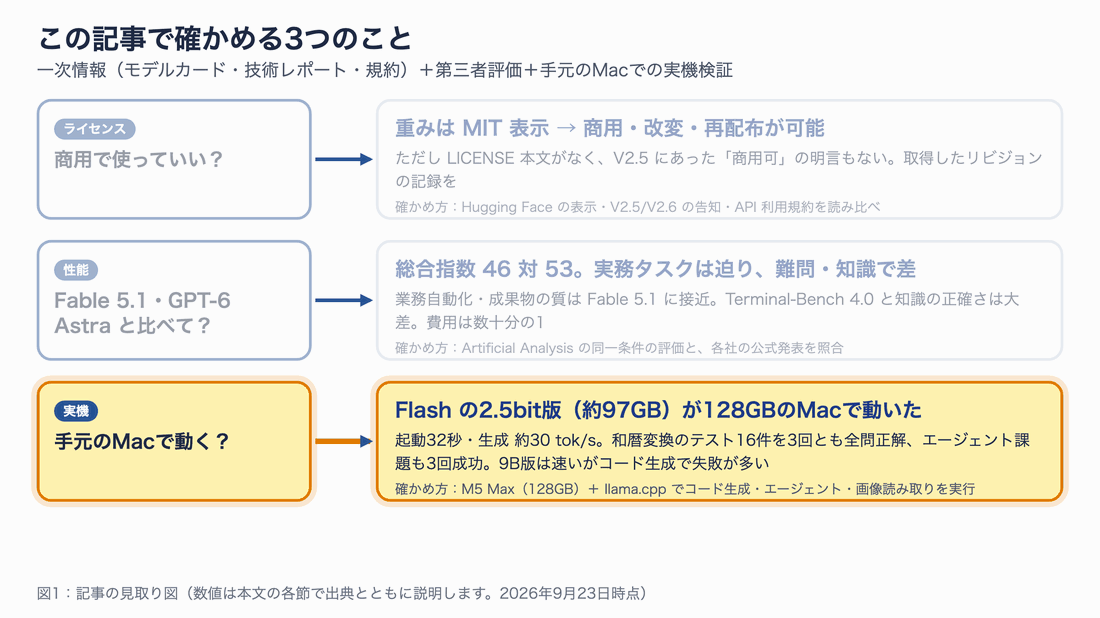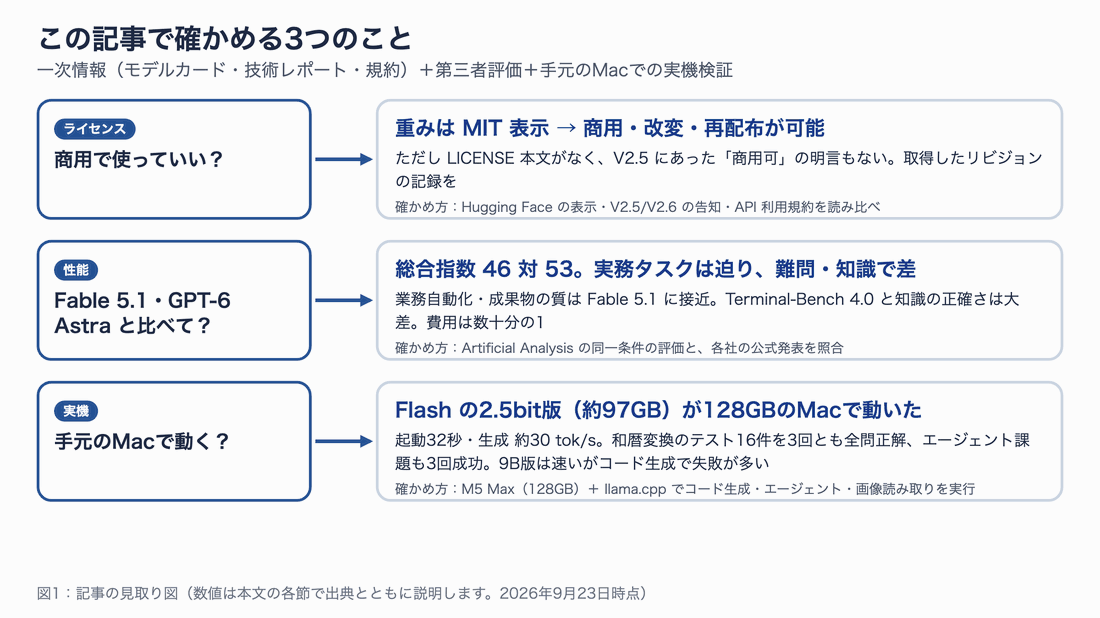
図1:記事全体の見取り図。静止画版は fig01-overview.png
想定読者は、Claude や ChatGPT などを業務で使っていて「オープンウェイトのモデルを自社やPCで使う選択肢」を検討し始めた方です。コマンドはコピーして使える形で載せていますが、ローカル実行の節を飛ばしても、ライセンスと性能比較は読めるように書いています。
MiMo-V2.6 とは:3つのモデルと「MoE」の仕組み
公開されたのは「大・中・小」の3つの重み
MiMo-V2.6 として Hugging Face に公開されたのは、次の3つです。どれも申請なしでダウンロードでき、ライセンス欄には License: mit と表示されています。
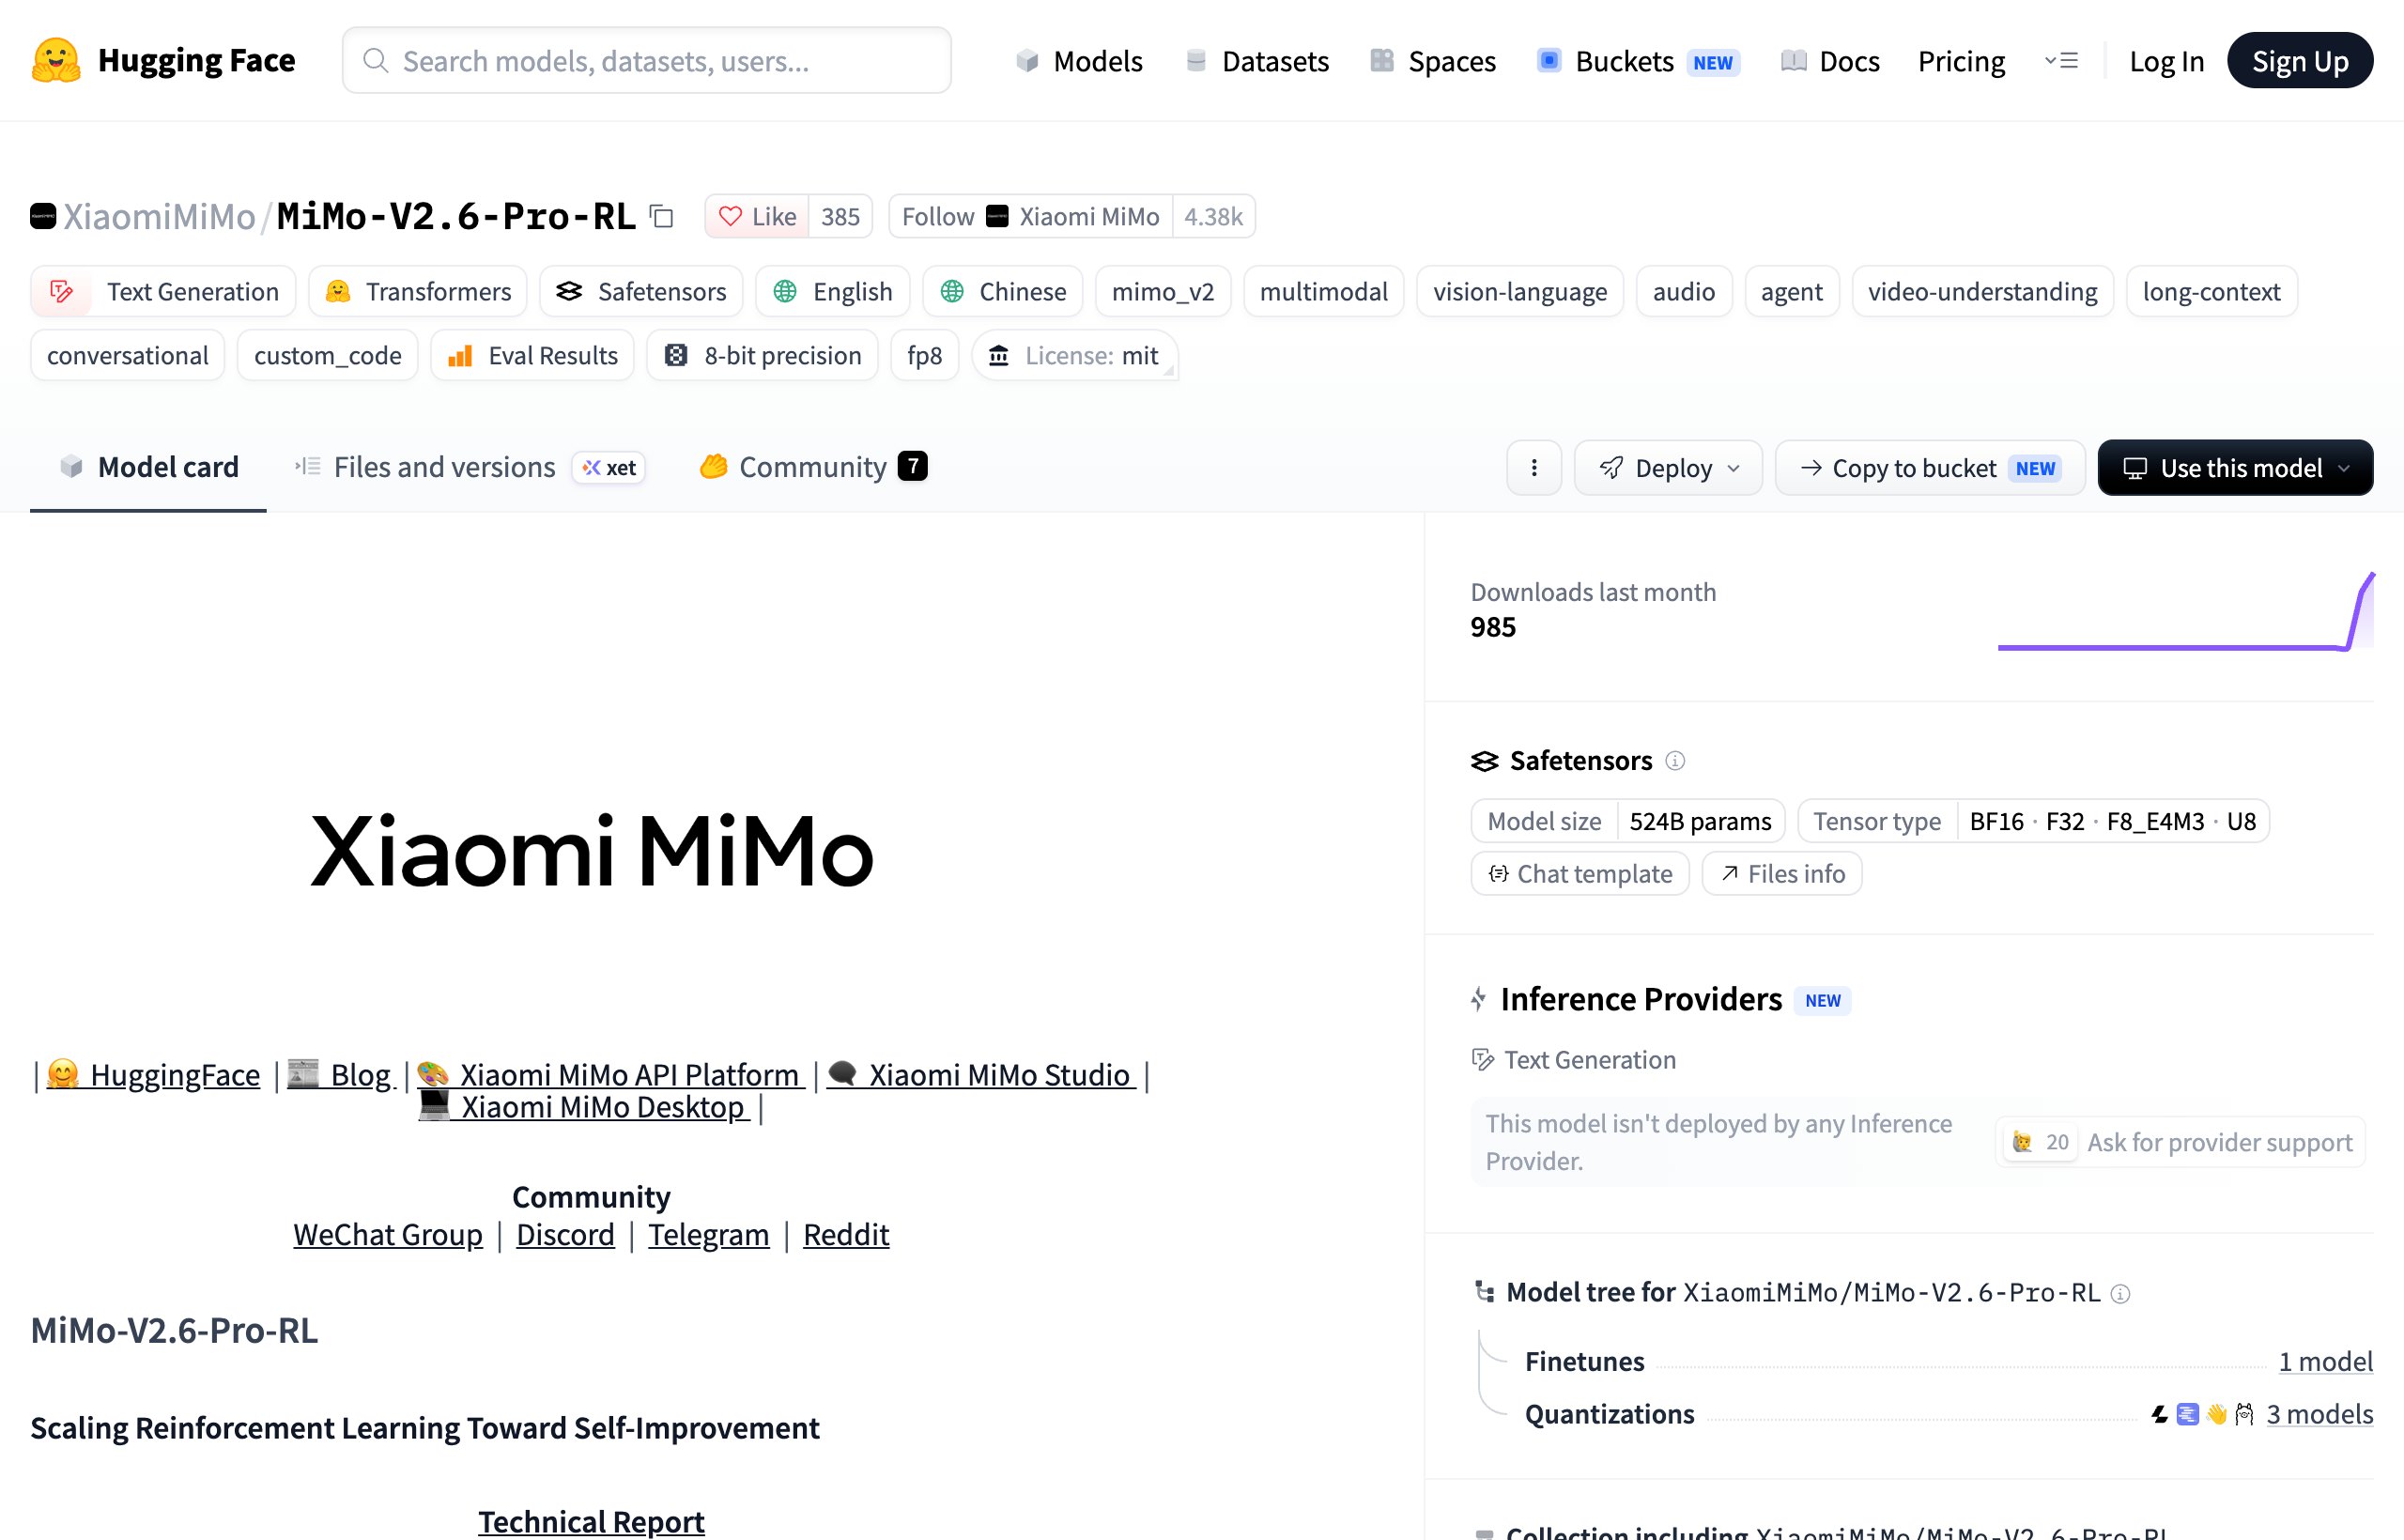
Hugging Face の XiaomiMiMo/MiMo-V2.6-Pro-RL(2026年9月23日撮影)。右側の「524B params」は Hugging Face の自動集計です。専門家部分の重みは4bit(MXFP4)で2つの数値を1バイトに詰めて保存しているため、実際の規模(1.02T)の約半分に見えています
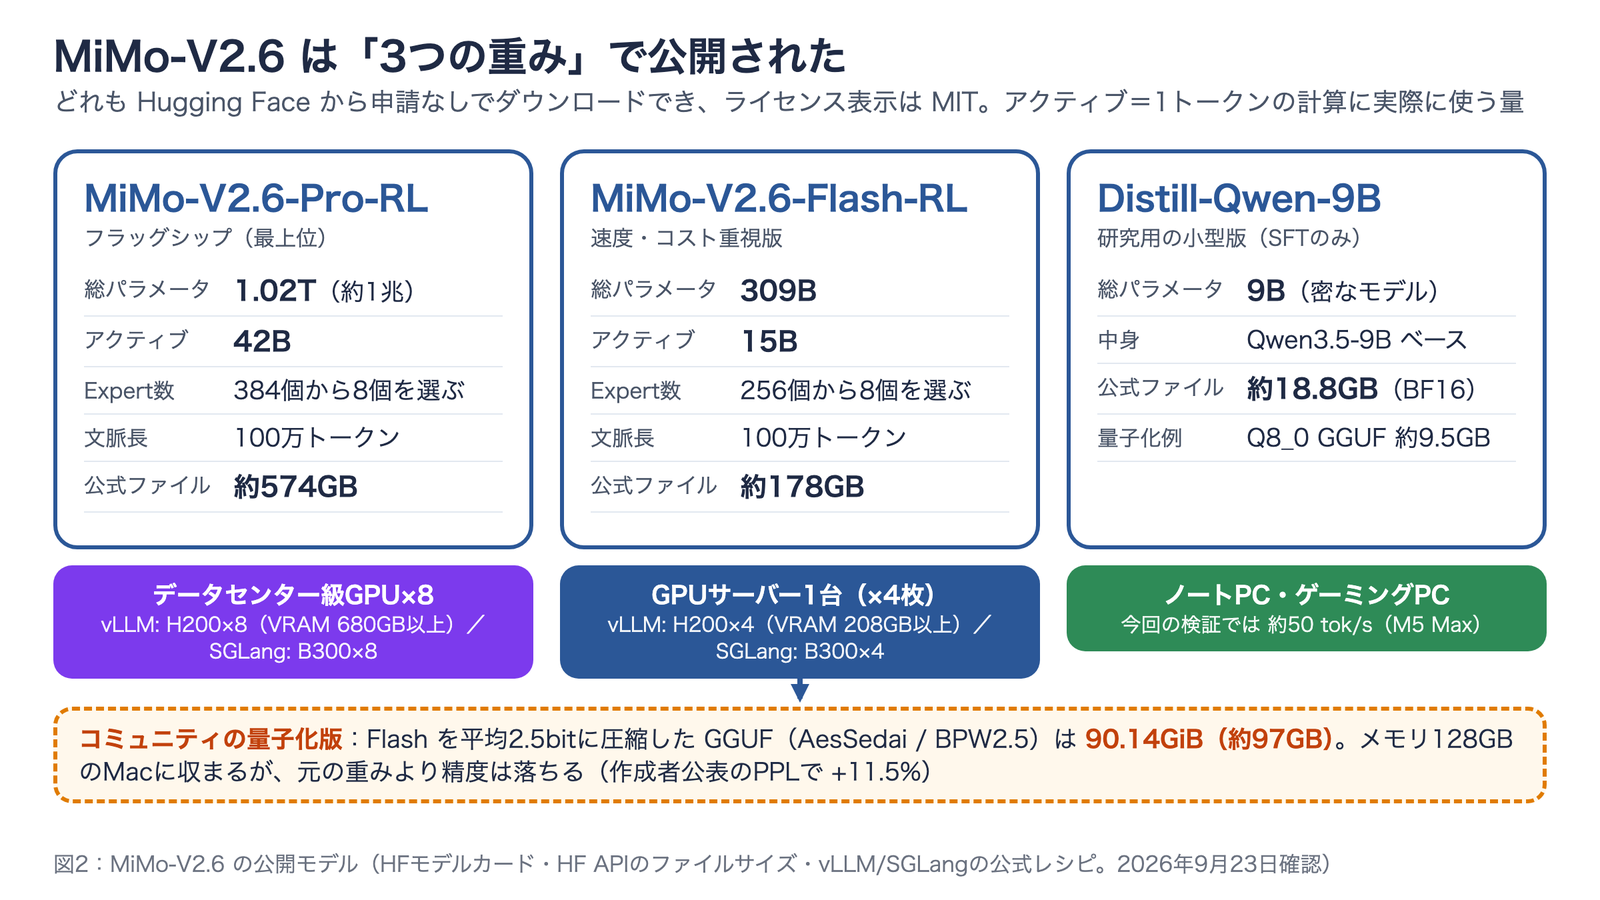
大きさと用途の違いを、図2にまとめました。見てほしいのは「公式ファイルの大きさ」と、その下の「動かすのに必要な機材」です。
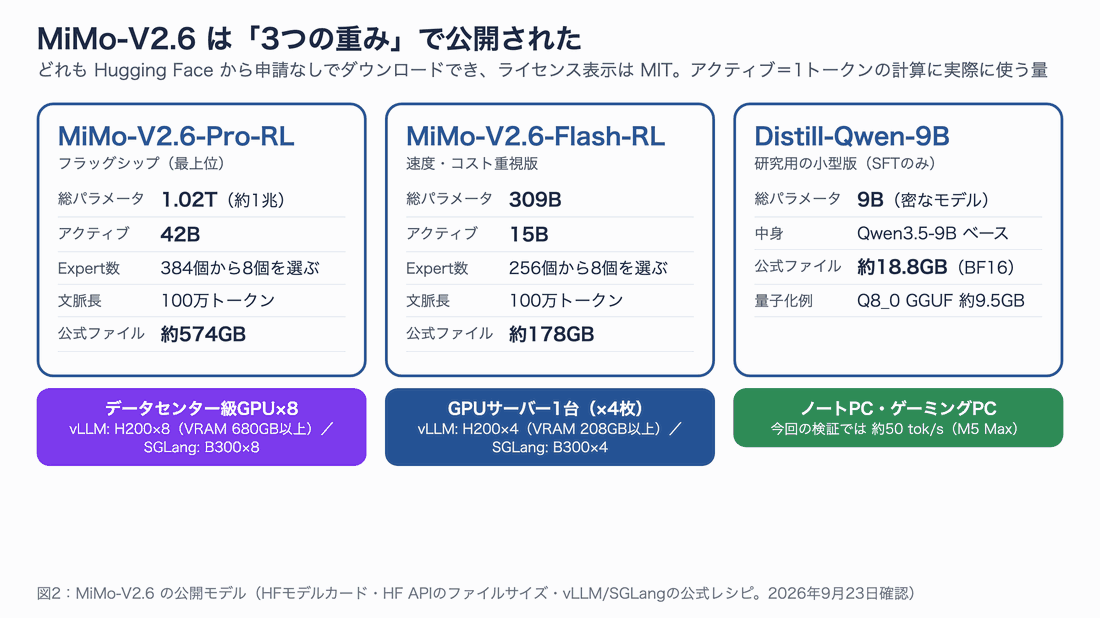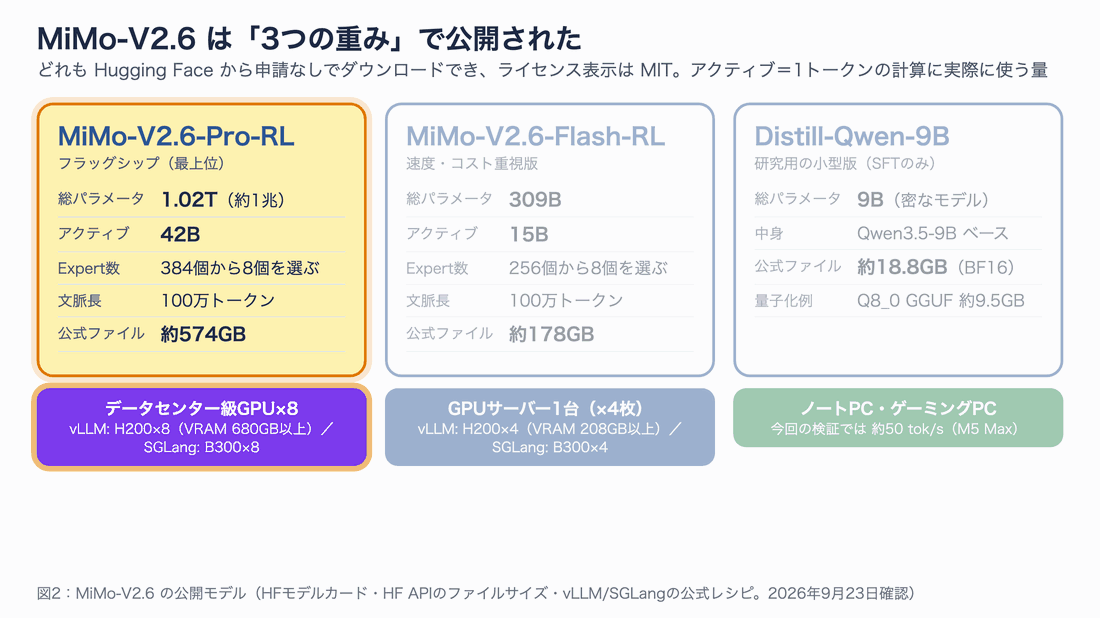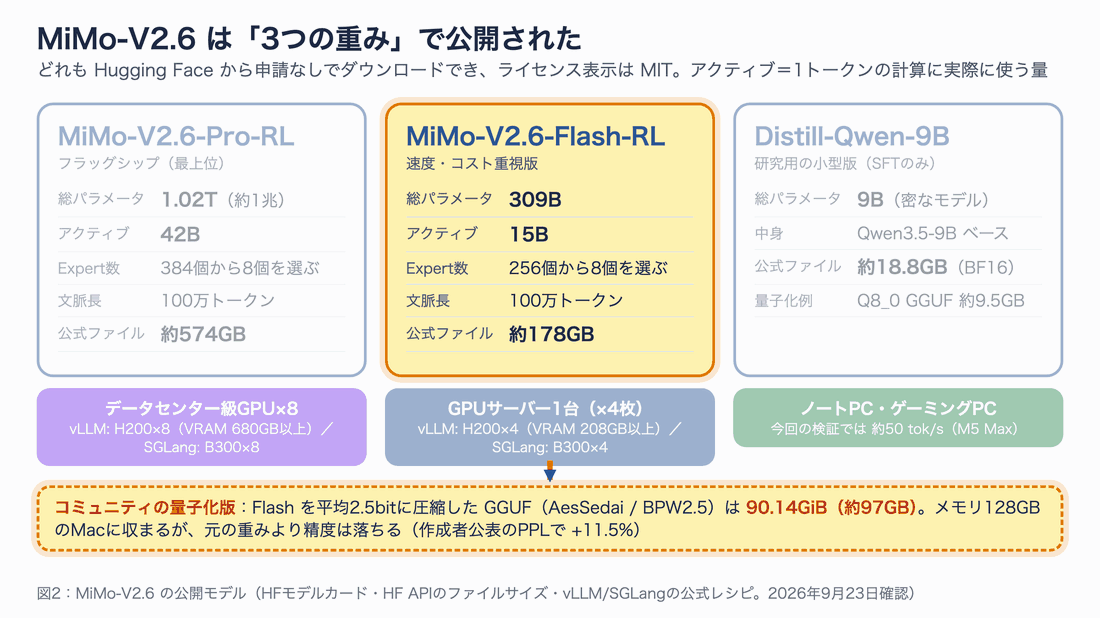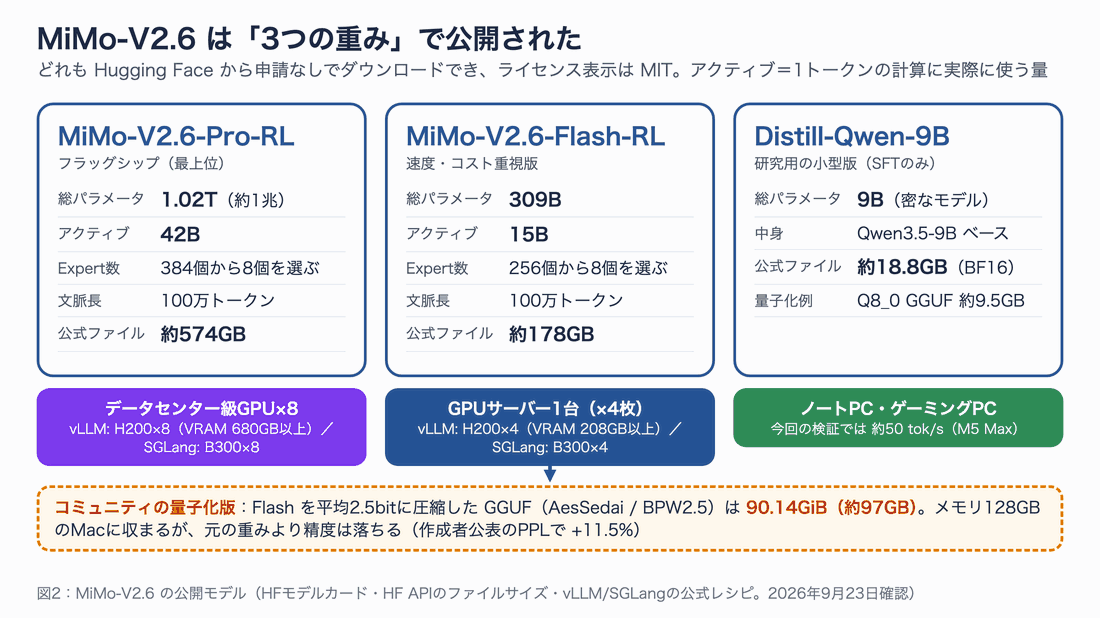
図2:3つのモデルの違い。静止画版は fig02-model-family.png
| モデル | 総パラメータ / アクティブ | 公式ファイル | 位置づけ |
|---|---|---|---|
| MiMo-V2.6-Pro-RL | 1.02T / 42B | 約574GB | フラッグシップ。vLLMのレシピでは H200×8(VRAM 680GB以上) |
| MiMo-V2.6-Flash-RL | 309B / 15B | 約178GB | 速度・コスト重視版。vLLMのレシピでは H200×4(208GB以上) |
| MiMo-V2.6-Distill-Qwen-9B | 9B(密なモデル) | 約18.8GB | Qwen3.5-9B を MiMo の出力で追加学習(SFT)した研究用の小型版 |
Pro と Flash は、テキスト・画像・動画・音声を1つのモデルで受け取れるネイティブのマルチモーダルモデルで、最大100万トークンの文脈を扱えます。API では、Pro を最大20倍速で返す「Pro-UltraSpeed」も提供されています(こちらは重みの公開なし)。
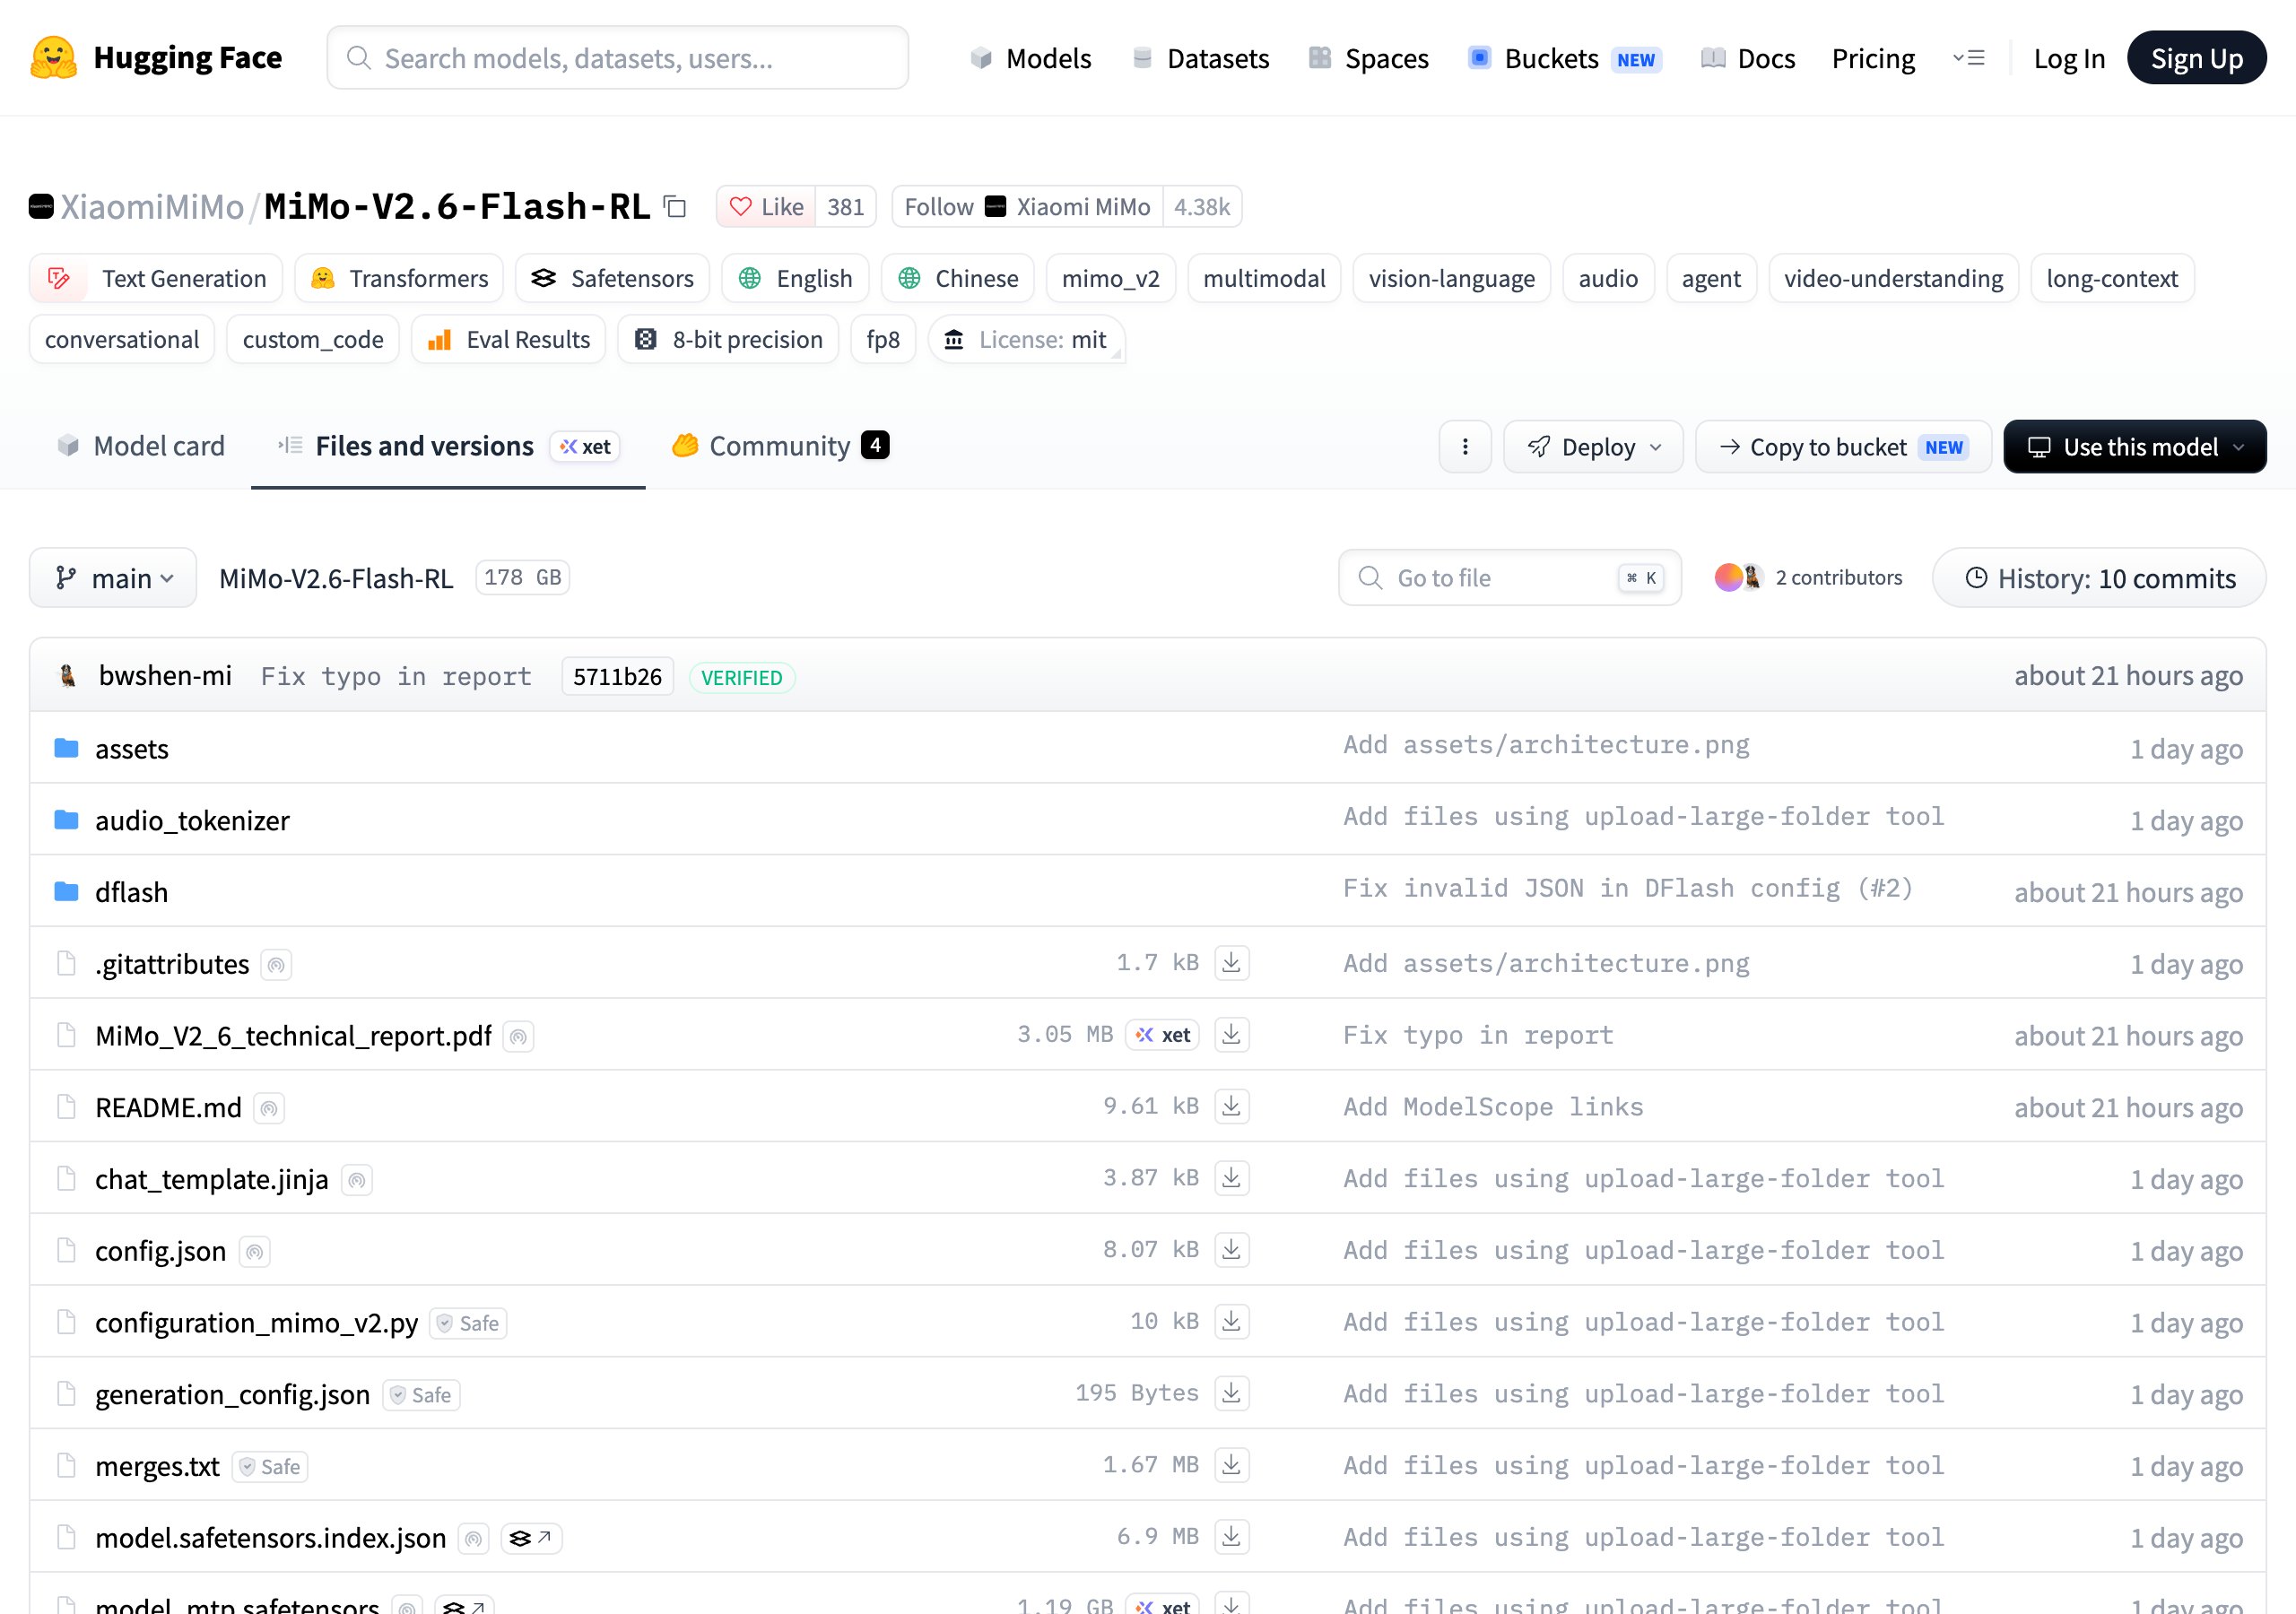
Flash のリポジトリは合計178GB。重みのほか、画像・音声のエンコーダー、投機的デコード用の小さなモデル(dflash)、技術レポートPDFが入っています
MoE:「使うのは一部」なのに「置き場所は全部」必要な理由
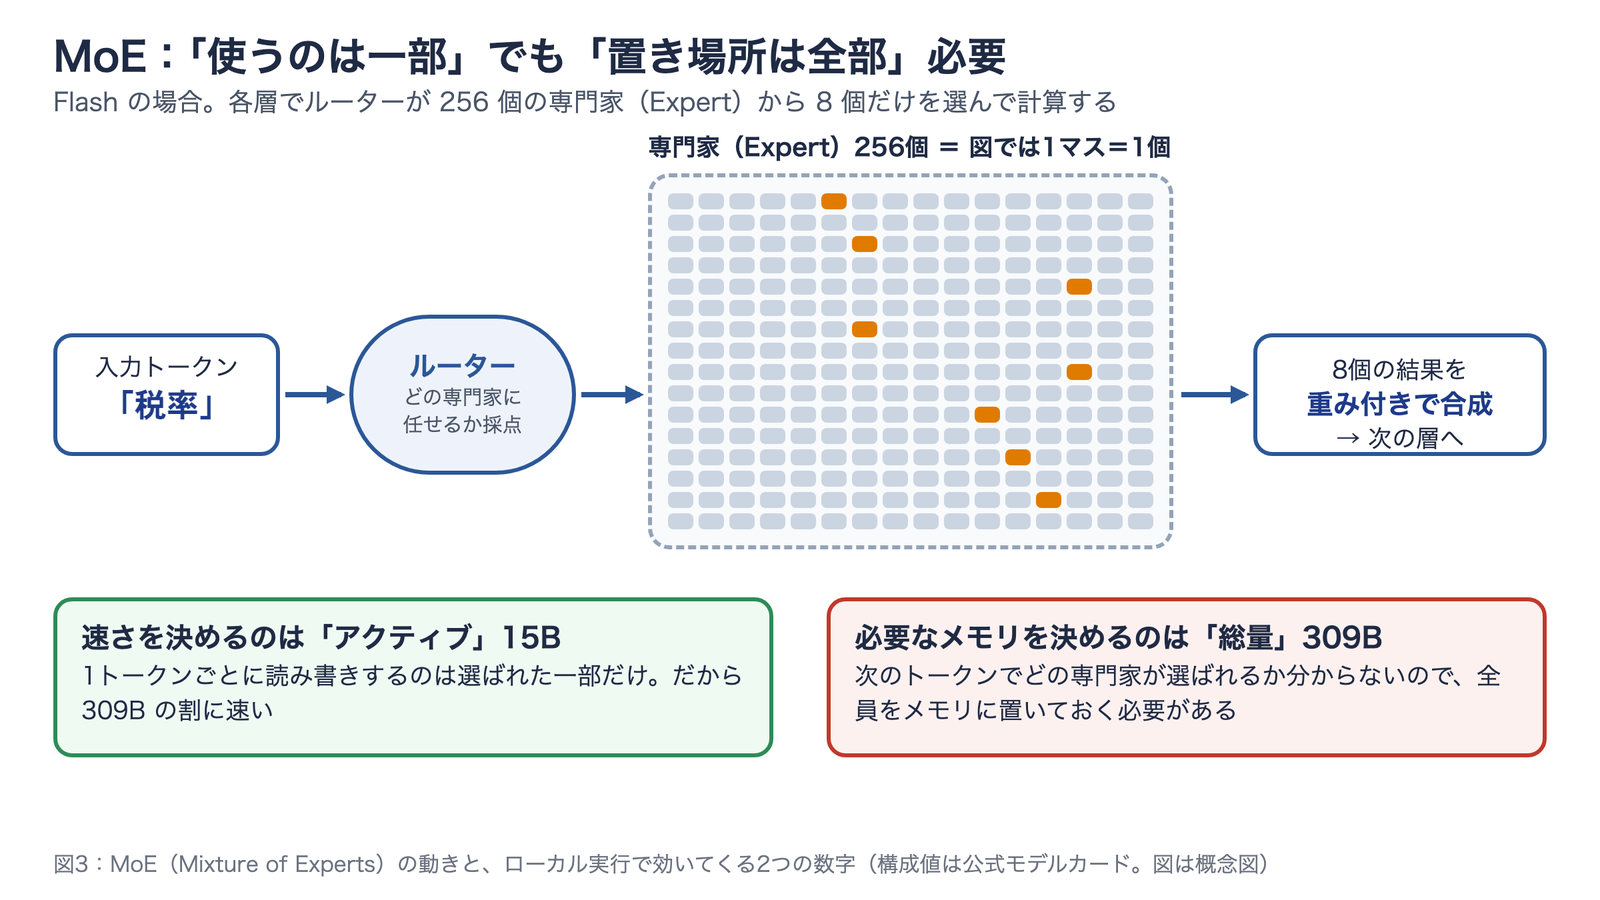
Pro と Flash は MoE(Mixture of Experts:専門家の混合) という構造です。ローカルで動かせるかどうかは、この仕組みでほぼ決まります。図3で、1つのトークンがどう処理されるかを追ってみてください。
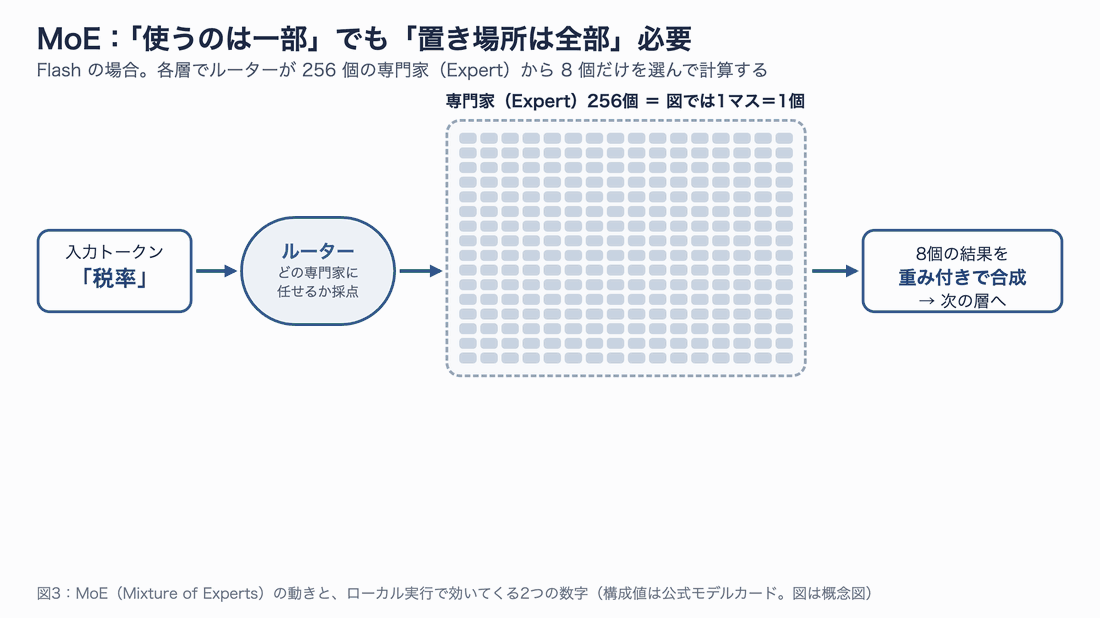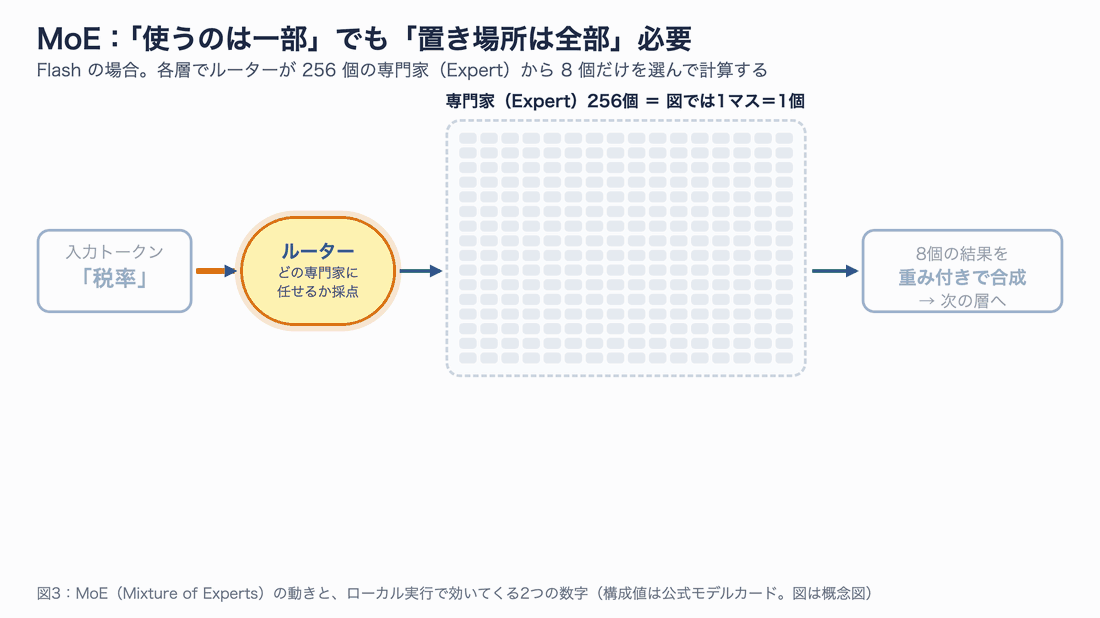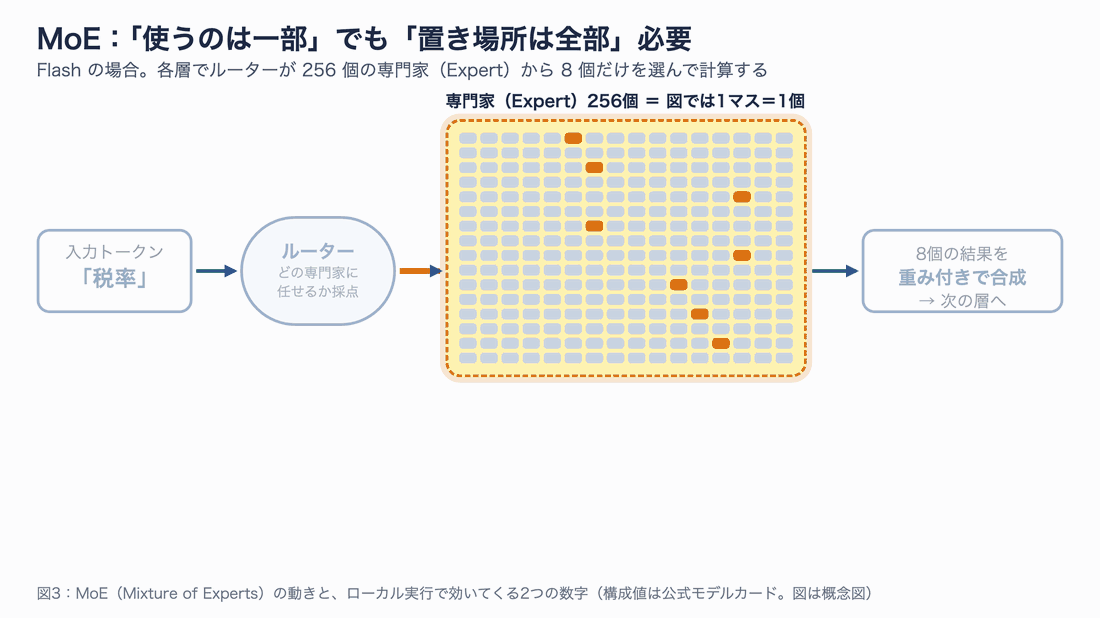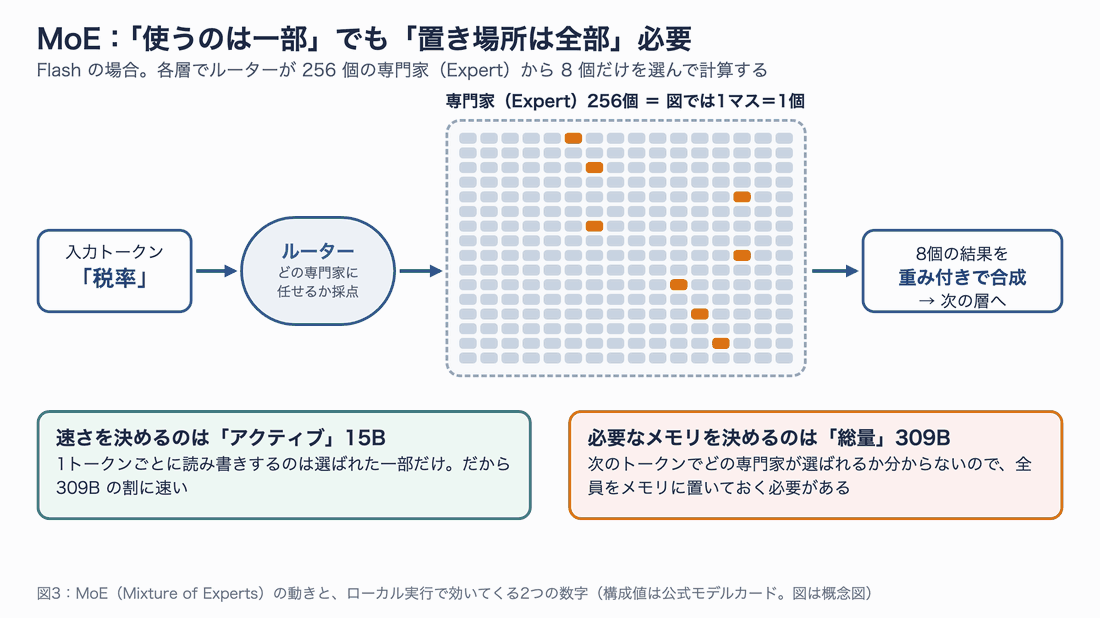
図3:MoE の動きと、ローカル実行に効く2つの数字。静止画版は fig03-moe-memory.png
Flash のほとんどの層には256個の「専門家(Expert)」がいて、ルーターがトークンごとに8個だけを選んで計算させます。そのため、1トークンあたりに動かすのは総パラメータ309Bのうち 15B(アクティブパラメータ) だけです。309Bの密なモデルよりずっと速く動きます。
一方で、次のトークンでどの専門家が選ばれるかは事前に分かりません。全員分の重みを常にメモリに置いておく必要があります。つまり「速さはアクティブ量、必要なメモリは総量」で決まります。Flash の公式ファイルは178GBなので、そのままでは128GBのMacに入りません。後半では、量子化(Quantization:数値の精度を落としてファイルを小さくする処理)でこの壁を越えます。
補足すると、MiMo-V2.6 は注意機構(Attention)にも工夫があります。Flash の48層のうち39層は、直前の128トークンだけを見るスライディングウィンドウ注意(SWA)です。全体を見渡す層は9層だけなので、長い文脈でも会話用のメモリ(KVキャッシュ)が膨らみにくい設計です。
何が新しいのか:強化学習の「採点」まで大規模化した
MiMo-V2.6 の技術レポートの副題は「Scaling Reinforcement Learning Towards Self-Improvement(自己改善に向けた強化学習のスケール)」です。モデルの大きさより、事後学習(Post-training)での強化学習(RL)の回し方に新しさがあります。要点は3つです。
- You Only RL Once:コーディング(68%)、一般的なツール利用、デザイン、サイバーセキュリティなどを、分野ごとに別々ではなく1回の混合RLでまとめて学習した。1ステップで1,568問 × 16通りの解答を生成する規模
- 学習を公開で実施:Pro と Flash の RL を約6日間、進み具合をダッシュボードで公開しながら回した。公式ブログによるRLの費用は Pro 約262万ドル、Flash 約85万ドル
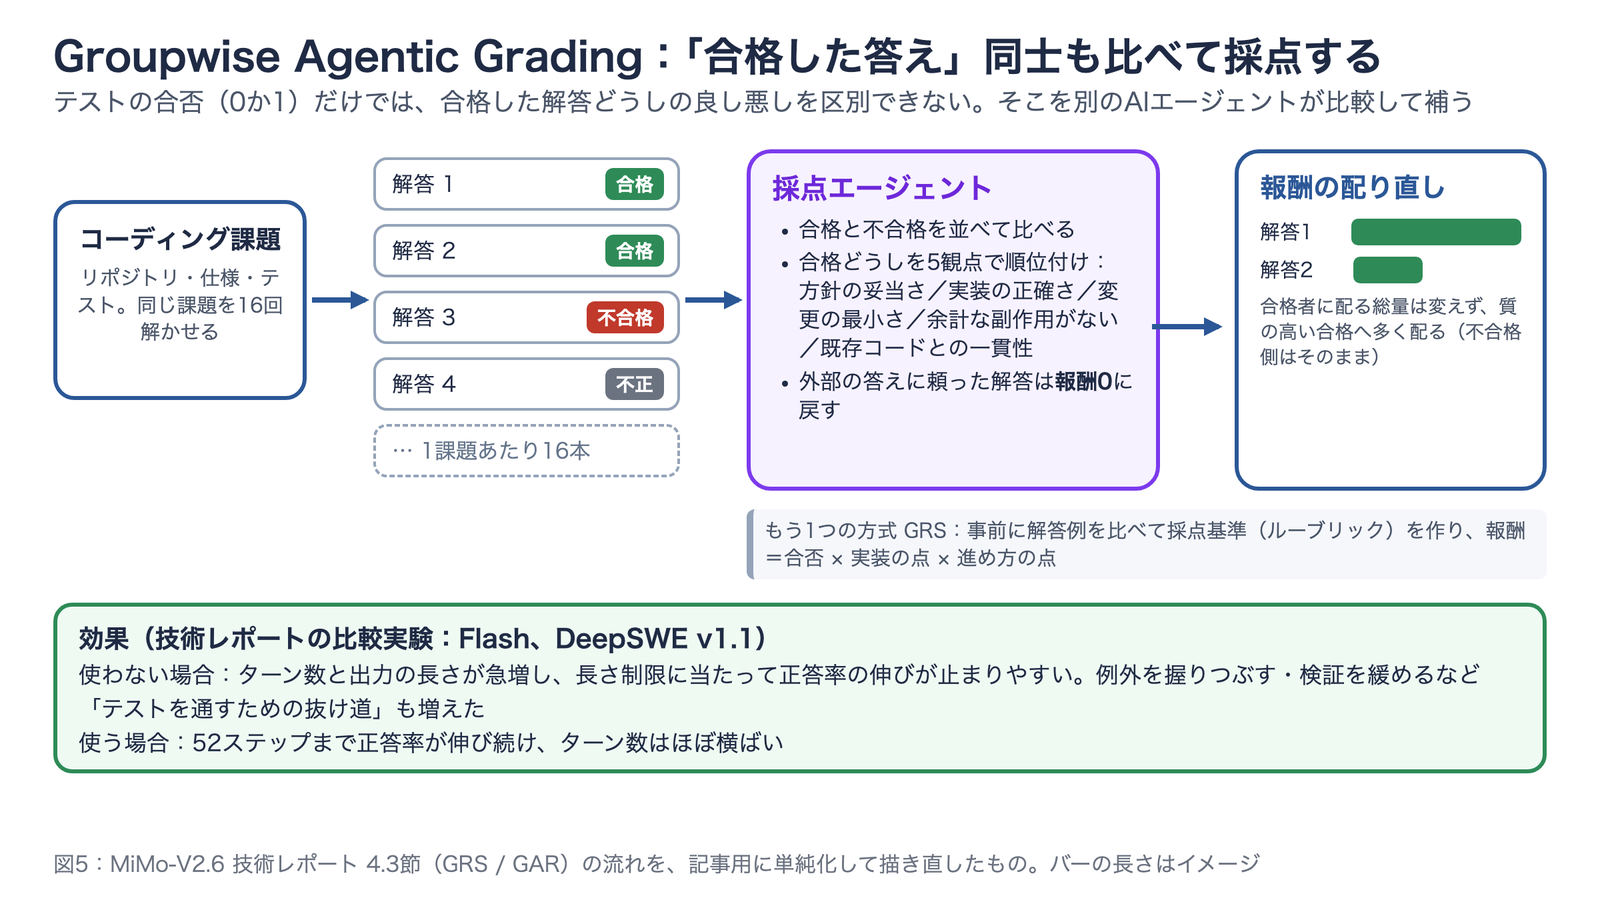
- Groupwise Agentic Grading:テストの合否だけでなく、合格した解答どうしの良し悪しも別のAIエージェントに比べさせて、報酬(Reward)を配り直す
3つ目は、実務でエージェントを作っている人にも参考になる考え方です。図5で流れを追ってみてください。
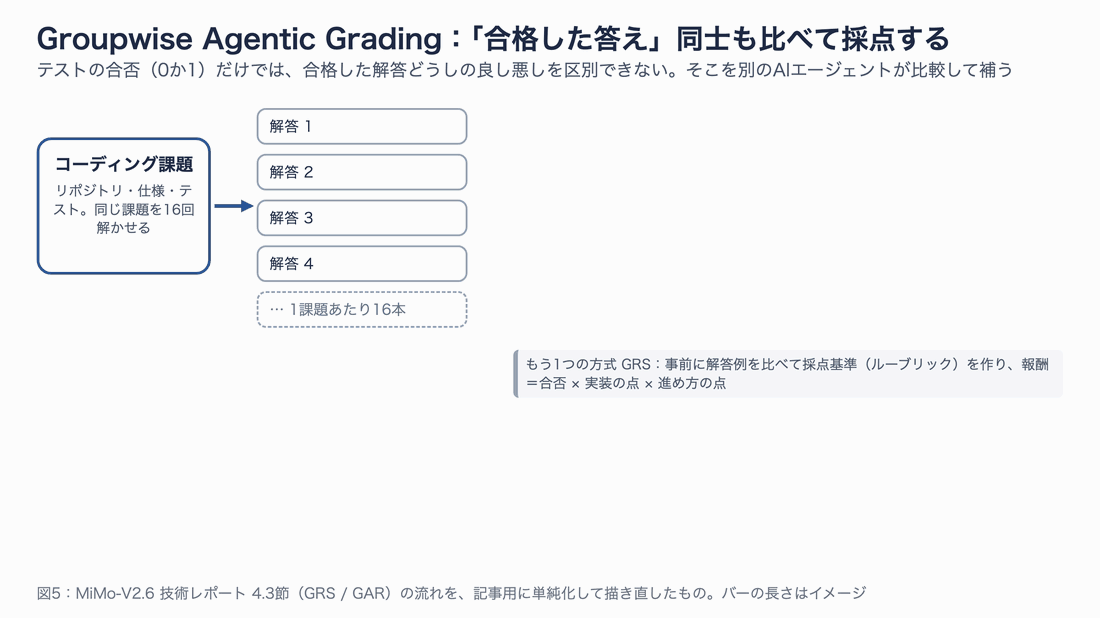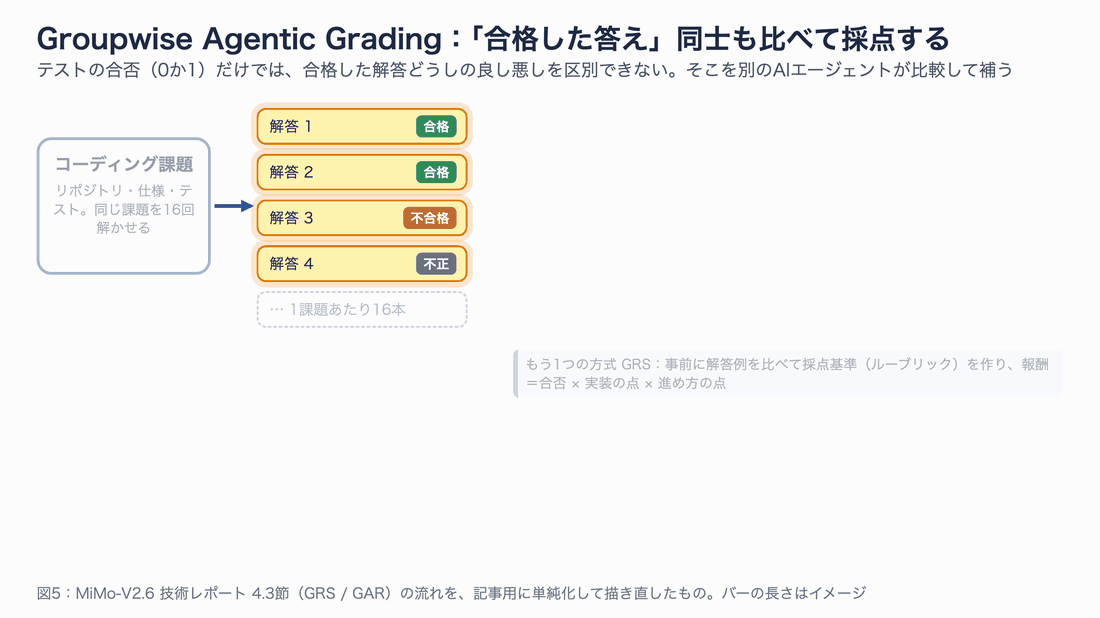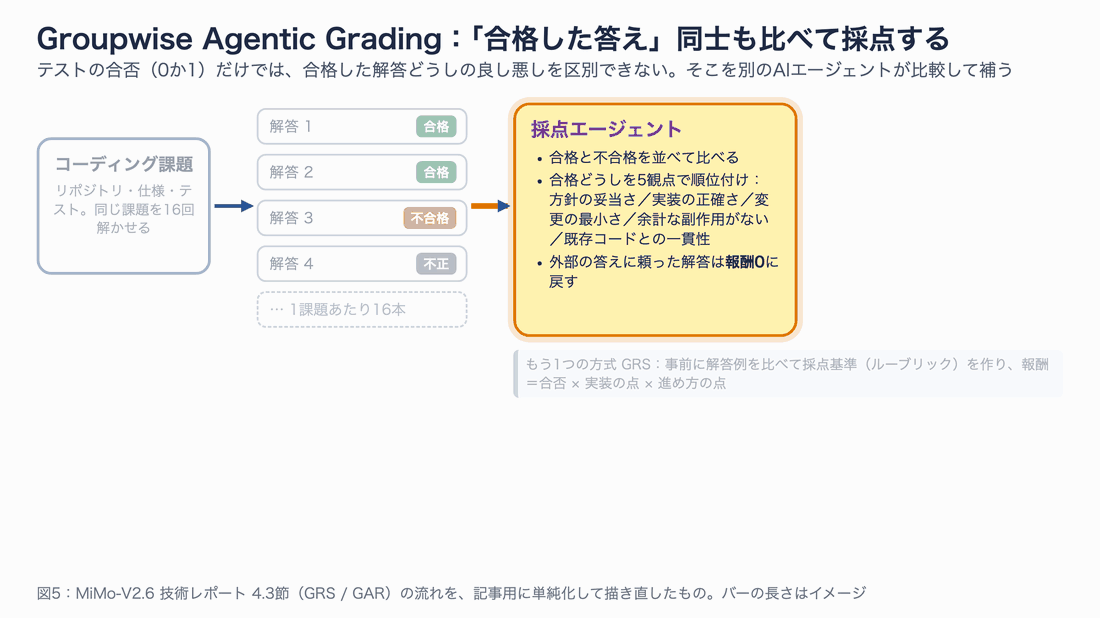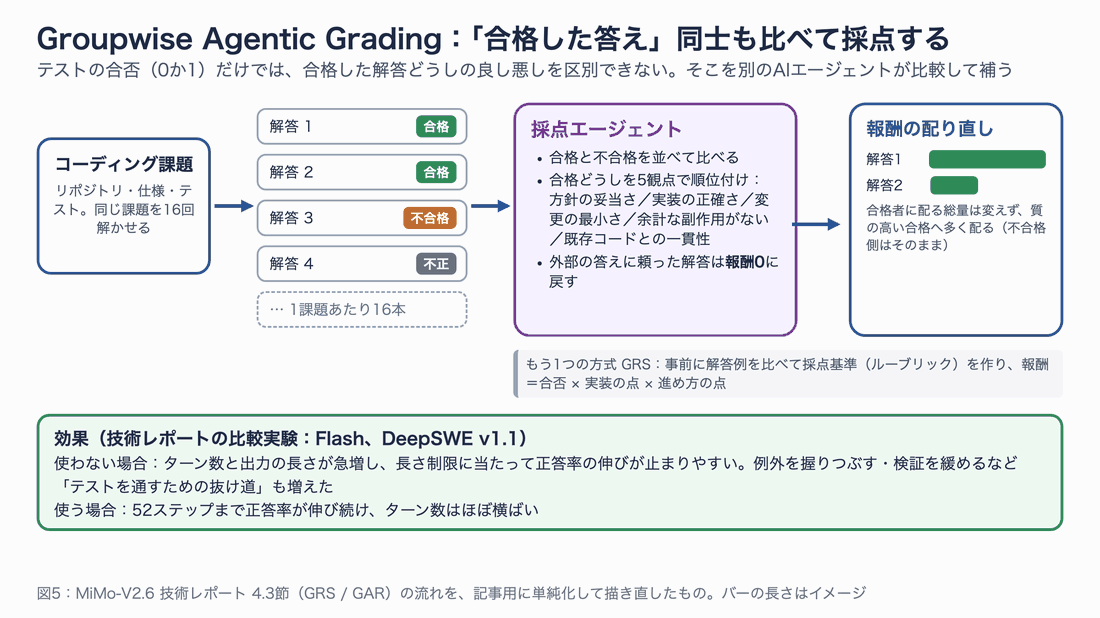
図5:Groupwise Agentic Grading の流れ(技術レポート4.3節を単純化)。静止画版は fig05-groupwise-grading.png
テストの合否(0か1)だけを報酬にすると、「とりあえずテストが通る」雑な解答も満点になります。レポートでは、採点エージェントを使わずに学習させると、例外を握りつぶす・検証を緩めるといったテストを通すための抜け道が増えたと報告されています。そこで採点エージェントが、同じ課題に対する合格解を「方針の妥当さ」「変更の最小さ」「既存コードとの一貫性」などで順位付けし、質の高い解に報酬を寄せます。外部の答えを盗み見た解答は報酬0に戻します。
「合否だけでは区別できない差を、グループ内の比較で拾う」という発想は、社内でエージェントの出力を評価するときにも応用できます。
ライセンス:商用利用はできるのか
結論:重みは「MIT表示」だが、記録を残して使うのが安全
モデルを業務で使う前に、まずライセンスを確認します。前回の記事で扱った画像生成モデル Qwen-Image-2.1 は「研究・評価目的のみ(Non-Commercial)」で、商用には別契約が必要でした。MiMo-V2.6 はどうでしょうか。
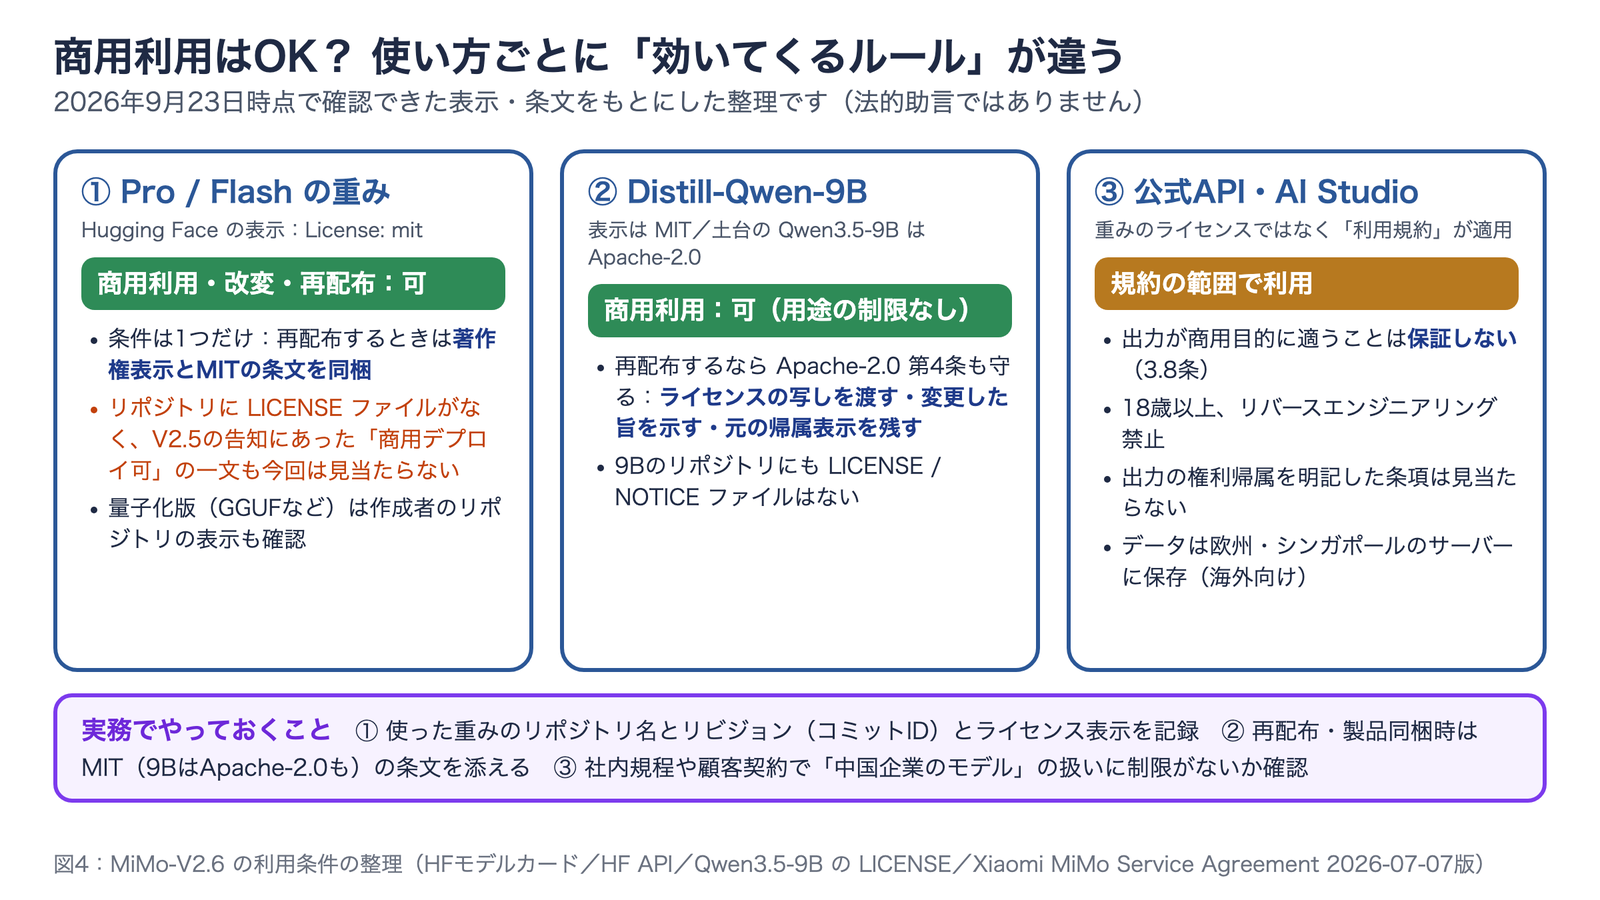
使い方によって効いてくるルールが違うので、図4で3つに分けて整理しました。
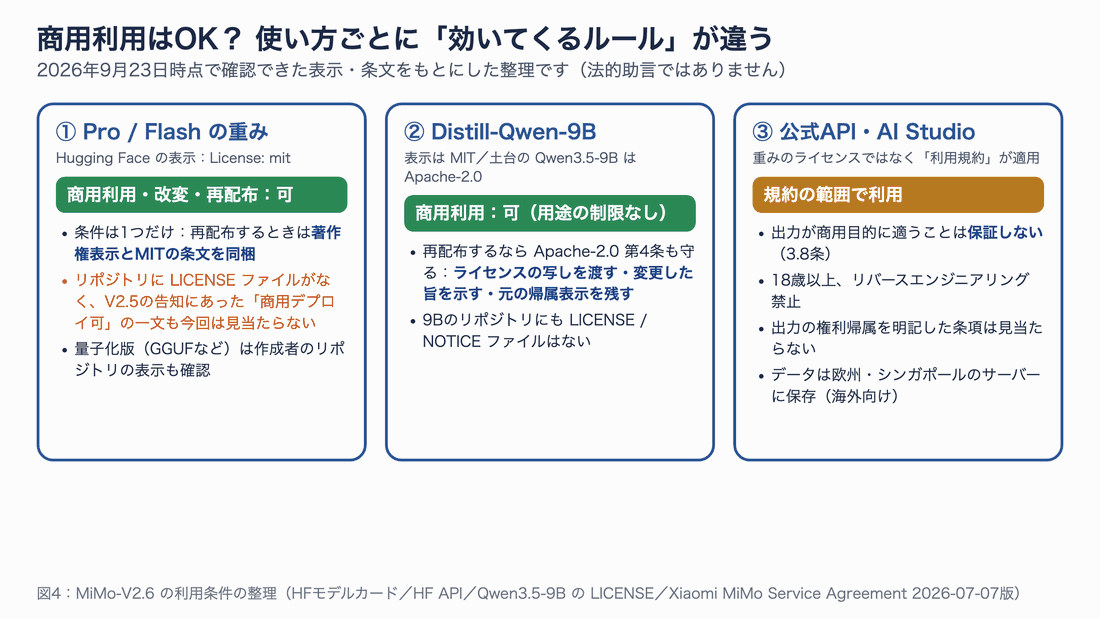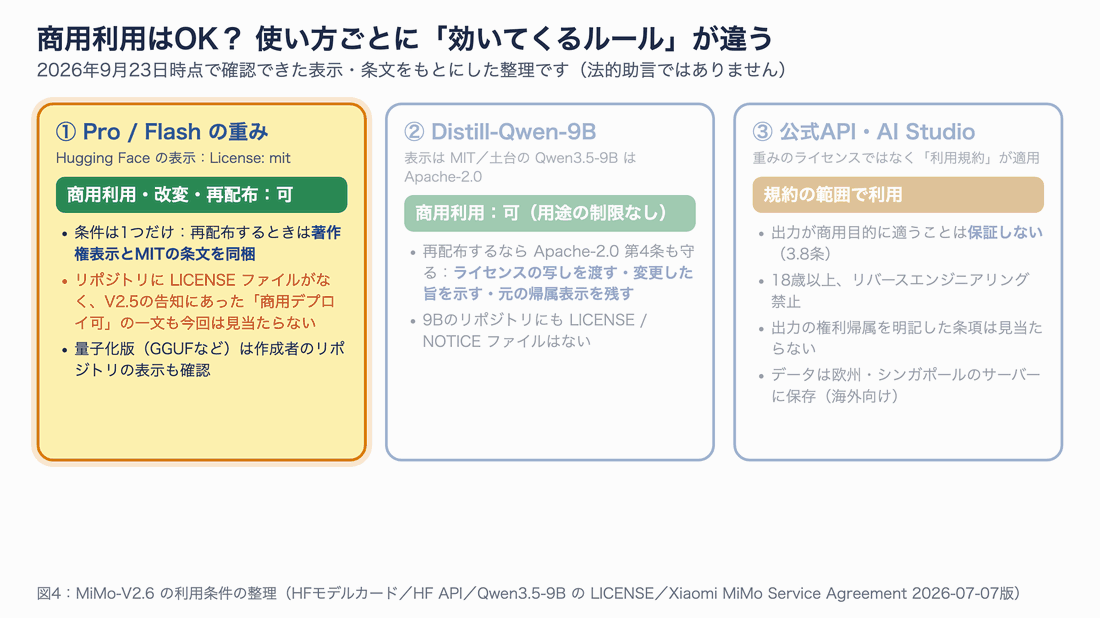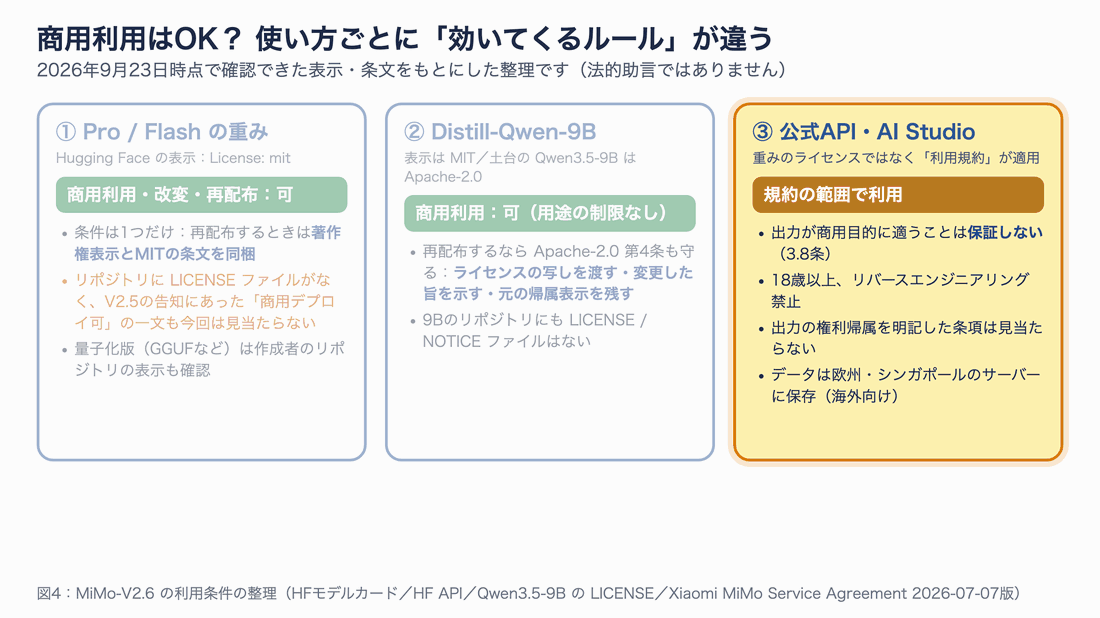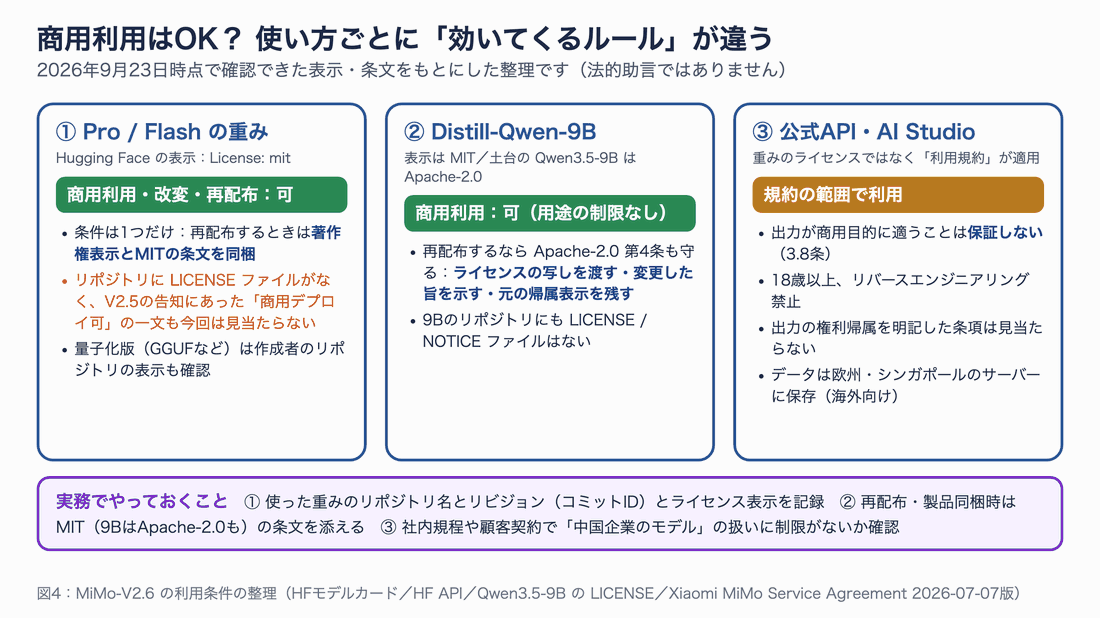
図4:使い方ごとの利用条件(2026年9月23日時点の表示・条文による整理。法的助言ではありません)。静止画版は fig04-license-map.png
| 使い方 | 効いてくるルール | 商用利用 | 主な条件・注意点 |
|---|---|---|---|
| Pro / Flash の重みをダウンロードして使う | MIT(Hugging Face のライセンス表示) | 可 | 再配布時は著作権表示とMITの条文を同梱。リポジトリに LICENSE ファイルはない |
| Distill-Qwen-9B を使う | MIT表示 + 土台の Qwen3.5-9B は Apache-2.0 | 可 | 再配布時は Apache-2.0 第4条(ライセンスの写し・変更の明示・帰属表示の保持)も守る |
| 公式API・AI Studio を使う | Xiaomi MiMo Service Agreement(2026年7月7日版) | 規約の範囲で可 | 出力が商用目的に適うことは保証しない、18歳以上、リバースエンジニアリング禁止など |
| RL用のコード(公開された3リポジトリ) | verl・uni-agent は Apache-2.0、mimoagent は MIT | 可 | それぞれのフォーク元のライセンスを引き継ぐ |
MITライセンスは、オープンソースのライセンスの中でも最も制約が少ない部類です。商用利用・改変・再配布・製品への組み込みが認められ、条件は「著作権表示と許諾文をコピーに含めること」だけです。
気をつけたい3つの点
ただし、今回の公開には注意しておきたい点もあります。
- LICENSE ファイルがない:3つのリポジトリには、メタデータの
license: mitがあるだけで、著作権者名の入ったライセンス本文が同梱されていません。量子化版などを再配布する場合は、MITの本文を自分で添えることになります - 「商用可」の明言が消えている:前バージョン V2.5 のオープンソース告知には、「商用の推論デプロイと追加学習を認め、別途の許諾は不要」という一文がありました。V2.6 の告知・ブログ・技術レポートには、ライセンスへの言及そのものが見当たりません
- APIの出力には別のルール:公式APIを使う場合、適用されるのはモデルのライセンスではなく利用規約です。出力の権利が利用者に帰属すると明記した条項も見つかりませんでした
MITの表示がある以上、商用利用はできると読むのが自然です。ただ、後から表示が変わる可能性もゼロではありません。業務で使うなら、取得したリポジトリ名・リビジョン(コミットID)・その時点のライセンス表示を記録しておきましょう。次のコマンドで、手元に落としたモデルのリビジョンを確認できます。
# Hugging Face のモデル情報(リビジョンとライセンス表示)を記録しておく
curl -s https://huggingface.co/api/models/XiaomiMiMo/MiMo-V2.6-Flash-RL \
  | python3 -c "import json,sys; d=json.load(sys.stdin); print(d['sha'], d['cardData']['license'], d['lastModified'])"
また、社内規程や取引先との契約で「海外製モデルの利用」に条件がある組織もあります。重みを自社環境で動かす場合はデータが外に出ませんが、APIを使う場合、海外向けサービスのデータは欧州とシンガポールのサーバーに保存されると規約に書かれています。どちらの使い方をするかで確認先が変わる点に注意してください。
ベンチマークで見る「フロンティアとの距離」
公式の比較表は「1世代前」が相手
まず、Xiaomi が公開した公式の比較表を見てみます。
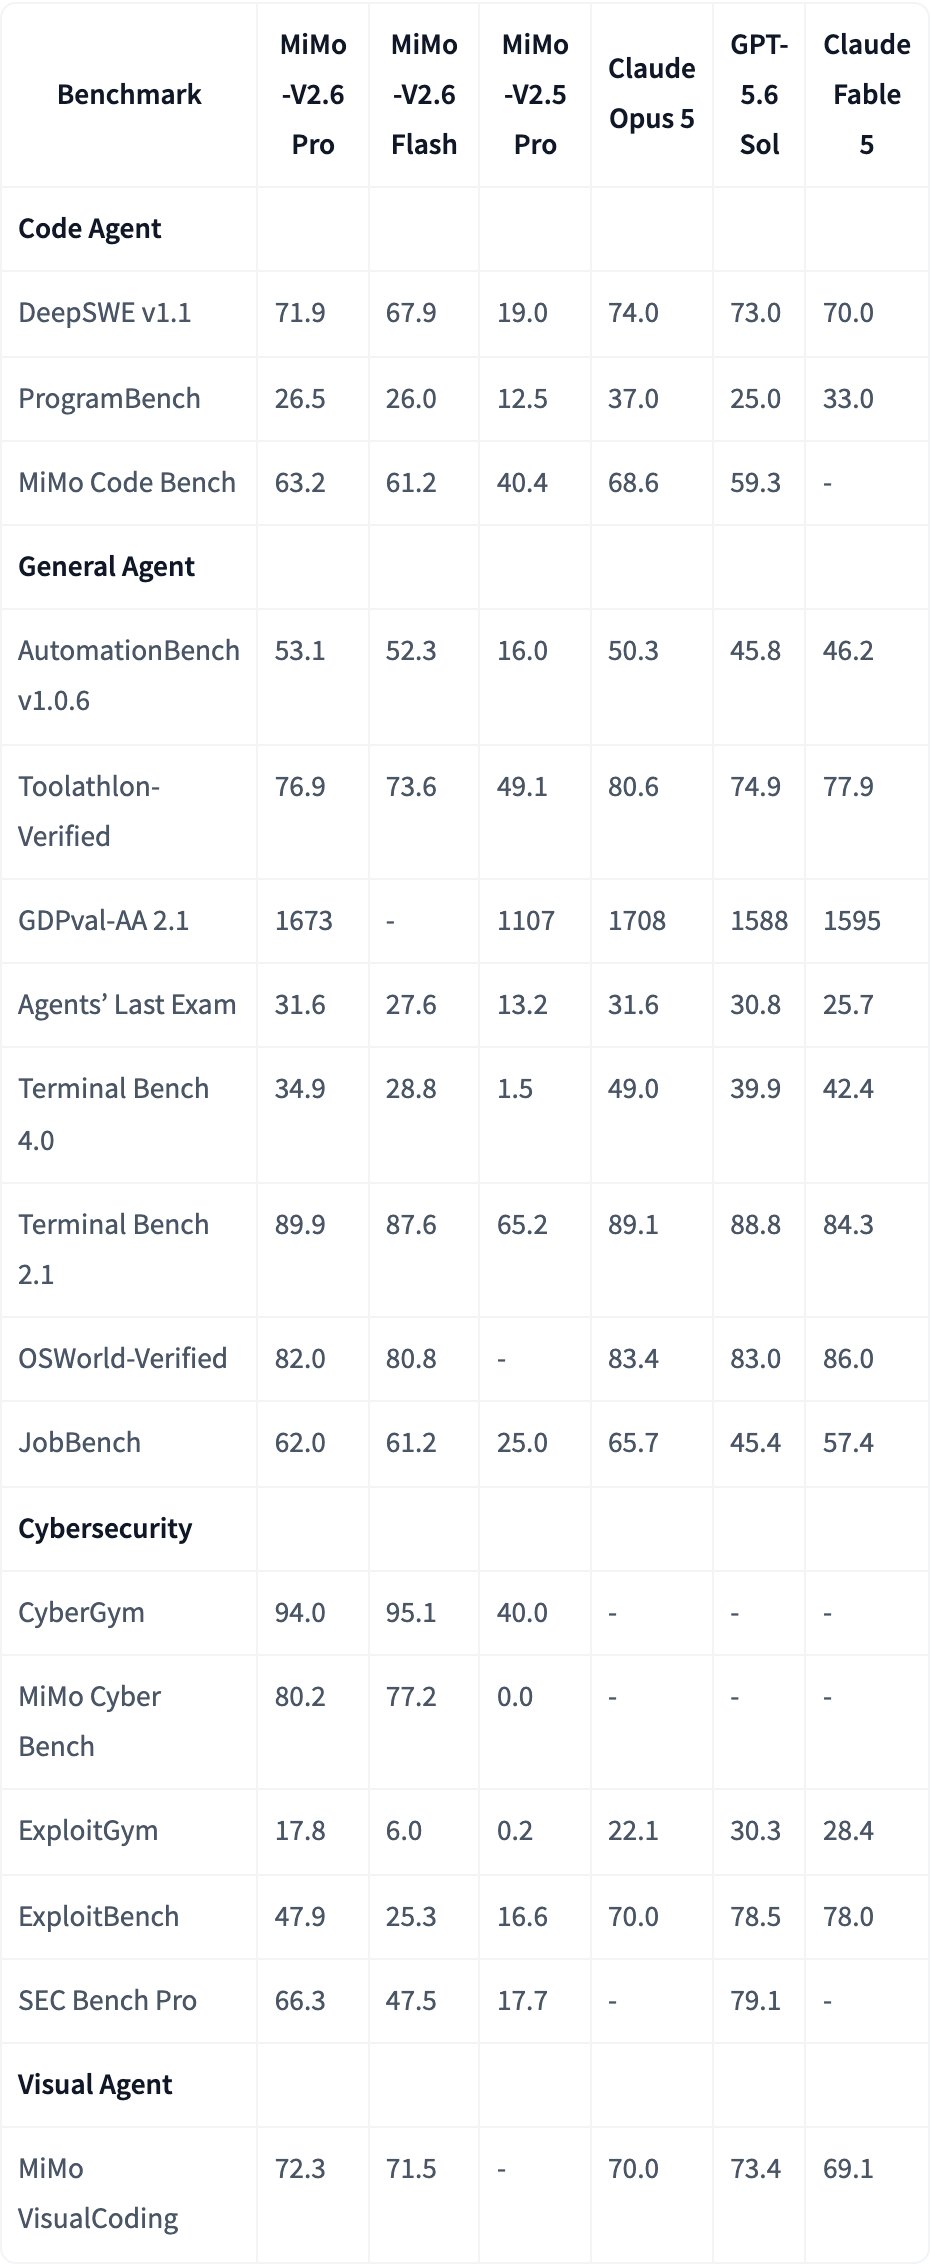
公式モデルカードの評価表(Hugging Face、2026年9月23日撮影)
ここで気づくのは、比較相手が Claude Opus 5・GPT-5.6 Sol・Claude Fable 5 になっていることです。9月1日に出た Claude Fable 5.1 や、9月3日に出た GPT-6 Astra は入っていません。1世代前の相手に対しては、DeepSWE(実際のリポジトリでの修正タスク)で 71.9 対 70.0〜74.0、Terminal Bench 2.1 では 89.9 と表の最高値を出しており、「肩を並べた」と言える水準です。
しかし、この表をそのまま最新モデルと比べることはできません。ベンチマークごとにバージョンや集計方法がベンダーごとに違うからです。調べた範囲では、次のような食い違いがありました。
- Agents’ Last Exam:OpenAI の発表では Opus 5 が 55.5 なのに、Xiaomi の表では 31.6。指標か版が違う
- AutomationBench:Zapier の公開リーダーボード版、Artificial Analysis 版、Xiaomi の v1.0.6 版の3系統があり、スケールが別
- GDPval-AA:Anthropic の発表は v2(Fable 5.1 = 1853)、Artificial Analysis と Xiaomi は v2.1(Fable 5.1 = 1735)
同じ物差しで比べる:Artificial Analysis の独立評価
そこで、第三者の評価機関 Artificial Analysis(AA) が、全モデルを自前の同じ環境で測った値を使います。MiMo-V2.6-Pro は AA の総合指数(Intelligence Index v4.3.2)で 46。オープンウェイトのモデルとしては1位です。
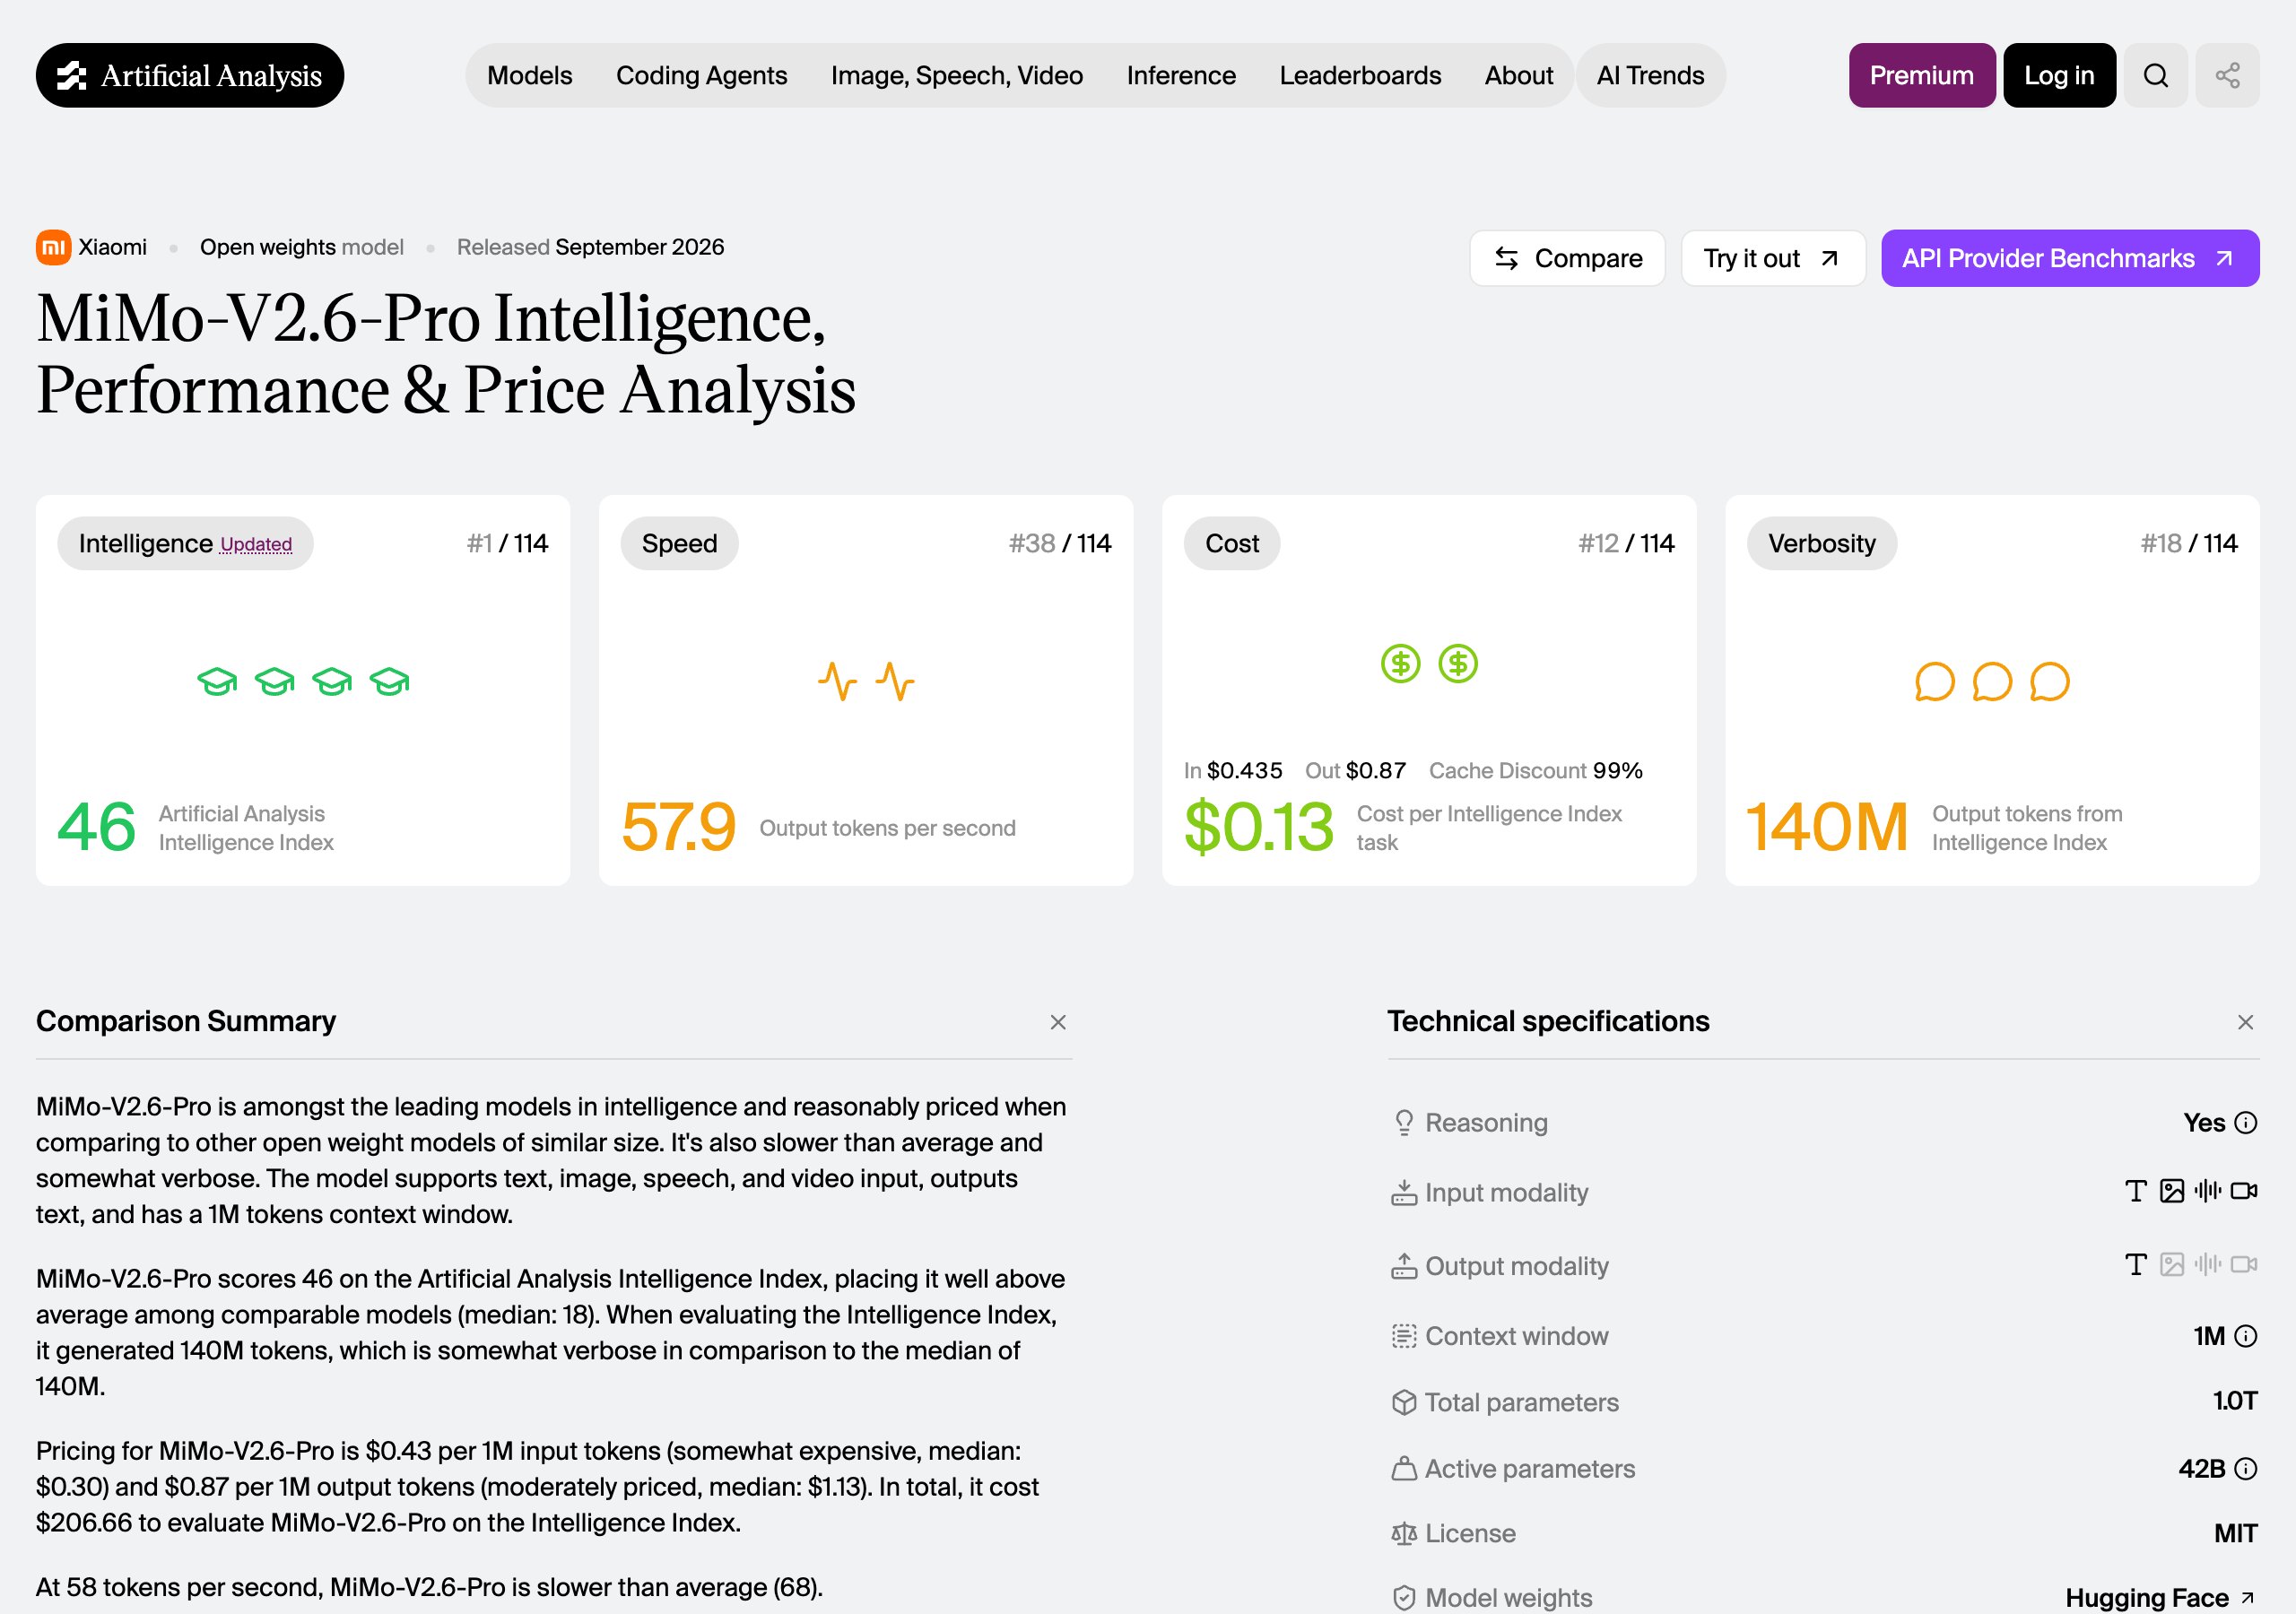
Artificial Analysis の MiMo-V2.6-Pro ページ(2026年9月23日撮影)。比較対象の114モデル中、知能指数で1位
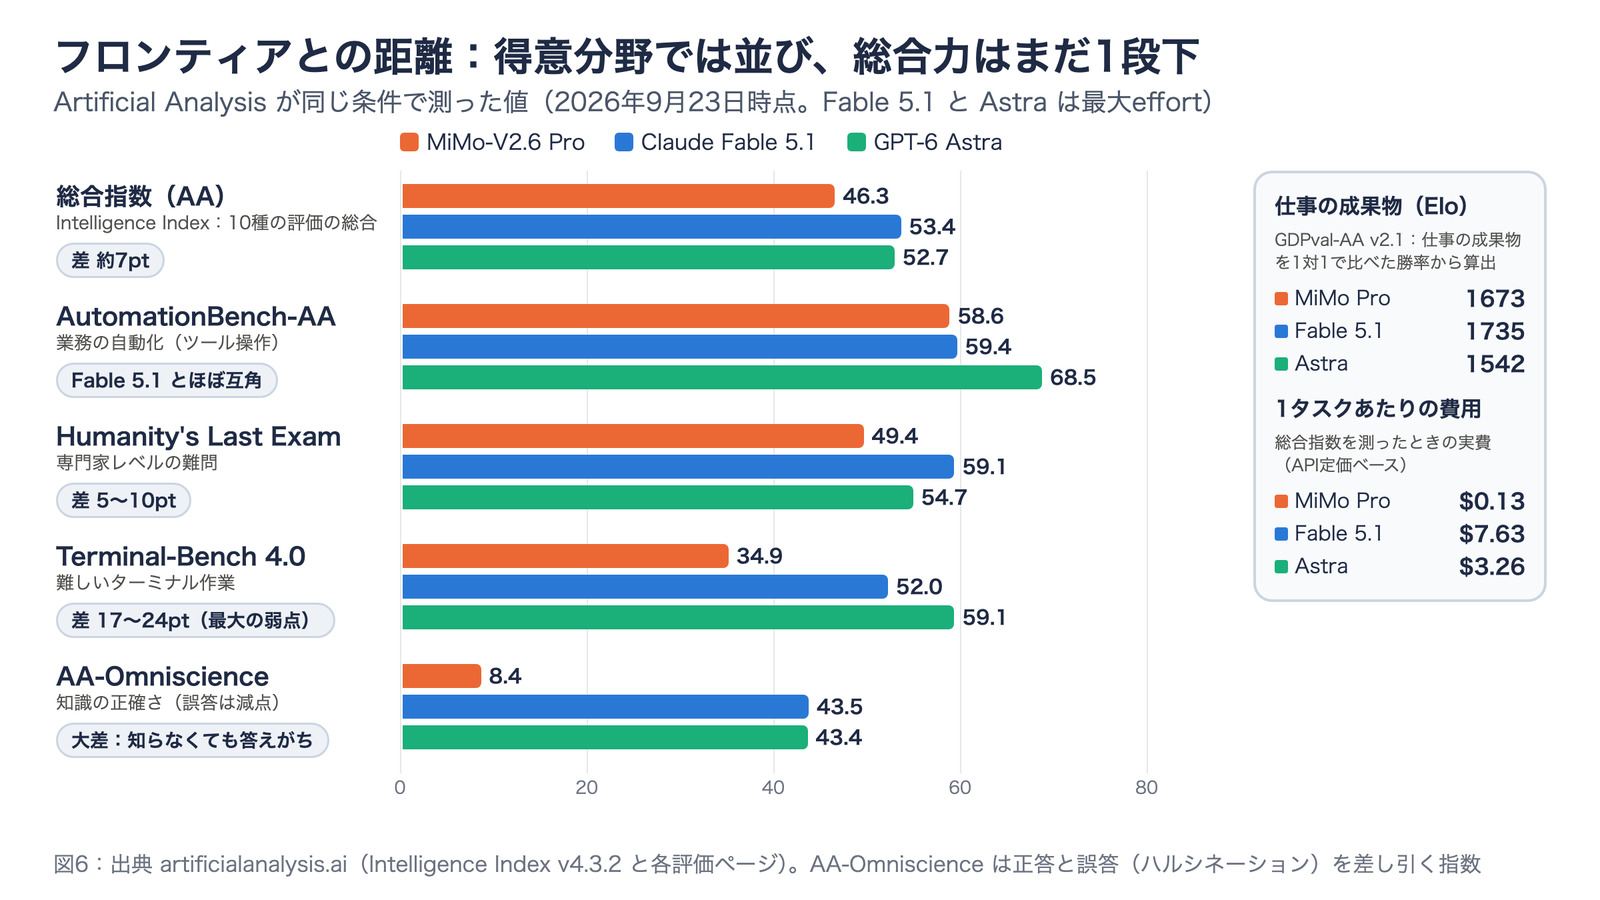
では、Fable 5.1 と GPT-6 Astra と並べるとどうなるでしょうか。図6は、AA が同じ条件で測った5つの評価を並べたものです。行ごとに順番に強調されるので、差の大きさを見比べてください。
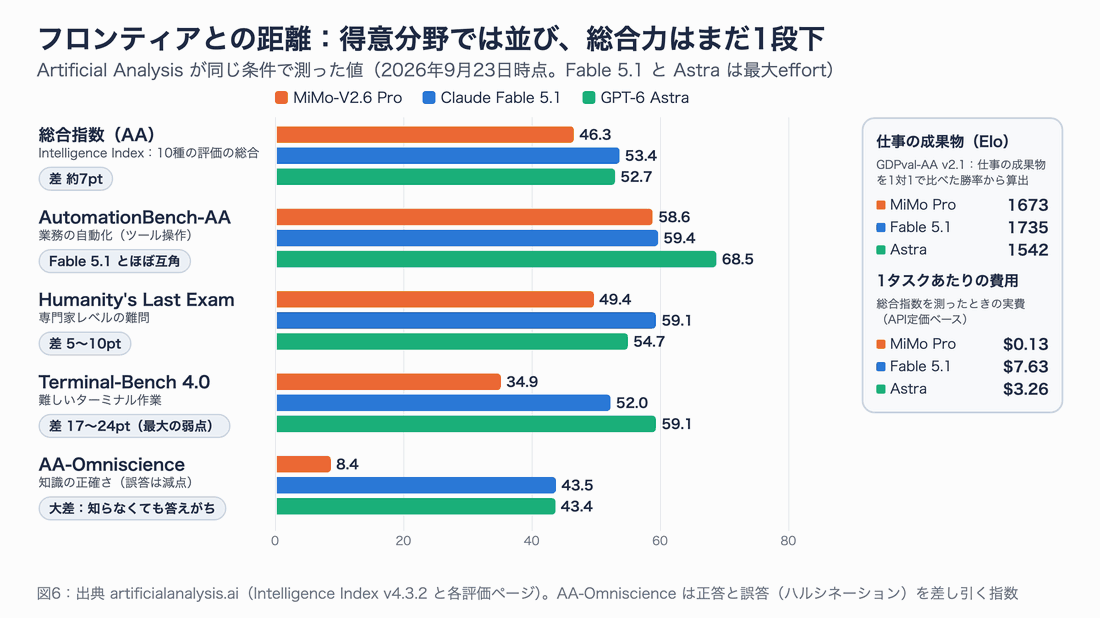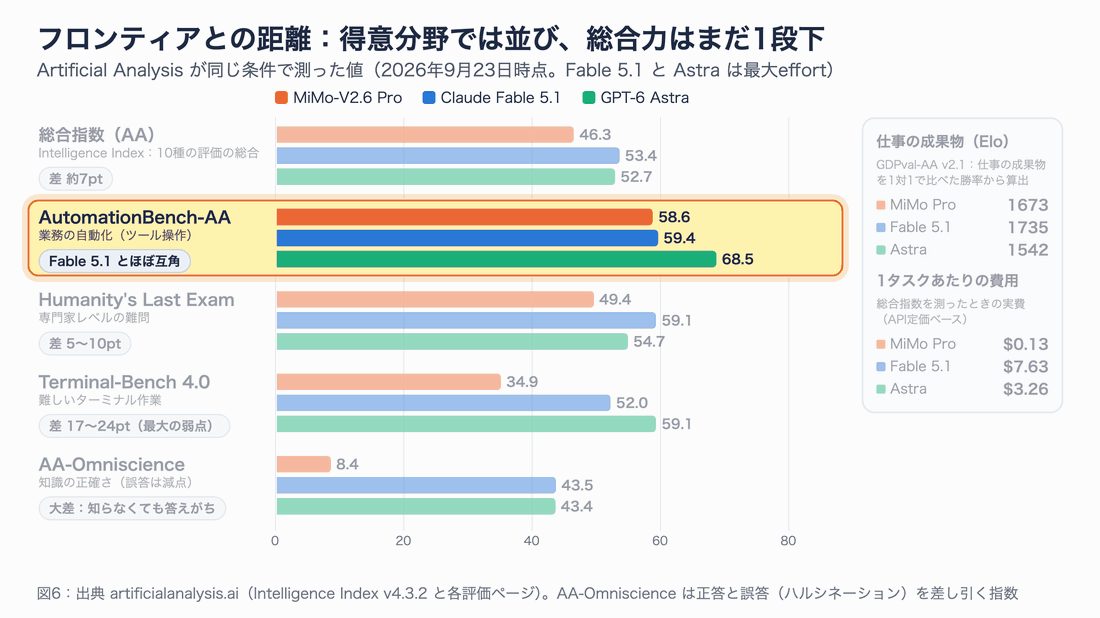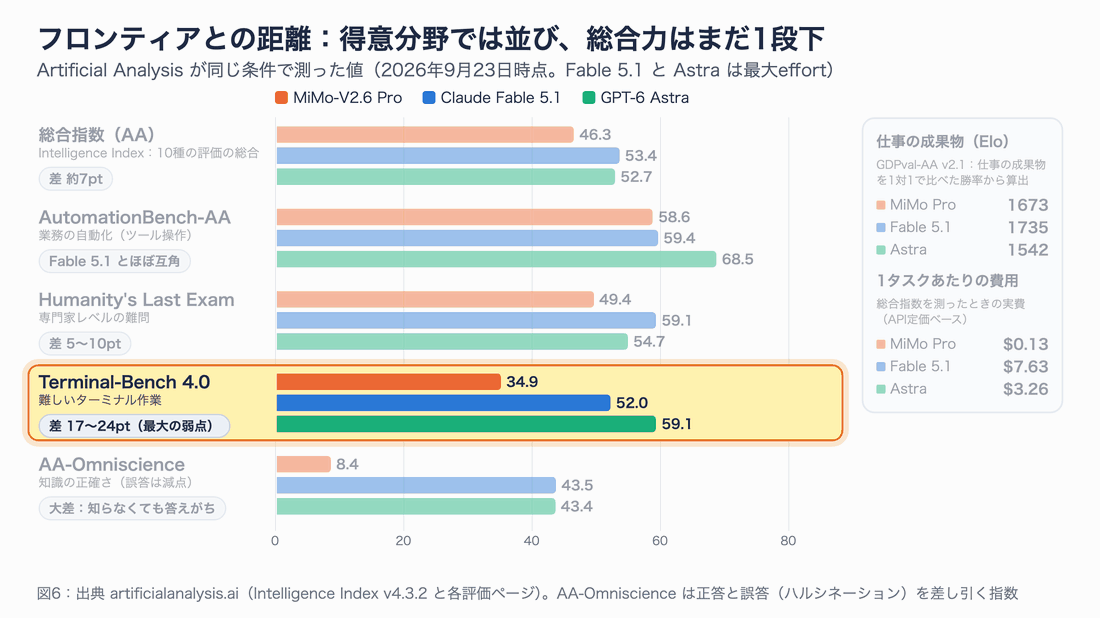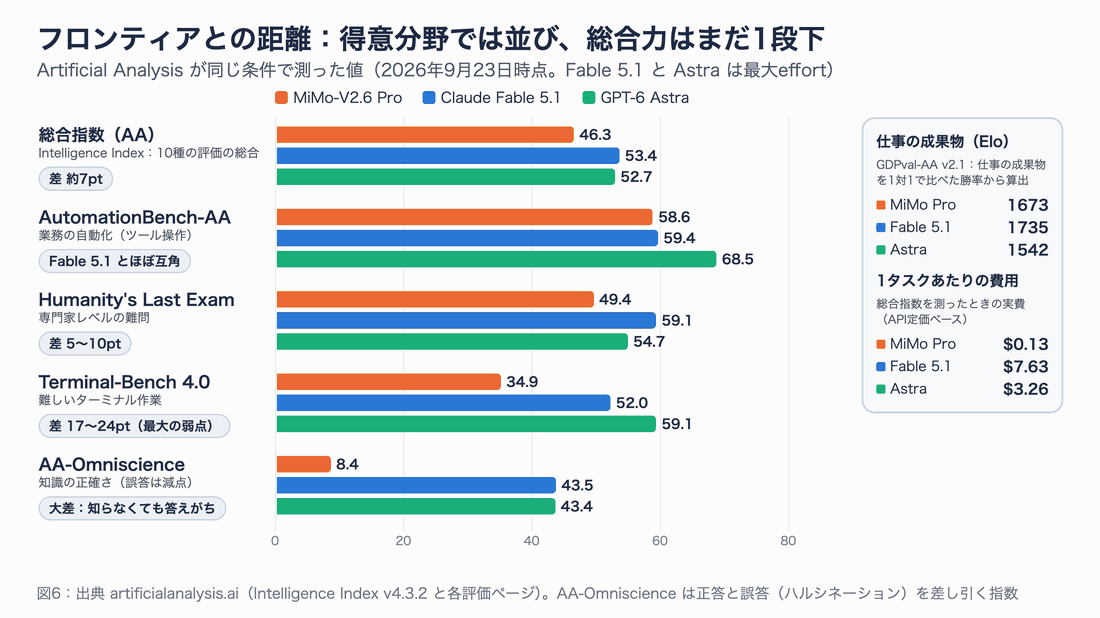
図6:フロンティアとの距離(Artificial Analysis、2026年9月23日時点)。静止画版は fig06-frontier-gap.png
| 評価(AA、同条件) | MiMo-V2.6 Pro | Claude Fable 5.1 | GPT-6 Astra | 読み取れること |
|---|---|---|---|---|
| 総合指数(Intelligence Index) | 46.3 | 53.4 | 52.7 | 約7ポイント差。Fable 5.1・Astra の「low」設定(46.8 / 46)とほぼ同じ |
| AutomationBench-AA(業務の自動化) | 58.6 | 59.4 | 68.5 | Fable 5.1 とほぼ互角 |
| GDPval-AA v2.1(仕事の成果物、Elo) | 1673 | 1735 | 1542 | Astra を上回り、Fable 5.1 に迫る |
| Humanity’s Last Exam(専門家レベルの難問) | 49.4 | 59.1 | 54.7 | 5〜10ポイント差 |
| Terminal-Bench 4.0(難しいターミナル作業) | 34.9 | 52.0 | 59.1 | 17〜24ポイント差。最大の弱点 |
| AA-Omniscience(知識の正確さ) | 8.4 | 43.5 | 43.4 | 大差。知らないことにも答えてしまう傾向 |
| 1タスクあたりの費用(総合指数の測定時) | $0.13 | $7.63 | $3.26 | Fable 5.1 の約1/59、Astra の約1/25 |
「近づいたところ」と「まだまだのところ」
数字を整理すると、MiMo-V2.6 の現在地がはっきりします。
フロンティアに大きく近づいたところは、業務の自動化(AutomationBench)、仕事の成果物の質(GDPval-AA)、実リポジトリでのバグ修正(DeepSWE。各社の自己申告値で Fable 5.1 が67.4、Astra が74.1、MiMo Pro が71.9)といった、RLで大量に練習した「エージェント型の実務タスク」です。GDPval-AA では GPT-6 Astra を上回っています。
まだ差が大きいところは3つあります。1つ目は、最新の難しいターミナル作業(Terminal-Bench 4.0)で、17〜24ポイント差です。2つ目は、知識の正確さ(AA-Omniscience)で、8.4 対 43台と大差があります。この指数は誤答を減点するので、「知らないのに答えてしまう」傾向が強いと読めます。3つ目は、公式表でも差が目立つサイバー攻撃系の評価(ExploitBench など)です。
Xiaomi 自身も、公式ニュースでこの差を認めています。
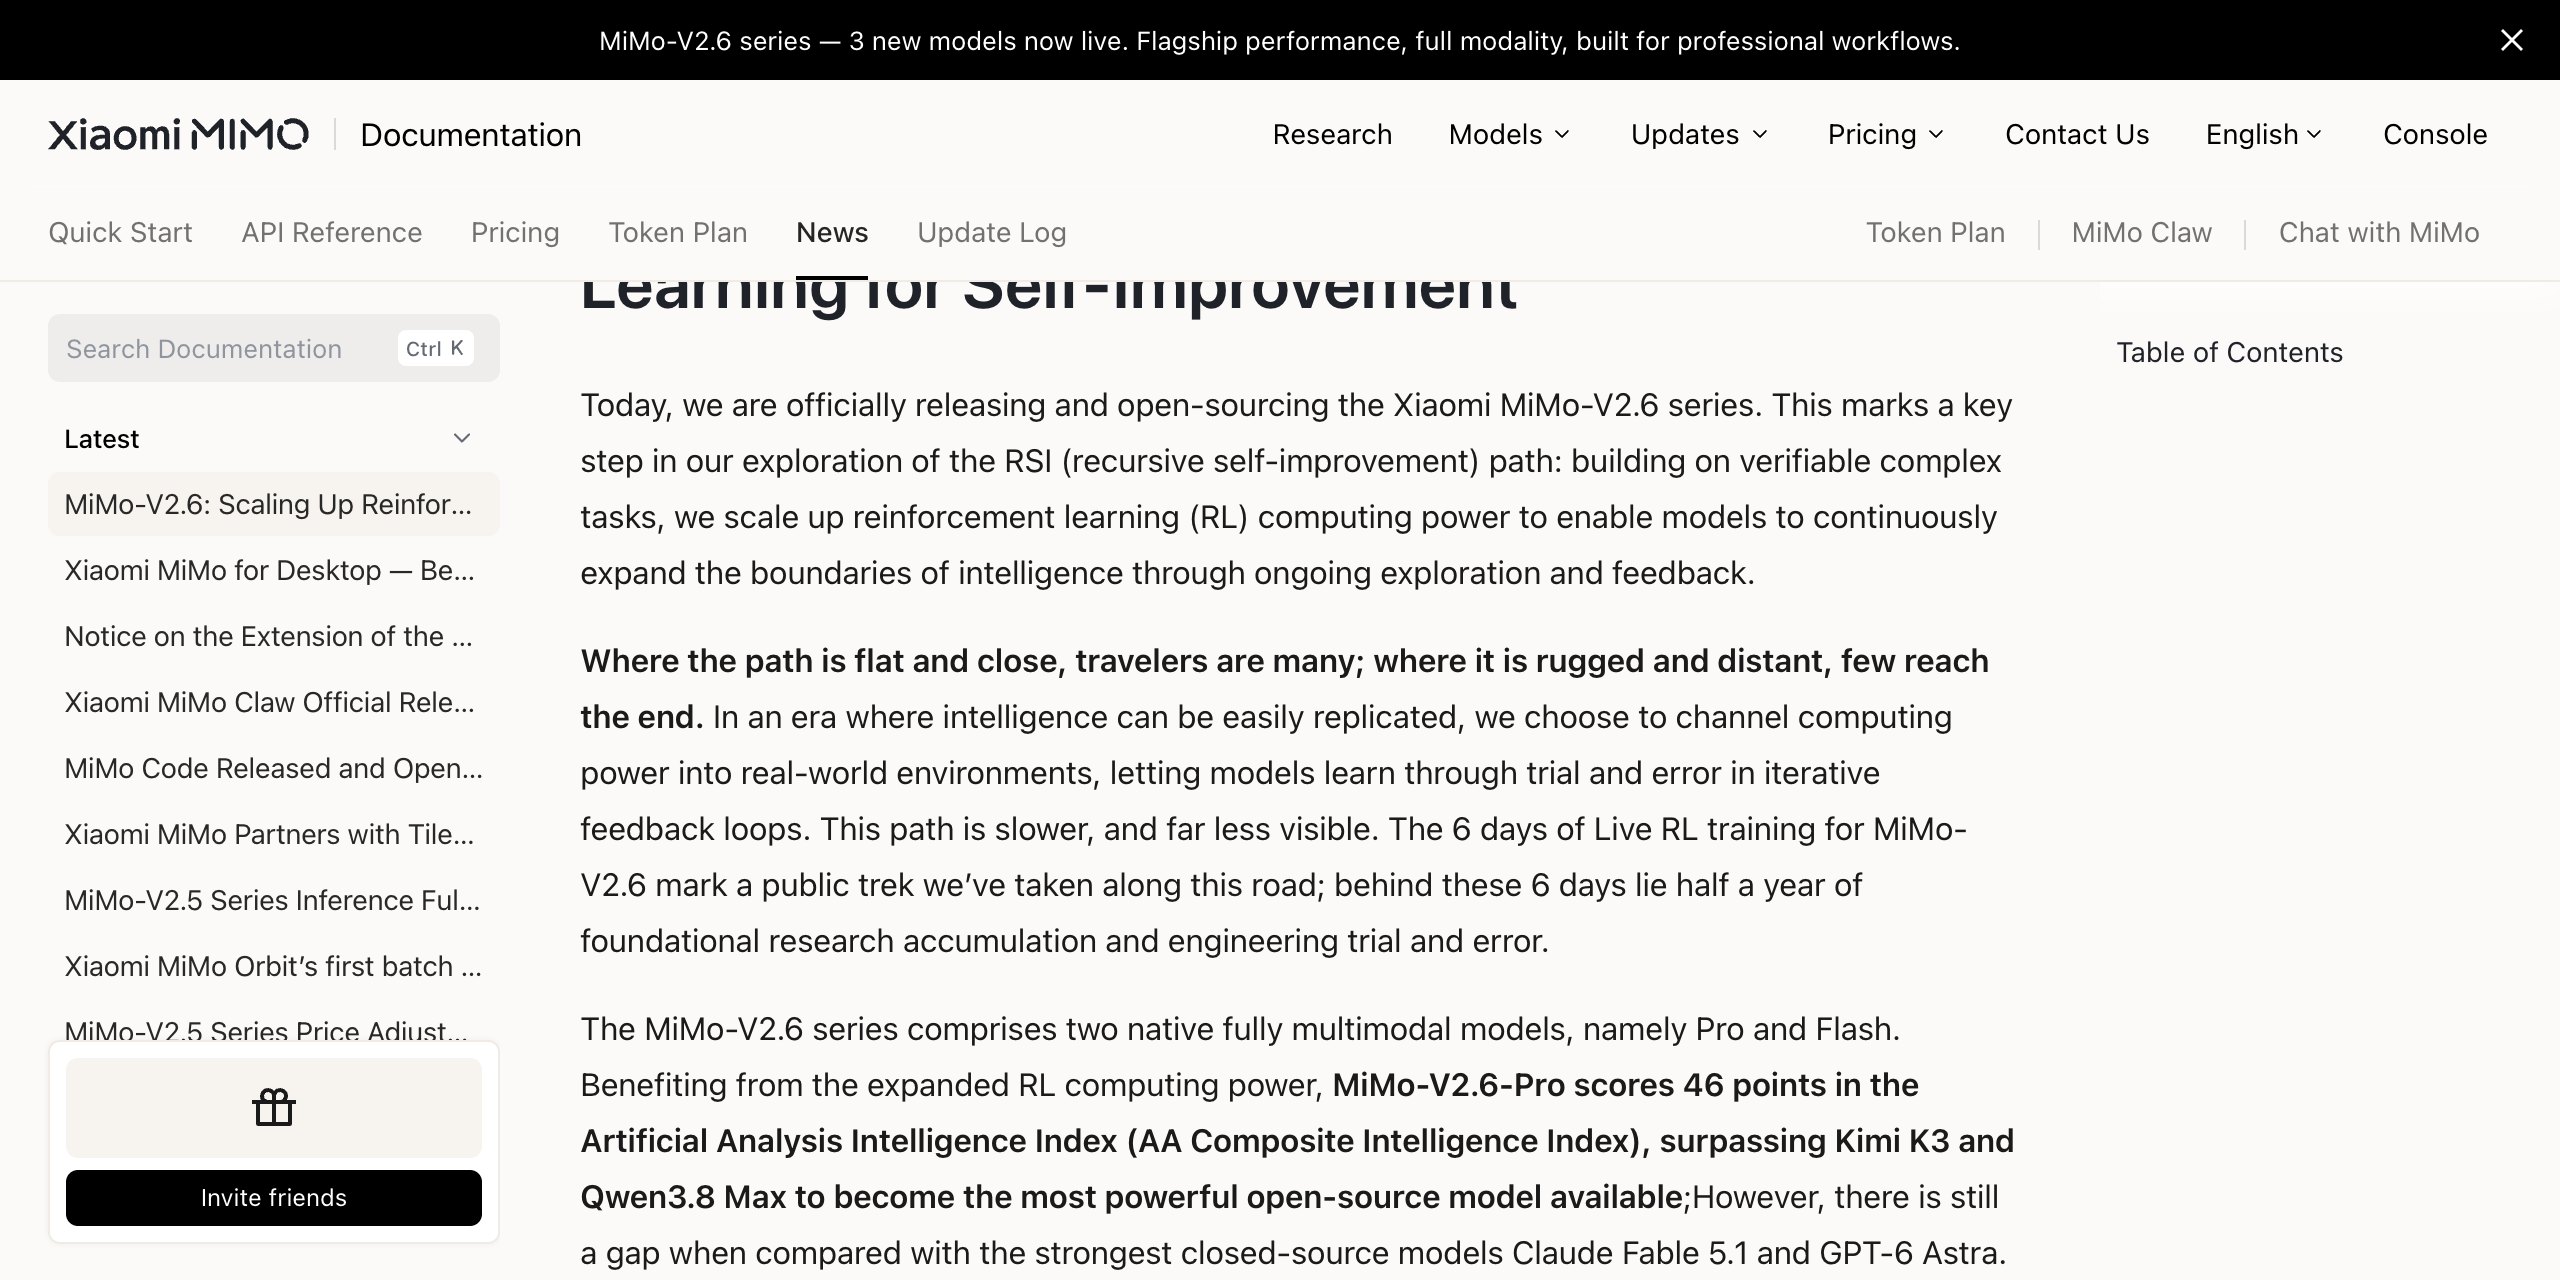
Xiaomi MiMo 公式ニュース(英語版、2026年9月23日撮影)。最後の文で「最強のクローズドモデル(Claude Fable 5.1 と GPT-6 Astra)とはまだ差がある」と述べています
まとめると、総合力は「フロンティアの1段下」、ただし価格は数十分の1です。なお、9月22日には Claude Opus 5.5 が公開され、AA の総合指数で 57.6 と首位に立っています。フロンティアの先頭は今も動き続けている点も、頭に入れておくとよいでしょう。
実際にMacへ入れて動かす
ここからは、手元の MacBook Pro で MiMo-V2.6 を動かした記録です。検証環境は次のとおりです。
| 項目 | 内容 |
|---|---|
| マシン | MacBook Pro(Apple M5 Max、18コア、メモリ128GB) |
| OS | macOS 26.6.2 |
| 推論エンジン | llama.cpp b11115(2026年9月22日UTCの公式リリース、Metal) |
| モデル① | MiMo-V2.6-Flash-RL の 2.5bit GGUF(AesSedai / BPW2.5、90.14GiB)+画像用の mmproj(Q8_0) |
| モデル② | MiMo-V2.6-Distill-Qwen-9B の Q8_0 GGUF(ggml-org、9.5GB)+ mmproj |
| 生成設定 | 公式推奨の temperature=1.0、top_p=0.95。思考(reasoning)はオン |
どのモデルを入れるか
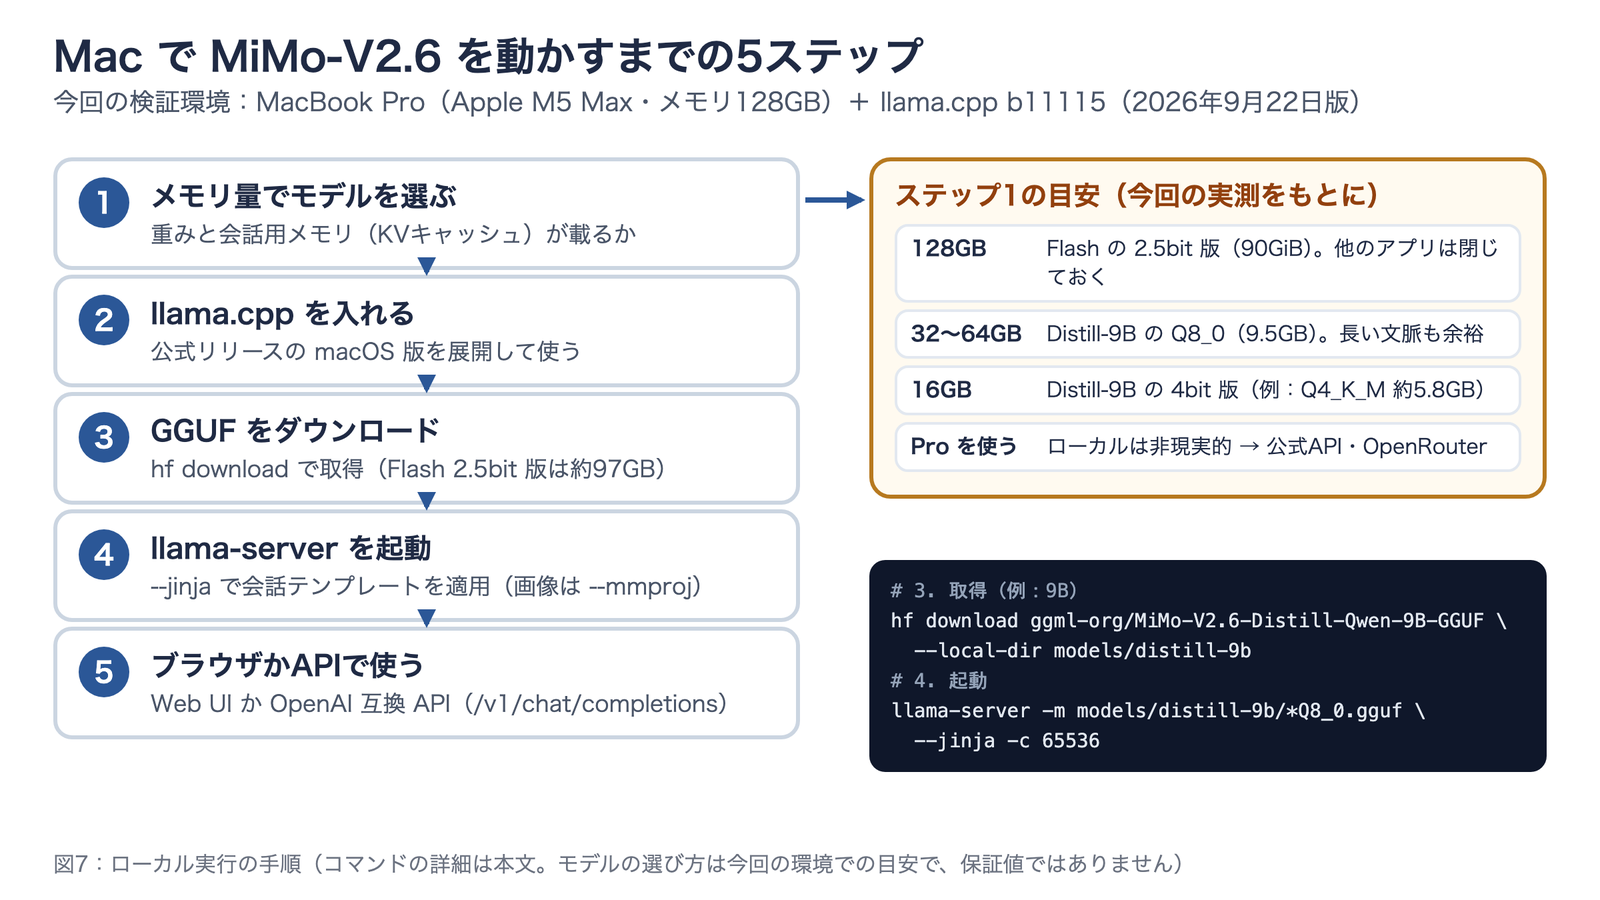
最初に決めるのは「どのモデルを、どこまで圧縮して入れるか」です。図3で見たとおり、必要なメモリは総パラメータで決まります。図7で手順の全体を確認してください。
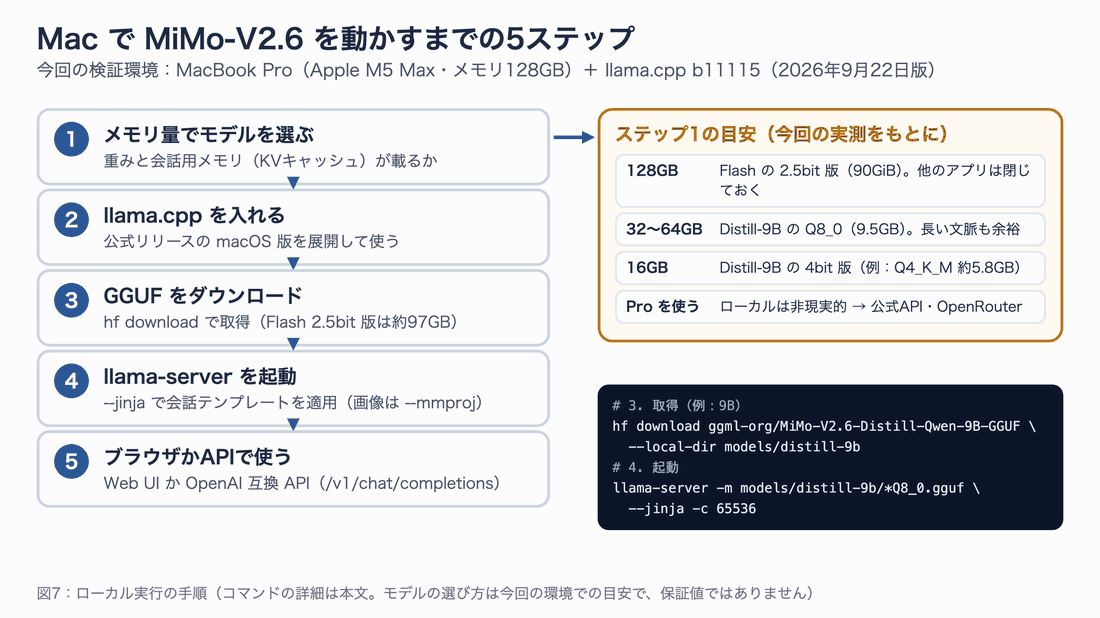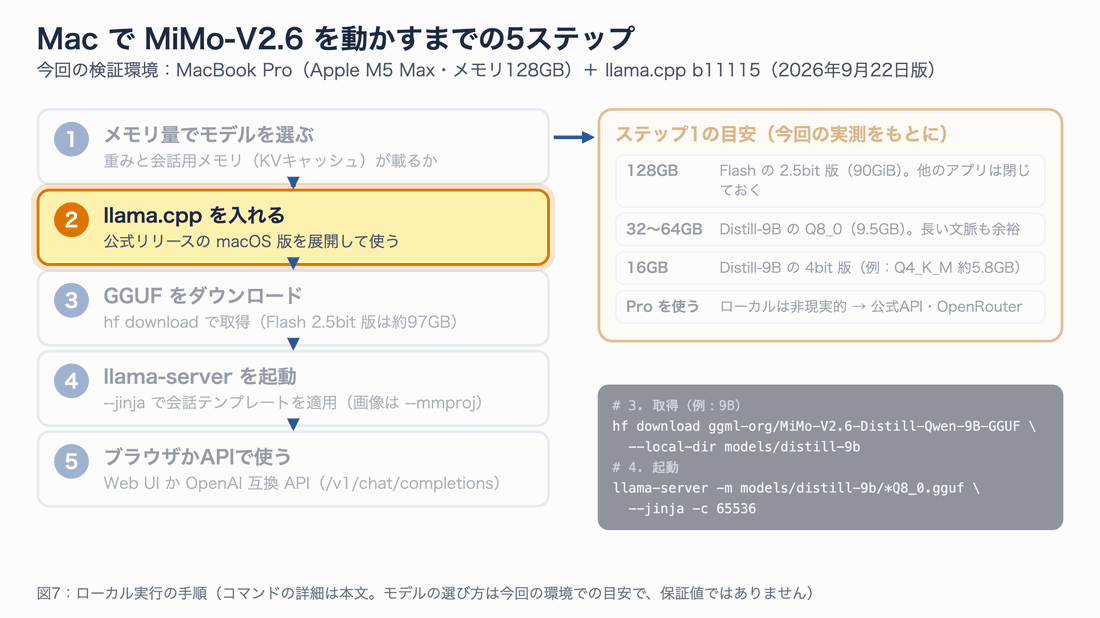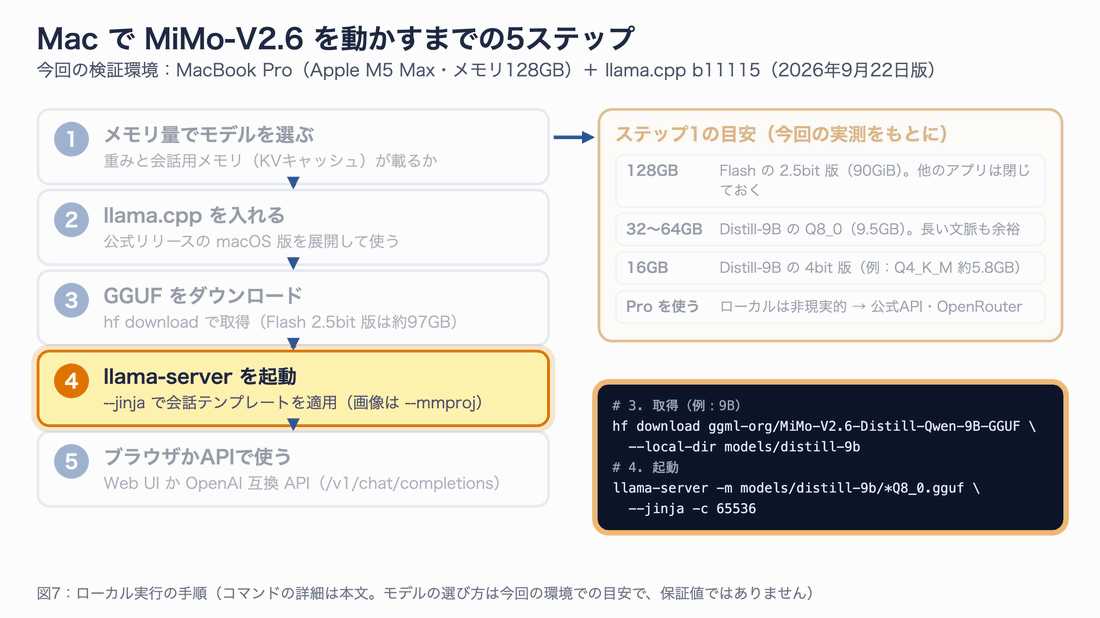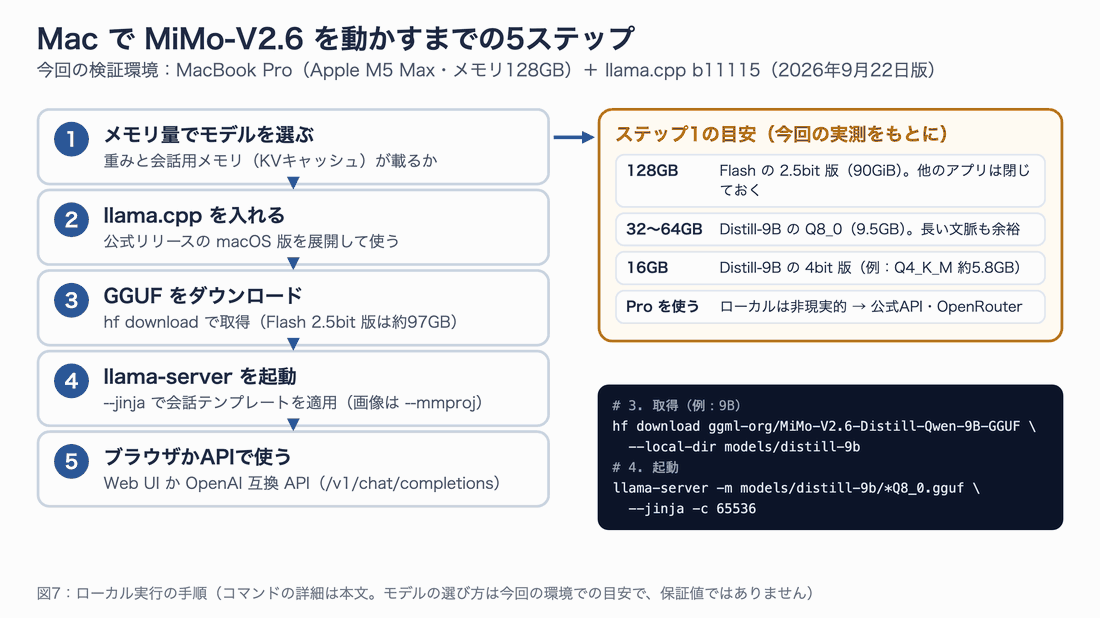
図7:Macで動かすまでの5ステップ。静止画版は fig07-mac-setup.png
Flash については、コミュニティが複数の量子化版を公開しています。今回選んだのは、AesSedai 氏の「BPW2.5」です。サイズの割に品質の落ち込みが小さくなるよう、容量の大半を占める専門家部分だけを強く圧縮し、それ以外は8bit近くで残す作り方をしています。
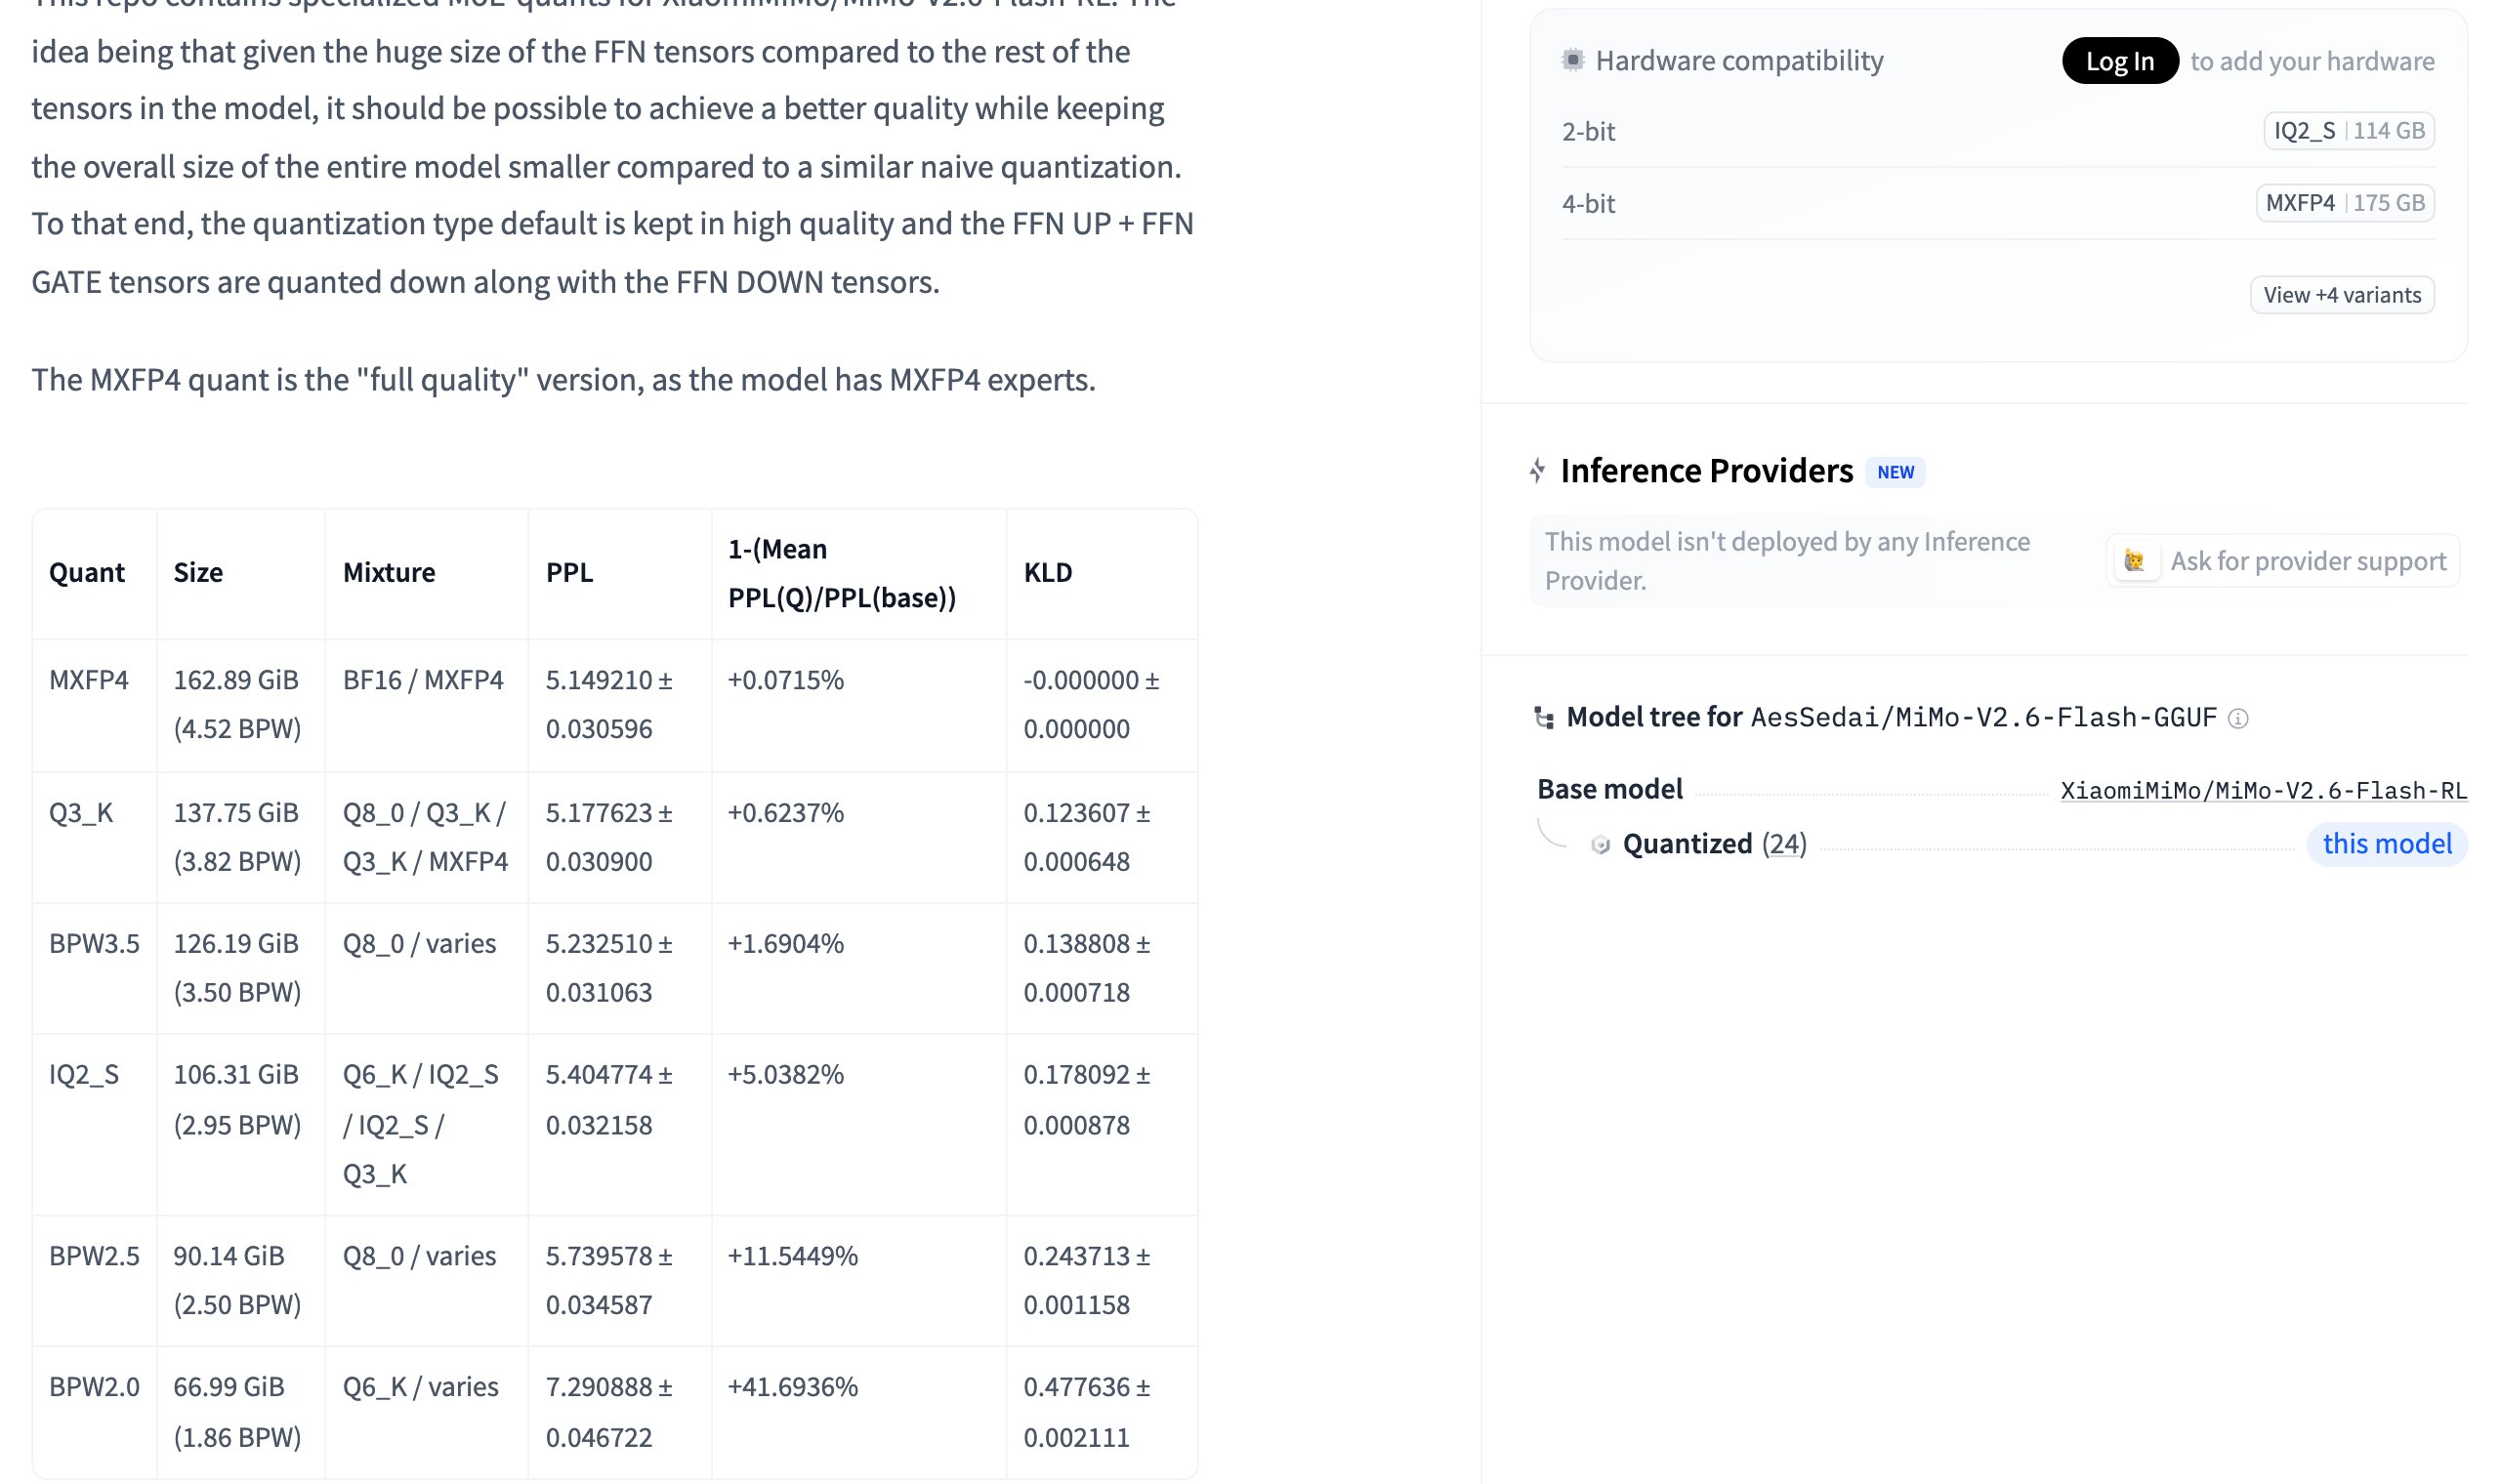
量子化版の比較表(AesSedai/MiMo-V2.6-Flash-GGUF、2026年9月23日撮影)。PPL(パープレキシティ)は元の重みとのずれの目安で、小さいほど元に近い
| 量子化 | サイズ | 元の重みからのPPLの悪化(作成者の測定) | 128GBのMacでは |
|---|---|---|---|
| MXFP4(ほぼ元の品質) | 162.89GiB | +0.07% | 入らない |
| IQ2_S | 106.31GiB | +5.0% | 計算上は入るが余裕がほぼない(未検証) |
| BPW2.5(今回) | 90.14GiB | +11.5% | 入る |
| BPW2.0 | 66.99GiB | +41.7% | 余裕はあるが劣化が大きい |
macOS では、GPU が使えるメモリに上限があります。今回の Mac では、llama.cpp の起動ログに recommendedMaxWorkingSetSize = 115448.73 MB(約113GiB)と表示されました。BPW2.5 の90.14GiB なら、会話用のメモリを足しても上限に収まります。
手順1:llama.cpp を入れる
llama.cpp(C/C++製の軽量な推論エンジン)は、公式リリースの macOS 版を使いました。Homebrew でも入りますが、執筆時点の Homebrew 版は9月14日のビルドで、新しいモデル向けの修正が入っていない可能性があります。
# 作業用フォルダを作る
mkdir -p ~/mimo-local && cd ~/mimo-local

# llama.cpp の公式リリース(macOS / Apple Silicon 版)を取得して展開
curl -L -O https://github.com/ggml-org/llama.cpp/releases/download/b11115/llama-b11115-bin-macos-arm64.tar.gz
tar -xzf llama-b11115-bin-macos-arm64.tar.gz
mv llama-b11115 llama-bin

# バージョンを確認(build 11115 と出ればOK)
./llama-bin/llama-server --version
手順2:モデルをダウンロードする
ダウンロードには Hugging Face の公式CLI(hf コマンド)を使います。Python の仮想環境に入れておくと、ほかの環境を汚しません。
cd ~/mimo-local
python3 -m venv .venv
.venv/bin/pip install -U "huggingface_hub[hf_xet]"

# 9B版(約10GB): 軽く試したい人はまずこちら
.venv/bin/hf download ggml-org/MiMo-V2.6-Distill-Qwen-9B-GGUF \
  MiMo-V2.6-Distill-Qwen-9B-Q8_0.gguf mmproj-MiMo-V2.6-Distill-Qwen-9B-Q8_0.gguf \
  --local-dir models/distill-9b

# Flash の2.5bit版(約97GB): メモリ128GB以上のMac向け
.venv/bin/hf download AesSedai/MiMo-V2.6-Flash-GGUF \
  --include "BPW2.5/*" --include "mmproj-MiMo-V2.6-Flash-RL-Q8_0.gguf" \
  --local-dir models/flash-bpw2.5
ここで1つつまずきました。最初は --include "BPW2.5/*" "mmproj-….gguf" のように、1つの --include の後ろにパターンを2つ並べていました。すると2つ目が「ファイル名の指定」と解釈され、hf は「ファイル名が指定されたので –include は無視する」と警告して、画像用の mmproj だけを落として終わりました。パターンが複数あるときは、上のように --include をパターンごとに付けてください。--dry-run を付けると、実際に落とすファイルの一覧を先に確認できます。
今回の回線では平均28MB/s前後で、Flash の97GBに約57分かかりました。未ログインだとレート制限が低いので、大きなモデルを落とすときは hf auth login でログインしておくと安心です。途中で止まっても、同じコマンドを再実行すれば続きから再開します。
手順3:llama-server を起動する
llama.cpp に付属する llama-server は、ブラウザで使えるチャット画面と、OpenAI互換のAPIを同時に立ち上げます。Flash は次のコマンドで起動しました。
cd ~/mimo-local
./llama-bin/llama-server \
  -m models/flash-bpw2.5/BPW2.5/MiMo-V2.6-Flash-RL-BPW2.5-00001-of-00003.gguf \
  --mmproj models/flash-bpw2.5/mmproj-MiMo-V2.6-Flash-RL-Q8_0.gguf \
  -c 65536 -np 1 -ngl 99 --jinja --port 8080
オプションの意味は次のとおりです。
| オプション | 意味 |
|---|---|
-m | モデルファイル。分割されたGGUFは1つ目(00001)を指定すれば残りも読み込まれる |
--mmproj | 画像を読むためのエンコーダー。画像を使わないなら省略できる |
-c 65536 | 扱える文脈の長さ(トークン数)。増やすほどメモリを使う |
-np 1 | 同時に処理する会話の数。1人で使うなら1でメモリを節約できる |
-ngl 99 | すべての層をGPU(Metal)で計算する |
--jinja | モデルに同梱された会話テンプレートを使う。ツール呼び出しや思考の分離に必要 |
実際に起動したときの様子が、次の録画です。
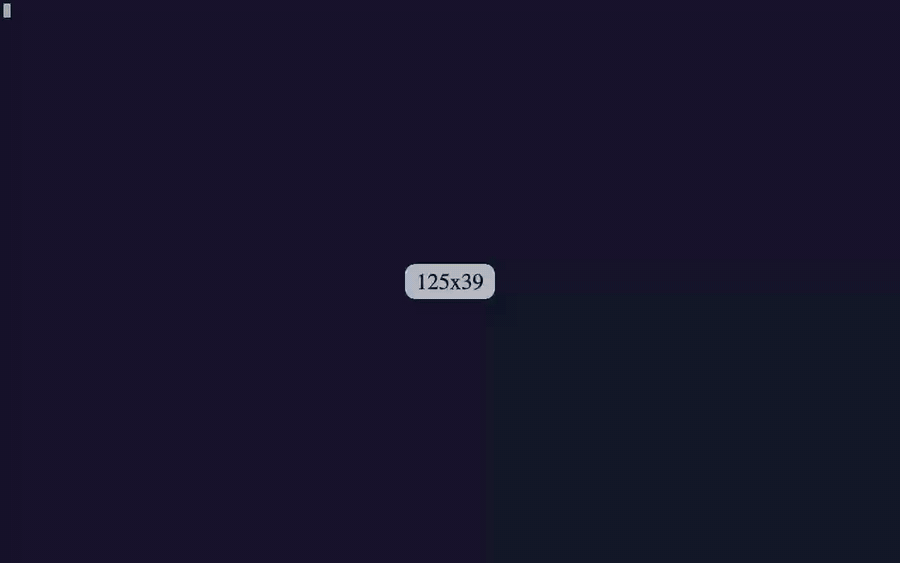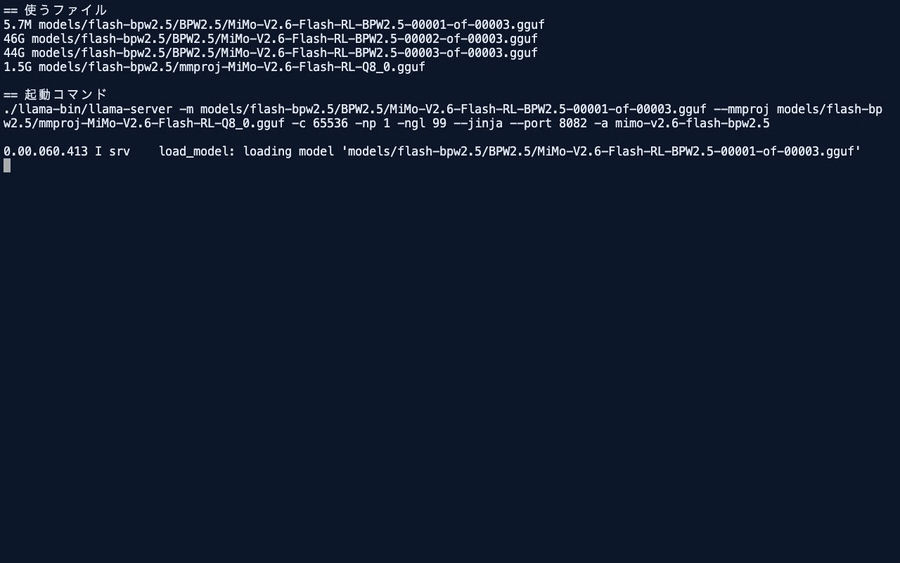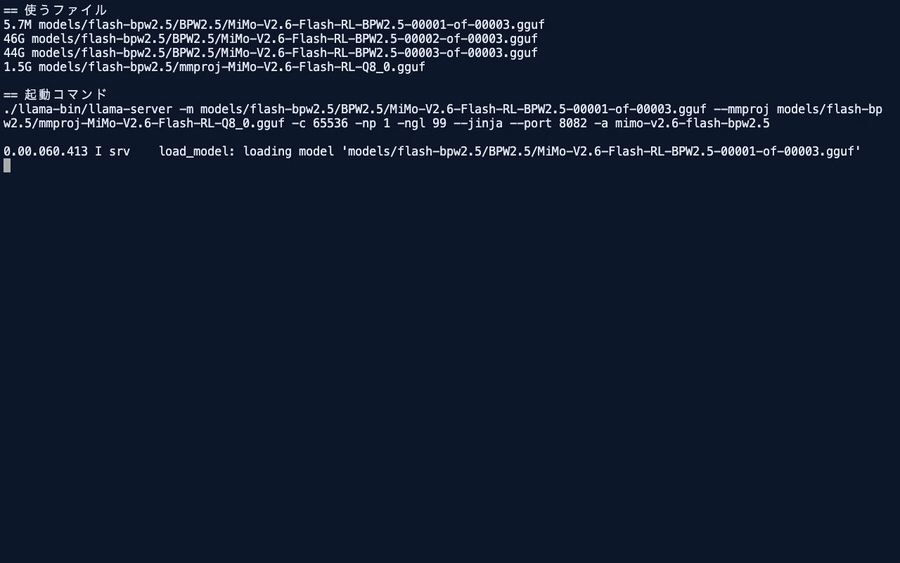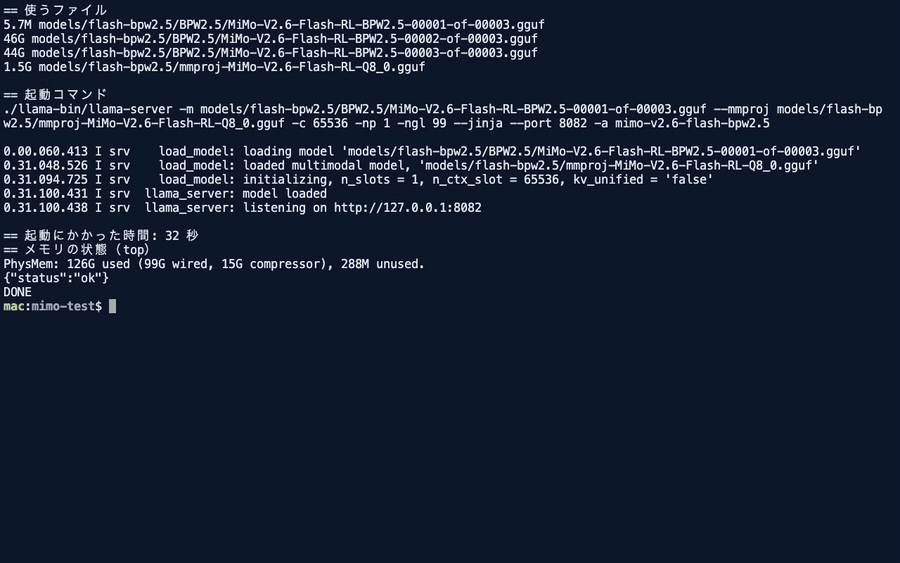
Flash の起動(実際のターミナルの録画、等速)。ログを見やすくするため、同じコマンドを小さな起動スクリプトから実行しています(ポート番号だけ8082)
読み込みは32秒で終わりました(ダウンロード直後で、ファイルがOSのキャッシュに残っていた影響もあります)。起動後のメモリは 99GBが「wired」(GPUが使うために固定された領域)になり、空きは300MB弱まで減りました。ほかのアプリの一部はスワップ(ストレージへの退避)に追い出されています。Flash を動かしている間は、ブラウザのタブを大量に開くような作業は避けたほうが無難です。
listening on http://127.0.0.1:8080 と表示されたら準備完了です。ブラウザで http://127.0.0.1:8080 を開くとチャット画面が使えます。プログラムからは、OpenAI と同じ形式のAPIで呼び出せます。
# OpenAI互換APIで質問する(思考を省略して速く返したい場合は chat_template_kwargs を付ける)
curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "messages": [{"role": "user", "content": "日本の首都は?一言で。"}],
    "temperature": 1.0, "top_p": 0.95,
    "chat_template_kwargs": {"enable_thinking": false}
  }'
検証結果:Flash(2.5bit)と 9B に同じ課題を出してみた
検証の方法
手元の2つのモデルに、同じ6種類の課題を出しました。採点は目視ではなく、できるものはプログラムで自動判定しています。答えが毎回変わるモデルなので、判定できる課題は3回ずつ試しました。呼び出しと採点は、OpenAI互換APIを叩く Python スクリプト(標準ライブラリのみ)で自動化しています。
| 課題 | 内容 | 判定方法 |
|---|---|---|
| ① 日本語の説明 | MoE を中学生向けに、たとえ話1つ・200字で | 目視 |
| ② 算数 | 1〜100のうち3でも5でも割り切れない数の和(正解2632) | 自動(3回) |
| ③ コード生成 | 和暦(昭和・平成・令和)を西暦の日付に変える関数 | 隠しテスト16件で自動(3回) |
| ④ 画像の読み取り | 公式ベンチマーク表の画像から「MiMo Pro が Opus 5 を上回る行」を答える(正解3行) | 自動+目視(3回) |
| ⑤ ゲーム作成 | 1ファイルのHTMLでブロック崩し | ブラウザで実際に操作(1回) |
| ⑥ エージェント | ツールを使って、バグのあるレジ計算プログラムを直す | テスト5件が通るか(3回) |
結果のまとめ
先に結果を表で示します。
| 課題 | Distill-9B(Q8_0) | Flash(2.5bit) |
|---|---|---|
| ① 日本語の説明 | 自然だが短め | 自然。条件どおりの長さとたとえ話 |
| ② 算数 | 3/3 正解 | 3/3 正解 |
| ③ 和暦変換(隠しテスト16件) | 7件・0件・7件(正しい変換は1件もできず) | 16件・16件・16件(全問正解) |
| ④ 画像の表の読み取り | 1/3 正解(列を読み違える) | 3/3 正解 |
| ⑤ ブロック崩し | ボールが画面に出ず、遊べない | 正しく動作 |
| ⑥ エージェントでバグ修正 | 2/3 成功(1回は途中で空回り) | 3/3 成功(4〜5ステップ、約30秒) |
| 生成速度(llama-bench の tg128) | 53 tok/s | 30 tok/s |
9Bは速いものの、コードを一から書く課題では失敗が目立ちました。Flash は2.5bitまで圧縮した状態でも、今回の課題をすべてこなしています。以下、課題ごとに見ていきます。
①② チャット画面で使ってみる
まずは llama.cpp のチャット画面から、Flash に質問しました。思考(Reasoning)が折りたたまれて表示され、その下に回答が出ます。
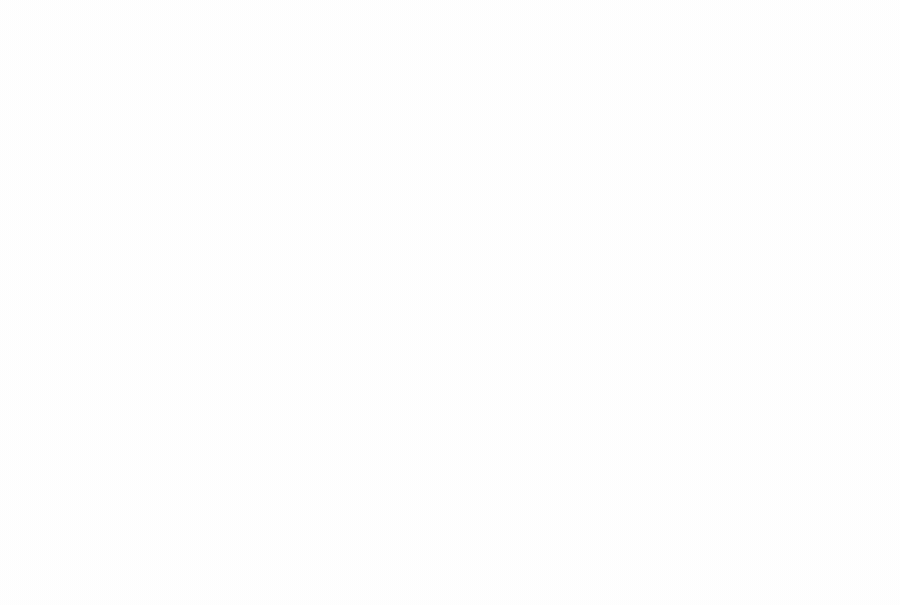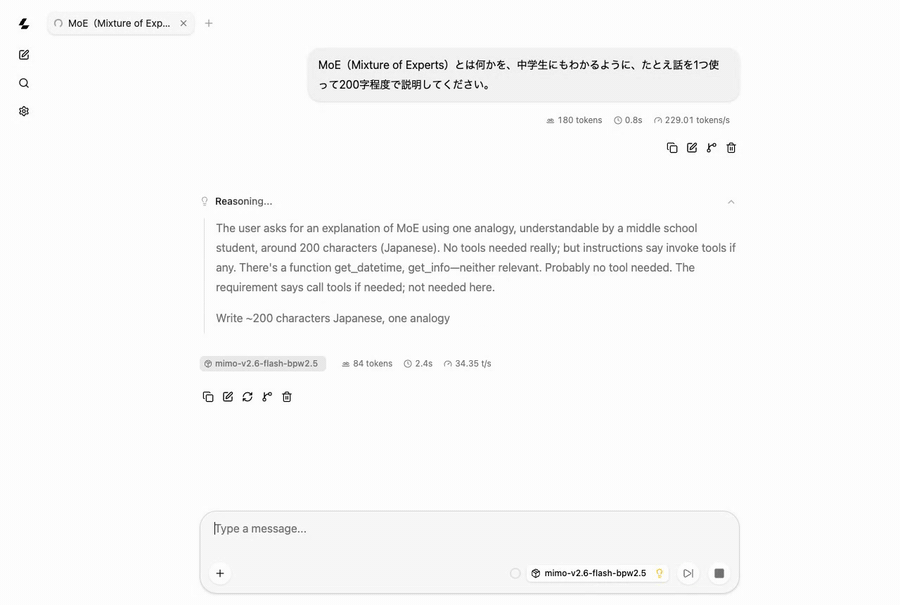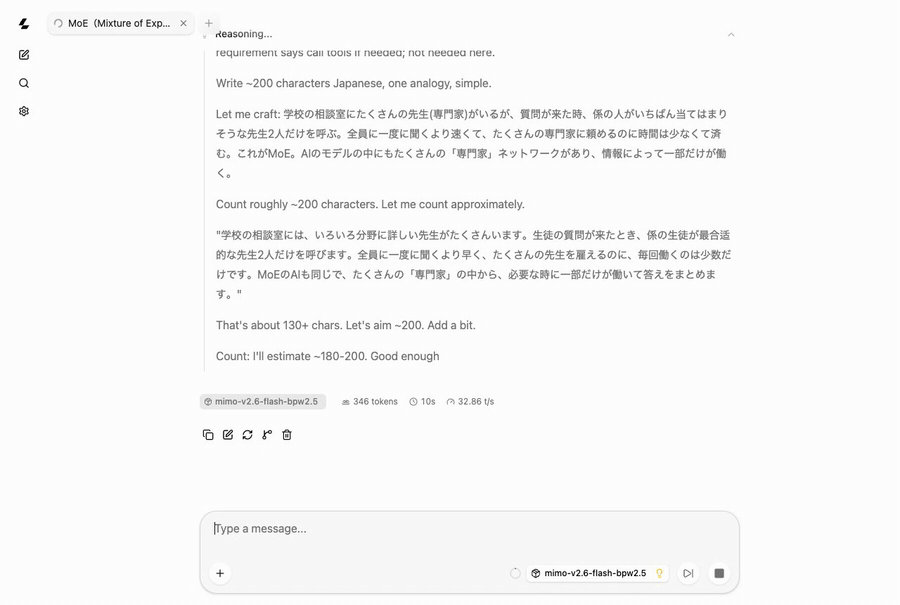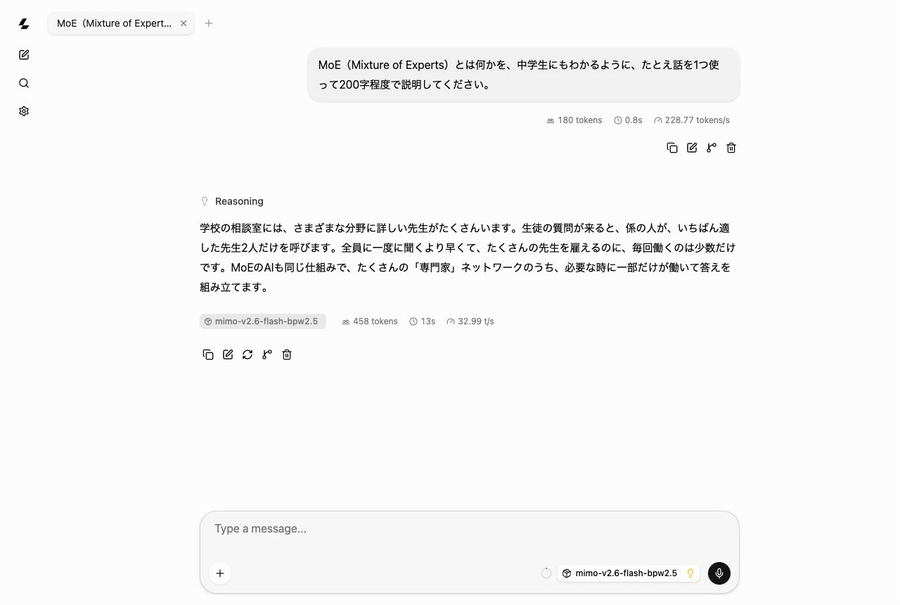
Flash とのチャット(実際のブラウザ画面の録画、等速)
日本語は自然で、「たとえ話を1つ」という条件も守っています。算数の問題は、両モデルとも3回すべて正解でした。この程度の質問なら、9Bでも十分に実用的です。
③ コード生成:和暦変換で大きな差
差がはっきり出たのは、和暦の日付文字列を datetime.date に変える関数を書かせる課題です。「令和元年」「全角数字」「R6.1.15 のような略記」「元号の境目(平成31年4月30日はOK、5月1日はNG)」など、見落としやすい条件を仕様に入れました。隠しテスト16件のうち7件は「エラーを出すべき入力」、9件は「正しく変換すべき入力」です。
Flash は3回とも16件すべてに合格しました。全角→半角の変換、「元年」の扱い、元号ごとの開始日と終了日のチェックを、読みやすい1つの関数にまとめています。
一方、9B は正しく変換すべき9件を1件も通せませんでした。7件合格に見えるのは、すべての入力にエラーを出したため「エラーを出すべき7件」だけが偶然合っただけです。生成されたコードを読むと、正規表現が [昭和平成令和](1文字だけにマッチする書き方)になっていて、「令和」という2文字の元号を読めていませんでした。元号の年を西暦に直す計算も抜けています。2回目は、元号の境目の計算を延々と考え続けて出力の上限(16,384トークン)に達し、コードを出さずに終わりました。
④ 画像の読み取り:表の列を正しく追えるか
MiMo-V2.6 は画像も入力できます。先ほどの公式ベンチマーク表のスクリーンショットをチャット画面に貼り、「MiMo-V2.6 Pro が Claude Opus 5 を上回っているベンチマーク」を答えさせました。正解は AutomationBench・Terminal Bench 2.1・MiMo VisualCoding の3行です(Agents’ Last Exam は 31.6 で同点なので除外)。
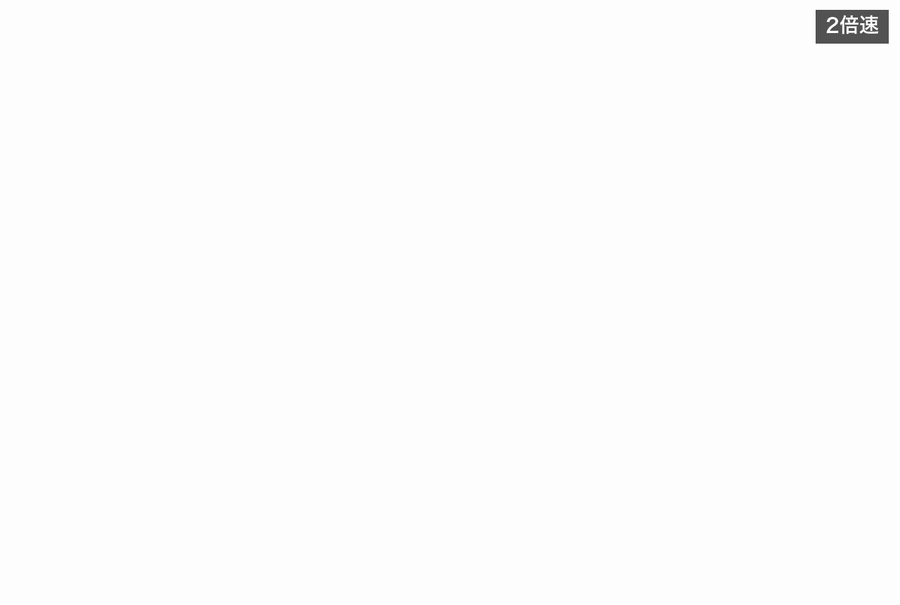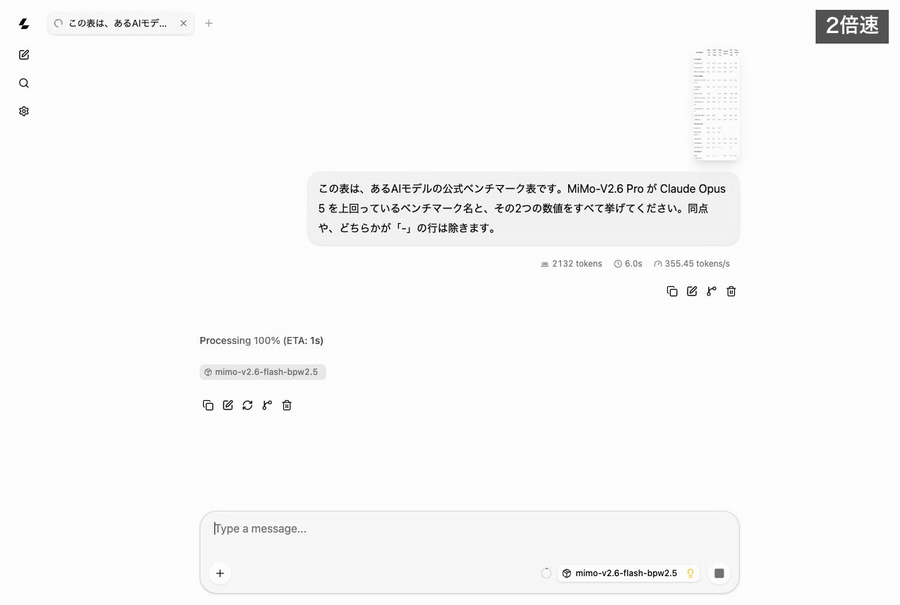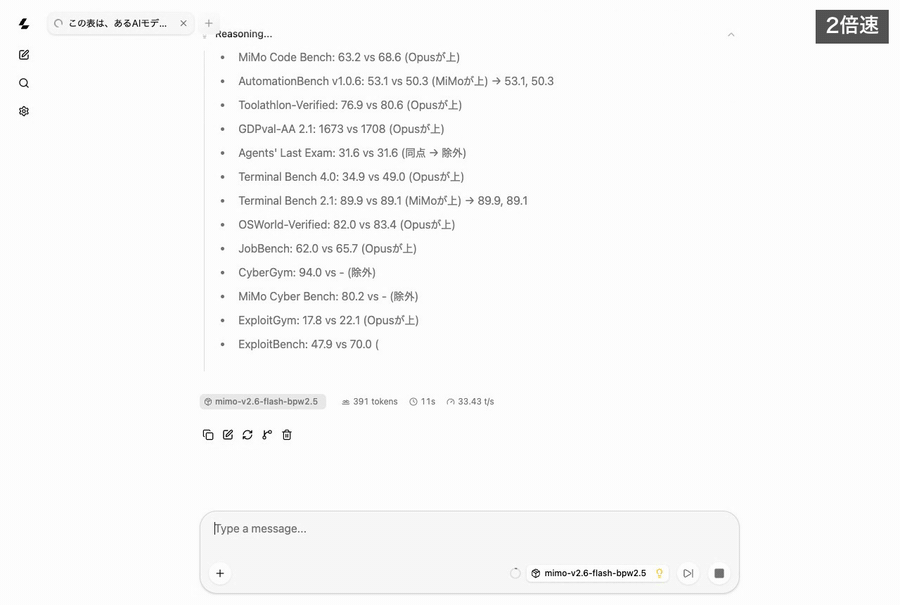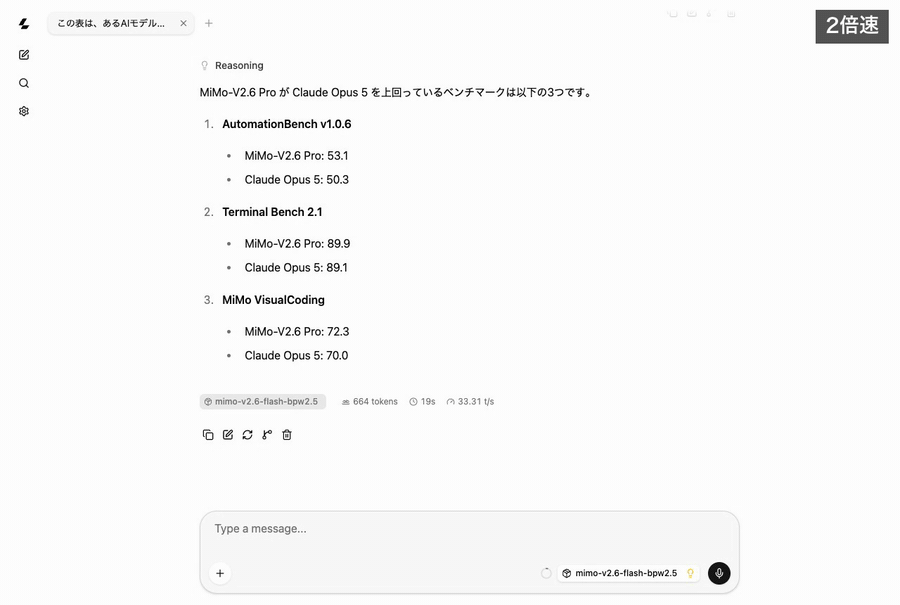
画像の読み取り(実際のブラウザ画面の録画、2倍速)
Flash は3回とも正解しました。9B は3回中2回、Agents’ Last Exam の Opus 5 の値を「30.8」と読み、「上回っている」に含めてしまいました。30.8 は隣の GPT-5.6 Sol の列の値です。細かい表で列を1つずれて読む、という典型的な失敗でした。
なお、画像を入れると読み込み(プロンプト処理)が重くなります。約2,100トークン分の画像と質問を処理するのに、Flash では最初の出力まで8.7秒、9B では4.1秒かかりました。
⑤ ゲーム作成:「見た目は立派でも動かない」
次に、1ファイルのHTMLでブロック崩しを作らせ、実際にブラウザで開いて操作しました。
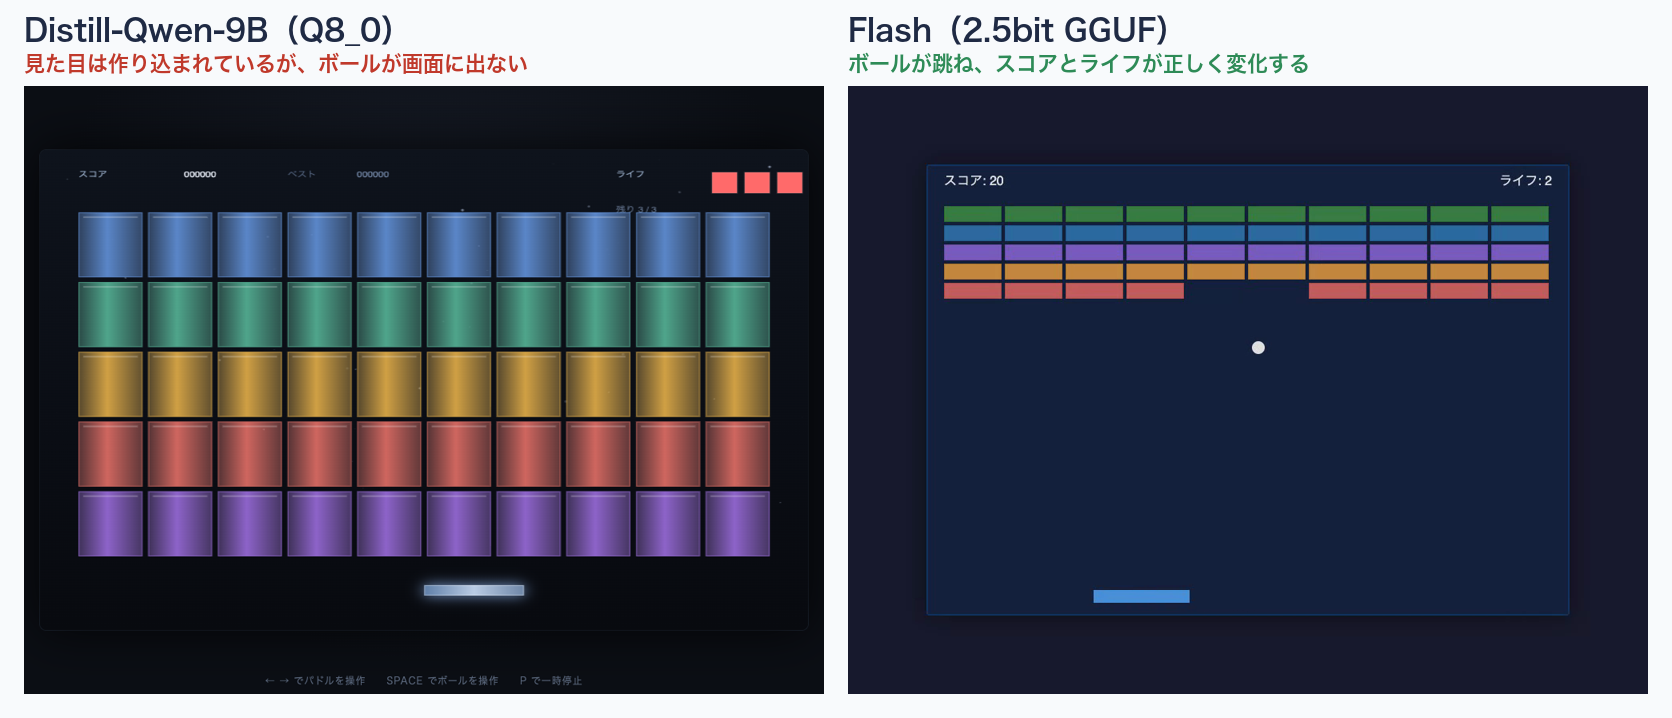
左:9B版、右:Flash版(どちらも実際にブラウザで操作した画面)
9B は645行の凝ったコード(効果音、パーティクル、ベストスコア)を書きましたが、ボールが画面に出ず、遊べませんでした。コードを確認すると、ボールを ball(1個)という変数で作っているのに、動かす処理と描く処理は balls(配列)を見ていて、配列は空のままでした。
Flash は230行の素直なコードで、要件をすべて満たしていました。自動操作なのでボールを取りこぼしていますが、ブロックが消え、スコアとライフが変わり、最後に「ゲームオーバー」が表示されます。
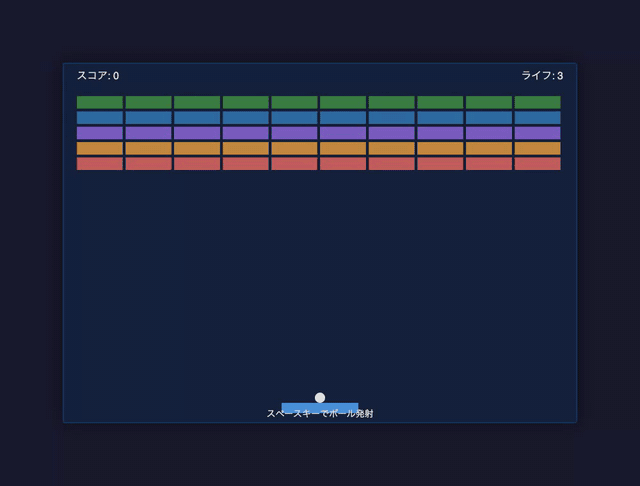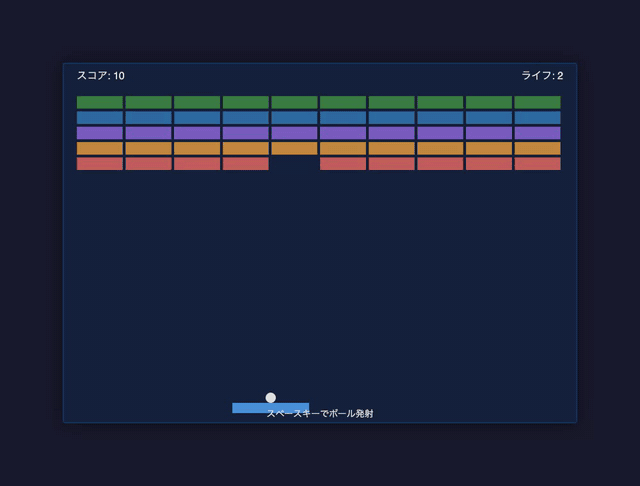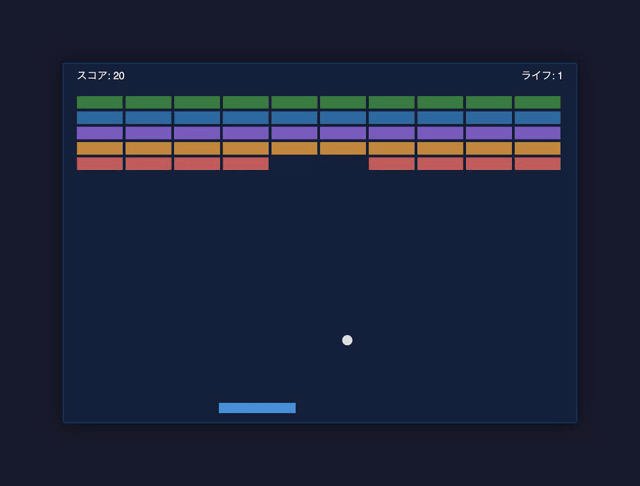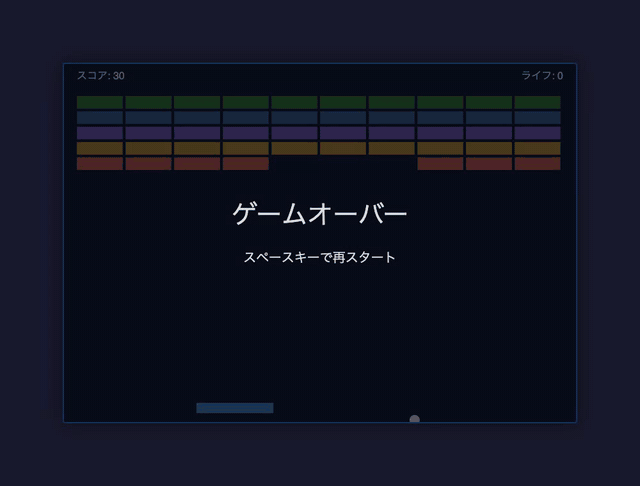
Flash 版のブロック崩し(実際のブラウザの録画、等速。操作は自動で左右に動かしているだけ)
⑥ エージェント:ツールを使ってバグを直す
最後に、MiMo-V2.6 が最も力を入れている「エージェント」としての動きを試しました。消費税の計算にバグが2つある小さなプログラム(食品の軽減税率の判定が逆・端数を四捨五入している)を用意し、4つのツール(ファイル一覧・読む・書く・テスト実行)だけを渡して「テストが落ちているので直して」と依頼します。エージェントの実行ループは、OpenAI互換APIのツール呼び出し(Function Calling)を使って自作した約120行のスクリプトです。
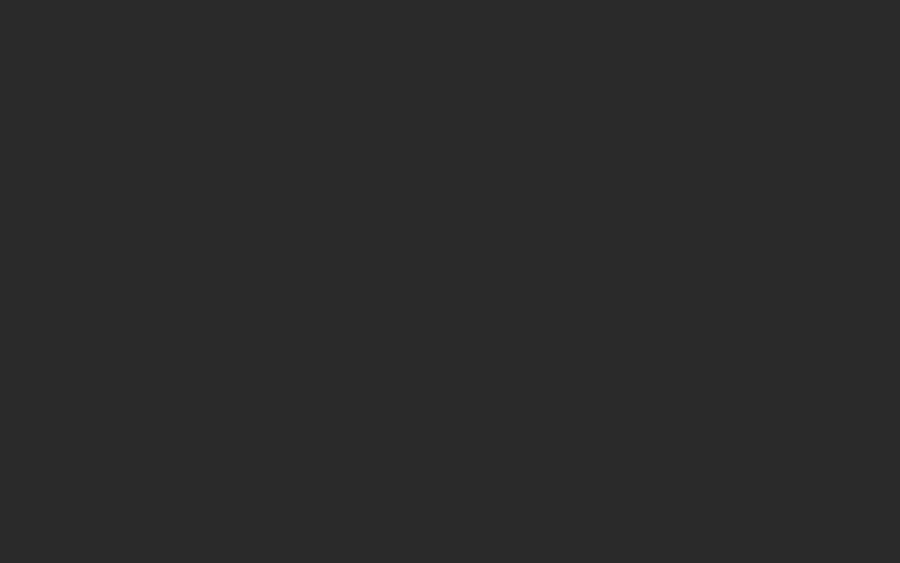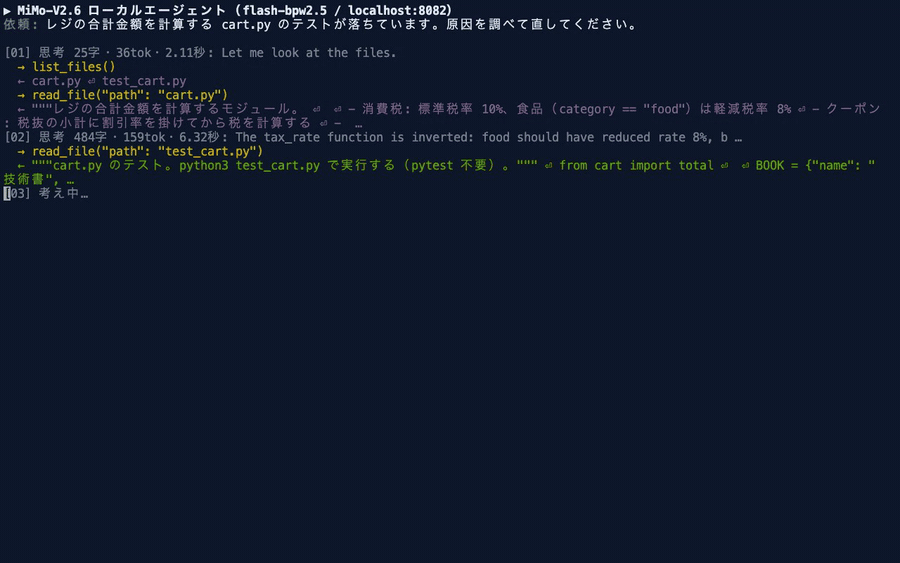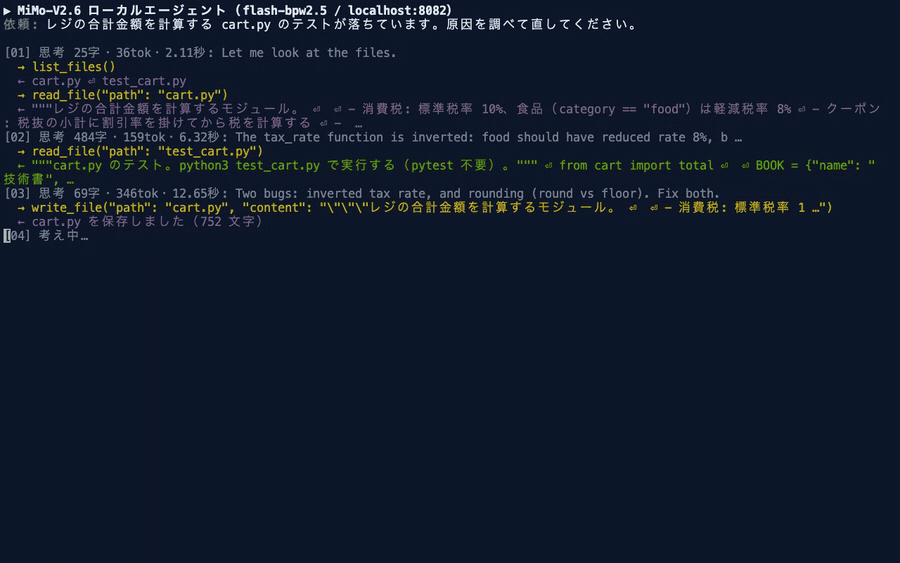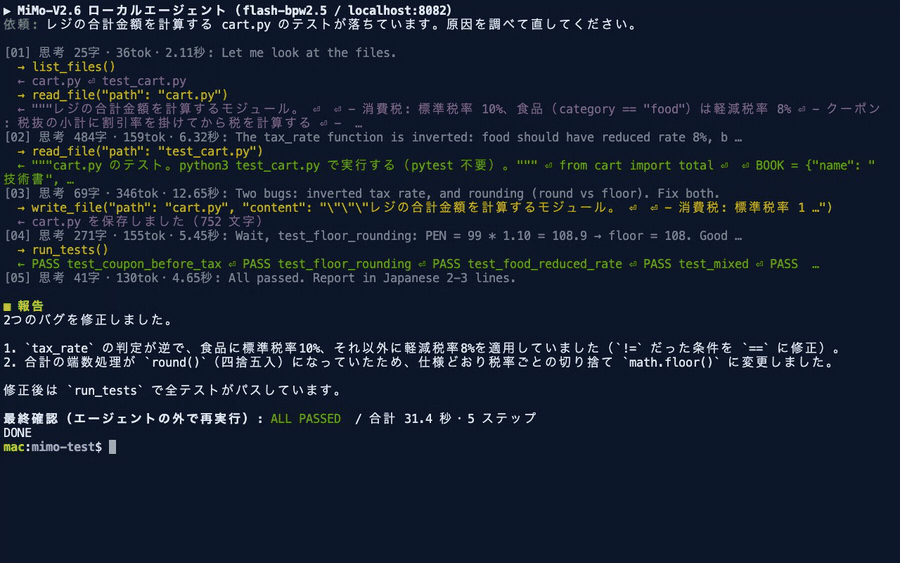
Flash のエージェント実行(実際のターミナルの録画、等速)
Flash は3回とも成功し、4〜5ステップ(モデルとツールの往復)、25〜31秒で直しました。テストを実行して失敗を確認し、ファイルを読み、2か所を最小限の変更で直して再テストする、という手順は、人間の開発者とほぼ同じです。最後の報告も「条件の != を == に」「round() を math.floor() に」と具体的でした。
9B も3回中2回は成功しました。コード生成は苦手でも、ツールを使う段取りは身についているのは、エージェント向けのデータで追加学習したモデルらしいところです。ただし失敗した1回では、いったんファイルを import math の1行だけで上書きし、次に元とほぼ同じ(バグが残ったままの)コードを書き戻しました。その後はテストを8回続けて実行するだけの空回りに陥り、15ステップの上限に達しています。
速度とメモリ
速度は、llama.cpp に付属する計測ツール llama-bench で揃えて測りました。
| 項目 | Distill-9B(Q8_0) | Flash(2.5bit) |
|---|---|---|
| ファイルサイズ | 9.5GB | 約97GB(90.14GiB) |
| 起動にかかった時間 | 約3秒 | 32秒 |
| プロンプト処理(pp512 / pp4096) | 2,510 / 2,300 tok/s | 387 / 432 tok/s |
| 生成(tg128) | 53 tok/s | 30 tok/s |
| 実際の会話での生成速度(今回の全試行) | 29〜57 tok/s | 22〜47 tok/s |
Flash の生成は、起動直後は40〜47 tok/s 出ていましたが、30分ほど連続で動かすと25 tok/s 前後まで下がりました(熱・電力制御かメモリの逼迫が考えられますが、原因は特定できていません)。それでも、日本語なら1秒に数十文字が流れる速さで、チャットで使うには十分です。一方、プロンプト処理は9Bの5分の1程度なので、長い資料を読ませると待ち時間が長くなります。約8,300トークンの英文を読み込ませたときは、処理に23秒かかりました。
検証の限界
この検証には、次のような限界があります。結果を読むときの前提として押さえておいてください。
- Flash は2.5bitに圧縮した版です。作成者の測定でPPL(元の重みとのずれの目安)が11.5%悪化しており、API で使える本来の Flash より精度は落ちているはずです
- 試行は各課題1〜3回で、統計的な比較ではありません。課題も公開ベンチマークよりずっと易しいものです
- Pro はメモリに載らないため試していません。Fable 5.1・GPT-6 Astra との比較は、前半のベンチマークによるものです
使い分けの考え方
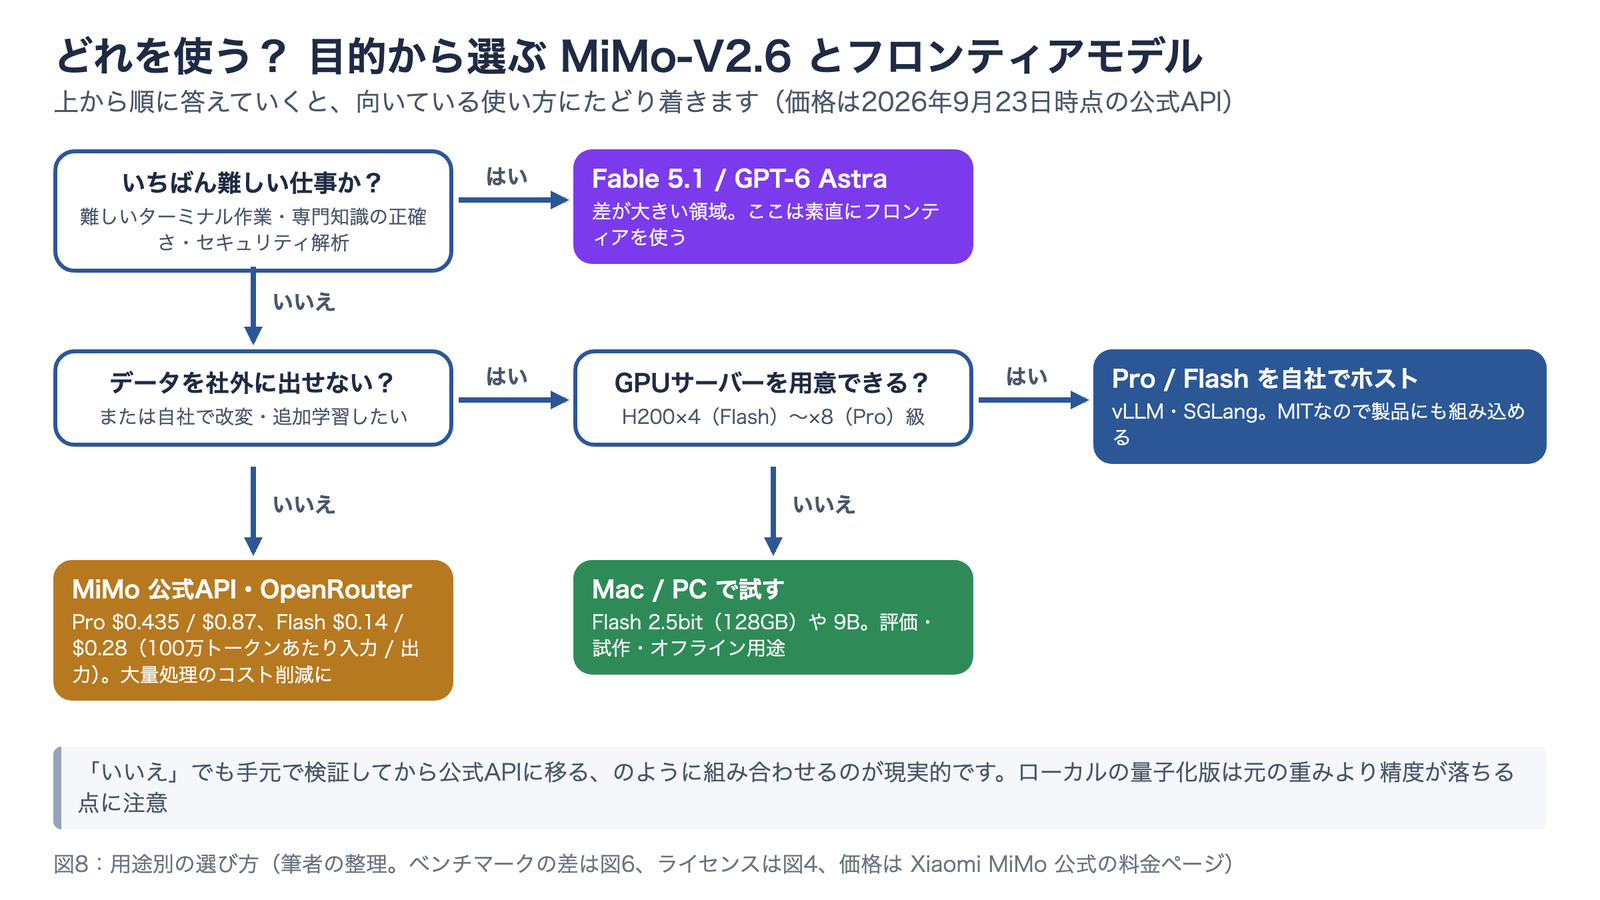
ここまでの結果を踏まえて、どの場面で何を使うかを図8にまとめました。上の質問から順に答えていってください。
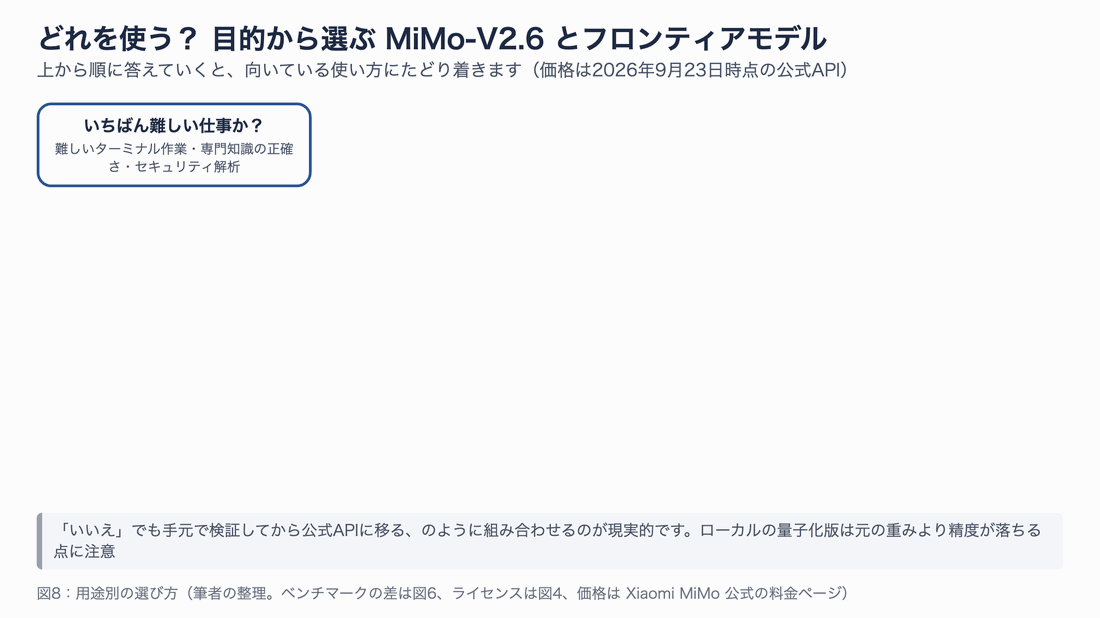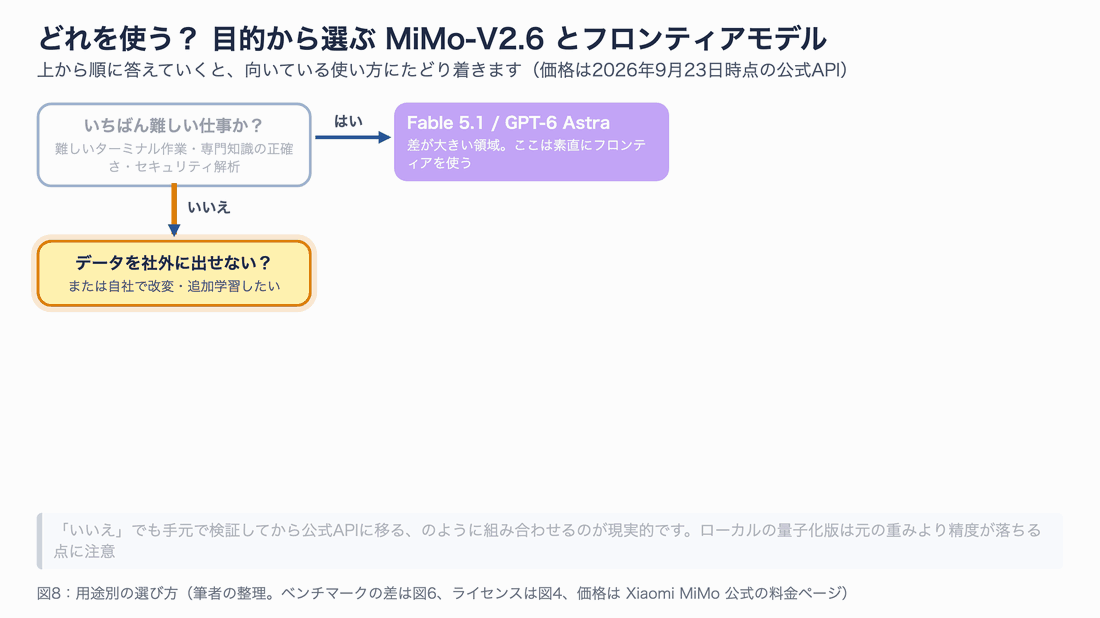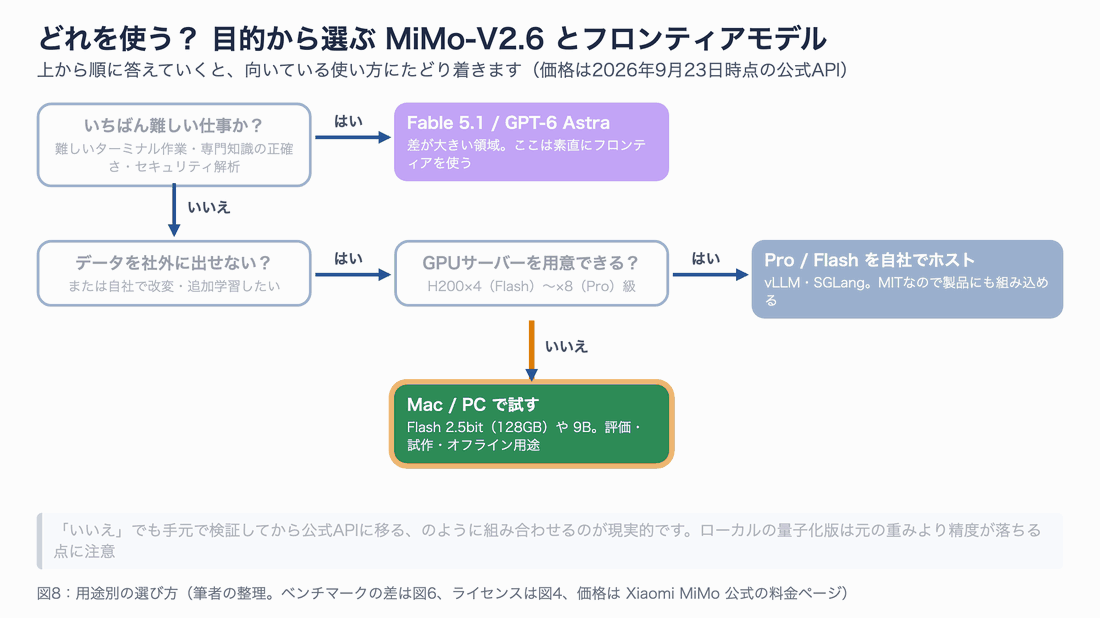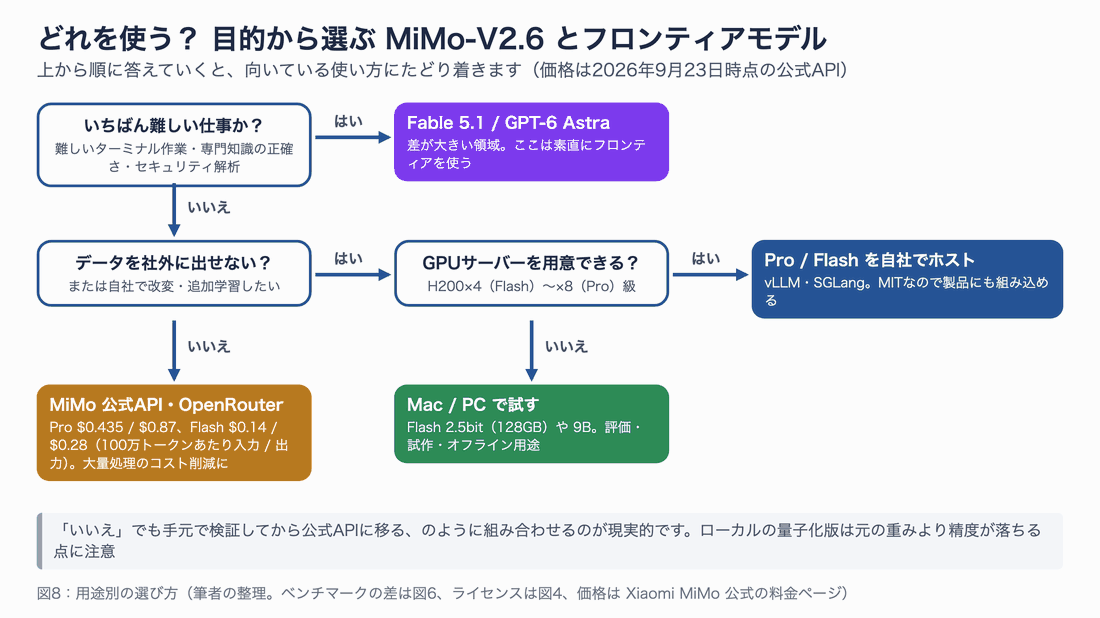
図8:目的から選ぶ MiMo-V2.6 とフロンティアモデル。静止画版は fig08-choose-route.png
判断のポイントは3つです。
- 最難関の仕事はフロンティアに任せる:Terminal-Bench 4.0 や知識の正確さでは、まだ大きな差があります。本番の重要な作業、専門知識の正確さが問われる調査は、Fable 5.1 や GPT-6 Astra が安心です
- 大量処理はMiMoでコストを下げる:API価格は Pro で入力0.435ドル・出力0.87ドル(100万トークンあたり)。1タスクあたりの費用は Fable 5.1 の約60分の1で、業務自動化の評価では肩を並べています。定型的なエージェント処理を大量に回す用途に向いています
- データを出せないなら自社で動かせる:MITなので、社内のGPUサーバーに置いて改変・追加学習もできます。Mac での Flash 2.5bit 版は、その前段の評価や試作に使えます
トラブルシューティング
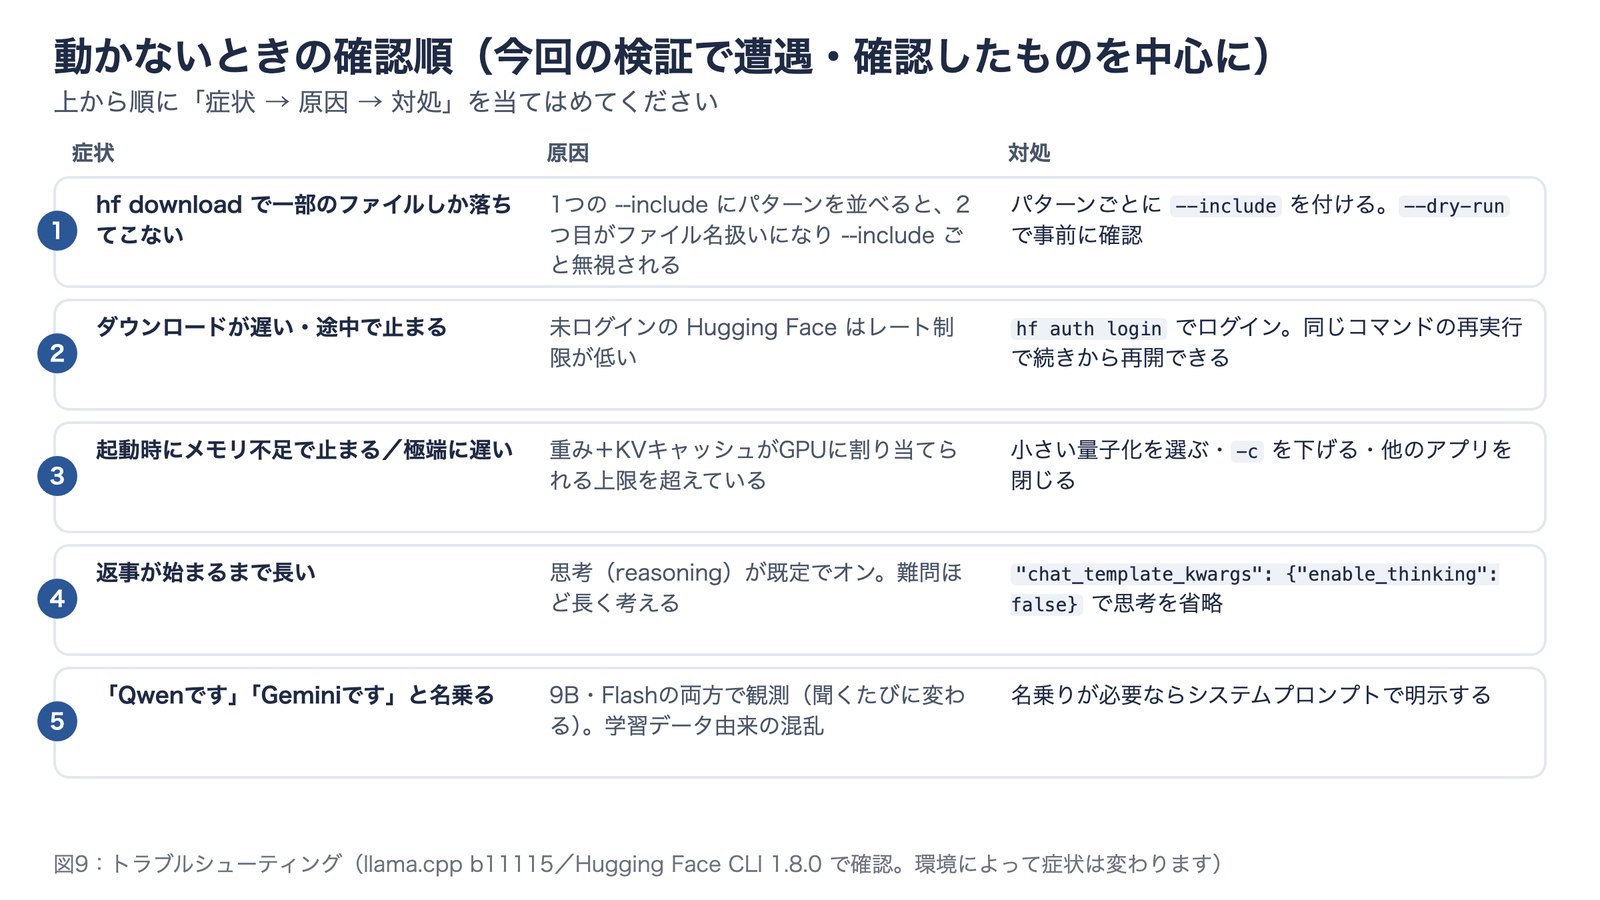
今回の検証で実際につまずいた点と、確認できた対処を図9にまとめました。
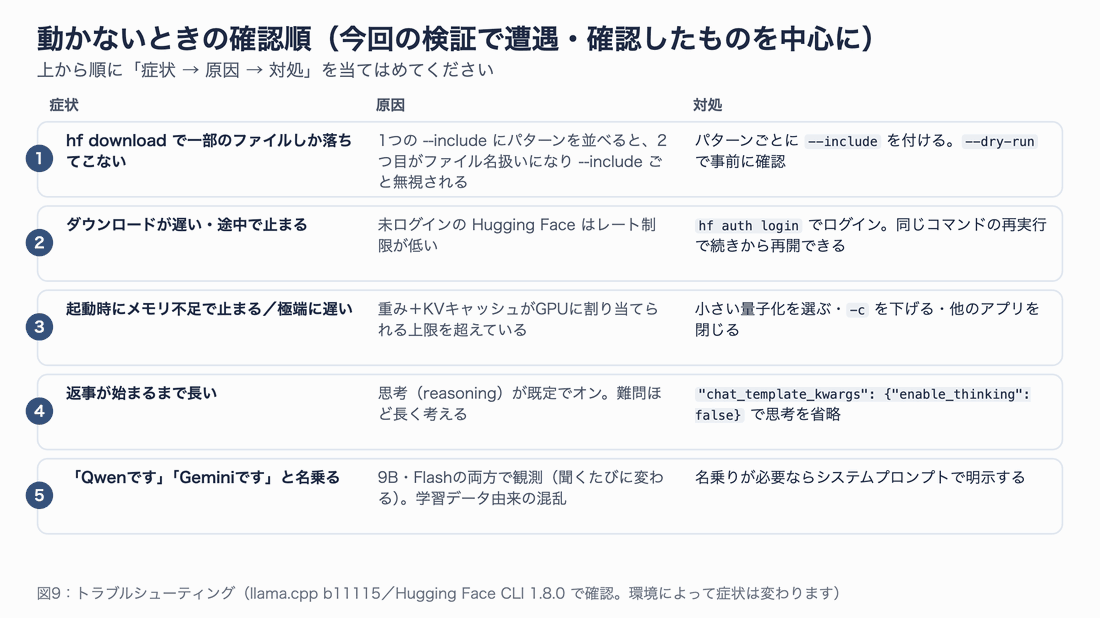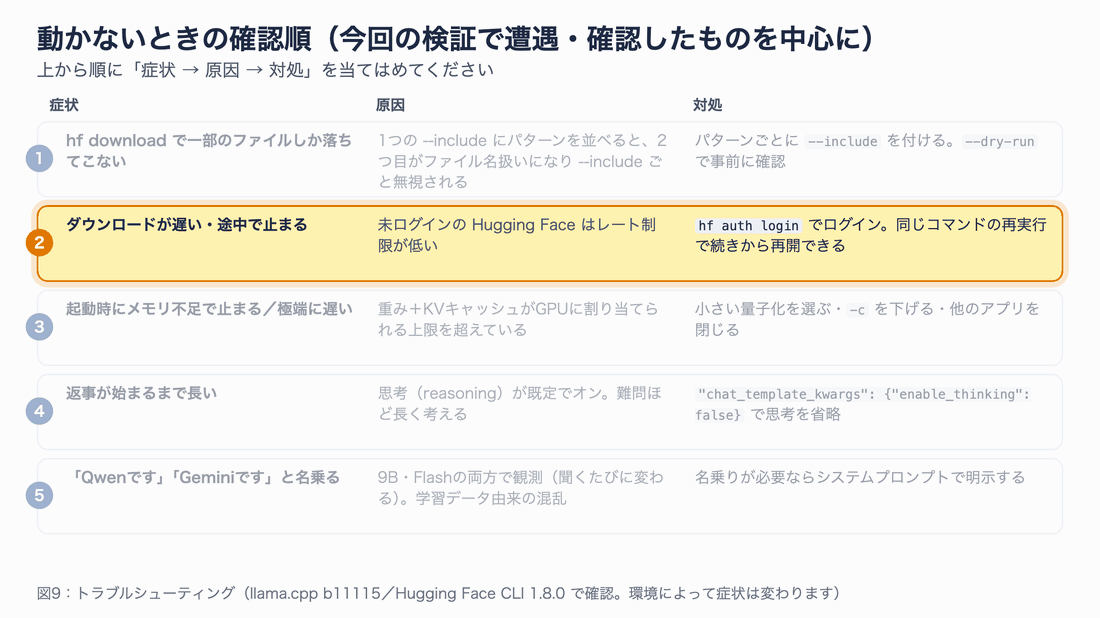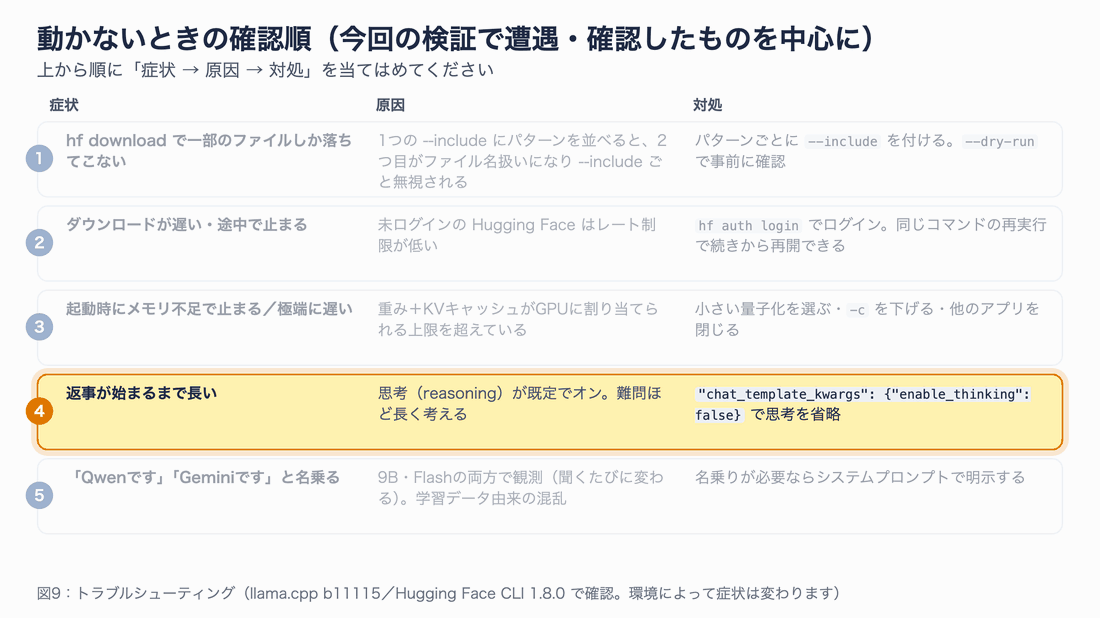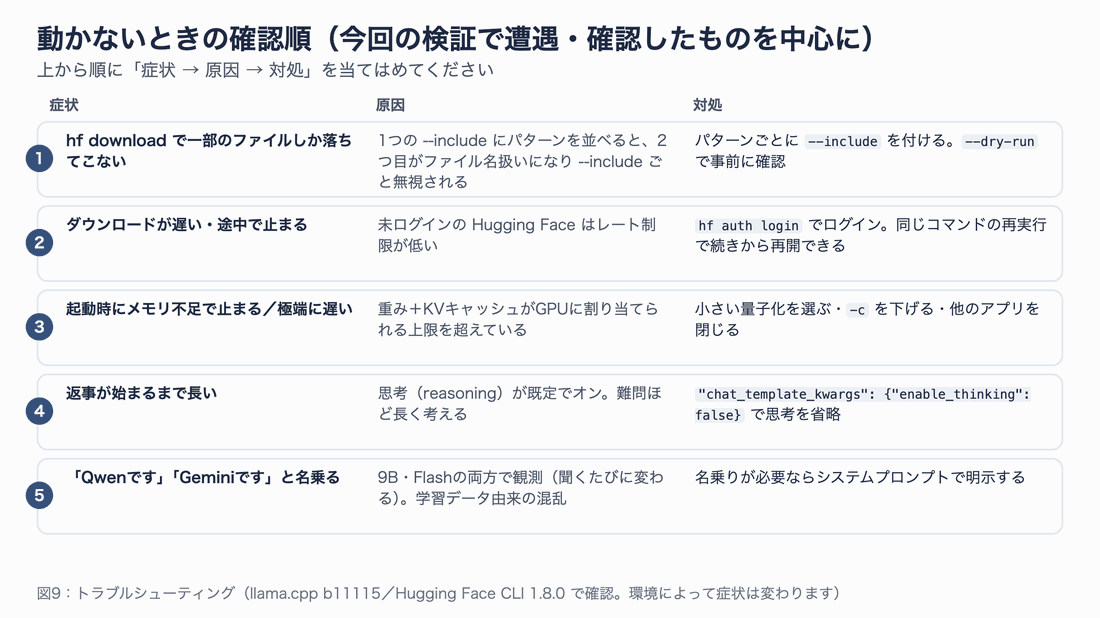
図9:動かないときの確認順。静止画版は fig09-troubleshoot.png
| 症状 | 原因 | 対処 |
|---|---|---|
hf download で一部のファイルしか落ちてこない | 1つの --include にパターンを並べると、2つ目がファイル名扱いになり --include ごと無視される | パターンごとに --include を付ける。--dry-run で事前に確認 |
| ダウンロードが遅い・途中で止まる | 未ログインの Hugging Face はレート制限が低い | hf auth login でログイン。同じコマンドを再実行すると続きから再開 |
| 起動時にメモリ不足で止まる/極端に遅い | 重み+KVキャッシュが、GPUに割り当てられる上限(今回の Mac では約113GiB)を超えている | 小さい量子化を選ぶ、-c を下げる、-np 1 にする、ほかのアプリを閉じる |
| 返事が始まるまで長い | 思考(reasoning)が既定でオン | APIでは "chat_template_kwargs": {"enable_thinking": false} で思考を省略できる(9B・Flash とも確認済み) |
| 「Qwenです」「Geminiです」と名乗る | 9B・Flash の両方で観測。聞くたびに答えが変わる | 名乗りが必要な用途では、システムプロンプトで明示する |
なお、今回は別の作業で起動したままだった画像生成ツール(ComfyUI)がメモリを約38GB確保していたため、Flash の起動前にそのモデルをメモリから解放しました。大きなモデルを動かす前に、アクティビティモニタでメモリを使っているアプリを確認するのがおすすめです。
まとめ
MiMo-V2.6 の公開で、「重みを手元に置けるモデル」の上限が一段上がりました。この記事で確かめたことを振り返ります。
- ライセンス:重みは MIT 表示で、商用利用・改変・再配布が可能と読めます。ただし LICENSE 本文がなく、前バージョンにあった「商用可」の明言もないため、取得したリビジョンの記録は必須です
- 性能:Artificial Analysis の総合指数は 46 で、Fable 5.1(53)や GPT-6 Astra(53)の最大設定には届きません。一方、業務自動化や仕事の成果物の評価では Fable 5.1 に迫り、1タスクあたりの費用は数十分の1です。難しいターミナル作業と知識の正確さには、まだ大きな差があります
- ローカル実行:Flash を2.5bitに圧縮した約97GBの版が、メモリ128GBの MacBook Pro で約30 tok/s で動きました。コード生成・画像の読み取り・エージェントの課題をすべてこなし、9B版との差ははっきりしていました
次の一歩としては、まず公式APIか OpenRouter で Pro を試し、自分の業務の課題でフロンティアモデルと比べてみるのがおすすめです。手元に128GBクラスのMacがあれば、Flash の量子化版で「社外にデータを出さないAI」を試作してみるのもよいでしょう。技術レポートに書かれた Groupwise Agentic Grading の考え方は、自社でエージェントの出力を評価する仕組みにも応用できます。
参考リソース
- MiMo-V2.6-Pro-RL(Hugging Face) / MiMo-V2.6-Flash-RL / MiMo-V2.6-Distill-Qwen-9B
- MiMo-V2.6 技術レポート(PDF)
- Xiaomi MiMo 公式ブログ「Introducing MiMo-V2.6 series」 / 公式ニュース(英語)
- Xiaomi MiMo API 料金 / Xiaomi MiMo Service Agreement
- Artificial Analysis:MiMo-V2.6-Pro / Claude Fable 5.1 / GPT-6 Astra
- Anthropic「Introducing Claude Fable 5.1 and Claude Mythos 5.1」 / OpenAI「GPT-6 Astra」
- AesSedai/MiMo-V2.6-Flash-GGUF(今回使った量子化版) / ggml-org/MiMo-V2.6-Distill-Qwen-9B-GGUF
- llama.cpp リリース b11115 / MiMo-V2.6 の変換対応 PR #29257
- vLLM Recipes:MiMo-V2.6-Pro-RL / SGLang cookbook:MiMo-V2.6
この記事の数値・ライセンス表示は2026年9月23日時点のものです。ライセンスに関する記述は公開情報の整理であり、法的助言ではありません。