- はじめに
- Kolibri-1 とはどんなモデルか
- 何が違うのか:「答えない」を訓練で教える Merlin–Arthur 方式
- 公式の数字を読む:実は Qwen と大差ない項目もある
- Mac で Kolibri-1 を動かす
- 検証の設計:同じ質問を「答えあり」と「答えなし」の両方で出す
- 結果1:指示なしでは、Kolibri がいちばん「答えてしまった」
- 結果2:「答えないで」の 1 文で、Kolibri がいちばんよく控えた
- 結果3:その代わり、答えがあるのに答えない失敗が増えた
- 結果4:「一部だけある」は 3 モデルとも苦手
- なぜ公式の主張と違って見えたのか
- 実務でどう使い分けるか
- 速さとメモリ:Mac でも RAG に使える速さは出る
- トラブルシューティング
- この検証の限界
- まとめ
- 参考リソース
はじめに
社内文書を検索して答える RAG(Retrieval-Augmented Generation、検索拡張生成)を作ると、いちばん困るのは「検索で見つかった資料に答えが書いていないのに、それらしい答えを返してしまう」ことです。読む側は資料に書いてあると思い込むので、ふつうの誤答よりもたちが悪い失敗です。
2026年10月3日、ドイツの Aleph Alpha が公開したオープンウェイトモデル Kolibri-1 は、この問題に正面から取り組んだと公表しています。「資料に根拠がなければ答えない」振る舞いを、プロンプトの工夫ではなく 訓練の段階で 教え込んだ、という主張です。
本当でしょうか。筆者は手元の MacBook Pro(M5 Max・メモリ 128GB)に Kolibri-1 を入れ、同じクラスの Qwen と 650 問で比べました。
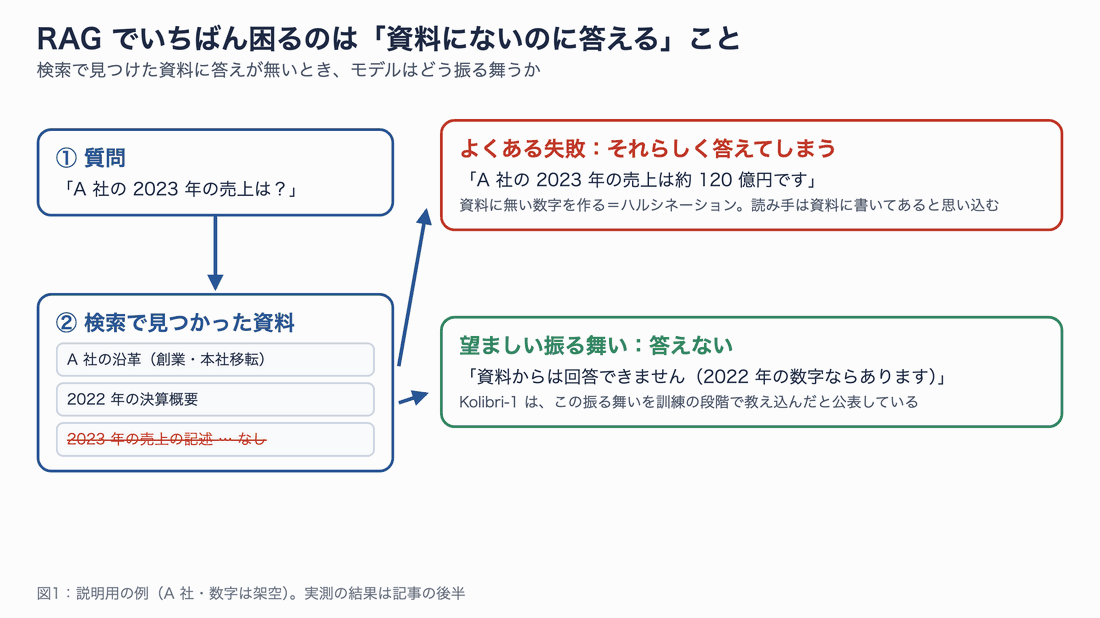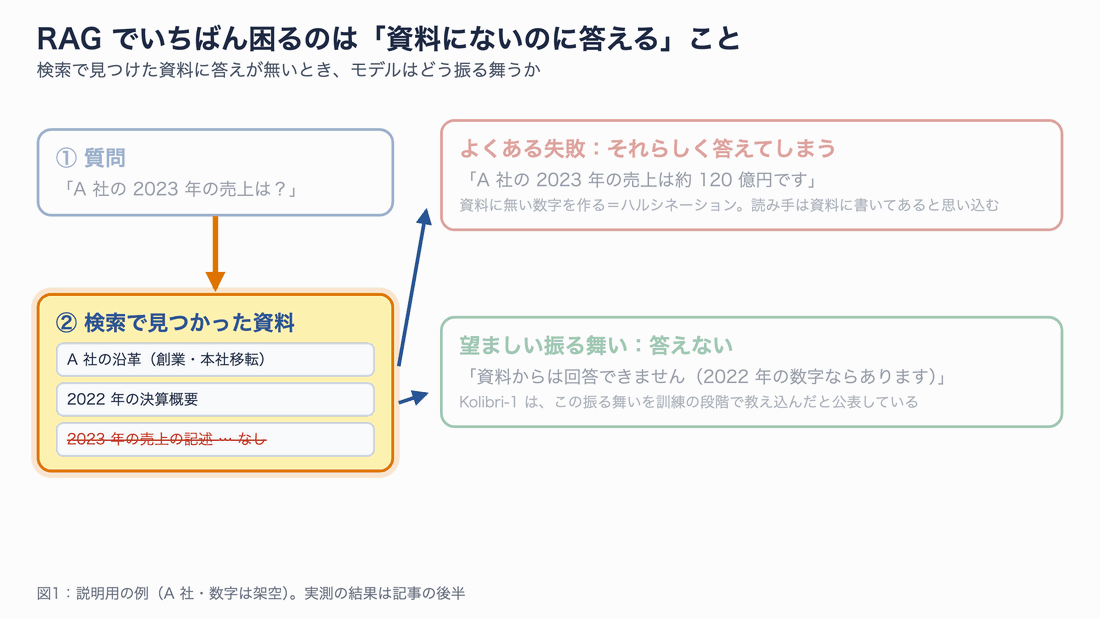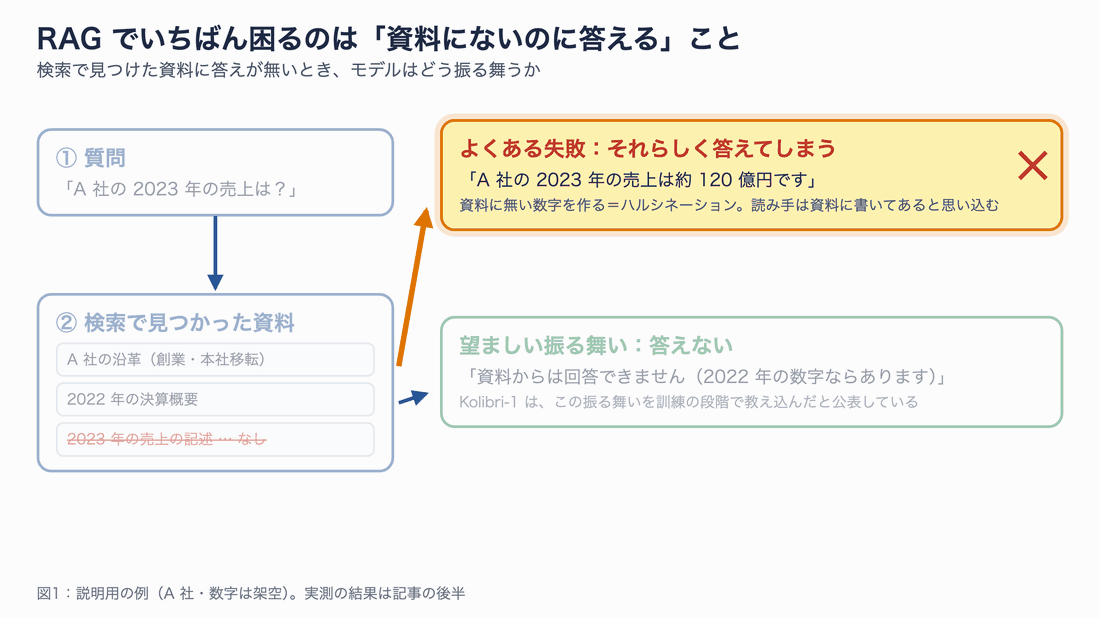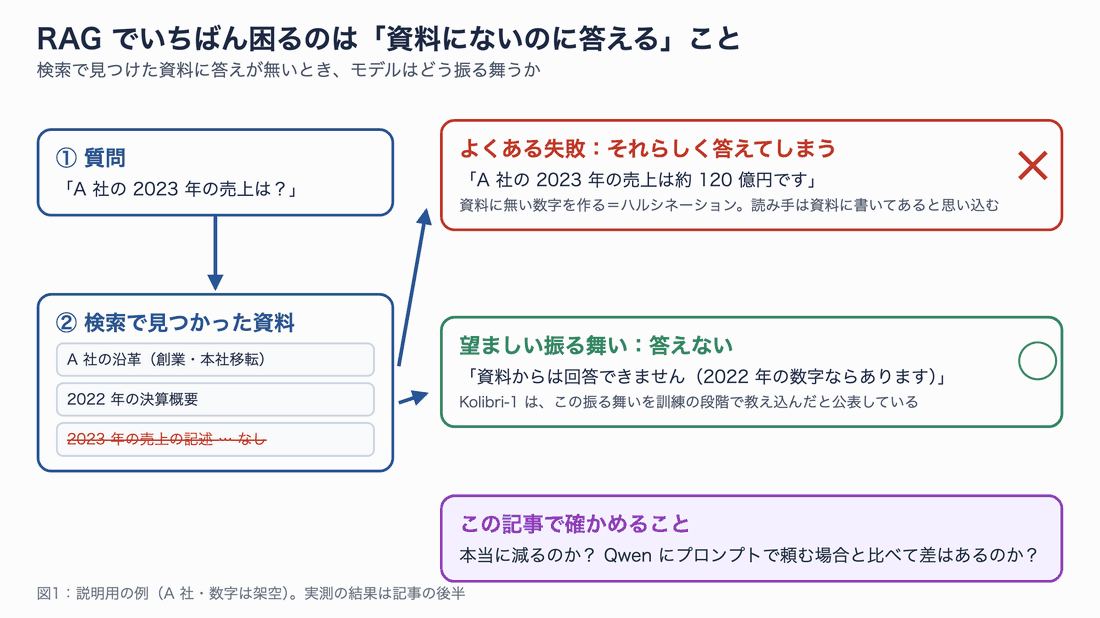
図1:検索で見つかった資料に答えが無いとき、それらしい数字を作る失敗(✕)と、資料からは答えられないと返す振る舞い(◯)。例は架空です。
先に結論
結論を先に書くと、「答えない能力」は確かにありましたが、公表の言葉から想像する形とは違いました。
- 「答えないで」と指示しないと、Kolibri は資料に答えが無い問題の 48% でしか控えず、Qwen3.6(60%)や Qwen3.5(55%)より 多く答えてしまった
- 「資料に答えが無ければ答えられないと返して」と 1 文足すと、Kolibri は 85% で控え、3 モデルの中でいちばん高くなった(Qwen3.6 79%、Qwen3.5 76%)
- 推論を深くしても(
reasoning_effortを low や high にしても)、指示なしで控える割合は上がらなかった - その代わり、指示ありの Kolibri は、答えがある問題でも「答えられない」と返しやすかった(250 問中 11 問。Qwen は 4 問)
- 日本語の問題では、Qwen との差はほとんど無かった
つまり Kolibri は「勝手に控えるモデル」ではなく、「控えてと頼まれたときに、いちばん素直に控えるモデル」 でした。以下で、手順と数字を順に見ていきます。
この記事の確認範囲
- 確認日:2026年10月4日
- 機材:MacBook Pro(Apple M5 Max・ユニファイドメモリ 128GB・macOS 26.6.2)
- モデル:Kolibri-1(公式 FP8 重みを筆者が MLX 6bit に変換)、Qwen3.6-35B-A3B(MLX 8bit)、Qwen3.5-35B-A3B(MLX 4bit)
- 実行環境:Python 3.12、MLX 0.32.3、Kolibri 対応の mlx-lm(有志の fork、コミット
5bc45adb) - 公式の情報源:Hugging Face のモデルカード、Aleph Alpha のブログと技術レポート(189 ページ)
想定読者は、RAG を作ったことがある、または作ろうとしているエンジニアです。オープンモデルを自分の環境で動かした経験はあると読みやすいですが、なくても手順はそのまま追えるように書いています。
Kolibri-1 とはどんなモデルか
Kolibri(コリブリ)はドイツ語で「ハチドリ」のことです。Aleph Alpha は欧州の行政や製造業向けに LLM を提供してきた会社で、Kolibri-1 は重みをすべて Apache 2.0 で公開した同社の新しいモデルです。モデルカードから、RAG の検証に関係する項目を抜き出します。
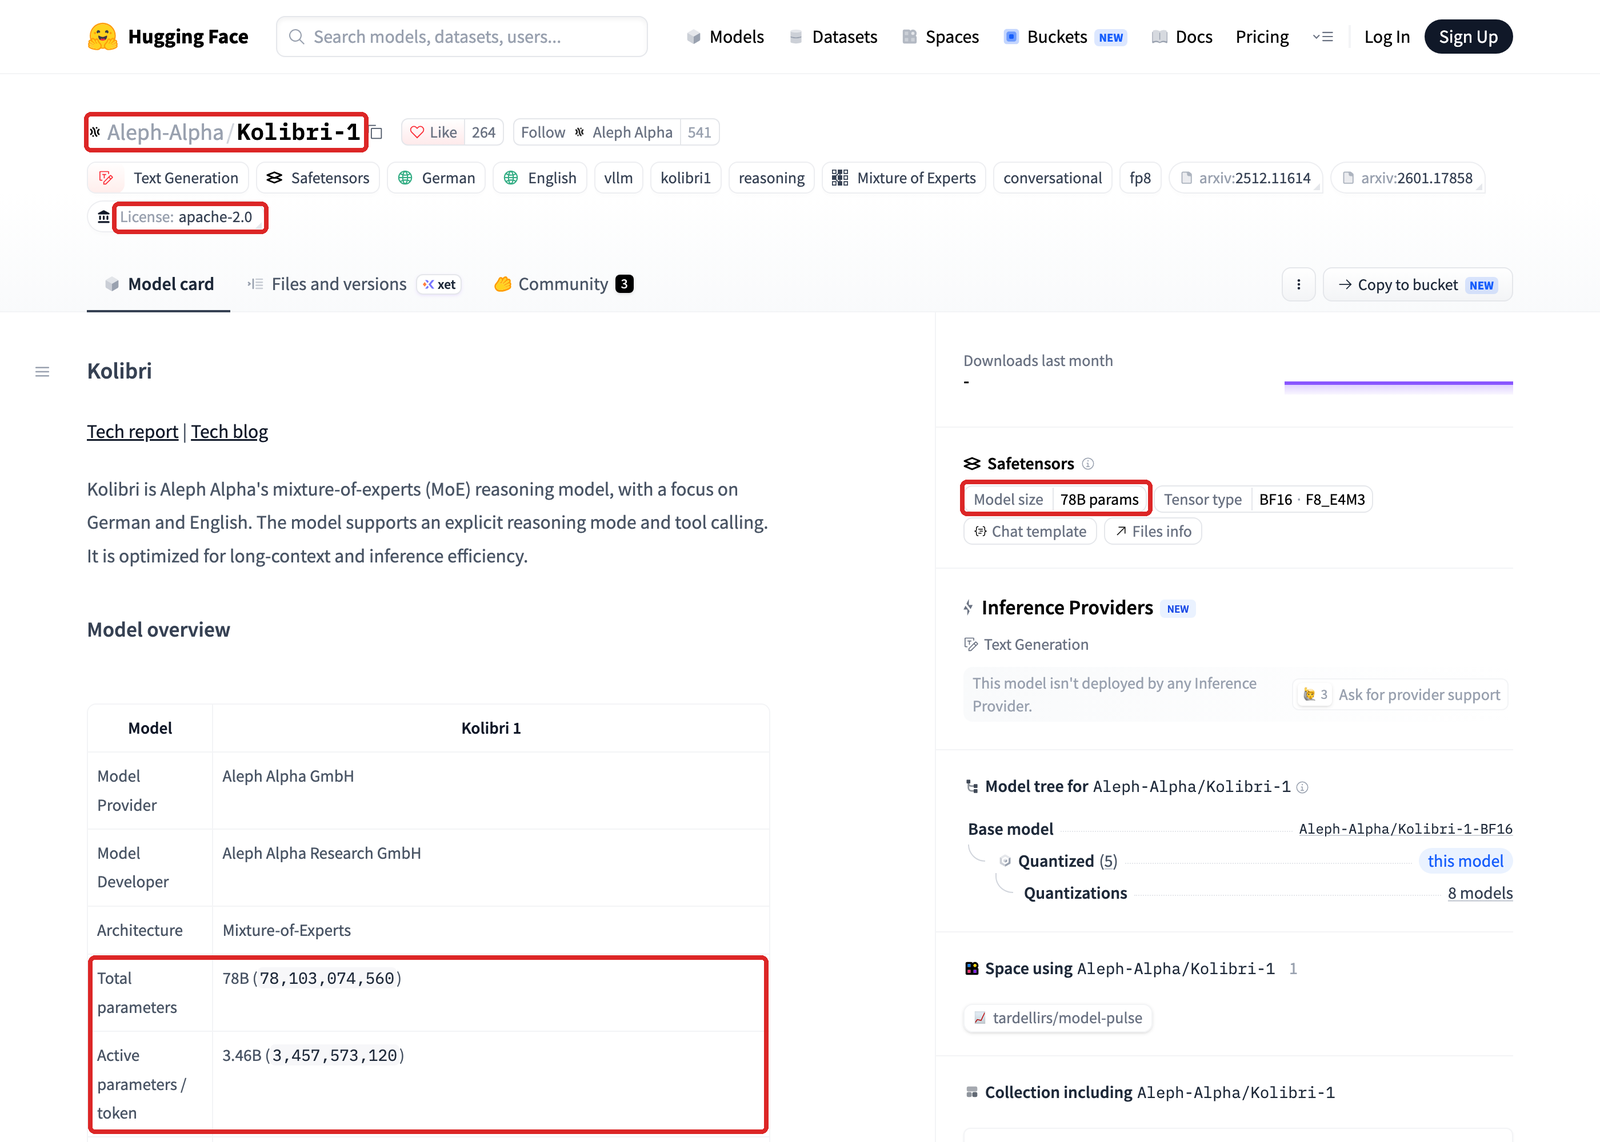
Hugging Face のモデルカード(2026年10月4日に撮影)。赤枠がライセンスとパラメータ数です。
| 項目 | 内容 |
|---|---|
| 構造 | MoE(Mixture of Experts、専門家の混合)。50 層、1 層あたり 384 の専門家から 6 つ+共有の 1 つを使う |
| パラメータ | 総数 78.1B、1 トークンあたり実際に使うのは 3.46B(総数の 4.4%) |
| 得意な言語 | ドイツ語と英語(事前学習データは英語 約 62.5%・ドイツ語 約 23.9%・コード 約 13.6%) |
| 文脈の長さ | 最大 約 100 万トークン。効率面では 262,144 トークン以下を推奨 |
| 推論モード | reasoning_effort を none / low / medium / high で指定。指定しないと high |
| ライセンス | Apache 2.0(商用利用可) |
| 公式の実行環境 | vLLM(NVIDIA GPU)。FP8 重みで約 78GB、最低 A100 80GB×2 か H200×1 |
MoE は、たくさんの小さな「専門家」ネットワークを用意しておき、入力ごとに一部だけを呼び出す構造です。全体の知識量は 78B 分ありながら、1 トークンの計算は 3.5B 程度で済みます。同じ 3B 級の活性パラメータを持つ Qwen3.6-35B-A3B や Qwen3.5-35B-A3B が、ちょうど良い比較相手になります。
何が違うのか:「答えない」を訓練で教える Merlin–Arthur 方式
ほかのモデルとの最大の違いは、ハルシネーション(もっともらしい誤り)を減らすための訓練です。技術レポートによると、Aleph Alpha は 2 種類の手を打っています。
- 正解が「分かりません」になる訓練データ(Abstention データ)を混ぜた
- 自社で考案した Merlin–Arthur 方式 の強化学習環境で訓練した
Merlin–Arthur 方式は、アーサー王伝説の登場人物になぞらえた 3 人のゲームです。訓練されるモデルが Arthur で、資料に手を加える役が 2 人います。
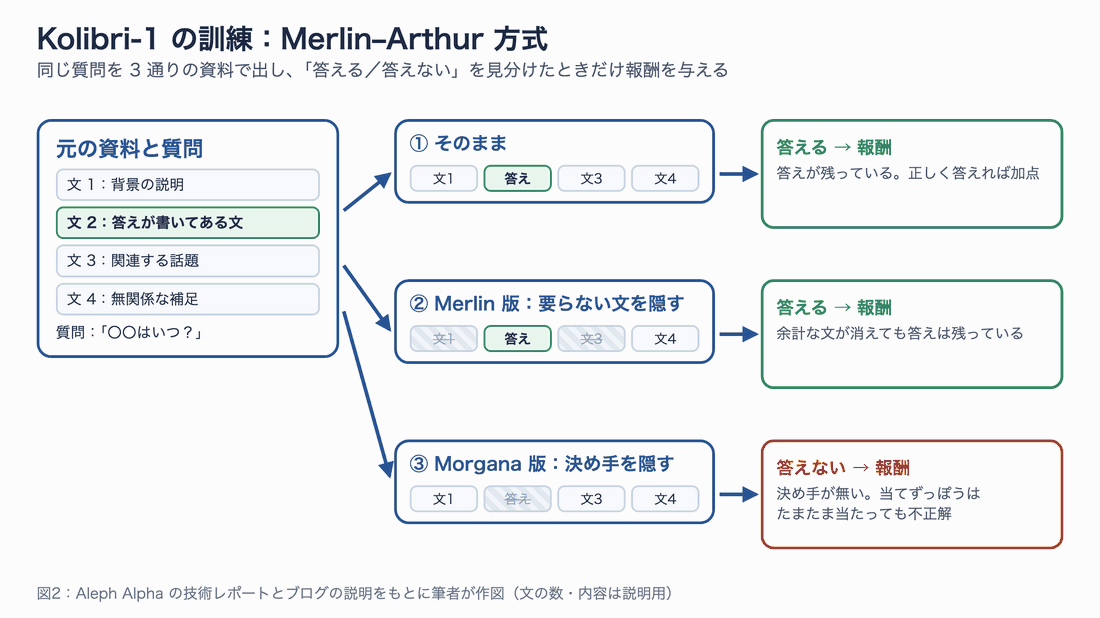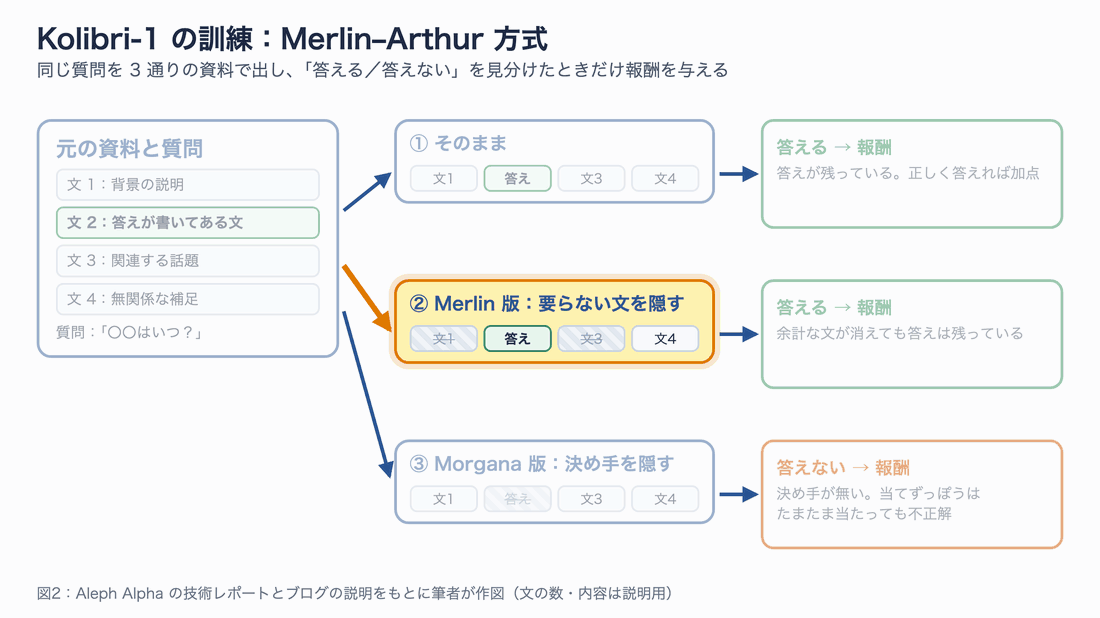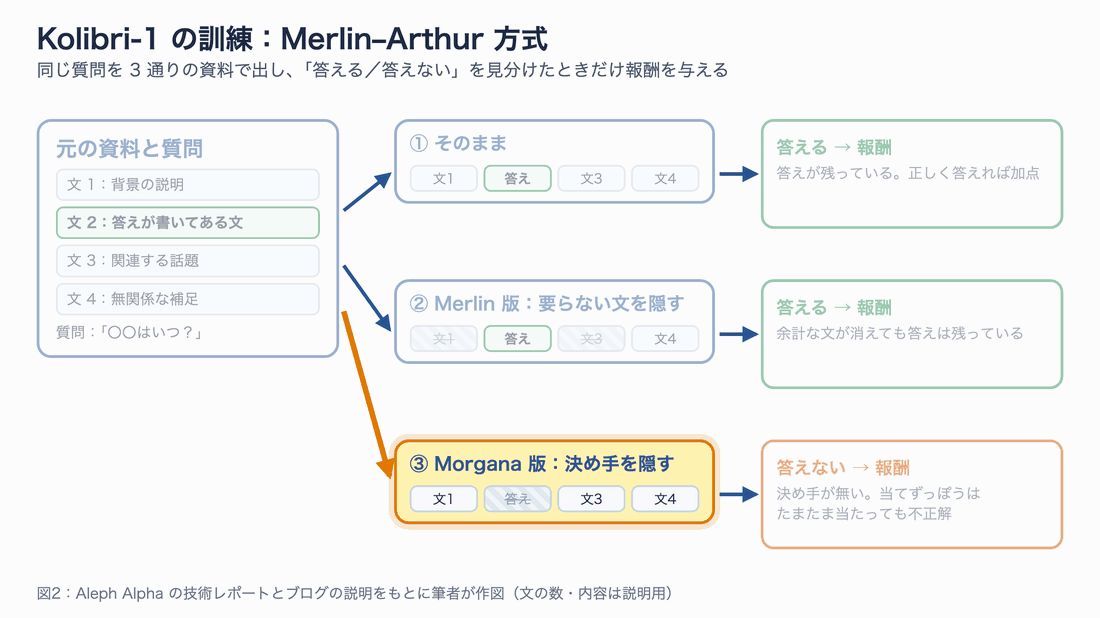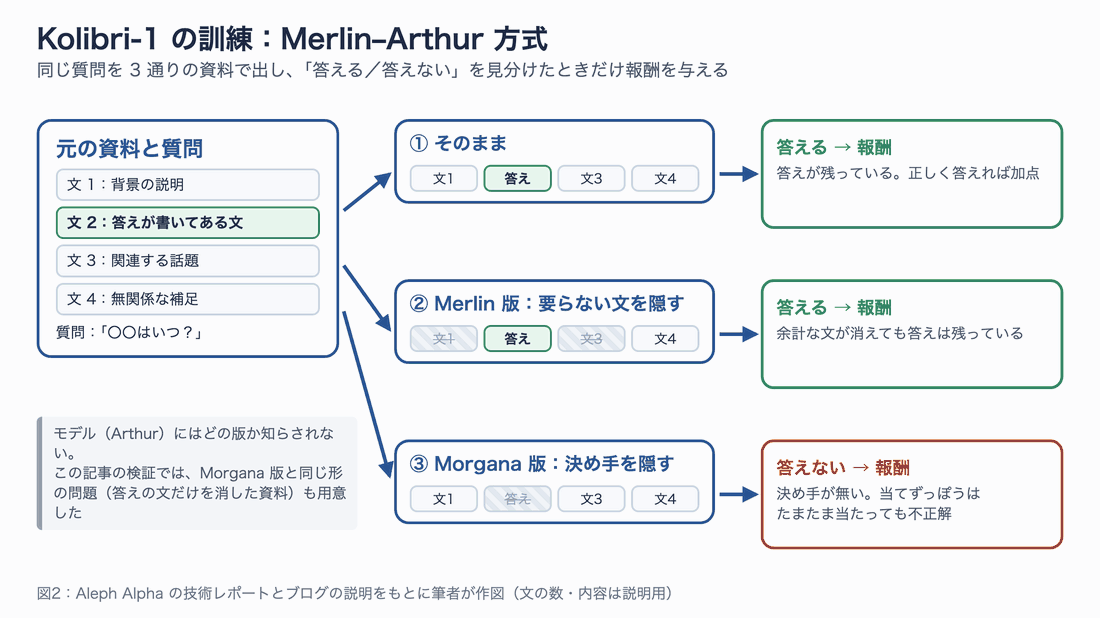
図2:Merlin は答えに関係ない文を隠し、Morgana は答えの決め手になる文を隠します。モデルはどの版を見ているか知らされません。
ポイントは、Morgana 版で当てずっぽうに答えると、たまたま正解しても不正解として扱う ことです。一般的な評価では、分からないときも何か答えたほうが得点の期待値が上がるため、モデルは「とりあえず答える」癖を身につけがちです。Aleph Alpha はブログで、規制の厳しい顧客にとって「答えを控えられるモデルかどうか」が、試験導入で終わるか本番に進めるかの分かれ目になると書いています。
公式の数字を読む:実は Qwen と大差ない項目もある
検証の前に、公式が出している数字を確認しておきます。技術レポートの比較表から、ハルシネーションに関係する行だけを抜き出しました。Aleph Alpha 自身が測った値で、技術レポートによると Kolibri は reasoning_effort を high(最も深く考える設定)、Qwen3.6 は既定の設定(思考モードあり)で測っています。
| 指標(高いほど良い) | Kolibri-1 | Qwen3.5-35B-A3B | Qwen3.6-35B-A3B |
|---|---|---|---|
| RGB Negative:資料に答えが無いとき答えを控えた割合 | 85.6 | 86.6 | 79.6 |
| SQuAD M/A Grounding Score:答えが資料由来だと保証できた割合(自社指標) | 23.4 | 23.0 | 12.1 |
| AA-Omniscience:正解できなかった問題のうち、誤答せず控えた割合 | 44.0 | 11.1 | 56.7 |
| RGB Closed-Book:資料なしで答えられた割合 | 51.0 | 81.0 | 79.0 |
ここで気づくことが 2 つあります。
- 資料に答えが無いとき控える力(RGB Negative)は、公式の表でも Qwen3.5 とほぼ同じ です。Kolibri の 85.6 に対して Qwen3.5 は 86.6 で、表に載った 14 モデルの中で Kolibri は 4 番手でした
- 資料なしで答える力(RGB Closed-Book)は 51.0 と、表の中で最下位です。訓練で「控える」側に寄せたぶん、手持ちの知識で答える場面が減っている可能性があります
つまり公式の数字だけでも、「Qwen よりはっきり答えを控える」とまでは言えません。そこで、実際に手元で同じ条件を作って確かめることにしました。
Mac で Kolibri-1 を動かす
公式が案内している実行方法は、NVIDIA GPU 向けの vLLM だけです。ただ公開から 1 日で、Mac 向けの MLX(Apple が作った機械学習ライブラリ)への移植版と変換済みの重みが、有志によって何本も公開されました。筆者は公式の FP8 重みを自分で MLX 形式に変換する方法を選びました。変換の中身を把握しておけるからです。
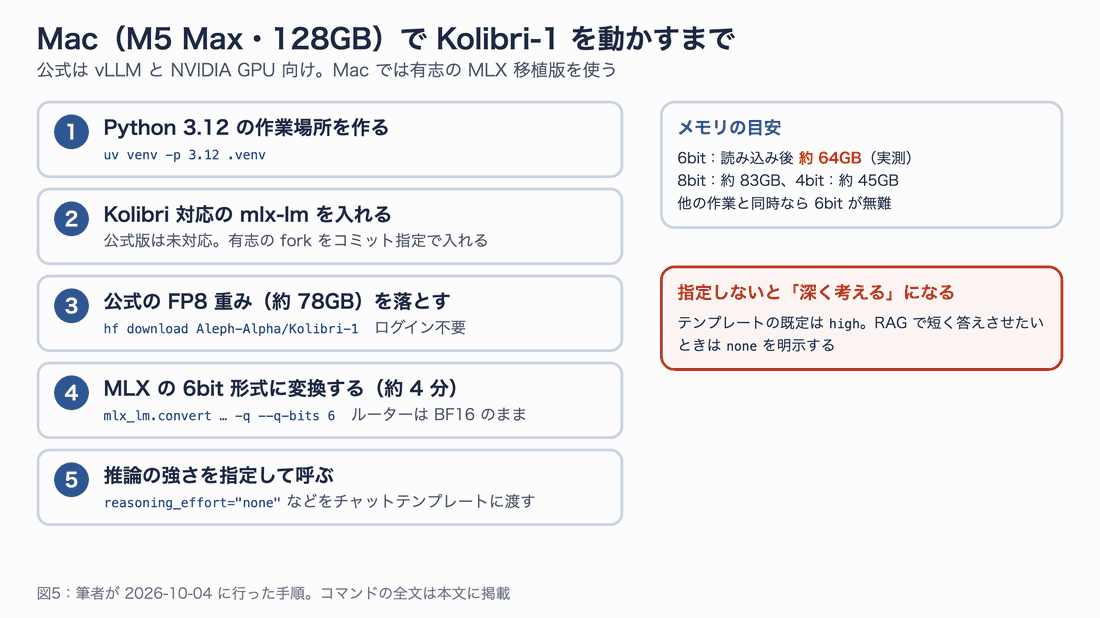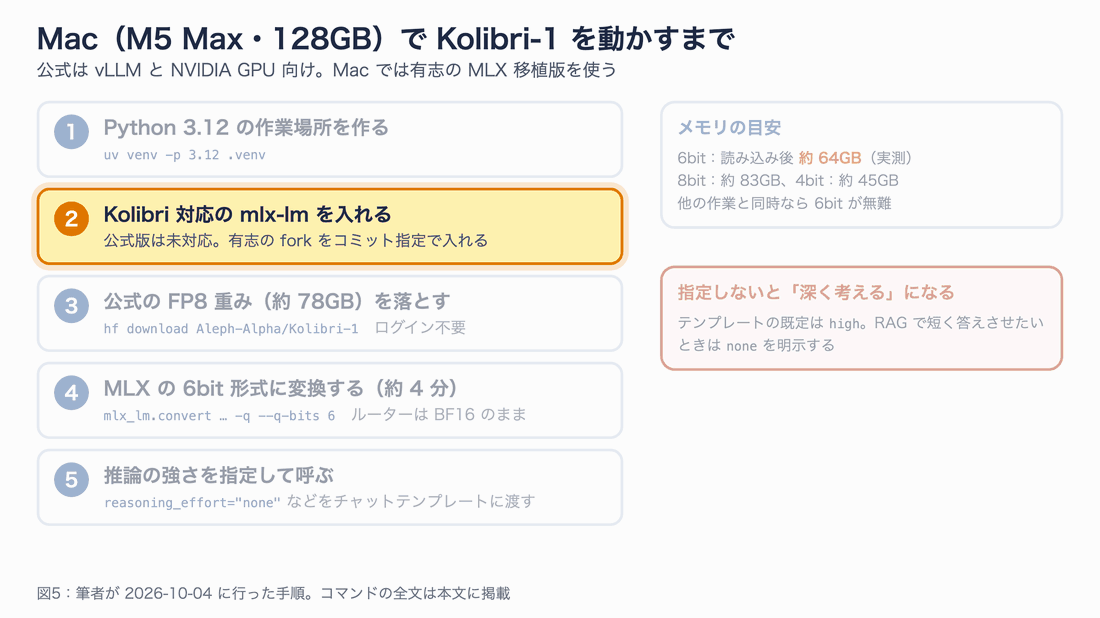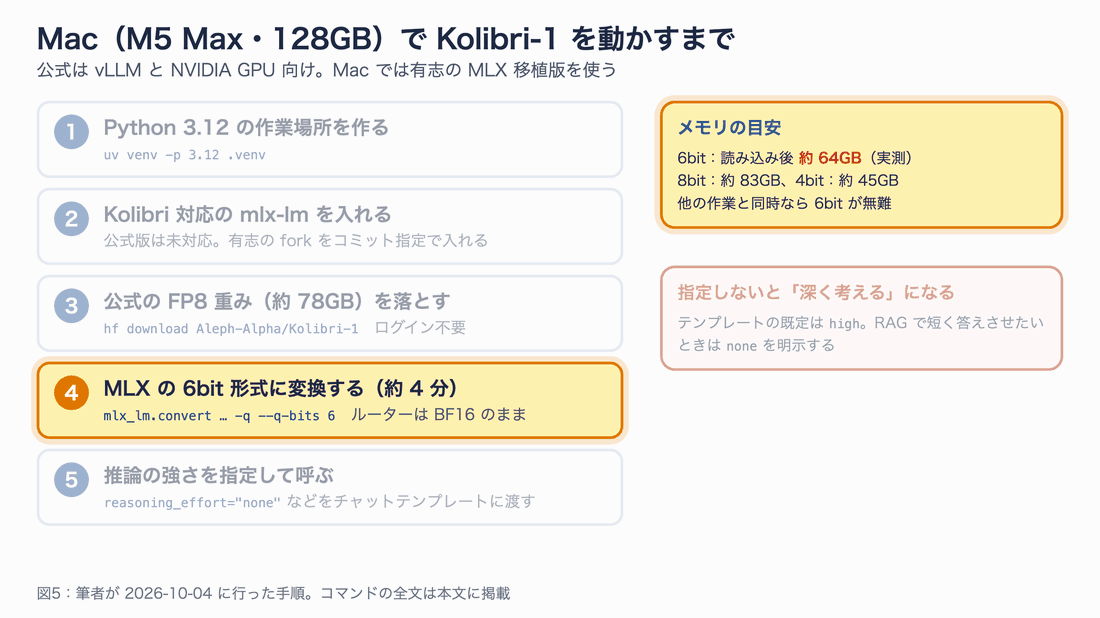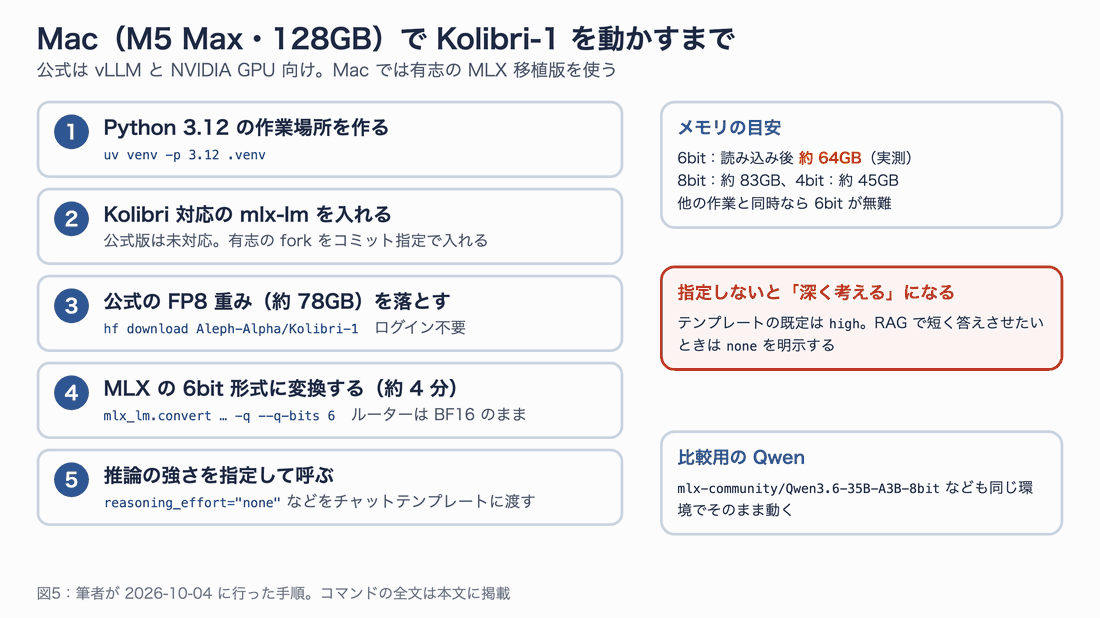
図5:Mac で動かすまでの流れ。右側は、メモリの目安と、つまずきやすい「推論の既定値」の注意です。
1. 作業場所を作り、Kolibri 対応の mlx-lm を入れる
2026年10月4日時点で、公式の mlx-lm(MLX で LLM を動かすためのライブラリ)は Kolibri の構造(kolibri1)にまだ対応していません。有志の fork に移植版があるので、コミットを固定して入れます。
# 作業用のフォルダと Python 3.12 の仮想環境を作る(uv を使用)
mkdir kolibri-lab && cd kolibri-lab
uv venv -p 3.12 .venv

# MLX、Kolibri 対応の mlx-lm(fork)、Hugging Face のダウンロード用 CLI を入れる
uv pip install --python .venv/bin/python mlx \
  "git+https://github.com/here-be-dragons-ai/mlx-lm@5bc45adb8733f9af29c1c03e9ea947d155328b75" \
  "huggingface_hub[hf_xet]"
2. 公式の重みを落とし、MLX 形式に変換する
重みのダウンロードにログインは要りません。ただし約 78GB あるので、回線によっては 1〜2 時間かかります。筆者の環境では途中で処理が止まり、同じコマンドを再実行しました。落とし終えたファイルは再ダウンロードされませんが、途中だったファイルは最初からやり直しになり、古い途中ファイル(.incomplete)も残るので、終わったら消しておきます。
# 公式の FP8 重み(32 ファイル・約 78GB)を落とす
.venv/bin/hf download Aleph-Alpha/Kolibri-1 --local-dir models/Kolibri-1-FP8

# MLX の 6bit 形式に変換する(8bit にするなら --q-bits 8)
.venv/bin/mlx_lm.convert --hf-path models/Kolibri-1-FP8 \
  --mlx-path models/Kolibri-1-MLX-6bit -q --q-bits 6 --q-group-size 64
変換は 6bit で約 4 分、8bit で約 5 分で終わり、変換中のメモリ使用量は最大 18〜20GB でした。ルーター(どの専門家を使うか決める部分)は、移植版の設定によって元の BF16 のまま残ります(変換後の重みで確認済み)。
| 形式 | ディスク上のサイズ | 読み込み後のメモリ | 向いている Mac |
|---|---|---|---|
| 公式 FP8(変換元) | 約 78GB | — | (MLX では直接使わない) |
| MLX 8bit | 約 83GB | 約 83GB | 128GB 以上で、ほかに大きな処理をしていないとき |
| MLX 6bit | 約 63GB | 約 64GB | 96GB 以上 |
| MLX 4bit(有志の変換版) | 約 45GB | 約 45GB | 64GB 以上 |
筆者は最初 8bit で比べるつもりでしたが、検証中は同じ Mac で別の作業(ほかのモデルの推論や音声の文字起こし)も動いていました。GPU に割り当てられる上限の目安(MLX が報告する値で約 115GB)に 8bit 版が収まらなかったため、本番の比較は 6bit 版で行いました。
3. reasoning_effort を必ず指定して呼び出す
Kolibri の推論の深さは、チャットテンプレートに reasoning_effort を渡して決めます。何も渡さないと high(最も深く考える設定)になる ので、RAG で短く答えさせたいときは none を明示します。
from mlx_lm import load, generate

model, tokenizer = load("models/Kolibri-1-MLX-6bit")
messages = [{"role": "user", "content": "Answer the question using the documents below. ...(資料と質問)"}]

# reasoning_effort: "none"(考えずに即答)/ "low" / "medium" / "high"(既定)
prompt = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=False, reasoning_effort="none"
)
print(generate(model, tokenizer, prompt=prompt, max_tokens=512))
reasoning_effort を指定すると、テンプレートがシステムプロンプトに「Reasoning is disabled.」などの決まった 1 文を書き込みます。推論ありにすると、回答の前に <think> から </think> までの思考が出力されるので、表示する前に取り除いてください。
検証の設計:同じ質問を「答えあり」と「答えなし」の両方で出す
「答えない」能力は、答えなさすぎても困ります。資料に答えがあるのに「分かりません」と返すモデルは、RAG としては役に立ちません。そこで、同じ質問を、答えを含む資料と含まない資料の両方で出す 形にしました。
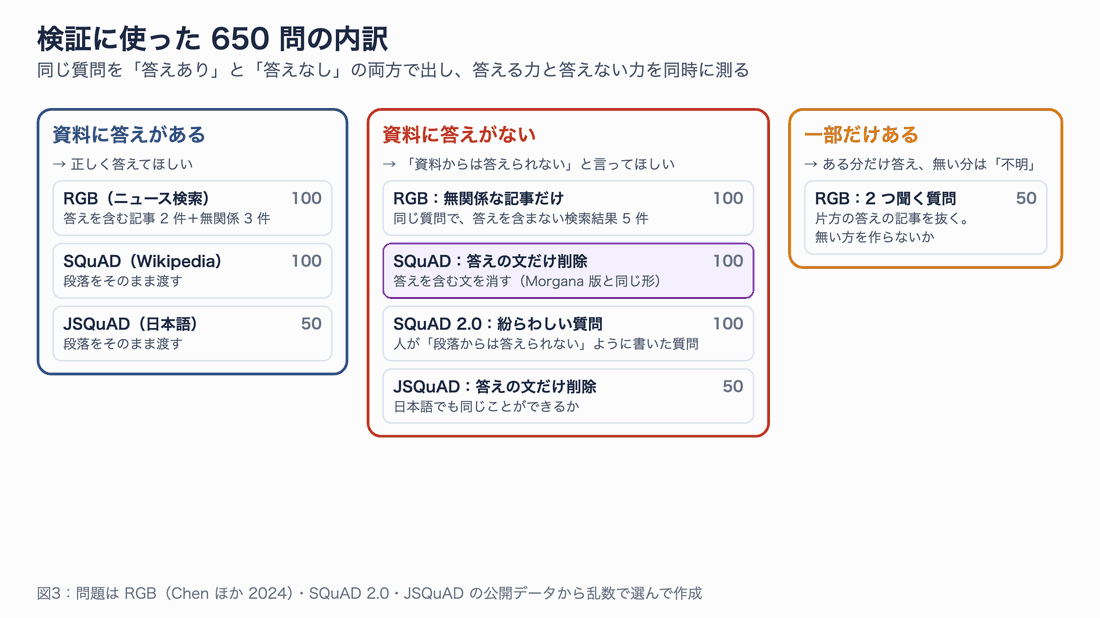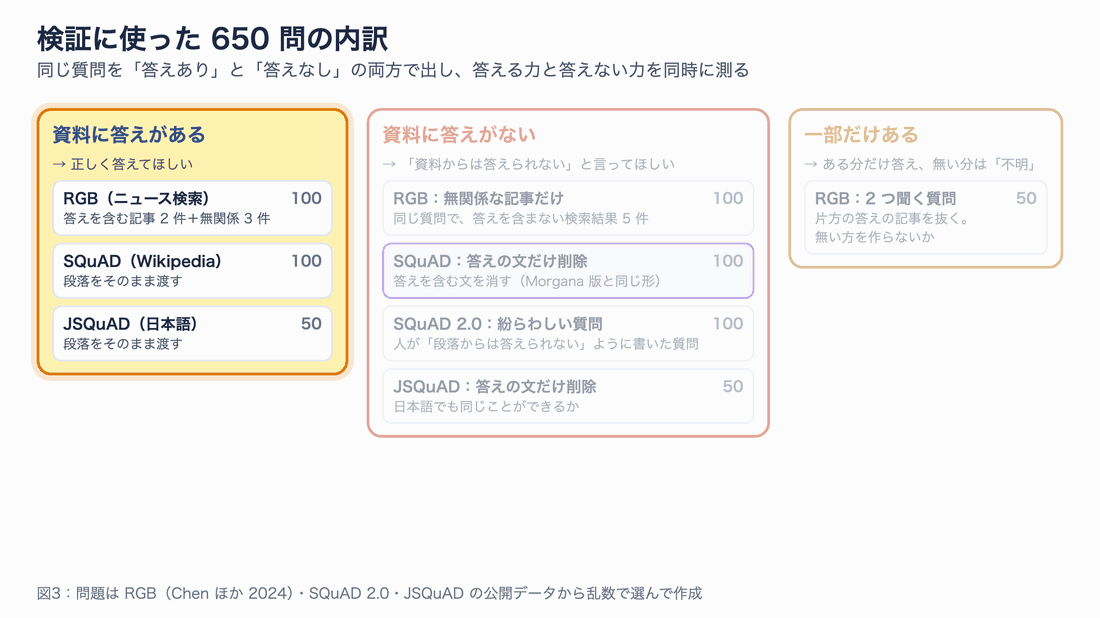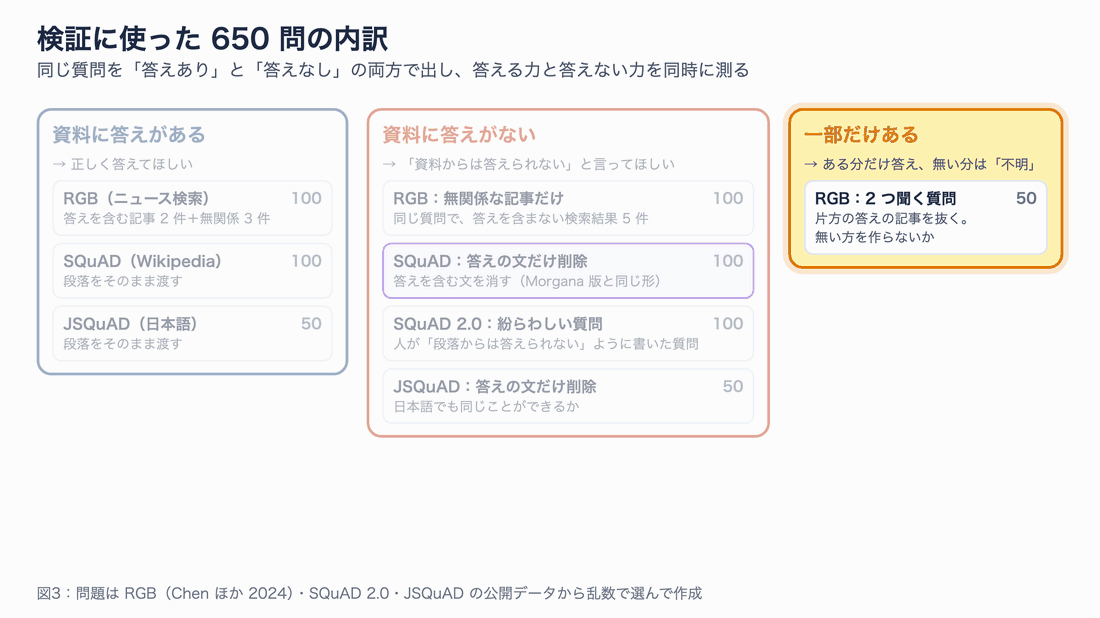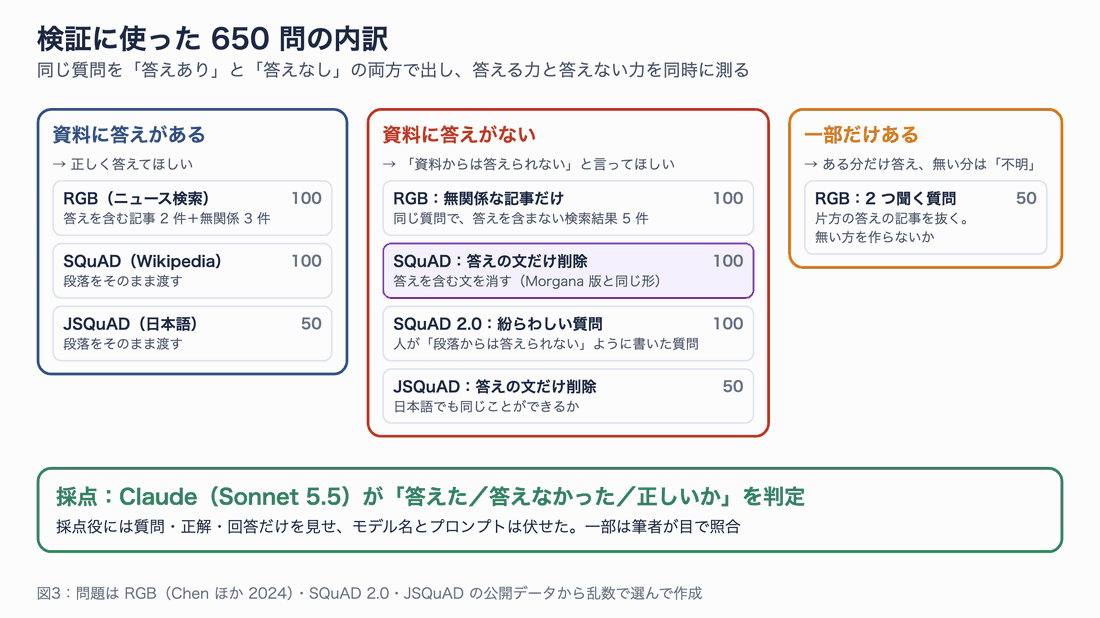
図3:問題は公開データから乱数で選びました。紫の枠が、Kolibri の訓練(Morgana 版)と同じ形の条件です。
使ったデータは次の 3 つです。どれも RAG の評価でよく使われる公開データです。
| データ | 中身 | 答えなし版の作り方 |
|---|---|---|
| RGB(Chen ほか 2024) | ニュースに関する質問と、検索エンジンで集めた記事 | 同じ質問に対して、答えを含まない記事だけを 5 件渡す |
| SQuAD 2.0 | Wikipedia の段落と質問 | ①段落から答えを含む文だけを消す、②人が「段落からは答えられない」ように書いた質問を使う |
| JSQuAD | 日本語 Wikipedia の段落と質問 | 段落から答えを含む文だけを消す |
SQuAD の「答えの文だけを消す」条件は、Kolibri の訓練で使われた Morgana 版とほぼ同じ形です。消したあとの段落に正解の文字列が 1 か所も残っていないことを、プログラムで確認しています。訓練と同じ形の問題で控えられないなら、訓練の効果はかなり疑わしい、ということになります。
比べた条件
モデルとプロンプトの組み合わせは次の通りです。
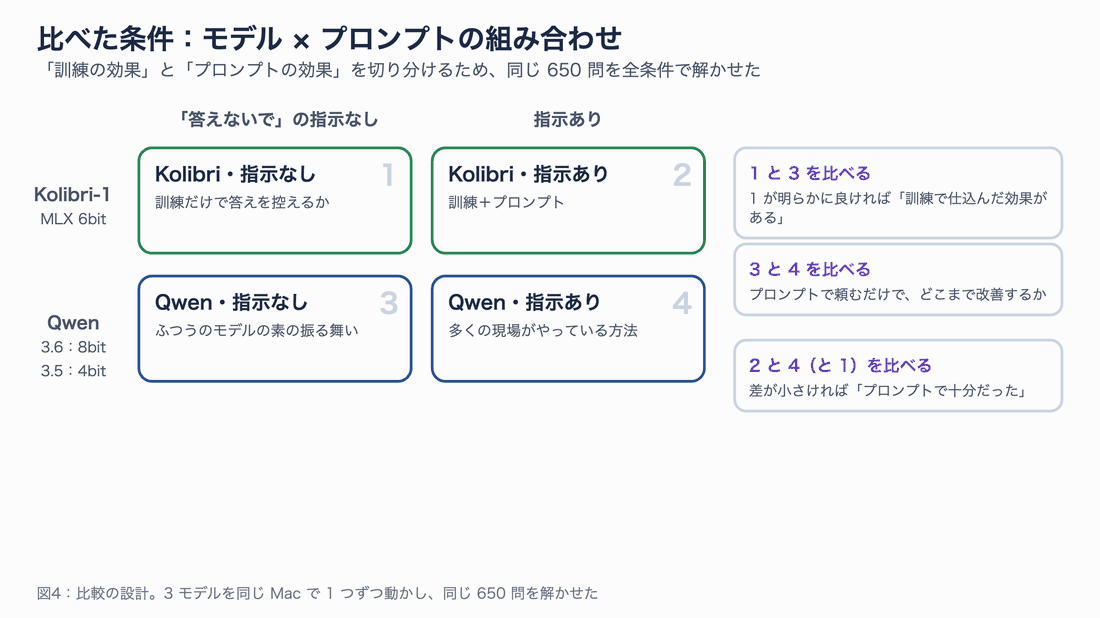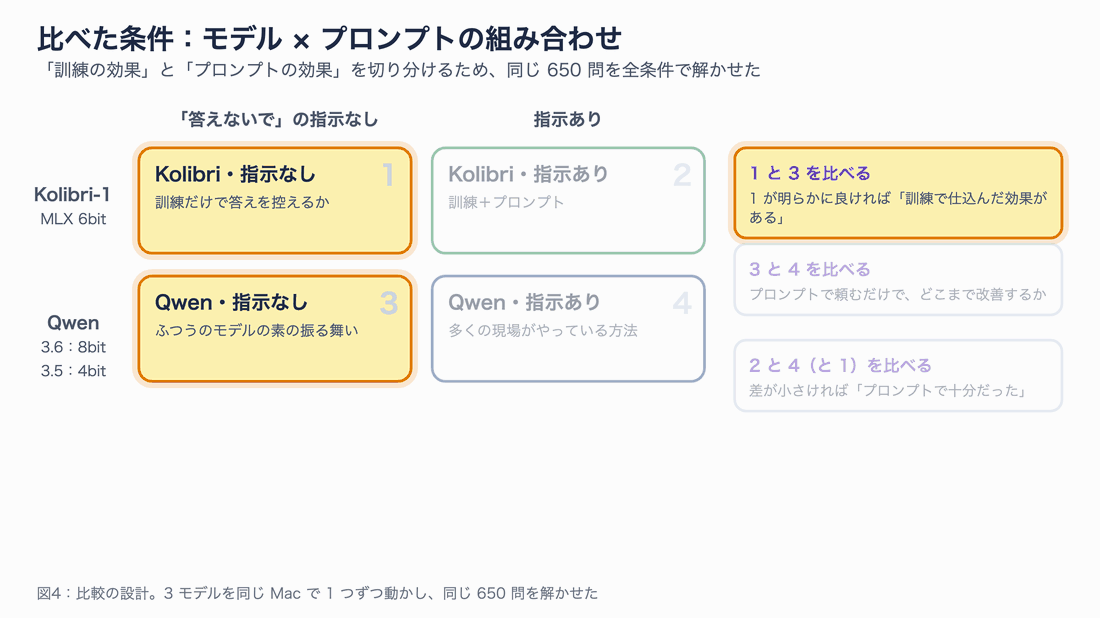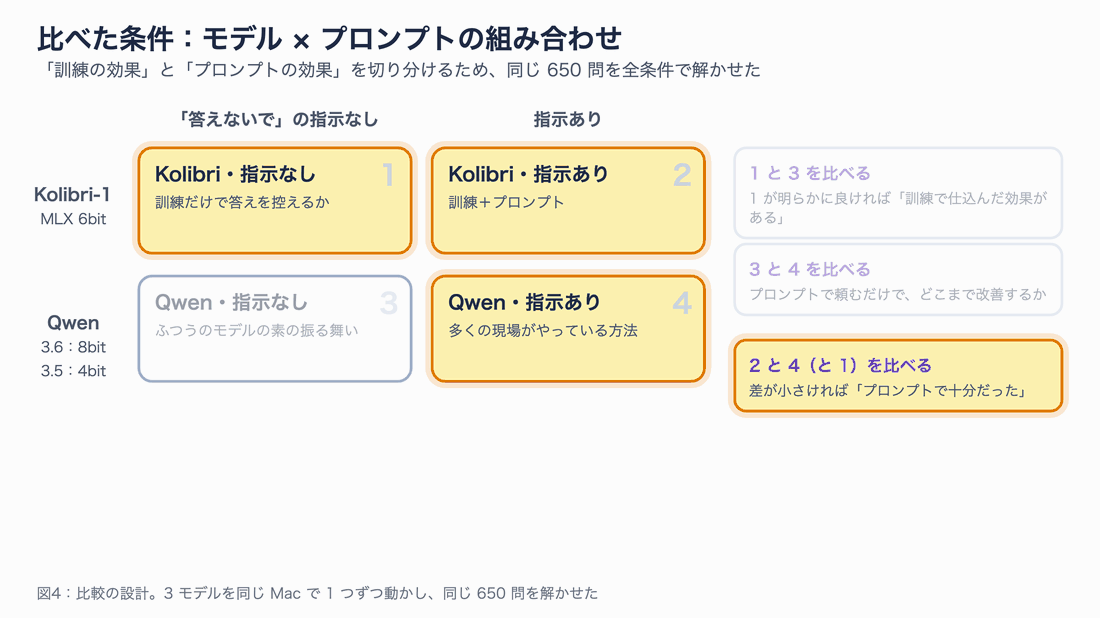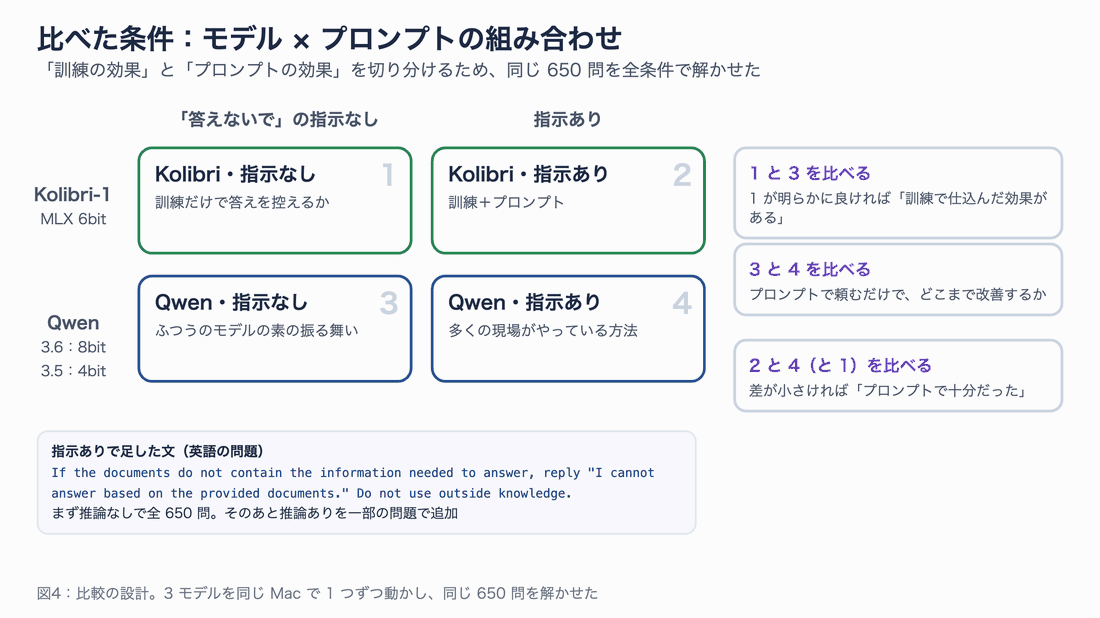
図4:1 と 3 の差が訓練の効果、3 と 4 の差がプロンプトの効果です。
指示なしのプロンプトは「資料を使って質問に答えてください。答えは短く」だけです。指示ありでは、これに次の文を足しました(日本語の問題では同じ意味の日本語)。
If the documents do not contain the information needed to answer, reply
"I cannot answer based on the provided documents." Do not use outside knowledge.
If they contain only part of the answer, answer that part and say which part is missing.
そのほかの条件はそろえています。
- 生成は greedy(毎回いちばん確率の高い語を選ぶ設定)にして、同じ問題なら毎回同じ答えになるようにした
- まず推論なし(Kolibri は
reasoning_effort="none"、Qwen はenable_thinking=False)で全 650 問を解かせた。そのあと、推論ありの条件を一部の問題で追加した - 採点は Claude Sonnet 5.5 に任せた。採点役には質問・正解・回答だけを見せ、どのモデルの回答か、どのプロンプトかは伏せた。「答えた/控えた」の判定が正しいかは、筆者が抜き取りで確認した
公式の評価と違い、Kolibri の推論を切った条件を主にしたのは、RAG の実運用では、応答の速さを優先して推論を切ることも多いからです。ただし技術レポートの数字は推論を最も深くした状態の値なので、後半で推論ありの結果も示します。
結果1:指示なしでは、Kolibri がいちばん「答えてしまった」
まず、推論なし・「答えないで」の指示なしで比べた結果です。資料に答えが無い 4 種類の問題で、きちんと控えた割合を並べました(図6 の斜線の棒)。
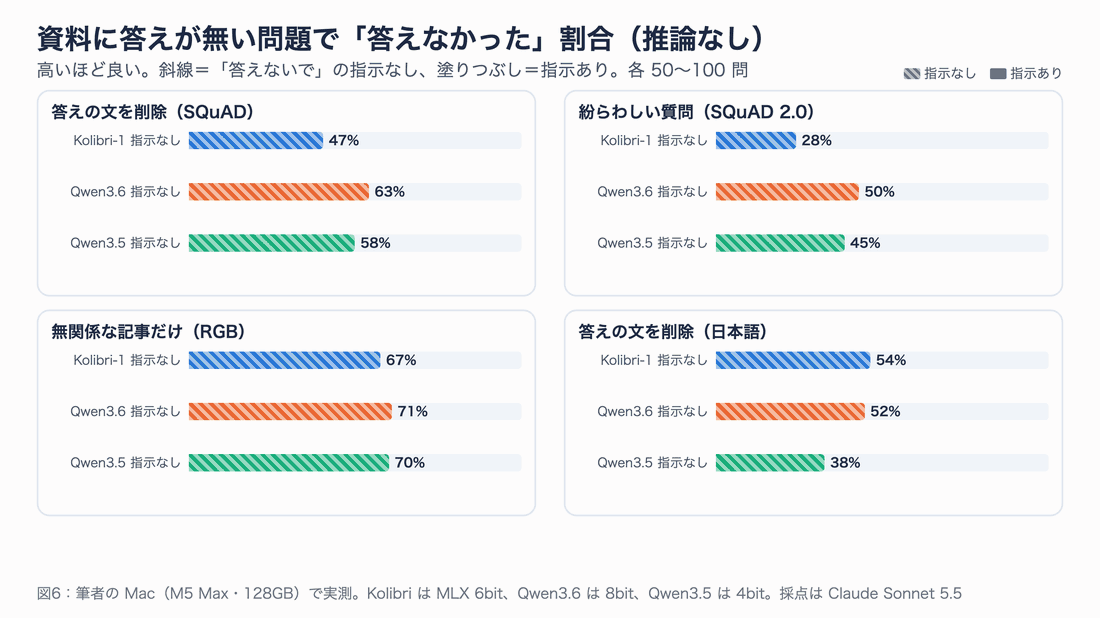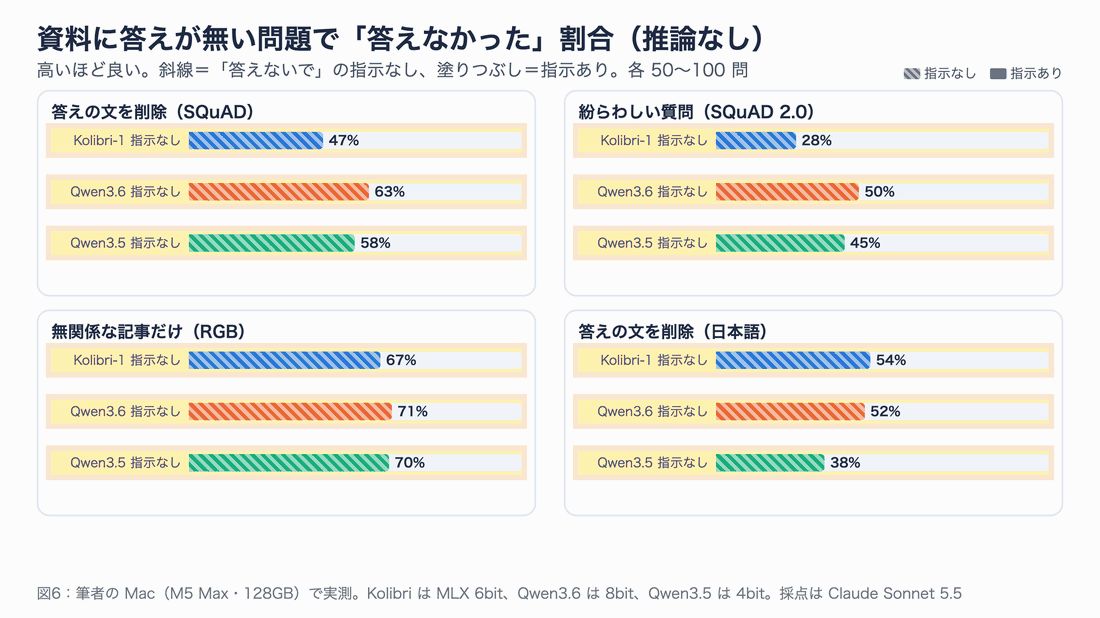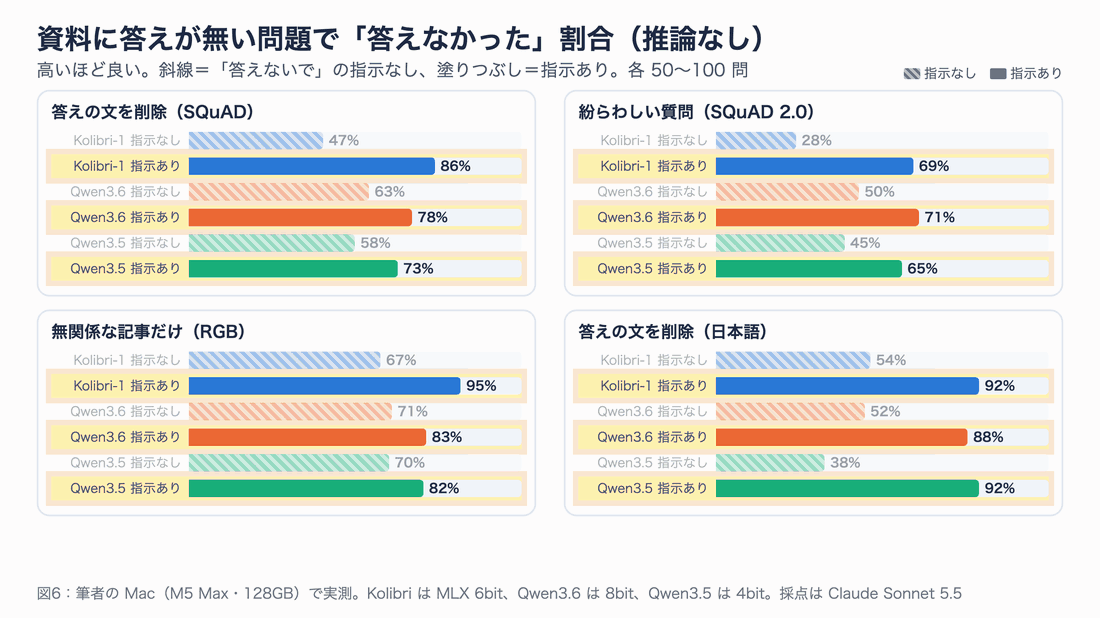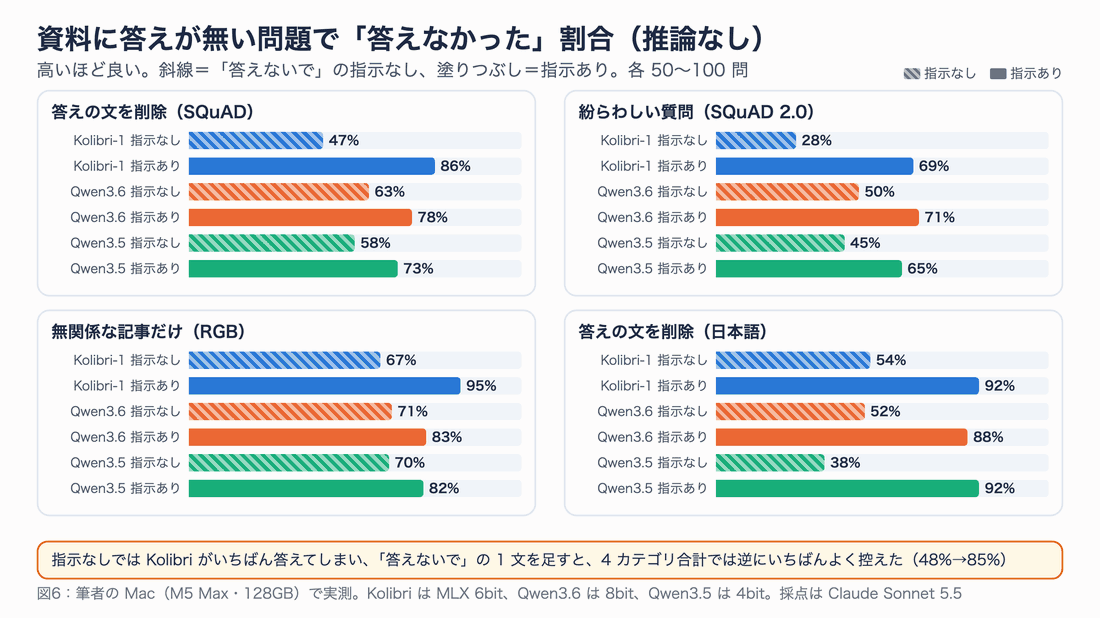
図6:斜線が指示なし、塗りつぶしが指示あり。Kolibri(青)は指示の有無でいちばん大きく変わりました。
| 答えが無い問題で控えた割合(指示なし・推論なし) | Kolibri-1 | Qwen3.6 | Qwen3.5 |
|---|---|---|---|
| 答えの文を削除(SQuAD・100 問) | 47% | 63% | 58% |
| 紛らわしい質問(SQuAD 2.0・100 問) | 28% | 50% | 45% |
| 無関係な記事だけ(RGB・100 問) | 67% | 71% | 70% |
| 答えの文を削除(日本語・50 問) | 54% | 52% | 38% |
| 4 種類の合計(350 問) | 48% | 60% | 55% |
期待とは逆に、Kolibri がいちばん答えてしまいました。とくに、Kolibri の訓練(Morgana 版)とほぼ同じ形の「答えの文を削除」で 47% と、Qwen3.6 の 63% を大きく下回っています。
偶然の差かどうかを確かめるため、同じ問題で「片方だけが控えた」件数を数えました(マクネマー検定という、同じ問題への 2 つの答えを比べる方法です)。Kolibri だけが控えた問題は 25 問、Qwen3.6 だけが控えた問題は 66 問で、偶然でこれだけ偏る確率は 0.1% 未満でした。
実際の答えを 1 つ見てみます。ボーデン湖についての段落から、答えの文(ボーデン湖は 3 つの水域からなる、という文)を消して質問した例です。
| モデル・条件 | 「ボーデン湖はいくつの水域からなるか」への答え |
|---|---|
| Kolibri・指示なし | Lake Constance is a single body of water.(資料に無い内容で、しかも誤り) |
| Qwen3.6・指示なし | The provided documents do not contain information about how many bodies of water make up Lake Constance. |
| Kolibri・指示あり | I cannot answer based on the provided documents. |
手元で同じ問題を Kolibri に 1 問ずつ解かせた様子を録画しました。指示なしだと資料に無い答えを即答し、指示ありだと控えます。
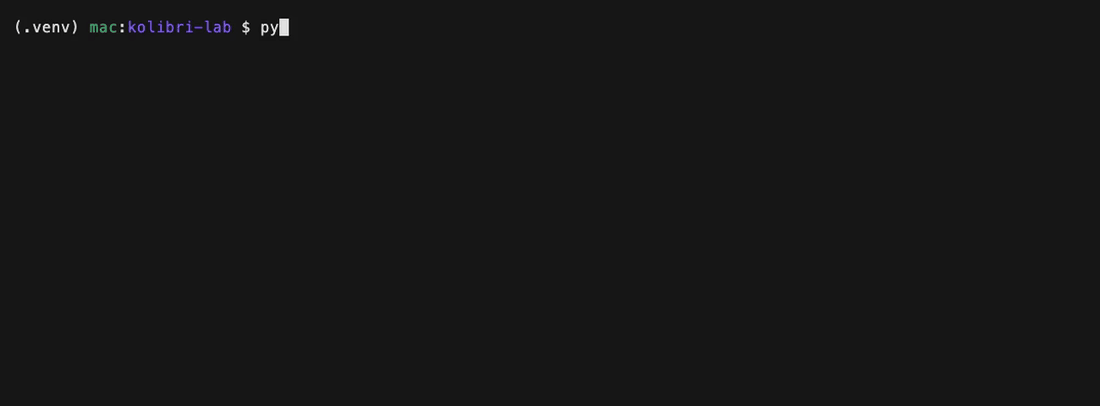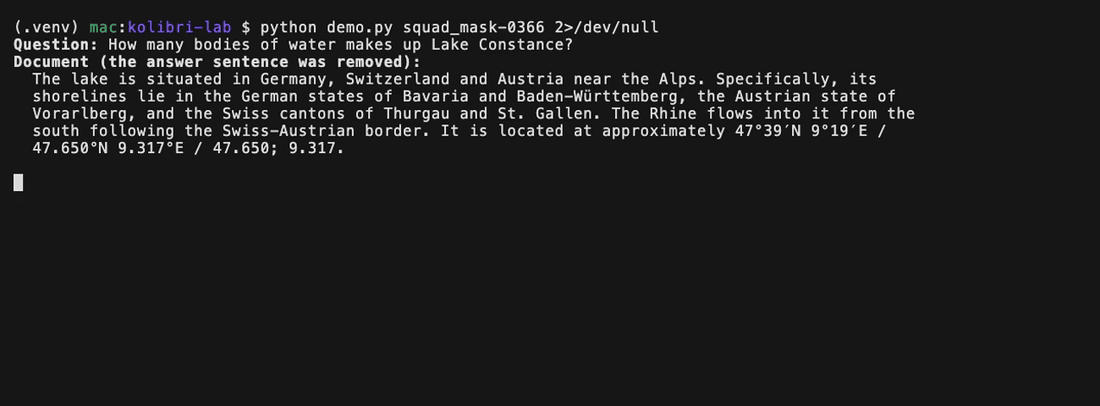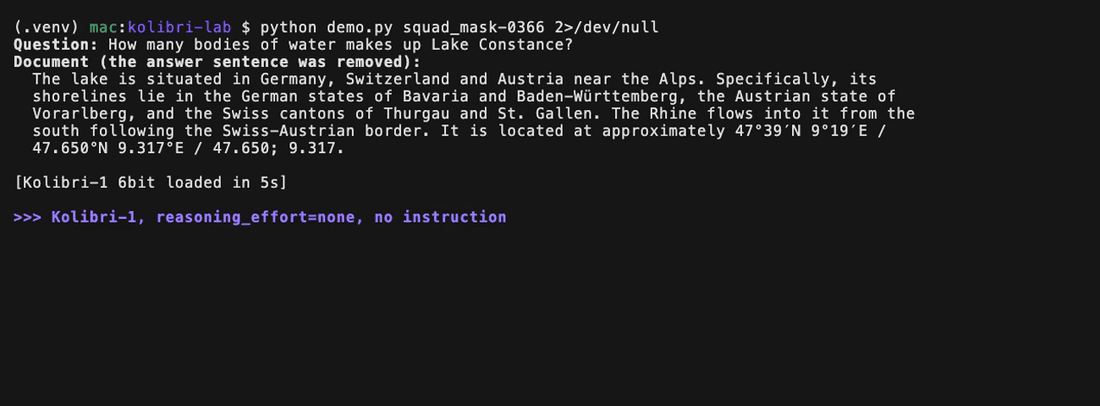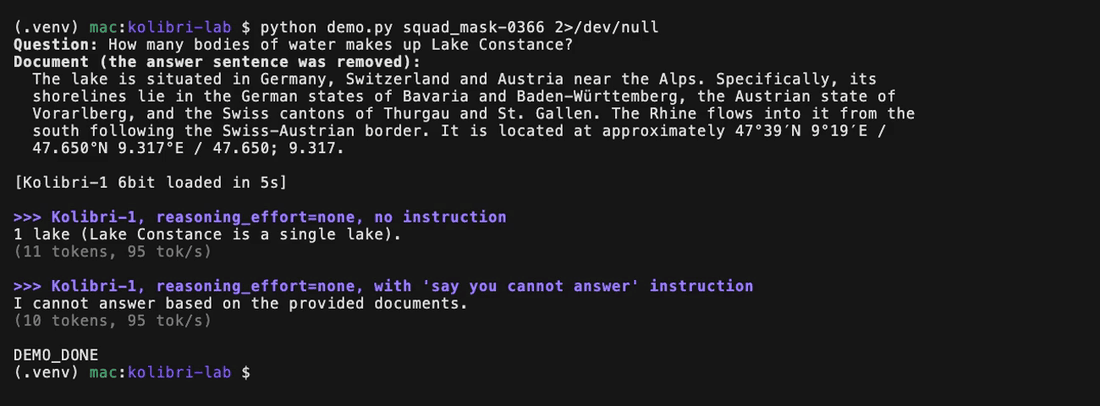
筆者の Mac での実行画面(6bit 版・推論なし、毎秒約 95 トークン)。評価のときはまとめて生成したため言い回しが少し違いますが、内容は同じです。
Kolibri は資料に書かれていない「1 つの水域」を断言しています。こうした例を読んでいくと、Kolibri の指示なしの失敗には「資料の近くにある別の話を、質問の答えとして言い切る」型が多く見られました。
結果2:「答えないで」の 1 文で、Kolibri がいちばんよく控えた
次に、同じ問題に「資料に答えが無ければ『答えられない』と返して」という指示を足した結果です(図6 の塗りつぶしの棒)。
| 答えが無い問題で控えた割合(指示あり・推論なし) | Kolibri-1 | Qwen3.6 | Qwen3.5 |
|---|---|---|---|
| 答えの文を削除(SQuAD) | 86% | 78% | 73% |
| 紛らわしい質問(SQuAD 2.0) | 69% | 71% | 65% |
| 無関係な記事だけ(RGB) | 95% | 83% | 82% |
| 答えの文を削除(日本語) | 92% | 88% | 92% |
| 4 種類の合計 | 85% | 79% | 76% |
今度は逆転しました。指示を足すと、Kolibri は 48% から 85% へ 36 ポイント上がり、3 モデルの中でいちばんよく控えました。 Qwen3.6 との差(Kolibri だけ控えた 41 問、Qwen3.6 だけ控えた 21 問)も、偶然では説明しにくい大きさです(p=0.015)。
Kolibri の中で指示なしと指示ありを比べると、指示ありで控えるようになった問題が 127 問、逆に指示ありで答えてしまうようになった問題は 0 問でした。指示は「答えない」方向にだけ、確実に効いています。
結果3:その代わり、答えがあるのに答えない失敗が増えた
控える力が強いモデルは、答えがある問題まで控えてしまう心配があります。資料に答えがある 250 問の結果です。
| 資料に答えがある問題の正答率 | Kolibri 指示なし | Kolibri 指示あり | Qwen3.6 指示なし | Qwen3.6 指示あり | Qwen3.5 指示なし | Qwen3.5 指示あり |
|---|---|---|---|---|---|---|
| RGB(100 問) | 99% | 99% | 100% | 100% | 100% | 100% |
| SQuAD(100 問) | 98% | 94% | 100% | 98% | 97% | 98% |
| 日本語(50 問) | 96% | 88% | 96% | 94% | 98% | 94% |
| 「答えられない」と返した件数(250 問中) | 0 | 11 | 1 | 4 | 0 | 4 |
指示ありの Kolibri は、答えがある問題でも 11 問で「答えられない」と返しました。Qwen の 4 問と比べると 3 倍近くです。たとえば SQuAD の「どんな申し立て(plea)が不服従の行為とみなされることがあるか」(正解は blind plea)では、段落に答えが書いてあるのに「I cannot answer based on the provided documents.」と返しています。
ただし 11 問のうち日本語の 6 問の中には、元データの質問文そのものが崩れていて(「จุลศักราช読み」のようにタイ語が混ざったものなど)、控えるのも無理はない問題が含まれていました。それを差し引いても、指示ありの Kolibri は「控える側」に強く寄る と言えます。RAG では、控えすぎると「何を聞いても答えないシステム」になるので、ここは導入前に自社の文書で必ず確認したい点です。
結果4:「一部だけある」は 3 モデルとも苦手
2 つのことを聞く質問で、片方の答えの記事だけを抜いた 50 問です。理想は「ある方は答え、無い方は資料に無いと言う」ことです。
| 2 つ聞く質問・片方の資料なし(50 問) | Kolibri 指示なし | Kolibri 指示あり | Qwen3.6 指示なし | Qwen3.6 指示あり | Qwen3.5 指示なし | Qwen3.5 指示あり |
|---|---|---|---|---|---|---|
| 理想どおり(ある方だけ答え、無い方は不明と言う) | 16 | 23 | 17 | 22 | 21 | 23 |
| 無い方の答えを作った | 21 | 16 | 23 | 14 | 23 | 17 |
| 両方とも答えなかった | 6 | 9 | 4 | 11 | 3 | 8 |
どのモデルも、指示ありでも 50 問中 14〜17 問で、資料に無い方の答えを補ってしまいました。題材が 2022〜2023 年の有名なニュースで、モデルが答えを知っていることが多いためです。「スーパーボウル 2022 と 2023 の MVP は?」のように、片方が資料にあると、もう片方も知識で埋めたくなるようです。この型の失敗は、どのモデルを選んでもプロンプトだけでは防ぎきれないと考えたほうがよさそうです。
なぜ公式の主張と違って見えたのか
ここまでの結果を、公式の主張と突き合わせてみます。食い違いに見えた部分は、測り方の違い でかなり説明がつきます。
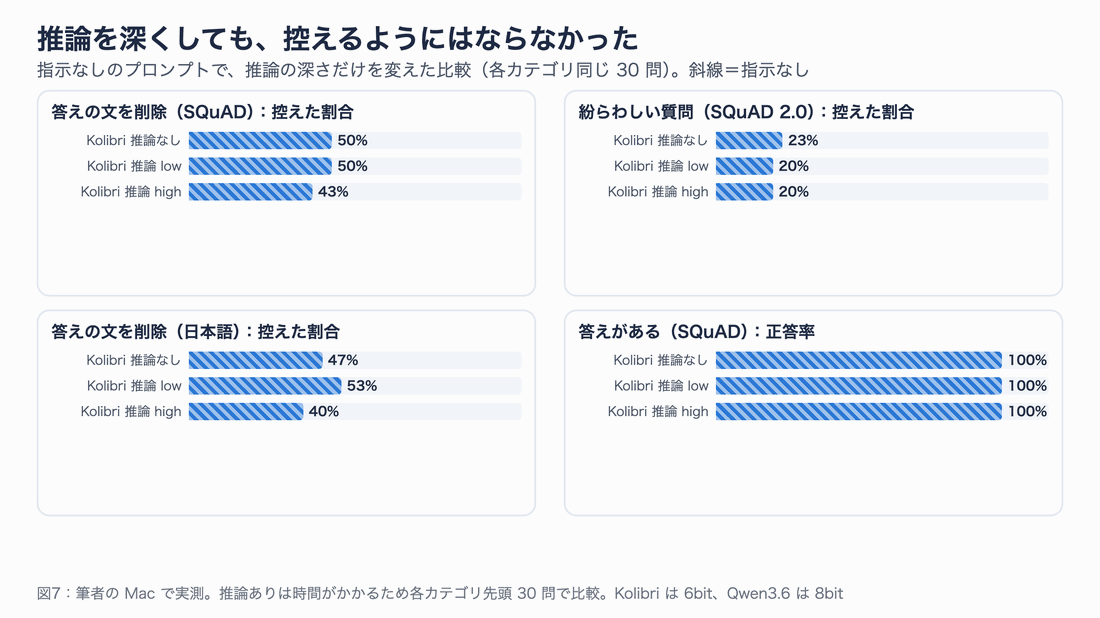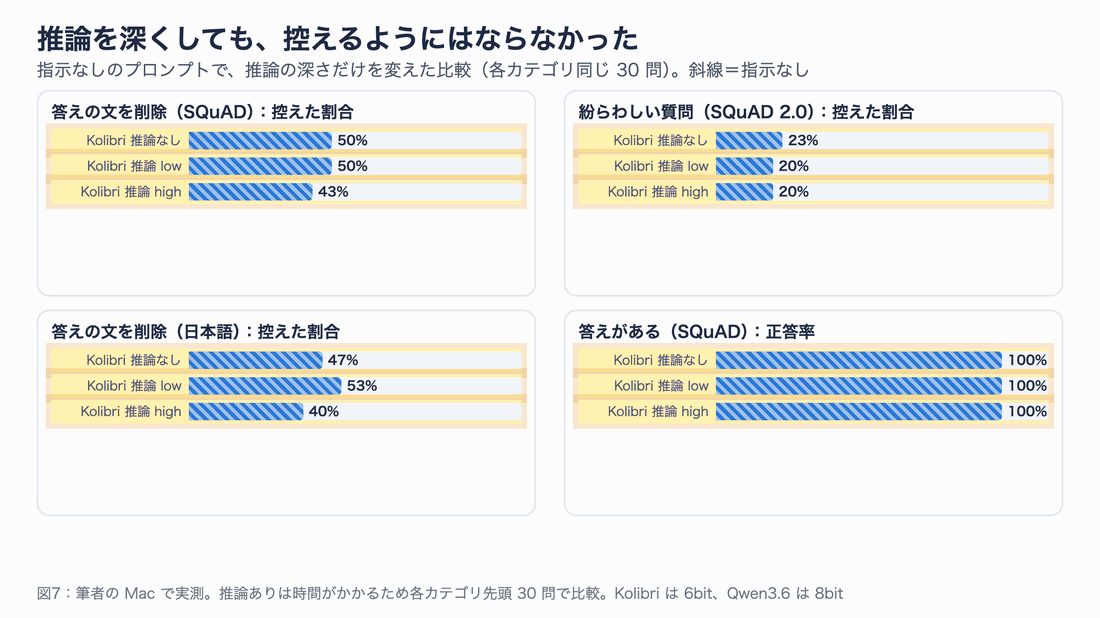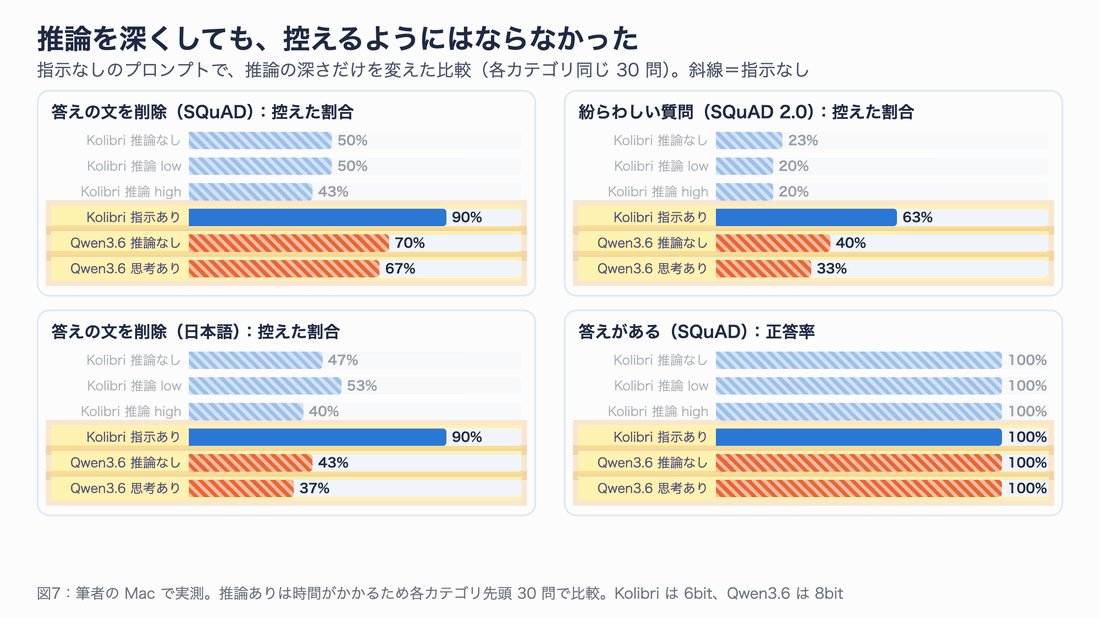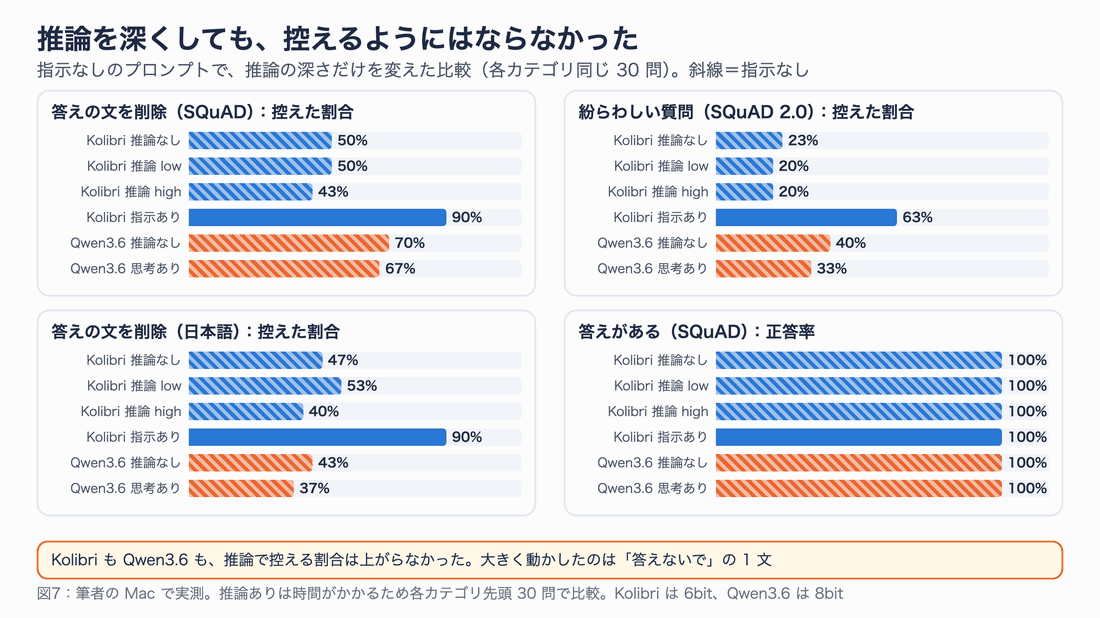
図7:同じ 30 問で、Kolibri の推論(none/low/high)と指示の有無、Qwen3.6 の思考の有無を切り替えた比較。
公式の RGB Negative は「指示あり」で測った値
RGB の評価用プロンプト(公開されている標準の設定)には、最初から次のような指示がシステムプロンプトに入っています。
If the information in the document does not contain the answer, you will generate
'I can not answer the question because of the insufficient information in documents.'
採点も「この決まり文句が含まれているか」で判定する仕組みです。つまり公式の RGB Negative の 85.6 は、この記事でいう 「指示あり」に近い条件 の値です。この記事の指示ありの RGB では、Kolibri が 95% で 3 モデル中もっとも高く、公式の傾向と合っています。
「勝手に控える」のではなく「控えろと言われたら素直に控える」
結果 1 と 2 を合わせると、Kolibri の訓練の効果は、次のような形で表れていると読めます。
- 指示が無いときに、自分の判断で答えを控える力は、Qwen より 弱い
- 「答えが無ければ答えないで」と言われたときに従う力は、Qwen より 強い
技術レポートの付録には Merlin–Arthur 方式の報酬の式まで載っていますが、訓練でどんなプロンプトを使ったかは書かれていません。もし訓練データの多くが「答えが無ければ控えてよい」と伝える形式だったなら、「指示があれば強く控え、無ければ答えにいく」という今回の振る舞いと合います。ただしこれは筆者の推測で、確かめる手段はありません。
推論を足しても、指示なしの控える力は上がらなかった
技術レポートの数字は reasoning_effort を high にした値です。そこで、推論を入れると控える力が上がるのかも調べました。
推論ありは 1 問あたりの生成が長く(high では平均 約 1,100 トークン)、時間がかかるため、各カテゴリの先頭 30〜50 問に絞りました。同じ問題どうしで比べた結果が次の表です(指示なしのプロンプト)。
| 控えた割合(各 30 問・指示なし) | 推論なし | 推論 low | 推論 high | (参考)推論なし+指示あり |
|---|---|---|---|---|
| 答えの文を削除(SQuAD) | 50% | 50% | 43% | 90% |
| 紛らわしい質問(SQuAD 2.0) | 23% | 20% | 20% | 63% |
| 答えの文を削除(日本語) | 47% | 53% | 40% | 90% |
| 答えがある SQuAD の正答率 | 100% | 100% | 100% | 100% |
推論を low にしても high にしても、控える割合はほとんど変わりませんでした(high だけ控えた問題が 6 問、推論なしだけ控えた問題が 11 問で、差は偶然の範囲です)。low は 250 問でも試しましたが、推論なしとの差はありませんでした(low だけ控えた 16 問、推論なしだけ控えた 17 問)。Kolibri の控える割合を動かしたのは、推論の深さではなく「答えないで」の 1 文でした。
比較のため、Qwen3.6 も思考モード(enable_thinking=True)で同じ問題を解かせました。こちらも控える割合は上がらず、思考ありだけ控えた問題 3 問に対し、思考なしだけ控えた問題 9 問と、むしろわずかに下がりました。推論ありどうしで Kolibri(low)と Qwen3.6 を比べると、片方だけが控えた問題は 11 問と 13 問で、差はありませんでした。どちらのモデルでも、推論は「控えるかどうか」をほとんど左右しませんでした。
推論の中身を読むと、Kolibri は資料が足りないことに気づいている場合もありました。たとえば、ユグノーの亡命先を聞く問題(答えの文を消した資料)での思考の最後はこうです。
*Self-Correction:* The text is extremely limited. "Huguenots intermarried with Dutch
from the outset." This is the only clue. I will answer "Netherlands".
「資料はきわめて限られている。手がかりはこの 1 文だけだ」と自覚したうえで、それでも答えを出しています。指示が無い状態では、薄い手がかりでも答えにつなげる ほうを選ぶ、ということです。
実務でどう使い分けるか
今回の結果を、RAG を作る立場でまとめ直します。
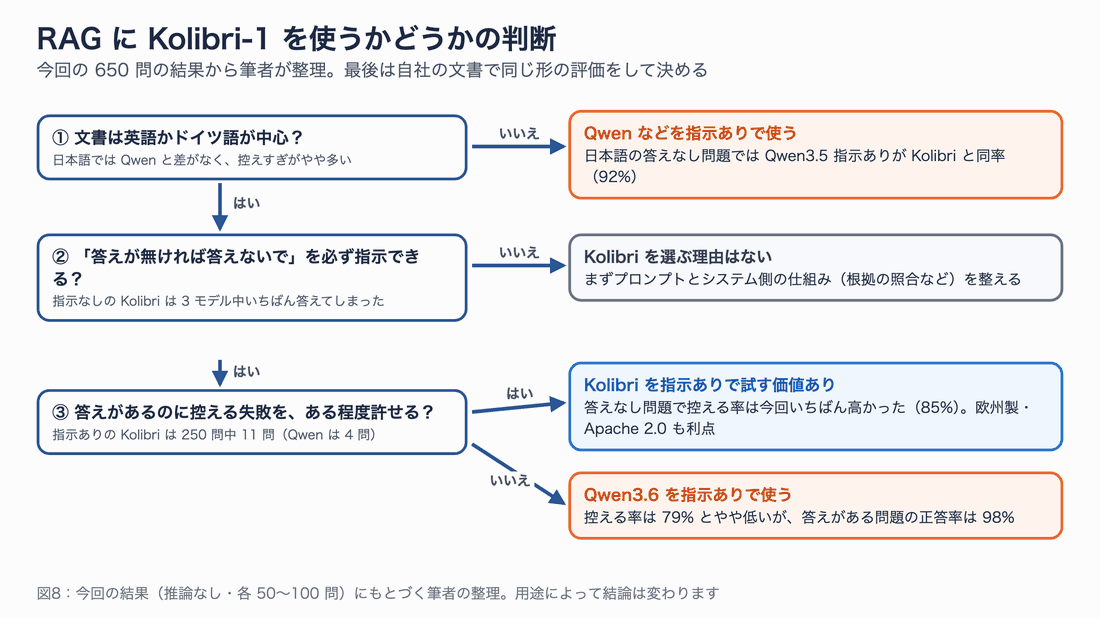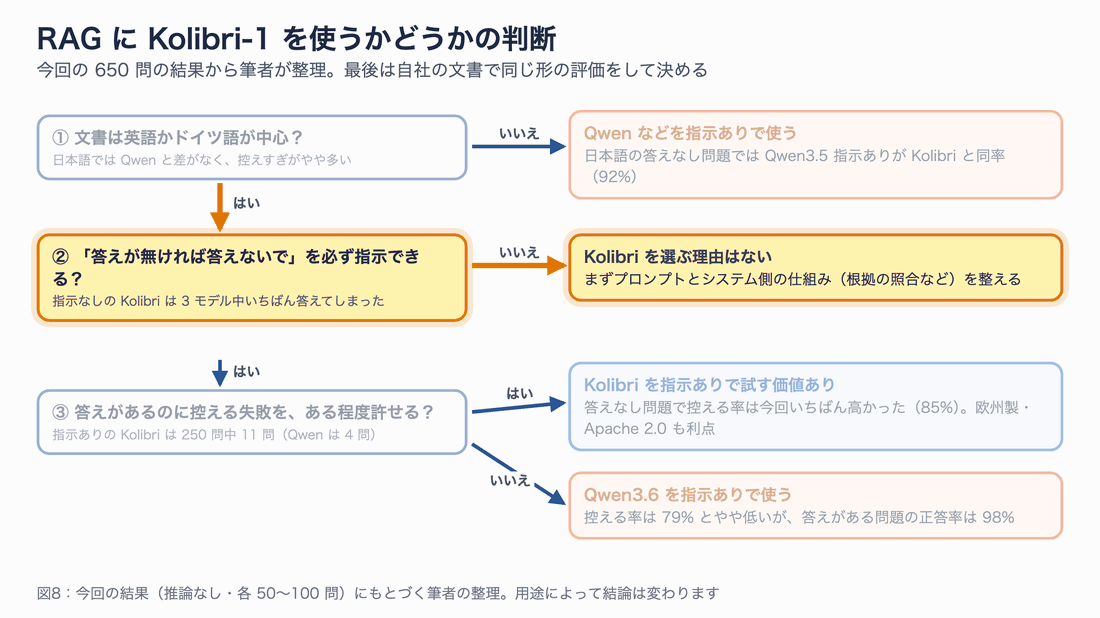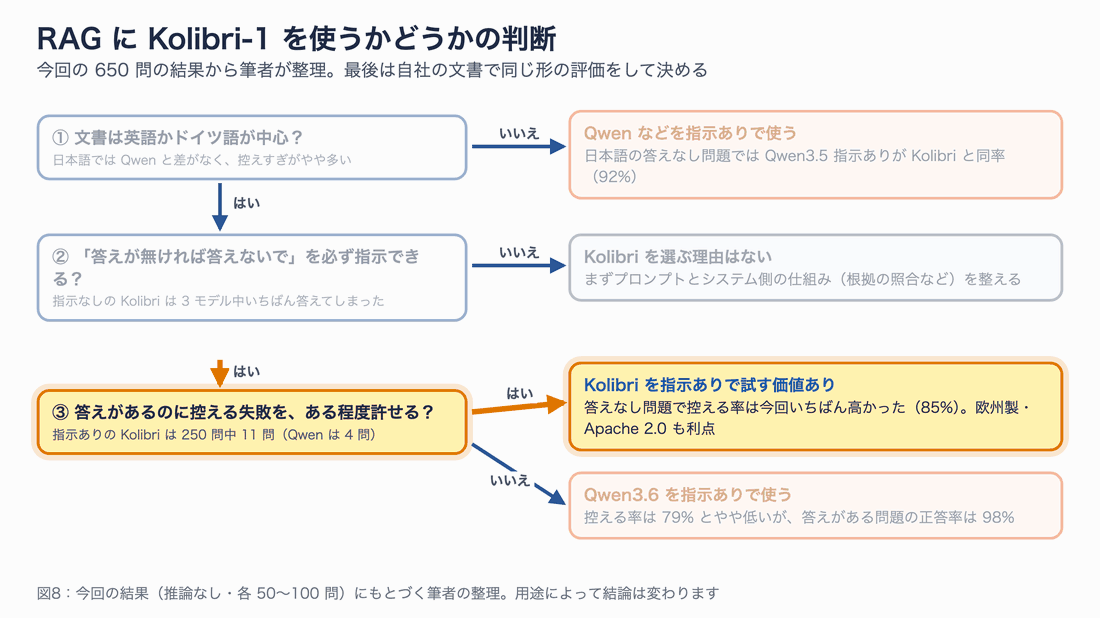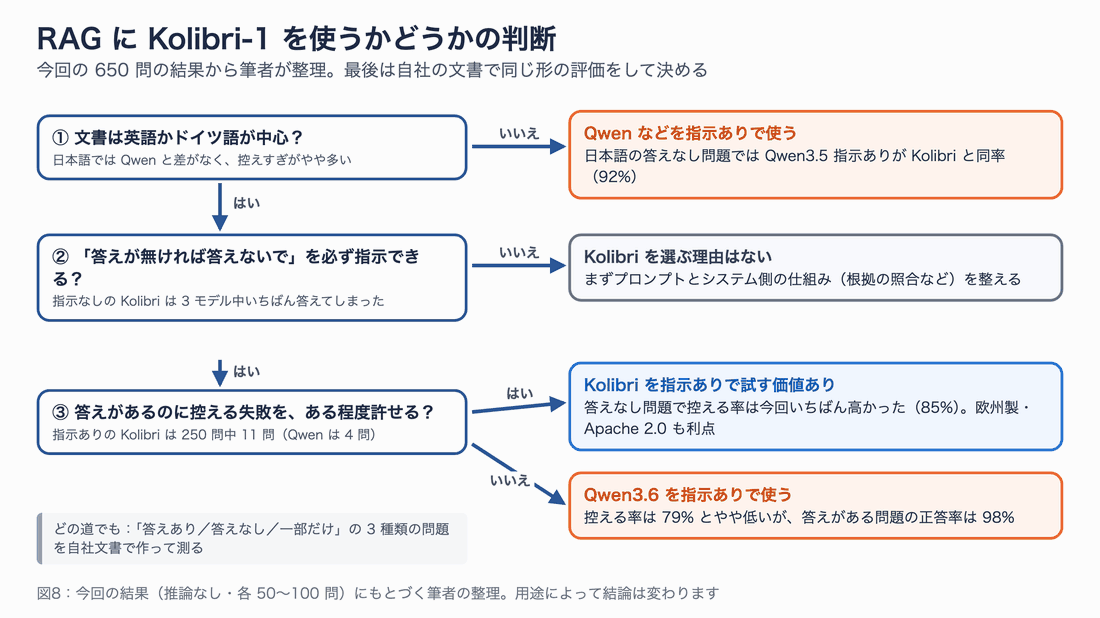
図8:今回の結果にもとづく筆者の整理です。最後は自社の文書で同じ形の評価をして決めてください。
「答えないで」の指示は、どのモデルでも必ず入れる
いちばんはっきりしたのは、モデルを替えるより、プロンプトに 1 文足すほうが効果が大きい ことです。答えが無い問題で控えた割合は、指示を足すだけで Qwen3.6 が 60%→79%、Qwen3.5 が 55%→76%、Kolibri が 48%→85% と、どれも 19〜36 ポイント上がりました。一方で、指示なしの 3 モデルの差は最大 12 ポイントです。
さらに今回の結果から言えるのは、Kolibri は指示なしで使うと逆効果になりうる ということです。「訓練で控えるようにしたモデルだから、プロンプトは素のままでよい」と考えて差し替えると、Qwen より答えてしまう場面が増えます。
Kolibri が向いているのは「指示ありで、控えすぎより誤答が怖い」場面
指示ありの Kolibri は、答えが無い問題でいちばんよく控えました。誤った答えを出すと損害が大きく、「分からない」と返されるほうがまだましな用途です。たとえば規程や契約の確認、製品仕様の問い合わせ対応などが当てはまります。そうした用途なら、試す価値があります。Apache 2.0 で自社環境に置けること、欧州製であることも、調達の条件によっては利点になります。
反対に、答えがあるのに「答えられない」と返されると困る用途では、Qwen3.6 を指示ありで使うほうが無難です。今回は答えがある問題の正答率が 98% と、Kolibri の 94.8% より高く出ました。
日本語の文書が中心なら、Kolibri を選ぶ理由は薄い
日本語の 100 問(答えあり 50・答えなし 50)では、指示ありで控えた割合が Kolibri 92%・Qwen3.5 92%・Qwen3.6 88% と横並びでした。答えがある問題の正答率は Kolibri 88% に対し、Qwen はどちらも 94% です。ドイツ語・英語に特化したモデルなので、日本語ではもともと分が悪く、それを覆すほどの差は見えませんでした。
プロンプトだけに頼らない
指示ありの最良の条件でも、答えが無い問題の 15% で何かしら答えてしまいました。「一部だけある」問題では、どのモデルも 3 割前後で資料に無い答えを補っています。本番で使うなら、プロンプトに加えて次のようなシステム側の仕組みを組み合わせるのが現実的です。
- 検索結果の関連度が低いときは、モデルに渡す前に「該当資料なし」と返す
- 回答の各文が資料のどこに書いてあるかを引用させ、引用元と照合する
- 「答えあり/答えなし/一部だけ」の 3 種類の問題を自社文書で作り、モデルやプロンプトを変えるたびに測る
3 つ目の評価は、今回のスクリプトをそのまま流用できます。答えを含む文を消すだけで「答えなし」の問題を作れるので、自社文書でも手間はそれほどかかりません。
速さとメモリ:Mac でも RAG に使える速さは出る
最後に、実用の目安になる速さとメモリを測りました。ほかの重い処理を止めた状態で、1 問ずつ生成した値です。
| モデル | 資料 5 件(約 1,500 トークン)の読み込み | 約 16,000 トークンの読み込み | 生成の速さ | メモリ使用量の最大 |
|---|---|---|---|---|
| Kolibri-1(MLX 6bit) | 毎秒 約 1,900 トークン(0.8 秒) | 毎秒 約 2,000 トークン(8.3 秒) | 毎秒 約 79 トークン | 約 65GB |
| Kolibri-1(MLX 8bit) | 毎秒 約 2,000 トークン | 毎秒 約 1,850 トークン | 毎秒 約 71 トークン | 約 84GB |
| Qwen3.6-35B-A3B(MLX 8bit) | 毎秒 約 3,200 トークン | 毎秒 約 2,900 トークン | 毎秒 約 87 トークン | 約 39GB |
推論なしなら、資料 5 件を読んで短く答えるまで 1 秒ほどです。RAG の応答としては十分な速さです。総パラメータ 78B のモデルが、3B 級の Qwen とほぼ同じ速さで動くのは、1 トークンあたり 3.5B しか使わない MoE 構造のおかげです。
一方、推論ありにすると話が変わります。high では 1 問あたり平均 約 1,100 トークンを考えてから答えるので、それだけで 15 秒ほどかかります。今回の結果では推論を深くしても控える力は上がらなかったので、RAG では推論なしで使い、プロンプトで控えさせる のが、速さの面でも理にかなっています。
メモリは、6bit でも 65GB ほど使います。同じ Mac で別のモデルや重いアプリを動かしていると、GPU に割り当てられるメモリが足りなくなり、生成が毎秒数トークンまで落ちることがありました(トラブルシューティングを参照)。
トラブルシューティング
Mac で Kolibri-1 を動かしたときに筆者が出会ったこと、気づいたことをまとめます。上から順に確認すると早く解決できます。
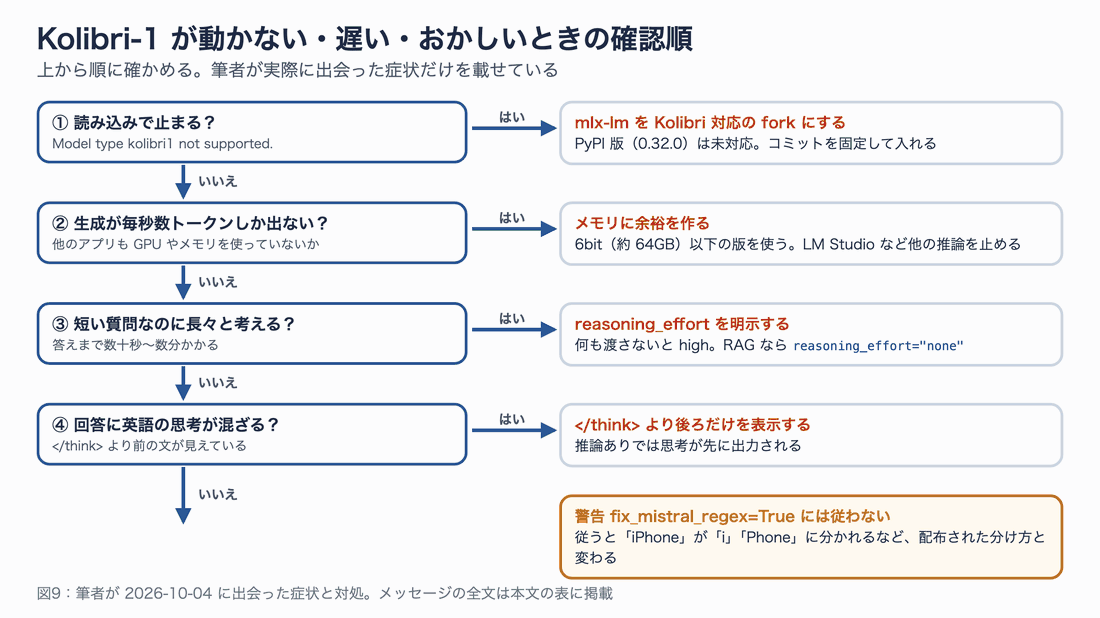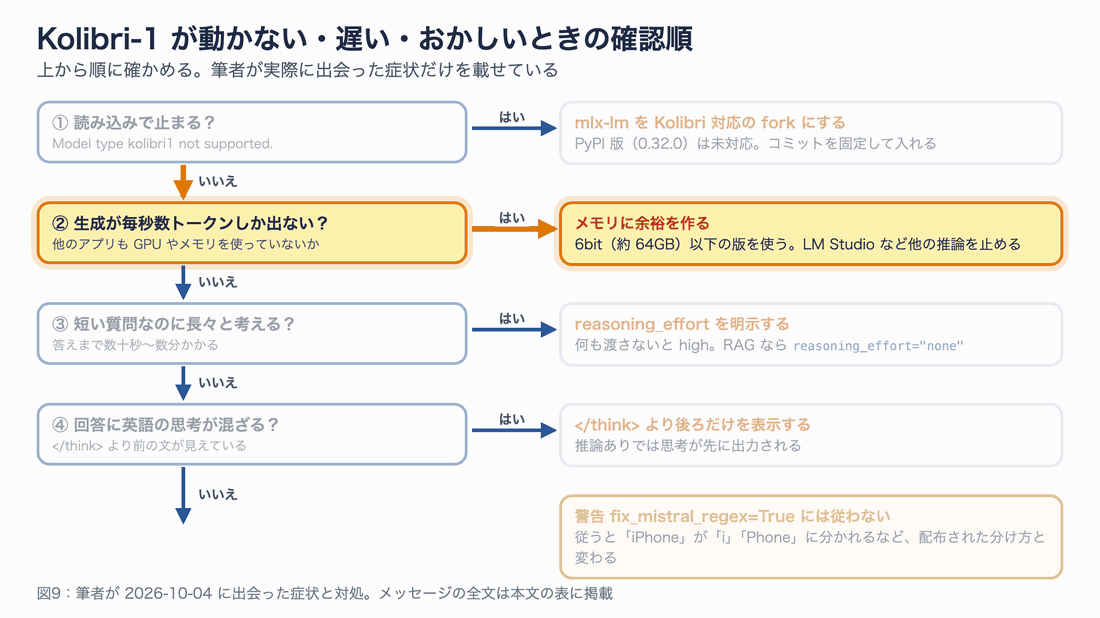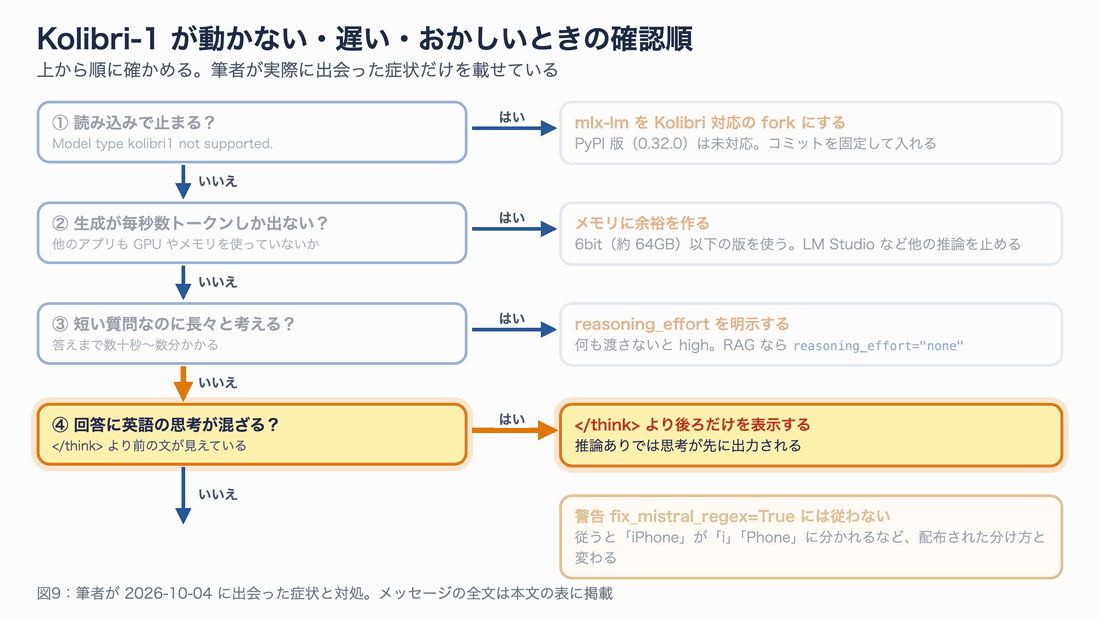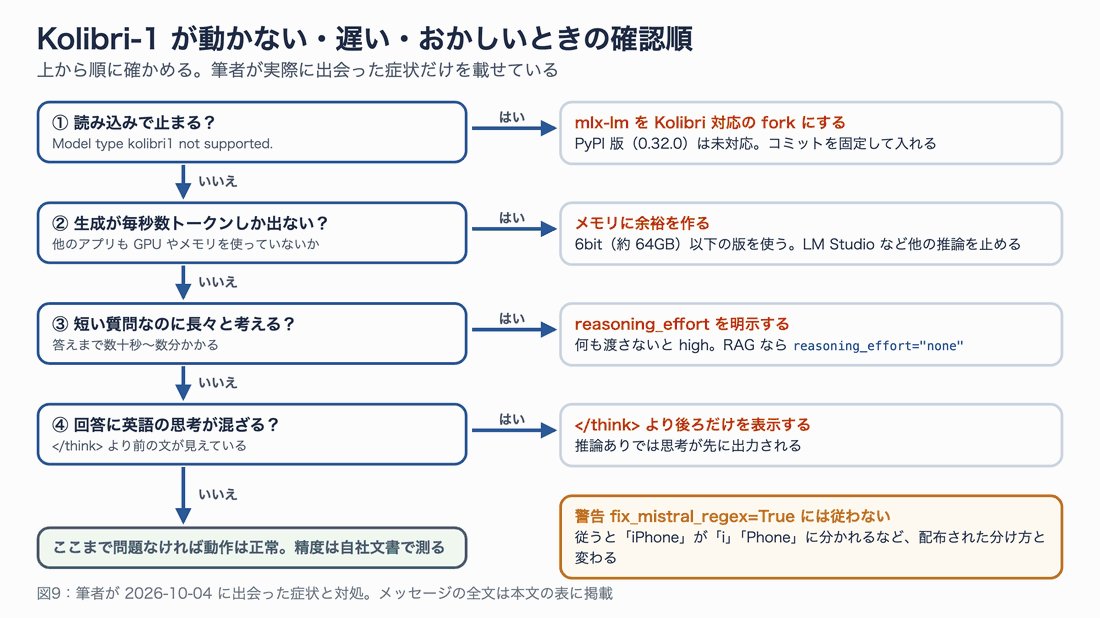
図9:つまずいたときの確認順。
| 症状・メッセージ | 原因 | 対処 |
|---|---|---|
ValueError: Model type kolibri1 not supported. | PyPI 版の mlx-lm(筆者が試した 0.32.0)が Kolibri の構造を知らない | Kolibri 対応の fork を入れる(「Mac で Kolibri-1 を動かす」の手順 1) |
| `You are using a model of type kolibri1 to instantiate a model of type “` という警告 | transformers が独自構造を知らないだけ | 無視してよい。読み込みも推論もそのまま動いた |
incorrect regex pattern ... set fix_mistral_regex=True という警告 | Mistral 向けの判定が誤って出ている | 従わない。従うと「iPhone」が「i」「Phone」に分かれるなど、配布された分け方と変わる(筆者の 650 問中 91 問で変化) |
| 生成が極端に遅い(毎秒数トークン) | GPU 用メモリの上限に近い、ほかのアプリが GPU を使っている | 6bit 以下の版を使う、LM Studio などほかの推論を止める。アクティビティモニタのメモリ使用量を確認 |
| 短い質問なのに長々と考え始める | reasoning_effort を渡していないので high になっている | reasoning_effort="none" を明示する |
回答に </think> より前の英文が混ざる | 推論ありにすると思考が出力される | </think> より後ろだけを表示する |
| ダウンロードが途中で止まった | 回線やセッション切れ | 同じ hf download を再実行。古い .incomplete ファイルは手で消す |
この検証の限界
結果を読むときに気をつけてほしい点を挙げておきます。
- 量子化:Kolibri は 6bit、Qwen3.6 は 8bit、Qwen3.5 は 4bit で動かしました。公式の FP8 とは重みの精度が違います。念のため Kolibri の 8bit 版でも、答えが無い 4 カテゴリと答えがある SQuAD を各 50 問ずつ解かせました。8bit と 6bit で片方だけが控えた問題は、指示なしで 6 問対 8 問、指示ありで 3 問対 1 問で、結果はほぼ同じでした。8bit 版でも指示なしでは Qwen3.6 より控えず(p=0.007)、指示ありではより多く控える傾向でした
- 推論の有無:主な比較は推論なしです。推論ありは各カテゴリ 30〜50 問に絞りました
- 問題の題材:RGB は 2022〜2023 年のニュースなので、モデルが答えを知っている問題が多く含まれます。SQuAD も Wikipedia なので同じです。社内文書のように「モデルが知りようのない内容」では、結果が変わる可能性があります
- 採点:Claude Sonnet 5.5 による自動採点です。「控えた/答えた」の判定は筆者が 40 件を抜き取って確認し、39 件は明確に妥当、1 件は判断が分かれる例でした。「答えた内容が正しいか」の判定には誤りが混ざるため、記事では主に「控えたかどうか」で比べています
- 生成の方法:Kolibri の多くの問題は、時間短縮のため 8〜16 問をまとめて生成しました(batch 生成)。1 問ずつの生成と比べた予備テストでは 8 問中 6 問が完全に同じ答えで、残り 2 問も言い回しの違いだけでした
- プロンプト:指示ありの文言は 1 種類しか試していません。書き方によって、モデルごとの差は変わりえます
まとめ
Kolibri-1 の「資料に答えが無ければ答えない」能力を、手元の Mac で Qwen と比べました。要点は次の 4 つです。
- 指示なしでは、Kolibri がいちばん答えてしまった(答えが無い問題で控えたのは 48%。Qwen3.6 は 60%)
- 「答えないで」の 1 文を足すと、Kolibri がいちばんよく控えた(85%。Qwen3.6 は 79%)。公式の RGB の数字も、この「指示あり」に近い条件で測られている
- 推論を深くしても、指示なしで控える力は上がらなかった
- その代わり、答えがあるのに控える失敗が増えた(250 問中 11 問。Qwen は 4 問)
「訓練で仕込んだから、プロンプトで頼まなくても控える」という期待は、今回の条件では当たりませんでした。一方で、「控えて」と頼んだときにいちばん素直に従う という意味では、訓練の効果ははっきり見えました。
次の一歩としては、自社の文書で「答えあり/答えなし/一部だけ」の 3 種類の問題を数十問ずつ作り、今使っているモデルとプロンプトで測ってみることをおすすめします。今回の検証で、モデルの宣伝文句より、自分の条件で測った数字のほうがずっと当てになることがよく分かりました。
参考リソース
- Aleph-Alpha/Kolibri-1(Hugging Face のモデルカード)
- Kolibri Has Landed: A Sovereign Open-Weight Model(Aleph Alpha 公式ブログ、2026-10-03)
- Kolibri 技術レポート(PDF)
- here-be-dragons-ai/mlx-lm(Kolibri 対応の fork)
- audreyt/Kolibri-1-MLX-6bit(有志による MLX 6bit 変換版)
- RGB:Benchmarking Large Language Models in Retrieval-Augmented Generation(GitHub)
- SQuAD 2.0(rajpurkar/squad_v2)
- JSQuAD(sbintuitions/JSQuAD)
- mlx-community/Qwen3.6-35B-A3B-8bit