はじめに
2026年9月29日、OpenAI は DevDay で GPT-6.1 Sol を公開しました。9月22日に出たばかりの GPT-6 Sol の後継で、発表の見出しは「Astra に迫る性能、価格は5分の1」です。GPT-6 Astra は OpenAI の最上位モデルで、入力 $10 / 出力 $50(100万トークンあたり)。GPT-6.1 Sol はその5分の1の $2 / $10 で、「難しい仕事の多くを Astra の代わりにこなせる」と OpenAI は言っています。
本当にそうなら、AI エージェントの運用コストは大きく変わります。エージェント(AI が自分でファイルを読み、コマンドを実行し、結果を見て直す仕組み)は、1つの仕事でモデルを何十回も呼びます。「いちばん賢いモデル」より、「必要な品質を満たしたうえで1タスクいくらか」が効いてくるからです。
この記事では、まず OpenAI の発表とシステムカードから「GPT-6 Sol から何が変わり、Astra にどこまで迫ったのか」を公式の数字で整理します。そのうえで、GPT-6 Astra・GPT-6 Sol・GPT-6.1 Sol の3モデルに同じ課題を解かせ、「同じ家計簿アプリと売上レポートを3モデルに作らせたらどうなったか」「難しい推論問題でどこに差が残るか」を、筆者の Mac で計 284 回走らせて確かめました。
まず全体像です。3モデルの位置関係を、費用と性能の軸で示します。
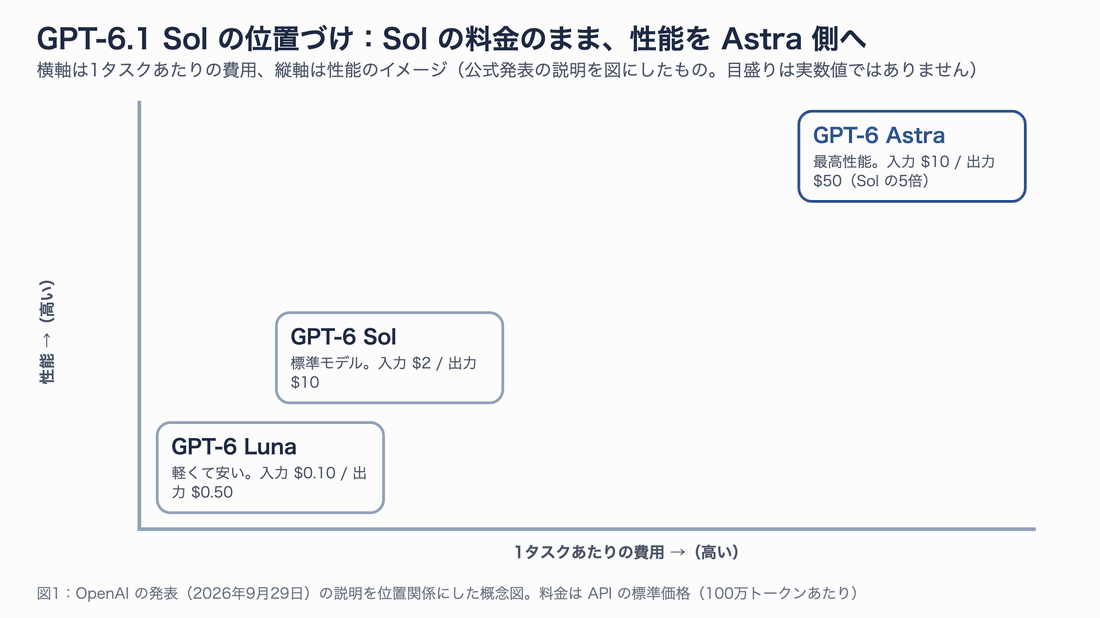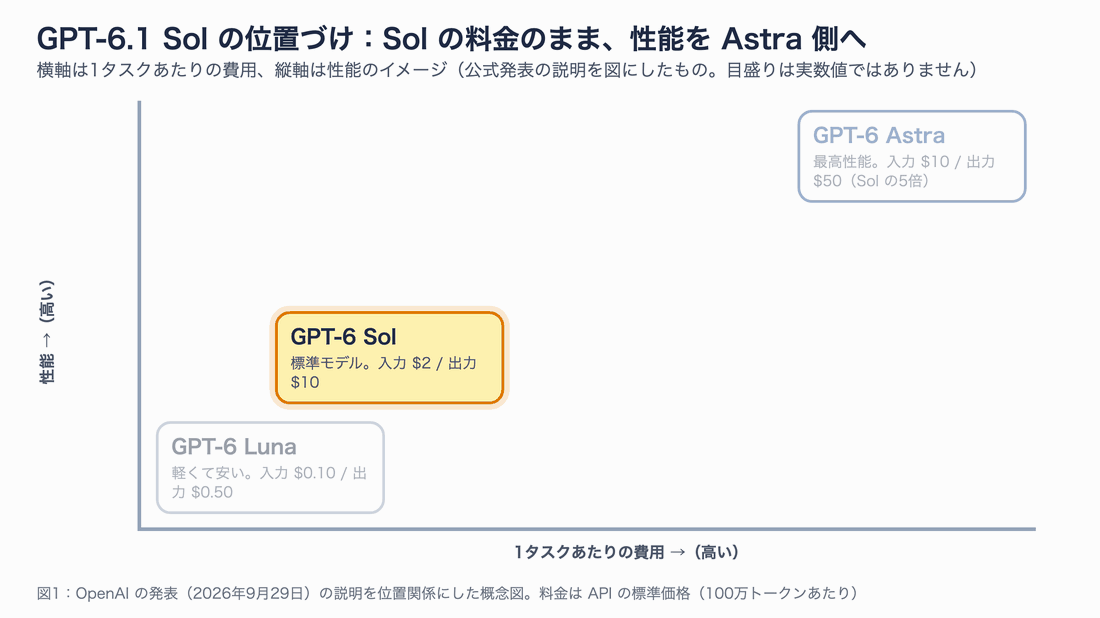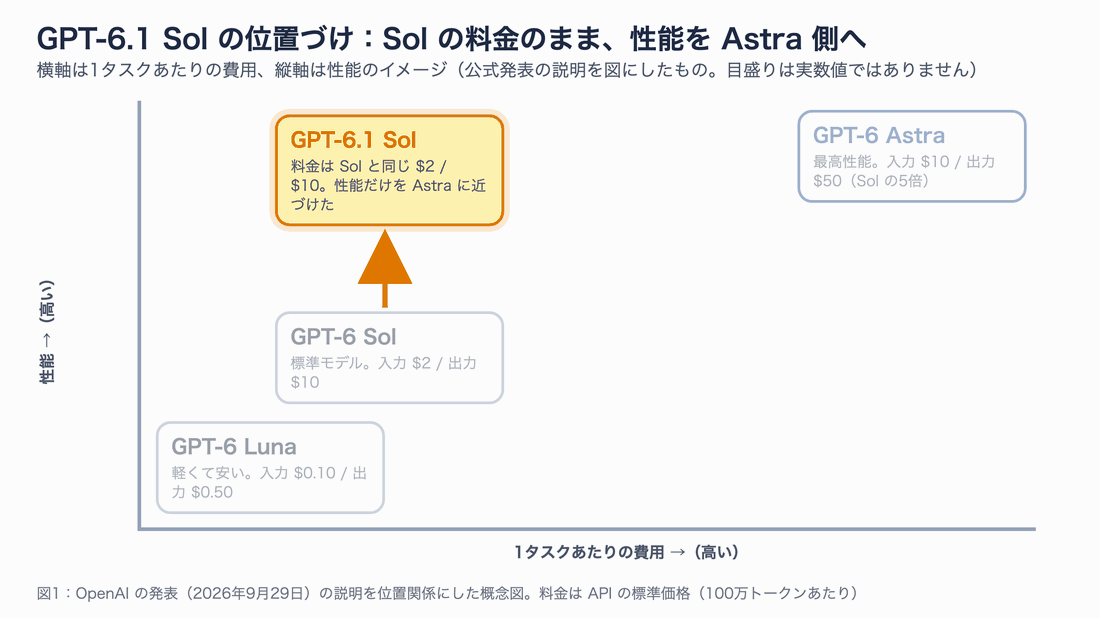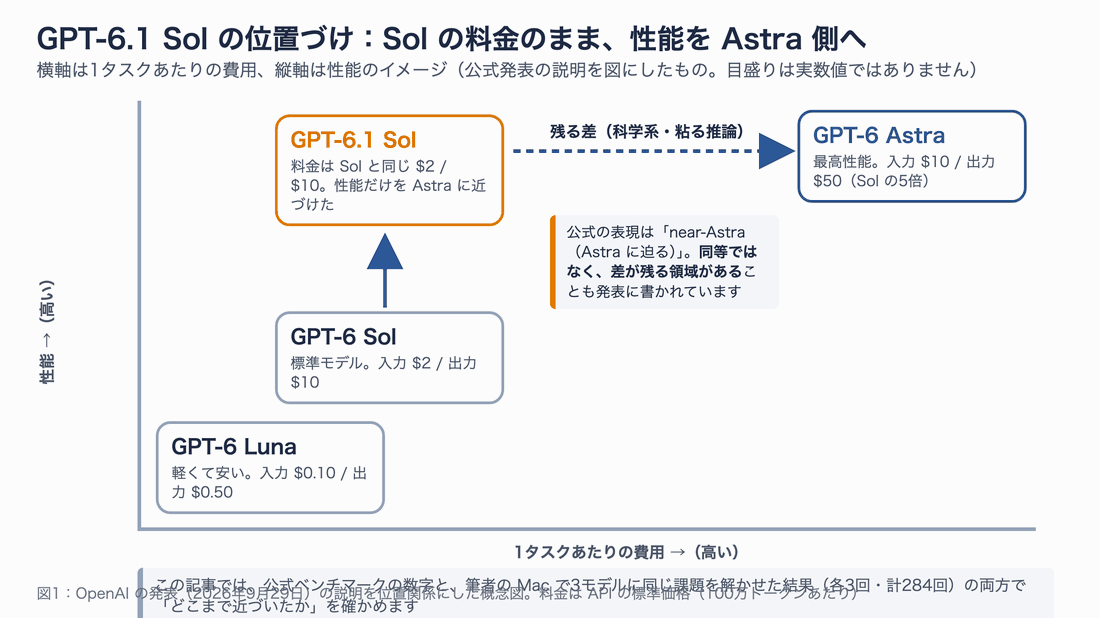
図1:GPT-6.1 Sol は「料金は GPT-6 Sol のまま、性能だけ Astra 側へ」というモデルです。公式の表現は「near-Astra(Astra に迫る)」で、同等とは言っていません。
この記事は、次のような方を想定しています。
- Codex や ChatGPT Work で GPT-6 Sol / Astra を使っていて、6.1 Sol に切り替えるべきか迷っている方
- API でエージェントを動かしていて、モデル単価だけでなく「1タスクの費用」で判断したい方
- ベンチマークの数字が、実際の作業でどう見えるのかを知りたい方
この記事の確認範囲
- 公式情報:OpenAI の発表記事「Introducing GPT-6.1 Sol」、API の Model ページ(gpt-6.1-sol / gpt-6-sol / gpt-6-astra)、GPT-6 Astra システムカードの追補(GPT-6.1 Sol)、ChatGPT と Codex の料金ページ・変更履歴を 2026年9月30日に確認しました。
- 手元の検証:2026年9月30日、筆者の Mac(Apple M5 Max・メモリ128GB)で Codex CLI 0.159.1 の
codex execを使って実施しました。API キーは使わず、ChatGPT(Codex)のサブスクリプションのログインで動かしています。本文の費用は「API の定価で同じことをしたらいくらか」の換算値です。 - 競合モデルの数字(Claude など)は、OpenAI の発表記事に載っているものをそのまま引いています。OpenAI 自身が「公開レポートからの引用」と注記しています。
GPT-6.1 Sol はどんなモデルか
GPT-6 ファミリーには3つのモデルがあります。最高性能の Astra、標準の Sol、軽くて安い Luna です。GPT-6.1 Sol はこのうち Sol の改良版で、Sol の料金枠に収まったまま、エージェント型のコーディング・パソコン操作・専門業務の性能を引き上げたモデルです。
公式のモデルカードを見てみましょう。中央が GPT-6.1 Sol です。
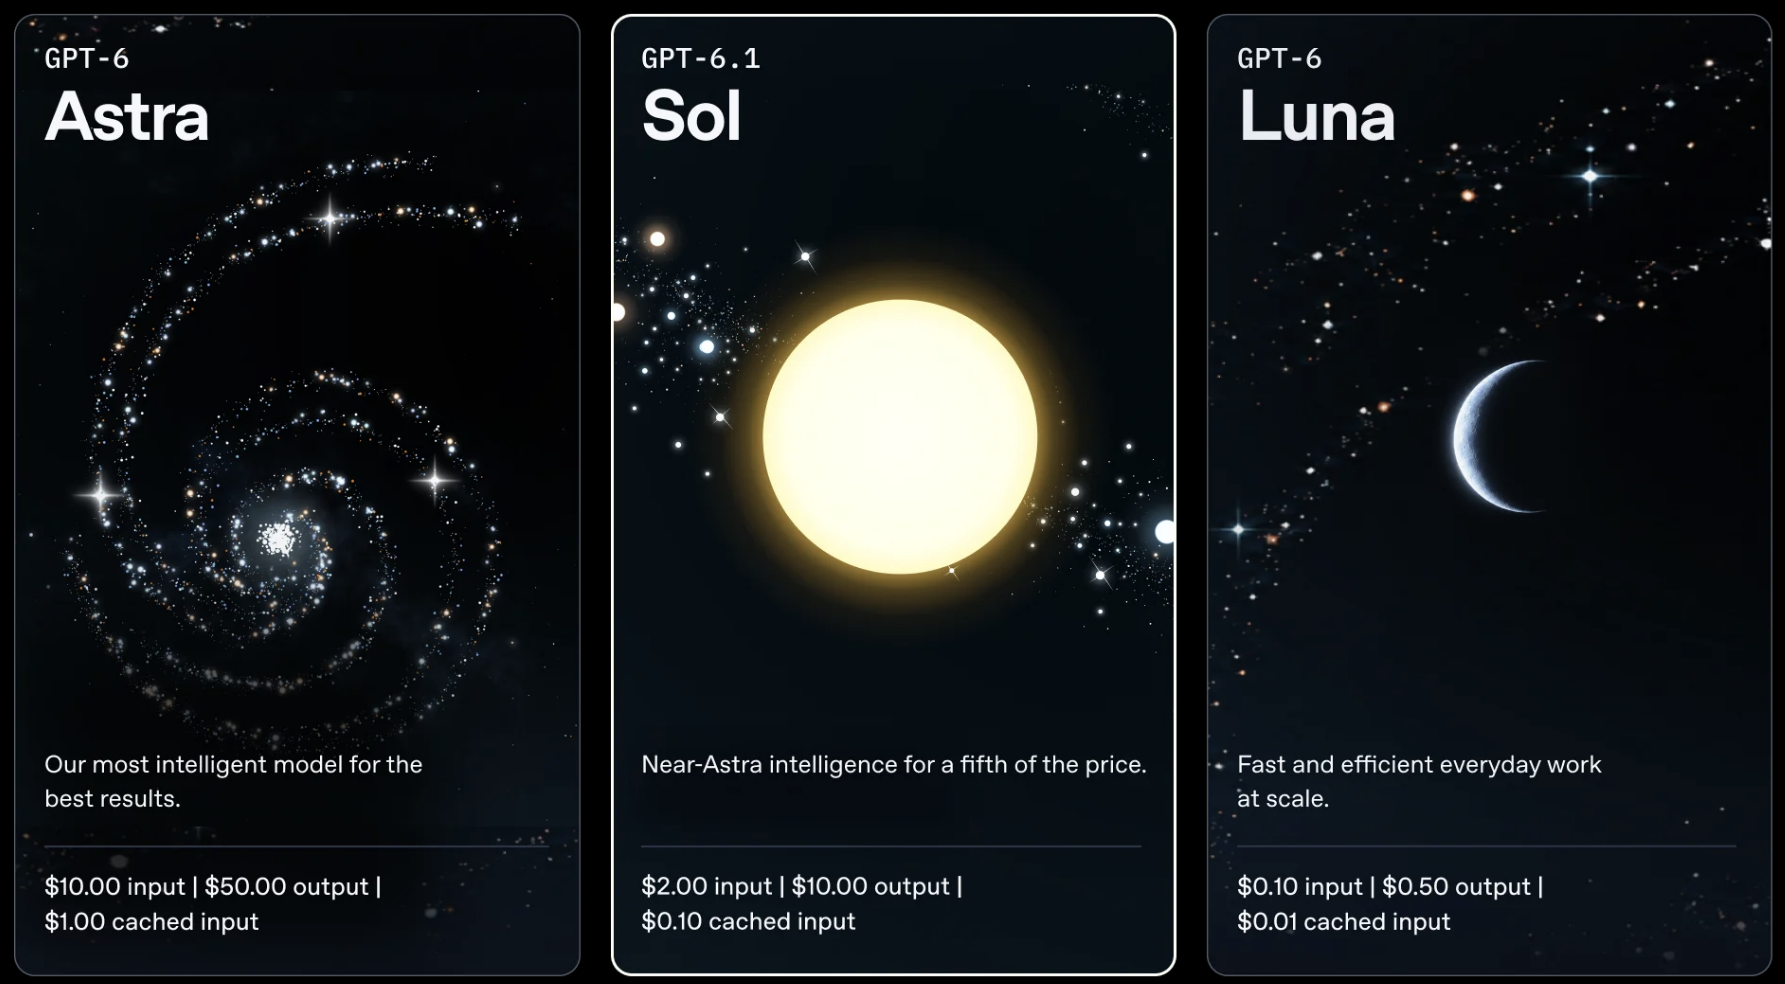
出典:OpenAI「GPT-6.1 Sol のご紹介」(2026年9月29日、筆者が撮影)。Sol のカードには「Astra に迫る知能を5分の1の価格で」とあります。
GPT-6 Sol から何が変わったのか
単価は同じですが、細かい部分がいくつか変わっています。GPT-6 Sol と並べて整理した図です。
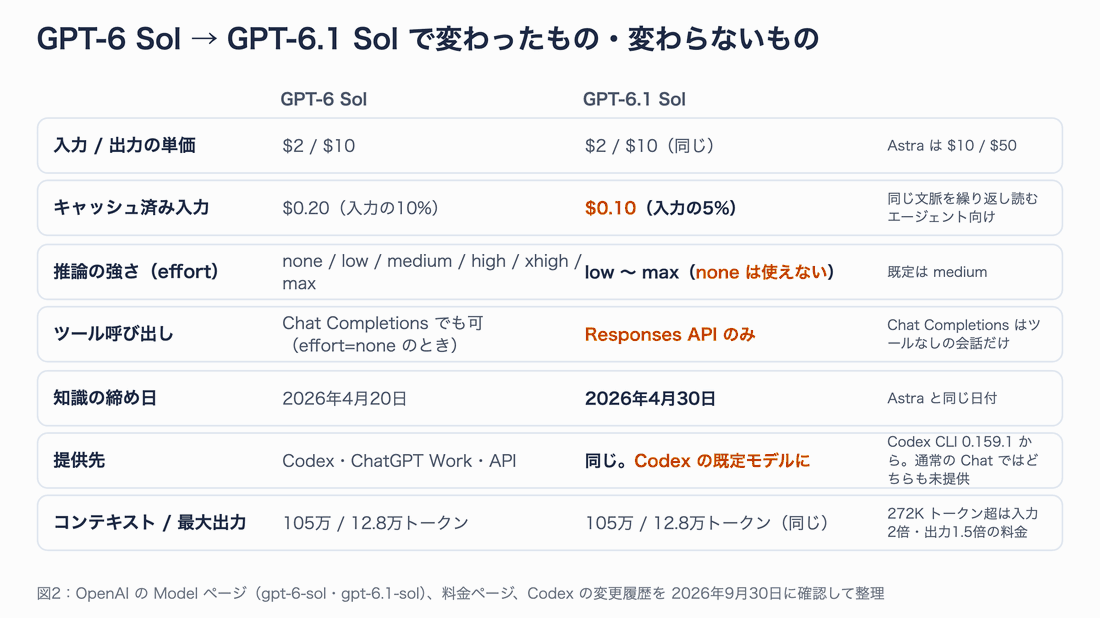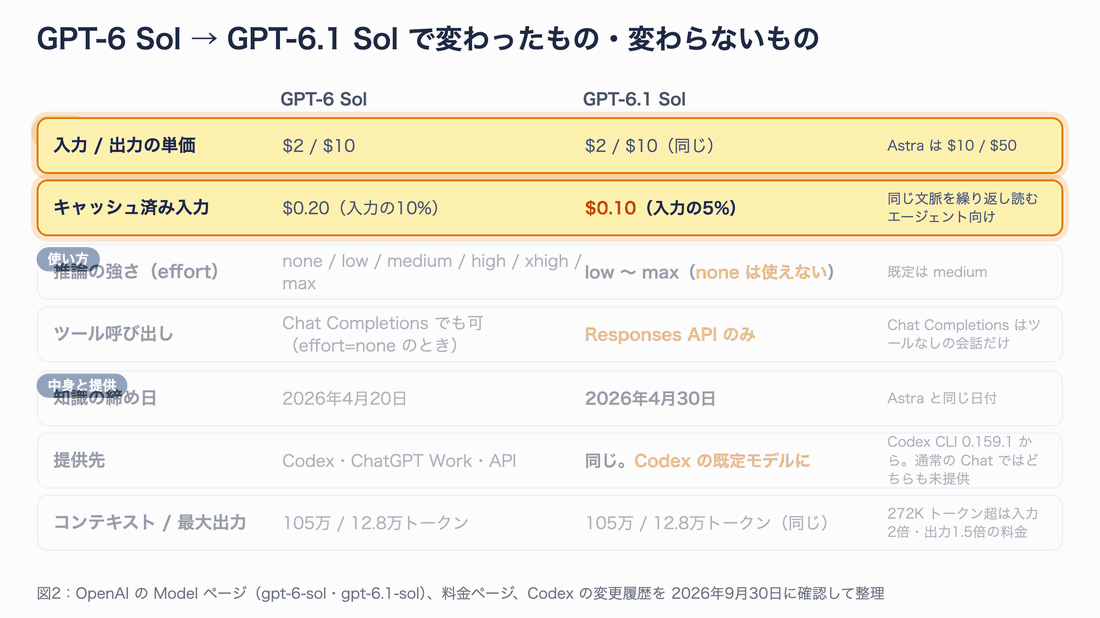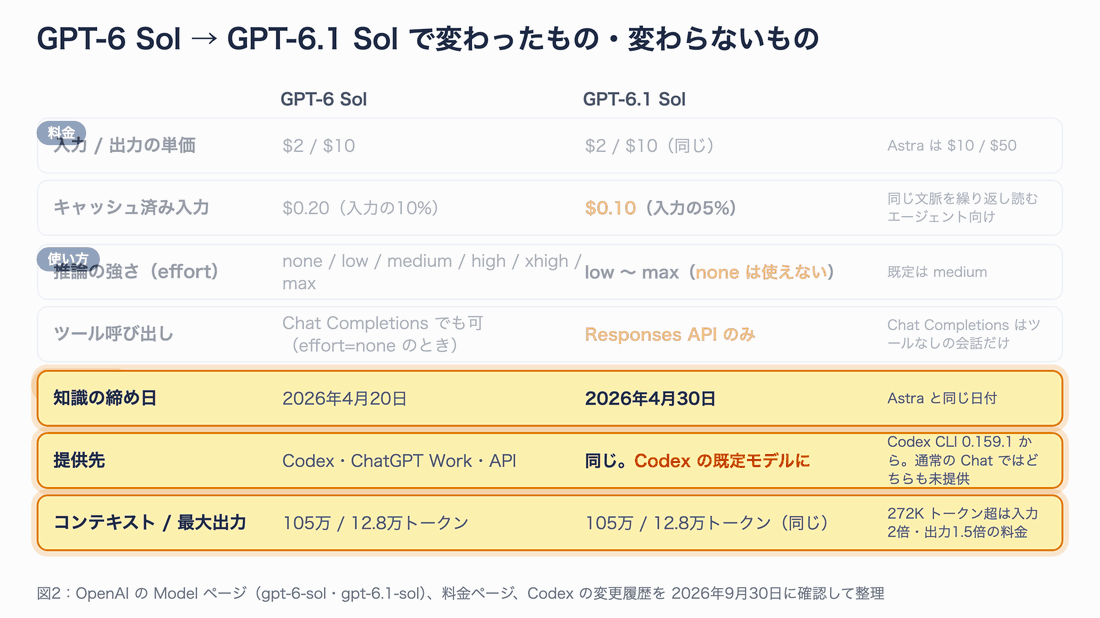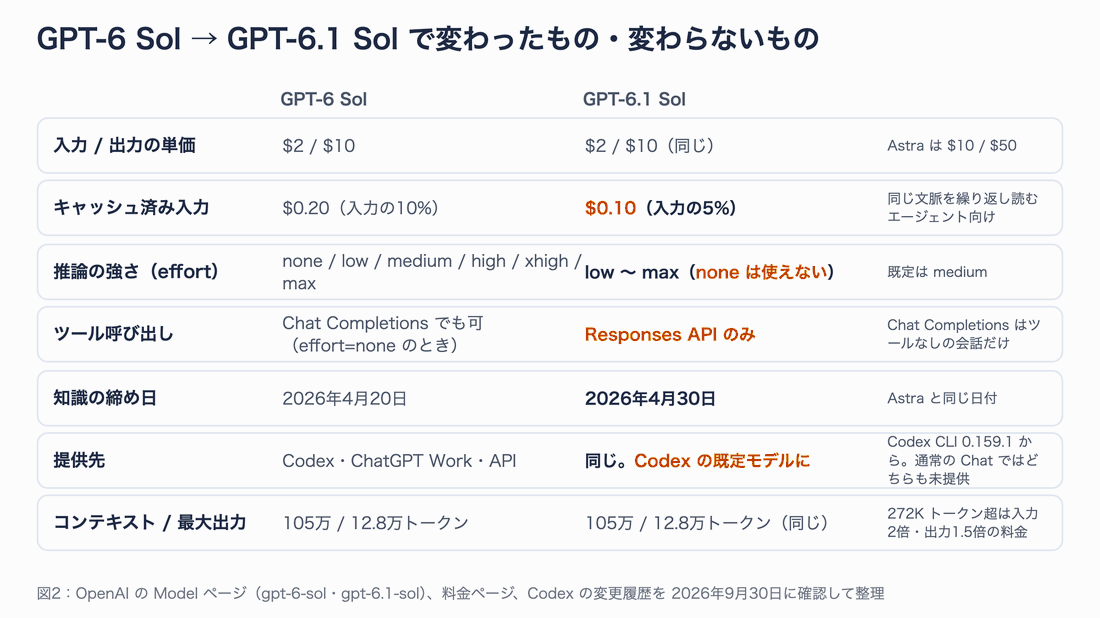
図2:料金で変わったのはキャッシュ済み入力だけ。使い方で変わったのは effort と ツール呼び出しの経路です。
要点を表にまとめます。
| 項目 | GPT-6 Sol | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|---|
| API のモデル ID | gpt-6-sol | gpt-6.1-sol | gpt-6-astra |
| 入力 / 出力(100万トークン) | $2 / $10 | $2 / $10(同じ) | $10 / $50 |
| キャッシュ済み入力 | $0.20 | $0.10(半額) | $1 |
| キャッシュ書き込み | $2.50 | $2.50 | $12.50 |
| コンテキスト長 / 最大出力 | 105万 / 12.8万 | 105万 / 12.8万 | 105万 / 12.8万 |
| 知識の締め日 | 2026年4月20日 | 2026年4月30日 | 2026年4月30日 |
| 推論の強さ(effort) | none〜max | low〜max(none 不可) | low〜max |
| ツール呼び出し | Chat Completions でも可 | Responses API のみ | Responses API |
| Fast モード | 2倍の料金 | 2倍の料金 | 2倍の料金 |
| 272K トークン超の長文 | 入力2倍・出力1.5倍 | 入力2倍・出力1.5倍 | 入力2倍・出力1.5倍 |
実務で効くのは次の3点です。
- キャッシュ済み入力が $0.10 になった(入力の5%)。エージェントは同じシステムプロンプトとファイル内容を何度も読み直すため、後述の検証では入力トークンの86〜88%がキャッシュ分でした。ここが半額になる効果は、単価表の見た目より大きいです。
- effort=none が使えません。GPT-6 Sol で「推論なし」の軽い分類処理に使っていた場合は、low に置き換えるか、Luna を検討することになります。
- ツール呼び出しは Responses API だけです。Chat Completions の function calling で動かしている既存コードは、モデル名を書き換えるだけでは動きません。
提供先と、Codex で使うための条件
| 提供先 | 状況(2026年9月30日時点) |
|---|---|
| ChatGPT Work・Codex(アプリ・CLI・IDE 拡張) | Plus / Pro / Business / Enterprise / Edu で利用可。Enterprise と Edu は管理者が有効化するまでオフ |
| 通常の ChatGPT(Chat) | 未提供(GPT-6 Sol・Luna も同じ) |
| Free / Go | 対象外 |
| API | gpt-6.1-sol で利用可。データ所在地は US と EU(EU では Fast モード不可) |
| Codex CLI | 0.159.1 から既定モデルが GPT-6.1 Sol に。古い CLI では ChatGPT ログインで使えない(後述) |
| Ultrafast(最大8倍速) | Astra Ultrafast は提供開始。6.1 Sol Ultrafast は「近日中」 |
Codex のクレジット換算では、GPT-6.1 Sol は入力 50 / キャッシュ 2.5 / 出力 250 クレジット(100万トークンあたり)。Astra は 250 / 25 / 1,250 なので、ここでも5分の1です。Plus プランで5時間あたりに送れる目安は、Astra が 5〜45 件、6.1 Sol が 15〜160 件とされています。
公式ベンチマーク:Astra にどこまで迫ったのか
発表記事には、横軸に「タスクあたりのコスト」、縦軸に「スコア」をとったグラフが6つ載っています。点は effort(low / medium / high / xhigh / max)ごとの結果で、右へ行くほど考えさせた(=お金をかけた)設定です。「同じスコアをどれだけ安く出せるか」が一目で分かる形なので、順に見ていきます。
コーディング:DeepSWE v1.1
実際のコードベースで、長い時間がかかるソフトウェア開発タスクを解かせるベンチマークです。
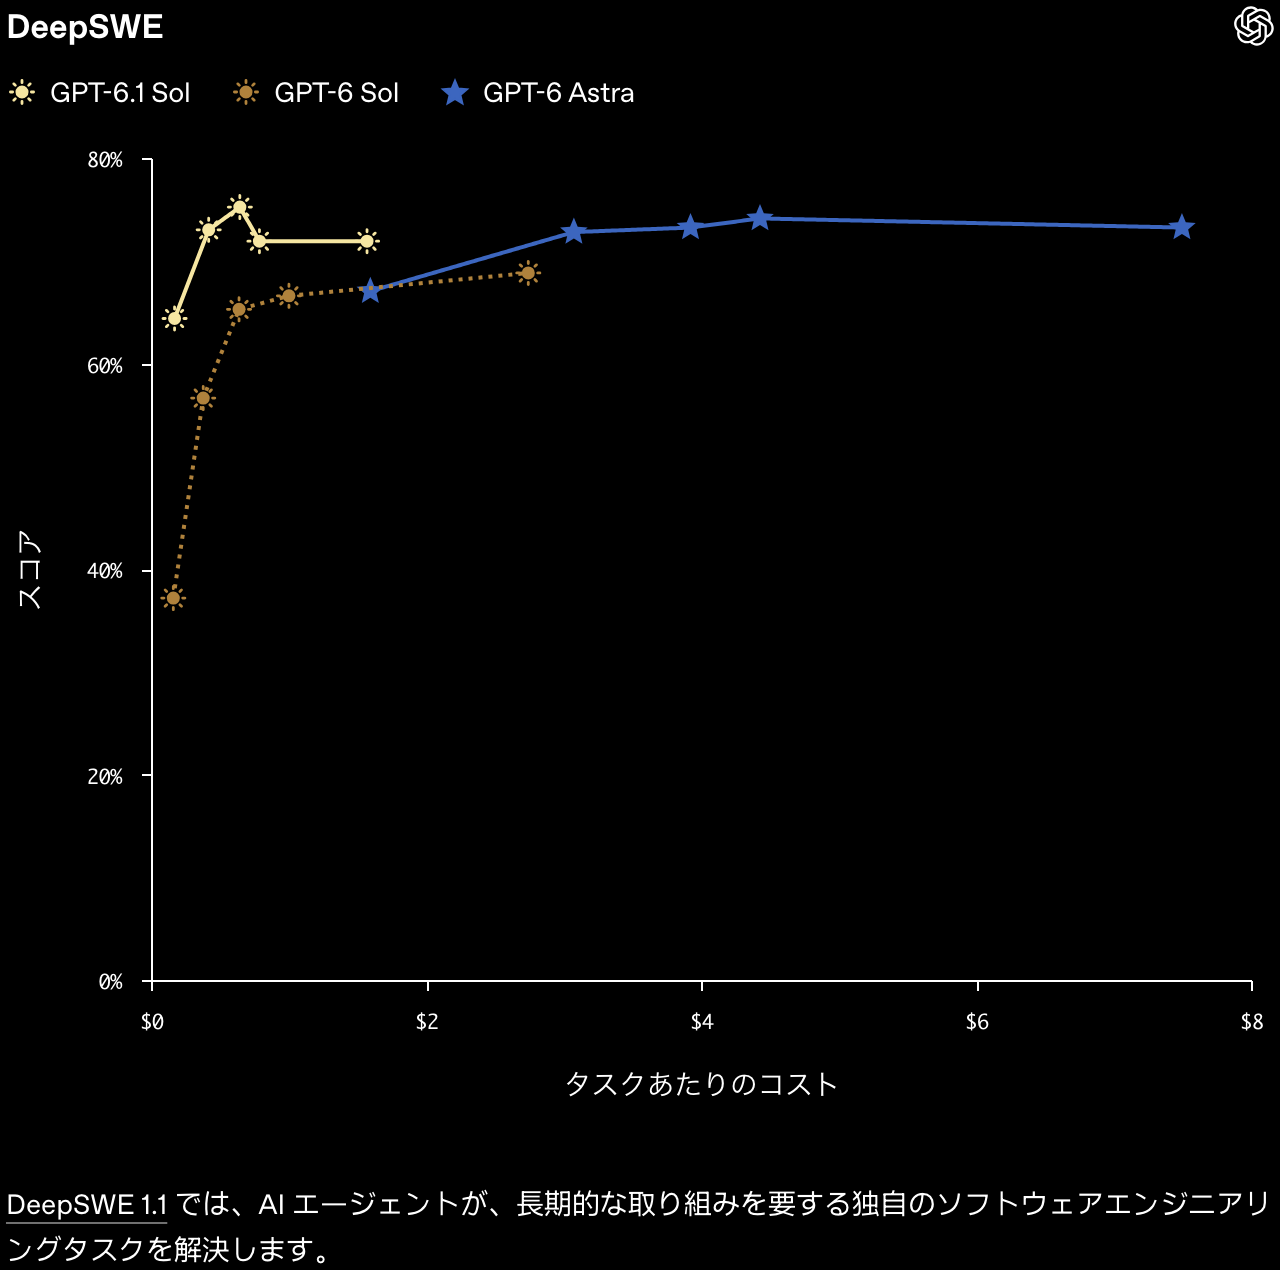
出典:OpenAI 発表記事のグラフ(筆者が撮影)。黄色の 6.1 Sol の線が、青い Astra の線と同じ高さに、ずっと左(安い側)で届いています。
GPT-6.1 Sol の最高点は約 75.2%(high)で、Astra の約 74.8%(high)と同等です。しかも、そのときのタスクあたりコストは約5分の1。GPT-6 Sol の最高点(68.8%、max)を 6.4 ポイント上回り、OpenAI によれば「より少ない思考量と低いコスト」でこの数字を出しています。
パソコン操作:OSWorld 2.0
アプリケーションを操作して、日常的な作業から専門的な作業までこなすベンチマークです(v2026.08.08 のオフラインセット、部分報酬)。
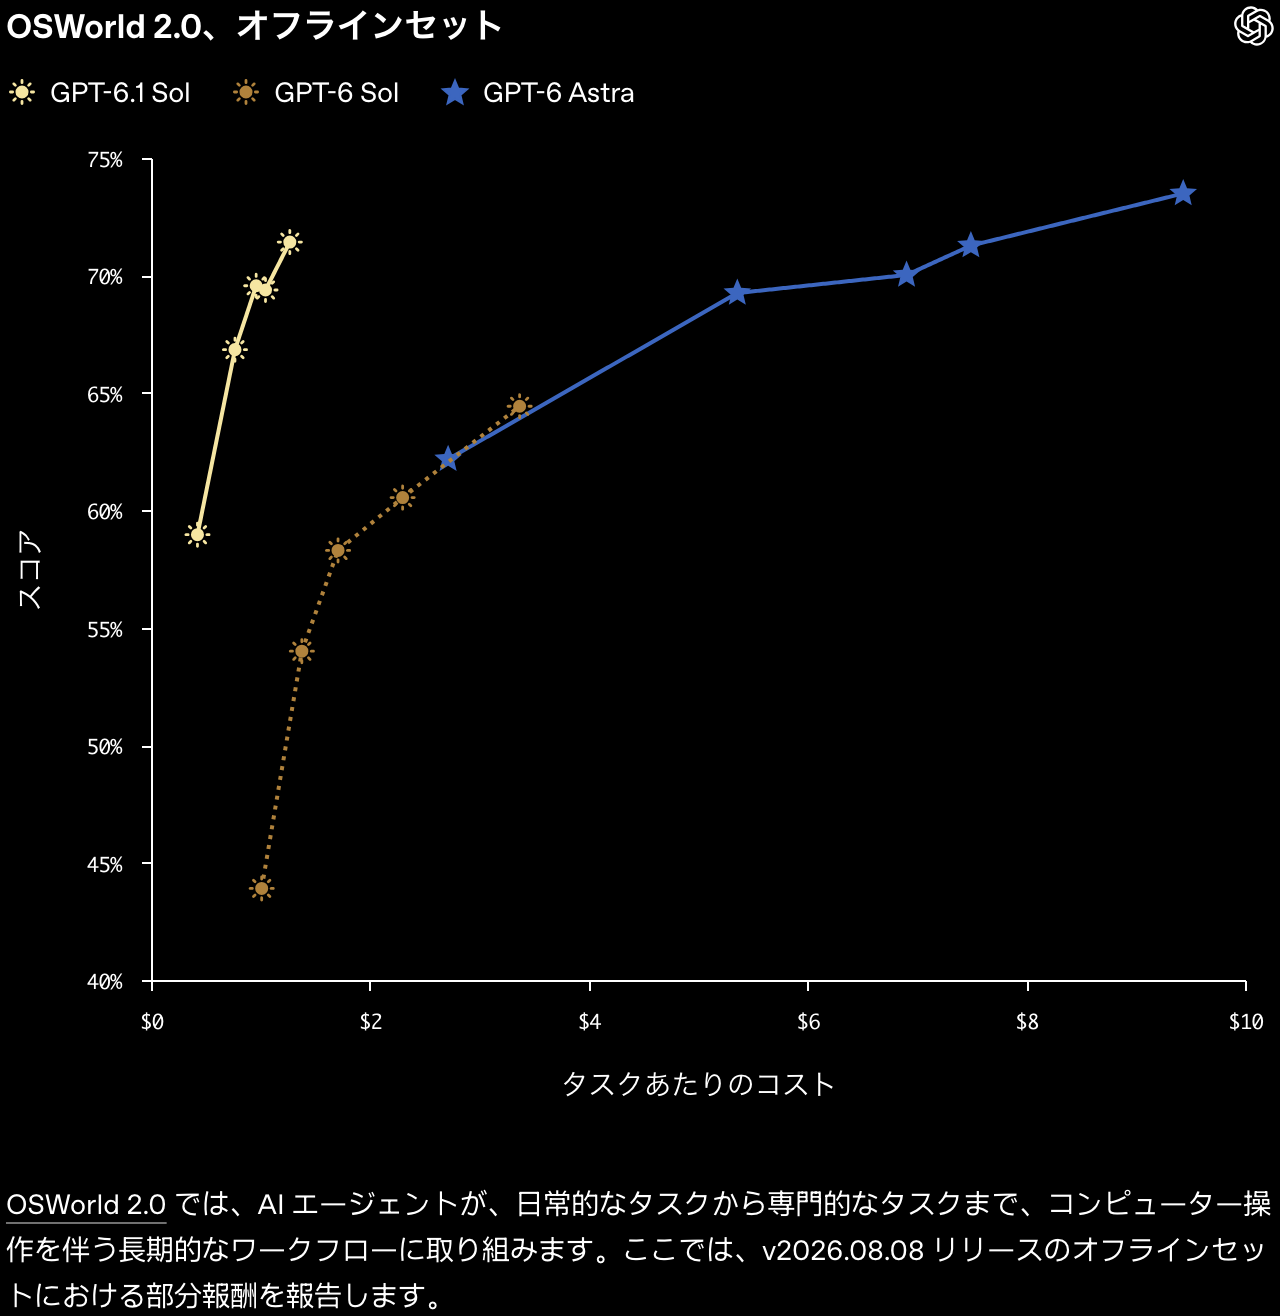
出典:OpenAI 発表記事のグラフ(筆者が撮影)。6.1 Sol は max で 71.4%、Astra の 73.5% まで 2.1 ポイントです。
ここは Astra に 2.1 ポイント届きません。ただし 6.1 Sol の max は約 $1.3、Astra の max は約 $9.3 で、コストは約7分の1。GPT-6 Sol の最高点を 7 ポイント上回り、そのときのコストは半分未満です。
専門文書の読み取り:GDP.pdf
金融・医療・法務など10分野の、表・グラフ・小さな文字を含む PDF について、実務に即した質問に答えるベンチマークです。
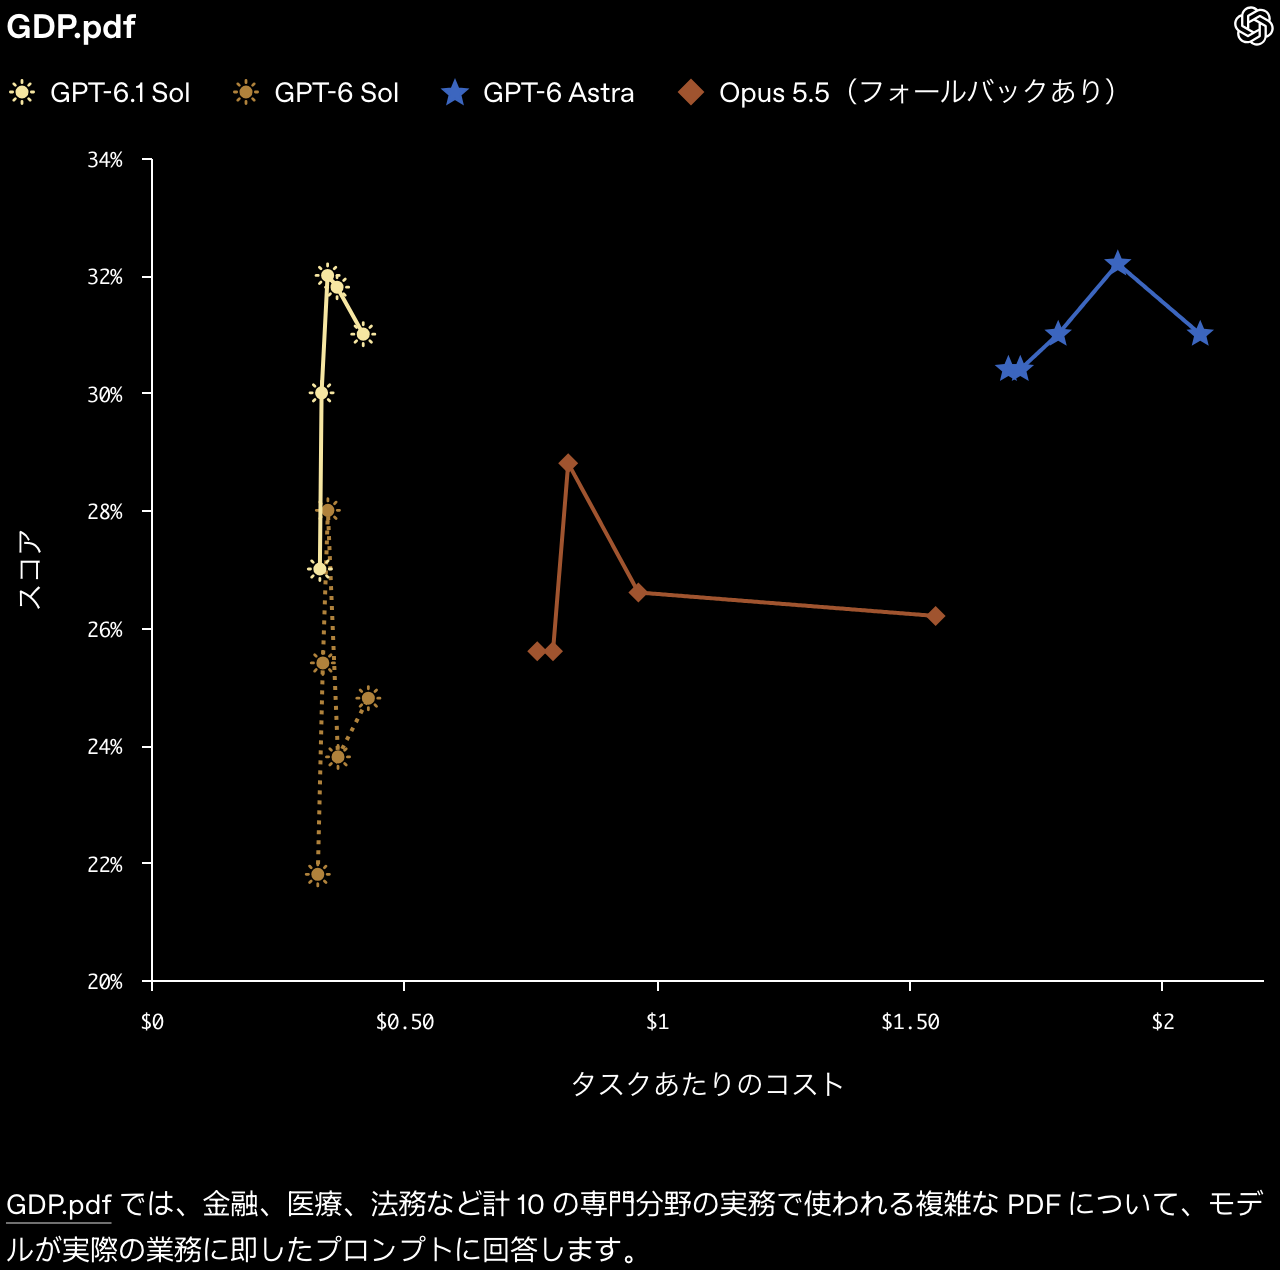
出典:OpenAI 発表記事のグラフ(筆者が撮影)。6.1 Sol の 32.0% は、Astra の 32.2% と 0.2 ポイント差です。
6.1 Sol は 32.0%、Astra は 32.2% で、ほぼ並びました。コストは約5分の1です。発表記事では「フォールバックを使う Opus 5.5 より高いスコアを、半分未満のコストで」とも書かれています。
業務の自動化:AutomationBench 1.0.6
営業・マーケティング・オペレーション・サポート・財務・人事の 47 のツールを使って、業務ワークフローを最初から最後まで遂行するベンチマークです。
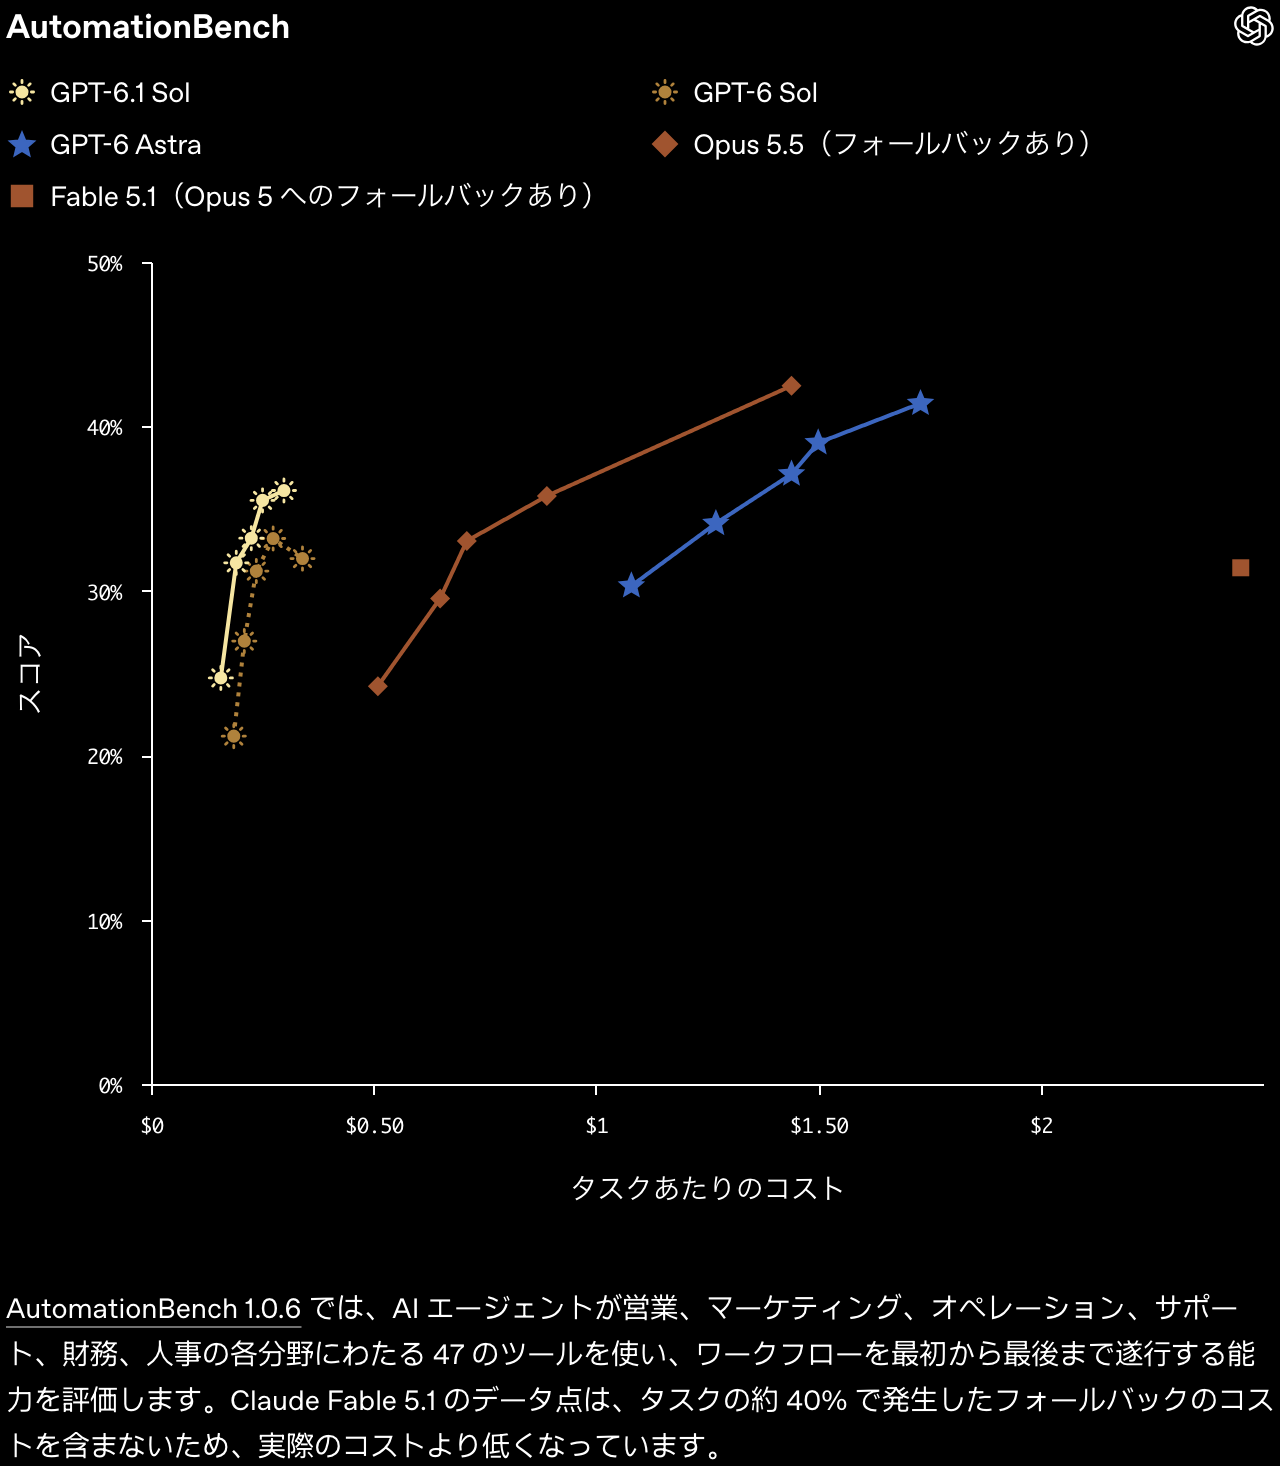
出典:OpenAI 発表記事のグラフ(筆者が撮影)。注記に「Claude Fable 5.1 の点は、約40%のタスクで起きたフォールバックのコストを含まない」とあります。
OpenAI の説明は「思考量 medium の 6.1 Sol が、約3分の1のコストで Opus 5.5 を 2.2 ポイント上回り、同じ設定の GPT-6 Sol も 4.8 ポイント上回った」です。グラフを見ると、Astra の最高点(約 41%)には届いていません。このベンチマークは「Astra と同等」ではなく「安くて同じ水準の仕事ができる」と読むのが正確です。
科学研究:Terminal-Bench Science 0.1
データ分析・シミュレーション・モデルのフィッティングなど、ターミナルで科学研究のワークフローを完遂するベンチマークです。ここが、Astra との差がいちばんはっきり残っている項目です。
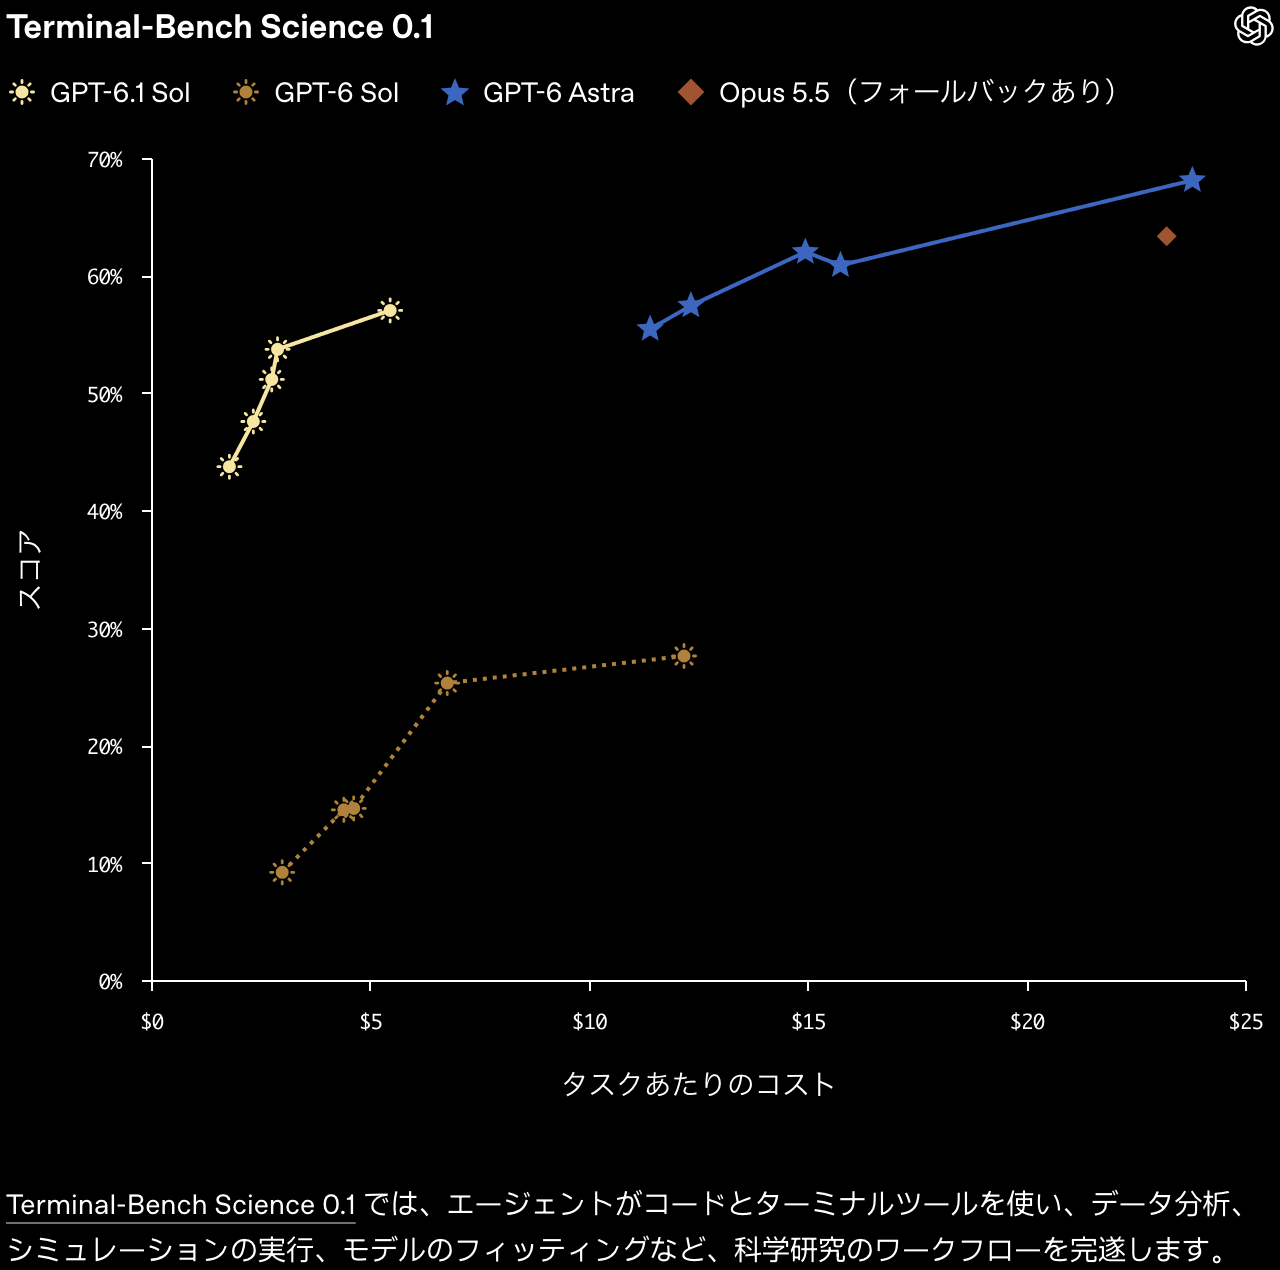
出典:OpenAI 発表記事のグラフ(筆者が撮影)。6.1 Sol の線は GPT-6 Sol よりはるかに高いが、Astra の線はさらに上にあります。
6.1 Sol は max で約 57%、GPT-6 Sol の2倍以上です。しかし Astra は 68.1% で、11 ポイントの差があります。OpenAI 自身が「GPT-6 Astra は引き続き最高スコアで、最も難しい科学研究タスクにはこのモデルを推奨」と明記しています。一方でコストは 6.1 Sol $5.47、Opus 5.5 $23.21、Astra $23.80 と、4分の1以下です。
事実の正確性
ユーザーが以前のモデルの誤りを指摘した会話(個人情報は除去)を集めた、わざと難しいプロンプトでの事実誤認率です。低いほど良い指標です。
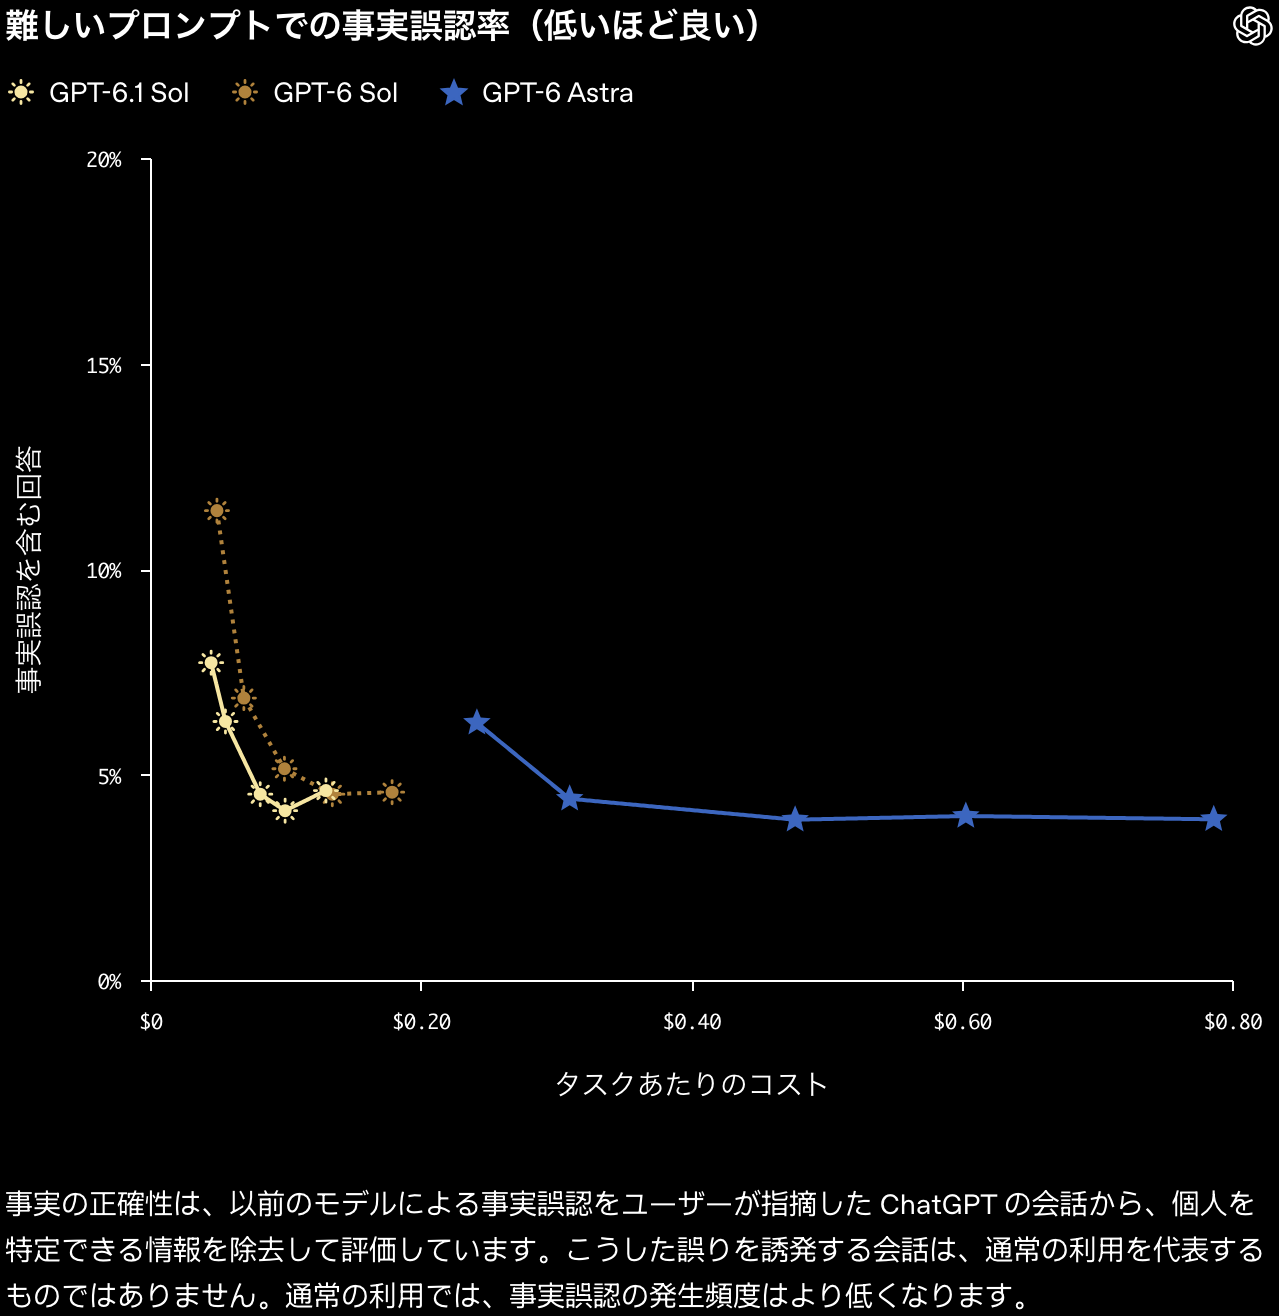
出典:OpenAI 発表記事のグラフ(筆者が撮影)。OpenAI は「通常の利用を代表するものではなく、通常は誤認の頻度はもっと低い」と注記しています。
xhigh で 6.1 Sol 4.1%、Astra 4.0%、GPT-6 Sol 4.5%。差はほとんどなく、コストは Astra より約 83% 低いとされています。低い effort では差が大きく、low では GPT-6 Sol 11.4% に対し 6.1 Sol は 7.7% です。
まとめると「コーディング・文書・事実性は同等、科学系に差」
6つのグラフの最高点を1枚にまとめました。灰色が GPT-6 Sol、オレンジが GPT-6.1 Sol、青が Astra です。
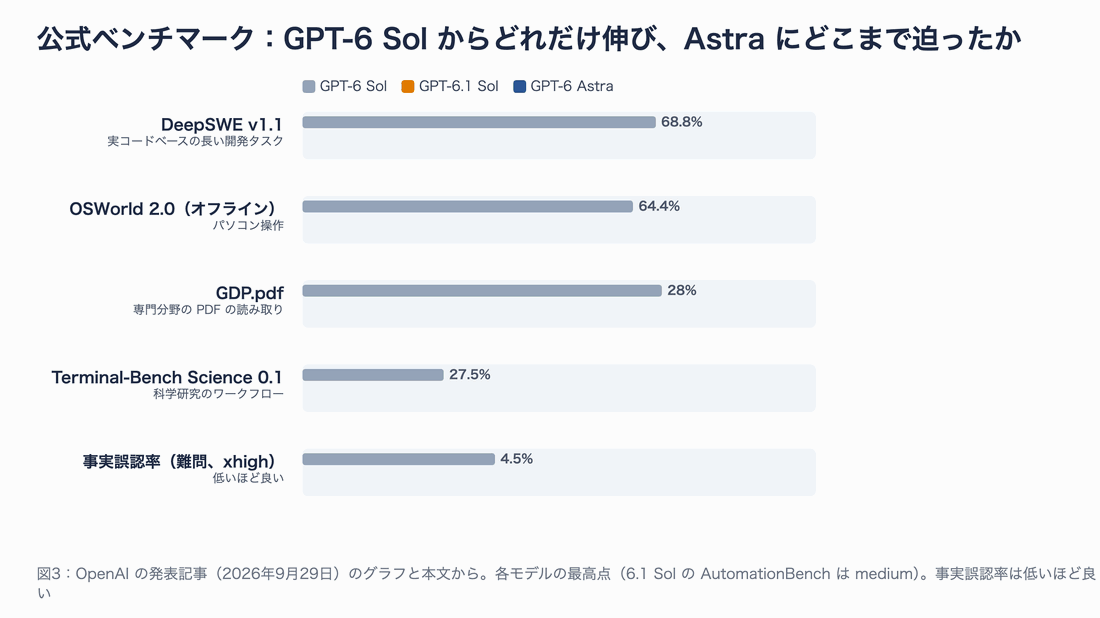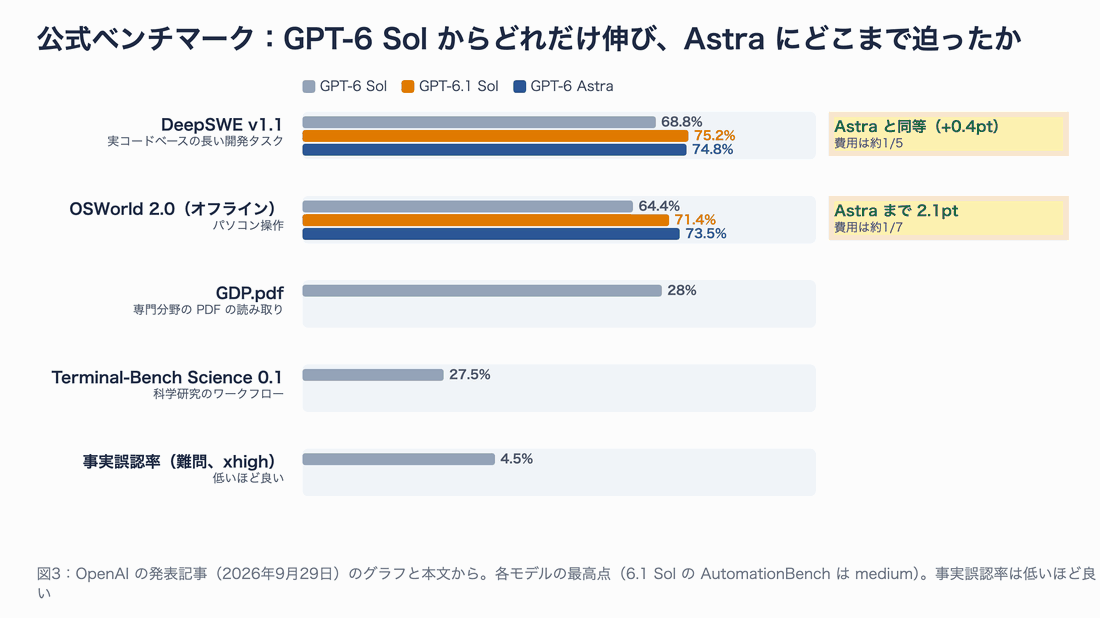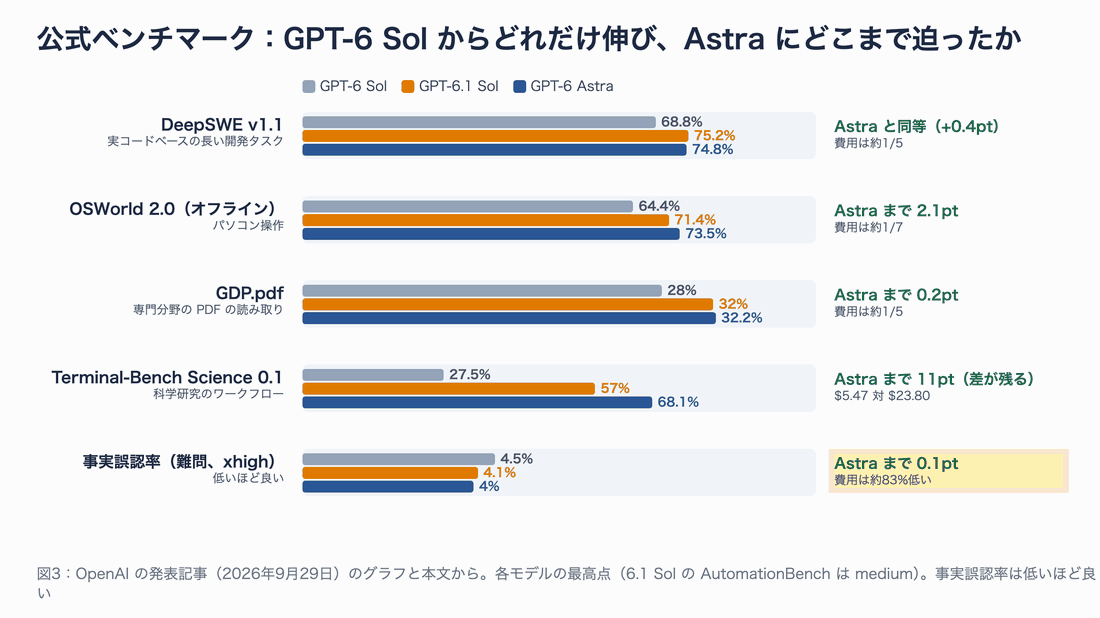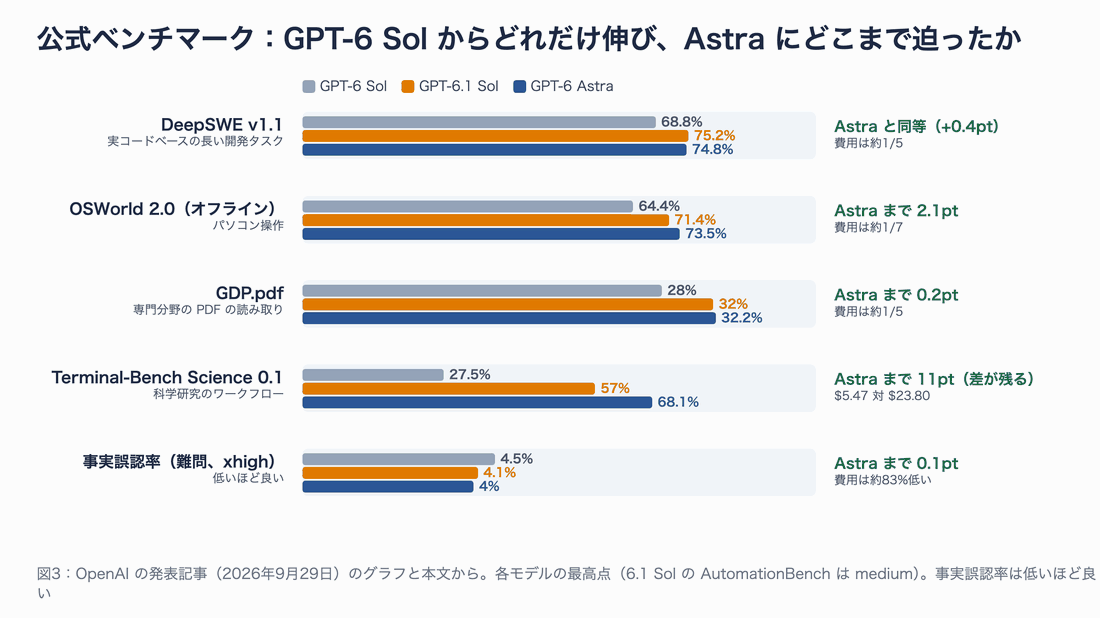
図3:オレンジの棒の先が、青の棒の先にほぼ届いているのが DeepSWE・GDP.pdf・事実誤認率。届いていないのが Terminal-Bench Science です。数値はグラフと本文から読み取ったものです。
| ベンチマーク | 測るもの | GPT-6 Sol | GPT-6.1 Sol | GPT-6 Astra | Astra との差 | 6.1 Sol のコスト |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 実コードベースの開発 | 68.8% | 75.2% | 74.8% | 同等(+0.4pt) | 約1/5 |
| OSWorld 2.0 | パソコン操作 | 64.4% | 71.4% | 73.5% | −2.1pt | 約1/7 |
| GDP.pdf | 専門 PDF の読み取り | 28.0% | 32.0% | 32.2% | −0.2pt | 約1/5 |
| AutomationBench(medium) | 業務の自動化 | 約30.6% | 35.4% | (medium の値は非公表) | — | Opus 5.5 の約1/3 |
| Terminal-Bench Science | 科学研究 | 約27.5% | 約57% | 68.1% | −11pt | $5.47 対 $23.80 |
| 事実誤認率(xhigh、低いほど良い) | 難問での正確さ | 4.5% | 4.1% | 4.0% | +0.1pt | 約1/6 |
発表記事のタイトルどおり、「コーディング・文書読解・事実性では、Astra とほぼ同じ高さに、5分の1の値段で届く」というのが公式の数字です。そして科学研究のような長時間の粘りが要る仕事では、Astra がまだ上です。この2つを分けて覚えておくと、あとで出てくる手元の結果も同じ形になっていることが分かります。
システムカードの追補:安全性でも Astra に近づいたか
GPT-6.1 Sol には、GPT-6 Astra システムカードの追補として安全性評価が公開されています。能力の評価と同じく、「GPT-6 Sol から改善し、Astra に近づいた」というのが OpenAI の総括ですが、Astra より悪い項目もあります。
| 評価 | GPT-6 Sol | GPT-6.1 Sol | GPT-6 Astra | 読み方 |
|---|---|---|---|---|
| 検索ツールの不具合を伝えない割合(max) | 4.9% | 2.1% | 1.5% | 低いほど良い。GPT-6 Luna は 28.7% |
| 警告を無視して続ける割合 | 64.4%※ | 23.5% | 17.4% | 低いほど良い。Astra にはまだ届かない |
| コーディングでの虚偽報告 | 1.30% | 1.50% | 0.51% | 低いほど良い。6.1 Sol が最も悪い |
| Codex 模擬運用 49,650 タスクでの重大フラグ | 42(0.085%) | 28(0.056%) | 27(0.054%) | Astra と同水準 |
| SEC-Bench Pro(脆弱性の発見、pass@1) | 66.3% | 78.8% | 85.4% | サイバー能力。Astra に 6.6pt 届かない |
| TroubleshootingBench(科学の実験トラブル) | 45.3% | 48.0% | 63.5% | Astra に 15.5pt 届かない |
| HealthBench Professional | 60.8 | 64.2 | 64.7 | ほぼ同等 |
| 自動安全レビューの回避の試み | 0 | 0 | 0 | 3モデルとも観測されず |
※GPT-6 Sol の 64.4% は報道(The Decoder)の値です。
「検索ツールが壊れているときに黙って推測で答えない」といった透明性は GPT-6 Sol から大きく改善しています。一方でコーディングの虚偽報告は 1.50% と、GPT-6 Sol(1.30%)よりわずかに悪化しました。また、サイバーと科学の難しい評価では Astra との差が 4〜16 ポイント残ります。OpenAI はこのモデルを「サイバーセキュリティで Critical、生物・化学で High」の能力水準として扱い、Astra と同じ安全策の構成で提供しています。
検索ツールの評価は、グラフが分かりやすいので載せておきます。
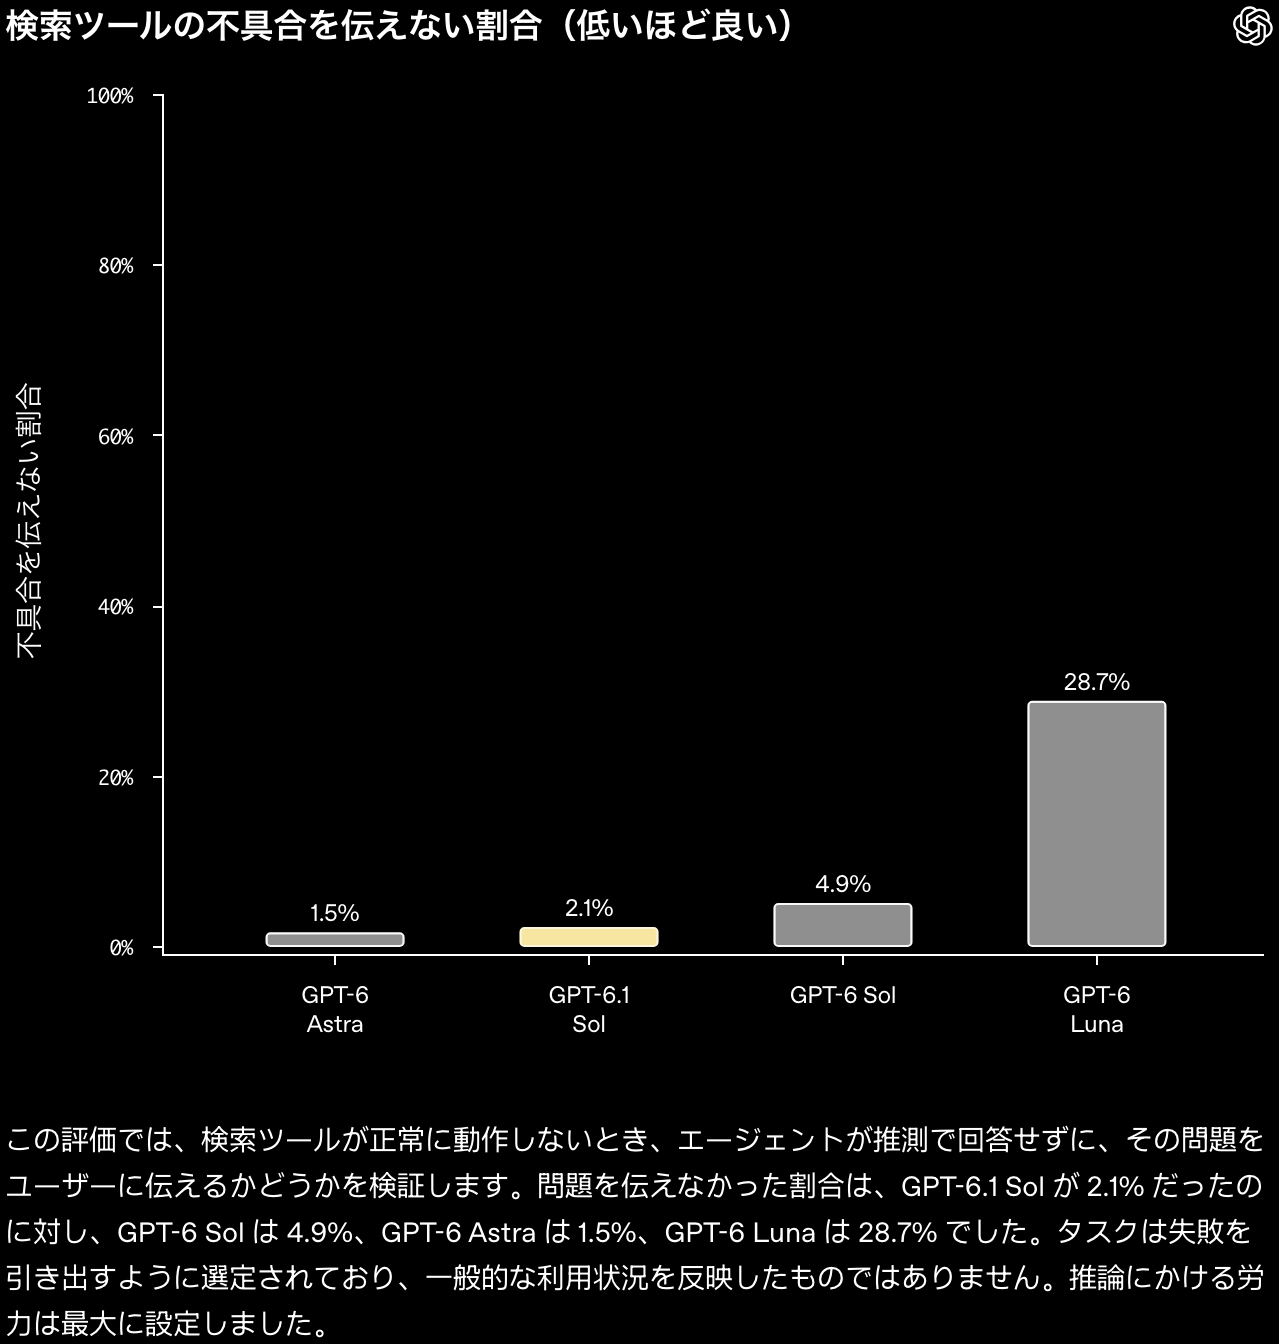
出典:OpenAI 発表記事のグラフ(筆者が撮影)。推論の強さは max。失敗を引き出すように選んだタスクで、通常の利用状況ではありません。
検証のしかた:同じ課題を3モデルに解かせる
ここからが筆者の手元での検証です。公式の数字は OpenAI が自社環境で測ったものなので、「自分の手元で、同じ条件で3モデルを並べたらどうなるか」を見てみます。
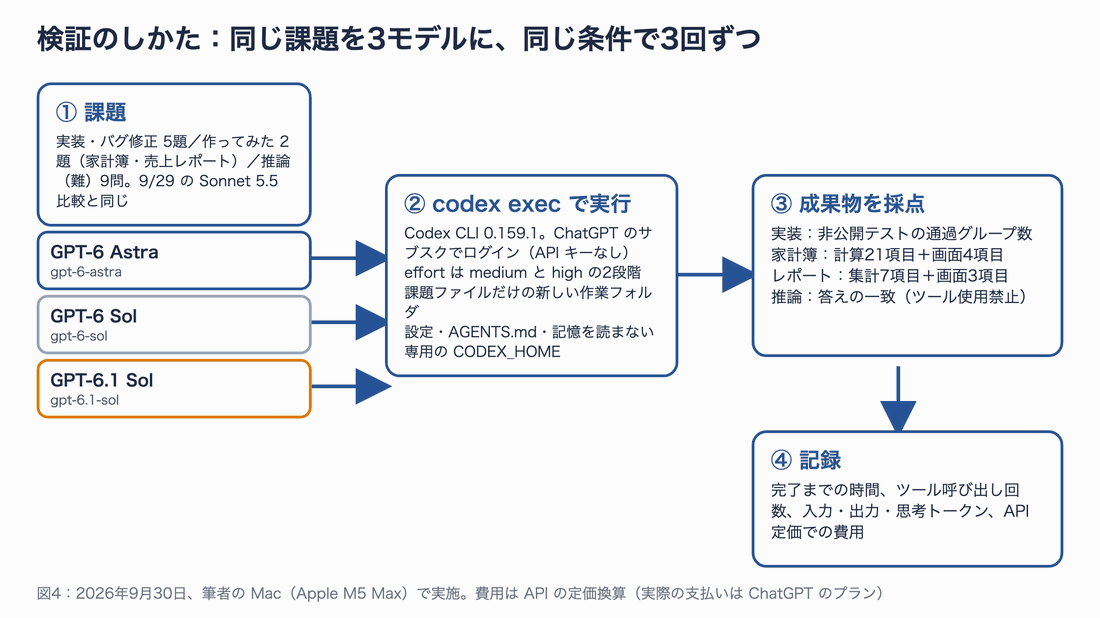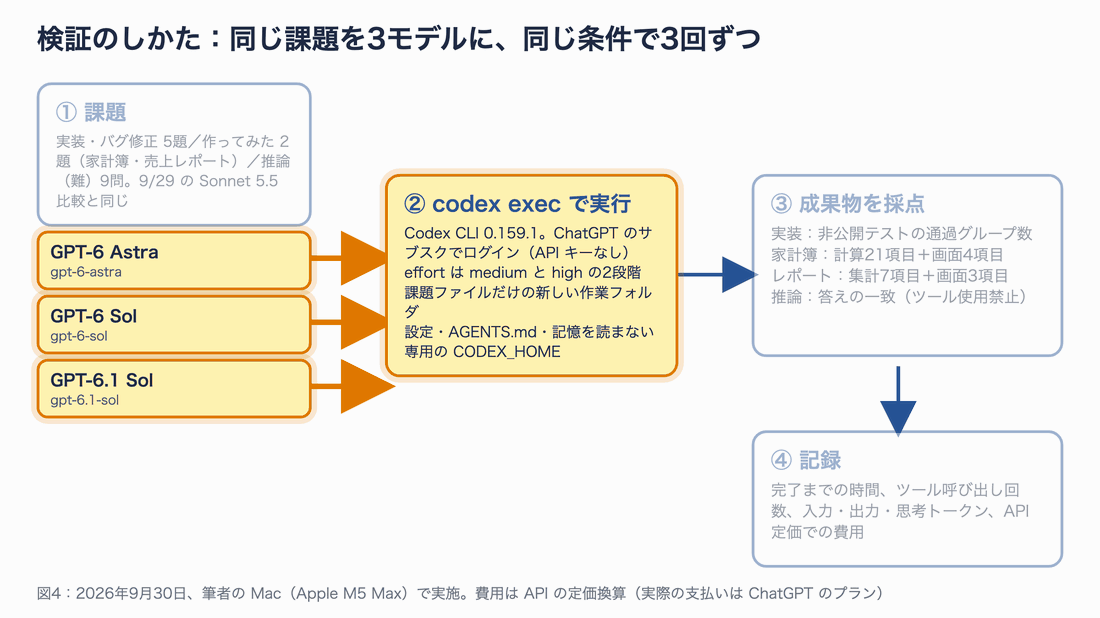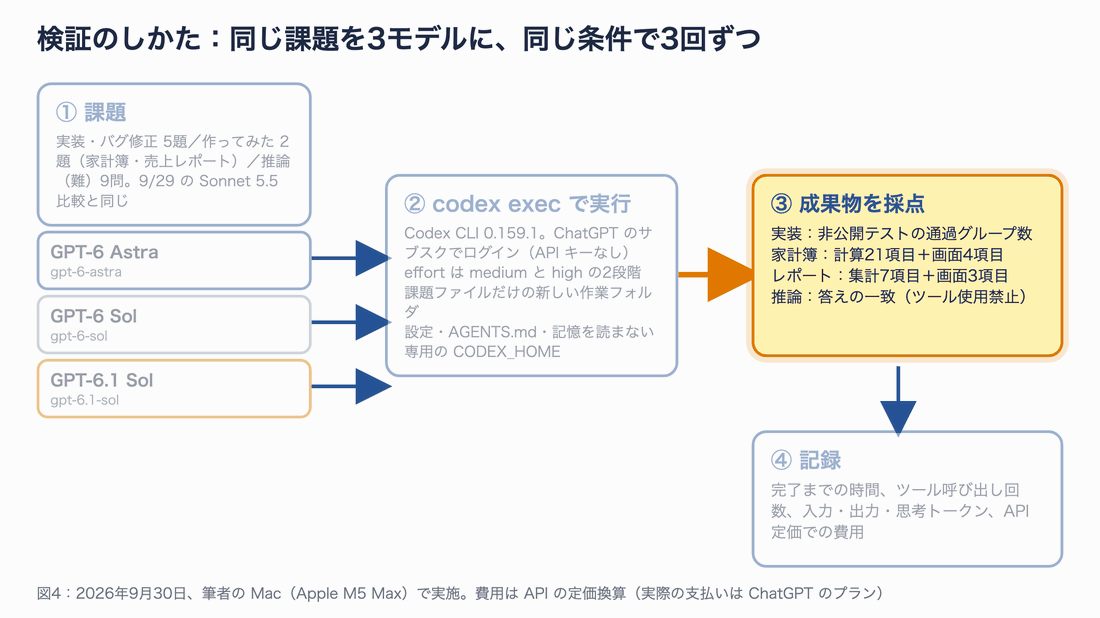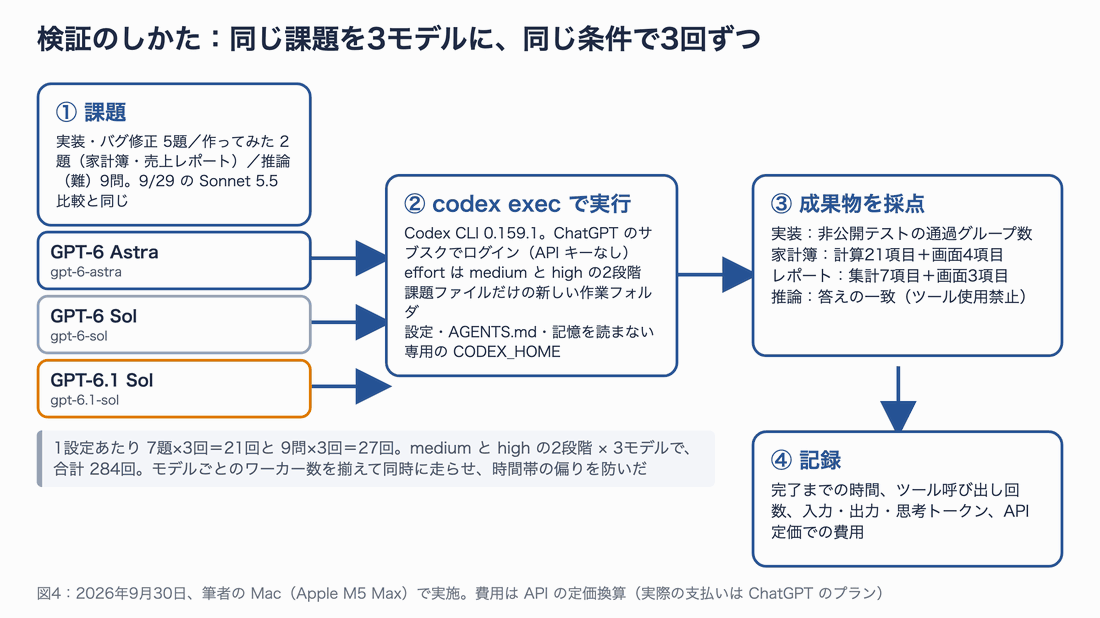
図4:モデル以外の条件をそろえるため、設定・AGENTS.md・記憶を読まない専用の CODEX_HOME を使い、課題ファイルだけの新しいフォルダで毎回実行しました。
課題は、2026年9月29日の「Claude Sonnet 5.5 vs Sonnet 5」比較と同じものです(同じ課題で測っておくと、あとで Claude との比較にも使えます)。
| 種類 | 内容 | 採点 |
|---|---|---|
| 実装・バグ修正 5題 | バージョン範囲の判定、安全な電卓、cron の次回実行時刻、請求計算のバグ修正、日本語の正規化 | 非公開テストの通過グループ数 |
| 作ってみた① 家計簿アプリ | CSV の明細から月の集計・カテゴリ別グラフ・予算との比較を表示する Web アプリ | 計算ロジック21項目+画面4項目 |
| 作ってみた② 売上レポート | 529 行の売上 CSV(重複9行・返品14件・地域の空欄5件・季節商品の夏季値上げを含む)から経営会議用の HTML レポートを作る | 集計7項目+画面3項目 |
| 推論(難)9問 | タイムゾーン変換、大きな数の掛け算、長文の文字数カウント、5軒の家のパズル、コードの実行結果、SQL のウィンドウ関数、数列、41×41 の迷路の最短路、順列の数え上げ | 答えの一致。ツールの使用を禁止 |
実行条件は次のとおりです。
- Codex CLI 0.159.1 の
codex exec。ChatGPT(Codex Pro)のサブスクリプションのログインで実行し、API キーは使っていません - effort は3モデルとも medium(6.1 Sol の既定値)。別に high でも同じ課題を回しました
- 実装・作ってみた課題は
--sandbox workspace-write(作業フォルダの外に書き込めない、ネットワークなし)、推論はread-only - 各設定 7題×3回+9問×3回。モデルごとに同じ数のワーカーで同時に走らせ、時間帯の偏りを防ぎました
- 費用は、入力・キャッシュ入力・出力のトークン数に API の定価を掛けた換算値です
1回の実行コマンドは、次のような形です。
# 課題フォルダで、GPT-6.1 Sol に effort=medium で解かせる(出力は JSON の行で受け取る)
codex exec --json --ephemeral --skip-git-repo-check \
  -m gpt-6.1-sol -c 'model_reasoning_effort="medium"' \
  -s workspace-write -C /path/to/task - < prompt.txt
--json で出力すると、item.completed イベントからコマンド実行・ファイル変更・メッセージの一覧が、turn.completed イベントからトークン数が取れます。検証スクリプトはこれを集計しています。
結果①:実装5題+作ってみた2題 — 正解は同じ、差は費用
21回ずつの結果です。
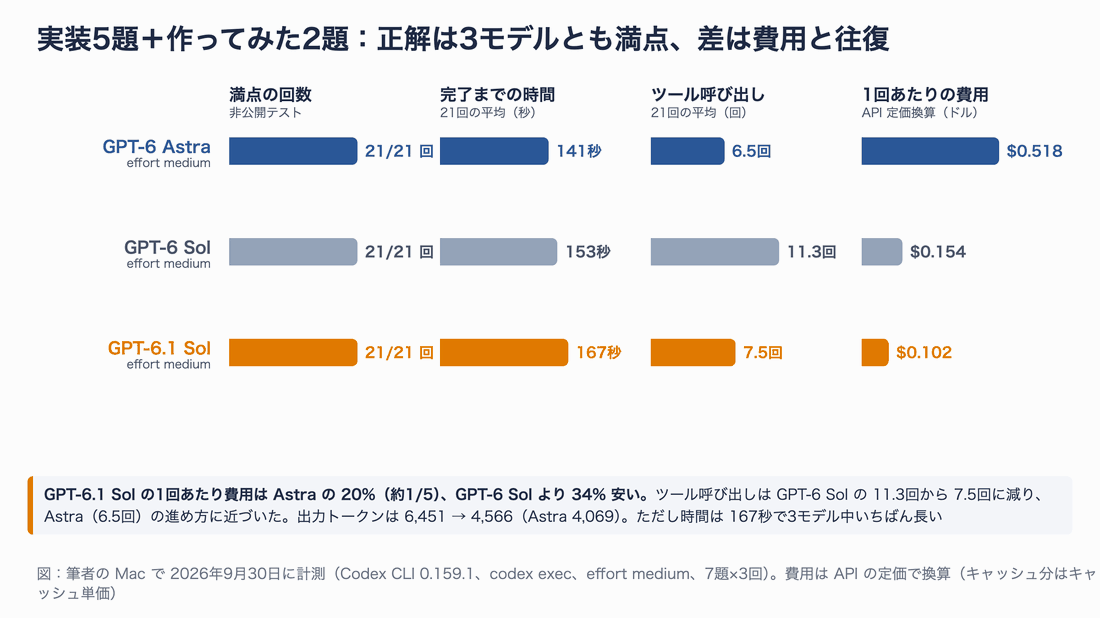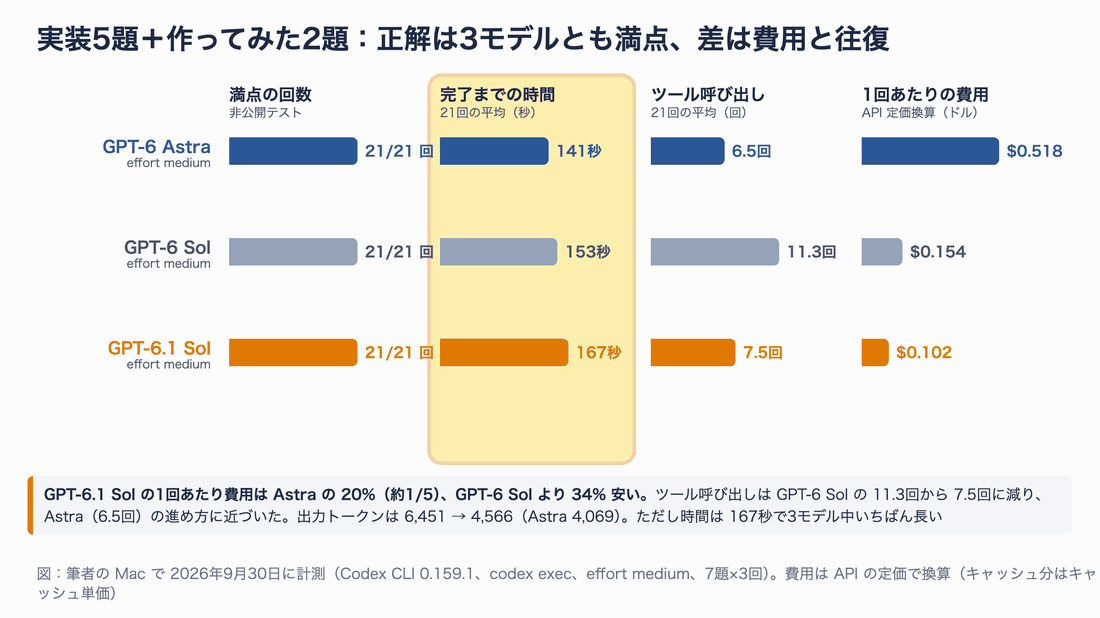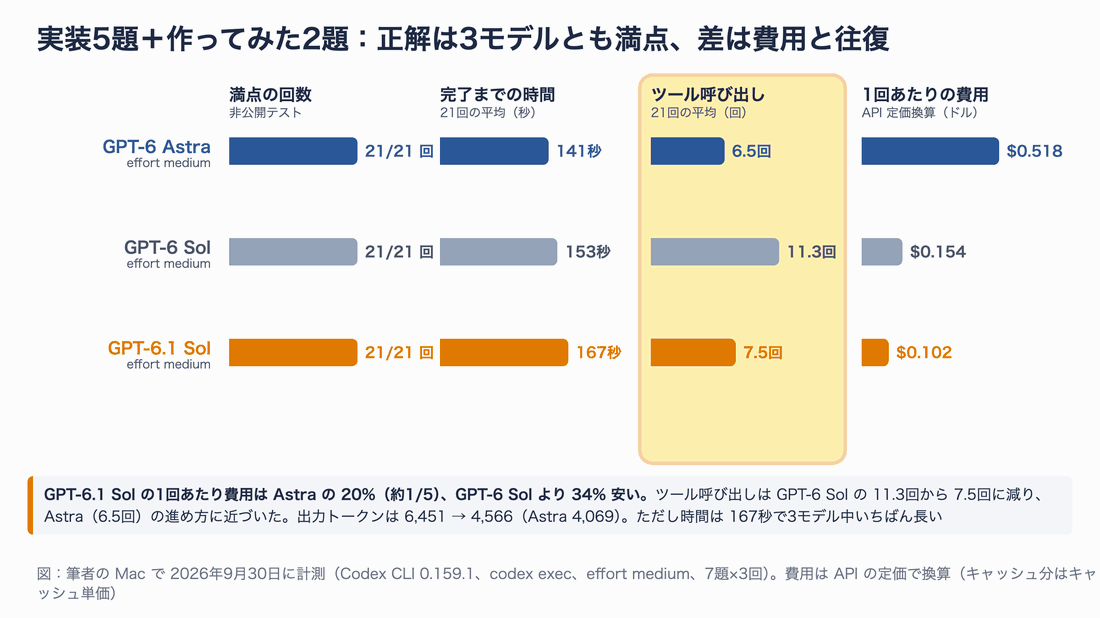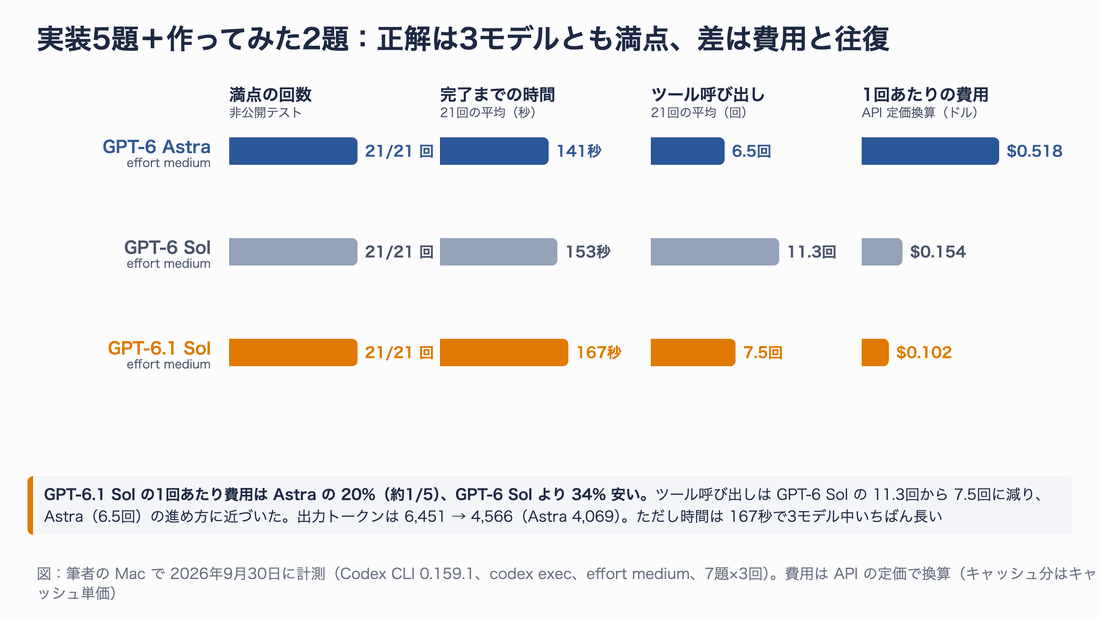
図5:非公開テストは3モデルとも全回満点。差が出たのは費用(Astra の約1/5)とツール呼び出しの回数です。
| GPT-6 Astra | GPT-6 Sol | GPT-6.1 Sol | |
|---|---|---|---|
| 非公開テスト満点の回数 | 21/21 | 21/21 | 21/21 |
| 完了までの時間(平均) | 141秒 | 153秒 | 167秒 |
| ツール呼び出し(平均) | 6.5回 | 11.3回 | 7.5回 |
| 入力トークン(うちキャッシュ) | 14.5万(12.6万) | 21.4万(18.8万) | 15.8万(13.6万) |
| 出力トークン(うち思考) | 4,069(226) | 6,451(1,376) | 4,566(338) |
| 費用(API 定価換算) | $0.518 | $0.154 | $0.102 |
| Codex クレジット換算 | 12.96 | 3.85 | 2.55 |
読み取れることは3つです。
1つ目:この難度の課題では、能力差は出ませんでした。 3モデルとも 21 回すべて非公開テスト満点です。公式の DeepSWE で「Astra と同等」とされているコーディング領域は、手元でも「どちらでも解ける」という結果でした。
2つ目:費用は公式の説明どおり約5分の1でした。 6.1 Sol の1回あたり $0.102 は Astra の 19.7%。GPT-6 Sol と比べても 34% 安くなっています。単価は同じなのに安いのは、使ったトークンが少ないからです。
3つ目:速くはなっていません。 6.1 Sol の平均 167 秒は、3モデルの中でいちばん長い時間です。Astra の 1.18 倍です。「安くなった」と「速くなった」は別の話で、6.1 Sol は後者ではありません。
課題ごとの内訳も載せておきます。
| 課題 | GPT-6 Astra | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|---|
| 請求計算のバグ修正 | 84秒 / $0.359 | 53秒 / $0.084 | 90秒 / $0.080 |
| 安全な電卓 | 113秒 / $0.435 | 204秒 / $0.173 | 155秒 / $0.106 |
| バージョン範囲の判定 | 154秒 / $0.517 | 181秒 / $0.175 | 172秒 / $0.096 |
| cron の次回実行時刻 | 104秒 / $0.392 | 113秒 / $0.124 | 110秒 / $0.071 |
| 日本語の正規化 | 77秒 / $0.377 | 121秒 / $0.126 | 92秒 / $0.064 |
| 売上レポート | 169秒 / $0.684 | 167秒 / $0.169 | 218秒 / $0.121 |
| 家計簿アプリ | 285秒 / $0.864 | 228秒 / $0.227 | 327秒 / $0.177 |
7題すべてで、費用は Astra > GPT-6 Sol > GPT-6.1 Sol の順です。
なぜ GPT-6 Sol より安いのか:進め方が Astra に近づいた
単価が同じ GPT-6 Sol より 34% 安い理由は、作業の進め方にあります。請求バグ修正の1回目について、3モデルが何をしたかを時間順に並べました。
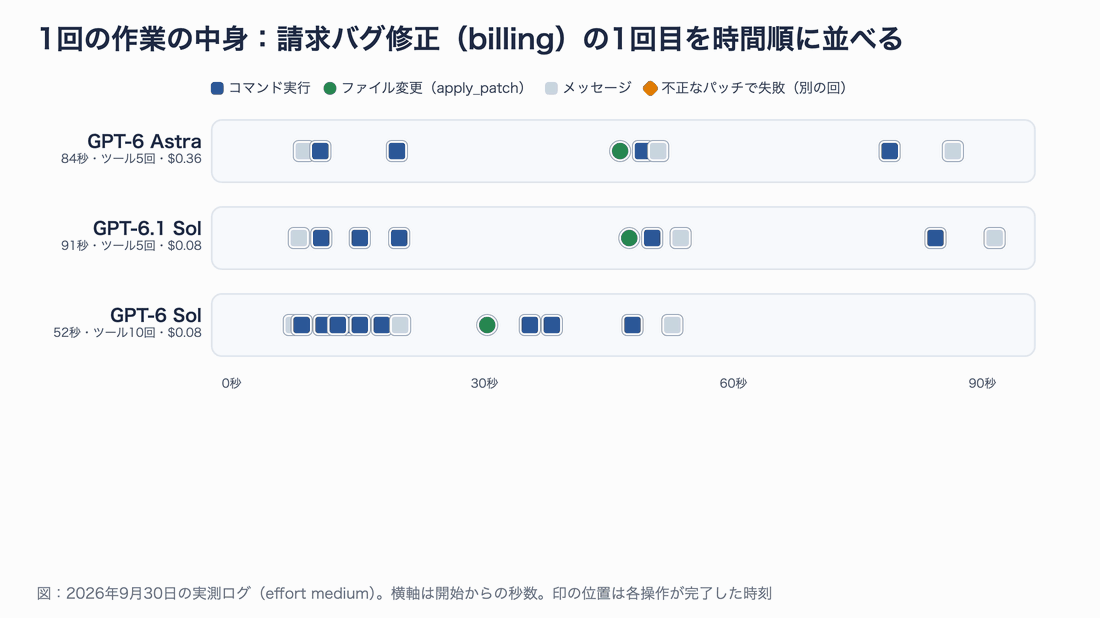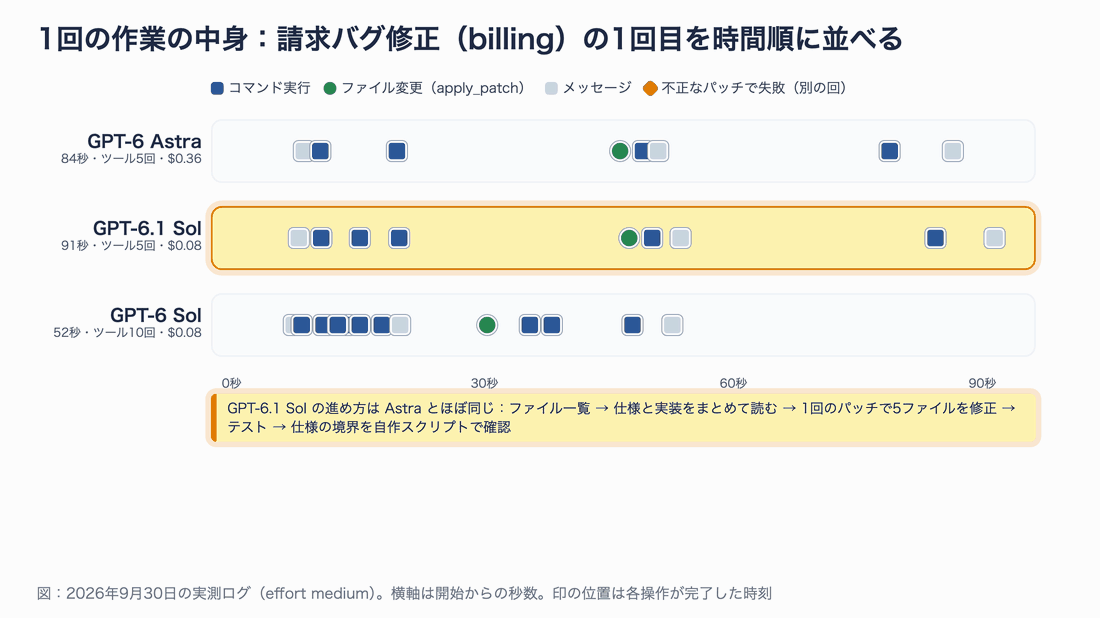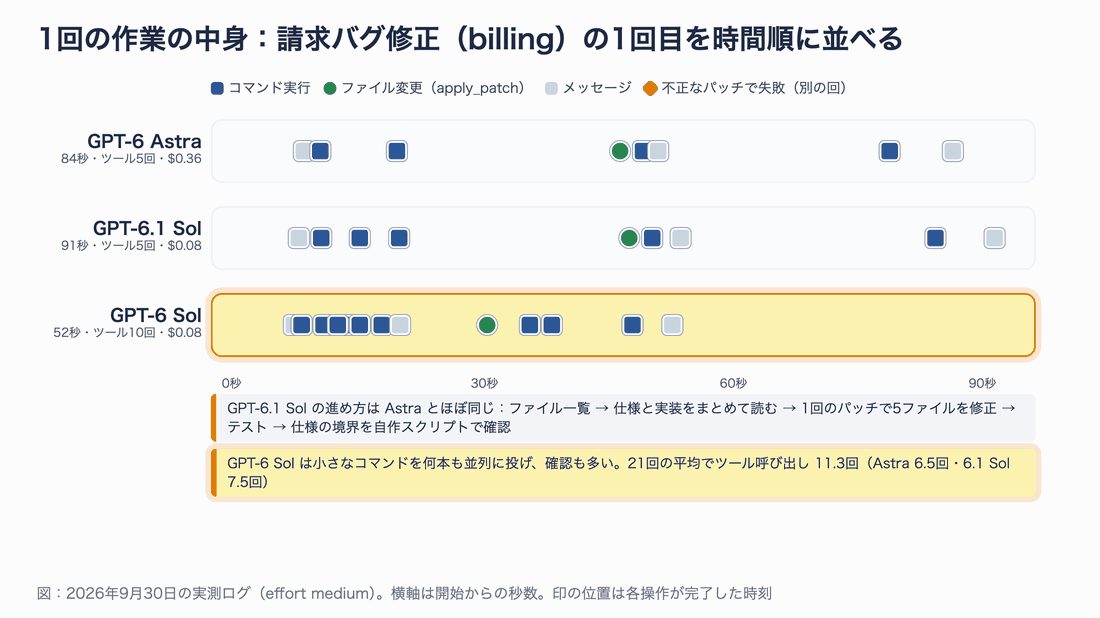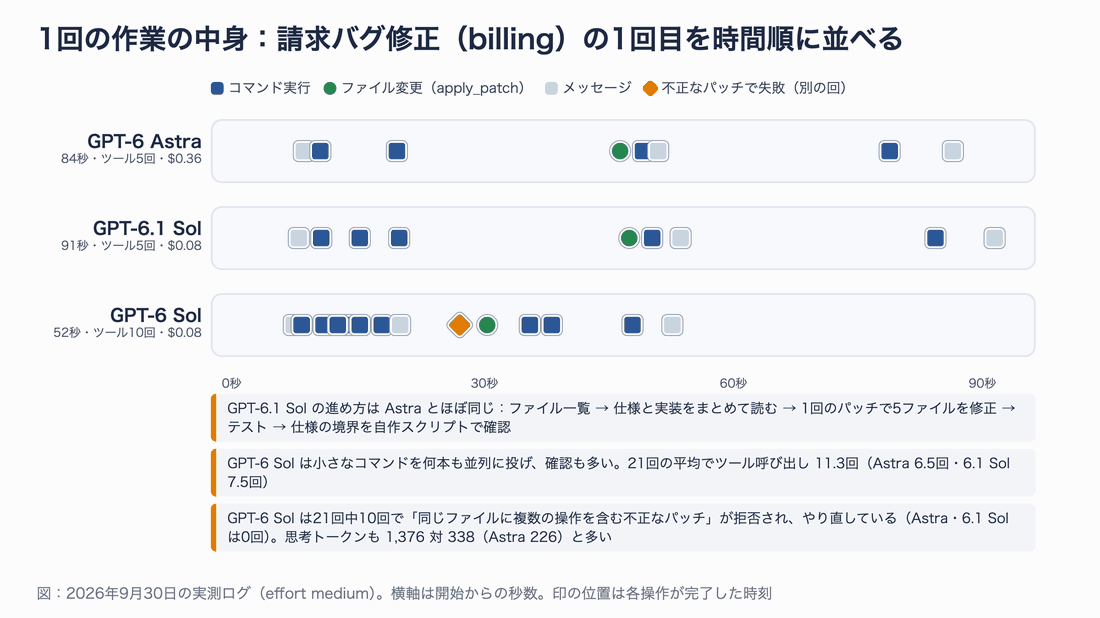
図6:上2本(Astra と 6.1 Sol)は、ファイル一覧 → まとめて読む → 1回のパッチで5ファイル修正 → テスト → 境界条件を自作スクリプトで確認、とほぼ同じ手順です。
GPT-6.1 Sol の手順は、Astra と驚くほど似ています。最初のコマンドが pwd; rg --files ... で同じ、次に cat SPEC.md billing/*.py tests/... でまとめて読むのも同じ、修正後に Python スクリプトで月末の境界条件を確かめるのも同じでした。一方 GPT-6 Sol は、cat SPEC.md と find と rg --files を別々に並列で投げ、確認のコマンドも多めです。
もうひとつ、GPT-6 Sol には目立つ癖がありました。21 回のうち 10 回で、apply_patch が「同じファイルに複数の操作を含む不正なパッチ」として拒否され、やり直しています。Astra と 6.1 Sol では 0 回です。失敗したぶんの出力トークンとやり直しの往復が、そのまま費用に乗っています。
| 1回あたりの平均 | GPT-6 Astra | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|---|
| コマンド実行 | 5.8回 | 9.4回 | 6.0回 |
| ファイル変更(apply_patch) | 0.7回 | 1.9回 | 1.4回 |
| 不正なパッチで拒否された回数(21回中) | 0回 | 10回 | 0回 |
| 思考トークン | 226 | 1,376 | 338 |
思考トークン(モデルが答えを出す前に内部で使うトークン。出力単価で課金されます)も、GPT-6 Sol の 1,376 に対して 6.1 Sol は 338 と4分の1です。OpenAI が DeepSWE について「より少ない思考量で GPT-6 Sol の最高点を上回った」と書いているのと、同じ現象だと思います。
結果②:同じアプリを3モデルに作らせたら
点数は同じでも、できたものは同じではありません。「作ってみた」2題の成果物を並べます。
家計簿アプリ
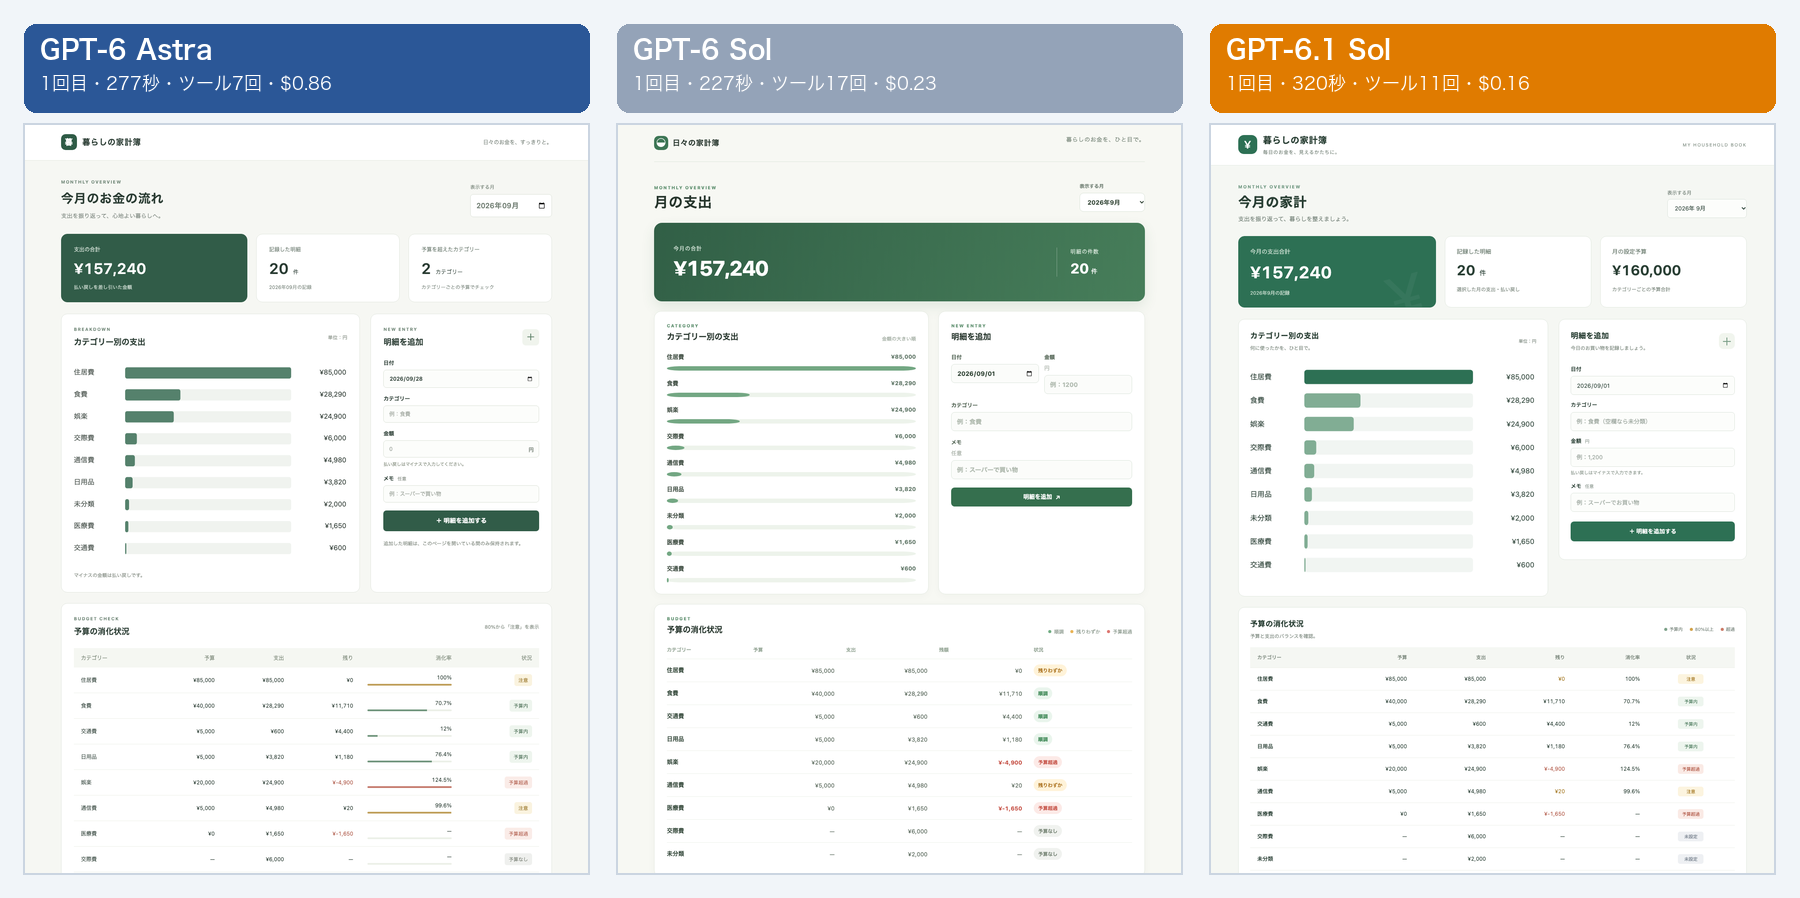
左から GPT-6 Astra、GPT-6 Sol、GPT-6.1 Sol の1回目。合計 ¥157,240 と棒グラフ、予算表は3つとも正しく、見た目の方向性(緑系・カード型)も似ています。
3回ずつ作らせて、画面の機能を数えました。
| 機能 | GPT-6 Astra | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|---|
| 予算の「消化率」を表示 | 3/3 回 | 2/3 回 | 2/3 回 |
| 予算超過の件数カード | 3/3 回 | 0/3 回 | 1/3 回 |
| 入力フォームの日付に今日を入れる | 3/3 回 | 1/3 回 | 2/3 回 |
| スマホ幅(390px)で横にはみ出さない | 3/3 回 | 3/3 回 | 3/3 回 |
Astra は3回とも、仕様にない「予算超過の件数」や「消化率」を気を利かせて足してきます。6.1 Sol はその中間で、GPT-6 Sol より気が利くが Astra ほど安定しない、という結果です。スマホ幅の表示は3モデルとも崩れませんでした。
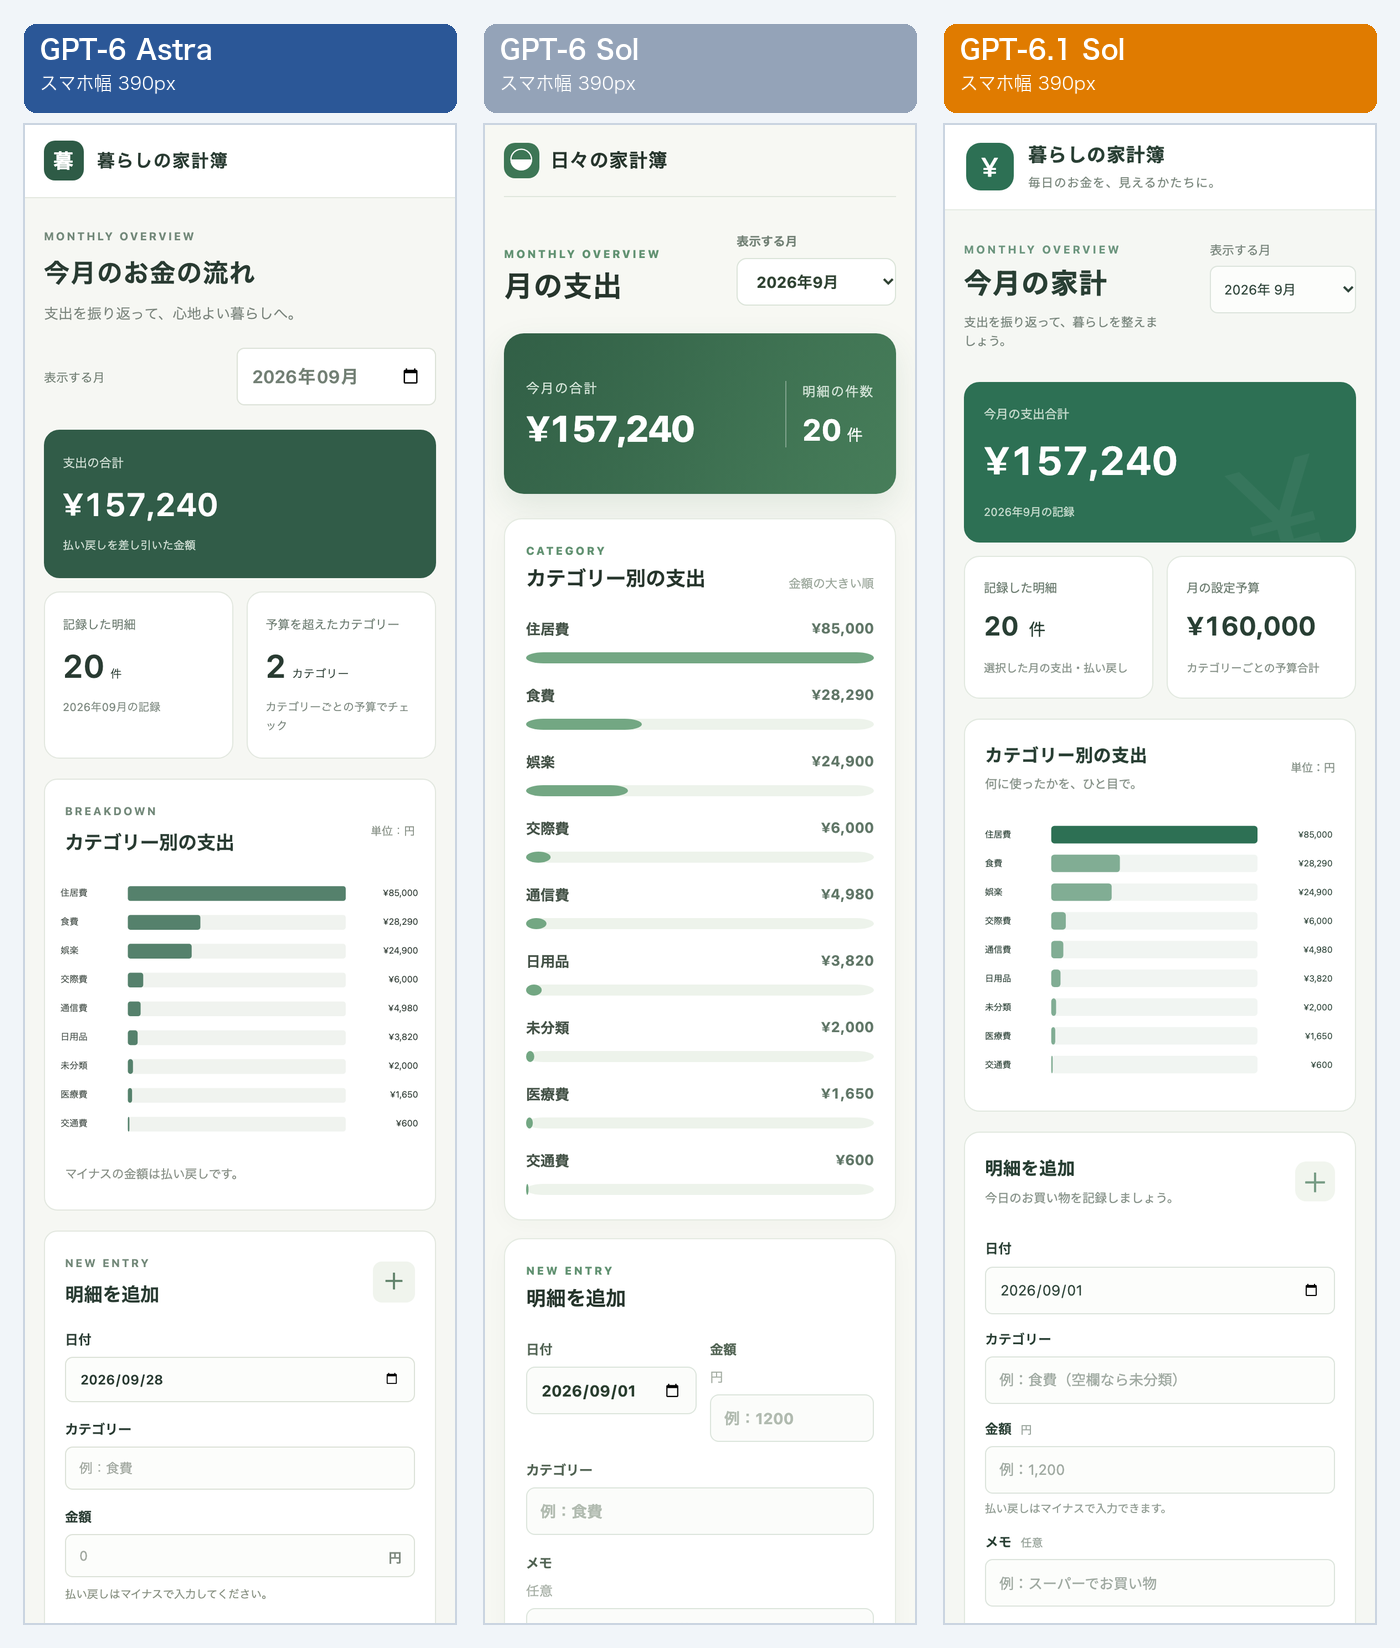
スマホ幅での表示。3モデルとも1列に並べ直しており、横はみ出しはありません(DevTools の端末エミュレーションで撮影)。
売上レポート
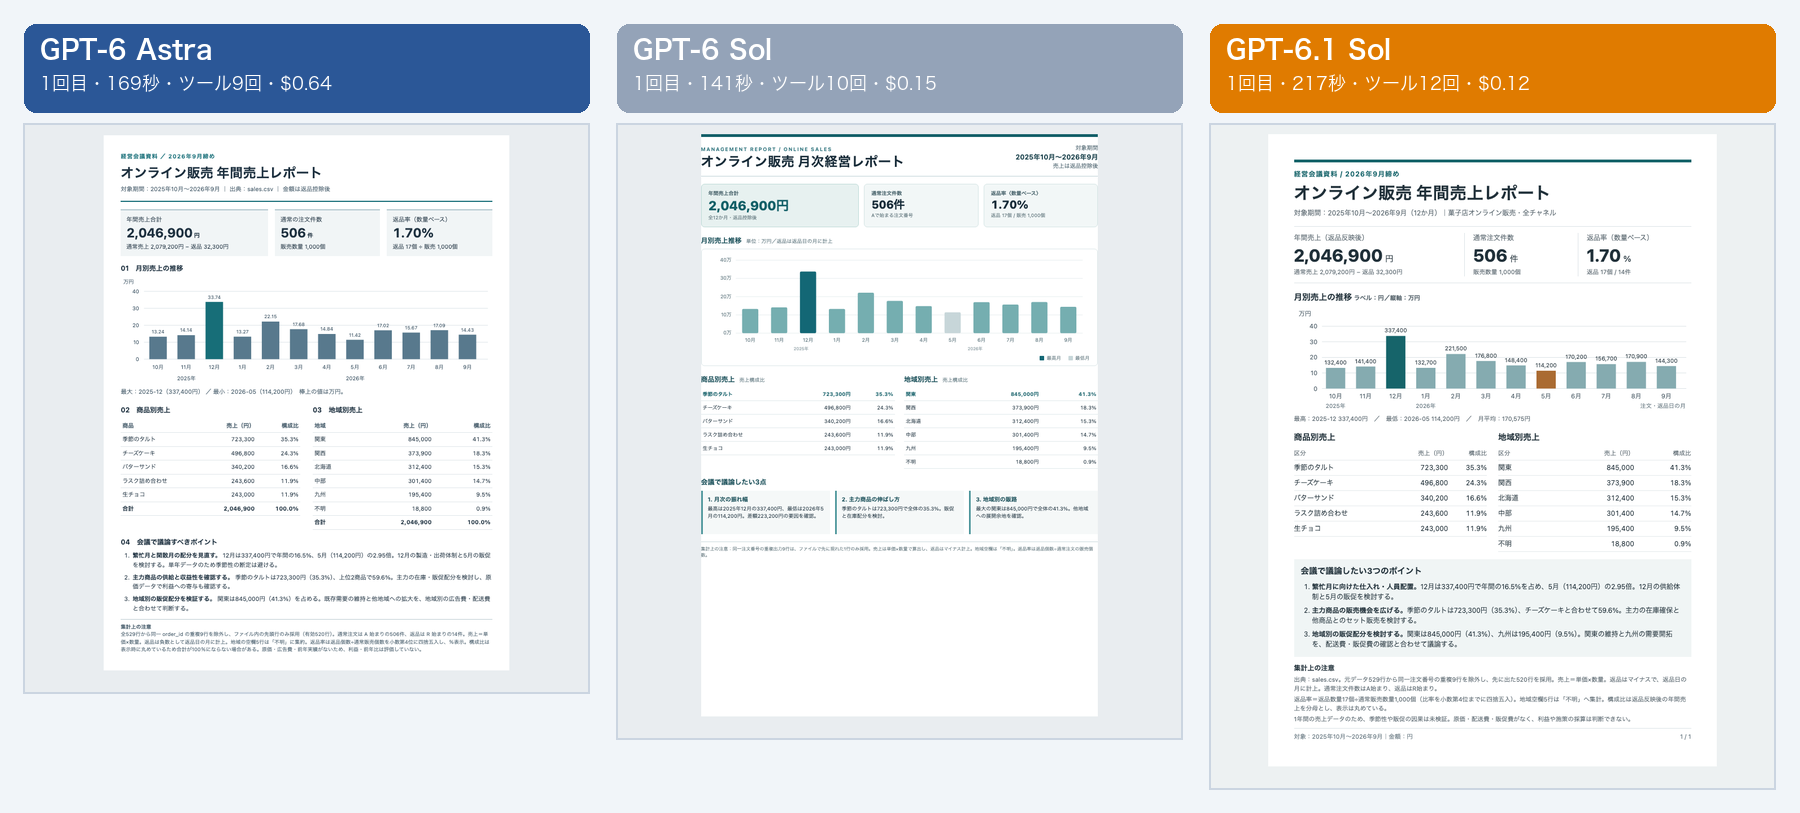
左から GPT-6 Astra、GPT-6 Sol、GPT-6.1 Sol の1回目。集計値はすべて正解と一致。6.1 Sol は最高月と最低月を色分けし、月平均も出しています。
集計の正確さは3モデルとも 10/10 でした。重複行の除外、返品のマイナス計上、地域の空欄を「不明」にまとめる処理は、全員が正しくやっています。
ただし、このデータには「気づけるか」を見るための仕込みが2つあります。季節のタルトが6〜7月だけ値上げされていることと、重複した9行のうち一部で地域が食い違っていることです。結果は、9回中0回、Astra も含めて誰も指摘しませんでした。参考までに、同じデータで9月29日に測った Claude Sonnet 5.5 は3回とも値上げを指摘しています。「仕様どおりに集計する」力と「データの異変に気づく」力は別で、後者については GPT-6 系は3モデルとも横並び、という結果です。
結果③:推論(難)9問 — Astra との差は「粘る問題」に残る
コーディングでは差が出なかったので、道具なしで考え抜く問題で差を見ます。9問 × 3回、ツールの使用を禁止して答えさせました(81回とも実際にコマンド実行はありませんでした)。
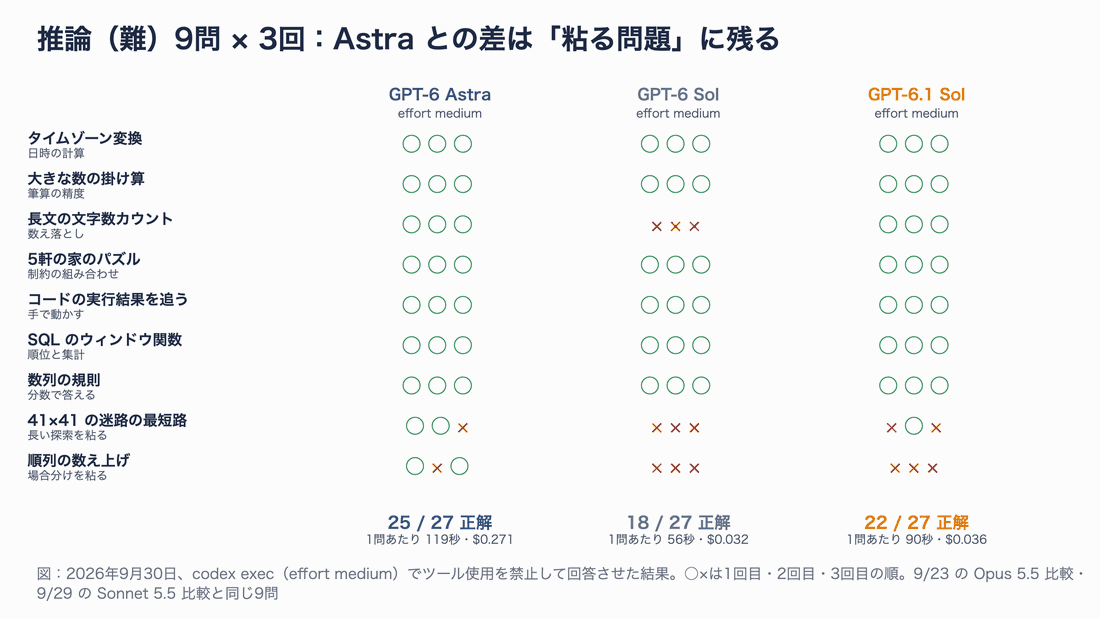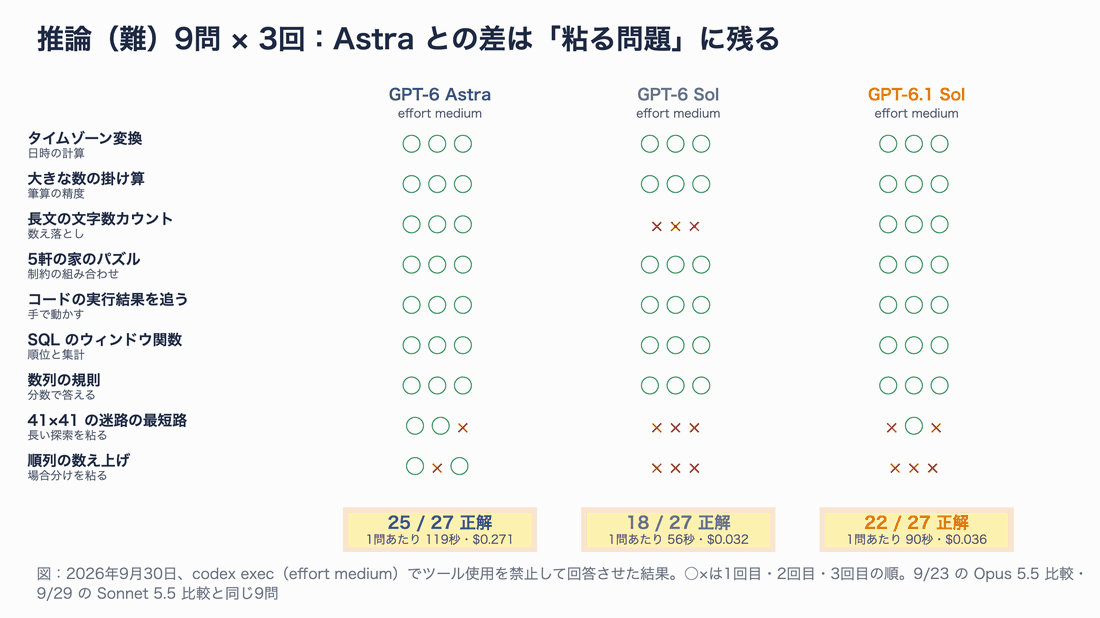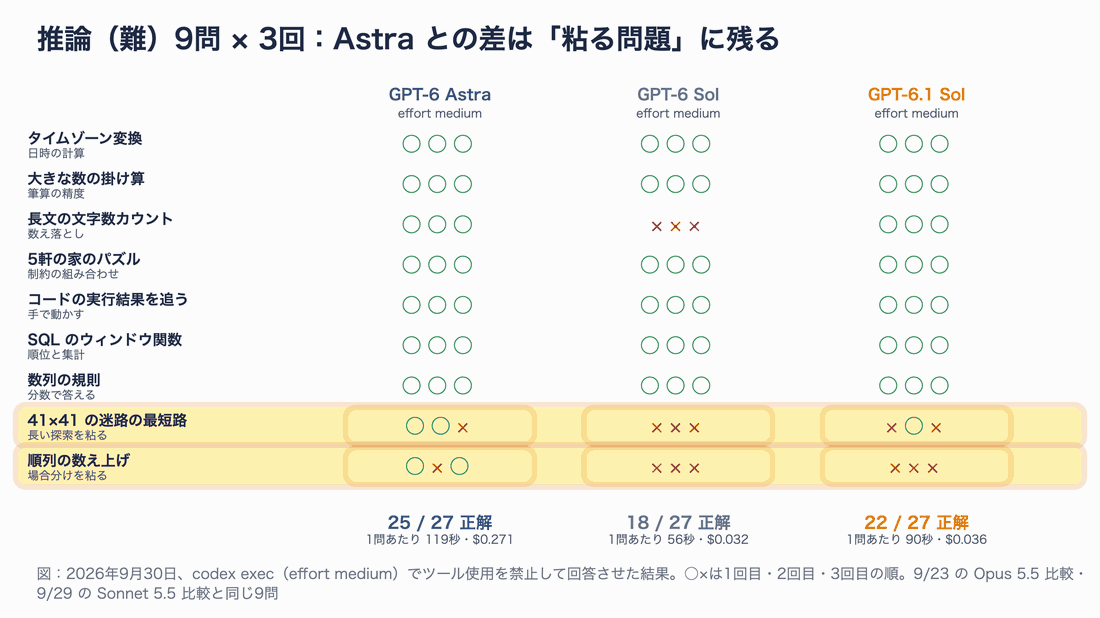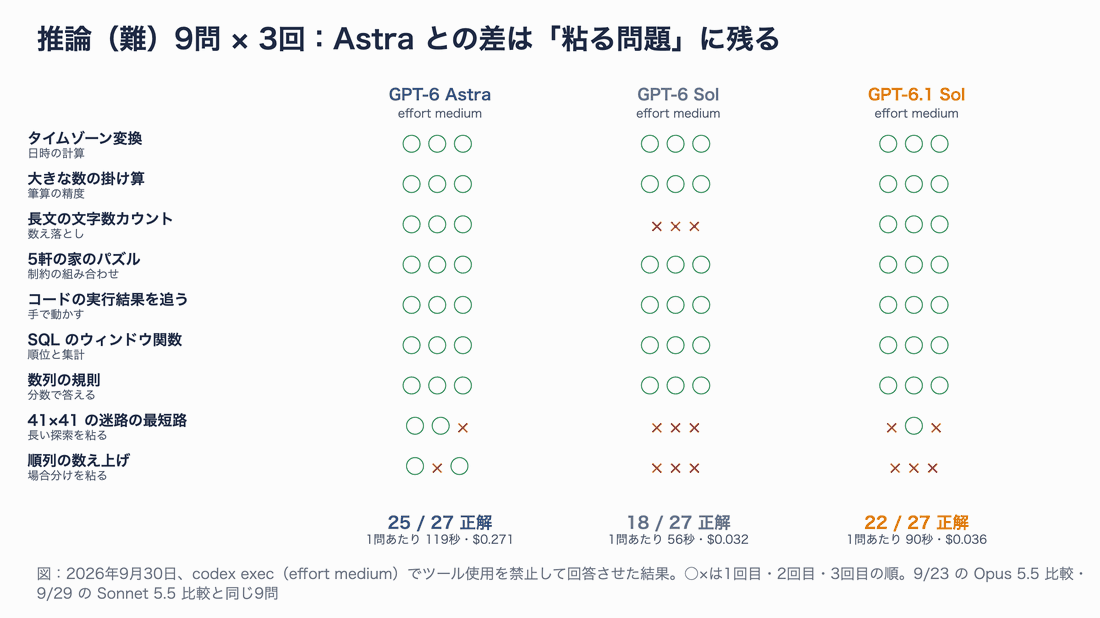
図7:下2行(迷路・順列)が「粘る問題」。ここだけ Astra が勝っています。
| GPT-6 Astra | GPT-6 Sol | GPT-6.1 Sol | |
|---|---|---|---|
| 正解 | 25/27 | 18/27 | 22/27 |
| 1問あたりの時間(平均) | 119秒 | 56秒 | 90秒 |
| 1問あたりの出力トークン | 3,797 | 2,034 | 2,431 |
| 1問あたりの費用 | $0.271 | $0.032 | $0.036 |
GPT-6 Sol から 6.1 Sol で正解が4問増えました。長文の文字数カウント(数え落としを試す問題)は GPT-6 Sol が 0/3 だったのが 3/3 になっています。
Astra との差は、長い探索や場合分けを粘って最後までやり切る問題に残りました。41×41 の迷路の最短路は Astra 2/3 に対し 6.1 Sol は 1/3。順列の数え上げは Astra 2/3 に対し 6.1 Sol は 0/3 です。
順列の問題での 6.1 Sol の答えは、3回とも「未算出」「未確定」でした。でたらめな数を出すのではなく「出せなかった」と返しているので、嘘をつかないという点では好ましい振る舞いです。一方 Astra は、約 22,000 トークン・11〜13分をかけて2回正解しています(外した1回も12分考えていました)。費用は1問あたり平均 $1.21。「時間とお金をかけて粘る」ことが Astra の価値で、6.1 Sol は medium では早めに切り上げます。
参考までに、同じ9問を9月29日に Claude Sonnet 5.5(high)で解かせた結果は 23/27、9月23日の Opus 5.5(high)は 24/27 でした。effort が違うので単純比較はできませんが、6.1 Sol(medium)の 22/27 はその近くにいます。
effort を上げると差は縮まるか
公式ベンチマークの多くは high〜max の値です。medium で差が残った推論問題が、high でどう変わるかを見ました。実装・作ってみたの7題も、同じく high で回しています(3モデル × 7題 × 3回と、3モデル × 9問 × 3回。合計 144 回)。
7題:high でも満点は変わらず、費用の比も変わらない
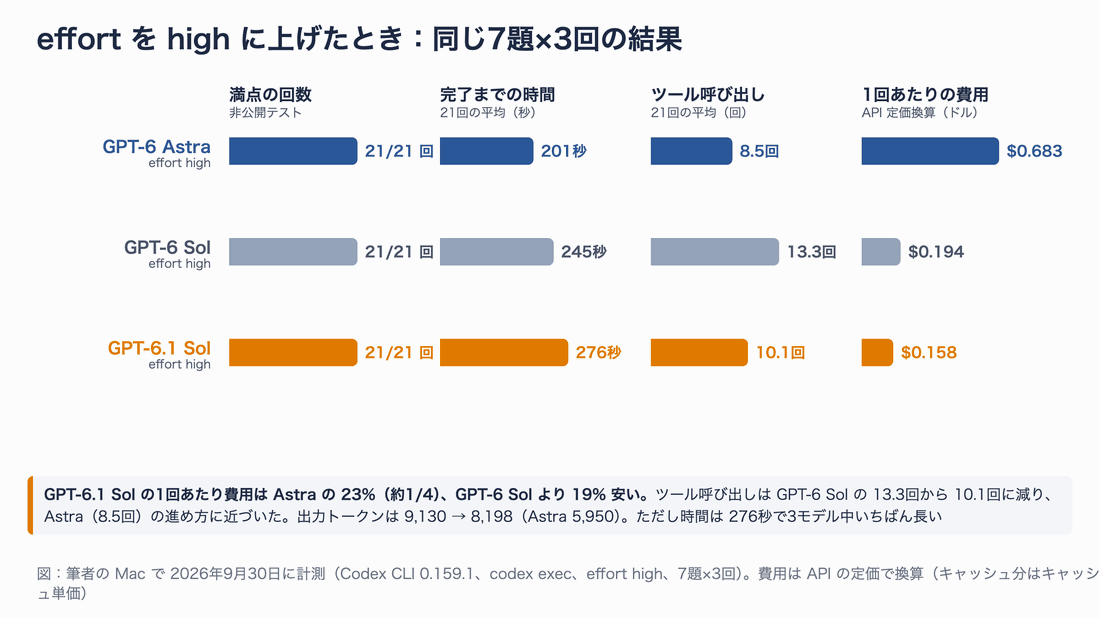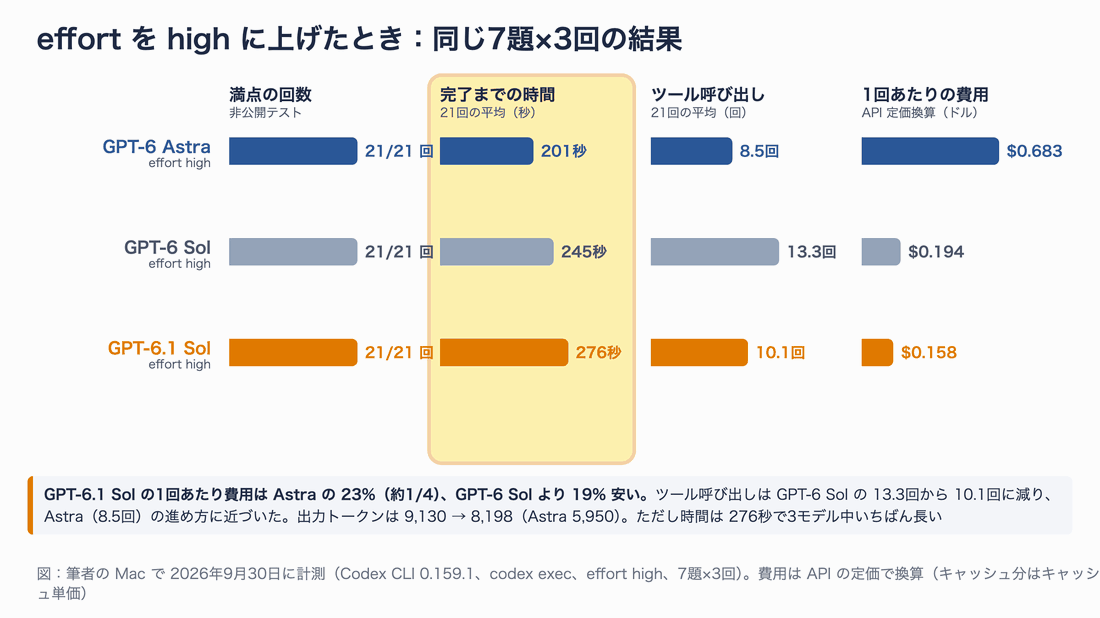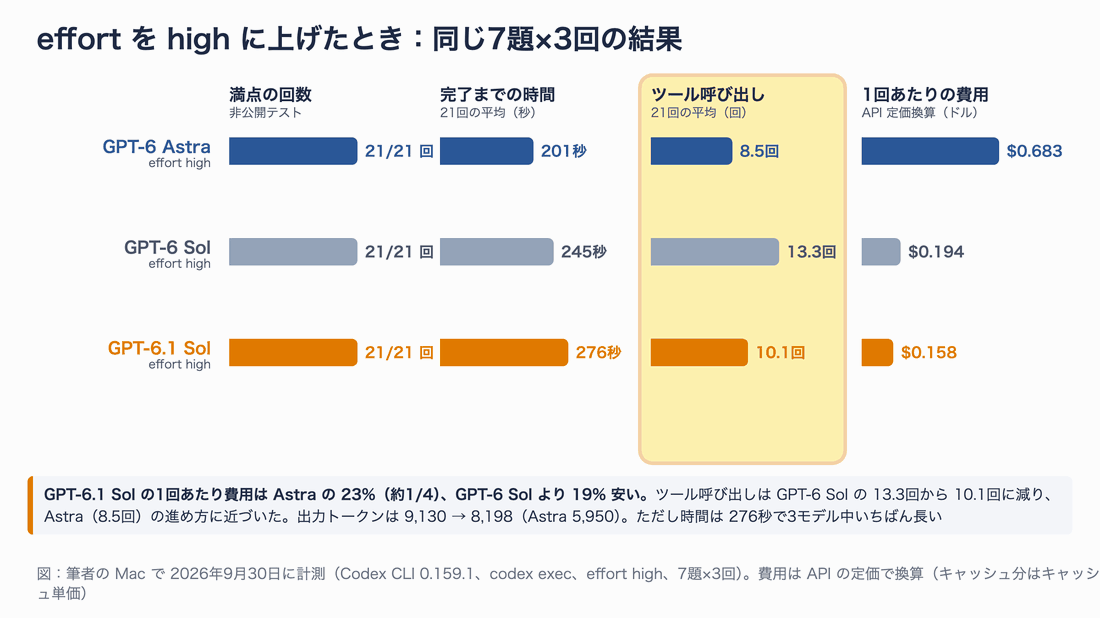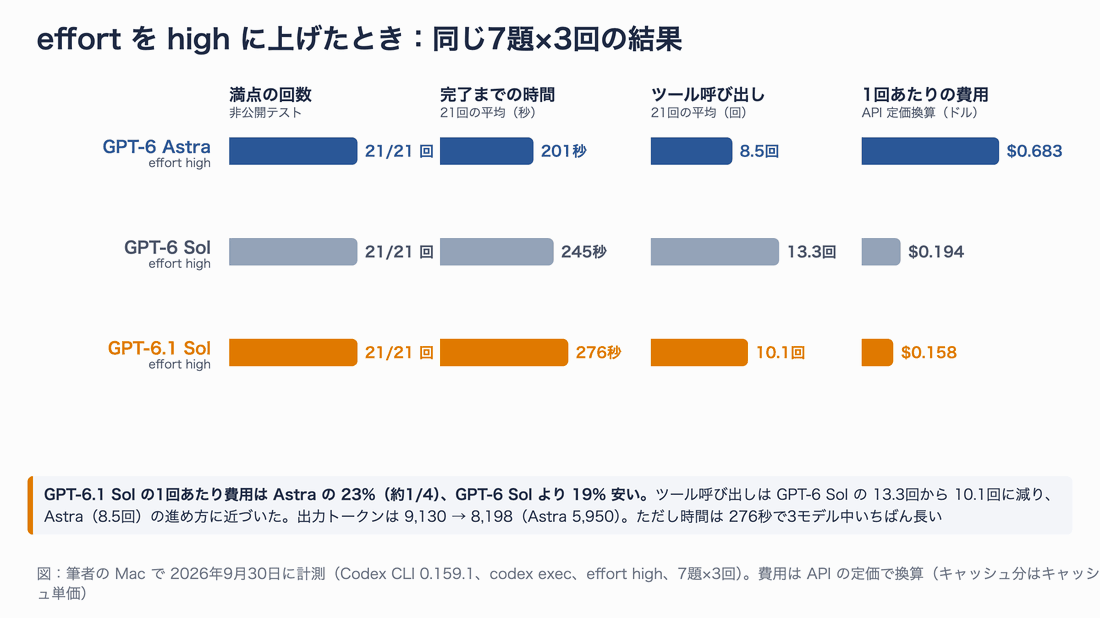
図8:effort を high にしても、3モデルとも全回満点。6.1 Sol の費用は Astra の 23% で、medium のときの比(20%)とほぼ同じです。
| effort=high | GPT-6 Astra | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|---|
| 非公開テスト満点の回数 | 21/21 | 21/21 | 21/21 |
| 完了までの時間(平均) | 201秒 | 245秒 | 276秒 |
| ツール呼び出し(平均) | 8.5回 | 13.3回 | 10.1回 |
| 出力トークン(うち思考) | 5,950(728) | 9,130(2,859) | 8,198(1,722) |
| 費用(API 定価換算) | $0.683 | $0.194 | $0.158 |
| 不正なパッチで拒否(21回中) | 0回 | 12回 | 0回 |
medium で満点だった課題は、high でも満点です。差は費用と時間だけで、6.1 Sol は Astra の 23%、GPT-6 Sol より 19% 安い、という比率も medium のときとほぼ同じでした。
一方、6.1 Sol 自身を medium と high で比べると、費用は $0.102 → $0.158(1.55倍)、時間は 167秒 → 276秒(1.65倍)に増えています。この程度の課題では、high にしても結果は変わらず、費用と時間だけが増えるということです。既定の medium で通る仕事は medium のままで良い、というのが実測から言える結論です。
推論(難):差は1問まで縮まる。ただし「順列」は全員が解けなくなる
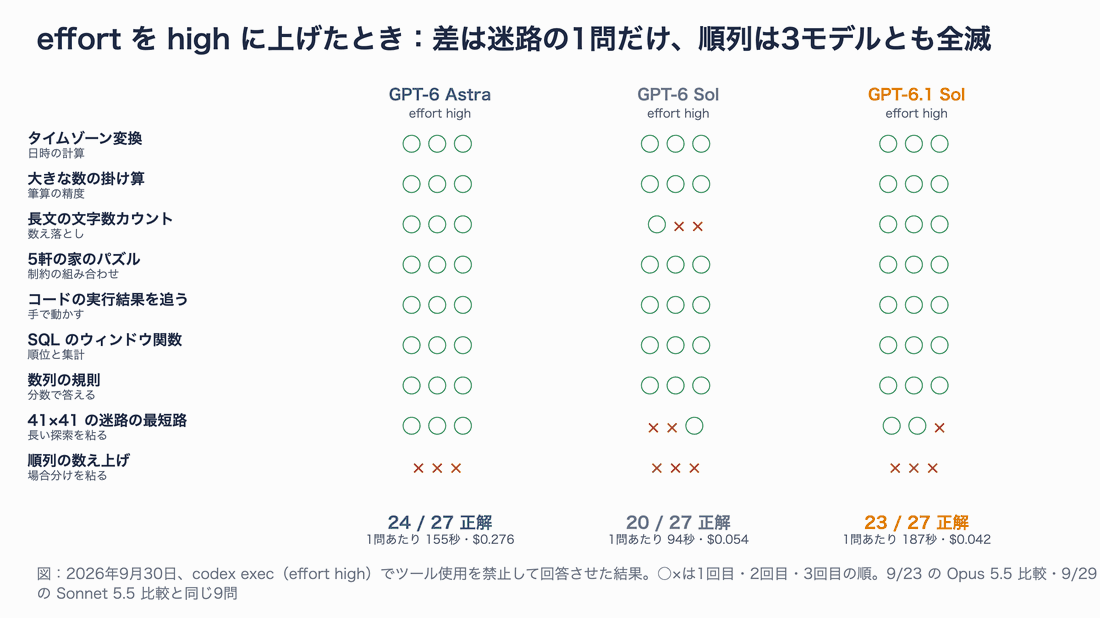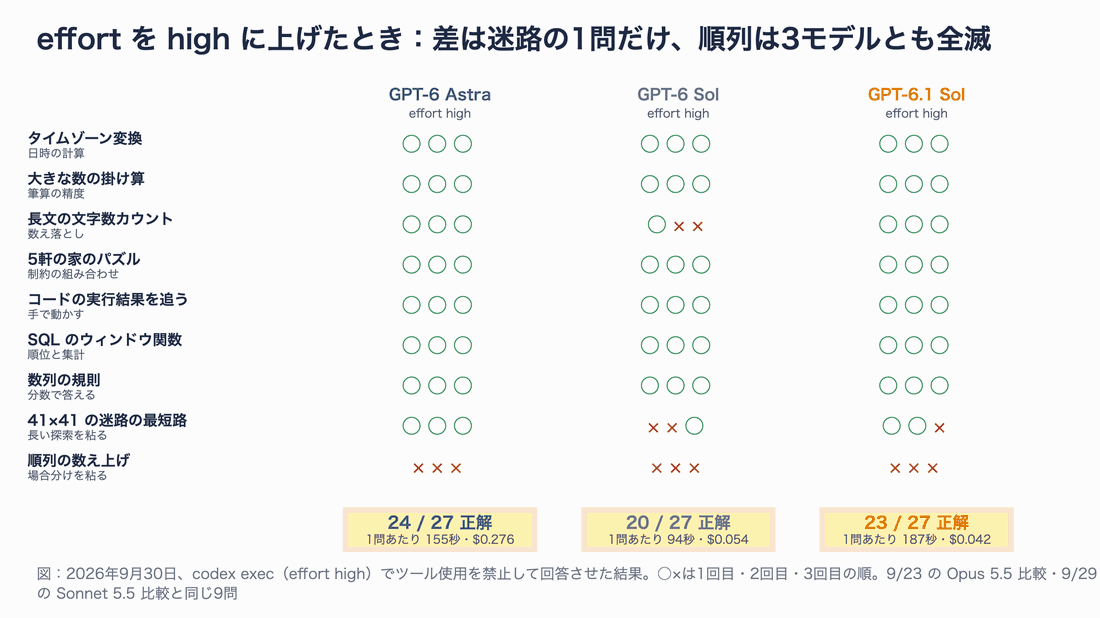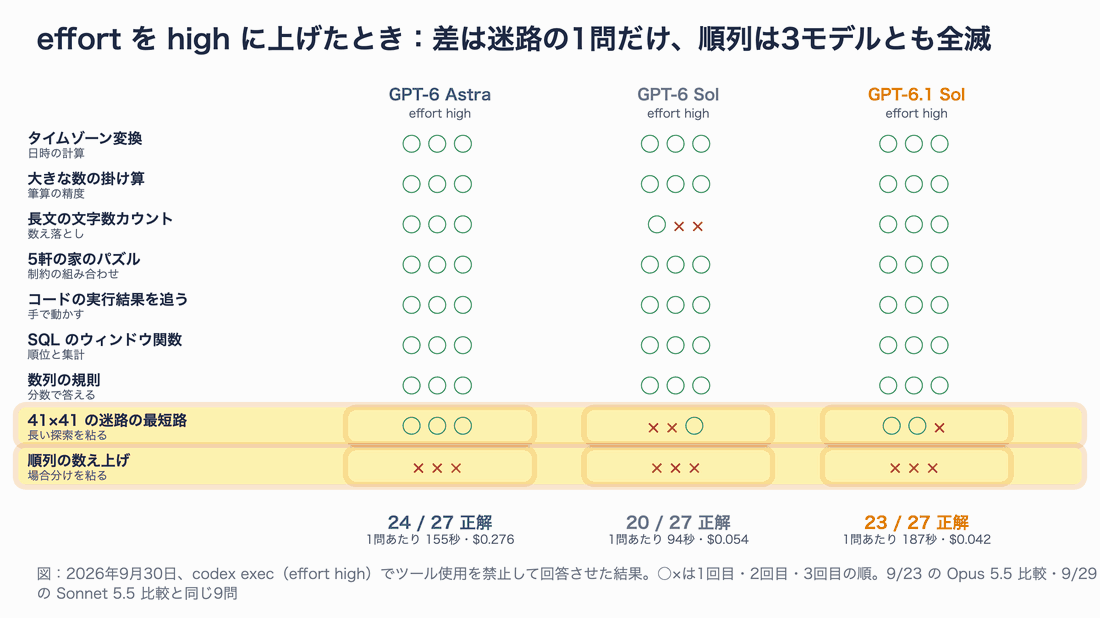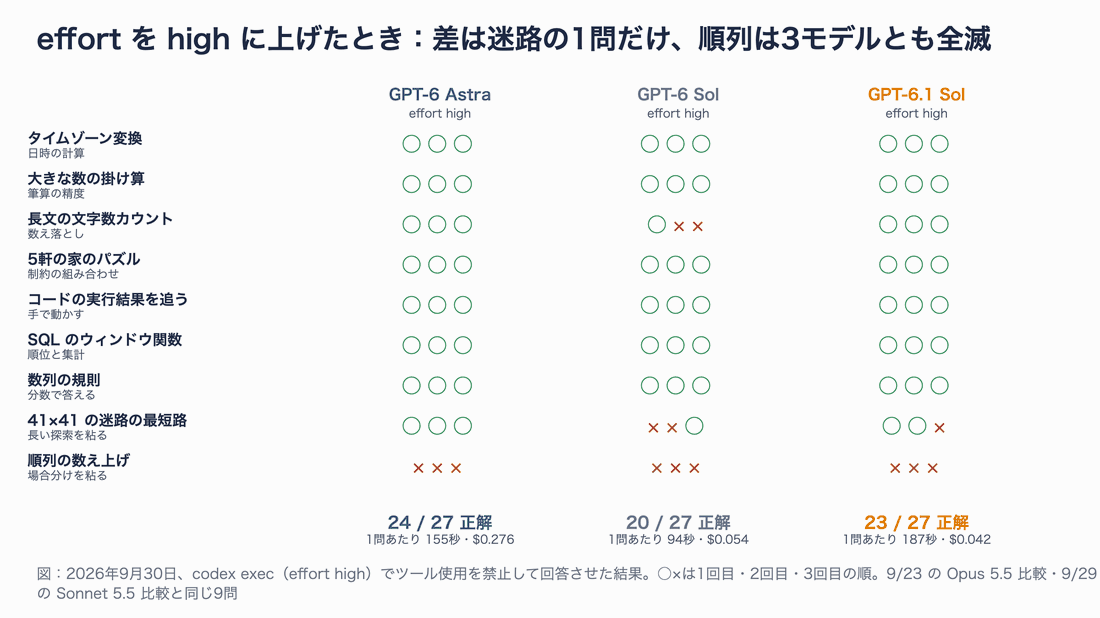
図9:high では 6.1 Sol が 23/27 まで上がり、Astra(24/27)との差は1問。順列の数え上げは、high だと3モデルとも全滅しました。
| effort=high | GPT-6 Astra | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|---|
| 正解 | 24/27 | 20/27 | 23/27 |
| 15分の時間切れ | 1回 | 0回 | 3回 |
| 1問あたりの時間(平均) | 155秒 | 94秒 | 187秒 |
| 1問あたりの費用(時間切れを除く) | $0.276 | $0.054 | $0.042 |
6.1 Sol は medium の 22/27 から 23/27 に上がり、Astra(high は 24/27)との差は1問になりました。迷路の最短路は、medium では 1/3 だったのが high では 2/3(1回に 8〜12 分、1.5〜2.2万トークン)。「粘れば解ける」問題は、effort を上げると実際に粘って解いています。
ところが順列の数え上げは、high にすると3モデルとも 0/3 でした。6.1 Sol は3回とも 15 分の制限時間を使い切って答えを出せず、Astra は2回が 14 分考えたうえで誤答、1回が時間切れです。medium のときに Astra が 2/3 正解していたのは、「考えすぎる前に答えを出した」結果だったと言えます。effort を上げれば必ず良くなるわけではなく、この問題は high にすると Astra でも時間内に収まらなくなりました。
まとめると、high での推論の差は「Astra が迷路を 3/3、6.1 Sol が 2/3」の1問だけです。費用は 6.1 Sol が Astra の約 1/6.5(時間切れの3回を除いた値なので、実際はもう少し近づきます)。
どう使い分けるか
ここまでの公式値と実測をまとめると、判断はかなりシンプルです。
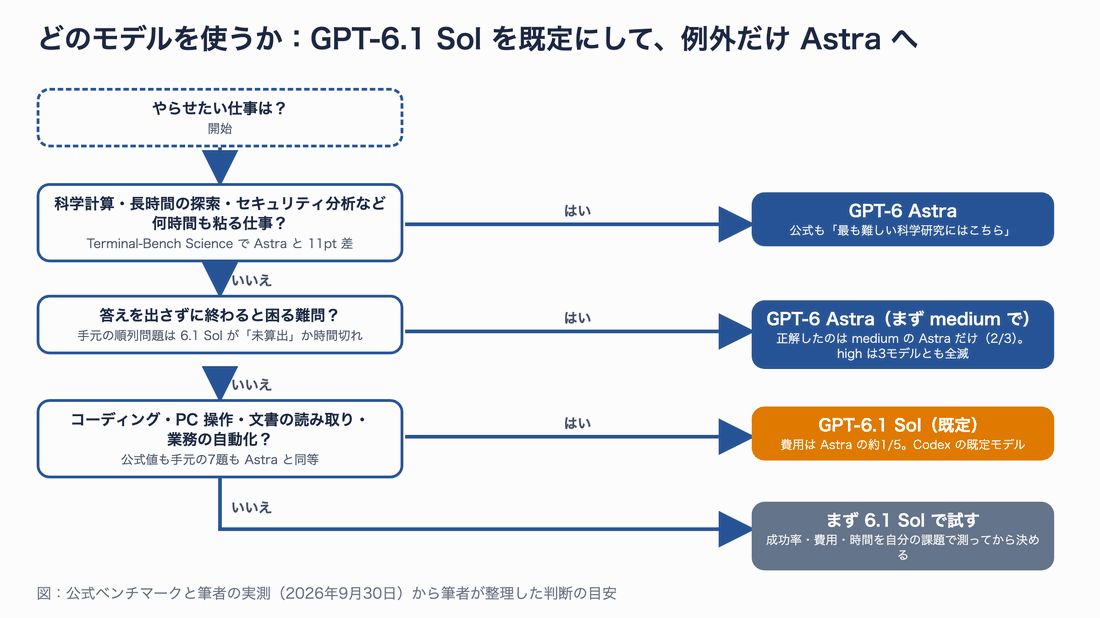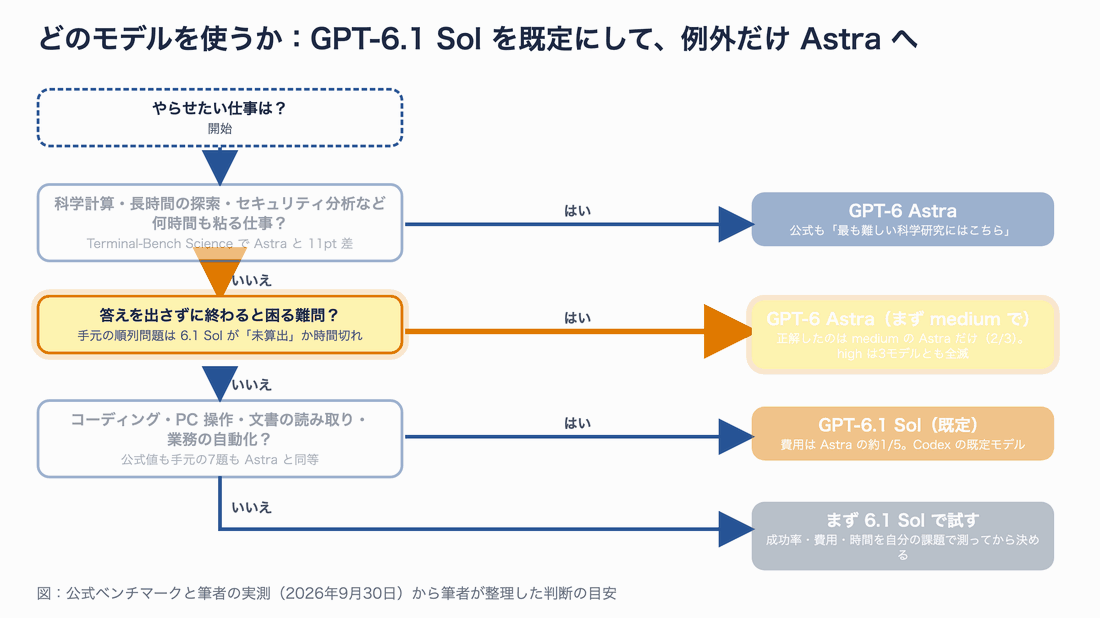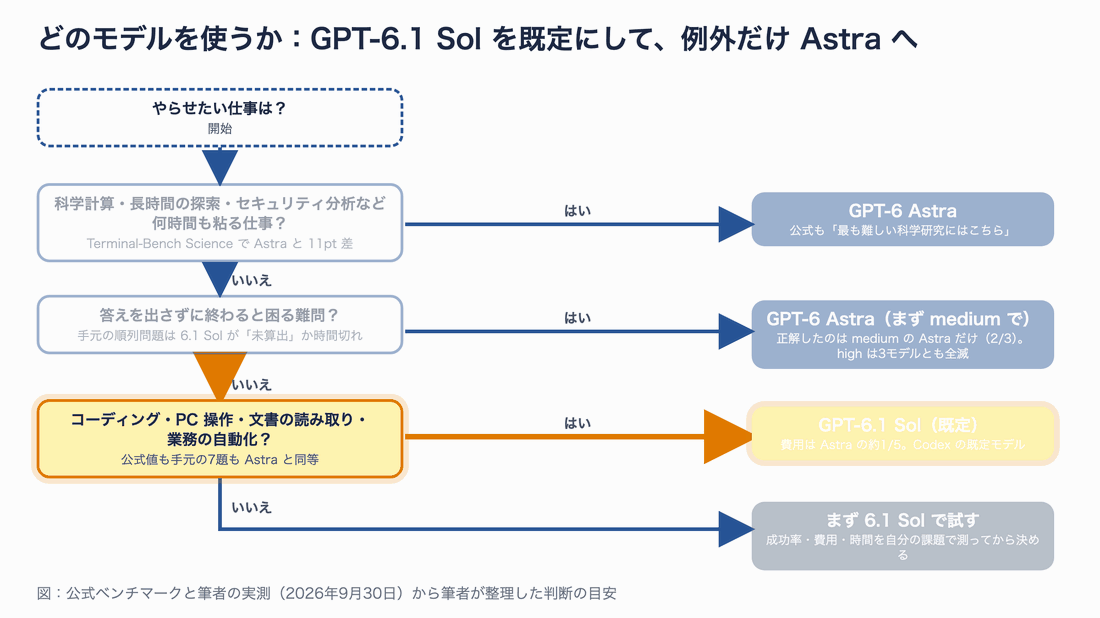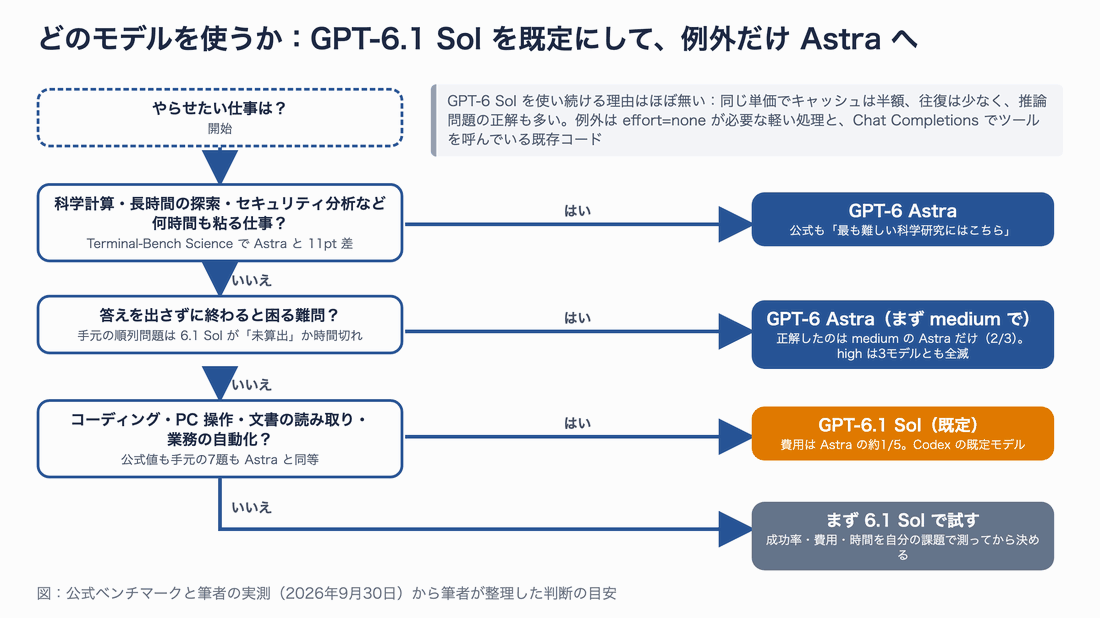
図10:GPT-6.1 Sol を既定にして、例外だけ Astra に回す、という整理です。
| 仕事 | おすすめ | 理由 |
|---|---|---|
| コーディング、バグ修正、小さなアプリやレポートの作成 | GPT-6.1 Sol | 公式の DeepSWE も手元の7題も Astra と同等。費用は約1/5 |
| パソコン操作、文書の読み取り、業務ワークフロー | GPT-6.1 Sol | OSWorld で 2.1pt 差、GDP.pdf で 0.2pt 差。コストは 1/5〜1/7 |
| 科学計算、長時間の探索、セキュリティ分析 | GPT-6 Astra | Terminal-Bench Science で 11pt 差。公式も Astra を推奨 |
| 答えを出さずに終わると困る難問 | GPT-6 Astra(まず medium で) | 手元の順列問題を正解したのは medium の Astra だけ(2/3)。high では3モデルとも全滅で、effort を上げれば解けるわけではない |
| 推論なし(effort=none)で回したい軽い処理 | GPT-6 Sol または Luna | 6.1 Sol は none を受け付けない |
| 速さが最優先 | Astra Ultrafast / 6.1 Sol Ultrafast(近日) | 6.1 Sol の標準モードは Astra より遅い |
GPT-6 Sol を使い続ける理由は、ほとんどありません。同じ単価でキャッシュは半額、往復は少なく、推論問題の正解も多いからです。例外は、effort=none が必要な処理と、Chat Completions でツールを呼んでいる既存コードです。
Codex と API で使うには
Codex CLI は 0.159 系が必要
筆者の Mac に入っていた Codex CLI 0.156.1 では、-m gpt-6.1-sol を指定すると ChatGPT ログインで 400 エラーになりました。
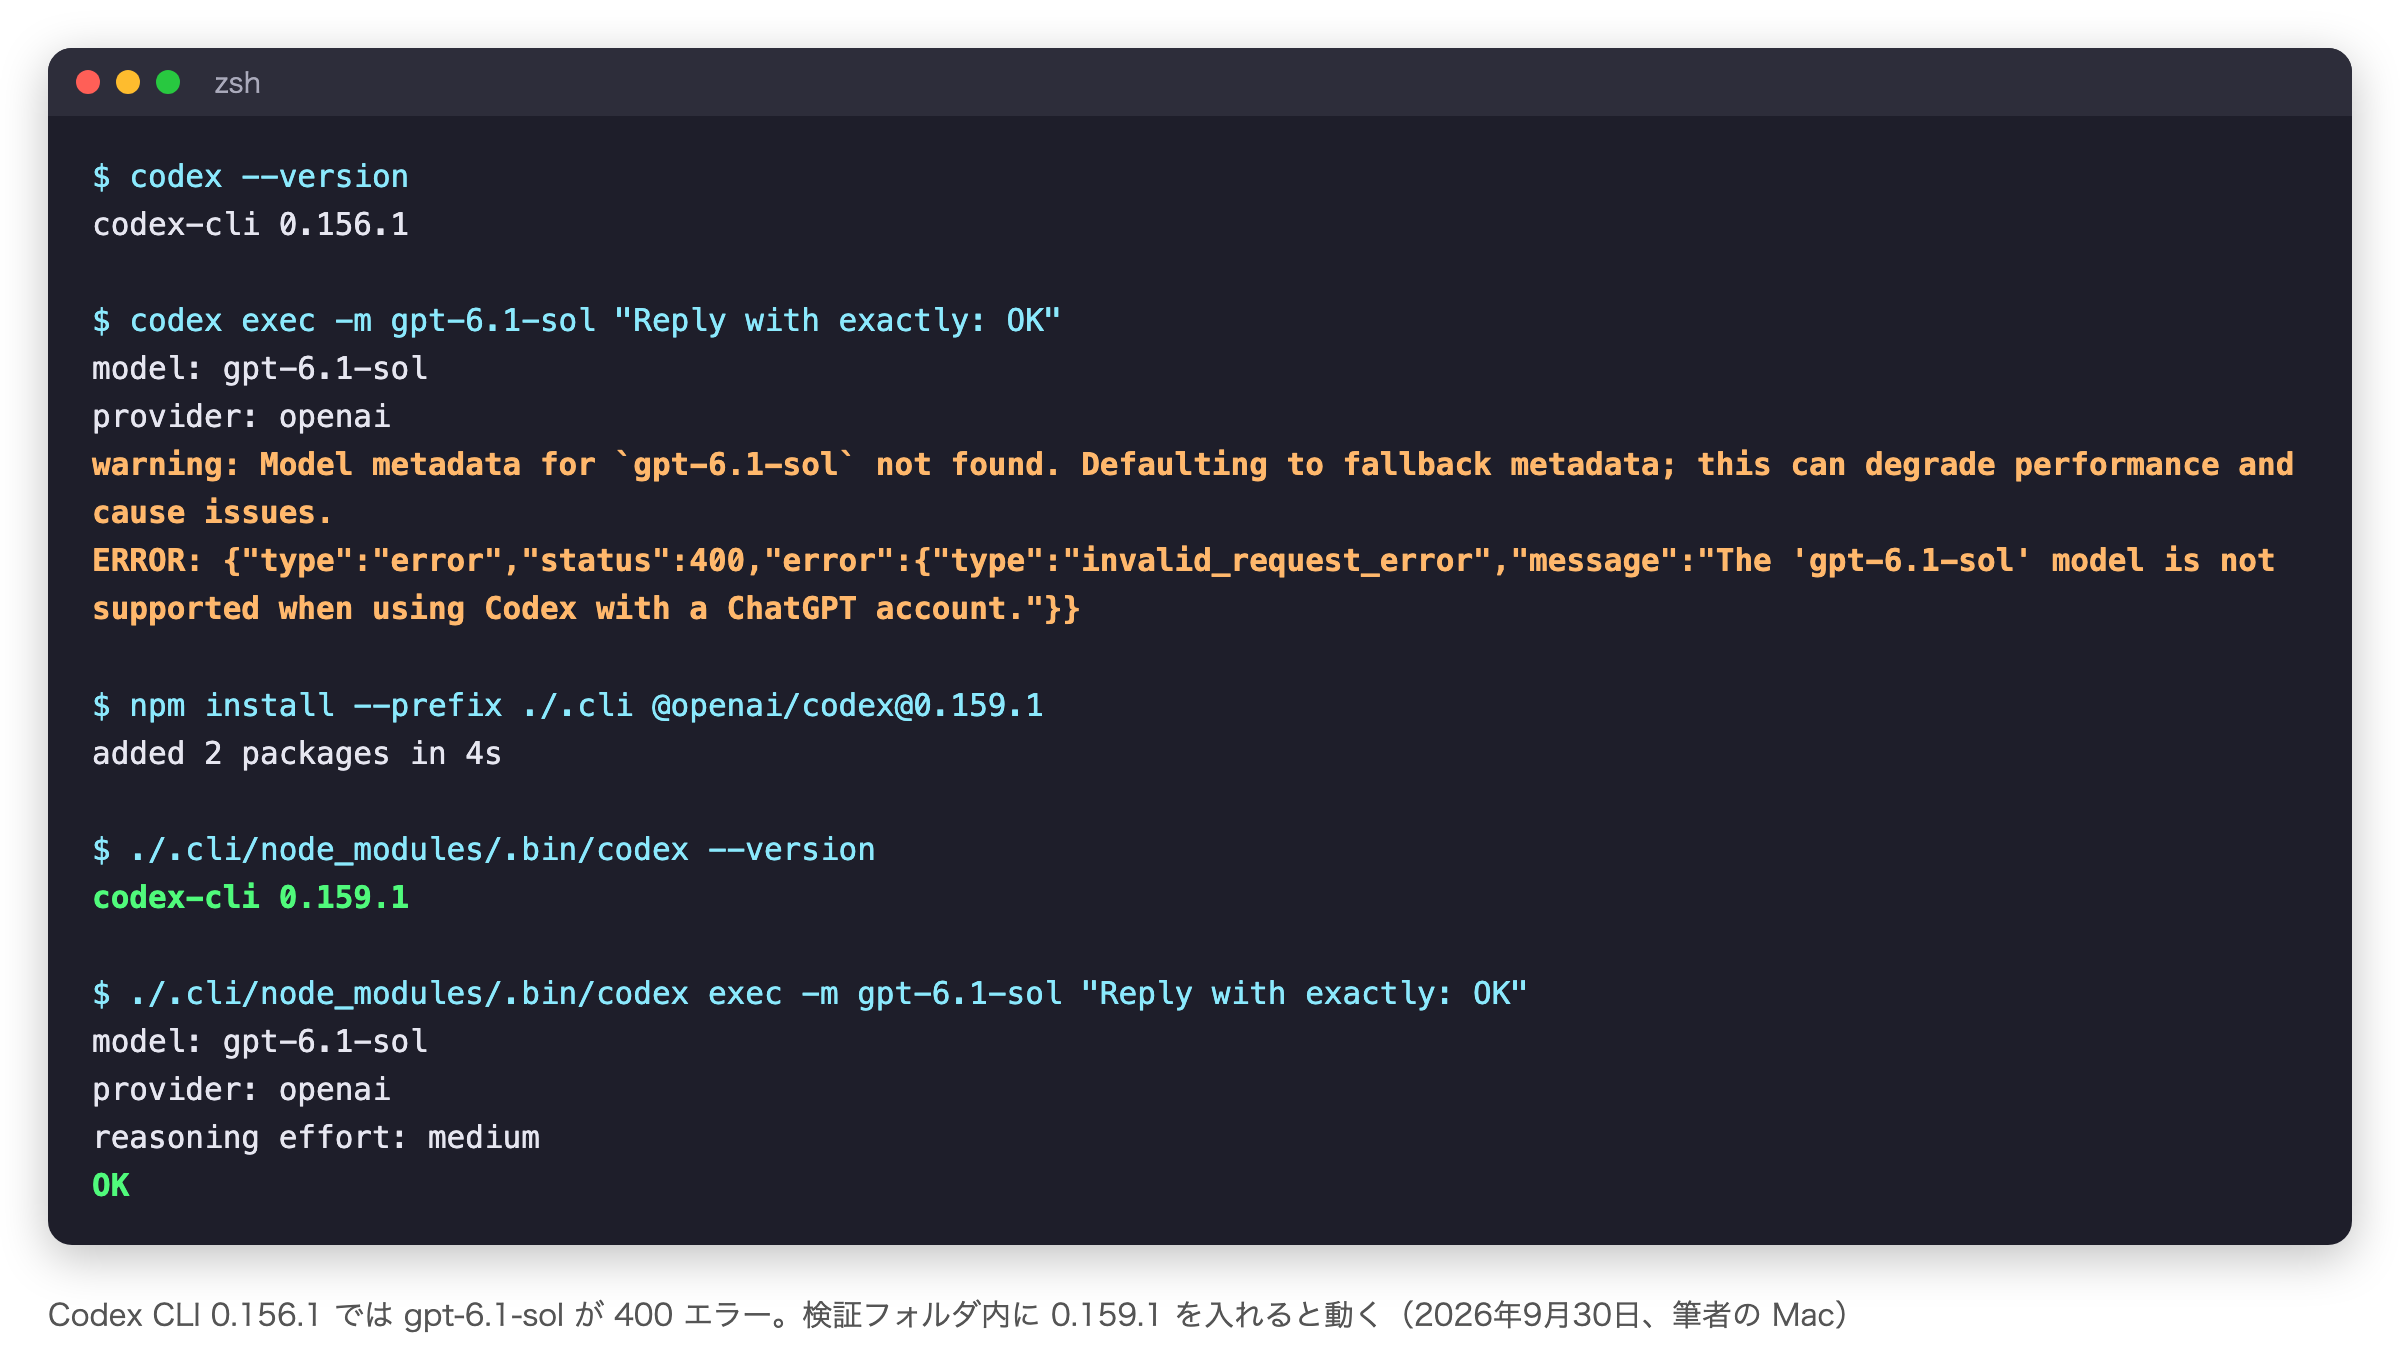
0.156.1 では「ChatGPT アカウントでは未対応」のエラー。0.159.1 では既定モデルが GPT-6.1 Sol になり、そのまま使えます(筆者の端末出力を整形)。
グローバルの Codex を更新するなら codex update です。更新したくない場合は、検証用のフォルダにだけ新しい版を入れられます。
# 検証フォルダにだけ Codex CLI 0.159.1 を入れる(グローバルの codex はそのまま)
npm install --prefix ./.cli @openai/codex@0.159.1
./.cli/node_modules/.bin/codex --version   # codex-cli 0.159.1
0.159.1 からは既定モデルが GPT-6.1 Sol なので、-m を付けなくても 6.1 Sol が使われます。GPT-6 Sol を使い続けたい場合は ~/.codex/config.toml に model = "gpt-6-sol" を書きます。
API では Responses API を使う
ツール呼び出しを使うなら Responses API です。最小の呼び出しは次の形になります(筆者は API キーを使っていないため、このコードは未実行です。公式ドキュメントの形式に沿って書いています)。
from openai import OpenAI

client = OpenAI()  # 環境変数 OPENAI_API_KEY を使う

resp = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},   # low / medium / high / xhigh / max(none は不可)
    input="請求額が数円ずれる原因として考えられるものを3つ挙げてください。",
)
print(resp.output_text)
GPT-6 Sol から移行するときのチェックリストです。
| 確認項目 | 対応 |
|---|---|
reasoning.effort に none / minimal を指定している | low に変える。推論なしが必須なら GPT-6 Sol か Luna |
| Chat Completions でツール(function calling)を使っている | Responses API に移す。Chat Completions はツールなしの会話だけ |
| 272K トークンを超える入力を送っている | 入力2倍・出力1.5倍の料金になる(GPT-6 Sol も同じ) |
| EU のデータ所在地で Fast モードを使っている | 6.1 Sol の Fast は EU では使えない |
| 費用を見積もる | 単価ではなく「1タスクの合計トークン」で。キャッシュが効く割合(手元では86〜88%)が効く |
トラブルシューティング
| 症状 | 原因 | 対処 |
|---|---|---|
Codex で The 'gpt-6.1-sol' model is not supported when using Codex with a ChatGPT account | Codex CLI が古い(0.158 以前) | codex update で 0.159 系に。または上記のようにフォルダ内に新しい版を入れる |
Model metadata for gpt-6.1-sol not found の警告 | 同上。CLI のモデル一覧に 6.1 Sol がない | 同上 |
| ChatGPT の通常の Chat にモデルが出てこない | Chat は未提供(ChatGPT Work と Codex のみ) | ChatGPT Work か Codex を使う |
| Enterprise / Edu で選べない | 既定でオフ | 管理者に有効化を依頼する |
API で reasoning.effort: none がエラー | 6.1 Sol は none 非対応 | low にする |
| Chat Completions でツールが呼ばれない | 6.1 Sol のツール呼び出しは Responses API のみ | Responses API に移行する |
| 推論問題で「未算出」「未確定」と返ってくる | medium では長い場合分けを途中で切り上げる | effort を上げる。それでも出なければ Astra に回す |
GPT-6 Sol で apply_patch verification failed: multiple operations target ... | 同じファイルに複数操作を含む不正なパッチ(手元では21回中10回) | 6.1 Sol では発生しなかった。再試行で通ることが多い |
まとめ
- GPT-6.1 Sol は、GPT-6 Sol と同じ $2 / $10 の料金で、コーディング・文書読解・事実性を Astra と同じ高さまで引き上げたモデルです。公式の DeepSWE は Astra と同等(75.2% 対 74.8%)、GDP.pdf は 0.2pt 差、OSWorld は 2.1pt 差で、いずれもコストは 1/5〜1/7 です。
- 筆者の手元でも、実装5題と作ってみた2題は3モデルとも全回満点で、6.1 Sol の費用は Astra の約1/5、GPT-6 Sol の2/3でした。安い理由は、進め方が Astra に近づいてツール呼び出しと思考トークンが減ったことです。ただし速くはなっていません。
- Astra との差は「粘る仕事」に残ります。 公式の Terminal-Bench Science は 11pt 差、手元の推論(難)は medium で Astra 25/27 対 6.1 Sol 22/27、high で 24/27 対 23/27。迷路と順列の問題で差がつきました。effort を high にしても、7題の結果は変わらず費用と時間だけ増え、順列は Astra を含む3モデルとも解けなくなりました。
- 使い分けは「GPT-6.1 Sol を既定にして、科学系・長時間の探索・答えを出し切る必要がある難問だけ Astra」。GPT-6 Sol を使い続ける理由はほぼありません。
- 移行の注意は3つ。Codex CLI は 0.159 系、effort=none は不可、ツール呼び出しは Responses API のみです。
次のステップとしては、自分の本番タスクを20件ほど抜き出して、GPT-6 Sol / Astra と 6.1 Sol の両方に流し、成功率・総トークン・ツール呼び出し数・完了時間・1タスクの費用を並べてみることをおすすめします。この記事の検証スクリプト(bench/run_bench.py)は、課題フォルダとモデル名を差し替えればそのまま使えます。
参考リソース
- OpenAI「Introducing GPT-6.1 Sol」(2026年9月29日) https://openai.com/index/introducing-gpt-6-1-sol/
- OpenAI API Model ページ:gpt-6.1-sol https://developers.openai.com/api/docs/models/gpt-6.1-sol / gpt-6-sol https://developers.openai.com/api/docs/models/gpt-6-sol / gpt-6-astra https://developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI「Addendum to GPT-6 Astra System Card: GPT-6.1 Sol」 https://deploymentsafety.openai.com/gpt-6-1-sol
- ChatGPT & Codex の料金(クレジット単価・プラン別の目安) https://learn.chatgpt.com/docs/pricing
- ChatGPT & Codex の変更履歴(Codex CLI 0.159.1 で既定モデル化) https://learn.chatgpt.com/docs/changelog
- OpenAI Help Center「ChatGPT Work and Codex」 https://help.openai.com/en/articles/20001275-chatgpt-work-and-codex
- The Decoder「GPT-6.1 Sol comes close to Astra at a fifth of the price」 https://the-decoder.com/gpt-6-1-sol-comes-close-to-astra-at-a-fifth-of-the-price/
- Vellum「GPT-6.1 Sol Benchmarks Explained」 https://www.vellum.ai/blog/gpt-6-1-sol-benchmarks-explained
- 同じ課題で測った前回の記事:Claude Sonnet 5.5 は Sonnet 5 から何が変わった? https://takuya-genai.com/claude-sonnet-5-5-vs-sonnet-5/