はじめに
「簡単な質問は安い小型モデル、難しい質問は大型モデル」。このようなモデルの使い分け(モデルルーティング)は、判定モデル(Decision Model)の登場でぐっと身近になりました。質問を受け付けた瞬間に「この質問はどのモデル向きか」を判定し、振り分ける方式です。
ただ、この方式には弱点があります。1 回の回答の中で本当に難しいのは、考え方の向きを決める一部分だけということが多いのです。それでも「難しい」と判定された質問は、問題文の書き写しや単純な計算のような、小型モデルでも書ける部分まで含めて、最後まで大型モデルが書きます。
そこで注目されているのが、回答を書いている途中でも、1 トークンごとに担当モデルを切り替える「トークン単位ルーティング(Token-level Routing)」です。2026 年 10 月 8 日、清華大学のチームが、この方式を実用的な速さで動かすための推論基盤 TokenRouter を論文とともに公開しました。
この記事では、次の 3 つを順に紹介します。
- モデルの使い分けが「リクエスト単位」から「トークン単位」へ進んできた流れ
- TokenRouter が何を解決し、どんな仕組みで速くしているのか
- 実際に Mac 上で、公式の学習済みルーターを使って Qwen3-0.6B と Qwen3-32B をトークン単位で切り替えてみた結果(動画・画像つき)
先に結果を少しだけ紹介すると、数学の問題 30 問で、正解数は 0.6B のみ 20 問、トークン単位の切り替え 23 問、32B のみ 27 問でした。32B に任せたのは全トークンの 28.3% で、時間は 32B のみの約 56% です。そして 32B に回ったのは、数字ではなく「since」「But」「Wait」のような推論の向きを決める言葉でした。良い点も、1 台の Mac では見えにくい点も、順に見ていきます。
まずは、この記事全体で扱う「単位の違い」を図で見てください。上が従来のリクエスト単位、下がトークン単位です。
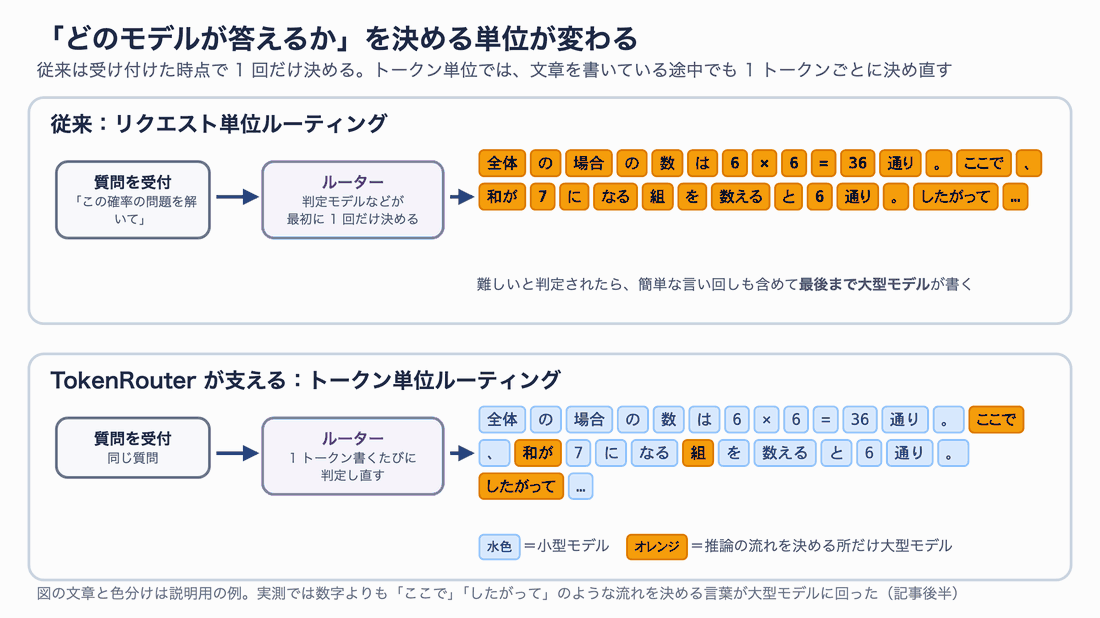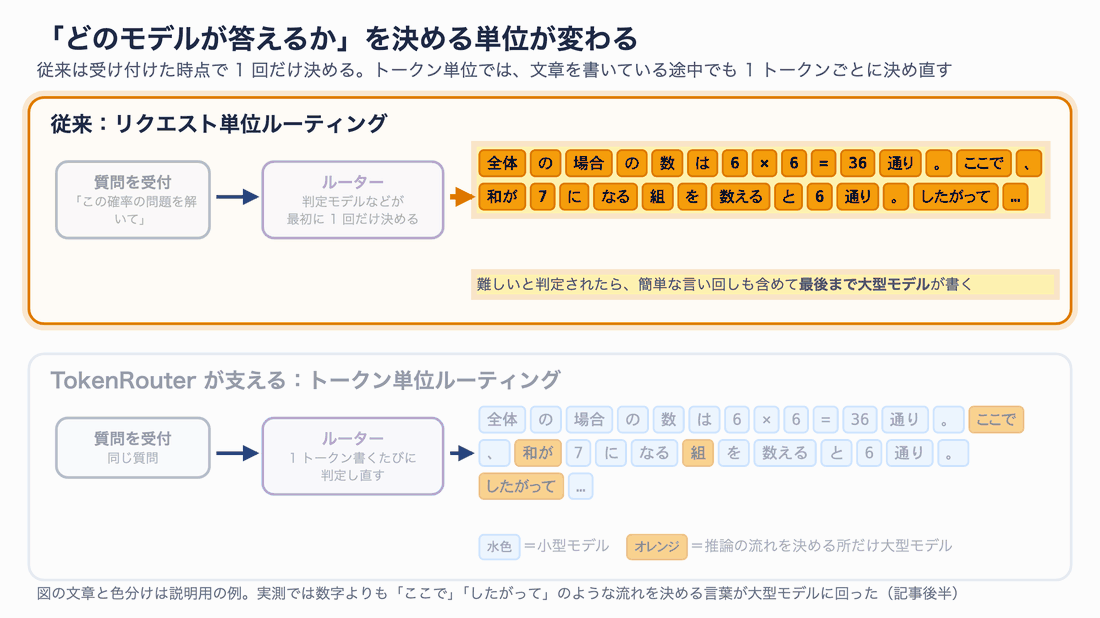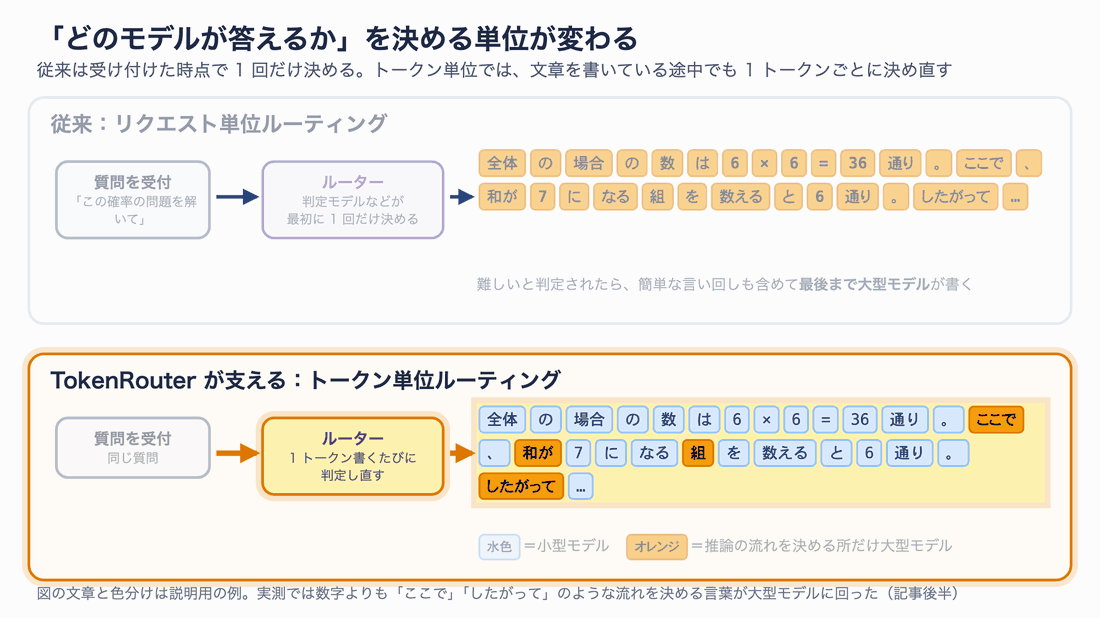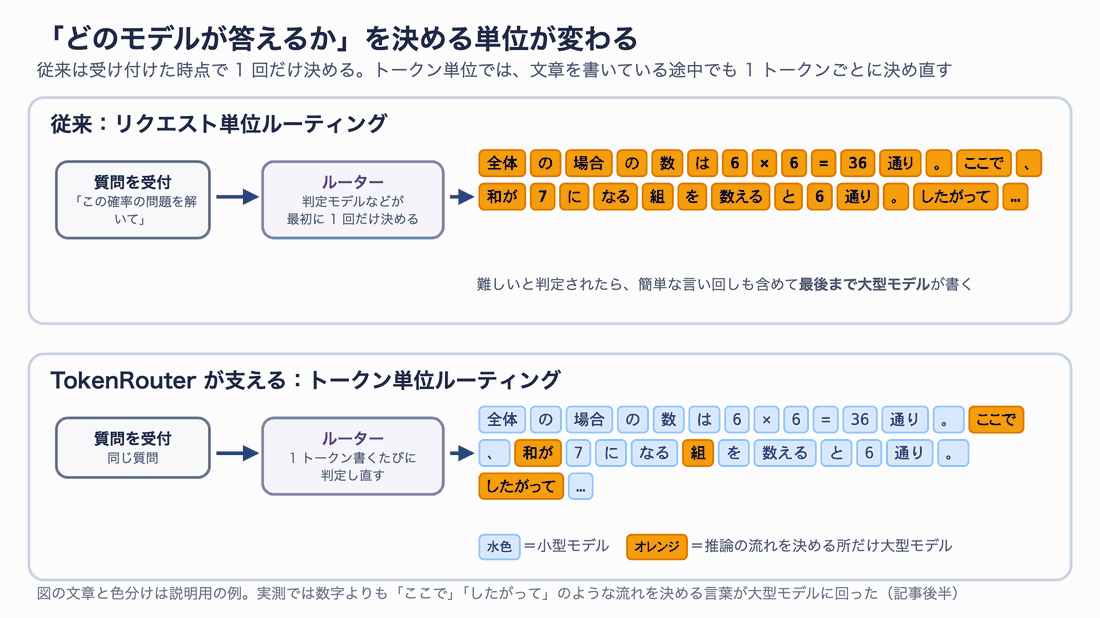
図1 従来は受け付けた時点で 1 回だけ決める。トークン単位では、水色(小型)の中に必要な所だけオレンジ(大型)が混ざる
想定読者は、LLM を API やローカルで使ったことがあり、「モデルの使い分け」でコストや速度を改善したい方です。GPU サーバーの専門知識がなくても読めるように、専門用語には短い説明を添えます。
この記事の確認範囲
- 確認日:2026 年 10 月 12 日
- 一次情報:論文「TokenRouter: Efficient Serving System for Token-Level LLM Routing」(arXiv:2610.12242 v1、NeurIPS 2026 採択)、公式リポジトリ thu-nics/TokenRouter(2026 年 10 月 9 日時点のコード)、プロジェクトページ
- 検証環境:MacBook Pro(Apple M5 Max・メモリ 128GB)、MLX 0.32 系(mlx-lm 0.32.0)、Python 3.12
- TokenRouter 本体は NVIDIA GPU(CUDA)専用のため、今回は本体のサーバーは動かしていません。公式の学習済みルーターと同じ切り替え手順を Mac(MLX)に移植し、トークン単位ルーティングそのものの効果を確かめました。どこが同じでどこが違うかは、後半の検証の節で詳しく書きます
モデルの使い分けは「細かく」なってきた
段階 1:モデルを 1 つに固定する
一番単純なのは、どんな質問も同じモデルに答えさせる方法です。設定は簡単ですが、大型モデルに固定すれば簡単な質問にも高いお金と時間がかかり、小型モデルに固定すれば難しい質問で間違えます。
段階 2:リクエスト単位で振り分ける
次に広まったのが、質問を受け付けた時点で担当モデルを決めるリクエスト単位(クエリ単位)ルーティングです。研究では RouteLLM などが知られ、実務では判定モデル(TypeSafe の Jev や OpenAI の Decisions API など)に「この質問は難しいか」「どの窓口向きか」を判定させて振り分ける作り方が手軽になりました。TokenRouter の論文も、ChatGPT や Cursor のような商用サービスがクエリ単位で別モデルへ振り分けている例として挙げています。
ただし、一度振り分けたら、その回答は最後まで同じモデルが書きます。回答の一部だけが難しい場合でも、全体を大型モデルに任せるしかありません。
段階 3:トークン単位で切り替える
そこで「回答の途中でも担当を替えればよいのでは」という発想が生まれます。これがトークン単位ルーティングです。トークン(token)とは、LLM が文章を読み書きするときの最小単位で、英語ならおおむね単語や単語の一部、日本語なら 1〜数文字にあたります。
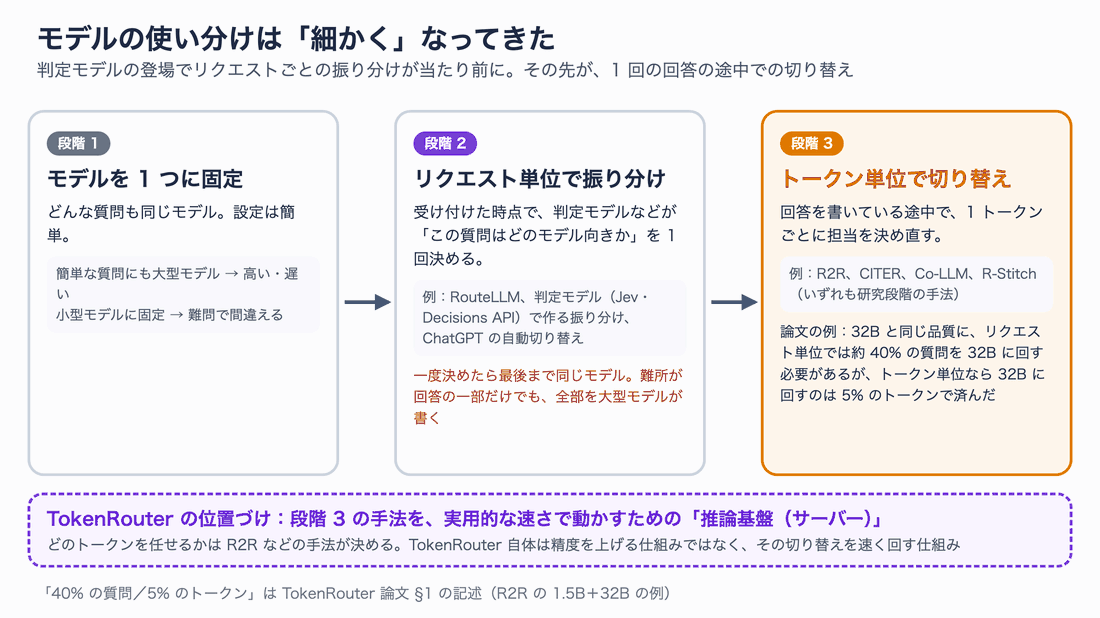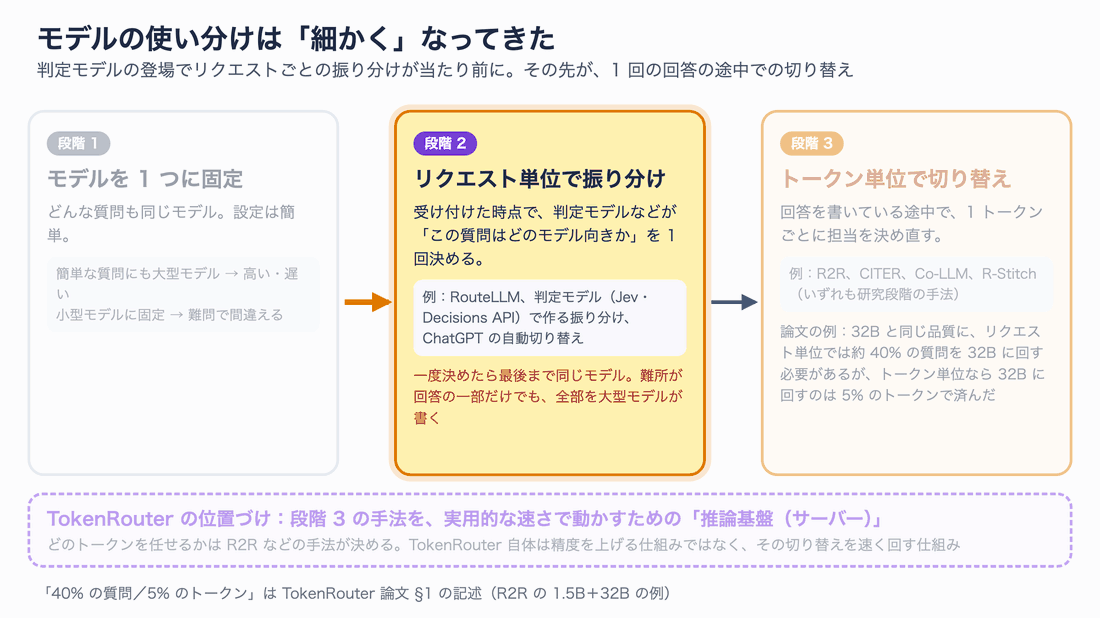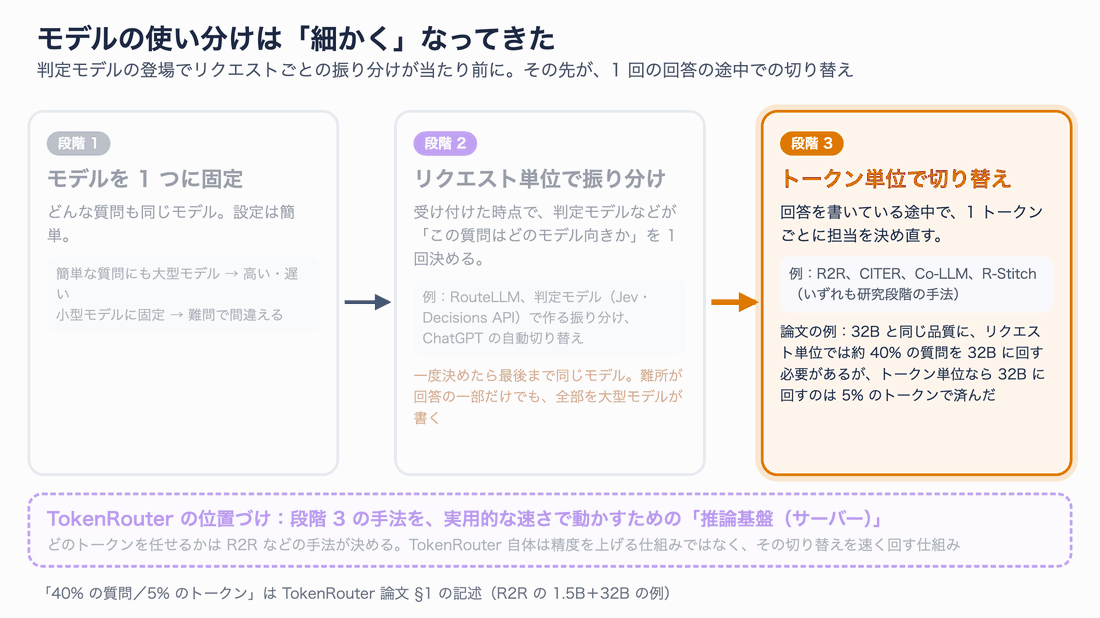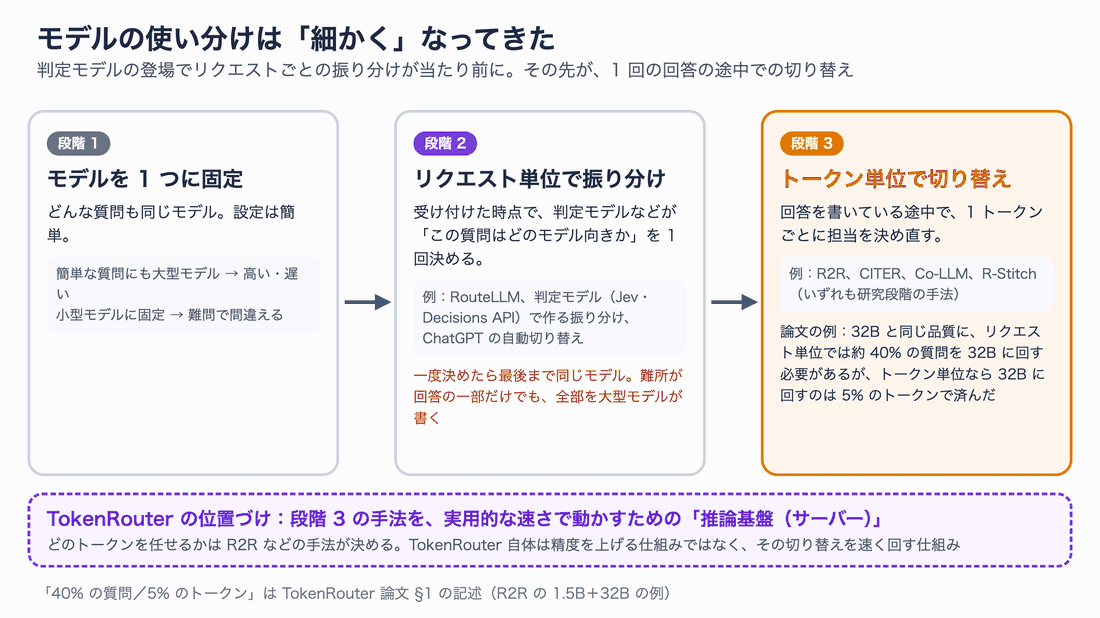
図2 段階 2 から段階 3 へ。TokenRouter は「どのトークンを任せるか」を決める手法ではなく、それを速く回すための土台
なぜトークン単位にすると得なのでしょうか。論文の導入では、R2R という手法の例として「32B モデルと同じ品質を出すのに、クエリ単位では約 40% の質問を 32B に回す必要があるが、トークン単位なら 32B に回すのは 5% のトークンで済む」と説明しています。
R2R の論文(arXiv:2505.21600)の分析も、この直感を裏付けています。大型モデル(DeepSeek-R1-Distill-Qwen-32B)が書いた約 760 万トークンについて、各位置で小型モデル(同 1.5B)の予測と比べると、予測が食い違うのは約 11% だけでした。しかもその中には「let’s」と「let us」のような意味の変わらない違いも含まれ、推論の流れそのものを変えてしまうトークン(divergent token)は全体の 4.9% でした。残りの 9 割以上は、小型モデルに任せても問題がないわけです。
判定モデルによるリクエスト単位の振り分けが「どのモデルに任せるか」の判断だったとすれば、トークン単位ルーティングはその判断を、文章を書いている最中の 1 トークンずつにまで細かくしたものと言えます。
代表的な手法 R2R:怪しいトークンだけ大型モデルが書き直す
TokenRouter のリポジトリで最初の例として使われているのが、同じ清華大学のチームによる R2R(Roads to Rome) です。今回の検証でもこの R2R を使います。仕組みは次のとおりです。
- 小型モデル(例:Qwen3-0.6B)が、いつもどおり次のトークンを 1 つ出します
- ルーターと呼ばれる小さなニューラルネット(約 5,500 万パラメータ)が、「このトークンのせいで、この先の推論が大型モデルとずれそうか」の確率を出します。入力は、小型モデルの最終層の内部状態(hidden states)、次のトークン候補の上位 100 個のスコア(logits)、実際に出したトークンの 3 つです
- 確率が閾値以上なら、小型モデルのトークンを捨て、大型モデル(例:Qwen3-32B)がその位置の 1 トークンだけを出し直します
- 次のトークンからは、また小型モデルに戻ります
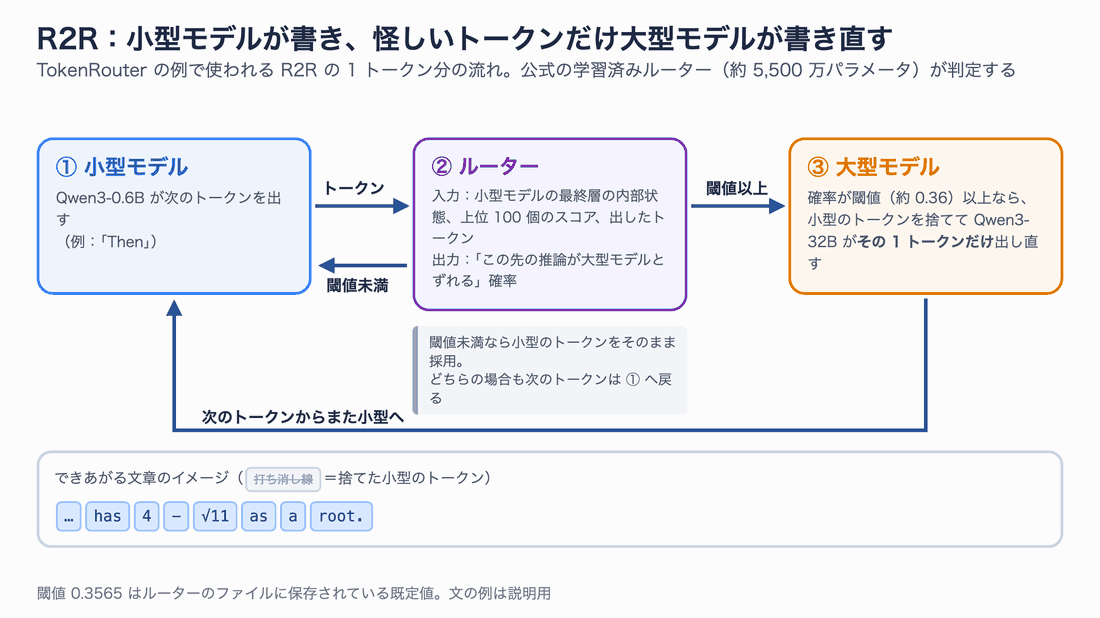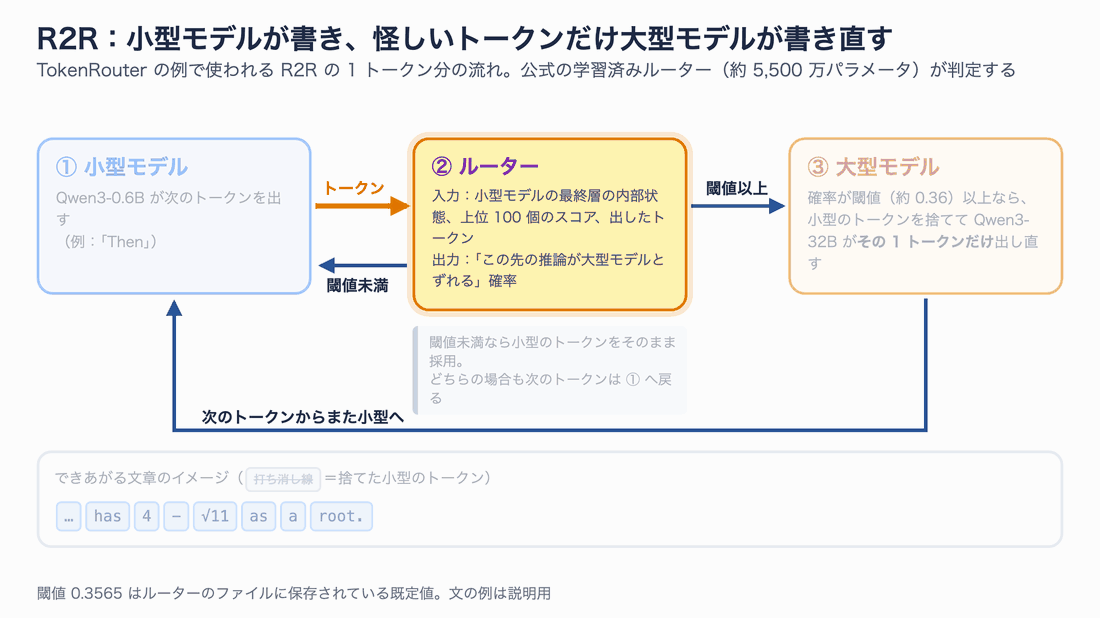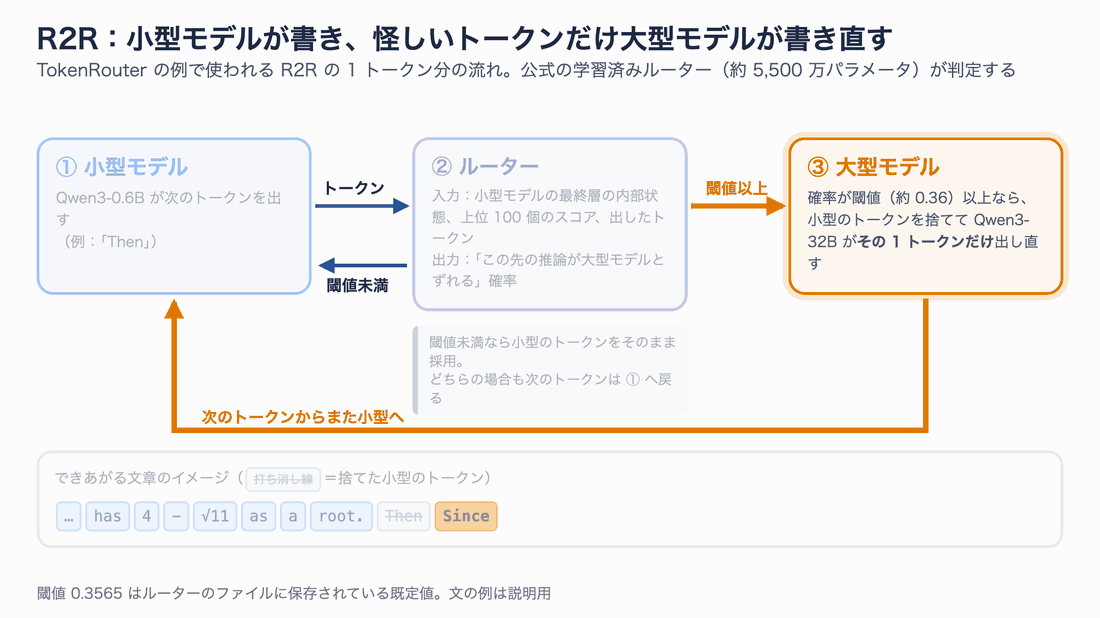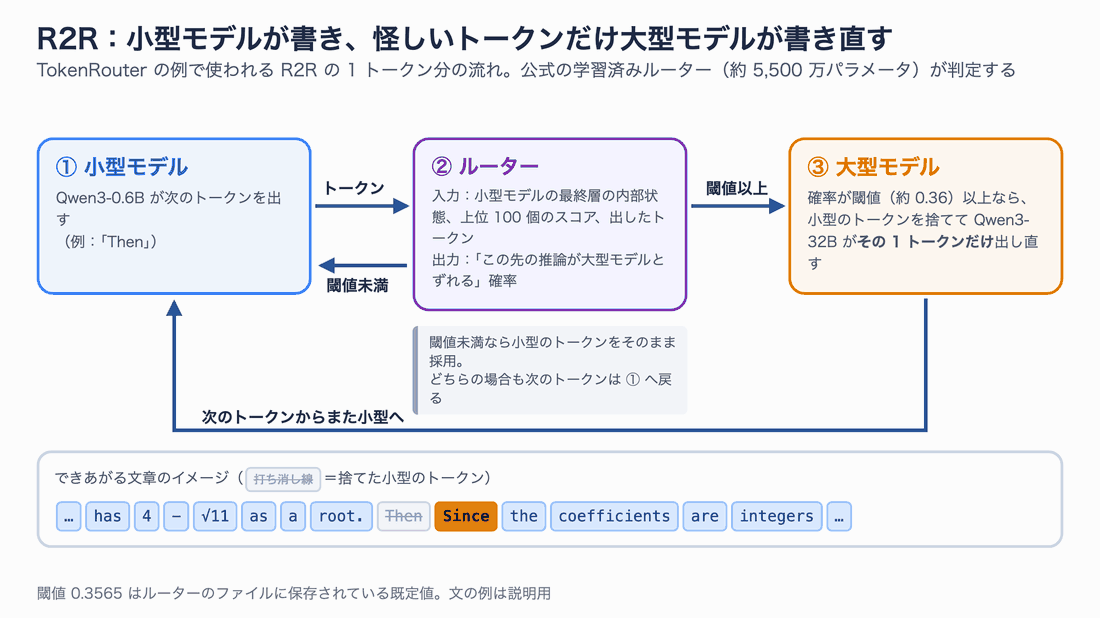
図3 R2R の流れ。大型モデルは「1 トークン出したら戻る」を繰り返す
よく似た仕組みに投機的デコーディング(Speculative Decoding)があります。小型モデルが下書きし、大型モデルがまとめて検証する高速化の手法です。違いは「出力が大型モデル単体と同じになるか」です。投機的デコーディングは大型モデルの出力と完全に一致させるのが目的で、品質は変わりません。一方のトークン単位ルーティングは、意味の変わらない違いは小型モデルのまま受け入れるので、出力は大型モデル単体と同じとは限りません。その代わり、大型モデルを呼ぶ回数を大きく減らせます。品質とコストの釣り合いを、閾値 1 つで調整できるのも特徴です。
TokenRouter とは:トークン単位ルーティング専用の推論基盤
TokenRouter は、清華大学(電子工学系の NICS-EFC 研究室)を中心とする 7 人のチームが公開した、トークン単位ルーティング専用のサービング基盤(推論サーバー)です。サービング基盤とは、vLLM や SGLang のように、たくさんの利用者からのリクエストをまとめて効率よく LLM に処理させるサーバーのことです。
公式リポジトリ thu-nics/TokenRouter(2026 年 10 月 12 日撮影)
公開内容をまとめると、次のようになります。
| 項目 | 内容 |
|---|---|
| 公開 | 論文 arXiv v1 が 2026 年 10 月 8 日、リポジトリも同日作成。NeurIPS 2026 採択 |
| 作者 | 清華大学(1 人はカーネギーメロン大学)の Tianyu Fu、Tengxuan Liu ほか |
| 位置づけ | R2R・CITER・Co-LLM・R-Stitch などのトークン単位ルーティング手法を動かすための基盤。ルーティングの判断方法そのものは各手法が決める |
| 実装 | SGLang 0.5.1 をベースに拡張。PyTorch 2.8・CUDA・FlashInfer に依存(NVIDIA GPU 前提) |
| 使い方 | YAML 1 つで設定し、OpenAI 互換の API サーバーとして起動。Python から直接呼ぶ TokenRoutingEngine もある |
| 開発者が書くもの | route()・send()・receive() の 3 つの関数 |
| 同梱の手法 | R2R、CITER、Co-LLM、R-Stitch、GlimpRouter、ME(3 モデルの組み合わせ)、比較用のクエリ単位ルーティングとランダム |
| ライセンス | 論文は CC BY 4.0。リポジトリは pyproject.toml に Apache と書かれているが、LICENSE ファイルは置かれていない(2026 年 10 月 12 日時点) |
プロジェクトページには、Session(会話単位)・Query(質問単位)・Token(トークン単位)の 3 つの粒度でモデルの割り当てがどう変わるかを再生できるアニメーションがあります。
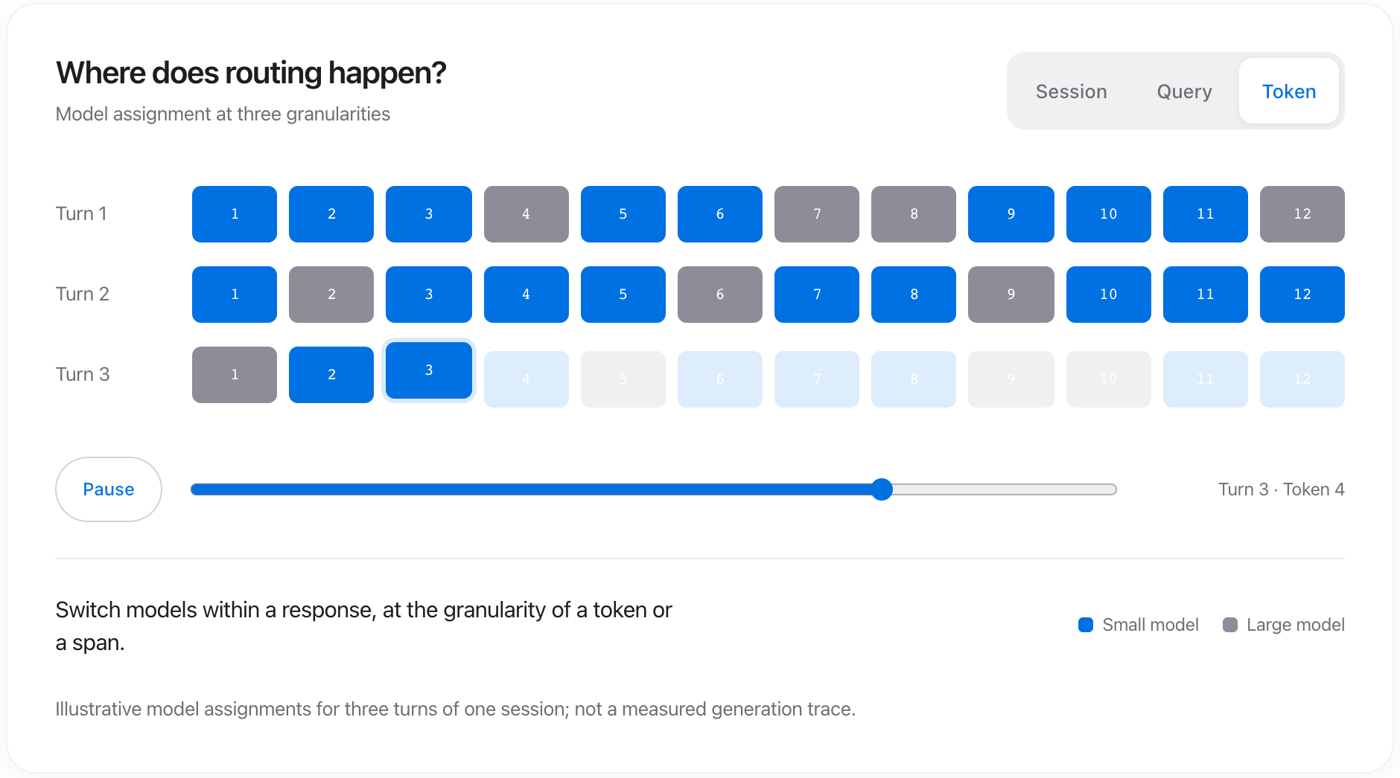
プロジェクトページの粒度の比較(Token を選んだ状態)。ページの注記どおり、説明用の割り当てで実測ではありません
なぜ「専用の基盤」が必要なのか
トークン単位ルーティングのアイデア自体は、R2R など以前からありました。それでも TokenRouter が必要になった理由は、既存の推論サーバーが「1 つのリクエストは 1 つのモデルが最後まで処理する」前提で作られているからです。
vLLM や SGLang は、処理中のリクエストをまとめて 1 つのバッチにし、全員で 1 歩(1 トークン)ずつそろって進みます。ところがトークン単位ルーティングでは、1 歩ごとに担当モデルが変わります。論文はここで起きる問題を 3 つ挙げています。
| 問題 | 何が起きるか |
|---|---|
| ステップのずれ | 小型と大型では 1 歩の時間が大きく違う。全員をそろえて進めると、毎回いちばん遅い大型モデルを待つことになり、小型モデルが遊ぶ |
| バッチへの受け入れ待ち | 切り替えが頻繁なので、リクエストが届いたとき相手のモデルはたいてい前のバッチを処理中。次のバッチまで待たされ、バッチも細切れになる |
| 実装の難しさ | 既存のサーバーには「1 歩ごとに行き先を決める」書き場所がない。巨大なコードを改造し、連続バッチ処理やキャッシュとの整合も取らなければならない |
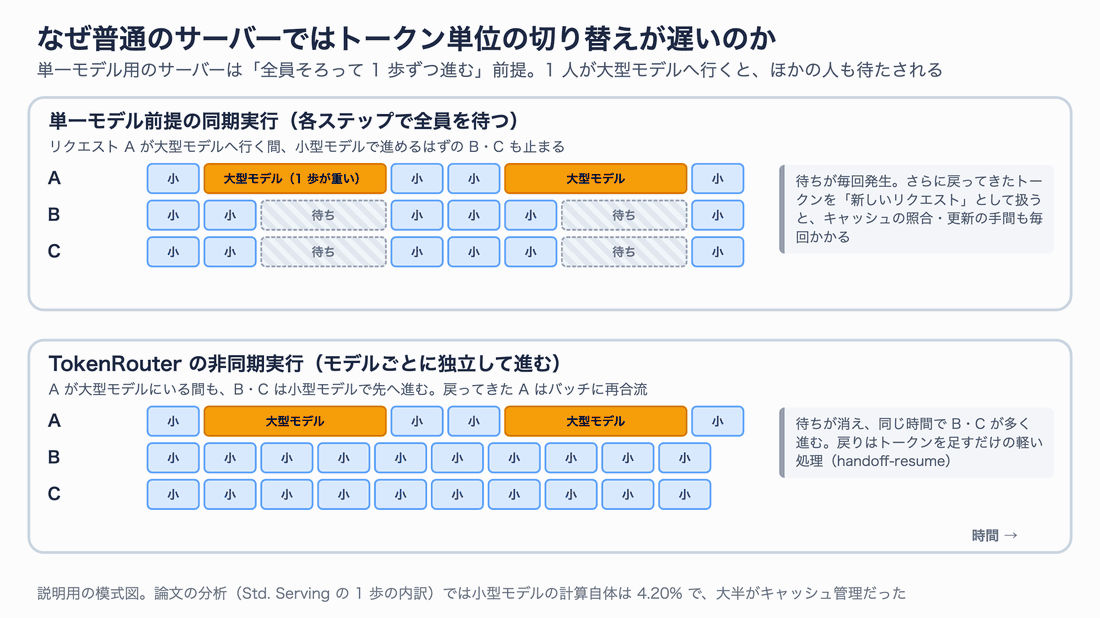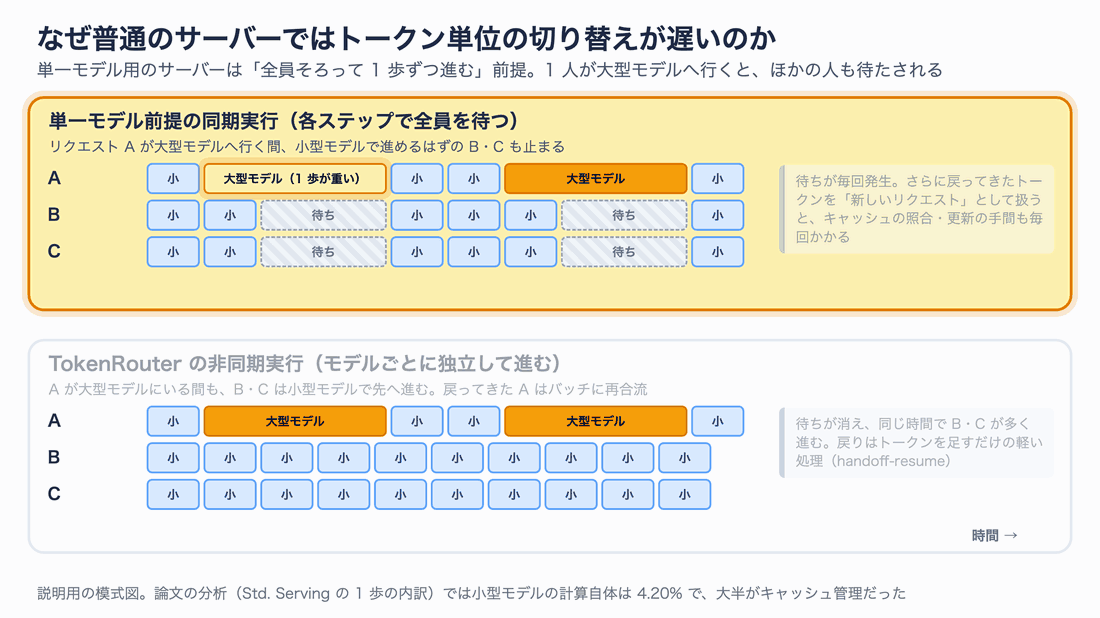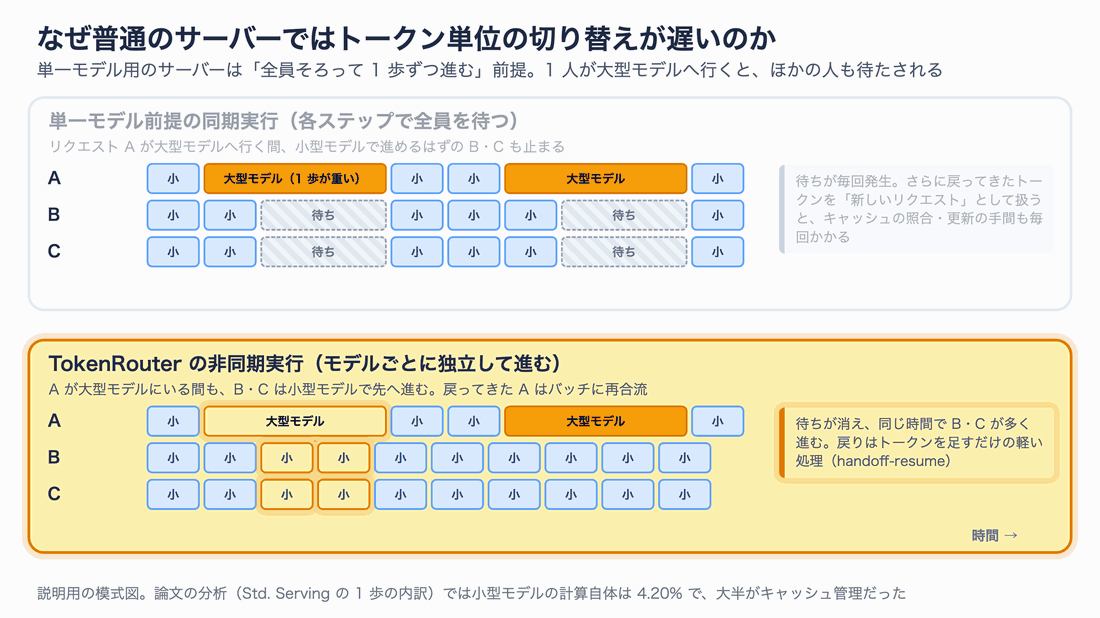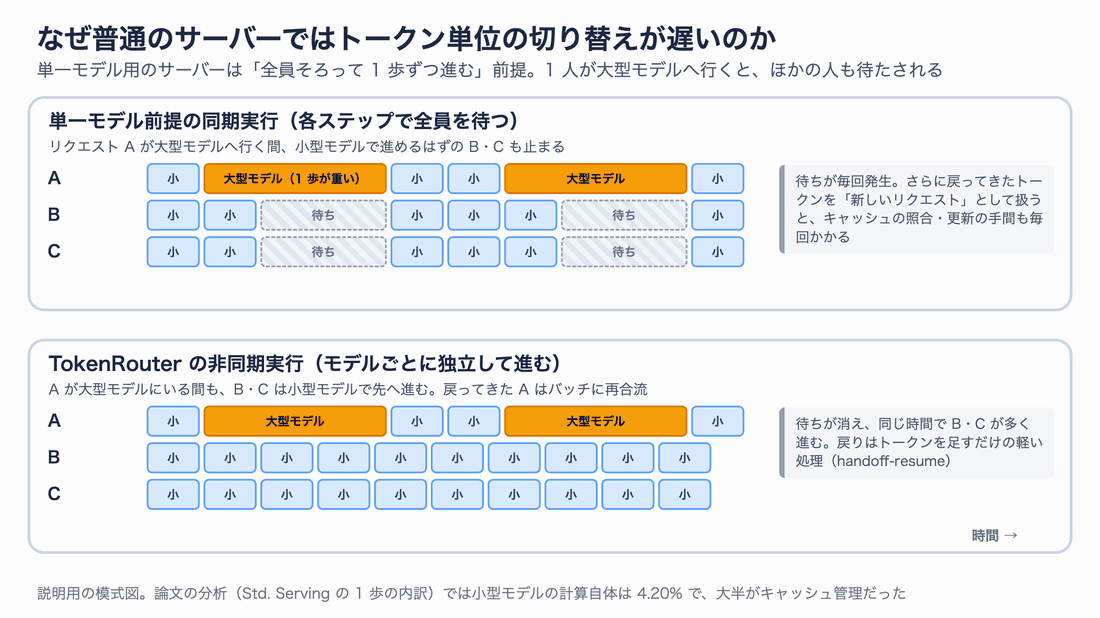
図4 同期実行では、1 人が大型モデルへ行くたびに全員が待つ。非同期実行ではそれぞれが自分のペースで進む
論文は、SGLang のサーバーをモデルごとに立てて外から 1 トークンずつ振り分ける素直な構成(論文では「Std. Serving」)も試しています。2,048 トークン生成の終盤で小型モデル側の 1 歩を分解すると、小型モデルの計算そのものは 4.20% だけで、残りはキャッシュの照合(20.94%)、ロック(17.47%)、ロック解除(13.81%)、キャッシュ更新(32.62%)などの管理作業でした。戻ってきたトークンを毎回「新しいリクエスト」として扱うため、照合や更新が毎回走ってしまうのです。
TokenRouter の仕組み
モデルごとに独立した「サブサーバー」
TokenRouter の基本方針は、論文の言葉で「リクエスト中心に書き、モデル中心に実行する」です。開発者は「1 つのリクエストがモデル間をどう移るか」だけを書き、実行はモデルごとに用意されたサブサーバーが受け持ちます。
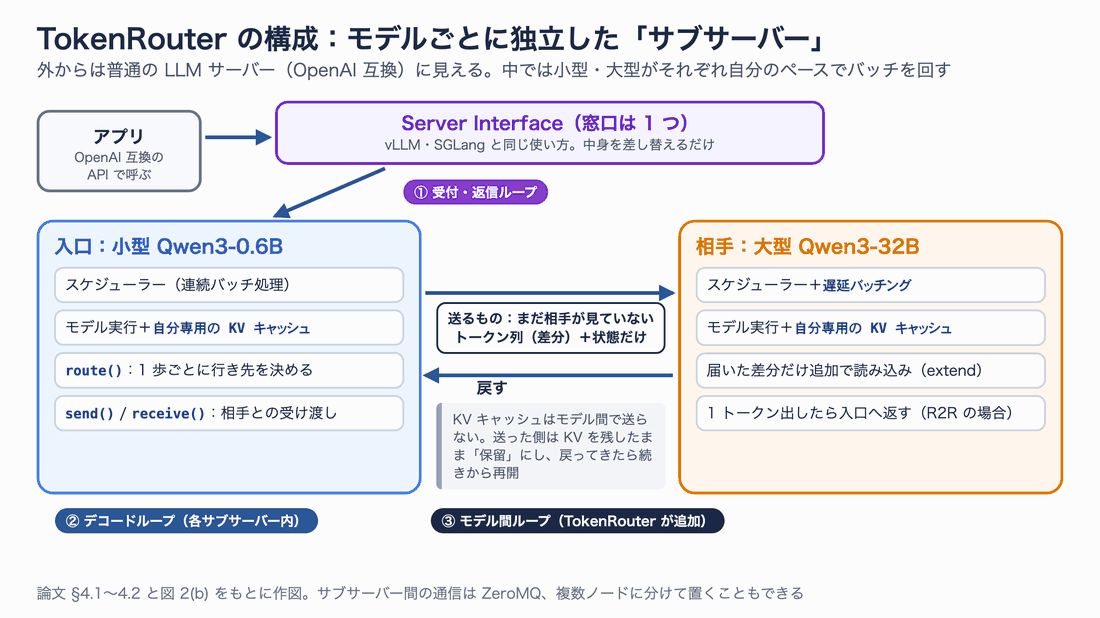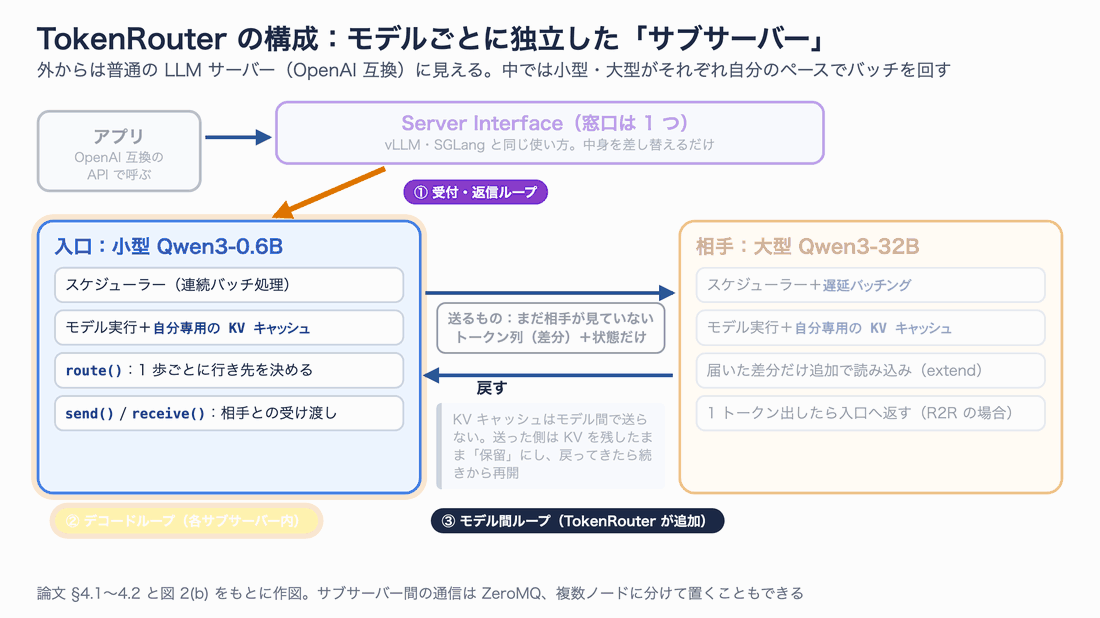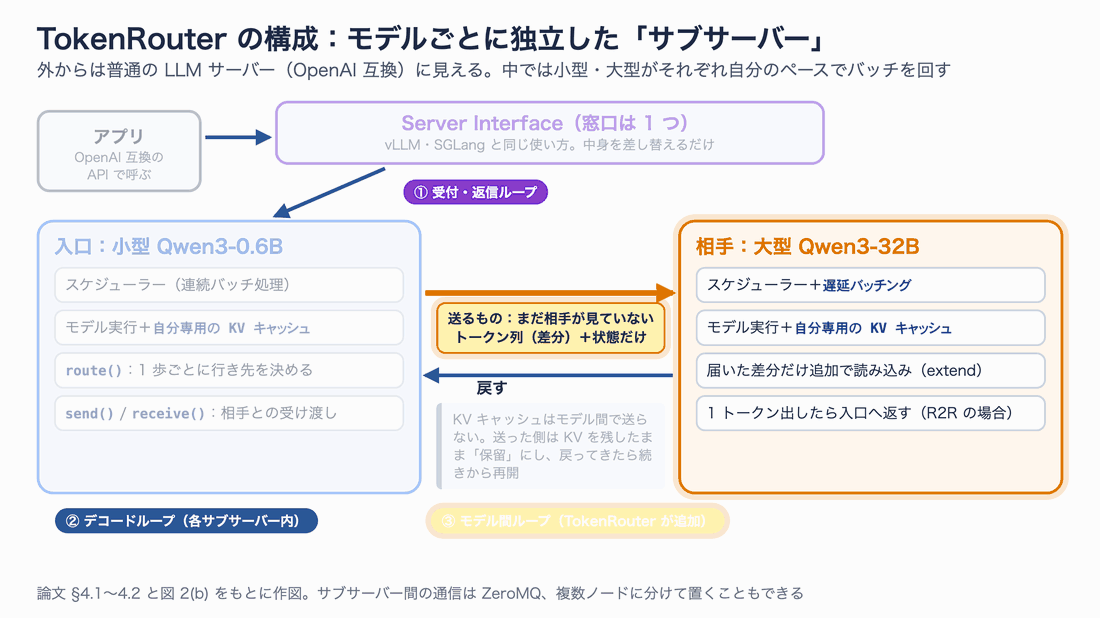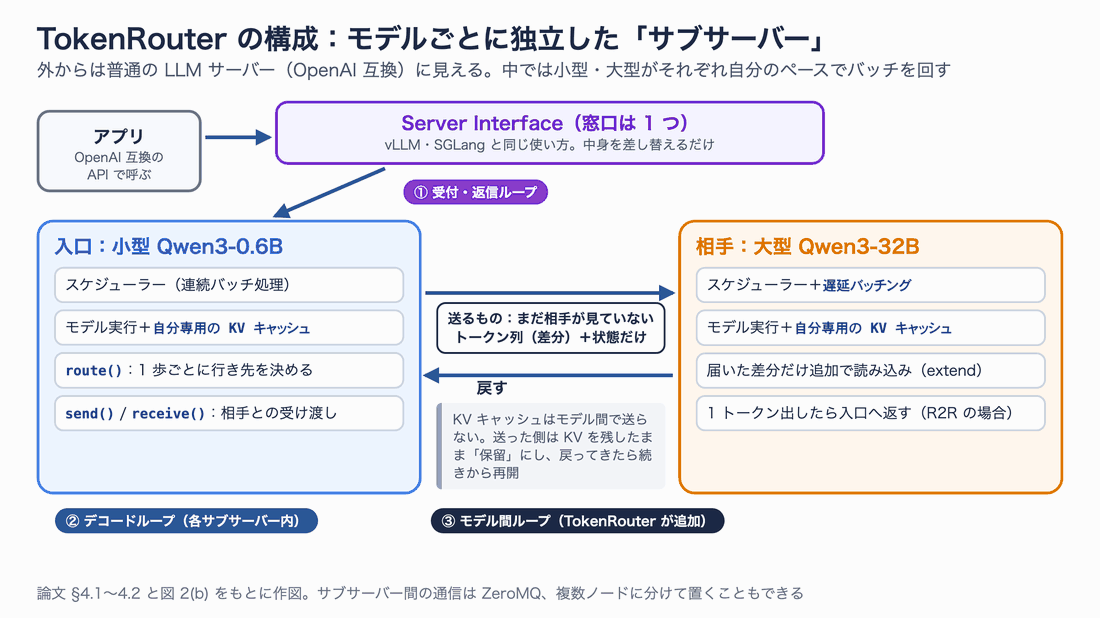
図5 外から見ると普通の LLM サーバー。中では小型・大型のサブサーバーが独立にバッチを回す
ポイントは 3 つあります。
- 窓口は 1 つ:外からは vLLM や SGLang と同じ OpenAI 互換のサーバーに見えます。アプリ側は接続先を差し替えるだけです
- 3 つ目のループ:普通のサーバーは「受付・返信」と「デコード(生成)」の 2 つのループで動きますが、TokenRouter はサブサーバー同士でリクエストを送り合う「モデル間ループ」を足しています。あるリクエストが大型モデルに行っている間も、残りのリクエストは小型モデルで生成を続けられます
- KV キャッシュは送らない:KV キャッシュとは、それまでの文脈の計算結果を保存しておく領域です。モデルが違えば形も違うので、TokenRouter はモデル間で KV キャッシュを送らず、相手がまだ見ていないトークン列(差分)と状態だけを送ります。送り出した側は KV キャッシュを残したまま「保留(pending)」にしておき、戻ってきたらトークンを足すだけで再開します。論文はこれを、切り替えが「トークンを 1 つ追加するのとほぼ同じ手間」になると表現しています
論文の原図(図 2(b))も載せておきます。紫が受付・返信ループ、青がデコードループ、黒がモデル間ループです。
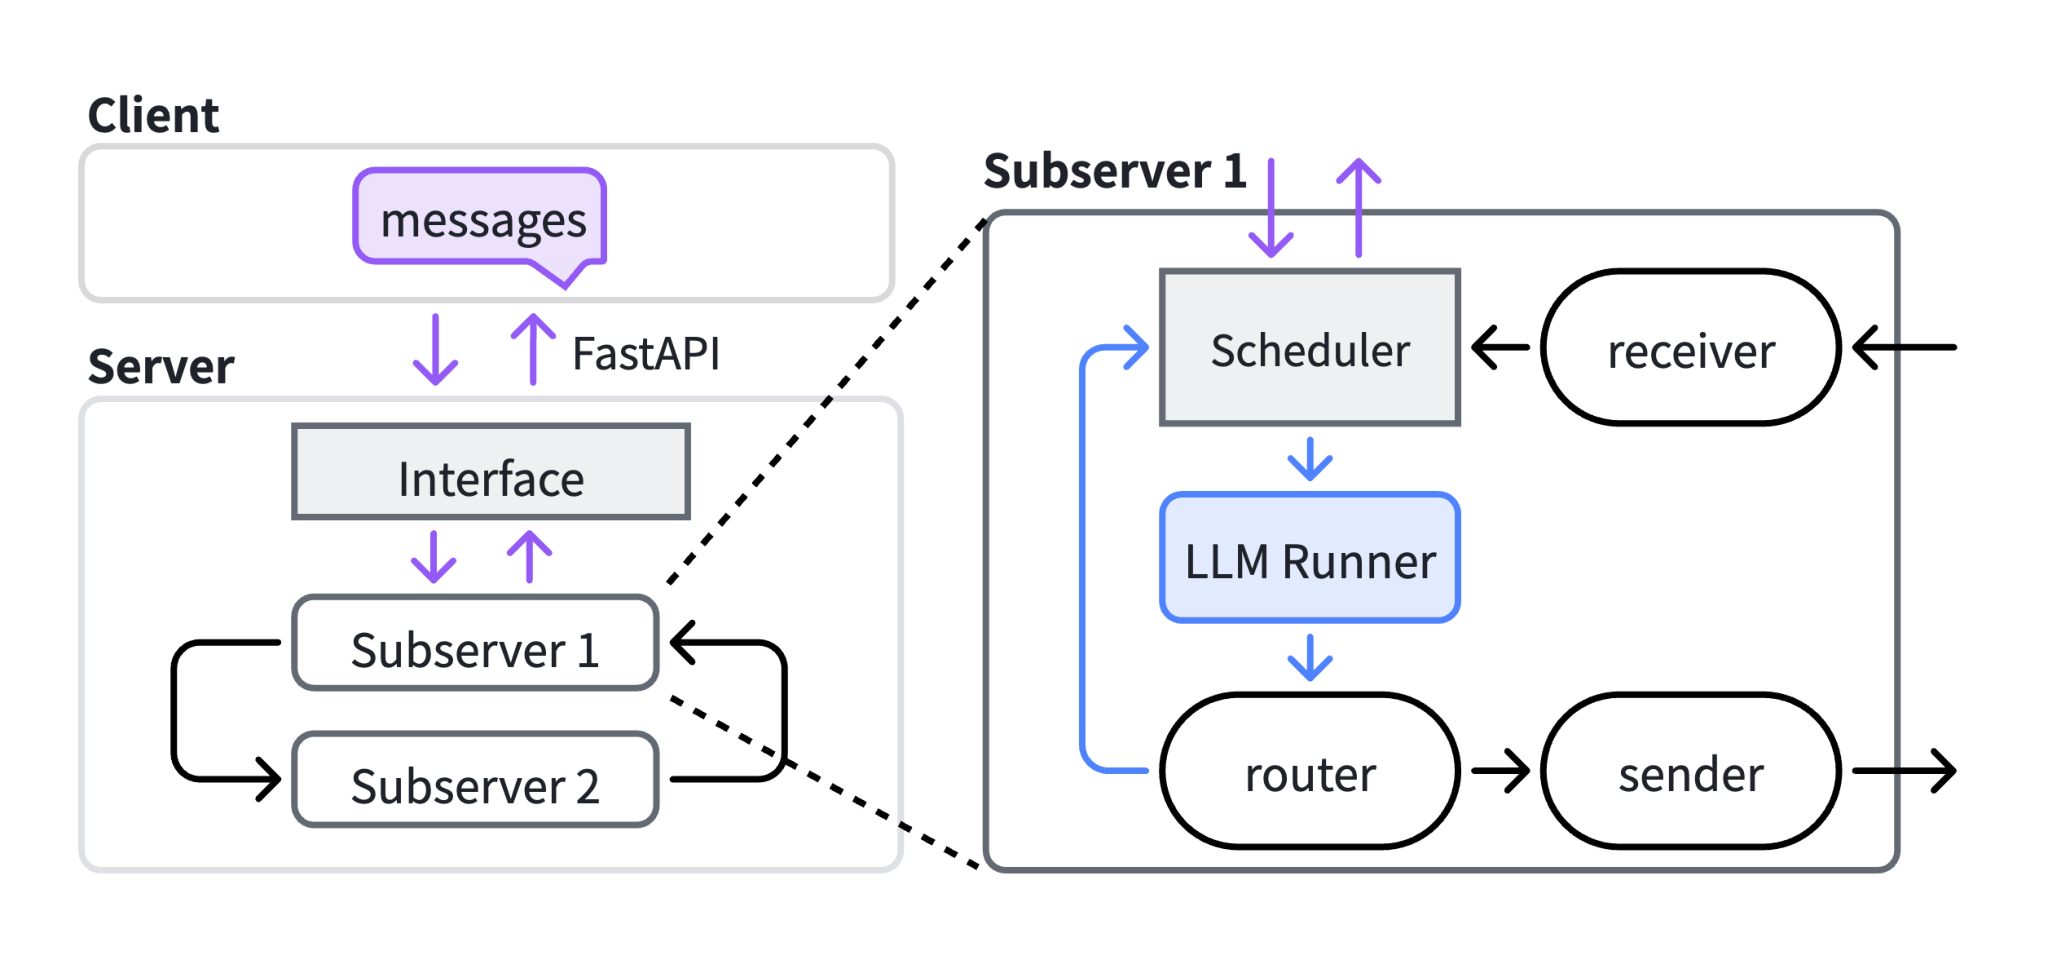
出典:Fu et al., “TokenRouter: Efficient Serving System for Token-Level LLM Routing”, arXiv:2610.12242, Figure 2(b)(CC BY 4.0)
遅延バッチング:少しだけ待って、まとめて動かす
非同期にすると待ちは減りますが、今度は大型モデルに 1 件ずつばらばらにリクエストが届き、バッチが小さくなってしまいます。大型モデルは、1 件だけ処理しても 2 件まとめて処理しても 1 歩の時間がほとんど変わりません(GPU の計算より、重みの読み込みに時間がかかるため)。
そこで TokenRouter は遅延バッチング(Delayed Batching)を入れています。大型モデル側では、届いたリクエストがある数(閾値 B)たまるまで少しだけ待ち、まとめて 1 回で処理します。
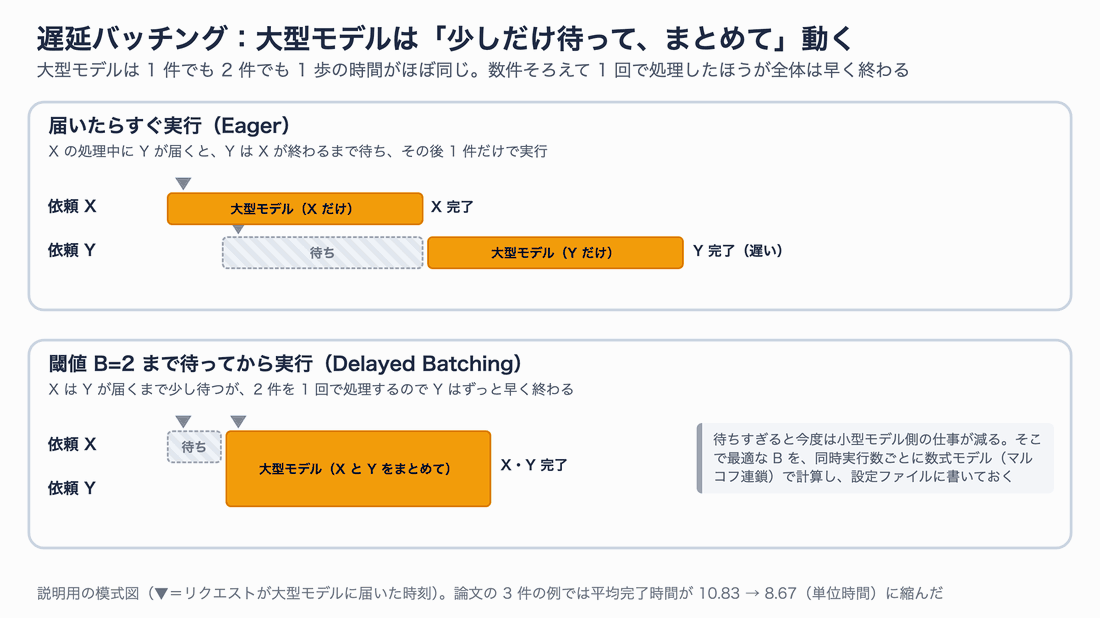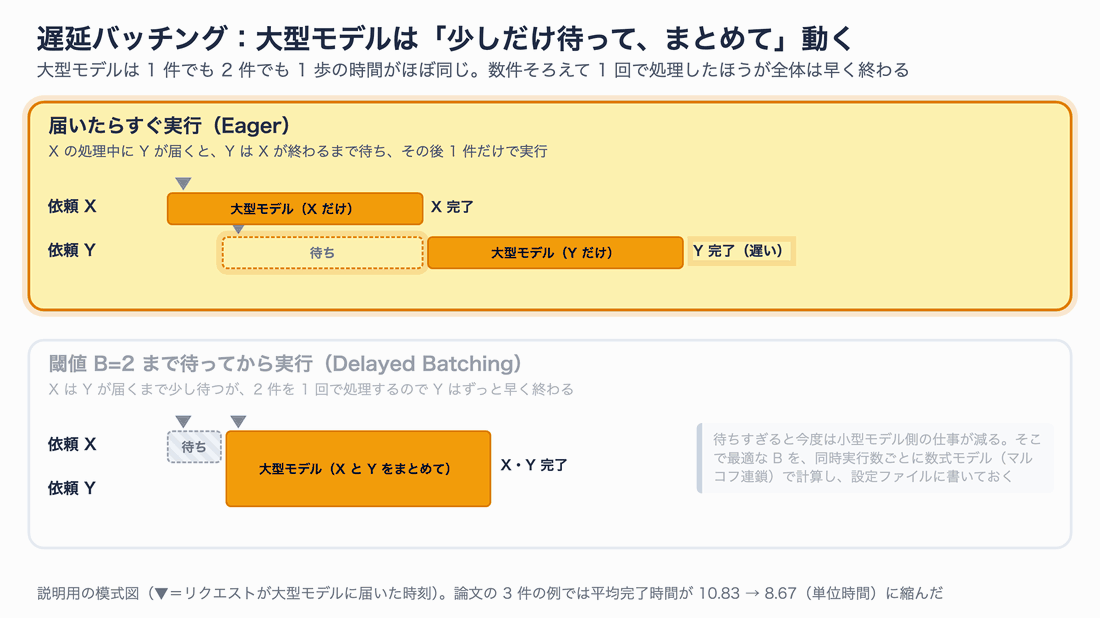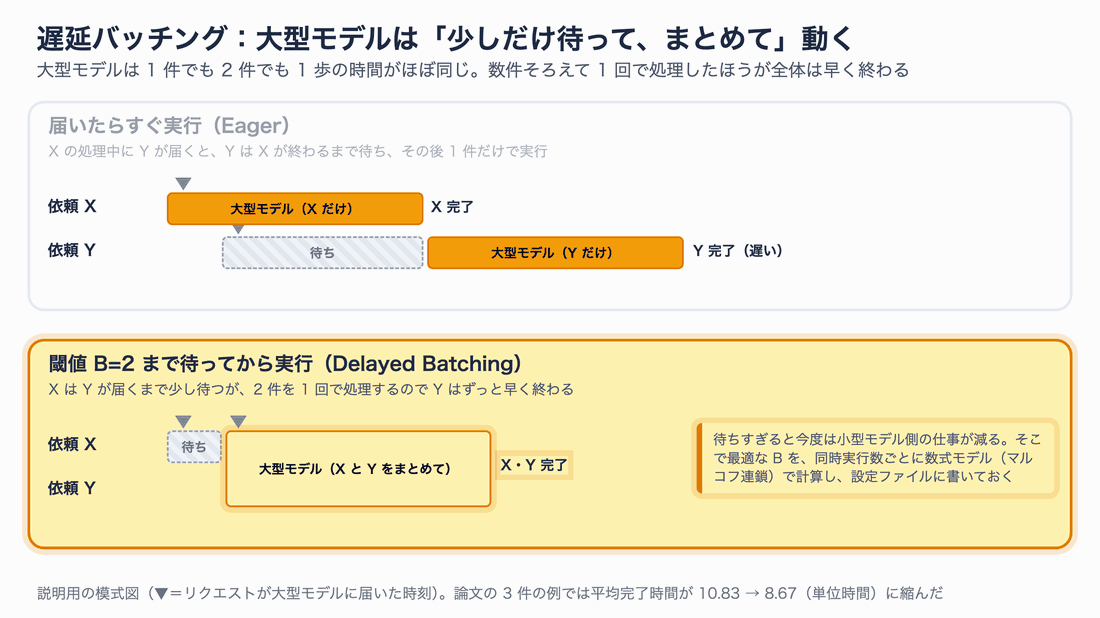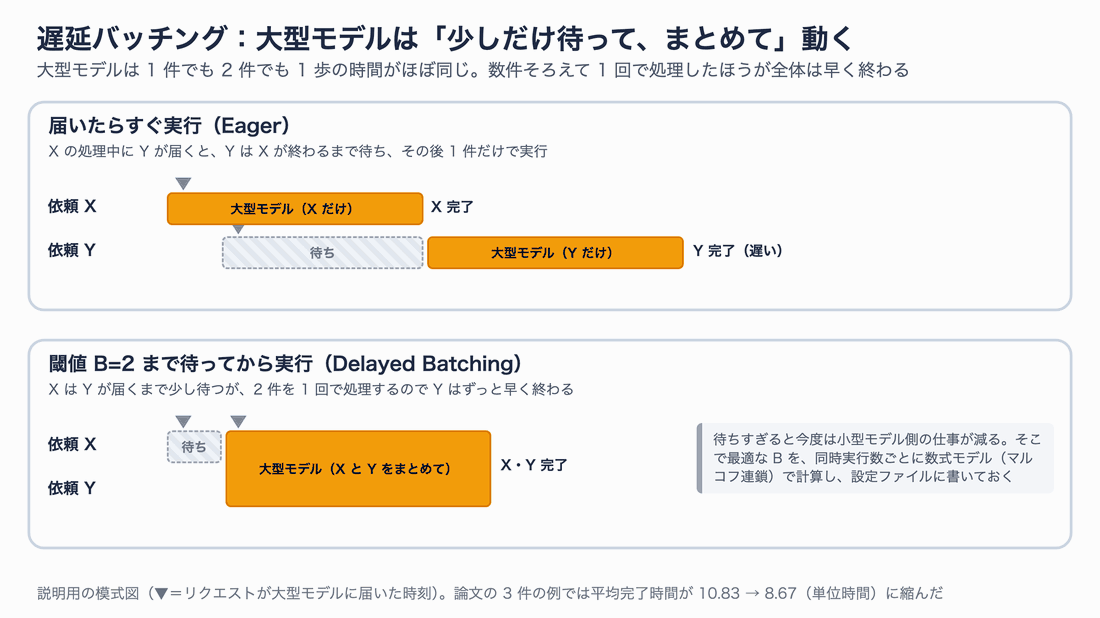
図6 先に着いた X は少し待つが、全体では早く終わる
待たせすぎると、今度は小型モデル側の仕事がなくなります。最適な B は同時実行数によって変わるので、TokenRouter はルーティングの様子を数式モデル(離散時間マルコフ連鎖)で表し、同時実行数ごとの最適値を計算するスクリプトを同梱しています。計算した値は、設定ファイルの delayed_batching_threshold に同時実行数ごとのリストとして書きます(R2R の Qwen3-0.6B/32B の設定では、同時実行数 1 で 1、4 で 3、16 で 13)。
論文の検証では、R2R・同時実行数 4 で、理論上最適と予測した閾値(B=3、207.9 トークン/秒)と、実測で最も速かった閾値(B=3、197.4 トークン/秒)が一致しました。
開発者が書くのは 3 つの関数だけ
新しいルーティング手法を載せるときに書くのは、route()・send()・receive() の 3 つです。
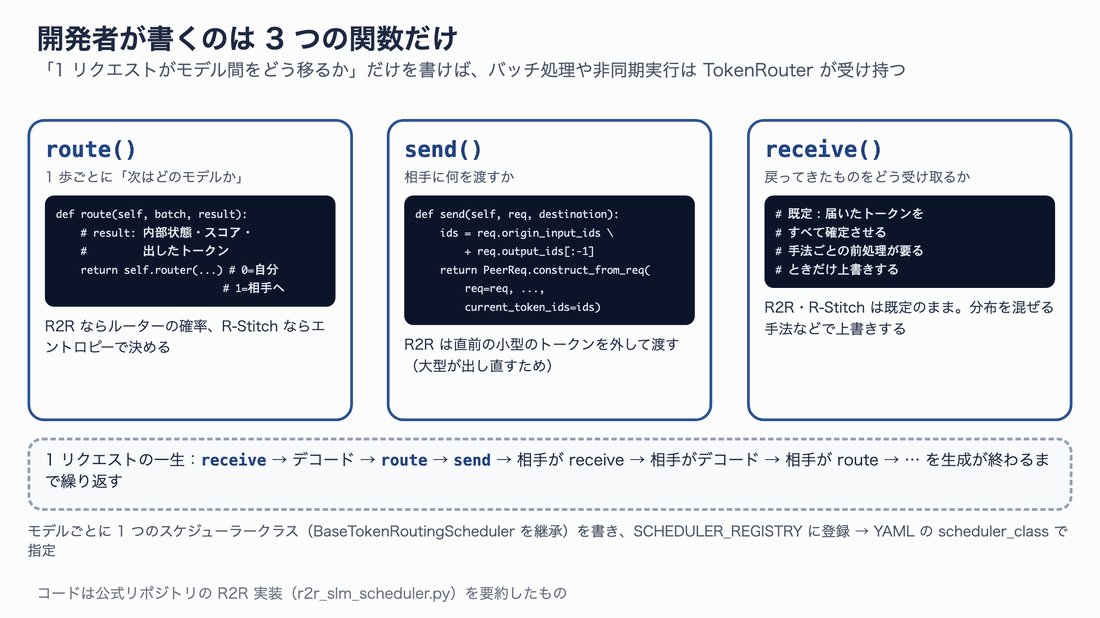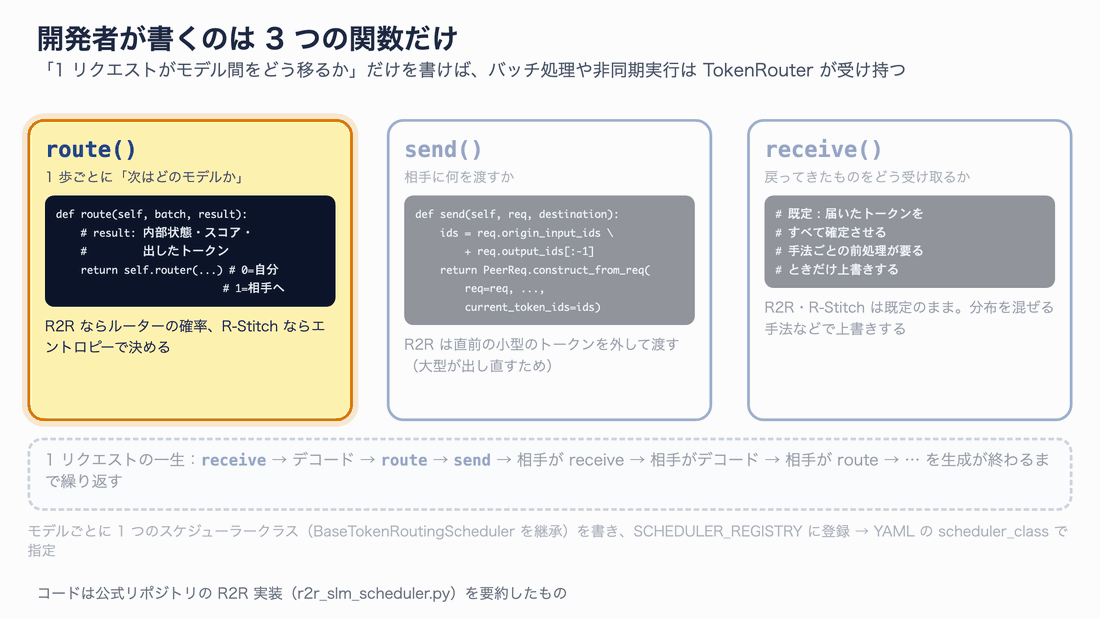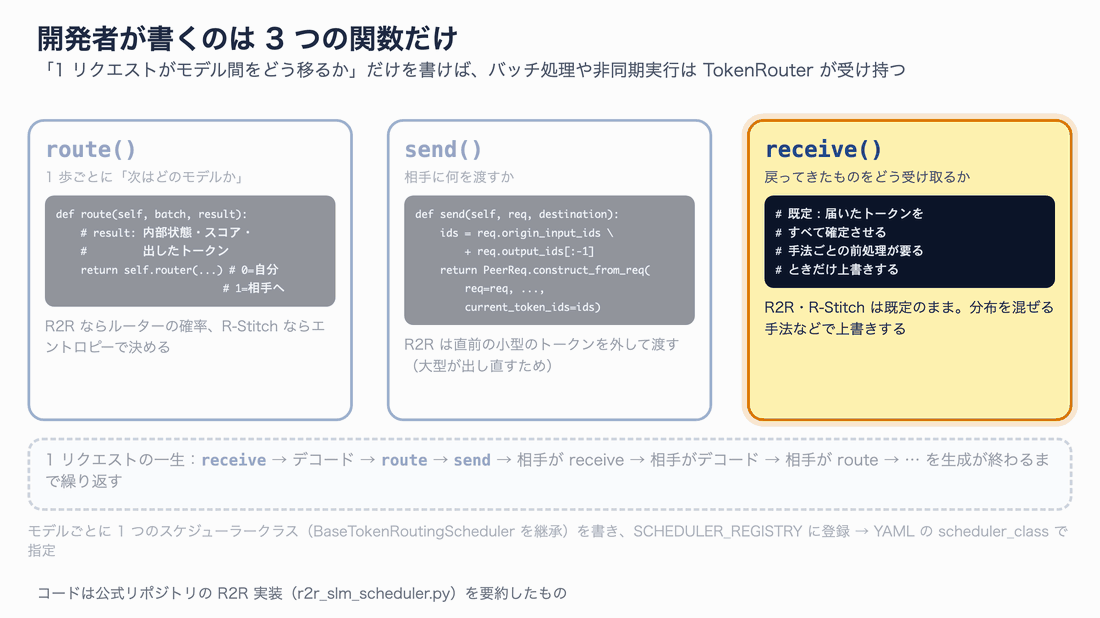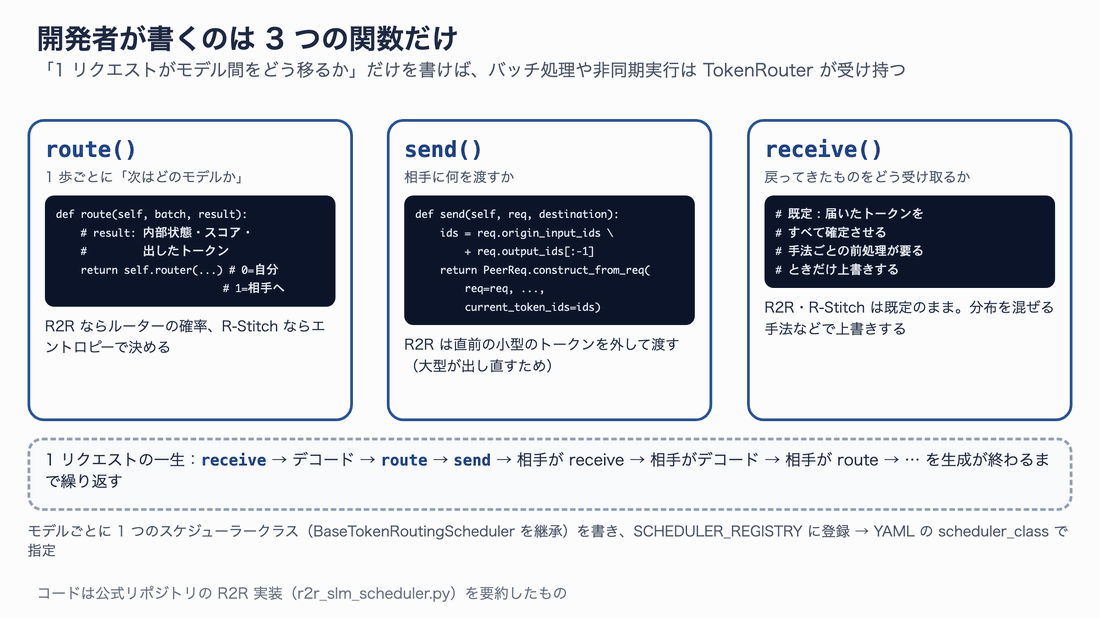
図7 3 つの関数の役割と、1 リクエストの一生
実際のコードも短いものです。次は、公式リポジトリにある R-Stitch(小型モデルの迷いが大きいトークンだけ大型モデルに任せる手法)の小型モデル側の route() です。出力の確率分布のエントロピー(迷いの大きさ)を計算し、閾値を超えたリクエストだけ相手に送ります。
# tokenrouter/managers/schedulers/rstitch_slm_scheduler.py(公式リポジトリより抜粋)
def route(self, batch, result) -> torch.Tensor:
    logits = result.logits_output.next_token_logits  # batch_size, vocab_size
    probs = torch.softmax(logits, dim=-1)
    log_probs = torch.log(probs)
    # 語彙数で正規化したエントロピー(0〜1)。大きいほど小型モデルが迷っている
    entropy = -torch.sum(probs * log_probs, dim=-1) / math.log(probs.shape[-1])
    return (entropy > self.threshold).cpu()  # True のリクエストだけ大型モデルへ
R2R の場合は、ここが学習済みルーターの呼び出しに変わります。send() では、直前に小型モデルが出したトークンを外して(req.output_ids[:-1])渡し、大型モデルにその位置から出し直させます。receive() は既定のまま(届いたトークンをすべて確定させる)で動きます。
モデルごとに 1 つのスケジューラークラス(BaseTokenRoutingScheduler を継承)を書いて SCHEDULER_REGISTRY に登録すれば、YAML の scheduler_class で指定できるようになります。バッチ処理や非同期実行、遅延バッチングを自分で書く必要はありません。
論文の性能:「2.01〜64.15 倍」をどう読むか
紹介記事でよく引用される「2.01〜64.15 倍のスループット」は、少し読み方に注意が必要です。
論文の主な評価は、8 枚の A100(80GB)を積んだ 1 台のサーバーで、Qwen3-0.6B(GPU 1 枚)と Qwen3-32B(GPU 2 枚)を組み合わせて行われました。手法は CITER・R2R・R-Stitch・Co-LLM・ME の 5 つ、作業は「短い推論(AIME、最大 2,048 トークン)」「長い推論(最大 8,192 トークン)」「エージェント作業(SWE-smith の履歴、入力約 8,192 トークン)」の 3 つで、合計 15 通りです。
比べる相手は、各手法の公式実装と、SGLang をモデルごとに立てて外から振り分ける構成(Std. Serving)のうち速い方です。同時に 4 件を処理したとき、TokenRouter はこの 15 通りすべてで 2.01〜64.15 倍速くなりました。
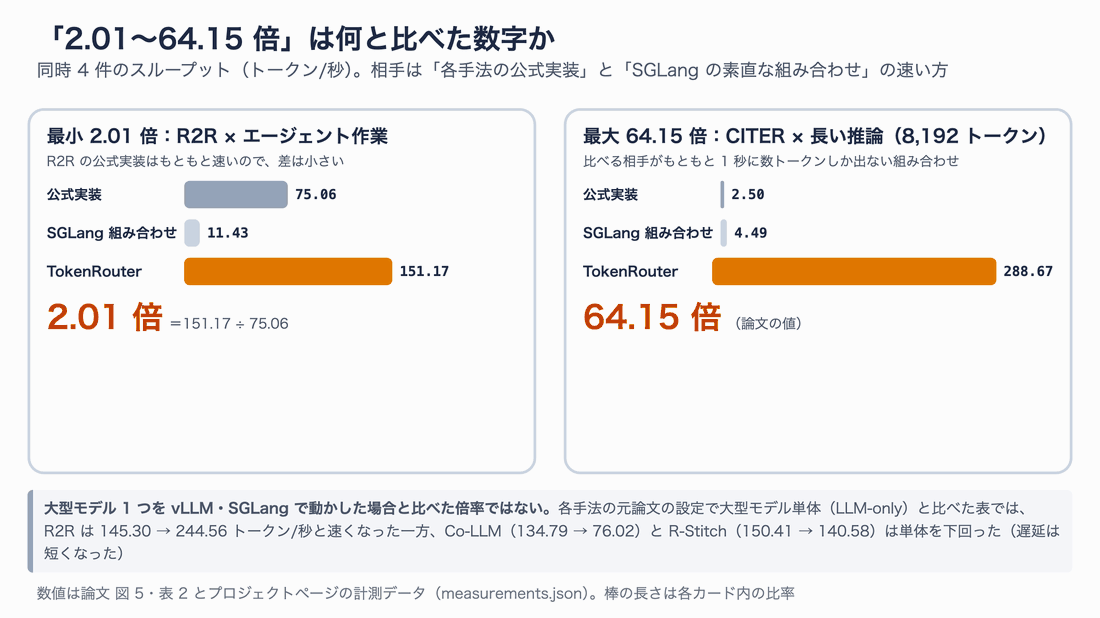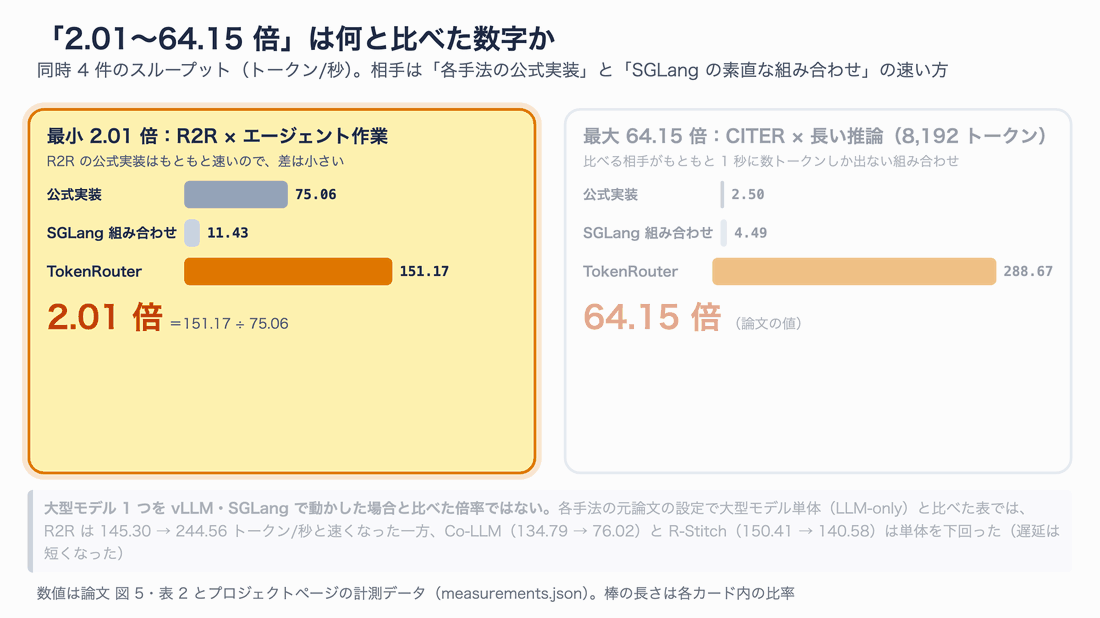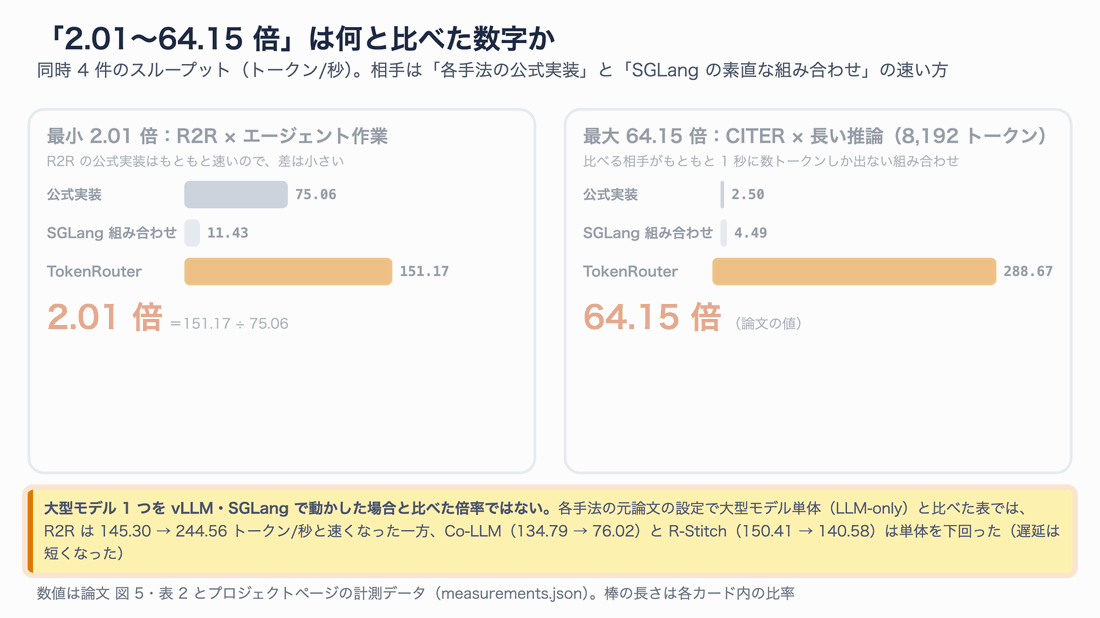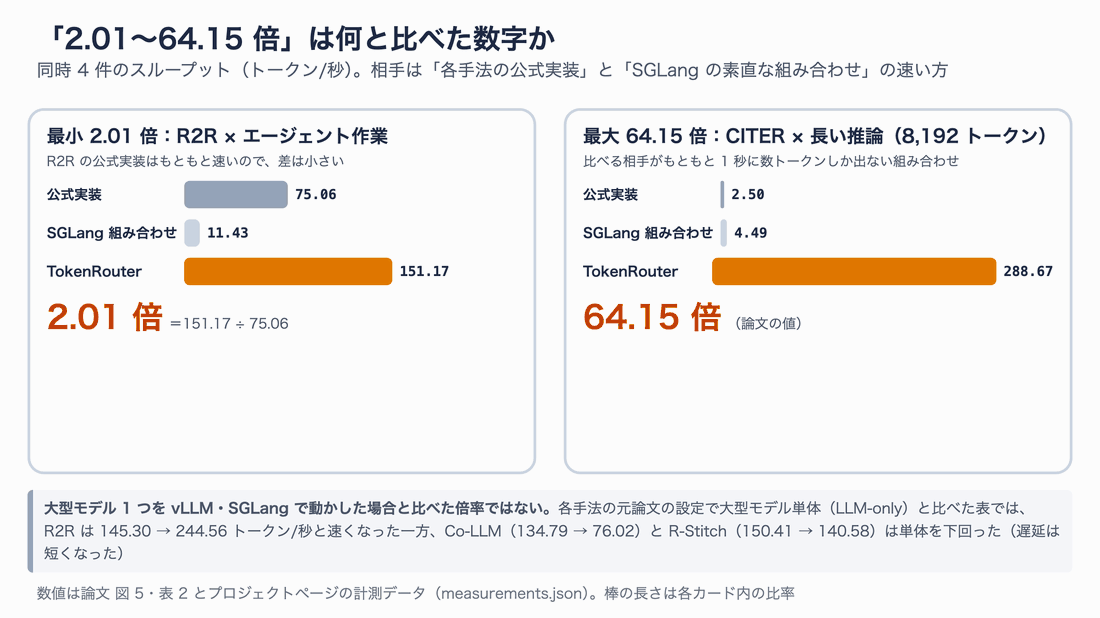
図8 倍率が大きいのは、比べる相手がもともと極端に遅い組み合わせ
数字の読み方で押さえておきたい点をまとめます。
- 大型モデル 1 つを vLLM や SGLang で動かした場合との比較ではありません。 比較相手は「トークン単位ルーティングの既存の動かし方」です
- 大型モデル単体より必ず速いわけでもありません。 各手法の元論文の設定で大型モデル単体(LLM-only)と比べた表では、R2R は 145.30 → 244.56 トークン/秒と速くなりましたが、Co-LLM(134.79 → 76.02)と R-Stitch(150.41 → 140.58)は単体を下回りました(どちらも完了までの時間は短くなっています)
- R2R の公式実装はもともと速いため、R2R に対する倍率は 2.01〜2.62 倍にとどまります
- 同時実行数 1 では、非同期実行と遅延バッチングの効果はゼロです(論文の内訳表で、同時実行数 1 は 73.02 トークン/秒のまま)。1 人で使うときの高速化は、主に CUDA Graph などの実装の工夫によるものです。TokenRouter が本領を発揮するのは、たくさんのリクエストを同時に処理する場面です
- プロジェクトページにある「18.58 倍」は、TokenRouter の同時実行数 16 と公式 R2R の同時実行数 1 を比べた数字です(ページにも条件が違うと注記があります)
内訳を見ると、R2R・同時実行数 8 で、素直な実装の 132.78 トークン/秒が、CUDA Graph などの工夫で 230.79、非同期実行で 296.86、遅延バッチングで 372.48 トークン/秒まで上がっています(積み上げた結果で、それぞれの効果を単純に足せるわけではありません)。
精度については、TokenRouter はルーティングの判断方法を変えない「基盤」なので、論文での比較は AMC23 を使った速度と精度の関係の図 1 枚だけです。そこでは、TokenRouter 上の R2R が、RouteLLM 系のクエリ単位ルーティングより「同じ精度でより速い」側に位置すると報告されています。
実際に使ってみた:Mac でトークン単位ルーティングを再現する
ここからは、実際に手を動かして確かめた結果です。
なぜ「再現」なのか
TokenRouter 本体は、SGLang 0.5.1・CUDA Graph・FlashInfer など NVIDIA GPU 専用の部品の上に作られています。筆者の手元は MacBook Pro(M5 Max・メモリ 128GB)なので、本体のサーバーはそのままでは起動できません。
そこで今回は、TokenRouter の R2R 設定(Qwen3-0.6B ⇄ Qwen3-32B)と同じ手順・同じ学習済みルーターを、Apple の機械学習フレームワーク MLX の上に移植しました。何が同じで何が違うかを先に整理しておきます。
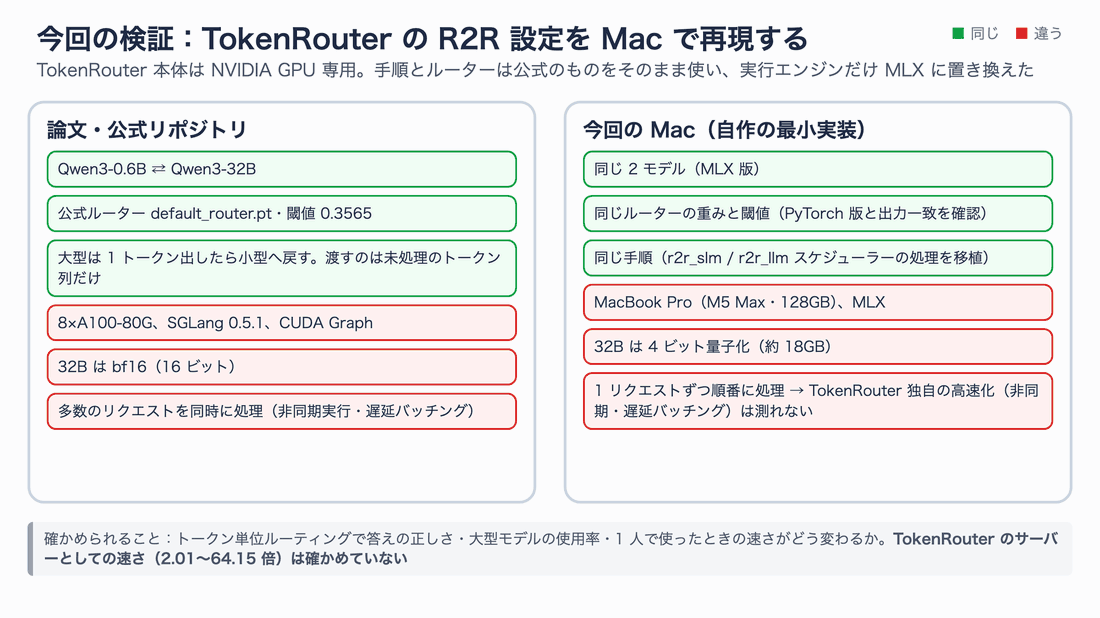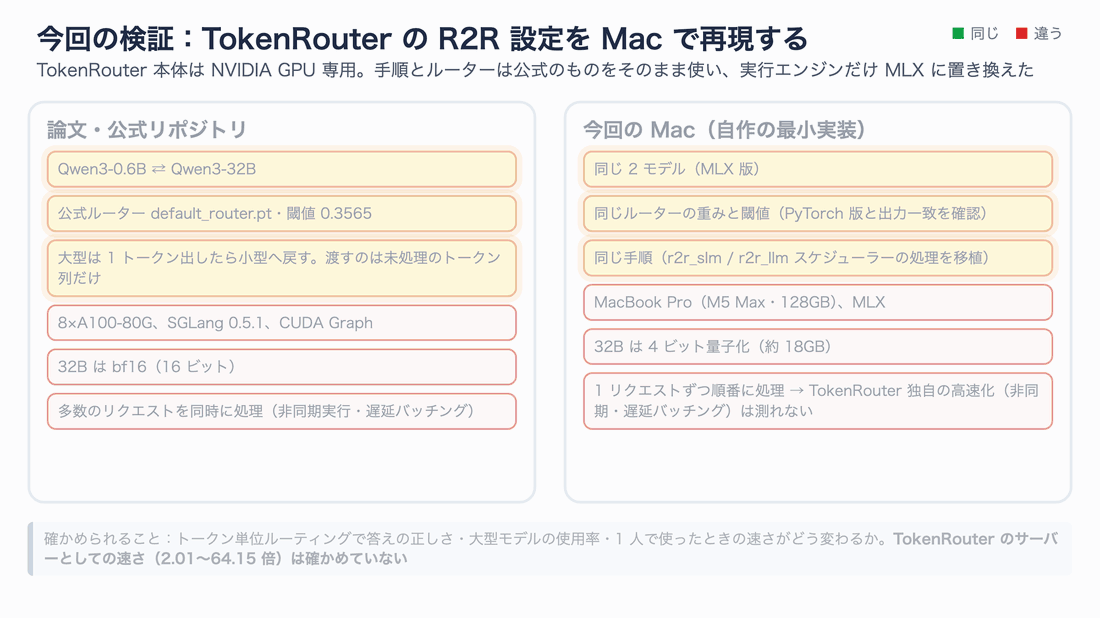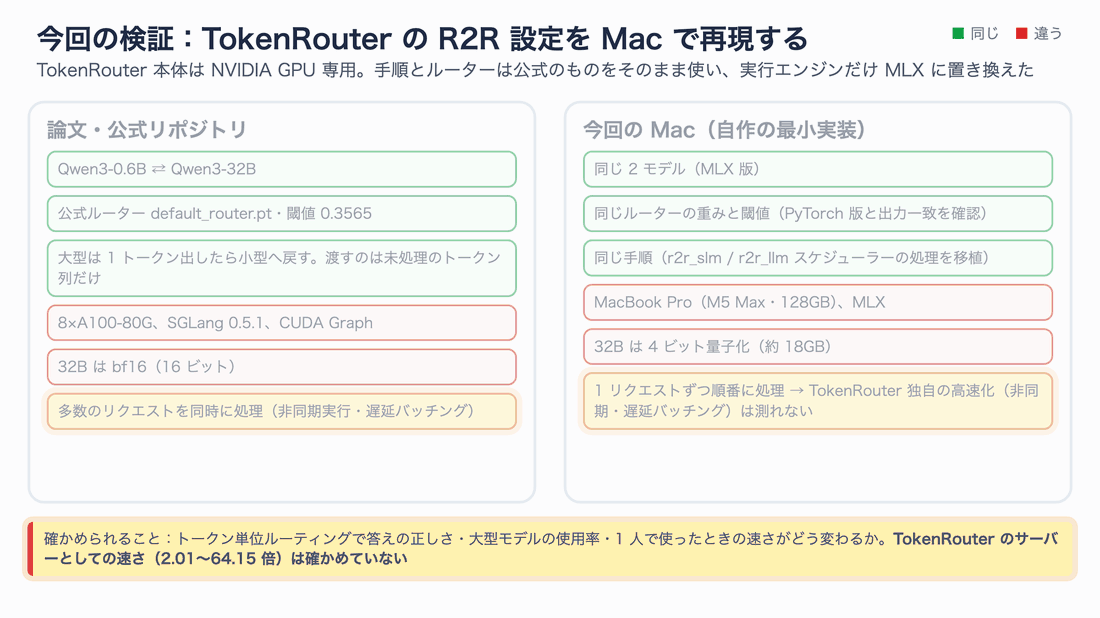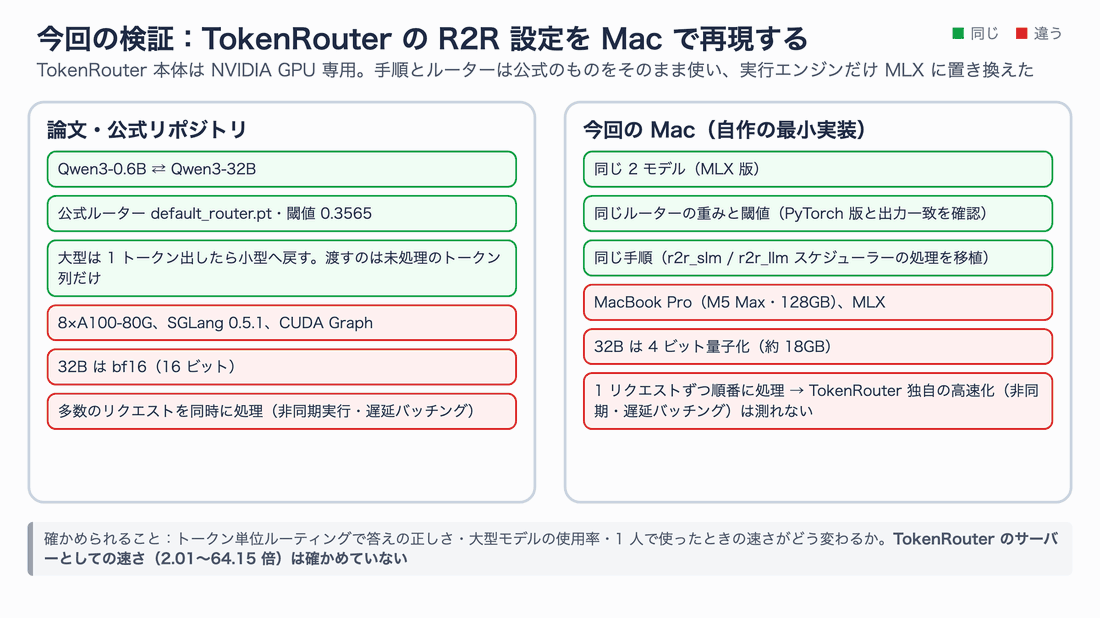
図9 確かめられるのは「トークン単位ルーティングそのものの効果」。TokenRouter のサーバーとしての速さは確かめていない
準備
Python 3.12 の仮想環境に、MLX と、ルーターを読み込むための PyTorch などを入れます。
# 作業フォルダで仮想環境を作る(uv を使う例。python -m venv でもよい)
uv venv -p 3.12 .venv
source .venv/bin/activate
uv pip install mlx mlx-lm torch transformers huggingface_hub scikit-learn pandas numpy math-verify datasets

# ルーターの定義(router.py)を読むために公式リポジトリを取得する(インストールはしない)
git clone --depth 1 https://github.com/thu-nics/TokenRouter.git

# 公式の学習済みルーター(Qwen3-0.6B + Qwen3-32B 用、約 220MB)
hf download nics-efc/R2R_router_collections --include "Qwen3-0.6B+Qwen3-32B/*" --local-dir router

# 小型モデル(bf16、約 1.2GB)と大型モデル(4 ビット量子化、約 18GB)
hf download mlx-community/Qwen3-0.6B-bf16
hf download mlx-community/Qwen3-32B-4bit
32B の重みは約 18GB あるので、ダウンロードが途中で止まることがあります。筆者の環境でも止まったため、curl の再開オプション(-C)でファイルごとに取得し、Hugging Face に載っている SHA-256 と照合しました。
移植したコードの核心
TokenRouter の r2r_slm(小型側)と r2r_llm(大型側)のスケジューラーがやっていることを、1 リクエスト分のループに書き直すと次のようになります。全体は約 200 行で、核心はこの部分だけです。
# lab/tr_mac.py より(R2R の 1 トークン分の処理。読みやすさのため変数名などを簡略化)
h = slm.model(mx.array(prompt)[None], cache=s_cache)[0, -1]   # 小型モデルの最終層の内部状態
llm_pos = 0                                                  # 大型モデルが読み込み済みのトークン数
while len(out) < max_new:
    logits = slm.model.embed_tokens.as_linear(h)              # 小型モデルの次トークンのスコア
    tok = mx.argmax(logits)                                   # 小型モデルが選んだトークン
    p = router.prob_mx(h, logits, tok)                        # ルーター:大型とずれる確率
    mx.eval(tok, p)
    if p.item() >= router.threshold:                          # 閾値(0.3565)以上なら
        # 小型のトークンを捨て、大型モデルに「まだ読んでいない差分」だけを渡して 1 トークン出させる
        ll = llm(mx.array(toks[llm_pos:])[None], cache=l_cache)[0, -1]
        llm_pos = len(toks)
        tok, src = mx.argmax(ll).item(), "L"
    else:
        tok, src = tok.item(), "S"
    toks.append(tok); out.append((tok, src))
    if tok in EOS_IDS:
        break
    h = slm.model(mx.array([[tok]]), cache=s_cache)[0, -1]    # 次のトークンへ(どちらが出しても小型が読む)
ポイントは、大型モデルに渡すのが toks[llm_pos:]、つまり前回呼ばれてから小型モデルが書き進めた差分だけという点です。大型モデルは自分の KV キャッシュを持ち続け、呼ばれるたびに差分を追加で読み込んで(TokenRouter の用語では extend)、その位置の 1 トークンだけを出します。TokenRouter の「KV キャッシュは送らず、未処理のトークン列だけを送る」設計と同じ形です。
ルーターは公式の router.py をそのまま読み込んで重みを復元しました。ただし CPU 上の PyTorch で毎トークン動かすと 1 トークンあたり 3.4ms かかり、小型モデルの 1 歩(約 4ms)と同じくらい重くなります。そこで同じ重みを MLX に移して GPU で計算するようにしたところ 1.4ms になりました。300 トークン分で PyTorch 版と出力を比べ、確率の差は最大 3.9×10⁻⁷、判定(大型に回すかどうか)が食い違ったトークンは 0 でした。
測り方
比べたのは次の 3 つの方式と、判定モデルを使ったリクエスト単位の振り分けです。
| 方式 | 中身 |
|---|---|
| 0.6B のみ | Qwen3-0.6B(bf16)がすべてのトークンを書く |
| 32B のみ | Qwen3-32B(MLX 4 ビット)がすべてのトークンを書く |
| トークン単位(R2R) | 0.6B が書き、ルーターが判定したトークンだけ 32B が書き直す |
| リクエスト単位(判定モデル) | OpenAI の Decisions API(gpt-6-luna)に問題文を渡し、「0.6B では解けなさそうか」の確率を出させる。確率の高い順に 32B へ回す問題を増やし、残りは 0.6B(生成し直さず、上の 2 方式の結果を組み合わせて計算) |
問題は数学の問題集 MATH-500 から、難易度レベル 2〜5 を 30 問(レベル 2 が 6 問、3〜5 が 8 問ずつ、乱数の種 0 で抽出)選びました。Qwen3 の思考モード(<think> の中で考えてから答える)を有効にし、最大 8,192 トークン、毎回いちばん確率の高いトークンを選ぶ貪欲デコードで生成します。答えは \boxed{} の中身を取り出し、math-verify というライブラリで正解と照合しました。
GPU の混み具合で速度がぶれないように、1 問ごとに 3 方式を順番に流しています。それでも、時間の数字は「この Mac で 1 問ずつ解いた場合」のものです。
動作の様子:小型と大型が 1 トークンずつ入れ替わる
まずは動いている様子を見てください。思考モードを切った短い回答で、日本語の文章題を解かせました。水色が Qwen3-0.6B、オレンジの背景が Qwen3-32B に切り替えたトークンです。録画は実時間(早送りなし)です。
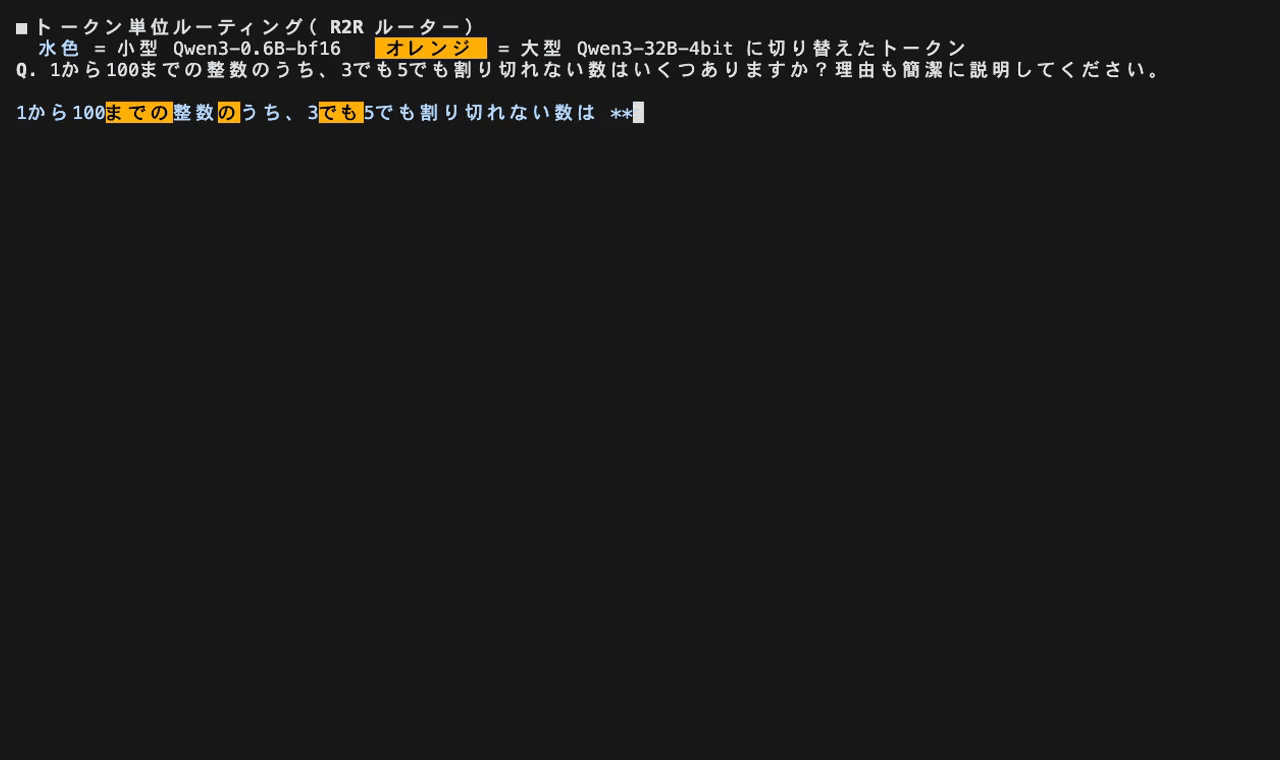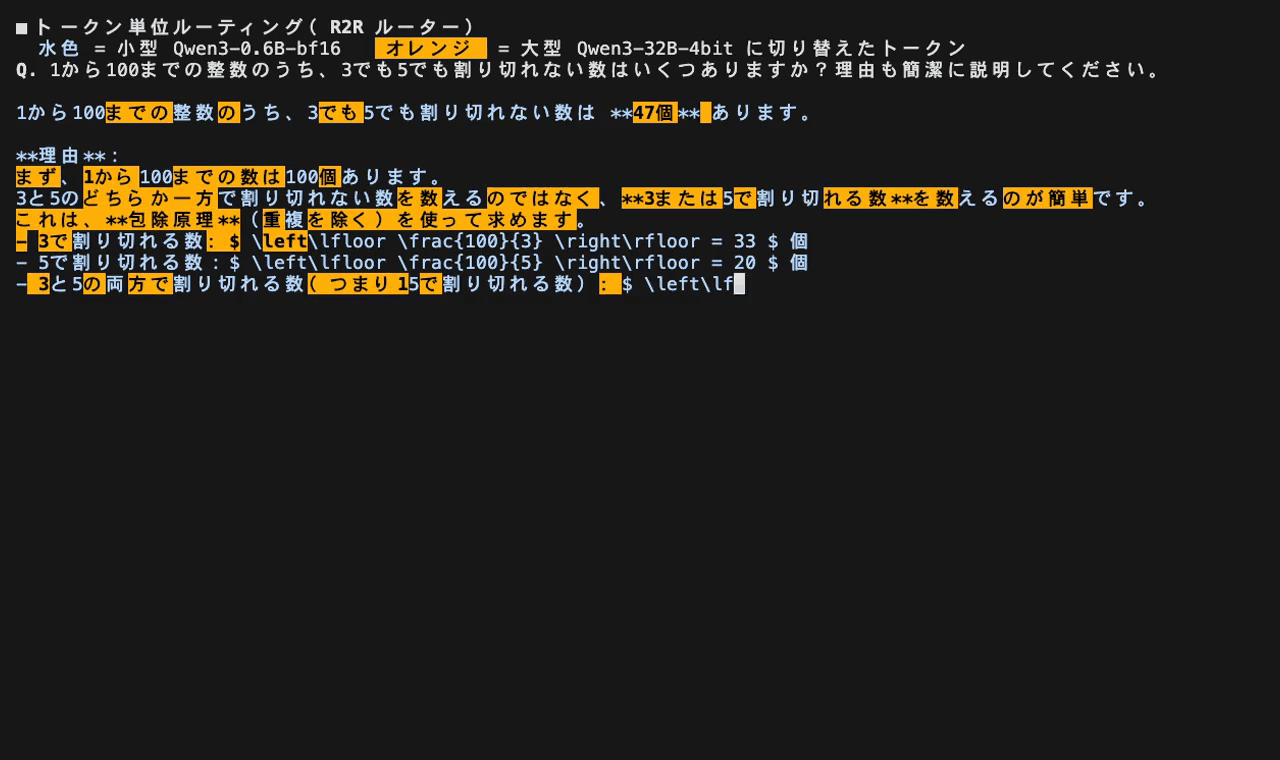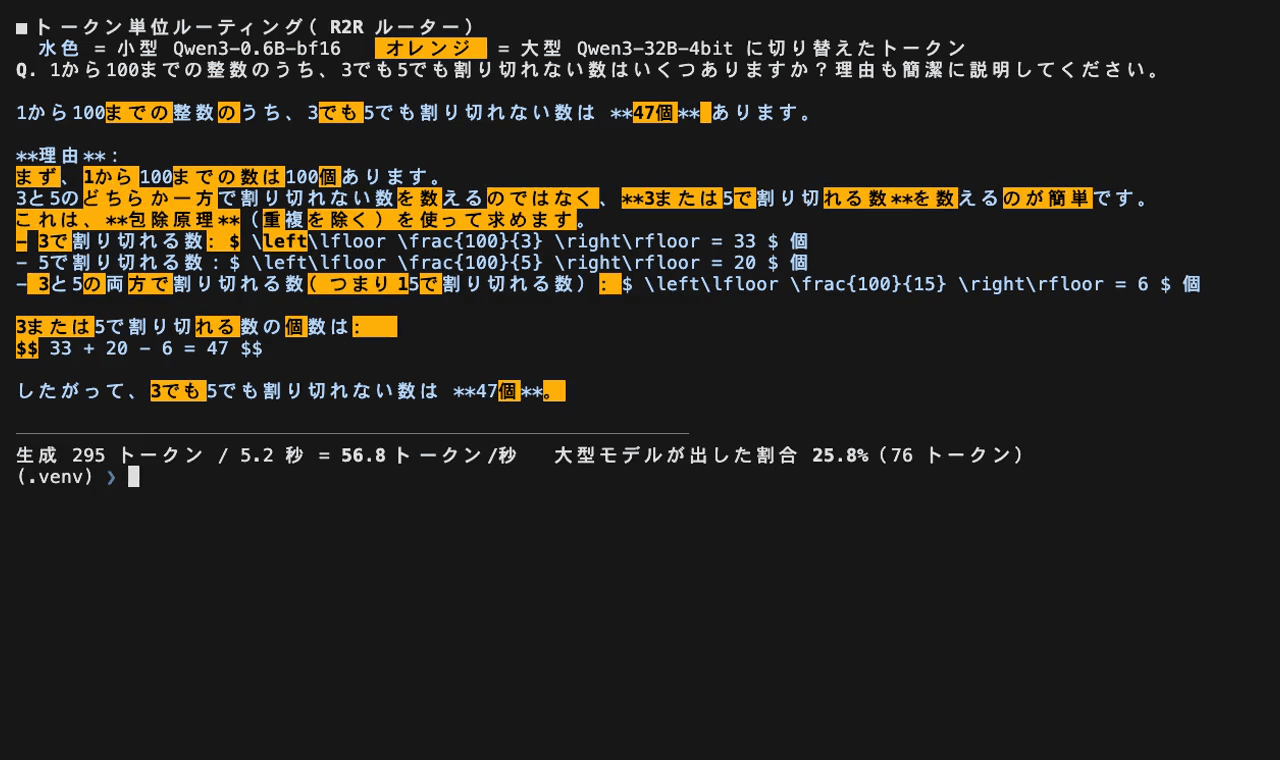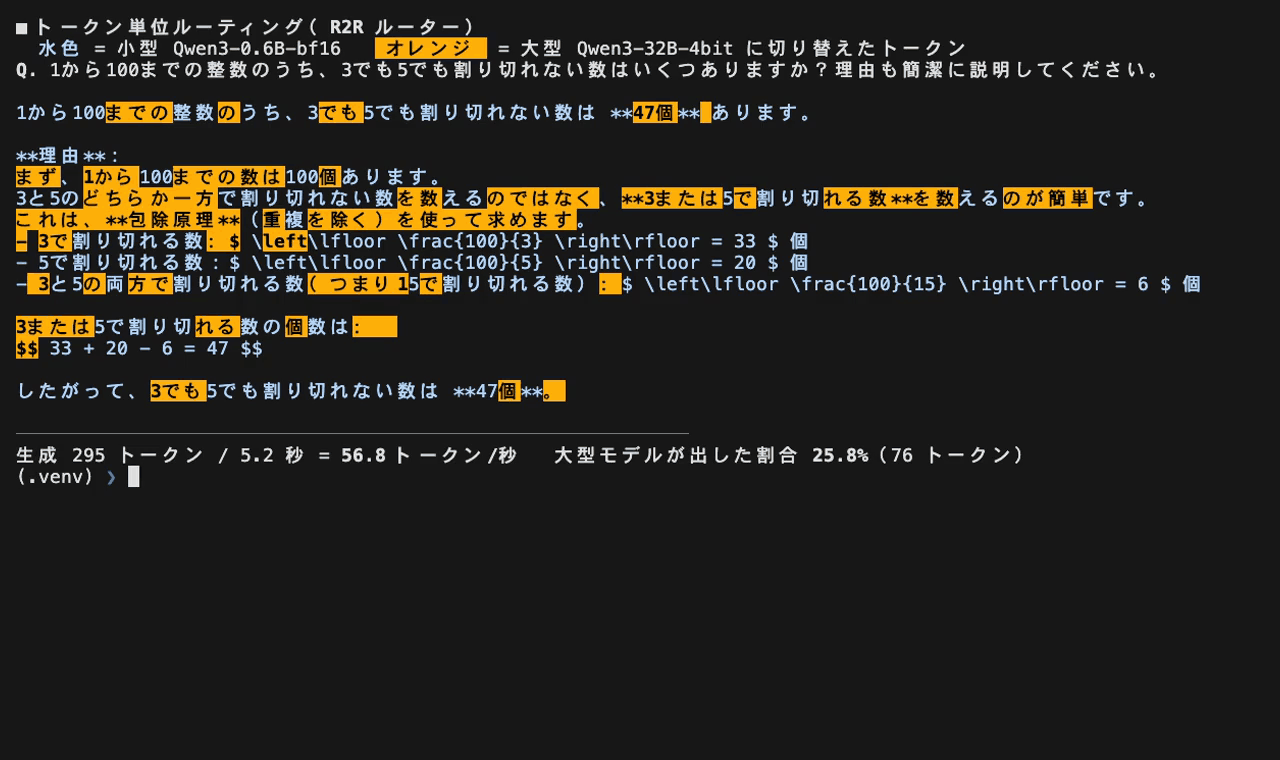
トークン単位ルーティングの実行画面(実時間)。オレンジは「まず」「どちらか一方」「のではなく」など文の組み立てに関わる所に多い
1 トークンごとに担当が入れ替わっているのが分かります。ただ、この回答には大事な落とし穴があります。手順(包除原理で「3 または 5 で割り切れる数」を 33+20−6=47 と数える)は正しいのに、最後に 47 をそのまま答えにしてしまい、本当の答えの 53(100−47)を出せていません。
同じ質問を 3 つの方式で解かせ、生成が始まる瞬間をそろえて並べたのが次の動画です。
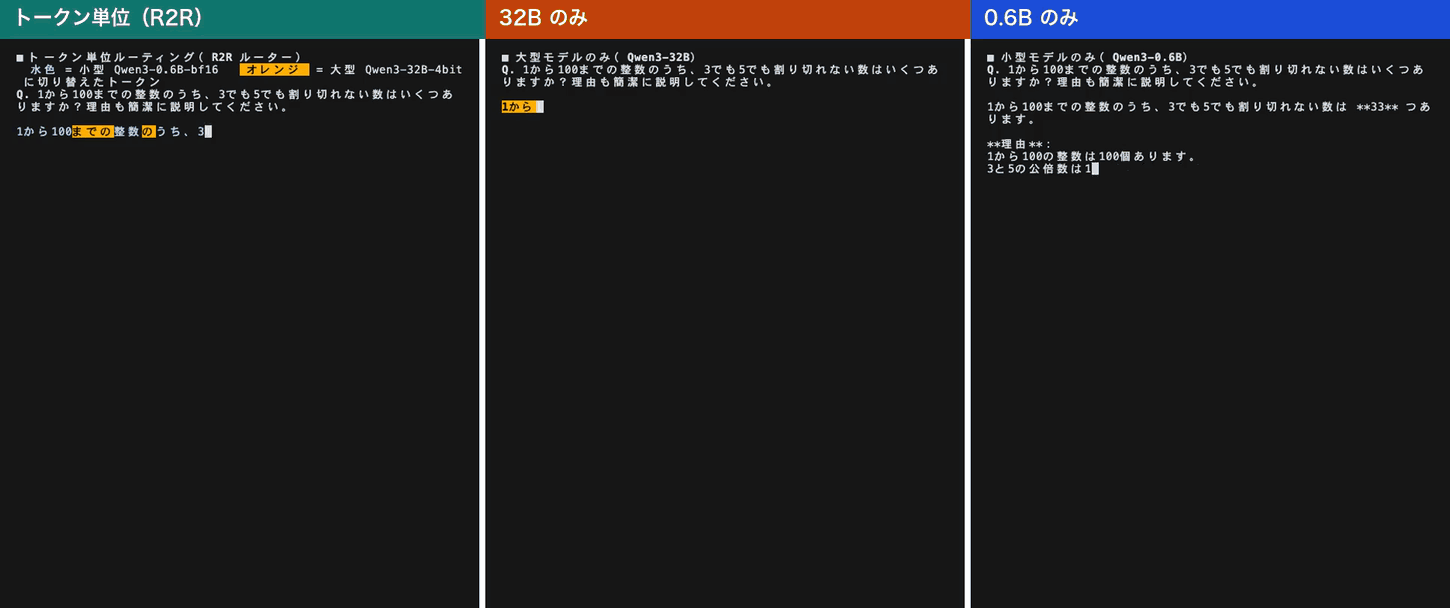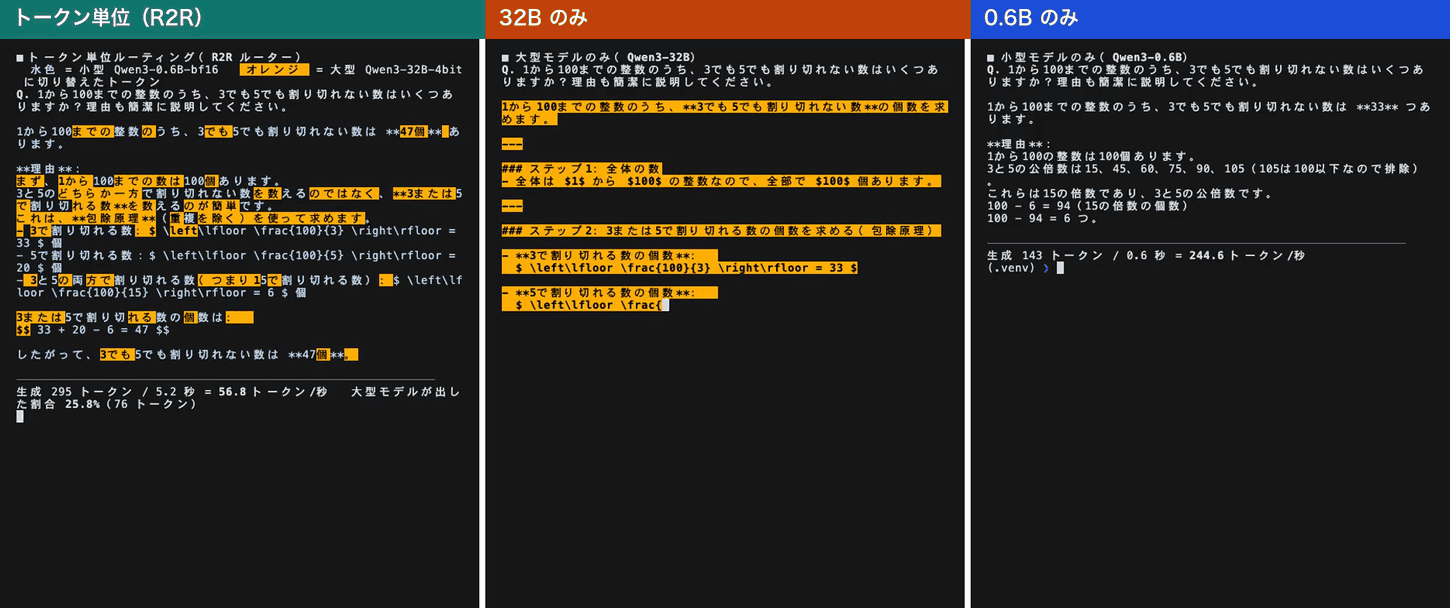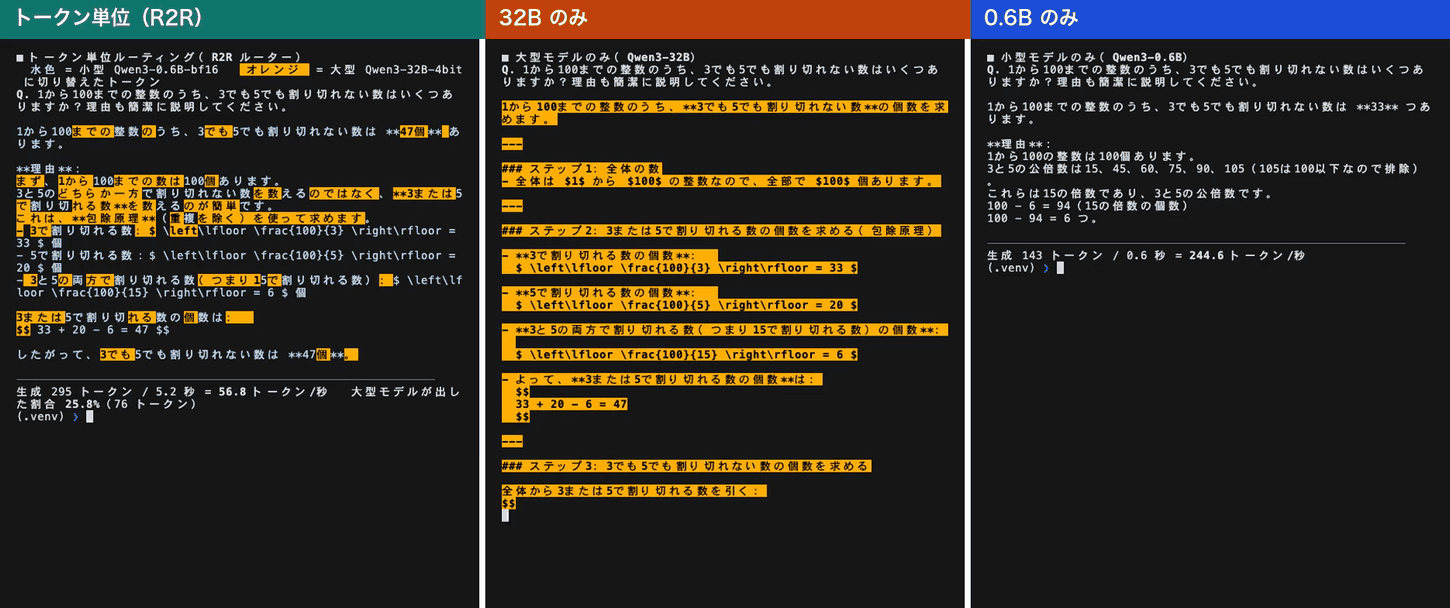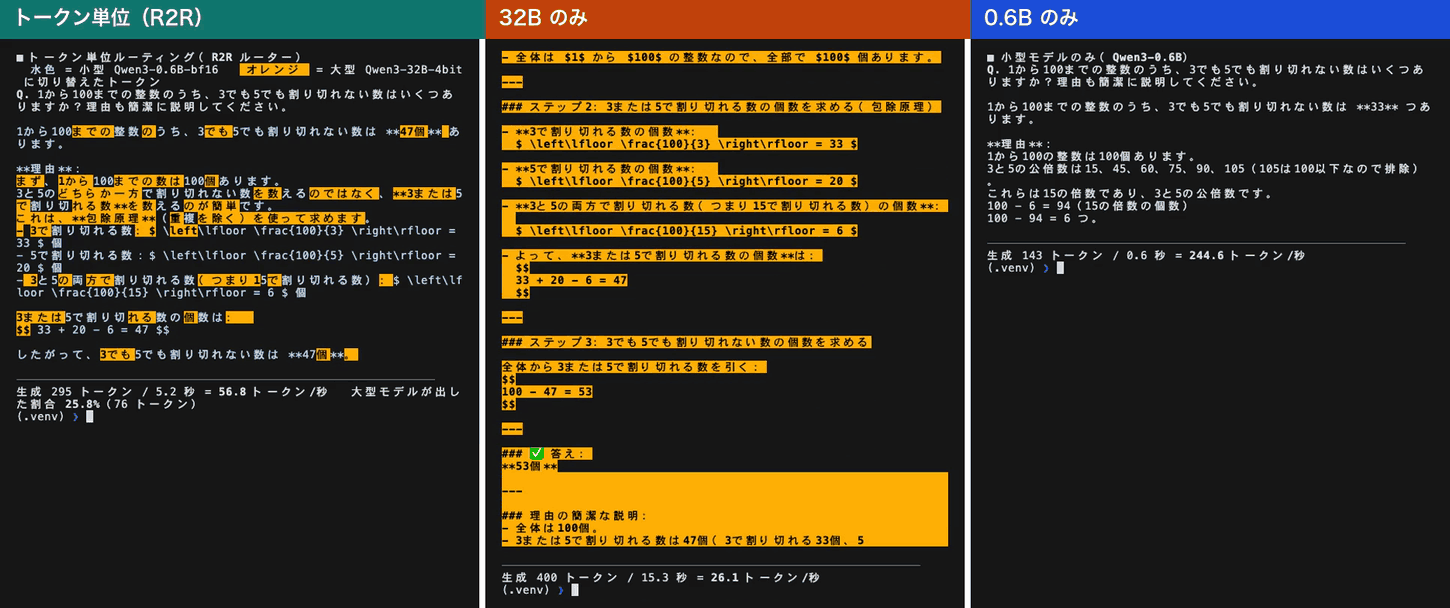
同じ質問を 3 方式で(実時間)。0.6B は 0.6 秒で「33 個」(誤り)、トークン単位は 5.2 秒で「47 個」(誤り)、32B は 15.3 秒で「53 個」(正解)
トークン単位の回答は、0.6B 単体(理由がほぼ破綻)よりずっと筋の通った手順になっていますが、最後の一歩で 32B に任せる判定が出ず、0.6B の誤りがそのまま残りました。ルーターは「怪しいトークン」を確率で選ぶので、取りこぼしは起こります。
一方、別の文章題ではうまくいきました。りんごとみかんの個数を求める問題です。
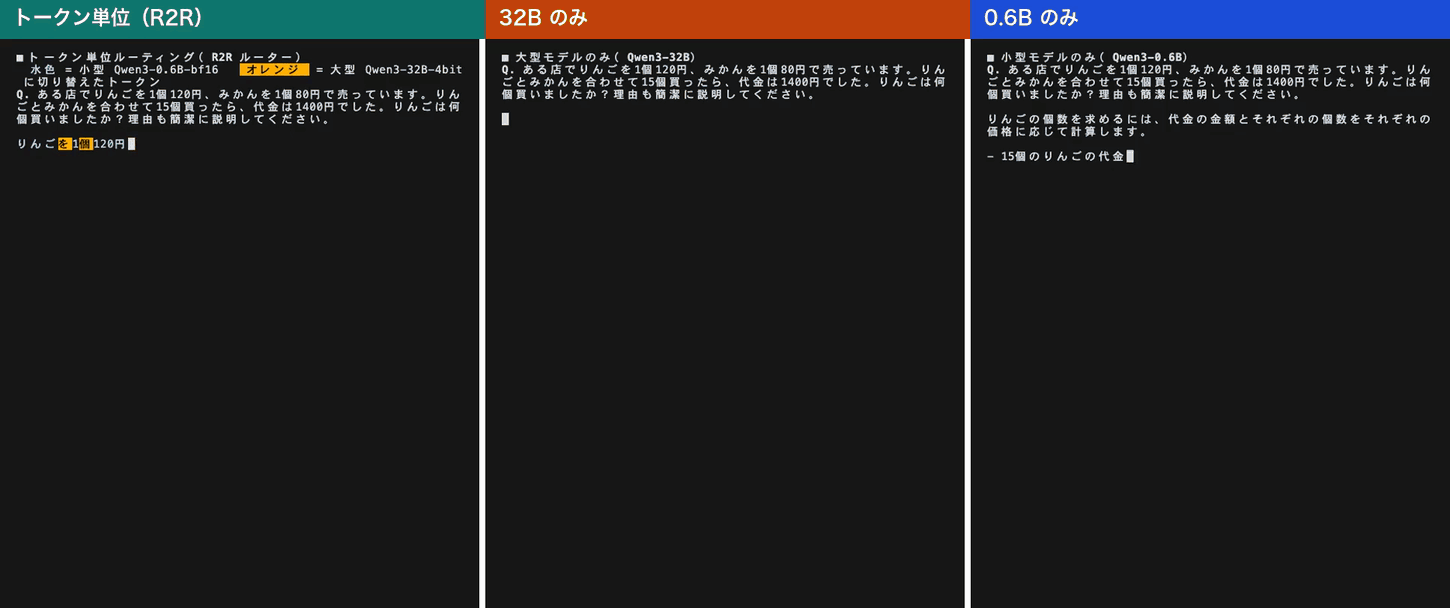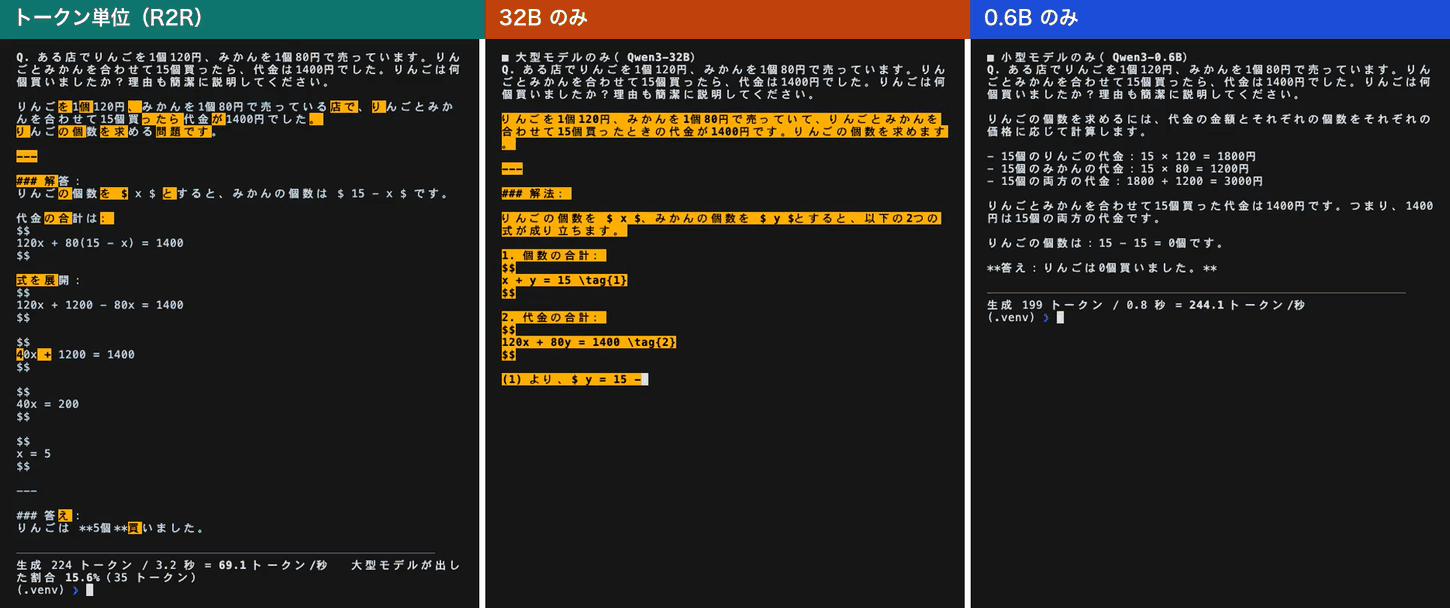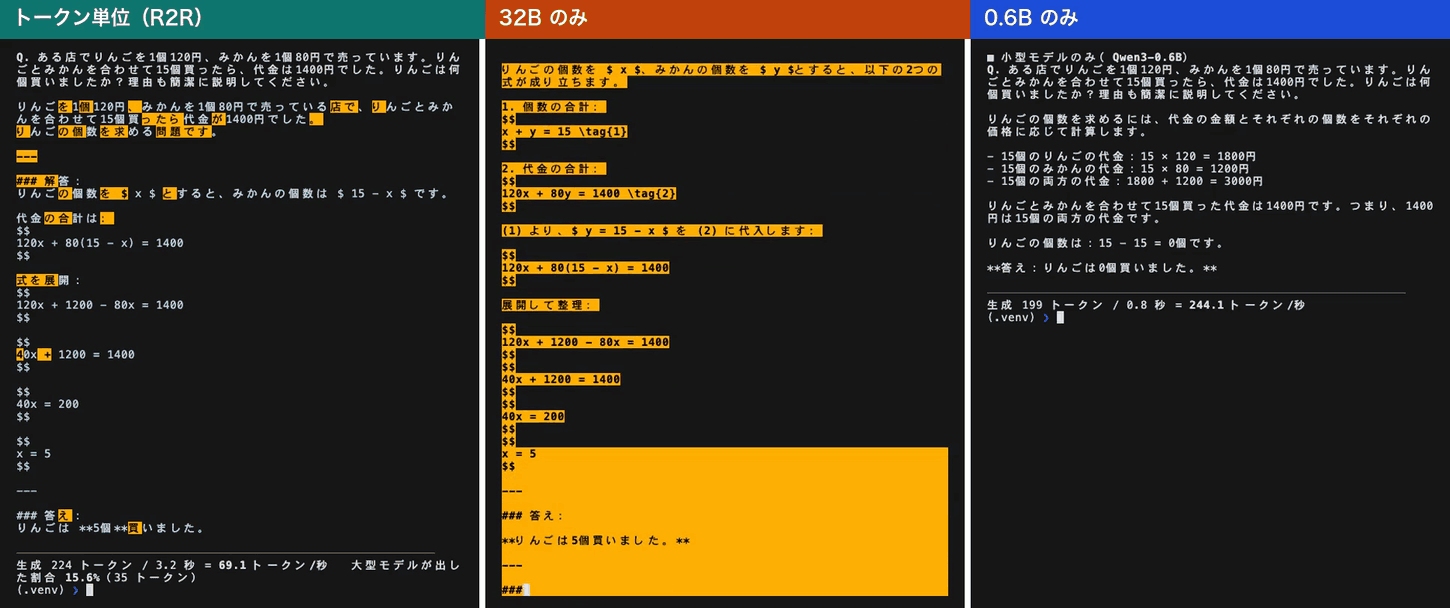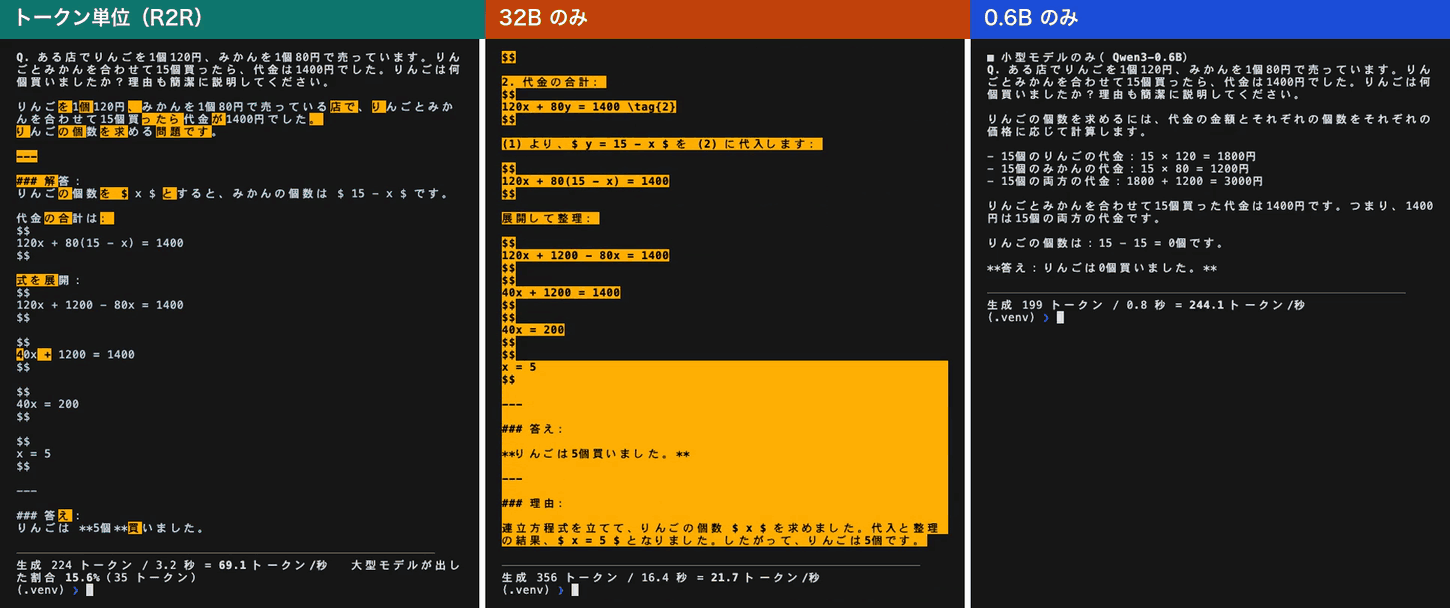
りんごとみかんの問題(実時間)。0.6B は「0 個」(誤り)、トークン単位は 3.2 秒で「5 個」(正解、32B の割合 15.6%)、32B は 16.4 秒で「5 個」(正解)
この問題では、トークン単位は 32B と同じ答えに、およそ 5 分の 1 の時間でたどり着きました。32B が書いたのは 224 トークン中 35 トークン(15.6%)だけです。録画前に試した 2 問(この問題と、旅人算の問題)は、どちらも「0.6B は誤り、トークン単位と 32B は正解」でした。2 つの動画は、成功例と失敗例を 1 つずつ選んで載せています。
30 問の結果:正解数と時間
次に、MATH-500 の 30 問を思考モードで解かせた結果です。
| 方式 | 正解 | 合計時間 | 速度 | 32B の割合 | 打ち切り |
|---|---|---|---|---|---|
| 0.6B のみ | 20 / 30 | 16.1 分 | 146.1 トークン/秒 | 0% | 9 問 |
| トークン単位(R2R) | 23 / 30 | 85.9 分 | 25.0 トークン/秒 | 28.3% | 7 問 |
| 32B のみ | 27 / 30 | 154.1 分 | 13.2 トークン/秒 | 100% | 3 問 |
難易度別の正解数は次のとおりです。
| レベル(問題数) | 0.6B のみ | トークン単位 | 32B のみ |
|---|---|---|---|
| 2(6 問) | 4 | 6 | 6 |
| 3(8 問) | 7 | 8 | 8 |
| 4(8 問) | 7 | 5 | 6 |
| 5(8 問) | 2 | 4 | 7 |
トークン単位ルーティングは、0.6B のみより 3 問多く正解し、時間は 32B のみの 約 56%(85.9 分 ÷ 154.1 分)でした。0.6B と 32B の差 7 問のうち 3 問を取り戻した形です。32B が書いたトークンは全体の 28.3% で、TokenRouter 論文の同じ組み合わせの設定(小型の 1 歩の後に大型へ行く確率 0.35)と近い水準でした。
中身を見ると、トークン単位が 0.6B の誤りを直した問題が 6 問、逆に 0.6B は正解したのにトークン単位で落とした問題が 3 問あり、差し引きで +3 問です。トークン単位で間違えた 7 問のうち 6 問は、8,192 トークンの上限まで考え続けて打ち切られたものでした。小型モデルが同じ考えを繰り返し始めると、ルーターが大型モデルに任せても抜け出せないことがあるようです(今回は毎回いちばん確率の高いトークンを選ぶ設定なので、繰り返しが起きやすい条件でもあります)。32B のみの誤り 3 問も、すべて上限による打ち切りでした。
なお、時間の数字には注意があります。計測中、この Mac では他のアプリも GPU を使っていたため、何も動かしていないとき(0.6B が約 225〜250 トークン/秒、32B が短い回答で約 26 トークン/秒)より全体に遅めです。方式の比較が公平になるよう 1 問ごとに 3 方式を順番に流しましたが、絶対値は参考程度に見てください。0.6B のみは別の時間帯にも 1 回流し、30 問すべてで出力が 1 トークンも違わないこと(同じ条件なら毎回同じ出力になること)を確かめています。
リクエスト単位の振り分けと比べると
では、判定モデルを使ったリクエスト単位の振り分けと比べるとどうでしょうか。下の図の紫の線は、Decisions API が「0.6B では解けなさそう」と判定した順に、32B に回す問題を 0 問から 30 問まで 1 問ずつ増やしたときの結果です。
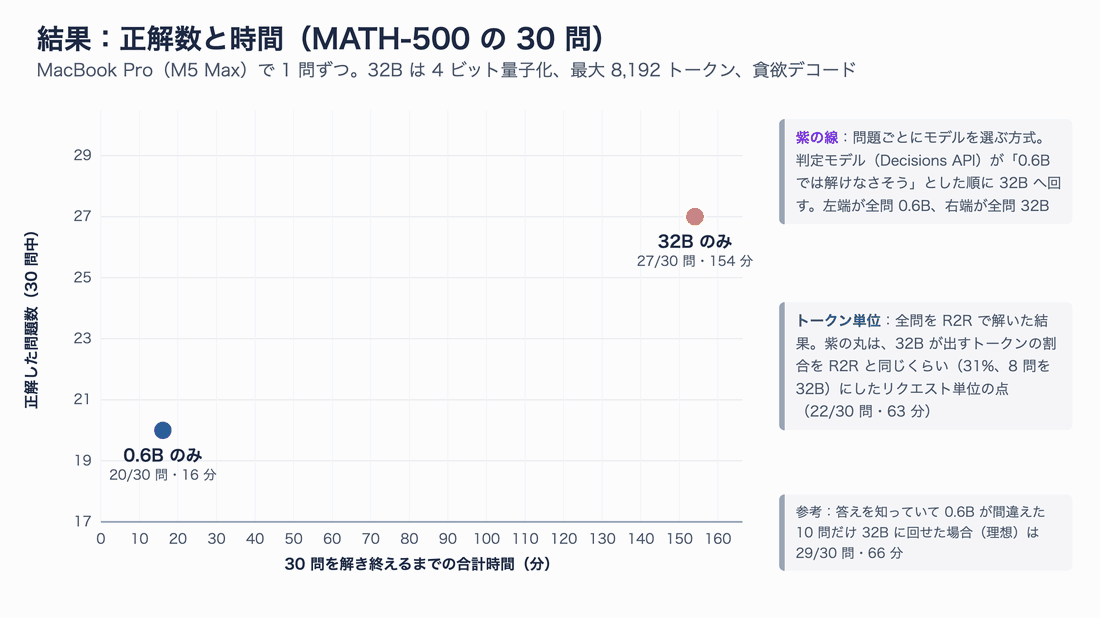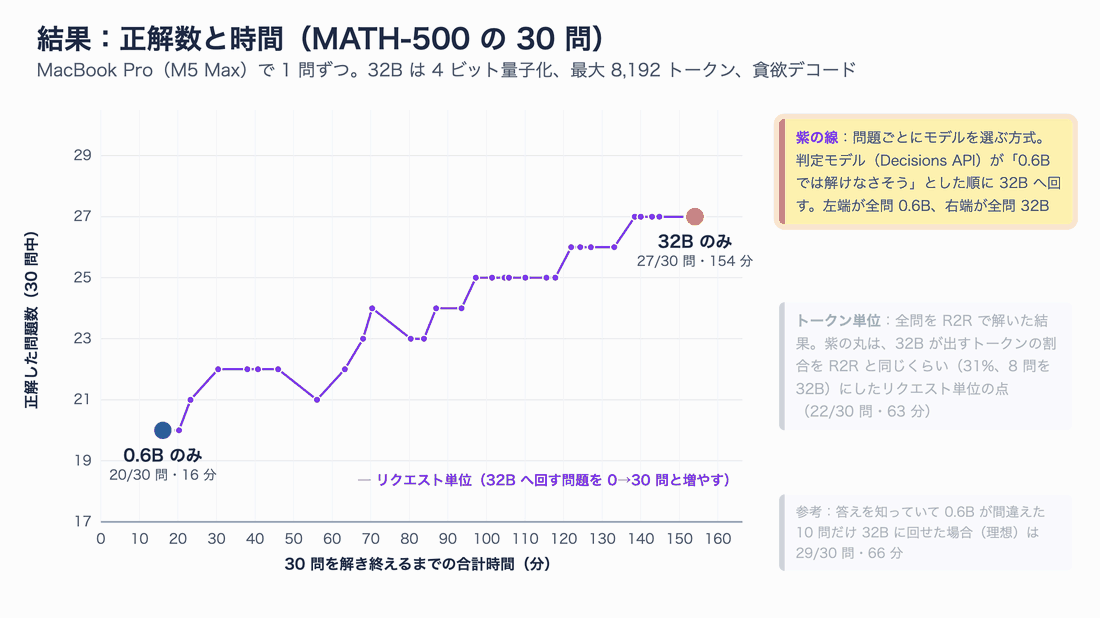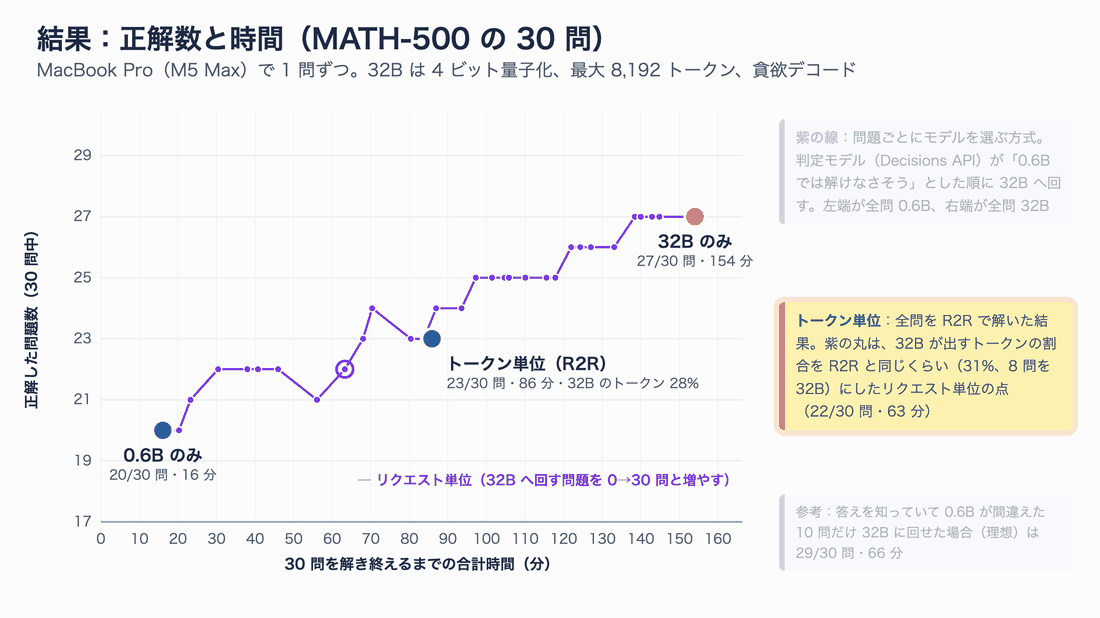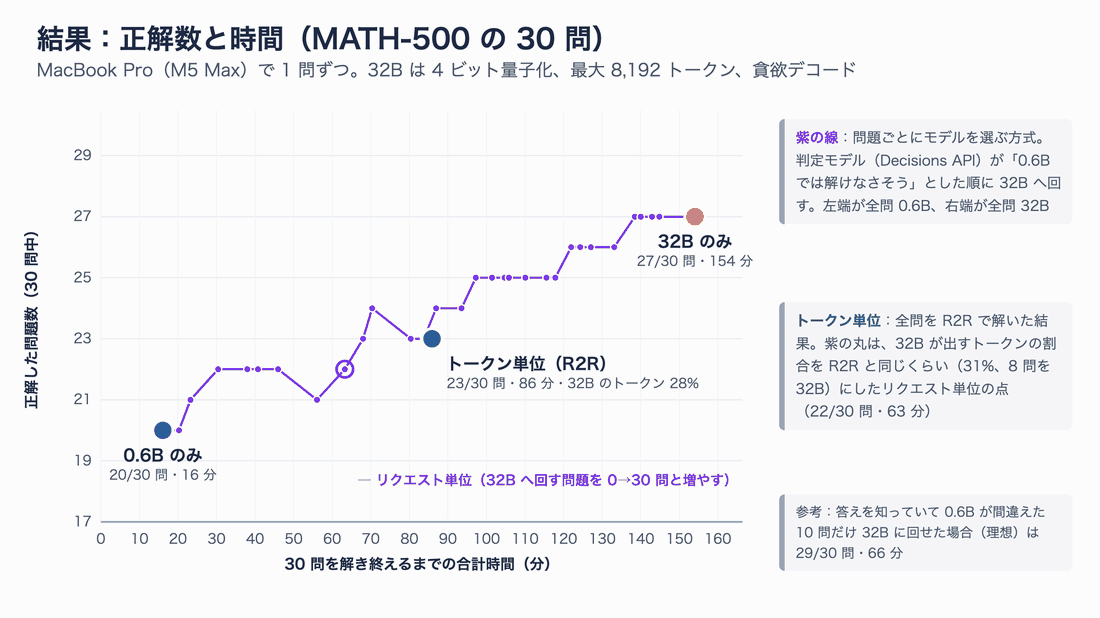
図10 トークン単位(緑)は紫の線のすぐ近く。32B の使用割合をそろえると 23 対 22、時間をそろえると 23 対 24
結果を整理すると次のとおりです。
| 比べ方 | トークン単位(R2R) | リクエスト単位(判定モデル) |
|---|---|---|
| 32B が書くトークンの割合をそろえる(約 3 割) | 23 問・86 分(28.3%) | 22 問・63 分(8 問を 32B へ、30.5%) |
| かかった時間をそろえる(約 86 分) | 23 問 | 24 問(13 問を 32B へ) |
| 判定モデルの確率が 0.5 以上の問題だけ 32B へ | − | 20 問(該当は 1 問だけ) |
| 参考:答えを知っていて、0.6B が間違える 10 問だけ 32B へ | − | 29 問・66 分 |
今回の 30 問・Mac・1 リクエストずつという条件では、トークン単位とリクエスト単位の差はほぼ互角で、どちらかがはっきり勝つ結果にはなりませんでした。30 問のうち 1〜2 問の差は、偶然でも十分に起こる幅です。
ここから読み取れることが 2 つあります。
1 つ目は、リクエスト単位の難しさは「どれを回すか見抜くこと」だという点です。答えを知っていれば 10 問を 32B に回すだけで 29 問まで届きます。ところが、問題文だけを見た判定モデルの確率が 0.5 を超えたのは 30 問中 1 問だけ(しかもその問題は 0.6B でも解けた)で、難しさをほとんど見抜けていませんでした。問題文の見た目と、小型モデルが実際につまずくかどうかは、事前には分かりにくいのです。トークン単位ルーティングは、この「事前の見極め」をやめ、生成しながら小型モデル自身の内部状態を見て判断することでこの問題を避けています。
2 つ目は、1 人で使う Mac では、トークン単位の切り替えにかかる手間が速さを打ち消しやすいという点です。今回の実装では、大型モデルに回すたびに 32B を 1 回動かすので、28.3% のトークンを任せると 32B を 36,388 回呼ぶことになります。1 トークンだけを出すための 32B の 1 回は、普通に生成するときの 1 歩とほぼ同じ時間がかかります。TokenRouter は、この 32B の呼び出しを多数のリクエストでまとめて処理する(非同期実行と遅延バッチング)ことで効率を上げる基盤ですが、1 リクエストずつの今回の検証ではその効果は再現できません。トークン単位ルーティングの本当の速さは、同時に多くの利用者がいる GPU サーバーで TokenRouter と組み合わせたときに出るものです。
どんなトークンが大型モデルに回ったのか
最後に、30 問の出力(R2R、合計 128,700 トークン)を分析し、ルーターがどんなトークンを 32B に任せたかを調べました。
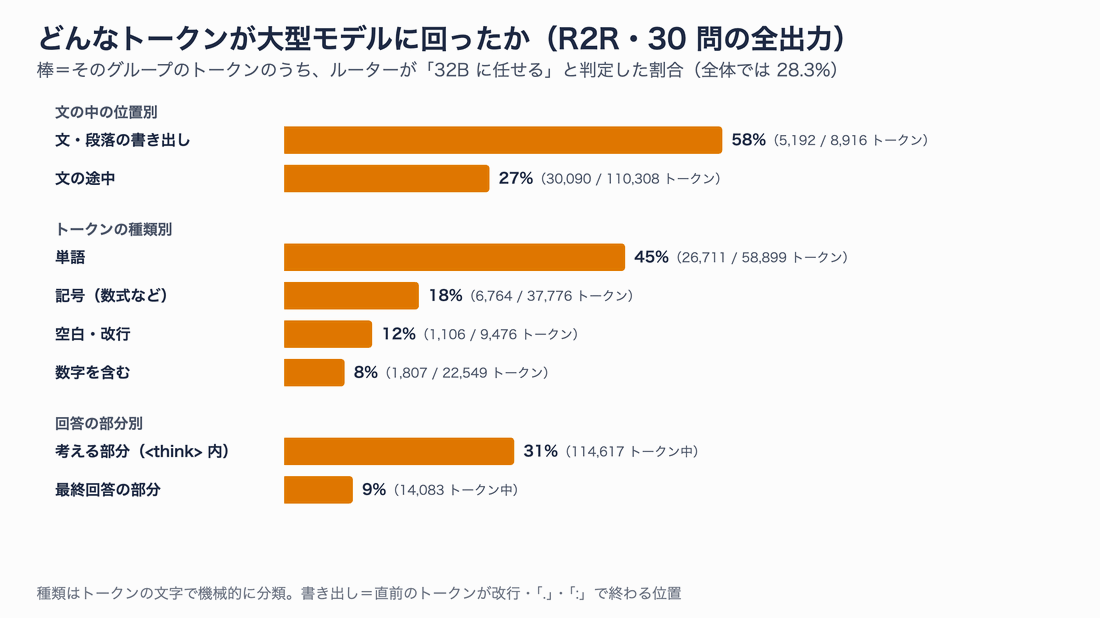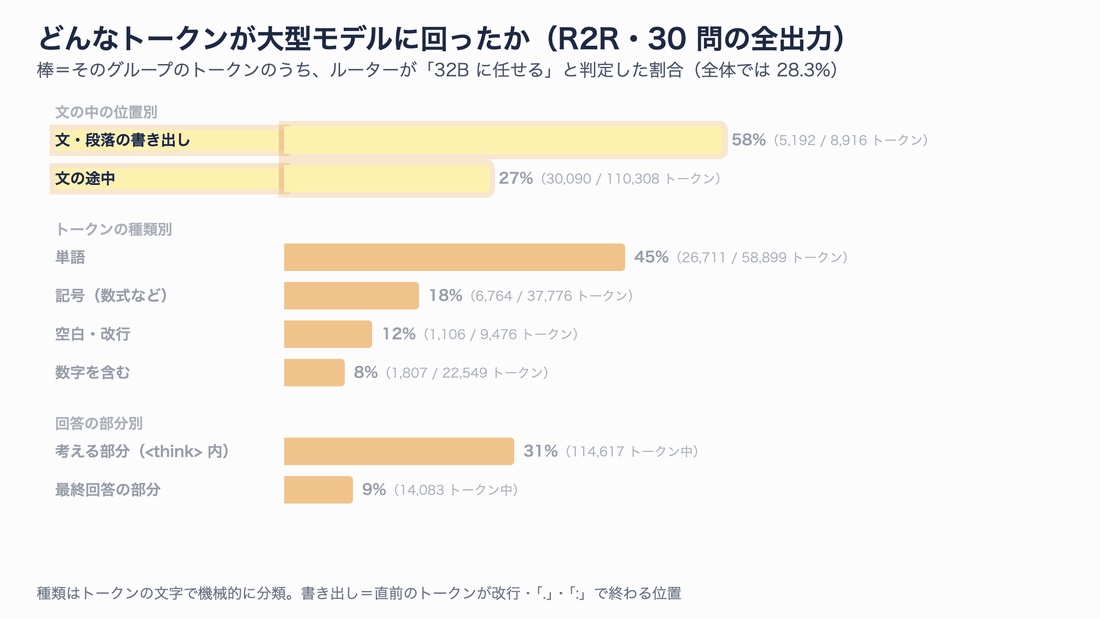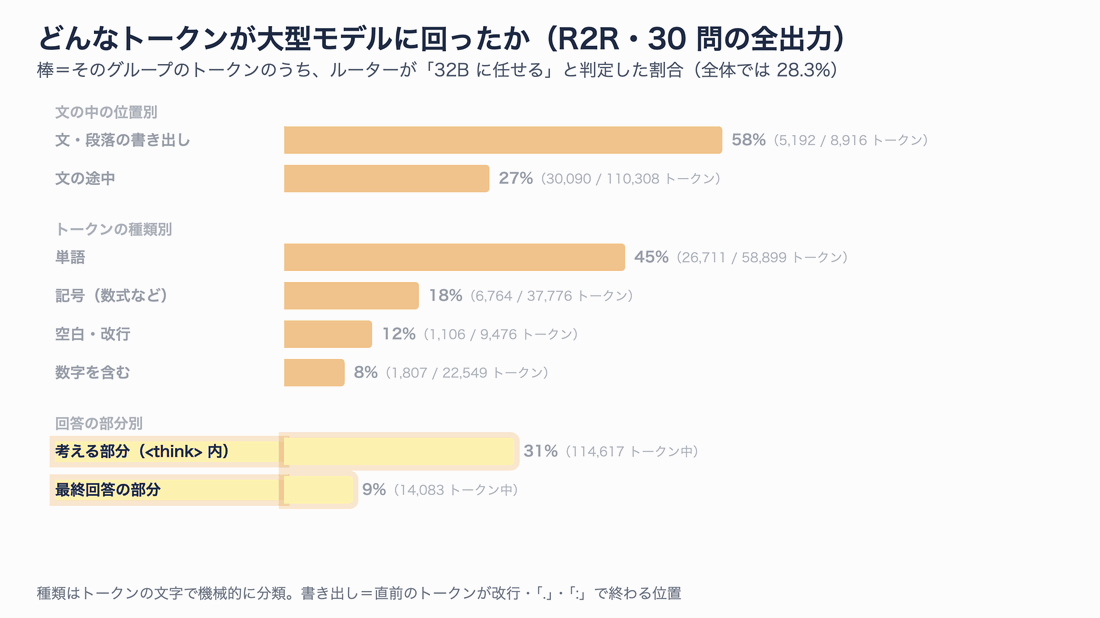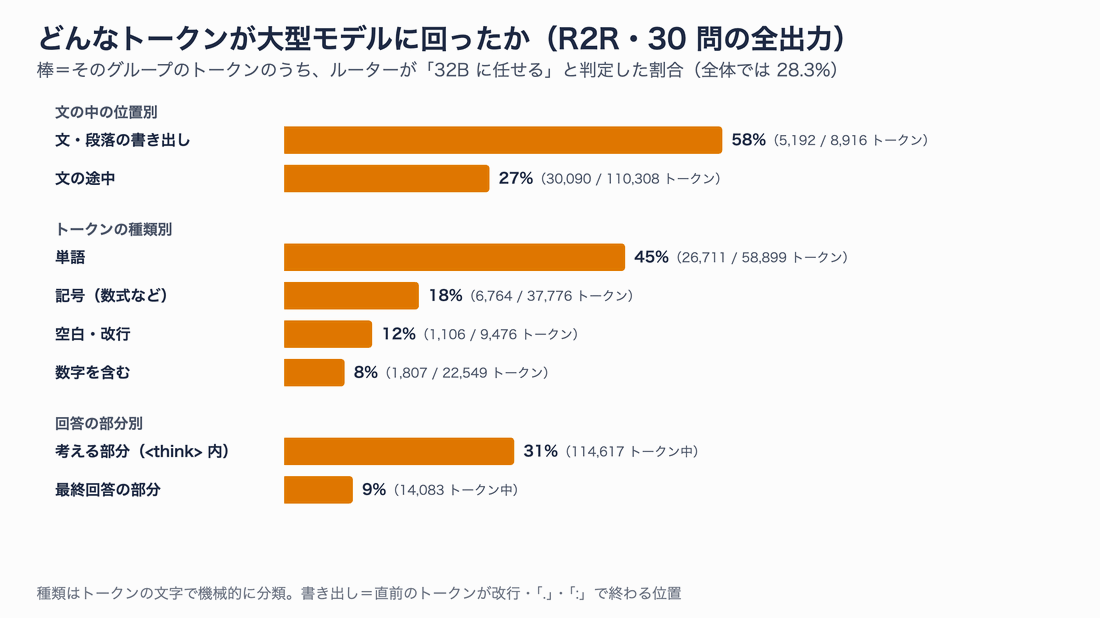
図11 大型モデルに回るのは数字や記号より「単語」、それも文の書き出しが多い
予想に反して、数字を含むトークンが 32B に回った割合は 8.0% と低く、計算そのものはほとんど 0.6B が書いていました。代わりに多かったのが単語(45.4%)で、特に文や段落の書き出し(58.2%)です。80 回以上出てきたトークンの中で、32B に回った割合が高かったものを並べると、傾向がはっきりします。
| トークン | 32B に回った割合 | 回数 |
|---|---|---|
| perhaps | 98.9% | 89 / 90 |
| since | 97.0% | 195 / 201 |
| Maybe | 96.4% | 81 / 84 |
| Since | 95.4% | 104 / 109 |
| maybe | 94.2% | 242 / 257 |
| But | 90.8% | 119 / 131 |
| Alternatively | 90.0% | 207 / 230 |
| Let(前に空白が付く形) | 85.7% | 580 / 677 |
| So(段落の先頭) | 83.4% | 176 / 211 |
| Wait | 71.5% | 348 / 487 |
「たぶん」「なぜなら」「しかし」「別の方法として」「待って」――どれも推論の向きを決めたり、変えたりする言葉です。R2R の論文は、大型モデルに任せるべきトークンを「その後の推論の流れを分岐させるトークン(divergent token)」と定義していますが、実際にルーターが選んでいたのはまさにこの種類の言葉でした。答えを書く部分(9.1%)より考える部分(30.6%)で多く回っているのも、同じ理由だと考えられます。
実際の出力で見ると、次のようになります。0.6B のみでは繰り返しに入って打ち切られ、トークン単位では正解できたレベル 5 の問題の冒頭です。
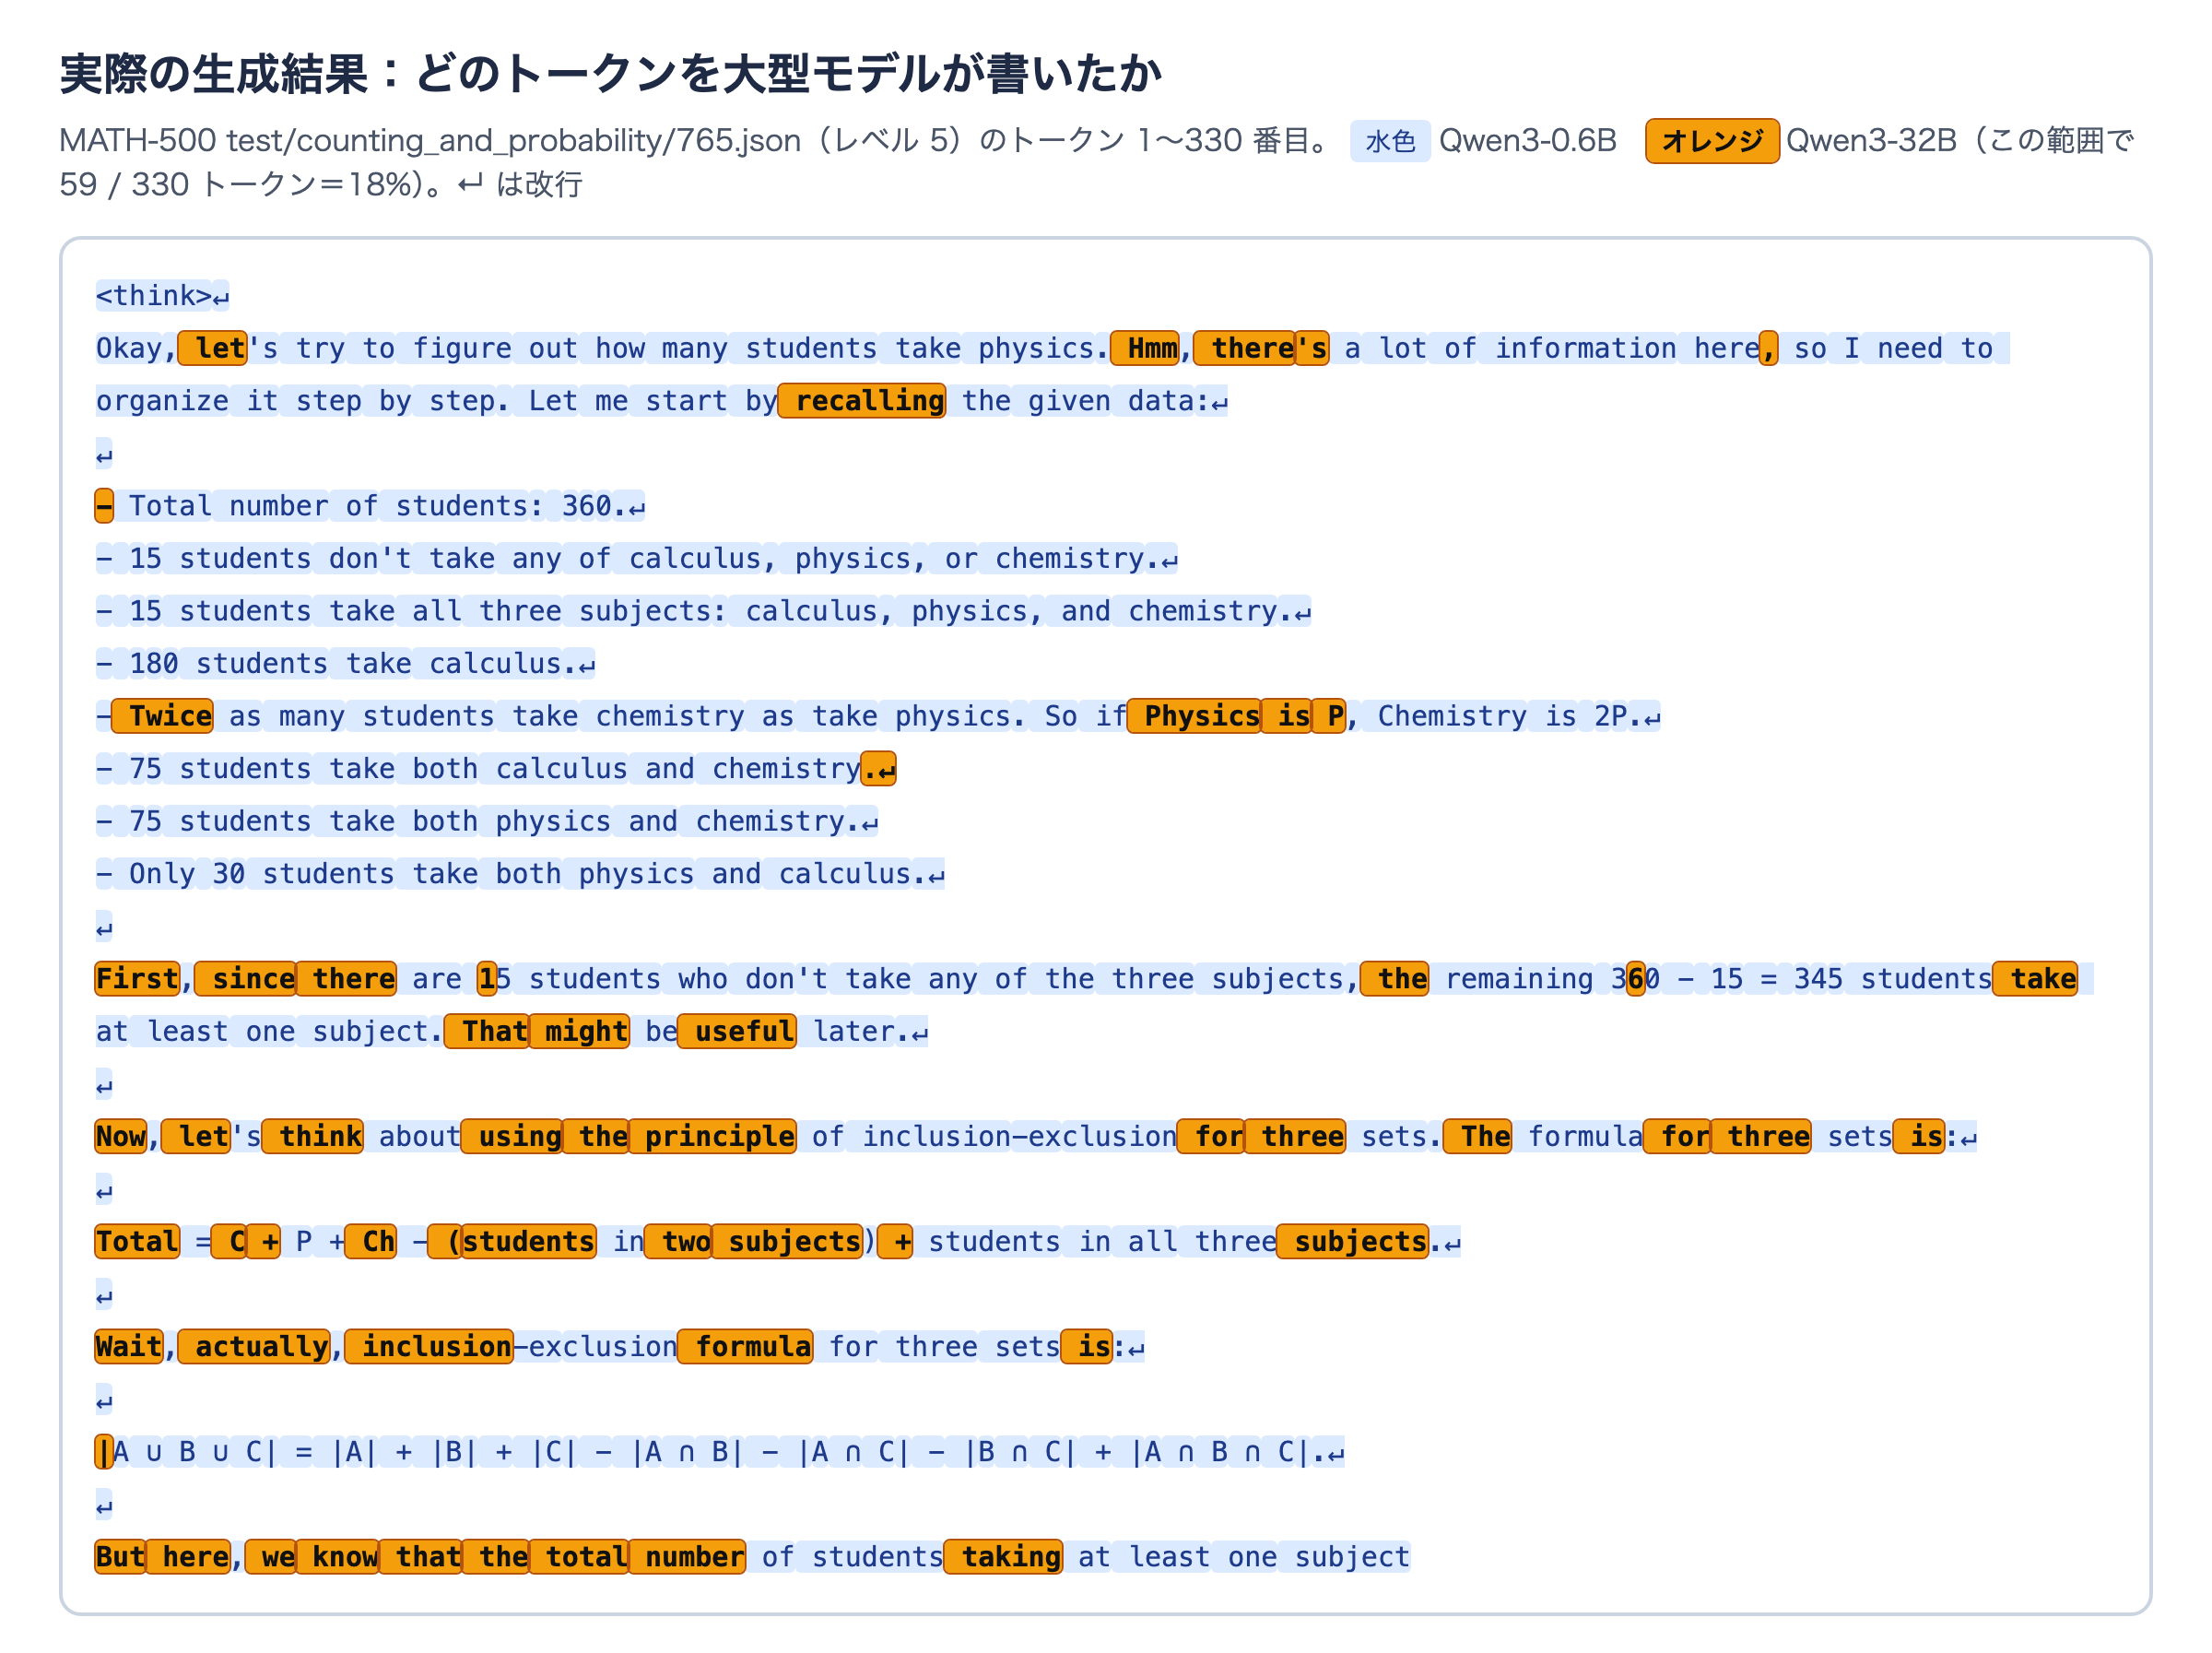
問題文の条件を書き写す所は小型、方針を決める「First, since」「Wait, actually」「But here」などは大型(30 問の実測データから作成)
問題の条件を書き写す行はほぼ水色(0.6B)のままで、「まず」「では、包除原理を使って考えよう」「待って、実は」「しかしここでは」と方針を決める所でオレンジ(32B)が現れます。小型モデルが手を動かし、大型モデルが要所で舵を取る――トークン単位ルーティングの狙いが、そのまま色分けに出ています。
公式の手順で TokenRouter 本体を動かすには(NVIDIA GPU)
ここからは、NVIDIA GPU のサーバーで TokenRouter 本体を動かす場合の手順を、公式 README に沿ってまとめます。この節のコマンドは筆者の環境(Mac)では実行していません。 公式の Qwen3-0.6B/Qwen3-32B の設定は、32B を bf16 のまま GPU 2 枚(テンソル並列)に載せる構成なので、80GB 級の GPU が 2〜3 枚あると安心です。
1. インストール
# 公式リポジトリを取得する
git clone https://github.com/thu-nics/TokenRouter.git
cd TokenRouter

# Python 3.10 の環境を作り、TokenRouter を入れる(torch 2.8・SGLang 0.5.1 なども一緒に入る)
conda create -n tokenrouter python=3.10
conda activate tokenrouter
pip install -e .
2. 同じ GPU に 2 つのモデルを載せるなら CUDA MPS を起動する
複数のモデルが同じ GPU を共有する構成では、CUDA MPS(複数のプロセスで 1 つの GPU を同時に使う仕組み)の利用が推奨されています。
# 作業用のフォルダを作り、MPS の制御デーモンを起動する
mkdir -p tmp/mps_r2r_30000
export CUDA_MPS_PIPE_DIRECTORY=$PWD/tmp/mps_r2r_30000/pipe
export CUDA_MPS_LOG_DIRECTORY=$PWD/tmp/mps_r2r_30000/log
nvidia-cuda-mps-control -d
3. 設定ファイルを選んでサーバーを起動する
設定は YAML 1 つです。config/r2r/Qwen3-0.6B_Qwen3-32B.yaml の要点だけ抜き出すと、次のようになっています。
model:
  quick:                              # 入口になる小型モデル
    model_path: "Qwen/Qwen3-0.6B"
    port: 30000
    tp_size: 1
    scheduler_class: "r2r_slm"        # 小型モデル側の R2R スケジューラー
    scheduler_kwargs:
      switching_strategy: "neural"    # 学習済みルーターで判定する
      model_path: "nics-efc/R2R_router_collections/Qwen3-0.6B+Qwen3-32B/default_router.pt"
  reference:                          # 相手の大型モデル
    model_path: "Qwen/Qwen3-32B"
    tp_size: 2                        # GPU 2 枚に分けて載せる
    delayed_batching_threshold: [1,2,2,3,4,5,5,6,7,8,9,10,10,11,12,13]  # 同時実行数ごとの閾値 B
    scheduler_class: "r2r_llm"
system:
  entry_model: "quick"
  mem_fraction_static: 0.85
ルーターの重みは Hugging Face の nics-efc/R2R_router_collections から自動でダウンロードされます。起動は次の 1 行です。
# R2R(Qwen3-0.6B ⇄ Qwen3-32B)の設定でサーバーを起動する(既定のポートは 30000)
python -m tokenrouter.launch_server --config_path config/r2r/Qwen3-0.6B_Qwen3-32B.yaml
手法を変えるときは、設定ファイルを差し替えるだけです。
| 手法 | 設定ファイル |
|---|---|
| R2R | config/r2r/Qwen3-0.6B_Qwen3-32B.yaml |
| CITER | config/citer/Qwen3-0.6B_Qwen3-32B.yaml |
| Co-LLM | config/collm/Qwen3-0.6B_Qwen3-32B.yaml |
| R-Stitch | config/rstitch/Qwen3-0.6B_Qwen3-32B.yaml |
| ME(3 モデル) | config/me/Qwen3-0.6B_Qwen3-8B_Qwen3-32B.yaml |
| クエリ単位(比較用) | config/query_level/Qwen3-0.6B_Qwen3-32B.yaml |
4. OpenAI 互換の API で呼ぶ
サーバーは OpenAI 互換なので、いつもの OpenAI SDK で接続先を変えるだけで呼べます。
# OpenAI SDK で TokenRouter のサーバーを呼ぶ(公式の examples/openai_chat_completion.py を簡略化)
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:30000/v1", api_key="EMPTY")
response = client.chat.completions.create(
    model="default",
    messages=[{"role": "user", "content": "1から100までの整数のうち、3でも5でも割り切れない数はいくつ?"}],
    temperature=0,
    max_tokens=2048,
)
print(response.choices[0].message.content)
print("usage:", response.usage)
クエリ単位の比較用設定では、リクエストの model に "quick"(小型)や "reference"(大型)を指定すると、そのリクエストを指定したモデルに最初から任せられます。リクエスト単位とトークン単位を同じサーバーで比べられるようになっているわけです。
サーバーを立てずに Python から直接使う場合は、TokenRoutingEngine を使います。
# サーバーを起動せずに Python から直接生成する(公式 README の例)
from tokenrouter.entrypoints.engine import TokenRoutingEngine

with TokenRoutingEngine("config/r2r/Qwen3-0.6B_Qwen3-32B.yaml") as engine:
    response = engine.generate(
        prompt="<|im_start|>user\nSay hello in one short sentence.<|im_end|>\n<|im_start|>assistant\n",
        sampling_params={"temperature": 0, "max_new_tokens": 256},
    )
    print(response["text"])
5. スループットを測る
論文と同じ作業量で測るためのスクリプトも入っています。
# 同時実行数 4、ポート 30000、入力 30 件 × 1 回、最大 2048 トークンで AIME の問題を流す
bash evaluation/test_throughput.sh 4 30000 30 1 2048 out/r2r evaluation/datasets/aime.json

# 結果の CSV を集計する
python evaluation/report.py --result out/r2r/result.csv
遅延バッチングの閾値を自分の環境に合わせて計算し直す場合は、evaluation/calculate_delayed_batching.py を使います。
# 2 モデル、同時実行数 4、1 歩の時間(小型 6.0ms・大型 27.9ms)、小型の後に大型へ行く確率 0.35 の例
python evaluation/calculate_delayed_batching.py \
  --M 2 --N 4 --latencies 6.0 27.9 \
  --P '[[0.65, 0.35], [1, 0]]' \
  --C '[[1, 0], [1, 0]]' \
  --delta 0.1
ここで 1 つ注意があります。README の例では --P '[[0.35, 0.65], [1, 0]]' となっていますが、論文の定義(小型の 1 歩の後に大型へ行く確率 p=0.35 が 1 行 2 列目)に従うと [[0.65, 0.35], [1, 0]] になるはずです。論文の付録の数値(N=4 で最適 B=[1,3]、207.95 トークン/秒)を再現できたのは後者でした(記事の調査で両方を実行して確認)。README の値は行が入れ替わっている可能性があるので、使う前に論文の付録 D と見比べてください。
どの使い分け方を選べばよいか
ここまでの内容を踏まえて、どの方式を選ぶかを整理します。トークン単位ルーティングは強力ですが、条件がそろって初めて効く方式です。
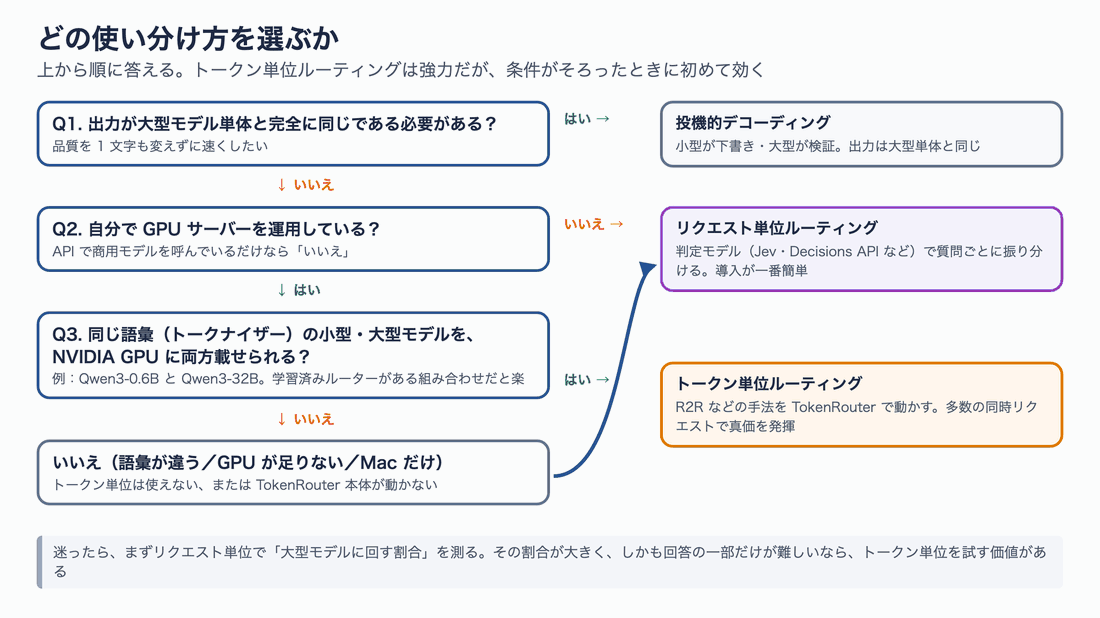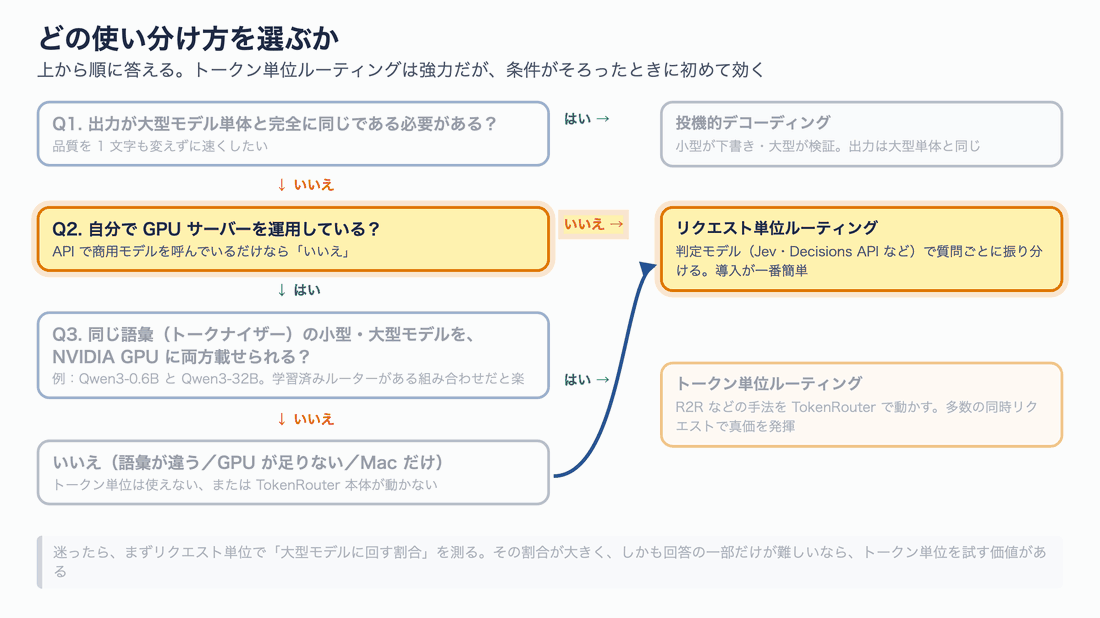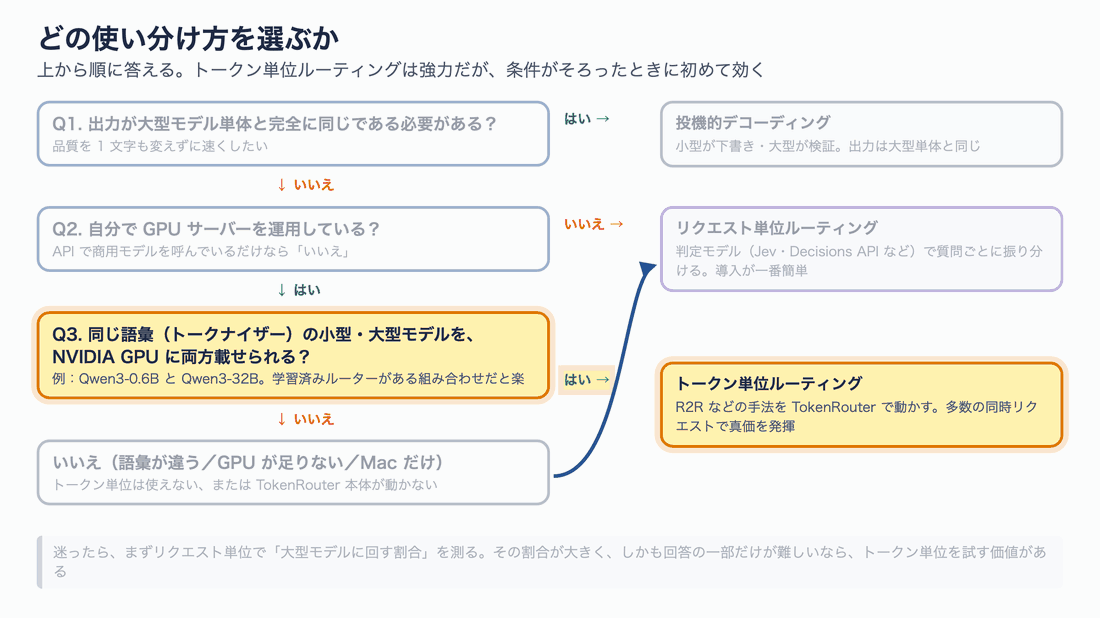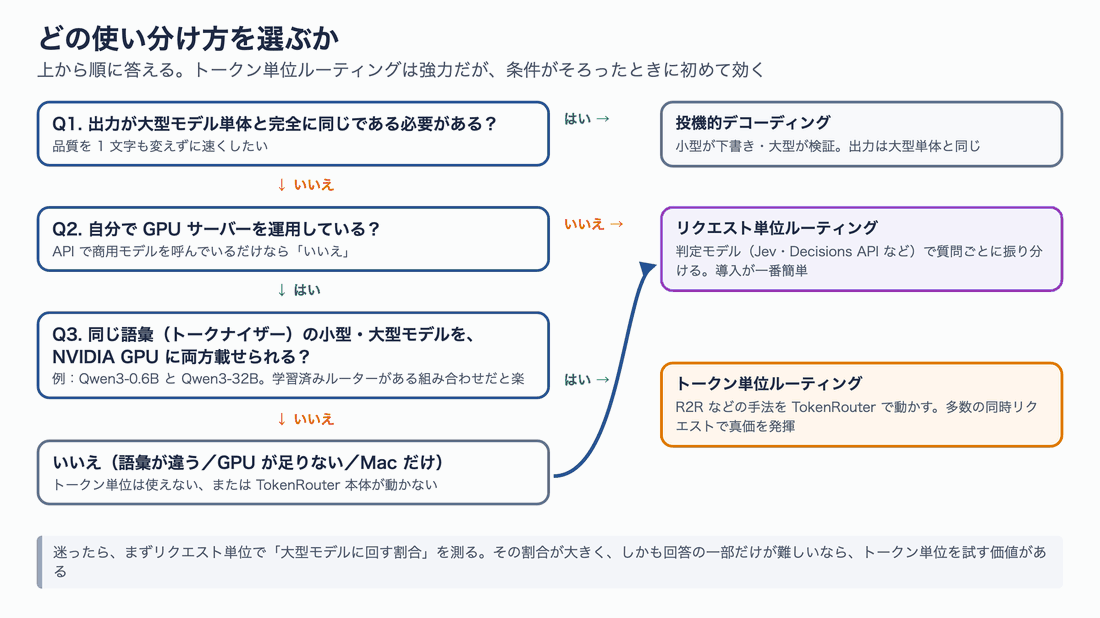
図12 上から順に答えて選ぶ
判断のポイントを補足します。
- API で商用モデルを使っているだけなら、トークン単位は選べません。 1 トークンごとに別の API を呼び分けることはできないからです。判定モデルなどによるリクエスト単位の振り分けが現実的です
- 小型と大型は同じトークナイザー(語彙)である必要があります。 片方が出したトークン列を、もう片方がそのまま読み込んで続きを書くからです。Qwen3 の 0.6B と 32B のように、同じ系列のモデルを組み合わせます
- ルーターの学習データがある組み合わせだと楽です。 R2R の学習済みルーターは、2026 年 10 月 12 日時点で Qwen3-0.6B と組み合わせる 8B・30B-A3B・32B の 3 種類が公開されています。それ以外の組み合わせでは、ルーターを学習するか、R-Stitch のように学習の要らない判定(エントロピー)を使います
- TokenRouter の高速化が効くのは、同時に多くのリクエストを処理するときです。 1 人で使う場合は、非同期実行と遅延バッチングの効果はありません(今回の Mac の検証も、この 1 人で使う場合にあたります)
- 出力の品質は「大型モデル単体と同じ」ではありません。 閾値を上げるほど大型モデルを使う割合が減って速くなり、下げるほど大型モデルに近づきます。自分の用途の評価データで精度を測ってから閾値を決めるのが安全です
トラブルシューティング
TokenRouter 本体を動かすとき、および今回のように Mac で仕組みを試すときに、つまずきやすい点をまとめます。Mac 側は筆者が実際に遭遇したもの、GPU 側は公式資料から読み取れる注意点です。
| 症状・疑問 | 原因 | 対処 |
|---|---|---|
Mac で pip install -e . が失敗する | sgl-kernel・flashinfer-python・cuda-python など CUDA 専用の依存がある | 本体は NVIDIA GPU のマシンで動かす。Mac では今回のように仕組みだけを移植して試す |
| ルーターを読み込むと Hugging Face から Qwen3-0.6B を取りに行く | ルーターのファイルにトークン埋め込みが入っておらず、router.py が元モデルから複製する作り | 先に Qwen3-0.6B をダウンロードしておく。今回は MLX 版の同じ重みを渡して回避した |
| ルーターの判定が CPU だと 1 トークン 3.4ms かかる | 5,500 万パラメータの MLP を毎トークン動かすため | GPU 上で動かす(公式は CUDA Graph 化、今回は MLX に移植して 1.4ms) |
| 大型モデルに回る割合が想定より多い(3 割前後) | Qwen3-0.6B と 32B の組み合わせでは差が大きい。今回の実測は 28.3%、論文の評価設定でも小型の 1 歩の後に大型へ行く確率は 0.35 | 閾値を上げると割合が減る(その分、精度は下がる)。R2R 論文の 11〜15% は別のモデルの組み合わせの数字 |
| Qwen3-32B のダウンロード(約 18GB)が途中で止まる | 同時に複数のダウンロードがあると止まりやすい | curl の再開オプション(-C)でファイルごとに取得すると再開できる |
| 遅延バッチングの閾値を計算すると論文と合わない | README の例の行列 P の行が論文と逆になっている可能性 | 論文の付録 D どおり [[0.65, 0.35], [1, 0]] で計算する |
| 小型モデルが同じ文を繰り返して上限まで止まらない | 毎回いちばん確率の高いトークンを選ぶ設定(貪欲デコード)で起きやすい。今回トークン単位で間違えた 7 問のうち 6 問がこれ | 最大トークン数を決めておく。Qwen3 の推奨どおり温度つきのサンプリングにする手もあるが、その場合は結果が毎回変わる |
| 同時実行数 1 で試したら、思ったほど速くない | 非同期実行と遅延バッチングは、同時に複数のリクエストがあるときに効く仕組み | 実運用に近い同時実行数で evaluation/test_throughput.sh を使って測る |
まとめ
- 判定モデルの普及で「質問ごとにモデルを振り分ける」ことは当たり前になりました。その先にあるのが、回答を書いている途中でも 1 トークンごとに担当を替えるトークン単位ルーティングです
- 清華大学の TokenRouter は、その切り替えを実用的な速さで動かすための推論基盤です。モデルごとのサブサーバー、トークン列だけを渡す受け渡し、遅延バッチングによって、既存の動かし方より 2.01〜64.15 倍のスループットを出しました(同時実行数 4、比較相手は各手法の公式実装か SGLang の素直な組み合わせ)
- 開発者は
route()・send()・receive()の 3 つを書くだけで、新しいルーティング手法を載せられます - Mac で R2R の仕組みを再現したところ、MATH-500 の 30 問で正解は 0.6B のみ 20 問 → トークン単位 23 問 → 32B のみ 27 問、時間は 32B のみの約 56% でした。32B が書いたのは全トークンの 28.3% で、その中心は数字ではなく「since」「But」「Wait」のような推論の向きを決める言葉でした
- 一方、1 人で使う Mac では、判定モデルによるリクエスト単位の振り分けとほぼ互角でした。トークン単位の速さが本当に生きるのは、多数のリクエストを TokenRouter でまとめて処理する GPU サーバーです
次の一歩としては、まず自分のサービスでリクエスト単位の振り分けを入れ、「大型モデルに回している質問の割合」と「その回答のうち本当に難しい部分の割合」を測ってみるのがおすすめです。大型モデルに回す割合が大きく、しかも難しいのは回答の一部だけ、という状況なら、トークン単位ルーティングを試す価値があります。
参考リソース
- 論文:TokenRouter: Efficient Serving System for Token-Level LLM Routing(arXiv:2610.12242)
- 公式リポジトリ:thu-nics/TokenRouter
- プロジェクトページ:TokenRouter · A serving engine for token-level LLM routing
- Hugging Face Papers:2610.12242
- R2R 論文:R2R: Efficiently Navigating Divergent Reasoning Paths with Small-Large Model Token Routing(arXiv:2505.21600)
- R2R リポジトリ:thu-nics/R2R
- 学習済みルーター:nics-efc/R2R_router_collections
- 検証データ:HuggingFaceH4/MATH-500