はじめに
請求書や運用報告書、補助金の一覧表のような PDF から、決まった項目を取り出して表やデータベースに入れたい。この作業は、生成 AI が普及した今でも意外と手間がかかります。
1ページの請求書ならうまくいくのに、数百行の明細になると途中で止まってしまう。1件の記録が次のページへ続くと、隣の記録と混ざってしまう。スキャンした手書きの帳票では、二重線で消した数字を拾ってしまう。こうした経験がある方は多いと思います。
2026年10月1日、LlamaIndex は文書からの項目抽出サービス Extract v2.5 を公開しました。モデルを新しくしただけではありません。文書の抽出に特化した「エージェント・ハーネス(モデルの周りで、読む順番や作業メモ、検算を管理する仕組み)」を新たに入れたのが特徴です。公式ブログによると、長いリストやページをまたぐ記録、スキャンした帳票で精度が上がっています。
ただし、公式の例はどれも英語の文書です。日本語の帳票でも同じように効くのかは、自分で試さないと分かりません。そこでこの記事では、従来の方法では扱いにくい形の日本語文書を4種類作りました。それを「従来の方法」「旧版の Extract」「v2.5」で読み取らせ、正解データと1項目ずつ突き合わせています。
先に結論を図にまとめます。
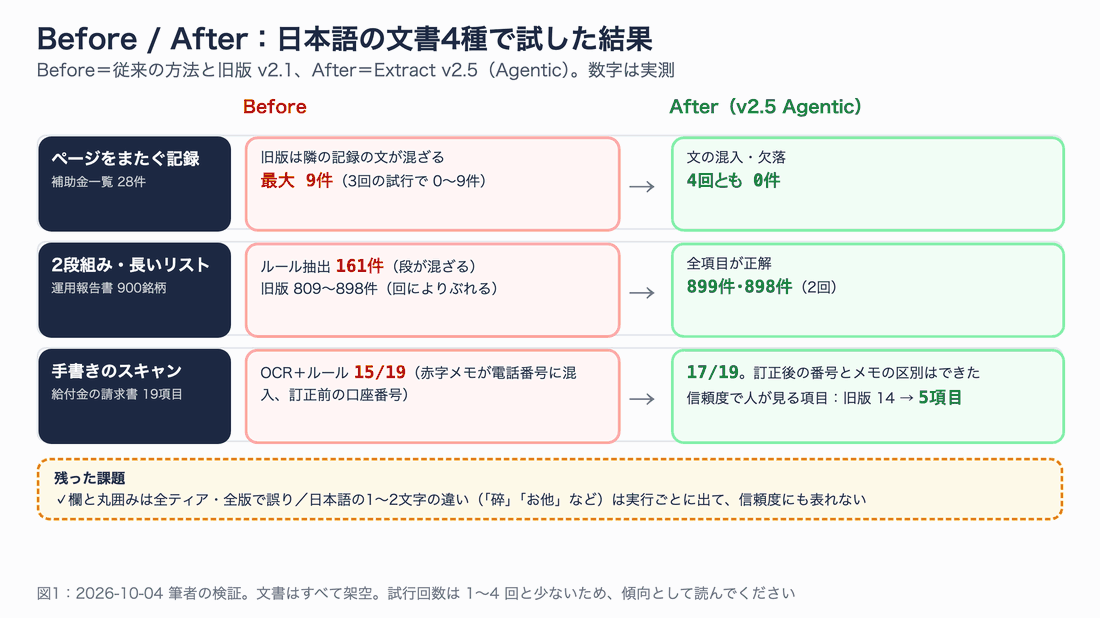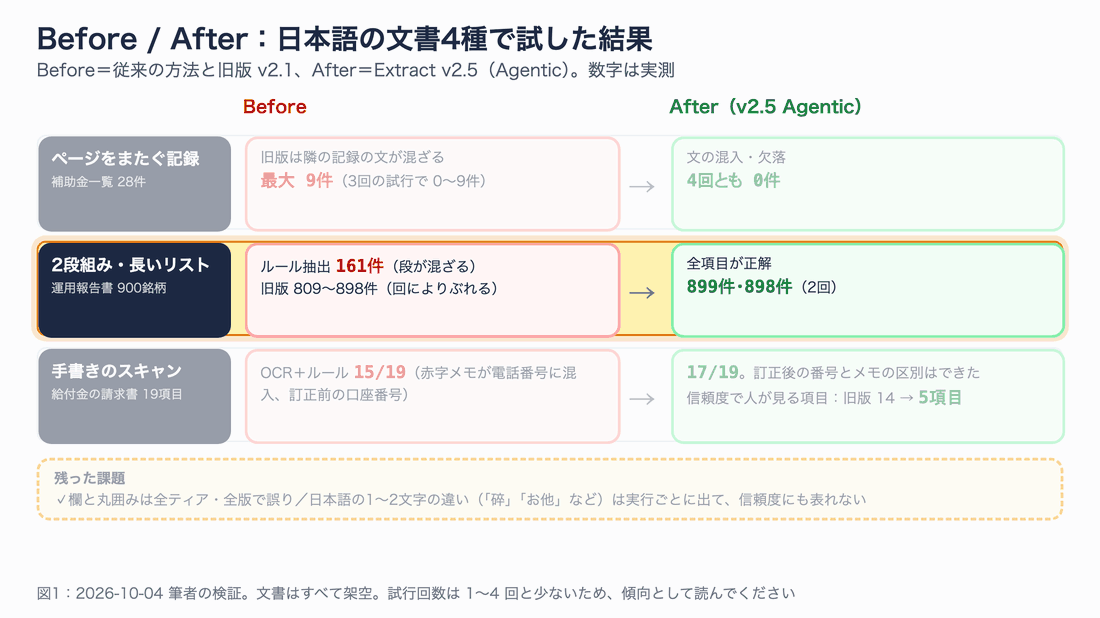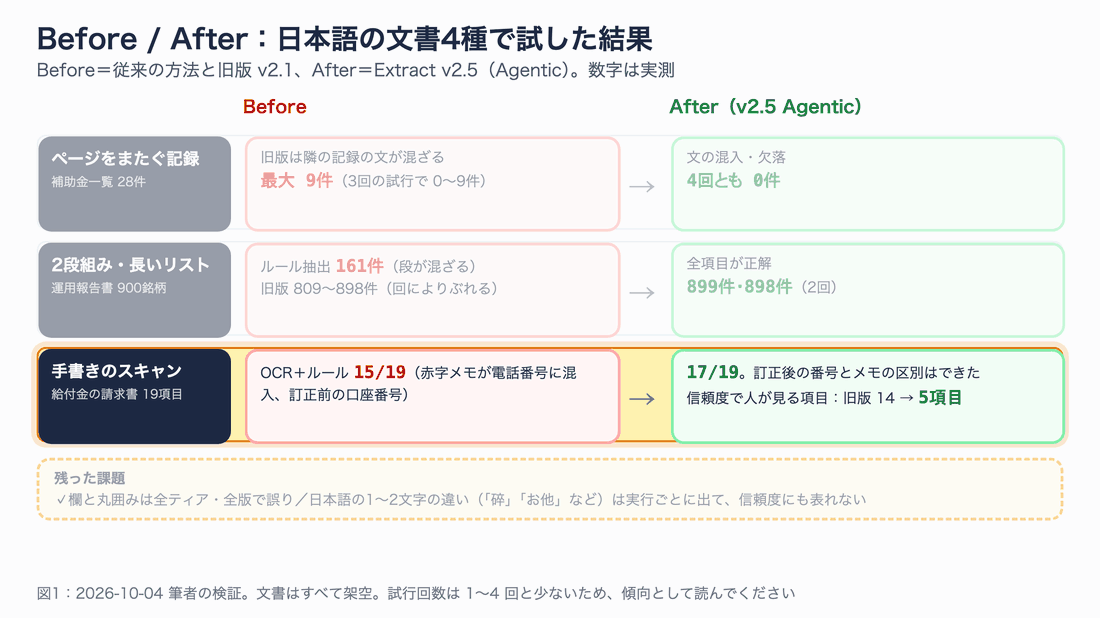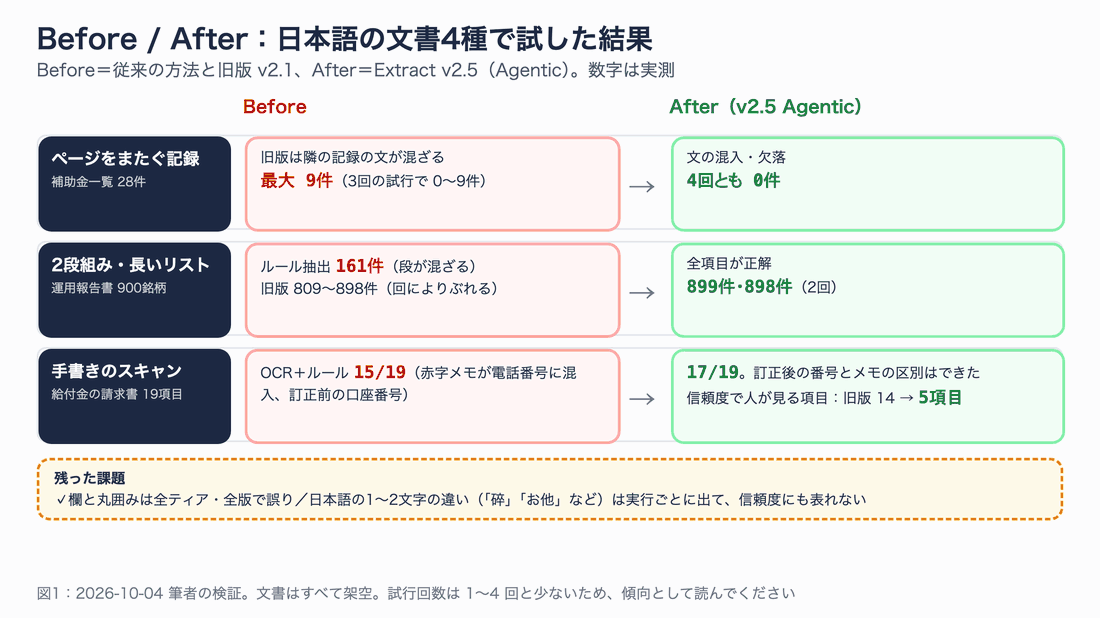
図1:Before/After のまとめ。ページをまたぐ記録で文が混ざる誤りは v2.5 Agentic で4回ともゼロになりました。一方、チェック欄と日本語の1〜2文字の違いは残りました。
この記事で分かることは次の4つです。
- Extract v2.5 の「専用ハーネス」が何をしているのか
- 日本語の文書4種で、従来の方法・旧版・v2.5 がそれぞれどこで間違えたか(スクリーンショットと動画つき)
- 自分の PC から API で試す手順と、そのまま動くコード
- 実務で使うときの、信頼度と件数の検算の組み合わせ方
想定している読者は、PDF からのデータ抽出や RAG(検索拡張生成:文書を検索して AI の回答に使う仕組み)を業務で扱う方です。Python の基本が分かれば、手順どおりに再現できます。
この記事の確認範囲
| 項目 | 内容 |
|---|---|
| 実施日 | 2026年10月4日 |
| 使った環境 | MacBook Pro(Apple M5 Max・128GB)、macOS 26.6.2、Python 3.12.15 |
| SDK | llama-cloud 2.16.0(Python) |
| 比較したバージョン | v2.5 と、v2.5 公開前の日付指定で動いた v2.1 |
| 文書 | 筆者が作った架空の日本語文書4種(実在の銘柄・団体・人物とは関係ありません) |
| 試行回数 | 条件ごとに1〜4回。統計的な評価ではなく、傾向をつかむための検証です |
Extract v2.5 で何が変わったのか
「PDF を渡せば終わり」ではなかった
文書からの項目抽出は、よく次のような流れで作られてきました。PDF から文字を取り出して大きなモデルに丸ごと渡し、「この JSON の形で書き出して」と頼む方法です。短い文書なら、これで十分に動きます。
問題は、文書が長く複雑になったときです。モデルは JSON を最初から一気に書き出すので、数百件のリストでは途中で書くのをやめてしまうことがあります。似た記録が並ぶと、ある記録の文を隣の記録に書いてしまうこともあります。公式ブログでも、17ページ・238銘柄のファンド資料で、旧版の Cost Effective が87件しか返さなかった例が紹介されています。
専用ハーネスは「分けて読み、確かめてから出す」
v2.5 では、この「一気に書く」部分を、文書の抽出に特化したハーネスに置き換えました。公式ブログは、コーディングエージェントの作り方を参考にしたと説明しています。内部の実装は公開されていないので、ここでは公式の説明を筆者が単純化して図にします。
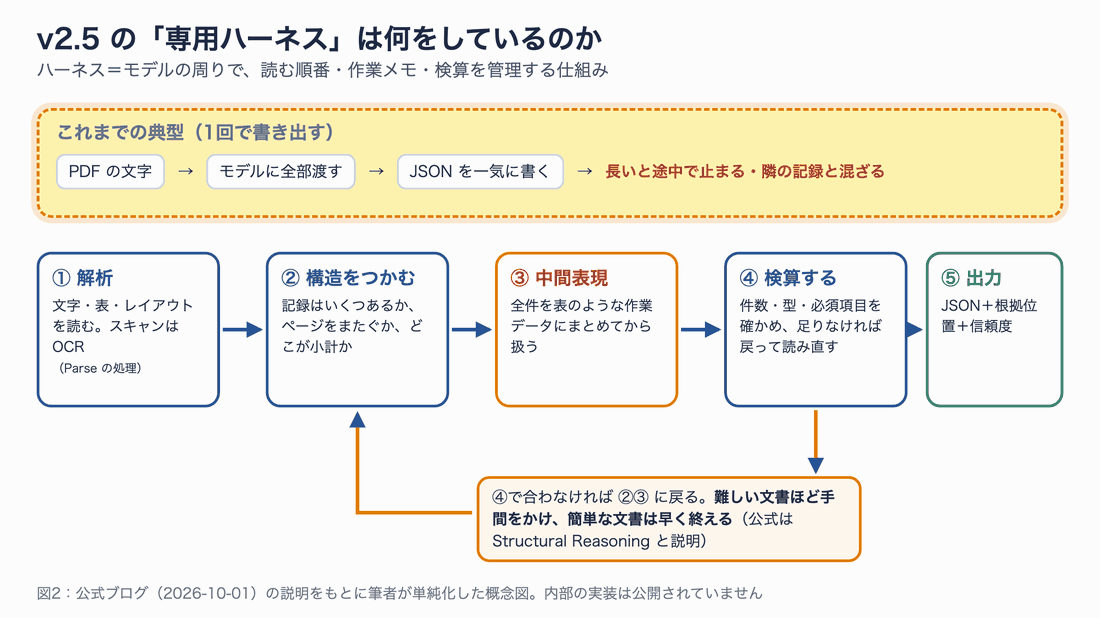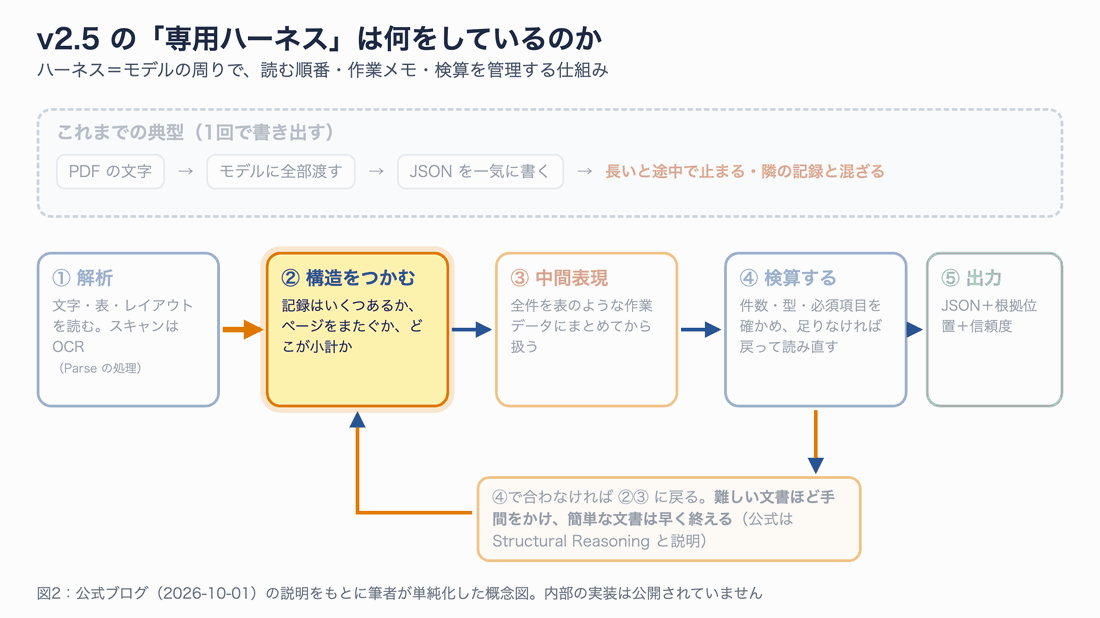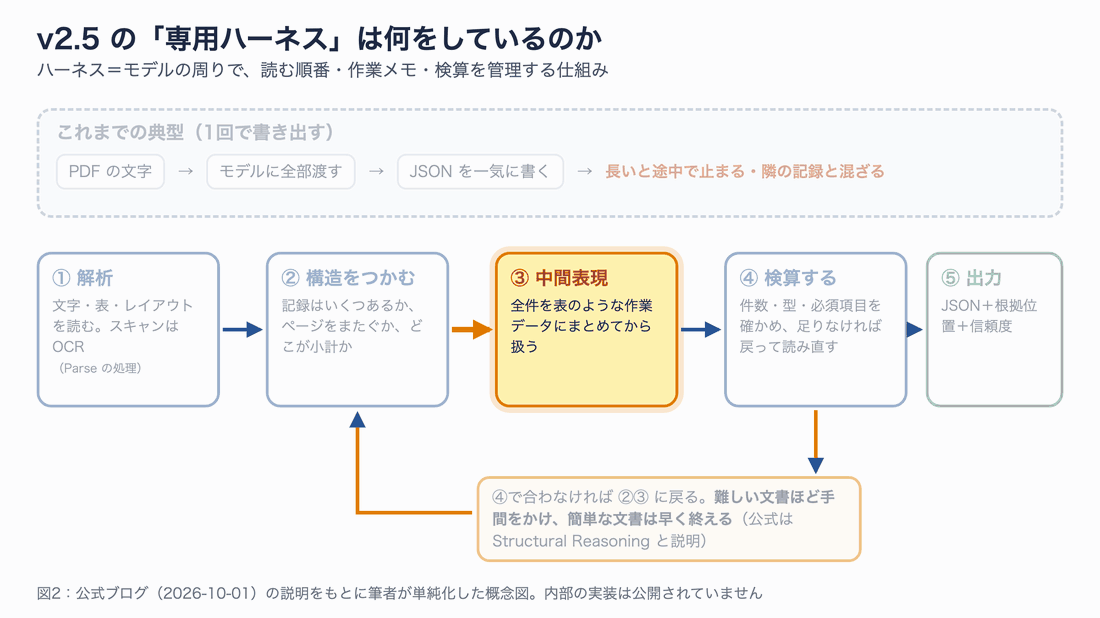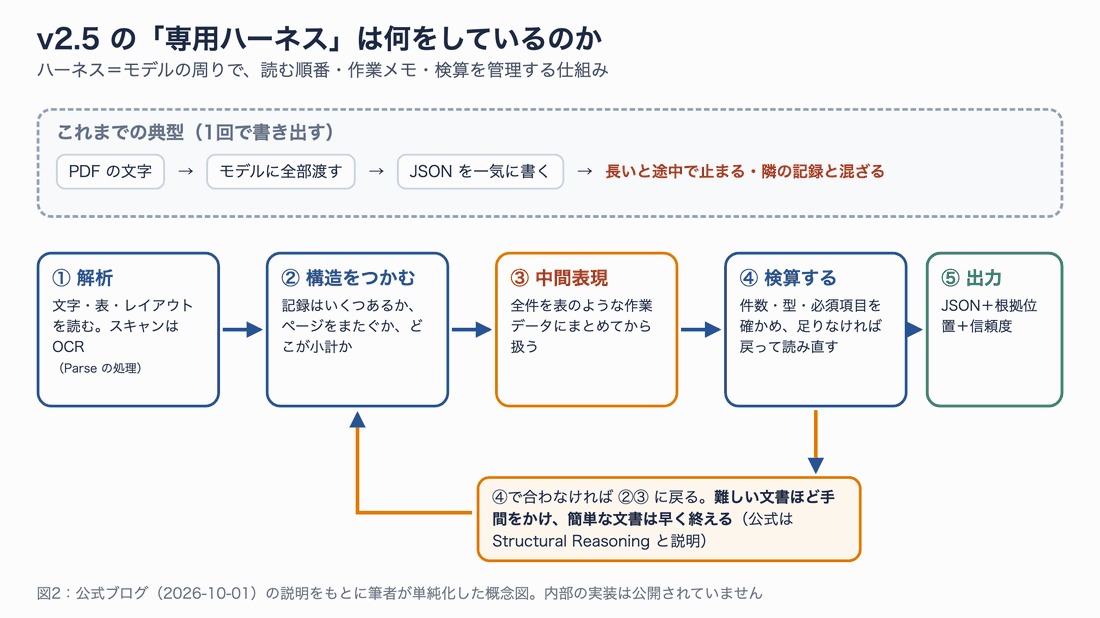
図2:v2.5 のハーネスの概念図。全件をいったん作業用のデータ(中間表現)にまとめ、スキーマに照らして確かめてから出力します。
ポイントは2つです。
- 中間表現(intermediate representation):最終の JSON を書く前に、全件を作業用の表のような形にまとめます。数百行のリストでも、最後まで扱いきれるようになります。
- スキーマで検算する:取り出した結果を、指定した形(スキーマ)に照らして確かめます。足りなければ読み直します。公式はこれを「Structural Reasoning」と呼び、難しい文書ほど手間をかけると説明しています。
公式が発表した数値
公式ブログでは、自社のベンチマーク「ExtractBench」で次のように改善したと報告しています。どれも LlamaIndex 自身による測定である点は、割り引いて読む必要があります。
| ティア | 全体の値の F1(旧 → v2.5) | 1ページの消費クレジット | 1ページの料金の目安 |
|---|---|---|---|
| Cost Effective | 87.1 → 93.9 | 8(抽出5+解析3) | 約0.01ドル |
| Agentic | 89.8 → 95.8 | 25(抽出15+解析10) | 約0.031ドル |
| Agentic Plus | 95.1 → 96.4 | 60(抽出50+解析10) | 約0.075ドル |
F1 は、取りこぼしの少なさと間違いの少なさをまとめた指標で、100 に近いほど良い値です。料金は1,000クレジットあたり1.25ドルで、毎月10,000クレジットまで無料です。v2.5 でページ単価は上がっていません。
検証の設計:従来の方法が苦手な文書を4つ作る
4つの文書と4つの読み取り方
検証の公平さを保つため、文書は筆者が作り、正解データも同時に作りました。どの文書にも、従来の方法が苦手な特徴を入れてあります。
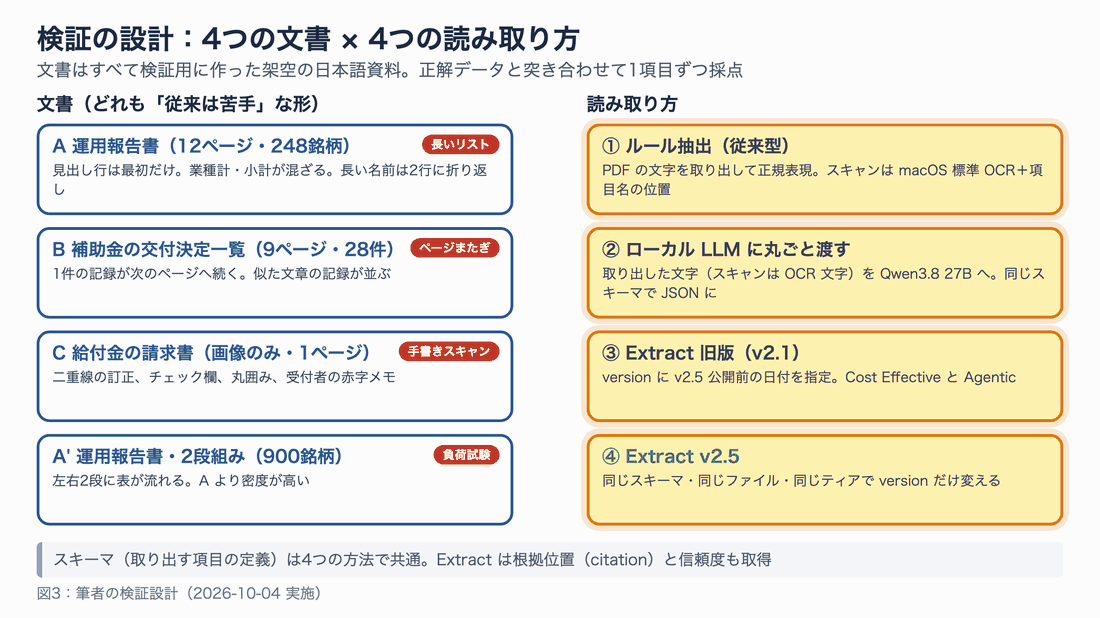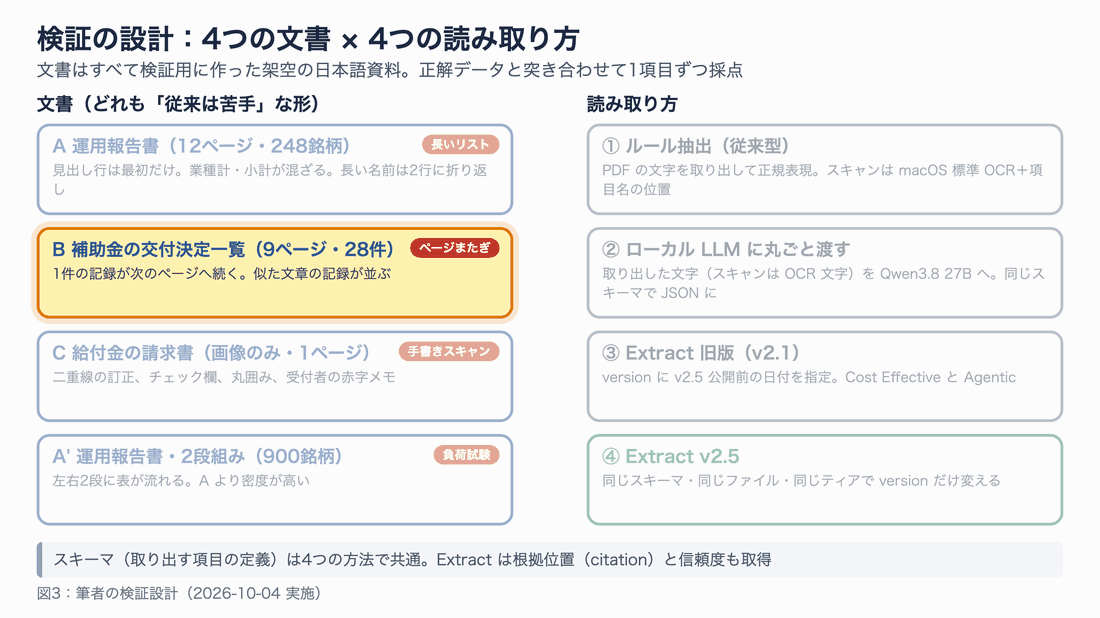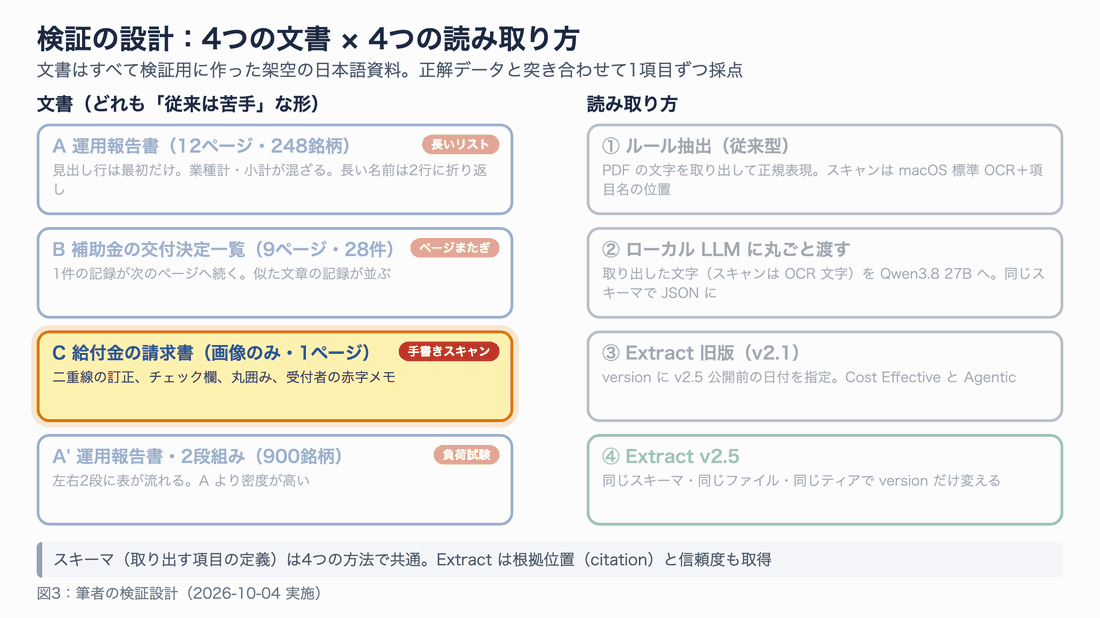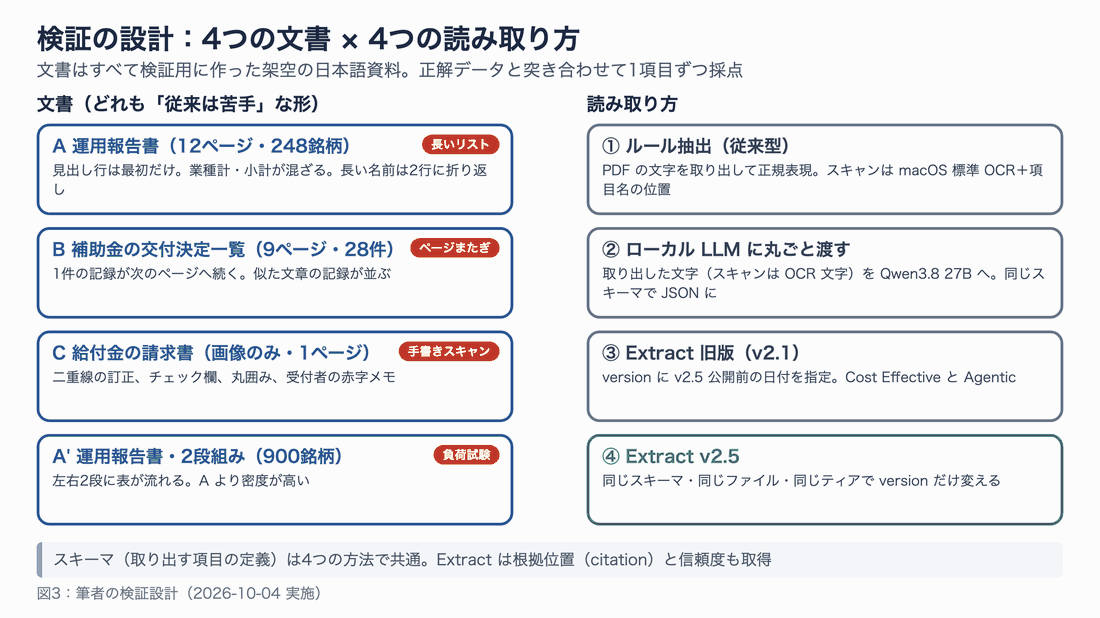
図3:検証の組み合わせ。取り出す項目の定義(スキーマ)は4つの方法で共通にしました。
実際の文書は次のとおりです。
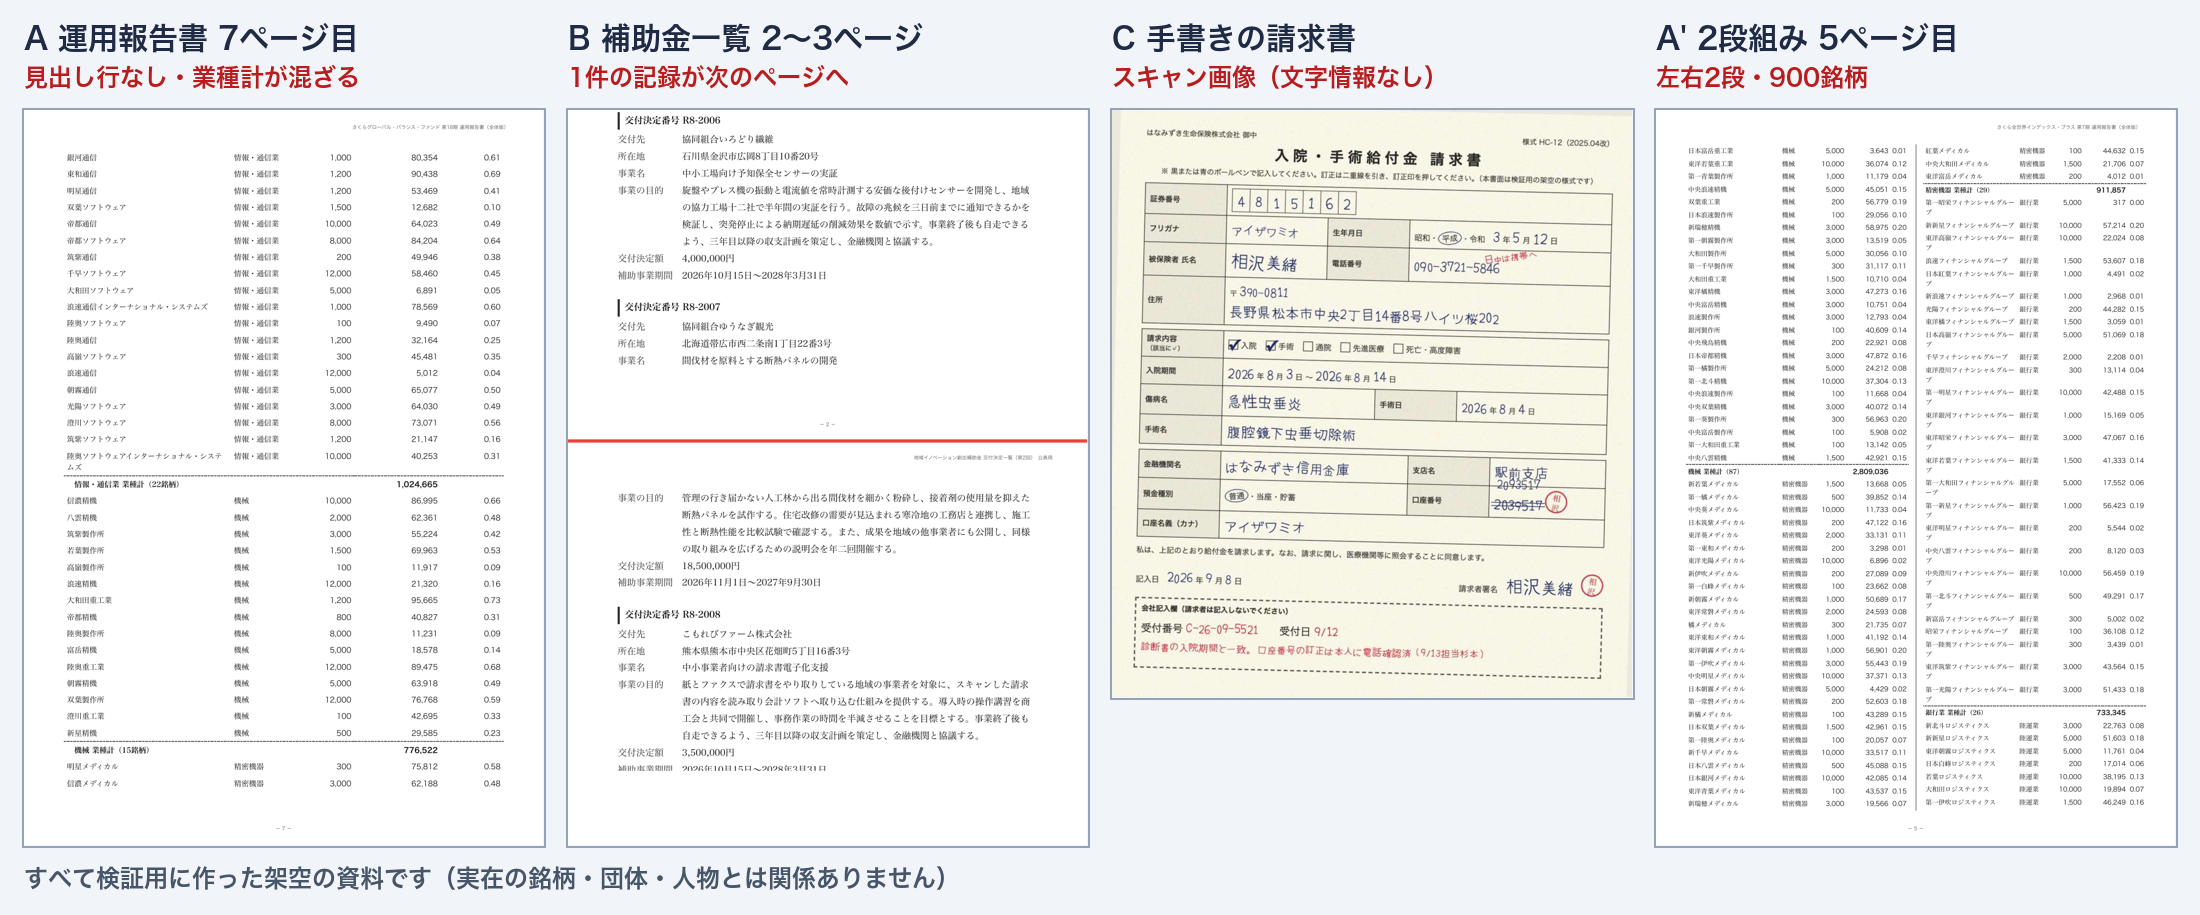
4つの文書の見本。B の赤い線がページの境目で、交付決定番号 R8-2007 の「事業の目的」は次のページに続いています。
| 文書 | 分量 | 入れた難しさ |
|---|---|---|
| A 運用報告書 | 12ページ・248銘柄 | 見出し行は最初の1回だけ。業種計・小計の行が混ざる。長い銘柄名は2行に折り返す |
| B 補助金の交付決定一覧 | 9ページ・28件 | 1件の記録が次のページへ続く。似た文章の記録が並ぶ |
| C 給付金の請求書 | 1ページ(画像のみ) | 手書き、チェック欄、丸囲み、二重線の訂正、受付者の赤字メモ |
| A’ 運用報告書(2段組み) | 12ページ・900銘柄 | 左右2段に表が流れる。A より密度が高い負荷試験 |
C の請求書には、人間なら迷わないものの、機械には難しい罠を6つ入れました。
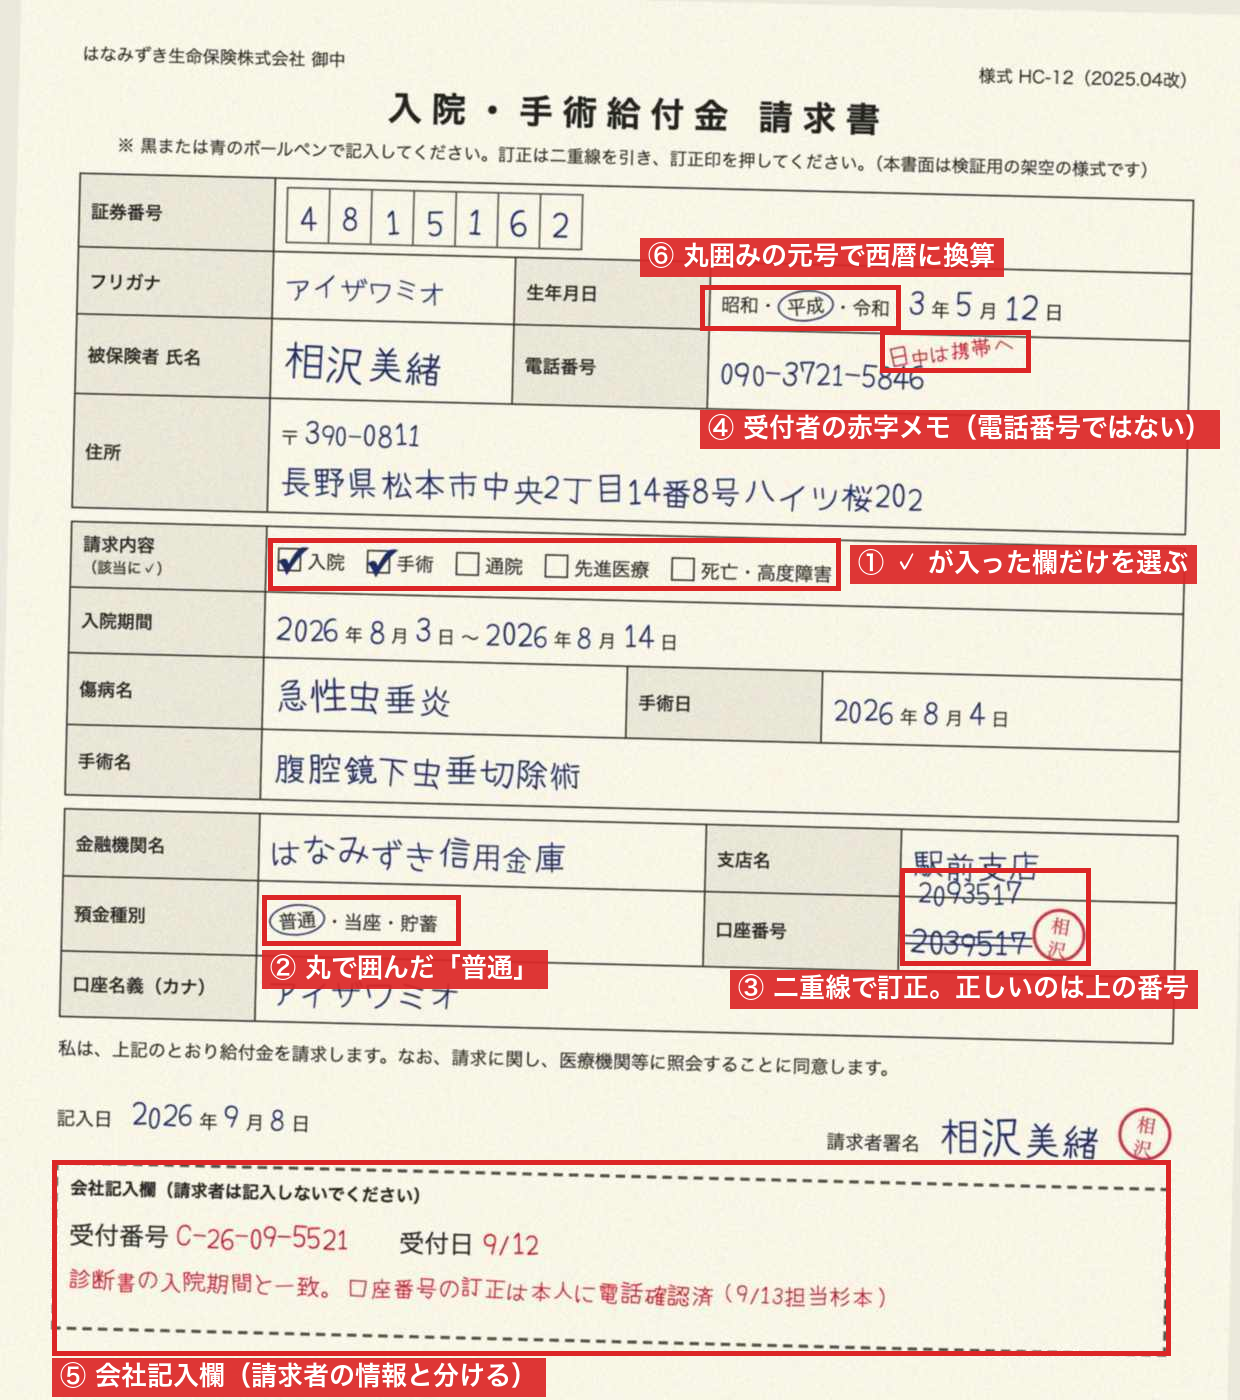
請求書の罠。正しい口座番号は二重線の上に書かれた「2093517」です。「日中は携帯へ」は受付者のメモで、電話番号の一部ではありません。
比べた4つの方法
| 方法 | 中身 |
|---|---|
| ① ルール抽出(従来型) | pdfplumber で PDF の文字を取り出し、正規表現で拾う。スキャンは macOS 標準の OCR(Vision)で読み、項目名の右にある文字を拾う |
| ② ローカル LLM | ①で取り出した文字(スキャンは OCR の文字)を、手元の Qwen3.8 27B(LM Studio)に丸ごと渡し、同じスキーマの JSON にさせる |
| ③ Extract 旧版 | version に v2.5 公開前の日付 2026-09-30 を指定。実際には v2.1 で動いたことを結果の情報で確認 |
| ④ Extract v2.5 | ③と同じファイル・スキーマ・ティアで、version だけ 2.5 に変える |
①のルールは、文書の形を知っている前提で書いています。実務で「この様式専用の抽出処理」を作った場合に近い条件です。
準備:自分の PC から API で呼ぶ
Extract はクラウドのサービスです。手元の PC からは API で呼び出し、処理は LlamaIndex のサーバーで行われます。文書は外部に送られるので、試すときは架空のデータか、外に出してよい文書を使ってください。
1. アカウントと API キーを用意する
- cloud.llamaindex.ai でアカウントを作ります。リージョンは「Global(US)」と「EU」から選べます。
- 画面の「API Keys」でキーを発行します。キーは
llx-で始まります。 - キーを環境変数に入れます。ファイルに保存しておき、使うときに読み込むと、コードやコマンド履歴にキーが残りません。
# キーをコピーした状態で実行すると、ファイルに保存される(macOS)
mkdir -p ~/.config/llamacloud && pbpaste > ~/.config/llamacloud/api_key
chmod 600 ~/.config/llamacloud/api_key

# 使うときに環境変数へ読み込む
export LLAMA_CLOUD_API_KEY=$(cat ~/.config/llamacloud/api_key)
EU リージョンのキーは、US 向けの API では通りません。EU で作った場合は LLAMA_CLOUD_BASE_URL=https://api.cloud.eu.llamaindex.ai も設定してください。
2. SDK を入れる
# 作業用フォルダと仮想環境を作る
mkdir extract-test && cd extract-test
python3 -m venv .venv
source .venv/bin/activate

# Python SDK(今回は 2.16.0)
pip install -U llama-cloud pydantic
3. API の流れ
呼び出しは、スキーマを書く、アップロードする、抽出ジョブを動かす、結果を受け取る、の4段階です。
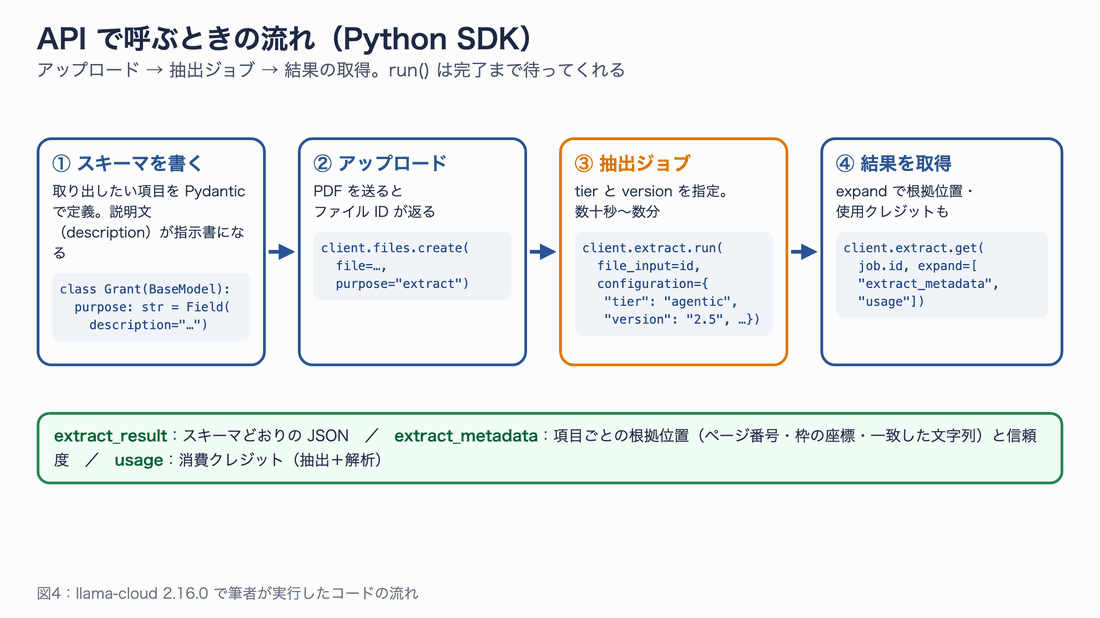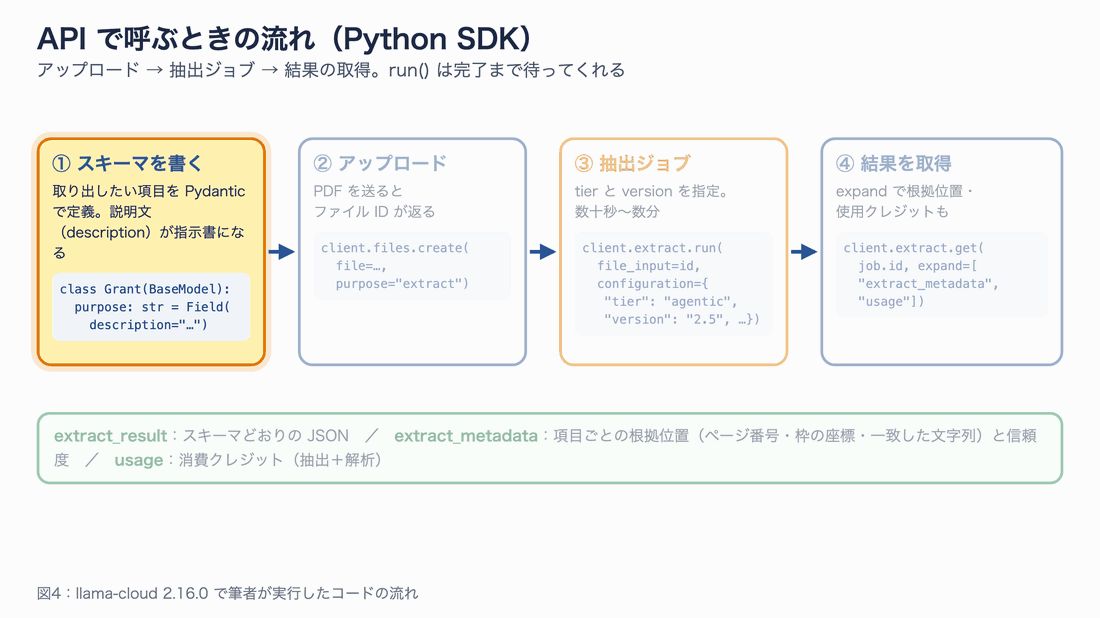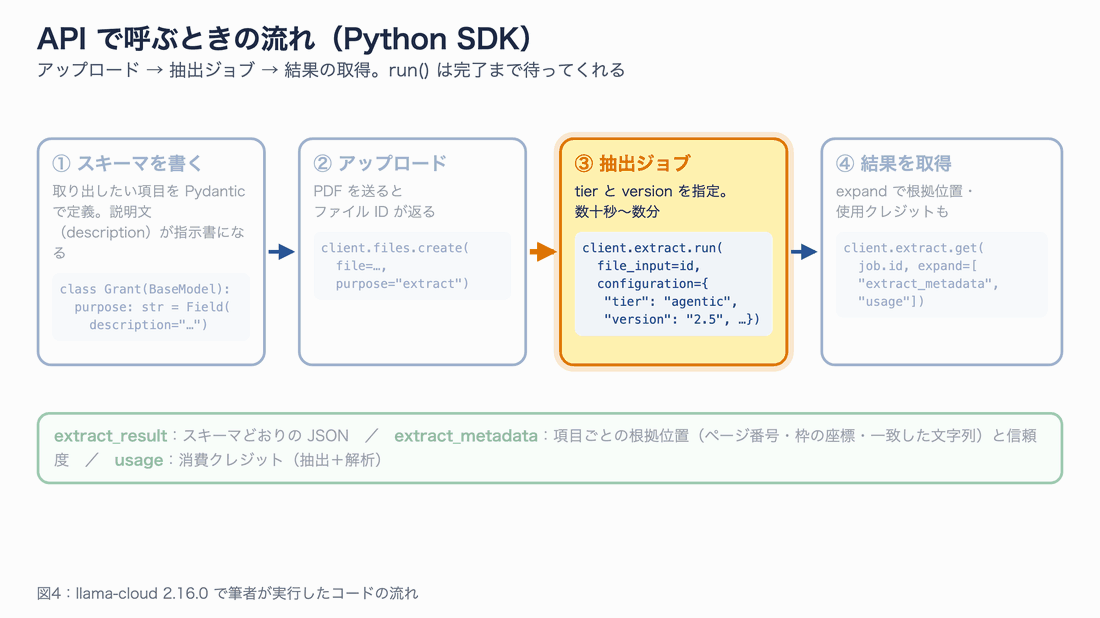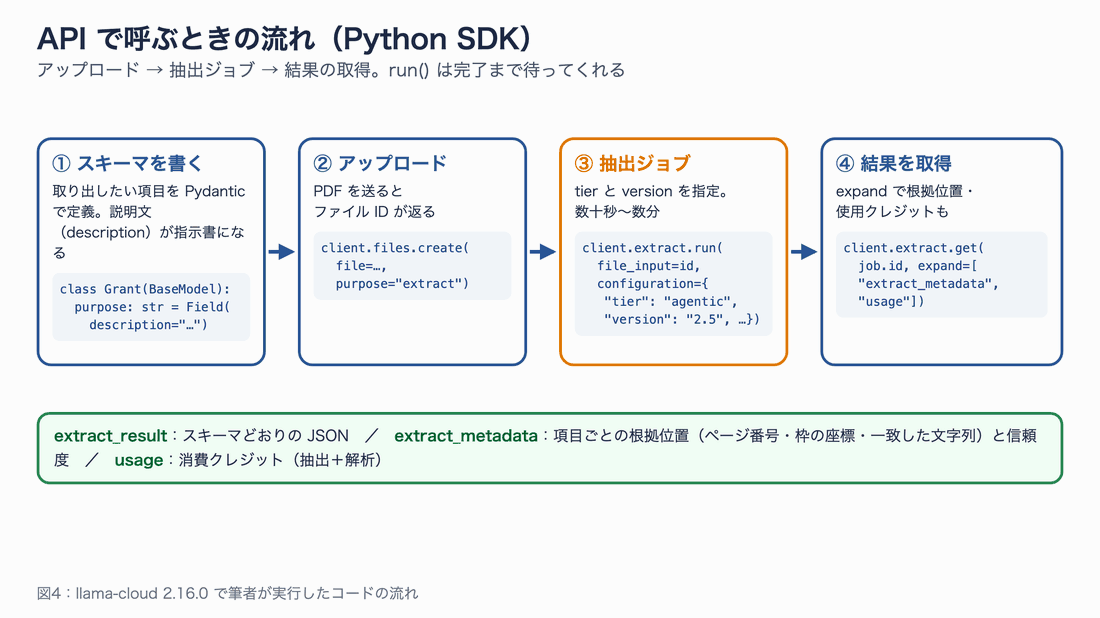
図4:Python SDK での流れ。extract.run() はジョブが終わるまで待ってから戻ります。
次のコードは、C の請求書から6項目を取り出します。さらに、信頼度が 0.8 未満の項目に「要確認」と付けます。筆者の環境でこのまま動かしたものです。
"""Extract v2.5 の最小例:PDF から項目を取り出し、信頼度の低い項目だけを「要確認」に分ける。
使い方: python quickstart.py claim_form.pdf"""
import sys
from typing import Literal, Optional
from pydantic import BaseModel, Field
from llama_cloud import LlamaCloud

class Claim(BaseModel):
    insured_name: str = Field(description="被保険者の氏名")
    phone: str = Field(description="電話番号")
    claim_types: list[Literal["入院", "手術", "通院", "先進医療", "死亡・高度障害"]] = Field(description="請求内容のうちチェックが入っている項目だけ")
    account_type: Literal["普通", "当座", "貯蓄"] = Field(description="預金種別(丸で囲まれたもの)")
    account_number: str = Field(description="口座番号(数字のみ)。二重線で訂正されている場合は訂正後の番号")
    reviewer_notes: Optional[str] = Field(None, description="会社記入欄や受付担当者の赤字の書き込み")

client = LlamaCloud()  # 環境変数 LLAMA_CLOUD_API_KEY を読む
path = sys.argv[1]
with open(path, "rb") as f:
    file = client.files.create(file=(path, f.read(), "application/pdf"), purpose="extract")

job = client.extract.run(            # 完了まで待ってくれる
    file_input=file.id,
    configuration={
        "tier": "agentic",
        "version": "2.5",            # 旧版と比べるときは "2026-09-30" のような日付
        "extraction_target": "per_doc",
        "data_schema": Claim.model_json_schema(),
        "cite_sources": True,        # 根拠位置
        "confidence_scores": True,   # 信頼度
    },
)
res = client.extract.get(job.id, expand=["extract_metadata", "usage", "configuration"])
meta = res.extract_metadata.field_metadata.document_metadata
print("実行バージョン:", res.configuration.version, "/ 消費クレジット:", res.usage.credits)

for key, value in res.extract_result.items():
    m = meta.get(key)
    if isinstance(m, list):          # リストは要素ごとに信頼度がつく。いちばん低い値を見る
        conf = min((x["confidence"] for x in m), default=None)
    else:
        conf = (m or {}).get("confidence")
    flag = "要確認" if conf is None or conf < 0.8 else "OK"
    print(f"{flag:4} {key:16} {str(value).replace(chr(10), ' '):40.40} 信頼度={conf if conf is None else round(conf, 2)}")
実行結果は次のとおりです(25クレジット、約30秒)。
実行バージョン: 2.5 / 消費クレジット: 25.0
OK   insured_name     相沢美緒                                     信頼度=0.85
OK   phone            090-3721-5846                            信頼度=0.95
要確認  claim_types      []                                       信頼度=None
要確認  account_type     貯蓄                                       信頼度=0.75
OK   account_number   2093517                                  信頼度=0.96
OK   reviewer_notes   受付番号 C-26-09-5521 受付日 9/12 診断書の入院期間と一致。口 信頼度=0.89
コードの要点は3つです。
- スキーマの
descriptionが指示書になる:「二重線で訂正されている場合は訂正後の番号」のように、人に頼むときと同じ言葉で書きます。 versionで版を固定する:省略すると最新版(latest)で動きます。日付を書くと、その日までに出ていた版で動きます。実際に動いた版はconfiguration.versionで確かめられます。cite_sourcesとconfidence_scores:値を読み取った位置(ページと座標)と信頼度を返します。公式ドキュメントによると、指定すると処理が遅くなります。
実際に動かしたところ
補助金一覧(B)を v2.5 の Agentic で処理する様子を録画しました。待ち時間(約80秒)は10倍速にしています。
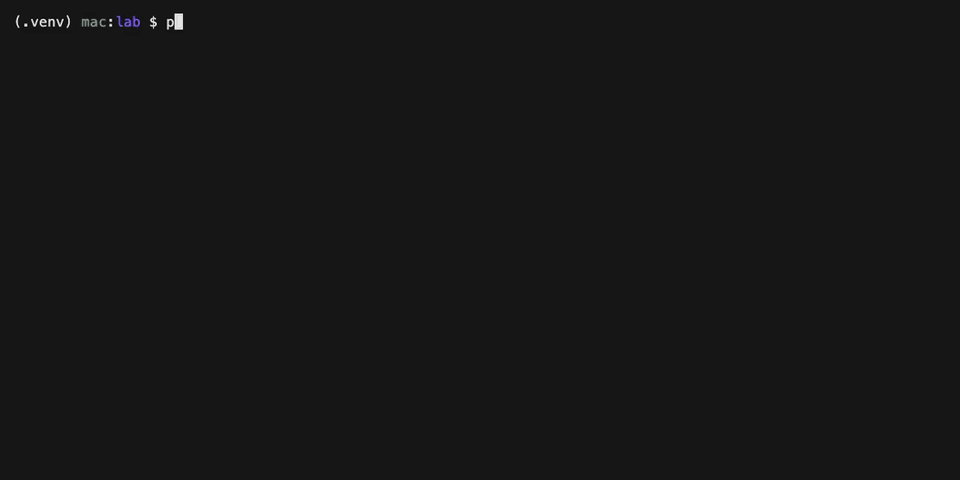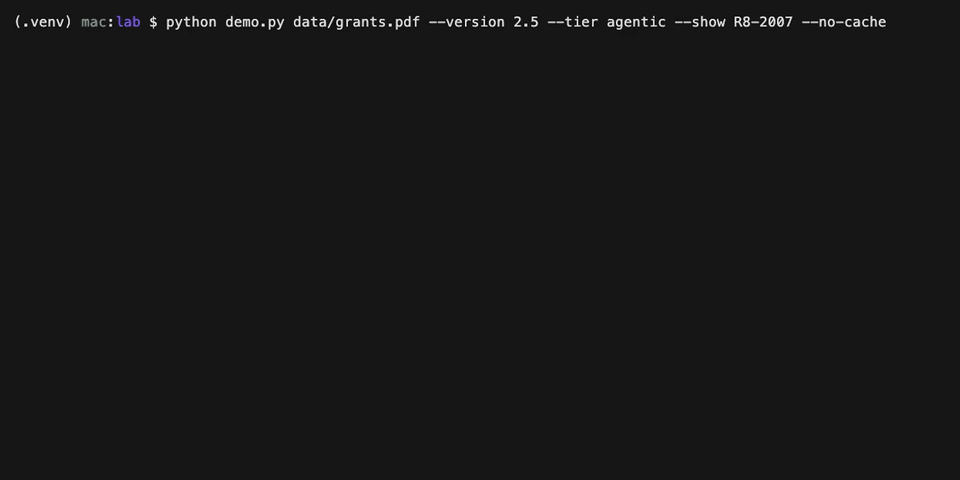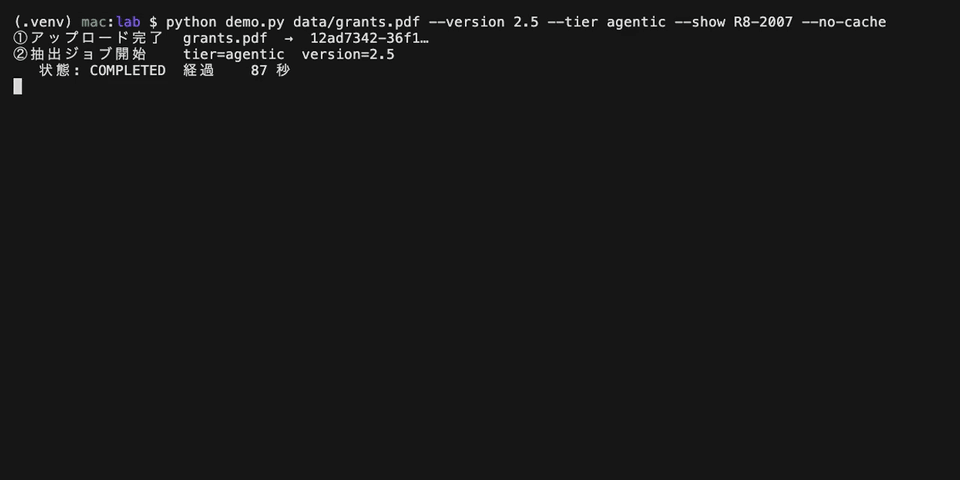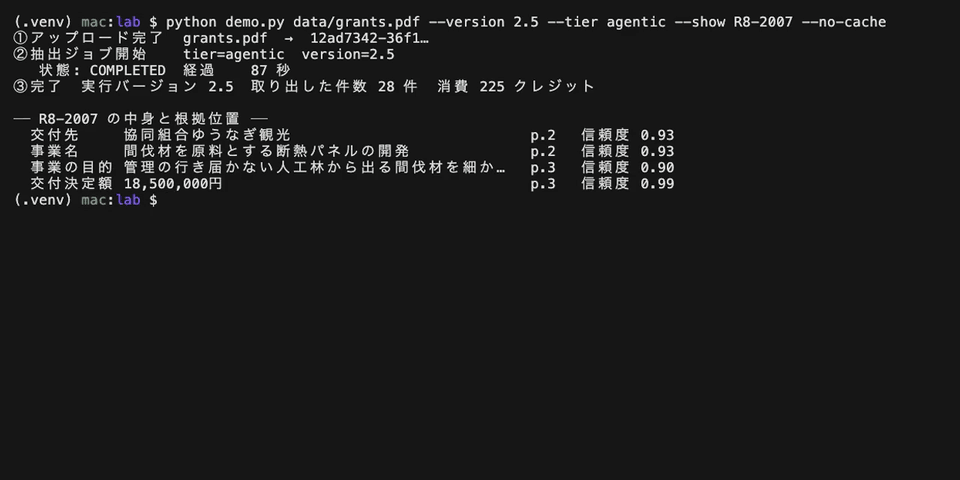
v2.5 Agentic で補助金一覧を処理した録画。キャッシュを無効にして87秒、225クレジットでした。R8-2007 の「交付先」は2ページ目、「事業の目的」は3ページ目から読み取ったことが分かります。
結果1:ページをまたぐ記録は「混ざらなく」なった
旧版は、隣の記録の文を付け足した
補助金一覧(B)では、28件それぞれの「事業の目的」が正解と一致するかを見ました。誤りは2種類に分けて数えています。1つは、文がまるごと混ざったり抜けたりする構造の誤りです。もう1つは、1〜2文字だけ違う文字の誤りです。
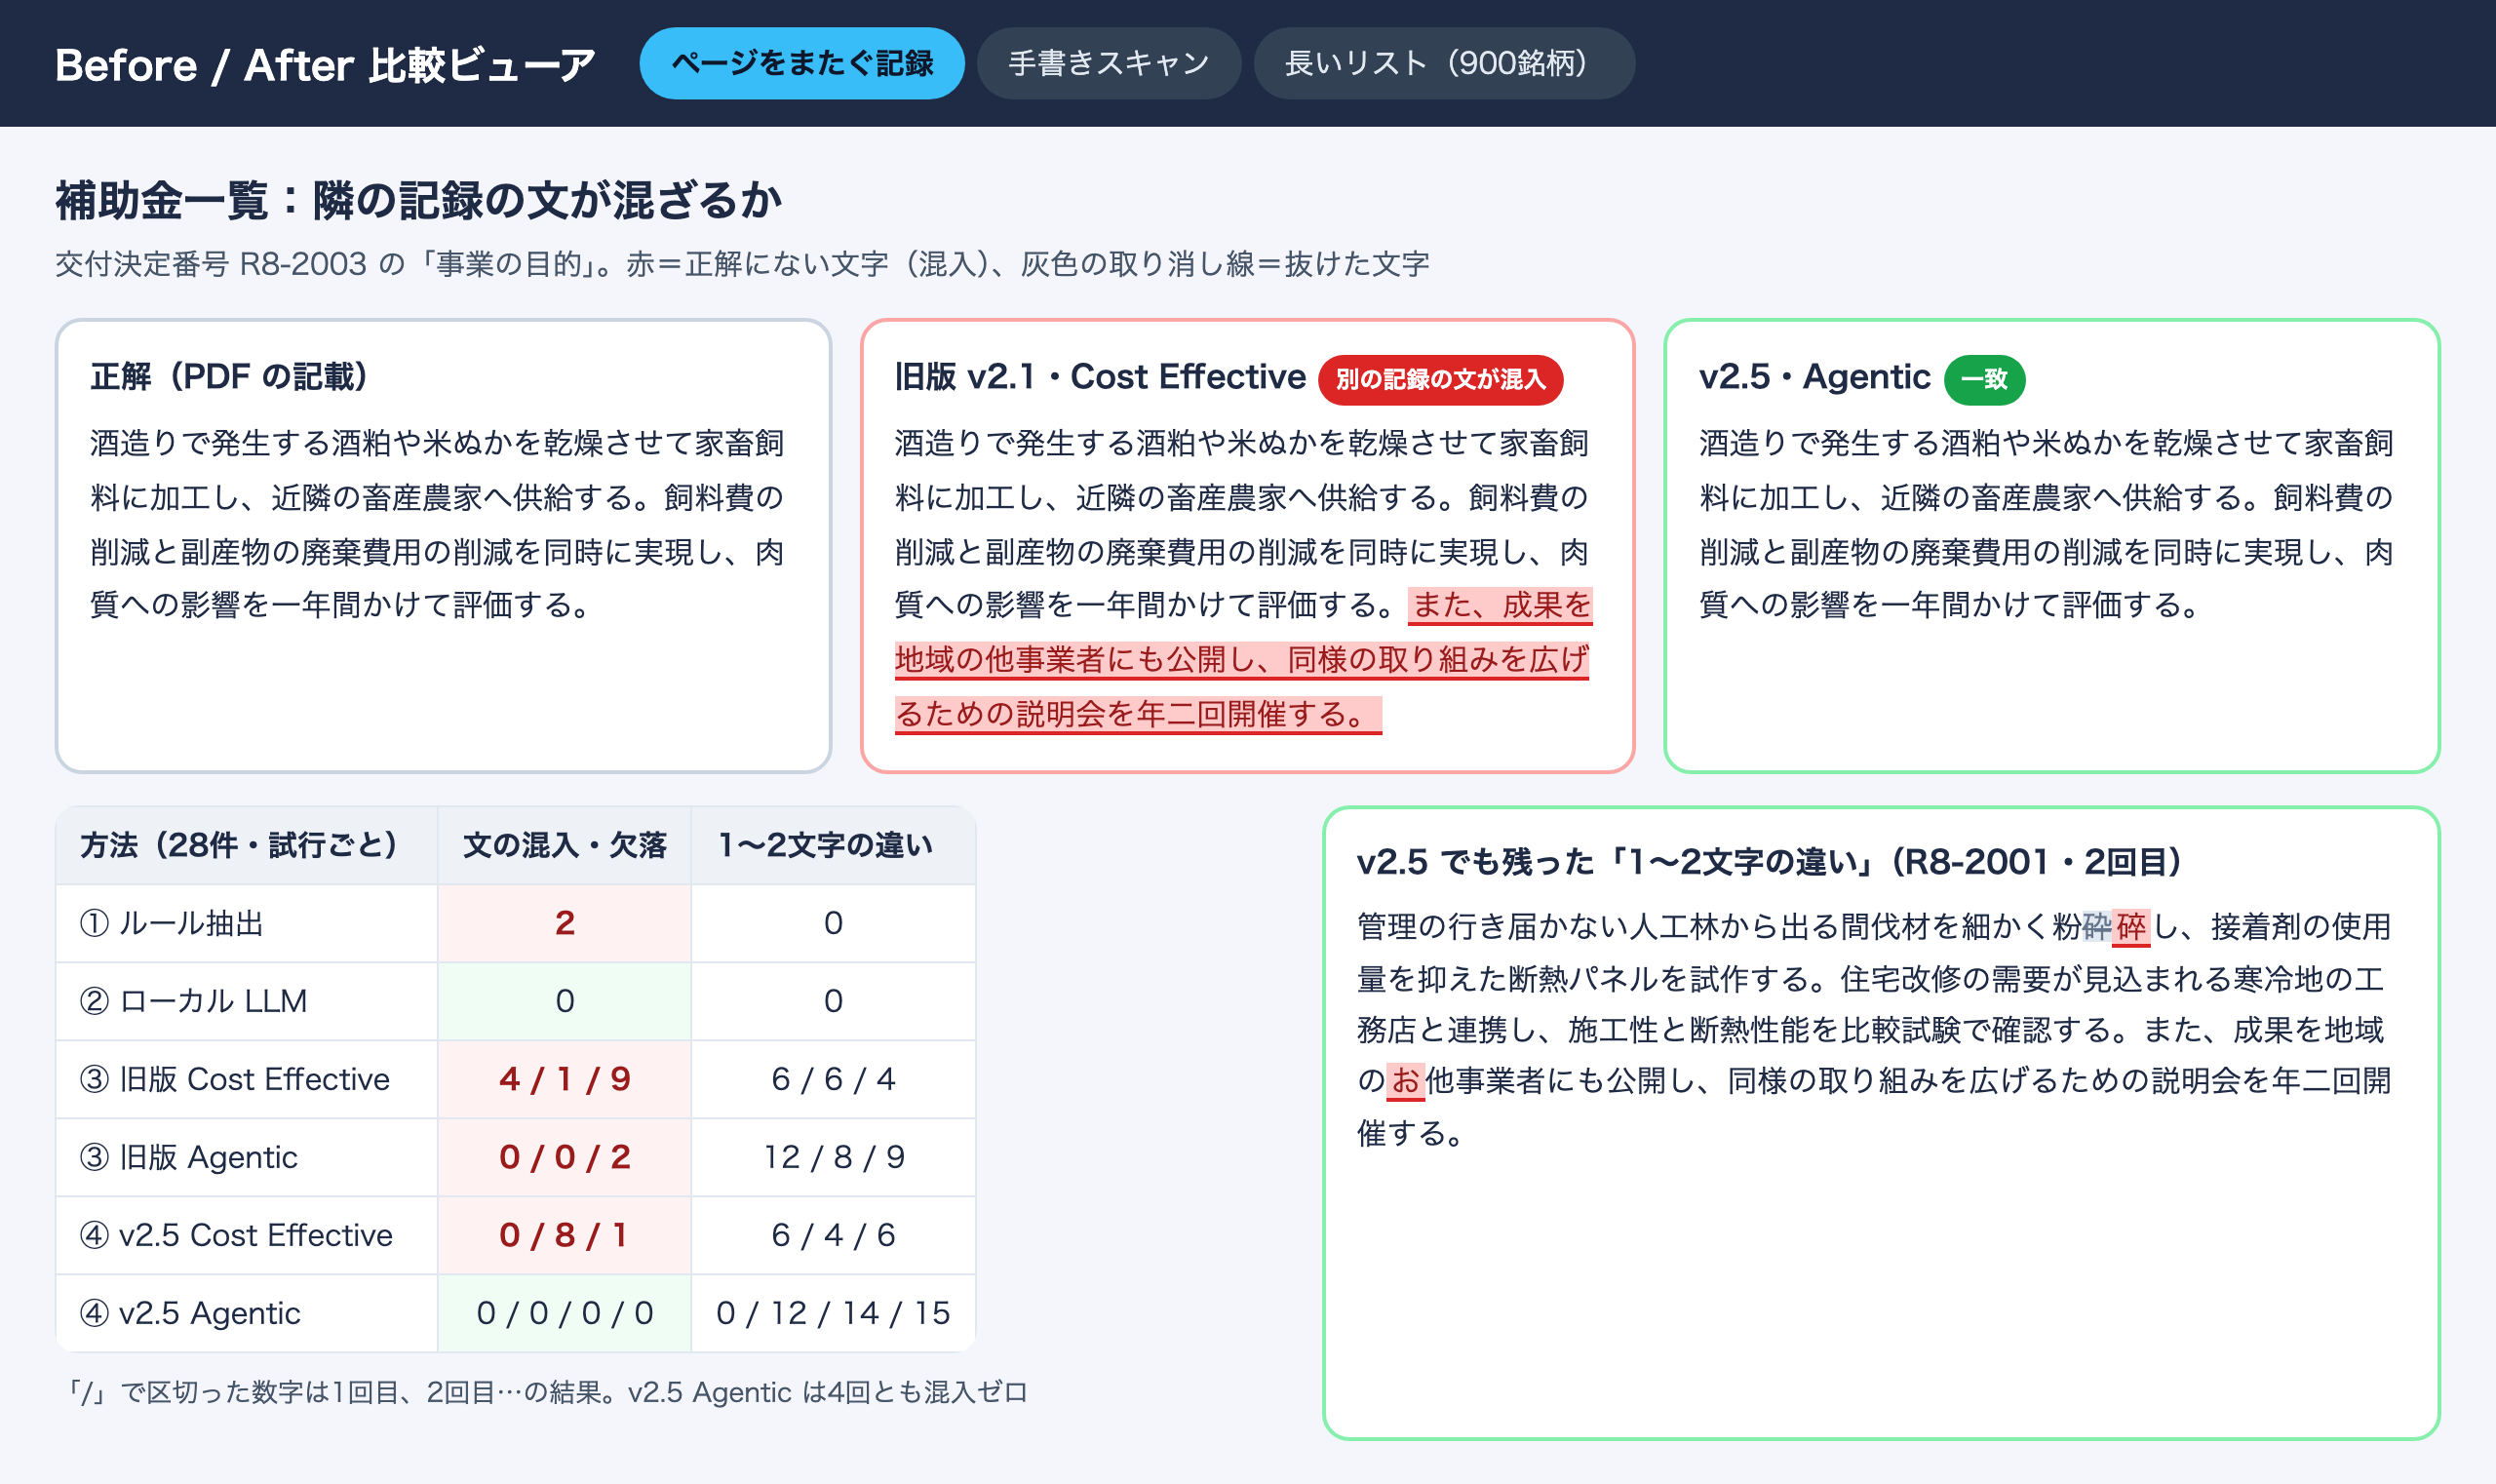
R8-2003 の比較。旧版の Cost Effective は、別の交付先の記録にある「また、成果を地域の他事業者にも公開し…」という一文を付け足していました。
構造の誤りの件数を、試行ごとに並べると次のようになります。
| 方法 | 構造の誤り(28件中、試行ごと) | 文字の誤り(同) |
|---|---|---|
| ① ルール抽出 | 2 | 0 |
| ② ローカル LLM | 0 | 0 |
| ③ 旧版 Cost Effective | 4 / 1 / 9 | 6 / 6 / 4 |
| ③ 旧版 Agentic | 0 / 0 / 2 | 12 / 8 / 9 |
| ④ v2.5 Cost Effective | 0 / 8 / 1 | 6 / 4 / 6 |
| ④ v2.5 Agentic | 0 / 0 / 0 / 0 | 0 / 12 / 14 / 15 |
v2.5 の Agentic は、4回とも文の混入・欠落がゼロでした。 旧版の Agentic でも2件の混入が出た回がありました。似た記録を取り違えない点は、v2.5 の改善がはっきり表れた部分です。
①のルール抽出の2件は、ページの境目にあるページ番号と見出し(「- 3 -地域イノベーション創出補助金 交付決定一覧(第2回) 公表用」)が、文の途中に入り込んだものでした。同じ混入は「事業名」でも3件起きています。さらに所在地では、「西」が部首用の別の文字「⻄」で取り出されるなど、6件が正解と一致しませんでした。ページをまたぐ文書をルールで扱うには、ヘッダーの除去や文字の正規化まで作り込む必要があります。
根拠位置は、ページをまたいでも正しく指した
v2.5 が返した根拠位置を、PDF の画像に描き込みました。
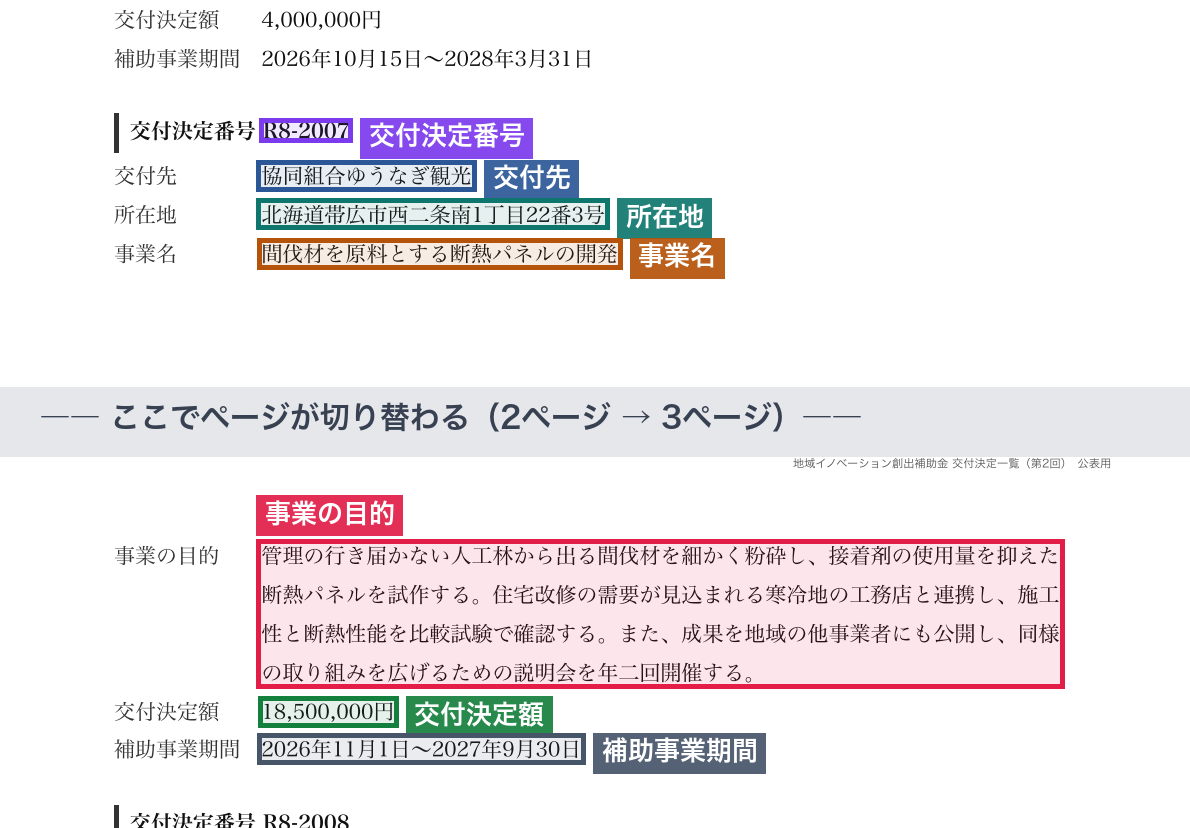
R8-2007 の根拠位置。1件の記録が2ページにまたがっていても、項目ごとに正しいページと位置を指しています。
根拠位置があると、抽出結果を人が確かめるとき、PDF の該当箇所をすぐ開けます。確認作業の手間が大きく変わる部分です。
一方で、1〜2文字の違いは v2.5 でも残った
1回目の v2.5 Agentic は28件すべてが完全に一致しました。しかし、キャッシュを無効にした2〜4回目は、12〜15件で文字の誤りが出ています。
| 正解 | v2.5 の出力 | 種類 |
|---|---|---|
| 細かく粉砕し | 細かく粉碎し | 字形の違う漢字 |
| 地域の他事業者 | 地域のお他事業者 | 書かれていない文字の追加 |
| 紙とファクスで | 紙とファックスで | 言い回しの「補正」 |
旧版にも同じ種類の誤りがありました。対照的に、②のローカル LLM は「事業の目的」を28件すべて一字一句そのまま写しました(間違えたのは、取り出した文字の時点で部首用の文字になっていた所在地の6件だけです)。ただし処理には約45分かかっています。今回の文書は文字情報を持つデジタル PDF です。それでも誤りが出るので、文字の読み取り(解析)の段階か、モデルが書き写す段階で起きていると考えられます。ハーネスの改善は記録の取り違えには効きましたが、日本語の文字を1文字単位で正確に写す点は別の課題として残りました。
結果2:手書きの請求書は「区別」はできたが、チェック欄は読めなかった
C の請求書では、19項目の正解数を比べました。
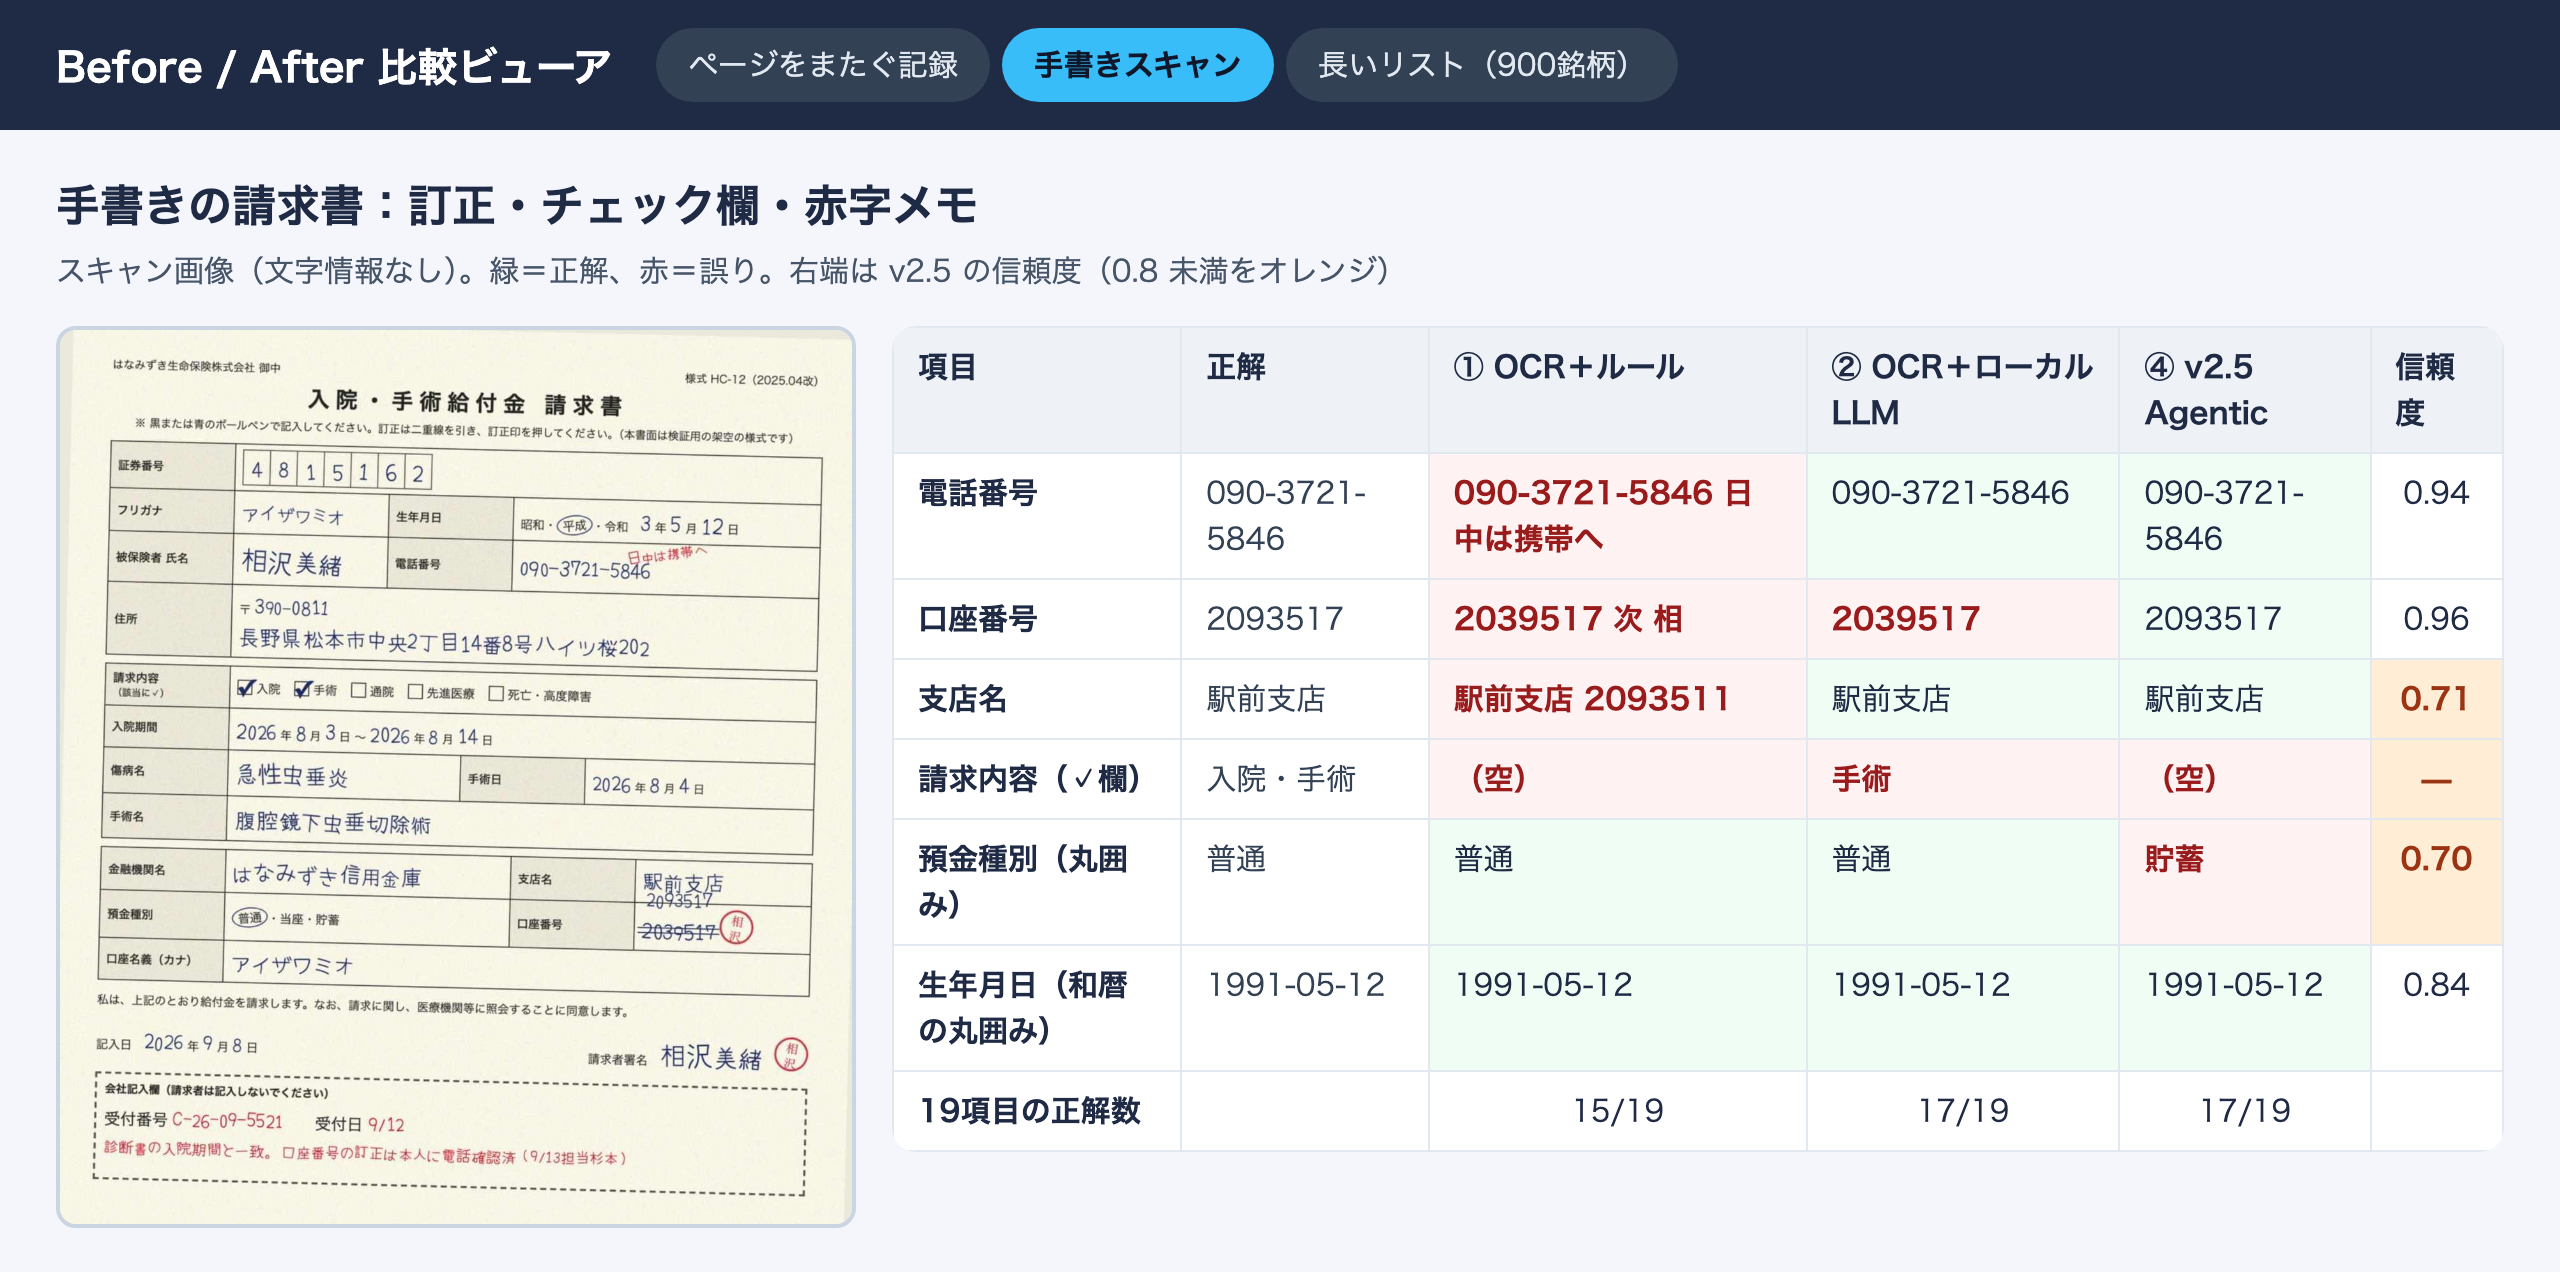
請求書の比較。緑が正解、赤が誤りです。右端は v2.5 の信頼度で、0.8 未満をオレンジにしています。
| 方法 | 19項目の正解数 | 間違えた項目 |
|---|---|---|
| ① OCR+ルール | 15 | 電話番号に赤字メモが混入、口座番号に訂正前の番号、支店名に数字が混入、チェック欄が空 |
| ② OCR+ローカル LLM | 17 | 訂正前の口座番号を選んだ、チェック欄の「入院」が抜けた |
| ③ 旧版(3ティア) | 17 | チェック欄が空、預金種別が「貯蓄」 |
| ④ v2.5(3ティア) | 17 | チェック欄が空、預金種別が「貯蓄」 |
Before と比べて良くなったのは「区別」です。 OCR+ルールは、電話番号の横の赤字メモ「日中は携帯へ」を電話番号に含めてしまいました。口座番号も、二重線で消した番号を拾っています。Extract は旧版・v2.5 ともに、訂正後の番号を選び、受付者のメモを reviewer_notes に分けました。②のローカル LLM が訂正前の番号を選んだのは、OCR の文字だけを受け取っていて、二重線が見えないためです。画像を直接見られることが、Extract の強みとして表れました。
一方で、✓欄と丸囲みは、どのティア・どの版でも読めませんでした。 最上位の Agentic Plus でも同じ2項目を間違え、チェックのない「死亡・高度障害」を選んだ回もあります。v2.5 で改善したとされる「スキャンした帳票」は、少なくともこの日本語の様式の✓欄と丸囲みでは効果が見えませんでした。
信頼度で「人が見る項目」を絞れる
ここで役に立ったのが信頼度です。v2.5 Agentic の根拠位置を、信頼度で色分けして描き込みました。
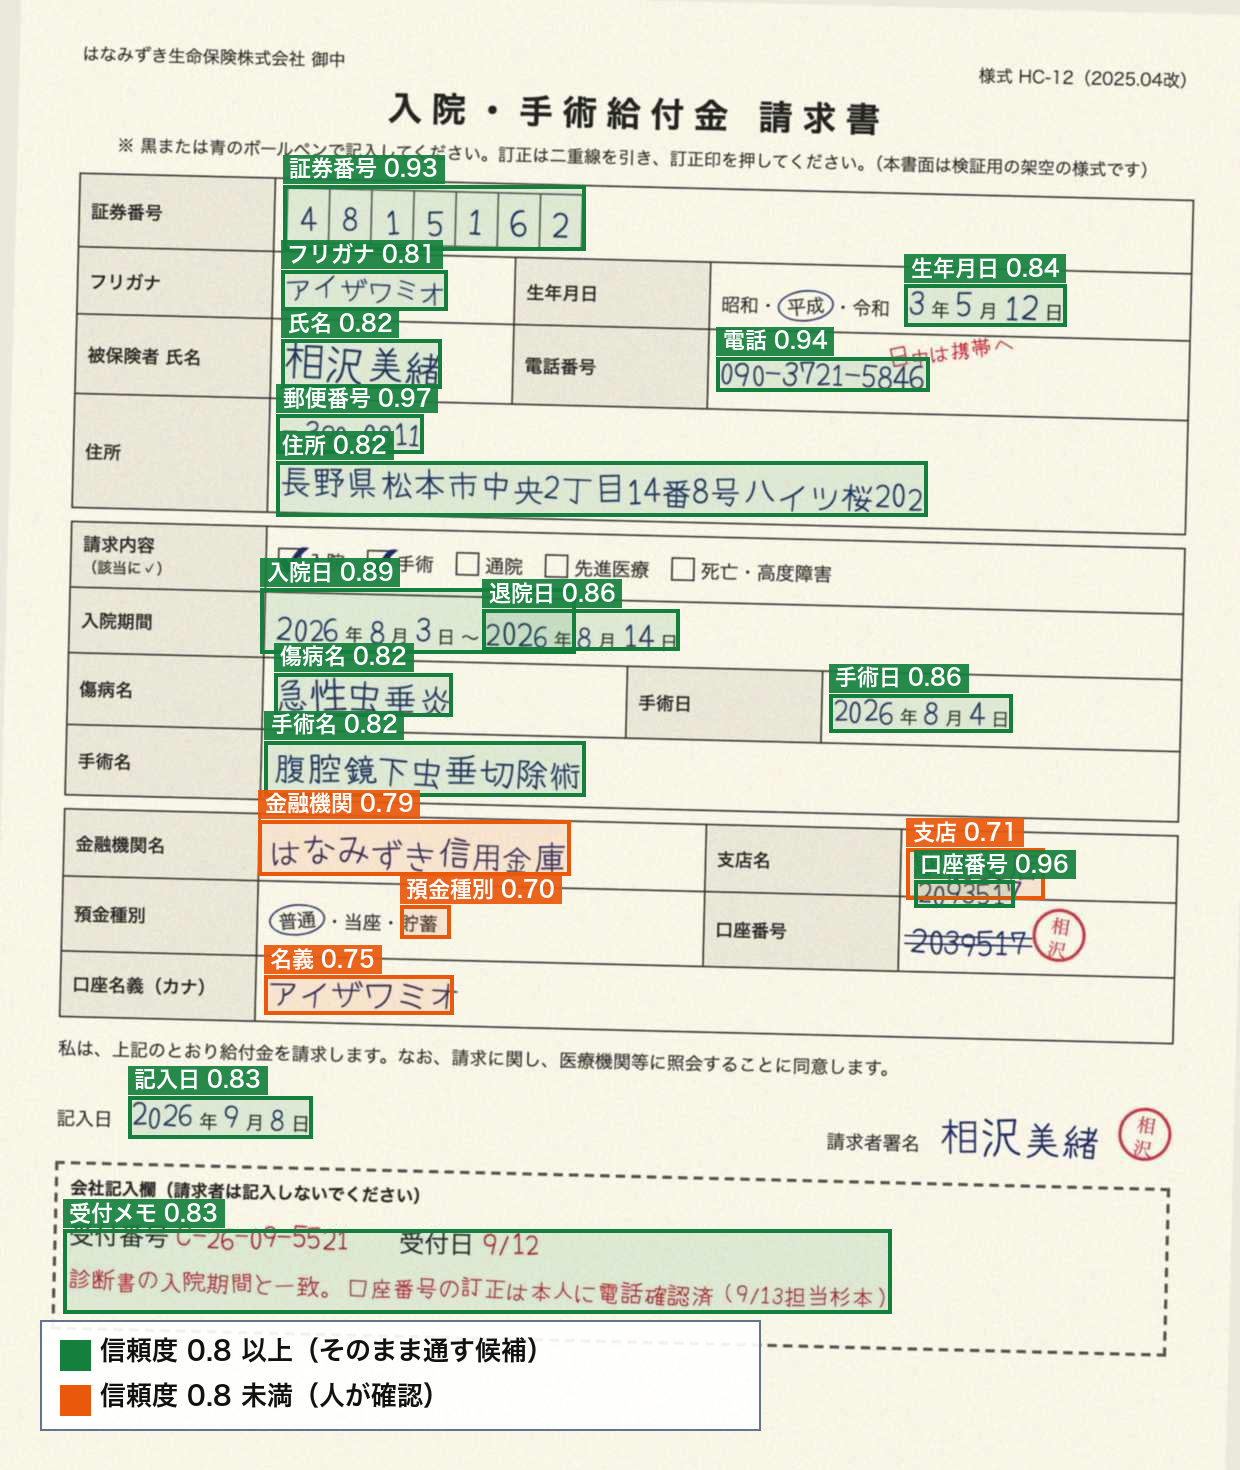
v2.5 Agentic の根拠位置と信頼度。間違えた「預金種別」は、丸で囲んだ「普通」ではなく「貯蓄」を指していて、信頼度も 0.70 と低めです。
公式ドキュメントが目安とする 0.8 を境に「人が確認する項目」を決めると、確認する項目数は次のようになりました。
| 方法 | 0.8 未満または信頼度なしの項目 | 間違えた2項目は含まれたか |
|---|---|---|
| ③ 旧版 Agentic | 14 / 19 | 含まれた |
| ③ 旧版 Cost Effective | 15 / 19 | 含まれた |
| ④ v2.5 Cost Effective | 15 / 19 | 含まれた |
| ④ v2.5 Agentic | 5 / 19 | 含まれた |
| ④ v2.5 Agentic Plus | 5 / 19 | 含まれた |
どの方法でも、間違えた項目は確認対象に入りました。違いは、正しい項目まで「念のため確認」に回る量です。v2.5 Agentic では、人が見る項目が19項目中5項目まで減りました。正答率は旧版と同じでも、確認作業の量で差が出たのが今回の大きな発見です。
ただし、信頼度がいつも頼りになるわけではありません。補助金一覧の「1〜2文字の違い」では、誤りの信頼度の中央値が 0.93 で、正解の 0.94 とほとんど変わりませんでした。0.8 未満になった誤りは1件もありません。長い文章の1文字の違いは、信頼度では見つけられないと考えてください。
結果3:900銘柄の2段組みは v2.5 Agentic が安定した
A の運用報告書(248銘柄・1段組み)では、旧版も v2.5 もほぼ全件を正しく取り出せました。公式ブログの「87件で止まる」現象は、この規模では再現しませんでした。ルール抽出も244件が正解で、1段組みの整ったデジタル PDF なら従来の方法でも十分に戦えます。間違えた4件は、2行に折り返した名前の後半が欠けたもの(「…インターナショナル・システ」)と、「青」が部首用の別の文字コード(⻘)で取り出されたものでした。②のローカル LLM も246件が正解でした。折り返した名前は正しくつなげましたが、渡した文字の時点で「⻘」になっていた2件はそのまま写しています。ただし、この12ページの処理に約97分かかりました。
そこで、密度を上げた A’(2段組み・900銘柄)で負荷をかけました。
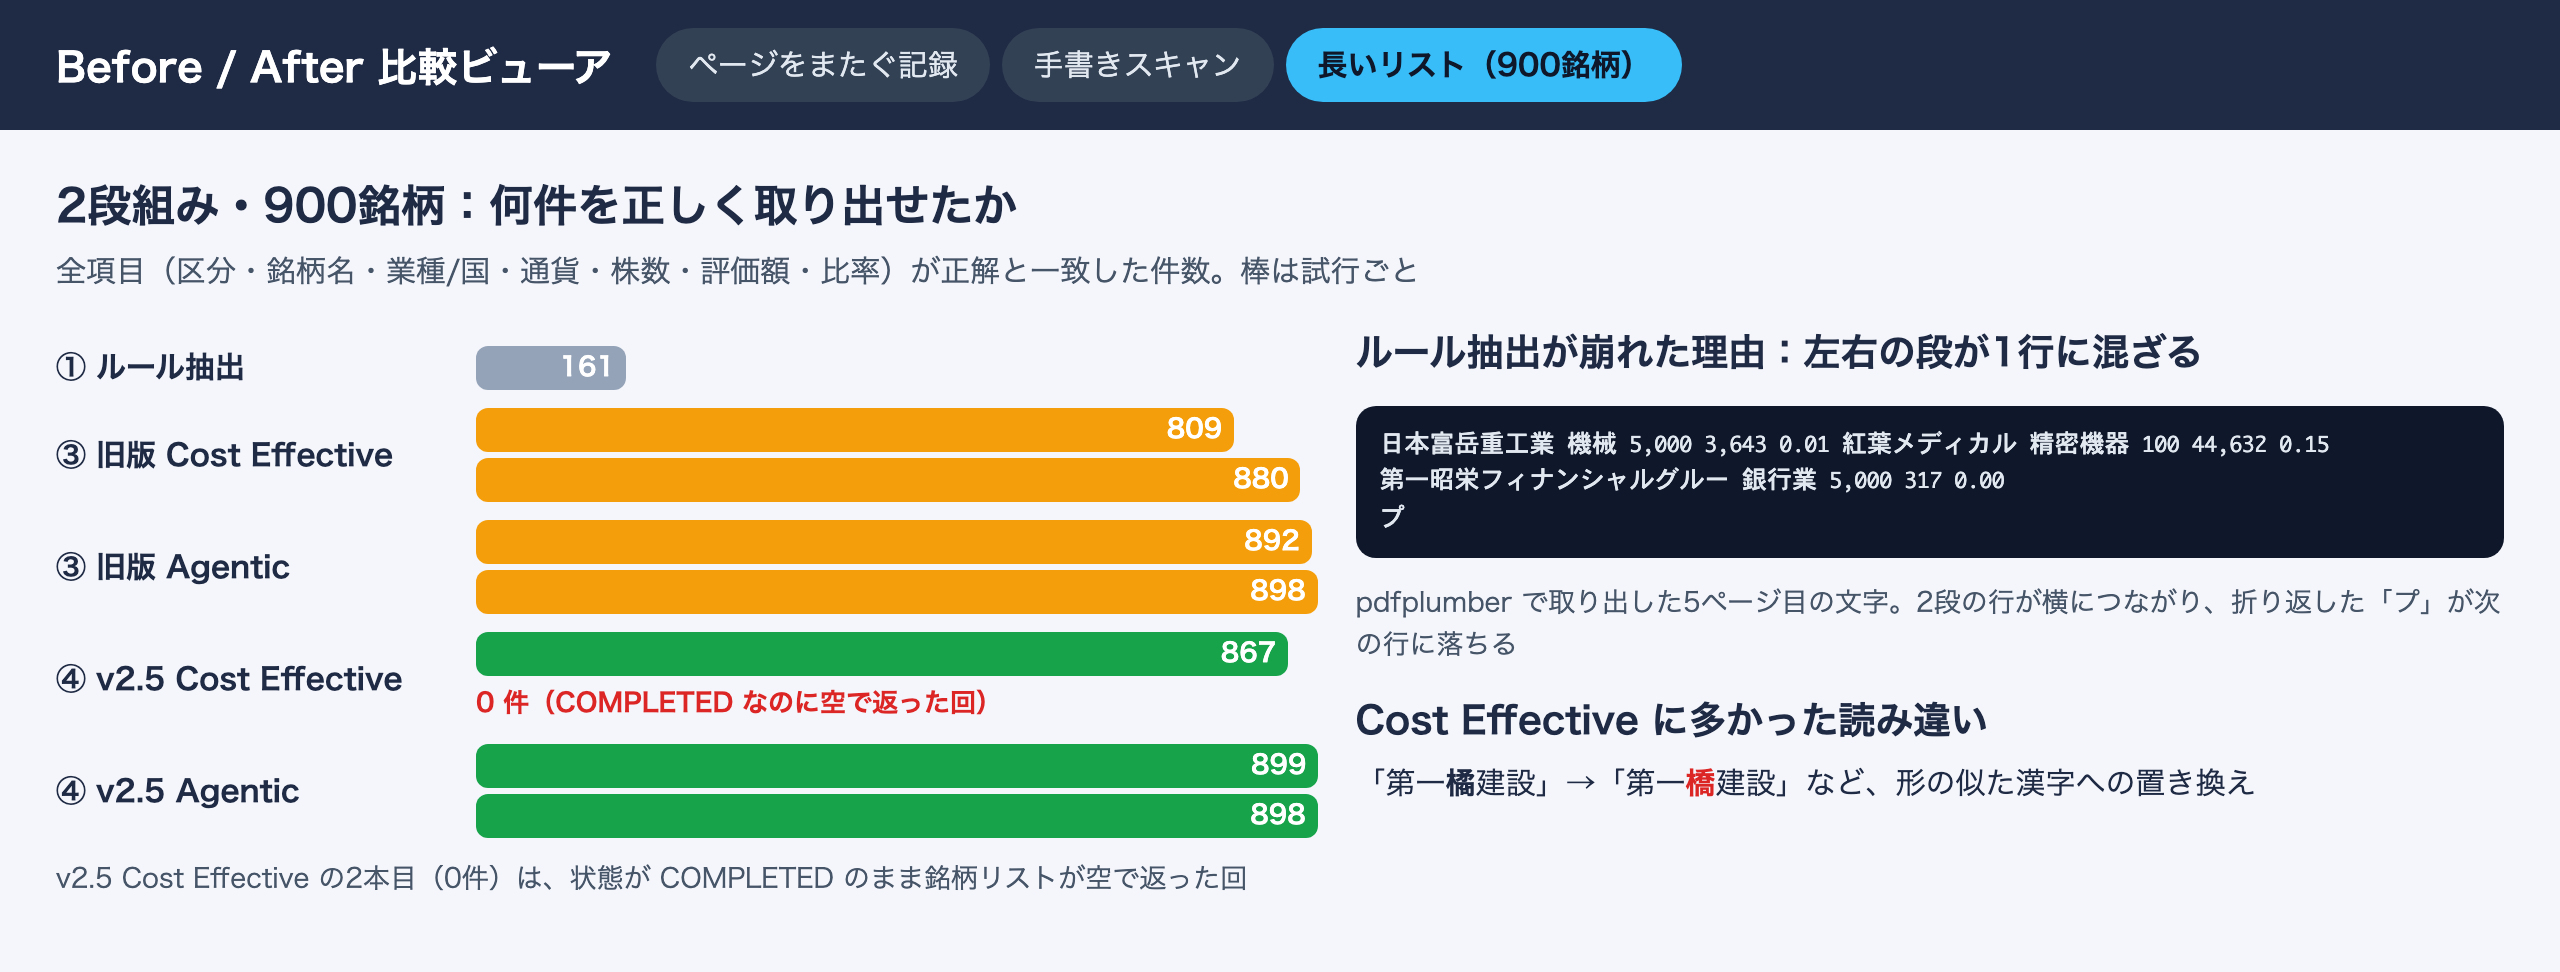
900銘柄の結果。棒は試行ごとの値です。
| 方法 | 全項目が正解(900件中) | 主な誤り |
|---|---|---|
| ① ルール抽出 | 161 | 左右の段が1行に混ざる |
| ② ローカル LLM | 未実施 | 処理に数時間かかる見込みのため見送り |
| ③ 旧版 Cost Effective | 809 / 880 | 折り返した名前を別の銘柄として数える、値が隣の行とずれる |
| ③ 旧版 Agentic | 892 / 898 | 1ページ目の不動産業7行をまとめて落とした回がある |
| ④ v2.5 Cost Effective | 867 / 0 | 「橘」を「橋」と読む。2回目は空のリストが返った |
| ④ v2.5 Agentic | 899 / 898 | ページの境目の1行を、隣の「Class A」と取り違えた |
v2.5 の Agentic は2回とも898件以上で、ぶれが小さい結果でした。旧版は回によって809〜898件と差が大きく、「たまたまうまくいく」ことがある状態です。
注意したいのは、v2.5 の Cost Effective の2回目です。ジョブの状態は COMPLETED(完了)なのに、銘柄のリストが空で返ってきました。 エラーにはならないので、件数を確かめる仕組みがないと、空のデータをそのまま次の処理に流してしまいます。
件数の検算を組み込む
対策として、文書に書かれている小計の銘柄数もスキーマで取り出し、リストの件数と突き合わせる方法を試しました。合わなければ、キャッシュを無効にしてもう1回だけ実行します。
"""件数の検算つき抽出:小計に書かれた銘柄数と、取り出したリストの件数を突き合わせる。"""
import collections
from pydantic import BaseModel, Field
from llama_cloud import LlamaCloud

class Holding(BaseModel):
    section: str = Field(description="区分(国内株式・外国株式・公社債)")
    name: str = Field(description="銘柄名。2行に折り返している場合はつなげる")
    market_value_thousand_yen: int = Field(description="評価額(千円)")

class SectionCount(BaseModel):
    section: str = Field(description="区分(国内株式・外国株式・公社債)")
    count: int = Field(description="その区分の小計行に書かれた銘柄数")

class FundWithCounts(BaseModel):
    holdings: list[Holding] = Field(description="明細表のすべての銘柄。業種計・小計・合計の行は含めない")
    stated_counts: list[SectionCount] = Field(description="各区分の小計行に書かれた銘柄数")

client = LlamaCloud()
with open("fund_xl.pdf", "rb") as f:
    fid = client.files.create(file=("fund_xl.pdf", f.read(), "application/pdf"), purpose="extract").id

for attempt in (1, 2):
    job = client.extract.run(file_input=fid, configuration={
        "tier": "cost_effective", "version": "2.5",
        "data_schema": FundWithCounts.model_json_schema(),
        "disable_cache": attempt > 1})          # 2回目は前の結果を使わない
    r = client.extract.get(job.id).extract_result
    got = collections.Counter(h["section"] for h in r["holdings"])
    want = {c["section"]: c["count"] for c in r["stated_counts"]}
    ok = bool(want) and all(got.get(s, 0) == n for s, n in want.items())
    print(f"{attempt}回目: 取り出した件数 {dict(got)} / 小計の記載 {want} → {'一致' if ok else '不一致'}")
    if ok:
        break
else:
    print("2回とも合わないので、人の確認に回す")
このコードをそのまま A’ の PDF で実行した結果です(1回96クレジット)。
1回目: 取り出した件数 {'国内株式': 619, '外国株式': 131, '公社債': 100} / 小計の記載 {'国内株式': 640, '外国株式': 160, '公社債': 100} → 不一致
2回目: 取り出した件数 {'国内株式': 622, '外国株式': 160, '公社債': 100} / 小計の記載 {'国内株式': 640, '外国株式': 160, '公社債': 100} → 不一致
2回とも合わないので、人の確認に回す
1回目は国内株式で21件、外国株式で29件の取りこぼしがありました。再実行しても18件足りず、検算が働いて「人の確認」に止まっています。同じ検算を、Holding を7項目にした版で別に実行したときは、1回目で3区分とも一致しました。Cost Effective は、同じ文書でも回によって取りこぼしが出ます。だからこそ、この検算が効きます。
件数の検算で見つかるのは、取りこぼしと空の結果です。「橘」を「橋」と読むような中身の誤りは見つかりません。名前の誤りまで拾いたい場合は、取引先マスタのような手元の一覧と照合する処理を足してください。
比較ビューアを操作して、3つの結果を順に見ていく様子も録画しました。
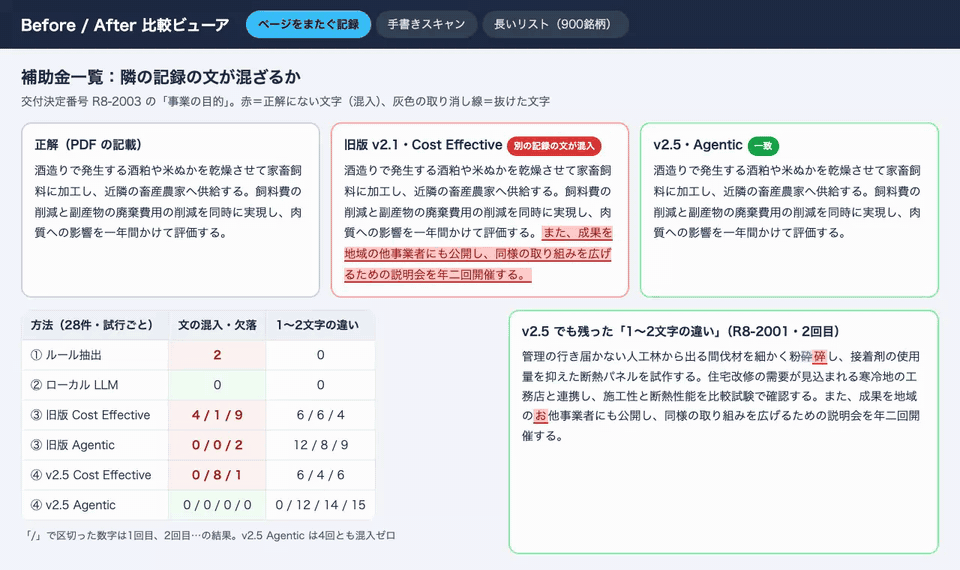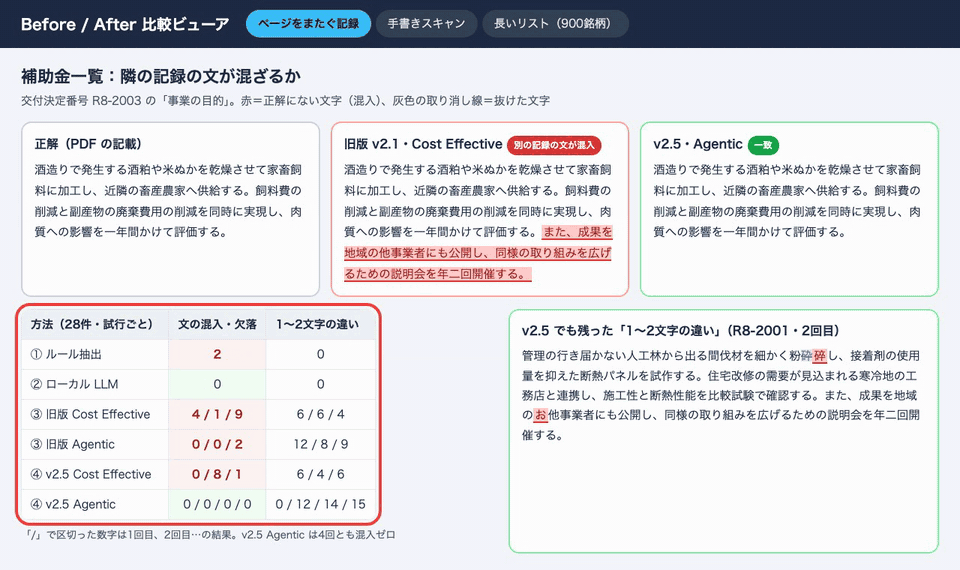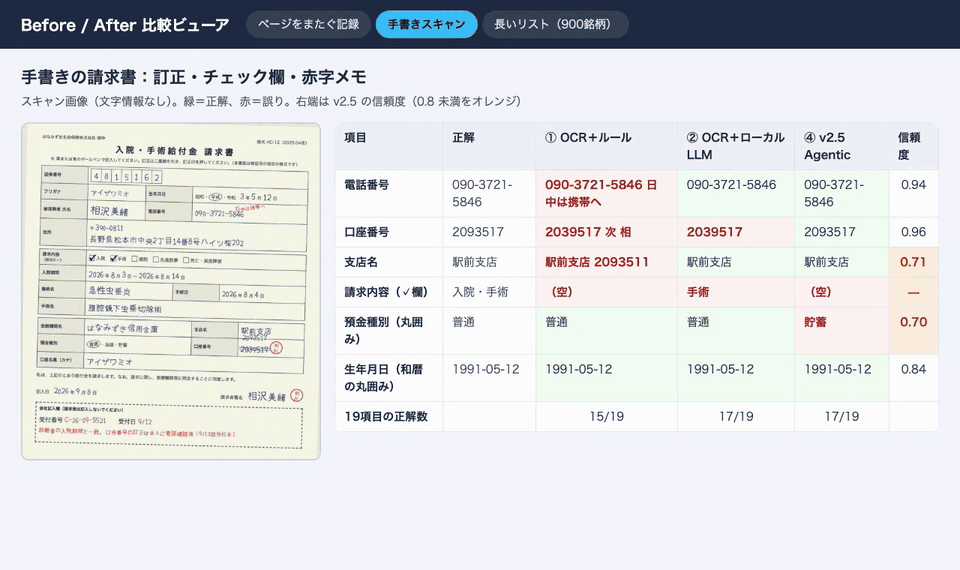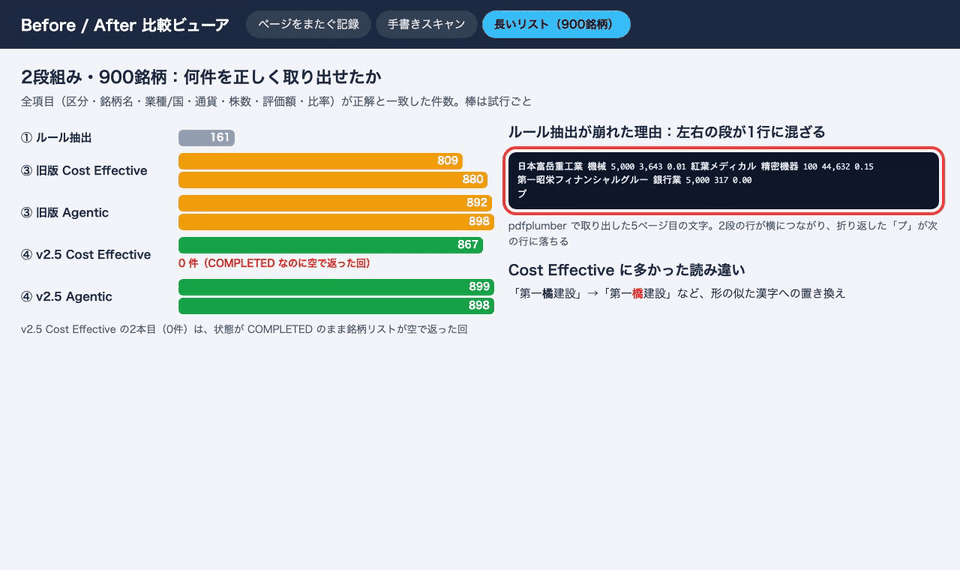
比較ビューアの操作録画。
時間と費用
今回の検証で記録した処理時間です。旧版と v2.5 の違いを見やすくするため、Agentic の値を並べます。
| 文書 | ページ数 | 旧版 Agentic | v2.5 Agentic | 1回の消費クレジット |
|---|---|---|---|---|
| 請求書 | 1 | 27〜43秒 | 23〜34秒 | 25 |
| 補助金一覧 | 9 | 67〜92秒 | 87〜131秒 | 225 |
| 運用報告書 | 12 | 84秒 | 90秒 | 300 |
| 2段組み900銘柄 | 12 | 114〜151秒 | 124〜134秒 | 300 |
補助金一覧では v2.5 のほうが時間がかかりました。似た記録を取り違えないよう手間をかけている、という公式の説明と合う動きです。
試行を繰り返したため、消費は合計で約5,300クレジットになりました。料金に直すと約6.6ドルですが、毎月の無料枠(10,000クレジット)の範囲に収まったので、支払いは発生していません。
ローカル LLM(②)は、手書きの請求書1枚に24分、補助金一覧(9ページ)に約45分、運用報告書(12ページ・248銘柄)に約97分かかりました。思考モードのまま動かしたため、請求書では思考だけで約16,800トークンを使っています。生成速度は毎秒約12トークンでした。文書を外に出さずに済む代わりに、時間の面では大きな差があります。
どう使い分けるか
今回の結果から、使い分けの目安を図にまとめます。
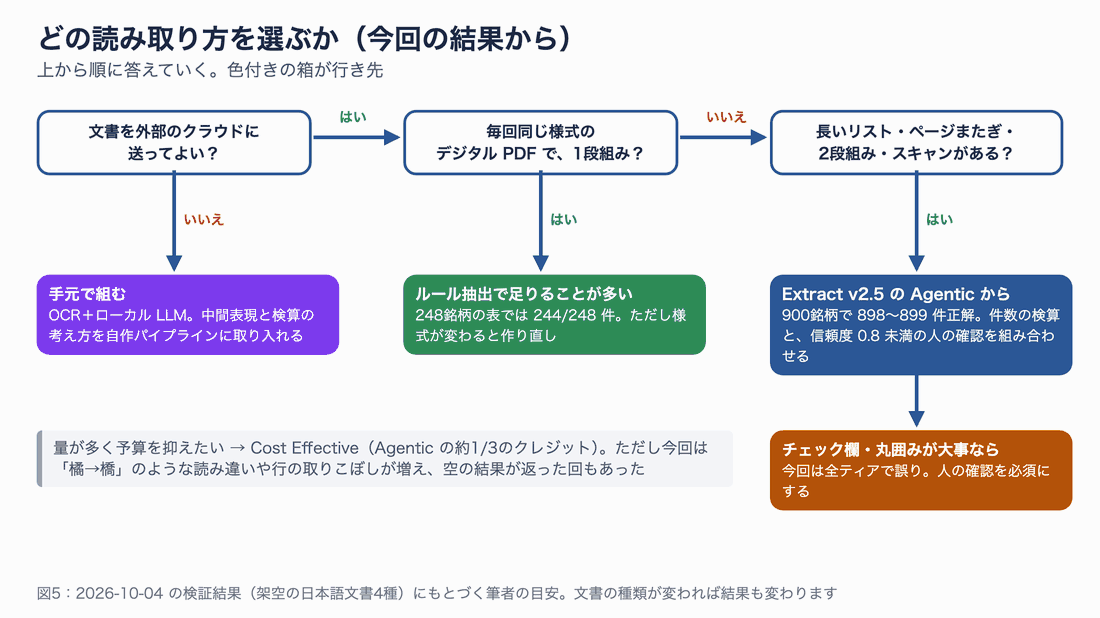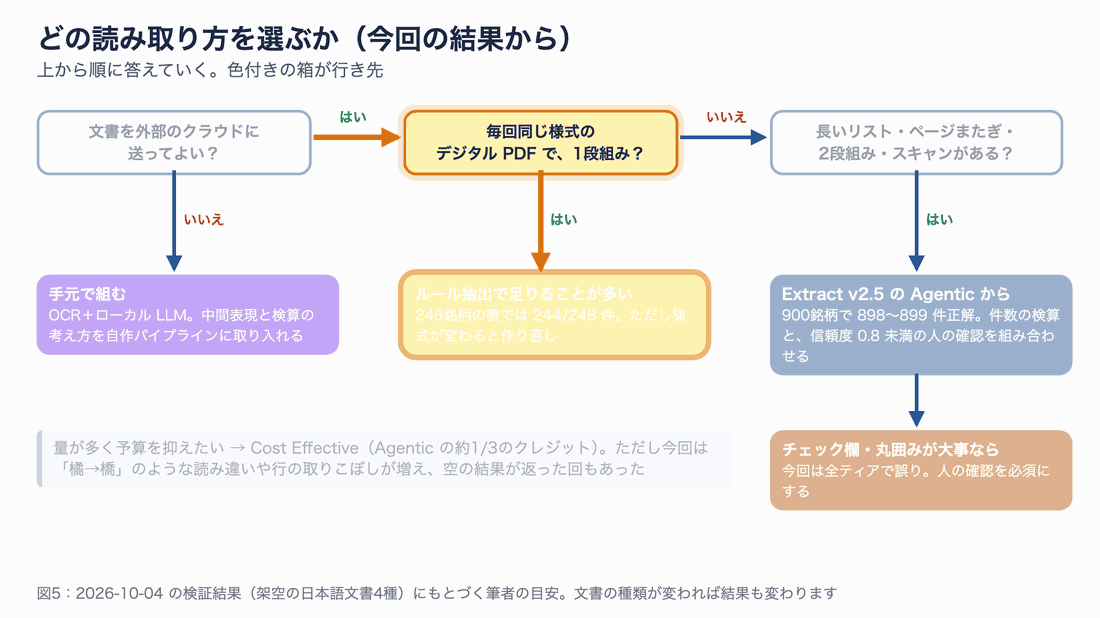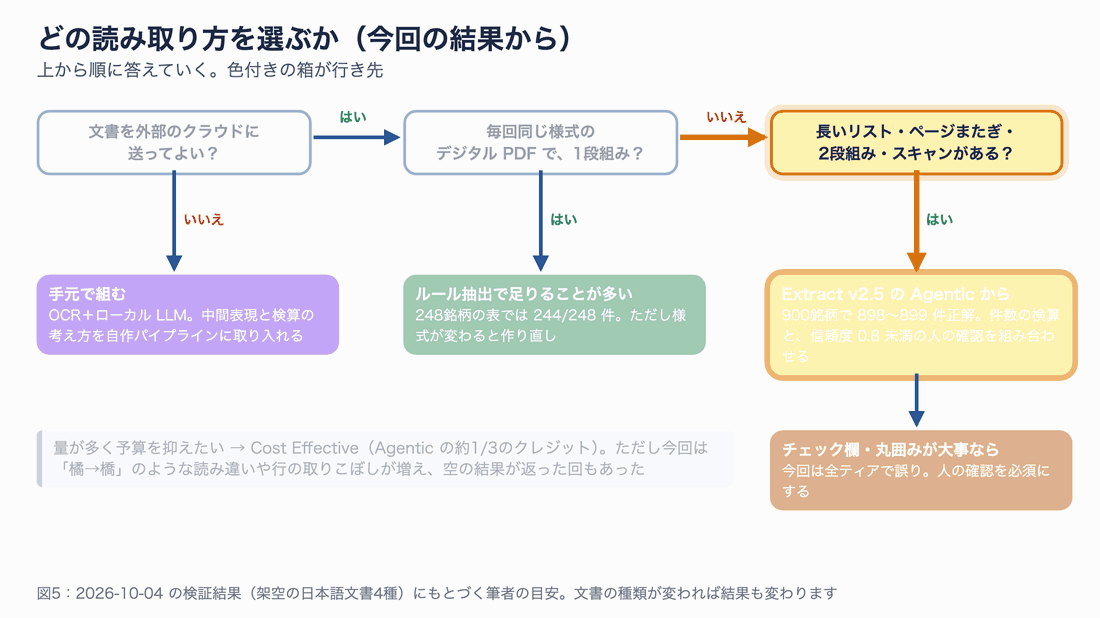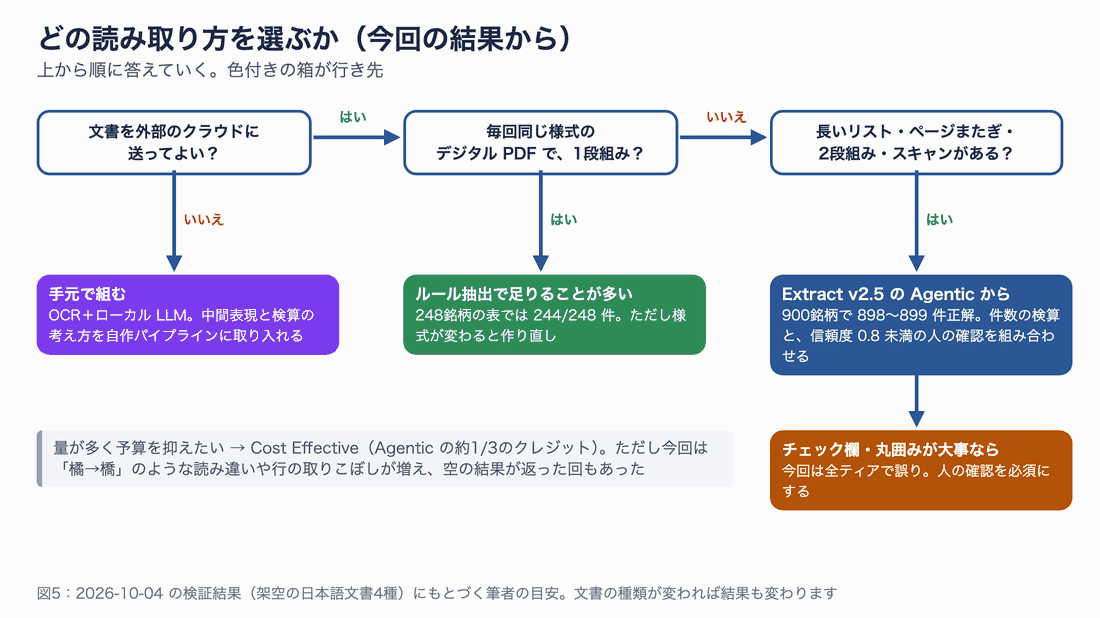
図5:使い分けの目安。今回の4文書にもとづく筆者の判断で、文書の種類が変われば結果も変わります。
実務に組み込むなら、次の3つを組み合わせるのがおすすめです。
- ティアは Agentic から始める:Cost Effective は Agentic の約3分の1の費用で済みます。ただし今回は、読み違いと取りこぼし、空の結果が増えました。まず Agentic で精度を確かめ、許容できる文書だけ Cost Effective に下げます。
- 件数の検算を入れる:小計や合計の件数を一緒に取り出して突き合わせます。空のリストや取りこぼしは、これで止められます。
- 信頼度で人の確認に回す:0.8 未満の項目と、チェック欄・丸囲みのような項目は、必ず人が見ます。根拠位置を使って、PDF の該当箇所を並べて表示すると確認が速くなります。
文書を外部に出せない場合でも、今回の結果は自作のパイプラインの設計に使えます。全件をいったん中間表現にまとめ、件数とスキーマで検算してから出力する、という流れは手元の LLM でも組めます。
つまずいたときの確認順
実際に試して引っかかった点と、公式ドキュメントの注意をまとめます。
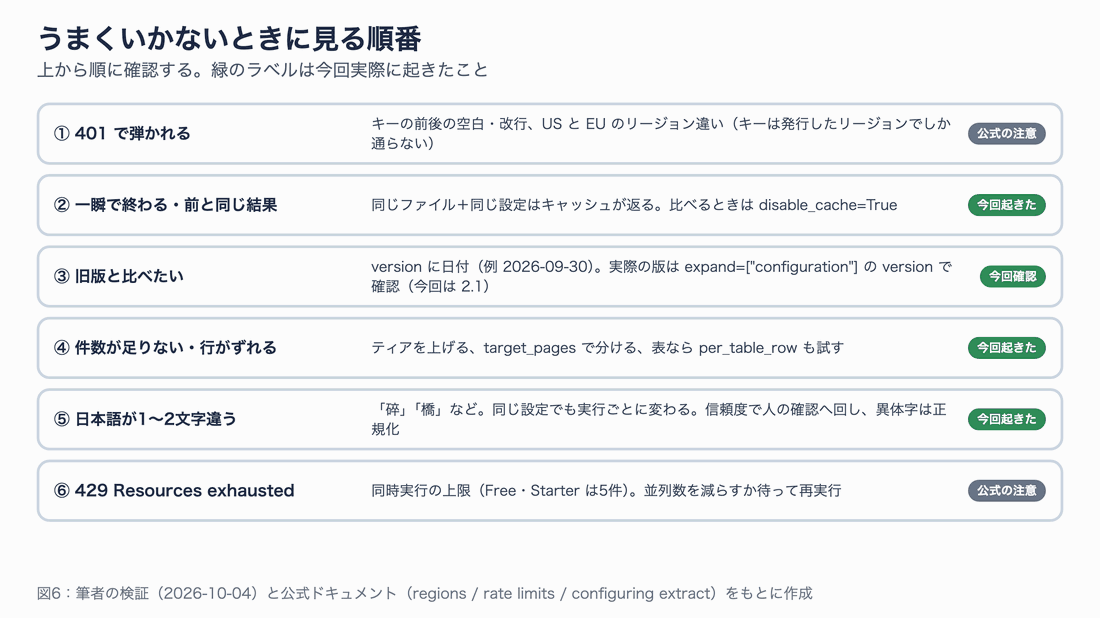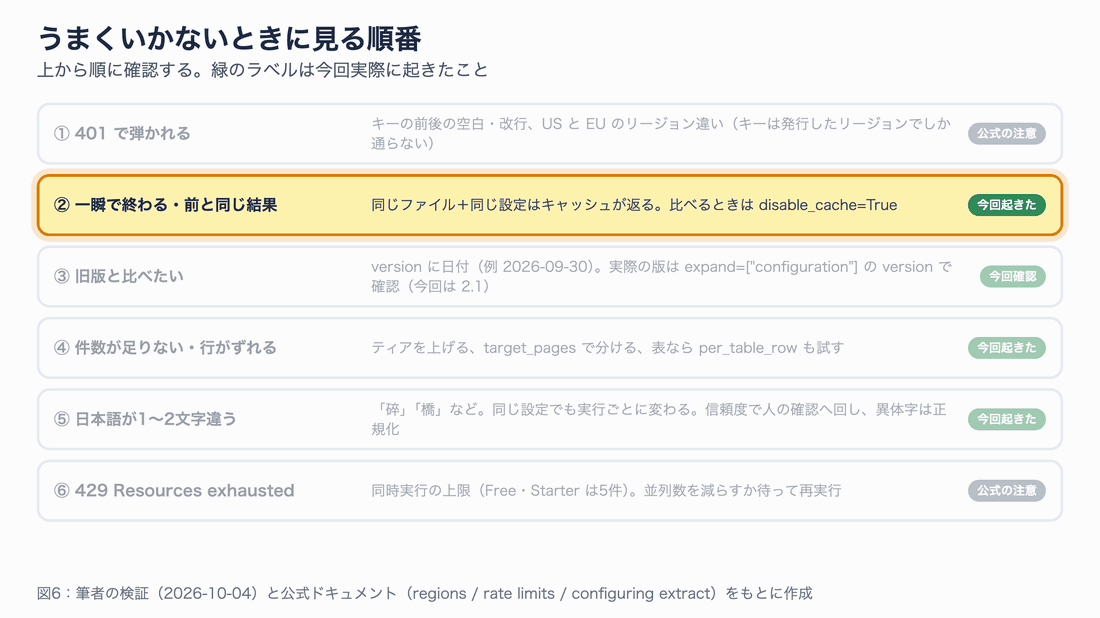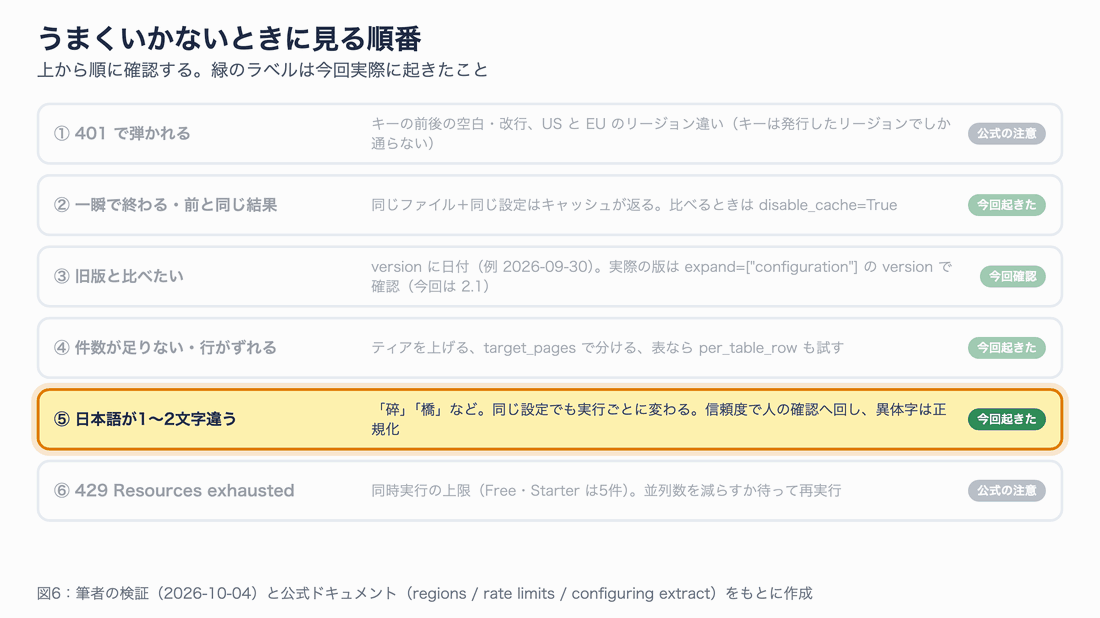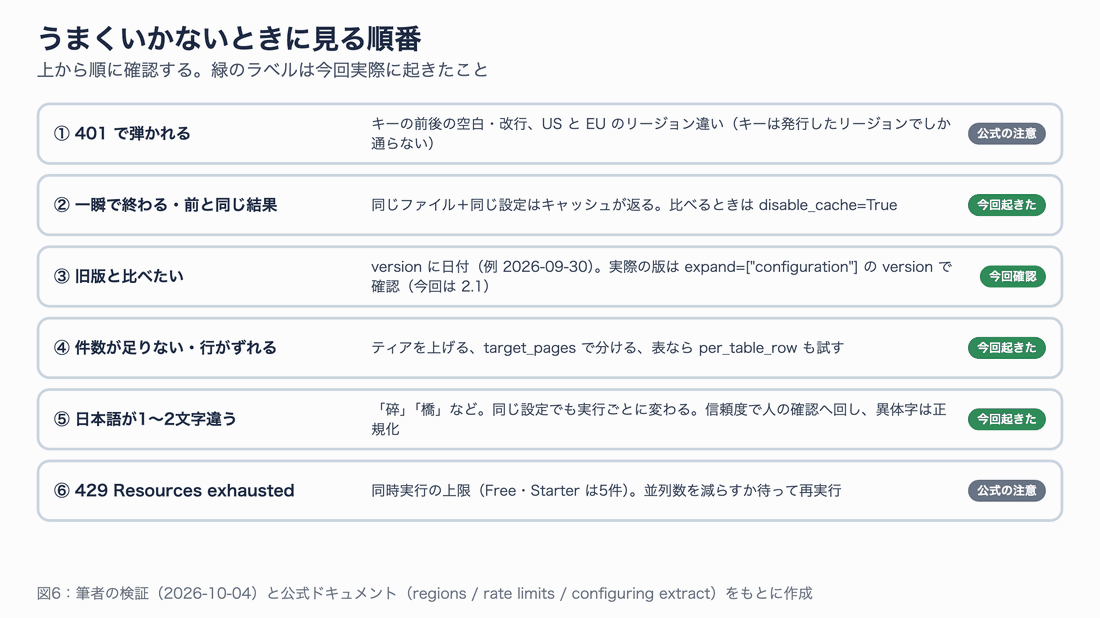
図6:確認する順番。緑のラベルは、今回の検証で実際に起きたことです。
| 症状 | 原因 | 対処 |
|---|---|---|
| 401 エラー | キーの前後の空白・改行、リージョン違い | キーを貼り直す。EU のキーなら LLAMA_CLOUD_BASE_URL を EU に |
| 一瞬で終わる、前と同じ結果 | 同じファイル+同じ設定はキャッシュが返る | 比べるときは "disable_cache": True |
| 旧版と比べたい | version 省略時は最新版 | "version": "2026-09-30" のように日付を指定し、expand=["configuration"] で実際の版を確認 |
| 件数が足りない、行がずれる | ティアが低い、文書が長い | ティアを上げる、target_pages で分ける、表なら per_table_row も試す |
| 日本語が1〜2文字違う | 解析・書き写しの揺れ | 信頼度では拾えない。マスタとの照合、異体字の正規化 |
| 429 Resources exhausted | 同時実行の上限(Free・Starter は5件) | 並列数を減らす、待って再実行 |
まとめ
日本語の架空文書4種で、Extract v2.5 を従来の方法・旧版と比べた結果をまとめます。
- ページをまたぐ記録:旧版で起きた「隣の記録の文が混ざる」誤りが、v2.5 Agentic では4回の試行すべてでゼロになりました。
- 長いリスト:900銘柄・2段組みで、v2.5 Agentic は898〜899件と安定しました。旧版は回によるぶれが大きく、ルール抽出は2段組みに対応できませんでした。
- 手書きスキャン:訂正後の番号と受付者のメモの区別はできました。一方、✓欄と丸囲みはどの版・どのティアでも読めませんでした。v2.5 Agentic は、信頼度で人が見る項目を19項目中5項目まで絞れた点が実用上の利点です。
- 残った課題:日本語の1〜2文字の違いは実行ごとに出て、信頼度にも表れません。文字情報のあるデジタル PDF では、取り出した文字をローカル LLM に渡すほうが一字一句の正確さでは上でした(ただし約45分かかりました)。空の結果が「完了」として返ることもあります。
「高性能なモデルに PDF を渡せば終わり」ではなく、分けて読み、検算してから出すハーネスが効いている。この点は、日本語の文書でも確かめられました。そのうえで、件数の検算と信頼度による振り分けを自分のパイプライン側に持つことが、実務で安心して使うための条件だと感じます。
次の一歩としては、実際に困っている文書(外に出してよいもの)を2〜3種類選び、Agentic で試してみてください。見るべきは、件数の取りこぼし、ページまたぎの欠落、根拠位置の正しさの3点です。