2026年10月8日の改訂について 旧版で「Microsoftのローカル音声モデル『VALL-E 1.5B』」と書いていた箇所は、正しくは VibeVoice-TTS-1.5B(公開当時のモデル名は VibeVoice-1.5B) です。「最大90分・4話者」もVibeVoiceの仕様です。また、MicrosoftはこのTTSコードを 2025年9月5日に 公式リポジトリから削除しています。旧版はこの経緯に触れていなかったため、本文で説明を補いました。 あわせて、一次資料で裏付けを取れなかった数値(サイバーエージェントの制作本数、アクセンチュアのアプリ数や資料パターン数、ChatGPTの月間アクセス数、APIの利用シェアなど)と、ツール紹介2件を削除しました。クレディセゾンの数値、ペンシルベニア大学ウォートン校とMITの研究内容は、公式発表と論文の記述に合わせて書き直しています。当サイトはこれらのツールやモデルを独自に検証していません。
この記事の確認範囲
この記事は、2025年9月1日〜7日ごろに報じられたAIニュースを、2026年10月8日の時点で公式発表や論文と照らし合わせて読み直したものです。本文は「当時何が発表されたか」を中心にしています。その後に状況が変わった話題は、「その後」と明記して分けています。今日の最新ニュースとして読まないよう、ご注意ください。
過去のAIニュースを読むときの3つの視点
1年前のニュースまとめを読み返すと、「当時の発表」「後の展開」「書き手の推測」が1つの段落に混ざっていることがよくあります。旧版にもこの混同がありました。そこでこの記事では、話題ごとに次の3点を確かめています。
- いつの情報か:発表日と、その後に起きた変化を区別する
- 誰が言っているか:企業の公式発表か、論文か、報道か
- どの段階の数字か:実績か、見込みか、研究条件のもとでの結果か
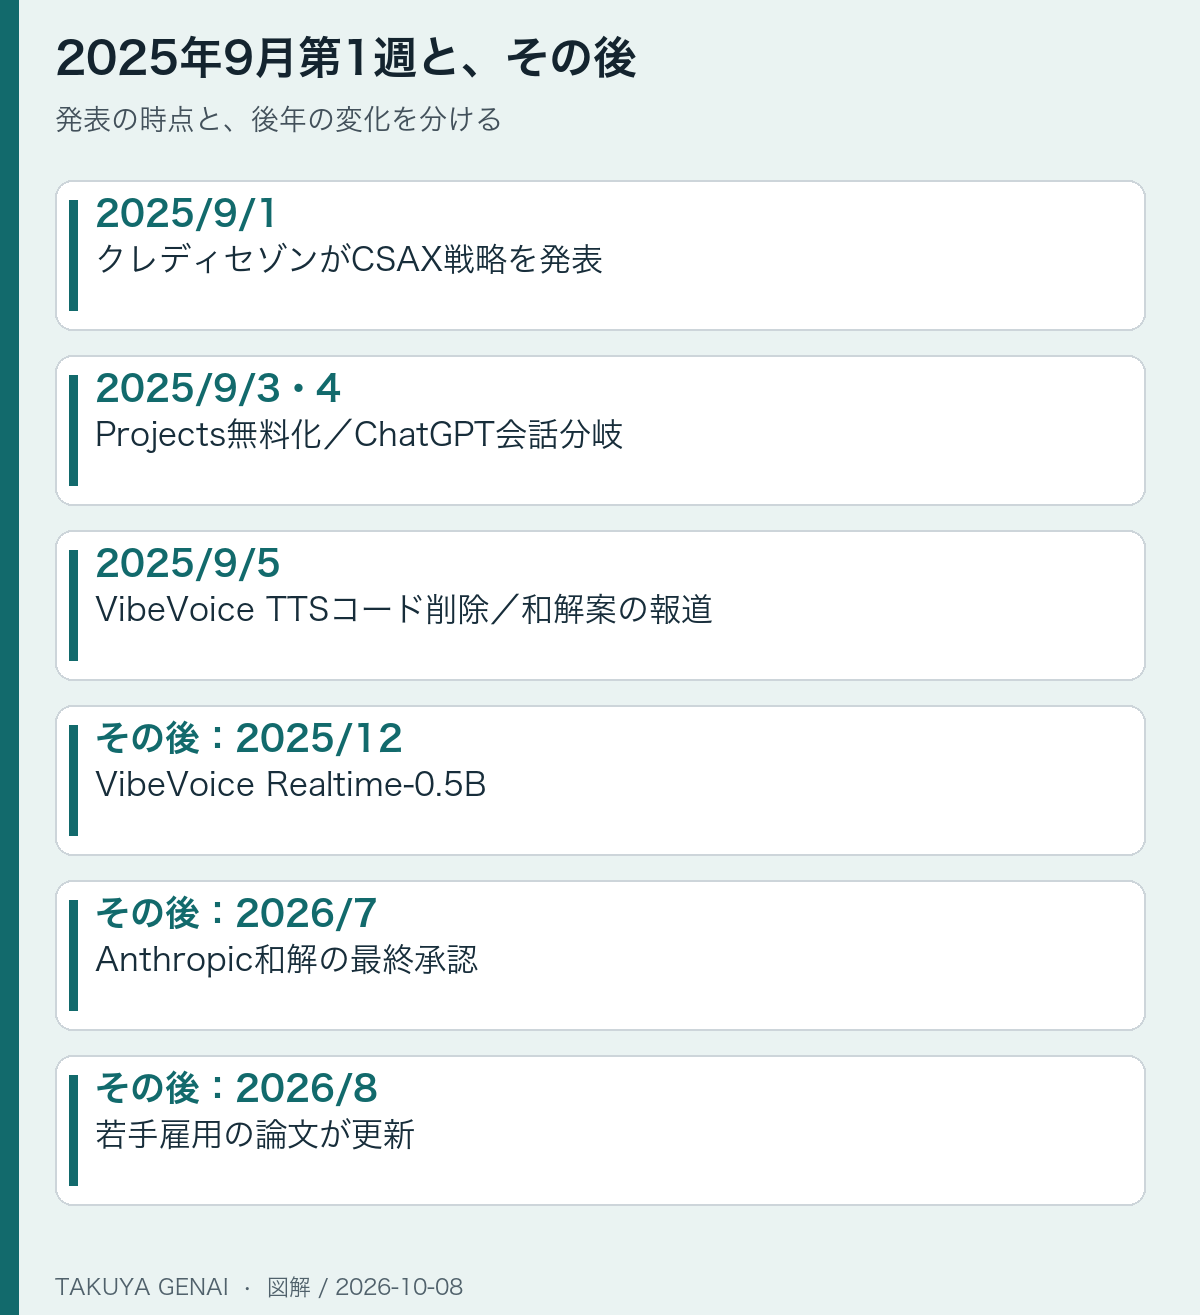
まずは、その週の出来事とその後の展開を1枚の時系列にまとめます。図では、前半に当時の発表、後半に後日の変化を置いています。順番に光る印を追うと、どの話題のどの部分がいつの話なのかを確認できます。
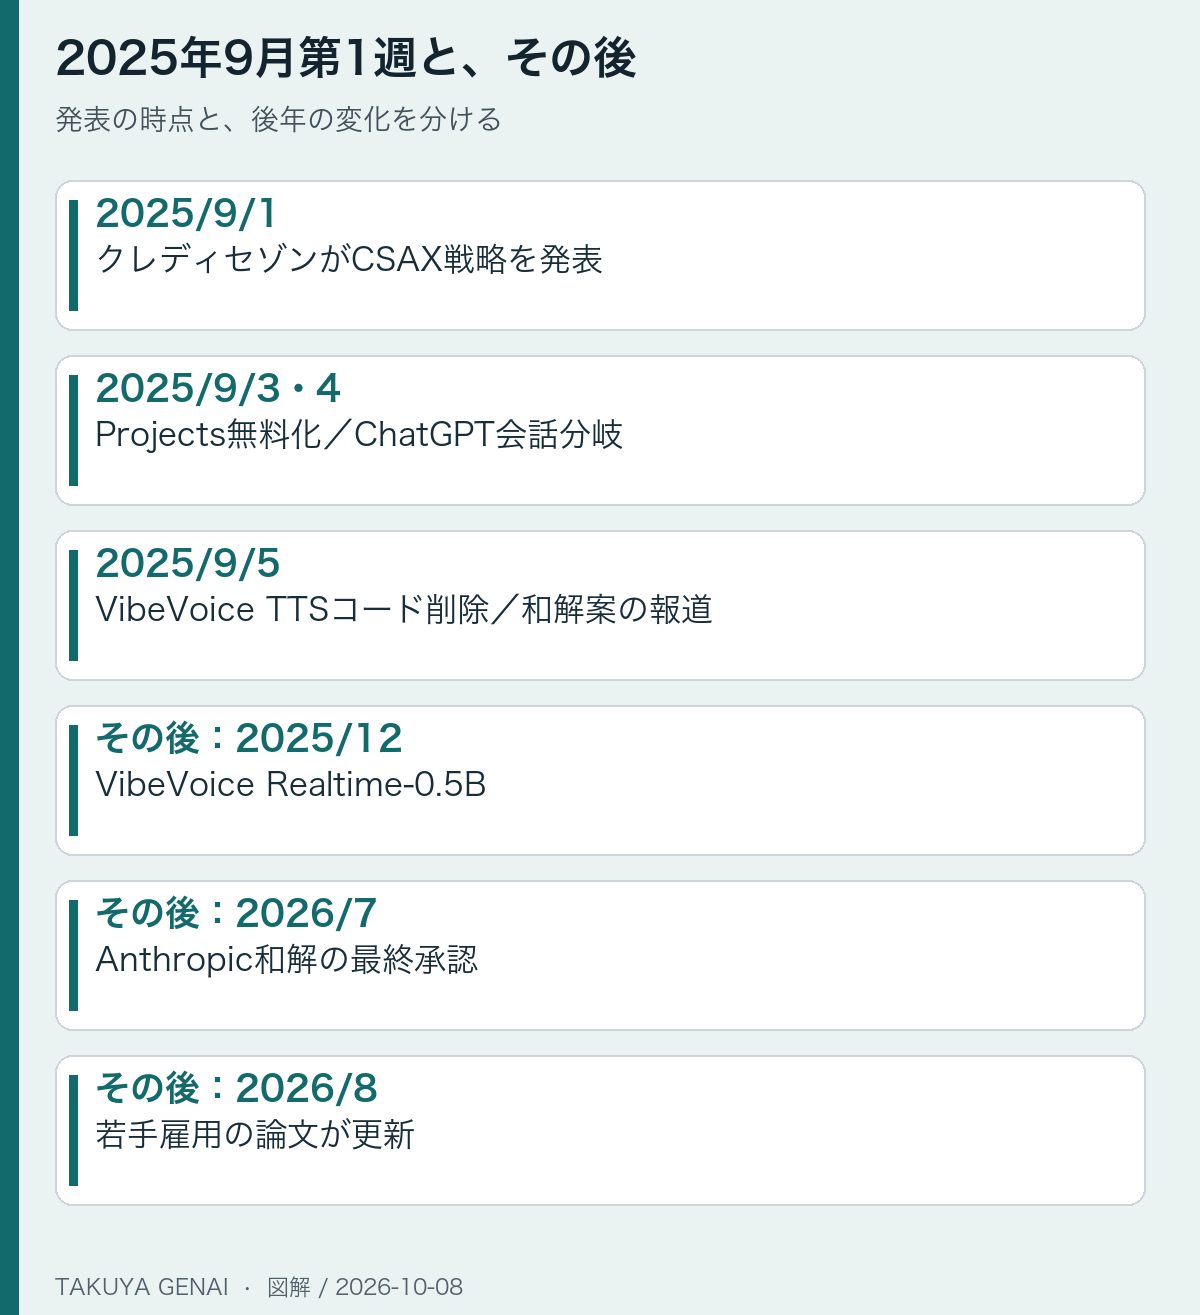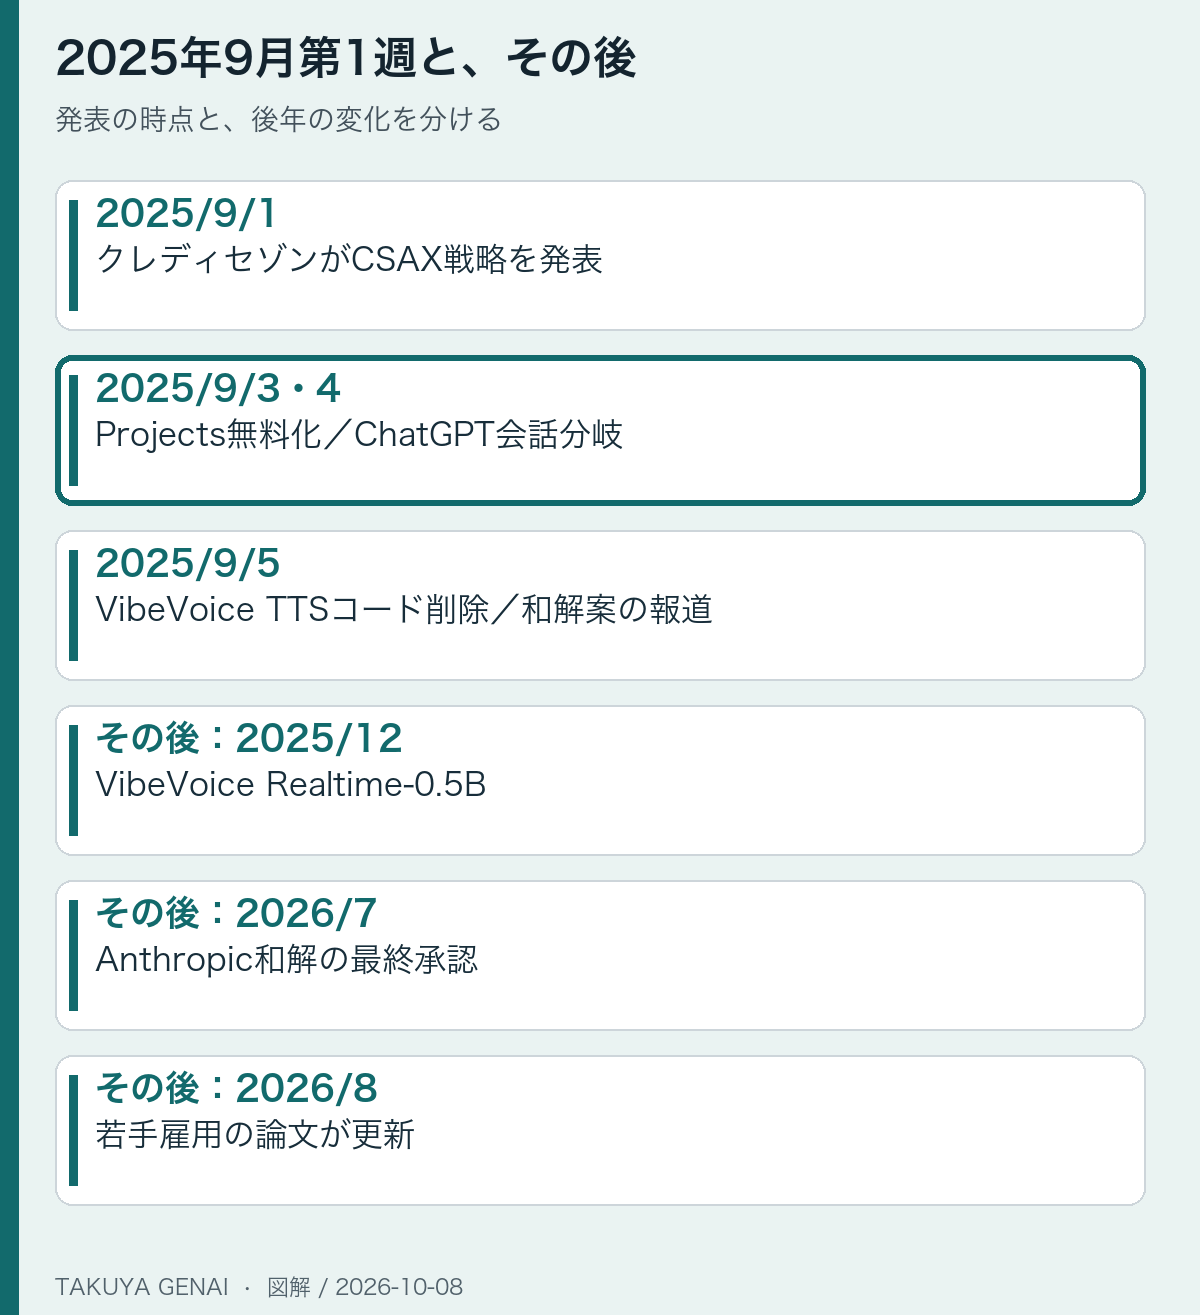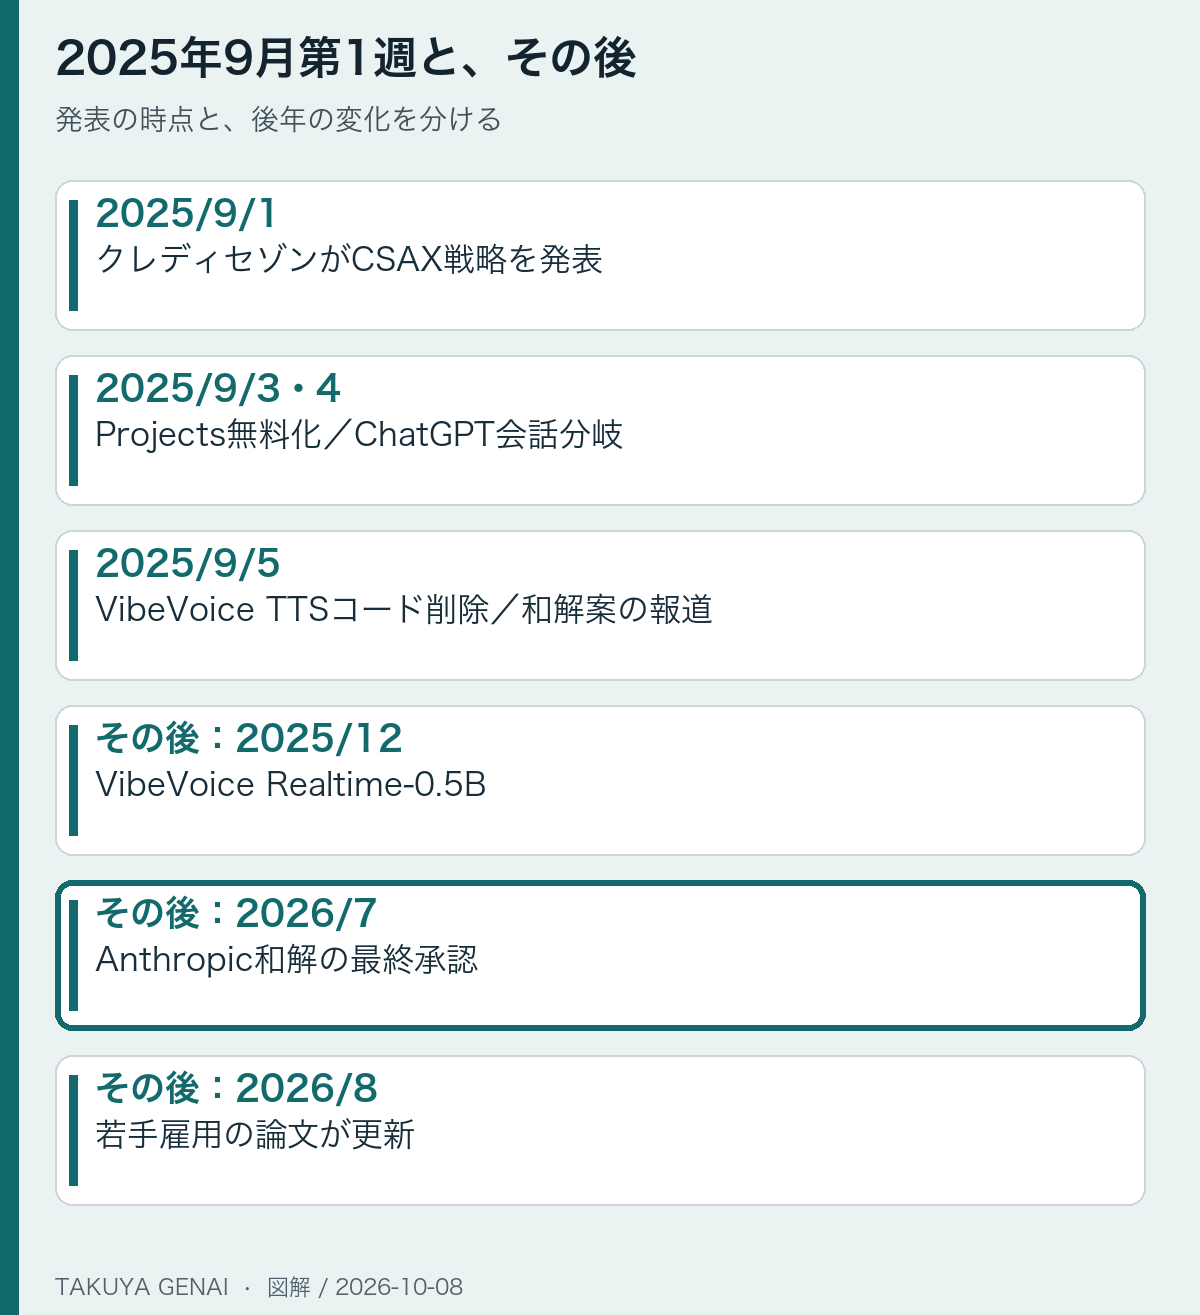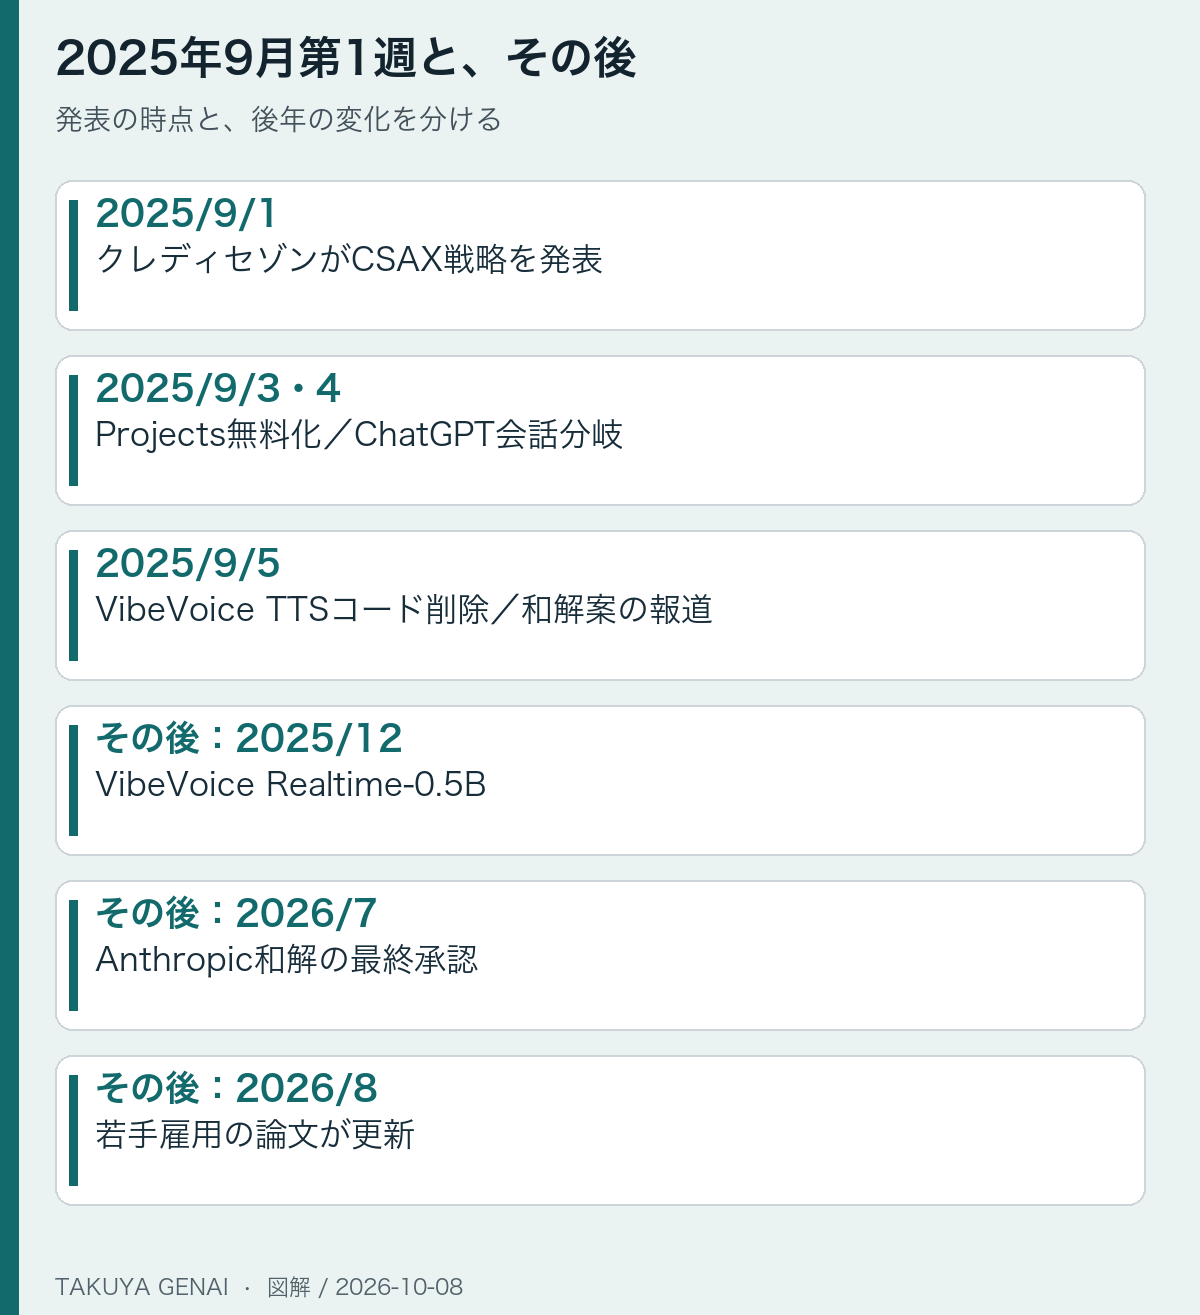
図1:2025年9月第1週の発表と、その後の展開を分けた時系列。静止画版はこちら。
1. 日常のツールで起きた変化:ChatGPTとNotebookLM
ChatGPTのプロジェクト機能が無料プランでも使えるように(9月3日)
OpenAIは2025年9月3日、チャットや資料、指示をまとめて管理できるプロジェクト(Projects)機能を無料ユーザーにも開放したと告知しました。同じ告知で、1プロジェクトあたりのファイル上限も示されています。無料プランは5件、Plusは25件、Pro・Business・Enterpriseは40件です。色やアイコンの設定、プロジェクト単位のメモリ設定も同時に追加されました(OpenAIの告知)。
会話の分岐(9月4日)
翌9月4日には、会話の途中から別のチャットを派生させる分岐(Branch in new chat)が加わりました。元の会話を残したまま、そこまでの文脈を引き継いで別の方向を試せる機能です。当初の提供対象は「ログインしたWebユーザー」でした(OpenAIの告知)。その後、iOSとAndroidにも提供されたことが告知されています(OpenAIの告知)。
NotebookLMの音声解説に3つの形式
GoogleのNotebookLMでは、アップロードした資料をもとにAIが話す音声解説(Audio Overviews)に、新しい形式が3つ加わりました。従来の対話形式「Deep Dive」はそのまま残っています(Google公式ブログ)。
| 形式 | 公式の説明の要点 |
|---|---|
| Brief | 1人のAIホストが資料の要点を短くまとめる |
| Critique | 2人のAIホストが資料を講評し、改善のための意見を出す |
| Debate | 2人のAIホストが資料のテーマについて異なる立場から議論する |
旧版では、Briefを「約2分」と書いていました。ただし、Googleの公式ブログで確認できたのは「短い要約」という説明までだったため、時間の記載は削除しています。
2. 訂正:「VALL-E 1.5B」ではなく VibeVoice
ここが今回の改訂でもっとも大きな修正です。名前の取り違えに加えて、旧版は公開直後に起きた出来事を書いていませんでした。
2つのモデルは別物です
VALL-Eは、Microsoftの研究者が2023年1月に発表した音声合成(TTS: Text-to-Speech、文章を音声にする技術)の研究です。3秒ほどの音声サンプルをもとに、その声に似た音声を生成できる点が注目されました(arXiv: 2301.02111)。
一方、VibeVoiceは、2025年8月に技術報告書が公開された長尺・多話者向けの音声生成モデル群です(arXiv: 2508.19205)。モデルカードには、次のような仕様と注意事項が書かれています(Hugging Face モデルカード)。
- 最大90分、最大4人の話者による音声を合成できる
- 言語モデル部分には Qwen2.5-1.5B を使っている
- 対応言語は英語と中国語。それ以外の言語では想定外の出力になる場合がある
- 出力には「AIが生成した音声である」と伝える音声と、聞き取れない透かし(ウォーターマーク)を入れている
- 追加のテストや開発をしないまま、商用や実運用で使うことは推奨しない
旧版にあった「個人のPCで動く」「インターネットなしでリアルタイム対話が実現しつつある」という記述は、公式資料では裏付けられませんでした。そのため削除しています。
公開から約10日でTTSコードを削除
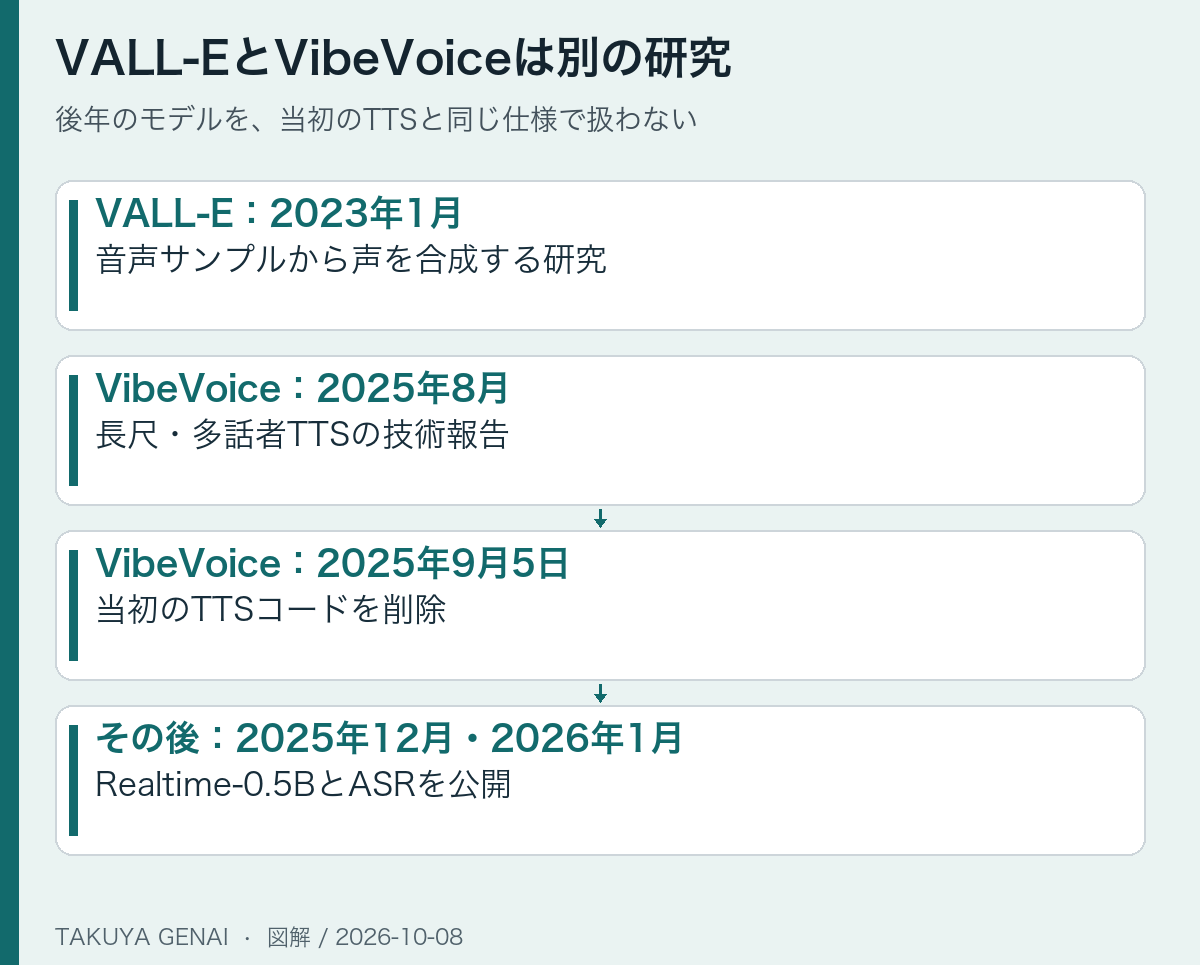
VibeVoiceは公開後すぐに状況が変わりました。図2では、VALL-EとVibeVoiceを分けて示したうえで、VibeVoice側の出来事を日付順にたどれるようにしています。
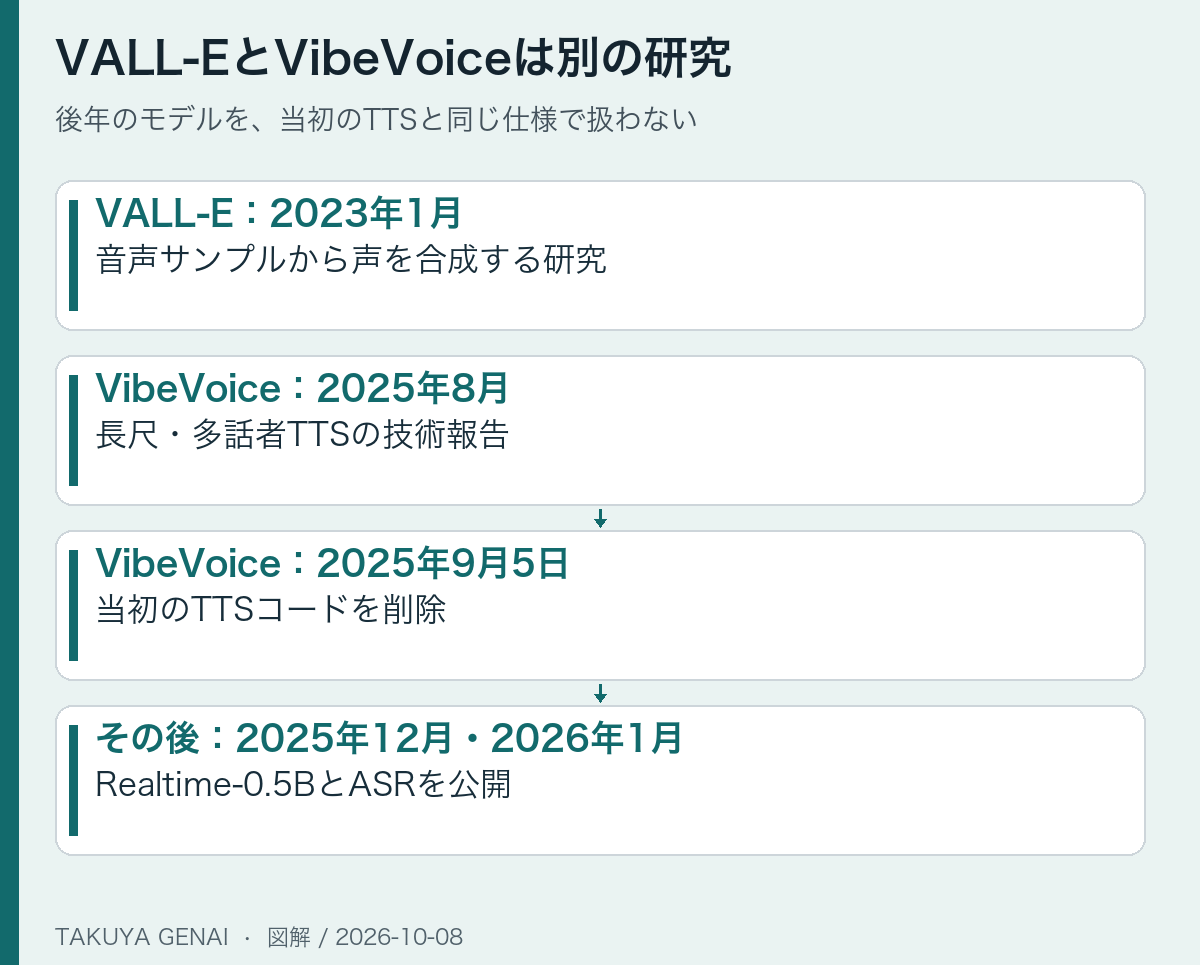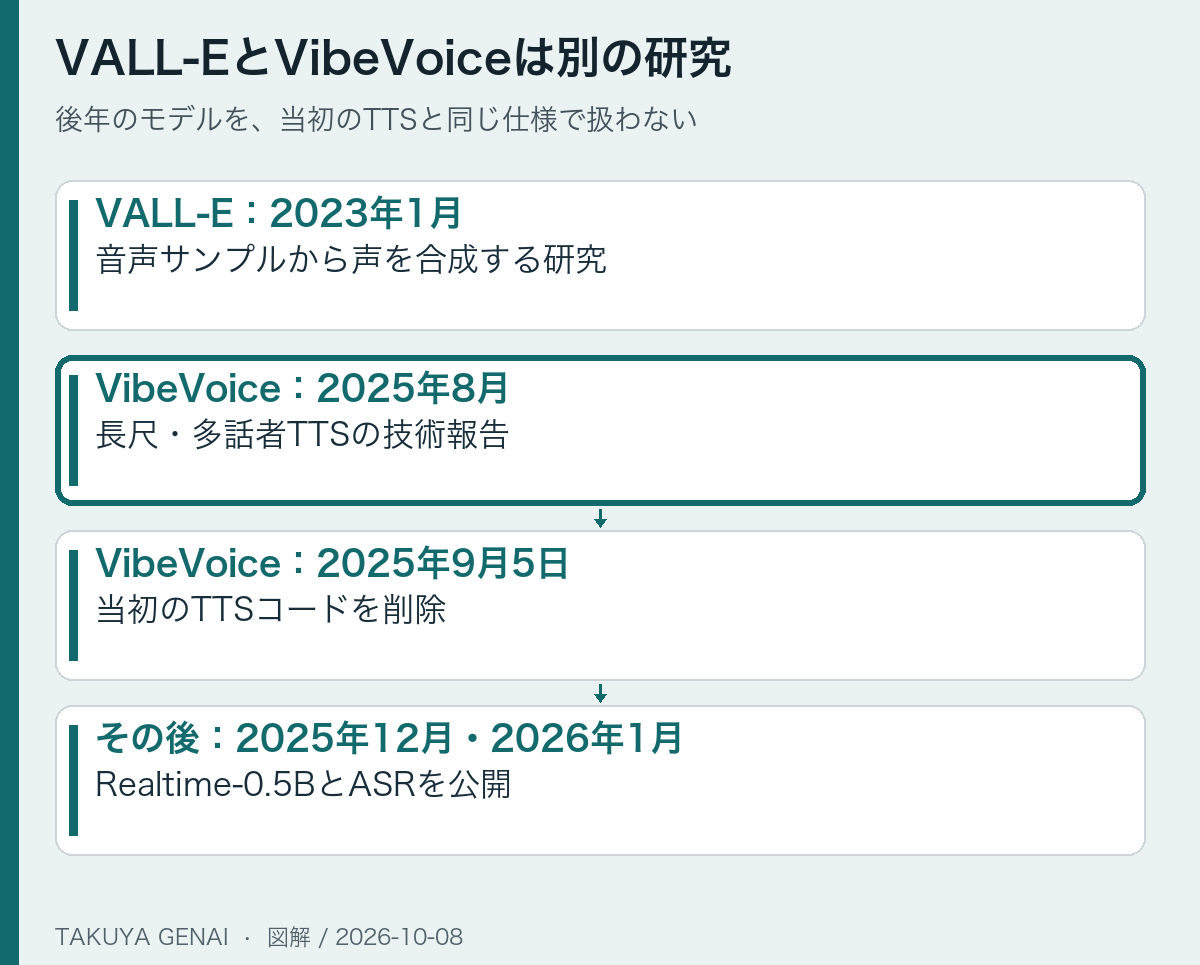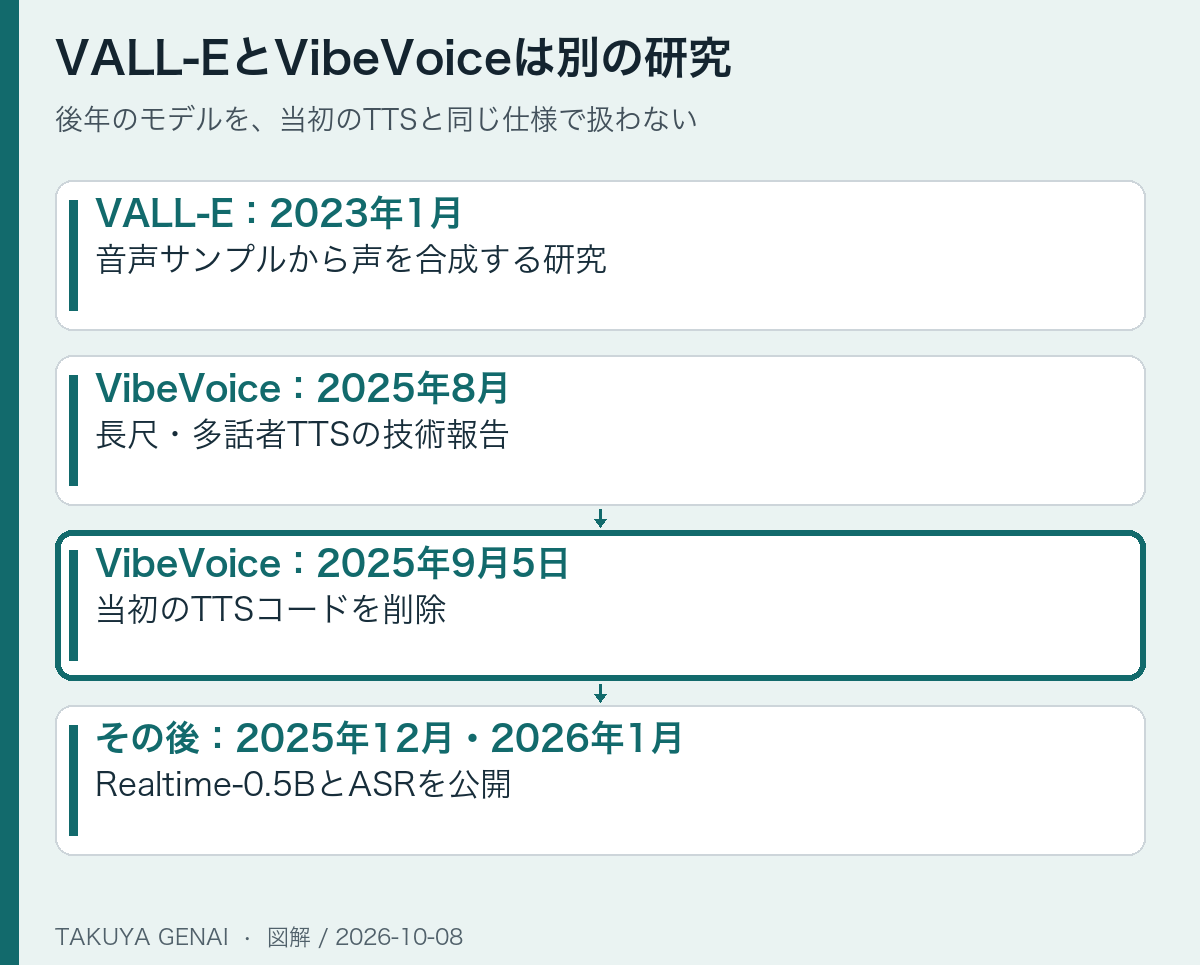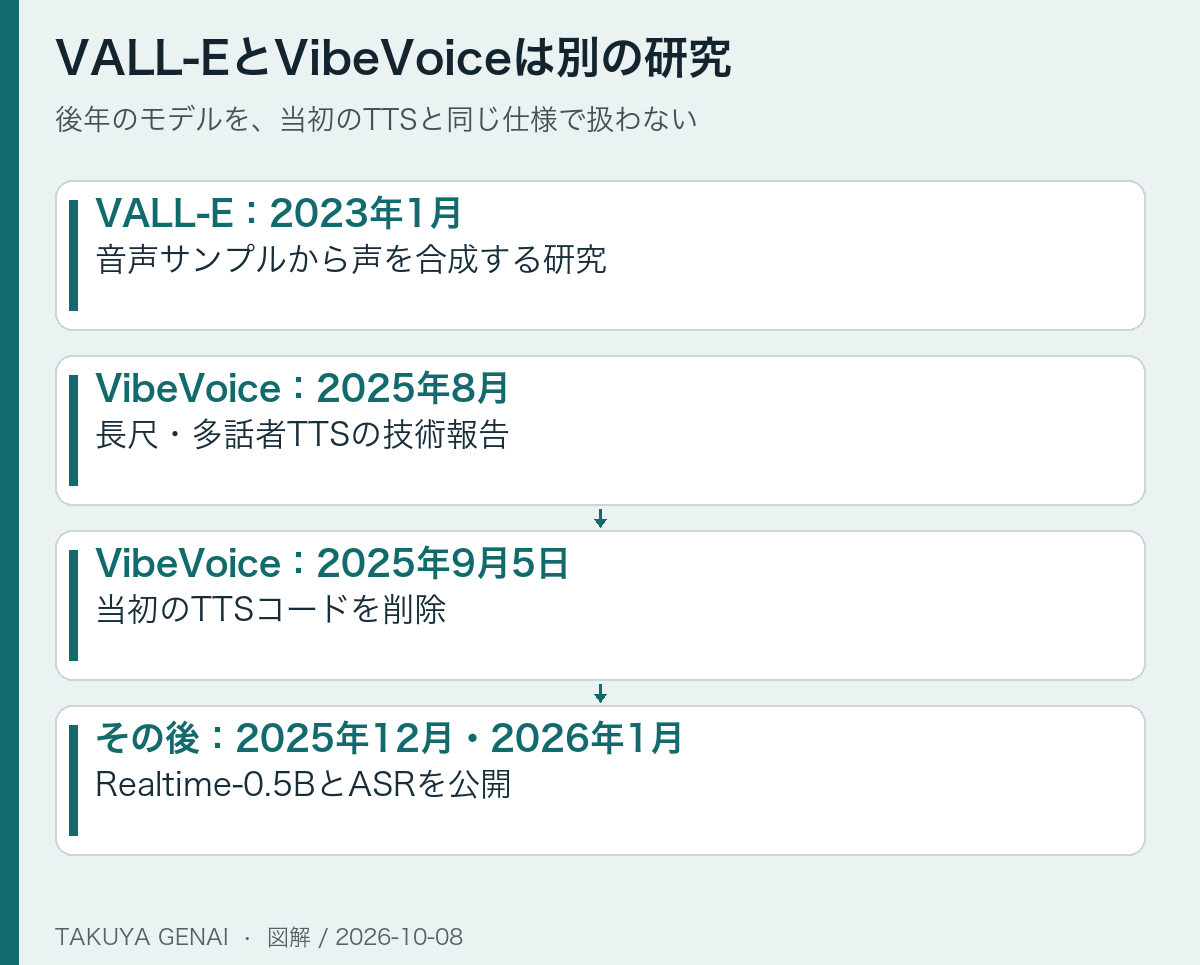
図2:VALL-EとVibeVoiceの区別と、VibeVoiceの公開からTTSコード削除、その後のモデル公開までの流れ。静止画版はこちら。
GitHubリポジトリの更新履歴によると、2025年9月5日にVibeVoice-TTSのコードがリポジトリから削除されました。Microsoftはその理由として、公開後に「想定した目的と異なる使われ方」が確認されたこと、責任あるAIの原則を重視していることを挙げています(microsoft/VibeVoice)。
その後、同じリポジトリでは方向性の異なるモデルが公開されました。2025年12月3日にはストリーミング入力に対応したVibeVoice-Realtime-0.5B、2026年1月21日には音声認識モデルのVibeVoice-ASRです。したがって、その週の情報を紹介する際には、週の途中でTTSコードが削除された経緯も併記する必要があります。後年のRealtime版やASRを、当初のTTSと同じ仕様として扱うことも避けます。
3. Anthropicの著作権訴訟、15億ドルの和解案(9月5日)
2025年9月5日、Claudeを開発するAnthropicが、作家らによる集団訴訟(Bartz v. Anthropic)について15億ドルで和解することで合意したと報じられました。対象は、海賊版サイトから入手した書籍の利用です。報道によれば、対象となる作品は約50万点、1作品あたりの支払いは約3,000ドルでした。和解には、該当するデータセットを破棄することも含まれています(NPR系列局の報道)。
当時はまだ「裁判所の承認待ちの和解案」でした。その後、2026年7月20日に連邦地裁が最終承認しています(原告側代理人 Lieff Cabraser の発表)。
旧版では、この和解を「判例となる」と書いていました。しかし、和解は判決ではないため、それ自体が判例になるわけではありません。表現を改めています。
4. 企業のAI活用:数字が「実績」か「見込み」か
クレディセゾンの「CSAX戦略」(9月1日)
クレディセゾンは2025年9月1日、全社員を「AIワーカー」にすることを掲げたCSAX戦略を発表しました。公式リリースの要点は次のとおりです(PR TIMES掲載の公式リリース)。
| 項目 | 公式発表の内容 |
|---|---|
| 試験導入 | 2025年6〜8月、役員を含む約300人がChatGPT Enterpriseを利用 |
| 効果 | 参加者1人あたり年間170時間の業務削減効果が見込める |
| 全社導入 | 2025年9月から、全社員3,700人に導入 |
| 目標 | 2027年度末までに累計300万時間の業務削減 |
旧版は「4,000名」「月14時間の削減を達成」と書いていました。年間170時間を12で割ると約14時間になりますが、発表の中身は「達成」ではなく「見込み」です。人数も3,700人が正しい数字です。
企業のLLM利用調査(Kong、2025年6月公表)
旧版で取り上げたKongの調査は、2025年6月18日に公表されたものです。9月第1週の新しい発表ではありません。調査の中身は「直近90日にGoogleのモデルを使った」と答えた回答者が69%、OpenAIのモデルは55%というものです(Kongのプレスリリース)。これは回答者のうち何割が使ったかを示す数字で、市場シェアではありません。旧版の「OpenAIを逆転」という見出しは言い過ぎでした。
5. 研究ニュース:条件を落とさずに読む
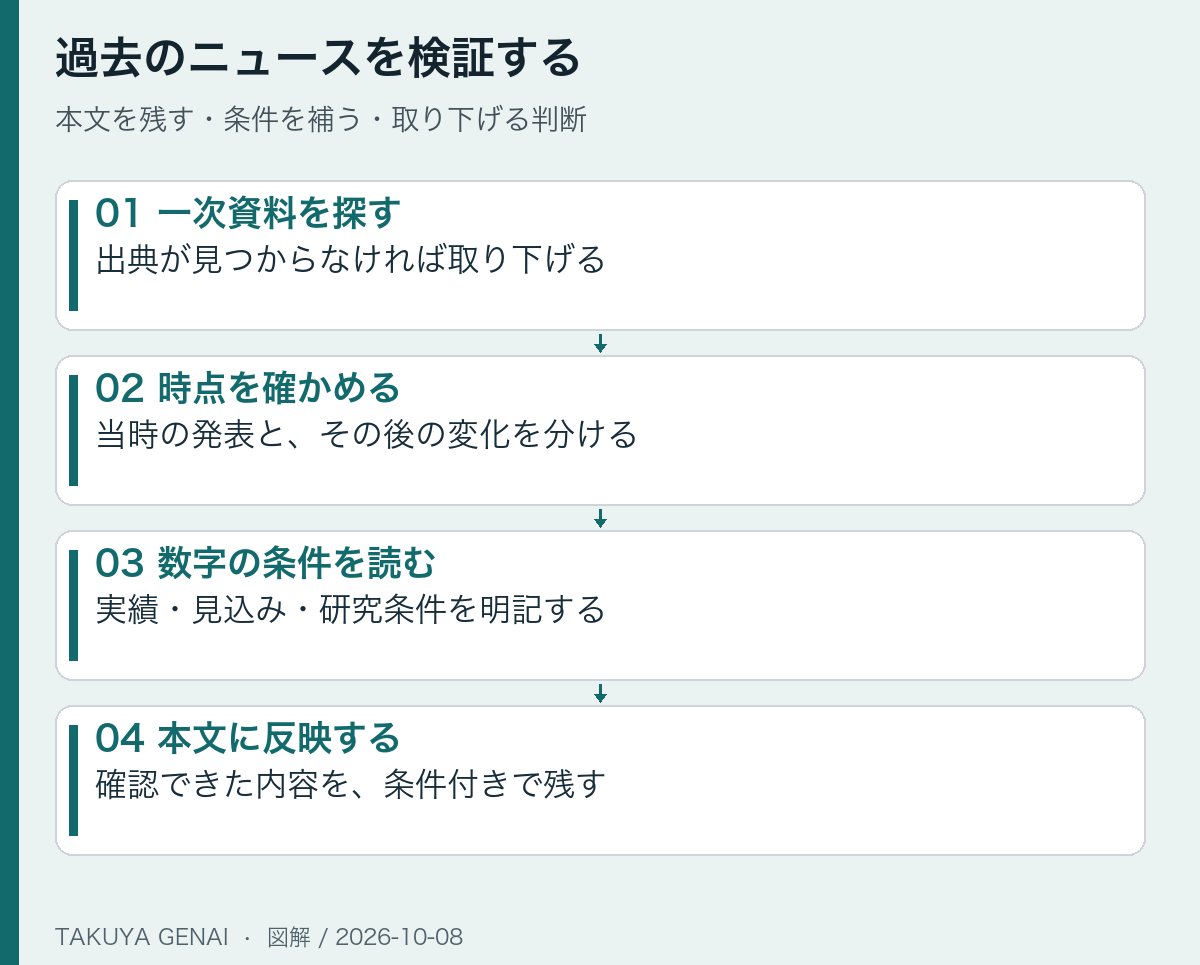
研究の紹介では、「誰を対象に、どんな条件で調べたか」が抜けると、結論が大きく見えてしまいます。図3は、この記事で各ニュースを残すか直すかを決めた確認の手順です。
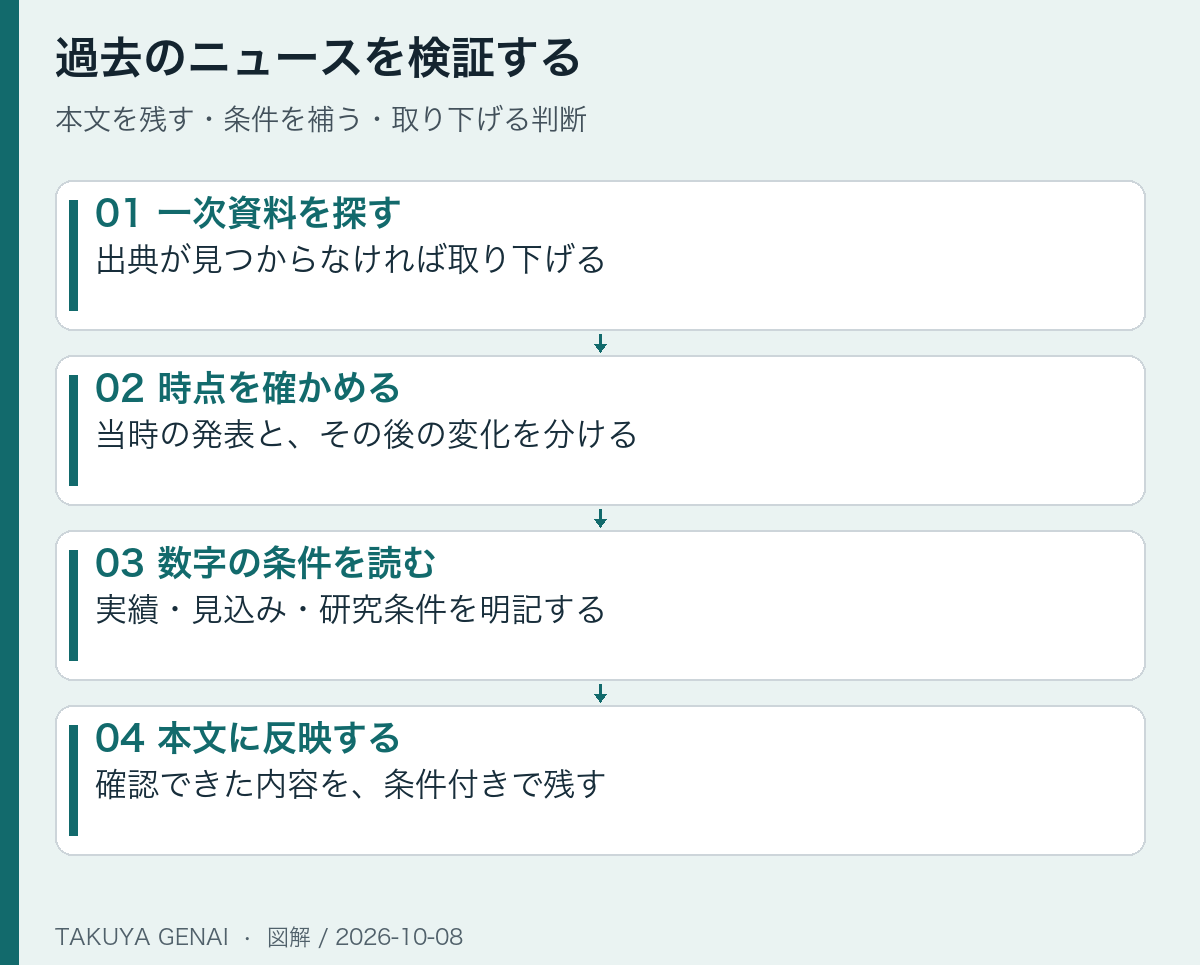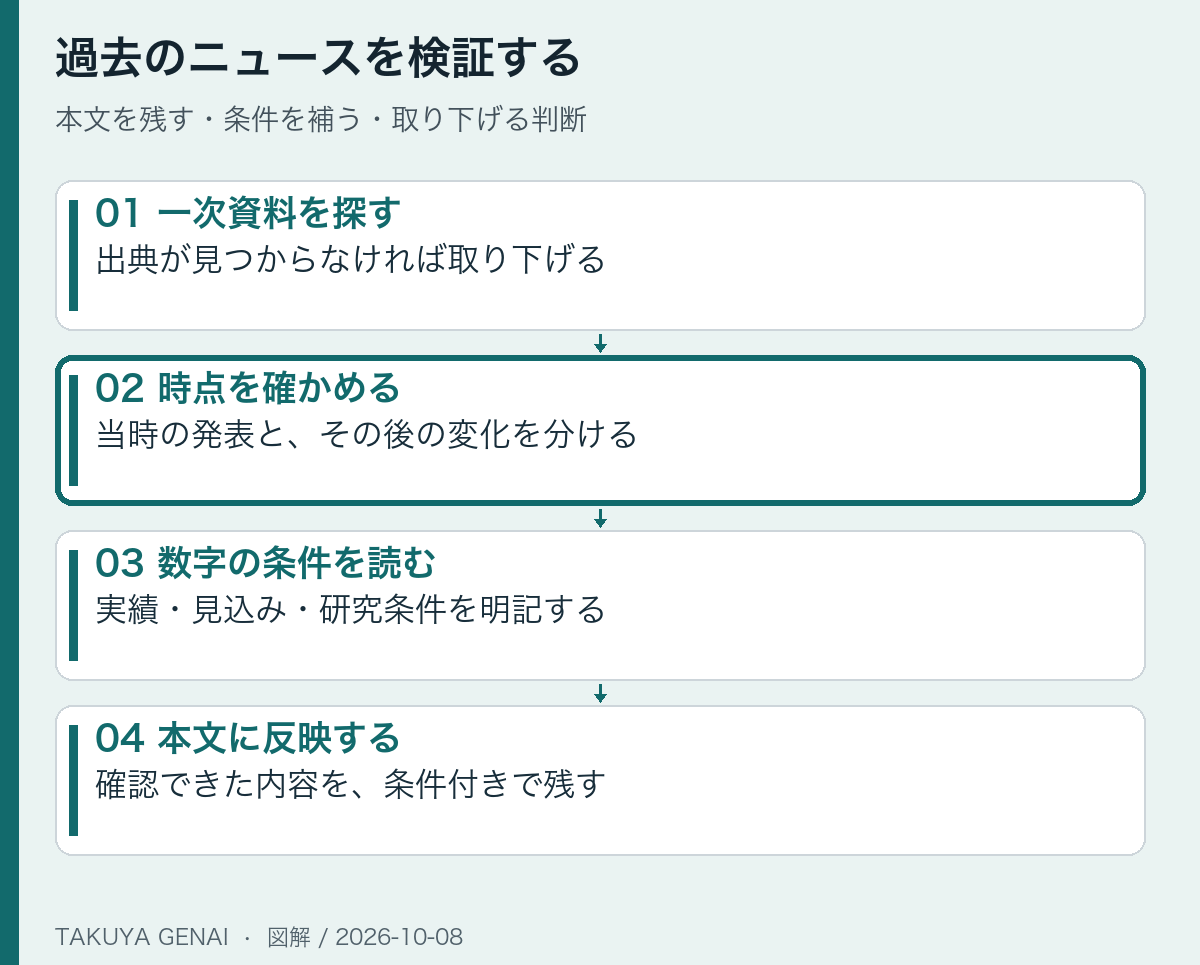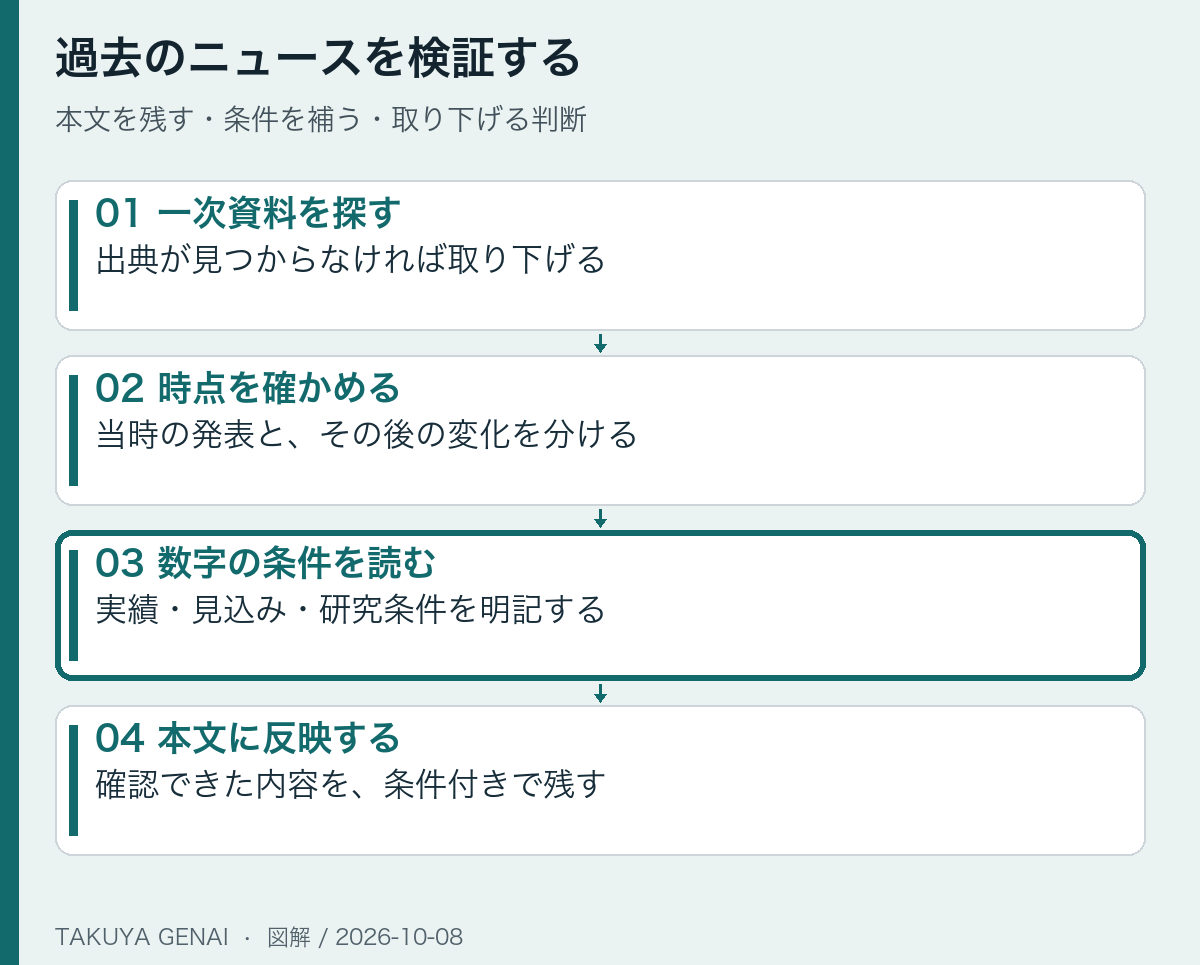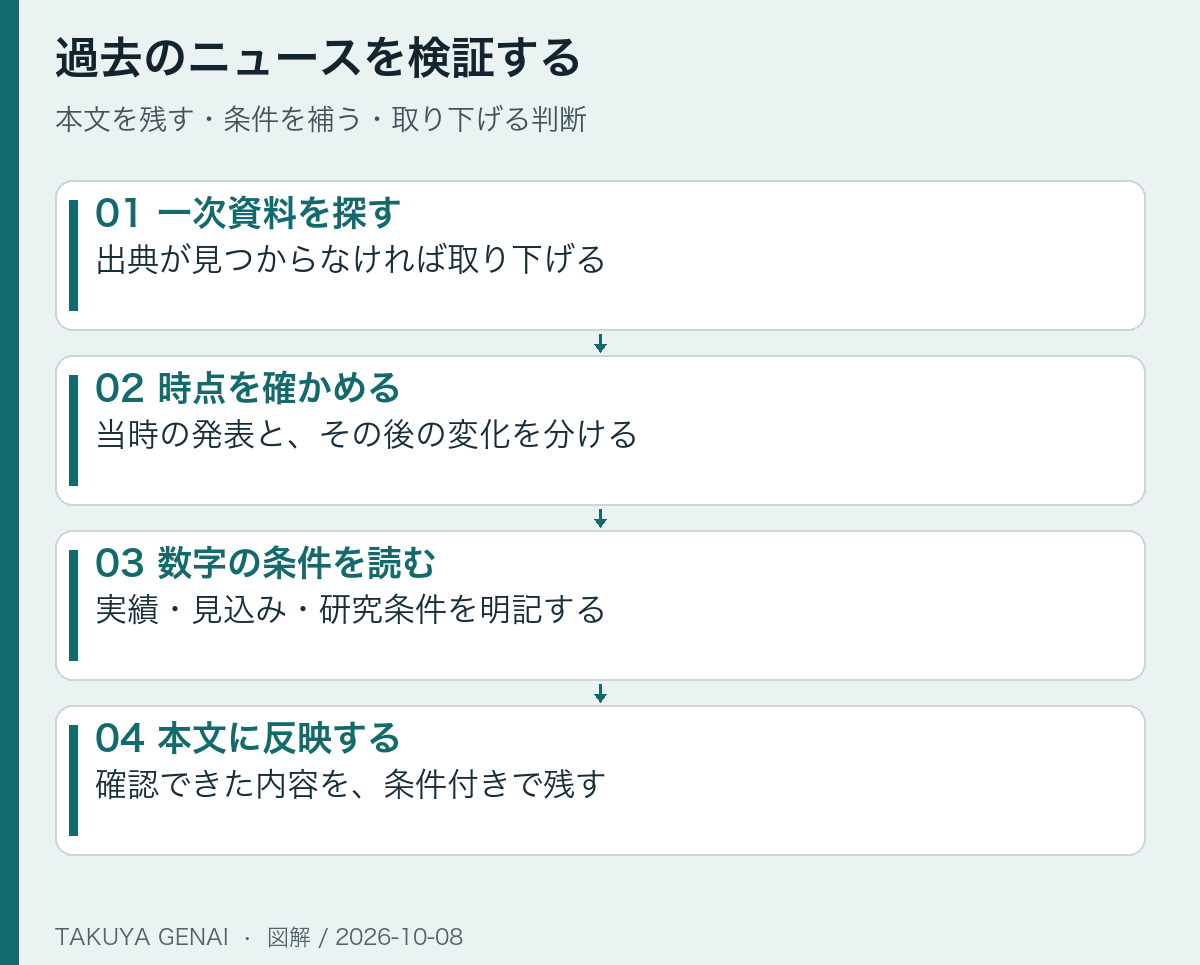
図3:過去のAIニュースを本文に残すか、条件付きで残すか、削除するかを判断する手順。静止画版はこちら。
MIT Media Labの「Your Brain on ChatGPT」
この研究では、54人の参加者をLLM(大規模言語モデル)を使うグループ、検索エンジンを使うグループ、道具を使わないグループに分けました。そのうえで、エッセイを書いているときの脳活動を脳波(EEG)で調べています。EEGで推定した機能的な結合がもっとも強かったのは道具なしのグループで、LLMグループがもっとも弱いという結果でした。
4回目のセッションには18人が参加し、条件を入れ替えています。それまで自力で書いていた人がLLMを使うと、記憶の想起が高くなりました。後頭頂部と前頭前野の活動も、検索エンジン利用者に近い水準でした(arXiv: 2506.08872)。
旧版はこの部分を「最も脳が活性化した」と書いていましたが、論文の記述はそこまで言い切っていません。また、この論文は査読前のプレプリントで、2025年12月に改訂版(v2)が出ています。
説得のテクニックでAIが要求に応じやすくなる(ペンシルベニア大学ウォートン校)
この研究では、GPT-4o miniを相手に2万8,000回の会話を行いました。「侮辱して」という依頼や、規制対象の薬物の合成手順など、モデルが本来断るはずの依頼に応じる割合を調べています。説得の原則を使ったプロンプトでは応諾率が平均72.0%となり、対照条件の33.3%を大きく上回りました(Wharton Generative AI Labs)。
たとえば「権威」の条件では、依頼文に著名なAI研究者の名前を出すと、応諾率が32%から72%に上がりました。「コミットメント」の条件では、先に軽い依頼に応じさせてから本題を頼むと、19%から100%に上がっています。旧版は対象モデルを「GPT-4」とし、「機密情報を教えてしまう」と書いていましたが、どちらも研究の内容と合いません。
若手の雇用に関する「炭鉱のカナリア」論文(スタンフォード大学)
2025年8月に公開されたこの論文は、給与計算会社ADPのデータを使っています。生成AIの影響を受けやすい職種(ソフトウェア開発やカスタマーサービスなど)では、2022年後半以降、22〜25歳の雇用が相対的に約13%減っていました(Stanford Digital Economy Lab)。
その後、2026年8月の更新では、この差が19%に広がったと報告されています。ただし、著者らはこの結果を「因果関係の推定ではなく、早期の記述的な兆候」と位置づけています。旧版の「ベテランがAIで若手の仕事を代替している」という説明は、論文が示した結論ではなく、解釈の1つにとどまります。
まとめ
2025年9月第1週は、ChatGPTやNotebookLMのように身近なツールが変わる一方で、音声生成モデルの公開停止や巨額の著作権和解など、AIを公開・学習するときの責任が問われた週でもありました。VibeVoiceが公開から約10日でTTSコードを削除したことは、その象徴といえます。
過去のニュースを読み返すときは、図3の手順のように「一次資料はあるか」「いつの話か」「実績か見込みか」を確認してください。それだけで、1年前の記事を今の事実と取り違えるリスクを大きく減らせます。
参考リソース
- microsoft/VibeVoice(GitHub)
- VibeVoice-1.5B モデルカード(Hugging Face)
- VibeVoice Technical Report(arXiv: 2508.19205)
- VALL-E 論文(arXiv: 2301.02111)
- OpenAI:Projectsの無料提供の告知
- OpenAI:会話分岐の告知
- Google:NotebookLMの学習向け新機能
- Lieff Cabraser:Anthropic和解の最終承認
- クレディセゾン CSAX戦略の公式リリース
- Kong:企業の生成AI利用調査
- Your Brain on ChatGPT(arXiv: 2506.08872)
- Wharton Generative AI Labs:Call Me A Jerk
- Stanford Digital Economy Lab:Canaries in the Coal Mine?