はじめに
AIチャットボットに質問を送って、回答が表示されるまでの数秒間を「なんとなく待たされているな」と感じたことはないでしょうか。じつはあの待ち時間の何割かは、AIが回答の文章を書いている時間ではなく、「この質問はどういう種類のものか」「急ぎかどうか」といった回答の前段階の判断に使われています。
2026年9月15日に、TypeSafe AIというスタートアップが「Jev(ジェヴ)」という新しいAIモデルを早期アクセスとして公開しました。特徴は2つで、文章を書かずに判断だけを返すこと、そしてその判断が最大でも0.5秒程度で終わることです。
ただし「判断だけをするAI」と聞いても、AIを組み込んだアプリを作ったことがない方には、何がうれしいのか想像しにくいと思います。そこでこの記事では、次の3点を順に解説します。
- Jevが何をするモデルで、従来のAIと何が違うのか
- なぜ「判断だけ」を切り出したAIが求められていたのか(AIアプリの裏側の事情)
- 普段AIを使うだけの人にとって、Jevのような仕組みがどう関係してくるのか
想定読者は、ChatGPTやClaudeなどを仕事で使っている方、あるいはこれからAIチャットボットや業務自動化に関わる可能性のある方です。プログラミングの知識は前提にしていません。後半に実装の入り口として短いコード例を載せますが、読み飛ばしても記事の主旨は追えるようにしています。
まず、記事全体の「困りごと」と「解決後の姿」を1枚の図で示します。
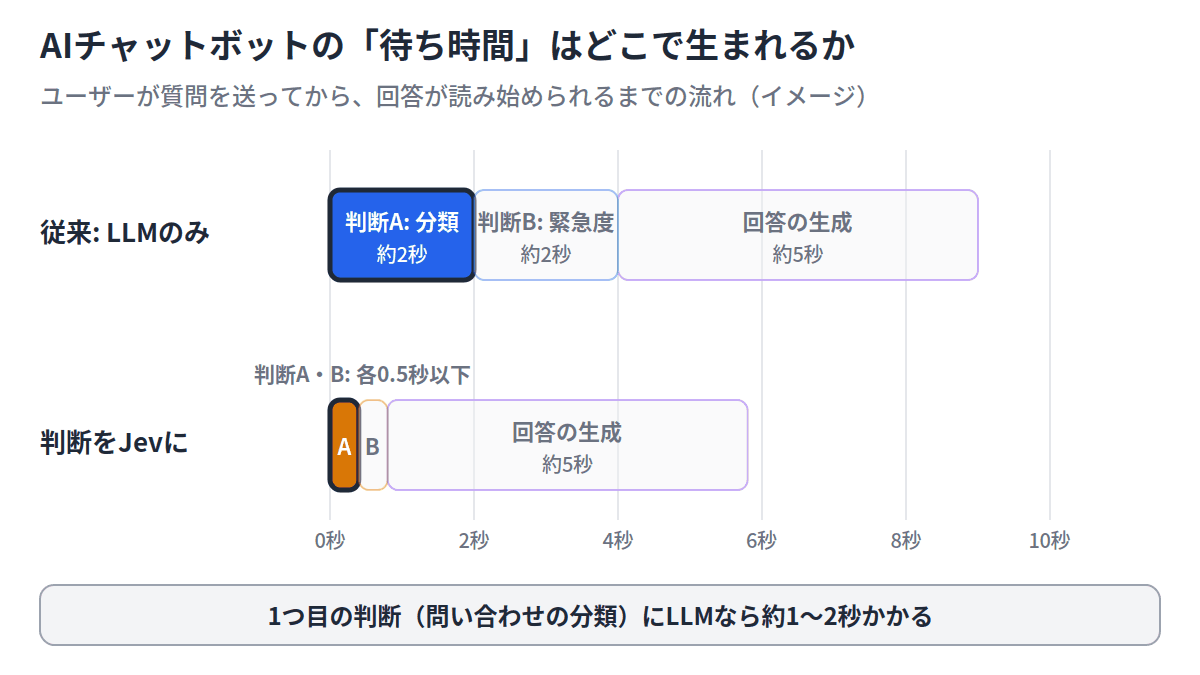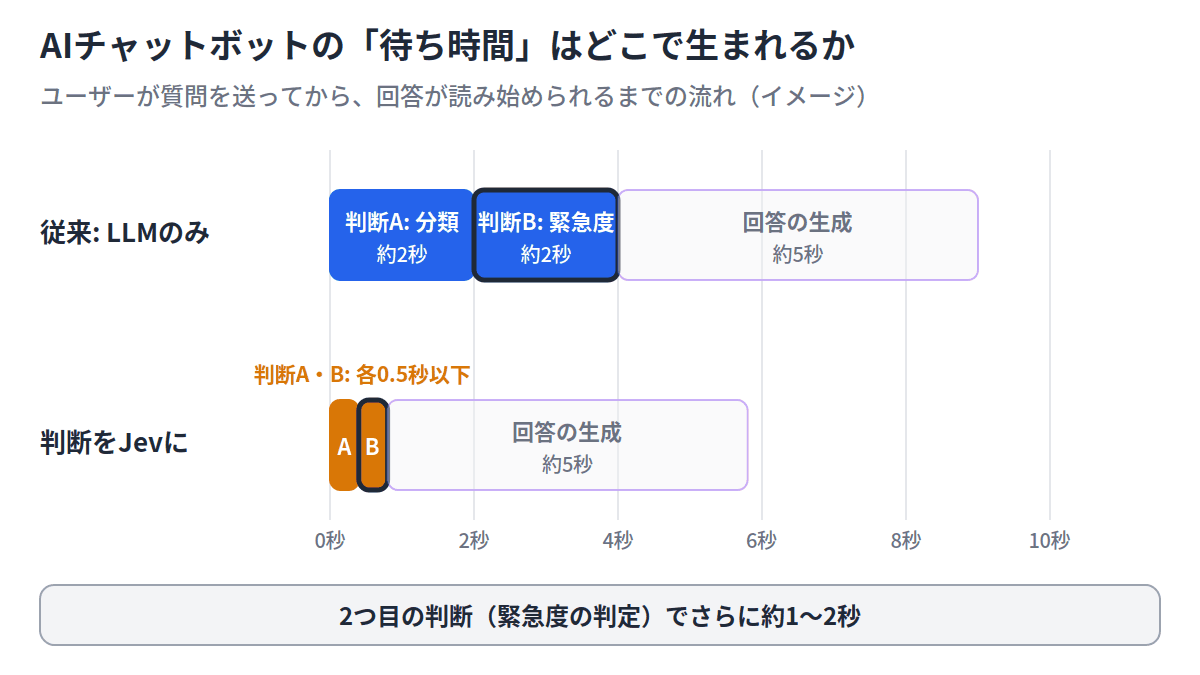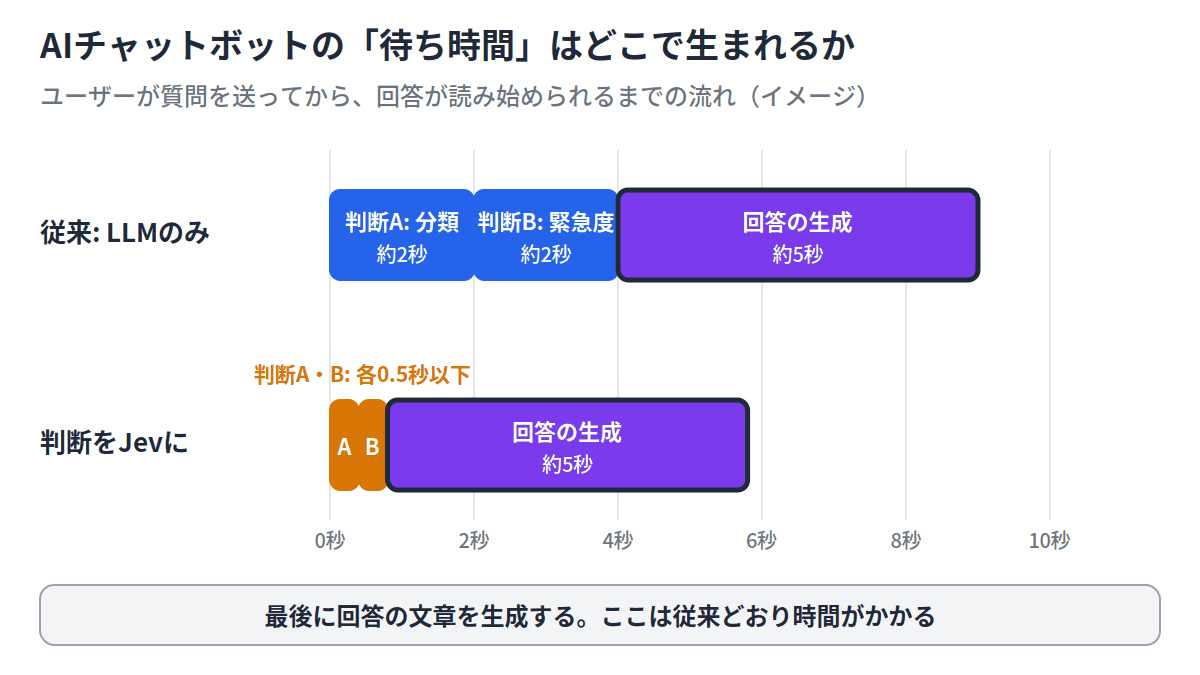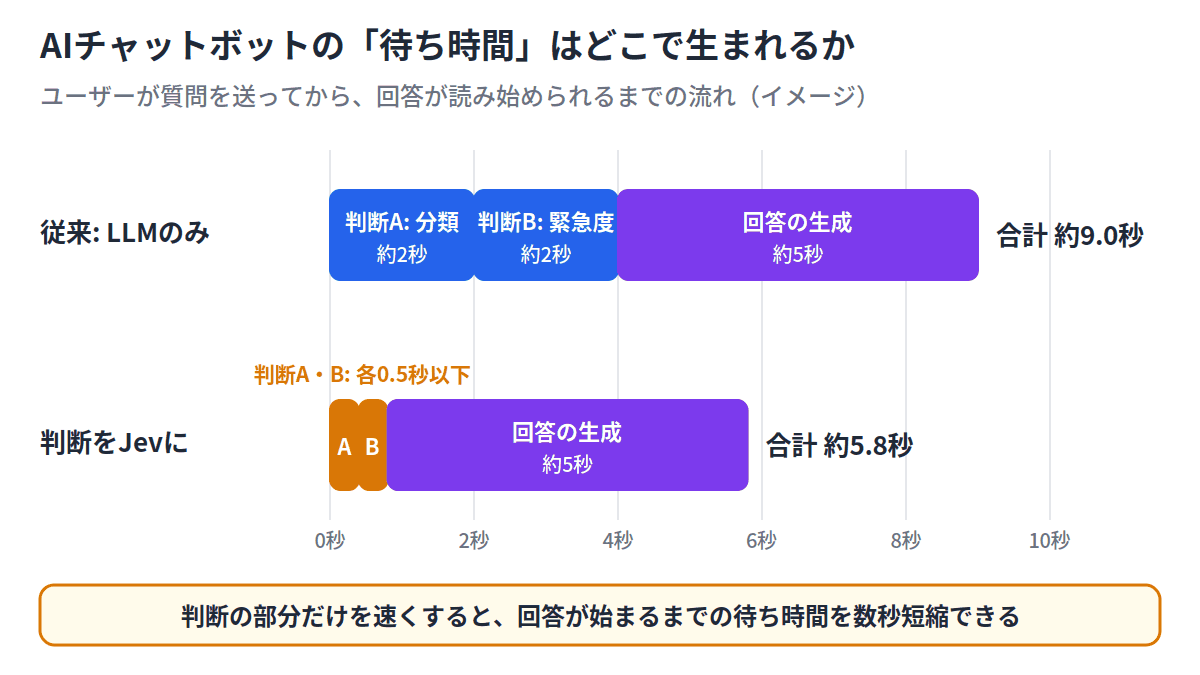
図1: 判断の工程だけを速くすると、回答が読み始められるまでの待ち時間を数秒短縮できます(数値は説明用のイメージです)。
図の上段が従来の構成、下段が判断部分をJevに置き換えた構成です。回答の生成そのものは変わらないのに、合計の待ち時間が3秒以上短くなっていることが分かります。この差がどこから来るのかを、これから見ていきます。
Jevとは何か — 文章を書かず、選択肢から選ぶAI
「System One(システム1)モデル」という新しい分類
Jevを開発したTypeSafe AIは、元OpenAIの研究者で、ChatGPTの土台になった学習手法(RLHF: 人間のフィードバックによる強化学習)の共同発明者でもあるDiogo Almeida氏が創業した会社です。同社はJevを「System One(システム1)モデル」と呼んでいます。
「システム1」は心理学者ダニエル・カーネマンの用語で、速くて直感的な思考を指します。対になる「システム2」は、じっくり考える遅い思考です。ChatGPTのような大規模言語モデル(LLM: Large Language Model)は文章を1文字ずつ書きながら考えるので、システム2に近い動きをします。TypeSafe AIの主張は、ソフトウェアの中で必要とされる判断の多くは「これはどの箱に入れる?」「これは急ぎ?」のようなシステム1の仕事なのに、これまではわざわざシステム2を借りてやらせていた、というものです。
文章を生成しない、という割り切り
Jevと従来のLLMの最大の違いは、Jevは文章をまったく生成しないことです。入力として「状況を表すデータ(state)」と「型が決まった質問」を受け取り、あらかじめ用意した選択肢の中から確率つきで答えを返します。
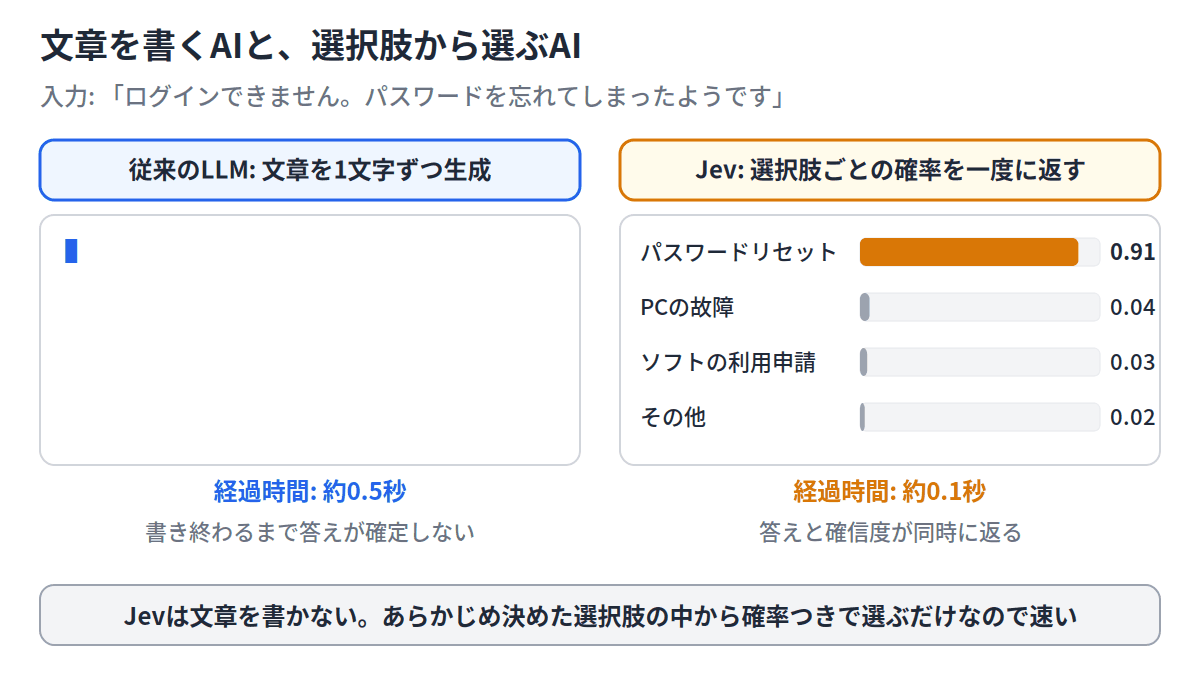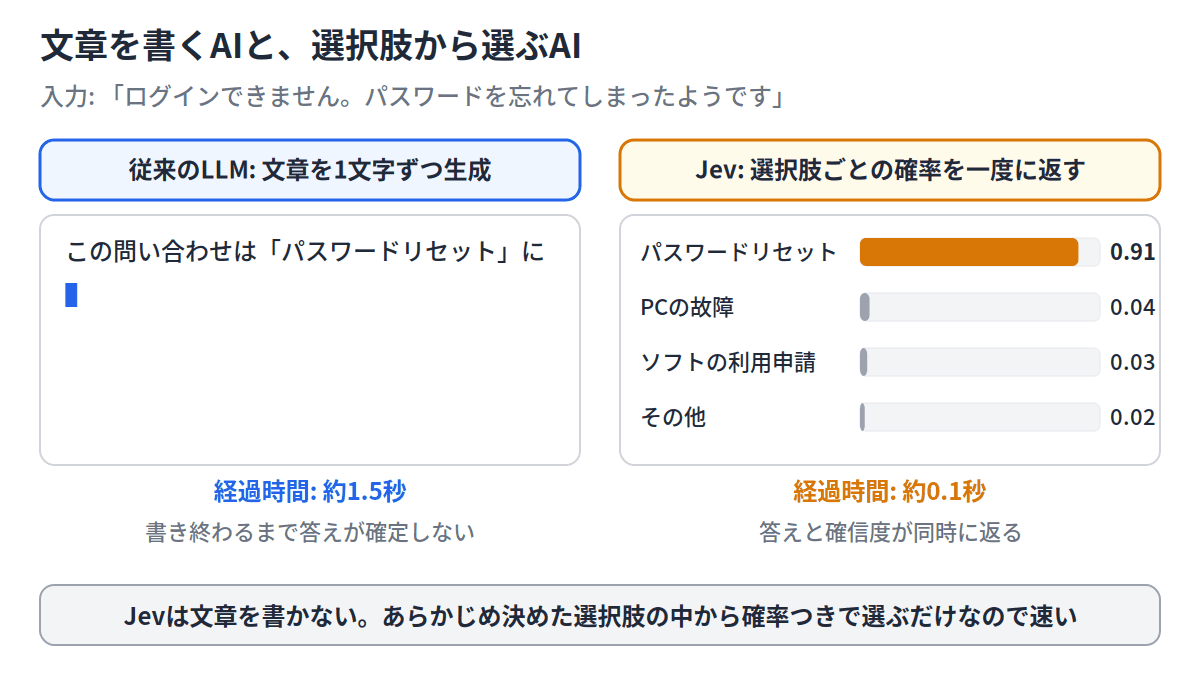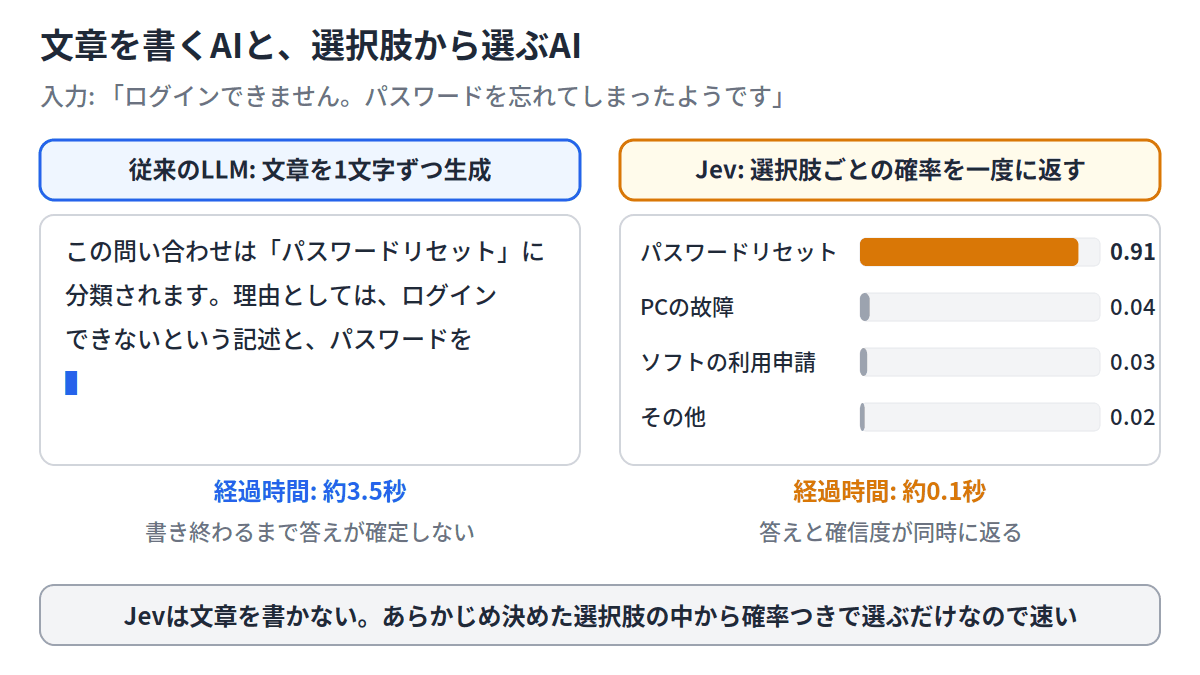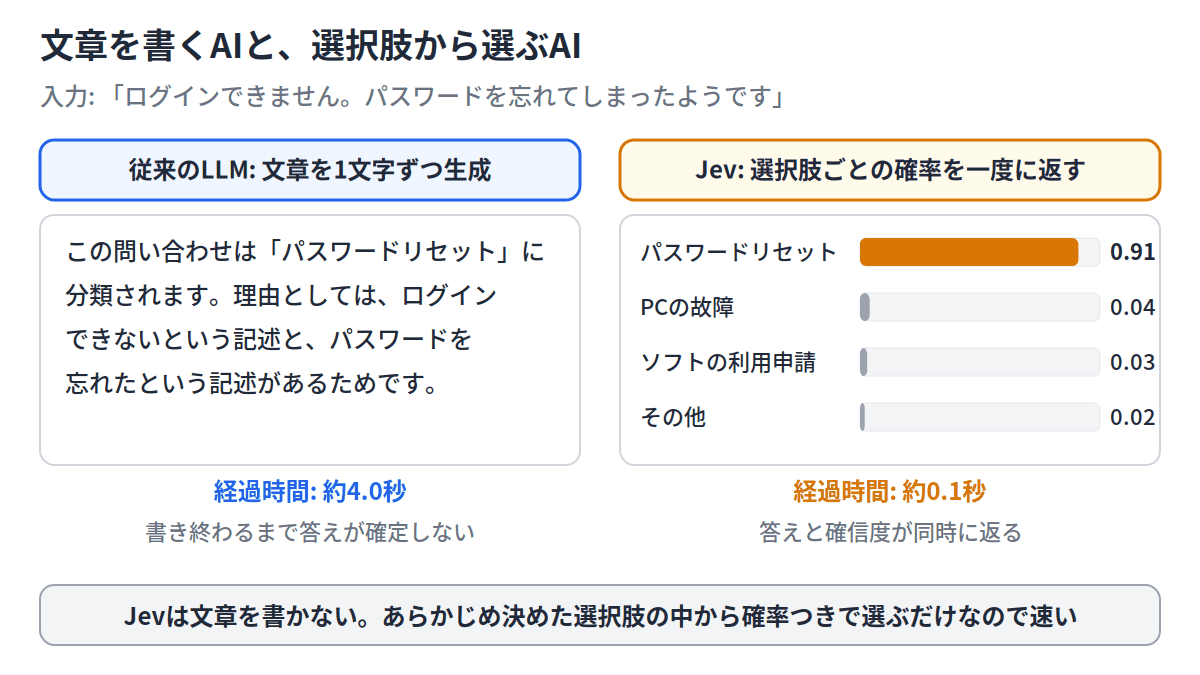
図2: 同じ問い合わせに対して、LLMは説明文を書き終わるまで答えが確定しません。Jevは選択肢ごとの確率を一度に返します。
図の左側は、従来のLLMに「この問い合わせを分類してください」と頼んだときの様子です。「この問い合わせは『パスワードリセット』に分類されます。理由としては……」と文章が書かれていき、書き終わるまで答えが確定しません。右側のJevは「パスワードリセット 0.91、PCの故障 0.04、……」のように、各選択肢の確率をまとめて返します。文字を順番に生成する工程がないので、応答が桁違いに速くなります。
公式ドキュメントでは、Jevの応答時間はおおむね70ミリ秒から500ミリ秒とされています。TypeSafe AIのデモページでは、同じ判断をJevが0.114秒、OpenAIのGPT-5.6 Terraが8.566秒で返した比較が掲載されています。
答えられる質問は3種類
Jevに投げられる質問の型は3つだけです。この3つで表現できない判断は、そもそもJevの守備範囲ではありません。
| 質問の型 | 答えの形 | 例 |
|---|---|---|
| Choice(選択) | 選択肢のうち1つ+各選択肢の確率+確信度 | 「この問い合わせはどの分類か(パスワード/PC故障/申請/その他)」 |
| Score(採点) | 2〜10段階の目盛り上の位置(段階の間の値も返る) | 「緊急度は5段階でどれか」 |
| Noul(はい/いいえ) | 「はい」である確率(0〜1) | 「この文章に個人情報が含まれるか」 |
Choiceは最大255個まで選択肢を渡せます。また、どの型でも**確信度(confidence)**という「自分の判断にどれくらい自信があるか」を示す数値が一緒に返ってきます。この確信度がJevの使い方を大きく左右するので、後ほど改めて取り上げます。
複数の質問を同時に処理できる
もう1つ重要な性質があります。Jevは1回の呼び出しに複数の質問を含められて、それらを並列に評価します。質問を1つ送っても3つ送っても、かかる時間はほとんど変わりません。
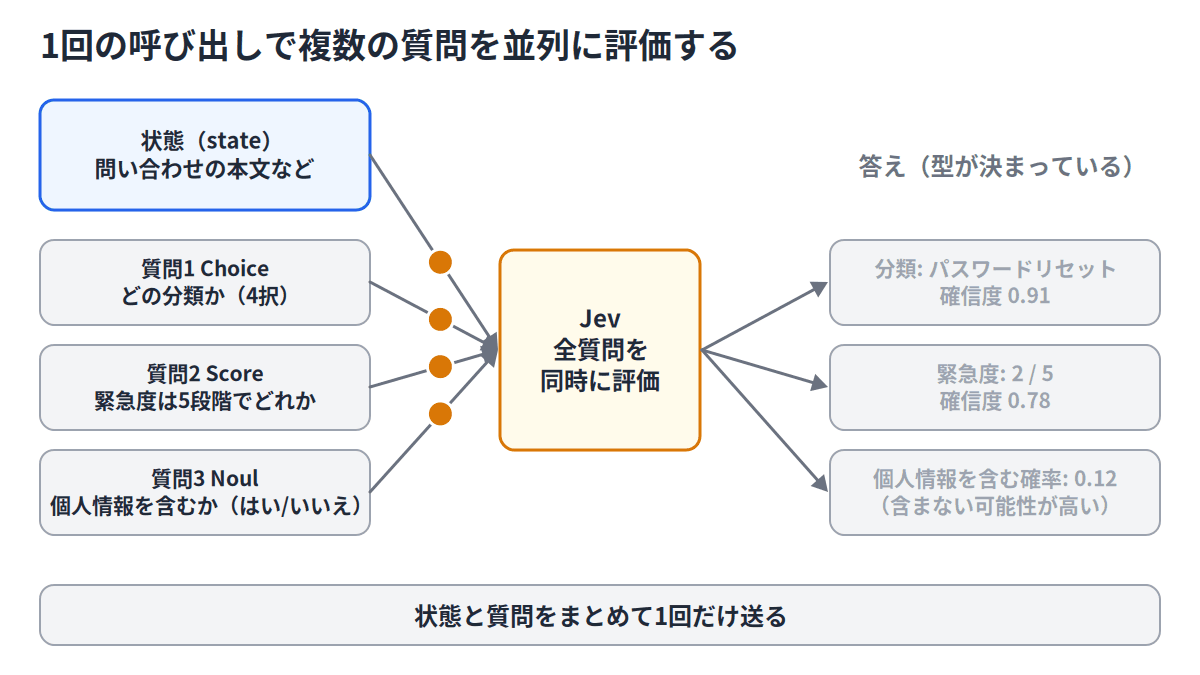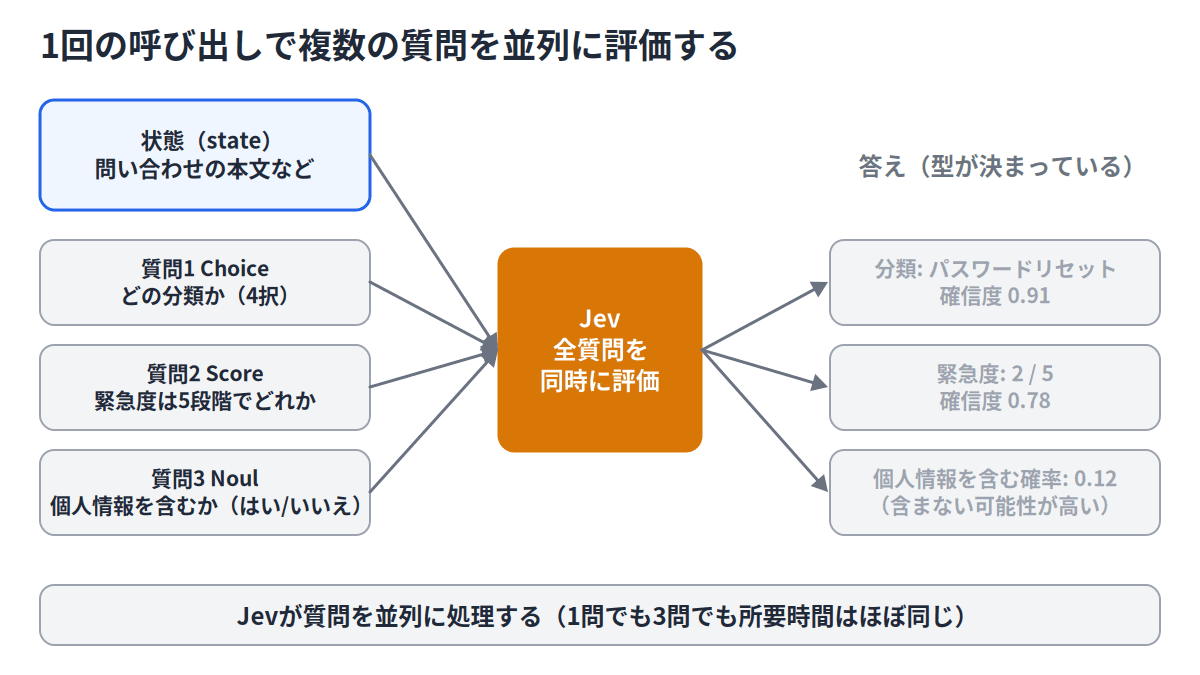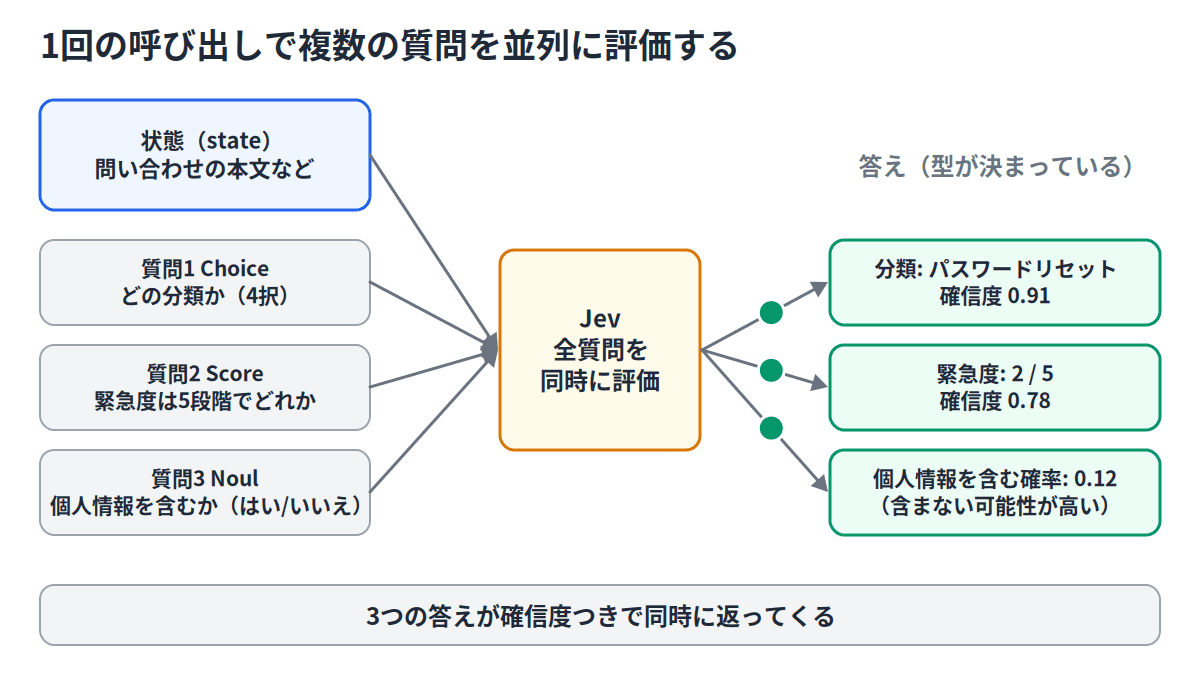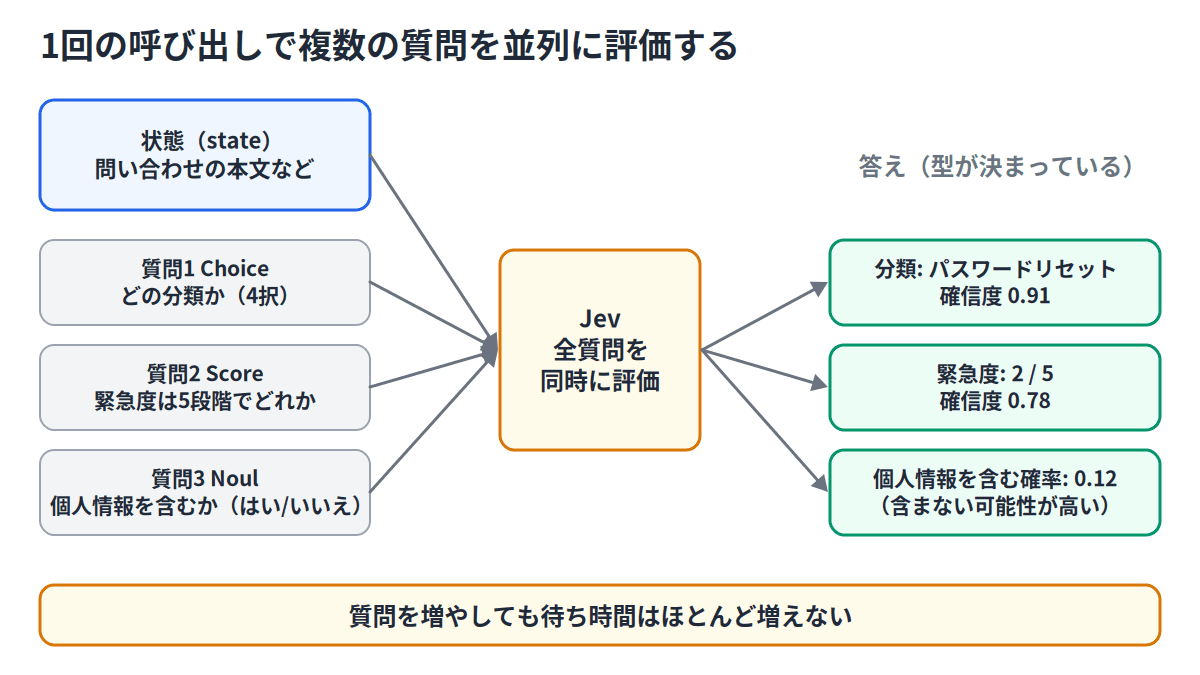
図3: 状態(問い合わせの本文など)と複数の質問を1回で送ると、Jevは全質問を同時に評価して答えを返します。
TypeSafe AIが公開しているサンプルでは、13個の質問を1回にまとめて送った場合と1問ずつ送った場合を比べて、まとめた方が約12倍安く約10倍速く、答えは同じだったと報告されています。「後で必要になるかもしれない判断は、とりあえず全部聞いておく」という設計が現実的になるわけです。
なぜ「判断だけ」のAIが求められたのか
ここからが本題です。判断だけなら、従来のLLMでもプロンプトで「次の4つのどれかで答えてください」と頼めばできます。それなのに、なぜ判断専用のモデルがわざわざ作られたのでしょうか。理由を理解するには、AIアプリが裏側でどう組み立てられているかを知る必要があります。
AIアプリは「判断」と「文章生成」を分けて作る
社内ヘルプデスクのAIチャットボットを例に考えます。「ログインできません。パスワードを忘れてしまったようです」という問い合わせが来たとき、素朴に考えれば、LLMに問い合わせ文をそのまま渡して回答を書かせればよさそうです。
しかし実際のAIアプリでは、まず「この問い合わせはパスワードリセット/PCの故障/ソフトの利用申請/その他のどれか」を判断させ、その結果に応じて処理を分岐させる、という2段階の構成をとることが多くあります。
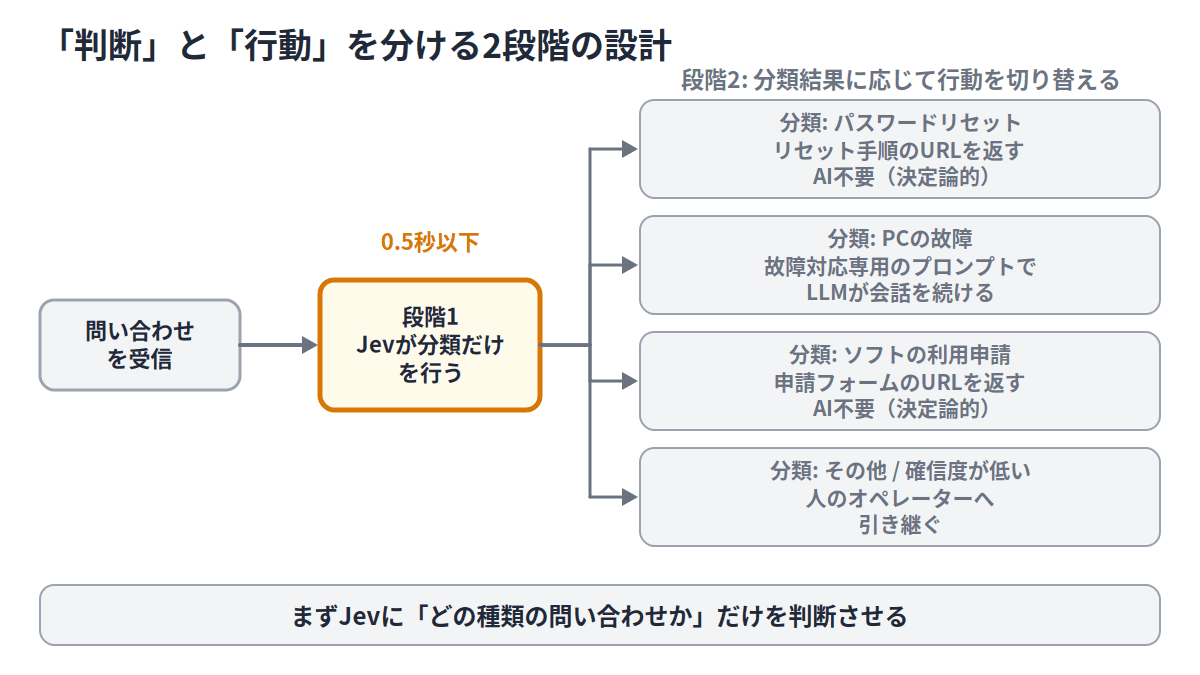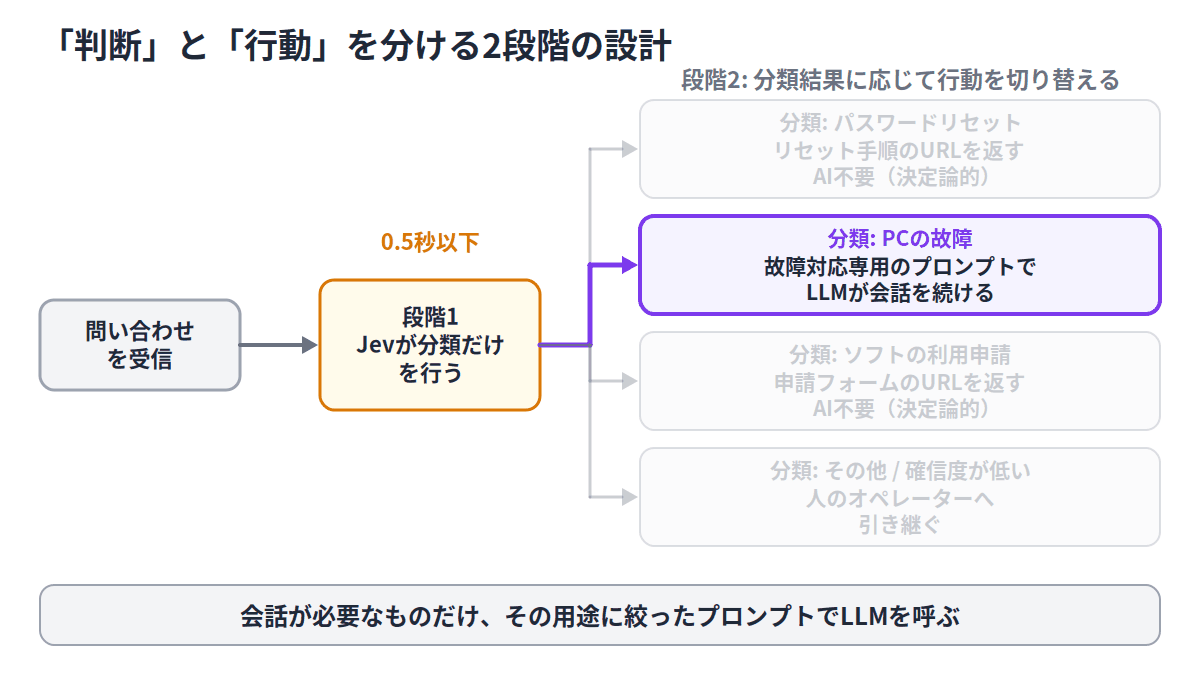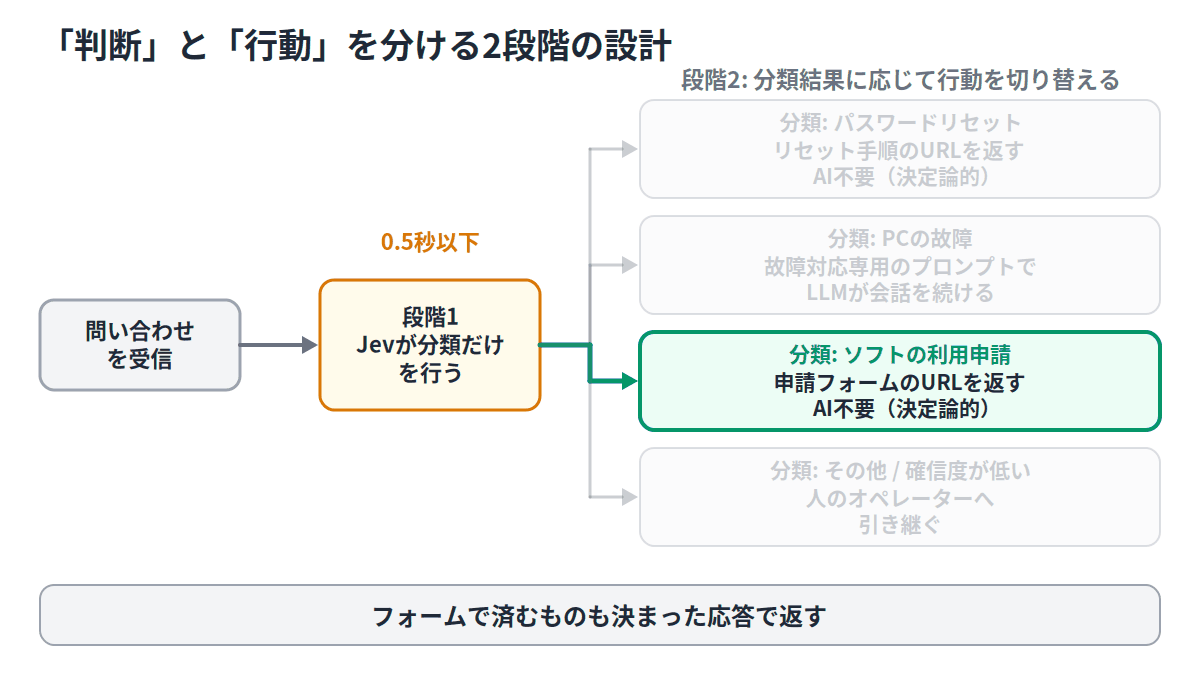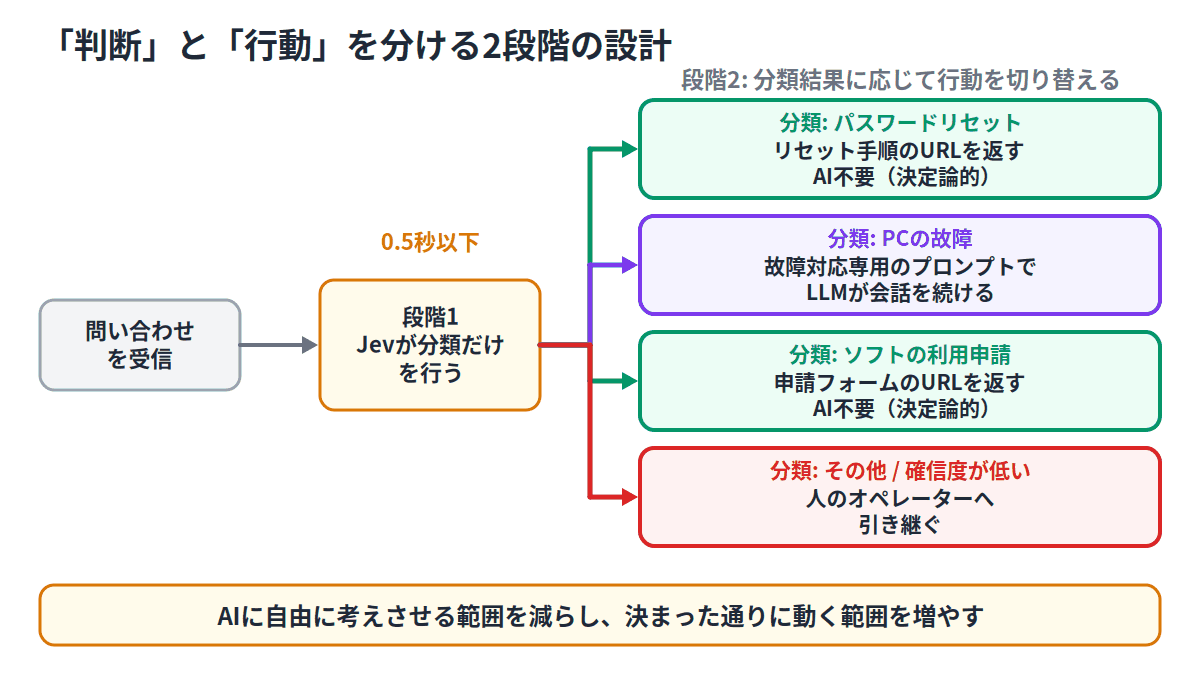
図4: 段階1で分類だけを行い、段階2で分類ごとに行動を切り替えます。決まった手順で済むものにはAIに文章を書かせません。
なぜ1回で済ませずに2段階にするのか。理由は「速度・コスト・品質のバランス」です。
- 速度: ユーザーと直接やりとりするAIには、長時間考えさせる余裕がありません。何十秒も考えるAIエージェントは開発作業には便利ですが、チャット画面でそれをやると利用者が離脱します。
- コスト: 利用者が増えるほどAIの呼び出し回数も増えるので、実際のプロダクトでは軽量で安価なモデルを使うことが多くなります。
- 品質: 軽量なモデルに「分類して、対応方針を決めて、回答も書いて」と全部まとめて頼むと、どこかでミスをしやすくなります。1回に考えさせることを1つに絞った方が、安定して正しい答えを出せます。
「決まった通りに動く部分」を増やすのが自動化のコツ
2段階に分けることには、もう1つ大事な効果があります。判断さえ済めば、AIに文章を書かせる必要すらないケースがあることです。
図4の「パスワードリセット」の分岐を見てください。分類が確定したら、あとは決まったリセット手順のURLを返すだけで済みます。ここにLLMは登場しません。同じ入力に対して毎回必ず同じ結果になる動き方を決定論的(deterministic)、LLMの文章生成のように毎回結果が変わりうる動き方を非決定論的と呼びます。AIで業務を自動化するときは、何でもAIに任せるのではなく、決定論的にできる部分をなるべく増やすことが、品質を安定させる基本方針になります。
Jevは、この「判断」の部分を専門に担当するモデルです。答えが選択肢の中から確率で返ってくるので、その後の処理はプログラムで確実に分岐できます。
それでも「判断」は遅かった
ここで1つ問題が残ります。判断だけを頼んでも、従来のLLMでは1回あたり1〜2秒程度はかかることが多い、ということです。
冒頭の図1をもう一度思い出してください。分類の判断に2秒、緊急度の判断に2秒、そこから回答を生成するとなると、利用者は回答が書かれ始めるまでに10秒近く待たされることになります。「精度を上げるために判断のステップを足したいけれど、足すと遅くなるから諦める」という判断が、これまでは日常的に起きていました。
Jevはこの問題にぴったり当てはまる解決策です。判断にかかっていた数秒が0.数秒になれば、細かい判断のステップを足すことをためらう理由がなくなります。そして料金は入力100万トークンあたり0.042ドル、出力は無料と公表されており、TypeSafe AI自身のベンチマークでは、判断タスクの正答率がGPT-5.6 Terraと同程度とされています(この数字の読み方には注意点があるので、後述します)。
確信度をどう使うか — 「自動化する範囲」を数値で決める
Jevが返す確信度は、単なるおまけではありません。Jevは「RLCD(Reinforcement Learning for Calibrated Decisions)」という学習手法で訓練されていて、これは「人間が好む答えを出す」ことではなく「確率が実際の正解率と一致する」ことを目標にした学習です。つまり、確信度0.9と返したときは実際に9割程度当たっている、という関係が成り立つように作られています。
この性質を使うと、「どこまで自動化して、どこから人に回すか」を数値で決められます。
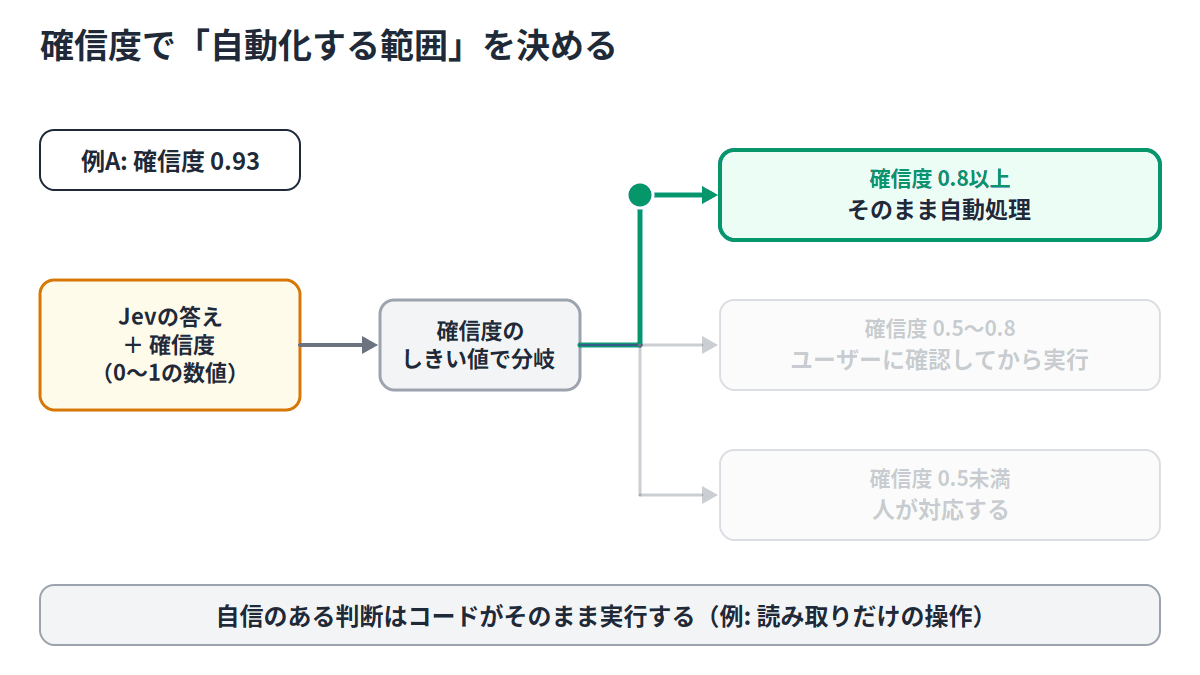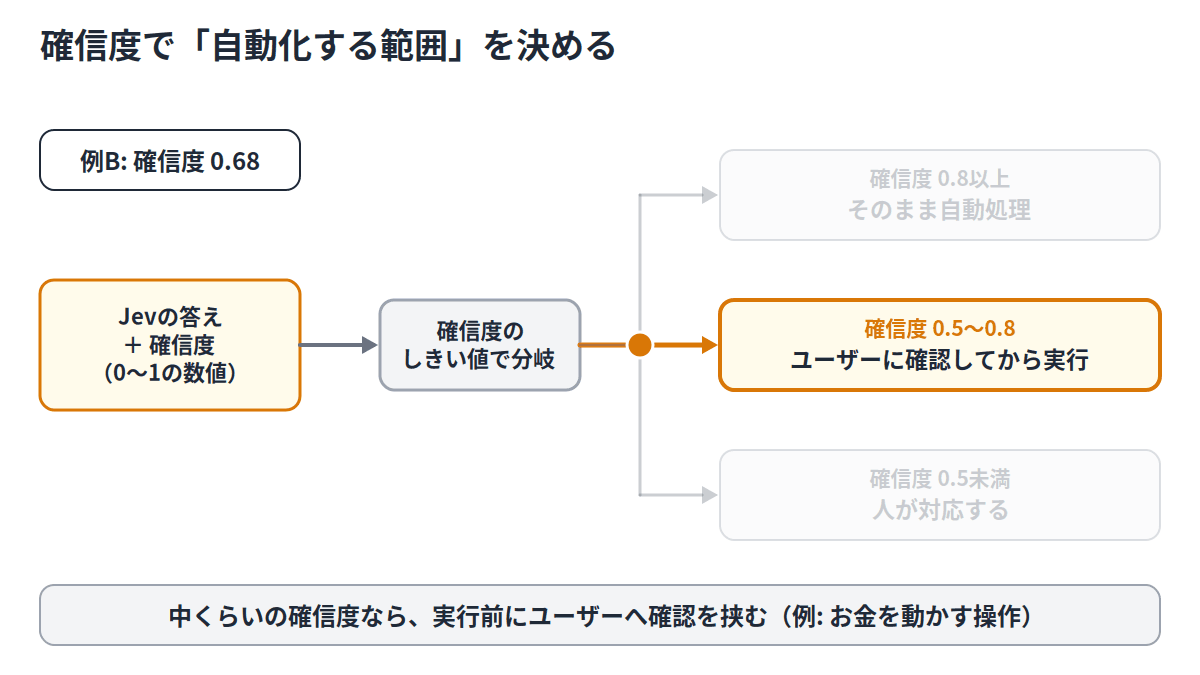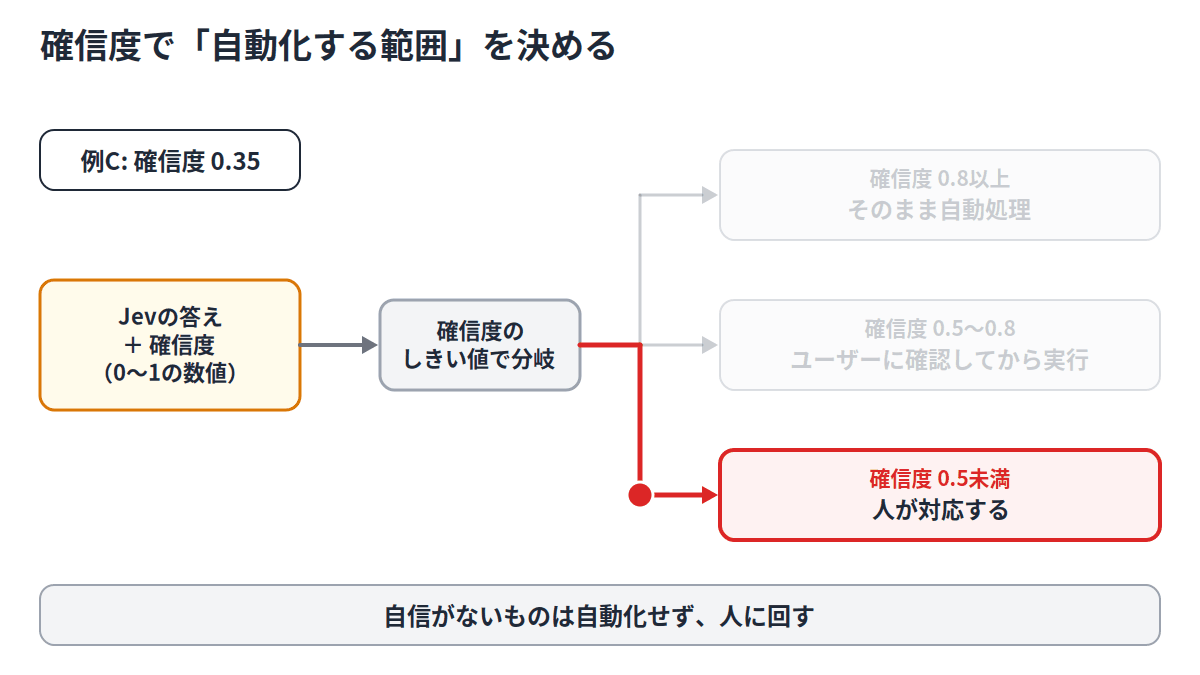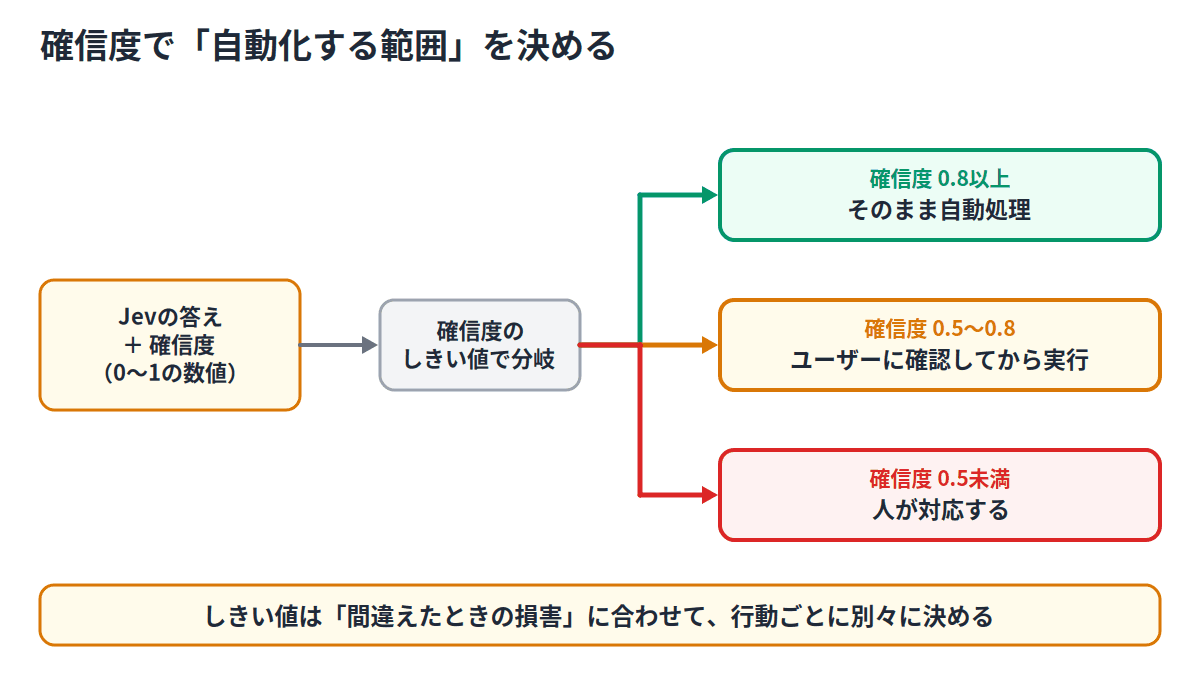
図5: 確信度のしきい値によって、自動処理・確認してから実行・人が対応、の3つに振り分けます。
ポイントは、しきい値を「間違えたときの損害」に合わせて行動ごとに別々に決めることです。残高を表示するだけの操作なら確信度が多少低くても自動で進めてよい一方、お金を動かす操作は高い確信度のときだけ自動実行し、それ以外は本人に確認を挟む、といった設計になります。AIに「ここから先は自信がないので人に聞く」という振る舞いを、プログラムのレベルで組み込めるわけです。
普段のAI利用にどう関係するのか — AIエージェントが速くなる
ここまでの話は、AIアプリを作る人にだけ関係があるように聞こえるかもしれません。しかし、Claude CodeやCodexのようなAIエージェントを日常的に使っている方にとっても、Jevのようなモデルは無関係ではありません。
AIエージェントはループで動いている
AIエージェントの動きを大まかに言うと、「情報を集める」「操作する」「結果を検証する」を繰り返しながら仕事を進めています。Jevはこのループの2か所に入り込めます。
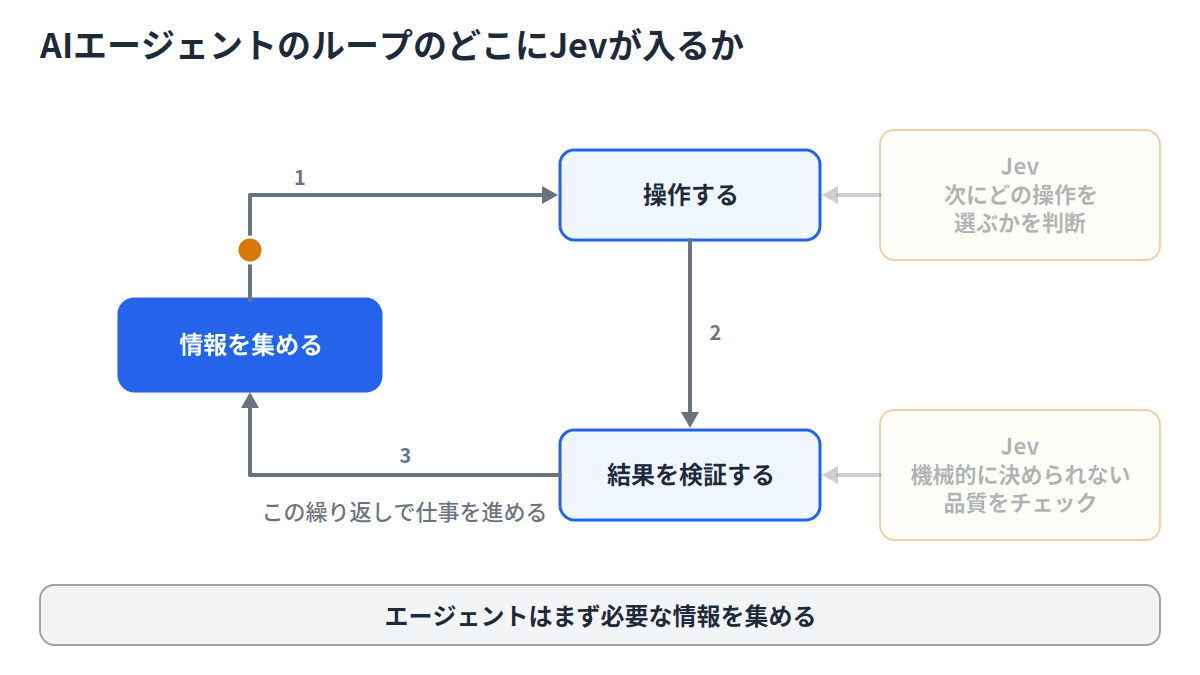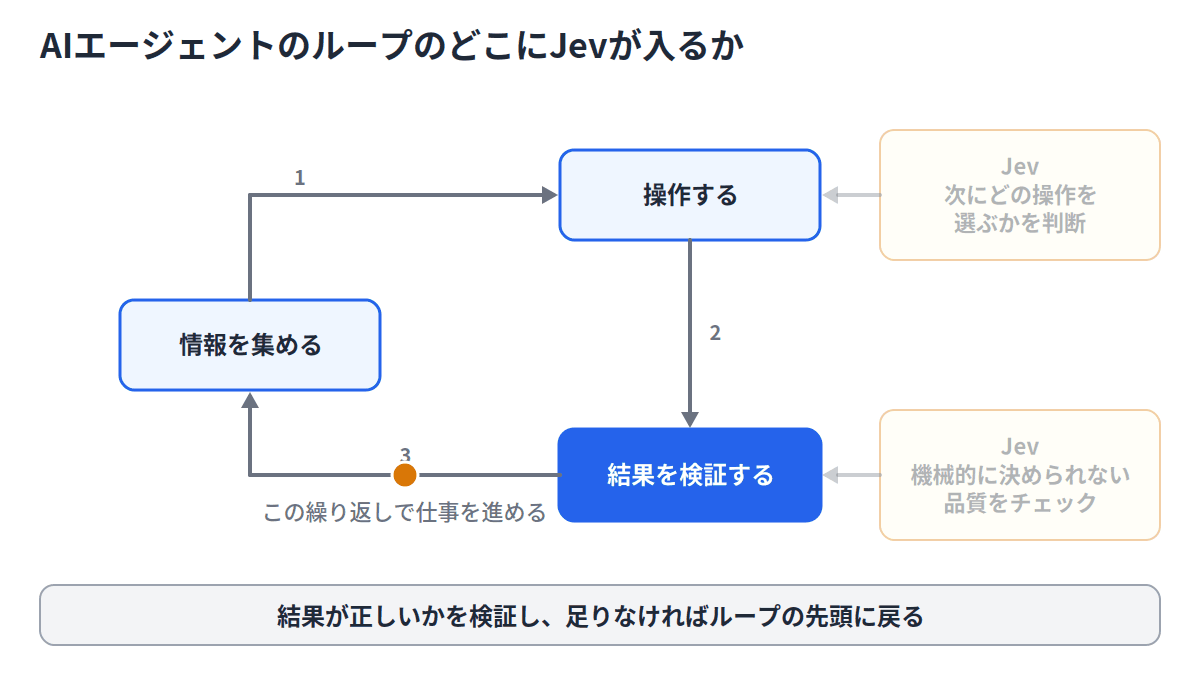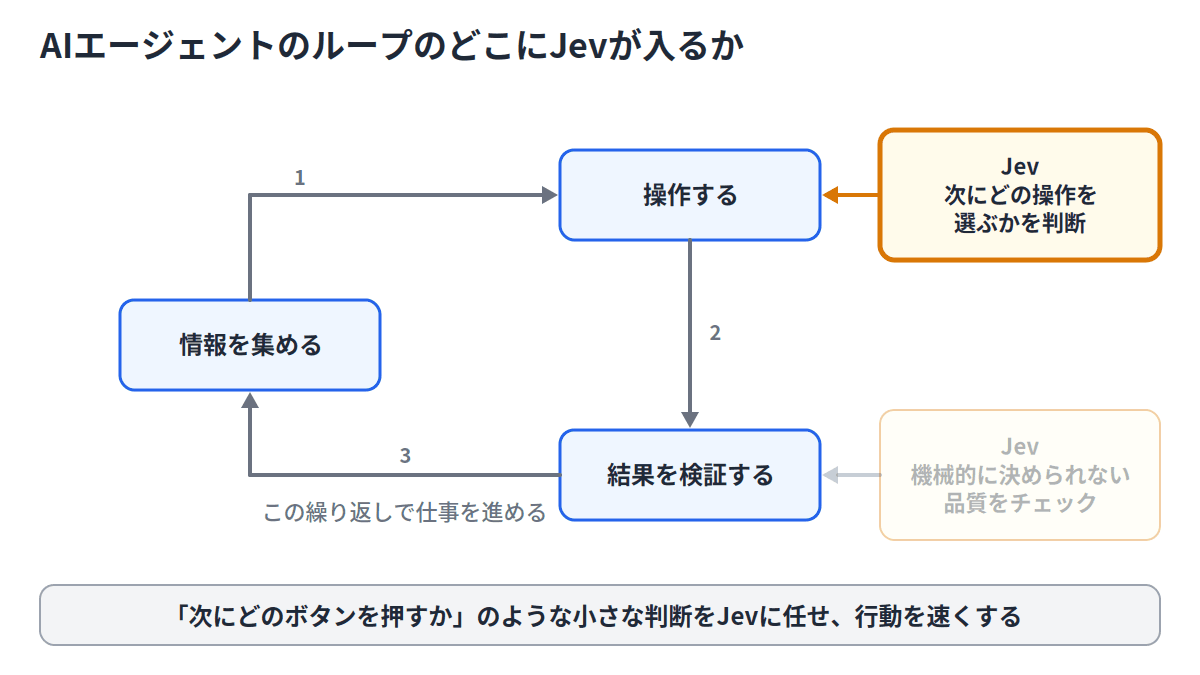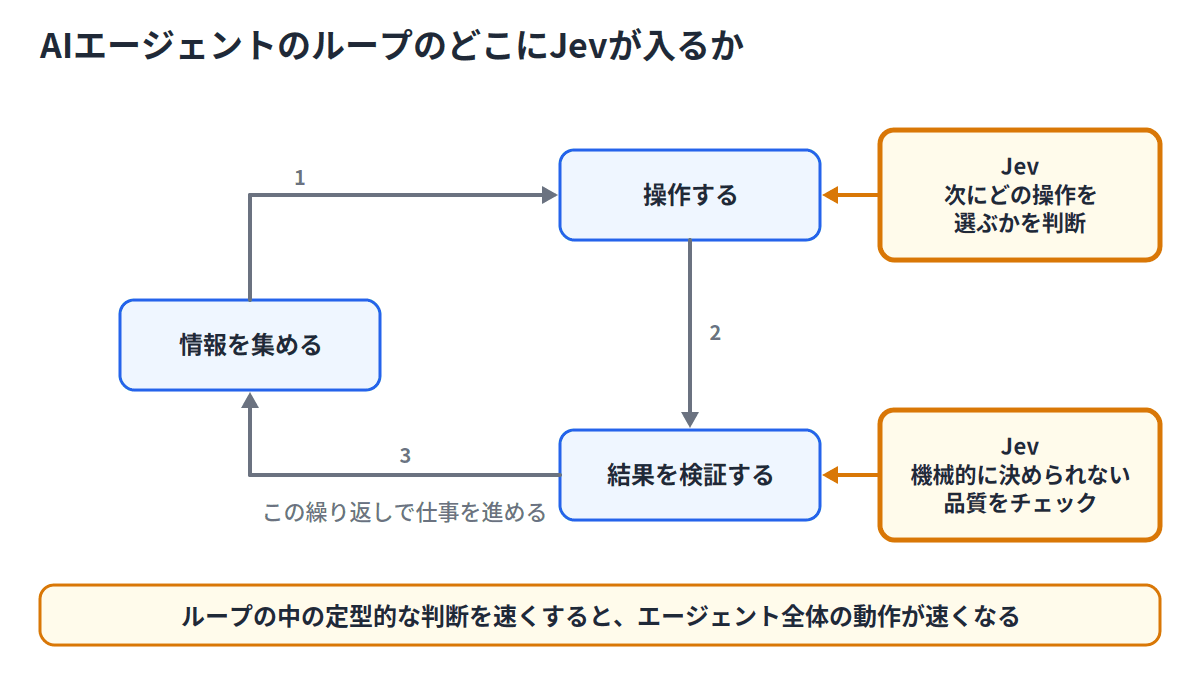
図6: ループ内の定型的な判断をJevに任せると、エージェント全体の動作が速くなります。
1つ目は検証の場面です。たとえばAIエージェントに週報の下書きを作らせるとします。「文字数が上限を超えていないか」「使ってはいけない表現が入っていないか」はプログラムで機械的にチェックできます。一方で「冒頭に結論が書かれているか」「専門用語が説明なしに使われていないか」のような判断は、機械的なルールにはしにくいものです。こうしたチェックをJevに任せ、引っかかった箇所だけをエージェントに直させる、という使い方が考えられます。エージェント自身にチェックさせると数十秒かかることもあるので、検証が何度も発生する場面では大きな高速化につながります。
2つ目は操作の場面です。AIによるブラウザ操作は「次にどのボタンを押すか」「どの入力欄に何を入れるか」という小さな判断の連続で、画面操作そのものはプログラムが担うので速いのに、判断のたびにLLMが考えるのがボトルネックでした。実際に、ブラウザ操作エージェントで知られるBrowser Useの開発者は、Jevを使って画面上の要素を番号つきの表に変換し、「どの操作を、どの要素に行うか」を1回の呼び出しで決めさせる構成を公開しています。この構成で、実際のGoogle Flightsでの航空券検索と選択を7.1秒、費用0.0039ドルで完了したと報告されています。
「賢い部分」と「決まった部分」の役割分担
Jev公開直後に作られた事例に共通しているのは、ループ処理・安全装置・計算はふつうのプログラムに任せ、プログラムでは書きにくい真ん中の狭い判断だけをJevにやらせるという設計です。たとえば自律ドローンの事例では、飛行制御や安全反射は高頻度で動くプログラムが担い、Jevは毎秒2〜3回の「戦術的な判断」を助言として返すだけ、という役割分担になっています。
現状では、Jevを使うには自分でAPIを呼ぶ仕組みを用意する必要があります。ただ、Jevと同じ思想のモデルは、今後ほかのAIベンダーからも出てくる可能性が高いと筆者は考えています。そうなれば、Claude CodeやCodexのようなエージェントが、内部でこの種のモデルを使って「気づいたら速くなっていた」という未来もありえます。
実際に触ってみる — 使い始めまでの流れ
Jevは記事執筆時点で早期アクセス(ウェイトリスト登録制)です。使い始めるまでの流れは次の通りです。
- TypeSafe AIの公式サイトからウェイトリストに登録します。
- 招待が届いたら、コンソール(console.typesafe.ai)でAPIキーを発行します。
- まずはWeb上の「プレイグラウンド」で、問い合わせ文と分類の選択肢を入力して動作を試します。ボタンを押した瞬間に分類結果と確信度が返ってくる感覚を掴めます。
- アプリに組み込む場合は、PythonまたはJavaScript/TypeScriptのSDKを使うか、
POST https://api.typesafe.ai/v1/systemoneのエンドポイントを直接呼びます。
Python SDKでの最小例
以下は公式ガイドの記法に基づく例です。筆者の環境ではAPIを実行して動作確認していないため、実際に使う際は公式ドキュメントの最新の記法を確認してください。
# Python 3.10以上を想定。任意の作業ディレクトリで実行する
pip install typesafe-sdk

# APIキーを環境変数に設定する(SDKが自動で読み込む)
export TYPESAFE_API_KEY="<YOUR_API_KEY>"
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()  # 環境変数 TYPESAFE_API_KEY を読み込む

# 判断させたい「状況」と、3種類の「質問」を1回でまとめて送る
response = client.system_one(
    state={
        "message": "ログインできません。パスワードを忘れてしまったようです。",
    },
    questions={
        "category": Choice(
            instructions="この問い合わせはどの種類か",
            criteria={
                "password_reset": "パスワードの再設定やログイン不可",
                "pc_failure": "PCやハードウェアの故障",
                "software_request": "ソフトウェアの利用申請",
                "other": "上記のどれにも当てはまらない",  # 逃げ道の選択肢を必ず用意する
            },
        ),
        "urgency": Score(
            instructions="対応の緊急度",
            criteria=["急がない", "今週中", "今日中", "いますぐ"],
        ),
        "has_pii": Noul(instructions="本文に個人情報(氏名・電話番号など)が含まれている"),
    },
)

category = response.answers["category"]
print(category.choice, category.confidence)     # 例: password_reset 0.91
print(response.answers["urgency"].score)        # 例: 1.8(段階の間の値も返る)
print(response.answers["has_pii"].noul)         # 例: 0.12(「はい」の確率)

# 確信度でその後の処理を分岐する
if category.confidence < 0.5:
    print("人のオペレーターへ引き継ぐ")
elif category.choice == "password_reset":
    print("リセット手順のURLを返す")  # ここではAIに文章を書かせない
コードを読むと、Jevの使い方が「関数を呼んで型の決まった値を受け取る」という、ふつうのプログラミングと同じ形になっていることが分かります。文章をパースして答えを取り出す処理が要らないのが、開発者にとっての大きな利点です。
注意点 — Jevが苦手なこと、数字の読み方
Jevは万能ではありません。TypeSafe AI自身が「苦手なこと」を公開しているのは好感が持てる点なので、主なものを整理します。
| 苦手なこと | 内容 | 対処 |
|---|---|---|
| 文字通りに読む | 否定形や暗黙の条件は書いたとおりに解釈される | 「本当はこう聞きたかった」と思った内容を、そのまま質問文に書く |
| 数えられない | 個数のカウントは信頼できず、対象が大きいほど誤差が増える | プログラム側で繰り返し、1件ずつはい/いいえで聞く |
| 日付の前後関係 | 日付を文字列として扱うので、どちらが先か・期間内かの判定は不安定 | 日付の抽出だけJevに任せ、比較や計算はプログラムで行う |
| 情報が多いと精度が落ちる | 質問に関係ない情報で状態を埋めると正答率が下がる | 先にプログラムで絞り込んでから渡す |
| 入力を疑わない | 自分の分類を誘導するように書かれた文章で答えが動きうる | 利用者が自由に書いた文を渡すなら、誘導への対策は使う側で用意する |
| 文章を作らない | 要約・説明・コード生成はできない | 候補を別の手段で作り、Jevには選ばせる |
そして、公開されている数字を見るときの注意も3つあります。
- 「GPT-5.6 Terraと同等の正答率」の測り方: このベンチマークには人手で作った正解データがなく、GPT-6 AstraとClaude Fable 5.1の答えを平均した「合意ラベル」との一致率を測っています。つまり2つのフロンティアモデルとどれだけ意見が合うかを見ており、しかもTypeSafe AI自身が設計して実行したもので、第三者による再現はまだありません。自分の業務データで評価してから採用を決めるのが安全です。
- 「ハルシネーションしない」の意味: Jevはスキーマ(選択肢)の外の値を返すことはできませんが、正しい形式の間違った答えを返すことはあります。「形式が崩れない」と「必ず正しい」は別の話です。
- 価格の持続性: TypeSafe AIは現在の価格が補助的なものでないことを証明できないとしつつ、上がるよりは下がる方向を見込んでいると述べています。価格に依存した設計をするなら、この点は頭に入れておく必要があります。
その仕事はJev向きか — 判断の順番
ここまでの内容を踏まえて、「自分の仕事にJevのようなモデルが役立つか」を確認する順番を図にまとめました。
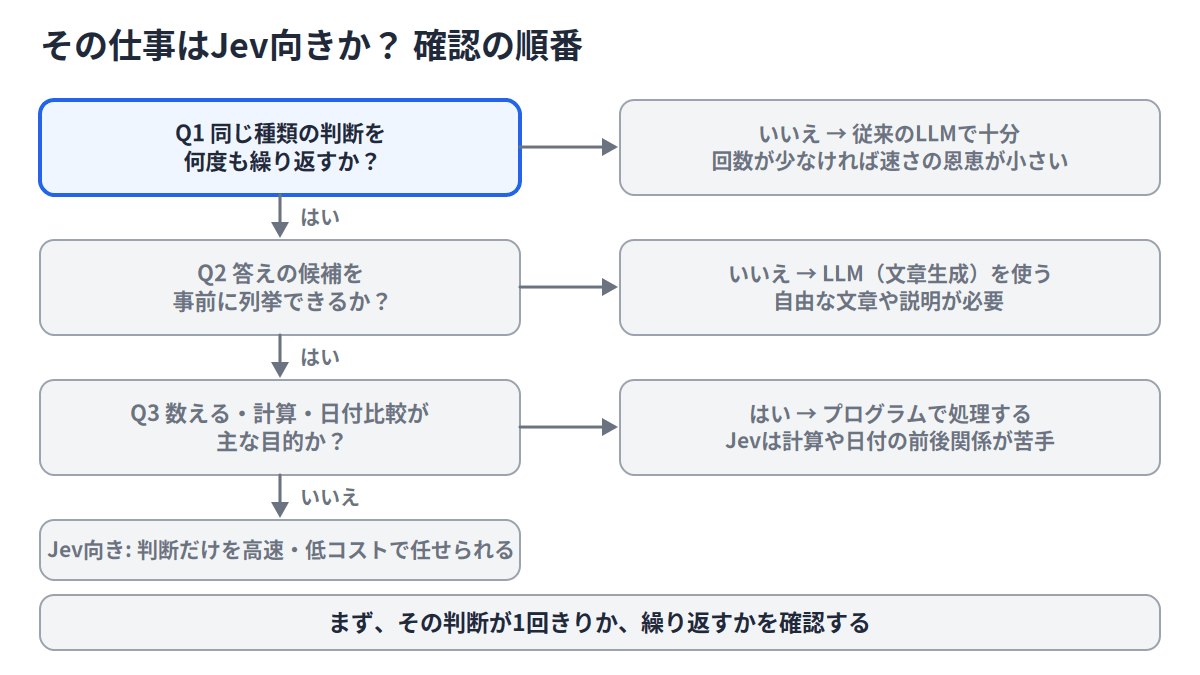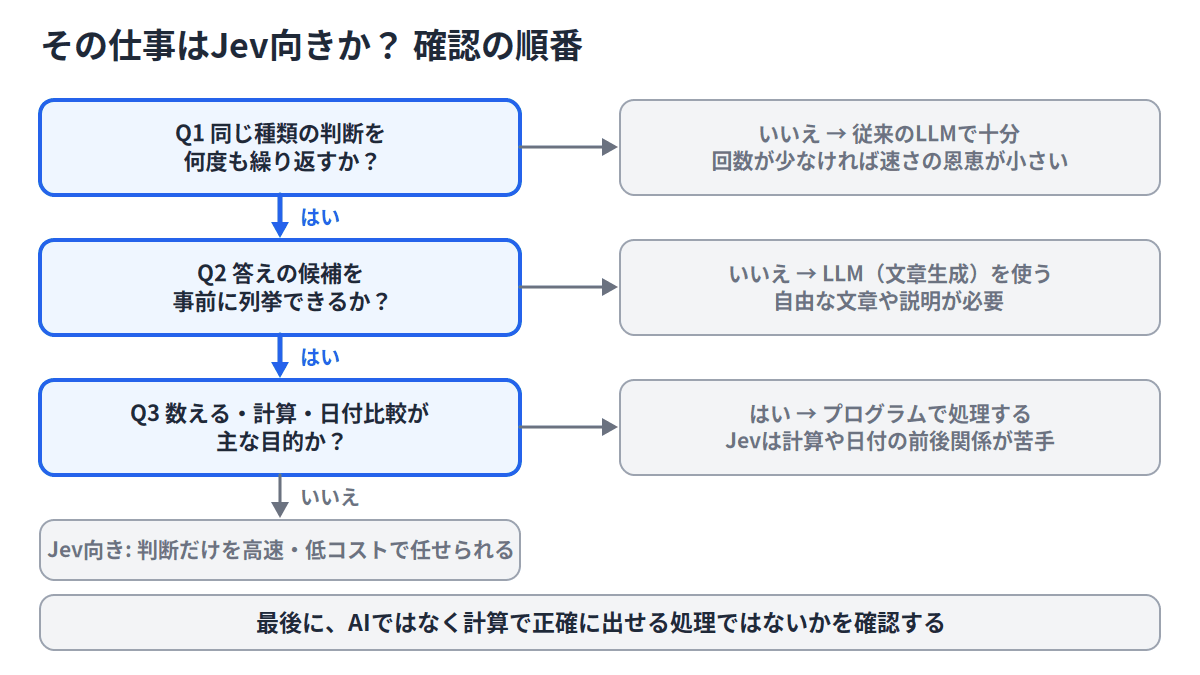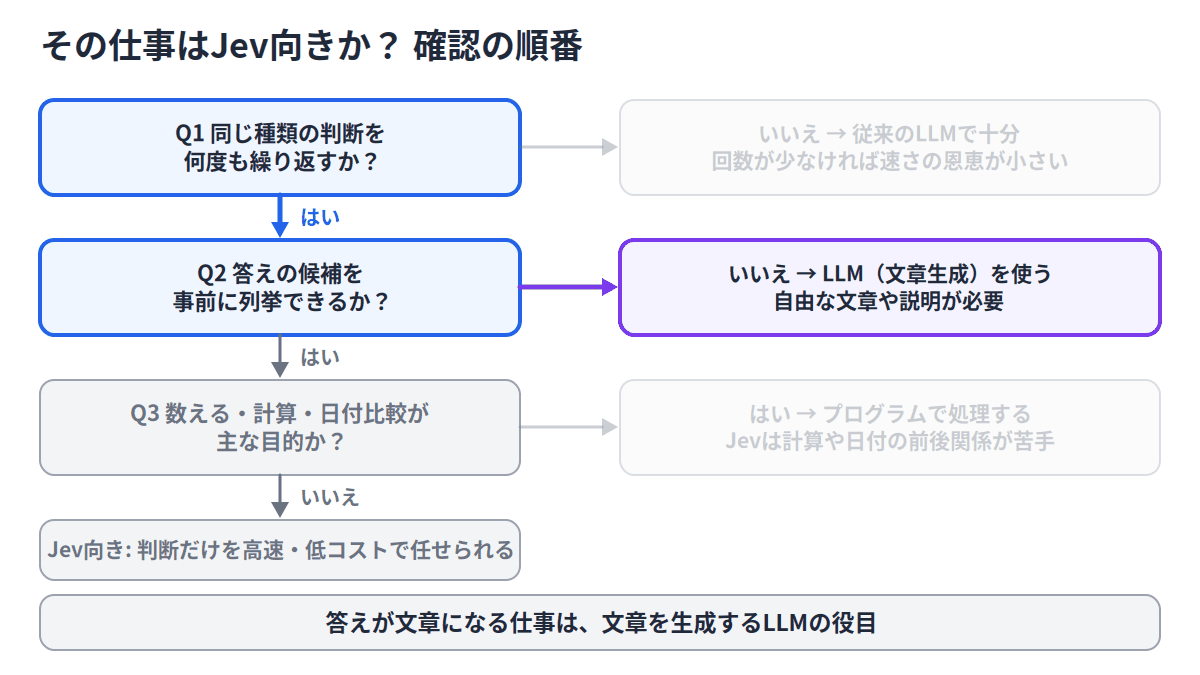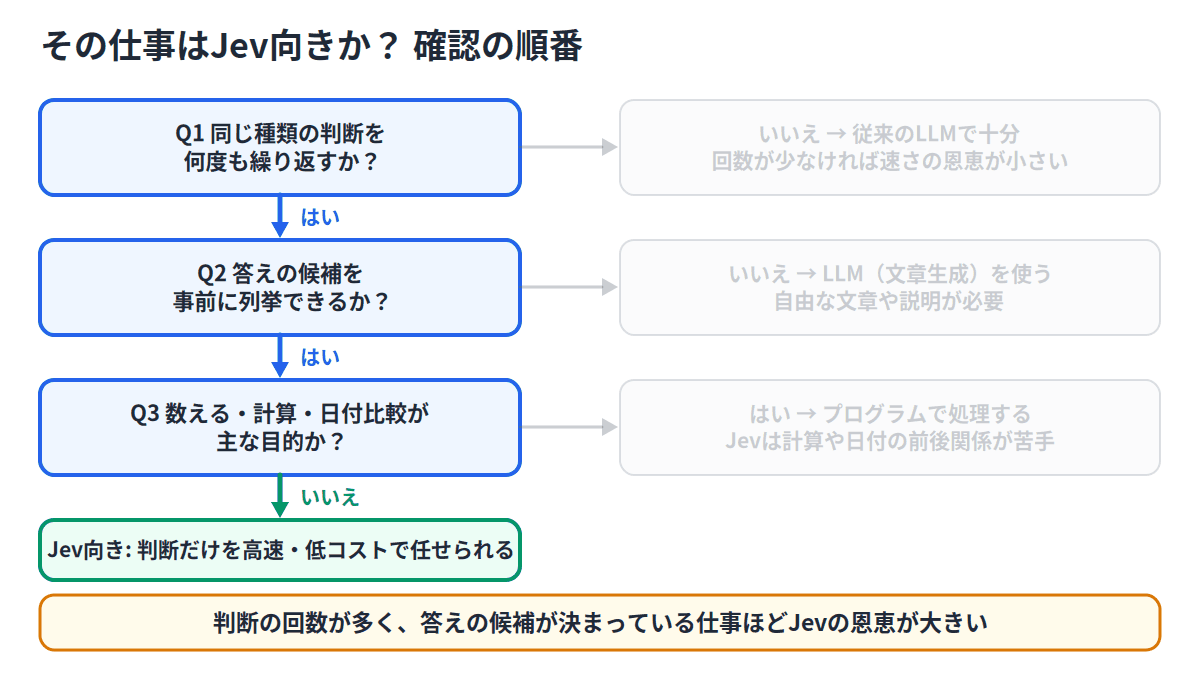
図7: 3つの質問を順に確認し、すべて通ればJevに任せる価値が高い仕事です。
最も重要なのは1つ目の「判断の回数が多いか」です。1回きりの判断なら、2秒が0.2秒になっても体感の差はほとんどありません。逆に、問い合わせの仕分け、大量の文書のタグ付け、エージェントのループ内の検証のように、同じ判断を何百回・何千回と繰り返す仕事ほど、速さと安さの恩恵が大きくなります。
もう1つ見落としがちなのが、「判断したら、その後の仕事で気にする範囲が減る」という効果です。分類が確定すれば、後段の処理はその分類に特化した狭い仕事になり、決定論的に組みやすくなります。これはJevを使うかどうかに関わらず、AIエージェントに思い通りの仕事をしてもらうための重要な発想です。
まとめ
この記事の要点を振り返ります。
- Jevは文章を生成せず、選択肢から確率つきで選ぶだけの「判断専用」AIモデルです。応答は最大でも0.5秒程度で、複数の質問を並列に処理できます。
- AIアプリは「判断」と「文章生成」を分けて作るのが定石で、判断が済めばAIに文章を書かせなくてよい場面も多くあります。決定論的に動く部分を増やすことが、自動化の品質を安定させます。
- これまでは「判断を足すと遅くなる」のが悩みでしたが、Jevはその判断の時間を桁違いに短くします。
- 確信度を使えば「どこまで自動化し、どこから人に回すか」を行動ごとに数値で決められます。
- AIエージェントのループ内の検証や操作選択にも使えるので、エージェントを使うだけの人にとっても、将来的に「気づいたら速くなっていた」という形で関係してきます。
- 苦手なこと(計算、日付、文章生成)と、公開されている数字の測り方には注意が必要です。
次のステップとしては、まず自分の業務の中で「同じ種類の判断を何度も繰り返している箇所」を棚卸ししてみることをおすすめします。速さの制約で諦めていた自動化が、判断専用モデルの登場で現実的になっているかもしれません。
参考リソース
- TypeSafe AI 公式サイト: https://typesafe.ai/
- TypeSafe AI ブログ「Introducing System One Models & Jev」: https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI ドキュメント(Introduction): https://docs.typesafe.ai/introduction
- LangChain ブログ「What Is Jev? A Guide to TypeSafe AI’s System One Model」: https://www.langchain.com/blog/building-a-harness-with-jev
- DEV Community「How to Use Jev: A practical guide to TypeSafe’s System One model」: https://dev.to/valyuai/how-to-use-jev-a-practical-guide-to-typesafes-system-one-model-g5e
- The Register「TypeSafe AI debuts model for machines that plays Doom」: https://www.theregister.com/ai-and-ml/2026/09/16/typesafe-ai-debuts-model-for-machines-that-plays-doom/5296711
- DataCamp「Jev: TypeSafe’s System One Model That Never Hallucinates」: https://www.datacamp.com/blog/system-one-models-jev
- 参考動画「爆速で”判断だけ”するAI『Jev』の何が重要なのかを理解する動画」: https://www.youtube.com/watch?v=qwYs8zgrBXE