はじめに
画像生成AIを仕事で使おうとすると、だいたい3つの壁にぶつかります。
- 1枚ごとにAPI料金がかかる
- 商品写真や社内資料をクラウドに送ってよいのか判断できない
- できあがった画像を商用で使ってよいのか分からない
「自分のPCで動くオープンなモデルがあれば全部解決するのでは」と考えて、2026年9月20日に公開された Qwen-Image-2.1 を手元のMacBook Pro(M5 Max、ユニファイドメモリ128GB)で動かし、OpenAIの最新モデル GPT-Image-2.5(ChatGPT Images 2.5)と同じプロンプトで比べました。
結論を先に書きます。
- 品質は一段下、ただし用途によっては十分です。日本語の文字描画と透過PNGは互角、人が多い構図と「雰囲気づくり」で差が出ました。
- 商用利用はライセンス上できません。公式リポジトリのLICENSE原文を読むと、許されているのは「研究または評価目的のみ」です。
想定読者は、「画像生成AIをローカルで試したいエンジニア」と「使ってよいかどうかを判断したい非エンジニアの方」の両方です。技術的な部分は読み飛ばしても、比較画像とライセンスの節だけで判断材料がそろうように書きました。
検証条件についての正直な注記 GPT側は当初、API(
gpt-image-2.5-flare/gpt-image-2.5-sunburst)で比較する予定でしたが、検証環境にOpenAIのAPIキーが無かったため、ChatGPT(Pro)のWeb版に搭載された「ChatGPT Images 2.5」 で生成しています。OpenAIの発表では、ChatGPTのImages 2.5とAPIの2モデルは同じ世代の改善を共有するとされていますが、FlareとSunburstの違いは本記事では検証できていません。また、ChatGPTはプロンプトを内部で書き換えてから画像モデルに渡すのに対し、Qwen側は公式のプロンプト書き換えモデルを使っていません。「モデル同士の純粋な比較」ではなく「ローカルのQwenと、誰でも使えるChatGPTの比較」として読んでください。
Qwen-Image-2.1とは何か
AlibabaのQwenチームが公開した、テキストからの画像生成と画像編集を1つのモデルに統合したオープンウェイトのモデルです。公式READMEによると、画像生成部分(Single-Stream DiT)は32層・70億パラメータで、次の4点を売りにしています。
- 軽くて速い: 7Bという小ささで、混合粒度のアテンションとprefix KVキャッシュにより計算量を抑える
- 透過画像をネイティブ生成: RGBA(アルファチャンネル付き)の画像を直接出力し、透過レイヤーの編集や写真からの被写体切り抜きもできる
- 編集が多機能: 参照画像を最大10枚渡せる。編集位置は丸で囲む・塗る・別マスクを渡すの3通りで指定でき、人物や商品の同一性を保つ
- 質感と文字: タイポグラフィ、ポートレートのライティング、細部の描写を改善
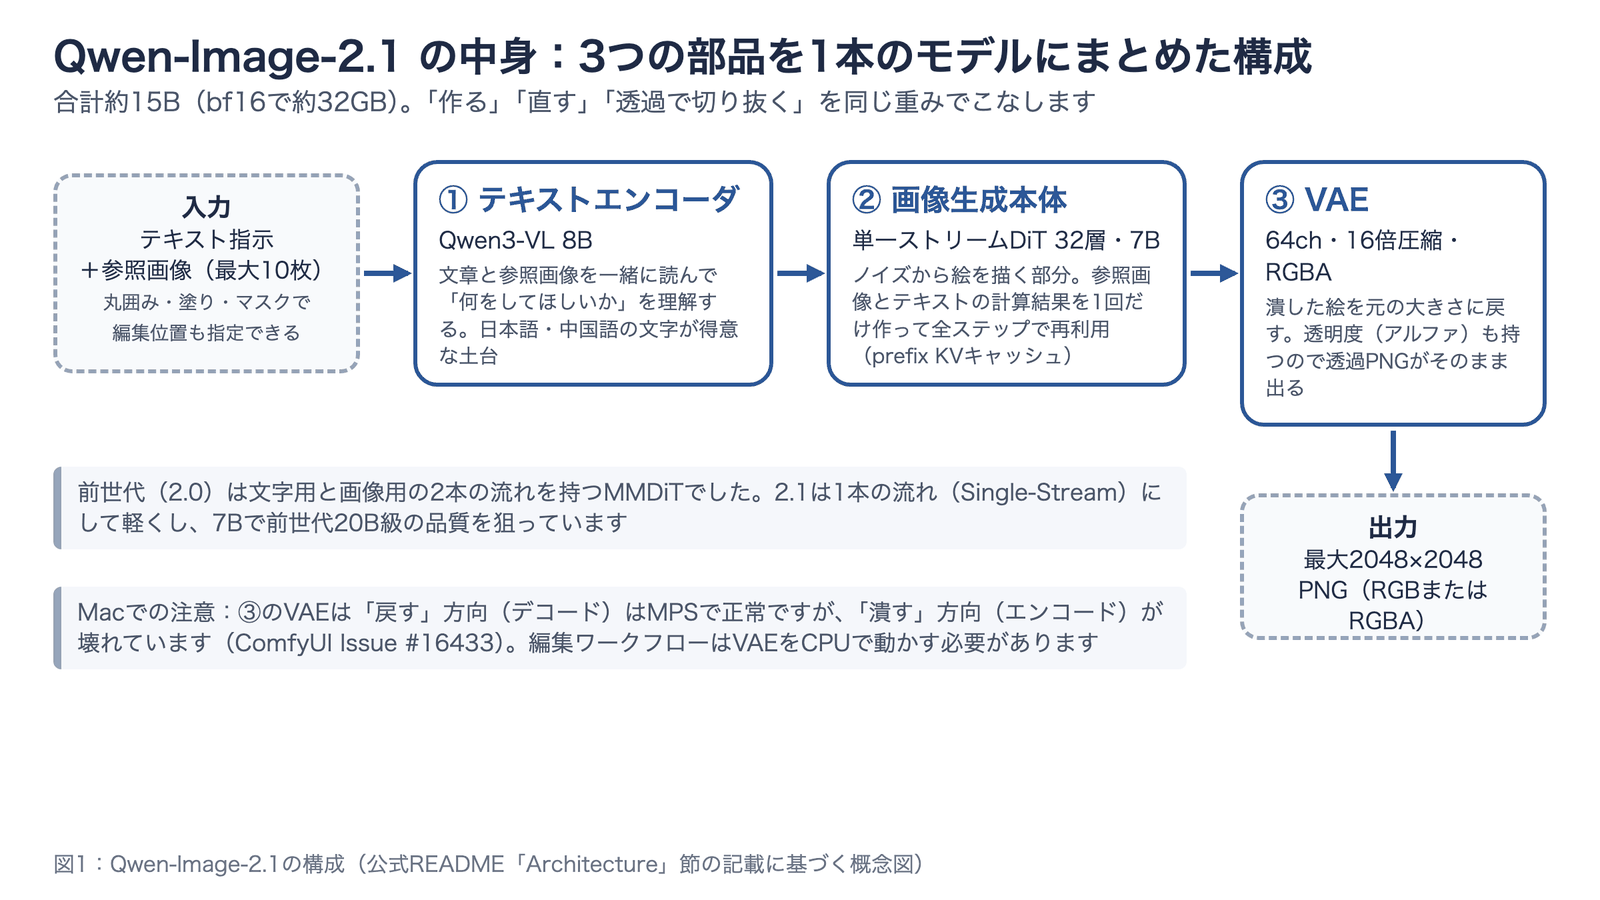
まず中身を図で押さえます。テキストを読む部品、絵を描く部品、絵を元の大きさに戻す部品の3つに分かれていて、それぞれの役割を順番に追ってください。
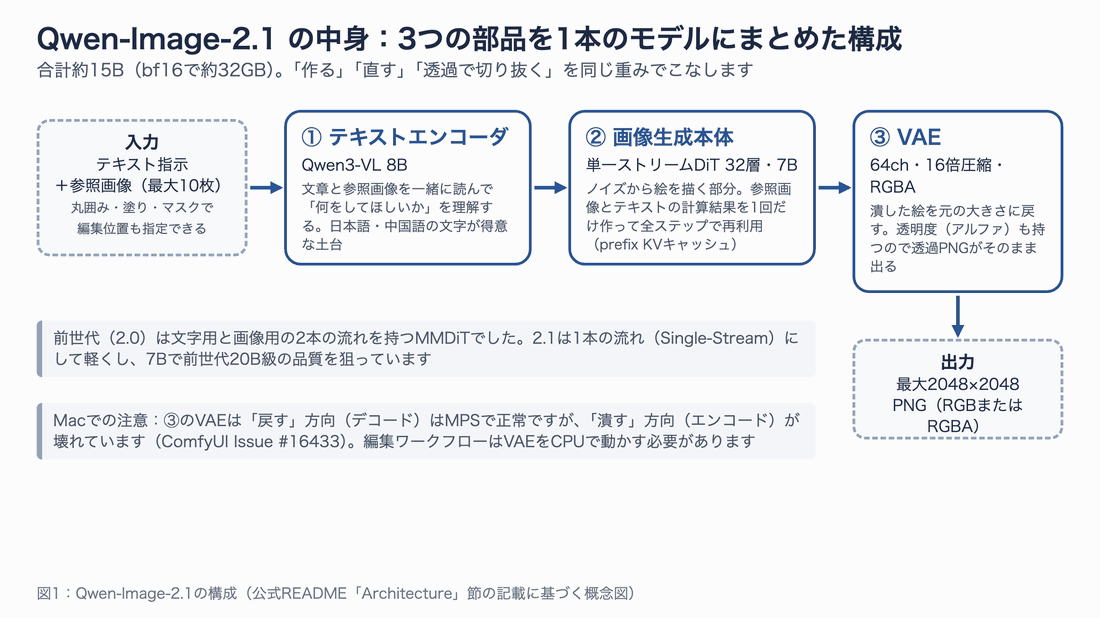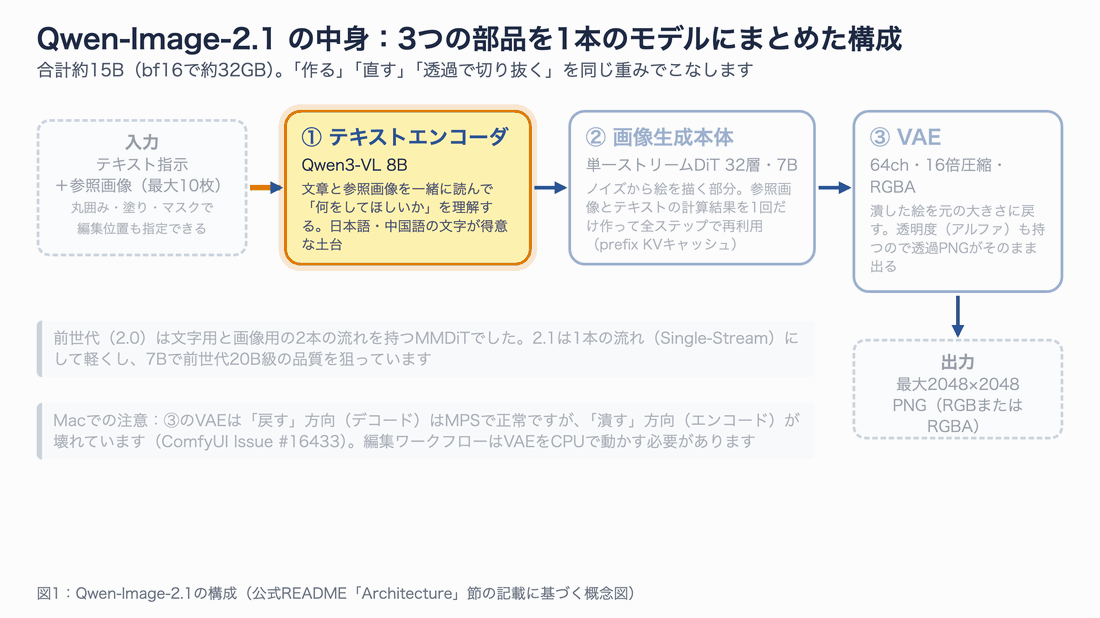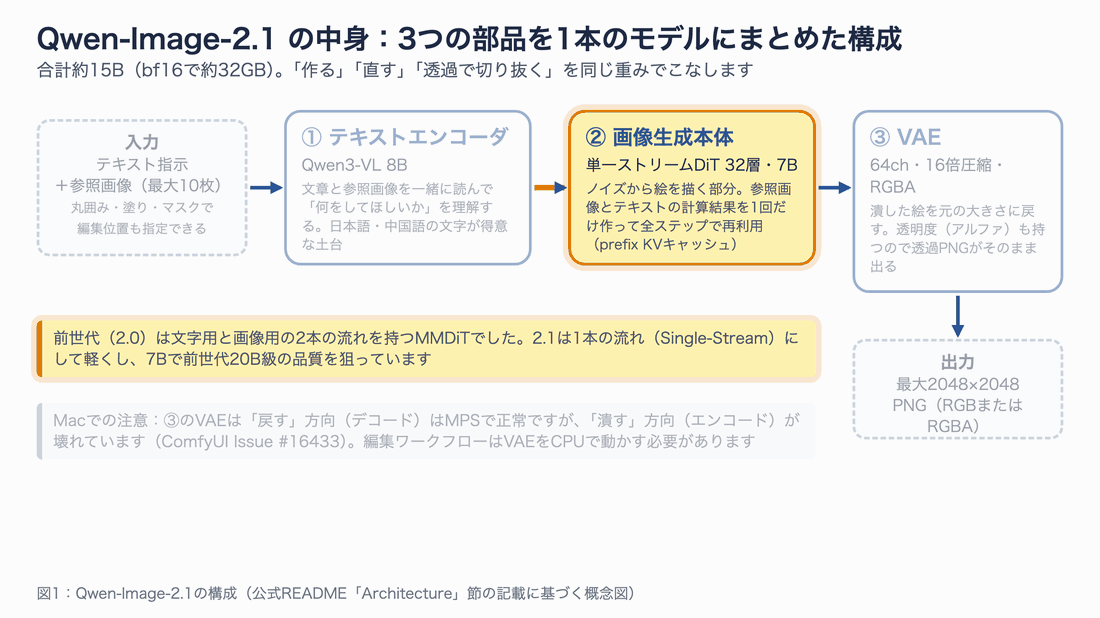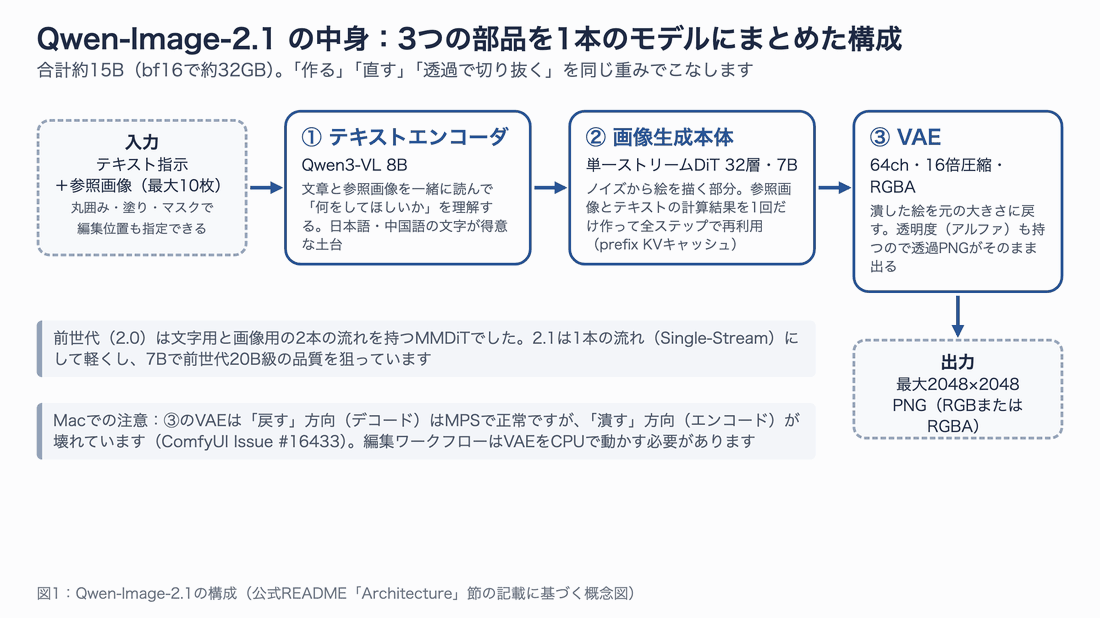
図1: 3つの部品がどうつながっているか。①がQwen3-VL 8Bという視覚言語モデルで、文章と参照画像を一緒に読んで「何をしてほしいか」を理解します。②が絵を描く本体、③が絵を元の解像度に戻すVAE(Variational Autoencoder、画像を小さな潜在表現に圧縮・復元する部品)です。③がアルファチャンネルを持つので透過PNGがそのまま出てきます。静止画版は fig01-architecture.png。
前世代のQwen-Image-2.0は、文字用と画像用の2本の流れを持つMMDiT(Multimodal Diffusion Transformer)でした。2.1は1本の流れ(Single-Stream)に統一し、7Bという小さいサイズで前世代20B級の品質を狙う設計です。合計すると①8B+②7B+③のVAEで約15B、bf16(16ビット浮動小数点)の重みで合計約32GBになります。
ちなみにテクニカルレポートはまだ出ていません(2026年9月22日時点)。READMEのリンクはModelScope、Hugging Face、ブログ、デモ、Discordだけで、arXivにも2.1のレポートは見当たりませんでした。設計の一次情報として今一番詳しいのは、READMEの「Architecture」節と、DiffusersやComfyUIの実装コードです。
公式リポジトリのREADME(2026年9月22日撮影)。
比較相手: ChatGPT Images 2.5とGPT-Image-2.5
OpenAIは2026年9月8日に ChatGPT Images 2.5 を発表しました。発表文によると、より自然な光と質感、参照写真の被写体をより忠実に保つこと、複数ターンにわたる編集指示への追従を改善し、生成の待ち時間はImages 2.0比で最大50%短縮されています。ChatGPTのすべてのプラン、ChatGPT Work、Codexのユーザーが使えます。
開発者向けには、APIに2つのモデルが追加されました。
| APIモデルID | 位置づけ(OpenAI Developersの説明) |
|---|---|
gpt-image-2.5-flare | Fast, high-quality everyday image generation。GPT-Image-2より高品質な画像を50%短い待ち時間で生成する標準モデル |
gpt-image-2.5-sunburst | Our most capable model for image generation and editing。生成時間を長く取り、編集の厳密な制御を重視 |
本記事で使ったのはChatGPT側のImages 2.5です。API側の使い方は付録に載せました。
ベンチマークで見る立ち位置
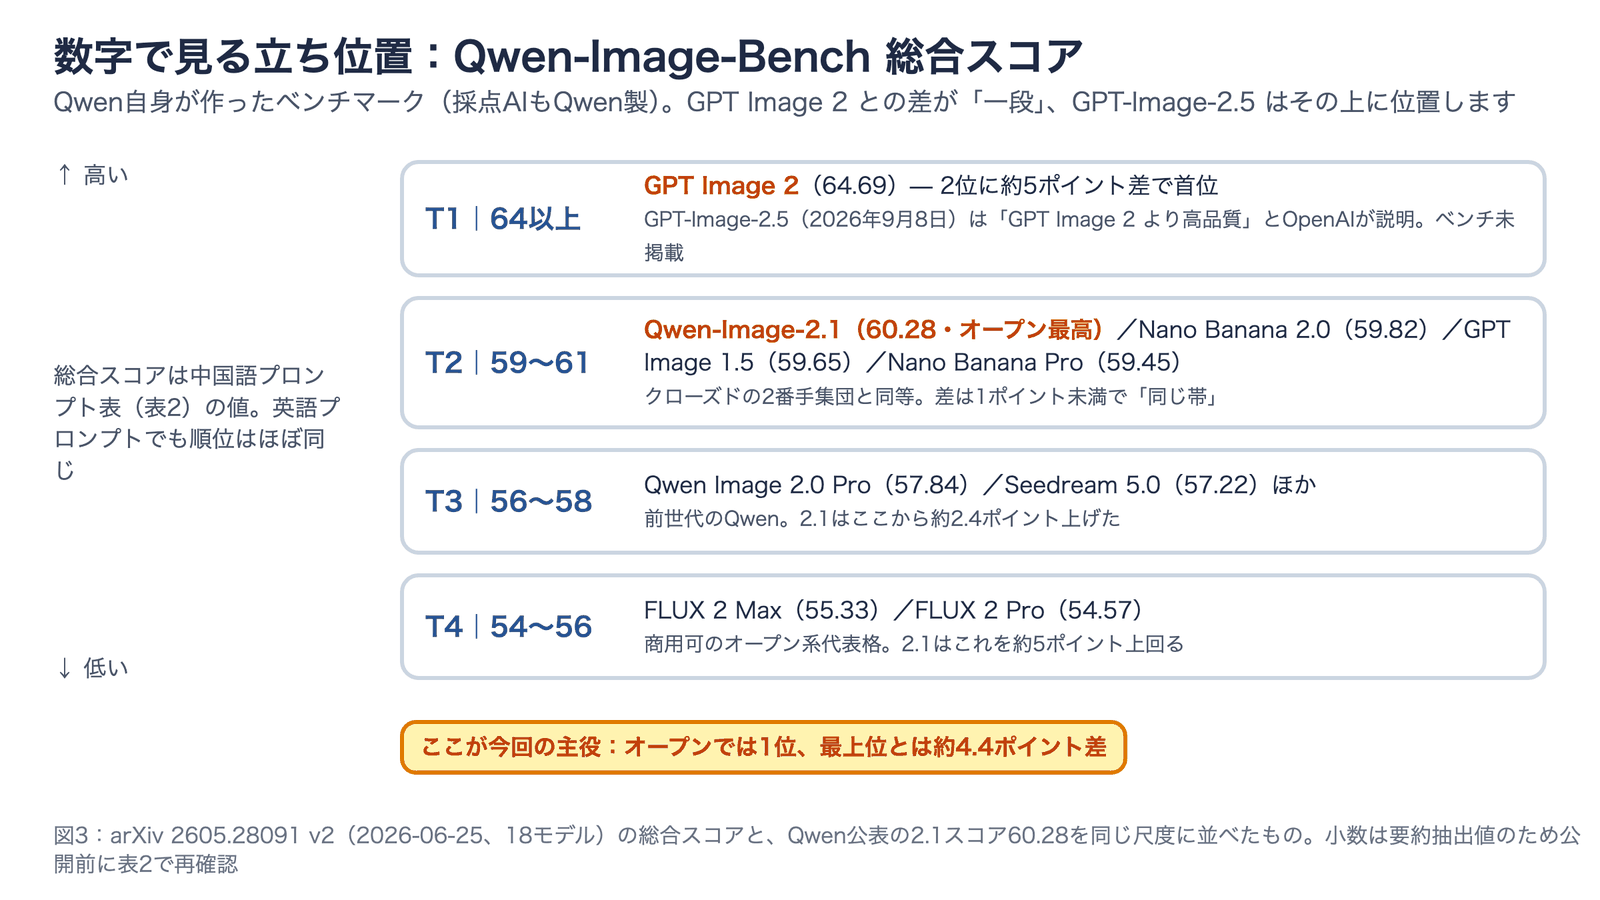
Qwenが公開している自社ベンチマーク Qwen-Image-Bench(arXiv 2605.28091)の総合スコアで、Qwen-Image-2.1は60.28です。Qwen自身の発表資料では、Nano Banana 2.0の59.82、GPT Image 1.5の59.65、FLUX 2 Maxの55.33を上回ると説明されています。
ただし、Qwenの発表資料には肝心の GPT Image 2 が載っていません。ベンチマークの論文本体を読むと、GPT Image 2が総合64.7(中国語プロンプト)で首位、2位のNano Banana 2.0に約5ポイント差をつけています。同じ尺度に並べ直したのが図3です。上から順に、どの帯にどのモデルがいるかを追ってください。
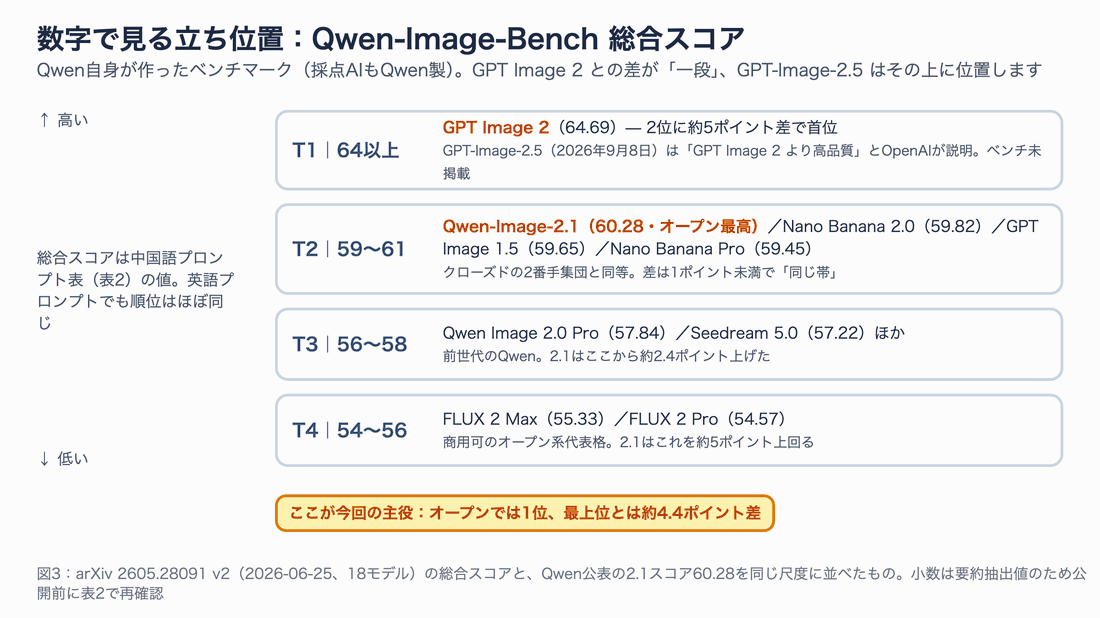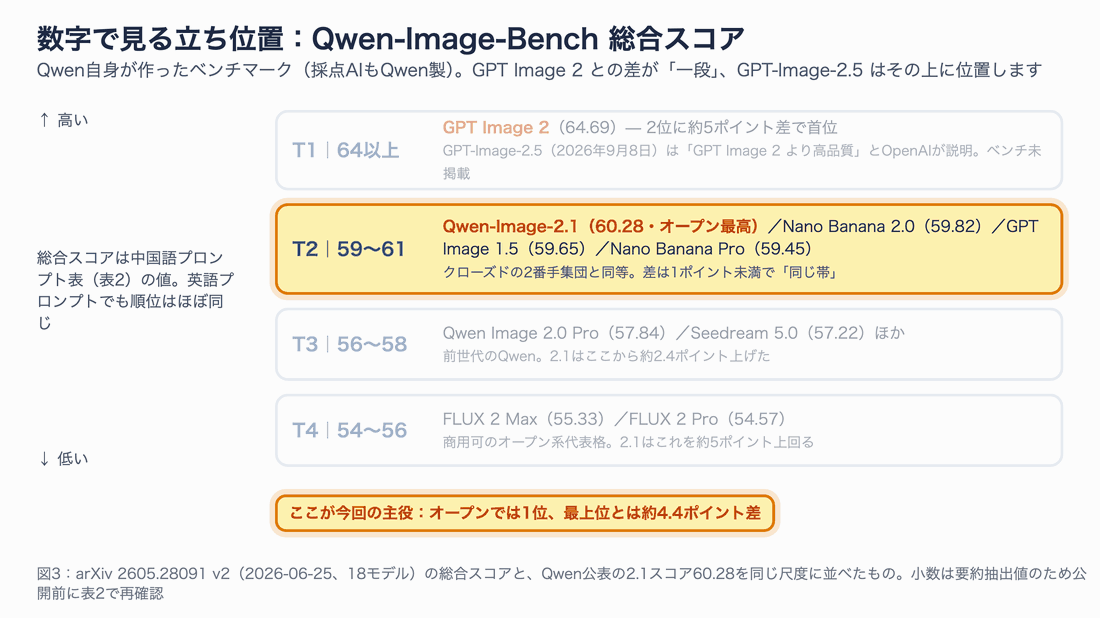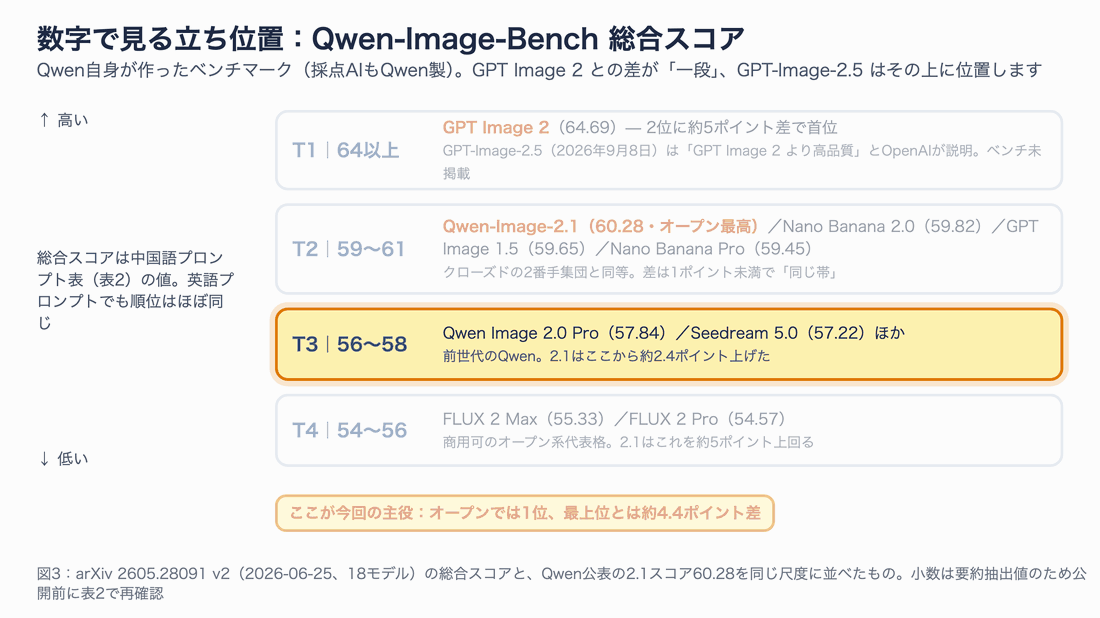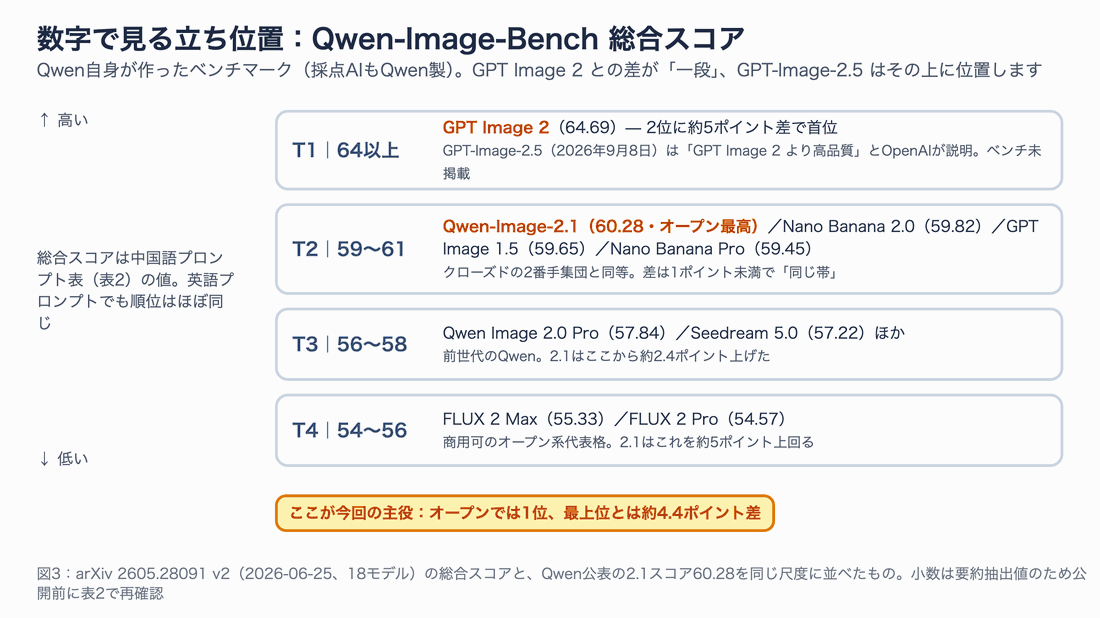
図3: Qwen-Image-2.1はオープンモデルでは1位、クローズドの2番手集団と同じ帯、最上位のGPT Image 2とは約4.4ポイント差。GPT-Image-2.5はそのGPT Image 2より高品質とOpenAIが説明しているので、差はさらに開いている前提で見るべきです。静止画版は fig03-tiers.png。
| 階層 | 総合スコア | モデル |
|---|---|---|
| T1 | 64以上 | GPT Image 2(64.69) |
| T2 | 59〜61 | Qwen-Image-2.1(60.28)、Nano Banana 2.0(59.82)、GPT Image 1.5(59.65)、Nano Banana Pro(59.45) |
| T3 | 56〜58 | Qwen Image 2.0 Pro(57.84)、Seedream 5.0(57.22) |
| T4 | 54〜56 | FLUX 2 Max(55.33)、FLUX 2 Pro(54.57) |
読むときの注意が2つあります。第一に、このベンチマークはQwen製で、採点AI(Q-Judger)もQwen3.6-27Bベースです。自社に有利に働く可能性は差し引いてください。第二に、小数点以下の数値は論文の表2から抽出した値で、GPT Image 2以外の順位・スコアは論文本体で再確認することをおすすめします。
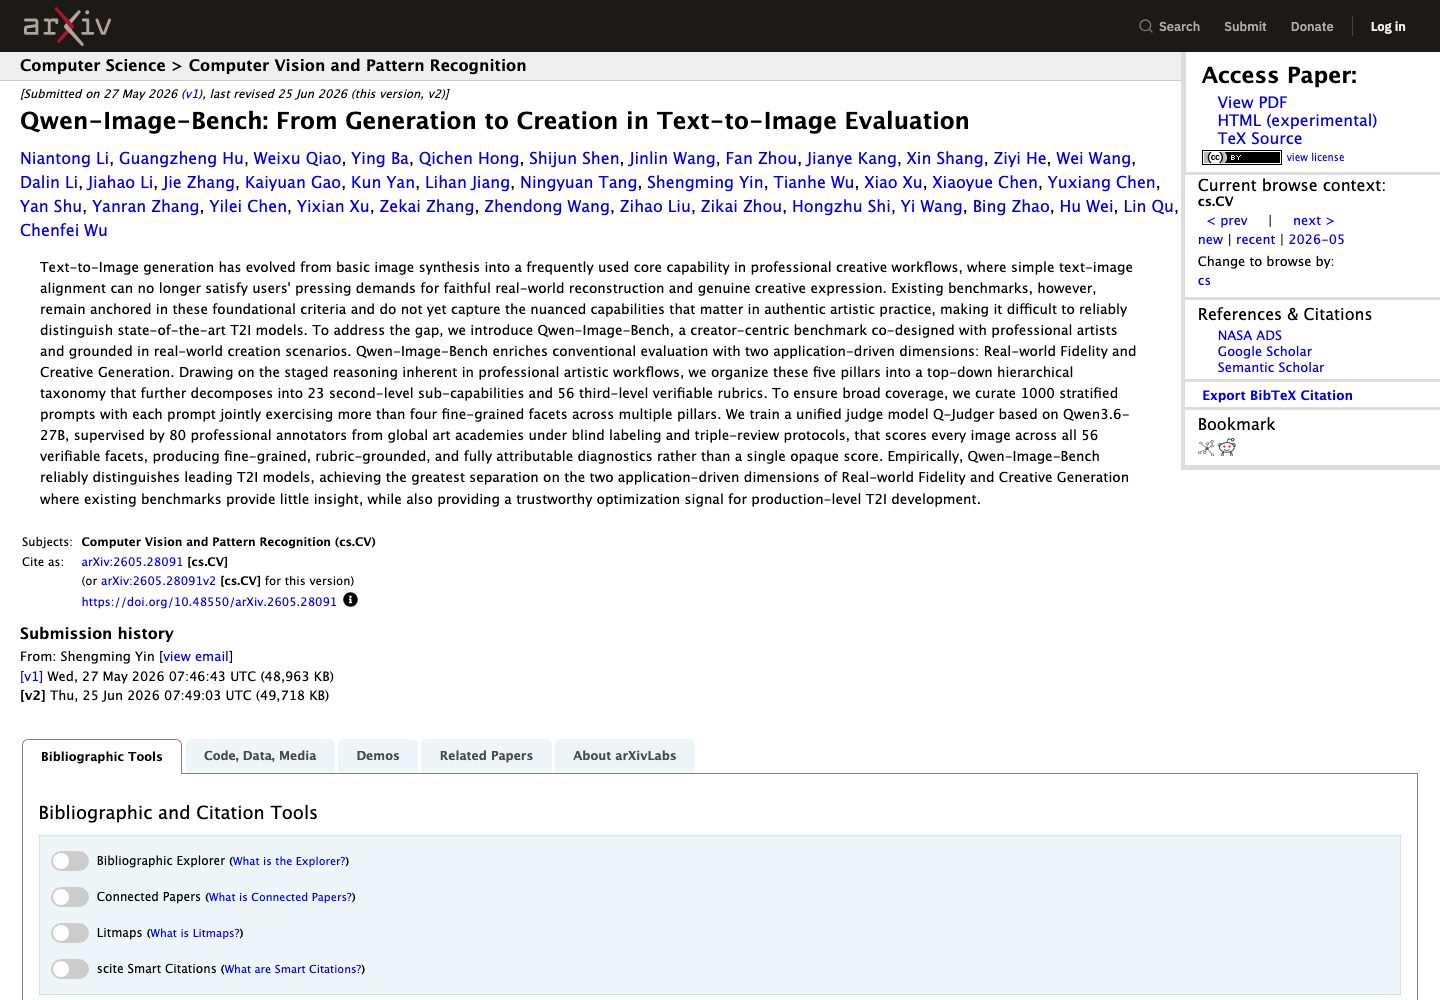
arXiv 2605.28091(v2は2026年6月25日)。18モデルを評価しています。
M5 Max(128GB)で動かす手順
ここはエンジニア向けです。非エンジニアの方は「1枚あたり1.5〜2.5分かかった」という結果だけ持って次の節へ進んでください。
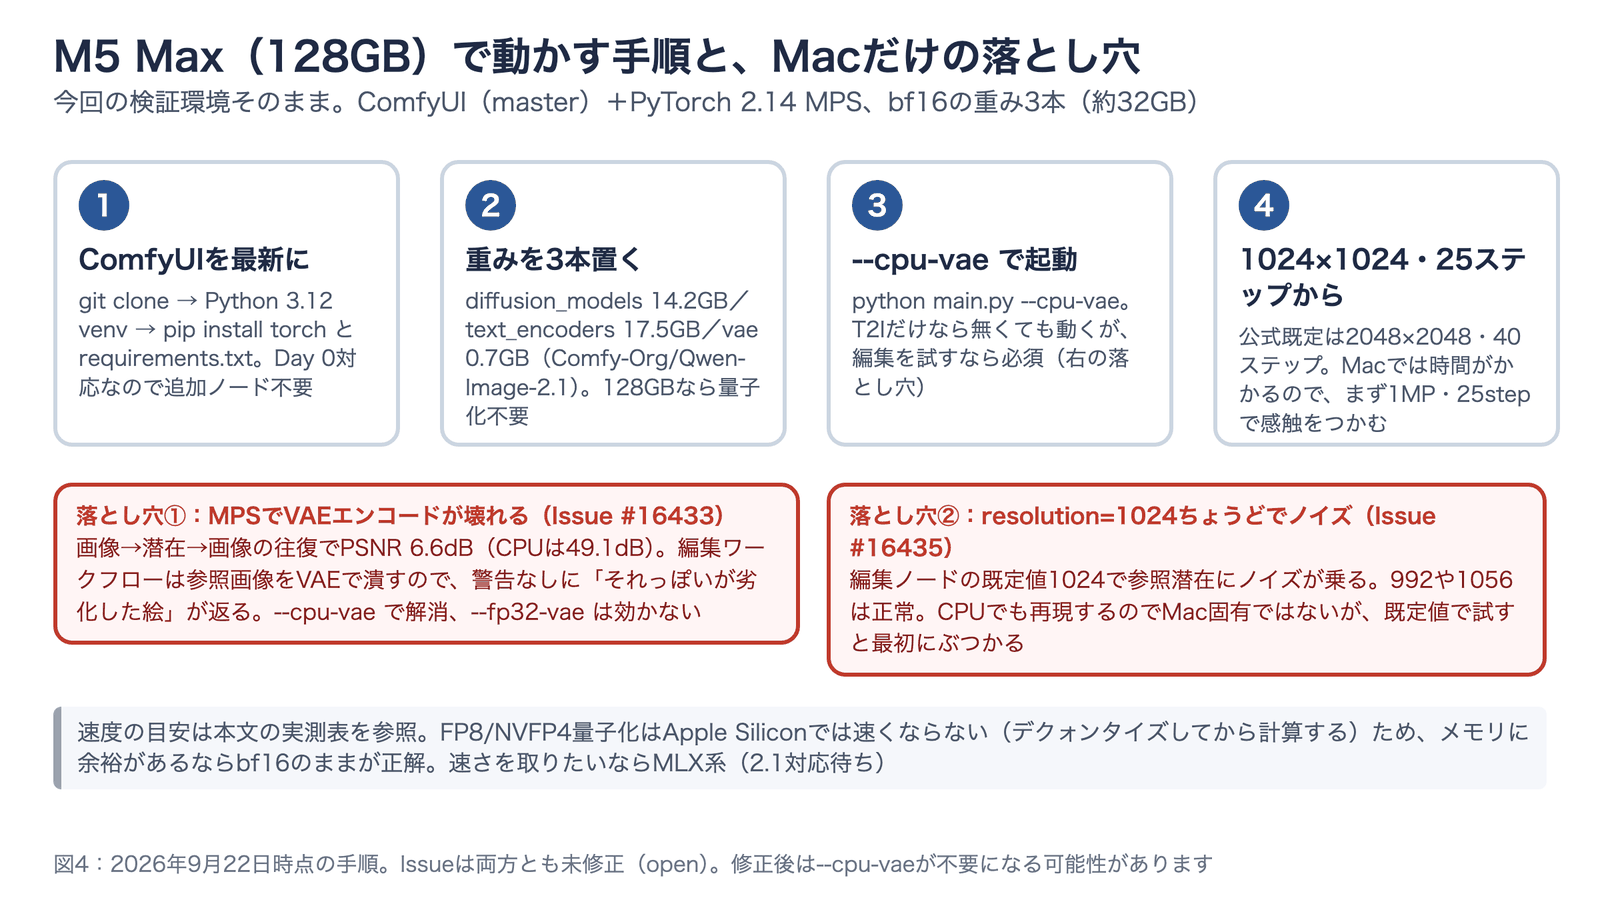
まず全体の手順と、Macだけで踏む落とし穴を図4で確認します。①から④の順に見て、最後に赤い枠の2つを読んでください。
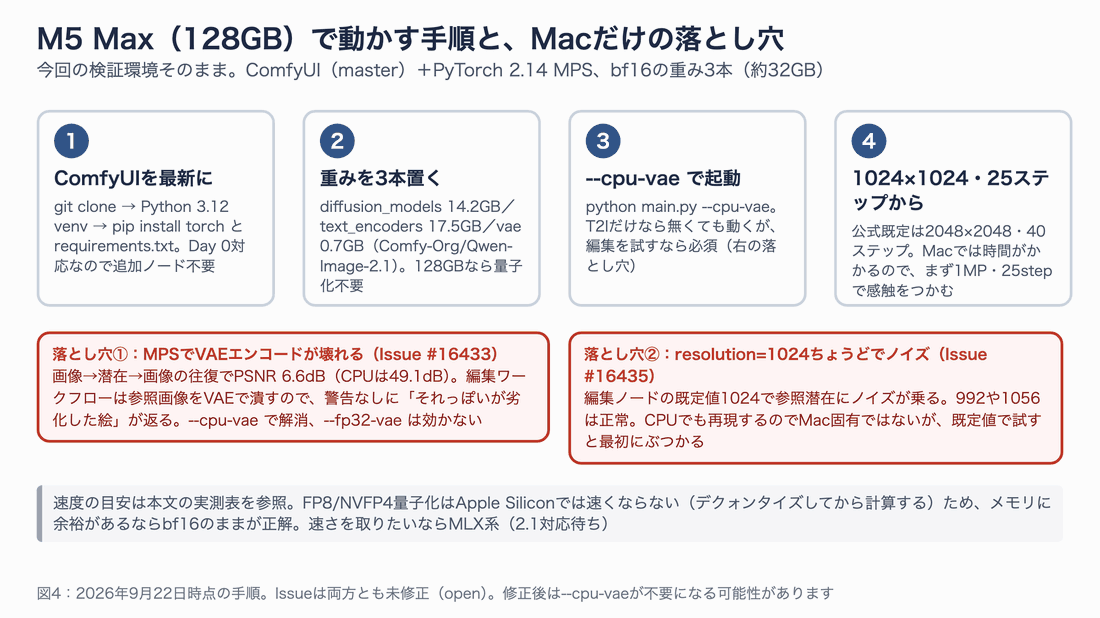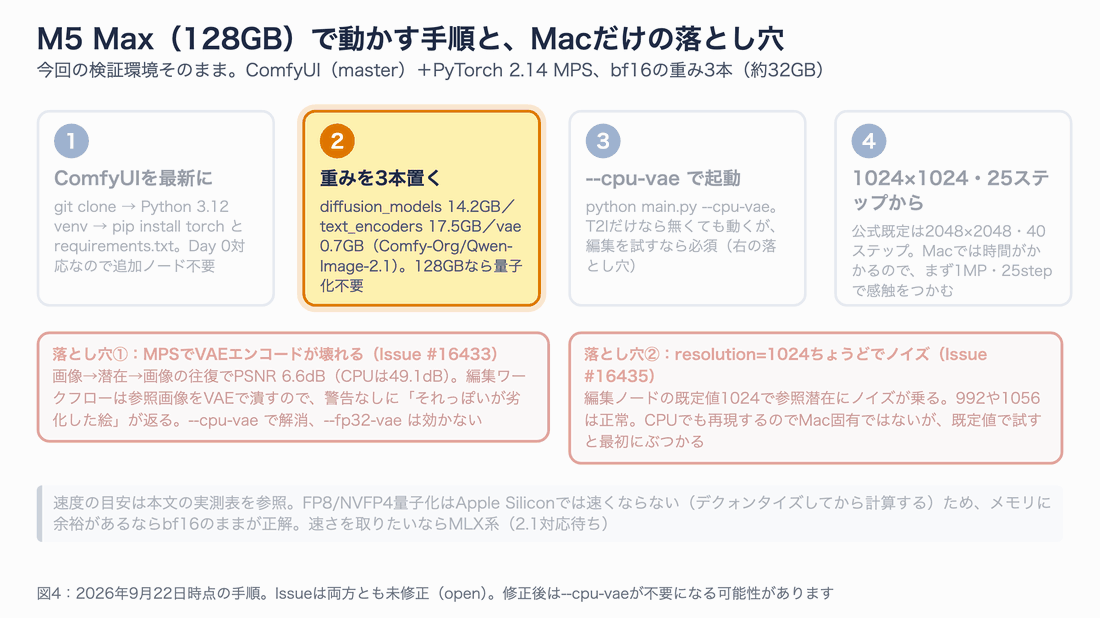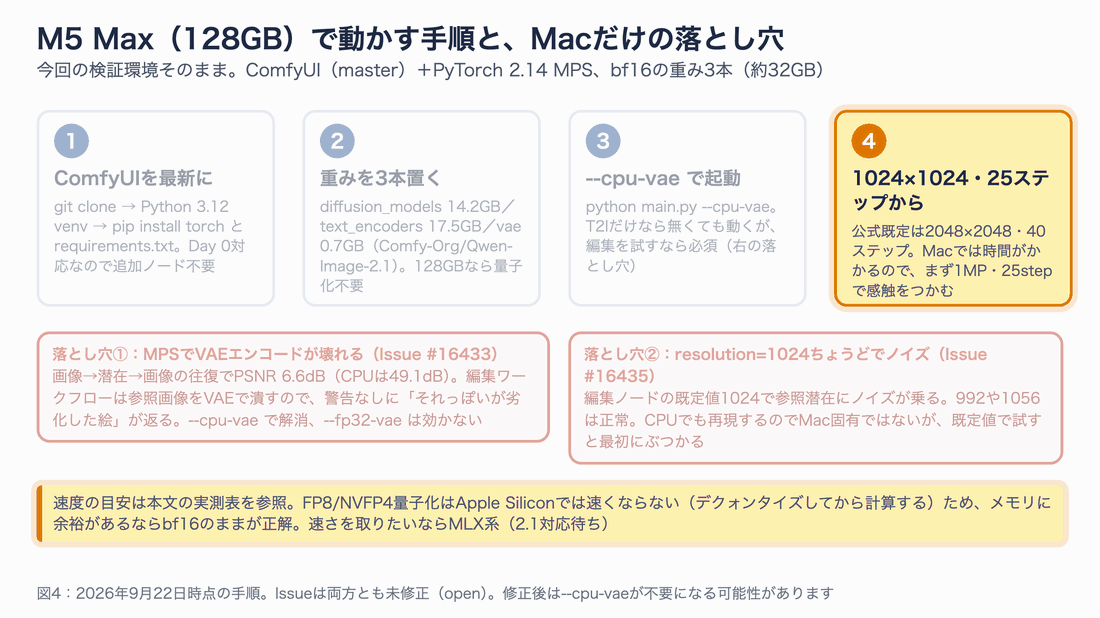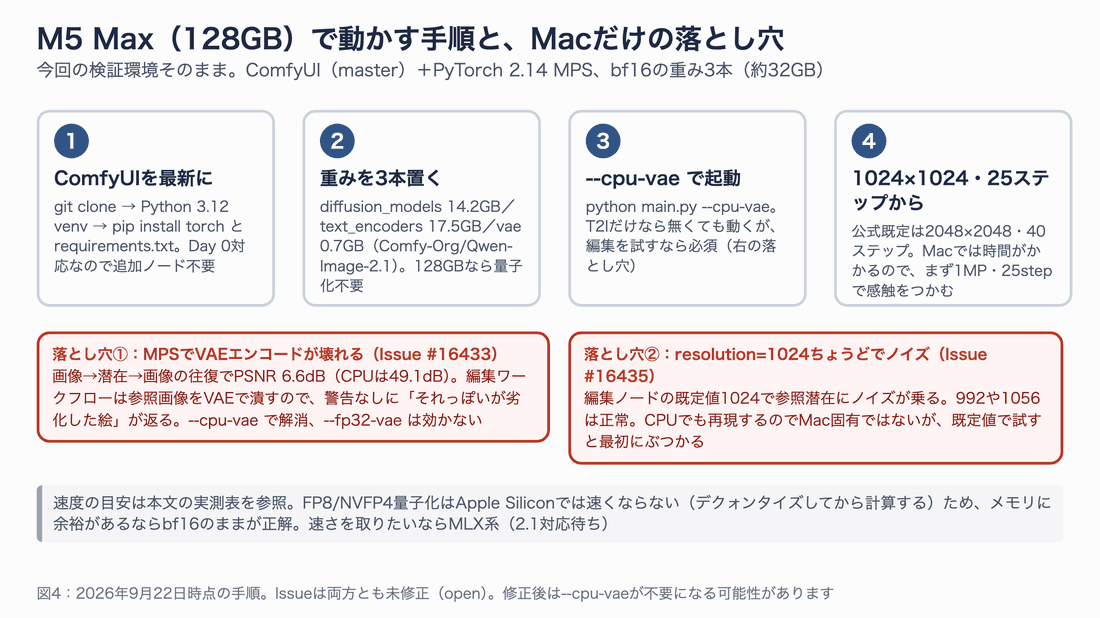
図4: 手順自体は4つだけ。ただし編集ワークフローを試すなら、VAEをCPUで動かす起動オプションが必須です。静止画版は fig04-mac-workflow.png。
1. ComfyUIを用意する
ComfyUIは公開初日(Day 0)からQwen-Image-2.1にネイティブ対応しています。追加のカスタムノードは不要です。
# ComfyUI本体を取得し、Python 3.12の仮想環境を作る
git clone --depth 1 https://github.com/Comfy-Org/ComfyUI.git ~/ComfyUI
cd ~/ComfyUI
python3.12 -m venv .venv
.venv/bin/pip install torch torchvision torchaudio   # Apple SiliconはMPS対応のwheelが入る
.venv/bin/pip install -r requirements.txt
検証時のバージョンは、ComfyUI master(2026年9月21日のコミット e638023)、PyTorch 2.14.0、Python 3.12です。
2. 重みを3本置く
ComfyUI向けの重みは Hugging Face の Comfy-Org/Qwen-Image-2.1 にあります。128GBのメモリがあるならbf16のまま使えます。
| 種類 | ファイル | サイズ | 置き場所 |
|---|---|---|---|
| 拡散モデル | qwen_image_2.1_bf16.safetensors | 14.2GB | models/diffusion_models/ |
| テキストエンコーダ | qwen3vl_8b_bf16.safetensors | 17.5GB | models/text_encoders/ |
| VAE | qwen_image_2.1_vae_bf16.safetensors | 0.7GB | models/vae/ |
# Hugging Faceから3本をダウンロードする(合計約32GB。回線速度32MB/sで約17分だった)
B=https://huggingface.co/Comfy-Org/Qwen-Image-2.1/resolve/main
cd ~/ComfyUI/models
curl -L -C - -o diffusion_models/qwen_image_2.1_bf16.safetensors $B/diffusion_models/qwen_image_2.1_bf16.safetensors
curl -L -C - -o text_encoders/qwen3vl_8b_bf16.safetensors        $B/text_encoders/qwen3vl_8b_bf16.safetensors
curl -L -C - -o vae/qwen_image_2.1_vae_bf16.safetensors           $B/vae/qwen_image_2.1_vae_bf16.safetensors
同じリポジトリにはint8版(拡散モデル7.3GB、テキストエンコーダ9.4GB)や、短いプロンプトを詳細化するプロンプト書き換えモデル(qwen3.5_9b_qwen_image_2.1_pe_t2i など、各9.5GB)も置かれています。メモリが少ないマシンではint8版が候補ですが、Apple Siliconでは量子化しても速くはならない点に注意してください(後述)。
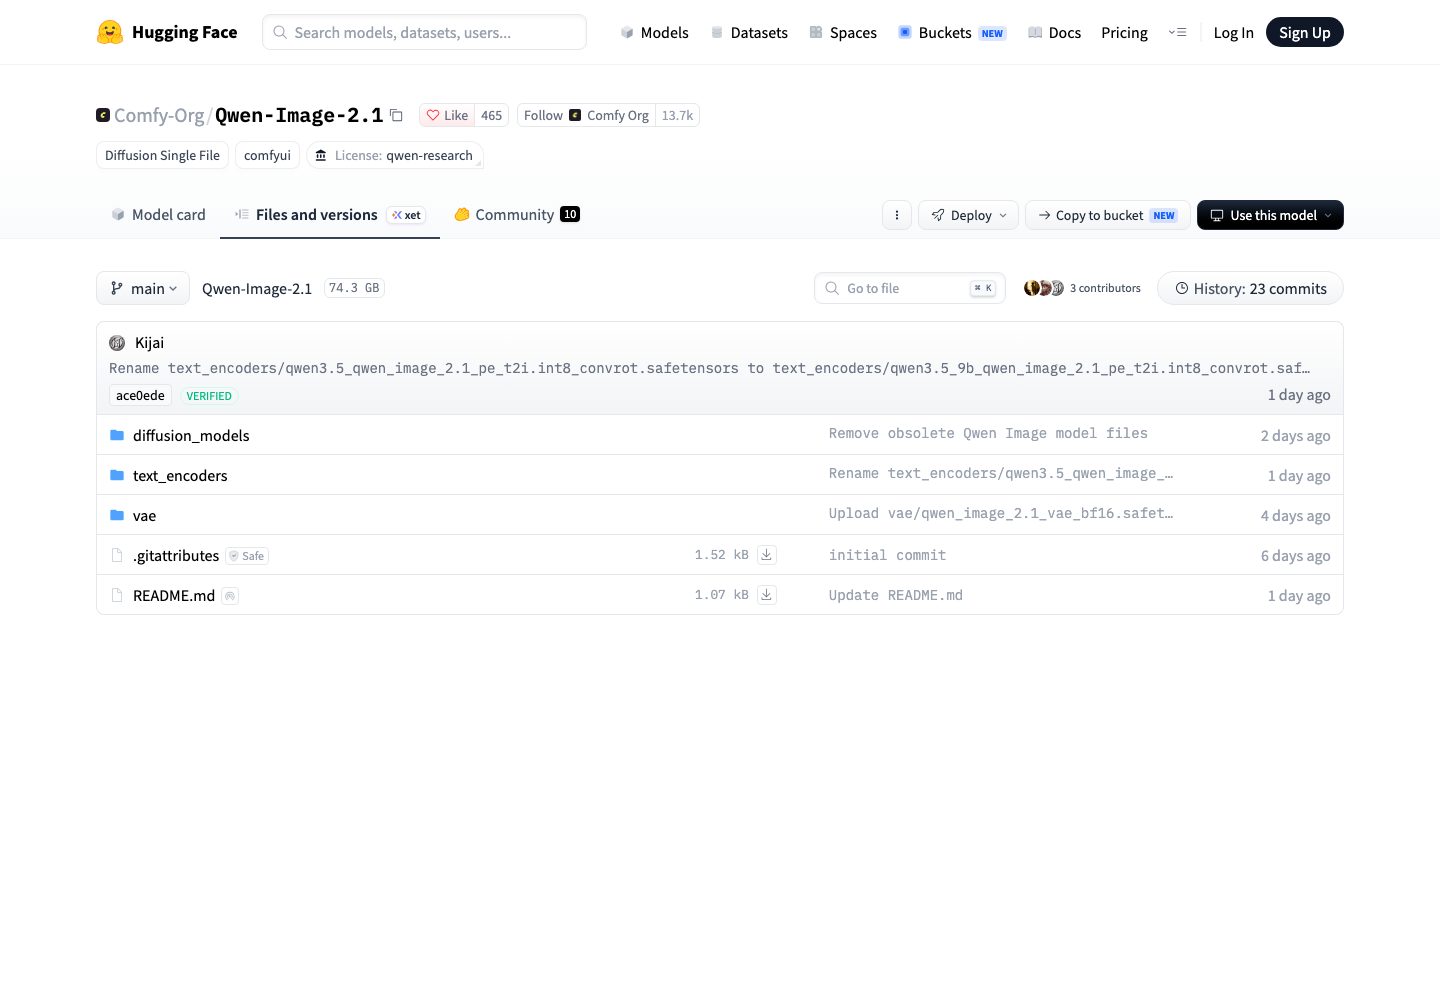
Comfy-Org/Qwen-Image-2.1のファイル一覧。ライセンス欄が qwen-research になっています。
3. --cpu-vae を付けて起動する
# Apple Siliconでは --cpu-vae を付ける(理由は次の「落とし穴」で説明)
cd ~/ComfyUI
.venv/bin/python main.py --listen 127.0.0.1 --port 8188 --cpu-vae
ブラウザで http://127.0.0.1:8188 を開き、テンプレートから「Qwen-Image-2.1 text to image」を読み込めば生成できます。
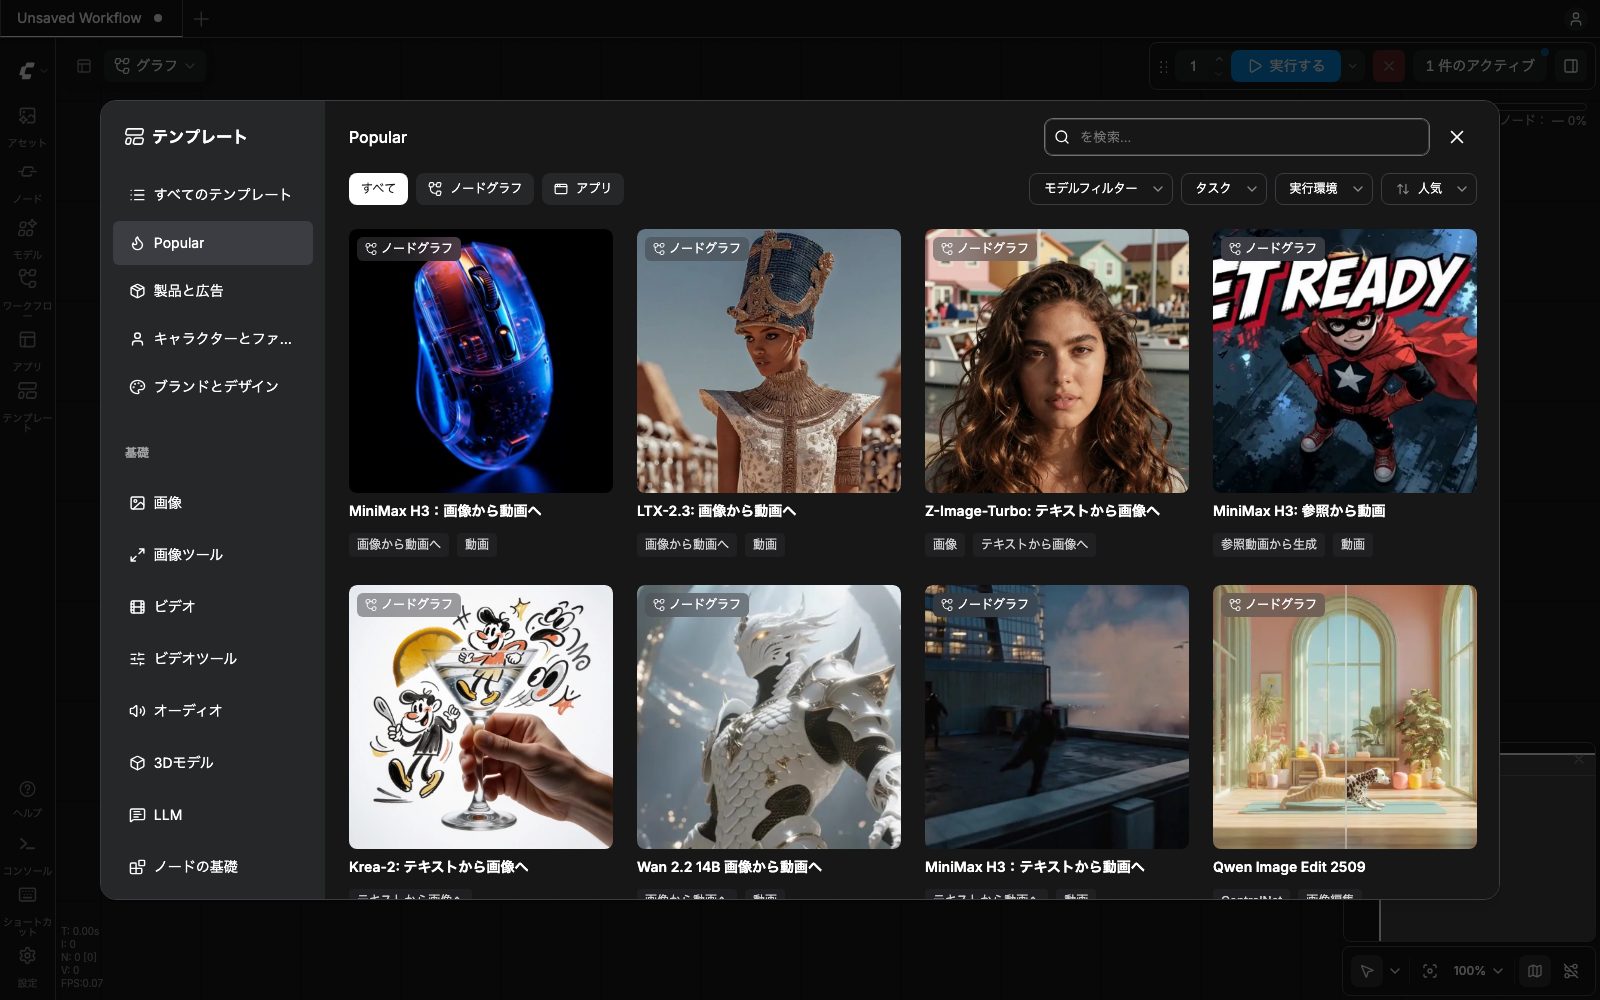
起動直後のComfyUI。テンプレート一覧からQwen-Image-2.1のワークフローを選べます。
落とし穴①: MPSでVAEエンコードが壊れる
公開翌日にComfyUIへ報告されたIssue #16433によると、Apple SiliconのMPS(Metal Performance Shaders、PyTorchのGPUバックエンド)上でQwen-Image-2.1のVAEエンコードが壊れています。画像→潜在→画像と往復させたときのPSNR(元画像との近さ。高いほど良い)が、CPUでは49.1dBなのにMPSでは6.6dBしかありません。
厄介なのは、エラーも警告も出ない ことです。テキストから画像を作るだけならVAEはデコードしか使わないので正常ですが、画像編集ワークフローは参照画像をVAEでエンコードするため、公式テンプレートを含む全ての編集が「それっぽいが劣化した画像」を黙って返します。モデルやプロンプトの問題と誤認しやすい症状です。
対処は --cpu-vae で起動することです。--fp32-vae では直りません。本記事のQwen側の画像は、条件をそろえるためテキスト生成も含めて全て --cpu-vae で作りました。
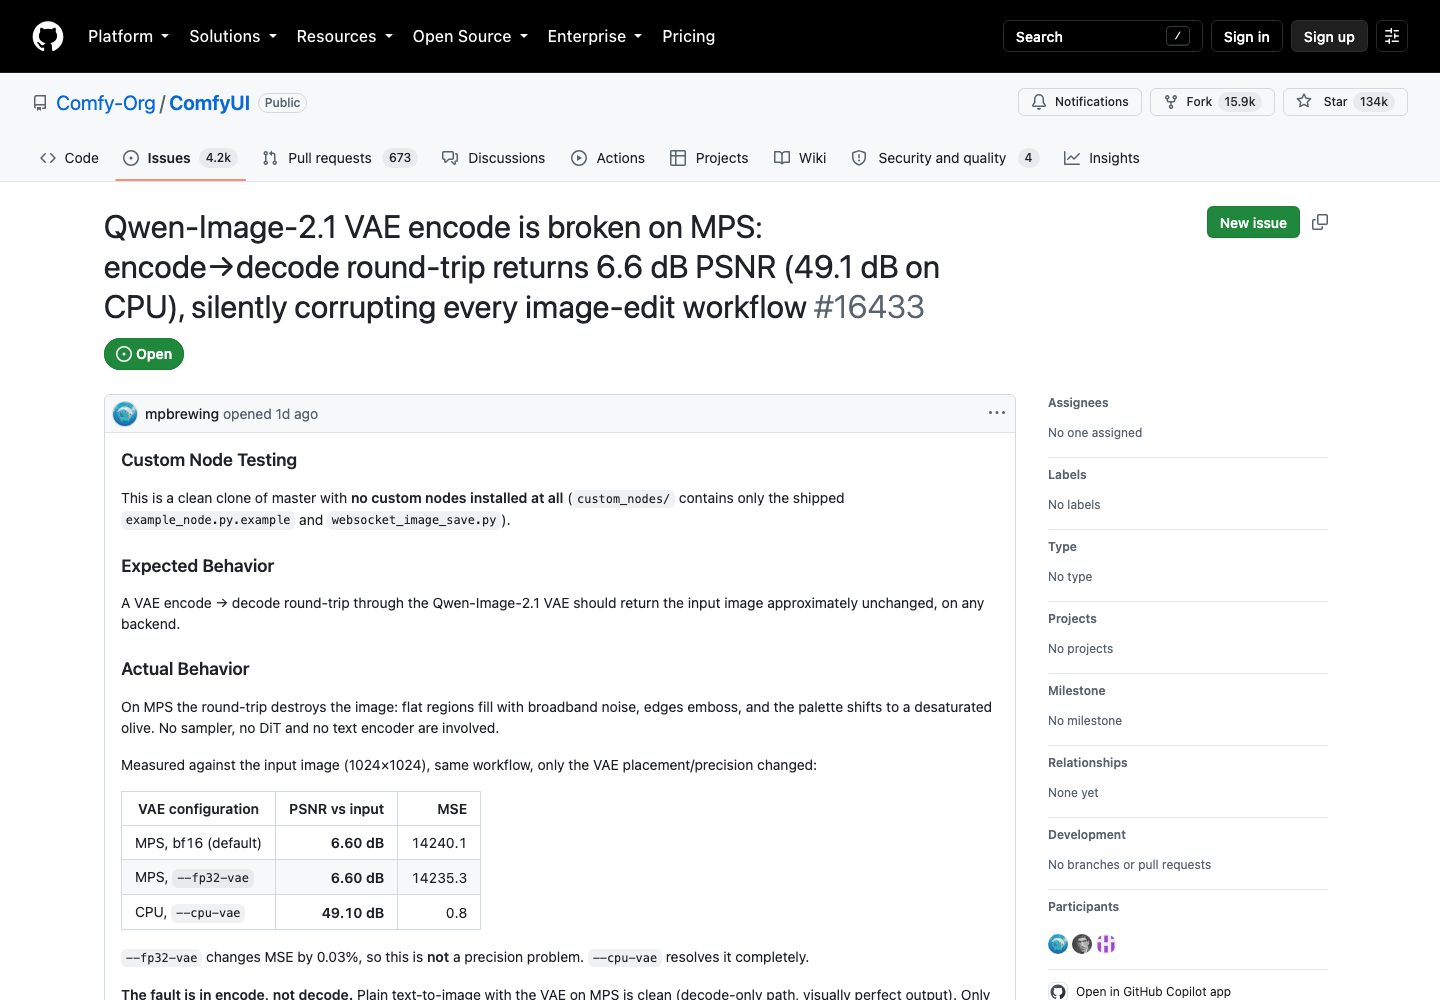
Issue #16433(2026年9月20日起票、記事執筆時点でopen、修正PRなし)。
落とし穴②: 編集ノードの resolution=1024 でノイズ
もう1つ、Issue #16435では、編集ノード「Text Encode Qwen Image 2.1」の resolution が既定値の1024ちょうどのとき、参照画像の潜在にノイズが乗ると報告されています。992や1056では正常で、CPUでも再現するのでMac固有ではありません。本記事の編集検証では resolution=1056 を使いました。
実測: 1枚あたりの時間
1024×1024、25ステップ、euler/simple、cfg 1.0での実測です。時間はテキストエンコーダの読み込み、サンプリング、CPUでのVAEデコードを全て含みます。
| ケース | 所要時間 | 備考 |
|---|---|---|
| ケース1 日本語ポスター | 108秒 | 初回はモデル読み込み込み |
| ケース2 ポートレート | 86秒 | |
| ケース3 6人の集合写真 | 118秒 | |
| ケース5 透過アイコン | 144秒 | |
| ケース4 編集(参照画像2枚、resolution 1056) | 約3分(サンプリングのみ) | 6.7〜7.6秒/ステップ |
サンプリング速度は2.1〜4.4秒/ステップでした。同じMacでヘッドレスChromeを回していた時間帯は遅くなっているので、専有できれば2秒台が出ます。公式の既定値は2048×2048・40ステップなので、その設定では1枚あたり10分オーダーを覚悟してください。まず1024×1024・25ステップで感触をつかむのが現実的です。
なお、FP8やNVFP4の量子化版はApple Siliconでは高速化しません。ComfyUIがデクォンタイズしてから計算するフォールバックになるため、メモリは減っても速度は出ず、bf16よりやや遅くなります。128GBならbf16のままが正解です。速さを求めるならMLX系の実装が本命ですが、2.1対応はまだありません。
ヘッドレスで回す(任意)
比較のために同じ条件で何枚も生成したかったので、ComfyUIのHTTP APIを叩く小さなスクリプトを書きました。公式テンプレートのサブグラフと同じノード構成(UNETLoader、CLIPLoader、VAELoader、TextEncodeQwenImage21、EmptyLatentImage、KSampler、VAEDecode、SaveImage)をAPI形式で組み、POST /prompt で投げて GET /history/{id} で完了を待つだけのものです。全文は記事末尾のリポジトリ構成を参照してください。
# テキストから画像
python3 scripts/qwen_gen.py t2i --prompt "A poster for a Tokyo coffee shop opening ..." --seed 1 --steps 25 --out case1 --dest out/
# 参照画像を使った編集(<image1> が編集対象、<image2> 以降が参照)
python3 scripts/qwen_gen.py edit --prompt "Replace the mug in <image1> with the mug in <image2>. Keep everything else unchanged." \
  --image1 base.png --image2 ref.png --resolution 1056 --out case4_edit --dest out/
実際に生成して比べる(5本勝負)
条件は次の通りです。
- Qwen-Image-2.1: 上記のローカル環境、bf16、1024×1024、25ステップ、seed固定(1〜3)
- ChatGPT Images 2.5: ChatGPT(Pro)のWeb版で「Generate one image, square 1:1. Prompt: 〜. Use the prompt exactly as written.」と指示。出力は1254×1254、または自動判断で1536×1024になった試行あり
- プロンプトは英語で統一。Qwen側はseed違いを3枚、GPT側は各1回(ChatGPTが自動で再生成した場合は2枚)
- 掲載画像は左がQwen、右がChatGPT。所要時間は上の表を参照
ケース1: 日本語の文字を含むポスター
A poster for a Tokyo coffee shop opening. Headline in Japanese “新装開店” at the top, subtext “2026年10月1日 OPEN” below, minimalist design, warm beige background
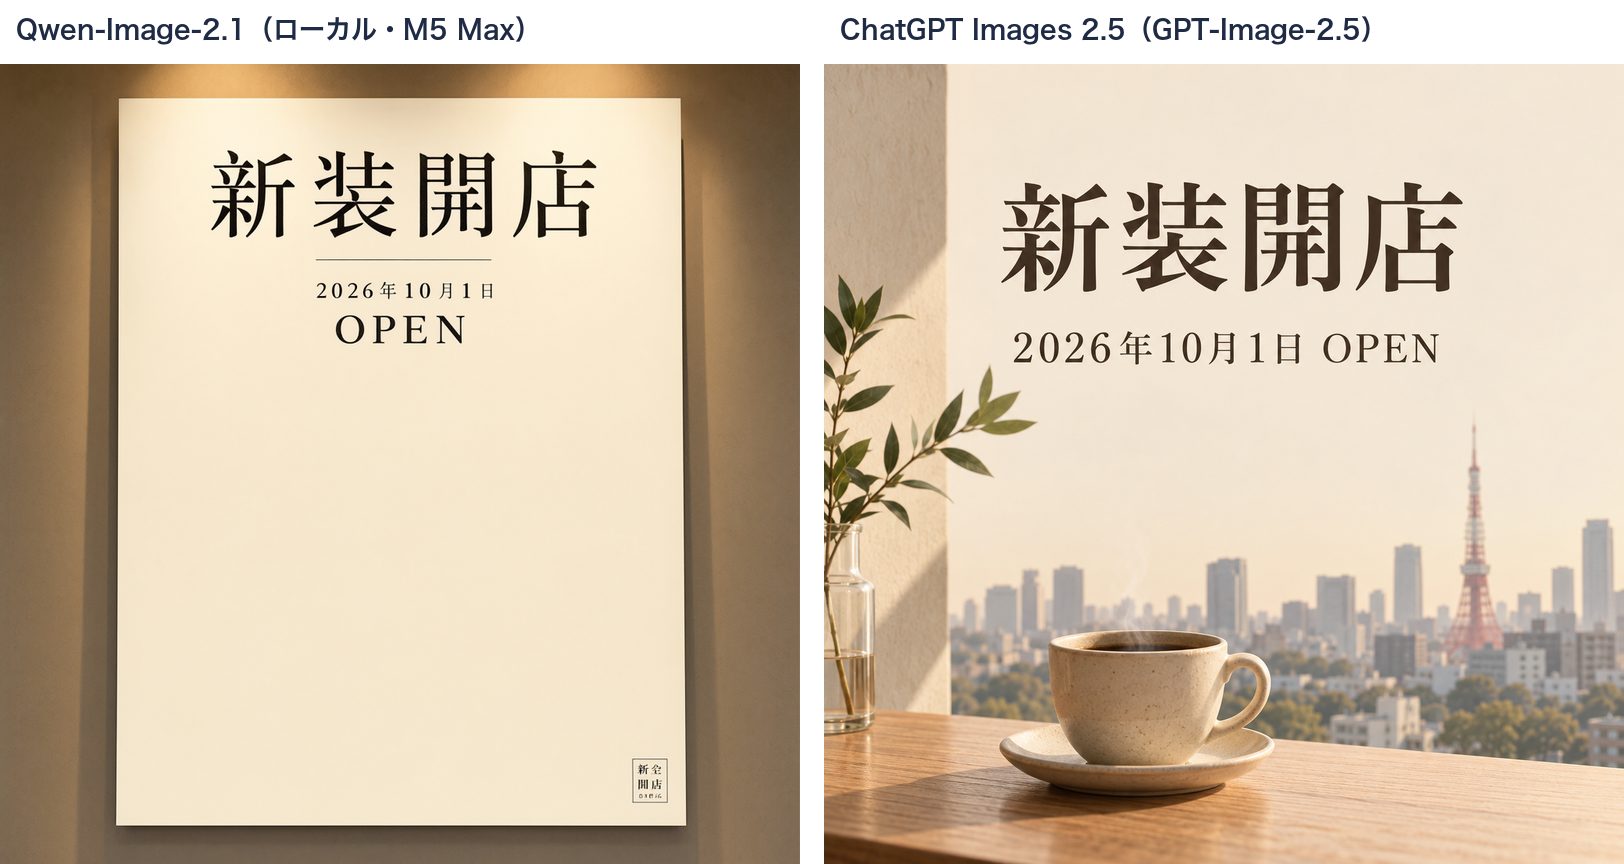
ケース1の比較。両方とも漢字は一画も崩れていません。
結果: 文字は互角、指示への忠実さはQwen、見栄えはGPT。
「新装開店」の「装」「開」のような画数の多い字を、両モデルとも正確に描きました。Qwen-Imageシリーズが伝統的に得意としてきた文字描画は2.1でも健在で、ここはクローズドモデルに追いついていると言えます。
違いは解釈です。Qwenは「ミニマル」の指示どおり紙とテキストだけで構成しましたが、右下に読めない小さな判子風の文字を勝手に足しました。GPTは文字を正確に出しつつ、東京タワー、湯気の立つカップ、植物を追加し、日付と「OPEN」を1行にまとめています。ポスターとして魅力的なのはGPTですが、「言った通りに作ってほしい」用途ではQwenの方が扱いやすいと感じました。
Qwenのseedを変えた3枚も載せます。seed2は余計な判子も消えて、指示に最も忠実な1枚でした。
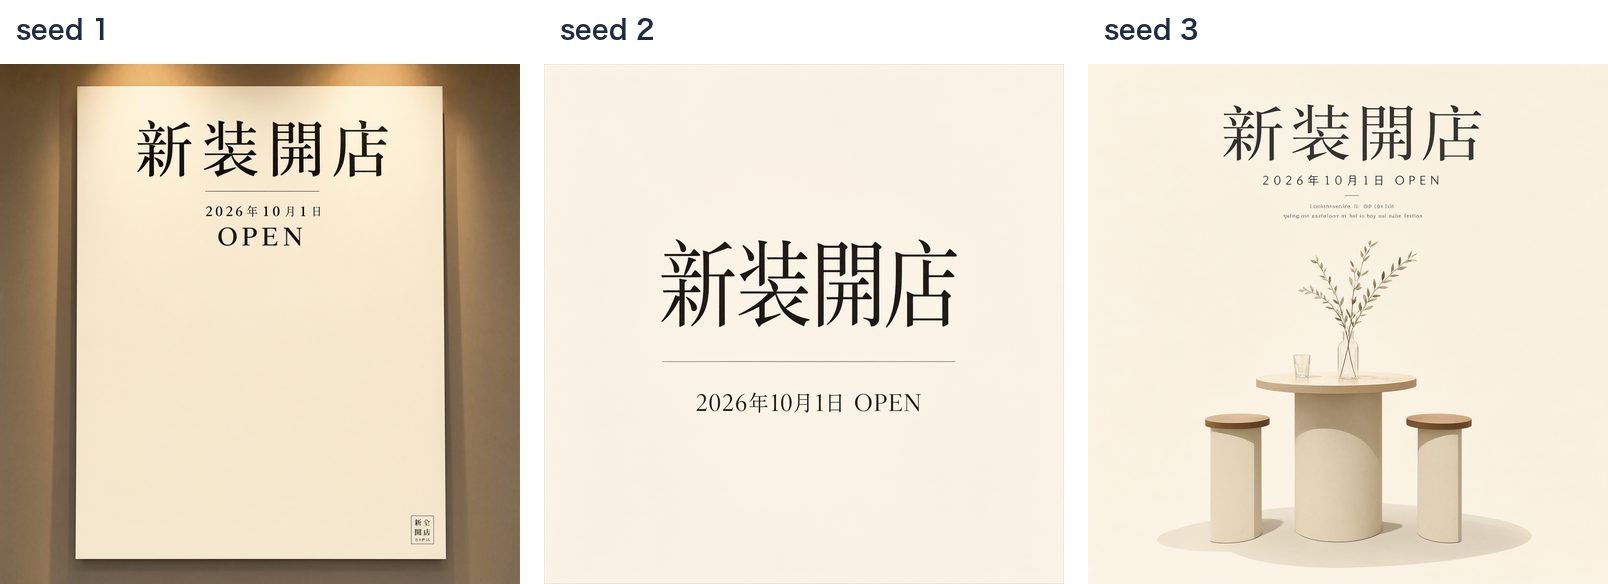
Qwen-Image-2.1のseed違い。3枚とも文字は正確でした。
ケース2: 人物ポートレート(顔・手・肌の質感)
Candid portrait of a woman in her 30s holding a ceramic mug with both hands, natural window light, 85mm lens, shallow depth of field, photorealistic
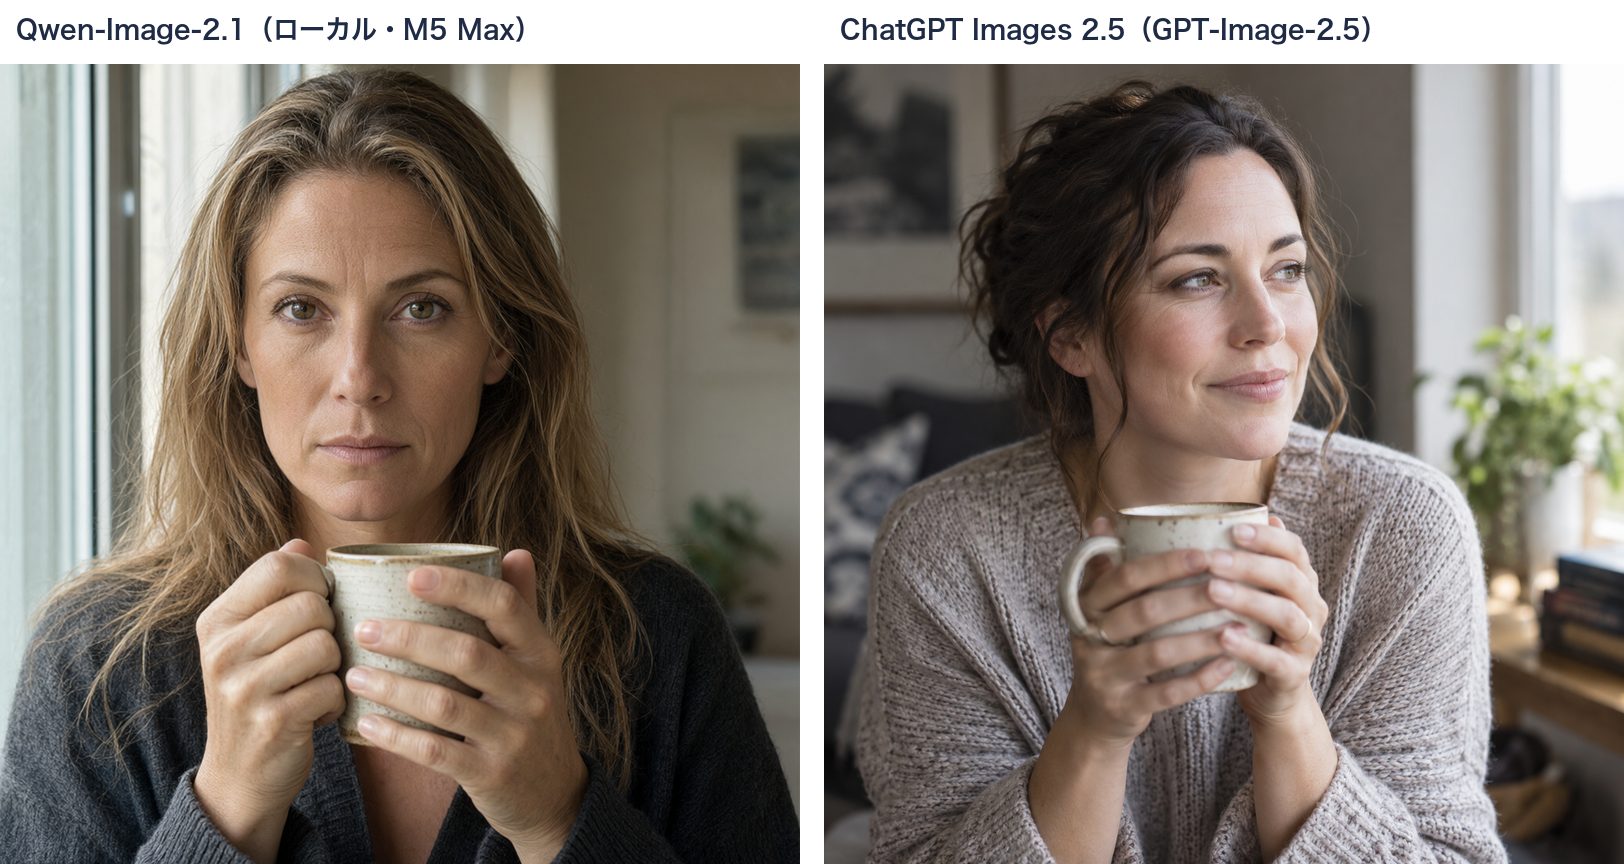
ケース2の比較。手指の本数・関節はどちらも破綻していません。
結果: 破綻はどちらも無し。「写真らしさ」でGPTが一歩先。
心配していた手指は、両方とも本数・関節ともに自然でした。GPTは指輪まで描いています。差が出たのは表現です。Qwenは真正面・硬い表情でライティングが平板で、「証明写真的」な印象があります。GPTは視線を外した自然な表情、窓からの柔らかい光、背景のボケ(被写界深度)の表現が上手く、「candid(自然な瞬間)」という単語をきちんと解釈していました。
Qwenは肌の質感そのものは自然で、いわゆる「AIっぽいツルツル感」はありません。一方で構図やライティングの選び方が保守的で、事前情報として耳にしていた「合成データで学習した痕跡」に近い硬さを感じます。公式のプロンプト書き換えモデルを噛ませて指示を詳細化すれば、ここは縮まる可能性があります。
ケース3: 複数人の集合写真
Group photo of six coworkers in a modern office lobby, each with a distinct outfit and expression, all faces in focus, natural smiles
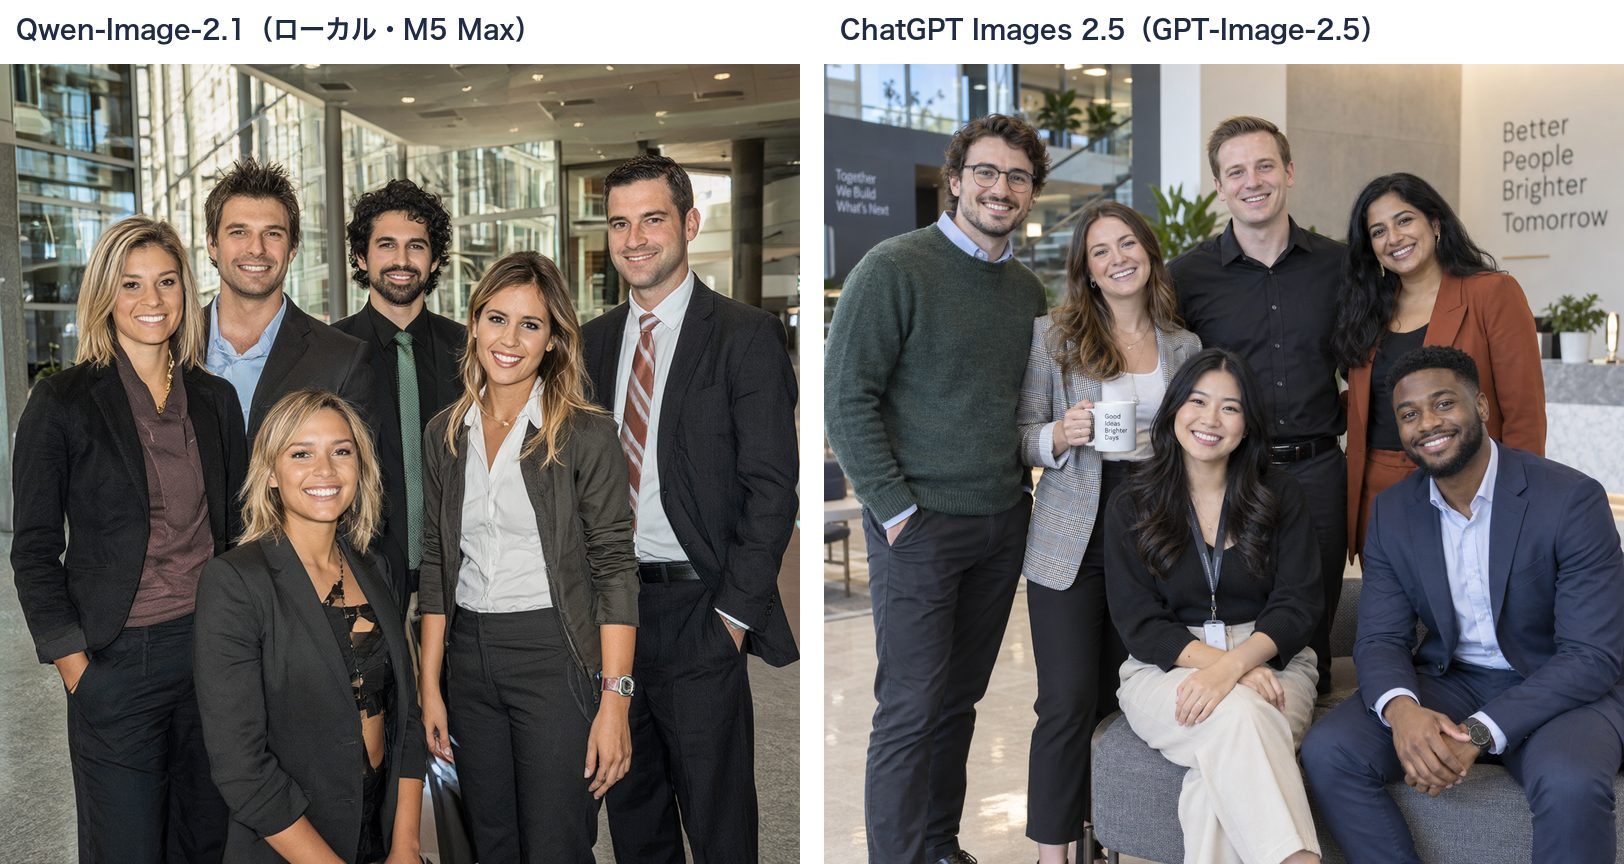
ケース3の比較。人数は両方とも正確に6人です。
結果: 5ケースで最も差が出た。多様性と細部でGPTが明確に上。
人数はどちらも正確に6人でした。しかし細部を見ると差が大きいです。Qwenは手前中央の女性の衣装が黒いストラップ状の不自然な形に崩れており、全員が黒スーツ寄りの似た装いで、「each with a distinct outfit」の追従が弱いです。顔の系統も似通っています。
GPTは服装(ニット、ジャケット、ブレザー、シャツ)、人種、姿勢(立つ・座る)の多様性を出し、背景の壁に書かれた「Better People Brighter Tomorrow」という文字まで破綻がありません。事前に指摘されていた「人が密集した場面での失敗、時折の身体構造の誤り」は、まさにこのケースで再現しました。ここが「まだ追いついていない」最大のポイントです。
ケース4: 参照画像を使った編集(商品の差し替え)
編集の検証には、同じ入力を両モデルに渡す必要があります。そこで元画像(白いマグが置かれたカフェの窓辺)と参照画像(黒×オレンジの持ち手のマグ)をQwenで生成し、両モデルに同じ指示を出しました。
Replace the mug on the table in the first image with the mug in the second image. Keep the lighting, shadows, table, window and everything else unchanged.
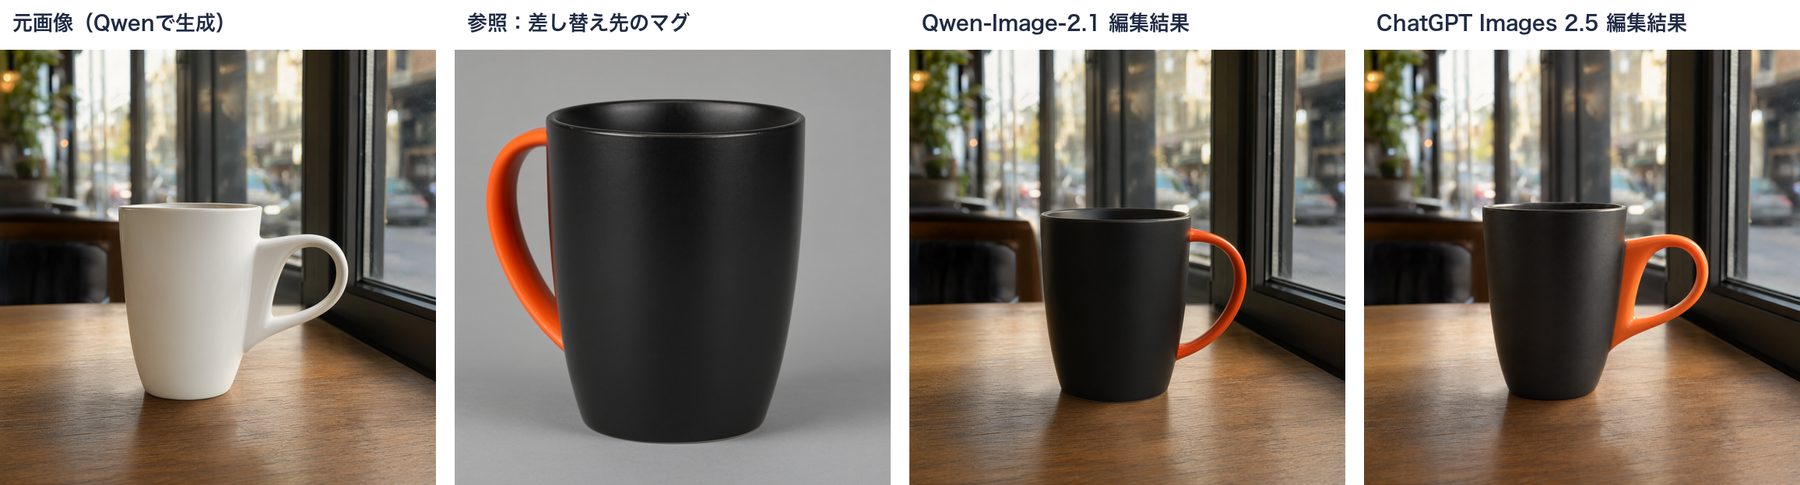
ケース4の比較。Qwenは参照マグの形を持ち込み、GPTは元マグの形を残して色だけ変えました。
結果: 形の再現はQwen、「変えていない部分」の保持はGPT。
面白い結果になりました。Qwenは参照マグの「丸い胴とオレンジの持ち手」をそのまま持ち込み、指示どおり「差し替え」ました。GPTは元マグの背の高い形を残したまま、色と持ち手だけを黒×オレンジに塗り替えています。参照画像の形状を忠実に反映したのはQwenです。
一方で、記事の主眼だった「変えていない部分が微妙に変わっていないか」は数値で確認しました。マグ周辺の矩形を除いた領域について、元画像との平均絶対差(0〜255)と、差が20を超えたピクセルの割合を計算しました。
| 非編集領域の平均絶対差 | 差20超のピクセル | |
|---|---|---|
| Qwen-Image-2.1 | 7.00 | 6.3% |
| ChatGPT Images 2.5 | 4.76 | 0.7% |
GPTの方が背景をよく保っています。ただしQwenは出力が1056×1056で、比較のため1024×1024へ縮小してから計算しているぶん不利です。差分をヒートマップ(白いほど差が大きい)にすると、両方とも「マグ以外はほぼ同じだが、完全一致ではない」ことが分かります。どちらも背景を再生成しているので、ピクセル単位で元画像を保ちたいならQwenのマスク指定方式(別マスクを渡す)を使うべきです。
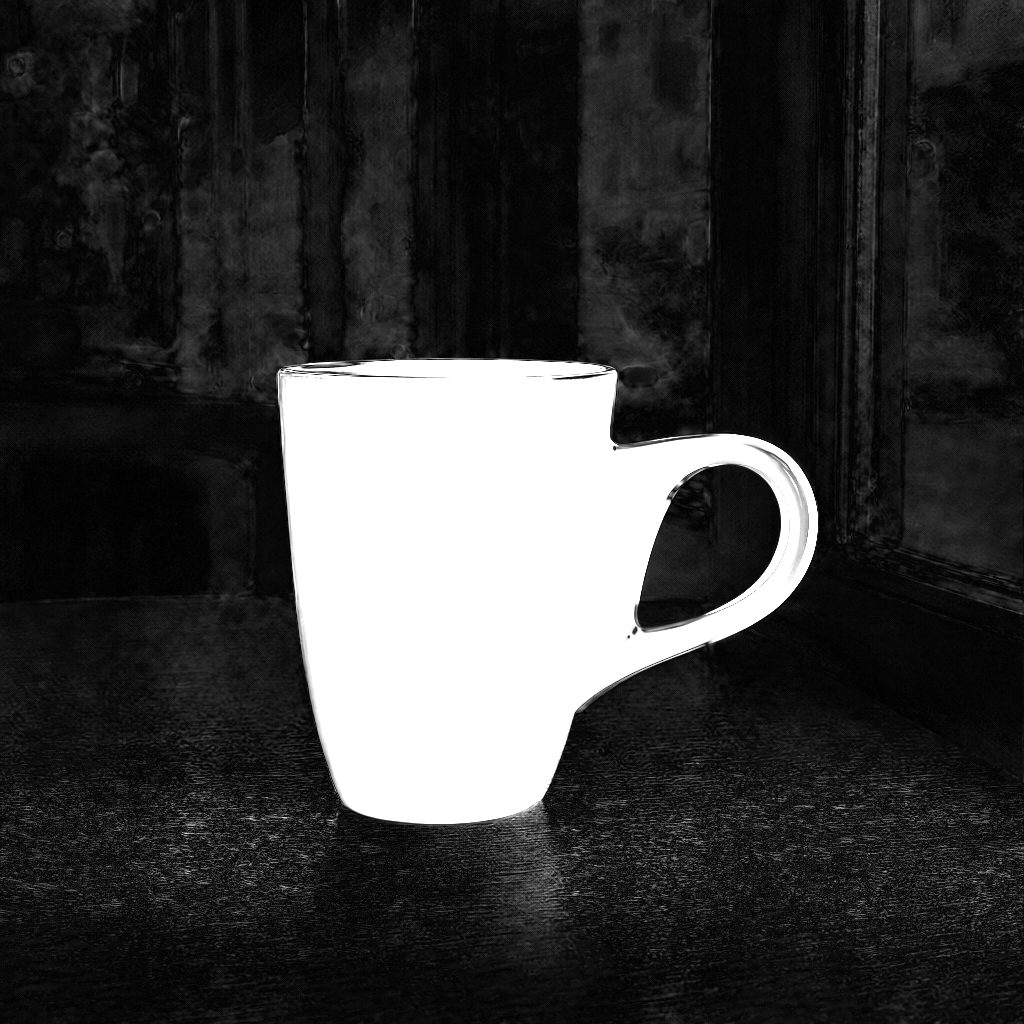
ChatGPT側の差分ヒートマップ。白いほど元画像との差が大きい。背景の差は小さいが、木目や窓枠にごく薄い差があります。
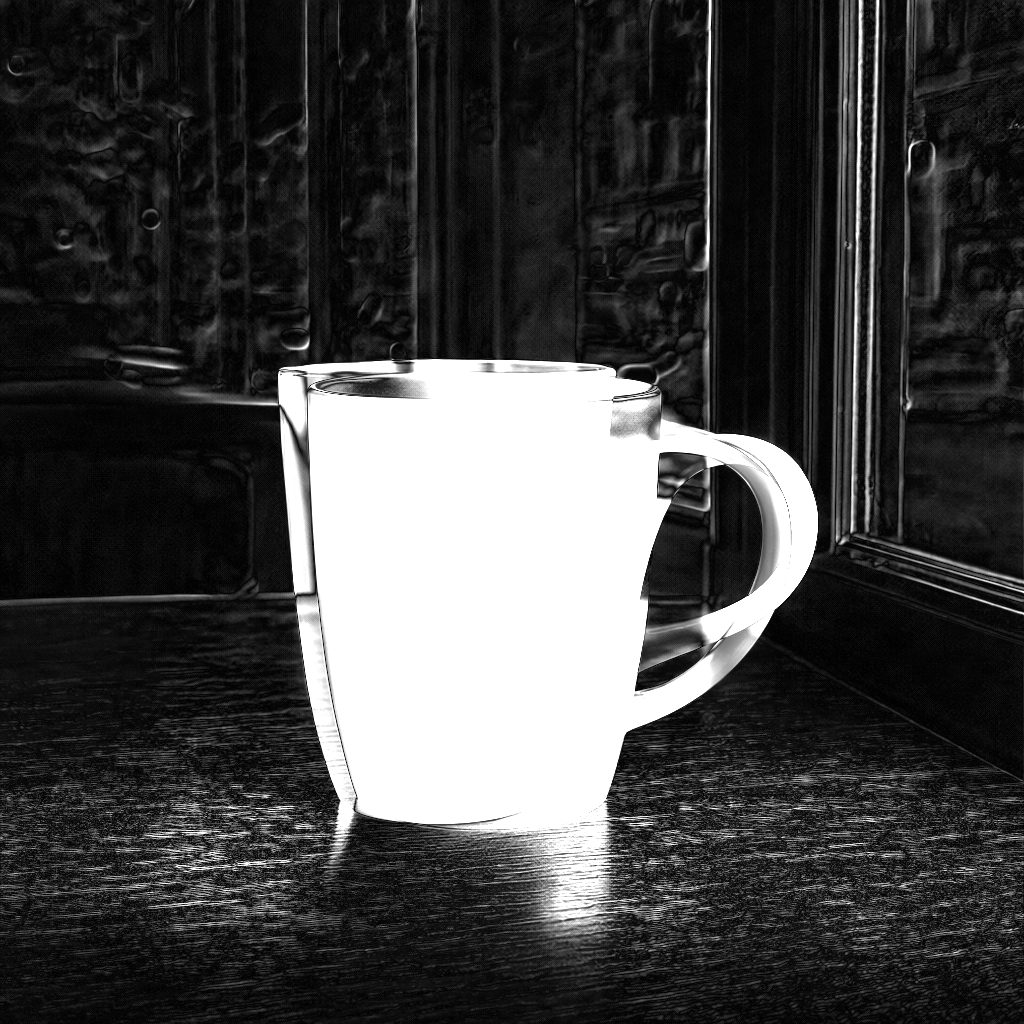
Qwen側の差分ヒートマップ。背景の差がGPTより広く残っています。
ケース5: 透過PNGの生成(Qwenの独自機能)
Qwenの公式READMEが推奨する書式でプロンプトを書きました。
This is an RGBA image with transparency. A flat-design icon of a paper airplane, blue gradient. The image has alpha channel and the background is transparent.
ChatGPT側は「Generate one image with a transparent background (PNG with alpha)」と指示しました。透過が本物かどうかを見るため、市松模様の上に合成して並べています。
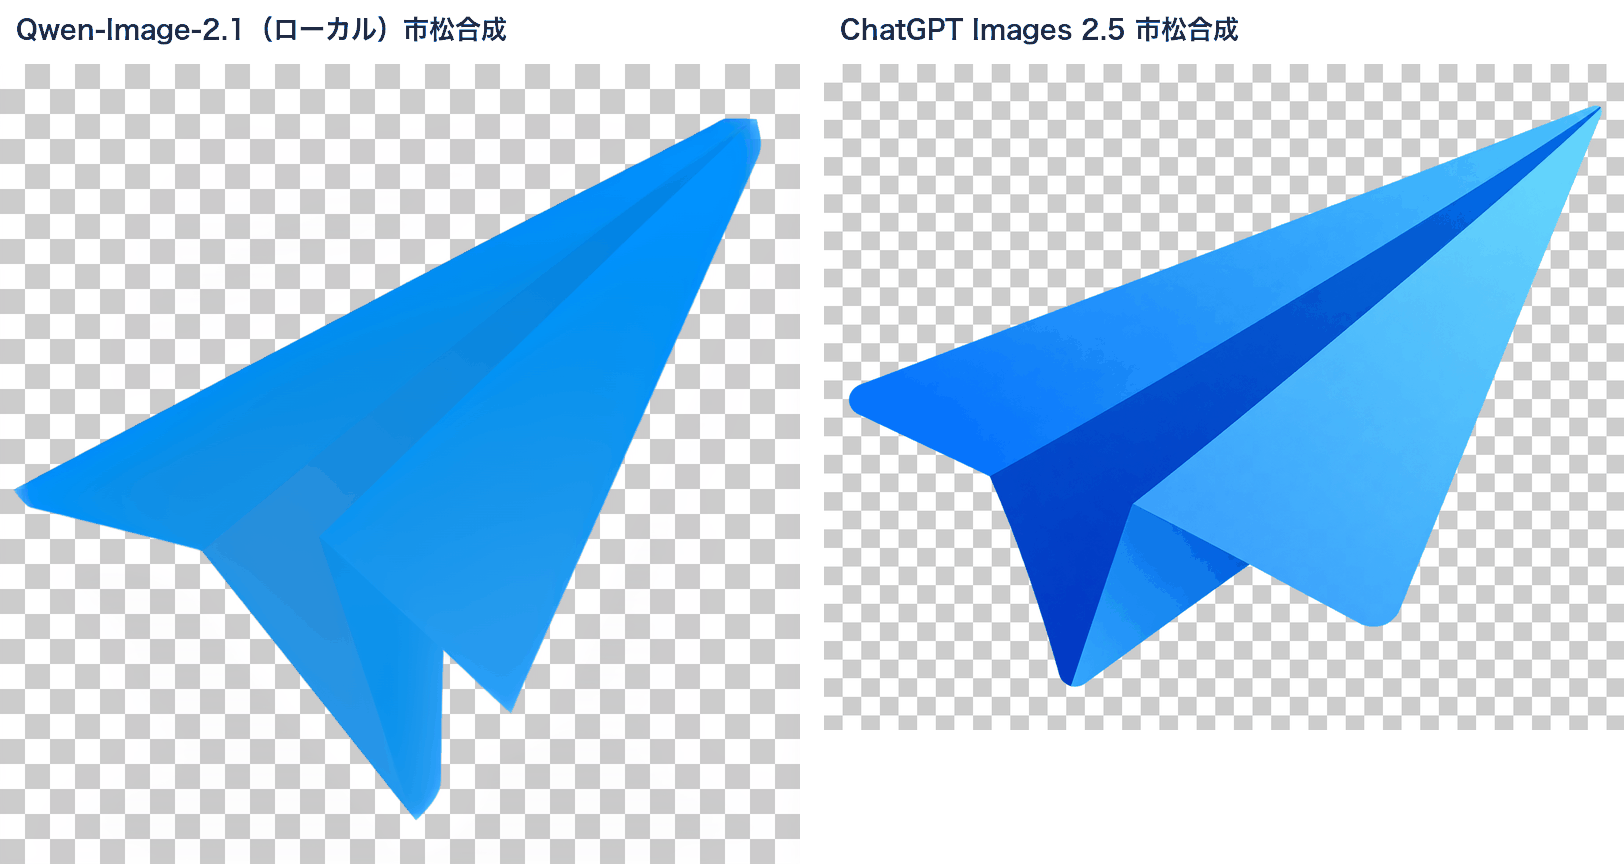
ケース5の比較。両方とも本物のアルファチャンネル付きPNGでした。
結果: 互角。ただしアルファの中身は少し違う。
両方ともRGBAモードのPNGで、背景除去ノードもマッティングモデルも使わずに透過画像が出てきました。Qwenは1024×1024、GPTは1374×1145です。アルファチャンネルの値を数えると、性格の違いが見えました。
| 完全透明(alpha 0) | 半透明(1〜127) | ほぼ不透明(240〜254) | 完全不透明(255) | |
|---|---|---|---|---|
| Qwen-Image-2.1 | 31% | 37% | 31% | 0% |
| ChatGPT Images 2.5 | 62% | 0.5% | 37% | 0.1% |
Qwenは縁が綺麗な一方、背景側に薄い半透明のノイズが広く残っています(alpha 1〜127が37%)。市松模様の上では目立ちませんが、白以外の背景に載せると薄くにじむ可能性があります。GPTは背景がきっぱり透明ですが、本体が「ほぼ不透明」で完全不透明のピクセルがほとんど無く、わずかに透けています。ロゴやアイコンとして使うなら、どちらも書き出し後にアルファをしきい値処理する一手間が要りそうです。
まだ追いついていないところ(整理)
5ケースを通して見えた差を、非エンジニアの方向けに言い換えるとこうなります。
| 観点 | ChatGPT Images 2.5 / GPT-Image-2.5 | Qwen-Image-2.1(ローカル) |
|---|---|---|
| 全体の品質 | 最上位ティア | 2番手ティアの上端 |
| 複雑な指示の理解 | 「candid」「minimalist」の意図を読んで演出まで足す | 短い指示だと意図を外しやすい。公式の書き換えモデル併用が前提 |
| 複数人・複雑な構図 | 安定(ケース3) | 衣装の崩れ、多様性の不足(ケース3) |
| 文字(日本語) | 正確(ケース1) | 正確(ケース1)。ただし余計な小文字を足すことがある |
| 編集で参照画像の形を反映 | 色だけ変えた(ケース4) | 形まで差し替えた(ケース4) |
| 編集で「変えない部分」の保持 | 高い(差20超 0.7%) | やや低い(差20超 6.3%)。マスク指定なら改善見込み |
| 透過PNG | 対応。本体がわずかに半透明 | ネイティブ対応。背景側に薄いノイズ |
| 参照画像の枚数 | 複数枚 | 最大10枚(強み) |
| 1枚あたりの時間 | 50〜80秒(ChatGPT表示値) | 86〜145秒(M5 Max、1024²、25step) |
| 生成コスト | サブスクまたはAPI課金 | 電気代のみ |
| データの外部送信 | あり | なし |
| 商用利用 | 可(OpenAIの利用規約に従う) | 不可(後述) |
ざっくり言うと、「1発で決めたい」「難しい構図」「人が多い」ならGPT、「何度も試したい」「データを外に出せない」「透過素材が大量に要る」「参照画像の形を忠実に反映したい」ならQwen、という分かれ方です。
なお、Qwenのプロンプト書き換えモデル(Qwen3.5-VL 9Bをファインチューニングした2種、T2I用と編集用)を噛ませると差が縮まる見込みです。ChatGPTは同じことを内部でやっているので、公平に比べるならQwen側にもこれを付けるべきでした。本記事では未検証です。
ライセンス: 本当に商用利用できないのか
ここが一番大事なので、公式リポジトリの LICENSE ファイル(Qwen RESEARCH LICENSE AGREEMENT、Release Date: September 20, 2026)を原文で読みました。
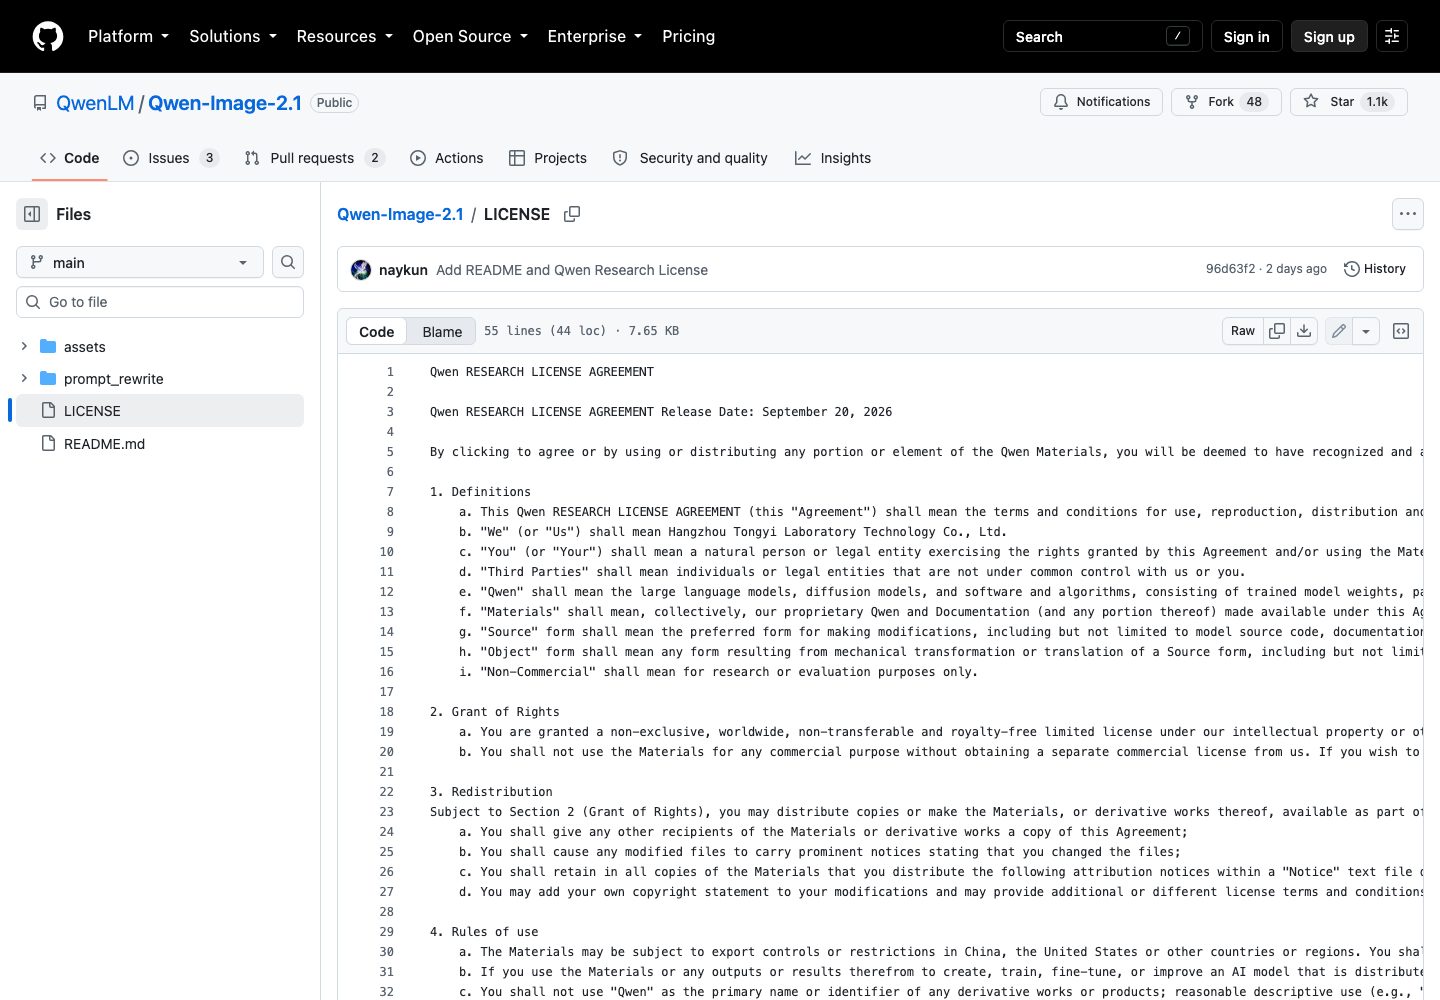
LICENSE原文(2026年9月22日撮影)。
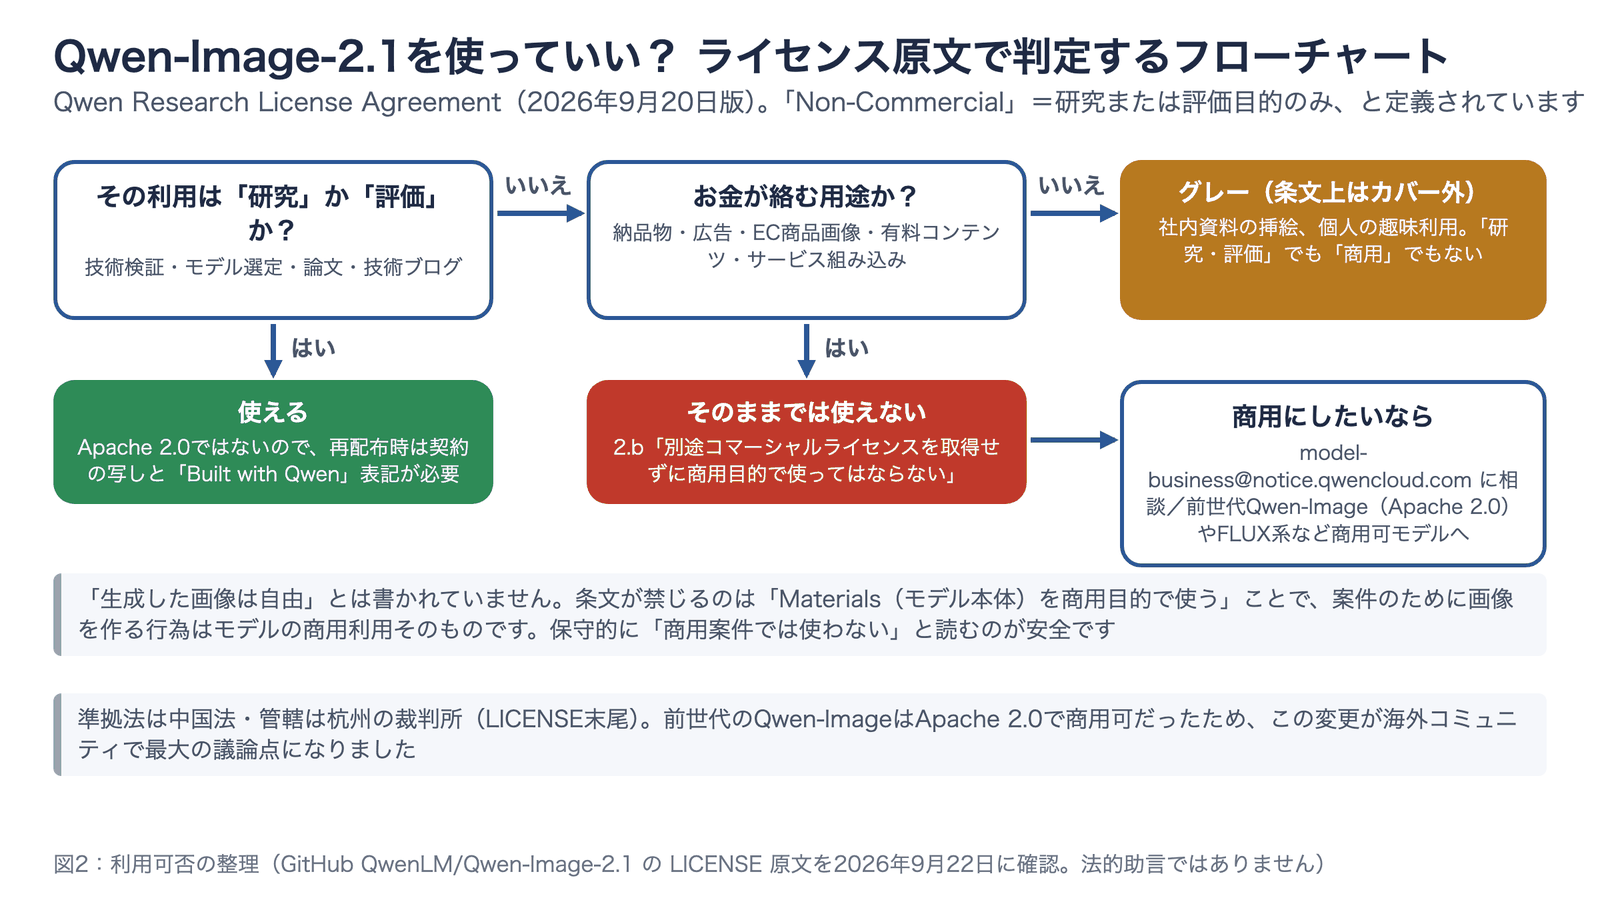
判定のしかたを図2のフローチャートにまとめました。「研究か評価か」→「お金が絡むか」の順に分岐を追ってください。
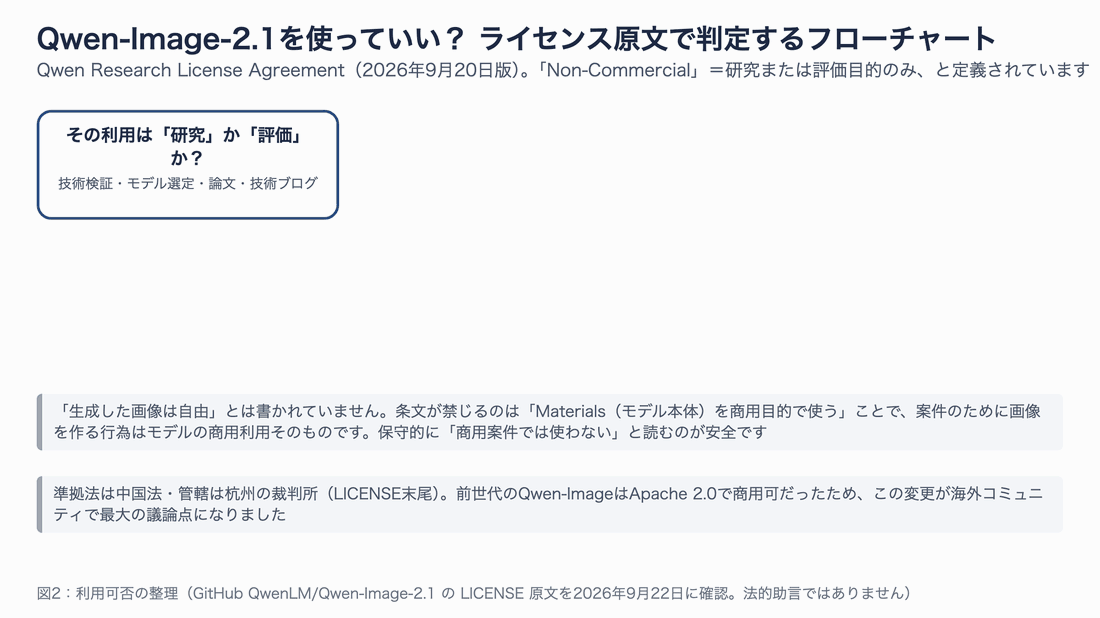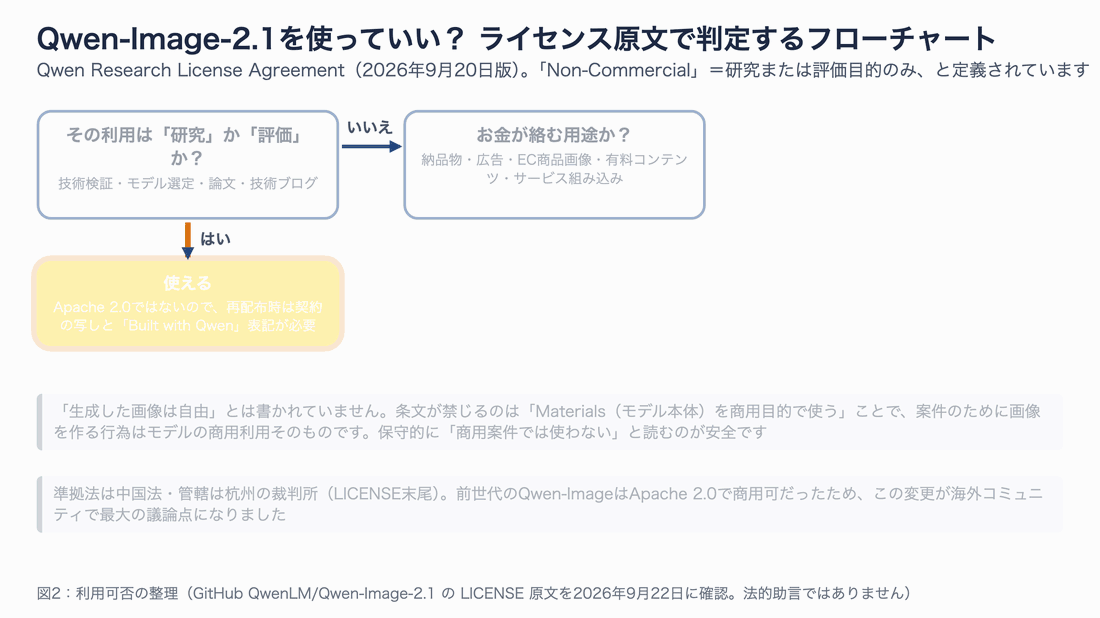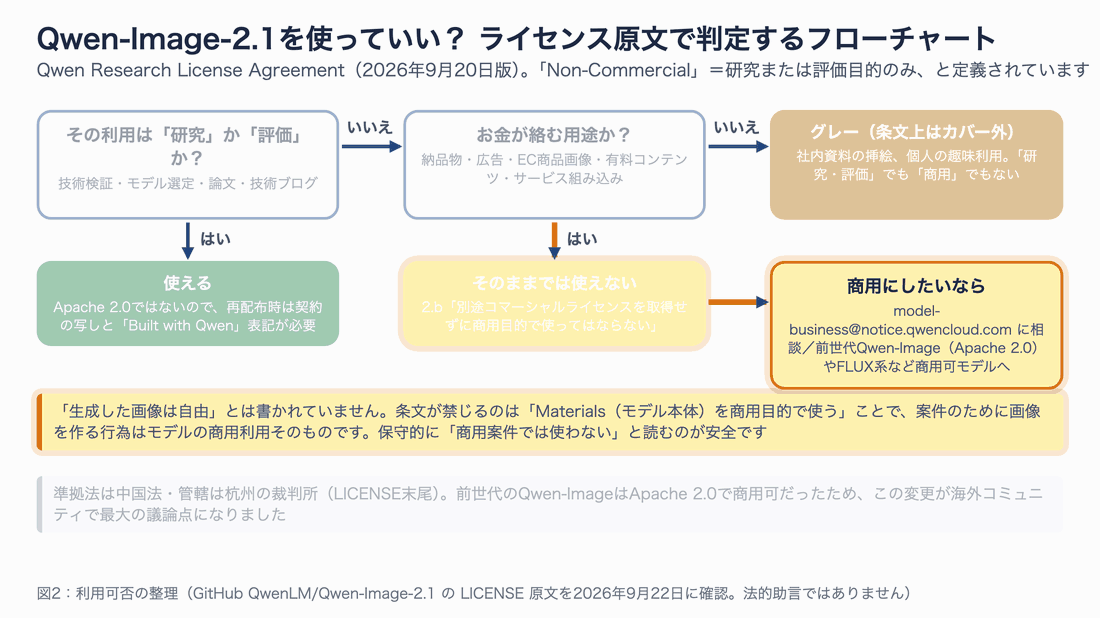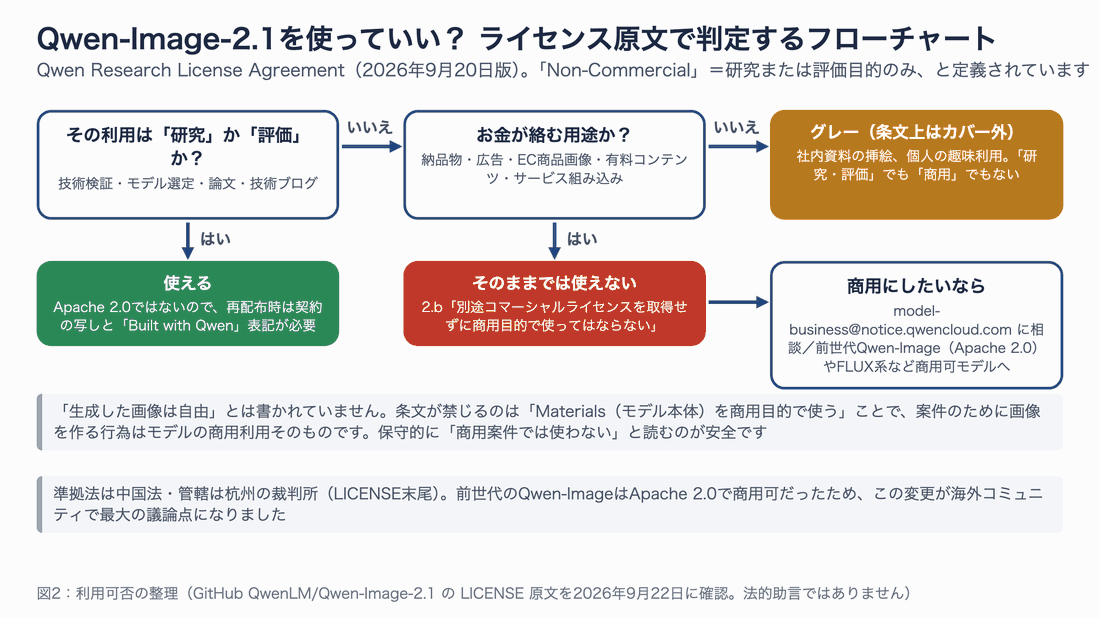
図2: 判断は「研究・評価か」「商用か」の2段階。どちらでもない用途(社内資料の挿絵、趣味)は条文がカバーしていないグレーです。法的助言ではありません。静止画版は fig02-license-flow.png。
条文から読み取れるポイントは4つです。
- 利用は非商用に限定。 2.aで、使用・複製・配布・派生物の作成は「FOR NON-COMMERCIAL PURPOSES ONLY」と明記されています。
- 「非商用」の定義がかなり狭い。 1.iで、Non-Commercialは「research or evaluation purposes only(研究または評価目的のみ)」と定義されています。「お金を取らなければOK」ではなく、「研究か評価か」が基準です。
- 商用利用には別途契約が必要。 2.bで、商用目的で使うには別のコマーシャルライセンスを取得する必要があり、問い合わせ先として
model-business@notice.qwencloud.comが指定されています。 - 準拠法は中国法、管轄は杭州の裁判所。 揉めたときに日本法で争えません。権利者は Hangzhou Tongyi Laboratory Technology Co., Ltd. です。
初代Qwen-ImageはApache 2.0で商用も自由でした。2.1ではこれを捨てて研究ライセンスに変わったため、海外のコミュニティではアーキテクチャよりライセンスの方が議論の中心になりました。Hugging Faceのモデルカードでもライセンス欄は qwen-research です。
生成した画像の扱いはどうなるのか
LICENSEには「生成画像(Output)は商用不可」という直接の条文はありません。ただし禁じられているのは「Materials(モデル本体と文書)を商用目的で使う」ことで、クライアント案件のために画像を生成する行為は、モデルの商用利用そのものです。「出力物は自由」と読むのは無理があるので、保守的に「商用案件で生成した画像は使えない」と解釈するのが安全です。
もう一点、ファインチューニングして再配布する場合は、契約の写しの添付、変更箇所の明示、「Built with Qwen」の表記義務があり、派生モデルの名前に「Qwen」を主要な識別子として使うことも禁じられています。
どういうケースなら使えるのか
定義(研究または評価目的)に照らして整理します。
使える
- 社内でのPoC・技術検証(「このモデルで自社の商品画像編集が成立するか」を評価する)
- モデル選定のための比較評価(まさにこの記事のような用途)
- ComfyUIワークフローの検証、量子化や高速化の実験
- 研究、論文、技術ブログでの検証結果の公開
- 学習目的で個人が触ること
使えない
- クライアントへの納品物(バナー、LP、パンフレット)
- ECサイトの商品画像、広告クリエイティブ
- 有料note、有料講座、書籍の挿絵
- 自社SaaSやアプリへの組み込み
- 生成画像を素材として販売すること
グレー(避けた方が無難)
- 社内向け資料の挿絵(利益目的ではないが「研究・評価」でもない)
- 個人の趣味での利用(同上。実際に問題になる可能性は低いが、条文上はカバーされていない)
商用で使いたい場合の選択肢
- 上記の問い合わせ先に商用ライセンスを相談する(条件は公開されていません)
- 前世代のQwen-Image(20B、Apache 2.0)を使う。文字描画は今でも強く、ComfyUIでbf16なら約40GB、FP8で約16GB、GGUFや4bit量子化なら8GB VRAM級まで落として動かせます
- Alibaba Cloudの有償APIから使う。API利用規約はモデルの研究ライセンスとは別体系のはずですが、2.1がAPI提供されているか、その規約が商用可かは本記事執筆時点で未確認です。使う前に必ず確認してください
- 商用可の別モデル(FLUX系など)と組み合わせる
まとめ
- Qwen-Image-2.1はオープンモデルとして最高水準で、ChatGPT Images 2.5とは「一段差」。差が出るのは複数人の構図と、指示の意図を汲んだ演出。
- 日本語の文字描画と透過PNGは互角。参照画像の形を忠実に反映する編集はQwenが上。
- M5 Max 128GBなら量子化なしで動き、1024×1024が1.5〜2.5分。編集を試すなら
--cpu-vaeが必須。 - ただしライセンスは「研究・評価のみ」で、商用案件には使えない。定義が狭いので「無料なら大丈夫」とは考えない方がよい。
- 今のところ現実的な使い方は「手元で検証して、本番は商用可のモデルかAPIで」。
ライセンスは変わることがあります。この記事は2026年9月22日時点のLICENSEファイルに基づいています。
付録: 再現手順とスクリプト
Qwen-Image-2.1(ComfyUI、Mac)
- ComfyUIを最新に更新する
Comfy-Org/Qwen-Image-2.1からqwen_image_2.1_bf16.safetensors(diffusion_models)、qwen3vl_8b_bf16.safetensors(text_encoders)、qwen_image_2.1_vae_bf16.safetensors(vae)を配置する--cpu-vaeを付けて起動する- テンプレート「Qwen-Image-2.1 text to image」を読み込む。Resolution Selectorを1:1・1.0MPに、stepsを25にする(テンプレート既定値のcfg 1、euler、simpleはそのまま)
- 編集ワークフローでは
resolutionを1024ちょうど以外(1056など)にする
GPT-Image-2.5(API、動作未確認)
本記事ではAPIを使えなかったため未検証ですが、公式ドキュメントのモデルIDに合わせたコードを載せます。quality には low / medium / high / xhigh / max / auto が指定できます。
# 動作未確認。OPENAI_API_KEY を環境変数に設定してから実行する
from openai import OpenAI
import base64

client = OpenAI()
PROMPT = "A poster for a Tokyo coffee shop opening ..."
for model in ["gpt-image-2.5-flare", "gpt-image-2.5-sunburst"]:
    r = client.images.generate(model=model, prompt=PROMPT, size="1024x1024", quality="high", n=1)
    with open(f"{model}.png", "wb") as f:
        f.write(base64.b64decode(r.data[0].b64_json))
評価の記録シート(今回の結果)
| ケース | 観点 | Qwen-Image-2.1 | ChatGPT Images 2.5 |
|---|---|---|---|
| 1 | 日本語の正確さ | ◎ | ◎ |
| 1 | レイアウト追従 | ◎(ただし余計な判子) | ○(演出を追加) |
| 2 | 手・指 | ○ | ○ |
| 2 | 肌・光の自然さ | △(平板) | ◎ |
| 3 | 人数の正確さ | ◎ | ◎ |
| 3 | 衣装・顔の多様性 | ×(衣装が崩れる) | ◎ |
| 4 | 参照画像の形の反映 | ◎ | △(色のみ) |
| 4 | 非指示部分の保持 | ○(差20超 6.3%) | ◎(差20超 0.7%) |
| 5 | 縁の品質 | ◎ | ◎ |
| 5 | アルファの素性 | 背景に半透明ノイズ | 本体がわずかに半透明 |
参考リソース
- QwenLM/Qwen-Image-2.1(GitHub) — README、LICENSE原文
- Qwen/Qwen-Image-2.1(Hugging Face) — モデルカード
- Comfy-Org/Qwen-Image-2.1(Hugging Face) — ComfyUI用の重み
- Qwen-Image-2.1 in ComfyUI(ComfyUI公式ブログ、2026-09-20)
- ComfyUI Issue #16433: MPSでVAEエンコードが壊れる / Issue #16435: resolution=1024でノイズ
- Introducing ChatGPT Images 2.5(OpenAI、2026-09-08)
- OpenAI Developers: Models / Image generation guide
- Qwen-Image-Bench(arXiv 2605.28091)
- 関連レポート: Qwen-Image-2.0 Technical Report(arXiv 2605.10730)、Qwen-Image-VAE-2.0(arXiv 2605.13565)、Qwen-Image-2.0-RL(arXiv 2606.27608)