はじめに
2026年9月22日、Anthropic が Claude Opus 5.5 を公開しました。発表ページには「ほとんどの作業で Claude Fable 5.1 と同じ水準の性能を出し、Opus 5 より40%安く動かせる」とあります。ベンチマーク表では、最上位モデルの Fable 5.1 と OpenAI の GPT-6 Astra を上回る数字が並んでいます。
ただ、新しいモデルが出るたびに、次のような疑問がわいてきます。
- 前のモデル(Opus 5)から、具体的に何が変わったのか。今のコードはそのまま動くのか
- 「Fable 5.1 並み」は本当か。料金が2.5倍の Fable 5.1 を使う理由は残るのか
- 他社の GPT-6 Astra と比べて、どちらを選べばよいのか
発表ページの数字をそのまま並べても、この疑問には答えにくいです。あとで詳しく見ますが、同じモデル・同じベンチマークでも、発表する会社によって数値が違うことがよくあるからです。
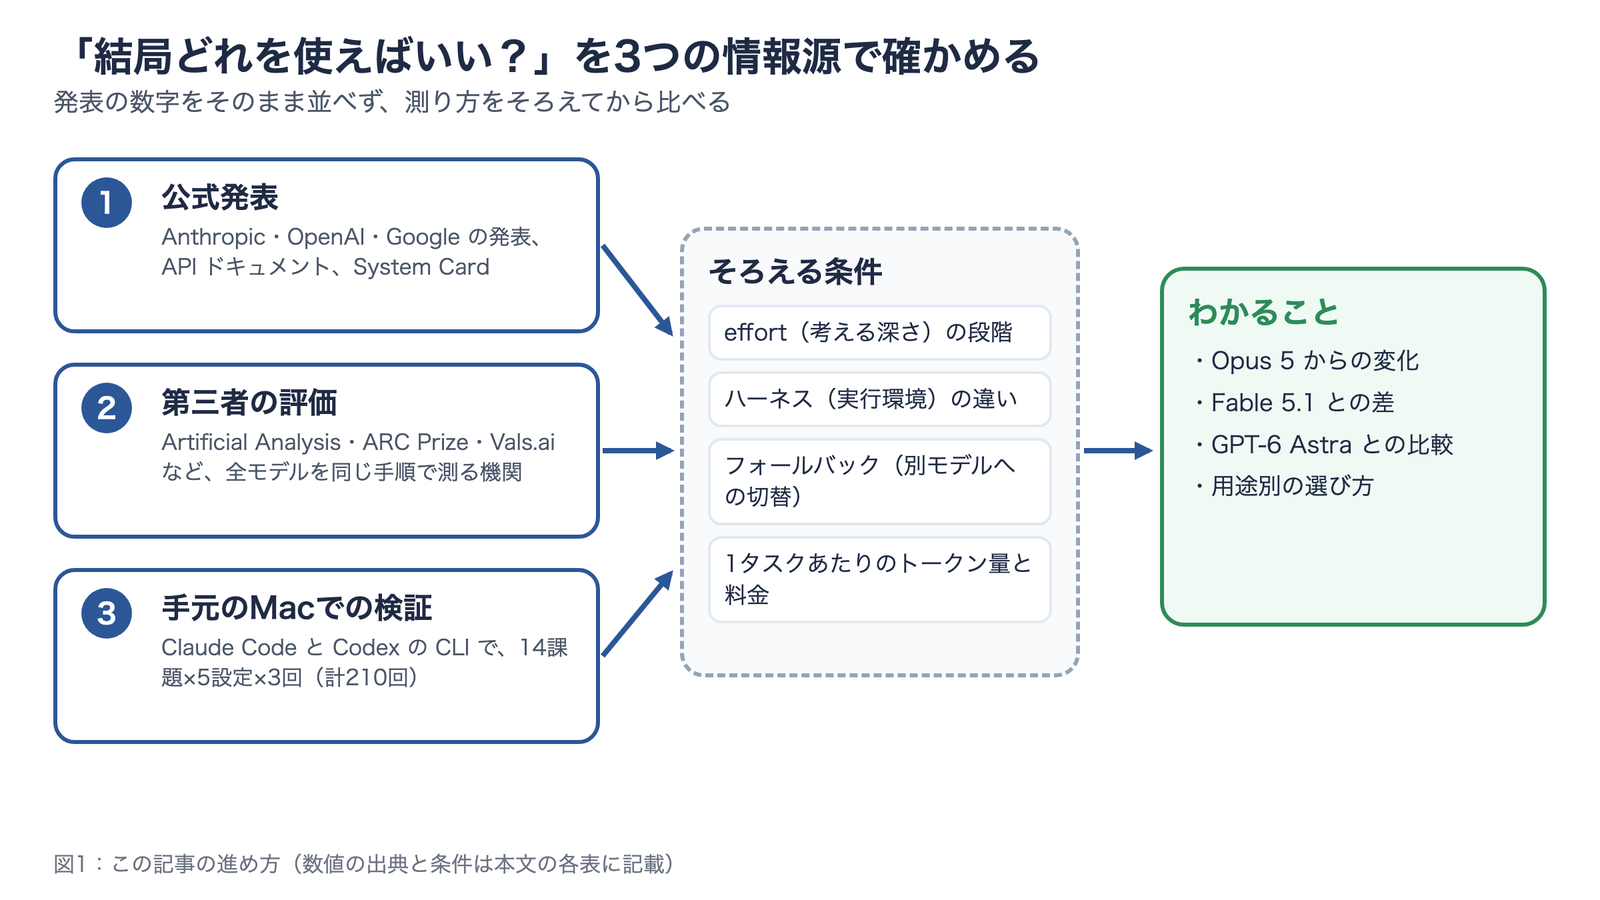
そこでこの記事では、3つの情報源を突き合わせます。1つ目は各社の公式発表、2つ目は第三者の評価機関、3つ目は筆者のMacで実際に動かした結果です。手元の検証では、Claude Code と Codex の CLI を使い、同じ24個の課題を5つの設定で3回ずつ解かせました(合計360回)。
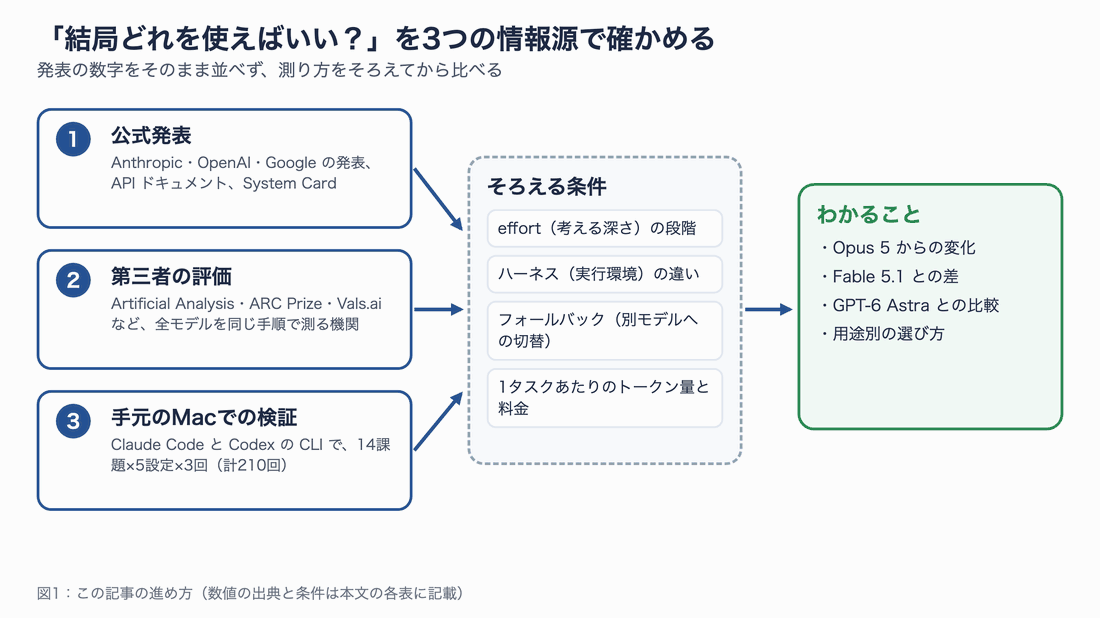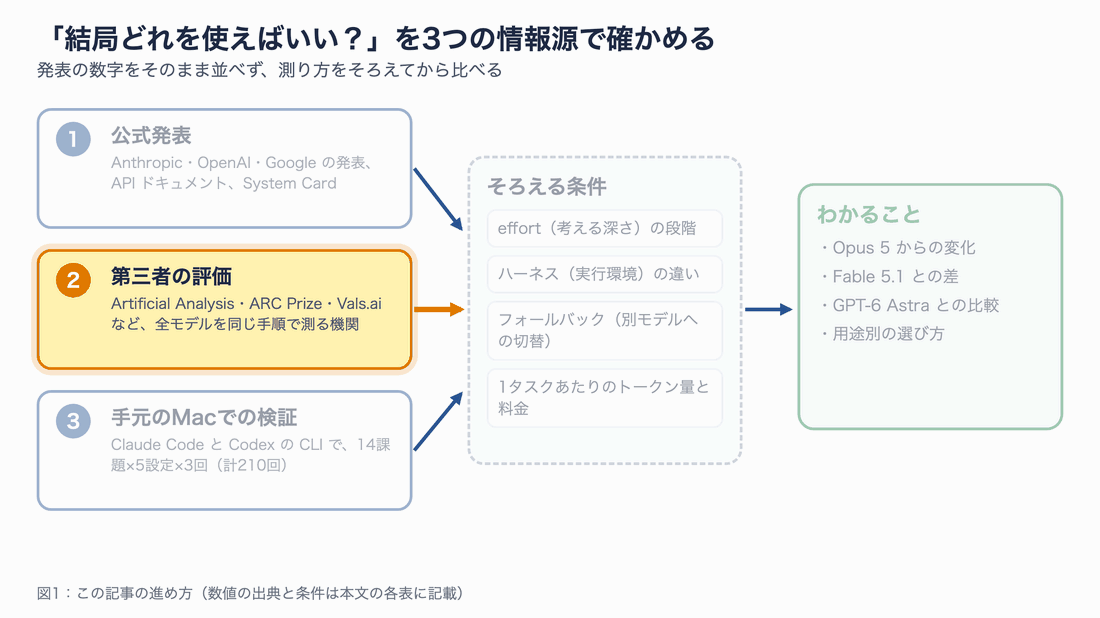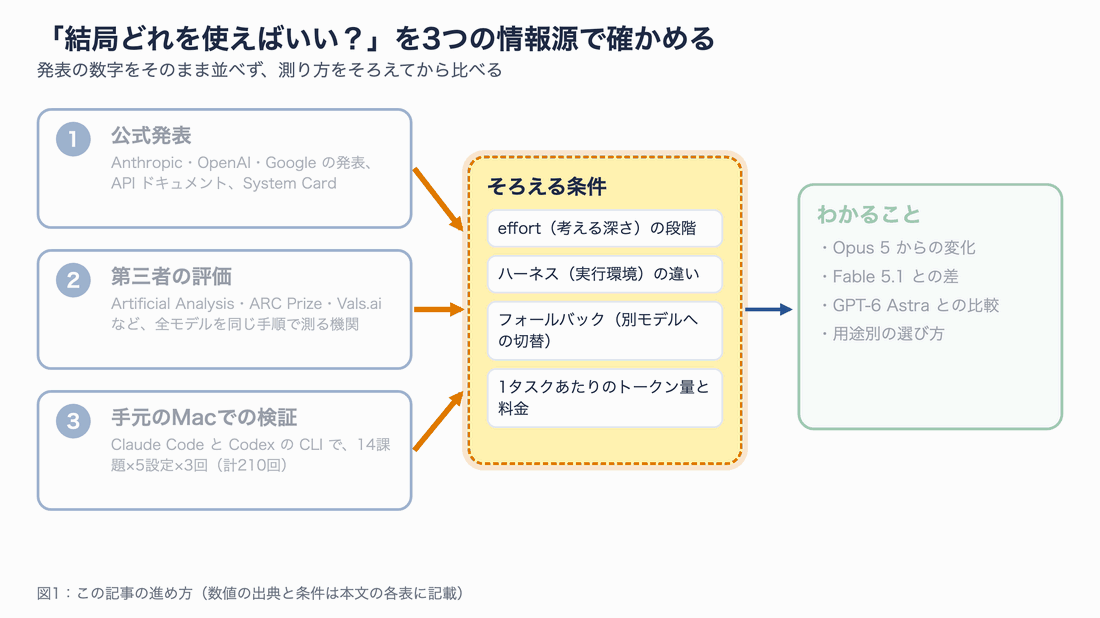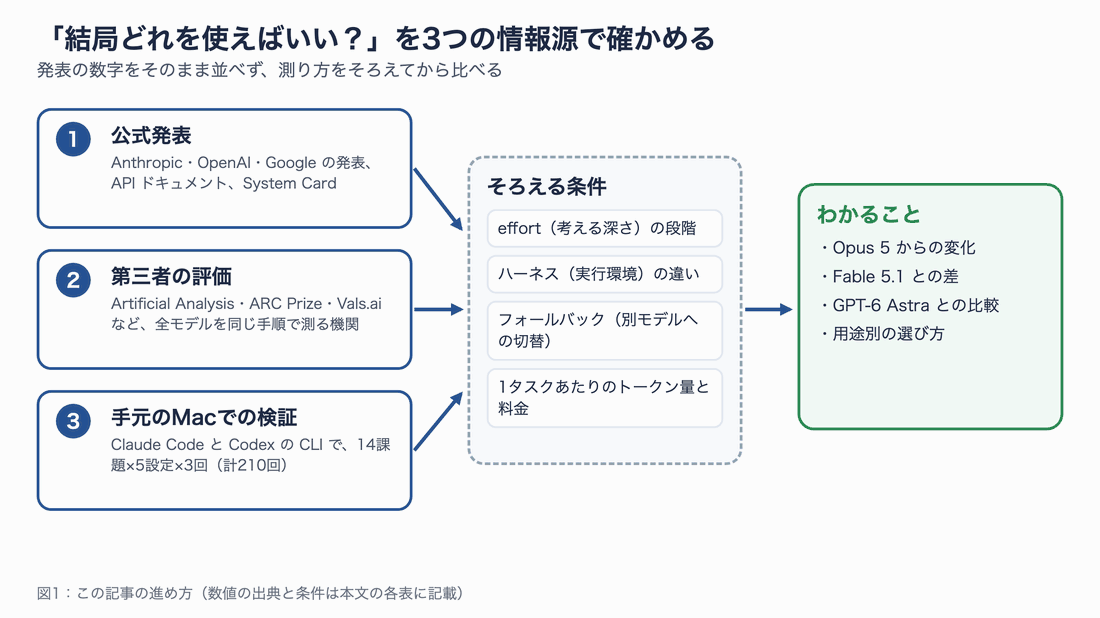
図1:この記事の進め方。数字を読む前に、測り方の条件(effort・ハーネス・フォールバック・トークン量)をそろえます。静止画版
想定している読者は、Claude や ChatGPT を仕事や開発で使っていて、「どのモデルを、どの設定で使えばよいか」を判断したい方です。API のコードを書かない方でも読めるように、専門用語には短い説明を添えます。
先に結論
時間がない方向けに、要点を先にまとめます。根拠は各節で説明します。
| 知りたいこと | 結論 |
|---|---|
| Opus 5 からの変化 | 単価が20%下がり($5/$25 → $4/$20)、キャッシュ読み取りは60%下がった。effort の既定値が high → medium に下がり、thinking(回答前の推論)はオフにできなくなった。Opus 5 のコードは4か所で400エラーになり得る |
| Fable 5.1 との差 | 公式の比較表では9項目すべてで Opus 5.5 が上。Anthropic 自身は「実際に使うと差はスコアほど大きくない」と書いている。単価は Opus 5.5 が 2.5分の1 |
| GPT-6 Astra との差 | 第三者の総合指標では Opus 5.5(max)が上。一方で Astra は1タスクあたりの出力トークンが4分の1以下で、数学・科学系の一部では Astra が上 |
| 手元の検証 | 正答率はほぼ横並び(コーディングは全設定が全回満点。難問は Opus 5.5 high が27問中24問で最多)。差が出たのは時間と費用で、Opus 5.5(medium)がコーディング1題 40秒・$0.23 と最速・最安。Opus 5(high)と比べて費用は約7割減 |
Claude Opus 5.5 とは
Opus 5.5 は、Anthropic の「Claude 5.5 ファミリー」の最初のモデルです。Anthropic は、同じファミリーの Sonnet 5.5 と Haiku 5.5 を「今後数週間のうちに」出すと予告しています。
Anthropic のモデルには、性能と料金の順に Fable(最上位)、Opus、Sonnet、Haiku があります。Opus 5.5 は Opus の最新版で、長時間のエージェント作業(AI が自分でツールを使いながら進める作業)とコーディング、知的労働向けと位置づけられています。
API のモデル ID は claude-opus-5-5 です。Claude API のほか、Amazon Bedrock、Google Cloud、Microsoft Foundry でも公開日から使えます。Claude Code では v2.1.280 から使えるようになり、opus という別名(エイリアス)の指す先が Opus 5.5 に変わりました(Microsoft Foundry を除く)。
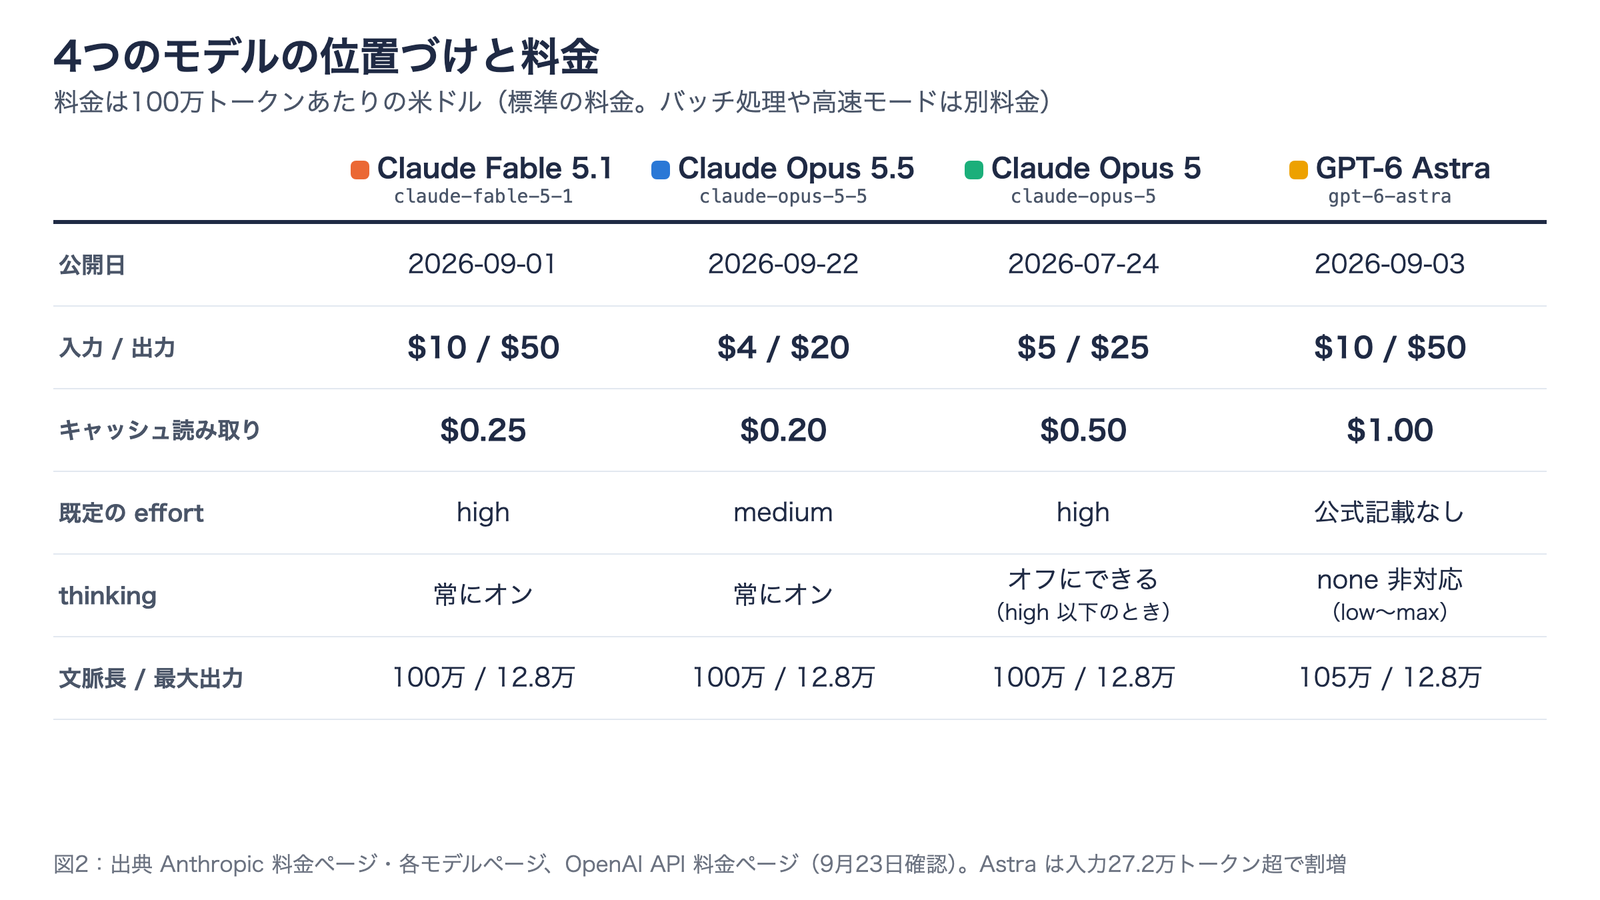
比較する4つのモデルの基本情報を、1枚の表にまとめました。
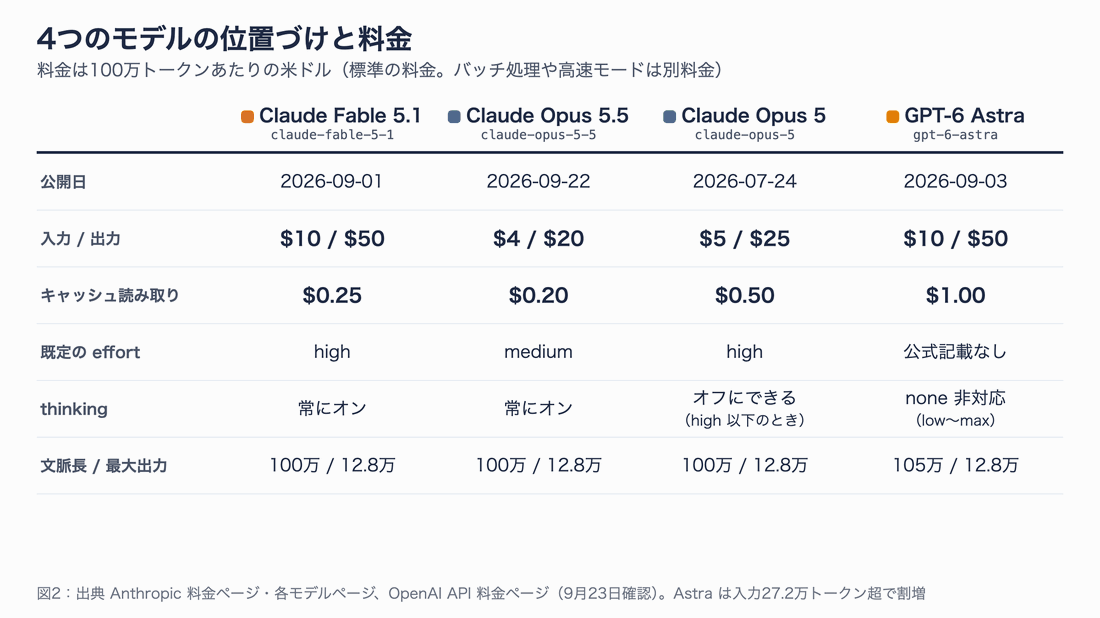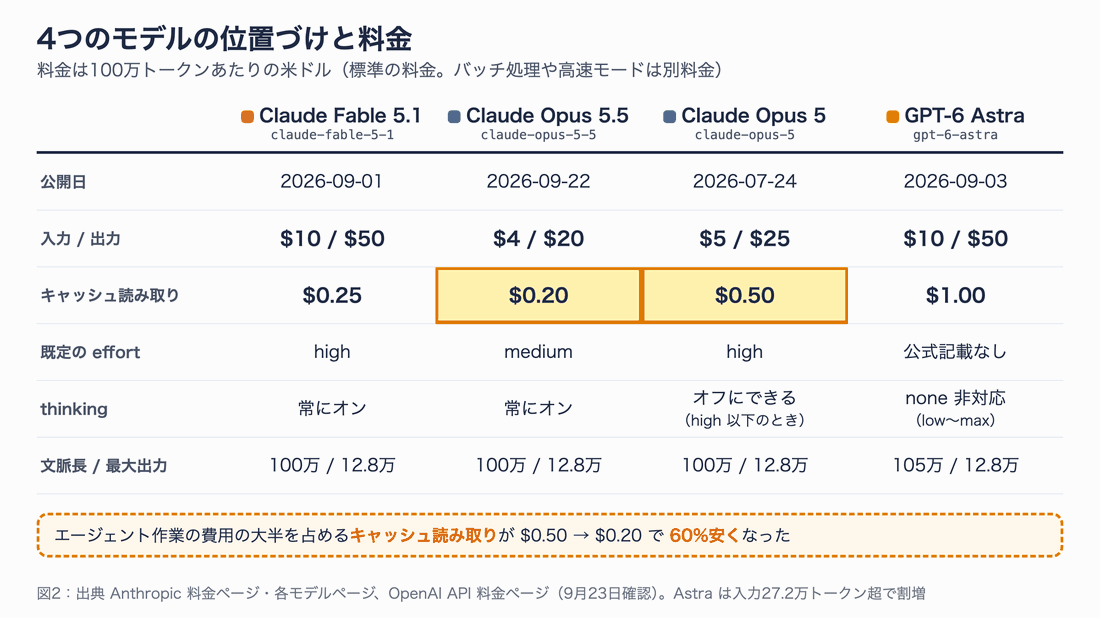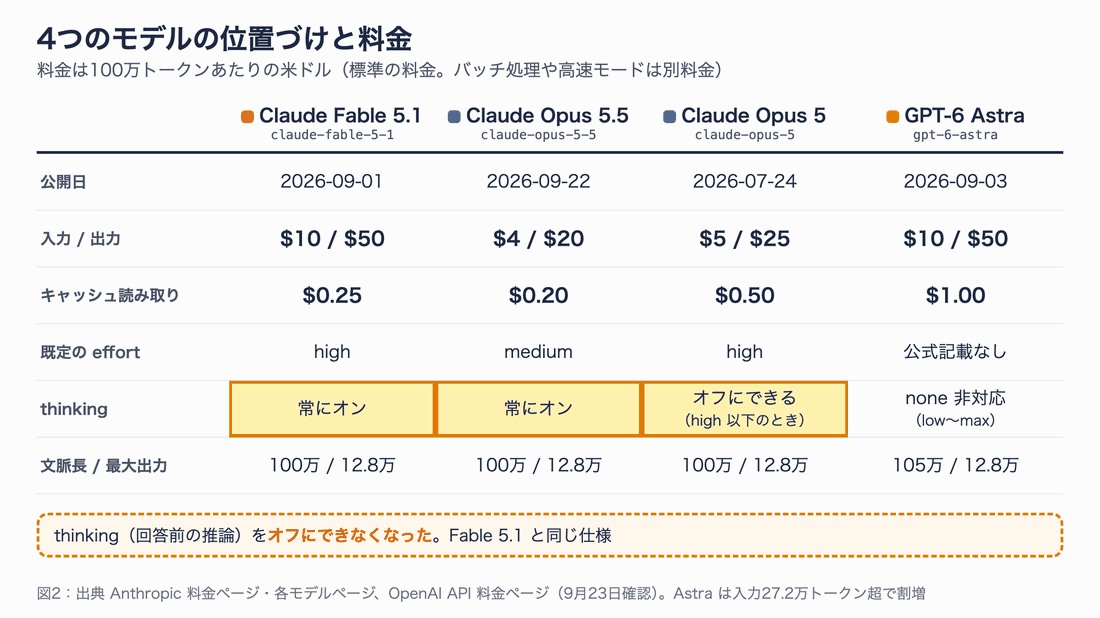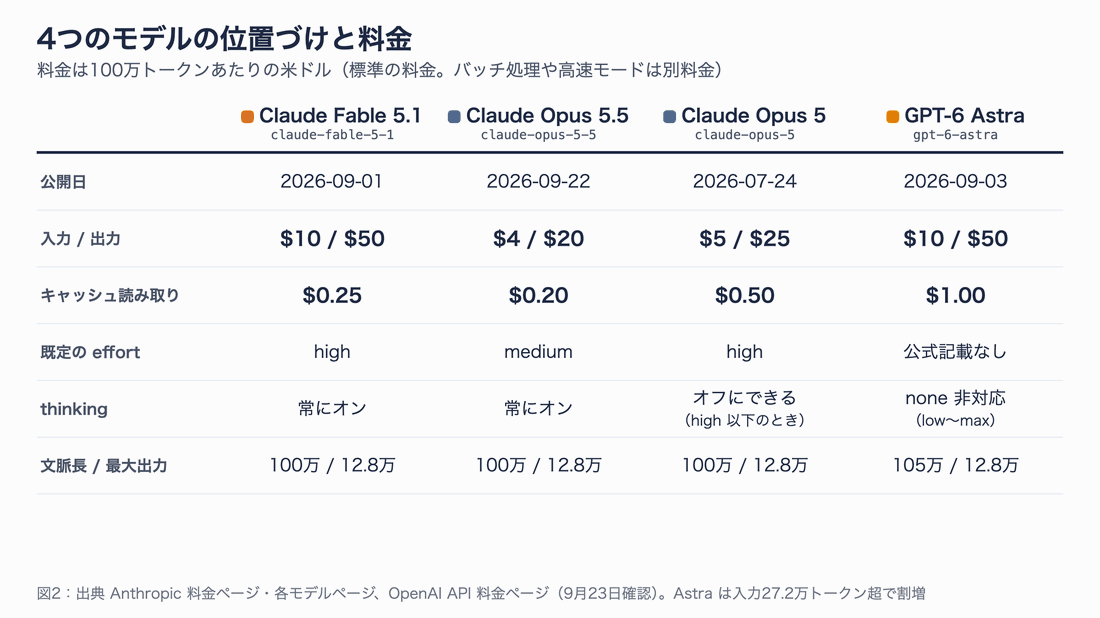
図2:4つのモデルの位置づけと料金。料金は100万トークンあたりの米ドルです。アニメーションでは、Opus 5 から変わった行を順に示します。静止画版
表からわかるのは、料金の軸では Opus 5.5 が4モデルの中で最も安いことです。Fable 5.1 と GPT-6 Astra は、入力・出力とも Opus 5.5 の2.5倍の単価です。
Claude Code と Codex で使い始める
Claude Code で Opus 5.5 を使うには、バージョン 2.1.280 以降が必要です。筆者の環境では、ターミナルの claude が 2.1.272 のままで、Opus 5.5 を指定すると次のエラーになりました。
API Error: 400 Claude Code 2.1.272 does not support this model; version 2.1.280 or newer is required.
更新とモデルの指定は、次のコマンドで行います。
# Claude Code を最新版に更新して、バージョンを確認する
claude update
claude --version   # 2.1.280 以上であること

# Opus 5.5 を指定して起動する(opus と書いても 2.1.280 以降なら Opus 5.5 になる)
claude --model claude-opus-5-5
起動したあとは、/model でモデルを、/effort で effort を切り替えられます。筆者が確かめたところ、--model opus の行き先は 2.1.280 では claude-opus-5-5、2.1.272 では claude-opus-5 でした。バージョンによって同じ opus でも別のモデルになるので、比較するときはモデル ID をそのまま書くほうが確実です。
比べる相手の GPT-6 Astra は、Codex CLI で次のように指定します。
# GPT-6 Astra を effort high で起動する
codex -m gpt-6-astra -c model_reasoning_effort="high"
Opus 5 から何が変わったか
料金:単価は20%、キャッシュ読み取りは60%下がった
Anthropic の料金ページに載っている単価を、Opus 5 と並べます。
| 100万トークンあたり | Opus 5 | Opus 5.5 | 変化 |
|---|---|---|---|
| 入力 | $5 | $4 | −20% |
| 出力 | $25 | $20 | −20% |
| キャッシュ読み取り | $0.50 | $0.20 | −60% |
| キャッシュ書き込み(5分) | $6.25 | $5 | −20% |
| キャッシュ書き込み(1時間) | $10 | $8 | −20% |
| バッチ処理(入力/出力) | $2.50 / $12.50 | $2 / $10 | −20% |
| 高速モード(入力/出力) | $10 / $50 | $8 / $40 | −20% |
とくに大きいのが、キャッシュ読み取りの値下げです。プロンプトキャッシュ(prompt caching)とは、前回と同じ前半部分(システムプロンプトやそれまでの会話)を再利用して、2回目以降を安く読み込む仕組みです。
Claude Code のようなエージェントは、ツールを1回呼ぶたびに、それまでの会話全体をモデルに送り直します。そのため、入力トークンの大半がキャッシュからの読み取りになります。Anthropic も発表ページで「キャッシュ読み取りは、エージェントやコーディングの費用の大半を占める」と書いています。
発表ページの見出しにある「40%安い」は、単価の話ではありません。「既定の設定で、典型的な作業をしたときの費用が40%下がる」という意味です。単価が下がったことに加えて、Opus 5.5 は1つの作業に使うトークンが少ないため、合わせて40%になる、と説明されています。既定の設定どうしの比較なので、Opus 5.5 は medium、Opus 5 は high で比べた数字と読めます。
手元の検証で、この「40%」がどのくらい当てはまるかも確かめました。結果は後半の「手元のMacで検証してみた」で紹介します。
速度:出力が30%以上速くなった(公式発表)
Anthropic によると、Opus 5.5 は Opus 5 より 30%以上速く出力を生成します。これとは別に、料金が2倍の「高速モード」(fast mode)を使うと、出力速度が最大2.5倍になります。高速モードは Claude API と Claude Code で使えますが、Bedrock・Google Cloud・Foundry では使えません。
第三者の Artificial Analysis の計測では、1秒あたりの出力トークン数は Opus 5.5(high)が 90.2、Opus 5(high)が 55.8 でした。この数字の比では、約1.6倍です(計測日や条件によって変わる値です)。
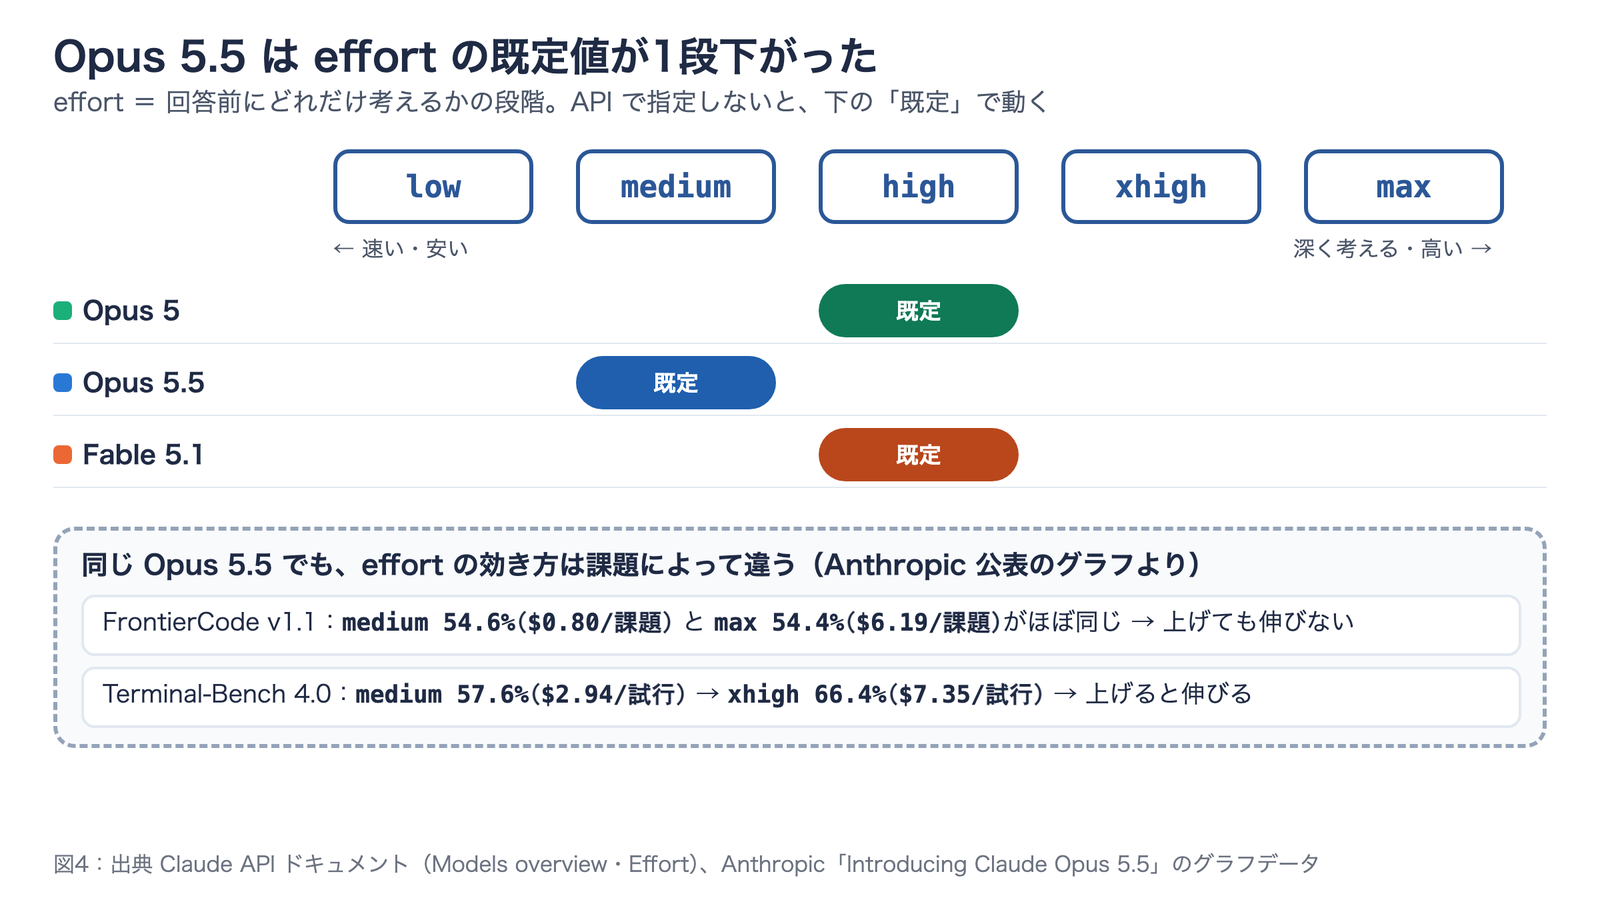
effort の既定値が medium に下がった
effort は、モデルが回答する前にどれだけ考えるかを決める設定です。low・medium・high・xhigh・max の5段階があり、上げるほど丁寧に考える代わりに、時間と費用が増えます。
Opus 5.5 では、この effort の既定値が high から medium に1段下がりました。API で effort を指定していないコードをそのまま Opus 5.5 に切り替えると、以前より1段低い設定で動くことになります。Claude Code も、Opus 5.5 は medium から始まります。
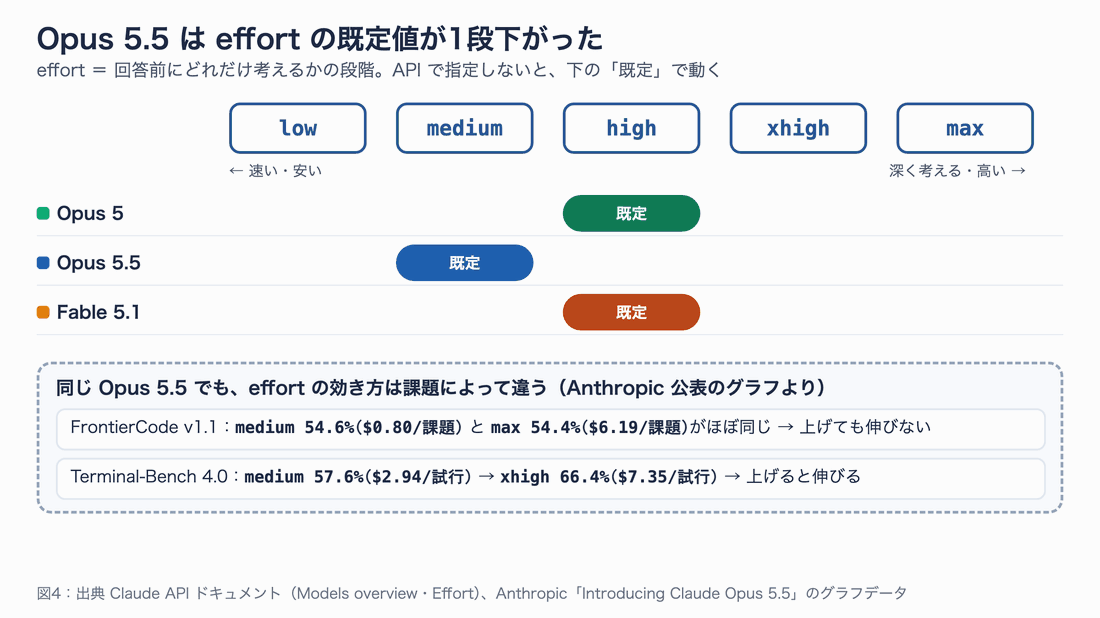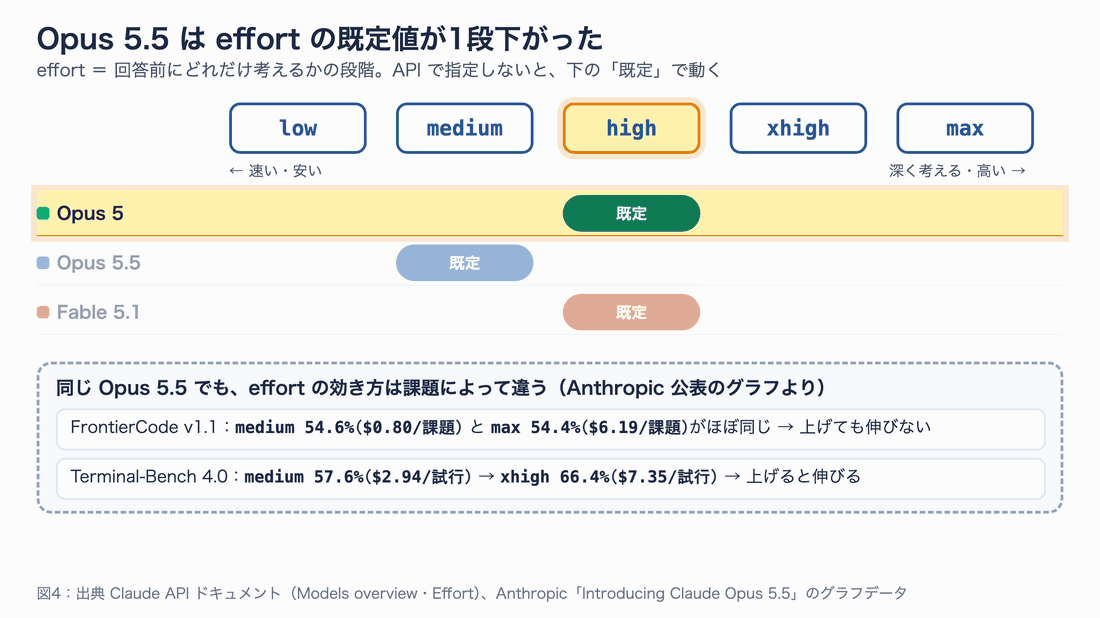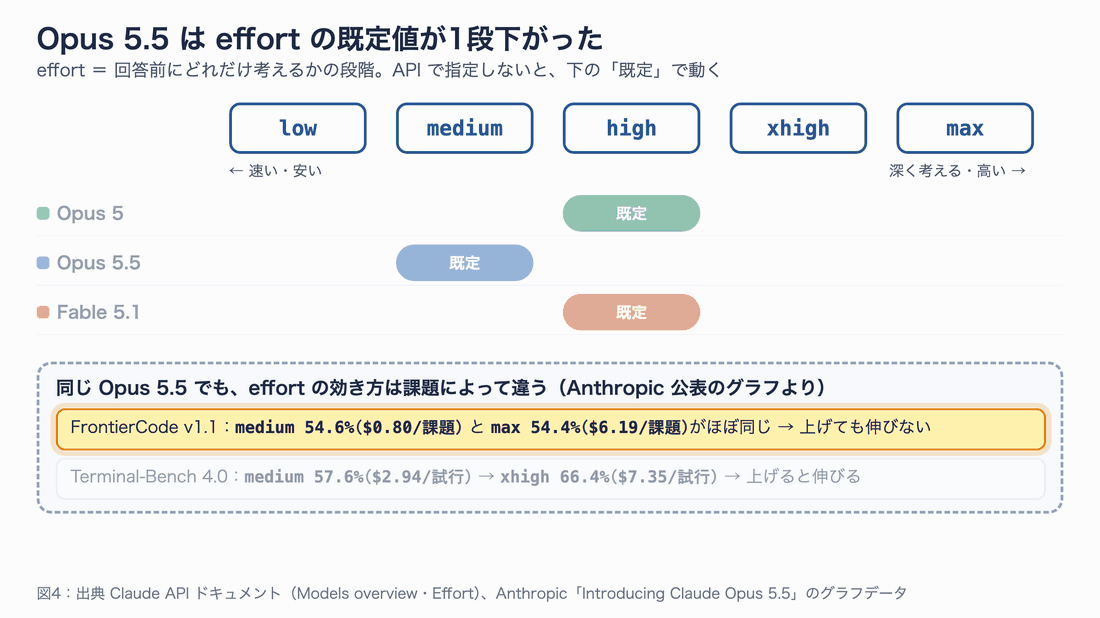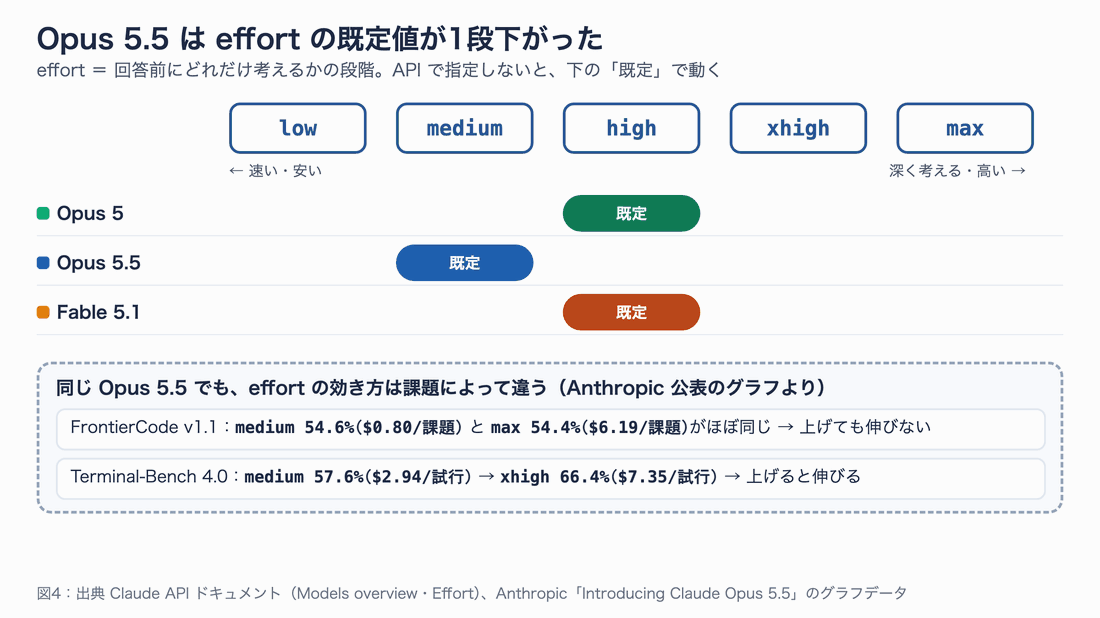
図4:effort の既定値と、課題による効き方の違い。数値は Anthropic の発表ページに載っているグラフのデータです。静止画版
図の下段が示すように、effort を上げたときの伸び方は課題によって違います。FrontierCode(コーディング)では medium の54.6%と max の54.4%がほぼ同じで、費用は8倍近く違います。一方、Terminal-Bench 4.0(ターミナル操作)では、medium の57.6%から xhigh の66.4%まで伸びました。
Anthropic の移行ガイドも「effort の比較(effort sweep)をやり直す」ことを勧めています。自分の用途で2〜3段階を試して、品質と費用のバランスが良いところを選ぶのが確実です。
thinking をオフにできないなど、4つの破壊的変更
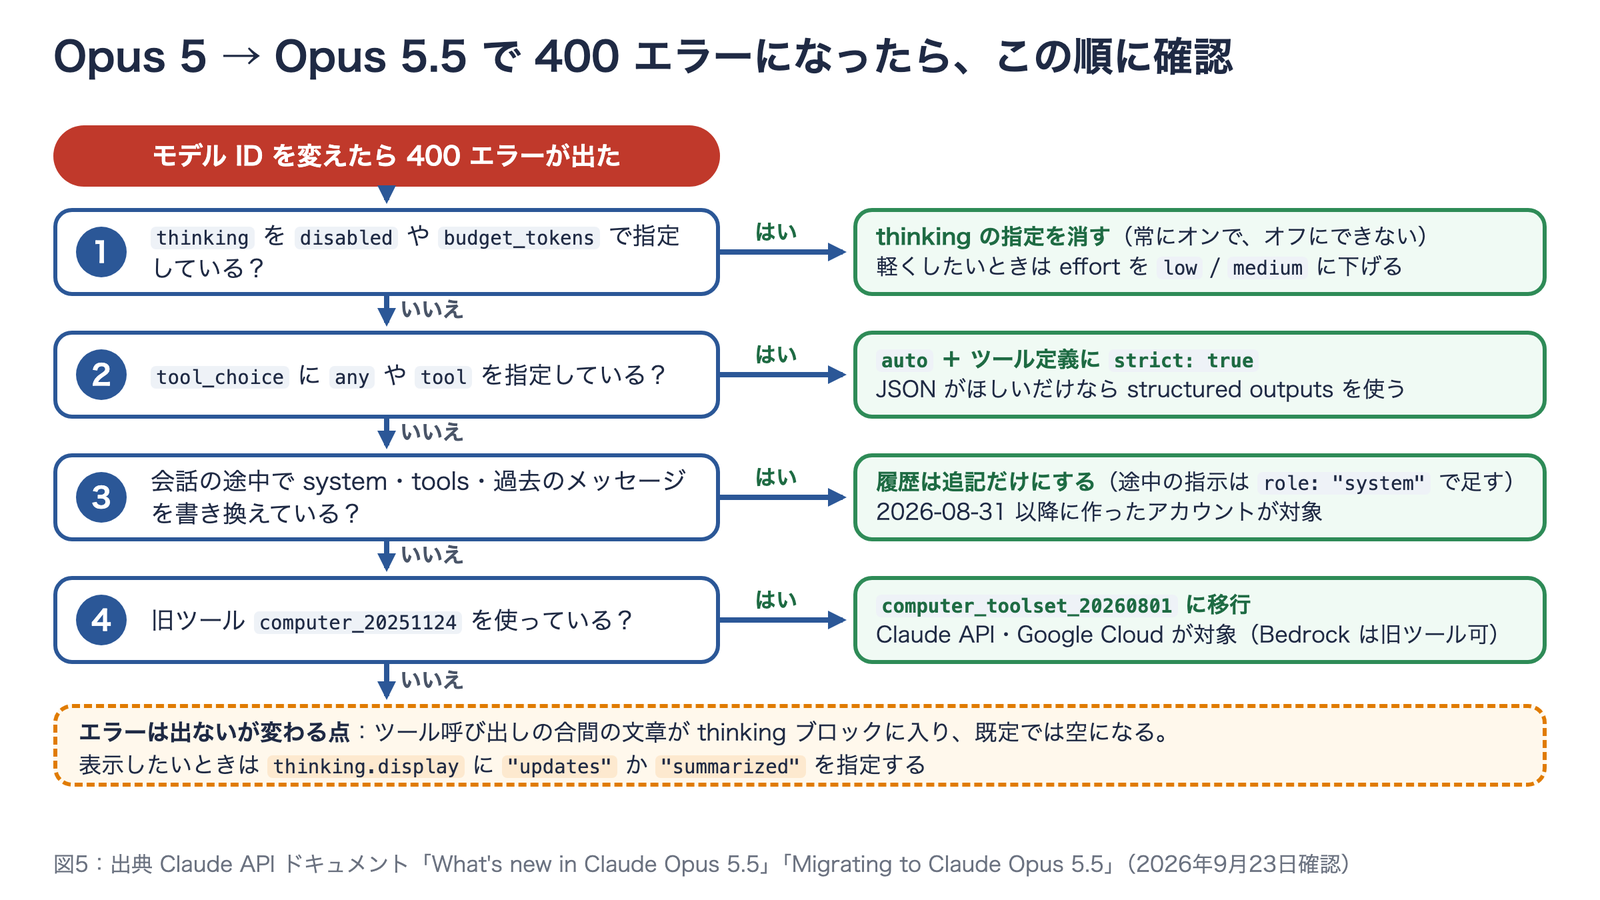
API で Opus 5 を使っている場合は、ここが一番大事です。Anthropic のドキュメントには、Opus 5 で動いていたコードが Opus 5.5 ではエラーになる変更が4つ載っています。
| # | 変更点 | Opus 5 では | Opus 5.5 では |
|---|---|---|---|
| 1 | thinking の無効化 | effort が high 以下なら {"type": "disabled"} を指定できた | 常にオン。disabled も budget_tokens も400エラー |
| 2 | ツールの強制指定 | tool_choice に any や tool を指定できた | 400エラー。auto と strict: true で代用する |
| 3 | thinking ブロックの扱い | 会話の途中で履歴を書き換えても動いた | thinking ブロックがモデルと会話に結びつく(preserved thinking)。2026年8月31日以降に作ったアカウントでは、履歴を書き換えると400エラー |
| 4 | 旧コンピューター操作ツール | computer_20251124 が使えた | Claude API と Google Cloud では400エラー。computer_toolset_20260801 を使う(Bedrock では旧ツールも動く) |
1〜3は、先に Fable 5.1 で入った仕組みと同じです。3の「preserved thinking」は、モデルの推論内容を別のモデルの学習に流用されること(蒸留)を防ぐための仕組みで、Anthropic は蒸留対策(anti-distillation)と説明しています。
エラーにはならないものの、応答の形も1つ変わりました。ツール呼び出しの合間にモデルが書く短い文章が、通常のテキストではなく thinking ブロックに入り、既定では空になります。画面に進み具合を表示しているアプリでは、表示が消えたように見えるので注意が必要です。
400エラーが出たときに確認する順番を、流れ図にしました。
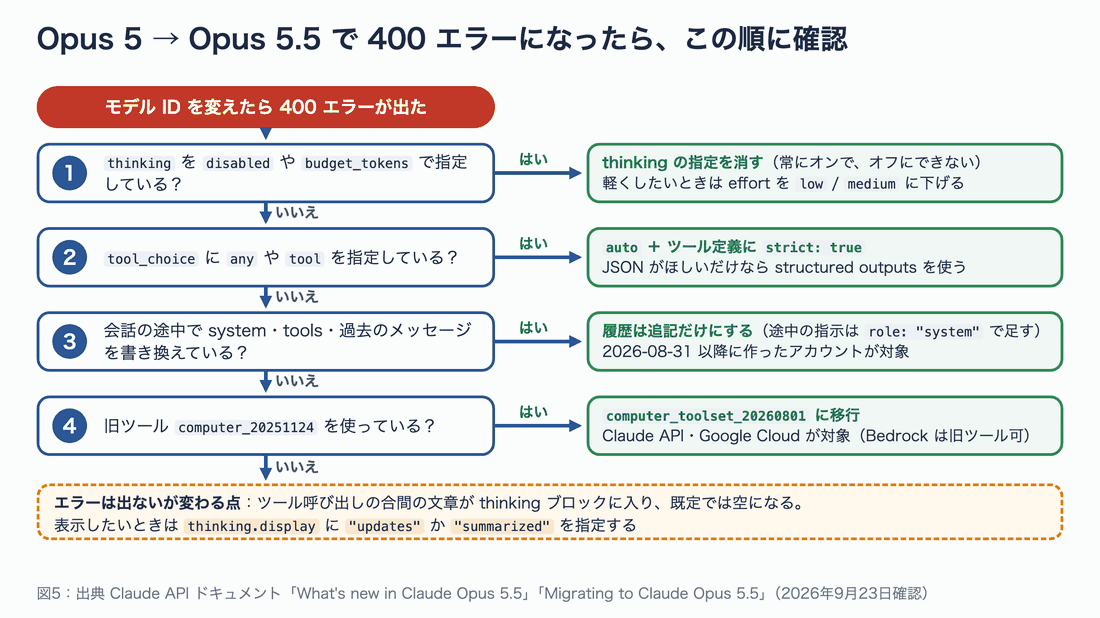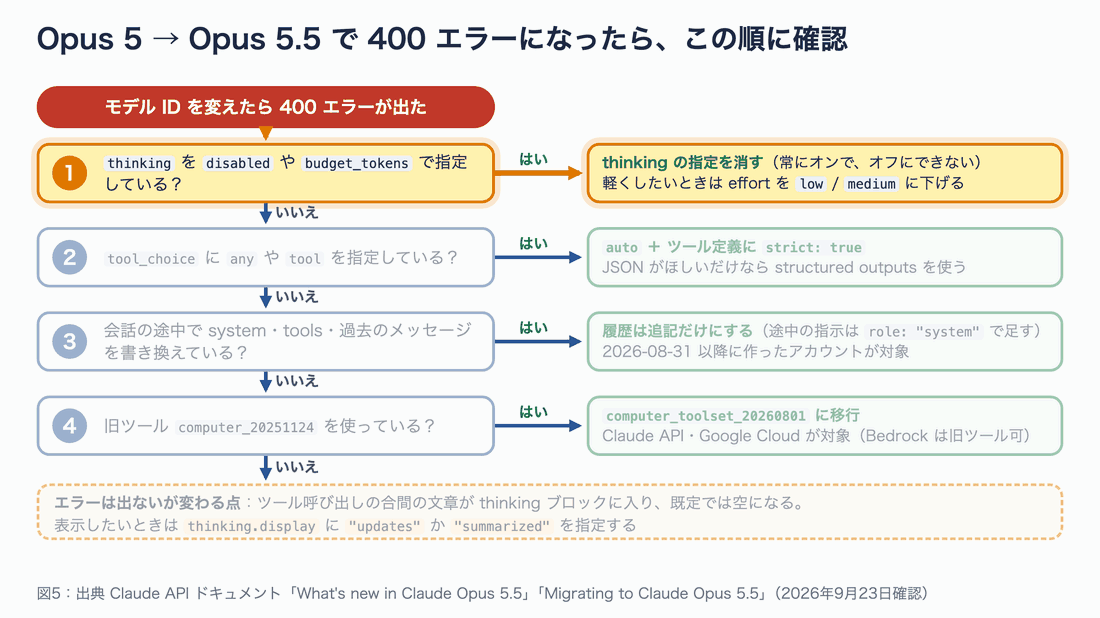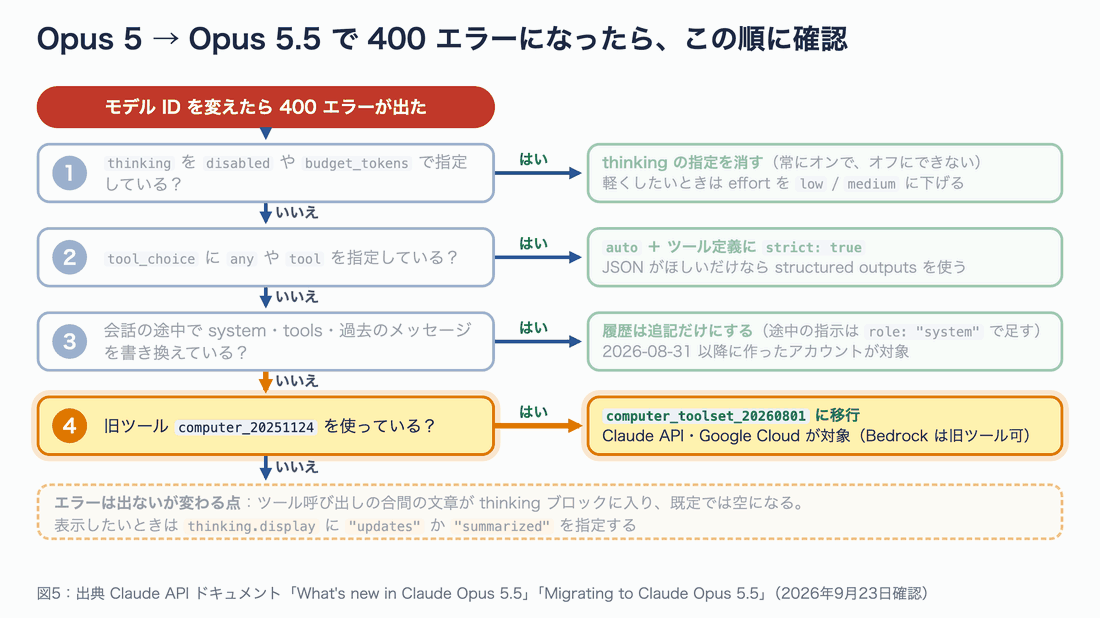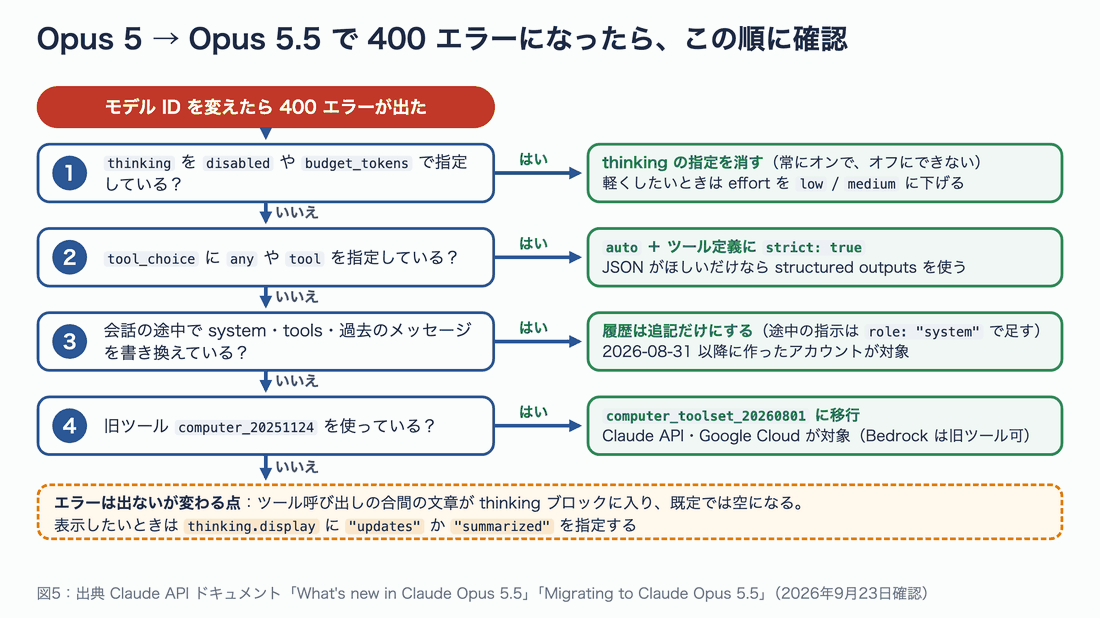
図5:Opus 5.5 への移行で400エラーが出たときの確認順。最後の枠は、エラーは出ないが表示が変わる点です。静止画版
1と2の直し方を、Python のコードで示します。Anthropic の Python SDK のドキュメントに載っている書き方に合わせています。筆者の環境には API キーがないため、このコードは実行して確かめていません。
import anthropic

client = anthropic.Anthropic()  # 環境変数 ANTHROPIC_API_KEY を読む

save_invoice_tool = {
    "name": "save_invoice",
    "description": "請求書の内容を保存する",
    "strict": True,  # 引数がスキーマどおりになることを保証する
    "input_schema": {
        "type": "object",
        "properties": {
            "customer_id": {"type": "string"},
            "total": {"type": "integer"},
        },
        "required": ["customer_id", "total"],
        "additionalProperties": False,
    },
}

# Opus 5 では動いたが、Opus 5.5 では400エラーになる書き方
# thinking={"type": "disabled"}
# tool_choice={"type": "tool", "name": "save_invoice"}

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    output_config={"effort": "low"},  # thinking は切れないので、軽くしたいときは effort を下げる
    tools=[save_invoice_tool],
    tool_choice={"type": "auto"},     # any / tool は使えないので auto にする
    messages=[{
        "role": "user",
        "content": "次の内容を save_invoice ツールで保存してください。顧客 c-102、合計 4,400 円",
    }],
)
ツールを必ず呼ばせたいときは、上のように指示文で「save_invoice ツールで」と明示します。ツールを使う目的が「決まった形の JSON を受け取ること」だけなら、structured outputs(output_config の format)に置き換えるほうが確実です。
3の preserved thinking は、アプリの作りによって影響が大きく変わります。Claude Code や claude.ai、Agent SDK は履歴を書き換えないので、利用者が気にする必要はありません。自分で messages の配列を組み立てているアプリで、途中の system プロンプトやツール一覧、過去のメッセージを書き換えている場合は、追記だけで済む作りに直す必要があります。詳しい手順は、Anthropic の移行ガイド「Migrating to Claude Opus 5.5」にあります。
安全策と、別モデルへの自動切り替え
Opus 5.5 は、Opus として初めて、Fable 5.1 と同じ種類の安全策を備えて公開されました。サイバーセキュリティや生物学の危険な依頼を判定する分類器が動いていて、該当すると判断した依頼は別のモデルで処理されます(フォールバック)。Claude Code のドキュメントによると、生物学の依頼は Opus 5 に、サイバーセキュリティの依頼は Opus 4.8 に回されます。
この仕組みは、ベンチマークの読み方にも関わります。Anthropic の公式スコアは、安全策を有効にしたまま計測されています。途中で別のモデルが処理したタスクも、そのまま成績に含まれています。第三者の評価でも同じ条件のものがあり、後の節で具体例を紹介します。
Fable 5.1 と比べてどれくらいの精度か
公式の比較表では9項目すべてで Opus 5.5 が上
Anthropic の発表ページには、9つのベンチマークの比較表があります。Opus 5.5・Fable 5.1・Opus 5・GPT-6 Astra の4モデル分を、グラフにしました(表には GPT-5.6 Sol の列もありますが、この記事では省きます)。
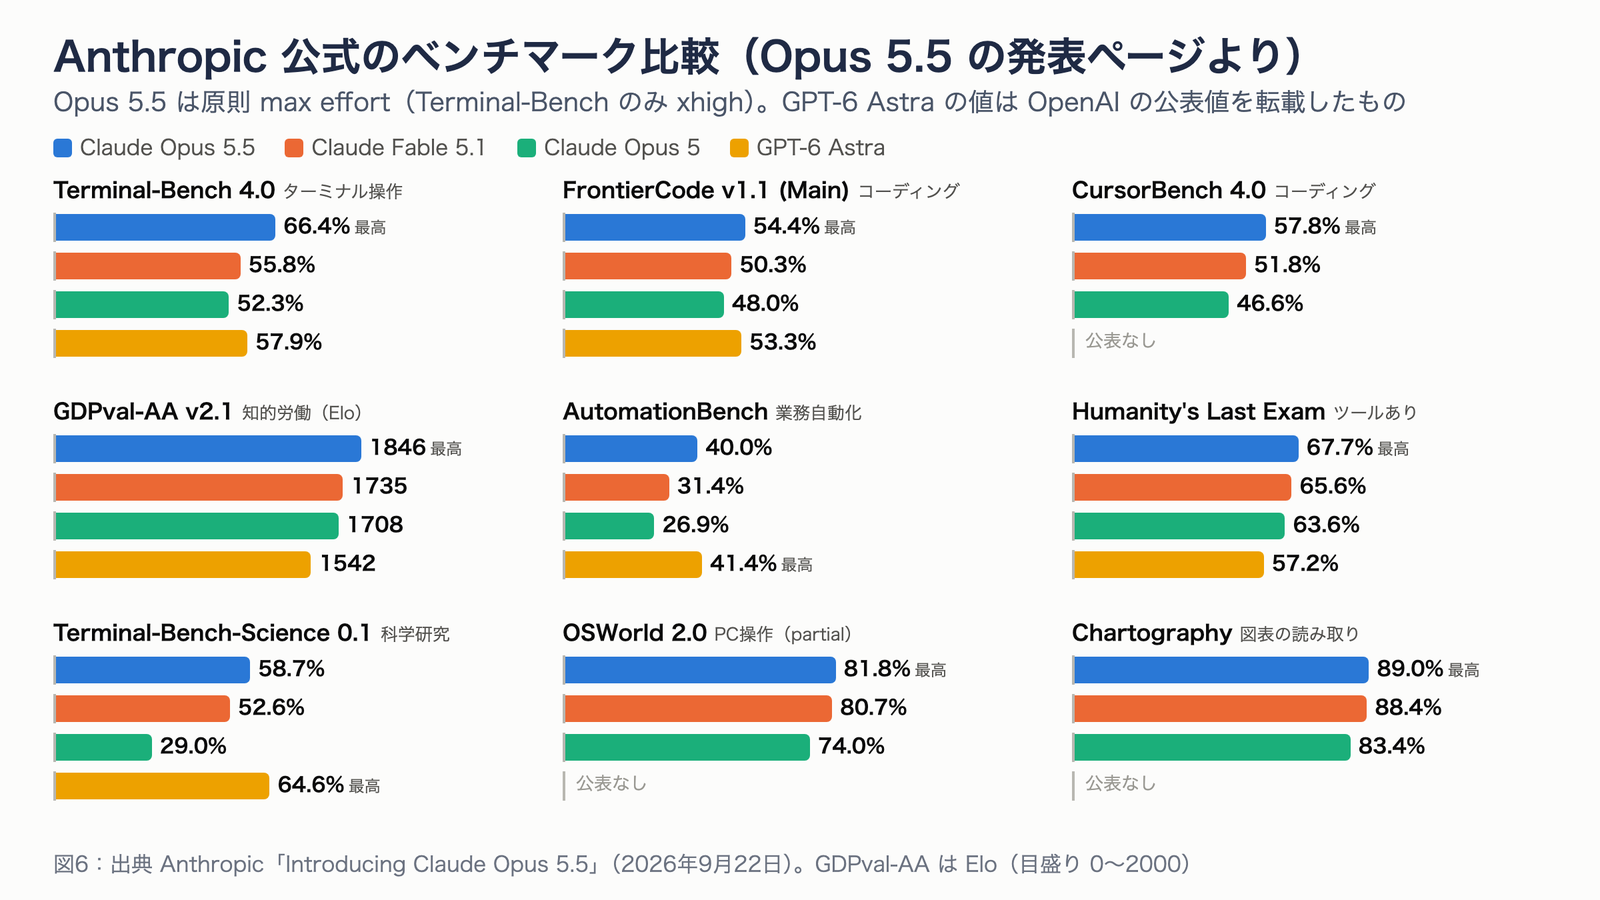
図6:Anthropic が公表した比較表。Opus 5.5 は原則 max effort で、Terminal-Bench 4.0 だけ xhigh の値です。GPT-6 Astra の値は、OpenAI の公表値を Anthropic が転載したものです。
Fable 5.1 と比べると、Opus 5.5 は9項目すべてで上回っています。差が大きいのは Terminal-Bench 4.0(66.4% 対 55.8%)と GDPval-AA(Elo 1846 対 1735)で、差が小さいのは OSWorld 2.0(81.8% 対 80.7%)と Chartography(89.0% 対 88.4%)です。
発表と同じ日に公開された System Card(安全性と性能の詳しい報告書)には、ほかのベンチマークも載っています。たとえば SWE-bench Pro(実際の GitHub の課題を解くテスト)は Opus 5.5 が 89.9、Fable 5.1 が 81.2、Opus 5 が 79.2 です。
「実際に使うと差はスコアほど大きくない」
ただし、Anthropic 自身が次のように書いている点は見逃せません。
In our own use, the gap between Opus 5.5 and Claude Fable 5.1 is narrower than these scores suggest. (社内で実際に使ってみると、Opus 5.5 と Fable 5.1 の差は、これらのスコアが示すほど大きくない)
発表ページでは、この差を示す社内テストの例も紹介されています。HAProxy(C言語で書かれたロードバランサー)を Rust に書き直す作業では、どちらのモデルも HAProxy 自身の回帰テストをほぼすべて通しました。そのうえで、所要時間は Opus 5.5 が9.5時間、Fable 5.1 が12時間で、費用は Opus 5.5 が51%少なかったそうです。
つまり「精度が同じくらいなら、速くて安い Opus 5.5」というのが公式のメッセージです。Claude API のドキュメントも、「ほとんどの作業は Opus 5.5 から始め、難しい推論や長時間のエージェント作業、Opus 5.5 の effort を上げても足りない場合に Fable 5.1 を使う」と勧めています。
第三者の評価でも Opus 5.5 が上
独立した評価機関の数字も見てみます。Artificial Analysis は、10種類の評価をまとめた総合指標「Intelligence Index v4.3.2」を公開しています。max effort 同士で比べると、Opus 5.5 は 58、Fable 5.1 は 53、Opus 5 は 51 でした。Artificial Analysis は「これまで計測した中で最高のスコアを数ポイント上回った」と書いています。
もう1つの例が、Vals.ai の Terminal-Bench 4.0 です。Vals.ai は全モデルを同じ実行環境(Terminus 2 というハーネス)で走らせていて、Opus 5.5 が61.62%、Fable 5.1 が49.49%でした。
ここで、前の節で触れたフォールバックが関係してきます。Vals.ai によると、Opus 5.5 の198回の試行のうち30回は、安全策によって Opus 5 か Opus 4.8 が処理していました。この30回を失敗として数えると、Opus 5.5 のスコアは53.54%に下がり、GPT-6 Astra(57.07%)を下回ります。Vals.ai はこの点をページに明記しています。
GPT-6 Astra など他社モデルと比べて
OpenAI の発表:数学・科学に強い
GPT-6 Astra は、OpenAI が2026年9月3日に公開したモデルです。料金は入力 $10、出力 $50(100万トークンあたり)で、Fable 5.1 と同じ水準です。API ではコンテキストが105万トークンあります。ただし、入力が27.2万トークンを超えるリクエストは、入力が2倍、出力が1.5倍の料金になります。
OpenAI の発表ページの比較表には、Opus 5.5 の列はありません(Opus 5.5 の公開前の発表だからです)。そのため、Opus 5 と Fable 5.1 との比較になります。Astra が大きく上回っているのは、数学と科学の分野です。
| ベンチマーク(OpenAI 発表) | GPT-6 Astra | Fable 5.1 | Opus 5 |
|---|---|---|---|
| FrontierMath Tier 4(最難関の数学) | 97.6% | 87.8% | 73.2% |
| Terminal-Bench Science 0.1(科学研究) | 64.6% | 52.6% | 30.0% |
| GPQA Diamond(大学院レベルの科学) | 96.0% | 93.7% | 93.7% |
| Humanity’s Last Exam(ツールあり) | 57.2% | 65.0% | 63.6% |
Anthropic の比較表でも、Terminal-Bench-Science(Astra 64.6%、Opus 5.5 58.7%)と AutomationBench(Astra 41.4%、Opus 5.5 40.0%)では Astra が上でした。
第三者の総合指標:Opus 5.5 が上、トークン効率は Astra
Artificial Analysis の総合指標で、各モデルの effort ごとのスコアと、1タスクあたりのコストを並べたのが次の図です。
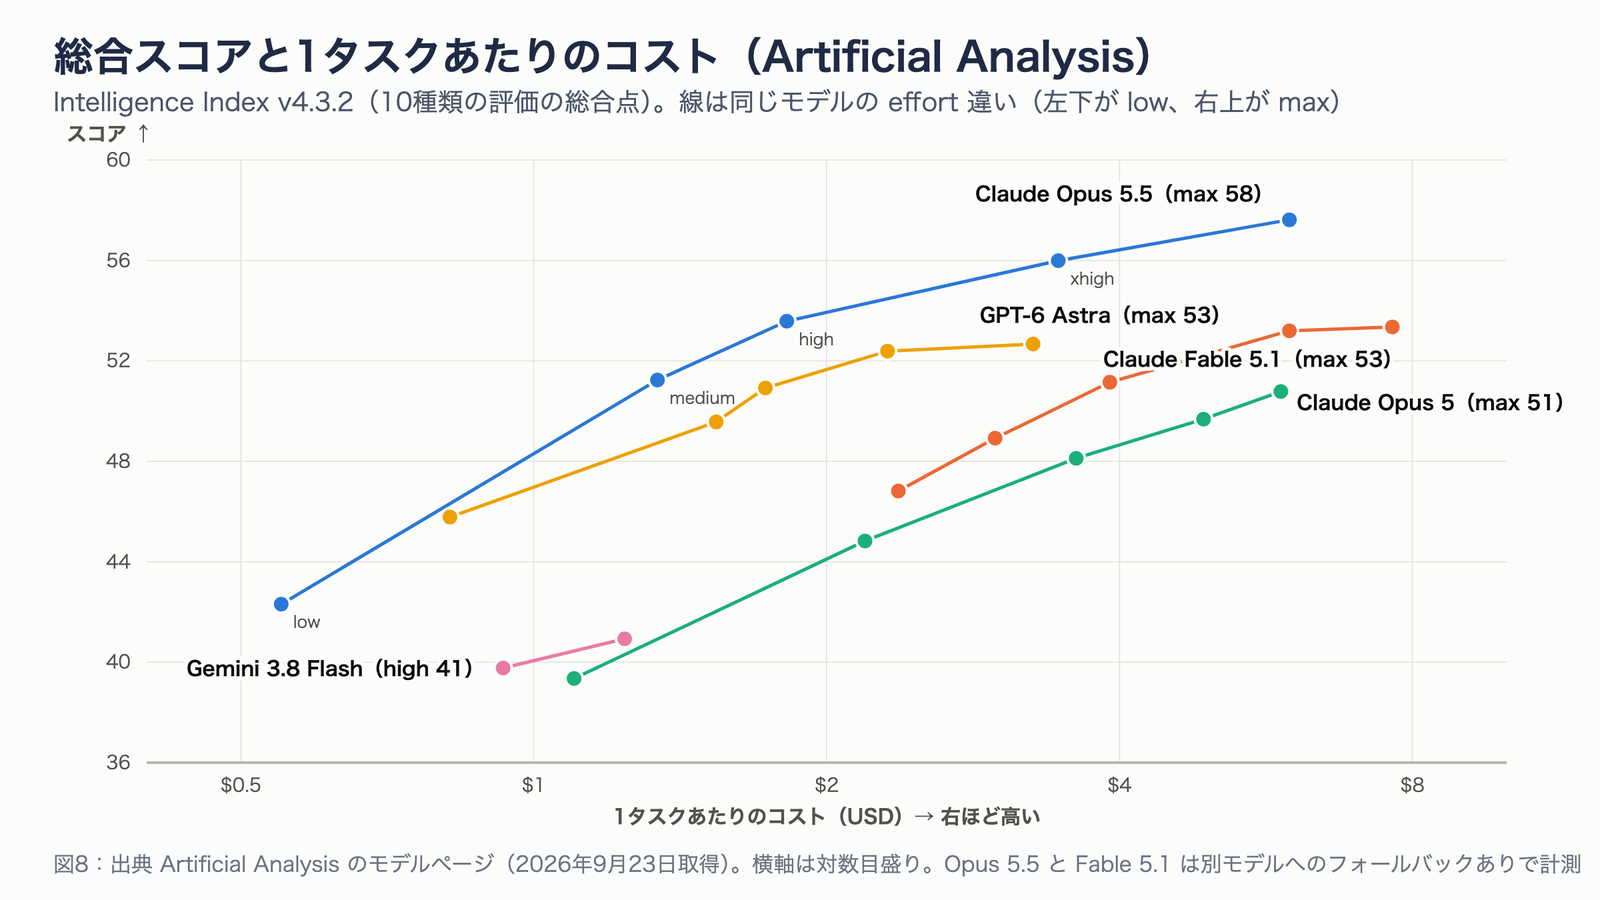
図8:Artificial Analysis の総合指標と1タスクあたりのコスト。線は同じモデルの effort 違いで、左上にあるほど「安くて賢い」ことを表します。
図から読み取れることは3つあります。
- 最高スコアは Opus 5.5(max)の58です。Fable 5.1(max)と GPT-6 Astra(max)はどちらも53でした。
- Opus 5.5 は、安い設定でも他社の最上位設定と同じくらいのスコアを出します。たとえば Opus 5.5 の high は1タスク$1.82で53.6、GPT-6 Astra の max は$3.26で52.7でした。
- 最上位の設定同士では、Astra のほうが安いです。Opus 5.5(max)は1タスク$5.98、Astra(max)は$3.26でした。
3つ目の差を生んでいるのは、出力トークンの量です。1タスクあたりの出力トークンは、Opus 5.5(max)が約11.9万、GPT-6 Astra(max)が約2.7万でした。Astra は Opus 5.5 の4分の1以下のトークンで、近いスコアを出しています。単価は Astra が2.5倍高いものの、使うトークンが少ないぶん、1タスクあたりでは安くなるわけです。
Google の Gemini 3.8 Flash(9月2日公開)も同じ図に入れました。総合指標は41で上位3モデルとは差がありますが、料金は入力 $0.75、出力 $3.75(2026年末までの導入価格)と桁違いに安く、出力速度は約297トークン/秒と、ほかのモデルの3〜6倍でした。
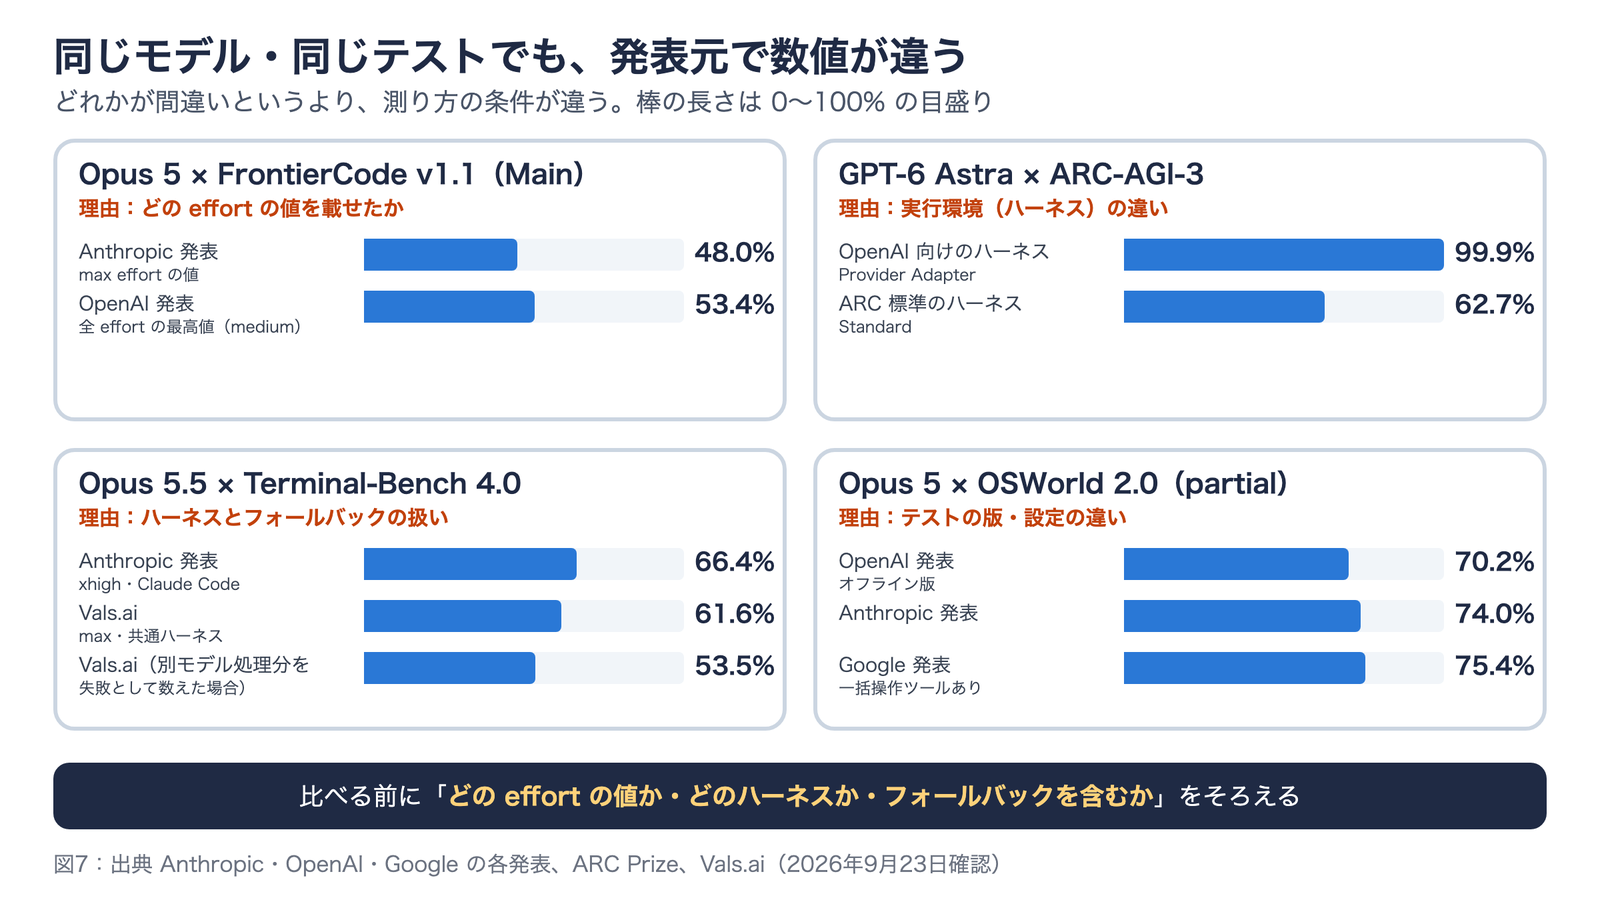
注意:発表元によって同じモデルの数値が違う
ここまで各社の数字を並べてきましたが、読むときに注意してほしい点があります。同じモデル・同じベンチマークでも、発表元によって数値が違うことです。調べた中から、4つの例を図にしました。
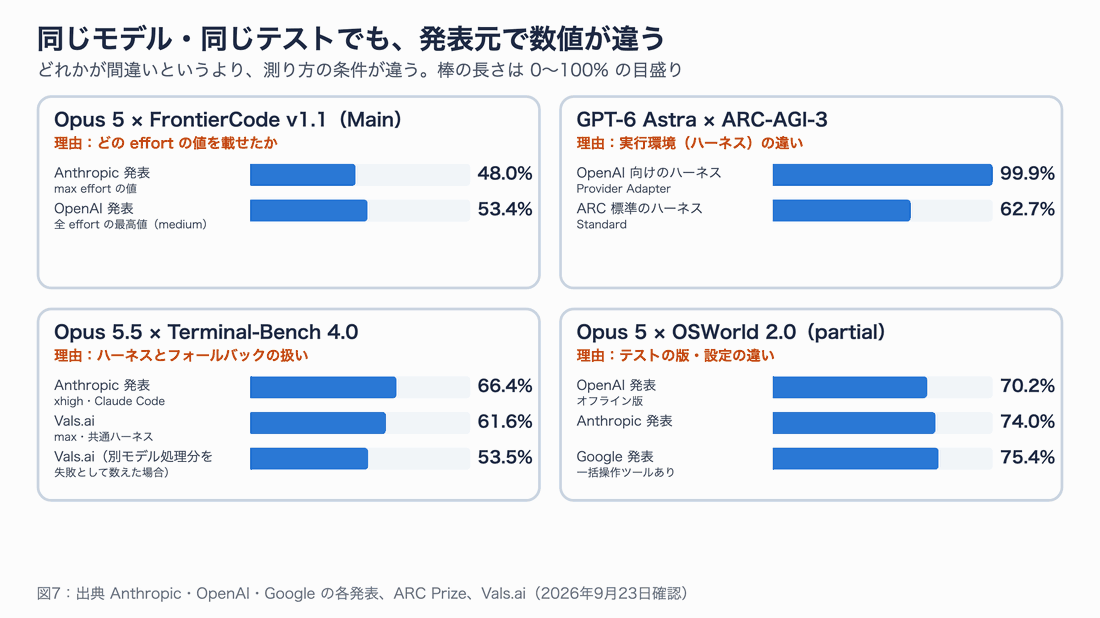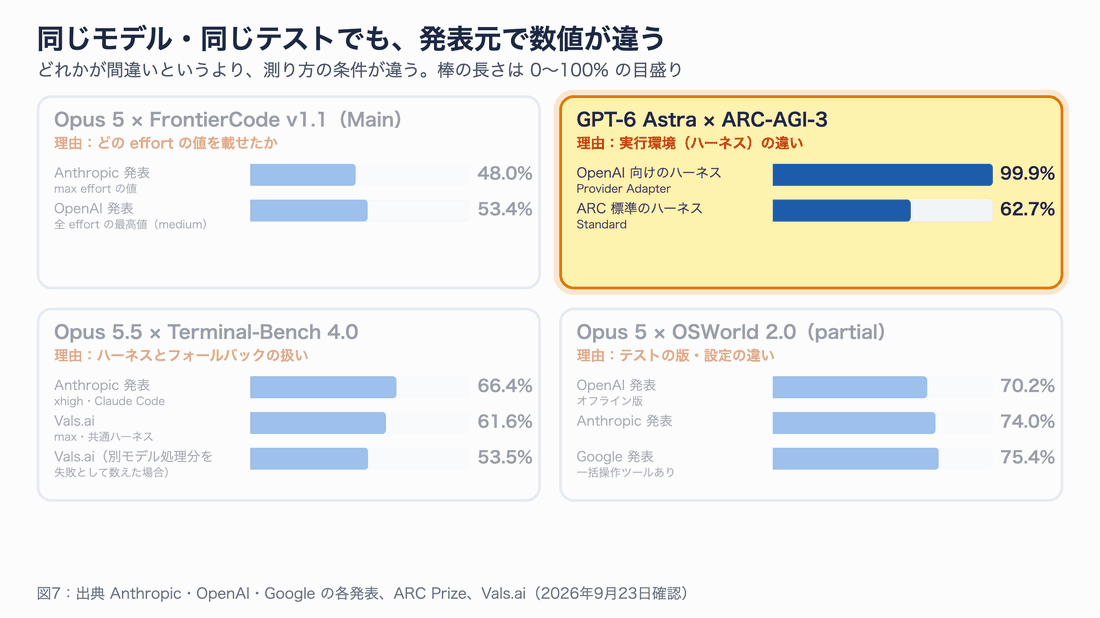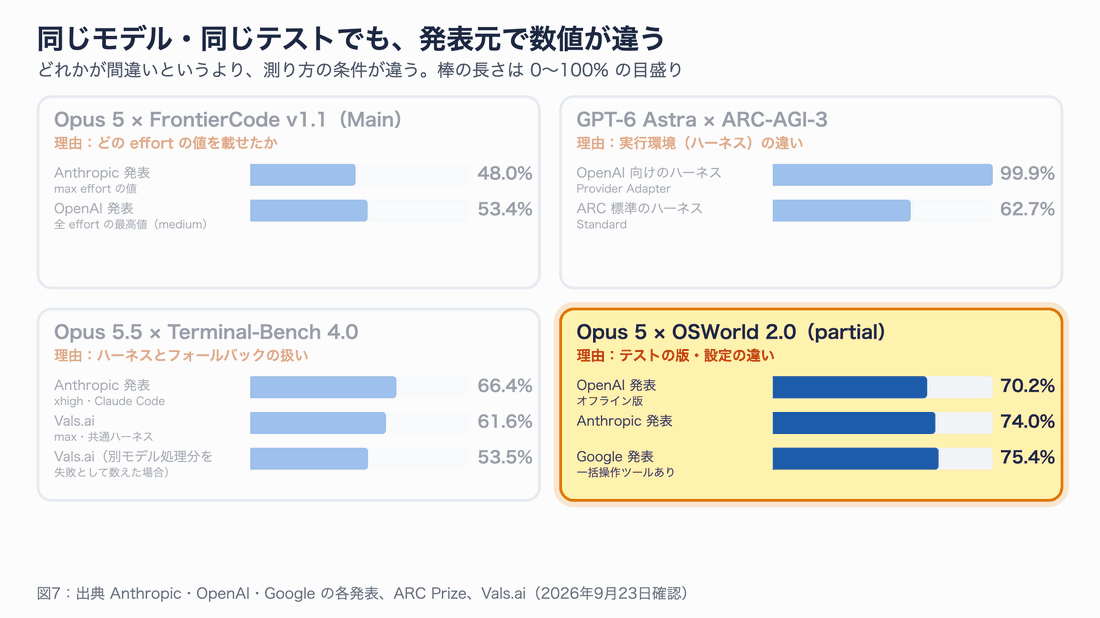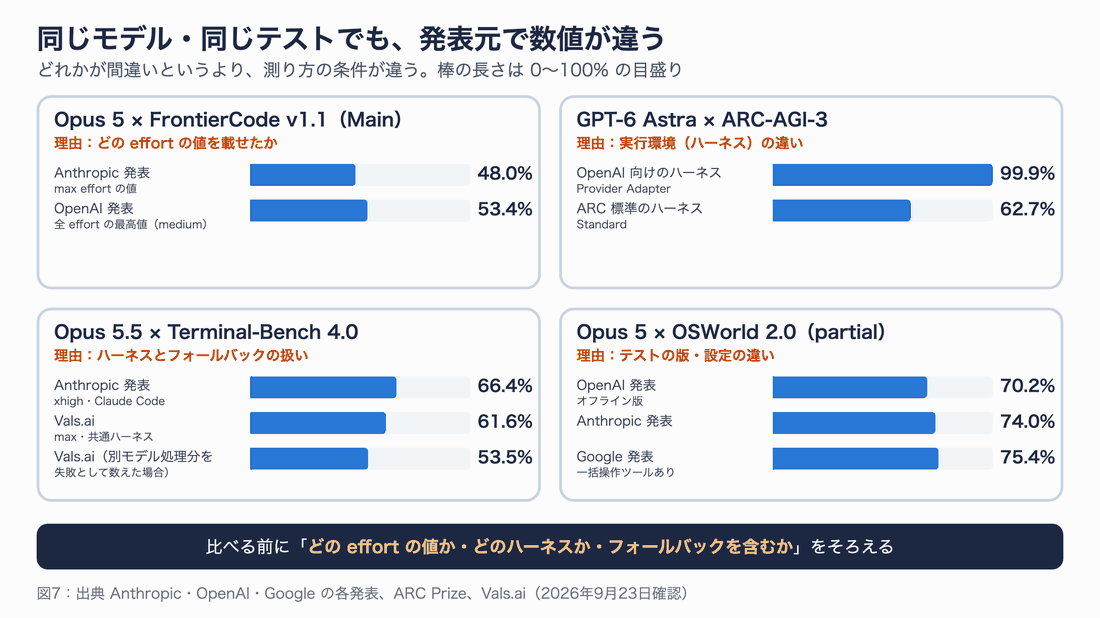
図7:発表元によって数値が違う例。どれかが間違っているというより、測った条件が違います。静止画版
それぞれの理由は次のとおりです。
- どの effort の値を載せたか:OpenAI は「すべての effort の中の最高値」を載せています。Opus 5 の FrontierCode は medium のときに最高(53.4%)で、Anthropic は max の値(48.0%)を載せていました。
- ハーネス(実行環境)の違い:GPT-6 Astra の ARC-AGI-3 の99.9%は、OpenAI のモデルが推論の状態を引き継げる専用の実行環境(Provider Adapter)での値です。ARC Prize の標準の実行環境では62.7%でした。ARC Prize は2つの値を区別して載せていて、他社のモデルと同じ条件で比べられるのは標準の値のほうです。
- フォールバックの扱い:前の節で紹介した Vals.ai の例です。
- テストの版や設定の違い:OSWorld 2.0 は、オフライン版を使ったか、一括操作ツールを使ったかなどで、3社の値が違っていました。
発表の数字は、それぞれの会社が選んだ条件で測られています。数字を比べるときは、どの effort の値か、どの実行環境か、別モデルが処理した分を含むか、の3点をそろえてから比べると安全です。こうした条件の違いがあるので、最後は自分の用途に近い課題で確かめるのが一番確実です。次の節では、それを筆者のMacで試しました。
手元のMacで検証してみた
公式発表と第三者の評価を見てきましたが、どちらも「自分の用途でどうか」までは教えてくれません。そこで、筆者のMacで同じ課題を解かせて比べました。
検証環境
| 項目 | 内容 |
|---|---|
| マシン | Mac(Apple M5 Max・メモリ128GB・macOS 26.6.2) |
| Claude 系の実行 | Claude Code 2.1.280(claude -p)。Claude Max プランのログインで実行 |
| GPT-6 Astra の実行 | Codex CLI 0.154.0(codex exec)。ChatGPT Pro プランのログインで実行 |
| 実施日 | 2026年9月23日(Opus 5.5 公開の翌日) |
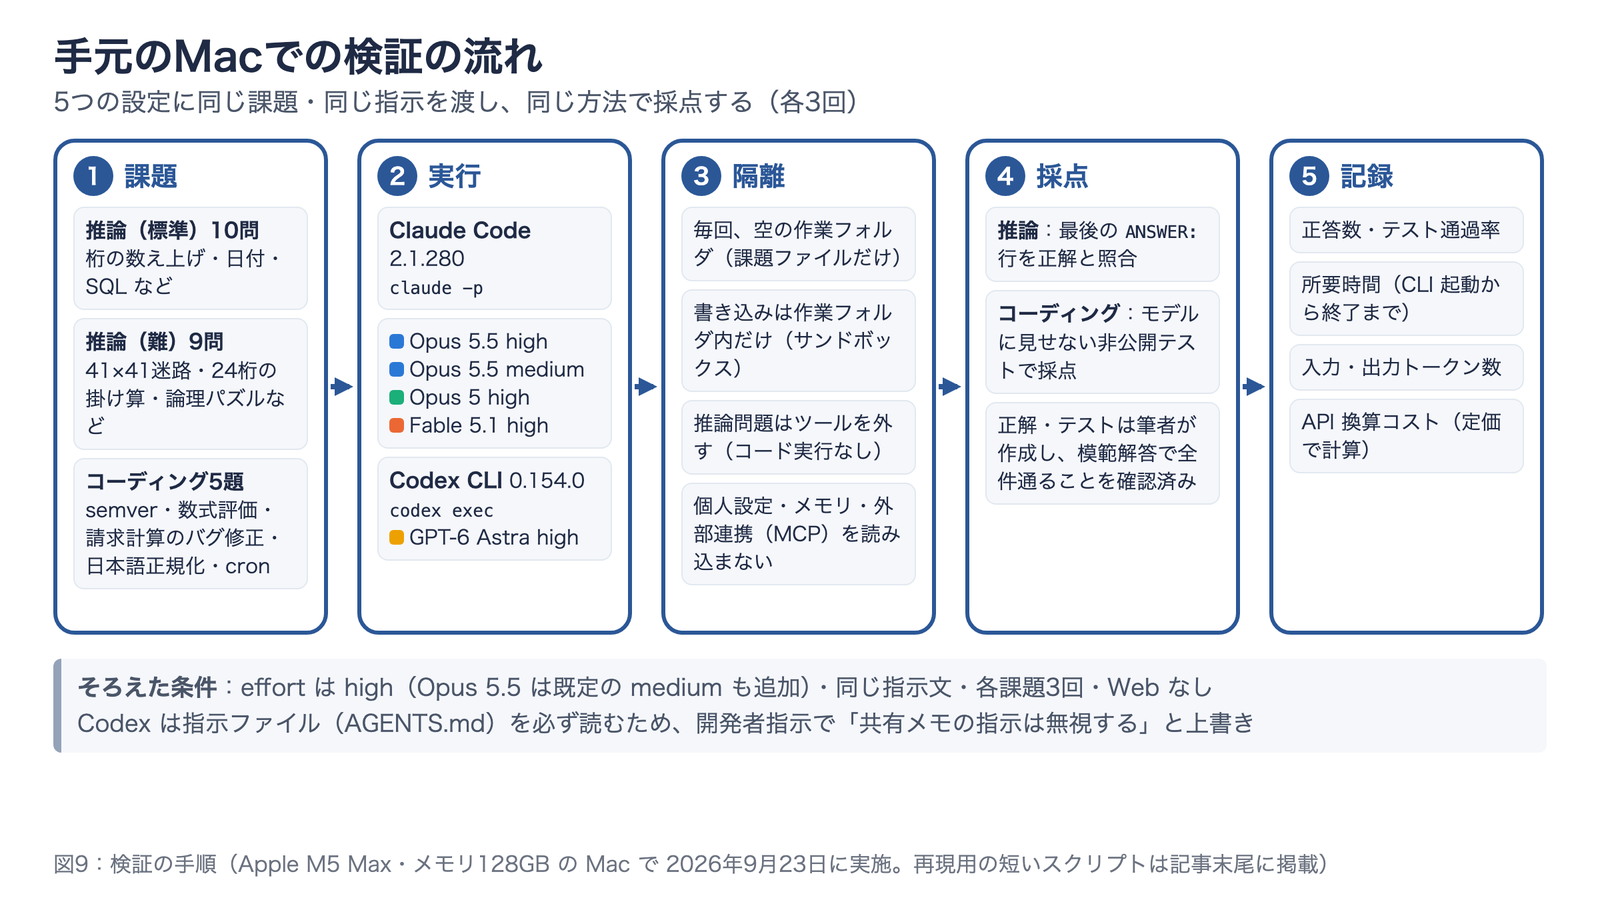
| 課題 | 推論(標準)10問・推論(難)9問・コーディング5題。各3回 |
API キーは使っていません。API で同じことをしたときの費用は、記録したトークン数に各社の定価を掛けて計算しました(以下「API 換算コスト」)。Claude Code が出力する金額は、公式の単価で計算し直した値と一致することを確かめています。
比べた5つの設定
モデルごとの既定の effort が違うため、全モデルを high にそろえました。そのうえで、Opus 5.5 だけは既定の medium も加えています。「何も設定せずに使ったらどうなるか」も知りたかったからです。
| 設定名 | モデル | effort | 実行した CLI |
|---|---|---|---|
| Opus 5.5(high) | claude-opus-5-5 | high | Claude Code |
| Opus 5.5(medium) | claude-opus-5-5 | medium(既定) | Claude Code |
| Opus 5(high) | claude-opus-5 | high(既定) | Claude Code |
| Fable 5.1(high) | claude-fable-5-1 | high(既定) | Claude Code |
| GPT-6 Astra(high) | gpt-6-astra | high | Codex CLI |
解かせた課題
課題はすべて筆者が作りました。公開済みのベンチマークは、モデルが学習の中で答えを見ている可能性があるからです。正解はプログラムで計算し、コーディング課題の非公開テストは、筆者の模範解答で全件通ることを確認しています。
| 種類 | 数 | 内容 | 採点 |
|---|---|---|---|
| 推論(標準) | 10問 | 各桁の和が27になる数の個数、1000日後の日付と曜日、サイコロの期待値、Python の出力予測、15×15の迷路、日本語の文字数カウント、正直者とうそつき、7の2026乗の下3桁、SQL の結果予測、正規表現の判定 | 最後の ANSWER: 行を正解と照合 |
| 推論(難) | 9問 | 41×41の迷路、24桁×24桁の掛け算、長文の文字数カウント、5軒の家の論理パズル、難しめの Python 出力予測、条件付き順列の数え上げ、夏時間をまたぐ時刻計算、ウィンドウ関数の SQL、コイン列が出るまでの期待回数 | 同上 |
| コーディング | 5題 | npm 形式のバージョン範囲判定(semver)、小数の数式評価器、請求計算のバグ修正(日本語の仕様書)、日本語テキストの正規化(日本語の仕様書)、cron 式の次回実行時刻 | モデルに見せない非公開テストの通過率 |
推論の問題では、Claude Code のツールをすべて外し、Codex もシェルとコード実行を外しました。プログラムを書いて答えを出すのではなく、モデル自身が考えて答える条件です。コーディング課題では、どちらもファイルの読み書きとシェルを使えます。仕様書(TASK.md や SPEC.md)と一部の公開テストを渡し、「非公開テストでも採点する」と伝えました。
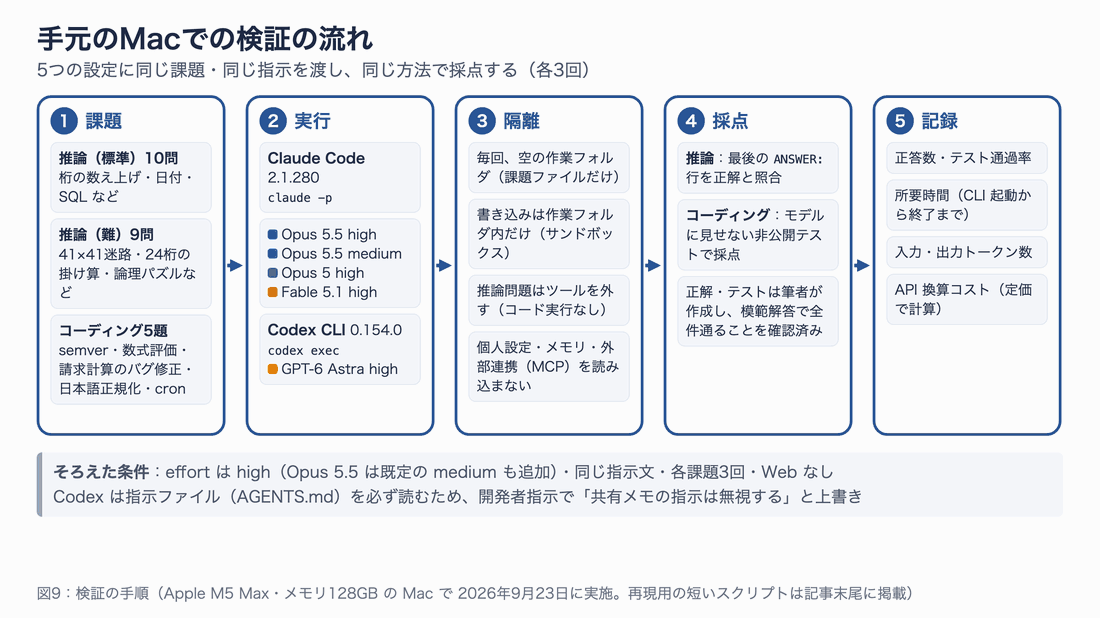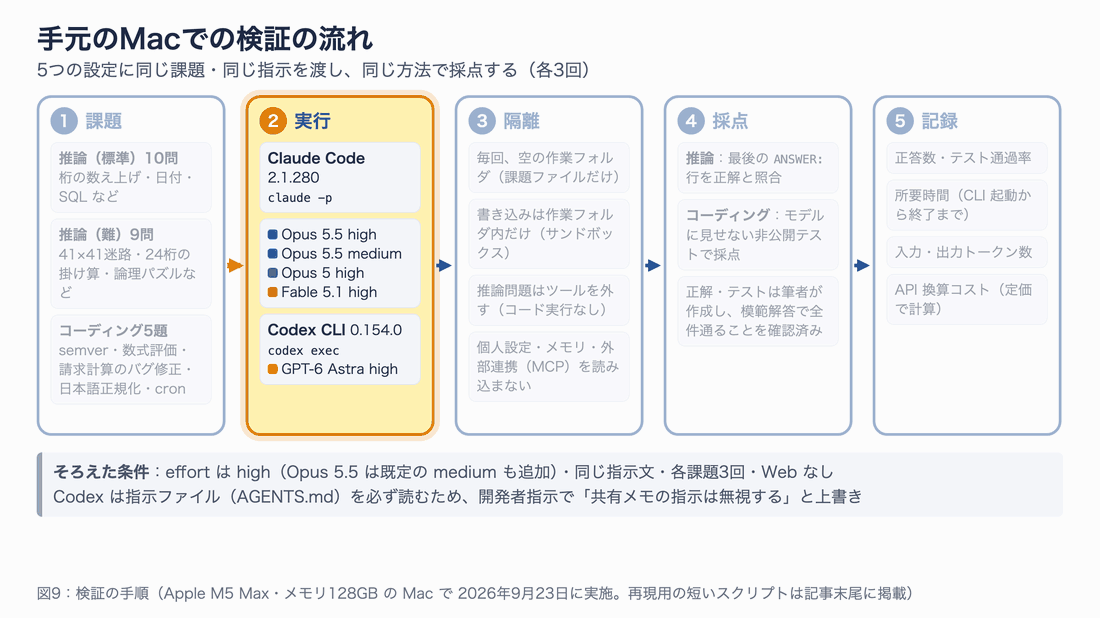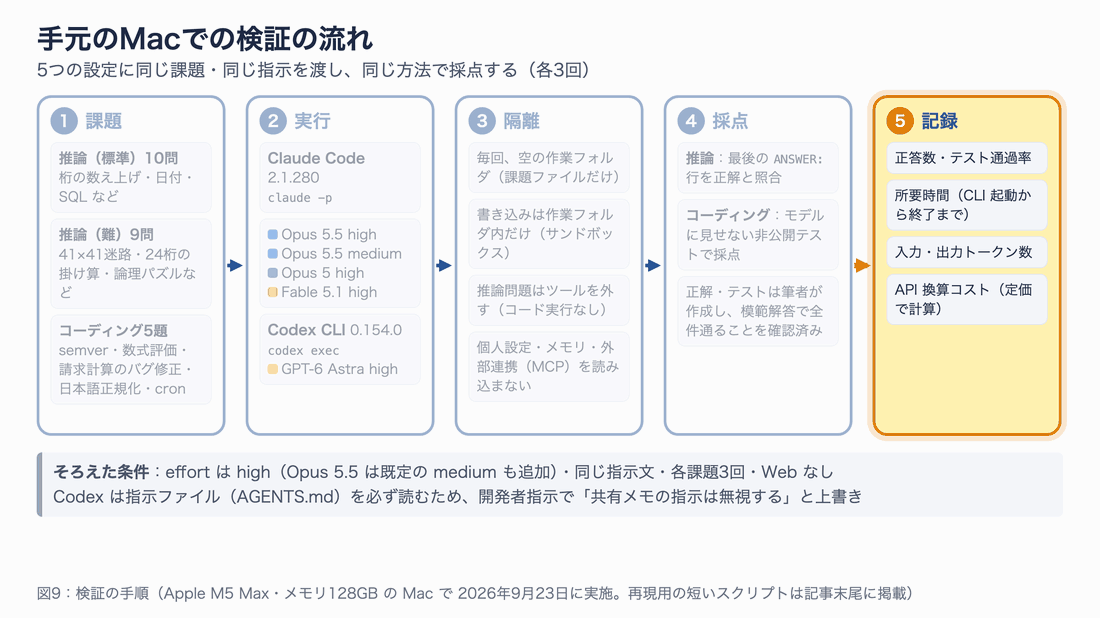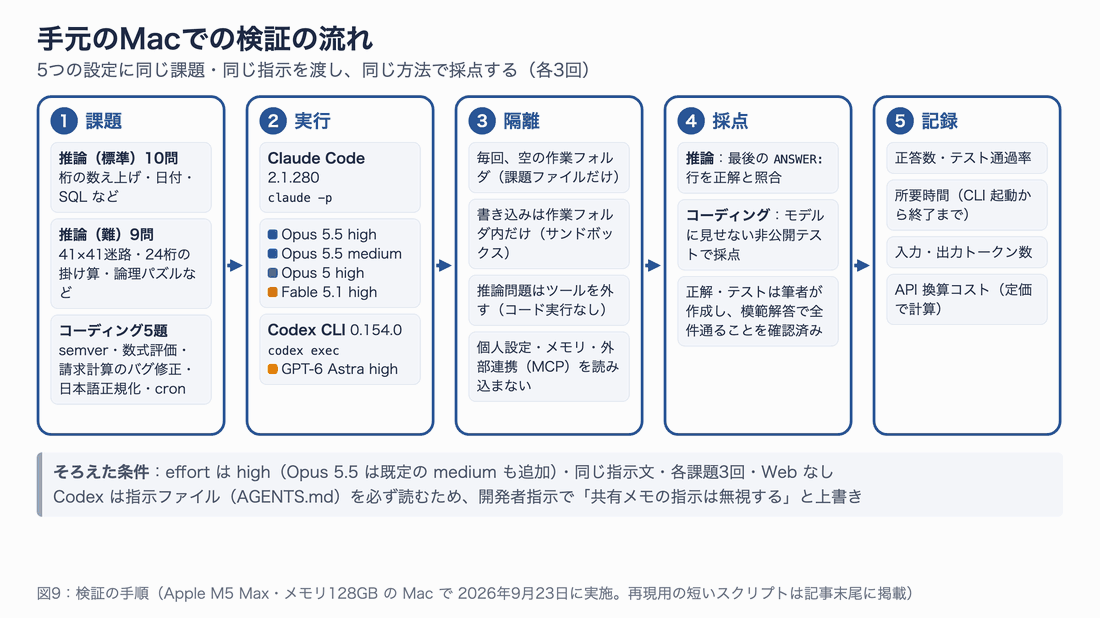
図9:検証の手順。5つの設定に同じ課題と同じ指示を渡し、同じ方法で採点しました。静止画版
条件をそろえるための工夫
普段使っている CLI をそのまま動かすと、個人の設定や指示ファイルが混ざってしまいます。そこで、実行ごとに空の作業フォルダを作り、次のように起動しました。Claude Code は推論問題の例、Codex はコーディング課題の例です。
# Claude Code:ユーザー設定・CLAUDE.md・フック・MCP を読み込まず、ツールもなしで1問解かせる
cat problem.txt | claude -p --model claude-opus-5-5 --effort high \
  --setting-sources "" --strict-mcp-config --no-session-persistence \
  --tools "" --output-format json

# Codex CLI:ユーザー設定を読まず、作業フォルダの中だけ書き込めるサンドボックスで実行する
codex exec -m gpt-6-astra -c model_reasoning_effort="high" \
  --ignore-user-config --ephemeral --skip-git-repo-check --json \
  --disable apps --disable multi_agent --disable memories \
  -s workspace-write -C ./work "TASK.md を読んで実装してください(以下略)"
コーディング課題の Claude Code では、Bash・Read・Edit・Write・Glob・Grep だけを使えるようにしました。Bash はサンドボックスの中で動かし、作業フォルダの外には書き込めない設定です(--settings で sandbox.enabled を有効にしています)。Codex の -s workspace-write とほぼ同じ条件です。
1つだけ、完全にはそろえられなかった点があります。Codex は --ignore-user-config を付けても、ユーザーの指示ファイル(~/.codex/AGENTS.md)を読み込みます。そのため、開発者指示(developer_instructions)で「共有メモなどの指示は無視し、作業フォルダの外は読まない」と上書きしました(公平にするため、Claude Code にも --append-system-prompt で同じ文を渡しています)。また、推論問題1問あたりに読み込む量は、Codex が約1.5万トークン(システムプロンプトと指示ファイル)、Claude Code が約3千トークンでした。この差は、推論問題の API 換算コストに効いてきます。
1回あたりの制限時間は、推論問題が15分、コーディング課題が30分です。時間内に終わらなかった回は不正解として数えました。
結果1:正答率はほぼ横並び。差が出たのは難しい問題だけ
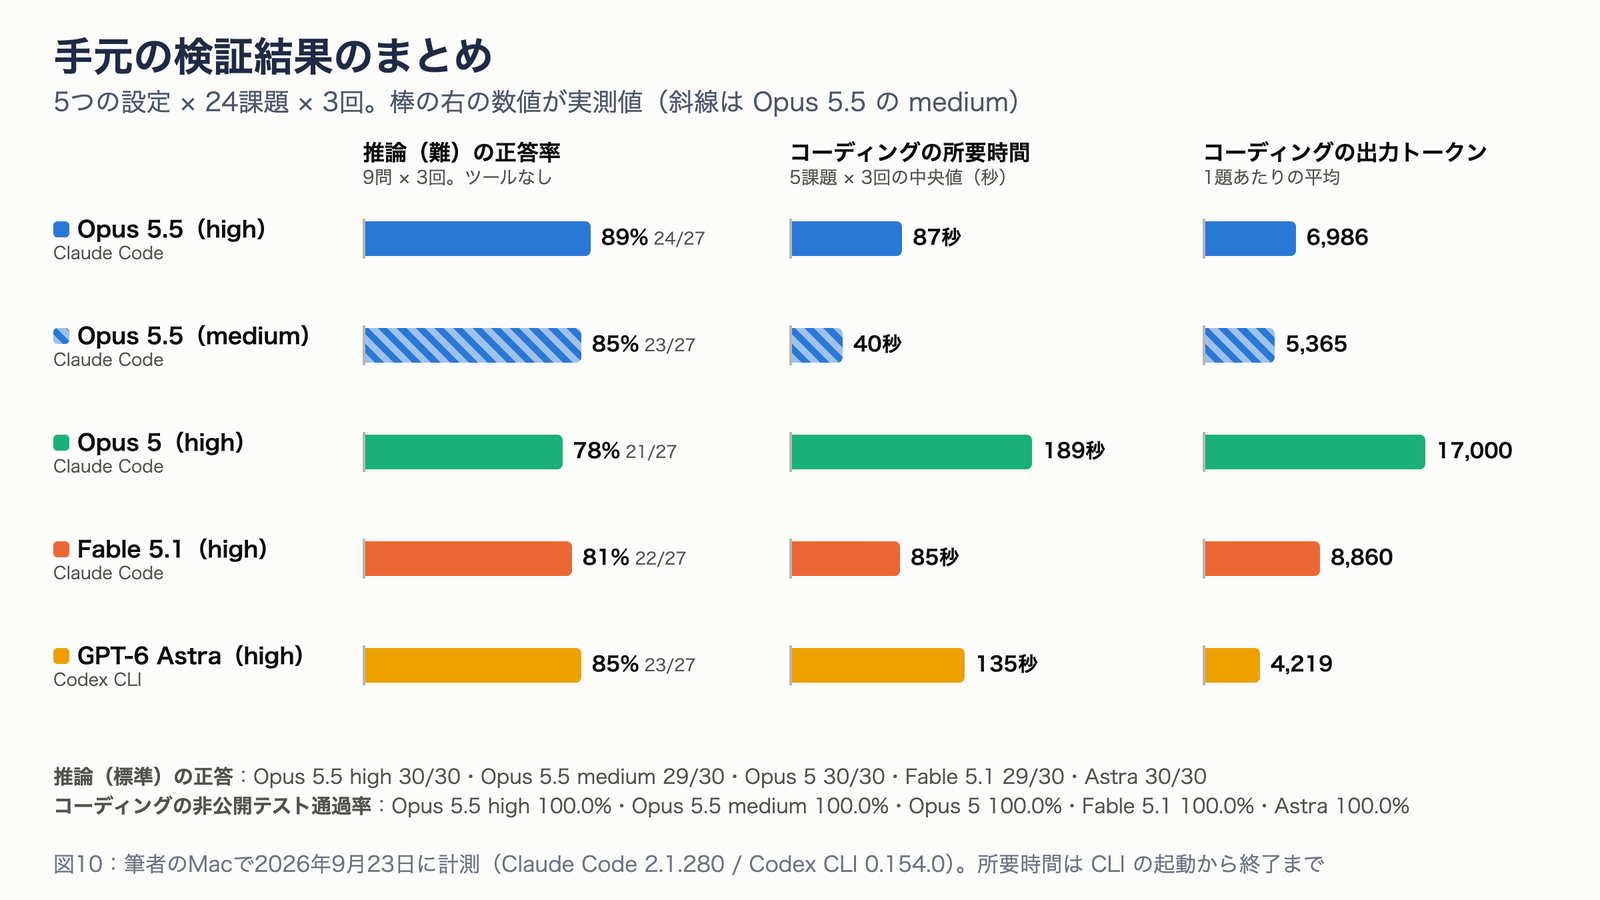
まず、正答率です。コーディング課題は、5つの設定すべてが全15回で非公開テストに100%通りました。標準の推論問題も、全設定が30回(10問×3回)中29〜30回正解しています。この2つでは、モデルの差はほとんど出ませんでした。
| 設定 | 推論(標準)10問×3回 | 推論(難)9問×3回 | コーディング5題×3回(非公開テスト) |
|---|---|---|---|
| Opus 5.5(high) | 30/30 | 24/27 | 100%(15回すべて満点) |
| Opus 5.5(medium) | 29/30 | 23/27 | 100%(15回すべて満点) |
| Opus 5(high) | 30/30 | 21/27 | 100%(15回すべて満点) |
| Fable 5.1(high) | 29/30 | 22/27 | 100%(15回すべて満点) |
| GPT-6 Astra(high) | 30/30 | 23/27 | 100%(15回すべて満点) |
差がついたのは、推論(難)の一部の問題です。どの設定が、どの問題を落としたかをまとめます。
| 問題 | Opus 5.5 high | Opus 5.5 medium | Opus 5 high | Fable 5.1 high | GPT-6 Astra high |
|---|---|---|---|---|---|
| 41×41の迷路(正解248歩) | 3/3 | 2/3 | 0/3(3回とも15分で時間切れ) | 2/3 | 2/3 |
| 条件付き順列の数え上げ | 0/3(時間切れ) | 0/3(時間切れ) | 0/3(時間切れ) | 0/3(時間切れ) | 0/3(毎回答えたが不正解) |
| ウィンドウ関数の SQL | 3/3 | 3/3 | 3/3 | 2/3 | 3/3 |
| 標準の迷路・文字数カウント | 全問正解 | 文字数カウントを1回誤り | 全問正解 | 15×15迷路を1回誤り | 全問正解 |
Opus 5.5(high)は、条件付き順列の数え上げ以外をすべて正解しました。41×41の迷路は、Opus 5.5(high)が3回とも約3分で正解しました。一方、Opus 5 は3回とも15分の制限時間内に答えられませんでした。
条件付き順列の数え上げ(1〜9の並べ方のうち、2つの条件を満たすものを数える問題)は、どの設定も1回も解けませんでした。正解は15,482通りです。プログラムを書けば一瞬で求まりますが、今回はツールを外していたので、頭の中だけで数え上げる必要がありました。この問題は、「コードを書かせれば解ける問題を、書かせずに解かせるのは無駄」という当たり前のことを確かめる結果になりました。
結果2:所要時間は Opus 5.5(medium)が最短
所要時間は、設定によって大きく違いました。コーディング課題1題あたりの所要時間(CLI を起動してから終わるまで、15回の中央値)は次のとおりです。
| 設定 | コーディング1題(中央値) | 1題あたりのやり取りの回数(平均) |
|---|---|---|
| Opus 5.5(medium) | 40秒 | 3.9回 |
| Fable 5.1(high) | 85秒 | 7.0回 |
| Opus 5.5(high) | 87秒 | 4.6回 |
| GPT-6 Astra(high) | 135秒 | (コマンド実行 6.3回) |
| Opus 5(high) | 189秒 | 13.5回 |
「やり取りの回数」は、Claude Code がモデルを呼び出した回数です(Codex は数え方が違うため、代わりにコマンドを実行した回数を載せています)。Opus 5 は1題あたり平均13.5回モデルを呼び出していて、Opus 5.5(medium)の3.5倍でした。Opus 5.5 が速いのは、出力の速さに加えて、少ない手数で仕上げているからだとわかります。
Opus 5(high)から Opus 5.5(medium)に替えると、コーディング課題の所要時間は約4.7分の1になりました。公式発表の「出力が30%以上速い」は1秒あたりの出力量の話なので、手数が減った分も含めると、体感の差はそれよりずっと大きくなります。
推論問題は、ほとんどが10秒前後で、どの設定もあまり変わりませんでした。差が出たのは長く考える問題で、41×41の迷路は Opus 5.5 が約3分、GPT-6 Astra が約5分、Fable 5.1 が約6分かかりました。
結果3:コストは Opus 5.5 が最安。Opus 5 比で約7割減
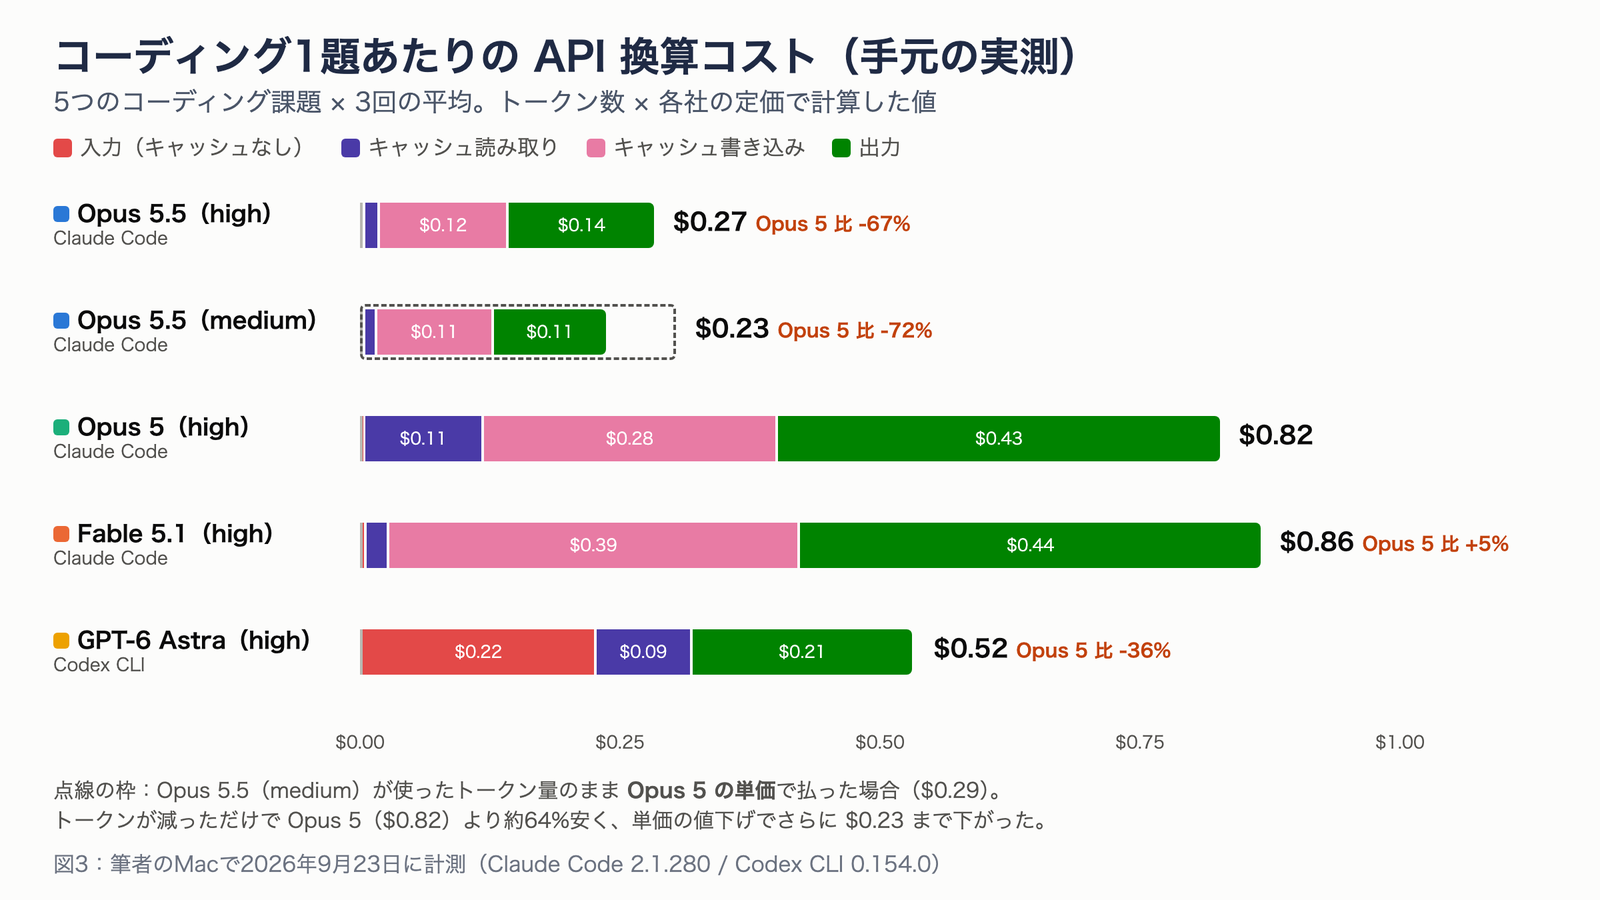
最後に、API で同じことをしたときの費用です。コーディング課題1題あたりの API 換算コストと、その内訳を図にしました。
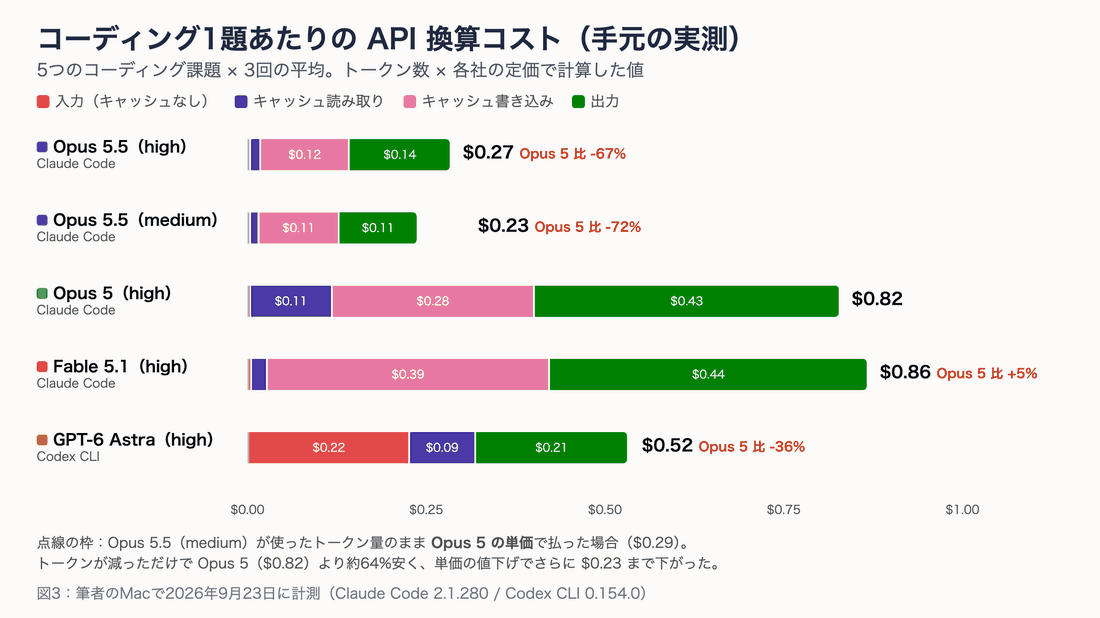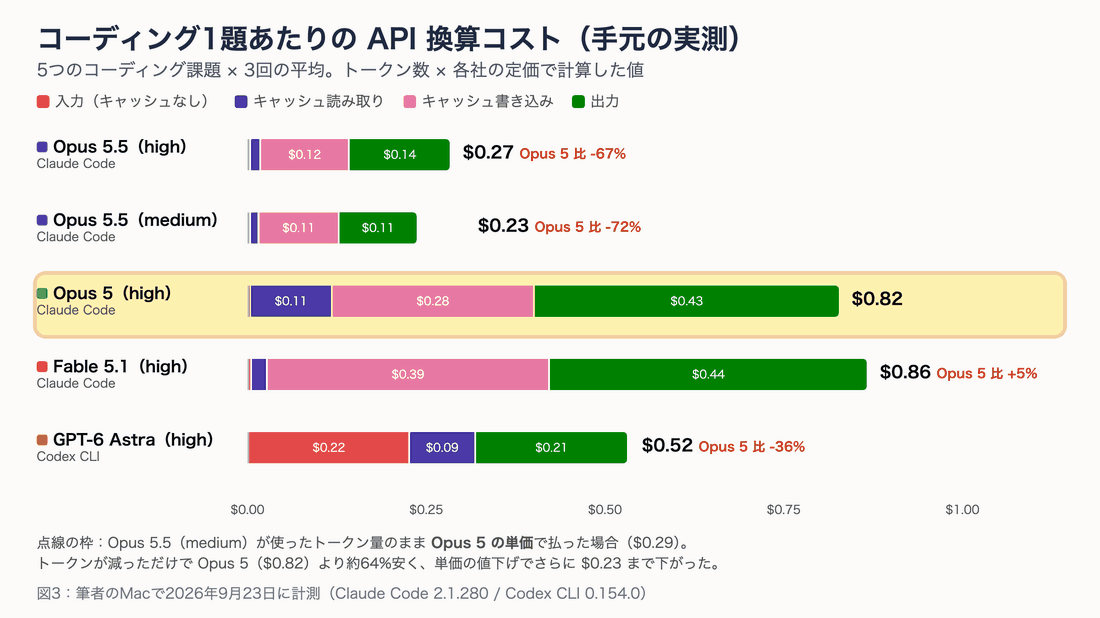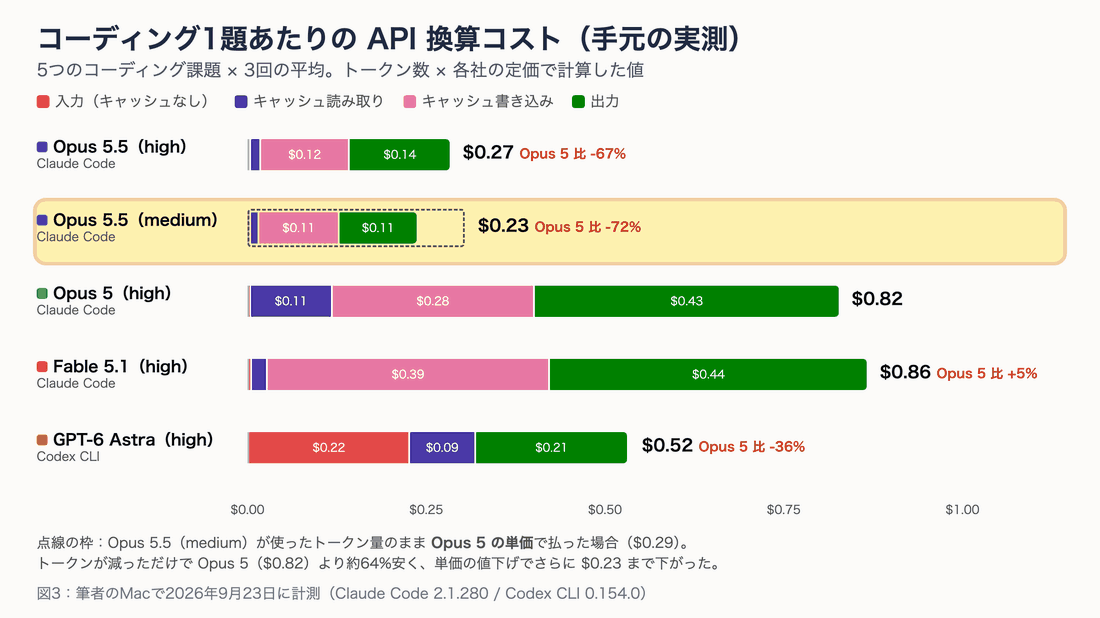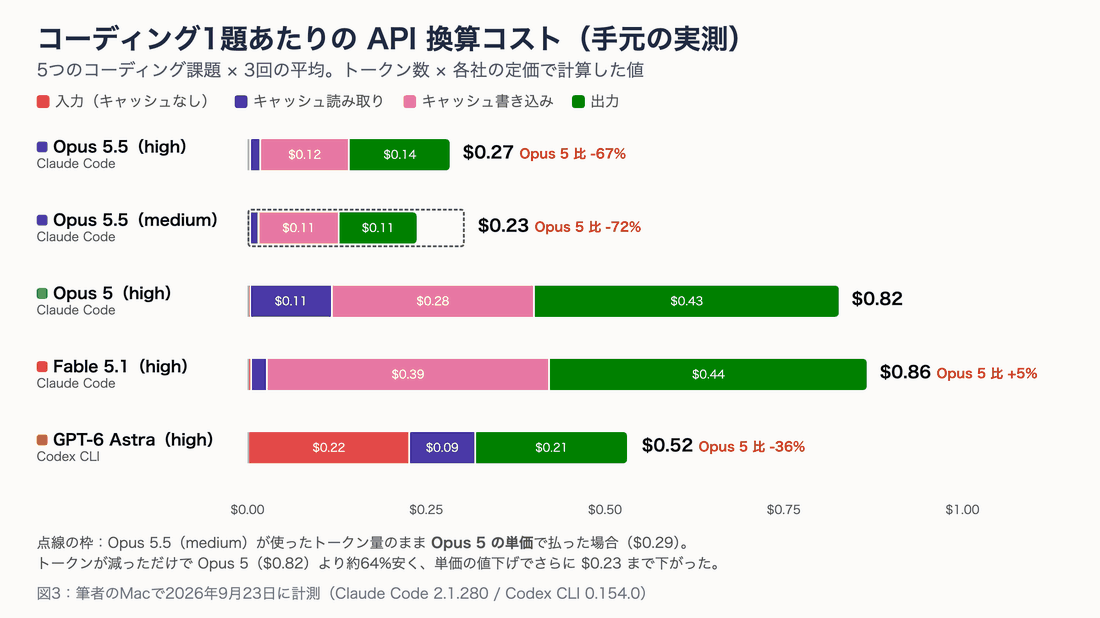
図3:コーディング1題あたりの API 換算コスト(手元の実測)。アニメーションで、Opus 5 と Opus 5.5 の差を順に示します。静止画版
図から、3つのことが読み取れます。
- Opus 5.5(medium)は1題$0.23で最安でした。Opus 5(high)の$0.82と比べて約72%安く、公式の「40%安い」を大きく上回りました。
- 安くなった理由の大半は、使うトークンの減少です。Opus 5.5(medium)が使ったトークン量のまま Opus 5 の単価で払っても$0.29で、これだけで約64%安くなります。単価の値下げは、そこからさらに約$0.07下げた計算です。
- GPT-6 Astra は出力トークンが最少(1題あたり約4,200)でも、費用は$0.52でした。Codex がキャッシュを使わずに送る入力(1題あたり約2.2万トークン)が$0.22を占め、単価も Opus 5.5 の2.5倍だからです。
公式の「40%」より差が大きくなったのは、今回の課題が短かったからだと考えられます。Opus 5 は1題あたり平均17,000トークンを出力していて、Opus 5.5(medium)の約3.2倍でした。何度も試しながら進むぶん、会話を送り直す回数も増えています。数時間かかるような長い作業では、比率は変わるはずです。
内訳にも注目すると、今回のような短い課題では、費用の大半は「出力」と「キャッシュ書き込み」でした。Anthropic が強調している「キャッシュ読み取りが費用の大半を占める」状況は、会話が長く続くエージェント作業の話です。短い作業では、キャッシュ読み取りの値下げはあまり効きません。
推論問題1問あたりの API 換算コストは、Opus 5.5(medium)が$0.067、Opus 5.5(high)が$0.072、Opus 5 が$0.091、GPT-6 Astra が$0.184、Fable 5.1 が$0.251でした。Astra は、前述の約1.5万トークンの読み込みだけで、キャッシュが効かない回は約$0.15かかります。時間切れになった回はトークン数が記録されないため、コストの平均から除いています。
全360回の API 換算コストの合計は約$77でした(時間切れの回を除く)。設定別に見ると、Opus 5.5(medium)が$7.0、Opus 5.5(high)が$8.0、Opus 5 が$16.9、GPT-6 Astra が$18.3、Fable 5.1 が$26.4です。
結果のまとめ
3つの結果を1枚にまとめました。
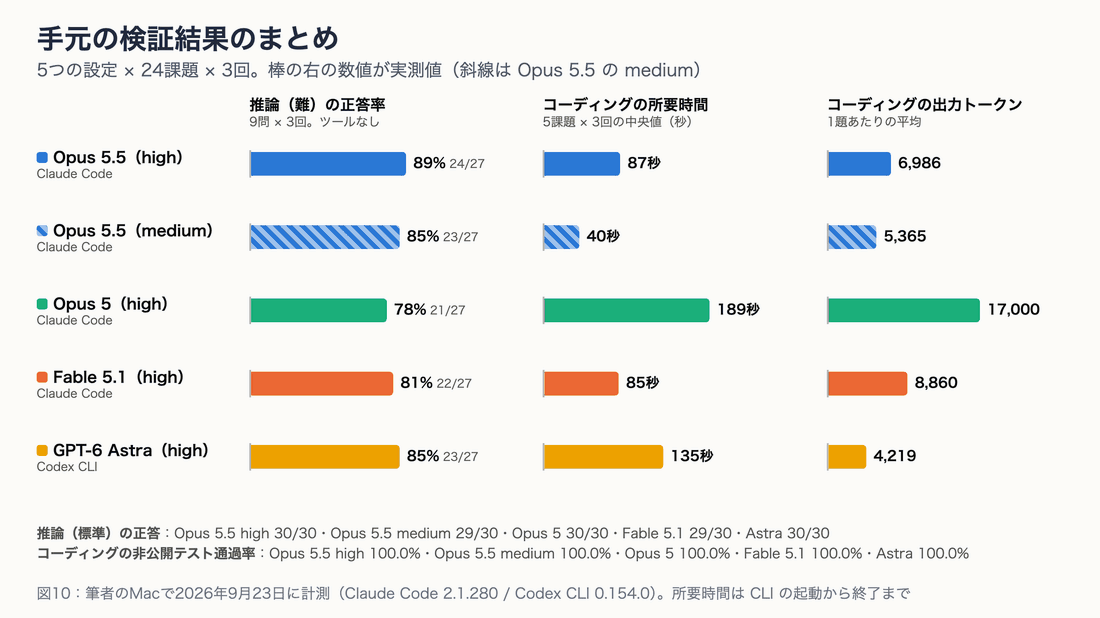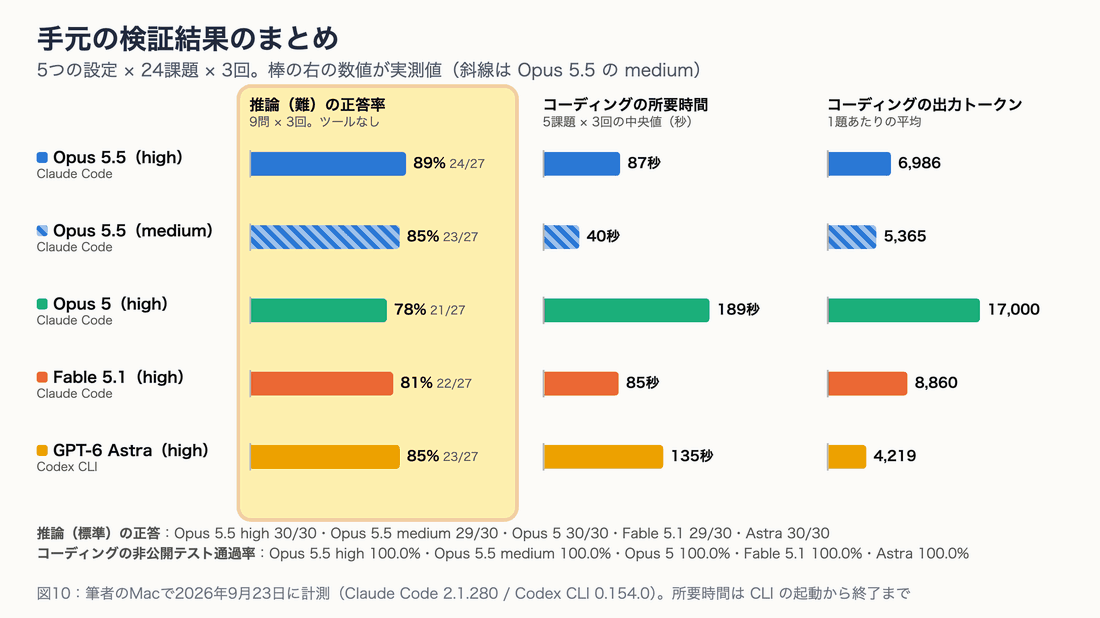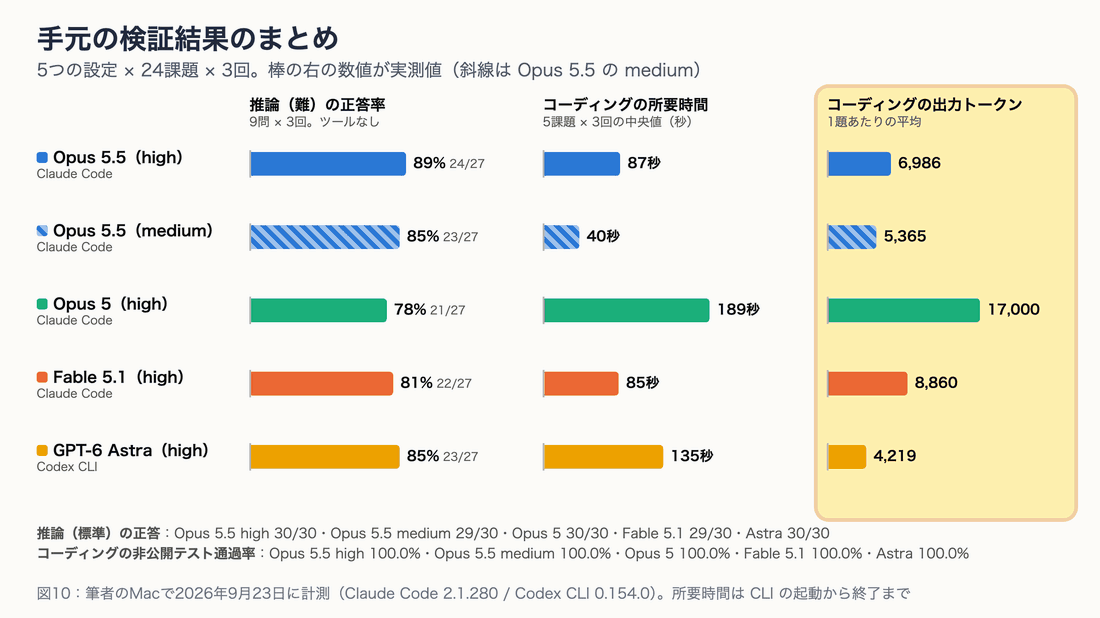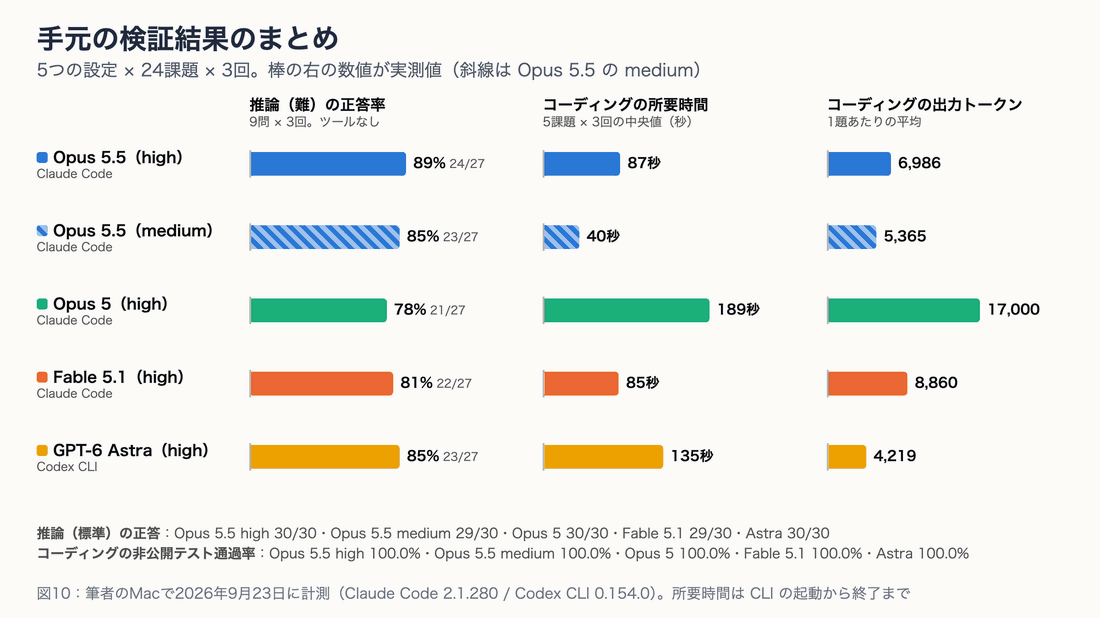
図10:手元の検証結果のまとめ。斜線の棒は Opus 5.5 の medium です。静止画版
今回の検証から言えることは、次の4つです。
- 正答率の差は小さい。筆者が用意した程度の課題なら、どのモデルでもほぼ解けます。難しい問題では、Opus 5.5(high)がいちばん安定していました。
- 差がはっきり出たのは、時間と費用。Opus 5.5(medium)はコーディング課題で最速かつ最安で、正答率も落ちませんでした。
- Opus 5 からの乗り換え効果は大きい。今回の短い課題では、所要時間が約4.7分の1、費用が約7割減になりました。
- Fable 5.1 の出番は見つからなかった。正答率で Opus 5.5(high)を上回った課題はなく、費用は5設定の中で最も高くなりました。
この検証の限界
結果を読むときは、次の点に注意してください。
- 規模が小さい。24課題×3回なので、統計的に意味のある差を示せる規模ではありません。とくに推論(難)の1〜2問の差は、たまたまの可能性があります。
- 課題は筆者の自作。数時間続くエージェント作業や、大きなコードベースでの作業は含んでいません。Anthropic が Fable 5.1 を勧めている「長時間の自律作業」は、この検証では確かめていません。
- 「モデル単体」ではなく「CLI+モデル」の比較。Claude Code と Codex では、システムプロンプトやツールの作りが違います。GPT-6 Astra の結果には、Codex の作りの影響も含まれます。
- effort の中身は各社で違う。同じ「high」でも、どれだけ考えるかはモデルごとに違います。
- 速度は時間帯で変わる。サブスクリプション経由で実行したので、混み具合によって応答時間は変わります。
- API 換算コストは定価での試算。実際に支払ったのはサブスクリプションの料金で、上の金額は「API で同じことをしたら」の目安です。
自分のPCで再現する
検証の仕組みは単純で、問題文を CLI に渡し、返ってきた JSON から答え・時間・トークン数を取り出しているだけです。1問を Opus 5.5 と GPT-6 Astra に解かせる最小のスクリプトを載せておきます。Python 3.9 以上の標準ライブラリだけで動き、Claude Code(2.1.280 以降)と Codex CLI にログインしていれば、そのまま実行できます。
#!/usr/bin/env python3
"""1問を Claude Code と Codex CLI で解かせて、答え・所要時間・出力トークン・API換算コストを表示する。"""
import json
import subprocess
import time

PROMPT = "7の2026乗を1000で割った余りを答えてください。ツールは使わず、最後の行に ANSWER: <答え> と書いてください。"


def run_claude(model, effort):
    # ユーザー設定・CLAUDE.md・MCP を読み込まず、ツールもなしで1問だけ解かせる
    cmd = ["claude", "-p", "--model", model, "--effort", effort,
           "--setting-sources", "", "--strict-mcp-config", "--no-session-persistence",
           "--tools", "", "--output-format", "json"]
    t0 = time.monotonic()
    out = subprocess.run(cmd, input=PROMPT, capture_output=True, text=True).stdout  # 問題文は標準入力で渡す
    d = json.loads(out)
    u = d["modelUsage"][model]
    return d["result"], time.monotonic() - t0, u["outputTokens"], u["costUSD"]


def run_codex(model, effort):
    # ユーザー設定を読まず、シェルとコード実行を外して1問だけ解かせる
    cmd = ["codex", "exec", "-m", model, "-c", f'model_reasoning_effort="{effort}"',
           "--ignore-user-config", "--ephemeral", "--skip-git-repo-check", "--json",
           "--disable", "shell_tool", "--disable", "unified_exec", "--disable", "code_mode_host",
           "-s", "read-only", PROMPT]
    t0 = time.monotonic()
    out = subprocess.run(cmd, capture_output=True, text=True, stdin=subprocess.DEVNULL).stdout
    text, usage = "", {}
    for line in out.splitlines():
        e = json.loads(line)
        if e.get("type") == "item.completed" and e["item"].get("type") == "agent_message":
            text = e["item"]["text"]
        if e.get("type") == "turn.completed":
            usage = e["usage"]
    cached = usage["cached_input_tokens"]
    # GPT-6 Astra の定価(100万トークンあたり 入力 $10・キャッシュ入力 $1・出力 $50)で計算
    cost = ((usage["input_tokens"] - cached) * 10 + cached * 1 + usage["output_tokens"] * 50) / 1e6
    return text, time.monotonic() - t0, usage["output_tokens"], cost


for name, fn, model in [("Claude Opus 5.5", run_claude, "claude-opus-5-5"),
                        ("GPT-6 Astra", run_codex, "gpt-6-astra")]:
    text, sec, out_tok, cost = fn(model, "high")
    answers = [line for line in text.splitlines() if line.startswith("ANSWER:")]
    print(f"{name}: {answers[-1] if answers else '(答えなし)'} / {sec:.0f}秒 / 出力 {out_tok} トークン / API換算 ${cost:.3f}")
筆者の環境で実行した結果は次のとおりです(1回分)。
Claude Opus 5.5: ANSWER: 649 / 7秒 / 出力 398 トークン / API換算 $0.027
GPT-6 Astra: ANSWER: 649 / 12秒 / 出力 174 トークン / API換算 $0.104
PROMPT を自分の問題に、"high" をほかの effort に替えれば、自分の用途で同じ比較ができます。コーディング課題を比べたいときは、作業フォルダを用意して、Claude Code では --tools にファイル操作と Bash を、Codex では -s workspace-write を指定します(本文の「条件をそろえるための工夫」を参照)。サブスクリプションで動かすので追加の料金はかかりませんが、プランの利用枠は消費します。
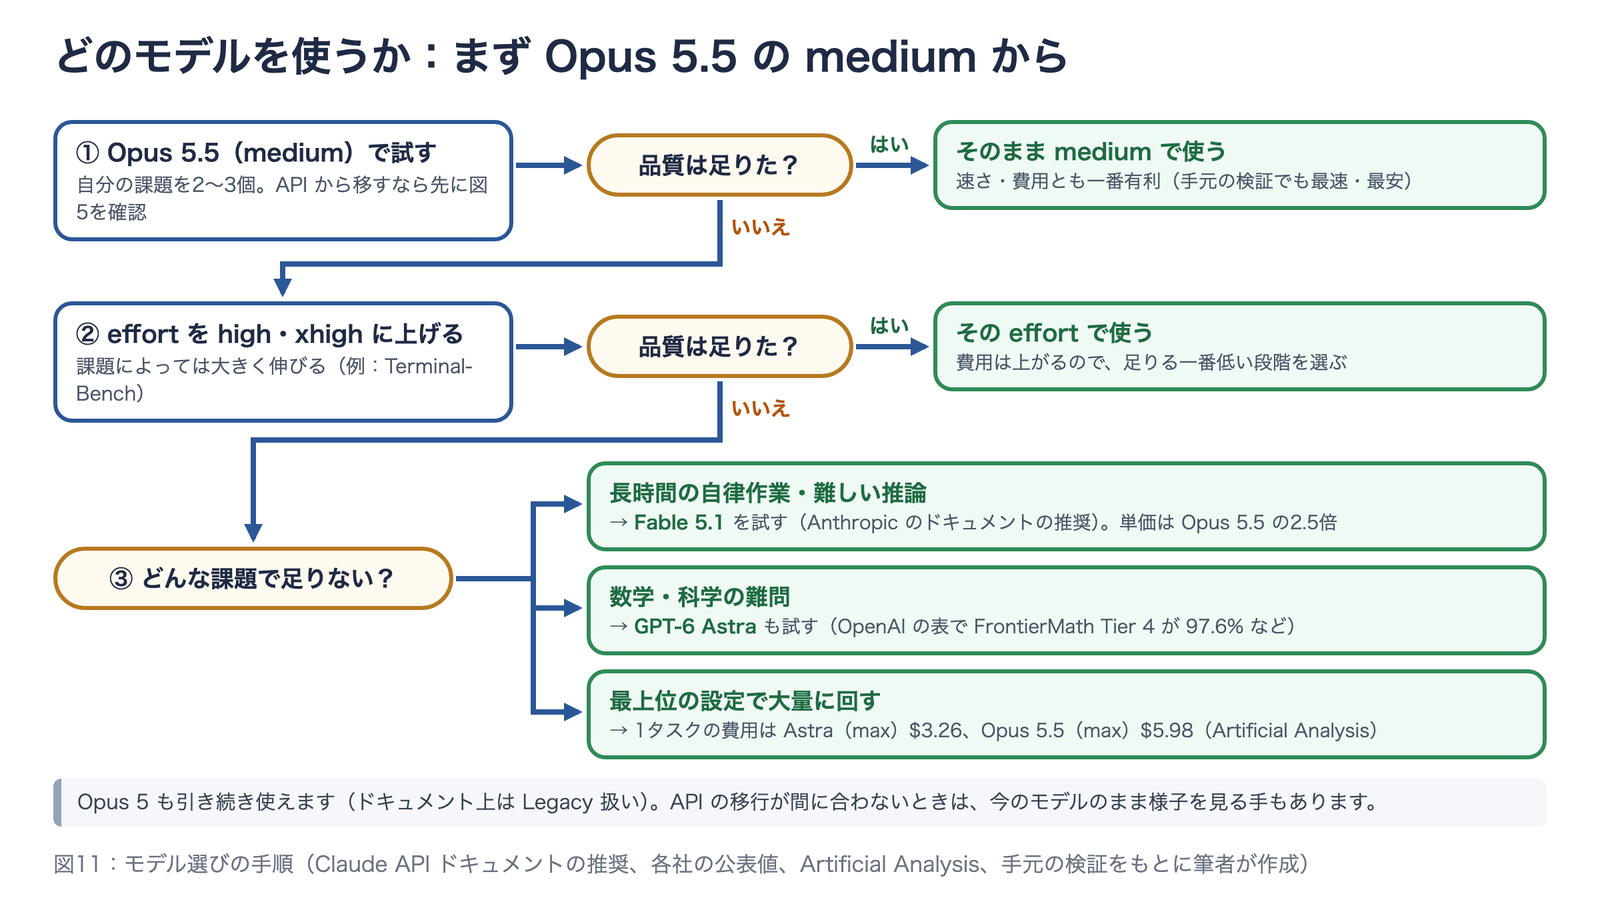
どのモデルを選ぶか
ここまでの公式データ、第三者の評価、手元の検証をまとめて、モデルを選ぶ手順を流れ図にしました。基本の考え方は、Anthropic のドキュメントが勧めている「まず Opus 5.5 から始める」です。
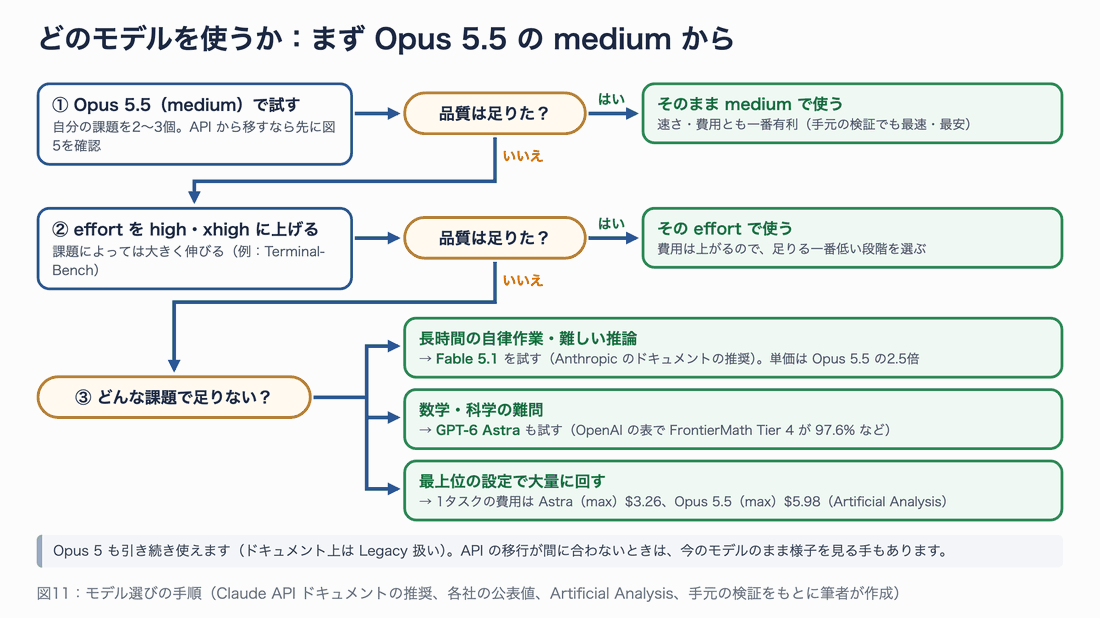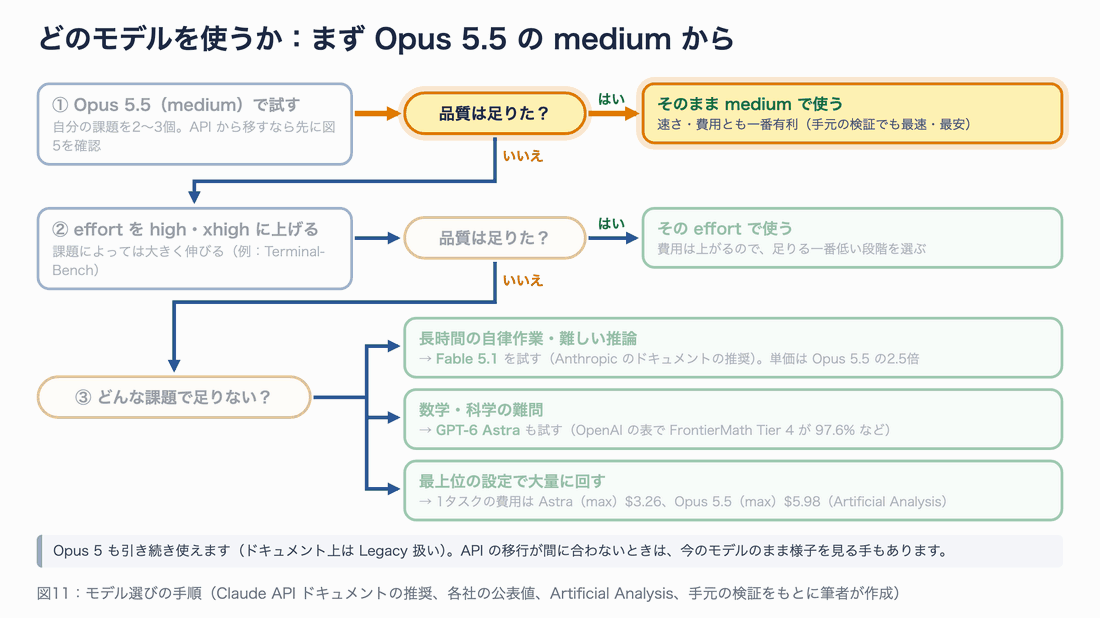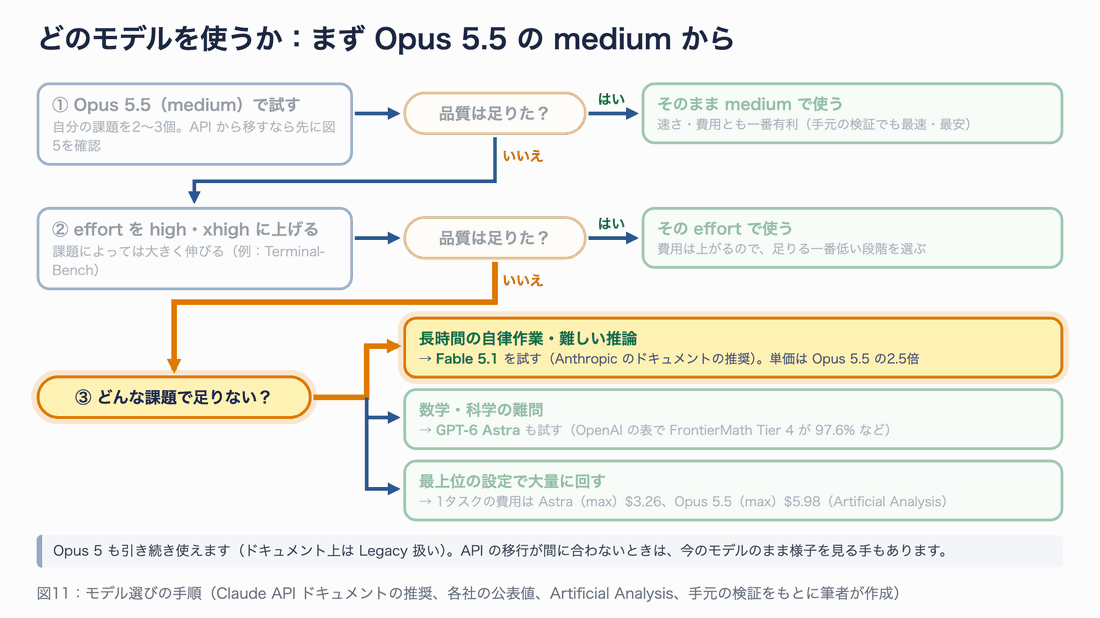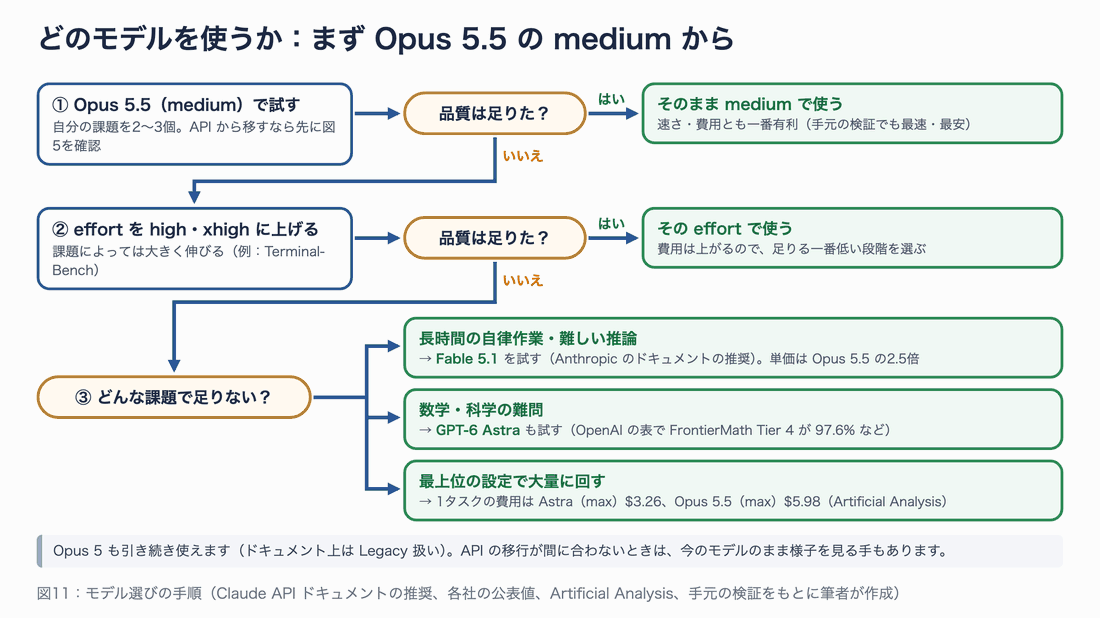
図11:モデル選びの手順。最初の一歩は Opus 5.5 の medium です。静止画版
流れ図の各段階の根拠を、表にまとめます。
| 場面 | おすすめ | 根拠 |
|---|---|---|
| 普段のコーディング・エージェント作業 | Opus 5.5(medium) | 手元の検証でコーディング5題を全回満点。所要時間・API 換算コストとも5設定の中で最小 |
| medium で品質が足りない | Opus 5.5(high・xhigh) | 公式グラフでは、Terminal-Bench のように effort を上げると伸びる課題がある |
| 長時間の自律作業・最難関の推論 | Fable 5.1 を試す | Anthropic のドキュメントの推奨。ただし公式の比較表と第三者の総合指標では Opus 5.5 が上で、手元の検証でも Fable 5.1 が上回った課題はなかった |
| 数学・科学の難問 | GPT-6 Astra も試す | OpenAI の表で FrontierMath Tier 4 が97.6%、Anthropic の表でも Terminal-Bench-Science は Astra が最高 |
| 最上位の設定で大量に回す | GPT-6 Astra(max) も候補 | Artificial Analysis の計測で、1タスクあたりの費用は Astra(max)$3.26、Opus 5.5(max)$5.98 |
| API の移行作業がすぐにできない | Opus 5 のまま様子を見る | Opus 5 は引き続き使える(ドキュメント上は Legacy 扱い) |
注意してほしいのは、手元の検証は24課題という小さな規模だという点です。「今回の課題では差が出なかった」ことは、「どんな課題でも差がない」ことを意味しません。自分の用途の課題を2〜3個用意して、候補のモデルで実際に比べるのが一番確実です。記事末尾の「自分のPCで再現する」のスクリプトも、問題文を差し替えれば同じ仕組みで比べられます。
移行時のトラブルシューティング
API から移行するときの400エラーは、図5の順番で確認すると原因を絞り込めます。ここでは、エラーの文面と対処をまとめます。「確認」の列は、筆者が実際にこの環境で出会ったもの(実測)か、ドキュメントに書かれているもの(公式)かを表します。
| 症状・エラー | 原因 | 対処 | 確認 |
|---|---|---|---|
API Error: 400 Claude Code 2.1.272 does not support this model; version 2.1.280 or newer is required. | Claude Code が古い | claude update で 2.1.280 以降にする | 実測 |
"thinking.type.disabled" is not supported for this model. Use "thinking.type.adaptive" and "output_config.effort" ... | thinking をオフにしようとした | thinking の指定を消し、軽くしたいときは effort を下げる | 公式 |
tool_choice: type "tool" and "any" are not supported for this model. | ツールを強制指定した | tool_choice を auto にし、ツール定義に strict: true を付ける | 公式 |
| 会話を続けると400エラーになる(履歴を編集するアプリ) | preserved thinking の検査に引っかかった | 履歴を追記だけにする。検証中は beta ヘッダー thinking-binding-controls-2026-08-01 と prefix_mismatch_behavior: "drop_block" で影響を確認できる | 公式 |
computer_20251124 を含むリクエストが400エラー | 旧コンピューター操作ツール | computer_toolset_20260801 に移行する | 公式 |
| エラーは出ないが、答えが浅くなった気がする | effort の既定値が medium に下がった | output_config={"effort": "high"} のように明示する | 公式 |
| ツール呼び出しの合間の進み具合の表示が消えた | 合間の文章が thinking ブロックに入り、既定では空になる | thinking の display を "updates"(beta ヘッダー thinking-display-updates-2026-08-18)か "summarized" にする | 公式 |
stop_reason が "refusal" で返ってくる | 安全策の分類器が反応した(bio・reasoning_extraction・cyber など) | stop_details.category を見て、依頼の書き方を見直す。フォールバック先を設定する | 公式 |
検証スクリプトを作る途中で出会ったつまずきも、2つ書いておきます。どちらも CLI を自動実行するときに起きやすいものです。
| 症状 | 原因 | 対処 | 確認 |
|---|---|---|---|
claude -p --tools "" "問題文" が Input must be provided either through stdin or as a prompt argument で止まる | --tools は複数の値を受け取るオプションなので、後ろの問題文までツール名として読まれた | 問題文を標準入力で渡す(echo "問題文" \| claude -p --tools "") | 実測 |
codex exec で、ユーザーの ~/.codex/AGENTS.md の指示に従って別の作業を始めようとする | --ignore-user-config を付けても AGENTS.md は読み込まれる | -c developer_instructions="..." で「その指示は無視する」と上書きする | 実測 |
まとめ
最後に、この記事の要点を振り返ります。
- Opus 5.5 は「Fable 5.1 並みの性能を、Opus の価格帯で」出すモデルです。公式の比較表では9項目すべてで Fable 5.1 を上回り、第三者の総合指標でも最高点でした。単価は Fable 5.1 の2.5分の1です。
- Opus 5 からの移行では、4つの破壊的変更と effort の既定値に注意が必要です。thinking のオフ、ツールの強制指定、履歴の書き換え、旧コンピューター操作ツールの4つが400エラーの原因になります。effort は指定しないと medium で動きます。
- GPT-6 Astra は、数学・科学の難問とトークン効率に強みがあります。最上位の設定同士なら、1タスクの費用は Astra のほうが安いという第三者の計測もあります。
- 数字を比べるときは条件をそろえる。同じモデルでも、effort・ハーネス・フォールバックの扱いによって、発表元ごとに数値が変わります。
- 手元の検証では、正答率はほぼ横並びで、時間と費用に大きな差が出ました。Opus 5.5(medium)が最速・最安で、Opus 5(high)と比べて費用は約7割減でした。
次にやるとよいのは、自分の課題を2〜3個用意して、Opus 5.5 の medium と high を比べることです。品質が足りていれば medium のまま使い、足りなければ effort を上げ、それでも足りない課題だけ Fable 5.1 や GPT-6 Astra を試すと、無駄な費用をかけずに済みます。
Anthropic は、Sonnet 5.5 と Haiku 5.5 を今後数週間のうちに出すと予告しています。公開されたら同じ検証スクリプトで比べると、Opus 5.5 との使い分けが見えてくるはずです。
参考リソース
公式発表・ドキュメント(Anthropic)
- Introducing Claude Opus 5.5(2026年9月22日)
- What’s new in Claude Opus 5.5
- Migrating to Claude Opus 5.5
- Models overview / Pricing / Effort
- System Card: Claude Opus 5.5(PDF・230ページ)
- Claude Code: Model configuration / Changelog
公式発表・ドキュメント(OpenAI・Google)
- GPT-6 Astra(OpenAI)(2026年9月3日)
- GPT-6 Astra のモデルページ / OpenAI API Pricing
- How two settings tripled our ARC-AGI-3 scores(OpenAI)
- Introducing Gemini 3.8 Flash(Google)
第三者の評価
- Artificial Analysis:Claude Opus 5.5 / GPT-6 Astra
- ARC Prize:OpenAI’s GPT-6 Astra on ARC-AGI-3 / リーダーボード
- Vals.ai:Terminal-Bench 4.0
数値はすべて2026年9月23日(日本時間)に確認したものです。各社のページや評価機関の数値は、あとから更新されることがあります。