- はじめに:その判断、毎回エージェントに考えさせていませんか
- 誰が作ったのか:AgentRun と Jev は別々の会社の製品
- Jev とは:文章を書かず「判断だけ」返すモデル
- AgentRun の考え方:仕事を3つの担当に仕分ける
- 準備:必要な環境
- 手順1:新しいプロジェクトで5分体験する
- 手順2:リポジトリを取得して付属デモを動かす
- 手順3:テストで作りの丁寧さを確かめる
- 手順4:自分の業務で組んでみる(経費精算の一次チェック)
- 手順5:既存のエージェント(Claude Code)をつなぐ
- 手順6:判定も Claude で代用すると何が起きるか
- 本番で Jev をつなぐには
- 実務での評価:どこで効き、どこに注意するか
- トラブルシューティング
- まとめ
- 付録:サンプルコード全文
- 参考リンク
はじめに:その判断、毎回エージェントに考えさせていませんか
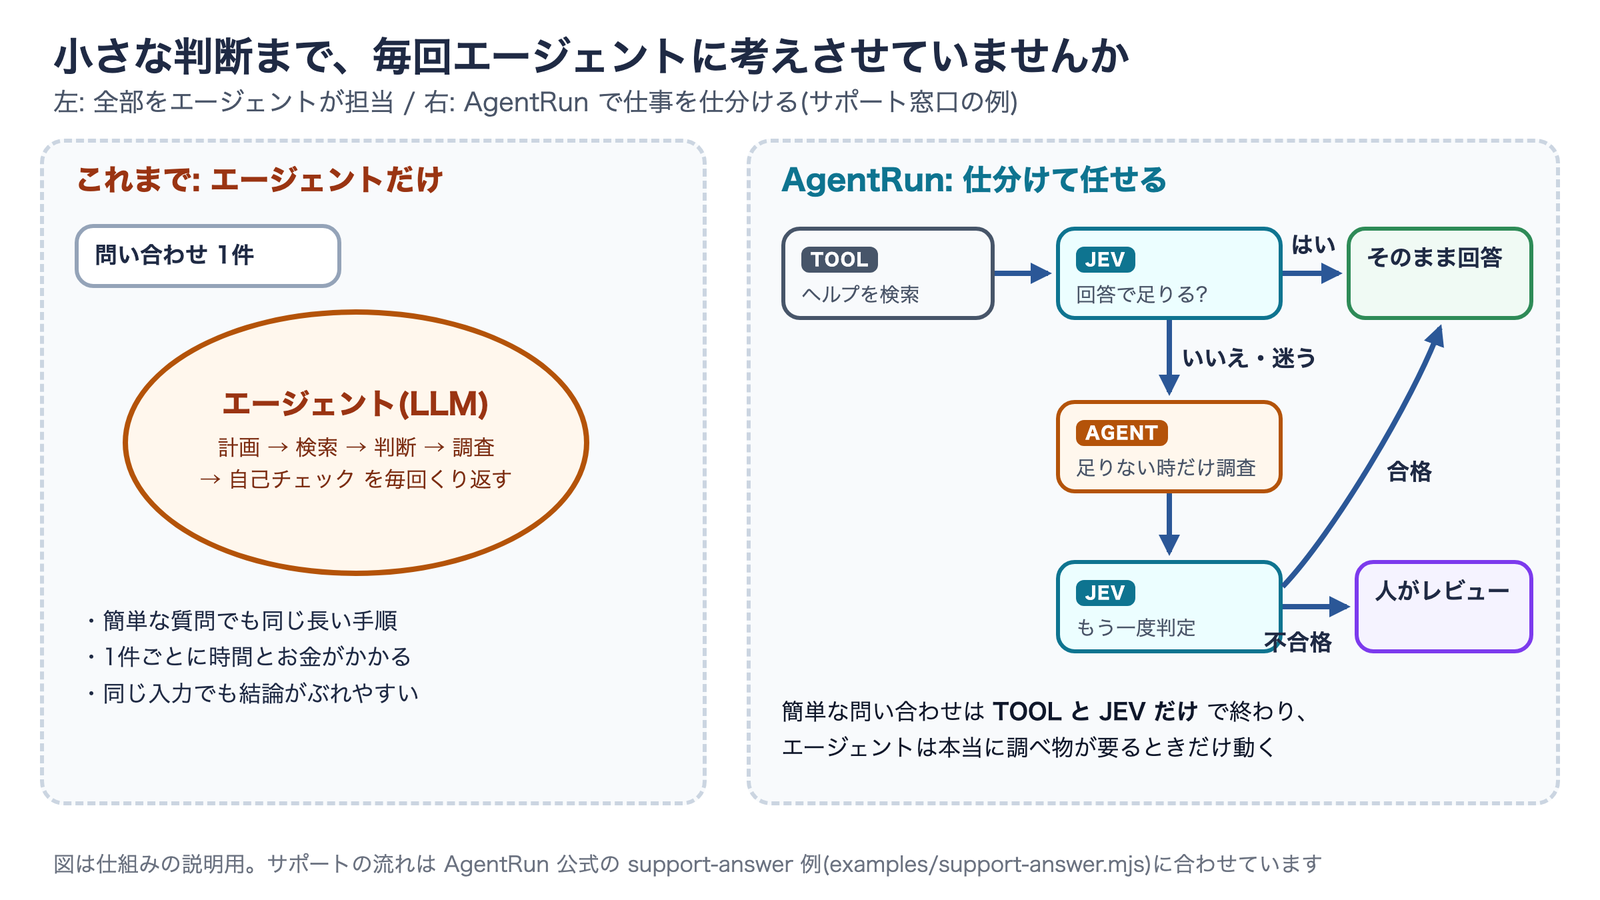
AIエージェントを業務に入れると、多くのチームが同じところでつまずきます。「この問い合わせはどのチームの担当か」「この回答で足りているか」といった小さな判断まで、毎回エージェントに長く考えさせてしまう問題です。
エージェントは計画を立て、ツールを呼び、結果を読み、自分でチェックする、という手順を1件ごとにくり返します。簡単な質問でも同じ手順を踏むので、件数が増えるほど時間とお金がかかります。同じ入力でも結論が揺れやすく、あとから「なぜこの判断になったのか」を説明しにくい点も悩みの種です。
この課題に取り組むOSS(オープンソースソフトウェア)として、Grep AI(旧Parcha Labs)が AgentRun を公開しました。決まった処理は通常のコード(Tool)、形の決まった小さな判断は判断専用モデル Jev、調べ物が必要な仕事だけを既存のエージェント、と仕事を仕分けるためのワークフロー言語(DSL)です。ライセンスは Apache-2.0 です。
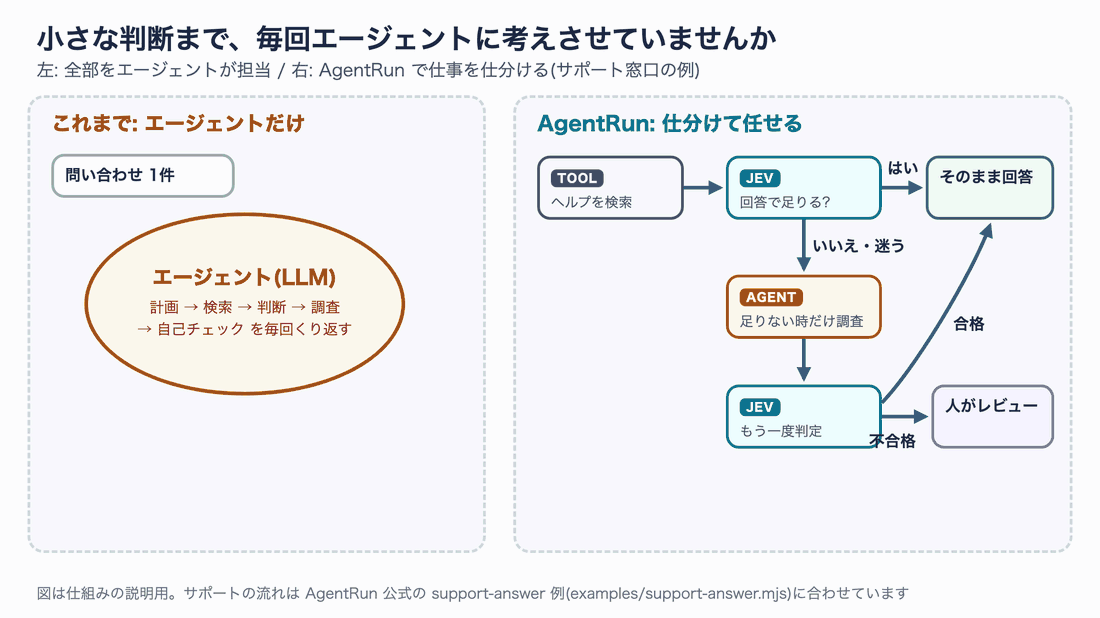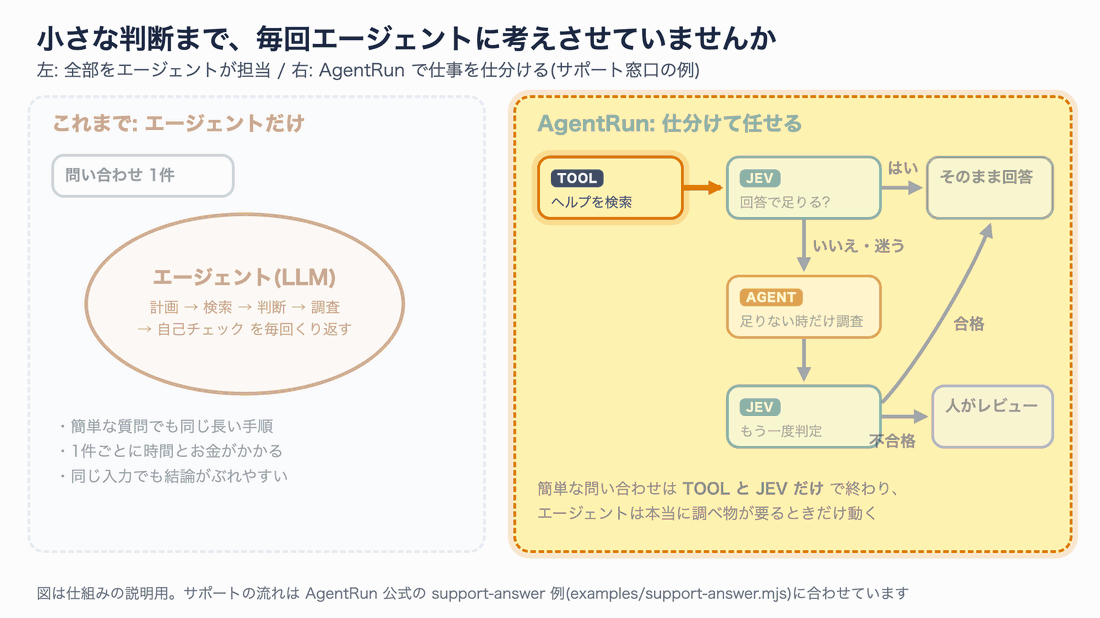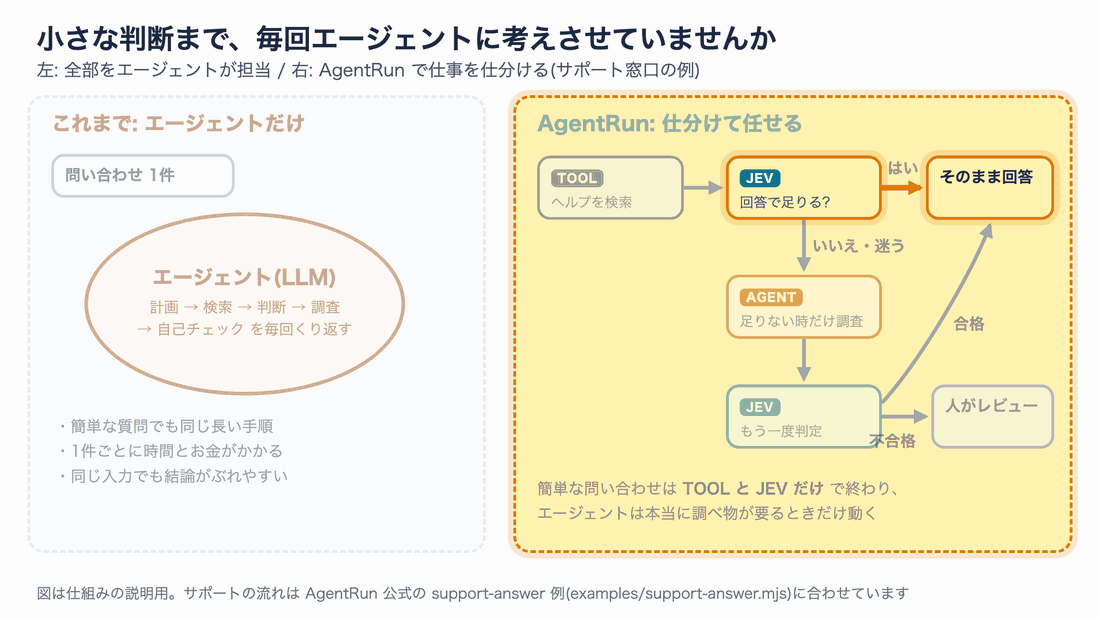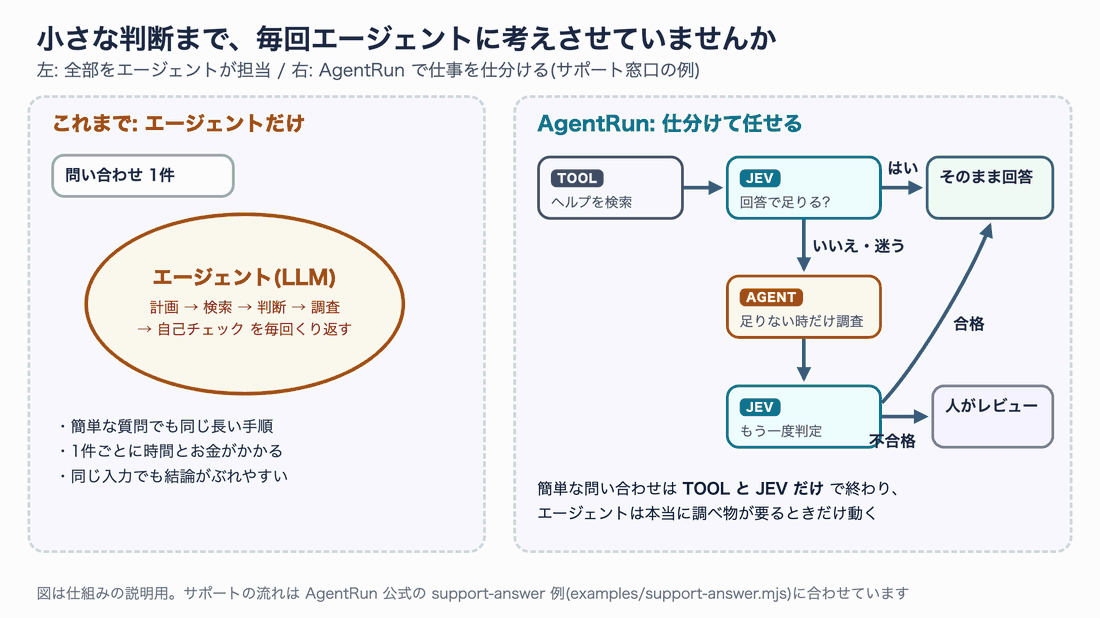
図1 左が「全部エージェント」、右がAgentRunの仕分け。簡単な問い合わせはToolとJevだけで終わる(静止画)
この記事では、AgentRunとJevの概要、開発元の顔ぶれを整理したうえで、実際に手元のMacへリポジトリを入れて動かした結果を、端末の録画とスクリーンショットつきで紹介します。付属デモに加えて、「経費精算の一次チェック」というオリジナルのワークフローを組み、エージェント役に Claude Code をつないだ実行も試しました。
想定読者は、AIエージェントを業務に組み込みたいエンジニアと、その設計を判断する立場の方です。コマンドを打たない方も、図と「結果」の段落だけで要点がつかめるように書いています。
この記事の確認範囲
| 項目 | 内容 |
|---|---|
| 確認日 | 2026年9月26日 |
| 対象 | AgentRun 0.1.0-beta.4(GitHub main のコミット e248ed6)、npm の @parcha/agentrun-dsl / -jev / -pi いずれも 0.1.0-beta.4 |
| 検証環境 | macOS 26.6.2(Apple Silicon)、Node.js 22.23.2、npm 10.9.8、Claude Code 2.1.280(claude-haiku-4-5-20251001) |
| 実行したもの | npm版のクイックスタート、リポジトリのビルド・付属デモ・テスト一式、CLIの inspect / validate / dry-run、自作ワークフロー(台本の判定/Claude Code をエージェントに接続/判定も Claude で代用) |
| 実行していないもの | Jev 本体(TypeSafe API)へのライブ接続、Pi 拡張、Lean 4 の形式仕様のチェック |
Jev本体を呼んでいないのは、この検証では Jev の APIキーを使っていないためです。そのため、この記事の Jev の速度・価格・精度はすべて開発元の公称値として扱い、実測値とは区別して書いています。
誰が作ったのか:AgentRun と Jev は別々の会社の製品
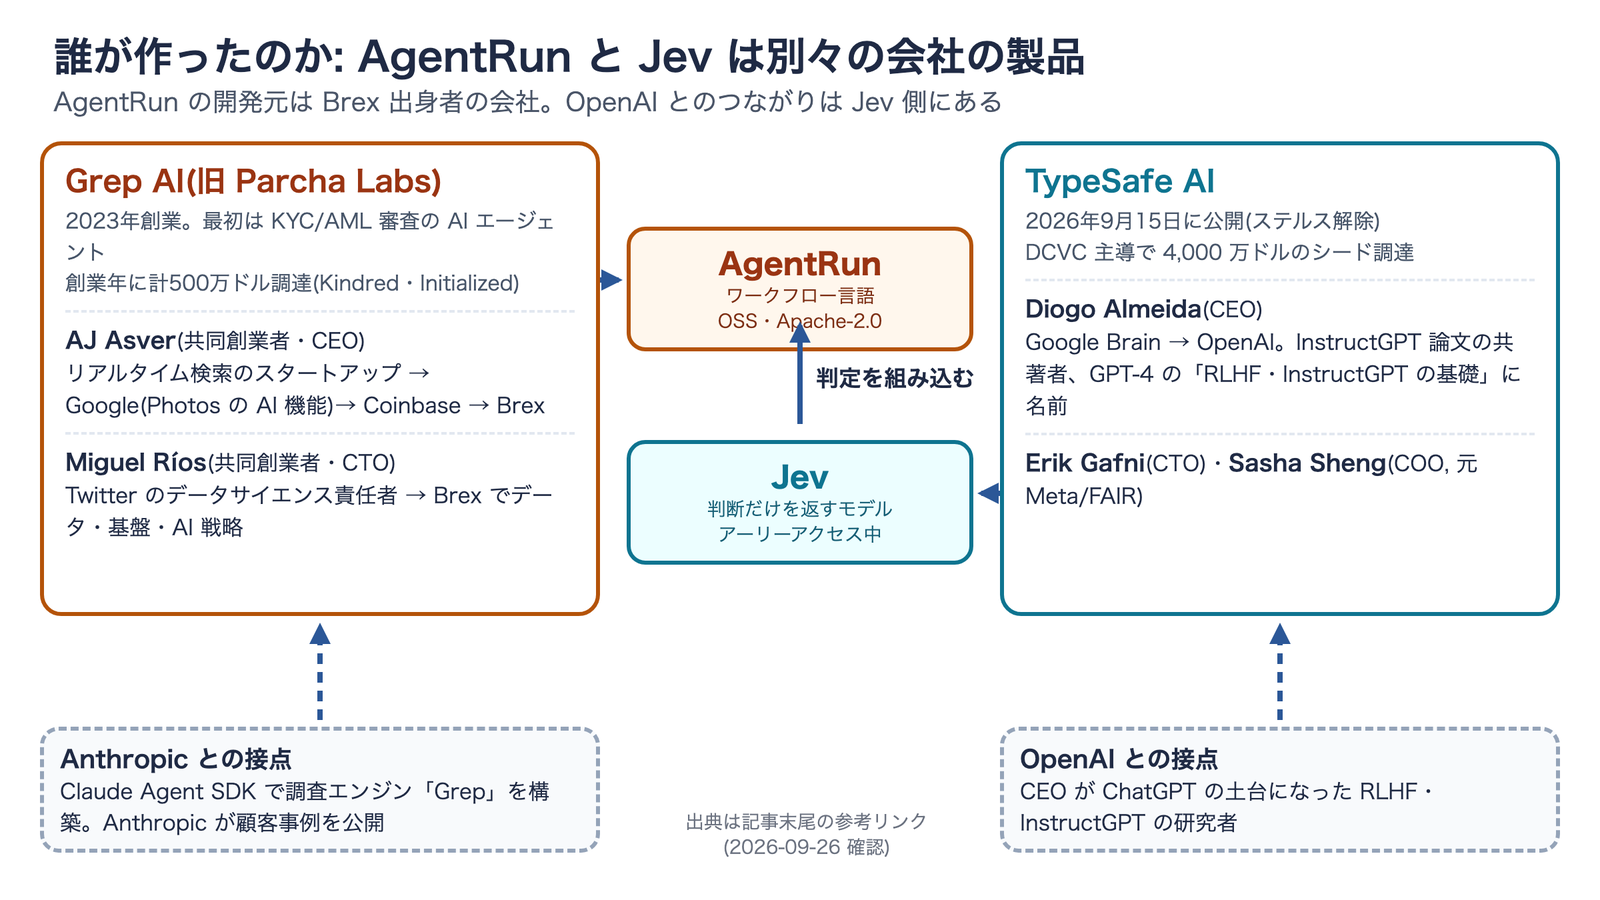
最初に押さえておきたいのは、AgentRun と Jev は開発元が違うという点です。AgentRun は Grep AI(旧 Parcha Labs)のOSSで、Jev は TypeSafe AI という別の会社の商用モデルです。AgentRun は Jev を「判定を担当する部品」として組み込んでいます。
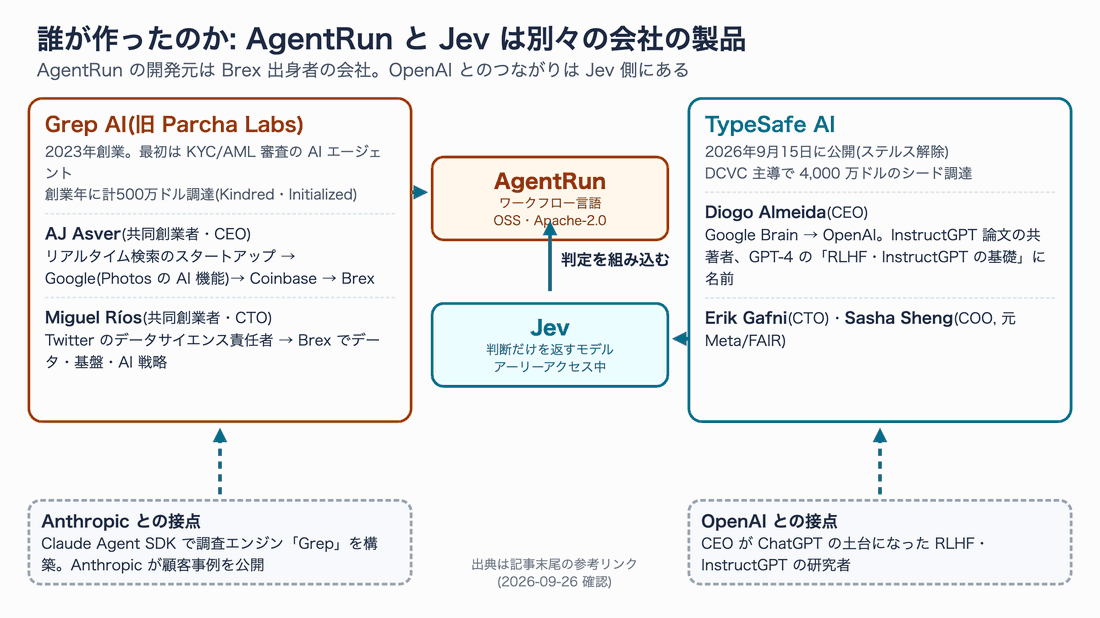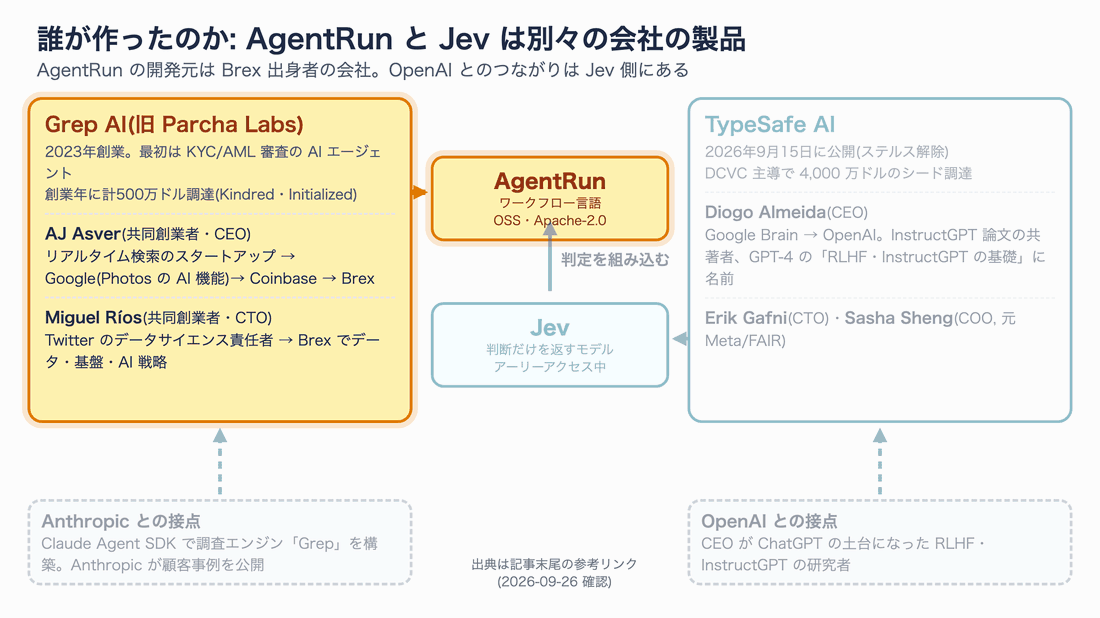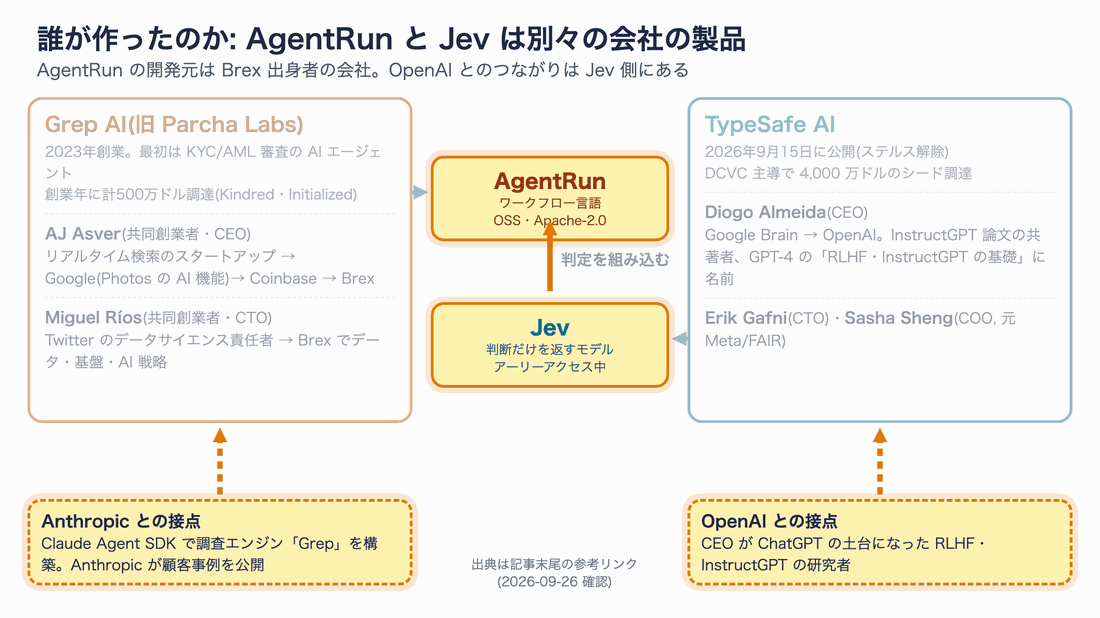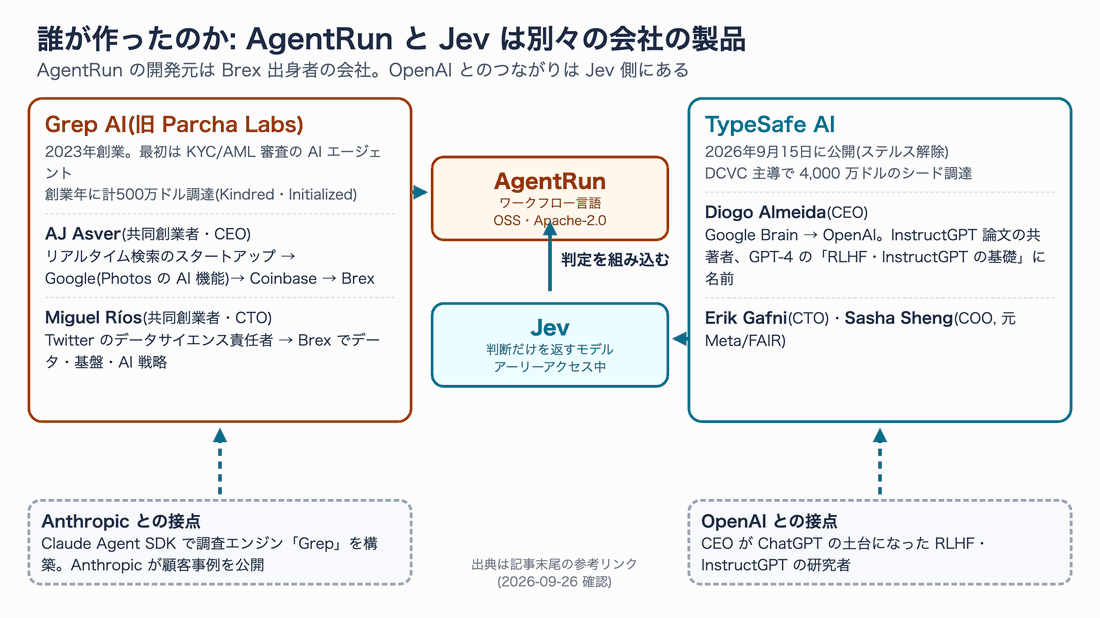
図2 開発元の関係。OpenAIとのつながりはJev側、Anthropicとのつながりは Grep AI 側にある(静止画)
AgentRun の開発元:Brex 出身の2人が創業した Grep AI
Parcha Labs は、OpenAI や Anthropic の出身者が作った会社ではありません。フィンテック企業 Brex で一緒に働いていた2人が2023年に創業したスタートアップです。創業当初は、KYC(本人確認)や AML(マネーロンダリング対策)のアラート審査を自動化するエージェントを提供していました。2023年には Kindred Ventures と Initialized Capital から計500万ドルを調達しています。
| 人物 | 役割 | 主な経歴(公開情報から) |
|---|---|---|
| AJ Asver | 共同創業者・CEO | 2009年にリアルタイム検索のスタートアップを立ち上げ、チームごと Google へ(2011年)。Google Photos の AI 機能、Coinbase でリスク・コンプライアンス領域のデータプロダクト、Brex で Director of Product |
| Miguel Ríos | 共同創業者・CTO | Parcha のブログによると、メリーランド大学の博士課程を離れて Twitter へ。60人超のデータサイエンス組織を率い、Brex では Head of Data、Head of Platform Engineering、AI 戦略を担う Office of the CTO を担当 |
その後、同社は企業調査向けのディープリサーチエンジン「Grep」を開発し、現在は Parcha の公式サイトで「Parcha is now Grep AI」と案内しています。Grep は Anthropic の Claude Agent SDK の上に作られていて、Anthropic は Parcha の顧客事例(Claude Agent SDK で顧客審査エージェントを2週間で作った話)を公開しています。Anthropic との接点はここです。
AgentRun は、この Grep の社内ハーネス(エージェントを動かす土台)で使っているワークフロー言語を切り出したものです。Hacker News の「Show HN」投稿によると、エージェントが仕事のあとに残すトレース(実行記録)や振り返りメモを見て、どの部分をワークフロー化できるかを見つけているそうです。毎回フルのエージェントループを回さなくてよい部分を切り出す、というのが出発点です。
Jev の開発元:InstructGPT の研究者が率いる TypeSafe AI
知名度の面で注目したいのは Jev の開発元、TypeSafe AI です。2026年9月15日にステルス(非公開の開発期間)を解除し、DCVC 主導で4,000万ドルのシード資金を調達したと発表しました。
CEO の Diogo Almeida 氏は Google Brain を経て OpenAI に在籍した研究者で、ChatGPT の前身にあたる InstructGPT の論文(2022年)の共著者です。GPT-4 のテクニカルレポートでも、貢献者一覧の「Foundational RLHF and InstructGPT work」(RLHF と InstructGPT の基礎研究)の項目に名前があります。RLHF は、人の評価をもとにモデルを調整する手法で、ChatGPT の使い心地を作った中核技術です。CTO は Erik Gafni 氏、COO は Meta の研究部門 FAIR 出身の Sasha Sheng 氏です。
まとめると、AgentRun は「ChatGPT の土台を作った RLHF 研究者の判断モデル」を、「Brex 出身の実務派チーム」がエージェント基盤に組み込んだ OSS、と位置づけられます。
リポジトリの現状
2026年9月26日時点の GitHub の画面です。リポジトリは9月23日に公開されたばかりで、Star は75、Fork は7でした。
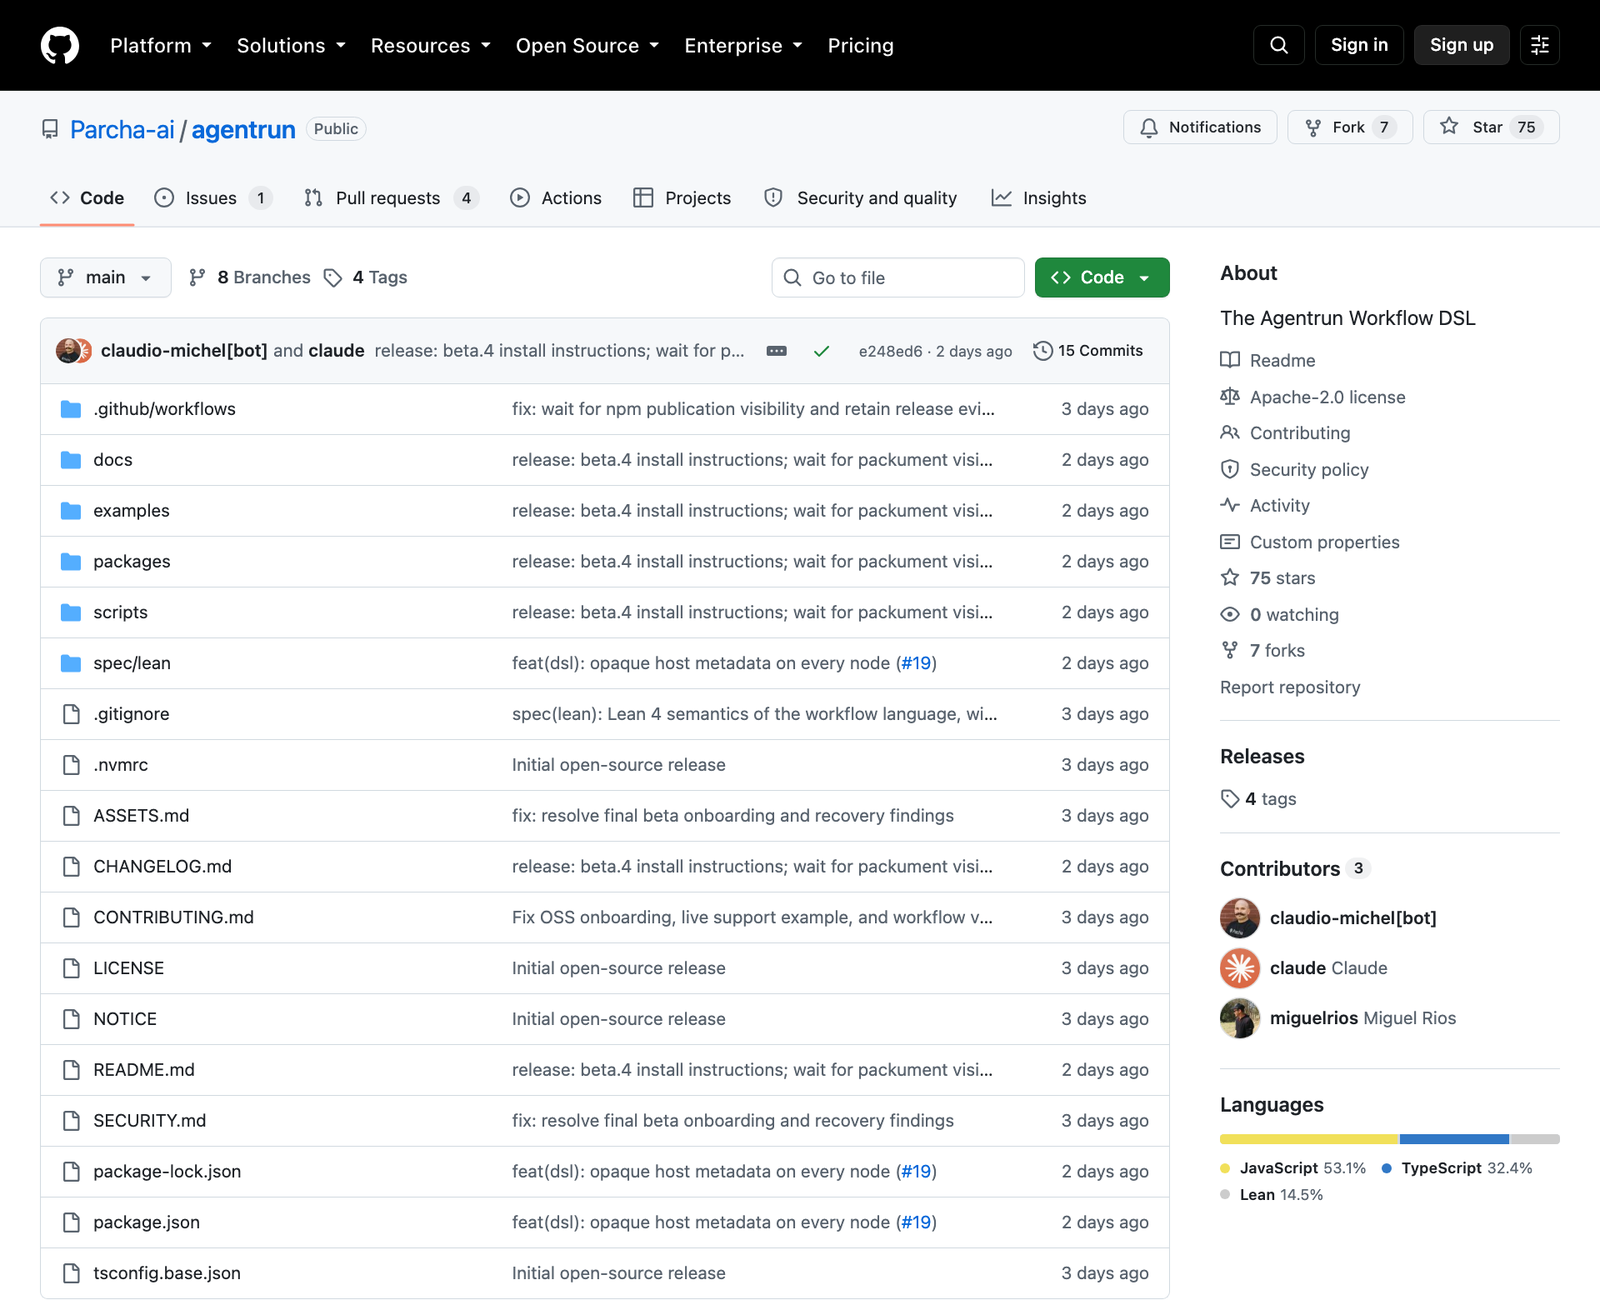
画面1 GitHub のリポジトリ(2026-09-26 撮影)。Contributor 3件のうち1件は bot、1件は claude
Contributor の欄を見ると、人間は Miguel Ríos 氏1人で、残りは claudio-michel[bot] と claude です。コミットの多くはAIエージェント経由と見られます。言語の内訳に Lean(定理証明の言語)が14.5%含まれているのは、ワークフロー言語の動きを Lean 4 で形式的に定義しているためです。成熟度の評価は後半の「実務での評価」で詳しく扱います。
Jev とは:文章を書かず「判断だけ」返すモデル
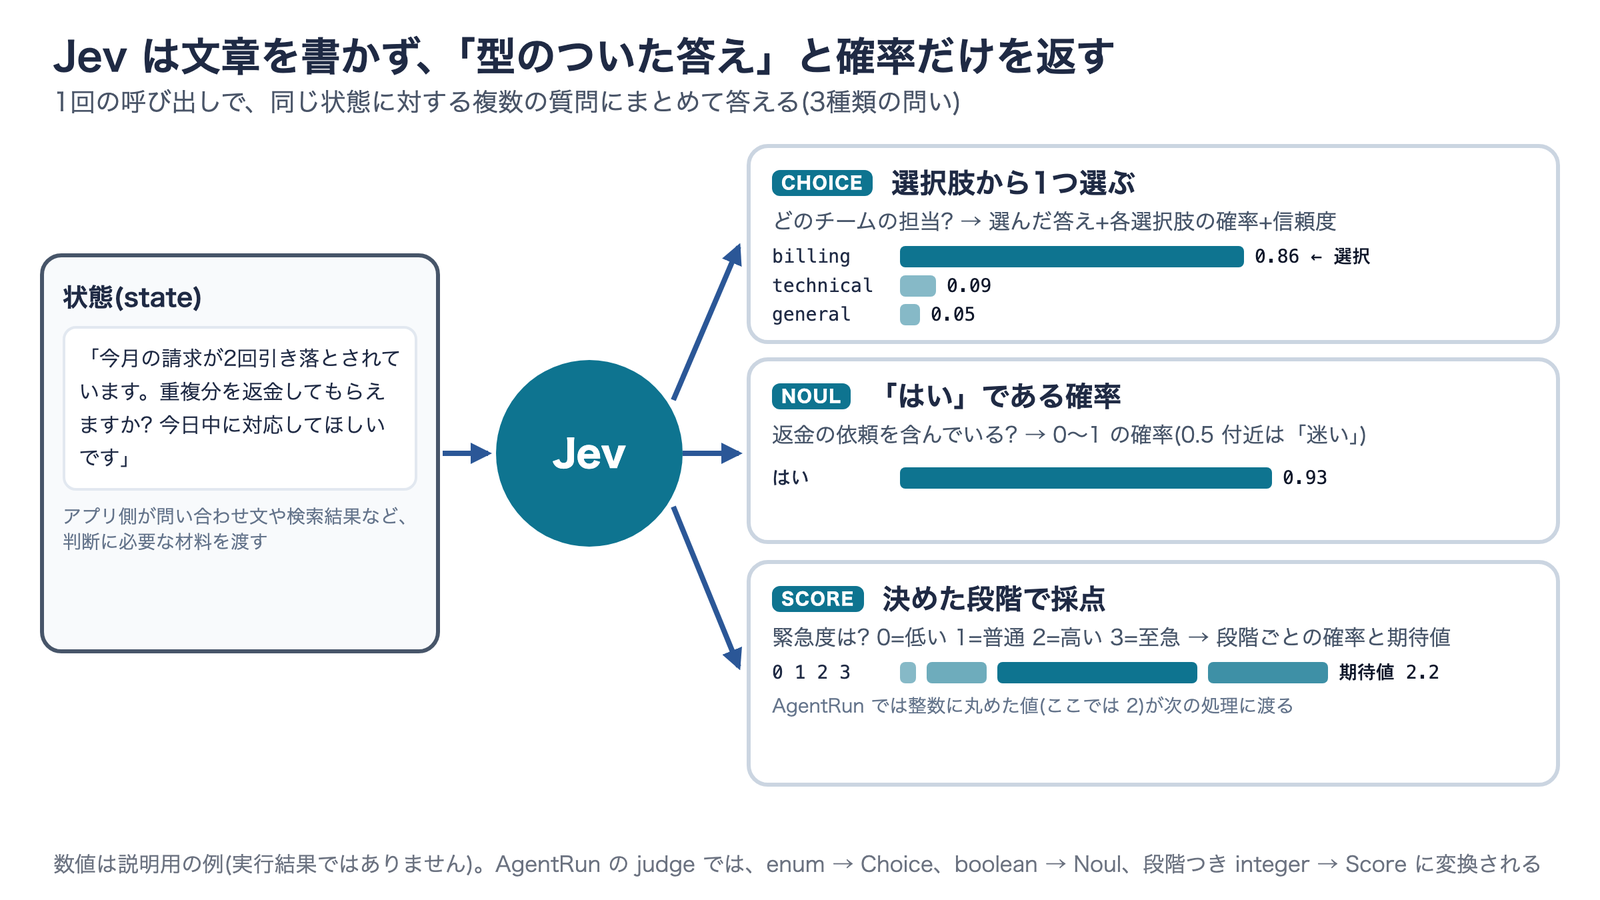
Jev は、テキストを生成しない AI モデルです。アプリが「状態(判断の材料)」と「質問」を渡すと、決められた形の答えと確率だけを返します。TypeSafe は、心理学者カーネマンの『ファスト&スロー』でいう直感的で速い「システム1」になぞらえて、System One Model と呼んでいます。名前は経済学者ジェヴォンズと、効率化が消費を増やす「ジェヴォンズのパラドックス」に由来します。
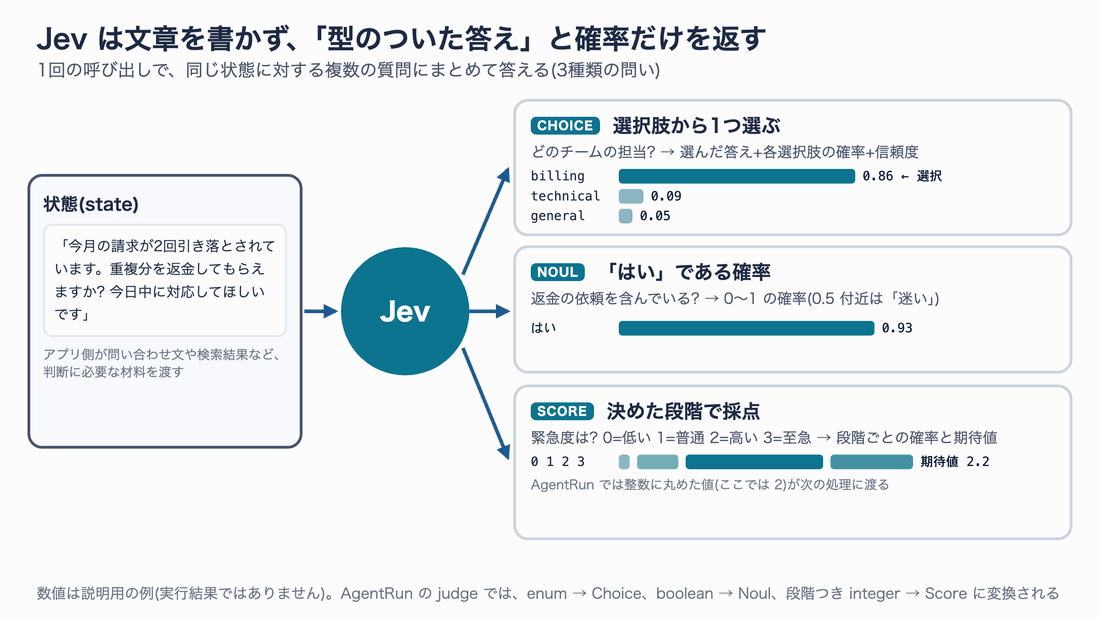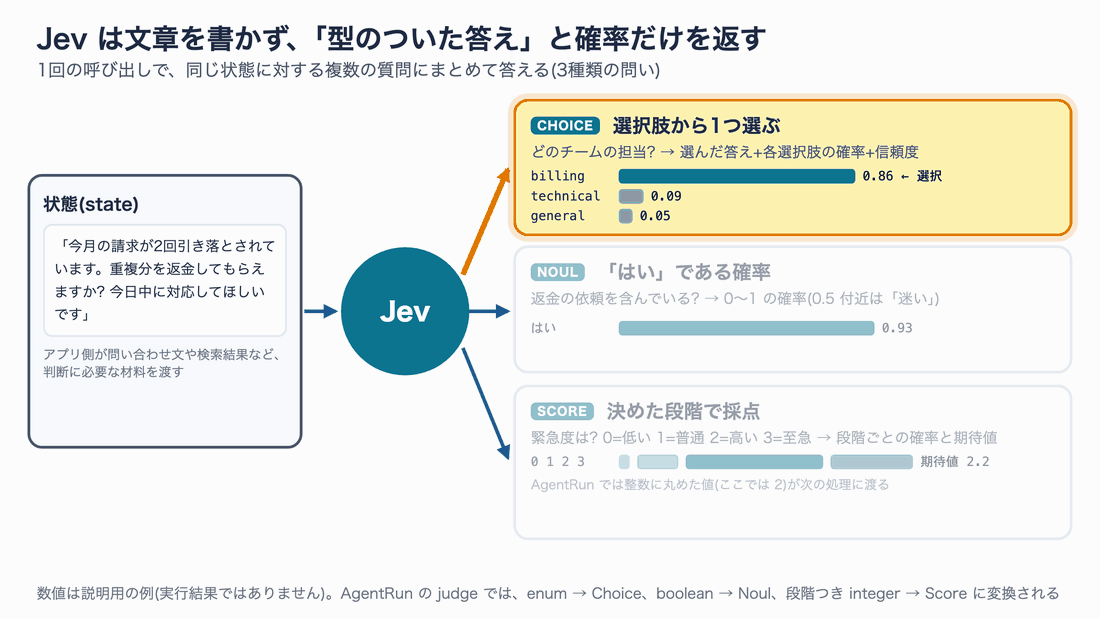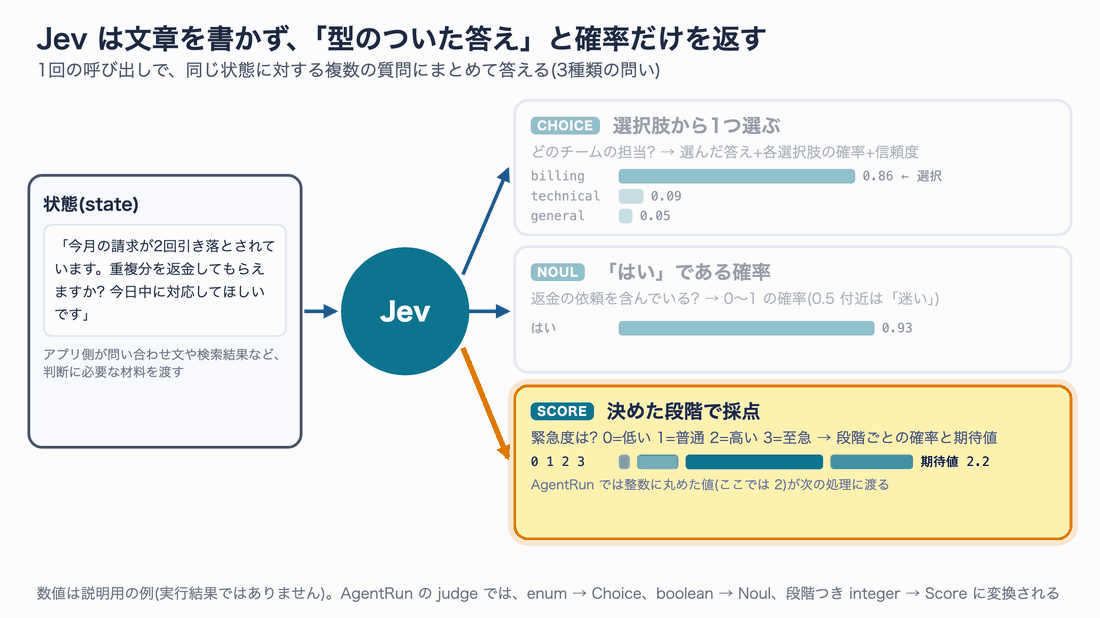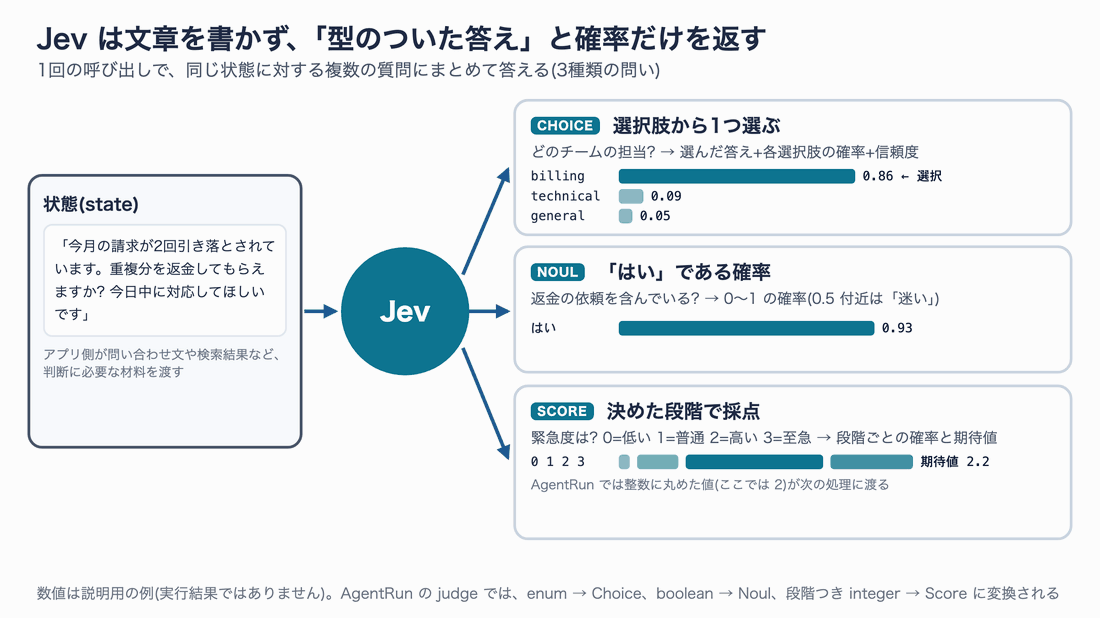
図3 Jev の3種類の問い。数値は説明用の例(静止画)
| 問いの種類 | 返すもの | 使いどころの例 |
|---|---|---|
| Choice | 選択肢から1つ+各選択肢の確率・信頼度 | 問い合わせの担当チーム振り分け |
| Noul | 「はい」である確率(0〜1) | 返金の依頼を含むかどうか |
| Score | 決めた段階(2〜10段階)ごとの確率と期待値 | 回答の品質、問題の深刻度 |
生成系のLLMに「JSONで答えて」と頼む方法と比べると、存在しない選択肢を返す・JSONが壊れるといった失敗が起きにくい設計です。AgentRun 側でも、返ってきた答えの形(確率の合計、選択肢の名前、段階の範囲など)を検証してから使います。
速度と価格について、TypeSafe のブログは「フロンティアLLM比で40〜200倍速い」「1回70〜500ミリ秒」「入力100万トークンあたり0.042ドル、出力は無料」としています。一方で、同日のプレスリリースには「100ミリ秒未満」「最大100倍速く安い」という表現もあり、数字は資料によって異なります。いずれも開発元の数値で、現時点ではウェイトリスト制のアーリーアクセスです。
外部の評価としては、Simon Willison 氏が9月21日のブログで「新しい形のモデル」として取り上げています。速さと安さを評価しつつ、理由の説明がなく数値だけが返ってくるため、採用選考のような用途では偏りが見えにくくなる、という懸念も書いています。Jev そのものの詳しい解説は、以前の記事「AIに“判断だけ”させると何が変わるのか — 0.5秒で答える新モデル「Jev」を理解する」にまとめています。
AgentRun の考え方:仕事を3つの担当に仕分ける
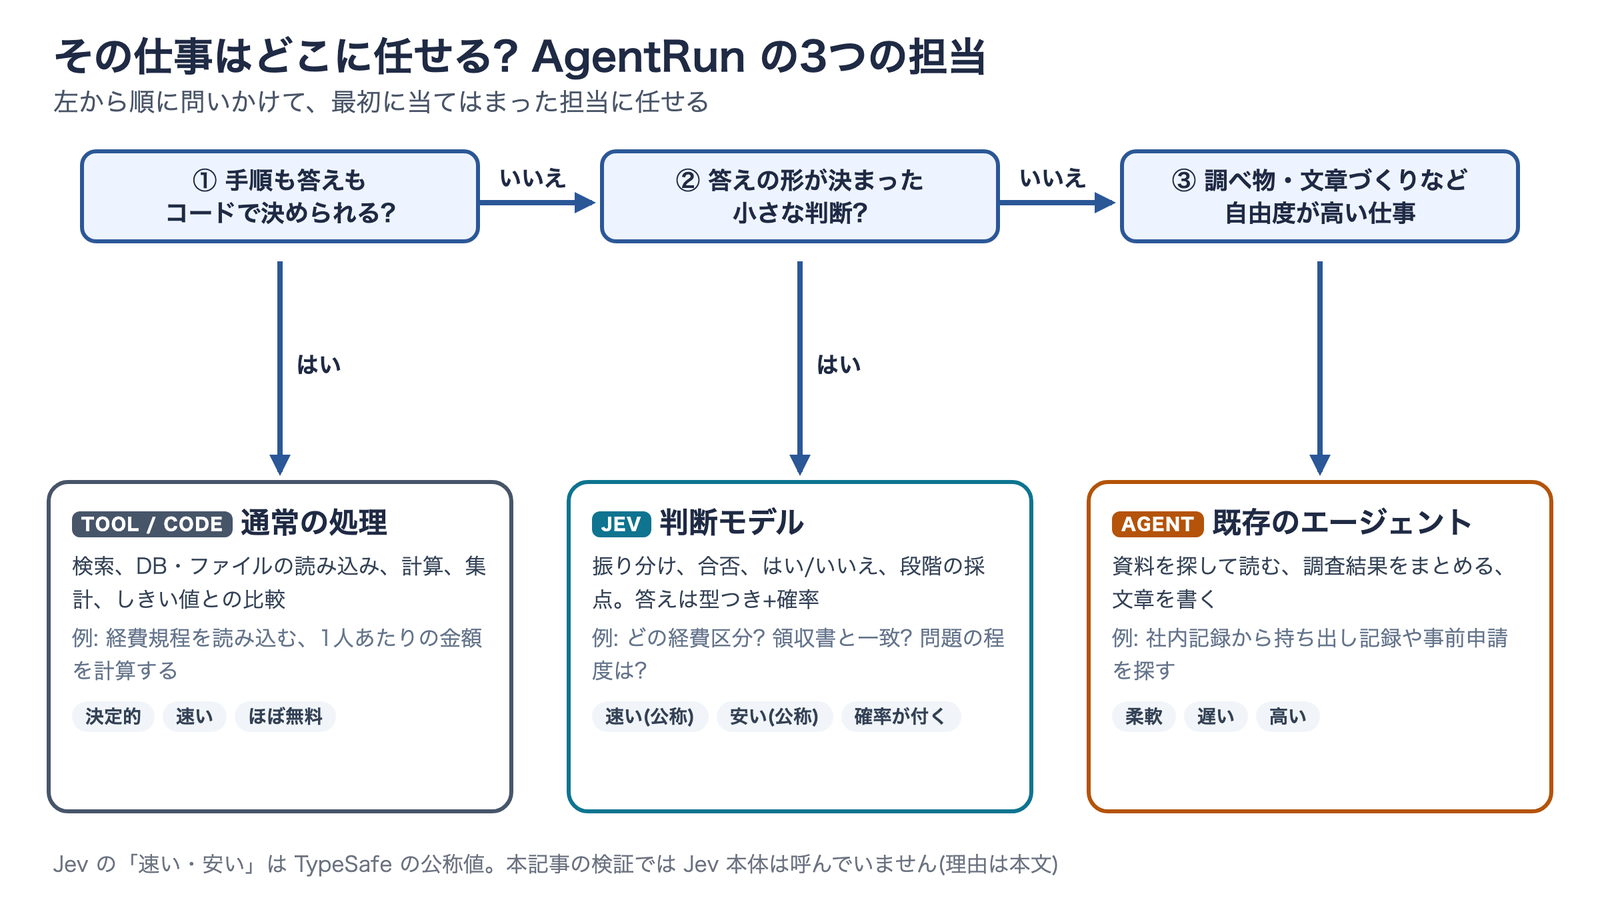
AgentRun の核は、エージェントに任せていた仕事を「処理の性質」で3つに分けることです。左から順に問いかけて、最初に当てはまった担当に任せる、と考えると分かりやすくなります。
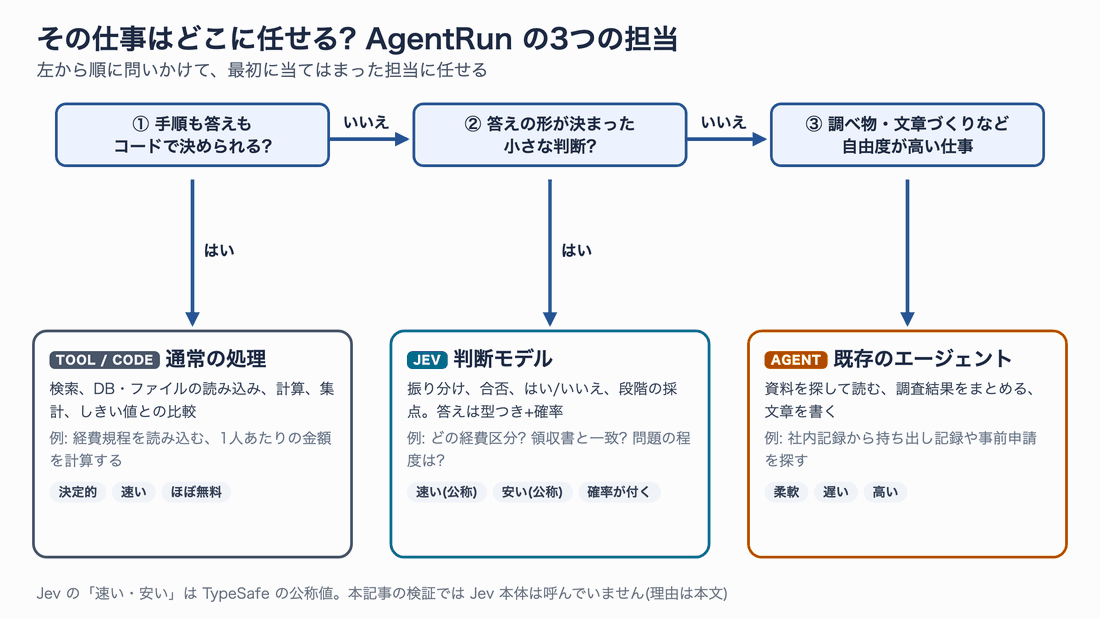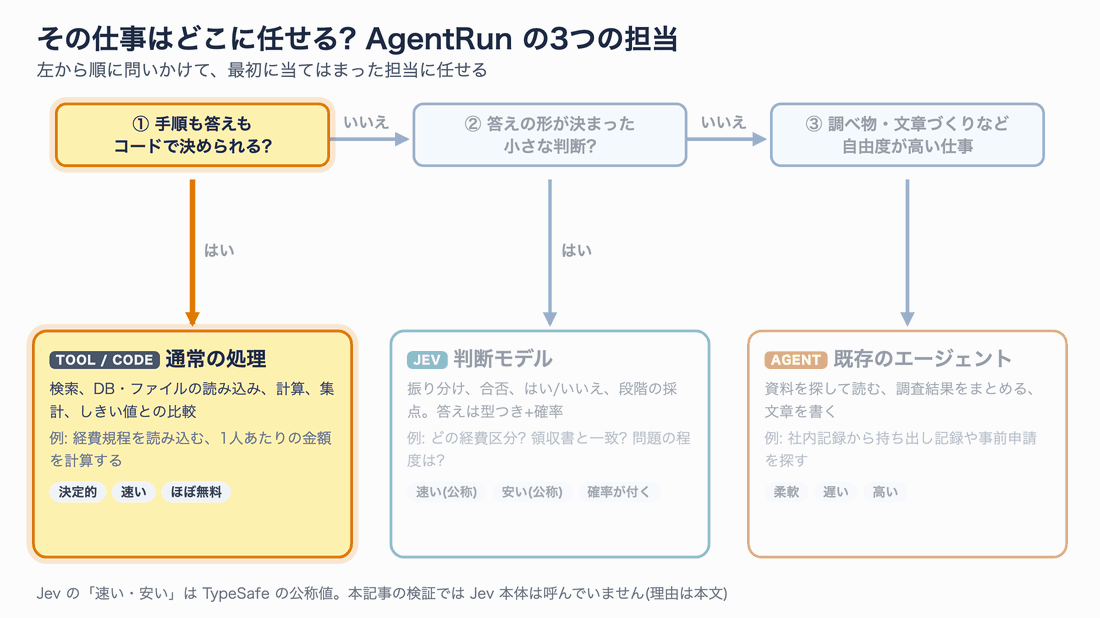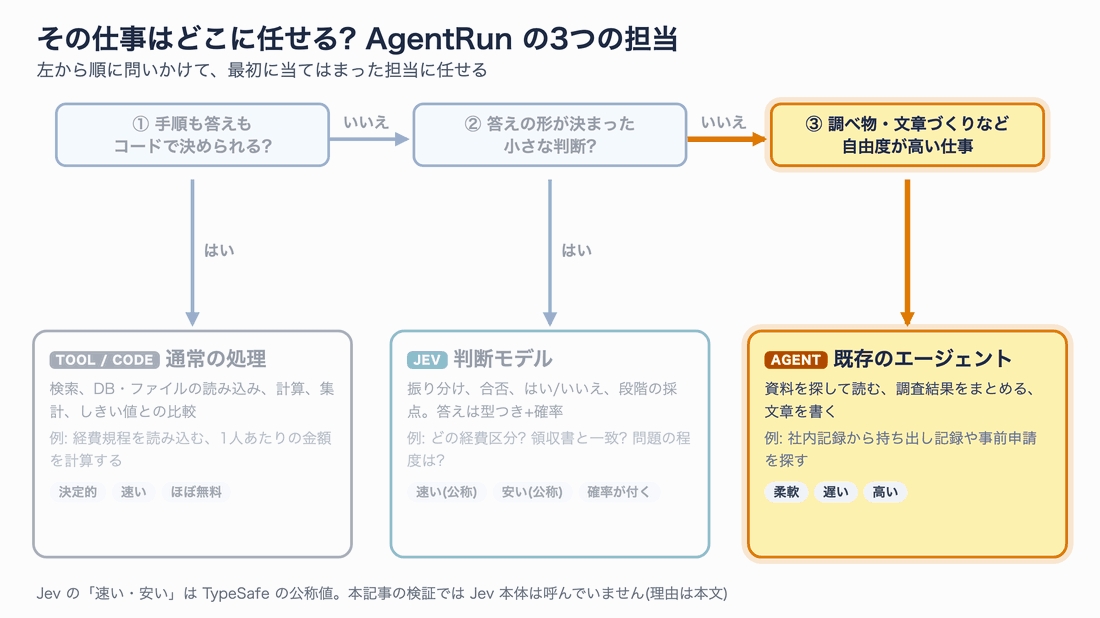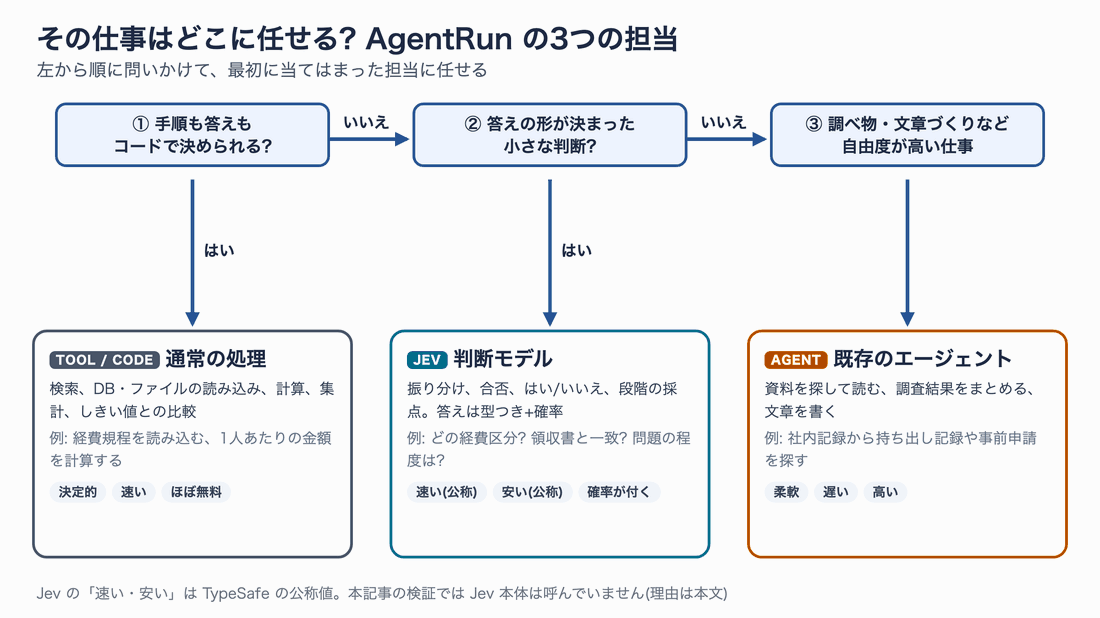
図4 どこに任せるかの判断順。Jev の「速い・安い」は公称値(静止画)
| 担当 | 任せる仕事 | 性質 |
|---|---|---|
| Tool / Code | 検索、DB・ファイルの読み込み、計算、しきい値との比較 | 決定的で速く、ほぼ無料 |
| Jev | 振り分け、合否、はい/いいえ、段階の採点 | 速く安い(公称)、答えに確率が付く |
| Agent | 資料探し、調査結果のまとめ、文章づくり | 柔軟だが遅く高い |
「コスト91%減」の中身
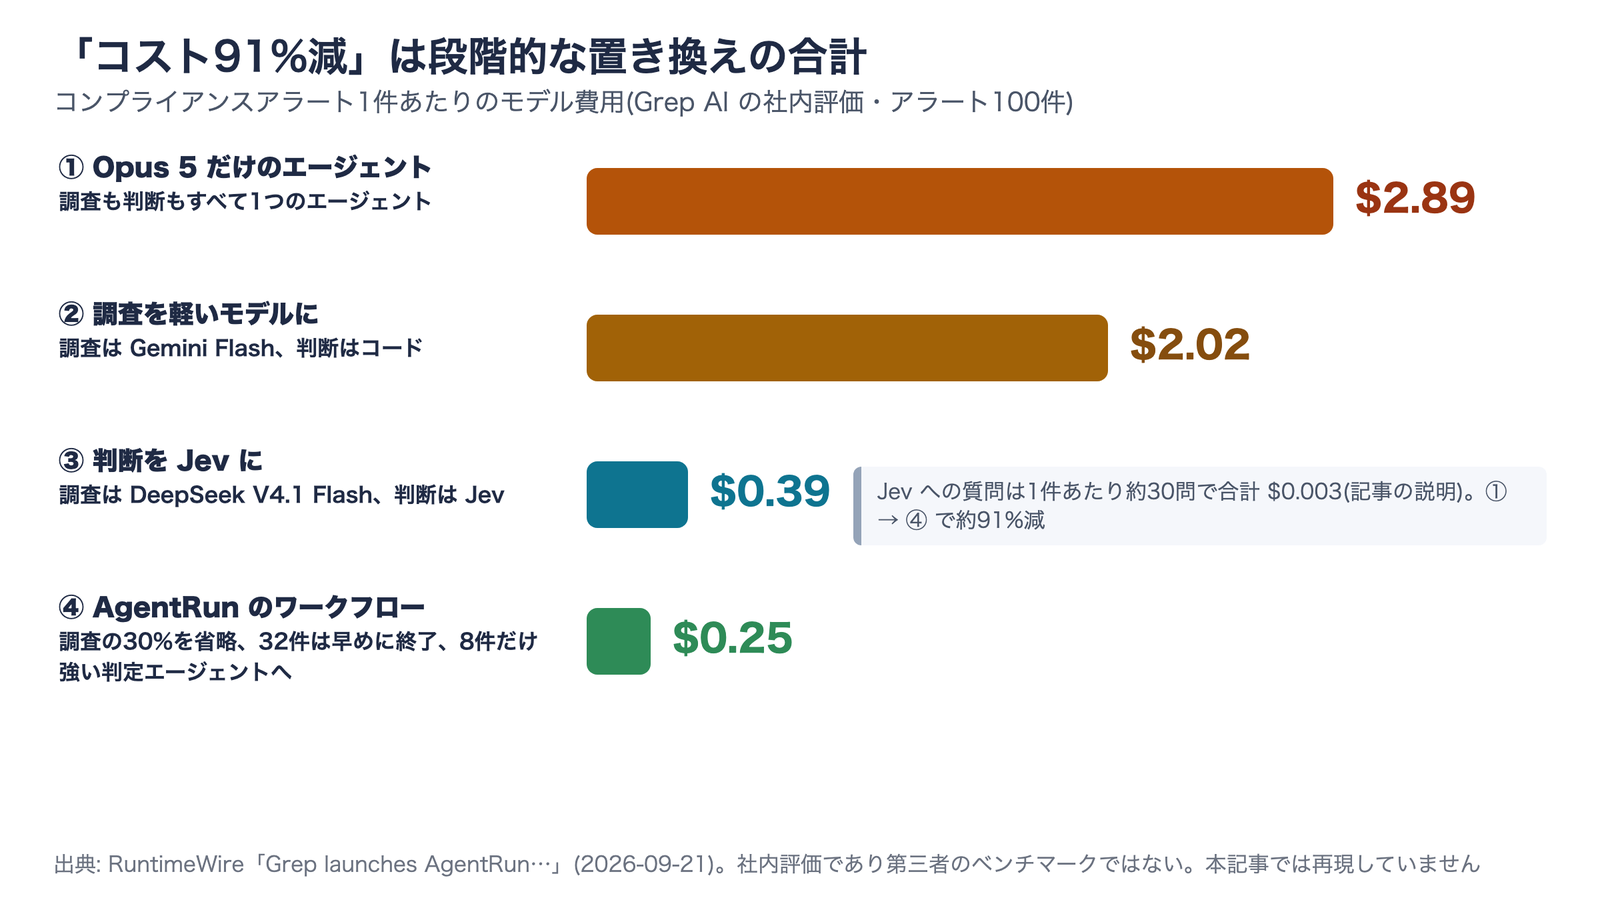
AgentRun の紹介でよく引用されるのが「コスト91%減」という数字です。これは RuntimeWire の記事(9月21日)で、Grep AI が社内で行ったコンプライアンスアラート100件の評価として紹介されたものです。中身を見ると、Jev に置き換えただけで下がったわけではありません。
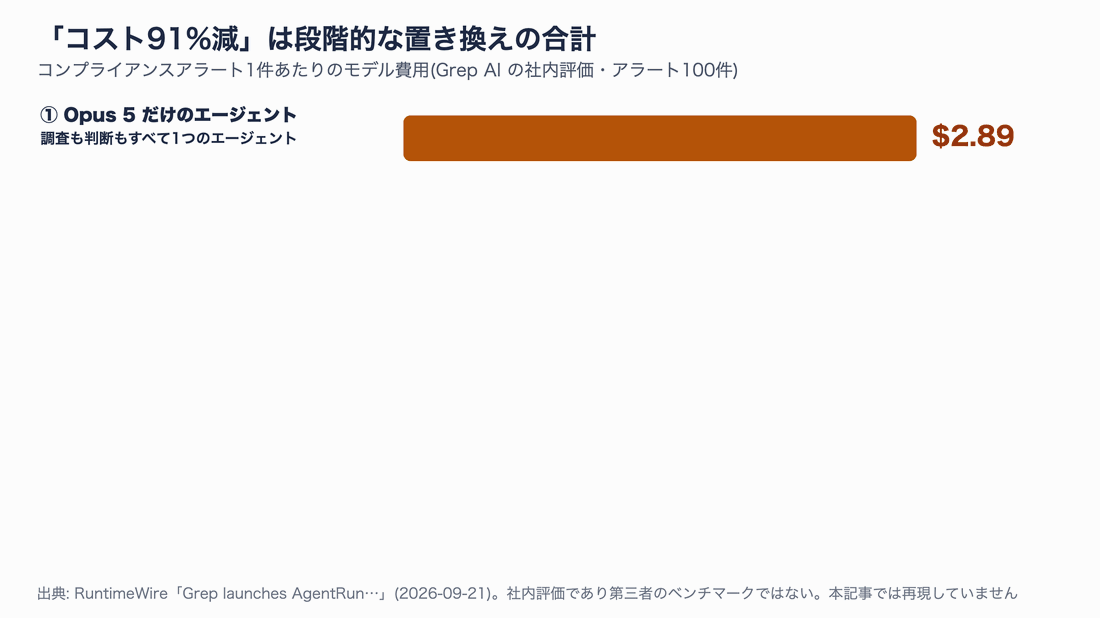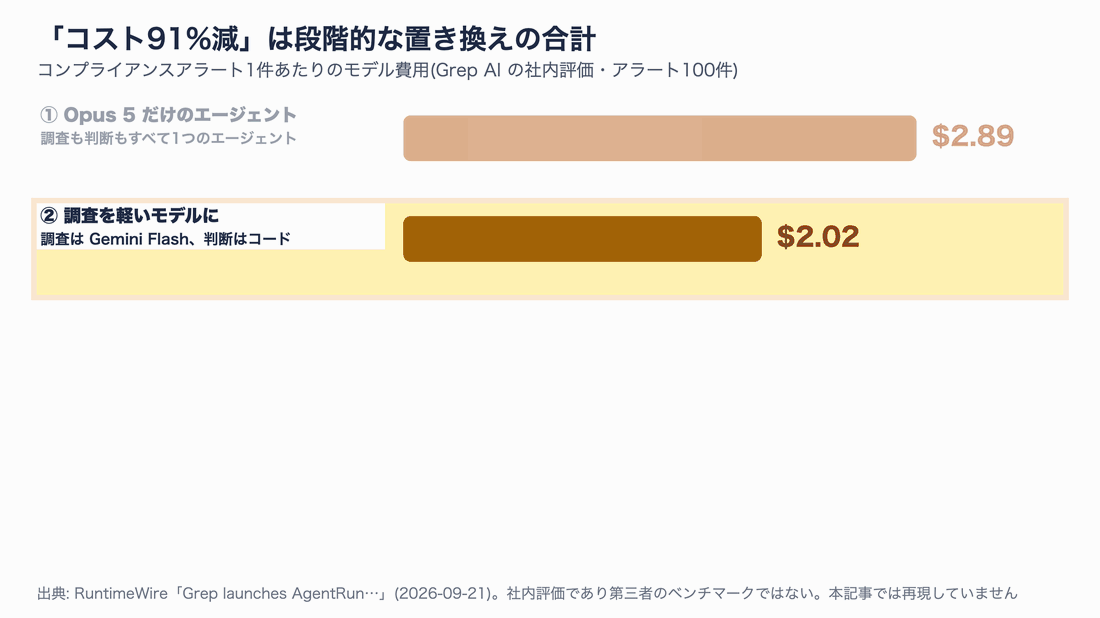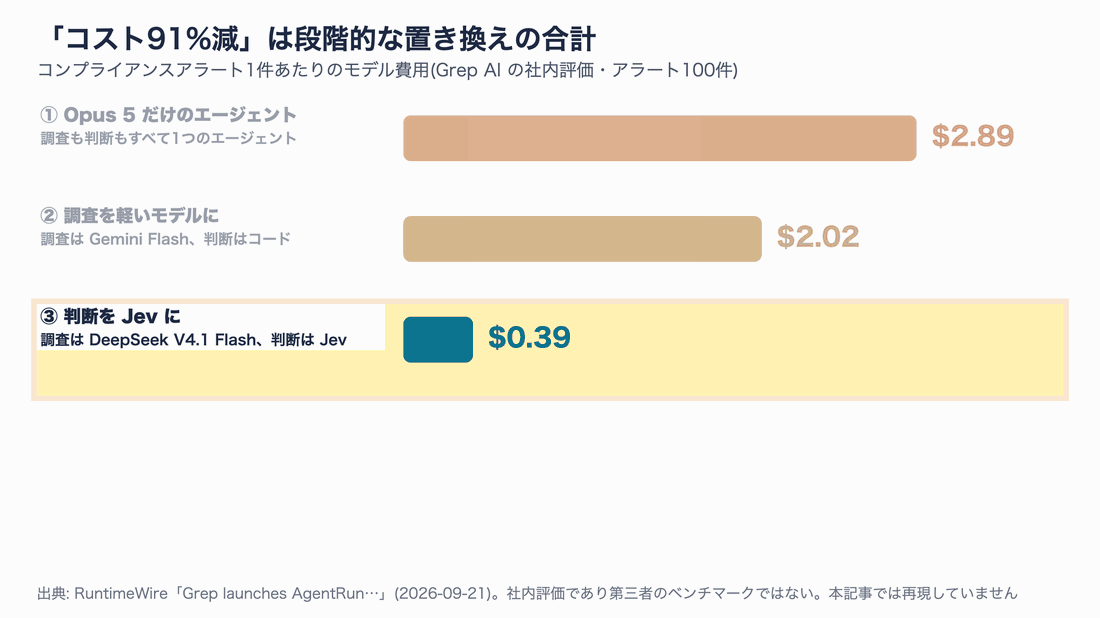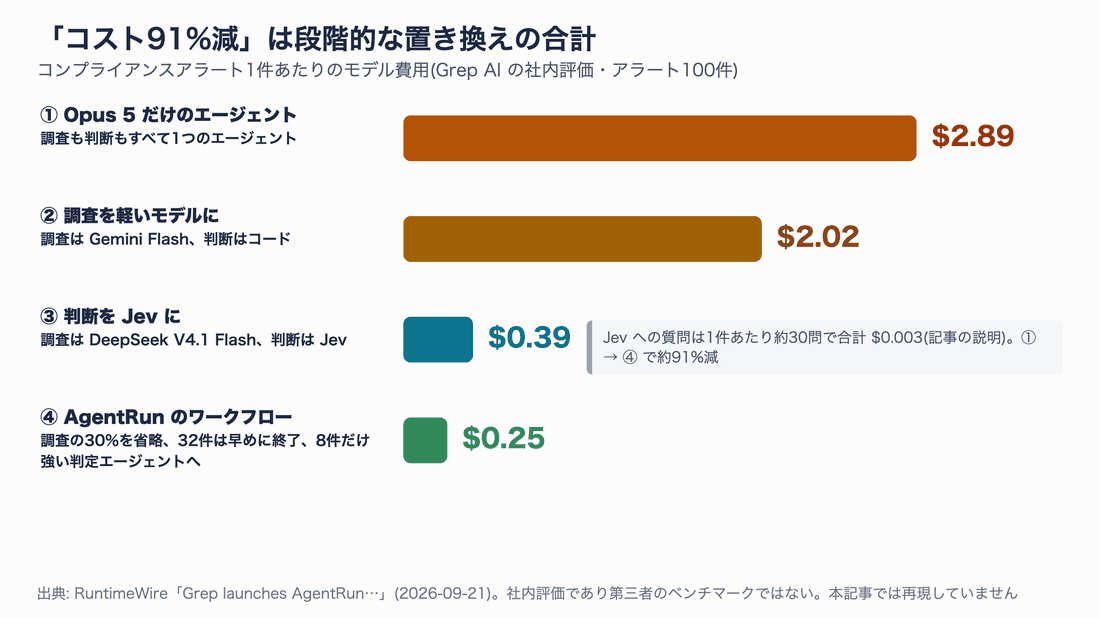
図5 費用は段階的に下がっている。社内評価で第三者のベンチマークではない(静止画)
最初の2.89ドルは Opus 5 だけのエージェントで、調査と判断をすべて任せた場合です。調査を軽いモデルに移すと2.02ドル、さらに調査を DeepSeek V4.1 Flash、判断を Jev に移すと0.39ドルまで下がります。最後に AgentRun のワークフローで、調査の30%を省略し、100件中32件を早めに打ち切り、判断が難しい8件だけを強い判定エージェントに回した結果が0.25ドルです。
つまり、効果の大半は「担当を分けること」から来ています。記事によると Jev への質問は1件あたり約30問で、その費用は合計0.003ドルでした。判断が安く速くなるから、ワークフローの中で何度も判定をはさめる、という関係です。
準備:必要な環境
AgentRun を試すのに必要なのは Node.js と npm だけです。付属デモは判定やエージェントの応答が台本(固定値)になっているため、APIキーは要りません。
| 項目 | 条件 | 今回の環境 |
|---|---|---|
| Node.js | 22.19 以上 | 22.23.2 |
| npm | Node に付属 | 10.9.8 |
| APIキー | 付属デモでは不要。ライブの Jev には TYPESAFE_API_KEY | 未使用 |
| エージェント(任意) | 自前のエージェント。今回は Claude Code | Claude Code 2.1.280 |
Node のバージョンは次のコマンドで確認できます。
# 22.19 以上なら OK
node -v
手順1:新しいプロジェクトで5分体験する
まずは README のクイックスタートどおり、空のプロジェクトに npm パッケージを入れてデモを動かします。
# 空のフォルダーで実行する
mkdir agentrun-try && cd agentrun-try
npm init -y
npm install @parcha/agentrun-dsl@beta

# チケット振り分けのデモ(判定は台本・APIキー不要)
npx agentrun demo
実際に打ち込んだ様子です。インストールは1〜2秒で終わり、追加されたパッケージは2つ(本体と、依存する typebox)、脆弱性は0件でした。
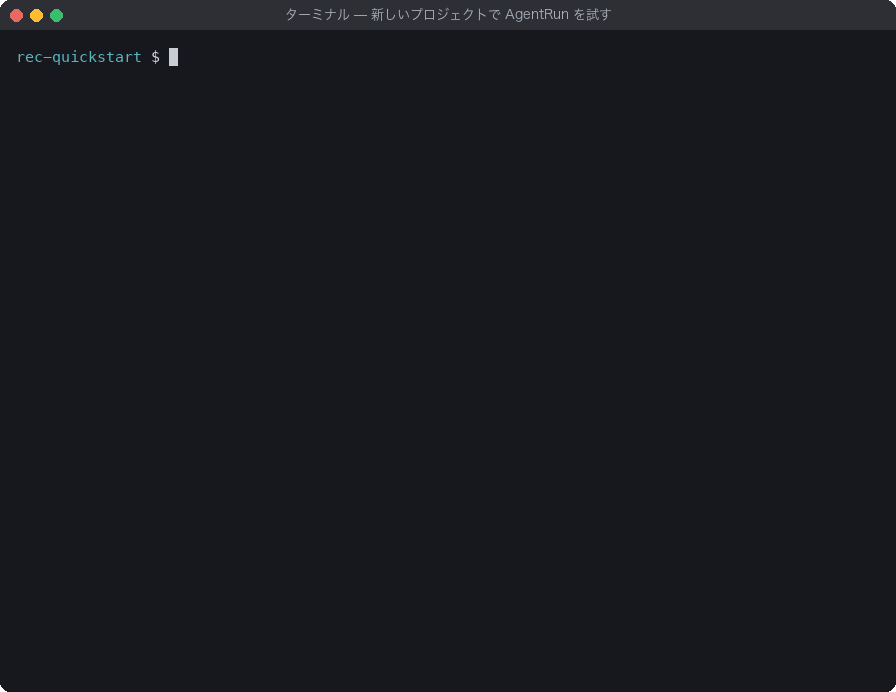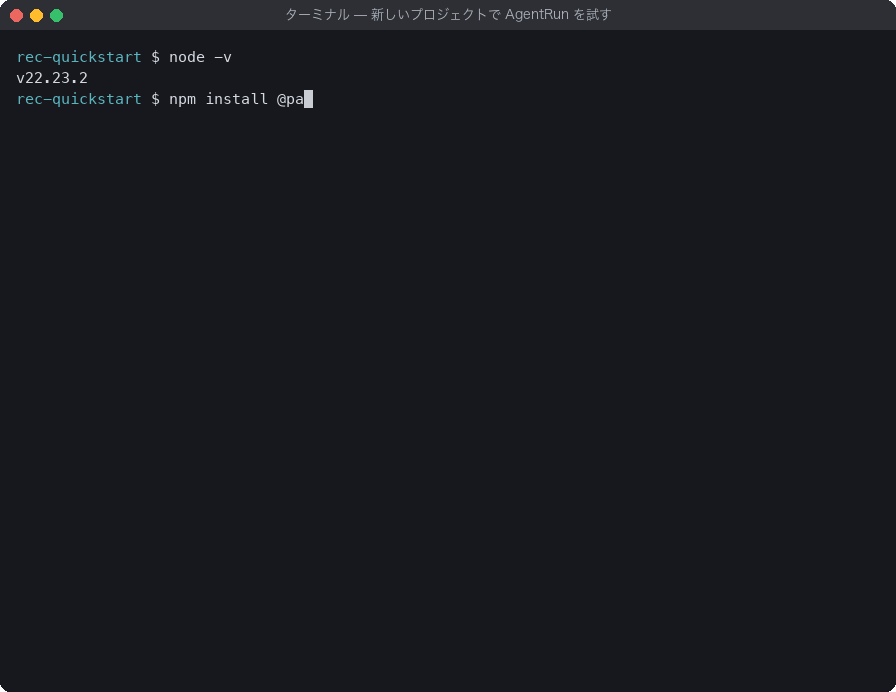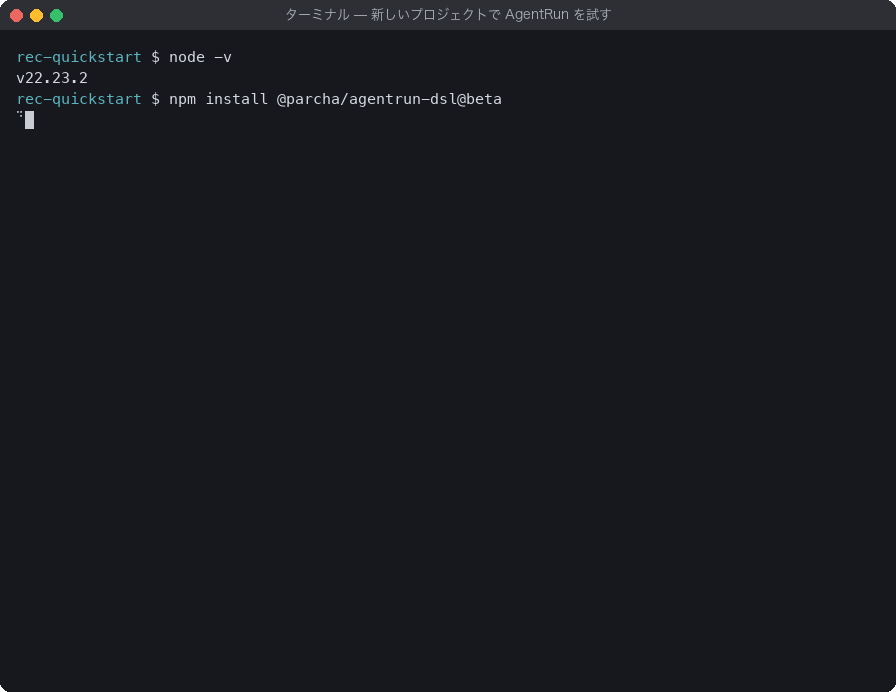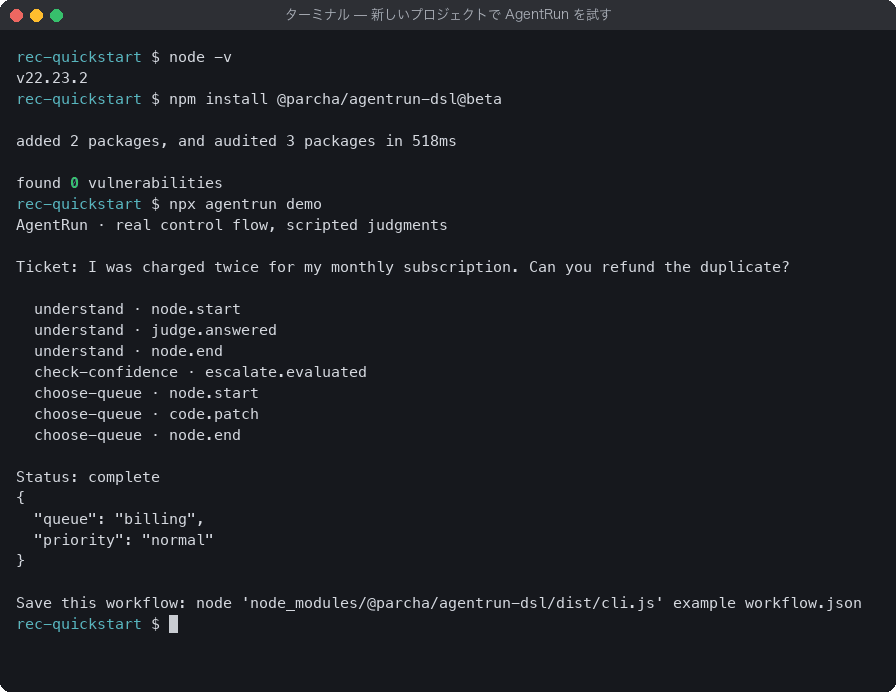
動画1 クイックスタートの実行(実際の端末出力を記録。MP4版: rec01-quickstart.mp4)
デモは「月額料金が2回引き落とされた」というチケットを、understand(判定)→ check-confidence(信頼度チェック)→ choose-queue(振り分け)の順に処理し、billing(請求担当)・normal(通常の優先度)という結果を返しました。判定は台本ですが、ワークフローを動かしているのは本物のインタプリタです。
判断に迷うチケットは人へ回る
--scenario ambiguous を付けると、「プランの問題か接続の問題か分からない」という曖昧なチケットで試せます。
npx agentrun demo --scenario ambiguous
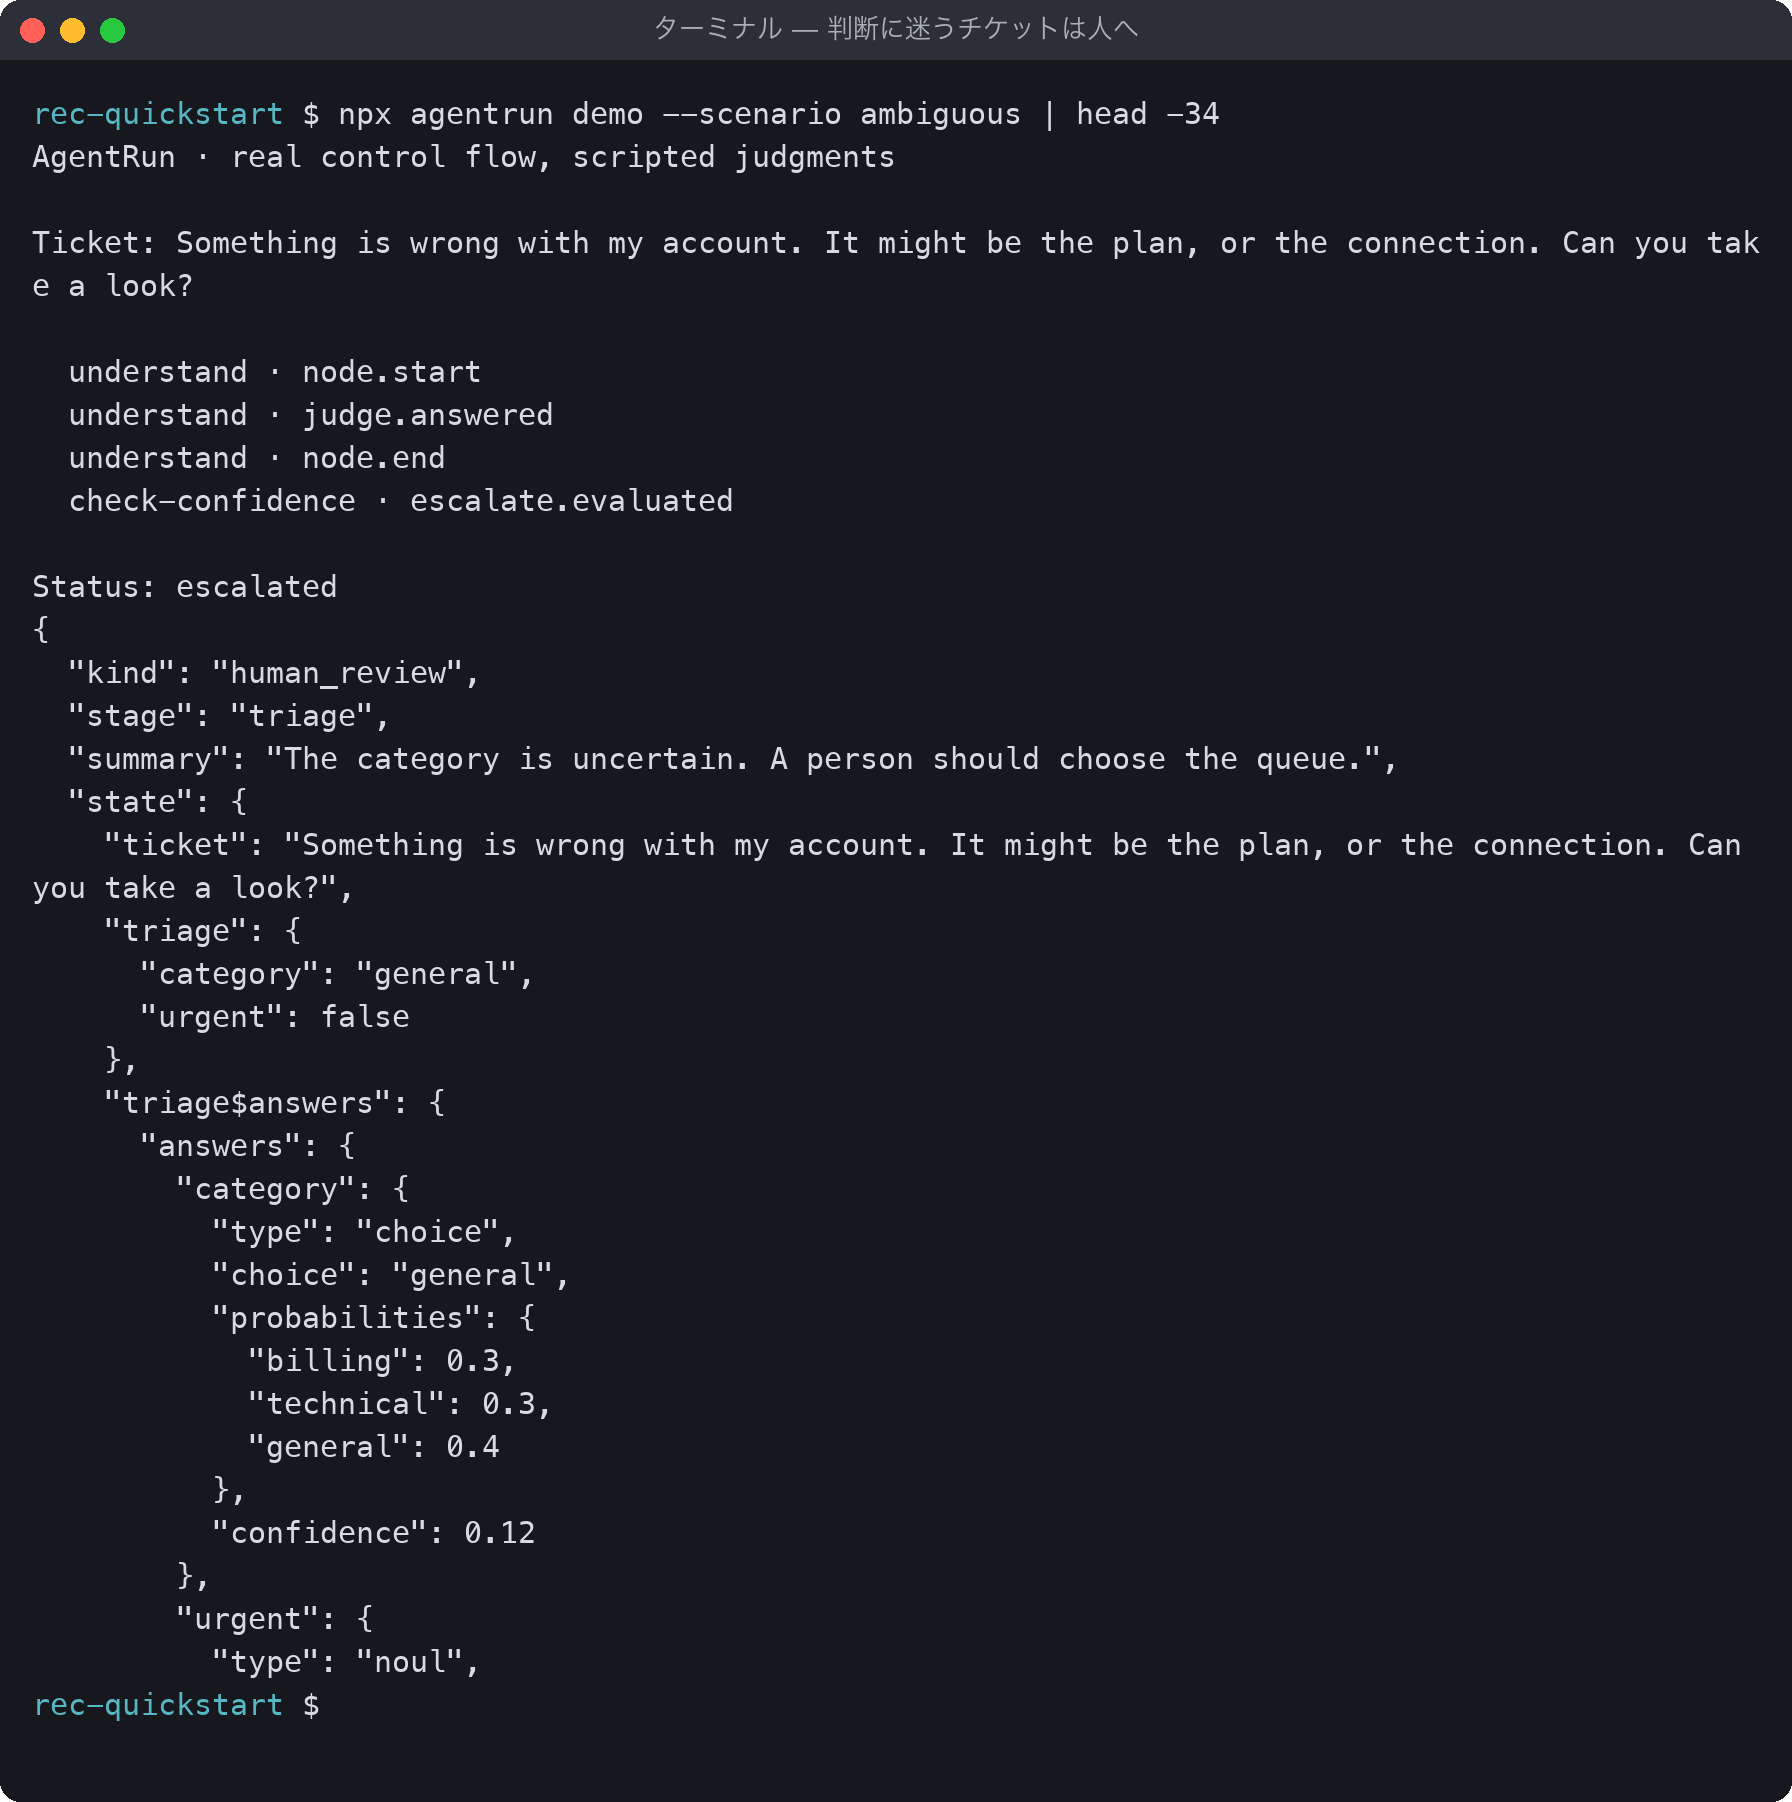
画面2 信頼度0.12がしきい値0.7を下回り、human_review として人へ回された
担当の確率は billing 0.3、technical 0.3、general 0.4 と割れていて、信頼度(confidence)は0.12でした。デモのワークフローは「信頼度が0.7未満なら人へ」と決めているので、結果は escalated(エスカレーション)になり、判断材料の状態をまるごと返しています。AgentRun の結果は、この「完了(complete)」か「人へ(escalated)」のどちらかになります。
なお、この CLI デモはエスカレーションでも終了コード0で終わりました。後述するサポート例の実行スクリプトは、エスカレーションを終了コード2で返します。CI などで結果を判定する場合は、終了コードではなく出力の Status を見るほうが確実です。
手順2:リポジトリを取得して付属デモを動かす
次に、GitHub からリポジトリを取得してビルドし、README の図に対応するサポート窓口のデモを動かします。
git clone --branch main --single-branch https://github.com/Parcha-ai/agentrun.git
cd agentrun
# 依存パッケージを lockfile どおりに入れる(インストールスクリプトは実行しない)
npm ci --ignore-scripts
npm run build
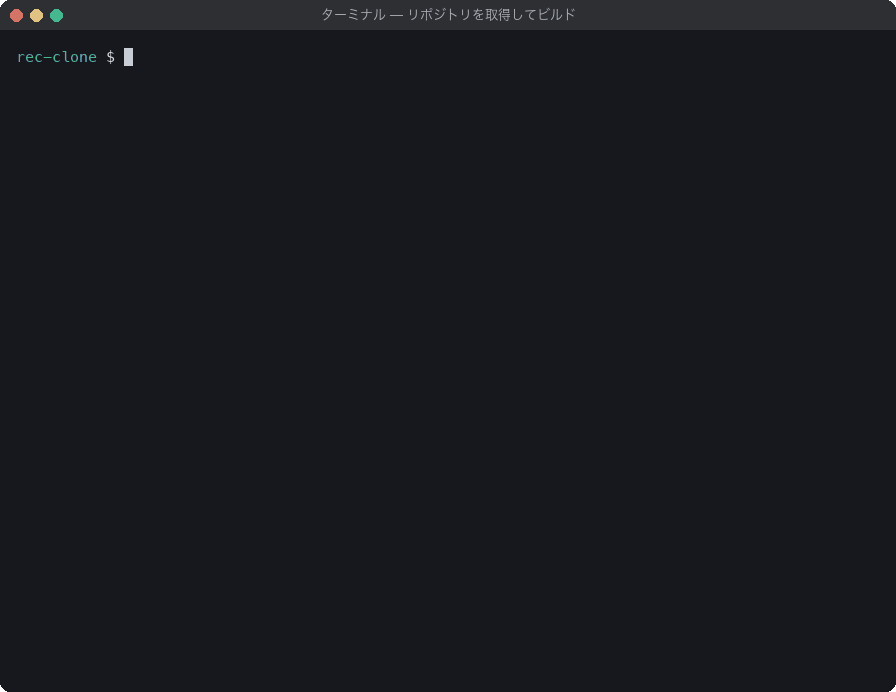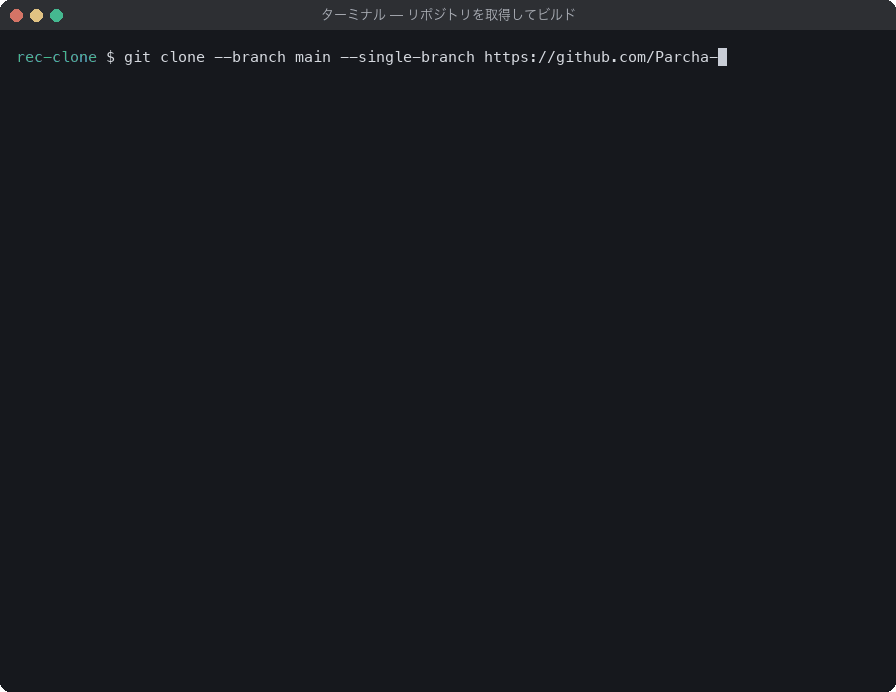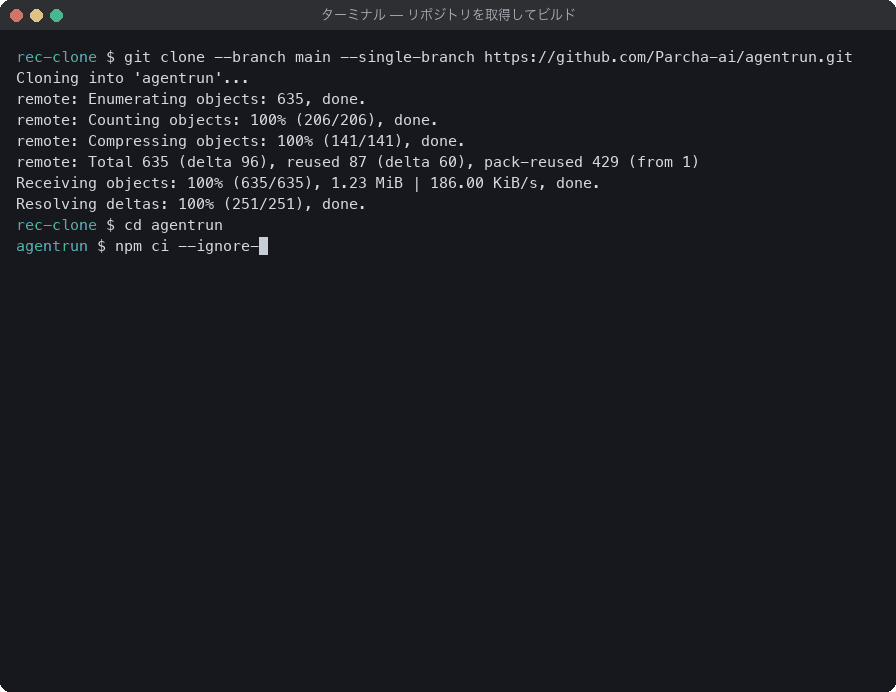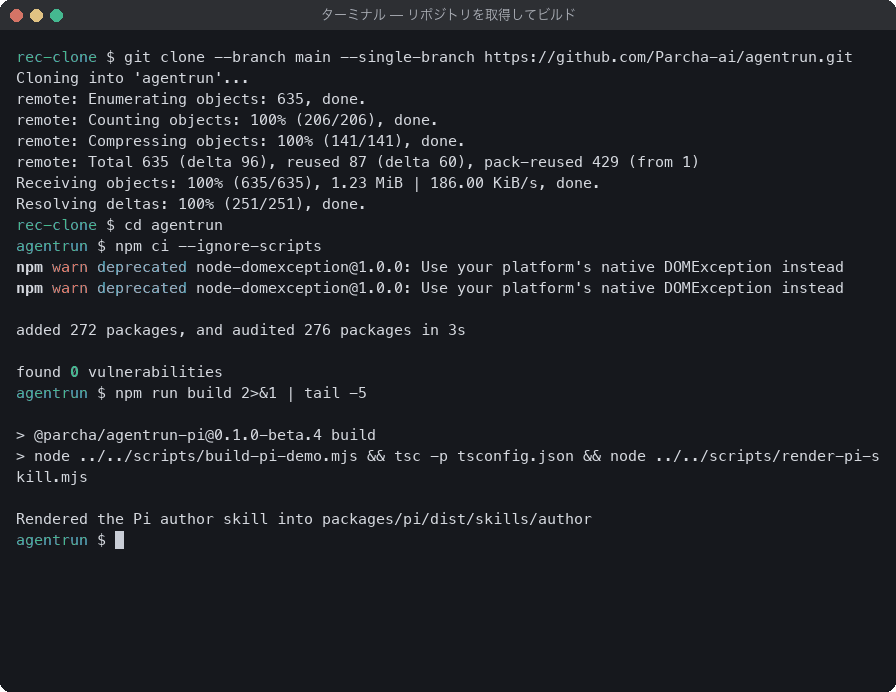
動画2 取得からビルドまで(MP4版: rec02-clone-build.mp4)
npm ci は272パッケージを追加して脆弱性0件、npm run build は3つのパッケージ(本体・Jev アダプタ・Pi 拡張)のビルドが5秒ほどで終わりました。node-domexception の非推奨警告が出ますが、ビルドには影響しません。
サポート例:4つの問い合わせがたどる道
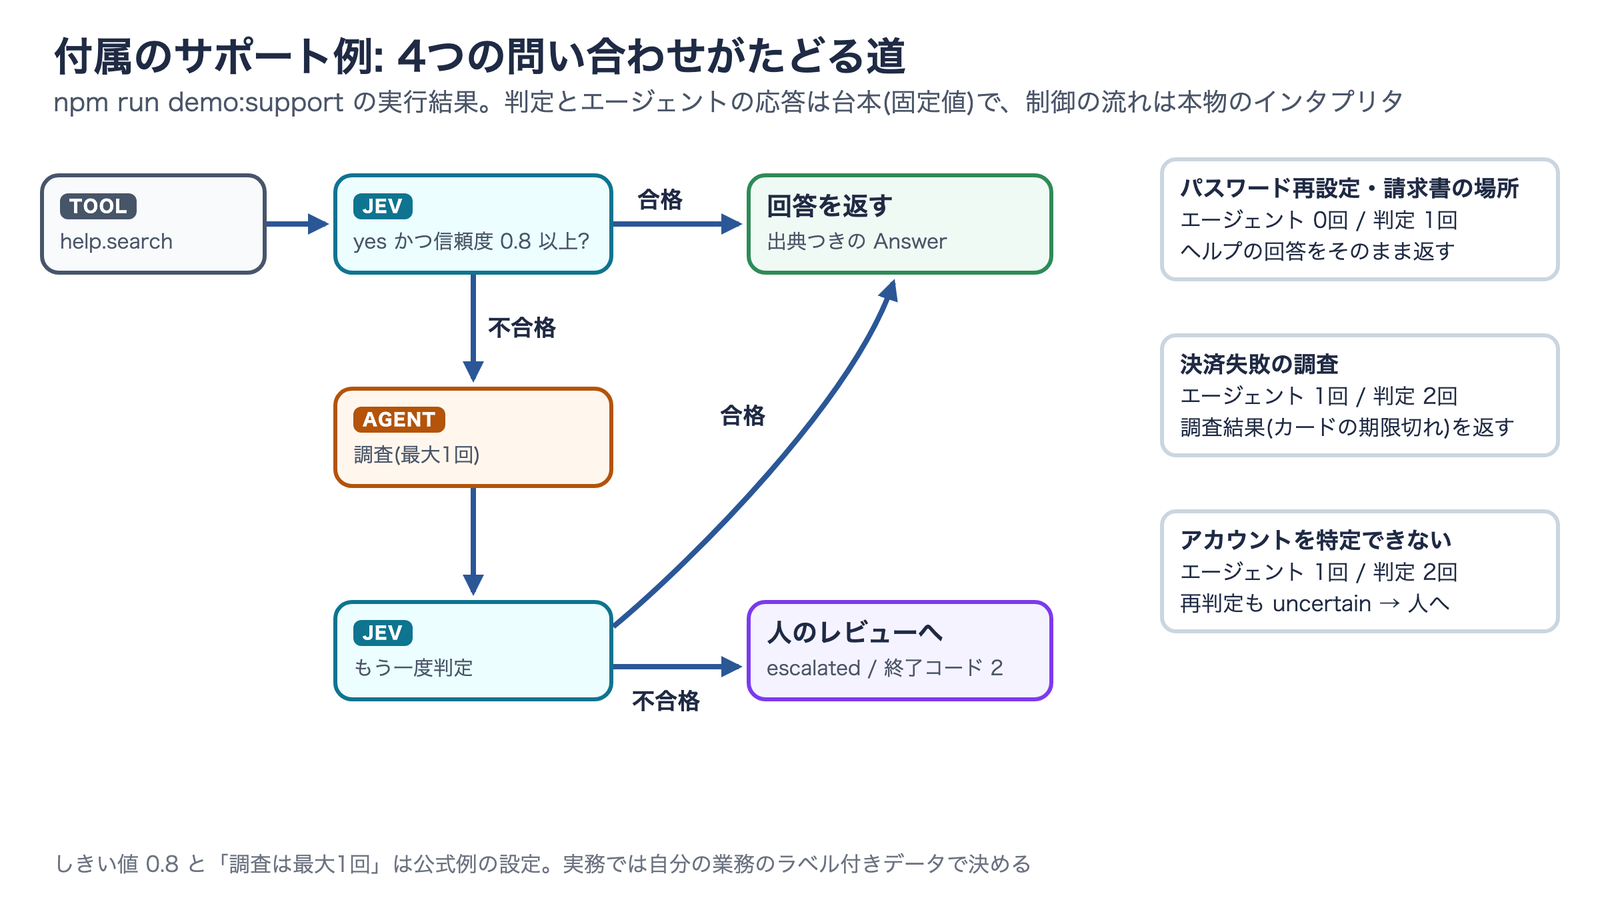
付属のサポート例は、「ヘルプを検索 → 回答で足りるか Jev が判定 → 足りなければエージェントが1回だけ調査 → もう一度判定 → だめなら人のレビュー」という流れです。4つの問い合わせがそれぞれ別の道をたどります。
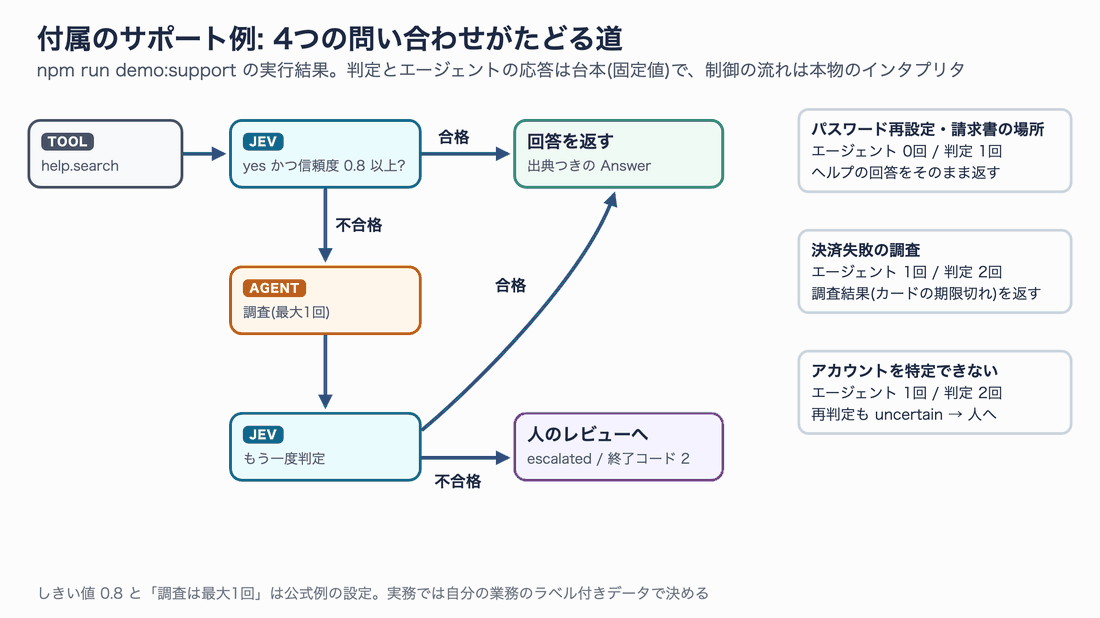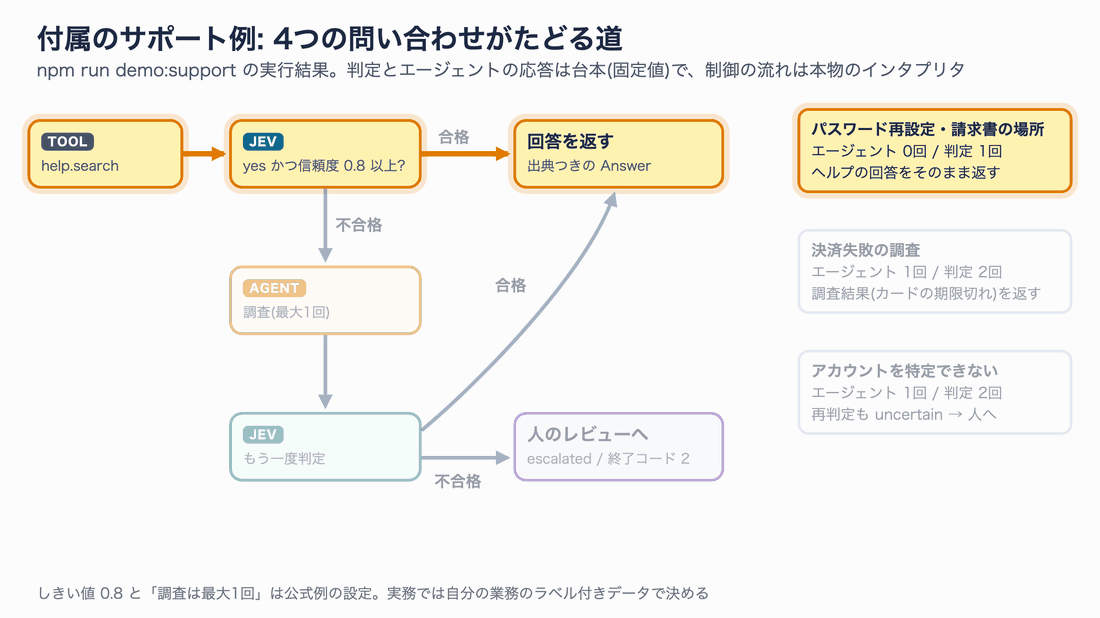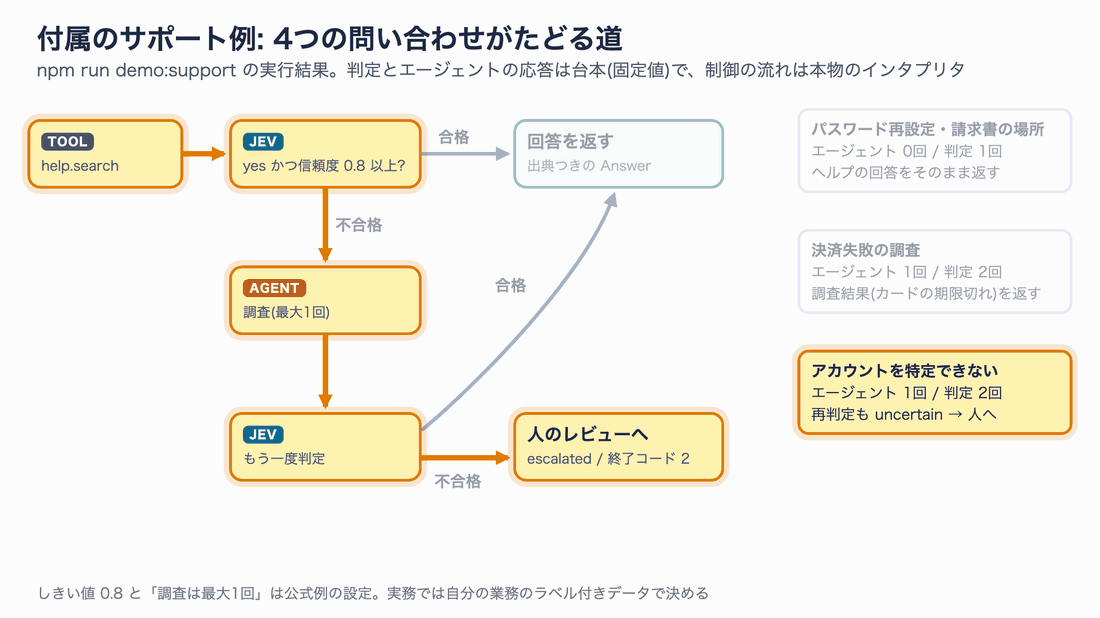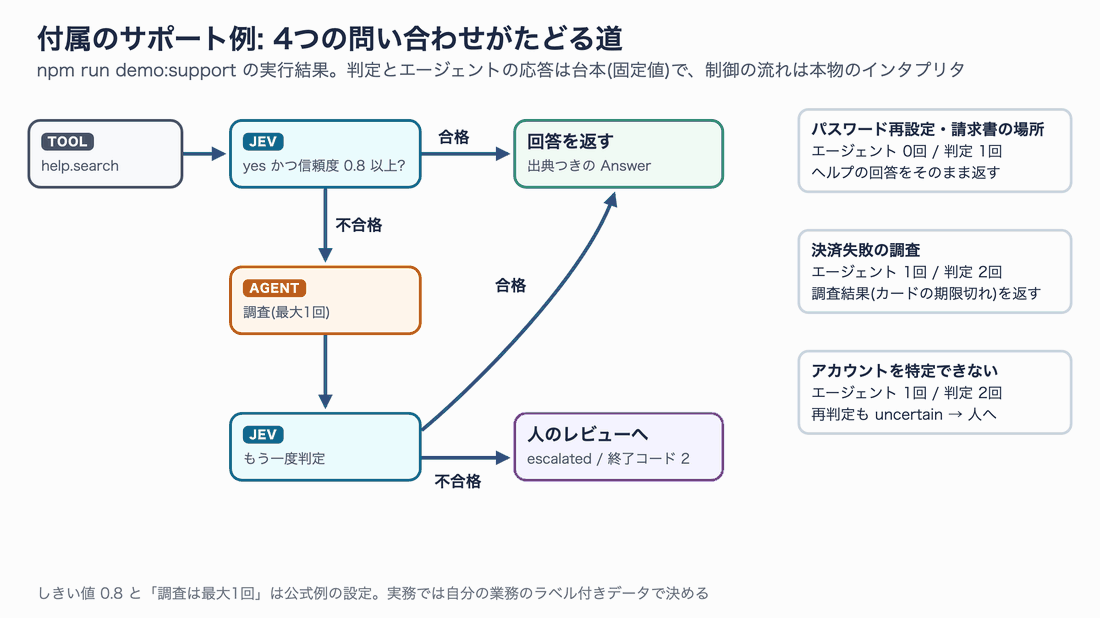
図6 付属のサポート例の分岐(静止画)
# 4つの問い合わせをまとめて実行
npm run demo:support

# 1件だけ実行する場合
npm run demo:support -- payment
npm run demo:support -- unresolved; echo "終了コード: $?"
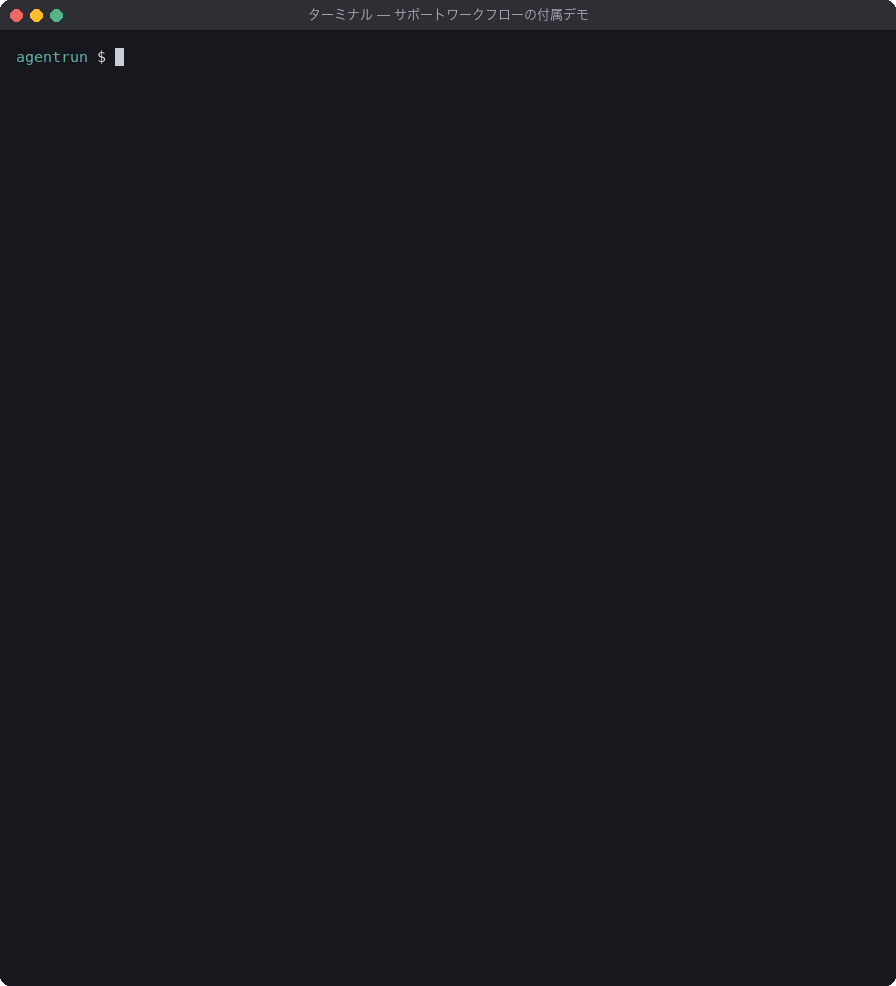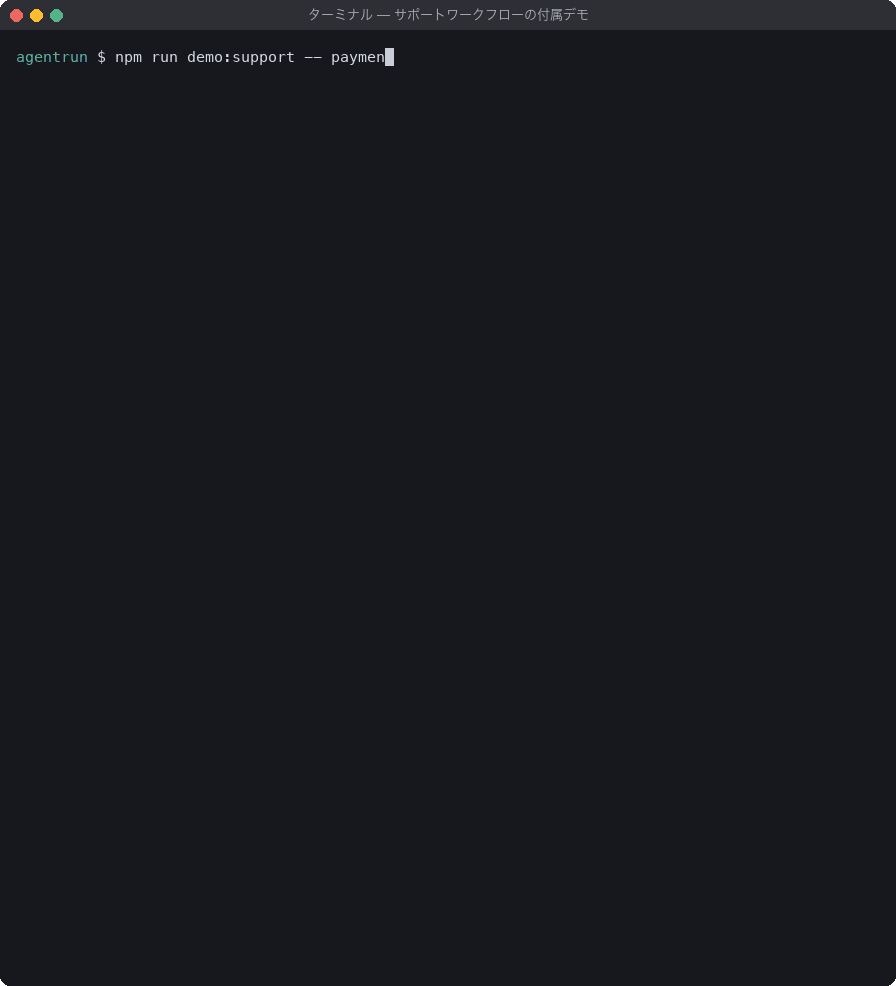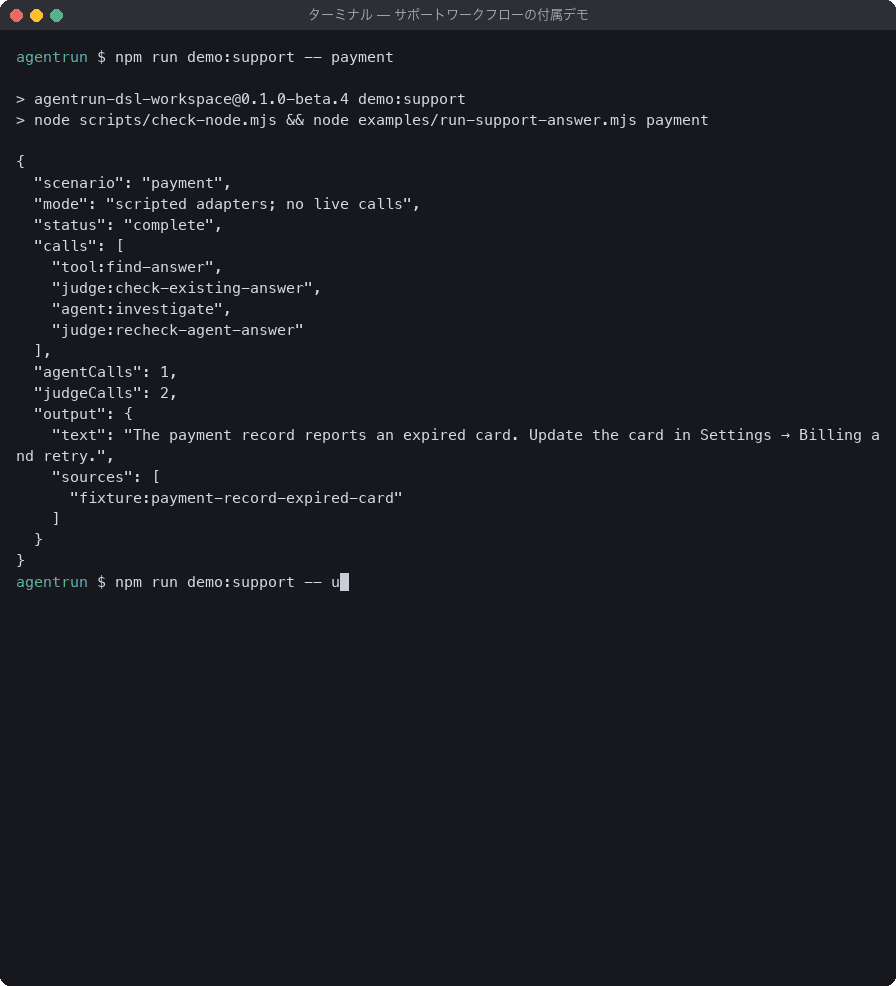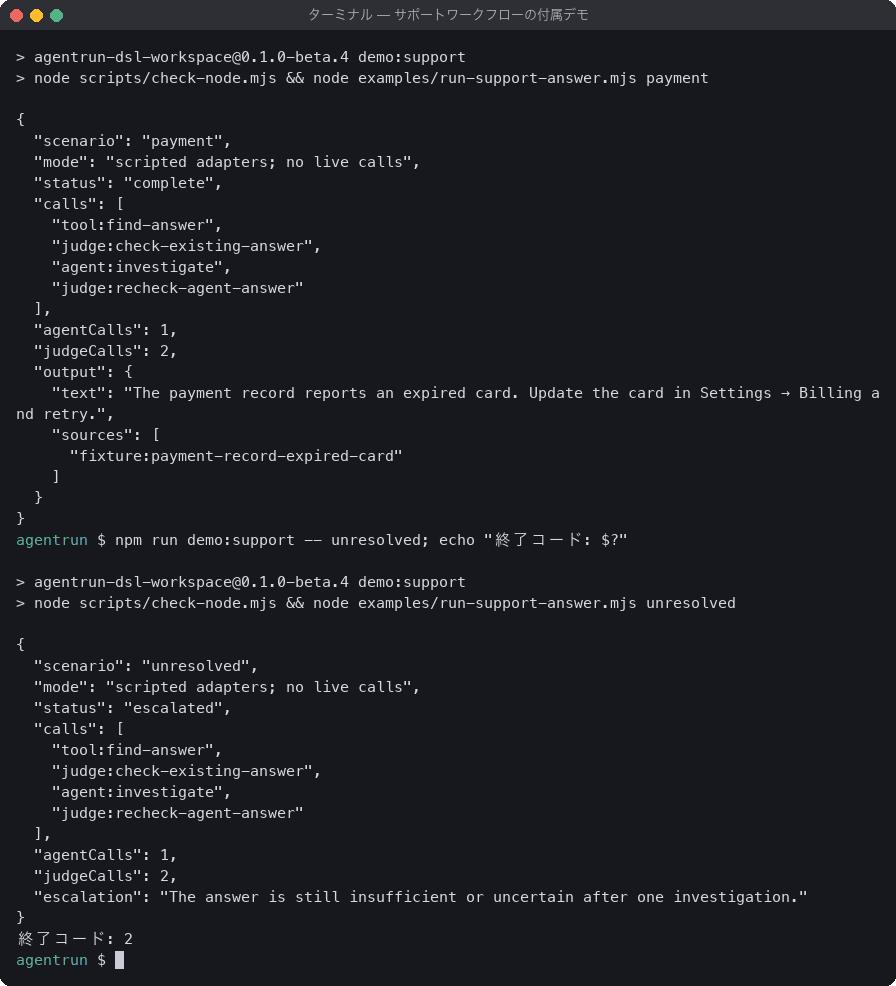
動画3 決済失敗(payment)と未解決(unresolved)の実行(MP4版: rec03-support.mp4)
4件すべてを実行した結果は、README の表と一致しました。
| 問い合わせ | エージェント | 判定 | 結果 |
|---|---|---|---|
| パスワードの再設定 | 0回 | 1回 | ヘルプの回答を返す |
| 請求書の場所 | 0回 | 1回 | ヘルプの回答を返す |
| 決済失敗の調査 | 1回 | 2回 | 調査結果(カードの期限切れ)を返す |
| アカウントを特定できない | 1回 | 2回 | 人のレビューへ(終了コード2) |
簡単な問い合わせではエージェントが一度も呼ばれていない点がポイントです。台本の応答なので「判断が正しいか」は分かりませんが、「どの条件でどこへ進むか」という制御の流れは、この段階で確かめられます。
手順3:テストで作りの丁寧さを確かめる
公開直後の OSS を評価するとき、テストの厚さは目安になります。リポジトリのテストを実行しました。
npm test
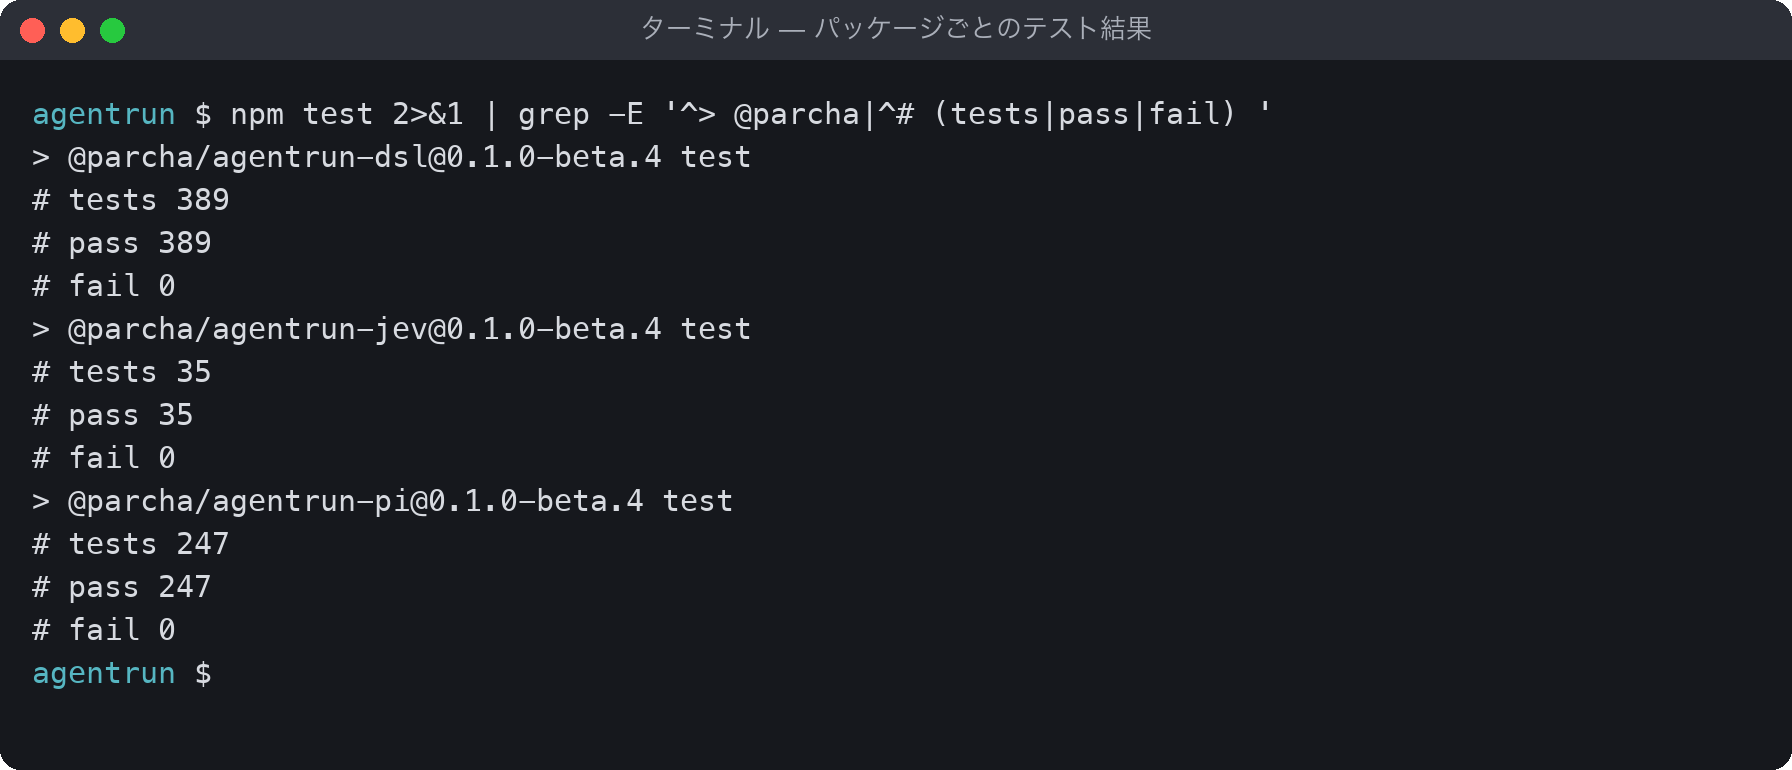
画面3 パッケージごとのテスト結果。合計671件がすべて成功
本体389件、Jev アダプタ35件、Pi 拡張247件の計671件がすべて成功し、10秒ほどで終わりました。付属例のテスト(npm run test:examples)56件も成功しています。すべてモデルを呼ばない台本のテストなので、APIキーは要りません。
一方、開発者向けの一括チェック npm run check では、リリース用のテスト39件のうち2件が失敗しました。
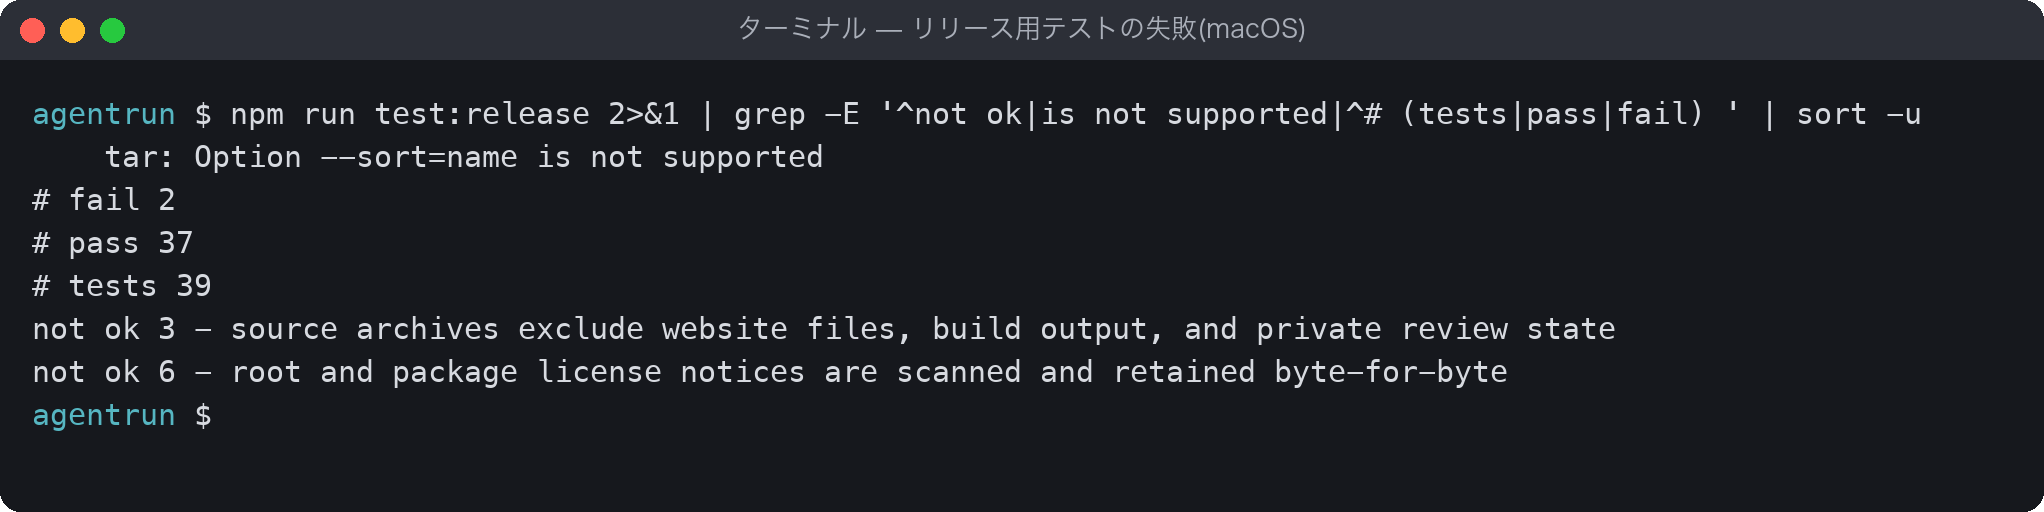
画面4 macOS 標準の tar が --sort=name に対応していないために失敗
原因は、ソースコードの配布用アーカイブを作るスクリプトが GNU tar の --sort=name を使っていて、macOS 標準の tar(bsdtar)が対応していないことでした。配布作業用のテストだけの問題で、AgentRun を使う側には影響しません。これを含めると、今回動かしたテストは766件で、失敗はこの2件だけです。開発中のプルリクエストには「npm run check で784件成功」という記載があり、テストは今も増えています。
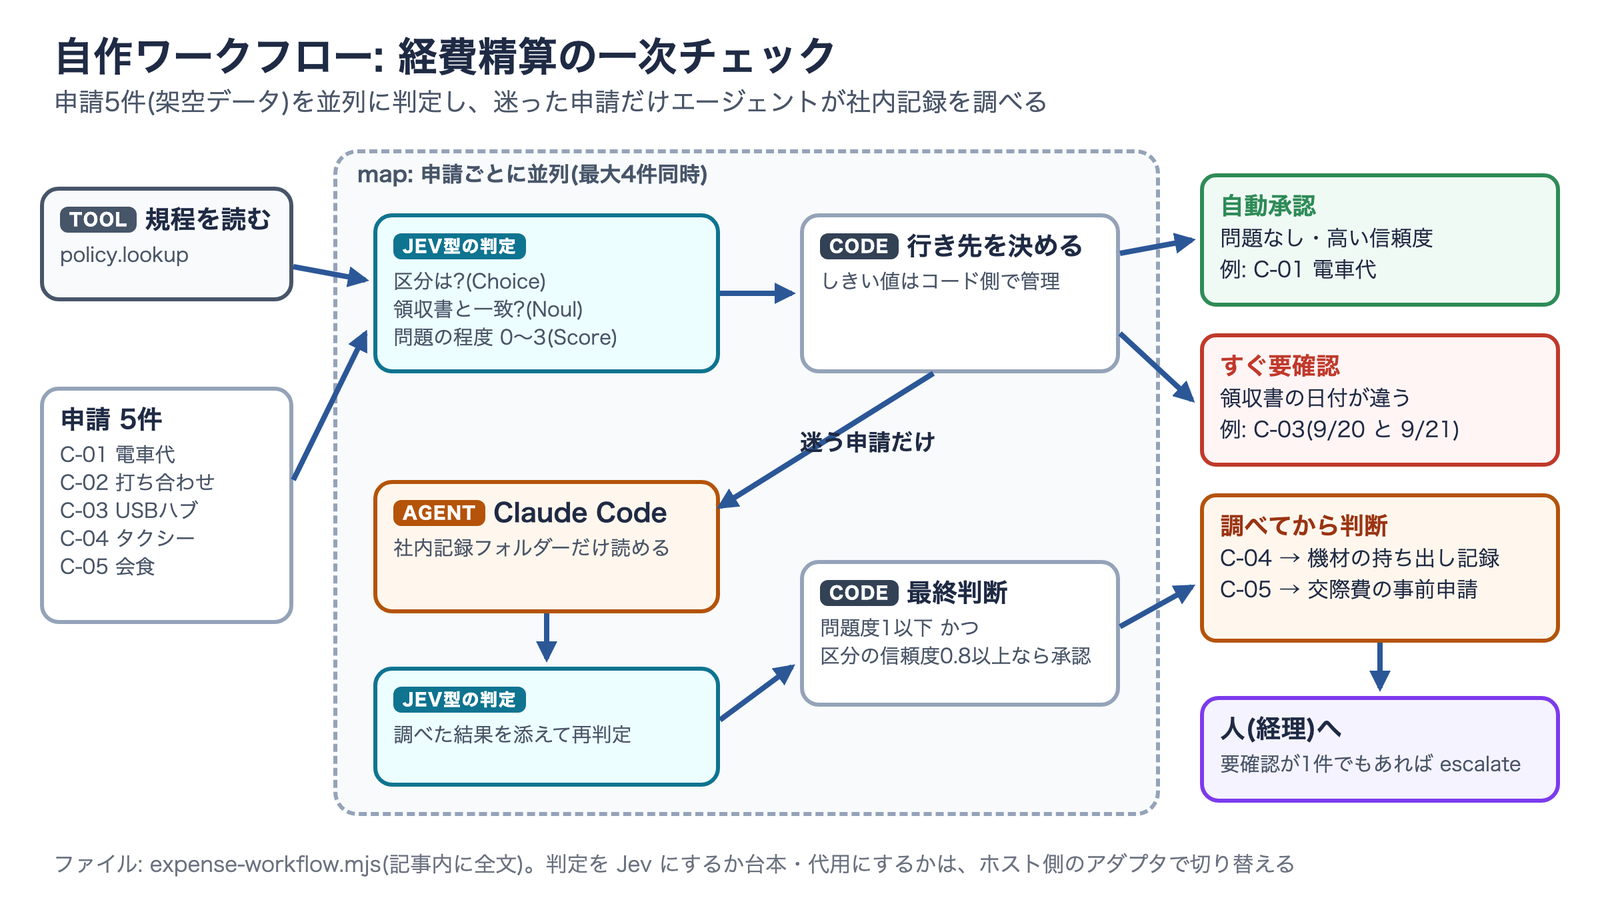
手順4:自分の業務で組んでみる(経費精算の一次チェック)
付属デモだけでは、実際の業務にどう当てはめるかが見えにくいので、オリジナルの例を組みました。題材は経費精算の一次チェックです。データはすべて架空で、規程・申請5件・社内記録2ファイルを用意しました。
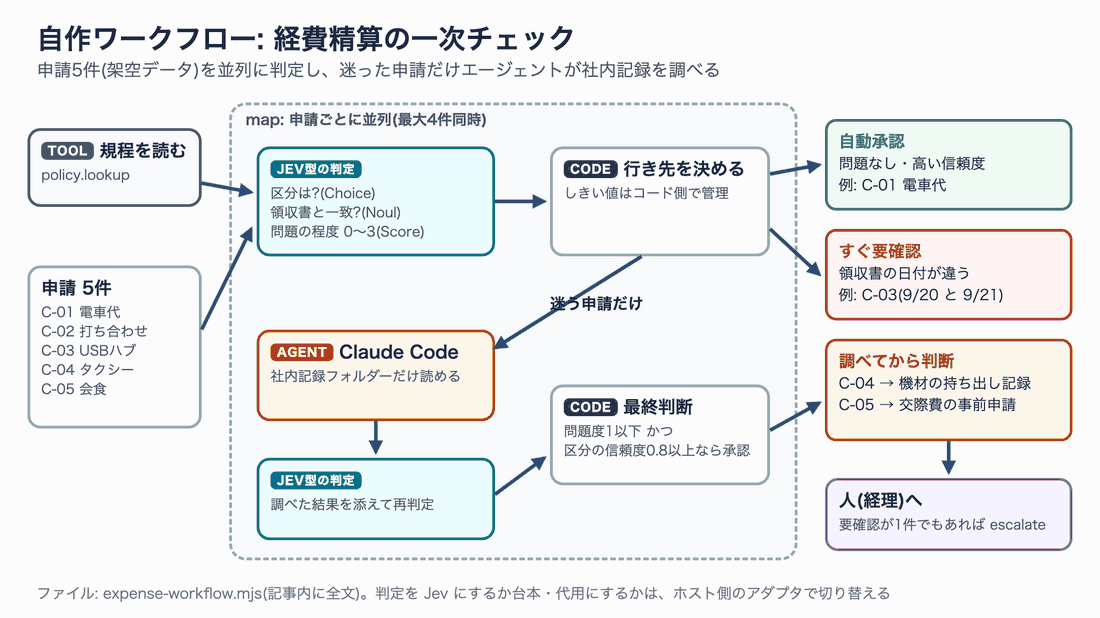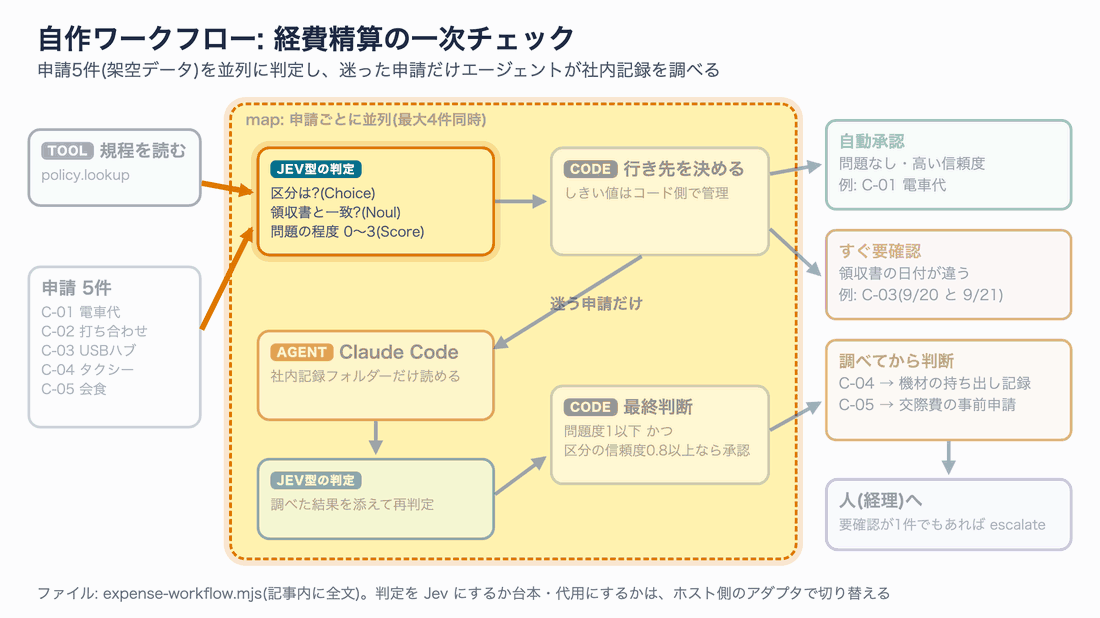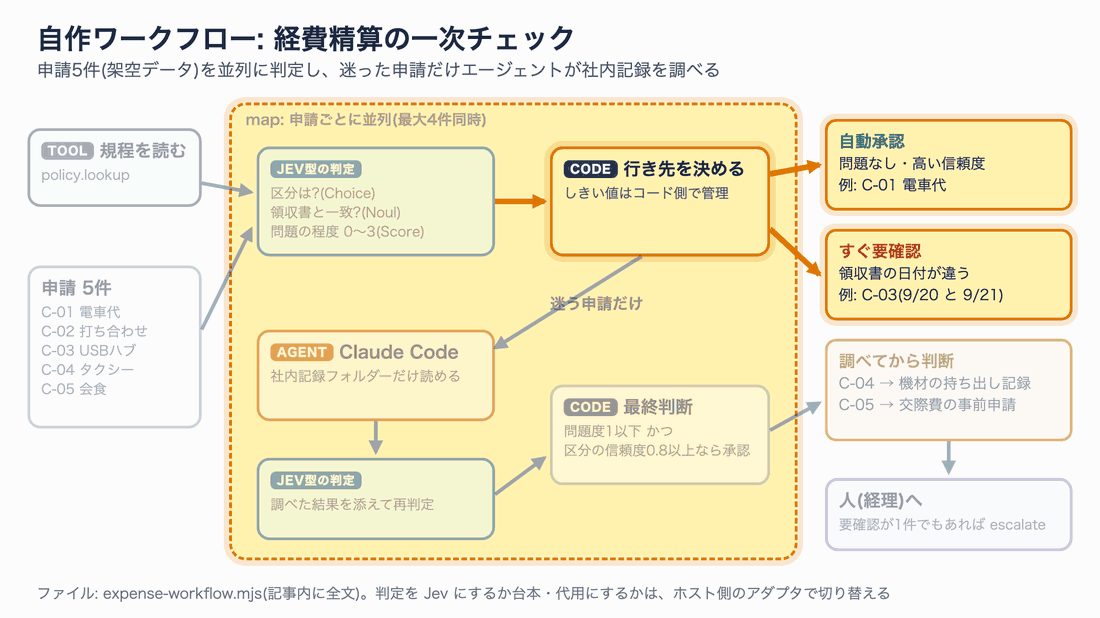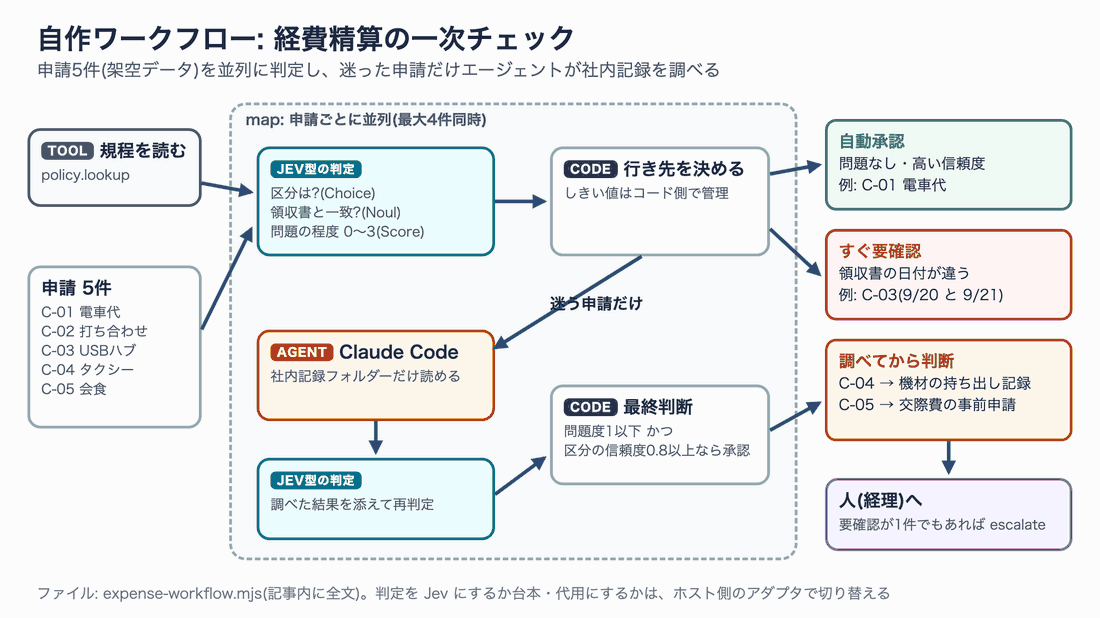
図7 自作ワークフローの流れ(静止画)
| 申請 | 内容 | 仕込んだポイント |
|---|---|---|
| C-01 | 電車代 356円 | 問題なし |
| C-02 | 取引先との打ち合わせ(2名)4,400円 | 1人2,200円で会議費の範囲内 |
| C-03 | USB-Cハブ 3,980円 | 申請日9/20に対し領収書は9/21 |
| C-04 | タクシー 6,800円(18時台) | 規程では22時以降か大きな荷物がある場合だけ。機材の持ち出し記録がある |
| C-05 | 会食(2名)15,000円 | 1人7,500円で交際費。事前申請が必要だが記録がない |
判定の問いはスキーマで書く
AgentRun の judge(判定)ノードは、質問をJSONスキーマで書きます。文字列の選択肢(enum)は Choice、真偽値(boolean)は Noul、段階の説明つきの整数は Score に自動で変換されます。1回の判定で3つの問いをまとめて聞く定義は次のとおりです(抜粋)。
// judge の出力スキーマ(Check)。説明文(description)がそのまま質問になる
Check: object({
  category: {                      // Choice: 経費区分を選ぶ
    type: 'string', enum: ['transport', 'meeting', 'entertainment', 'supplies', 'not_allowed'],
    description: '`claim` の支出は `policy` のどの経費区分に当たるか。',
    criteria: {
      transport: '交通費(業務での移動)',
      meeting: '会議費(社外との打ち合わせの飲食、1人5,000円以下)',
      entertainment: '交際費(1人5,000円を超える飲食や贈答)',
      supplies: '消耗品費(10万円未満の文具・備品)',
      not_allowed: '対象外(私的な支出など)',
    },
  },
  receiptMatches: {                // Noul: 「はい」の確率
    type: 'boolean',
    description: '`claim.receipt` の日付・金額・支払先は、`claim` の date・amount・memo と矛盾なく一致しているか。',
  },
  risk: {                          // Score: 0〜3 の4段階(maximum は段階数 − 1)
    type: 'integer', minimum: 0, maximum: 3,
    description: '`policy` の条件に照らして、この申請にどの程度の問題があるか。',
    criteria: ['問題なし', '軽微(記載の補足で足りる)', '要確認(申請内容だけでは分からない)', '規程違反の疑い'],
  },
}),
しきい値はコードで持つ
判定の結果をどう使うかは、code ノードに JavaScript で書きます。判定モデルに「承認してよいか」まで決めさせず、確率としきい値の比較はコード側で行うのが AgentRun の流儀です。判定の結果は check に、確率や信頼度は check$answers に入ります。
// 申請ごとの行き先を決める code ノード
{ node: 'code', label: 'choose-next-step', code: `s => {
    const a = s['check$answers'];
    const receipt = a.answers.receiptMatches.noul;     // 領収書が一致する確率
    let first = null;
    if (s.check.category === 'not_allowed') first = { status: 'review', reason: '規程の対象外の支出' };
    else if (receipt < 0.5) first = { status: 'review', reason: '領収書と申請内容が一致しない' };
    else if (s.check.risk === 0 && a.confidence.category >= 0.8 && receipt >= 0.9)
      first = { status: 'approved', reason: '判定のみで自動承認' };
    // 決めきれない申請だけ、次の map でエージェントに調べさせる(0件か1件)
    return { first, investigate: first ? [] : [s.item] };
  }` },
全体では、Tool で規程を読み込み、map ノードで申請ごとに並列処理し、最後に要確認が1件でもあれば escalate ノードで人へ回します。ファイルの全文は記事末尾の付録に載せています。
実行前に構造を確かめる
ワークフローを JSON に書き出すと、CLI で構造を確認できます。inspect はコードを実行せずに、ノードの入れ子と必要なアダプタを表示します。
npx agentrun inspect expense-workflow.json
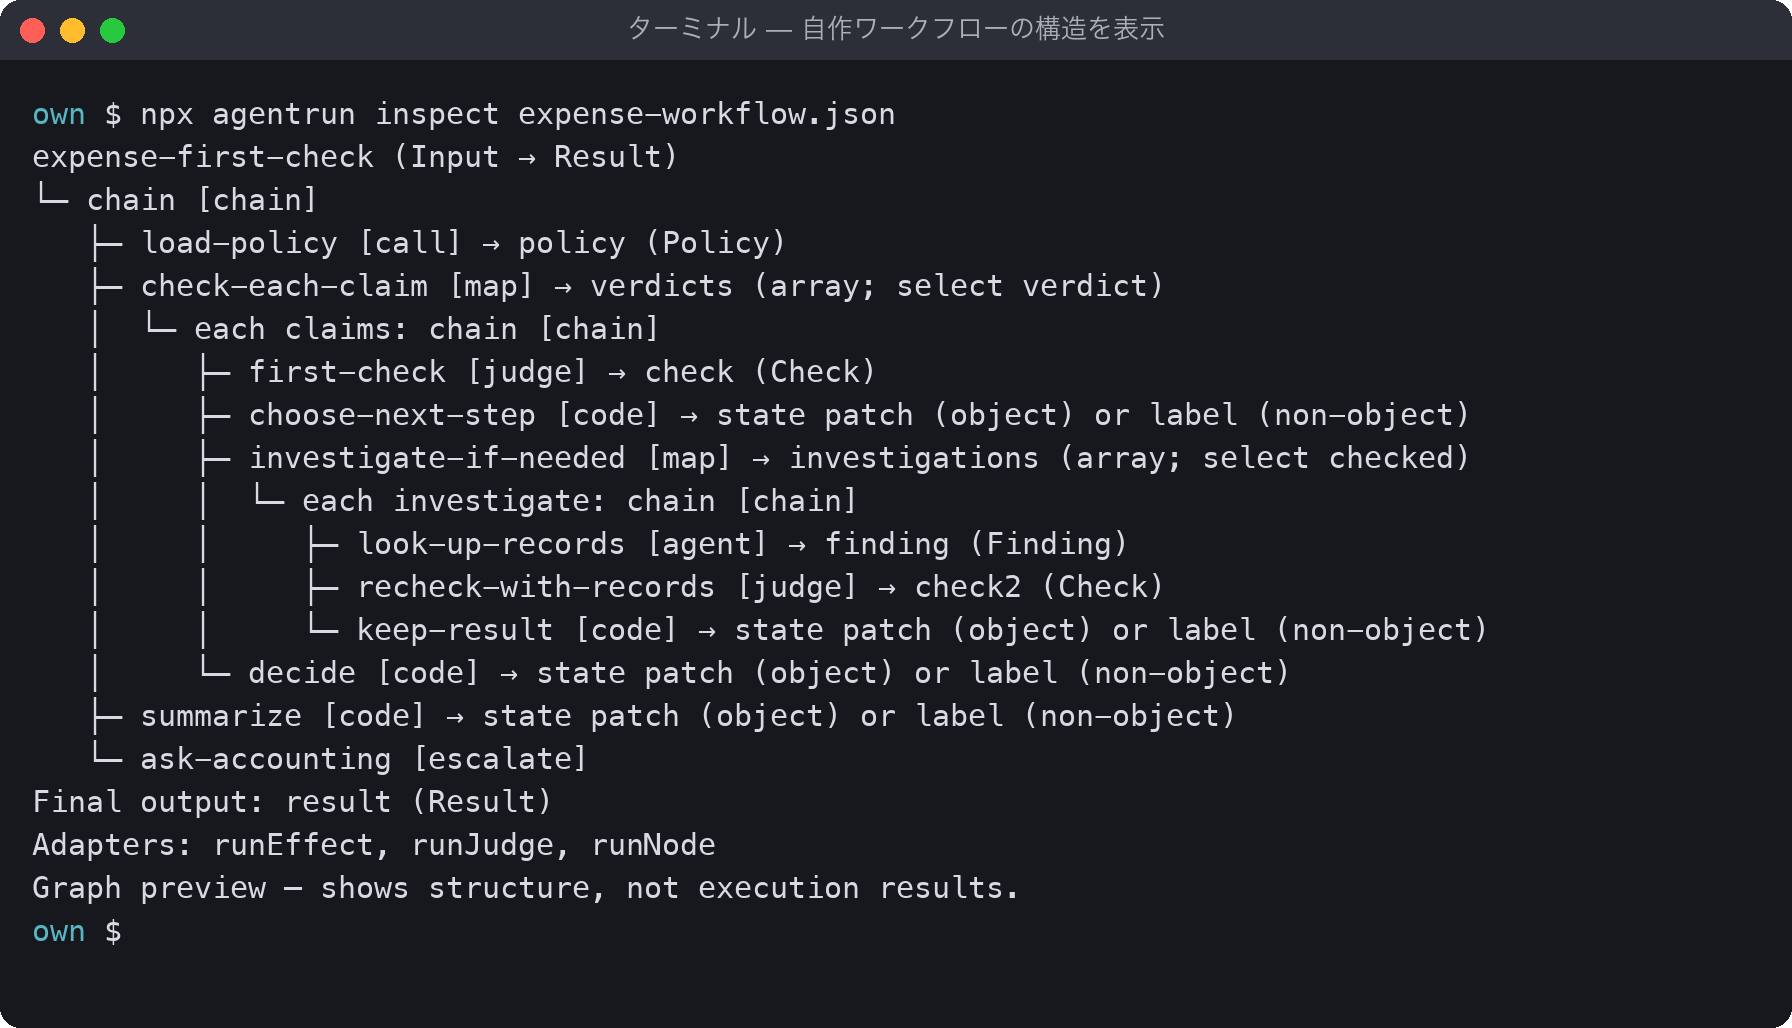
画面5 自作ワークフローの構造。必要なアダプタは runEffect・runJudge・runNode の3つ
次に validate(静的な検証)と dry-run(合成した値での試運転)です。ここで一つ発見がありました。状態を参照する {policy.text} をわざと {polcy.text} と書き間違えたところ、validate は通ってしまい、dry-run で初めて見つかったのです。
# --trusted: ワークフロー内の JavaScript が実行されうることを了承するフラグ
npx agentrun validate expense-workflow.json claims.json --trusted
npx agentrun dry-run broken-path.json claims.json --trusted
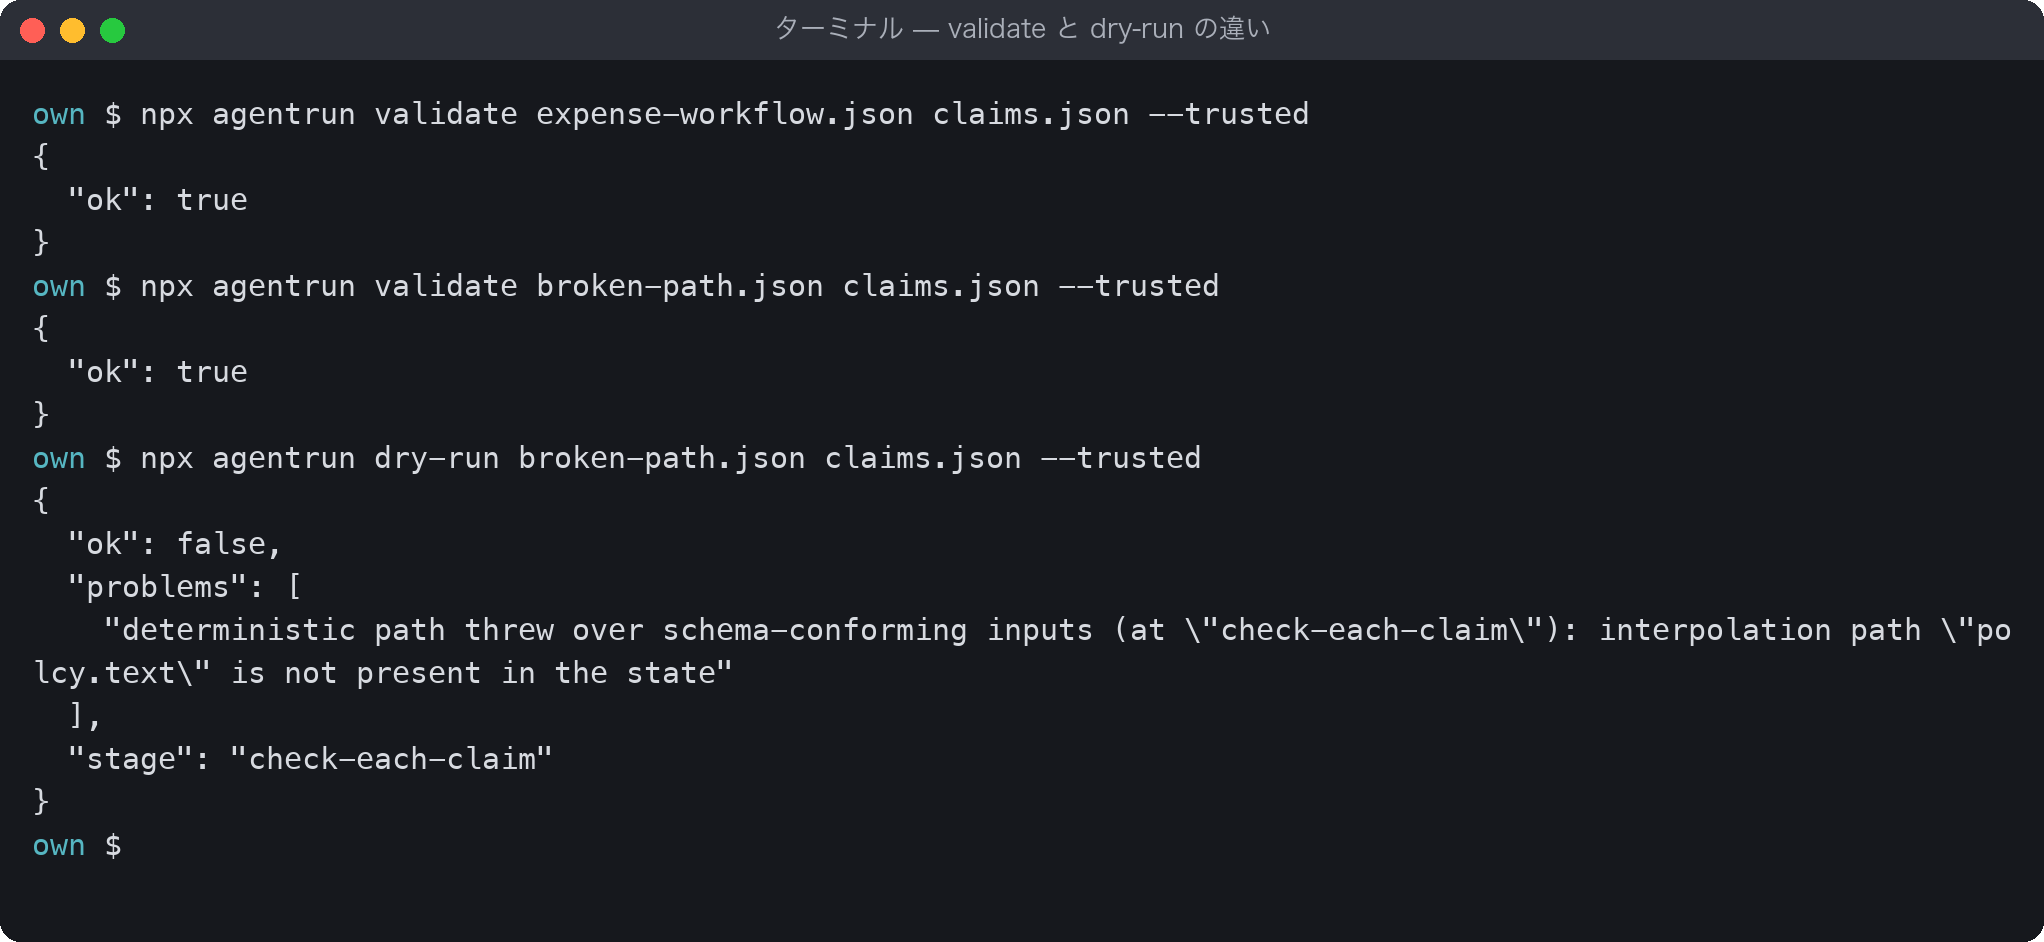
画面6 書き間違いは validate を通り、dry-run で検出された
一方、Score の maximum を段階数と合わない4にした定義は、validate の段階で「a score’s maximum is its last level index (3)」とはっきり指摘されました。スキーマの形は validate、状態の受け渡しは dry-run、と両方を通す習慣をつけると安心です。
手順5:既存のエージェント(Claude Code)をつなぐ
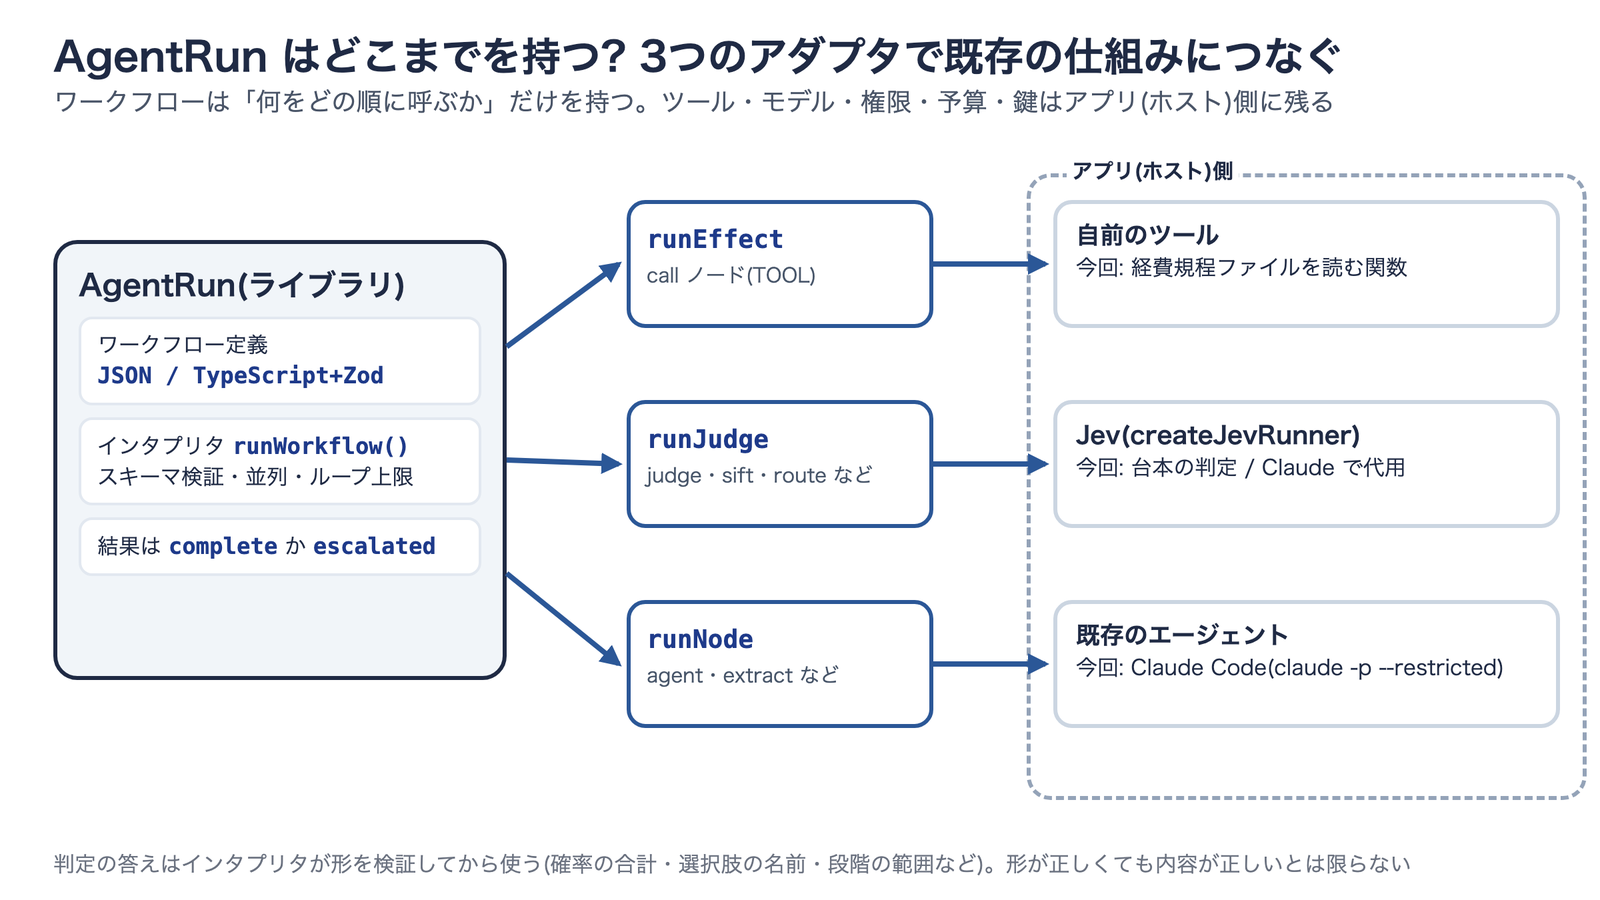
AgentRun 自体は、ツールもモデルも持っていません。ワークフローは「何をどの順に呼ぶか」だけを持ち、実際の処理は3つのアダプタを通してアプリ(ホスト)側に任せます。
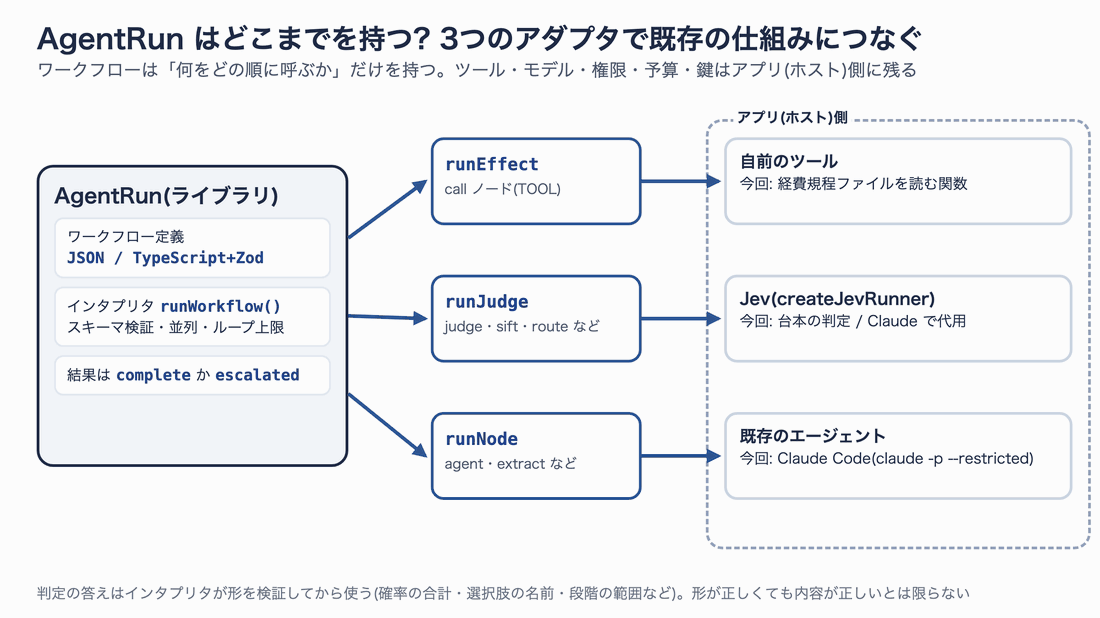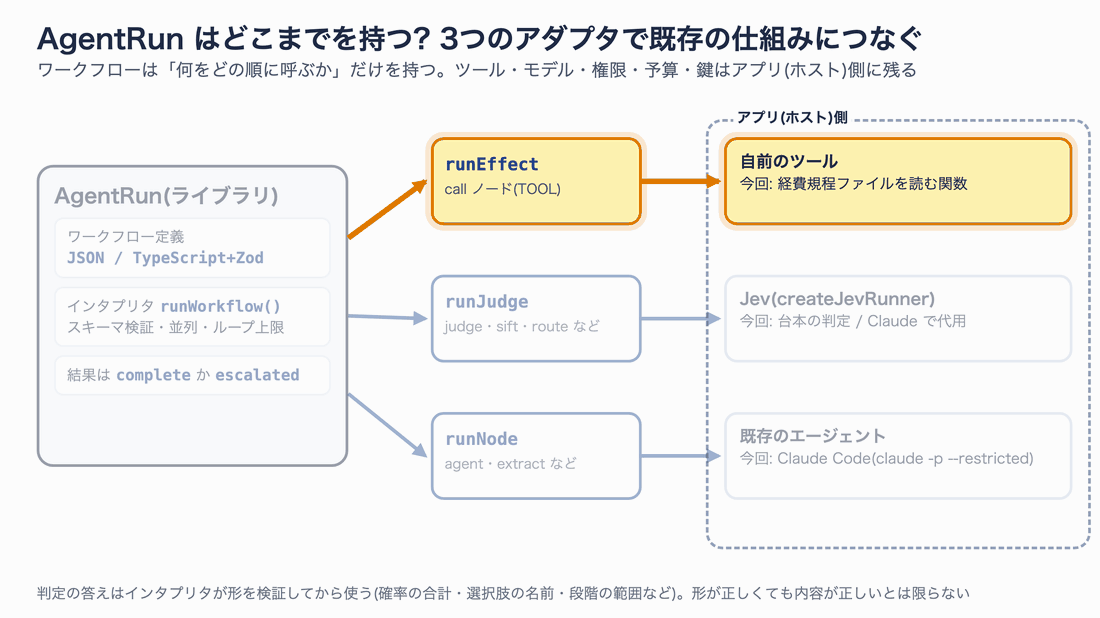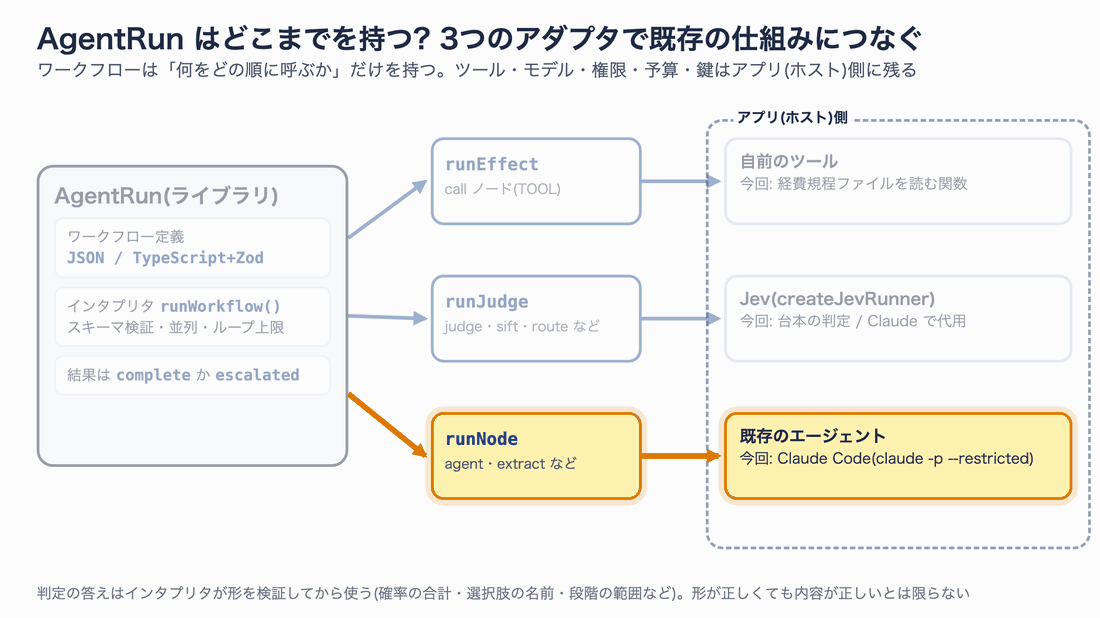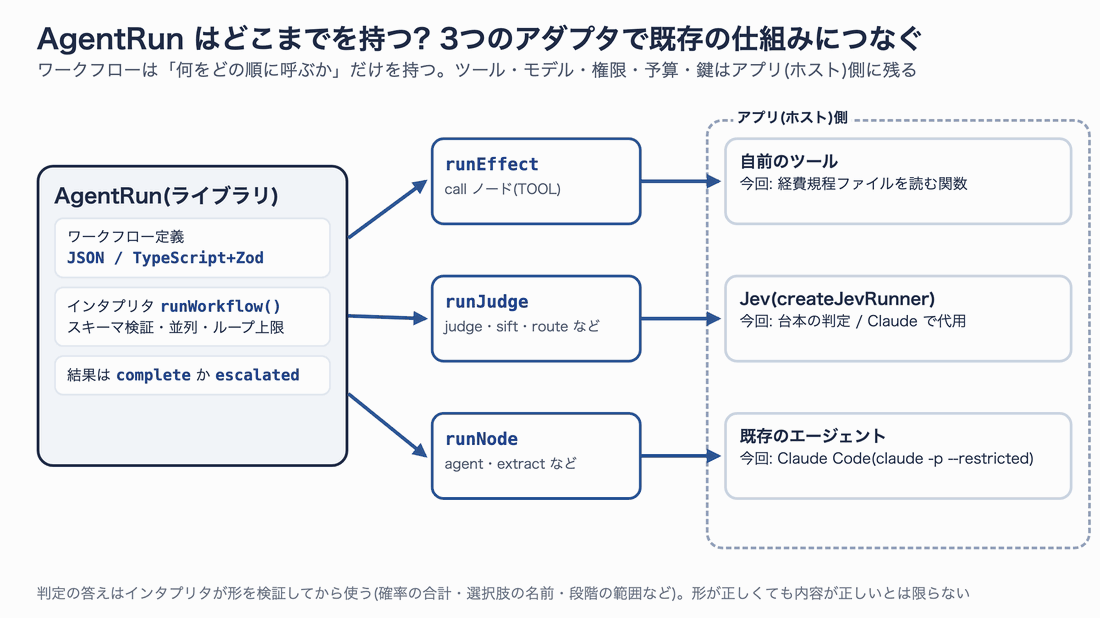
図8 3つのアダプタ。権限・予算・APIキーはアプリ側に残る(静止画)
| アダプタ | 呼ばれるノード | 今回つないだもの |
|---|---|---|
runEffect | call(Tool) | 経費規程のファイルを読む関数 |
runJudge | judge・sift・route など | 台本の判定、または Claude で代用(本番は Jev の createJevRunner()) |
runNode | agent・extract など | Claude Code のヘッドレスモード |
エージェント役には、Claude Code をヘッドレスモード(claude -p)で呼ぶアダプタを書きました。ワークフローが求める出力の形(スキーマ)を --json-schema にそのまま渡し、--restricted で作業フォルダー(社内記録)以外のファイルを読めず、コマンドも実行できない状態にしています。
// runNode: AgentRun の agent ノードを Claude Code に任せる
export async function claudeAgent({ system, user, schema, tools, signal }) {
  // ワークフローが名乗ったツール名だけを許可し、社内記録フォルダーの読み取りに対応づける
  if (tools.join() !== 'records_read') throw new Error(`tool not allowed: ${tools}`);
  const r = await claude([
    '--restricted', '--strict-mcp-config', '--model', 'haiku', '--output-format', 'json',
    '--tools', 'Read,Grep,Glob',          // 読み取りだけ
    '--append-system-prompt', system,     // ノードの指示
    '--json-schema', JSON.stringify(schema), // ワークフローが求める出力の形
  ], { cwd: RECORDS, prompt: user, signal });
  return r.structured_output;             // 形の検証は AgentRun 側でもう一度行われる
}
claude() は claude -p を起動して JSON の結果を受け取る小さな関数です(付録の adapters.mjs に全文があります)。判定は台本のままにして、エージェントだけ本物にした実行が次の動画です。
# 付録のファイルを置いたフォルダーで実行する
npm install
npm run offline # 判定もエージェントも台本(APIキー・Claude Code 不要)
npm run agent   # エージェントだけ Claude Code(= node run.mjs --judge scripted --agent claude)
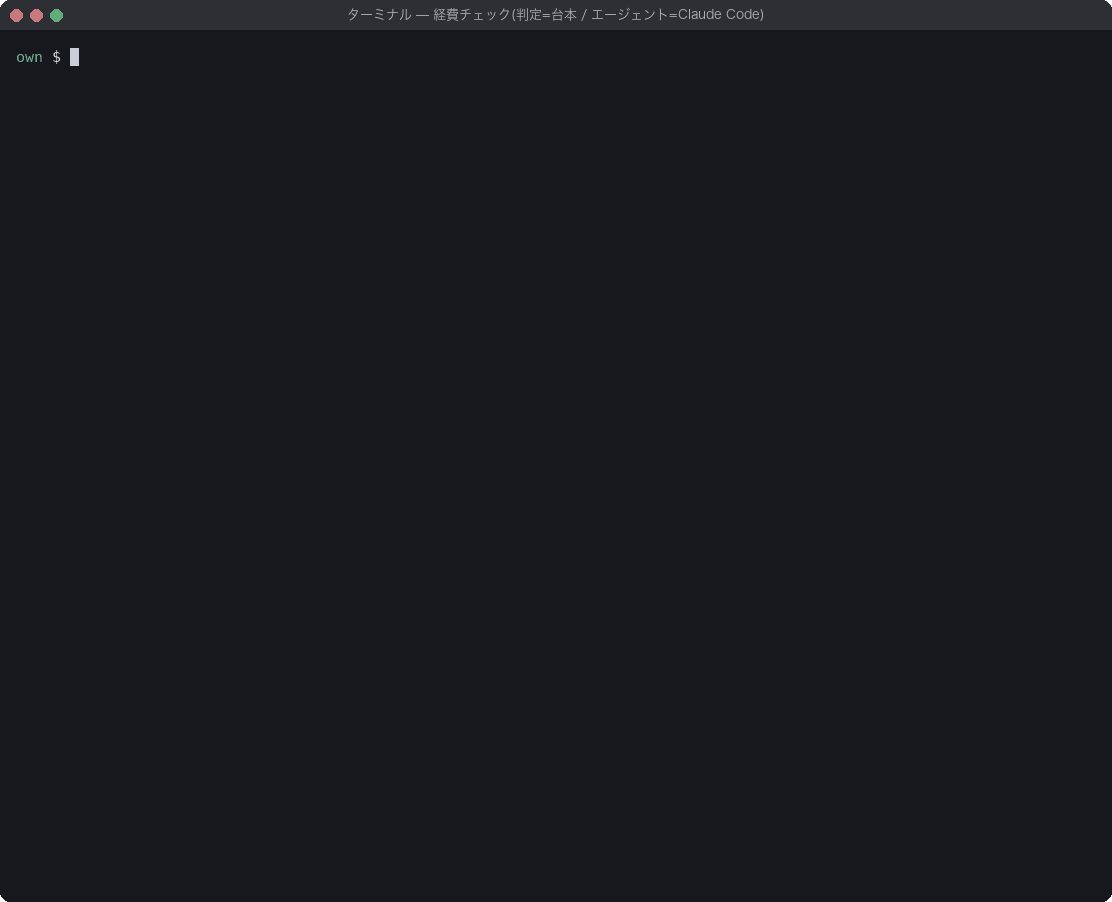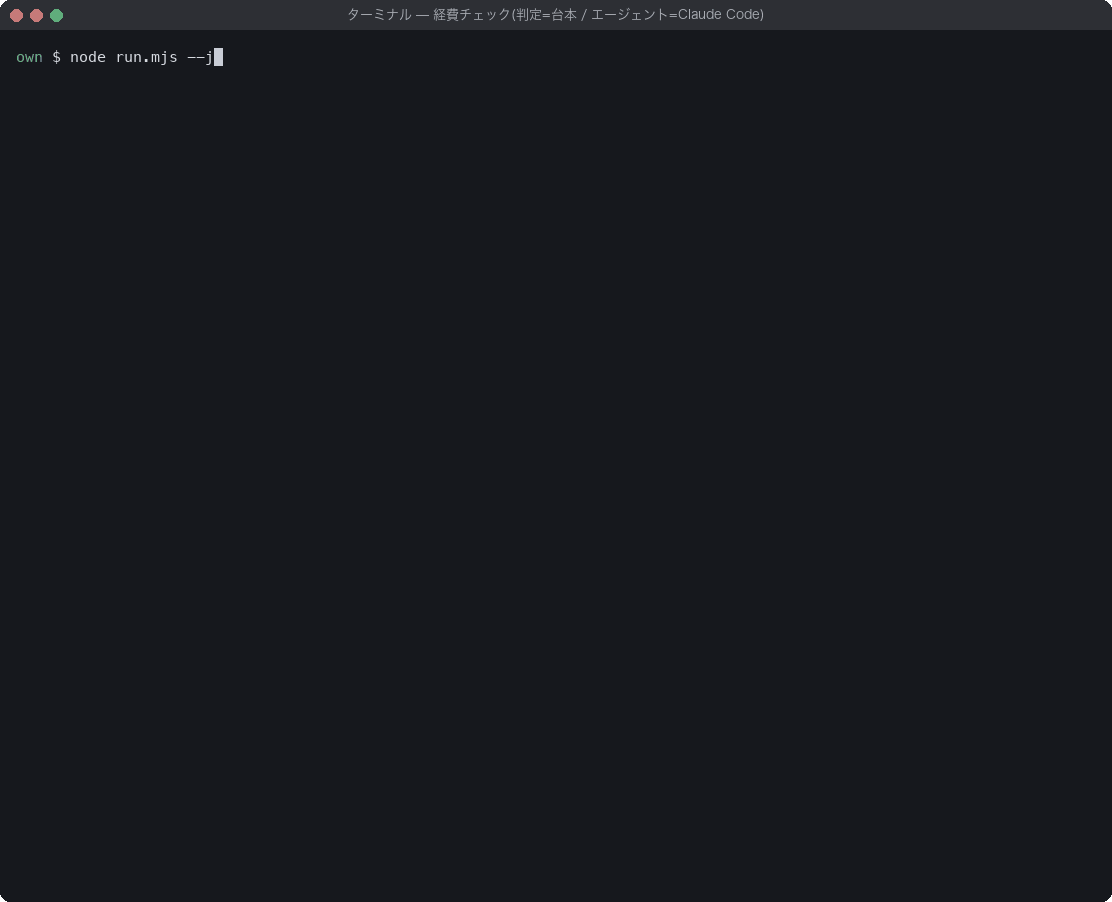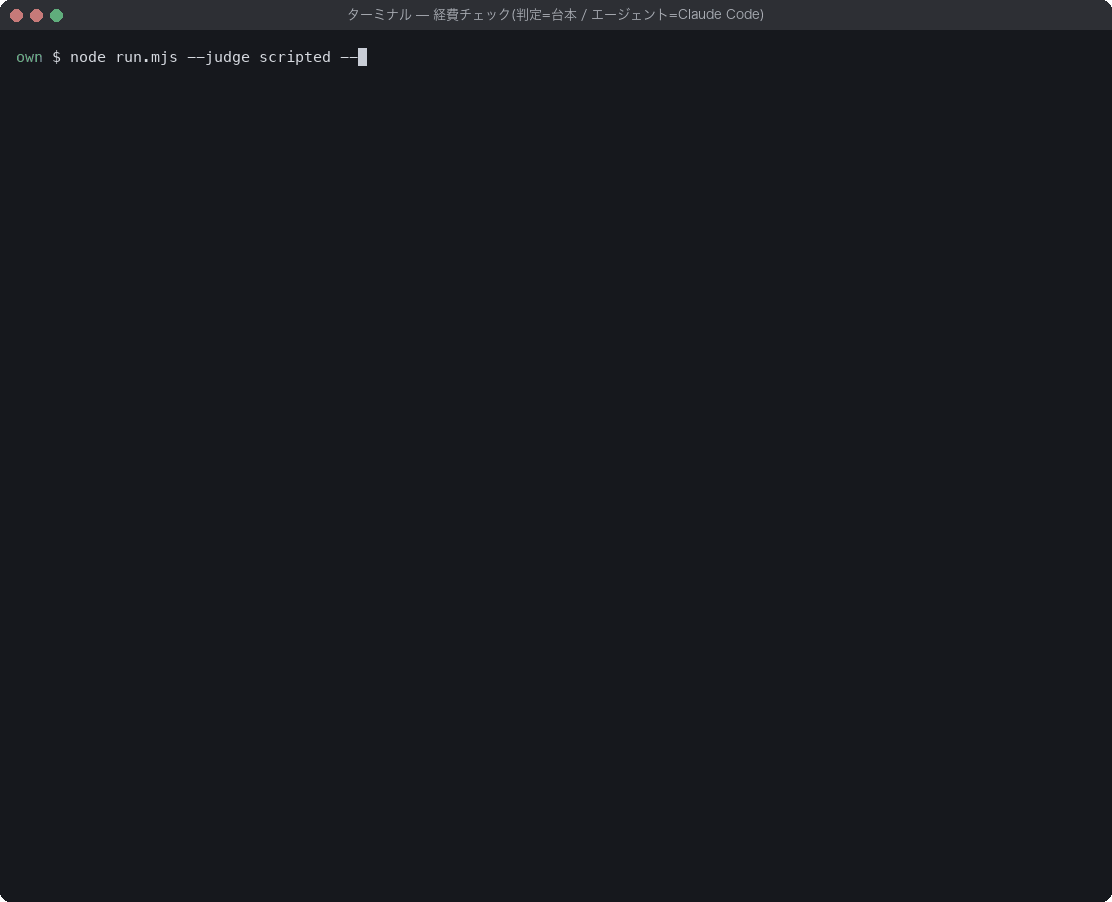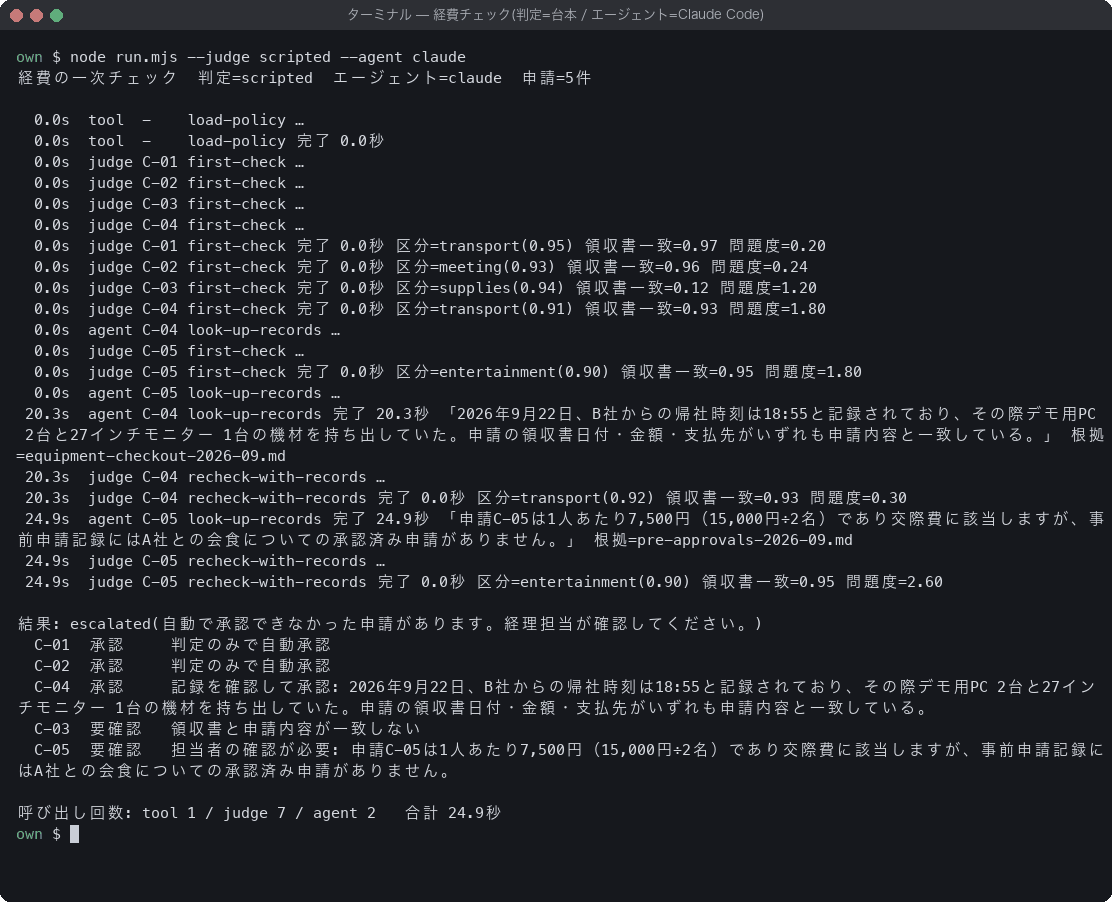
動画4 エージェントに Claude Code をつないだ実行。待ち時間は短縮して表示(MP4版: rec08-own-agent.mp4)
結果は狙いどおりでした。C-01・C-02 は判定だけで承認、C-03 は領収書の日付違いですぐ要確認、C-04 と C-05 だけエージェントが呼ばれました。C-04 では Claude Code が equipment-checkout-2026-09.md から「デモ用PC2台と27インチモニターを持ち出していた」記録を見つけて承認、C-05 では事前申請の記録が見つからず要確認になっています。2件の調査は並列に進み、全体で約25秒でした。
同じ指示でも、調べ方が揺れた回があった
同じ構成を合計4回(台本判定で2回、代用判定で2回)動かしたところ、1回だけ、C-05 の調査でエージェントが事前申請のファイルを読まずに答えを返しました。根拠(sources)には「提供されたクレーム記録(claim)」「提供されたポリシー(policy)」と書かれていて、ファイル名ではありません。
それでも AgentRun の出力チェックは通りました。スキーマが求めていたのは「根拠が1つ以上ある文字列の配列」で、それがファイル名かどうかまでは見ていないからです。README にも「型のついた判断や出力スキーマの検証は、答えが事実として正しいことを保証しない」と明記されています。
この回は、再判定と「要確認なら人へ」という出口があったため、誤って承認されることはありませんでした。本番では、根拠をファイル名の一覧(enum)に限定する、ツールで実在を確かめる code ノードを挟む、といった対策を組み合わせるのが現実的です。
手順6:判定も Claude で代用すると何が起きるか
Jev のキーがない環境でも、runJudge のアダプタを差し替えればワークフローは動きます。そこで、判定も Claude(Haiku)に確率分布を答えさせる代用アダプタを書き、判定もエージェントも本物のモデルで動かしてみました。代用アダプタは、Claude に選択肢ごとの確率をJSONで返させ、Jev と同じ形に変換しています。これは仕組みの確認用で、Jev の代わりになるという意味ではありません。
npm run live # = node run.mjs --judge claude --agent claude
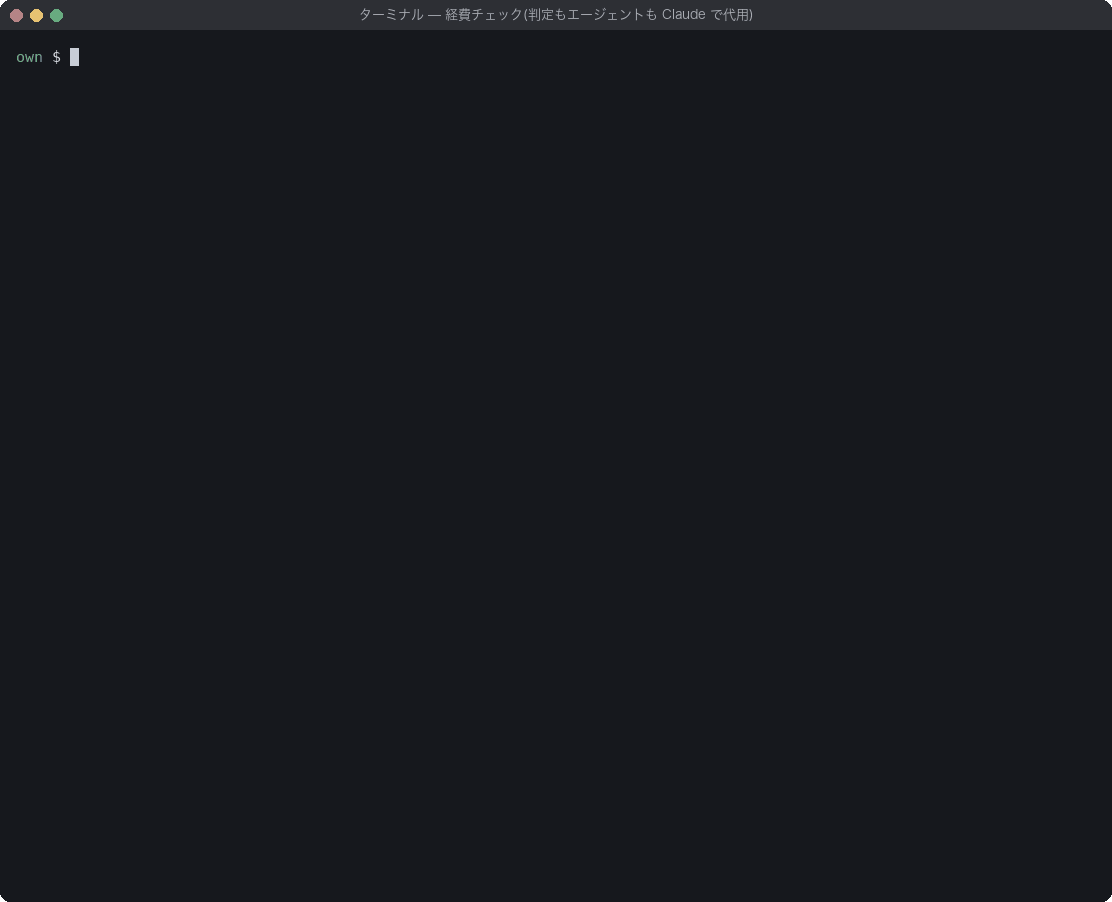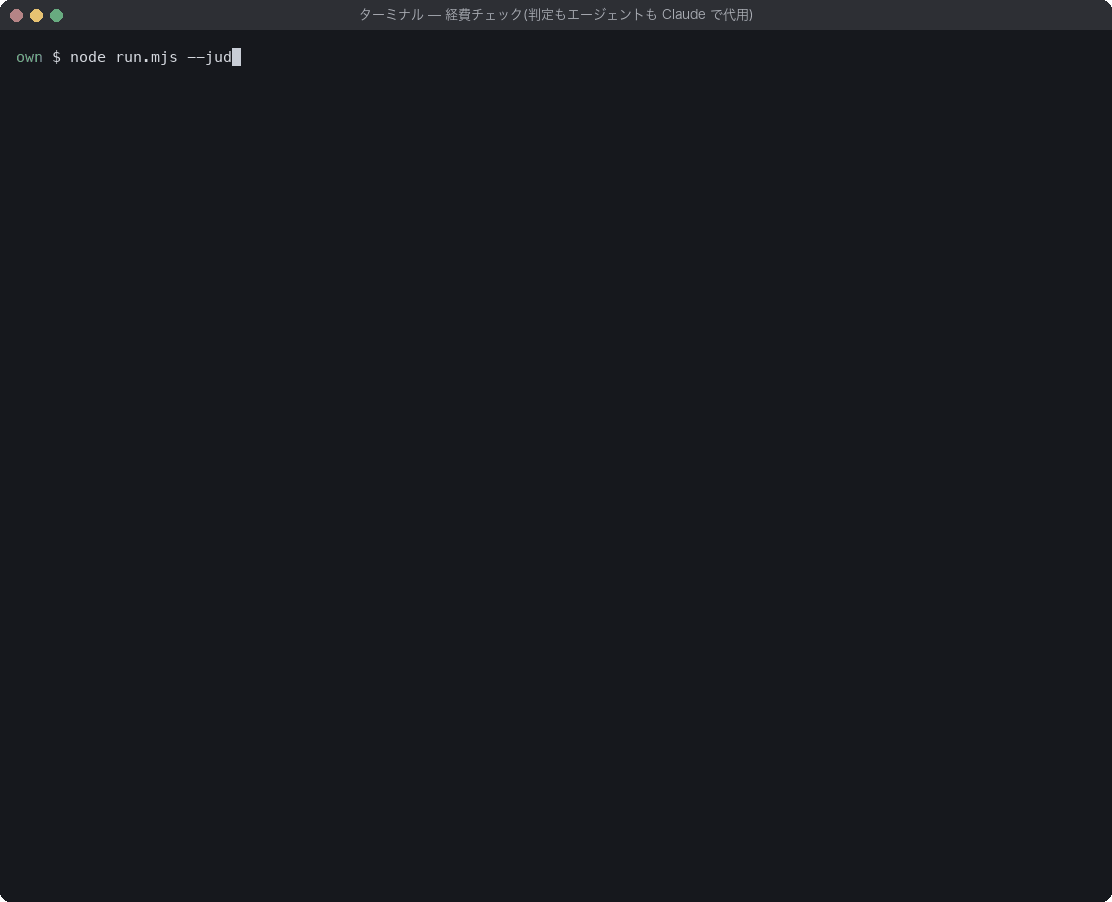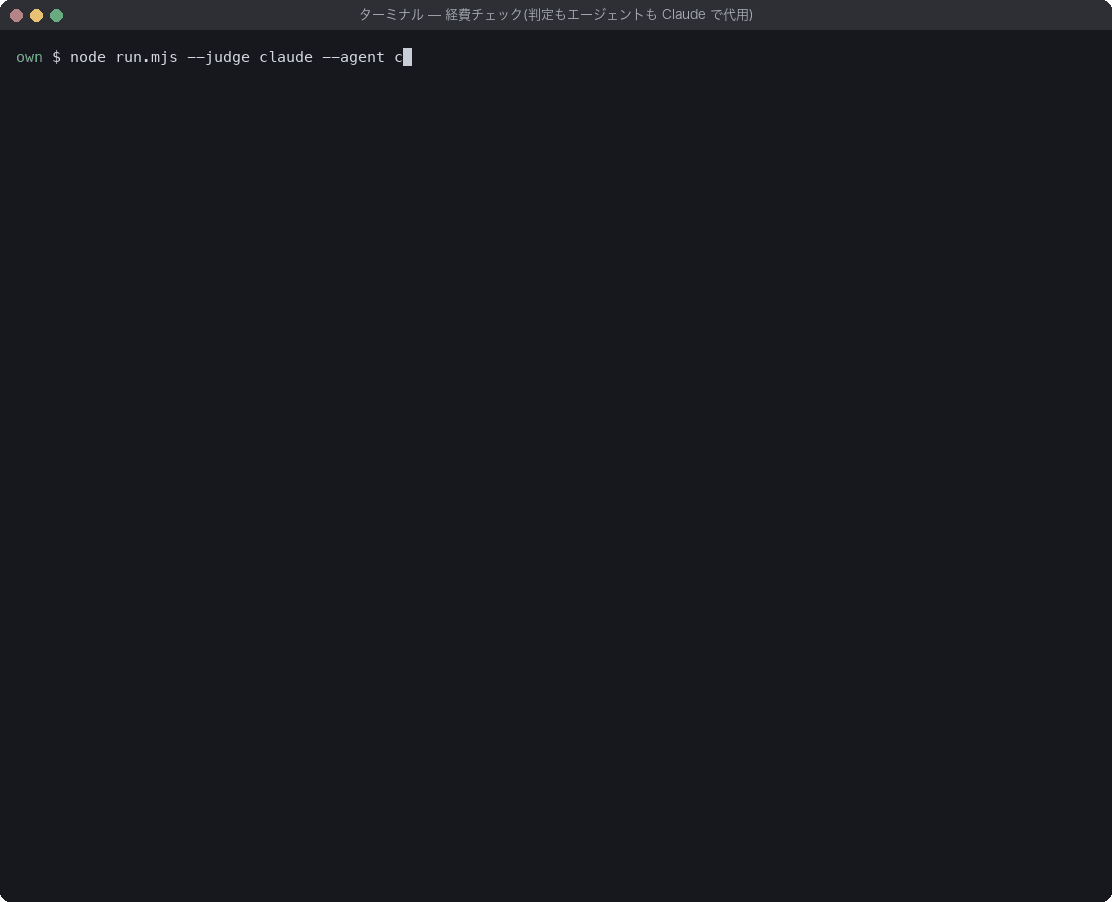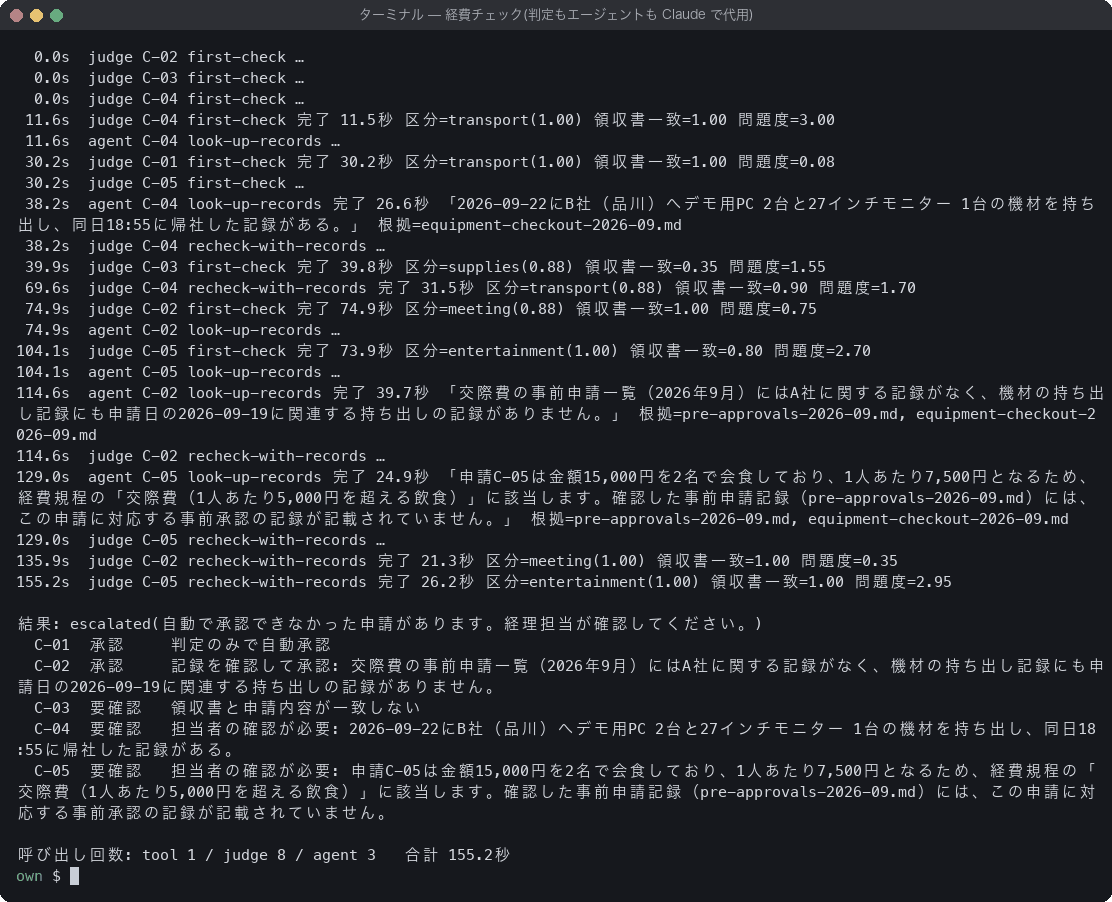
動画5 判定もエージェントも Claude で代用した実行。実時間155秒を約25秒に短縮(MP4版: rec09-own-live.mp4)
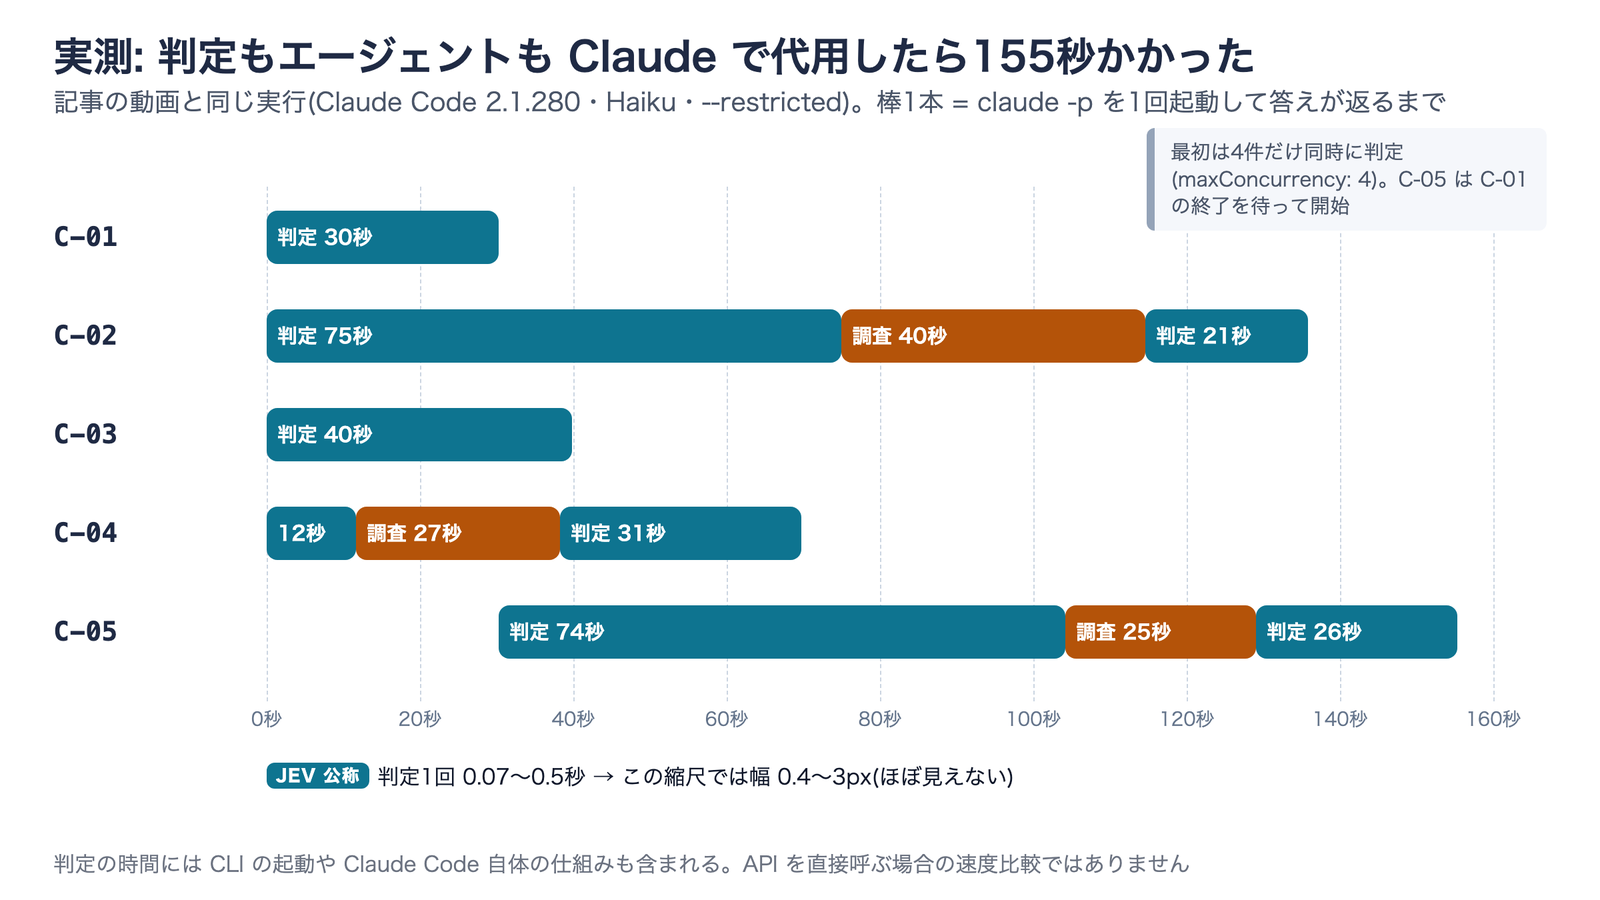
全体で155秒かかりました。呼び出しごとの開始と終了を並べたのが次の図です。
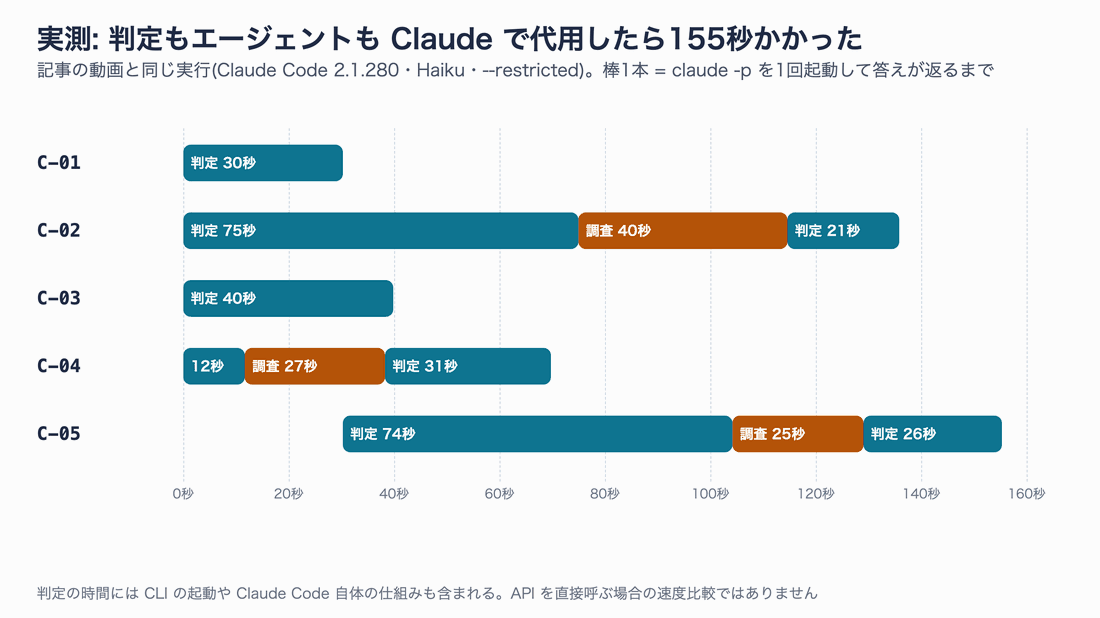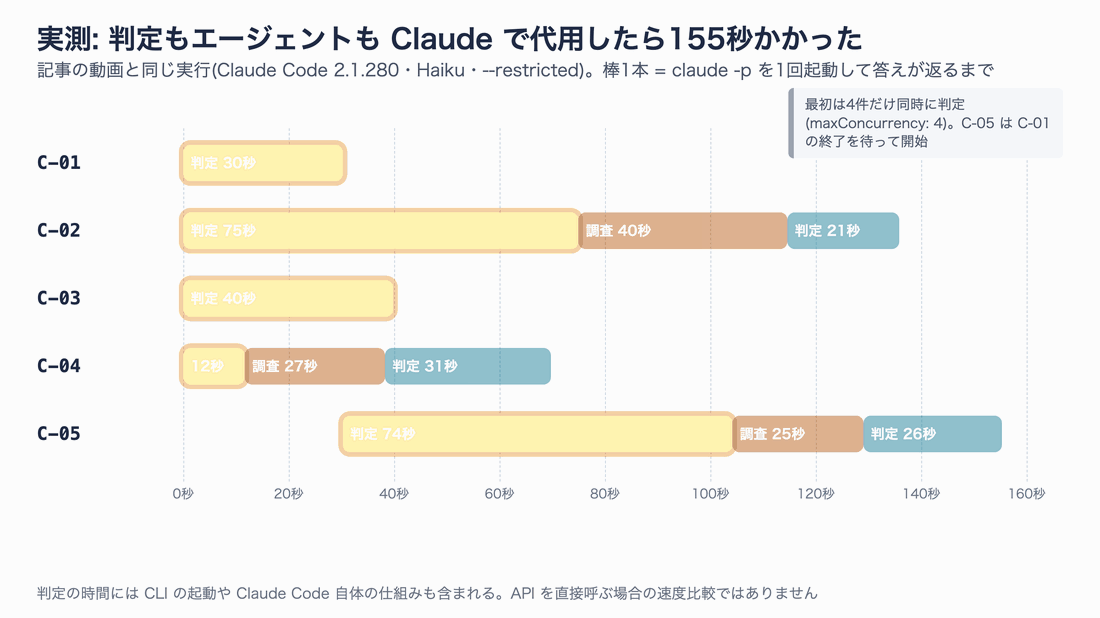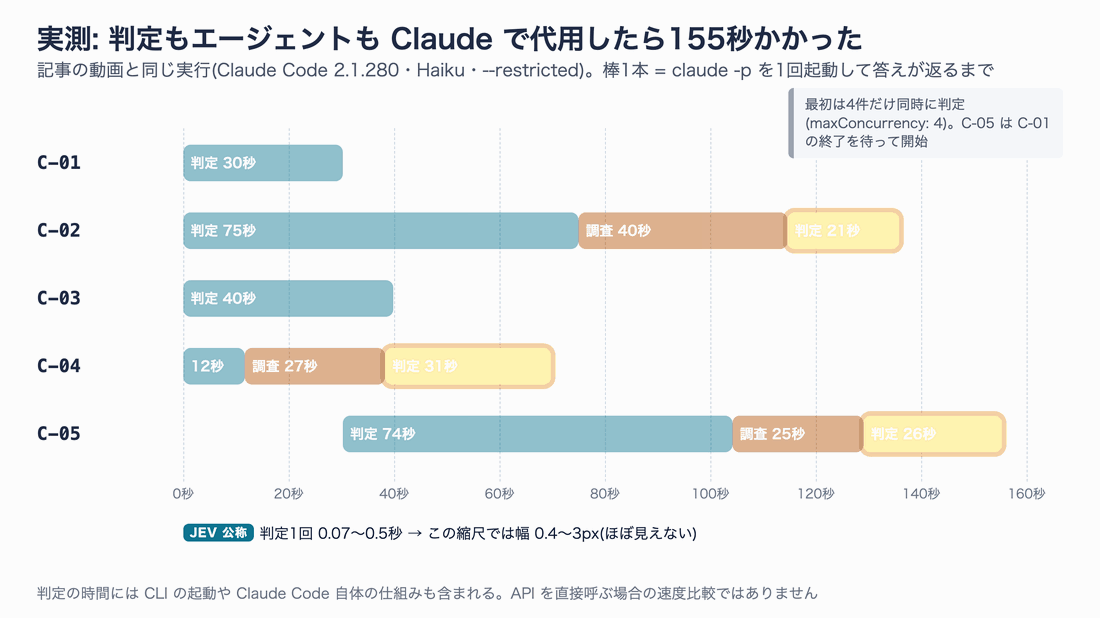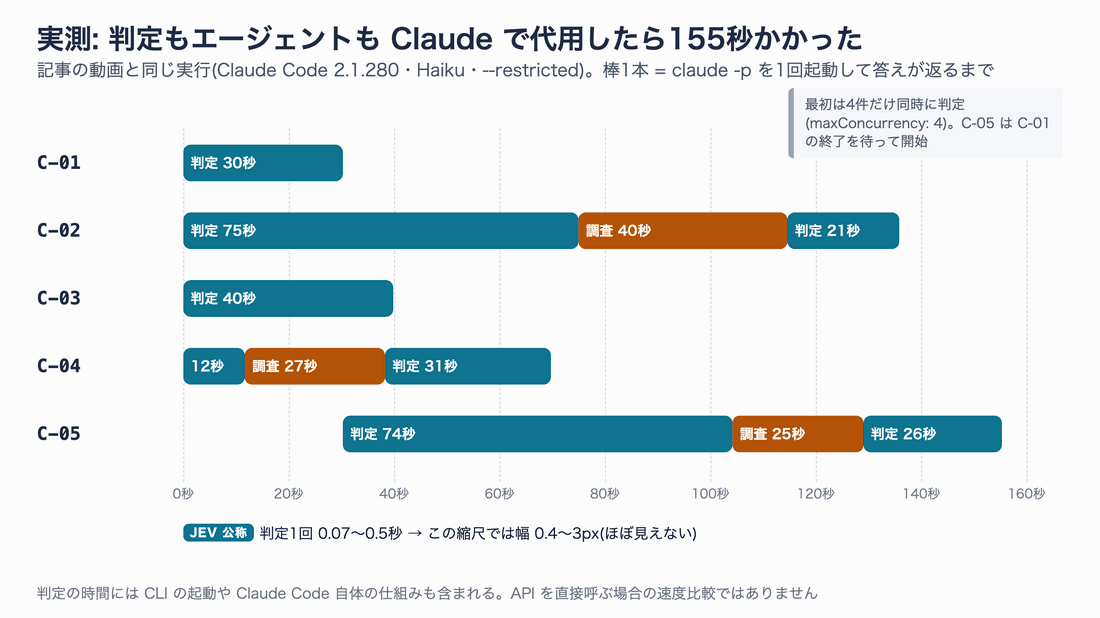
図9 動画5の実行のタイムライン(静止画)
判定1回に12〜75秒かかっているのは、判定のたびに Claude Code を起動し、エージェント用の大きな仕組みの上で答えを作っているためです。API を直接呼べばもっと速くなるので、この数字を「LLMとJevの速度差」とは読まないでください。それでも、小さな判断をエージェント用の仕組みで代用すると、ワークフロー全体が判定待ちになることは体感できました。Jev の公称値(1回0.07〜0.5秒)が実現するなら、この図の判定の棒はほとんど見えなくなります。
もう一つ分かったのは、代用判定の結論が実行ごとに揺れることです。同じ入力で2回動かした結果を比べます。
| 申請 | 1回目(130.8秒) | 2回目(155.2秒・動画5) |
|---|---|---|
| C-01 電車代 | 判定のみで承認 | 判定のみで承認 |
| C-02 打ち合わせ | 判定のみで承認 | 問題度0.75 → 調査 → 承認 |
| C-03 USBハブ | 領収書不一致で要確認 | 領収書不一致で要確認 |
| C-04 タクシー | 調査 → 問題度0.04 → 承認 | 調査 → 問題度1.70 → 要確認 |
| C-05 会食 | 調査 → 要確認 | 調査 → 要確認 |
C-04 は、同じ持ち出し記録を見つけたにもかかわらず、再判定の問題度が0.04と1.70に分かれ、結論が逆になりました。しきい値の近くでは、判定の小さな揺れが結論を変えます。Jev が同じ条件でどれだけ安定するかは今回確かめていませんが、どの判定モデルを使うにしても、正解ラベル付きの事例で揺れ幅を測り、しきい値を決める作業は欠かせません。
本番で Jev をつなぐには
本番で Jev を使う場合は、判定アダプタを @parcha/agentrun-jev の createJevRunner() に差し替えます。公式ドキュメントの手順は次のとおりです。この部分は今回実行していません(APIキーを使っていないため)。
npm install @parcha/agentrun-dsl@beta @parcha/agentrun-jev@beta
# キーは TypeSafe のダッシュボードで発行し、サーバー側の環境変数に置く
export TYPESAFE_API_KEY="<YOUR_TYPESAFE_API_KEY>"
import { runWorkflow } from '@parcha/agentrun-dsl';
import { createJevRunner } from '@parcha/agentrun-jev';

// 公式 README の設定例。再試行は一時的なエラー(408・429・5xx など)だけ
const runJudge = createJevRunner({ timeoutMs: 30_000, maxAttempts: 3 });
const result = await runWorkflow(workflow, input, { runEffect, runJudge, runNode });
付録のサンプルコードにも、判定を本物の Jev に切り替える --judge jev を用意しました。キーを入れた .env を置いて npm run jev(中身は node --env-file=.env run.mjs --judge jev --agent scripted)を実行すると、台本の判定の代わりに Jev が呼ばれます。キーを設定せずに実行すると、Could not configure Jev. Supply apiKey or set TYPESAFE_API_KEY というエラーで止まることは確認済みです。
注意点として、Claude Code や Codex のログインは Jev の認証の代わりになりません。.env ファイルも自動では読み込まれないので、Node の --env-file やアプリの秘密情報の仕組みで渡します。キーをブラウザ側のコードに置かないことも、公式ドキュメントで繰り返し注意されています。
実務での評価:どこで効き、どこに注意するか
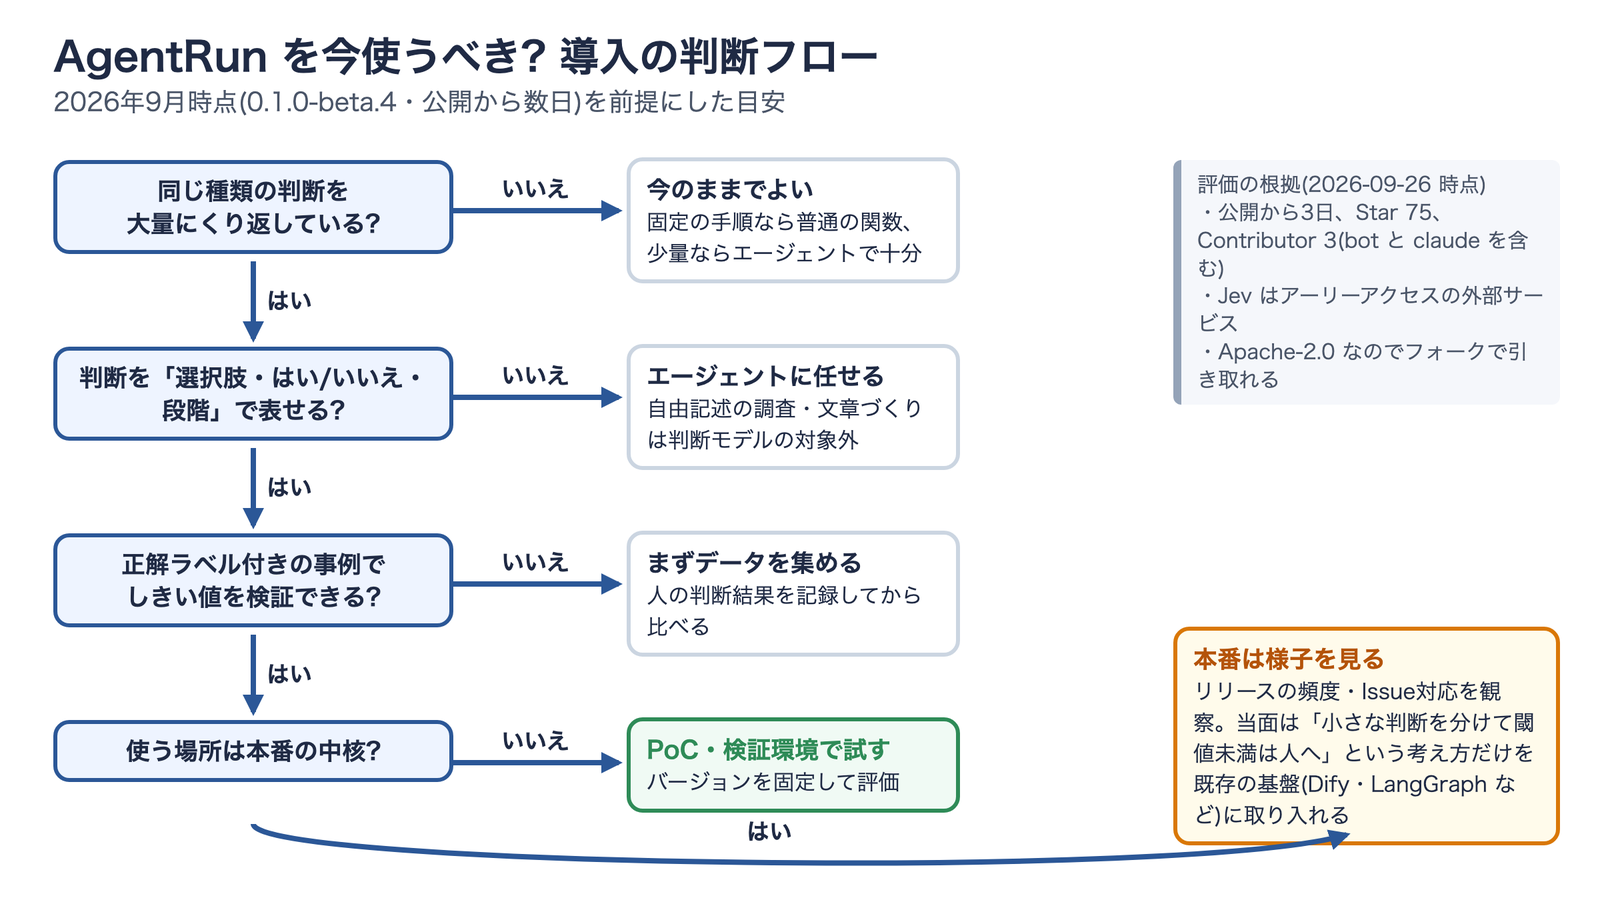
結論から言うと、AgentRun は「大量・反復・判断が小さい」業務で最も効きます。問い合わせの一次対応、コンプライアンスアラートの一次審査、RAG(検索拡張生成)の回答品質チェックなどが典型です。一方で、2026年9月時点では公開から数日のベータ版です。導入を考えるときの判断の順番を図にしました。
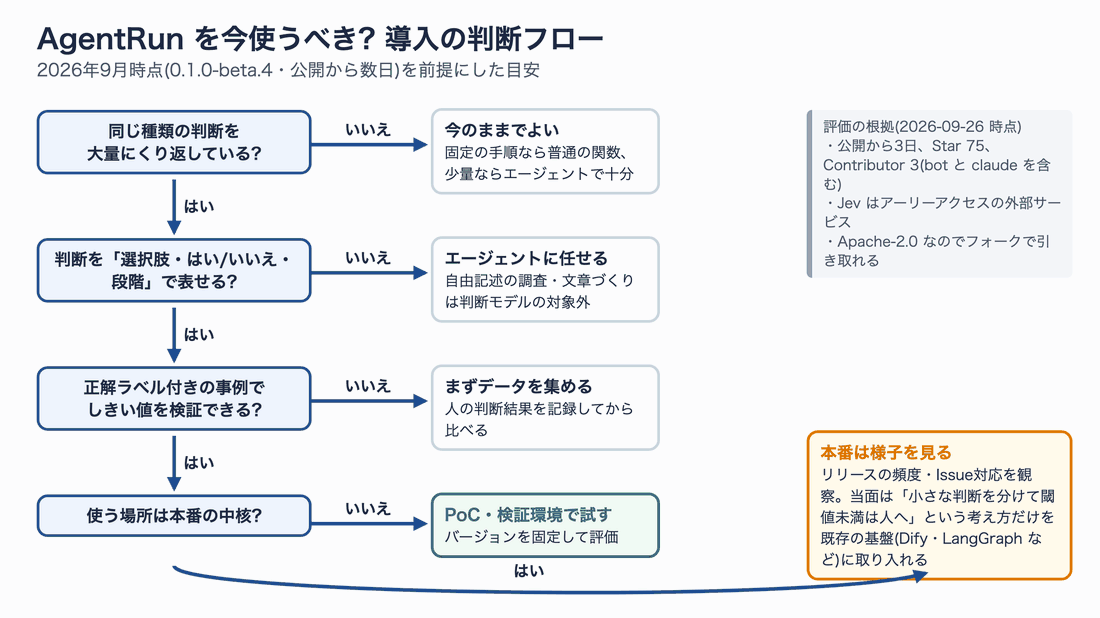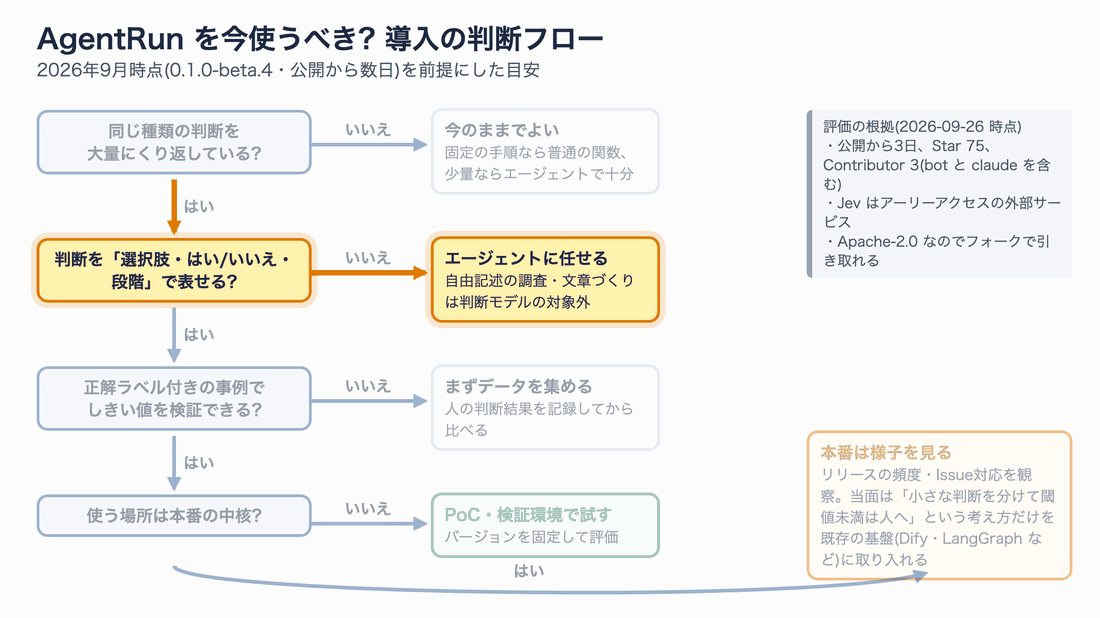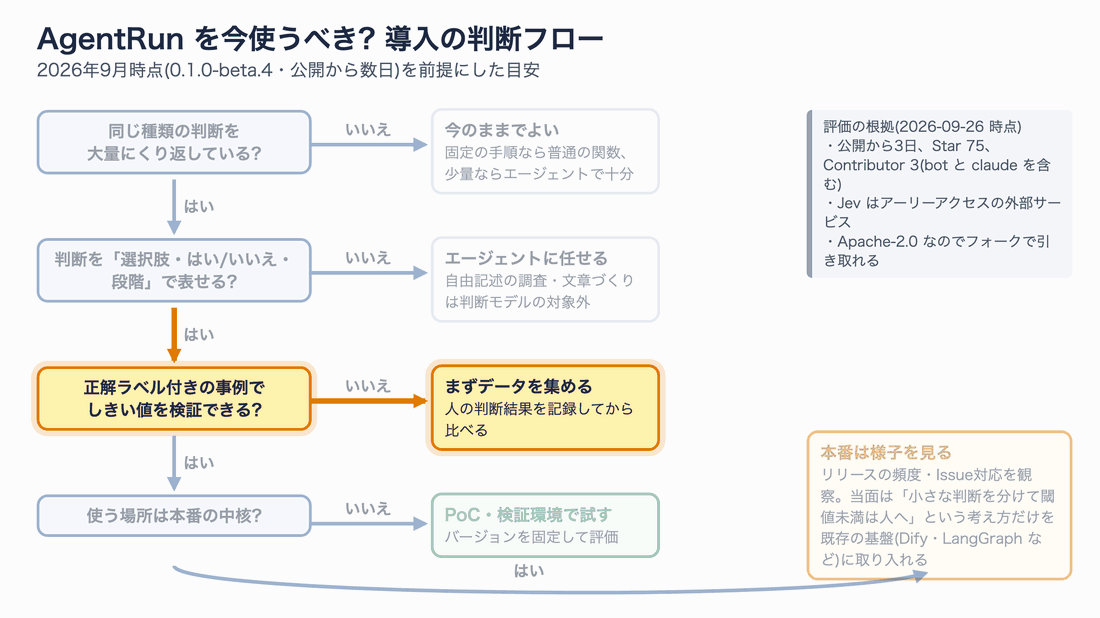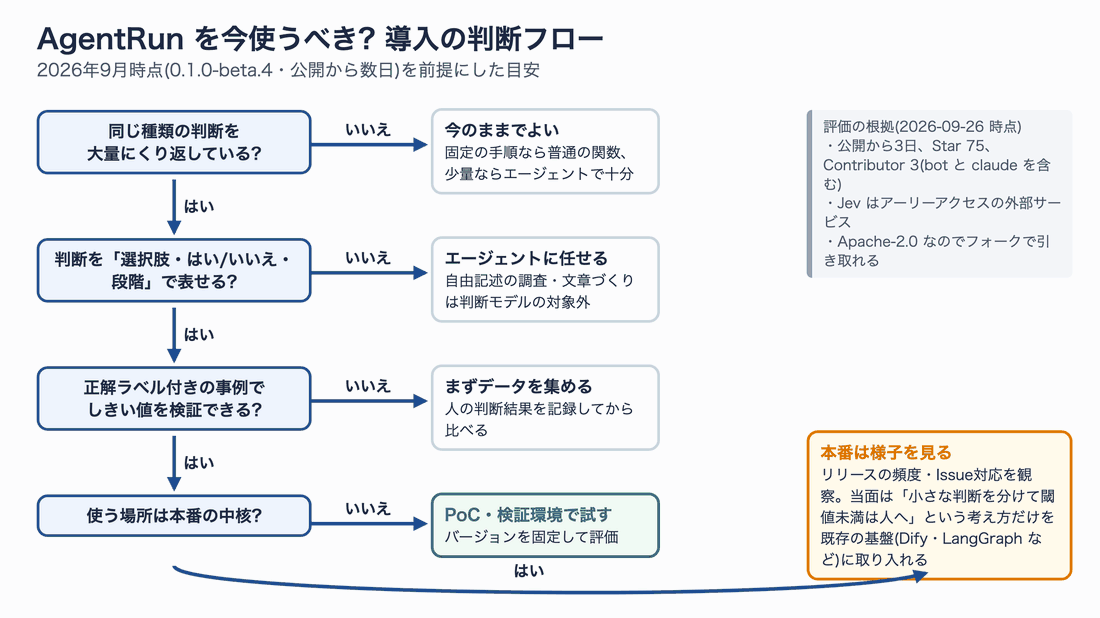
図10 導入の判断フロー(静止画)
成熟度の見立て
| 観点 | 2026年9月26日時点の状況 | 評価 |
|---|---|---|
| 公開からの日数 | 9月23日公開、npm は9月23〜24日の2日間で beta.1〜beta.4 を公開 | API は今後も変わる前提 |
| テスト | 766件を実行し、失敗は macOS の tar 起因の2件だけ。Lean 4 の形式仕様もある | 公開直後としてはかなり厚い |
| 開発体制 | Contributor 3件(人は1人、ほかは bot と claude) | 担い手が少なく、継続性に不安 |
| リリース工程 | GitHub の npm-release デプロイは4回とも失敗表示。ただし npm には3パッケージとも beta.4 が公開済み | 公開後の検証工程がまだ安定していない |
| 判定レイヤー | Jev はアーリーアクセスの外部サービス | データの扱い・ベンダー依存の評価が必要 |
| ライセンス | Apache-2.0 | 自社でフォークして引き取る逃げ道がある |
スター数はまだ少ないですが、スターは「知られているか」の指標で、品質の指標ではありません。テストの厚さと運営主体の明確さは評価できる一方、開発の担い手とリリース工程にはまだ不安が残ります。
| 用途 | 判断の目安 |
|---|---|
| 記事や勉強会での紹介、設計の参考 | 問題なし |
| 社内 PoC・検証環境での評価 | 問題なし(バージョンを固定する) |
| 顧客案件の本番基盤 | 当面は見送り。リリース頻度と Issue への対応を半年ほど観察 |
実務では、AgentRun そのものを採用するより、考え方を取り入れるほうが現実的な場面も多いはずです。つまり「小さな判断は判断専用モデルや軽量モデルに回し、しきい値未満は人へ回す」という設計を、既存の Dify や LangGraph のフローに持ち込む形です。たとえば Dify の IF/ELSE や質問分類器を LLM で回している箇所は、そのまま置き換え候補になります。
導入前に押さえたい注意点
AgentRun の README と今回の検証から、導入前に確認しておきたい点をまとめます。
- code ノードはプロセスの権限で JavaScript を実行します。 信頼できない人がワークフローを書ける環境では、アプリ側でサンドボックス(隔離環境)を用意する必要があります。
- 型の正しさは、内容の正しさを保証しません。 手順5のように、形は正しくても根拠が弱い答えが通ることがあります。
- しきい値は自分のデータで決めます。 公式例の0.7や0.8は説明用の値で、手順6のように判定の揺れで結論が変わることがあります。
- 固定の手順だけなら普通の関数で十分です。 ワークフローとして保存・再実行したり、エージェントから呼び出したりしたい場合に価値が出ます。
- Jev は外部 SaaS です。 判断材料(state)がTypeSafe に送られるため、送ってよいデータかどうかを事前に確認します。
トラブルシューティング
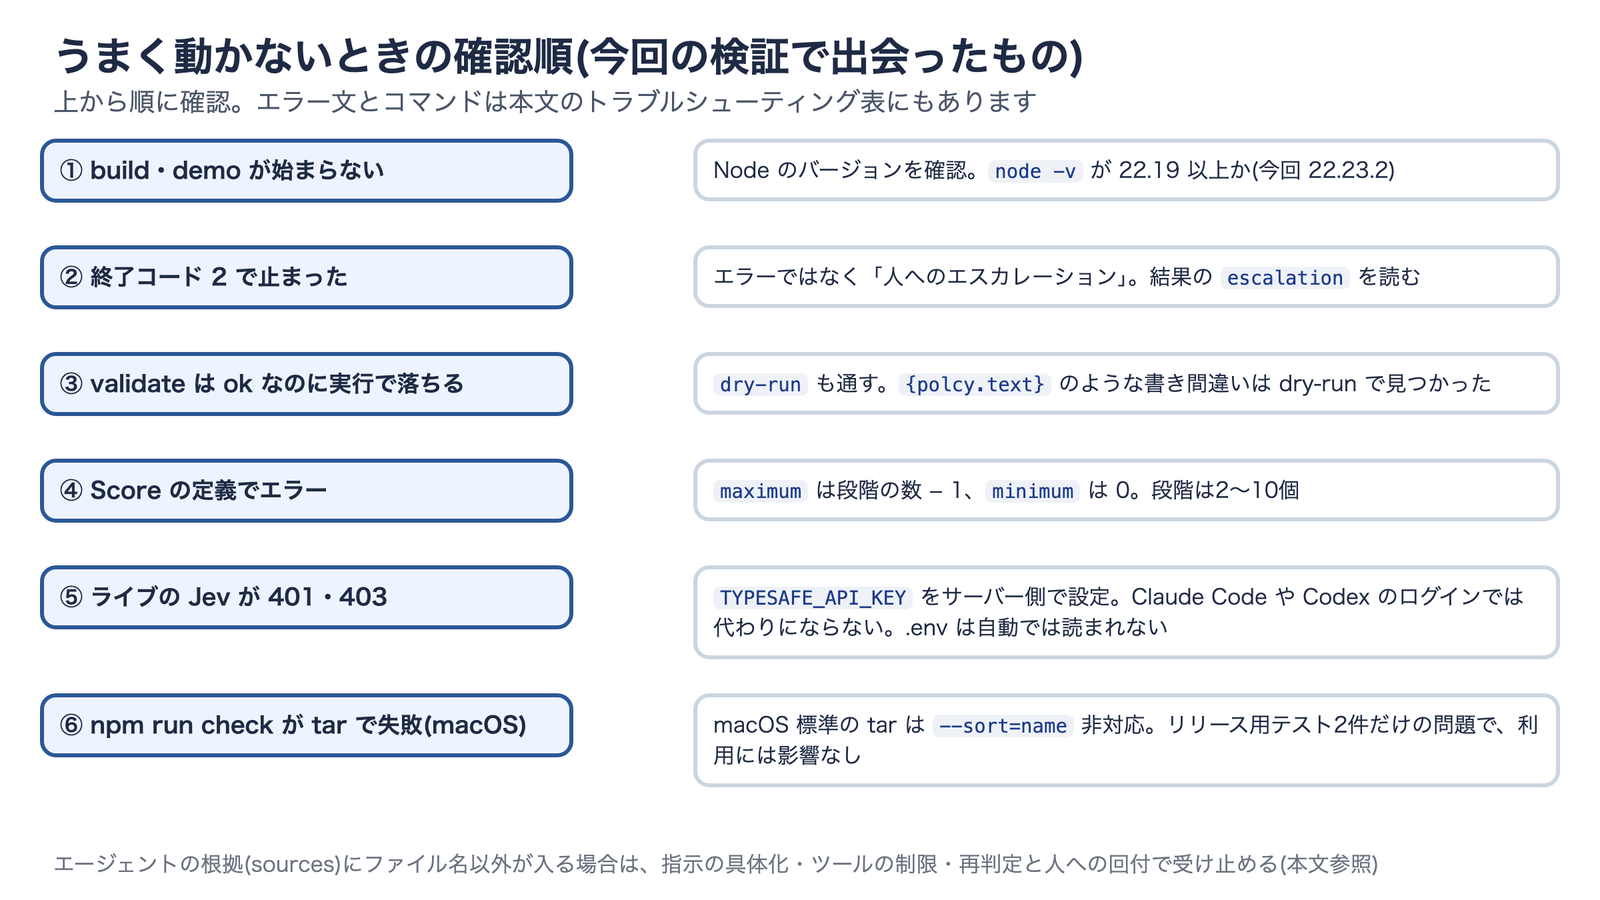
今回の検証で実際に出会ったつまずきを、確認する順番に並べました。
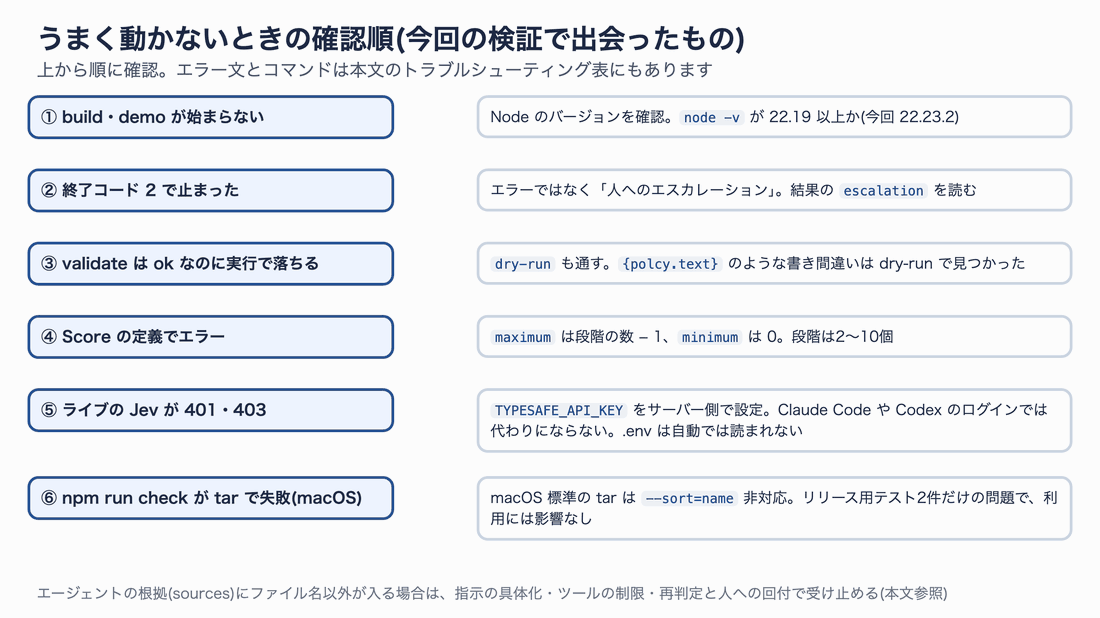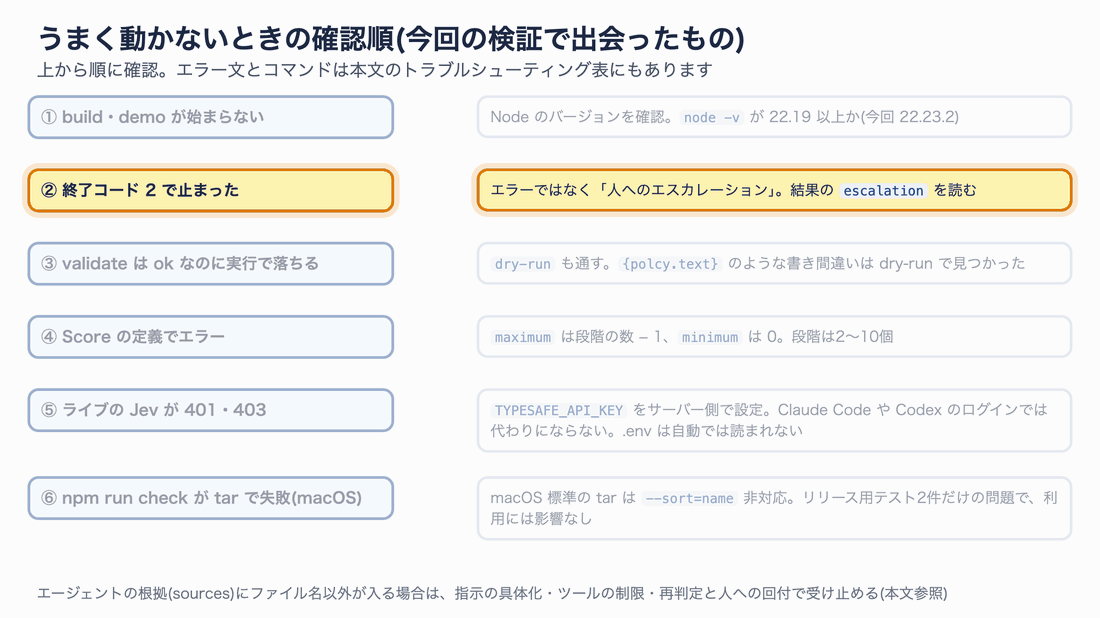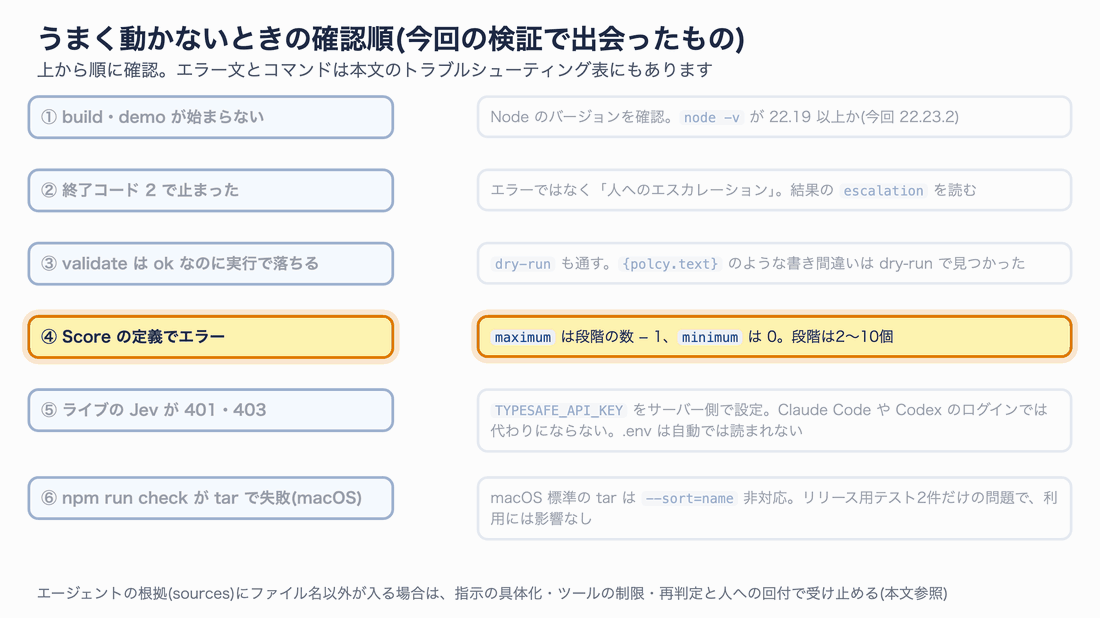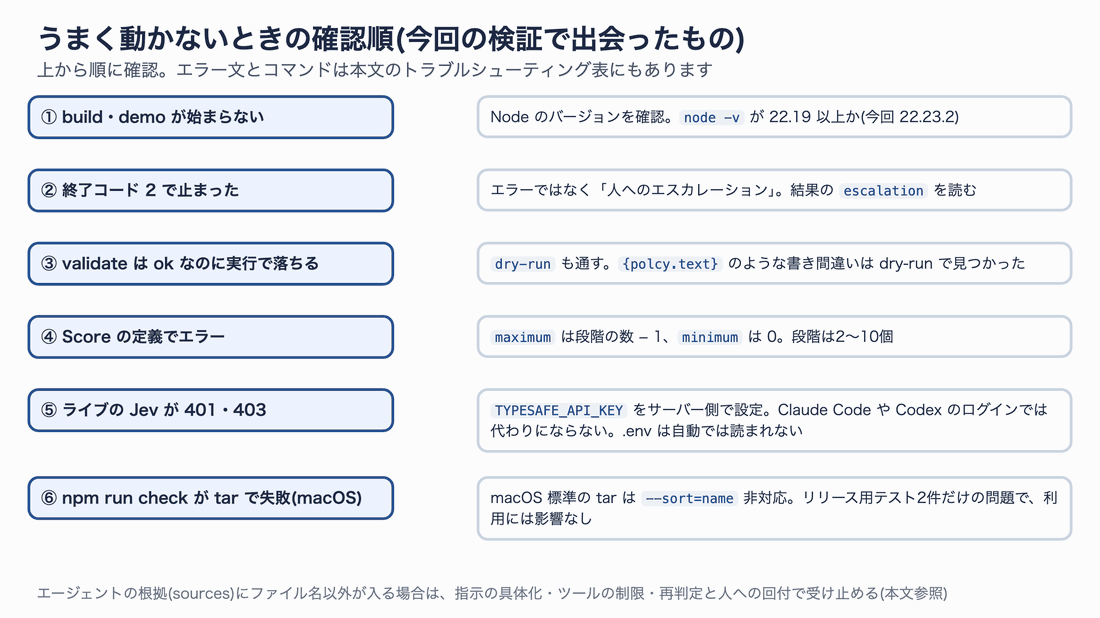
図11 確認の順番(静止画)
| 症状・エラー文 | 原因 | 対処 |
|---|---|---|
| build やデモが始まらない | Node が古い | node -v で 22.19 以上か確認し、必要なら更新する(nvm なら nvm install && nvm use) |
終了コード 2 で止まる | エラーではなく人へのエスカレーション | 出力の escalation を読む。CI では status で判定する |
interpolation path "polcy.text" is not present in the state | 状態を参照するパスの書き間違い。validate では見つからない | npx agentrun dry-run <workflow.json> <input.json> --trusted も必ず通す |
a score's maximum is its last level index (3) | Score の maximum が段階数 − 1 になっていない | minimum: 0、maximum: 段階数 − 1 にする(段階は2〜10個) |
Could not configure Jev. Supply apiKey or set TYPESAFE_API_KEY | Jev のキーが環境変数に入っていない | サーバー側の環境変数に設定する。.env は自動では読まれないので node --env-file=.env などで明示的に読む |
| ライブの Jev が 401・403 | キーが無効、またはエージェントのログインで代用しようとしている | TypeSafe のダッシュボードで発行したキーを使う。Claude Code や Codex のログインは代わりにならない |
tar: Option --sort=name is not supported | macOS 標準の tar が GNU tar のオプションに非対応 | リリース用テストだけの問題なので利用には影響なし。開発に参加するなら GNU tar を入れる |
エージェントの sources にファイル名以外が入る | スキーマが「文字列の配列」しか求めていない | 根拠の候補を enum で限定する、実在を確かめる code ノードを挟む、再判定と人への回付を残す |
まとめ
AgentRun は、「全部をエージェントに考えさせない」ための設計図を、動くコードとして示した OSS です。今回の検証で分かったことを振り返ります。
- 開発元は Brex 出身者が創業した Grep AI(旧 Parcha Labs)。OpenAI とのつながりは、判定を担う Jev の開発元 TypeSafe AI 側にある
- npm から入れて5分でデモが動き、付属デモは README の表どおりに分岐した。テストは766件中764件が成功し、失敗2件は macOS の tar に起因するものだった
- 自作の経費チェックでは、Claude Code を
runNodeにそのままつなげた。エージェントが呼ばれたのは判断に迷った申請だけだった - 判定を Claude で代用すると、1回12〜75秒かかり、結論も実行ごとに揺れた。速くて安定した判定レイヤーが、この設計の前提になっている
- 型とスキーマの検証は「形」を保証するだけで、内容の正しさは保証しない。再判定と人への回付を必ず残す
まだベータで、公表されている数値も開発元の社内評価が中心です。それでも、エージェントのコストや待ち時間に悩んでいるなら、まずは自社のフローのどこが「小さな判断」なのかを洗い出すところから始めてみてください。その判断を正解ラベル付きの事例で測れるようになったとき、Jev のような判断モデルや AgentRun の出番が来ます。
付録:サンプルコード全文
手順4〜6で使ったファイルの全文です。データはすべて架空です。Node.js 22.19 以上で動きます。npm run offline はAPIキーもログインも不要です。npm run agent と npm run live は Claude Code(claude コマンド)にログイン済みであることが前提で、claude -p を1回呼ぶごとに Claude の利用枠を使います。npm run jev は、同じフォルダーの .env に TYPESAFE_API_KEY を入れておく必要があります(.env は Git などで公開しないでください)。
フォルダー構成
expense-check/
├── package.json
├── expense-workflow.mjs   # ワークフロー定義
├── adapters.mjs           # Tool・判定・エージェントのアダプタ
├── run.mjs                # 実行と記録
├── claims.json            # 申請5件
├── sandbox/               # 代用判定を動かす空フォルダー
└── data/
    ├── policy.md
    └── records/
        ├── equipment-checkout-2026-09.md
        └── pre-approvals-2026-09.md
package.json
{
  "name": "agentrun-expense-check-sample",
  "private": true,
  "type": "module",
  "description": "AgentRun で経費精算の一次チェックを試すサンプル(データはすべて架空)",
  "scripts": {
    "offline": "node run.mjs --judge scripted --agent scripted",
    "agent": "node run.mjs --judge scripted --agent claude",
    "live": "node run.mjs --judge claude --agent claude",
    "jev": "node --env-file=.env run.mjs --judge jev --agent scripted"
  },
  "dependencies": {
    "@parcha/agentrun-dsl": "0.1.0-beta.4",
    "@parcha/agentrun-jev": "0.1.0-beta.4"
  }
}
expense-workflow.mjs
// 経費精算の一次チェック(検証用のオリジナル例。データはすべて架空)
// Tool で規程を取り、申請ごとに Jev 型の判定(Choice / Noul / Score)を並列に行い、
// 自信が足りない申請だけエージェントに社内記録を調べさせ、最後に人へ回す。
const text = { type: 'string', minLength: 1 };
const object = properties => ({
  type: 'object', properties, required: Object.keys(properties), additionalProperties: false,
});
const Claim = object({ id: text, date: text, amount: { type: 'integer', minimum: 1 }, memo: text, receipt: text });
const Verdict = object({ id: text, status: { type: 'string', enum: ['approved', 'review'] }, reason: text });

export const workflow = {
  v: 2,
  name: 'expense-first-check',
  schemas: {
    Input: object({ claims: { type: 'array', items: Claim, minItems: 1 } }),
    Policy: object({ text, source: text }),
    // judge のスキーマ: enum → Choice、boolean → Noul、段階つき integer → Score
    Check: object({
      category: {
        type: 'string', enum: ['transport', 'meeting', 'entertainment', 'supplies', 'not_allowed'],
        description: '`claim` の支出は `policy` のどの経費区分に当たるか。',
        criteria: {
          transport: '交通費(業務での移動)',
          meeting: '会議費(社外との打ち合わせの飲食、1人5,000円以下)',
          entertainment: '交際費(1人5,000円を超える飲食や贈答)',
          supplies: '消耗品費(10万円未満の文具・備品)',
          not_allowed: '対象外(私的な支出など)',
        },
      },
      receiptMatches: {
        type: 'boolean',
        description: '`claim.receipt` の日付・金額・支払先は、`claim` の date・amount・memo と矛盾なく一致しているか。',
      },
      risk: {
        type: 'integer', minimum: 0, maximum: 3,
        description: '`policy` の条件に照らして、この申請にどの程度の問題があるか。`finding` があればその記録も根拠にする。',
        criteria: [
          '問題なし(規程の条件を満たすことが明らか)',
          '軽微(記載の補足で足りる)',
          '要確認(規程の条件を満たすかどうか、申請内容だけでは分からない)',
          '規程違反の疑い(必要な条件を満たしていない)',
        ],
      },
    }),
    Finding: object({ summary: text, sources: { type: 'array', items: text, minItems: 1 } }),
    Result: object({ approved: { type: 'array', items: Verdict }, review: { type: 'array', items: Verdict } }),
  },
  input: { schemaId: 'Input' },
  output: { schemaId: 'Result', path: 'result' },
  root: {
    node: 'chain',
    steps: [
      // ① Tool: 経費規程を取ってくる(決まった処理はコードに任せる)
      { node: 'call', label: 'load-policy', via: 'tool', tool: 'policy.lookup', args: {},
        out: 'Policy', as: 'policy', deadline_s: 5 },
      // ② 申請ごとに並列で処理する
      {
        node: 'map', label: 'check-each-claim', itemsPath: 'claims', maxConcurrency: 4,
        as: 'verdicts', resultPath: 'verdict',
        body: { node: 'chain', steps: [
          // ③ Jev 型の判定: 区分(Choice)・領収書の一致(Noul)・問題の程度(Score)を一度に聞く
          { node: 'judge', label: 'first-check',
            state: { claim: '{item}', policy: '{policy.text}' }, out: 'Check', as: 'check' },
          // ④ コードで次の行き先を決める(しきい値はここで管理)
          { node: 'code', label: 'choose-next-step', code: `s => {
              const a = s['check$answers'];
              const receipt = a.answers.receiptMatches.noul;
              let first = null;
              if (s.check.category === 'not_allowed') first = { status: 'review', reason: '規程の対象外の支出' };
              else if (receipt < 0.5) first = { status: 'review', reason: '領収書と申請内容が一致しない' };
              else if (s.check.risk === 0 && a.confidence.category >= 0.8 && receipt >= 0.9)
                first = { status: 'approved', reason: '判定のみで自動承認' };
              return { first, investigate: first ? [] : [s.item] };
            }` },
          // ⑤ 迷った申請だけエージェントに記録を調べさせる(0件か1件なので上限つき)
          { node: 'map', label: 'investigate-if-needed', itemsPath: 'investigate', maxConcurrency: 1,
            as: 'investigations', resultPath: 'checked',
            body: { node: 'chain', steps: [
              { node: 'agent', label: 'look-up-records',
                instructions: '経費申請(claim)が経費規程(policy)の条件を満たすか確かめるため、利用できる社内記録を読んで関係する記録を探してください。記録に書かれている事実だけを summary に日本語で1〜2文で書き、根拠にしたファイル名を sources に入れてください。該当する記録がなければ「該当する記録なし」と書き、確認したファイル名を sources に入れてください。承認・却下の判断はしないでください。',
                state: { claim: '{item}', policy: '{policy.text}' },
                tools: ['records_read'], out: 'Finding', as: 'finding' },
              // ⑥ 調べた結果を添えて、もう一度 Jev 型の判定
              { node: 'judge', label: 'recheck-with-records',
                state: { claim: '{item}', policy: '{policy.text}', finding: '{finding}' },
                out: 'Check', as: 'check2' },
              { node: 'code', label: 'keep-result', code: `s => ({ checked: {
                  finding: s.finding, check: s.check2,
                  categoryConfidence: s['check2$answers'].confidence.category,
                  receipt: s['check2$answers'].answers.receiptMatches.noul } })` },
            ] } },
          { node: 'code', label: 'decide', code: `s => {
              if (s.first) return { verdict: { id: s.item.id, ...s.first } };
              const r = s.investigations[0];
              const ok = r.check.category !== 'not_allowed' && r.check.risk <= 1
                && r.categoryConfidence >= 0.8 && r.receipt >= 0.5;
              return { verdict: { id: s.item.id, status: ok ? 'approved' : 'review',
                reason: (ok ? '記録を確認して承認: ' : '担当者の確認が必要: ') + r.finding.summary } };
            }` },
        ] },
      },
      { node: 'code', label: 'summarize', code: `s => ({ result: {
          approved: s.verdicts.filter(v => v.status === 'approved'),
          review: s.verdicts.filter(v => v.status === 'review') } })` },
      // ⑦ 1件でも確認が必要なら、人(経理担当)へエスカレーション
      { node: 'escalate', label: 'ask-accounting',
        when: { predicate: 'count_gte', path: 'result.review', n: 1 },
        kind: 'expense_review', stage: 'first-check',
        summary: '自動で承認できなかった申請があります。経理担当が確認してください。' },
    ],
  },
};
adapters.mjs
// ホスト側のアダプタ。AgentRun の本体は「どの順に何を呼ぶか」だけを持ち、
// 実際のツール・判定モデル・エージェントはここで差し込む。
import { readFile } from 'node:fs/promises';
import { spawn } from 'node:child_process';
import { join, dirname } from 'node:path';
import { fileURLToPath } from 'node:url';

const HERE = dirname(fileURLToPath(import.meta.url));
const RECORDS = join(HERE, 'data', 'records');

// ---------- Tool(runEffect): 決まった処理 ----------
export async function runEffect({ node }) {
  if (node.tool !== 'policy.lookup') throw new Error(`unknown tool ${node.tool}`);
  return { text: await readFile(join(HERE, 'data', 'policy.md'), 'utf8'), source: 'data/policy.md' };
}

// ---------- Judge(runJudge): 台本の判定 ----------
// Jev の応答と同じ形(Choice / Noul / Score)を固定値で返す。制御フローの確認用で、内容は見ていない。
const SCRIPT = {
  'C-01': { 'first-check': ['transport', 0.95, 0.97, 0, 0.9] },
  'C-02': { 'first-check': ['meeting', 0.93, 0.96, 0, 0.88] },
  'C-03': { 'first-check': ['supplies', 0.94, 0.12, 1, 0.7] },
  'C-04': { 'first-check': ['transport', 0.91, 0.93, 2, 0.7], 'recheck-with-records': ['transport', 0.92, 0.93, 0, 0.85] },
  'C-05': { 'first-check': ['entertainment', 0.9, 0.95, 2, 0.7], 'recheck-with-records': ['entertainment', 0.9, 0.95, 3, 0.8] },
};
const spread = (keys, chosen, p) =>
  Object.fromEntries(keys.map(k => [k, k === chosen ? p : (1 - p) / (keys.length - 1)]));
function scoreAnswer(q, probabilities) {
  const score = Object.entries(probabilities).reduce((sum, [k, p]) => sum + Number(k) * p, 0);
  const legend = Object.fromEntries(q.criteria.map((t, i) => [String(i), t]));
  return { type: 'score', score, legend, probabilities, confidence: concentration(Object.values(probabilities)) };
}
// 分布の集中度(1 − 正規化エントロピー)。台本・代用判定でのみ使う近似
function concentration(ps) {
  const h = -ps.reduce((s, p) => s + (p > 0 ? p * Math.log(p) : 0), 0);
  return Math.max(0, Math.min(1, 1 - h / Math.log(ps.length)));
}
export async function scriptedJudge({ label, state, questions }) {
  const [category, cConf, receipt, risk, rConf] = SCRIPT[state.claim.id][label];
  const cKeys = Object.keys(questions.category.criteria);
  const rKeys = questions.risk.criteria.map((_, i) => String(i));
  const cProbs = spread(cKeys, category, cConf);
  return { answers: {
    category: { type: 'choice', choice: category, probabilities: cProbs, confidence: cConf },
    receiptMatches: { type: 'noul', noul: receipt },
    risk: scoreAnswer(questions.risk, spread(rKeys, String(risk), rConf)),
  } };
}

// ---------- Judge(本番): Jev ----------
// TYPESAFE_API_KEY をサーバー側の環境変数から読む(値はコードに書かない)。
let jevRunner;
export async function jevJudge(params) {
  if (!jevRunner) {
    const { createJevRunner } = await import('@parcha/agentrun-jev');
    jevRunner = createJevRunner({ timeoutMs: 30_000, maxAttempts: 3 });
  }
  return jevRunner(params);
}

// ---------- Claude Code をヘッドレスで呼ぶ共通処理 ----------
function claude(args, { cwd, prompt, signal }) {
  return new Promise((resolve, reject) => {
    const child = spawn('claude', ['-p', ...args], { cwd, signal, stdio: ['pipe', 'pipe', 'pipe'] });
    let out = '', err = '';
    child.stdout.on('data', d => (out += d));
    child.stderr.on('data', d => (err += d));
    child.on('error', reject);
    child.on('close', code => {
      try {
        const r = JSON.parse(out);
        if (code !== 0 || r.is_error || !r.structured_output) throw new Error(r.result ?? err);
        resolve(r);
      } catch (e) { reject(new Error(`claude failed (${code}): ${String(e.message).slice(0, 300)}`)); }
    });
    child.stdin.end(prompt);
  });
}
const BASE = ['--restricted', '--strict-mcp-config', '--model', 'haiku', '--output-format', 'json'];

// ---------- Judge の代用: Claude(Haiku)に確率分布を答えさせる ----------
// Jev のキーがない環境で「判定アダプタは差し替えられる」ことを確かめるための代用品。Jev そのものではない。
export async function claudeJudge({ state, questions, signal }) {
  const properties = {};
  for (const [id, q] of Object.entries(questions)) {
    if (q.type === 'noul') properties[id] = { type: 'number', minimum: 0, maximum: 1 };
    else {
      const keys = q.type === 'choice' ? Object.keys(q.criteria) : q.criteria.map((_, i) => String(i));
      properties[id] = { type: 'object', additionalProperties: false, required: keys,
        properties: Object.fromEntries(keys.map(k => [k, { type: 'number', minimum: 0, maximum: 1 }])) };
    }
  }
  const schema = { type: 'object', additionalProperties: false, required: Object.keys(properties), properties };
  const prompt = [
    '次の状態(state)について、各質問に確率で答えてください。文章の説明は不要です。',
    'choice と score は選択肢ごとの確率(合計1)、noul は「はい」である確率(0〜1)を返します。',
    `state: ${JSON.stringify(state)}`,
    `questions: ${JSON.stringify(questions)}`,
  ].join('\n');
  const r = await claude([...BASE, '--tools', '', '--json-schema', JSON.stringify(schema)],
    { cwd: join(HERE, 'sandbox'), prompt, signal });
  const answers = {};
  for (const [id, q] of Object.entries(questions)) {
    const raw = r.structured_output[id];
    if (q.type === 'noul') { answers[id] = { type: 'noul', noul: raw }; continue; }
    const total = Object.values(raw).reduce((a, b) => a + b, 0) || 1;
    const probabilities = Object.fromEntries(Object.entries(raw).map(([k, p]) => [k, p / total]));
    if (q.type === 'choice') {
      const choice = Object.entries(probabilities).sort((a, b) => b[1] - a[1])[0][0];
      answers[id] = { type: 'choice', choice, probabilities, confidence: concentration(Object.values(probabilities)) };
    } else answers[id] = scoreAnswer(q, probabilities);
  }
  return { answers, model: 'claude-haiku (stand-in)', meta: { ms: r.duration_ms, usd: r.total_cost_usd } };
}

// ---------- Agent(runNode): 既存のエージェント = Claude Code ----------
// records_read を「data/records だけを読める Read/Grep/Glob」に対応づける。書き込み・コマンド実行はさせない。
export const agentMeta = [];
export async function claudeAgent({ system, user, schema, tools, signal }) {
  if (tools.join() !== 'records_read') throw new Error(`tool not allowed: ${tools}`);
  const r = await claude([...BASE, '--tools', 'Read,Grep,Glob', '--append-system-prompt', system,
    '--json-schema', JSON.stringify(schema)], { cwd: RECORDS, prompt: user, signal });
  agentMeta.push({ ms: r.duration_ms, usd: r.total_cost_usd, turns: r.num_turns });
  return r.structured_output;
}

// 台本のエージェント(オフライン確認用)
export async function scriptedAgent({ user }) {
  const { claim } = JSON.parse(user);
  return claim.id === 'C-04'
    ? { summary: '2026-09-22に田中がデモ用PC2台と27インチモニター1台をB社へ持ち出した記録がある。', sources: ['equipment-checkout-2026-09.md'] }
    : { summary: '該当する記録なし(A社との会食の事前申請は見当たらない)。', sources: ['pre-approvals-2026-09.md'] };
}
run.mjs
// 使い方: node run.mjs [--judge scripted|claude|jev] [--agent scripted|claude] [--trace out.json]
import { readFile, writeFile } from 'node:fs/promises';
import { runWorkflow } from '@parcha/agentrun-dsl';
import { workflow } from './expense-workflow.mjs';
import * as A from './adapters.mjs';

const opt = (name, def) => { const i = process.argv.indexOf(`--${name}`); return i > 0 ? process.argv[i + 1] : def; };
const judgeMode = opt('judge', 'scripted'), agentMode = opt('agent', 'scripted'), tracePath = opt('trace');
const input = JSON.parse(await readFile(new URL('./claims.json', import.meta.url), 'utf8'));

const t0 = Date.now();
const sec = () => ((Date.now() - t0) / 1000).toFixed(1).padStart(5);
const trace = [];
const who = p => p.state?.claim?.id ?? JSON.parse(p.user ?? '{}').claim?.id ?? '-';
// 呼び出しごとの所要時間を記録するラッパー
const timed = (kind, fn) => async params => {
  const id = who(params), label = params.label ?? params.node?.label, start = Date.now();
  console.log(`${sec()}s  ${kind.padEnd(5)} ${id.padEnd(4)} ${label} …`);
  const value = await fn(params);
  const ms = Date.now() - start;
  trace.push({ kind, id, label, ms, value });
  let note = '';
  if (kind === 'judge') {
    const a = value.answers;
    note = `区分=${a.category.choice}(${a.category.confidence.toFixed(2)}) 領収書一致=${a.receiptMatches.noul.toFixed(2)} 問題度=${a.risk.score.toFixed(2)}`;
  } else if (kind === 'agent') note = `「${value.summary}」 根拠=${value.sources.join(', ')}`;
  console.log(`${sec()}s  ${kind.padEnd(5)} ${id.padEnd(4)} ${label} 完了 ${(ms / 1000).toFixed(1)}秒 ${note}`);
  return value;
};

console.log(`経費の一次チェック  判定=${judgeMode}  エージェント=${agentMode}  申請=${input.claims.length}件\n`);
const result = await runWorkflow(workflow, input, {
  runEffect: timed('tool', A.runEffect),
  runJudge: timed('judge', { claude: A.claudeJudge, jev: A.jevJudge }[judgeMode] ?? A.scriptedJudge),
  runNode: timed('agent', agentMode === 'claude' ? A.claudeAgent : A.scriptedAgent),
});

const state = result.status === 'complete' ? { result: result.output } : result.escalation.state;
console.log(`\n結果: ${result.status}${result.status === 'escalated' ? `(${result.escalation.summary})` : ''}`);
for (const v of [...state.result.approved, ...state.result.review]) {
  console.log(`  ${v.id}  ${v.status === 'approved' ? '承認    ' : '要確認  '} ${v.reason}`);
}
const count = k => trace.filter(t => t.kind === k).length;
console.log(`\n呼び出し回数: tool ${count('tool')} / judge ${count('judge')} / agent ${count('agent')}   合計 ${((Date.now() - t0) / 1000).toFixed(1)}秒`);
if (tracePath) await writeFile(tracePath, JSON.stringify({ judgeMode, agentMode, status: result.status, trace, agentMeta: A.agentMeta, state: state.result }, null, 2));
process.exitCode = result.status === 'escalated' ? 2 : 0;
claims.json
{
  "claims": [
    { "id": "C-01", "date": "2026-09-18", "amount": 356, "memo": "B社への往復(電車) 新宿→品川→新宿",
      "receipt": "交通系ICの利用履歴 2026/09/18 新宿→品川 178円 / 品川→新宿 178円" },
    { "id": "C-02", "date": "2026-09-19", "amount": 4400, "memo": "A社 山田様と打ち合わせ 2名 カフェ",
      "receipt": "カフェ・モカ 2026/09/19 合計4,400円 2名" },
    { "id": "C-03", "date": "2026-09-20", "amount": 3980, "memo": "会議室用のUSB-Cハブ",
      "receipt": "家電量販店 2026/09/21 USB-Cハブ 3,980円" },
    { "id": "C-04", "date": "2026-09-22", "amount": 6800, "memo": "B社から帰社 タクシー",
      "receipt": "品川交通 2026/09/22 18:20乗車 6,800円" },
    { "id": "C-05", "date": "2026-09-23", "amount": 15000, "memo": "A社 佐藤様と会食 2名",
      "receipt": "レストラン青山 2026/09/23 合計15,000円 2名" }
  ]
}
data/policy.md
# 経費規程(抜粋・検証用の架空データ)

- 交通費: 業務での移動にかかった電車・バス代。タクシーは「22時以降の移動」または「機材などの大きな荷物がある移動」に限る。
- 会議費: 社外の人との打ち合わせでの飲食。1人あたり5,000円以下。相手の会社名と人数を書く。
- 交際費: 1人あたり5,000円を超える飲食や贈答。事前申請(承認済み)が必要。
- 消耗品費: 10万円未満の文具・備品。
- 対象外: 私的な支出、ギフト券・ポイントの購入。
- 共通: 領収書の日付・金額・支払先が申請内容と一致していること。
data/records/equipment-checkout-2026-09.md
# 機材の持ち出し記録(2026年9月・検証用の架空データ)

| 日付 | 担当 | 持ち出した機材 | 行き先 | 帰社 |
|---|---|---|---|---|
| 2026-09-08 | 鈴木 | 展示用パネル 2枚 | D社(横浜) | 17:10 |
| 2026-09-22 | 田中 | デモ用PC 2台、27インチモニター 1台 | B社(品川) | 18:55 |
data/records/pre-approvals-2026-09.md
# 交際費の事前申請(2026年9月・検証用の架空データ)

| 申請日 | 申請者 | 相手先 | 予定日 | 予算 | 状態 |
|---|---|---|---|---|---|
| 2026-09-05 | 鈴木 | C社 | 2026-09-12 | 20,000円 | 承認済み |
| 2026-09-15 | 田中 | E社 | 2026-09-30 | 12,000円 | 承認待ち |
CLI で inspect・validate・dry-run を試すときは、次のコマンドでワークフローを JSON に書き出します。
node -e "import('./expense-workflow.mjs').then(m => require('fs').writeFileSync('expense-workflow.json', JSON.stringify(m.workflow, null, 2)))"
npx agentrun inspect expense-workflow.json
npx agentrun validate expense-workflow.json claims.json --trusted
npx agentrun dry-run expense-workflow.json claims.json --trusted
参考リンク
- Parcha-ai/agentrun(GitHub)
- @parcha/agentrun-dsl(npm)
- Show HN: AgentRun: DSL to turn agents into workflows(Hacker News、2026-09-23)
- Grep launches AgentRun, says code-first harness cuts agent costs 91%(RuntimeWire、2026-09-21)
- Parcha Raises $5M(Parcha Blog、2023-08-30)
- Our Investment in Parcha(Kindred Ventures)
- Grep AI について(About)
- Claude in a Box: Building Grep on the Agents SDK(Grep AI Blog)
- How Parcha built a universal customer diligence agent with Claude Agent SDK(Claude 顧客事例)
- TypeSafe AI Team
- Introducing System One Models and Jev(TypeSafe Blog、2026-09-15)
- TypeSafe AI Emerges From Stealth With $40M in Funding(Business Wire、2026-09-15)
- Jev introduces a new shape of LLM(Simon Willison、2026-09-21)
- Training language models to follow instructions with human feedback(InstructGPT、arXiv)
- GPT-4 Technical Report(arXiv)
- TypeSafe ドキュメント(Jev)