はじめに
2026年10月1日、AI コードレビューの Qodo(コード)が「Qodo 3.0」を発表しました。うたい文句は、コーディングエージェントが大量に書いたコードを見張り、レビューし、統制(ガバナンス)する層です。
この発表を ChatGPT に要約させたあと、私は次のことを続けて聞きました。
- そもそもどういう会社で、信用できるのか
- OpenAI や Anthropic、GAFAM などの大手テック企業とつながりはあるのか
- オープンソースで試せるのか
- Claude Code や Codex でも PR の自動レビューはできるのに、何が違うのか
ChatGPT の答えはもっともらしいものでしたが、確かめてみると古い情報や言い過ぎが混ざっていました。この記事では、公式の発表・資料で裏を取り直した結果に加えて、OSS 版の PR-Agent・Claude Code・Codex の3つに、わざと「組み合わせると壊れる」PR を3本レビューさせた実験の結果をまとめます。
先に結論を書きます。
- 1本ずつのレビューなら、Claude Code・Codex・PR-Agent(手元の LLM)のどれでも、ルール違反はかなり見つかりました
- ところが 3本をマージすると起きる TypeError は、1本ずつのレビューでは誰も気づけませんでした
- 3本を「1つの作業のかたまり」として見せると、27B のローカルモデルでも見つかりました
Qodo 3.0 が売ろうとしているのは、この「束ねて見せる」仕組みを組織の規模で自動化することです。
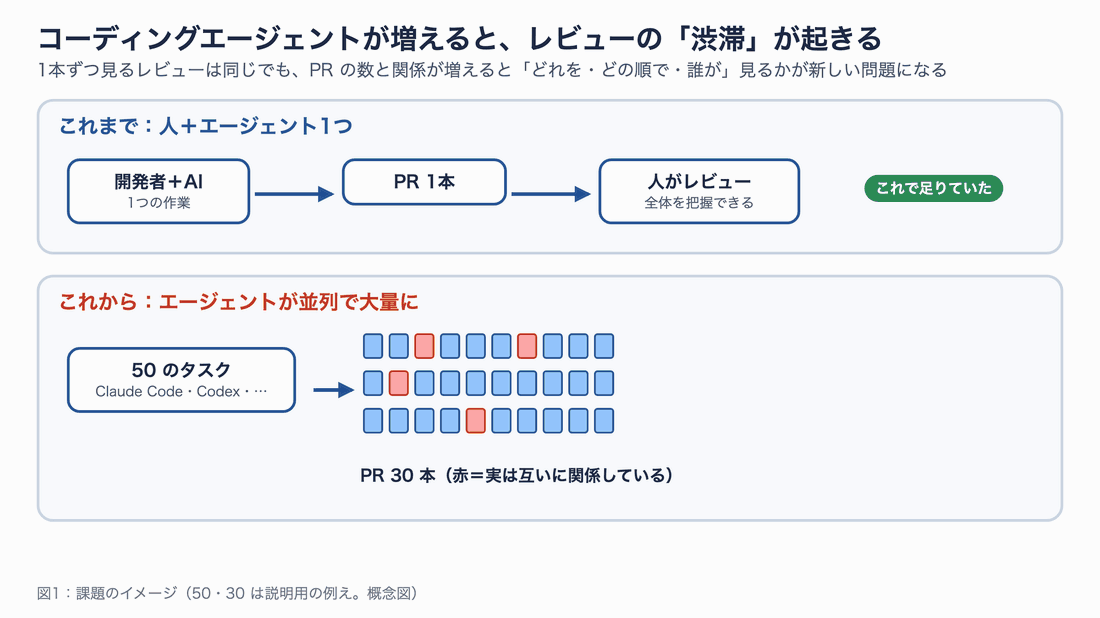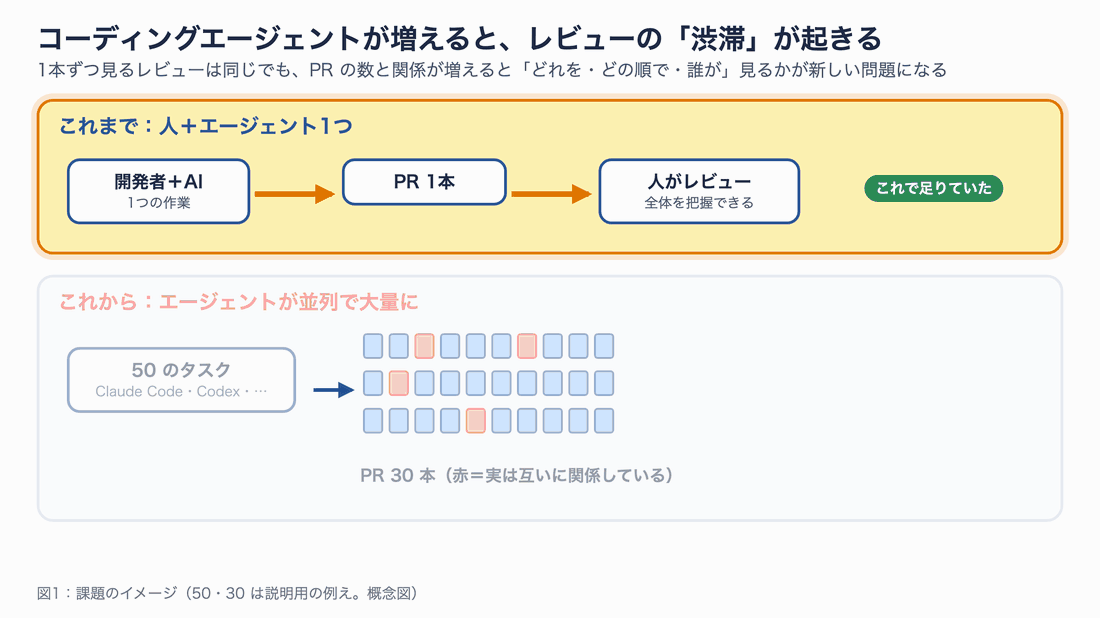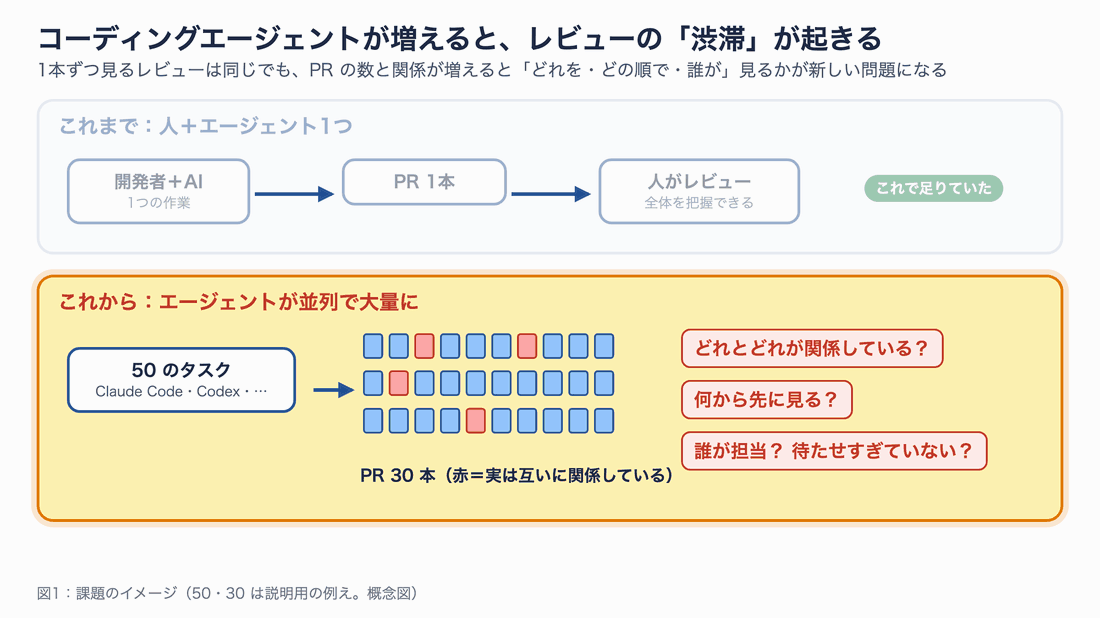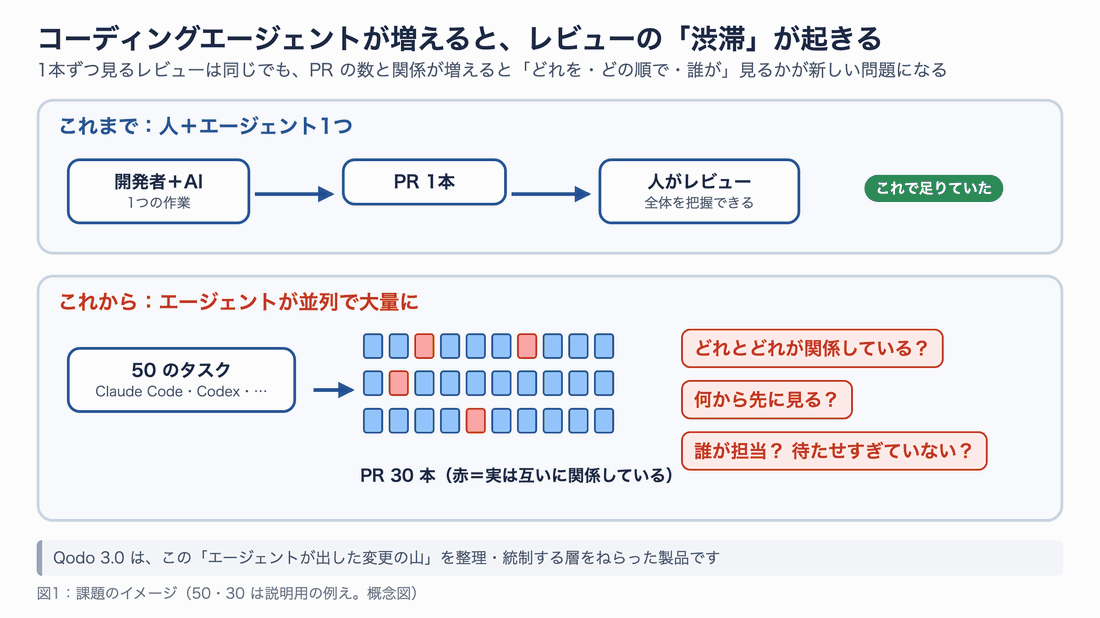
図1:エージェントが増えると、レビューの中身より「どれを・どの順で・誰が見るか」が詰まりやすくなる(数字は例え)
この記事の確認範囲
- 会社・製品の情報:Qodo の公式ブログ、プレスリリース、料金ページ、PR-Agent の GitHub・ドキュメントなどで 2026-10-04 に確認しました。出典は末尾にまとめています
- 実験:Mac(Apple M5 Max・128GB・macOS 26.6.2)で、PR-Agent 0.47.0、Claude Code 2.1.288(Opus 5.5)、Codex CLI 0.159.2 を使いました。各条件1回ずつの実行です
- Qodo の商用版(PR Triage など)は、アカウントを作る必要があるため触っていません。商用版について書く内容は公式発表にもとづきます
想定読者は、Claude Code や Codex をチームで使い始めていて、「レビューは AI に任せられそうだけど、エージェントが増えたらどうなるの?」と気になっている方です。
Qodo はどういう会社か
歩み:テスト生成ツールから「AI コードの統制」へ
Qodo の前身は CodiumAI です。2022年に Itamar Friedman 氏(CEO)と Dedy Kredo 氏(CPO)が創業し、最初は AI でテストコードを作るツールを出していました。2024年9月に社名を Qodo(Quality と Code を合わせた造語)に変え、同時にシリーズ A で 4,000万ドルを調達しています。
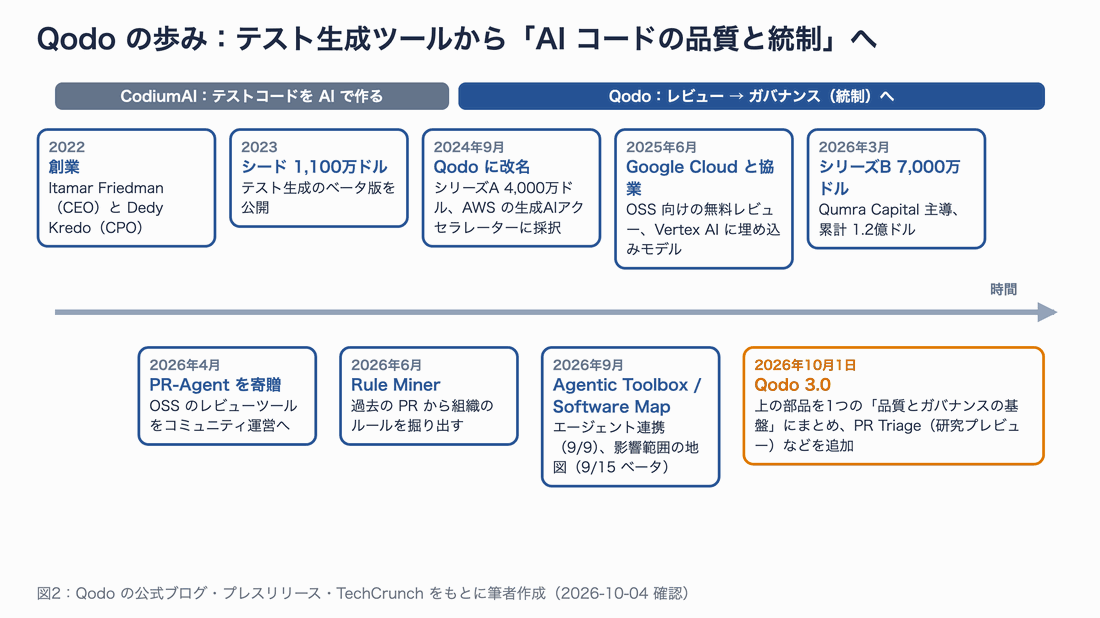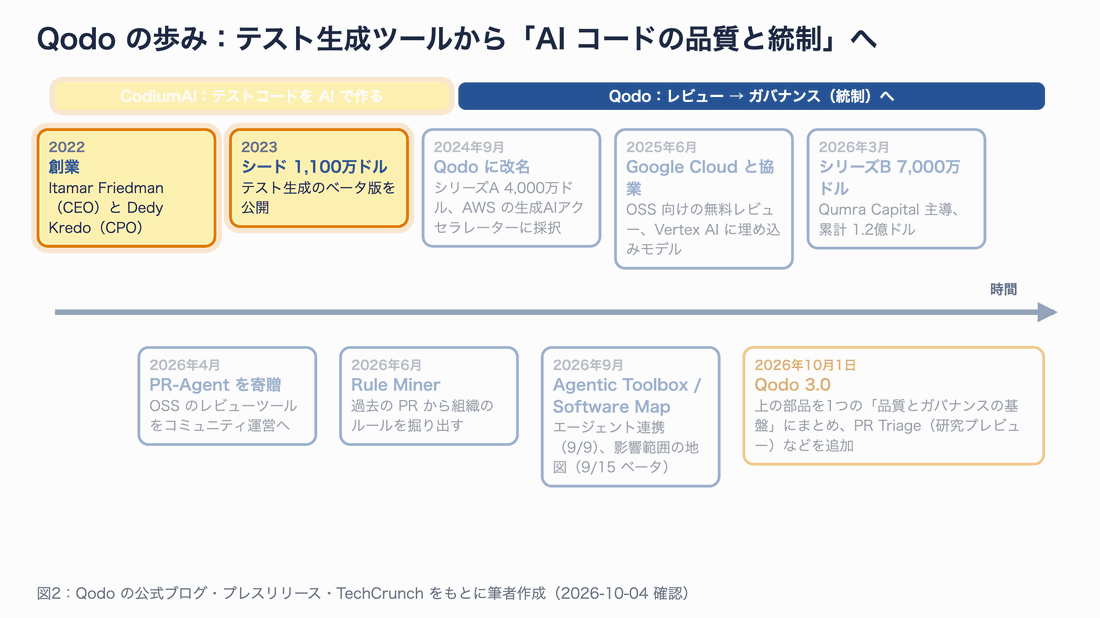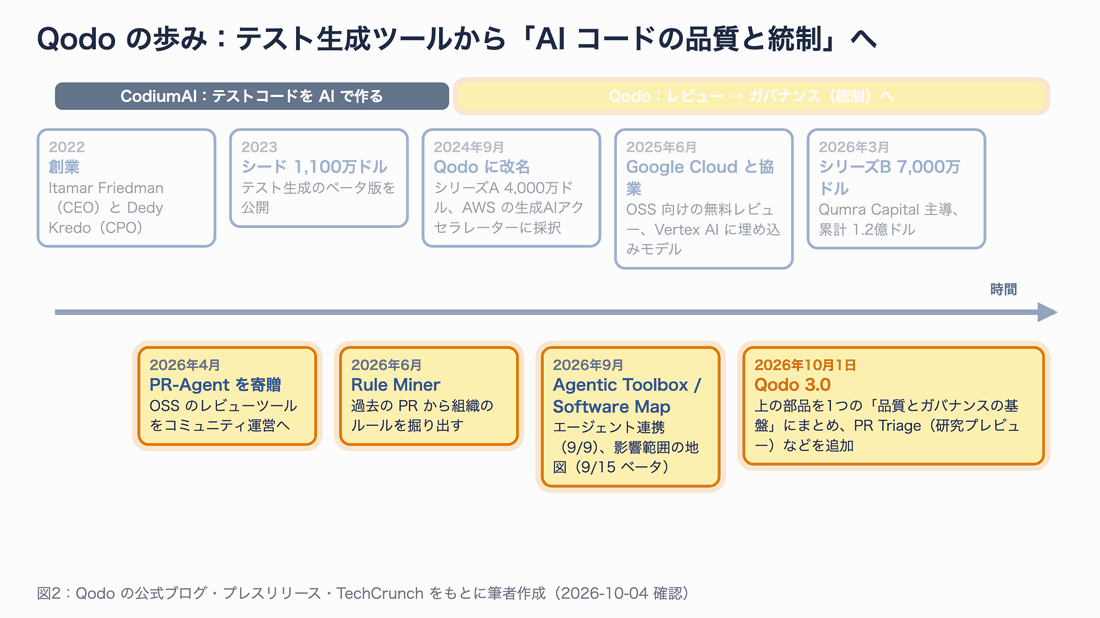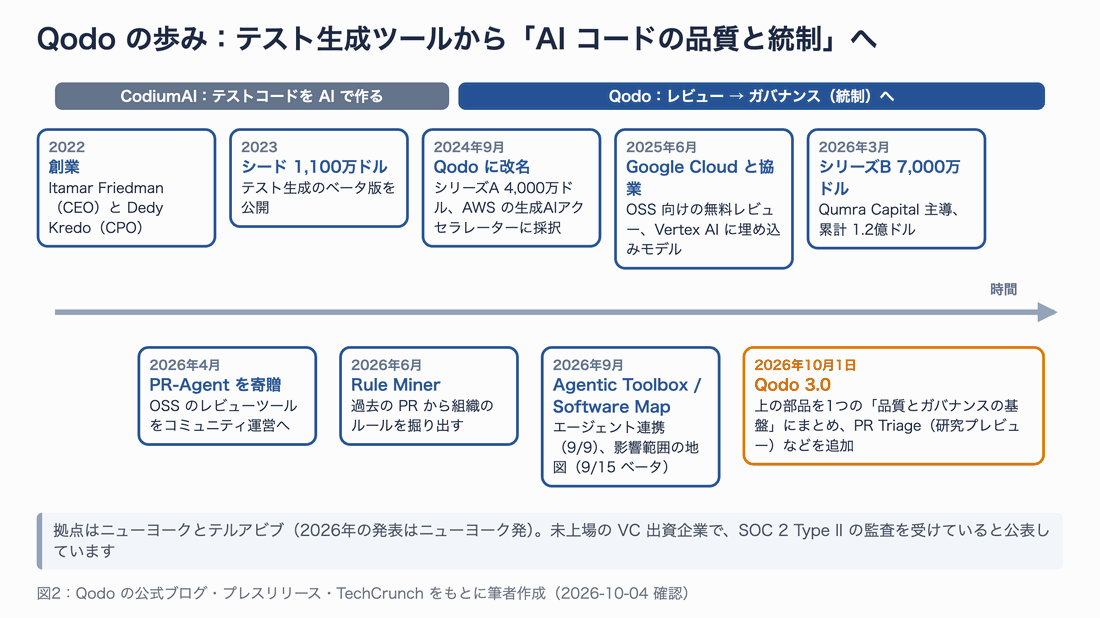
図2:3.0 は突然出た製品ではなく、9月までに出した部品を1つにまとめたもの
図2の後半を見ると分かるとおり、3.0 の部品の多くは発表前から出ていました。エージェントと連携する Agentic Toolbox は 2026年9月9日、影響範囲を地図にする Software Map は9月15日にベータとして先に発表されています。3.0 は「それらを1つの品質・ガバナンス基盤にまとめ、PR Triage などを足した版」と見るのが正確です。
ChatGPT は「テルアビブ拠点」と答えましたが、ここは少し古い情報でした。2024年の発表には「本社テルアビブ」とありますが、2026年のプレスリリースはすべてニューヨーク発です。採用ページの勤務地はボストン・ニューヨーク・テルアビブなので、「ニューヨークとテルアビブに拠点があり、開発の中心はテルアビブ」と書くのが安全です。
信用できるか
スタートアップとしては、信用できる材料がそろっている部類です。判断材料を表にまとめます。
| 観点 | 確認できたこと | 注意点 |
|---|---|---|
| 資金 | 2026年3月に Qumra Capital 主導で 7,000万ドルのシリーズB。累計 1.2億ドル | 未上場の VC 出資企業。業績は非公開 |
| 顧客 | Walmart、NVIDIA、Red Hat、Box、Intuit、Ford、Monday.com(シリーズB の発表) | 自社発表ベース。3.0 の発表には顧客名がない |
| セキュリティ | SOC 2 Type II(第三者の監査)を公表。コードを保存・学習に使わないと明記 | ISO 27001 などほかの認証は今回未確認 |
| 導入形態 | SaaS・シングルテナント・オンプレ・エアギャップ(ネット遮断環境)・自社ホストのモデル | オンプレや Gerrit 対応は Enterprise プラン |
| 製品の性能 | ベンチマーク首位を主張 | 数字は媒体ごとに違う(64.3% と F1 50.3%)。自社主導のベンチマーク |
注意したいのは競争環境です。CodeRabbit は 2026年8月に評価額 15億ドルで資金を調達し、GitHub Copilot や Claude Code のレビュー機能もエージェント型へ進化しています。会社として怪しいわけではありませんが、「数年後も今の立ち位置にいるか」は別の問題です。導入を検討するなら、契約条件と、やめるときにルールやデータを持ち出せるかも確認しておくと安心です。
OpenAI・Anthropic・大手テック企業とのつながり
ここは「つながり」の種類を分けて考えると分かりやすくなります。
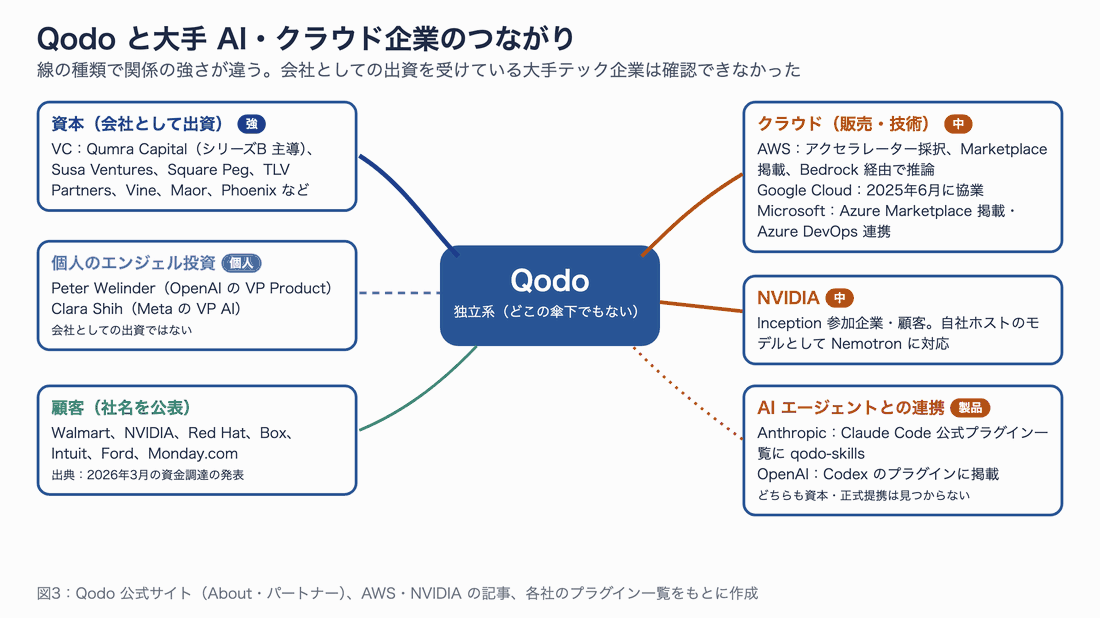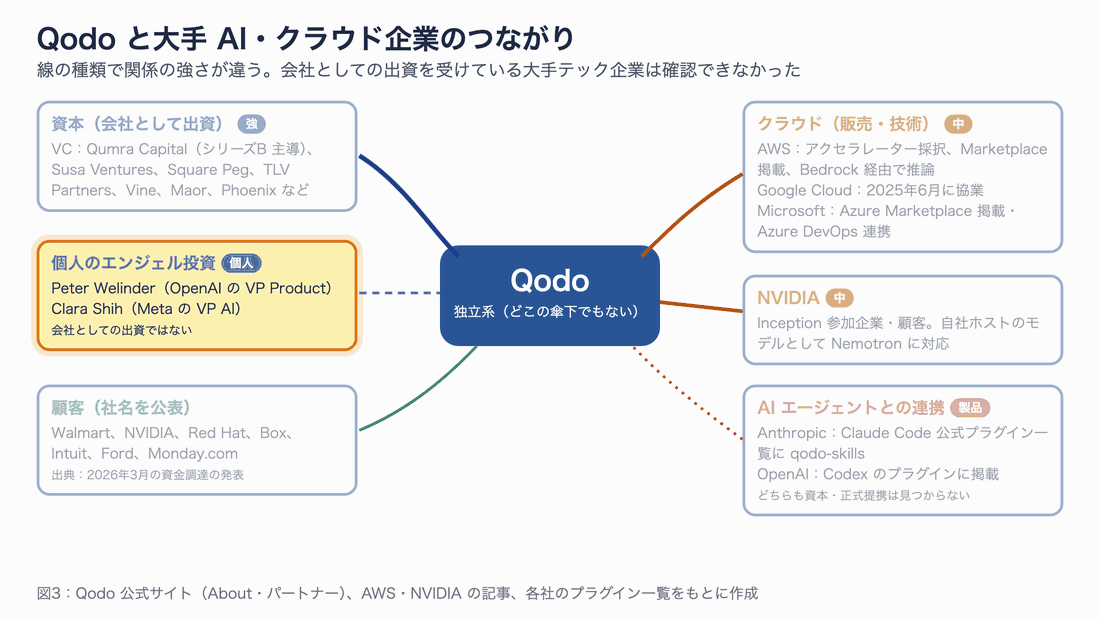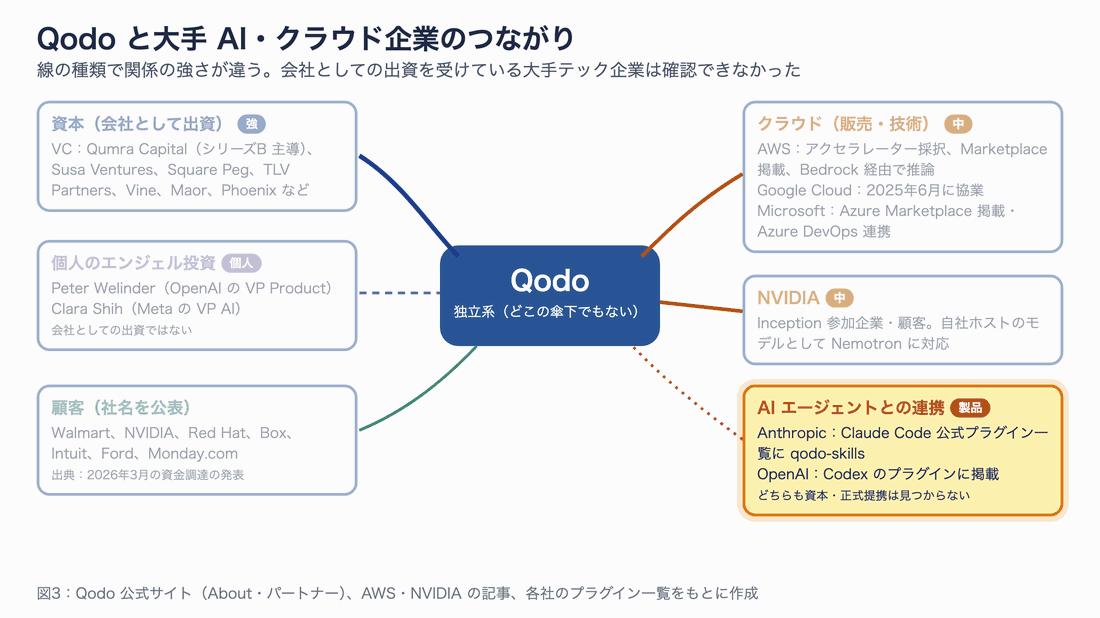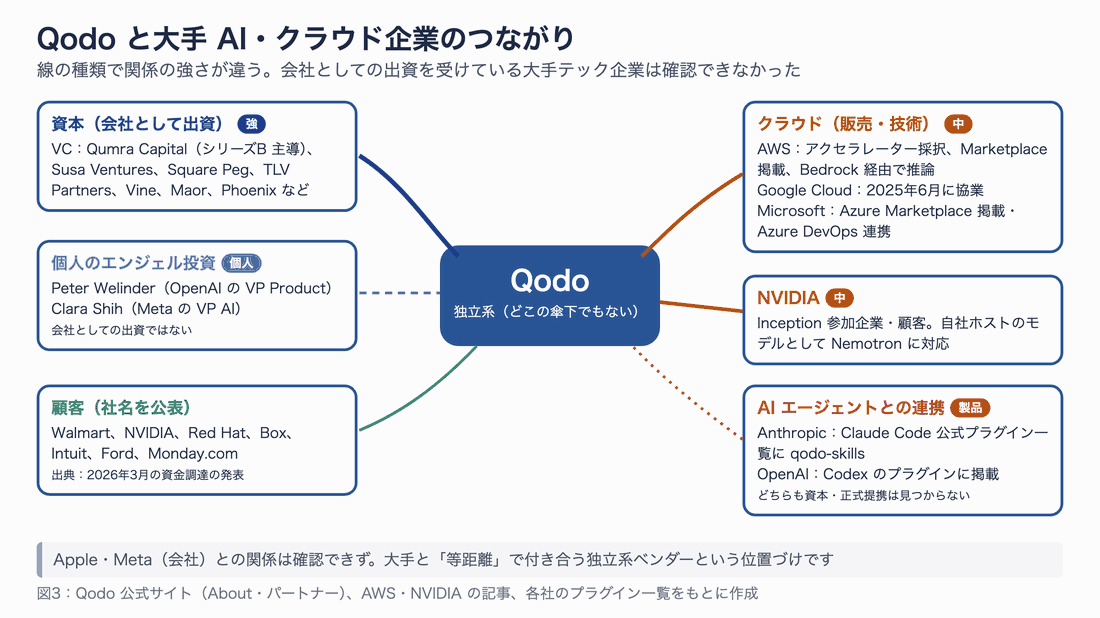
図3:大手テック企業から会社として出資を受けている事実は見つからなかった
図3のとおり、関係はおおむね次の4種類に分かれます。
- 個人のエンジェル投資:OpenAI の VP Product である Peter Welinder 氏と、Meta の VP AI である Clara Shih 氏が名を連ねています。ただし個人としての投資で、OpenAI や Meta という会社の出資ではありません
- クラウドでの販売・技術:いちばん関係が深いのは AWS です。生成 AI アクセラレーターに採択され、AWS Marketplace で販売し、推論を自社の Amazon Bedrock 経由にもできます。Google Cloud とは 2025年6月に協業を発表しました。Microsoft とは資本や共同発表はありませんが、Azure Marketplace に掲載され、Azure DevOps と連携します
- 技術パートナー:NVIDIA は顧客であり、スタートアップ支援の Inception にも参加しています。自社ホストのモデルとして NVIDIA Nemotron に対応しています
- エージェント製品との連携:ChatGPT は「Anthropic との接点は見当たらない」と答えましたが、実際には Qodo のスキル(qodo-skills)が Claude Code の公式プラグイン一覧に載っています。OpenAI の Codex のプラグインにも掲載されています。どちらも製品連携で、資本提携ではありません
Apple と、会社としての Meta との関係は確認できませんでした。まとめると、Qodo はどこかの傘下ではなく、各社と等距離で付き合う独立系ベンダーです。この立ち位置は、後で説明する「どのエージェントにもかぶせる品質の層」という製品の考え方とも一致しています。
Qodo 3.0 で何が変わったのか
3.0 の中身を、エージェントの作業の流れに沿って並べると図4のようになります。
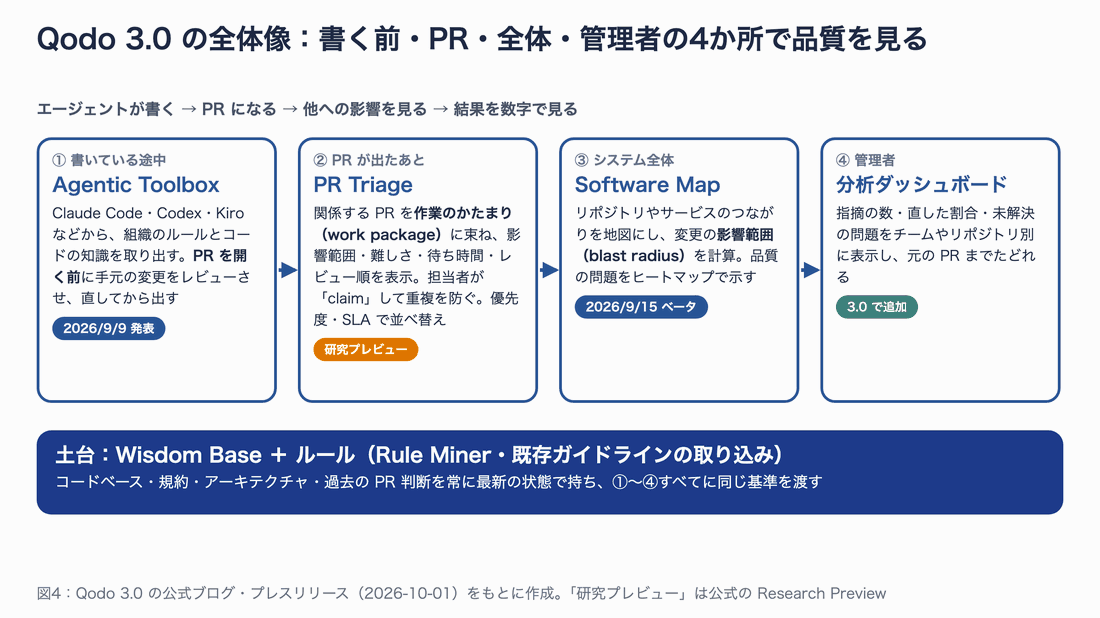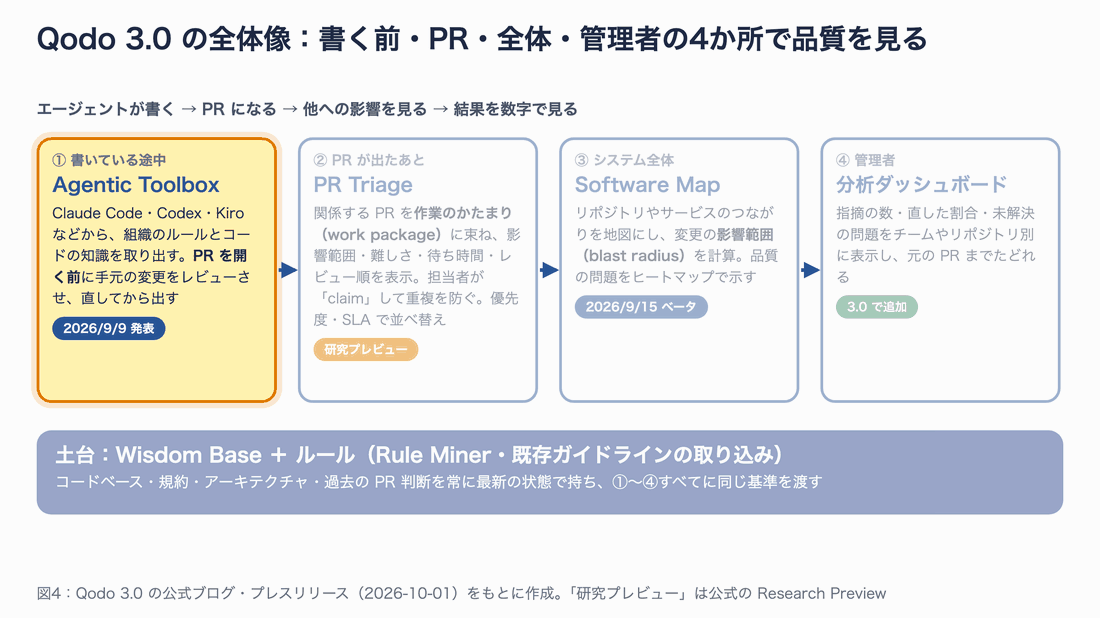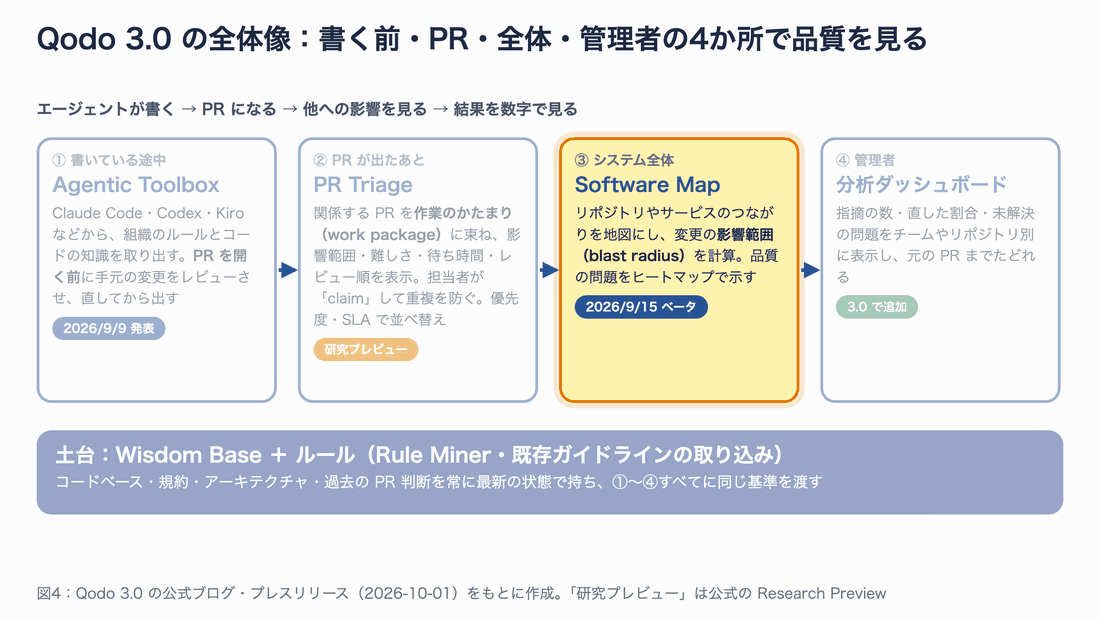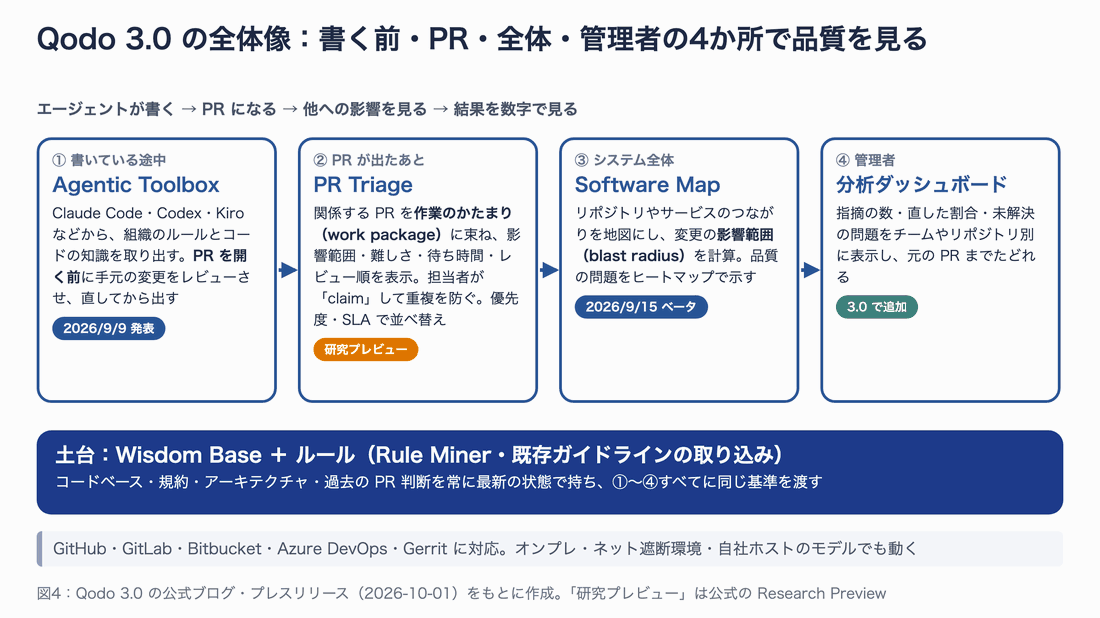
図4:4つの場所で、同じ組織の基準を使って品質を見る
いちばん下の土台が Wisdom Base です。コードベース、コーディング規約、アーキテクチャ、過去の PR でどう判断したかを、常に最新の状態で持ちます。ルールは Rule Miner(過去にマージされた PR から慣習を掘り出す機能、2026年6月に登場)で作れるほか、3.0 では既存のガイドラインを取り込んでルールにすることもできるようになりました。
その上に4つの機能が乗ります。
- Agentic Toolbox(書いている途中):Claude Code・Codex・Kiro などのエージェントが、作業中に Qodo のルールやコードの知識を取り出せます。PR を開く前に手元の変更をレビューさせ、直してから出せます
- PR Triage(PR が出たあと):関係する PR をリポジトリや Git ホストをまたいで「work package(作業のかたまり)」に束ねます
- Software Map(システム全体):リポジトリやサービスのつながりを地図にし、変更の影響範囲(blast radius)を計算します
- 分析ダッシュボード(管理者):指摘の数・直した割合・未解決の問題をチームやリポジトリ別に見られます
3.0 でいちばん新しく、この記事の実験とも関係が深いのが PR Triage です。公式ブログでは次のように説明されています。
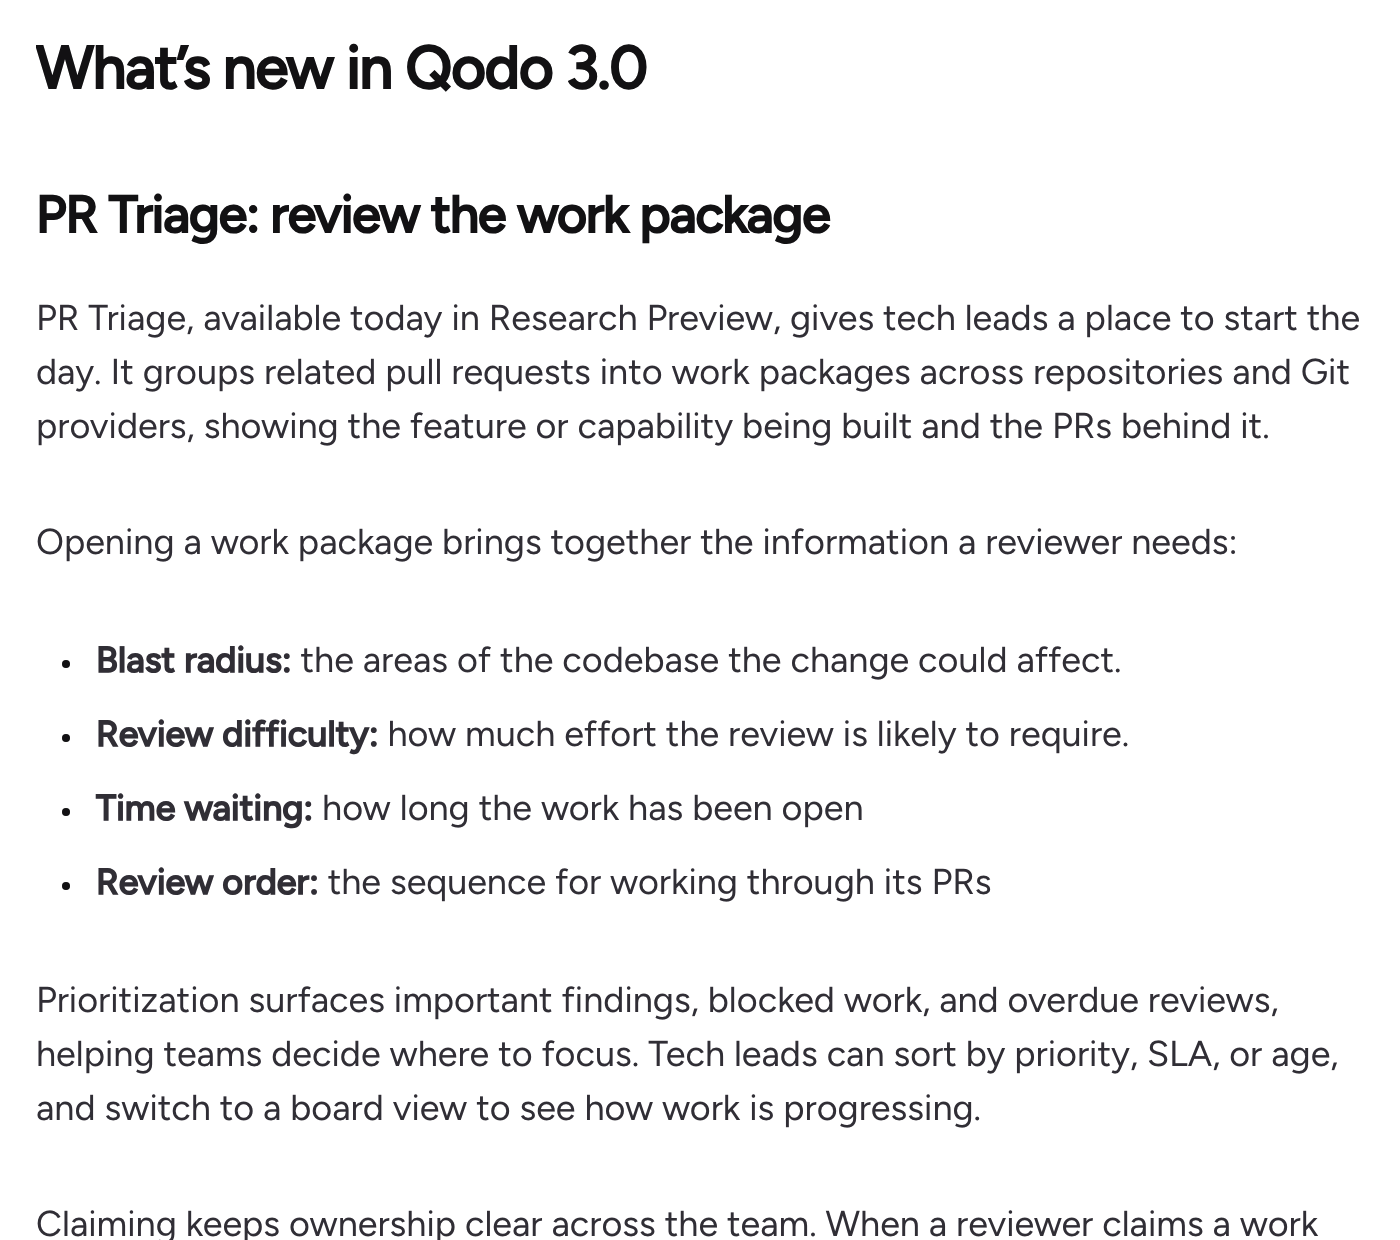
公式ブログ「Introducing Qodo 3.0」の PR Triage の節(2026-10-04 撮影)
work package を開くと、影響範囲・レビューの難しさ・待ち時間・レビュー順がまとめて表示されます。レビュー担当者が work package を「claim(担当を宣言)」すると、ほかの人にも誰が見ているかが分かり、二重レビューを防げます。さらに、PR どうしの関係や影響範囲をまとめた「brief(要約)」を作って、Claude Code や Codex に渡すこともできます。
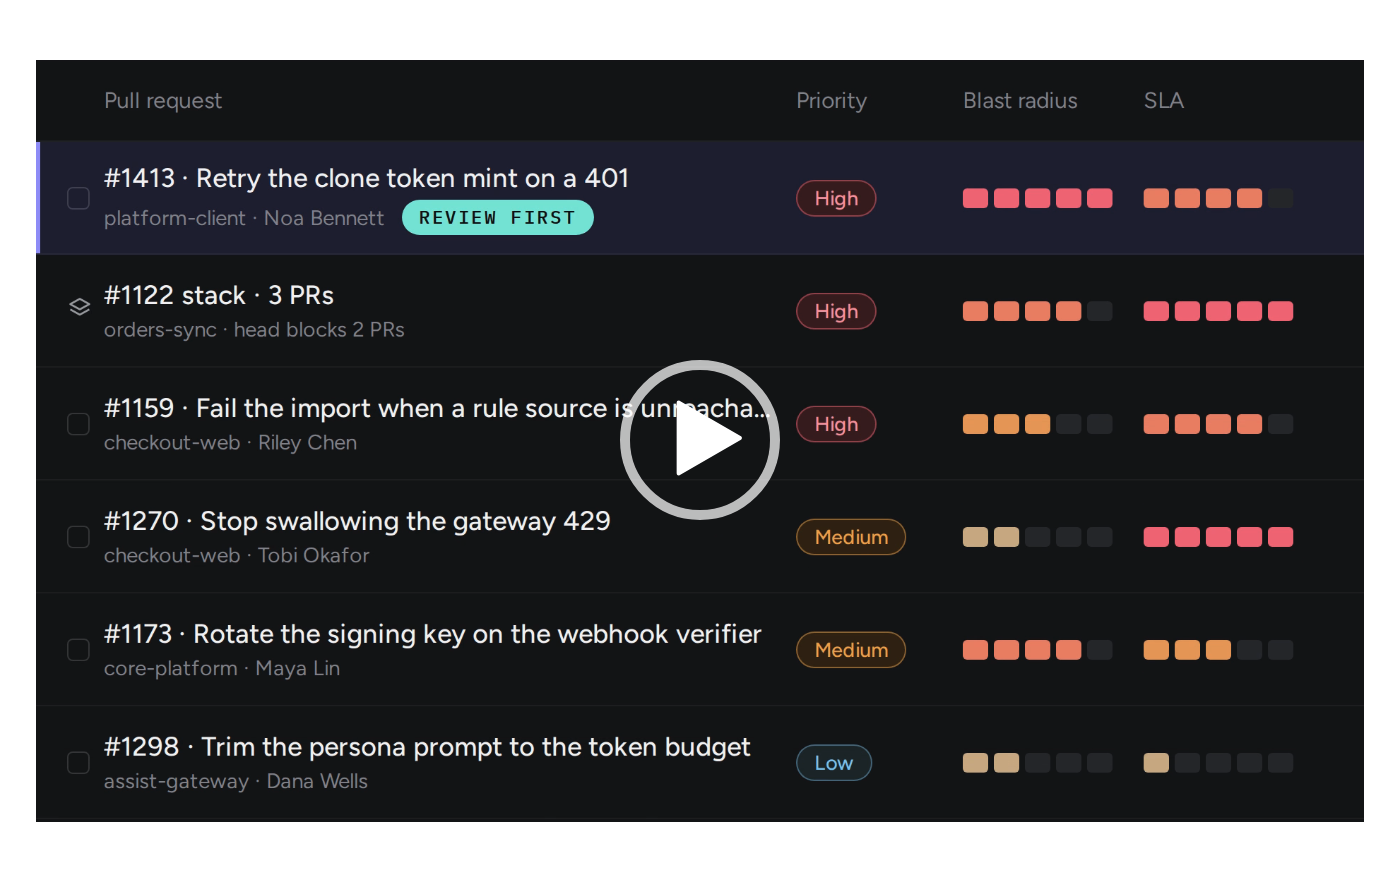
公式ブログに載っている PR Triage の画面(動画の1コマ)。PR ごとに優先度・影響範囲・SLA が並ぶ
注意点として、PR Triage は「Research Preview(研究プレビュー)」と明記されています。3.0 全体が正式版になったとは書かれていないので、評価するときはこの点を割り引いて考える必要があります。
管理者向けには、図のようなダッシュボードも用意されています。
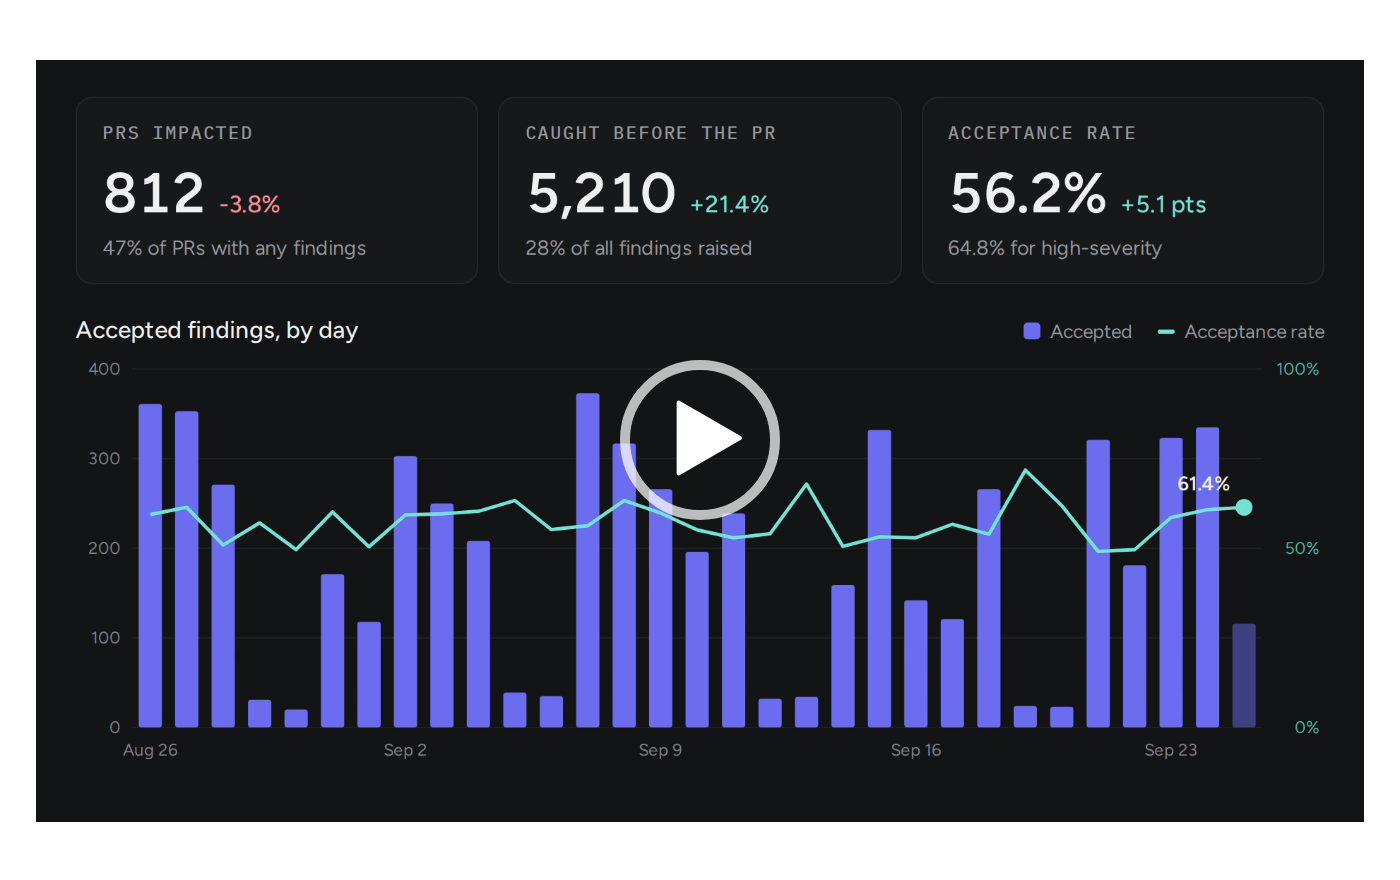
公式ブログに載っている分析ダッシュボード(動画の1コマ)
対応する Git ホストは GitHub・GitLab・Bitbucket・Azure DevOps・Gerrit の5つで、3.0 で Gerrit が加わりました。
オープンソースで試せる範囲
「OSS で試せますか?」という質問への答えは、「一部だけ」です。
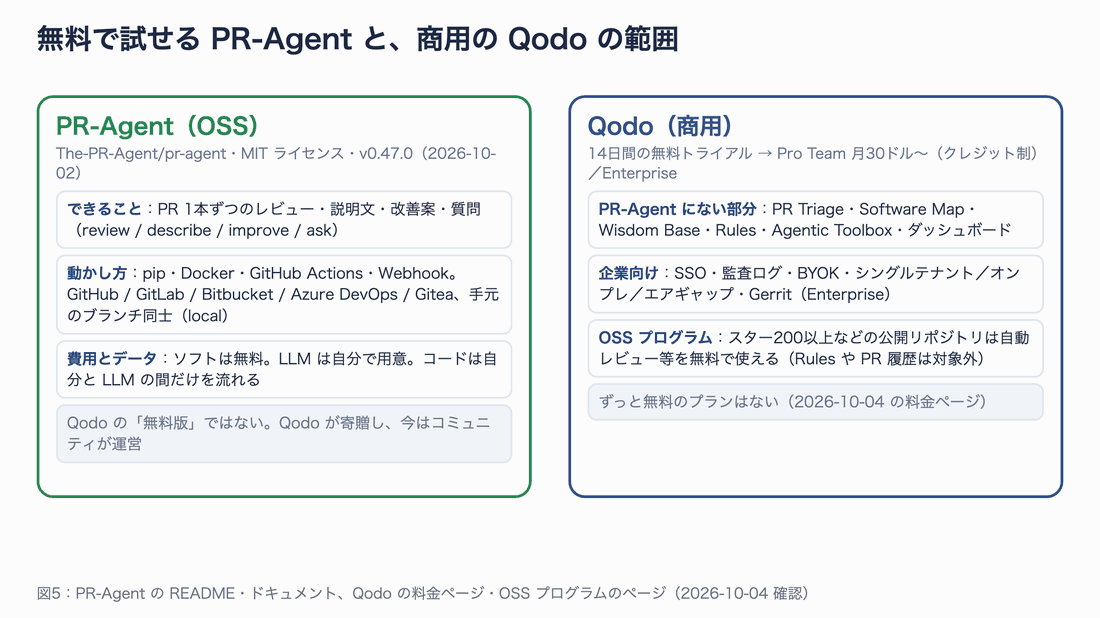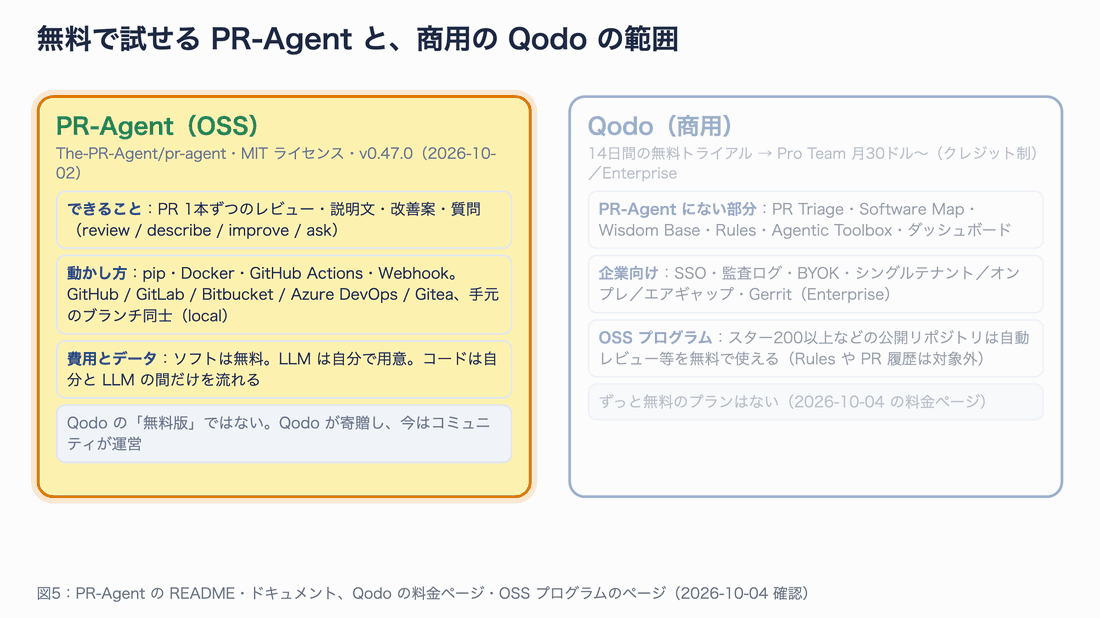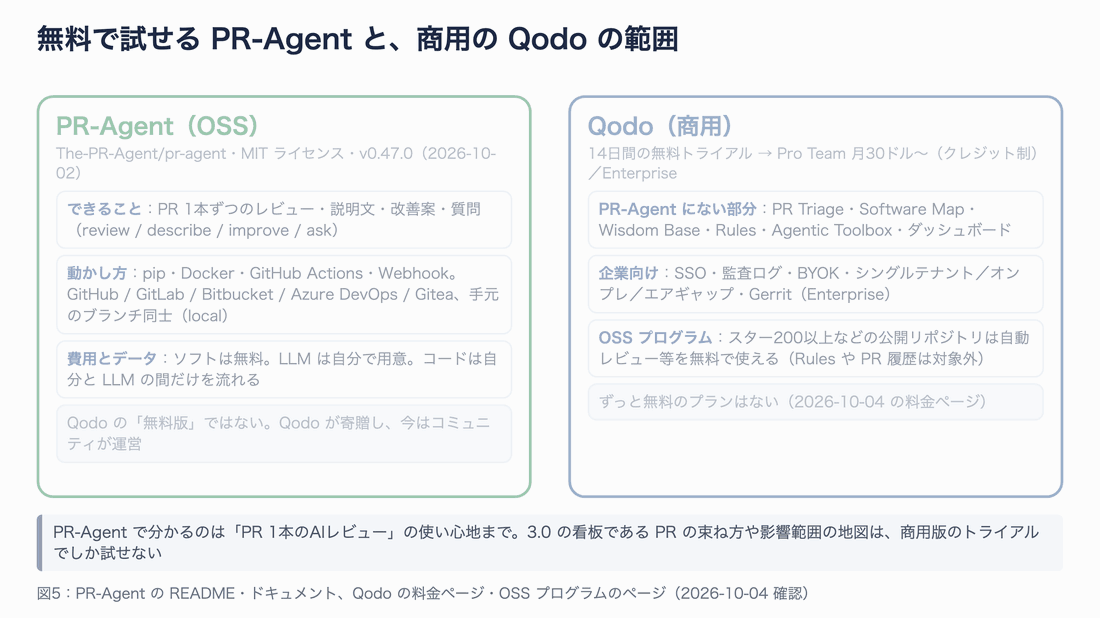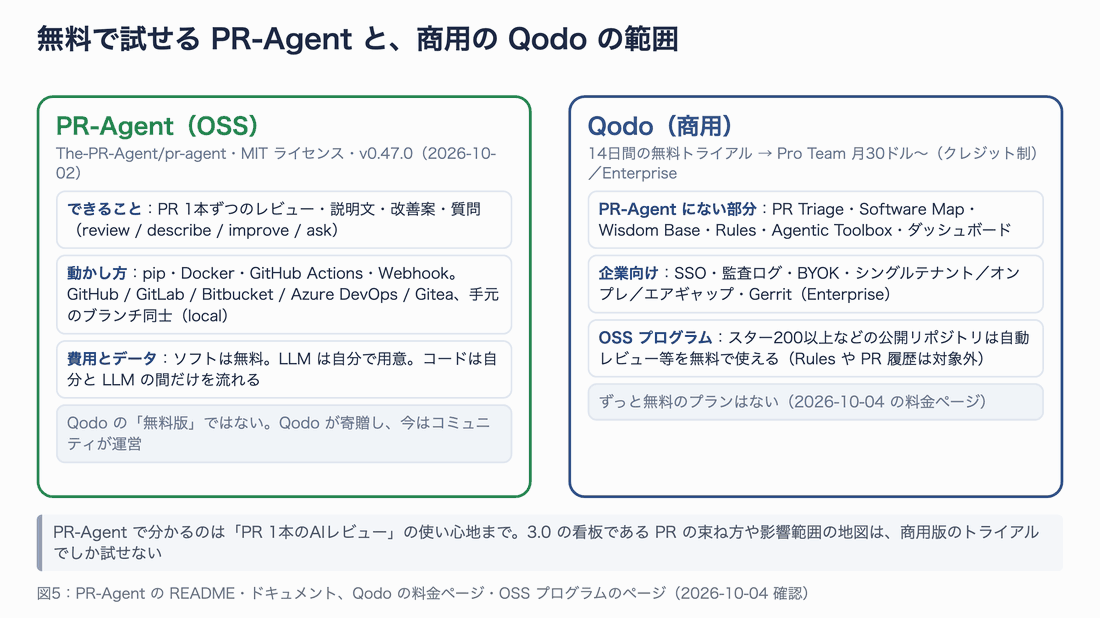
図5:PR-Agent で試せるのは「PR 1本の AI レビュー」まで
OSS として触れるのは PR-Agent です。Qodo のレビュー機能の源流にあたるツールで、2026年4月に Qodo がコミュニティへ寄贈しました。今は GitHub の The-PR-Agent という組織で、コミュニティが運営しています。
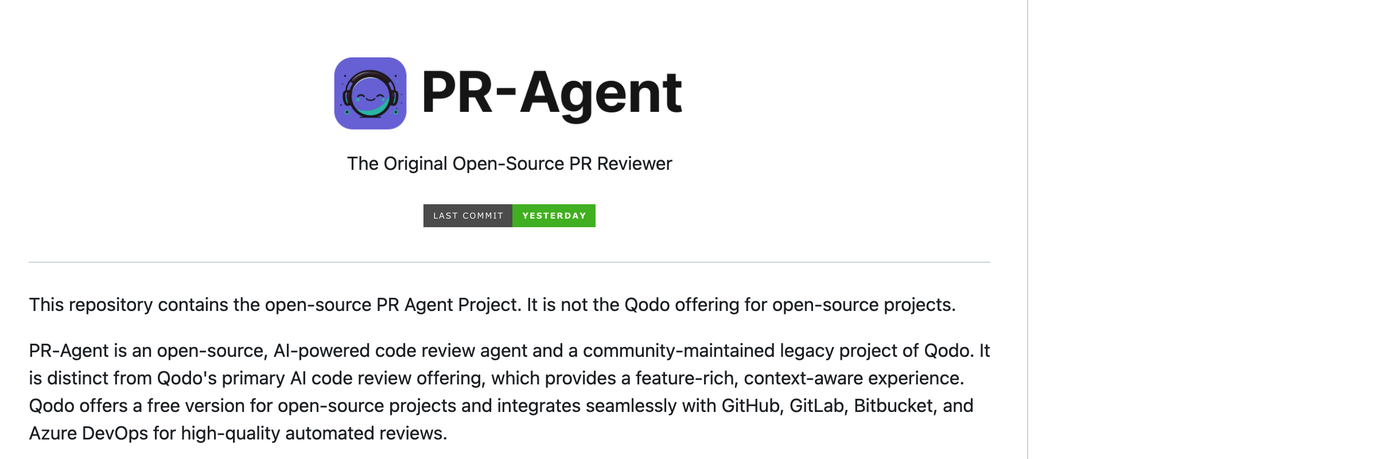
PR-Agent の README(2026-10-04 撮影)。「Qodo の OSS 向けの提供物ではない」とはっきり書かれている
ChatGPT の説明から更新しておくべき点が3つあります。
- ライセンスは今は MIT:AGPL-3.0 → Apache-2.0(2026年5月)→ MIT(2026年7月)と変わってきました
- 最新は v0.47.0(2026年10月2日)。スターは約1.3万です
- 商用版にずっと無料のプランはありません。14日間の無料トライアルのあと、Pro Team が月30ドルから(クレジット制)です。OSS 向けの無料プログラムはありますが、スター200以上などの公開 GitHub リポジトリが対象です
PR-Agent はソフト自体が無料で、LLM は自分で用意します。自分の LLM を使えば、コードは自分と LLM の提供元のあいだだけを流れ、Qodo のサーバーは通りません。今回はさらに、LLM も Mac の中で動かして、コードが外に一切出ない構成で試しました。
実験:3本の PR を3つのレビュー役に見せる
用意したもの
検証用に、小さな通販の金額計算コード「minishop」を作りました。ルールは AGENTS.md に4つだけ書いてあります。
1. 金額は必ず `Decimal` で計算する。`float` を金額計算に使わない。
2. 税込金額の端数は `ROUND_HALF_UP`(四捨五入)で円単位にする。
   端数処理は `shop/pricing.py` の `round_yen()` だけで行い、他のファイルで独自に丸めない。
3. 公開関数の引数や戻り値を変えるときは、同じ PR で呼び出し元をすべて直す。
4. クーポンコードは外部入力なので、大文字にそろえてから `shop/coupons.py` で検証する。
そのうえで、「別々のエージェントが同時に作った PR」を想定して、main からブランチを3本切りました。どれも単独ではテストが通るようにしてあります。
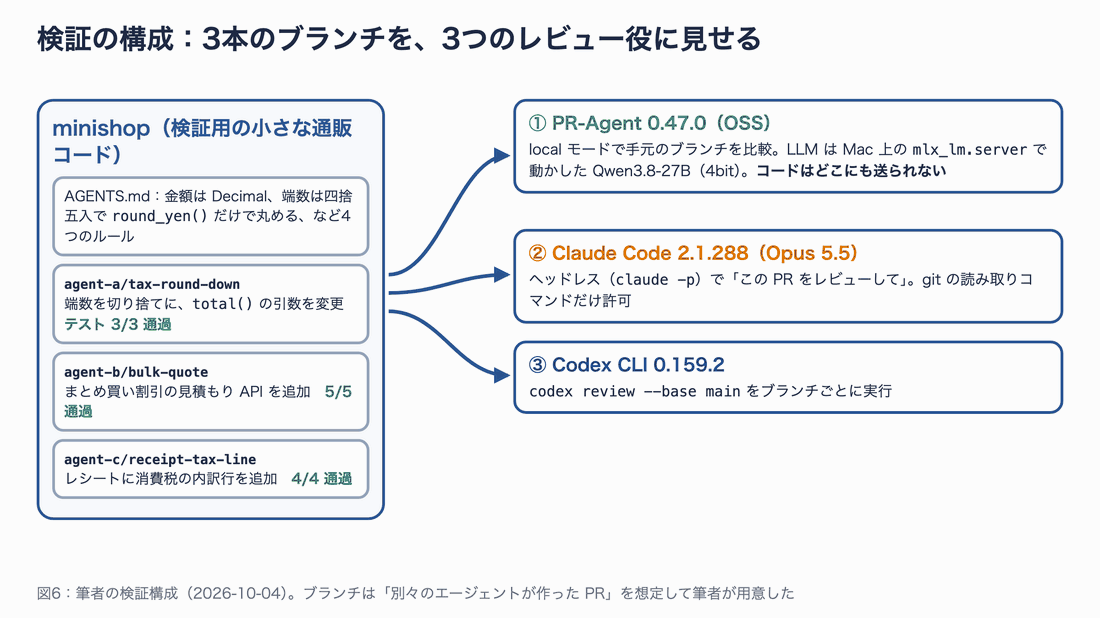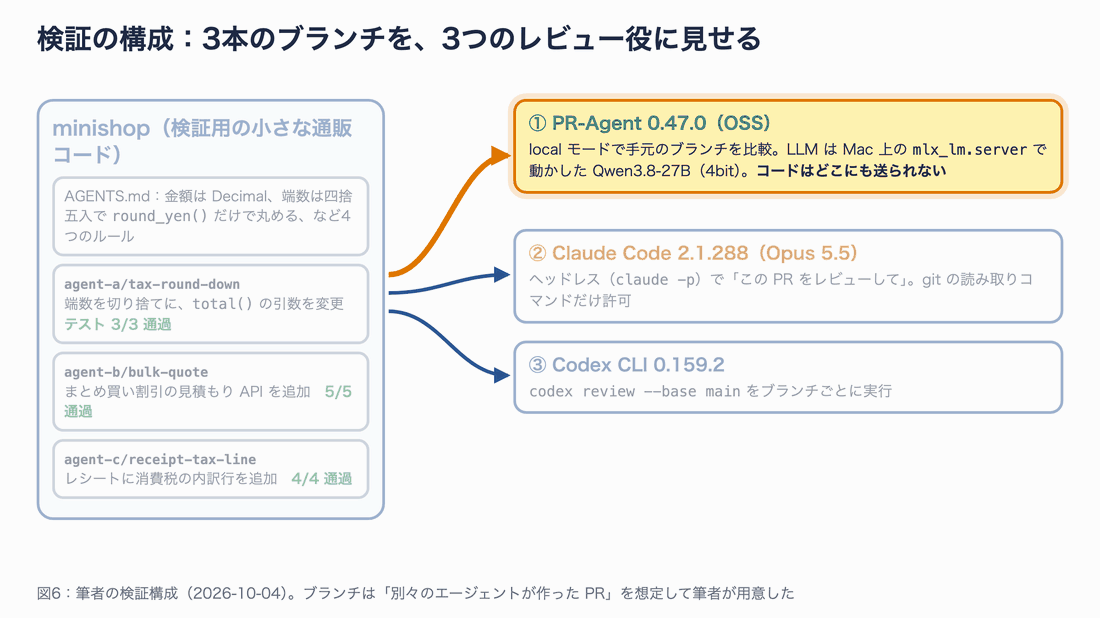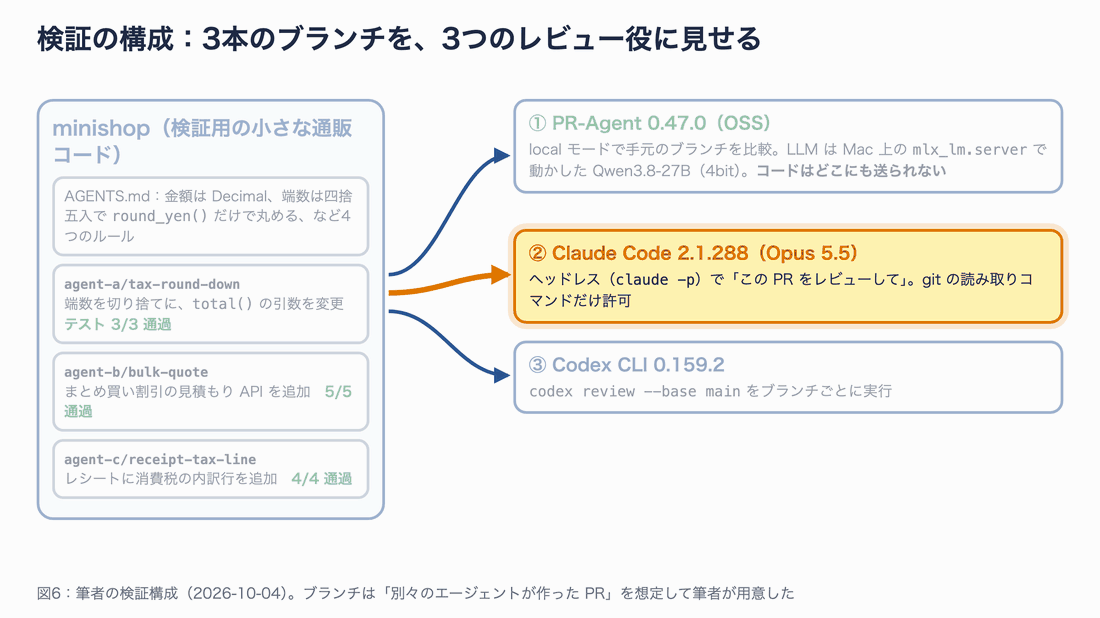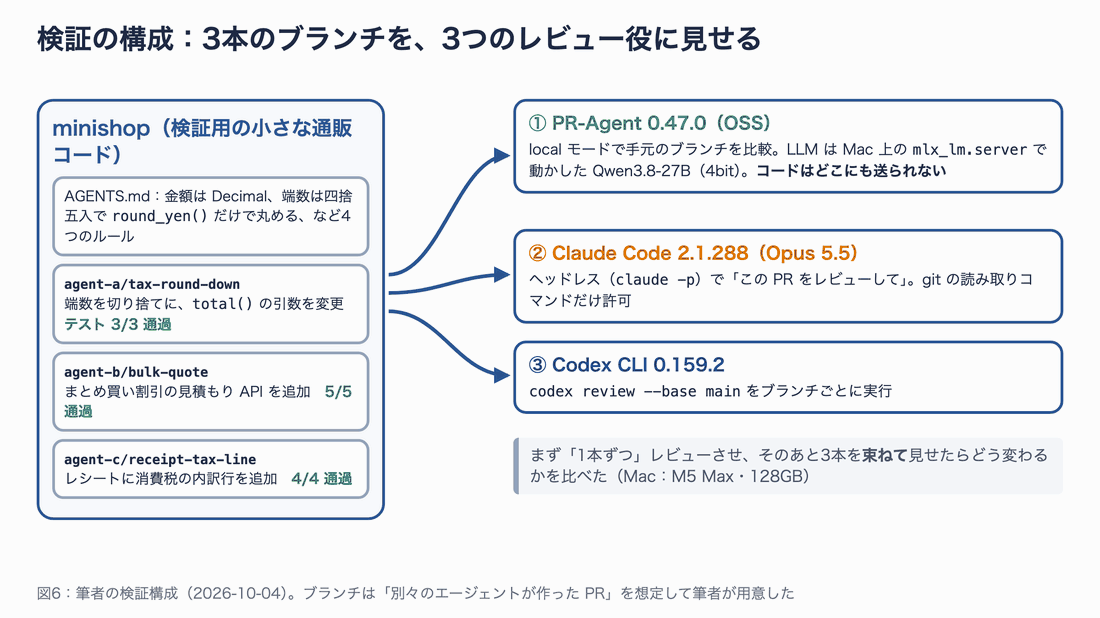
図6:検証の構成。まず1本ずつ、次に3本を束ねてレビューさせた
3本の中身は次のとおりです。
| ブランチ | 想定した依頼 | 仕込んだ問題 |
|---|---|---|
A:agent-a/tax-round-down | 経理の依頼で端数を切り捨てに。ついでに total() の引数をキーワード専用の coupon_code に変更 | ルール2違反(四捨五入のはず)。引数の変更は自分が知る呼び出し元だけ直した |
B:agent-b/bulk-quote | まとめ買い割引つきの見積もり API を新規追加 | float で5%引きして int() で切り捨て(ルール1・2違反)。main の古い total() を前提に書いた |
C:agent-c/receipt-tax-line | レシートに「うち消費税」の行を追加 | 消費税を自前で四捨五入(ルール2違反) |
A の差分の中心はこの部分です。
 def round_yen(amount: Decimal) -> int:
-    """円未満を四捨五入して整数の円にする。"""
-    return int(amount.quantize(Decimal("1"), rounding=ROUND_HALF_UP))
+    """円未満を切り捨てて整数の円にする(2026-10 経理の依頼で四捨五入から変更)。"""
+    return int(amount.quantize(Decimal("1"), rounding=ROUND_DOWN))

-def total(items: list[dict], coupon: str | None = None) -> int:
+def total(items: list[dict], *, coupon_code: str | None = None) -> int:
B が新しく足したファイルは次のとおりです。B を作った時点の main では、total(items, coupon) は正しい呼び方でした。
"""見積もり API:まとめ買い割引つきの金額を返す。"""
from shop.pricing import total

BULK_THRESHOLD = 10  # 合計点数がこの数以上ならまとめ買い割引


def quote(items: list[dict], coupon: str | None = None) -> dict:
    amount = total(items, coupon)
    if sum(i["qty"] for i in items) >= BULK_THRESHOLD:
        amount = int(amount * 0.95)  # まとめ買いで 5% 引き
    return {"estimate": amount, "currency": "JPY"}
PR-Agent を「GitHub なし・クラウド LLM なし」で動かす
PR-Agent には、GitHub などに PR を作らずに手元のブランチ同士を比べる local モードがあります。結果は PR へのコメントではなく review.md というファイルに書き出されます。これと、Mac 上で動かした OpenAI 互換の LLM サーバーを組み合わせました。
まず、LLM サーバーを起動します。今回は Apple Silicon 向けの mlx-lm(0.32.0)で、Qwen3.8-27B の4bit 版を使いました。
# LLM サーバー用の仮想環境(uv を使用)
uv venv -p 3.12 .mlx
uv pip install -p .mlx mlx-lm

# OpenAI 互換の API を 127.0.0.1:8090 で起動する(初回はモデルのダウンロードあり)
.mlx/bin/mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8090 \
  --max-tokens 4096 --chat-template-args '{"enable_thinking":false}'
次に PR-Agent を入れ、設定を環境変数で渡します。PR-Agent の設定は <表の名前>__<キー> という形の環境変数(アンダースコア2つ)で上書きできます。
# PR-Agent 用の仮想環境
uv venv -p 3.12 .pragent
uv pip install -p .pragent pr-agent   # 今回は 0.47.0

# pragent.env:source して使う
export CONFIG__GIT_PROVIDER=local                             # 手元のブランチ同士を比べる
export CONFIG__MODEL="openai/mlx-community/Qwen3.8-27B-4bit"  # 先頭の openai/ で OpenAI 互換として呼ぶ
export CONFIG__FALLBACK_MODELS='[]'
export CONFIG__CUSTOM_MODEL_MAX_TOKENS=32000                  # 一覧にないモデルは必須
export CONFIG__RESPONSE_LANGUAGE=ja-JP
export OPENAI__API_BASE=http://127.0.0.1:8090/v1              # 手元の mlx_lm.server
export OPENAI__KEY=local-dummy                                # ローカルなので何でもよい
レビューしたいブランチに切り替えて、比べる先のブランチ名を --pr_url に渡します。名前は URL ですが、local モードではブランチ名を書きます。
source pragent.env
cd minishop
git switch agent-b/bulk-quote
pr-agent --pr_url main review   # 結果は minishop/review.md に書き出される
実際に動かした様子が次の録画です。
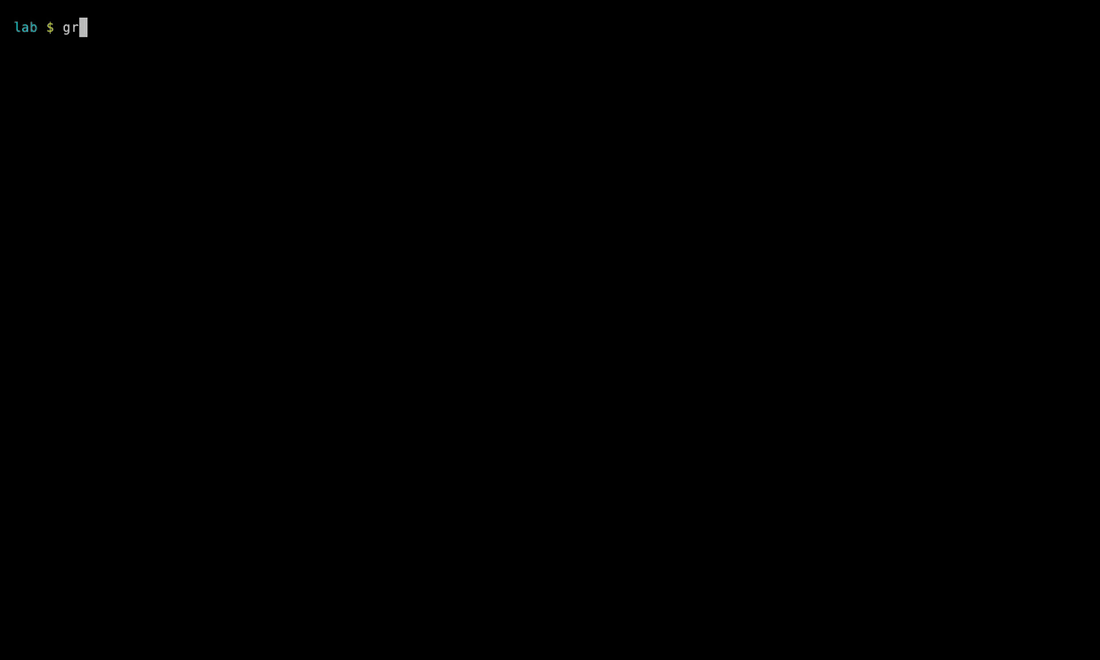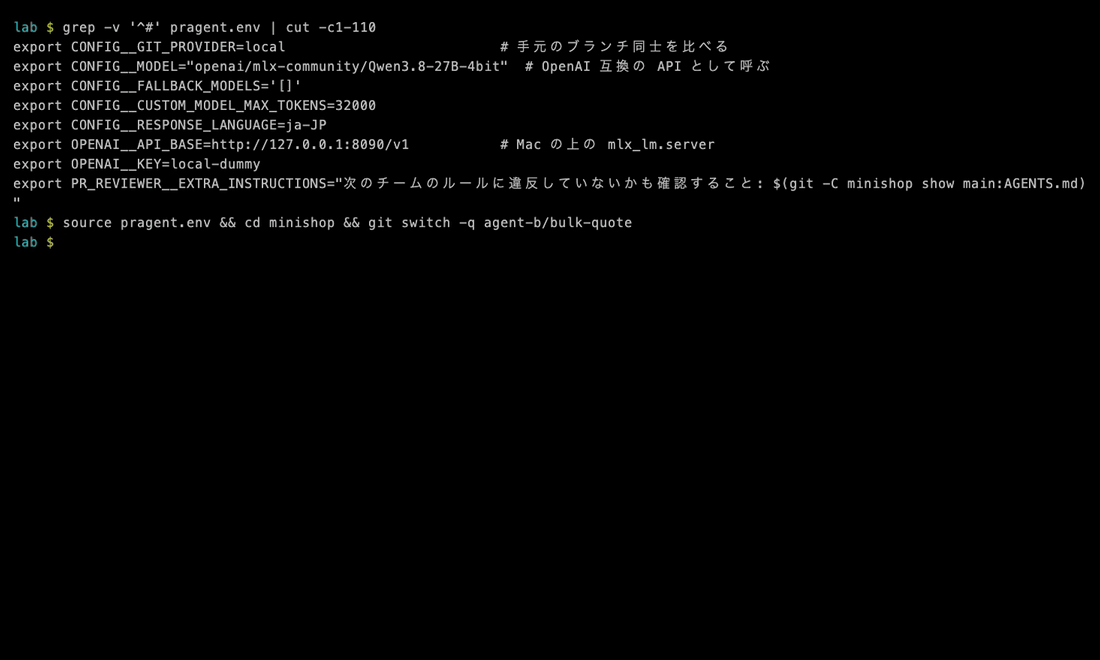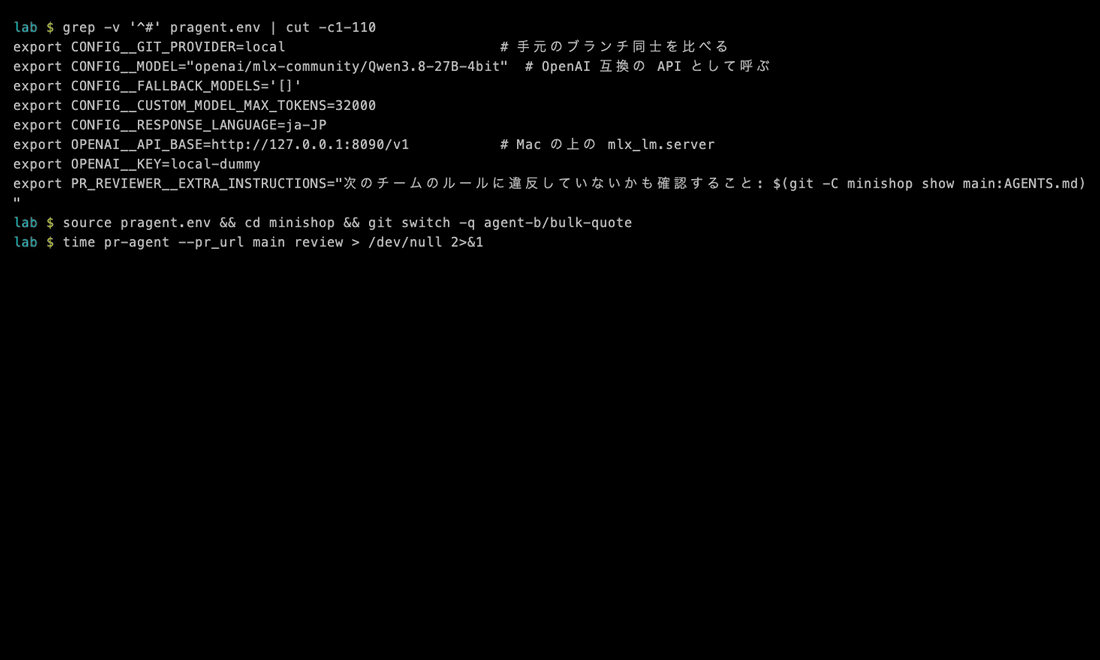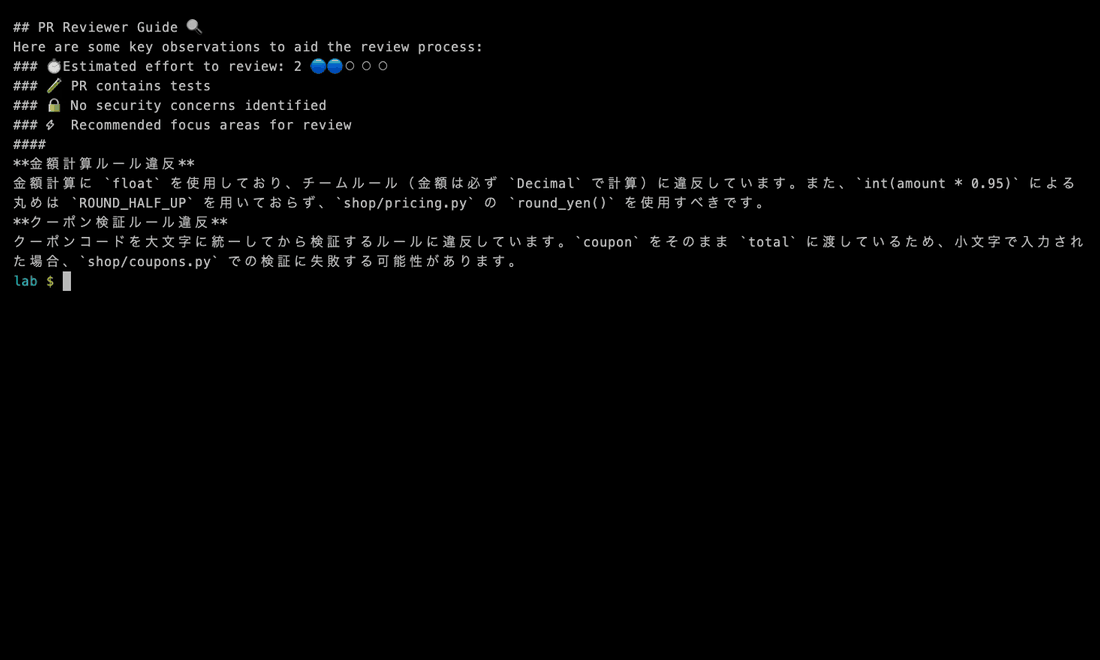
録画1:PR-Agent をローカル LLM で動かした様子(実時間)。最後の「クーポンを大文字にしていない」は誤指摘
ここで1つ大きなつまずきがありました。PR-Agent は本来、リポジトリの AGENTS.md を自動で読んでレビューの前提にします(設定 repo_context_files の初期値が ["AGENTS.md"])。ところが local モードはこの読み込みに対応しておらず、ログに「LocalGitProvider はリポジトリのファイル取得に未対応なので、リポジトリの前提情報を飛ばす」と出ていました。そこで、ルールを追加の指示として渡す設定も足して、2通りで比べました。
# local モードでは AGENTS.md が読まれないので、ルールを追加の指示として渡す
export PR_REVIEWER__EXTRA_INSTRUCTIONS="次のチームのルールに違反していないかも確認すること: $(git -C minishop show main:AGENTS.md)"
Claude Code と Codex には、いつもどおり頼む
Claude Code は、ヘッドレス(画面なし)モードで「この PR をレビューして」と頼みました。ファイルを書き換えないよう、git の読み取りコマンドとファイルの読み込みだけを許可しています。
claude -p "このリポジトリで、ブランチ agent-b/bulk-quote を main にマージする PR としてコードレビューしてください。git diff main...agent-b/bulk-quote で差分を確認し、必要ならファイルを読んでください。ファイルは変更しないでください。指摘は重要度の高い順に最大5件、日本語で。" \
  --allowedTools "Bash(git diff:*)" "Bash(git show:*)" "Bash(git log:*)" "Read" "Grep" "Glob" \
  --output-format json
Codex CLI には、レビュー専用の review サブコマンドがあります。ブランチを切り替えて、比べる先を指定するだけです。
git switch agent-b/bulk-quote
codex review --base main < /dev/null   # スクリプトから呼ぶときは標準入力を閉じる
結果1:3本とも単独では正しいのに、マージすると壊れる
レビューの前に、仕込んだ問題が本当に起きるかを確かめました。
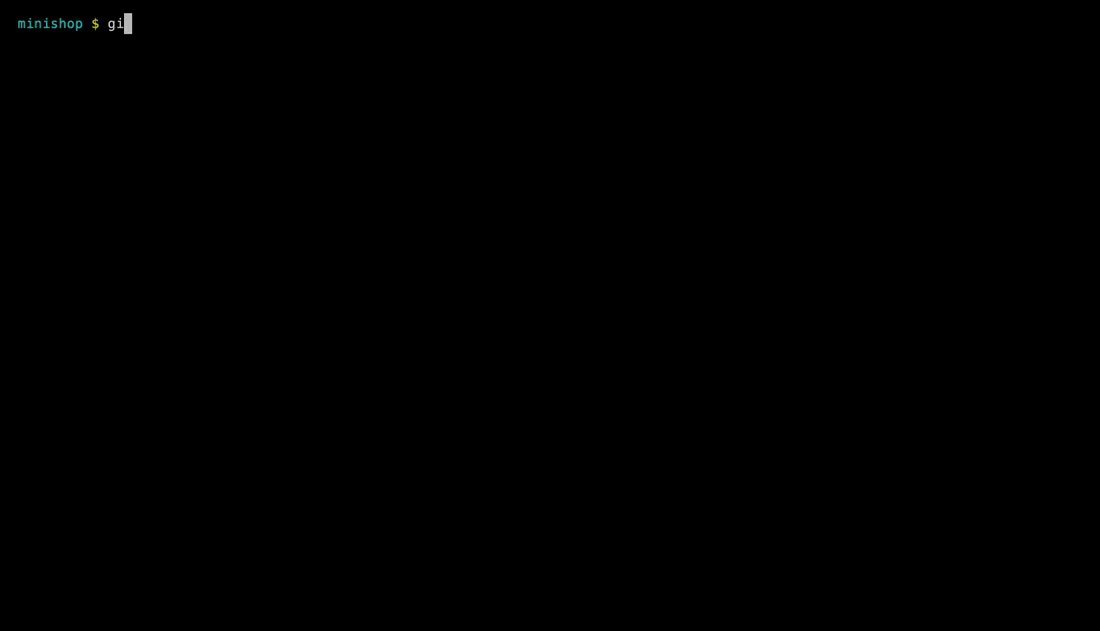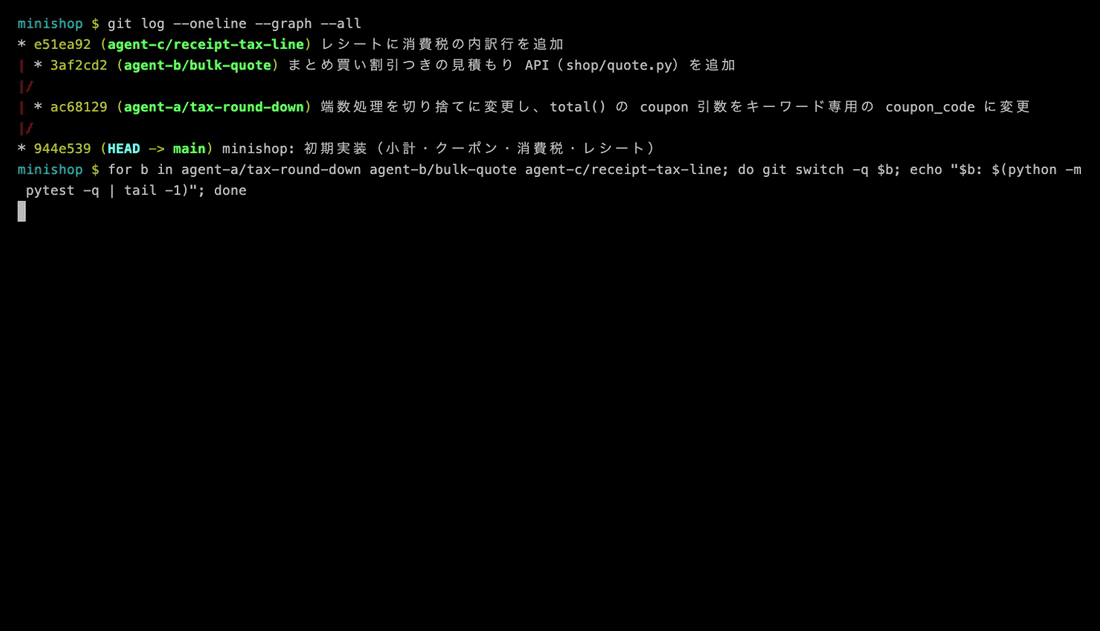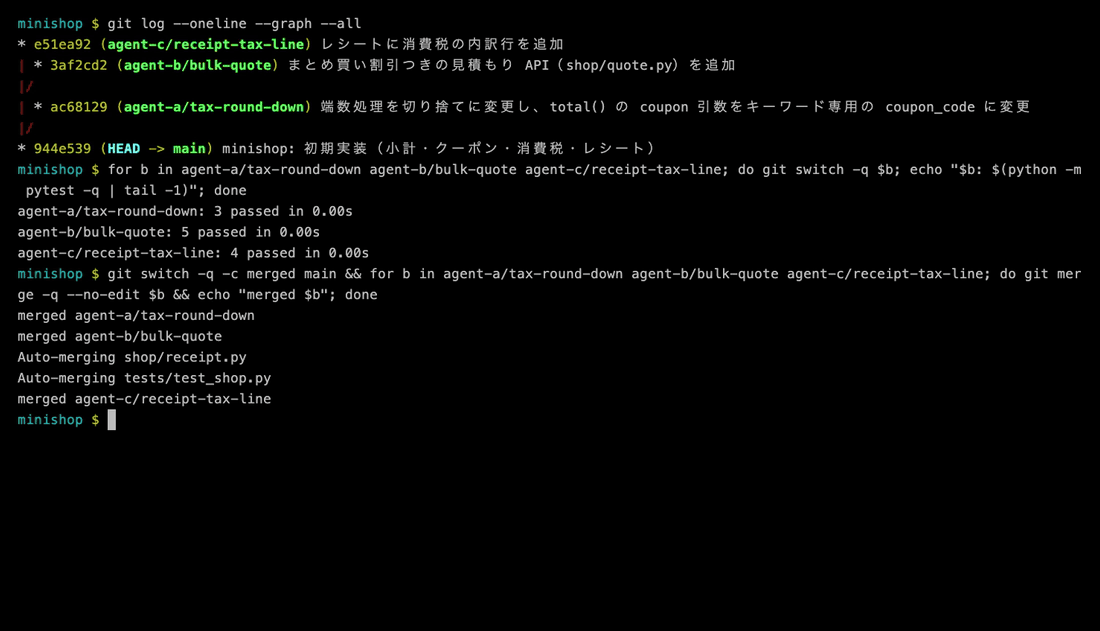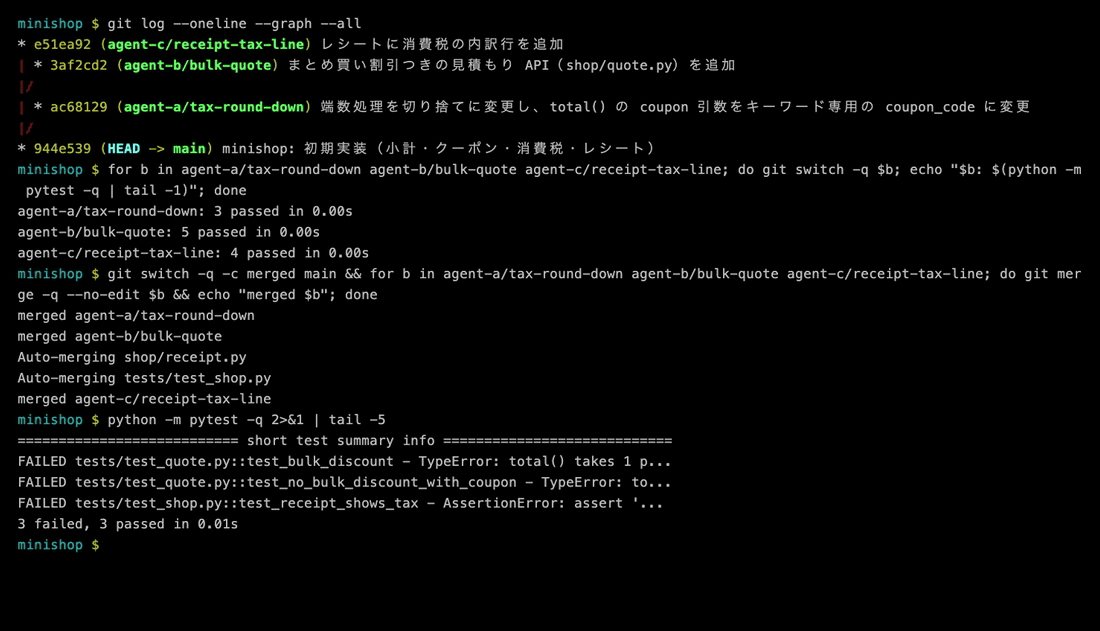
録画2:各ブランチではテストが全部通る。3本をマージしても Git のコンフリクトは0件。それでもテストは3件失敗する
Git はテキストとしてぶつからなければ、黙ってマージしてくれます。今回は3本とも触った行が違ったので、コンフリクトは1件も出ませんでした。それでもテストは3件落ちます。
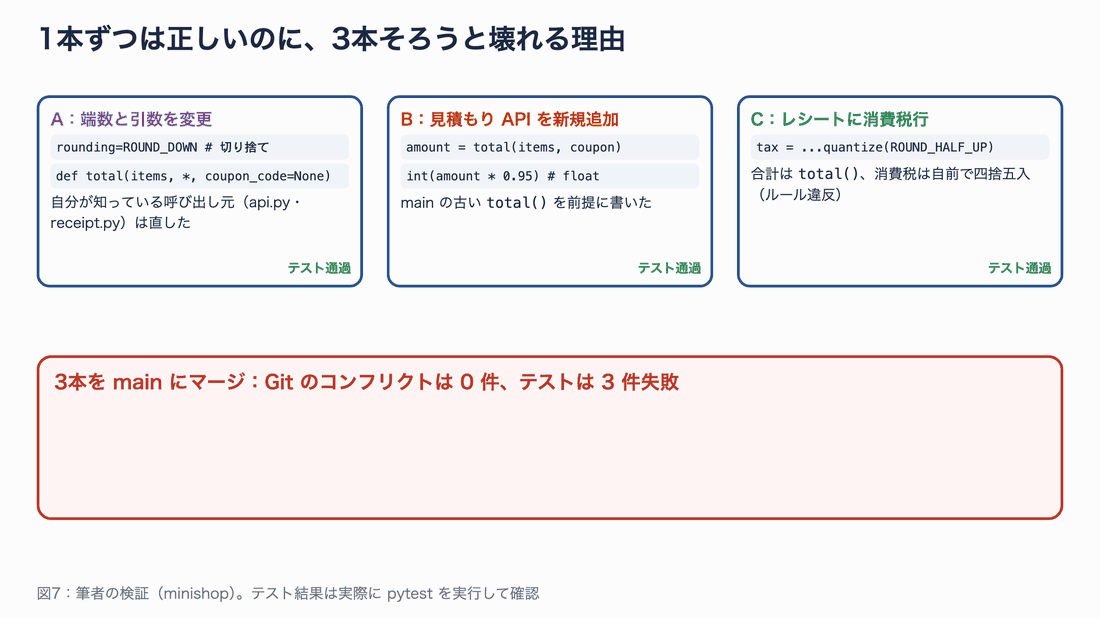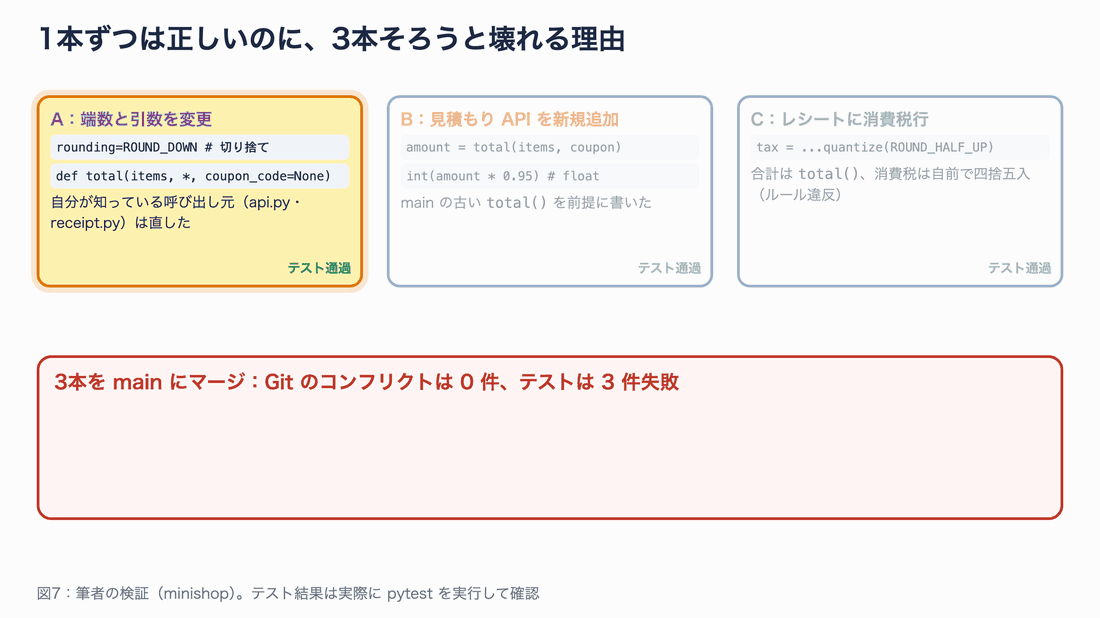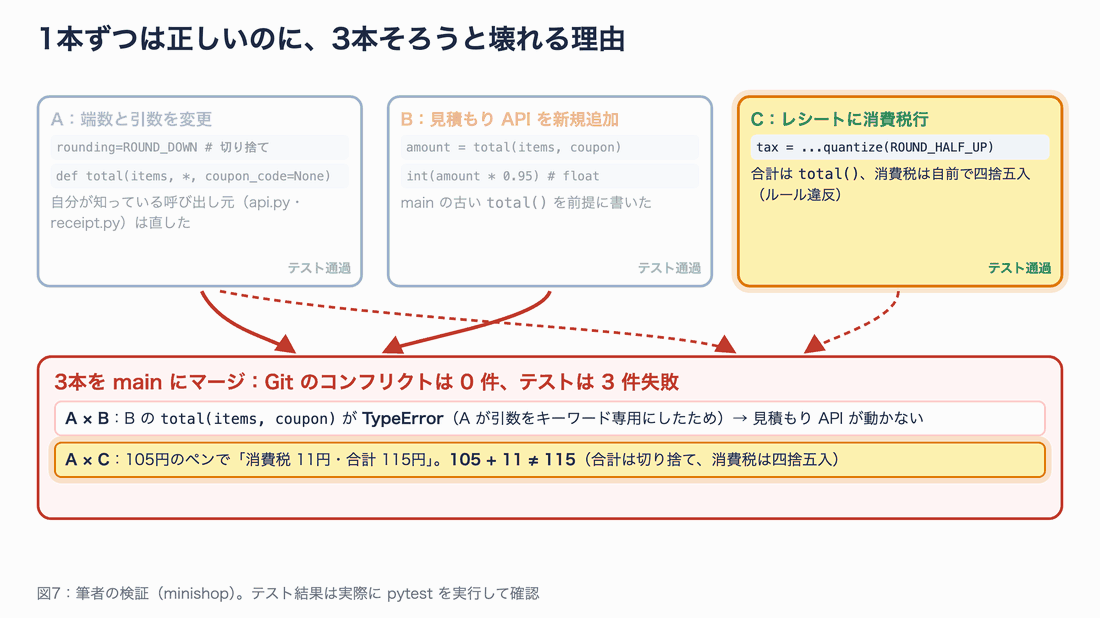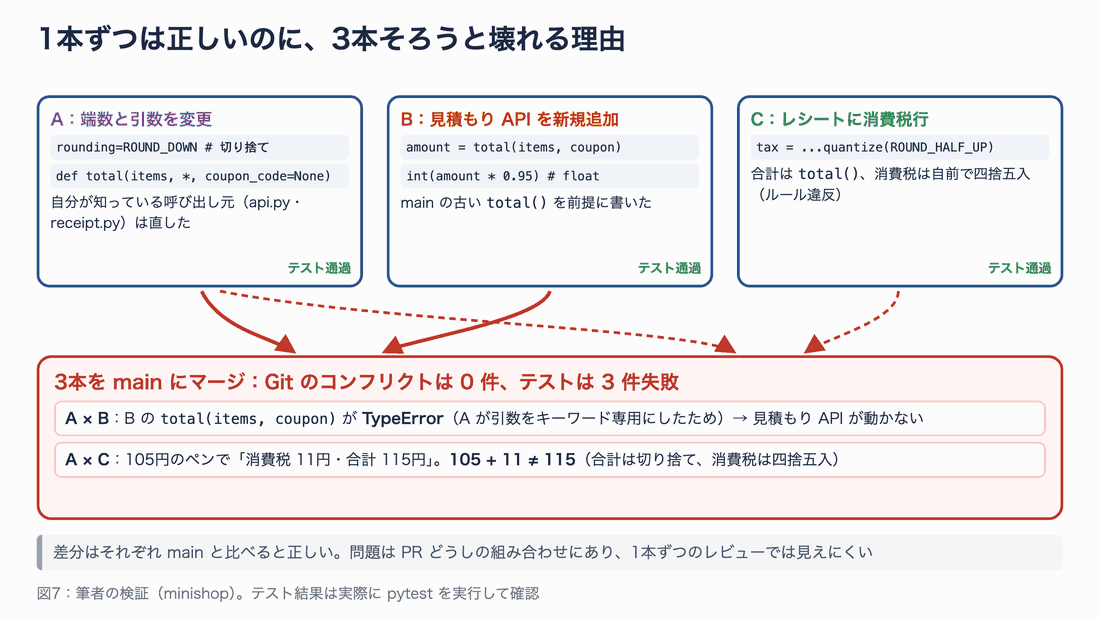
図7:問題は各 PR の中ではなく、PR どうしの組み合わせにある
壊れ方は2種類です。
- A × B:A が
total()の引数をキーワード専用にしたので、B のtotal(items, coupon)がTypeErrorになります。見積もり API がまるごと動きません - A × C:105円のペンを1本買うと、レシートに「うち消費税 11円・合計 115円」と出ます。合計は A の切り捨て(115.5 → 115)、消費税は C の四捨五入(10.5 → 11)で、105 + 11 ≠ 115 です
どちらも、各 PR を main と比べている限りは見えません。B を書いた時点の main では、B の呼び方が正しかったからです。
結果2:1本ずつのレビューでは、誰も TypeError に気づけない
3つのレビュー役の結果を1枚にまとめたのが図8です。
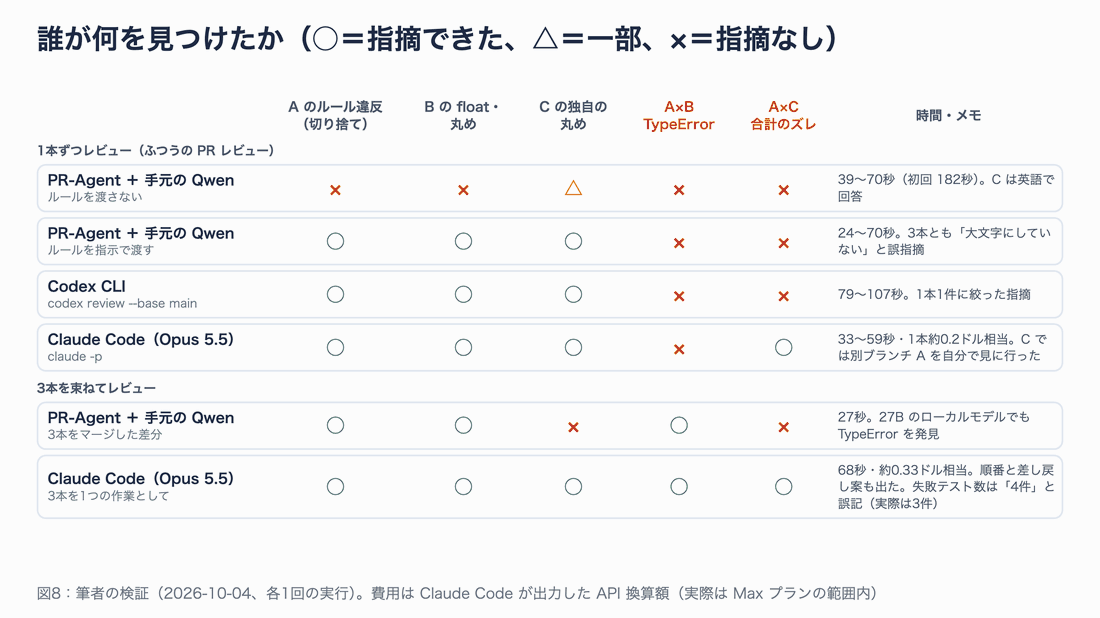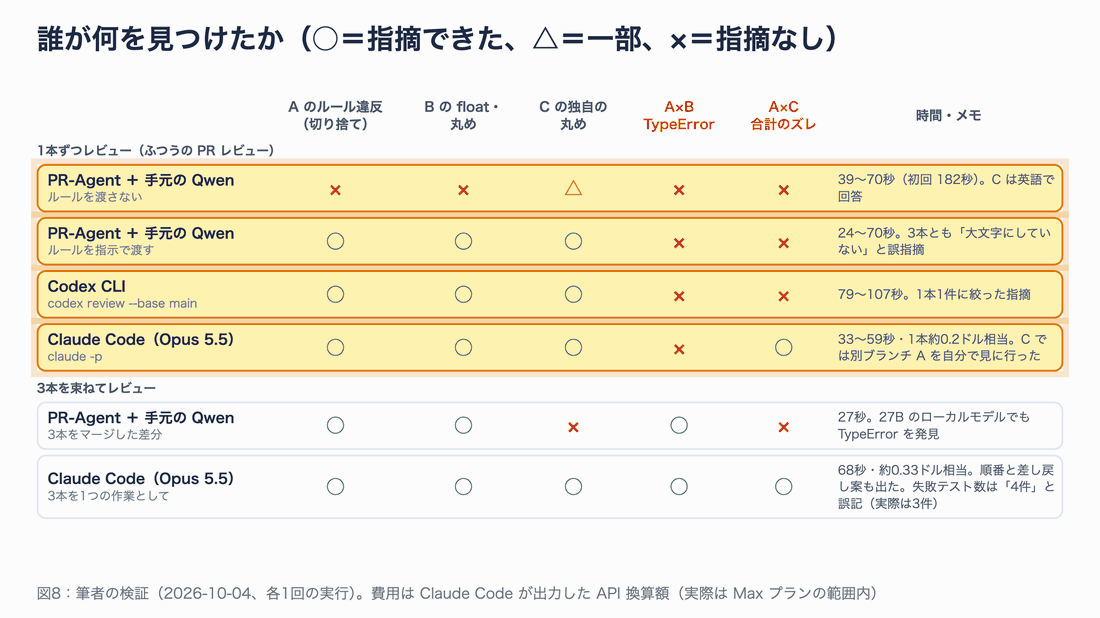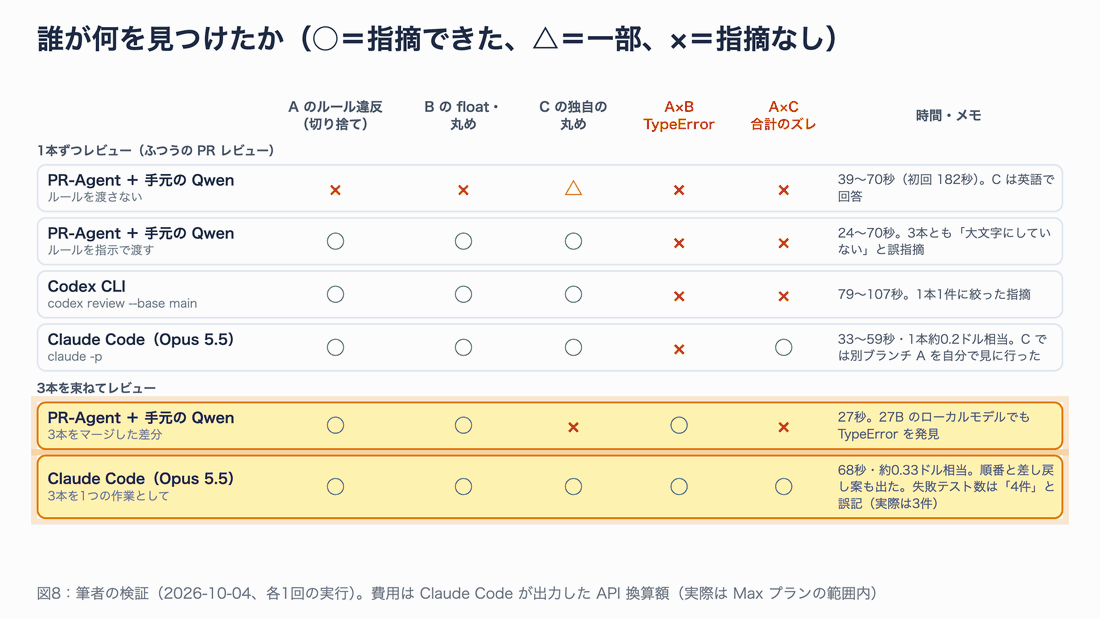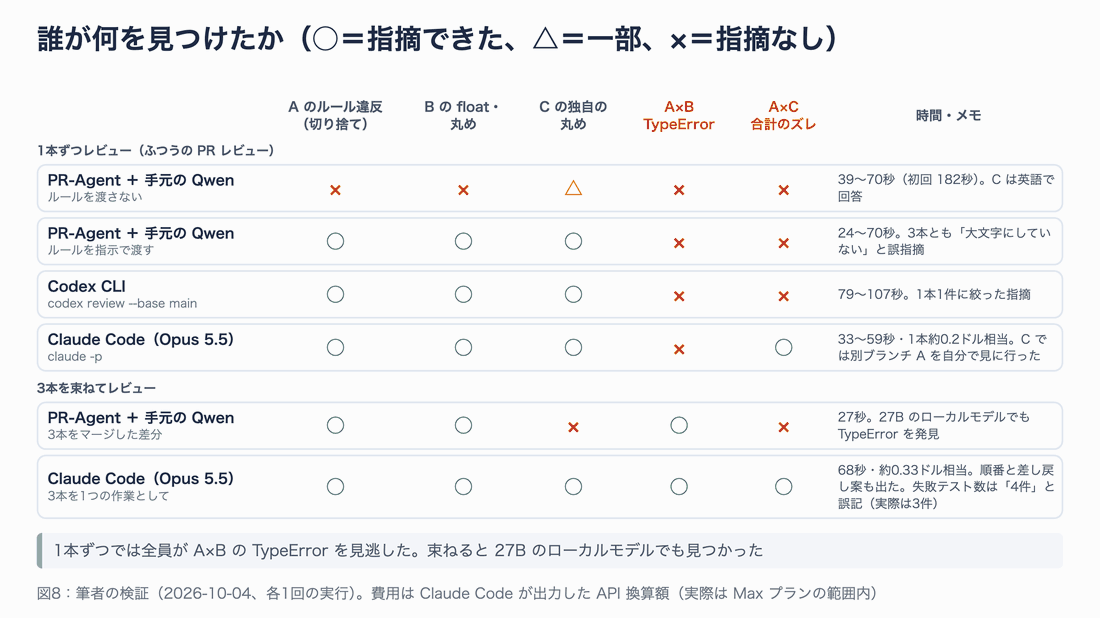
図8:1本ずつのレビュー(上の4行)では、A×B の列がすべて×になった
1本ずつのレビューで分かったことを、ツールごとに書きます。
- PR-Agent + ローカルの Qwen(ルールを渡さない):A と B は「大きな問題なし」と判定しました。C だけ「消費税と合計がずれるかもしれない」と英語で指摘しましたが、計算例は正確ではありませんでした
- PR-Agent + ローカルの Qwen(ルールを渡す):3本とも、仕込んだルール違反を正しく指摘しました。ただし3本とも「クーポンを大文字にしていない」とも指摘しました。実際は
coupon_rate()の中で大文字にしているので、これは誤指摘です - Codex:3本とも AGENTS.md を自分で読み、各 PR のルール違反を1件ずつ、重要度 P2 として出しました。B では「単価102円×10個で1円少なくなる」という具体例を、実際にコードを動かして示しています
- Claude Code:3本とも AGENTS.md を読んでルール違反を指摘したうえで、テストの弱さや仕様の矛盾まで5件ずつ挙げました。C のレビューでは、手元のリポジトリにあった別ブランチ A を自分で見に行き、「A が先にマージされると端数処理が食い違う」と指摘しています
最後の点は面白い結果ですが、「Claude Code なら PR どうしの関係も見てくれる」と考えるのは早計です。今回は3本のブランチが同じ手元のリポジトリにあったので、たまたま見つけられました。それでも B のレビューでは、A の引数変更による TypeError に触れていません。GitHub の PR レビューのように、その PR のブランチしか渡されない環境では、この偶然も期待できません。
時間と費用も書いておきます。PR-Agent(ローカル)は1本24〜70秒で、初回だけモデルの読み込みを含めて182秒かかりました。Claude Code は1本33〜59秒で、API に換算すると1本約0.2ドルです(私は Max プランの範囲内で使いました)。Codex は1本79〜107秒でした。
結果3:束ねて見せると、小さなモデルでも見つかる
次に、同じ道具で「3本を束ねて」レビューさせました。
PR-Agent には、3本をマージした統合ブランチを作り、main との差分を1つの PR としてレビューさせました。すると 27B のローカルモデルでも「B の total(items, coupon) は TypeError になる」と正しく指摘しました(27秒)。モデルは同じで、変えたのは見せた差分だけです。
Claude Code には、3本をまとめて「1つの作業のかたまり」として扱うよう頼みました。
claude -p "このリポジトリには、別々の AI エージェントが作った3本のブランチ(agent-a/tax-round-down、agent-b/bulk-quote、agent-c/receipt-tax-line)があり、それぞれ main への PR になっています。3本を1つの作業のかたまりとして扱い、(1) 3本の関係、(2) すべてマージしたときに壊れる箇所(git merge-tree で統合結果を読んでよい)、(3) レビューとマージの順番、(4) 各作者エージェントへの差し戻し内容をまとめてください。ファイルは変更しないでください。" \
  --allowedTools "Bash(git diff:*)" "Bash(git show:*)" "Bash(git log:*)" "Bash(git merge-tree:*)" "Read" "Grep" "Glob" \
  --output-format json
git merge-tree は、作業ツリーを変えずにマージ結果を計算できるコマンドです。Claude Code はこれで統合後のコードを読み、68秒(API 換算で約0.33ドル)で次のような整理を返しました。
| 項目 | Claude Code の答え(要約) |
|---|---|
| 関係 | 3本とも total() と端数ルールに触れている。A の変更が B と C の前提を壊す |
| 壊れる箇所 | B の TypeError、C のテストの失敗、レシートで「105 + 11 ≠ 115」、B の丸め2回 |
| 順番 | まず人が「切り捨ては本当に経理の依頼か」を決める → A → C → B |
| 差し戻し | A には AGENTS.md の更新と根拠の提示、B には新しい引数と Decimal、C には round_yen() の利用 |
PR Triage がやろうとしている「関係・影響範囲・レビュー順・担当への引き継ぎ」に近い答えが、プロンプト1つで返ってきました。ただし細かい誤りもあり、壊れるテストを「4件」と書いていました(実際は3件)。束ねた答えも、最後は人が確かめる必要があります。
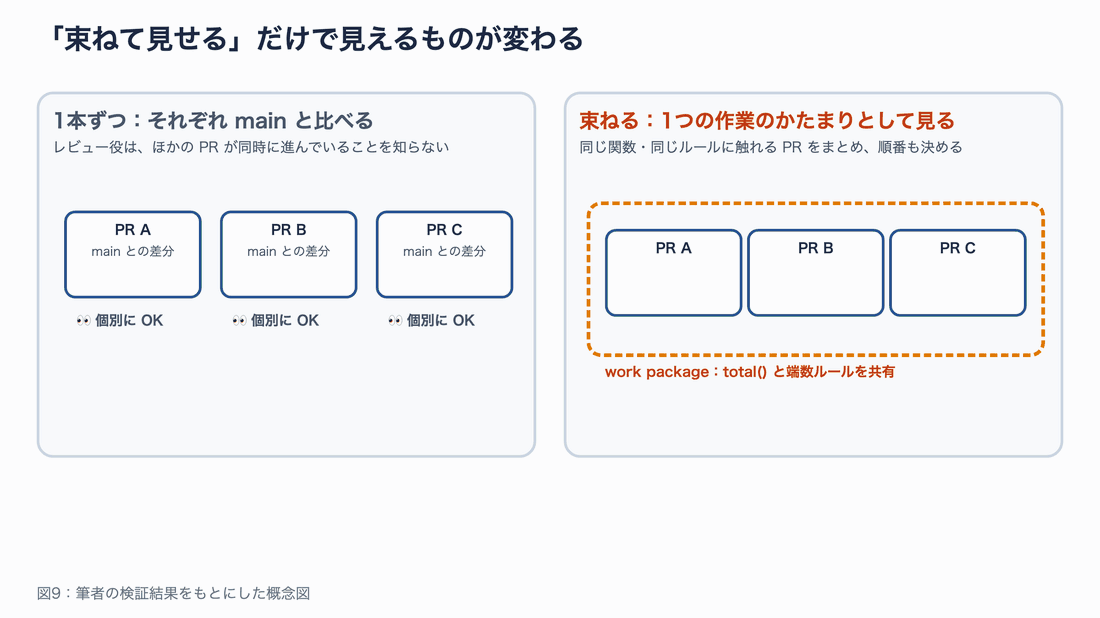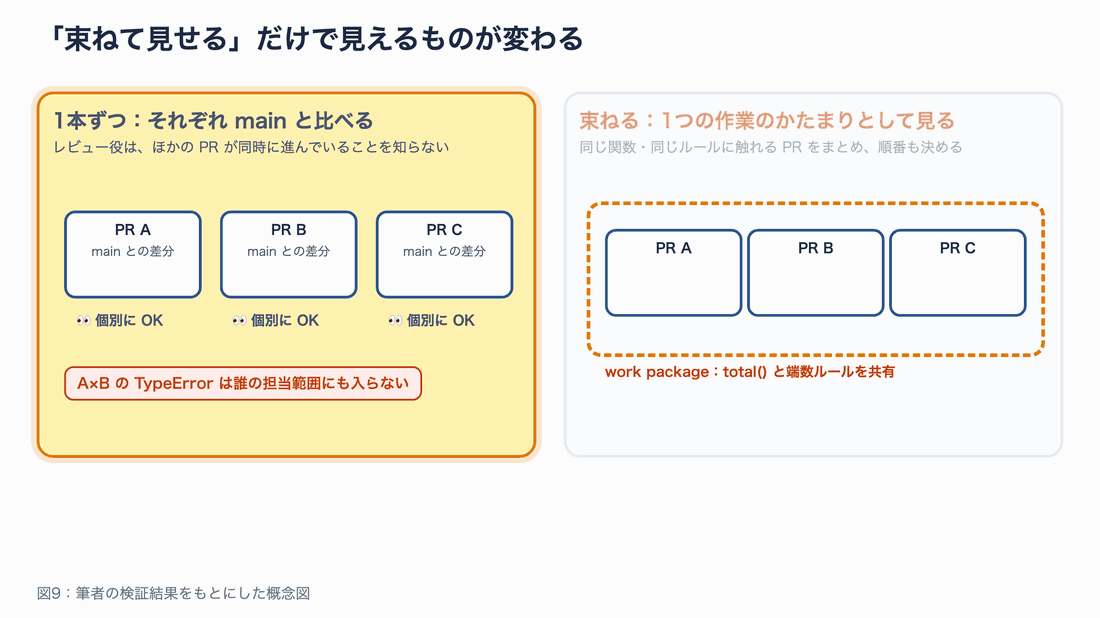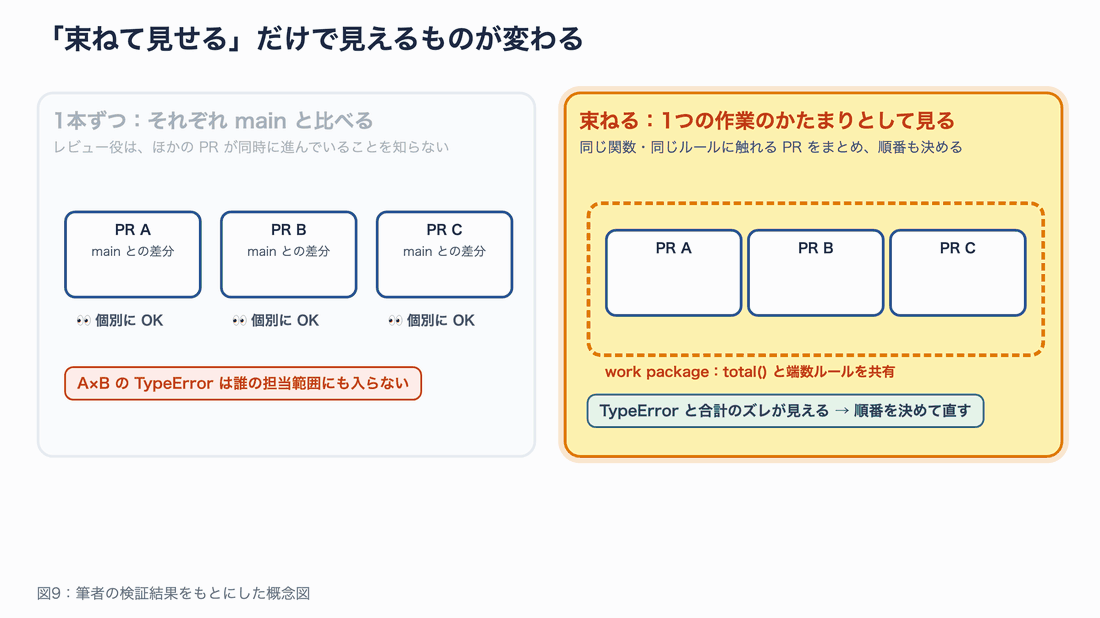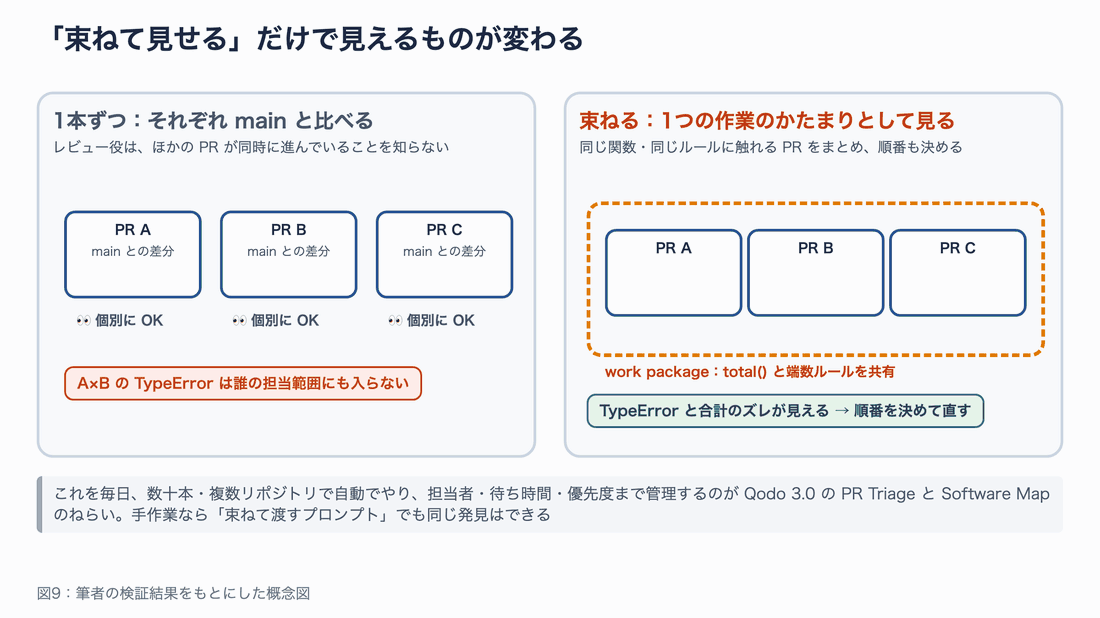
図9:差を生んだのはモデルの賢さより「何をまとめて見せたか」
Claude Code・Codex のレビューと Qodo は何が違うのか
実験を踏まえて、冒頭の質問に答えます。
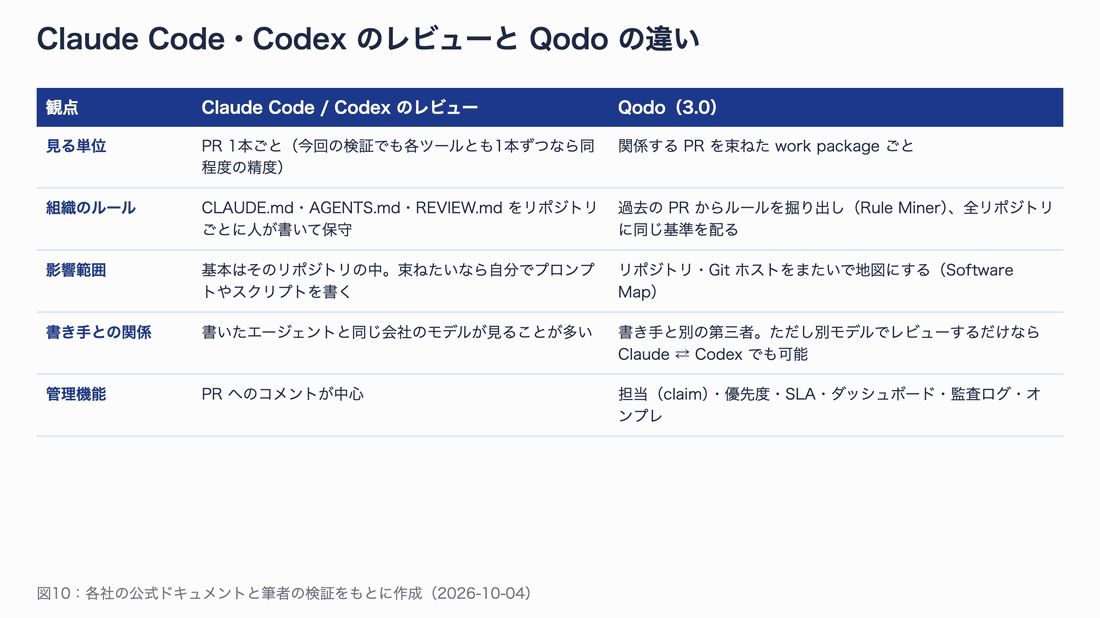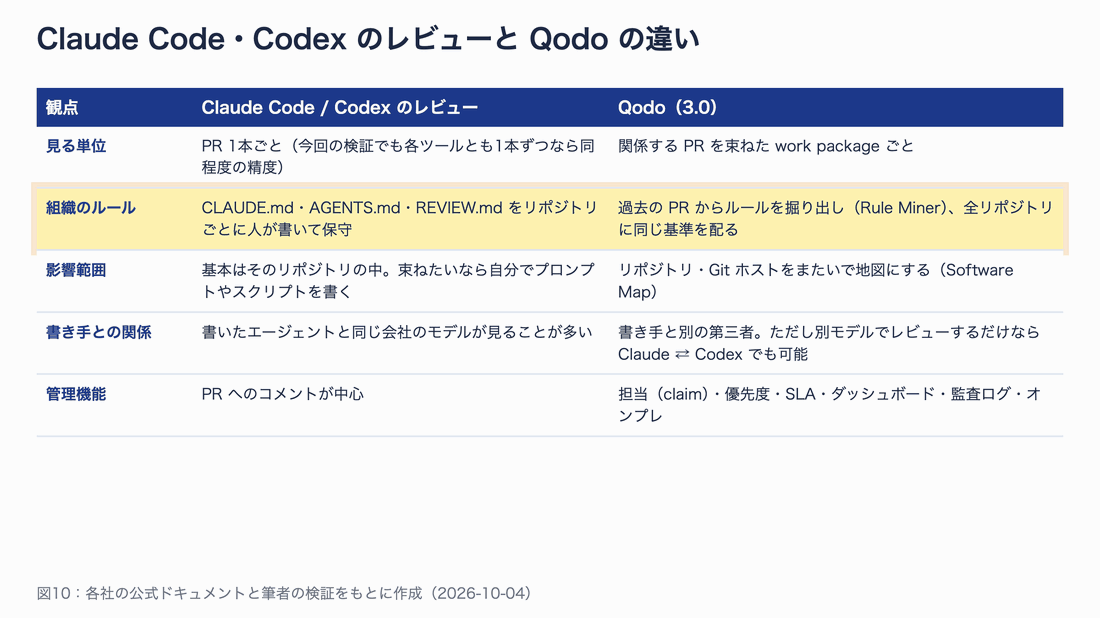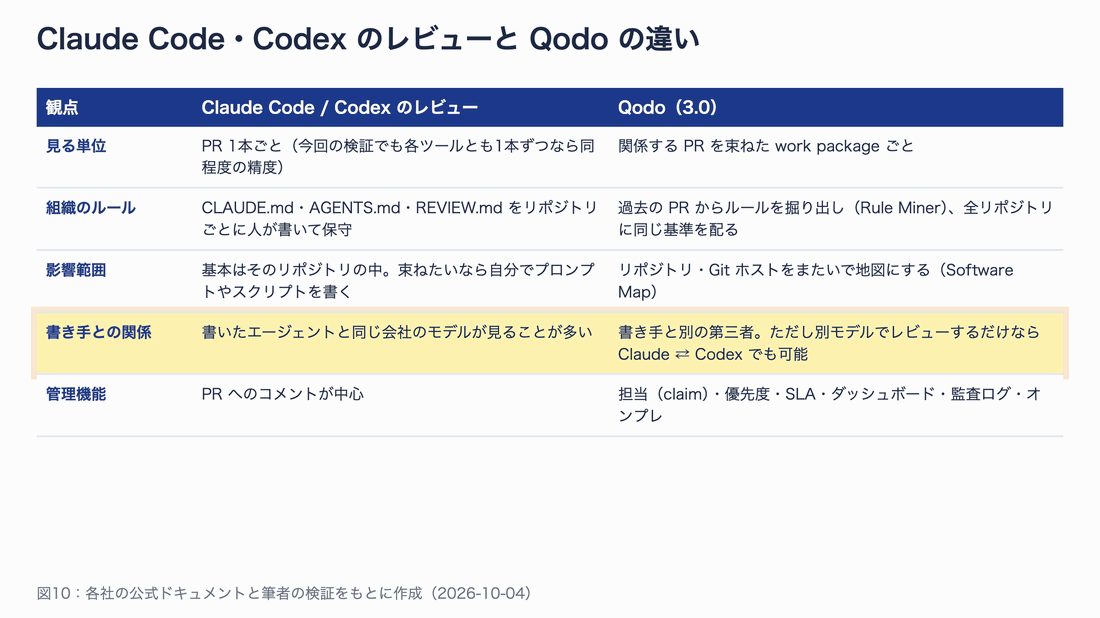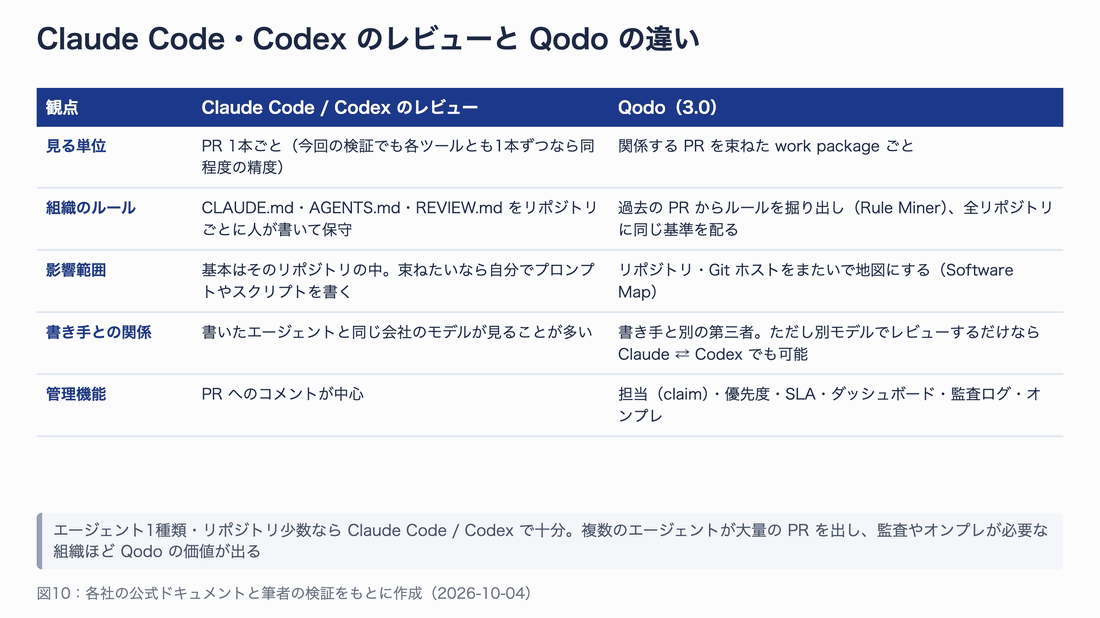
図10:1本の PR を見る力では大差がない。違いは「PR の外側」にある
PR 1本のレビューだけなら、今回の結果を見る限り Claude Code や Codex で十分です。むしろ、AGENTS.md を自分で読んで具体例まで示してくれる分、手軽で強力でした。
違いが出るのは PR の外側です。
- 束ねる単位:Qodo は関係する PR を自動で work package にまとめます。Claude Code でも同じことはできますが、「どの PR を束ねるか」を人かスクリプトが決めて渡す必要があります
- 組織のルールの保守:CLAUDE.md や AGENTS.md はリポジトリごとに人が書いて直すものです。リポジトリが100個あると、ルールをそろえるだけで手間がかかります。Qodo は過去の PR からルールを掘り出し、全リポジトリに同じ基準を配る仕組みを持っています
- 管理の仕組み:担当の宣言、待ち時間、SLA、ダッシュボード、監査ログ、オンプレ運用など、レビューを「業務として回す」ための機能です。ここは Claude Code や Codex の守備範囲の外です
一方で、「書き手と別の会社のモデルがレビューするから安心」という Qodo の主張には、宣伝の面もあります。別のモデルに見せたいだけなら、Claude Code で書いて Codex にレビューさせる構成でも実現できます。
応用:まずは手元で「束ねるレビュー」を始める
いきなり商用ツールを入れなくても、今回の実験はそのまま自分のチームで試せます。判断の目安を図11にまとめました。
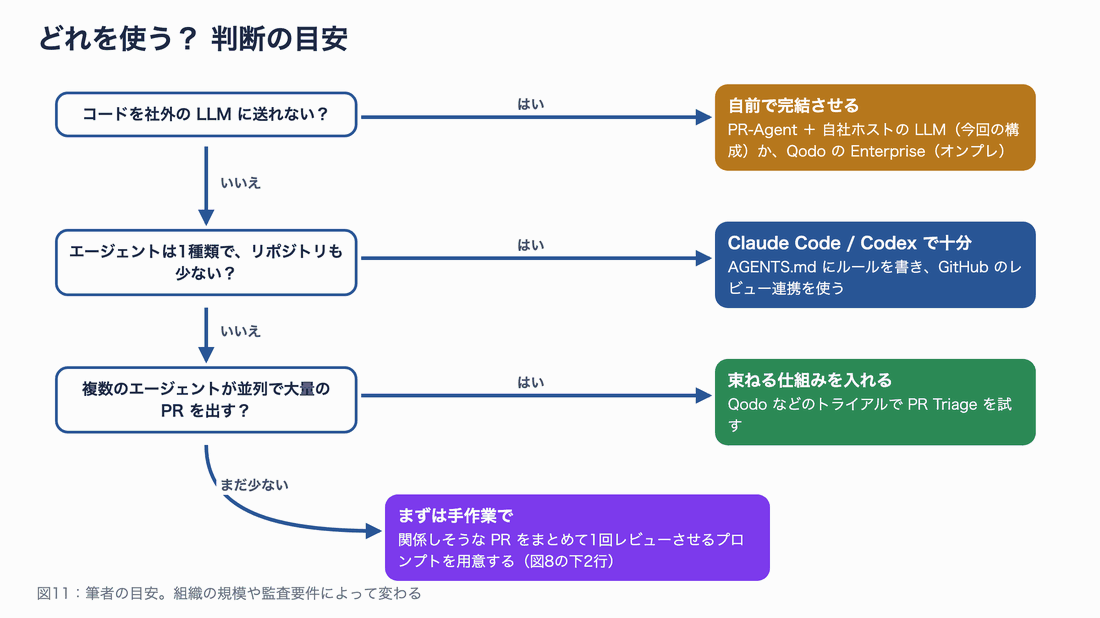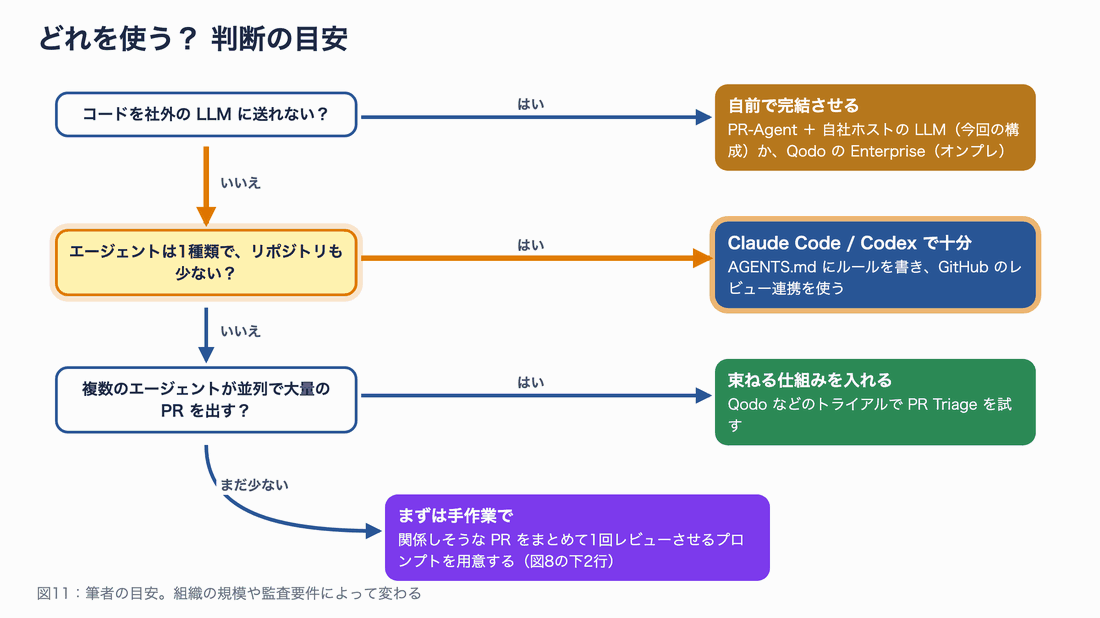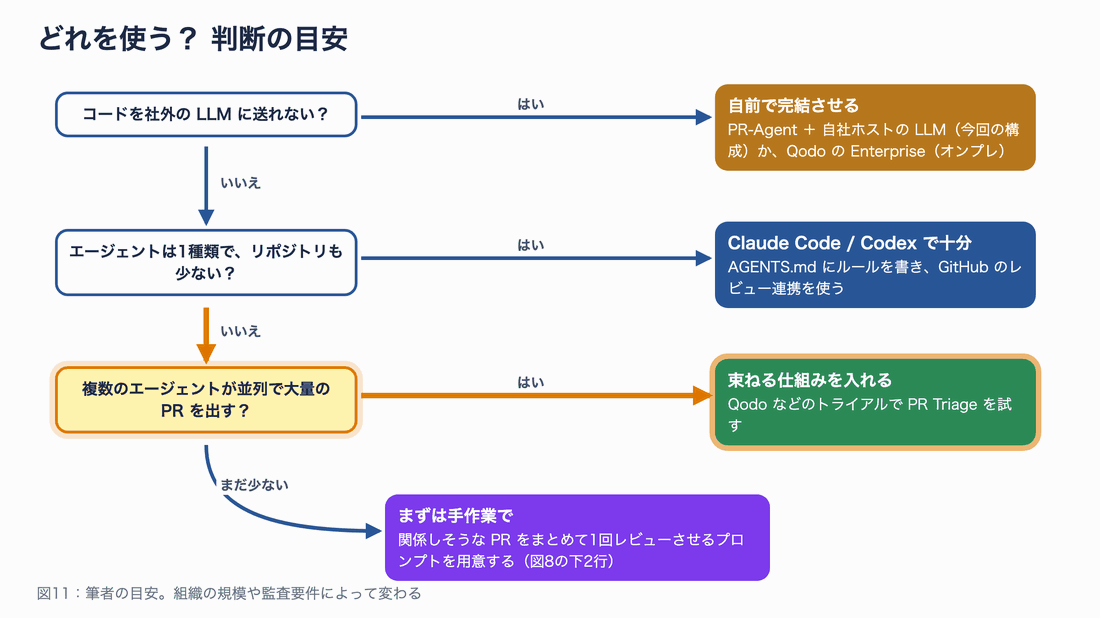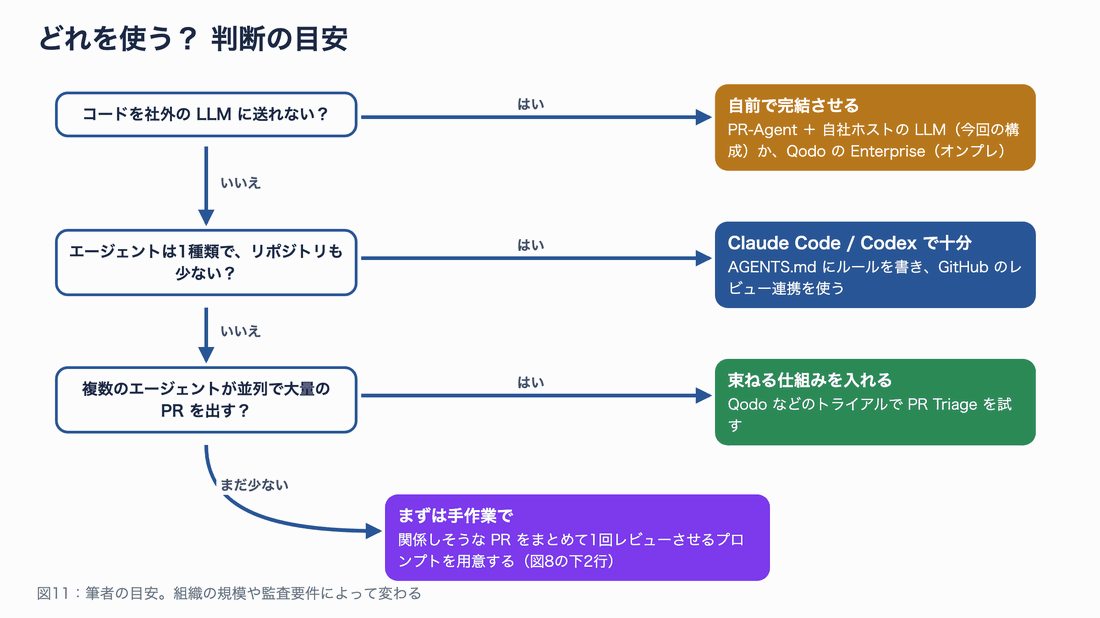
図11:どれを使うかの目安。規模や監査要件で変わる
手作業で始めるなら、次の手順がおすすめです。
- 同じ日に開いた PR のうち、同じファイルや同じ関数に触れているものを
git diff --statで洗い出す - それらを統合したブランチを作るか、
git merge-tree --write-tree main <ブランチ>...で統合結果を計算する - 統合した差分を、Claude Code・Codex・PR-Agent のどれかに「1つの作業として」レビューさせる
- 返ってきた順番と差し戻しを、各 PR の作者(人またはエージェント)に戻す
これを毎日・数十本・複数リポジトリで回すのがつらくなってきたら、PR Triage のような専用ツールを検討する段階です。
トラブルシューティング
PR-Agent をローカルで動かしたときに実際に出た症状と、対処をまとめます。
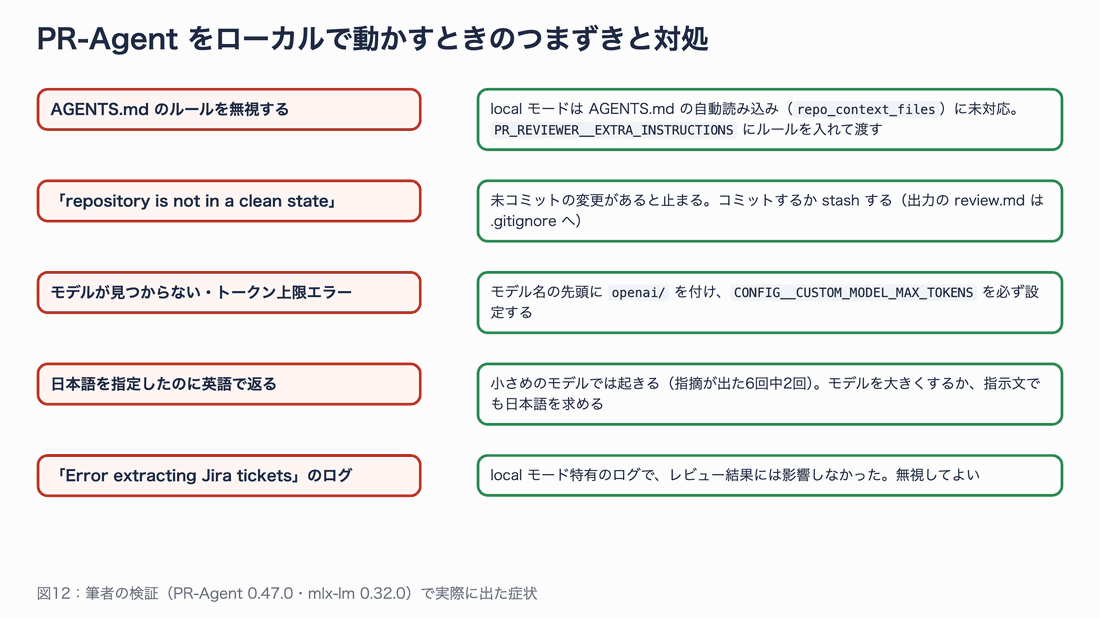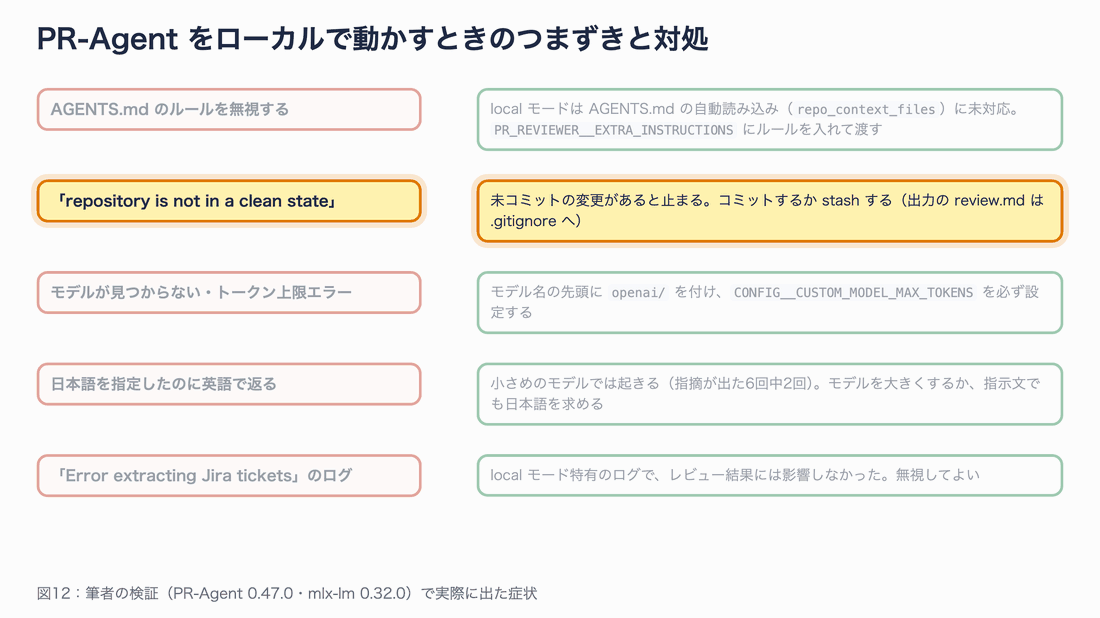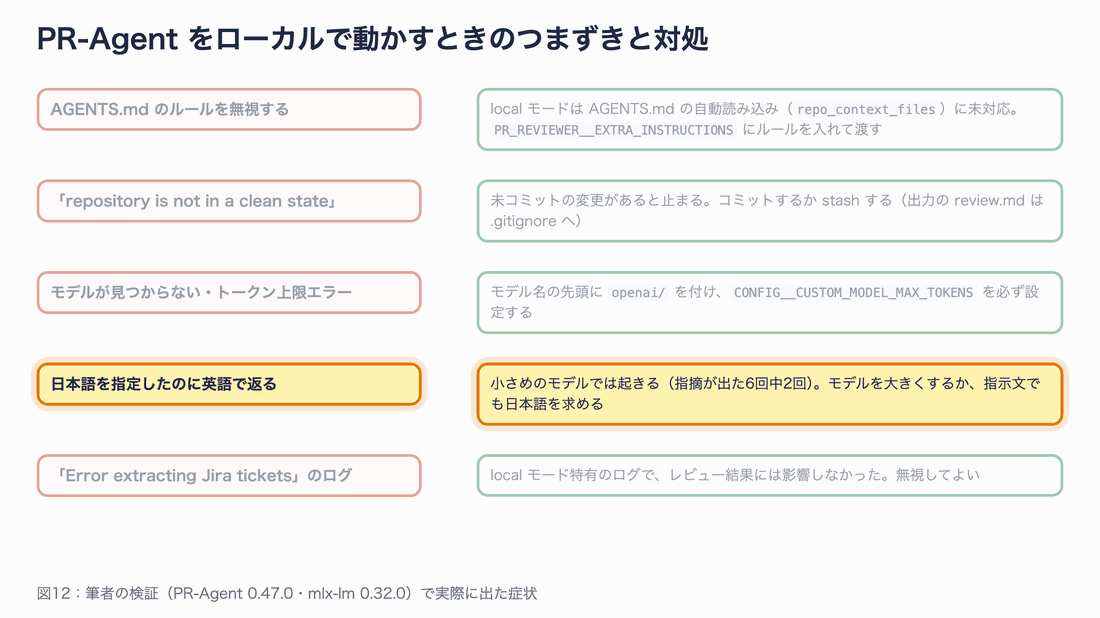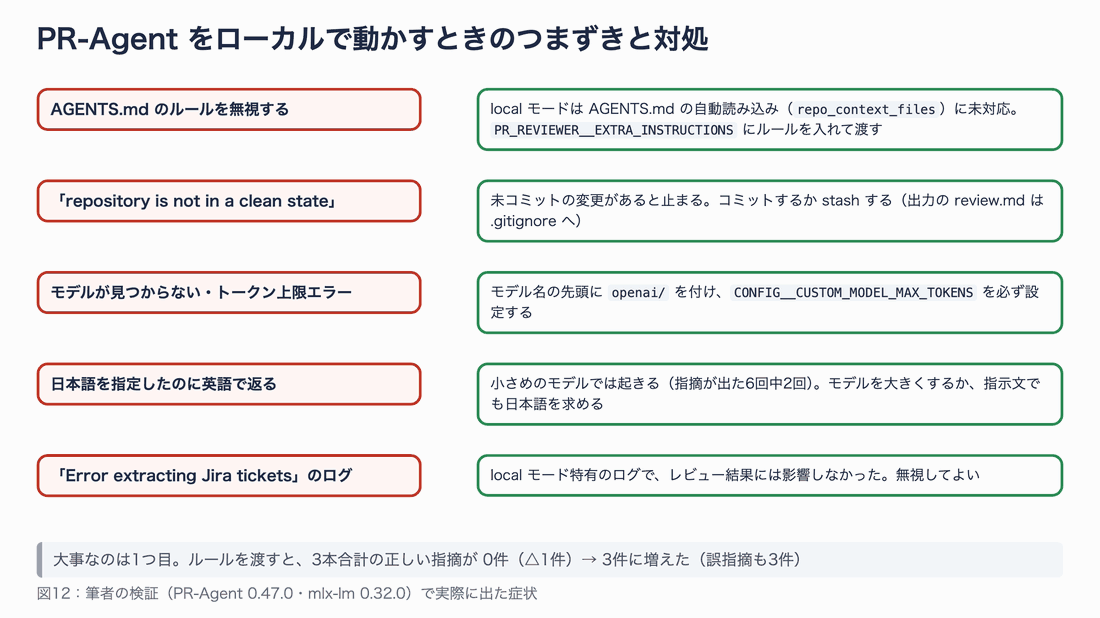
図12:いちばん効いたのは、ルールを指示として渡すこと
| 症状 | 原因 | 対処 |
|---|---|---|
| AGENTS.md のルールを見ていない | local モードは repo_context_files に未対応 | PR_REVIEWER__EXTRA_INSTRUCTIONS にルールを入れる |
The repository is not in a clean state | 未コミットの変更がある | コミットか stash。出力の review.md は .gitignore に入れる |
| モデルが見つからない・トークン数のエラー | OpenAI 互換の経路を通っていない | モデル名の先頭に openai/、CONFIG__CUSTOM_MODEL_MAX_TOKENS を設定 |
| 日本語を指定したのに英語で返る | 小さめのモデルで起きやすい(今回は指摘が出た6回中2回) | モデルを大きくする、指示文でも日本語を求める |
Error extracting Jira tickets のログ | local モード特有のログ | レビュー結果には影響しなかったので無視してよい |
また、自分の PC でエージェントを動かすときの注意も1つ書いておきます。今回 Codex にレビューを頼んだところ、私の個人設定(作業の終わりに共有メモへ記録する指示)に従って、検証用リポジトリのレビュー記録をメモに書き込んでいました。レビューを頼んだだけでも、エージェントは設定次第でファイルを書きます。CI などで自動レビューを回すときは、読み取り専用の権限と専用の設定で動かすのが安全です。
まとめ
- Qodo(旧 CodiumAI)は、累計 1.2億ドルを調達し、SOC 2 Type II を公表している独立系のスタートアップです。大手テック企業からの出資は確認できませんでしたが、AWS・Google Cloud・Microsoft・NVIDIA とは販売や技術の面で、Anthropic・OpenAI とはエージェント製品のプラグインとしてつながっています
- Qodo 3.0 は、9月までに出した部品を「書く前・PR・全体・管理者」の4か所で品質を見る基盤にまとめたものです。目玉の PR Triage は研究プレビューです
- OSS で試せるのは PR-Agent(MIT)による PR 1本のレビューまでです。ローカルの LLM と組み合わせれば、コードを外に出さずに動かせます
- 実験では、1本ずつのレビューでは3つのツールとも PR どうしの組み合わせで起きる TypeError を見逃しました。3本を束ねて見せると、27B のローカルモデルでも見つかりました
- Claude Code・Codex との違いは「レビューの賢さ」ではなく、「どの PR を束ねて、誰がどの順で見るか」を組織の規模で回す仕組みにあります
次の一歩としては、自分のチームで同じ日に開いた PR を束ねて、一度 Claude Code か Codex にレビューさせてみてください。見つかるものが変わるかどうかで、Qodo のような専用ツールが必要かどうかを判断できます。
参考リソース
- Introducing Qodo 3.0(Qodo 公式ブログ、2026-10-01)
- Qodo 3.0 Brings Enterprise-Grade Quality Control to Agentic Software Development(プレスリリース、2026-10-01)
- Qodo のシリーズB の発表(2026-03-30)
- Qodo About(創業者・投資家)
- Qodo 料金ページ
- Qodo is handing PR-Agent over to the community(2026-04-23)
- The-PR-Agent/pr-agent(GitHub)
- PR-Agent ドキュメント:Local Git provider
- Qodo のスキル(Claude Code プラグイン)
- AWS スタートアップ記事:Qodo
- Codex の GitHub 連携とコードレビュー(OpenAI)
- Claude Code の Code Review(Anthropic)