はじめに
生成 AI をエージェント用途で本番に載せると、モデルの賢さとは別のところで壁にぶつかります。
- 数十〜数百回のツール呼び出しをまたぐタスクで、途中から精度が崩れる
- 「1M トークン対応」を謳うモデルでも、長い文脈を毎回投げると請求額が跳ね上がる
- 最上位のプロプライエタリモデルは優秀だが、大量のバッチ処理や社内データを扱う案件では、コストとデータの取り扱いが決裁を通らない
2026 年 7 月に Moonshot AI が公開した Kimi K3 の技術レポート(Kimi Team, “Kimi K3: Open Frontier Intelligence”)は、まさにこの 3 つの壁を正面から扱った論文です。2.8 兆パラメータの MoE(Mixture-of-Experts、複数の専門家ネットワークを切り替えて使う方式)モデルで、100 万トークンの文脈を扱い、重みは全公開。論文の主張を一言でまとめると「最上位モデルに迫る領域があり、長期エージェントの一部評価では大幅に低いタスクコストを示した」です。
この記事では、47 ページの技術レポートを 「何が新しいのか」「どこが改善したのか」「実務でどう使うのか」 の 3 点に絞って読み解きます。数式は最小限にし、設計判断の理由と、実際に導入するときに効いてくるポイントを中心にまとめます。
想定読者は、生成 AI をエージェントや RAG(検索拡張生成)として業務に組み込む立場のエンジニア・企画担当者です。MoE や Attention の基礎知識があれば読み進められるように、専門用語には初出時に短い説明を添えています。
図はこの記事用に作成した概念図で、論文の図表をそのまま転載したものではありません。
Kimi K3 とは何か: 3 行で
まず全体像を押さえます。
- 規模: 総パラメータ 2.8T、1 トークンあたり発火するのは 104B。896 個の routed expert から 16 個を選び、常時通る shared expert が 2 個。
- 文脈と入力: 100 万トークンの文脈長。テキスト・画像・動画を単一のバックボーンで処理するネイティブマルチモーダル。
- 位置づけ: オープンウェイトとして初の 3T 級。Kimi K2 比でスケーリング効率(同じ損失に到達するのに必要な計算量の逆数)が約 2.5 倍。
前世代の Kimi K2 との差分を表にすると、何が「増えた」のか、何が「変わった」のかが見えてきます。
| 項目 | Kimi K2 | Kimi K3 | 変化 |
|---|---|---|---|
| 層数 | 61 | 93 | 増加 |
| 総 / アクティブパラメータ | 1.04T / 32.6B | 2.78T / 104.2B | 増加 |
| Routed expert 数 / 発火数 | 384 / 8 | 896 / 16 | 増加 |
| Shared expert | 1 | 2 | 増加 |
| 隠れ次元 | 7,168 | 7,168 | 同じ |
| Latent MoE 次元 | なし | 3,584(半分) | 新規 |
| Attention | MLA のみ | KDA と MLA のハイブリッド(69 + 24 層) | 変更 |
| 活性化関数 | SwiGLU | SiTU-GLU | 変更 |
| 学習時コンテキスト | 128K | 1M | 8 倍 |
| Vision encoder | 別途(K2.5 は SigLIP 初期化) | MoonViT-V2(401M、スクラッチ学習) | 変更 |
「増加」の行は単純なスケールアップですが、「変更」「新規」の行が本論文の技術的な中身です。以降はこの部分を順に見ていきます。
背景: なぜオープンモデルは 1T で止まっていたのか
論文の導入部は、LLM のスケーリングを 2 つの軸で整理しています。
- 横軸: 事前学習の規模。より大きなモデルを、より多くのデータで学習する従来の軸
- 縦軸: テスト時計算。推論時に長く考える、ツールを何百回も呼ぶ、といった「使うときの計算量」の軸
OpenAI の o 系列や DeepSeek-R1 以降、業界の関心は縦軸に集中しました。オープンモデルも RL(強化学習)でこの軸を急速に伸ばしましたが、横軸は 1T 前後で足踏みしていた、というのが著者らの現状認識です。同程度の土台に同程度の RL を載せても、オープン勢は互いに似た性能へ収束し、最上位との差は開いていく。これを打開するには両軸を同時に伸ばすしかない、というのが K3 の出発点です。
下の図は、この「1T の壁」と K3 の狙いを模式的に示したものです。オープン群が縦方向だけに伸びる様子と、K3 が右上へ抜ける様子を順に追ってください。
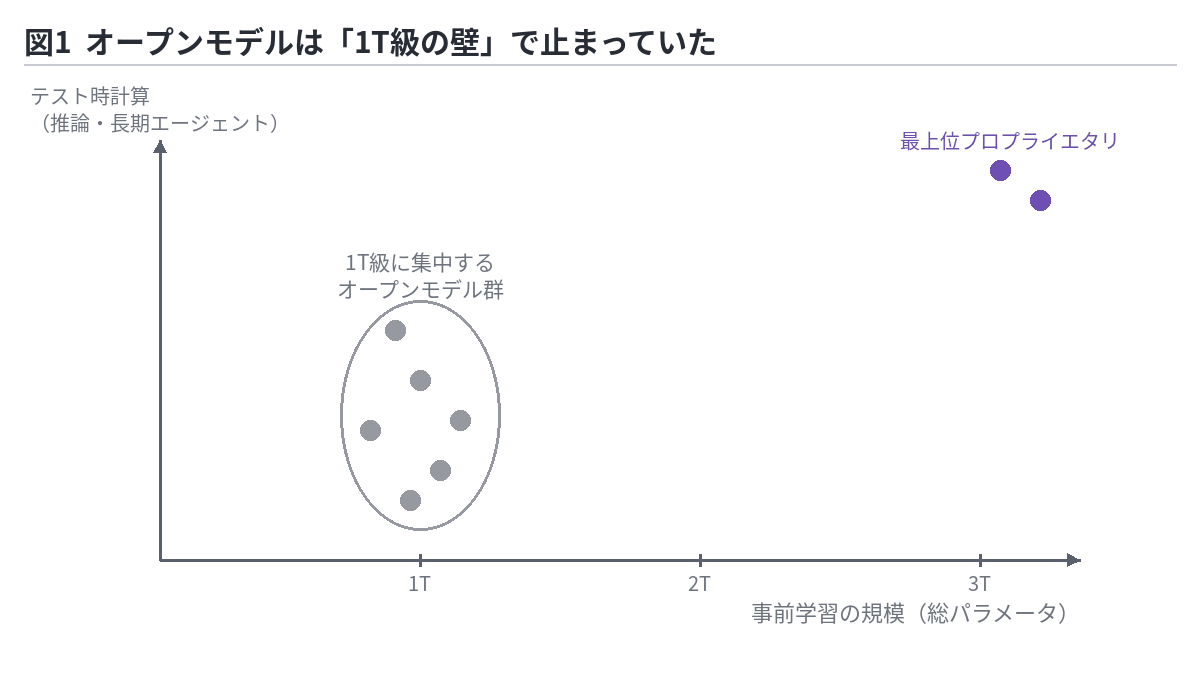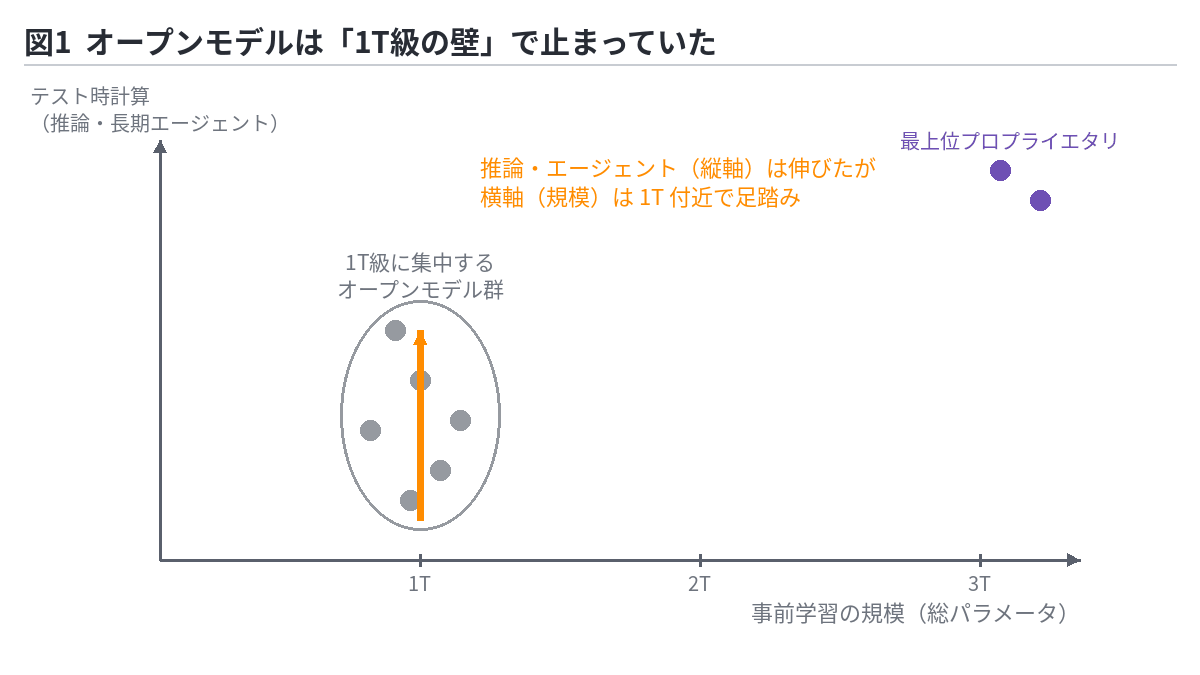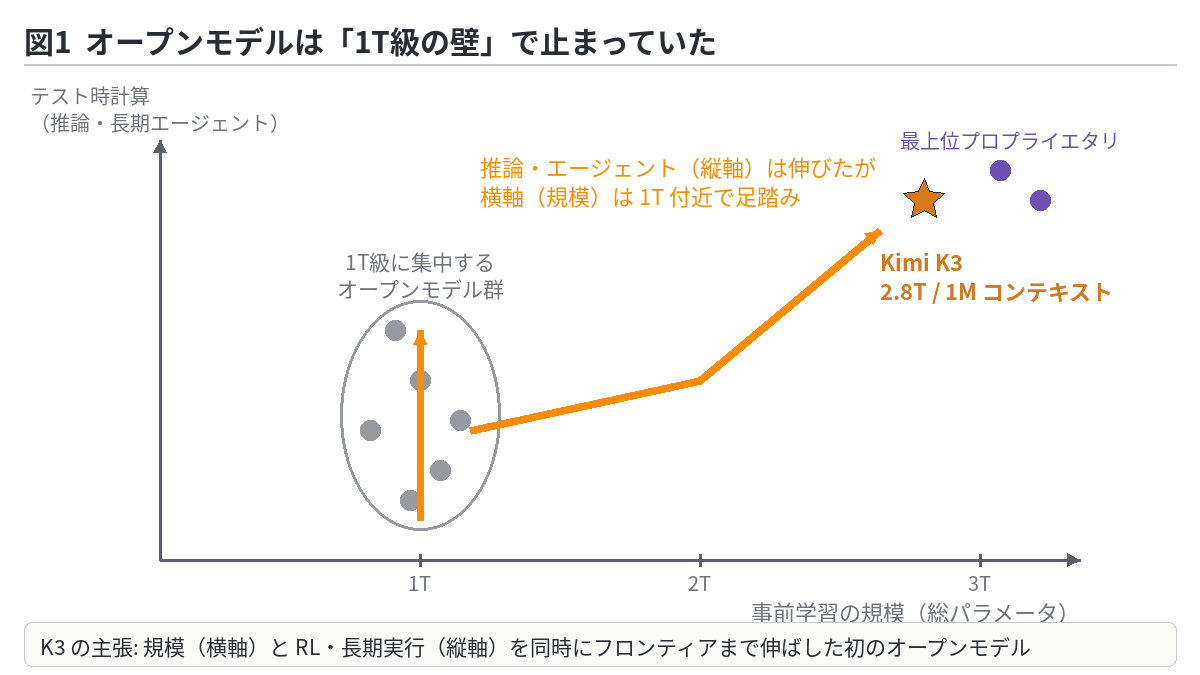
図1: 横軸(規模)と縦軸(推論・長期実行)。オープンモデル群は縦軸で伸びたが横軸で止まっていた、というのが論文の問題設定です(静止画版)。
ただし、横軸を 3 倍に伸ばすのは「GPU を 3 倍用意すれば済む」話ではありません。1M トークンの文脈で 2.8T のモデルを RL するには、Attention のメモリ、MoE の負荷分散、サンドボックスの寿命管理といった、システム側の問題を同時に解く必要があります。論文の半分近くがインフラの記述に割かれているのはそのためです。
仕組み 1: 1M トークンを現実的なコストで扱う Hybrid Attention
3 層の線形アテンションに 1 層の全体アテンション
通常の Transformer では、Attention は過去のすべてのトークンの Key と Value を保持します(KV キャッシュ)。このキャッシュは文脈長に比例して増えます。文脈長を N とすると、KV メモリと 1 トークン生成時の Attention 計算は概ね O(N)、通常の全結合 Attention による入力全体の計算は O(N²) になるため、1M トークンでは負荷が大きくなります。
K3 は、これを Kimi Delta Attention(KDA) と Gated MLA のハイブリッドで解きます。1 ブロックは「KDA 3 層 + Gated MLA 1 層」の 3:1 構成で、これを 93 層にわたって繰り返します。末尾には必ず MLA が来るように 1 層追加されています。
図2 で 1 ブロックの構成を確認してください。青が KDA、紫が Gated MLA、緑が各 Attention 層の後ろに置かれる MoE 層です。左側の矢印は後述する AttnRes です。
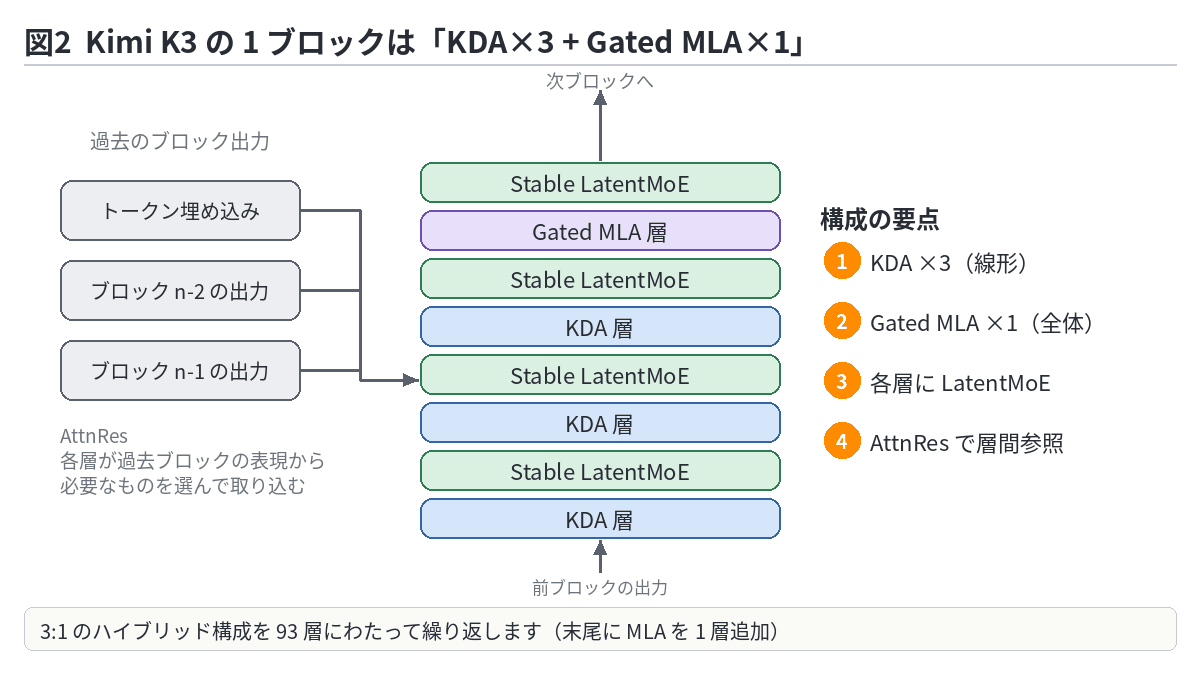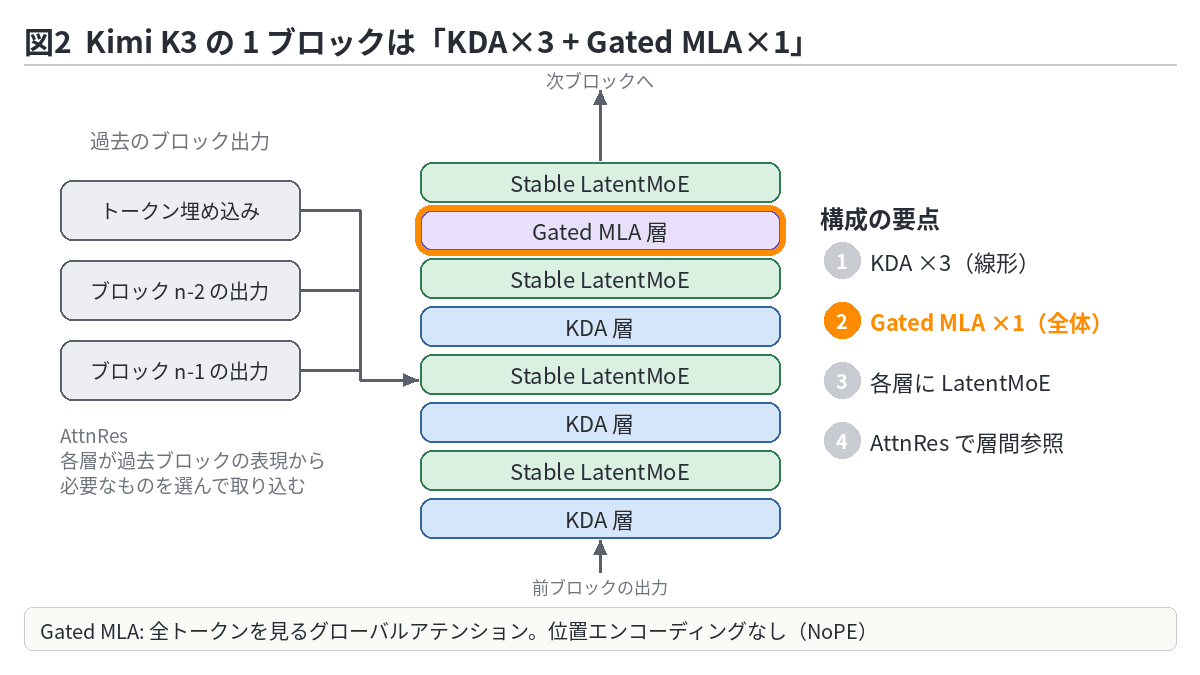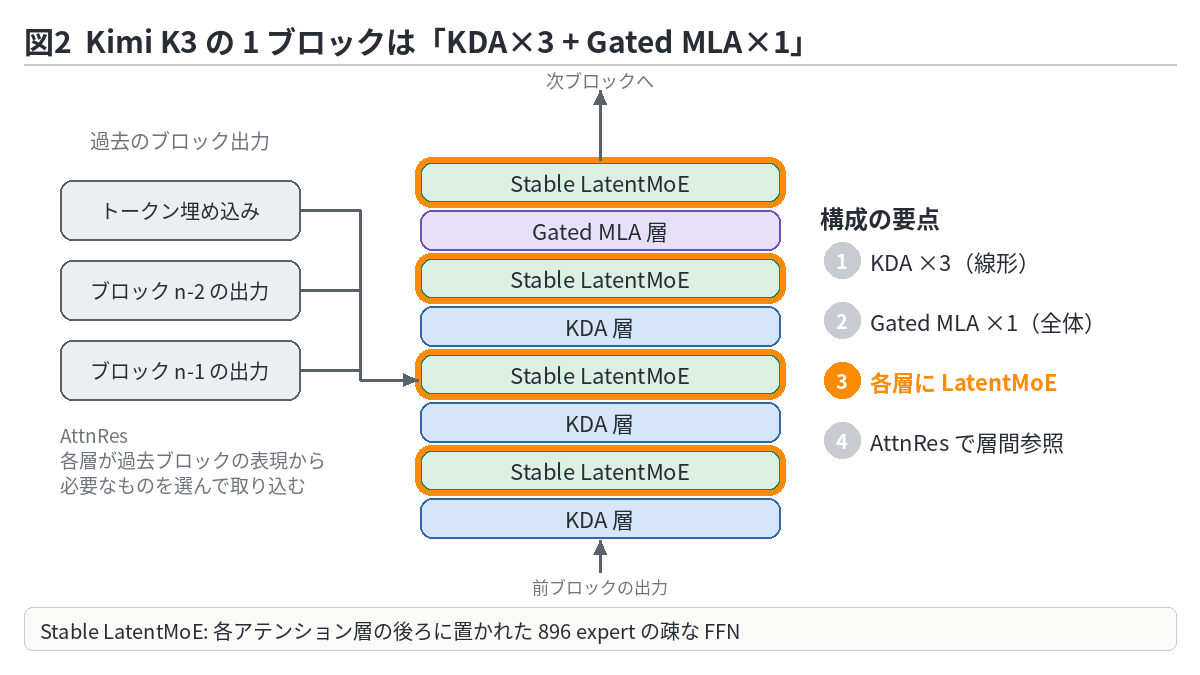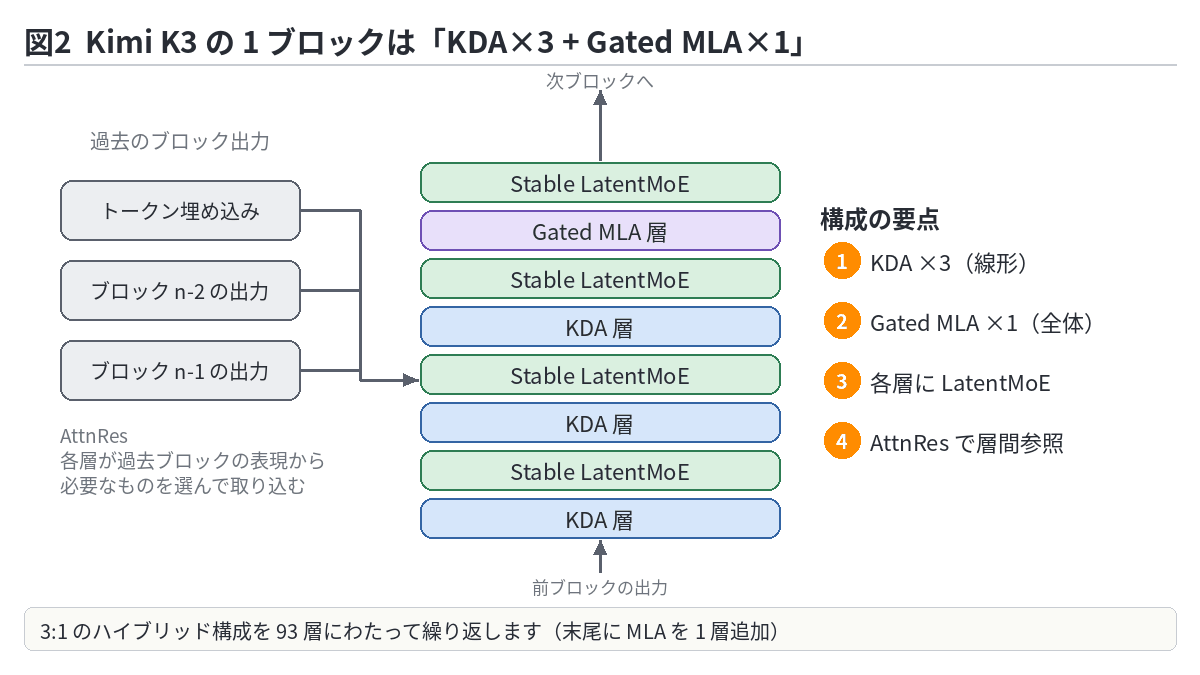
図2: 3:1 のハイブリッド構成。動きは KDA、Gated MLA、LatentMoE、AttnRes の順に強調しています(静止画版)。
KDA は線形アテンション(linear attention)の一種で、過去の情報を「固定サイズの行列 1 枚」に圧縮して持ちます。デルタ則(delta rule)と呼ばれる更新式で、新しいトークンごとに古い情報を少し消して新しい情報を書き込みます。チャネルごとに忘却の強さを変えられるゲートが付いているのが特徴です。
一方 Gated MLA は DeepSeek-V2 で導入された Multi-head Latent Attention で、KV を低次元に圧縮してキャッシュしつつ、全トークンへの参照を保ちます。K2 でも使われていましたが、K3 では出力にトークン依存のゲートが追加されています。
何が増えて、何が増えないのか
この構成の意味を、文脈が伸びていく様子で確認します。
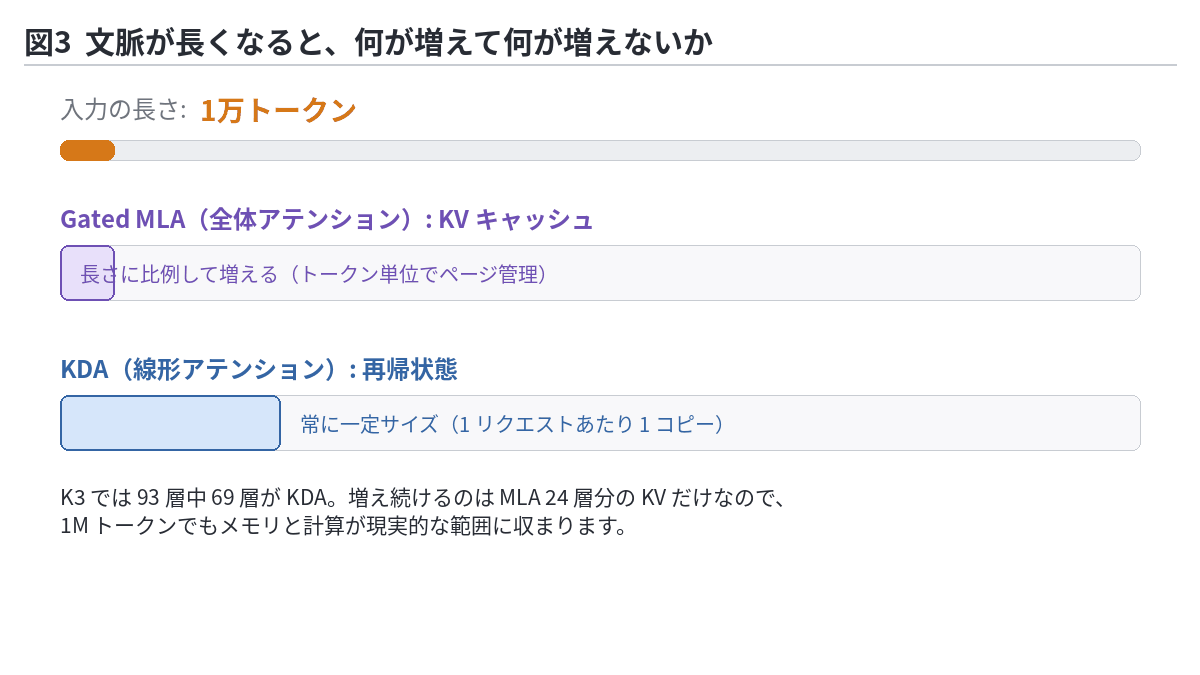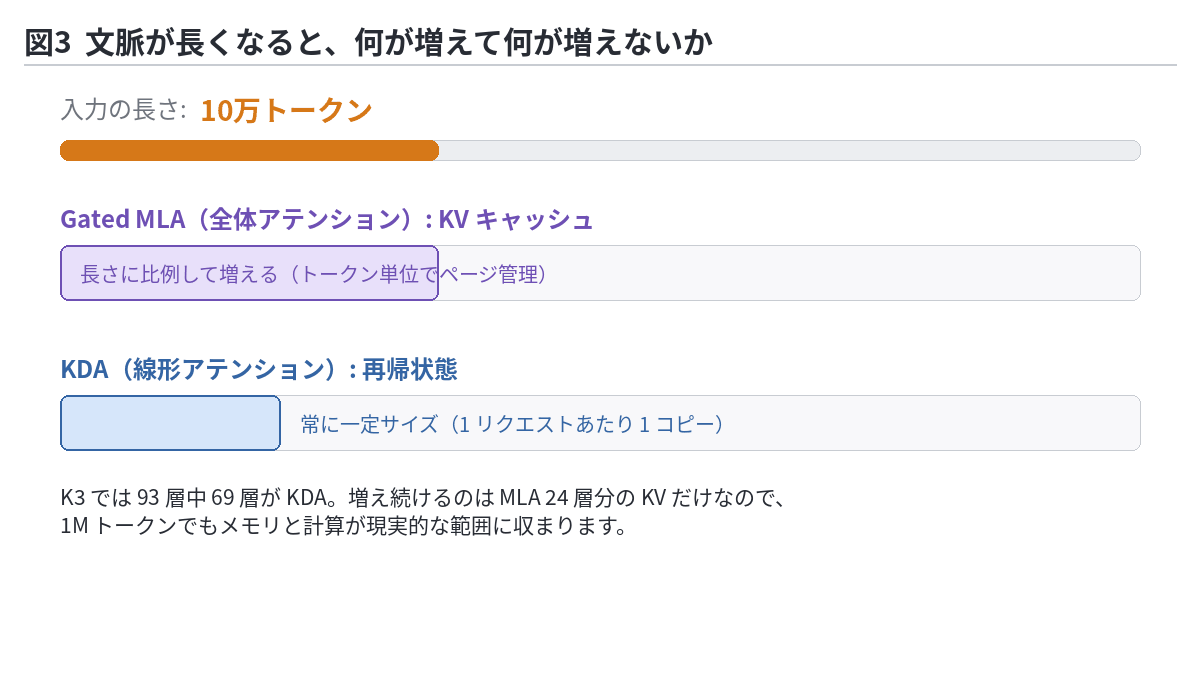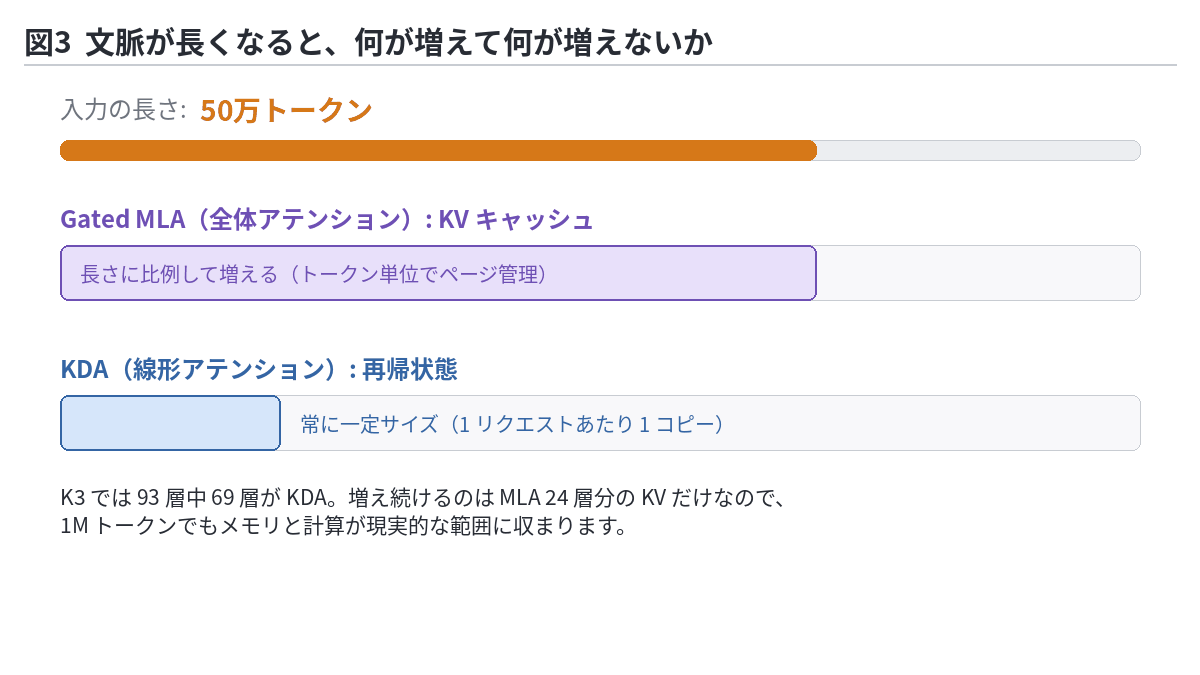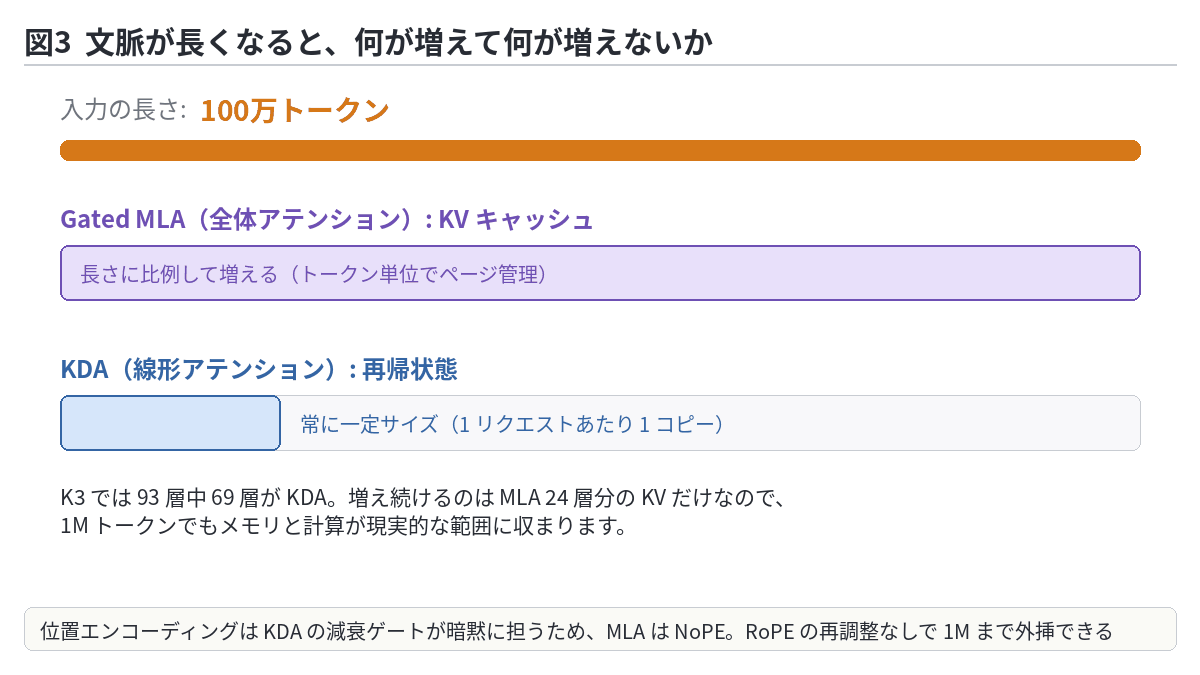
図3: 増え続けるのは 24 層分の MLA の KV だけ。69 層の KDA は 1 リクエストあたり固定サイズの状態しか持ちません(静止画版)。
93 層のうち 69 層が KDA なので、文脈長に比例して増えるメモリは 24 層分の MLA の KV に限られます。これが「1M トークンでもサービングが成立する」根拠です。
位置エンコーディングをなくした
もう一つ、実務に効く設計判断があります。K3 の MLA 層には 位置エンコーディングがありません(NoPE)。位置情報は KDA の減衰ゲートが暗黙に担うため、MLA には RoPE のような明示的な位置情報を与えていません。
通常、学習時より長い文脈で推論するには RoPE の周波数を再調整したり YaRN のような補間を入れたりする必要があります。K3 はこれが不要で、1M まで直接外挿できるとしています。モデルを扱う側から見ると「文脈拡張のたびに設定を変える工程が消えた」ということです。
カーネルの都合を数式で吸収した
細かい点ですが、設計思想がよく表れている箇所です。前身の Kimi Linear では、KDA の減衰係数に下限がなく、チャンク内の計算で BF16 の範囲を超える可能性がありました。そのため対角ブロックだけ位置ペアごとの個別計算が必要で、これがボトルネックでした。
K3 は減衰の対数を「scaled sigmoid で g_min = -5 に下限を設ける」形に変え、16 トークン単位の累積減衰が必ず有限範囲に収まるようにしました。結果として対角ブロックも Tensor Core の密行列積で計算できます。数式の形をハードウェアに合わせて変えた、という判断です。
仕組み 2: 残差接続を「層方向のアテンション」に置き換える AttnRes
Transformer の残差接続は、各層の出力を前の層の状態に足し込みます。これは「過去のすべての層の情報を 1 つの状態に圧縮する」構造で、系列方向で言えば RNN と同じボトルネックです。
Attention Residuals(AttnRes) はこの発想をひっくり返します。各層が学習可能なクエリを持ち、トークン埋め込みと過去のブロック出力に対してアテンションを張り、必要な表現だけを選択的に取り込みます。「層」を「時刻」と読み替えれば、RNN を Transformer に置き換えたのと同じことを深さ方向でやっている、と理解できます。
全層に対して張ると各層の出力をすべて保持する必要があり、メモリと通信が層数に比例します。K3 は 12 層ずつ 8 ブロックにまとめ、ブロック単位の表現に対してアテンションを張る Block AttnRes を採用しています。推論時も状態のサイズが有界になり、オンライン softmax でブロック間の結果を順次マージできます。
仕組み 3: 896 個の専門家を壊さずに動かす Stable LatentMoE
幅を半分にした潜在空間で routed expert を回す
MoE の expert 数と発火数を増やすと表現の幅は広がりますが、従来設計では各 expert が隠れ次元(7,168)のフル表現を受け取るため、通信量と expert 重みの読み出しが発火数に比例して増えます。
LatentMoE はこれを「共通の変換はフル幅の shared expert、専門的な変換は半分の幅(3,584)の routed expert」と役割分担することで抑えます。データの流れを図4 で追ってください。
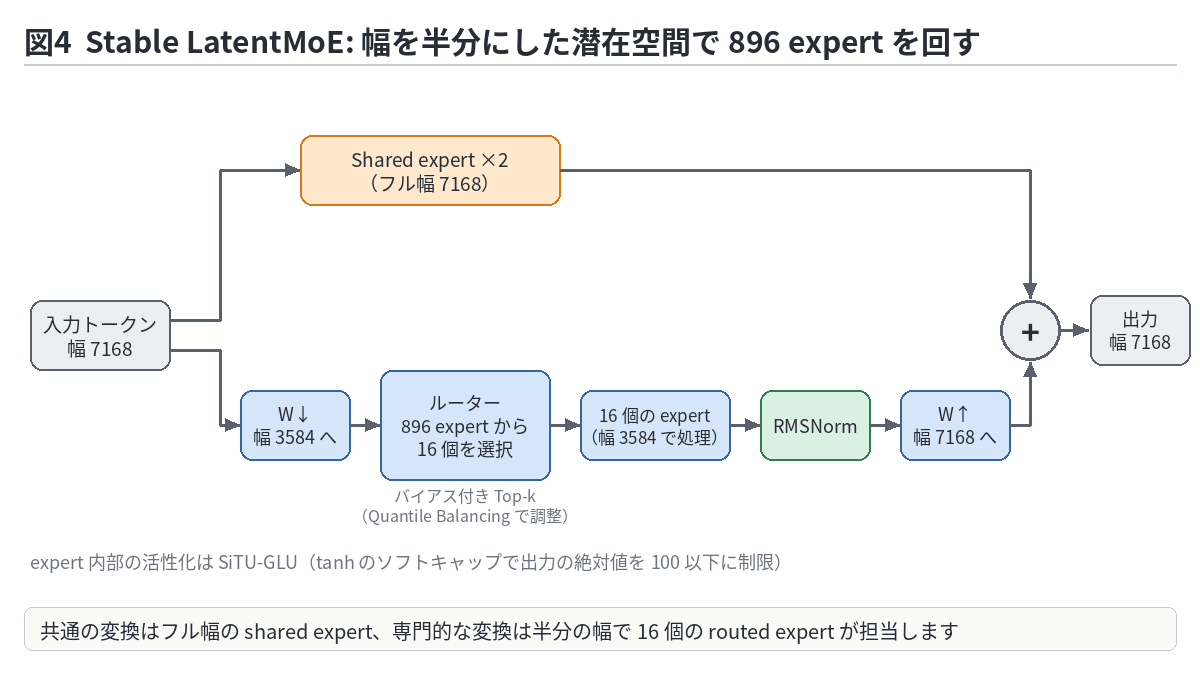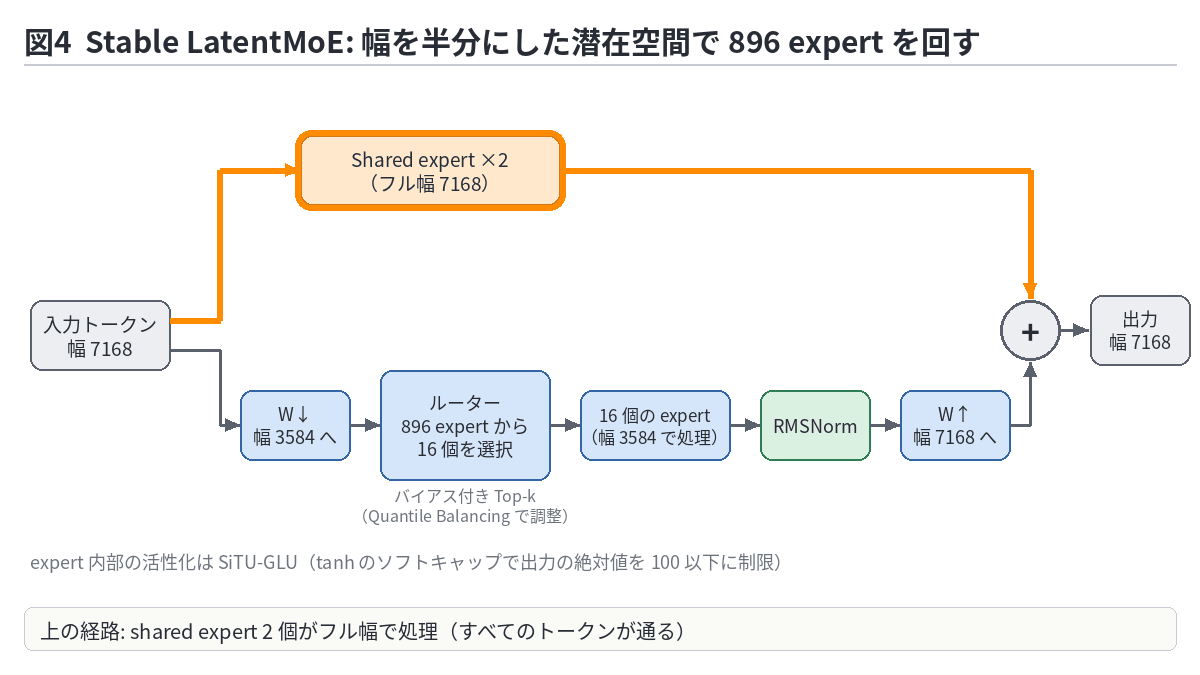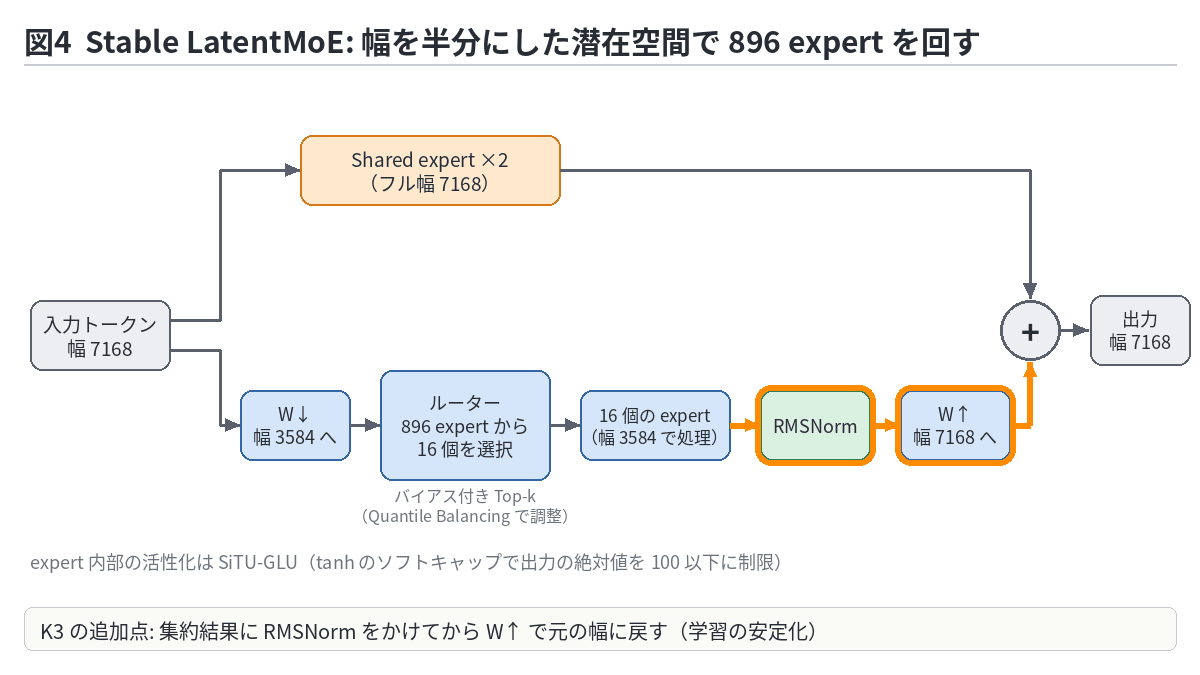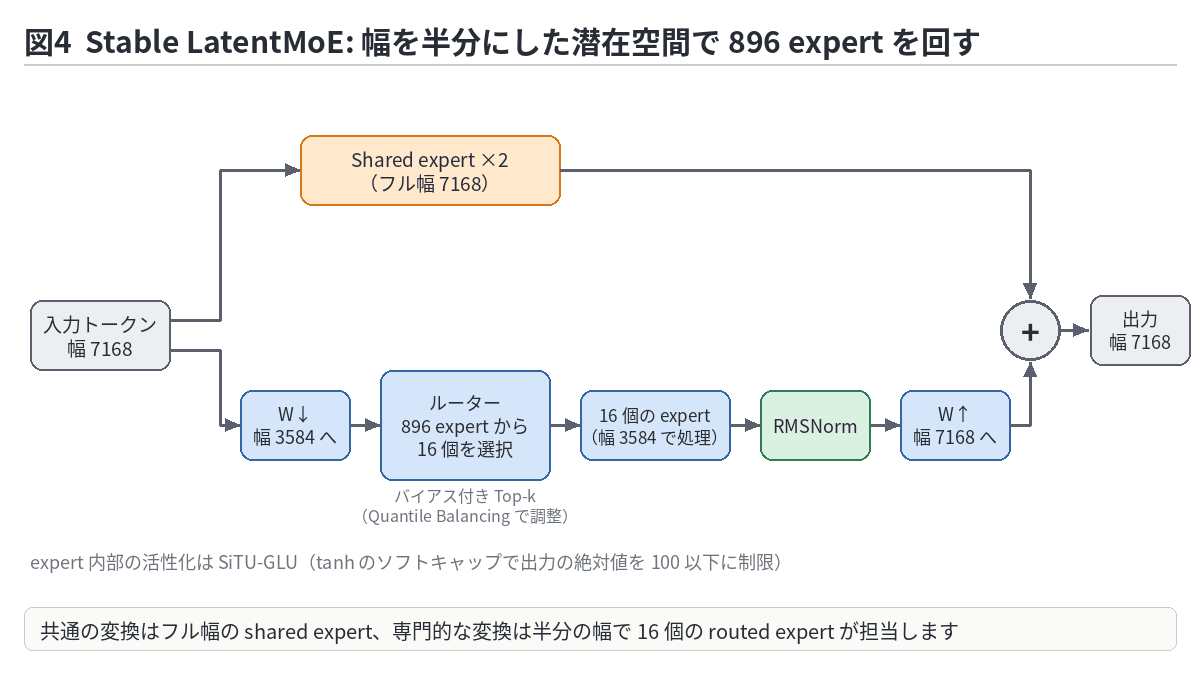
図4: 下の経路が K3 の工夫の中心。W↓ で圧縮し、ルーターが 16 個を選び、集約結果を RMSNorm してから W↑ で戻します(静止画版)。
極端なスパース性で起きる 2 つの故障モード
896 個中 16 個、というスパース性(論文では「56」と表現)では、素朴な LatentMoE は 2 つの問題を起こしたと論文は述べています。
- 活性化の爆発: 圧縮、expert の FFN、復元と、行列積が 4 回近く連続する構造は条件が悪く、2.8T 規模では routed 経路の内部活性化が発散する。
- 負荷の偏り: 1,000 個近い expert の負荷を、既存の補助損失なし手法(固定幅でバイアスを動かす方式)では均しきれない。
前者に対する処方箋が 2 つあります。1 つは集約結果に RMSNorm を挟んでから復元すること。これは学習の安定化だけでなく、検証損失と下流ベンチマークも一貫して改善したとされています。もう 1 つが活性化関数の変更です。
SiTU-GLU: SwiGLU にソフトキャップをかける
SwiGLU はゲート側も値側も上限がないため、両方が同時に大きくなると積が外れ値になり、低精度演算でオーバーフローしやすくなります。K3 の SiTU-GLU は、ゲートの線形項と値側にそれぞれ β·tanh(x/β) のソフトキャップをかけます。β は gate 側 4、up 側 25 で、出力の絶対値は 4 × 25 = 100 を超えません。
原点付近では β·tanh(x/β) ≈ x なので SwiGLU と一次の範囲で一致し、表現力を損ないません。ハードクリップと違って飽和領域でも勾配がゼロにならないため、学習の挙動が良い、というのが採用理由です。
Quantile Balancing: 分位点で負荷を一発補正
後者の負荷分散には Quantile Balancing(QB) という手法を導入しています。従来の補助損失なし手法は、負荷が目標より多い expert のバイアスを固定幅で下げ、少ない expert のバイアスを上げる、という符号ベースの更新でした。この方式は歩幅の調整が難しく、収束が遅いか振動するかのトレードオフがあります。
QB は「各 expert が目標負荷ちょうどになるスコアの分位点」を直接求めて、それをバイアスにします。図5 でイメージを確認してください。
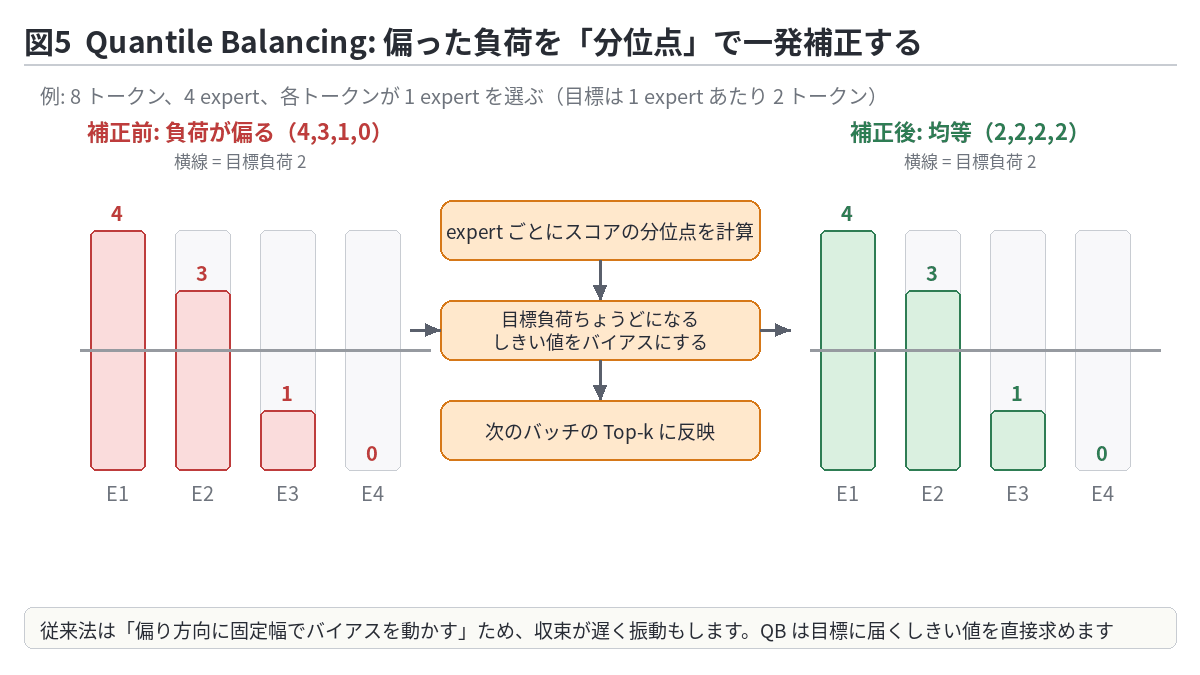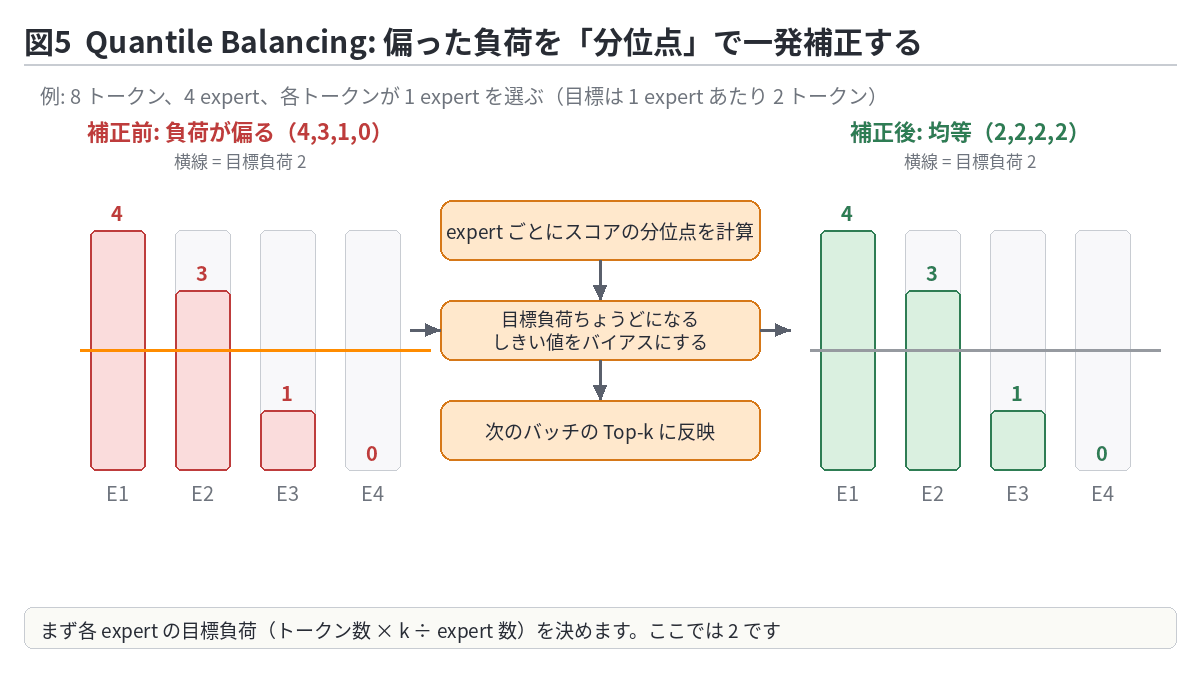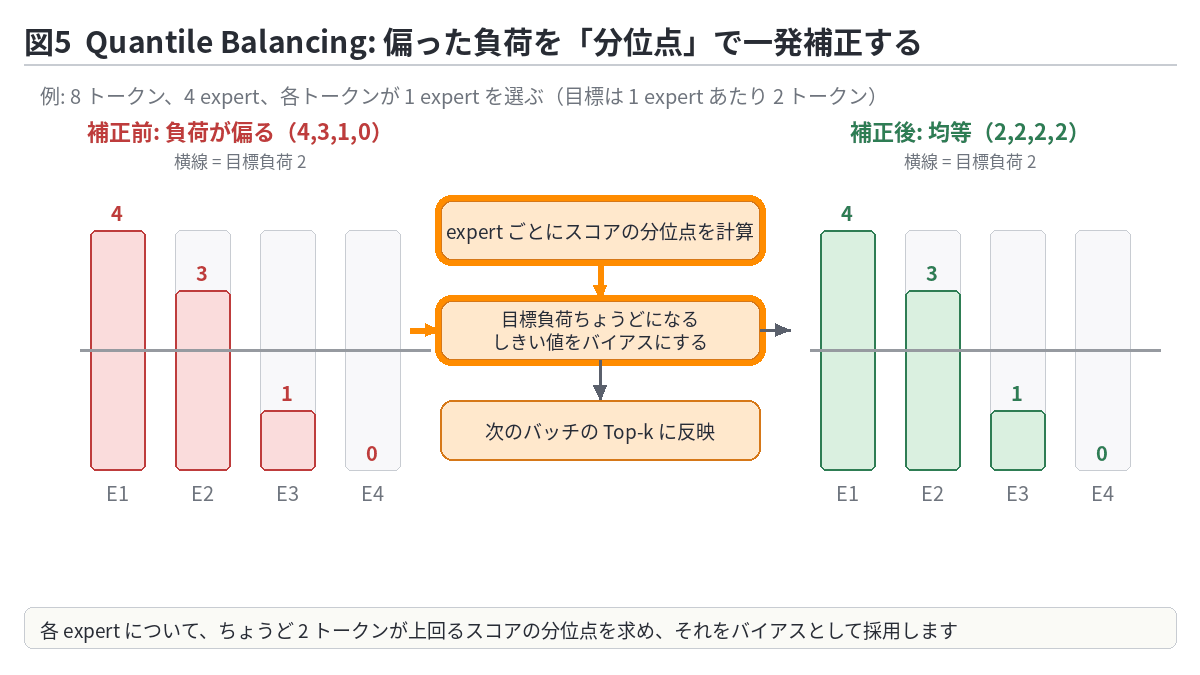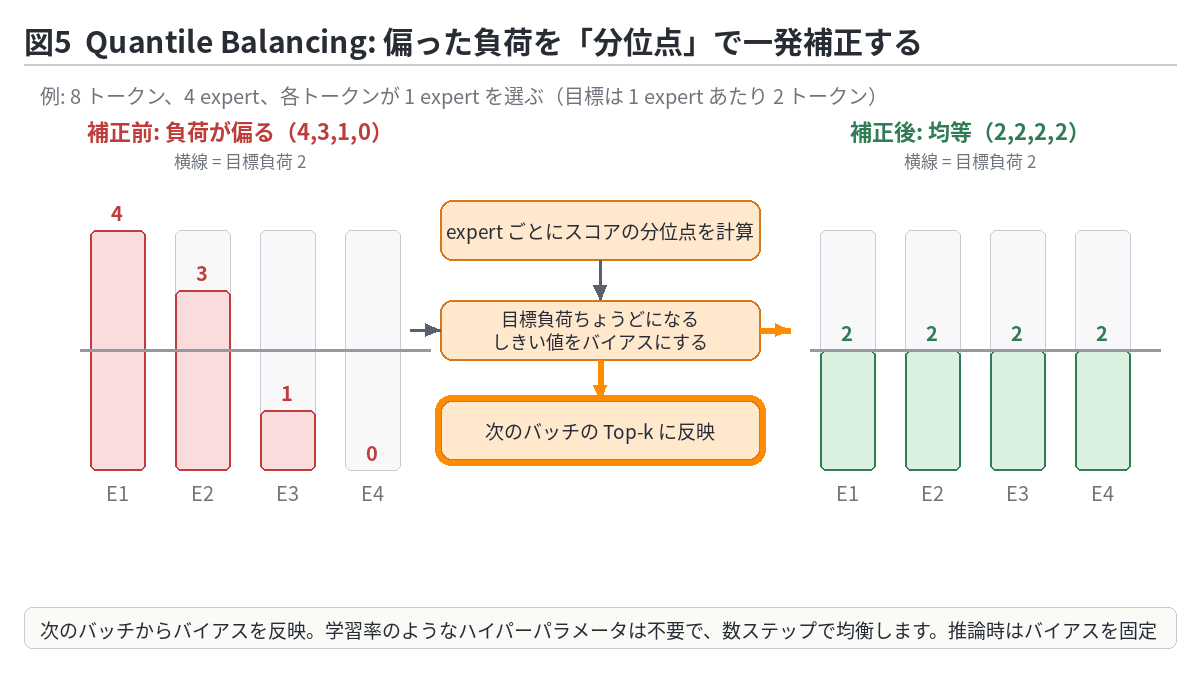
図5: 学習率のようなハイパーパラメータがなく、数ステップで均衡するのが利点。推論時はバイアスを固定するので、配布された重みを使う側は意識する必要がありません(静止画版)。
実装上は、数百万トークン分のスコアを集めて正確な分位点を取るのは現実的でないため、expert ごとにヒストグラム(数百 bin)を持ち、それを all-reduce して分位点を読み取ります。通信量は bin 数に比例するだけで、トークン数には依存しません。
付録では、この QB が「最適な均衡割り当て問題」の双対問題の座標最小化に一致することも導出されています。従来の符号ベース更新は、同じ目的関数に対する SignSGD として位置づけられます。
仕組み 4: 視覚エンコーダをゼロから学習する
マルチモーダルモデルの慣例では、SigLIP など対照学習済みのエンコーダで視覚側を初期化します。K2.5 もそうでした。K3 はこれをやめ、27 層 0.4B の MoonViT-V2 を next-token prediction でスクラッチから学習しています。
理由は学習の安定性です。学習済みエンコーダを LLM に接続すると勾配ノルムのスパイクが頻発し、スクラッチ学習のほうが一貫して安定だったと論文は報告しています。加えて、対照学習は大域的な意味を優先しがちで、文字や構造といった細粒度の手がかりが弱くなる、という指摘もあります。視覚評価では SigLIP 初期化と同等の性能に達しており、「大規模なら対照事前学習は不要」というのは業界の慣行に反する主張として注目に値します。
画像は 2 × 2 の pixel shuffle で視覚トークンを 1/4 に圧縮し、最大 3,584 × 3,584 ピクセルを 1M 文脈の中で扱えるようにしています。
学習の流れ: 9 人の専門家を 1 人にまとめる
3 段構成のポストトレーニング
事前学習後の工程は 3 段階です。
- SFT(教師あり微調整): エージェント行動のコールドスタート。この段階から expert 重みを MXFP4、活性化を MXFP8 で扱う量子化認識学習(QAT)を入れます。学習と推論が同じ量子化スキームなので、配布されるモデルは「量子化で性能が落ちた版」ではなく「最初からその精度で学習した版」です。
- RL(強化学習): 「一般タスク / 一般エージェント / コーディングエージェント」の 3 ドメイン × 推論努力 {low, high, max} の 3 段階で、9 個の専門家モデルを作ります。max を先に作り、トークン予算の係数を絞って high と low を派生させます。
- MOPD(Multi-Teacher On-Policy Distillation): 9 個の専門家を教師にして、1 つの生徒モデルに蒸留します。報酬は教師と生徒の対数確率の差で、ドメインと努力レベルに応じて教師を切り替えます。
図6 でこの流れを追ってください。
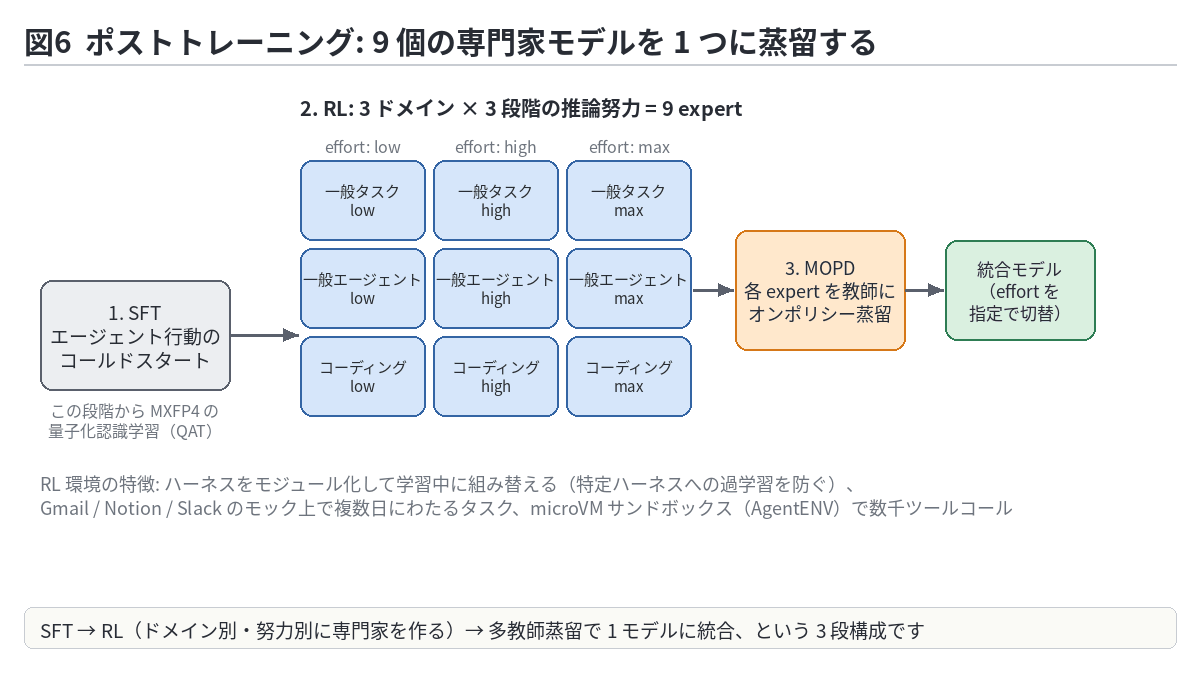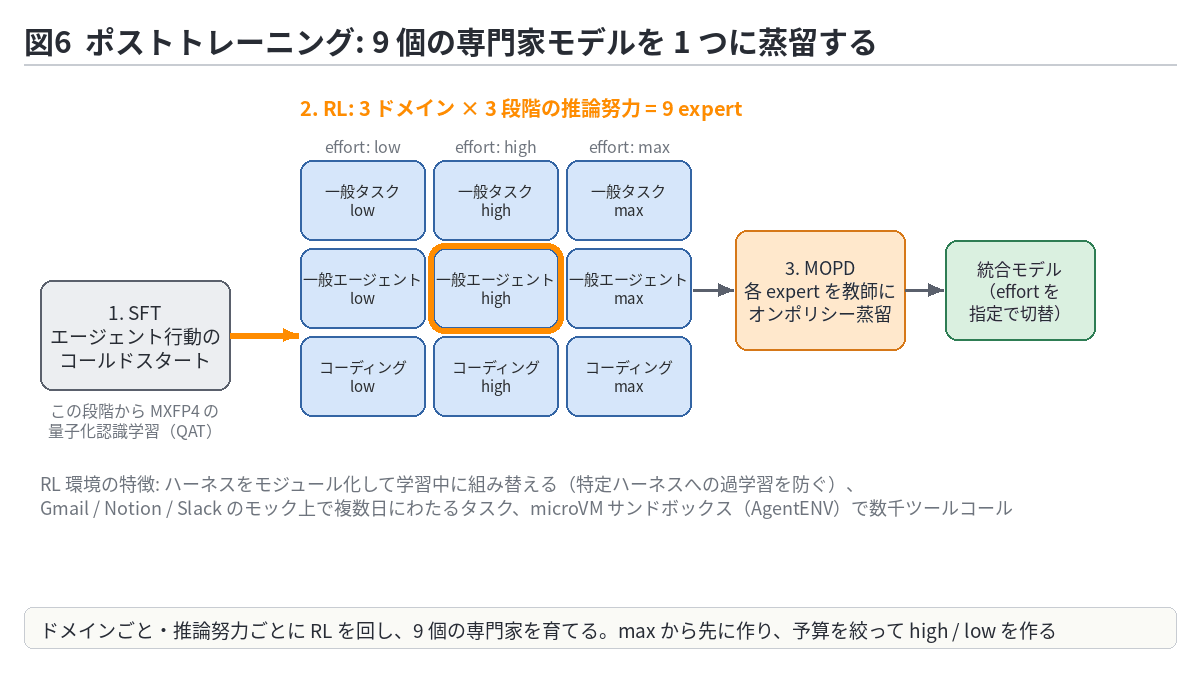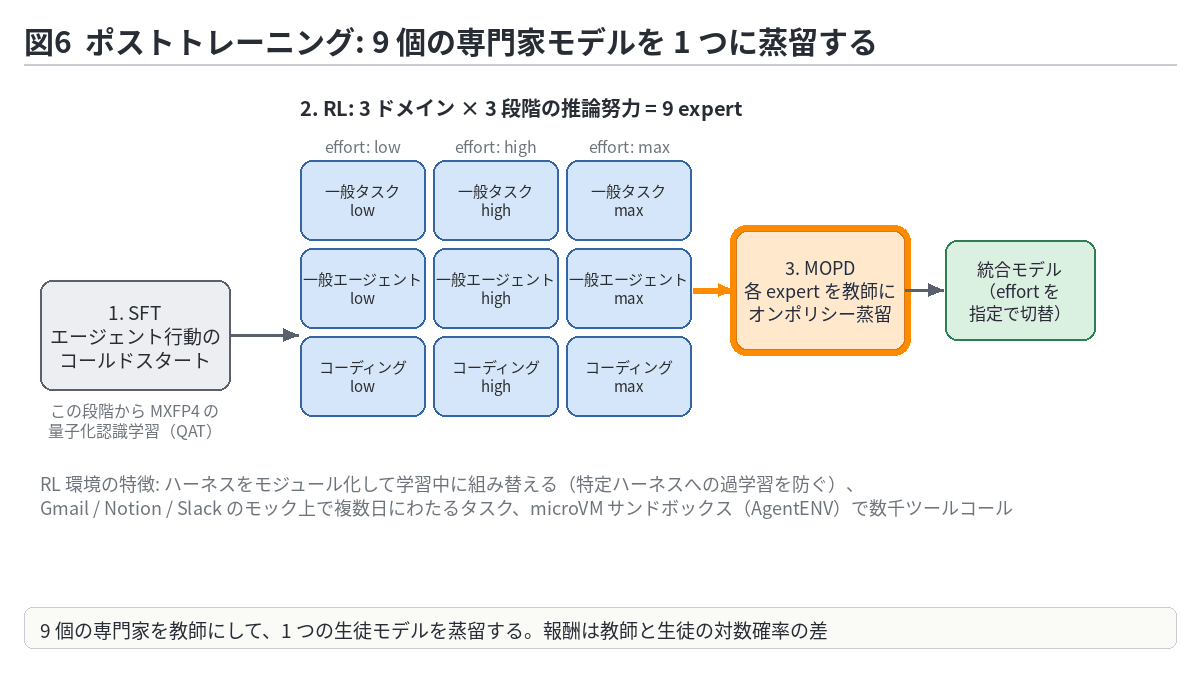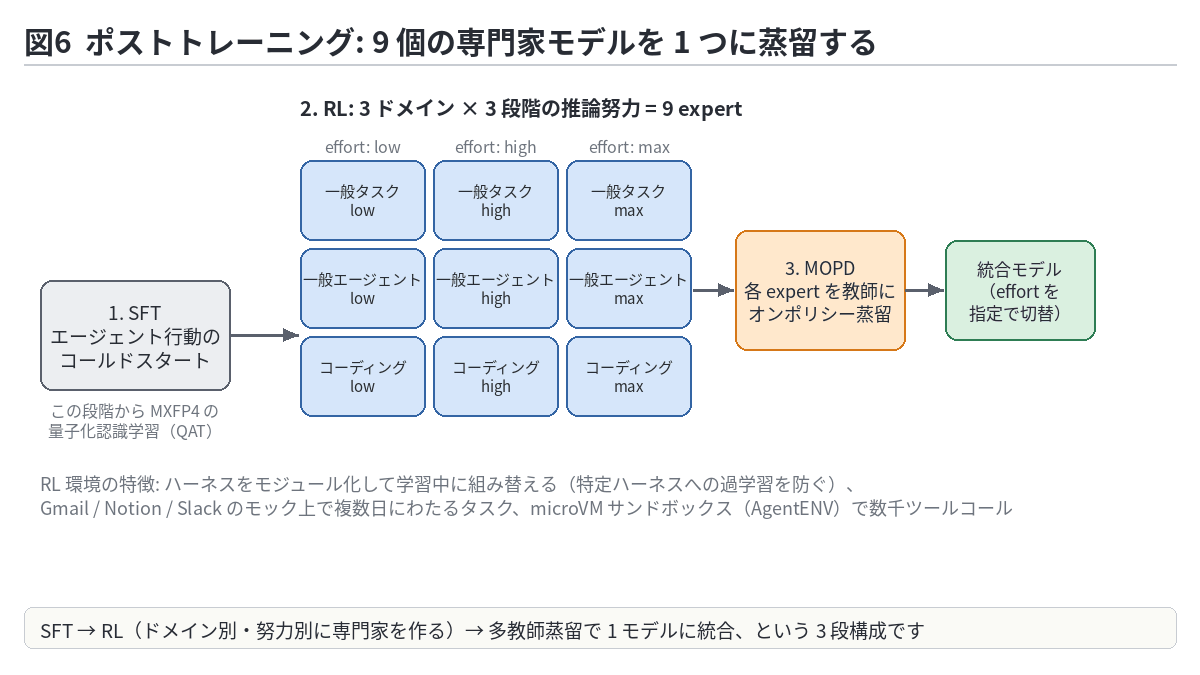
図6: 出来上がるのは 1 つの重み。API では推論努力を指定するだけで振る舞いが切り替わります(静止画版)。
RL 環境で目を引く 3 点
RL の中身で、実務に関係の深い設計が 3 つあります。
ハーネス非依存の学習。特定のエージェントハーネス(Claude Code や Codex のようなツール定義・システムプロンプト・文脈管理の枠組み)だけで学習すると、そのハーネスの流儀に過学習します。K3 は、ハーネスをツールインタフェース、システムプロンプト、文脈管理、skills、memory、サブエージェントといったモジュールに分解し、学習中に構成を組み替えます。論文は Kimi Code、Claude Code、Codex、OpenClaw、Hermes を構成で再現できると述べています。運用側から見ると「既存のハーネスに差し替えても崩れにくい」ことが期待できます。
モックアプリ上の長期タスク。Gmail、Notion、Slack、Canvas の模倣実装を用意し、人事・法務・財務のような業務シナリオで、複数の模擬日にわたって発生するイベントを処理させます。1 ロールアウトで数千のツール呼び出し、数百万トークンに達するものもあり、それぞれのイベントに評価基準が付いています。
AgentENV。Firecracker の microVM をベースにしたサンドボックスで、コンテナ方式では防げなかったカーネルパニックやデッドロックを隔離しつつ、エージェントがディスクをマウントしたり VM を立ち上げたりできる自由度を確保しています。チェックポイント 133 ms、再開 49 ms、一時停止中はメモリも CPU も消費しない(サンドボックスの寿命の最大 98% がモデルの推論待ち)といった数字が挙がっており、学習と評価を通じて 5,100 万個以上のサンドボックスが作られたとしています。GitHub で公開されています。
このほか、GPU カーネル最適化タスクでは CUDA Graph の再生や精度の切り下げといった reward hacking を検知する仕組みを備えていること、Web 開発タスクではビルド失敗や「実装せずに偽装した成果物」に報酬ゼロを与えることが明記されています。
推論効率のための Draft モデル
事前学習時から持っている MTP(multi-token prediction)層を、EAGLE-3 方式の draft モデルに微調整しています。損失は KL ではなく、投機的デコーディングの受理率そのものの対数(LK loss)を直接最大化します。この draft モデルも同じ MXFP4 の QAT 設定で学習されています。
見えないところで効いている推論インフラ
prefix cache が 1M 文脈の経済性を決める
長い文脈を扱うモデルを本番で運用するとき、コストを決めるのは「毎回どれだけ再計算するか」です。論文は、典型的なコーディングの入力が 40 万トークンのプレフィックスに 4 千トークンの増分、という例を挙げています。プレフィックスキャッシュにヒットするかどうかで、コストが桁で変わります。
ここで K3 固有の難しさが出ます。MLA の KV はトークン単位でページ管理できますが、KDA の状態は「1 リクエストにつき 1 枚の大きな行列」なので、任意の位置でスナップショットを取るわけにはいきません。素朴に実装すると、キャッシュの粒度が物理ブロック(1,024〜6,144 トークン)に引きずられ、短いリクエストは一切再利用できなくなります。
K3 は 2 つの粒度を切り離しました。図7 で確認してください。
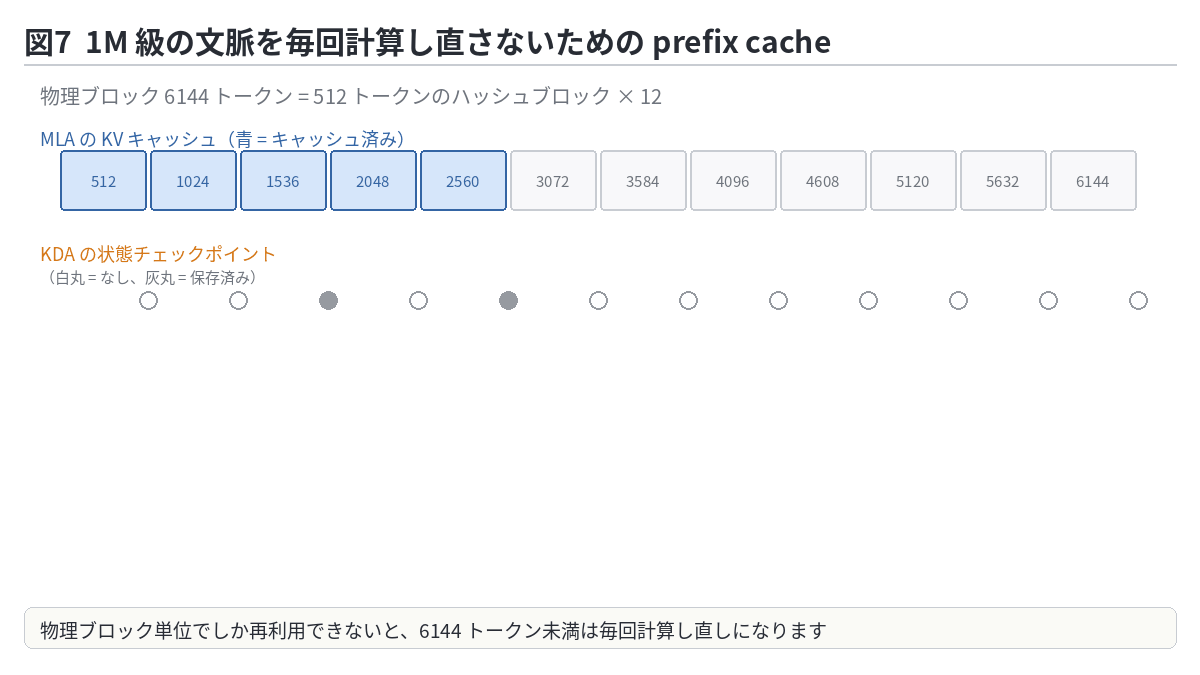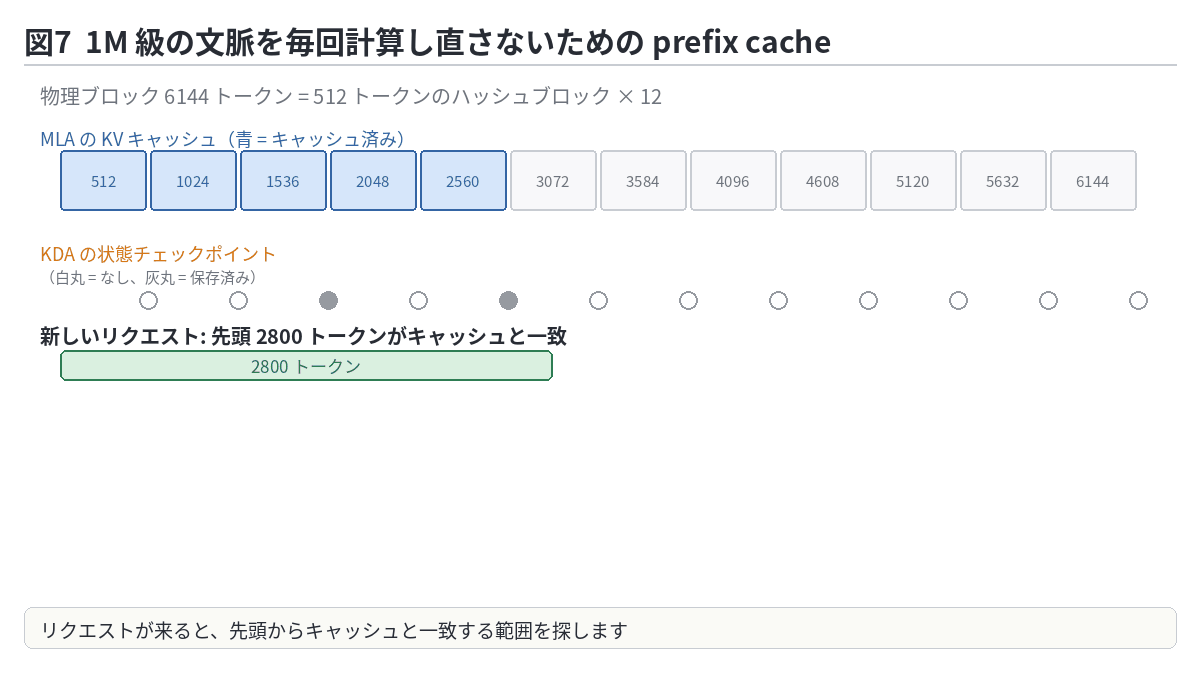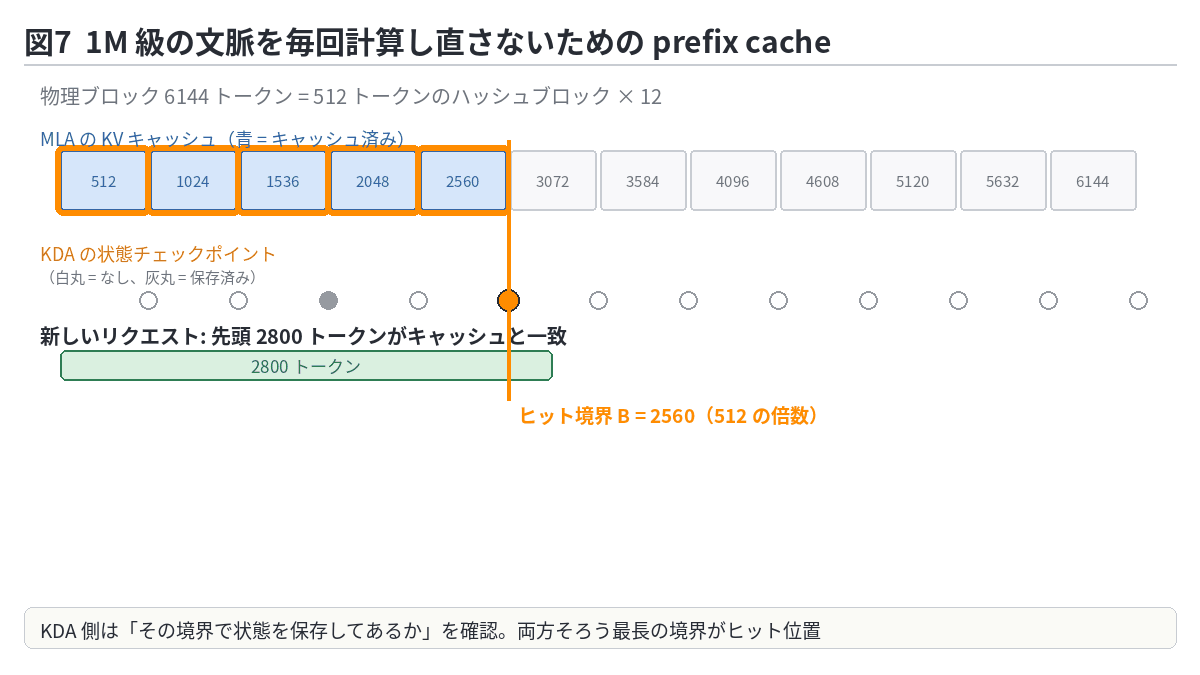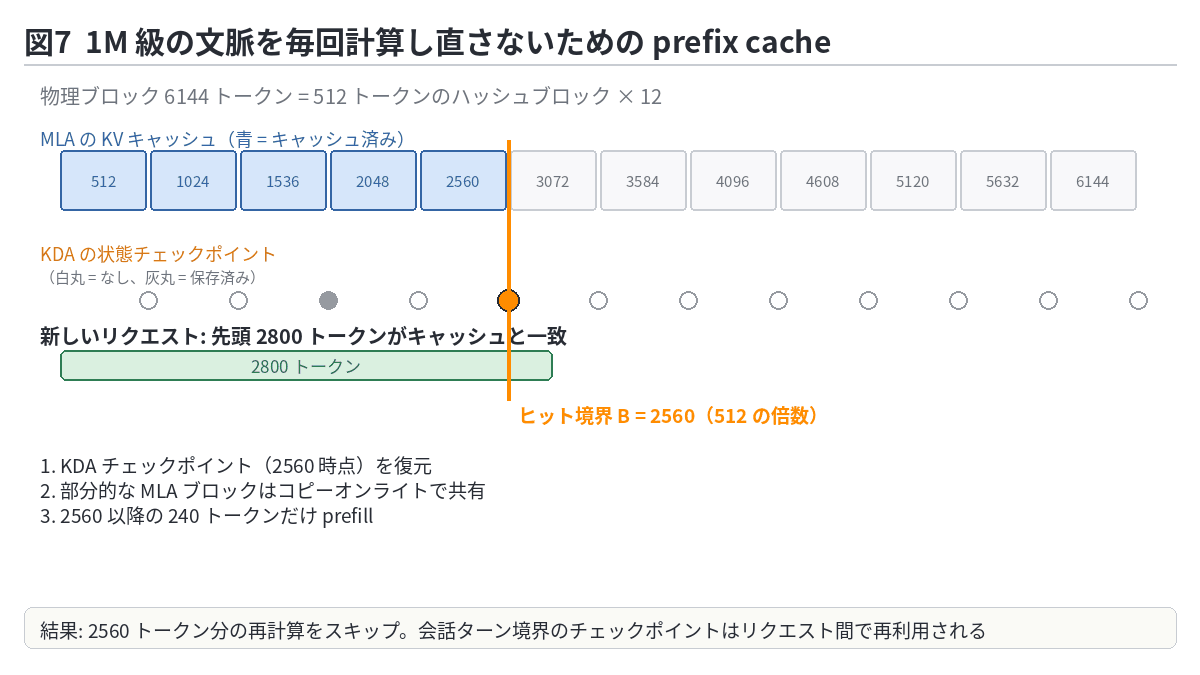
図7: MLA 側は 512 トークン単位のハッシュで一致判定、KDA 側は「その境界にチェックポイントがあるか」で判定。両方そろう最長の境界がヒット位置です(静止画版)。
チェックポイントは会話ターンの境界で保持され、リクエスト間で再利用されます。運用側の含意は明確で、プロンプトの共通部分を先頭に固定し、ターン境界を揃える設計にするほどキャッシュが効くということです。
クラスタをまたぐスケジューリング
さらに上のレイヤーでは 2 つの方針が述べられています。
- キャッシュ親和性ルーティング: セッションを、そのプレフィックスキャッシュを持つクラスタに固定する。障害時は consistent hashing で事前に割り当てた副クラスタが引き継ぐ。副クラスタはキャッシュを持たないので再 prefill が必要だが、その負荷はフリート全体に分散する。
- 予算ベースの受付制御: 2K トークン未満の短いリクエストと 1M の長いリクエストが混在すると、コストは 3 桁ちがう。長文リクエストのバーストが短いリクエストの TTFT(最初のトークンまでの時間)を悪化させないよう、リクエストクラスごとに資源予算を分ける。
いずれも「1M 対応」を実際のサービスとして成立させるための工夫で、セルフホストする場合はこれらを自前で組む必要があります。
ベンチマークをどう読むか
主要な結果
論文の Table 2 から、判断材料になりやすい項目を抜粋します。すべて各モデルの最大推論努力での比較です。
| ベンチマーク | 領域 | Kimi K3 | Claude Fable 5 | GPT-5.6 Sol | Claude Opus 4.8 |
|---|---|---|---|---|---|
| GPQA Diamond | 推論 | 93.5 | 92.6 | 94.1 | 91.0 |
| HLE-Full(ツールあり) | 研究レベル推論 | 56.0 | 63.0 | 58.0 | 57.9 |
| ProgramBench | コーディング | 77.8 | 76.8 | 77.6 | 71.9 |
| Terminal-Bench 2.1 | コーディング | 88.3 | 88.0 | 88.8 | 84.6 |
| FrontierSWE | 長期コーディング | 81.2 | 86.6 | 71.3 | 66.7 |
| SWE-Marathon | GPU カーネル | 42.0 | 35.0 | 39.0 | 40.0 |
| BrowseComp | ブラウジング | 91.2 | 88.0 | 90.4 | 84.3 |
| MCPMark-Verified | MCP ツール利用 | 94.5 | 87.4 | 92.9 | 76.4 |
| GDPval-AA v2(Elo) | 知識労働 | 1686 | 1747 | 1736 | 1593 |
| OSWorld 2.0 | コンピュータ操作 | 58.3 | 66.1 | 62.6 | 55.7 |
| OmniDocBench | 文書 OCR | 91.1 | 89.8 | 85.8 | 87.9 |
得意と不得意がはっきり分かれています。
強い領域は、長期のエージェント実行(ブラウジング、MCP ツール利用、自動化)、GPU カーネル最適化に寄ったコーディング、Web 開発、文書の読み取りです。社内ベンチでは Swarm Bench(複数エージェントの統率)と Deep Research Bench で大差の 1 位、Kimi Webdev Bench の盲検評価では Opus 4.8 に対して勝率差 +31 pt、特に 3D / WebGL / シェーダーで +59 pt としています。
弱い領域は、研究レベルの推論(HLE、CritPt)、OS 操作型のコンピュータユース、Elo で測る知識労働系(GDPval、AA-Briefcase)です。社内ベンチの Agent Behavior Bench(ツール利用の効率や規律を採点)でも Fable 5 や GPT-5.6 Sol に 10 pt 以上の差があります。論文自身が「研究レベルの推論は主要な改善課題」と明記しています。
自社評価であることを織り込む
この種の技術レポートを読むときの注意点を整理しておきます。
- 表には Moonshot 自身の評価と、外部リーダーボードから引用した結果が混在します。Claude Fable 5 の結果は「fallback 含む」、GPT-5.6 Sol は「cyberguard 含む」と注記されており、SWE-Marathon は H20 GPU 向けに再調整した版で、Fable 5 は 35% のタスクで fallback が発生しています。
- コーディングのハーネスは Kimi Code、Claude Code、Codex から選ばれ、Terminal-Bench は「ハーネス間の最良スコア」で比較しています。
- 論文が紹介する公開当時の独立評価では、Artificial Analysis の Intelligence Index v4.1 で 580 モデル中 4 位(57.1。Fable 5 が 59.9、GPT-5.6 Sol が 58.9)、Vals AI の Vals Index で 39 モデル中 2 位(74.7)、WebDev Arena で 99 モデル中 1 位、Text Arena で 200 モデル中 8 位です。これらは論文掲載時点の順位であり、現在の順位を保証しません。評価時点と条件を確認して読み比べてください。
サイバー能力の評価
論文は 6.2.2 節でサイバーセキュリティ能力を 2 段階で評価しています。Tier 1(脆弱性発見)では、人手レビューを経た候補の約 70% が実在の脆弱性と確認され、6 プロジェクトで 16 件の未知の脆弱性が含まれていたとしています。Tier 2(エクスプロイト開発)では 36 タスク中 14 を解き、GLM-5.2 の 8 を上回りました。ただし英国 AISI と米国 CAISI の独立評価では、フロンティアのサイバー対応モデルには届かず、41 タスクで任意コード実行に至ったものは 0 件です。
コスト効率
実務的に一番効くのはここです。論文はスコアとタスクあたりコストを 4 つのスイートで比較しています。
- Kimi Code Bench 2.0: Fable 5 に 4.0 pt 差で、コストは 38%。high 設定では Opus 4.8 の max 設定と同スコアを約 1/3 のコストで達成。
- BrowseComp: 91.2% を 1 タスク $2.03 で達成。GPT-5.6 Sol の半額、Claude 系の max 設定に対して 1 桁安い。
- GDPval-AA v2: GPT-5.6 Sol に 50 Elo 以内で 13% 安く、Fable 5 の 2.6 分の 1 のコスト。
「最高性能ではないが、性能あたりコストのフロンティアに乗っている」というポジションが、数字の上でも一貫しています。
ケーススタディ
論文の第 7 章には、性能を実感しやすい事例が並んでいます。24 時間予算での GPU カーネル最適化では、AttnRes のレイテンシを 283.6 ms から 114.4 ms に短縮し、Fable 5 と同等、Opus 4.8 や GPT 系を大きく上回ったとされています。Triton 風のコンパイラ MiniTriton を DSL から PTX 生成まで一貫して構築した例、48 時間の自律実行で Nangate45 ライブラリを使った推論チップの RTL を設計・検証した例(4 mm² で 100 MHz、8,700 tokens/s)、天体物理の I-Love-Q 関係を 20 本超の論文から約 2 時間で再現した例などが紹介されています。
実務での使い方
利用形態を決める
まず「どこで動かすか」を決めます。判断フローを図8 にまとめました。

図8: API で実測し、データ要件・費用・運用負担を比較して利用形態を選びます。下段は形態によらず確認する項目です(静止画版)。
2026 年 9 月時点で確認できる提供状況は以下のとおりです(各社の公開情報にもとづきます。料金や条件は変わるため、契約前に必ず一次情報で確認してください)。
| 形態 | 概要 | 目安 |
|---|---|---|
| 公式 API | https://api.moonshot.ai/v1、モデル ID kimi-k3。OpenAI 互換 |
入力 $3.00、キャッシュヒット入力 $0.30、出力 $15.00(100 万トークンあたり)。1M 文脈全域で同一レート |
| 第三者ホスト | OpenRouter、Baseten、Runpod、Novita などが day-0 で対応 | OpenRouter は提供事業者によって異なる。2026-09-11 確認では最安表示が入力 $2.34 / 出力 $11.70、Relace は $2.40 / $12.00 / キャッシュ $0.24 |
| セルフホスト | HuggingFace の moonshotai/Kimi-K3。vLLM と SGLang が day-0 対応 |
MXFP4 でも重みは 1.4〜1.56TB。8×B300、16×B200、または 32×H100 級の構成 |
セルフホストの損益分岐は、GPU の契約価格、稼働率、入力と出力の比率、キャッシュヒット率、運用人件費で変わります。月間トークン数だけで一律に決めず、後述のタスク単位の API 費用と設備・運用費を比較してください。まず API で負荷と成功率を測り、データを社外に出せない場合や継続的な高負荷がある場合にセルフホストを検討するのが現実的です。
公式 API の呼び出し
OpenAI 互換なので、既存のクライアントがそのまま使えます。Dify や LangChain のような OpenAI 互換プロバイダを持つツールからも、ベース URL とモデル ID を変えるだけで接続できます。
以下は Python SDK での最小例です。2026-09-11 に確認した公式 Quickstartでは、推論努力はトップレベルの reasoning_effort に low / high / max(既定値)を指定します。Python 3.9 以上と OpenAI SDK が必要です。SDK は python3 -m pip install --upgrade openai で導入し、API キーを環境変数 MOONSHOT_API_KEY に設定してください。以下の API 呼び出しは構文確認のみで、実アカウントでの通信実行は行っていません。
# 公式 API を OpenAI SDK で呼ぶ最小例
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key=os.environ["MOONSHOT_API_KEY"],
)

resp = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {"role": "system", "content": "あなたは社内向けの技術アシスタントです。"},
        {"role": "user", "content": "次のログから障害の原因候補を 3 つ挙げてください。..."},
    ],
    reasoning_effort="high",
)

print(resp.choices[0].message.content)
論文の評価設定は temperature 1.0、top-p は単発の推論・知識タスクで 0.95、エージェントタスクで 1.0 です。一方、現在の公式 API では temperature=1.0、top_p=0.95 が固定され、リクエストでは省略するよう案内されています。論文の評価条件と公開 API の仕様を分けて扱ってください。複数ターンやツール呼び出しでは、返された assistant メッセージを reasoning_content と tool_calls ごと保持して次のリクエストに渡します。
コストは「タスク単位」で測る
K3 は推論(思考)が常時オンで、思考トークンは通常の出力トークンとして課金されます。入力単価だけを見て見積もると外れます。
以下は、1 タスクの入力・キャッシュヒット・出力トークン数からコストを概算する小さな関数です。実際のトークン数は API のレスポンスに含まれる usage を使ってください。
# 公式 API の公開単価(USD / 100万トークン)でタスクあたりコストを概算する
PRICE = {"input": 3.00, "cached_input": 0.30, "output": 15.00}

def cost_per_task(input_tokens: int, cached_tokens: int, output_tokens: int) -> float:
    """cached_tokens は input_tokens のうちキャッシュヒットした分"""
    uncached = input_tokens - cached_tokens
    return (
        uncached * PRICE["input"]
        + cached_tokens * PRICE["cached_input"]
        + output_tokens * PRICE["output"]
    ) / 1_000_000

# 例: 40万トークンのプレフィックス(うち 39.6万がキャッシュヒット)+ 思考込み 2万トークンの出力
print(round(cost_per_task(400_000, 396_000, 20_000), 3))  # -> 0.431
# 同じ入力でキャッシュが効かない場合
print(round(cost_per_task(400_000, 0, 20_000), 3))        # -> 1.5
この例では、キャッシュの有無で 3 倍以上の差が出ます。論文の prefix cache の設計(512 トークン境界、会話ターン境界のチェックポイント)を踏まえると、システムプロンプトと参照文書を先頭に固定し、可変部分を末尾に置く構成が最も効きます。
長文は「圧縮する」前提で組む
1M 文脈が使えることと、1M を毎回投げるべきことは別です。論文自身が BrowseComp の評価で「30 万トークンに達したら文脈を圧縮する」戦略を採り、圧縮なしの 1M 運用(90.4%)より良いスコア(91.2%)を出しています。長期エージェントを組むなら、要約・圧縮のタイミングを設計に含めてください。
ハーネスとの相性
論文のコーディング評価は Kimi Code、Claude Code、Codex の 3 ハーネスで行われており、社内ベンチの Kimi Code Bench 2.0 では Claude Code ハーネス経由で 73.7、自社の Kimi Code で 72.9 を出しています。学習段階でハーネスを組み替えているため、既存の Claude Code 互換ワークフローにモデルだけ差し替えて試す、というのが最短の検証方法です。
構造化出力の扱い
現在の公式 Quickstartでは、response_format の json_schema と strict: true による構造化出力が案内されています。検証する対象は最終回答の message.content です。第三者ホストは提供事業者ごとに対応が異なるため、JSON モードとスキーマ強制の対応を個別に確認してください。業務上の値の妥当性は、Pydantic などを使いアプリ側でも検証します。
セルフホストの現実
vLLM は 2026 年 7 月 27 日に day-0 サポートを発表しており、KDA カーネル、MXFP4 MoE、KV キャッシュ管理、prefill / decode 分離、投機的デコーディングを統合したとしています。SGLang も同日付の専用ビルドで対応しています。
ただし、以下は覚悟が要ります。
- 重みのダウンロードだけで 1.5TB 級。ノードごとに 1.7TB のローカル NVMe か共有ボリュームが必要
- 32×H100 構成では各ランクが約 60GB を常駐させる。注意機構・KDA・AttnRes・視覚エンコーダはランクごとに複製されるため、単純な「重み ÷ GPU 数」より大きい
- prefill / decode 分離は RDMA 前提で、単一ノードでは動かない構成もある
起動コマンドはエンジンのバージョンで頻繁に変わるため、ここには載せません。vLLM のブログ記事と SGLang のクックブック(参考リソース参照)を一次情報として参照してください。
ライセンスとデータの取り扱い
企業利用で先に確認すべき 2 点です。
ライセンス: 重みは Kimi K3 License で公開されており、商用利用は可能です。ただし、Model-as-a-Service 事業を運営し、利用者と関連会社の合計売上が連続する 12 か月で $20M を超える場合、商用利用前に Moonshot との別契約が必要です。月間 1 億 MAU または月商 $20M を超える商用プロダクトには「Kimi K3」の表示条件があります。ライセンスで定義された内部利用と、Moonshot 公式製品または認定推論パートナー経由の利用には、これら第 2・3 条の例外があります。ライセンス原文を確認してください。一部の解説記事は「Modified MIT」と報じていましたが、実際に公開された条件は上記のとおりなので、原文を確認してください。
データ: API への入力・出力の扱いは、利用する公式サービスまたは第三者ホストの契約条件で確認してください。学習利用の有無だけでなく、サービス改善目的の利用、保存先、保持期間、削除方法を分けて確認する必要があります。機密データを扱う場合は、契約と DPA(データ処理契約)に必要な条件を明記します。特定の保存先や保持期間は本稿では保証しません。
向いている用途、向いていない用途
論文の結果と提供条件を踏まえて整理します。
| 向いている | 理由 |
|---|---|
| 長期のリサーチ・ブラウジングエージェント | BrowseComp、Deep Research Bench で最高スコア |
| MCP ツールを多用する自動化 | MCPMark-Verified 94.5、AutomationBench 30.8 で 1 位 |
| Web フロントエンド生成 | WebDev Arena 1 位、3D / WebGL で Opus 4.8 に大差 |
| 帳票・PDF の読み取りと図表理解 | OmniDocBench 91.1 で 1 位、Python ツール併用で CharXiv 91.3 |
| 大量トークンを消費するバッチ処理 | タスクあたりコストが Claude 系の max 設定より 1 桁安い |
| 向いていない | 理由 |
|---|---|
| 研究レベルの推論精度が必要な用途 | HLE-Full、CritPt で Fable 5 と GPT-5.6 Sol に明確な差 |
| OS 操作型のコンピュータユース | OSWorld 2.0 で 8 pt 差 |
| ツール利用の「規律」を重視する用途 | Agent Behavior Bench で 10 pt 以上の差 |
| 厳格なデータ主権が要る案件での API 利用 | 保存先と規約の確認が必要。セルフホストは設備コストが高い |
導入時につまずきやすい点
| 症状 | 原因 | 対処 |
|---|---|---|
| 想定の数倍の請求が来る | 思考トークンが出力課金。長文をキャッシュなしで投げている | usage でタスク単位に計測。プレフィックスを固定し、キャッシュヒット率を監視 |
| 長いエージェント実行で後半の品質が落ちる | 文脈が肥大化 | 30 万トークン付近で圧縮・要約する設計に変更 |
| JSON の形が崩れる | ホスト側の対応差、指定不足、出力打ち切り | 公式 API の json_schema / strict を確認し、content を検証。第三者ホストの対応も確認 |
| 推論努力を変えても挙動が変わらない | パラメータ名や指定方法が異なる | 公式ドキュメントで指定方法を確認。low / high / max のどれが有効か確認 |
| セルフホストで起動しない | メモリ不足、専用ビルド未使用 | 重み 1.5TB + 複製分を見積もる。エンジンは K3 対応版を明示的に指定 |
まとめ
Kimi K3 の技術レポートを、新規性・改善点・使い方の 3 つの軸で読み解きました。要点を振り返ります。
- 新規性: KDA と MLA のハイブリッド(3:1、NoPE)、層方向のアテンション AttnRes、幅半分の潜在空間で 896 expert を安定に回す Stable LatentMoE(RMSNorm、SiTU-GLU、Quantile Balancing)、スクラッチ学習の視覚エンコーダ。いずれも「1M 文脈 × 3T 級」を成立させるための設計判断です。
- 改善点: K2 比でスケーリング効率 2.5 倍、文脈 8 倍。長期エージェント、ブラウジング、Web 開発、文書読解では最上位と並ぶか上回り、研究レベル推論と OS 操作では差が残ります。性能あたりコストは一貫して優位です。
- 使い方: ほとんどの用途は公式 API か第三者ホストで足ります。コストはタスク単位で測り、プレフィックスキャッシュと文脈圧縮を前提に設計します。ライセンスの規模条項とデータ規約は契約前に確認が必要です。
「最上位のプロプライエタリを置き換えるか」という問いへの答えは、現時点では「用途次第」です。研究レベルの推論や慎重さが問われる場面では差が残る一方、大量のツール呼び出しを回すエージェントや、コストが支配的なバッチ処理では有力な選択肢になります。まずは既存のハーネスにモデルだけ差し替え、タスク単位のコストと成功率で比較するところから始めるのが現実的です。
次のステップとしては、Kimi Linear の論文(KDA の元になった設計)と Attention Residuals のプレプリントを読むと、本稿で省略した数式の背景がつながります。
参考リソース
- Kimi Team, “Kimi K3: Open Frontier Intelligence” 技術レポート(本稿の一次資料)
- Kimi K3 公式リポジトリ
- 公式 API Quickstart
- 公式料金ページ
- vLLM Kimi K3 レシピ
- SGLang Kimi K3 Cookbook
- Kimi K3 モデル重み: https://huggingface.co/moonshotai/Kimi-K3
- Moonshot AI 公式ブログ(Kimi K3 発表): https://www.kimi.com/blog/kimi-k3
- vLLM ブログ “Kimi K3 Is Here: Efficient Day-0 Support on vLLM”: https://vllm-project.github.io/2026/07/27/k3.html
- Baseten “How to build a day-0 API for Kimi K3”: https://www.baseten.co/blog/how-to-build-a-day-zero-api-for-kimi-k3/
- OpenRouter の Kimi K3 ページ(第三者ホストの料金と仕様): https://openrouter.ai/moonshotai/kimi-k3
- AgentENV(microVM サンドボックス): https://github.com/kvcache-ai/AgentENV
- MoonEP(Expert Parallelism 実装): https://github.com/MoonshotAI/MoonEP
- FlashKDA: https://github.com/MoonshotAI/FlashKDA
- UK AISI / CAISI による Kimi K3 サイバー能力の予備評価: https://www.aisi.gov.uk/blog/preliminary-assessment-of-kimi-k3s-cyber-capabilities
- Kimi Linear(KDA の元論文): https://arxiv.org/abs/2510.26692
本稿の図はすべてこの記事用に作成した概念図です。数値は技術レポートおよび上記の公開情報にもとづきますが、料金・ライセンス・対応状況は変更される可能性があります。