はじめに
社内文書を RAG(Retrieval-Augmented Generation:検索した資料をもとに AI に答えさせる仕組み)に入れようとして、こんな経験はないでしょうか。
- 請求書の明細表を取り込んだら、数字が1行ずつばらばらになり「どの拠点の売上か」が分からなくなった
- 研究資料の数式が
𝑝𝑖= 𝑒𝑧𝑖 ∑𝑗= 1のような記号の羅列になった - 3段組の社内報で、左右の段の文章が交互に混ざった
- 古いスキャン資料は、そもそも文字が1文字も取れなかった
検索の精度は、検索より前の「文書を正しく読み取れたか」で大きく変わります。表の行と列の対応が崩れた状態でいくら検索を工夫しても、正しい数字は返せません。
2026年11月13日、Datalab が文書解析のオープンソース「Surya(スーリヤ)」の v0.24.0 を公開しました。689M パラメータの文書専用モデル「Surya 2.5」が、文字だけでなく表の結合セル・数式・読み順まで含めた構造を1回の処理で書き出します。今回の版では PyTorch などの重い依存を外し、Mac でも pip install と Homebrew だけで動くようになりました。
この記事では、次の3つを順に説明します。
- 従来の PDF 抽出や OCR は、どんな場面で何が崩れていたのか
- Surya v0.24.0 は何を変え、その結果どの読み取りが強くなったのか(手元の Mac で34ページを実測)
- 実際に使うときの手順(インストール、CLI、閲覧画面、Python、RAG 用のチャンク化)
想定読者は、RAG や文書検索を作っている(これから作る)エンジニアと、社内文書の AI 活用を検討している方です。Python のコマンドを打ったことがあれば読み進められます。
この記事の確認範囲
- 確認日:2026年11月16日。surya-ocr 0.24.0(モデル Surya 2.5、旧モデル Surya 2 は比較用)
- 実行環境:MacBook Pro(Apple M5 Max・メモリ 128GB)、macOS、Python 3.12、llama.cpp 0.4.1(Homebrew)
- 比較した従来手法:PyMuPDF 2.1(
get_text())、pymupdf4llm 2.1(PDF→Markdown)、macOS 標準の Vision(行ごとの OCR) - 数値のうち「公式」と書いたものは Datalab の GitHub リリースノートと README の値。それ以外は手元の測定です
最初に、この記事の結論を1枚にまとめます。
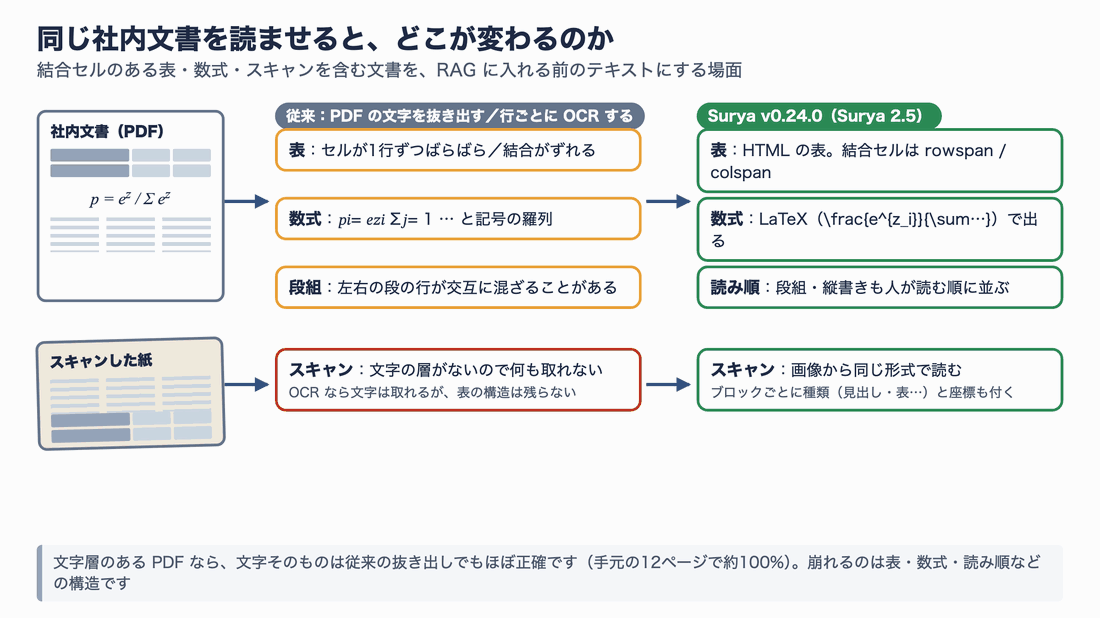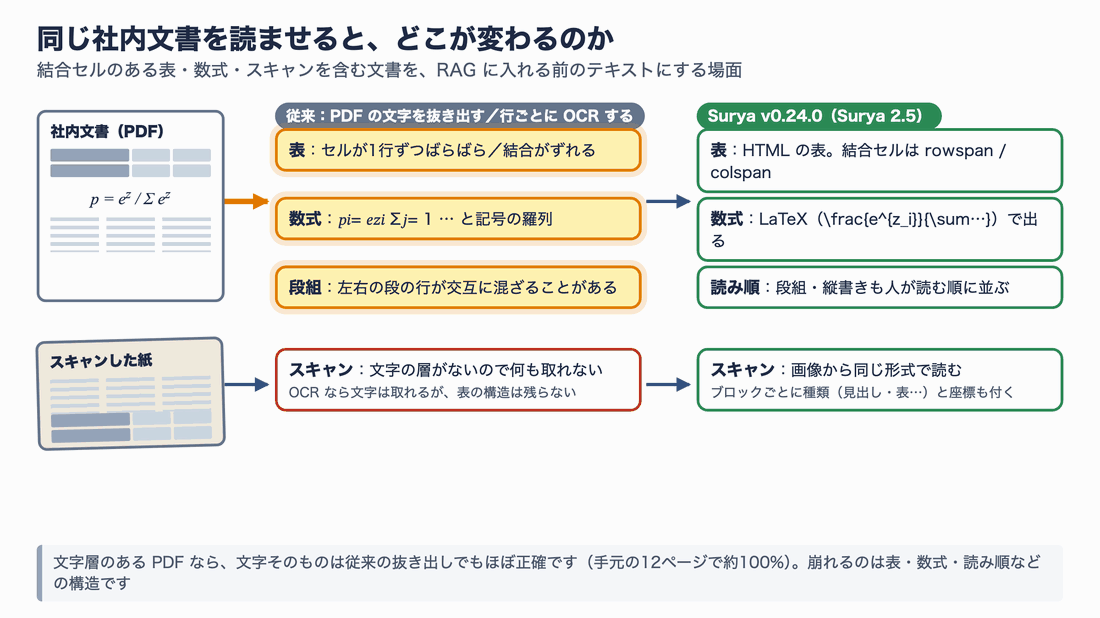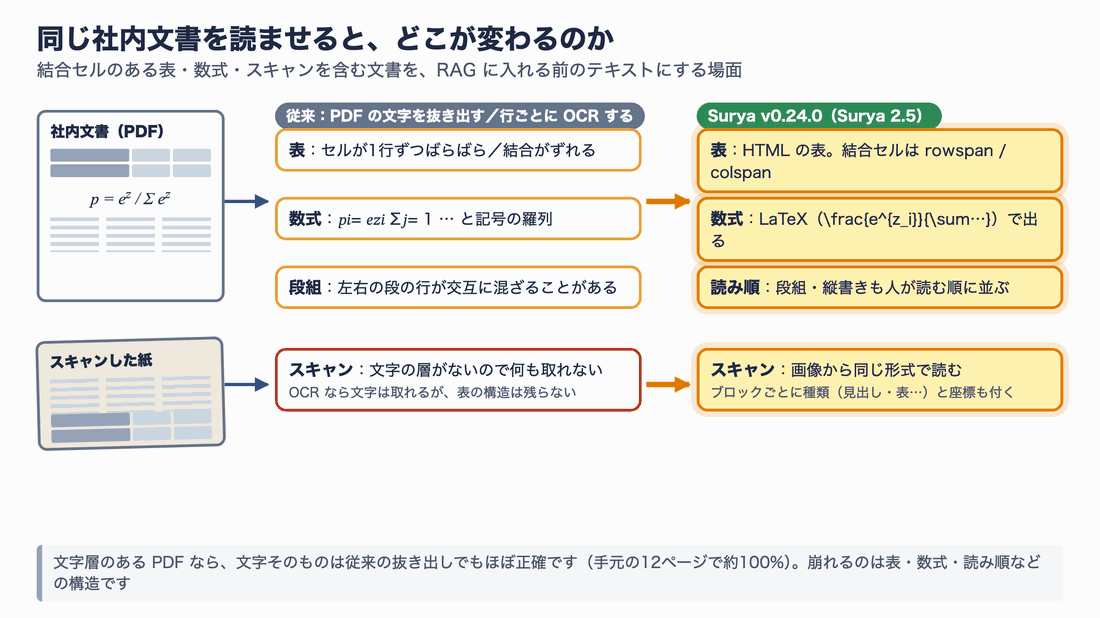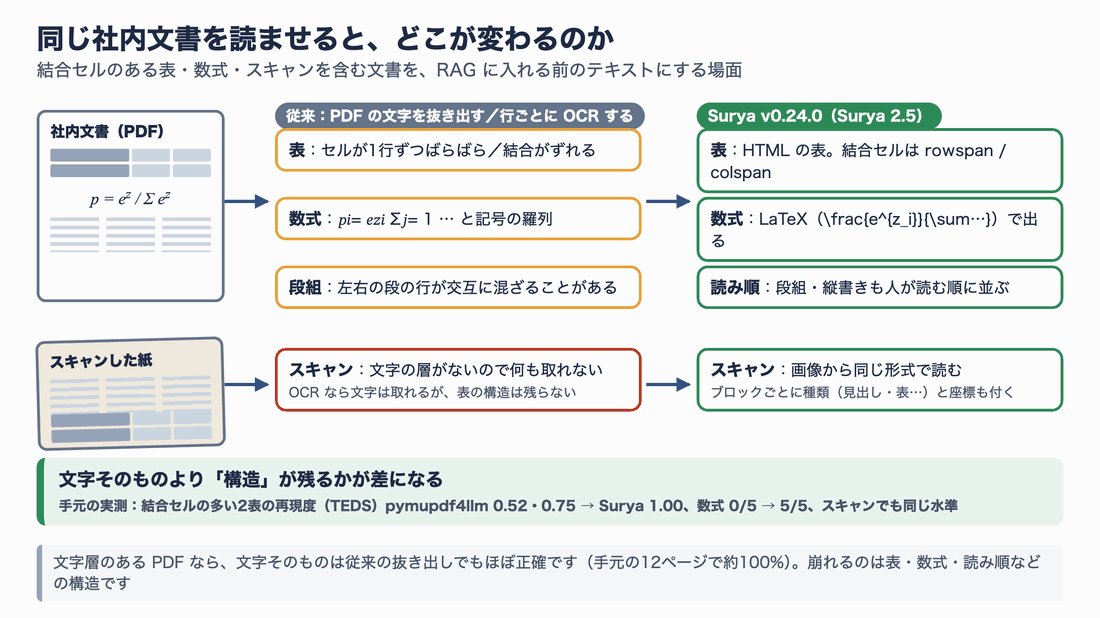
図1:同じ文書を読ませたときの違い。文字そのものより「構造が残るか」で差がつきます
そもそも、従来の読み取りは何が苦手だったのか
従来の2つのやり方
PDF からテキストを取り出す方法は、大きく2つありました。
1つ目は PDF の文字の層を抜き出す方法です。Word や Chrome から作った PDF には、見た目の裏に「文字の層」(テキストレイヤー)が入っています。PyMuPDF などのライブラリはこれを読むので、速くて文字も正確です。手元でも1ページ0.06秒、文字の正しさはほぼ100%でした。
2つ目は 画像から文字を読む OCR(Optical Character Recognition:光学文字認識)です。スキャンした紙や写真のように文字の層がない資料に使います。Tesseract や macOS 標準の Vision が代表例で、画像の中から「行」を見つけて1行ずつ文字に直します。
どちらも「文字」を取り出すのは得意です。苦手なのは、文字と文字の関係、つまり構造です。
5つの苦手場面
手元で検証用のページを作り、従来の方法で読ませたときに崩れた場面を表にまとめました。
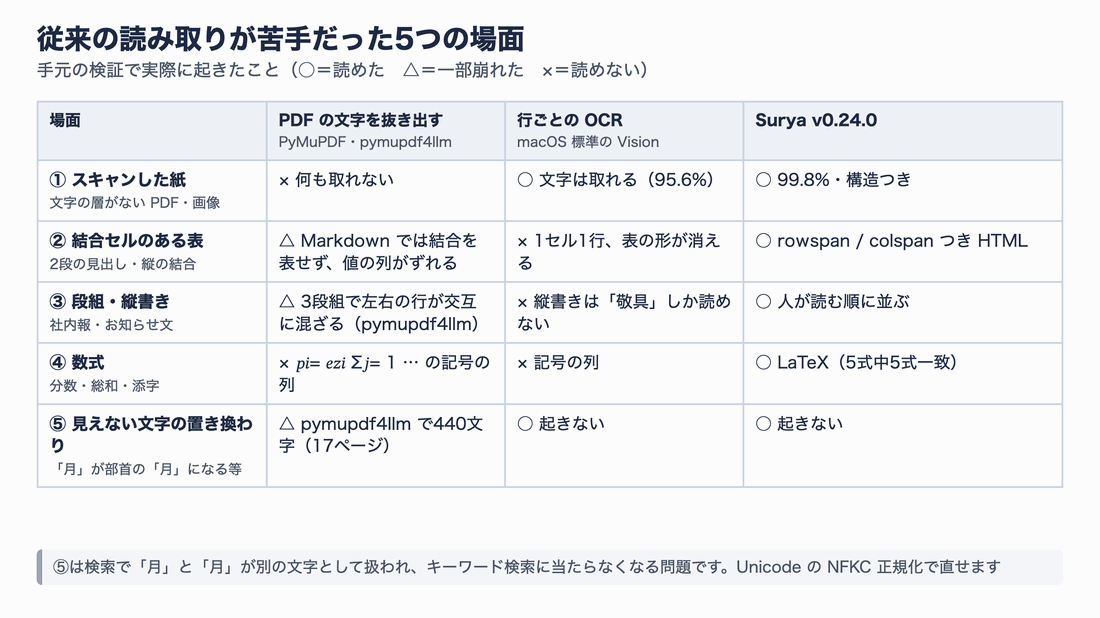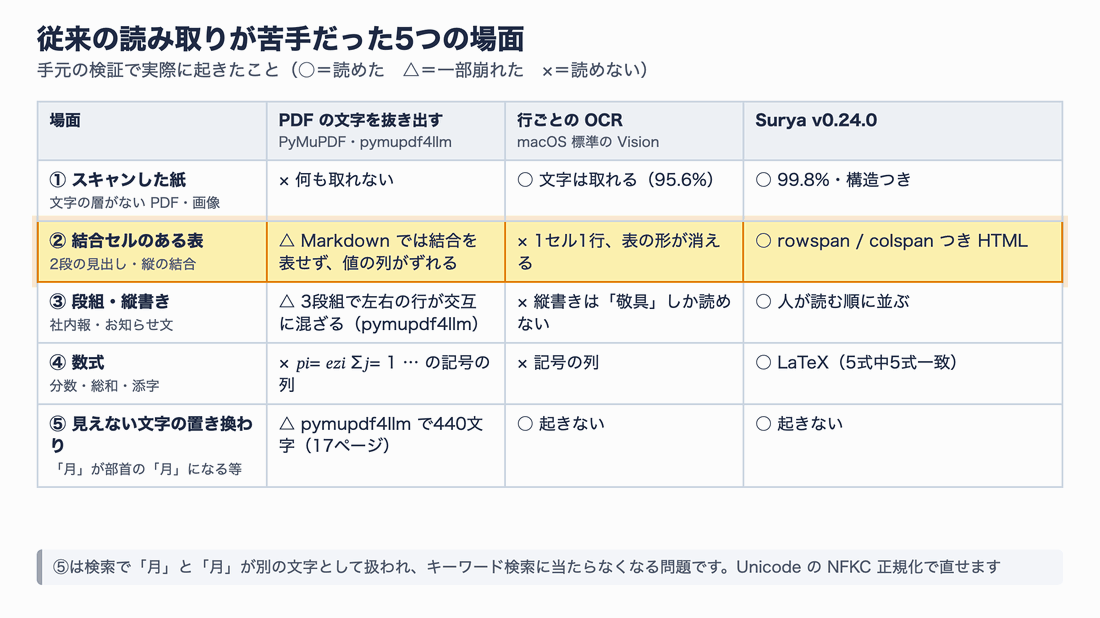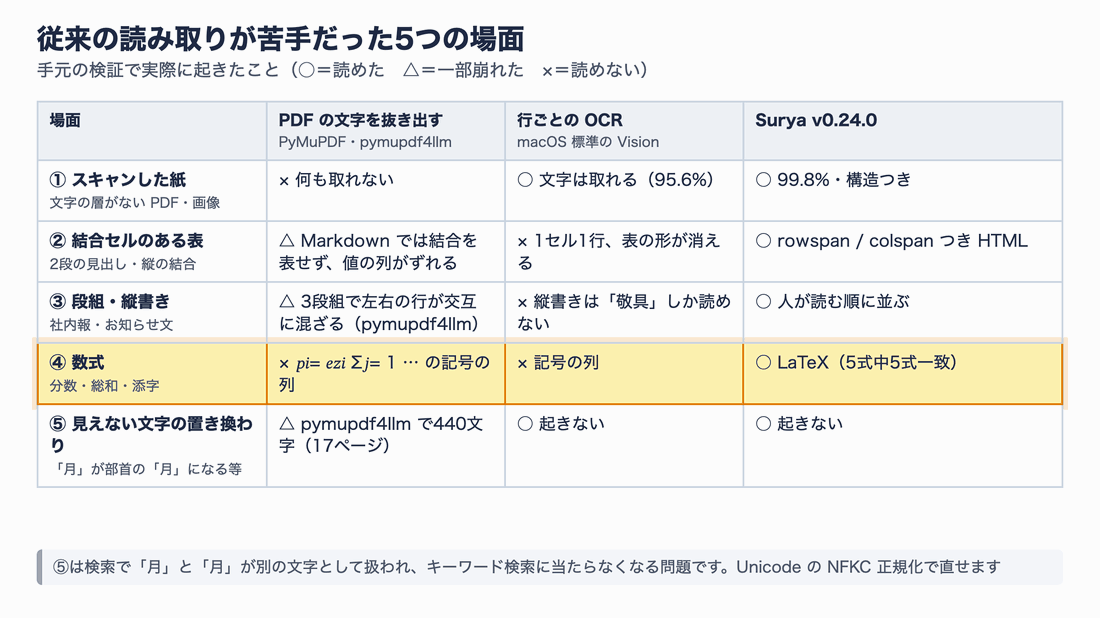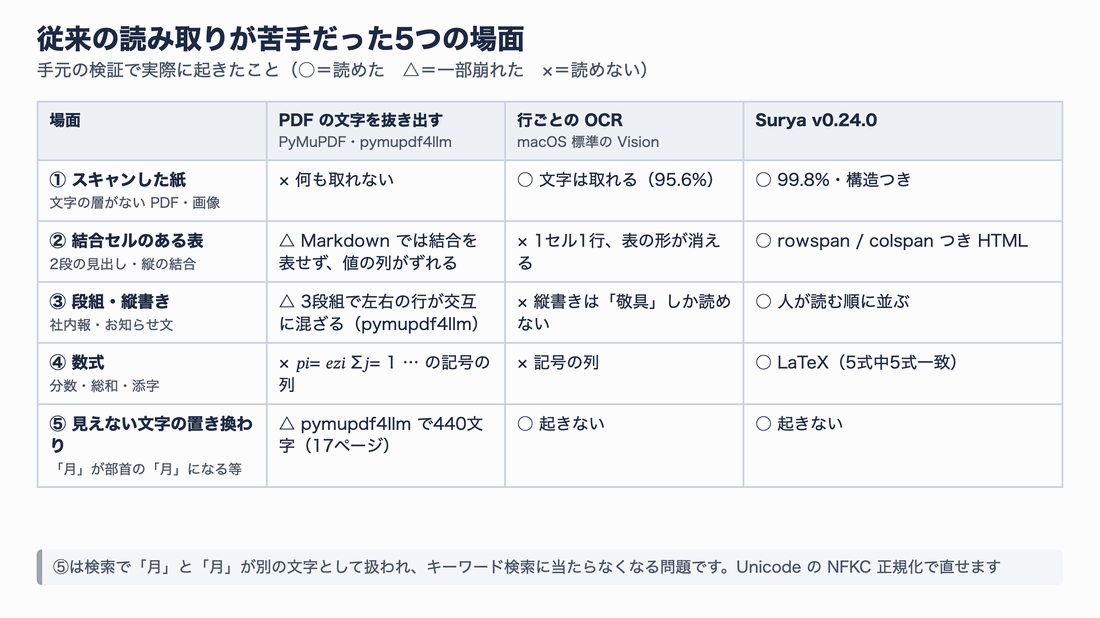
図2:手元の検証で実際に起きたこと。○は読めた、△は一部崩れた、×は読めなかったもの
それぞれ、何が起きているのかを補足します。
| 場面 | 何が起きるか | なぜ起きるか |
|---|---|---|
| ① スキャンした紙 | PDF 抽出では何も取れない | 文字の層がなく、ページ全体が1枚の画像だから |
| ② 結合セルのある表 | 「上期」が「上|期」に割れる、値の列がずれる | Markdown の表は結合セルを表せない。行 OCR は表という単位を持たない |
| ③ 段組・縦書き | 左右の段の行が交互に混ざる。縦書きが読めない | 「上から下・左から右」に並べるだけでは、人の読む順にならない |
| ④ 数式 | 分数の上下や添字の関係が消えて記号の列になる | 数式は2次元の配置そのものが意味を持つから |
| ⑤ 見えない文字の置き換わり | 「月」が部首の「⽉」(U+2F49)になる | PDF 内のフォントの文字対応表によっては、見た目が同じ別の文字で抜き出される |
⑤は見落としやすい問題です。手元では pymupdf4llm の出力に、この種の文字(康熙部首など)が17ページで440文字含まれていました(多い順に「⽉」「⽇」「⽤」「⾏」)。同じ PDF を PyMuPDF の get_text() で読むと0文字です。ほかに、全角スペースが文字化けの印「�」になった箇所も22ありました。画面では区別できませんが、キーワード検索で「11月」と打っても「11⽉」には当たりません。PDF 抽出を使う場合は、Unicode の NFKC 正規化(見た目が同じ文字を標準の文字にそろえる処理)を必ず入れてください。
import unicodedata

text = "2026年11⽉10⽇発⾏"            # pymupdf4llm の出力に実際にあった形
print(unicodedata.normalize("NFKC", text))  # → 2026年11月10日発行
まとめると、従来の方法は「文字は取れるが、表・数式・読み順という構造が残らない」「スキャンは文字すら取れないか、取れても構造がない」という弱点を抱えていました。
Surya v0.24.0 で何が変わったのか
Surya とは
Surya は、米 Datalab 社がオープンソースで公開している文書解析ツールです。名前はインド神話の太陽神スーリヤに由来します。OCR、レイアウト解析(見出し・本文・表・図などの領域を見つけること)、読み順の推定、表の認識を、90以上の言語で行います。
コードは Apache 2.0 ライセンスです。一方でモデルの重みは独自の条件付きライセンスなので、業務で使う前に後述の「ライセンスの注意」を確認してください。
v0.24.0 の変更点は、大きく3つに分けられます。
変化1:1つのモデルが「構造つき」で書き出す
中心にあるのは、文書専用の視覚言語モデル(VLM:画像を見て文章を書くモデル)「Surya 2.5」です。パラメータ数は689M(6.89億)で、Qwen3.5 系の構成をもとに学習されています。Surya 2.5 は v0.23.0(2026年10月29日)で既定のモデルになり、v0.24.0 で移行が完了しました。
このモデルは、ページ画像を受け取ると、ブロックごとに「種類・座標・中身」を読む順に書き出します。手元の表ページで、モデルの生の出力を取り出してみたのが次の図です。
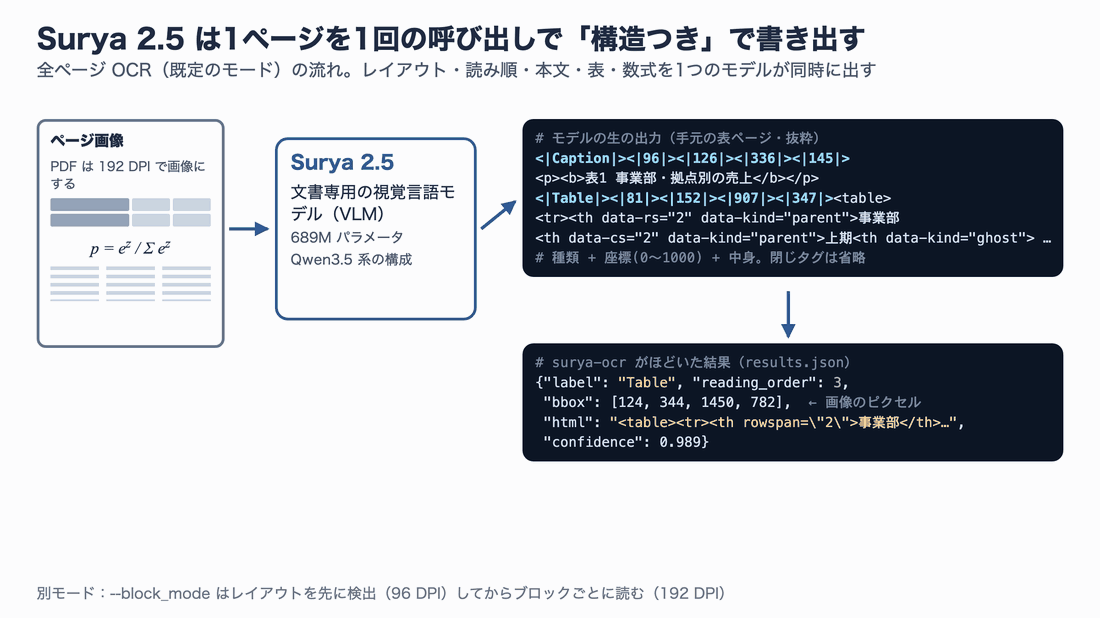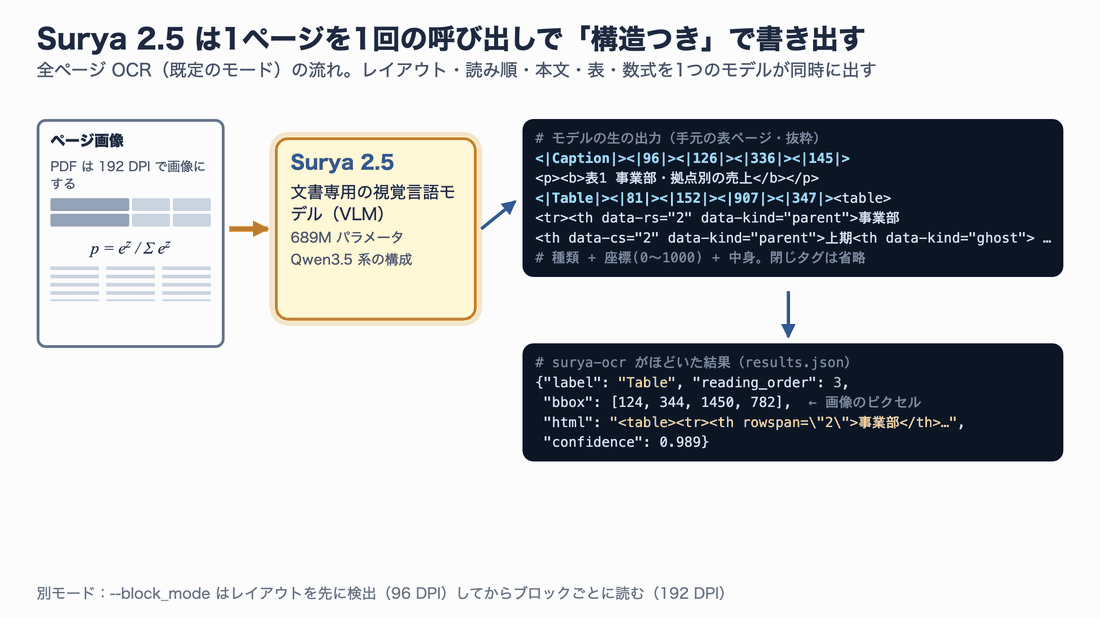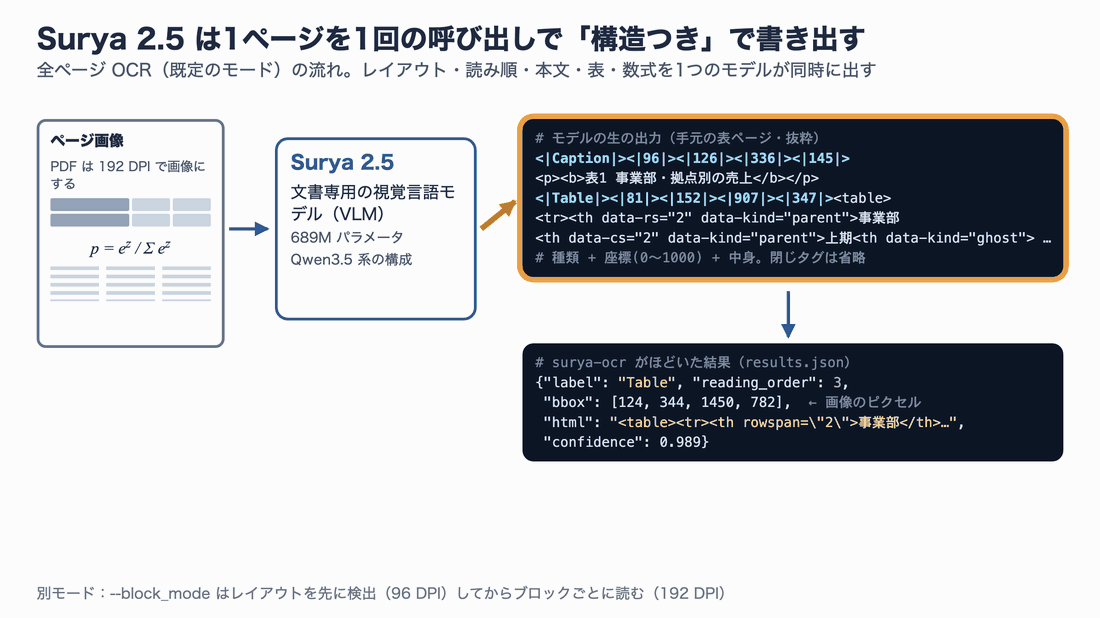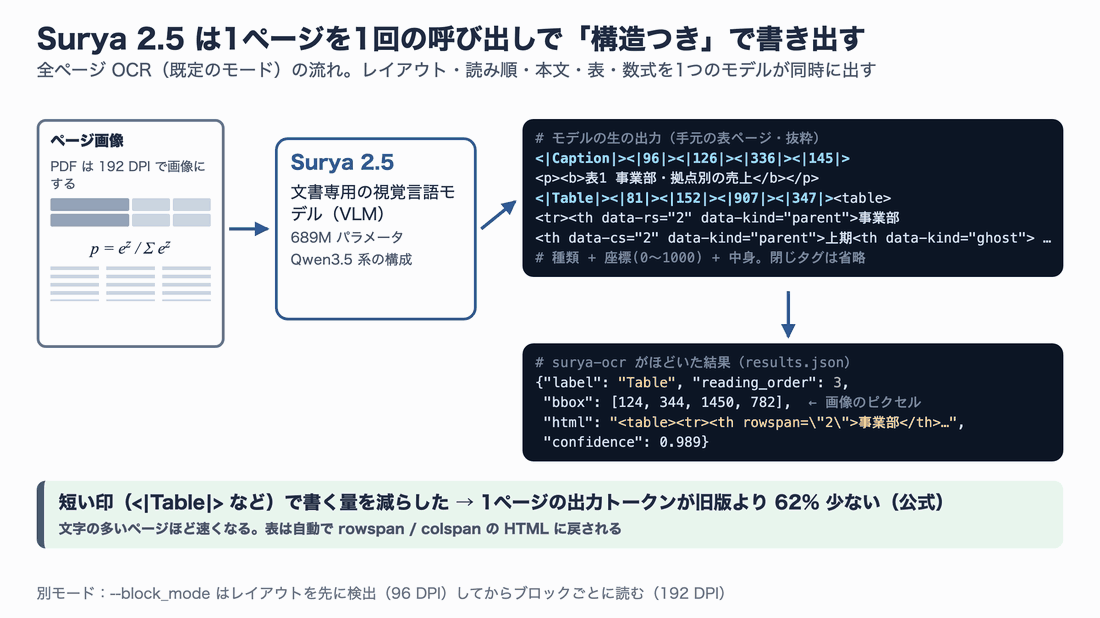
図3:全ページ OCR(既定のモード)の流れ。中央上のコードはモデルの実際の出力の抜粋です
ポイントは3つあります。
- 1回の呼び出しで全部出る:レイアウト検出・読み順・本文・表・数式を、別々のモデルでつなぐ必要がありません
- 表は HTML、数式は LaTeX:表は
<table>、結合セルはrowspan/colspan、数式は<math>タグの中に LaTeX(数式を書くための記法)で出ます - 短縮形式で書く量を減らした:
<|Table|><|81|><|152|><|907|><|347|>のような短い印で種類と座標を書き、表の閉じタグも省きます。公式によると、これで1ページあたりの出力トークンが旧モデルより62%減りました
3つ目が速さの源です。LLM は出力を1トークンずつ書くので、書く量が減れば、そのぶん速く終わります。
変化2:重い依存を外し、モデルを動かす部分を外に出した
v0.24.0 でいちばん目に見える変化は、インストールの軽さです。
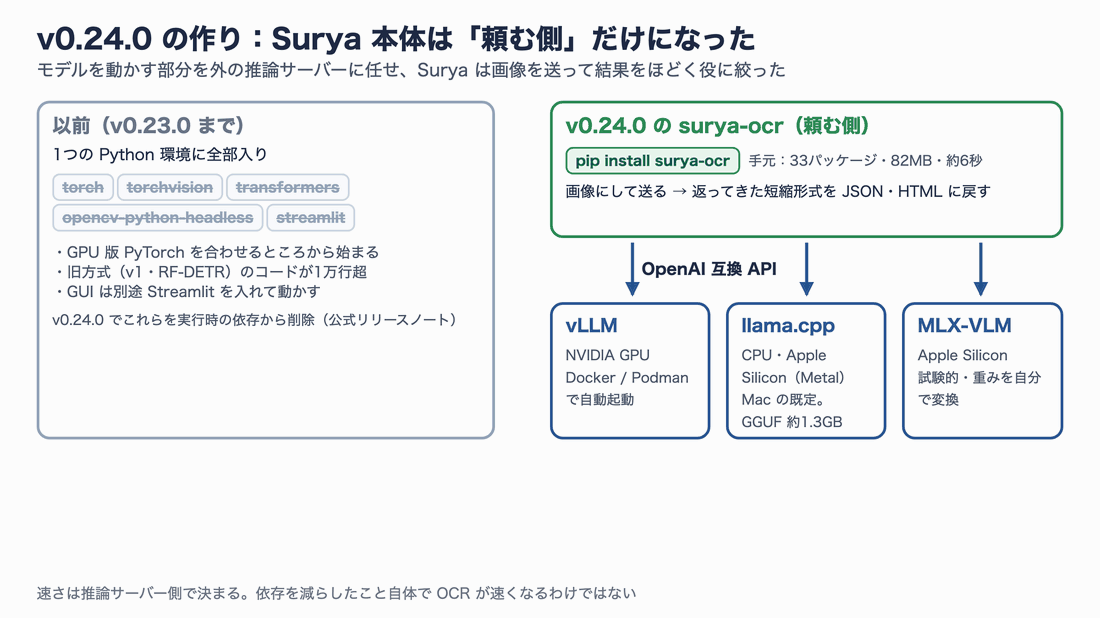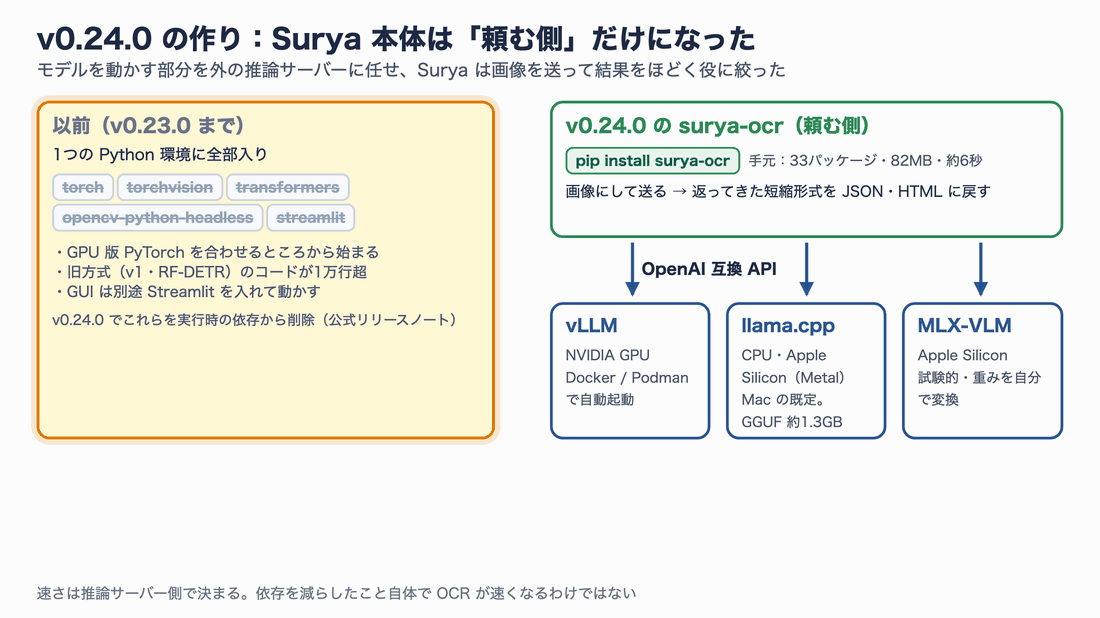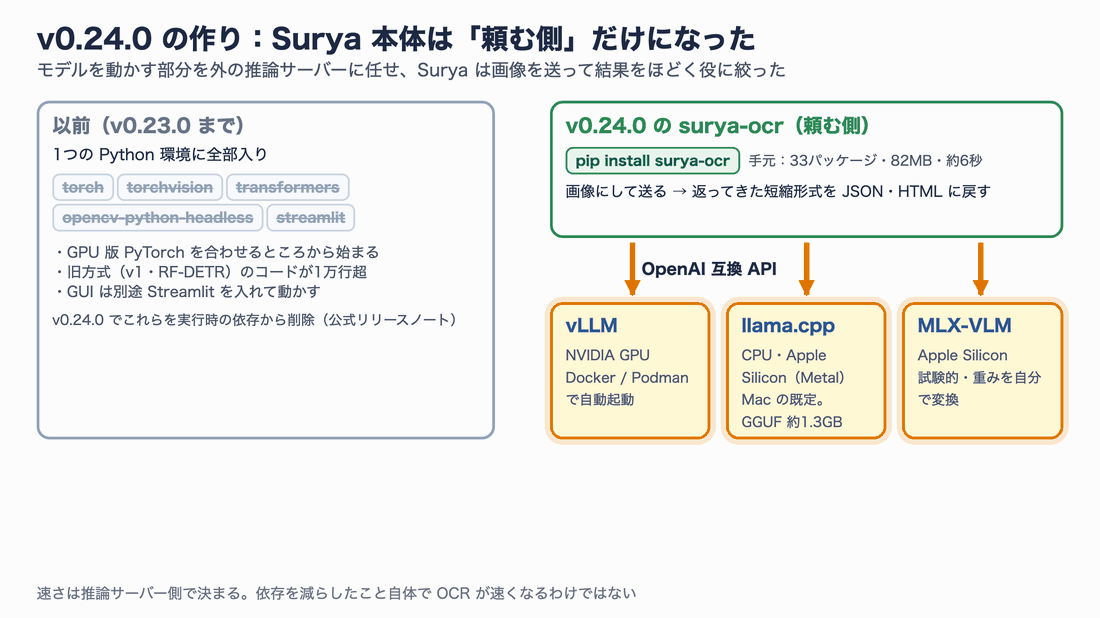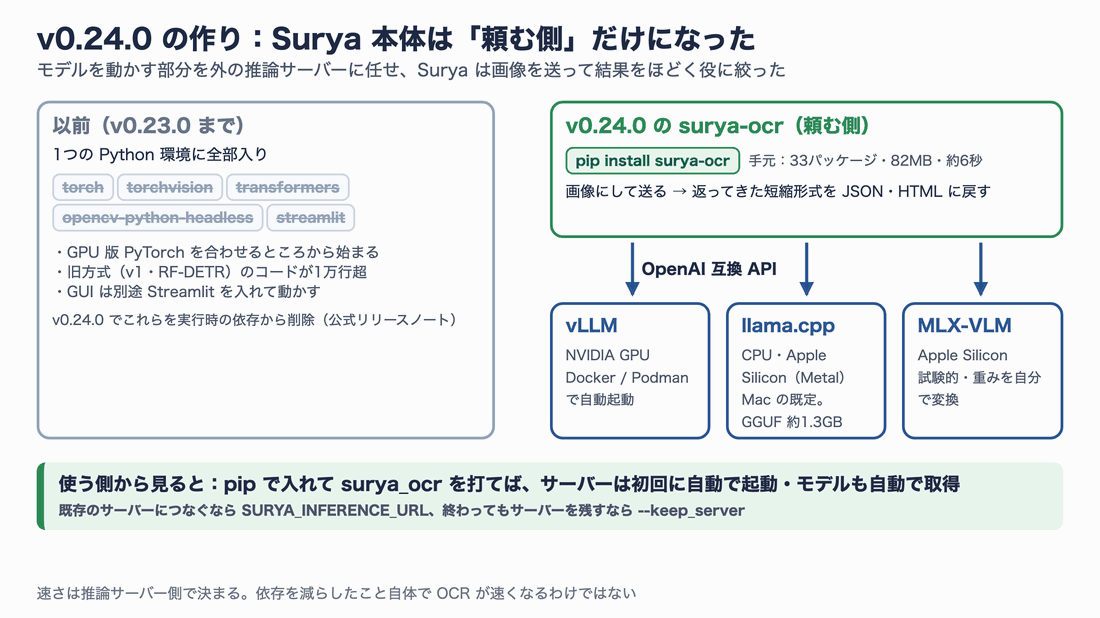
図4:v0.24.0 の surya-ocr は、画像を送って結果をほどく「頼む側」になりました
以前の Surya は、PyTorch・torchvision・Transformers・OpenCV を1つの Python 環境に入れて、その中でモデルを動かしていました。v0.24.0 ではこれらを実行時の依存から外し、モデルの実行を外部の推論サーバーに任せます。推論サーバーは環境に合わせて3種類から選びます。
| 推論サーバー | 向いている環境 | 起動のされ方 |
|---|---|---|
| vLLM | NVIDIA GPU | Docker / Podman のコンテナとして自動起動 |
| llama.cpp(llama-server) | CPU、Apple Silicon(Metal) | Mac の既定。GGUF 形式のモデル(約1.3GB)を自動取得して起動 |
| MLX-VLM | Apple Silicon | 試験的。自分で MLX 形式に変換した重みを指定 |
手元で、旧版と新版を空の仮想環境に入れ比べました(ダウンロードのキャッシュなし)。
| surya-ocr 0.23.0 | surya-ocr 0.24.0 | |
|---|---|---|
| 入ったパッケージ数 | 56 | 33 |
| 仮想環境の大きさ | 895MB | 82MB |
| インストールにかかった時間 | 約41秒 | 約6秒 |
| PyTorch / Transformers / OpenCV | 入る | 入らない |
ただし、0.24.0 の82MBには推論サーバーとモデルが含まれていません。Mac では Homebrew の llama.cpp(約18MB)と、初回に自動で取得されるモデル(約1.3GB)が別に必要です。
なお、紹介記事などで「依存を減らしたことで高速化した」と読める書き方を見かけますが、速さを決めているのは推論サーバーとモデルの出力量です。依存の削減は「入れやすさ」の改善と考えるのが正確です。
変化3:閲覧画面と、エージェント向けの CLI
使い勝手の面では次の2つが加わりました。
- surya_gui の作り直し:以前は Streamlit を別に入れる必要がありましたが、Python の標準ライブラリだけで動く閲覧画面になりました。PDF や画像を渡すと、レイアウトの枠・読み順・KaTeX で組版した数式・HTML の表・JSON をページごとに確認できます
- AI エージェント向けの CLI:
--stdoutで結果の JSON を標準出力に流せるようになり、シェルのパイプや AI エージェントから扱いやすくなりました。surya_ocr --skillで Claude Code などに読ませるスキル(SKILL.md)も出力できます
公式が出している数字
Datalab が公開している評価結果を整理しておきます(いずれも公式の値)。
| 項目 | Surya 2 | Surya 2.5 |
|---|---|---|
| OmniParseBench(総合) | 83.3 | 85.9(1B 未満の公開モデルで最高と発表) |
| うち表 | 74.3 | 78.3 |
| olmOCR-bench | 82.8 | 83.7 |
| 91言語の社内ベンチマーク | 74.5% | 74.9% |
| うち日本語 | 78.8% | 80.5% |
| H100・192 DPI の処理量 | 2.72 ページ/秒(MTP あり) | 4.52 ページ/秒(1.7倍) |
| Apple Silicon(M4 Max・llama.cpp・96 DPI) | 0.061 ページ/秒 | 0.198 ページ/秒(3.2倍) |
精度の伸びは数ポイントで、目立つのは速さです。そこで手元では「構造がどれだけ残るか」と「速さはどんなページで効くか」の2点を確かめました。
手元の Mac で確かめた:どこがどれだけ強くなったか
検証の設計
日本語の業務文書を中心に、正解つきのページを34枚用意しました。
| 区分 | ページ | 内容 |
|---|---|---|
| 日本語の業務文書 | 12ページ+スキャン版12ページ | 請求書、見積書、契約書、2段組の規約、API 仕様書、売上報告、論文風の2段組、申込書、社内報、操作マニュアル、議事録など(以前の OCR 検証で作った正解つきの帳票) |
| 苦手場面のページ | 5ページ+スキャン版5ページ | ①結合セルの多い表2つ ②数式4本+文中の式 ③3段組+囲み記事 ④縦書きのお知らせ ⑤罫線なしの表と小さな文字 |
スキャン版は、元の画像を150 DPI 相当に縮め、0.6〜1.5度傾け、ぼかし・ノイズ・紙の色を加えて JPEG で保存したものです。PDF 抽出の2つ(PyMuPDF・pymupdf4llm)は文字の層つき PDF を、Vision と Surya はページ画像を読みます。
評価の指標は次の4つです。
- 文字の正しさ:正解の各ブロックの文字が出力のどこかに正しく現れているか(全角・半角の違いと空白は除いて比較)
- 表の再現度(TEDS):表を木構造として比べ、形とセルの文字がどれだけ一致するか。1.00 が完全一致
- 数式:Surya が出した LaTeX が、正解の LaTeX と(空白などを除いて)一致した数
- 読み順:段落が崩れずに、正しい順で出てきたか
結合セルの表:Markdown では表せない形が残る
まず、結合セルの多い表です。原本と、3つの方法で読んだ結果を並べました。中身はすべて実際の出力です。
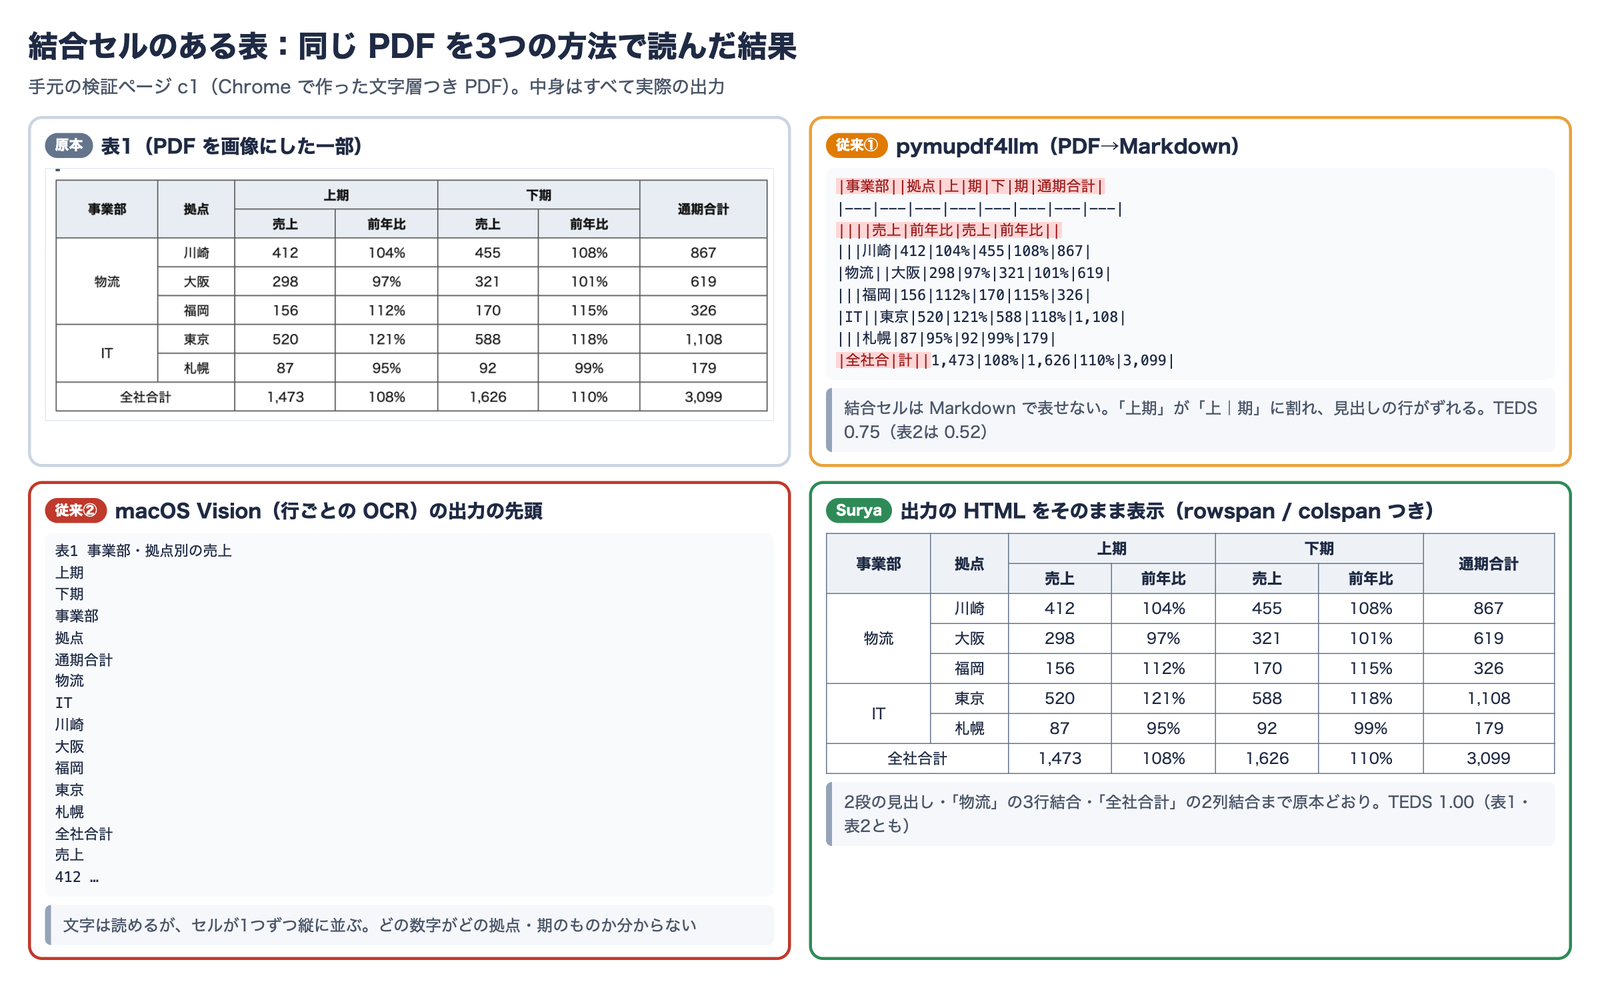
図5:pymupdf4llm は「上期」が「上|期」に割れ、Vision は1セル1行になりました。Surya は rowspan / colspan つきで原本どおりです
pymupdf4llm は罫線を手がかりに表を見つけるので、単純な表なら上手に読めます(14表の平均 TEDS は0.91)。崩れるのは結合セルです。Markdown の表は「このセルは2列ぶん」を表す書き方がないため、見出しの行がずれ、TEDS は0.75と0.52まで下がりました。
Surya の出力は <th rowspan="2">事業部</th> のような HTML です。「物流」が3行ぶん、「全社合計」が2列ぶんという関係がそのまま残るので、「福岡の下期の売上は?」に対して「170」と答える材料になります。
数式:記号の列ではなく LaTeX で出る
次は数式です。PyMuPDF の get_text() は数式も文字として抜き出しますが、配置の情報が消えます。
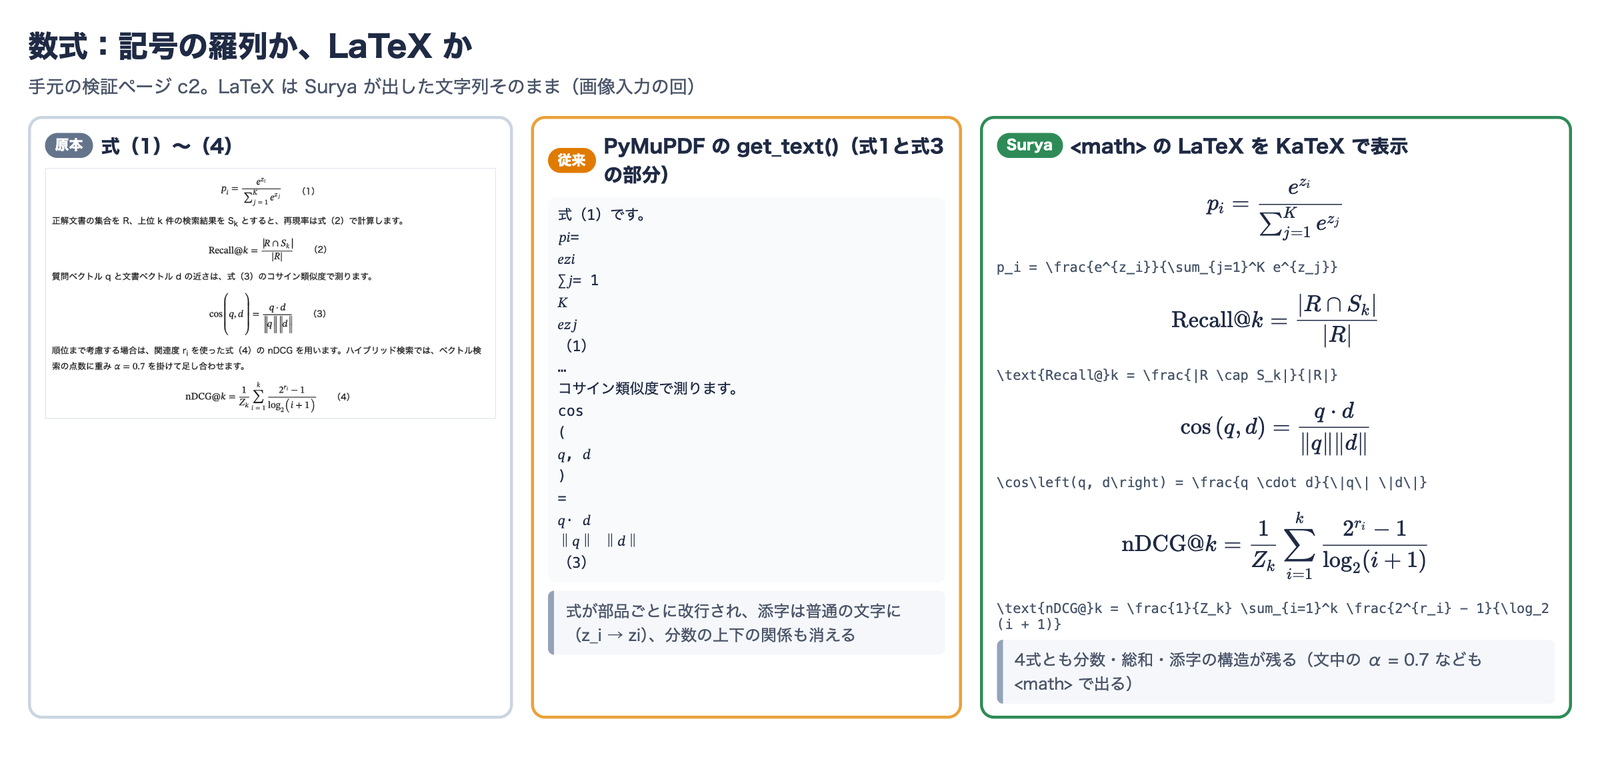
図6:PyMuPDF は分数や添字の関係が消え、Surya は4式とも LaTeX で構造を保ちました
たとえばソフトマックスの式(1)は、PyMuPDF だと pi= ezi ∑j= 1 K ezj と部品ごとに改行され、どれが分子でどれが分母かが分からなくなります。Surya は p_i = \frac{e^{z_i}}{\sum_{j=1}^K e^{z_j}} と書き出しました。正解の LaTeX と照らし合わせると、ブロックの式4本と文中の \alpha = 0.7 の計5つがすべて一致しました(スキャン版でも5/5)。
LaTeX で残っていれば、検索結果を画面に出すときに KaTeX で組版し直せますし、LLM も式の意味を正しく読み取れます。
段組と縦書き:人が読む順に並ぶ
3段組の社内報と、縦書きのお知らせです。
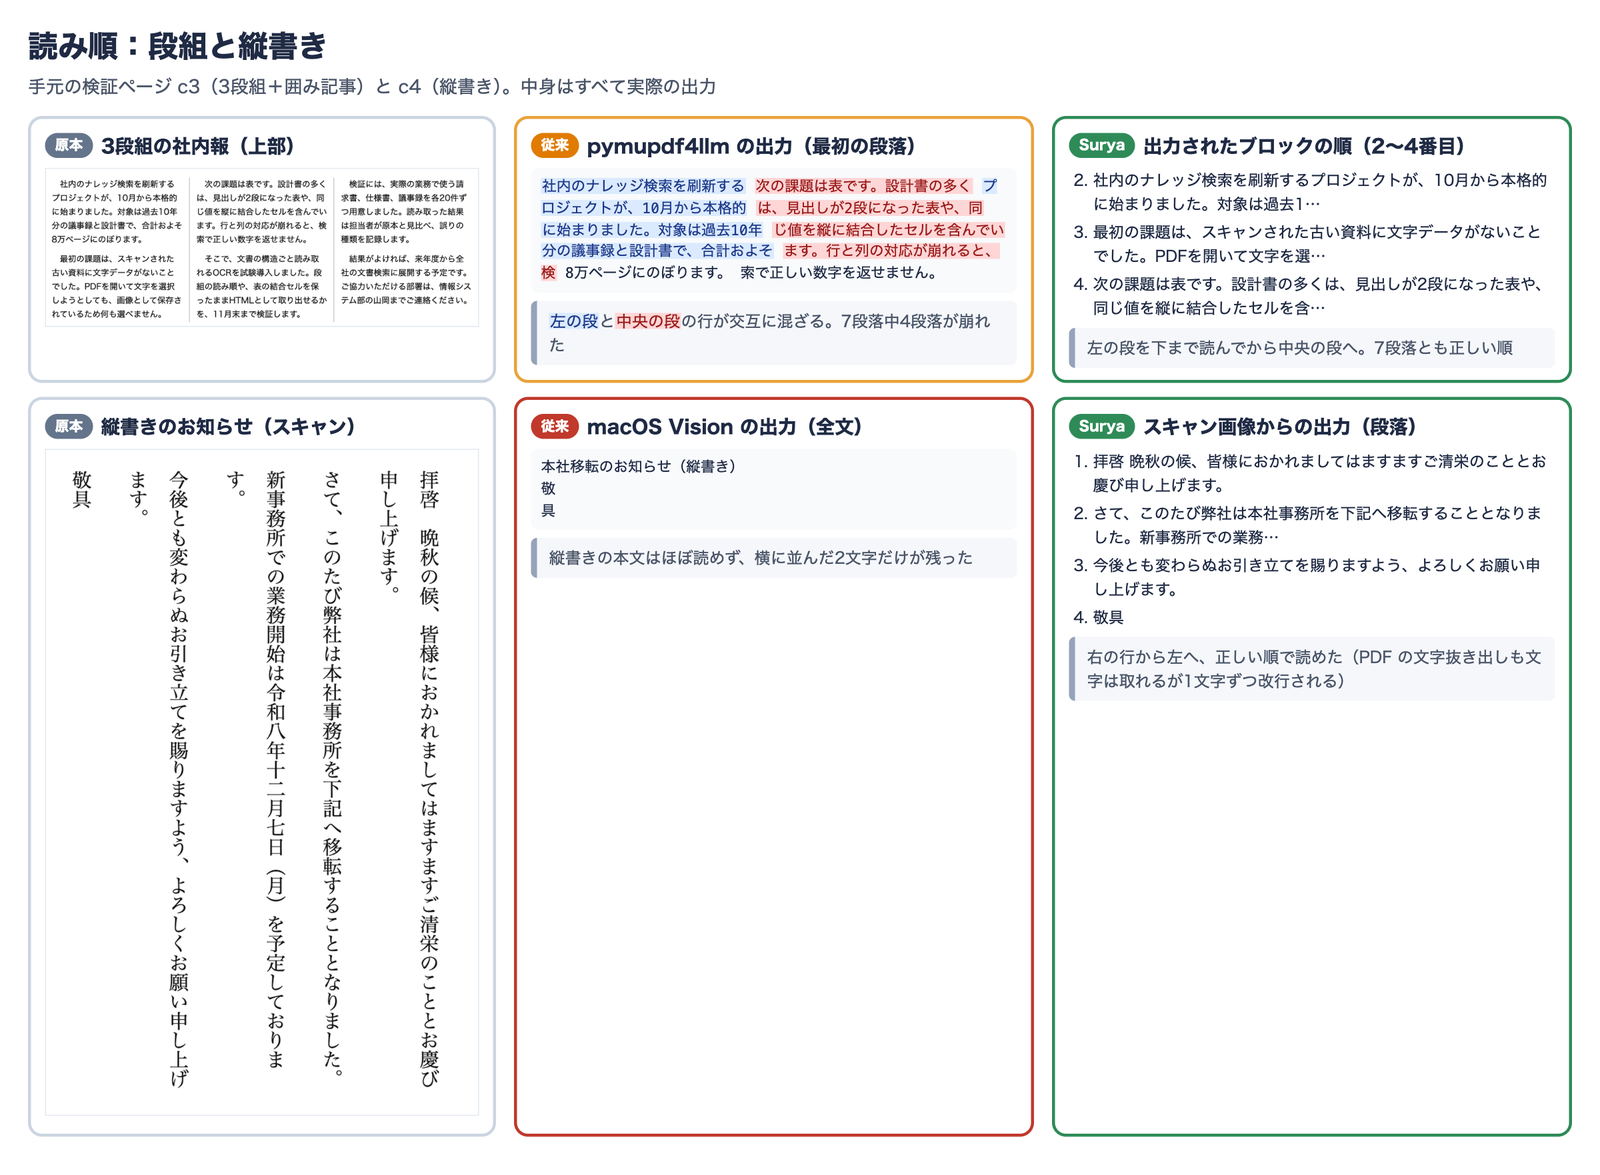
図7:pymupdf4llm は左右の段の行が交互に混ざり、Vision は縦書きをほぼ読めませんでした
3段組では、pymupdf4llm が左の段と中央の段の行を交互につないでしまい、7段落中4段落が崩れました。縦書きのページでは、pymupdf4llm は1文字ずつのセルが並ぶ表として出力し、Vision は本文を読めず「敬」「具」の2文字だけが残りました。
Surya は、3段組を「左の段を下まで → 中央の段 → 右の段 → 囲み記事」の順に、縦書きを「右の行から左へ」の順に並べました。スキャン版でも順番は崩れていません。
なお、PyMuPDF の get_text() は縦書きの文字自体は取れますが、1文字ごとに改行されます。改行を取り除けば読めるので、文字の層がある縦書き PDF なら後処理で対応できます。
スキャン:文字の層がなくても同じ形で出る
スキャン版17ページでは、PDF 抽出の2つは当然0%です。Vision は文字を95.6%読めましたが、表・数式・縦書きの構造はありません。Surya は文字の正しさ99.8%、表の TEDS 1.00 で、きれいな画像とほとんど変わりませんでした。傾き・ぼかし・ノイズを加えた程度のスキャンなら、品質はあまり落ちないと言えます。
結果のまとめ
ここまでの結果を1つの表にしました。
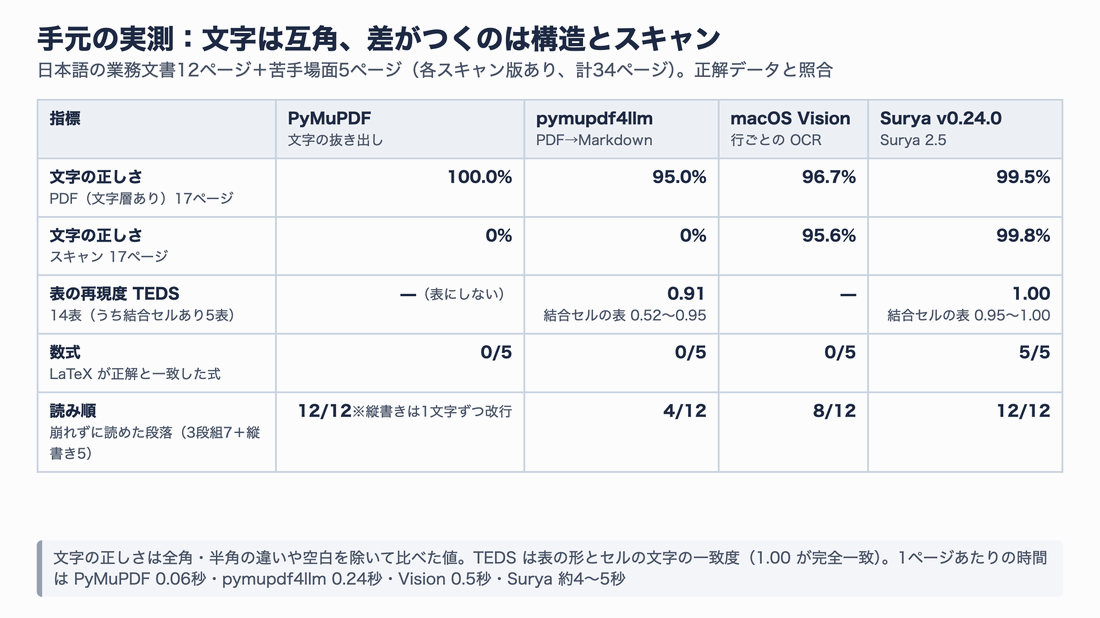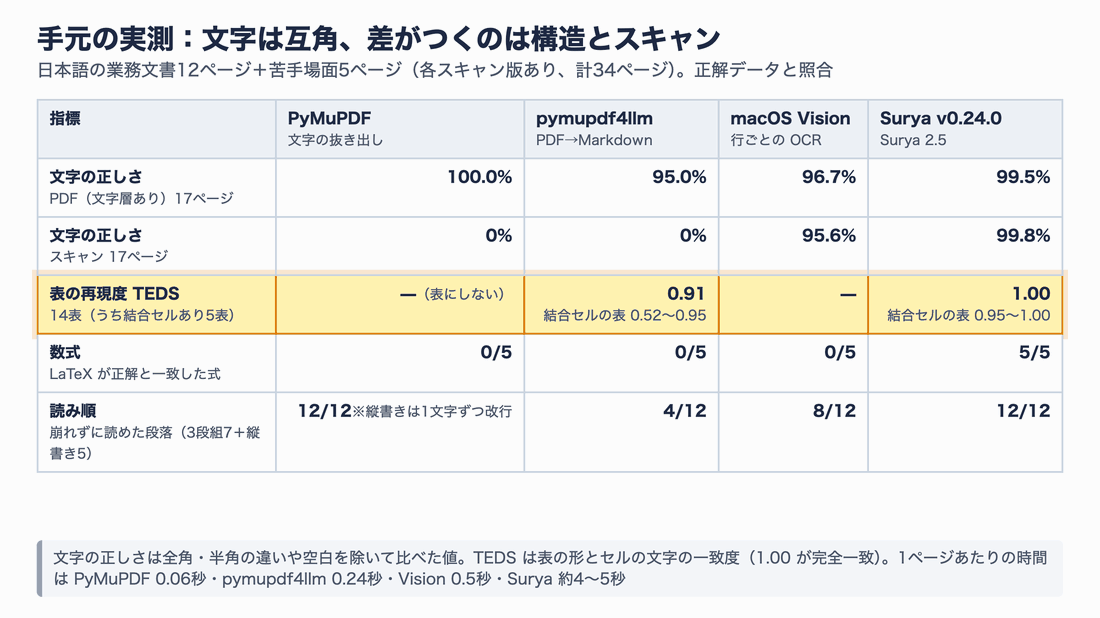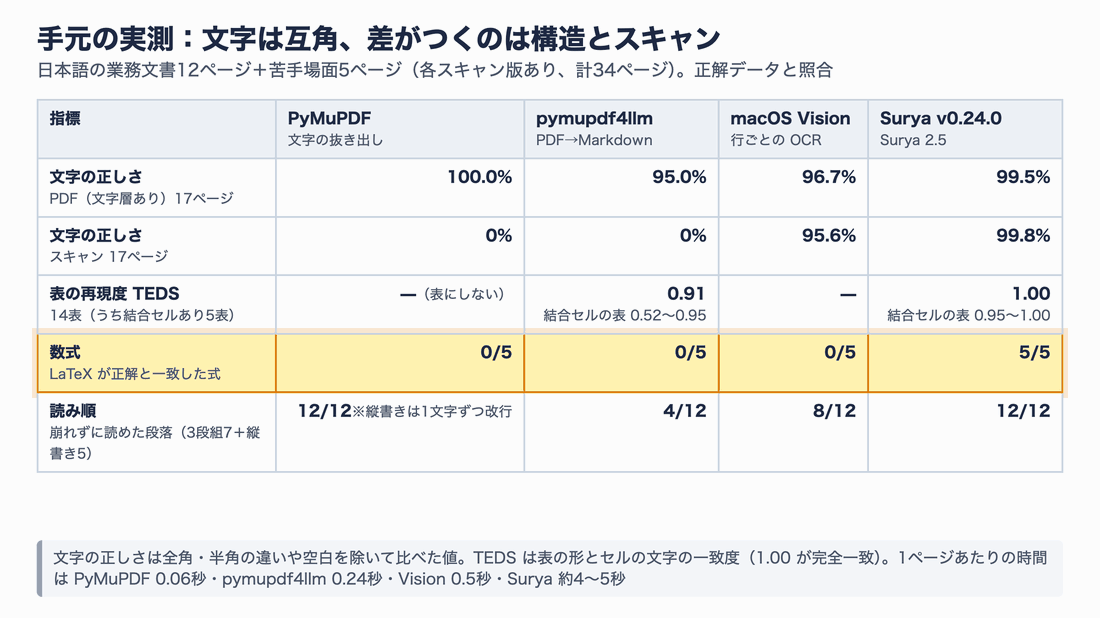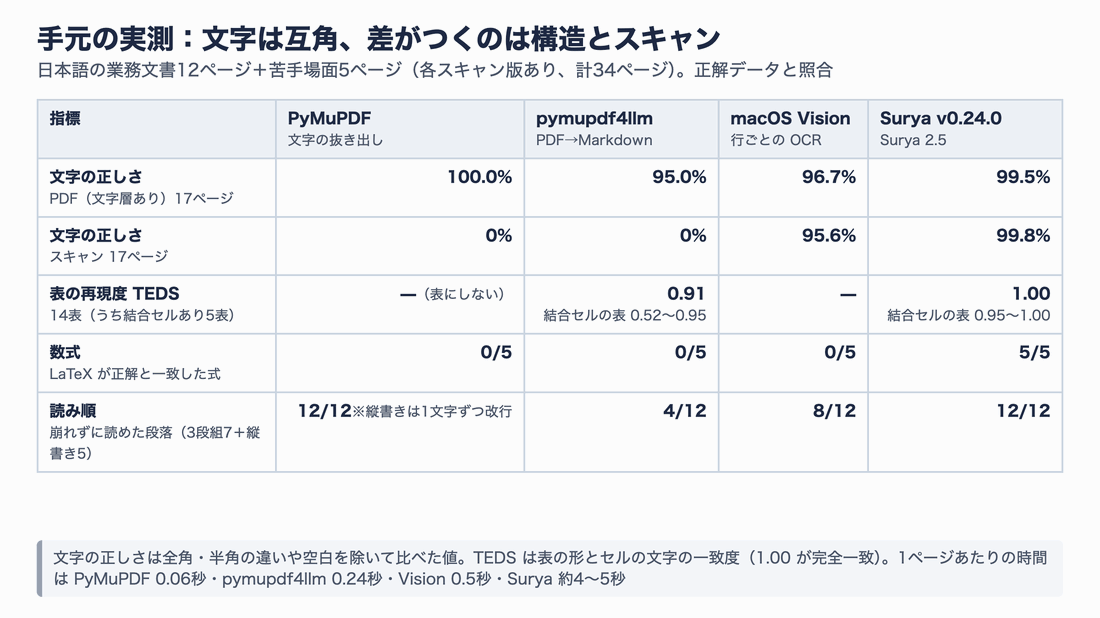
図8:文字の正しさは互角。差がつくのは表・数式・読み順とスキャンです
文字の層がある PDF では、PyMuPDF の文字の正しさ(100.0%)が Surya(99.5%)を上回っています。文字を取るだけなら、従来の抽出のほうが正確で、しかも数十倍速いという点は押さえておきたいところです。Surya を使う意味は、表・数式・読み順の構造と、スキャンへの対応にあります。
Surya も間違える
完璧ではありません。手元で見つかった誤りを挙げます。
| 誤りの種類 | 実際の例 |
|---|---|
| 形の似た字 | 「罫線なし」→「野線なし」、「ブース」→「プース」、「レーザー」→「レーザ一」(長音が漢数字の一) |
| 記号 | 著者名の「†1」→「+1」、「[出荷]」→「〔出荷〕」 |
| 大文字・小文字 | PDF から読んだ回だけ、式(1)の z_i が Z_i になった(画像から読んだ回は正しい) |
| 表の結合の幅 | 請求書の「小計」行を colspan="6" で出力(正しくは5列ぶん)。この表の TEDS は0.95 |
| 読み順 | 請求書で左右に並んだ宛先と差出人を、行ごとに交互に読んだ(文字はすべて正しい) |
金額・型番・日付のように1文字の誤りが問題になる項目は、桁数や合計のチェック、原本との照合を後段に入れてください。
速さ:「3.2倍」は文字の多いページで効く
最後に速さです。旧モデル Surya 2 と新モデル Surya 2.5 を、同じ surya-ocr 0.24.0・同じ llama-server の設定で動かし、1ページずつ処理しました(Surya 2 は環境変数でモデルを切り替えられます)。
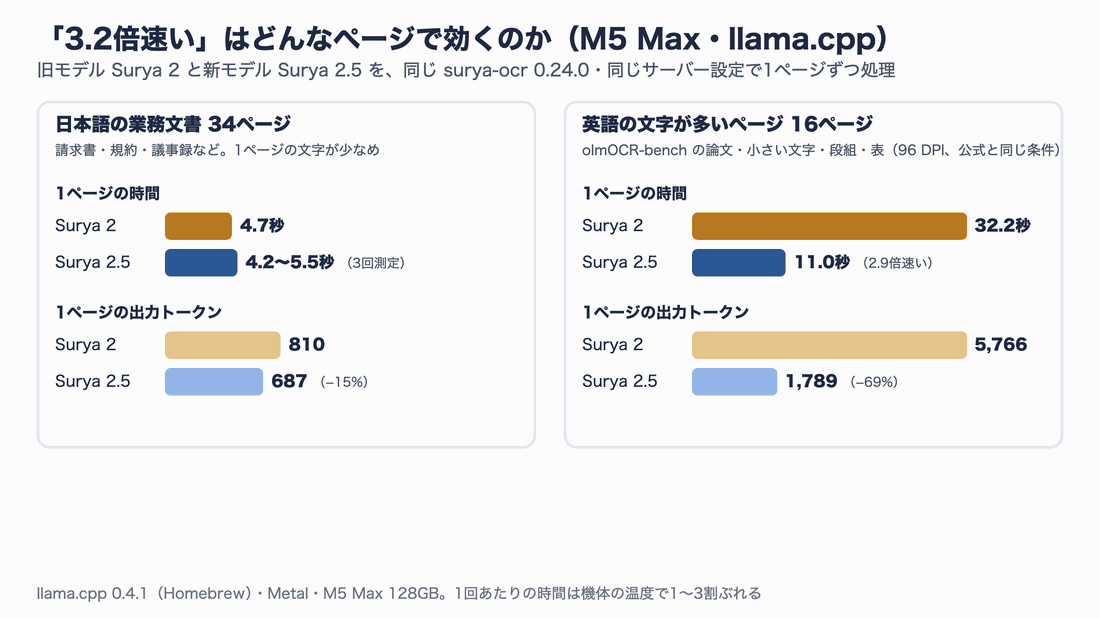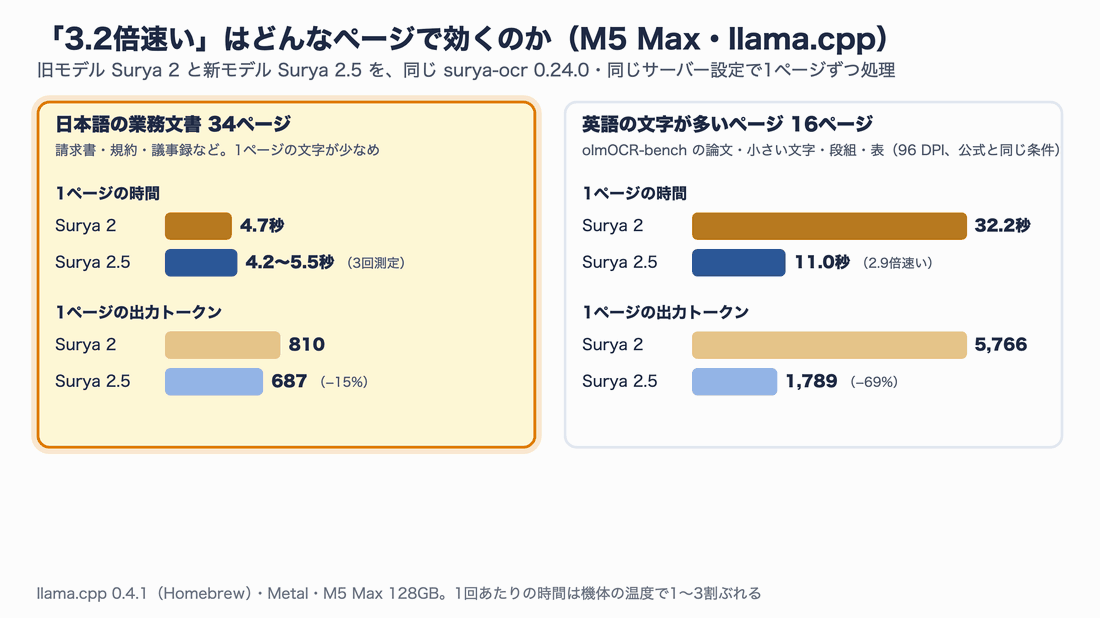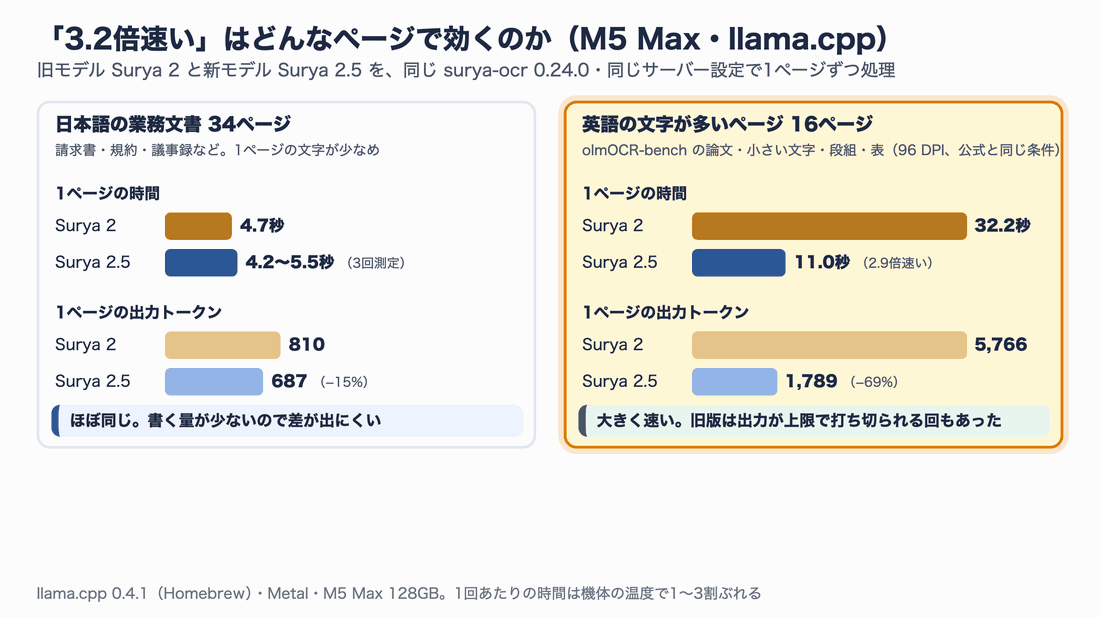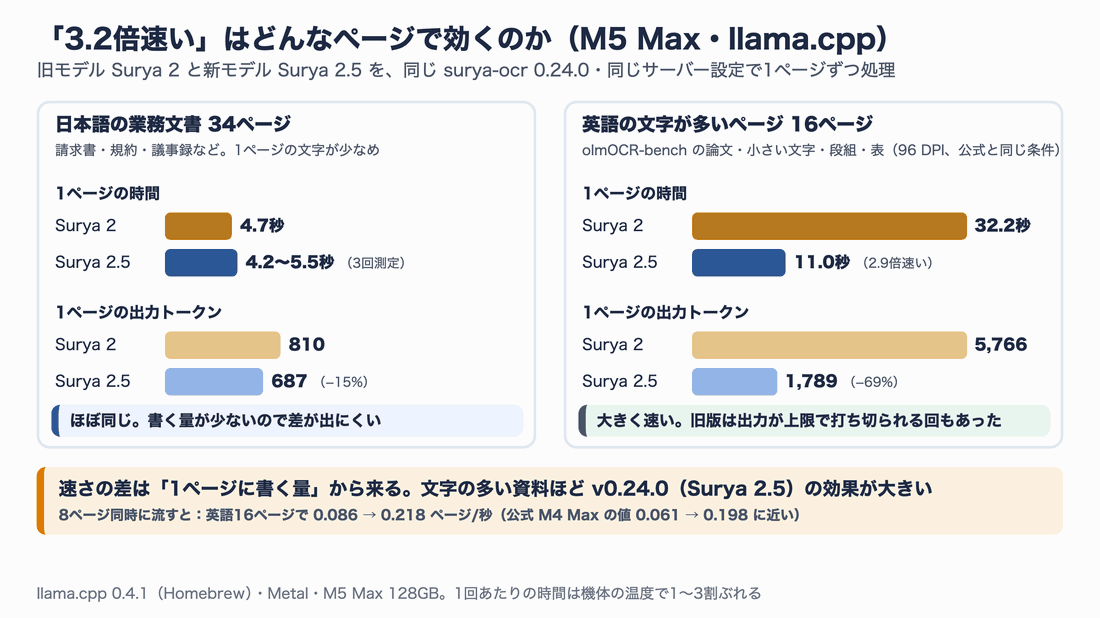
図9:日本語の業務文書ではほぼ同じ速さ、英語の文字が多いページでは2.9倍速くなりました
日本語の業務文書34ページでは、1ページあたり Surya 2 が4.7秒、Surya 2.5 が4.2〜5.5秒(3回測定)で、差はありませんでした。出力トークンが810から687へ15%減っただけで、もともと書く量が少ないからです。むしろ手元の llama.cpp 0.4.1 では、Surya 2.5 のほうが画像の読み込みと1トークンの生成がやや遅く(生成は毎秒225→190トークン)、その分で相殺されました。
一方、公式の測定に近い条件(olmOCR-bench の英語論文・小さな文字・段組・表を96 DPI で読む)の16ページでは、Surya 2 が平均32.2秒、Surya 2.5 が11.0秒と2.9倍速くなりました。出力トークンは5,766から1,789へ69%減っています。Surya 2 は文字の多いページで同じ内容を書き続け、出力の上限で打ち切られる回もありました。8ページを同時に流したときの処理量は 0.086 → 0.218 ページ/秒で、公式の M4 Max の値(0.061 → 0.198)に近い結果です。
つまり「3.2倍速い」は、1ページに書く量が多い資料ほど効く改善です。論文や細かい字の報告書を大量に処理するなら恩恵は大きく、1ページの文字が少ない帳票中心なら速さの差はあまり期待できません。
参考までに、従来手法の1ページあたりの時間は PyMuPDF 0.06秒、pymupdf4llm 0.24秒、Vision 約0.5秒でした。Mac の llama.cpp で動かす Surya は、1ページ数秒〜十数秒かかる前提で設計してください。
実際に使う:インストールから RAG 用の出力まで
ここからは手順です。Apple Silicon の Mac を例にしますが、Linux や Windows でも llama.cpp を入れれば同じ流れで動きます。
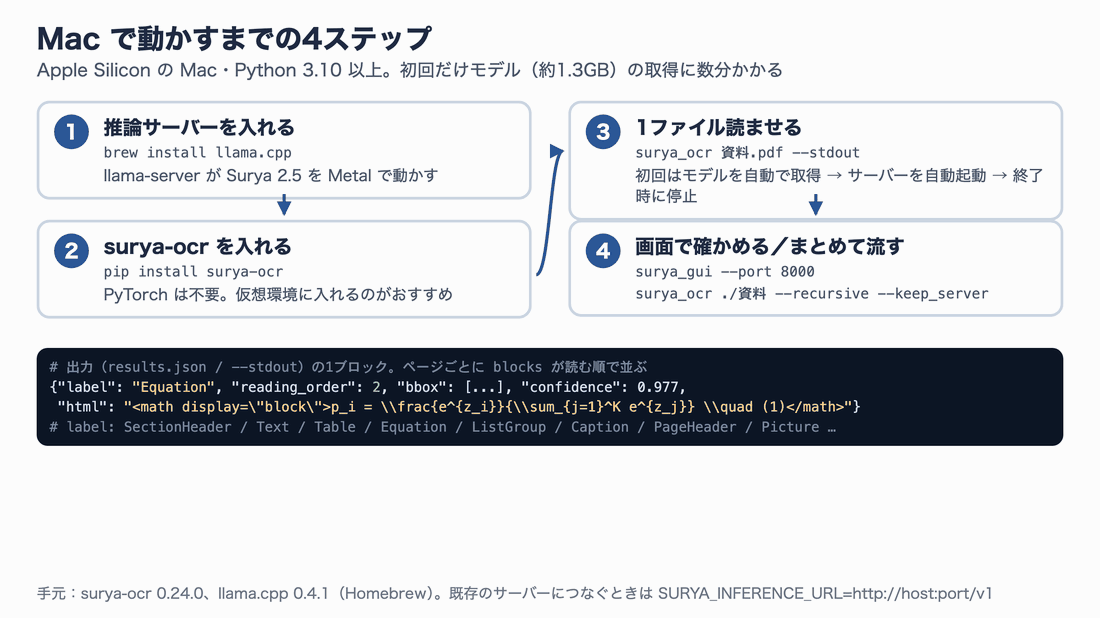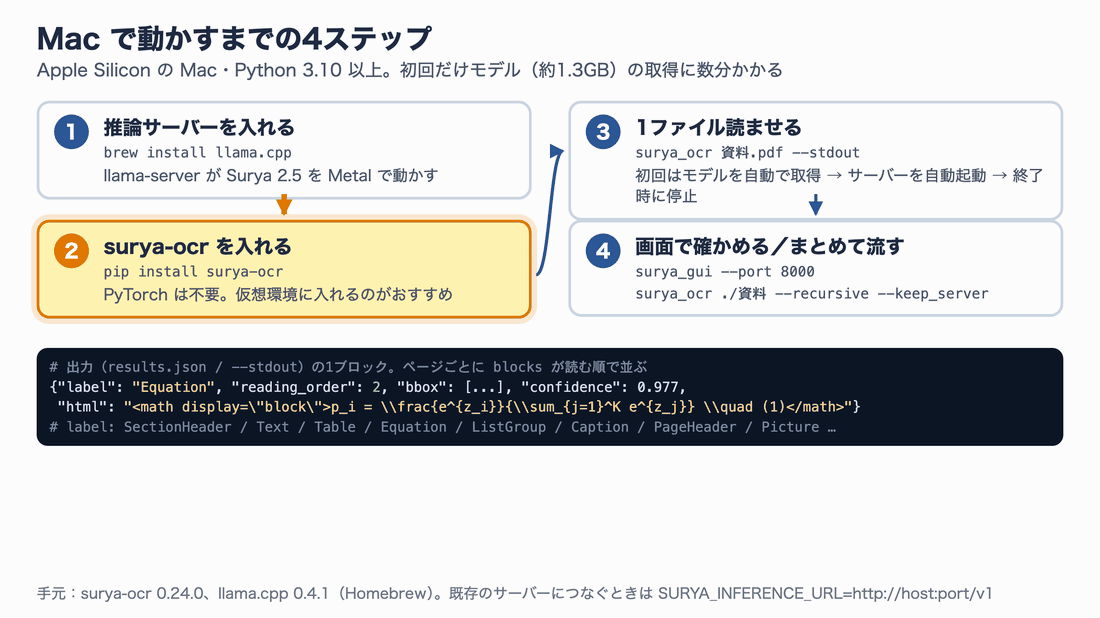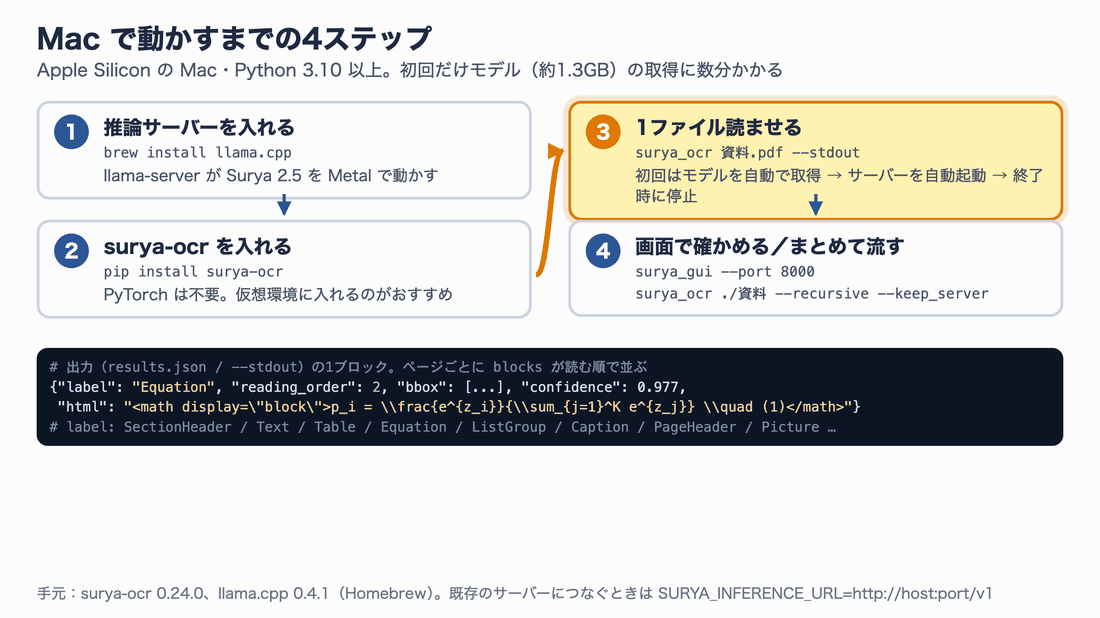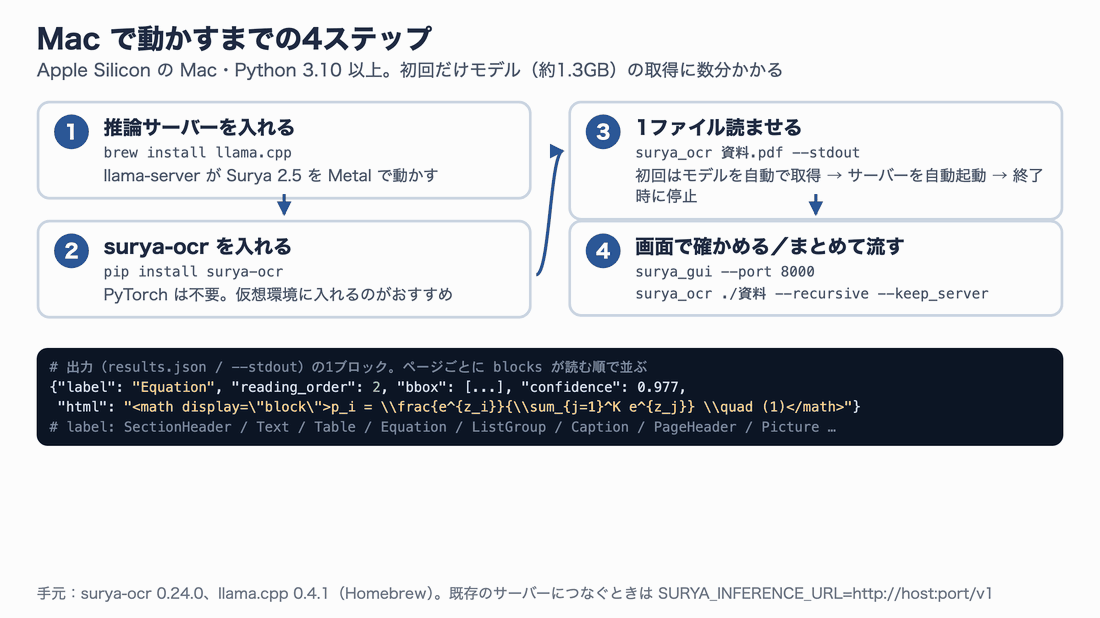
図10:初回だけモデル(約1.3GB)の取得に数分かかります
1. 準備:llama.cpp と surya-ocr を入れる
推論サーバーの llama.cpp を Homebrew で入れます。
# 推論サーバー(llama-server)を入れる
brew install llama.cpp
llama-server --version   # 手元では version: 0.4.1
次に surya-ocr を仮想環境に入れます。Python は3.10以上が必要です。
# 作業フォルダと仮想環境を作る
mkdir surya-test && cd surya-test
python3 -m venv .venv
source .venv/bin/activate

# surya-ocr 0.24.0 を入れる(PyTorch は入らない)
pip install "surya-ocr==0.24.0"
2. CLI で1ファイル読ませる
PDF か画像を1つ渡すだけです。初回はモデルの取得と llama-server の起動が自動で行われます(手元では取得に約4分)。
# 結果を results/<ファイル名>/results.json に保存する
surya_ocr 資料.pdf --output_dir ./results

# 結果の JSON を画面(標準出力)に流す
surya_ocr 資料.pdf --stdout
--stdout の JSON は、jq で必要な部分だけ取り出すと見やすくなります。数式のページで、ブロックの順番・種類・中身を1行ずつ出したのが次の画面です。
surya_ocr c2_math.pdf --stdout | jq -r '.c2_math[0].blocks[] | "\(.reading_order) \(.label) \(.html)"'
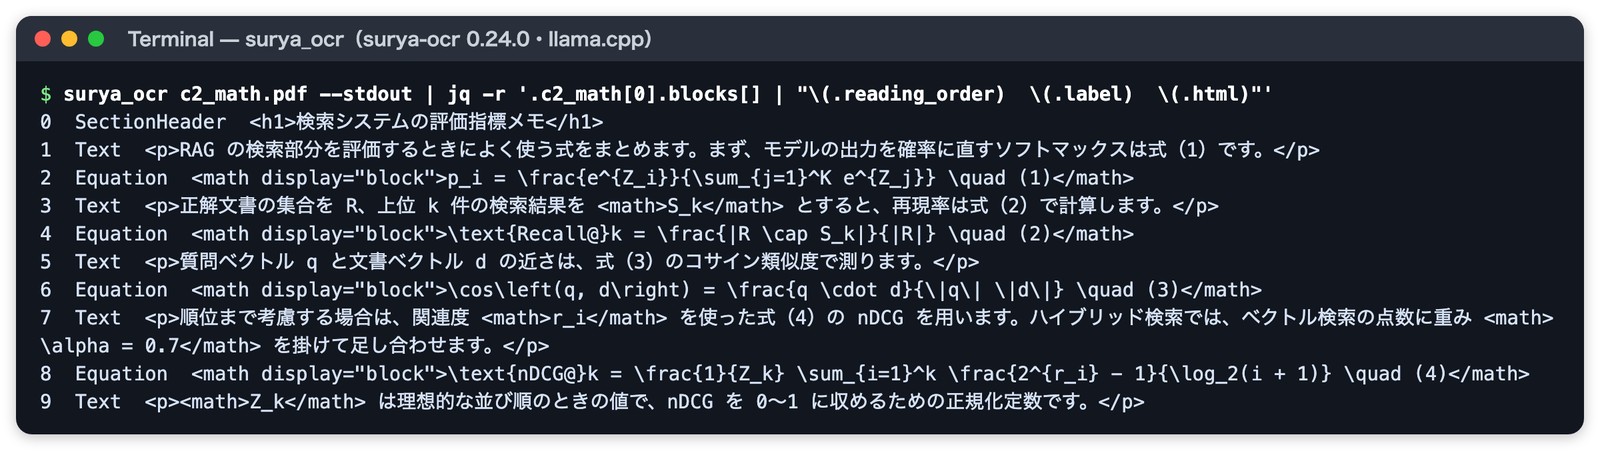
図11:実際の実行結果。見出し・本文・数式(Equation)が読む順に並んでいます
出力の各ブロックには、次の項目が入っています。
| 項目 | 内容 |
|---|---|
label | ブロックの種類。SectionHeader(見出し)、Text、Table、Equation、ListGroup、Caption、PageHeader、PageFooter、Picture など |
reading_order | 読む順番(0から) |
html | 中身。表は <table>、数式は <math>。図などで読み取らなかったブロックは空 |
bbox / polygon | ページ画像上の位置(ピクセル) |
confidence | トークンごとの確からしさの平均(0〜1) |
skipped / error | 読み取りを省いた・失敗したか |
表だけが欲しいときは surya_table を使います。手元の表ページでは、2つの表を自動で見つけて HTML にしました。
surya_table 資料.pdf --stdout
3. surya_gui で結果を目で確かめる
閲覧画面を起動して、ブラウザで開きます。
surya_gui --port 8000
# → ブラウザで http://127.0.0.1:8000 を開き、PDF か画像をドラッグ&ドロップ
左側の「Full OCR / Block OCR / Layout / Tables」でモードを切り替えられます。右側の「Preview / Blocks / HTML / JSON」のタブで結果を確認し、「Download .json」で保存できます。
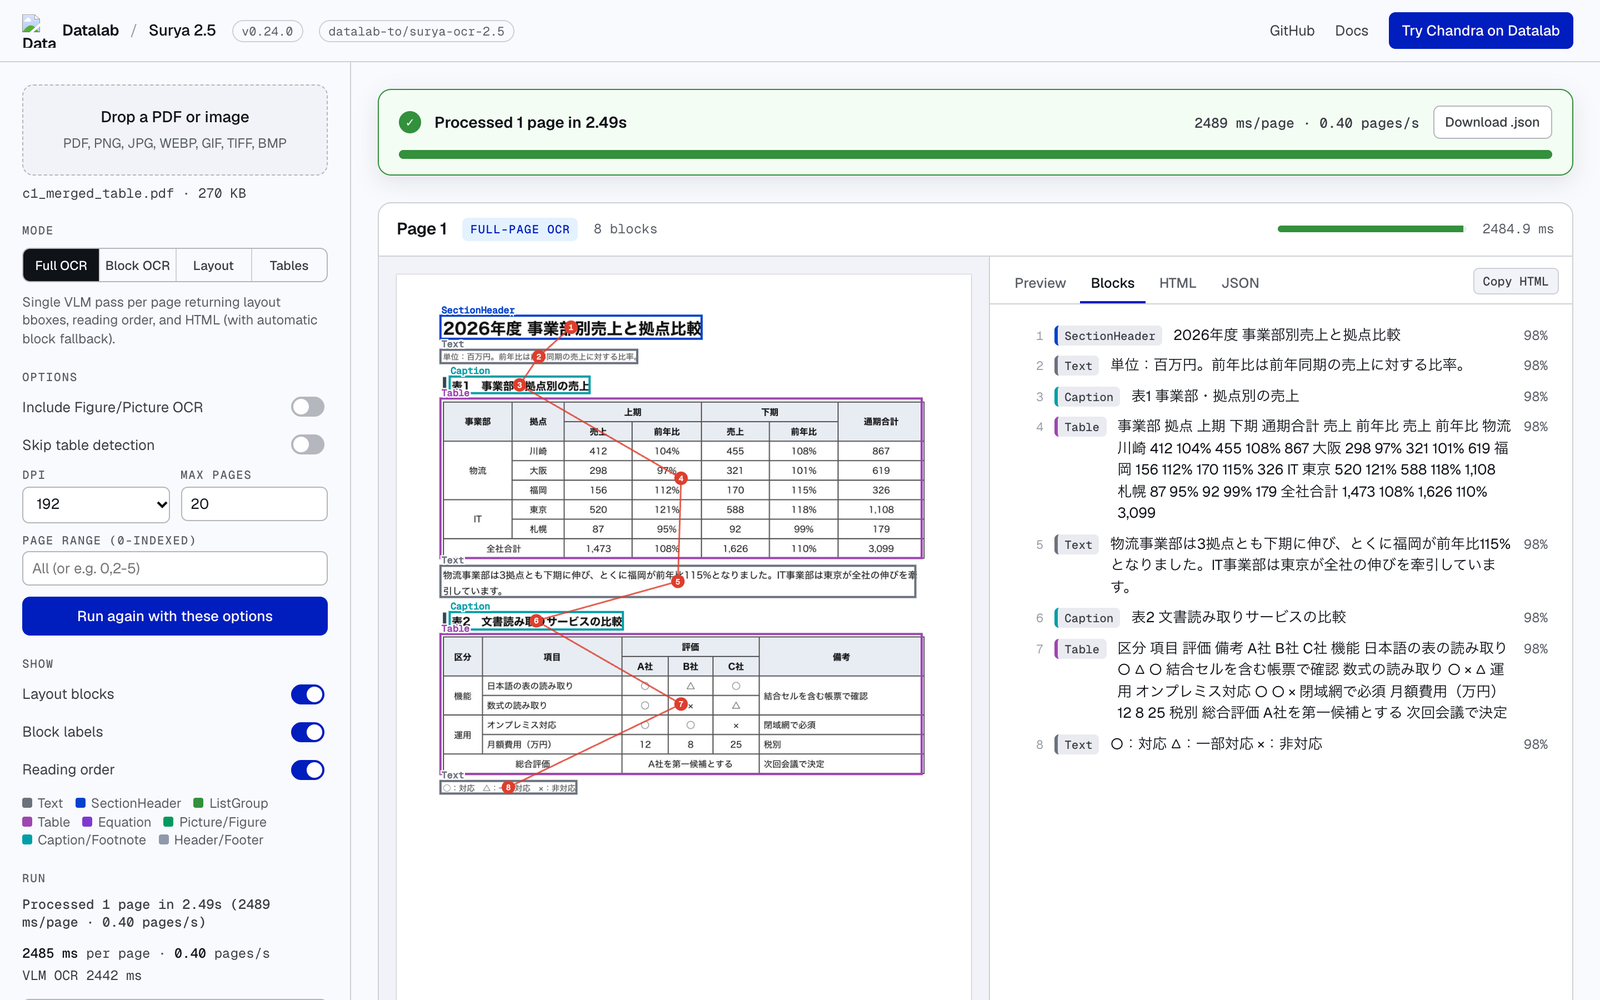
図12:表のページ。枠の色がブロックの種類、赤い番号と線が読み順です(Blocks タブ)
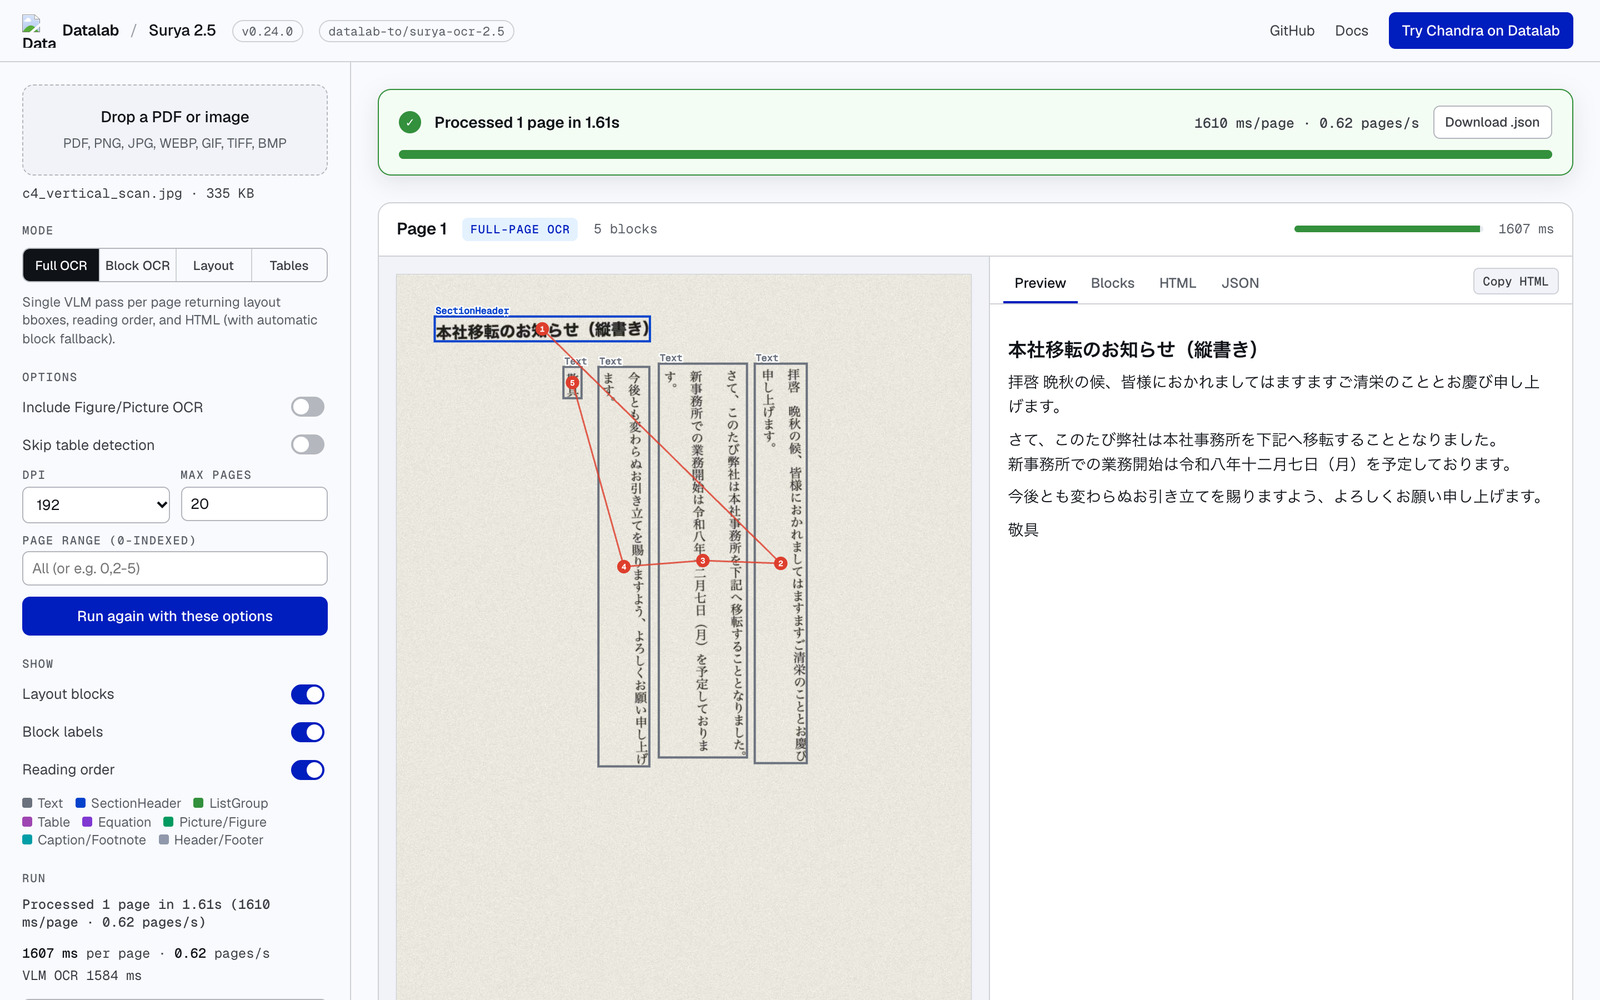
図13:縦書きのスキャン。読み順の線が右の行から左へ進んでいます
RAG に入れる前に「この種類の文書でどこが崩れるか」を目で確かめるのに便利です。読み順の線が飛んでいるページや、表の枠が出ないページがあれば、そこが要注意の箇所です。
4. Python から使う
Python では、推論サーバーを管理する SuryaInferenceManager と、OCR を行う RecognitionPredictor を使います。
from PIL import Image
from surya import RecognitionPredictor, SuryaInferenceManager

manager = SuryaInferenceManager()          # 推論サーバーを起動(または既存のものにつなぐ)
rec = RecognitionPredictor(manager)

image = Image.open("sample.png").convert("RGB")
page = rec([image])[0]                     # 画像のリストを渡し、ページごとの結果を受け取る

for b in page.blocks:                      # ブロックは読む順に並んでいる
    print(b.reading_order, b.label, b.html[:50])

tables = [b.html for b in page.blocks if b.label == "Table"]   # 表だけ取り出す
手元の表ページで動かした出力の一部です。
0 SectionHeader <h1>2026年度 事業部別売上と拠点比較</h1>
1 Text <p>単位:百万円。前年比は前年同期の売上に対する比率。</p>
2 Caption <p><b>表1 事業部・拠点別の売上</b></p>
3 Table <table><tr><th rowspan="2">事業部</th><th rowspan="2"
ひとつ注意があります。リリースノートの例にある TableRecPredictor(manager)([image]) にページ全体の画像を渡したところ、手元では表を切り出さず、ページ全体を1つの結果として返しました。TableRecPredictor は表の部分だけを切り抜いた画像に使い、ページから表を探したいときは上のように label == "Table" のブロックを使うか、CLI の surya_table を使うのが確実です。
5. RAG 用のチャンクにする
Surya の出力をそのまま文章として連結すると、せっかくの構造が無駄になります。ブロックの種類に応じてチャンク(検索の単位となる文章のかたまり)の切り方を変えましょう。
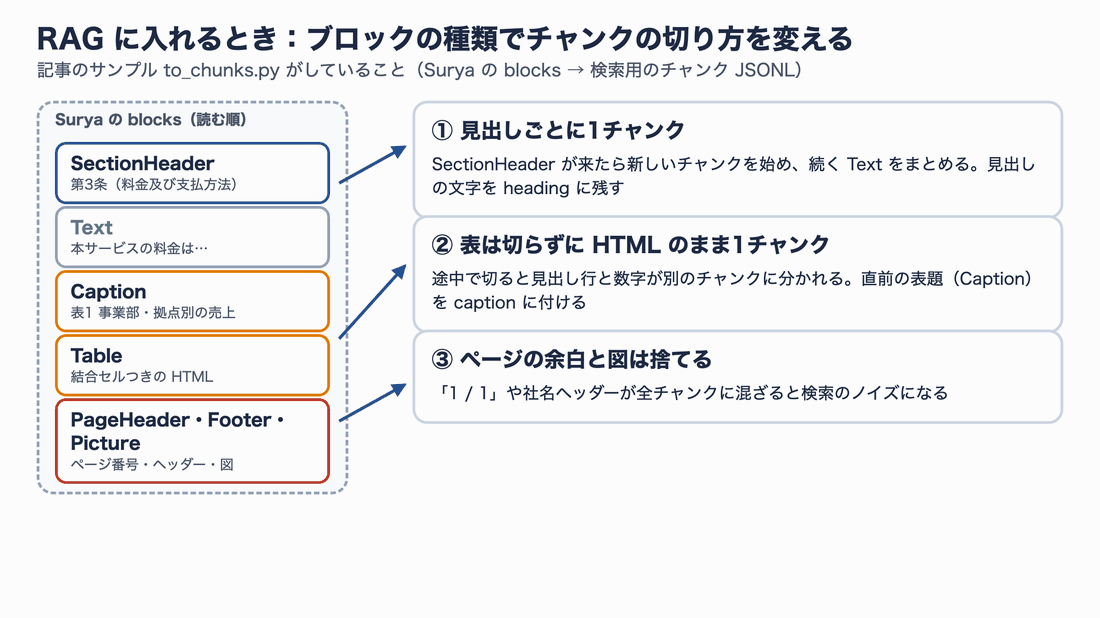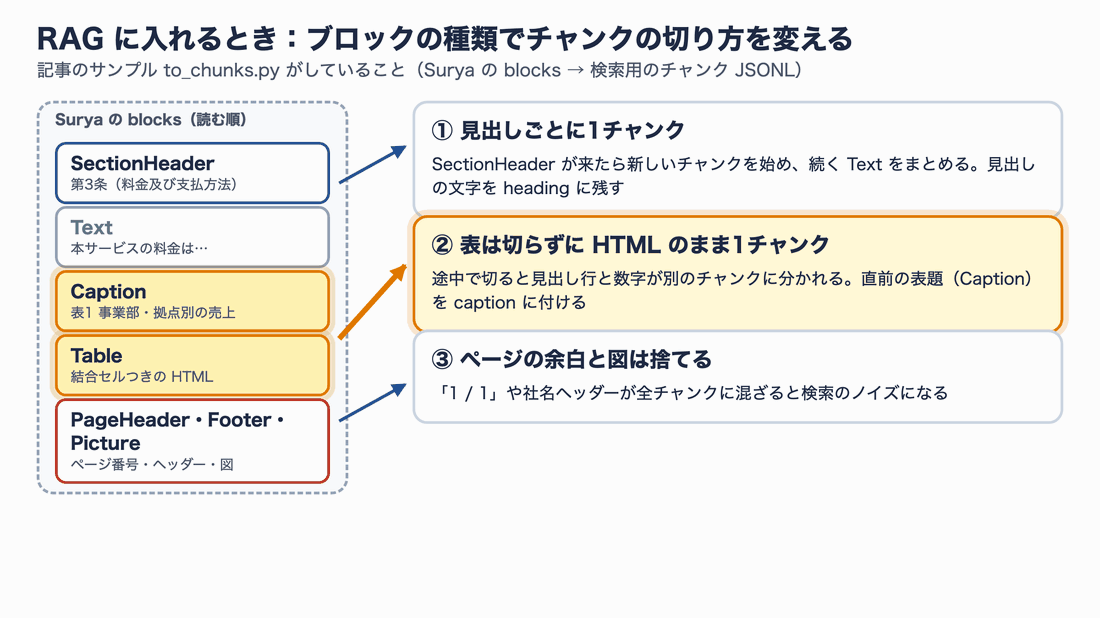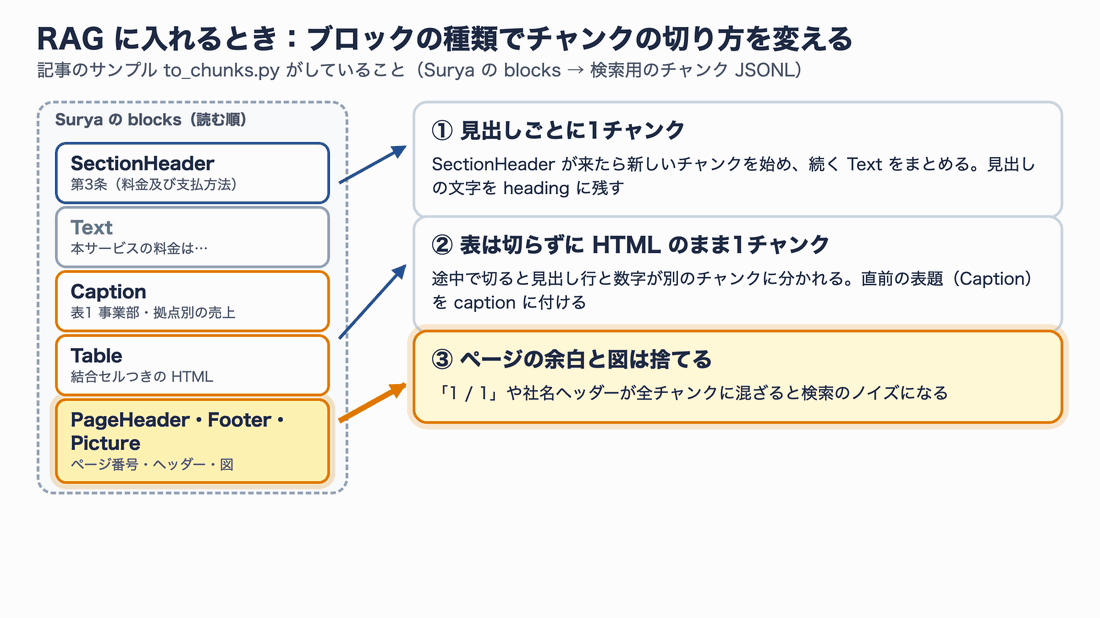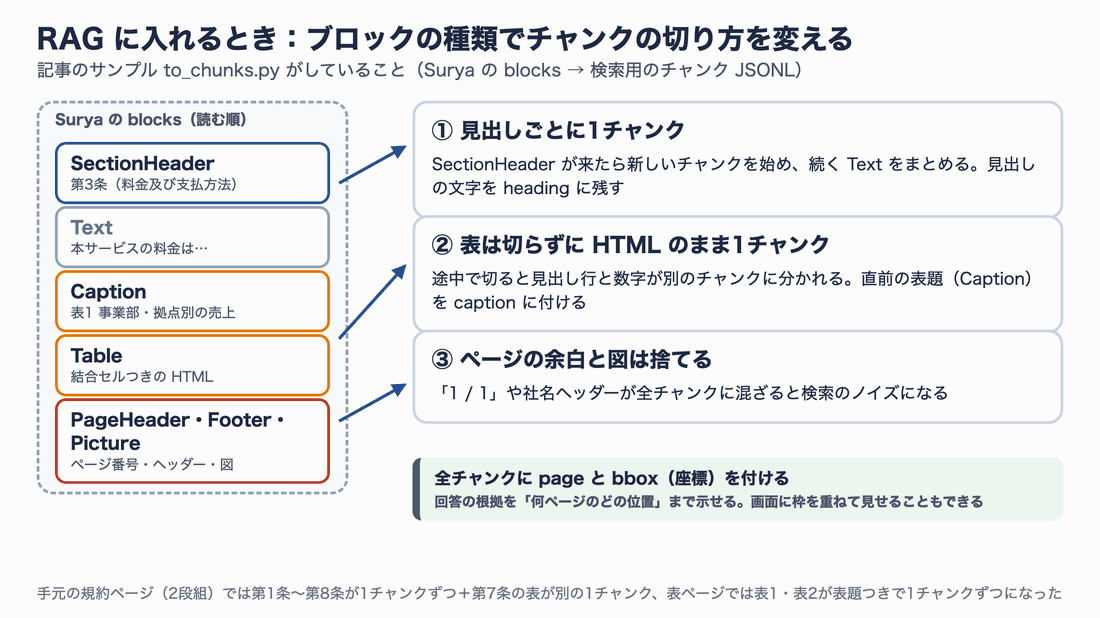
図14:見出しごとにまとめ、表は切らずに残し、ページの余白は捨てます
手元で動作を確認した最小のサンプルです。
"""PDF / 画像を Surya で読み、RAG 用のチャンク(JSONL)にする最小サンプル。
使い方: python to_chunks.py 入力.pdf > chunks.jsonl
"""
import json
import re
import sys

from surya import RecognitionPredictor, SuryaInferenceManager
from surya.input.load import load_from_file
from surya.settings import settings

SKIP = {"PageHeader", "PageFooter", "Picture", "Figure"}  # 検索のノイズになるブロック


def to_text(html: str) -> str:
    """表以外のブロックを、数式を残したプレーンテキストにする"""
    s = re.sub(r"<math[^>]*>(.*?)</math>", lambda m: f"${m.group(1).strip()}$", html, flags=re.S)
    s = re.sub(r"<br\s*/?>|</(p|li|h\d)>", "\n", s)
    s = re.sub(r"<[^>]+>", "", s)
    return re.sub(r"\n{2,}", "\n", s).strip()


def main(path: str):
    images, _ = load_from_file(path, dpi=settings.IMAGE_DPI_HIGHRES)  # PDF を 192 DPI で画像にする
    pages = RecognitionPredictor(SuryaInferenceManager())(images)

    chunks, cur = [], None
    for page_no, page in enumerate(pages, start=1):
        blocks = [b for b in sorted(page.blocks, key=lambda b: b.reading_order) if b.label not in SKIP and b.html]
        for i, b in enumerate(blocks):
            meta = {"source": path, "page": page_no, "bbox": [round(v) for v in b.bbox], "label": b.label}
            nxt = blocks[i + 1].label if i + 1 < len(blocks) else None
            if b.label == "SectionHeader":            # 見出しが来たら新しいチャンク
                cur = {"heading": to_text(b.html), "text": "", "metadata": meta}
                chunks.append(cur)
            elif b.label == "Caption" and nxt == "Table":
                continue                               # 表題は次の表のチャンクに付ける
            elif b.label == "Table":                   # 表は切らずに HTML のまま1チャンク
                heading = cur["heading"] if cur else ""
                prev = blocks[i - 1] if i > 0 else None
                caption = to_text(prev.html) if prev is not None and prev.label == "Caption" else ""
                chunks.append({"heading": heading, "caption": caption, "text": b.html,
                               "metadata": meta | {"format": "html"}})
            else:                                      # 本文は今の見出しのチャンクに足す
                if cur is None:
                    cur = {"heading": "", "text": "", "metadata": meta}
                    chunks.append(cur)
                cur["text"] += to_text(b.html) + "\n"
    for c in chunks:
        if c["text"].strip():
            print(json.dumps(c, ensure_ascii=False))


if __name__ == "__main__":
    main(sys.argv[1])
2段組の利用規約のページで実行すると、第1条〜第8条がそれぞれ1チャンクになり、第7条の中の表は別の1チャンクになりました。表のページでは、表1と表2が表題つきで1チャンクずつです。出力の1行は次のような形です(長い部分は省略)。
{"heading": "2026年度 事業部別売上と拠点比較", "caption": "表1 事業部・拠点別の売上", "text": "<table><tr><th rowspan=\"2\">事業部</th>…</table>", "metadata": {"source": "c1_merged_table.pdf", "page": 1, "bbox": [124, 346, 1450, 782], "label": "Table", "format": "html"}}
設計のポイントを補足します。
- 表は HTML のまま渡す:LLM は HTML の表を読めます。Markdown に変換すると結合セルの情報が消えるので、変換しないほうが安全です。埋め込み(ベクトル化)用には、タグを除いた文字列を別に作ってもかまいません
- page と bbox を残す:回答の根拠を「何ページのどこ」まで示せます。surya_gui と同じように、原本の画像に枠を重ねて見せることもできます
- 見出しが来ない長い本文:このサンプルは見出しの単位でまとめるだけなので、1つの節が長い文書では、文字数で分割する処理を後ろに足してください
6. 大量に処理するときの設定
フォルダごと処理する場合や、速さと精度のバランスを変えたい場合の設定です。
| やりたいこと | 方法 |
|---|---|
| フォルダをまとめて処理 | surya_ocr ./資料 --recursive --output_dir ./results |
| コマンドのたびのサーバー起動を省く | --keep_server を付けて起動したままにする(後で pkill llama-server などで止める) |
| 既に動いているサーバーにつなぐ | SURYA_INFERENCE_URL=http://127.0.0.1:8080/v1(末尾は /v1) |
| 同時に送るページ数 | SURYA_INFERENCE_PARALLEL(llama.cpp の既定は8) |
| 小さい文字の精度を上げる | IMAGE_DPI_HIGHRES=300(既定192、遅くなる) |
| とにかく速く | IMAGE_DPI_HIGHRES=96 |
| レイアウトを先に検出してからブロックごとに読む | --block_mode |
| 一部のページだけ | --page_range "0,5-10" |
| 旧モデルに戻す | SURYA_MODEL_CHECKPOINT=datalab-to/surya-ocr-2 と SURYA_GGUF_REPO=datalab-to/surya-ocr-2-gguf など |
Mac で試験的な MLX バックエンドを使う場合は、モデルを MLX 形式に変換してから指定します。変換には PyTorch などを含む [build] の追加パッケージが必要です。
# 変換用の環境(PyTorch が入る)
pip install "surya-ocr[build]==0.24.0" "mlx-vlm==0.7.10"
python -m surya.scripts.build_mlx --checkpoint datalab-to/surya-ocr-2.5 --out-dir ./mlx-build --q-bits 8
# → ./mlx-build/surya-ocr-2.5-mlx-q8 ができる

# 変換したモデルで OCR する(mlx_vlm.server が自動で起動する)
export SURYA_INFERENCE_BACKEND=mlx
export SURYA_MLX_MODEL=$PWD/mlx-build/surya-ocr-2.5-mlx-q8
surya_ocr 資料.pdf --stdout
手元でも変換して試しました。変換は22秒で終わり、8bit のモデルは793MB でした(Hugging Face からの取得が途中で止まったので、重みを curl で取得し、--checkpoint にそのフォルダを指定しています)。同じ34ページで llama.cpp と比べた結果です。
| llama.cpp(既定・GGUF) | MLX(8bit に変換) | |
|---|---|---|
| 1ページずつの平均時間 | 4.2〜5.5秒 | 2.4秒 |
| 8ページ同時の処理量 | 0.60〜0.82 ページ/秒 | 0.82 ページ/秒 |
| 文字の正しさ(PDF/スキャン) | 99.5%/99.8% | 99.3%/98.3% |
| 表の TEDS(形だけ) | 0.996(0.996) | 0.985(0.996) |
| 数式 | 5/5 | 5/5 |
| 記号の文字化け | なし | 「¥」「×」「○」が「�」になった箇所が7つ |
1ページずつなら MLX が約2倍速く、表の形・数式・読み順も同じでした。一方で、金額の「¥」や評価欄の「×」「○」が文字化けの印「�」に置き換わる箇所がありました。公式も「試験的」としている段階なので、記号の多い帳票では既定の llama.cpp を使うほうが安全です。なお、llama.cpp 側は8bit に量子化していないモデルなので、量子化の条件をそろえた比較ではありません。
どれを使うか:文書の中身で選ぶ
ここまでの結果から、使い分けの目安をまとめます。
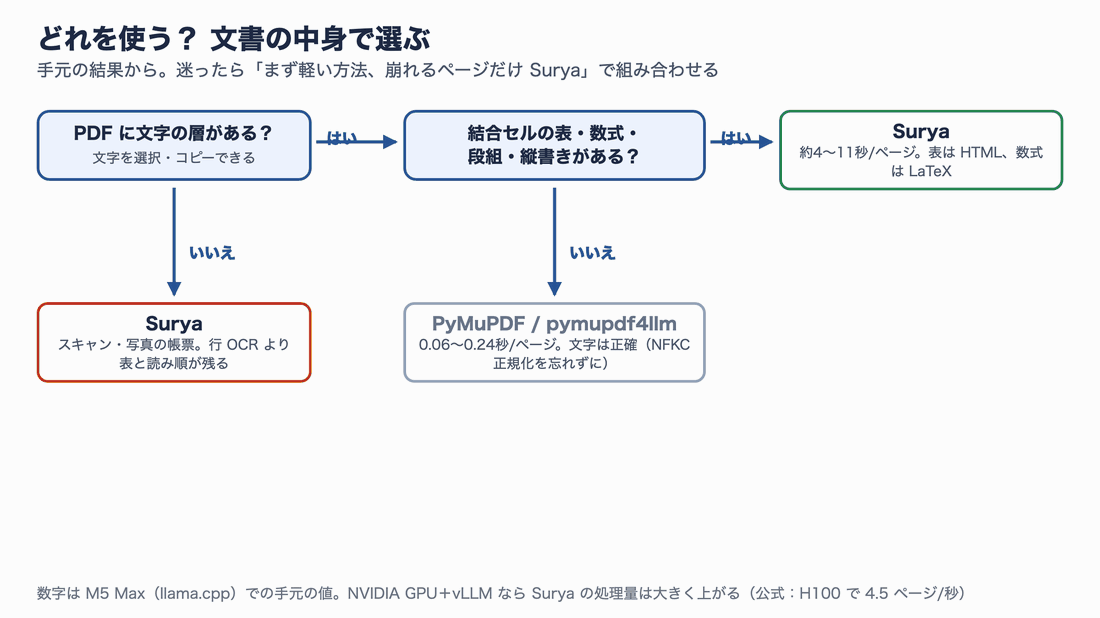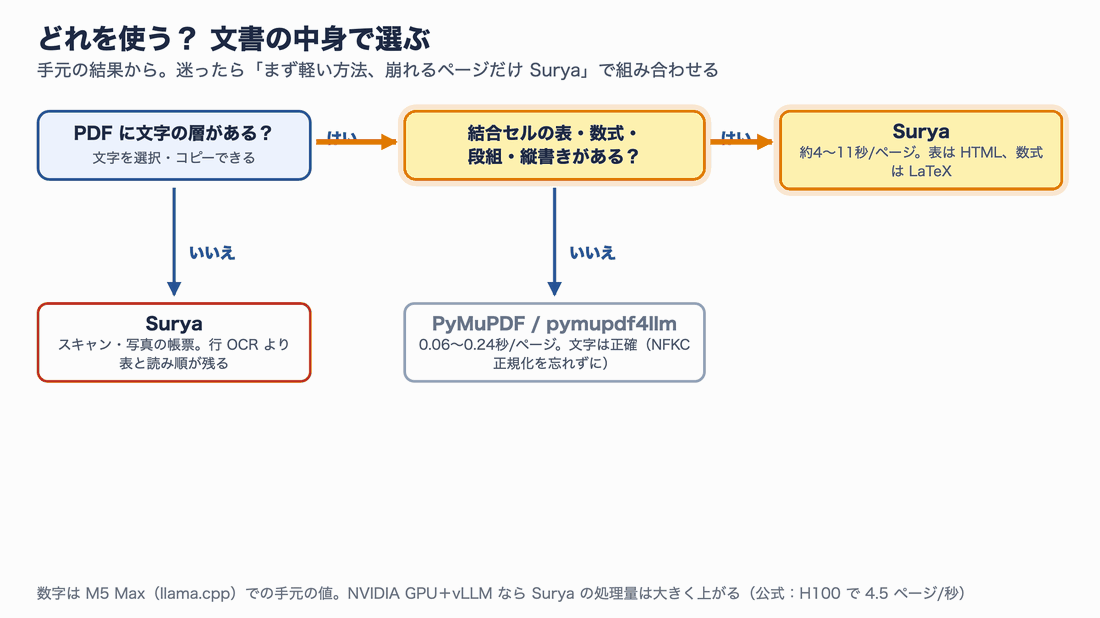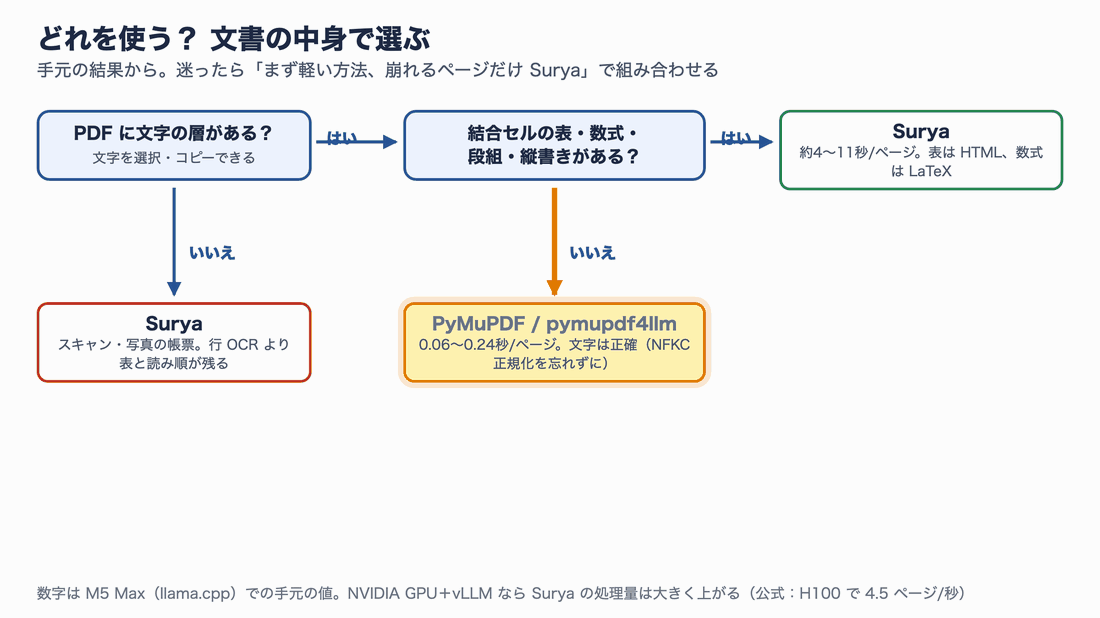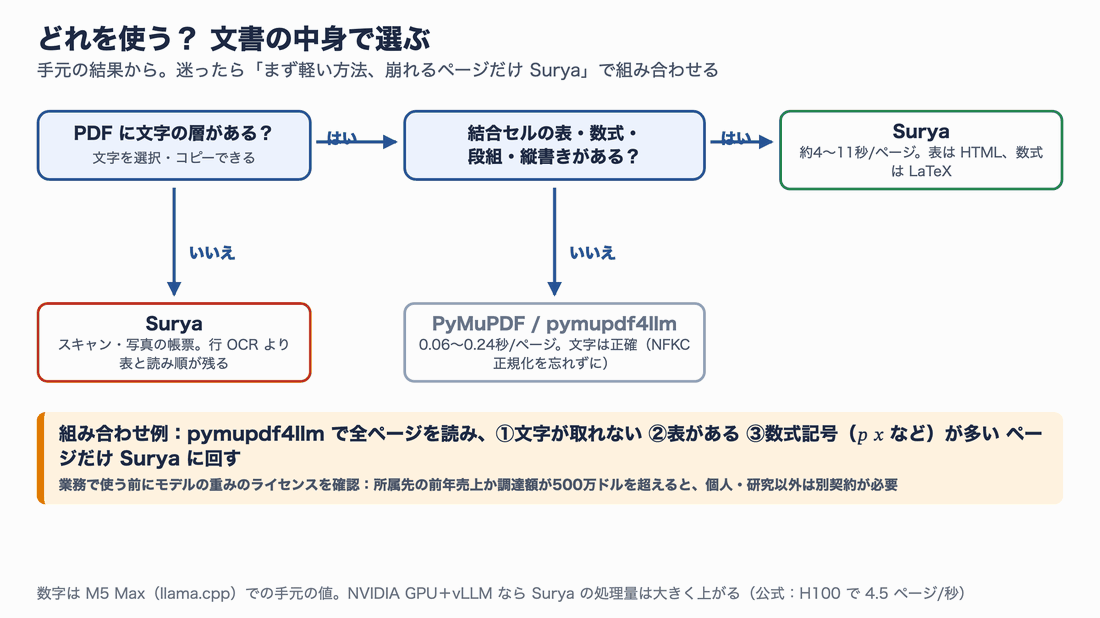
図15:迷ったら「まず軽い方法、崩れるページだけ Surya」で組み合わせます
文字の層がある PDF で、表も数式も段組もなければ、PyMuPDF や pymupdf4llm で十分です。速く、文字も正確です(NFKC 正規化は忘れずに)。スキャンした資料や、結合セルの表・数式・段組・縦書きを含む資料では、Surya の価値がはっきり出ます。
全ページを Surya に通すと時間がかかるので、次のような組み合わせが現実的です。
- まず pymupdf4llm で全ページを読む
- 文字がほとんど取れないページ(スキャン)、表があるページ、数式用の文字(𝑝 𝑥 などの数学用英字)が多いページを見つける
- そのページだけ Surya に回し、結果を差し替える
ライセンスの注意
Surya のコードは Apache 2.0 ですが、モデルの重みは AI Pubs Open RAIL-M を改変したライセンスです。モデルに付いているライセンス文書では、次の場合の利用を(個人利用・研究目的を除いて)認めていません。
- 利用者(勤務先・所属先を含む)の前年の総売上が500万ドルを超える場合
- 利用者が合計500万ドルを超える資金(出資・借入)を調達している場合
- Datalab の製品・サービスと競合するものを提供している場合
多くの企業の業務利用は、この条件に当てはまるはずです。その場合は Datalab の商用ライセンスを検討するか、同社の API(Datalab API)を使うことになります。社内で試す前に、法務や情報システム部門と確認してください。
トラブルシューティング
うまく動かないときは、「サーバーの起動 → 接続 → 結果の解釈」のどこで止まっているかを順に確かめます。
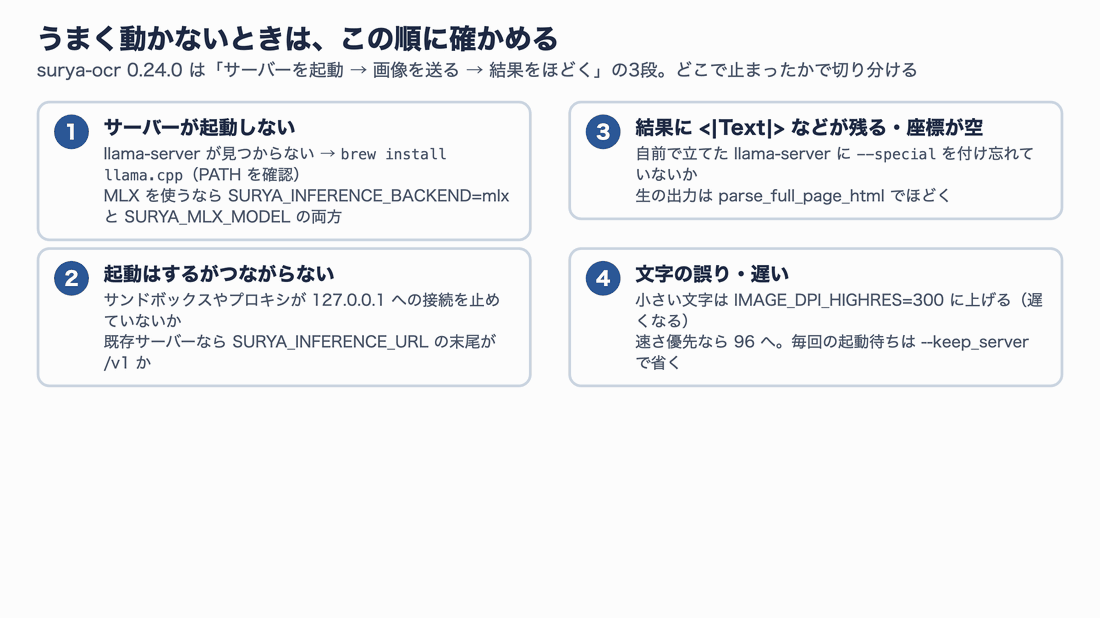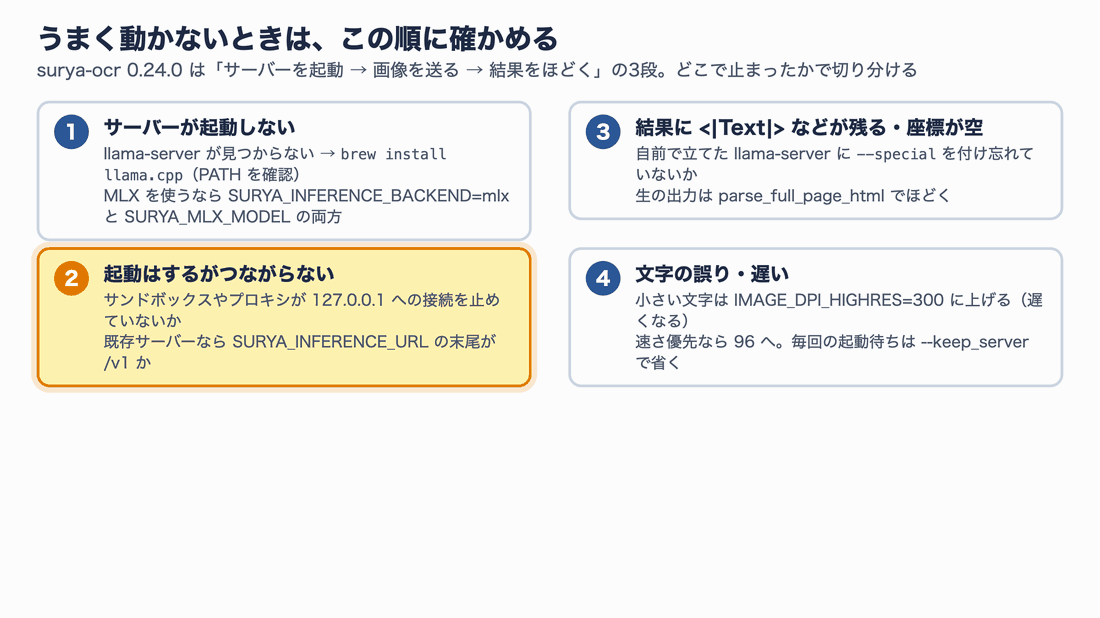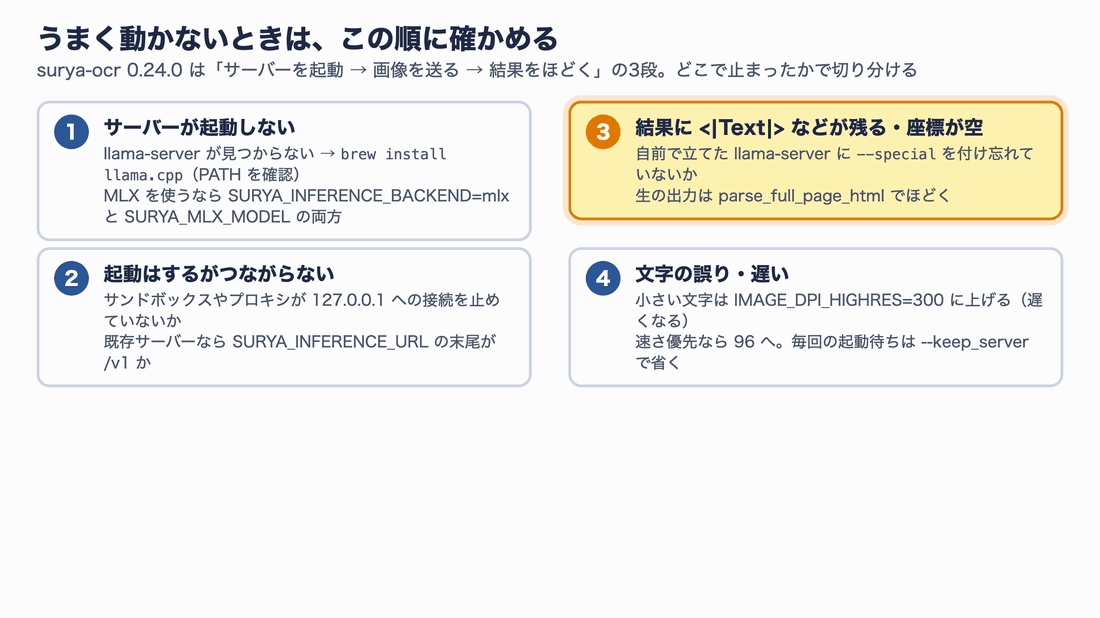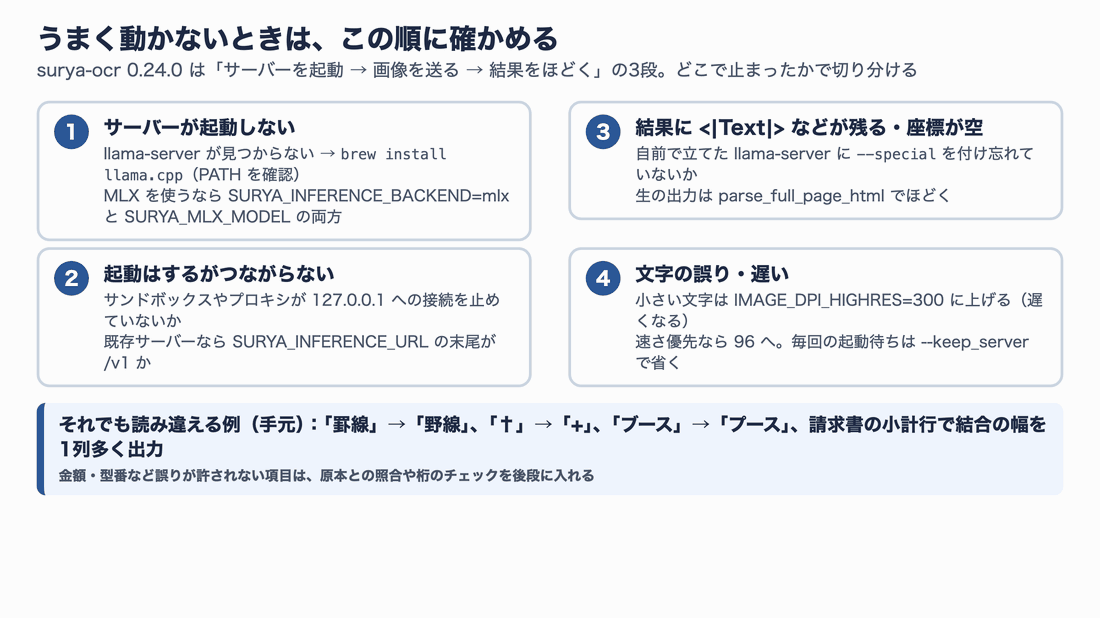
図16:上から順に確かめると、原因を切り分けやすくなります
よくある症状と対処を表にまとめます。
| 症状 | 原因の候補 | 対処 |
|---|---|---|
llama-server が見つからないというエラー | llama.cpp が入っていない、PATH が通っていない | brew install llama.cpp、which llama-server で確認 |
| 初回の実行が長く止まる | モデル(約1.3GB)の取得中 | そのまま待つ。止まったままなら ~/.cache/huggingface の .incomplete を消して再実行 |
| サーバーは起動したのにつながらない | サンドボックスやプロキシが 127.0.0.1 への接続を止めている | 実行環境のネットワーク制限を確認。既存サーバーなら URL の末尾が /v1 か確認 |
| 結果に特殊な印(Text などのラベルを囲んだ記号)が残る・座標が空 | 自分で起動した llama-server に --special がない | --special を付けて起動する(自動起動なら付いている) |
| 小さい文字の誤りが多い | 画像の解像度が足りない | IMAGE_DPI_HIGHRES=300 で試す |
| 毎回の起動待ちが長い | コマンドのたびにサーバーを起動・停止している | --keep_server を使う |
| MLX が使われない | 環境変数が足りない | SURYA_INFERENCE_BACKEND=mlx と SURYA_MLX_MODEL(変換後のフォルダ)の両方を設定 |
| MLX で「¥」「×」「○」が「�」になる | 試験的な MLX バックエンドでの記号の扱い(手元で7か所) | 記号が重要な文書は llama.cpp に戻す |
手元では、Hugging Face からのモデル取得が途中で止まることがありました。その場合は、ファイルの URL を curl -L -C - で取得すると途中から再開できます。
まとめ
この記事の要点を振り返ります。
- 従来の PDF 抽出や行単位の OCR は、文字は取れても表の結合セル・数式・段組や縦書きの読み順という構造が崩れ、スキャンでは文字すら取れないことがありました
- Surya v0.24.0 は、689M の文書専用モデル Surya 2.5 が、ブロックの種類・座標・中身を読む順に、表は HTML、数式は LaTeX で書き出します。重い依存を外し、Mac でも
brew install llama.cppとpip install surya-ocrで動きます - 手元の34ページでは、結合セルの多い表の TEDS が 0.52〜0.75 → 1.00、数式は 0/5 → 5/5、縦書き・3段組の読み順も正しく、スキャンでも品質はほぼ落ちませんでした
- 一方、文字の層がある PDF の文字そのものは従来の抽出が速く正確です。「3.2倍速い」は文字の多いページで効く改善で、日本語の短い帳票では旧版と同程度でした
- 業務で使う前に、モデルの重みのライセンス(売上・調達額500万ドル超は要契約)を必ず確認してください
次の一歩としては、自社の代表的な文書を10〜20ページ選び、surya_gui で崩れる箇所がないかを確かめることをおすすめします。そのうえで、pymupdf4llm と組み合わせて「崩れるページだけ Surya」に回す流れを作ると、速さと精度のバランスを取りやすくなります。