「PDF を RAG(検索拡張生成)に入れたいけれど、文字認識・レイアウト検出・表の解析・図の説明と、部品がどんどん増えていく……」
社内文書を AI に読ませる仕組みを作ったことがある人なら、一度はこう感じたはずです。2026年10月8日(日本時間9日)に LightOn が公開した LightOnOCR-3 は、この多段の処理を1つの小さなモデルにまとめると発表しました。0.8B〜4B のモデルが、ページの文字だけでなく、見出し・表・図の位置、写真の説明、グラフの数値まで1回で返すというものです。
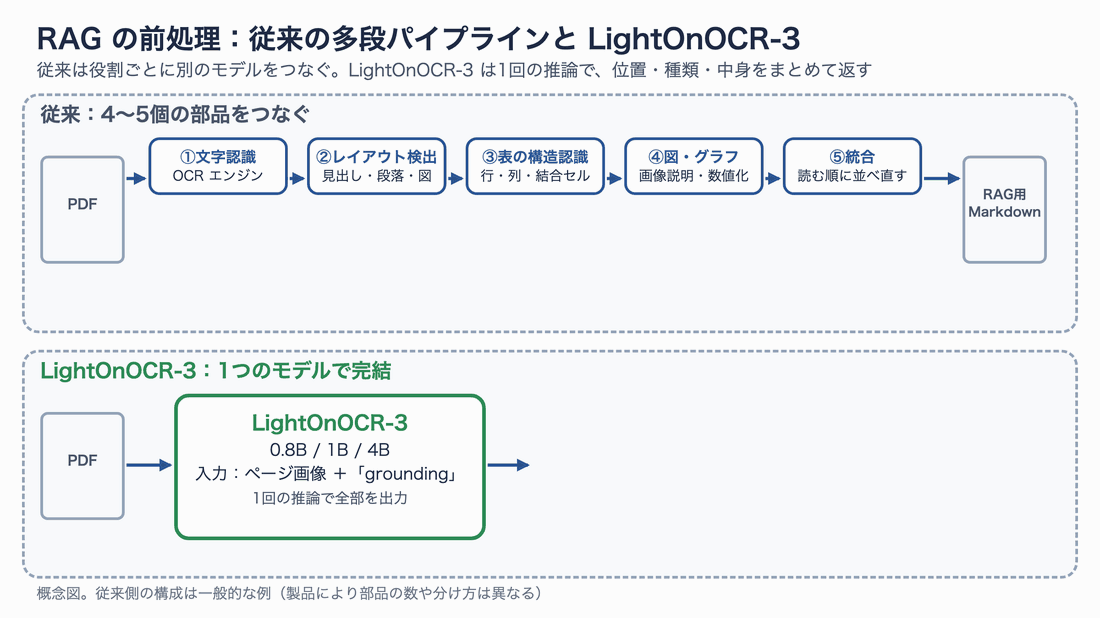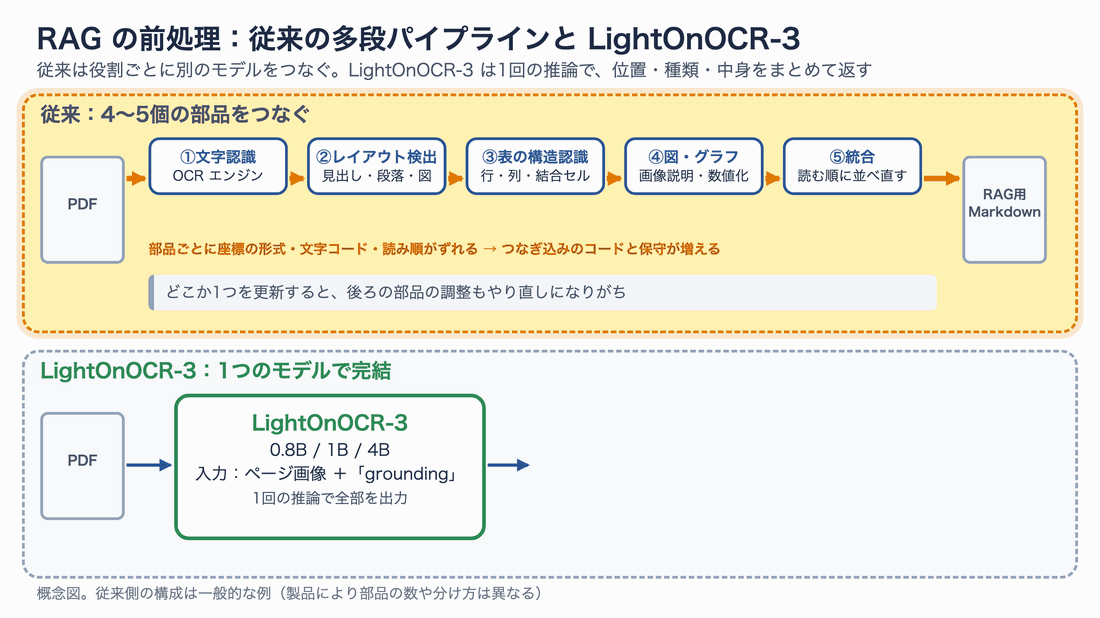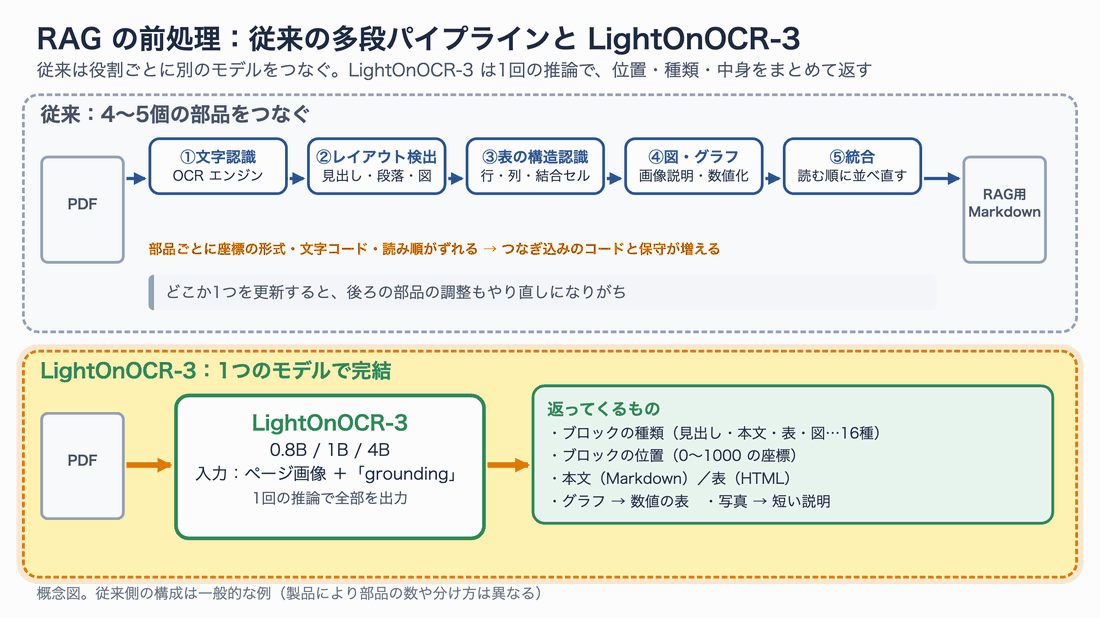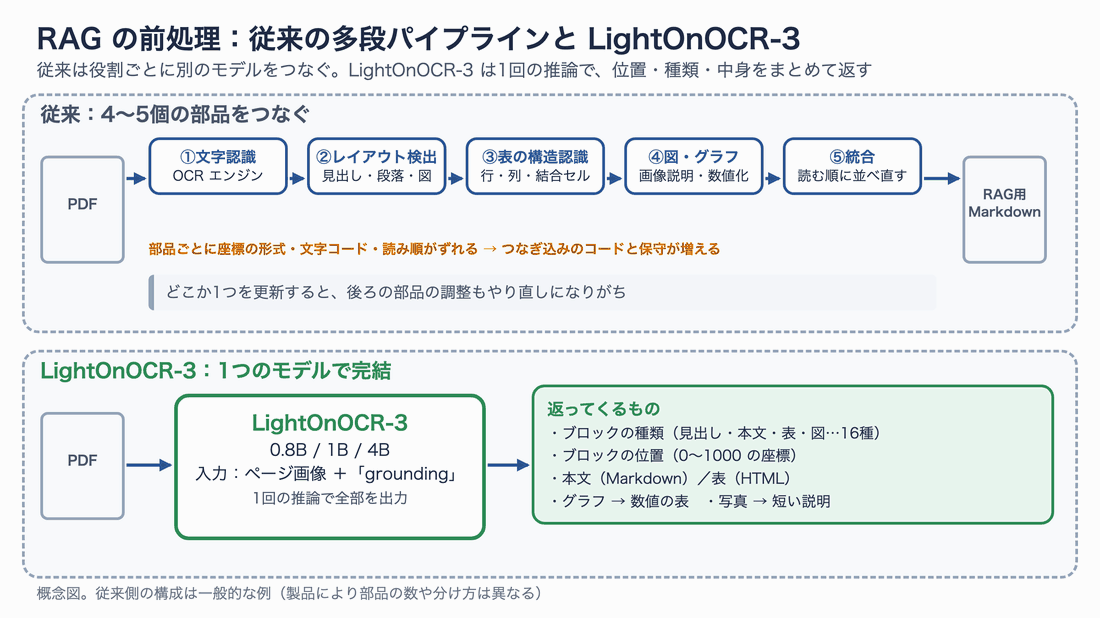
従来の多段パイプライン(上)と、LightOnOCR-3(下)。部品の数が減れば、つなぎ込みのコードと保守も減る
ただ、公式のベンチマークは英語とフランス語の文書が中心です。日本語の請求書や契約書でも本当に使えるのか。手元の Mac で動くのか。同じ用途の PaddleOCR-VL-1.6 や olmOCR-2 と比べてどうなのか。この記事では、正解が分かる日本語の帳票を自作して、5つのモデルを同じ条件で比べました。
先に結論を書きます。
- 日本語の文字と表は、5モデルとも 99% 台で読めた。請求書・契約書・2段組み・スキャン風の劣化ページまで、LightOnOCR-3 は 0.8B でも本文の文字の正確さ 99.6%。差がついたのは文字ではなく「グラフ」と「枠」でした
- グラフの数値化は LightOnOCR-3-4B と 0.8B が強い。数値が印字されていないグラフでも、4B は目盛りから読んだ値の 96% が誤差 5% 以内。PaddleOCR-VL も数値自体は同等に読めましたが、項目名が「契约」「空调」のように中国語の簡体字になることがありました
- 位置(Bounding Box)は 4B と PaddleOCR-VL が約 97%。LightOnOCR-3 は段落や箇条書きを1つの枠にまとめるので、RAG のチャンク分けにそのまま使いやすい
- 写真の説明は要注意。写真の近くにキャプションがあると、写真の中身ではなくキャプションの文言を説明として出しました。わざと誤ったキャプションを付けると、4B は4枚中4枚でそれをそのまま写しました
- 速さは、Mac(M5 Max)で 0.8B が1ページ約6秒、4B が約33秒(いずれも grounding モード、実測の中央値)。PaddleOCR-VL(約5秒)とほぼ同じ速さで、文字に加えて位置とグラフの数値まで出せるのが 0.8B の強みです。olmOCR-2 は約32秒でした
想定読者は、社内文書の RAG や文書のデータ化に取り組んでいるエンジニアと、ローカルで動く OCR を探している人です。前半で LightOnOCR-3 の仕組みと Mac での動かし方を、後半で検証の結果と、RAG に組み込むコードを紹介します。
この記事の確認範囲
- 検証日:2026年10月9日。モデルは Hugging Face の
lightonai/LightOnOCR-3-0.8B・-1B・-4B(10月8日公開版)、PaddlePaddle/PaddleOCR-VL-1.6、mlx-community/olmOCR-2-7B-1025-bf16(allenai/olmOCR-2-7B-1025の MLX 変換版) - 実行環境:MacBook Pro(Apple M5 Max・メモリ 128GB)、macOS 26.6.2、Python 3.12、mlx-vlm 0.7.6、transformers 5.19.0、PaddlePaddle 3.3.1(CPU 版)、PaddleOCR 3.7.0。重みは bf16 のまま(量子化なし)
- 公式情報:LightOn の Hugging Face ブログ「LightOnOCR-3: High-Performance OCR and Layout Extraction in One Model」(2026-10-08)、3モデルのモデルカード、GitHub の lightonai/LightOnOCR(再現用コード)、PaddleOCR-VL-1.6 と olmOCR-2 のモデルカード
- 検証データ:自作の日本語帳票12ページ(+スキャン風12ページ)、グラフ12枚、olmOCR-Bench から抜き出した105ページ、総務省「令和7年版 情報通信白書」の6ページ。帳票の会社名・人名・数値はすべて架空です
- 公式の数値と筆者の実測は、本文で区別して書きます
- LightOnOCR-3 とは:何が1つのモデルにまとまったのか
- 比べた相手と、検証の進め方
- Mac で動かす:環境構築とコード
- 結果1:日本語の文字と表は、5モデルとも実用の水準
- 結果2:グラフを数値にする力は 4B と 0.8B が頭ひとつ抜けた
- 結果3:枠(Bounding Box)は 4B と PaddleOCR-VL が正確
- 結果4:写真の説明は「キャプション」に引っぱられる
- 結果5:速度とメモリ
- 結果6:英語の公開ベンチマークも、Mac で公式とほぼ同じ点になった
- 実在の資料で試す:情報通信白書の6ページ
- 応用:grounding の出力を RAG に組み込む
- どれを選ぶか
- トラブルシューティング
- まとめ
- 参考リソース
LightOnOCR-3 とは:何が1つのモデルにまとまったのか
3つのサイズと、2つの使い方
LightOnOCR-3 は、フランスの AI 企業 LightOn が公開した文書解析モデルの第3世代です。Hugging Face のブログ記事と各モデルカードの内容を表にまとめます。
| 項目 | LightOnOCR-3-0.8B | LightOnOCR-3-1B | LightOnOCR-3-4B |
|---|---|---|---|
| 位置づけ(公式) | 最小・最速 | 前世代と同じ構造、置き換え用 | 最も高精度、多くの用途に推奨 |
| 土台のモデル | Qwen3.5-0.8B | LightOnOCR-2-1B と同じ(Pixtral 系の画像部+Qwen3 系の言語部) | Qwen3.5-4B |
| 重みのファイル | 1.7GB | 2.0GB | 9.1GB |
| 推奨の画像サイズ | 長辺 2048px | 長辺 1540px | 長辺 2048px |
| ライセンス | Apache 2.0 | Apache 2.0 | Apache 2.0 |
ライセンスは3つとも Apache 2.0 で、研究にも商用にも使えます。0.8B と 4B は Alibaba の Qwen3.5 の視覚言語モデルを土台にしており、transformers では Qwen3_5ForConditionalGeneration という汎用のクラスで読み込めます。1B だけは前の世代(LightOnOCR-2-1B)の構造を引き継いでいて、すでに LightOnOCR-2 を使っている環境で差し替えやすいように用意されています。
使い方は2つだけです。
- plain(文字起こし)モード:ページ画像だけを渡すと、ページの文字を読む順に Markdown で返します。表は HTML、数式は LaTeX です。前の世代と同じ使い方で、プロンプト(指示文)は空のままです
- grounding モード:ページ画像に
groundingという一語を添えると、ブロックごとに「種類」と「位置」の印を付けて返します。写真には短い説明、グラフには読み取った数値の表が付きます
公式のモデルカードは、この2つ以外の指示は学習の範囲外なので使わないように、と明記しています。「この表だけ抜き出して」のような自由な指示を出す使い方は想定されていません。
grounding モードの出力は「1行目に種類と位置」
grounding モードでは、各ブロックの先頭に  という印が付きます。座標はページの幅と高さをそれぞれ 1000 とした値です。
次の図は、検証用に作った架空の月次報告書を 0.8B に読ませたときの、実際の出力です。左のページに描いた枠は、右の出力の座標をそのまま描いたものです。
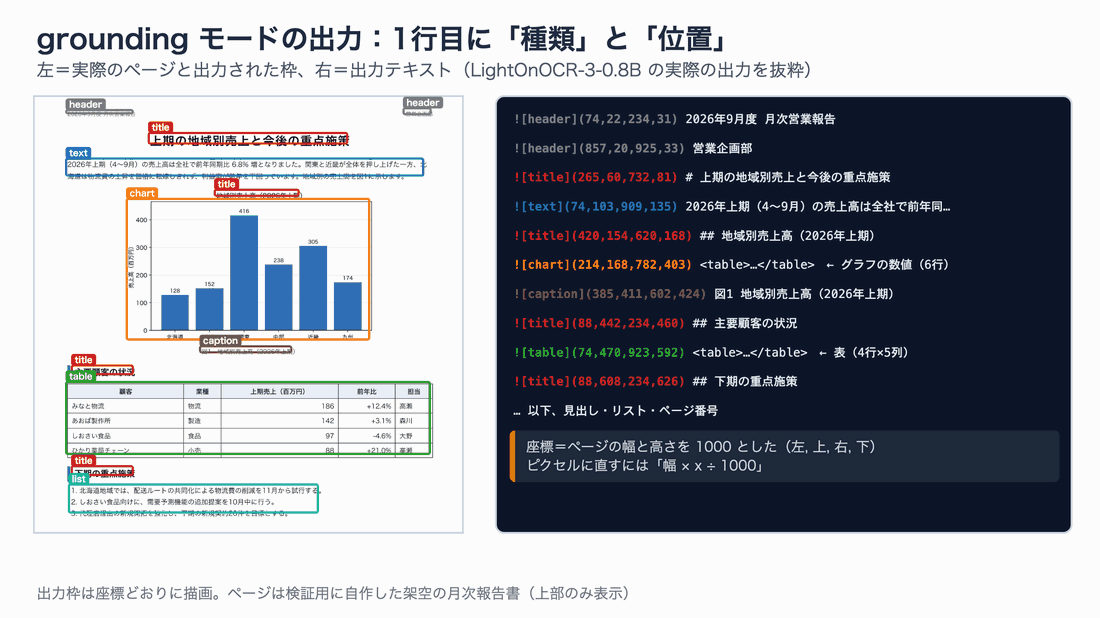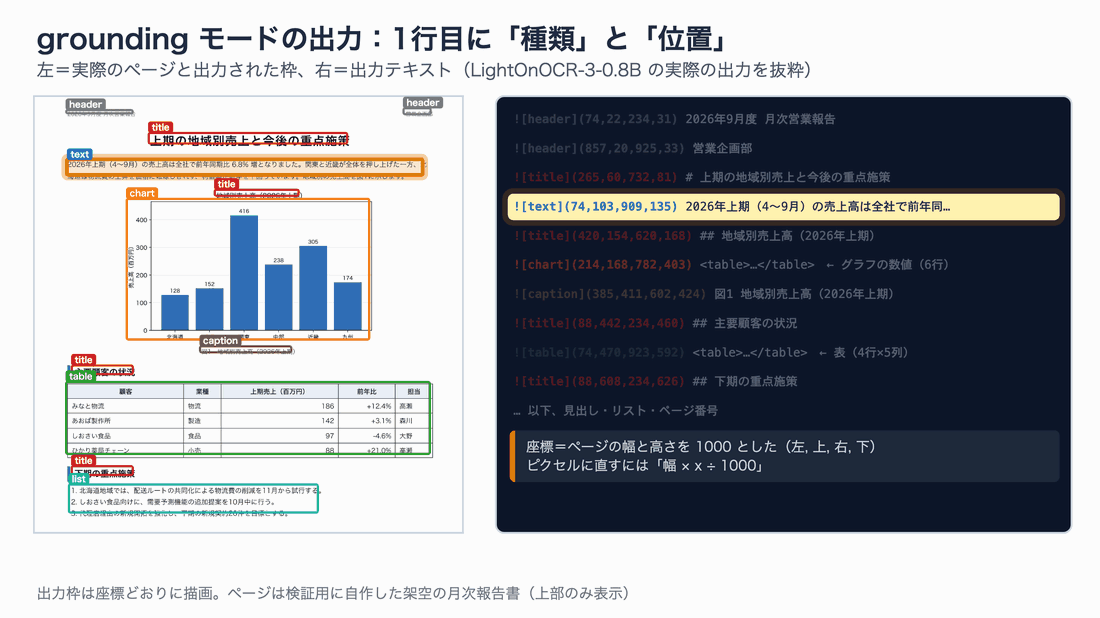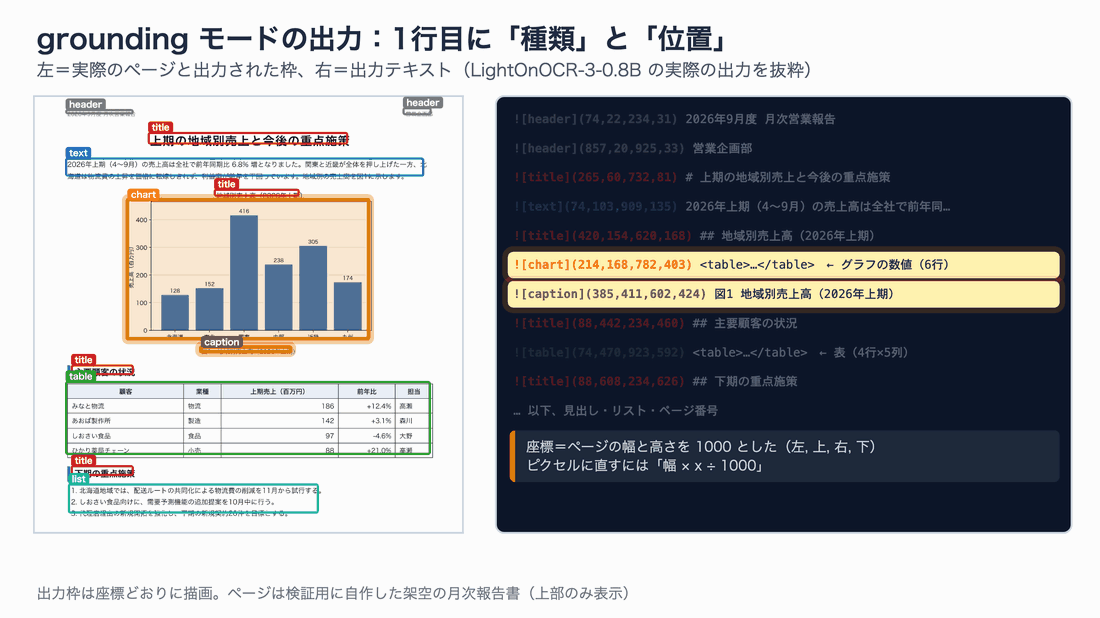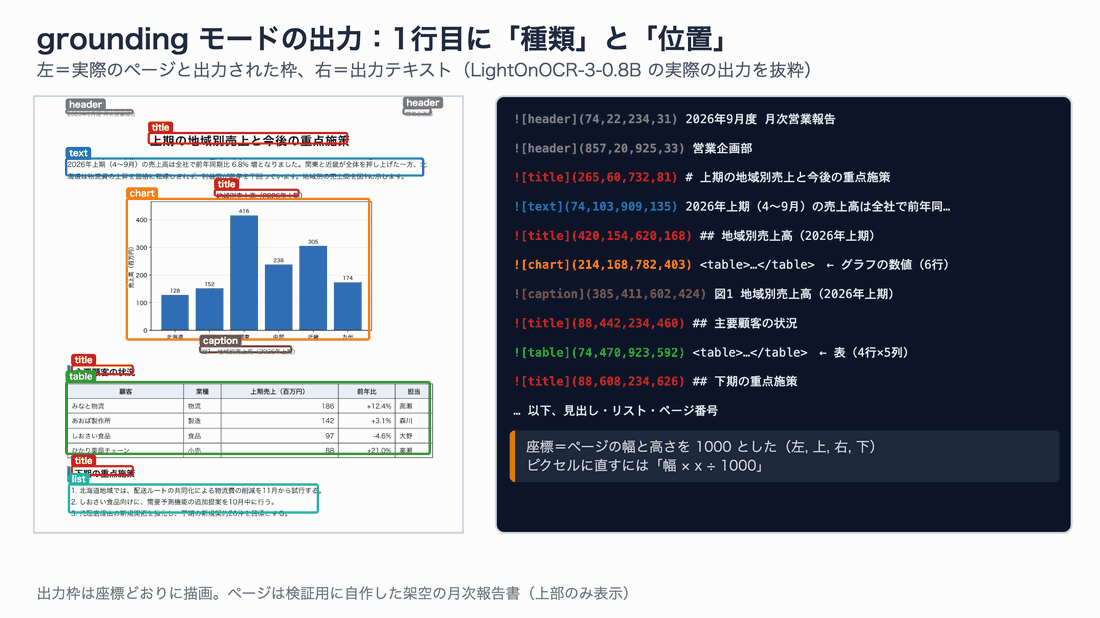
見出し(title)、本文(text)、グラフ(chart)、図の説明(caption)、表(table)が、それぞれの座標と一緒に出てくる。グラフのブロックの中身は、棒の高さを読み取った6行の表になっている
種類(ラベル)は、公式モデルカードで次の16種類が定義されています。
| ラベル | 意味 | ラベル | 意味 |
|---|---|---|---|
title | 文書・節の見出し | table | 表(中身は HTML) |
text | 本文の段落 | chart | グラフ(中身は数値の HTML 表) |
list | 箇条書き | image | 写真・図(中身は短い説明) |
caption | 図表の説明文 | formula | 数式(LaTeX) |
footnote | 脚注 | code | コード |
header / footer | ページ上端・下端の文字 | header_image / footer_image | ロゴなど上端・下端の画像 |
page_number | ページ番号 | aside_text | 欄外の文字 |
ラベルの後ろに + が付いたもの(text+ など)は、前のブロックの続き、たとえば段組みの次の列へ流れた段落を表します。
公式によると、grounding モードは文字起こしだけのときより出力トークンが平均で約 25% 増えます(4B で 1ページ 1,158 → 1,433 トークン)。位置の情報を HTML や JSON ではなく短い印で書くことで、増え方を抑えているとのことです。
公式のベンチマーク
公式ブログに載っている、英語中心の公開ベンチマーク olmOCR-Bench の結果の一部です(数値は公式発表のまま)。
| モデル | パラメータ数 | olmOCR-Bench 総合 | 表 | 古いスキャン | 長い小さな文字 |
|---|---|---|---|---|---|
| Infinity Parser Pro | 35.1B | 87.6 | 91.2 | 58.2 | 92.5 |
| LightOnOCR-3-4B | 4.0B | 86.3 | 90.2 | 52.5 | 93.2 |
| Chandra 2 | 4.0B | 85.8 | 92.1 | 51.1 | 93.7 |
| LightOnOCR-3-0.8B | 0.8B | 85.5 | 90.8 | 48.7 | 94.1 |
| LightOnOCR-3-1B | 1.0B | 84.5 | 89.9 | 48.3 | 93.7 |
| LightOnOCR-2-1B | 1.0B | 83.2(※) | 89.0 | 42.2 | 91.4 |
※ LightOnOCR-2-1B の総合点は「ヘッダー・フッター」の項目を除いた値で、他の行とは直接比べられないと公式が注記しています。
0.8B が 35.1B のモデルに約 2 点差まで迫っている、というのが公式の主張の中心です。表やグラフ、レイアウトの位置を採点する ParseBench でも、4B(75.1)と 0.8B(74.6)が Infinity Parser Pro(74.3)を上回ったと報告されています。
ただし、公式の採点方法には読み落としやすい前提があります。LightOn の再現用リポジトリを読むと、olmOCR-Bench の点数は次の条件で出したものでした。
- plain モードではなく grounding モードで読み、ヘッダー・フッター・ページ番号のブロックを捨ててから採点している
- 採点の前に、olmOCR-Bench 向けに調整した後処理(PP3)をかけている。リポジトリの結果表では、後処理ありが 4B 86.1・0.8B 85.4、後処理なしが 85.4・84.7 で、約 0.7 点の差がある(ブログの 86.3 とは別の回の測定)
- 1ページを 3回読み、多数決で合否を決めている
- ページは 400dpi(上限 500 万画素)で画像にしている。モデルカードが推奨する長辺 2048px より細かい
公式ブログ自身も「表記のゆれを直す単純な書き換えで、抽出した中身は同じでも点数が目に見えて変わる」と書いています。ベンチマークの点数は、モデル単体の力というより「モデル+後処理+読ませ方」の点数として見るのが妥当です。この記事の後半では、この条件をできるだけそろえて Mac で再現できるかも確かめます。
比べた相手と、検証の進め方
比較した2つのモデル
RAG の前処理によく使われる、同じ用途のオープンなモデル2つと比べました。どちらも Apache 2.0 で、ローカルで動かせます。
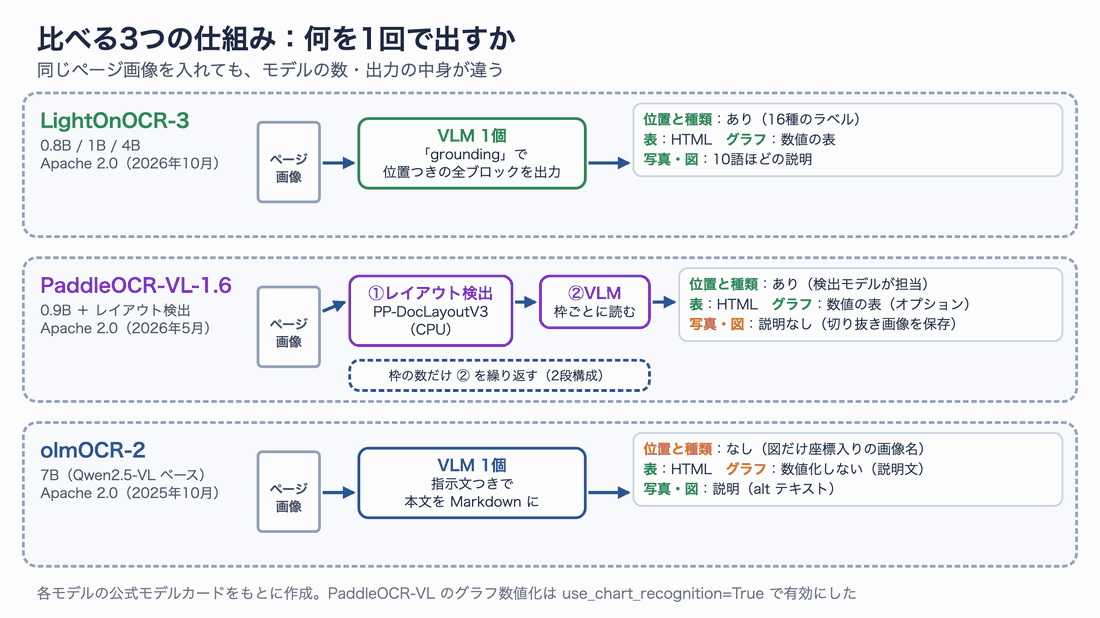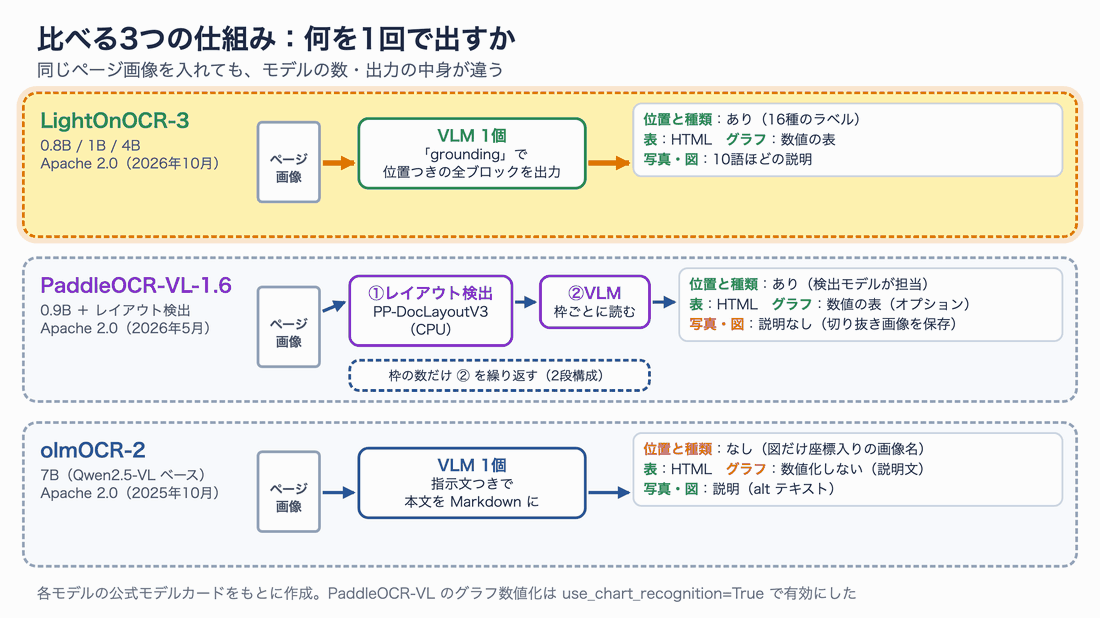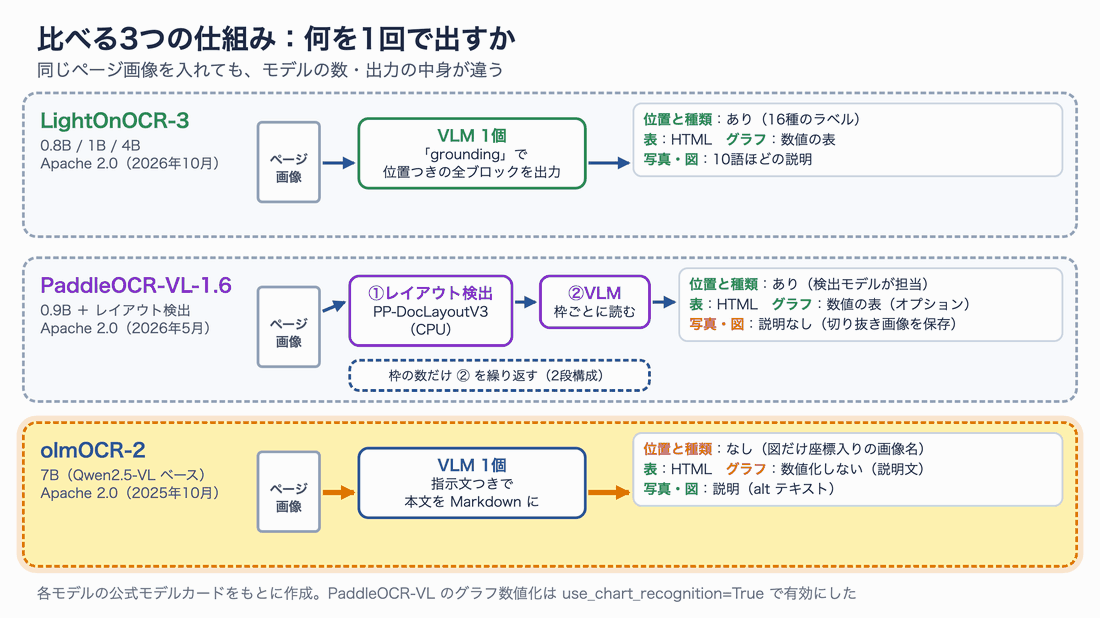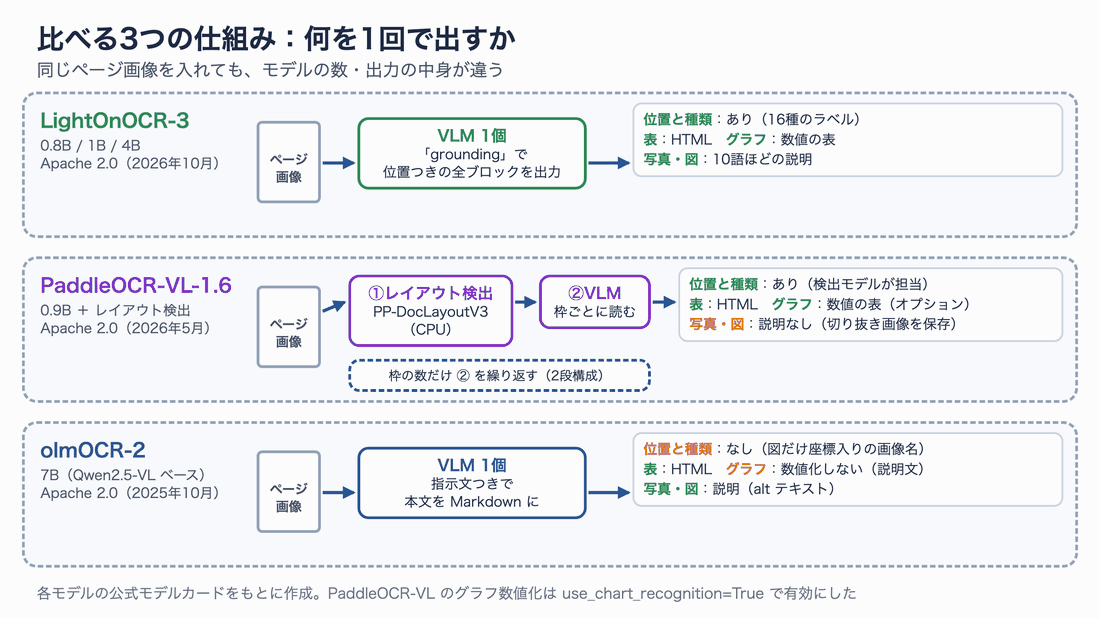
同じページ画像を入れても、出てくるものが違う。位置・グラフの数値・写真の説明までを1つのモデルの1回の推論で出すのは LightOnOCR-3 だけ
- PaddleOCR-VL-1.6(Baidu、2026年5月):レイアウト検出モデル PP-DocLayoutV3 でページを枠に分け、枠ごとに 0.9B の VLM で読む2段構成です。PaddleOCR の公式ドキュメントによると、シリーズとして109言語に対応しています。LightOnOCR-3 の公式の比較表には入っていません
- olmOCR-2-7B(Allen Institute for AI、2025年10月):Qwen2.5-VL-7B を文書の文字起こし用に学習させたモデルです。本文を Markdown で返し、図は「説明つきの画像リンク」として書きます。位置の情報は出しません。公式の olmOCR-Bench の点数は 82.3 です
何を、どう測ったか
検証の全体像です。
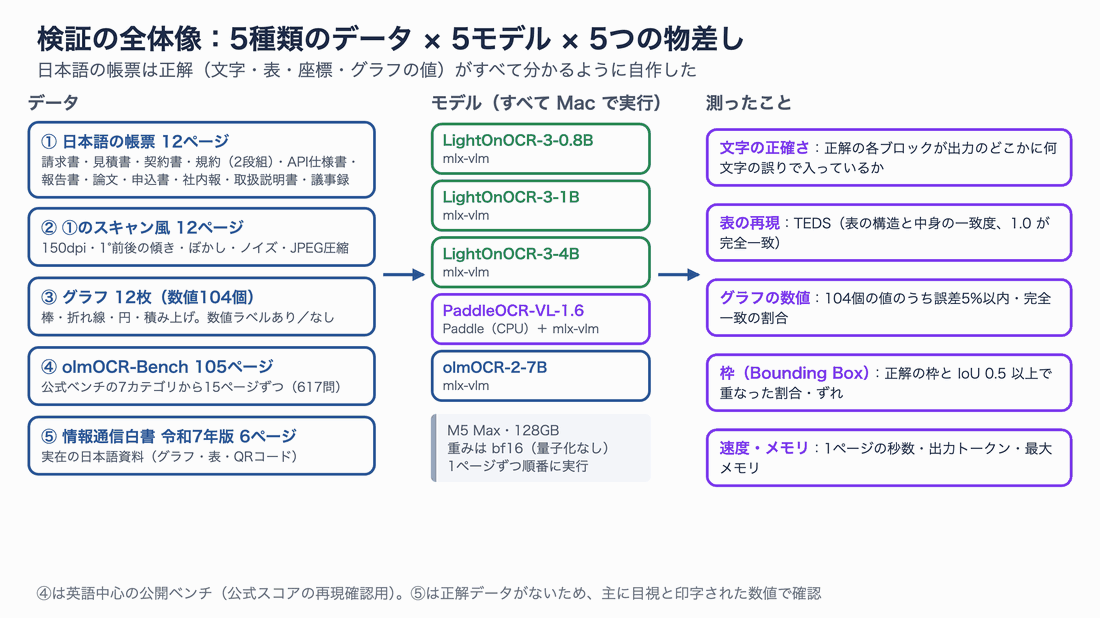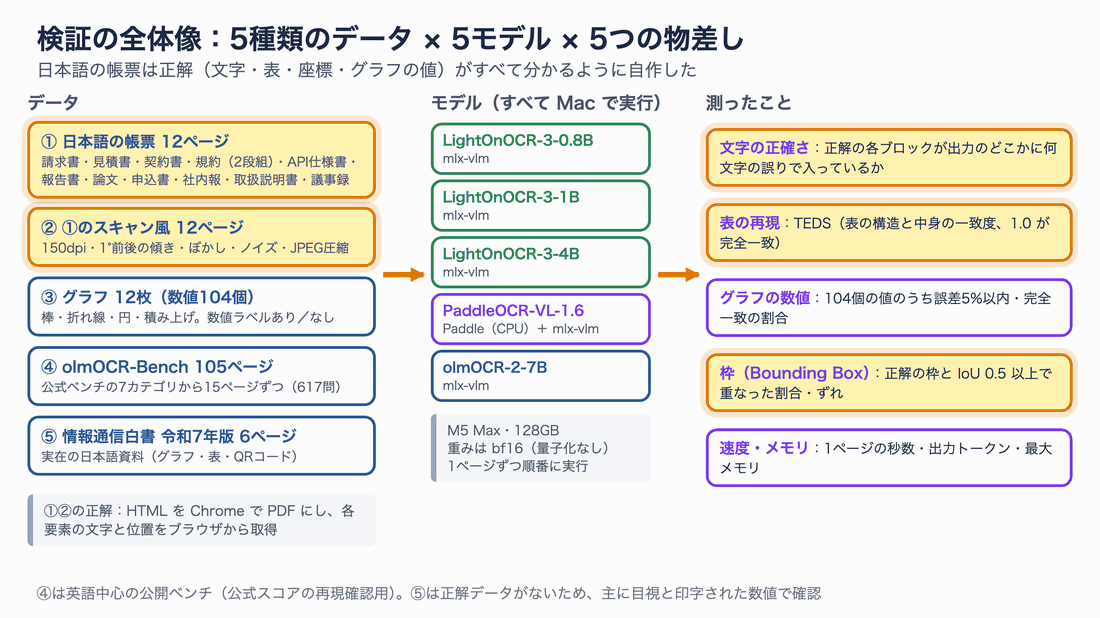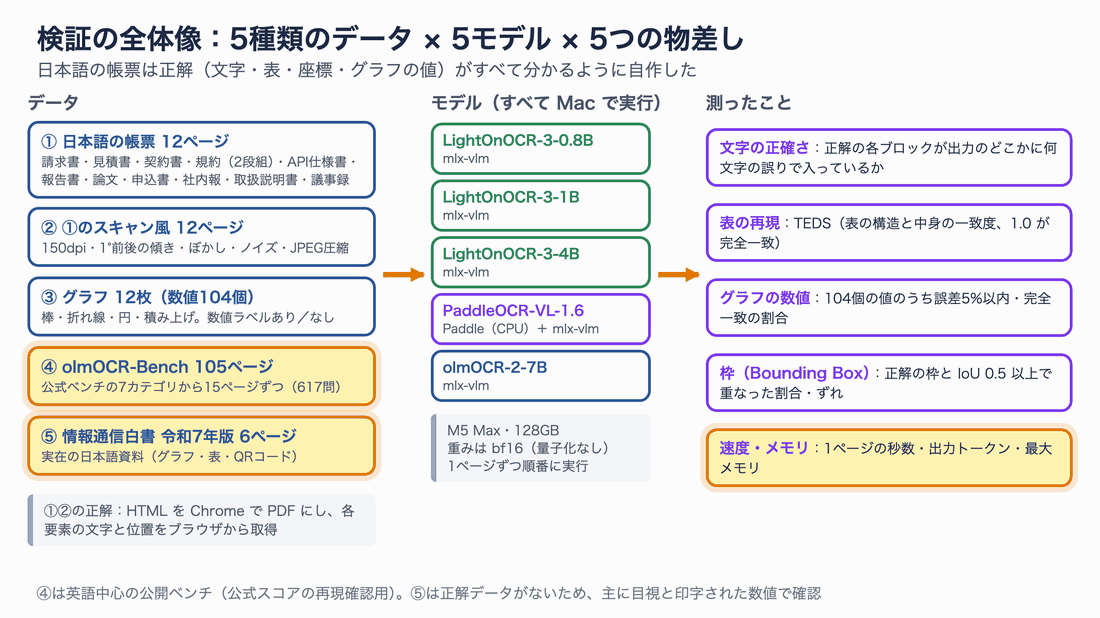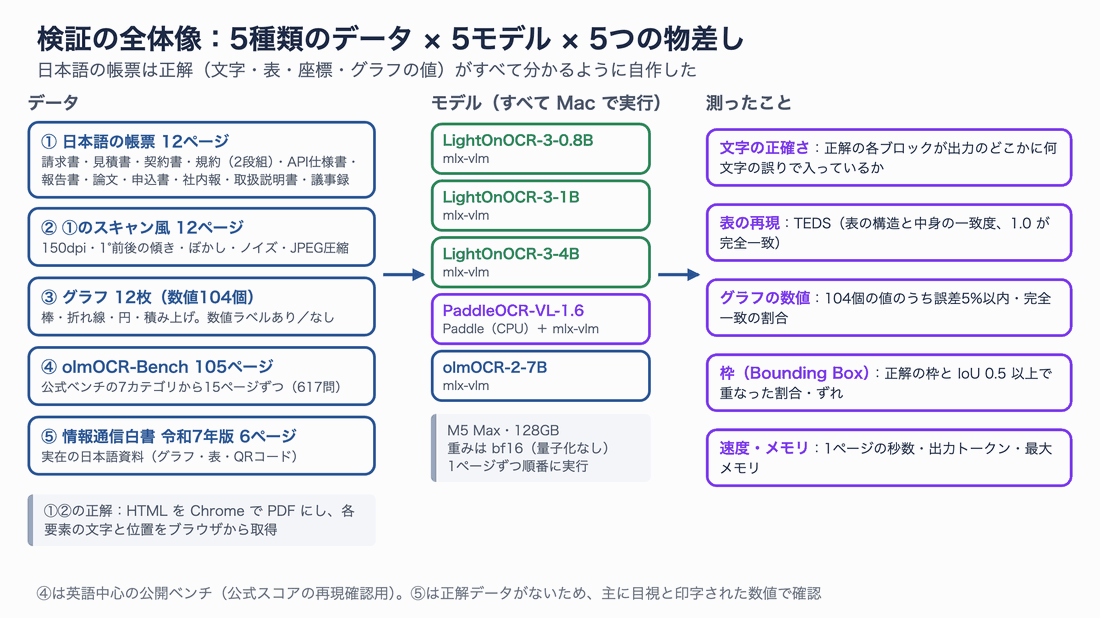
日本語の帳票は、正解の文字・表・座標・グラフの値がすべて分かるように自作した
いちばん力を入れたのは、正解が完全に分かる日本語の帳票を作ることです。公開されている日本語の文書には、文字や枠の正解データがほとんどありません。そこで、請求書、見積書(結合セルのある表)、業務委託契約書(明朝体で文字がぎっしり)、2段組みの利用規約、API 仕様書(コードと表)、グラフ入りの報告書、2段組みの論文(数式・脚注つき)、申込書(チェック欄つき)、写真入りの社内報、取扱説明書、議事録の12ページを HTML で作りました。会社名や人名はすべて架空です。
これを Chrome で PDF にし、同時にブラウザから「各要素の文字」と「各要素の位置(座標)」を取り出して正解にしています。グラフは matplotlib で値を決めて描いたので、正しい数値も分かっています。さらに、紙をスキャンしたときの劣化を再現するため、150dpi への縮小・1度前後の傾き・ぼかし・ノイズ・JPEG 圧縮をかけた「スキャン風」の12ページも作りました。
採点の方法は次のとおりです。
| 観点 | 測り方 |
|---|---|
| 文字の正確さ | 正解の各ブロックの文字列が、出力のどこかに何文字の誤りで含まれているかを数え、全体の正解率にする。空白・Markdown の記号・全角半角の違いは無視。読む順番が入れ替わると減点される |
| 表の再現 | TEDS(表を木構造として比べ、構造と中身がどれだけ一致するかを 0〜1 で表す標準的な指標)。PubTabNet や OmniDocBench でも使われる |
| グラフの数値 | 正解の値 104 個それぞれについて、出力された表の値が誤差 5% 以内か、完全に一致するか |
| 枠(Bounding Box) | 正解の枠と出力の枠が IoU(重なりの割合)0.5 以上で重なったか。1つの段落を行ごとに分けて出すモデルもあるため、正解の枠の内側にある複数の枠はまとめてから判定した |
| 速度 | 1ページあたりの秒数。他の処理を止め、モデルを1つずつ読み込んで3ページ×2周を測った(最初の1回は準備運転として除外) |
設定は各モデルの公式の推奨に合わせました。LightOnOCR-3 は grounding モード、温度 0.1、0.8B と 4B は長辺 2048px、1B は 1540px。PaddleOCR-VL は公式の既定(グラフの数値化だけオン)、olmOCR-2 は公式ツールの指示文と長辺 1288px です。重みはすべて bf16(量子化なし)で、筆者の MacBook Pro(M5 Max・128GB)で1ページずつ順番に実行しています。
Mac で動かす:環境構築とコード
公式の手順は、NVIDIA の GPU で動く vLLM(大規模言語モデルを高速に配信するサーバー)を前提にしています。Mac の GPU では vLLM の公式版が使えないので、ここでは Apple シリコン向けの推論ライブラリ mlx-vlm を使います。モデルカードにある transformers のコードも Mac で試しましたが、0.8B は非常に遅く、1B は正しく動きませんでした(詳しくは後半の「速度」の節)。
全体の組み立てを図にしておきます。
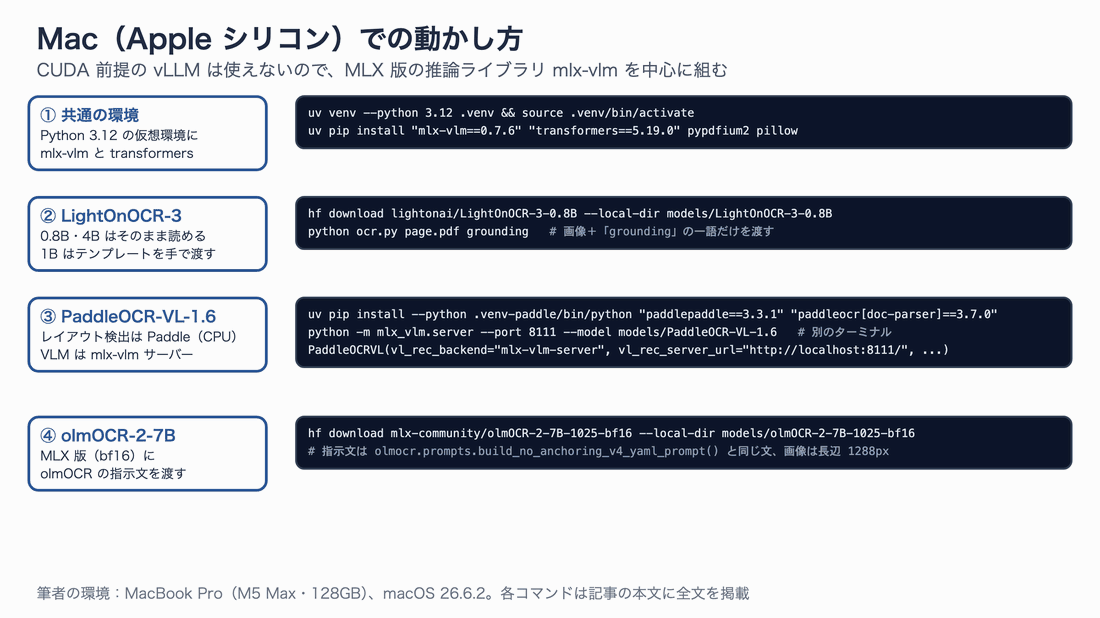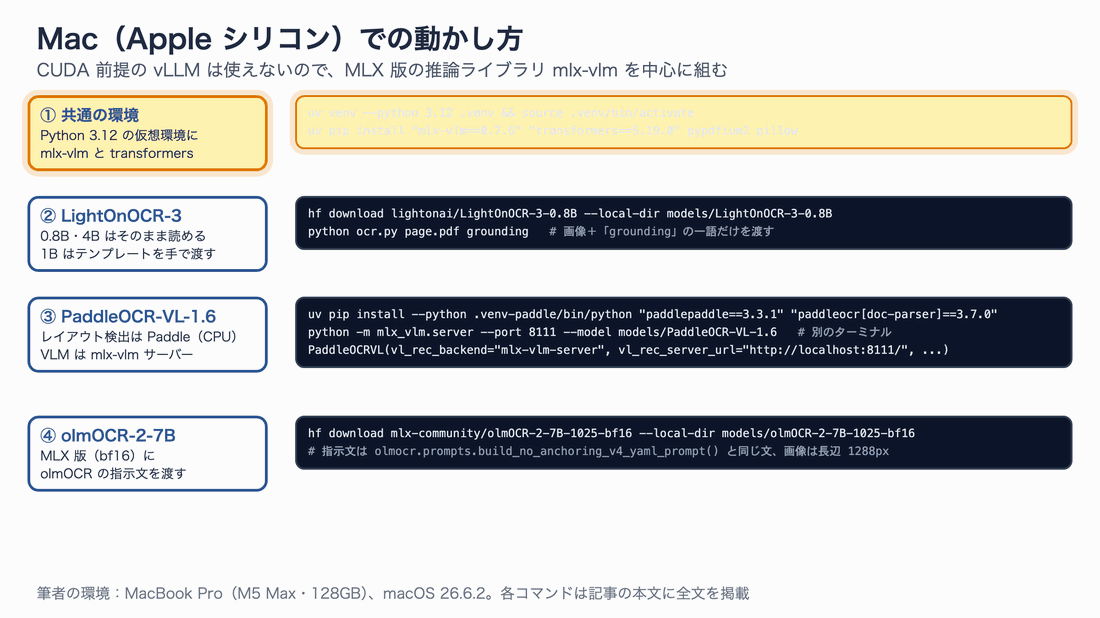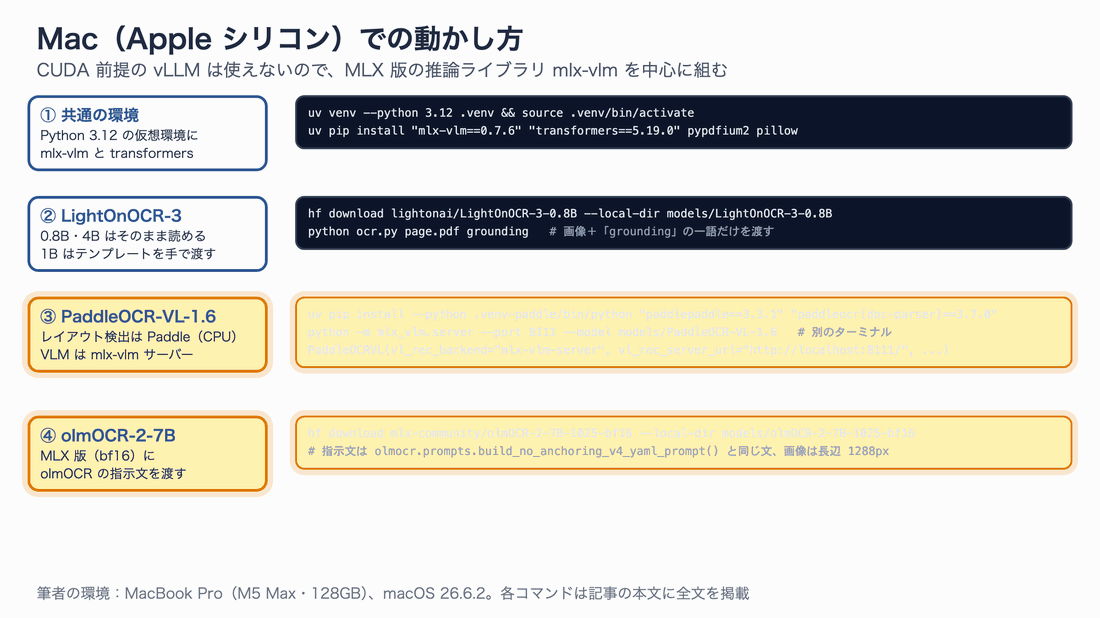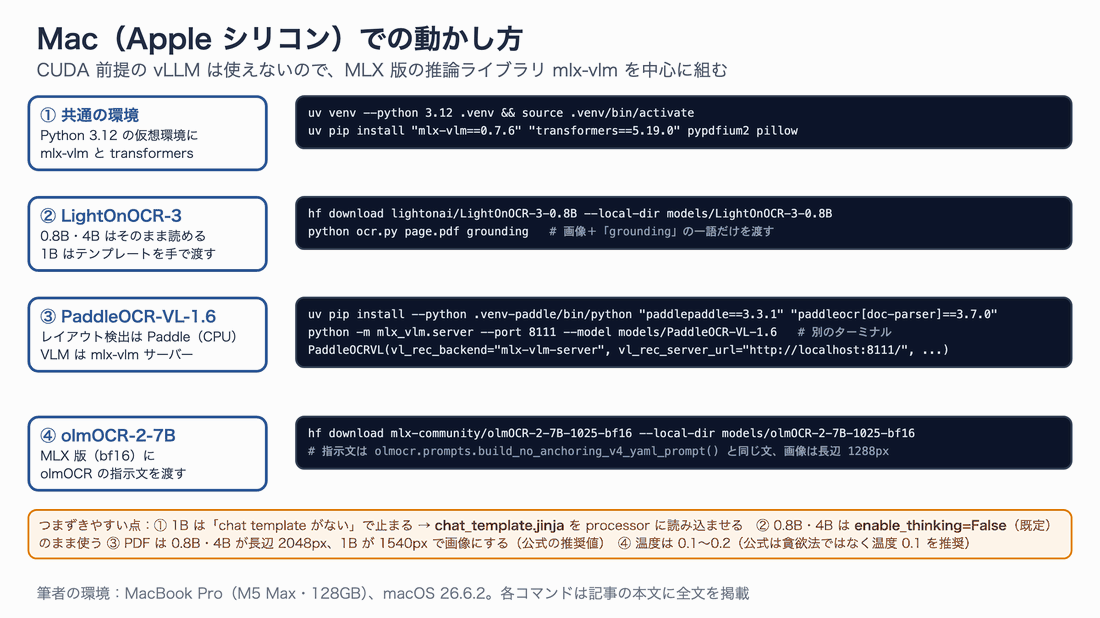
つまずきやすい点は、1B のチャットテンプレートと、モデルごとの画像サイズ。どちらも以下のコードに入れてある
手順1:Python 環境を作る
uv(Python のパッケージ管理ツール)で仮想環境を作り、必要なライブラリを入れます。筆者が検証したバージョンに固定しています。
# 作業フォルダを作って移動する
mkdir lightonocr3-lab && cd lightonocr3-lab

# Python 3.12 の仮想環境を作って有効にする
uv venv --python 3.12 .venv
source .venv/bin/activate

# mlx-vlm(Mac の GPU で動く推論ライブラリ)と、PDF を画像にする pypdfium2 を入れる
uv pip install "mlx-vlm==0.7.6" "transformers==5.19.0" pypdfium2 pillow "huggingface_hub[cli]"
手順2:モデルをダウンロードする
Hugging Face からモデルを取得します。ログインやアクセス申請は不要です。
# 0.8B(1.7GB)。まずはこれだけで十分
hf download lightonai/LightOnOCR-3-0.8B --local-dir models/LightOnOCR-3-0.8B

# 必要に応じて 1B(2.0GB)と 4B(9.1GB)も
hf download lightonai/LightOnOCR-3-1B --local-dir models/LightOnOCR-3-1B
hf download lightonai/LightOnOCR-3-4B --local-dir models/LightOnOCR-3-4B
手順3:1ページを読ませるスクリプト
次の ocr.py を作業フォルダに保存します。PDF の1ページ目か画像を受け取り、plain か grounding のどちらかで読ませて結果を表示します。モデルに渡したページ画像も 〇〇_page.png として保存するので、後で枠を描くときに使えます。
"""LightOnOCR-3 を Mac(mlx-vlm)で1ページ動かす最小スクリプト

使い方: python ocr.py <PDFまたは画像> [plain|grounding] [モデルのフォルダ]
例:     python ocr.py invoice.pdf grounding models/LightOnOCR-3-0.8B
"""
import sys
from pathlib import Path

import pypdfium2 as pdfium
from mlx_vlm import generate, load
from PIL import Image

src = Path(sys.argv[1])
mode = sys.argv[2] if len(sys.argv) > 2 else "grounding"
model_dir = Path(sys.argv[3] if len(sys.argv) > 3 else "models/LightOnOCR-3-0.8B")
longest = 1540 if "-1B" in model_dir.name else 2048  # 公式の推奨: 1B は 1540px、0.8B・4B は 2048px

# 1. ページを画像にする(PDF は1ページ目、画像は長辺を合わせて縮小)
if src.suffix.lower() == ".pdf":
    page = pdfium.PdfDocument(str(src))[0]
    w, h = page.get_size()
    image = page.render(scale=longest / max(w, h)).to_pil().convert("RGB")
else:
    image = Image.open(src).convert("RGB")
    image.thumbnail((longest, longest))
image.save(src.with_name(src.stem + "_page.png"))  # 枠を描くときに使うページ画像

# 2. モデルを読み込む(1B は chat_template.jinja を自分で渡す)
model, processor = load(str(model_dir))
if getattr(processor, "chat_template", None) is None:
    processor.chat_template = (model_dir / "chat_template.jinja").read_text()

# 3. 入力は「画像」+(grounding のときだけ)「grounding」の一語
content = [{"type": "image"}]
if mode == "grounding":
    content.append({"type": "text", "text": "grounding"})
prompt = processor.apply_chat_template([{"role": "user", "content": content}],
                                       add_generation_prompt=True, tokenize=False, enable_thinking=False)

# 4. 生成(公式の推奨どおり温度 0.1。貪欲法にはしない)
result = generate(model, processor, prompt, image=[image], max_tokens=8192, temperature=0.1, top_p=1.0)
print(result.text)
print(f"\n# {result.generation_tokens} tokens, {result.generation_tps:.0f} tokens/s, peak {result.peak_memory:.1f} GB",
      file=sys.stderr)
ポイントは3つです。
- 入力は画像と
groundingの一語だけです。「表を抜き出して」などの指示を足すと、学習していない使い方になります - 0.8B と 4B は
enable_thinking=Falseで使います。土台の Qwen3.5 には「考えてから答える」機能がありますが、LightOnOCR-3 はそれを切った状態で学習・評価されています(同梱のテンプレートも既定でオフ) - 1B は mlx-vlm で読み込むとチャットテンプレートが付いてこないため、
Cannot use apply_chat_template because this processor does not have a chat templateというエラーで止まります。モデルのフォルダにあるchat_template.jinjaを読み込ませると動きます
実行してみます。
# 請求書の PDF を 0.8B の grounding モードで読む
python ocr.py invoice.pdf grounding models/LightOnOCR-3-0.8B
初回はモデルの読み込みに数秒かかり、その後 0.8B なら1ページ約6秒で結果が出ます。
比較に使った2つのモデルの動かし方
比較相手の PaddleOCR-VL-1.6 と olmOCR-2 も Mac で動かしました。自分で比べてみたい人向けに、要点だけ書いておきます。
PaddleOCR-VL-1.6 は、レイアウト検出(PP-DocLayoutV3)と文字認識の VLM の2段構成です。公式のモデルカードは「macOS は Docker で」と書いていますが、PaddleOCR の Apple シリコン向け手順では、レイアウト検出を PaddlePaddle の CPU 版で、VLM を mlx-vlm のサーバーで動かす方法が案内されています。依存関係がぶつからないよう、仮想環境を分けます。
# PaddleOCR 用の仮想環境(CPU 版の PaddlePaddle は Apple シリコン用の配布物がある)
uv venv --python 3.12 .venv-paddle
uv pip install --python .venv-paddle/bin/python "paddlepaddle==3.3.1" "paddleocr[doc-parser]==3.7.0"

# VLM の重みを取得し、mlx-vlm のサーバーを起動しておく(別のターミナルで)
hf download PaddlePaddle/PaddleOCR-VL-1.6 --local-dir models/PaddleOCR-VL-1.6
.venv/bin/python -m mlx_vlm.server --port 8111 --model models/PaddleOCR-VL-1.6
# .venv-paddle の Python で実行する
from pathlib import Path
from paddleocr import PaddleOCRVL

pipe = PaddleOCRVL(
    pipeline_version="v1.6",
    vl_rec_backend="mlx-vlm-server",            # VLM の部分だけ mlx-vlm のサーバーに任せる
    vl_rec_server_url="http://localhost:8111/",
    vl_rec_api_model_name=str(Path("models/PaddleOCR-VL-1.6").resolve()),
    use_chart_recognition=True,                 # グラフの数値化(既定はオフ)
)
for res in pipe.predict("invoice.png"):
    res.save_to_markdown(save_path="out")       # Markdown
    res.save_to_json(save_path="out")           # ブロックの種類と座標
グラフの数値化は既定でオフなので、比較では use_chart_recognition=True にしています。
olmOCR-2-7B は、MLX 形式に変換済みの bf16 版(mlx-community/olmOCR-2-7B-1025-bf16)を mlx-vlm で読み込み、olmOCR の公式ツールが使う指示文(olmocr.prompts.build_no_anchoring_v4_yaml_prompt() の戻り値)を画像の前に置いて読ませました。画像は公式ツールの既定どおり長辺 1288px です。olmOCR は公式ツールで動かすと「回転の補正」「失敗時の再試行」も行いますが、今回は1回だけ読ませています。
結果1:日本語の文字と表は、5モデルとも実用の水準
まず結論から見てください。4つの観点を1枚にまとめました。
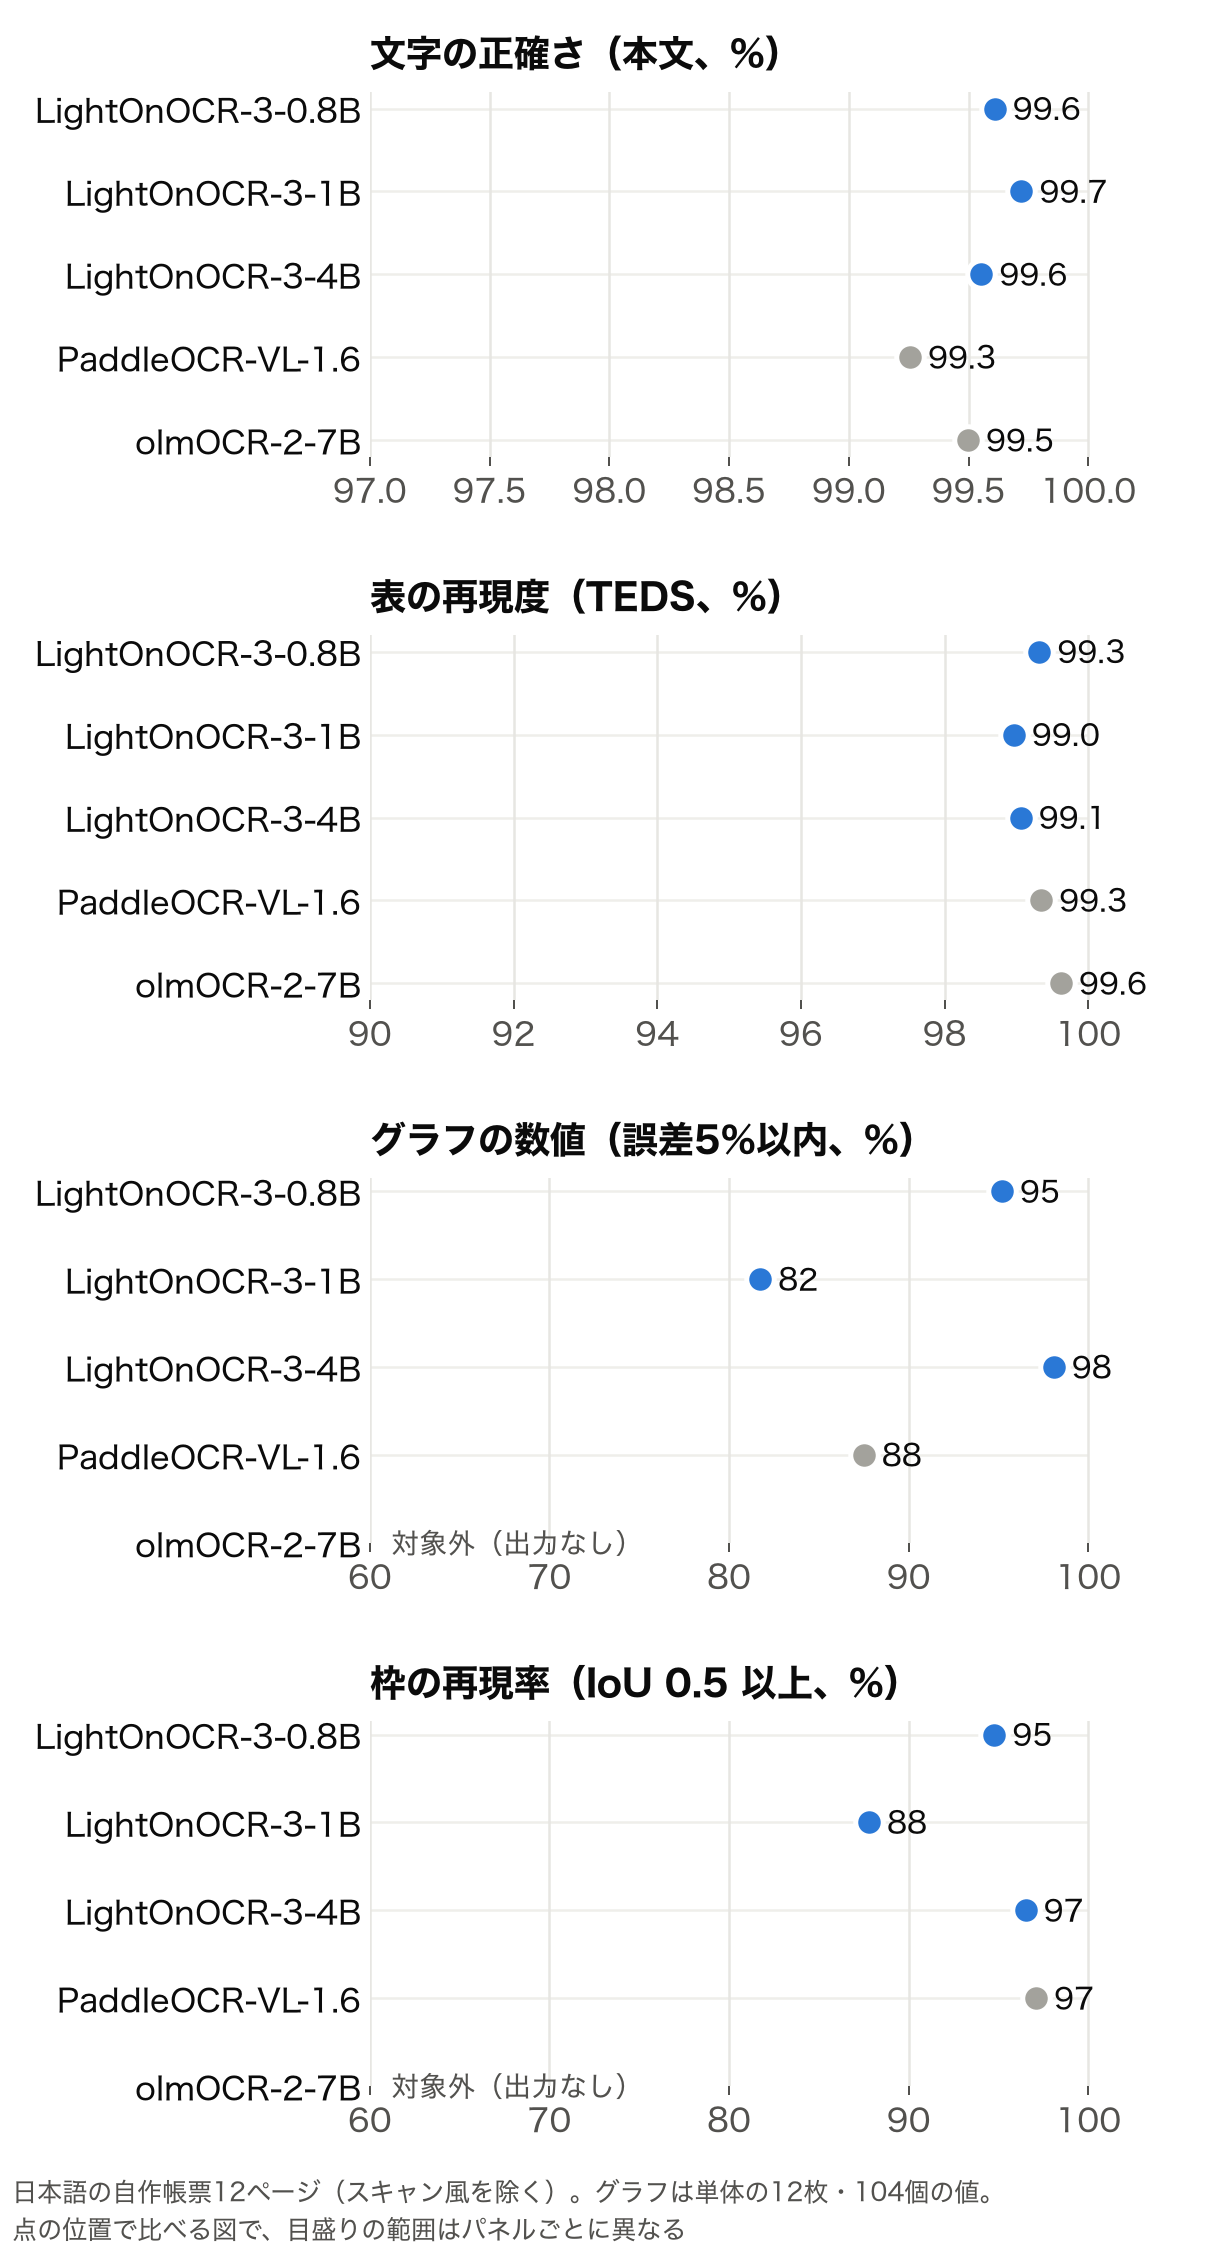
文字と表では差がほとんどつかない。差が出たのは、グラフの数値化と枠の正確さ
細かい数字を表にします。「スキャン風」は劣化させたページでの値です。
| モデル | 文字(本文) | 文字(スキャン風) | 表 TEDS | 表 TEDS(スキャン風) | ヘッダー・フッターの文字 |
|---|---|---|---|---|---|
| LightOnOCR-3-0.8B | 99.6% | 99.4% | 0.993 | 0.993 | 98.9% |
| LightOnOCR-3-1B | 99.7% | 99.7% | 0.990 | 0.990 | 98.9% |
| LightOnOCR-3-4B | 99.6% | 99.6% | 0.991 | 0.990 | 99.6% |
| PaddleOCR-VL-1.6 | 99.3% | 99.3% | 0.993 | 0.993 | 98.9% |
| olmOCR-2-7B | 99.5% | 98.3% | 0.996 | 0.993 | 25.6%(※) |
※ olmOCR はヘッダー・フッターを意図的に出力しない設計です(RAG ではむしろ都合がよい場合もあります)。
LightOnOCR-3 のモデルカードには対応言語の記載がなく、0.8B のメタデータには英語(en)だけが書かれています。それでも、日本語の請求書や契約書を 99% 台後半の正確さで読めました。0.8B でも、明朝体の契約書1ページ(本文 約 970 文字)の誤りは 2 文字だけでした。
誤りの中身も見ておきます。どのモデルも、間違いは「似た記号への置き換え」がほとんどでした。
- カッコの種類が変わる:取扱説明書の「[出荷]を押します」が、LightOnOCR-3 の 0.8B・4B と olmOCR では「「出荷」を押します」になりました。意味は同じですが、角カッコが鉤カッコに置き換わっています(1B と PaddleOCR-VL は半角の [ ] で、これは採点上は同じ文字として扱いました)
- 中国語の簡体字が混ざる:PaddleOCR-VL は、スキャン風のページを中心に「営業企画」を「营巢企画」、「地域別」を「地域别」、「単位」を「单位」と、日本語の漢字を中国語の簡体字で書くことが、筆者が数えた範囲で7か所ありました(グラフの項目名を含む)。LightOnOCR-3 の 0.8B と 4B ではゼロ、1B と olmOCR は1か所ずつでした
- 英単語に置き換わる:0.8B の plain モードで「パッチ」が「patch」に、4B で「使用する」が「使用using」になった例がありました(後者は後述の写真のページ)。頻度は低いものの、日本語の文書を読ませるときは知っておきたい癖です
表は、どのモデルも TEDS 0.99 前後でした。差がついたのは結合セルのある見積書だけです。LightOnOCR-3 は3サイズとも、縦に結合した見出しセル(「区分」「項目」)を、2行目に空のセルを並べる形で書きました。見た目の表としては読めますが、構造としては正解と違うので、この1枚だけ TEDS が 0.90〜0.93 に下がっています。PaddleOCR-VL は rowspan を正しく使い、表の構造(TEDS-S)は11個の表すべてで満点でした。
plain モードと grounding モード、文字の正確さは変わる?
grounding モードは位置の情報を足すぶん出力が長くなるので、文字の正確さが落ちないかも確認しました。結果は、落ちないどころか、grounding のほうが取りこぼしが少ない場面がありました。
| モデル | plain の文字(本文) | grounding の文字(本文) | 出力トークン(plain → grounding) |
|---|---|---|---|
| 0.8B | 99.5% | 99.6% | 632 → 1,025 |
| 1B | 99.8% | 99.7% | 688 → 1,039 |
| 4B | 98.9% | 99.6% | 637 → 1,011 |
差の原因は、写真の下の説明文(キャプション)でした。plain モードの 4B は、社内報の写真2枚とグラフの下にあるキャプション3つを出力から落としていました。plain モードでは写真が  という置き場所だけになり、その近くの文字ごと省かれることがあります。RAG の前処理に使うなら、plain ではなく grounding を使い、不要なブロックを後から捨てるほうが安全です。
出力トークンは約 1.6 倍に増えました。公式が言う「約 25% 増」より多いのは、日本語の帳票は1ブロックの文字数が少なく、座標の印の割合が大きくなるためと考えられます。
結果2:グラフを数値にする力は 4B と 0.8B が頭ひとつ抜けた
グラフ12枚(棒・折れ線・円・積み上げ、合計 104 個の値)を、グラフ単体の画像として読ませました(報告書などのページに埋め込んだ5枚も、ページのまま読ませて同じ傾向を確認しています)。半分は棒の上に数値が印字されたグラフ、残り半分は数値が書かれておらず、目盛りから読み取るしかないグラフです。
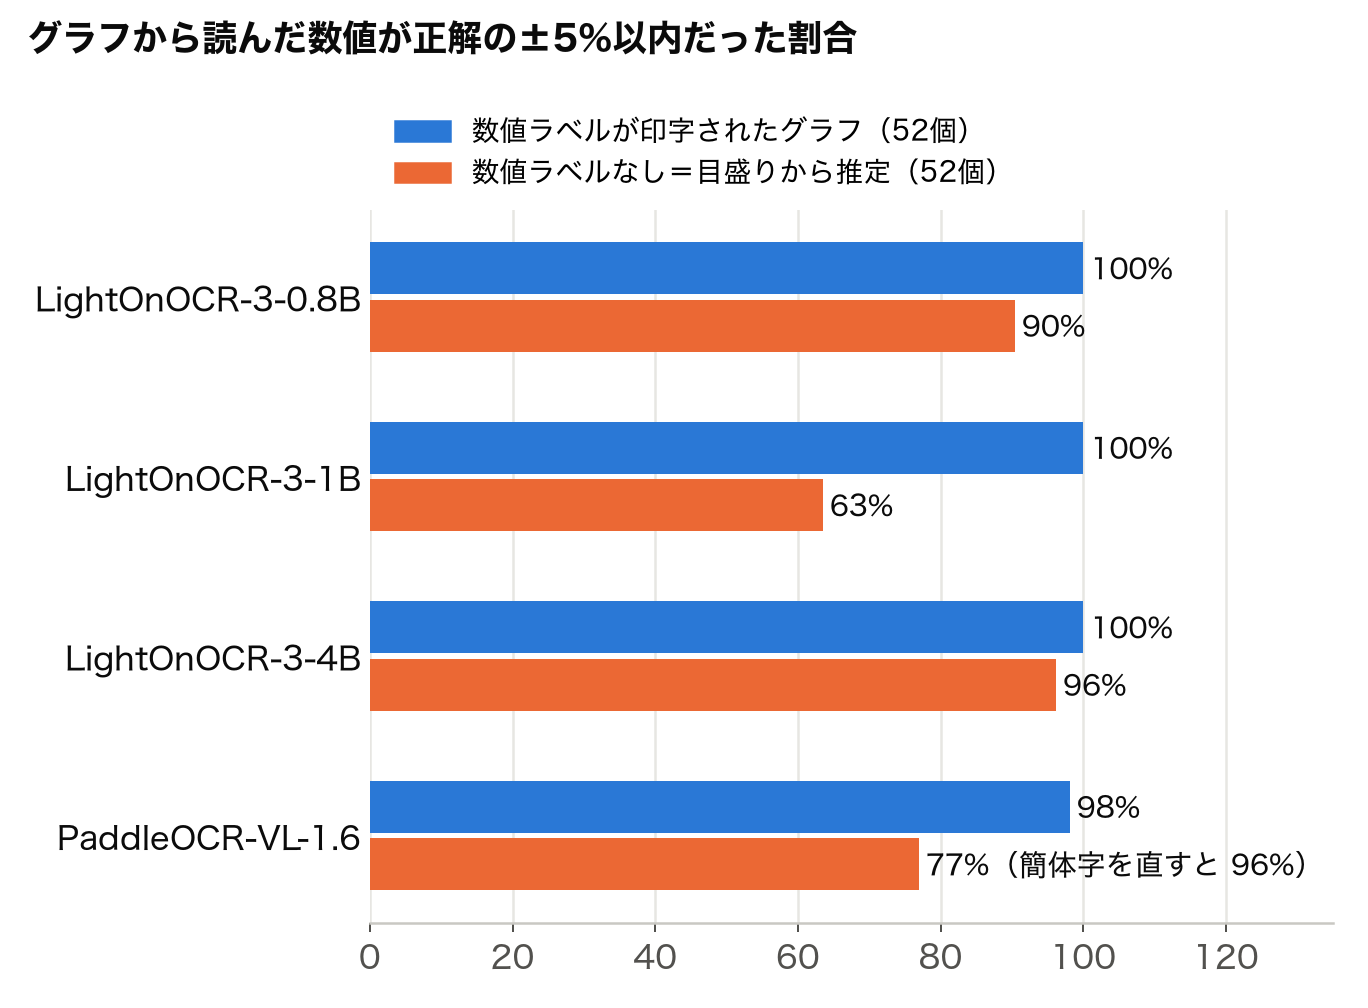
数値が印字されていれば、どのモデルもほぼ正確に書き写す。差がつくのは「目盛りから読む」とき
数値が印字されたグラフは、どのモデルもほぼ完璧に書き写しました。目盛りから推定するグラフでは差が開き、4B は 52 個中 50 個、0.8B は 47 個を誤差 5% 以内で読み取りました。たとえば数値の書かれていない3系列の棒グラフ(拠点別の採用人数)では、0.8B と 4B が12個中11個の値を完全に一致させています。外したのは、57 を 56 と読んだ1個だけでした。
PaddleOCR-VL の点が低く見えるのには、別の理由があります。数値そのものはほぼ正しく読めていて、項目名の照合に失敗していたのです。
| グラフ | 正解の項目名 | PaddleOCR-VL の出力 |
|---|---|---|
| 拠点別の採用人数 | 契約 | 契约 |
| 月別の電力使用量 | 空調 | 空调 |
| 販売チャネル別の売上構成比 | 店舗 | 店铺(列の見出しも「类别」「百分比」) |
ここでも日本語の漢字が中国語の簡体字に置き換わっています。表の見出しが「契约」になると、「契約社員の採用数は?」という検索に当たりにくくなります。簡体字を日本の字に読み替えて採点し直すと、PaddleOCR-VL の数値の正解率は 98.1%(誤差 5% 以内)で、4B と並びました。数値を読む力は同等、日本語の書き方で差がついたというのが正確なところです。
1B は、ラベルなしのグラフで値を大きく外すことが多く、63% にとどまりました。公式ブログも ParseBench の結果について「1B と 0.8B の差の大部分はグラフと位置の項目で、視覚の事前学習を受けたモデルを土台にした効果」と説明しており、手元の結果もそれと合っています。
olmOCR-2 は、そもそもグラフを数値の表にしません。印字された数値は「北海道 128」のように本文として書き写しますが、2系列の折れ線では値がどちらの系列のものかが失われ、ラベルのないグラフでは数値を1つも出しませんでした。
結果3:枠(Bounding Box)は 4B と PaddleOCR-VL が正確
正解の枠と IoU 0.5 以上で重なった割合は、4B が 96.5%、PaddleOCR-VL が 97.1%、0.8B が 94.8%、1B が 87.8% でした(日本語12ページ、172 個の枠)。スキャン風のページでも 4B は 96.5% のままで、傾きやノイズに強い結果です。
次の画像は、2段組みの論文ページで、正解の枠と各モデルの枠を並べたものです。
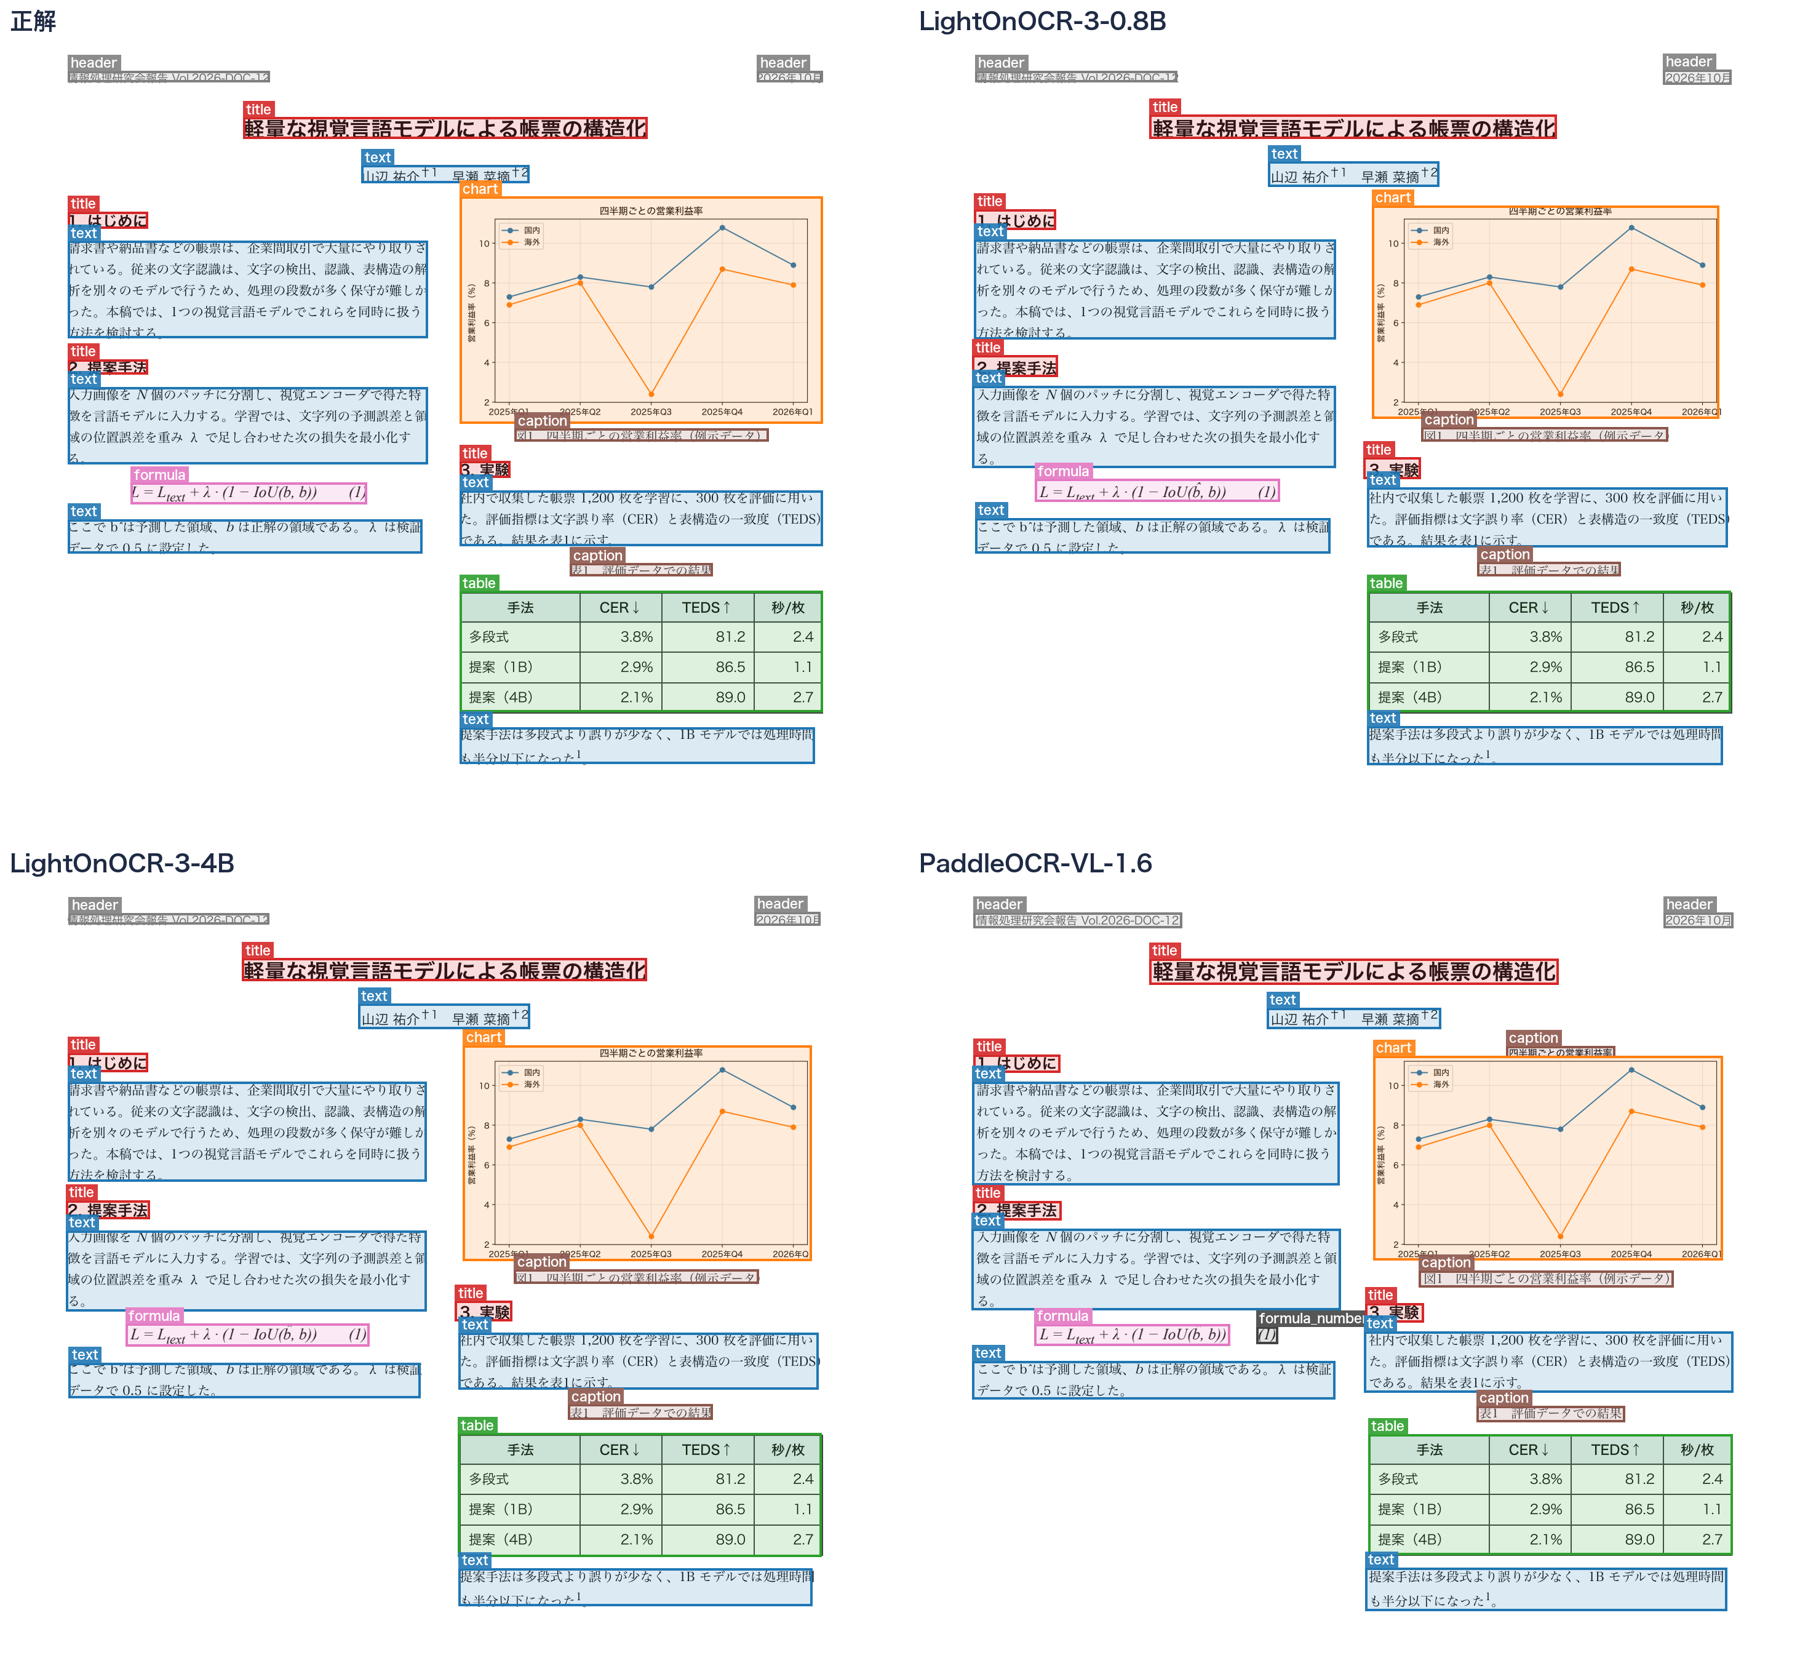
このくらいの整ったレイアウトなら、どのモデルも正解とほぼ同じ枠を出す。違いは枠の「単位」に出る
数字だけでは見えない違いが、枠の単位です。LightOnOCR-3 は、箇条書き全体や複数行の段落を1つの枠にまとめます。PaddleOCR-VL は、箇条書きを1項目ずつ、請求書の右上の3行(請求書番号・発行日・支払期限)を1行ずつ、別の枠にしました。正解の枠 172 個に対して PaddleOCR-VL の枠は 208 個(約 1.2 倍)あり、そのまま1枠を1チャンクにすると細かすぎる場面があります。LightOn のブログが「視覚的な行ではなく、文書の論理的な単位で枠を作るよう学習データを工夫した」と書いているとおりの差でした。
一方、ページ番号のような小さな文字の枠は、LightOnOCR-3 の 0.8B と 1B が外しやすく(ヘッダー・フッター類の再現率 71〜79%)、4B と PaddleOCR-VL(93%)との差が出ました。
結果4:写真の説明は「キャプション」に引っぱられる
grounding モードでは、写真や図に短い説明が付きます。画像検索や「この写真には何が写っている?」という質問に答えるのに便利な機能です。ところが日本語の社内報で試すと、気になる出力がありました。国際宇宙ステーションの実物の写真に「国際宇宙ステーションの模型展示コーナー」という説明が付いたのです。これは写真の下にあるキャプションの文言そのままで、写真に写っているのは模型ではなく宇宙空間の本物です。
そこで、同じ4枚の写真(NASA の公開写真)を並べたページを3通り作って確かめました。キャプションなし、正しいキャプション、わざと入れ替えた誤りのキャプションの3つです。
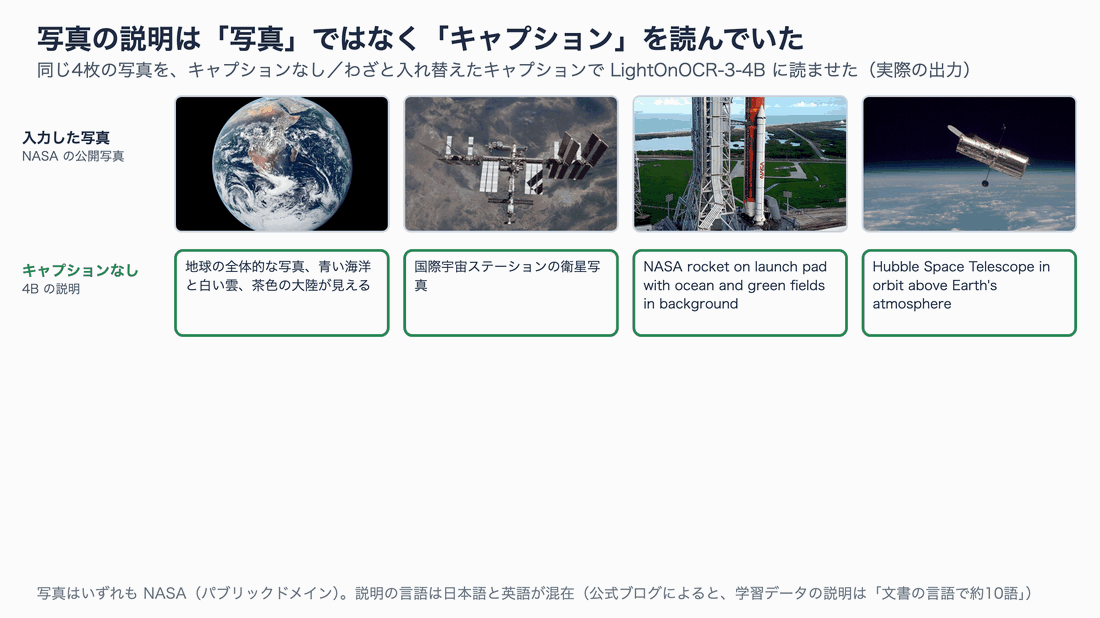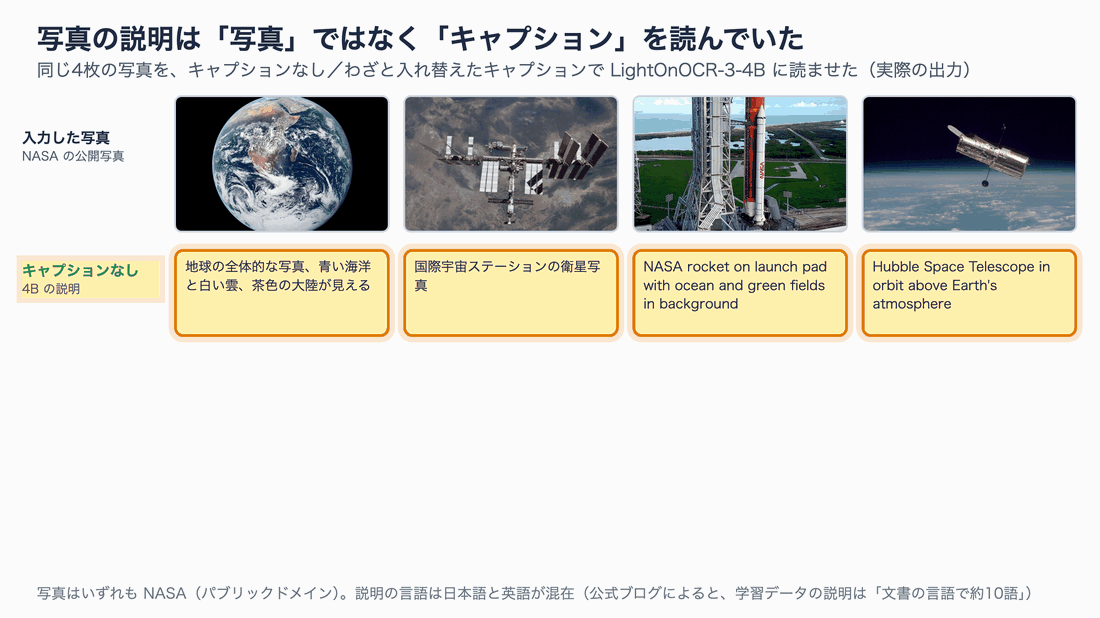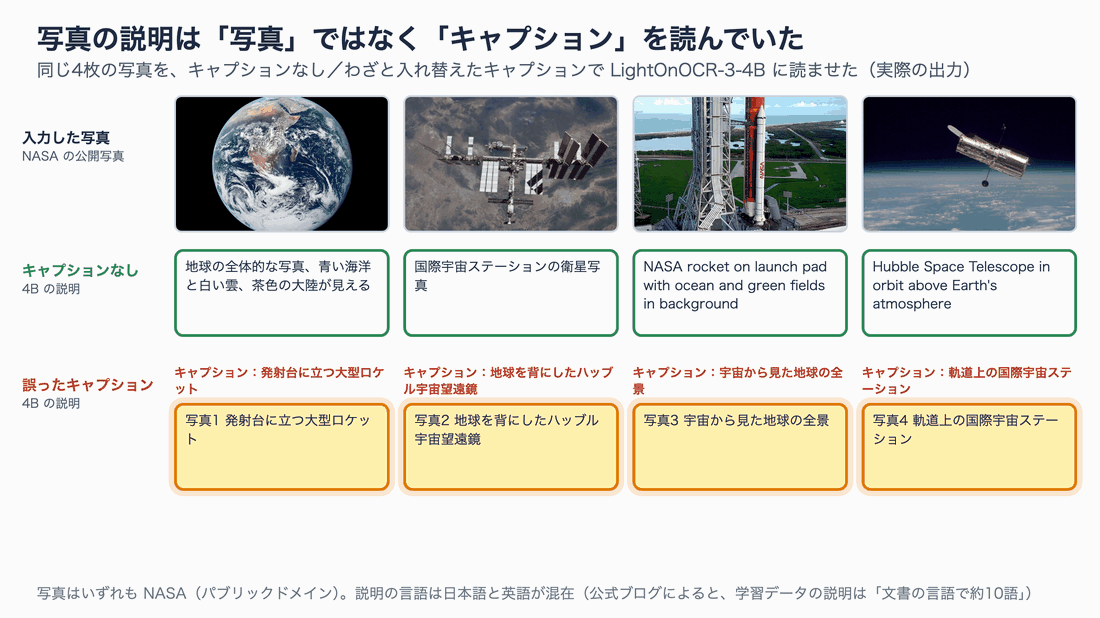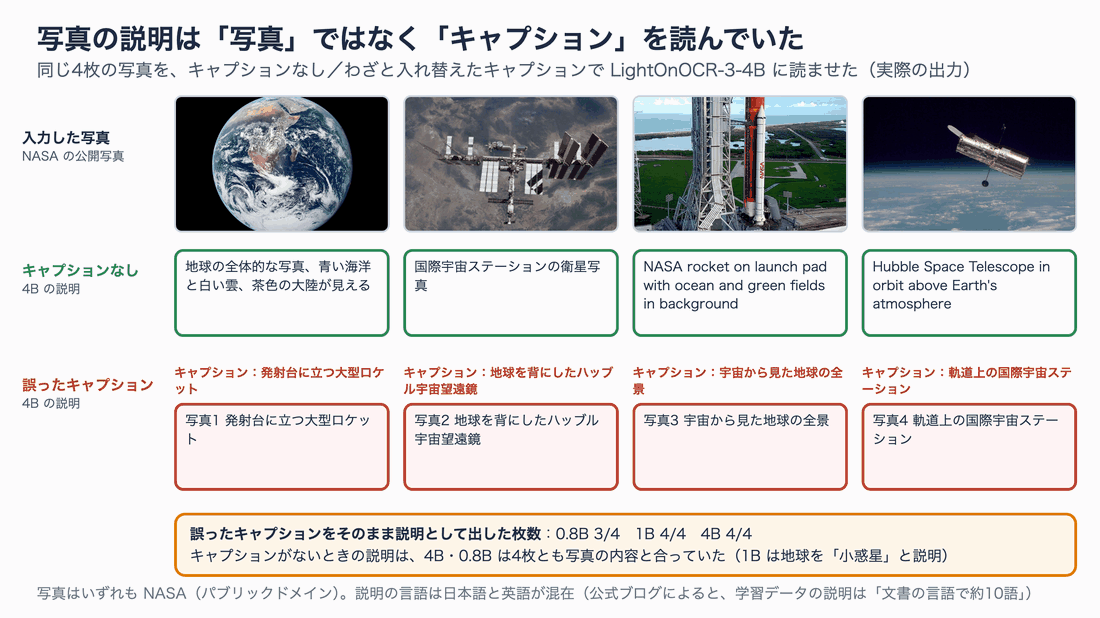
キャプションがないときは写真を正しく説明できる。キャプションがあると、内容が間違っていてもそれを写す
結果ははっきりしていました。
- キャプションがないとき、4B と 0.8B は4枚とも写真の内容に合った説明を出しました(地球、宇宙ステーション、発射台のロケット、ハッブル宇宙望遠鏡)。1B は地球の写真を「オレンジ色の核を持つトゲのある小惑星」と説明し、外しています
- 誤りのキャプションを付けると、4B と 1B は4枚すべて、0.8B は4枚中3枚で、キャプションの文言を説明としてそのまま出しました。地球の写真に「発射台に立つ大型ロケット」と説明が付くわけです
- 説明の言語は、日本語の文書でも英語になることがありました(0.8B はキャプションなしの4枚すべて英語)
公式ブログによると、学習データの画像の説明は、ページ全体と画像の切り抜きを大きなモデル(Qwen3-VL-235B)に見せて作っています。ページの文字も手がかりにした説明で学習しているため、キャプションがあるとそれに強く寄るのだと考えられます。画像の説明は「写真の中身の要約」ではなく「近くの文字の言い換え」になりうると考えて、検索に使うときはキャプションと同じ重みで扱うのが無難です。
写真そのものの説明が欲しいときは、ひと手間で回避できました。grounding が返した画像ブロックの枠でページを切り抜き、その画像だけをもう一度 grounding で読ませる方法です。誤りのキャプションのページから切り抜いた4枚では、0.8B は4枚とも、4B は4枚中3枚で写真どおりの説明が返りました(4B は宇宙ステーションの切り抜きに何も返さず、0.8B は説明と同じ文を text のブロックとしても重ねて出すことがありました)。1枚あたり 1〜2 秒の追加で済むので、写真の検索が重要な用途なら試す価値があります。
比較の2モデルについても書いておくと、PaddleOCR-VL は画像の説明を出さず(切り抜いた画像を保存するだけ)、olmOCR-2 は日本語の文書ページでは写真の説明(alt テキスト)自体を出しませんでした(グラフ単体の画像では出しました)。
結果5:速度とメモリ
1ページの処理時間は、他の処理を止めた状態で、モデルを1つずつ読み込み、3ページ(請求書・月次報告書・2段組み論文)を2周ずつ読ませて測りました(最初の1回は準備運転として除外)。
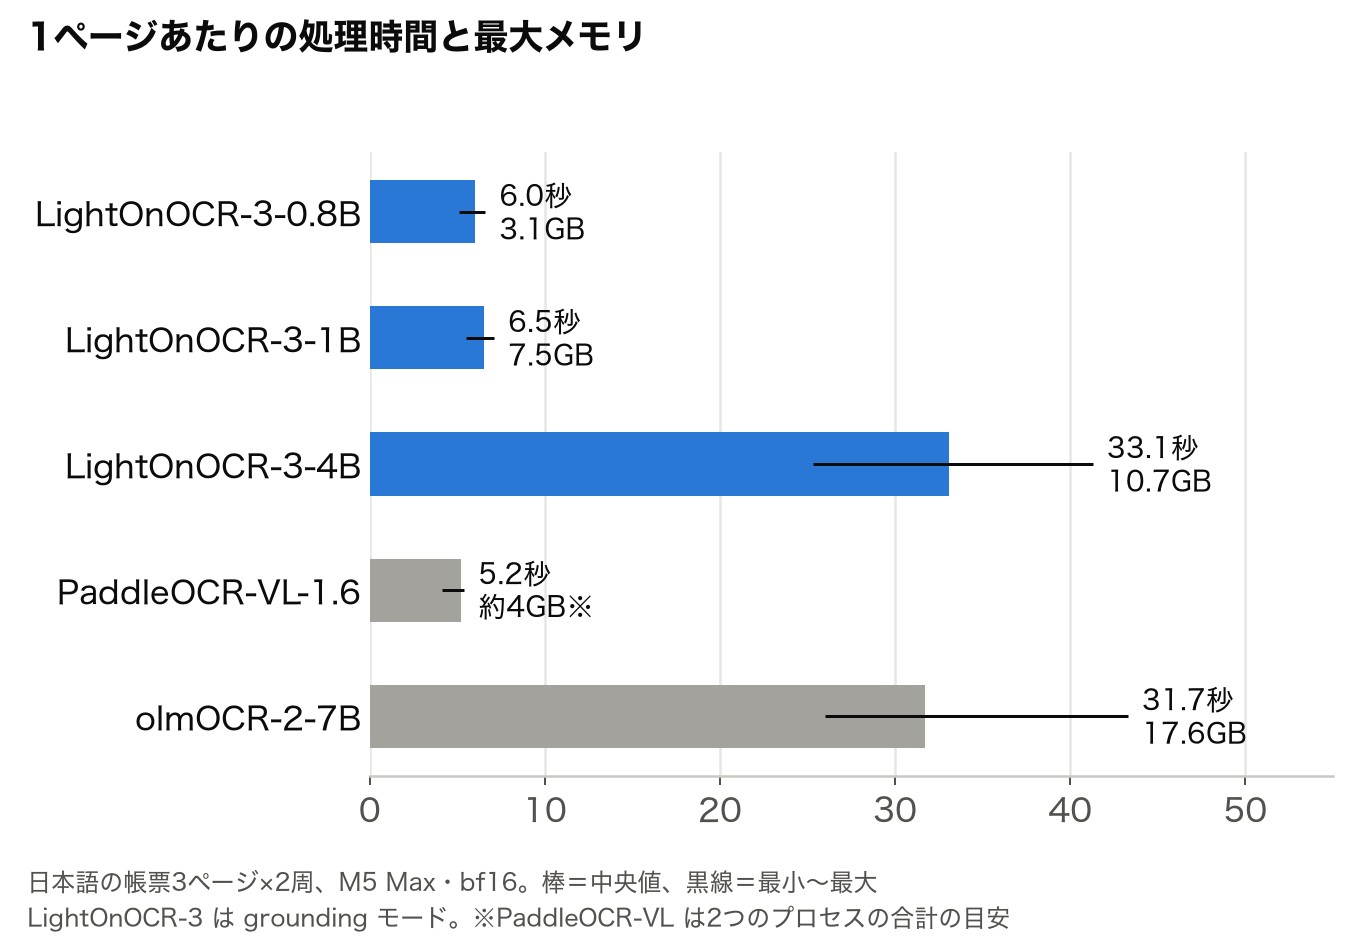
M5 Max・bf16 で1ページずつ実行。棒は中央値、黒線は最小〜最大。0.8B と 1B は PaddleOCR-VL と同じくらい速い
| モデル(モード) | 1ページの時間(中央値) | 最小〜最大 | 出力トークン | 生成の速さ | 最大メモリ |
|---|---|---|---|---|---|
| LightOnOCR-3-0.8B(grounding) | 6.0 秒 | 5.1〜6.6 秒 | 1,238 | 220 トークン/秒 | 3.1GB |
| LightOnOCR-3-0.8B(plain) | 5.9 秒 | 4.2〜8.7 秒 | 714 | 140 トークン/秒 | 3.1GB |
| LightOnOCR-3-1B(grounding) | 6.5 秒 | 5.5〜7.1 秒 | 1,249 | 220 トークン/秒 | 7.5GB |
| LightOnOCR-3-4B(grounding) | 33.1 秒 | 25.3〜41.3 秒 | 1,238 | 40 トークン/秒 | 10.7GB |
| LightOnOCR-3-4B(plain) | 21.4 秒 | 17.9〜32.9 秒 | 709 | 38 トークン/秒 | 10.7GB |
| PaddleOCR-VL-1.6 | 5.2 秒 | 4.1〜5.4 秒 | — | — | 約4GB(※) |
| olmOCR-2-7B | 31.7 秒 | 26.0〜43.3 秒 | 732 | 24 トークン/秒 | 17.6GB |
※ PaddleOCR-VL はレイアウト検出のプロセスと mlx-vlm のサーバーの2つに分かれるため、両方の使用メモリを足した目安です。
0.8B と 1B は1ページ約6秒で、PaddleOCR-VL(約5秒)と同じくらいの速さでした。4B は約33秒と5倍以上かかり、生成の速さも1秒あたり約40トークンと 0.8B(約220トークン)の5分の1です。日本語の帳票では、文字・表・枠の精度は 0.8B と 4B でほとんど変わらなかったので、グラフの目盛り読みが重要でなければ 0.8B で十分です。
最大メモリは 0.8B で約3GB、4B でも約11GB でした。同じ 4B でもページによって 25〜41 秒とばらつきが大きく、長時間の連続実行では本体の温度などの影響も受けていると考えられます。なお、公式ブログの速度(H100 1枚と vLLM で、0.8B が最大毎秒 4.78 ページ、4B が 3.36 ページ)は、多数のページを同時に処理したときの値なので、1ページずつ順番に処理した今回の数字とは比べられません。
公式の transformers のコード(モデルカードどおり)を Mac の GPU(MPS)でも動かしてみました。0.8B と 4B は mlx-vlm とほぼ同じ出力(文字列の一致度 99% 以上)になり、変換による品質の差はありませんでした。ただし速さは大きく違い、4B は mlx-vlm の約 1.5 倍の時間がかかりました。0.8B はさらに極端で、1ページに10分以上かかりました(同じ条件の前の測定では1ページ45〜60分)。transformers は、Qwen3.5 の線形注意の層に使う高速な実装(flash-linear-attention、NVIDIA の GPU 向け)が入っていないと「PyTorch の参照実装に切り替える。正しいがずっと遅い」と警告を出しており、Mac ではこれが遅さの原因と考えられます。
1B は、transformers 5.19.0 でも、再現用リポジトリが指定する 5.16.1 でも、読み込み時に言語部分の重みが「MISSING(見つからない)」と表示されて正しく読み込まれず、意味のない文字列しか出ませんでした(2026年10月9日時点、モデルカードのコードのまま)。mlx-vlm では問題なく動いたので、Mac では mlx-vlm を使うのが無難です。
結果6:英語の公開ベンチマークも、Mac で公式とほぼ同じ点になった
ここまでは日本語の自作データでした。最後に、公式が使っている英語中心の olmOCR-Bench でも、手元の環境で同じ水準の点が出るかを確かめました。全 1,403 ページのうち、7つのカテゴリから 15 ページずつ無作為に選んだ 105 ページ(721 問)で、olmOCR-Bench の公式の採点プログラムを使っています。LightOnOCR-3 は公式の再現手順どおり、grounding モードで 400dpi(上限 500 万画素)の画像を読ませ、ヘッダー・フッター類を捨ててから後処理(PP3)をかけました。公式は1ページを3回読んで多数決をとっていますが、時間の都合で1回だけ読ませています。
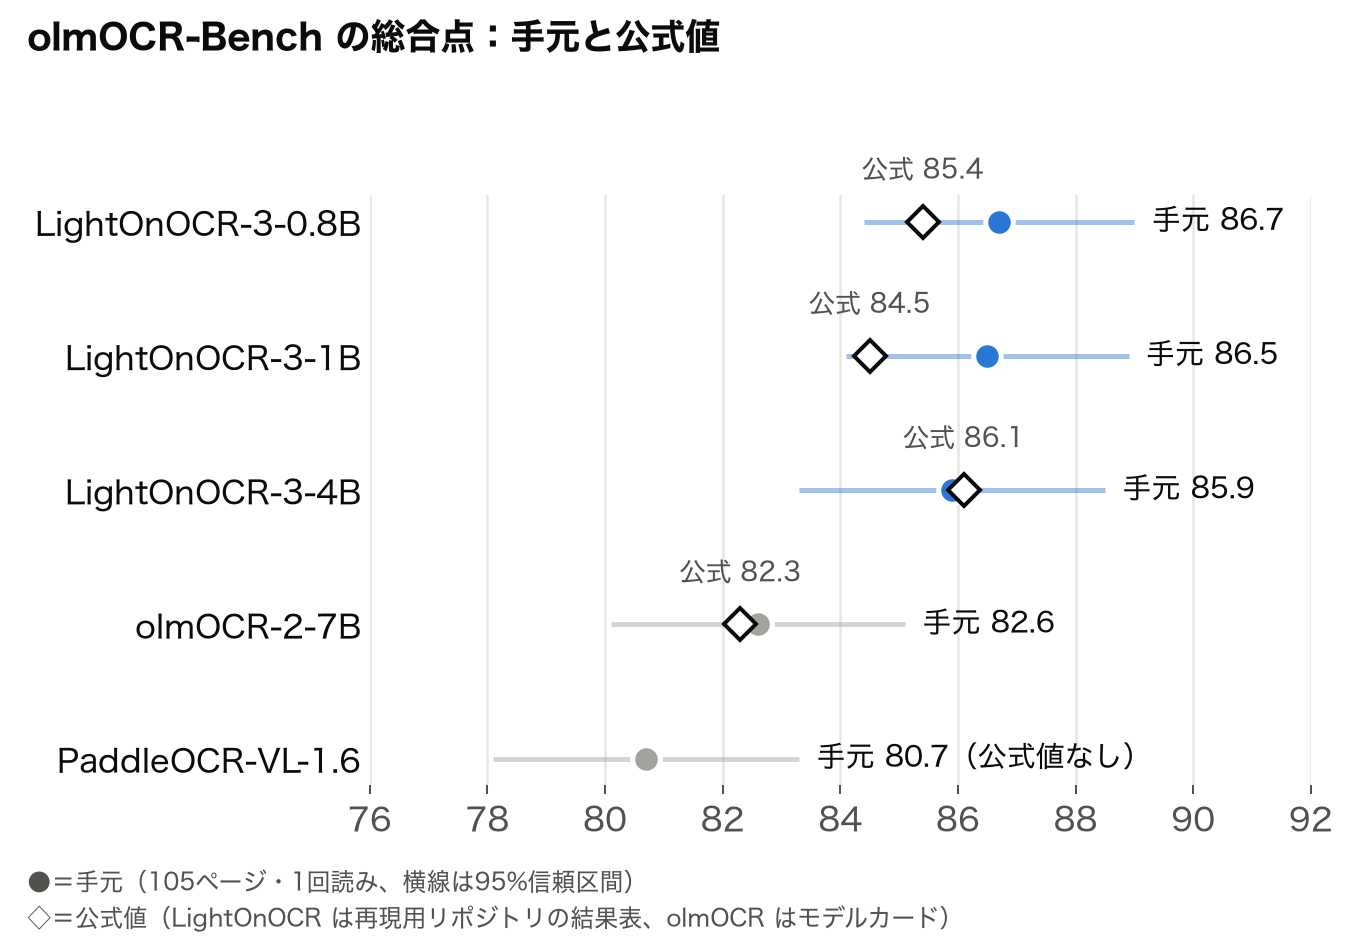
手元の値は公式値の±2点以内。ページ数が少ないぶん誤差の幅(横線)は大きいが、Mac でも公式の性能が出ていると言える
| カテゴリ(問題数) | 0.8B | 1B | 4B | olmOCR-2 | PaddleOCR-VL |
|---|---|---|---|---|---|
| arXiv の数式(88) | 97.7 | 97.7 | 97.7 | 90.9 | 89.8 |
| 古いスキャンの数式(167) | 88.6 | 85.0 | 86.8 | 86.2 | 73.7 |
| 表(85) | 89.4 | 89.4 | 85.9 | 76.5 | 80.0 |
| 古いスキャン(75) | 40.0 | 42.7 | 45.3 | 46.7 | 37.3 |
| ヘッダー・フッター(38) | 86.8 | 89.5 | 84.2 | 92.1 | 97.4 |
| 段組み(52) | 98.1 | 96.2 | 94.2 | 92.3 | 90.4 |
| 長い小さな文字(112) | 92.9 | 92.9 | 92.9 | 75.9 | 80.4 |
| 基本(104) | 100.0 | 99.0 | 100.0 | 100.0 | 97.1 |
| 総合 | 86.7 | 86.5 | 85.9 | 82.6 | 80.7 |
olmOCR-2 の手元の値(82.6)が公式(82.3)とほぼ一致したことから、ページの選び方と採点の手順は妥当だと考えています。LightOnOCR-3 の3サイズも公式の 84.5〜86.3 とほぼ同じ範囲に入りました。手元では 4B が3サイズの中でいちばん低く出ましたが、95% 信頼区間が ±2.5 点ほどあるので、この 105 ページだけで順位は決められません。
カテゴリ別に見ると、LightOnOCR-3 は表と「長い小さな文字」で olmOCR-2 と PaddleOCR-VL を上回り、ヘッダー・フッターの扱い(不要な部分を出力しない)では PaddleOCR-VL と olmOCR-2 が上でした。「古いスキャン」はどのモデルも 40% 前後で、公式の結果でもいちばん低いカテゴリです。
後処理の影響も確認できました。PP3 をかけない状態(ヘッダー類を捨てるだけ)だと、0.8B は 86.0、1B は 86.2、4B は 84.9 で、0.3〜1.0 点下がります。公式ブログが書いているとおり、ベンチマークの点数は後処理でも動くので、1点前後の差でモデルの優劣を判断しないほうが安全です。
なお、105 ページのうち1〜2ページで、同じ文の繰り返しが止まらず出力の上限(8,192 トークン)に達しました(0.8B と 4B が1ページ、1B と olmOCR-2 が2ページ)。日本語の帳票では一度も起きませんでしたが、長い文書を大量に処理するなら、上限の設定と読み直しの仕組みは必須です。
実在の資料で試す:情報通信白書の6ページ
自作の帳票はレイアウトが整っていて、実際の資料より易しい面があります。そこで、総務省の「令和7年版 情報通信白書」から、グラフと表が多い6ページを選んで読ませました。白書のグラフは、元の数値が CSV で公開されているので(白書の「データ集」)、グラフから読み取った値を公式の元データと照合できます。
まず、レイアウトの枠は実物でもきれいに取れました。次の画像は、白書の2ページに 0.8B の grounding の出力をそのまま描いたものです。
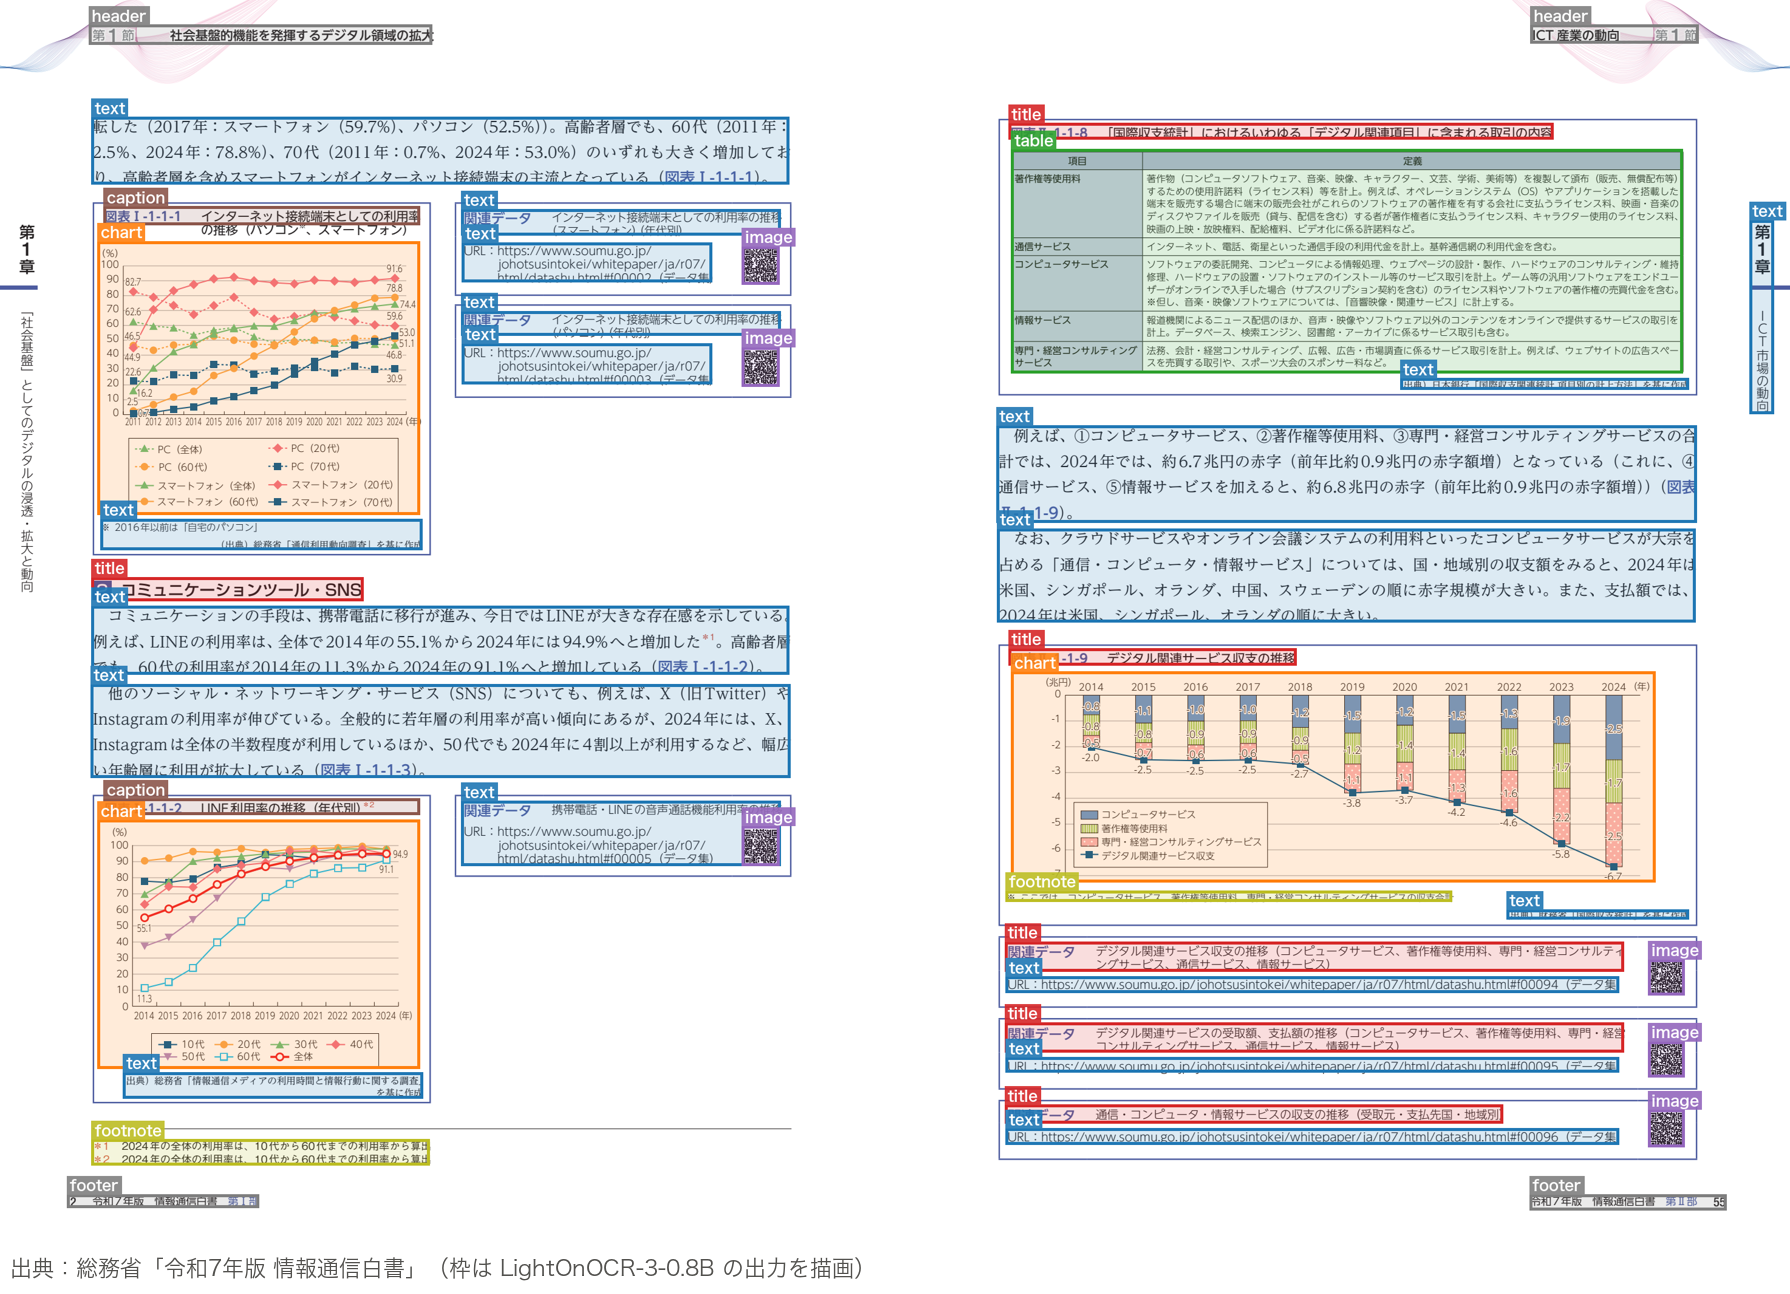
本文、図表番号のキャプション、グラフ、表、QR コード(image)、脚注まで、種類と位置はほぼ正確。ページ端の縦書きの章見出しだけは、取りこぼしたり本文(text)扱いになったりした。出典:総務省「令和7年版 情報通信白書」
一方、グラフの数値は、グラフに数値が印字されているかどうかで結果がはっきり分かれました。
| 白書の図表 | グラフの形 | 数値の印字 | 0.8B | 4B | PaddleOCR-VL |
|---|---|---|---|---|---|
| Ⅱ-1-1-2 世界のICT市場規模 | 棒(9本) | すべて | 9/9 | 9/9 | 9/9 |
| Ⅱ-1-1-3 産業別のGDP | 円 | すべて | 9/9 | 9/9 | 0/9(表の構造が崩れた) |
| Ⅱ-1-1-7 日米の情報化投資 | 折れ線(2本) | すべて | 58/58 | 58/58 | 57/58 |
| Ⅱ-1-1-9 デジタル関連サービス収支 | 積み上げ棒+折れ線 | すべて | 42/44 | 44/44 | 44/44 |
| Ⅱ-1-1-12 企業研究費 | 棒+折れ線 | すべて | 36/36 | 36/36 | 36/36 |
| Ⅰ-1-1-12 クラウドの利用状況 | 折れ線(1本) | 両端だけ | 11/11 | 9/11 | 11/11 |
| Ⅰ-1-1-2 LINE の利用率 | 折れ線(7本) | 両端だけ | 33/77 | 38/77 | 62/77 |
| Ⅰ-1-1-1 接続端末の利用率 | 折れ線(8本) | 両端だけ | 10/112 | 10/112 | 20/112 |
| Ⅰ-1-1-13 クラウドの利用用途 | 折れ線(6本) | なし | 32/66 | 38/66 | 62/66 |
| Ⅱ-1-1-6 我が国の情報化投資 | 積み上げ棒(44年分)+折れ線 | 折れ線だけ(棒は最終年のみ) | 44/176 | 34/176 | 33/176 |
※ 数字は「公式データと誤差 5% 以内だった値の数/値の総数」。1B と olmOCR-2 は表から省略(1B は全体で 25%、olmOCR-2 はグラフを表にしないため 3%)。
数値が印字されたグラフでは、LightOnOCR-3 はほぼ満点でした。自作のグラフで見た「印字された数値は正確に写す」という結果が、実物でも確かめられたことになります。
問題は、線が何本も重なり、数値が両端にしか書かれていない折れ線グラフです。8本の折れ線が重なる図表Ⅰ-1-1-1 では、0.8B も 4B も 112 個中 10 個しか合いませんでした。しかも、外れ方に特徴があります。4B の出力を見ると、2011 年の値は印字された数値を(系列を取り違えながら)使い、そこから先は「25.0, 28.0, 30.0, 32.0, 34.0」「1.0, 1.5, 2.0, 2.5, 3.0」のように、一定の幅で増えていく、もっともらしい数字を並べていました。読み取れない値を、それらしく埋めてしまうハルシネーションです。
LightOn の公式ブログには、学習データを作るときに「2つの列がまったく同じ」「同じ値が3回以上続く」ような、モデルが読めずにでっち上げた表を取り除いた、と書かれています。それでも、密集した実物のグラフでは等間隔の数字で埋める振る舞いが残っていました。PaddleOCR-VL も同じグラフで大きく外していて、これは LightOnOCR-3 だけの弱点ではありませんが、出力が表の形できれいに整っているぶん、間違いに気づきにくい点に注意が必要です。
実務では、グラフのブロックから取り出した数値は「数値が印字されたグラフ」のときだけ信用し、それ以外は「元データ(Excel や CSV)を別に取り込む」「数値ではなく説明文として扱う」のが安全です。
応用:grounding の出力を RAG に組み込む
ここまでの結果から、LightOnOCR-3 の grounding モードは「文字を読む」だけでなく、検索の単位(チャンク)を作る材料として使えることが分かりました。最後に、その具体的なコードを紹介します。
方針は単純です。
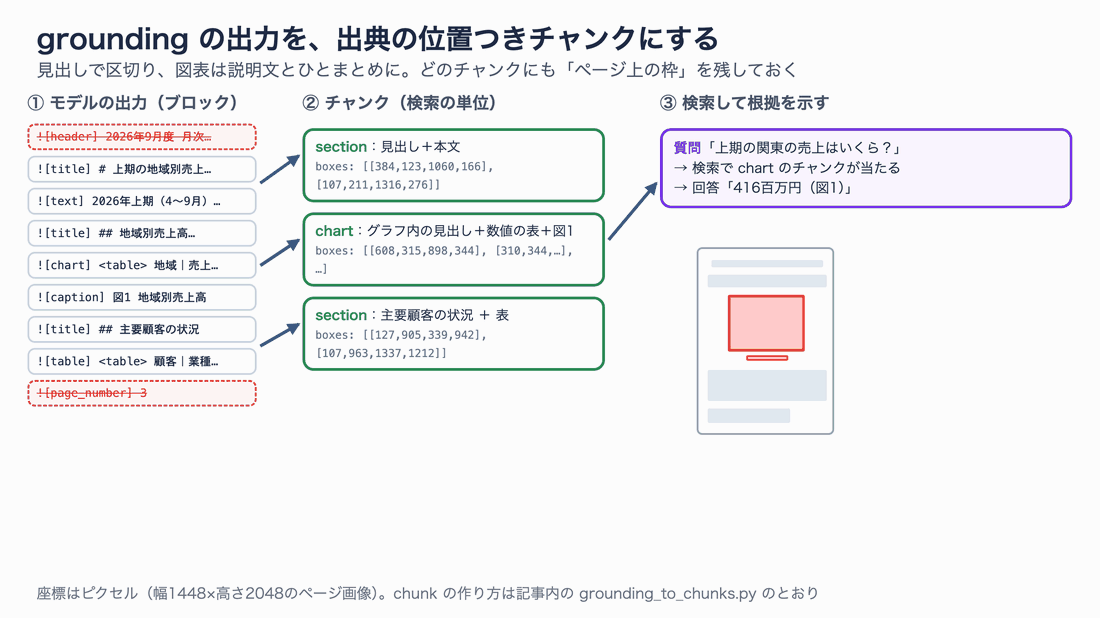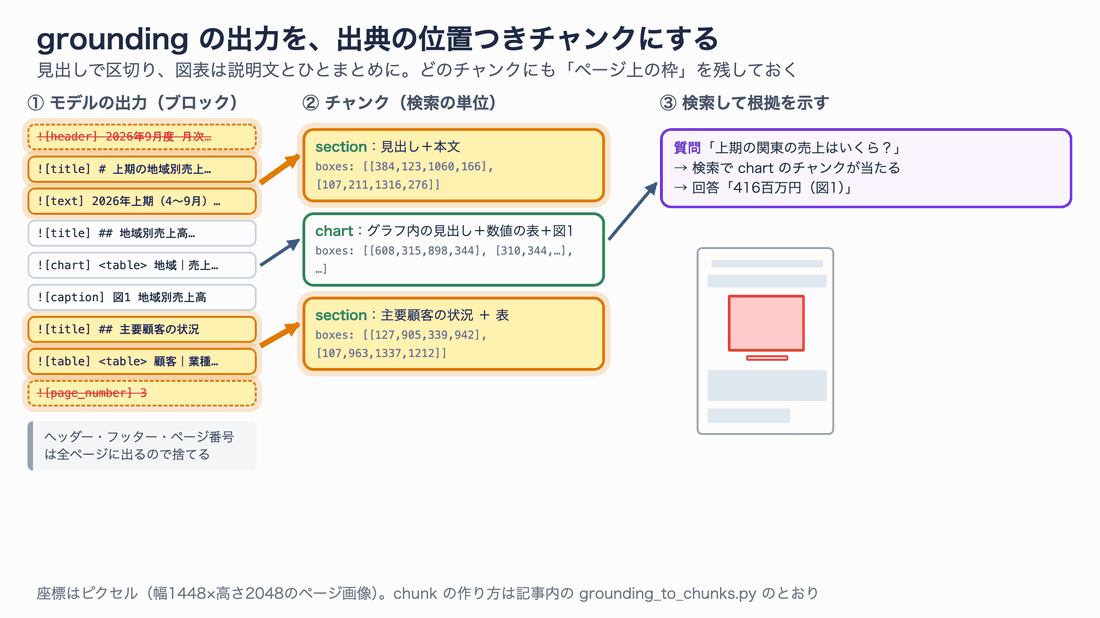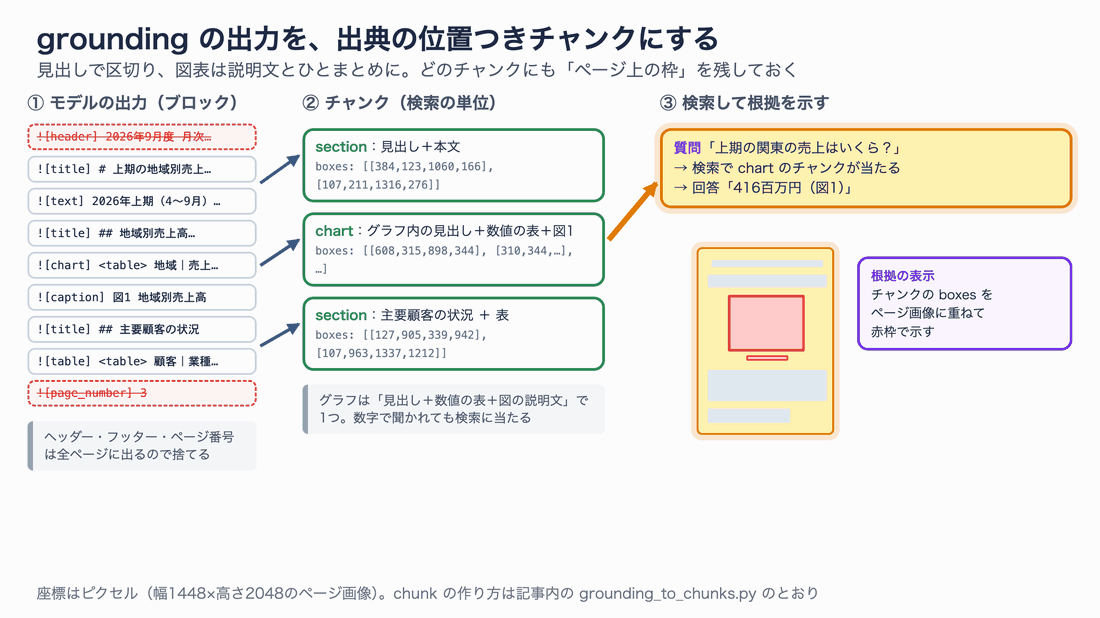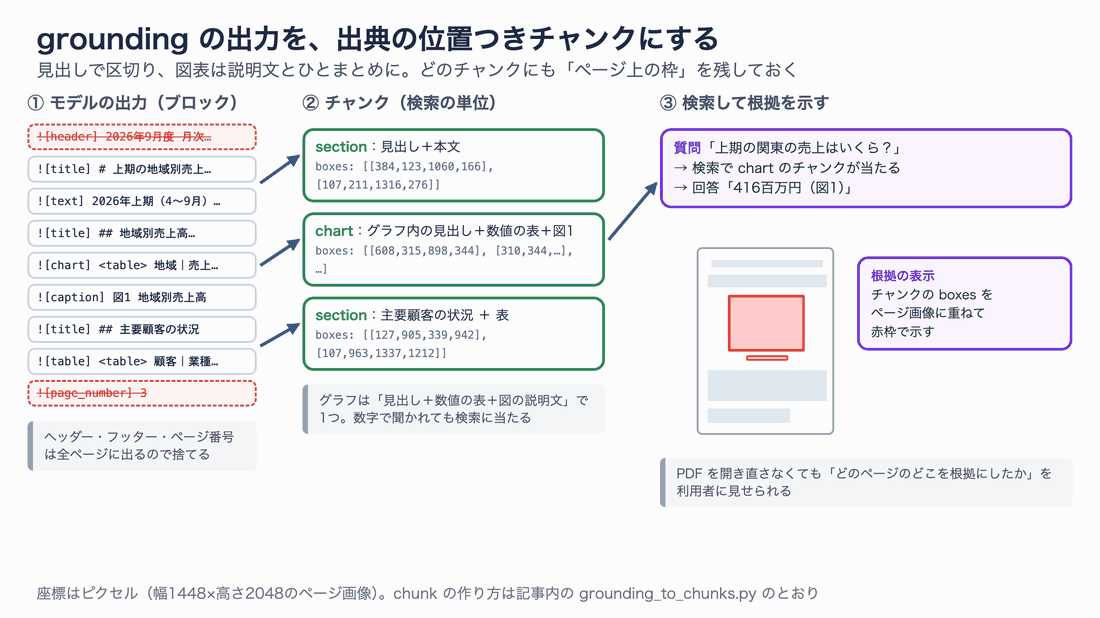
チャンクに「ページ上の枠」を残しておくと、回答の根拠をページの画像で示せる
- ヘッダー・フッター・ページ番号のブロックは、全ページに同じものが出て検索の邪魔になるので捨てる
- 見出し(
title)が来たら新しいチャンクを始め、続く本文・箇条書き・表を同じチャンクに入れる - 写真とグラフは単独のチャンクにし、すぐ上の見出しとすぐ下の説明文(
caption)を一緒に入れる。グラフは数値の表ごと入るので、「関東の売上は?」のように数字で聞かれても検索に当たる - どのチャンクにも、元になったブロックの枠(ピクセル座標)を残す
次の grounding_to_chunks.py は、ページ画像と grounding の出力テキストを受け取り、チャンクの JSON を書き出します。
"""LightOnOCR-3 の grounding 出力を、出典の位置つきチャンク(RAG の検索単位)にする
使い方: python grounding_to_chunks.py ページ画像.png 出力.txt [chunks.json] [根拠を赤枠で示した画像.png]
"""
import json
import re
import sys
from PIL import Image, ImageDraw
#  の印。種類の後ろの「+」は前のブロックの続きを表す
MARKER = re.compile(r"!\[([A-Za-z_]+)(\+?)\]\(\s*(\d+)\s*,\s*(\d+)\s*,\s*(\d+)\s*,\s*(\d+)\s*\)[ \t]*")
DROP = {"header", "footer", "page_number", "header_image", "footer_image"} # 全ページに出るので捨てる
VISUAL = {"image", "chart"} # 写真・図・グラフ
def parse_blocks(raw):
"""出力テキストを {種類, 座標(0〜1000), 中身} のブロックに分ける。中身は次の印の直前まで"""
marks = list(MARKER.finditer(raw))
for i, m in enumerate(marks):
end = marks[i + 1].start() if i + 1 < len(marks) else len(raw)
yield {"label": m.group(1), "box": [int(m.group(k)) for k in range(3, 7)], "text": raw[m.end():end].strip()}
def to_chunks(raw, width, height, page=1):
def px(b): # 0〜1000 の座標をピクセルに直す
x1, y1, x2, y2 = b
return [round(x1 * width / 1000), round(y1 * height / 1000), round(x2 * width / 1000), round(y2 * height / 1000)]
chunks, cur = [], None
blocks = [b for b in parse_blocks(raw) if b["label"] not in DROP]
for i, b in enumerate(blocks):
prev = blocks[i - 1] if i > 0 else None
nxt = blocks[i + 1] if i + 1 < len(blocks) else None
if b["label"] == "caption" and prev and prev["label"] in VISUAL:
continue # 直前の図にまとめ済み
if b["label"] == "title" and nxt and nxt["label"] in VISUAL:
continue # 図のすぐ上の見出し(グラフ内のタイトルなど)は図にまとめる
if b["label"] in VISUAL:
# 図は単独のチャンク。上の見出しと下の説明文(caption)を一緒に入れる
text, boxes = b["text"], [px(b["box"])]
if prev and prev["label"] == "title":
text = prev["text"].lstrip("# ") + "\n" + text
boxes.insert(0, px(prev["box"]))
if nxt and nxt["label"] == "caption":
text = nxt["text"] + "\n" + text
boxes.append(px(nxt["box"]))
chunks.append({"type": b["label"], "page": page, "text": text, "boxes": boxes})
cur = None
continue
if b["label"] == "title" or cur is None: # 見出しが来たら新しいチャンク
cur = {"type": "section", "page": page, "text": "", "boxes": []}
chunks.append(cur)
cur["text"] = (cur["text"] + "\n\n" + b["text"]).strip()
cur["boxes"].append(px(b["box"]))
return chunks
def highlight(img, chunk, color=(255, 64, 64)):
"""チャンクの枠をページ画像に重ねる(回答の根拠を見せる)"""
img = img.convert("RGB")
d = ImageDraw.Draw(img, "RGBA")
for x1, y1, x2, y2 in chunk["boxes"]:
d.rectangle((x1 - 4, y1 - 4, x2 + 4, y2 + 4), outline=color + (255,), width=6, fill=color + (40,))
return img
if __name__ == "__main__":
img = Image.open(sys.argv[1])
raw = open(sys.argv[2], encoding="utf-8").read()
chunks = to_chunks(raw, *img.size)
out = sys.argv[3] if len(sys.argv) > 3 else "chunks.json"
json.dump(chunks, open(out, "w", encoding="utf-8"), ensure_ascii=False, indent=1)
print(len(chunks), "chunks ->", out)
if len(sys.argv) > 4: # 例として、最初のグラフのチャンクを赤枠で示す
hit = next(c for c in chunks if c["type"] == "chart")
highlight(img, hit).save(sys.argv[4])
前の節の ocr.py と組み合わせると、次のように使えます。
# 1. grounding モードで読む(出力を保存。ページ画像は report_page.png として保存される)
python ocr.py report.pdf grounding models/LightOnOCR-3-0.8B > report_grounding.txt

# 2. チャンクにし、グラフのチャンクの根拠を赤枠で描く
python grounding_to_chunks.py report_page.png report_grounding.txt chunks.json evidence.png
座標は 0〜1000 の値なので、ページをどの解像度で画像にしても、その画像の幅と高さで換算できます。月次報告書のページで実行すると、4つのチャンク(見出し+本文、グラフ、表、箇条書き)ができ、グラフのチャンクの根拠は次のように描かれました。
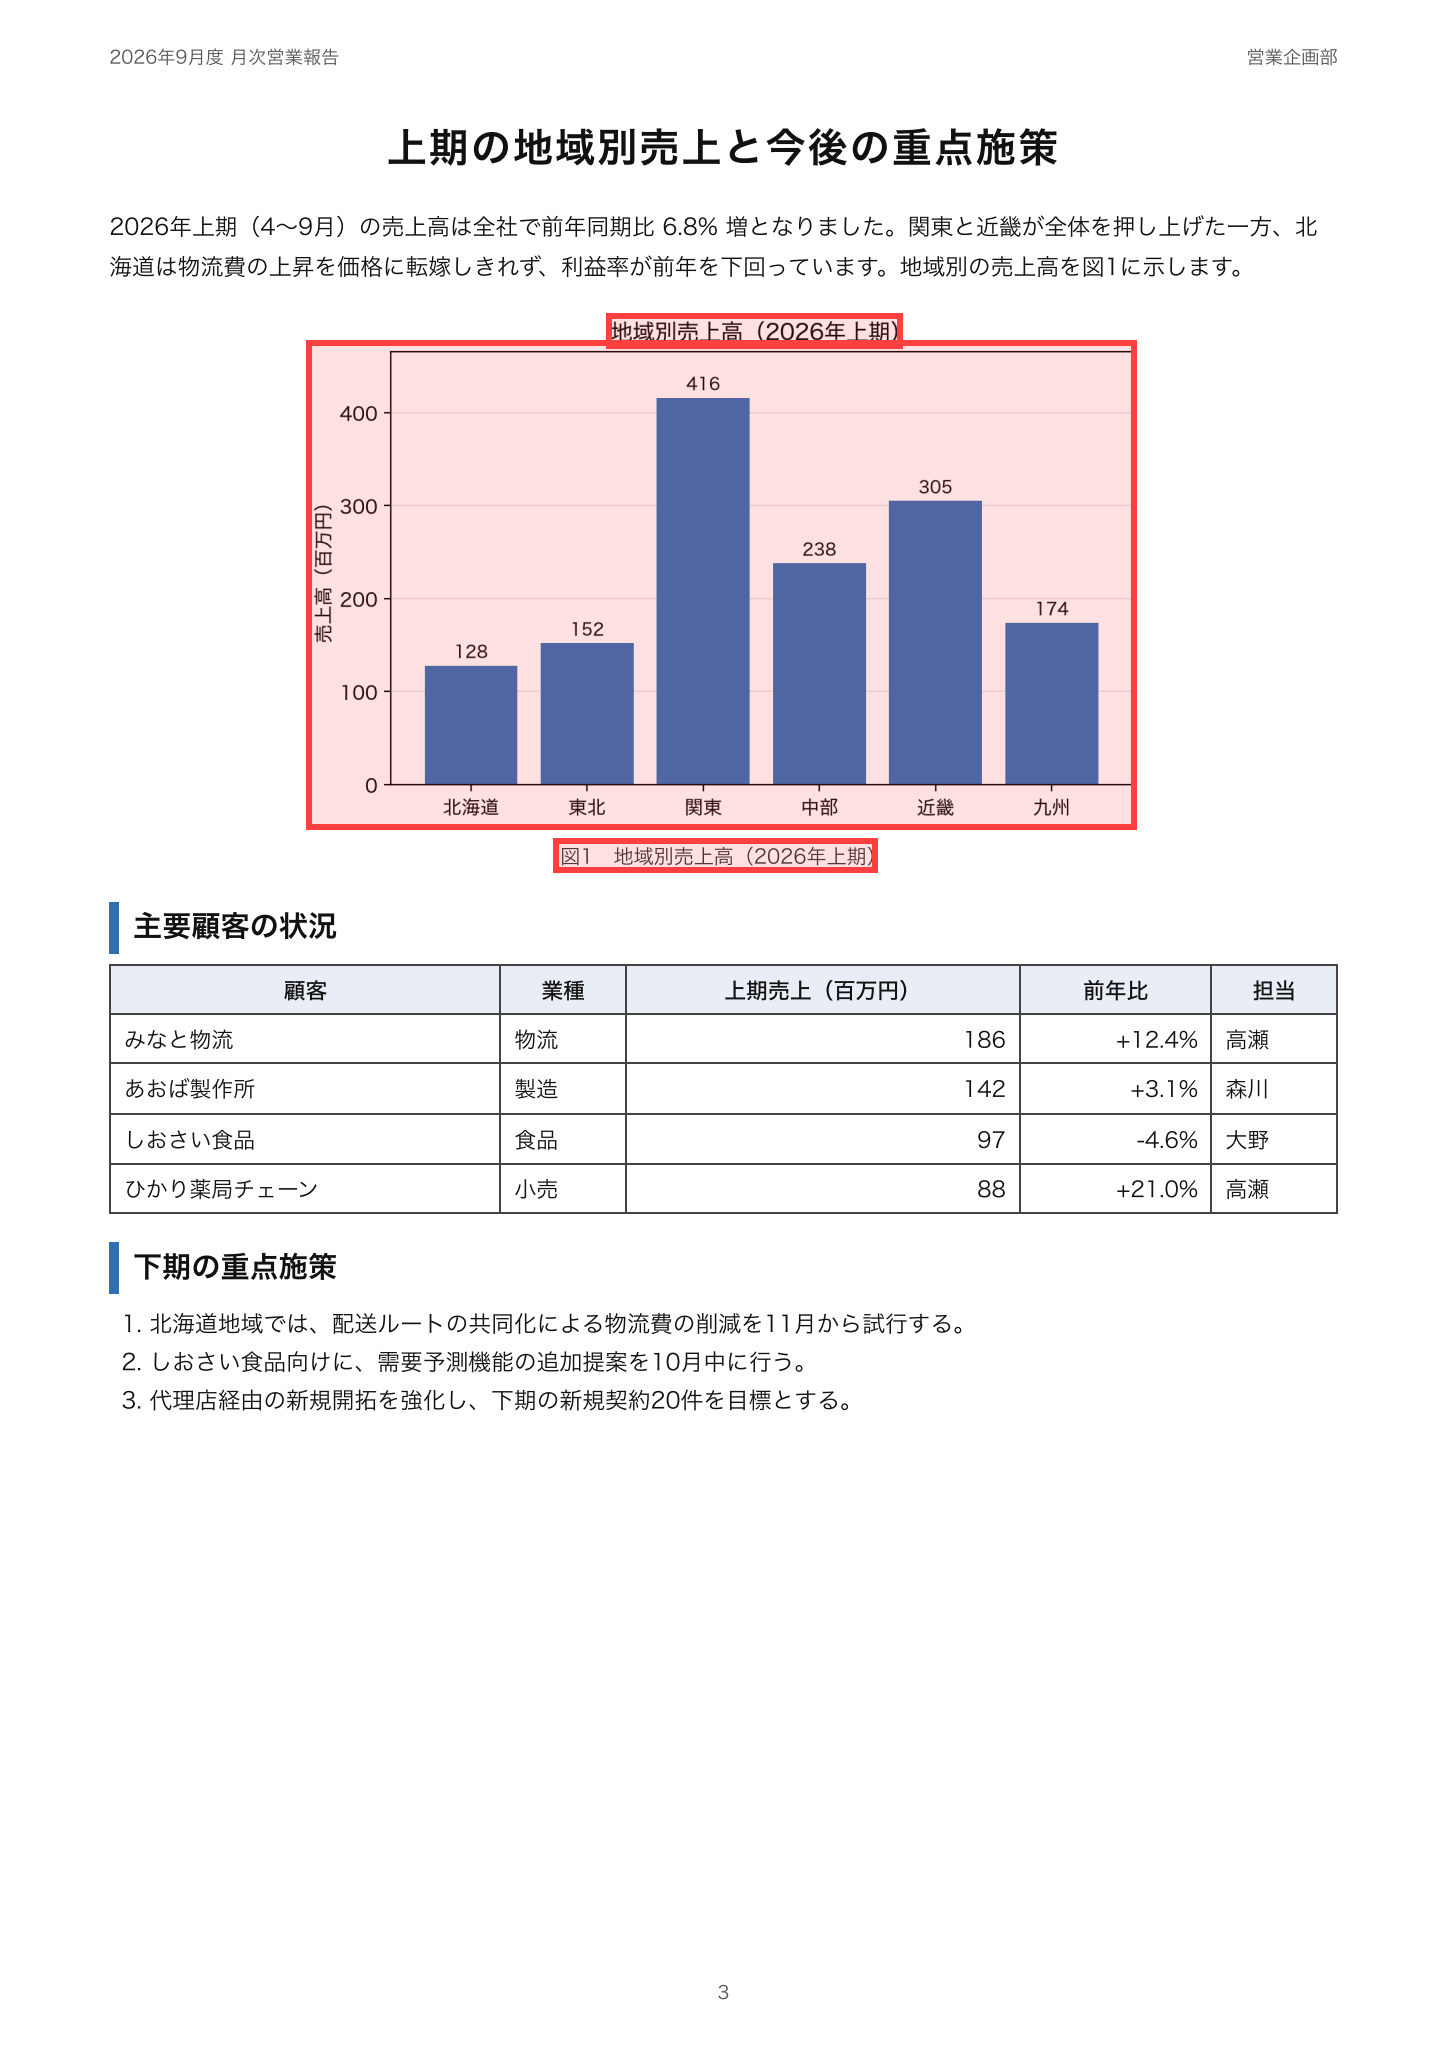
「上期の関東の売上は?」に対する根拠として、グラフと図の説明文の位置を示した例。枠の座標は LightOnOCR-3-0.8B の出力そのまま
あとは、各チャンクの text をベクトル化して好きなベクトルデータベースに入れ、page と boxes をメタデータとして持たせておくだけです。回答を返すときに当たったチャンクの枠をページ画像に重ねれば、利用者は PDF を開き直さずに根拠を確かめられます。
実務で使うときの注意も書いておきます。
- 写真のチャンクの説明文は、前述のとおりキャプションの言い換えになりやすいので、写真の検索が重要なら枠で切り抜いて読ませ直します
- 表は HTML のまま入れています。行数の多い表は、行ごとに見出し行を付けて分割したほうが検索に当たりやすくなります
- 複数ページにまたがる段落は
text+のように+付きのラベルで続きが示されます。上のコードは1ページ単位なので、ページをまたいでつなぐ処理は必要に応じて足してください
どれを選ぶか
検証の結果を、判断の流れにまとめました。
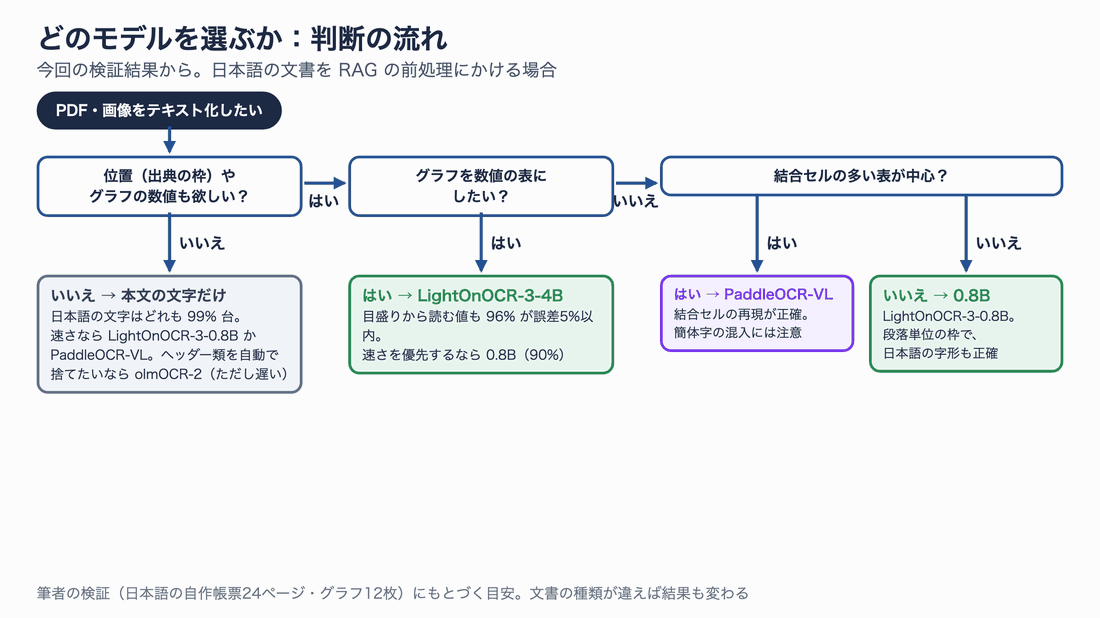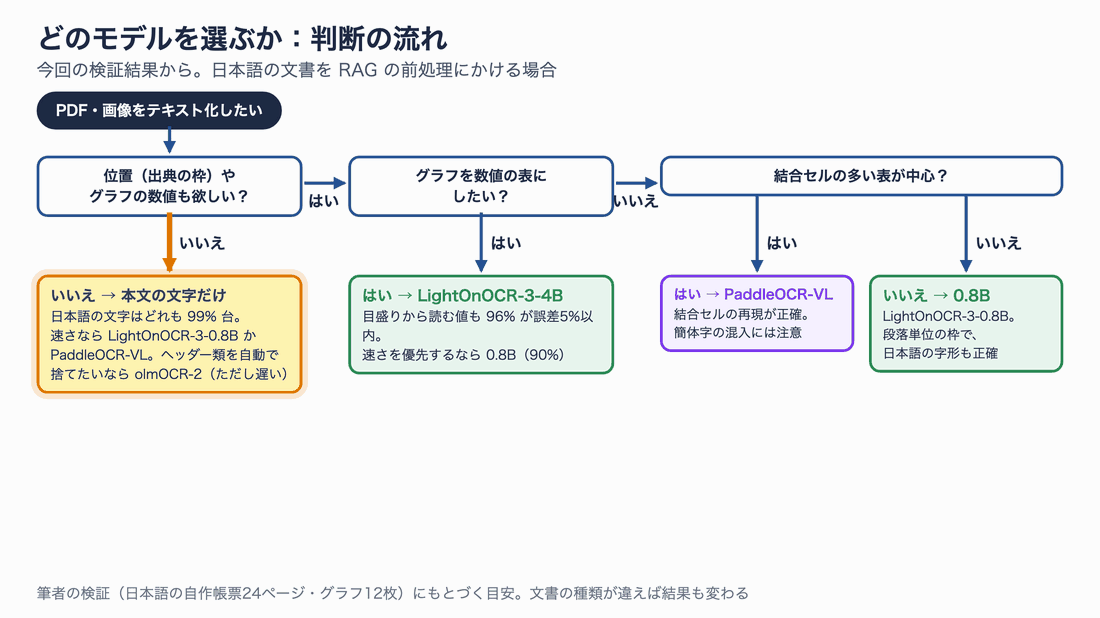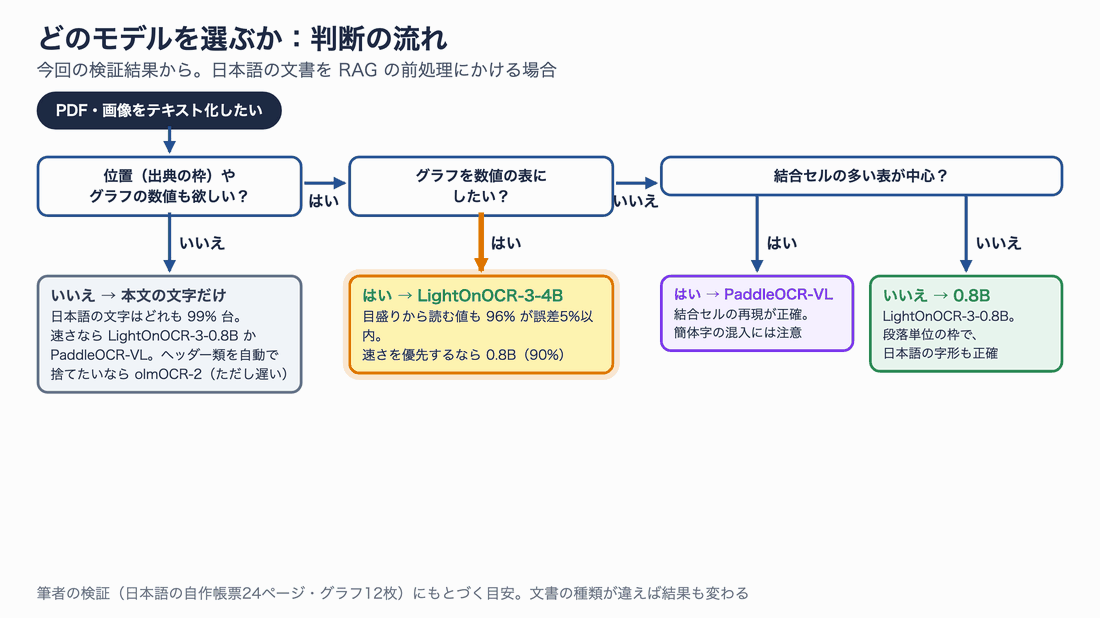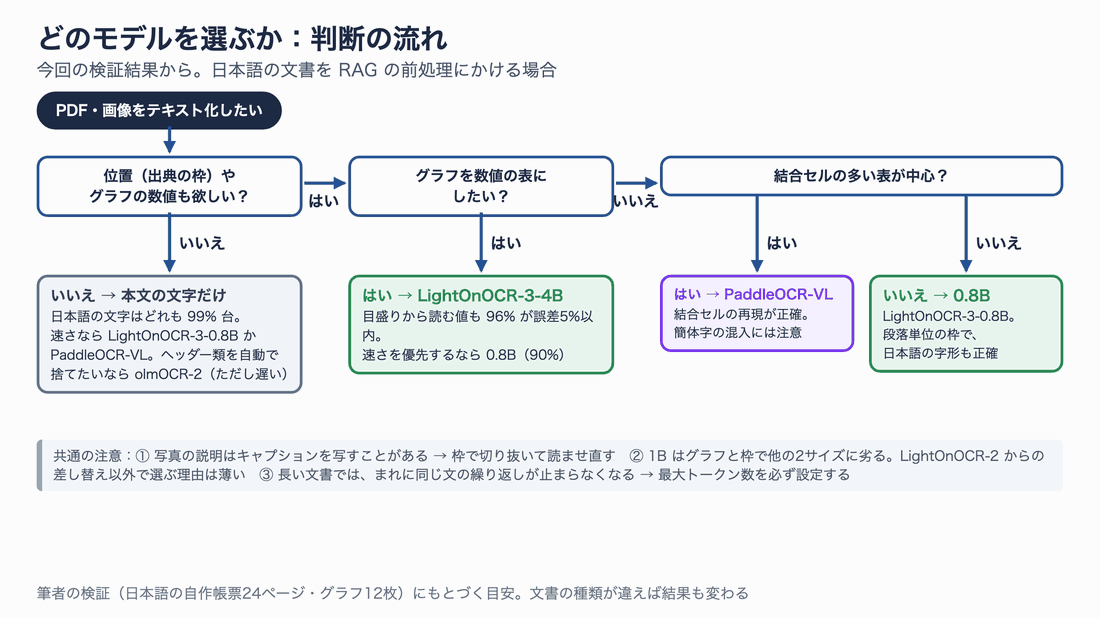
日本語の帳票を RAG にかける場合の目安。文書の種類が変われば結果も変わる
まとめると、次のように選ぶのがよさそうです。
- まず試すなら LightOnOCR-3-0.8B。1ページ約6秒・メモリ約3GBで、日本語の文字・表・枠・グラフの数値がそろって取れます。今回の日本語の帳票では、4B との差はグラフの目盛り読み(90% 対 96%)くらいでした
- グラフの数値を重視するなら 4B。ただし時間は約5倍かかります。また、数値が印字されていない密集したグラフは、4B でも信用しないことが前提です
- 結合セルの多い表や、ヘッダー・フッターを確実に捨てたい用途なら PaddleOCR-VL-1.6。速さは 0.8B と同等です。日本語の文書では、簡体字の混入を後処理で直す前提で使います
- 英語の論文や書籍が中心で、位置の情報が不要なら olmOCR-2 も選択肢です。ただし Mac では1ページ30秒以上かかります
トラブルシューティング
検証の途中で実際に出た症状と、効いた対処です。
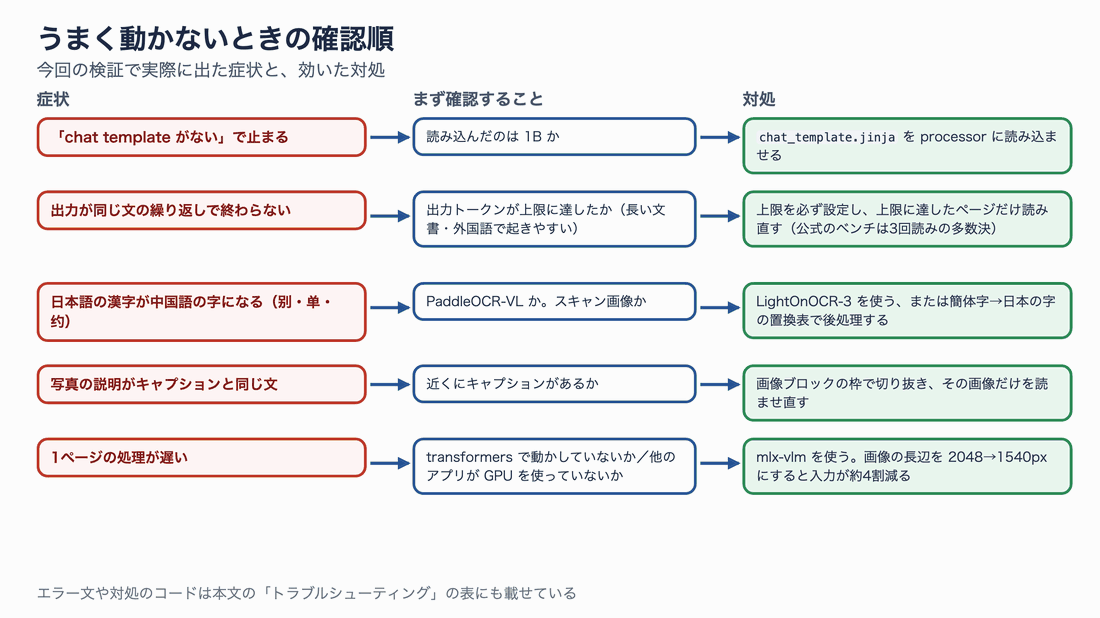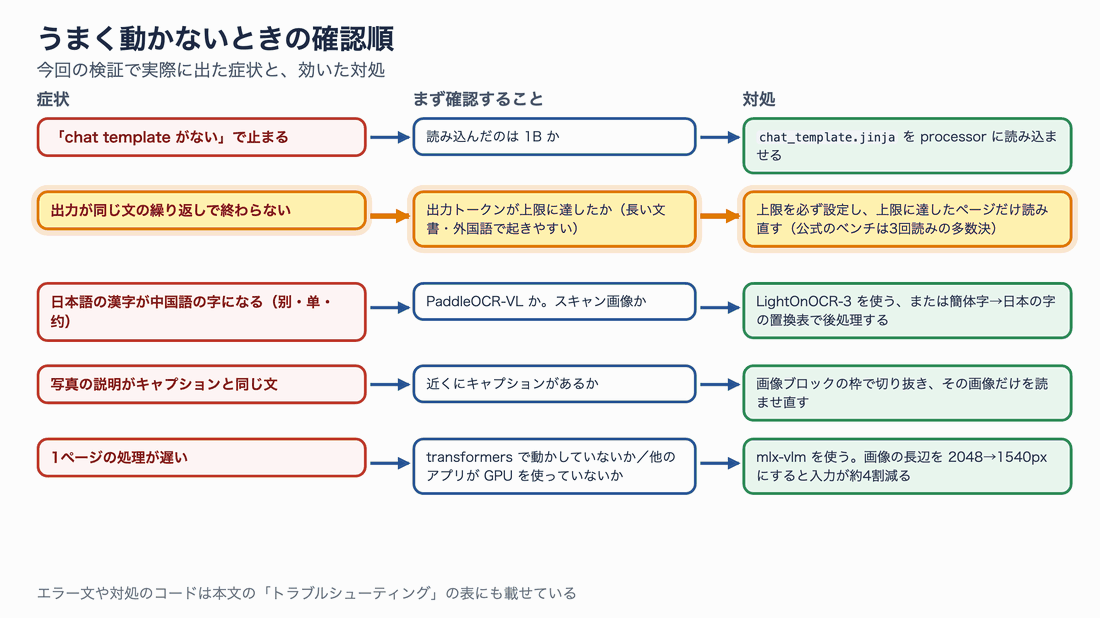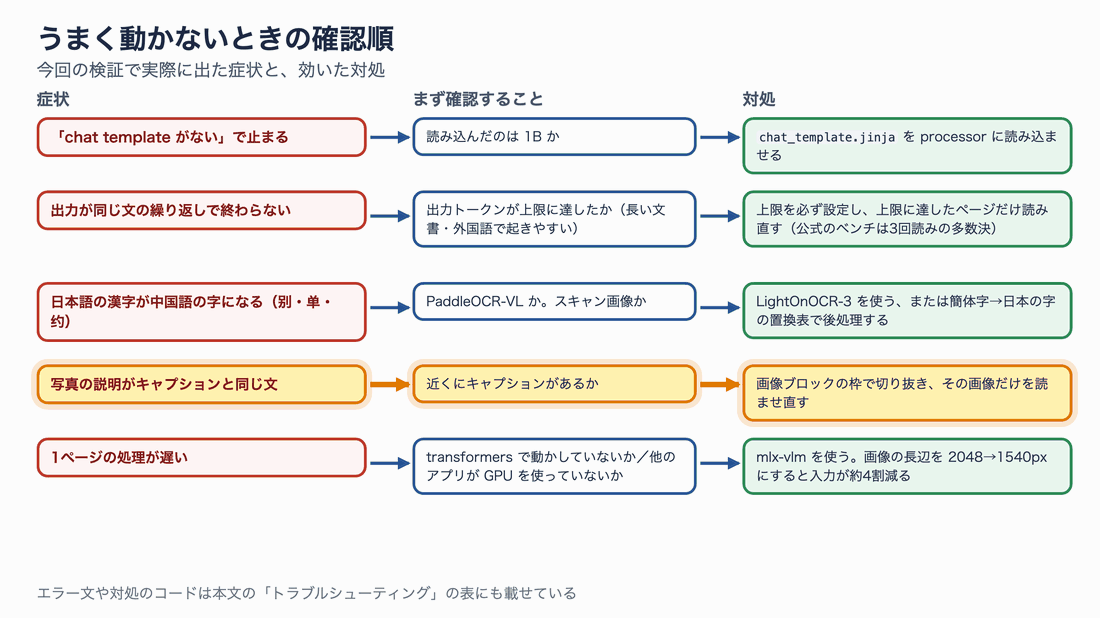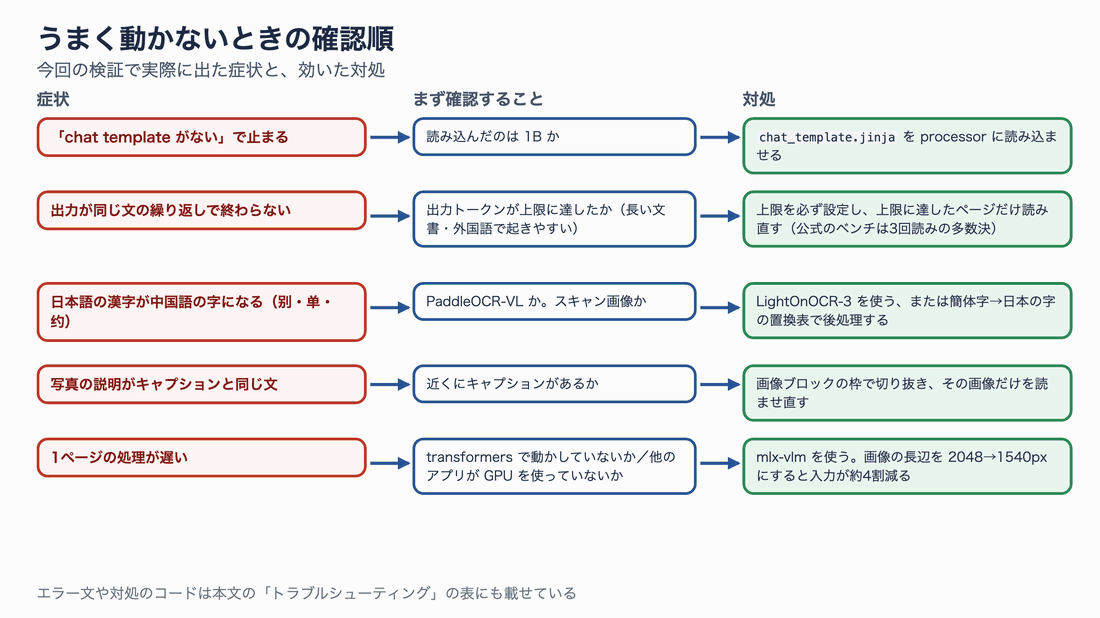
症状から順に確認すれば、たいていはこの5つのどれかで解決する
| 症状・エラー | 原因 | 対処 |
|---|---|---|
ValueError: Cannot use apply_chat_template because this processor does not have a chat template. | 1B を mlx-vlm で読み込むと、チャットテンプレートが processor に付かない | processor.chat_template = (model_dir / "chat_template.jinja").read_text() を読み込みの直後に入れる |
| 出力が同じ文の繰り返しになり、上限まで止まらない | 長いページや外国語のページで、まれに繰り返しから抜けられなくなる(olmOCR-Bench の105ページで0.8B と 4B が1ページ、1B と olmOCR-2 が2ページ) | max_tokens を必ず設定する。上限に達したページだけ読み直す。公式のベンチマークは1ページを3回読んで多数決をとっている |
| 日本語の漢字が中国語の簡体字になる(別→别、約→约) | PaddleOCR-VL の癖。スキャン画像やグラフの項目名で起きやすい | LightOnOCR-3 を使うか、簡体字→日本の字の置換表で後処理する |
1B を transformers で動かすと意味のない文字列が出る(読み込み時に MISSING の一覧が出る) | 2026年10月9日時点の transformers(5.16.1・5.19.0 で確認)では、1B の言語部分の重みが読み込まれない | mlx-vlm で動かす。transformers の新しい版やモデルの更新で直る可能性があるので、読み込み時の MISSING の表示を必ず確認する |
| 写真の説明がキャプションと同じ文になる | 学習データの作り方の影響と考えられる | 画像ブロックの枠で切り抜き、その画像だけを読ませ直す |
| PaddleOCR-VL の起動のたびに「Checking connectivity to the model hosters」で待たされる | モデルの配布元への接続確認 | 環境変数 PADDLE_PDX_DISABLE_MODEL_SOURCE_CHECK=True を設定する(モデルを取得済みの場合) |
| 1ページの処理が遅い | transformers で動かしている(0.8B・4B は線形注意の層が PyTorch の参照実装に切り替わる)、または他のアプリが GPU を使っている | mlx-vlm を使う。画像の長辺を 2048px から 1540px にすると入力のトークンが約4割減る(公式はこの設定でスループットが上がると説明) |
まとめ
LightOnOCR-3 を日本語の帳票で試した結果をまとめます。
- 1つのモデルで、文字・位置・表・グラフの数値・写真の説明が取れるのは本当でした。日本語は公式に対応をうたっていませんが、0.8B でも本文の文字は 99.6%、表の TEDS は 0.99 でした
- 比較の2モデルと比べた強みは、グラフの数値化(4B・0.8B)と、日本語の字形の正確さ(PaddleOCR-VL のような簡体字の混入がない)、段落単位の枠の3つです
- 弱みは、写真の説明がキャプションに引っぱられることと、結合セルの表の構造です。1B はグラフと枠で他の2サイズより明確に劣るので、LightOnOCR-2 からの差し替え以外では 0.8B か 4B を選ぶのがよさそうです
- Mac でも mlx-vlm で問題なく動きます。0.8B は1ページ約6秒・メモリ約3GBなので、手元の Mac で社内文書を前処理する用途なら十分に現実的です。一方、公式どおりの transformers のコードは Mac では遅いか(0.8B)、正しく動かない(1B)ので注意してください
次に試すなら、自社の実際の帳票(手書き、印影、FAX)での確認と、ページをまたぐ表のつなぎ込みです。公式の再現用リポジトリには、ブロックを Markdown に戻す関数やビューアーも入っているので、まずは手元の PDF を数枚 grounding モードで読ませ、枠を描いて眺めてみるのがおすすめです。
参考リソース
- LightOnOCR-3: High-Performance OCR and Layout Extraction in One Model(LightOn、Hugging Face ブログ、2026-10-08)
- lightonai/LightOnOCR-3-0.8B・1B・4B(モデルカード)
- LightOnOCR-3 Demo(ブラウザで試せるデモ)
- lightonai/LightOnOCR(クライアント・ビューアー・ベンチマークの再現コード)
- PaddlePaddle/PaddleOCR-VL-1.6、PaddleOCR-VL Apple Silicon Usage Tutorial
- allenai/olmOCR-2-7B-1025、olmOCR-Bench
- mlx-vlm(Apple シリコン向けの VLM 推論ライブラリ)
- 令和7年版 情報通信白書(総務省)
- 写真:NASA Image and Video Library(as17-148-22727、s132e012232、KSC-20220915-PH-JNP01_0003、PIA18165。いずれもパブリックドメイン)