はじめに
2026年9月28日、Anthropic が Claude Sonnet 5.5 を公開しました。9月22日の Opus 5.5 に続く、Claude 5.5 ファミリーの2つ目のモデルです。発表の見出しは「Sonnet 5 より出力が30%以上速く、たいていの仕事で最大30%安い」。一方で、トークンの単価は Sonnet 5 と同じ据え置きです。
単価が同じなのに安くなるのはなぜか。ベンチマークの数字はどれくらい伸びたのか。そして実際に使うと、何が変わって見えるのか。この記事では、公式の発表・料金表・システムカードで「変わった点」を整理したうえで、同じ課題を Sonnet 5 と Sonnet 5.5 の両方に解かせ、「Sonnet 5 で作ったらこうなった/Sonnet 5.5 で作ったらこうなった」を並べて比べます。
まず、変わらないものと変わったものの全体像です。左の「変わらない」と右の「変わった」を順に強調します。
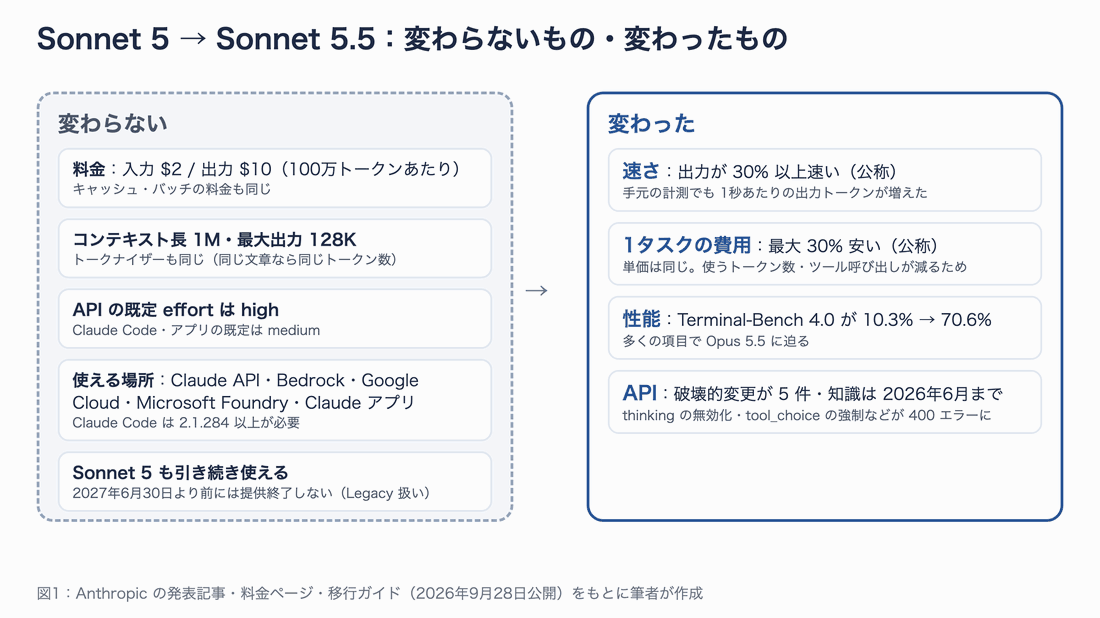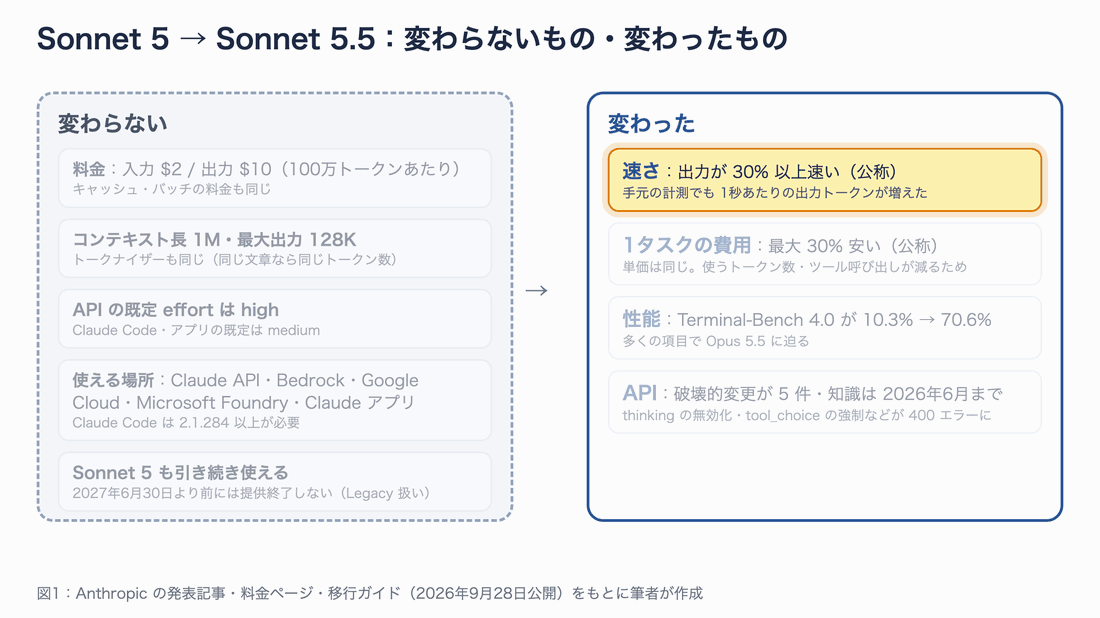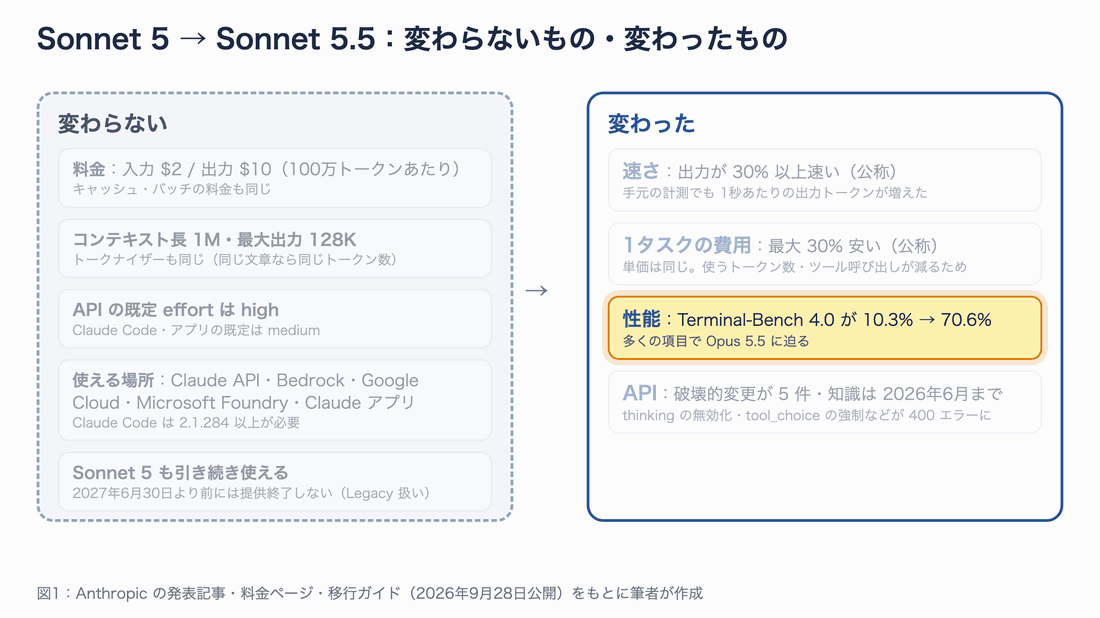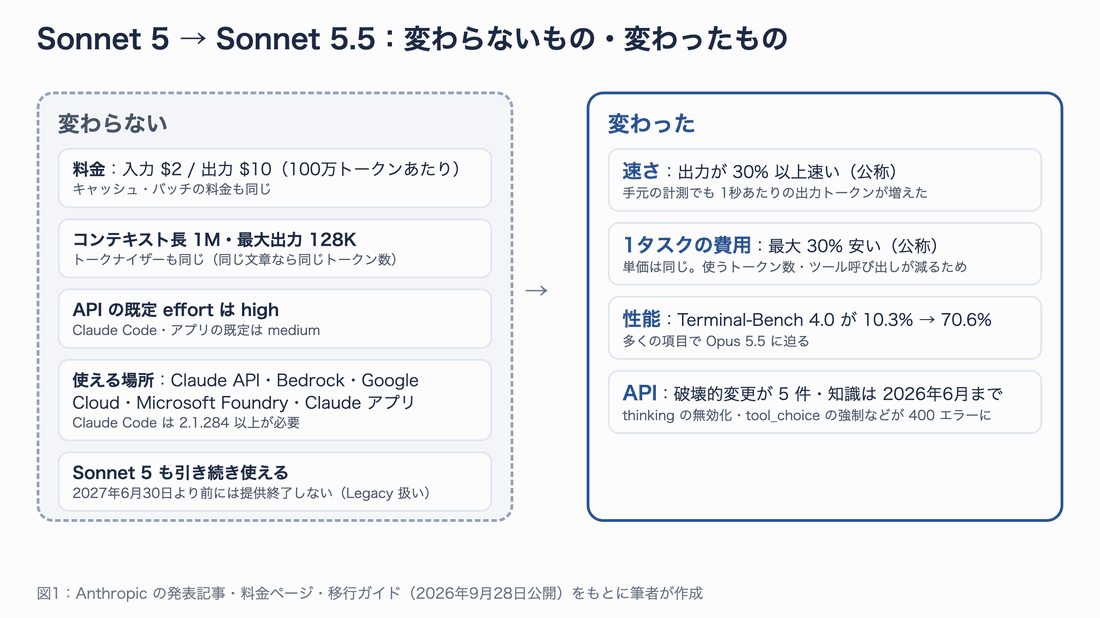
図1:料金やコンテキスト長はそのまま。変わったのは「速さ」「1タスクあたりの費用」「性能」「API の細部」の4つです。
この記事は、次のような方を想定しています。
- Claude Code や Claude API で Sonnet 5 を使っていて、切り替えるべきか迷っている方
- 「Sonnet と Opus をどう使い分けるか」を決めたい方
- ベンチマークの数字だけでなく、実際の仕事での違いを知りたい方
この記事の確認範囲
- 公式情報:Anthropic の発表記事、Claude API ドキュメント(モデル概要・料金・What’s new・移行ガイド)、Sonnet 5.5 システムカード、Claude Code の変更履歴を 2026年9月29日に確認しました。報道は Reuters 配信記事などを参照しています。
- 手元の検証:2026年9月29日、筆者の Mac(Apple M5 Max・メモリ128GB)で Claude Code 2.1.284 を使って実施しました。API キーは使わず、Claude Max のログインで動かしています。費用は「API で同じことをしたらいくらか」の目安です。
Sonnet 5.5 はどんなモデルか
Claude の主なラインナップには、難問に強い Opus、速さと費用のバランスをとった Sonnet、軽くて安い Haiku があります(さらに上位の Fable もあります)。Sonnet 5.5 はこのうち Sonnet の最新版で、公式の説明では「バグ修正、日常的なコーディング、文書・スライド・表計算の作成」のように、やることがはっきり決まった実務を、大量に・速く・安く回すためのモデルと位置づけられています。
AI エージェント(AI が自分でツールを使いながら作業を進める仕組み)では、1回の依頼の中でモデルを何十回も呼び出します。ファイルを読む、コマンドを実行する、結果を見て直す、を繰り返すからです。そのため「1回の賢さ」だけでなく、「1回あたりの速さと費用」「完了までの往復回数」が、そのまま待ち時間と請求額に効いてきます。Sonnet 5.5 の売りは、まさにこの部分です。
基本情報を表にまとめます。
| 項目 | Sonnet 5 | Sonnet 5.5 |
|---|---|---|
| 公開日 | 2026年6月30日 | 2026年9月28日 |
| API のモデル ID | claude-sonnet-5 | claude-sonnet-5-5 |
| 料金(100万トークンあたり) | 入力 $2 / 出力 $10 | 入力 $2 / 出力 $10(同じ) |
| コンテキスト長(一度に読める量) | 100万トークン | 100万トークン |
| 最大出力 | 12.8万トークン | 12.8万トークン |
| 知識のカットオフ | 2026年1月 | 2026年6月 |
| キャッシュできる最小のプロンプト長 | 1,024 トークン | 512 トークン |
| 提供終了 | 2027年6月30日より後 | 2027年9月28日より後 |
最大出力は API ドキュメントの値です。なお手元の Claude Code 2.1.284 が出力する情報では、Sonnet 5 の最大出力は 64,000、Sonnet 5.5 は 128,000 と表示されていました(Claude Code 側の上限設定とみられます)。
Claude API のほか、Amazon Bedrock・Google Cloud・Microsoft Foundry、Claude のアプリでも使えます。Claude Code では バージョン 2.1.284 以上が必要で、このバージョンから Anthropic API での sonnet という別名(エイリアス)が Sonnet 5.5 を指すようになりました。ただし Claude Code 全体の既定モデルは Opus 5.5 のままです。
公式ベンチマーク:どれくらい上がったのか
発表記事の比較表
まずは公式の数字です。発表記事に載っている比較表を、そのまま撮影しました。青い枠が Sonnet 5.5、その右が Sonnet 5 です。
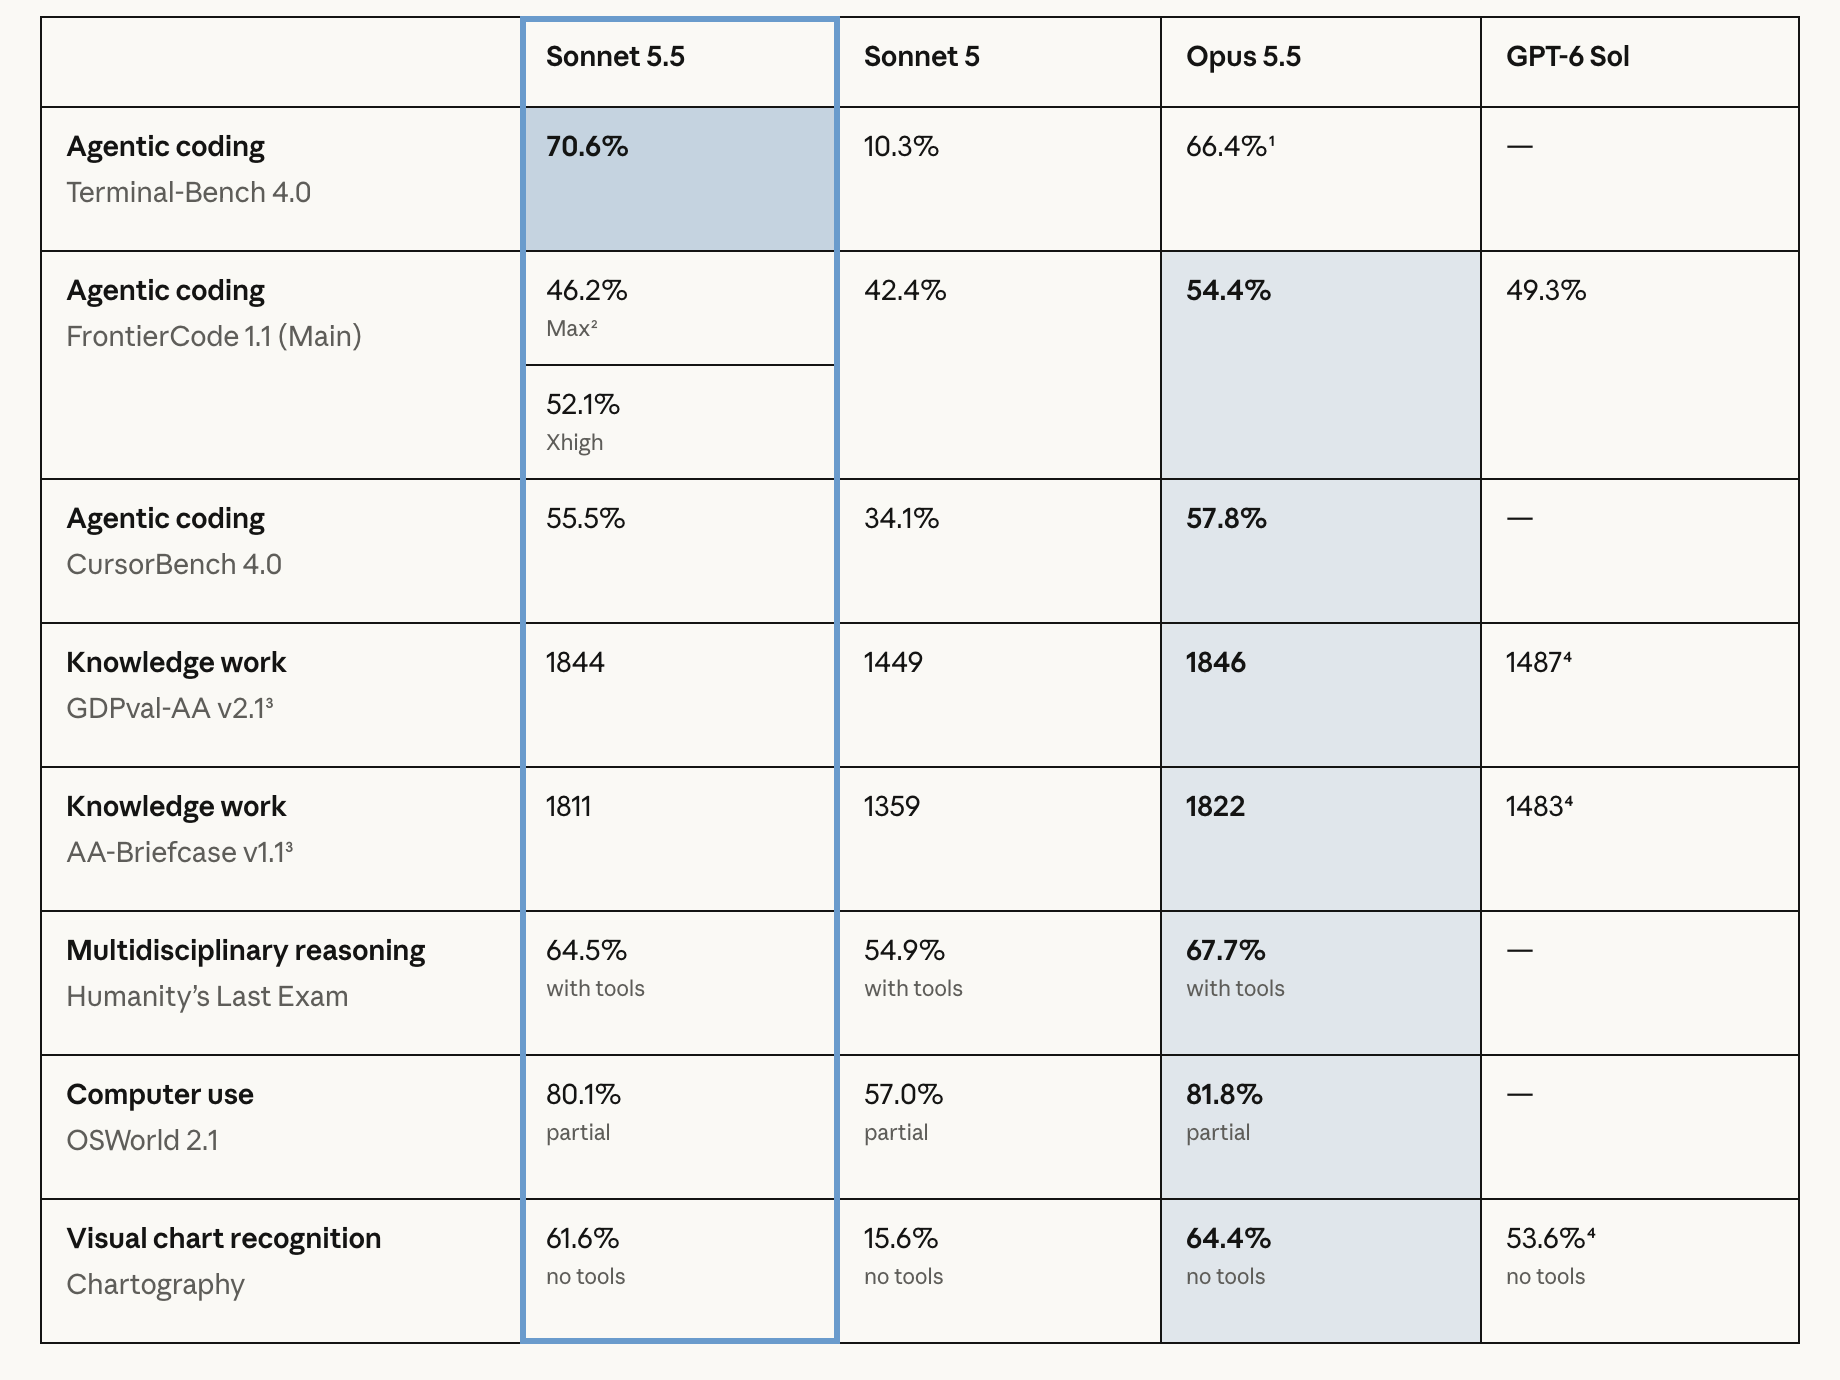
出典:Anthropic「Claude Sonnet 5.5」発表記事の比較表(2026年9月28日、筆者が撮影)。①Opus 5.5 は xhigh の値 ②Max では Claude Code の code-review スキルが動いてタイムアウトなどが起き、Xhigh より低く出た ③リリース前の環境で測定 ④GPT-6 Sol は測定後に不具合が修正された、という脚注があります。
数字が並ぶと差がつかみにくいので、Sonnet 5 からの「上乗せ分」が見えるように棒グラフにしました。灰色が Sonnet 5 のスコア、青がそこから Sonnet 5.5 で増えた分、オレンジの縦線が Opus 5.5 です。
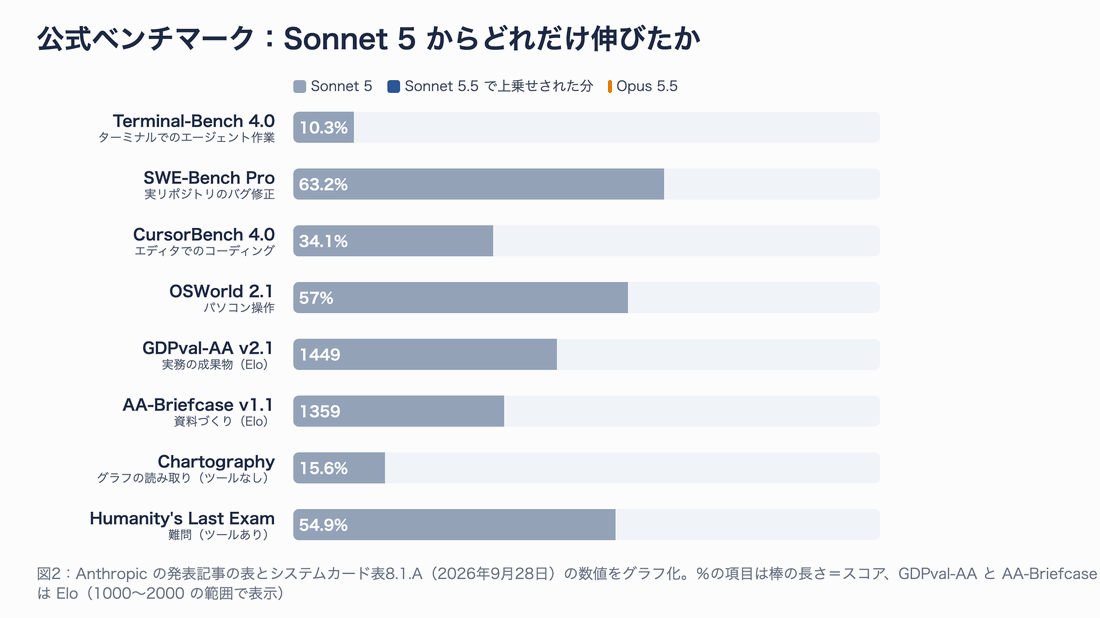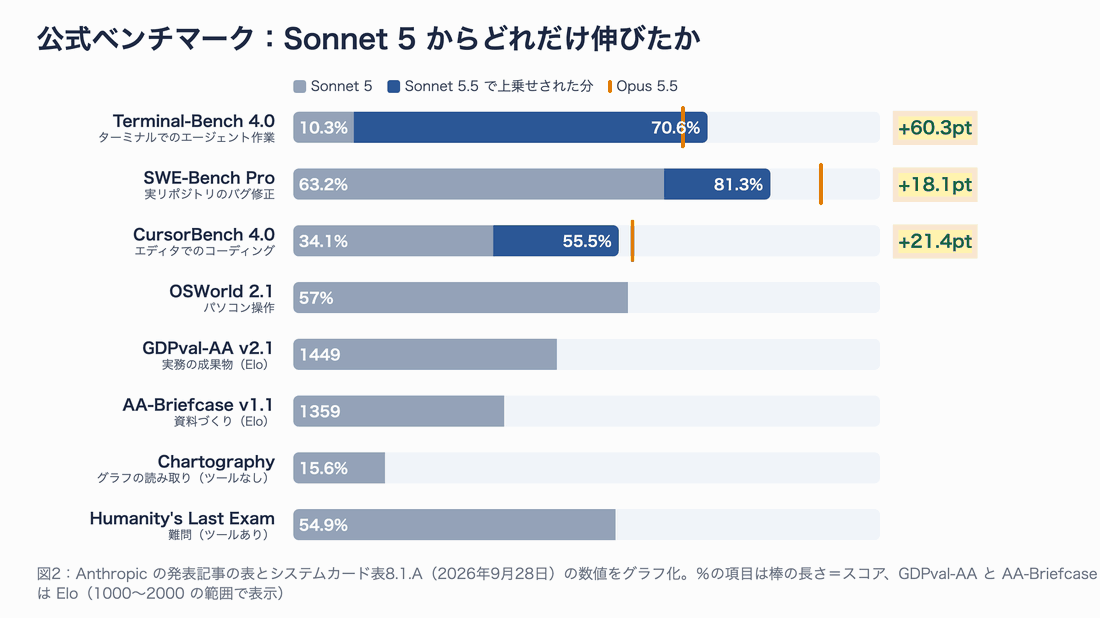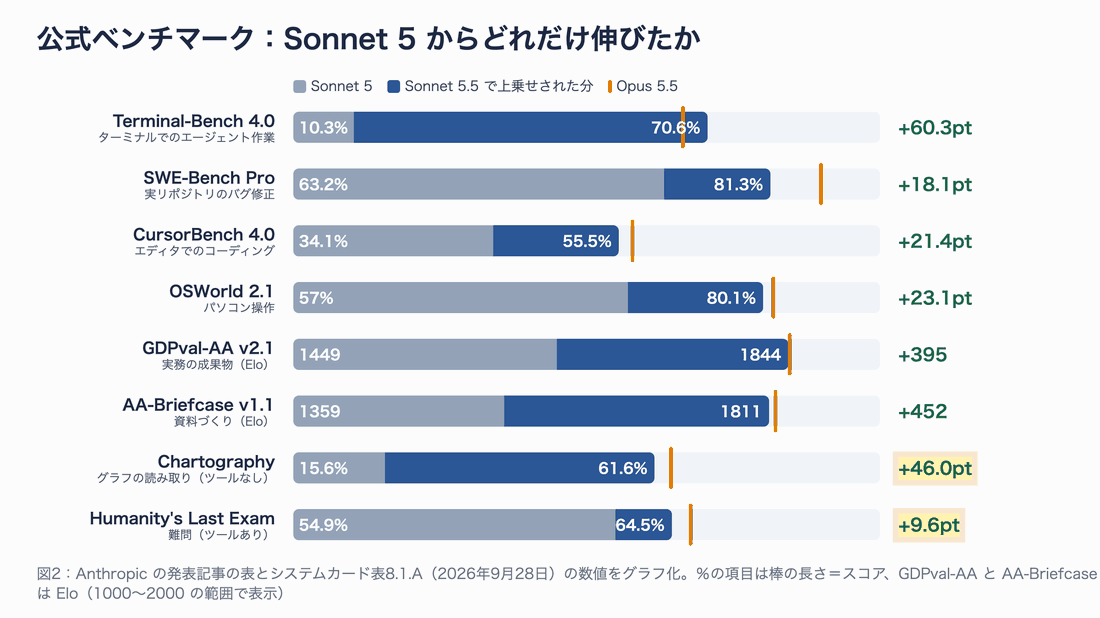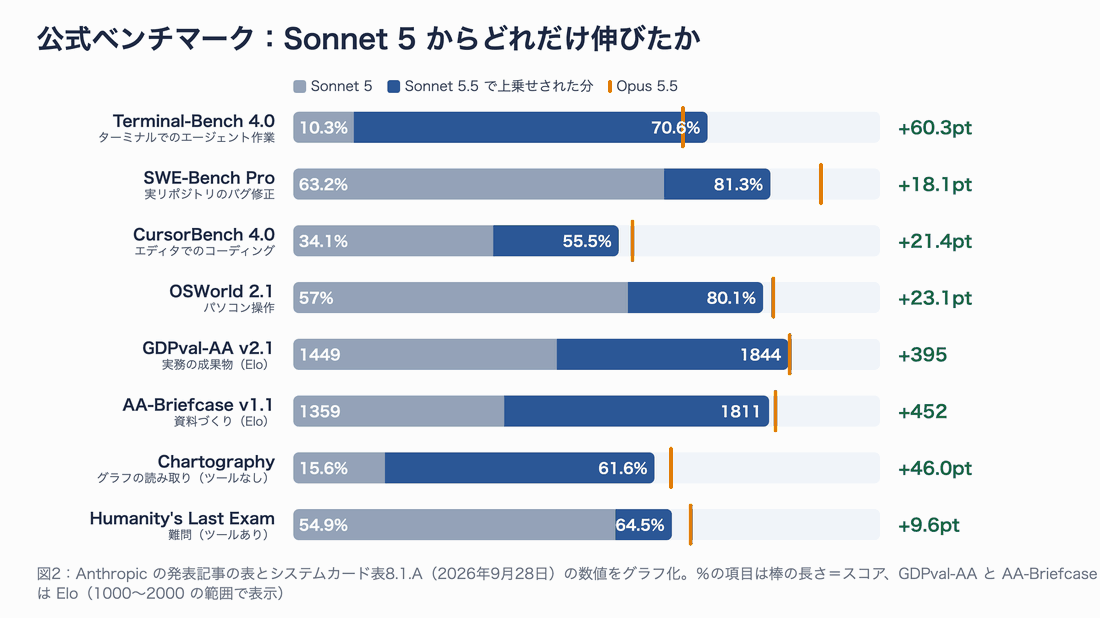
図2:コーディング系から順に、伸び幅を表示します。ほとんどの項目で、青い棒の先が Opus 5.5 の線のすぐ手前まで届いています。
伸び幅を表にすると、次のとおりです(pt は「ポイント」、つまり%の差です)。
| ベンチマーク | 測るもの | Sonnet 5 | Sonnet 5.5 | 伸び | Opus 5.5 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | ターミナルでのエージェント作業 | 10.3% | 70.6% | +60.3pt(約6.9倍) | 66.4% |
| SWE-Bench Pro | 実リポジトリのバグ修正 | 63.2% | 81.3% | +18.1pt | 89.9% |
| CursorBench 4.0 | エディタでのコーディング | 34.1% | 55.5% | +21.4pt | 57.8% |
| FrontierCode 1.1 | 難しいコーディング | 42.4% | 46.2%(xhigh は 52.1%) | +3.8〜9.7pt | 54.4% |
| OSWorld 2.1 | パソコン操作 | 57.0% | 80.1% | +23.1pt | 81.8% |
| GDPval-AA v2.1 | 実務の成果物づくり(Elo) | 1449 | 1844 | +395 | 1846 |
| AA-Briefcase v1.1 | 資料づくり(Elo) | 1359 | 1811 | +452 | 1822 |
| Chartography | グラフの読み取り(ツールなし) | 15.6% | 61.6% | +46.0pt | 64.4% |
| Humanity’s Last Exam | 難問(ツールあり) | 54.9% | 64.5% | +9.6pt | 67.7% |
ざっくり言うと、コーディングとパソコン操作は20pt前後、ターミナル作業は60pt、資料づくりの Elo は400前後伸びています。Elo は対戦形式の評価で、差が400あると「強いほうが9割以上の確率で勝つ」くらいの開きです。GDPval-AA では Opus 5.5 との差はわずか2で、ほぼ並びました。
一方で、差が残っている項目もあります。システムカードの表 8.1.A を見てみましょう。
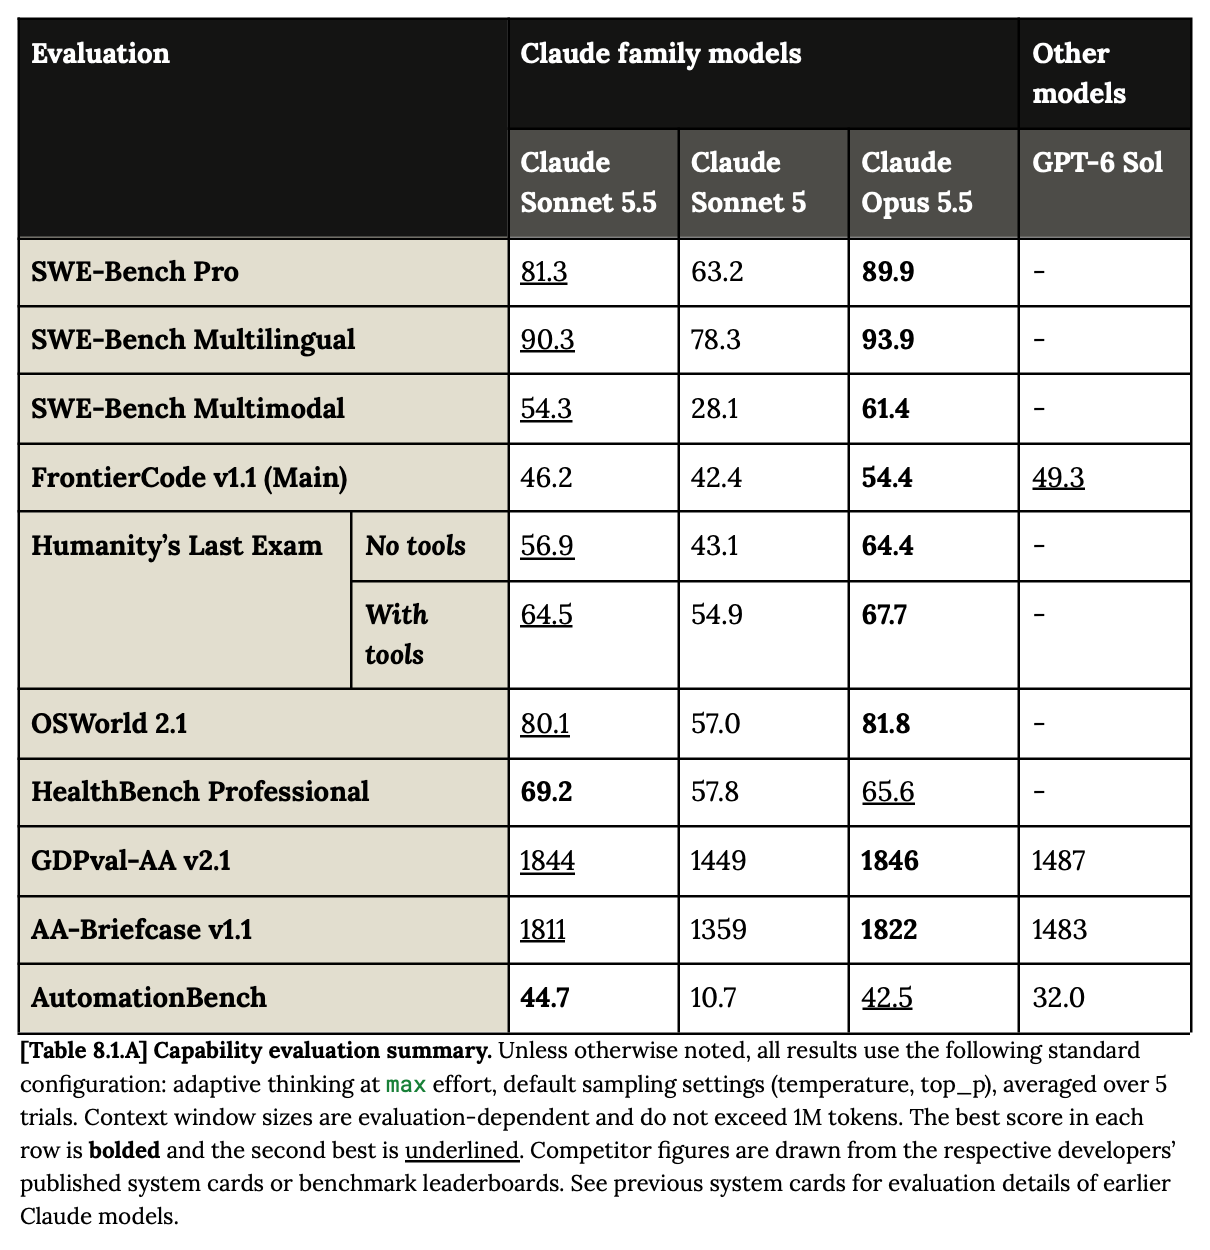
出典:Claude Sonnet 5.5 System Card の Table 8.1.A(109ページ、筆者が PDF から画像化)。すべて max effort・5回の平均。太字が1位、下線が2位です。
SWE-Bench Pro は 81.3% 対 89.9%、ツールなしの Humanity’s Last Exam は 56.9% 対 64.4% と、難しいバグ修正や、道具なしで考え抜く問題では Opus 5.5 がはっきり上です。逆に HealthBench Professional と AutomationBench では Sonnet 5.5 が Opus 5.5 を上回っています。
「同じ点数を、どれだけ安く出せるか」のグラフ
ベンチマークでもうひとつ大事なのが、そのスコアを出すのにいくらかかったかです。発表記事には、横軸に1回あたりのコスト(対数目盛り)、縦軸にスコアをとったグラフが載っています。点は effort(どれだけ考えさせるかの段階)ごとの結果です。
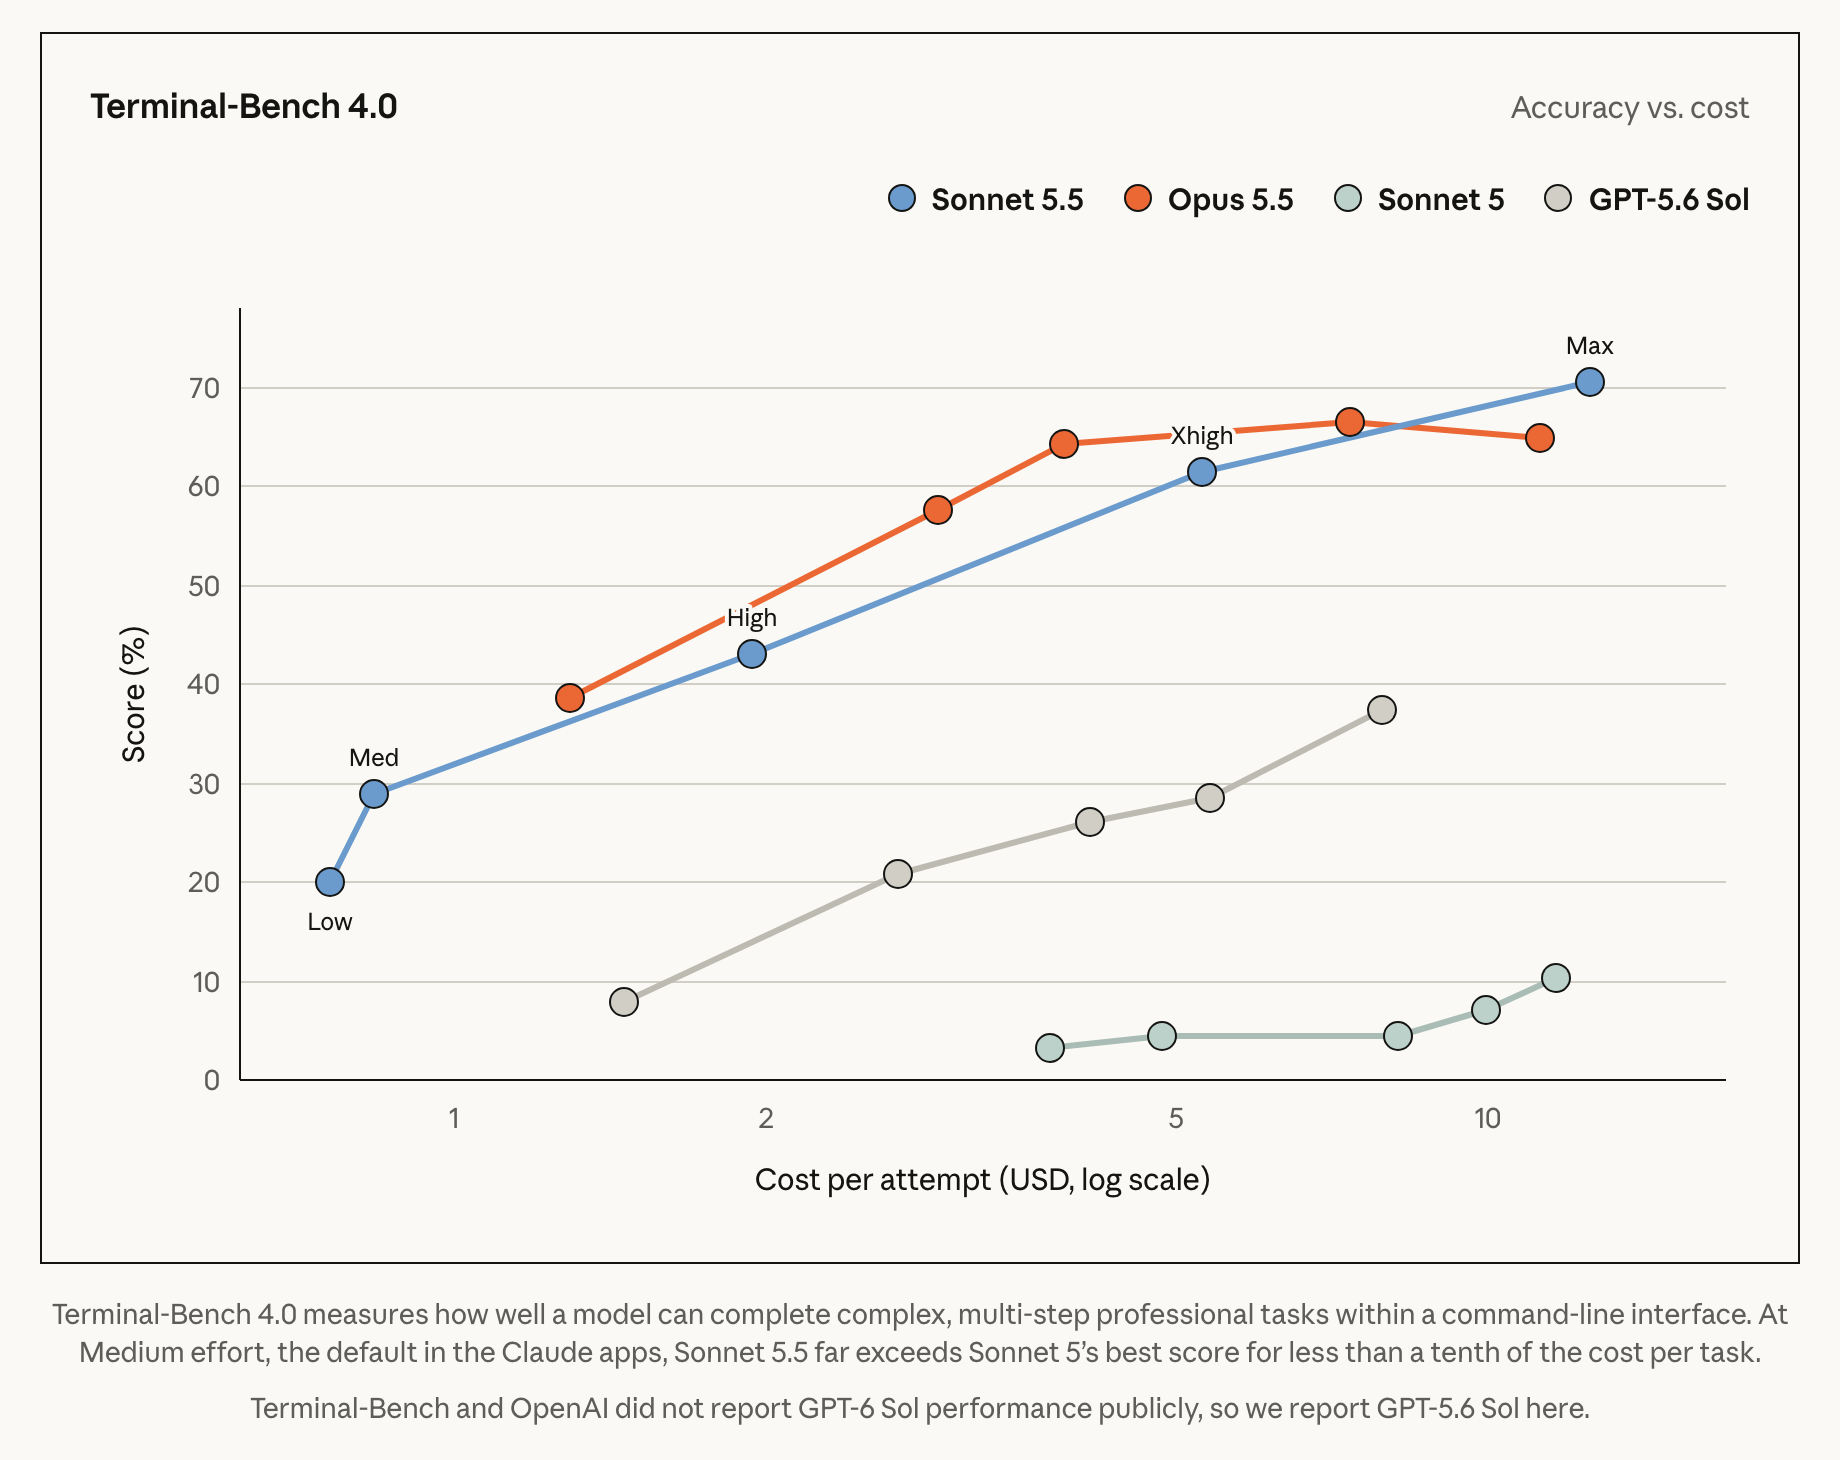
出典:Anthropic の発表記事「Terminal-Bench 4.0:Accuracy vs. cost」(筆者が撮影)。グラフ下の注記には「Claude アプリの既定である Medium effort で、Sonnet 5.5 は Sonnet 5 の最高スコアを、タスクあたり10分の1未満のコストで大きく上回る」とあります。
注目してほしいのは、青い Sonnet 5.5 の Med(medium)の点です。約1ドル弱で約29%。Sonnet 5 は右端の最高設定でも約10%で、コストは10ドル前後かかっています。「同じお金で、ずっと先まで行ける」ことが一目でわかります。
なお、Terminal-Bench の 70.6% は Sonnet 5.5 の max effort での値で、Opus 5.5 の 66.4% は xhigh の値です。条件がそろった比較ではない点は割り引いて読んでください。
トークン単価はどう変わったのか
料金表
料金は発表記事にも表があります。比較相手は Opus 5.5 です。
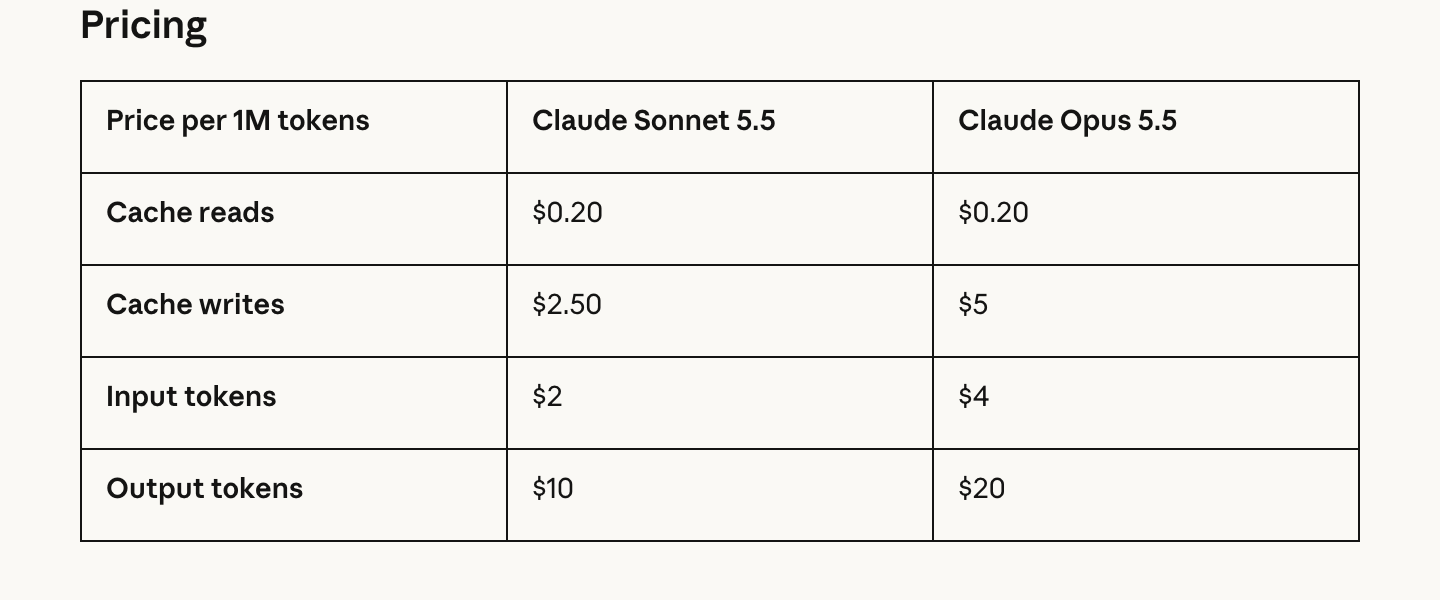
出典:Anthropic の発表記事の料金表(100万トークンあたり、筆者が撮影)。
Sonnet 5 との関係も含めて整理したのが次の図です。
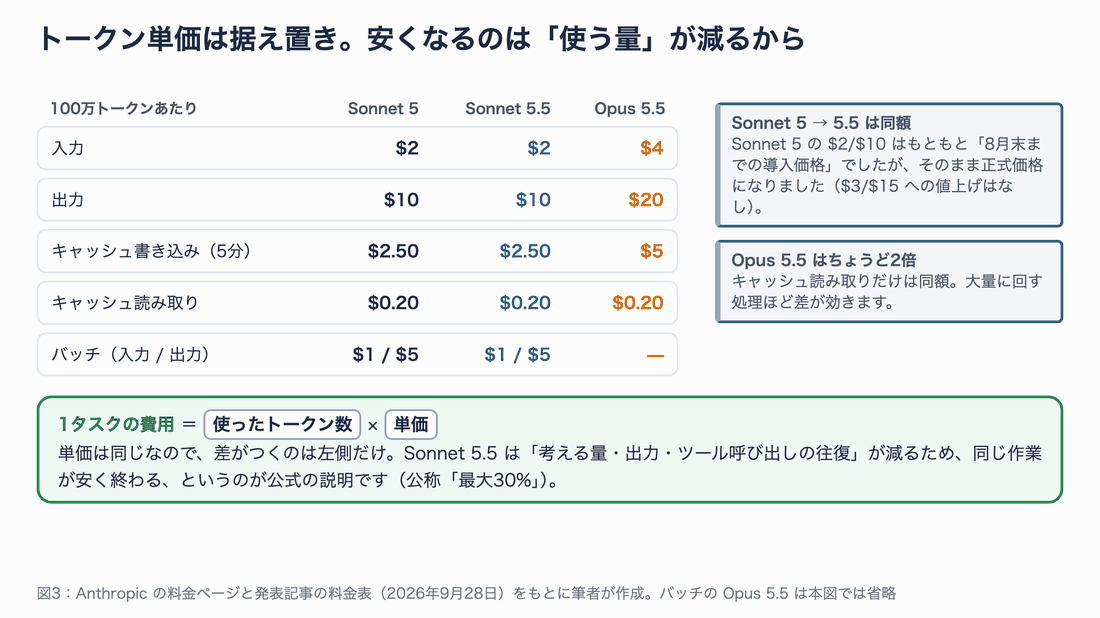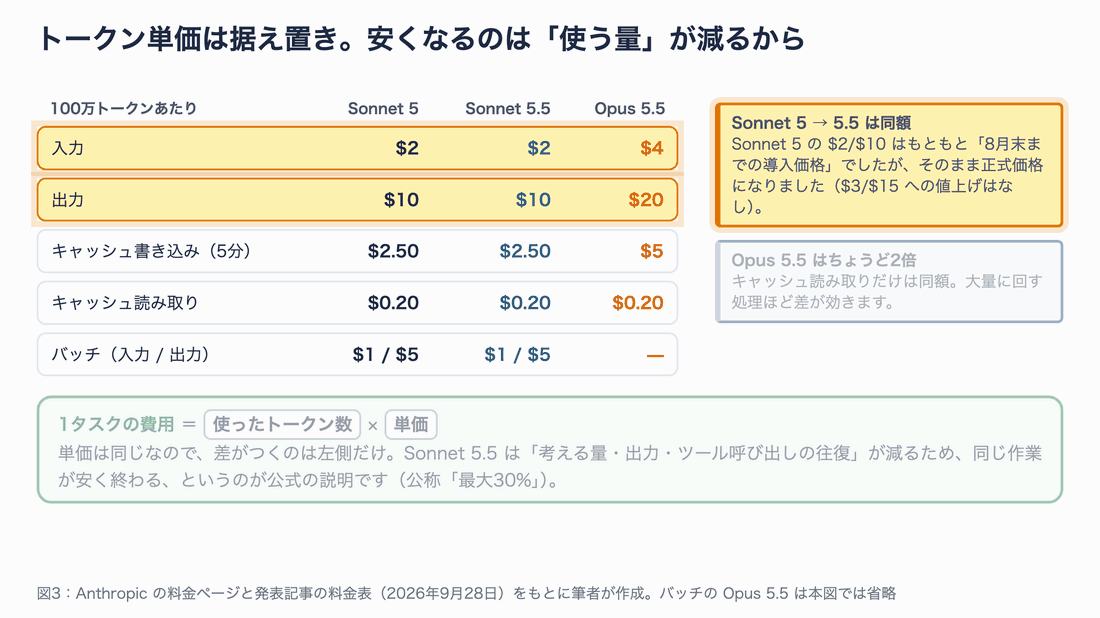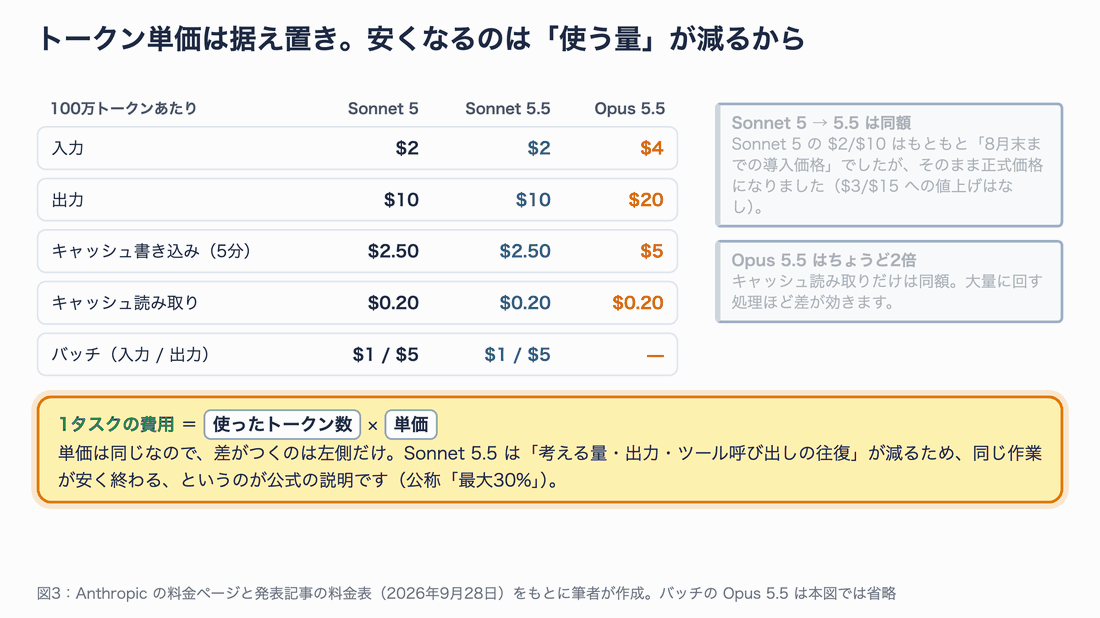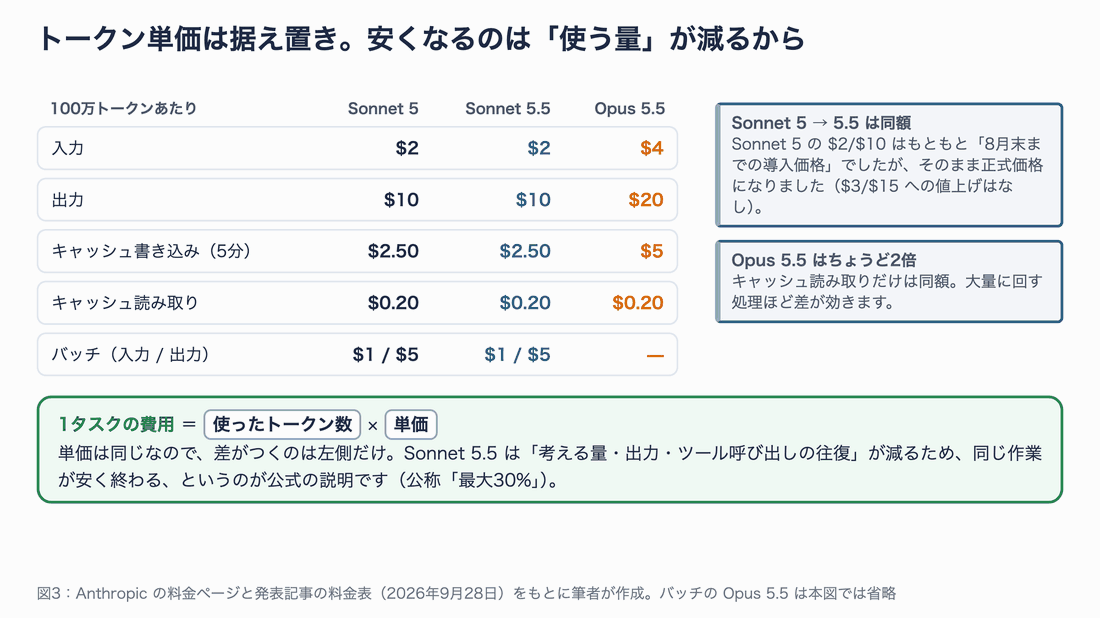
図3:Sonnet 5 → 5.5 は同額、Opus 5.5 はちょうど2倍(キャッシュ読み取りだけ同額)。差がつくのは「使ったトークン数」の側です。
ポイントは3つです。
- Sonnet 5 と Sonnet 5.5 の単価はまったく同じです。入力 $2、出力 $10、キャッシュ書き込み(5分)$2.50、キャッシュ読み取り $0.20、バッチは半額の $1 / $5。
- Sonnet 5 の $2 / $10 は、もともと「2026年8月31日までの導入価格」として発表されていました。料金ページの脚注によると、この価格がそのまま正式価格になり、9月1日に予定されていた $3 / $15 への値上げは行われません。
- Opus 5.5 は入力 $4・出力 $20 で、Sonnet 5.5 のちょうど2倍です。
「30%速い」「30%安い」の中身
では「最大30%安い」はどこから来るのか。公式の説明は「タスクあたりに必要なトークンが少ない(requires fewer tokens per task)」です。単価が同じなので、使うトークン数が減れば、そのぶん1タスクの費用が下がる、という理屈です。
発表記事には、先行して使った企業の数字も載っています。
| 企業 | 公表された変化 |
|---|---|
| Box | 2.4倍速く、総トークンが12%減 |
| Slack | 出力トークンが約14%減 |
| Lovable | ツール呼び出しが3分の1減り、シェル実行はほぼ半分 |
| Balyasny | 回答1件あたり 12.1万トークン(Sonnet 5 は 49.7万) |
| Zendesk | 20%速い |
ただし「30%以上速い」がどう測った数字なのか(1秒あたりの出力トークン数なのか、タスクの完了時間なのか)は公表されていません。VentureBeat が問い合わせたものの、回答はなかったと報じています。だからこそ、自分の手元で測る価値があります。
手元で比べてみた:同じ課題を Sonnet 5 と Sonnet 5.5 に
検証のしかた
公式の数字はあくまで Anthropic の環境での結果です。そこで、筆者の Mac で同じ課題を両モデルに解かせました。条件をそろえるため、Claude Code のヘッドレスモード(claude -p、画面を開かずに1回だけ実行する使い方)を使い、毎回まっさらなフォルダで動かしています。
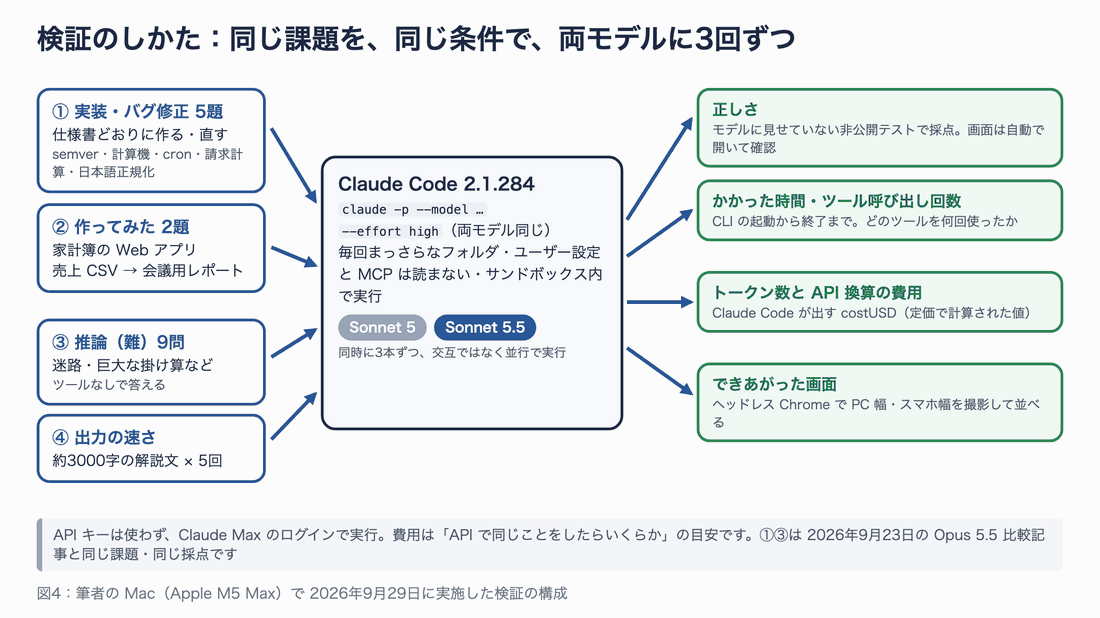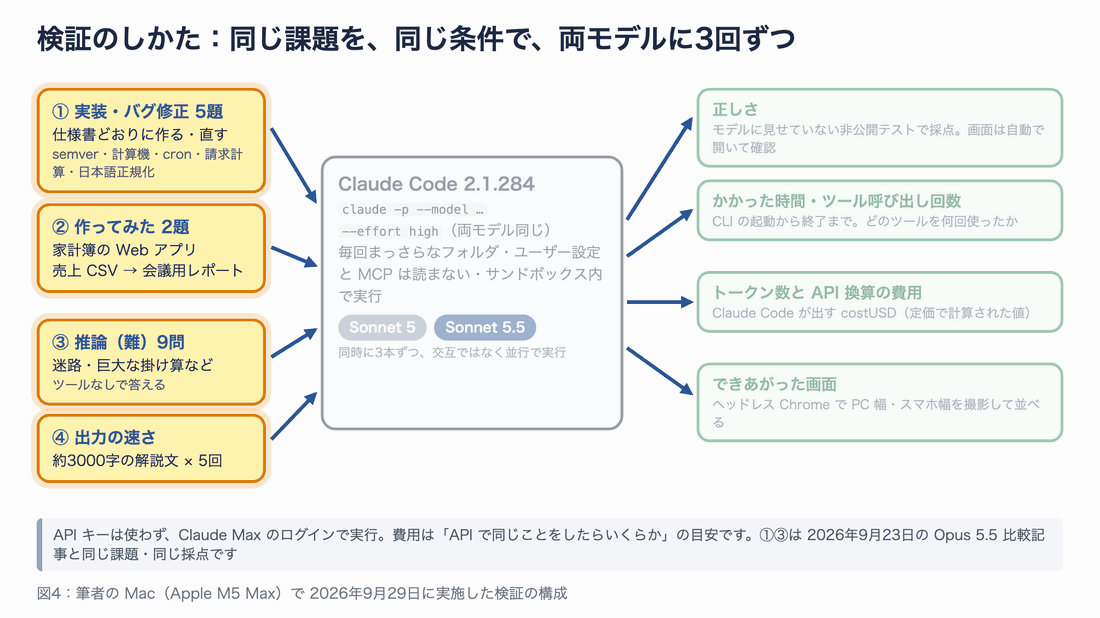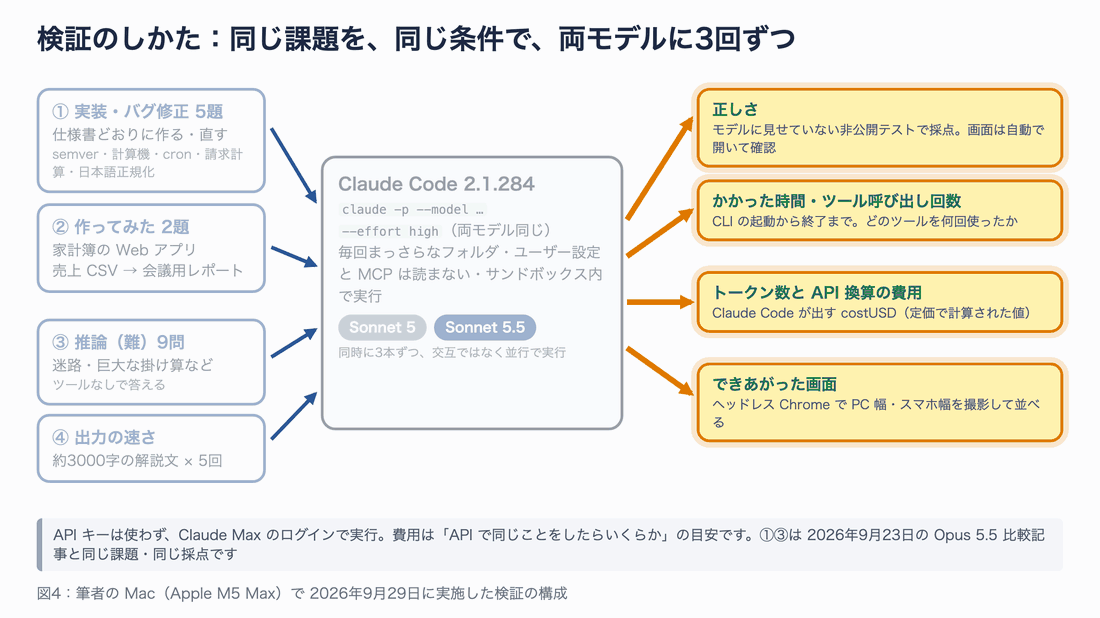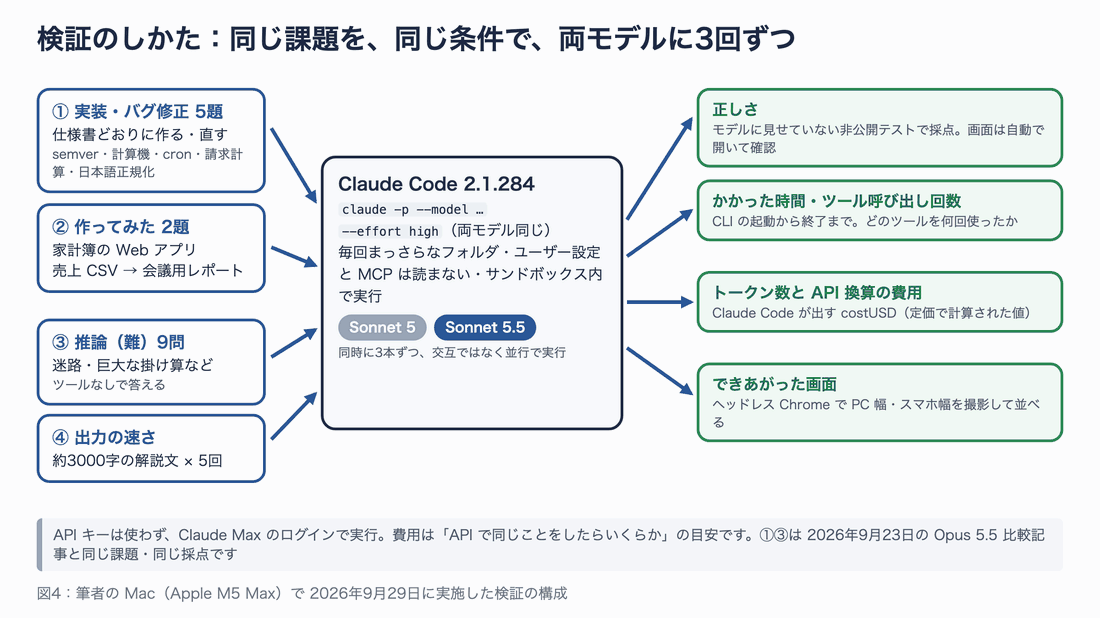
図4:課題 → Claude Code → 測るもの、の順に強調します。①と③は、9月23日に公開した Opus 5.5 の比較記事と同じ課題・同じ採点です。
課題は次のとおりです。どれも「やることと完成の条件がはっきりした仕事」で、Sonnet 5.5 がねらう領域そのものです。
| 種類 | 課題 | 採点 |
|---|---|---|
| 実装・バグ修正(5題) | semver(バージョン範囲の判定)、calc(安全な電卓)、cron(次の実行時刻)、billing(請求額が数円ずれるバグの修正)、ja_normalize(日本語の正規化) | モデルに見せていない非公開テスト |
| 作ってみた①(1題) | 家計簿の Web アプリ(CSV の読み込み・月別集計・予算の消化状況・グラフ・入力フォーム) | 計算ロジック21項目の非公開テスト+画面の自動チェック4項目 |
| 作ってみた②(1題) | 売上 CSV(1年分・529行)から経営会議用の1枚レポートを作る | 集計値7項目+レポート3項目 |
| 推論(難)(9問) | 迷路、24桁の掛け算、論理パズルなど。ツールなしで答える | 正解との一致 |
| 出力の速さ | 約3000字の解説記事を書かせる | 1秒あたりの出力トークン数 |
実行条件は次のとおりです。
- Claude Code 2.1.284、effort は両モデルとも
high(API の既定値) - 実装と作ってみたの7題は各3回ずつ(合計42回)、出力の速さは各5回
- ユーザー設定・CLAUDE.md・MCP は読み込まず(
--setting-sources ""・--strict-mcp-config)、コマンドはサンドボックス内で実行 - 費用は Claude Code が出力する
costUSD(定価で計算した API 換算の金額)
実際に流したコマンドの形は次のとおりです(課題の文章は標準入力で渡しています)。
# 作業フォルダ(課題のファイルだけが入っている)で実行する
claude -p --model claude-sonnet-5-5 --effort high \
  --setting-sources "" --strict-mcp-config --no-session-persistence \
  --output-format stream-json --verbose \
  --tools "Bash,Read,Edit,Write,Glob,Grep" --allowedTools Bash \
  --permission-mode acceptEdits \
  --settings '{"sandbox":{"enabled":true,"autoAllowBashIfSandboxed":true,"allowUnsandboxedCommands":false}}' \
  < prompt.txt
--output-format stream-json にすると、どのツールを何秒目に呼んだかが1行ずつ記録されるので、ツール呼び出しの回数と順番を数えられます。
結果1:正しさは同じ。時間・往復・費用は半分以下に
まず結論です。42回すべて、両モデルとも非公開テストで満点でした。仕様がはっきりした仕事では、どちらも正しく仕上げます。差が出たのは「そこに至るまで」です。
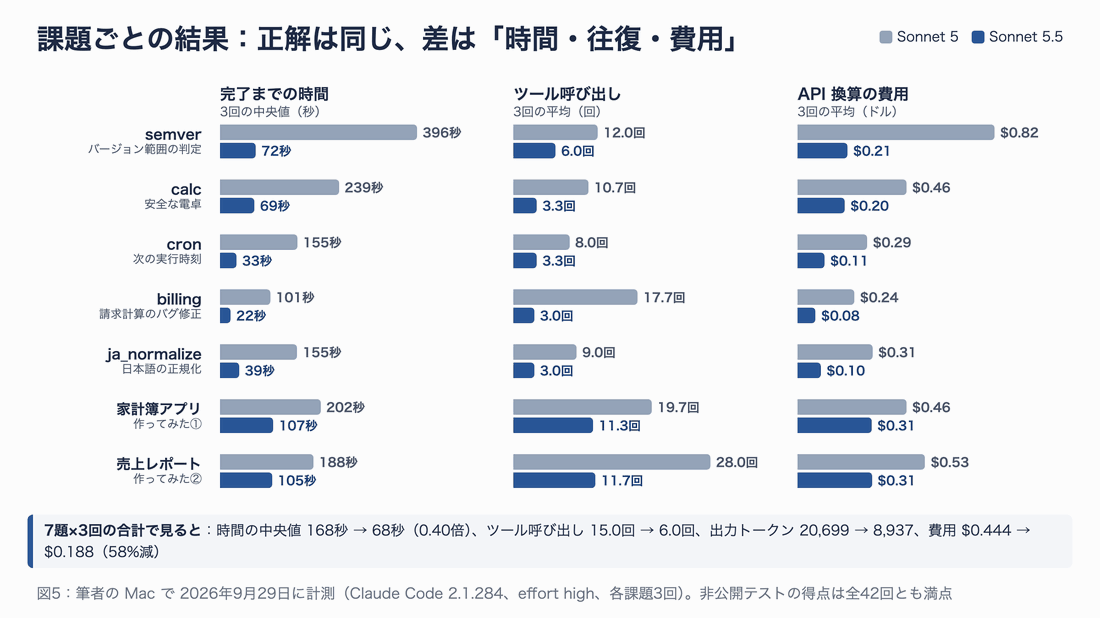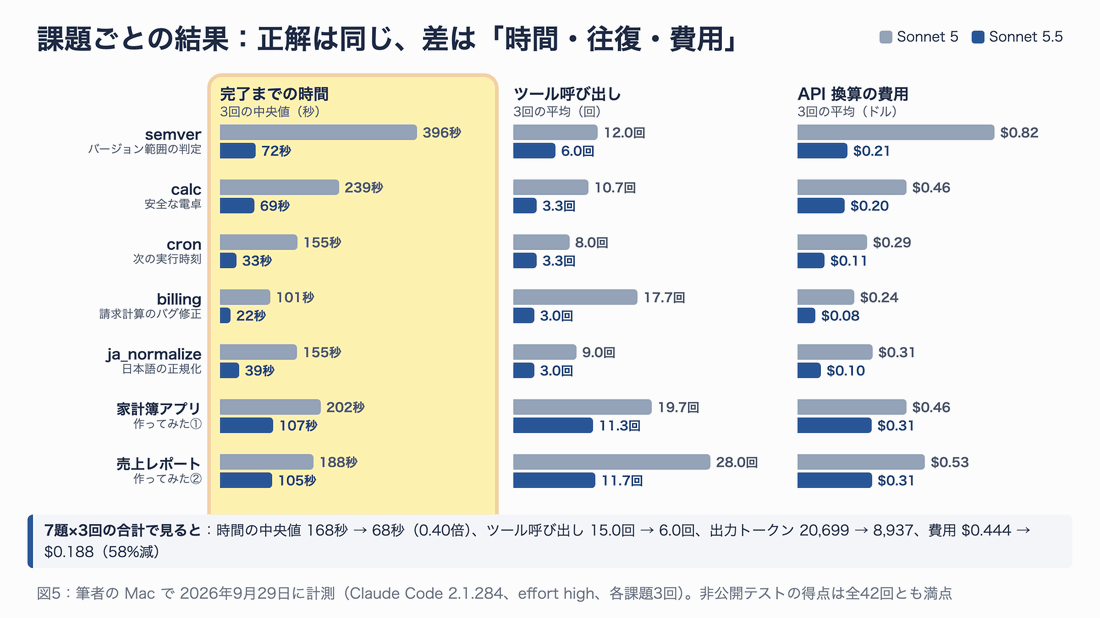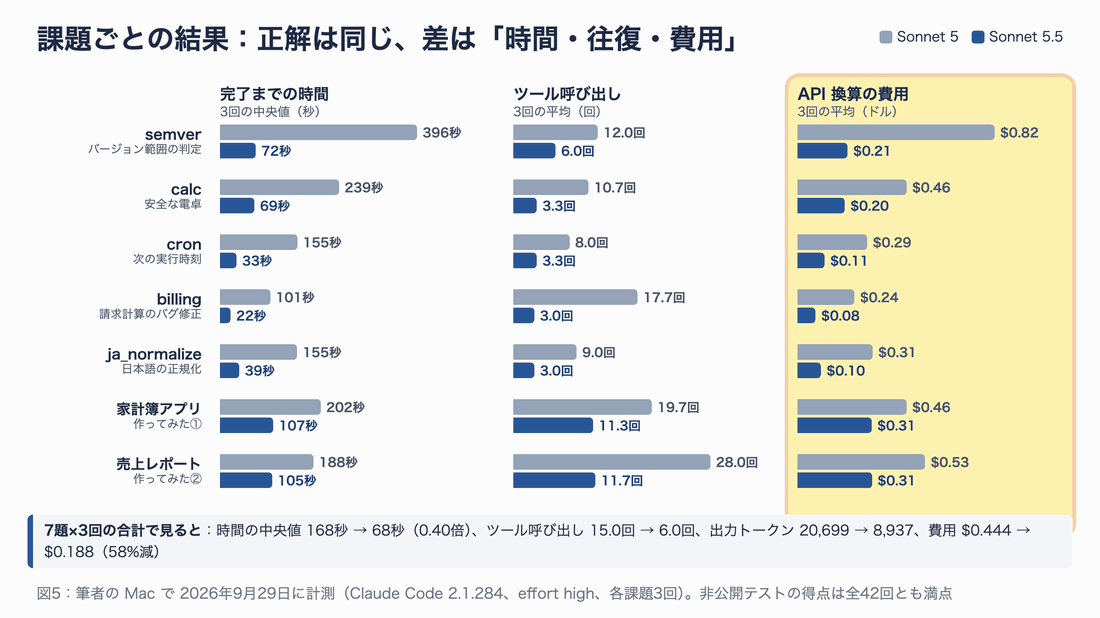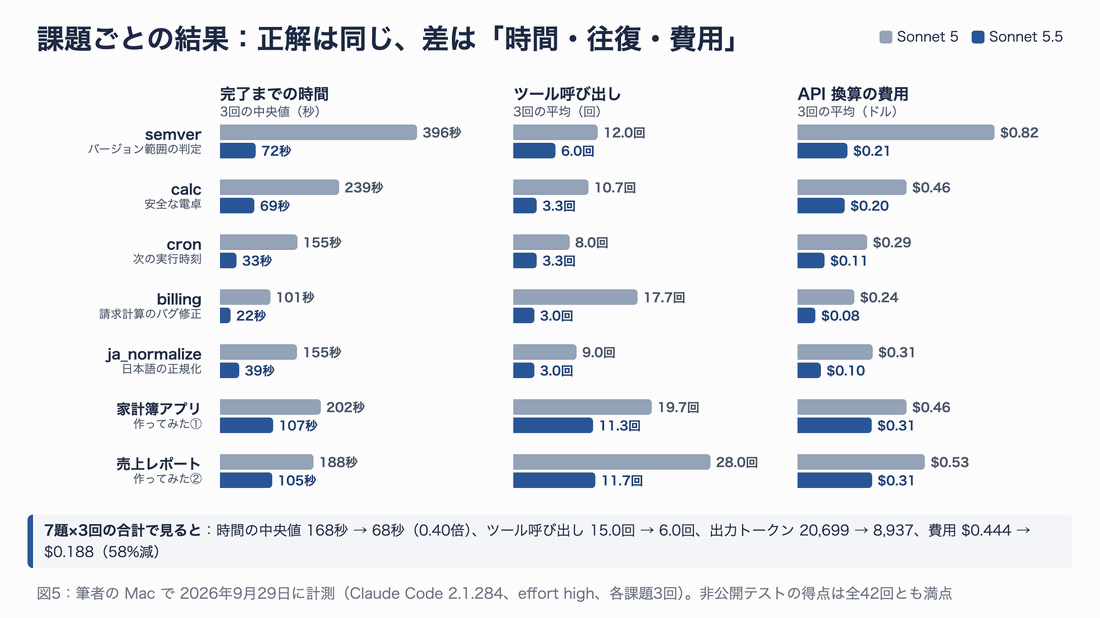
図5:左から「時間」「ツール呼び出し」「費用」の列を順に強調します。7題すべてで Sonnet 5.5 のほうが短く、安く終わりました。
7題×3回をまとめると、次のようになります。
| 指標(1題あたり) | Sonnet 5 | Sonnet 5.5 | 5.5 ÷ 5 |
|---|---|---|---|
| 非公開テストの得点 | 21/21 回が満点 | 21/21 回が満点 | 同じ |
| 完了までの時間(中央値) | 168秒 | 68秒 | 0.40倍 |
| ツール呼び出し(平均) | 15.0回 | 6.0回 | 0.40倍 |
| 出力トークン(平均) | 20,699 | 8,937 | 0.43倍 |
| 入力トークン(キャッシュ込み・平均) | 51.2万 | 11.7万 | 0.23倍 |
| API 換算の費用(平均) | $0.444 | $0.188 | 0.42倍(58%減) |
種類別に見ると、仕様どおりに実装する5題では時間が 0.24倍(160秒 → 39秒)、費用が 0.33倍($0.424 → $0.139)。画面や資料まで作る2題では時間が 0.55倍(195秒 → 107秒)、費用が 0.63倍($0.494 → $0.310)でした。
公称は「最大30%安い」でしたが、今回の課題では 58%安くなりました。ただし、これは筆者が用意した小さめの課題での結果です。移行ガイドには「effort の強さの基準が変わった」とあり、同じ high でも Sonnet 5.5 のほうが考える量を抑えている可能性があります。仕事の種類によって差は変わるはずなので、「自分の課題で測る」前提で読んでください。
参考までに、9月23日の記事で同じ実装5題を Opus 5.5(high)に解かせたときは、中央値87秒・1題 $0.27 でした(満点)。Sonnet 5.5 は39秒・$0.14 なので、このくらいの仕事なら Opus 5.5 と同じ結果を、半分の時間と費用で出せています(計測日と Claude Code のバージョンが違うため、あくまで目安です)。
なぜ速いのか:「まとめて読んで、まとめて直す」
費用の差の正体は、ツール呼び出しの回数です。AI エージェントは、ツールを1回呼ぶたびに、それまでの会話をもう一度モデルに読ませて次の手を考えさせます。往復が減れば、待ち時間も、読み直しの入力トークンも減ります。上の表で入力トークンが 0.23倍になっているのはこのためです。
billing 課題(「請求額が数円ずれる」「月末の利用が翌月に入らない」というお客様の声からバグを直す)の1回目のログを、時間軸に並べてみました。
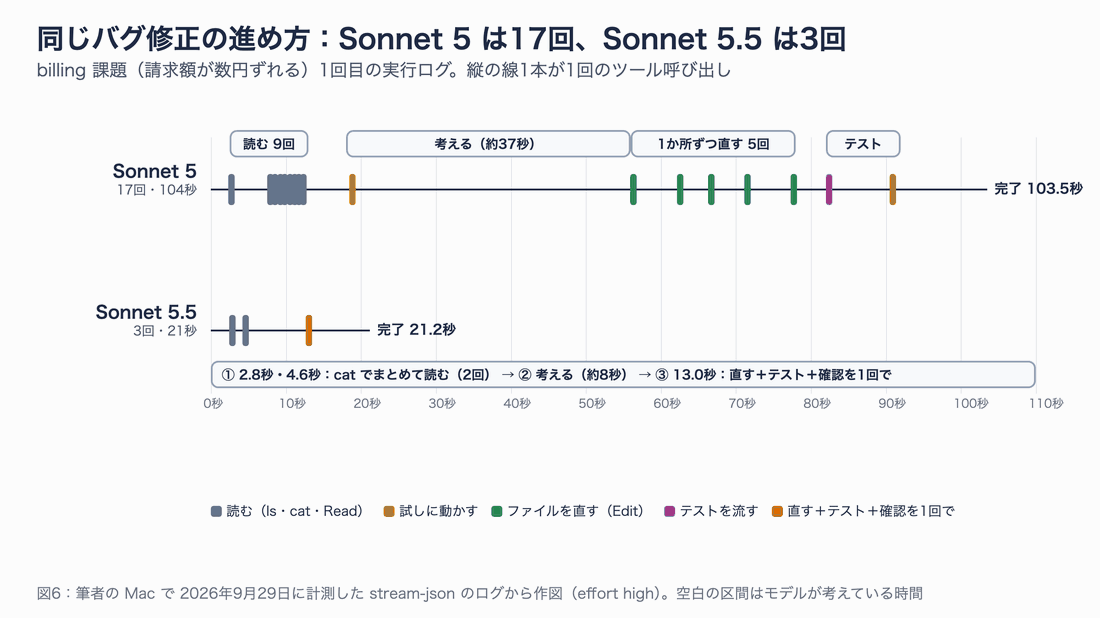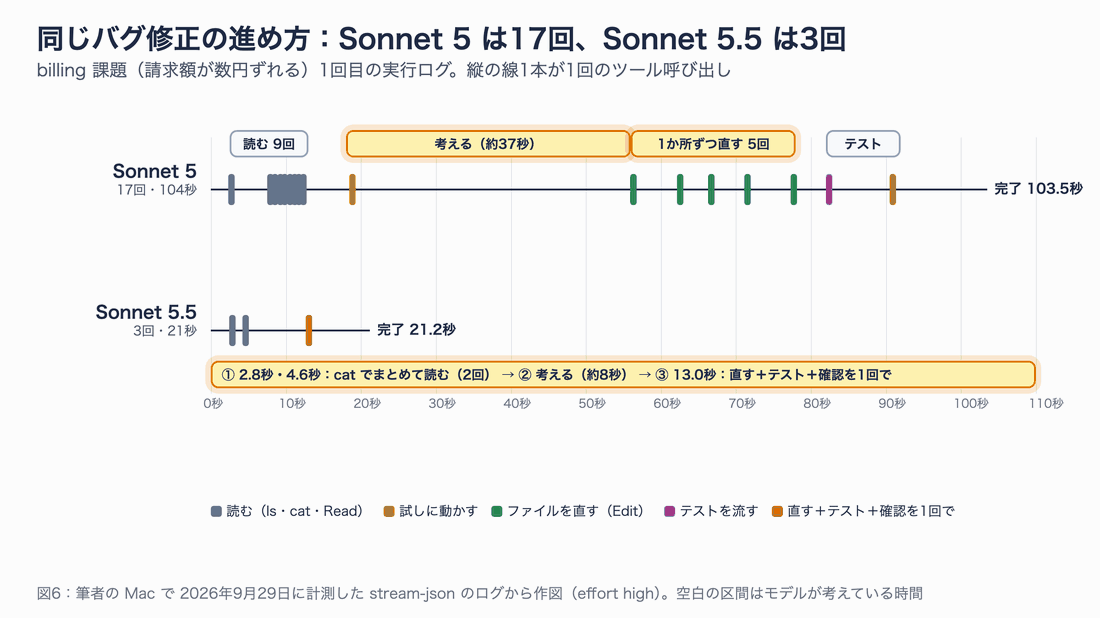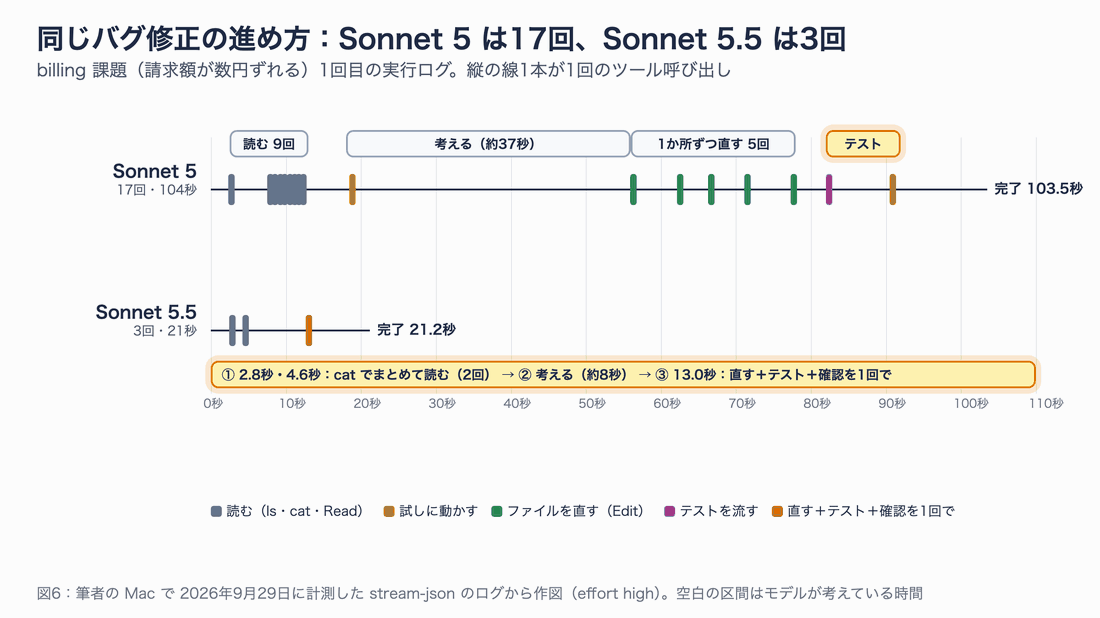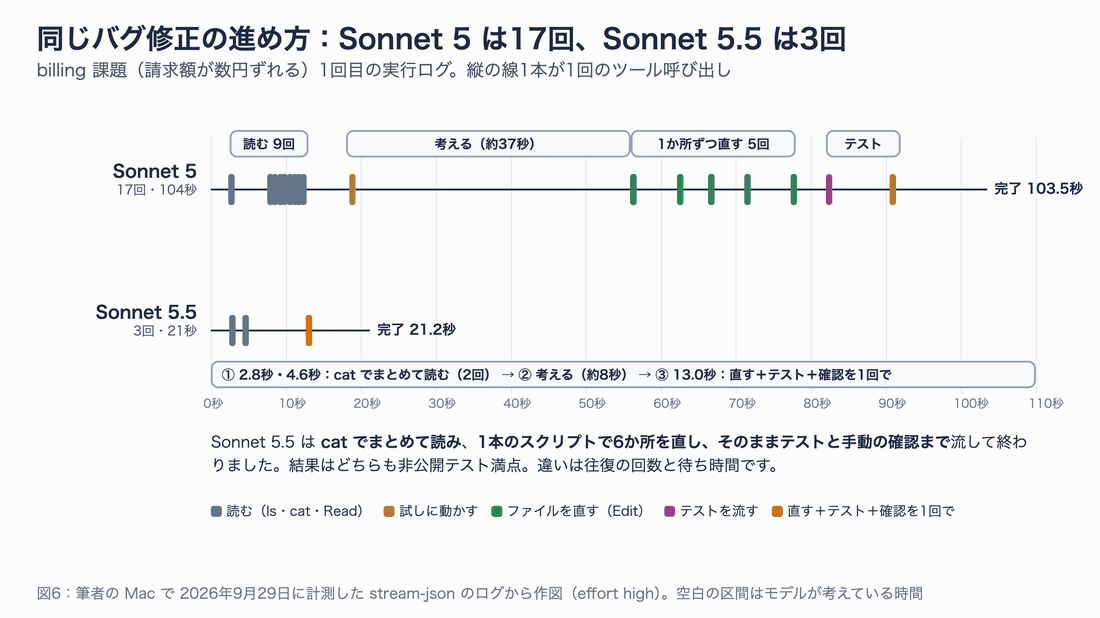
図6:「読む」「考える・直す」「確かめる」の区間を順に強調します。Sonnet 5.5 は6か所の修正とテスト実行・動作確認を、1回のコマンドにまとめていました。
Sonnet 5 は、ファイルを1つずつ8回読み、5回に分けて1か所ずつ直し、テストを流して確かめました。丁寧ですが、そのぶん往復が多くなります。Sonnet 5.5 は cat billing/*.py で全ファイルをまとめて読み、Python の小さなスクリプトで6か所を一度に書き換え、同じコマンドの中でテストと手動の確認まで流して終わりました。最後の報告には「非公開テストは手元にないので未実行です」と、確認していないことまで書いてあります。Lovable が発表記事で挙げていた「ツール呼び出しが3分の1減り、シェル実行はほぼ半分」という変化を、手元でも確認できた形です。
作ってみた①:家計簿アプリ
ここからは「作ったもの」を見比べます。仕様書(TASK.md)には、計算ロジックの関数・画面に必要な要素・スマホ幅でも崩れないこと、を書いておきました。デザインは自由です。
Sonnet 5 で作ったときとSonnet 5.5 で作ったときの画面(どちらも1回目)を、PC 幅で並べます。
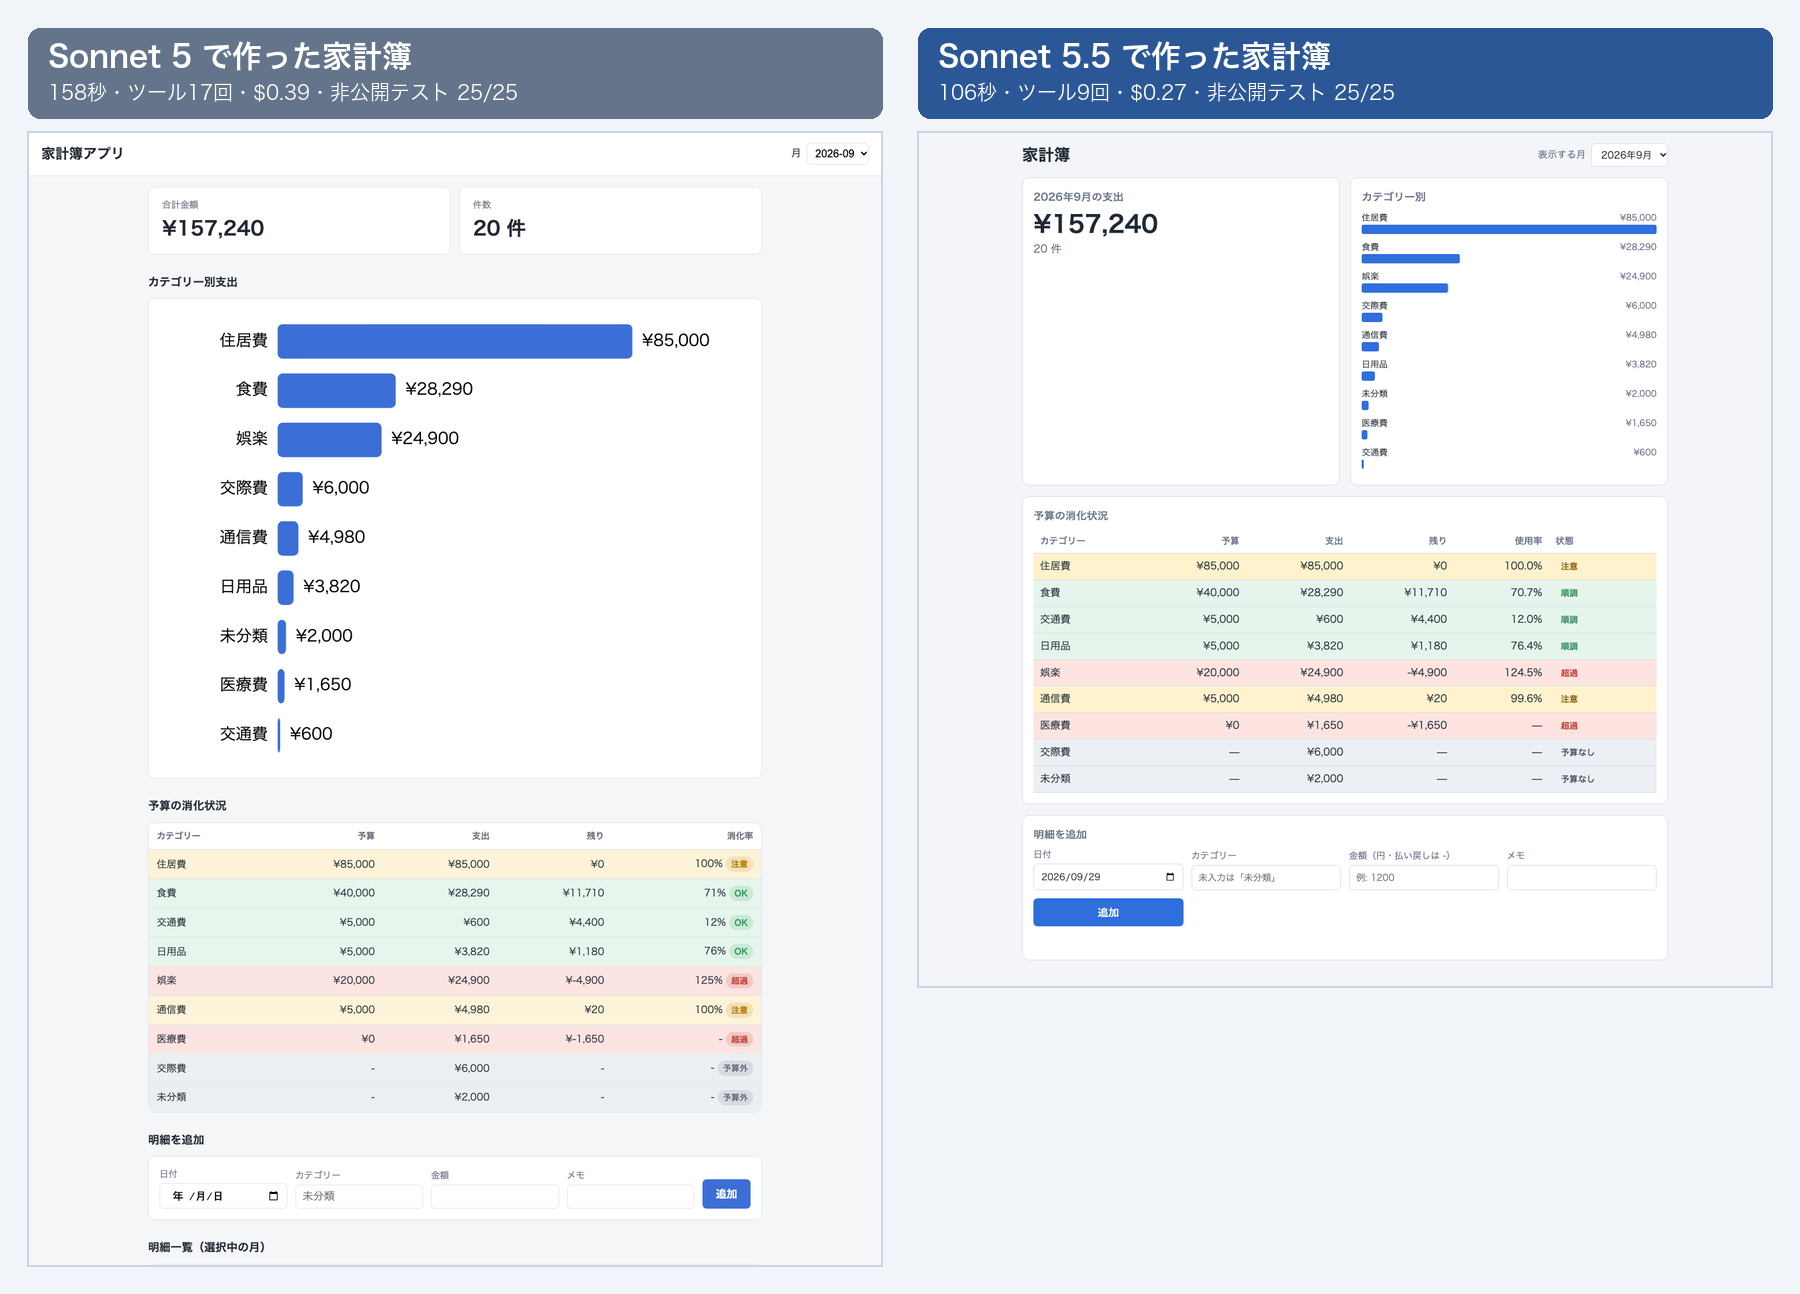
Sonnet 5(左):158秒・ツール17回・$0.39。Sonnet 5.5(右):106秒・ツール9回・$0.27。どちらも非公開テスト25/25(計算21項目+画面4項目)。
同じ仕様書から、同じ数字(9月の支出 ¥157,240・20件)を正しく出しています。違うのは画面の組み立て方です。Sonnet 5 はグラフを大きく1列に並べ、予算表は下へスクロールした先にあります。Sonnet 5.5 は合計とグラフを横に並べ、予算表まで1画面に収まるダッシュボード型でした。
スマホ幅(390px)でも見てみます。スマホの画面は、ブラウザの開発者ツールの端末エミュレーションで撮影しました。
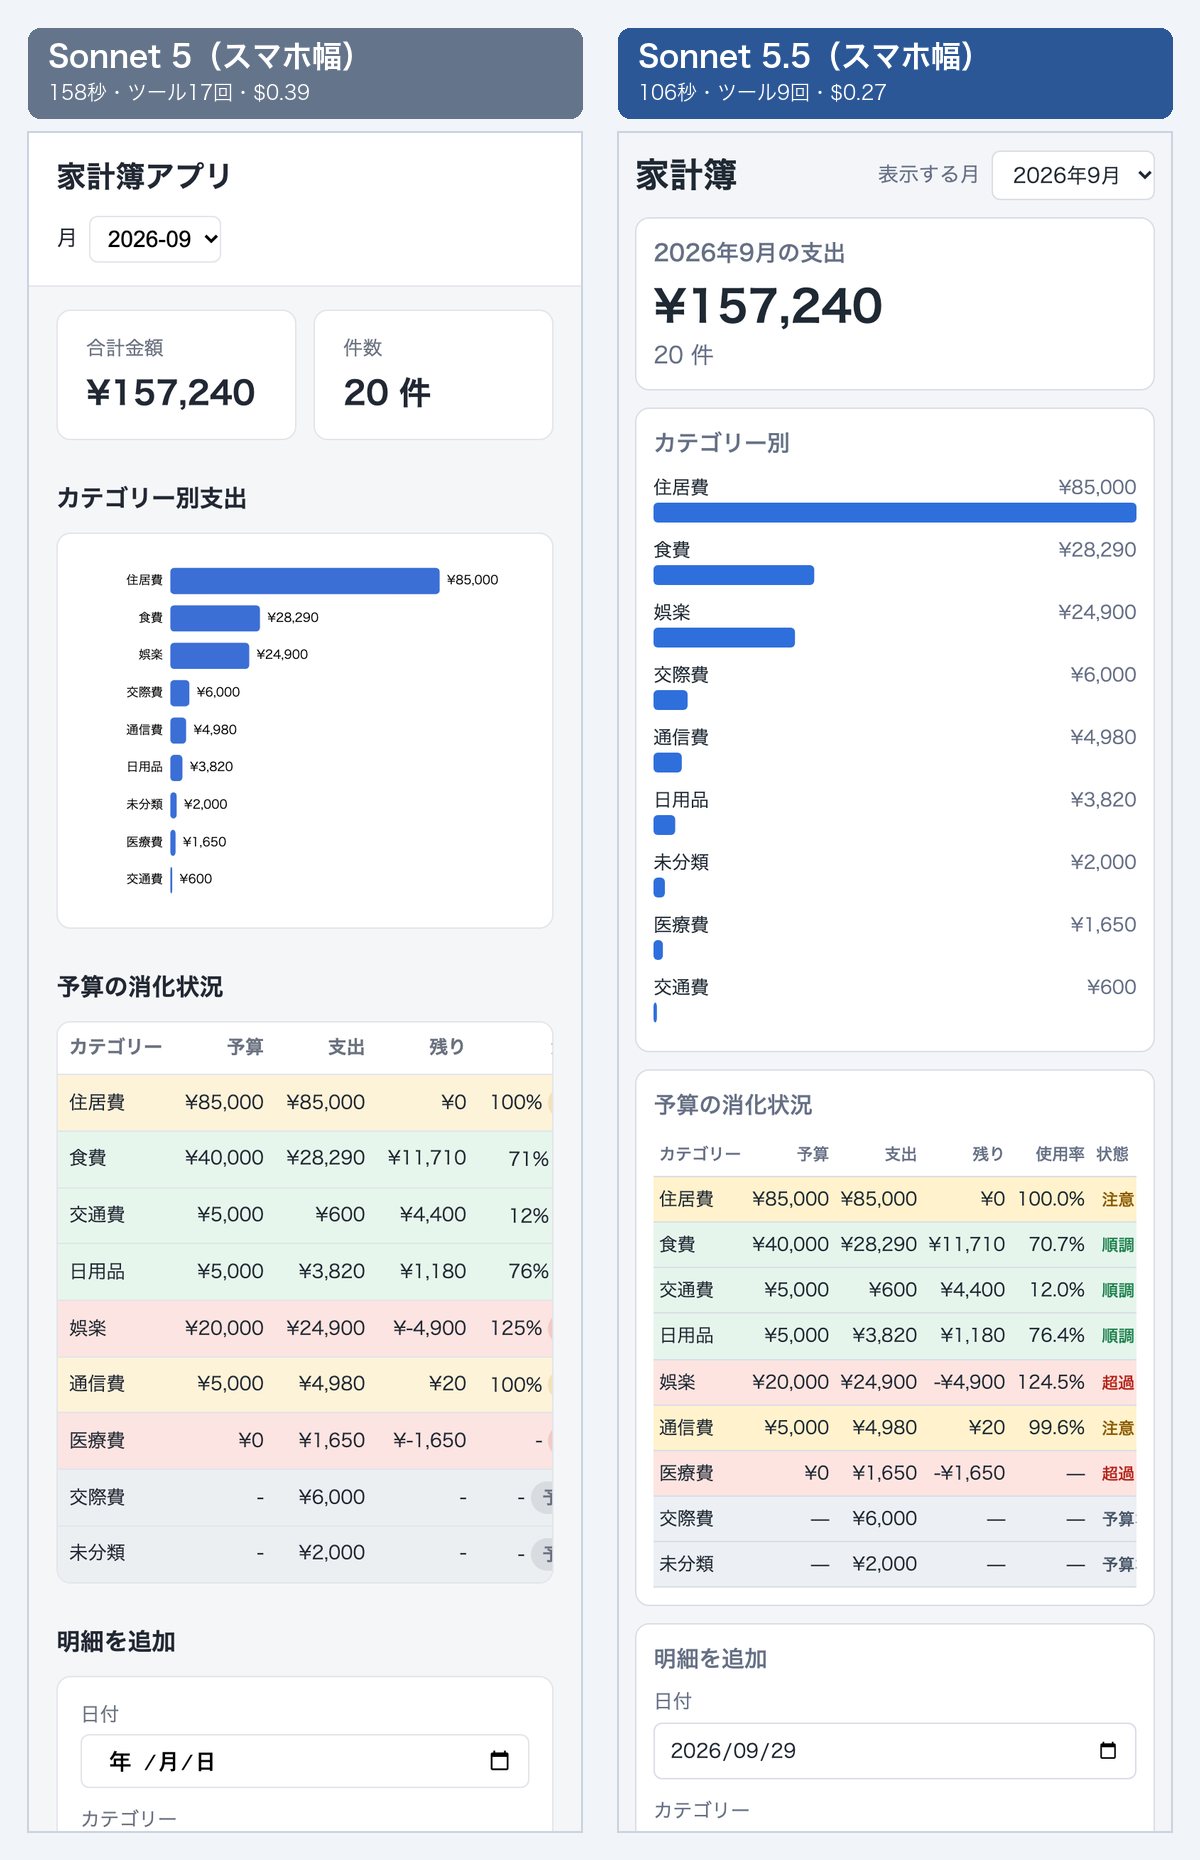
どちらも横にはみ出さない(ページ幅 390px)ことは確認済みです。細部の作り込みに差が出ました。
違いを表にまとめます。「3回とも」と書いたものは、3回分のコードを確認した結果です。
| 観点 | Sonnet 5 で作ったとき | Sonnet 5.5 で作ったとき |
|---|---|---|
| 計算ロジック・画面の要件 | 3回とも満点 | 3回とも満点 |
| かかった時間(3回) | 158秒・221秒・202秒 | 106秒・107秒・122秒 |
| ツール呼び出し(3回) | 17回・19回・23回 | 9回・12回・13回 |
| 費用(3回) | $0.39・$0.48・$0.50 | $0.28・$0.31・$0.35 |
| グラフの描き方 | 決まった幅で描いた SVG を画面に合わせて縮める(スマホでは文字も小さくなる) | 表示枠の実際の幅に合わせて SVG を描く(3回中2回は画面幅が変わると描き直す) |
| 入力フォームの日付 | 空欄(3回とも) | 今日の日付が入っている(3回とも) |
| スマホ幅の予算表(1回目) | 横スクロールしないと状態の列が見えない | 状態の列まで画面内 |
画面のデザインは回ごとに少しずつ変わるので、見た目の好みで優劣はつけられません。それでも「入力する人が次にすること(今日の日付で入力する)」まで先回りした作りは、Sonnet 5.5 の3回すべてに共通していました。
作ってみた②:売上データから経営会議用のレポート
2つ目は、ある菓子店の1年分の注文データ(529行)から、経営会議で配る1枚ものの資料を作る課題です。データには、筆者がわざと「気づいてほしい点」を仕込んでおきました。
- システムの二重出力で、同じ注文番号が9行ある(そのうち1件は、重複した行どうしで地域の値が違う)
- 返品が別の注文番号でマイナスの数量として入っている
- 「季節のタルト」だけ、6〜7月に単価が 3,200円 → 3,500円 に上がっている(仕様書には書いていない)
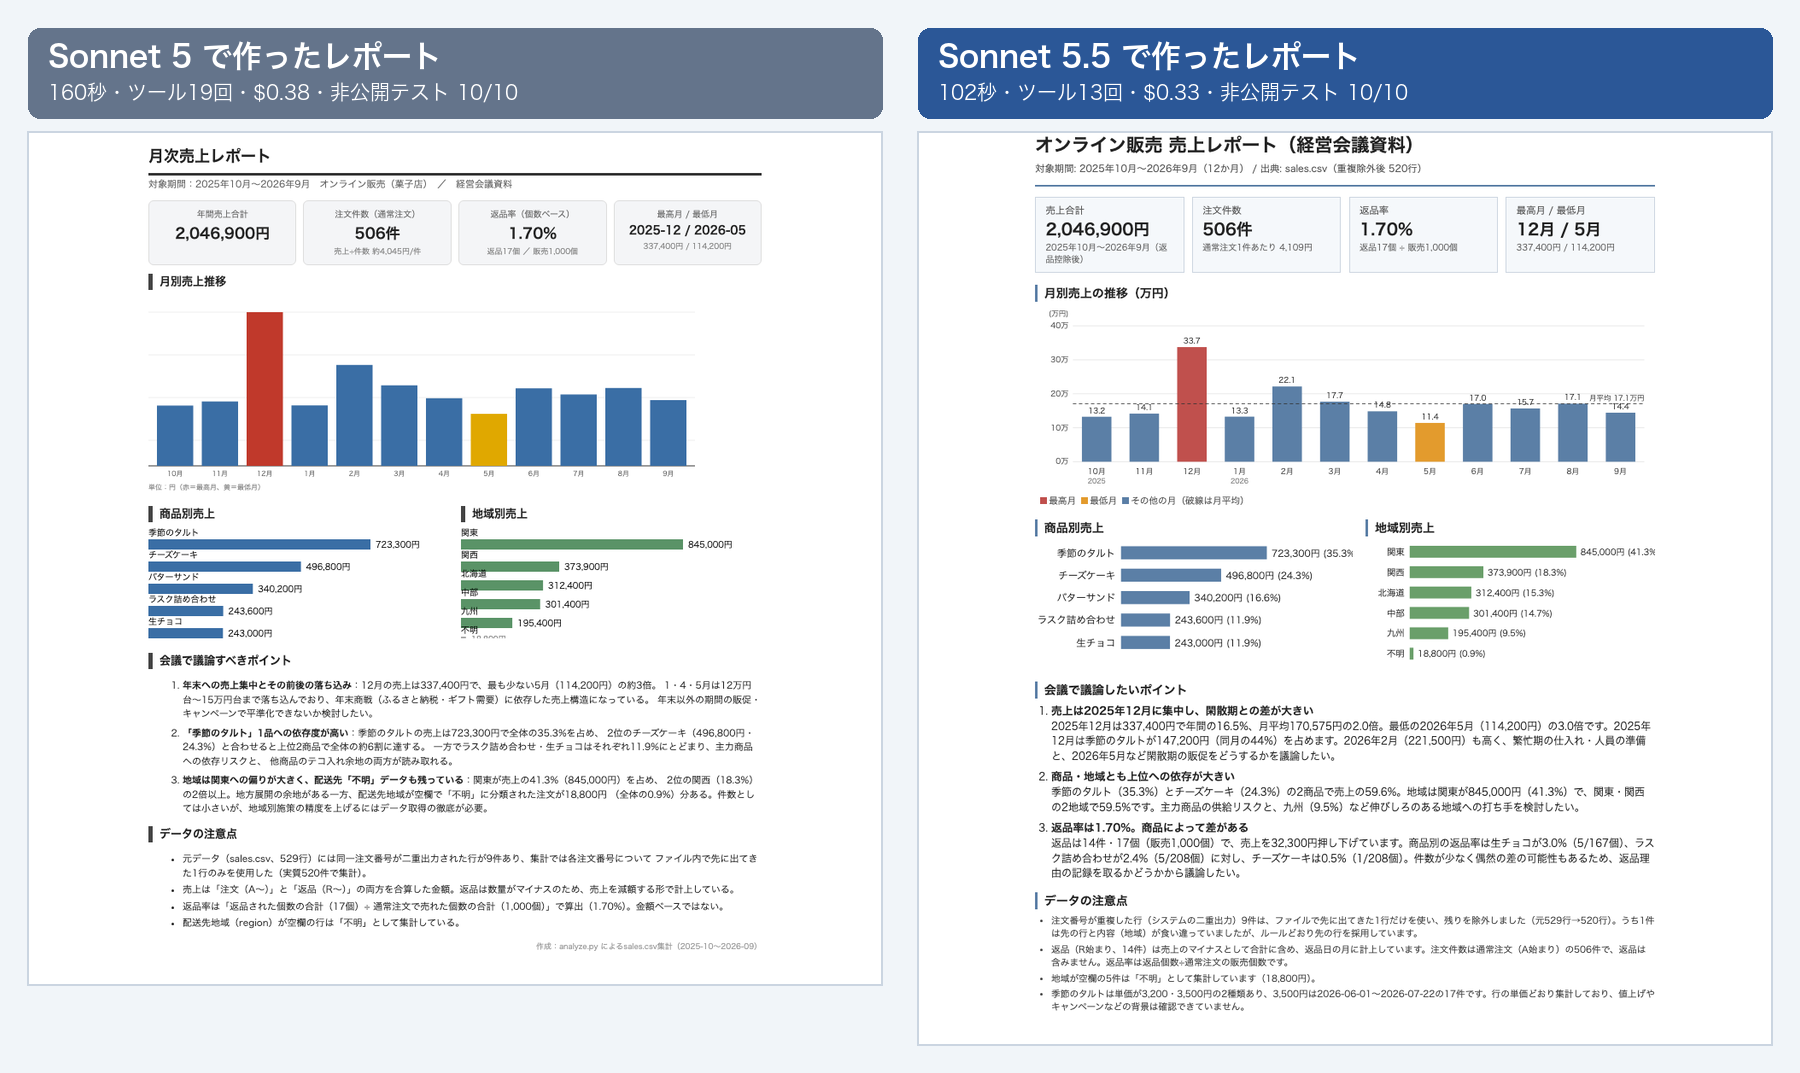
Sonnet 5(左):160秒・ツール19回・$0.38。Sonnet 5.5(右):102秒・ツール13回・$0.33。集計値はどちらも7項目すべて正解。
集計の数字(売上合計 2,046,900円、注文506件、返品率1.70% など)は、両モデルとも6回すべて正解です。重複行を除くルールも、返品の扱いも仕様書どおりでした。
差が出たのは「頼まれていないけれど、会議で役に立つ気づき」です。
| 気づき | Sonnet 5(3回) | Sonnet 5.5(3回) |
|---|---|---|
| 重複行を除いたこと・返品の扱いを注記 | 3回とも書いた | 3回とも書いた |
| 季節のタルトの単価が6〜7月だけ 3,500円 | 0回 | 3回とも指摘 |
| 重複行の1件で地域の値が食い違っている | 0回 | 3回とも指摘 |
| 月別グラフの棒に金額ラベル | 2回 | 3回とも |
| 月別グラフに月平均の線 | 0回 | 3回とも |
たとえば Sonnet 5.5 の3回目は、注意点に「単価は通常3,200円だが2026年6月〜7月のみ3,500円で、8月以降は3,200円に戻っている」、重複行については「1件(A100139)は重複行の間で地域が食い違い(先=空欄、後=北海道)、規則どおり先の行を採用」と書いていました。どちらも、データを1行ずつ確かめていなければ出てこない指摘です。
ここで面白いのは、Sonnet 5.5 のほうが往復は少ない(平均11.7回 対 28.0回)のに、データはより細かく見ていることです。Sonnet 5 は、書いたレポートを Edit で部分修正する回数が多く(3回の実行で1回・9回・17回)、そのたびに往復が増えていました。Sonnet 5.5 は、最初にデータを調べ上げてからレポートを一度で書き上げ、あとから Edit で直したのは 0回・0回・1回だけでした。
出力の速さ:1秒あたり約1.5倍
最後に、ツールを使わず文章だけを書かせたときの速さです。「約3000字の解説記事」を5回ずつ書かせ、1秒あたりの出力トークン数を測りました。
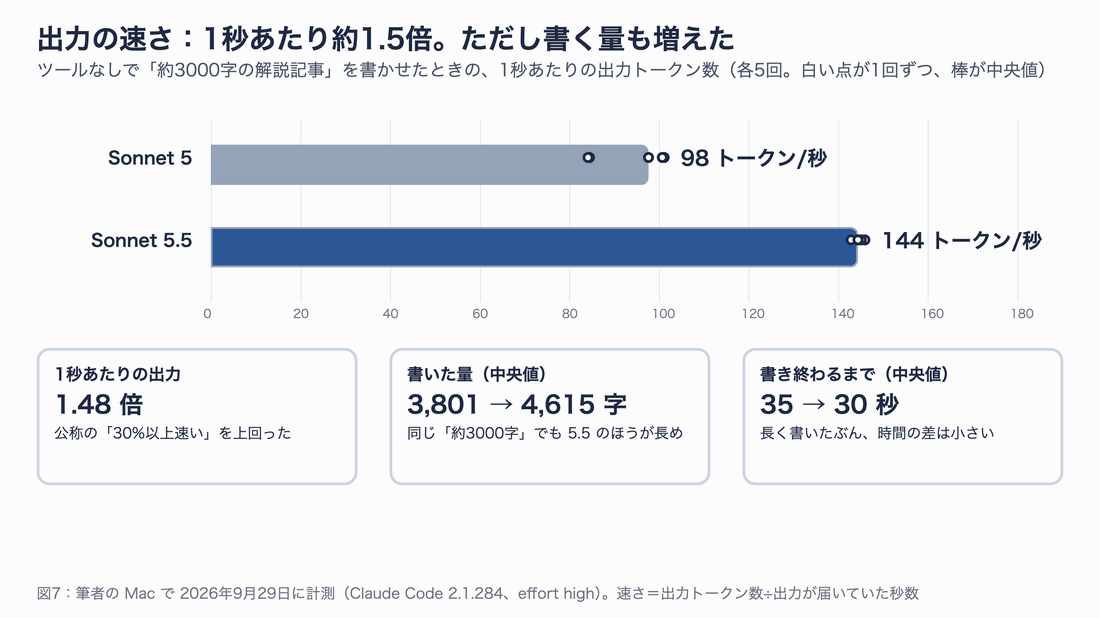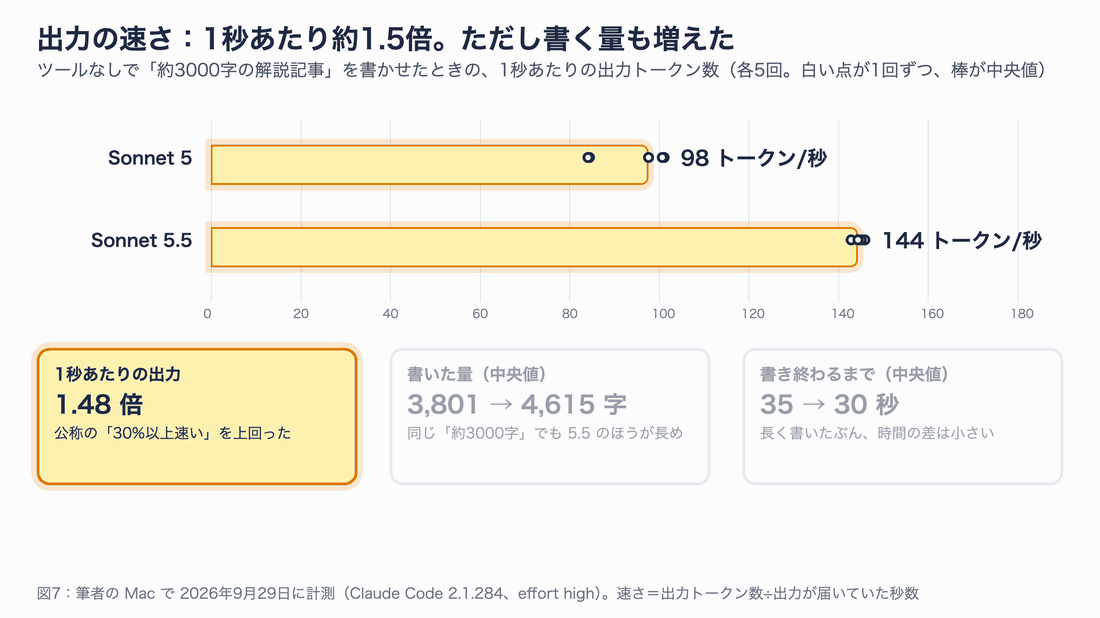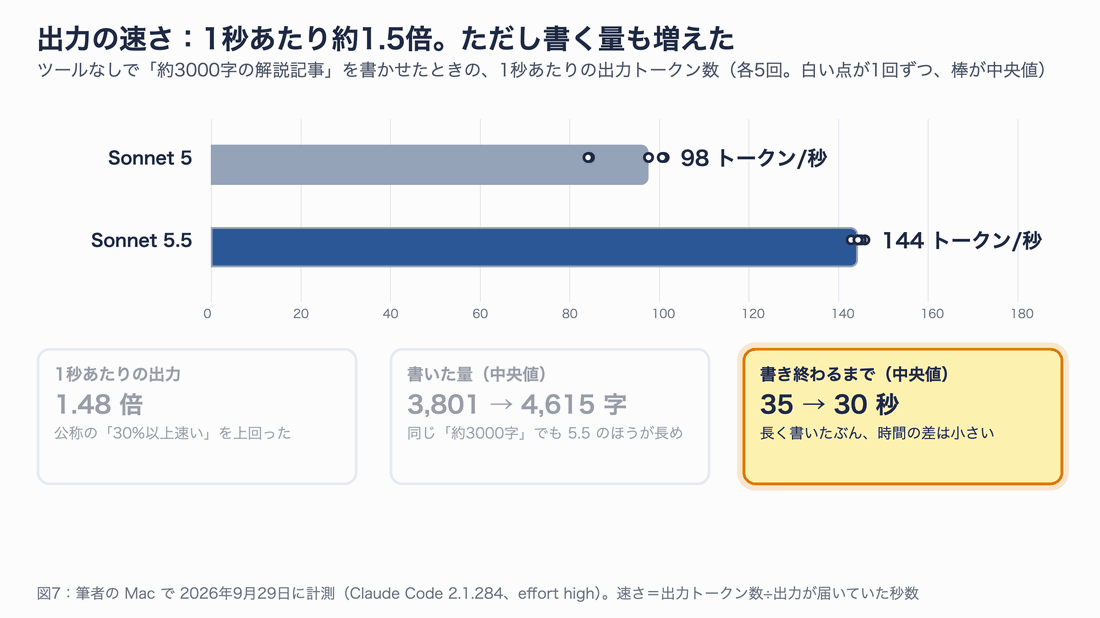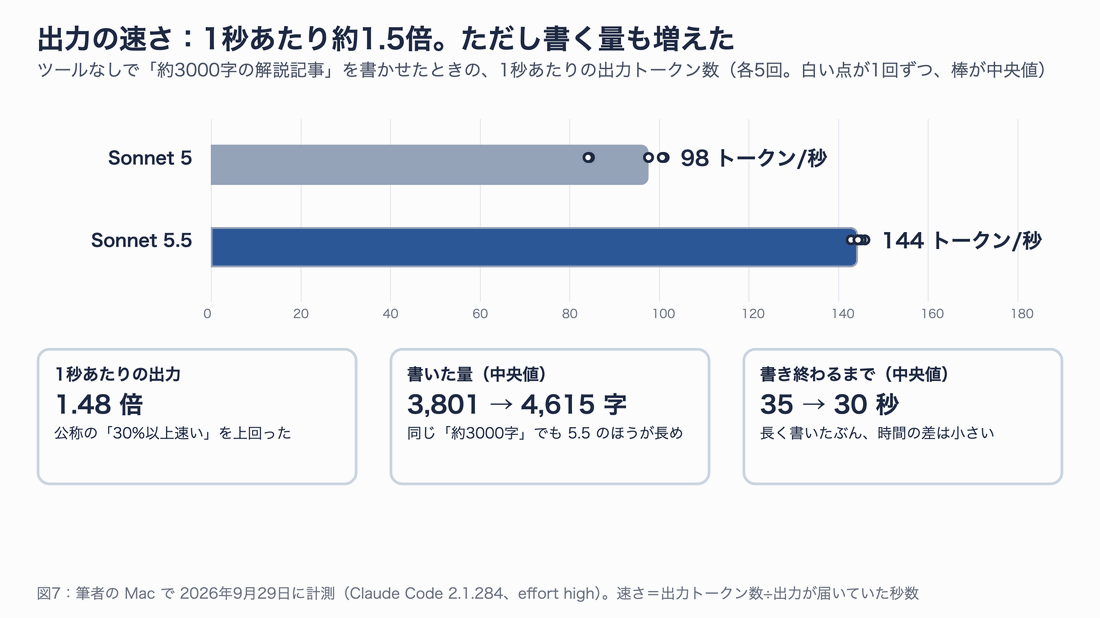
図7:1秒あたりの出力、書いた量、書き終わるまでの時間を順に強調します。
| 指標(5回の中央値) | Sonnet 5 | Sonnet 5.5 |
|---|---|---|
| 1秒あたりの出力トークン | 98 | 144(1.48倍) |
| 5回の値 | 101・101・98・84・84 | 146・145・144・143・144 |
| 最初の文字が出るまで | 1.8秒 | 1.6秒 |
| 書いた量 | 3,801字 | 4,615字 |
| 書き終わるまで | 35秒 | 30秒 |
1秒あたりの出力は約1.5倍で、公称の「30%以上速い」を上回りました。Sonnet 5.5 は5回とも 143〜146 トークン/秒でほとんどぶれず、Sonnet 5 は 84〜101 と日によって(あるいは混み具合によって)揺れています。
一方で、Sonnet 5.5 は同じ「約3000字」の指示で2割ほど長く書きました。そのため、書き終わるまでの時間の差は 35秒 → 30秒 と小さくなっています。エージェントの仕事では「往復が減る」効果が大きく、単純な文章生成では「速く書けるが、少し長く書く」、というのが今回の結果です。
推論(難):考え抜く問題ではどうか
最後に、Opus 5.5 の比較記事でも使った「推論(難)」9問を、ツールなしで3回ずつ解かせました。迷路の最短経路、24桁どうしの掛け算、論理パズルなど、道具を使わずに頭の中で考え抜く必要がある問題です。参考として、9月23日に同じ問題を解かせた Opus 5.5(high)の結果も並べます。
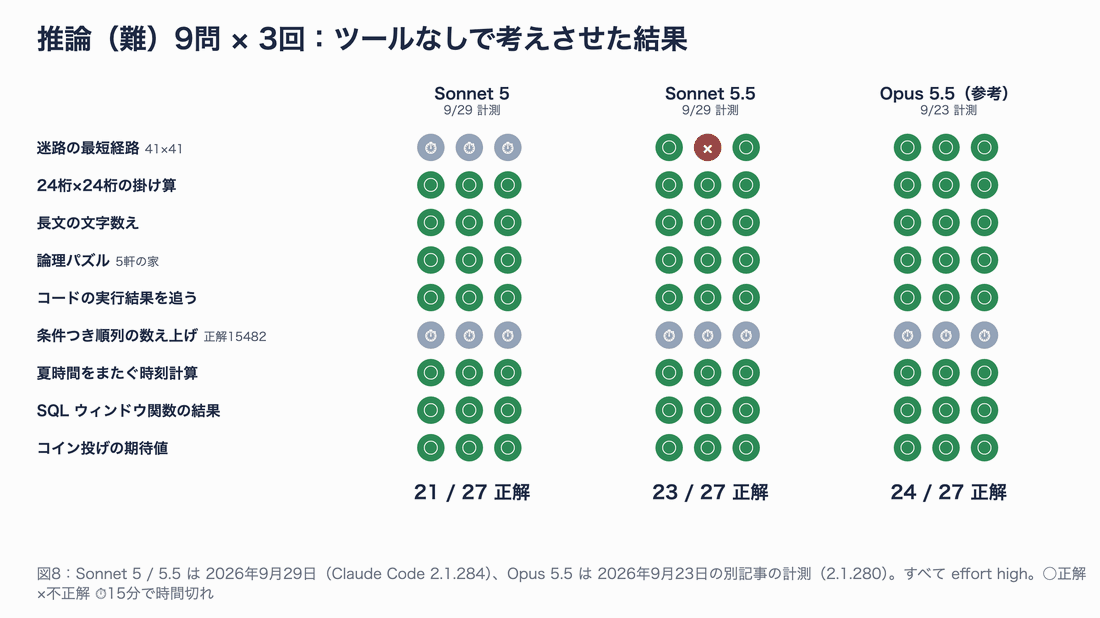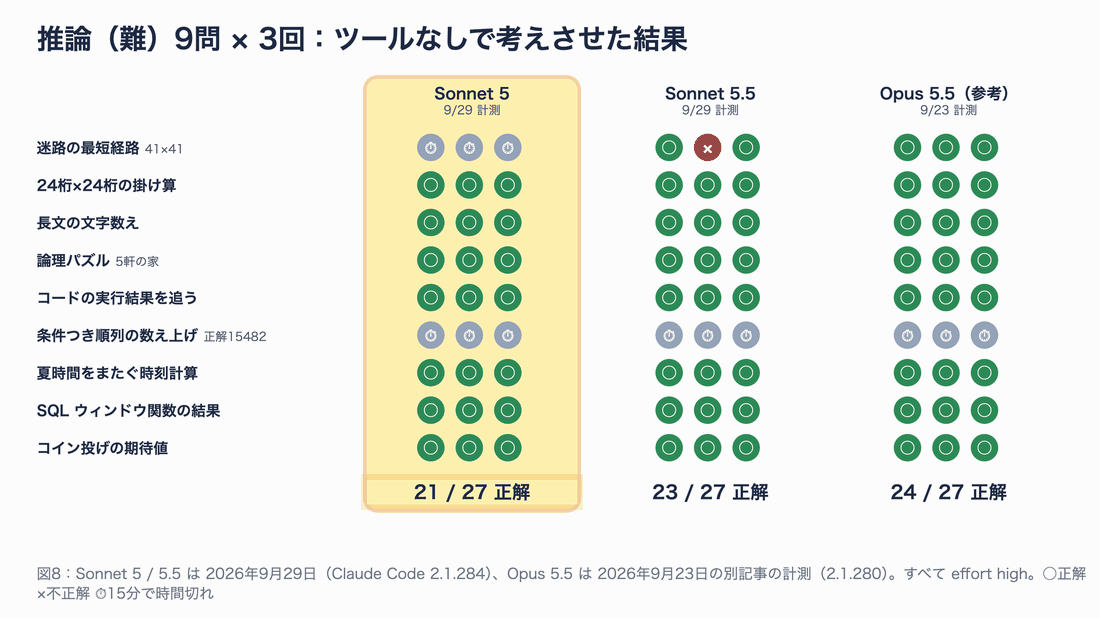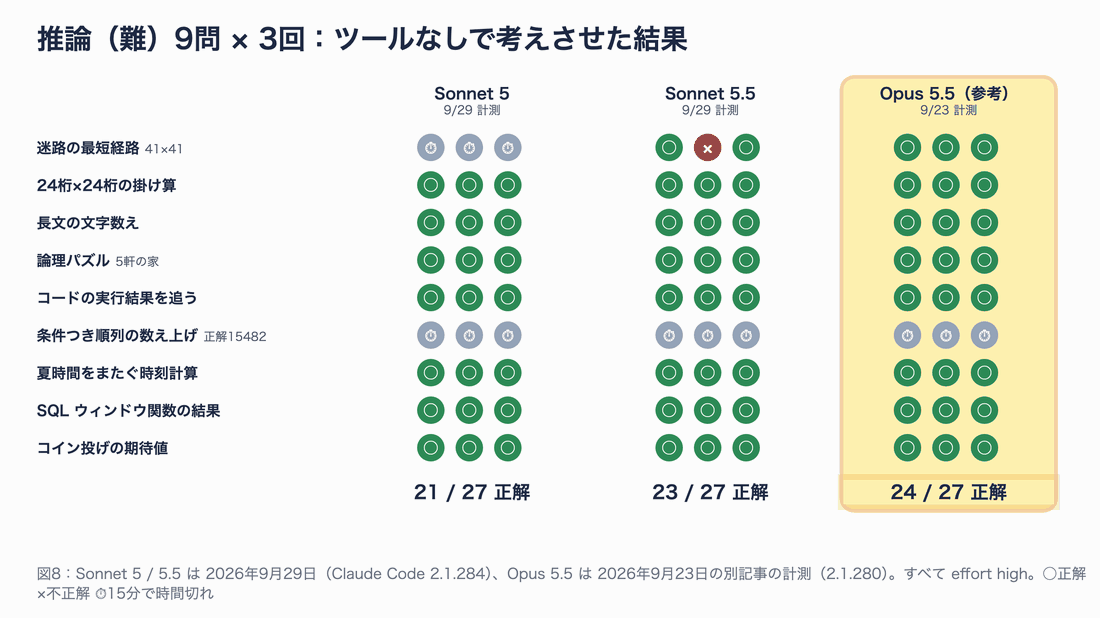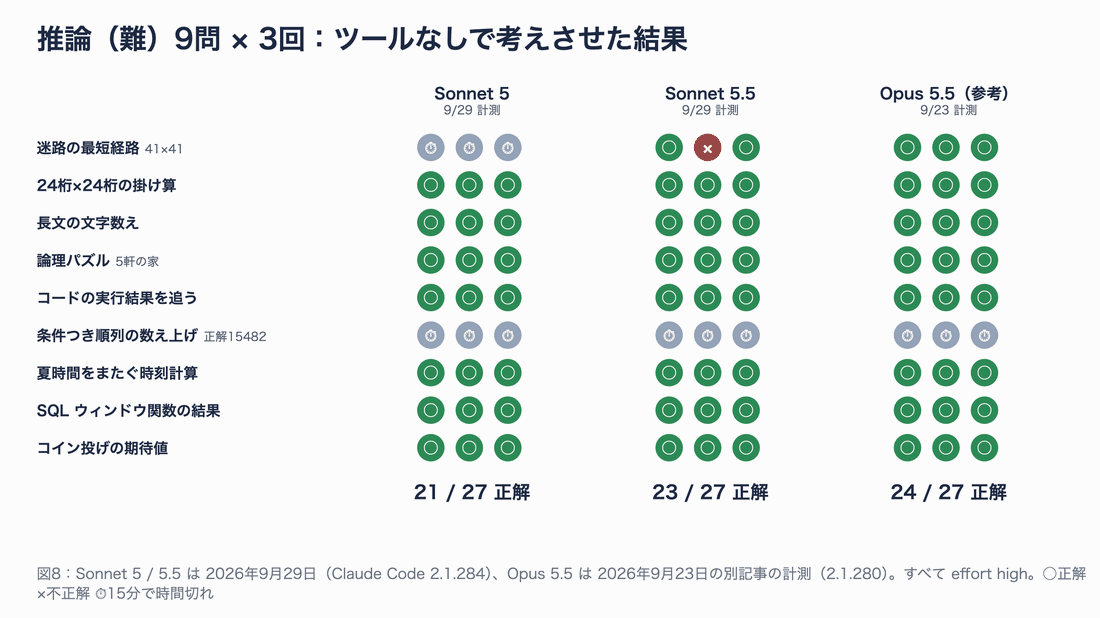
図8:Sonnet 5、Sonnet 5.5、Opus 5.5 の列を順に強調します。緑の○が正解、赤の×が不正解、灰色が15分の時間切れです。
| 指標 | Sonnet 5 | Sonnet 5.5 | Opus 5.5(参考・9/23) |
|---|---|---|---|
| 正解 | 21/27 | 23/27 | 24/27 |
| 迷路の最短経路(41×41) | 3回とも時間切れ | 2回正解(外した1回は 248 に対して 247) | 3回とも正解 |
| 条件つき順列の数え上げ | 3回とも時間切れ | 3回とも時間切れ | 3回とも時間切れ |
| 1問あたりの時間(中央値) | 37秒 | 12秒 | — |
Sonnet 5.5 は、Sonnet 5 が15分かけても答えを出せなかった迷路を、3〜5分で解くようになりました(1回は1歩だけずれました)。ほかの問題はどちらも全問正解で、時間は約3分の1です。一方で、Opus 5.5 は迷路を3回とも正解しており、考え抜く問題ではまだ Opus 5.5 に一日の長がある、という公式の表(ツールなしの HLE で 56.9% 対 64.4%)と同じ傾向が、手元の小さな問題でも見えました。
検証の限界
この検証には、次の限界があります。数字を自分の判断に使うときは、割り引いて読んでください。
- 課題は筆者が用意した小〜中規模のもので、各3回(速さは5回)しか回していません
- effort は両モデルとも
highにそろえましたが、移行ガイドのとおり effort の強さの基準自体が変わっています - 同時に複数の実行を走らせているので、時間は混み具合の影響を受けます(両モデルとも同じ本数を同時に走らせてそろえました)
- 費用は API 換算の目安で、実際はサブスクリプションの利用枠を消費しています
- Opus 5.5 の数値は9月23日の別の計測(Claude Code 2.1.280)で、条件が完全には一致しません
どんな仕事に Sonnet 5.5 を使うか
公式のベンチマークと手元の検証を合わせると、使い分けの目安は次のようになります。
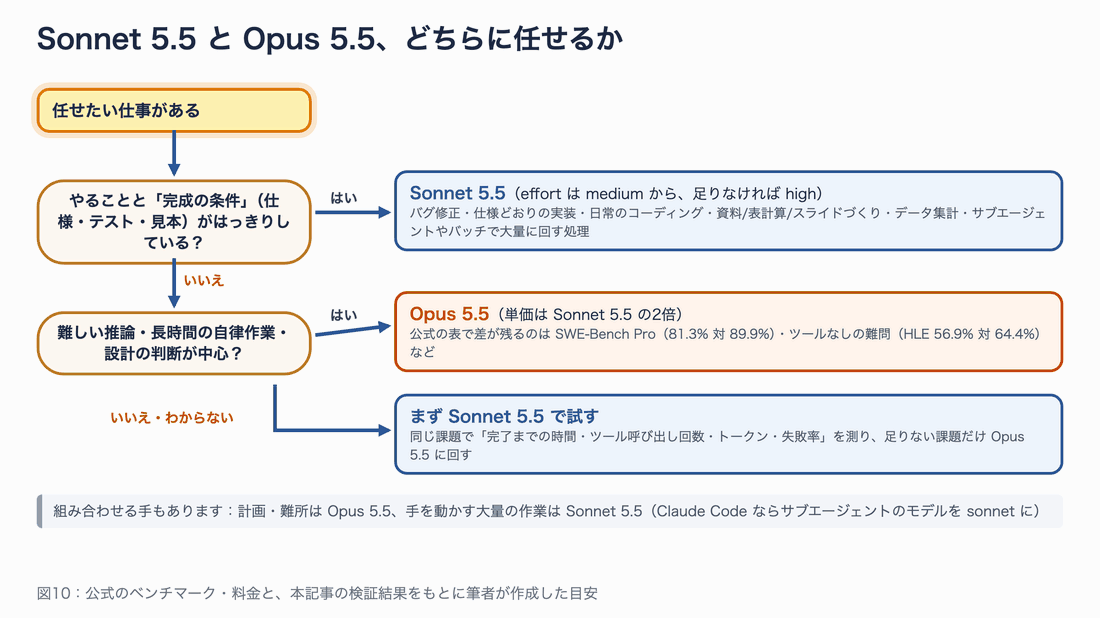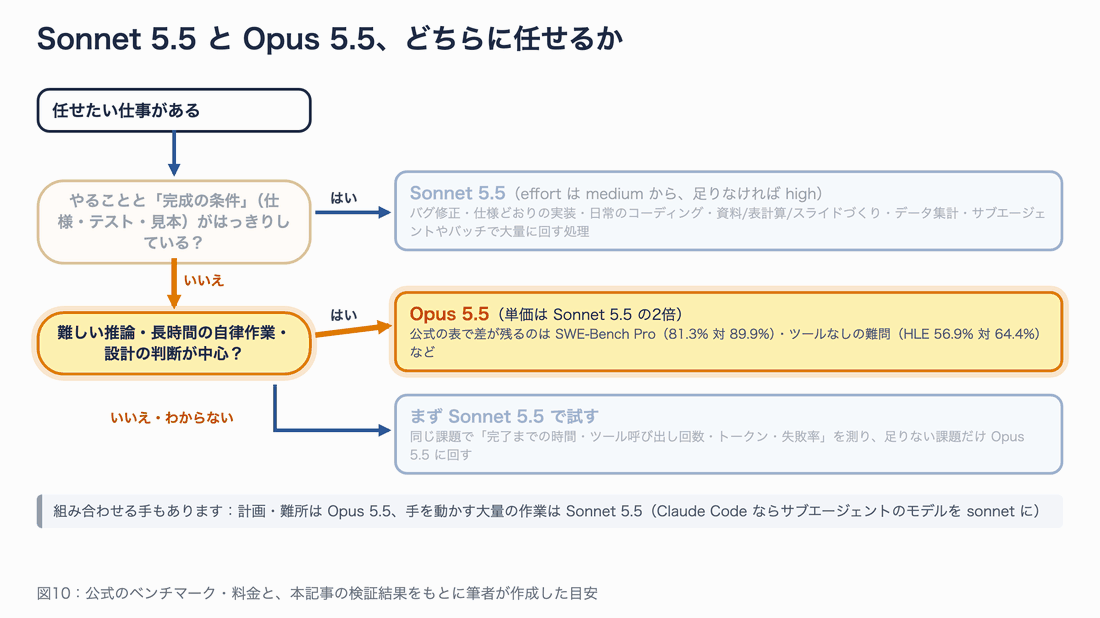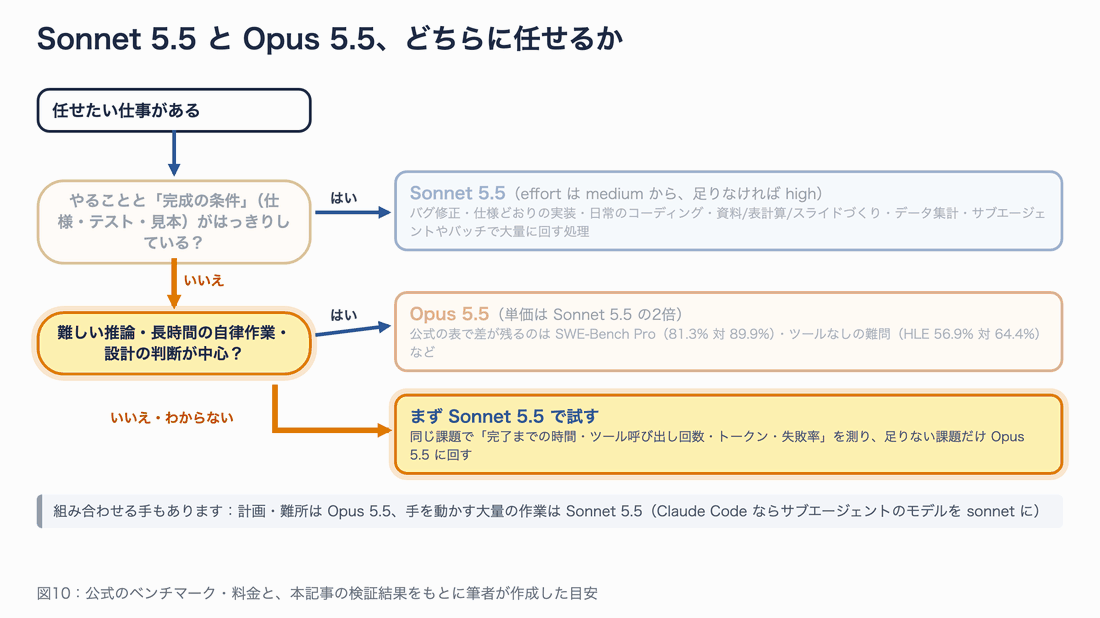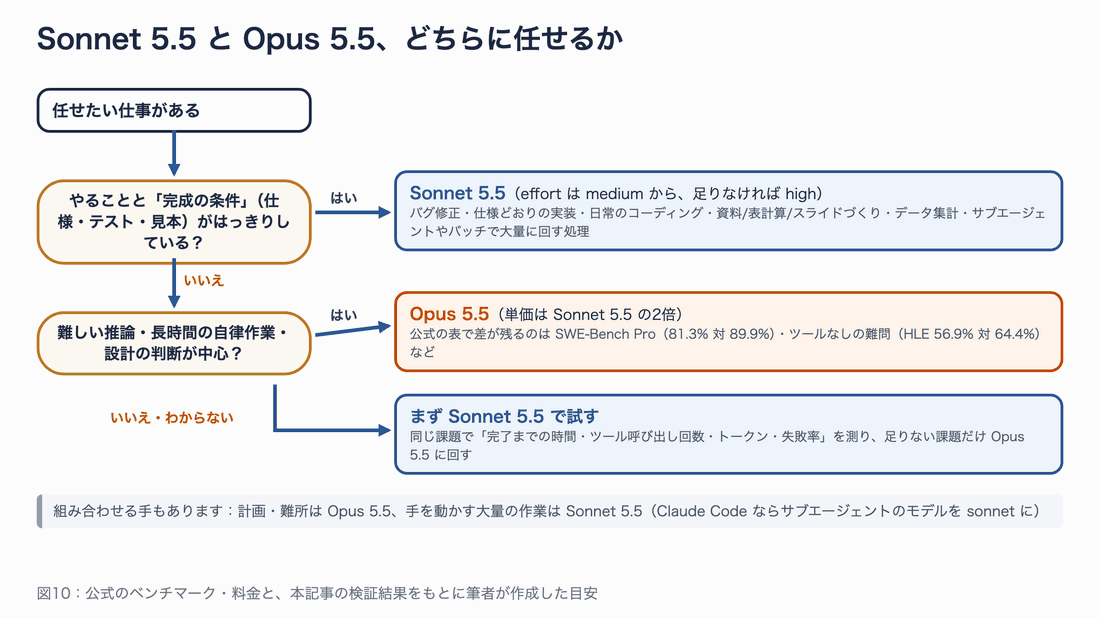
図10:上の分岐から順に強調します。最後に「組み合わせる」使い方を示します。
Sonnet 5.5 が向いている仕事は、やることと完成の条件がはっきりしていて、数をこなす仕事です。
| 仕事 | Sonnet 5.5 が向く理由 |
|---|---|
| バグ修正・仕様どおりの実装 | 今回の5題で Opus 5.5 と同じ満点を、半分の時間と費用で出した |
| 日常的なコーディング(テスト追加・リファクタリング・小さな機能追加) | ツール呼び出しが少なく、待ち時間が短い |
| 文書・スライド・表計算・データ集計 | GDPval-AA・AA-Briefcase で Opus 5.5 とほぼ同点。今回のレポートでも細かい気づきがあった |
| サブエージェント・バッチ処理・CI での自動修正 | 単価が Opus 5.5 の半分で、1回あたりのトークンも少ない。大量に回すほど差が効く |
| パソコン操作(コンピュータ・ユース) | OSWorld 2.1 で 80.1%(Opus 5.5 は 81.8%) |
Opus 5.5 に任せたほうがよい仕事は、正解の形がはっきりしない仕事や、考え抜く必要がある仕事です。公式の表で差が残っているのは、難しいバグ修正(SWE-Bench Pro:81.3% 対 89.9%)や、道具なしで考える難問(HLE:56.9% 対 64.4%)でした。設計の判断、原因がわからない障害の調査、長時間の自律作業などは、Opus 5.5 を選ぶ価値があります。
いちばん現実的なのは、両方を組み合わせる使い方です。Claude Code なら、メインの会話は Opus 5.5 で計画を立て、手を動かす作業はサブエージェント(model: sonnet)の Sonnet 5.5 に任せる、という分担ができます。そして、今使っている Sonnet 5 の処理は、単価が同じなのでそのまま Sonnet 5.5 に切り替えるだけで、待ち時間と請求額が下がる可能性が高いです。
Claude Code・API で使い始める
Claude Code で使う
Claude Code では、まずバージョンを確認します。2.1.284 より古いと、Sonnet 5.5 を「知らないモデル」として扱います。 筆者の環境で、2.1.280 と 2.1.284 に同じ依頼を出した結果が次の画面です。
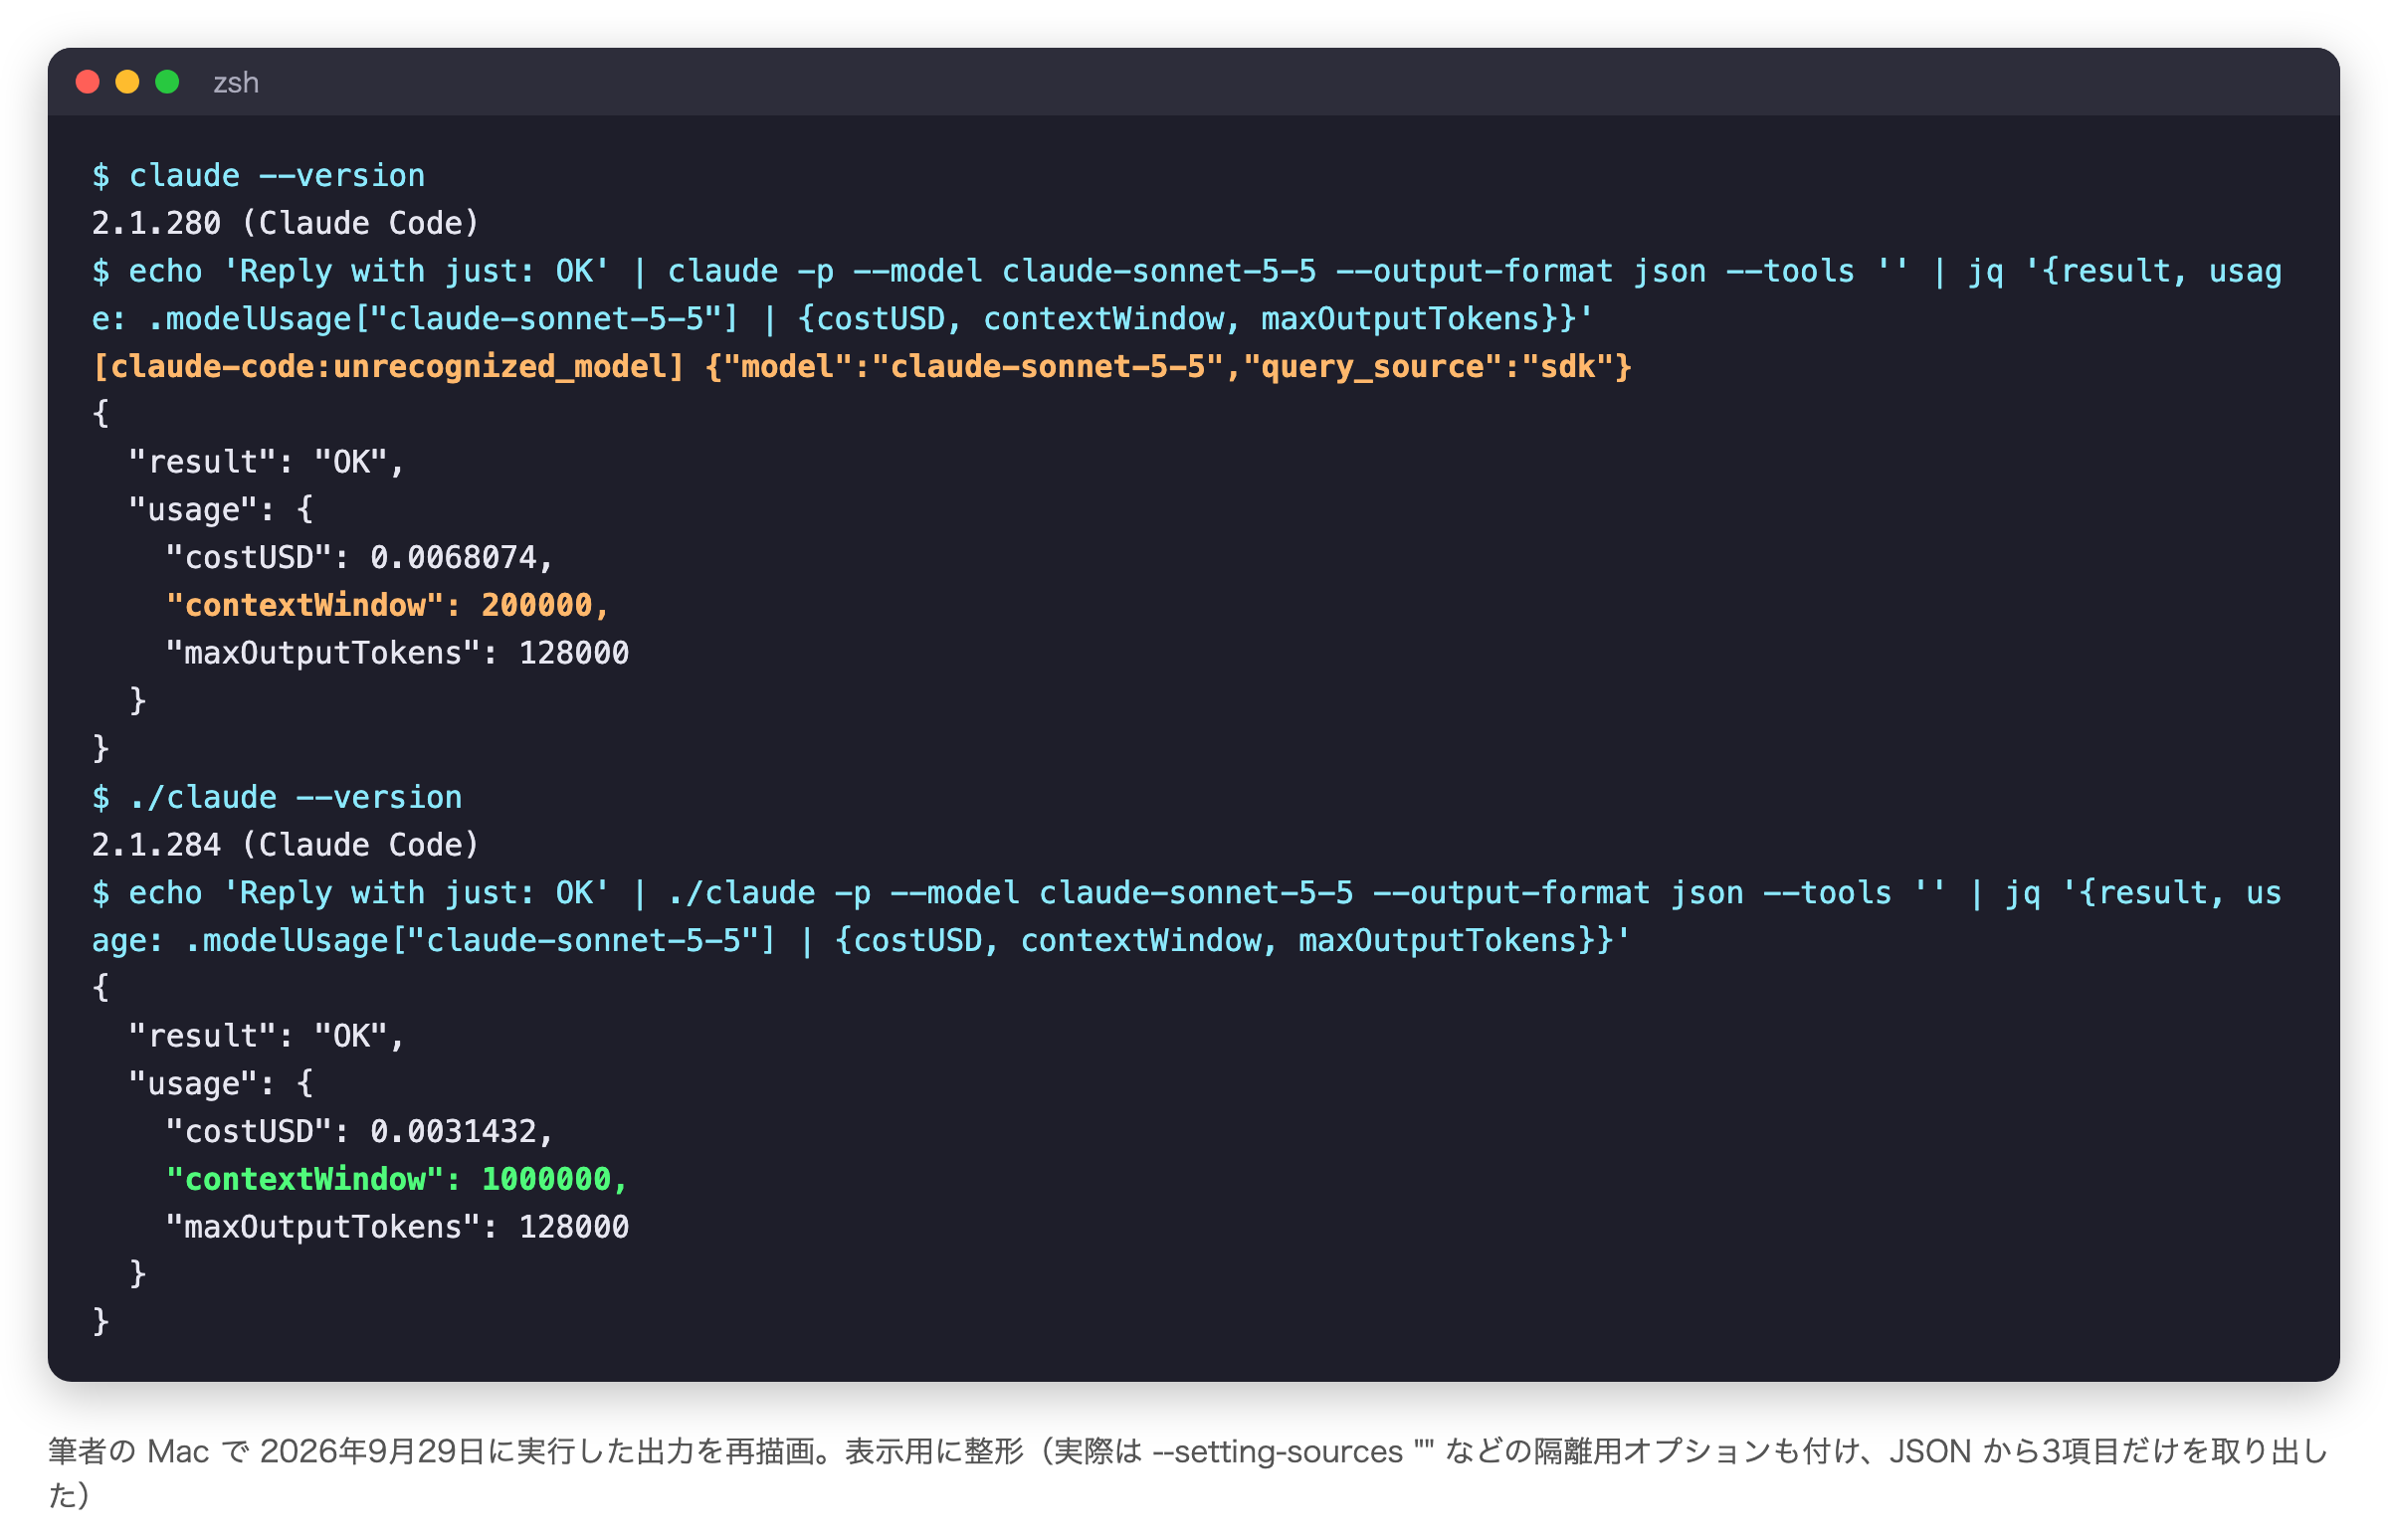
2.1.280 でも返事は返ってきますが、警告が出て、コンテキスト長が100万ではなく20万として扱われていました。
動いてしまうぶん気づきにくいので、先に更新しておきましょう。
# バージョンを確認する(2.1.284 以上が必要)
claude --version

# 更新する(ネイティブ版のインストーラーで入れた場合)
claude update
更新したら、モデルを指定して起動します。
# 対話モードで Sonnet 5.5 を使う
claude --model claude-sonnet-5-5

# 起動中のセッションで切り替える場合は、入力欄で次を実行する
# /model sonnet

# 1回だけの実行(ヘッドレスモード)。effort も指定できる
claude -p --model claude-sonnet-5-5 --effort medium "tests/ を実行して、失敗しているテストを直してください"
サブエージェント(Claude Code の中で別の作業を任せる小さなエージェント)だけを Sonnet 5.5 にすることもできます。.claude/agents/ のエージェント定義に model: sonnet と書けば、計画は Opus 5.5、手を動かす作業は Sonnet 5.5、という分担になります。
API で使う:モデル ID を変える前に
API では、モデル ID を claude-sonnet-5-5 に変えるだけで動く場合がほとんどです。ただし、移行ガイドには Sonnet 5 から変わった「壊れる変更」が5つあります。400 エラーが出たら、次の順に確認してください。
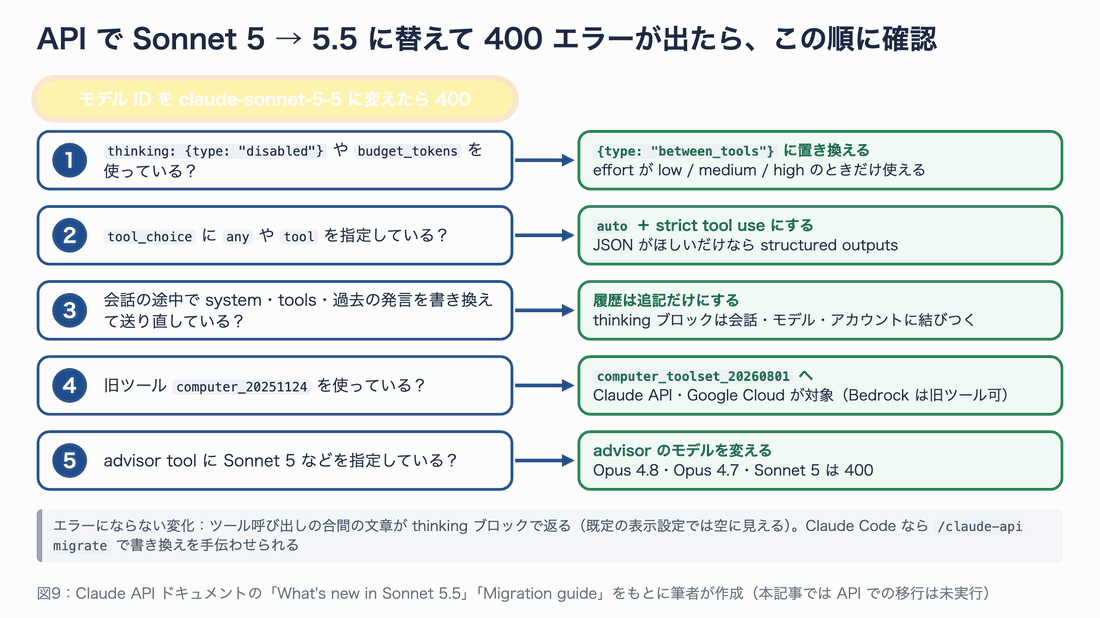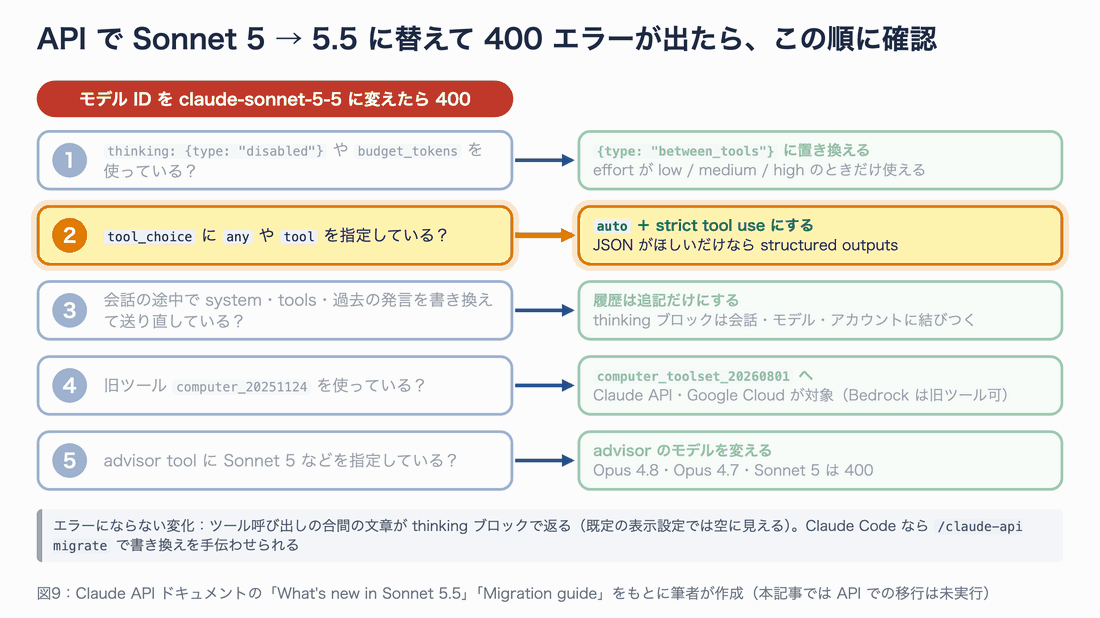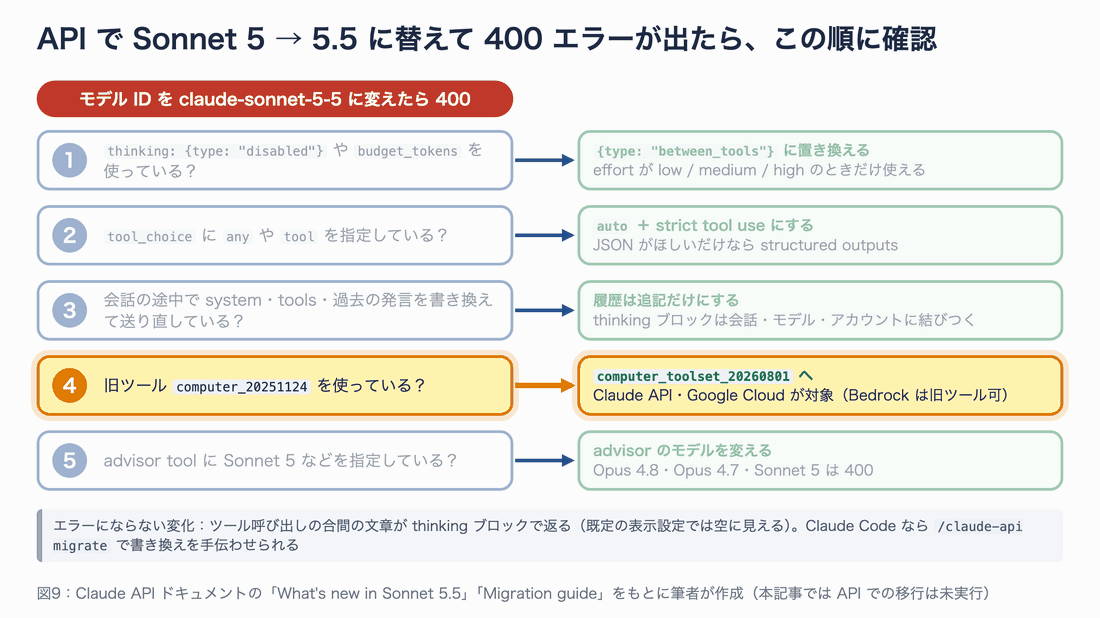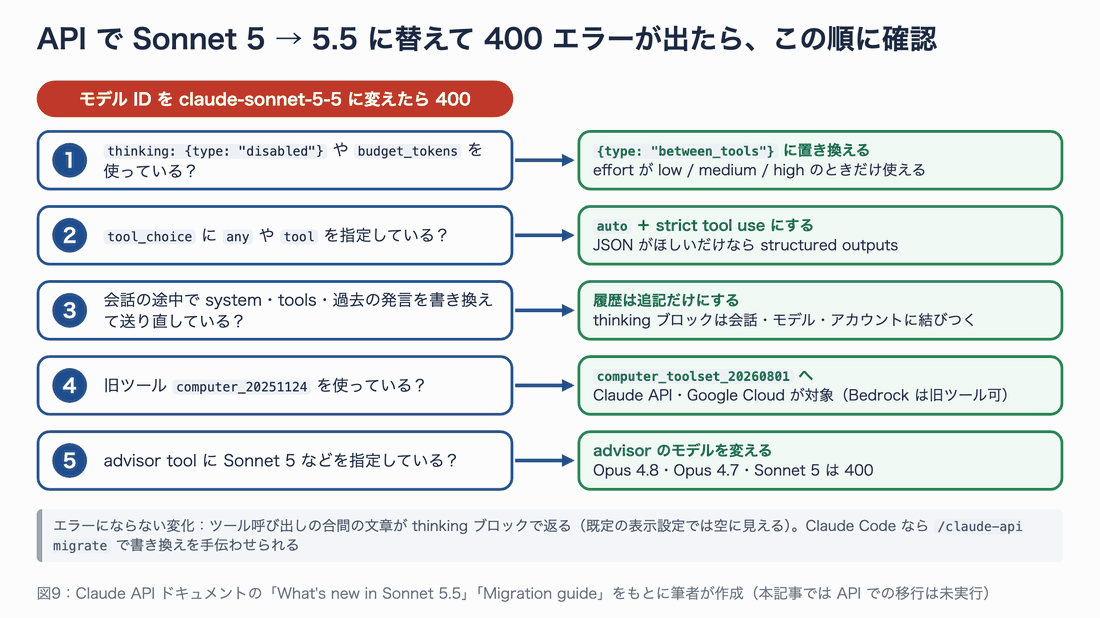
図9:上から順に、よく使われていそうなものから並べています。本記事では API での移行そのものは実行していません(ドキュメントの内容の整理です)。
たとえば、これまで thinking(考える過程)を切って速くしていたコードは、次のように書き換えます。
import anthropic

client = anthropic.Anthropic()  # 環境変数 ANTHROPIC_API_KEY を読む

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    # Sonnet 5 の thinking={"type": "disabled"} は 400 エラーになる。
    # 代わりに between_tools を使う(effort が low / medium / high のときだけ有効)
    thinking={"type": "between_tools"},
    messages=[{"role": "user", "content": "この関数のバグを1行で説明してください: ..."}],
)
print(response.content)
このコードは移行ガイドの記述をもとに書いたもので、筆者は API キーを使っていないため実行は未確認です。移行ガイドには、ほかに次の注意もあります。
- effort の強さの基準が変わったので、Sonnet 5 の設定をそのまま使わず測り直す(目安:通常は high、エージェント型のコーディングは medium から、チャットは medium か low)
- 推論の過程を回答本文に書き出させる指示は、「推論の抜き出し」とみなされて拒否されることがある
- Claude Code の
/claude-api migrateで、書き換えを手伝わせられる
まとめ
Sonnet 5.5 で変わったこと・変わらないことを、公式情報と手元の検証から振り返ります。
| 観点 | Sonnet 5 → Sonnet 5.5 |
|---|---|
| トークン単価 | 据え置き(入力 $2・出力 $10)。Opus 5.5 のちょうど半額。Sonnet 5 の導入価格がそのまま正式価格になった |
| 公式ベンチマーク | Terminal-Bench 4.0 が 10.3% → 70.6%、SWE-Bench Pro +18.1pt、OSWorld +23.1pt、資料づくりの Elo +400前後。多くの項目で Opus 5.5 に迫る |
| Opus 5.5 との差 | 難しいバグ修正(SWE-Bench Pro 81.3% 対 89.9%)と、道具なしの難問(HLE 56.9% 対 64.4%)では、まだ Opus 5.5 が上 |
| 手元の実装・作ってみた(42回) | 正しさは同じ(全回満点)。時間 0.40倍・ツール呼び出し 0.40倍・費用 58%減 |
| 作ったものの違い | 家計簿は、スマホでも読めるグラフや今日の日付の初期値など、使う人を先回りした作り。レポートは、仕込んだデータの落とし穴(値上げ・重複行の食い違い)に3回とも気づいた |
| 出力の速さ | 1秒あたり 98 → 144 トークン(1.48倍)。ただし長めに書くので、文章だけの仕事では時間の差は小さい |
| 推論(難) | 21/27 → 23/27。Sonnet 5 が解けなかった迷路を解くようになったが、Opus 5.5(24/27)には届かない |
| 使い始めるとき | Claude Code は 2.1.284 以上に更新。API は破壊的変更5件(thinking の無効化・tool_choice の強制など)を確認してから |
ひとことでまとめるなら、Sonnet 5.5 は「同じ値段のまま、同じ仕事を、少ない往復で速く終わらせるようになった Sonnet」です。仕様やテストで「完成の形」を示せる仕事、たとえばバグ修正、日常のコーディング、資料や集計づくり、サブエージェントやバッチで大量に回す処理は、Opus 5.5 ではなく Sonnet 5.5 に任せるのが、速さと費用の両面で合理的です。考え抜く必要がある難所や設計の判断だけを Opus 5.5 に回す、という分担がいちばん効率的でしょう。
次に試すなら、自分のリポジトリや業務でよくある作業を3〜5個選び、この記事と同じように「完了までの時間・ツール呼び出し回数・トークン・失敗率」を Sonnet 5 と 5.5 で測ってみてください。検証に使ったスクリプトは、Claude Code とサブスクリプションのログインだけで動きます。
参考リソース
- Introducing Claude Sonnet 5.5(Anthropic)
- Claude Sonnet 5.5 System Card
- Sonnet 5.5 モデル概要(Claude API ドキュメント)
- What’s new in Claude Sonnet 5.5
- Sonnet 5.5 への移行ガイド
- Prompting Claude Sonnet 5.5
- 料金(Claude API ドキュメント)
- Claude Code の変更履歴(2.1.284)
- Claude Code のモデル設定
- Anthropic rolls out second Claude 5.5 model as it builds toward IPO(Reuters 配信)
- VentureBeat の報道