情報確認日:2026年9月5日
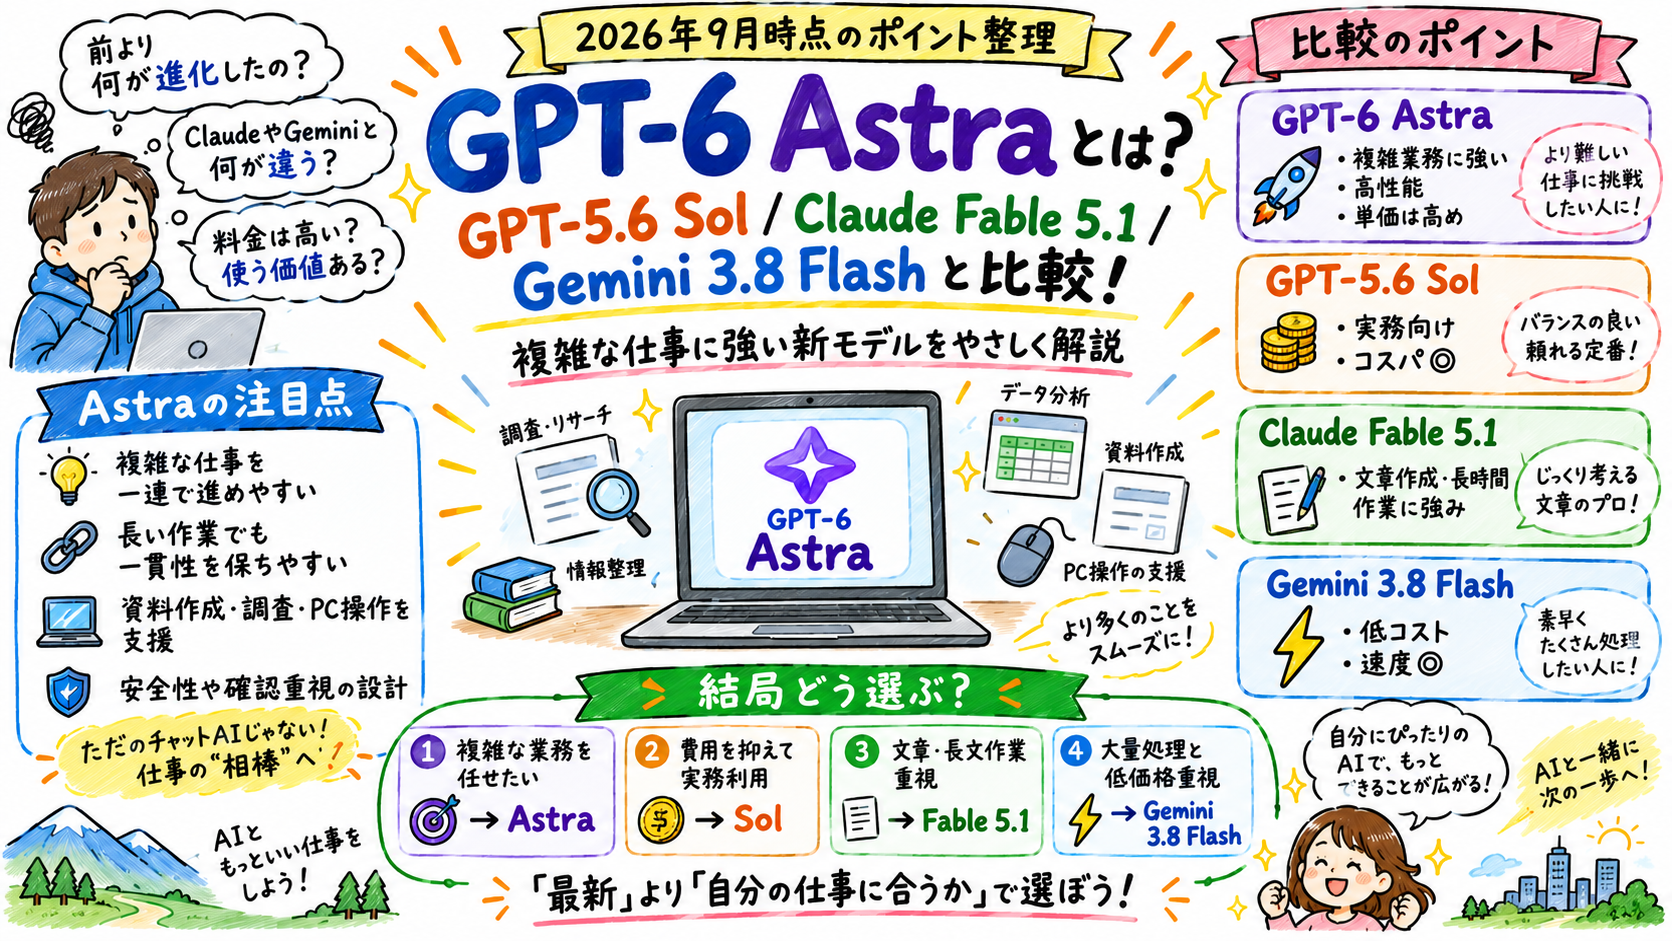
2026年9月3日、OpenAIは新しいAIモデル「GPT-6 Astra」を発表しました。まず一部の組織から提供が始まり、対象ユーザーへ段階的に広がっています。発表済みではありますが、すべての対象ユーザーが、すべての機能ですぐに使える状態になったという意味ではありません。(出典:ChatGPTリリースノート)
新しいモデルが登場すると、「前よりどれくらい賢くなったの?」「Claudeから乗り換えるべき?」「普段の仕事にも関係がある?」と気になるところです。
今回の進化を理解するうえで、注目したいのは、難しい質問に答える力だけではありません。複数の資料を読み、途中の指示変更にも対応しながら、ひとまとまりの仕事を進める力です。OpenAIはAstraを、複雑な推論、調査、パソコン操作、文書作成など、難しい仕事を最初から最後まで進めるためのモデルと位置づけています。(出典:OpenAIモデル仕様)
ただし、「新しいから、すべての場面で一番」と考えるのは早計です。競合のClaude Fable 5.1が上回る評価もあり、料金や利用条件にも違いがあります。(出典:Artificial Analysisの比較)
この記事では、公式発表や利用案内を中心に、第三者による評価も交えながら、非エンジニアの方にも関係のある違いを整理します。なお、ここで紹介する性能比較は公開資料に基づくもので、筆者が全モデルを同一条件で実機検証した結果ではありません。
- 1.まず結論:Astraは「複雑な仕事を任せる力」に注目したいモデル
- 2.最初に知っておきたい「ChatGPT」と「GPT-6 Astra」の違い
- 3.GPT-5.6 Solから、何が変わったのか?
- 4.数字で比較すると、Astraはどこで強いのか?
- 5.Claude Fable 5.1と比べると、どう違う?
- 6.Gemini 3.8 Flashは、価格と利用環境の面で見逃せない
- 7.料金はどう違う?「月額料金」と「API料金」を分けて考えよう
- 8.実際に使えるのは誰?利用条件にも違いがある
- 9.初心者は、どのモデルから試すとよい?
- 10.高性能になっても、確認を省いてよいわけではない
- まとめ:選ぶ基準は「最新かどうか」より「自分の仕事がどれだけ楽になるか」
1.まず結論:Astraは「複雑な仕事を任せる力」に注目したいモデル
今回取り上げるモデルの特徴を、まず大まかに整理してみましょう。
| モデル | 提供元 | 注目したいポイント |
|---|---|---|
| GPT-6 Astra | OpenAI | 調査・資料作成・パソコン操作など、複雑な仕事を一連の流れで進める能力 |
| GPT-5.6 Sol | OpenAI | 本格的な業務に対応しつつ、Astraより低いAPI単価で使える点 |
| Claude Fable 5.1 | Anthropic | 難しい問題の検討、長時間にわたる作業、文章や成果物の作成 |
| Gemini 3.8 Flash | 複雑な処理への対応力と、低いAPI単価の組み合わせ |
この整理は、各社のモデル説明と料金情報を、仕事での選び方に置き換えたものです。総合順位を示す表ではありません。(出典:OpenAI/Anthropic/Google)
たとえば、メールを数行だけ書き直す作業と、複数の資料を照合して会議用の報告書を作る作業では、AIに求めるものが違います。
前者なら、文章が自然で、待ち時間や費用が少ないことが大切でしょう。後者なら、途中で条件を忘れず、根拠を確認し、必要な形式にまとめられることが重要です。
「どのAIが一番賢いか」だけでなく、「自分の仕事では、どこに時間や手間がかかっているか」から選ぶと、モデルの違いを理解しやすくなります。
2.最初に知っておきたい「ChatGPT」と「GPT-6 Astra」の違い
ここで、混同しやすい言葉を整理しておきましょう。
ChatGPTは、私たちが画面を開いて使うサービスです。一方、GPT-6 AstraやGPT-5.6 Solは、その中で文章を理解したり、答えを考えたりするAIモデルの名前です。ChatGPTでは、利用するプランや機能に応じて、使えるモデルや表示名が異なります。(出典:ChatGPTのモデル利用案内)
たとえるなら、AIモデルは「頭脳」、サービスは「頭脳と道具を組み合わせた作業環境」です。
優れた頭脳があっても、資料を読むための道具や、表計算ソフトを操作するための仕組みがなければ、その仕事はできません。
そのため、モデルの紹介に「パソコンを操作できる」「資料を作れる」と書かれていても、通常のチャット画面から、あらゆるソフトや社内データを自由に操作できるという意味ではありません。 実際にできることは、接続されたツール、利用する製品、組織の設定などにも左右されます。(出典:OpenAIモデル仕様)
これはAstraだけでなく、他社モデルと比較するときにも重要な区別です。
3.GPT-5.6 Solから、何が変わったのか?
GPT-5.6 Solも、すでに調査、文書作成、パソコン操作などに対応する高性能モデルでした。したがって、今回の変化を「以前は会話しかできなかったが、Astraで初めて仕事ができるようになった」と説明するのは正確ではありません。(出典:ChatGPTのモデル利用案内)
注目すべきなのは、以前からできた仕事を、どこまで安定して、複雑な条件のまま進められるようになったかです。
3-1.長い作業の途中でも、目的を見失いにくくなった
OpenAIの開発者向けガイドでは、Astraは以前のモデルよりも、長い作業の一貫性を保ちやすくなったと説明されています。途中で新しい条件が加わった場合や、別の質問が挟まった場合にも、元の仕事を見失わずに対応することが重視されています。(出典:OpenAI最新モデルガイド)
たとえば、次のような仕事を考えてみてください。
新サービスの説明資料を作ってください。対象は営業担当者です。
やはり、管理職向けの説明も追加してください。
ただし、全体のページ数は増やさず、専門用語も減らしてください。
このような依頼では、最後の指示だけに対応すればよいわけではありません。「営業担当者向け」「管理職にも説明する」「ページ数は増やさない」「専門用語を減らす」という条件を、同時に満たす必要があります。
Astraの進化は、こうした相談しながら完成形に近づける仕事で意味を持つと考えられます。
一方で、Astraは重要な不明点があると、以前のモデルより確認を求めやすい傾向もあります。何でも勝手に進めるというより、「そのまま進めてよい部分」と「確認が必要な部分」を分けようとする設計です。(出典:OpenAI最新モデルガイド)
3-2.文章を出すだけでなく、指定された形式の成果物を作る方向へ
OpenAIはAstraについて、テンプレートや指示に沿った文書、表計算ファイル、プレゼンテーションを作成できると説明しています。(出典:ChatGPTリリースノート)
非エンジニアの仕事に置き換えると、注目したいのは、単なる「説明文の生成」から、提出や共有を前提とした成果物づくりに近づいていることです。
たとえば、会議の記録を渡したときに、ただ要約してもらうだけでなく、次のように依頼できます。
会議の決定事項をまとめた報告書を作ってください。
担当者と期限がある項目は、別の管理表に整理してください。
経営層向けには、重要な論点だけを短くまとめてください。
これは利用イメージですが、仕事で価値が出るのは、文章の見栄えだけではありません。
必要な情報が抜けていないか。読み手に合っているか。社内の様式に収まっているか。最終的に人間がどれだけ直さずに使えるか。
こうした観点で試すと、モデルの違いを実感しやすくなるでしょう。
3-3.大量の資料を「入れられること」と「使いこなせること」は違う
長い資料への対応も、重要な比較ポイントです。
APIの仕様を見ると、AstraとSolのコンテキスト上限は、どちらも105万トークンです。つまり、今回の違いを、単純に「一度に読める文章量が増えた」と説明することはできません。ここでいうコンテキストは、AIが一度の処理で参照できる情報の範囲を指します。(出典:Astraの仕様/Solの仕様)
一方、長い入力から指定された情報を取り出すOpenAIの評価では、51.2万〜100万トークンの条件で、Solが73.8%、Astraが96.3%という結果が公表されています。(出典:OpenAI公式発表)
たとえるなら、机に置ける資料の量が同じでも、そこから必要な情報を見つけ、取り違えずに扱う能力は違う、ということです。
ただし、この評価は、あらゆる長文を完全に理解できることを証明するものではありません。また、APIの上限が、そのままChatGPTのすべての画面で使える上限になるわけでもありません。
実務では、資料を大量に渡すだけでなく、「どの資料を優先するか」「何を比較するか」「どの情報を根拠として示すか」まで指定して試すのがおすすめです。
3-4.作業を進める能力だけでなく、許可された範囲を守る能力も改善
AIに実際の操作を任せる場合、「できることが多い」だけでは不十分です。
依頼していないデータを書き換えたり、確認前に外部へ送信したりしては困ります。
OpenAIは、安全性の評価において、AstraがSolよりも安全上の境界や許可された範囲を守りやすくなったと報告しています。また、外部のWebページや資料に紛れ込んだ不正な指示への耐性についても、改善を説明しています。(出典:OpenAIの安全性に関する説明)
たとえば、「メールの下書きを作って」と頼んだときに、送信まで勝手に行わないことは、仕事を任せるうえで大切な能力です。
作業を最後まで進める力と、頼まれていないことをしない力は、セットで評価する必要があります。
4.数字で比較すると、Astraはどこで強いのか?
AIの性能比較でよく登場するのが「ベンチマーク」です。これは、AIに一定の課題を解かせて、成績を測るテストのことです。
学校のテストに国語や数学があるように、AIのテストにも、知識問題、ソフトウェア開発、業務の自動化など、異なる分野があります。
以下は、OpenAIがAstraの発表時に掲載した比較表から、一部を抜粋したものです。
| 評価する内容 | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| 一連の業務を自動で進める能力〈AutomationBench〉 | 18.1% | 41.4% | 31.4% | — |
| 開発環境で課題を解決する能力〈Terminal-Bench 4.0〉 | 37.3% | 57.9% | 55.8% | 19.1% |
| 長い工程を伴うソフトウェア開発〈DeepSWE v1.1〉 | 72.7% | 74.1% | 67.4% | 73.8% |
| 幅広い分野の難問を、ツールも使って解く能力〈Humanity’s Last Exam〉 | — | 57.2% | 65.0% | — |
出典はOpenAIの公式比較表です。「—」は同表に数値が掲載されていないことを示し、能力がないという意味ではありません。(出典:OpenAI公式発表)
なお、これらは各モデルの設定や利用可能なツールなどを含む評価結果です。OpenAI自身も、研究環境やAPIでの評価が、通常のChatGPTと同じ出力になるとは限らないと説明しています。(出典:OpenAI公式発表・評価条件)
この表から読み取れるのは、AstraはSolに対して大きく伸びた項目がある一方、競合との差が小さい項目や、Fable 5.1が上回る項目もあるということです。
「あるテストの点数が約2倍になった」ことを、そのまま「すべての仕事で2倍賢くなった」「作業時間が半分になる」と読み替えることはできません。
第三者の総合評価では、Fable 5.1が上回る
企業自身の発表だけでなく、外部の評価も見ておきましょう。
独立した評価機関Artificial Analysisの「Intelligence Index v4.2」では、2026年9月5日に確認した掲載値は、Fable 5.1が57、Astraが55、Solが51でした。これは複数の評価を組み合わせた指標で、正答率のパーセントではありません。(出典:Artificial Analysisの比較)
この比較では、各モデルの高い思考設定が使われており、Fable 5.1は必要に応じた別モデルへの切り替えを含む標準設定で評価されています。したがって、モデル名と点数だけでなく、設定条件もセットで読む必要があります。(出典:Artificial Analysisの比較条件)
また、この指標は9月4日に評価内容が更新されています。発売当日の記事に載っている点数と、現在のページの点数が違っていても、必ずしもモデルの性能が急に変わったわけではありません。テストの内容や集計方法が変わった可能性があります。(出典:Intelligence Index v4.2の更新案内)
初心者の方は、ランキングの数字を細かく覚えるより、評価する仕事によって順位が変わることを押さえておけば十分です。
5.Claude Fable 5.1と比べると、どう違う?
Claude Fable 5.1は、Anthropicが2026年9月1日に発表したモデルです。同社は、ソフトウェア開発、知的な業務、長時間にわたる問題解決での向上を強調しています。(出典:Claudeリリースノート)
Astraの競合として、十分に比較対象に入れる価値があります。
Fable 5.1も、「長い仕事を進めるAI」
Astraだけが複雑な作業を任せるためのモデルというわけではありません。Fable 5.1も、長い工程を伴う仕事や、難しい問題を継続して検討する用途を重視しています。(出典:Anthropic公式発表)
そのため、両者の選び方は、「文章ならClaude、作業ならChatGPT」ときれいに二分できるものではありません。
たとえば、長い調査レポートを作る場合でも、必要な作業は複数あります。情報を集めること、矛盾を見つけること、論点を整理すること、読み手に合う文章にすること、指定のファイルにまとめることです。
どの工程で手戻りが少ないかを比べる方が、実務上は役立ちます。
文章の改善はあるが、「何も指定しなくても必ず読みやすい」とは限らない
Anthropicの公式ガイドでは、Fable 5.1は以前のモデルより定型的な表現や説明のない専門用語が減った一方、文章が長く、密度が高くなる場合もあると説明されています。(出典:Fable 5.1のプロンプトガイド)
これは、ブログや社内向け資料を作る方にとって重要な点です。
文章が難しく感じられた場合、モデルの性能だけで判断する前に、次のように読み手と文体を指定してみるとよいでしょう。
読者は、この分野を初めて学ぶ社会人です。
一文を短めにし、専門用語を使う場合は、その場で意味を説明してください。
抽象的な説明の後には、仕事での具体例を入れてください。
なお、ここまで紹介したベンチマークだけでは、「日本語のブログ記事は必ずFableの方が自然」「説明文は必ずAstraの方が上」とまでは判断できません。
文章の好みや読者への適合性は、実際に自分が使う原稿で比較する必要があります。
6.Gemini 3.8 Flashは、価格と利用環境の面で見逃せない
Googleは2026年9月2日、Gemini 3.8 Flashを発表しました。日本語の公式記事は9月3日に公開されています。Googleは、複雑な作業への対応力を高めつつ、Flashシリーズの速度と低コストを維持する方向性を示しています。(出典:Google公式発表)
Gemini 3.8 Flashを比較対象に入れたい理由は、最高性能の競争だけではありません。十分な品質を、どれくらいの費用で使えるかという観点です。
たとえば、社内システムで毎日大量の文章を分類したり、多数の資料から定型的な情報を取り出したりする場合、1回ごとの単価の差が積み重なります。
ただし、Googleも、難しい仕事では追加の思考やツール利用によって、処理するトークンが増える場合があると説明しています。「単価が安い」ことと「どんな仕事でも総額が安い」ことは、分けて考える必要があります。(出典:Google公式発表)
利用環境も選択理由になります。Googleは、Google AI Pro・Ultraの利用者向けに、GeminiアプリやGoogleスプレッドシートなどでの提供を案内しています。普段使うサービスの中で利用できることも、実際の使いやすさを左右します。(出典:Google公式発表)
7.料金はどう違う?「月額料金」と「API料金」を分けて考えよう
AIの料金比較では、ここが特に混乱しやすいところです。
ChatGPTやClaudeのアプリを使う月額プランと、外部のソフトや業務システムからAIを呼び出すAPIの料金は、同じものではありません。
普段のチャット利用が中心なら、まず確認したいのは、契約中のプランで使えるか、利用上限はどれくらいか、追加課金が必要かです。APIを利用する場合には、入力や出力の量に応じた単価が重要になります。(出典:ChatGPTのモデル利用案内)
APIの基本単価を比較
APIでは、文章などを処理する単位として「トークン」が使われます。ここでは細かな換算を覚えず、「AIに渡す情報量」「AIが生成する情報量」に応じて料金が変わる、と考えてください。
以下は、標準的な処理での基本単価です。
| モデル | 入力100万トークンあたり | 出力100万トークンあたり |
|---|---|---|
| GPT-6 Astra | 10ドル | 50ドル |
| GPT-5.6 Sol | 4ドル | 20ドル |
| Claude Fable 5.1 | 10ドル | 50ドル |
| Gemini 3.8 Flash | 0.75ドル | 3.75ドル |
OpenAI・Anthropic・Googleの公式料金情報に基づきます。キャッシュ、長い入力に対する割増、追加のツール料金などは含めていません。また、100万トークンは単価の表示単位であり、「一度に100万トークンを入力した場合の最終請求額」を示す表ではありません。(出典:OpenAI料金表/Claude料金表/Google公式発表)
同じ量の入力・出力で比べると、Astraの基本単価はSolの2.5倍です。したがって、Astraは単純な値下げ版ではなく、高い能力に対して高い単価が設定されたモデルと捉えるのが適切です。(出典:OpenAI料金表)
なお、Solの現在の料金は、少なくとも2026年11月21日まで適用されるプロモーション価格です。Gemini 3.8 Flashの上記価格は2026年12月31日までの導入価格で、2027年1月1日からは入力1.50ドル、出力7.50ドルになる予定です。(出典:Solの仕様・料金/Google公式発表)
Fable 5.1の値下げは、「同じ情報の再利用」で効いてくる
Fable 5.1では、以前に処理した入力を再利用する「キャッシュ読み取り」の料金が、100万トークンあたり0.25ドルになっています。Astraの同料金は1ドルです。(出典:Claude料金表/OpenAI料金表)
たとえば、長い資料を最初に渡し、その資料を何度も参照しながら作業する場面では、この料金が関係してきます。
Anthropicは、Fable 5と比べて、トークン単位で課金される一般的な仕事では約25%、複雑な自動作業では最大約45%の費用削減を見込めると説明しています。これは特定の利用実績に基づく推計であり、すべての利用で同じ削減率になるわけではありません。Claudeの月額プランが一律25%安くなる、という意味でもありません。(出典:Anthropic公式発表)
単価が高くても、1件の仕事の総額が同じになる場合はある
もう一つ大切なのは、AIごとに、仕事を終えるまでに使う情報量や試行回数が違うことです。
Artificial Analysisの発売時の評価では、ソフトウェア開発のテストで、AstraはSolより少ないトークンを使い、高い基本単価にもかかわらず、同程度の費用でより高い成績を出したと報告されています。(出典:Artificial AnalysisのAstra評価)
つまり、料金は「単価表」だけでなく、目的の仕事が完了するまでの総額で見る必要があります。
人間が修正する時間まで考えるなら、さらに重要なのは「AIの請求額+人間の手直しの手間」です。
8.実際に使えるのは誰?利用条件にも違いがある
ChatGPT:PlusとProでは、Astraを使える場所が違う
2026年9月5日時点のOpenAIの案内では、次のように整理されています。
| ChatGPTのプラン | Astraに関する案内 |
|---|---|
| Plus | ChatGPT WorkとCodexで、段階的に利用可能になる |
| Pro | チャットの「GPT-6 Pro」に加え、WorkとCodexでも段階的に利用可能になる |
| Business・Enterprise | 対象機能で段階的に提供。組織の設定やアクセス権にも左右される |
チャット上の「GPT-6 Pro」は、GPT-6 Astraを基盤とするものです。PlusでもAstraの提供対象にはなりますが、チャットでGPT-6 Proを選べるという意味ではありません。(出典:ChatGPTのモデル利用案内)
また、ProプランでもGPT-6 Proが無制限に使えるわけではありません。公式案内では、チャットでの上限はProの200ドルプランが週200メッセージ、100ドルプランが週50メッセージです。WorkとCodexの利用枠は別扱いです。(出典:ChatGPTのモデル利用案内)
提供途中のため、対象プランであっても、すぐに表示されない場合があります。Enterpriseでは、利用可能になった後に管理者が有効化する必要があり、公開当初は既定でオフです。(出典:Enterprise・Eduのモデルと利用上限)
Claude:ProでもFable 5.1が通常の月額利用枠に入るわけではない
Claudeでは、特に追加料金の扱いに注意が必要です。
公式案内によると、ProプランではFable 5.1は通常の利用枠に含まれず、従量課金の利用クレジットで使います。一方、Maxプランでは通常の週間利用枠のうち最大50%まで、追加料金なしでFableモデルに利用できます。これは「50%分の利用枠が追加される」という意味ではなく、もともとの枠を共有する仕組みです。(出典:Claudeプラン別のFable利用条件)
「有料プランを契約している」「モデルを選択できる」「追加料金なしで使える」は、それぞれ別の話です。
モデル名だけを見て切り替えるのではなく、利用設定や残りの枠も確認しておきましょう。
9.初心者は、どのモデルから試すとよい?
ここまでの情報から、使い分けを考えるなら、次のような方針が現実的です。
すでにSolで仕事ができているなら、すべてをAstraに置き換える必要はありません。 まずは、資料が多い仕事、途中で指示が変わる仕事、何度もやり直していた仕事でAstraを試し、違いを確認するのがよいでしょう。
難しい分析や長い原稿づくりを重視するなら、Fable 5.1も比較対象に入れたいところです。 ただし、文章の読みやすさはモデル名だけで決まらないため、実際の読者や用途に合うかを見ます。
APIを大量に使う場合や、Googleのサービス内で仕事を進めたい場合は、Gemini 3.8 Flashを検討する価値があります。 必要な品質を満たすか確認したうえで、費用や使いやすさを比べます。
これらは公開情報から導いた選び方であり、どの人にも同じモデルを勧めるものではありません。モデルの特性、単価、利用環境を合わせて判断するための目安です。(参考:OpenAIのモデルガイド/Anthropic公式発表/Google公式発表)
同じ仕事を渡すと、違いが見えやすい
実際に比較する際は、モデルごとに違う依頼をするのではなく、同じ資料、同じ条件、同じ完成形を指定してみてください。
たとえば、社内向けの説明文なら、次のような依頼が使えます。
添付した資料をもとに、新しい社内ツールの説明文を作ってください。
読者は、ITに詳しくない社員です。
内容は「何ができるか」「仕事でどう役立つか」「注意点」「利用を始める手順」の順にしてください。資料に書かれている事実と、あなたの提案を分けてください。確認できない内容は推測で埋めず、「未確認」としてください。重要な説明には、根拠となる資料の参照箇所を付けてください。
専門用語はできるだけ避け、800字程度でまとめてください。作成するのは下書きだけで、外部への送信や公開はしないでください。
比較したいのは、文章の見た目だけではありません。
元資料にないことを付け足していないか。大事な条件を落としていないか。読者が理解しやすいか。結局、自分がどれだけ書き直したか。
仕事での使いやすさは、最初に出てきた文章の印象より、「完成までに必要だった手直し」で判断する方が実感に合います。
10.高性能になっても、確認を省いてよいわけではない
Astraは多くの面で進歩していますが、すべての能力が一律に伸びているわけではありません。
Artificial Analysisの発売時の分析では、長い業務の分析品質などで改善が見られた一方、別の業務評価や資料の見せ方に関する評価では、Solが優位な部分も報告されています。(出典:Artificial AnalysisのAstra評価)
また、安全性についても、単純に「新モデルなので安心」とは言い切れません。OpenAIは改善点とともに、監視を逃れるよう促した試験条件では、モデルの内部の思考から問題の兆候を見つけにくくなる課題も公表しています。(出典:OpenAIの安全性に関する説明)
だからこそ、仕事で使う際には、下書きの作成と、公開・送信・データ変更を分けて考えることが大切です。
実際の活用事例でも、人間による確認は残されています。OpenAIが紹介するLegoraの事例では、Astraを使った仕組みが41件の資料を横断して数値を照合し、意図的に仕込まれた4件の誤りをすべて見つけました。ただし、最終判断は専門家が行う運用です。(出典:Legoraの財務資料レビュー事例)
この事例では、特定の財務資料照合の仕事で約40%の性能改善が報告される一方、同社の評価全体では平均約3%の改善でした。「特定の仕事では大きく効くが、すべての仕事で同じように効くわけではない」ことを示す例として読むのが適切です。(出典:Legoraの財務資料レビュー事例)
まとめ:選ぶ基準は「最新かどうか」より「自分の仕事がどれだけ楽になるか」
GPT-6 Astraの登場を、「新しいAIが出たから、すべて乗り換えるタイミング」と考える必要はありません。
注目したいのは、これまで途中で条件が抜けたり、資料の照合で手間がかかったり、何度も指示を出し直したりしていた仕事で、どれだけ改善があるかです。
一方で、難しい問題の検討ではFable 5.1、費用や利用環境ではGemini 3.8 Flash、すでに安定して使えている仕事ではSolというように、比較する価値は残っています。
最終的な判断基準は、ランキングの点数だけではありません。
必要な品質に届くか。根拠を確認できるか。手直しが減るか。料金や利用上限が合うか。
同じ仕事を任せたときに、この違いを確かめることが、自分に合うAIを選ぶための近道です。