「Sonnet 5.5 で十分賢いし、速さも困っていない。わざわざ一段下の Haiku を選ぶ理由ってあるの?」
2026年10月7日に Anthropic が Claude Haiku 5.5 を公開したとき、多くの人がまずこう思ったはずです。実際、同じ日の発表には「Sonnet 5.5 のキャッシュ読み出しを半額にした」という知らせも入っていました。Sonnet 自体が安くなったのなら、なおさら Sonnet 一本でよさそうに見えます。
この記事では、その疑問に実験で答えます。Claude Code(2.1.293)を使い、同じ課題を Haiku 5.5・Sonnet 5.5・Haiku 4.5 に解かせて、正解率・費用・時間を比べました。課題は、公式が「Haiku 5.5 に向いている」と挙げる仕事(サブエージェント、分類)と、「Sonnet のほうが向いている」と挙げる仕事(コーディング)の両方から選んでいます。
先に結論を書きます。
- 品質だけで比べれば「Sonnet で十分」は正しい。Haiku 5.5 にできることは Sonnet 5.5 にもでき、77 種類の問い合わせ分類では Sonnet 5.5 が 81%、Haiku 5.5 は 60% と大差がつきました。公式のベンチマークでも、長く複雑なコーディング作業では、Haiku 5.5 を最大の effort で動かすより、それより安く済む設定の Sonnet 5.5 のほうが正解率が高くなっています
- それでも Haiku 5.5 を使う理由は、同じ結果が出る仕事を、Sonnet 5.5 の 1/4〜1/9 の費用でこなせるからです(1 トークンの単価は 1/20)。コードを調べて答える 9 問は両者とも全問正解で、費用は約 1/8。範囲を区切ったバグ修正・機能追加 12 課題も両者とも全部合格で、費用は約 1/4.5 でした。ただし、コーディングでは Haiku 5.5 のほうがやり取りの回数が多く、待ち時間はむしろ長くなりました
- いちばん現実的な使い方は「Sonnet をやめて Haiku にする」ではなく、Sonnet を指揮役に残し、調べものをする係(サブエージェント)だけ Haiku 5.5 にすることです。この構成で、正解率を落とさずに費用が 58% 減りました
想定読者は、Claude Code や Claude API をふだん使っていて、モデルの使い分けに迷っている人です。前半で Haiku 5.5 の中身を整理し、後半で 5 つの実験の結果と、Claude Code での設定方法を説明します。
この記事の確認範囲
- 検証日:2026年10月8日。モデルは
claude-haiku-5-5・claude-sonnet-5-5・claude-haiku-4-5 - 実行環境:Claude Code 2.1.293(npm で実験フォルダにだけ導入)を
claude -p(対話なしの実行モード)で起動。認証は Claude Max のログイン。macOS(Apple M5 Max) - 費用:Claude Code が表示する推定額ではなく、記録したトークン数に公式料金表の単価を掛けて計算しました(理由は後述)
- 公式情報:Anthropic の発表ページ「Introducing Claude Haiku 5.5」、Claude Platform の料金ページ、Claude Code ドキュメント(Sub-agents・Model configuration)。いずれも 2026-10-08 に確認
- 実験に使った題材:Python のライブラリ sqlite-utils 3.38(Apache 2.0)と、問い合わせ分類のデータセット Banking77(CC BY 4.0)
結論を 1 枚で:Sonnet を残して、調査係だけ替える
まず、この記事でいちばん伝えたい構成を図で見てください。左が「全部 Sonnet 5.5」、右が「指揮役は Sonnet 5.5、調べものの係だけ Haiku 5.5」です。
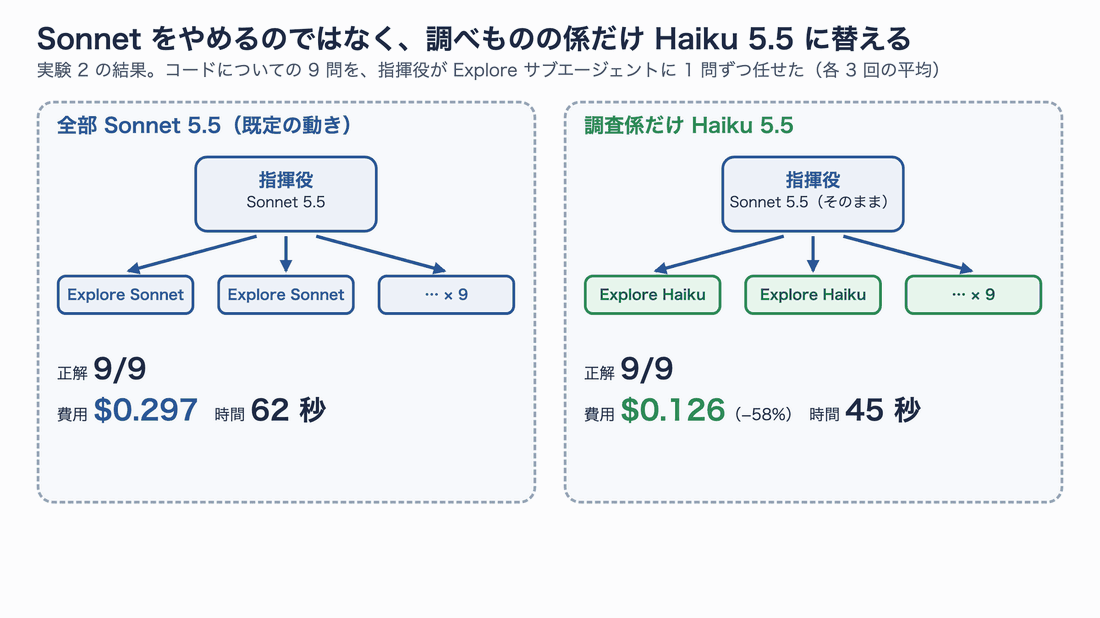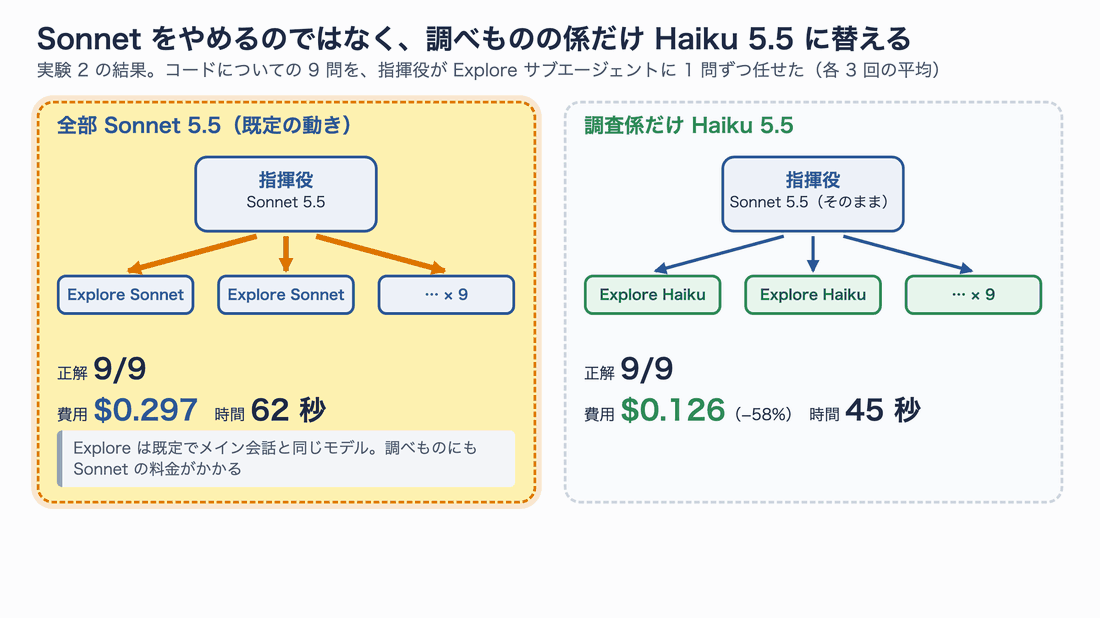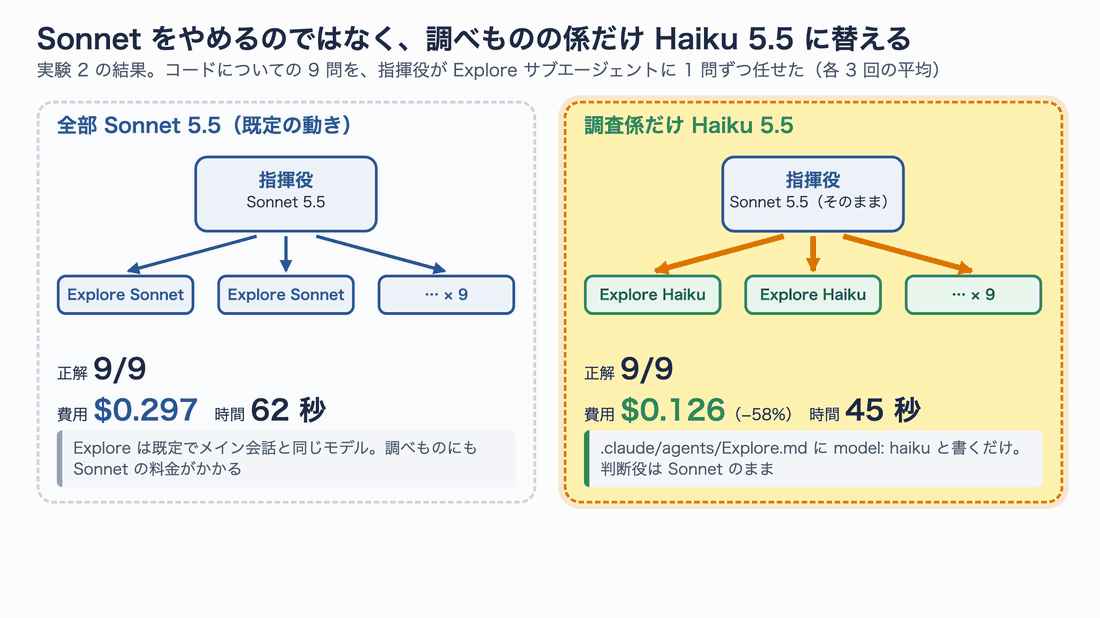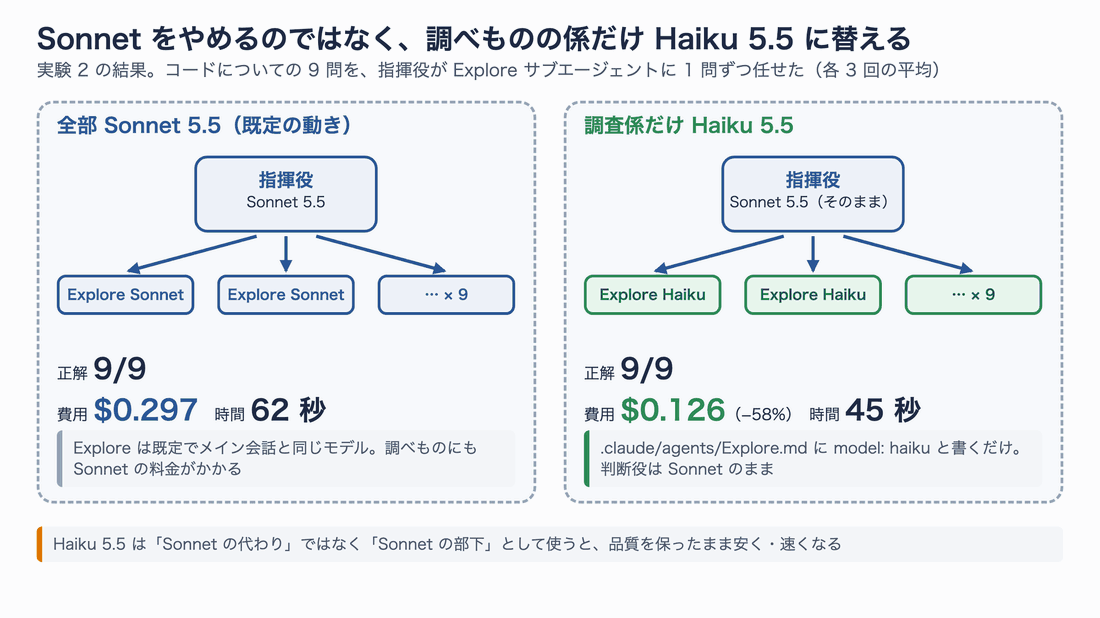
同じ 9 問・同じ指示で 3 回ずつ実行した平均。正解はどちらも 9 問中 9 問。費用は 58% 減、時間も 62 秒から 45 秒に縮んだ
Haiku 5.5 は「Sonnet の代わり」ではなく、「Sonnet の部下」として使うと強みが出ます。答えが 1 か所に決まる調べもの、要約、定型の判断のように、範囲がはっきりした小さな仕事を数多くこなす役目です。逆に、全体の設計や、似た選択肢の細かい違いを見分ける判断は、Sonnet 以上に任せたほうが安全です。
この線引きを、ここから順番に確かめていきます。
Claude Haiku 5.5 とは:何が変わったのか
主な仕様
公式発表と料金ページの内容を表にまとめます。比較のため、前の世代の Haiku 4.5 と Sonnet 5.5 も並べました。
| 項目 | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| API のモデル ID | claude-haiku-5-5 | claude-haiku-4-5 | claude-sonnet-5-5 |
| 入力(100 万トークンあたり) | $0.10(10 万超は $0.50) | $1.00 | $2.00 |
| 出力(同) | $0.50(10 万超は $2.50) | $5.00 | $10.00 |
| キャッシュ読み出し(同) | $0.01(10 万超は $0.05) | $0.10 | $0.10(10/7 に $0.20 から値下げ) |
| effort(考える深さ)の調整 | low〜max の 5 段階 | なし | low〜max の 5 段階 |
| API での effort の既定値 | medium | — | high |
| コンテキスト長 | 100 万トークン | 20 万トークン | 100 万トークン |
| 最大出力 | 12.8 万トークン | 6.4 万トークン | 12.8 万トークン |
ここで押さえておきたい点が 3 つあります。
1 つ目は、1 トークンあたりの値段が Sonnet 5.5 のちょうど 20 分の 1 だということです。Haiku 4.5 と比べても 10 分の 1 になりました。
2 つ目は、プロンプトが 10 万トークンを超えると単価が 5 倍になることです。公式は「Haiku 4.5 へのリクエストの約 9 割は 10 万トークン以下だった」と説明しています。5 倍になっても Sonnet 5.5 の 4 分の 1 なので割高ではありませんが、後で説明するように、気づかないうちに 10 万を超える使い方をしていることがあります。
3 つ目は、Haiku で初めて effort を選べるようになったことです。effort は「どれだけ考えてから答えるか」の設定で、low にすると速く安く、max にすると時間とトークンを使って慎重に答えます。
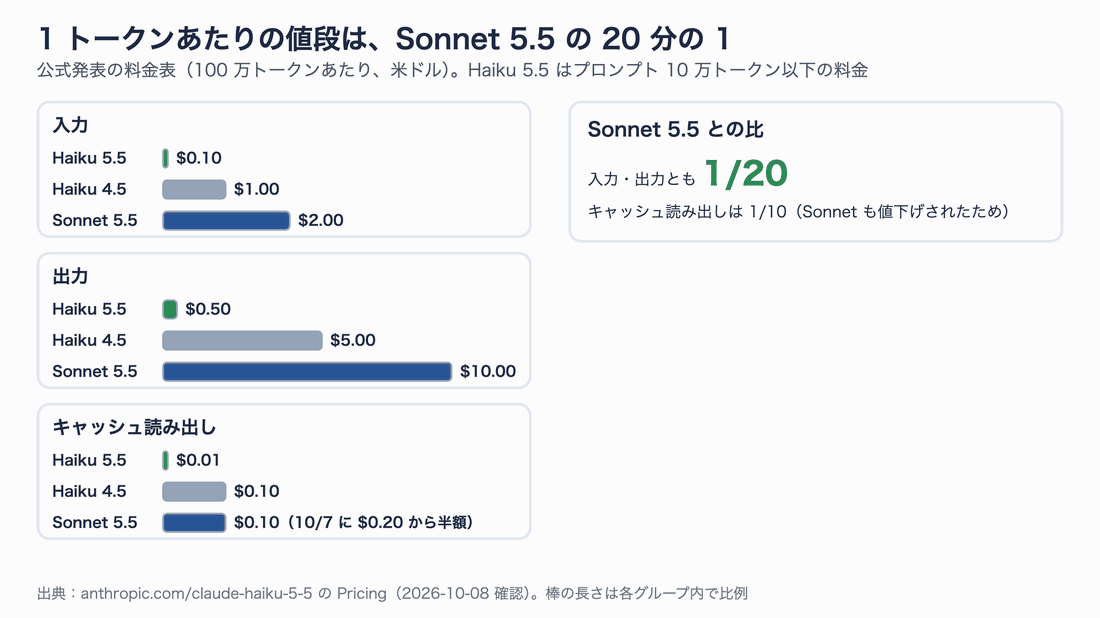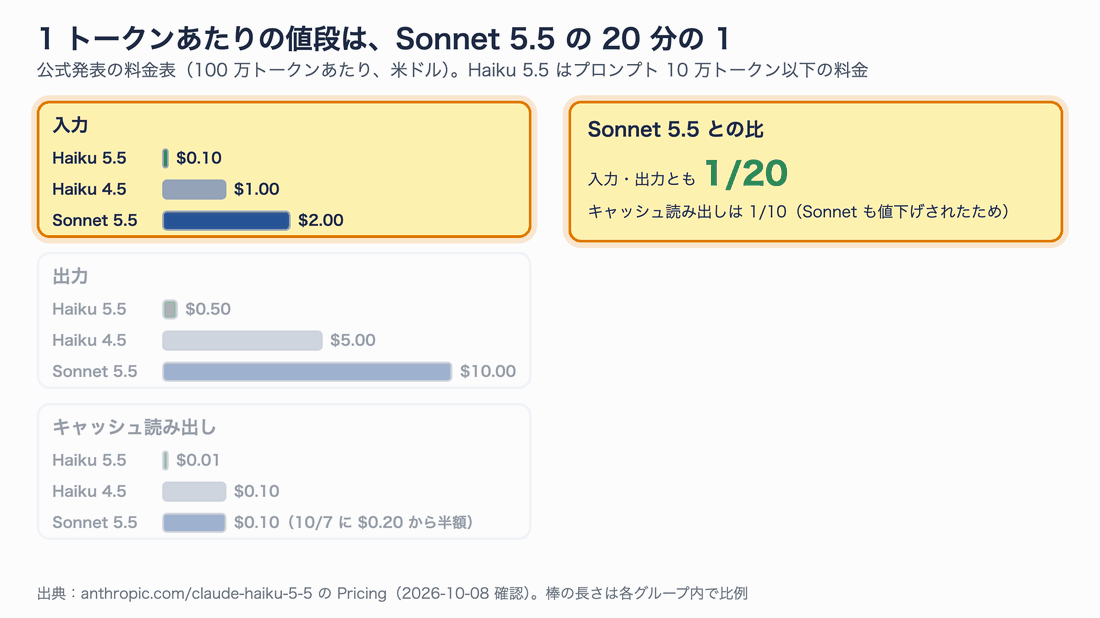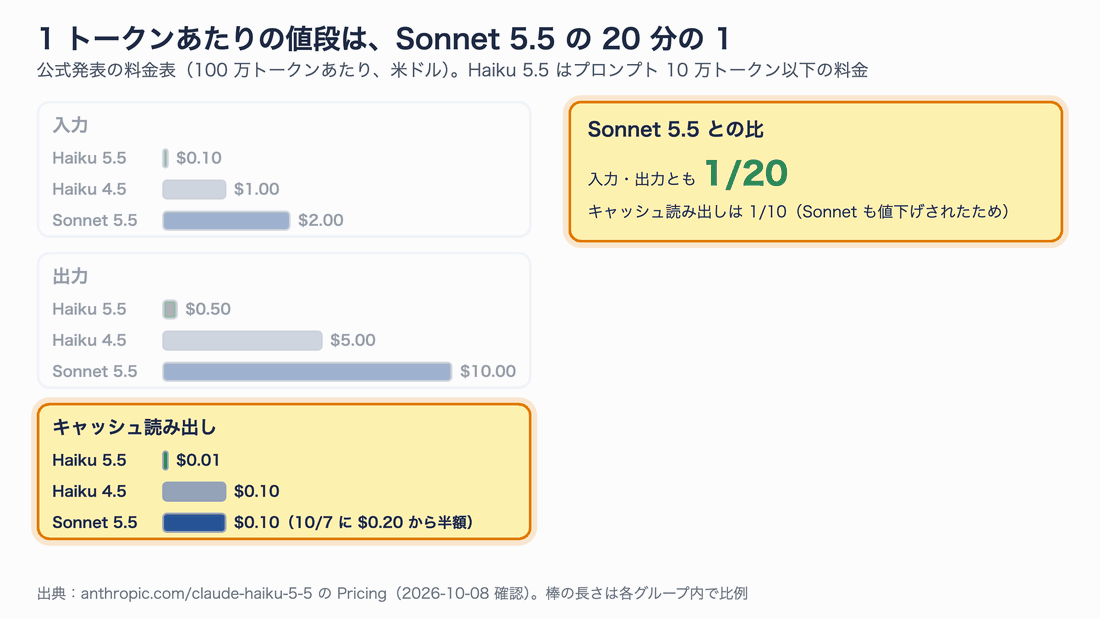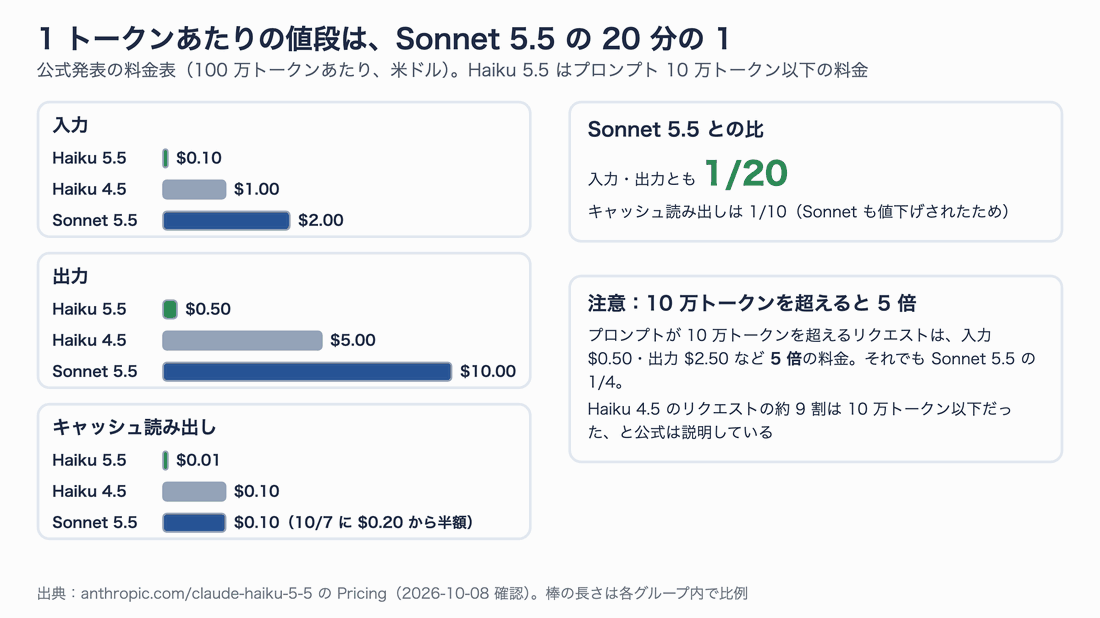
棒はグループごとに比例。Sonnet 5.5 も同じ日にキャッシュ読み出しが半額になったので、キャッシュ読み出しだけは差が 10 倍に縮んでいる
公式ページの料金表は次のとおりです。
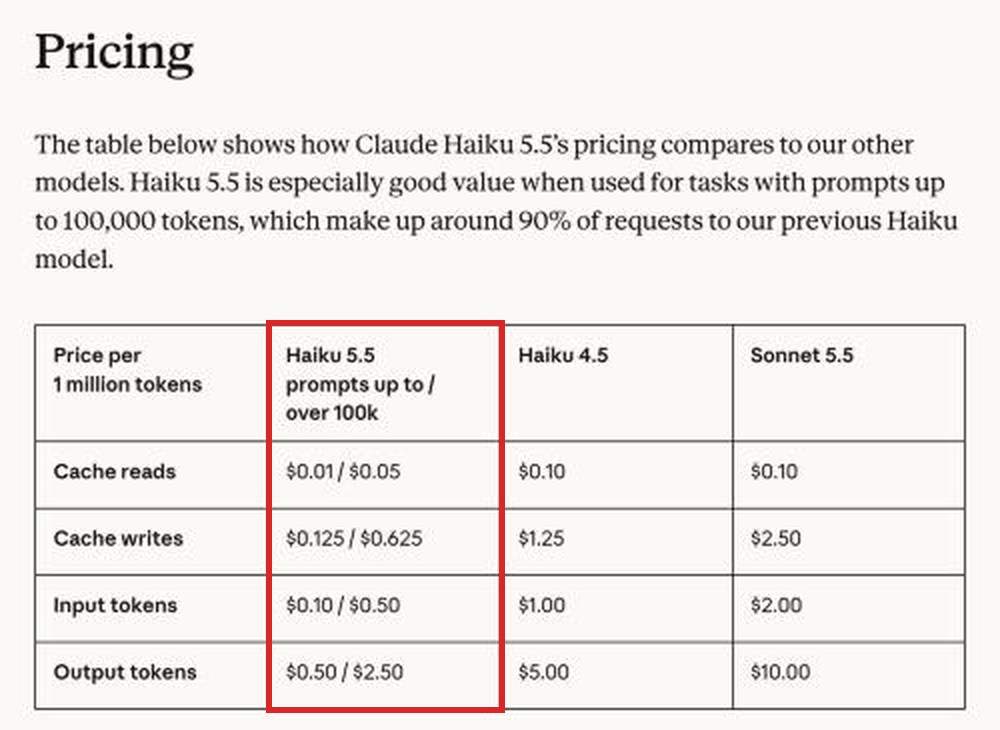
出典:Anthropic「Introducing Claude Haiku 5.5」の Pricing(2026-10-08 に撮影)
公式ベンチマークで見る「得意・不得意」
公式発表には、Haiku 5.5・Haiku 4.5・Sonnet 5.5 などのベンチマーク結果が載っています。主なものを抜き出しました。
| ベンチマーク(測るもの) | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| OSWorld 2.1(パソコン操作) | 72.4% | 15.7% | 83.9% |
| GDPval-AA v2.1(知的作業) | 1620 | 735 | 1840 |
| Humanity’s Last Exam(難問、道具なし) | 45.9% | 10.2% | 56.9% |
| Terminal-Bench 4.0(端末での長いコーディング作業) | 39.2% | 0.0% | 70.6% |
Haiku 4.5 からの伸びは大きく、パソコン操作では Sonnet 5.5 にかなり近づいています。一方、Terminal-Bench 4.0 だけは Sonnet 5.5 の半分ほどです。これは、端末の上で何十手もかけて課題を解く、長く複雑な作業を測るベンチマークです。
公式ページには、この Terminal-Bench 4.0 の「正解率と費用」のグラフも載っています。
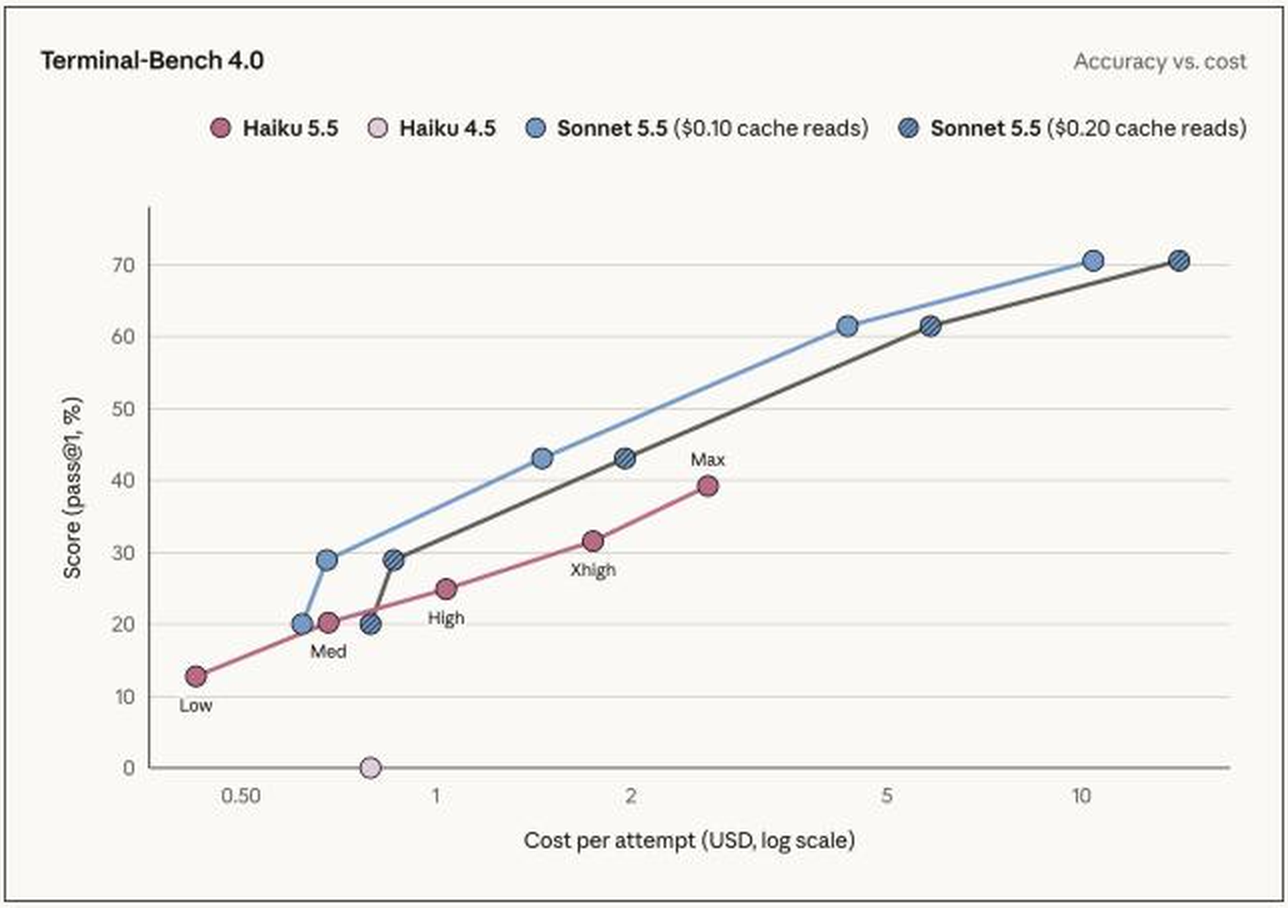
出典:Anthropic「Introducing Claude Haiku 5.5」(2026-10-08 に撮影)。赤い線が Haiku 5.5 の effort ごとの点、青い線が値下げ後の Sonnet 5.5
このグラフは「Sonnet で十分では?」という疑問に対する、公式からの率直な答えになっています。グラフから読み取った概数ですが、Haiku 5.5 は effort を max まで上げると 1 回 2.5 ドルほどかかって約 39% です。一方、Sonnet 5.5(値下げ後)は 1 回 1.5 ドル前後の点ですでに約 43% に届いています。同じ 0.6〜0.7 ドルほどの費用で比べても、Haiku 5.5 の medium が約 20%、Sonnet 5.5 は約 20〜29% です。長く複雑なコーディングでは、Haiku を頑張らせるより Sonnet を使うほうが、安くて正解率も高いのです。公式も「複雑なエージェント型コーディングには Sonnet 5.5 と Opus 5.5 のほうが向いている。Haiku 5.5 は、要約・コンパクション(会話の圧縮)・サブエージェントのような範囲の狭い仕事に向く」と書いています。
同じ日に発表された、ほかの変更
Haiku 5.5 の発表には、次の 2 つも含まれていました。どちらも使い分けの判断に関わります。
- Sonnet 5.5 のキャッシュ読み出しが半額(100 万トークンあたり $0.20 → $0.10)。エージェントの処理はキャッシュ読み出しが多いため、公式は「多くのエージェント処理で Sonnet 5.5 の費用が約 20% 下がる」としています
- Max・Team プランに毎月の API クレジット。Max 5x は月 $100、Max 20x は月 $200、Team は最大 $500(利用者全員で共有)。どのモデルにも使えます
Sonnet が安くなったぶん、「Sonnet で十分」という感覚はさらに強くなりました。それでも Haiku を使う意味があるのかを、ここから実験で確かめます。
検証の設計:5 つの実験
実験は、Haiku 5.5 に任せたくなる仕事と、任せるか迷う仕事から 5 つ選びました。
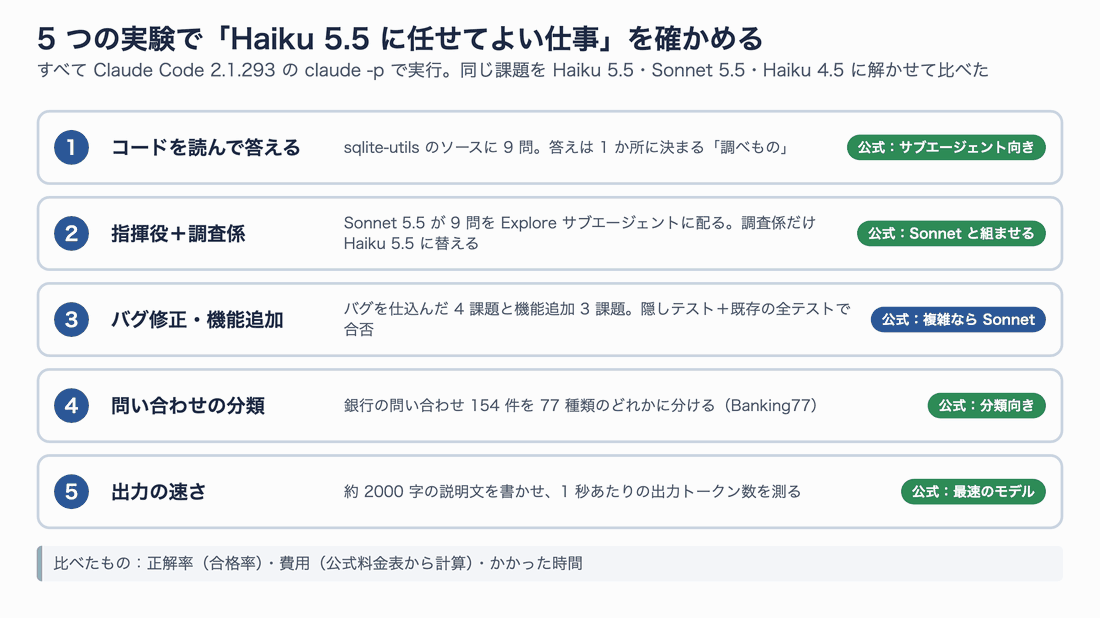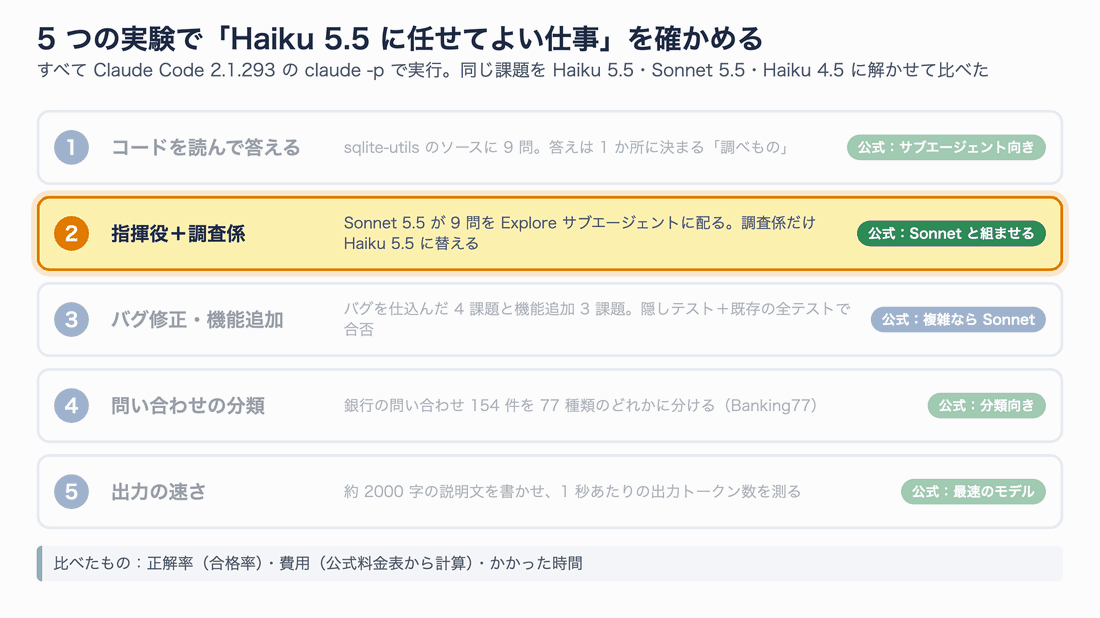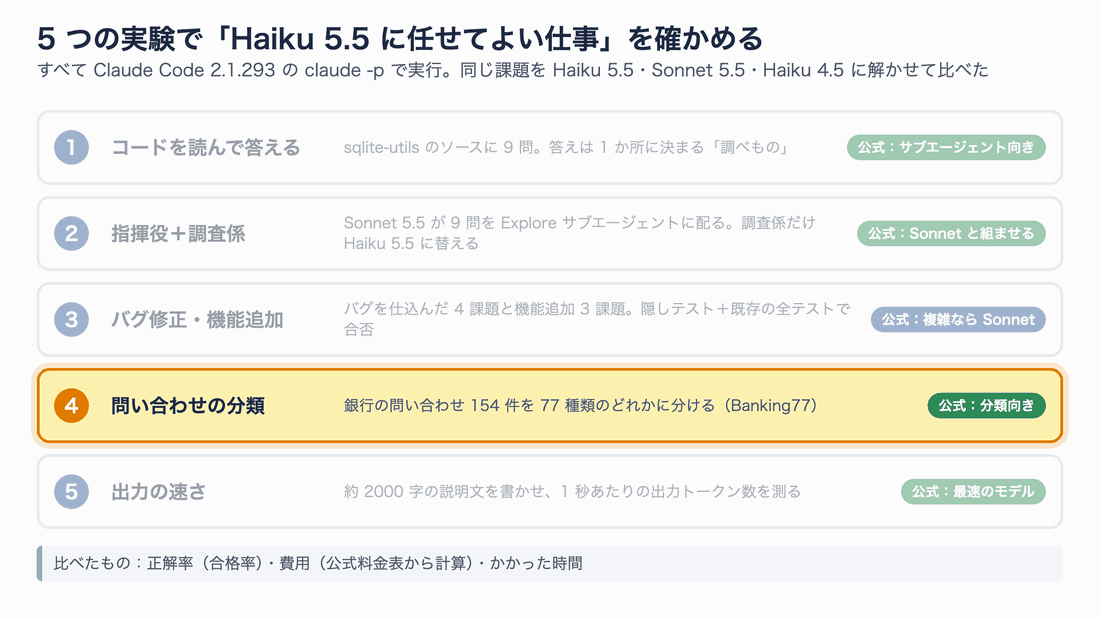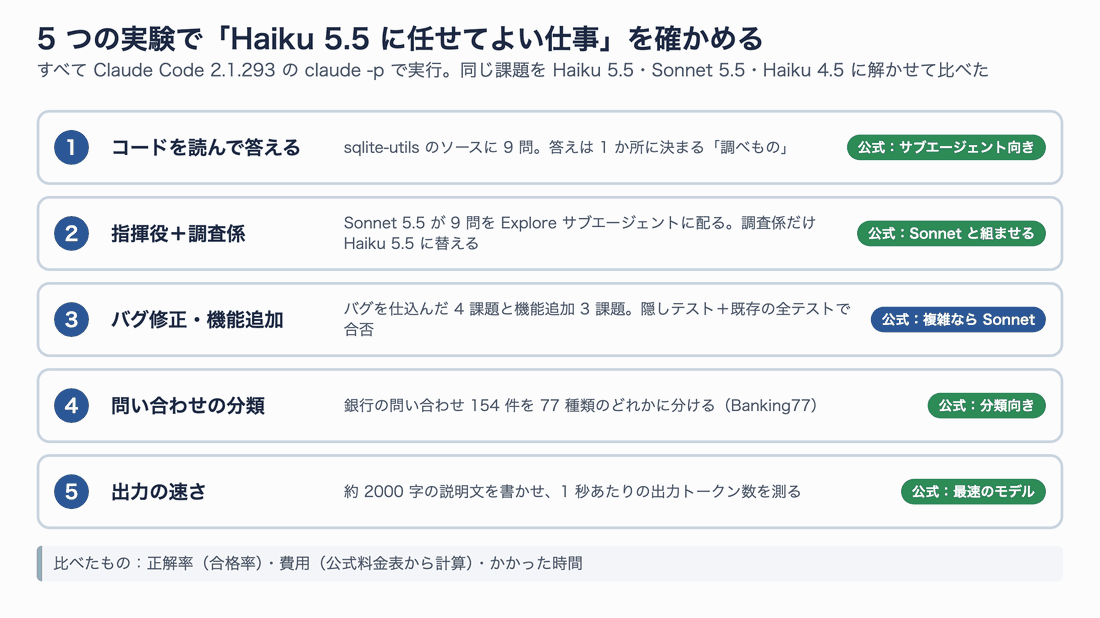
実験 1・2・4・5 は公式が Haiku 5.5 の用途として挙げる仕事、実験 3 は公式が「複雑なら Sonnet」とする仕事
比べたモデルと設定は次のとおりです。
| 呼び名 | モデル | effort |
|---|---|---|
| Haiku 5.5 low | claude-haiku-5-5 | low |
| Haiku 5.5 medium | claude-haiku-5-5 | medium(既定) |
| Haiku 5.5 high | claude-haiku-5-5 | high(実験 3・4 のみ) |
| Haiku 5.5 max | claude-haiku-5-5 | max(実験 4 のみ) |
| Sonnet 5.5 | claude-sonnet-5-5 | medium(API の既定は high。Haiku と条件をそろえた) |
| Haiku 4.5 | claude-haiku-4-5 | (設定なし) |
実験の準備
実験はすべて、Claude Code を claude -p で起動して行いました。Claude Code の本体はふだん使っているものとは別に、実験フォルダにだけ最新版を入れています。
# 実験用フォルダに Claude Code 2.1.293 を入れる(本体の更新はしない)
mkdir -p lab/cc && cd lab/cc
npm init -y
npm install @anthropic-ai/claude-code@2.1.293
./node_modules/.bin/claude --version   # 2.1.293 (Claude Code)
Haiku 5.5 を正しく扱えるのは 2.1.293(10月7日公開)からです。手元にあった 2.1.288 で --model claude-haiku-5-5 を指定すると、動きはするものの unrecognized_model という警告が出て、「OK とだけ返して」という 1 回の呼び出しの費用推定が $0.078 と表示されました。同じトークン数を Haiku 5.5 の単価で計算すると約 $0.002 なので、40 倍近い過大表示です。2.1.293 では正しい単価で計算されます。
1 回の実行は、次のような形です。ふだんの設定(個人用の CLAUDE.md やフック)が結果に混ざらないよう、実験フォルダの .claude/settings.local.json で切り離しています。
# 実験に使うフォルダ(lab/ と同じ階層)で実行する
# 個人用の CLAUDE.md とフックを無効にする(<HOME> は自分のホームディレクトリの絶対パスに置き換える)
mkdir -p .claude
cat > .claude/settings.local.json <<'EOF'
{"claudeMdExcludes": ["<HOME>/.claude/CLAUDE.md"], "disableAllHooks": true}
EOF

# Haiku 5.5(effort low)に、読み取り系のツールだけを渡して質問する
CLAUDE_CODE_DISABLE_ADVISOR_TOOL=1 ./lab/cc/node_modules/.bin/claude -p "質問文" \
  --model claude-haiku-5-5 --effort low \
  --tools "Read,Grep,Glob,Bash" \
  --setting-sources project,local \
  --strict-mcp-config \
  --output-format stream-json --verbose < /dev/null > log.jsonl
--output-format stream-json にすると、1 回ごとのリクエストのトークン数(入力・キャッシュの読み書き・出力)が記録されます。費用はこの数字に公式の単価を掛けて計算しました。Claude Code が最後に出す推定額(total_cost_usd)を使わなかったのは、2.1.293 でも Sonnet 5.5 のキャッシュ読み出しを値下げ前の $0.20 で計算していたためです。なお Claude Code はキャッシュを 1 時間保持する設定で書き込むため、キャッシュ書き込みは入力単価の 2 倍で計算しています。
計測でつまずいた点:コネクタがプロンプトを膨らませる
最初の試運転で、Haiku 5.5 に 1 問解かせただけで費用が $0.156 になりました。調べると、3 回目のリクエストのプロンプトが 15 万トークンに膨らんでいました。
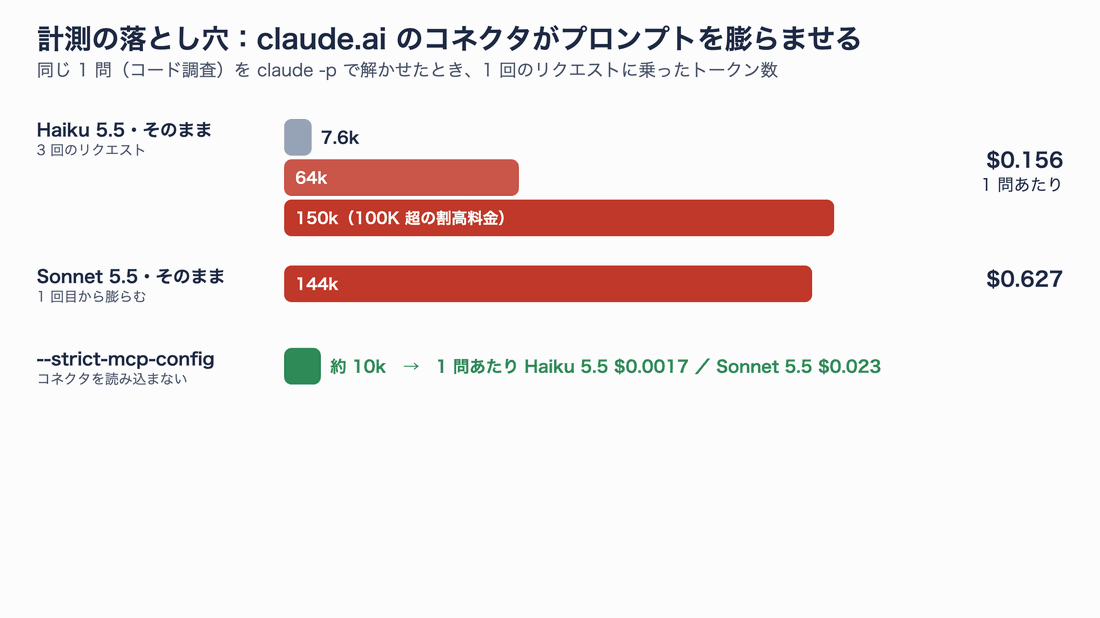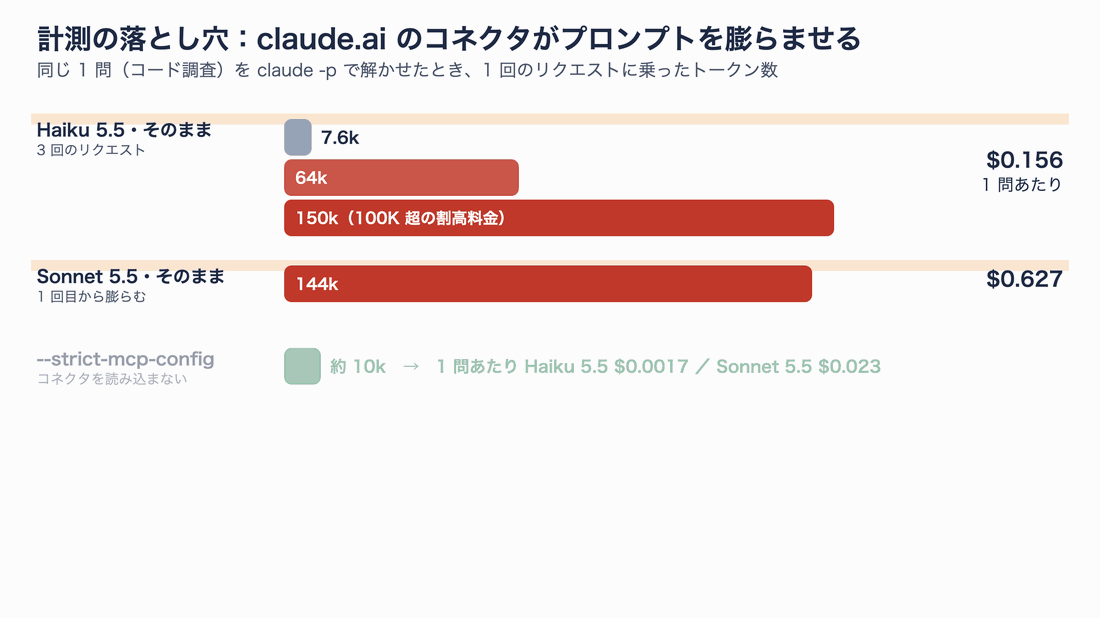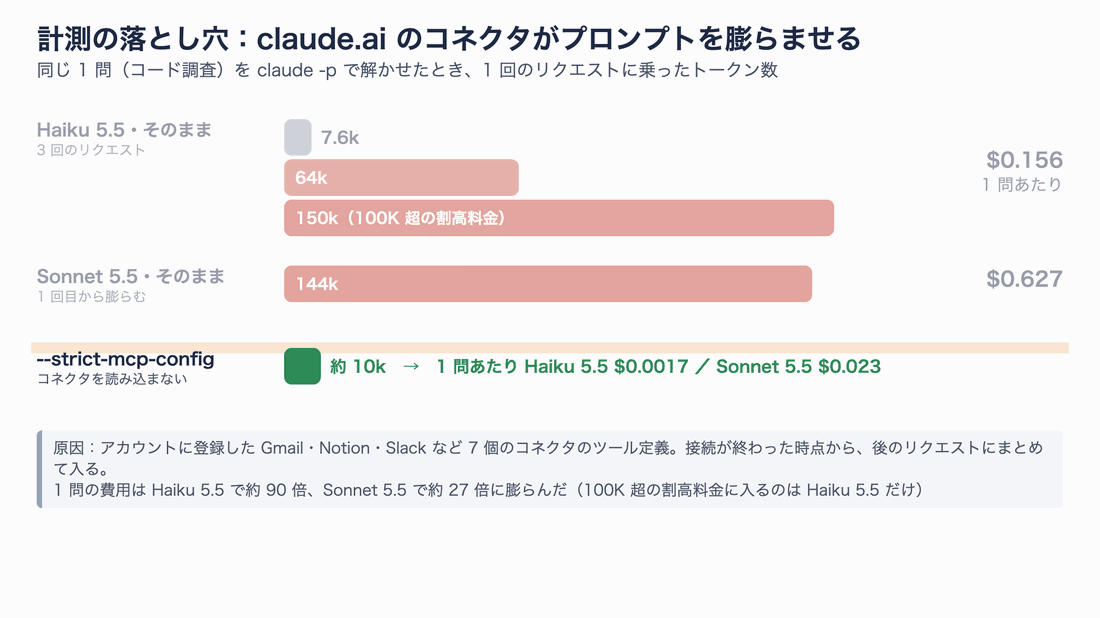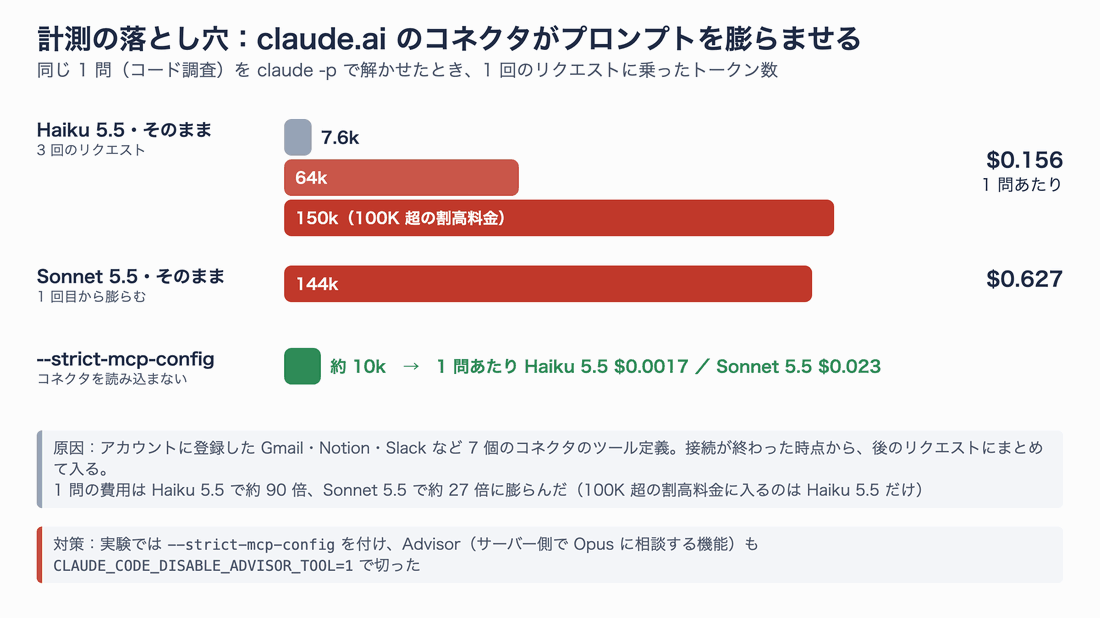
原因は claude.ai に登録しているコネクタ(Gmail・Notion・Slack など 7 個)のツール定義。接続が終わった時点から、後のリクエストにまとめて入る
--tools で使えるツールを絞っても、claude.ai 側のコネクタ(MCP サーバー)は別扱いで読み込まれます。接続は非同期なので、最初の数リクエストは小さく、接続が終わった時点から一気に増えます。Haiku 5.5 の場合は 10 万トークンを超えて単価 5 倍の料金帯に入り、1 問の費用が約 90 倍になっていました。
--strict-mcp-config を付けるとコネクタが読み込まれなくなり、プロンプトは約 1 万トークンに収まりました。あわせて、サーバー側で Opus 5.5 に相談する「Advisor」機能も CLAUDE_CODE_DISABLE_ADVISOR_TOOL=1 で切り、モデル単体の比較にしています。
これは実験だけの話ではありません。ふだんの Claude Code でも、コネクタを多く登録していると、その定義が毎回のプロンプトに乗ります。Haiku 5.5 を安く使うつもりなら、10 万トークンの境目を意識して、不要なコネクタを外しておくのが効果的です。
実験 1:コードを読んで答える(サブエージェントの典型的な仕事)
やったこと
sqlite-utils 3.38 のソースコードに対して、答えが 1 か所に決まる質問を 9 問作りました。たとえば「insert_all() は既定で何行ずつ INSERT するか。列が多いときはどう減らすか」「sqlite-utils memory に同じ名前の CSV を 2 つ渡すと、2 つ目は何というテーブルになるか」といった質問です。正解は実際にコードを読み、いくつかはコマンドを実行して確かめました。
各モデルには Read・Grep・Glob・Bash の 4 つのツールだけを渡し、「推測せずコードで確かめ、最後の行に ANSWER: で答える」よう指示しました。9 問を 2 回ずつ、計 18 回です。これは、Claude Code の Explore サブエージェント(調べもの専門の係)がふだんしている仕事とほぼ同じです。
結果
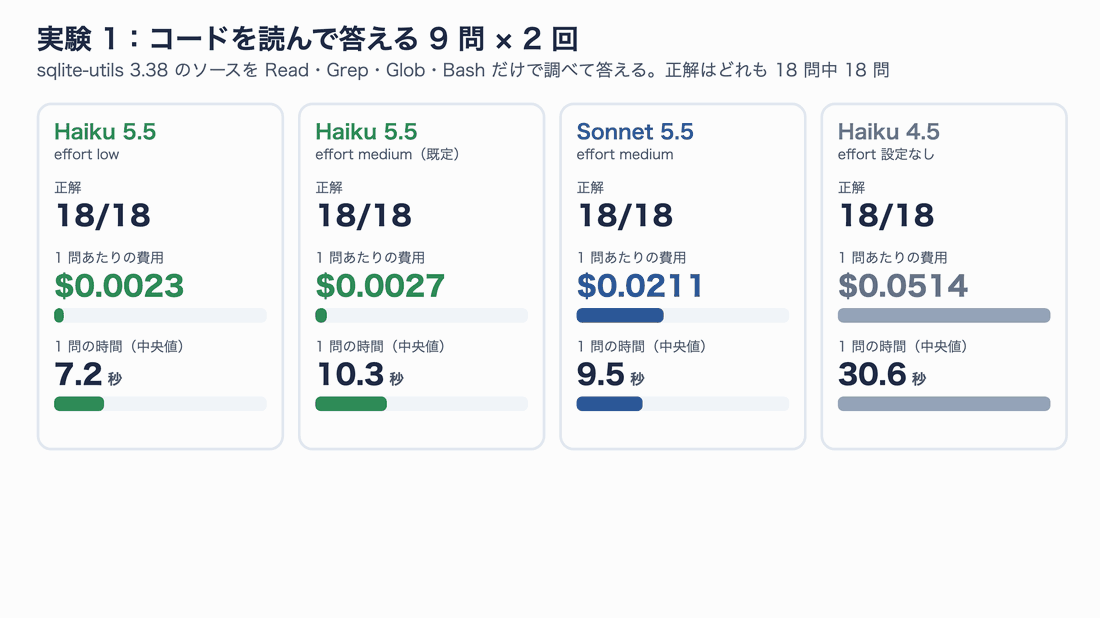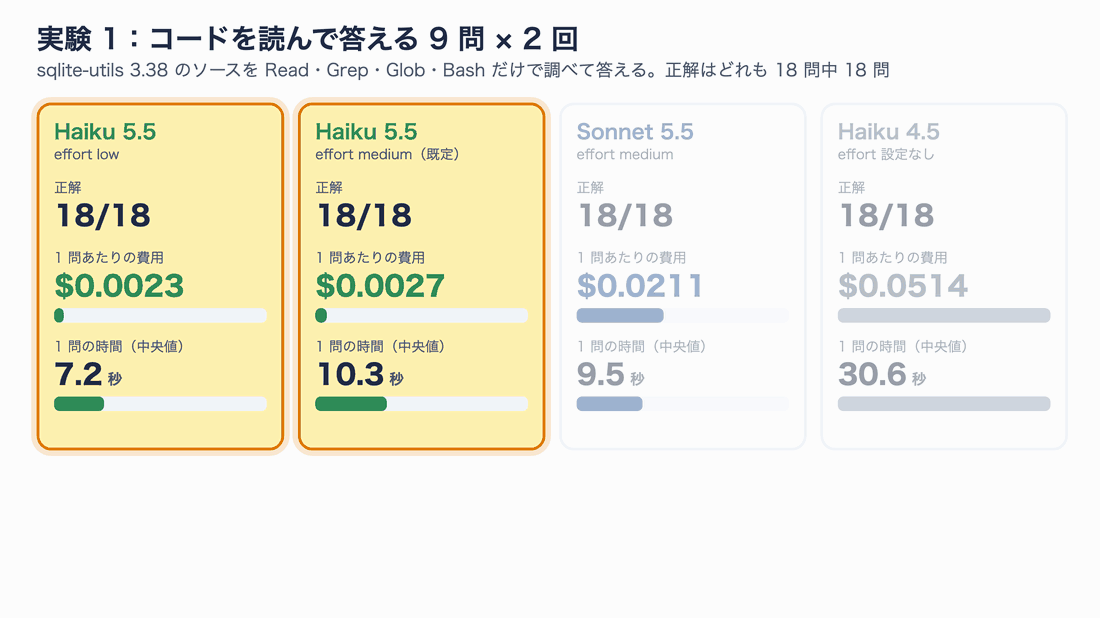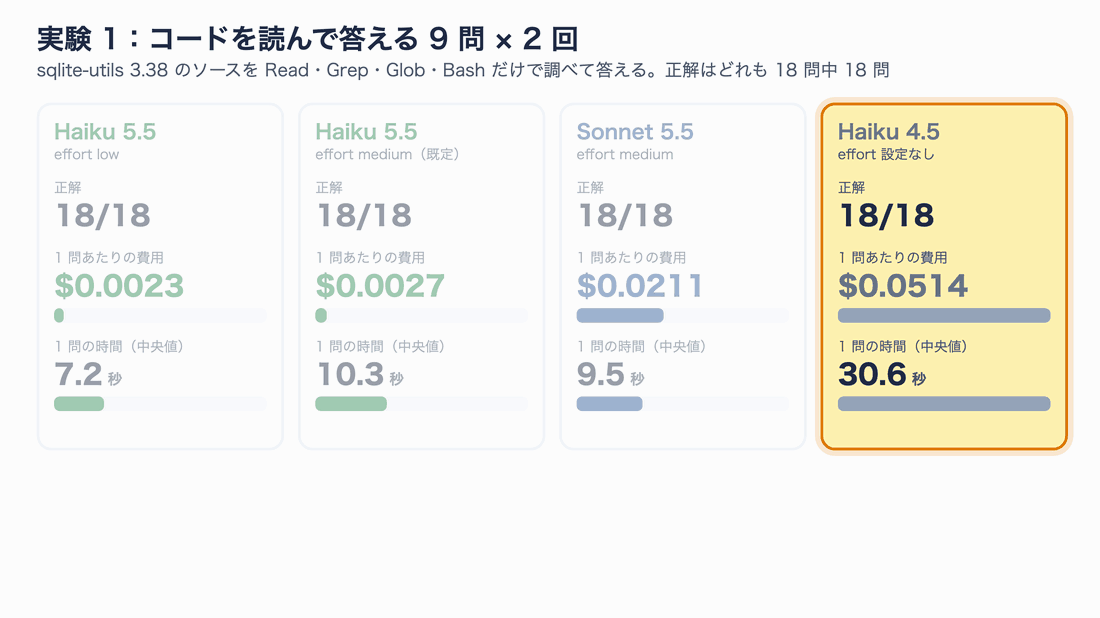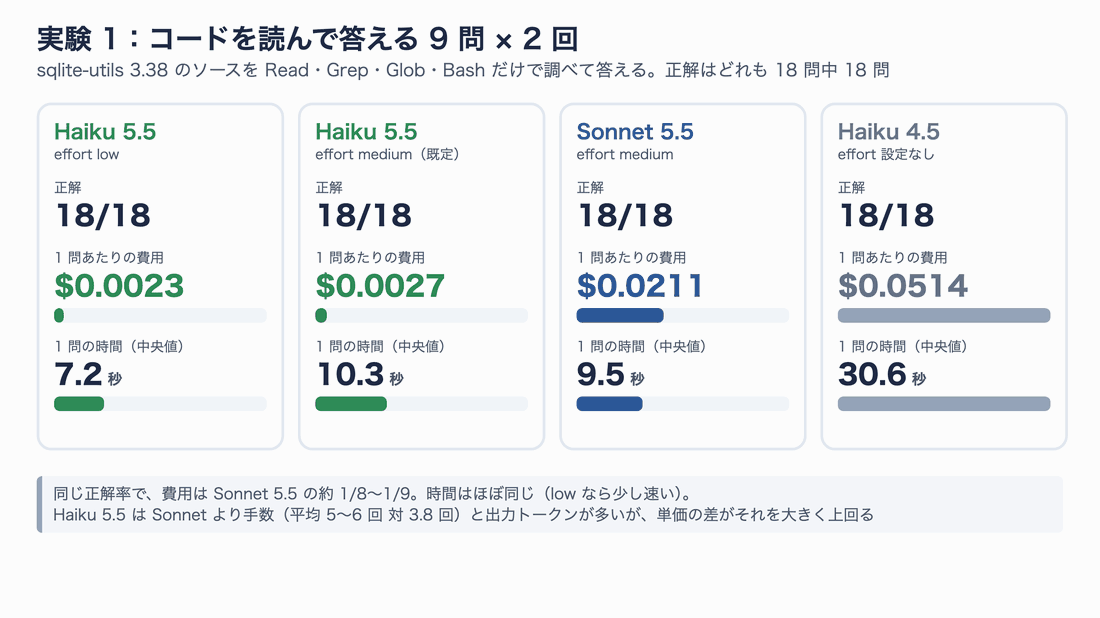
正解率は全設定で同じ。差が出たのは費用と時間だけだった
| 設定 | 正解 | 1 問の費用 | 1 問の時間(中央値) | 平均の手数(ターン) |
|---|---|---|---|---|
| Haiku 5.5 low | 18/18 | $0.0023 | 7.2 秒 | 5.2 |
| Haiku 5.5 medium | 18/18 | $0.0027 | 10.3 秒 | 6.4 |
| Sonnet 5.5 | 18/18 | $0.0211 | 9.5 秒 | 3.8 |
| Haiku 4.5 | 18/18 | $0.0514 | 30.6 秒 | 9.3 |
全設定が全問正解でした。こうした「答えが 1 か所に決まる調べもの」では、Sonnet 5.5 の賢さは結果に表れません。差が出たのは費用で、Haiku 5.5 は Sonnet 5.5 の約 1/8〜1/9 でした。
面白いのは、Haiku 5.5 のほうが手数が多いことです。Sonnet 5.5 が平均 3.8 回のやり取りで答えるところを、Haiku 5.5 は 5〜6 回かけ、出力トークンも 1.5〜1.8 倍使っていました。公式も「Haiku 5.5 は新しいトークナイザーのため、同じ仕事に少し多くのトークンを使う」と説明していますが、今回の差はそれよりも、ツールを呼ぶ回数の差によるものが大きいようです。それでも単価が 20 分の 1 なので、合計では大差で安くなります。
時間は、medium の Haiku 5.5 と Sonnet 5.5 がほぼ同じで、low にすると少し速くなりました。前の世代の Haiku 4.5 は手数が多く(9.3 回)、時間も費用も Sonnet 5.5 より悪い結果でした。「Haiku=安くて速い」は 5.5 で初めて、このような調べもので本当になったと言えます。
実験 2:指揮役は Sonnet 5.5、調査係だけ Haiku 5.5
やったこと
実際の Claude Code では、メインの会話(指揮役)がサブエージェントに仕事を配ります。ここで注意が必要なのは、組み込みの Explore サブエージェントは、既定ではメイン会話と同じモデルで動くことです。メインが Sonnet 5.5 なら、調べものも Sonnet 5.5 が担当します。
そこで、実験 1 の 9 問をまとめて Sonnet 5.5 に渡し、「1 問ずつ Explore に任せ、自分ではファイルを読まない」と指示しました。Explore の定義だけを差し替えた 2 つの構成と、参考として全部 Haiku 5.5 の構成を、3 回ずつ実行しています。
- 全部 Sonnet 5.5:Explore は
model: inherit(メインと同じ) - 調査係だけ Haiku:Explore は
model: haiku(2.1.293 では Haiku 5.5) - 全部 Haiku 5.5:メインも Haiku 5.5
Explore の差し替えには、プロジェクトの .claude/agents/Explore.md を使いました。
---
name: Explore
description: Read-only codebase search agent. Use it to locate code and answer questions about this repository; give it one focused question at a time.
tools: Read, Grep, Glob, Bash
model: haiku
---

You are a read-only code search agent for this repository. Find the code that answers the question you are given, verify it by reading the relevant lines, and reply with a concise answer that cites file paths and line numbers. Do not modify any files.
結果
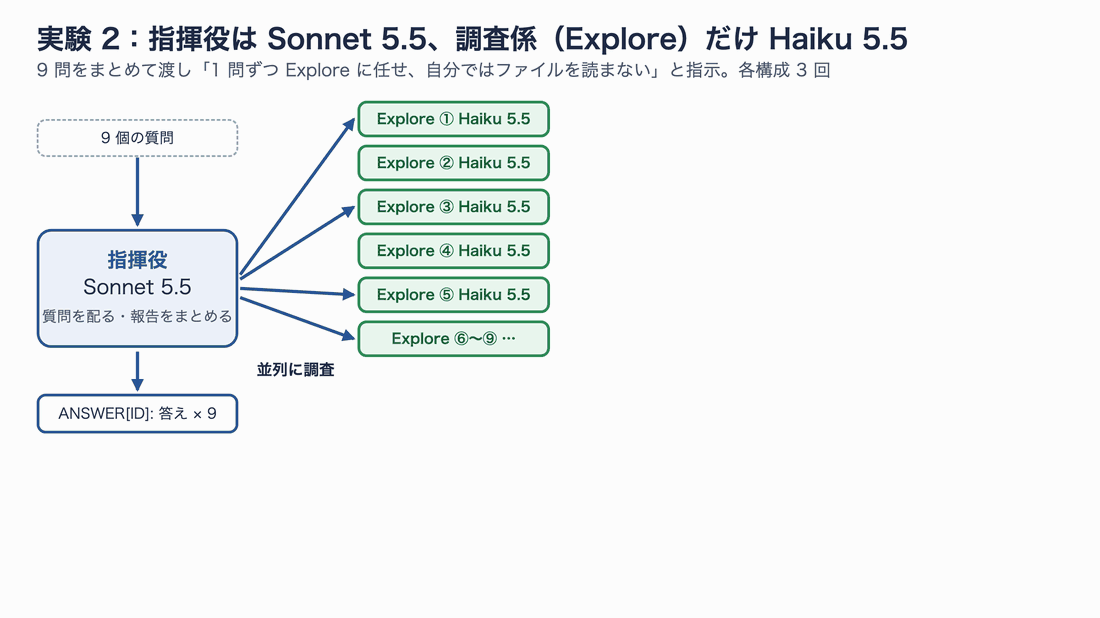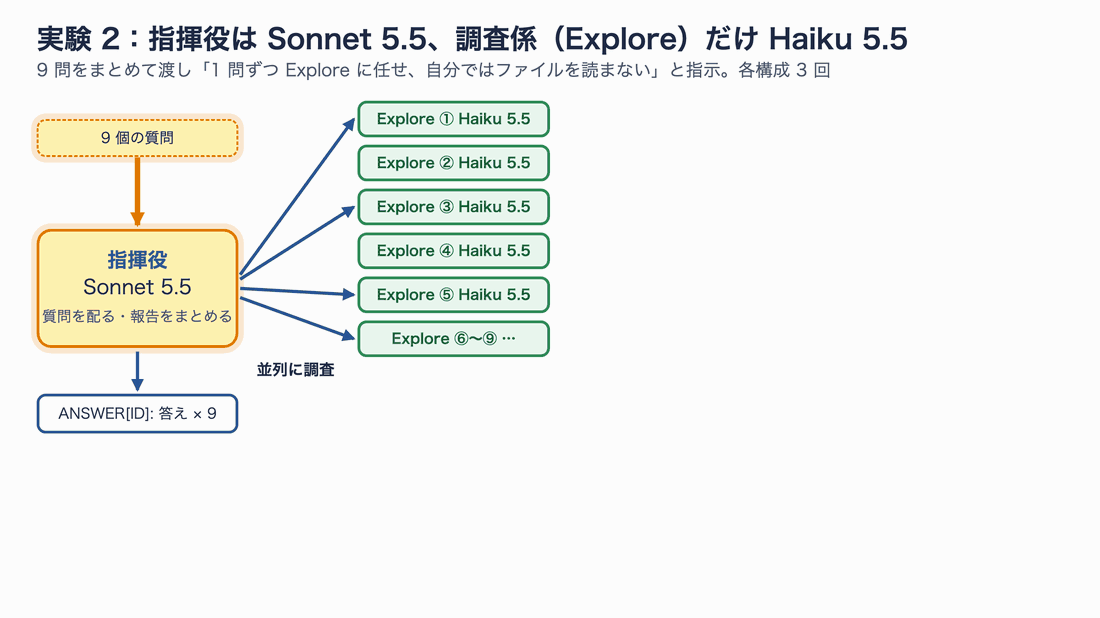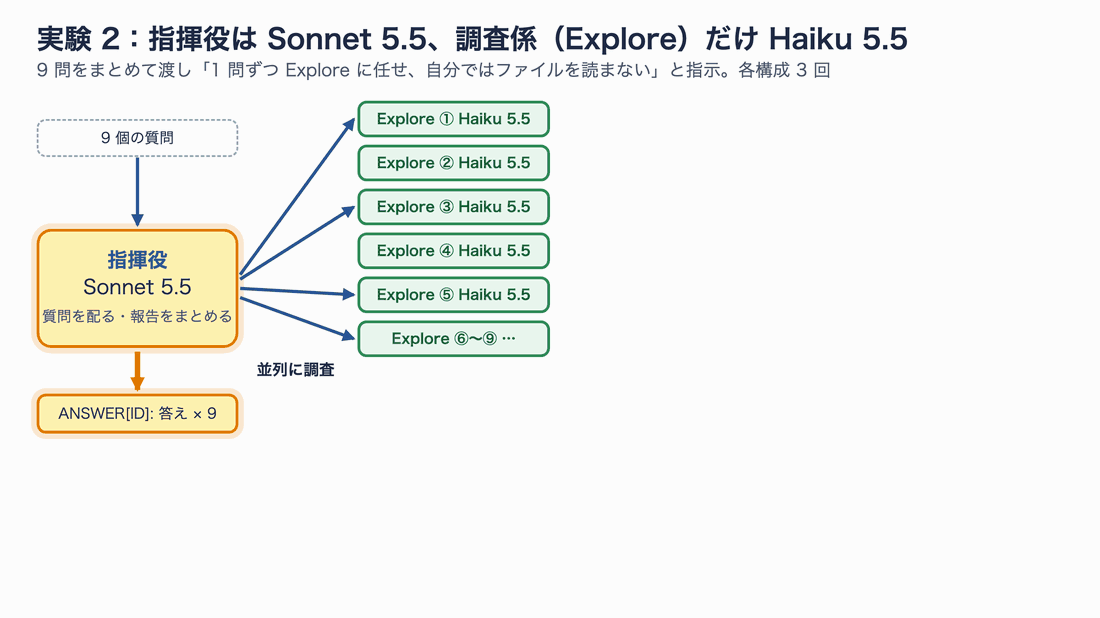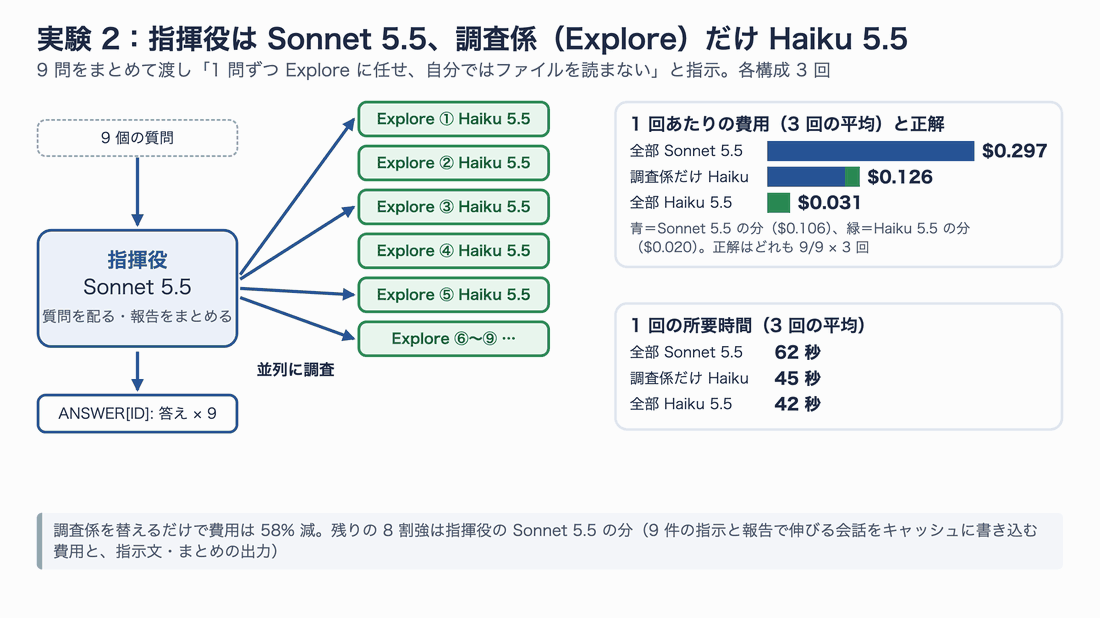
3 構成とも 9 問すべて正解(3 回とも)。調査係を替えただけで費用は 58% 減った
| 構成 | 正解 | 1 回の費用 | うち Sonnet 5.5 | うち Haiku 5.5 | 1 回の時間 |
|---|---|---|---|---|---|
| 全部 Sonnet 5.5 | 9/9 × 3 回 | $0.297 | $0.297 | — | 62 秒 |
| 調査係だけ Haiku 5.5 | 9/9 × 3 回 | $0.126 | $0.106 | $0.020 | 45 秒 |
| 全部 Haiku 5.5 | 9/9 × 3 回 | $0.031 | — | $0.031 | 42 秒 |
どの構成も、3 回とも 9 問すべて正解しました。指揮役は毎回 9 体の Explore を起動し、自分ではファイルを読まずに(Bash を使ったのは報告を待つ sleep だけでした)、9 件の報告をまとめて答えています。
調査係を Haiku 5.5 に替えると、費用は $0.297 から $0.126 へ 58% 減り、時間も 62 秒から 45 秒に縮みました。残った費用の 8 割強は指揮役の Sonnet 5.5 の分です。内訳を見ると、9 件の指示と報告で伸びていく会話をキャッシュに書き込む費用と、指示文やまとめの出力が大半でした。
全部 Haiku 5.5 にすればさらに 1/4 になります。ただ、今回の 9 問は「配って、集める」だけの単純な指揮でした。実際の開発では、指揮役が設計を考え、調査結果をもとに方針を決めます。その判断の質を Haiku に任せてよいかは、次の実験 3・4 の結果と公式の Terminal-Bench を合わせて考える必要があります。
実験 3:バグ修正と機能追加
やったこと
公式が「複雑なら Sonnet」とするコーディングでは、どこまで Haiku 5.5 に任せられるのでしょうか。sqlite-utils 3.38 を使って、次の 12 課題を作りました。
| 課題 | 種類 | 内容 | 合否の判定 |
|---|---|---|---|
| T1 | 仕込んだバグ | 「テストがいくつか落ちている。テストは変えずに直して」とだけ伝える | 既存テスト |
| T2 | 仕込んだバグ | transform() で外部キー列の名前を変えると外部キーが壊れる | 既存テスト |
| T3 | 仕込んだバグ | int と bool が混ざった列が FLOAT になる | 隠しテスト |
| T4 | 仕込んだバグ | キーの順番が違うと hash_id が変わる(以前の値との互換も必要) | 隠しテスト |
| T5 | 機能追加 | duplicate() と CLI に、行を絞り込む where 引数を足す | 隠しテスト |
| T6 | 機能追加 | --detect-types で true/false の列を INTEGER にする | 隠しテスト |
| T7 | 機能追加 | 2 つの DB のテーブル差分を出す新コマンド compare(仕様 8 項目) | 隠しテスト |
| R1〜R4 | 実際の不具合 | sqlite-utils の 4.x で修正された不具合 4 件(Issue 554・PR 764・Issue 702・PR 811)を利用者からの報告の形で渡す | 隠しテスト(修正時のテストを移植) |
| R-all | 実際の不具合 | R1〜R4 の 4 件を 1 回でまとめて直させる | 隠しテスト 4 本 |
「隠しテスト」は、モデルには見せずに、作業が終わった後でリポジトリに足して実行するテストです。合格の条件は、隠しテストと既存の全テスト(約 1,000 本)がすべて通ることにしました。T7 は新しいコマンドを足すので、ドキュメントにも載せないと既存の「全コマンドが文書化されているか」のテストが落ちます。全テストを自分で回して気づけるかも試しています。
各モデルには Read・Edit・Write・Grep・Glob・Bash を渡し、課題ごとに新しいコピーで 2 回ずつ解かせました。
結果
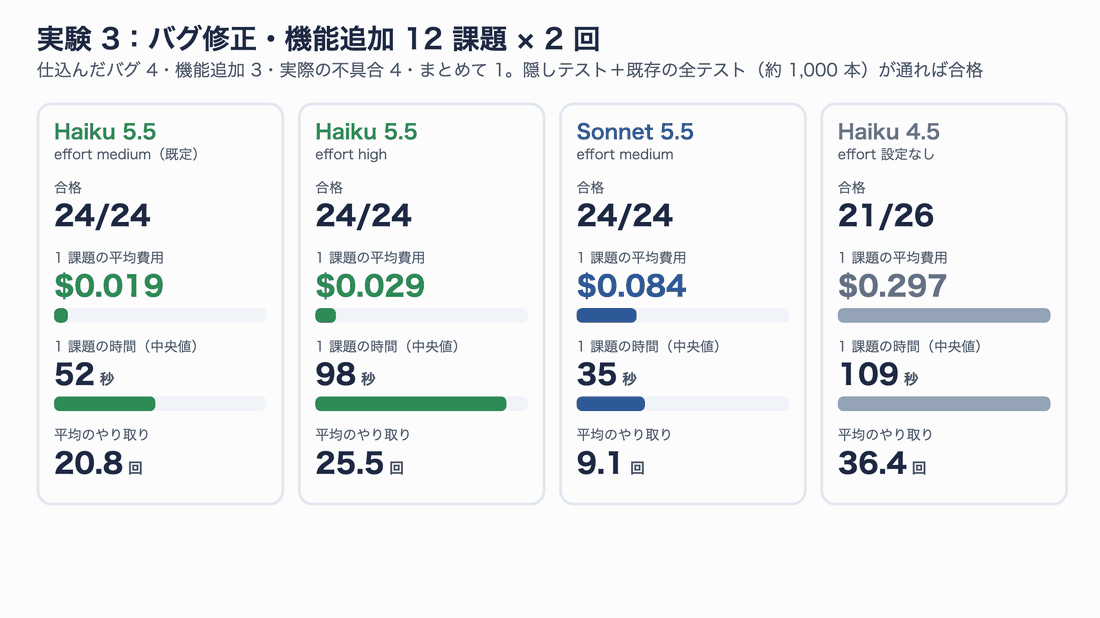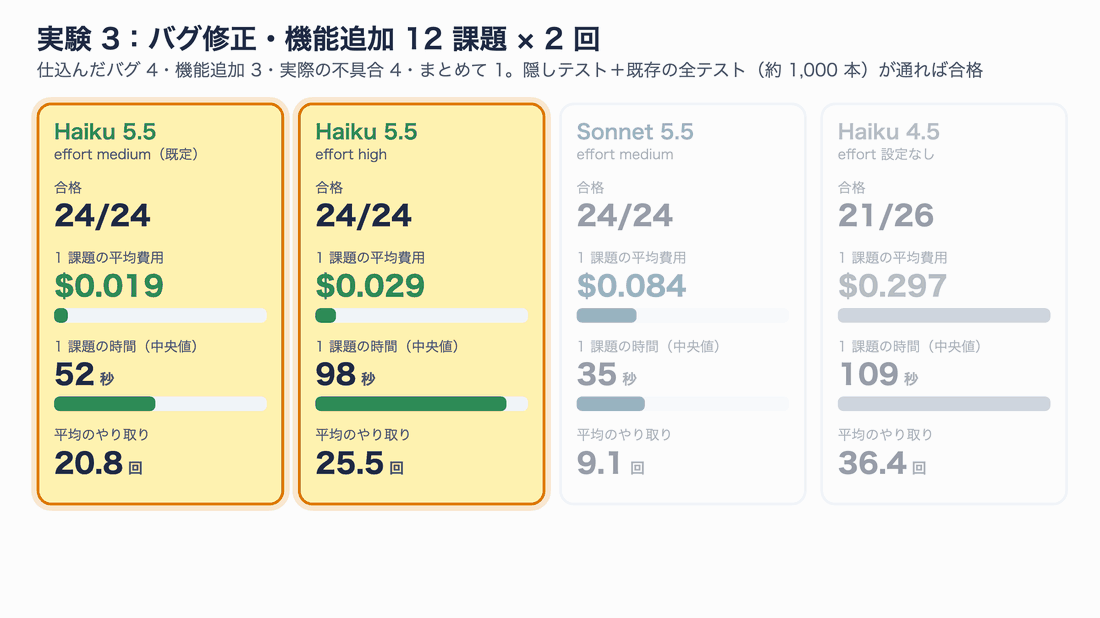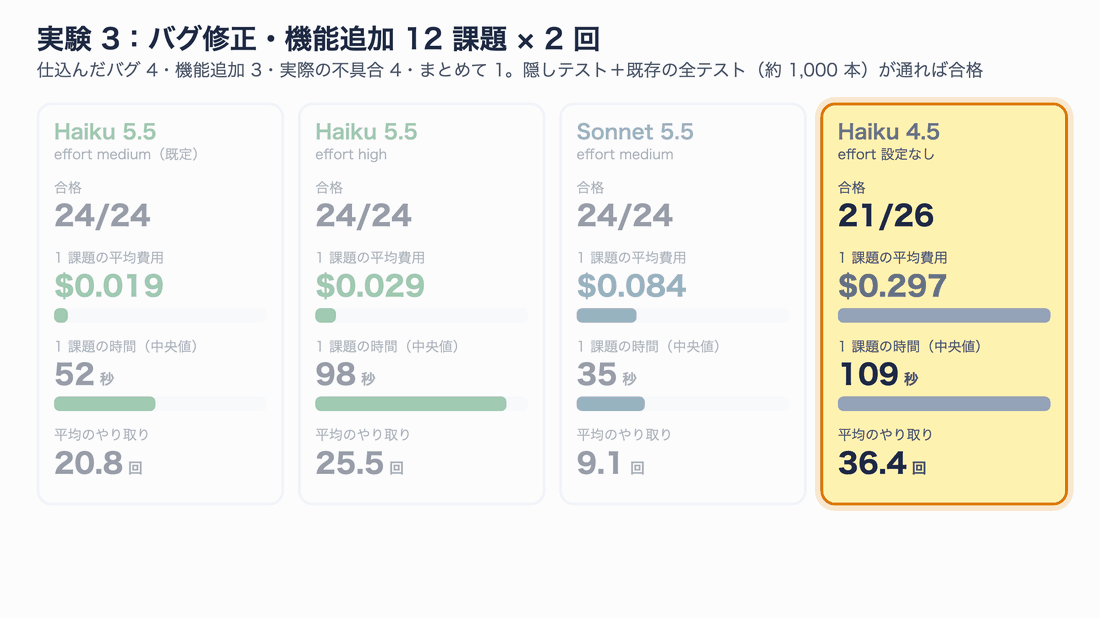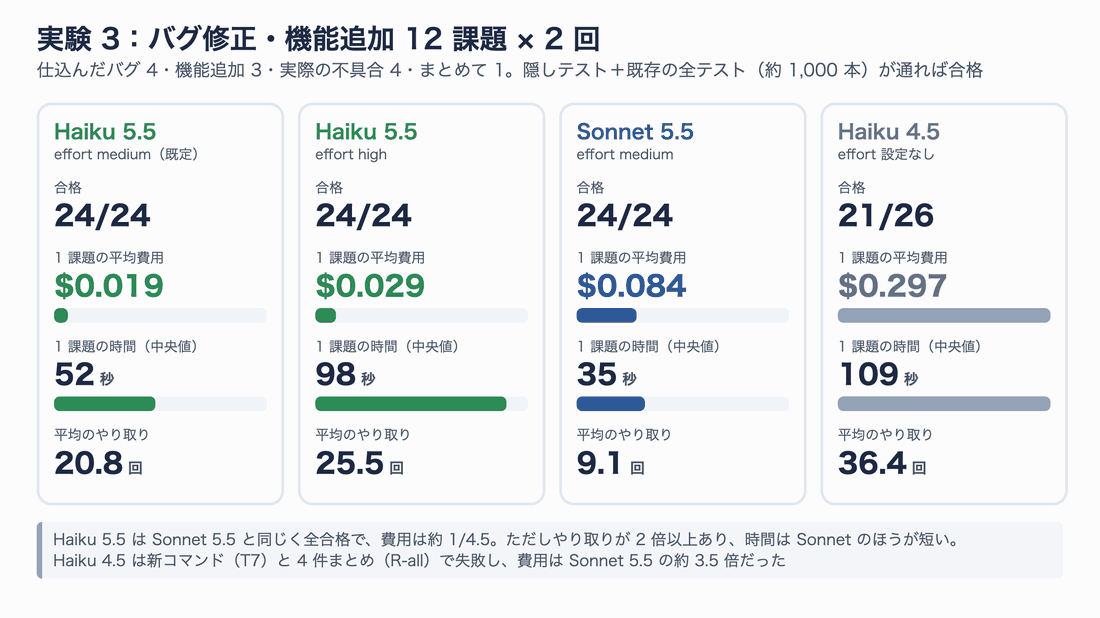
合格率は Haiku 5.5 と Sonnet 5.5 で同じ。費用は Haiku 5.5 が約 1/4.5、時間は Sonnet 5.5 のほうが短かった
| 設定 | 合格 | 1 課題の平均費用 | 1 課題の時間(中央値) | 平均のやり取り回数 | 不合格だった課題 |
|---|---|---|---|---|---|
| Haiku 5.5 medium | 24/24 | $0.019 | 52 秒 | 20.8 | — |
| Haiku 5.5 high | 24/24 | $0.029 | 98 秒 | 25.5 | — |
| Sonnet 5.5 medium | 24/24 | $0.084 | 35 秒 | 9.1 | — |
| Haiku 4.5 | 21/26 | $0.297 | 109 秒 | 36.4 | T7(4 回中 3 回)、R-all(2 回とも) |
Haiku 4.5 の T7 は、実行の重なりで 4 回走ったため 4 回とも数えています。
範囲がはっきりしていて、テストで確かめられる修正なら、Haiku 5.5 でも全部合格しました。実際に 4.x で直された不具合 4 件をまとめて渡した R-all も、2 回とも通っています。費用は 1 課題あたり平均で Sonnet 5.5 の約 4.5 分の 1 です。前の世代の Haiku 4.5 は、仕様の細かい新コマンド(T7)でエラー文言や rowid テーブルの扱いを取りこぼし、4 件まとめた R-all では 2 回とも一部の不具合を直しきれませんでした。しかも 1 課題の費用は Sonnet 5.5 の約 3.5 倍です。Haiku 4.5 の時代の「Haiku は安いが力不足」という印象は、5.5 ではコーディングでも当てはまりません。
一方で、時間は Sonnet 5.5 のほうが短いという、実験 1 とは逆の結果になりました。Haiku 5.5 は 1 課題に平均 21 回ほどやり取りをし、Sonnet 5.5 の 9 回の 2 倍以上かかっています。テストを実行し、結果を見て直し、また実行する、という往復が多いのです。1 回あたりの出力は速くても、往復の回数で逆転します。4 件まとめた R-all では、Sonnet 5.5 が約 80 秒、Haiku 5.5 medium が約 210 秒でした。
effort を high にした Haiku 5.5 は、合格率は同じまま、時間と費用が増えただけでした。T7 では 1 回のリクエストのプロンプトが 10 万トークンを超え、単価 5 倍の料金帯に入ったリクエストもありました。往復が増えると会話が伸び、この境目に近づきます。
なお、今回の 12 課題は「何を直せばよいか」がはっきりしていて、テストで合否を確かめられるものばかりです。公式の Terminal-Bench 4.0 のように、何十手もかけて環境を調べながら進める課題では、Haiku 5.5 と Sonnet 5.5 の差は大きく開きます。「Haiku 5.5 でもコーディングはできる。ただし、範囲を区切って、テストという答え合わせがある仕事に限る」と考えるのが妥当です。
実験 4:問い合わせの分類(Haiku 5.5 の弱点が出た)
やったこと
公式が Haiku 5.5 の用途として挙げる「分類」を試しました。題材は、銀行への問い合わせ文を 77 種類の意図(「カードが届かない」「暗証番号がロックされた」など)に分ける Banking77 です。各意図から 2 件ずつ、乱数の種を固定して 154 件を選びました。
1 件ずつ、ツールなし・システムプロンプトに 77 個のラベルを並べて、ラベル名だけを答えさせています。API を 1 回呼ぶのに近い形です。
# 分類 1 件の呼び出し(システムプロンプトを差し替え、ツールは使わない)
claude -p "Classify the following customer message.

<message>
I think the atm ate my card.
</message>" \
  --model claude-haiku-5-5 --effort medium \
  --system-prompt "$(cat classifier_system_prompt.txt)" \
  --tools "" --strict-mcp-config --setting-sources project,local \
  --output-format json
結果
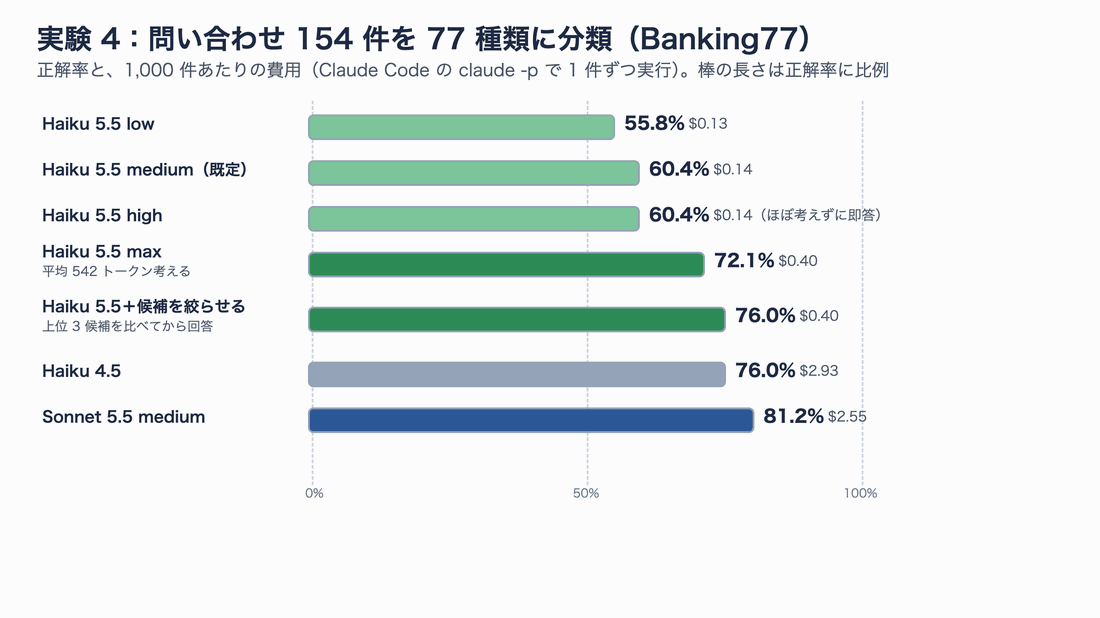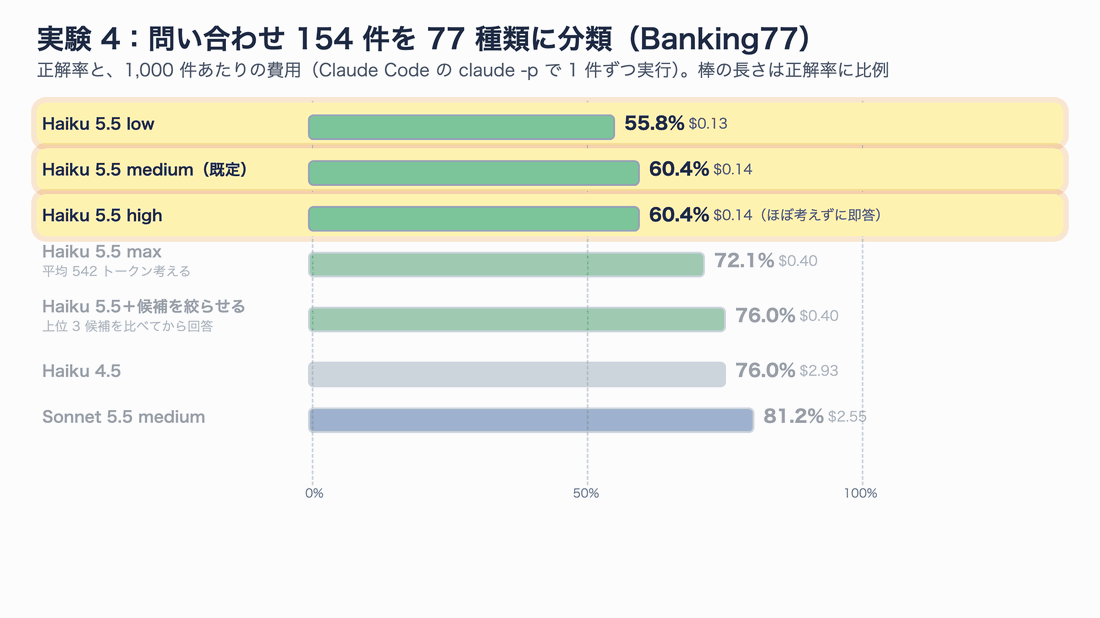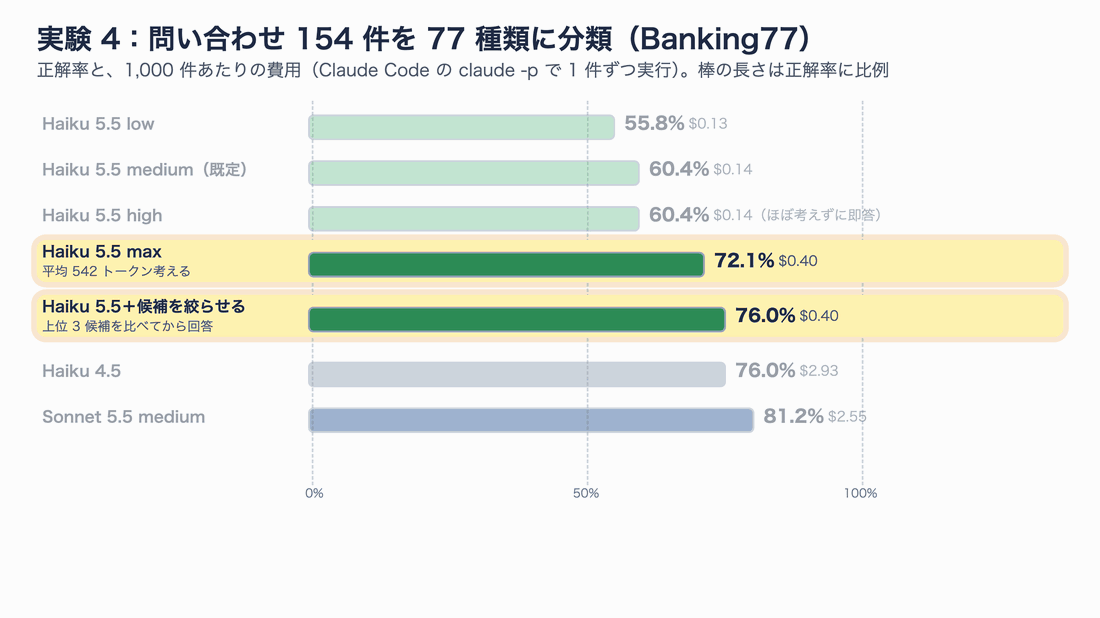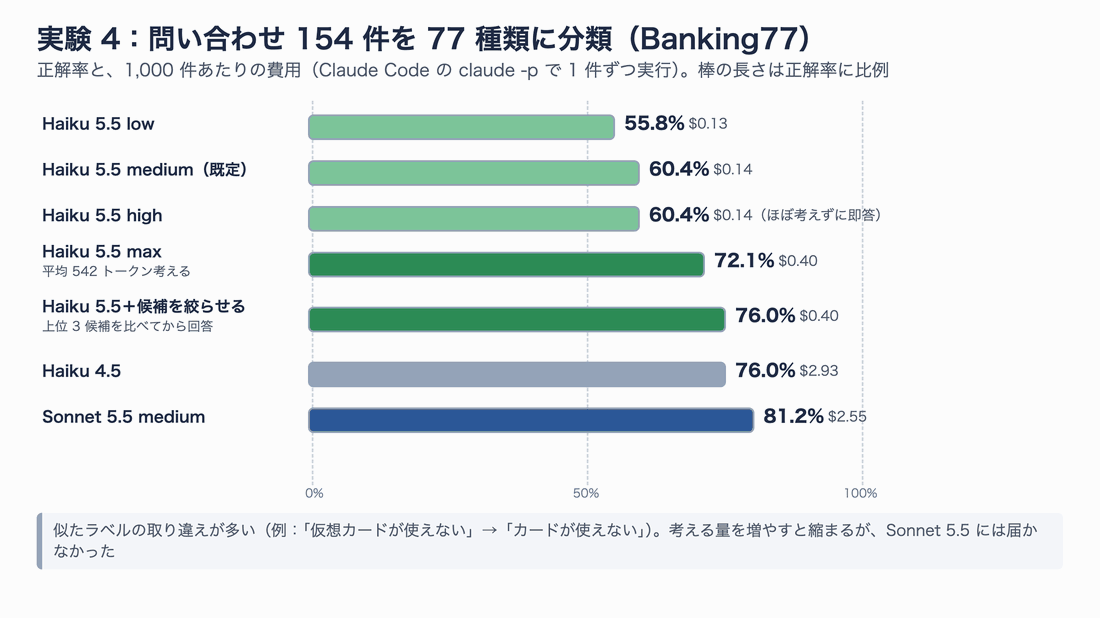
費用は 1,000 件あたり(Claude Code 経由で 1 件ずつ実行した実測から計算)。Haiku 5.5 は既定の設定では Haiku 4.5 より低かった
| 設定 | 正解率 | 一覧にないラベルを答えた件数 | 1,000 件の費用 | 1 件の時間(中央値) | 平均の思考トークン |
|---|---|---|---|---|---|
| Haiku 5.5 low | 55.8% | 6 | $0.13 | 0.65 秒 | 4 |
| Haiku 5.5 medium | 60.4% | 4 | $0.14 | 0.66 秒 | 11 |
| Haiku 5.5 high | 60.4% | 5 | $0.14 | 0.65 秒 | 19 |
| Haiku 5.5 max | 72.1% | 1 | $0.40 | 1.34 秒 | 542 |
| Haiku 5.5 medium+候補を絞らせる | 76.0% | 2 | $0.40 | 2.89 秒 | 302 |
| Haiku 4.5 | 76.0% | 0 | $2.93 | 2.95 秒 | 357 |
| Sonnet 5.5 medium | 81.2% | 0 | $2.55 | 1.23 秒 | 12 |
| Sonnet 5.5 medium+候補を絞らせる | 77.9% | 2 | $4.80 | 3.09 秒 | 1 |
時間は API の応答時間(Claude Code の起動時間を除く)です。
これは、この記事でいちばん意外な結果でした。公式が得意分野に挙げる分類で、既定の Haiku 5.5 は 60% にとどまり、Sonnet 5.5(81%)どころか前の世代の Haiku 4.5(76%)にも負けました。
誤りの中身を見ると、「似たラベルの取り違え」がほとんどです。
| 問い合わせ(要約) | 正解 | Haiku 5.5 の答え |
|---|---|---|
| 店で仮想カードが使えなかった | virtual_card_not_working | card_not_working |
| チャージしたのにアプリが受け付けない | top_up_failed | pending_top_up |
| ATM の手数料が間違っている | cash_withdrawal_charge | extra_charge_on_statement |
| 本人確認の方法を知りたい | verify_my_identity | why_verify_identity |
| 英国外でもカードを作れるか | country_support | supported_cards_and_currencies |
どれも「大まかには合っているが、より細かいラベルがある」ケースです。Sonnet 5.5 はこれらを正しく選べていました。
手がかりは思考トークンの量にありました。Haiku 5.5 は low〜high のどれでも、1 件あたり 4〜19 トークンしか考えずに即答しています。effort を high にしても、モデルが「考えるまでもない」と判断すると思考が増えないのです。max にすると平均 542 トークン考えるようになり、正解率は 72% まで上がりました。
さらに、システムプロンプトに「答える前に、もっともらしいラベルを 3 つ挙げ、問い合わせの文言と比べてから、最後の行に LABEL: <ラベル> と書く」という指示を足すと、medium のままで 76% になりました。Haiku 4.5 と同じ正解率を、7 分の 1 以下の費用で出せたことになります。ただし、同じ指示を Sonnet 5.5 に足すと 78% に下がりました。考える手順を指示で補うのは Haiku 5.5 には効くが、Sonnet 5.5 には不要(むしろ逆効果)でした。
実は最初の試行では、問い合わせ文をそのまま渡していました。すると Haiku 5.5 は 154 件中 11〜12 件で、ラベルではなく「I’m…」「Yes,…」で始まる顧客への返事を書いてしまい、さらに 5 件で一覧にないラベルを作っていました(Sonnet 5.5 は作ったラベルが 1 件、Haiku 4.5 は返事が 1 件)。上のコマンドのように <message> タグで囲み、「次の問い合わせを分類して」と明示すると、返事を書く誤りは 1 件に減りました。Haiku 5.5 には、入力の役割をはっきり書いたほうが安定します。
まとめると、選択肢が多く、細かい違いを見分ける分類は、そのままでは Haiku 5.5 に任せられません。費用を優先するなら「候補を絞ってから答えさせる」指示を入れて Haiku 4.5 並みに引き上げる、正解率を優先するなら Sonnet 5.5 を使う、という選択になります。
実験 5:出力の速さ
公式は Haiku 5.5 を「標準の速度では、これまでで最速のモデル」としています。約 2000 字の説明文を書かせ、文字が届き始めてから終わるまでの 1 秒あたりの出力トークン数を、5 回ずつ測りました。
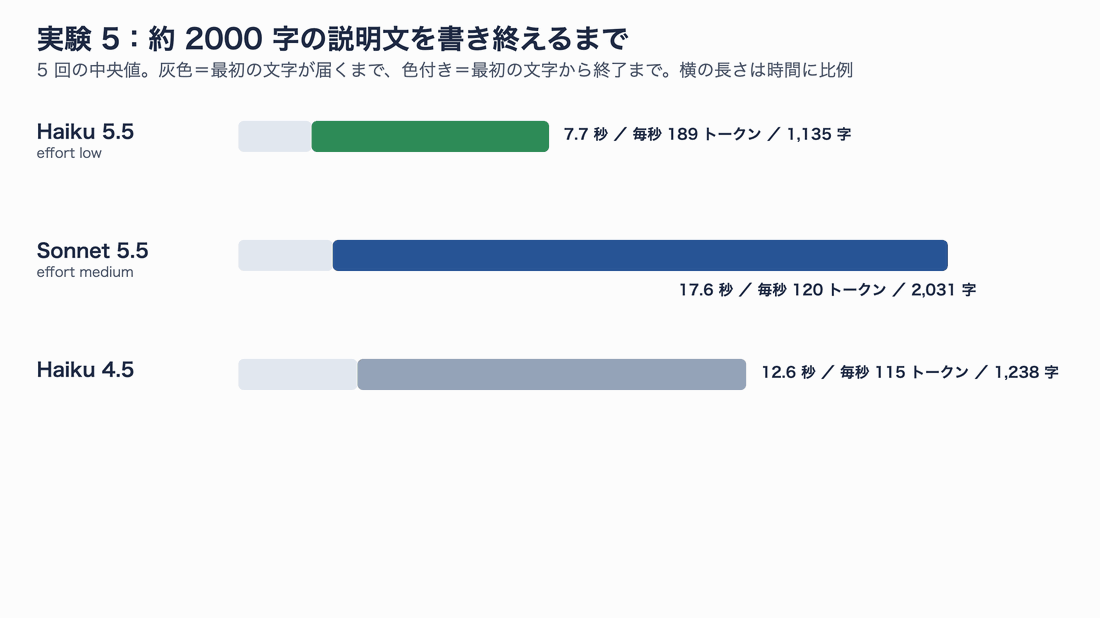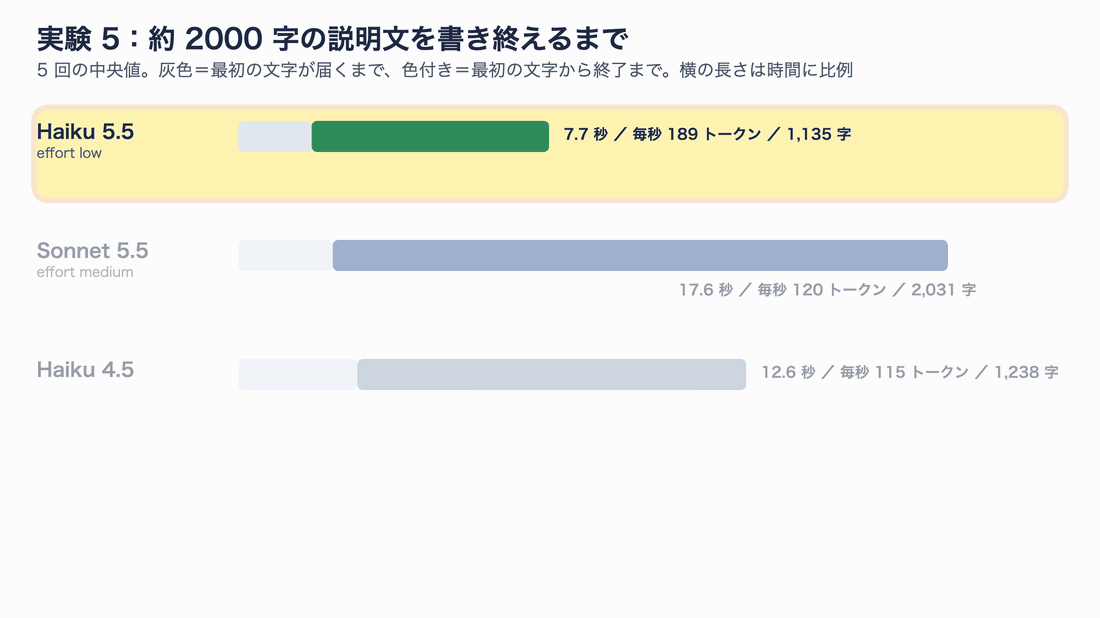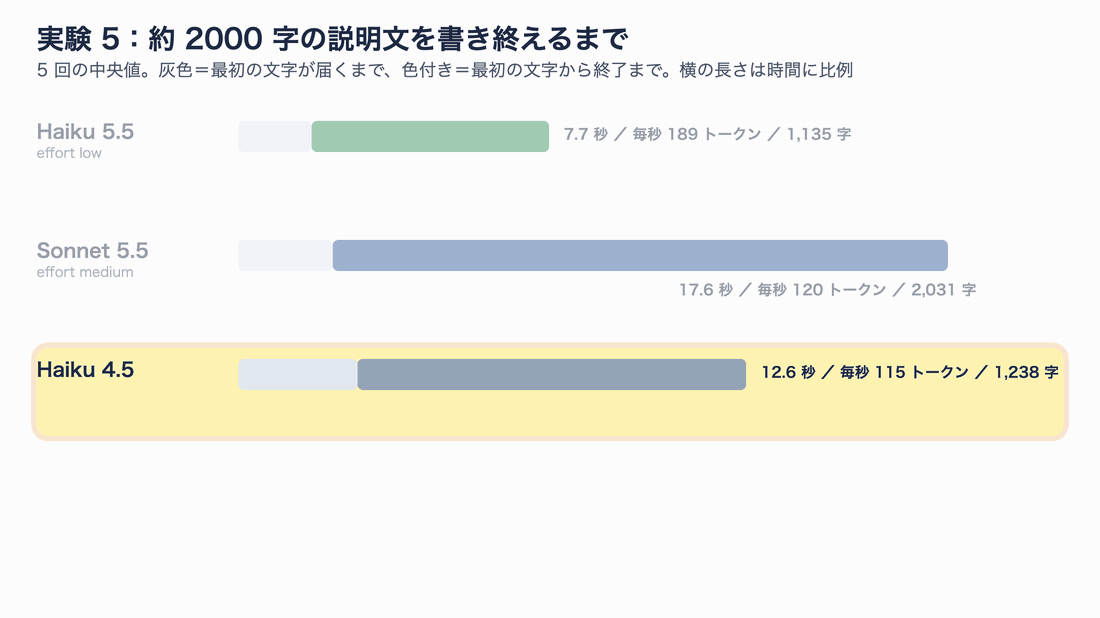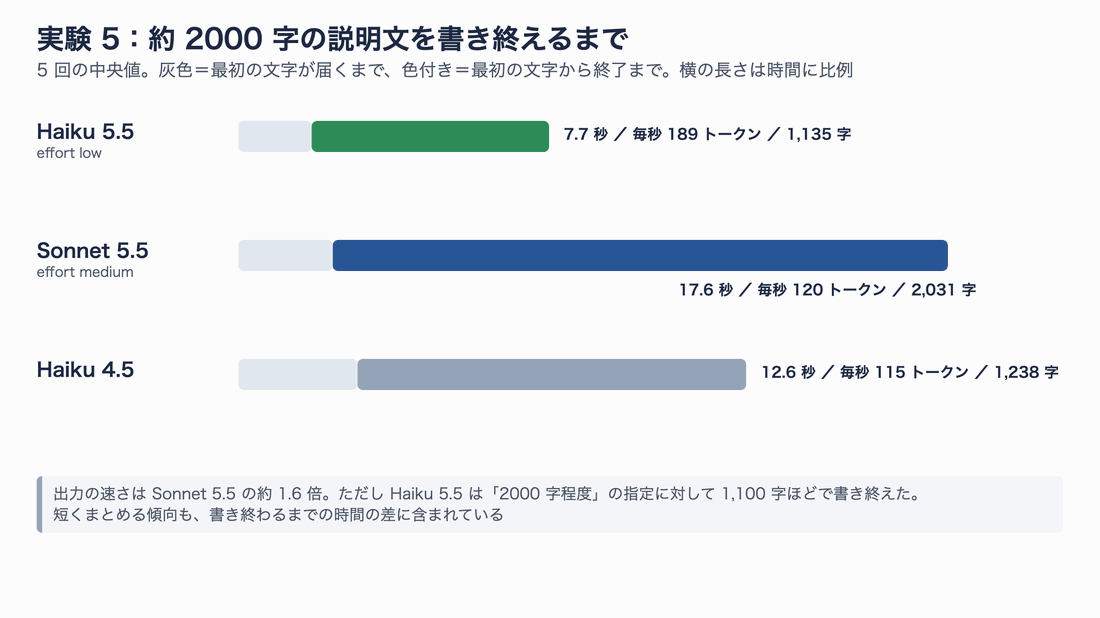
中央値。Haiku 5.5 は指定より短く書く傾向があり、文章量の差も時間の差に含まれている
| 設定 | 出力速度(トークン/秒) | 最初の文字まで | 書き終わるまで | 書いた文字数 |
|---|---|---|---|---|
| Haiku 5.5 low | 189 | 1.8 秒 | 7.7 秒 | 1,135 字 |
| Sonnet 5.5 | 120 | 2.4 秒 | 17.6 秒 | 2,031 字 |
| Haiku 4.5 | 115 | 3.0 秒 | 12.6 秒 | 1,238 字 |
Haiku 5.5 の出力速度は Sonnet 5.5 の約 1.6 倍でした。一方で、「2000 字程度で」と頼んだのに Haiku 5.5 は 1,100 字前後で書き終えていました。速さの数字を見るときは、文章を短くまとめる傾向も一緒に効いていることに注意してください。分量の指定を守らせたい用途では、指示を具体的にするか、出来上がりの長さを確認する必要があります。
使い分けの判断:どの仕事を Haiku 5.5 に任せるか
5 つの実験と公式のベンチマークをまとめると、判断の順番は次のようになります。
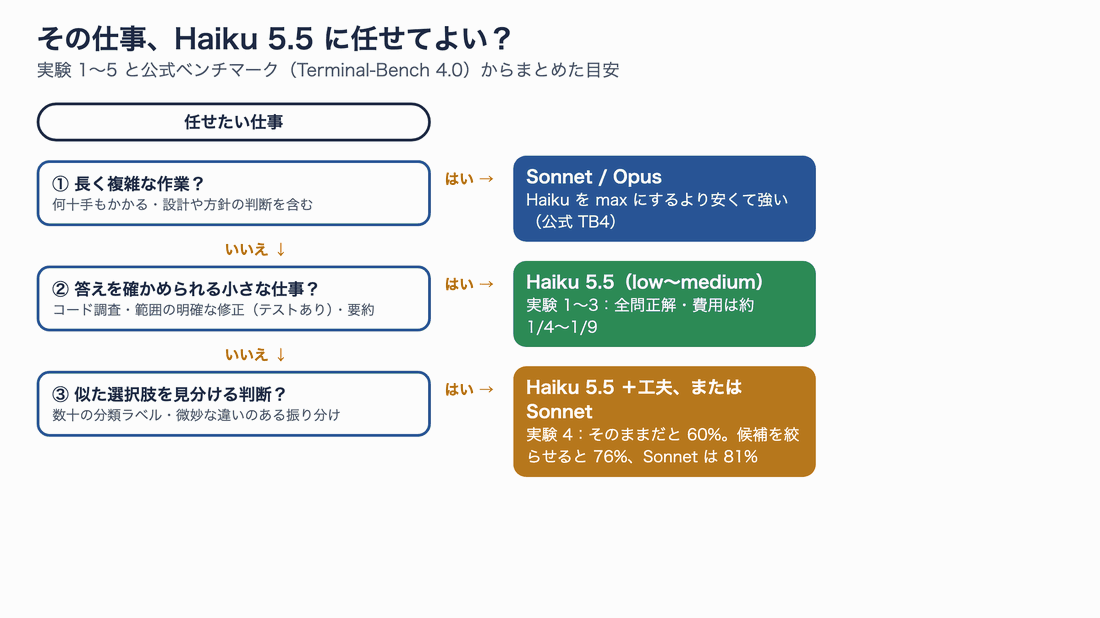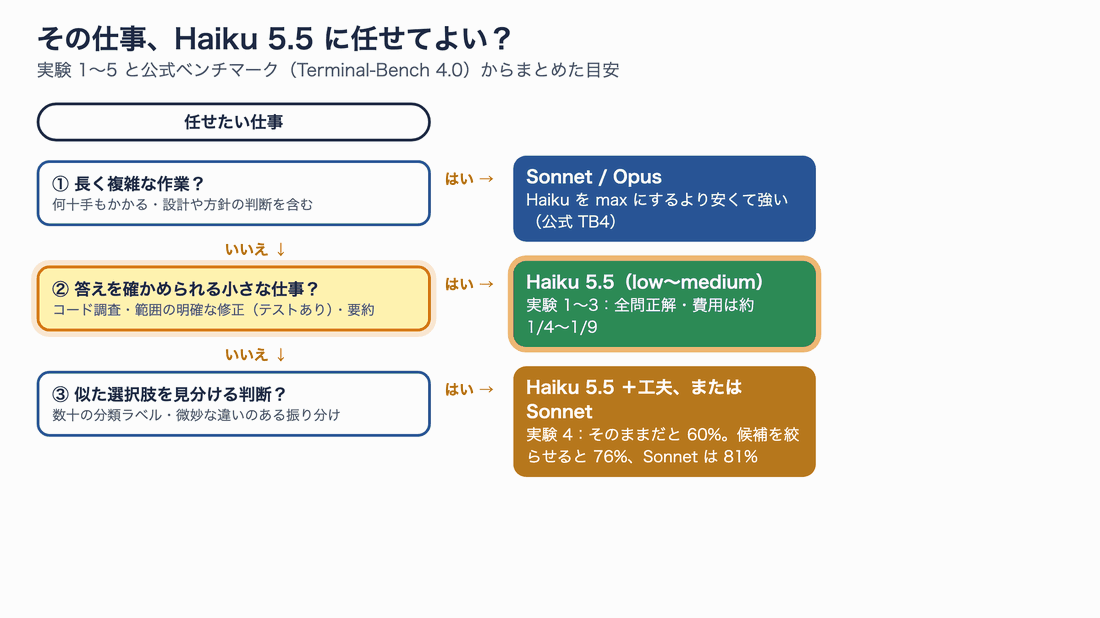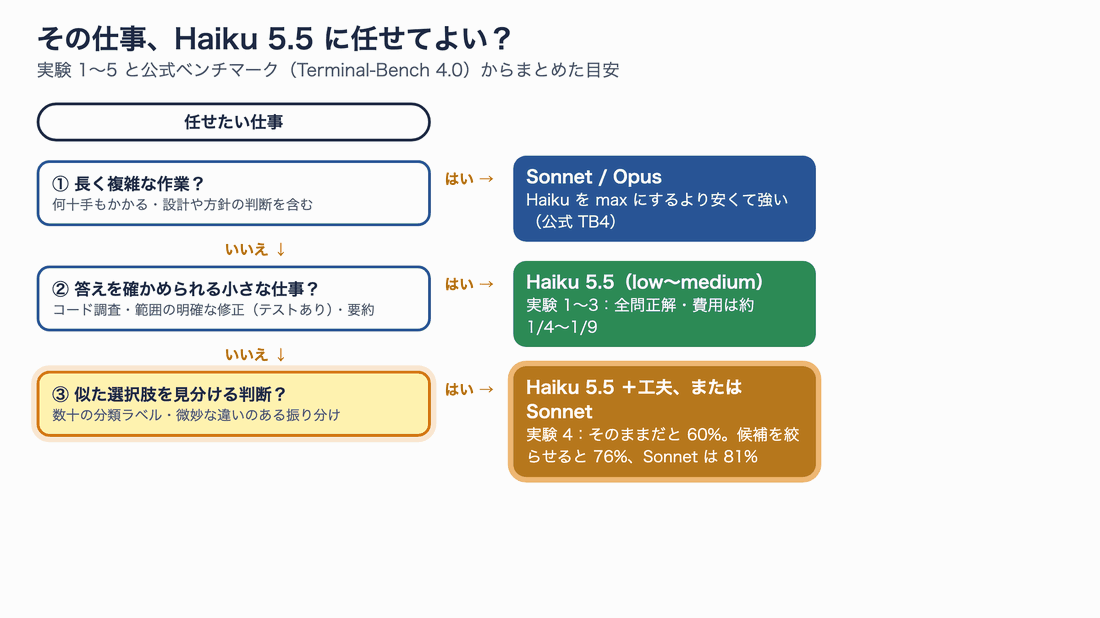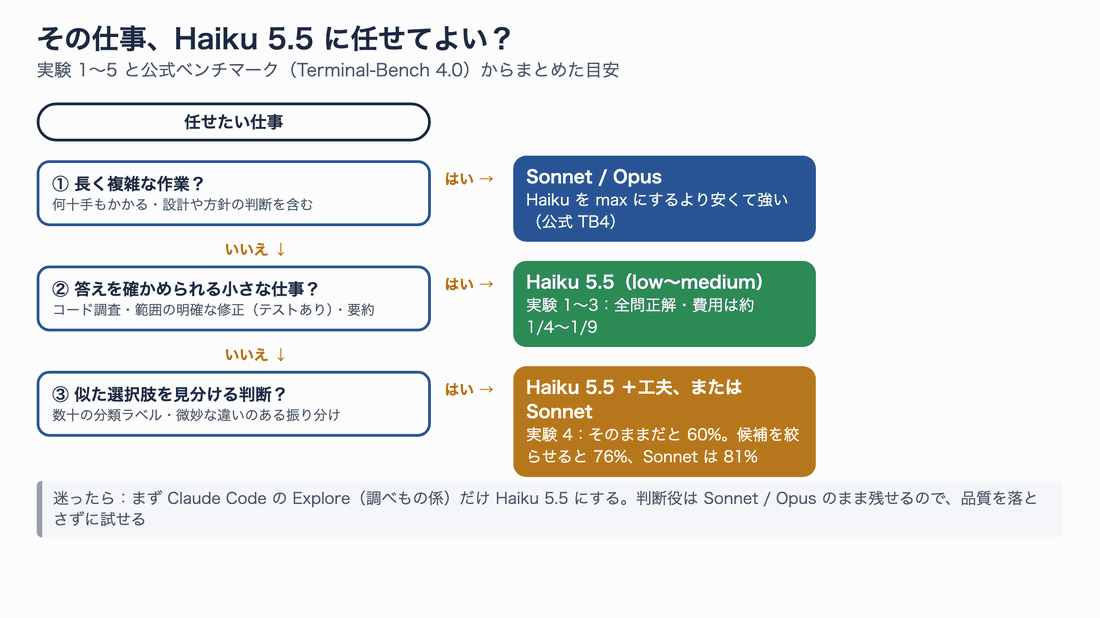
実験結果と公式ベンチマークからまとめた目安。迷ったら、まず調査係から Haiku 5.5 にしてみるのが安全
判断のポイントを、図の順に補足します。
① 長く複雑な作業は Sonnet 以上に任せる。 公式の Terminal-Bench 4.0 では、Haiku 5.5 を max にしても、それより安い Sonnet 5.5 に正解率で負けます。設計を考える、環境を調べながら何十手も進める、といった仕事を Haiku に回しても、安くはなりません。
② 答えを確かめられる小さな仕事は Haiku 5.5 に任せる。 実験 1〜3 では、コード調査も、範囲を区切ったバグ修正・機能追加も、Haiku 5.5 は Sonnet 5.5 と同じく全部正解・全部合格でした。費用は 1/4〜1/9 です。ただしコーディングでは往復が多く、待ち時間は Sonnet 5.5 より長くなることがあります。待ち時間を減らしたいなら Sonnet、費用を減らしたいなら Haiku、と目的で選んでください。
③ 似た選択肢を見分ける判断は、工夫するか Sonnet にする。 実験 4 のように、そのままの Haiku 5.5 は細かい違いを取り違えます。「候補を絞ってから答えさせる」指示や effort max で差は縮まりますが、Sonnet 5.5 には届きませんでした。
effort の選び方も、今回の結果から目安を書いておきます。
| effort | 向いている使い方(今回の結果から) |
|---|---|
| low | 答えが 1 か所に決まる調べもの。medium と同じ正解率で、少し速く安い |
| medium(既定) | 迷ったらこれ。コーディング課題も全部合格した |
| high | 今回の実験では medium より良くなった場面がなく、時間と費用だけ増えた |
| max | 分類のように「考えずに即答して間違える」仕事。思考が増えて正解率が上がった |
なお、Haiku 4.5 を使っている場合は、移行を検討する価値があります。今回の実験では、分類を除くすべてで Haiku 5.5 のほうが安く、同等以上の結果でした。公式のモデル一覧では、Haiku 4.5 の提供終了(retirement)は「2026年10月15日より前には行わない」と書かれています。つまり、それ以降は終了する可能性があります。ただし分類のように既定設定で Haiku 4.5 より下がる仕事もあるので、切り替える前に自分の課題で比べてください。
Claude Code で Haiku 5.5 を使う設定
サブエージェントのモデルが決まる順番
Claude Code でサブエージェントのモデルがどう決まるかは、公式ドキュメント(Sub-agents)に書かれています。
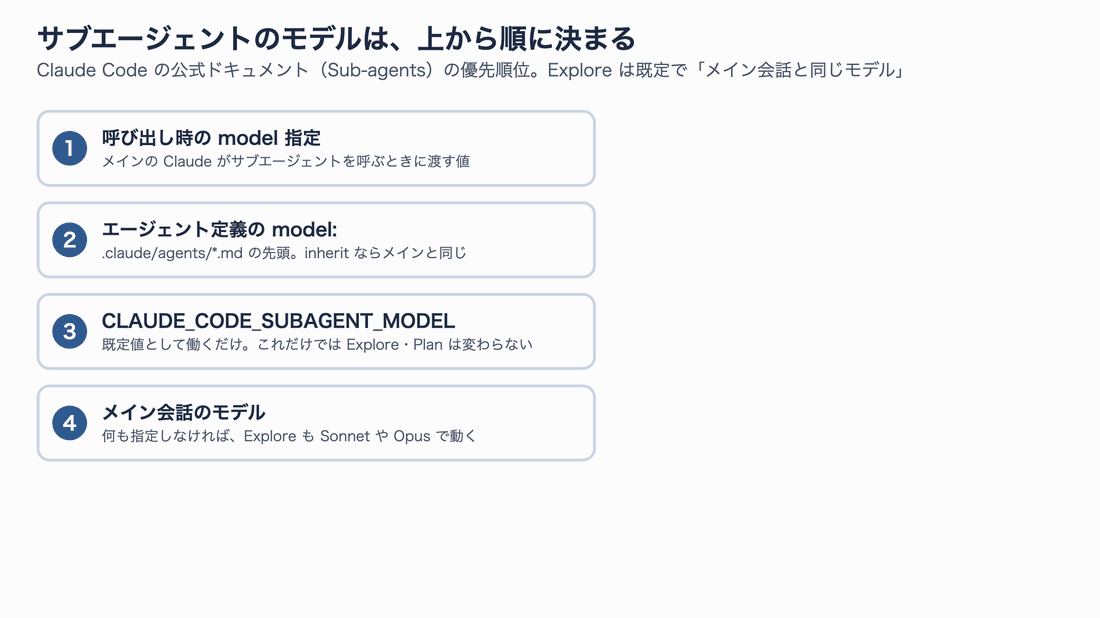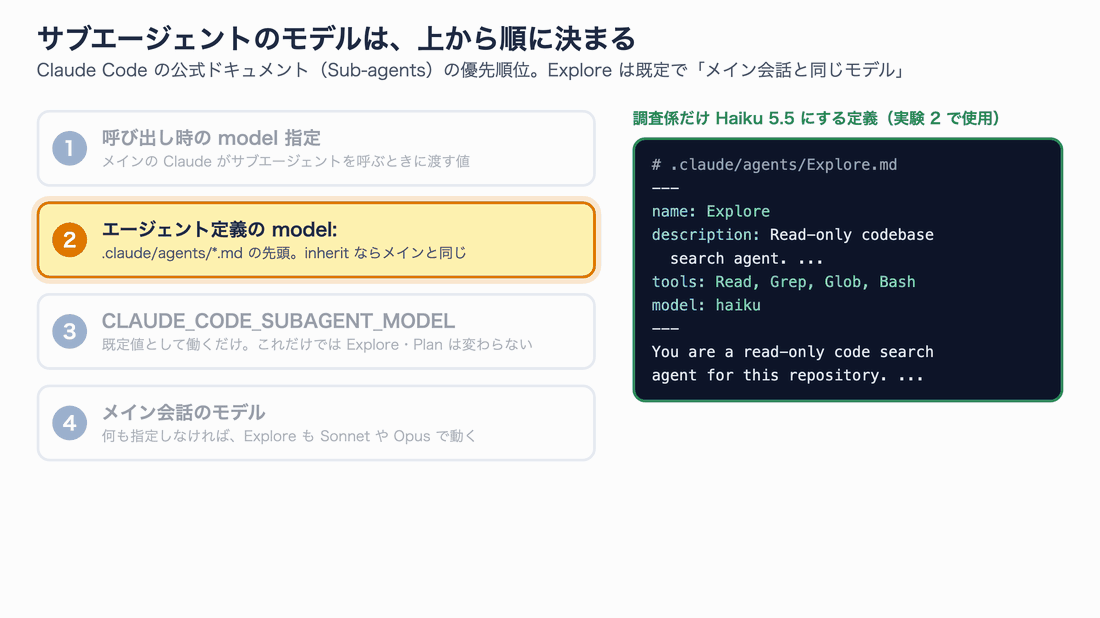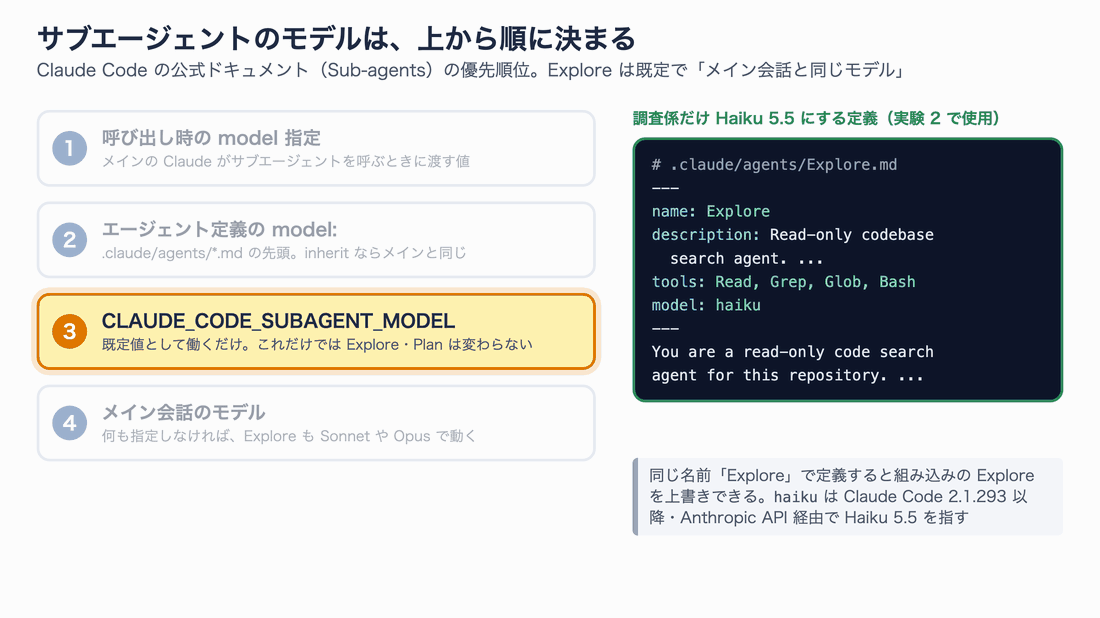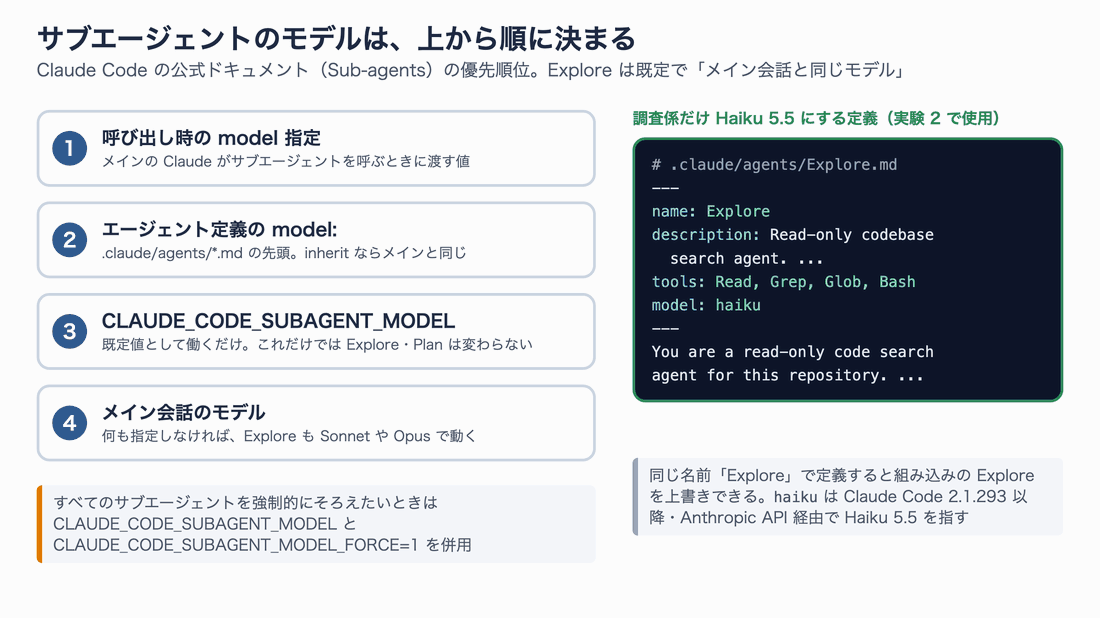
環境変数 CLAUDE_CODE_SUBAGENT_MODEL だけでは、組み込みの Explore と Plan は変わらない点に注意
設定方法を、目的別にまとめます。
| やりたいこと | 設定 |
|---|---|
| 調べもの(Explore)だけ Haiku 5.5 にする | .claude/agents/Explore.md を作り、model: haiku を書く(上の例) |
| 自作のサブエージェントを Haiku 5.5 にする | そのエージェント定義の先頭に model: haiku(必要なら effort: low) |
| すべてのサブエージェントを Haiku 5.5 にそろえる | 環境変数 CLAUDE_CODE_SUBAGENT_MODEL=haiku と CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1 |
| メインの会話ごと Haiku 5.5 にする | claude --model haiku、または会話中に /model |
| Haiku 5.5 の effort を変える | claude --effort low など。サブエージェントは定義の effort: |
「haiku」がどのモデルを指すかに注意
haiku という呼び名がどのモデルになるかは、Claude Code のバージョンと接続先で変わります。
- Claude Code 2.1.293 以降で、Anthropic の API(Claude のログインを含む)につないでいる場合は Haiku 5.5
- 2.1.292 以前、または Amazon Bedrock・Google Cloud・Microsoft Foundry・Claude Platform on AWS 経由では Haiku 4.5(2026-10-08 時点のドキュメント)
古いバージョンのまま model: haiku と書いても Haiku 4.5 で動きます。実験 1 のとおり、Haiku 4.5 は調べものでも Sonnet 5.5 より遅く高くつくので、まず claude update で更新してください。
# Claude Code を更新してバージョンを確かめる
claude update
claude --version   # 2.1.293 以降なら haiku = Haiku 5.5

# モデルを確かめる(JSON の modelUsage にモデル名が出る)
claude -p "OK とだけ返して" --model haiku --output-format json | python3 -c \
  "import json,sys; print(list(json.load(sys.stdin)['modelUsage']))"
# ['claude-haiku-5-5']
Max プランで使っている人にとっての意味
Claude Code を Max プランの定額で使っている場合、ここまでの「費用」はそのまま請求額にはなりません。それでも Haiku 5.5 を検討する価値は 2 つあります。
1 つは速さです。調べものの係を Haiku 5.5 にした構成では、待ち時間が 62 秒から 45 秒に縮みました。サブエージェントを多く使う人ほど体感の差は大きくなります。
もう 1 つは、今回始まった毎月の API クレジット(Max 20x なら月 $200)です。自作のツールやエージェントを API で動かすとき、Haiku 5.5 なら実験 1 の調べもの 1 問 $0.0023 として、$200 で約 8 万 7 千問をこなせる計算になります。同じ仕事を Sonnet 5.5 で動かすと約 9 千 5 百問です。
うまくいかないときの確認ポイント
Haiku 5.5 を試して「思ったより高い」「思ったほど賢くない」と感じたときは、次の順に確かめてください。
| 症状 | 確認すること | 対処 |
|---|---|---|
unrecognized_model と出る、費用表示が異常に高い | claude --version が 2.1.293 未満 | claude update で更新する |
| 1 回の費用が予想の何十倍にもなる | ログのプロンプトサイズが 10 万トークンを超えていないか | 不要なコネクタ(MCP)を外す。大きなファイルを丸ごと読ませない |
model: haiku なのに遅い・高い | 実際のモデル名(modelUsage)が claude-haiku-4-5 になっていないか | Claude Code を更新する。Bedrock などではモデル ID を直接書く |
| 分類のラベルが一覧にない語になる | 出力が指定の候補から外れていないか | 入力をタグで囲む。候補を絞ってから答えさせる。最後に一覧と照合する |
| 似た選択肢を取り違える | 誤りの多いラベルの組み合わせ | Sonnet 5.5 に切り替えるか、怪しいものだけ Sonnet で再判定する |
| 文章が指定より短い | 出力の文字数 | 分量を数値で指定し、足りなければ続きを書かせる |
まとめ
「Sonnet 5.5 で十分では?」という疑問への答えは、品質の面では Yes、費用の面では No です。速さは仕事によって逆転します。
- 答えが 1 か所に決まる調べもの(実験 1)では、Haiku 5.5 は Sonnet 5.5 と同じ正解率を、約 1/8 の費用で出しました
- Sonnet 5.5 を指揮役に残し、調査係だけ Haiku 5.5 にすると、正解を落とさずに費用が 58% 減り、時間も 3 割短くなりました(実験 2)
- 範囲を区切ったバグ修正・機能追加(12 課題)も Haiku 5.5 は全部合格し、費用は Sonnet 5.5 の約 1/4.5 でした。ただし往復が多く、時間は Sonnet 5.5 のほうが短くなりました(実験 3)
- 77 種類の分類のように、似た選択肢の細かい違いを見分ける判断では、Haiku 5.5 は 60% で Sonnet 5.5 の 81% に大きく届きませんでした(実験 4)
- 出力速度は Sonnet 5.5 の約 1.6 倍でした(実験 5)
まずは、Claude Code を 2.1.293 以降に更新し、.claude/agents/Explore.md で調べものの係だけ Haiku 5.5 にしてみてください。指揮役の Sonnet や Opus はそのままなので、判断の質を保ったまま、待ち時間と費用だけを減らせます。そのうえで、自分の仕事のどこまでを Haiku に任せられるかを、今回のような小さな比較で確かめていくのがおすすめです。
参考リソース
- Anthropic「Introducing Claude Haiku 5.5」 https://www.anthropic.com/claude-haiku-5-5
- Claude Platform「Pricing」 https://platform.claude.com/docs/en/about-claude/pricing
- Claude Platform「Models overview」 https://platform.claude.com/docs/en/models/overview
- Claude Platform「Effort」 https://platform.claude.com/docs/en/build-with-claude/effort
- Claude Code Docs「Create custom subagents」 https://code.claude.com/docs/en/sub-agents
- Claude Code Docs「Model configuration」 https://code.claude.com/docs/en/model-config
- sqlite-utils(Simon Willison、Apache 2.0) https://github.com/simonw/sqlite-utils
- Banking77(PolyAI、CC BY 4.0) https://github.com/PolyAI-LDN/task-specific-datasets