画像生成AIを業務で使っていると、いちばん困るのは「1枚目はいい感じなのに、直そうとすると壊れる」ことではないでしょうか。価格だけ変えたいのにマグカップの形まで変わる、色を変えただけなのに文字が崩れる。結局、修正のたびに丸ごと作り直しになってしまう・・・
2026年9月8日(米国時間)にOpenAIがリリースしたGPT-Image-2.5は、まさにこの「直すと壊れる」問題を解消するためのアップデートです。
この記事では、前半でGPT-Image-2から何が変わったのかを公式情報ベースで整理し、後半でリリース翌日の9月9日にChatGPT Web版を実際に操作し試した結果を、画像付きで解説します。
先に結論を書いておきます。
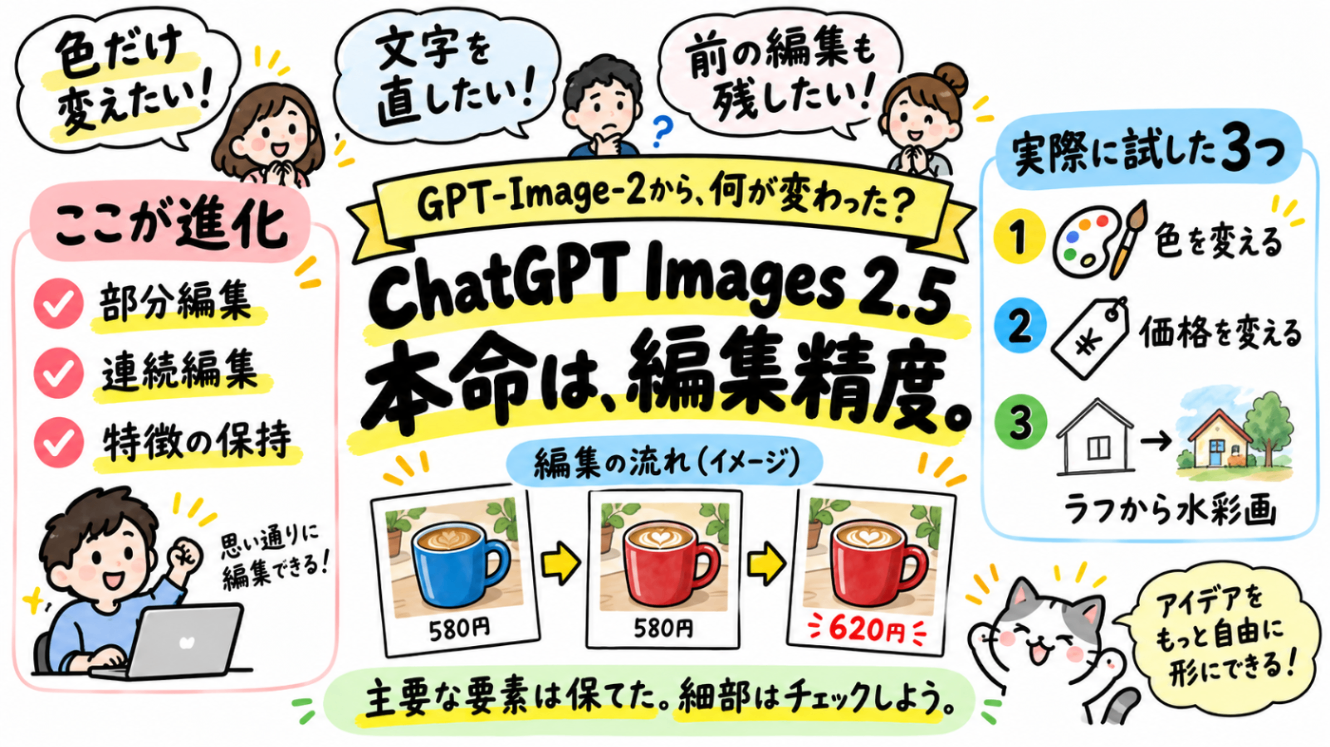
- 変わったのは「絵の良さ」より「編集の挙動」。指定した箇所だけを変え、それ以外を維持する能力と、編集を重ねたときの一貫性が向上した。
- 実機検証でも、マグカップの色変更と価格変更の2回の連続編集を、文字・物体数・構図を保ったまま通せた。
- ただし「指定外は完全固定」ではない。編集した2枚の画素差分を取ると、輪郭や質感のレベルで画像全体に小さな差分が出た。
GPT-Image-2からGPT-Image-2.5で何が変わったのか
GPT-Image-2.5の全体像
GPT Imageシリーズは、2025年4月のgpt-image-1、10月のgpt-image-1-mini、12月のgpt-image-1.5を経て、2026年4月に推論モデルを生成に組み込んだgpt-image-2が登場しました。2.5はそこから約4.5か月後のリリースになります。
提供形態は以下の2つです。
- ChatGPT向け: 「ChatGPT Images 2.5」として、全ChatGPT・ChatGPT Work・Codexユーザーに展開
- API向け: 「GPT-Image-2.5 Flare」と「GPT-Image-2.5 Sunburst」の2モデルを同時展開
APIが2モデル体制になった点は、GPT-Image-2(1モデル)からの大きな変化です。
最大の変化は「編集の挙動」
公式が挙げている主な改善は次の4つです。
- 忠実度: 参照写真の被写体を別の設定・スタイル・構図に変換する際、被写体の特徴をより保持するようになった
- 精密編集: 指示された箇所だけを編集し、それ以外の詳細を維持するようになった
- マルチターン一貫性: 長い会話の中で以前の変更を保持し、ターンを重ねても品質が劣化しにくくなった
- 理解力とスタイル: 複雑な視覚指示、実世界情報を含む画像、透明背景を含むレイアウト、スタイル再現が改善された
上記のうち3つが「編集」と「一貫性」に関するものです。速度面ではImages 2.0比で最大50%のレイテンシ削減(画像ができるまでの待ち時間の短縮)が公称値として示されています。
第三者ベンチマークもこの方向と整合しています。Arena.aiの暫定リーダーボードでは、Text-to-Image、Image Edit、Multi-Image Editの3部門すべてでSunburstが1位、Flareが2位で、GPT-Image-2(medium)からの上昇幅は次のとおりです。
| 部門 | Sunburst | Flare |
|---|---|---|
| Text-to-Image | +40 | +18 |
| Single-Image Edit | +59 | +30 |
| Multi-Image Edit | +81 | +47 |
生成より編集、単一画像編集より複数画像編集のほうが伸びが大きい構造です。ただし投票数の少ない暫定値なので、数字そのものより「編集側に寄っている」という傾向として見るのが適切です。
日本語圏の実測レビューも同じ方向を指しています。一発生成の画質は劇的には変わっておらず、2.0で指摘されていたノイズ感も残る一方で、複数箇所の同時差し替えや服装・髪色の変更といった編集で構図や雰囲気が崩れにくくなった、というのが共通した所感です。逆に「指定部分以外が完全に維持されるわけではない」という指摘(料理写真の肉を増やしたら隣のタレの色味も変わった、編集を重ねると肌や背景の質感が少しずつ変わる)も複数出ています。
つまり「2.0で撮れていた絵は2.5でもほぼ同じ絵が出る。変わったのは、その絵を直したときに壊れにくくなったこと」が本質です。
2.0と2.5の差分一覧
| 項目 | GPT-Image-2(2026年4月) | GPT-Image-2.5(2026年9月) |
|---|---|---|
| APIモデル数 | 1(gpt-image-2) | 2(Flare = 速度、Sunburst = 編集精度) |
| 品質設定 | low / medium / high / auto | low / medium / high / xhigh / max / auto |
| レイテンシ | 基準 | Flareで最大50%削減(公称) |
| 編集の挙動 | 再描画気味で指定外も変わりやすい | 指定箇所のみ変更、周辺維持を主眼に改善 |
| マルチターン編集 | 回を重ねると劣化 | 以前の変更を保持、劣化を抑制 |
| 参照写真の忠実度 | 標準 | 顔・特徴の保持が向上 |
| 透明背景・複雑レイアウト | 対応 | 改善 |
| 来歴管理(生成元などを確認する仕組み) | C2PA + 不可視透かし | C2PA + Google DeepMindのSynthID |
| 解像度・アスペクト比 | 任意サイズ、最大3840×2160、1:3〜3:1 | 同じ |
| トークン単価 | 画像入力$8 / 画像出力$30(1Mトークン) | 同じ(モデル・品質設定によって1枚あたりの消費量は異なる) |
FlareとSunburstの使い分け
| Flare | Sunburst | |
|---|---|---|
| 位置づけ | 高品質な日常用途向けの最速モデル | 生成・編集で最も高性能。編集精度が最重要な用途向け |
| 公式表記 | Performance: Higher / Speed: Very fast | Performance: Highest / Speed: Medium |
| 想定用途 | SNSコンテンツ、プロダクト体験、ビジュアル検索、高速プロトタイピング、大量生成 | キャンペーン制作物や製品画像など、複数回の編集で厳密な制御が必要なプレミアム用途 |
| モデルID | gpt-image-2.5-flare(日付付き: -2026-09-08) | gpt-image-2.5-sunburst(日付付き: -2026-09-08) |
公式の推奨は「ほとんどのアプリはFlareから始め、編集の精度と制御が追加で必要な場合にSunburst」というものです。単価は両モデルで同一です。
ChatGPT側に追加された4機能
ChatGPT(Webアプリ)には、モデル更新とあわせて次の4つが追加されました。後半の検証ではこのうち3つ(Templates、画像上コメント、Sketch)を実際に使っています。
- Sketch: ChatGPT内で直接描いたラフを参照にして生成する機能。「@」からSketchを起動します
- Templates: ポスター、ロゴ、製品写真などの定型フォーマット
- 画像上コメントによる局所編集: 生成画像の任意の位置にコメントを置いて、その箇所の編集を指示
- プロンプト付きの画像共有
エンジニア向けの細かい変更点
既存のgpt-image-2呼び出しからの移行に関係する部分だけ抜粋します。
| 項目 | 変更点・移行時の確認事項 |
|---|---|
| 移行方法 | 移行はmodel文字列の差し替えで動きます。生成・編集のエンドポイントとパラメータ体系(任意サイズ、quality、edits、mask)はGPT-Image-2と共通です |
| 品質設定 | quality にxhighとmaxが追加され、5段階の指定(low / medium / high / xhigh / max)と自動選択(auto)を使えます |
| Responses APIのaction | Responses APIのimage_generationツールには action パラメータがあり、auto / generate / edit で挙動を固定できます。editを強制してコンテキストに画像がない場合はエラーです |
| マスク編集 | マスク編集は従来どおりプロンプトベースで、マスクは「ガイド」扱いです。形状に完全には従わない場合があり、複数入力画像がある場合は1枚目に適用されます |
| トークン単価 | 料金はテキスト入力$5.00、画像入力$8.00、画像出力$30.00(いずれも1Mトークンあたり)で、GPT-Image-2と同じ単価です。 |
| 1枚あたりのコスト | 公式の画像生成ガイドには2.5用の出力トークン・出力料金計算機があります。旧GPT-Image-2用の計算機を2.5に流用せず、モデル・サイズ・qualityを指定して見積もります。入力分などは別なので、本番投入前には同一条件で返却されるusage全体を記録し、入力・出力の消費量と合計料金を実測してください |
| バージョン固定 | モデルのバージョンを固定したい場合は、日付付きスナップショット(-2026-09-08)を明示指定します。同一画像が毎回生成されることを保証するものではありません |
安全性と来歴管理
システムカードでは、写実性の向上によって実在の人物・場所・出来事のより説得力のあるディープフェイクが生成されうることを新たなリスクとして明記し、生成前のLLMベースの方針チェック、入力の監視、出力画像の最終チェックという多層構成で対処しています。来歴については従来のC2PAメタデータに加え、Google DeepMindのSynthIDによる不可視透かしがChatGPT、Codex、APIの全面に組み込まれました。OpenAIがGoogleの透かし技術を採用した点は、業界動向としても注目に値します。
ChatGPT Web版で実際に検証してみた
検証環境と方針
- 日時: 2026年9月9日(リリース翌日)
-
環境: 本人のログイン済みChatGPT Web(Chrome)。
-
Templates → Poster を選んだときの挙動
- 日本語4文字列と物体の配置を指定したポスターの生成
- 画像上コメントで「マグカップの色だけ」を変える部分編集
- 同じ画像を続けて編集する連続編集(価格だけを580円→620円へ)
- Sketchで描いたラフを構図指示にした水彩画の生成
なお、これはChatGPT Web上の検証です。APIモデルを指定した試験ではなく、UIにはFlare / Sunburstのどちらが使われたかは表示されません。
1. Templatesからポスターを選ぶ
画像生成の入力欄の下にTemplatesが並んでいます。Poster、Interior design、Logo、Illustrationのほか、人物・パターン・製品・Tシャツなどのテンプレートが確認できます。
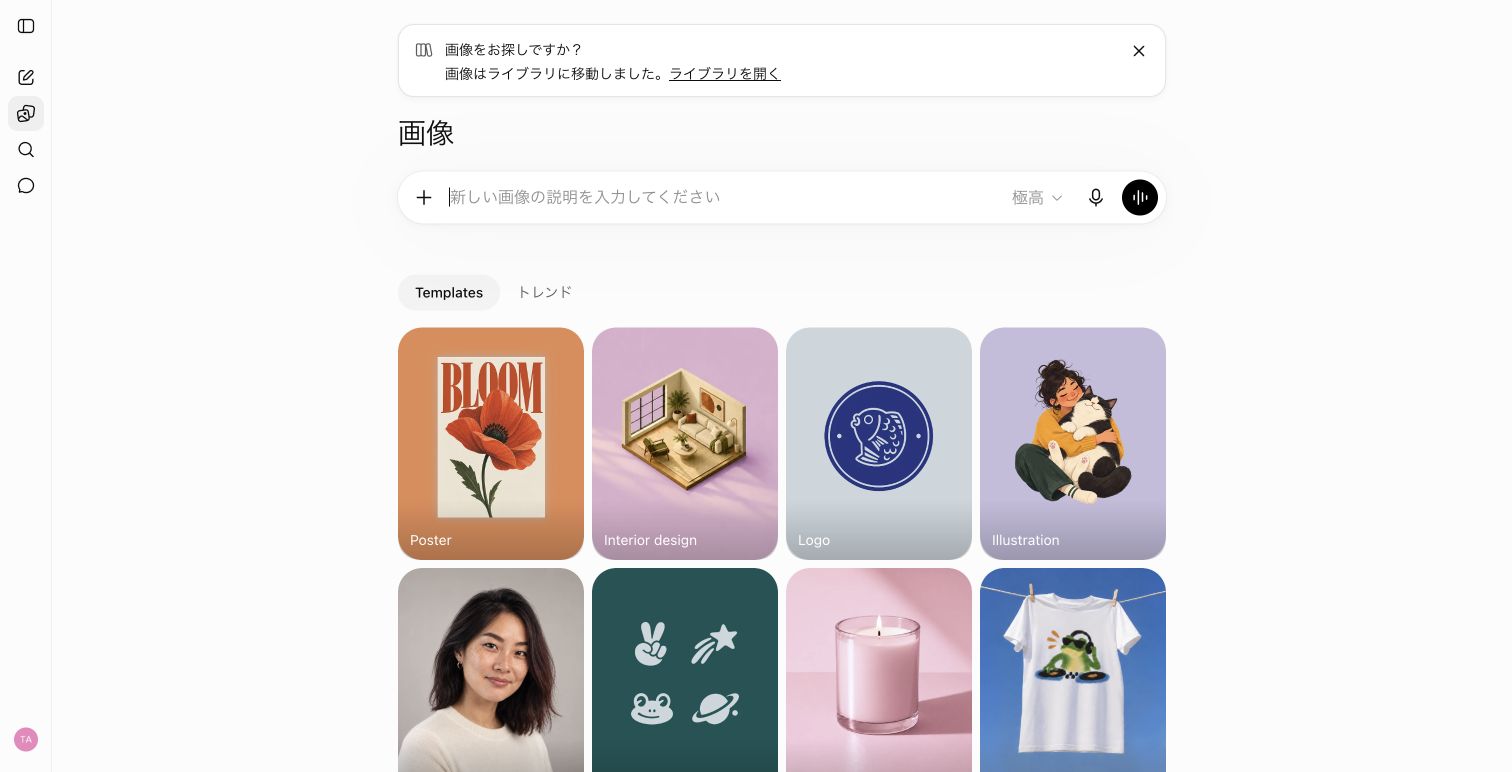
Posterを選ぶと、ポスター作成用の指示文(英語)が入力欄に挿入されます。内容は「視覚的階層・可読テキスト・画像とタイポグラフィの調和」「与えられた情報だけを使い、イベント名や日付・ロゴを勝手に追加しない」「不足があれば質問する」といった、汎用的なポスター用の指示です。
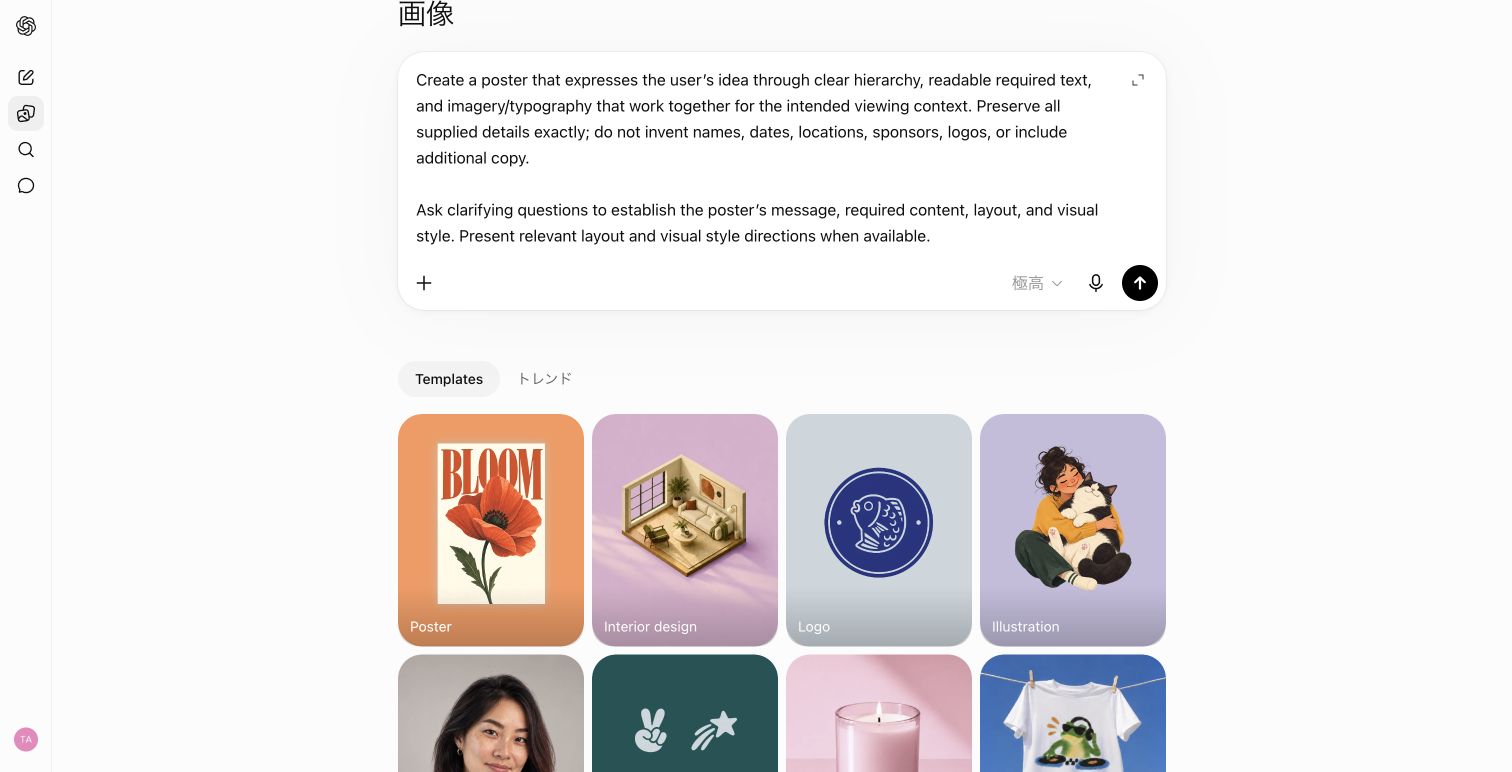
このテンプレート文はそのまま使わず、検証条件を具体的に書いた日本語プロンプトに置き換えて送信します。
2. 日本語4文字列と構図を指定して生成する
プロンプトは次のとおりです。文字列4つ、物体(マグカップ1個・シナモン2本・葉1枚)、左右の配置、背景色、余白まで指定しています。
Posterテンプレートを使って、次の指定どおりに画像を1枚生成してください。条件は確定しているので質問は不要です。
架空のカフェの正方形広告ポスター。背景は均一なアイボリー色。上部に濃いブラウンの日本語見出し「秋のほうじ茶ラテ」。その下に小さく「香ばしさ、ひとくち。」。中央に、取っ手が右側にある青い無地の陶器マグカップを一つ、斜め前から見たリアルな商品写真。マグカップには淡いベージュのラテ、上にラテアート。マグカップの左にシナモンスティックを2本、右に小さな緑の葉を1枚。机の上にはやわらかい影。下部中央に価格「580円」、最下部に「こもれび喫茶」。指定した4つの文字列をそのまま正しく描写してください。それ以外の文字・ロゴは追加しない。すっきりした余白の多い高品質な広告。
送信すると、モザイク状のプレビューが徐々に精細になる進捗表示が出ます。
結果がこちらです。
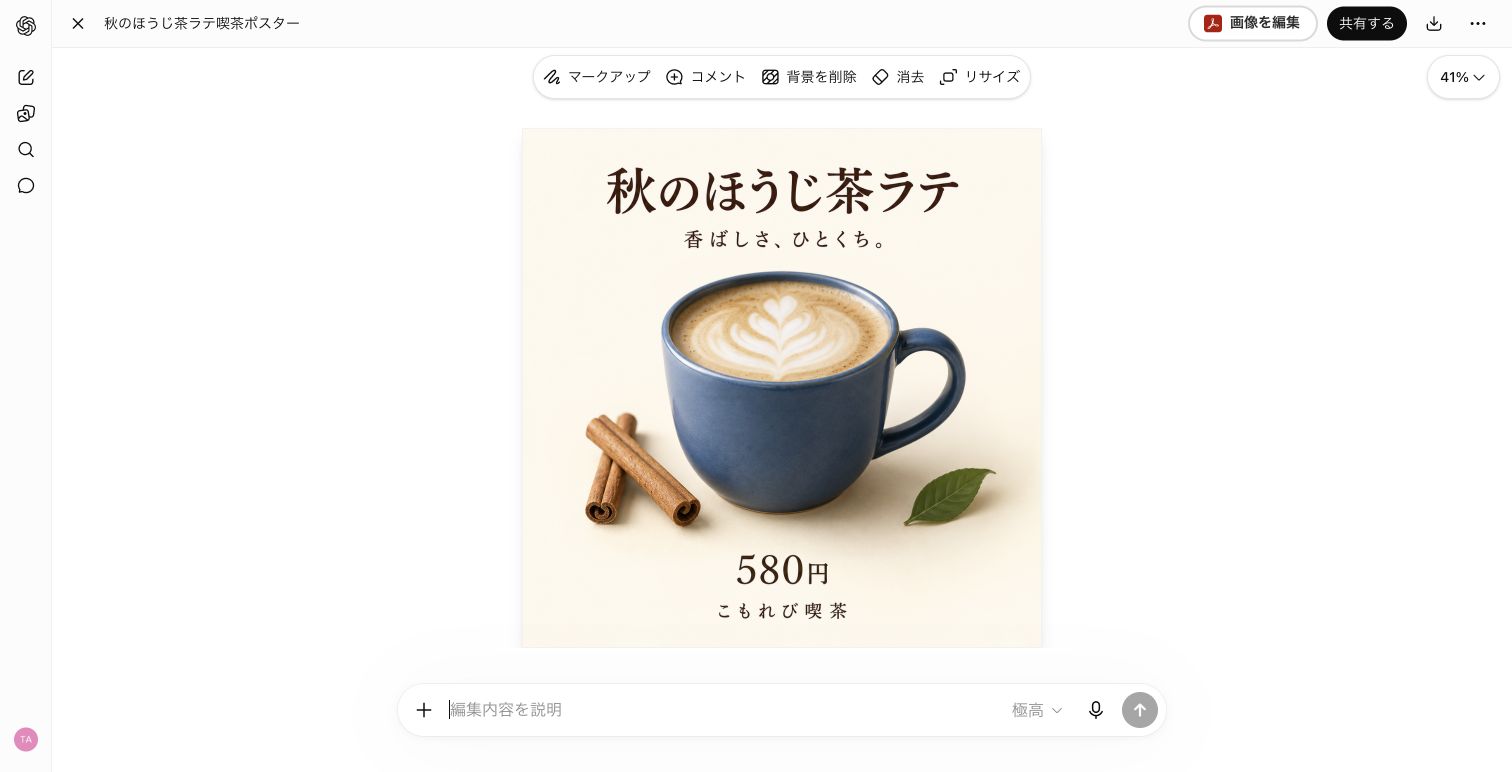
確認できたことは次のとおりです。
- 「秋のほうじ茶ラテ」「香ばしさ、ひとくち。」「580円」「こもれび喫茶」の4文字列がすべて読み取れる状態で描かれている
- マグカップ1個・シナモン2本・葉1枚という物体数と、シナモンが左・葉が右という配置が指示どおり
- 取っ手は右側、ラテアートあり、背景はアイボリー、やわらかい影という細部も一致
- 指定外の文字やロゴは追加されていない
小さい文字もきちんと表示できていることが分かります。
3. 画像上コメントで「マグカップの色だけ」を変える
生成画像を開くと、上部に「マークアップ」「コメント」「背景を削除」「消去」「リサイズ」といった編集ツールが並びます。今回は「コメント」を使いました。
手順は次のとおりです。
- 生成画像の上で「コメント」を選ぶ
- 変更したい対象(マグカップ本体)の位置をクリックする
- 表示されたコメント欄に編集指示を入力して保存する
- 送信する
コメントに入れた指示は次のとおりです。変える対象を1つに絞り、維持してほしい要素を列挙しています。
マグカップ本体と取っ手の青い部分だけを、深い赤色に変更してください。形・位置・大きさ・ラテアート・背景・影・シナモン2本・葉1枚・すべての文字と580円はそのまま維持してください。
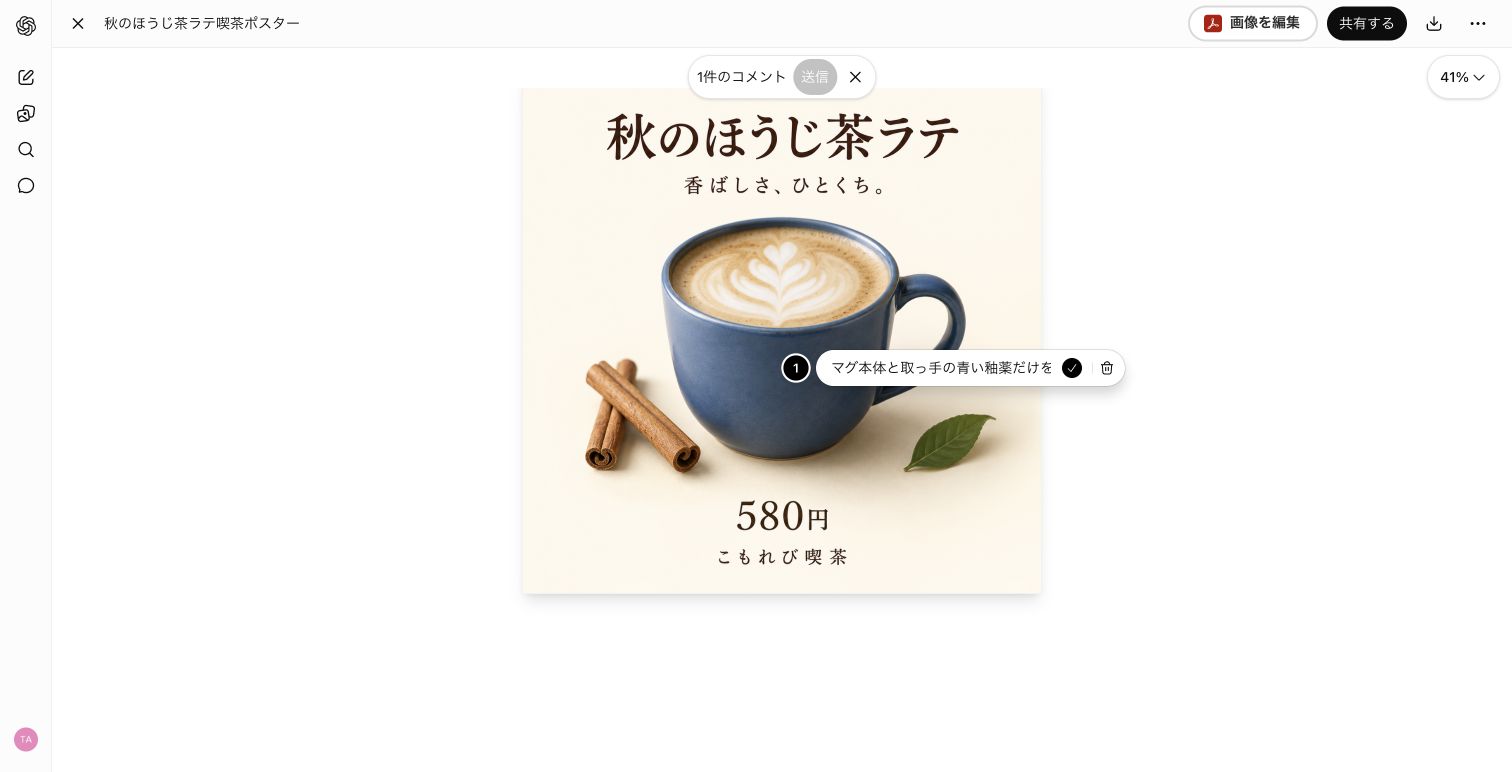
結果がこちらです。
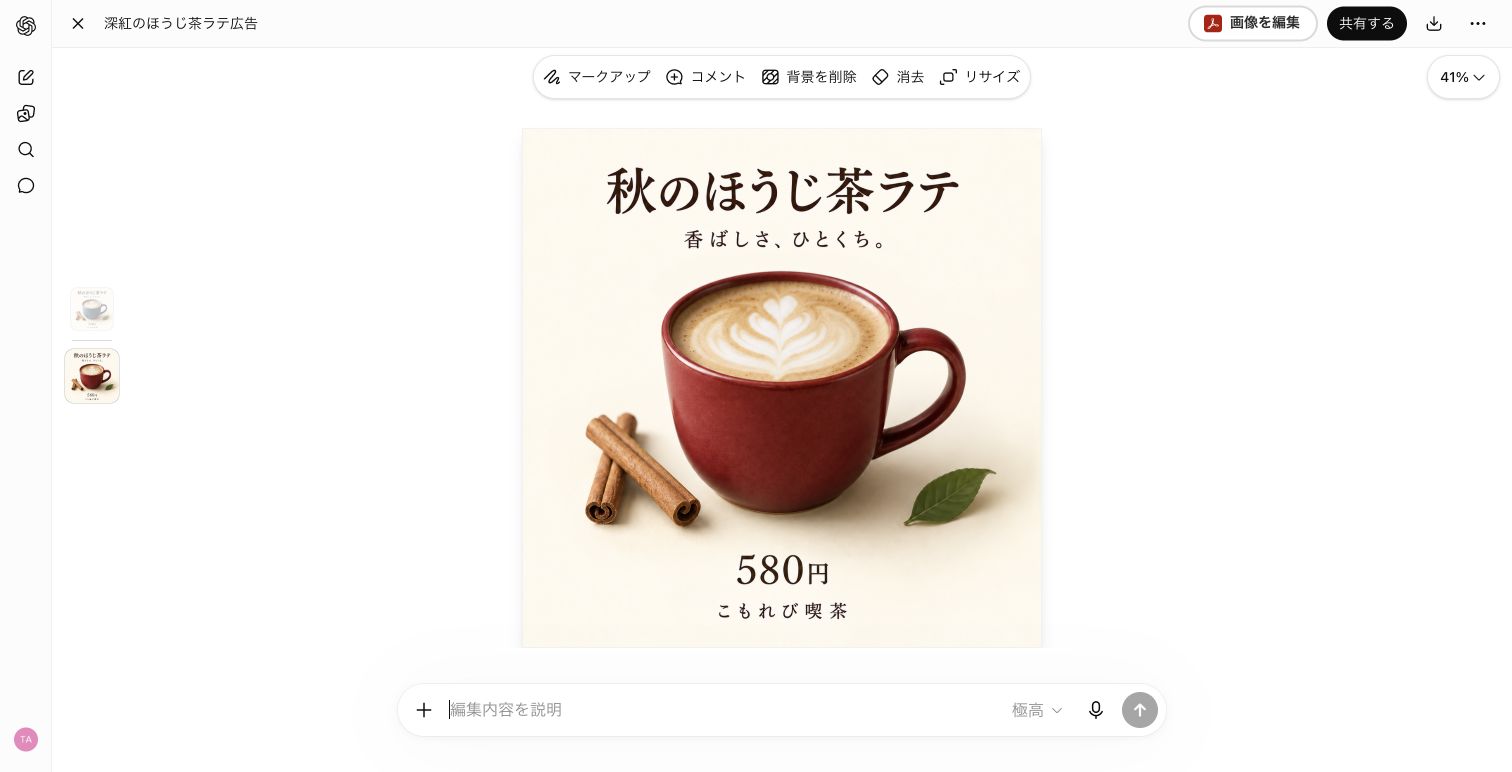
マグカップの色は青から深い赤に変わり、4つの文字列、価格、シナモン2本、葉1枚、マグカップの形と取っ手の向き、影の付き方はいずれも維持されました。
4. 同じ画像を続けて編集する(580円→620円)
次に、赤いマグカップの画像に対してテキストで追加指示を送り、価格だけを変えました。連続編集で「直前の変更(赤色)が維持されるか」が見どころです。
直前の赤いマグカップの画像を編集してください。変更は1点だけです。下部中央の価格「580円」を「620円」に置き換えてください。同じ書体・文字サイズ・色・位置にしてください。赤いマグカップの色・形・位置、ラテアート、シナモン2本、葉1枚、背景、影、見出し「秋のほうじ茶ラテ」、コピー「香ばしさ、ひとくち。」、店名「こもれび喫茶」はすべて維持してください。
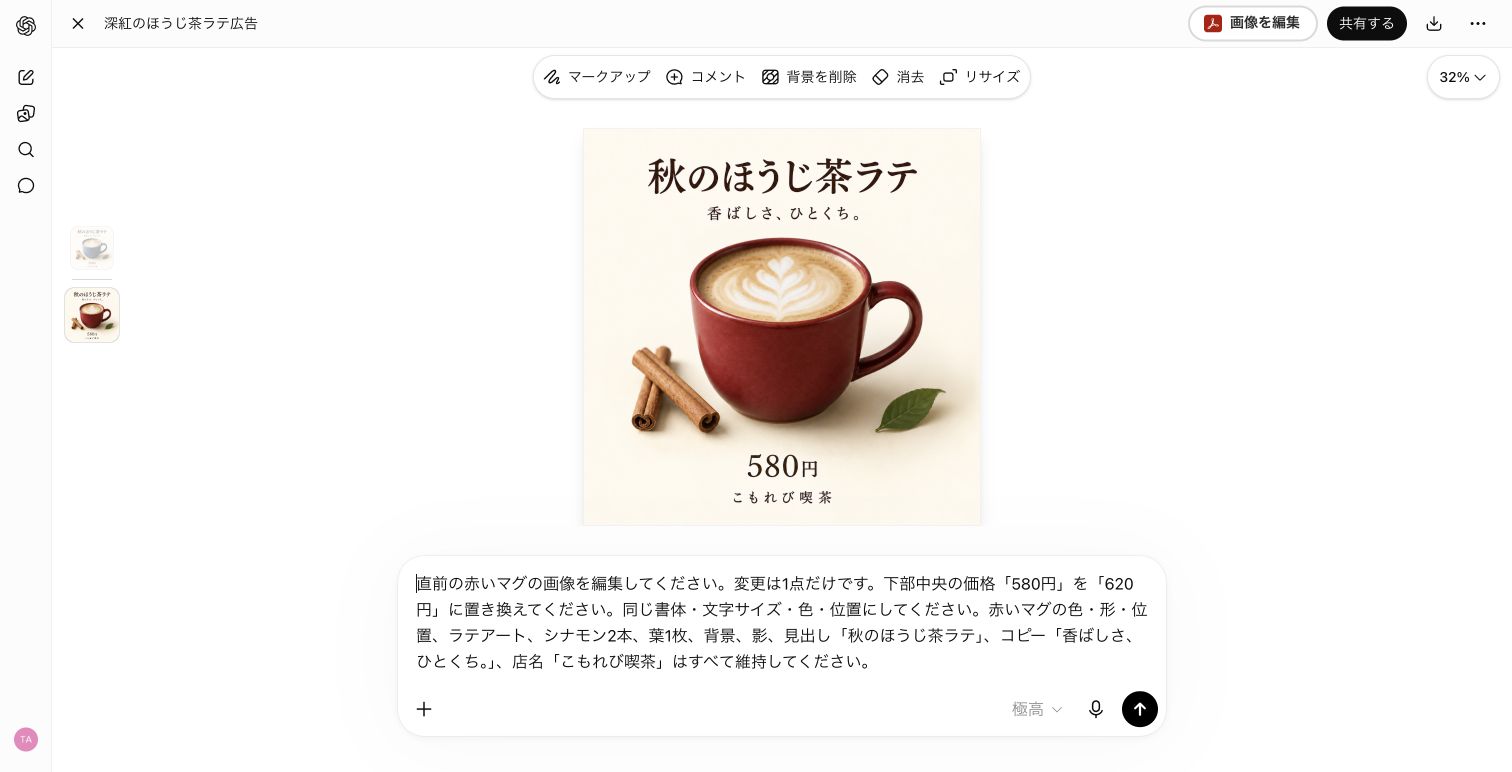
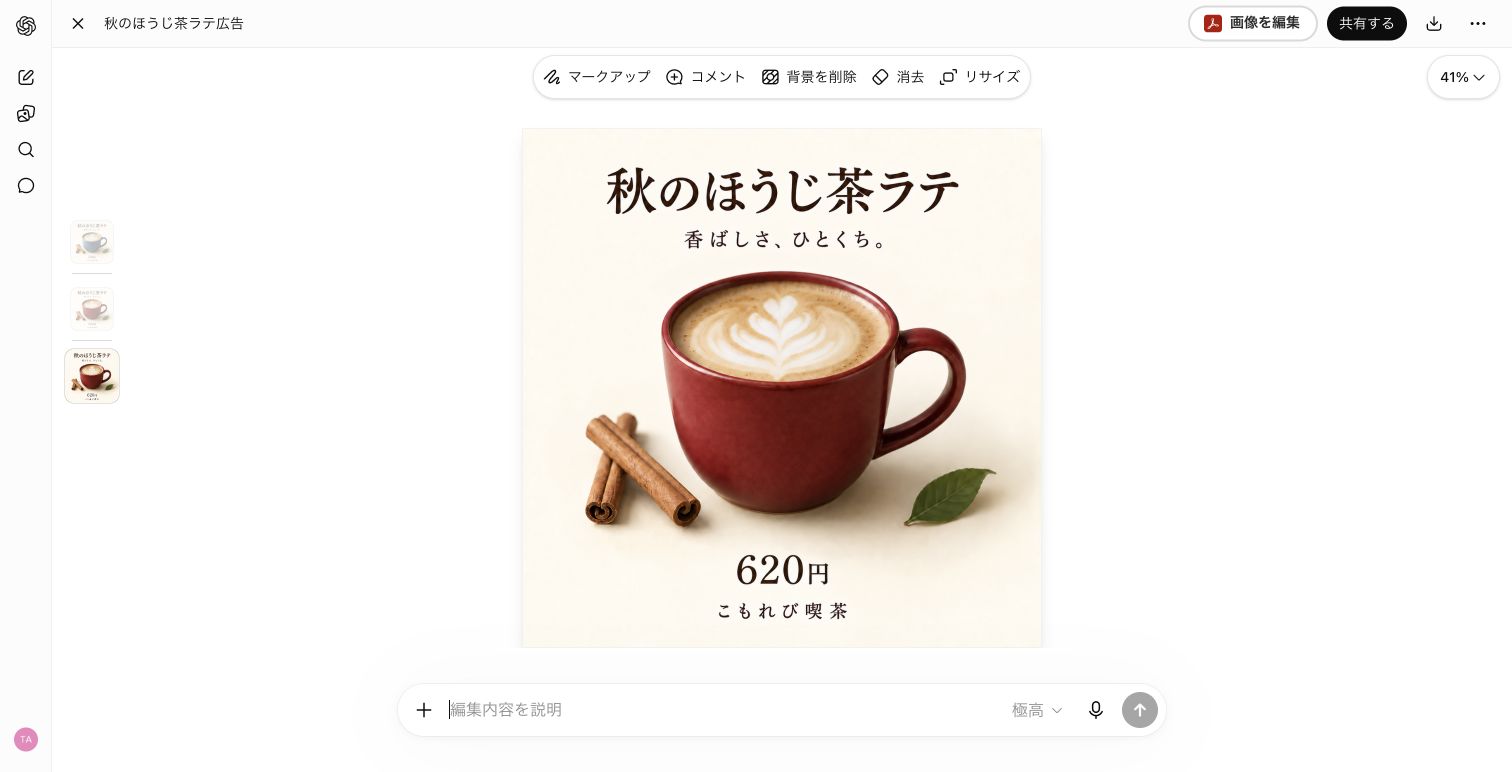
価格は「620円」に置き換わり、書体・サイズ・位置も元と揃っています。直前の編集で変えた赤色も保持され、ほかの日本語・物体数・構図は維持されました。3枚を並べると変化の流れがわかりやすいです。
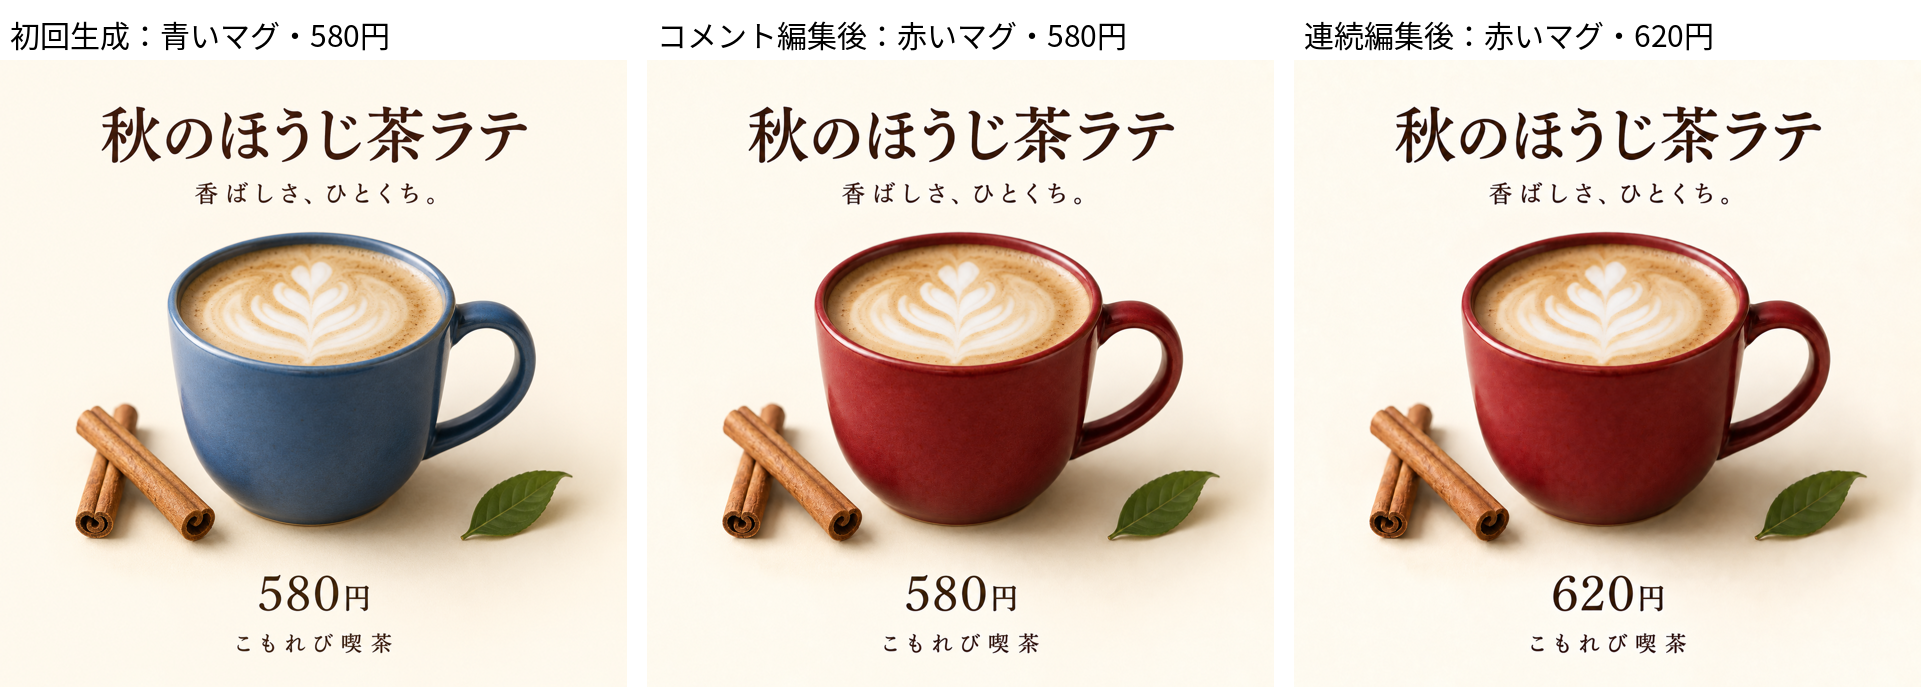
ここで注目したいのが「指定外の部分はどこまで固定されているか」です。目視では、ラテアートの模様、泡の質感、シナモンの表面の細かいテクスチャが2枚目と3枚目でわずかに違って見えます。
そこで、保存した生成画像(赤・580円と赤・620円、いずれも1254×1254)の画素差分を取ってみました。
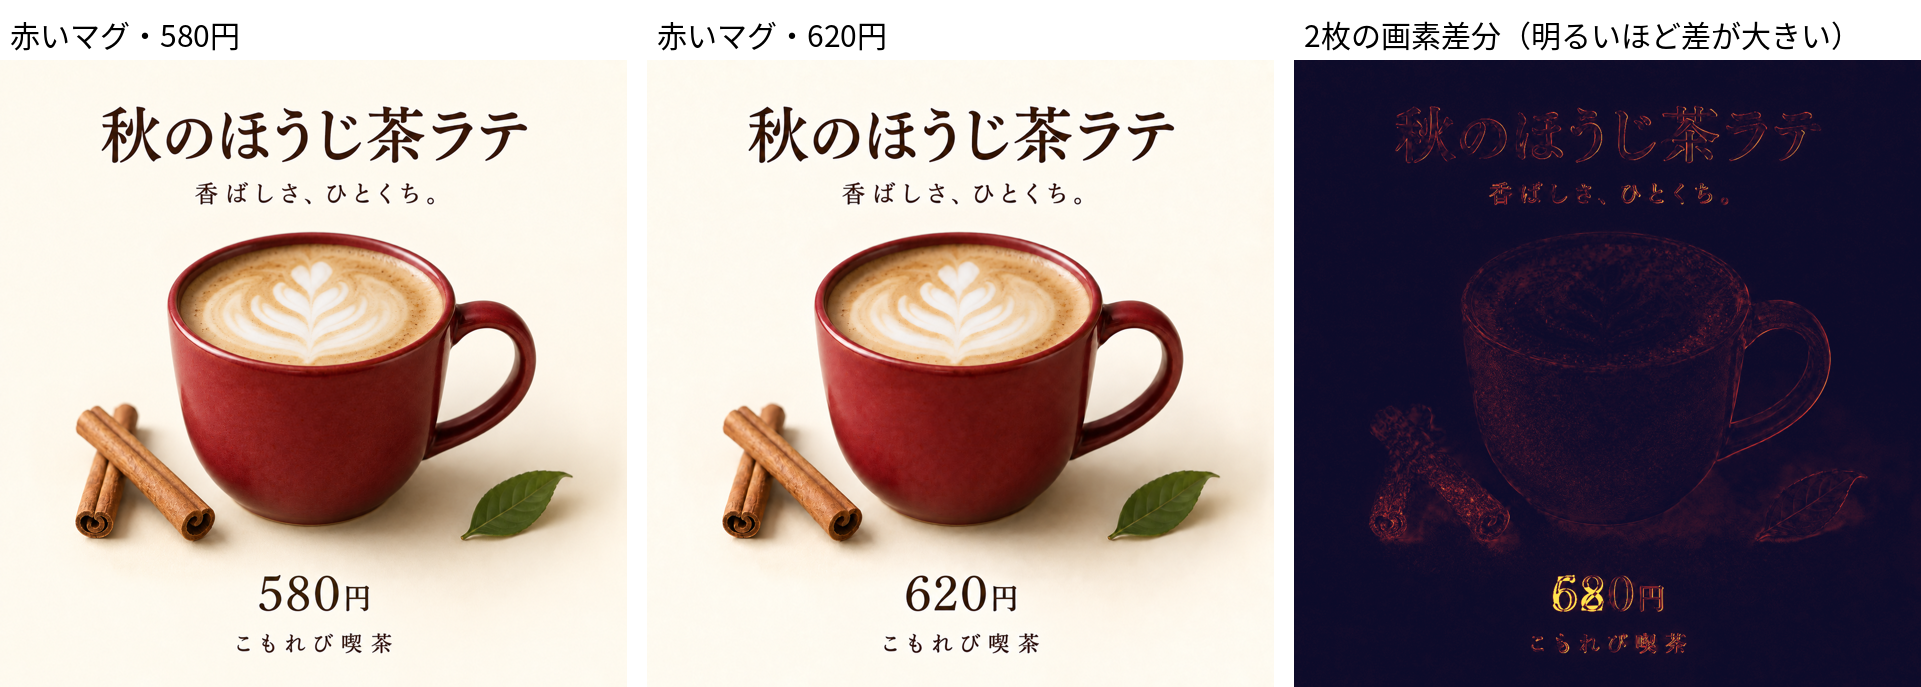
差分は価格の部分に最も強く出ており、意図どおりです。一方で、見出し文字の縁、マグカップの輪郭、ラテアート、シナモン、葉の輪郭にも薄く差分が出ています。数値で見ると、画素あたりの平均差は約2(0〜255スケール)とごく小さいものの、価格周辺以外がゼロではなく、差が8を超える画素が全体の約2.5%、24を超える画素が約0.6%あります。背景の均一な領域はほぼゼロです。
つまり2.5の「指定外を維持する」は、主要な要素(文字、物体数、配置、色)のレベルでは成立していますが、ピクセルレベルで固定されているわけではありません。輪郭や質感は編集のたびに微妙に描き直されています。これは公式ヘルプに「選択範囲外にも編集が及びうる」と書かれている挙動と一致しますし、他のレビューが指摘している「編集を重ねると質感が少しずつ変わる」現象の実例でもあります。
5. Sketchで描いたラフから水彩画を生成する
最後にSketch機能です。公式ヘルプではSketchとコメントの一部手順がモバイル向けに説明されていますが、今回の本人アカウントではWeb版でも起動・生成できました。全アカウントで同じ提供状況かは確認していません。
手順は次のとおりです。
- 入力欄で「@」を入力し、スケッチを選ぶ
- 表示されたキャンバスにラフを描く(ペン・色の選択が可能)
- 描き終えたら添付する
- 生成指示のプロンプトを入力して送信する
ラフは意図的に雑に、左に家・右に木だけを描きました。
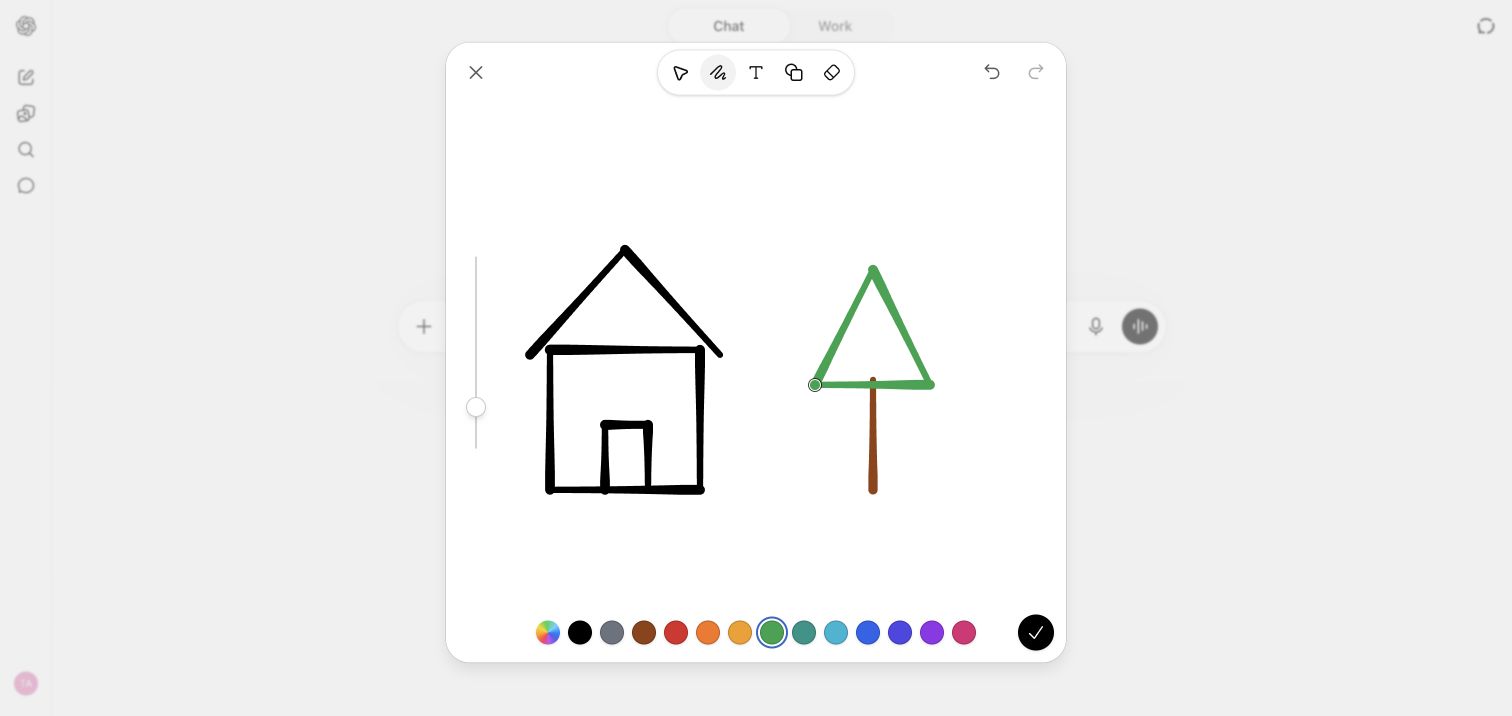
プロンプトでは、スケッチを「構図の指示」として使うこと、色や画材、描かないでほしいものを文章で補っています。
添付したスケッチを構図の指示として使い、やさしい水彩画の画像を1枚生成してください。左に赤い三角屋根とクリーム色の壁の小さな家を1軒、右に緑の木を1本。スケッチの左右関係・大きさの比率・空白を保ってください。空は淡い水色、足元は草地。人・車・文字・別の建物・追加の木は描かないでください。ラフの線をそのまま残さず、完成した絵本の挿絵に仕上げてください。
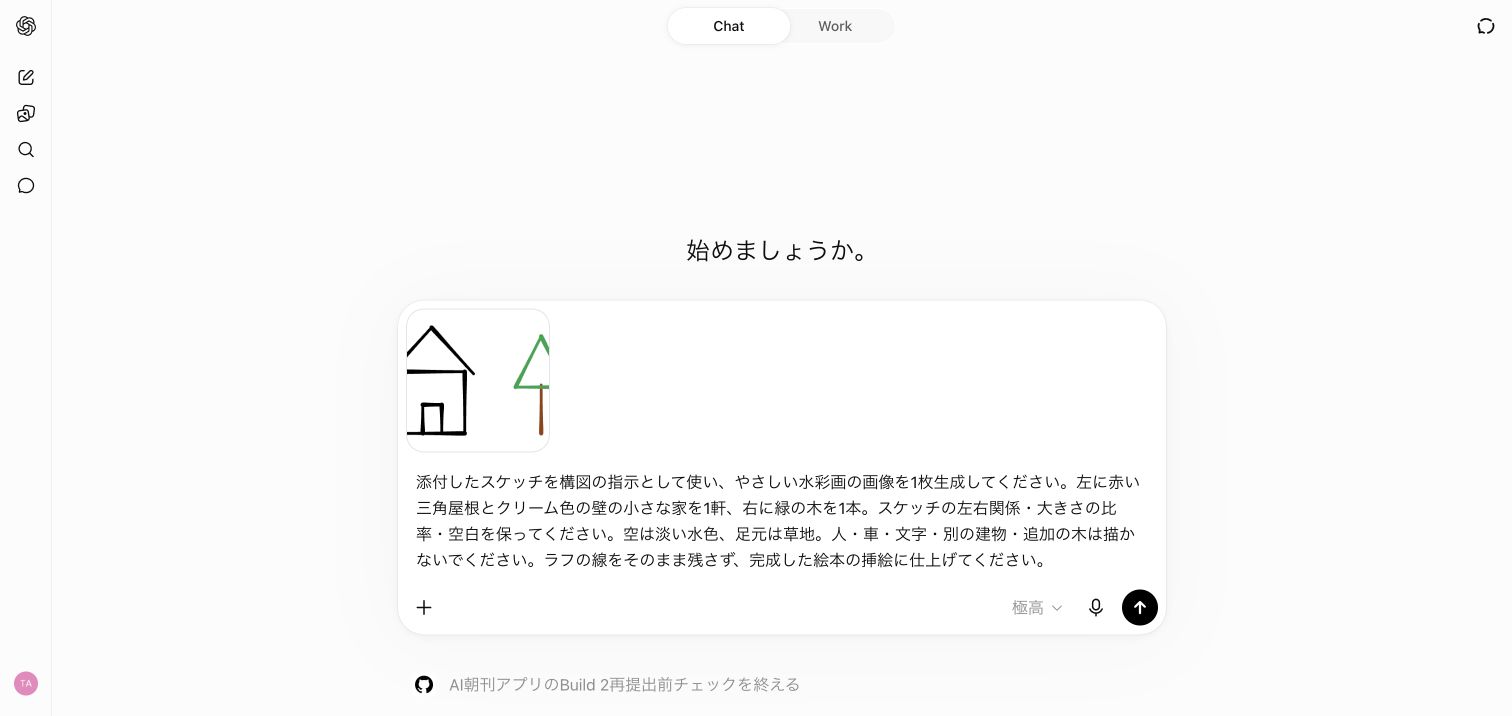
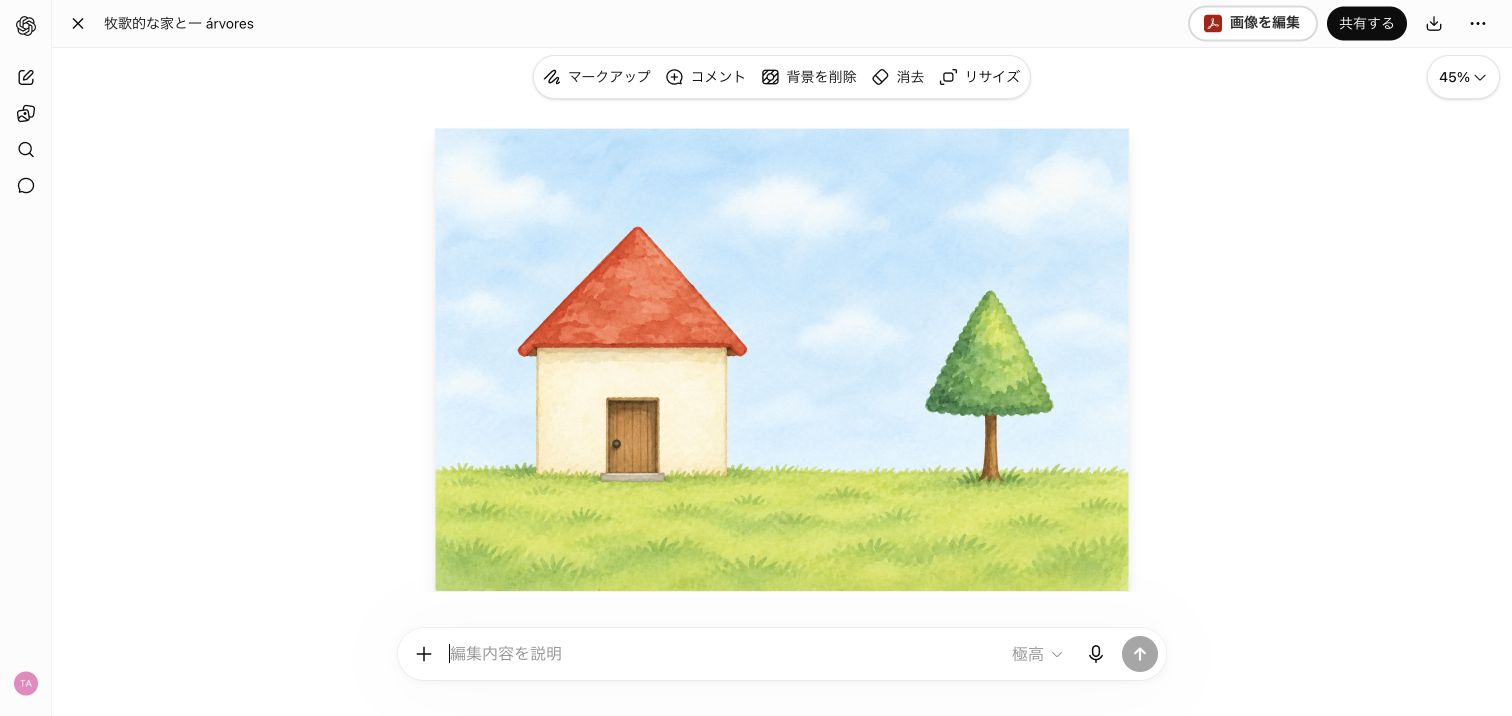
左に家1軒、右に木1本という構図と物体数は維持され、赤い三角屋根・クリーム色の壁・淡い水色の空・草地という文章で指定した要素も反映されました。ラフの線は残っておらず、絵本の挿絵として成立しています。
一方で、木の相対的な大きさや余白はスケッチと完全には一致していません。ラフでは家と木がほぼ同じ高さでしたが、生成結果では木がやや小さく、家寄りに配置されています。Sketchは「何をどこに置くか」を伝える手段としては有効ですが、比率や余白を厳密に守らせる手段ではない、という理解が正確です。絵の上手さより「主役を大きく描く」「空けたい余白を示す」ことが効くという他のレビューの指摘とも整合しています。
生成時間について
送信から画面で完成を確認した時点までの時間も記録しましたが、初回生成が約56秒、色変更が約85秒、価格変更が約79秒、Sketchからの生成が約132秒でした。これは画面で完成を確認するまでの観測値で、表示確認の間隔や通信時間も含みます。モデル単体の処理時間ではありません。
今回検証していないこと
少数例による動作確認なので、次の項目は未検証です。
- GPT-Image-2との同条件比較
- Flare / Sunburstの個別指定と比較(UIにモデル名が表示されないため、今回どちらが使われたかも特定していません)
- APIの料金・1枚あたりのトークン消費量
- 最大50%高速化の実測
- 透過出力
- 人物の同一性保持
- 複数参照画像による生成
- SynthID透かしの検証
- 密度の高い小さい文字のレンダリング
検証からわかったこと
「指定外は維持」の実態
今回の検証で最も重要な発見は、2.5の「指定箇所だけを変える」が、主要要素レベルでは成立しつつ、ピクセルレベルでは成立していないことが分かりました。
これは実務上、次のように言い換えられるかと思います。
- 商品差し替え、コピー差し替え、色違いのバリエーション作成といった「見た目が保たれていればよい」用途には十分実用域
- ブランドロゴの厳密な再現や、規制上ピクセル単位で変えてはいけない要素がある場合は、編集後の目視チェックまたは自動差分チェックの工程が必要
- 編集を何段も重ねる場合は、初回生成の画像を「原本」として保持し、毎回原本から編集し直す設計のほうが質感のドリフトを抑えられる
プロンプト設計の型
今回の部分編集・連続編集が通った要因として、プロンプトの書き方も影響していると考えられます。共通して意識したのは次の3点です。
- 変える対象を1つに絞り、「変更は1点だけ」と明示する
- 維持してほしい要素を省略せず列挙する(文字列、物体数、色、位置、背景、影)
- 文字列は「」で囲んでそのまま書き、勝手な追加を禁止する
API経由で編集パイプラインを組む場合、この「変更点1つ + 維持要素の列挙」をテンプレート化しておくと安定しやすいはずです。
開発者としての判断
- 一発生成の品質だけが目的なら、2.0からの差は小さく、急いで移行する理由は薄いです
- 編集パイプライン(商品差し替え、コピー差し替え、多段修正)を持っているなら移行価値は明確です。まずFlareに切り替え、編集チェーンで動かしてはいけない要素がある工程だけSunburstを試すのが公式推奨に沿った進め方です
- 単価が同じでも1枚あたりのコストは同じとは限りません。公式の2.5対応計算機で出力分を見積もり、本番投入前にusage全体で入力・出力の実消費量を確認してください
- Sunburstは公式に「Speed: Medium」のモデルです。複雑なプロンプトは最大2分かかる場合があるとされているため、同期呼び出しではなくバックグラウンド実行やタイムアウト設定を前提に設計する必要があります
- 別々の生成間でキャラクターやブランド要素がドリフトしうる点は2.5でも残っています。同一性が必要なら、繰り返しの説明より参照画像を使うほうが確実です
まとめ
GPT-Image-2.5は「絵が良くなった」というより「編集ツールとして実用域に入った」アップデートです。公式の説明、Arenaのスコア、各所の実測レビューの三者がこの点で一致しており、今回のWeb版での検証でも、色変更と価格変更の2段階の編集を主要要素を保ったまま通せました。
ただし「指定外は完全固定」ではなく、輪郭や質感は編集のたびに微妙に描き直されます。この挙動を前提に、チェック工程や原本からの再編集を設計に組み込めば、ポスターや商品画像のバリエーション作成はかなり効率化できそうです。
情報源はリリースから1日以内のものが中心で、1枚あたりのコストや第三者による品質比較は今後更新される可能性があります。
参考
- OpenAI Help:Images in ChatGPT — Templates・Sketch・編集の手順と、選択範囲外にも編集が及びうる旨の説明
- GPT-Image-2.5 Flare モデルページ
- GPT-Image-2.5 Sunburst モデルページ
- OpenAI:画像生成ガイド — APIの使用方法・制限・2.5対応の出力トークン/料金計算機
- OpenAI公式動画:Introducing ChatGPT Images 2.5 / Sketch with ChatGPT Images 2.5 / Templates with ChatGPT Images 2.5
※ API・料金の記述は2026年9月9日の公式ページで確認しています。