「社内の資料 PDF、スクリーンショット、ソースコード、会議の録音。全部まとめて、日本語の質問1つで探せたら便利なのに」。ローカルで RAG(検索拡張生成)を組んだことがある人なら、一度はそう思ったはずです。ところが実際には、文章はテキスト用の埋め込みモデル、画像は CLIP 系のモデル、音声はいったん文字起こし、とデータの種類ごとに別の仕組みを用意するのが当たり前でした。
2026年10月6日に Google DeepMind が公開した EmbeddingGemma 2 は、この前提を変えにいくモデルです。740M(7.4億)パラメータという小ささで、テキスト・コード・画像・動画・音声を1つの 768 次元のベクトル空間に置きます。ライセンスは Apache 2.0 で、ノート PC やスマートフォンで動かすことを前提に作られています。
この記事では、公式の発表とモデルカードから「従来のエンベディングと何が変わったのか」「公式ベンチマークの数字はどう動いたのか」を整理したうえで、手元の Mac(M5 Max)で6つの実験を行い、日本語で本当に使えるのかを確かめます。結論を先に書くと、写真・動画・文書ページの検索は日本語でもはっきり使える水準でした。一方で、日本語のテキスト検索は旧版とほぼ同じ、話し声の検索は「文字起こししてからテキストで埋め込む」従来の方法のほうがまだ強く、さらに全部を1つの索引にそのまま混ぜると、テキストが上位を独占するという落とし穴も見つかりました。
想定読者は、RAG やベクトル検索を一度は触ったことがあり、マルチモーダルな検索を自分の環境に入れるか迷っている人です。最初の2節は、埋め込みを使ったことがない方にも読めるように書いています。
この記事の確認範囲
- 検証日:2026年10月7日。モデルは Hugging Face の
google/embeddinggemma-2(2026-10-06 公開版)と、比較用の旧版 EmbeddingGemma(300M) - 環境:MacBook Pro(Apple M5 Max・メモリ 128GB)、Python 3.12、PyTorch 2.14(MPS・bfloat16)、transformers 5.19.0、sentence-transformers 6.1.0、mteb 2.22.5
- 公式情報:Google の発表ブログ、Google Developers Blog、Hugging Face のモデルカード(いずれも 2026-10-06)
- データはすべて公開データセットです。音声メモ40件だけは、この記事のために macOS の音声合成で作りました
はじめに:データの種類ごとに検索の仕組みが分かれていた
まず、これまでのローカル検索がどう組まれていたかを、EmbeddingGemma 2 の構成と並べて見てください。左が従来、右が今回のモデルです。
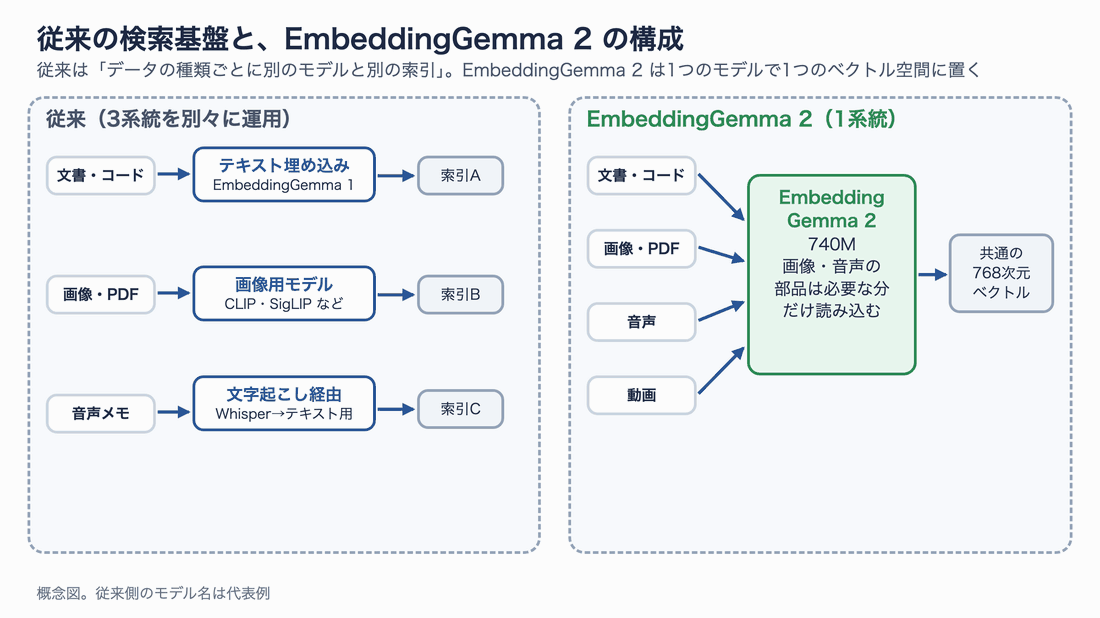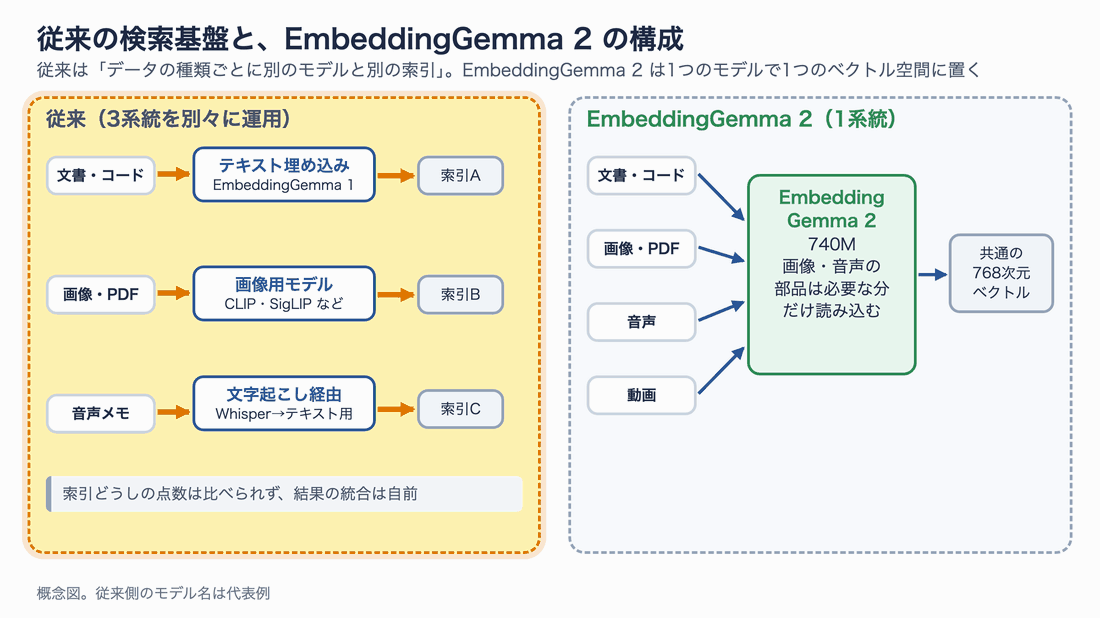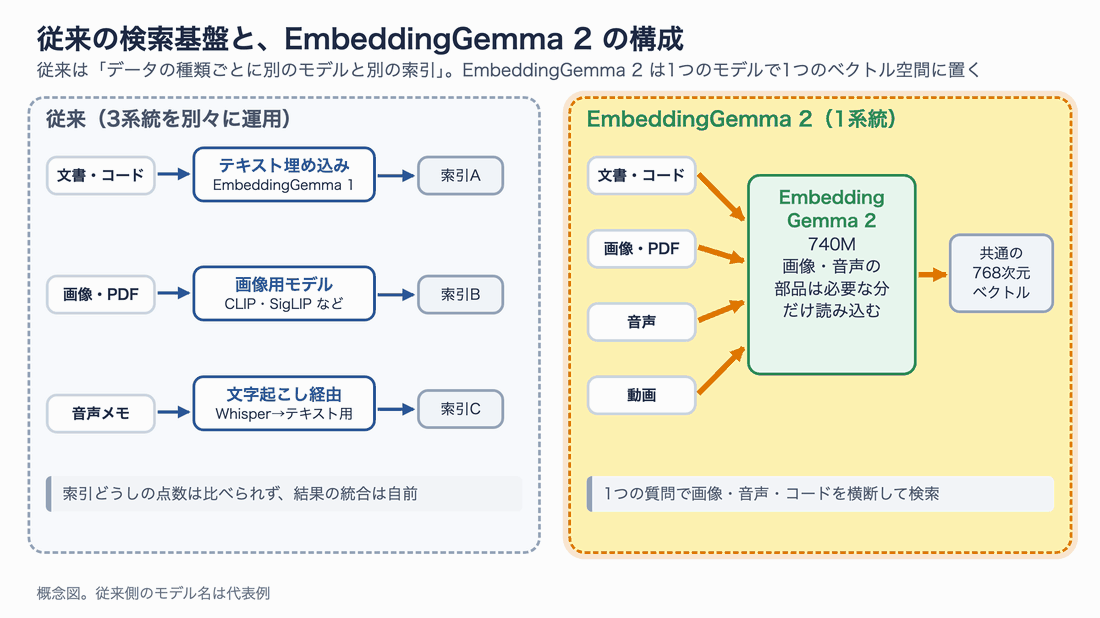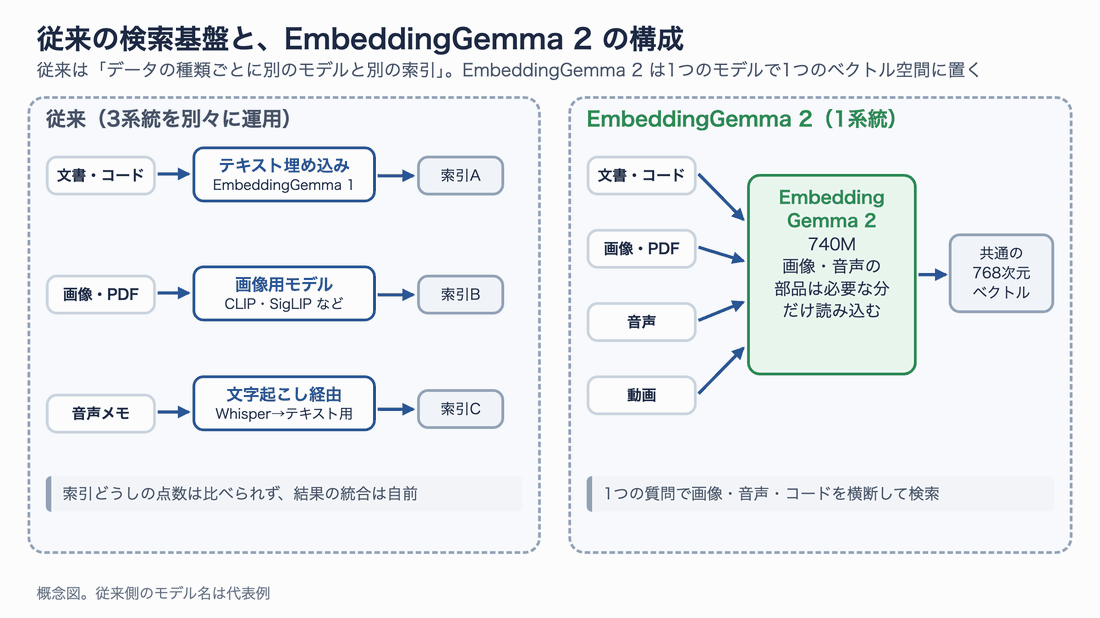
従来は3系統の索引が別々で、点数どうしを比べられないため結果の統合を自前で書く必要があった。EmbeddingGemma 2 では入口が1つになり、出口のベクトルも共通になる
従来の構成でも検索はできます。ただ、索引ごとに類似度の尺度が違うので、「文章の検索結果の1位」と「画像の検索結果の1位」のどちらが質問に近いのかは、そのままでは決められません。結果を混ぜる処理を自分で書き、モデルも3つ管理する必要がありました。
EmbeddingGemma 2 は、この「入口と出口がばらばら」という問題を、1つのモデルと1つのベクトル空間で解こうとしています。では、本当に1つの空間で横断検索できるのか。どこまで従来の専用モデルに迫れるのか。それを確かめるのがこの記事の目的です。
埋め込み(エンベディング)の基本をおさらい
埋め込みを使ったことがない方のために、仕組みを1枚で説明します。
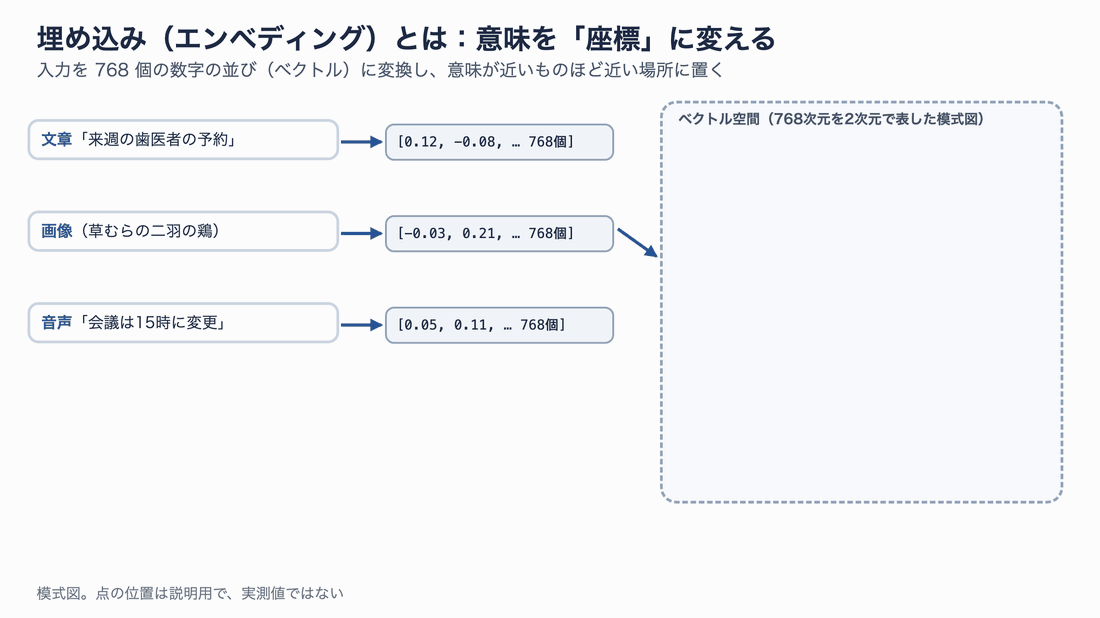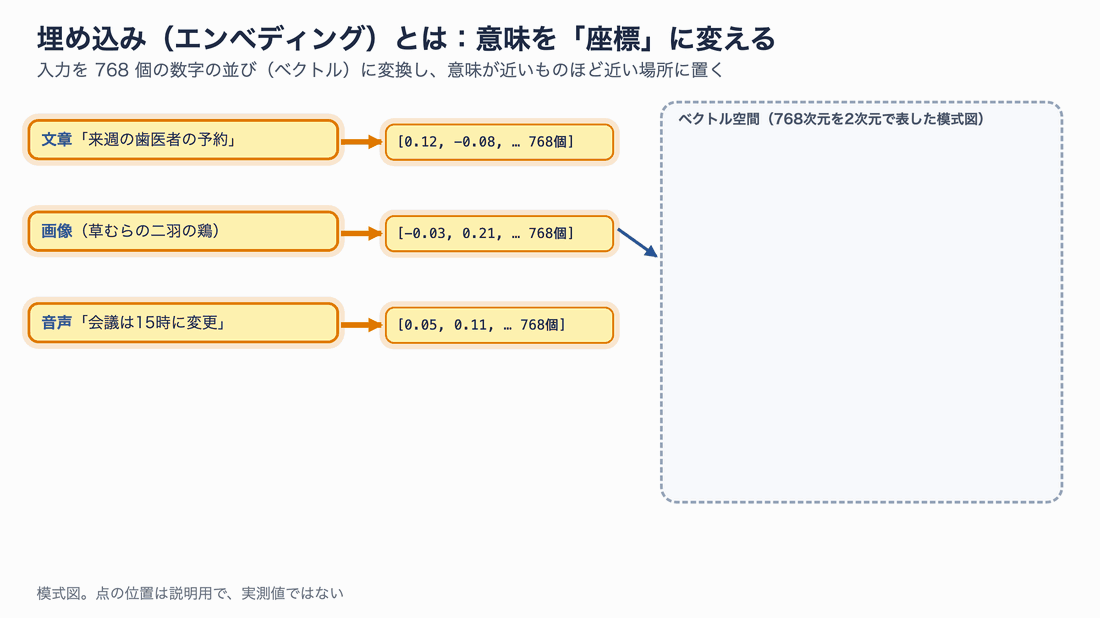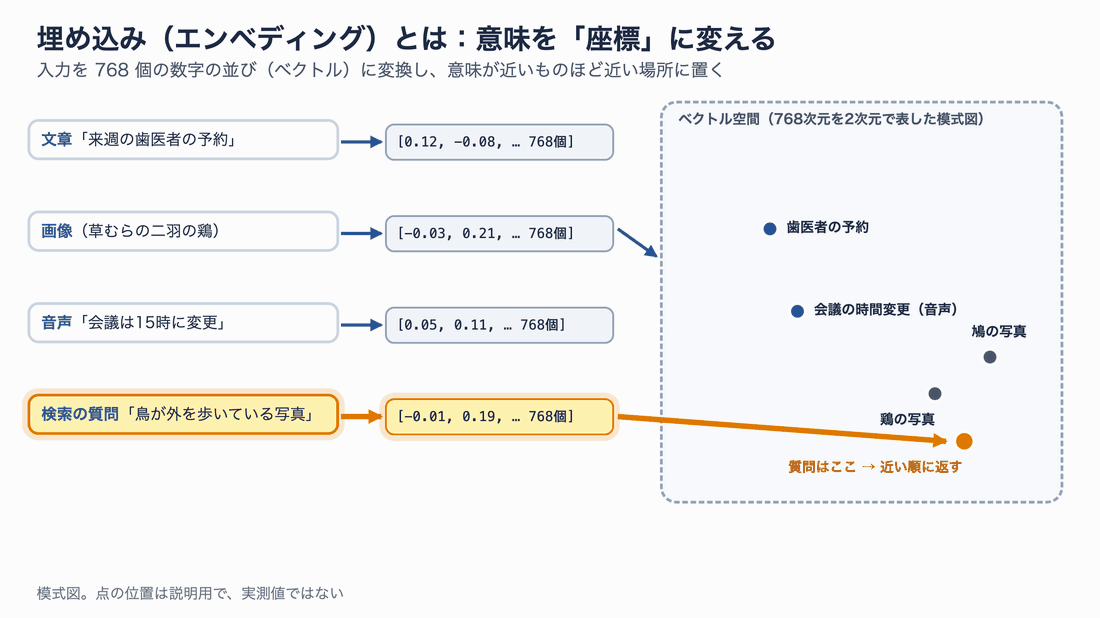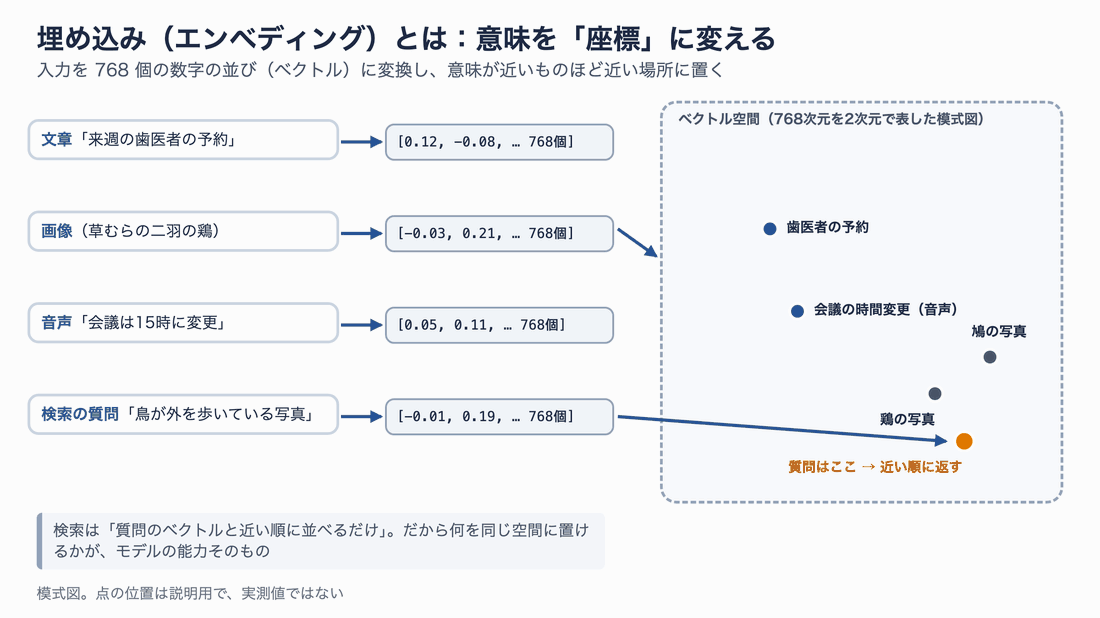
埋め込みモデルは、入力を「意味の座標」に変換する装置。検索は、質問の座標から近い順に並べるだけで済む
埋め込み(embedding)とは、文章や画像を、決まった長さの数字の並び(ベクトル)に変換することです。EmbeddingGemma の場合は 768 個の数字になります。うまく学習されたモデルでは、「歯医者の予約」と「歯科の予約日」のように意味が近い入力ほど、ベクトル同士の向きが近くなります。この近さをコサイン類似度(2本の矢印の向きがどれだけそろっているか)で測るのが一般的です。
検索システムは、あらかじめ文書を全部ベクトルにして保存しておき(これを索引、インデックスと呼びます)、質問が来たら質問もベクトルにして、近い順に返します。RAG では、こうして見つけた文書を LLM に渡して回答を作らせます。
ここで大事なのは、「何を同じ空間に置けるか」がモデルの能力そのものだという点です。テキスト専用のモデルは、画像を座標に変換できません。EmbeddingGemma 2 は、ここに画像・動画・音声を加えました。
EmbeddingGemma 1 から何が変わったのか
主な違いの一覧
前の世代の EmbeddingGemma(2025年9月公開、308M)との違いを、公式のモデルカードと発表ブログの記載をもとに表にしました。
| 項目 | EmbeddingGemma 1(300m) | EmbeddingGemma 2 |
|---|---|---|
| 公開日 | 2025年9月4日 | 2026年10月6日 |
| 扱える入力 | テキスト(コード含む) | テキスト・コード・画像・動画・音声 |
| パラメータ数 | 約 308M | 740M(テキスト部分だけなら 270M) |
| 文脈長 | 2,048 トークン | 8,192 トークン(4倍) |
| 出力次元 | 768(512 / 256 / 128 に切り詰め可) | 768(512 / 256 / 128 に切り詰め可) |
| ベース | Gemma 3 | Gemma 4 |
| ライセンス | Gemma 利用規約(ダウンロードに同意が必要) | Apache 2.0(同意不要、商用利用しやすい) |
| 対応言語 | 100以上 | 100以上 |
いちばん大きいのは、もちろん扱える入力がテキストだけから、画像・動画・音声を加えた4種類に増えたことです。次に効いてくるのがライセンスです。旧版は Gemma の利用規約に同意しないと Hugging Face からダウンロードできず、今回の検証でも最初に「Access denied」で止まりました。新版は Apache 2.0 なので、社内の製品に組み込むときの確認がずっと簡単になります。
中身は「必要な部品だけ読み込める」構成
740M という数字だけを見ると旧版の2倍以上に重くなったように見えますが、実際は部品の組み合わせです。
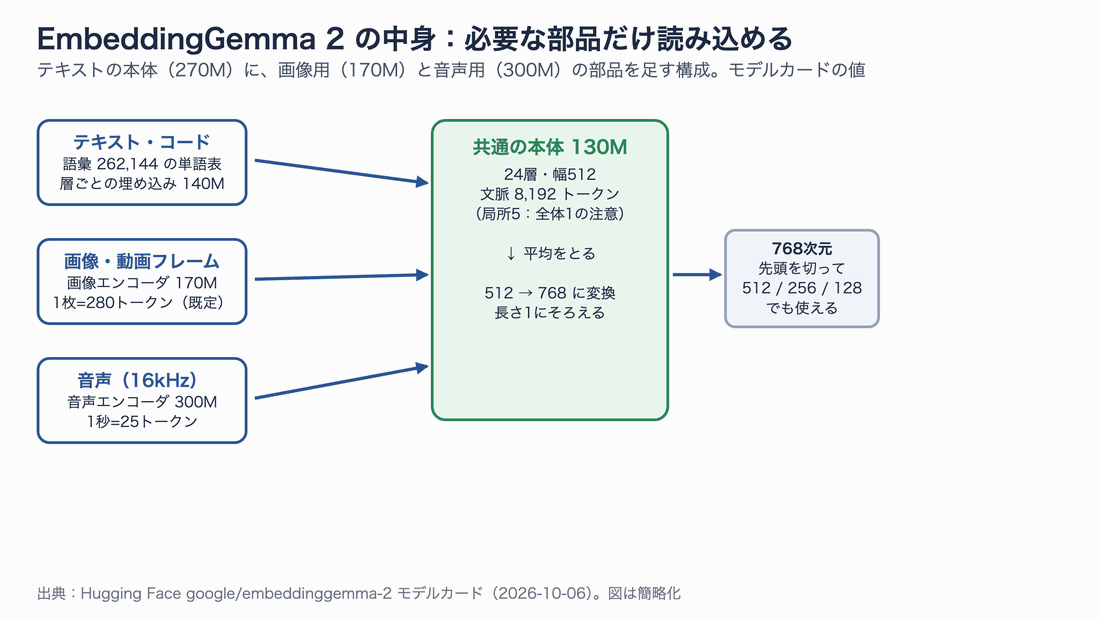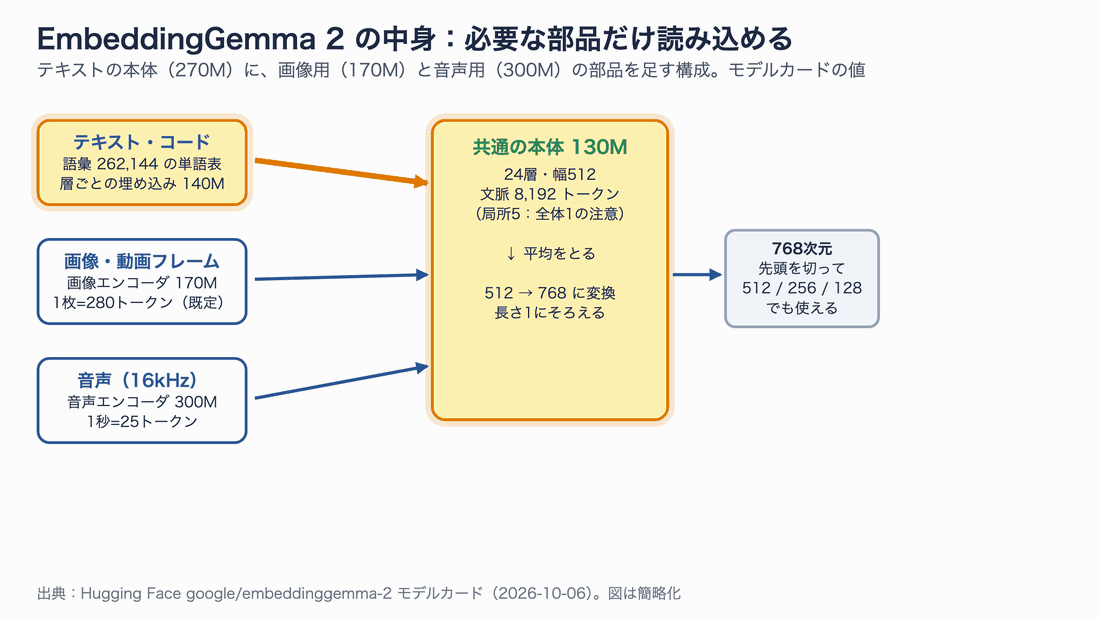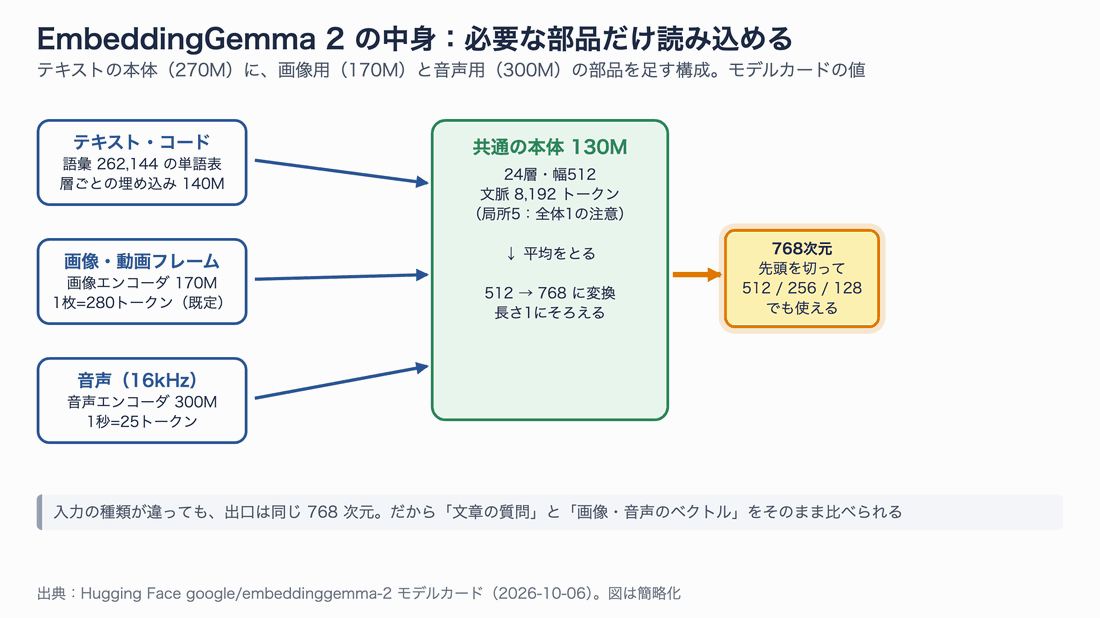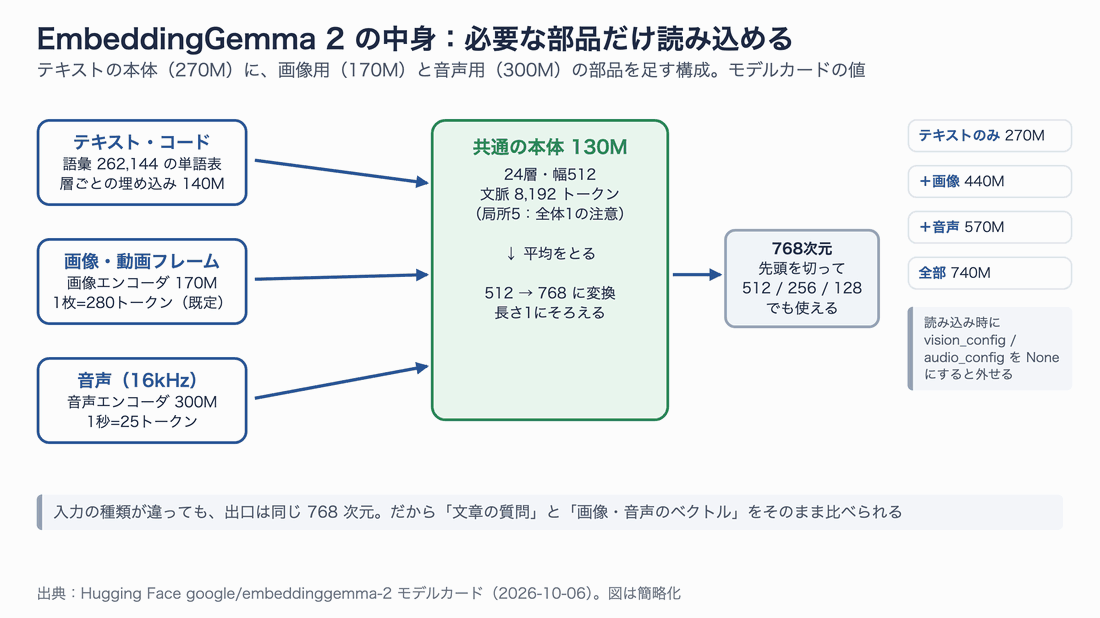
テキスト・画像・音声はそれぞれの入口で「トークン」に変換され、共通の本体(24層)を通って平均され、768次元に変換される。使わない入口は読み込まなくてよい
モデルカードによると、テキストの本体は 270M(Transformer 本体 130M + 層ごとの埋め込み表 140M)で、そこに画像エンコーダ 170M と音声エンコーダ 300M を足して合計 740M です。読み込むときに画像や音声の部品を外せるので、テキストだけなら 270M、テキストと画像なら 440M で動きます。sentence-transformers では次のように指定します。
import torch
from sentence_transformers import SentenceTransformer

# テキストだけ使う場合:画像と音声の部品を読み込まない(270M)
model = SentenceTransformer(
    "google/embeddinggemma-2",
    model_kwargs={"torch_dtype": torch.bfloat16},  # float16 は不可(後述)
    config_kwargs={"vision_config": None, "audio_config": None},
)
画像や音声は、本体に入る前に「トークン」という単位に変換されます。モデルカードの値では、画像は1枚あたり既定で 280 トークン、動画は1フレーム 140 トークン(既定は1秒1フレーム)、音声は1秒 25 トークンです。文脈長が 8,192 トークンなので、画像なら約29枚、音声なら約5.5分を1つのベクトルにまとめられます。テキストと画像を交互に並べた「商品説明+写真+動画」のような入力も、1本のベクトルにできます。
テキストには「接頭辞」を付ける
EmbeddingGemma シリーズは、テキストの先頭に短い指示文(接頭辞、プレフィックス)を付けて学習されています。付け忘れても動きますが、精度が落ちます。これは旧版と同じ作法です。
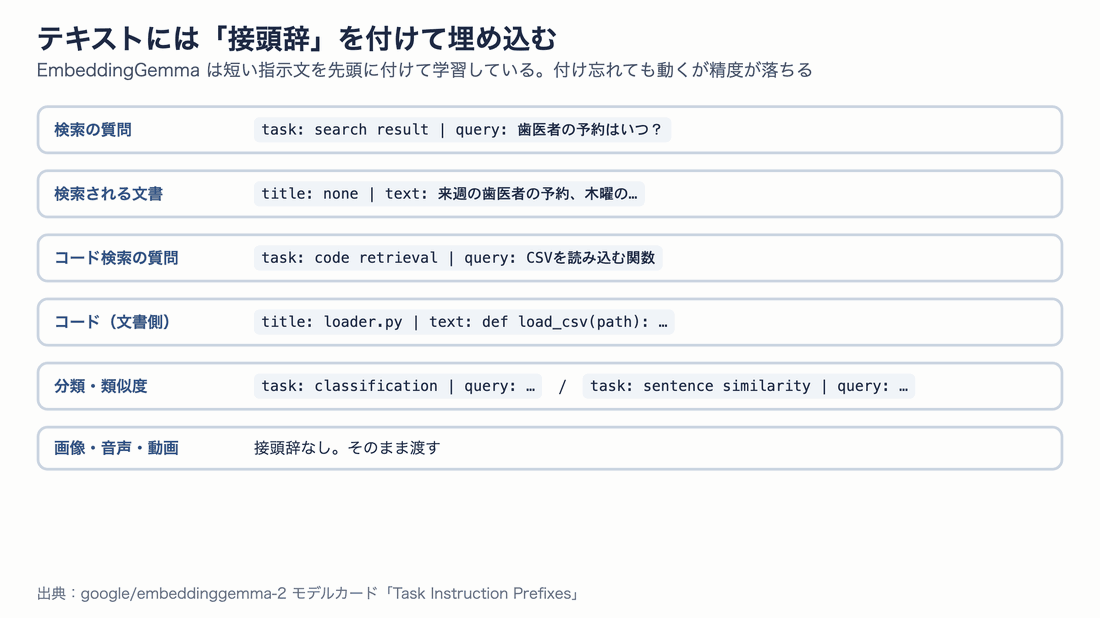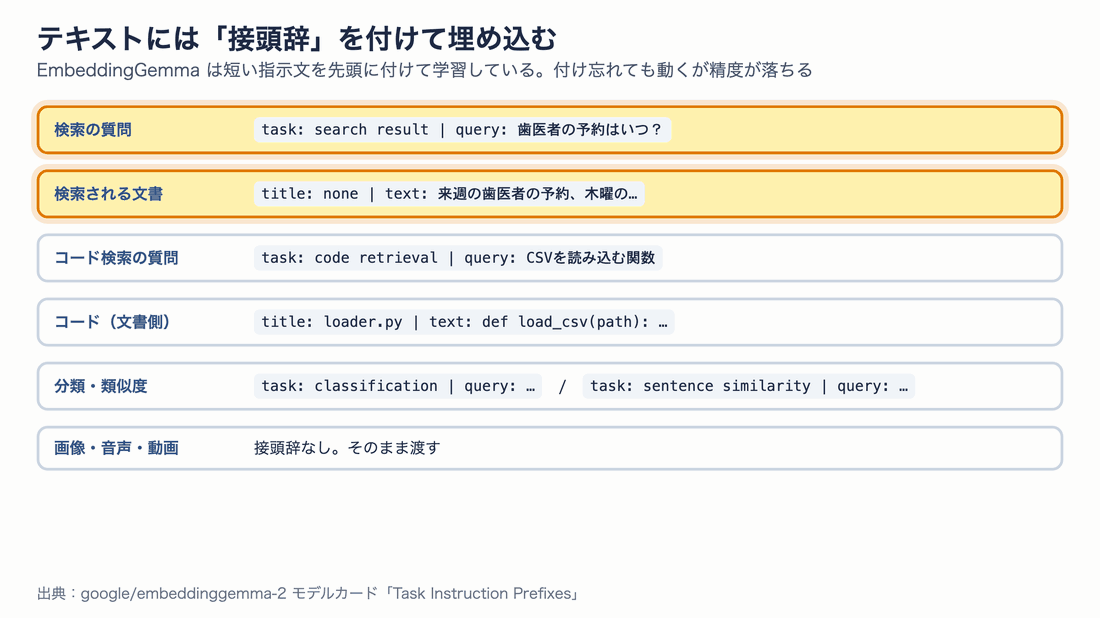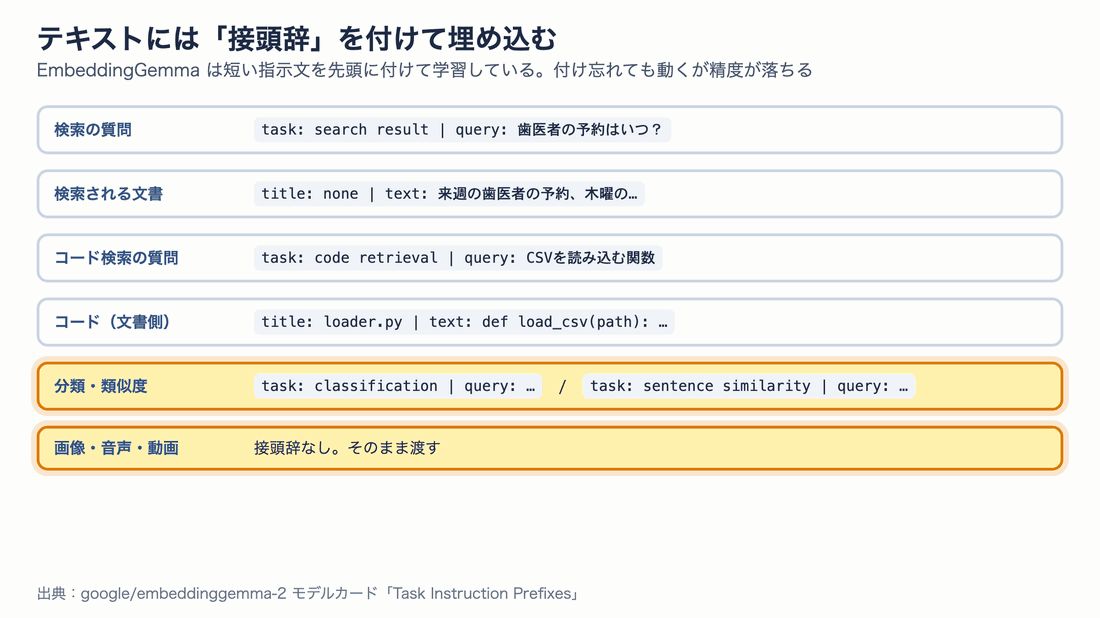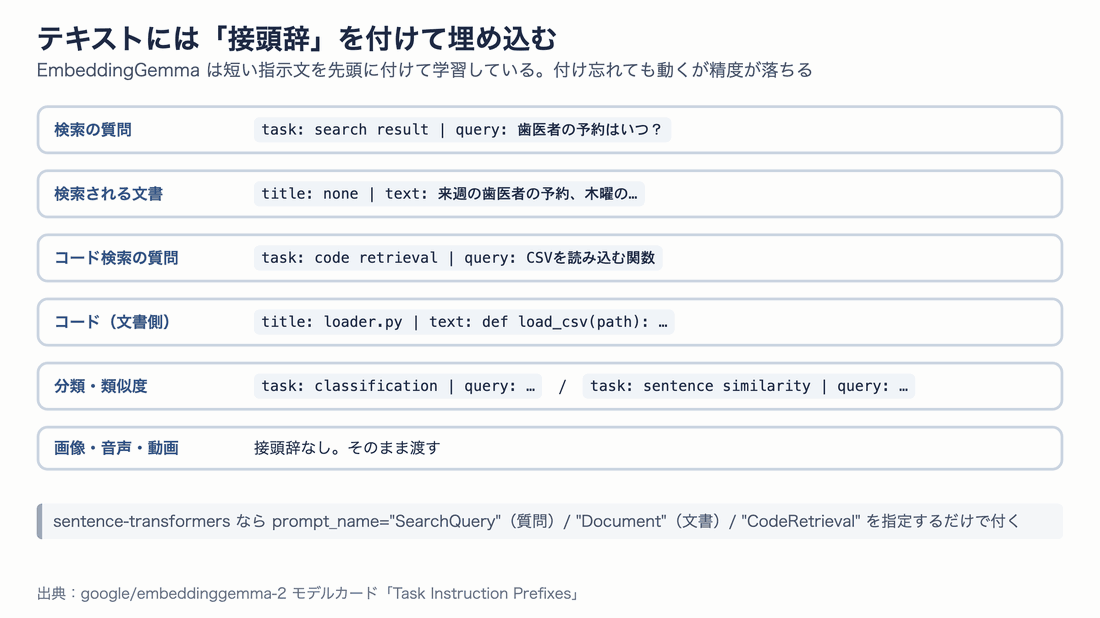
質問と文書で付ける接頭辞が違う「非対称」なタスクと、両方に同じものを付ける分類・類似度のタスクがある
sentence-transformers を使う場合は、モデルに接頭辞の一覧が同梱されているので、prompt_name を指定するだけで済みます。
query_emb = model.encode("歯科の予約はいつに変わった?", prompt_name="SearchQuery")
doc_emb = model.encode("来週の歯医者の予約、木曜の午前十時に変更してもらった。", prompt_name="Document")
print(model.similarity(query_emb, doc_emb))
今回の写真検索の実験では、質問に接頭辞を付けない場合、1位の正解率が 77.0% から 74.8% に下がりました。付け忘れは静かに精度を削るので注意してください。
次元を切り詰めても使える
旧版から引き継いだ機能に、マトリョーシカ表現学習(Matryoshka Representation Learning、MRL)があります。人形の中に小さな人形が入っているように、768 個の数字の「先頭の 512 個」「先頭の 256 個」だけを取り出しても、それなりに意味のあるベクトルになるよう学習する方法です。
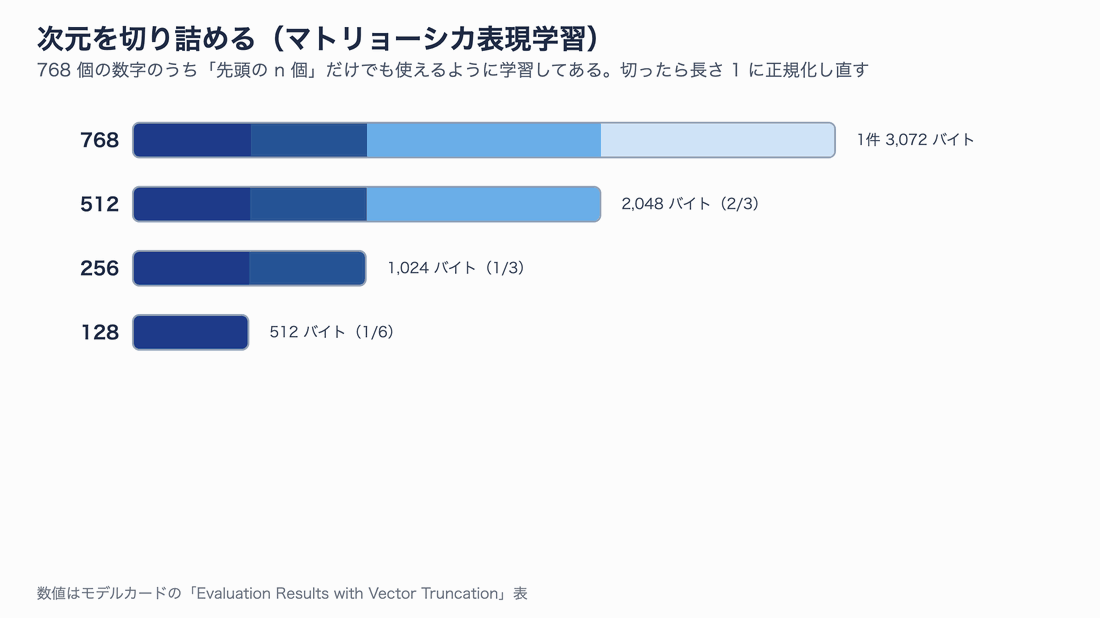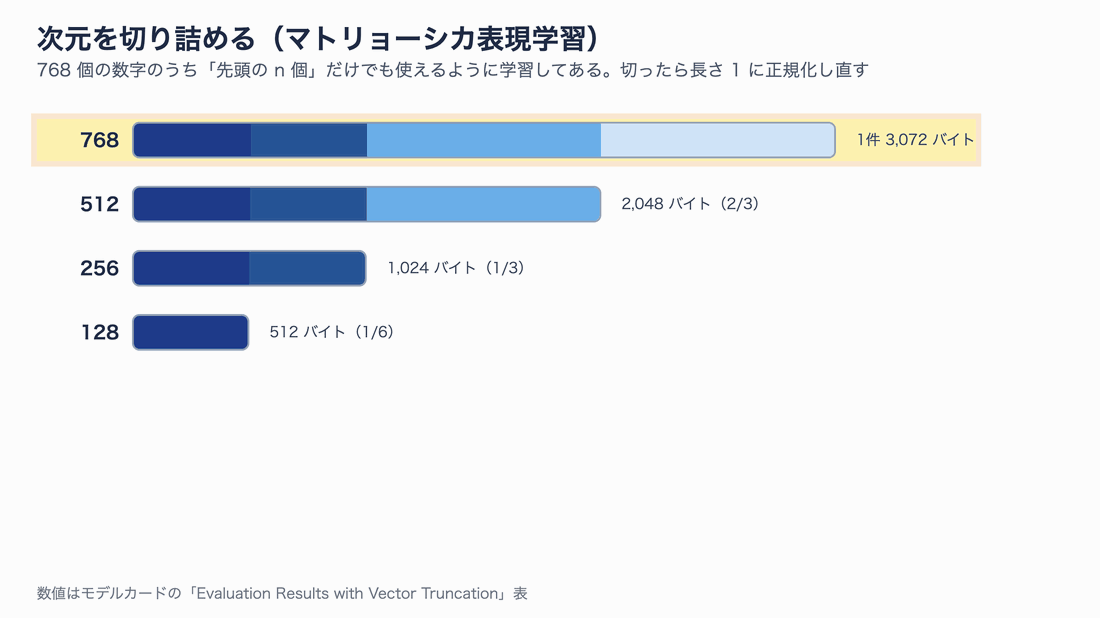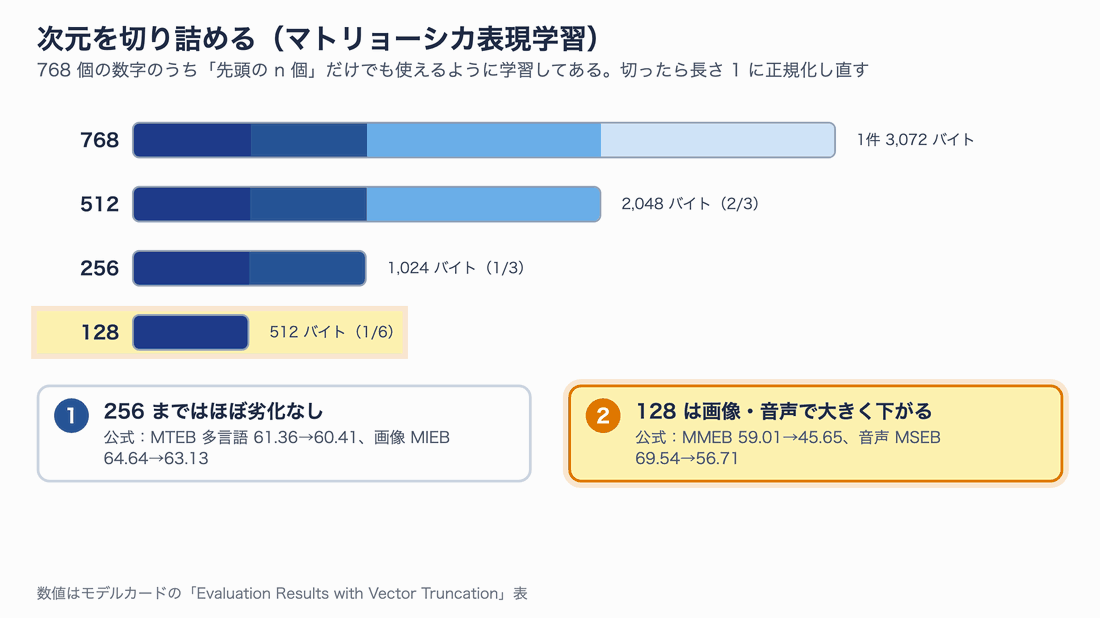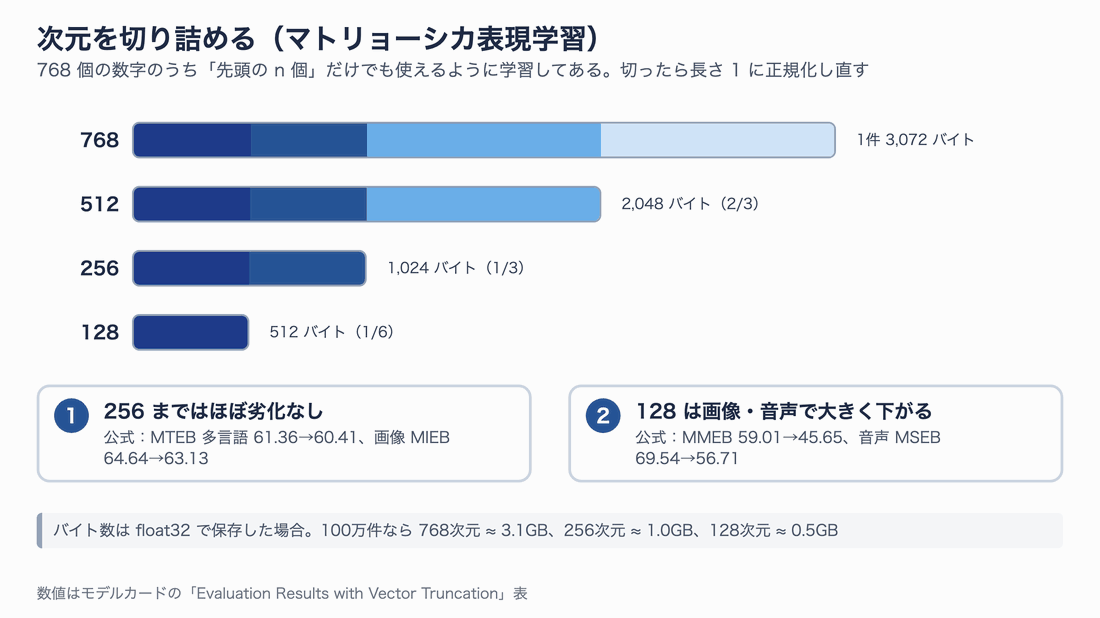
切り出したあとは、長さを1にそろえ直す(再正規化する)必要がある。忘れるとエラーにならずに順位だけが崩れる
保存する数字が減れば、ベクトルデータベースの容量と検索時間がそのまま減ります。float32 で保存するなら、768 次元で1件 3,072 バイト、128 次元なら 512 バイトで、容量は6分の1です。sentence-transformers なら truncate_dim を渡すだけです。
emb = model.encode(texts, prompt_name="Document", truncate_dim=256, normalize_embeddings=True)
公式ベンチマークの数字はどう変わったか
次に、Google が公表している数字を見ます。まず押さえておきたいのは、旧版と同じ土俵で比べられるのはテキストとコードだけだということです。画像・動画・音声は旧版が対応していないので、比較相手がいません。
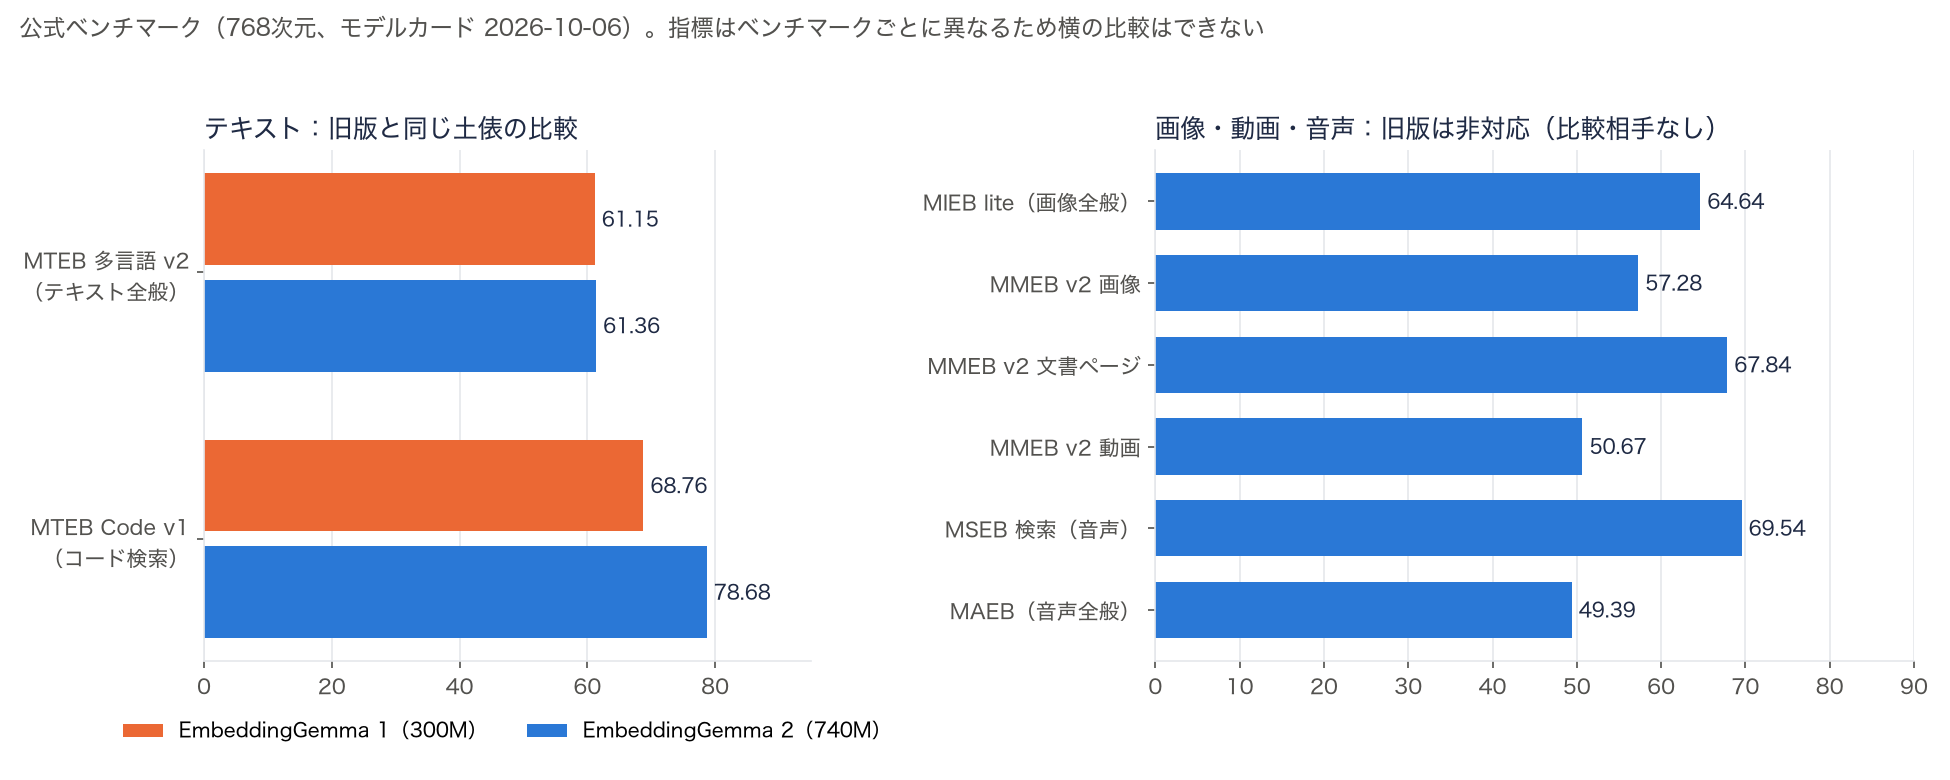
左はモデルカードの「EmbeddingGemma 2 / EmbeddingGemma 1」の表。右は新版だけの値で、ベンチマークごとに指標が違うため棒の長さを横に比べることはできない
数字を読むと、性格がはっきり分かれています。
- テキスト全般(MTEB 多言語 v2)は 61.15 → 61.36 で、ほぼ横ばいです。旧版は公開当時、500M 未満のモデルで最上位とされていたので、ここは「維持した」と読むのが妥当です
- コード検索(MTEB Code v1)は 68.76 → 78.68 で、9.92 点の大幅な改善です。モデルカードでは「約14%の改善」と書かれています。公式ブログのグラフでは、テキスト部分(270M)の2倍以上の大きさがある Qwen3-Embedding-0.6B より上に置かれています
- 画像・動画・音声は新規です。画像全般の MIEB lite が 64.64、文書ページ検索の MMEB VisDoc が 67.84、音声検索の MSEB が 69.54 です
公式ブログには、他社モデルとの比較グラフ(横軸がモデルの大きさ、縦軸がスコア)も3枚載っています。画像の MIEB lite では、siglip-so400m(画像とテキストだけに対応)や jina-embeddings-v5-omni-small より上で、3B クラスの LCO-Embedding-Omni に迫る位置です。一方、音声全般の MAEB では jina-embeddings-v5-omni-nano をわずかに下回る位置にあり、どの分野でも1位というわけではありません。グラフは発表ブログで確認できます。
次元を切り詰めたときのスコアも、モデルカードに表があります。768 次元を 100% としたときの比率をグラフにしました。
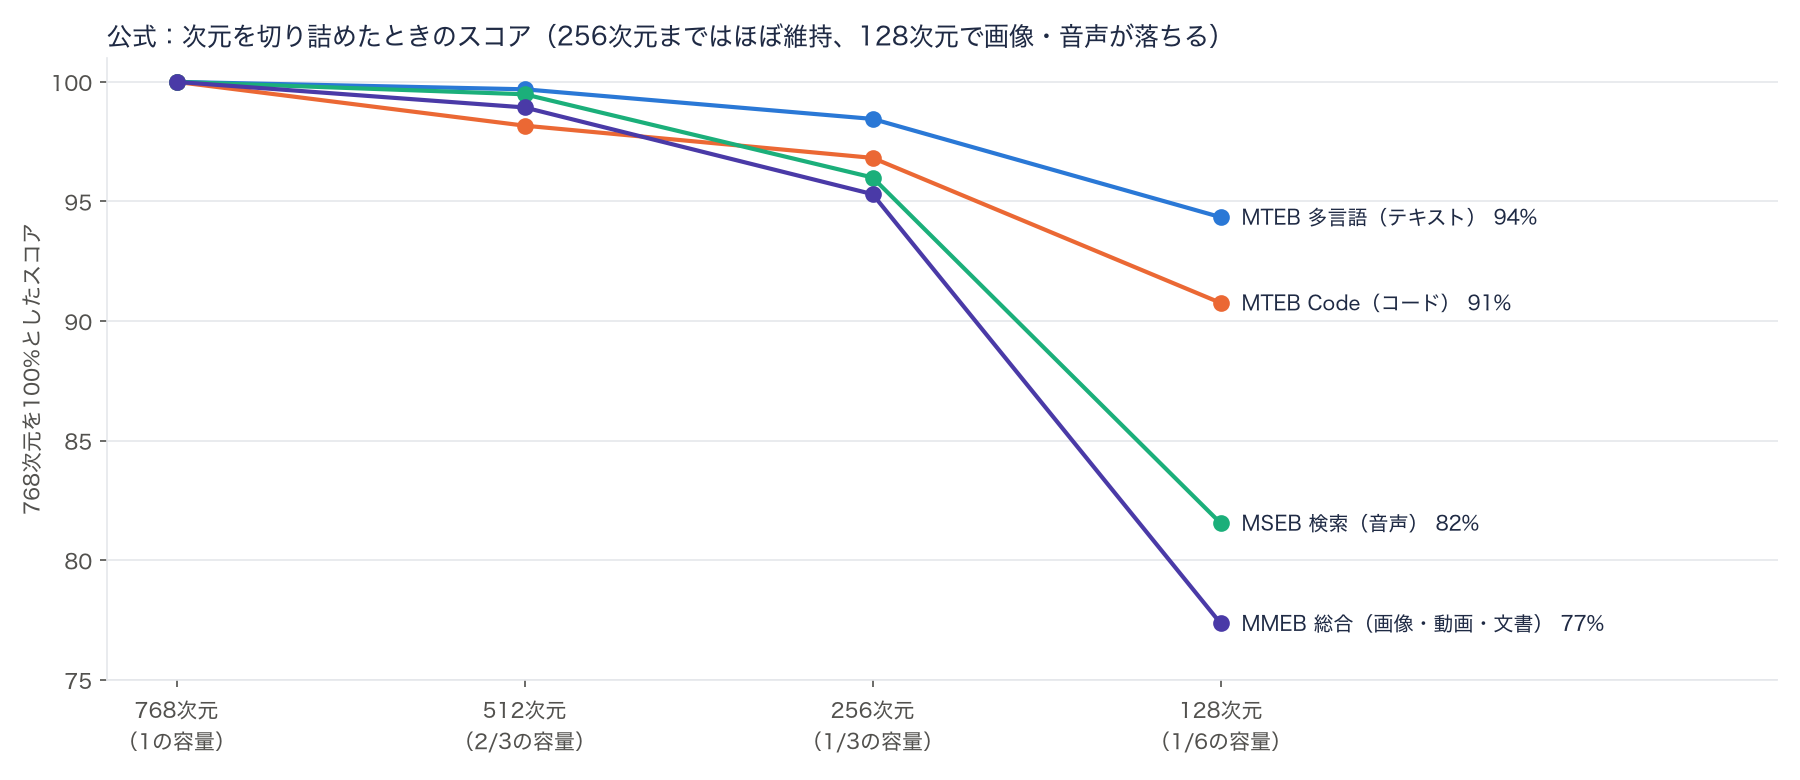
モデルカード自身も「256 次元まではほぼ無損失、128 次元はテキスト専用の用途向き」と書いている
テキストは 128 次元でも 94% を保ちますが、画像・動画・文書をまとめた MMEB 総合は 77%、音声検索は 82% まで下がります。マルチモーダルで使うなら 256 次元が下限の目安です。
検証の全体像
ここからは手元の Mac で確かめた結果です。公式の数字はほとんどが英語中心のベンチマークなので、日本語で同じ傾向が出るのかを中心に、6つの実験を組みました。
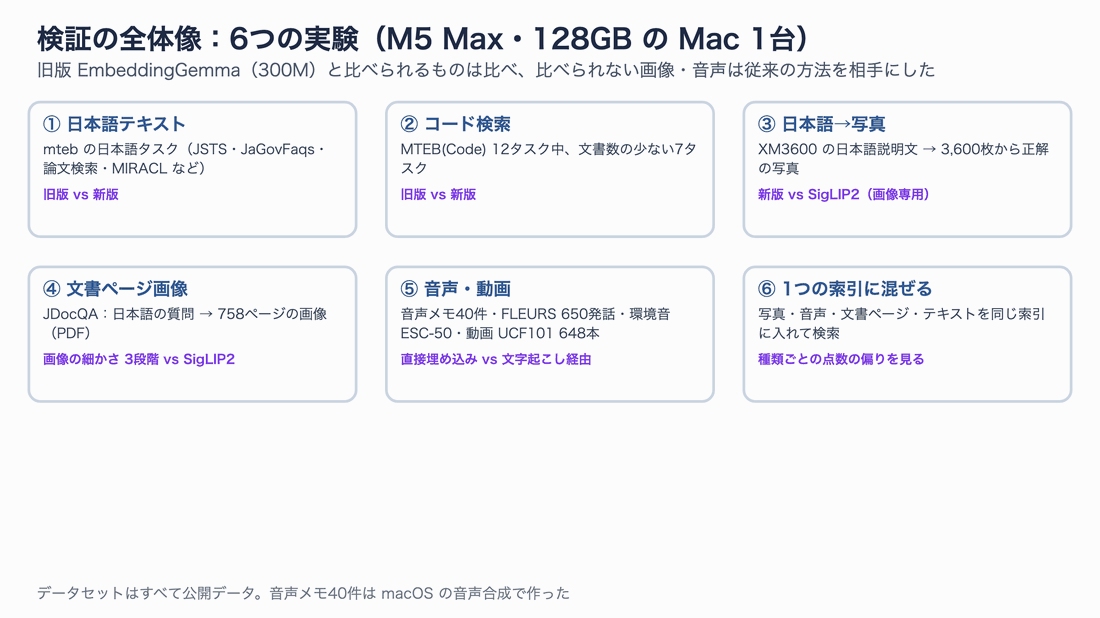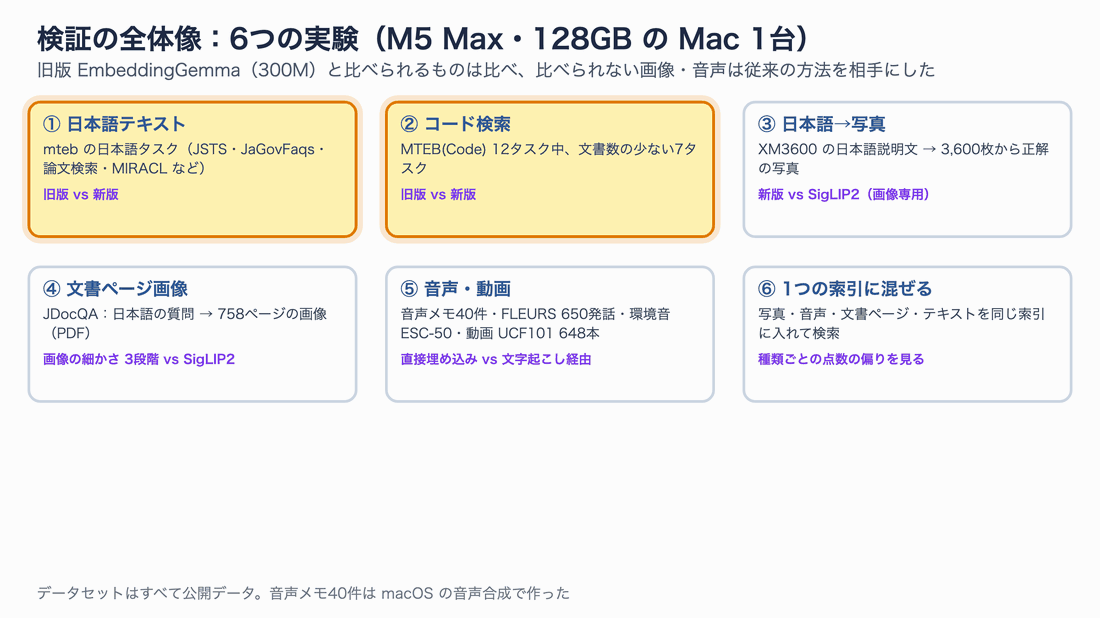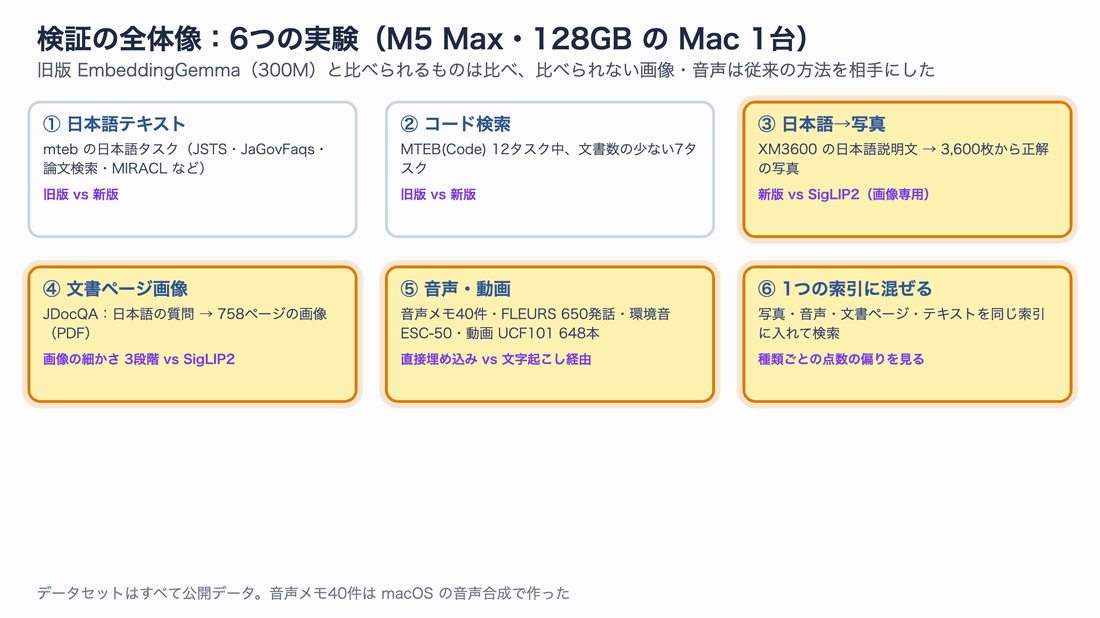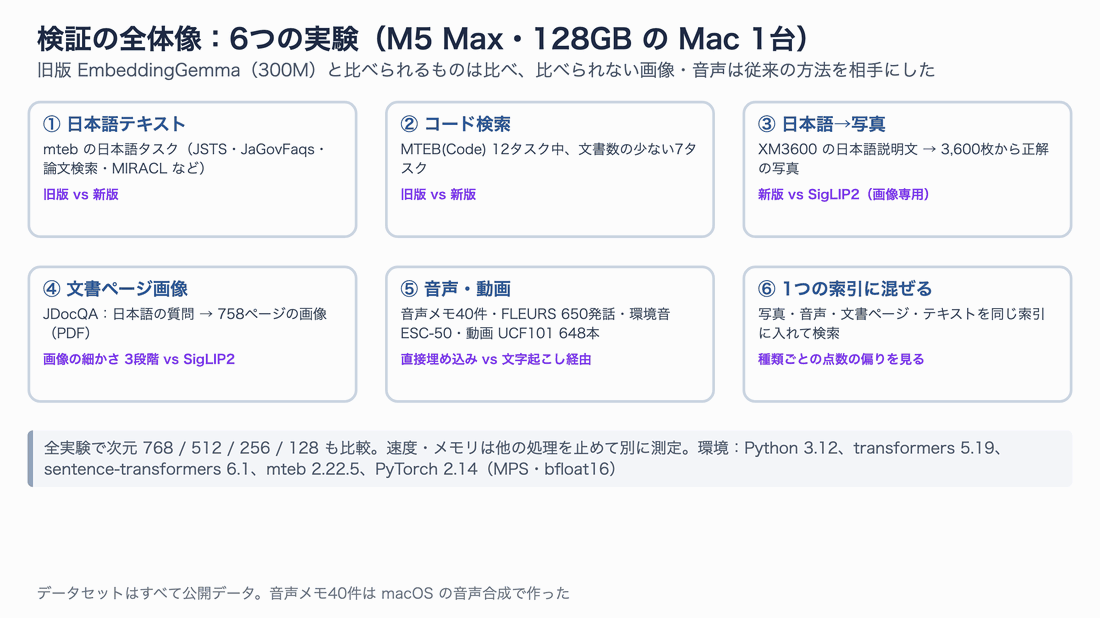
旧版と比較できるテキストとコードは旧版と、旧版が扱えない画像と音声は「従来ならこうする」方法と比べた
比較相手は次のとおりです。
| 実験 | データ | 比較相手 | 指標 |
|---|---|---|---|
| ① 日本語テキスト | mteb の日本語タスク(JSTS、JSICK、JaGovFaqs、論文検索、MIRACL など) | 旧版 EmbeddingGemma | 各タスクの主指標 |
| ② コード検索 | MTEB(Code, v1) のうち文書数の少ない 7 タスク | 旧版 EmbeddingGemma | nDCG@10 |
| ③ 日本語 → 写真 | XM3600 の日本語説明文と写真 3,600 枚 | SigLIP2-base(画像専用、375M) | 1位正解率(R@1)など |
| ④ 文書ページ画像 | JDocQA(日本語の質問 744 件、ページ画像 758 枚) | OCR → テキスト埋め込み、SigLIP2-base | R@1 など |
| ⑤ 音声・動画 | 音声メモ 40 件、FLEURS 日本語 650 発話、環境音 ESC-50、動画 UCF101 の 648 本 | Whisper で文字起こし → テキスト埋め込み | R@1、正解率 |
| ⑥ 混在索引 | ③④⑤の写真・説明文・音声・ページを1つの索引に | 種類ごとの索引 | R@1、1位の種類の割合 |
R@1(Recall@1)は「1位に正解が来た割合」、R@10 は「10位以内に正解が入った割合」です。nDCG@10 は、正解が上位にあるほど高くなる 0〜1 の指標で、ここでは 100 倍して表示しています。
環境構築
検証に使った環境は、次のコマンドで再現できます。モデル本体は約 1.4GB です。
# 作業フォルダと Python 3.12 の仮想環境を作る(uv を使用)
mkdir -p ~/embeddinggemma2-lab && cd ~/embeddinggemma2-lab
uv venv -p 3.12 .venv && source .venv/bin/activate

# 埋め込み・評価・音声と動画の読み込みに使うライブラリ
uv pip install -U torch torchvision torchaudio "sentence-transformers>=6.1" transformers \
  mteb datasets soundfile librosa pillow torchcodec mlx-whisper

# モデルを取得(新版は同意不要。旧版 google/embeddinggemma-300m は Gemma 規約への同意が必要)
hf download google/embeddinggemma-2 --local-dir models/embeddinggemma-2
sentence-transformers は 6.1.0 以上が必要です。モデルの設定ファイルに「古い版はマルチモーダル入力の順番を無視する」と明記されています。動画を読むには torchcodec も要ります(torchvision の動画読み込みはすでに廃止されています)。
画像・音声・動画は、辞書で渡します。
import torch
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("models/embeddinggemma-2", device="mps",
                            model_kwargs={"torch_dtype": torch.bfloat16})
model.max_seq_length = 8192  # 公開版は最大長が未設定なので明示する(後述のトラブル⑧)

q = model.encode("草むらを歩く鶏の写真", prompt_name="SearchQuery")
img = model.encode({"image": "photo.jpg"})            # 画像(PIL.Image でも可)
aud = model.encode({"audio": "memo.wav"})             # 音声(16kHz モノラル推奨)
vid = model.encode({"video": "clip.mp4"})             # 動画(既定は1秒1フレーム)
print(model.similarity(q, img), model.similarity(q, aud))
検証① 日本語テキスト:旧版とほぼ同じ
最初は、旧版と同じ条件で比べられる日本語テキストです。mteb(埋め込みモデルの評価ツール)の日本語タスクから、文の類似度・検索・分類をまとめて回しました。接頭辞はどちらのモデルも同梱の一覧を使っています。新版はテキスト部分(270M)だけを読み込みました。
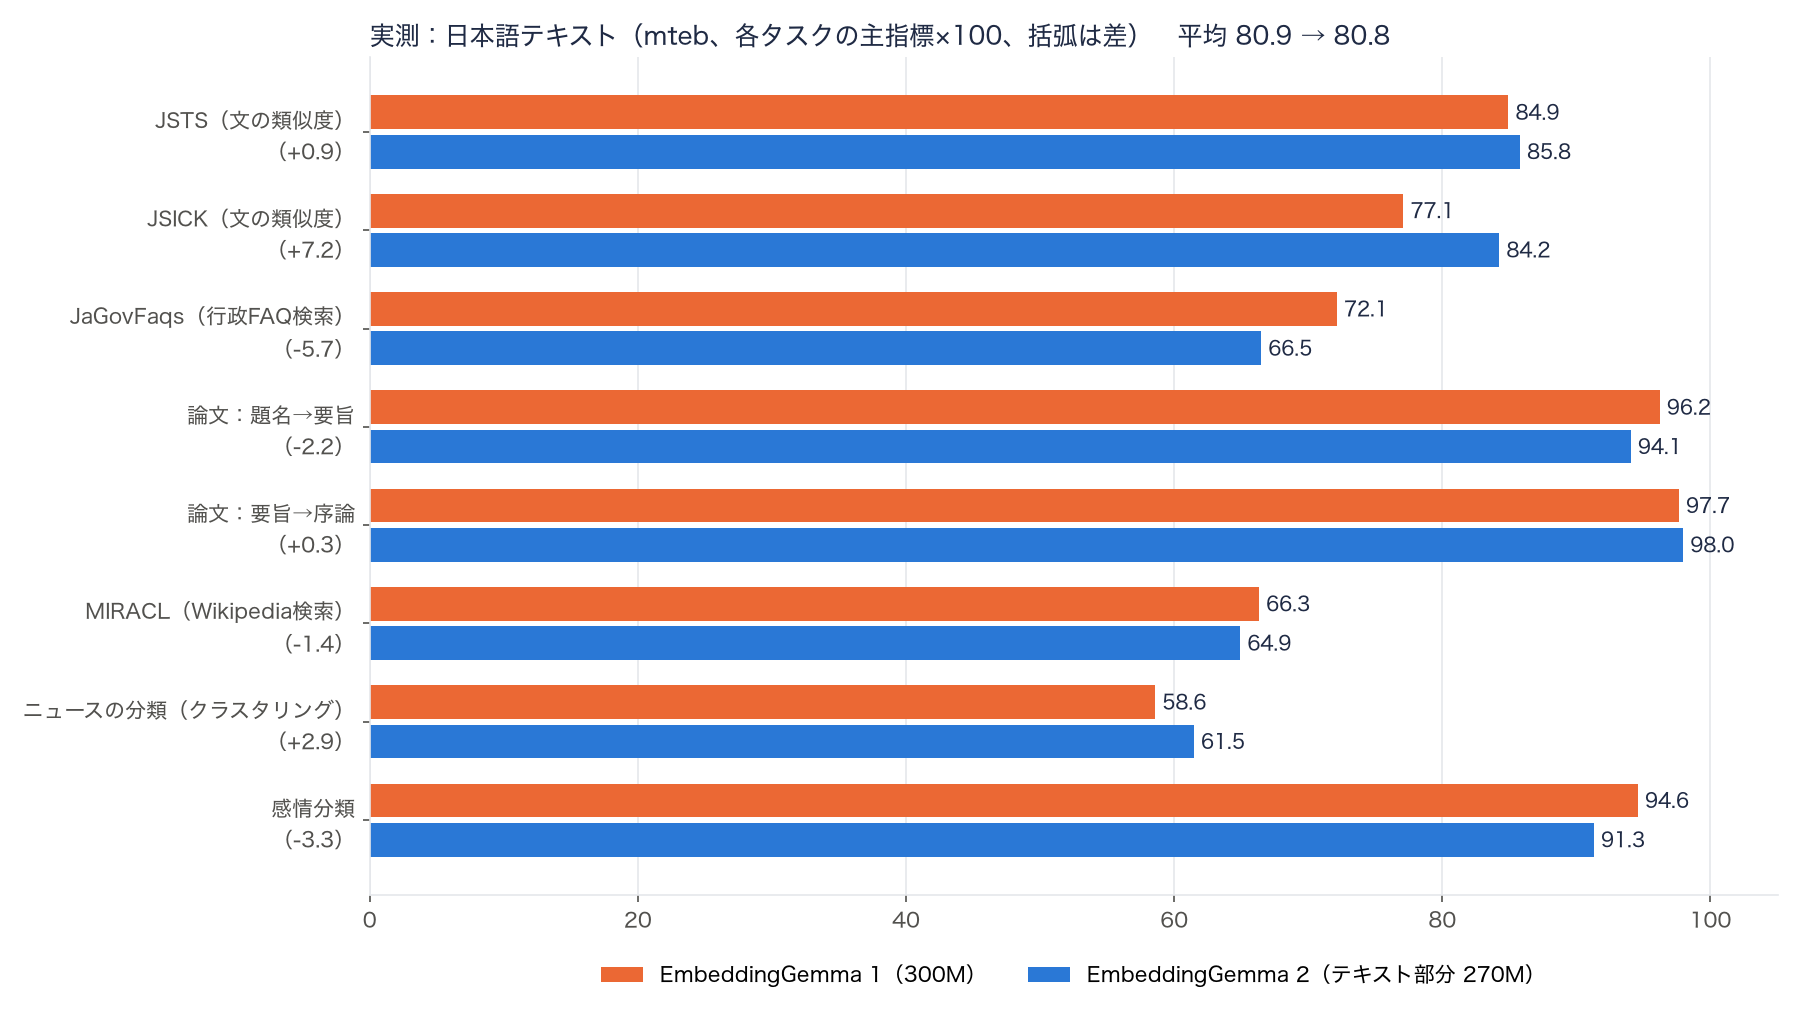
8タスクの平均は 80.9 → 80.8 でほぼ同じ。上がったタスクと下がったタスクが混在する
結果は、公式の「テキスト全般はほぼ横ばい」と同じ傾向でした。8 タスクの平均は 80.9 → 80.8 です。中身を見ると、上下がはっきり分かれています。
- 上がった:文の意味の近さを測る JSICK が +7.2、ニュース記事のクラスタリングが +2.9、JSTS が +0.9
- 下がった:行政の FAQ を探す JaGovFaqs が −5.7、感情分類が −3.3、論文の題名から要旨を探すタスクが −2.2、Wikipedia 検索の MIRACL が −1.4
つまり、日本語の文章検索だけを目的に、旧版から乗り換える理由は今のところ見当たりません。とくに FAQ 検索のように「短い質問と短い回答」を結びつける用途では、旧版のほうが良い結果でした。一方、文の意味の細かい違い(JSICK)は新版が明確に上です。
もう1つ確かめたかったのは、新版の文脈長 8K が効くかどうかです。論文の要旨から本文全体を探すタスク(本文は数千〜数万字)は、旧版でも 2,048 トークンで切り詰めた状態で 98.7 と、ほぼ満点でした。差の出る余地がないため、ここでは新版の評価を省きました。要旨と序論を結ぶタスクも 97.7 → 98.0 で、ほぼ同じです。「長い文書をそのまま1本のベクトルにできる」ことの価値は、今回のような公開ベンチマークでは測りにくく、自分の長い文書で確かめる必要があります。
なお、JSICK は mteb 公式の結果(旧版 84.4)と手元の値(77.1)が大きくずれています。公式の結果は古い版のデータで測られているためで、手元では両モデルを同じ版のデータで比べています。比較に使えるのは、同じ表の中での差です。
検証② コード検索:公式どおり大きく伸びた
公式の数字でいちばん伸びたコード検索を、手元でも確かめました。MTEB(Code, v1) は12タスクありますが、そのうち2つは文書が約100万件あり、この Mac では1タスクに数時間かかります。そこで、文書数の少ない7タスクで旧版と新版を比べました。質問側の接頭辞は、両モデルとも公式推奨の task: code retrieval | query: にそろえています。
まず、評価の設定が正しいかを確認しました。mteb の公式結果リポジトリには、旧版の12タスクのスコアが公開されています。その平均を計算すると 68.76 で、モデルカードに載っている旧版の値(68.76)と一致しました。手元で測った旧版の値も、CodeSearchNet が 90.11(公式 90.15)、Apps が 84.26(公式 84.39)と、ほぼ同じです。同じ物差しで測れていると考えてよさそうです。
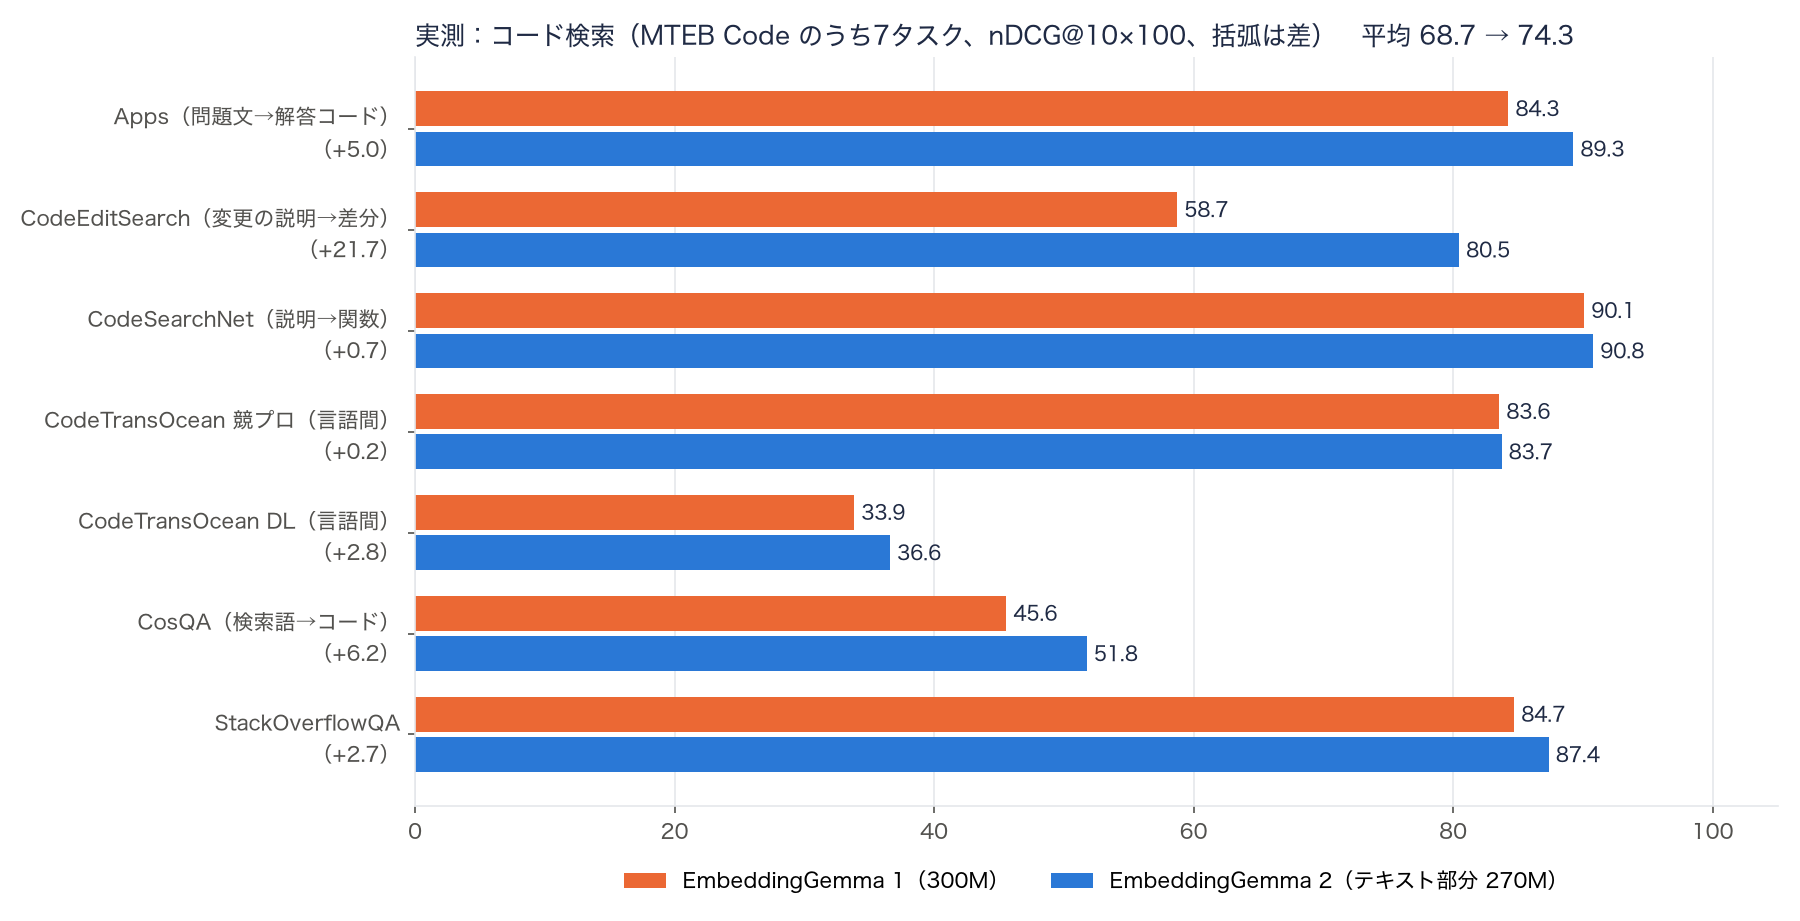
7タスクすべてで新版が上回った。伸び方はタスクによって大きく違う
7タスクの平均は 68.7 → 74.3(+5.6)で、すべてのタスクで新版が上回りました。伸び方には特徴があります。
- CodeEditSearch(変更内容の説明 → コードの差分)が +21.7。「エラー処理を追加した」のような説明文から、該当する差分(diff)を探すタスクです。コーディングエージェントが過去の変更履歴を探す用途に直結します
- CosQA(検索エンジンに打つような短い語 → コード)が +6.2、Apps(プログラミングの問題文 → 解答コード)が +5.0。自然な言葉からコードを探す系統で伸びています
- CodeSearchNet(関数の説明文 → 関数)や言語間の変換(CodeTransOcean)は +0.2〜+2.8。旧版がすでに高かったタスクは、伸びしろが小さいようです
公式の +9.92 点は12タスク全体の平均なので、手元の 7 タスクの +5.6 とは単純に比べられません。それでも、「コード検索は明確に良くなった」という方向は手元でも再現しました。リポジトリ検索や、エージェントに過去の変更を探させる用途なら、乗り換える理由になります。
検証③ 日本語の説明文から写真を探す:画像専用モデルの約2倍
ここからは、旧版ではできなかった検索です。XM3600 は、世界36言語で写真 3,600 枚に説明文を付けたデータセットで、日本語の説明文はネイティブの話者が書いています。「草むらを歩いている二羽のおんどり」のような説明文1つを質問にして、3,600 枚から元の写真を探します。比較相手は、Google の画像・テキスト用モデル SigLIP2-base(多言語対応、375M)です。
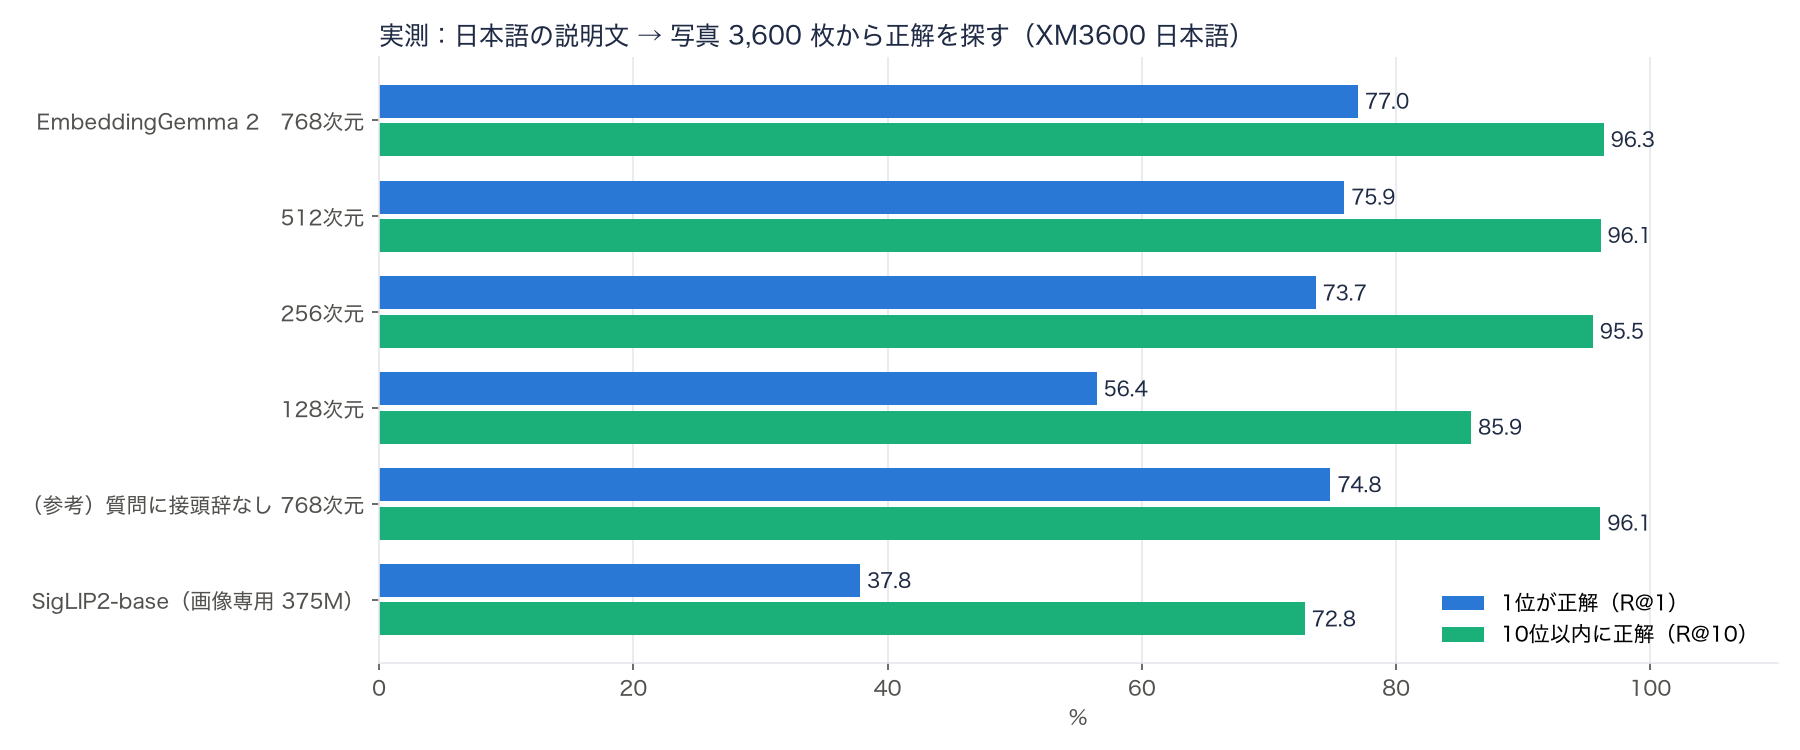
3,600 枚の中から1位で正解を当てた割合は、EmbeddingGemma 2 が 77.0%、SigLIP2-base が 37.8%。10位以内なら 96.3% 対 72.8%
差ははっきりしています。1位の正解率で約2倍です。SigLIP2-base は英語では強いモデルですが、日本語の説明文を正しく読む力では EmbeddingGemma 2 が大きく上回りました。テキスト側に Gemma 4 系の多言語の言語モデルを持っていることが効いていると考えられます(これは推測で、内部の理由は公表されていません)。
次元を切り詰めた結果は、公式の傾向と一致しました。256 次元で 73.7%(768 次元の 96%)、128 次元で 56.4%(同 73%)です。写真の検索に使うなら 256 次元までと考えてよさそうです。
一方で速度は大きく違います。GPU を空けた状態で測ると、EmbeddingGemma 2 は1秒に 10.9 枚、SigLIP2-base は 134 枚で、約12倍の差がありました。数万枚程度なら気になりませんが、数百万枚を索引し直すような用途では、速度との兼ね合いになります。
検証④ 文書ページ画像:PDF をそのまま検索できるか
社内の資料は、PDF やスキャン画像のことがよくあります。従来は、まず OCR(画像から文字を読み取る処理)でテキストにしてから、テキスト用のモデルで埋め込むのが定番でした。EmbeddingGemma 2 なら、ページを画像のまま埋め込めます。どちらが良いのかを確かめました。
JDocQA は、日本の公的機関などがウェブで公開している PDF 文書(パンフレット・報告書・スライドなど)のページ画像と、それについての日本語の質問を集めたデータセットです。今回は、質問 744 件から正解のページを 758 枚の中から探す検索版を使いました。質問は「八王子神社は『はちおっつぁん』と呼ばれ住民に親しまれていますが、事故が起きたような言い伝えはありますか。」のような具体的な文です。
ここでは、もう1つ確かめたいことがありました。画像1枚を何トークンで表すか(画像トークン予算)です。既定は 280 トークンですが、モデルカードによると 70〜1,120 の範囲で変えられます。文字の細かい文書ページでは、多いほうが有利なはずです。sentence-transformers では、次のように設定します。
# 画像1枚あたりのトークン数を 560 に増やす(既定は 280)
model[0].processor.image_processor.max_soft_tokens = 560
page_emb = model.encode([{"image": p} for p in page_images], batch_size=4)
従来の方法の比較には、macOS 標準の文字認識(Vision フレームワーク、日本語・高精度モード)で全ページを OCR し、そのテキストを新版と旧版で埋め込んだものを使いました。
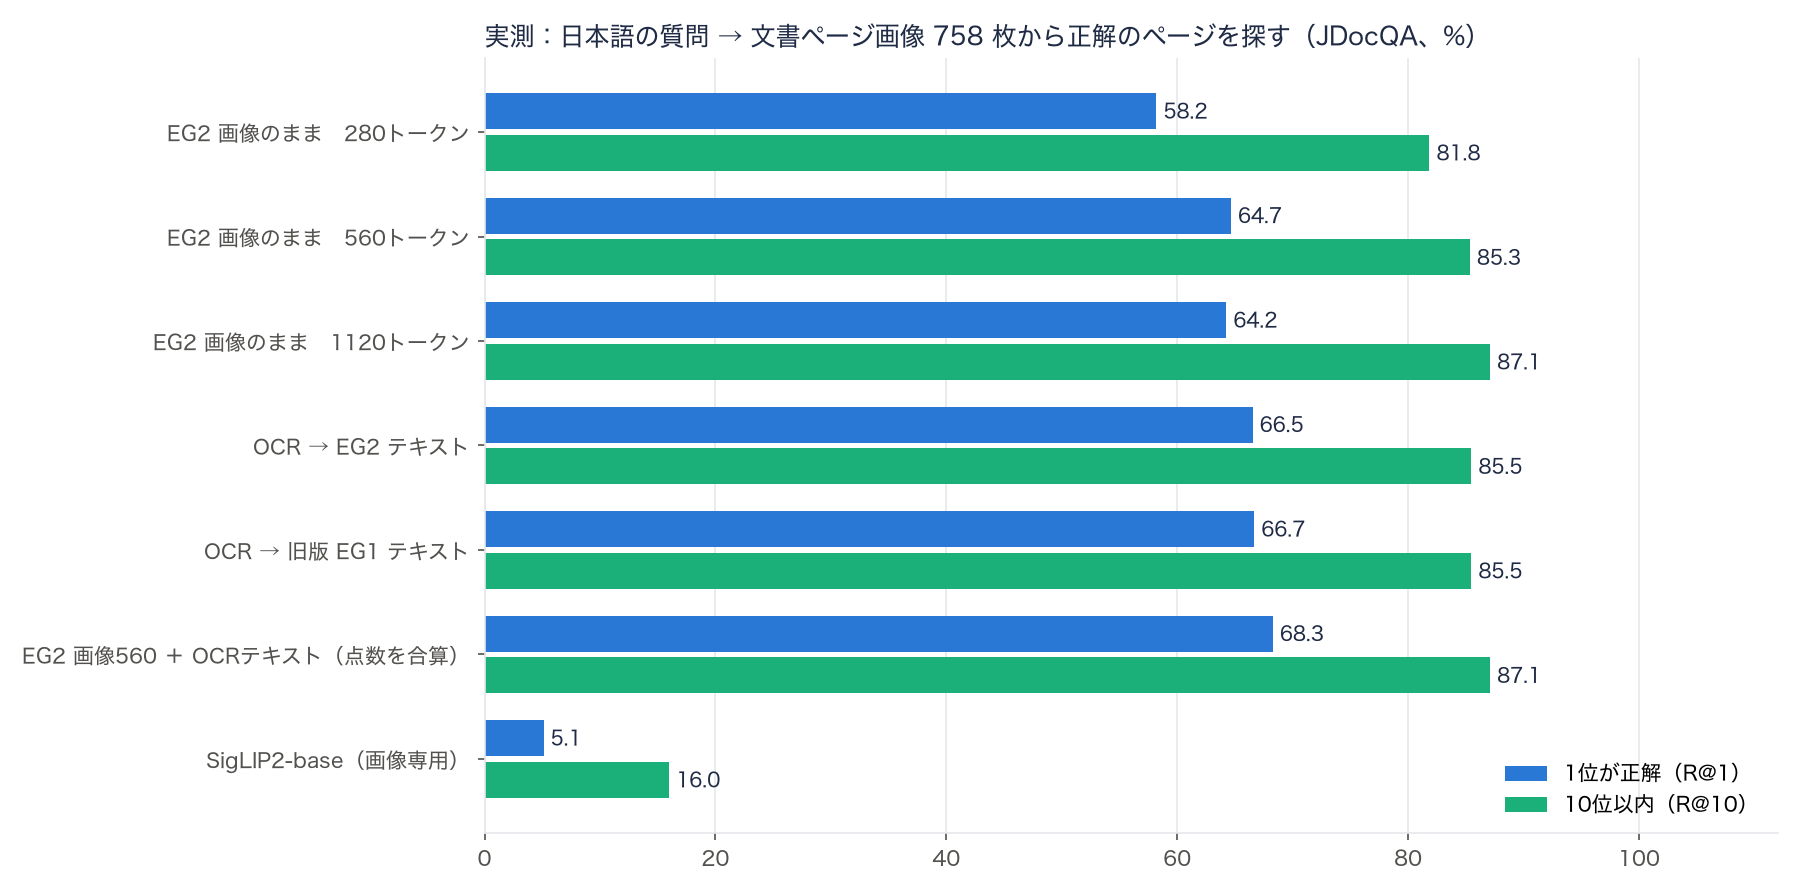
1位の正解率で見ると、OCR 経由(66.5%)と画像のまま 560 トークン(64.7%)はほぼ互角。両方の点数を足すと 68.3% で最も高い
読み取れることは4つあります。
- 画像トークン予算は効く。280 → 560 で 58.2% → 64.7% と 6.5 ポイント上がりました。ただし 1,120 に増やしても 64.2% で伸びは止まり、処理時間は約3倍になります。文書ページなら 560 前後が費用対効果のよい設定でした
- OCR 経由とほぼ互角。OCR → 新版テキストは 66.5% で、画像のまま(560)より 1.9 ポイント高いだけでした。OCR の手間(1ページ約1秒)と、OCR の誤読や表・図の崩れを気にしなくてよいことを考えると、画像のまま埋め込む価値は十分にあります
- 両方使うと最も良い。画像のベクトルと OCR テキストのベクトルの類似度を足すだけで 68.3% になりました。文字情報とレイアウト情報が補い合っていると考えられます
- 画像専用の小型モデルは文書ページに使えない。SigLIP2-base は 5.1% で、日本語の細かい文字を読む用途には向きません
なお、OCR テキストを旧版で埋め込んでも 66.7% で、新版とほぼ同じでした。テキストになってしまえば、旧版でも十分に戦えることがここでも分かります。
検証⑤ 音声と動画:音声は言い換えに弱く、動画は強い
音声は、今回いちばん意外な結果が出たところです。まず、2つのやり方を比べた図を見てください。
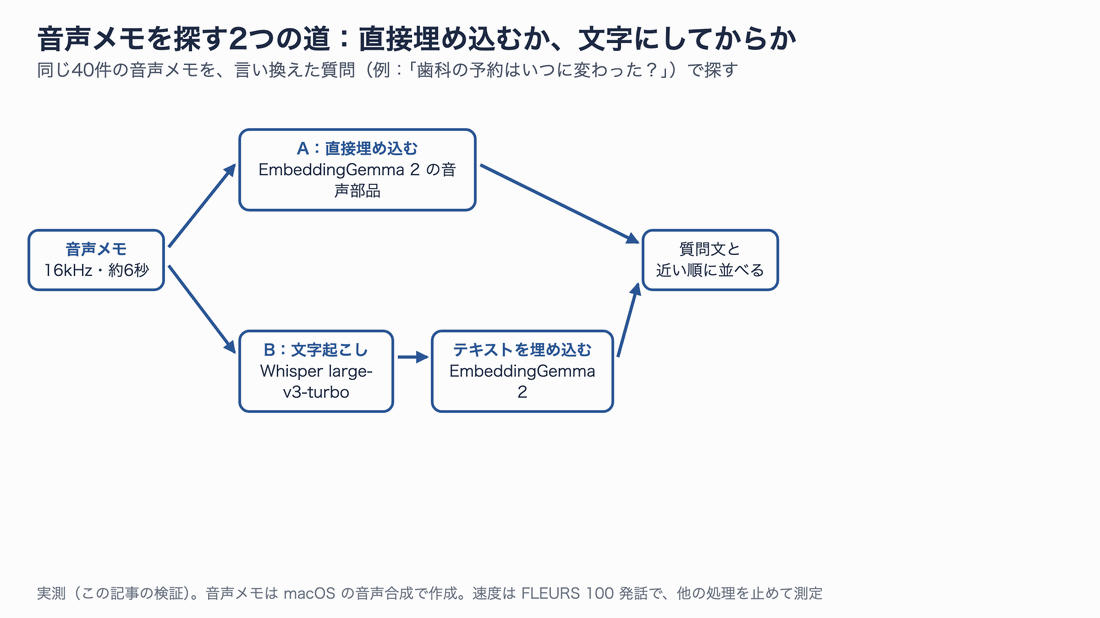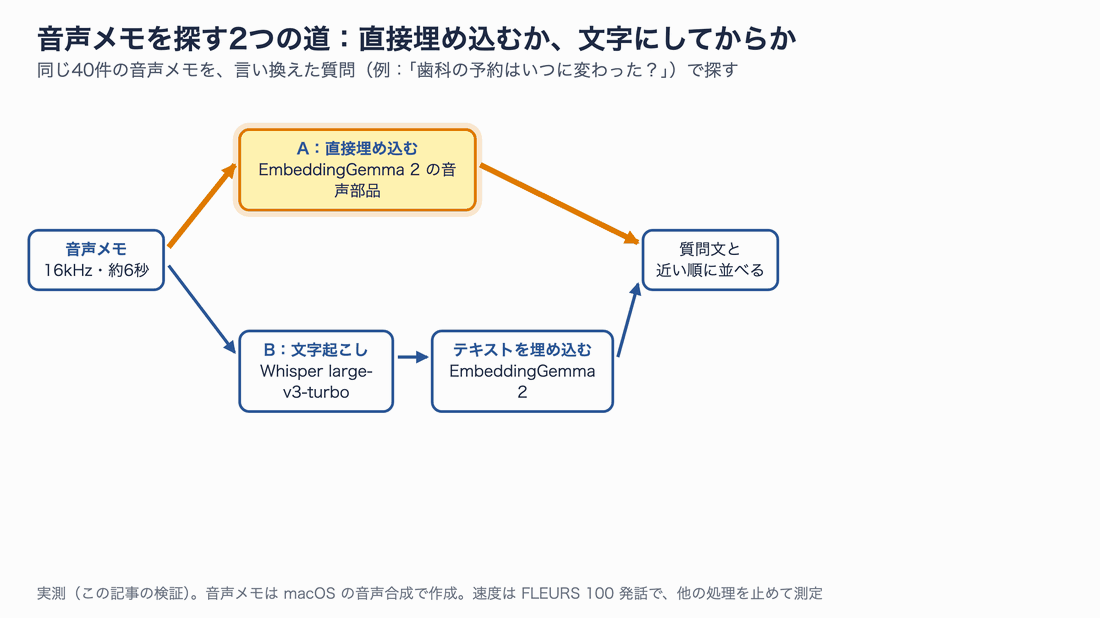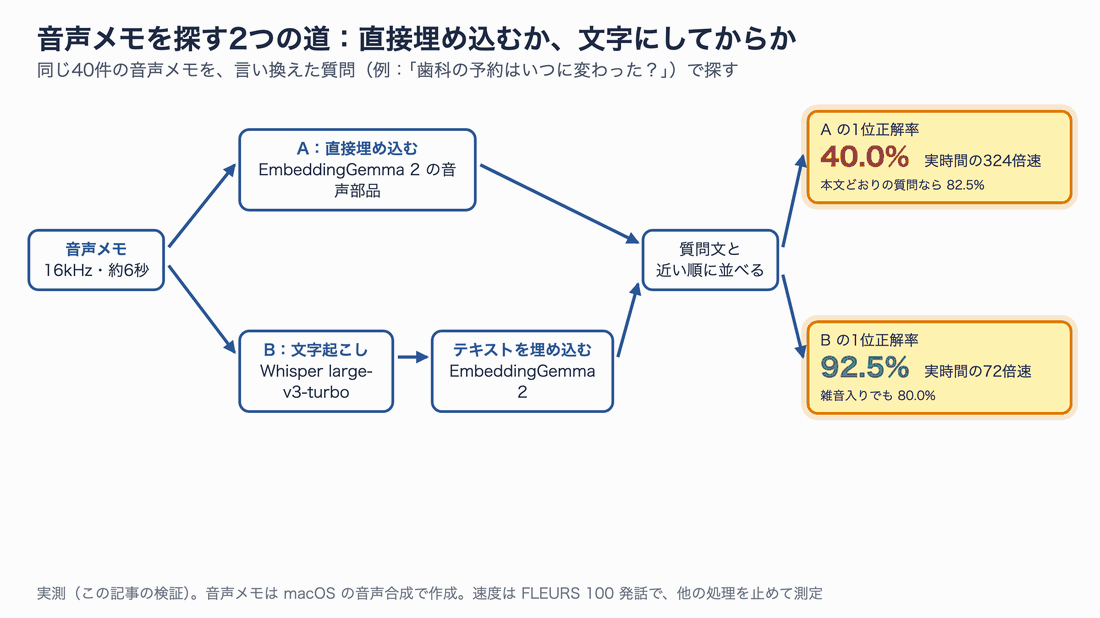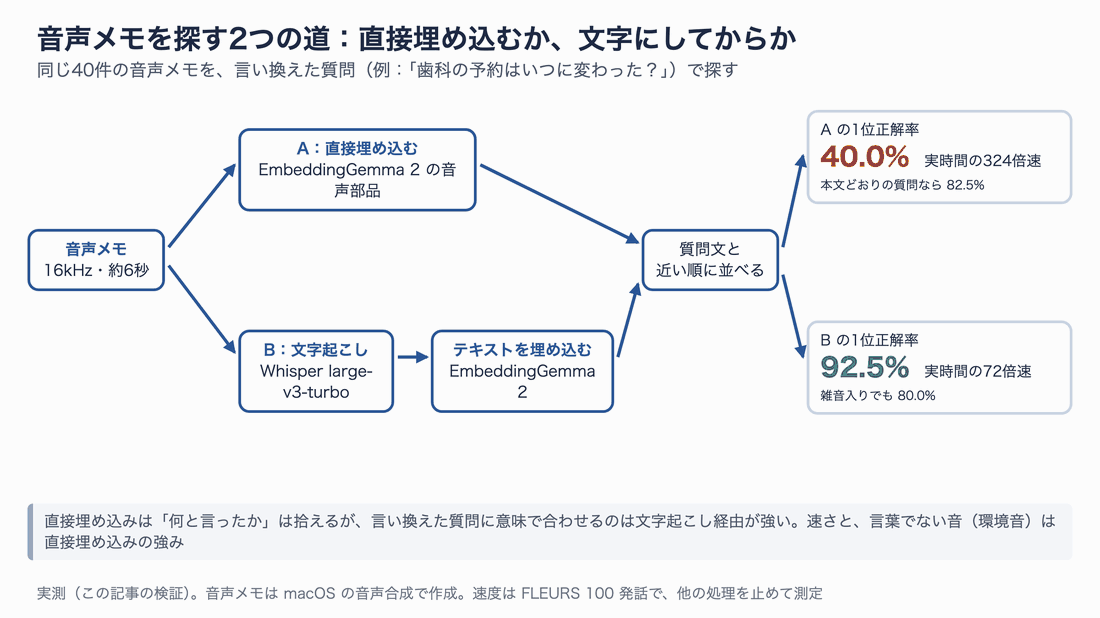
同じ40件の音声メモを、同じ質問で探した。直接埋め込む方式は文字起こしの手間がいらないが、言い換えた質問への強さでは文字起こし経由が上回った
音声メモ40件:言い換えた質問で探す
「来週の歯医者の予約、木曜の午前十時に変更してもらった」のような短い音声メモを40件作り(macOS の音声合成で6種類の声を使用、平均約6秒)、「歯科の予約はいつに変わった?」のように言い換えた質問で探しました。メモの文面をそのまま使わないのは、実際の検索では、録音したときの言葉をそのまま覚えている人はいないからです。さらに、キーボードの音・雨音・時計の音を信号対雑音比 5dB で重ねた「雑音入り」も作りました。
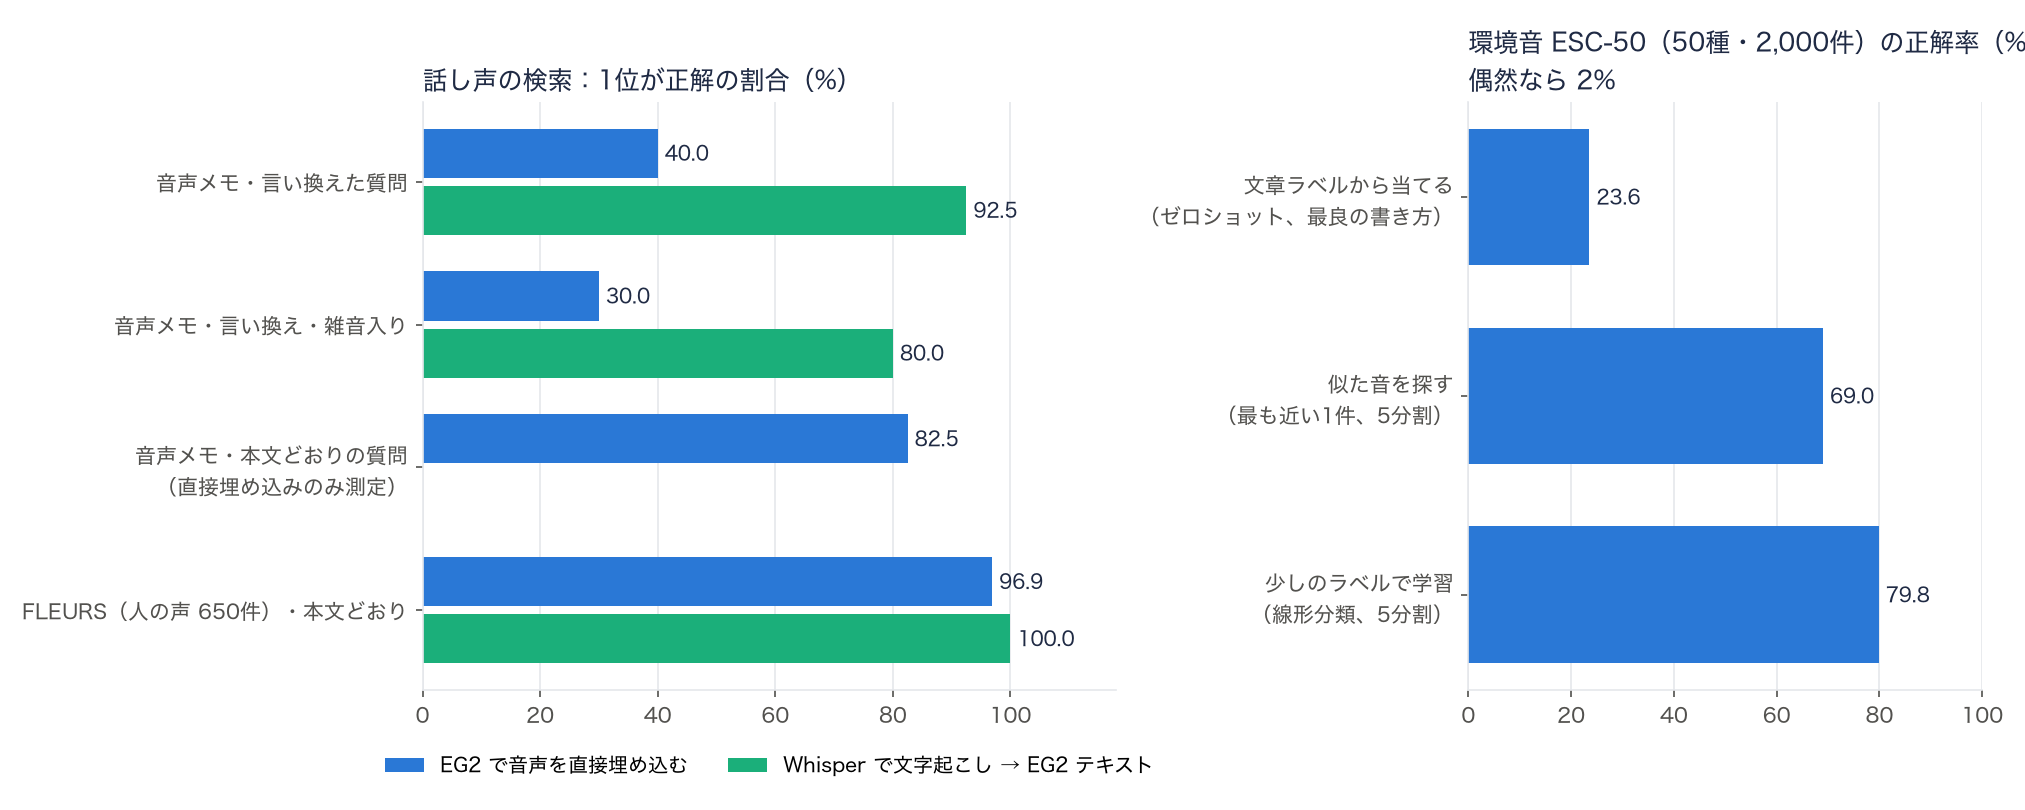
左:話し声を探したときの1位正解率。右:環境音 ESC-50 の分類の正解率
結果は次のとおりです。
| 条件 | 直接埋め込み(EG2 音声) | 文字起こし → EG2 テキスト | 文字起こし → 旧版 |
|---|---|---|---|
| 言い換えた質問 | 40.0% | 92.5% | 95.0% |
| 言い換え+雑音入り | 30.0% | 80.0% | 82.5% |
| メモの本文どおりの質問 | 82.5% | — | — |
直接埋め込みは、メモの本文をそのまま質問にすれば 82.5% 当たります。つまり「何と言ったか」は捉えています。ところが言い換えると 40.0% に落ちます。一方、Whisper(large-v3-turbo)で文字にしてからテキストとして埋め込むと 92.5% で、旧版のテキスト埋め込みでも 95.0% でした。意味で探す用途では、まだ文字起こし経由が強いというのが今回の結論です。
念のため、人が実際に読み上げた音声でも確かめました。FLEURS の日本語テストデータ(650 発話・321 文、平均13秒)で、読み上げた文そのものを質問にすると、直接埋め込みで R@1 96.9%、文字起こし経由で 100% でした。本文どおりの質問なら、人の声でも直接埋め込みは十分に当たります(FLEURS は学習データに含まれている可能性があり、ここは割り引いて見てください)。
約30秒の長いメモ(前半20秒が雑談、最後に本題)でも試しました。音声が途中で切り捨てられていないかを確かめるためです。30秒の音声は 731 トークンに変換され、切り捨ては起きていませんでした。12件から言い換え質問で探して1位正解率は 58.3% で、短いメモより下がりました。前半の雑談がベクトルに混ざるためと考えられます。
環境音:文章から探すのは苦手、音どうしなら得意
言葉ではない音はどうでしょうか。ESC-50 は、犬の鳴き声・雨音・掃除機など50種類の環境音を各40件集めたデータセットです。「犬の鳴き声」のような文章ラベルとの近さで分類するゼロショット分類は、書き方を6通り試して最良でも 23.6% でした(偶然に当たる確率は2%)。英語ラベルと日本語ラベルの差はほとんどありませんでした。
ところが、音どうしの近さで分類すると 69.0%(最も近い1件の種類を答える方式、5分割の交差検証)、各種類32件の正解ラベルで簡単な線形分類器を学習させると 79.8% まで上がります。音のベクトル自体は種類の違いをよく捉えていて、弱いのは「文章と環境音の対応づけ」だと分かります。「この音に似た録音を探す」「少しだけラベルを付けて分類する」用途なら十分に使えます。
動画:日本語の言葉からでもよく当たる
最後に動画です。UCF101 は「アーチェリー」「歯みがき」「ボウリング」など、人の動作を撮った短い動画のデータセットです。今回はテスト用データの一部(17 種類・648 本、1本数秒)を使い、「アーチェリーの動画」のような日本語のラベルとの近さで種類を当てました。動画は既定の設定(1秒1フレーム)で埋め込んでいます。
| 方法 | 正解率 |
|---|---|
| 日本語ラベルから当てる(ゼロショット) | 89.4% |
| 英語ラベルから当てる(ゼロショット) | 88.4% |
| 動画どうしの近さ(最も近い1本の種類、1本抜き) | 99.7% |
17 種類なので、偶然に当たる確率は約 5.9% です。環境音とは違い、言葉から動画を探す力ははっきり実用レベルでした。日本語と英語のラベルで差がないのも心強い点です。なお、UCF101 は同じ撮影から切り出した似た動画が多く含まれるため、「動画どうしの近さ」の 99.7% は割り引いて見てください。処理速度は、他の評価と同時に動かした状態で1秒あたり約 2.5 本でした。
検証⑥ 1つの索引に混ぜると何が起きるか
「1つのベクトル空間に置ける」なら、写真も音声も文書ページも、1つのベクトルデータベースにまとめて入れたくなります。「埋め込みモデル1つ → 共通のベクトル DB」は、マルチモーダル埋め込みのいちばんの売り文句でもあります。そこで、③④⑤で作ったベクトルをそのまま1つの索引に入れて、同じ質問で探し直しました。
索引に入れたのは、写真 3,600 枚、その写真の別の説明文(テキスト)3,585 件、音声メモ 40 件、文書ページ 758 枚の合計約 8,000 件です。説明文を入れたのは、実際の社内データでも「写真と、その写真について書かれた文章」が両方あるのが普通だからです。
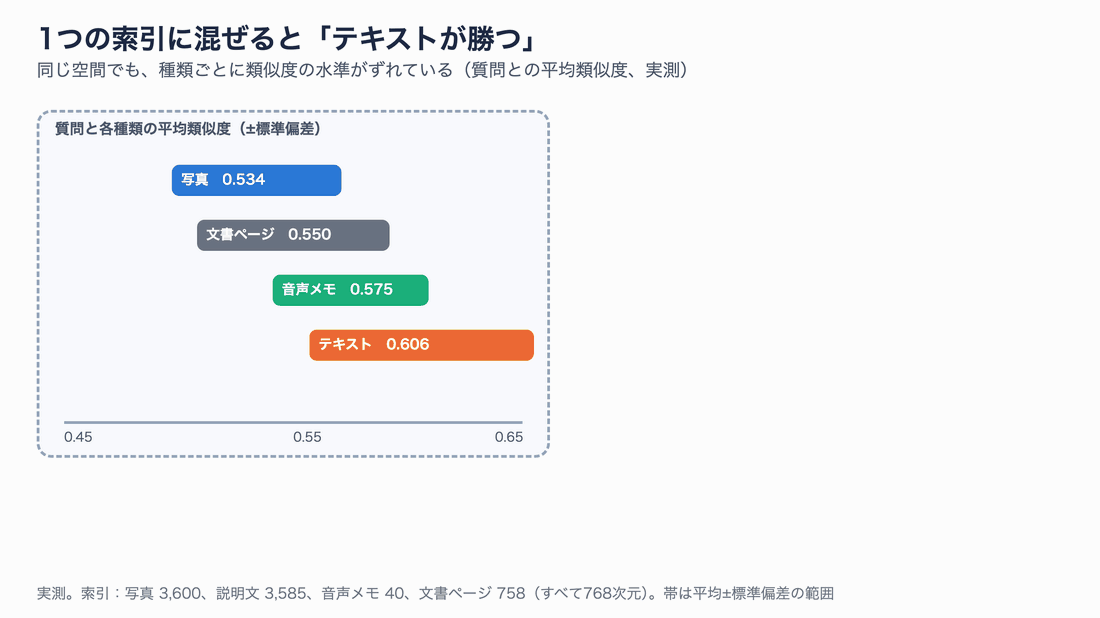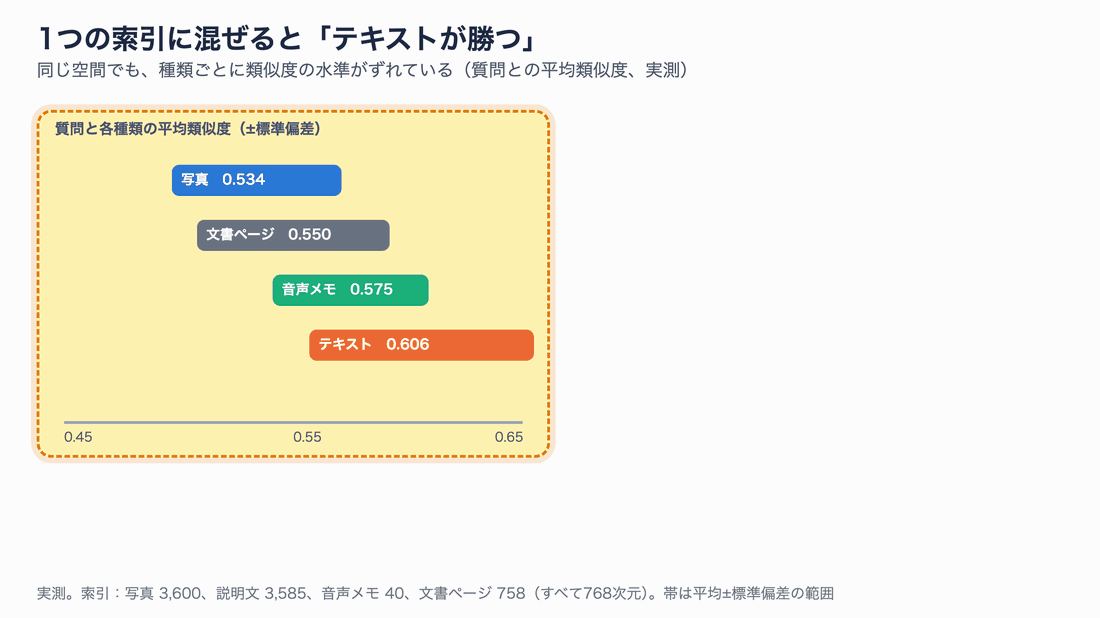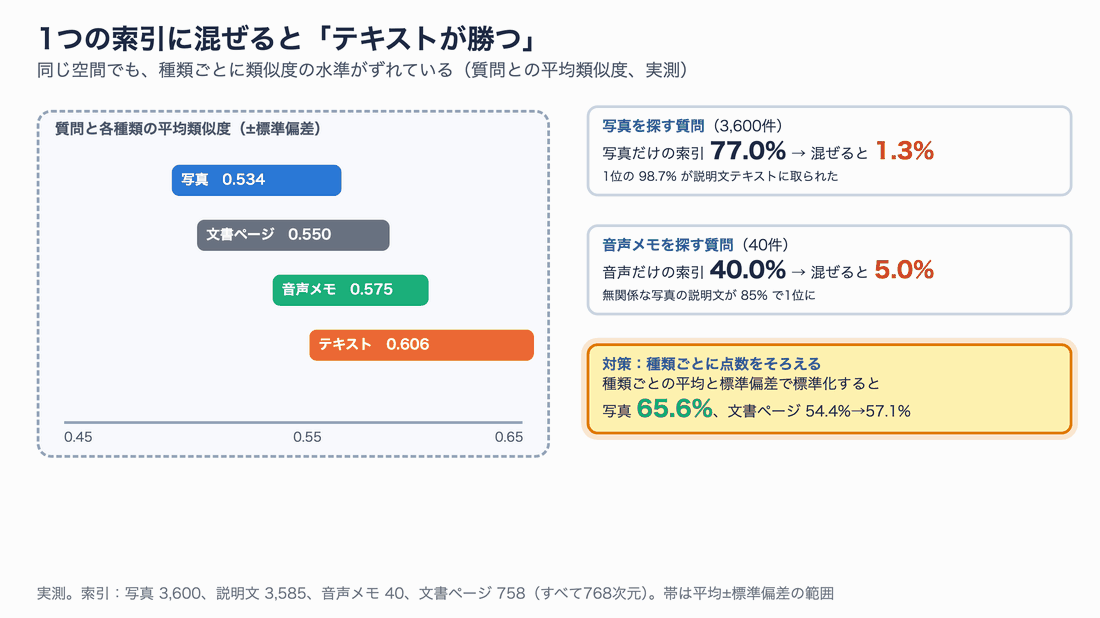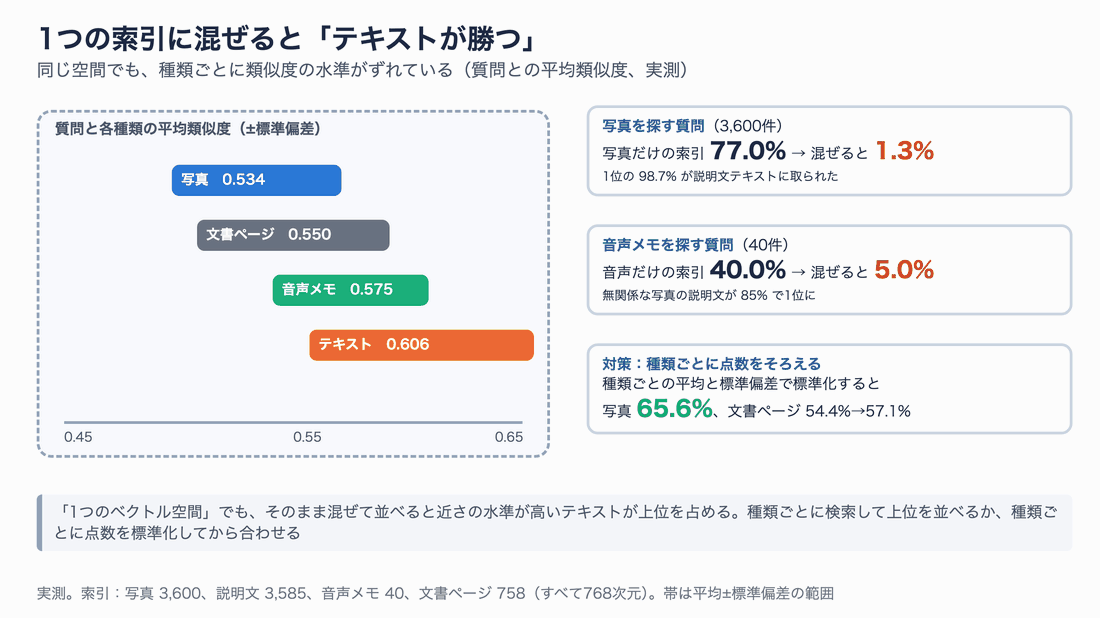
左は、質問と各種類のベクトルとの類似度の平均と広がり(実測)。テキストどうしの類似度は、もともと他の種類より高い位置にある
結果ははっきりしていました。
| 質問 | 種類ごとの索引 | そのまま混ぜた索引 | 種類ごとに点数を標準化 |
|---|---|---|---|
| 写真を探す(3,600件) | 77.0% | 1.3%(1位の98.7%がテキスト) | 65.6% |
| 音声メモを探す(40件) | 40.0% | 5.0%(1位の85%が無関係な説明文) | 12.5% |
| 文書ページを探す(744件) | 58.1% | 54.4% | 57.1% |
写真を探す質問では、1位の 98.7% を説明文テキストが取りました。そのうち多くは「同じ写真の別の説明文」なので、写真か説明文のどちらかが当たれば正解とみなすと R@1 は 53.4% です。それでも、写真だけの索引の 77.0% より大きく下がっています。もっと深刻なのは音声メモで、まったく関係のない写真の説明文が 85% の質問で1位に来ました。
原因は、図の左に示した「類似度の水準のずれ」です。質問(テキスト)とテキストの類似度は平均 0.606、質問と写真は 0.534 で、同じ質問に対してもテキストのほうが一律に高い点になります。これは CLIP 系のモデルでも知られている「モダリティギャップ」と呼ばれる現象で、EmbeddingGemma 2 でもなくなってはいませんでした。
対策として、種類ごとに類似度の平均と標準偏差を求めて標準化(zスコア化)してから並べると、写真は 65.6% まで戻りました。ただし音声メモは 12.5% にとどまり、種類別の索引の 40.0% には届きません。実用上は、次のどちらかが安全です。
- 種類ごとに別々に検索し、それぞれの上位 k 件を並べて見せる(または LLM や再ランキングモデルに渡す)
- 1つの索引に入れる場合も、種類のラベルを付けておき、種類ごとに点数を標準化してから統合する
「1つのモデルで同じ空間に置ける」ことと、「何も考えずに1つの箱に混ぜてよい」ことは別だ、というのが今回いちばん実務に効く学びでした。
速度・メモリと、次元を切ったときの節約効果
最後に、ほかの評価を一時停止して GPU を空けた状態で、速度とメモリを測りました。PyTorch(MPS)で bfloat16 のまま動かした値です。公式が紹介している LiteRT(Google のオンデバイス推論エンジン)や量子化版では、もっと軽く速くなるはずです。
読み込み直後のメモリ(GPU に確保された量)
| 読み込んだ部品 | パラメータ数 | GPU メモリ |
|---|---|---|
| 旧版 EmbeddingGemma(参考) | 308M | 615MB |
| 新版・テキストのみ | 271M | 542MB |
| 新版・テキスト+画像 | 439M | 883MB |
| 新版・テキスト+音声 | 577M | 1,153MB |
| 新版・全部 | 744M | 1,495MB |
テキストだけなら、旧版より少し軽くなっています。公式は、量子化したモデルを Pixel 11 Pro で動かしたときの実使用メモリを、テキストのみ約 191MB、全部入りで約 567MB と報告しています。今回は量子化していないので、その約3倍です。
処理速度(M5 Max、他の処理を止めて測定)
| 処理 | 速度 |
|---|---|
| テキスト(日本語の文、平均約50字) | 新版 622 文/秒、旧版 727 文/秒 |
| 写真(既定の 280 トークン) | 10.9 枚/秒 |
| 写真(1,120 トークン) | 1.8 枚/秒 |
| 音声(FLEURS 100 発話・合計約22分) | 実時間の 324 倍(22分の音声を約4秒) |
| 参考:Whisper large-v3-turbo で文字起こし | 実時間の 72 倍 |
| 動画(60秒、既定で最大32フレーム) | 1本 1.79 秒 |
音声の直接埋め込みは、文字起こしより約4.5倍速く処理できます。検証⑤の精度差と合わせると、「大量の録音をとにかく速く索引したい」「言葉ではない音を扱う」なら直接埋め込み、「言い換えた質問で正確に探したい」なら文字起こし経由、という使い分けになります。
次元を切ったときの節約効果
100 万件のベクトルを float32 で持ち、1つの質問で全件の類似度を計算して上位10件を取る時間(NumPy、CPU)を測りました。
| 次元 | 索引の大きさ(100万件) | 1回の検索時間 | 写真検索 R@1 | 音声 FLEURS R@1 | 文書ページ R@1 |
|---|---|---|---|---|---|
| 768 | 3.07GB | 28.1ms | 77.0% | 96.9% | 58.2% |
| 512 | 2.05GB | 19.4ms | 75.9% | — | — |
| 256 | 1.02GB | 10.3ms | 73.7% | 96.0% | 54.6% |
| 128 | 0.51GB | 8.2ms | 56.4% | 90.0% | — |
256 次元にすると、索引は3分の1、検索時間は約3分の1で、精度の低下は数ポイントに収まりました。128 次元は、写真検索で 20 ポイント以上下がります。公式の「マルチモーダルなら 256 次元まで」という説明は、日本語でもそのまま当てはまりました。
どう使い分けるか
ここまでの結果を、判断の目安にまとめました。
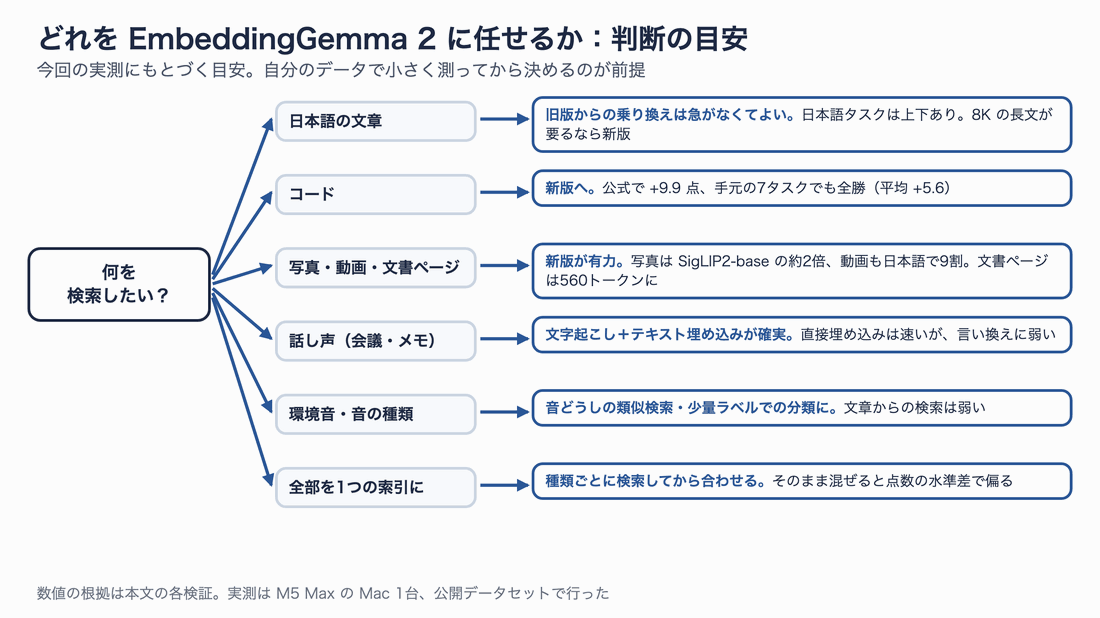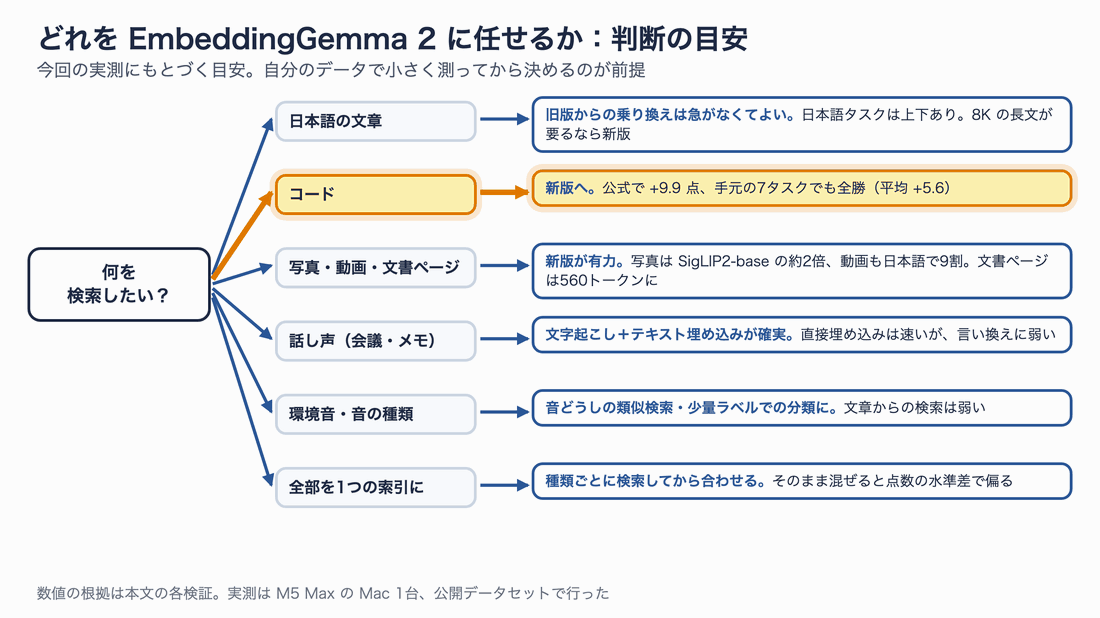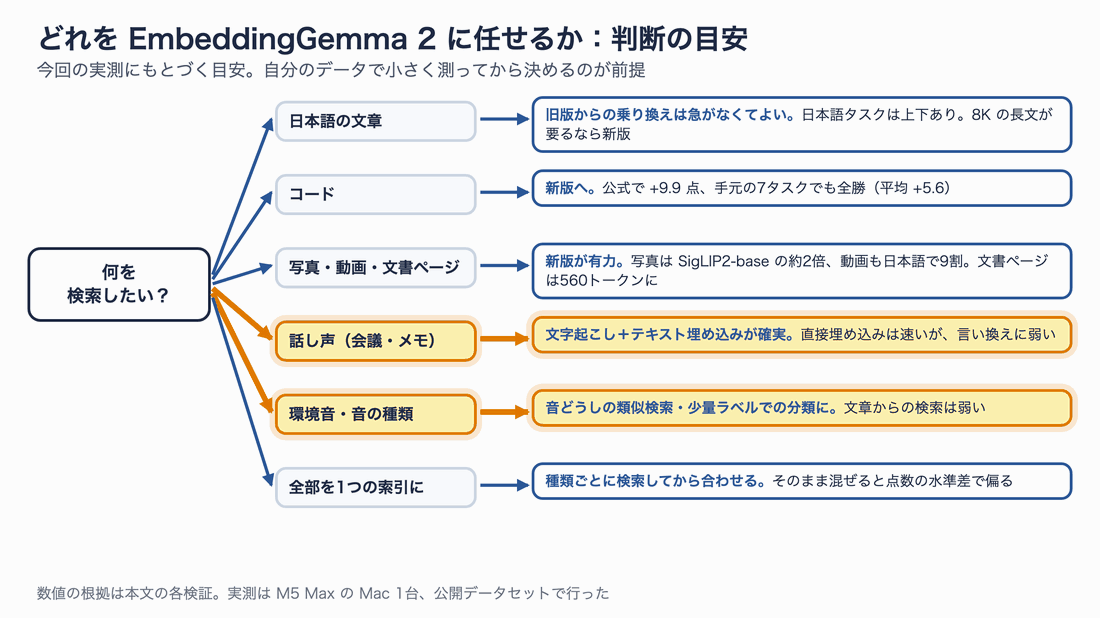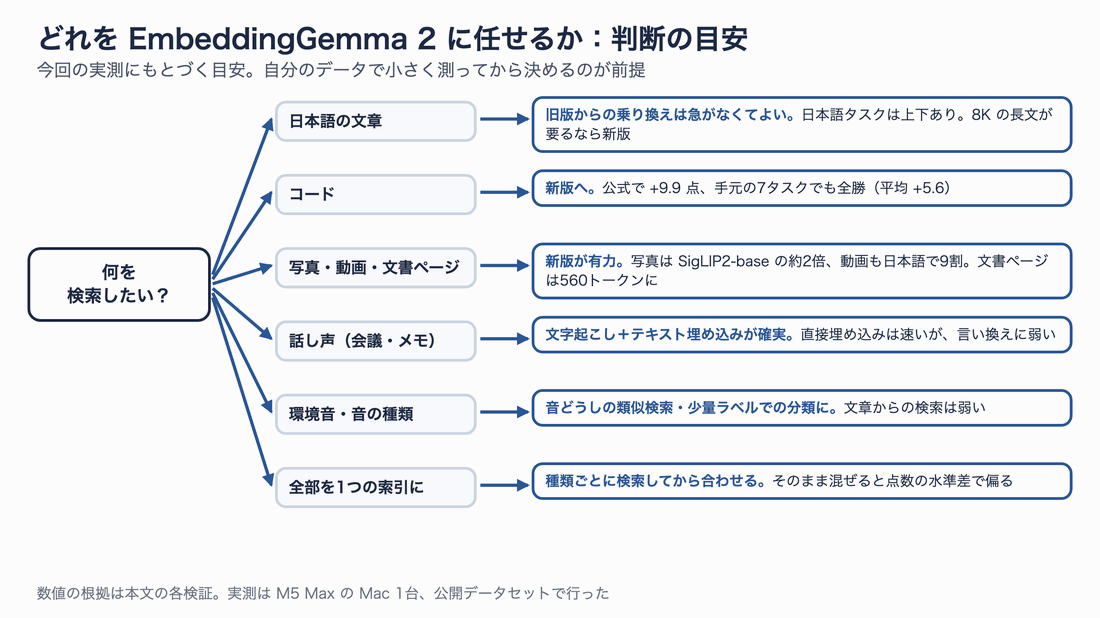
今回の実測にもとづく目安。データの性質で結果は変わるので、自分のデータで小さく測ってから決めるのが前提
補足すると、判断のポイントは「何を探したいか」と「何で探したいか」の組み合わせです。
- 日本語の文章を文章で探すだけなら、旧版から急いで乗り換える必要はありません。日本語のタスクでは上がるものと下がるものがあり、平均はほぼ同じでした。ライセンスを Apache 2.0 にそろえたい、8K の長い文書をそのまま埋め込みたい、という理由があれば新版を選びます
- コードを探すなら新版です。公式でも手元でも、はっきり伸びました
- 写真・動画・文書ページを日本語で探すなら、新版が第一候補です。写真は画像専用の SigLIP2-base の約2倍の正解率、動画も日本語ラベルで約9割当たりました。文書ページは画像トークンを 560 程度に増やし、可能なら OCR テキストと点数を合わせると最も良くなります
- 話し声を意味で探すなら、今のところは文字起こし(Whisper など)+テキスト埋め込みが確実です。直接埋め込みは4倍以上速いので、「まず大量に索引して、候補を絞ってから文字起こしする」二段構えも考えられます
- 環境音は、文章からの検索には向きません。「この音に似た録音」を探す、少しラベルを付けて分類する、という使い方なら十分に実用的です
- 全部を1つの索引に入れる場合は、種類ごとに検索して結果を並べるか、種類ごとに点数を標準化してから統合します。そのまま混ぜると、テキストが上位を独占します
トラブルシューティング
今回の検証で実際に踏んだ問題を、起きる順に並べました。
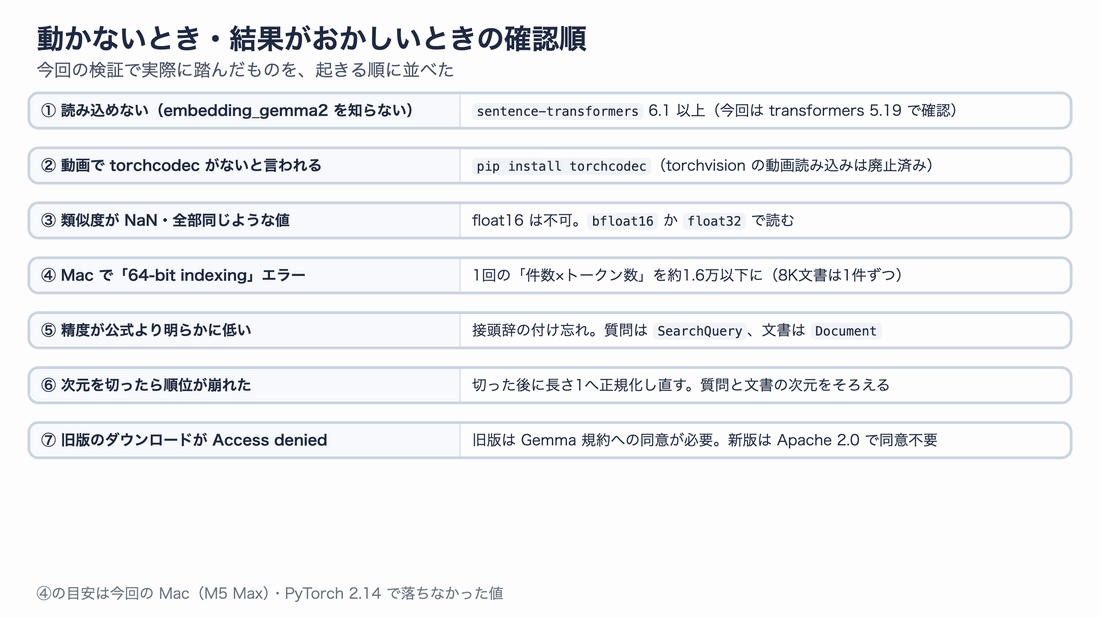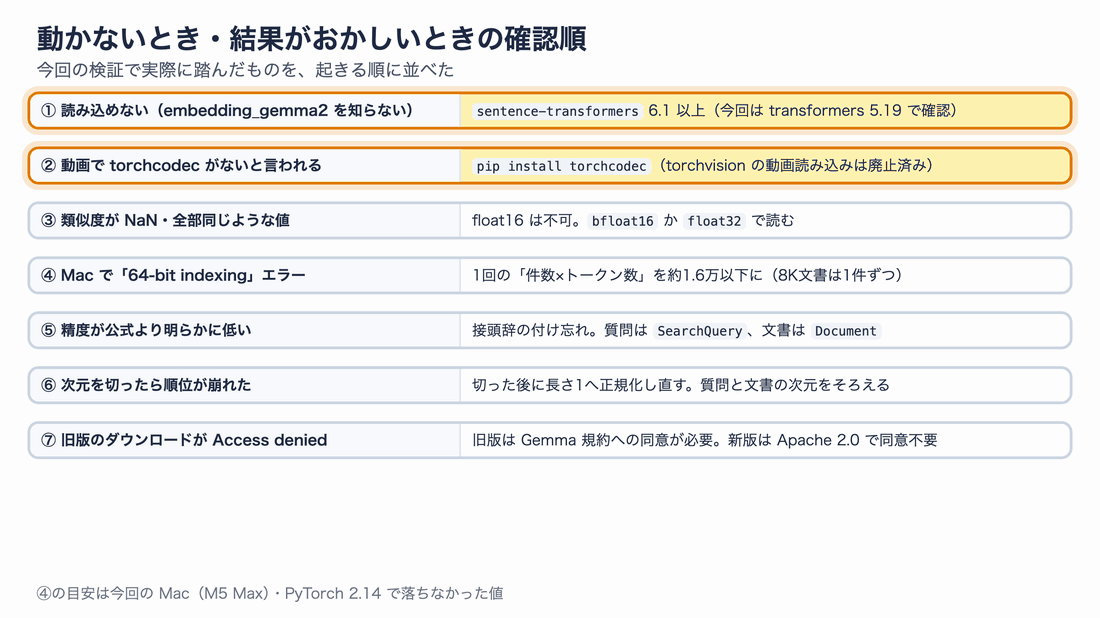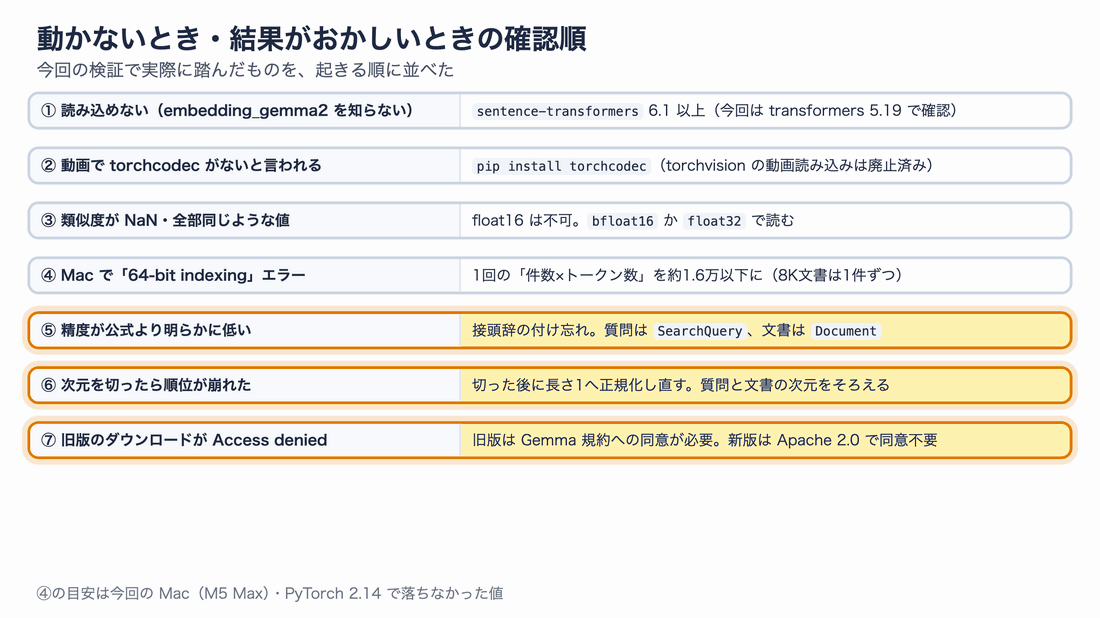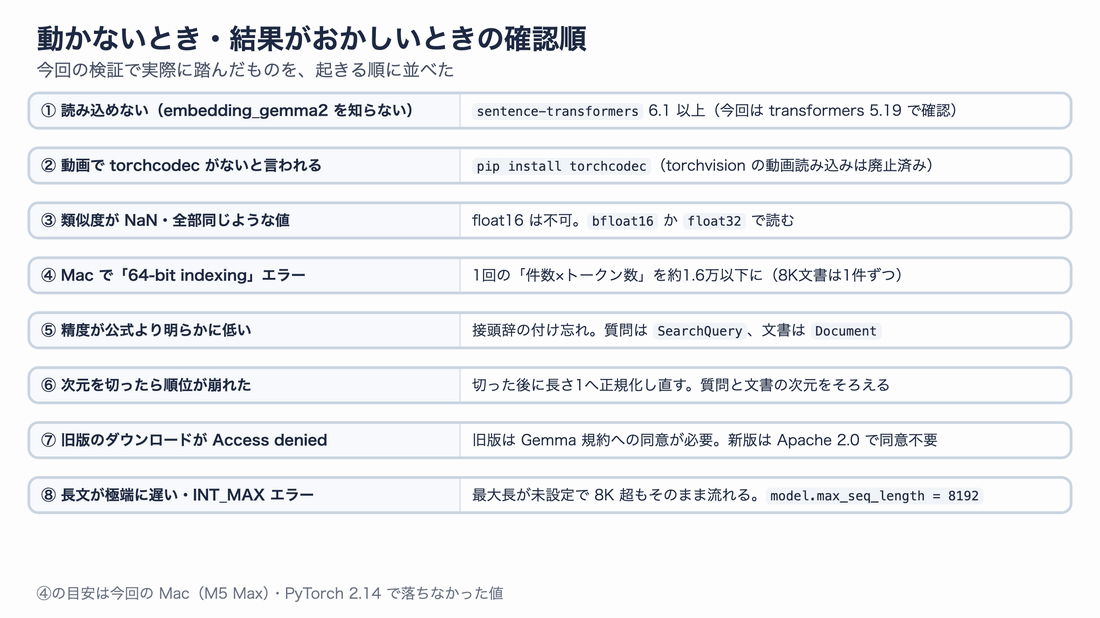
上から順に確認する。③⑤⑥はエラーにならずに結果だけが悪くなるので、とくに気づきにくい
| 症状 | 原因 | 対処 |
|---|---|---|
embedding_gemma2 を認識しない | ライブラリが古い | sentence-transformers 6.1 以上(今回は transformers 5.19.0 で確認) |
動画で torchcodec is not installed | torchvision の動画読み込みが廃止 | pip install torchcodec |
| 類似度が NaN、またはどれも似た値 | float16 で読み込んだ | bfloat16 か float32 を使う(モデルカードに明記) |
MPS ... 64-bit indexing are not supported | 長文を大きなバッチでまとめて流した | 1回の「件数×トークン数」を減らす。8K トークンの文書は1件ずつ |
| 公式の数字より明らかに低い | 接頭辞の付け忘れ | 質問は SearchQuery、文書は Document |
| 次元を切ったら順位が崩れた | 再正規化していない、質問と文書で次元が違う | truncate_dim と normalize_embeddings=True を両方に指定 |
旧版が Access denied | Gemma 規約への同意が必要 | Hugging Face で同意する(新版は不要) |
長文がとても遅い、MPSGraph does not support tensor dims larger than INT_MAX | 公開版の設定に最大長がなく、8,192 トークンを超える文書も切り詰められずに流れる | model.max_seq_length = 8192 を明示する |
④の MPS のエラーは、Mac で長文を扱うときに必ず当たります。EmbeddingGemma 2 は「層ごとの埋め込み表」を使うため、1回の処理で「件数×トークン数×層数×幅」に比例する大きな中間データを作ります。8,192 トークンの論文本文を8件まとめて流したところ、要素数が約46億になり、Apple の GPU の上限(約21億)を超えて止まりました。今回は、1回の合計トークン数を約1.6万に抑えるようにバッチを組み直して回避しました。
もう1つ見落としやすいのが⑧です。2026年10月6日公開版の sentence-transformers 用の設定には最大長が書かれておらず、model.max_seq_length が事実上無限大になっています(旧版は 2,048)。そのため、8,192 トークンを超える文書も切り詰められずにモデルへ入ります。学習した文脈長を超えた部分の品質は保証されないうえ、Mac では注意機構の計算が GPU の上限を超えて落ちました。今回は論文本文の検索タスクが54分走ったところでこのエラーになり、上限を明示してやり直しました。長い文書を扱うなら、読み込み直後に次の1行を入れておくのが安全です。
model.max_seq_length = 8192 # 公式の文脈長。これを超える部分は切り捨てる
mteb で評価する人向けの注意もあります。SentenceTransformerEncoderWrapper に model_prompts を渡すと、モデルに同梱された接頭辞の一覧が丸ごと置き換わります。コード検索用の接頭辞だけ足したつもりが、検索用の接頭辞まで消えていました。同梱の一覧を読み込み、足してから渡してください。
まとめ
EmbeddingGemma 2 で変わったこと、新しくできるようになったこと、手元で確かめたことを振り返ります。
何が変わったか
- 入力がテキストだけから、テキスト・コード・画像・動画・音声の5種類になり、すべて同じ 768 次元の空間に置けるようになった
- 部品を必要な分だけ読み込める構成(テキストのみ 270M〜全部 740M)、文脈長は 2K から 8K に、ライセンスは Apache 2.0 になった
- 公式ベンチマークは、テキスト全般が 61.15 → 61.36 でほぼ横ばい、コード検索が 68.76 → 78.68 で大幅に改善。画像・動画・音声は新規
新しくできるようになったこと(日本語での実測)
- 日本語の説明文から写真を探す:R@1 77.0%(画像専用の SigLIP2-base は 37.8%)
- 日本語の質問から文書ページの画像を探す:R@1 64.7%(OCR 経由 66.5% とほぼ互角、両方使うと 68.3%)
- 日本語のラベルから動画の種類を当てる:17 種類で 89.4%
- 音声を文字起こしせずに埋め込む:実時間の 324 倍速。本文どおりの質問なら FLEURS で R@1 96.9%
まだ従来の方法が強いところ・注意点
- 日本語のテキスト検索は旧版とほぼ同じで、タスクによっては下がった
- 言い換えた質問で話し声を探すと、直接埋め込み 40.0% に対し、文字起こし経由は 92.5%
- 環境音を文章から探すのは苦手(ゼロショット 23.6%)。音どうしの比較なら 69〜80%
- 1つの索引にそのまま混ぜると、テキストが上位を独占する(写真の R@1 が 77.0% → 1.3%)
- 公開版は最大長が未設定なので、
max_seq_length = 8192を自分で指定する
「1つのモデルで全部を同じ空間に置ける」ことは、間違いなく大きな前進です。ただし、そのまま1つの箱に混ぜれば何でも探せる、という段階にはまだありません。データの種類ごとの得意・不得意を知ったうえで組み合わせるのが、今のいちばん賢い使い方だと思います。
次のステップとしては、自分の手元のデータ(資料 PDF、スクリーンショット、音声メモ)で、今回のように「質問と正解」の組を20〜40件作って測ってみることをおすすめします。モデルの得意・不得意は、公開ベンチマークよりも自分のデータで測ったほうがはっきり見えます。
参考リソース
- Google 公式ブログ「EmbeddingGemma 2 is a best-in-class open model for natively multimodal embeddings」(2026-10-06)https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/
- Google Developers Blog「Bring multimodal semantic search to the edge with EmbeddingGemma 2」https://developers.googleblog.com/google-ai-edge-with-embeddinggemma-2/
- Hugging Face モデルカード google/embeddinggemma-2 https://huggingface.co/google/embeddinggemma-2
- 旧版のモデルカード google/embeddinggemma-300m https://huggingface.co/google/embeddinggemma-300m
- mteb(Massive Text Embedding Benchmark)https://github.com/embeddings-benchmark/mteb
- データセット:XM3600(floschne/xm3600)、JDocQA(jinaai/jdocqa_beir)、FLEURS(mteb/fleurs)、ESC-50(mteb/esc50)、UCF101(mteb/UCF101-51VA)
- 比較に使ったモデル:SigLIP2(google/siglip2-base-patch16-256)、Whisper large-v3-turbo(mlx-community/whisper-large-v3-turbo)